Zendesk, sfruttato il sistema di ticketing per una campagna di spam massiva


Zendesk, nota piattaforma di ticketing, sta venendo sfruttata per una campagna di phishing massiva che sta colpendo utenti in tutto il mondo. A partire dal 18 gennaio, migliaia di utenti hanno infatti iniziato a segnalare di aver ricevuto centinaia di email sospette provenienti da mittenti apparentemente legittimi.

I messaggi arrivano da sistemi di supporto ufficiali di nomi quali Discord, Tinder, Riot Games e Dropbox. Come riporta Bleeping Computer, gli attaccanti stanno sfruttando una vulnerabilità nei processi di gestione dei ticket di Zendesk.

La campagna sta abusando delle funzionalità di automazione di Zendesk: molte aziende configurano il proprio supporto clienti per consentire a chiunque, ovvero anche utenti non registrati, di inviare un ticket. Quando un utente invia una richiesta, il sistema genera automaticamente un’email di conferma ricevuta.

Zendesk

Gli attaccanti hanno automatizzato l’operazione usando liste con migliaia di indirizzi email e testi arbitrati da usare come oggetto della richiesta, aprendo ticket in maniera massiva. I server di Zendesk, agendo come un relay, hanno quindi cominciato a inviare migliaia di email agli utenti. Dal momento che queste email provengono da domini legittimi, riescono a bypassare quasi tutti i filtri antispam tradizionali.

Gli oggetti delle email sono spesso scritti con caratteri Unicode per catturare l’attenzione o eludere ulteriori controlli. Tra gli oggetti più comuni ci sono “FREE DISCORD NITRO!!” e “LEGAL NOTICE FROM ISRAEL”, oppure comunicazioni di presunti ordini di rimozione da parte della Cina o degli USA. Figurano anche richieste d’aiuto con tono disperato e conferme di acquisto fittizie. Anche se i messaggi appaiono allarmanti, gli esperti di sicurezza hanno notato che, al momento, la maggior parte di essi non contiene link malevoli o tentativi di phishing diretti; è probabile quindi che la campagna sia finalizzata solo al trolling o a testare la capacità di saturazione dei sistemi.

L’attacco ha colpito una vasta gamma di settori, dai videogiochi ai servizi governativi; tra le aziende colpite ci sono CD Projekt, Riot Games, Konami, Square Enix, Discord, Dropbox e i dipartimenti del Lavoro e delle Entrate del Tennessee e della Louisiana.

Alcune aziende hanno comunicato ai propri utenti di ignorare le email di questo tipo, rassicurandoli sul fatto che riceverle non implica la compromissione del loro account personale.

Lato Zendesk, un portavoce dell’azienda ha dichiarato a BleepingComputer di aver introdotto nuove misure di sicurezza, come l’implementazione di alcune restrizioni per bloccare più rapidamente i flussi di spam. La compagnia aveva in realtà già avvertito i propri clienti nel dicembre precedente riguardo questo rischio, consigliando di limitare la creazione di ticket ai soli utenti verificati.

In seguito all’attacco, Zendesk ha rinnovato alle aziende le raccomandazioni per ridurre il rischio di campagne simili: oltre a ribadire di consentire l’invio di ticket solo a utenti con indirizzo email verificato, è consigliato rimuovere specifici placeholder (come {{ticket.title}}{{ticket.requester.first_name}}) per evitare che il testo inserito dall’utente nell’oggetto del ticket venga riportato automaticamente nell’email di conferma inviata dal sistema. Infine, occorre implementare CAPTCHA per rendere il sistema a prova di bot.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/01/23/zendesk-sfruttato-il-sistema-di-ticketing-per-una-campagna-di-spam-massiva/?utm_source=rss&utm_medium=rss&utm_campaign=zendesk-sfruttato-il-sistema-di-ticketing-per-una-campagna-di-spam-massiva


Overrun with AI slop, cURL scraps bug bounties to ensure “intact mental health”

The project developer for one of the Internet’s most popular networking tools is scrapping its vulnerability reward program after being overrun by a spike in the submission of low-quality reports, much of it AI-generated slop.

“We are just a small single open source project with a small number of active maintainers,” Daniel Stenberg, the founder and lead developer of the open source app cURL, said Thursday. “It is not in our power to change how all these people and their slop machines work. We need to make moves to ensure our survival and intact mental health.”

Manufacturing bogus bugs

His comments came as cURL users complained that the move was treating the symptoms caused by AI slop without addressing the cause. The users said they were concerned the move would eliminate a key means for ensuring and maintaining the security of the tool. Stenberg largely agreed, but indicated his team had little choice.

In a separate post on Thursday, Stenberg wrote: “We will ban you and ridicule you in public if you waste our time on crap reports.” An update to cURL’s official GitHub account made the termination, which takes effect at the end of this month, official.

cURL was first released three decades ago, under the name httpget and later urlget. It has since become an indispensable tool among admins, researchers, and security professionals, among others, for a wide range of tasks, including file transfers, troubleshooting buggy web software, and automating tasks. cURL is integrated into default versions of Windows, macOS, and most distributions of Linux.

As such a widely used tool for interacting with vast amounts of data online, security is paramount. Like many other software makers, cURL project members have relied on private bug reports submitted by outside researchers. To provide an incentive and to reward high-quality submissions, the project members have paid cash bounties in return for reports of high-severity vulnerabilities.

https://arstechnica.com/security/2026/01/overrun-with-ai-slop-curl-scraps-bug-bounties-to-ensure-intact-mental-health/


Hacker who stole 120,000 bitcoins wants a second chance—and a security job

“When I was a black hat hacker, I was isolated and paranoid,” he wrote. “Working with the good guys, being part of a team solving a bigger problem felt surprisingly good. I realized that I could use my technical skills to make a difference.”

Lichtenstein, who did not immediately respond to Ars’ request for comment, noted that he was sentenced to 60 months in prison and spent “nearly [four] years in some of the harshest jails in the country.” While in prison, Lichtenstein says that he spent as much time as he could in the prison library studying math books to engage his mind and distract himself from his surroundings.

The 38-year-old added that he was “released to home confinement earlier this month.”

Convicted hackers cooperating with federal authorities or turning their lives around is not without precedent.

One notable example is the late Kevin Mitnick, who was convicted of multiple phone and computer crime cases in the 1980s and 1990s. Mitnick eventually started his own security consulting company and became a penetration tester and public speaker for many years before his death in 2023.

“Now begins the real challenge of regaining the community’s trust,” Lichtenstein concluded, noting that he wants to work in cybersecurity.

“I think like an adversary,” he said. “I’ve been an adversary. Now I can use those same skills to stop the next billion-dollar hack.”

https://arstechnica.com/security/2026/01/hacker-who-stole-120000-bitcoins-wants-a-second-chance-and-a-security-job/


De-americanizzazione IT: l’Europa abbandona Microsoft per la sovranità digitale

De-americanizzazione IT: un’espressione che fino a pochi anni fa sarebbe suonata come uno slogan ideologico, oggi descrive una trasformazione concreta in atto nelle istituzioni europee. La dipendenza tecnologica dai colossi statunitensi, a lungo accettata come inevitabile costo della modernizzazione digitale, viene ora riconsiderata alla luce di nuove variabili: tensioni geopolitiche, conflitti normativi transatlantici e una crescente consapevolezza che il controllo sull’infrastruttura digitale equivale al controllo sull’autonomia decisionale. Questo articolo analizza i casi più significativi di migrazione da ecosistemi proprietari americani verso soluzioni europee e open source, offrendo ai professionisti della sicurezza informatica una mappa per orientarsi in uno scenario in rapida evoluzione.

La frattura silenziosa: quando la geopolitica riscrive l’architettura IT

La de-americanizzazione IT non è più un’ipotesi accademica o un manifesto ideologico: è diventata una strategia operativa. Il 31 ottobre 2025, la Corte Penale Internazionale (ICC) all’Aja ha confermato la migrazione da Microsoft 365 a openDesk, una suite open source sviluppata dal Centro tedesco per la Sovranità Digitale (ZenDiS). Poche settimane prima, lo stato tedesco dello Schleswig-Holstein aveva completato la transizione di oltre 40.000 caselle email da Microsoft Exchange a Open-Xchange e Mozilla Thunderbird.

Non si tratta di episodi isolati. Danimarca, Austria, Francia e Italia stanno tracciando rotte parallele verso l’indipendenza tecnologica. La domanda che ogni CISO europeo dovrebbe porsi oggi non è più se considerare alternative ai vendor statunitensi, ma quando e come farlo senza compromettere continuità operativa e sicurezza.

L’incidente Khan: il punto di non ritorno

Il catalizzatore di questa accelerazione ha un nome e una data. Nel maggio 2025, il procuratore capo dell’ICC Karim Khan è stato temporaneamente bloccato dal proprio account Microsoft Outlook. L’episodio è seguito alle sanzioni imposte dall’amministrazione Trump contro i funzionari della Corte, rei di aver emesso mandati di arresto per il primo ministro israeliano Benjamin Netanyahu.

Microsoft, attraverso il presidente Brad Smith, ha negato qualsiasi coinvolgimento diretto, affermando che “in nessun momento Microsoft ha cessato o sospeso i propri servizi all’ICC”. Tuttavia, la sola possibilità che un’istituzione giudiziaria internazionale possa perdere l’accesso ai propri strumenti di comunicazione per ragioni geopolitiche ha rappresentato un campanello d’allarme impossibile da ignorare.

Come ha sottolineato il Dr. Benjamin Thorne dell’Università di Reading: “La decisione della Corte Penale Internazionale di abbandonare Microsoft segna una rottura significativa dalla dipendenza tecnologica statunitense, in un contesto di crescenti preoccupazioni sulle potenziali sanzioni americane”.

Il CLOUD Act: l’elefante nella server room

Per comprendere la portata della de-americanizzazione IT europea, occorre analizzare il quadro normativo che la alimenta. Il CLOUD Act (Clarifying Lawful Overseas Use of Data Act), approvato negli Stati Uniti nel 2018, consente alle autorità americane di richiedere l’accesso ai dati detenuti da aziende statunitensi, indipendentemente dalla localizzazione fisica dei server.

Questo crea un conflitto diretto con il GDPR europeo, in particolare con l’articolo 48, che vieta il trasferimento di dati personali verso paesi terzi in assenza di adeguate garanzie giuridiche. Le aziende europee si trovano così in una posizione impossibile: conformarsi al CLOUD Act significa violare il GDPR (con sanzioni fino al 4% del fatturato globale), mentre ignorare le richieste americane può comportare conseguenze legali negli Stati Uniti.

La conferma più esplicita di questo conflitto irrisolto è arrivata il 10 giugno 2025, quando Anton Carniaux, direttore degli affari pubblici e legali di Microsoft Francia, ha ammesso sotto giuramento al Senato francese che Microsoft “non può garantire” che i dati europei archiviati nei datacenter europei siano al sicuro da richieste di accesso del governo statunitense.

Schleswig-Holstein: anatomia di una migrazione riuscita

Se l’ICC rappresenta il simbolo politico della de-americanizzazione IT, lo Schleswig-Holstein ne costituisce il caso di studio operativo più avanzato. Il Land tedesco ha completato il 2 ottobre 2025 una migrazione che ha coinvolto:

  • 40.000 caselle email migrate da Exchange a Open-Xchange;
  • oltre 100 milioni di email e voci di calendario trasferite;
  • 30.000 dipendenti pubblici interessati, dalla Cancelleria ai ministeri, dalla magistratura alla polizia;
  • 6 mesi di lavoro per il completamento dell’operazione.

Il ministro per la Digitalizzazione Dirk Schrödter ha dichiarato “missione compiuta”, sottolineando come questo rappresenti “un traguardo per la sovranità digitale del paese”. La migrazione email è solo la prima fase di una strategia più ampia che prevede:

  • sostituzione di Microsoft Office con LibreOffice (raggiunto l’80% entro dicembre 2025);
  • migrazione da SharePoint a Nextcloud per la collaborazione documentale;
  • sostituzione di Microsoft Active Directory con Univention Corporate Server;
  • test pilota per il passaggio a Linux come sistema operativo desktop.

Lezioni operative per i CISO

La transizione dello Schleswig-Holstein offre insight preziosi per chi sta valutando percorsi analoghi:

Approccio graduale: la migrazione non è stata un big bang, ma un processo incrementale, con periodi di coesistenza tra vecchi e nuovi sistemi.

Formazione intensiva: il Competence Center Office di Dataport ha fornito supporto di primo e secondo livello, mentre società specializzate come Schad hanno gestito le complessità tecniche più avanzate.

Gestione delle eccezioni: il 20% delle postazioni che ancora utilizza Microsoft Word o Excel corrisponde a casi con dipendenze tecniche specifiche, gestiti come eccezioni documentate piuttosto che ostacoli bloccanti.

Standard aperti come fondamento: l’adozione dell’Open Document Format (ODF) come standard ufficiale dal 1° agosto 2024 ha creato le precondizioni per la transizione, eliminando il lock-in a livello di formato documentale.

Il panorama europeo della de-americanizzazione IT

Lo Schleswig-Holstein non è un caso isolato. Una mappatura dei principali progetti di migrazione rivela un movimento strutturato:

Germania
Austria
Danimarca
  • Ministero degli Affari Digitali: migrazione da Office 365 a LibreOffice avviata a giugno 2025, completamento previsto in autunno;
  • Copenhagen e Aarhus: le due maggiori città danesi hanno avviato processi analoghi;
Francia
  • 11 ministeri: 500.000 postazioni con LibreOffice installato;
  • Gendarmerie Nationale: oltre 100.000 workstation su Ubuntu Linux (GendBuntu) da oltre quindici anni, rappresentando una delle più ampie implementazioni Linux nel settore pubblico europeo;
  • Ministero dell’Economia e delle Finanze: progetto NUBO, cloud privato basato su OpenStack per dati sensibili
Italia
  • Ministero della Difesa: 150.000 PC migrati a LibreOffice e Open Document Format;
  • Regioni (Emilia-Romagna, Perugia, Trento, Bolzano): adozione progressiva di soluzioni open source.

openDesk: l’architettura della sovranità

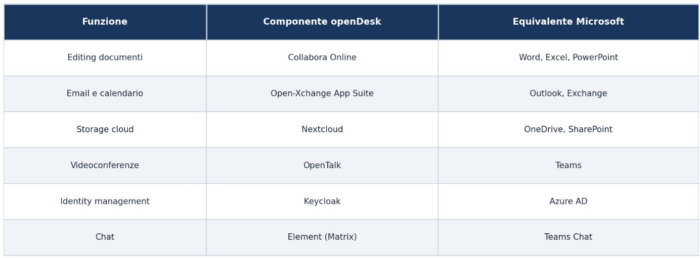
Al centro di molte di queste migrazioni c’è openDesk, la suite sviluppata da ZenDiS per conto del Ministero dell’Interno tedesco. A differenza dell’ecosistema integrato Microsoft, openDesk adotta un approccio modulare che assembla componenti di diversi fornitori europei:

De-americanizzazione IT: casi europei di migrazione da Microsoft Meta Description: Dalla Corte Penale Internazionale allo Schleswig-Holstein: analisi dei casi europei di abbandono di Microsoft. Motivazioni geopolitiche, implicazioni per CISO e prospettive strategiche.

Questa architettura presenta vantaggi e svantaggi che i security architect devono valutare attentamente.

Vantaggi:
  • Nessun single point of failure giurisdizionale
  • Codice sorgente verificabile
  • Hosting sotto giurisdizione europea
  • Interoperabilità basata su standard aperti (IMAP, CalDAV, CardDAV)
Svantaggi:
  • Minore integrazione nativa tra componenti
  • Feature parity non garantita (eDiscovery avanzata, deep integration con AD)
  • Curva di apprendimento per gli utenti
  • Complessità di gestione multi-vendor

I rischi del sovereignty washing

Non tutto ciò che viene etichettato come “sovrano” garantisce effettiva indipendenza. Come ha evidenziato l’economista Cristina Caffarra, esiste un fenomeno di sovereignty washing in cui i grandi provider statunitensi riconfezionano offerte esistenti con alcune modifiche, presentandole come soluzioni sovrane senza modificare proprietà, controllo o dipendenza giuridica.

Microsoft ha risposto alle pressioni europee con diverse iniziative:

  • Microsoft Cloud for Sovereignty: configurazioni Azure con maggiori controlli su localizzazione dati e accesso;
  • Bleu (Francia): joint venture con Capgemini e Orange per un cloud de confiance;
  • Partnership SAP-Arvato (Germania): iniziativa sovereign cloud simile.

Tuttavia, come ha sottolineato il survey IDC 2025 sulla sovranità digitale, il nuovo principale driver per le soluzioni sovereign in Europa è la “protezione contro richieste di accesso ai dati extraterritoriali” – una garanzia che nessun provider statunitense può offrire finché rimane soggetto al CLOUD Act.

Un caso emblematico delle vulnerabilità residue: nel novembre 2025, Kyndryl (spin-off di IBM) ha annunciato l’intenzione di acquisire Solvinity, provider cloud olandese scelto specificamente dal Comune di Amsterdam e dal Ministero della Giustizia olandese per ridurre la dipendenza da aziende americane. Un’acquisizione che ha sollevato immediate preoccupazioni sul futuro della sovranità dei dati olandesi.

Il consorzio Digital Commons: verso un’infrastruttura condivisa

La risposta europea alla frammentazione delle iniziative nazionali è arrivata il 29 ottobre 2025, quando Germania, Francia, Italia e Paesi Bassi hanno costituito il Digital Commons European Digital Infrastructure Consortium (DC-EDIC). L’obiettivo è sviluppare e scalare congiuntamente strumenti digitali sovrani come openDesk.

Parallelamente, l’EU Cloud and AI Development Act (CADA), la cui proposta legislativa è attesa per il primo trimestre 2026, mira a:

  • stabilire requisiti di idoneità EU-wide per i cloud service provider;
  • armonizzare i processi di procurement pubblico;
  • incoraggiare la costruzione di nuovi datacenter;
  • fornire maggiore capacità computazionale alle startup, specialmente quelle focalizzate sull’AI.

Per i professionisti della sicurezza, questo significa che i criteri di valutazione dei vendor potrebbero presto includere requisiti normativi vincolanti sulla sovranità, non più solo best practice opzionali.

Implicazioni per i CISO: framework decisionale

La de-americanizzazione IT non è un imperativo universale, ma una valutazione rischio-beneficio che ogni organizzazione deve condurre in base al proprio profilo. Ecco un framework per strutturare l’analisi:

Fattori che aumentano l’urgenza della migrazione

  • Trattamento di dati classificati o sensibili (difesa, giustizia, sanità);
  • Esposizione a settori geopoliticamente sensibili;
  • Obblighi contrattuali con enti pubblici europei;
  • Requisiti di compliance con framework nazionali (es. NIS2 per operatori essenziali);
  • Elevata concentrazione su un singolo vendor per funzioni critiche.

Fattori che consentono approcci più graduali

  • Dati prevalentemente non personali o non sensibili;
  • Operatività limitata al mercato domestico;
  • Assenza di requisiti regolamentari stringenti;
  • Elevati costi di switching dovuti a integrazioni profonde;
  • Disponibilità limitata di competenze interne su alternative open source.

Raccomandazioni operative

  1. Audit delle dipendenze: mappare quali sistemi critici dipendono da provider soggetti al CLOUD Act;
  2. Classificazione dei dati: identificare quali dataset richiedono protezione sovereign;
  3. Piano di contingenza: definire procedure per mantenere operatività in caso di interruzione dei servizi;
  4. Piloti controllati: testare alternative open source su perimetri limitati prima di migrazioni estese;
  5. Monitoraggio normativo: seguire l’evoluzione di CADA e altri framework che potrebbero rendere obbligatorie determinate scelte.

Prospettive: il nuovo equilibrio digitale

La de-americanizzazione IT europea non rappresenta una rottura totale con i provider statunitensi – scenario che Forrester definisce “irrealistico” – ma una riconfigurazione strategica delle dipendenze. Come emerge dai dati IDC, la maggioranza delle organizzazioni europee basa le proprie decisioni sulla sovranità su un equilibrio tra performance, prezzo e sensibilità dei dati gestiti.

Il futuro più probabile è un ecosistema ibrido in cui:

  • Workload ad alta sensibilità (dati giudiziari, militari, sanitari) migrano verso infrastrutture europee o open source;
  • Applicazioni commodity (booking sale riunioni, tool di produttività individuale) possono rimanere su piattaforme globali con adeguate garanzie contrattuali;
  • Portabilità diventa un requisito architetturale fondamentale, con container e standard aperti che facilitano exit strategy credibili.

Come evidenziato dall’europarlamentare tedesca Alexandra Geese, architetto chiave del Digital Services Act, l’Europa rischia di trovarsi in una posizione di dipendenza sia dai giganti tecnologici americani che da quelli cinesi. La risposta non è l’isolazionismo digitale, ma la costruzione di alternative credibili che restituiscano potere negoziale.

Per i professionisti della sicurezza informatica, questo significa una cosa sopra tutte: la sovranità digitale non è più un tema per policy maker, ma un criterio di risk assessment che entra di diritto nelle valutazioni architetturali, nei processi di procurement e nelle strategie di business continuity.

La de-americanizzazione IT è qui. La domanda non è se prepararsi, ma come farlo in modo strategico, graduato e consapevole.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/de-americanizzazione-it/


Legge 132/2025 e GDPR: il nuovo regime sanzionatorio per l’IA in Italia

La Legge 132/2025 e il GDPR rappresentano oggi i due pilastri normativi che ridefiniscono il perimetro di responsabilità per chi sviluppa, distribuisce e utilizza sistemi di intelligenza artificiale in Italia. L’entrata in vigore, il 10 ottobre 2025, del primo quadro normativo organico nazionale sull’IA non ha semplicemente aggiunto un nuovo strato di compliance: ha innescato una trasformazione sistemica che impone ai professionisti della sicurezza informatica di ripensare processi, documentazione e governance. Questo contributo analizza le implicazioni operative concrete per CISO, DPO, security architect e legal counsel, identificando i nodi critici dell’integrazione tra normativa privacy e regolamentazione dell’intelligenza artificiale.

Il contesto: una convergenza normativa senza precedenti

Chi osserva l’evoluzione del quadro regolatorio europeo con l’occhio del practitioner riconosce immediatamente la portata della sfida. Nel 2025, le autorità privacy dello Spazio Economico Europeo hanno inflitto 335 sanzioni per violazioni del GDPR, per un ammontare complessivo di 1,1 miliardi di euro secondo il GDPR Enforcement Tracker. Tre soli provvedimenti – TikTok (530 milioni di euro), Google (325 milioni di euro, comminati dalla CNIL francese in applicazione della normativa nazionale) e Shein (150 milioni di euro) – rappresentano il 91% del totale, ma sarebbe un errore considerare questo dato come rassicurante per le organizzazioni di dimensioni minori.

La media delle sanzioni “ordinarie”, esclusi i dieci provvedimenti più elevati, si attesta infatti a 298.000 euro: un importo che può compromettere seriamente la sostenibilità di una PMI. E questo scenario si inserisce in un momento storico in cui l’Italia ha deciso di non limitarsi a recepire passivamente il Regolamento UE 2024/1689 (AI Act), ma di anticiparne l’applicazione con una legge nazionale che introduce obblighi specifici e un apparato sanzionatorio autonomo.

La Legge 23 settembre 2025, n. 132, pubblicata in Gazzetta Ufficiale il 25 settembre e operativa dal 10 ottobre, rappresenta il primo intervento organico del legislatore italiano in materia di intelligenza artificiale. Non si tratta di un documento di principi: è una norma che tocca la responsabilità penale, civile e amministrativa di chiunque interagisca con sistemi di IA e che impone un ripensamento radicale delle strategie di compliance.

Legge 132/2025 e GDPR: l’integrazione funzionale tra due mondi normativi

L’elemento distintivo della Legge 132/2025 risiede nella scelta del legislatore di non creare un sistema parallelo al GDPR, ma di costruire un’architettura di integrazione funzionale. L’articolo 4 della legge italiana stabilisce con chiarezza cristallina che “l’utilizzo di sistemi di intelligenza artificiale garantisce il trattamento lecito, corretto e trasparente dei dati personali e la compatibilità con le finalità per le quali sono stati raccolti, in conformità al diritto dell’Unione europea in materia di dati personali”.

Questo richiamo esplicito ai principi dell’articolo 5 del GDPR non è una clausola di stile: è il fondamento di una accountability condivisa che distribuisce le responsabilità lungo l’intera catena del valore dell’IA. Sviluppatori, fornitori e utilizzatori (deployer) non possono più trincerarsi dietro compartimentazioni formali delle competenze. Il principio di responsabilizzazione richiede che ogni attore della filiera sia in grado di dimostrare la conformità delle proprie attività, anche quando dipendono da componenti tecnologici sviluppati da terzi.

Per il DPO, questo significa assumere un ruolo di coordinamento che travalica i confini tradizionali della funzione. La valutazione dei rischi privacy deve ora integrarsi con l’analisi dei rischi specifici dell’intelligenza artificiale: discriminazione algoritmica, erosione dell’autonomia decisionale umana, opacità dei processi decisionali automatizzati. Non è più sufficiente verificare che esista una base giuridica per il trattamento: occorre valutare se il sistema di IA rispetti i requisiti di trasparenza, spiegabilità e proporzionalità imposti dalla nuova normativa.

Articolo 11: gli obblighi per i datori di lavoro nell’era dell’IA

Se il quadro generale delineato dall’articolo 4 impone un ripensamento strategico, l’articolo 11 della Legge 132/2025 traduce questi principi in obblighi operativi specifici per il contesto lavorativo. La norma introduce una disciplina dettagliata sull’uso dell’intelligenza artificiale nei rapporti di lavoro, stabilendo che il datore di lavoro che utilizzi strumenti basati su IA deve informare preventivamente i lavoratori secondo le modalità previste dal D.lgs. 152/1997, come modificato dalla stessa legge.

L’informativa deve indicare in modo chiaro e comprensibile elementi che fino a ieri appartenevano al lessico esclusivo dei data scientist: finalità e ambito di applicazione dell’IA nel contesto lavorativo, logica di funzionamento anche in termini non tecnici, parametri e metriche utilizzati per la valutazione o la profilazione, livello di accuratezza e robustezza del sistema, potenziali rischi di bias o discriminazioni.

Per i CISO e i security architect, questa disposizione implica un coinvolgimento diretto nella definizione delle specifiche tecniche dei sistemi di IA destinati alla gestione del personale. Non è più possibile acquisire soluzioni “chiavi in mano” senza una due diligence approfondita sulla documentazione tecnica fornita dal vendor. Il deployer deve essere in grado di spiegare ai lavoratori come funziona il sistema che li riguarda: se non dispone di questa conoscenza, non può adempiere agli obblighi informativi.

La connessione con l’articolo 4 dello Statuto dei Lavoratori (Legge 300/1970), richiamato esplicitamente dalla norma, aggiunge un ulteriore strato di complessità. L’utilizzo di sistemi di IA per finalità di ottimizzazione o miglioramento delle prestazioni non può tradursi in forme di sorveglianza o monitoraggio senza le garanzie previste dalla legge: accordo sindacale o autorizzazione dell’Ispettorato Nazionale del Lavoro. Il confine tra “supporto decisionale” e “controllo a distanza” diventa oggetto di interpretazioni che richiederanno tempo per consolidarsi, ma il rischio di sanzioni nel periodo di incertezza è reale e non trascurabile.

Articolo 26: le aggravanti penali e il nuovo reato di deepfake

Il Capo V della Legge 132/2025 rappresenta probabilmente l’innovazione più significativa sul piano sistematico: l’introduzione di fattispecie penali autonome e circostanze aggravanti specifiche per l’uso illecito dell’intelligenza artificiale. L’Italia è il primo Stato membro dell’UE ad approvare una normativa di questo tipo, e la scelta di non limitarsi a principi generali o raccomandazioni etiche merita attenzione.

L’articolo 26, comma 1, lettera a), introduce una nuova circostanza aggravante comune all’articolo 61 del codice penale (numero 11-decies): il reato è aggravato quando è commesso “mediante l’impiego di sistemi di intelligenza artificiale, quando gli stessi, per la loro natura o per le modalità di utilizzo, abbiano costituito mezzo insidioso, ovvero quando il loro impiego abbia comunque ostacolato la pubblica o la privata difesa, ovvero aggravato le conseguenze del reato”.

La portata di questa disposizione è trasversale: si applica a qualsiasi reato, dalla truffa alle minacce, dall’estorsione alla diffamazione. Per le organizzazioni che utilizzano sistemi di IA, questo significa che un utilizzo improprio o negligente della tecnologia può trasformare un illecito “ordinario” in un reato aggravato, con conseguenze sul piano sanzionatorio e, potenzialmente, sulla responsabilità amministrativa degli enti ai sensi del D.lgs. 231/2001.

L’articolo 26 introduce inoltre il nuovo articolo 612-quater del codice penale: “Illecita diffusione di contenuti generati o alterati con sistemi di intelligenza artificiale”. La norma punisce con la reclusione da uno a cinque anni chiunque cagioni un danno ingiusto a una persona cedendo, pubblicando o diffondendo senza il suo consenso immagini, video o voci falsificati o alterati mediante l’impiego di sistemi di intelligenza artificiale e idonei a indurre in inganno sulla loro genuinità.

Per i professionisti della cybersecurity, questa disposizione impone una riflessione sulla gestione dei sistemi di IA generativa all’interno delle organizzazioni. Chi può utilizzare questi strumenti? Per quali finalità? Con quali controlli? L’assenza di policy interne chiare può esporre l’organizzazione a rischi penali diretti, oltre che reputazionali.

La DPIA estesa: valutare i rischi specifici dell’intelligenza artificiale

La Legge 132/2025 estende l’ambito della valutazione d’impatto sulla protezione dei dati (DPIA) prevista dall’articolo 35 del GDPR, introducendo l’obbligo di considerare i rischi specifici dell’intelligenza artificiale. Questa non è una semplice integrazione documentale: è un cambio di paradigma che sposta il focus dalla protezione dei dati alla governance dell’algoritmo lungo l’intero ciclo di vita del sistema.

La DPIA tradizionale si concentra sui rischi per i diritti e le libertà degli interessati derivanti dal trattamento dei dati personali. La DPIA estesa per l’IA deve includere anche la valutazione della discriminazione algoritmica: il rischio che il sistema produca output che penalizzano sistematicamente determinate categorie di persone in base a fattori protetti (sesso, età, origini etniche, orientamento religioso o sessuale).

Il caso Amazon del 2018 – un algoritmo di recruiting che aveva “imparato” a preferire candidati maschi perché addestrato su dataset storici dove le donne erano sottorappresentate – non è un aneddoto: è l’archetipo di un rischio che ogni organizzazione che utilizza IA nel processo di selezione deve saper riconoscere, valutare e mitigare. E la discriminazione può emergere anche in forme meno evidenti, attraverso correlazioni statistiche che sfuggono all’osservazione diretta.

È in questo contesto che assumono rilevanza i principi di explainable AI (XAI) e machine unlearning promossi dalla Legge 132/2025. L’obbligo di spiegabilità non si esaurisce nella generazione di documentazione tecnica per gli esperti: le informazioni devono essere rese “con linguaggio chiaro e semplice, in modo da garantire all’utente la conoscibilità dei relativi rischi e il diritto di opporsi ai trattamenti autorizzati dei propri dati personali” (articolo 4, comma 3).

Il machine unlearning, ovvero la capacità di rimuovere l’influenza di specifici dati dal modello addestrato, diventa uno strumento essenziale per garantire l’esercizio effettivo del diritto alla cancellazione previsto dall’articolo 17 del GDPR. Se un interessato richiede la cancellazione dei propri dati e questi sono stati utilizzati per addestrare un modello di IA, l’organizzazione deve essere in grado di dimostrare che l’influenza di quei dati è stata effettivamente eliminata.

Il coordinamento multi-autorità: Garante Privacy, AgID, ACN

La governance dell’intelligenza artificiale in Italia si articola su tre pilastri istituzionali: il Garante per la protezione dei dati personali, l’Agenzia per l’Italia Digitale (AgID) e l’Agenzia per la Cybersicurezza Nazionale (ACN). L’articolo 20 della Legge 132/2025 designa AgID e ACN quali autorità nazionali responsabili dell’attuazione della normativa nazionale ed europea sull’IA, mentre il Garante mantiene le proprie competenze in materia di protezione dei dati personali.

Questo assetto istituzionale impone alle organizzazioni di gestire interlocuzioni multiple e potenzialmente sovrapposte. Un incidente che coinvolga un sistema di IA può richiedere la notifica al Garante (se comporta una violazione di dati personali), all’ACN (se rientra negli obblighi NIS2) e potenzialmente ad AgID (per profili di conformità dell’IA). La mancanza di un coordinamento efficace può tradursi in oneri amministrativi significativi e nel rischio di comunicazioni incoerenti.

Il caso OpenAI è emblematico di questa complessità. Il 20 dicembre 2024, il Garante per la protezione dei dati personali ha comminato a OpenAI una sanzione di 15 milioni di euro per violazioni connesse alla gestione del servizio ChatGPT: mancata notifica del data breach del marzo 2023, trattamento dei dati personali per l’addestramento del modello senza adeguata base giuridica, violazione del principio di trasparenza, assenza di meccanismi per la verifica dell’età. Il Tribunale di Roma ha successivamente sospeso la sanzione con ordinanza del 21 marzo 2025, ma il procedimento prosegue e le questioni di fondo restano aperte.

Per i CISO e i DPO, questo precedente offre indicazioni operative concrete: la conformità al GDPR per i sistemi di IA richiede attenzione specifica alla base giuridica del trattamento per finalità di addestramento, alla trasparenza delle informative, ai meccanismi di verifica dell’età per servizi accessibili ai minori. Non basta dichiarare di essere compliant: occorre essere in grado di dimostrarlo.

Implicazioni operative: una checklist per i professionisti

La transizione verso un regime di compliance integrata GDPR-IA richiede interventi su più livelli. Per i professionisti della sicurezza informatica, della privacy e della compliance, alcuni adempimenti risultano prioritari.

Aggiornamento delle informative privacy. Le informative esistenti devono essere integrate per includere informazioni specifiche sull’utilizzo di sistemi di IA: finalità del trattamento automatizzato, logica decisionale, conseguenze previste per l’interessato, diritto di ottenere l’intervento umano. Il linguaggio deve essere accessibile anche a utenti non tecnici.

Formazione obbligatoria. L’articolo 4 dell’AI Act europeo impone obblighi di alfabetizzazione in materia di IA che si applicano già dal 2 febbraio 2025. La Legge 132/2025 rafforza questo obbligo nel contesto italiano. Le organizzazioni devono predisporre programmi formativi per il personale che sviluppa, gestisce o utilizza sistemi di IA, con particolare attenzione ai rischi etici, alla discriminazione algoritmica e ai diritti degli interessati.

Revisione dei Modelli 231. Le nuove fattispecie penali introdotte dalla Legge 132/2025 – in particolare l’aggravante generale e le aggravanti speciali per manipolazione del mercato e aggiotaggio – richiedono un aggiornamento dei Modelli di Organizzazione, Gestione e Controllo ai sensi del D.lgs. 231/2001. I protocolli devono includere controlli specifici sull’utilizzo di sistemi di IA.

Mappatura dei sistemi di IA. Le organizzazioni devono procedere a un censimento completo dei sistemi di IA in uso, identificando per ciascuno: fornitore, finalità, categorie di dati trattati, base giuridica, documentazione tecnica disponibile, rischi specifici. Questo inventario è il presupposto per qualsiasi valutazione d’impatto.

Clausole contrattuali con i vendor. I contratti con i fornitori di sistemi di IA devono includere clausole specifiche su: responsabilità per violazioni della normativa privacy e IA, obblighi di documentazione tecnica, diritti di audit, procedure di incident response, cooperazione in caso di esercizio dei diritti degli interessati.

Prospettive: verso una compliance dinamica

La Legge 132/2025 delega il Governo a emanare, entro dodici mesi dall’entrata in vigore, decreti legislativi per adeguare la normativa nazionale all’AI Act europeo e specificare la disciplina dei casi di realizzazione e impiego illeciti di sistemi di IA. Questo significa che il quadro normativo è destinato a evolversi rapidamente, e le organizzazioni devono prepararsi a una compliance dinamica che richiede monitoraggio continuo e capacità di adattamento.

Il tasso di adozione dell’IA nelle imprese italiane si attesta all’8,2% contro una media UE del 13,5% secondo i dati ISTAT 2024. Questo gap competitivo rischia di ampliarsi se la normativa viene percepita esclusivamente come un ostacolo anziché come un’opportunità per costruire un ecosistema di intelligenza artificiale affidabile. Le organizzazioni che avranno già avviato il processo di adeguamento si troveranno in posizione di vantaggio, potendo influenzare l’evoluzione interpretativa della normativa attraverso il dialogo costruttivo con le autorità.

La sfida per i professionisti della sicurezza informatica, della privacy e della compliance non è solo tecnica: è culturale. Richiede la capacità di dialogare con interlocutori diversi – sviluppatori, data scientist, giuristi, management – e di tradurre requisiti normativi complessi in procedure operative sostenibili. La Legge 132/2025 e il GDPR forniscono gli strumenti; sta a noi saperli utilizzare.

Conclusioni

Il regime sanzionatorio per l’IA delineato dalla Legge 132/2025 e dal GDPR impone un cambio di passo nella gestione della compliance. Non si tratta più di adempimenti formali o checklist da spuntare: è necessaria una governance integrata che consideri l’intero ciclo di vita dei sistemi di intelligenza artificiale, dalla progettazione all’utilizzo, dalla valutazione dei rischi alla risposta agli incidenti.

Per CISO, DPO, threat researcher, security architect e legal counsel, questo significa assumere un ruolo proattivo nella definizione delle strategie organizzative sull’IA. La Legge 132/2025 e il GDPR non sono vincoli esterni da subire: sono il perimetro entro cui costruire innovazione responsabile.

Il precedente OpenAI, le sanzioni miliardarie del GDPR Enforcement Tracker 2025, le nuove aggravanti penali per l’uso illecito dell’IA: sono tutti segnali di un enforcement che diventerà sempre più incisivo. Chi attende di essere costretto alla compliance rischia di trovarsi impreparato; chi anticipa i requisiti normativi costruisce resilienza organizzativa e vantaggio competitivo.

La Legge 132/2025 e il GDPR segnano l’inizio di una nuova fase nella regolamentazione dell’intelligenza artificiale in Italia. I prossimi mesi saranno decisivi per definire le prassi interpretative e applicative. I professionisti che sapranno guidare le proprie organizzazioni in questa transizione non saranno solo compliance officer: saranno architetti di un futuro digitale responsabile.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/legge-132-2025-ia/


Sfruttate 37 vulnerabilità zero-day nel primo giorno di Pwn2Own Automotive


Dopo l’ultima edizione tenutasi in Irlanda lo scorso ottobre, il Pwn2Own è tornato nella veste Automotive: tante squadre di hacker si sono sfidate nel cercare e sfruttare nuove vulnerabilità nel mondo dell’industria automobilistica.

Il bilancio della prima giornata di contest è ottimo: le squadre vincitrici hanno portato a casa, in totale, oltre 516.000 dollari per aver trovato 37 vulnerabilità zero-day. La classifica attuale vede in testa il team Fuzzware.io, seguito in ordine da Team DDOS, Compass Security, Synacktiv, arrivato terzo allo scorso Pwn2Own, e PetoWorks.

Pwn2Own Automotive

Le infrastrutture di ricarica sono state quelle più “martellate” dagli hacker con exploit che hanno permesso non solo il controllo del dispositivo, ma anche la manipolazione del segnale di ricarica. Il team di Fuzzware.io ha messo a segno uno dei colpi più spettacolari riuscendo a concatenare due vulnerabilità (mancanza di autenticazione e verifica errata delle firme crittografiche) sull’Autel MaxiCharger, riuscendo a eseguire codice arbitrario e a manipolare il segnale di ricarica.

Grande successo anche per PetoWorks che ha utilizzato una catena di tre bug (un Denial of Service (DoS), una race condition e una command injection) contro il controller Phoenix Contact CHARX, ottenendo il controllo totale del segnale. Team DDOS ha colpito il ChargePoint Home Flex tramite una command injection, mentre SKShieldus (Team 299) ha sfruttato alcune credenziali cablate nel codice per ottenere l’esecuzione di codice sul Grizzl-E Smart.

Durante il Pwn2Own Automotive c’è stato un duro colpo per Tesla: Synacktiv è riuscito a concatenare un leak di informazioni e un out-of-bounds write per compromettere il sistema di Infotainment di Tesla via USB, guadagnando $35.000 e punti preziosi per aggiudicarsi il titolo di “Master of Pwn”.

Molti team si sono concentrati su unità aftermarket popolari come Alpine, Sony e Kenwood. Il team Neodyme AG ha aperto la giornata sfruttando uno stack-based buffer overflow sull’unità Alpine iLX-F511, mentre Synacktiv ha colpito il Sony XAV-9500ES, concatenando tre vulnerabilità per ottenere l’esecuzione di codice a livello root. Infine, il ricercatore Yannik Marchand ha sfruttato un out-of-bounds write per compromettere il Kenwood DNR1007XR.

La competizione durerà fino a venerdì 23 gennaio. Al termine della giornata, verrà incoronato il “Master of Pwn”, ovvero il team o ricercatore che avrà guadagnato complessivamente più punti.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/01/21/sfruttate-37-vulnerabilita-zero-day-nel-primo-giorno-di-pwn2own-automotive/?utm_source=rss&utm_medium=rss&utm_campaign=sfruttate-37-vulnerabilita-zero-day-nel-primo-giorno-di-pwn2own-automotive


Tailscale: la VPN open source semplice e sicura

Tailscale ha reso le VPN finalmente accessibili a tutti. Open source, basato sul potente protocollo WireGuard e pronto all’uso in pochi secondi: ecco perché sempre più utenti e aziende lo stanno adottando.

Privacy digitale e protezione dei dati

La privacy digitale ha come mission la protezione delle informazioni personali e dei dati degli individui nel contesto delle tecnologie digitali e di Internet. Con l’aumento dell’uso di dispositivi connessi, social media, servizi online e cloud computing, la tutela della privacy è diventata una questione centrale sia a livello individuale che sociale.

Le aziende e i servizi online raccolgono dati per vari scopi, come personalizzare contenuti, pubblicità o migliorare i servizi. La normativa come il GDPR (Regolamento Generale sulla Protezione dei Dati) in Europa stabilisce regole rigorose su come questi dati devono essere trattati, ma fuori dall’Europa non valgono le stesse regole. Gli utenti dovrebbero essere informati su quali dati vengono raccolti e come vengono utilizzati, e dovrebbero poter esprimere un consenso libero e informato; tuttavia internet è un ambiente dove i server ospitati potrebbero essere in stati dove la privacy non esiste.

È fondamentale implementare misure di sicurezza per proteggere i dati da accessi non autorizzati, furti o perdite: ecco la necessità delle VPN.

Minacce alla sicurezza online

Tra le principali minacce ci sono malware, phishing, raccolta indesiderata di dati, sorveglianza di massa, e violazioni di sicurezza, specialmente in reti WiFi aperte o da luoghi in cui ci sono connessioni non supervisionate. Il progetto Tailscale, facendo forza sul concetto VPN, aiuta in queste situazioni.

Cos’è una VPN e come funziona Tailscale

Le VPN, in italiano reti private virtuali, sono strumenti che consentono di creare una connessione sicura e crittografata tra un dispositivo e un server remoto attraverso Internet. Questo permette di navigare in modo più sicuro e privato, proteggendo i dati da eventuali intercettazioni o monitoraggi. Quando si è connessi a una VPN, il traffico internet del dispositivo viene incanalato attraverso il server VPN, che può trovarsi in una diversa località geografica. La connessione viene crittografata, quindi i dati che si inviano e ricevono risultano invisibili a terzi, come provider di servizi internet, cracker o governi.

Tailscale è un software di rete basato su WireGuard, un protocollo VPN noto per le sue alte prestazioni e semplicità di configurazione.

La particolarità di Tailscale è permettere di creare reti private tra dispositivi in modo immediato, senza la complessità tradizionale delle configurazioni VPN tramite router/firewall e porte da aprire in entrata. Si tratta di una soluzione zero-configuration che sfrutta il concetto di mesh networking, consentendo ai dispositivi di comunicare direttamente tra loro, ovunque si trovino nel mondo.

Questo modo di navigare con maggiore protezione porta con sé la riduzione della velocità di navigazione e la qualità quindi del servizio varia tra i provider; alcuni possono conservare logs o avere politiche di privacy diverse.

WireGuard: il protocollo alla base di Tailscale

Tailscale è un software di rete basato su WireGuard per stabilire connessioni crittografate end-to-end, garantendo che i dati siano protetti durante il transito. WireGuard è un protocollo VPN noto per le sue alte prestazioni e semplicità di configurazione. Il progetto WireGuard è opensource, creato da Jason A.Donenfeld e rilasciato nel 2016 con caratteristiche innovative. Il codice di WireGuard è molto più compatto rispetto ad altri protocolli VPN come OpenVPN o IPSec, rendendo più facile la revisione, la verifica e la manutenzione; essendo un progetto con un design minimalista offre alte prestazioni e bassa latenza.

Il progetto utilizza algoritmi crittografici all’avanguardia come Curve25519, ChaCha20, Poly1305, BLAKE2s e HKDF per garantire comunicazioni sicure. WireGuard crea tunnel VPN crittografati tra dispositivi. Ogni dispositivo ha una coppia di chiavi pubblica e privata. La configurazione coinvolge l’assegnazione di indirizzi IP alle interfacce WireGuard e la definizione delle chiavi pubbliche degli altri peer. Una volta configurato, il traffico tra i dispositivi avviene attraverso un canale crittografato molto efficiente.

La peculiarità di Tailscale: mesh networking e semplicità

La peculiarità di Tailscale è che permette di creare reti private tra dispositivi in modo immediato, senza la complessità tradizionale delle configurazioni VPN. Le VPN in generale portano con sé vantaggi come nascondere l’IP reale, rendendo più difficile tracciare le attività online, proteggere i dati sensibili soprattutto in reti WiFi pubbliche e permettere di accedere a servizi e siti web disponibili solo in determinate regioni. Si tratta di una soluzione zero-configuration che sfrutta il concetto di mesh networking, consentendo ai dispositivi di comunicare direttamente tra loro, ovunque si trovino nel mondo.

Open source e comunità

Tra i punti di forza, è un progetto open source, permettendo alla comunità di contribuire allo sviluppo e di verificare la sicurezza del software. Il software open source è un tipo di software il cui codice sorgente è reso pubblicamente disponibile e accessibile a chiunque desideri visualizzarlo, modificarlo, migliorarlo e distribuirlo. Questa filosofia si basa sui principi di trasparenza, collaborazione e condivisione, promuovendo lo sviluppo collettivo e aperto di applicazioni e strumenti informatici.

Il termine Open Source indica che chiunque può vedere e studiare come è stato scritto il software, gli utenti possono condividere il software modificato e non modificato con altri e gli utenti possono adattare il software alle proprie esigenze. Il codice è disponibile su GitHub, favorendo trasparenza e collaborazione, all’indirizzo (https://github.com/tailscale/tailscale).

Installazione e gestione

L’installazione e la configurazione sono estremamente semplici. Basta installare il client sui dispositivi desiderati, autenticarsi con un account (ad esempio Google, Microsoft o altri provider OAuth), e la rete si configura automaticamente.

La dashboard Machines di Tailscale: gestione dei dispositivi connessi e supporto multipiattaforma per sistemi operativi, cloud provider e container.

Tailscale supporta Windows, macOS, Linux, Android, iOS, QNAP NAS e Synology NAS, permettendo di collegare dispositivi di diverse tipologie senza difficoltà. Attraverso il pannello di controllo web, gli amministratori possono gestire facilmente gli accessi e le configurazioni della rete. Non è necessario configurare firewall o regole complicate come per le solite soluzioni VPN; tutto viene gestito automaticamente.

Il pannello Access Controls permette di definire regole di accesso tramite editor visuale o JSON, senza configurazioni complesse.

Gli utenti mantengono il controllo sui propri dati e sulla propria rete, senza dipendere da servizi di terze parti centralizzate.

Essendo open source, Tailscale beneficia di una vivace comunità di sviluppatori e utenti che contribuiscono al miglioramento del software. La comunità si confronta su forum, GitHub e altri canali, condividendo suggerimenti, patch e nuove funzionalità. Questo approccio aperto favorisce un rapido sviluppo e una maggiore sicurezza, poiché il codice viene sottoposto a controlli continui da parte di esperti di tutto il mondo.

Conclusioni

Tailscale rappresenta una soluzione all’avanguardia per creare reti private sicure, semplici da configurare e gestire, grazie alla sua natura open source e all’uso di tecnologie moderne come WireGuard. È ideale per utenti individuali tramite account free al portale (tailscacle.com), professionisti e aziende con soluzioni premium o enterprise per collegamenti Kubernetes e dedicato supporto.

Tailscale usa un alto livello di sicurezza, grazie a una crittografia moderna, usa anche un approccio del minimo codice, quindi meno possibilità di bug o vulnerabilità e facile da configurare e mantenere. Essendo relativamente nuovo come progetto, alcune configurazioni avanzate potrebbero richiedere un po’ più di attenzione rispetto a soluzioni più tradizionali,e quindi meno integrazioni o funzionalità avanzate rispetto ad altri protocolli più maturi per il momento.

È sicuramente una soluzione da considerare, un progetto open source in costante evoluzione, ideale per chi desidera proteggere le proprie comunicazioni senza complicazioni tecniche e costi elevati. Il codice aperto permette di individuare e correggere rapidamente vulnerabilità e può essere adattato alle esigenze specifiche, contando su una comunità di utenti e sviluppatori in crescita pronti a offrire assistenza e aggiornamenti.

Profilo Autore

Fabio Carletti aka Ryuw è un White Hat del gruppo (SoldierX Hacker team).

Esperto di sicurezza informatica con una vasta esperienza nel campo della protezione dei sistemi, delle reti e dei dati sensibili. Con più di 20 anni di esperienza nel settore della sicurezza informatica, ha lavorato con diverse organizzazioni per implementare strategie di difesa avanzate e mitigare le minacce informatiche in continua evoluzione.

Collabora come membro volontario del Tor Project team.

Ospite di rilevanti eventi italiani riguardanti la privacy, gnu/linux e software open source dedica le sue energie alla ricerca nella sicurezza informatica.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/tailscale-vpn-open-source/


StackWarp: scoperta una nuova vulnerabilità nei processori AMD


I ricercatori del CISPA Helmholtz Center for Information Security hanno scoperto StackWarp, una nuova vulnerabilità hardware che colpisce i processori AMD di tutte le generazioni.

Nel paper relativo alla scoperta i ricercatori spiegano che il bug consente di manipolare in modo deterministico lo stack pointer all’interno delle Confidential Virtual Machines alterando di fatto la garanzie di integrità di SEV-SNP (Secure Encrypted Virtualization – Secure Nested Paging).

A differenza di vulnerabilità già note che si concentrava sulla gerarchia della memoria o sulle unità di esecuzione, StackWarp sfrutta un difetto nello stack engine, il componente che si occupa di ottimizzare la gestione dello stack pointer, presente nell’esecuzione di operazioni comuni quali push, pop, call e ret.

StackWarp

Per evitare di appesantire le unità logiche generali, l’engine traccia internamente gli spostamenti dello stack pointer. I ricercatori hanno scoperto che esiste però un bit non documentato che consente di abilitare o disabilitare l’engine: poiché lo stato del registro mantenuto dal motore non viene sincronizzato tra i sibling logical cores (unità di elaborazione logica che derivano da un singolo core fisico della CPU), un attaccante può agire su uno dei thread per disattivare il motore dello stack mentre l’altro thread, in esecuzione sull’altro core logico, sta processando istruzioni dello stack.

Ciò provoca un congelamento del delta accumulato nel registro: la CPU continua a eseguire istruzioni, ma l’aggiornamento dello stack pointer viene sospeso e rilasciato successivamente in un unico passaggio, quando il motore viene riabilitato. Un attaccante può eseguire uno spostamento dello stack pointer fino a 640 byte, agendo con precisione chirurgica a livello di singola istruzione senza la necessità di iniettare interrupt o leggere la memoria cifrata.

Il team di ricerca ha documentato quattro scenari di attacco reali condotti su processori AMD di ultima generazione. Nel primo caso, sono riusciti a recuperare una chiave privata RSA-2048 inducendo un errore preciso in una firma digitale, mentre in un secondo scenario sono riusciti a bypassare l’autenticazione tramite password di OpenSSH manipolando il valore di ritorno delle funzioni di controllo.

Un terzo exploit ha mostrato come ottenere privilegi di root tramite il comando sudo, alterando i dati dello stack durante la chiamata di sistema getuid. Infine, l’ultimo attacco ha dimostrato che è possibile eseguire codice arbitrario a livello kernel attraverso una tecnica di Return-Oriented Programming (ROP), reindirizzando lo stack pointer verso un buffer controllato dall’attaccante.

Il team ha spiegato che per risolvere StackWarp sono necessari interventi a livello di microcodice o hardware che impediscano il controllo incrociato del motore dello stack tra diversi thread quando sono attive le Confidential Virtual Machines.

AMD ha iniziato a rilasciare patch per i propri clienti prima della divulgazione pubblica. Nel caso non fossero ancora disponibili le patch o non fosse possibile applicarle, si può disabilitare temporaneamente  il multithreading simultaneo i sistemi che eseguono carichi di lavoro sensibili in ambienti cloud multi-tenant.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/01/20/stackwarp-scoperta-una-nuova-vulnerabilita-nei-processori-amd/?utm_source=rss&utm_medium=rss&utm_campaign=stackwarp-scoperta-una-nuova-vulnerabilita-nei-processori-amd


Framework SLSA: guida completa ai livelli di sicurezza e strategie di implementazione per la Software Supply Chain

L’ecosistema digitale contemporaneo poggia su fondamenta invisibili ma critiche: la catena di approvvigionamento del software. Ogni applicazione moderna integra centinaia di dipendenze, librerie e componenti esterni, creando una superficie di attacco che si estende ben oltre i confini del codice proprietario. Gli attacchi alla supply chain software hanno registrato un incremento del 200% nel 2023 rispetto all’anno precedente secondo il State of the Software Supply Chain Report di Sonatype, trasformando quello che era un vettore di attacco marginale in una minaccia sistemica per l’intero ecosistema tecnologico globale.

L’attacco a SolarWinds nel dicembre 2020 ha rappresentato un punto di non ritorno: la compromissione del processo di build ha permesso la distribuzione di aggiornamenti malevoli a oltre 18.000 organizzazioni, incluse agenzie governative statunitensi e corporation Fortune 500. Questo evento ha catalizzato la nascita di SLSA, un framework che ambisce a definire standard universali per la sicurezza della software supply chain.

Che cos’è il Framework SLSA: origini e architettura concettuale

SLSA (pronunciato “salsa”) è l’acronimo di Supply-chain Levels for Software Artifacts. Sviluppato originariamente da Google e successivamente adottato dalla Open Source Security Foundation (OpenSSF) come progetto community-driven, SLSA rappresenta un framework di sicurezza che definisce requisiti progressivi per proteggere l’integrità degli artefatti software durante l’intero ciclo di vita della produzione.

La filosofia architetturale di SLSA si distingue per tre caratteristiche fondamentali.

La prima è la progressività strutturata: anziché imporre requisiti monolitici, il framework articola la sicurezza in livelli incrementali che permettono un’adozione graduale, calibrata sulla maturità organizzativa e sulle risorse disponibili.

La seconda è la verificabilità empirica: ogni requisito SLSA è progettato per essere verificabile attraverso evidenze oggettive, principalmente mediante attestazioni crittograficamente firmate che documentano la provenance degli artefatti.

La terza è l’agnosticismo tecnologico: il framework prescinde da specifiche tecnologie o piattaforme, concentrandosi su principi universali applicabili a qualsiasi stack tecnologico.

La specifica corrente, SLSA v1.0, rilasciata il 19 aprile 2023, ha consolidato anni di iterazioni e feedback dalla community, introducendo una struttura più coerente e requisiti più pragmatici rispetto alle versioni precedenti. Una novità significativa della v1.0 è la suddivisione dei requisiti in track separati: la versione attuale definisce il Build Track con i livelli 1-3, mentre altri track (come il Source Track) sono previsti per versioni future.

Anatomia dei livelli SLSA: dal livello 0 al livello 3

Il framework SLSA nella versione 1.0 articola la maturità della supply chain security attraverso il Build Track, che comprende quattro livelli progressivi (da L0 a L3). Ciascun livello è caratterizzato da requisiti specifici che rafforzano le garanzie di integrità e provenance degli artefatti software.

Build L0: assenza di requisiti

Il livello zero rappresenta l’assenza di SLSA: nessun requisito è soddisfatto e non esistono garanzie di integrità degli artefatti. Questo livello descrive lo stato di partenza della maggior parte dei progetti software prima dell’adozione del framework.

Build L1: documentazione della provenance

Il primo livello operativo rappresenta il punto di ingresso nel framework e si focalizza sulla creazione di una traccia documentale del processo di build.

Il Livello 1 richiede che il processo di build produca attestazioni di provenance che documentino quale sorgente è stata utilizzata, quale processo di build è stato eseguito e quali artefatti sono stati generati. Queste attestazioni seguono il formato standardizzato in-toto, un framework per la supply chain integrity sviluppato alla NYU Tandon School of Engineering e ora progetto graduated della Cloud Native Computing Foundation.

La provenance al Livello 1 non richiede ancora garanzie crittografiche robuste: l’obiettivo primario è stabilire visibilità sul processo di build, creando le fondamenta per i livelli successivi. Come specificato nella documentazione SLSA, questo livello può essere facilmente aggirato o falsificato, ma fornisce comunque benefici significativi per audit e incident response.

Sebbene le garanzie di sicurezza al Livello 1 siano limitate, l’adozione di questo livello fornisce immediate capacità di tracciamento. In caso di vulnerabilità scoperta in una dipendenza, l’organizzazione può rapidamente identificare quali build sono potenzialmente compromessi.

Build L2: attestazioni firmate e build service autenticato

Il Livello 2 introduce requisiti crittografici che trasformano le attestazioni di provenance da semplici documenti a evidenze verificabili.

Le attestazioni di provenance devono essere crittograficamente firmate utilizzando chiavi gestite dal servizio di build. Questo garantisce che le attestazioni non possano essere falsificate o modificate retroattivamente senza invalidare la firma.

Il processo di build deve essere eseguito su un hosted build service che implementi controlli di autenticazione e autorizzazione. Piattaforme come GitHub Actions, Google Cloud Build e GitLab CI/CD offrono funzionalità native per la generazione di attestazioni SLSA Livello 2.

Il Livello 2 introduce un significativo incremento della fiducia: le attestazioni firmate permettono a consumatori terzi di verificare l’autenticità della provenance senza dover fidarsi implicitamente del produttore del software.

Build L3: isolamento del build e hardening della piattaforma

Il Livello 3 rappresenta il massimo livello di sicurezza attualmente definito nella specifica v1.0, introducendo requisiti architetturali che proteggono il processo di build da manipolazioni interne.

Il build deve essere eseguito in un ambiente isolato che impedisca interferenze da altri processi o build concorrenti. L’isolamento deve garantire che il processo di build non possa essere influenzato da fattori esterni non documentati nelle attestazioni di provenance.

La piattaforma di build deve implementare meccanismi di hardening che prevengano la compromissione del sistema di generazione delle attestazioni, anche in presenza di codice sorgente malevolo. Questo requisito, noto come unforgeable provenance, impone che la generazione e firma delle attestazioni avvenga in un dominio di sicurezza separato dal codice in esecuzione.

La specifica SLSA Build Track dettaglia i requisiti tecnici per l’isolamento, includendo la necessità di ambienti effimeri che vengono distrutti dopo ogni build, l’impossibilità per i custom build steps di accedere ai materiali crittografici usati per firmare la provenance, e l’isolamento completo tra build differenti anche all’interno dello stesso progetto.

Il Livello 3 fornisce garanzie contro minacce interne e compromissioni del processo di sviluppo. Anche se un attaccante ottiene accesso al repository sorgente o al sistema CI/CD, la generazione di attestazioni fraudolente risulta significativamente più complessa.

Prospettive future: Build L4 e Source Track

La specifica SLSA v1.0 si concentra deliberatamente sul Build Track con livelli 1-3, rimandando a versioni future requisiti più avanzati. Come indicato nella documentazione What’s New in SLSA v1.0, sono previsti sviluppi che includono un Build Level 4 (con requisiti come il two-party review e i reproducible builds) e un Source Track dedicato alla protezione dell’integrità del codice sorgente.

Questa scelta architetturale riflette un approccio pragmatico: consolidare requisiti stabili e implementabili prima di estendere l’ambito del framework.

Implementazione pratica del Framework SLSA

L’adozione del framework SLSA richiede un approccio metodico che integri modifiche tecnologiche, processuali e organizzative. Le seguenti linee guida delineano un percorso di implementazione strutturato.

Fase 1: assessment e gap analysis

Prima dell’implementazione, è essenziale condurre una valutazione dello stato corrente della supply chain. La specifica SLSA fornisce criteri dettagliati che possono essere utilizzati come checklist per identificare gap rispetto ai requisiti di ciascun livello.

L’assessment dovrebbe mappare le piattaforme di build attualmente utilizzate e le loro capacità native di attestazione, i processi di code review esistenti, le pratiche di gestione delle dipendenze e la visibilità sulla loro provenance, e le capacità di verifica delle attestazioni nei processi di deployment.

Fase 2: infrastruttura di attestazione

L’implementazione delle attestazioni SLSA richiede l’integrazione di componenti specifici nella pipeline CI/CD. I SLSA GitHub Generators offrono implementazioni di riferimento per GitHub Actions che generano automaticamente attestazioni conformi.

Per ambienti enterprise, Sigstore, un progetto OpenSSF, fornisce un’infrastruttura completa per la firma e verifica delle attestazioni, includendo Fulcio (Certificate Authority per identità effimere), Rekor (Transparency log immutabile per attestazioni) e Cosign (strumento per firma e verifica di container e artefatti).

L’integrazione con SLSA Verifier permette la validazione automatizzata delle attestazioni durante i processi di deployment, garantendo che solo artefatti con provenance verificata raggiungano gli ambienti di produzione.

Fase 3: hardening del build environment

Il raggiungimento del Livello 3 richiede investimenti significativi nell’hardening dell’infrastruttura di build. Le raccomandazioni del NIST Secure Software Development Framework (SSDF) forniscono guidance complementare per l’implementazione di ambienti di build sicuri.

Elementi critici includono l’implementazione di build ermetici che isolino completamente il processo, la separazione dei privilegi tra l’ambiente di esecuzione del build e il sistema di attestazione, il monitoring e logging completo delle operazioni di build per finalità forensi, e la rotazione periodica delle chiavi di firma con audit dei meccanismi di accesso.

Fase 4: integrazione organizzativa

L’aspetto organizzativo risulta critico per il successo dell’implementazione. Anche se il two-party review formale è previsto per livelli futuri, stabilire processi robusti di revisione del codice fin dalle prime fasi dell’adozione SLSA prepara l’organizzazione per requisiti più stringenti.

Le best practice includono la definizione di policy chiare per la revisione del codice, il training dei team di sviluppo sui principi SLSA e sulle procedure operative, l’integrazione dei controlli SLSA nei processi di vendor assessment per dipendenze esterne, e il reporting periodico sulla conformità e sui gap identificati.

Ecosistema e interoperabilità: SLSA nel contesto normativo

Il framework SLSA non opera in isolamento ma si integra in un ecosistema più ampio di standard e normative per la software security.

Sinergie con SBOM e VEX

L’Executive Order 14028 dell’amministrazione Biden, firmato il 12 maggio 2021, ha imposto requisiti di Software Bill of Materials (SBOM) per i fornitori del governo federale USA. SLSA e SBOM sono complementari: mentre SBOM documenta i componenti presenti nel software, SLSA attesta la provenance e l’integrità del processo che ha prodotto quei componenti.

Il formato VEX (Vulnerability Exploitability eXchange), promosso dalla CISA, si integra con le attestazioni SLSA per fornire informazioni sulla applicabilità delle vulnerabilità agli artefatti specifici.

Allineamento con NIS2 e Cyber Resilience Act

La Direttiva NIS2 dell’Unione Europea, applicabile dal 17 ottobre 2024, introduce requisiti espliciti per la sicurezza della supply chain software, particolarmente per operatori di servizi essenziali e fornitori di servizi digitali. L’adozione del framework SLSA costituisce un meccanismo concreto per dimostrare conformità ai requisiti di supply chain risk management previsti dalla direttiva.

Il Cyber Resilience Act, entrato in vigore il 10 dicembre 2024 con piena applicazione prevista dall’11 dicembre 2027, impone requisiti di cybersecurity per prodotti con elementi digitali immessi sul mercato europeo. Il regolamento richiede ai produttori di garantire la sicurezza lungo l’intero ciclo di vita del prodotto, includendo requisiti sulla gestione delle vulnerabilità e sulla trasparenza della supply chain che si allineano strettamente con i principi SLSA.

Prospettive future: SLSA e l’evoluzione della Supply Chain Security

Il framework SLSA rappresenta un punto di partenza, non una destinazione finale, nell’evoluzione della software supply chain security. Diverse direttrici di sviluppo stanno emergendo nella community e nelle organizzazioni di standardizzazione.

Attestazioni per Source Code e dipendenze

Come indicato nella sezione Current Activities del sito SLSA, la community sta lavorando attivamente su nuovi track che estenderanno le garanzie oltre il processo di build. Il Source Track in sviluppo definirà requisiti per la protezione dell’integrità dei repository e per la tracciabilità delle modifiche al codice sorgente. Un Dependency Track è inoltre in fase di elaborazione per affrontare i rischi introdotti dalle dipendenze esterne.

Integrazione con AI/ML Supply Chain

L’emergere di modelli di machine learning come componenti critici delle applicazioni moderne pone sfide uniche per la supply chain security. Iniziative come Model Transparency stanno esplorando l’applicazione di principi SLSA alla provenance dei modelli AI, includendo attestazioni sui dataset di training e sui processi di fine-tuning.

Hardware-Backed Attestations

L’integrazione con tecnologie di attestazione hardware, come Trusted Platform Module (TPM) e Confidential Computing, promette di fornire root of trust basata su hardware per le attestazioni SLSA, elevando ulteriormente le garanzie di integrità.

Conclusioni: SLSA come imperativo strategico

L’adozione del framework SLSA trascende la mera conformità tecnica per configurarsi come imperativo strategico nell’economia digitale contemporanea. In un ecosistema dove la fiducia nel software è prerequisito per qualsiasi transazione digitale, la capacità di attestare rigorosamente la provenance e l’integrità degli artefatti software costituisce un differenziatore competitivo e un requisito per l’operatività in settori regolamentati.

L’implementazione progressiva dei livelli SLSA permette alle organizzazioni di calibrare gli investimenti in sicurezza rispetto al profilo di rischio specifico, evitando sia il sottoinvestimento che espone a compromissioni catastrofiche, sia il sovrainvestimento che drena risorse da altre priorità strategiche.

Il framework SLSA rappresenta la codificazione di principi che la community di sicurezza ha elaborato attraverso decenni di incidenti e lezioni apprese. Con l’entrata in vigore di normative come NIS2 e il Cyber Resilience Act, e con la crescente sofisticazione degli attacchi alla supply chain, la sua adozione non è più questione di “se” ma di “quando” per qualsiasi organizzazione che produca o consumi software in contesti critici.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/framework-slsa/


CERT-AGID 10-16 gennaio: ancora phishing PagoPA e nuovi malware bancari


Nel periodo compreso tra il 10 e il 16 gennaio, il CERT-AGID ha rilevato e analizzato 63 campagne malevole attive in Italia.

Di queste, 46 hanno avuto obiettivi specificamente italiani, mentre 17 campagne di natura generica hanno comunque interessato utenti e organizzazioni nel Paese.

Complessivamente, il CERT-AGID ha messo a disposizione degli enti accreditati 487 indicatori di compromissione (IoC).

I temi della settimana

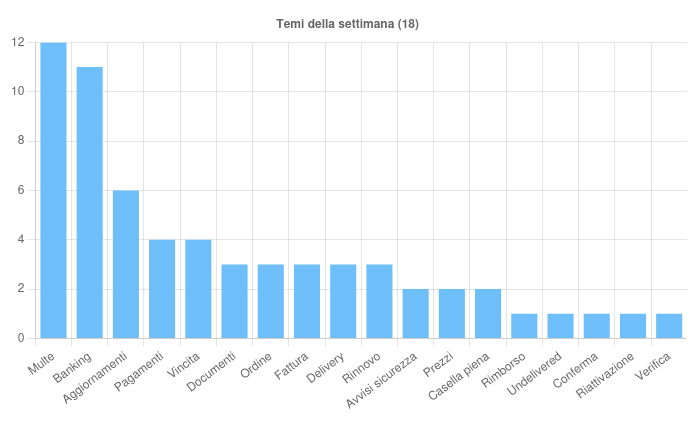
Sono 18 i temi sfruttati per veicolare campagne di phishing e malware.

Il tema Multe continua a dominare con 12 campagne di phishing italiane, tutte veicolate tramite email e costruite come finte notifiche PagoPA relative a presunte sanzioni stradali non pagate. L’obiettivo, come sempre, è indurre le vittime a inserire dati personali e bancari.

Il tema Banking è stato utilizzato in sette campagne di phishing italiane rivolte ai clienti di BPM, BNL, Hype e SumUp.

Lo stesso tema è stato inoltre sfruttato per quattro campagne malware, tre delle quali italiane, che hanno diffuso DonutLoader, Remcos, Copybara e deVixor.

La truffa Tessera Sanitaria si evolve e ora punta anche ai dati delle carte di pagamento. Continuano le campagne PagoPA e debuttano DonutLoader e AMOS

Il tema Aggiornamenti è comparso in sei campagne, cinque generiche e una italiana. Le campagne generiche hanno diffuso principalmente AsyncRAT, mentre quella italiana ha veicolato phishing ai danni di utenti Subito.it.

Il tema Pagamenti è stato sfruttato in tre campagne di phishing ai danni di Aruba e PayPal, oltre a una campagna malware che ha diffuso AgentTesla.

Tra gli eventi di particolare interesse, il CERT-AGID segnala l’individuazione di ulteriori domini malevoli impiegati nel phishing a tema Sistema Tessera Sanitaria, già rilevato la settimana precedente.

Una delle nuove varianti introduce un passaggio aggiuntivo: dopo aver sottratto i dati anagrafici, la vittima viene indirizzata a una schermata che richiede anche le informazioni della carta di credito.

Come scrivevamo sopra, continuano inoltre le campagne ai danni di PagoPA, diffuse tramite email con riferimenti a falsi avvisi di sanzioni stradali.

Fonte: CERT-AGID

Malware della settimana

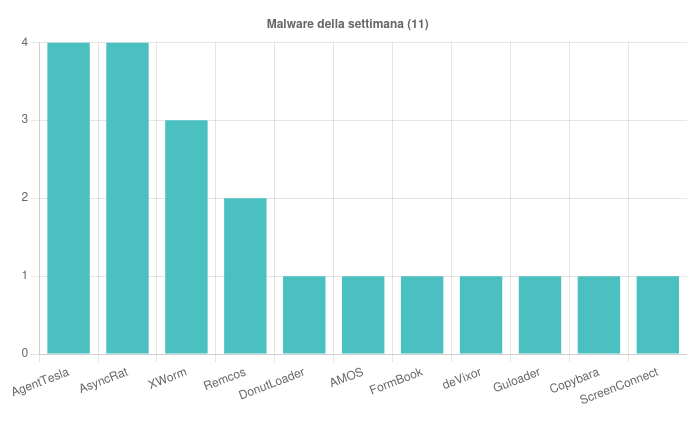
Nel corso della settimana sono state individuate 11 famiglie di malware attive in Italia.

AgentTesla è stato rilevato in una campagna italiana a tema “Ordine” e in tre campagne generiche a tema “Documenti”, “Pagamenti” e “Delivery”, diffuse tramite email con allegati RAR, XZ e TAR.

AsyncRAT è comparso in quattro campagne generiche, tutte a tema “Aggiornamenti” e veicolate tramite allegato ZIP.

XWorm è stato osservato in tre campagne generiche a tema “Ordine”, “Prezzi” e “Fattura”, distribuite mediante allegati RAR e XLSM.

Remcos è stato individuato in una campagna italiana a tema “Banking” veicolata con allegato 7Z e in una campagna generica “Delivery” con allegato RAR.

Copybara e deVixor sono stati rilevati in due campagne a tema “Banking”, una italiana e una generica, veicolate tramite SMS contenenti link per il download di APK malevoli.

Fonte: CERT-AGID

DonutLoader è comparso in una campagna italiana a tema “Banking” diffusa mediante email con allegato 7Z.

AMOS è stato rilevato in una campagna italiana a tema “Documenti” diffusa tramite link a script PS1 malevolo.

Sono state infine osservate campagne generiche che hanno diffuso FormBook, Guloader e ScreenConnect, sfruttando i temi “Ordine”, “Prezzi” e “Aggiornamenti” con allegati RAR, DOCX e MSI.

Phishing della settimana

Sul fronte del phishing, questa settimana i criminali hanno preso di mira 21 brand differenti.

A guidare la classifica delle identità più sfruttate troviamo ancora una volta PagoPA, seguito da Aruba, SumUp e BPM.

Fonte: CERT-AGID

Siamo dunque di fronte a un mix di servizi di pagamento, hosting e istituti bancari che conferma la tendenza degli attaccanti a colpire dove girano soldi e credenziali di valore.

Formati e canali di diffusione

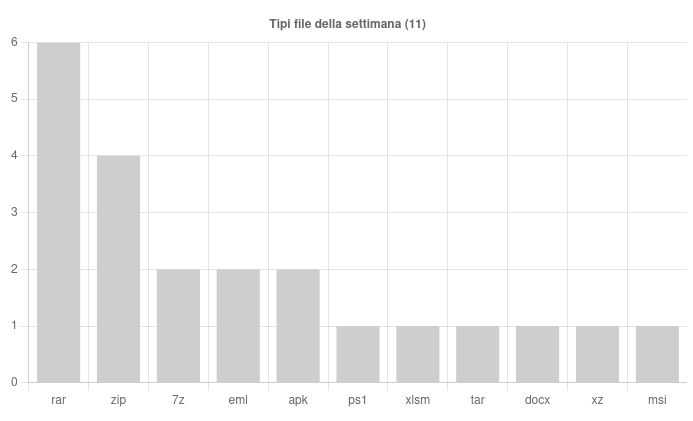
Nel periodo osservato sono state individuate 11 tipologie di file.

Il formato RAR è al primo posto con 6 utilizzi, seguito da ZIP (4). 7Z, EML e APK compaiono con 2 utilizzi ciascuno, mentre PS1, XLSM, TAR, DOCX, XZ e MSI sono stati osservati in un solo caso.

Per quanto riguarda i canali di distribuzione, la posta elettronica rimane dominante con 61 campagne, seguita da 2 campagne veicolate via SMS.

Fonte: CERT-AGID

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/01/19/cert-agid-10-16-gennaio-phishing-pagopa-malware-bancari/?utm_source=rss&utm_medium=rss&utm_campaign=cert-agid-10-16-gennaio-phishing-pagopa-malware-bancari