Patch Tuesday, Microsoft risolve una vulnerabilità già sfruttata e due zero-day


Nel bollettino del Patch Tuesday di dicembre Microsoft ha riportato di aver risolto 57 vulnerabilità, di cui una sfruttata attivamente e due zero-day già rese note.

Il bug già sfruttato dagli attaccanti è il CVE-2025-62221, una vulnerabilità Use-After-Free che consente agli attaccanti di elevare i propri privilegi sul sistema e prenderne il controllo. Il bug colpisce il driver Windows Cloud Files Mini Filter. La vulnerabilità è particolarmente pericolosa perché non richiede né l’interazione dell’utente per essere sfruttata, né precondizioni particolari del sistema.

Patch Tuesday

Le altre due vulnerabilità particolarmente d’interesse sono la CVE-2025-64671 e la CVE-2025-54100. Nel primo caso si parla di un bug di command injection presente in Copilot che consente agli attaccanti di eseguire codice da remoto sulla macchina compromessa. Anche in questo caso, non è necessaria l’interazione utente e non servono privilegi particolari per sfruttarlo.

“Tramite un Cross Prompt Inject dannoso in file non attendibili o server MCP, un attaccante potrebbe eseguire comandi aggiuntivi aggiungendoli ai comandi consentiti nelle impostazioni di approvazione automatica del terminale dell’utente” si legge nel dettaglio della vulnerabilità.

La seconda vulnerabilità è sempre una Command Injection, ma colpisce PowerShell. Come il primo bug, anche questo permette a un attaccante di eseguire codice sulla macchina colpita; in questo caso, però, è necessaria l’interazione dell’utente per eseguire l’attacco.

Oltre a queste tre vulnerabilità, il Patch Tuesday di dicembre include le patch per 28 bug di elevation dei privilegi, 19 bug che consentono l’esecuzione di codice da remoto, 4 bug di information disclosure, 3 bug di denial of service e 2 bug di spoofing.

La lista di 57 vulnerabilità non considera le 13 CVE aggiuntive che colpiscono Edge e che sono state analizzate a inizio mese.

È ovviamente consigliato applicare il prima possibile le patch rilasciate dalla compagnia.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/12/11/patch-tuesday-microsoft-risolve-una-vulnerabilita-gia-sfruttata-e-due-zero-day/?utm_source=rss&utm_medium=rss&utm_campaign=patch-tuesday-microsoft-risolve-una-vulnerabilita-gia-sfruttata-e-due-zero-day


LIME e SHAP: intelligenza artificiale spiegabile per la security intelligence

L’implementazione di LIME e SHAP nella cybersecurity rappresenta oggi uno spartiacque nella relazione tra analisti di sicurezza e sistemi di intelligenza artificiale. Quando un sistema di machine learning classifica un file come malware, blocca una transazione sospetta o identifica un’anomalia nel traffico di rete, comprendere il processo decisionale sottostante non è più una curiosità tecnica ma un requisito operativo, normativo e strategico fondamentale.

Il paradosso della complessità algoritmica nella cybersecurity

Il settore della sicurezza informatica si trova oggi di fronte a un dilemma crescente: quanto più sofisticati diventano i modelli predittivi basati su intelligenza artificiale, tanto più opaca risulta la loro logica decisionale. In un contesto dove ogni decisione automatizzata può avere conseguenze legali, operative e reputazionali significative, questa opacità non è più sostenibile.

LIME (Local Interpretable Model-agnostic Explanations) e SHAP (SHapley Additive exPlanations) rappresentano due approcci matematicamente fondati per decostruire le predizioni dei modelli complessi, trasformando l’AI da oracolo imperscrutabile a collaboratore intelligibile.

LIME: spiegazioni locali per decisioni globali

LIME, proposto nel 2016 da Marco Tulio Ribeiro, Sameer Singh e Carlos Guestrin, affronta il problema dell’interpretabilità con un’intuizione elegante: invece di tentare di comprendere l’intera complessità di un modello globale, si concentra su spiegazioni locali, specifiche per ogni singola predizione.

Quando un sistema di threat detection identifica un comportamento anomalo, LIME costruisce un modello semplificato che approssima il comportamento del classificatore complesso solo nell’intorno di quella specifica istanza. La forza di questo approccio risiede nella sua agnosticità rispetto al modello: funziona indipendentemente dall’architettura sottostante, che si tratti di random forest, reti neurali profonde o ensemble complessi.

Per un team di security operations, questo significa poter interrogare qualsiasi sistema di rilevamento, indipendentemente dalla sua complessità interna, ottenendo risposte comprensibili sulle feature che hanno contribuito a una specifica allerta. L’integrazione di LIME nei sistemi di intrusion detection permette agli analisti di validare le decisioni del modello e identificare potenziali falsi positivi in tempo reale.

SHAP: la matematica della responsabilità algoritmica

SHAP, sviluppato da Scott Lundberg e Su-In Lee nel 2017, porta l’interpretabilità a un livello superiore ancorandosi a una base teorica rigorosa: la teoria dei giochi cooperativi e i valori di Shapley. L’approccio calcola il contributo di ogni feature considerando tutte le possibili combinazioni con le altre variabili, garantendo proprietà matematiche fondamentali come coerenza e additività.

Quando un sistema SIEM basato su machine learning genera un alert di alta priorità, SHAP può quantificare esattamente quanto ogni indicatore di compromissione ha pesato nella decisione. Questa granularità diventa cruciale per discriminare tra falsi positivi e minacce reali, permettendo agli analisti di concentrare l’attenzione sui fattori veramente determinanti.

Le applicazioni pratiche di SHAP nella cybersecurity includono:

  • Intrusion Detection Systems: identificazione delle feature di rete più rilevanti per la classificazione delle minacce
  • Malware Analysis: comprensione dei comportamenti che determinano la classificazione malevola
  • Fraud Detection: quantificazione del peso di ciascun pattern anomalo nelle transazioni
  • Behavioral Analytics: spiegazione delle deviazioni comportamentali degli utenti

GDPR, AI Act e interpretabilità: il contesto normativo europeo

L’aspetto più rilevante di questi framework emerge nell’intersezione con il panorama normativo europeo. Il GDPR (Regolamento UE 2016/679), attraverso l’articolo 22, stabilisce il diritto dell’interessato a non essere sottoposto a decisioni basate unicamente su trattamenti automatizzati che producano effetti giuridici significativi. Sebbene il regolamento non utilizzi esplicitamente l’espressione “diritto alla spiegazione”, gli articoli 13, 14 e 15 impongono obblighi di trasparenza che richiedono di fornire “informazioni significative sulla logica utilizzata” nei processi decisionali automatizzati.

L’AI Act (Regolamento UE 2024/1689), entrato in vigore nell’agosto 2024 con applicazione graduale, estende e rafforza questi requisiti. Per i sistemi di IA ad alto rischio, l’articolo 13 prescrive che i sistemi siano progettati e sviluppati “in modo da garantire che il loro funzionamento sia sufficientemente trasparente” per consentire ai deployer di “interpretare l’output del sistema e utilizzarlo adeguatamente”.

Trasparenza algoritmica e compliance normativa

LIME e SHAP offrono un linguaggio tecnico per rispondere a questi requisiti normativi, traducendo il funzionamento interno dei modelli in termini comprensibili. Tuttavia, è fondamentale distinguere tra spiegabilità tecnica e giustificazione legale: una spiegazione generata automaticamente non costituisce necessariamente una giustificazione valida dal punto di vista giuridico se il modello identifica correlazioni spurie o bias nascosti nei dati di addestramento.

Le organizzazioni che implementano sistemi di IA nella cybersecurity devono quindi:

  1. Documentare i processi decisionali automatizzati con spiegazioni LIME/SHAP
  2. Validare che le correlazioni identificate siano significative dal punto di vista della security
  3. Monitorare continuamente i modelli per identificare drift o bias emergenti
  4. Garantire la supervisione umana nelle decisioni critiche

Digital Forensics e catene di custodia cognitive

Nel campo della digital forensics, l’utilizzo di modelli di machine learning per l’analisi di grandi volumi di dati è ormai consolidato. Dalla classificazione automatica di file sequestrati all’identificazione di pattern di comunicazione sospetti, dall’analisi di timeline complesse al riconoscimento di tecniche di data exfiltration, l’IA è diventata uno strumento investigativo essenziale.

Ma ogni volta che un modello ML contribuisce a un’indagine, si pone il problema della sua ammissibilità probatoria. Un giudice, un perito di parte o un collegio difensivo devono poter comprendere non solo il risultato di un’analisi, ma il percorso logico che ha condotto a quella conclusione.

LIME e SHAP trasformano il modello da strumento opaco a componente documentabile di una catena investigativa. Quando un algoritmo identifica un cluster di documenti come rilevanti per un caso di sottrazione di informazioni riservate, SHAP può mostrare quali caratteristiche linguistiche, metadati temporali o pattern di accesso hanno determinato quella classificazione.

Questa tracciabilità rappresenta una garanzia epistemologica che permette di identificare quando un modello sta “ragionando” in modo sensato rispetto al contesto investigativo e quando invece sta seguendo correlazioni artefatte dai dati.

I limiti intrinseci dell’interpretabilità post-hoc

Sarebbe ingenuo considerare LIME e SHAP come soluzioni definitive al problema dell’opacità algoritmica. Entrambi i framework presentano limitazioni intrinseche che è fondamentale riconoscere:

Limitazioni di LIME:

  • Fornisce spiegazioni approssimate: il modello semplificato locale non cattura necessariamente la vera complessità del sistema originale
  • Instabilità: piccole perturbazioni nei dati possono produrre spiegazioni diverse
  • Selezione del vicinato: la definizione dell’intorno locale per dati tabulari rimane una questione irrisolta

Limitazioni di SHAP:

  • Complessità computazionale: i requisiti crescono esponenzialmente con il numero di feature, rendendolo impraticabile per modelli con centinaia o migliaia di variabili
  • Assunzione di indipendenza: assume implicitamente l’indipendenza tra feature, che raramente si verifica nella realtà
  • Tempo di calcolo: per applicazioni real-time può risultare troppo lento

In cybersecurity, dove il panorama delle minacce evolve continuamente e gli attaccanti adattano le proprie tecniche per eludere i sistemi di rilevamento, queste distinzioni sono cruciali. La ricerca sull’interpretabilità automatizzata sta esplorando nuove frontiere per superare queste limitazioni.

Implementazione pratica nei Security Operations Center

L’adozione di LIME e SHAP nei Security Operations Center (SOC) richiede un approccio strutturato che bilanci esigenze operative, requisiti normativi e vincoli computazionali.

Framework di implementazione

  1. Assessment iniziale:
    • Identificare i modelli ML critici che richiedono interpretabilità
    • Valutare i requisiti normativi specifici (GDPR, AI Act, NIS2)
    • Determinare i vincoli di latency accettabili
  2. Integrazione tecnica:
    • Implementare SHAP per analisi offline e validazione dei modelli
    • Utilizzare LIME per spiegazioni real-time sugli alert critici
    • Sviluppare dashboard di visualizzazione per gli analisti
  3. Formazione e change management:
    • Formare gli analisti sull’interpretazione delle spiegazioni
    • Integrare l’XAI nei processi decisionali esistenti
    • Creare procedure per l’escalation dei casi ambigui
  4. Monitoraggio e validazione continua:
    • Verificare la coerenza delle spiegazioni nel tempo
    • Identificare drift nei modelli attraverso l’analisi delle spiegazioni
    • Documentare le decisioni per audit e compliance

Verso una Security Intelligence trasparente e responsabile

Il vero valore di LIME e SHAP risiede non tanto nella loro capacità di rendere ogni decisione algoritmica completamente trasparente, quanto nel modo in cui ridefiniscono il rapporto tra intelligenza artificiale ed expertise umano nel dominio della security. Questi strumenti non sostituiscono il giudizio dell’analista, ma lo potenziano, fornendo insight azionabili che permettono di validare, contestare o raffinare le predizioni automatiche.

In un settore dove la velocità di risposta è determinante ma l’errore può avere conseguenze devastanti, questa sinergia tra automazione e interpretabilità rappresenta l’unico percorso sostenibile. Non si tratta di rinunciare alla potenza predittiva dei modelli complessi in nome di una trasparenza assoluta, né di accettare ciecamente le decisioni algoritmiche in nome dell’efficienza.

Si tratta di costruire sistemi che siano tanto potenti quanto interrogabili, tanto sofisticati quanto responsabili. L’adozione diffusa di framework come LIME e SHAP nei security operations center, nei sistemi di threat intelligence e negli strumenti di digital forensics non è quindi solo una questione tecnica o una risposta a obblighi normativi.

È un passo necessario verso una concezione più matura dell’intelligenza artificiale in cybersecurity, dove la capacità di spiegare è considerata non meno importante della capacità di predire. L’integrazione di approcci ibridi e neuro-simbolici promette di superare le attuali limitazioni, mantenendo l’interpretabilità come proprietà intrinseca dei sistemi.

In un dominio dove le decisioni hanno conseguenze reali su persone, organizzazioni e infrastrutture critiche, l’opacità non è più un prezzo accettabile da pagare per l’innovazione. La convergenza tra requisiti normativi europei e necessità operative sta spingendo l’intera industria della cybersecurity verso standard più elevati di trasparenza e accountability.

Fonti:

Ribeiro, M.T., Singh, S., Guestrin, C. (2016). “Why Should I Trust You?”: Explaining the Predictions of Any Classifier. KDD 2016.

Lundberg, S.M., Lee, S.I. (2017). A Unified Approach to Interpreting Model Predictions. NIPS 2017.

Regolamento (UE) 2016/679 (GDPR) – Testo ufficiale

Regolamento (UE) 2024/1689 (AI Act) – Testo ufficiale

LIME – GitHub Repository

SHAP – GitHub Repository

SHAP Documentation

Frontiers in Artificial Intelligence (2025). A systematic review on the integration of explainable artificial intelligence in intrusion detection systems.

IEEE (2024). Explainable AI for Intrusion Detection Systems: LIME and SHAP Applicability on Multi-Layer Perceptron.

PLOS ONE (2025). Advancing malware imagery classification with explainable deep learning using SHAP, LIME and Grad-CAM.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/lime-e-shap/


L’AI Factory italiana per l’autonomia digitale europea: la strategia di ACN presentata al Forum ICT Security 2025

Durante la 23a edizione del Forum ICT Security, tenutosi a Roma il 19 e 20 novembre 2025, Luca Nicoletti, direttore del servizio programmi industriali, tecnologici e di ricerca dell’Agenzia per la Cybersicurezza Nazionale (ACN), ha presentato un intervento di grande rilevanza strategica dal titolo “The Italian AI Factory for the European Digital Autonomy: securing AI development and deployment”.

Al centro della presentazione: IT4LIA, l’infrastruttura che rappresenta il cuore della strategia italiana per conquistare autonomia tecnologica nel campo dell’intelligenza artificiale e della cybersicurezza, in un contesto geopolitico sempre più complesso e imprevedibile.

La strategia nazionale: un percorso già tracciato

ai technologies
AI technologies: the strategic priorities

Luca Nicoletti ha aperto il proprio intervento ripercorrendo brevemente il cammino strategico intrapreso dall’Italia negli ultimi anni. Una strada segnata da tappe fondamentali:

  • Giugno 2021: promulgazione della Legge 82/2021 che istituisce ACN e definisce le prime linee guida sulla cybersicurezza nazionale
  • Maggio 2022: pubblicazione della Strategia 2022-2026 e del Piano di Implementazione, documenti che traducono in azioni concrete la visione strategica
  • Marzo 2023: definizione dell’Agenda Strategica del Centro Europeo di Competenza in Cybersicurezza
  • Giugno 2023: pubblicazione dell’Agenda Ricerca e Innovazione di ACN
  • Luglio 2024: approvazione dell’AI Act europeo (Regolamento UE 1689/2024)
  • Settembre 2025: trasposizione italiana con la Legge n. 132/2025, che designa ACN come autorità di vigilanza del mercato

Con l’AI Act, l’Agenzia ha assunto responsabilità ancora maggiori, moltiplicando i propri compiti «in uno scenario che è assolutamente critico per lo sviluppo della nostra economia», come ha sottolineato il direttore.

Il nuovo ruolo di ACN nell’ecosistema dell’intelligenza artificiale

Con l’entrata in vigore della normativa europea e italiana sull’intelligenza artificiale, ACN ha assunto un ruolo centrale e multifunzionale:

  • Autorità di vigilanza del mercato: responsabile della sorveglianza sui prodotti AI, delle azioni correttive e dei poteri investigativi e sanzionatori
  • Punto di contatto unico con le istituzioni dell’Unione Europea
  • Rappresentante italiano nell’AI Board europeo, l’organismo composto da rappresentanti di tutti gli Stati membri
  • Autorità di certificazione per i sistemi di intelligenza artificiale
  • Promotore dello sviluppo tecnologico: sviluppo, trasferimento e miglioramento delle tecnologie AI in ambito cybersicurezza

L’Italia, come precisato nell’intervento, promuove un approccio centrato sull’essere umano (human-centered approach) all’intelligenza artificiale, con particolare enfasi sulla valorizzazione dei benefici e sulla gestione attenta dei rischi, salvaguardando i diritti fondamentali.

ai factory
AI ACT and ACN role

AGID (Agenzia per l’Italia Digitale), invece, è stata designata come autorità di notifica, insieme ad altre entità che compongono l’ecosistema nazionale dell’innovazione digitale.

IT4LIA: il cuore pulsante dell’autonomia digitale italiana

Il fulcro dell’intervento si è concentrato sull’AI Factory italiana, denominata IT4LIA, un’infrastruttura strategica in fase di sviluppo a Bologna che rappresenta uno dei pilastri della strategia nazionale per l’indipendenza tecnologica.

«Riteniamo in ACN che il tema dell’intelligenza artificiale sia assolutamente centrale. Già oggi, ancora di più lo sarà nei prossimi anni», ha dichiarato Nicoletti, evidenziando come l’AI stia rapidamente diventando un autentico game changer – un elemento di svolta radicale – per l’economia, i servizi pubblici, lo sviluppo di prodotti competitivi sul mercato e, più in generale, per la qualità della vita del sistema Paese.

L’esperto ha tenuto a precisare che il discorso non è «beceramente economico»: si tratta piuttosto di una questione che riguarda la qualità della vita complessiva e la resilienza del sistema Paese in un contesto geopolitico sempre più complesso e imprevedibile.

L’importanza strategica dell’autonomia infrastrutturale

«Abbiamo assolutamente bisogno di sviluppare maggiormente le nostre infrastrutture perché non possiamo dipendere, soprattutto in un contesto geopolitico che sta cambiando con una velocità impressionante, da infrastrutture proprietarie di infrastrutture che siano collocate all’interno dell’Unione europea», ha affermato con forza il relatore.

Il punto è cruciale: oggi le tecnologie e le infrastrutture digitali sono sviluppate ed erogate principalmente da grandi multinazionali americane. Questa dipendenza rappresenta un rischio strategico inaccettabile, soprattutto considerando i rapidi e imprevedibili stravolgimenti dello scenario geopolitico globale a cui assistiamo quotidianamente.

ai factory
IT4LIA: focus on key priorities

Le quattro priorità verticali di IT4LIA

L’AI Factory italiana si concentra su quattro settori strategici fondamentali per l’economia e la sicurezza nazionale:

  1. Cybersecurity
    Lo sviluppo di soluzioni avanzate per rilevare e mitigare minacce digitali rappresenta naturalmente la priorità principale, considerando il ruolo di ACN come principale finanziatore dell’iniziativa. L’obiettivo è creare sistemi di intelligenza artificiale specificamente progettati per la sicurezza informatica, capaci di identificare pattern anomali, prevenire attacchi e rispondere rapidamente alle minacce emergenti.
  2. Agritech e Agrifood
    Il settore agroalimentare italiano è un’eccellenza riconosciuta a livello mondiale. L’applicazione dell’AI può supportare lo sviluppo di un’agricoltura più sostenibile e efficiente, ottimizzare le produzioni agroalimentari e garantire tracciabilità e qualità. «Potete immaginare facilmente quante applicazioni si possono fare delle tecnologie di intelligenza artificiale al campo dell’agrifood», ha commentato il direttore.
  3. Earth
    L’analisi di dati ambientali e la modellazione predittiva sono essenziali per affrontare le sfide climatiche. «È immediatamente immaginabile da un lato sicuramente sistemi di previsione della situazione meteorologica, ma anche relativa all’inquinamento, relativo al tema del riscaldamento globale e così via», ha spiegato Nicoletti, evidenziando le molteplici applicazioni possibili in questo ambito.
  4. Manufacturing
    L’Italia è un Paese la cui economia è fondata prevalentemente sulla manifattura. «Fondamentale, se vogliamo di nuovo competere sul mercato globale, poter ricorrere alle tecnologie più importanti» per ottimizzare i processi industriali, ridurre gli sprechi, migliorare la qualità produttiva e aumentare la competitività internazionale.

Una strategia integrata: i quattro pilastri dell’innovazione

ai factory
National cybersecurity strategy towards European Digital Autonomy

La strategia di ACN, già incorporata nella legge istitutiva del 2021 e formalizzata nel documento pubblicato nel 2022, si articola su quattro pilastri fondamentali strettamente interconnessi tra loro, che coprono l’intero ciclo dell’innovazione: dalla ricerca di base fino alla messa a terra di infrastrutture nazionali operative.

1. Ricerca e innovazione: la base della piramide

«La ricerca è fondamentale per creare nuove opportunità, per creare nuova tecnologia», ha affermato il relatore. ACN sta attualmente finanziando circa 60 borse di dottorato, con l’obiettivo di arrivare a circa 90 borse attive a regime. La maggior parte di queste borse è dedicata a temi legati all’intelligenza artificiale.

Nei prossimi mesi e semestri verranno lanciate anche iniziative verticali sui gruppi di ricerca, specificatamente orientate verso il trasferimento tecnologico. Un punto importante sottolineato dall’esperto: «La nostra ricerca deve essere ricerca volta verso il trasferimento tecnologico». Pur riconoscendo l’importanza della ricerca di base, ACN concentra i propri finanziamenti su progetti che abbiano una chiara prospettiva di applicazione pratica e di sviluppo industriale.

2. Iniziative per le startup: colmare il divario critico

«Il link in questo momento è il punto più debole del nostro ecosistema italiano», ha dichiarato con franchezza il direttore, riferendosi al collegamento tra ricerca e impresa. «Il gap che c’è tra chi fa ricerca e chi fa impresa tutt’oggi è troppo ampio».

Questo divario ha cause molteplici e complesse:

  • Difficoltà di accesso al mercato per le giovani imprese innovative
  • Difficoltà di accesso al venture capital, che in Italia e in Europa non è ancora sufficientemente maturo
  • Carenza di competenze specifiche nel capitale di rischio tecnologico

Come ha spiegato Nicoletti, «il venture capital in questo ambito deve avere due caratteristiche fondamentali: la competenza e la velocità nel rispondere agli stimoli che vengono appunto dai nostri gruppi di ricerca, e non sempre questo purtroppo è completamente presente».

Per questo motivo, ACN sta sostenendo una serie di iniziative dedicate specificamente alle startup, fornendo non solo supporto finanziario ma anche servizi di accompagnamento e mentoring per facilitare il percorso verso il mercato.

3. Networking: costruire ponti tra innovazione e sistema produttivo

«Una volta che abbiamo queste startup bisogna metterle in grado di poter lavorare con i grandi gruppi, con le grandi pubbliche amministrazioni», ha sottolineato l’esperto. Questo è un altro tema sul quale, onestamente, «dobbiamo lavorare parecchio ancora in Italia».

Lo sviluppo di un efficace sistema di networking è fondamentale per creare un ecosistema maturo e funzionale. Questo tema viene sviluppato anche a livello europeo attraverso il National Coordination Centre (NCC), che rappresenta la componente italiana del Centro Europeo di Competenza in Cybersicurezza.

Il NCC facilita la collaborazione tra ricerca, industria e pubblica amministrazione, promuove eventi di matchmaking tra domanda e offerta di innovazione, e lavora all’analisi continua dell’ecosistema per identificare opportunità e criticità.

4. Infrastrutture nazionali: il tassello strategico finale

«Ultimo ma non ultimo», come ha precisato il relatore, si arriva al tema delle infrastrutture nazionali, elemento su cui si è concentrata la parte finale e più sostanziale dell’intervento.

Oltre all’AI Factory IT4LIA, ACN sta sviluppando un intero ecosistema di infrastrutture strategiche:

  • ENSOC (National Cyber Hub): iniziativa che rientra nell’ambito del Cyber Solidarity Act europeo, rappresenta un centro di concentrazione di tutte le informazioni di natura cyber raccolte nell’ecosistema nazionale. «Non necessariamente incidenti, noi vogliamo collezionare proprio eventi che poi in qualche modo, dopo una opportuna elaborazione, possano rivelare comportamenti o fenomeni in qualche maniera effettivamente malevoli», ha precisato.
  • Sandbox regolatorie: «Un altro strumento fondamentale per le nostre imprese, per comprendere come muoversi all’interno di uno scenario complesso, molto complesso, come è quello dell’AI», soggetto a numerose regolamentazioni sovrapposte: AI Act, Cyber Resilience Act, direttiva NIS2, direttiva CER, regolamento DORA in ambito finanziario. «C’è una enorme sovrapposizione di norme che non sempre è immediato comprendere e collocare correttamente».
  • Megaride: infrastruttura di high performance computing per la cybersicurezza nazionale, già installata a Napoli.
  • AI Gigafactory: il passo successivo, di scala ancora maggiore rispetto all’AI Factory, di cui si è accennato ma che non è stato oggetto di approfondimento specifico.
  • Cable Labs: ulteriore strumento per il monitoraggio delle infrastrutture critiche, non soltanto di comunicazione ma anche di approvvigionamento e distribuzione energetica.

Il mercato europeo della cybersicurezza: numeri e opportunità

ai factory
The European cybersecurity market context

«Questa è l’unica slide di numeri che vi faccio vedere», ha premesso il relatore prima di illustrare alcuni dati particolarmente significativi relativi al 2024 (in attesa di quelli del 2025, previsti in crescita di circa il 10%).

Un mercato da quasi 200 miliardi di euro

Il mercato globale della cybersicurezza vale circa 200 miliardi di dollari, di cui circa la metà (91 miliardi) sviluppati in Europa, seguita dagli Stati Uniti (184 miliardi) e dal resto del mondo (48 miliardi).

«Siamo una grande economia, siamo probabilmente uno dei posti principali, insieme agli Stati Uniti, dove fare impresa e dove sviluppare tecnologia», ha affermato con orgoglio Nicoletti, ribadendo un concetto fondamentale: «Questo discorso non deve essere visto in maniera sterile. Il tema – purtroppo o per fortuna viviamo in un’economia di mercato – della capacità, della possibilità di mettere a terra e di sviluppare economia è fondamentale per il nostro continente e per lo stile di vita che abbiamo noi in Europa».

L’Italia: terza potenza europea

L’Italia si posiziona come terzo Paese nell’Unione Europea per quota di mercato della cybersicurezza, preceduta solo da Germania e Francia. Un risultato significativo che testimonia la solidità dell’ecosistema italiano in questo settore strategico.

Una crescita superiore a USA e Israele

Il mercato europeo sta crescendo a un ritmo del 8,9% annuo (periodo 2022-2024), superando la crescita di Israele (6,4%) e allineandosi agli Stati Uniti (8,8%). Un segnale che l’Europa sta recuperando terreno e che gli investimenti in questo settore stanno dando frutti concreti.

Le acquisizioni: un ecosistema che si rafforza

Un dato particolarmente interessante emerso dall’analisi riguarda le acquisizioni di aziende europee di cybersicurezza. Nel 2024, 134 aziende europee del settore sono state acquisite da altre aziende o fondi di private equity, con un incremento del 13% rispetto al 2023.

Il dato più rilevante è che oltre due terzi delle acquisizioni (72%) sono state condotte da investitori europei, mentre solo il 25% da investitori statunitensi e il restante 4% dal resto del mondo. Questo rappresenta un segnale molto positivo: indica che l’ecosistema continentale si sta consolidando e rafforzando internamente, riducendo la dipendenza da capitali esterni.

Una doppia vittoria strategica

«La cyber security, lo sviluppo di questo tipo di tecnologia è una doppia vittoria», ha spiegato efficacemente il relatore. «Nel momento in cui riusciamo veramente a mettere a terra queste cose che stiamo provando a fare, da un lato ci garantiremo un ecosistema più sicuro, quindi più attrattivo per le persone che possono venire a lavorare in Europa. Dall’altra parte abbiamo la possibilità di creare economia, di creare posti di lavoro, di creare ricchezza e in definitiva di stare meglio complessivamente a livello europeo».

Un approccio integrato ai servizi dell’AI Factory

ai factory
IT4LIA: an Integrated Services Approach to AI

IT4LIA non è semplicemente un’infrastruttura di calcolo: è una piattaforma integrata di servizi che copre l’intera filiera dell’intelligenza artificiale, dalla gestione dei dati fino alla formazione delle competenze.

I quattro cluster di servizi

1. Servizi relativi ai dati (Data-related services)

Comprendono accesso, trasferimento, gestione e generazione di dati. «Come si accede, come si trasferisce, come si gestisce, come si prepara un dataset ben fatto per applicazione di intelligenza artificiale», ha elencato il direttore. La qualità e la corretta preparazione dei dati sono infatti fondamentali per ottenere risultati affidabili dai sistemi di AI.

2. Servizi orizzontali (Horizontal services)

Coprono tutti gli aspetti trasversali dello sviluppo AI: setup iniziale, sviluppo vero e proprio, verifica del trust (affidabilità) dei sistemi, testing, integrazione in rete. «Come si fa il setup, come si sviluppa, come si fa a verificare il trust in questi sistemi, come si fa a testarli, come si fa a metterli in una rete e così via», ha sintetizzato.

3. Servizi verticali (Vertical services)

Servizi specializzati nei quattro ambiti prioritari: agrifood, cybersicurezza, earth e manufacturing. Ogni settore richiede competenze specifiche e soluzioni dedicate che tengano conto delle peculiarità del dominio applicativo.

4. AI Skill

«Anzi dal mio punto di vista è quello più importante», ha sottolineato con particolare enfasi il relatore, introducendo il tema cruciale delle competenze.

La carenza di competenze: l’emergenza silenziosa

Il tema delle competenze (skill) è stato identificato come prioritario e urgente. «Soffriamo una carenza di skill gigantesca in tutti i campi tecnologici», ha dichiarato senza mezzi termini lo speaker.

Il sistema universitario: eccellenza ma inerzia strutturale

«Purtroppo il sistema universitario ha una certa inerzia, non si può pensare che dall’oggi al domani triplichiamo il numero di laureati STEM che siamo in grado di produrre», ha spiegato realisticamente Nicoletti, che però ha tenuto a precisare: «Dobbiamo essere fieri del nostro sistema universitario, perché tutt’ora, con tutte le difficoltà nel quale si dibatte, produce laureati di ottima qualità».

La fuga dei cervelli: un’emorragia continua

Il problema è che questi laureati di ottima qualità «molto spesso ci vengono rapiti all’estero». La cosiddetta “fuga dei cervelli” (brain drain) rappresenta una perdita secca per il Paese, che investe nella formazione ma poi vede i propri talenti migliori attratti da opportunità all’estero, principalmente negli Stati Uniti e in altri Paesi europei più competitivi.

L’AI Factory come palestra per i talenti

«Uno degli scopi di queste grandi infrastrutture è proprio di mettere a disposizione delle palestre sulle quali i nostri talenti si possano esercitare, le nostre startup possano lavorare», ha spiegato il direttore. Questo diventa un elemento fondamentale, una condizione chiaramente necessaria, non sufficiente, ma necessaria per trattenere questi talenti nel nostro Paese.

L’idea è creare un ambiente stimolante, dotato di tecnologie all’avanguardia, dove giovani ricercatori, data scientist e sviluppatori possano lavorare su progetti sfidanti e di frontiera senza dover necessariamente emigrare all’estero.

IT4LIA offrirà quindi servizi di training, capacity building, up-skilling e re-skilling, creando percorsi formativi continui che permettano ai professionisti di rimanere aggiornati in un settore che evolve con rapidità esponenziale.

EUSAiR: le sandbox regolatorie per accelerare l’innovazione

ai factory
THE EUSAiR Project

Un’iniziativa particolarmente innovativa menzionata nell’intervento è il progetto EUSAiR (EU Regulatory Sandboxes for AI), dedicato allo sviluppo di sandbox regolatorie per l’intelligenza artificiale.

Cosa sono le sandbox regolatorie

Le AI Regulatory Sandboxes (AIRS) sono ambienti controllati dove le imprese, in particolare PMI e startup, possono sviluppare e testare sistemi di intelligenza artificiale innovativi prima dell’ingresso sul mercato, verificando la conformità con l’AI Act e le altre normative europee e nazionali.

Come previsto dall’articolo 57 dell’AI Act e dall’articolo 20, comma 1, lettera c della Legge italiana 132/2025, ogni Stato membro dell’UE deve istituire almeno una sandbox per:

  • Supportare l’innovazione e lo sviluppo responsabile dell’AI
  • Garantire la conformità legale e la gestione dei rischi
  • Fornire chiarezza normativa e facilitare l’apprendimento regolatorio
  • Migliorare la cooperazione tra autorità e stakeholder
  • Facilitare l’accesso al mercato, in particolare per PMI e startup

Un progetto multidisciplinare coordinato da giuristi

«È interessante notare che è un progetto, una volta tanto, pur essendo in ambito AI, pur essendo in ambito quindi molto tecnologico, coordinato dal dipartimento di giurisprudenza dell’Università di Bologna», ha evidenziato con soddisfazione il relatore.

«Quindi è interessante che c’è il professore di giurisprudenza che coordina questo tipo di progetto. Questo anche per far capire quanto poi l’ambito sia sempre di più diventando multidisciplinare e aperto a diversi tipi di competenze che sono necessarie».

Un segnale importante: l’intelligenza artificiale non è solo una questione tecnica, ma richiede l’integrazione di competenze giuridiche, etiche, economiche e sociali per uno sviluppo veramente responsabile e sostenibile.

La sinergia tra IT4LIA e EUSAiR

La Commissione europea sta utilizzando il progetto EUSAiR come riferimento per definire le regole di costruzione delle sandbox regolatorie in tutta Europa. Questo rappresenta un riconoscimento importante per l’Italia e per l’approccio metodologico adottato.

La collaborazione tra IT4LIA e EUSAiR crea un percorso bidirezionale virtuoso:

  • Le imprese possono accedere ai servizi AI Trust di IT4LIA per ricevere orientamento regolatorio prima di sviluppare modelli o sistemi AI, e poi testarli nelle sandbox
  • Oppure possono accedere prima alle sandbox per ricevere consulenza sulla conformità normativa, e poi sviluppare concretamente i sistemi AI nell’infrastruttura della Factory

«IT4LIA può preparare i fornitori di AI per una sperimentazione regolatoria nelle sandbox. EUSAiR beneficerà dell’insieme di servizi AI Trust erogati dalla Factory. Le sinergie aiuteranno a costruire un ecosistema AI coerente che supporta la sperimentazione, la conformità e un accesso più rapido al mercato», si legge nelle slide presentate.

L’obiettivo finale è ridurre i costi di conformità per le imprese e migliorare il time-to-market, fattori cruciali soprattutto per le piccole e medie imprese e le startup che non dispongono di risorse legali interne paragonabili a quelle delle grandi multinazionali.

L’adozione sicura dell’AI: un approccio a 360 gradi

ai factory
Safe Adoption of AI: An Integrated Services Approach

Un’intera sezione delle slide è dedicata all’adozione sicura dell’intelligenza artificiale, un tema centrale per ACN in quanto autorità di vigilanza.

Servizi orizzontali e AI Trust

L’implementazione di servizi volti a garantire che i sistemi AI siano affidabili, etici, trasparenti e conformi alle normative applicabili include:

  • Analisi delle implicazioni di cybersicurezza (es. NIS2 e CRA – Cyber Resilience Act)
  • AI e protezione dei dati (es. GDPR e Codice Privacy italiano)
  • Legal Triage: una guida alla conformità regolatoria AI (es. AI Act, Legge n. 132/2025, Strategia Nazionale AI)

Servizi verticali per la cybersicurezza

Nel settore della cybersicurezza, IT4LIA svilupperà:

  • Identificazione e selezione di dataset AI-ready nei domini verticali (agrifood, osservazione della Terra, cybersicurezza, manifatturiero)
  • Preparazione e standardizzazione dei dati per i modelli AI in questi settori verticali
  • Selezione e caratterizzazione di modelli AI specifici per dominio
  • Sviluppo di modelli AI per supportare applicazioni di cybersicurezza data-driven, che serviranno come fondamento per soluzioni specializzate all’interno della Factory

L’approccio multidisciplinare di EUSAiR

Le sandbox regolatorie adottano un approccio multidisciplinare che integra:

  • Aspetti regolatori e di policy
  • Accesso a infrastrutture di supercalcolo
  • Casi d’uso del tessuto produttivo europeo

Questo permette di testare in condizioni realistiche la conformità dei sistemi AI, identificando eventuali criticità prima del lancio sul mercato e riducendo significativamente i rischi legali ed economici per le imprese.

Il contesto europeo: 16 AI Factory per l’autonomia continentale

Quello che sta accadendo in Italia non è un caso isolato, ma si inserisce in una strategia europea coordinata e ambiziosa. Come ha rivelato il relatore, «oltre alla AI Factory italiana ne sono state finanziate altre 15 in Europa».

L’anno prossimo, ha proseguito, «saranno finanziate probabilmente quattro o cinque Gigafactory che saranno addirittura di ordine di grandezza ancora più grande». Un ecosistema continentale di infrastrutture AI che mira a ridurre progressivamente la dipendenza dalle piattaforme americane e cinesi.

«L’obiettivo è creare tecnologia, ma anche semplicemente avere a disposizione l’infrastruttura è già un fattore di autonomia», ha spiegato lucidamente Nicoletti. «Perché anche se utilizzassimo software non necessariamente prodotti in Italia o in Europa, però almeno lo faremo girare su infrastrutture nostre».

Un punto fondamentale: l’autonomia strategica non significa necessariamente autarchia tecnologica totale. Anche solo disporre delle infrastrutture fisiche su suolo europeo, pur utilizzando eventualmente software sviluppati altrove, rappresenta già un livello base ma essenziale di autonomia, che protegge dalla volatilità geopolitica e dalle pressioni politiche esterne.

Quantum computing: l’urgenza di una preparazione immediata

Nel corso dell’intervento, il relatore ha anche affrontato il tema del quantum computing, già ampiamente discusso durante la giornata del Forum. Diversamente da chi mantiene un approccio più cauto sulle tempistiche, Nicoletti si è dichiarato decisamente meno ottimista riguardo all’arrivo di computer quantistici capaci di compromettere gli algoritmi di crittografia classici attualmente in uso.

«Secondo me siamo veramente a pochi anni da quando succederà e non siamo per niente preparati», ha affermato con una nota di preoccupazione che ha sottolineato l’urgenza della situazione. Il rischio è concreto: quando i computer quantistici raggiungeranno la potenza necessaria per violare gli standard crittografici attuali, l’intero ecosistema digitale potrebbe trovarsi vulnerabile.

Proprio per questa ragione, ACN ha recentemente inaugurato un servizio specifico dedicato alla crittografia, che nei prossimi mesi inizierà operativamente a seguire questa componente cruciale della strategia di sicurezza nazionale. Un passo necessario per non farsi trovare impreparati di fronte a una rivoluzione tecnologica ormai alle porte.

Non ripetere con il quantum gli errori commessi con l’AI

Nella parte conclusiva del suo intervento, il direttore è tornato con ancora maggiore enfasi sul tema del quantum computing, legandolo strettamente alla lezione appresa con l’intelligenza artificiale.

«L’altra rivoluzione che sta arrivando è quella del quantum. L’auspicio che noi stiamo facendo è di non farci trovare anche in quel caso impreparati, come abbiamo fatto con l’intelligenza artificiale, trovandoci poi costretti a rincorrere», ha dichiarato con tono preoccupato ma determinato.

L’Italia ha le competenze necessarie

Sul quantum computing, l’Italia non parte da zero. «Ci sono una serie di iniziative che sta mettendo in campo sia la Commissione» europea, ha ricordato Nicoletti. «Pochi mesi fa è stata anche rilasciata la Strategia Quantum Nazionale».

E soprattutto: «Anche in quel caso dobbiamo puntare a produrre tecnologia. In Europa abbiamo tutte le competenze, in Italia in particolare le abbiamo assolutamente le competenze sul quantum».

Ammettere i ritardi senza perdere la speranza

Il relatore non ha nascosto le responsabilità: «È vero, è verissimo quello che diceva il professore nell’intervento precedente, che siamo rimasti fermi troppo a lungo».

Ma ha voluto chiudere con una nota di ottimismo costruttivo: «Però di nuovo, anche in questo caso vorrei essere ottimista e dire che ci sono tutti i presupposti per riuscire. E ci sono anche dei privati che stanno facendo investimenti importanti, vediamo un pochettino dove arriveremo».

Il nuovo servizio ACN sulla crittografia

«Noi come ACN – e qua mi fermo perché ho finito il tempo – abbiamo anche da pochissimo inaugurato proprio un servizio specifico che è dedicato alla crittografia e che nei prossimi mesi comincerà a lavorare e seguire anche questa parte della strategia che necessariamente va seguita per ottenere questa autonomia della quale abbiamo assolutamente bisogno», ha concluso il direttore, collegando idealmente il tema del quantum a quello della crittografia post-quantistica, un ambito di ricerca cruciale per preparare le difese dell’ecosistema digitale all’era dei computer quantistici.

Conclusioni: un ottimismo consapevole per il futuro digitale italiano ed europeo

L’intervento di Luca Nicoletti si è concluso con un messaggio di ottimismo consapevole e ragionato, lontano tanto dall’euforia acritica quanto dal pessimismo paralizzante.

«Abbiamo di fronte delle sfide gigantesche», ha riconosciuto apertamente. Due rivoluzioni tecnologiche in particolare: una già in corso (l’intelligenza artificiale), l’altra imminente (il quantum computing).

L’Europa si è svegliata, anche se in ritardo

Sull’intelligenza artificiale, ha ammesso con franchezza: «Chiaramente siamo molto indietro». L’Europa «si sta muovendo, si sta muovendo in ritardo, si sta muovendo a volte in maniera un po’ disordinata».

Tuttavia, ha voluto sottolineare un aspetto positivo: «Io ho sempre un animo molto ottimista e dico anche che comunque in qualche maniera ci siamo, tra virgolette, svegliati. Queste spinte esogene che ci vengono sia dagli Stati Uniti che dalla Cina hanno messo in moto comunque una reazione lato europeo».

Le infrastrutture come fondamento dell’autonomia

«La possibilità di disporre però di grandi infrastrutture in Europa è fondamentale», ha ribadito con forza. Anche nell’ipotesi – non auspicabile ma realistica – di continuare a utilizzare software non europei, «almeno lo faremo girare su infrastrutture nostre».

Un livello minimo ma essenziale di sovranità digitale, che protegge da interruzioni improvvise del servizio dovute a decisioni politiche esterne, garantisce il rispetto delle normative europee sulla privacy e sui dati, e crea le basi per uno sviluppo autonomo futuro.

Un impegno concreto verso l’autonomia strategica

L’AI Factory IT4LIA, insieme alle altre 15 factory europee e alle future Gigafactory, rappresenta quindi non solo un’infrastruttura tecnologica, ma un tassello fondamentale di una strategia complessiva che punta a:

  • Ridurre la dipendenza tecnologica da attori extra-europei
  • Sviluppare competenze locali attraverso formazione continua e trattenimento dei talenti
  • Creare opportunità economiche per startup e PMI innovative
  • Garantire sicurezza e autonomia digitale in un contesto geopolitico sempre più imprevedibile
  • Proteggere i diritti fondamentali dei cittadini europei attraverso un’AI etica e trasparente

Il percorso è lungo e complesso, le sfide sono effettivamente «gigantesche», come ha ammesso il relatore. Ma la direzione è tracciata, le risorse (anche se non sufficienti) cominciano ad essere allocate, e soprattutto – forse per la prima volta – c’è una consapevolezza diffusa della natura strategica e urgente di queste scelte.

Come ha efficacemente sintetizzato Nicoletti chiudendo il suo intervento: l’obiettivo è garantire «questa autonomia della quale abbiamo assolutamente bisogno» per preservare non solo la competitività economica, ma lo stesso modello di società aperta e democratica che caratterizza l’Europa.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Luca Nicoletti è nato a Roma nel 1970, si è laureato in Fisica presso l’Università degli Studi di Roma “La Sapienza” nel 1996 con il punteggio di 110/110. Dopo aver svolto il servizio Militare come Ufficiale di Marina, dal 1997 lavora in ambito informatico, interessandosi fin dall’inizio di sistemi distribuiti e tecnologie Web.

I suoi campi di interesse principali sono le Architetture Orientate ai Servizi, virtualizzazione di sistemi e applicazioni, Cloud Computing, sistemi di Identity & Access management, temi sui quali ha prodotto articoli ed è stato chiamato a svolgere seminari.

Tra il 1998 e il 2000 si è occupato di sistemi di Controllo di Gestione per importanti aziende Italiane di Telecomunicazioni ed Energetica. Tra il 2000 ed il 2013 lavora in Consip, prima nell’area “Architetture Tecnologiche” quindi nell’area “System Solution”. Nel 2013 si trasferisce in Sogei S.p.A. nell’area “Architetture e Servizi Tecnologici” e dal 2018 fino a tutto il 2019 è stato responsabile del gruppo di Demand Management Tecnologico.

Prima In Consip, poi in Sogei, ha inoltre partecipato a numerosi progetti europei nell’ambito del settimo programma quadro (FP7) e del programma Horizon 2020. Dal 2015 al 2018, in rappresentanza del MEF, è stato il Technical Leader del progetto H2020 “Sunfish” e dal 2018 del progetto H2020 “Poseidon”.

Dal 2019 al 2021 ha lavorato in Presidenza del Consiglio dei Ministri, ricoprendo incarichi di responsabile dei servizi IT Dipartimentali e coordinando numerosi gruppi di lavoro, tra i quali quello per la scrittura dei DPCM attuativi del Perimetro di Sicurezza Cibernetica, quello che ha elaborato la componente 5 della Missione 1 del PNRR relativa alla Cybersecurity, quello che ha elaborato la Strategia Cloud Italia e quello relativo alla Strategia Nazionale di Cybersicurezza. Ha partecipato inoltre al gruppo di lavoro che ha elaborato il DL 82/2021 tramite il quale è stata creata l’Agenzia Nazionale per la Cybersicurezza.

Nel corso degli anni ha sviluppato approfondita conoscenze del codice degli appalti pubblici e procedure di gara, nonché nell’esecuzione di contratti complessi.

Attualmente è responsabile del Servizio Programmi Industriali, Tecnologici e di ricerca presso l’Agenzia Nazionale per la Cybersicurezza dove si occupa dell’attuazione della componente Cybersecurity del PNRR e dello sviluppo di nuove capacità industriali e tecnologiche nel settore della sicurezza cibernetica. Con provvedimento a firma del Presidente del Consiglio del 28 febbraio 2022, è stato nominato membro italiano del board del Centro Europeo di Competenza in Cybersecurity (ECCC) di cui al regolamento (UE) 2021/887 del Parlamento europeo e del Consiglio del 20 maggio 2021.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ai-factory-italiana/


Resilienza IT/OT per la NIS2: dall’esperienza nel settore militare alla protezione delle infrastrutture critiche civili dalla vita reale alla cyber resilience

L’intervento “Autonomia operativa in ambienti critici: Resilienza IT/OT per la NIS2” di Nicola Mugnato, CTO e Co-Founder di Gyala, al 23° Forum ICT Security ha illustrato come le lezioni apprese dalla difesa militare possano trasformare l’approccio alla cybersecurity delle infrastrutture critiche.

La Direttiva NIS2 rappresenta oggi una sfida impellente per le aziende italiane. Ma quali sono le implicazioni operative concrete per chi gestisce infrastrutture critiche, specialmente quando la complessità dei sistemi OT si aggiunge a quella tradizionale dell’IT? Nicola Mugnato, CTO e Co-Founder di Gyala, ha affrontato questa questione durante il 23° Forum ICT Security tenutosi a Roma, offrendo un punto di vista originale che nasce dall’esperienza maturata nel contesto della difesa militare.

L’evoluzione dalla NIS1 alla NIS2: uniformare la resilienza europea

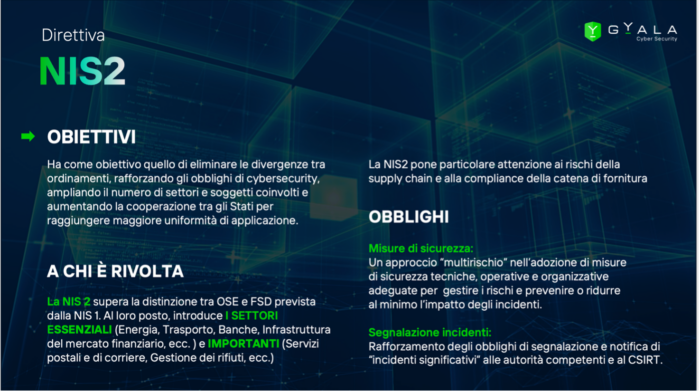
L’intervento ha preso le mosse dall’analisi degli obiettivi che hanno portato l’Europa a modificare la precedente direttiva. Come ha spiegato il relatore, la NIS1 era stata concepita per garantire una capacità abbastanza uniforme di resilienza a livello europeo e favorire lo scambio di informazioni sulle minacce tra le diverse nazioni. Tuttavia, ogni Stato membro l’aveva interpretata in modo leggermente diverso, sia nella definizione delle organizzazioni dei servizi essenziali, sia soprattutto nell’imposizione di requisiti di cybersecurity che variavano significativamente da paese a paese.

Questa disomogeneità nell’implementazione ha spinto il legislatore europeo a intervenire con la NIS2, che introduce categorie molto precise di servizi critici ed estremamente critici, e soprattutto definisce obblighi puntuali per le singole nazioni. Un elemento centrale della nuova direttiva, come sottolineato durante la presentazione, è l’approccio multirischio: non si tratta più di valutare soltanto l’aspetto strettamente cyber, ma anche quello operativo che le infrastrutture devono garantire.

resilienza it
“Direttiva NIS2: Obiettivi, Obblighi, A chi è rivolta”

Il Decreto Legislativo 138 del settembre 2024 ha recepito la direttiva in Italia, suddividendo i soggetti interessati in quattro allegati: i primi due definiscono i settori ad alta criticità (energia, trasporti, banche, sanità, acqua potabile) e i settori critici (servizi postali, gestione rifiuti, produzione alimentare). Gli altri due allegati riguardano la pubblica amministrazione, con le amministrazioni centrali e regionali considerate essenziali, mentre comuni sotto i 100.000 abitanti e altri enti rientrano tra i soggetti importanti.

Due scenari a confronto: la PA centrale e la centrale elettrica

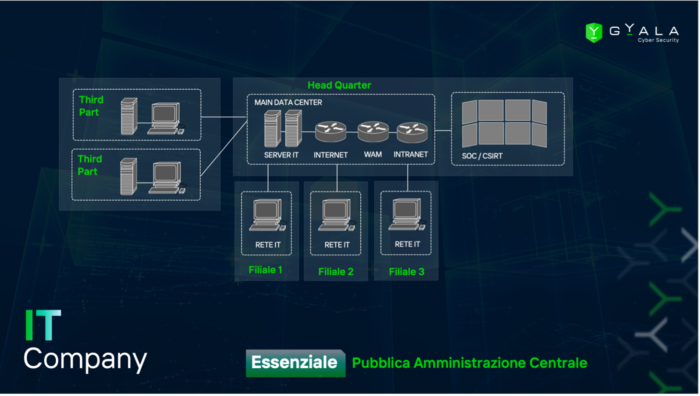
Per illustrare concretamente gli impatti della direttiva, Mugnato ha proposto un’analisi comparativa tra due tipologie di infrastrutture: una pubblica amministrazione centrale – usando come esempio un ente che gestisce dati contributivi e pensionistici – e un impianto di produzione di energia elettrica.

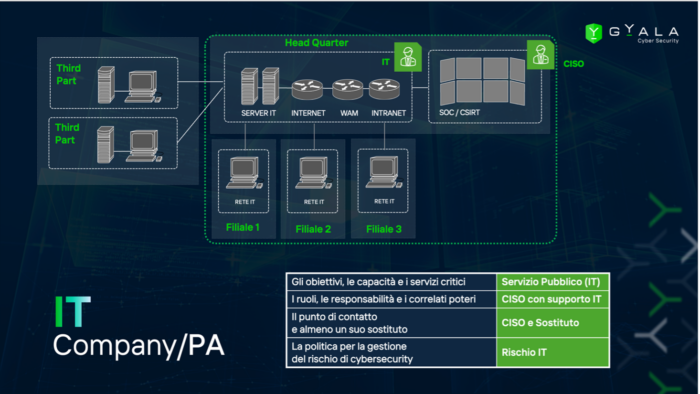
Nel primo caso, l’infrastruttura risulta relativamente centralizzata: un headquarter con data center centrali, eventualmente filiali periferiche, e sistemi IT che devono principalmente gestire dati; considerando anche Le terze parti che supportano l’esercizio di questi servizi e che sono tipicamente collegate alle infrastrutture centralizzate.

resilienza it
Infrastruttura IT Company – Pubblica Amministrazione Centrale

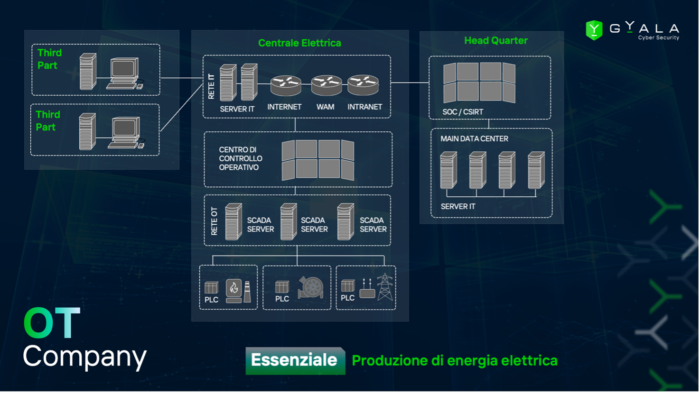
La situazione si complica notevolmente quando si passa a considerare un’azienda che produce energia elettrica. Qui, oltre alla componente IT per la gestione amministrativa, la fatturazione e i rapporti con i clienti, esistono numerose infrastrutture OT indipendenti distribuite sul territorio che devono garantire la produzione effettiva. All’interno di ciascun impianto, la parte operativa deve gestire una serie di sottosistemi quasi indipendenti: dalla produzione del vapore o dei gas che alimentano le turbine, alla gestione della turbina stessa, fino al controllo dell’alta tensione.

resilienza it
Infrastruttura OT Company – Centrale Elettrica

Un aspetto cruciale evidenziato durante l’intervento riguarda le terze parti. Nel mondo IT, è leggermente più semplice imporre requisiti alla propria supply chain, se sono piccole aziende. Mentre in caso di multinazionali e particolarmente nel mondo OT, invece, ci si confronta con aziende che gestiscono centinaia di impianti nel mondo e impongono le proprie policy e procedure di accesso. Come ha osservato il relatore: “Andare a dire al fornitore ‘tu per entrare nel nostro impianto usi il mio firewall con la mia autenticazione’ è impossibile”. C’è da dire che queste grandi aziende applicano normalmente policy di sicurezza efficaci e paradossalmente, il rischio maggiore spesso proviene dalle terze parti IT più piccole e meno strutturate.

La governance distribuita: il ruolo del capo impianto

La determinazione del Direttore Generale dell’Agenzia per la Cybersicurezza Nazionale del 14 aprile 2025 ha fornito le disposizioni di dettaglio per l’implementazione della NIS2, selezionando i requisiti del framework di cybersecurity nazionale applicabili come requisiti minimi.

Nel contesto IT, l’applicazione risulta lineare: il CISO è il punto di contatto con l’ACN, responsabile della definizione delle politiche interne e, in caso di incidente, della gestione e comunicazione verso l’Autorità.

resilienza it
Governance IT

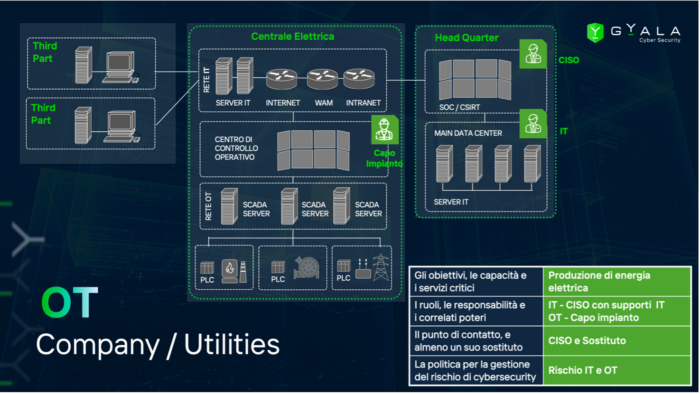
Ma quando ci si sposta nel mondo OT di una centrale elettrica, i ruoli si sdoppiano.

resilienza it
Governance OT

Come ha efficacemente spiegato Mugnato, il capo impianto diventa “il comandante della nave”: è lui che decide cosa si fa, come si interviene, quali sono le azioni di ripristino sugli incidenti cyber o non cyber.

L’ownership della gestione operativa resta in capo a questa figura, mentre il CISO mantiene il coordinamento generale e le comunicazioni verso le autorità. Le politiche di sicurezza devono quindi considerare sia i rischi IT che quelli OT, e la formazione deve raggiungere entrambi gli ambiti.

Questa dicotomia si riflette anche nella fase di risposta agli incidenti. Nel mondo IT esistono metodologie consolidate per backup, disaster recovery e business continuity. Nel mondo OT la situazione è più complessa: l’infrastruttura gode di una certa indipendenza operativa ma dipende fortemente dalle terze parti specializzate per la manutenzione e la gestione dei problemi. I piani di ripristino sono molto più articolati e la loro esecuzione resta in capo ai singoli capi impianto, non al governo centralizzato.

Dal contesto militare alle infrastrutture critiche civili

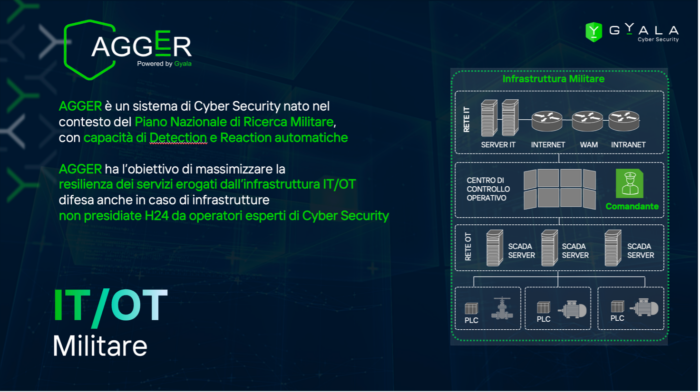
L’intervento ha poi illustrato come questi problemi si amplifichino ulteriormente nel contesto militare, dove le infrastrutture IT/OT sono impegnate in operazioni e non possono sempre essere connesse a Security Operation Center o CSIRT remoti. Gli operatori in campo non hanno esperienza cyber, sono esperti della missione che devono compiere e la tecnologia a supporto deve essere resiliente. Il governo dell’infrastruttura è interamente in capo al comandante della postazione.

resilienza it
Origine militare di Agger

È proprio da questo scenario militare che è nato nel 2016 Agger, la soluzione di cybersecurity sviluppata da Gyala nel contesto del Piano Nazionale di Ricerca Militare inizialmente con Marina Militare ed Esercito.
Oggi la soluzione protegge anche il mercato civile ed è estesa a centrali elettriche, acquedotti, strutture sanitarie e altre tipologie di infrastrutture critiche. L’idea fondante è dotare le infrastrutture di capacità di autodifesa che non solo siano in grado di identificare e bloccare potenziali incidenti, ma che possano ripristinare autonomamente i servizi IT/OT, garantendo al comandante della nave – o al capo impianto nel caso del contesto civile – che l’infrastruttura compia esattamente le operazioni richieste e senza mettere a repentaglio la safety locale.

Un sistema di resilienza automatizzata

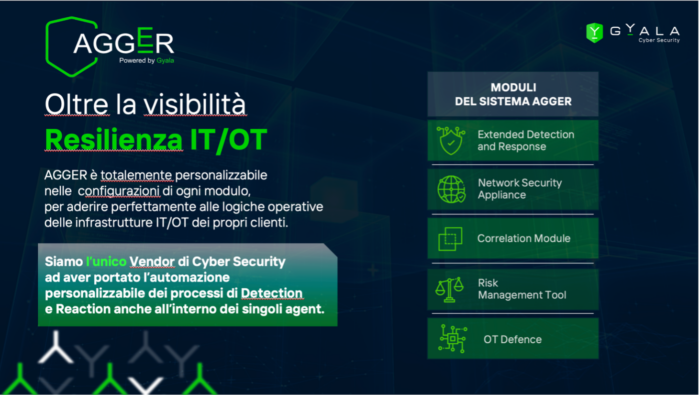
Il sistema, interamente sviluppato in Italia, si articola in diversi moduli complementari. Gli agent installati sui computer analizzano i processi in esecuzione e possono bloccarli o ripristinarli secondo regole di detection e di reaction personalizzabili. Le sonde di rete rilevano anomalie di comunicazione, mentre interrogazioni dirette verificano lo stato degli apparati OT su cui non è possibile installare software. Un sistema di coordinamento centrale con regole totalmente personalizzabili garantisce non solo la capacità di identificare anomalie rispetto al comportamento normale, ma soprattutto di reagire in maniera opportuna.

resilienza it
Moduli del sistema Agger

Come ha sottolineato il relatore, Gyala è l’unico vendor di cybersecurity ad aver portato l’automazione personalizzabile dei processi di detection e reaction anche all’interno dei singoli agent. Questo approccio risponde a una necessità concreta: trasferire logiche operative all’interno di ogni singola macchina.

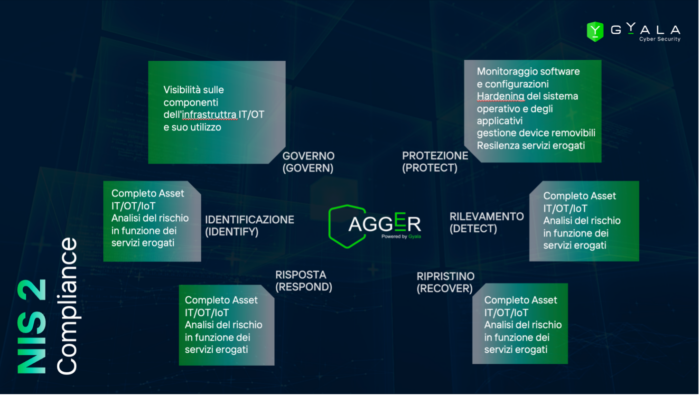
Nel contesto aziendale IT, gli agent coprono tutti i computer con sistemi operativi Windows e Linux – inclusi sistemi legacy come XP, ancora diffusi nel mondo dell’automazione industriale – mentre le sonde analizzano il traffico di rete. Nel mondo OT, ogni impianto mantiene una propria autonomia con visione e gestione locale della console per la gestione degli incidenti, mentre i dati vengono comunque remotizzati verso i SOC/CSIRT dove il CISO mantiene una visione d’insieme a livello aziendale.

resilienza it
NIS 2 Compliance

Una risposta nata sul campo

La conclusione dell’intervento ha evidenziato come un prodotto nato per rispondere alle esigenze di resilienza dei sistemi militari si sia rivelato capace di soddisfare tutti i requisiti che oggi la NIS2 e l’ACN richiedono alle infrastrutture critiche italiane. Non si tratta di una coincidenza: le sfide della cybersecurity operativa in contesti disconnessi, con operatori non specializzati e necessità di continuità assoluta, anticipano e amplificano quelle che oggi le aziende civili si trovano ad affrontare nell’implementazione della nuova direttiva europea.

L’approccio proposto suggerisce che la vera resilienza non può dipendere esclusivamente da un SOC remoto o da interventi centralizzati, ma deve essere incorporata nell’infrastruttura stessa, con capacità di autodifesa, auto-rilevamento e auto-ripristino che possano operare anche in condizioni di isolamento o quando il personale presente non dispone di competenze cyber specialistiche.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Nel 2000, Nicola Mugnato ha fondato una società con l’obiettivo di supportare tecnicamente le attività operative delle forze dell’ordine nazionali e internazionali, sviluppando sonde per l’intercettazione di comunicazioni internet e software Trojan.

Dopo aver ceduto l’azienda al Gruppo Finmeccanica nel 2007, diventa Head of Finmeccanica Group Cybers Security, con la responsabilità di definire ed implementare l’intero sistema di sicurezza informatica per tutte le aziende Finmeccanica worldwide.

Nel 2015 ha fondato Gyala, una società di sicurezza informatica che sviluppa soluzioni avanzate di sicurezza informatica per il mercato civile e militare.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/resilienza-it-ot/


Human-in-the-loop security: l’equilibrio strategico tra automazione e giudizio umano nella cybersecurity

L’intelligenza artificiale sta ridefinendo i confini della cybersecurity, promettendo di individuare minacce in millisecondi, automatizzare risposte e alleggerire i team di sicurezza da compiti ripetitivi. Eppure, proprio mentre celebriamo questi progressi tecnologici, emerge una consapevolezza critica: i sistemi completamente autonomi eccellono nell’identificazione di pattern, ma falliscono quando serve interpretare il contesto, valutare sfumature o assumere decisioni che impattano persone e organizzazioni in modi complessi.

Da questa tensione nasce l’approccio Human-in-the-Loop (HITL), che non rappresenta un regresso rispetto all’automazione, ma la sua evoluzione più matura. Come evidenziato da ricerche specializzate sulla sicurezza cognitiva, non si tratta di mantenere l’elemento umano “nel circuito” per nostalgia o diffidenza verso le macchine, ma perché determinate decisioni di sicurezza richiedono capacità che restano prerogativa della cognizione umana: intuizione strategica, esperienza contestuale, giudizio etico e la capacità di valutare rischi in scenari inediti.

La problematica dell’automazione totale nella security

Negli ultimi anni, l’industria della cybersecurity ha inseguito con determinazione la promessa dell’automazione integrale. Le piattaforme Security Orchestration, Automation and Response (SOAR) hanno proliferato rapidamente – secondo analisi di mercato specializzate, il concetto è stato coniato da Gartner nel 2015 –, i sistemi Extended Detection and Response (XDR) promettono correlazione automatica tra domini multipli, e gli algoritmi di machine learning vengono presentati come soluzione definitiva al problema del sovraccarico di alert che affligge i Security Operations Center.

Questo paradigma ignora una realtà fondamentale: la sicurezza informatica non è esclusivamente un problema tecnico, ma anche profondamente umano e organizzativo. Un alert di potenziale data exfiltration può indicare un attacco sofisticato o semplicemente un dipendente che trasferisce file legittimamente per lavorare in remoto. Un comportamento anomalo su un endpoint può segnalare malware o un utente che ha modificato le proprie abitudini lavorative. La differenza non risiede nei bit, ma nel contesto.

L’alert fatigue e i suoi costi reali

Secondo uno studio pubblicato su ACM Computing Surveys, i team dei SOC affrontano quotidianamente volumi, velocità e varietà di alert che generano un carico cognitivo insostenibile. Una ricerca di Trend Micro condotta nel 2021 ha rivelato che il 70% dei professionisti dei SOC si sente emotivamente sopraffatto dal volume di alert di sicurezza, con conseguenze che si estendono anche alla vita personale.

I numeri sono impressionanti e documentati: i team gestiscono in media 3.832 alert al giorno, con il 62% di questi che vengono ignorati. Uno studio condotto da IDC ha rivelato che le aziende con 500-1.499 dipendenti ignorano o non investigano il 27% di tutti gli alert, percentuale che sale al 30% per organizzazioni con 1.500-4.999 dipendenti. Ancora più preoccupante: il 55% dei team di sicurezza ammette di perdere alert critici, con il 41% che dichiara che questo accade settimanalmente e il 22% quotidianamente.

Le conseguenze degli errori nei sistemi automatizzati possono essere gravi. Un sistema che blocca automaticamente un account per attività sospette può fermare un dirigente durante una negoziazione critica. Una risposta automatica a un presunto ransomware può eliminare file legittimi crittografati per ragioni di compliance. Il caso emblematico del data breach di Target nel 2013 illustra perfettamente questo problema: FireEye aveva sollevato l’allarme almeno cinque volte dopo aver rilevato malware sulla rete di Target, ma il team di sicurezza della società aveva ignorato gli alert.

Il paradosso dell’automazione: più strumenti, più complessità

Uno studio ESG ha rivelato che il 44% degli alert non vengono investigati a causa di una combinazione di scarsità di talenti e molteplicità di soluzioni di sicurezza che generano volumi enormi di alert. Il Ponemon Institute ha documentato che il SOC medio utilizza dozzine di strumenti per proteggere dati e sistemi, e questi strumenti generano un numero stordente di alert.

La ricerca di Computer Weekly su 427 leader IT ha scoperto che il 70% ha visto il volume di alert di sicurezza più che raddoppiare dal 2015, mentre il 99% ha affermato che gli alti volumi di alert causano problemi ai team di sicurezza e l’83% ha dichiarato che il proprio personale soffre di alert fatigue.

Il valore strategico del giudizio umano nell’approccio human-in-the-loop

Il punto di forza dell’approccio Human-in-the-Loop non sta nel rallentare i processi, ma nel posizionare l’intelligenza umana dove questa apporta massimo valore. Come evidenziato da analisi approfondite sui sistemi HITL, l’expertise umana viene integrata nei processi automatizzati per migliorare l’accuratezza del rilevamento delle minacce, la precisione della risposta e il decision-making strategico.

Un analista esperto apporta elementi che nessun algoritmo può replicare: la conoscenza approfondita del business, la memoria di incidenti passati simili ma non identici, la capacità di percepire quando qualcosa non quadra anche in assenza di indicatori tecnici evidenti. Michael Noory, Lead Threat Hunter di CYDEF, ha sottolineato: “Per quanto comoda possa sembrare la sicurezza al 100% guidata dall’AI a un team IT, questi sistemi non sono ancora al punto in cui possono rilevare in modo affidabile tutte le minacce”.

Human-in-the-loop vs human-on-the-loop: differenze critiche

È fondamentale distinguere l’approccio Human-in-the-Loop da modelli alternativi. Nel modello Human-on-the-Loop (HOTL), gli esseri umani progettano, configurano e distribuiscono sistemi automatizzati ma non sono direttamente coinvolti nelle decisioni quotidiane o nella supervisione. Il sistema opera indipendentemente fino a quando non è necessaria una revisione importante o un aggiornamento.

Nel Human-over-the-Loop, la supervisione umana si concentra sulla governance complessiva e sulla supervisione umana di un intero sistema AI, garantendo che non causi danni o “impazzisca”. Come spiegato da Marsh nella loro analisi sui rischi AI, il primo è definito dalla governance e dalla supervisione umana su un sistema AI complessivo, mentre il secondo si concentra sulla fase operativa dove esiste un forte desiderio di mitigare i rischi di autonomia o di decisioni automatiche del sistema AI.

L’Human-in-the-Loop, invece, mantiene le persone strettamente coinvolte nel decision-making attivo. Nella cybersecurity, dove il contesto può cambiare rapidamente e il costo di una decisione errata può essere elevato, HITL offre un approccio più bilanciato.

Human-in-the-loop e advanced persistent threats

Consideriamo il caso delle Advanced Persistent Threats (APT). Gli indicatori tecnici possono risultare ambigui, le tecniche possono simulare comportamenti legittimi, e la vera natura dell’attacco emerge solo correlando elementi apparentemente scollegati nel corso di giorni o settimane. Come documentato da IBM nella loro analisi XDR, le minacce avanzate possono nascondersi per mesi prima di essere rilevate, preparando attacchi su larga scala o breach.

È in questo contesto che l’intuizione dell’analista, alimentata da anni di esperienza, diventa insostituibile. L’automazione può presentare i frammenti del puzzle, ma serve una mente umana per visualizzare l’immagine complessiva. Gli analisti umani eccellono nel decision-making strategico, nella valutazione dell’impatto potenziale delle minacce e nella prioritizzazione delle azioni basate sulla criticità del business. L’intuizione umana e la capacità di collegare punti apparentemente non correlati sono inestimabili per scoprire attacchi sofisticati e multi-stadio che potrebbero eludere il rilevamento automatico.

Dimensione etica e legale delle decisioni di security

Ancora più critico è il ruolo umano nelle decisioni con implicazioni etiche o legali. Quando un sistema rileva che un dipendente sta potenzialmente sottraendo proprietà intellettuale, la decisione su come procedere non può essere delegata a un algoritmo. Entrano in gioco considerazioni su privacy, diritti del lavoratore, normative come il GDPR o l’HIPAA, potenziali danni reputazionali.

Come evidenziato nell’analisi di Medium sullo sfruttamento dell’expertise umana, gli esseri umani possono interpretare le intuizioni generate dall’AI, considerando fattori che le macchine potrebbero non comprendere pienamente, come sfumature organizzative, dinamiche geopolitiche e attori di minacce emergenti. Gli incidenti di sicurezza tipicamente coinvolgono informazioni personali, e i SOC devono affrontare framework legali complessi. I fattori legali sono essenziali durante un incidente, e per questo gli analisti umani possono analizzare questi aspetti e garantire che le azioni intraprese durante un incidente siano conformi alle normative.

Progettare sistemi human-in-the-loop efficaci

La sfida non è decidere se includere l’elemento umano nel processo, ma determinare dove, come e quando. Un approccio Human-in-the-Loop ben progettato non significa semplicemente aggiungere un pulsante di approvazione manuale a ogni processo automatizzato. Significa ripensare il workflow della sicurezza per massimizzare i punti di forza sia dell’automazione che dell’intelligenza umana.

Stratificazione intelligente delle decisioni

In pratica, questo si traduce in una stratificazione intelligente delle decisioni che rispetta la natura e il rischio di ogni tipo di intervento:

Automazione completa per azioni a basso rischio: Bloccare indirizzi IP riconosciuti come malevoli, applicare patch critiche, isolare endpoint compromessi basandosi su Indicators of Compromise (IoC) ben definiti. In questi casi l’automazione eccelle e l’intervento umano costituirebbe solo un collo di bottiglia. Come documentato nelle linee guida Microsoft per la riduzione dell’alert fatigue, i team con alti livelli di automazione risolvono la maggior parte degli alert di sicurezza lo stesso giorno (66%), rispetto al 34% dei team con bassi livelli di automazione.

Approccio semi-automatico per decisioni di medio livello: L’automazione esegue analisi preliminari e prepara raccomandazioni, ma l’analista mantiene la decisione finale. Il sistema effettua il lavoro oneroso di correlazione e analisi, presenta le opzioni con relativi pro e contro, ma l’ultima parola spetta all’umano. Questo modello funziona efficacemente per situazioni dove il contesto è rilevante ma il tempo di risposta resta un fattore critico.

Centralità umana per decisioni ad alto impatto: Per le decisioni ad alto impatto o elevata incertezza, il ruolo umano diventa centrale fin dall’inizio. L’automazione supporta fornendo dati, visualizzazioni e analisi, ma strategia, valutazione del rischio e decisione finale restano saldamente nelle mani di professionisti esperti. È qui che si gioca la partita più importante: quando un CISO deve decidere se dichiarare pubblicamente un breach, quando serve valutare se un incidente è parte di un attacco coordinato più ampio, quando bisogna bilanciare sicurezza e continuità operativa.

Architetture operative dei sistemi HITL

Dal punto di vista architetturale, i sistemi Human-in-the-Loop per l’automazione dei SOC integrano la velocità dell’automazione con la conoscenza dell’analista. Utilizzando HITL, i SOC possono analizzare ed elaborare numerosi alert, identificare minacce nuove ed esotiche, e scegliere la migliore linea d’azione quando si affronta un incidente.

Un’architettura efficace prevede:

Livello di raccolta dati: Integrazione con SIEM, EDR, NDR, fonti di threat intelligence e altri strumenti di sicurezza per aggregare telemetria completa.

Livello di analisi automatizzata: Algoritmi di machine learning che eseguono correlazione iniziale, identificazione di anomalie, arricchimento contestuale degli alert e classificazione preliminare della gravità.

Livello di decisione umana: Interfaccia che presenta agli analisti solo gli alert che richiedono giudizio umano, con contesto completo, opzioni di risposta preconfigurate e raccomandazioni basate su playbook.

Livello di risposta orchestrata: Esecuzione automatica delle azioni approvate dall’analista attraverso integrazioni con strumenti di sicurezza, con capacità di rollback e audit completo.

Metriche e KPI per sistemi HITL efficaci

Per valutare l’efficacia di un sistema Human-in-the-Loop, le organizzazioni dovrebbero monitorare metriche specifiche:

Tasso di override umano: Percentuale di volte in cui gli analisti sovrascrivono le raccomandazioni dell’AI. Un tasso troppo alto indica che il sistema non è ben calibrato; troppo basso può indicare automation bias.

Tempo medio di decisione: Quanto tempo impiegano gli analisti per prendere decisioni sui casi escalati. Questo dovrebbe diminuire nel tempo man mano che il sistema impara.

Precisione delle raccomandazioni AI: Percentuale di raccomandazioni AI che gli analisti confermano come corrette.

Riduzione dei falsi positivi: Confronto tra il tasso di falsi positivi prima e dopo l’implementazione HITL. Secondo ricerche documentate, tra il 20% e il 40% degli alert sono falsi positivi.

Carico cognitivo degli analisti: Misurato attraverso sondaggi sulla soddisfazione lavorativa e sul burnout.

Mean Time to Detect (MTTD) e Mean Time to Respond (MTTR): Le piattaforme SOAR ben implementate possono ridurre significativamente questi tempi grazie all’integrazione intelligente tra automazione e supervisione umana.

Le sfide dell’implementazione human-in-the-loop

Implementare efficacemente un approccio Human-in-the-Loop presenta complessità significative che richiedono attenzione strategica e pianificazione accurata.

Il rischio di alert fatigue 2.0

La prima insidia è quella che potremmo definire “alert fatigue 2.0″: se ogni azione automatizzata richiede approvazione umana, il risultato è un diluvio di richieste che desensibilizza gli analisti, portandoli ad approvare meccanicamente senza reale valutazione. È il paradosso del loop mal progettato: invece di sfruttare il giudizio umano, lo erode.

Come documentato da Splunk nella loro guida sui sistemi HITL, incorporare gli esseri umani nel ciclo dell’AI offre vantaggi significativi ma presenta anche sfide: miglioramento dell’accuratezza attraverso la supervisione umana che può correggere errori e affinare le prestazioni del modello, ma anche il rischio che la qualità dei giudizi umani degradi sotto pressione cognitiva.

La soluzione sta nel progettare soglie intelligenti: solo gli alert che superano determinate soglie di incertezza o criticità dovrebbero essere escalati agli umani. Il sistema deve essere abbastanza intelligente da riconoscere quando è “confuso” e ha bisogno di aiuto, piuttosto che chiedere costantemente conferma.

Competenze e formazione nei sistemi HITL

La seconda sfida riguarda formazione e competenze. Gli analisti devono essere in grado non solo di comprendere cosa sta eseguendo l’automazione, ma anche di valutare quando fidarsi delle sue raccomandazioni e quando sovrascriverle. Serve una nuova generazione di professionisti fluenti sia nel linguaggio della security che in quello del machine learning, capaci di interpretare le decisioni degli algoritmi e riconoscerne i limiti.

Come evidenziato nell’analisi pubblicata su Medium riguardo l’expertise umana nella cybersecurity, garantire che i team di sicurezza posseggano le competenze necessarie per comprendere e lavorare efficacemente con i sistemi AI è fondamentale. Esiste un divario di competenze significativo nella cybersecurity, e integrare l’AI richiede ulteriori competenze specializzate.

Le organizzazioni dovrebbero investire in:

Programmi di formazione continua: Su AI/ML nella cybersecurity, interpretazione degli output algoritmici, riconoscimento dei bias nei modelli.

Certificazioni specializzate: Che combinano competenze tradizionali di security con conoscenza dei sistemi AI.

Simulazioni e tabletop exercises: Che testano come gli analisti interagiscono con i sistemi HITL in scenari di crisi.

Accountability e responsabilità nei sistemi ibridi

Esiste poi il problema della responsabilità. Quando un sistema automatizzato suggerisce un’azione e un umano la approva, chi è responsabile se le cose vanno male? Se la risposta è sempre “l’umano”, allora il loop diventa una foglia di fico per scaricare la responsabilità. Se è “il sistema”, allora l’umano diventa un timbro di gomma.

Come discusso nell’analisi di Marsh sulla gestione del rischio AI, richiedere la supervisione umana per i sistemi AI non è di per sé una panacea per mitigare i rischi dell’AI e può, nel migliore dei casi, portare a un falso senso di sicurezza e, nel peggiore dei casi, aggravare i rischi. Risolvere i rischi dell’AI con HITL richiede: definire chiaramente il loop applicabile, specificare chiaramente i principi sottostanti per guidare la supervisione in modo che l’essere umano appropriato possa essere assegnato al ruolo, e dove possibile, avere metriche appropriate per valutare i risultati abilitati dall’AI per tenere conto dei bias intrinseci e della fallibilità del giudizio umano e delle limitazioni tecnologiche.

Serve chiarezza sui ruoli e sulle responsabilità, con framework decisionali che specifichino:

Livelli di autorità: Chi può approvare quali tipi di decisioni e in quali circostanze.

Protocolli di escalation: Quando una decisione deve essere elevata a un livello superiore di autorità.

Audit trail completi: Registrazione di ogni decisione, chi l’ha presa, su quale base e con quale risultato.

Revisione post-incidente: Analisi sistematica delle decisioni HITL per identificare pattern di errore o miglioramento.

Bias cognitivi e automazione

Un rischio sottile ma significativo è quello dell’automation bias: la tendenza umana a favorire i suggerimenti provenienti da sistemi automatizzati, anche quando contraddicono informazioni corrette da fonti non automatizzate. Come documentato in letteratura sulla fatica da alert, se gli esseri umani che sono nel loop hanno bias propri, il Reinforcement Learning from Human Feedback (RLHF) potrebbe peggiorare le cose anziché migliorarle.

Per mitigare questo rischio:

Presentazione di informazioni contrarie: Il sistema dovrebbe attivamente presentare prove che contraddicono la propria raccomandazione.

Rotazione degli analisti: Evitare che gli stessi analisti approvino sempre lo stesso tipo di decisioni.

Revisione periodica randomizzata: Un campione di decisioni approvate dovrebbe essere rivisto da un secondo analista.

Metriche di diversità decisionale: Monitorare se gli analisti stanno effettivamente usando il loro giudizio o semplicemente approvando automaticamente.

Casi d’uso e applicazioni pratiche dell’human-in-the-loop

Risposta automatizzata al phishing con supervisione umana

Un’applicazione classica dell’HITL è la gestione del phishing. Quando gli utenti segnalano email sospette, un sistema automatizzato può estrarre indicatori (URL, indirizzi IP, domini), interrogare feed di threat intelligence per determinare reputazione o malevolenza nota, e quarantenare automaticamente l’email dalle caselle di posta degli utenti.

Tuttavia, gli agenti AI nella cybersecurity possono generare falsi positivi, specialmente con email legittime da partner nuovi o messaggi che utilizzano servizi di abbreviazione URL. L’HITL interviene quando:

Email ambigue: L’AI non è sicura della classificazione (punteggio di confidenza medio).

Email da mittenti VIP: Messaggi da dirigenti o clienti importanti richiedono revisione umana prima della quarantena.

Campagne nuove: Quando viene rilevato un nuovo pattern di phishing mai visto prima.

L’analista umano può esaminare il contesto completo – cronologia del mittente, contenuto del messaggio, tempistica – e decidere se confermare la quarantena o rilasciare l’email come falso positivo. Nel frattempo, il sistema apprende da questa decisione per migliorare le classificazioni future.

Gestione delle vulnerabilità e patch management

Nel vulnerability management, l’automazione può identificare vulnerabilità attraverso scansioni continue, valutare la gravità tecnica (CVSS scores), e persino applicare patch automaticamente in ambienti non critici.

L’intervento umano diventa cruciale per:

Valutazione del rischio contestuale: Una vulnerabilità critica su un sistema esposto a Internet richiede azione immediata, ma la stessa vulnerabilità su un sistema isolato in una rete di sviluppo può aspettare. L’analista considera l’architettura di rete, i controlli compensativi esistenti, la criticità del business.

Decisioni di patch in produzione: Applicare una patch può causare interruzioni o incompatibilità. L’analista deve bilanciare il rischio della vulnerabilità contro il rischio dell’interruzione del servizio.

Eccezioni temporanee: In alcuni casi, un sistema non può essere patchato immediatamente a causa di dipendenze applicative. L’analista approva eccezioni temporanee con controlli compensativi.

Threat hunting guidato dall’AI

Il threat hunting proattivo beneficia enormemente dall’approccio HITL. Gli algoritmi di machine learning possono analizzare enormi volumi di dati di rete, log di sistema e telemetria endpoint per identificare anomalie comportamentali che potrebbero indicare minacce latenti.

Il sistema AI potrebbe notare:

  • Connessioni di rete insolite a orari anomali
  • Pattern di accesso ai dati che deviano dalle baseline
  • Sequenze di eventi che, pur essendo individualmente innocue, insieme potrebbero indicare lateral movement

L’hunter umano utilizza questi lead generati dall’AI come punto di partenza, ma poi applica intuizione e creatività:

Formulazione di ipotesi: “Se questo fosse un attacco APT, quali altri indicatori dovrei cercare?”

Investigazione contestuale: Correlazione con eventi di business (fusioni, licenziamenti, progetti sensibili).

Identificazione di TTPs: Collegamento dei comportamenti osservati a Tactics, Techniques, and Procedures note di gruppi APT specifici.

Il risultato è un processo di hunting che combina la scala e velocità dell’AI con l’intuizione investigativa umana.

Gestione degli incidenti di sicurezza complessi

Durante un incidente di sicurezza significativo, le piattaforme SOAR possono automatizzare molte azioni di risposta iniziali: isolamento degli endpoint compromessi, raccolta di forensics, notifiche alle parti interessate. Tuttavia, come analizzato nelle best practice di automazione della security, l’expertise umana rimane indispensabile.

Gli Incident Responder umani devono:

Valutare la portata completa: L’automazione può identificare sistemi direttamente compromessi, ma gli umani devono ipotizzare quali altri sistemi potrebbero essere stati toccati.

Prendere decisioni di contenimento: Isolare completamente una rete potrebbe fermare l’attacco ma anche paralizzare il business. Serve giudizio per bilanciare sicurezza e operatività.

Comunicazione strategica: Decidere quando e come comunicare l’incidente agli stakeholder interni, ai clienti, alle autorità regolatorie e potenzialmente ai media.

Analisi delle cause radice: Identificare non solo come l’attacco è avvenuto, ma perché i controlli esistenti hanno fallito.

Il futuro: loop adattivi e contestuali

Guardando al futuro, l’evoluzione dell’Human-in-the-Loop Security sarà probabilmente verso loop sempre più adattivi e contestuali. I sistemi futuri non avranno un punto fisso dove interviene l’umano, ma sapranno dinamicamente decidere quando richiedere input umano basandosi sulla fiducia nelle proprie analisi, sulla criticità della situazione e sulla disponibilità di esperti.

AI generativa e human-in-the-loop

Come evidenziato in recenti analisi sull’intelligenza artificiale e cybersecurity nel 2025, l’AI generativa potrebbe giocare un ruolo trasformativo in questo contesto, non per prendere decisioni, ma per amplificare le capacità analitiche umane.

Le applicazioni emergenti includono:

Generazione di scenari what-if: L’AI generativa può creare simulazioni di come un attacco potrebbe evolvere sotto diverse strategie di risposta, permettendo agli analisti di valutare le opzioni prima di agire.

Sintesi automatica di intelligence: Trasformazione di centinaia di pagine di threat intelligence in riassunti concisi e actionable.

Supporto alla documentazione: Generazione automatica di report di incidente basati sulle azioni intraprese, riducendo il carico amministrativo sugli analisti.

Assistenza nella threat modeling: Aiuto agli analisti nell’identificazione di potenziali vettori di attacco che potrebbero non aver considerato.

Tuttavia, come sottolineato dal World Economic Forum nel Global Cybersecurity Outlook 2025, gli attacchi informatici sono in forte crescita. Negli ultimi quattro anni, il loro numero medio settimanale è più che raddoppiato: da 818 per organizzazione nel secondo trimestre del 2021 a 1.984 nell’ultimo trimestre del 2024. Questo rende ancora più critico l’equilibrio tra capacità AI e supervisione umana.

Sistemi HITL adattivi basati su reinforcement learning

Immaginiamo sistemi che, dopo aver osservato migliaia di decisioni di un team di security, imparano non solo a replicare quelle decisioni, ma anche a riconoscere quando la situazione esce dai pattern noti e serve l’intervento di un esperto specifico.

Questi sistemi potrebbero:

Apprendimento delle preferenze del team: Ogni team di security ha una propria “firma” di risk tolerance e priorità. Il sistema apprende questi pattern e si adatta.

Riconoscimento dell’incertezza: Invece di forzare una classificazione, il sistema riconosce quando i dati sono insufficienti o ambigui e chiede aiuto.

Escalation intelligente: Non solo “passare all’umano”, ma identificare quale specifico esperto nel team è più qualificato per quel particolare tipo di decisione.

Apprendimento continuo: Ogni decisione umana diventa un nuovo punto dati per affinare i modelli, in un ciclo virtuoso di miglioramento.

Integrazione con architetture zero trust

L’evoluzione verso architetture Zero Trust richiede decisioni continue di autorizzazione basate su molteplici fattori contestuali. L’HITL in questo contesto significa:

Validazione di accessi anomali: Un utente che accede da una nuova località geografica potrebbe essere legittimo (viaggio d’affari) o indicare compromissione delle credenziali. L’AI può bloccare temporaneamente e richiedere autenticazione aggiuntiva, ma un analista può valutare il contesto più ampio.

Definizione dinamica di policy: Gli analisti umani definiscono le policy di Zero Trust a livello strategico, ma l’AI le applica e adatta tatticamente basandosi sui pattern di comportamento osservati.

Gestione delle eccezioni: In situazioni di emergenza business, potrebbe essere necessario concedere eccezioni temporanee ai principi Zero Trust. Questa è una decisione che richiede giudizio umano senior.

Best practices per l’implementazione human-in-the-loop

Iniziare con un approccio incrementale

Non tentare di implementare HITL su tutti i processi di sicurezza contemporaneamente. Iniziare con un caso d’uso ben definito, dimostrarne il valore, e poi espandere gradualmente.

Fase 1 – Pilota su singolo caso d’uso: Scegliere un processo con alto volume ma bassa complessità (es. phishing response).

Fase 2 – Misurazione e ottimizzazione: Raccogliere metriche per 3-6 mesi, ottimizzare le soglie di escalation.

Fase 3 – Espansione controllata: Estendere a 2-3 casi d’uso aggiuntivi, mantenendo il focus sulla qualità.

Fase 4 – Integrazione enterprise: Solo dopo aver dimostrato ROI chiaro, espandere all’intero stack di sicurezza.

Investire nell’interfaccia analista

Il successo dell’HITL dipende criticamente dalla qualità dell’interfaccia attraverso cui gli analisti interagiscono con il sistema. Come evidenziato nell’analisi su Medium riguardo la collaborazione umano-AI, progettare interfacce intuitive, visualizzazioni chiare e workflow semplificati che facilitino l’interazione e la condivisione di informazioni tra analisti umani e sistemi AI è cruciale.

Un’interfaccia efficace dovrebbe:

Minimizzare il carico cognitivo: Presentare solo le informazioni essenziali per la decisione, non sovraccaricare con dati non rilevanti.

Fornire contesto ricco: Cronologia dell’entità, comportamento baseline, decisioni precedenti su casi simili.

Offrire opzioni chiare: Non “approva/rifiuta” generico, ma opzioni di risposta specifiche con conseguenze previste.

Supportare il feedback rapido: L’analista può fornire feedback sulla qualità della raccomandazione con un clic, alimentando il miglioramento continuo.

Visualizzazione dell’incertezza: Mostrare chiaramente il livello di confidenza dell’AI e quali fattori contribuiscono all’incertezza.

Costruire una cultura di fiducia calibrata

Un rischio è che gli analisti sviluppino o troppa fiducia (approvando ciecamente) o troppo poca fiducia (ignorando raccomandazioni valide) nel sistema AI. Serve una “fiducia calibrata”.

Trasparenza algoritmica: Gli analisti devono capire, almeno a livello concettuale, come il sistema arriva alle sue raccomandazioni.

Validazione continua: Pubblicare regolarmente metriche sull’accuratezza del sistema, confrontate con le decisioni umane.

Cultura dell’errore produttivo: Quando il sistema sbaglia, trattarlo come opportunità di apprendimento, non di colpa.

Empowerment degli analisti: Gli analisti devono sentirsi autorizzati a sovrascrivere il sistema quando il loro giudizio lo richiede, senza timore di ritorsioni.

Pianificazione per la governance e compliance

Le normative emergenti come l’AI Act europeo richiedono accountability nei sistemi AI utilizzati per decisioni ad alto impatto. L’implementazione HITL può supportare la compliance:

Audit trail completi: Registrazione di ogni decisione AI, revisione umana e outcome.

Explainability delle decisioni: Capacità di spiegare perché il sistema ha fatto una particolare raccomandazione.

Meccanismi di ricorso: Processo per contestare decisioni automatizzate e ottenere revisione umana.

Valutazioni di impatto: Documentazione di come il sistema HITL impatta i diritti degli individui e la sicurezza dell’organizzazione.

Oltre la tecnologia: una questione di governance

In ultima analisi, l’Human-in-the-Loop Security ci ricorda che la sicurezza informatica non è solo questione di tecnologia, ma di persone, processi e giudizio. In un’era dove l’automazione è spesso presentata come soluzione a ogni problema, questo approccio riconosce con onestà intellettuale che esistono dimensioni della sicurezza dove l’intelligenza umana resta insostituibile.

Non è un rifiuto del progresso tecnologico, ma un’affermazione che il progresso autentico sta nel creare sistemi che amplificano le capacità umane piuttosto che tentare inutilmente di rimpiazzarle. È il riconoscimento che le decisioni migliori nascono quando macchine e umani lavorano insieme, ciascuno portando i propri punti di forza complementari.

Come sottolineato dal Dr. Victoria Baines, ricercatrice di cybersecurity: “Siamo abituati a descrivere la cybersecurity in termini di persone, processi e tecnologia. Troppo spesso, però, le persone sono ritratte come una vulnerabilità piuttosto che come una risorsa, e le difese tecniche sono prioritizzate rispetto alla resilienza umana. È giunto il momento di rinnovare il nostro investimento nelle nostre risorse di sicurezza umane”.

Per i CISO e i team di security, questo significa ripensare non solo quali strumenti adottare, ma come progettare i workflow, quali competenze sviluppare nei team e come costruire una cultura che valorizzi tanto l’efficienza dell’automazione quanto la saggezza dell’esperienza umana. È una sfida complessa, ma forse è proprio questa complessità il segno che stiamo finalmente ponendo le domande giuste sul futuro della cybersecurity.

L’Human-in-the-Loop non è una soluzione temporanea fino a quando l’AI diventerà “abbastanza buona” da operare autonomamente. È piuttosto un principio fondamentale per lo sviluppo di sistemi di sicurezza robusti, affidabili e responsabili, capaci di navigare la complessità del mondo reale e garantire che le decisioni critiche riflettano valori umani, considerazioni etiche e comprensione contestuale che nessuna macchina, per quanto avanzata, può pienamente replicare.

Fonti:

Rapid7, “Human-in-the-Loop in Cybersecurity”

ACM Computing Surveys, “Alert Fatigue in Security Operations Centres”

Trend Micro, “70% Of SOC Teams Emotionally Overwhelmed”

IBM, “What is SOAR?”

Microsoft Security Blog, “6 strategies to reduce alert fatigue”

CYDEF, “What is Human-in-the-Loop Cybersecurity?”

Splunk, “Human in the Loop in Practice”

Medium, “Leveraging Human Expertise in Cybersecurity”

Marsh, “Human in the Loop in AI Risk Management”

IBM, “What is XDR?”

Expel, “Alert fatigue, burnout, turnover”

XenonStack, “Human-in-the-loop in SOC Automation”

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/human-in-the-loop/


Prompt injection, un problema che potrebbe non venire mai risolto. La visione dell’NCSC


Secondo il National Cyber Security Centre (NCSC), l’agenzia governativa del Regno Unito per la cybersecurity, il problema della prompt injection (PI) potrebbe non venire mai risolto.

In un approfondimento dedicato l’agenzia ha spiegato che, nonostante le due vulnerabilità vengano spesso accostate, sono in realtà concettualmente molto diverse. Assumere che siano simili significa rischiare di sottovalutare la PI e di conseguenza applicare  misure di mitigazione inefficaci.

“Sebbene il confronto tra la prompt injection e la SQL injection possa essere allettante, è anche pericoloso. La seconda può essere adeguatamente mitigata con query parametrizzate, ma è probabile che la prima non possa mai essere adeguatamente mitigata allo stesso modo. Il meglio che possiamo sperare è di ridurre la probabilità o l’impatto degli attacchi” si legge nel post.

prompt injection

Il concetto dietro le due vulnerabilità è lo stesso: in entrambi i casi si tratta di una gestione errata di dati e istruzioni che consente di eseguire l’input utente come un comando. Nel caso della SQL injection la mitigazione standard è l’uso di query parametrizzate che trattano sempre l’input come dato e mai come istruzione.

Nel caso degli LLM questa distinzione non esiste: quando il chatbot riceve un prompt, lo elabora senza distinguere le istruzioni dai dati, cercando sempre di prevedere il token successivo più probabile. Poiché non c’è una separazione vera tra istruzione e dato a livello del modello, non esiste un equivalente delle query parametrizzate deterministico e risolutivo.

Ad oggi la mitigazione della prompt injection è un’area di ricerca molto attiva e include già diversi approcci, come l’individuazione dei tentativi di injection, l’addestramento dei modelli per prioritizzare le istruzioni rispetto a “dati che sembrano istruzioni” e istruire il modello su cosa sono i “dati“. Di fatto le metodologie si basano sempre sull’idea di separare ciò che è “dato” da ciò che è “istruzione”; poiché però gli LLM operano in maniera intrinsecamente diversa dagli altri sistemi, la mitigazione non è definitiva. 

Prompt injection: urge applicare strategie di mitigazione

Per ridurre il rischio, è fondamentale che sviluppatori e team di sicurezza comprendano che la PI è un rischio persistente che non può essere mitigato completamente con un prodotto o un’appliance esterna.

È necessario che i modelli e le applicazioni vengano progettate seguendo i principi del Secure Design, soprattutto quando l’LLM è autorizzato a chiamare strumenti esterni o API. La protezione deve includere: l’implementazione di controlli di sicurezza non-LLM che vincolino le azioni del sistema e l’applicazione del principio del least privilege.

È possibile inoltre usare tecniche per ridurre la probabilità che l’LLM agisca sulle istruzioni iniettate usando marcatori come i tag XML per incapsulare e separare la sezione “dati” dalle “istruzioni”. L’NCSC in questo caso sconsiglia di affidarsi a delle deny-list di frasi malevole, in quanto la complessità degli LLM offre infinite riformulazioni che possono eludere questi filtri.

Infine, è essenziale monitorare prompt e dati per identificare attività sospette, inclusi l’input e l’output completi dell’LLM, e le chiamate a strumenti o API. Poiché gli attaccanti spesso devono affinare i loro attacchi, il rilevamento e la risposta a chiamate API o strumenti fallite possono indicare le fasi iniziali di una violazione.

L’NCSC avverte che, come è successo con le SQL Injection, c’è il rischio che, se non si adottano fin da subito approcci di sicurezza migliori, avvenga un picco di compromissioni e fughe di dati. “Rischiamo di vedere questo modello ripetersi con la prompt injection, dato che stiamo per integrare la genAI nella maggior parte delle applicazioni. Se queste applicazioni non sono progettate tenendo conto della prompt injection, potrebbe verificarsi un’ondata simile di violazioni“.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/12/10/prompt-injection-un-problema-che-potrebbe-non-venire-mai-risolto-la-visione-dellncsc/?utm_source=rss&utm_medium=rss&utm_campaign=prompt-injection-un-problema-che-potrebbe-non-venire-mai-risolto-la-visione-dellncsc


Governance AI e protezione dati: la roadmap EDPS tra accountability e complessità algoritmica

L’11 novembre 2025 segna una svolta nell’approccio europeo alla governance AI e alla protezione dei dati: il Garante europeo della protezione dei dati (EDPS) ha pubblicato una guida operativa per il risk management che, per la prima volta, traduce i principi del GDPR in misure tecniche concrete per i sistemi di intelligenza artificiale. Non si tratta dell’ennesimo documento teorico, ma di un framework operativo basato sulla metodologia ISO 31000:2018 per la gestione dei rischi che affronta una delle contraddizioni più complesse della trasformazione digitale: come garantire i diritti fondamentali quando i sistemi che elaborano dati personali sono, per loro natura, opachi e probabilistici.

La guida si inserisce in un momento cruciale. Mentre il Regolamento UE 2024/1689 del 13 giugno 2024 definisce il perimetro normativo dell’intelligenza artificiale in Europa, rimane aperta la questione su come le organizzazioni possano effettivamente implementare controlli che rispettino il Regolamento 2018/1725 (EUDPR), equivalente del GDPR per le istituzioni UE. La distanza tra requisiti legali e fattibilità tecnica non è mai stata così evidente come nell’ambito dell’AI, dove concetti come “rettifica” o “cancellazione” dei dati personali si scontrano con l’architettura stessa delle reti neurali profonde.

L’illusione della neutralità algoritmica e la tassonomia dei bias

Il documento dell’EDPS parte da un presupposto raramente esplicitato con questa chiarezza: l’AI non è neutra. I sistemi di machine learning tendono ad amplificare i bias esistenti, incorporando nei loro parametri le distorsioni presenti nei dataset di addestramento. La guida va oltre questa constatazione, proponendo una tassonomia articolata delle fonti di bias che spazia dalla qualità dei dati (data quality bias) alla rappresentatività del campione (sampling bias), dall’architettura algoritmica (algorithmic bias) alle distorsioni interpretative degli analisti umani (interpretation bias).

L’approccio è pragmatico e richiede un sistema di gestione che garantisca applicazione e conformità: l’EDPS non chiede l’impossibile – l’eliminazione totale del bias – ma richiede alle istituzioni di identificarlo, misurarlo e documentare gli sforzi di mitigazione. È un cambio di paradigma rispetto alla compliance formale: non basta dimostrare di aver scelto il fornitore “giusto” o di aver inserito clausole contrattuali appropriate. Serve una comprensione tecnica profonda di come il sistema funziona, quali sono i suoi failure mode, dove si annidano i rischi per i diritti delle persone.

La tensione tra performance e data minimisation nel machine learning

Una delle questioni più delicate riguarda il principio di minimizzazione dei dati nel contesto della governance AI e della protezione dati. I modelli di machine learning, per loro natura, traggono beneficio da grandi quantità di dati: più esempi vedono durante l’addestramento, migliore è – in teoria – la loro capacità di generalizzazione. Ma il GDPR impone di processare solo dati adeguati e pertinenti, limitati a quanto necessario. Come si conciliano queste esigenze?

La guida suggerisce diverse strategie: dal data sampling (selezionare sottoinsiemi rappresentativi invece di utilizzare l’intero dataset) all’uso di dati sintetici, dall’anonimizzazione alla pseudonimizzazione. Ma ogni tecnica porta con sé trade-off complessi. I dati sintetici, per esempio, possono preservare la privacy ma rischiano di introdurre nuovi bias o di non catturare pattern marginali ma significativi. L’anonimizzazione, se mal implementata, può essere vulnerabile ad attacchi di re-identificazione, specialmente quando i modelli sono esposti tramite API pubbliche.

Emerge qui una delle tensioni fondamentali della governance AI e della protezione dati: la protezione dei dati non può essere un vincolo esterno aggiunto a posteriori, ma deve essere embedded nella progettazione stessa del sistema. Il concetto di privacy by design trova nell’AI la sua massima espressione – e la sua massima sfida operativa.

Explainability e interpretability: i prerequisiti dimenticati nella governance AI

Il documento dedica un’intera sezione a interpretability ed explainability, definendole come sine qua non – prerequisiti essenziali per qualsiasi altra forma di compliance. È una scelta significativa, in linea con gli strumenti di valutazione d’impatto dell’AI che permettono di identificare, analizzare e mitigare i rischi associati ai sistemi automatizzati.

Troppo spesso, la discussione sull’AI si concentra su metriche di performance (accuracy, precision, recall) trascurando la comprensibilità del sistema. Ma senza explainability, come può un’organizzazione verificare che il modello rispetti il principio di fairness? Come può identificare e correggere errori sistematici? Come può rispondere alle richieste dei data subject di comprendere le decisioni automatizzate che li riguardano?

La distinzione operata tra interpretability (la capacità di comprendere il funzionamento interno del modello) ed explainability (la capacità di spiegare specifiche decisioni) è particolarmente utile. Un modello può non essere interpretabile nella sua totalità – pensiamo ai transformer con miliardi di parametri – ma deve comunque essere possibile spiegare perché ha prodotto un determinato output per un determinato input. Tecniche come LIME per spiegazioni locali interpretabili o SHAP basato sui valori di Shapley vengono citate come esempi, ma il documento non nasconde che si tratta di approssimazioni, non di spiegazioni complete.

Il problema del machine unlearning e i diritti dei data subject

Tra i passaggi più interessanti della guida c’è quello dedicato ai diritti dei data subject, in particolare al diritto di rettifica e cancellazione. Come si “dimentica” un dato che è stato incorporato nei pesi di una rete neurale addestrata su milioni di esempi? Il documento introduce il concetto di machine unlearning – la capacità di rimuovere selettivamente l’influenza di specifici punti dati dal modello.

Ma la guida non nasconde le difficoltà: l’unlearning “esatto” richiederebbe di riaddestrare il modello da zero escludendo i dati da rimuovere, un processo computazionalmente proibitivo per modelli di grandi dimensioni. L’unlearning “approssimato”, invece, introduce incertezze sulla completezza della rimozione. È un’area di ricerca attiva, ma con soluzioni ancora immature per il deployment in produzione.

In alternativa, viene suggerito l’output filtering: intercettare e bloccare in tempo reale le risposte del modello che potrebbero contenere dati personali. È una soluzione più praticabile, ma che sposta il problema: richiede sistemi di rilevamento affidabili e introduce latenza nelle risposte. Inoltre, non risolve il problema alla radice: i dati restano nel modello, semplicemente vengono oscurati nell’output.

La supply chain dell’AI e il procurement consapevole nella governance AI e protezione dati

Un aspetto spesso sottovalutato, ma al quale la guida dedica attenzione significativa, è la fase di procurement. La maggior parte delle organizzazioni non sviluppa i propri modelli di AI da zero, ma integra soluzioni di terze parti, spesso tramite API. Questo crea una catena di responsabilità complessa dove il data controller (l’istituzione UE) ha visibilità limitata su come i dati vengono effettivamente processati.

La guida propone una checklist dettagliata di informazioni da richiedere ai fornitori: non solo specifiche funzionali, ma documentazione completa sui dataset di addestramento, sulle metriche di fairness e accuracy misurate su diverse demographic, sui processi di quality assurance, sulle misure di sicurezza implementate. È un approccio esigente, che potrebbe incontrare resistenze da parte di fornitori abituati a considerare questi aspetti come “segreti commerciali”.

Ma è proprio qui che si gioca la partita della governance AI e della protezione dati: senza trasparenza sulla supply chain, il principio di accountability rimane una dichiarazione d’intenti. L’EDPS sta sostanzialmente dicendo alle istituzioni UE: non potete delegare la compliance, anche quando procurate tecnologie sviluppate altrove. Un principio rafforzato anche dalla recente Legge 132/2025 che disciplina sviluppo e uso dell’AI, entrata in vigore il 10 ottobre 2025, che ha introdotto obblighi specifici per l’uso dell’AI nel contesto nazionale.

Oltre la checklist: verso una cultura della risk literacy

Ciò che distingue questo documento da molte altre linee guida è il rifiuto della compliance meccanica. Non si tratta di spuntare caselle, ma di sviluppare una capacità organizzativa di risk assessment specifica per l’AI. Il framework ISO 31000 viene adottato come base metodologica, ma viene esplicitato che ogni organizzazione dovrà adattarlo al proprio contesto, alle proprie use case, ai propri risk appetite.

Le metriche proposte negli annex – da BLEU e ROUGE per il NLP, a ImageNet e COCO per la computer vision, fino a MMLU per la comprensione multimodale del linguaggio – non sono prescrittive ma esemplificative. L’invito è a sviluppare una “risk literacy” che permetta di navigare la complessità dell’AI senza cadere né nell’entusiasmo acritico né nel rifiuto preconcetto.

L’approccio europeo si distingue per il tentativo di bilanciare innovazione e protezione attraverso un framework basato sul rischio che potrebbe influenzare gli standard globali, sebbene evidenze preliminari del 2025 mostrino un’adozione internazionale più limitata del previsto rispetto all’atteso “Effetto Bruxelles”.

Zone d’ombra e domande aperte nella governance AI

Nonostante il rigore e la completezza, il documento lascia inevitabilmente alcune questioni in sospeso. La prima riguarda l’enforcement: quali saranno le conseguenze per le istituzioni che non riusciranno a implementare questi controlli? Il GDPR prevede sanzioni significative, ma applicarle in un contesto dove la “conformità perfetta” è probabilmente irraggiungibile richiede una dose di pragmatismo che deve ancora essere calibrata.

La seconda questione riguarda l’evoluzione tecnologica: il documento è datato novembre 2025, ma i sistemi di AI si evolvono con una velocità che rende qualsiasi framework rapidamente obsoleto. Come mantenere rilevante questa guida quando emergeranno nuove architetture, nuove modalità di addestramento, nuovi vettori di attacco? La sfida è creare framework sufficientemente robusti attraverso norme ISO specifiche che resistano al cambiamento tecnologico ma rimangano abbastanza flessibili da adattarsi all’innovazione.

Infine, c’è la questione della competenza: implementare questi controlli richiede team interdisciplinari con competenze profonde sia in machine learning che in data protection law. Quante organizzazioni dispongono realmente di queste risorse? Il rischio è che la guida diventi un documento aspirazionale, consultato ma non implementato, o implementato in modo superficiale per pura facciata.

Un cambio di paradigma necessario per la governance AI e la protezione dati

Nonostante questi interrogativi, la guida dell’EDPS rappresenta un passo avanti significativo. Per la prima volta, un’autorità di controllo europea tenta di colmare il gap tra principi legali e implementazione tecnica nell’ambito dell’AI, senza rifugiarsi in astrazioni né in tecnicismi inaccessibili.

Il messaggio di fondo è chiaro: l’adozione dell’AI nelle istituzioni pubbliche europee non può essere guidata solo da considerazioni di efficienza o innovazione. Deve essere un processo consapevole, dove ogni scelta tecnologica viene valutata anche – e soprattutto – in termini di impatto sui diritti fondamentali delle persone. Non è una posizione luddista o anti-tecnologica, ma una riaffermazione dei valori che dovrebbero caratterizzare l’azione pubblica in una democrazia liberale.

Resta da vedere se questo approccio rigoroso alla governance AI e alla protezione dei dati diventerà lo standard anche al di fuori delle istituzioni UE, influenzando il mercato più ampio dell’AI. Le dinamiche competitive potrebbero spingere le organizzazioni a privilegiare velocità e performance rispetto alla compliance approfondita. Ma forse è proprio questo il test decisivo: riuscirà l’Europa a dimostrare che è possibile sviluppare e utilizzare l’AI in modo potente ed efficace senza sacrificare la protezione dei dati personali?

La risposta a questa domanda definirà non solo il futuro della governance tecnologica, ma l’identità stessa del progetto europeo nell’era digitale. Come evidenziato nell’analisi sulla ridefinizione del concetto di sicurezza nazionale nell’era AI, la sfida principale consiste nel mantenere un controllo razionale e democratico su uno sviluppo tecnologico di portata epocale, preservando i valori fondamentali delle società libere attraverso una governance multilivello che bilanci innovazione e protezione.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/governance-ai/


React2Shell: più di 160.000 indirizzi IP vulnerabili, oltre 30 organizzazioni già colpite


React2Shell, una vulnerabilità di React che consente l’esecuzione di codice da remoto, è già stata sfruttata dagli attaccanti per colpire più di 30 organizzazioni di diversi settori.

La vulnerabilità (CVE-2025-55182), scoperta dal ricercatore di sicurezza Lachlan Davidson, è stata resa nota lo scorso 3 dicembre. Il bug consente a un attaccante di “eseguire codice da remoto senza autenticazione sfruttando un errore nel modo in cui React decodifica i payload inviati agli endpoint di React Server Function“, come si legge nel blog della compagnia.

Il giorno dopo, il 4 dicembre, il ricercatore Maple3142 ha condiviso su X una PoC per dimostrare l’efficacia degli attacchi che sfruttano React2Shell contro i server React vulnerabili.

React2Shell

A distanza di qualche giorno, l’impatto di React2Shell appare preoccupante: secondo i dati condivisi e aggiornati quotidianamente dal gruppo ShadowServer, a oggi sono 165.712 gli indirizzi IP vulnerabili, un numero che negli scorsi giorni ha continuato ad aumentare. Stando alla mappa della distribuzione geografica degli IP, gli Stati Uniti contano la maggior parte degli indirizzi IP vulnerabili a livello globale.

Come riporta anche Bleeping Computer, da quando la vulnerabilità è stata resa nota numerosi ricercatori e compagnie di sicurezza hanno segnalato uno sfruttamento piuttosto diffuso del bug. 

Secondo i report condivisi, gli attaccanti sfruttano la vulnerabilità per eseguire una prima ricognizione sui server; in seguito, tentano di sottrarre file di configurazione e credenziali AWS ed eseguono comandi arbitrari. Durante queste intrusioni, gli attaccanti hanno distribuito malware quali Snowlight e Vshell, una backdoor comunemente usata dai cyberattaccanti cinesi per muoversi lateralmente nelle reti compromesse.

I ricercatori hanno collegato agli attacchi gruppi APT cinesi come Earth Lamia, Jackpot Panda e UNC5174, un gruppo che sembrerebbe essere legato al Ministero della Sicurezza dello Stato cinese.

Per proteggersi dalla vulnerabilità, gli sviluppatori devono aggiornare React all’ultima versione ed effettuare di nuovo build e deploy delle applicazioni. La CISA ha richiesto alle agenzie federali di applicare le patch entro il 26 dicembre.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/12/09/react2shell-piu-di-160-000-indirizzi-ip-vulnerabili-oltre-30-organizzazioni-gia-colpite/?utm_source=rss&utm_medium=rss&utm_campaign=react2shell-piu-di-160-000-indirizzi-ip-vulnerabili-oltre-30-organizzazioni-gia-colpite


Security Leaders Discuss the Marquis Data Breach

Marquis Software Solutions experienced a data breach affecting approximately 780,000 individuals, according to filings with the Office of the Maine Attorney General, the Office of Attorney General of Iowa, and more. According to the filing in Maine, suspicious activity was detected on the organization’s systems on Aug. 14. This activity was determined to be a ransomware attack. 

Upon the launch of an investigation, it was discovered that the malicious actor accessed its network via its SonicWall firewall and may have acquired certain files. Personal data at risk may include:

  • Names
  • Dates of birth
  • Addresses 
  • Phone numbers
  • Taxpayer Identification Numbers
  • Financial account data 
  • Social Security numbers

At this time, there is no evidence that the data has been misused. 

Security Leaders Weigh In

David Stuart, Cybersecurity Evangelist at Sentra: 

Although the initial access in this incident came from a firewall vulnerability, the real damage occurred once attackers reached sensitive data. Breaches like this show how important it is to prevent credentials and encryption keys from being stored in unprotected locations or in unmasked forms. When secrets are exposed, attackers can move quickly and gain access to high-value information.

Organizations also need continuous visibility into where sensitive data lives and how it is being accessed. Detecting credit card numbers, Social Security numbers and other regulated data across all environments and validating that it is properly protected can significantly reduce occurrence of compliance violations and the impact of a compromise. Continuous monitoring for unusual data activity, such as unexpected access by third parties or unfamiliar IPs, is another key safeguard.

Strong password practices and timely patching will always matter, but reducing the blast radius requires a data-centric approach that limits what attackers can reach even if they do get in.

Sachin Jade, CPO at Cyware: 

Personal data focused exploitation attacks are ever increasing. Threat actors are employing both old and new techniques to breach, steal and misuse personal data.

In an increasingly connected world, financial firms are targeted by multiple threat vectors looking for gaps in their defenses, exacerbated with threat actors leveraging AI as well. Fraud and personal credential and data need to be an integral part of the overall risk and exposure management strategy.

Operationalizing threat intelligence data is paramount. Enterprises, including financial firms, can evaluate and incorporate a capability maturity model (CCM) that can enable them to leverage different threat intelligence data, correlate with identity and personalized data, evaluate value at risk, leverage trusted AI models and develop scenarios to help determine potential mitigation.

Clyde Williamson, Senior Product Security Architect at Protegrity: 

When we sign a contract with a vendor, partner or service provider, it is tempting to believe we have offloaded a problem. This is a critical flaw in business thinking today. We haven’t offloaded the problem, we’ve distributed the risk.

The Marquis breach could be framed as a simple technical failure. Their SonicWall firewall got hit; that’s the cost of business. Casting this as a “firewall issue,” though, misses the point entirely. I’m asked to comment on these sorts of events weekly. This is an ontological failure across our industry.

Hundreds of banks told their customers, “Trust us,” and then extended that trust to Marquis without their customers’ consent. Unlike formal logic, trust in cybersecurity cannot be simply passed along a chain of command. Banks believe they’re outsourcing work but actually retain liability while losing control. The lesson: failure to audit the entire trust chain betrays the customer, who only cares that their bank did not protect them.

The attackers lived inside the Marquis environment from August to October. Two months. We continue to build security doctrines around “walls” in an era where data isn’t in one place for long. A wall is a static, binary defense. It says “Yes” or “No” at the gate. Once the gate is breached, like with SonicWall, the wall offers no further opinion. This “dwell time” is the death knell of infrastructure-centric security. If we do not have intelligent, data-centric security in which the data itself can ask, “Why am I being moved?”, then we are simply building taller walls.

The real problem, though, is the asymmetry of the situation as a whole. The most impacted group, the customer, has little to no say in what happened to their data. The banks have the paper cover of a contract, and they can point the finger at someone else. Marquis will probably pay a little fine to a couple of states and offer some credit monitoring to the victims. Of course, some of the most common abuses of PII data (like what was stolen) aren’t solved by credit monitoring. Attackers who use the collected information to build personalized social engineering attacks will be harvesting value by abusing victims for years, long after the pittance of 24 months of credit monitoring has passed, while the banks and Marquis have enjoyed another profitable quarter. Profit is privatized, and Risk is socialized. The vendor saves money on “efficient” architectures, while the public pays the price in perpetuity.

Until we treat data as a liability to be protected, not an asset, this will continue. The core takeaway for every CISO: lasting trust cannot be bought or outsourced. It demands active stewardship, accountability and constant responsibility.

https://www.securitymagazine.com/articles/102034-security-leaders-discuss-the-marquis-data-breach


The New Real-Time Crime Center in an Age of Agentic AI

Police departments and corporate security leaders often struggle with limited resources when addressing a dizzying range of safety concerns.

Although overall crime rates in categories including gun assault, robbery, and homicide have decreased, instances of violent crime have increased, and cities with rising crime rates may struggle to adapt their operations to address the new threats plaguing their communities. 

Real-time crime centers — typically characterized as a centralized hub for security personnel to monitor disparate security technologies and alert systems — have become integral to many public safety efforts, coordinating real-time incident response across disaster recovery, common crime, and mass-casualty incidents. 

While police departments and some organizations have invested significant resources toward RTCCs, their playbooks are quickly becoming obsolete as new agentic AI capabilities radically transform what’s possible with security. 

To help evolve your safety strategy, let’s examine why traditional RTCCs are increasingly falling behind in the modern threat landscape, how agentic AI will significantly improve security strategy success, and what it takes to accomplish this reality.

The Shortcomings of Legacy RTCCs

In the past two decades, thousands of new security technologies have been introduced to address common security gaps and streamline operations with powerful capabilities. 

The challenge, however, is that solutions have traditionally failed to effectively integrate with other security solutions — meaning teams must manually monitor disconnected dashboards, assess alerts, and stitch together insights from disparate sources.

Real-time crime centers and similar security operations centers were built as a hub for police departments and select organizational security teams to unify their disparate technologies and alerts into a “single pane of glass.” It’s common for RTCCs to connect dozens of solutions, spanning: 

  • CCTV and video surveillance streams
  • Gunshot detection systems
  • Social media feeds
  • License plate reading (LPR) technology
  • Drone and body-worn camera feeds

As more technologies have been integrated into RTCCs, teams have encountered the same challenges they faced before: Too many alerts, an inefficient prioritization system, and too many notifications for humans to handle alone. 

Essentially, the noise has become too great to effectively address every incident that matters.

Agentic AI is the answer to this challenge. 

Technology has now advanced to a point where AI can effectively orchestrate time-intensive tasks and allow humans to focus their attention where and when it matters. Teams can also access tools that effectively deter events before they happen — reducing the overall volume of incidents that teams must address.

Achieving this reality, however, requires an entirely new approach to building a connected tech ecosystem. 

The Technology Behind Modern RTCCs

Agentic AI is a powerful form of AI that can orchestrate activities in ways indistinguishable from humans. Although the technology is in its infancy, it is evolving rapidly as teams learn how to best position their data and systems for AI.

The “single pane of glass” will move from a literal user interface interpretation to an agentically-centered systems platform interpretation. When positioned correctly, AI can access holistic, real-time insights across security technologies, implement features designed to deter unwanted behavior (such as issuing customized loudspeaker announcements or triggering alarm systems), and flag situations that require immediate human attention.

This foundation is built through the following elements:

  • Centralized data aggregation: Agentic systems need access to all security tools and an organization’s complete dataset to effectively orchestrate activities. Data needs to be aggregated centrally in the cloud and not on on-prem systems, because a data cloud provides optimal security measures and the necessary composability to connect to all business systems.

  • Agentic flow integrations: Agentic systems will require newly created standards for agentic flow, like model context protocol (MCP) servers and agent to agent (A2A) protocols, and integrations between systems will need to move from direct software integrations to agentic flow integrations.

  • Deterrence-capable hardware and software: Each component of the system must work in tandem to leverage deterrence features to help prevent crime. Cameras alone provide a baseline deterrence; however, that effect is amplified by agentic AI when a camera system detects abnormal behavior, so the AI triggers a customized audio warning through a connected speaker. A drone as a first responder system is also effective for deterrence and situational awareness, combining drones with strategically positioned spotlights, audio speakers, and other technologies.

Preventing Crime Proactively

Public safety and security teams have long battled a widening range of risks with increasingly limited resources. Agentic AI is an essential force multiplier that is capable of warding off routine risks effectively — while giving teams full situational awareness of incidents that require their immediate action.

https://www.securitymagazine.com/articles/102035-the-new-real-time-crime-center-in-an-age-of-agentic-ai