Responsabilità penale degli amministratori per data breach: quando la violazione dei dati diventa reato
Quando un’organizzazione subisce una violazione massiva di dati personali, l’attenzione si concentra immediatamente sulle sanzioni amministrative del Garante, che possono raggiungere i 20 milioni di euro o il 4% del fatturato mondiale annuo. Raramente, invece, ci si interroga sulla più insidiosa questione della responsabilità penale individuale degli amministratori che siedono nei consigli di amministrazione delle società coinvolte.

Eppure, è proprio su questo crinale che si gioca una partita fondamentale: quella tra accountability aziendale e personalità della responsabilità penale, tra obblighi preventivi e punizione degli illeciti, tra cultura della compliance e logiche sanzionatorie che possono portare, nei casi più gravi, a pene detentive fino a sei anni di reclusione.

La giurisprudenza italiana del biennio 2024-2025 offre un quadro tutt’altro che lineare, frammentato tra reati informatici, violazioni del Codice della privacy e applicazione del D.lgs. 231/2001. La sostanziale assenza di pronunce specificamente dedicate alla responsabilità penale per data breach in senso stretto crea una zona grigia che genera incertezza operativa per CISO, DPO, responsabili della sicurezza informatica e, soprattutto, per gli amministratori che devono comprendere i confini esatti della loro esposizione al rischio penale.

Il quadro normativo italiano: un sistema stratificato tra GDPR e codice penale

Il Regolamento (UE) 2016/679 (GDPR), nella sua complessa architettura sanzionatoria, ha volutamente privilegiato la responsabilità amministrativa, costruendo un sistema binario di sanzioni pecuniarie che distingue tra violazioni “minori” (fino a 10 milioni di euro o 2% del fatturato) e violazioni “gravi” (fino a 20 milioni o 4% del fatturato).

Tuttavia, il Considerando 149 del GDPR stabilisce espressamente che “gli Stati membri dovrebbero poter stabilire disposizioni relative a sanzioni penali per le violazioni del presente regolamento”, lasciando agli ordinamenti nazionali la facoltà – non l’obbligo – di introdurre fattispecie penali complementari.

La scelta italiana: mantenere le fattispecie penali del codice privacy

L’Italia ha scelto una strada peculiare: mantenere in vigore gli articoli 167, 167-bis e 167-ter del Codice della privacy (D.lgs. 196/2003, come modificato sostanzialmente dal D.lgs. 101/2018 in seguito all’entrata in vigore del GDPR), che puniscono il trattamento illecito di dati personali con pene detentive significative.

Questa scelta ha generato un sistema a “doppio binario” che molti esperti di diritto penale considerano problematico: da un lato la responsabilità amministrativa comminata dal Garante per la protezione dei dati personali, dall’altro la possibile responsabilità penale individuale per fattispecie che, in molti casi, presentano elementi costitutivi parzialmente sovrapponibili.

L’articolo 167 del codice privacy: elementi costitutivi del reato

L’art. 167, comma 1 del Codice privacy stabilisce testualmente: “Salvo che il fatto costituisca più grave reato, chiunque, al fine di trarre per sé o per altri profitto ovvero di arrecare danno all’interessato, operando in violazione di quanto disposto dagli articoli 123, 126 e 130 o dal provvedimento di cui all’articolo 129 arreca nocumento all’interessato, è punito con la reclusione da sei mesi a un anno e sei mesi”.

Questa norma presenta caratteristiche tecniche che ne limitano significativamente l’applicabilità pratica ai casi di data breach:

  1. Clausola di riserva: “Salvo che il fatto costituisca più grave reato” significa che l’art. 167 opera in via sussidiaria rispetto ad altre fattispecie penali più gravi (es. estorsione mediante ransomware, accesso abusivo a sistema informatico ex art. 615-ter c.p.)
  2. Dolo specifico alternativo: è richiesto il “fine di trarre profitto” oppure il “fine di arrecare danno”. Non è sufficiente la mera violazione colposa degli obblighi di sicurezza
  3. Nocumento effettivo: oltre al dolo specifico, è necessario che si verifichi un “nocumento” concreto all’interessato, non meramente ipotetico o potenziale
  4. Violazione di specifiche norme: il rinvio agli artt. 123, 126, 130 e 129 del Codice circoscrive le condotte rilevanti

La Cassazione penale, con la fondamentale sentenza n. 13102 del 14 marzo 2023 (depositata il 29 marzo 2023), ha precisato che l’art. 167 configura un reato comune, che può essere commesso da “chiunque” e non solo da soggetti qualificati come titolari o responsabili del trattamento. Questo amplia potenzialmente la platea dei soggetti perseguibili, ma al contempo la Corte ha ribadito che il nocumento deve essere “giuridicamente rilevante”, escludendo disagio o fastidio di lieve entità.

L’articolo 167-bis: la comunicazione illecita su larga scala

L’art. 167-bis, introdotto dal D.lgs. 101/2018, rappresenta un inasprimento significativo della tutela penale: “Salvo che il fatto costituisca più grave reato, chiunque comunica o diffonde al fine di trarre profitto per sé o altri ovvero al fine di arrecare danno, un archivio automatizzato o una parte sostanziale di esso contenente dati personali oggetto di trattamento su larga scala, in violazione degli articoli 2-ter, 2-sexies e 2-octies, è punito con la reclusione da uno a sei anni”.

Questa norma è stata pensata per colpire casi di massive data breach con successiva divulgazione intenzionale dei dati (tipicamente, la pubblicazione sul dark web di database sottratti). La pena edittale elevata (fino a 6 anni) riflette la gravità sociale di condotte che espongono milioni di persone a rischi concreti di furto d’identità, frodi finanziarie e altri crimini derivati.

Tuttavia, anche qui permane il requisito del dolo specifico: deve essere dimostrato il fine di profitto o di danno. Un data breach causato da negligenza nella gestione della sicurezza informatica – per quanto grave sul piano della compliance GDPR – difficilmente può essere ricondotto a questa fattispecie.

La posizione di garanzia degli amministratori: quando l’omissione diventa reato

Il vero nodo interpretativo per la responsabilità degli amministratori societari nel contesto dei data breach non riguarda tanto la commissione attiva del reato quanto la responsabilità omissiva: può un amministratore rispondere penalmente per non aver impedito una violazione dei dati causata da terzi o da inadeguatezza delle misure di sicurezza?

Il principio costituzionale della personalità della responsabilità penale

L’art. 27, comma 1, della Costituzione italiana stabilisce che “la responsabilità penale è personale”. Questo principio, apparentemente semplice, ha implicazioni profonde: non è possibile punire qualcuno per il solo fatto di ricoprire una determinata carica (responsabilità di posizione), ma è necessario dimostrare un contributo causale personale, attivo od omissivo, alla realizzazione dell’evento criminoso.

La giurisprudenza consolidata della Cassazione ha tradotto questo principio in regole operative stringenti, particolarmente rilevanti per gli amministratori:

  1. La posizione formale non basta: essere registrati come amministratore presso il Registro Imprese non è sufficiente per fondare una condanna
  2. Serve la prova del contributo causale: deve essere dimostrato cosa l’amministratore ha fatto o omesso di fare
  3. È necessario l’elemento psicologico: oltre al nesso causale, deve essere provato il dolo o, nei reati colposi, la negligenza, imprudenza o imperizia

La dottrina della posizione di garanzia nel diritto penale societario

La posizione di garanzia è un istituto del diritto penale (disciplinato dall’art. 40, comma 2, c.p.) secondo cui “non impedire un evento che si ha l’obbligo giuridico di impedire equivale a cagionarlo”. In altre parole, chi ha il dovere giuridico di evitare che si verifichi un determinato evento dannoso risponde penalmente se, potendo impedirlo, non interviene.

Gli amministratori di società sono tradizionalmente considerati garanti del patrimonio sociale e dell’integrità dell’organizzazione. Ma questa posizione di garanzia si estende anche alla protezione dei dati personali trattati dall’azienda?

La risposta è articolata:

  • Sul piano civilistico e amministrativo: sì, senza dubbio. Gli artt. 2381 e 2392 c.c. impongono agli amministratori doveri di diligente gestione, e il GDPR (art. 24) attribuisce al titolare del trattamento l’obbligo di implementare misure tecniche e organizzative adeguate
  • Sul piano penale: la questione è controversa. La dottrina prevalente ritiene che la posizione di garanzia penalmente rilevante debba essere fondata su una norma espressa, non su generici obblighi di vigilanza

Le sentenze della cassazione 2024: la svolta sulla consapevolezza effettiva

Il 2024 ha visto pronunce significative che ridefiniscono i confini della responsabilità penale degli amministratori. Due sentenze in particolare meritano un’analisi approfondita.

Cassazione n. 11968 del 26 gennaio 2024 – Il caso dell’amministratore “testa di legno”

Questa sentenza ha esaminato il caso di un amministratore unico di S.r.l., in carica dal 2013 al fallimento nel 2016, accusato di bancarotta fraudolenta documentale e patrimoniale. L’imputato sosteneva di essere un mero prestanome, senza effettivi poteri gestionali.

La Corte di Cassazione ha annullato la condanna con rinvio a nuovo giudizio, stabilendo un principio fondamentale: “Per affermare la responsabilità penale dell’amministratore di diritto non è sufficiente la sua posizione formale, ma occorre provare la sua effettiva e concreta consapevolezza delle condotte illecite poste in essere dagli amministratori di fatto o, comunque, il suo contributo causale alla realizzazione del reato”.

La motivazione è particolarmente significativa: “La posizione di garanzia che deriva dalla carica di amministratore non può trasformarsi in una presunzione di responsabilità penale che inverte l’onere della prova, imponendo all’imputato di dimostrare la propria estraneità ai fatti. Al contrario, è l’accusa che deve fornire la prova positiva del coinvolgimento, della consapevolezza e dell’elemento soggettivo del reato”.

Trasponendo questo principio ai data breach: un amministratore non può essere ritenuto penalmente responsabile per la sola circostanza che, durante il suo mandato, si sia verificata una violazione dei dati. Deve essere dimostrato che:

  • Era a conoscenza di vulnerabilità specifiche non risolte
  • Aveva ricevuto segnalazioni formali (es. dal DPO, dal CISO, dall’OdV) rimaste inascoltate
  • Aveva deliberatamente rifiutato stanziamenti di budget per investimenti in sicurezza ritenuti essenziali
  • Era stato informato di precedenti incidenti minori che avrebbero dovuto allertarlo

Cassazione n. 13620/2024 – La responsabilità nella gestione collegiale

Questa pronuncia ha affrontato il caso di una S.r.l. con tre amministratori, tutti condannati per bancarotta fraudolenta nonostante solo uno fosse il gestore di fatto. Gli altri due si difendevano sostenendo di essere stati esclusi dalla gestione.

La Cassazione ha confermato le condanne, ma con una motivazione che introduce elementi rilevanti: “L’amministratore non operativo è esente da responsabilità penale solo se dimostra di aver effettivamente vigilato sull’operato degli altri amministratori e di essersi attivato per impedire le condotte illecite, ad esempio formalizzando il proprio dissenso, convocando assemblee dei soci o, nei casi più gravi, rassegnando le dimissioni”.

Il principio chiave è quello della vigilanza attiva: non basta non partecipare alle decisioni illegittime; occorre attivarsi concretamente per contrastarle o, quantomeno, documentare il proprio dissenso.

Applicazione pratica ai data breach: in un CdA con più amministratori, se il CEO o l’amministratore delegato rifiuta di implementare raccomandazioni di sicurezza critiche, gli altri amministratori hanno l’obbligo di:

  1. Formalizzare il proprio dissenso in sede di consiglio
  2. Richiedere pareri tecnici esterni (consulenti, auditor)
  3. Nei casi più gravi, informare il collegio sindacale o rassegnare le dimissioni

La mera “non partecipazione” passiva alle decisioni insufficienti in materia di cybersecurity potrebbe non essere sufficiente a escludere la responsabilità.

Il decreto legislativo 231/2001: la responsabilità dell’ente come sistema di imputazione parallelo

L’art. 24-bis del D.lgs. 231/2001 ha introdotto nel 2008 (con la Legge 48/2008 di ratifica della Convenzione di Budapest sul cybercrime) i delitti informatici e il trattamento illecito di dati tra i reati presupposto della responsabilità amministrativa degli enti.

Questo meccanismo introduce un livello di complessità ulteriore nella gestione del rischio penale connesso ai data breach.

Come funziona la responsabilità ex 231: il meccanismo dell’imputazione “per ricochet”

Il sistema 231 si basa su un principio apparentemente paradossale: l’ente (società, associazione, fondazione) risponde “penalmente” (anche se tecnicamente si tratta di responsabilità amministrativa) per reati commessi da persone fisiche. È una deroga al principio societas delinquere non potest.

Il meccanismo funziona così:

  1. Un soggetto “apicale” (amministratore, direttore, dirigente con funzioni di rappresentanza) o un soggetto “sottoposto” (dipendente, collaboratore) commette uno dei reati presupposto elencati nel D.lgs. 231
  2. Il reato è commesso nell’interesse o a vantaggio dell’ente (non a vantaggio esclusivo personale dell’autore)
  3. L’ente non ha adottato un Modello di Organizzazione, Gestione e Controllo (MOG) idoneo a prevenire quel tipo di reato, oppure il modello è stato fraudolentemente eluso
  4. L’Organismo di Vigilanza (OdV) non ha vigilato efficacemente sul rispetto del modello

Se questi elementi ricorrono, l’ente può essere condannato a sanzioni pecuniarie (da 25.900 a 1.549.000 euro, calcolate a quote) e, nei casi più gravi, a sanzioni interdittive:

  • Interdizione dall’esercizio dell’attività
  • Sospensione o revoca di autorizzazioni, licenze o concessioni
  • Divieto di contrattare con la pubblica amministrazione
  • Esclusione da finanziamenti, contributi o sussidi
  • Divieto di pubblicizzare beni o servizi

Queste sanzioni interdittive possono essere devastanti per un’azienda, comportando di fatto la cessazione dell’attività economica.

I reati informatici rilevanti per i data breach

L’art. 24-bis include diverse fattispecie:

  • Art. 615-ter c.p. (Accesso abusivo a sistema informatico): pena per l’ente da 100 a 500 quote, se il reato è commesso da un dipendente che supera i propri privilegi di accesso
  • Art. 615-quater c.p. (Detenzione e diffusione abusiva di codici di accesso): rilevante quando vengono sottratte credenziali per accedere ai database
  • Art. 615-quinquies c.p. (Diffusione di programmi diretti a danneggiare o interrompere un sistema informatico): ransomware sviluppati internamente
  • Art. 617-quater c.p. (Intercettazione, impedimento o interruzione illecita di comunicazioni informatiche)
  • Art. 617-quinquies c.p. (Installazione di apparecchiature per intercettare comunicazioni)
  • Art. 635-bis c.p. (Danneggiamento di informazioni, dati e programmi informatici)
  • Art. 635-ter, quater, quinquies c.p. (Danneggiamento di sistemi informatici)
  • Art. 640-ter c.p. (Frode informatica)

Inoltre, sono inclusi gli artt. 167 e 167-bis del Codice privacy già analizzati.

Il paradosso del modello 231: scudo o amplificatore di responsabilità?

L’adozione di un Modello di Organizzazione, Gestione e Controllo efficace dovrebbe costituire una causa di esonero dalla responsabilità dell’ente ex art. 6 del D.lgs. 231/2001. In teoria, quindi, rappresenta uno “scudo” contro le sanzioni.

Tuttavia, nella pratica forense emerge un paradosso che pochi commentatori hanno evidenziato:

Scenario 1 – Ente senza MOG 231:

  • Si verifica un data breach
  • Un dipendente ha commesso un reato informatico (es. accesso abusivo, art. 615-ter)
  • L’ente non ha un modello 231
  • Conseguenza: l’ente risponde ex 231, ma è difficile imputare agli amministratori una responsabilità penale personale, perché l’assenza del modello è al massimo una violazione di obblighi civilistici

Scenario 2 – Ente con MOG 231 dettagliato:

  • Si verifica un data breach
  • L’ente ha un modello 231 che contiene protocolli specifici sulla cybersecurity
  • Nei verbali del CdA risulta che l’amministratore ha approvato procedure anti-ransomware, policy di gestione accessi, etc.
  • Conseguenza: è più facile per l’accusa sostenere che l’amministratore era pienamente consapevole dei rischi cyber e ha comunque omesso di vigilare adeguatamente

In altre parole, il MOG 231 può trasformarsi in un’arma a doppio taglio: da un lato protegge l’ente (se è stato efficacemente implementato), dall’altro cristallizza la consapevolezza dell’amministratore, rendendo più difficile sostenere di non essere a conoscenza dei rischi.

Il ruolo dell’organismo di vigilanza: sentinella della consapevolezza

L’Organismo di Vigilanza (OdV) è un organo interno dell’ente con funzioni di controllo sull’applicazione e l’efficacia del Modello 231. Può essere monocratico o collegiale, e deve possedere requisiti di autonomia, indipendenza, professionalità e continuità d’azione.

Il Parere del Garante del 27 gennaio 2020 (doc. web 9347842) ha chiarito la qualificazione privacy dell’OdV: non è né titolare autonomo né responsabile del trattamento, ma è parte integrante dell’ente. Tratta dati personali nell’ambito delle sue funzioni di vigilanza, ma la responsabilità per eventuali violazioni ricade sull’ente stesso.

Tuttavia, sul piano della dinamica della responsabilità penale degli amministratori, l’OdV svolge un ruolo cruciale come produttore di evidenze documentali. Le relazioni periodiche dell’OdV, le segnalazioni di criticità, le raccomandazioni non implementate sono tutti elementi che possono:

  1. Dimostrare la consapevolezza dell’amministratore: se l’OdV ha segnalato vulnerabilità di sicurezza e l’amministratore non ha stanziato i fondi necessari per risolverle, questo può integrare l’elemento soggettivo del reato
  2. Provare l’inadeguatezza del modello: un OdV che segnala ripetutamente le stesse criticità senza che vengano risolte dimostra che il modello non è “efficacemente attuato” ai sensi dell’art. 6 del D.lgs. 231
  3. Escludere la buona fede dell’amministratore: è più difficile sostenere di aver agito con la diligenza del “buon padre di famiglia” quando esistono segnalazioni formali ignorate

Analisi delle più recenti pronunce: insegnamenti dal diritto societario applicabili alla cybersecurity

In assenza di un corpus giurisprudenziale consolidato specificamente dedicato alla responsabilità penale per data breach, è necessario guardare alle pronunce in materia di reati societari, fallimentari e tributari che hanno affrontato la questione della responsabilità degli amministratori. Molti dei principi elaborati sono direttamente trasponibili al contesto della protezione dei dati.

Cassazione n. 35031 del maggio 2025: la consapevolezza della “macroscopica illegalità”

Questa sentenza, che ha confermato la condanna di un amministratore di diritto per reati tributari, introduce un concetto particolarmente rilevante: quello della “macroscopica illegalità”.

Il caso riguardava un soggetto che formalmente rivestiva la carica di amministratore, ma sosteneva di essere un mero prestanome, senza alcuna partecipazione alla gestione. La difesa aveva argomentato che, non essendo a conoscenza dei dettagli delle singole operazioni fiscalmente illecite, non poteva essere ritenuto responsabile.

La Cassazione ha respinto questa tesi con una motivazione articolata:

“In tema di reati tributari, la prova del dolo specifico dei delitti in capo all’amministratore di diritto di una società, che funge da mero prestanome, può essere desunta dal complesso dei rapporti tra questi e l’amministratore di fatto, nell’ambito dei quali assumono decisiva valenza la macroscopica illegalità dell’attività svolta e la consapevolezza di tale illegalità”.

Il concetto di “macroscopica illegalità” indica situazioni in cui l’illiceità è così evidente che non si può credibilmente sostenere di non essersene accorti. Esempi:

  • Fatturazioni per importi spropositati rispetto al fatturato reale
  • Movimenti bancari anomali e sistematici
  • Assenza totale di documentazione contabile
  • Utilizzo di società cartiere o soggetti fittizi

Trasposizione al contesto cyber: potrebbero configurare “macroscopica illegalità” in materia di protezione dati situazioni come:

  • Assenza totale di misure di sicurezza informatica (nessun firewall, nessun antivirus, nessuna gestione degli accessi)
  • Trattamento di dati sensibili (sanitari, giudiziari) senza alcuna crittografia
  • Violazione sistematica dei principi di minimizzazione e limitazione della conservazione (conservare dati per decenni senza alcuna ragione)
  • Database pubblicamente accessibili su internet senza protezione
  • Vendita deliberata di dati personali sul mercato nero

In questi casi estremi, un amministratore difficilmente potrebbe sostenere credibilmente di non essere a conoscenza della situazione.

Cassazione n. 2499 del 2024: l’inversione dell’onere della prova in caso di distrazioni

Questa sentenza, relativa a bancarotta fraudolenta, introduce un principio processuale rilevante: l’inversione dell’onere della prova in caso di mancata rendicontazione.

Il caso riguardava un amministratore di fatto (gestore effettivo pur senza carica formale) accusato di aver distratto beni aziendali. La difesa sosteneva che non vi era prova dell’effettiva distrazione, essendo possibile che i beni fossero stati utilizzati per finalità aziendali legittime.

La Cassazione ha stabilito: “La responsabilità dell’imprenditore in merito alla destinazione dei beni dell’impresa per la conservazione della garanzia patrimoniale verso i creditori giustifica l’apparente inversione dell’onere della prova a carico dell’amministratore della società fallita, in caso di mancato rinvenimento degli stessi o del loro ricavato, la cui violazione comporta responsabilità penale”.

In altre parole: se i beni aziendali mancano, spetta all’amministratore dimostrare dove sono finiti e che sono stati utilizzati correttamente. Non è l’accusa che deve provare la distrazione, ma è l’amministratore che deve giustificare l’assenza.

Applicazione ai data breach: questo principio potrebbe essere trasferito in contesti come:

  • Perdita di backup: se i backup dei dati sono scomparsi o non più accessibili, potrebbe spettare all’amministratore dimostrare che esisteva un’adeguata policy di backup e che è stata rispettata
  • Log mancanti: se non esistono log di accesso ai sistemi che avrebbero dovuto essere conservati per finalità di sicurezza, l’amministratore potrebbe dover giustificare questa assenza
  • Documentazione compliance: se non esiste documentazione sull’adozione di misure di sicurezza (DPIA, valutazioni del rischio, audit), l’onere di dimostrare che comunque le misure erano state prese potrebbe gravare sull’amministratore

Cassazione n. 13200 del 2024: la necessaria delimitazione temporale della responsabilità

Questa pronuncia affronta il caso di due amministratori che si erano succeduti nella gestione di una S.r.l. poi fallita. Entrambi erano stati condannati “in blocco” per le stesse condotte distrattive, senza che i giudici di merito avessero distinto quali atti fossero stati compiuti durante il mandato di ciascuno.

La Cassazione ha annullato la sentenza stabilendo un principio fondamentale: “Per affermare la responsabilità penale per bancarotta fraudolenta, non è sufficiente constatare l’esistenza di un danno per i creditori. È indispensabile dimostrare, al di là di ogni ragionevole dubbio, che una specifica condotta illecita, posta in essere da un determinato soggetto, abbia causato quel danno”.

La Corte ha quindi indicato che il giudice deve:

  1. Identificare temporalmente le singole condotte distrattive
  2. Collegare ciascuna condotta al periodo di gestione dell’amministratore in carica
  3. Motivare specificamente l’eventuale responsabilità per fatti avvenuti fuori dal mandato (es. accordo fraudolento con successore)

Trasposizione ai data breach: questo principio è cruciale quando:

  • Si succedono più amministratori: se un data breach emerge durante il mandato dell’amministratore B, ma deriva da vulnerabilità non risolte dall’amministratore A, occorre verificare: quando è stata segnalata la vulnerabilità? A chi? Chi aveva l’obbligo di risolverla? Chi aveva il budget?
  • Sistemi legacy: molti data breach derivano da vulnerabilità in sistemi informatici obsoleti ereditati da gestioni precedenti. L’amministratore attuale può essere responsabile solo se aveva conoscenza del rischio e disponibilità dei mezzi per porvi rimedio
  • Processi di M&A: in caso di fusioni o acquisizioni, occorre distinguere tra responsabilità per sistemi ereditati dalla società incorporata e responsabilità per mancata due diligence in fase pre-acquisizione

Scenari applicativi e casistica operativa: quando si configura il rischio penale concreto

Dopo aver analizzato il framework normativo e giurisprudenziale, è necessario calare questi principi nella pratica operativa, esaminando scenari reali che potrebbero configurare responsabilità penale per gli amministratori.

Scenario 1 – Attacco ransomware con exfiltration e pubblicazione dati

Fatto: Un’azienda sanitaria privata subisce un attacco ransomware. Gli attaccanti criptano i server, rendendo inaccessibili le cartelle cliniche di 50.000 pazienti. Contestualmente, exfiltrano 200 GB di dati sanitari (diagnosi, terapie, referti) che successivamente pubblicano sul dark web dopo il rifiuto di pagare il riscatto di 500.000 euro.

Profili di responsabilità amministrativa (Garante):

  • Violazione art. 32 GDPR (misure di sicurezza inadeguate)
  • Violazione art. 33 GDPR se la notifica non avviene entro 72 ore
  • Sanzioni potenziali: fino a 20 milioni o 4% fatturato (trattandosi di dati sanitari, categoria particolare ex art. 9 GDPR)

Profili di responsabilità penale dell’amministratore:

  1. Art. 167 Codice privacy: difficilmente applicabile, perché l’amministratore non ha “trattato illecitamente” i dati. Sono stati gli attaccanti a farlo. La mera omissione di adeguate misure di sicurezza non integra il reato commissivo dell’art. 167
  2. Art. 615-ter c.p. (accesso abusivo): l’amministratore non ha commesso personalmente l’accesso. Potrebbe rispondere solo se fosse dimostrato che ha agevolato l’accesso (es. fornendo credenziali, disabilitando sistemi di sicurezza dietro compenso)
  3. Responsabilità omissiva ex art. 40 cpv c.p.: potrebbe essere configurabile se si dimostra che:
    • L’amministratore aveva ricevuto audit di sicurezza che segnalavano vulnerabilità critiche non risolte
    • Il CISO o il DPO avevano formalmente raccomandato investimenti in sicurezza (es. implementazione di backup offline, segmentazione della rete)
    • L’amministratore aveva deliberatamente negato i fondi necessari o rimandato gli interventi nonostante la consapevolezza del rischio

Elemento discriminante: la documentazione della consapevolezza. Se esistono:

  • Email del CISO all’amministratore con alert su vulnerabilità
  • Verbali del CdA in cui si discute di investimenti in cybersecurity non approvati
  • Relazioni dell’OdV 231 che segnalano carenze nei protocolli di sicurezza
  • Report di penetration test non seguiti da interventi correttivi

…allora il rischio penale per l’amministratore diventa concreto, non tanto per l’art. 167, quanto per una possibile imputazione colposa ex art. 40 cpv (omesso impedimento di evento che si aveva l’obbligo di impedire).

Scenario 2 – Accessi abusivi sistematici da parte di dipendenti

Fatto: In una banca, emerge che 15 dipendenti di varie filiali hanno effettuato nel corso di 3 anni oltre 5.000 accessi abusivi ai conti correnti di clienti VIP, politici, personaggi dello spettacolo, per mera curiosità (cd. “snooping”). I dati sono stati in alcuni casi condivisi informalmente con amici e conoscenti.

Profili di responsabilità amministrativa:

  • Violazione art. 32 GDPR (mancanza di controlli tecnici sugli accessi)
  • Violazione principio di integrità e riservatezza
  • Sanzioni Garante: già comminate in casi simili tra 500.000 e 1.000.000 euro

Profili di responsabilità penale:

  1. Dei dipendenti: sicuramente configurabile l’art. 615-ter c.p. (accesso abusivo a sistema informatico). La recente Cass. n. 28887 del 1° novembre 2025 ha confermato condanne per dipendenti che accedevano a dati al di fuori delle proprie mansioni. Inoltre, è applicabile l’art. 167 Codice privacy se gli accessi hanno causato nocumento (es. diffusione di informazioni riservate che hanno danneggiato la reputazione degli interessati)
  2. Dell’amministratore delegato: potrebbe rispondere se:
    • Era stato informato di precedenti casi di snooping e non ha implementato controlli (es. sistemi di log, alert automatici per accessi anomali, audit periodici)
    • Non ha disposto formazione adeguata del personale sulle policy aziendali di accesso ai dati
    • Non ha previsto sanzioni disciplinari efficaci nei regolamenti interni

La Cassazione n. 28887/2025 è particolarmente rilevante: ha confermato il licenziamento di una dipendente di una ASL che aveva effettuato 30 accessi illeciti a fascicoli sanitari di vicini di casa con cui aveva controversie in corso. La Corte ha sottolineato che “la responsabilità dell’agente si configura anche per la forzatura dei limiti dell’autorizzazione concessa dal titolare del domicilio informatico”.

Elemento chiave: la prevenzione e la reazione. Se l’amministratore:

  • Ha implementato sistemi tecnici di monitoraggio (SIEM, log analysis, Data Loss Prevention)
  • Ha disposto audit periodici sugli accessi
  • Ha formato il personale con percorsi obbligatori e tracciabili
  • Ha sanzionato tempestivamente i primi casi emersi

…allora ha dimostrato la diligenza richiesta e difficilmente potrà essere chiamato a rispondere penalmente.

Al contrario, se i casi di snooping erano emersi in passato e nulla è stato fatto, la responsabilità omissiva diventa plausibile.

Scenario 3 – Omessa notifica al Garante e agli interessati

Fatto: Una piattaforma e-commerce subisce un data breach che compromette email, password (hasgate con algoritmo debole MD5) e dati di carte di credito di 800.000 clienti. Il breach viene scoperto dal team IT dopo 3 settimane. L’amministratore delegato, per timore di danni reputazionali e crollo delle vendite, decide di non notificare né al Garante né agli interessati. Mesi dopo, i dati vengono messi in vendita sul dark web e la violazione diventa pubblica.

Profili di responsabilità amministrativa:

  • Violazione art. 33 GDPR (obbligo di notifica entro 72 ore): sanzione fino a 10 milioni o 2% fatturato
  • Violazione art. 34 GDPR (obbligo di comunicazione agli interessati): stessa sanzione
  • Aggravanti: durata dell’omissione, numero di interessati, tipologia di dati (includono dati di pagamento)

Profili di responsabilità penale dell’amministratore:

  1. Art. 167 Codice privacy: potrebbe essere configurabile? La questione è controversa:
    • Tesi positiva: l’omessa notifica ha aggravato il nocumento, perché gli interessati non sono stati posti in condizione di proteggersi (es. cambiare password, bloccare carte). Il “fine di trarre profitto” potrebbe essere individuato nel vantaggio economico derivante dal non perdere clienti
    • Tesi negativa (prevalente): l’art. 167 punisce il trattamento illecito di dati, non l’omessa notifica. Quest’ultima è un obbligo procedimentale, la cui violazione è sanzionata sul piano amministrativo ma non configura autonomo reato
  2. Responsabilità per il reato continuato: se l’omessa notifica si protrae per mesi, con decisioni reiterate di non comunicare, potrebbe configurarsi una condotta unitaria aggravata
  3. Rilevanza processuale: la mancata notifica può costituire elemento di prova del dolo o della consapevolezza in altri reati. Il fatto che l’amministratore abbia deciso di nascondere la violazione dimostra che ne era pienamente consapevole e ne comprendeva la gravità

Elemento critico: la decisione deliberata di occultare. Se l’amministratore:

  • Ha convocato riunioni per decidere di non notificare
  • Ha dato istruzioni al personale di mantenere il silenzio
  • Ha occultato prove o distrutto log

…allora si configura una condotta dolosa che può aggravare ogni profilo di responsabilità e può integrare, in concorso con altri reati (es. truffa verso i clienti che continuano ad affidargli dati), fattispecie più gravi.

Scenario 4 – Data breach causato da fornitore cloud inadeguato

Fatto: Un’azienda affida i propri database a un fornitore cloud low-cost, senza adeguata due diligence. Il fornitore non implementa nemmeno le misure di sicurezza basilari. Si verifica un massiccio data breach. L’azienda sostiene di non essere responsabile perché “il fornitore era il responsabile del trattamento ex art. 28 GDPR”.

Profili di responsabilità:

  1. Dell’azienda (titolare): art. 32 GDPR prevede che il titolare debba assicurarsi che anche il responsabile implementi misure adeguate. Il titolare risponde in solido con il responsabile per danni causati dal trattamento (art. 82 GDPR)
  2. Del fornitore cloud (responsabile): violazione obblighi art. 28 e 32 GDPR
  3. Dell’amministratore dell’azienda: potrebbe rispondere se:
    • Ha scelto il fornitore solo sul prezzo, ignorando segnalazioni di inadeguatezza tecnica
    • Non ha verificato le certificazioni del fornitore (es. ISO 27001, SOC 2)
    • Non ha previsto clausole contrattuali adeguate ex art. 28 GDPR
    • Non ha effettuato audit periodici sul fornitore come richiesto dal GDPR

Un caso emblematico è il Provvedimento Garante dell’8 febbraio 2024 n. 66 contro una società informatica responsabile del trattamento per una banca. Il fornitore:

  • Aveva comunicato il data breach alla banca con grave ritardo
  • Aveva subappaltato attività a terzi senza autorizzazione preventiva del titolare
  • Non aveva implementato misure di sicurezza adeguate

Il Garante ha sanzionato sia la banca (provvedimento n. 65) che il fornitore (provvedimento n. 66), evidenziando che la responsabilità è solidale e che il titolare non può “scaricare” le proprie responsabilità sul responsabile.

Implicazioni penali: se l’amministratore ha deliberatamente scelto un fornitore inadeguato pur essendo consapevole dei rischi (es. per risparmiare costi), e se questo ha causato un data breach con conseguente danno agli interessati, potrebbe configurarsi una responsabilità colposa aggravata.

La compliance integrata GDPR-231: costruire un sistema difensivo efficace

Alla luce della complessità del quadro normativo e giurisprudenziale, emerge con chiarezza che la protezione dell’amministratore dalla responsabilità penale non può fondarsi sull’ignoranza o sulla speranza che “non succeda nulla”, ma deve basarsi su un sistema di compliance integrato, documentato e sostanziale.

I pilastri della compliance efficace

Un sistema di compliance che minimizzi il rischio penale per gli amministratori deve poggiare su sei pilastri fondamentali:

  1. Governance formale e sostanziale

Non basta nominare un DPO e un CISO. Occorre:

  • Definire chiaramente ruoli, responsabilità e linee di reporting
  • Prevedere budget dedicati e adeguati per la cybersecurity (percentuale del fatturato IT tipicamente 8-12% nelle aziende mature)
  • Stabilire KPI misurabili per valutare l’efficacia delle misure di sicurezza
  • Inserire la cybersecurity come punto fisso all’ordine del giorno dei CdA
  1. Documentazione sistematica e tracciabilità

Ogni decisione rilevante deve essere:

  • Verbalizzata nei CdA con dettaglio delle motivazioni
  • Supportata da analisi tecniche (DPIA, risk assessment, penetration test)
  • Archiviata in modo da poter essere recuperata in sede processuale

Questa documentazione svolge una doppia funzione:

  • Prova della diligenza: dimostra che l’amministratore si è attivato, ha valutato i rischi, ha preso decisioni informate
  • Prova dei vincoli: se l’amministratore ha proposto investimenti in sicurezza bocciati dall’assemblea dei soci, il verbale lo scagiona
  1. Integrazione tra GDPR e Modello 231

I due sistemi devono dialogare:

  • Il MOG 231 deve contenere una sezione specifica sui “reati informatici e trattamento illecito di dati”
  • Le procedure 231 per la prevenzione dei reati cyber devono essere coerenti con le misure tecniche e organizzative GDPR
  • L’OdV deve ricevere flussi informativi dal DPO su data breach e near miss
  • Il DPO deve essere coinvolto nell’aggiornamento del MOG 231 per la parte cyber
  1. Formazione e consapevolezza diffusa

La formazione non deve essere un adempimento formale (corso online da 30 minuti con test a risposta multipla), ma un processo strutturato:

  • Formazione base obbligatoria per tutti i dipendenti (almeno annuale)
  • Formazione avanzata per ruoli critici (IT, HR, amministrazione)
  • Formazione specifica per amministratori e OdV su responsabilità e rischi penali
  • Simulazioni periodiche (phishing test, tabletop exercise su incident response)
  1. Incident Response Plan e gestione delle crisi

Un piano di risposta agli incidenti deve prevedere:

  • Fase 1 – Detection: come si rileva un data breach (SIEM, alert, segnalazioni)
  • Fase 2 – Assessment: chi valuta la gravità, con quali criteri, in quanto tempo
  • Fase 3 – Containment: procedure immediate per limitare il danno
  • Fase 4 – Notification: chi decide se notificare al Garante e agli interessati, con quali tempistiche
  • Fase 5 – Remediation: come si ripristinano i sistemi e si risolvono le vulnerabilità
  • Fase 6 – Lessons learned: analisi post-incidente e aggiornamento procedure

Cruciale: il piano deve essere testato con esercitazioni periodiche, non rimanere un documento sulla carta.

  1. Audit indipendenti e certificazioni

Affidarsi a valutazioni di terzi indipendenti:

  • Audit annuali ISO 27001 sulla sicurezza delle informazioni
  • Penetration test periodici (almeno annuali) condotti da società specializzate
  • DPIA affidate a consulenti esterni per i trattamenti più rischiosi
  • Certificazioni di settore (es. PCI-DSS per chi tratta dati di pagamento)

Questi elementi costituiscono prova oggettiva della diligenza dell’amministratore: “ho fatto tutto ciò che era ragionevolmente possibile nelle condizioni date”.

Il caso Postel: lezioni pratiche da un provvedimento del Garante

Il Provvedimento del Garante del 4 luglio 2024 contro Postel S.p.A. (doc. web 10063782) è particolarmente istruttivo. Postel, società che gestisce servizi di gestione documentale e comunicazione per enti pubblici e privati, ha subito un attacco ransomware nell’agosto 2023.

I fatti:

  • Vulnerabilità nota (CVE pubblicata) nei sistemi Postel era stata segnalata dai loro stessi sistemi di monitoraggio
  • Postel non aveva applicato la patch di sicurezza disponibile
  • Gli attaccanti hanno sfruttato proprio quella vulnerabilità
  • Si è verificato un data breach massivo con blocco dei server e sottrazione dati

La sanzione: 900.000 euro (ridotta da 1.200.000 per attenuanti)

Le motivazioni del Garante (rilevanti per la responsabilità degli amministratori):

  1. “La società non era intervenuta su una vulnerabilità già nota e segnalata dai propri sistemi”
  2. “Le misure di sicurezza erano inadeguate rispetto al rischio e al volume di dati trattati”
  3. “Non risulta implementato un adeguato sistema di gestione della sicurezza delle informazioni”

Implicazioni penali (ipotetiche, perché il Garante non esercita azione penale):

  • Gli amministratori di Postel avevano ricevuto report interni sulla vulnerabilità?
  • Era stato stanziato budget per l’aggiornamento dei sistemi?
  • Esisteva un processo formalizzato di patch management?

Se la risposta a queste domande fosse negativa, la consapevolezza del rischio e l’omissione di interventi potrebbero configurare l’elemento soggettivo di una responsabilità penale.

Conclusioni: navigare la zona grigia tra prevenzione e punizione

La responsabilità penale degli amministratori per data breach nell’ordinamento italiano rappresenta una frontiera giuridica ancora in via di definizione. La giurisprudenza penale specifica è scarsa, frammentata, costruita per accumulazione di principi elaborati in altri ambiti del diritto penale societario.

Tuttavia, alcune certezze emergono con chiarezza dall’analisi condotta:

  1. La posizione formale non è sufficiente per una condanna: la giurisprudenza costituzionale e di legittimità è fermissima nel richiedere la prova del contributo causale consapevole. Un amministratore non può essere il “parafulmine” automatico di ogni violazione dei dati.
  2. La consapevolezza è l’elemento discriminante: tra una violazione GDPR sanzionabile amministrativamente e un reato penalmente rilevante corre la linea della consapevolezza dell’amministratore. Le segnalazioni ricevute e ignorate, i report di audit disattesi, le raccomandazioni di DPO e CISO rimaste senza seguito sono gli elementi che possono trasformare una colpa amministrativa in dolo penale.
  3. La documentazione è protezione: un sistema di compliance ben strutturato, tracciabile, sostanziale (non meramente formale) costituisce la migliore difesa dell’amministratore. Non garantisce l’immunità, ma dimostra la diligenza e può spostare l’imputazione dall’individuo all’organizzazione.
  4. L’integrazione GDPR-231 non è opzionale: nelle aziende di dimensioni medio-grandi, la convergenza tra sistema di protezione dei dati e modello organizzativo 231 è necessaria sia per l’efficacia della prevenzione sia per la costruzione di un sistema di evidenze difensive.
  5. La latenza giurisprudenziale non deve generare falsa sicurezza: il fatto che ad oggi manchino sentenze penali di condanna di amministratori specificamente per data breach non significa che il rischio sia inesistente. Le Procure stanno acquisendo competenze cyber, gli strumenti di digital forensics si affinano, e i casi di domani potrebbero derivare dalle negligenze di oggi.

In ultima analisi, per amministratori, CISO, DPO e tutti i professionisti della security, emerge un imperativo operativo: la consapevolezza ignorata è più grave dell’ignoranza stessa.

Nel contesto della cybersecurity aziendale, come la Cassazione ha ribadito in materia societaria, non si può invocare la non conoscenza quando esistono sistemi di allerta, segnalazioni formalizzate, audit che evidenziano criticità. La colpa cosciente – sapere del rischio e scegliere di non agire – è ciò che trasforma una violazione amministrativa in possibile reato penale.

La responsabilità penale per data breach in Italia resta più un’ipotesi che una pratica consolidata. Ma questa condizione può cambiare rapidamente, con il primo caso eclatante che verrà portato all’attenzione della magistratura penale. Meglio costruire oggi il sistema di prevenzione e documentazione che domani potrebbe fare la differenza tra una sanzione amministrativa all’ente e un procedimento penale a carico delle persone fisiche.

Normativa di riferimento essenziale

Norme europee

Norme nazionali – Codice privacy

  • D.lgs. 196/2003 come modificato da D.lgs. 101/2018
  • Art. 167 – Trattamento illecito di dati (reclusione 6 mesi – 1,5 anni)
  • Art. 167-bis – Comunicazione illecita su larga scala (reclusione 1-6 anni)
  • Art. 167-ter – Acquisizione fraudolenta di dati

Norme nazionali – Reati informatici

  • Art. 615-ter c.p. – Accesso abusivo a sistema informatico
  • Art. 615-quater c.p. – Detenzione abusiva codici accesso
  • Art. 617-quater c.p. – Intercettazione comunicazioni informatiche
  • Art. 635-bis c.p. – Danneggiamento di dati e programmi
  • Art. 640-ter c.p. – Frode informatica

Responsabilità degli enti

  • D.lgs. 231/2001 – Art. 24-bis (delitti informatici)
  • Art. 5 – Soggetti in posizione apicale
  • Art. 6 – Modelli di organizzazione e Organismo di Vigilanza

Riferimenti giurisprudenziali citati

  • Cass. pen. n. 13102/2023 – Natura comune reato art. 167
  • Cass. pen. n. 11968/2024 – Responsabilità amministratore di diritto
  • Cass. pen. n. 13620/2024 – Vigilanza attiva in organi collegiali
  • Cass. pen. n. 13200/2024 – Delimitazione temporale responsabilità
  • Cass. pen. n. 35031/2025 – Macroscopica illegalità
  • Cass. pen. n. 28887/2025 – Accesso abusivo dipendenti
  • Cass. pen. n. 2499/2024 – Onere della prova distrazioni

Provvedimenti Garante Privacy

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/responsabilita-penale-degli-amministratori-per-data-breach/


CERT-AGID 29 novembre – 5 dicembre: phishing a tema Governo italiano e Agenzia delle Entrate


Nel periodo compreso tra il 29 novembre e il 5 dicembre, il CERT-AGID ha analizzato 77 campagne malevole dirette verso cittadini, aziende e pubbliche amministrazioni italiane.

Di queste, 43 hanno avuto obiettivi specifici in Italia, mentre 34 campagne generiche hanno comunque coinvolto utenti italiani.

Gli enti accreditati hanno ricevuto 1.615 indicatori di compromissione (IoC), uno dei volumi più alti delle ultime settimane.

I temi della settimana

Sono 24 i temi utilizzati dai criminali per diffondere phishing e malware, con una prevalenza di attività legate a banking, multe, verifiche documentali e ordini commerciali.

Il tema Banking è stato sfruttato in sette campagne di phishing, quasi tutte italiane, che hanno preso di mira i clienti di SumUp, Morgan Stanley, Crédit Agricole, Intesa Sanpaolo e Unicredit.

77 campagne malevole rilevate in Italia, con 1.615 indicatori di compromissione.

In parallelo, attività malware hanno diffuso varianti come Copybara, AgentTesla, Lokibot, GoldFactory e PhantomStealer, confermando l’interesse costante dei criminali verso le credenziali finanziarie.

Il tema Multe, osservato in nove campagne, ha continuato a generare un forte volume di phishing basato su finte comunicazioni PagoPA. Le email simulano avvisi di sanzioni non pagate e indirizzano le vittime su pagine malevole progettate per sottrarre dati personali e bancari.

Il tema Verifica è emerso in sette campagne, quattro delle quali italiane. I criminali hanno abusato del nome di Mooney, Roundcube, iCloud, MetaMask e persino del Governo italiano, sfruttando la pressione esercitata dalle richieste di aggiornamento dei dati per convincere gli utenti a inserire credenziali e informazioni sensibili.

Il tema Ordine, presente in sei campagne, è stato usato esclusivamente per veicolare malware come AgentTesla, FormBook, StrRAT, XWorm e Remcos, confermando l’efficacia degli allegati fittizi relativi a spedizioni e acquisti.

Tra gli eventi di particolare interesse, il CERT-AGID ha segnalato una campagna di phishing che sfrutta nome e insegne della Presidenza del Consiglio dei Ministri, veicolata tramite email che invita le vittime a “verificare i dati bancari” per rispettare presunte nuove disposizioni.

La pagina di destinazione replica l’aspetto di un portale istituzionale e propone un menu di selezione multi-banca, attraverso il quale i criminali tentano di catturare le credenziali di home banking.

Fonte: CERT-AGID

Un’ulteriore campagna di rilievo riguarda un phishing che imita il sito ufficiale dell’Agenzia delle Entrate, promettendo un rimborso di 115,50 euro e conducendo le vittime a inserire dati personali e della carta di credito in una replica della piattaforma originale.

Malware della settimana

Sono 18 le famiglie di malware registrate nella settimana.

Remcos è stato diffuso tramite una campagna italiana a tema “Ordine”, veicolata con allegato RAR, e attraverso cinque campagne generiche legate a “Aggiornamenti”, “Contratti”, “Preventivi” e “Prezzi”. I criminali hanno utilizzato formati diversi, tra cui file Z, ZIP, RAR, 7Z e DOCX.

FormBook è comparso in cinque campagne generiche a tema “Delivery”, “Pagamenti”, “Ordine” e “Prezzi”, tramite allegati ZIP, 7Z, RAR e DOCX, confermandosi uno dei trojan più ricorrenti del trimestre.

AgentTesla è stato osservato in due campagne italiane, relative ai temi “Fattura” e “Ordine”, distribuite tramite file TAR, oltre che in due campagne generiche a tema “Banking” e “Booking”, veicolate con archivi ZIP e 7Z.

Fonte: CERT-AGID

XWorm ha riguardato due campagne italiane, con temi “Contratti” e “Booking”, distribuite rispettivamente tramite RAR e PDF, mentre due campagne generiche hanno sfruttato formati XLAM e RAR.

DarkCloud è stato individuato in due campagne generiche a tema “Pagamenti” e “Fattura”, mentre Lokibot ha colpito tramite due campagne generiche a tema “Banking” e “Pagamenti”, diffuse con allegati ZIP e DOC.

La settimana ha registrato anche una serie di campagne distribuite via SMS che hanno sfruttato APK dannosi.

Tra queste compaiono Albiriox a tema “Aggiornamenti”, Copybara in una campagna italiana a tema “Banking”, GoldFactory in una campagna generica sempre legata al settore finanziario e SeedSnatcher in un’operazione a tema “Cryptovalute”.

Completano il quadro ulteriori campagne che hanno diffuso ClayRat, Grandoreiro a tema Documenti, e PhantomStealer, PureLogs Stealer, StrRAT a tema Banking, Contratti e Ordine.

Si segnalano infine due campagne generiche QuasarRAT e zgRAT a tema Pagamenti e Prezzi, veicolate attraverso file RAR e ZIP

Phishing della settimana

Sono 25 i brand coinvolti nelle campagne di phishing rilevate nel periodo.

Prevalgono ancora una volta le campagne che imitano PagoPA, insieme a quelle che sfruttano iCloud e le numerose webmail non brandizzate, usate per sottrarre credenziali personali e aziendali.

Fonte: CERT-AGID

Formati e canali di diffusione

Gli archivi compressi restano lo strumento più utilizzato per diffondere malware.

Sono state individuate 15 tipologie di file, con RAR al primo posto (9 utilizzi), seguito da ZIP (6) e APK (5).

Seguono i formati 7Z (4), HTM, TAR e DOCX (2), mentre MSI, DOC, Z, PDF, ISO, VBS, XLAM e JAR hanno avuto un solo utilizzo.

La posta elettronica si conferma il canale dominante con 72 campagne, seguita da 4 campagne via SMS e 1 tramite Chat.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/12/08/cert-agid-29-novembre-5-dicembre-phishing-governo-italiano-agenzia-entrate/?utm_source=rss&utm_medium=rss&utm_campaign=cert-agid-29-novembre-5-dicembre-phishing-governo-italiano-agenzia-entrate


Supply chain resilienti e sostenibili: il ruolo strategico dell’economia circolare

Uno studio empirico sulle imprese italiane rivela come le pratiche circolari possano rafforzare la capacità di risposta alle disruption

Le catene di approvvigionamento globali si trovano oggi ad affrontare sfide senza precedenti. La crescente complessità delle filiere produttive, unita a un contesto geopolitico ed economico sempre più instabile, ha reso le imprese particolarmente vulnerabili a eventi dirompenti capaci di compromettere l’intera continuità operativa. A questa realtà si aggiunge una pressione crescente verso modelli di produzione e consumo più sostenibili, che impongono alle aziende di ripensare radicalmente le proprie strategie.

Di questi temi ha parlato Roberta Pellegrino, docente di Risk management e Controllo di gestione al Politecnico di Bari, nel corso del suo intervento al 23° Forum ICT Security, intitolato “La resilienza delle catene di approvvigionamento e il ruolo dell’economia circolare nella gestione delle supply chain disruptions“. L’esperta ha presentato i risultati di due indagini empiriche condotte su imprese italiane tra il 2021 e il 2023, offrendo una prospettiva inedita sul rapporto tra sostenibilità e capacità di recupero delle filiere produttive.

Le supply chain moderne sono divenute strutture sempre più globali e complesse, esposte a tipologie di rischio eterogenee i cui impatti si propagano sia a monte (upstream) sia a valle (downstream) della catena del valore. La natura di questi impatti varia significativamente in funzione del settore industriale, della configurazione del network, delle tecnologie impiegate e della tipologia di prodotto.

“La risposta a questo tipo di eventi richiede oggi più che mai non soltanto la capacità di ridurre gli effetti delle disruption e incrementare la resilienza, ma di farlo in maniera sostenibile, nel rispetto delle componenti ambientali e sociali”

Proprio da questa esigenza nasce l’interesse della ricercatrice verso il paradigma dell’economia circolare come possibile driver di resilienza. La letteratura scientifica, pur avendo ampiamente studiato il tema della supply chain resilience, ha dedicato finora scarsa attenzione all’intersezione tra resilienza e sostenibilità, lasciando aperta una domanda cruciale: possono le pratiche di economia circolare rappresentare una risposta efficace alle crisi che colpiscono le filiere produttive?

La prima ricerca, condotta tra il 2021 e il 2022, ha analizzato come le imprese italiane abbiano risposto alla disruption pandemica, una delle più severe mai affrontate dal sistema economico globale. L’obiettivo era comprendere quali capability – ovvero capacità strategiche – le aziende abbiano effettivamente messo in campo per fronteggiare gli impatti e raggiungere la resilienza, e quale ruolo abbiano giocato le tecnologie digitali in questo processo.

Il gruppo di ricerca ha sviluppato un framework concettuale che mette in relazione gli impatti delle disruption con la resilienza della supply chain, mediata da quattro capability fondamentali: flessibilità, agilità, reattività ed efficienza. A queste si aggiunge il ruolo delle risorse tecnologiche digitali, ipotizzate come fattore sia diretto sia indiretto di resilienza.

Una metodologia rigorosa

L’indagine si è basata su un questionario strutturato, somministrato a un campione di 1.250 piccole e medie imprese italiane. Le 164 risposte valide raccolte – pari a un tasso di risposta del 13%, statisticamente significativo – hanno coperto settori diversi, prevalentemente manifatturieri, e aziende di differenti dimensioni. I dati sono stati analizzati mediante tecniche di statistica descrittiva e modelli di equazioni strutturali (PLS-SEM).

supply chain
Structural Model Results

Gli impatti percepiti e le strategie di risposta

I risultati hanno evidenziato che gli impatti più severi percepiti dalle imprese sono stati: l’aumento dei prezzi delle materie prime, i ritardi nelle consegne, le variazioni imprevedibili della domanda e, sul fronte finanziario, l’incremento dei costi operativi e la contrazione dei margini di profitto. Di fronte a queste sfide, le aziende hanno adottato un portafoglio diversificato di strategie, combinando approcci di flessibilità nella gestione dei fornitori, agilità operativa, reattività e controllo dei costi.

Tuttavia, l’analisi statistica ha rivelato risultati in parte sorprendenti. Non tutte le capability impiegate si sono dimostrate ugualmente efficaci nel favorire la resilienza. Nel campione analizzato, sono state le strategie di efficienza – quelle più orientate al contenimento dei costi nel breve periodo – a mostrare un impatto positivo significativo sulla capacità di recupero delle imprese.

“Agilità e reattività sono state ampiamente utilizzate dalle imprese, ma non vengono percepite come strategie in grado di accrescerne la resilienza. Probabilmente, di fronte a una disruption così rapida, le aziende hanno privilegiato azioni di breve termine piuttosto che avere il tempo di percepire il mercato e reagire di conseguenza”

supply chain
Risultati in sintesi

Il ruolo delle tecnologie digitali: un effetto indiretto

Un altro risultato degno di nota riguarda il ruolo della digitalizzazione. Contrariamente a quanto si potrebbe ipotizzare, le risorse tecnologiche non mostrano un impatto diretto sulla resilienza delle imprese. Le aziende non percepiscono le tecnologie digitali come capaci, da sole, di accrescere la capacità di risposta alle crisi.

L’effetto delle tecnologie diventa invece significativo quando è mediato dagli investimenti in altre capability. In altre parole, la digitalizzazione funziona come fattore abilitante: potenzia l’efficacia delle strategie aziendali, ma non le sostituisce. Questo suggerisce che gli investimenti tecnologici, per essere realmente efficaci in termini di resilienza, devono essere accompagnati da un parallelo sviluppo delle capacità organizzative e strategiche.

La seconda ricerca, condotta tra settembre e dicembre 2023, ha spostato il focus sull’economia circolare, indagando se l’adozione di pratiche sostenibili – come riciclo, recupero, riutilizzo e ri-manifattura – possa effettivamente contribuire alla resilienza delle imprese e al miglioramento delle loro performance.

Il modello concettuale sviluppato dal team di ricerca ipotizza che l’economia circolare possa avere un impatto positivo su tre dimensioni delle performance aziendali – di business, ambientali e finanziarie – oltre che sulla resilienza della supply chain. In questo quadro, il rischio di approvvigionamento (supply risk) agisce come moderatore: quanto maggiore e l’esposizione ai rischi di fornitura, tanto più forte dovrebbe essere l’effetto positivo delle pratiche circolari sulla resilienza.

supply chain
Background della ricerca e ipotesi (modello CE)

I risultati: conferme e sorprese

Il questionario è stato somministrato a circa 1.000 imprese italiane impegnate in pratiche di economia circolare, raccogliendo 125 risposte valide (tasso di risposta del 12%). I risultati confermano alcune ipotesi e ne smentiscono altre, offrendo un quadro articolato e ricco di implicazioni per il management.

In primo luogo, le imprese intervistate percepiscono un impatto positivo degli investimenti in economia circolare sulla resilienza. Questo effetto risulta tanto più marcato quanto maggiore è l’esposizione dell’azienda ai rischi di approvvigionamento: in contesti caratterizzati da elevata vulnerabilità delle forniture, le pratiche circolari si rivelano particolarmente efficaci nel rafforzare la capacità di risposta alle crisi.

Sul fronte delle performance, l’economia circolare mostra un effetto diretto significativo solo sulle performance di business – misurate attraverso indicatori come crescita delle vendite, reputazione aziendale e soddisfazione del cliente. Non emerge invece un effetto diretto sulle performance finanziarie, probabilmente perché l’economia circolare richiede investimenti iniziali che ne attenuano l’impatto economico immediato. Tuttavia, la resilienza agisce come meccanismo di mediazione: le imprese che investono in pratiche circolari e contemporaneamente sviluppano capacità di resilienza riescono a tradurre questi investimenti in vantaggi finanziari.

supply chain
Risultati in sintesi (economia circolare)

L’assenza di effetto sulle performance ambientali: l’effetto rebound

Un risultato apparentemente controintuitivo riguarda l’assenza di una relazione significativa tra economia circolare e performance ambientali. Ci si aspetterebbe che le pratiche circolari, per loro natura orientate alla sostenibilità, producano benefici ambientali diretti. I dati raccolti non confermano questa aspettativa.

La spiegazione proposta dalla ricercatrice chiama in causa il cosiddetto effetto rebound: quando le imprese investono in pratiche di economia circolare a “basso R” – ovvero quelle che non comportano una completa sostituzione della materia prima vergine – si possono generare dinamiche controproducenti. L’incremento delle vendite e dei consumi associato ai prodotti “circolari” può compensare o addirittura annullare i benefici ambientali attesi, un fenomeno già documentato nella letteratura scientifica.

“Le pratiche di economia circolare, soprattutto quelle a basso R, potrebbero generare un effetto rebound che si manifesta nell’aumento delle vendite e dei consumi, con conseguenze potenzialmente negative sulle performance ambientali”

I risultati delle due indagini offrono indicazioni concrete per il management delle imprese. In primo luogo, confermano che la resilienza non si costruisce con un’unica strategia, ma richiede un approccio integrato che combini diverse capability. In secondo luogo, evidenziano come l’economia circolare possa rappresentare una leva strategica non solo per la sostenibilità, ma anche per la competitività e la capacità di fronteggiare le crisi.

Il team di ricerca sta attualmente conducendo uno studio longitudinale per verificare se, a distanza di alcuni anni, la percezione delle imprese sia mutata. L’economia circolare è un investimento di medio-lungo periodo, e le sue ricadute potrebbero manifestarsi in modo diverso nel tempo. La relatrice ha invitato i partecipanti al Forum a contribuire alla ricerca, condividendo il questionario con i supply chain manager delle proprie organizzazioni.

Come ha sottolineato in chiusura del suo intervento: “Si tratta di un’indagine che merita ulteriore approfondimento. I modelli statistici ci permettono di capire quali relazioni esistono tra i diversi fenomeni, ma il perché e il come di certe dinamiche può essere compreso solo attraverso casi studio e analisi qualitative più puntuali”.

Guarda il video completo dell’intervento:

[embedded content]
References

Gaudenzi, B., Pellegrino, R., & Confente, I. (2023). Achieving supply chain resilience in an era of disruptions: a configuration approach of capacities and strategies. Supply Chain Management: An International Journal, 28(7), 97-111.

Pellegrino, R., & Gaudenzi, B. (2025). Supply chain resilience as a viable way to cope with disruptions: an empirical analysis of Italian firms. Review of Managerial Science, 1-31.

Pellegrino, R., Gaudenzi, B., Fraccascia, L., Genovese, A., & Basile, L. J. (2025). Can the adoption of circular economy practices foster supply chain resilience and performance improvements?. Business Strategy and the Environment.

Profilo Autore

Roberta Pellegrino è Professore Associato di Ingegneria Economico-Gestionale presso il Politecnico di Bari (Italia), dove insegna Risk Management e Controllo di Gestione. E’ coordinatore Erasmus per Ingegneria Gestionale. I suoi principali interessi di ricerca riguardano la gestione del rischio nelle supply chain, il partenariato pubblico-privato / Project Financing, e la teoria delle opzioni reali. È autrice o coautrice di numerose pubblicazioni su riviste e libri internazionali e nazionali, e di diversi articoli presentati a convegni internazionali.
Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/supply-chain-resilienti/


Network Detection and Response: la visione di Corelight per proteggere le reti moderne

La piattaforma Open NDR al centro della sicurezza informatica secondo Jean-Pierre Carlin di Corelight

Nel contesto del 23° Forum ICT Security, Jean-Pierre Carlin, Regional Sales Manager Southern Europe di Corelight, ha presentato una panoramica approfondita sul ruolo strategico del Network Detection and Response (NDR) nella sicurezza informatica contemporanea. L’intervento, dal titolo “Dati più intelligenti, rilevamenti più accurati, risposte più rapide: proteggere le reti moderne con Corelight Open NDR”, ha evidenziato come questa tecnologia rappresenti oggi un elemento imprescindibile per i Security Operations Center che si trovano ad affrontare minacce sempre più sofisticate.

“What is NDR?”

Cos’è l’NDR e perché è fondamentale

“NDR significa Network Detection and Response ed è una tecnologia che scansiona l’intera rete per individuare ogni tipo di evidenza”, ha spiegato il relatore nell’apertura del suo intervento. La soluzione analizza i dati per presentare agli analisti tutto ciò che riguarda violazioni, attacchi o comportamenti anomali all’interno del sistema IT, inviando tutte le informazioni al SIEM per essere elaborate automaticamente, eventualmente attraverso un SOAR.

L’esperto ha chiarito un punto fondamentale: “L’NDR non può essere autonomo di per sé, ma fa parte di una sicurezza globale, quella che chiamiamo triad”. Questa triade comprende l’EDR (Endpoint Detection and Response), che protegge server e endpoint, il SIEM che raccoglie log e dati per individuare correlazioni e attacchi, e appunto l’NDR che monitora il traffico di rete.

“Why NDR? – Integrated SOC Triad”

Il limite della sicurezza perimetrale

Carlin ha posto l’accento su una criticità spesso sottovalutata: “Se avete un EDR che protegge tutto il perimetro, potreste pensare di essere al sicuro perché il perimetro è protetto. Ma, come si può leggere sui giornali, quasi ogni settimana una importante azienda subisce una violazione. Anche se avete la sicurezza sul perimetro, gli hacker possono sempre entrare nel vostro sistema informativo”.

Ed è qui che entra in gioco l’NDR: “L’NDR è l’unico modo per scoprire cosa sta accadendo all’interno del vostro IT. Perché tutto ciò che gli hacker faranno passerà attraverso la rete in un modo o nell’altro. E l’NDR rileverà tutti questi movimenti nel vostro sistema IT”, ha sottolineato lo speaker.

Corelight: 15 anni di esperienza nella sicurezza di rete

Corelight è un’azienda americana specializzata in NDR, presente sul mercato da 15 anni con una gamma completa di capacità di rilevamento basate su firme, analisi comportamentale e molteplici tecnologie integrate. “In un unico appliance, che può essere virtuale o fisico, integriamo IDS, PCAP, NSM, YARA Host e tutti questi layer saranno in grado di rilevare specifici tipi di attacchi”, ha illustrato Carlin.

“Corelight is an Enterprise Class NDR”

Il DNA open source: Zeek

Un elemento distintivo di Corelight risiede nelle sue origini. L’azienda è stata fondata dalle stesse persone che, 25-30 anni fa, hanno creato Zeek (originariamente chiamato Bro), una tecnologia che trasforma qualsiasi flusso di rete in log. “Forse non conoscete Zeek perché il nome non è del tutto noto, ma probabilmente la maggior parte degli analisti usa Zeek anche quando non sanno che è Zeek”, ha rivelato il relatore.

Zeek è diventato uno standard de facto nel settore: “È open source e aziende come Microsoft, CrowdStrike e Splunk utilizzano Zeek. Abbiamo un linguaggio comune, una grammatica comune, che ci permette di comunicare tra noi e di interpretare e correlare tutti questi eventi”, ha spiegato l’esperto. Negli Stati Uniti, Zeek è ampiamente adottato dalle amministrazioni pubbliche e dal Dipartimento della Difesa, mentre Corelight protegge numerose istituzioni finanziarie e infrastrutture critiche nei settori dell’energia e dei trasporti.

Partnership strategiche per l’integrazione

Il modello di business di Corelight si basa su partnership strategiche particolarmente forti. “Abbiamo relazioni molto strette con aziende come CrowdStrike. CrowdStrike è un investitore di Corelight e parla il nostro stesso linguaggio, integrando anch’essa Zeek”, ha evidenziato Carlin.

Lo stesso vale per Cisco, Splunk e Mandiant. Un aspetto particolarmente interessante riguarda l’integrazione operativa: “CrowdStrike o Splunk possono acquisire i nostri dati e potete evitare di utilizzare la nostra interfaccia per gestire la soluzione – potete gestire Corelight direttamente da CrowdStrike o da Splunk. Questo vi evita di avere un ulteriore pannello di controllo per monitorare cosa sta accadendo nella rete”.

“Corelight Open NDR – SaaS Platform”

L’architettura della piattaforma

La piattaforma Corelight raccoglie dati da qualsiasi tipo di rete – fisica, cloud o OT – attraverso diversi sensori che normalizzano i dati in formato Zeek e altri standard, generando alert, log, file e packet capture. Questi dati possono essere inviati sia a un SIEM (come Splunk, Microsoft, Elastic o CrowdStrike) sia alla piattaforma proprietaria di Corelight.

“La nostra piattaforma esegue il triage degli alert, utilizza l’intelligenza artificiale per interpretarli e trasforma un alert espresso in termini tecnici in inglese, francese, italiano o qualsiasi altra lingua utilizziate, per renderlo facilmente comprensibile a tutti”, ha spiegato il relatore. Questa elaborazione assistita dall’AI fornisce una visione d’insieme degli alert e delle tendenze in corso.

I motori di rilevamento multipli

La piattaforma integra motori multipli per rilevamento, analisi dei file, NSM (Network Security Monitoring) e packet capture. Per quanto riguarda il rilevamento, Corelight analizza tutte le corrispondenze tra MITRE ATT&CK e i protocolli tecnici utilizzati dagli hacker, operando sia su base signature che comportamentale.

“Possiamo rilevare un cambiamento di comportamento sulla rete. Effettuiamo anche correlazioni con la threat intelligence, e tutta questa parte è integrata nel prodotto stesso”, ha dichiarato Carlin. Quando ci sono file nella rete, questi vengono analizzati con le regole YARA per individuare minacce attraverso queste tecniche.

Per l’analisi di rete, Corelight utilizza Zeek e dispone di un set completo di log standard utilizzati dal SIEM e correlati con l’EDR. “Possiamo anche ottenere informazioni dal traffico cifrato e dalle VPN. Naturalmente, non decifriamo il traffico, ma solo l’header ci fornisce molte informazioni che ci permettono di capire cosa sta succedendo ed eventualmente allertare quando c’è un attacco specifico”, ha precisato lo speaker.

Smart PCAP: l’ottimizzazione intelligente

Una funzionalità particolarmente innovativa è lo “Smart PCAP”, una cattura pacchetti intelligente. “Non inviamo ogni packet capture, che sarebbe piuttosto pesante per il SIEM e costerebbe molto denaro se inviassimo tutti i dati al SIEM”, ha spiegato Carlin. “Lo chiamiamo Smart PCAP perché inviamo solo la parte interessante di queste informazioni. E se l’informazione è ridondante, non inviamo gli stessi dati più e più volte – diciamo semplicemente che ci sono state X occorrenze dello stesso packet capture”.

“Multi-layered detection strategy”

Un approccio multilivello al rilevamento

Il relatore ha illustrato come ogni attacco abbia la propria tecnica o modo di procedere, e ogni approccio può essere rilevato con una tecnica diversa: comportamentale, signature-based, machine learning, rilevamento delle anomalie e altro ancora. “Invece di avere strumenti diversi per rilevare i diversi tipi di attacchi, tutto è integrato nei vostri sensori e nella vostra soluzione. Qualunque sia l’attacco, lo rileveremo perché abbiamo i diversi motori in grado di individuare questi diversi attacchi”, ha affermato con sicurezza.

Ma c’è di più: Corelight rileva anche la progressione di un attacco. “Rileveremo come l’attacco si sta muovendo e forniremo all’analista tutti i pattern dell’attacco stesso e il modo in cui sta evolvendo. E naturalmente forniremo informazioni su come fermare quell’attacco e quali sono i diversi modi per bloccarlo”, ha aggiunto Carlin.

“SOC Challenge – Pain points across the kill chain”

I problemi che Corelight risolve

L’intervento ha quindi affrontato le problematiche concrete che affliggono i Security Operations Center moderni:

1. Visibilità incompleta

“La maggior parte delle volte, quando avete un sistema informativo, sapete cosa sta succedendo sui bordi del vostro sistema, ma avete un punto cieco quando si tratta dell’interno”, ha osservato il relatore. La soluzione Corelight aiuta ad avere visibilità su ciò che accade all’interno della rete, compresi i movimenti laterali e gli spostamenti Est-Ovest.

2. Consolidamento degli strumenti

“Con una sola soluzione non avete bisogno di avere strumenti diversi per rilevare questo tipo di attacco e quell’altro tipo di attacco. Tutto è nella stessa soluzione, che rileverà qualsiasi tipo di attacco che possa essere individuato all’interno della rete”, ha sottolineato l’esperto.

3. Ottimizzazione dei costi

L’ottimizzazione dei log forniti al SIEM riduce i costi di utilizzo del SIEM stesso. “Dato che tutti i nostri strumenti sono integrati e inviano lo stesso tipo di alert, avremo un rilevamento coerente e alert consistenti in tutto il vostro sistema di sicurezza”, ha evidenziato Carlin.

4. Integrazione nativa

“Il fatto che possiamo dialogare molto strettamente con un SIEM come Splunk o con un EDR come Microsoft o CrowdStrike crea un sistema di allerta globale e coerente”, ha concluso il relatore.

“How can Corelight help you?”

Visibilità cloud e architetture ibride

Un aspetto particolarmente rilevante nell’era della trasformazione digitale riguarda la sicurezza cloud. “Quando ci si sposta da una rete on-site a una rete cloud o ibrida, si hanno altri punti ciechi relativi a cosa sta succedendo nel cloud e se è possibile ottenere informazioni dal cloud”, ha osservato Carlin. Corelight dispone di sensori che funzionano anche nel cloud, permettendo di estendere la copertura dell’intero sistema informativo.

Conclusioni

L’intervento di Jean-Pierre Carlin ha delineato un quadro chiaro del valore strategico dell’NDR nel panorama della cybersecurity moderna. In un contesto in cui le minacce evolvono costantemente e gli attacchi diventano sempre più sofisticati, avere una visibilità completa del traffico di rete – sia on-premise che in cloud – rappresenta non più un’opzione ma una necessità.

Corelight si posiziona come una soluzione enterprise-class che, grazie alle sue radici open source con Zeek, all’integrazione nativa con i principali player del settore e alle capacità di rilevamento multilivello assistite dall’intelligenza artificiale, offre ai team di sicurezza gli strumenti per identificare, comprendere e rispondere rapidamente alle minacce informatiche.

Come ha concluso il relatore invitando i partecipanti al Forum ICT Security a visitare lo stand per demo tecniche e discussioni approfondite, la vera forza di Corelight risiede nella combinazione di dati di altissima qualità, architettura flessibile e workflow intelligenti che accelerano il rilevamento delle minacce e la risposta agli incidenti.

Profilo Autore

Jean-Pierre Carlin ha oltre 25 anni di esperienza nel settore della sicurezza IT. Nel corso della sua carriera, Jean-Pierre ha avuto l’opportunità di lanciare e sviluppare commercialmente diverse filiali start-up nell’Europa meridionale. Prima di entrare a far parte di Corelight, Jean-Pierre ha avviato le attività di Swimlane, Recorded Future, Venafi, LogRhythm, A10 Networks, Proofpoint, Aventail/SonicWall, Netscreen e Netscout. Jean-Pierre si è laureato presso l’E.S.I.E.E. di Parigi come ingegnere di rete e telecomunicazioni.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/network-detection-and-response/


Explainable Security: dalle fiabe alla cybersecurity – quando Cenerentola insegna l’autenticazione multifattore

Al 23° Forum ICT Security, il Professor Luca Viganò del King’s College di Londra ha proposto un approccio rivoluzionario alla comunicazione della sicurezza informatica: utilizzare le narrazioni universali per rendere comprensibili concetti tecnici complessi.

La sicurezza informatica è difficile. È difficile da ottenere, da analizzare, da capire e, soprattutto, da spiegare. Se non fosse così, ha esordito Luca Viganò aprendo il suo intervento al Forum ICT Security 2025, “non saremmo qui. Probabilmente ci occuperemmo di altre cose perché avremmo risolto il problema.”

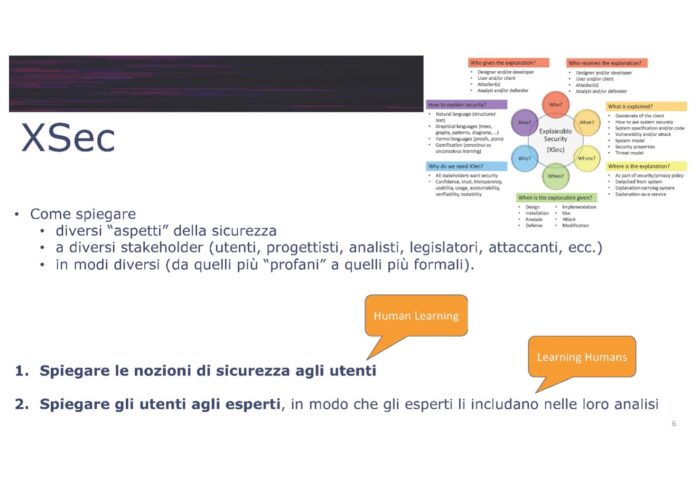
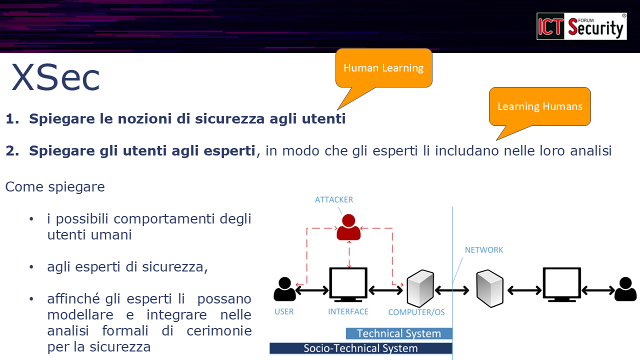
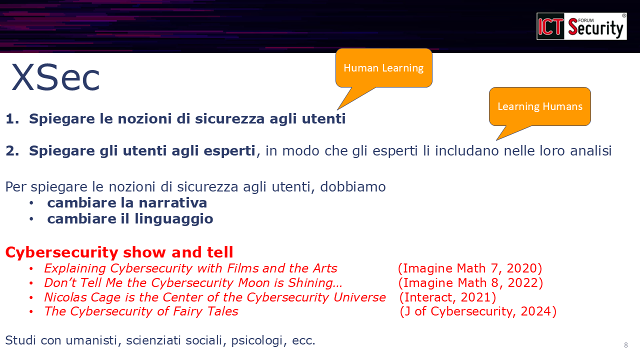
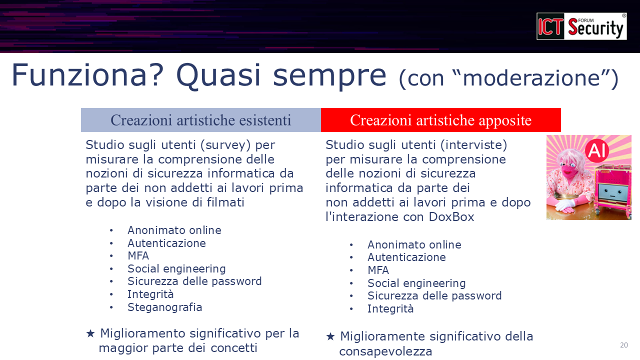
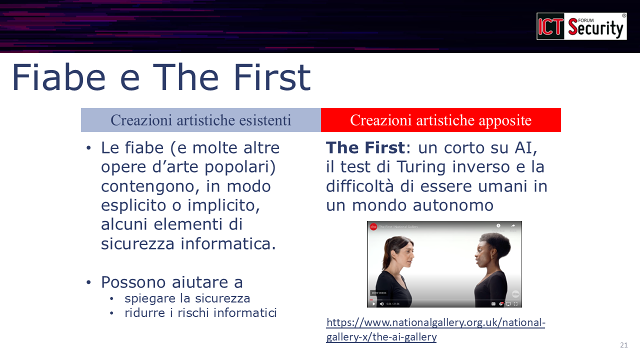
Il Professor Viganò, che dirige il Cybersecurity Group presso il Department of Informatics del King’s College di Londra, lavora all’intersezione tra sicurezza informatica, ingegneria del software, intelligenza artificiale e logica. Da questa posizione privilegiata ha sviluppato un approccio innovativo denominato Explainable Security (XSec), che affronta una questione tanto semplice quanto fondamentale: come comunicare efficacemente i concetti di sicurezza a pubblici diversi?

Il paradosso della colpa condivisa

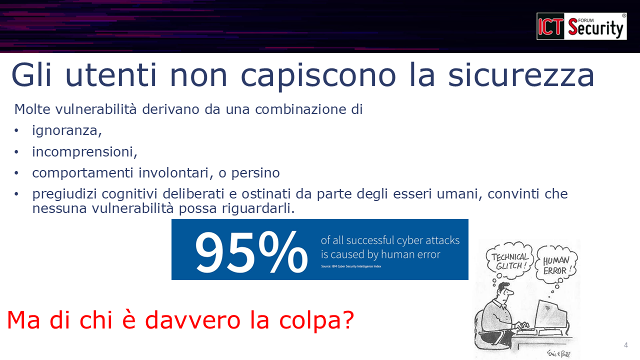
Uno studio IBM citato dal Professor Viganò rivela un dato impressionante: il 95% delle vulnerabilità informatiche deriva da errori umani. Questa statistica ha alimentato per decenni la narrazione secondo cui gli esseri umani rappresentano “l’anello più debole della catena” (the weakest link). Ma il relatore invita a una riflessione più profonda: di chi è davvero la colpa?

explainable security

“Se noi chiediamo al sistema, il sistema dirà: è stato un errore umano”, ha spiegato. “Ma se chiediamo all’utente, molto spesso l’utente non è nemmeno conscio di questa cosa, giustamente. E dirà: è stato un errore tecnico, un technical glitch.”

explainable security

Questa dissonanza rivela due problemi interconnessi che la Explainable Security si propone di affrontare. Il primo riguarda gli utenti che non comprendono la sicurezza, spesso per una combinazione di ignoranza (nel senso letterale di non conoscere, non sapere), incomprensioni e comportamenti involontari. Il secondo, forse meno ovvio, riguarda gli esperti che non comprendono gli utenti.

Il mondo non è in bianco e nero

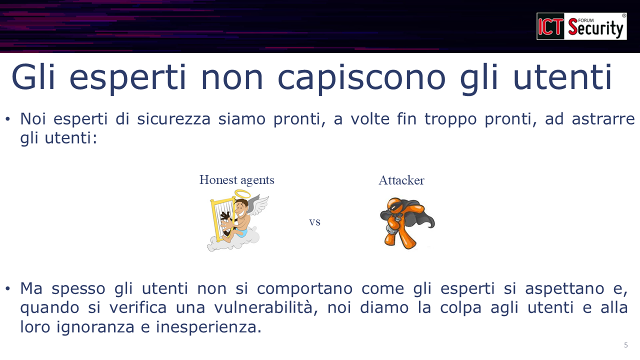
Il professore ha illustrato questo secondo problema attingendo alla propria esperienza di ricercatore specializzato in analisi formale. Nel modellare sistemi di sicurezza, gli esperti tendono a dividere il mondo in due categorie nette: da un lato gli attaccanti, dall’altro gli agenti onesti che si comportano esattamente come il programmatore aveva previsto.

“Questa divisione è molto utile perché ci consente di ottenere dei risultati”, ha ammesso. “Il problema è che gli esseri umani non sono neri, perché tipicamente non hanno le capacità di un attaccante, ma non sono nemmeno bianchi, perché magari non sanno nemmeno che cosa aveva in testa il programmatore.”

Con una punta di ironia, il professore ha ricordato l’evoluzione dei telefoni cellulari: “Sono vecchio a sufficienza da ricordarmi quando sono usciti i primi cellulari, che erano spessi diverse dita e arrivavano con un manuale spesso altrettanto. Oggigiorno i cellulari sono sottilissimi e non c’è il manuale.” Come può dunque un utente sapere esattamente come comportarsi?

La risposta dell’Explainable Security

Il framework dell’Explainable Security, sviluppato da Viganò insieme al collega Daniele Magazzini (oggi dirigente per JP Morgan), adotta un approccio sistematico basato sulle classiche sei domande del giornalismo: chi, cosa, come, dove, quando e perché.

explainable security

Chi fornisce le spiegazioni e chi le riceve? Cosa viene spiegato: un attacco, una strategia di difesa, un processo di recovery? Dove e quando si colloca la spiegazione nel ciclo di vita del software o nell’utilizzo di un sistema? E, naturalmente, perché abbiamo bisogno di questa spiegabilità e come possiamo realizzarla?

explainable security

Il cuore della proposta di Viganò sta nel passaggio da un approccio puramente tecnico a uno socio-tecnico. “La soluzione è molto semplice”, ha affermato: “invece di considerare un sistema tecnico, dobbiamo considerare un sistema socio-tecnico, ovvero includere esplicitamente gli esseri umani all’interno delle nostre analisi e delle nostre difese.”

Ma c’è un elemento in più, che il relatore chiama provocatoriamente Human Learning. “Parliamo tanto di machine learning”, ha osservato, “però non dobbiamo dimenticarci che dobbiamo fare in modo che siano anche gli utenti ad apprendere, non solamente le macchine e gli algoritmi.”

Cenerentola e l’autenticazione a due fattori

Come rendere concreto questo cambiamento culturale? La risposta di Viganò è tanto inaspettata quanto affascinante: attraverso le fiabe.

“Sono trent’anni che mi occupo di cybersecurity, sono trent’anni che sento Humans are the weakest link“, ha dichiarato. “E questo vuol dire che non abbiamo risolto il problema ancora, quindi forse è perché non abbiamo usato le parole giuste.”

In un articolo intitolato The Cybersecurity of Fairy Tales, il professore ha mappato 16 fiabe tradizionali su molteplici concetti di sicurezza informatica: dal controllo degli accessi all’anonimità, dall’autenticazione agli attacchi di tipo replay.

L’esempio più illuminante è quello di Cenerentola, una storia che esiste in circa 700 versioni diverse in tutto il mondo. Quando il principe cerca di identificare la misteriosa fanciulla del ballo usando la scarpetta di cristallo, sta essenzialmente implementando un protocollo di autenticazione. La scarpetta rappresenta un fattore biometrico: qualcosa che Cenerentola è (la dimensione del suo piede).

Ma il protocollo ha una vulnerabilità. Nella versione dei fratelli Grimm, le sorellastre tentano un attacco di impersonificazione, arrivando a mutilarsi i piedi per farli entrare nella scarpetta. L’attacco viene sventato solo grazie a quello che potremmo definire un runtime monitor: un soldato che nota il sangue.

La vera lezione arriva nel finale. Quando i soldati trovano finalmente Cenerentola, lei non si limita a calzare la scarpetta: estrae dalla tasca la seconda. “Cenerentola è una fiaba sull’autenticazione multifattore”, ha concluso Viganò. “Su qualcosa che Cenerentola è, un fattore biometrico, ovvero la dimensione del suo piede, e su un fattore di possesso, ovvero qualcosa che Cenerentola ha: la seconda scarpetta.”

Nella versione Disney, questo principio viene ulteriormente enfatizzato: quando la matrigna rompe la prima scarpetta, è il secondo fattore a salvare la situazione.

Da Ulisse a Pinocchio: un patrimonio nascosto

Ma Cenerentola non è un caso isolato. Il relatore ha dimostrato come l’autenticazione multifattore fosse già presente nell’Odissea. Quando Ulisse torna a Itaca dopo vent’anni di assenza, nessuno lo riconosce immediatamente. L’identificazione avviene attraverso tre fattori distinti: il cane Argo lo riconosce dall’odore (qualcosa che è), la nutrice Euriclea lo identifica da una cicatrice d’infanzia (qualcosa che ha sul corpo), e infine dimostra la propria identità tendendo l’arco che nessun altro può usare e scoccando una freccia attraverso dodici asce (qualcosa che sa fare). Esiste perfino un quarto fattore: la conoscenza del segreto del letto nuziale, costruito sopra un albero.

Alì Babà e i Quaranta Ladroni, dal canto suo, offre un vero catalogo di vulnerabilità: dalla password intercettata (“Apriti Sesamo”) alla coercizione, dalla password dimenticata all’anonimità compromessa.

E Pinocchio? L’episodio del Gatto e la Volpe nel Campo dei Miracoli rappresenta, secondo Viganò, l’archetipo della truffa nota come Nigerian Prince email scam. “Che cosa dicono il Gatto e la Volpe? Dicono: Pinocchio, ti faremo ricco. L’unica cosa, ci devi dare un po’ di monete d’oro prima, che le seppelliamo nel campo sotto l’albero e poi crescerà l’albero di monete.” È esattamente la struttura dello Spanish Prisoner e delle moderne truffe via email.

L’evidenza scientifica

Ma funziona davvero? Viganò non si è accontentato dell’intuizione: ha condotto studi empirici rigorosi per verificare l’efficacia di questo approccio. I risultati confermano che l’utilizzo di film, fiabe e altre forme artistiche migliora effettivamente la comprensione della sicurezza informatica da parte degli utenti.

“Il risultato è sì, anche se non sempre”, ha precisato con onestà scientifica. Per comprendere meglio questi limiti, ha collaborato con l’artista inglese Alistair Gentry, che si traveste da automa e interagisce con le persone interrogandole sulla sicurezza informatica.

Gli studi, sia quantitativi che qualitativi, hanno rivelato che l’approccio narrativo funziona, ma talvolta richiede moderazione: in alcuni casi l’efficacia è diretta, in altri serve un facilitatore che guidi la comprensione. Questo non diminuisce il valore dell’approccio, ma ne chiarisce le condizioni ottimali di applicazione.

Verso una nuova narrativa

L’intervento rappresenta un invito a ripensare radicalmente il modo in cui comunichiamo la sicurezza informatica. Non si tratta semplicemente di “semplificare” concetti complessi, ma di attingere a un patrimonio narrativo universale che contiene già, in forma implicita, le strutture logiche della sicurezza.

Il professore ha concluso menzionando The First, un cortometraggio di cui ha scritto la sceneggiatura, dedicato all’intelligenza artificiale, al test di Turing e “alla difficoltà di essere umani in un mondo autonomo”. Un progetto che testimonia come la contaminazione tra discipline scientifiche e umanistiche possa produrre nuove forme di comprensione.

Figlio di un’informatica e di un critico cinematografico, Viganò incarna questa sintesi. E la sua proposta ci ricorda che, forse, per affrontare le sfide più tecniche del nostro tempo, abbiamo bisogno di riscoprire le storie più antiche.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Luca Viganò is Professor at the Department of Informatics of King’s College London, UK, where he heads the Cybersecurity Group. His research focuses on formal analysis of socio-technical cybersecurity and on explainable cybersecurity, where, in addition to more formal approaches, he has been investigating how different kinds of storytelling can be used to explain cybersecurity.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/explainable-security/


Crittografia post-quantistica: tra minacce concrete e opportunità rivoluzionarie

Al Forum ICT Security 2025, Daniele Venturi dell’Università Sapienza traccia la roadmap di una rivoluzione crittografica già in corso. Quando il quantum computing diventerà realtà, i nostri sistemi di sicurezza attuali potrebbero crollare in pochi istanti. Ma la sfida quantistica nasconde anche opportunità straordinarie che cambieranno per sempre il modo in cui proteggiamo i dati.

L’intervento del professor Daniele Venturi, ordinario presso il Dipartimento di Informatica dell’Università di Roma Sapienza, ha aperto uno squarcio sul futuro della cybersecurity nell’era quantistica. Durante la 23ª edizione del Forum ICT Security, tenutosi a Roma il 19-20 novembre 2025, il relatore ha presentato un quadro complesso dove minacce e opportunità si intrecciano, delineando scenari che vanno ben oltre la semplice sostituzione degli algoritmi crittografici attuali.

Il titolo dell’intervento, “Crittografia (Post-)Quantistica: Sfide ed Opportunità”, racchiude già la duplice natura della rivoluzione in corso: da un lato la necessità urgente di proteggere i sistemi esistenti, dall’altro le straordinarie possibilità tecnologiche che le nuove assunzioni matematiche ci offrono.

Il paradigma della sicurezza dimostrabile: le fondamenta della crittografia moderna

“La crittografia moderna si basa su quello che chiamiamo il paradigma della sicurezza dimostrabile”, ha esordito Venturi, richiamando le pietre miliari poste da Shafi Goldwasser e Silvio Micali negli anni Ottanta. L’idea fondamentale è avere una prova matematica rigorosa della sicurezza di un crittosistema, non basarsi solo su intuizioni o test empirici.

crittografia post-quantistica
Crittografia classica – Schema del paradigma della sicurezza dimostrabile

Il primo passo è definire con precisione cosa significa che un cifrario o uno schema di firma è sicuro. Una volta stabilita la definizione, si procede alla dimostrazione matematica, che può avvenire in due modalità: incondizionata (è vera sempre, punto) oppure condizionata a specifiche assunzioni matematiche.

“Violare la sicurezza del sistema diventa equivalente a violare l’assunzione X”, ha spiegato l’esperto. Gli esempi classici di queste assunzioni sono la difficoltà computazionale di fattorizzare grandi numeri interi o calcolare logaritmi discreti in gruppi finiti: problemi su cui generazioni di matematici si sono arrovellate per centinaia di anni senza trovare algoritmi efficienti.

Questa solidità matematica ci rende sicuri: se esistesse un attacco efficace contro RSA o altri sistemi, avremmo automaticamente scoperto come fattorizzare numeri interi rapidamente, il “Santo Graal” della teoria dei numeri che i matematici inseguono da secoli.

L’algoritmo di Shor: quando la minaccia quantistica diventa concreta

In questo scenario consolidato irrompe la computazione quantistica. L’algoritmo di Shor, presentato da Peter Shor nei primi anni Novanta, ha dimostrato che un calcolatore quantistico sufficientemente potente può fattorizzare numeri interi e risolvere il problema del logaritmo discreto in tempo polinomiale – una velocità che renderebbe inutili gran parte dei sistemi crittografici attuali.

“Fattorizzare un intero di 1.024 bit richiede circa 2.050 qubit logici e miliardi di gate quantistici”, ha precisato Venturi, sottolineando che siamo ancora molto lontani da questo obiettivo tecnologico. Il record attuale di implementazione reale dell’algoritmo di Shor è la fattorizzazione del numero 21, senza progressi significativi negli ultimi dieci anni.

Eppure il NIST (National Institute of Standards and Technology) statunitense ha già avviato e in gran parte completato il processo di standardizzazione dei crittosistemi resistenti agli attacchi quantistici. Il motivo di questa apparente urgenza? Il principio precauzionale sintetizzato nell’espressione inglese “better safe than sorry” (meglio prevenire che curare).

“Gli attacchi quantistici potrebbero già stare avvenendo in questo momento”, ha ammonito il relatore con tono grave. “Un attaccante potrebbe raccogliere oggi grandi quantità di dati cifrati per decifrarli domani, quando i computer quantistici saranno finalmente disponibili”. Uno scenario noto come “harvest now, decrypt later” (raccogli ora, decifra poi) che rende urgente la migrazione verso algoritmi post-quantistici anche prima che i computer quantistici operativi esistano.

Post-quantistica versus quantistica: una distinzione cruciale

Lo speaker ha tenuto a chiarire una distinzione fondamentale, spesso confusa nel dibattito pubblico e nelle comunicazioni commerciali.

crittografia post-quantistica
Distinzione tra crittografia post-quantistica e quantistica

Nella crittografia post-quantistica, Alice e Bob (mittente e destinatario, secondo la nomenclatura classica) utilizzano computer tradizionali e scambiano messaggi classici attraverso canali di comunicazione standard. Tuttavia, devono proteggersi da un avversario che dispone di un computer quantistico. Il requisito minimo è quindi sfruttare assunzioni matematiche basate su problemi che rimangono difficili da risolvere anche per calcolatori quantistici.

Nella crittografia quantistica, invece, tutti i partecipanti – Alice, Bob e potenzialmente anche l’avversario – dispongono di capacità quantistiche. La comunicazione può avvenire tramite stati quantistici, i messaggi possono essere codificati in qubit, e le chiavi crittografiche stesse possono essere stati quantistici. Questa tecnologia sfrutta i principi fondamentali della fisica quantistica per realizzare applicazioni completamente impossibili nel mondo classico.

“La distinzione è cruciale”, ha sottolineato Venturi, “perché confondere i due ambiti porta a fraintendimenti sulle capacità reali e sui limiti delle tecnologie disponibili”.

Learning with Errors: la matematica dietro i nuovi standard

Per illustrare le basi matematiche della crittografia post-quantistica, il professore ha presentato uno dei problemi fondamentali alla base dei nuovi standard NIST: il problema Learning with Errors (LWE), letteralmente “apprendimento con errori”.

Si tratta essenzialmente di risolvere un sistema di equazioni lineari modulari (equazioni in aritmetica modulo un certo numero primo q) che sono state perturbate aggiungendo del “rumore” casuale con una specifica distribuzione statistica. Normalmente, se si dispone di un numero sufficiente di equazioni, un sistema lineare è sempre risolvibile in modo efficiente con gli algoritmi studiati nei corsi universitari di algebra lineare.

“Ma quando queste equazioni sono perturbate da rumore con una certa distribuzione, il problema diventa computazionalmente difficile da risolvere”, ha spiegato Venturi. Sotto specifiche condizioni parametriche e certe assunzioni matematiche, questo problema diventa equivalente ad alcuni classici problemi sui reticoli (lattice problems) che i matematici studiano da decenni senza aver trovato algoritmi efficienti – né classici né quantistici.

“Congetturiamo che questi algoritmi efficienti non esistano”, ha aggiunto il relatore, “ed è proprio su questa congettura che fondiamo la sicurezza dei nuovi crittosistemi post-quantistici”.

L’opportunità nascosta: la cifratura omomorfa

Ma ecco la svolta inaspettata, l’aspetto che ha acceso l’entusiasmo del relatore. “Queste nuove assunzioni matematiche, oltre ad aprire la porta a sistemi sicuri in ambito post-quantistico come quelli standardizzati dal NIST, ci permettono di realizzare forme completamente nuove di strumenti crittografici che prima erano impensabili”.

crittografia post-quantistica
Schema della cifratura omomorfa

Una di queste tecnologie rivoluzionarie è la cifratura omomorfa (fully homomorphic encryption), ovvero la capacità di eseguire calcoli arbitrari su dati cifrati senza mai doverli decifrare.

Il caso d’uso è illuminante: “Immaginate di cifrare un messaggio e inviarlo al cloud. Volete che il cloud calcoli una funzione sui vostri dati, ma non volete rivelargliela in chiaro per questioni di privacy. Come può il cloud operare su dati che non può vedere?”

La risposta sembra quasi magica. Il cloud, conoscendo solo la chiave pubblica, la descrizione della funzione da calcolare e i dati cifrati, applica un algoritmo speciale e produce un nuovo ciphertext (testo cifrato). Quando il proprietario dei dati lo decifra con la propria chiave privata, ottiene esattamente il risultato della funzione applicata ai dati originali – senza che il cloud abbia mai “visto” i dati in chiaro.

“Questa era una delle domande aperte più grandi e affascinanti nella crittografia a chiave pubblica fin dalla sua invenzione negli anni Settanta”, ha ricordato Venturi. Ron Rivest, uno degli inventori dell’algoritmo RSA, parlava già dei cosiddetti “privacy homomorphisms”. Alcuni crittosistemi classici come RSA o ElGamal soddisfano parzialmente questa proprietà, ma solo per operazioni molto ristrette (ad esempio la moltiplicazione): moltiplicando due ciphertext si ottiene un ciphertext che decifra al prodotto dei due plaintext originali.

“Quello che vogliamo fare è realizzare questa proprietà per tutte le funzioni computabili, non solo per operazioni elementari”, ha precisato il relatore. Questo problema è rimasto aperto per oltre trent’anni, fino a quando Craig Gentry, allora dottorando a Stanford, lo ha risolto nel 2009 con una costruzione basata proprio su problemi legati ai reticoli.

Il progresso da allora è stato rapidissimo. Oggi esistono librerie software che implementano schemi di cifratura omomorfa basati su LWE e su varianti correlate, con prestazioni che si avvicinano all’utilizzabilità pratica per applicazioni reali – dal calcolo su dati medici sensibili all’elaborazione di informazioni finanziarie nel cloud.

Offuscamento dei programmi: il codice che custodisce i propri segreti

Un’altra opportunità rivoluzionaria emersa dallo studio delle assunzioni post-quantistiche riguarda l’offuscamento dei programmi (program obfuscation).

La domanda di ricerca è tanto semplice quanto profonda: “È possibile che un programma mantenga i propri segreti anche quando il codice eseguibile sta fisicamente nelle mani di un attaccante, senza fare affidamento su alcun hardware fidato (trusted hardware)?”

L’esempio più immediato è un programma che contiene una password e la confronta con l’input dell’utente. Normalmente, per proteggere la password, si memorizza solo il suo hash crittografico, accettando l’input solo se il suo hash corrisponde. Ma per programmi più complessi questo approccio non è sufficiente.

L’obiettivo dell’offuscamento è creare una versione trasformata del programma originale che: (1) calcoli esattamente la stessa funzione dell’originale, (2) sia completamente incomprensibile, (3) non riveli alcuna informazione sui segreti incorporati nel codice, come password, chiavi crittografiche o logiche di business proprietarie.

“Questa tecnologia ha portato a una vera e propria rivoluzione nel mondo accademico della crittografia negli ultimi dieci anni”, ha sottolineato Venturi con enfasi. “Permette di costruire applicazioni crittografiche che erano completamente sconosciute in tutta la storia precedente della disciplina”.

La sfida aperta? “Costruire l’offuscamento dei programmi basandosi soltanto su LWE rimane ad oggi uno dei problemi aperti più importanti della crittografia teorica”. Le costruzioni esistenti richiedono assunzioni matematiche molto più forti e controverse rispetto a LWE, il che ne limita la fiducia e l’applicabilità pratica.

La trappola delle dimostrazioni: il riavvolgimento quantistico

Il professore ha poi affrontato un aspetto tecnico cruciale, spesso trascurato anche da esperti del settore: la transizione alla sicurezza post-quantistica non si limita a sostituire le assunzioni matematiche di base.

“L’illusione è che basti rimpiazzare l’assunzione con una variante resistente al quantistico e il gioco è fatto. Purtroppo non è così”, ha avvertito Venturi. “Anche le definizioni di sicurezza e le tecniche di dimostrazione devono essere compatibili con la presenza di avversari quantistici”.

L’esempio tecnico del riavvolgimento quantistico (quantum rewinding) illumina il problema. Molte dimostrazioni di sicurezza nella crittografia classica utilizzano una tecnica chiamata “riavvolgimento”: durante la dimostrazione matematica, si considera l’algoritmo dell’avversario e lo si “riavvolge” a uno stato precedente per analizzarne il comportamento.

Se l’avversario è un algoritmo classico, questa operazione è perfettamente lecita e non modifica il modello di calcolo. Ma se l’avversario dispone di un computer quantistico, “riavvolgendolo” si perturba inevitabilmente il suo stato quantistico interno, e l’avversario quantistico “se ne accorge” perché le leggi della fisica quantistica impediscono di copiare o riavvolgere stati quantistici sconosciuti senza disturbarli.

Questo effetto fa letteralmente “crollare” molte dimostrazioni di sicurezza classiche quando si tenta di applicarle al contesto quantistico. “È necessario intervenire con tecniche più sofisticate per estendere quelle dimostrazioni e renderle valide contro avversari quantistici”, ha spiegato il relatore.

“Questa è una misconception diffusa: non basta utilizzare assunzioni post-quantistiche. Bisogna verificare attentamente anche quali garanzie di sicurezza vengono fornite e come sono costruite le prove matematiche che le supportano”.

Quantum Key Distribution: promesse teoriche e limiti pratici

Passando alla crittografia quantistica vera e propria – quella dove anche gli utenti legittimi sfruttano tecnologie quantistiche – Venturi ha analizzato criticamente la Quantum Key Distribution (QKD), ovvero la distribuzione quantistica delle chiavi crittografiche.

La QKD sfrutta le leggi fondamentali della fisica quantistica, in particolare il principio che misurare uno stato quantistico lo perturba inevitabilmente, per permettere ad Alice e Bob di condividere una chiave segreta su un canale di comunicazione completamente insicuro e potenzialmente intercettato.

La buona notizia? “Nel mondo classico, condividere una chiave su un canale insicuro richiede assolutamente assunzioni computazionali, come la difficoltà della fattorizzazione. Non si può fare in maniera incondizionata, nemmeno per proteggere solo da intercettazioni passive. Nel mondo quantistico invece è possibile ottenere sicurezza incondizionata – garantita dalle leggi della fisica, non da congetture matematiche”.

Inoltre, non sono necessari computer quantistici universali completi: “Bastano tecnologie più accessibili come la comunicazione in fibra ottica con fotoni singoli o collegamenti da satellite”, ha precisato il relatore.

crittografia post-quantistica
Limiti della QKD con dati tecnici

Le cattive notizie, però, sono sostanziali. “Purtroppo la maggior parte dei fotoni non riescono ad arrivare da Alice a Bob, e questo effetto peggiora in modo esponenziale con la distanza”. Le attenuazioni tipiche nelle fibre ottiche limitano drasticamente la portata operativa.

I numeri parlano chiaro: il record mondiale è 511 chilometri di distanza con un bit rate di 3,37 bit al secondo. “È una velocità assolutamente bassissima, praticamente inutilizzabile per applicazioni reali”, ha commentato con realismo il professore.

Il problema si aggrava ulteriormente considerando che la vera sicurezza incondizionata richiede l’uso del cifrario di Vernam (o one-time pad), dove la chiave deve essere lunga esattamente quanto il messaggio da cifrare. “Questo è un limite inerente delle leggi dell’informatica: non si può fare di meglio. Quindi 3,37 bit al secondo per generare chiavi che devo poi usare per cifrare messaggi della stessa lunghezza… il conto non torna per usi pratici”.

I sistemi ibridi: un compromesso inevitabile

La soluzione pratica attualmente perseguita sono i sistemi ibridi QKD che combinano la distribuzione quantistica delle chiavi con cifrari simmetrici veloci come AES.

Lo schema funziona così: la QKD genera periodicamente chiavi condivise tra Alice e Bob, seppur a basso bit rate. Queste chiavi vengono poi utilizzate come input per cifrari a blocchi standard (come AES) che permettono di cifrare messaggi a velocità normale, praticamente illimitata. Le implementazioni più avanzate di sistemi ibridi raggiungono ad esempio 66 kilobit al secondo a 70 chilometri di distanza.

Ma qui Venturi ha inserito un’osservazione pungente che smonta gran parte della retorica commerciale sulla QKD: “A quel punto, però, potete ottenere esattamente lo stesso risultato con poche centinaia di righe di codice software, usando una Key Derivation Function (KDF) crittografica e AES”.

Lo schema alternativo classico funziona così: Alice e Bob condividono inizialmente una chiave segreta K (magari scambiata con un protocollo di key exchange tipo Diffie-Hellman post-quantistico). Poi utilizzano una KDF per generare da K una sequenza di chiavi derivate K₁, K₂, K₃… indipendenti tra loro, che usano con AES per cifrare i messaggi successivi. “Nessun dispositivo quantistico costoso, nessun limite di distanza ai 511 chilometri, nessun problema di attenuazione”.

L’unico vantaggio della QKD? “Se un attaccante compromette fisicamente l’intero dispositivo di Alice o Bob, con la soluzione classica perde tutta la sicurezza. Con la QKD mantieni alcune garanzie”. Ma anche questo vantaggio può essere ottenuto, ha notato il relatore, “al prezzo di utilizzare tecniche più complesse che sfruttano assunzioni post-quantistiche, come i sistemi basati su LWE”.

La conclusione implicita è chiara: i benefici pratici della QKD rispetto ad alternative post-quantistiche puramente software sono molto più limitati di quanto il marketing tecnologico lasci intendere.

Monete quantistiche: il denaro digitale non clonabile

Guardando al futuro post-computer quantistico, il relatore ha presentato due applicazioni affascinanti ma ancora lontane dalla realizzazione pratica.

Le monete quantistiche (quantum money) sfruttano uno dei principi fondamentali della meccanica quantistica: il teorema del no-cloning, che stabilisce che stati quantistici sconosciuti non possono essere copiati perfettamente. “Se gli stati quantistici non sono clonabili, posso usarli come banconote digitali?” La domanda, posta per la prima volta decenni fa, è brillante nella sua semplicità.

Il problema fondamentale del denaro digitale classico è infatti proprio la facilità di duplicazione: copiare un file è banale, quindi come impedire il double spending (la doppia spesa della stessa “banconota” digitale)? Le criptovalute come Bitcoin risolvono il problema con registri distribuiti (blockchain), ma richiedono infrastrutture complesse e consumano enormi quantità di energia.

“Con le monete quantistiche, la fisica stessa impedisce la clonazione. È un’idea geniale”, ha ammesso Venturi con entusiasmo. Purtroppo l’implementazione pratica è estremamente complicata.

Le uniche costruzioni funzionanti finora sono schemi “a chiave privata” (secret-key quantum money), dove per verificare l’autenticità di una moneta è necessario contattare direttamente l’ente che l’ha emessa. “Questo ovviamente non scala: è come dover chiamare la Banca Centrale ogni volta che qualcuno vuole verificare una banconota”.

Quello che servirebbe sono monete quantistiche a chiave pubblica (public-key quantum money), dove chiunque possa verificare autonomamente l’autenticità di una moneta quantistica senza dover contattare l’emittente. “Questo è molto, molto, molto più complicato da realizzare”, ha sottolineato il professore. “Esistono tantissimi tentativi falliti e una bellissima linea di ricerca attiva che studia questo problema, ma ad oggi rimane un problema aperto per essere risolto in maniera efficiente”.

Copyright protection quantistico: l’antipirateria definitiva

L’ultima applicazione futuristica presentata è la protezione quantistica del copyright (quantum copy protection), che affronta il problema della pirateria software.

L’idea, proposta dal fisico teorico Scott Aaronson nel 2009, è ancora una volta elegantemente semplice: “Se posso associare uno stato quantistico a un programma software, riesco a impedirne la copia illegale sfruttando il teorema del no-cloning?”

Nel mondo classico si usa il watermarking digitale: un marchio incastonato nel codice che tutti possono verificare ma che è difficile da rimuovere senza danneggiare il programma. È un deterrente contro la pirateria, non una protezione assoluta.

La protezione quantistica promette di più, ma ha limiti intrinseci. “Purtroppo è impossibile per programmi learnable“, ha spiegato Venturi. Se un programma è sufficientemente semplice da poter essere “imparato” sottoponendogli varie query di test e osservandone gli output, allora una volta imparato può comunque essere replicato, indipendentemente dalla protezione quantistica.

“Quindi questa forma di protezione funziona inerentemente solo per programmi complessi, non facilmente apprendibili tramite interrogazioni”. Ma il problema è che per questi programmi complessi “la protezione quantistica del copyright sembra implicare matematicamente l’esistenza di monete quantistiche a chiave pubblica”. E come abbiamo visto, quelle non sappiamo ancora costruirle efficientemente.

“Sembra anche implicare l’offuscamento dei programmi, un altro problema aperto”, ha aggiunto. Esistono costruzioni per sottoclassi ristrette di programmi, sotto assunzioni matematiche molto forti, ma nulla di pratico o generale.

Conclusioni: tra realismo e lungimiranza strategica

crittografia post-quantistica
Conclusioni

Nelle note conclusive, Venturi ha mantenuto un equilibrio sapiente tra entusiasmo per le possibilità future e realismo sullo stato attuale della tecnologia.

“C’è sempre la barzelletta nel settore: sono già vent’anni che il computer quantistico ‘uscirà tra cinque anni’”, ha scherzato il professore suscitando risate in platea. “Però staremo a vedere. La ricerca avanza, gli investimenti crescono, i progressi ci sono. Non sappiamo quando, ma probabilmente accadrà”.

Le conclusioni pratiche per i professionisti della sicurezza informatica sono chiare:

Sui crittosistemi post-quantistici: “Esistono già, sono basati su problemi che rimangono difficili anche per computer quantistici, e per le applicazioni crittografiche principali l’efficienza è ormai comparabile a quella delle soluzioni classiche attuali”. La transizione è quindi tecnicamente fattibile e va pianificata seriamente.

Sulle opportunità: “La cosa che spero di avervi comunicato è che utilizzare questo tipo di assunzioni matematiche apre nuovi orizzonti nel mondo della crittografia. Permette di realizzare applicazioni molto interessanti – come la cifratura omomorfa – che potranno essere utilizzate nel mondo classico, indipendentemente poi dallo sviluppo o meno dei computer quantistici”. La minaccia quantistica ha paradossalmente accelerato la scoperta di nuove possibilità crittografiche.

Sulla Quantum Key Distribution: qui il tono è diventato più critico. “I crittosistemi quantistici possono dare la possibilità di fare cose completamente impossibili nel mondo classico, come la QKD senza assunzioni computazionali. Però attenzione: brevi distanze, bit rate limitatissimo, e soprattutto è possibile in pratica solo se abbandoniamo la sicurezza incondizionata – che è l’unico aspetto veramente interessante e distintivo della QKD“.

“Questo aspetto è spesso trascurato nelle presentazioni commerciali e risulta in affermazioni esagerate sulle capacità reali della QKD”, ha ammonito il relatore con franchezza.

Sulle applicazioni futuristiche: “Le applicazioni più sorprendenti come le monete quantistiche e la protezione quantistica del copyright richiedono capacità computazionali quantistiche che sono ancora molto lontane dall’essere realizzate praticamente”.

Un intervento che ha saputo bilanciare rigore tecnico e visione strategica, evitando sia il catastrofismo sulla minaccia quantistica sia l’entusiasmo acritico per tecnologie ancora immature. La rivoluzione quantistica non è solo una minaccia da cui difendersi, ma anche – e forse soprattutto – un’opportunità storica per ripensare radicalmente i paradigmi fondamentali della sicurezza informatica e della protezione dei dati.

“Rimaniamo sintonizzati”, ha concluso Venturi con un sorriso. La partita è appena iniziata.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Daniele Venturi è Professore Ordinario presso il Dipartimento di Informatica dell’Università di Roma Sapienza, dove dirige il Laboratorio SCRYPTO dal 2016. La sua ricerca si focalizza sulla crittografia teorica ed applicata.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/crittografia-post-quantistica-minacce/


La sicurezza informatica riparte dall’individuo: il paradigma Human-Centric di Proofpoint

Al 23° Forum ICT Security, Marco Zani di Proofpoint ha illustrato come l’approccio incentrato sulla persona rappresenti la terza grande evoluzione della cybersecurity, superando i modelli tradizionali focalizzati su perimetro e applicazioni

Il fattore umano resta il cuore pulsante – e al tempo stesso il tallone d’Achille – della sicurezza informatica aziendale. È questo il messaggio centrale emerso dall’intervento “Human Centric Security, il valore della piattaforma” tenuto da Marco Zani, Country Manager Italia di Proofpoint, durante il Forum ICT Security 2025.

Il manager ha aperto il suo intervento con una riflessione che tocca le corde più profonde del dibattito sulla cybersecurity attuale: «Quando si parla di questi temi, sconfinare su ambiti legati alla psicologia e alla filosofia è immediato. Parlare di psicologia significa inevitabilmente parlare di social engineering, di meccanismi di manipolazione della persona facendo leva sulle emozioni: il senso di urgenza, l’altruismo, le vulnerabilità personali».

Un approccio olistico che mette la persona al centro

La Human-Centric Security, come ha spiegato il relatore, rappresenta un cambio di paradigma fondamentale: un approccio olistico alla cybersecurity che tiene conto dell’individuo e dei suoi comportamenti per definire la strategia di sicurezza, andando oltre la tradizionale attenzione rivolta esclusivamente a endpoint, applicazioni e reti.

Zani ha richiamato anche la filosofia del “capitale umanistico” di Brunello Cucinelli per sottolineare quanto sia determinante riconoscere la centralità della persona: «L’uomo è un individuo singolo, unico, che genera una causa-effetto nel nostro mondo della cybersecurity, con impatti importanti a livello economico e aziendale».

I numeri del Voice of the CISO 2025

A supporto della propria tesi, lo speaker ha presentato i risultati di un’indagine condotta su 1.600 Chief Information Security Officer in 16 paesi, tutti operanti in aziende con oltre 1.000 dipendenti.

Cybersecurity risk: still human risk

I dati sono eloquenti: il 68% dei CISO a livello globale ritiene che i dipendenti abbiano una comprensione adeguata della data security e delle best practice, ma questo non basta a mitigare il rischio. In Italia la percentuale si attesta al medesimo valore del 68%, mentre emerge un dato curioso relativo alla Spagna, che presenta un gap di quasi 30 punti percentuali rispetto agli Stati Uniti, storicamente benchmark di riferimento per l’innovazione tecnologica.

Le statistiche più allarmanti riguardano però la percezione del rischio imminente: «Il 76% dei CISO pensa che subirà un attacco nei prossimi 12 mesi», ha evidenziato l’esperto. «È interessante l’aspetto legato all’inesorabilità: sanno che accadrà, anche se non sanno in che misura e quale impatto potrà avere in termini economici e di operatività aziendale». A conferma di questa consapevolezza, l’89% dei CISO ha già subito una perdita materiale di dati sensibili nell’ultimo anno.

La tassonomia delle minacce interne

L’intervento ha offerto una classificazione dettagliata delle tipologie di attacco legate al fattore umano. Gli insider malintenzionati – dipendenti che utilizzano impropriamente i dati per danneggiare l’organizzazione – rappresentano il 34% del totale.

Alla stessa percentuale si attestano gli insider imprudenti, ovvero dipendenti che inconsapevolmente usano in modo improprio i dati, spesso con leggerezza. A questi si aggiungono gli insider compromessi, le cui credenziali sono state rubate: Zani ha ricordato il caso di un hacker che ha sottratto 70.000 identità da hotel di lusso nel Sud Italia, rimettendole in vendita nel dark web a 20.000 euro ciascuna.

L’intelligenza artificiale generativa come fattore di rischio

Un capitolo significativo dell’intervento è stato dedicato all’impatto dell’AI generativa sulla sicurezza aziendale. Il 60% dei CISO a livello globale considera la GenAI un fattore di alto rischio per la propria organizzazione, in aumento rispetto al 54% dell’anno precedente. In Italia la percentuale si attesta al 57%, con un incremento del 45% anno su anno.

2025 Voice of the CISO Report, GenAI risk

«I recenti sviluppi legati all’AI – i Large Language Model, Gemini, ChatGPT – hanno cambiato sostanzialmente le regole del gioco», ha osservato lo speaker. «Creare, condividere, salvare ed esporre informazioni nell’ombra è diventato molto facile».

La risposta delle organizzazioni è stata prudente: il 59% dei CISO blocca o restringe fortemente l’utilizzo dell’AI all’interno delle proprie strutture, mentre il 68% prevede di implementare soluzioni basate sull’intelligenza artificiale nei prossimi mesi, adottando al contempo politiche e approcci etici strutturati.

L’evoluzione del panorama delle minacce

Il confronto tra passato e presente offre una fotografia nitida della trasformazione in atto. Se prima l’email rappresentava il vettore di attacco principale, il social engineering era manuale e soggetto a errori, e la perdita dati avveniva principalmente attraverso email ed endpoint gestiti, oggi lo scenario è radicalmente mutato.

Evoluzione delle cyber minacce – Before vs Now

«C’è una scalabilità potente», ha spiegato l’esperto. «L’AI generativa sta creando opportunità senza precedenti per chi fa il mestiere criminale. Attraverso le app di collaborazione si ricevono link su cui si clicca molto facilmente; l’AI è in grado di definire con precisione i linguaggi a seconda del paese e del ruolo della persona, che spesso è molto presente sui social e quindi facilmente profilabile».

Tra le tecniche più insidiose, il relatore ha menzionato la TOAD (Telephone Oriented Attack Delivery), l’Advanced Persistent Threat e le frodi al pagamento anticipato, in cui la vittima viene contattata con false urgenze legate a spedizioni bloccate o presunti benefici economici.

La piattaforma Human-Centric: architettura e funzionamento

Zani ha quindi illustrato l’architettura della piattaforma Proofpoint, che si basa su due pilastri fondamentali: la Threat Resilience (attacco, vulnerabilità e privilegi) e la Data Security. Il sistema è in grado di applicare policy adattive in modo dinamico, evolvendo in funzione del rischio introdotto.

Human Risk in Context by Intent

La valutazione degli utenti a rischio avviene attraverso l’intersezione di tre dimensioni: utenti attaccati (soggetti ad account takeover, business email compromise, phishing avanzato), utenti vulnerabili (chi fallisce le simulazioni di phishing, non segue i training, clicca con leggerezza sui link) e utenti con privilegi elevati (CEO, CFO, amministratori di sistema, personale coinvolto in operazioni di M&A).

«Dobbiamo smettere di considerare il dipendente come un soggetto a rischio», ha sottolineato lo speaker, «e renderli parte di un processo aziendale seamless, nel corso del quale sviluppare una cultura forte, in linea con le policy e le regolamentazioni».

Verso la sicurezza agentica

L’intervento si è concluso con uno sguardo al futuro. La Human-Centric Security rappresenta, secondo l’esperto, la base per abbracciare con maggiore sicurezza lo spazio agentico e digitale che si sta delineando.

«La piattaforma odierna incentrata sulla persona è fondamentale per la sicurezza di domani, che sarà incentrata sia sull’uomo che sugli agenti», ha concluso Zani, annunciando un evento dedicato (“Protect”) previsto per il primo trimestre del prossimo anno, in cui verranno presentate le novità in ambito agentico. «Al di là della narrativa, c’è concretezza: i quick wins che possono già essere messi in campo oggi».

La correlazione degli eventi comportamentali e la gestione dei dati sensibili attraverso un approccio integrato alla sicurezza possono dunque essere implementate sin d’ora, posizionando le organizzazioni italiane al passo con quei paesi che, come evidenziato dai dati del report, mostrano già una maggiore predisposizione ad accogliere questo tipo di evoluzione tecnologica.

Profilo Autore

Marco Zani è Country Leader per l’Italia di Proofpoint, Inc., azienda leader globale nella cybersecurity e nella compliance. Nel suo ruolo è responsabile della strategia e delle operazioni sul mercato italiano, con focus sull’accelerazione della crescita e sul supporto alle aziende locali nel rafforzamento delle difese contro le minacce informatiche mirate all’individuo.

Professionista con oltre 25 anni di esperienza nel settore IT, Zani ha costruito una solida carriera ricoprendo posizioni di leadership in realtà internazionali di primo piano. In qualità di Country Manager di GitLab, ha guidato con successo la crescita strategica e lo sviluppo del business in Italia. Precedentemente ha ricoperto ruoli chiave in Snowflake e ServiceNow, dove ha costruito e coordinato team ad alte prestazioni, concludendo contratti complessi di grande valore.

Riconosciuto come esperto nel cloud computing enterprise e nelle tecnologie di sicurezza, Zani si distingue per la sua capacità di sviluppare strategie incentrate sul cliente e di guidare team eterogenei a livello europeo. Le sue consolidate competenze manageriali e relazionali, unite a una visione orientata alla crescita, lo rendono una figura chiave per il piano di espansione di Proofpoint nel mercato italiano.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-sicurezza-informatica-riparte-dallindividuo-il-paradigma-human-centric-di-proofpoint/


Iniezione indiretta di prompt: a rischio le informazioni aziendali


Lakera, società di Check Point, ha pubblicato una ricerca in cui dimostra che l’iniezione indiretta di prompt permette agli attaccanti di prendere di mira i dati acquisiti dall’IA e non i prompt inseriti dagli utenti. 

Con Gemini 3 il rischio di leak si moltiplica: secondo l’analisi dei ricercatori, gli attaccanti riescono a estrarre informazioni a livello aziendale come documenti, e-mail, link, PDF e contenuti condivisi.

Il team di Lakera evidenzia che, sebbene le capacità multimodali di Gemini 3 portano enormi vantaggi in termini di produttività, introducono nuove forme di rischio, come l’iniezione indiretta di prompt che porta al leak di dati sensibili.

Iniezione indiretta prompt

Il modello gemini-3-pro-preview è uno tra i sistemi attuali più potenti, in particolare per quanto riguarda gli scenari di estrazione diretta dei contenuti e di override delle istruzioni. “La vera trasformazione di Gemini 3 non è ciò che il modello conosce, ma ciò a cui il modello può accedere” affermano i ricercatori di Lakera.  Poiché l’IA ha a che fare con documenti, caselle di posta, API, flussi di lavoro e sistemi in tutto l’ambiente aziendale, di fatto il modello è autorizzato a dare pressoché qualsiasi cosa e accedere a ogni tipo di documento.

Gemini 3 è in grado di operare con un livello di autonomia molto elevato e, tra le altre cose, può riscrivere e instradare documenti, riassumere e agire su lunghi thread di e-mail, richiamare API e attivare automazioni del flusso di lavoro. Ciò significa che un attaccante, abusando dei prompt indiretti, può manipolare e ottenere documenti sensibili, inserendosi nel flusso operativo. “Man mano che l’IA diventa parte del livello di esecuzione, la superficie di attacco si espande e gran parte di questa espansione è invisibile ai controlli di sicurezza esistenti“.

Il pericolo aumenta se si considera che Gemini 3 introduce anche dei comportamenti “agentici”, ovvero la capacità di intraprendere azioni, non solo di fornire risposte. Di fatto, l’IA ha ora un “potere” molto più elevato rispetto alla semplice ricerca.

Lakera ha rilevato attacchi multimodali pratici, tra cui jailbreak basati sull’audio. I nuovi vettori d’attacco non sono coperti dagli attuali controlli di sicurezza delle e-mail, degli endpoint o dei contenuti.

Secondo il GenAI Security Readiness Report di Lakera,  le organizzazioni stanno adottando l’IA molto più rapidamente di quanto non stiano provvedendo alla sua sicurezza. La maggior parte di esse risulta priva di governance dell’IA, barriere protettive, soluzioni di monitoraggio degli agent e protezioni multimodali. L’avvento di Gemini 3 e in generale di tutte le IA in grado di manipolare documenti aziendali, amplifica questo divario.

L’IA è diventato il nuovo perimetro aziendale e per le organizzazioni è imperativo occuparsi di definire nuove strategie di sicurezza per proteggersi dalle nuove minacce.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/12/05/iniezione-indiretta-di-prompt-a-rischio-le-informazioni-aziendali/?utm_source=rss&utm_medium=rss&utm_campaign=iniezione-indiretta-di-prompt-a-rischio-le-informazioni-aziendali


Cyber Insurance in Italia: coperture, esclusioni e requisiti nel 2025

Il panorama della cyber insurance in Italia attraversa una fase di profonda trasformazione, sospesa tra l’accelerazione della domanda e la necessità di ridefinire i parametri di rischio in un contesto geopolitico e tecnologico sempre più complesso. Mentre il mercato globale delle assicurazioni informatiche si prepara a raggiungere i 32 miliardi di dollari entro il 2030 secondo le proiezioni contenute nel rapporto “Cyber Insurance – Risks and Trends 2025” di Munich Re, l’Italia rappresenta un territorio di sviluppo strategico ma ancora largamente sottoassicurato, con meno del dieci percento delle imprese dotate di una copertura specifica contro i rischi cyber.

La crescita del settore assicurativo cyber nel nostro Paese risponde a una convergenza di fattori che hanno progressivamente elevato la consapevolezza del rischio informatico da questione meramente tecnica a tema di governance aziendale.

L’implementazione del Regolamento UE 2016/679 (GDPR) ha rappresentato il primo vero spartiacque, rendendo tangibili e quantificabili le conseguenze economiche delle violazioni dei dati attraverso un sistema sanzionatorio che può arrivare fino al quattro percento del fatturato globale annuo. A questo si sono aggiunti gli obblighi derivanti dalla Direttiva NIS2, recepita in Italia con il decreto legislativo 138/2024 pubblicato in Gazzetta Ufficiale il 1° ottobre 2024, e l’entrata in vigore del regolamento DORA (Digital Operational Resilience Act) dal 17 gennaio 2025, che ha imposto al settore finanziario requisiti ancora più stringenti in materia di resilienza operativa digitale.

L’indagine IVASS sulle polizze cyber risk dell’ottobre 2023, che ha esaminato cinquanta contratti assicurativi (ventisei dedicati alle PMI e ventiquattro rivolti a privati e famiglie), ha messo in luce un’offerta caratterizzata da significative eterogeneità e ambiguità contrattuali. Circa trenta compagnie propongono soluzioni cyber ma con presupposti di assicurabilità, esclusioni e linguaggi tecnici spesso divergenti tra loro. Questa frammentazione genera complessità interpretative che possono tradursi in contenziosi al momento della liquidazione dei sinistri, quando l’assicurato scopre che determinate fattispecie di danno sono escluse o soggette a franchigie tali da ridurre significativamente l’indennizzo effettivo.

L’architettura delle coperture: tra danni propri e responsabilità verso terzi

Le polizze cyber italiane si articolano tipicamente su tre direttrici fondamentali, ciascuna con caratteristiche e limitazioni specifiche che richiedono un’attenta valutazione da parte del sottoscrittore. La prima direttrice riguarda i cosiddetti “danni propri” (first party coverage), ovvero l’insieme delle perdite dirette subite dall’organizzazione colpita. In questa categoria rientrano le spese di risposta all’emergenza cyber, che comprendono l’intervento di specialisti forensi per l’identificazione della causa e dell’estensione dell’attacco, i costi per il ripristino dei sistemi informatici compromessi e la ricostituzione dei dati danneggiati o crittografati.

La gestione della business interruption, ovvero la perdita di profitto derivante dall’indisponibilità totale o parziale dei sistemi IT, rappresenta uno degli aspetti più critici e onerosi, con impatti che in alcuni casi hanno raggiunto diverse settimane di fermo operativo.

La seconda direttrice concerne la responsabilità civile verso terzi (third party coverage), ambito particolarmente rilevante nell’economia digitale interconnessa dove una violazione può avere effetti a cascata su clienti, fornitori e partner commerciali. Le polizze coprono le richieste di risarcimento derivanti da violazioni della privacy e della riservatezza dei dati, dalla compromissione della sicurezza di rete e dai danni arrecati attraverso l’uso improprio di strumenti multimediali. A queste si aggiungono le coperture per diffamazione o calunnia online, violazione dei diritti di proprietà intellettuale e discriminazione perpetrata attraverso i canali digitali dell’azienda.

La terza componente riguarda gli aspetti legali e regolamentari, con particolare riferimento alle sanzioni amministrative previste dagli standard PCI-DSS Payment Card Industry (Payment Card Industry Data Security Standard) per le società che gestiscono transazioni con carte di pagamento e alle multe irrogate dalle autorità di vigilanza per violazioni normative. Alcune compagnie, prevalentemente di matrice anglosassone operanti sul mercato italiano, includono nella copertura anche i costi derivanti da estorsioni cyber, compreso il pagamento del riscatto in caso di attacco ransomware, sebbene tale aspetto sollevi evidenti questioni etiche e giuridiche legate al finanziamento di attività illecite.

Il territorio delle esclusioni: dove la copertura si arresta

L’efficacia di una polizza cyber risk si misura tanto per ciò che include quanto per ciò che esplicitamente esclude, e proprio su questo terreno si gioca spesso la differenza tra una copertura realmente protettiva e una mera illusione di sicurezza. La clausola di esclusione più controversa riguarda gli “atti di guerra”, presente nella stragrande maggioranza dei contratti analizzati dall’IVASS ma caratterizzata da un’ambiguità definitoria che può rivelarsi fatale in sede di liquidazione.

Il caso paradigmatico del malware NotPetya, che nel 2017 causò danni per oltre cento milioni di dollari a Mondelez International, ha evidenziato come gli assicuratori possano invocare l’esclusione per “guerra informatica” anche in presenza di attacchi che, pur essendo riconducibili ad attori statuali, colpiscono aziende private senza alcuna connotazione bellica formale.

Altrettanto problematica risulta la gestione degli attacchi ransomware nella copertura di base, frequentemente esclusi salvo sottoscrizione di estensioni specifiche a fronte di un premio aggiuntivo.

Questa scelta assicurativa appare paradossale se si considera che il ransomware rappresenta la minaccia informatica più diffusa e finanziariamente impattante per le imprese italiane, con un incremento registrato dal Rapporto Clusit 2024 sulla sicurezza ICT che ha visto l’Italia vittima del 7,6% degli attacchi globali con un aumento del 169% in soli dodici mesi. Gli attacchi di social engineering, incluse le tecniche di phishing e business email compromise, sono spesso esclusi dalla copertura base poiché considerati derivanti da negligenza umana piuttosto che da falle tecniche dei sistemi informatici, sebbene rappresentino uno dei vettori di attacco più efficaci utilizzati dai cybercriminali.

Le minacce interne, sia malevole che derivanti da negligenza dei dipendenti, raramente trovano tutela nelle polizze standard, così come sono tipicamente esclusi i danni causati da vulnerabilità note e non rimediate. Quest’ultima esclusione riveste particolare rilevanza pratica: se gli attaccanti sfruttano una falla di sicurezza di cui l’organizzazione era a conoscenza ma che non ha provveduto a correggere nei tempi appropriati, l’assicuratore può legittimamente negare l’indennizzo invocando la mancanza di diligenza da parte dell’assicurato. Analogamente, le interruzioni di sistema non causate da attacchi informatici ma da errori di configurazione, hardware failure o altri malfunzionamenti interni generalmente non rientrano nel perimetro di copertura.

I requisiti minimi di assicurabilità: dal questionario alla conformità

L’accesso a una polizza cyber richiede oggi la dimostrazione di un livello minimo di maturità nella gestione della sicurezza informatica, traducendosi in un processo di underwriting sempre più rigoroso e tecnicamente approfondito. Le compagnie assicurative sottopongono i potenziali assicurati a questionari dettagliati che indagano l’architettura dei sistemi IT, le politiche di sicurezza implementate e le procedure di gestione degli incidenti, con particolare attenzione ad alcuni requisiti divenuti ormai imprescindibili.

Il primo e più universale tra questi riguarda l’autenticazione multifattoriale (MFA), divenuta requisito tassativo dalla metà del 2022 per tutti gli accessi remoti ai sistemi aziendali. La pandemia ha dimostrato come le credenziali basate esclusivamente su username e password rappresentino il punto di ingresso privilegiato per gli attaccanti, rendendo l’MFA una misura di sicurezza fondamentale e non più negoziabile. Parallelamente, gli assicuratori richiedono l’implementazione di backup secondo la regola del 3-2-1, ovvero tre copie dei dati su due supporti diversi con almeno una copia disconnessa dalla rete aziendale.

La prassi di verificare periodicamente l’effettiva ripristinabilità dei backup attraverso test programmati è diventata parte integrante dei requisiti, dopo che numerosi sinistri hanno rivelato come le organizzazioni scoprissero l’inconsistenza o l’obsolescenza delle proprie copie di sicurezza solo al momento della necessità.

La protezione degli endpoint costituisce il terzo pilastro dei requisiti minimi, con gli assicuratori che non si accontentano più dei tradizionali antivirus ma richiedono soluzioni di Endpoint Detection and Response (EDR) o, preferibilmente, di Extended Detection and Response (XDR) che estendano la capacità di rilevamento e risposta anche ai server e agli apparati di rete.

La gestione delle vulnerabilità attraverso un processo strutturato di patch management e l’isolamento dei sistemi obsoleti non più supportati dai produttori completano il quadro dei presidi tecnici richiesti. A questi si aggiungono requisiti organizzativi quali la presenza di personale dedicato o di contratti di assistenza tecnica esterna, l’implementazione di programmi di formazione continua sulla security awareness e l’esistenza di un piano di disaster recovery e continuità operativa adeguatamente documentato e testato.

Secondo analisi condotte da operatori del settore assicurativo, circa il quaranta percento delle aziende italiane non è in grado di soddisfare questi requisiti minimi a causa di sistemi informatici sottodimensionati od obsoleti e di una scarsa attività di prevenzione, trovandosi di fatto escluse dalla possibilità di accedere al mercato della cyber insurance in Italia. Questo dato evidenzia un significativo protection gap che espone una vasta porzione del tessuto produttivo italiano a rischi finanziari potenzialmente devastanti, in un contesto dove gli attacchi informatici hanno registrato nel 2023 un impatto valutato come “elevato” nel 79% dei casi, rispetto al 50% dell’anno precedente.

L’impatto dei framework normativi: NIS2 e DORA come catalizzatori

L’evoluzione del quadro regolamentare europeo sta progressivamente ridefinendo i parametri di riferimento per la sottoscrizione delle assicurazioni cyber, introducendo standard di sicurezza più elevati che fungono da de facto requisiti anche per l’assicurabilità.

La Direttiva UE 2022/2555 (NIS2), che ha esteso significativamente il perimetro dei soggetti obbligati rispetto alla precedente versione, impone misure minime di cybersicurezza che includono l’analisi dei rischi, la gestione degli incidenti, la continuità operativa e la sicurezza della supply chain. I soggetti essenziali, che devono registrarsi entro il 28 febbraio 2025 presso la Piattaforma nazionale NIS dell’ACN, sono tenuti ad adottare l’autenticazione multifattoriale per tutti gli accessi, a implementare processi di gestione delle vulnerabilità e a garantire la segmentazione delle reti, requisiti che coincidono significativamente con quanto richiesto dalle compagnie assicurative.

Il Regolamento UE 2022/2554 (DORA), direttamente applicabile dal 17 gennaio 2025 senza necessità di recepimento nazionale, introduce per le entità finanziarie obblighi ancora più stringenti in materia di gestione dei rischi ICT, con particolare enfasi sulla resilienza operativa digitale e sulla gestione dei fornitori terzi di servizi critici. La normativa dedica trentasette articoli su sessantaquattro a requisiti in materia di sicurezza e resilienza, con un livello di dettaglio e prescrittività significativamente superiore rispetto alla NIS2. Per le organizzazioni che ricadono sotto entrambi i regimi normativi, DORA costituisce lex specialis e prevale sulla Direttiva NIS2, comportando l’applicazione del corpus normativo più rigoroso.

L’introduzione di questi framework normativi sta generando un effetto di convergenza tra compliance regolamentare e assicurabilità cyber, con le compagnie che sempre più frequentemente richiedono evidenze di conformità agli standard normativi come prerequisito per la sottoscrizione. Alcune realtà assicurative stanno sviluppando modelli di pricing che premiano le organizzazioni certificate secondo standard internazionali quali la ISO/IEC 27001:2022 per la sicurezza delle informazioni, riconoscendo un valore economico alla dimostrazione di processi strutturati e verificati da enti terzi.

Trend 2025: stabilizzazione, requisiti crescenti e segmentazione del mercato

L’anno in corso si configura come un momento di relativa stabilizzazione dopo il periodo turbolento che ha caratterizzato il biennio 2021-2022, quando i prezzi delle polizze cyber hanno subito aumenti drammatici a fronte di una escalation nella frequenza e gravità dei sinistri. Le analisi di S&P Global Ratings indicano prospettive stabili per il settore, ancorate ai guadagni di sottoscrizione conseguiti nel 2023 e 2024 grazie agli aumenti tariffari e alle condizioni di polizza più restrittive implementate nel periodo precedente.

I prezzi hanno registrato una diminuzione del quindici percento rispetto ai picchi raggiunti a fine 2021 e inizio 2022, pur rimanendo significativamente più elevati rispetto ai livelli pre-pandemia. S&P prevede che i premi annuali globali per le assicurazioni informatiche cresceranno da circa quattordici miliardi di dollari nel 2023 a ventitré miliardi di dollari entro il 2026, riflettendo un tasso di crescita annuale del 15-20%.

Il mercato europeo, che rappresenta attualmente circa il ventuno percento del mercato globale delle assicurazioni cyber contro il sessantanove percento del Nord America, è destinato a una crescita accelerata nei prossimi anni. Per le principali economie europee (Germania, Francia, Italia e Spagna), la potenziale crescita nella raccolta premi è stimata nell’ordine di settecento milioni di euro qualora si replicassero i livelli di penetrazione raggiunti nei mercati più maturi. Il mercato italiano specificamente è proiettato a crescere con un tasso annuale composto dell’11,091% nel periodo 2025-2035, passando dai duecento milioni di dollari stimati per il 2023 a settecentosei milioni entro il 2035.

Tuttavia, questa crescita non sarà uniforme né priva di sfide. Le compagnie assicurative stanno richiedendo requisiti di assicurabilità sempre più stringenti, con alcuni operatori che hanno pubblicamente dichiarato la volontà di ritirarsi dal mercato cyber a causa della difficoltà nel valutare accuratamente i rischi e nel gestire il potenziale accumulo di sinistri. La dichiarazione di Mario Greco, CEO di Zurich Insurance, sulla riluttanza a sottoscrivere nuove polizze cyber ha rappresentato un segnale della complessità che caratterizza questo ramo assicurativo, dove la mancanza di dati storici sufficienti e l’evoluzione continua delle minacce rendono estremamente complessa la modellizzazione attuariale del rischio.

Il segmento delle piccole e medie imprese rappresenta contemporaneamente la maggiore opportunità di crescita e la sfida più complessa per il mercato della cyber insurance in Italia. Le PMI, che costituiscono il tessuto portante dell’economia nazionale, sono sempre più esposte agli attacchi informatici ma spesso non dispongono delle risorse economiche e delle competenze tecniche necessarie per implementare i presidi di sicurezza richiesti dalle compagnie. Alcuni operatori stanno sviluppando piattaforme tecnologiche dedicate al segmento PMI che consentono di effettuare assessment automatizzati delle vulnerabilità esterne, di emettere polizze con condizioni flessibili che si adattano progressivamente ai miglioramenti della postura di sicurezza implementati dall’assicurato e di facilitare l’accesso al mercato riducendo gli oneri burocratici in ingresso.

L’intelligenza artificiale sta emergendo come fattore di trasformazione sia sul fronte delle minacce che delle opportunità. Da un lato, l’AI generativa sta potenziando le capacità offensive dei cybercriminali, rendendo più sofisticati gli attacchi di social engineering e accelerando lo sviluppo di malware polimorfi difficilmente rilevabili dai sistemi di difesa tradizionali. Dall’altro lato, le compagnie assicurative stanno integrando strumenti di intelligenza artificiale nei processi di sottoscrizione per analizzare più efficacemente i questionari, valutare automaticamente la postura di sicurezza attraverso l’analisi dell’esposizione digitale esterna e personalizzare i modelli di pricing sulla base di un numero più ampio di variabili di rischio.

Il fenomeno della doppia estorsione nei ransomware, dove oltre alla cifratura dei dati si procede all’esfiltrazione e alla minaccia di pubblicazione delle informazioni sottratte, sta modificando la struttura dei sinistri e la gestione delle richieste di indennizzo. Nel terzo trimestre del 2023, il novanta percento degli attacchi ransomware ha incluso questa modalità operativa, amplificando significativamente l’impatto reputazionale e le potenziali responsabilità verso terzi per le organizzazioni colpite. Le polizze stanno progressivamente adattando le coperture cyber per includere i costi di public relations e gestione della reputazione, oltre ai tradizionali aspetti di ripristino tecnico e interruzione operativa.

Criticità strutturali e prospettive evolutive

Il mercato italiano della cyber insurance si trova oggi di fronte a un paradosso: mentre la domanda potenziale è in costante crescita e la consapevolezza del rischio aumenta progressivamente, permangono significative barriere culturali e tecniche che ne limitano lo sviluppo. Cesare Burei, esperto di cyber risk insurance presso Margas, ha efficacemente sintetizzato questa situazione affermando di dover spesso agire come “mediatore culturale” piuttosto che come broker assicurativo, dovendo far dialogare al medesimo tavolo figure aziendali con basi culturali completamente diverse quali il CEO, il CFO, il direttore di produzione e il responsabile IT.

La mancanza di un linguaggio tecnico standardizzato tra le diverse compagnie assicurative rappresenta un ostacolo significativo alla comparabilità delle offerte e alla comprensione effettiva delle condizioni di polizza da parte degli assicurati. L’IVASS ha evidenziato come le definizioni di concetti fondamentali quali “attacco informatico”, “emergenza cyber” o “interruzione di attività” varino significativamente tra i diversi contratti, generando ambiguità interpretative che possono tradursi in contenziosi al momento della liquidazione. L’adozione di glossari standardizzati, quale il Cyber Lexicon del Financial Stability Board, rappresenterebbe un passo avanti fondamentale verso una maggiore chiarezza e trasparenza del mercato.

La questione dei cosiddetti “silent cyber risks”, ovvero le coperture implicite del rischio informatico presenti in polizze tradizionali non specificamente dedicate, costituisce un ulteriore elemento di complessità che richiede attenzione da parte sia degli assicuratori che degli assicurati. Molte polizze property o di responsabilità civile generale contengono clausole che potrebbero teoricamente coprire alcuni aspetti dei danni cyber senza che l’assicuratore abbia riservato una quota specifica di premio per questo rischio. Questa situazione genera incertezza sulla reale estensione delle coperture disponibili e può portare a sovrapposizioni o, al contrario, a lacune nella protezione complessiva dell’organizzazione.

Il ruolo degli intermediari specializzati, quali i broker con competenze specifiche nel cyber risk, sta diventando sempre più cruciale nel facilitare l’incontro tra domanda e offerta in un mercato caratterizzato da elevata complessità tecnica e continua evoluzione. Questi professionisti non si limitano a collocare polizze ma svolgono una funzione consulenziale che comprende l’analisi della postura di sicurezza dell’organizzazione, l’identificazione dei gap nei presidi implementati, il supporto nella selezione delle coperture più appropriate rispetto al profilo di rischio specifico e l’assistenza nella gestione del sinistro qualora si verifichi un incidente.

L’integrazione crescente tra coperture assicurative cyber e polizze Directors & Officers (D&O), che tutelano gli amministratori e i dirigenti dalle conseguenze delle loro decisioni gestionali, rappresenta un’evoluzione significativa nella protezione del top management. Le normative quali NIS2 e DORA attribuiscono responsabilità dirette agli organi di gestione in materia di cybersicurezza, richiedendo approvazione delle politiche di sicurezza, supervisione continua sull’implementazione delle misure e mantenimento di competenze aggiornate attraverso formazione specifica. Questa attribuzione di responsabilità personali sta generando una domanda crescente di soluzioni assicurative integrate che coprano tanto i danni all’organizzazione quanto le eventuali azioni di responsabilità nei confronti degli amministratori.

Conclusioni: verso una maturità del mercato

La cyber insurance in Italia si trova nel mezzo di una transizione fondamentale, che la sta conducendo da prodotto di nicchia per grandi organizzazioni sensibili al rischio a strumento standard di gestione del rischio per imprese di qualsiasi dimensione e settore. Il cammino verso questa maturità richiede tuttavia significativi progressi su molteplici fronti: la standardizzazione dei linguaggi contrattuali e delle definizioni tecniche, lo sviluppo di modelli attuariali più sofisticati basati su dataset più ampi e rappresentativi del contesto italiano, l’innalzamento generalizzato della postura di sicurezza delle organizzazioni attraverso investimenti in tecnologie e competenze, e l’evoluzione culturale che porti a considerare la cybersicurezza non come costo ma come investimento strategico per la continuità e la competitività aziendale.

I framework normativi europei, pur introducendo obblighi e complessità aggiuntive per le organizzazioni, stanno di fatto creando un terreno comune tra requisiti di compliance e condizioni di assicurabilità cyber, facilitando potenzialmente l’accesso al mercato assicurativo per quelle realtà che implementano seriamente i presidi richiesti dalle normative. La convergenza tra regolamentazione, standard tecnici internazionali e requisiti assicurativi rappresenta un’opportunità per elevare complessivamente il livello di resilienza del sistema economico italiano di fronte alle minacce cyber, trasformando la necessità di conformità in leva per la protezione effettiva delle organizzazioni e dei dati che esse gestiscono.

Il futuro della cyber insurance in Italia dipenderà dalla capacità del mercato di trovare equilibri sostenibili tra esigenze di redditività degli assicuratori, accessibilità economica per le imprese e ampiezza effettiva delle coperture offerte, in un contesto dove le minacce continueranno a evolversi e dove la trasformazione digitale dell’economia renderà il rischio cyber sempre più pervasivo e interconnesso. La sfida consiste nel costruire un ecosistema in cui la polizza assicurativa non sia percepita come sostituto della sicurezza ma come complemento naturale di una strategia complessiva di cyber risk management, dove prevenzione, protezione e trasferimento del rischio operino in sinergia per garantire la resilienza operativa delle organizzazioni nell’era digitale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cyber-insurance-in-italia/


Intelligenza artificiale e sviluppo software: perché il prompt engineering non sostituirà i programmatori

L’illusione manageriale del “no-code intelligente” e i rischi strategici per le aziende nei prossimi 10 anni

L’intelligenza artificiale nello sviluppo software sta creando una narrativa molto seducente per i livelli manageriali: l’idea che la programmazione possa essere “semplificata” a tal punto da sostituire la scrittura di codice con la scrittura di prompt. Una prospettiva affascinante, perché promette riduzione dei costi, accelerazione delle roadmap, autonomia dei team non tecnici, minore dipendenza da competenze specialistiche e sviluppo “magico” determinato dal linguaggio naturale.

Tuttavia, questa visione è profondamente distorsiva e rappresenta una delle maggiori minacce strategiche per le aziende nei prossimi 5-10 anni, perché è una proiezione, non un futuro realistico.

L’idea seducente che sta circolando nell’industria tech è il “prompt engineering” come nuova forma di programmazione. Secondo questa visione, presto non avremo più bisogno di programmatori tradizionali, ma di “orchestratori” capaci di dialogare con l’AI. La logica? La produce l’AI, l’architettura emerge automaticamente, il codice diventa una semplice commodity.

Ma c’è un problema fondamentale: questa narrativa confonde la scrittura del codice con l’ingegneria del software. Quando parliamo di costruire sistemi reali, production-ready, ci troviamo di fronte ad una serie di sfide che nessun prompt, per quanto ben scritto, può affrontare.

Complessità e determinismo nell’ingegneria del software

Un sistema software deve comportarsi in modo prevedibile. La complessità ciclomatica, l’idempotenza delle operazioni, la gestione dello stato distribuito non sono dettagli implementativi: sono decisioni architetturali che richiedono una comprensione profonda del problema e delle sue implicazioni.

Esistono aspetti come sicurezza e affidabilità, dove il threat modeling, la gestione delle eccezioni, i contratti tra servizi e il typing rigoroso rappresentano meccanismi di difesa contro l’entropia dei sistemi complessi. Questi elementi non possono emergere spontaneamente da una conversazione con un modello linguistico.

Sicurezza, scalabilità e compliance dei sistemi informatici

Scalabilità, sostenibilità, compliance e osservabilità non sono temi che possono essere “banalizzati”. Come si scala orizzontalmente un sistema? Come si mantiene nel tempo? Come si modella il dato in modo che resti coerente attraverso anni di evoluzione? Come si gestisce il refactoring senza compromettere funzionalità esistenti?

In contesti regolamentati, ogni decisione architetturale deve essere tracciabile, auditabile, giustificabile. L’osservabilità non è un add-on: è una proprietà emergente di un sistema ben progettato.

La programmazione non è mai stata principalmente la scrittura di codice. È progettazione di sistemi, capacità di modellare problemi complessi in strutture gestibili, anticipare casi limite e comportamenti emergenti, bilanciare trade-off tra performance e manutenibilità, pensare in termini di invarianti e garanzie, comprendere le implicazioni di lungo termine nelle scelte architetturali.

L’AI generativa può certamente accelerare la produzione di codice boilerplate, suggerire implementazioni, aiutare con la sintassi. Ma non può sostituire la capacità di pensare il sistema.

Ridurre la programmazione a prompt engineering è come dire che una laurea in architettura serve solo a saper usare AutoCAD, o che la laurea in medicina serve solo a prescrivere farmaci. È una semplificazione che sottovaluta la profondità della disciplina, crea false aspettative nei non-tecnici e rischia di produrre sistemi fragili e non manutenibili.

Ignorare decenni di best practice nell’ingegneria del software non è la strada giusta. L’AI è uno strumento potente, può democratizzare molti aspetti dello sviluppo software, accelerare processi, ridurre friction, ma come ogni strumento, la sua efficacia dipende da chi lo usa e dalla profondità della sua comprensione.

Michelangelo con martello e scalpello ha creato opere d’arte; se date gli stessi strumenti all’AI creerà la media ponderata di tutte le sculture mai viste. Sicuramente potrà sorprendere, ma è solo qualcosa che assomiglia ad un’opera d’arte, perché è realizzata senza avere la consapevolezza della bellezza.

L’AI non elimina, ma amplifica la necessità di competenze tecniche. L’AI è probabilistica, i sistemi sono deterministici. I modelli generativi operano nella sfera dell’incertezza; i sistemi software moderni richiedono invece determinismo, prevedibilità, riproducibilità. Un paradosso ingegneristico che solo gli sviluppatori possono risolvere stratificando: validazione, normalizzazione, sandboxing, controlli sintattici e semantici.

Nuovi failure modes nell’automazione software aziendale

L’AI introduce failure modes nuovi e più pericolosi. Con l’AI emergono errori silenziosi, allucinazioni strutturate, output formalmente corretti ma semanticamente errati, derive logiche nel tempo, dipendenza dal training data, deterioramento delle performance con il drift dei modelli, senza parlare delle vulnerabilità di prompt-injection.

Queste failure non sono “bug” tradizionali: sono problemi sistemici che richiedono esperienza di ingegneria del caos, modellazione del rischio, governance del ciclo del modello, infrastructure resiliency. Nessun prompt può sostituire queste capacità.

L’AI scrive codice, ma non progetta architetture. Un LLM può produrre funzioni, classi, micro-implementazioni, ma non può progettare un modello di dominio coerente, la gestione concorrente, il modello di error handling, una pipeline di scaling affidabile, la separazione delle responsabilità o boundary tra microservizi. Questi elementi non emergono dal linguaggio naturale: emergono dalla conoscenza profonda dell’ingegneria.

Il rischio strategico per manager e amministratori è la decrescita delle competenze. Se un’azienda sposa la narrativa del “codice scritto dall’AI”, vede un vantaggio immediato: riduzione apparente della dipendenza dagli sviluppatori. Nel breve periodo questo può sembrare efficiente; nel lungo periodo è devastante.

Gli sviluppatori diventano operatori di AI, non ingegneri. Si ha inevitabilmente un’erosione delle skill: si perdono le capacità di leggere criticamente il codice, identificare bug strutturali, costruire architetture scalabili, ottimizzare performance o garantire la sicurezza del software.

Ma un aspetto ancora più grave è il lock-in cognitivo: l’azienda diventa progressivamente dipendente da modelli, provider, workflow “opachi”, output non riproducibili. Quando la complessità diventa ingestibile, non esistono più skill interne per intervenire.

Il debito tecnico generativo, codice generato senza governance, cresce in modo esponenziale: sistemi ingestibili, vulnerabilità non tracciabili, performance degradate, dipendenza totale da consulenti esterni. L’incubo di qualsiasi manager coscienzioso.

Negli ultimi anni, piattaforme come n8n, Zapier, Make (ex Integromat) e una miriade di altri strumenti no-code o low-code stanno conquistando aziende e professionisti, che stanno vivendo una specie di speculazione “softeristica”, pensando e avendo l’illusione di poter realizzare, grazie all’AI, qualsiasi software e acquisire tramite essa competenze senza la necessità di una disciplina della materia.

Queste piattaforme promettono automazioni rapide, integrazioni immediate e la possibilità di “programmare senza programmare”. E grazie all’integrazione con l’intelligenza artificiale, la loro narrazione si è rafforzata: creare processi intelligenti senza scrivere codice sembra finalmente possibile. Il tormentone è sempre lo stesso: l’AI scriverà il codice al posto nostro, e questo tipo di applicazioni saranno la nuova normalità.

Il problema è che l’abuso di strumenti superficiali genera un progressivo appiattimento delle competenze: pensiamo che la logica dell’AI sia magica, accettiamo processi che non comprendiamo, smettiamo di approfondire come funzionano i sistemi, ci abituiamo ad un livello di astrazione così alto da non poter più intervenire davvero. È questa la più grande minaccia: una generazione di professionisti convinta di controllare l’AI senza capirne i meccanismi.

Questo fenomeno non è nuovo: lo abbiamo già visto con il cloud computing. Negli ultimi dieci anni è emersa una generazione di sistemisti “cloud-nativi” che sono cresciuti esclusivamente con AWS, Azure o Google Cloud. Sanno gestire container, orchestrare Kubernetes, configurare servizi gestiti, scalare automaticamente le risorse.

Ma se gli chiedi di installare un server Exchange on-premise, configurare una Active Directory su un server Windows fisico, o gestire una SAN tradizionale, vanno letteralmente in crisi. Non è una critica alle loro competenze cloud, che sono spesso eccellenti. È la constatazione di una lacuna fondamentale: questi professionisti hanno saltato completamente i “fondamentali”.

Non hanno mai dovuto configurare manualmente protocolli di rete, debuggare problemi di DNS a livello di sistema, gestire storage fisico, comprendere le implicazioni di latenza su hardware reale, o risolvere conflitti di risorse su macchine condivise. Non sono in grado di rendere autonoma un’organizzazione dal cloud.

Tre blackout devastanti in un mese: AWS, Azure e Cloudflare

Le conseguenze di questa dipendenza totale dal cloud si sono manifestate drammaticamente nel 2025. Tra ottobre e novembre, nell’arco di appena un mese, tre blackout devastanti hanno colpito l’internet globale:

AWS, 20 ottobre 2025: oltre 15 ore di disservizio causate da una race condition nel sistema DNS automatizzato di DynamoDB che ha svuotato i record DNS per l’endpoint regionale. Servizi colpiti: Signal, Snapchat, Lyft, Roblox, Fortnite, Alexa, EC2, Lambda.

Microsoft Azure, 29 ottobre 2025: circa 8 ore di interruzione dovuta a una configurazione errata in Azure Front Door che ha causato il malfunzionamento di numerosi nodi globali. Servizi colpiti: Microsoft 365, Teams, Xbox Live, Minecraft, Azure Portal.

Cloudflare, 18 novembre 2025: circa 6 ore di downtime provocato da una modifica ai permessi del database che ha raddoppiato le dimensioni di un file di configurazione critico per il sistema Bot Management. Servizi colpiti: X, ChatGPT, Spotify, Discord, Claude AI, Truth Social.

La cosa più allarmante? In tutti e tre i casi, i guasti sono derivati da errori interni nella configurazione e nel software delle infrastrutture core dei provider, non da attacchi esterni. E nessuna di queste organizzazioni aveva sistemi di backup on-premise funzionanti.

Quando il cloud è collassato, non c’era piano B. Nessun fallback locale, nessuna ridondanza fisica, nessuna capacità di continuare a operare in autonomia. Intere aziende si sono trovate completamente paralizzate, impotenti, in attesa che giganti tecnologici risolvessero problemi su cui non avevano alcun controllo.

Questo è il rischio concreto di una generazione che ha dimenticato, o mai imparato, come gestire infrastrutture indipendenti. Quando il livello di astrazione fornito dal cloud funziona, sono efficienti. Ma quando qualcosa va storto sotto quel livello di astrazione, quando il problema risiede in qualcosa che il pannello di controllo non mostra, quando è necessario comprendere cosa sta realmente accadendo “sotto il cofano”, si trovano spiazzati. Hanno imparato a orchestrare servizi, non a capire come quei servizi funzionano internamente.

I limiti strutturali delle piattaforme no-code

Similarmente, dietro promesse e sensazionalismi come il “vibe coding” si nasconde una realtà più complessa e molto meno comoda. Questi strumenti rappresentano una parte della gigantesca bolla narrativa dell’AI — una bolla che rischia di farci credere che la programmazione non sia più necessaria, che il controllo dei sistemi possa essere delegato a un’interfaccia visuale e che l’AI possa sostituire la comprensione tecnica.

In realtà, la storia ci insegna che, quando la tecnologia diventa più sofisticata, solo chi padroneggia la logica, l’architettura e il codice è davvero in grado di governarla.

Applicazioni come n8n, osannate sui social network, sono ottime per la didattica, per fare prototipi, piccoli workflow e automazioni operative, ma non possono essere considerate in processi critici, complessi o ad alto carico perché soffrono di limiti evidenti: dipendenza da un engine centrale, gestione delle eccezioni non nativa come nel software scritto a mano, performance legate al design del motore e non alle esigenze del progetto.

È la differenza tra montare Lego e costruire un edificio antisismico: la struttura visuale non è pensata per scenari limite.

La promessa è ridurre la complessità, ma spesso ciò che sparisce dall’interfaccia si ripresenta in altre forme: workflow difficili da versionare, debugging quasi impossibile quando un flusso si espande, logica distribuita tra decine di nodi difficili da tracciare, dipendenza totale dal motore dell’applicazione. Un sistema facile da creare e difficile da mantenere.

Gli strumenti low-code danno una falsa percezione di controllo e di potere: sposti blocchi, colleghi input e output, vedi subito una risposta. Ma si tratta spesso di un controllo superficiale: si lavora dentro limiti stabiliti dallo strumento, non si vedono i veri errori o colli di bottiglia e non si controlla davvero cosa accade negli strati sottostanti. In altre parole: hai le chiavi della macchina, ma il motore è sigillato.

L’AI è un moltiplicatore di competenze. Il futuro vincente è molto diverso dalla fantasia del “prompt-only”. Le aziende che prospereranno saranno quelle che comprenderanno che l’AI deve essere integrata come una parte della pipeline, non come sostituto della pipeline.

Gli sviluppatori devono diventare “AI-Augmented Engineers”, non prompt writer. La programmazione non svanirà: si evolverà verso livelli più alti di astrazione.

L’AI potenzia gli ingegneri capaci e penalizza i team privi di visione tecnica. L’AI eleva l’asticella: non abbassa la soglia di ingresso, ma alza la soglia di comprensione richiesta.

La verità tecnica che molti manager non vedono, o non vogliono vedere, è che gli sviluppatori del futuro continueranno a scrivere codice, analizzeranno il codice generato, metteranno guardrail ai modelli, costruiranno architetture e continueranno a fare debugging di pipeline complesse. “Scrivere prompt” è una micro-attività: chi pensa che “basta il prompt” rimarrà schiacciato dalla complessità reale dei sistemi basati su AI.

L’AI non sta eliminando il ruolo degli sviluppatori. Sta eliminando gli sviluppatori che non capiscono cosa stanno facendo. Sta funzionando come un acceleratore evolutivo professionale. Non elimina il valore della cognizione umana: la moltiplica quando è genuina e la elimina quando simulata.

Gli sviluppatori che “googlavano” soluzioni e le incollavano sono sostituibili. Quelli che capiscono architetture, trade-off, contesto di business e sanno usare l’AI come strumento di amplificazione cognitiva sono i nuovi “senior”, anche se giovani.

La discriminante finale non è più “quanti anni di esperienza hai” ma quanto profondamente capisci ciò che fai e sai adattarti a strumenti che cambiano settimanalmente.

Le aziende tech stanno dimostrando nei fatti di preferire dieci professionisti che comprendono a fondo ciò che fanno rispetto a cento che eseguono in modo meccanico. L’AI ha reso economicamente insostenibile mantenere questi ultimi.

Ma l’idea che il software del futuro sarà costruito “solo a colpi di prompt” è una semplificazione pericolosa: rischia di impoverire le competenze, ridurre la resilienza organizzativa e aumentare i rischi, producendo sistemi sempre più opachi e difficili da governare.

Perché alla fine, quando il sistema crasha in produzione alle 3 del mattino, quando i costi cloud esplodono, quando la sicurezza viene compromessa, quando il codice diventa impossibile da manutenere, nessun prompt risolverà quei problemi. Servirà qualcuno che capisca davvero come funzionano i sistemi.

Il futuro appartiene a chi saprà integrare l’AI nella propria professionalità, non a chi immagina di rimpiazzare le competenze umane con una semplice interfaccia testuale o interattiva.

Profilo Autore

Progettista di sistemi esperti, software developer, network e system engineer, con oltre 30 anni di esperienza nell’ambito della sicurezza delle informazioni, Francesco Arruzzoli è il Resp. del Centro Studi Cyber Defense Cerbeyra, dove svolge attività di R&D, analisi delle cyber minacce e progettazione di nuove soluzioni per la cyber security di aziende ed enti governativi. Esperto di Cyber Threat Intelligence e contromisure digitali, autore di libri ed articoli sue riviste del settore, in passato ha lavorato per multinazionali, aziende della sanità italiana, collaborato con enti governativi e militari. In qualità di esperto cyber ha svolto inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/prompt-engineering/