Crittografia post-quantistica: tra minacce concrete e opportunità rivoluzionarie

Al Forum ICT Security 2025, Daniele Venturi dell’Università Sapienza traccia la roadmap di una rivoluzione crittografica già in corso. Quando il quantum computing diventerà realtà, i nostri sistemi di sicurezza attuali potrebbero crollare in pochi istanti. Ma la sfida quantistica nasconde anche opportunità straordinarie che cambieranno per sempre il modo in cui proteggiamo i dati.

L’intervento del professor Daniele Venturi, ordinario presso il Dipartimento di Informatica dell’Università di Roma Sapienza, ha aperto uno squarcio sul futuro della cybersecurity nell’era quantistica. Durante la 23ª edizione del Forum ICT Security, tenutosi a Roma il 19-20 novembre 2025, il relatore ha presentato un quadro complesso dove minacce e opportunità si intrecciano, delineando scenari che vanno ben oltre la semplice sostituzione degli algoritmi crittografici attuali.

Il titolo dell’intervento, “Crittografia (Post-)Quantistica: Sfide ed Opportunità”, racchiude già la duplice natura della rivoluzione in corso: da un lato la necessità urgente di proteggere i sistemi esistenti, dall’altro le straordinarie possibilità tecnologiche che le nuove assunzioni matematiche ci offrono.

Il paradigma della sicurezza dimostrabile: le fondamenta della crittografia moderna

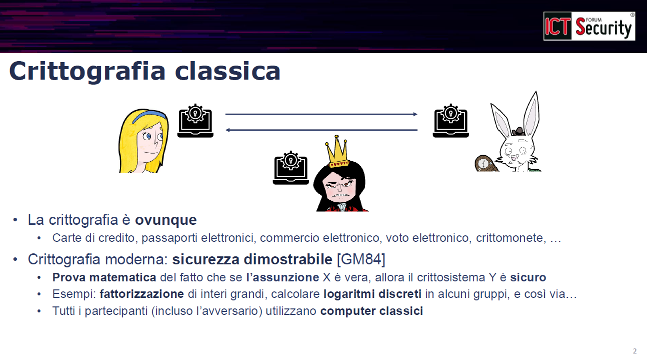
“La crittografia moderna si basa su quello che chiamiamo il paradigma della sicurezza dimostrabile”, ha esordito Venturi, richiamando le pietre miliari poste da Shafi Goldwasser e Silvio Micali negli anni Ottanta. L’idea fondamentale è avere una prova matematica rigorosa della sicurezza di un crittosistema, non basarsi solo su intuizioni o test empirici.

crittografia post-quantistica
Crittografia classica – Schema del paradigma della sicurezza dimostrabile

Il primo passo è definire con precisione cosa significa che un cifrario o uno schema di firma è sicuro. Una volta stabilita la definizione, si procede alla dimostrazione matematica, che può avvenire in due modalità: incondizionata (è vera sempre, punto) oppure condizionata a specifiche assunzioni matematiche.

“Violare la sicurezza del sistema diventa equivalente a violare l’assunzione X”, ha spiegato l’esperto. Gli esempi classici di queste assunzioni sono la difficoltà computazionale di fattorizzare grandi numeri interi o calcolare logaritmi discreti in gruppi finiti: problemi su cui generazioni di matematici si sono arrovellate per centinaia di anni senza trovare algoritmi efficienti.

Questa solidità matematica ci rende sicuri: se esistesse un attacco efficace contro RSA o altri sistemi, avremmo automaticamente scoperto come fattorizzare numeri interi rapidamente, il “Santo Graal” della teoria dei numeri che i matematici inseguono da secoli.

L’algoritmo di Shor: quando la minaccia quantistica diventa concreta

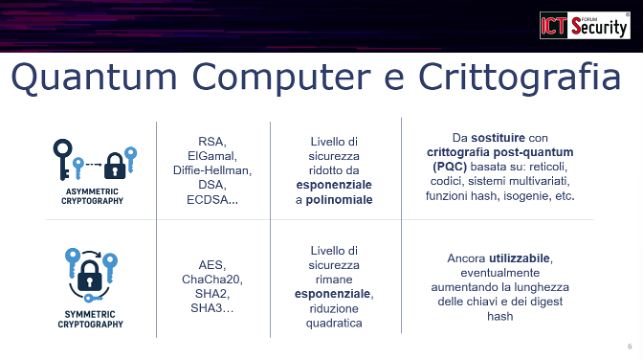
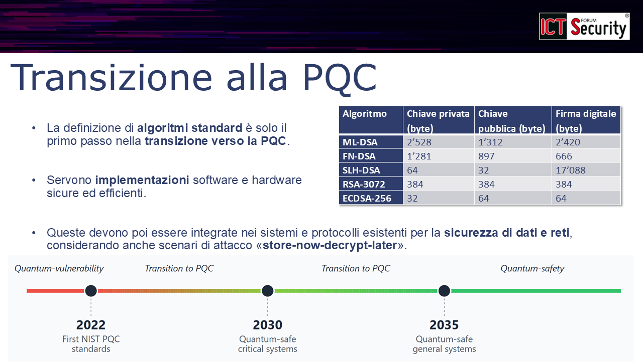
In questo scenario consolidato irrompe la computazione quantistica. L’algoritmo di Shor, presentato da Peter Shor nei primi anni Novanta, ha dimostrato che un calcolatore quantistico sufficientemente potente può fattorizzare numeri interi e risolvere il problema del logaritmo discreto in tempo polinomiale – una velocità che renderebbe inutili gran parte dei sistemi crittografici attuali.

“Fattorizzare un intero di 1.024 bit richiede circa 2.050 qubit logici e miliardi di gate quantistici”, ha precisato Venturi, sottolineando che siamo ancora molto lontani da questo obiettivo tecnologico. Il record attuale di implementazione reale dell’algoritmo di Shor è la fattorizzazione del numero 21, senza progressi significativi negli ultimi dieci anni.

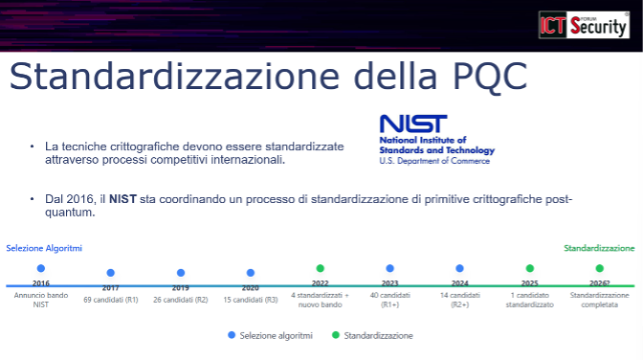
Eppure il NIST (National Institute of Standards and Technology) statunitense ha già avviato e in gran parte completato il processo di standardizzazione dei crittosistemi resistenti agli attacchi quantistici. Il motivo di questa apparente urgenza? Il principio precauzionale sintetizzato nell’espressione inglese “better safe than sorry” (meglio prevenire che curare).

“Gli attacchi quantistici potrebbero già stare avvenendo in questo momento”, ha ammonito il relatore con tono grave. “Un attaccante potrebbe raccogliere oggi grandi quantità di dati cifrati per decifrarli domani, quando i computer quantistici saranno finalmente disponibili”. Uno scenario noto come “harvest now, decrypt later” (raccogli ora, decifra poi) che rende urgente la migrazione verso algoritmi post-quantistici anche prima che i computer quantistici operativi esistano.

Post-quantistica versus quantistica: una distinzione cruciale

Lo speaker ha tenuto a chiarire una distinzione fondamentale, spesso confusa nel dibattito pubblico e nelle comunicazioni commerciali.

crittografia post-quantistica
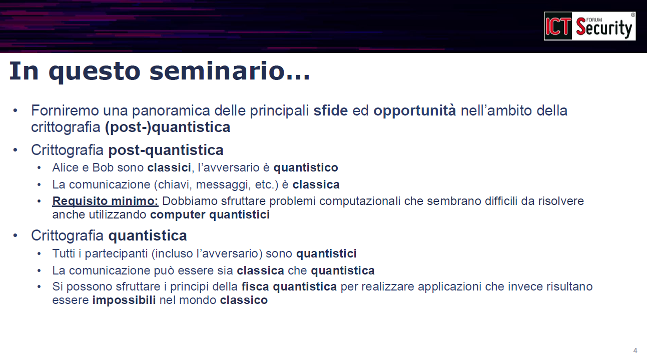
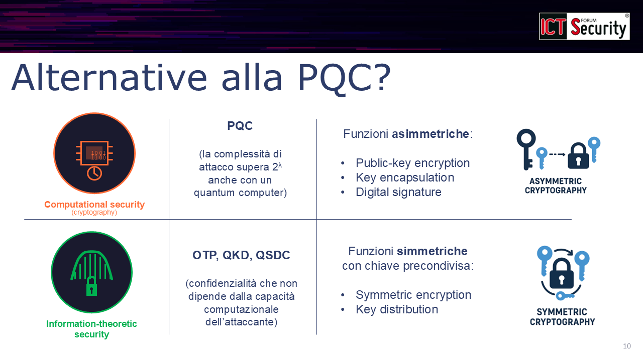
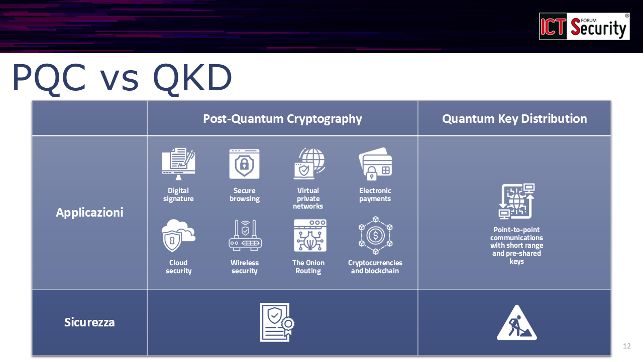
Distinzione tra crittografia post-quantistica e quantistica

Nella crittografia post-quantistica, Alice e Bob (mittente e destinatario, secondo la nomenclatura classica) utilizzano computer tradizionali e scambiano messaggi classici attraverso canali di comunicazione standard. Tuttavia, devono proteggersi da un avversario che dispone di un computer quantistico. Il requisito minimo è quindi sfruttare assunzioni matematiche basate su problemi che rimangono difficili da risolvere anche per calcolatori quantistici.

Nella crittografia quantistica, invece, tutti i partecipanti – Alice, Bob e potenzialmente anche l’avversario – dispongono di capacità quantistiche. La comunicazione può avvenire tramite stati quantistici, i messaggi possono essere codificati in qubit, e le chiavi crittografiche stesse possono essere stati quantistici. Questa tecnologia sfrutta i principi fondamentali della fisica quantistica per realizzare applicazioni completamente impossibili nel mondo classico.

“La distinzione è cruciale”, ha sottolineato Venturi, “perché confondere i due ambiti porta a fraintendimenti sulle capacità reali e sui limiti delle tecnologie disponibili”.

Learning with Errors: la matematica dietro i nuovi standard

Per illustrare le basi matematiche della crittografia post-quantistica, il professore ha presentato uno dei problemi fondamentali alla base dei nuovi standard NIST: il problema Learning with Errors (LWE), letteralmente “apprendimento con errori”.

Si tratta essenzialmente di risolvere un sistema di equazioni lineari modulari (equazioni in aritmetica modulo un certo numero primo q) che sono state perturbate aggiungendo del “rumore” casuale con una specifica distribuzione statistica. Normalmente, se si dispone di un numero sufficiente di equazioni, un sistema lineare è sempre risolvibile in modo efficiente con gli algoritmi studiati nei corsi universitari di algebra lineare.

“Ma quando queste equazioni sono perturbate da rumore con una certa distribuzione, il problema diventa computazionalmente difficile da risolvere”, ha spiegato Venturi. Sotto specifiche condizioni parametriche e certe assunzioni matematiche, questo problema diventa equivalente ad alcuni classici problemi sui reticoli (lattice problems) che i matematici studiano da decenni senza aver trovato algoritmi efficienti – né classici né quantistici.

“Congetturiamo che questi algoritmi efficienti non esistano”, ha aggiunto il relatore, “ed è proprio su questa congettura che fondiamo la sicurezza dei nuovi crittosistemi post-quantistici”.

L’opportunità nascosta: la cifratura omomorfa

Ma ecco la svolta inaspettata, l’aspetto che ha acceso l’entusiasmo del relatore. “Queste nuove assunzioni matematiche, oltre ad aprire la porta a sistemi sicuri in ambito post-quantistico come quelli standardizzati dal NIST, ci permettono di realizzare forme completamente nuove di strumenti crittografici che prima erano impensabili”.

crittografia post-quantistica
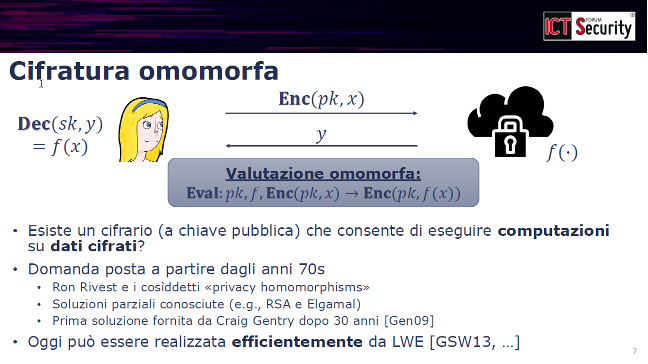
Schema della cifratura omomorfa

Una di queste tecnologie rivoluzionarie è la cifratura omomorfa (fully homomorphic encryption), ovvero la capacità di eseguire calcoli arbitrari su dati cifrati senza mai doverli decifrare.

Il caso d’uso è illuminante: “Immaginate di cifrare un messaggio e inviarlo al cloud. Volete che il cloud calcoli una funzione sui vostri dati, ma non volete rivelargliela in chiaro per questioni di privacy. Come può il cloud operare su dati che non può vedere?”

La risposta sembra quasi magica. Il cloud, conoscendo solo la chiave pubblica, la descrizione della funzione da calcolare e i dati cifrati, applica un algoritmo speciale e produce un nuovo ciphertext (testo cifrato). Quando il proprietario dei dati lo decifra con la propria chiave privata, ottiene esattamente il risultato della funzione applicata ai dati originali – senza che il cloud abbia mai “visto” i dati in chiaro.

“Questa era una delle domande aperte più grandi e affascinanti nella crittografia a chiave pubblica fin dalla sua invenzione negli anni Settanta”, ha ricordato Venturi. Ron Rivest, uno degli inventori dell’algoritmo RSA, parlava già dei cosiddetti “privacy homomorphisms”. Alcuni crittosistemi classici come RSA o ElGamal soddisfano parzialmente questa proprietà, ma solo per operazioni molto ristrette (ad esempio la moltiplicazione): moltiplicando due ciphertext si ottiene un ciphertext che decifra al prodotto dei due plaintext originali.

“Quello che vogliamo fare è realizzare questa proprietà per tutte le funzioni computabili, non solo per operazioni elementari”, ha precisato il relatore. Questo problema è rimasto aperto per oltre trent’anni, fino a quando Craig Gentry, allora dottorando a Stanford, lo ha risolto nel 2009 con una costruzione basata proprio su problemi legati ai reticoli.

Il progresso da allora è stato rapidissimo. Oggi esistono librerie software che implementano schemi di cifratura omomorfa basati su LWE e su varianti correlate, con prestazioni che si avvicinano all’utilizzabilità pratica per applicazioni reali – dal calcolo su dati medici sensibili all’elaborazione di informazioni finanziarie nel cloud.

Offuscamento dei programmi: il codice che custodisce i propri segreti

Un’altra opportunità rivoluzionaria emersa dallo studio delle assunzioni post-quantistiche riguarda l’offuscamento dei programmi (program obfuscation).

La domanda di ricerca è tanto semplice quanto profonda: “È possibile che un programma mantenga i propri segreti anche quando il codice eseguibile sta fisicamente nelle mani di un attaccante, senza fare affidamento su alcun hardware fidato (trusted hardware)?”

L’esempio più immediato è un programma che contiene una password e la confronta con l’input dell’utente. Normalmente, per proteggere la password, si memorizza solo il suo hash crittografico, accettando l’input solo se il suo hash corrisponde. Ma per programmi più complessi questo approccio non è sufficiente.

L’obiettivo dell’offuscamento è creare una versione trasformata del programma originale che: (1) calcoli esattamente la stessa funzione dell’originale, (2) sia completamente incomprensibile, (3) non riveli alcuna informazione sui segreti incorporati nel codice, come password, chiavi crittografiche o logiche di business proprietarie.

“Questa tecnologia ha portato a una vera e propria rivoluzione nel mondo accademico della crittografia negli ultimi dieci anni”, ha sottolineato Venturi con enfasi. “Permette di costruire applicazioni crittografiche che erano completamente sconosciute in tutta la storia precedente della disciplina”.

La sfida aperta? “Costruire l’offuscamento dei programmi basandosi soltanto su LWE rimane ad oggi uno dei problemi aperti più importanti della crittografia teorica”. Le costruzioni esistenti richiedono assunzioni matematiche molto più forti e controverse rispetto a LWE, il che ne limita la fiducia e l’applicabilità pratica.

La trappola delle dimostrazioni: il riavvolgimento quantistico

Il professore ha poi affrontato un aspetto tecnico cruciale, spesso trascurato anche da esperti del settore: la transizione alla sicurezza post-quantistica non si limita a sostituire le assunzioni matematiche di base.

“L’illusione è che basti rimpiazzare l’assunzione con una variante resistente al quantistico e il gioco è fatto. Purtroppo non è così”, ha avvertito Venturi. “Anche le definizioni di sicurezza e le tecniche di dimostrazione devono essere compatibili con la presenza di avversari quantistici”.

L’esempio tecnico del riavvolgimento quantistico (quantum rewinding) illumina il problema. Molte dimostrazioni di sicurezza nella crittografia classica utilizzano una tecnica chiamata “riavvolgimento”: durante la dimostrazione matematica, si considera l’algoritmo dell’avversario e lo si “riavvolge” a uno stato precedente per analizzarne il comportamento.

Se l’avversario è un algoritmo classico, questa operazione è perfettamente lecita e non modifica il modello di calcolo. Ma se l’avversario dispone di un computer quantistico, “riavvolgendolo” si perturba inevitabilmente il suo stato quantistico interno, e l’avversario quantistico “se ne accorge” perché le leggi della fisica quantistica impediscono di copiare o riavvolgere stati quantistici sconosciuti senza disturbarli.

Questo effetto fa letteralmente “crollare” molte dimostrazioni di sicurezza classiche quando si tenta di applicarle al contesto quantistico. “È necessario intervenire con tecniche più sofisticate per estendere quelle dimostrazioni e renderle valide contro avversari quantistici”, ha spiegato il relatore.

“Questa è una misconception diffusa: non basta utilizzare assunzioni post-quantistiche. Bisogna verificare attentamente anche quali garanzie di sicurezza vengono fornite e come sono costruite le prove matematiche che le supportano”.

Quantum Key Distribution: promesse teoriche e limiti pratici

Passando alla crittografia quantistica vera e propria – quella dove anche gli utenti legittimi sfruttano tecnologie quantistiche – Venturi ha analizzato criticamente la Quantum Key Distribution (QKD), ovvero la distribuzione quantistica delle chiavi crittografiche.

La QKD sfrutta le leggi fondamentali della fisica quantistica, in particolare il principio che misurare uno stato quantistico lo perturba inevitabilmente, per permettere ad Alice e Bob di condividere una chiave segreta su un canale di comunicazione completamente insicuro e potenzialmente intercettato.

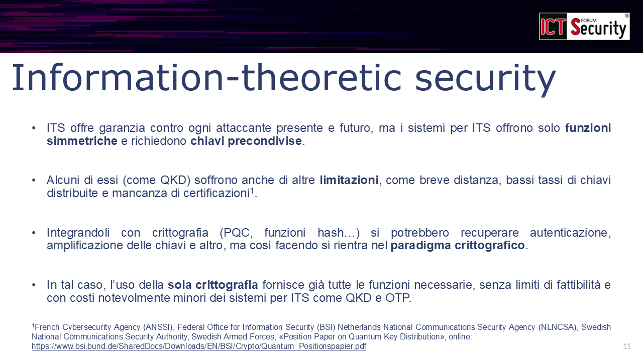
La buona notizia? “Nel mondo classico, condividere una chiave su un canale insicuro richiede assolutamente assunzioni computazionali, come la difficoltà della fattorizzazione. Non si può fare in maniera incondizionata, nemmeno per proteggere solo da intercettazioni passive. Nel mondo quantistico invece è possibile ottenere sicurezza incondizionata – garantita dalle leggi della fisica, non da congetture matematiche”.

Inoltre, non sono necessari computer quantistici universali completi: “Bastano tecnologie più accessibili come la comunicazione in fibra ottica con fotoni singoli o collegamenti da satellite”, ha precisato il relatore.

crittografia post-quantistica
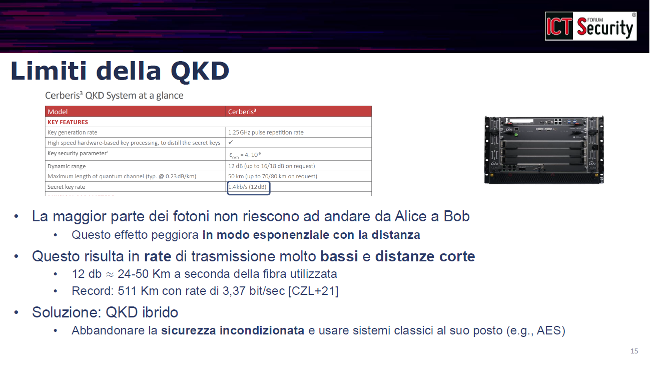
Limiti della QKD con dati tecnici

Le cattive notizie, però, sono sostanziali. “Purtroppo la maggior parte dei fotoni non riescono ad arrivare da Alice a Bob, e questo effetto peggiora in modo esponenziale con la distanza”. Le attenuazioni tipiche nelle fibre ottiche limitano drasticamente la portata operativa.

I numeri parlano chiaro: il record mondiale è 511 chilometri di distanza con un bit rate di 3,37 bit al secondo. “È una velocità assolutamente bassissima, praticamente inutilizzabile per applicazioni reali”, ha commentato con realismo il professore.

Il problema si aggrava ulteriormente considerando che la vera sicurezza incondizionata richiede l’uso del cifrario di Vernam (o one-time pad), dove la chiave deve essere lunga esattamente quanto il messaggio da cifrare. “Questo è un limite inerente delle leggi dell’informatica: non si può fare di meglio. Quindi 3,37 bit al secondo per generare chiavi che devo poi usare per cifrare messaggi della stessa lunghezza… il conto non torna per usi pratici”.

I sistemi ibridi: un compromesso inevitabile

La soluzione pratica attualmente perseguita sono i sistemi ibridi QKD che combinano la distribuzione quantistica delle chiavi con cifrari simmetrici veloci come AES.

Lo schema funziona così: la QKD genera periodicamente chiavi condivise tra Alice e Bob, seppur a basso bit rate. Queste chiavi vengono poi utilizzate come input per cifrari a blocchi standard (come AES) che permettono di cifrare messaggi a velocità normale, praticamente illimitata. Le implementazioni più avanzate di sistemi ibridi raggiungono ad esempio 66 kilobit al secondo a 70 chilometri di distanza.

Ma qui Venturi ha inserito un’osservazione pungente che smonta gran parte della retorica commerciale sulla QKD: “A quel punto, però, potete ottenere esattamente lo stesso risultato con poche centinaia di righe di codice software, usando una Key Derivation Function (KDF) crittografica e AES”.

Lo schema alternativo classico funziona così: Alice e Bob condividono inizialmente una chiave segreta K (magari scambiata con un protocollo di key exchange tipo Diffie-Hellman post-quantistico). Poi utilizzano una KDF per generare da K una sequenza di chiavi derivate K₁, K₂, K₃… indipendenti tra loro, che usano con AES per cifrare i messaggi successivi. “Nessun dispositivo quantistico costoso, nessun limite di distanza ai 511 chilometri, nessun problema di attenuazione”.

L’unico vantaggio della QKD? “Se un attaccante compromette fisicamente l’intero dispositivo di Alice o Bob, con la soluzione classica perde tutta la sicurezza. Con la QKD mantieni alcune garanzie”. Ma anche questo vantaggio può essere ottenuto, ha notato il relatore, “al prezzo di utilizzare tecniche più complesse che sfruttano assunzioni post-quantistiche, come i sistemi basati su LWE”.

La conclusione implicita è chiara: i benefici pratici della QKD rispetto ad alternative post-quantistiche puramente software sono molto più limitati di quanto il marketing tecnologico lasci intendere.

Monete quantistiche: il denaro digitale non clonabile

Guardando al futuro post-computer quantistico, il relatore ha presentato due applicazioni affascinanti ma ancora lontane dalla realizzazione pratica.

Le monete quantistiche (quantum money) sfruttano uno dei principi fondamentali della meccanica quantistica: il teorema del no-cloning, che stabilisce che stati quantistici sconosciuti non possono essere copiati perfettamente. “Se gli stati quantistici non sono clonabili, posso usarli come banconote digitali?” La domanda, posta per la prima volta decenni fa, è brillante nella sua semplicità.

Il problema fondamentale del denaro digitale classico è infatti proprio la facilità di duplicazione: copiare un file è banale, quindi come impedire il double spending (la doppia spesa della stessa “banconota” digitale)? Le criptovalute come Bitcoin risolvono il problema con registri distribuiti (blockchain), ma richiedono infrastrutture complesse e consumano enormi quantità di energia.

“Con le monete quantistiche, la fisica stessa impedisce la clonazione. È un’idea geniale”, ha ammesso Venturi con entusiasmo. Purtroppo l’implementazione pratica è estremamente complicata.

Le uniche costruzioni funzionanti finora sono schemi “a chiave privata” (secret-key quantum money), dove per verificare l’autenticità di una moneta è necessario contattare direttamente l’ente che l’ha emessa. “Questo ovviamente non scala: è come dover chiamare la Banca Centrale ogni volta che qualcuno vuole verificare una banconota”.

Quello che servirebbe sono monete quantistiche a chiave pubblica (public-key quantum money), dove chiunque possa verificare autonomamente l’autenticità di una moneta quantistica senza dover contattare l’emittente. “Questo è molto, molto, molto più complicato da realizzare”, ha sottolineato il professore. “Esistono tantissimi tentativi falliti e una bellissima linea di ricerca attiva che studia questo problema, ma ad oggi rimane un problema aperto per essere risolto in maniera efficiente”.

Copyright protection quantistico: l’antipirateria definitiva

L’ultima applicazione futuristica presentata è la protezione quantistica del copyright (quantum copy protection), che affronta il problema della pirateria software.

L’idea, proposta dal fisico teorico Scott Aaronson nel 2009, è ancora una volta elegantemente semplice: “Se posso associare uno stato quantistico a un programma software, riesco a impedirne la copia illegale sfruttando il teorema del no-cloning?”

Nel mondo classico si usa il watermarking digitale: un marchio incastonato nel codice che tutti possono verificare ma che è difficile da rimuovere senza danneggiare il programma. È un deterrente contro la pirateria, non una protezione assoluta.

La protezione quantistica promette di più, ma ha limiti intrinseci. “Purtroppo è impossibile per programmi learnable“, ha spiegato Venturi. Se un programma è sufficientemente semplice da poter essere “imparato” sottoponendogli varie query di test e osservandone gli output, allora una volta imparato può comunque essere replicato, indipendentemente dalla protezione quantistica.

“Quindi questa forma di protezione funziona inerentemente solo per programmi complessi, non facilmente apprendibili tramite interrogazioni”. Ma il problema è che per questi programmi complessi “la protezione quantistica del copyright sembra implicare matematicamente l’esistenza di monete quantistiche a chiave pubblica”. E come abbiamo visto, quelle non sappiamo ancora costruirle efficientemente.

“Sembra anche implicare l’offuscamento dei programmi, un altro problema aperto”, ha aggiunto. Esistono costruzioni per sottoclassi ristrette di programmi, sotto assunzioni matematiche molto forti, ma nulla di pratico o generale.

Conclusioni: tra realismo e lungimiranza strategica

crittografia post-quantistica
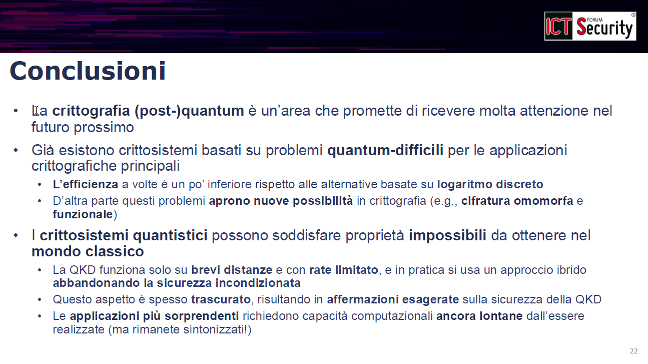
Conclusioni

Nelle note conclusive, Venturi ha mantenuto un equilibrio sapiente tra entusiasmo per le possibilità future e realismo sullo stato attuale della tecnologia.

“C’è sempre la barzelletta nel settore: sono già vent’anni che il computer quantistico ‘uscirà tra cinque anni’”, ha scherzato il professore suscitando risate in platea. “Però staremo a vedere. La ricerca avanza, gli investimenti crescono, i progressi ci sono. Non sappiamo quando, ma probabilmente accadrà”.

Le conclusioni pratiche per i professionisti della sicurezza informatica sono chiare:

Sui crittosistemi post-quantistici: “Esistono già, sono basati su problemi che rimangono difficili anche per computer quantistici, e per le applicazioni crittografiche principali l’efficienza è ormai comparabile a quella delle soluzioni classiche attuali”. La transizione è quindi tecnicamente fattibile e va pianificata seriamente.

Sulle opportunità: “La cosa che spero di avervi comunicato è che utilizzare questo tipo di assunzioni matematiche apre nuovi orizzonti nel mondo della crittografia. Permette di realizzare applicazioni molto interessanti – come la cifratura omomorfa – che potranno essere utilizzate nel mondo classico, indipendentemente poi dallo sviluppo o meno dei computer quantistici”. La minaccia quantistica ha paradossalmente accelerato la scoperta di nuove possibilità crittografiche.

Sulla Quantum Key Distribution: qui il tono è diventato più critico. “I crittosistemi quantistici possono dare la possibilità di fare cose completamente impossibili nel mondo classico, come la QKD senza assunzioni computazionali. Però attenzione: brevi distanze, bit rate limitatissimo, e soprattutto è possibile in pratica solo se abbandoniamo la sicurezza incondizionata – che è l’unico aspetto veramente interessante e distintivo della QKD“.

“Questo aspetto è spesso trascurato nelle presentazioni commerciali e risulta in affermazioni esagerate sulle capacità reali della QKD”, ha ammonito il relatore con franchezza.

Sulle applicazioni futuristiche: “Le applicazioni più sorprendenti come le monete quantistiche e la protezione quantistica del copyright richiedono capacità computazionali quantistiche che sono ancora molto lontane dall’essere realizzate praticamente”.

Un intervento che ha saputo bilanciare rigore tecnico e visione strategica, evitando sia il catastrofismo sulla minaccia quantistica sia l’entusiasmo acritico per tecnologie ancora immature. La rivoluzione quantistica non è solo una minaccia da cui difendersi, ma anche – e forse soprattutto – un’opportunità storica per ripensare radicalmente i paradigmi fondamentali della sicurezza informatica e della protezione dei dati.

“Rimaniamo sintonizzati”, ha concluso Venturi con un sorriso. La partita è appena iniziata.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Daniele Venturi è Professore Ordinario presso il Dipartimento di Informatica dell’Università di Roma Sapienza, dove dirige il Laboratorio SCRYPTO dal 2016. La sua ricerca si focalizza sulla crittografia teorica ed applicata.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/crittografia-post-quantistica-minacce/


La sicurezza informatica riparte dall’individuo: il paradigma Human-Centric di Proofpoint

Al 23° Forum ICT Security, Marco Zani di Proofpoint ha illustrato come l’approccio incentrato sulla persona rappresenti la terza grande evoluzione della cybersecurity, superando i modelli tradizionali focalizzati su perimetro e applicazioni

Il fattore umano resta il cuore pulsante – e al tempo stesso il tallone d’Achille – della sicurezza informatica aziendale. È questo il messaggio centrale emerso dall’intervento “Human Centric Security, il valore della piattaforma” tenuto da Marco Zani, Country Manager Italia di Proofpoint, durante il Forum ICT Security 2025.

Il manager ha aperto il suo intervento con una riflessione che tocca le corde più profonde del dibattito sulla cybersecurity attuale: «Quando si parla di questi temi, sconfinare su ambiti legati alla psicologia e alla filosofia è immediato. Parlare di psicologia significa inevitabilmente parlare di social engineering, di meccanismi di manipolazione della persona facendo leva sulle emozioni: il senso di urgenza, l’altruismo, le vulnerabilità personali».

Un approccio olistico che mette la persona al centro

La Human-Centric Security, come ha spiegato il relatore, rappresenta un cambio di paradigma fondamentale: un approccio olistico alla cybersecurity che tiene conto dell’individuo e dei suoi comportamenti per definire la strategia di sicurezza, andando oltre la tradizionale attenzione rivolta esclusivamente a endpoint, applicazioni e reti.

Zani ha richiamato anche la filosofia del “capitale umanistico” di Brunello Cucinelli per sottolineare quanto sia determinante riconoscere la centralità della persona: «L’uomo è un individuo singolo, unico, che genera una causa-effetto nel nostro mondo della cybersecurity, con impatti importanti a livello economico e aziendale».

I numeri del Voice of the CISO 2025

A supporto della propria tesi, lo speaker ha presentato i risultati di un’indagine condotta su 1.600 Chief Information Security Officer in 16 paesi, tutti operanti in aziende con oltre 1.000 dipendenti.

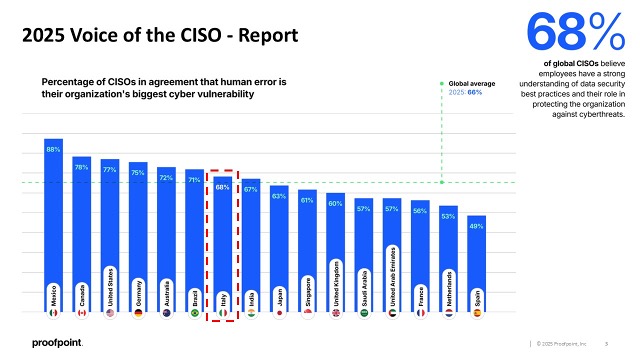
Cybersecurity risk: still human risk

I dati sono eloquenti: il 68% dei CISO a livello globale ritiene che i dipendenti abbiano una comprensione adeguata della data security e delle best practice, ma questo non basta a mitigare il rischio. In Italia la percentuale si attesta al medesimo valore del 68%, mentre emerge un dato curioso relativo alla Spagna, che presenta un gap di quasi 30 punti percentuali rispetto agli Stati Uniti, storicamente benchmark di riferimento per l’innovazione tecnologica.

Le statistiche più allarmanti riguardano però la percezione del rischio imminente: «Il 76% dei CISO pensa che subirà un attacco nei prossimi 12 mesi», ha evidenziato l’esperto. «È interessante l’aspetto legato all’inesorabilità: sanno che accadrà, anche se non sanno in che misura e quale impatto potrà avere in termini economici e di operatività aziendale». A conferma di questa consapevolezza, l’89% dei CISO ha già subito una perdita materiale di dati sensibili nell’ultimo anno.

La tassonomia delle minacce interne

L’intervento ha offerto una classificazione dettagliata delle tipologie di attacco legate al fattore umano. Gli insider malintenzionati – dipendenti che utilizzano impropriamente i dati per danneggiare l’organizzazione – rappresentano il 34% del totale.

Alla stessa percentuale si attestano gli insider imprudenti, ovvero dipendenti che inconsapevolmente usano in modo improprio i dati, spesso con leggerezza. A questi si aggiungono gli insider compromessi, le cui credenziali sono state rubate: Zani ha ricordato il caso di un hacker che ha sottratto 70.000 identità da hotel di lusso nel Sud Italia, rimettendole in vendita nel dark web a 20.000 euro ciascuna.

L’intelligenza artificiale generativa come fattore di rischio

Un capitolo significativo dell’intervento è stato dedicato all’impatto dell’AI generativa sulla sicurezza aziendale. Il 60% dei CISO a livello globale considera la GenAI un fattore di alto rischio per la propria organizzazione, in aumento rispetto al 54% dell’anno precedente. In Italia la percentuale si attesta al 57%, con un incremento del 45% anno su anno.

2025 Voice of the CISO Report, GenAI risk

«I recenti sviluppi legati all’AI – i Large Language Model, Gemini, ChatGPT – hanno cambiato sostanzialmente le regole del gioco», ha osservato lo speaker. «Creare, condividere, salvare ed esporre informazioni nell’ombra è diventato molto facile».

La risposta delle organizzazioni è stata prudente: il 59% dei CISO blocca o restringe fortemente l’utilizzo dell’AI all’interno delle proprie strutture, mentre il 68% prevede di implementare soluzioni basate sull’intelligenza artificiale nei prossimi mesi, adottando al contempo politiche e approcci etici strutturati.

L’evoluzione del panorama delle minacce

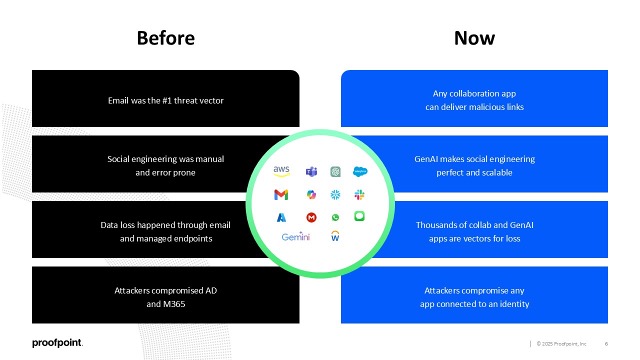
Il confronto tra passato e presente offre una fotografia nitida della trasformazione in atto. Se prima l’email rappresentava il vettore di attacco principale, il social engineering era manuale e soggetto a errori, e la perdita dati avveniva principalmente attraverso email ed endpoint gestiti, oggi lo scenario è radicalmente mutato.

Evoluzione delle cyber minacce – Before vs Now

«C’è una scalabilità potente», ha spiegato l’esperto. «L’AI generativa sta creando opportunità senza precedenti per chi fa il mestiere criminale. Attraverso le app di collaborazione si ricevono link su cui si clicca molto facilmente; l’AI è in grado di definire con precisione i linguaggi a seconda del paese e del ruolo della persona, che spesso è molto presente sui social e quindi facilmente profilabile».

Tra le tecniche più insidiose, il relatore ha menzionato la TOAD (Telephone Oriented Attack Delivery), l’Advanced Persistent Threat e le frodi al pagamento anticipato, in cui la vittima viene contattata con false urgenze legate a spedizioni bloccate o presunti benefici economici.

La piattaforma Human-Centric: architettura e funzionamento

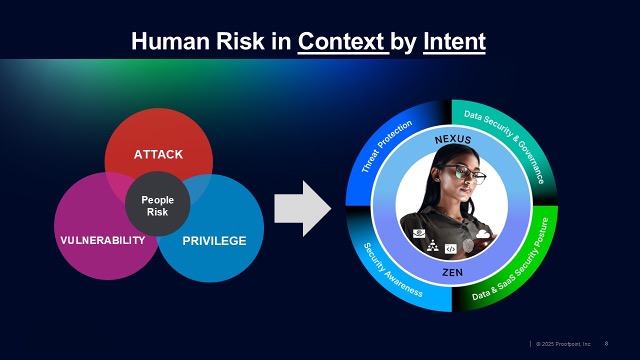
Zani ha quindi illustrato l’architettura della piattaforma Proofpoint, che si basa su due pilastri fondamentali: la Threat Resilience (attacco, vulnerabilità e privilegi) e la Data Security. Il sistema è in grado di applicare policy adattive in modo dinamico, evolvendo in funzione del rischio introdotto.

Human Risk in Context by Intent

La valutazione degli utenti a rischio avviene attraverso l’intersezione di tre dimensioni: utenti attaccati (soggetti ad account takeover, business email compromise, phishing avanzato), utenti vulnerabili (chi fallisce le simulazioni di phishing, non segue i training, clicca con leggerezza sui link) e utenti con privilegi elevati (CEO, CFO, amministratori di sistema, personale coinvolto in operazioni di M&A).

«Dobbiamo smettere di considerare il dipendente come un soggetto a rischio», ha sottolineato lo speaker, «e renderli parte di un processo aziendale seamless, nel corso del quale sviluppare una cultura forte, in linea con le policy e le regolamentazioni».

Verso la sicurezza agentica

L’intervento si è concluso con uno sguardo al futuro. La Human-Centric Security rappresenta, secondo l’esperto, la base per abbracciare con maggiore sicurezza lo spazio agentico e digitale che si sta delineando.

«La piattaforma odierna incentrata sulla persona è fondamentale per la sicurezza di domani, che sarà incentrata sia sull’uomo che sugli agenti», ha concluso Zani, annunciando un evento dedicato (“Protect”) previsto per il primo trimestre del prossimo anno, in cui verranno presentate le novità in ambito agentico. «Al di là della narrativa, c’è concretezza: i quick wins che possono già essere messi in campo oggi».

La correlazione degli eventi comportamentali e la gestione dei dati sensibili attraverso un approccio integrato alla sicurezza possono dunque essere implementate sin d’ora, posizionando le organizzazioni italiane al passo con quei paesi che, come evidenziato dai dati del report, mostrano già una maggiore predisposizione ad accogliere questo tipo di evoluzione tecnologica.

Profilo Autore

Marco Zani è Country Leader per l’Italia di Proofpoint, Inc., azienda leader globale nella cybersecurity e nella compliance. Nel suo ruolo è responsabile della strategia e delle operazioni sul mercato italiano, con focus sull’accelerazione della crescita e sul supporto alle aziende locali nel rafforzamento delle difese contro le minacce informatiche mirate all’individuo.

Professionista con oltre 25 anni di esperienza nel settore IT, Zani ha costruito una solida carriera ricoprendo posizioni di leadership in realtà internazionali di primo piano. In qualità di Country Manager di GitLab, ha guidato con successo la crescita strategica e lo sviluppo del business in Italia. Precedentemente ha ricoperto ruoli chiave in Snowflake e ServiceNow, dove ha costruito e coordinato team ad alte prestazioni, concludendo contratti complessi di grande valore.

Riconosciuto come esperto nel cloud computing enterprise e nelle tecnologie di sicurezza, Zani si distingue per la sua capacità di sviluppare strategie incentrate sul cliente e di guidare team eterogenei a livello europeo. Le sue consolidate competenze manageriali e relazionali, unite a una visione orientata alla crescita, lo rendono una figura chiave per il piano di espansione di Proofpoint nel mercato italiano.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-sicurezza-informatica-riparte-dallindividuo-il-paradigma-human-centric-di-proofpoint/


Iniezione indiretta di prompt: a rischio le informazioni aziendali


Lakera, società di Check Point, ha pubblicato una ricerca in cui dimostra che l’iniezione indiretta di prompt permette agli attaccanti di prendere di mira i dati acquisiti dall’IA e non i prompt inseriti dagli utenti. 

Con Gemini 3 il rischio di leak si moltiplica: secondo l’analisi dei ricercatori, gli attaccanti riescono a estrarre informazioni a livello aziendale come documenti, e-mail, link, PDF e contenuti condivisi.

Il team di Lakera evidenzia che, sebbene le capacità multimodali di Gemini 3 portano enormi vantaggi in termini di produttività, introducono nuove forme di rischio, come l’iniezione indiretta di prompt che porta al leak di dati sensibili.

Iniezione indiretta prompt

Il modello gemini-3-pro-preview è uno tra i sistemi attuali più potenti, in particolare per quanto riguarda gli scenari di estrazione diretta dei contenuti e di override delle istruzioni. “La vera trasformazione di Gemini 3 non è ciò che il modello conosce, ma ciò a cui il modello può accedere” affermano i ricercatori di Lakera.  Poiché l’IA ha a che fare con documenti, caselle di posta, API, flussi di lavoro e sistemi in tutto l’ambiente aziendale, di fatto il modello è autorizzato a dare pressoché qualsiasi cosa e accedere a ogni tipo di documento.

Gemini 3 è in grado di operare con un livello di autonomia molto elevato e, tra le altre cose, può riscrivere e instradare documenti, riassumere e agire su lunghi thread di e-mail, richiamare API e attivare automazioni del flusso di lavoro. Ciò significa che un attaccante, abusando dei prompt indiretti, può manipolare e ottenere documenti sensibili, inserendosi nel flusso operativo. “Man mano che l’IA diventa parte del livello di esecuzione, la superficie di attacco si espande e gran parte di questa espansione è invisibile ai controlli di sicurezza esistenti“.

Il pericolo aumenta se si considera che Gemini 3 introduce anche dei comportamenti “agentici”, ovvero la capacità di intraprendere azioni, non solo di fornire risposte. Di fatto, l’IA ha ora un “potere” molto più elevato rispetto alla semplice ricerca.

Lakera ha rilevato attacchi multimodali pratici, tra cui jailbreak basati sull’audio. I nuovi vettori d’attacco non sono coperti dagli attuali controlli di sicurezza delle e-mail, degli endpoint o dei contenuti.

Secondo il GenAI Security Readiness Report di Lakera,  le organizzazioni stanno adottando l’IA molto più rapidamente di quanto non stiano provvedendo alla sua sicurezza. La maggior parte di esse risulta priva di governance dell’IA, barriere protettive, soluzioni di monitoraggio degli agent e protezioni multimodali. L’avvento di Gemini 3 e in generale di tutte le IA in grado di manipolare documenti aziendali, amplifica questo divario.

L’IA è diventato il nuovo perimetro aziendale e per le organizzazioni è imperativo occuparsi di definire nuove strategie di sicurezza per proteggersi dalle nuove minacce.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/12/05/iniezione-indiretta-di-prompt-a-rischio-le-informazioni-aziendali/?utm_source=rss&utm_medium=rss&utm_campaign=iniezione-indiretta-di-prompt-a-rischio-le-informazioni-aziendali


Cyber Insurance in Italia: coperture, esclusioni e requisiti nel 2025

Il panorama della cyber insurance in Italia attraversa una fase di profonda trasformazione, sospesa tra l’accelerazione della domanda e la necessità di ridefinire i parametri di rischio in un contesto geopolitico e tecnologico sempre più complesso. Mentre il mercato globale delle assicurazioni informatiche si prepara a raggiungere i 32 miliardi di dollari entro il 2030 secondo le proiezioni contenute nel rapporto “Cyber Insurance – Risks and Trends 2025” di Munich Re, l’Italia rappresenta un territorio di sviluppo strategico ma ancora largamente sottoassicurato, con meno del dieci percento delle imprese dotate di una copertura specifica contro i rischi cyber.

La crescita del settore assicurativo cyber nel nostro Paese risponde a una convergenza di fattori che hanno progressivamente elevato la consapevolezza del rischio informatico da questione meramente tecnica a tema di governance aziendale.

L’implementazione del Regolamento UE 2016/679 (GDPR) ha rappresentato il primo vero spartiacque, rendendo tangibili e quantificabili le conseguenze economiche delle violazioni dei dati attraverso un sistema sanzionatorio che può arrivare fino al quattro percento del fatturato globale annuo. A questo si sono aggiunti gli obblighi derivanti dalla Direttiva NIS2, recepita in Italia con il decreto legislativo 138/2024 pubblicato in Gazzetta Ufficiale il 1° ottobre 2024, e l’entrata in vigore del regolamento DORA (Digital Operational Resilience Act) dal 17 gennaio 2025, che ha imposto al settore finanziario requisiti ancora più stringenti in materia di resilienza operativa digitale.

L’indagine IVASS sulle polizze cyber risk dell’ottobre 2023, che ha esaminato cinquanta contratti assicurativi (ventisei dedicati alle PMI e ventiquattro rivolti a privati e famiglie), ha messo in luce un’offerta caratterizzata da significative eterogeneità e ambiguità contrattuali. Circa trenta compagnie propongono soluzioni cyber ma con presupposti di assicurabilità, esclusioni e linguaggi tecnici spesso divergenti tra loro. Questa frammentazione genera complessità interpretative che possono tradursi in contenziosi al momento della liquidazione dei sinistri, quando l’assicurato scopre che determinate fattispecie di danno sono escluse o soggette a franchigie tali da ridurre significativamente l’indennizzo effettivo.

L’architettura delle coperture: tra danni propri e responsabilità verso terzi

Le polizze cyber italiane si articolano tipicamente su tre direttrici fondamentali, ciascuna con caratteristiche e limitazioni specifiche che richiedono un’attenta valutazione da parte del sottoscrittore. La prima direttrice riguarda i cosiddetti “danni propri” (first party coverage), ovvero l’insieme delle perdite dirette subite dall’organizzazione colpita. In questa categoria rientrano le spese di risposta all’emergenza cyber, che comprendono l’intervento di specialisti forensi per l’identificazione della causa e dell’estensione dell’attacco, i costi per il ripristino dei sistemi informatici compromessi e la ricostituzione dei dati danneggiati o crittografati.

La gestione della business interruption, ovvero la perdita di profitto derivante dall’indisponibilità totale o parziale dei sistemi IT, rappresenta uno degli aspetti più critici e onerosi, con impatti che in alcuni casi hanno raggiunto diverse settimane di fermo operativo.

La seconda direttrice concerne la responsabilità civile verso terzi (third party coverage), ambito particolarmente rilevante nell’economia digitale interconnessa dove una violazione può avere effetti a cascata su clienti, fornitori e partner commerciali. Le polizze coprono le richieste di risarcimento derivanti da violazioni della privacy e della riservatezza dei dati, dalla compromissione della sicurezza di rete e dai danni arrecati attraverso l’uso improprio di strumenti multimediali. A queste si aggiungono le coperture per diffamazione o calunnia online, violazione dei diritti di proprietà intellettuale e discriminazione perpetrata attraverso i canali digitali dell’azienda.

La terza componente riguarda gli aspetti legali e regolamentari, con particolare riferimento alle sanzioni amministrative previste dagli standard PCI-DSS Payment Card Industry (Payment Card Industry Data Security Standard) per le società che gestiscono transazioni con carte di pagamento e alle multe irrogate dalle autorità di vigilanza per violazioni normative. Alcune compagnie, prevalentemente di matrice anglosassone operanti sul mercato italiano, includono nella copertura anche i costi derivanti da estorsioni cyber, compreso il pagamento del riscatto in caso di attacco ransomware, sebbene tale aspetto sollevi evidenti questioni etiche e giuridiche legate al finanziamento di attività illecite.

Il territorio delle esclusioni: dove la copertura si arresta

L’efficacia di una polizza cyber risk si misura tanto per ciò che include quanto per ciò che esplicitamente esclude, e proprio su questo terreno si gioca spesso la differenza tra una copertura realmente protettiva e una mera illusione di sicurezza. La clausola di esclusione più controversa riguarda gli “atti di guerra”, presente nella stragrande maggioranza dei contratti analizzati dall’IVASS ma caratterizzata da un’ambiguità definitoria che può rivelarsi fatale in sede di liquidazione.

Il caso paradigmatico del malware NotPetya, che nel 2017 causò danni per oltre cento milioni di dollari a Mondelez International, ha evidenziato come gli assicuratori possano invocare l’esclusione per “guerra informatica” anche in presenza di attacchi che, pur essendo riconducibili ad attori statuali, colpiscono aziende private senza alcuna connotazione bellica formale.

Altrettanto problematica risulta la gestione degli attacchi ransomware nella copertura di base, frequentemente esclusi salvo sottoscrizione di estensioni specifiche a fronte di un premio aggiuntivo.

Questa scelta assicurativa appare paradossale se si considera che il ransomware rappresenta la minaccia informatica più diffusa e finanziariamente impattante per le imprese italiane, con un incremento registrato dal Rapporto Clusit 2024 sulla sicurezza ICT che ha visto l’Italia vittima del 7,6% degli attacchi globali con un aumento del 169% in soli dodici mesi. Gli attacchi di social engineering, incluse le tecniche di phishing e business email compromise, sono spesso esclusi dalla copertura base poiché considerati derivanti da negligenza umana piuttosto che da falle tecniche dei sistemi informatici, sebbene rappresentino uno dei vettori di attacco più efficaci utilizzati dai cybercriminali.

Le minacce interne, sia malevole che derivanti da negligenza dei dipendenti, raramente trovano tutela nelle polizze standard, così come sono tipicamente esclusi i danni causati da vulnerabilità note e non rimediate. Quest’ultima esclusione riveste particolare rilevanza pratica: se gli attaccanti sfruttano una falla di sicurezza di cui l’organizzazione era a conoscenza ma che non ha provveduto a correggere nei tempi appropriati, l’assicuratore può legittimamente negare l’indennizzo invocando la mancanza di diligenza da parte dell’assicurato. Analogamente, le interruzioni di sistema non causate da attacchi informatici ma da errori di configurazione, hardware failure o altri malfunzionamenti interni generalmente non rientrano nel perimetro di copertura.

I requisiti minimi di assicurabilità: dal questionario alla conformità

L’accesso a una polizza cyber richiede oggi la dimostrazione di un livello minimo di maturità nella gestione della sicurezza informatica, traducendosi in un processo di underwriting sempre più rigoroso e tecnicamente approfondito. Le compagnie assicurative sottopongono i potenziali assicurati a questionari dettagliati che indagano l’architettura dei sistemi IT, le politiche di sicurezza implementate e le procedure di gestione degli incidenti, con particolare attenzione ad alcuni requisiti divenuti ormai imprescindibili.

Il primo e più universale tra questi riguarda l’autenticazione multifattoriale (MFA), divenuta requisito tassativo dalla metà del 2022 per tutti gli accessi remoti ai sistemi aziendali. La pandemia ha dimostrato come le credenziali basate esclusivamente su username e password rappresentino il punto di ingresso privilegiato per gli attaccanti, rendendo l’MFA una misura di sicurezza fondamentale e non più negoziabile. Parallelamente, gli assicuratori richiedono l’implementazione di backup secondo la regola del 3-2-1, ovvero tre copie dei dati su due supporti diversi con almeno una copia disconnessa dalla rete aziendale.

La prassi di verificare periodicamente l’effettiva ripristinabilità dei backup attraverso test programmati è diventata parte integrante dei requisiti, dopo che numerosi sinistri hanno rivelato come le organizzazioni scoprissero l’inconsistenza o l’obsolescenza delle proprie copie di sicurezza solo al momento della necessità.

La protezione degli endpoint costituisce il terzo pilastro dei requisiti minimi, con gli assicuratori che non si accontentano più dei tradizionali antivirus ma richiedono soluzioni di Endpoint Detection and Response (EDR) o, preferibilmente, di Extended Detection and Response (XDR) che estendano la capacità di rilevamento e risposta anche ai server e agli apparati di rete.

La gestione delle vulnerabilità attraverso un processo strutturato di patch management e l’isolamento dei sistemi obsoleti non più supportati dai produttori completano il quadro dei presidi tecnici richiesti. A questi si aggiungono requisiti organizzativi quali la presenza di personale dedicato o di contratti di assistenza tecnica esterna, l’implementazione di programmi di formazione continua sulla security awareness e l’esistenza di un piano di disaster recovery e continuità operativa adeguatamente documentato e testato.

Secondo analisi condotte da operatori del settore assicurativo, circa il quaranta percento delle aziende italiane non è in grado di soddisfare questi requisiti minimi a causa di sistemi informatici sottodimensionati od obsoleti e di una scarsa attività di prevenzione, trovandosi di fatto escluse dalla possibilità di accedere al mercato della cyber insurance in Italia. Questo dato evidenzia un significativo protection gap che espone una vasta porzione del tessuto produttivo italiano a rischi finanziari potenzialmente devastanti, in un contesto dove gli attacchi informatici hanno registrato nel 2023 un impatto valutato come “elevato” nel 79% dei casi, rispetto al 50% dell’anno precedente.

L’impatto dei framework normativi: NIS2 e DORA come catalizzatori

L’evoluzione del quadro regolamentare europeo sta progressivamente ridefinendo i parametri di riferimento per la sottoscrizione delle assicurazioni cyber, introducendo standard di sicurezza più elevati che fungono da de facto requisiti anche per l’assicurabilità.

La Direttiva UE 2022/2555 (NIS2), che ha esteso significativamente il perimetro dei soggetti obbligati rispetto alla precedente versione, impone misure minime di cybersicurezza che includono l’analisi dei rischi, la gestione degli incidenti, la continuità operativa e la sicurezza della supply chain. I soggetti essenziali, che devono registrarsi entro il 28 febbraio 2025 presso la Piattaforma nazionale NIS dell’ACN, sono tenuti ad adottare l’autenticazione multifattoriale per tutti gli accessi, a implementare processi di gestione delle vulnerabilità e a garantire la segmentazione delle reti, requisiti che coincidono significativamente con quanto richiesto dalle compagnie assicurative.

Il Regolamento UE 2022/2554 (DORA), direttamente applicabile dal 17 gennaio 2025 senza necessità di recepimento nazionale, introduce per le entità finanziarie obblighi ancora più stringenti in materia di gestione dei rischi ICT, con particolare enfasi sulla resilienza operativa digitale e sulla gestione dei fornitori terzi di servizi critici. La normativa dedica trentasette articoli su sessantaquattro a requisiti in materia di sicurezza e resilienza, con un livello di dettaglio e prescrittività significativamente superiore rispetto alla NIS2. Per le organizzazioni che ricadono sotto entrambi i regimi normativi, DORA costituisce lex specialis e prevale sulla Direttiva NIS2, comportando l’applicazione del corpus normativo più rigoroso.

L’introduzione di questi framework normativi sta generando un effetto di convergenza tra compliance regolamentare e assicurabilità cyber, con le compagnie che sempre più frequentemente richiedono evidenze di conformità agli standard normativi come prerequisito per la sottoscrizione. Alcune realtà assicurative stanno sviluppando modelli di pricing che premiano le organizzazioni certificate secondo standard internazionali quali la ISO/IEC 27001:2022 per la sicurezza delle informazioni, riconoscendo un valore economico alla dimostrazione di processi strutturati e verificati da enti terzi.

Trend 2025: stabilizzazione, requisiti crescenti e segmentazione del mercato

L’anno in corso si configura come un momento di relativa stabilizzazione dopo il periodo turbolento che ha caratterizzato il biennio 2021-2022, quando i prezzi delle polizze cyber hanno subito aumenti drammatici a fronte di una escalation nella frequenza e gravità dei sinistri. Le analisi di S&P Global Ratings indicano prospettive stabili per il settore, ancorate ai guadagni di sottoscrizione conseguiti nel 2023 e 2024 grazie agli aumenti tariffari e alle condizioni di polizza più restrittive implementate nel periodo precedente.

I prezzi hanno registrato una diminuzione del quindici percento rispetto ai picchi raggiunti a fine 2021 e inizio 2022, pur rimanendo significativamente più elevati rispetto ai livelli pre-pandemia. S&P prevede che i premi annuali globali per le assicurazioni informatiche cresceranno da circa quattordici miliardi di dollari nel 2023 a ventitré miliardi di dollari entro il 2026, riflettendo un tasso di crescita annuale del 15-20%.

Il mercato europeo, che rappresenta attualmente circa il ventuno percento del mercato globale delle assicurazioni cyber contro il sessantanove percento del Nord America, è destinato a una crescita accelerata nei prossimi anni. Per le principali economie europee (Germania, Francia, Italia e Spagna), la potenziale crescita nella raccolta premi è stimata nell’ordine di settecento milioni di euro qualora si replicassero i livelli di penetrazione raggiunti nei mercati più maturi. Il mercato italiano specificamente è proiettato a crescere con un tasso annuale composto dell’11,091% nel periodo 2025-2035, passando dai duecento milioni di dollari stimati per il 2023 a settecentosei milioni entro il 2035.

Tuttavia, questa crescita non sarà uniforme né priva di sfide. Le compagnie assicurative stanno richiedendo requisiti di assicurabilità sempre più stringenti, con alcuni operatori che hanno pubblicamente dichiarato la volontà di ritirarsi dal mercato cyber a causa della difficoltà nel valutare accuratamente i rischi e nel gestire il potenziale accumulo di sinistri. La dichiarazione di Mario Greco, CEO di Zurich Insurance, sulla riluttanza a sottoscrivere nuove polizze cyber ha rappresentato un segnale della complessità che caratterizza questo ramo assicurativo, dove la mancanza di dati storici sufficienti e l’evoluzione continua delle minacce rendono estremamente complessa la modellizzazione attuariale del rischio.

Il segmento delle piccole e medie imprese rappresenta contemporaneamente la maggiore opportunità di crescita e la sfida più complessa per il mercato della cyber insurance in Italia. Le PMI, che costituiscono il tessuto portante dell’economia nazionale, sono sempre più esposte agli attacchi informatici ma spesso non dispongono delle risorse economiche e delle competenze tecniche necessarie per implementare i presidi di sicurezza richiesti dalle compagnie. Alcuni operatori stanno sviluppando piattaforme tecnologiche dedicate al segmento PMI che consentono di effettuare assessment automatizzati delle vulnerabilità esterne, di emettere polizze con condizioni flessibili che si adattano progressivamente ai miglioramenti della postura di sicurezza implementati dall’assicurato e di facilitare l’accesso al mercato riducendo gli oneri burocratici in ingresso.

L’intelligenza artificiale sta emergendo come fattore di trasformazione sia sul fronte delle minacce che delle opportunità. Da un lato, l’AI generativa sta potenziando le capacità offensive dei cybercriminali, rendendo più sofisticati gli attacchi di social engineering e accelerando lo sviluppo di malware polimorfi difficilmente rilevabili dai sistemi di difesa tradizionali. Dall’altro lato, le compagnie assicurative stanno integrando strumenti di intelligenza artificiale nei processi di sottoscrizione per analizzare più efficacemente i questionari, valutare automaticamente la postura di sicurezza attraverso l’analisi dell’esposizione digitale esterna e personalizzare i modelli di pricing sulla base di un numero più ampio di variabili di rischio.

Il fenomeno della doppia estorsione nei ransomware, dove oltre alla cifratura dei dati si procede all’esfiltrazione e alla minaccia di pubblicazione delle informazioni sottratte, sta modificando la struttura dei sinistri e la gestione delle richieste di indennizzo. Nel terzo trimestre del 2023, il novanta percento degli attacchi ransomware ha incluso questa modalità operativa, amplificando significativamente l’impatto reputazionale e le potenziali responsabilità verso terzi per le organizzazioni colpite. Le polizze stanno progressivamente adattando le coperture cyber per includere i costi di public relations e gestione della reputazione, oltre ai tradizionali aspetti di ripristino tecnico e interruzione operativa.

Criticità strutturali e prospettive evolutive

Il mercato italiano della cyber insurance si trova oggi di fronte a un paradosso: mentre la domanda potenziale è in costante crescita e la consapevolezza del rischio aumenta progressivamente, permangono significative barriere culturali e tecniche che ne limitano lo sviluppo. Cesare Burei, esperto di cyber risk insurance presso Margas, ha efficacemente sintetizzato questa situazione affermando di dover spesso agire come “mediatore culturale” piuttosto che come broker assicurativo, dovendo far dialogare al medesimo tavolo figure aziendali con basi culturali completamente diverse quali il CEO, il CFO, il direttore di produzione e il responsabile IT.

La mancanza di un linguaggio tecnico standardizzato tra le diverse compagnie assicurative rappresenta un ostacolo significativo alla comparabilità delle offerte e alla comprensione effettiva delle condizioni di polizza da parte degli assicurati. L’IVASS ha evidenziato come le definizioni di concetti fondamentali quali “attacco informatico”, “emergenza cyber” o “interruzione di attività” varino significativamente tra i diversi contratti, generando ambiguità interpretative che possono tradursi in contenziosi al momento della liquidazione. L’adozione di glossari standardizzati, quale il Cyber Lexicon del Financial Stability Board, rappresenterebbe un passo avanti fondamentale verso una maggiore chiarezza e trasparenza del mercato.

La questione dei cosiddetti “silent cyber risks”, ovvero le coperture implicite del rischio informatico presenti in polizze tradizionali non specificamente dedicate, costituisce un ulteriore elemento di complessità che richiede attenzione da parte sia degli assicuratori che degli assicurati. Molte polizze property o di responsabilità civile generale contengono clausole che potrebbero teoricamente coprire alcuni aspetti dei danni cyber senza che l’assicuratore abbia riservato una quota specifica di premio per questo rischio. Questa situazione genera incertezza sulla reale estensione delle coperture disponibili e può portare a sovrapposizioni o, al contrario, a lacune nella protezione complessiva dell’organizzazione.

Il ruolo degli intermediari specializzati, quali i broker con competenze specifiche nel cyber risk, sta diventando sempre più cruciale nel facilitare l’incontro tra domanda e offerta in un mercato caratterizzato da elevata complessità tecnica e continua evoluzione. Questi professionisti non si limitano a collocare polizze ma svolgono una funzione consulenziale che comprende l’analisi della postura di sicurezza dell’organizzazione, l’identificazione dei gap nei presidi implementati, il supporto nella selezione delle coperture più appropriate rispetto al profilo di rischio specifico e l’assistenza nella gestione del sinistro qualora si verifichi un incidente.

L’integrazione crescente tra coperture assicurative cyber e polizze Directors & Officers (D&O), che tutelano gli amministratori e i dirigenti dalle conseguenze delle loro decisioni gestionali, rappresenta un’evoluzione significativa nella protezione del top management. Le normative quali NIS2 e DORA attribuiscono responsabilità dirette agli organi di gestione in materia di cybersicurezza, richiedendo approvazione delle politiche di sicurezza, supervisione continua sull’implementazione delle misure e mantenimento di competenze aggiornate attraverso formazione specifica. Questa attribuzione di responsabilità personali sta generando una domanda crescente di soluzioni assicurative integrate che coprano tanto i danni all’organizzazione quanto le eventuali azioni di responsabilità nei confronti degli amministratori.

Conclusioni: verso una maturità del mercato

La cyber insurance in Italia si trova nel mezzo di una transizione fondamentale, che la sta conducendo da prodotto di nicchia per grandi organizzazioni sensibili al rischio a strumento standard di gestione del rischio per imprese di qualsiasi dimensione e settore. Il cammino verso questa maturità richiede tuttavia significativi progressi su molteplici fronti: la standardizzazione dei linguaggi contrattuali e delle definizioni tecniche, lo sviluppo di modelli attuariali più sofisticati basati su dataset più ampi e rappresentativi del contesto italiano, l’innalzamento generalizzato della postura di sicurezza delle organizzazioni attraverso investimenti in tecnologie e competenze, e l’evoluzione culturale che porti a considerare la cybersicurezza non come costo ma come investimento strategico per la continuità e la competitività aziendale.

I framework normativi europei, pur introducendo obblighi e complessità aggiuntive per le organizzazioni, stanno di fatto creando un terreno comune tra requisiti di compliance e condizioni di assicurabilità cyber, facilitando potenzialmente l’accesso al mercato assicurativo per quelle realtà che implementano seriamente i presidi richiesti dalle normative. La convergenza tra regolamentazione, standard tecnici internazionali e requisiti assicurativi rappresenta un’opportunità per elevare complessivamente il livello di resilienza del sistema economico italiano di fronte alle minacce cyber, trasformando la necessità di conformità in leva per la protezione effettiva delle organizzazioni e dei dati che esse gestiscono.

Il futuro della cyber insurance in Italia dipenderà dalla capacità del mercato di trovare equilibri sostenibili tra esigenze di redditività degli assicuratori, accessibilità economica per le imprese e ampiezza effettiva delle coperture offerte, in un contesto dove le minacce continueranno a evolversi e dove la trasformazione digitale dell’economia renderà il rischio cyber sempre più pervasivo e interconnesso. La sfida consiste nel costruire un ecosistema in cui la polizza assicurativa non sia percepita come sostituto della sicurezza ma come complemento naturale di una strategia complessiva di cyber risk management, dove prevenzione, protezione e trasferimento del rischio operino in sinergia per garantire la resilienza operativa delle organizzazioni nell’era digitale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cyber-insurance-in-italia/


Intelligenza artificiale e sviluppo software: perché il prompt engineering non sostituirà i programmatori

L’illusione manageriale del “no-code intelligente” e i rischi strategici per le aziende nei prossimi 10 anni

L’intelligenza artificiale nello sviluppo software sta creando una narrativa molto seducente per i livelli manageriali: l’idea che la programmazione possa essere “semplificata” a tal punto da sostituire la scrittura di codice con la scrittura di prompt. Una prospettiva affascinante, perché promette riduzione dei costi, accelerazione delle roadmap, autonomia dei team non tecnici, minore dipendenza da competenze specialistiche e sviluppo “magico” determinato dal linguaggio naturale.

Tuttavia, questa visione è profondamente distorsiva e rappresenta una delle maggiori minacce strategiche per le aziende nei prossimi 5-10 anni, perché è una proiezione, non un futuro realistico.

L’idea seducente che sta circolando nell’industria tech è il “prompt engineering” come nuova forma di programmazione. Secondo questa visione, presto non avremo più bisogno di programmatori tradizionali, ma di “orchestratori” capaci di dialogare con l’AI. La logica? La produce l’AI, l’architettura emerge automaticamente, il codice diventa una semplice commodity.

Ma c’è un problema fondamentale: questa narrativa confonde la scrittura del codice con l’ingegneria del software. Quando parliamo di costruire sistemi reali, production-ready, ci troviamo di fronte ad una serie di sfide che nessun prompt, per quanto ben scritto, può affrontare.

Complessità e determinismo nell’ingegneria del software

Un sistema software deve comportarsi in modo prevedibile. La complessità ciclomatica, l’idempotenza delle operazioni, la gestione dello stato distribuito non sono dettagli implementativi: sono decisioni architetturali che richiedono una comprensione profonda del problema e delle sue implicazioni.

Esistono aspetti come sicurezza e affidabilità, dove il threat modeling, la gestione delle eccezioni, i contratti tra servizi e il typing rigoroso rappresentano meccanismi di difesa contro l’entropia dei sistemi complessi. Questi elementi non possono emergere spontaneamente da una conversazione con un modello linguistico.

Sicurezza, scalabilità e compliance dei sistemi informatici

Scalabilità, sostenibilità, compliance e osservabilità non sono temi che possono essere “banalizzati”. Come si scala orizzontalmente un sistema? Come si mantiene nel tempo? Come si modella il dato in modo che resti coerente attraverso anni di evoluzione? Come si gestisce il refactoring senza compromettere funzionalità esistenti?

In contesti regolamentati, ogni decisione architetturale deve essere tracciabile, auditabile, giustificabile. L’osservabilità non è un add-on: è una proprietà emergente di un sistema ben progettato.

La programmazione non è mai stata principalmente la scrittura di codice. È progettazione di sistemi, capacità di modellare problemi complessi in strutture gestibili, anticipare casi limite e comportamenti emergenti, bilanciare trade-off tra performance e manutenibilità, pensare in termini di invarianti e garanzie, comprendere le implicazioni di lungo termine nelle scelte architetturali.

L’AI generativa può certamente accelerare la produzione di codice boilerplate, suggerire implementazioni, aiutare con la sintassi. Ma non può sostituire la capacità di pensare il sistema.

Ridurre la programmazione a prompt engineering è come dire che una laurea in architettura serve solo a saper usare AutoCAD, o che la laurea in medicina serve solo a prescrivere farmaci. È una semplificazione che sottovaluta la profondità della disciplina, crea false aspettative nei non-tecnici e rischia di produrre sistemi fragili e non manutenibili.

Ignorare decenni di best practice nell’ingegneria del software non è la strada giusta. L’AI è uno strumento potente, può democratizzare molti aspetti dello sviluppo software, accelerare processi, ridurre friction, ma come ogni strumento, la sua efficacia dipende da chi lo usa e dalla profondità della sua comprensione.

Michelangelo con martello e scalpello ha creato opere d’arte; se date gli stessi strumenti all’AI creerà la media ponderata di tutte le sculture mai viste. Sicuramente potrà sorprendere, ma è solo qualcosa che assomiglia ad un’opera d’arte, perché è realizzata senza avere la consapevolezza della bellezza.

L’AI non elimina, ma amplifica la necessità di competenze tecniche. L’AI è probabilistica, i sistemi sono deterministici. I modelli generativi operano nella sfera dell’incertezza; i sistemi software moderni richiedono invece determinismo, prevedibilità, riproducibilità. Un paradosso ingegneristico che solo gli sviluppatori possono risolvere stratificando: validazione, normalizzazione, sandboxing, controlli sintattici e semantici.

Nuovi failure modes nell’automazione software aziendale

L’AI introduce failure modes nuovi e più pericolosi. Con l’AI emergono errori silenziosi, allucinazioni strutturate, output formalmente corretti ma semanticamente errati, derive logiche nel tempo, dipendenza dal training data, deterioramento delle performance con il drift dei modelli, senza parlare delle vulnerabilità di prompt-injection.

Queste failure non sono “bug” tradizionali: sono problemi sistemici che richiedono esperienza di ingegneria del caos, modellazione del rischio, governance del ciclo del modello, infrastructure resiliency. Nessun prompt può sostituire queste capacità.

L’AI scrive codice, ma non progetta architetture. Un LLM può produrre funzioni, classi, micro-implementazioni, ma non può progettare un modello di dominio coerente, la gestione concorrente, il modello di error handling, una pipeline di scaling affidabile, la separazione delle responsabilità o boundary tra microservizi. Questi elementi non emergono dal linguaggio naturale: emergono dalla conoscenza profonda dell’ingegneria.

Il rischio strategico per manager e amministratori è la decrescita delle competenze. Se un’azienda sposa la narrativa del “codice scritto dall’AI”, vede un vantaggio immediato: riduzione apparente della dipendenza dagli sviluppatori. Nel breve periodo questo può sembrare efficiente; nel lungo periodo è devastante.

Gli sviluppatori diventano operatori di AI, non ingegneri. Si ha inevitabilmente un’erosione delle skill: si perdono le capacità di leggere criticamente il codice, identificare bug strutturali, costruire architetture scalabili, ottimizzare performance o garantire la sicurezza del software.

Ma un aspetto ancora più grave è il lock-in cognitivo: l’azienda diventa progressivamente dipendente da modelli, provider, workflow “opachi”, output non riproducibili. Quando la complessità diventa ingestibile, non esistono più skill interne per intervenire.

Il debito tecnico generativo, codice generato senza governance, cresce in modo esponenziale: sistemi ingestibili, vulnerabilità non tracciabili, performance degradate, dipendenza totale da consulenti esterni. L’incubo di qualsiasi manager coscienzioso.

Negli ultimi anni, piattaforme come n8n, Zapier, Make (ex Integromat) e una miriade di altri strumenti no-code o low-code stanno conquistando aziende e professionisti, che stanno vivendo una specie di speculazione “softeristica”, pensando e avendo l’illusione di poter realizzare, grazie all’AI, qualsiasi software e acquisire tramite essa competenze senza la necessità di una disciplina della materia.

Queste piattaforme promettono automazioni rapide, integrazioni immediate e la possibilità di “programmare senza programmare”. E grazie all’integrazione con l’intelligenza artificiale, la loro narrazione si è rafforzata: creare processi intelligenti senza scrivere codice sembra finalmente possibile. Il tormentone è sempre lo stesso: l’AI scriverà il codice al posto nostro, e questo tipo di applicazioni saranno la nuova normalità.

Il problema è che l’abuso di strumenti superficiali genera un progressivo appiattimento delle competenze: pensiamo che la logica dell’AI sia magica, accettiamo processi che non comprendiamo, smettiamo di approfondire come funzionano i sistemi, ci abituiamo ad un livello di astrazione così alto da non poter più intervenire davvero. È questa la più grande minaccia: una generazione di professionisti convinta di controllare l’AI senza capirne i meccanismi.

Questo fenomeno non è nuovo: lo abbiamo già visto con il cloud computing. Negli ultimi dieci anni è emersa una generazione di sistemisti “cloud-nativi” che sono cresciuti esclusivamente con AWS, Azure o Google Cloud. Sanno gestire container, orchestrare Kubernetes, configurare servizi gestiti, scalare automaticamente le risorse.

Ma se gli chiedi di installare un server Exchange on-premise, configurare una Active Directory su un server Windows fisico, o gestire una SAN tradizionale, vanno letteralmente in crisi. Non è una critica alle loro competenze cloud, che sono spesso eccellenti. È la constatazione di una lacuna fondamentale: questi professionisti hanno saltato completamente i “fondamentali”.

Non hanno mai dovuto configurare manualmente protocolli di rete, debuggare problemi di DNS a livello di sistema, gestire storage fisico, comprendere le implicazioni di latenza su hardware reale, o risolvere conflitti di risorse su macchine condivise. Non sono in grado di rendere autonoma un’organizzazione dal cloud.

Tre blackout devastanti in un mese: AWS, Azure e Cloudflare

Le conseguenze di questa dipendenza totale dal cloud si sono manifestate drammaticamente nel 2025. Tra ottobre e novembre, nell’arco di appena un mese, tre blackout devastanti hanno colpito l’internet globale:

AWS, 20 ottobre 2025: oltre 15 ore di disservizio causate da una race condition nel sistema DNS automatizzato di DynamoDB che ha svuotato i record DNS per l’endpoint regionale. Servizi colpiti: Signal, Snapchat, Lyft, Roblox, Fortnite, Alexa, EC2, Lambda.

Microsoft Azure, 29 ottobre 2025: circa 8 ore di interruzione dovuta a una configurazione errata in Azure Front Door che ha causato il malfunzionamento di numerosi nodi globali. Servizi colpiti: Microsoft 365, Teams, Xbox Live, Minecraft, Azure Portal.

Cloudflare, 18 novembre 2025: circa 6 ore di downtime provocato da una modifica ai permessi del database che ha raddoppiato le dimensioni di un file di configurazione critico per il sistema Bot Management. Servizi colpiti: X, ChatGPT, Spotify, Discord, Claude AI, Truth Social.

La cosa più allarmante? In tutti e tre i casi, i guasti sono derivati da errori interni nella configurazione e nel software delle infrastrutture core dei provider, non da attacchi esterni. E nessuna di queste organizzazioni aveva sistemi di backup on-premise funzionanti.

Quando il cloud è collassato, non c’era piano B. Nessun fallback locale, nessuna ridondanza fisica, nessuna capacità di continuare a operare in autonomia. Intere aziende si sono trovate completamente paralizzate, impotenti, in attesa che giganti tecnologici risolvessero problemi su cui non avevano alcun controllo.

Questo è il rischio concreto di una generazione che ha dimenticato, o mai imparato, come gestire infrastrutture indipendenti. Quando il livello di astrazione fornito dal cloud funziona, sono efficienti. Ma quando qualcosa va storto sotto quel livello di astrazione, quando il problema risiede in qualcosa che il pannello di controllo non mostra, quando è necessario comprendere cosa sta realmente accadendo “sotto il cofano”, si trovano spiazzati. Hanno imparato a orchestrare servizi, non a capire come quei servizi funzionano internamente.

I limiti strutturali delle piattaforme no-code

Similarmente, dietro promesse e sensazionalismi come il “vibe coding” si nasconde una realtà più complessa e molto meno comoda. Questi strumenti rappresentano una parte della gigantesca bolla narrativa dell’AI — una bolla che rischia di farci credere che la programmazione non sia più necessaria, che il controllo dei sistemi possa essere delegato a un’interfaccia visuale e che l’AI possa sostituire la comprensione tecnica.

In realtà, la storia ci insegna che, quando la tecnologia diventa più sofisticata, solo chi padroneggia la logica, l’architettura e il codice è davvero in grado di governarla.

Applicazioni come n8n, osannate sui social network, sono ottime per la didattica, per fare prototipi, piccoli workflow e automazioni operative, ma non possono essere considerate in processi critici, complessi o ad alto carico perché soffrono di limiti evidenti: dipendenza da un engine centrale, gestione delle eccezioni non nativa come nel software scritto a mano, performance legate al design del motore e non alle esigenze del progetto.

È la differenza tra montare Lego e costruire un edificio antisismico: la struttura visuale non è pensata per scenari limite.

La promessa è ridurre la complessità, ma spesso ciò che sparisce dall’interfaccia si ripresenta in altre forme: workflow difficili da versionare, debugging quasi impossibile quando un flusso si espande, logica distribuita tra decine di nodi difficili da tracciare, dipendenza totale dal motore dell’applicazione. Un sistema facile da creare e difficile da mantenere.

Gli strumenti low-code danno una falsa percezione di controllo e di potere: sposti blocchi, colleghi input e output, vedi subito una risposta. Ma si tratta spesso di un controllo superficiale: si lavora dentro limiti stabiliti dallo strumento, non si vedono i veri errori o colli di bottiglia e non si controlla davvero cosa accade negli strati sottostanti. In altre parole: hai le chiavi della macchina, ma il motore è sigillato.

L’AI è un moltiplicatore di competenze. Il futuro vincente è molto diverso dalla fantasia del “prompt-only”. Le aziende che prospereranno saranno quelle che comprenderanno che l’AI deve essere integrata come una parte della pipeline, non come sostituto della pipeline.

Gli sviluppatori devono diventare “AI-Augmented Engineers”, non prompt writer. La programmazione non svanirà: si evolverà verso livelli più alti di astrazione.

L’AI potenzia gli ingegneri capaci e penalizza i team privi di visione tecnica. L’AI eleva l’asticella: non abbassa la soglia di ingresso, ma alza la soglia di comprensione richiesta.

La verità tecnica che molti manager non vedono, o non vogliono vedere, è che gli sviluppatori del futuro continueranno a scrivere codice, analizzeranno il codice generato, metteranno guardrail ai modelli, costruiranno architetture e continueranno a fare debugging di pipeline complesse. “Scrivere prompt” è una micro-attività: chi pensa che “basta il prompt” rimarrà schiacciato dalla complessità reale dei sistemi basati su AI.

L’AI non sta eliminando il ruolo degli sviluppatori. Sta eliminando gli sviluppatori che non capiscono cosa stanno facendo. Sta funzionando come un acceleratore evolutivo professionale. Non elimina il valore della cognizione umana: la moltiplica quando è genuina e la elimina quando simulata.

Gli sviluppatori che “googlavano” soluzioni e le incollavano sono sostituibili. Quelli che capiscono architetture, trade-off, contesto di business e sanno usare l’AI come strumento di amplificazione cognitiva sono i nuovi “senior”, anche se giovani.

La discriminante finale non è più “quanti anni di esperienza hai” ma quanto profondamente capisci ciò che fai e sai adattarti a strumenti che cambiano settimanalmente.

Le aziende tech stanno dimostrando nei fatti di preferire dieci professionisti che comprendono a fondo ciò che fanno rispetto a cento che eseguono in modo meccanico. L’AI ha reso economicamente insostenibile mantenere questi ultimi.

Ma l’idea che il software del futuro sarà costruito “solo a colpi di prompt” è una semplificazione pericolosa: rischia di impoverire le competenze, ridurre la resilienza organizzativa e aumentare i rischi, producendo sistemi sempre più opachi e difficili da governare.

Perché alla fine, quando il sistema crasha in produzione alle 3 del mattino, quando i costi cloud esplodono, quando la sicurezza viene compromessa, quando il codice diventa impossibile da manutenere, nessun prompt risolverà quei problemi. Servirà qualcuno che capisca davvero come funzionano i sistemi.

Il futuro appartiene a chi saprà integrare l’AI nella propria professionalità, non a chi immagina di rimpiazzare le competenze umane con una semplice interfaccia testuale o interattiva.

Profilo Autore

Progettista di sistemi esperti, software developer, network e system engineer, con oltre 30 anni di esperienza nell’ambito della sicurezza delle informazioni, Francesco Arruzzoli è il Resp. del Centro Studi Cyber Defense Cerbeyra, dove svolge attività di R&D, analisi delle cyber minacce e progettazione di nuove soluzioni per la cyber security di aziende ed enti governativi. Esperto di Cyber Threat Intelligence e contromisure digitali, autore di libri ed articoli sue riviste del settore, in passato ha lavorato per multinazionali, aziende della sanità italiana, collaborato con enti governativi e militari. In qualità di esperto cyber ha svolto inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/prompt-engineering/


Dalla dottrina militare alla cybersecurity civile: come le Cyber Operations stanno ridefinendo la difesa digitale

Al 23° Forum ICT Security, Francesco Arruzzoli – Responsabile del Centro Studi Cyber Defense di Cerbeyra -ha illustrato perché la sicurezza informatica non può più essere solo tecnologia, ma deve diventare disciplina operativa

Quando si parla di cyber operations, il pensiero corre immediatamente alle attività militari nel dominio digitale. Eppure, come ha spiegato Francesco Arruzzoli, Responsabile del Centro Studi Cyber Defense di Cerbeyra, durante il suo intervento “Cyber Operations in ambito civile: difesa, intelligence e resilienza cibernetica” al 23° Forum ICT Security tenutosi a Roma il 20 novembre 2025, i principi delle operazioni cibernetiche militari stanno diventando sempre più rilevanti anche per il mondo civile.

«Oggi tutta la nostra continuità operativa, come società e come nazione, è sempre più legata al dominio cyber», ha esordito il relatore. «Infrastrutture tecnologiche, reti, telecomunicazioni che gestiscono la continuità della nostra attività sociale vengono gestite sempre più all’interno del dominio cyber».

Il concetto di guerra ibrida, ormai entrato nel lessico comune, descrive esattamente questa realtà: accanto ai domini tradizionali del conflitto — terra, mare, aria e spazio — si è aggiunto a pieno titolo il cyberspazio. Ma ciò che interessa maggiormente alle organizzazioni civili non è tanto la componente offensiva, quanto quegli «aspetti peculiari delle cyber operations che possono e devono essere riportati sempre più spesso nel mondo civile, perché ci danno la possibilità di contrastare tutta una serie di nuove minacce emergenti».

La lezione degli scarponi: quando la disciplina salva la vita

Per spiegare il valore della disciplina operativa, l’esperto ha attinto a un ricordo personale del servizio di leva. Durante l’addestramento presso un reparto operativo dell’esercito, le reclute erano tenute ogni sera a pulire gli anfibi e posizionarli in modo preciso davanti alla branda, a disporre la mimetica sempre nello stesso modo, il berretto sempre nella tasca destra. Rituali che sembravano quasi atti di nonnismo.

cyber operations
La regola degli scarponi

«Poi, dopo la terza settimana di addestramento, alle quattro della mattina, completamente al buio, veniamo svegliati per un allarme», ha raccontato. «La caserma era completamente al buio. Io ho visto in tre minuti persone vestirsi e mettersi in fila davanti all’armeria. Noi ci eravamo vestiti, preparati, equipaggiati senza vedere niente».

Nessuno si scontrò, nessuno perse gli anfibi. E gli scarponi erano pure lucidi. «Questo è un esempio di quello che può essere la disciplina quando andiamo a lavorare in determinati ambienti», ha sottolineato lo speaker. «Vuol dire essere pronti nel momento in cui si manifesta un’emergenza e non sappiamo quando si manifesta. Significa eliminare qualsiasi attrito».

Il parallelo con la cybersecurity è immediato: «Quando parliamo di attacchi cyber, ci riferiamo esattamente a questo. Ci riferiamo a minacce che sono l’equivalente digitale di un attacco notturno. Invisibili, imprevedibili, e spesso ce ne accorgiamo quando ormai è troppo tardi».

Malware che ragionano: la nuova frontiera delle minacce

Il cuore tecnico dell’intervento ha riguardato le nuove tipologie di malware potenziate dall’intelligenza artificiale, minacce che stanno emergendo dai laboratori di ricerca e che presto potrebbero diffondersi nel mondo reale.

cyber operations
PROMPTFLUX

La prima categoria presentata è quella del malware generativo adattivo, esemplificato da PROMPTFLUX. Si tratta di software malevolo capace di adattarsi all’ambiente in cui si trova, privo di codice malevolo riconoscibile al suo interno. «I sistemi normali non identificano quel software come malevolo perché non ha armi, non ha codice per fare reverse shell già integrato nel suo eseguibile», ha spiegato l’esperto. «Lui parla semplicemente con un’intelligenza artificiale esterna — potrebbe essere Gemini o qualsiasi altro LLM — e chiede istruzioni su come cambiare il suo codice, modificarlo, per rendersi invisibile a quella specifica infrastruttura».

cyber operations
WormGPT – Based Malware

La seconda tipologia riguarda i malware progettati direttamente dall’intelligenza artificiale, costruiti in modo specifico per una determinata organizzazione. È il concetto di spear-malware, analogo a quello di spear-phishing: non attacchi massivi e generici, ma strumenti costruiti su misura per penetrare una struttura specifica.

cyber operations
AI-Assisted Living-Off-The-Land (AI-LOTL)

La terza categoria, forse la più insidiosa, è quella denominata AI-Assisted Living Off The Land (AI-LOTL). Questi malware non portano con sé alcun payload malevolo: si presentano come normali applicazioni, invisibili agli antivirus e ai sistemi di intrusion detection. Il loro trucco? Sfruttano i comandi legittimi già presenti nei sistemi operativi.

L’intervento ha incluso una dimostrazione pratica: un malware che utilizza comandi PowerShell di Windows per esfiltrare un file password.txt attraverso una normale connessione HTTP. Ma la vera innovazione sta nella versione evoluta, dotata di un piccolo LLM locale addestrato su tutti i possibili comandi PowerShell. «Col primo malware, quando gli abbiamo chiuso la connessione HTTP, non era più in grado di esfiltrare il file», ha raccontato Arruzzoli. «Il secondo si è accorto che avevamo chiuso la connessione HTTP, è andato a controllare in tutti i possibili comandi PowerShell qual era una possibile soluzione, e l’ha trovata. Ha esfiltrato il file attraverso il DNS».

La conclusione è netta: «Qui ci troviamo di fronte a oggetti che ragionano, pensano. E siccome la capacità di elaborazione di un essere umano è infinitamente più lenta di un computer, voi capite che se ci mettiamo a ragionare su come difenderci da certi tipi di attacchi, è finita».

Harvest Now, Decrypt Later: la minaccia che viene dal futuro

Un’altra minaccia illustrata durante l’intervento ha un sapore quasi da spy story: il paradigma Harvest Now, Decrypt Later. Stati, enti governativi e criminali informatici stanno acquisendo enormi quantità di dati crittografati — comunicazioni TLS, trasferimenti bancari, dati su cloud — per immagazzinarli in attesa di poterli decifrare in futuro, quando i computer quantistici saranno sufficientemente potenti.

cyber operations
HNDL e Utah Data Center

«Il problema è che questo tipo di attacco non ce lo dobbiamo immaginare solamente da nemici, ma anche da alleati», ha precisato il relatore, citando il CLOUD Act del 2018 e la Sezione 702 del FISA. Queste normative statunitensi consentono alle agenzie di intelligence americane di acquisire dati dai data center delle Big Tech — Google, Amazon, Microsoft — anche quando si trovano su suolo straniero e riguardano cittadini non americani.

Esistono da tempo numerosi rumors che alimentano il sospetto che pratiche di sorveglianza avanzata siano già operative da anni. Un articolo pubblicato su Forbes nel 2013 segnalava l’esistenza di un sito nato come parodia della NSA, rivelatosi poi sorprendentemente ricco di informazioni provenienti da fonti governative statunitensi e abilmente correlate tra loro. Molti di quei contenuti ufficiali non sono oggi più raggiungibili attraverso i link originali, ma restano parzialmente consultabili grazie al servizio di archiviazione di archive.org.

Tra le immagini più emblematiche riportate da quel sito spicca la fotografia del data center NSA nello Utah, con la lapide d’ingresso che recita: «If you have nothing to hide, you have nothing to fear» — «Se non hai nulla da nascondere, non hai nulla da temere».

La risposta del relatore, citando l’hacker Kevin Mitnick, ribalta perfettamente la prospettiva: «Io non avrò nulla da temere, ma ho tante cose da proteggere».

La dottrina militare applicata alla sicurezza civile

Come rispondere a minacce così sofisticate? La soluzione proposta passa attraverso l’adozione della dottrina militare nel contesto civile. «Una delle particolarità della dottrina militare, se applichiamo le cyber operations in ambito civile, è il fatto che ci permette di operare nel caos», ha spiegato l’esperto. «Anche quando siamo nel caos più totale, siamo in grado di gestire la situazione».

cyber operations
Dottrina militare come fondamento

Tre sono le certezze da cui partire: non esistono organizzazioni troppo piccole per essere colpite; gli attacchi non chiedono permesso e non valutano il fatturato delle aziende prima di colpire; l’ecosistema tecnologico guidato dall’IA sta abbassando sempre di più i tempi di azione degli attacchi, fino a raggiungere i millisecondi.

«Le cyber operations non possiamo delegarle», ha aggiunto lo speaker. «Non è un lusso per pochi, è qualcosa che proprio perché coinvolge tutti, deve essere gestito da tutti».

cyber operations
Perché le Cyber Operations sono indispensabili

Playbook e Runbook: gli ordini di combattimento del cyberspazio

Nel trasferire la dottrina militare al mondo della sicurezza informatica, due strumenti emergono come fondamentali: i playbook e i runbook.

Playbook: Dottrina militare, strategia, regole d’ingaggio

«Quando un militare fa la ronda, se qualcuno si avvicina dà tre comandi: alt chi va là, un colpo in aria, il colpo addosso. Non ci sono particolari protocolli», ha esemplificato Arruzzoli. «Così vale anche per le cyber operations».

I playbook rappresentano la componente strategica: definiscono cosa fare quando si verifica un ransomware, un data breach, un attacco specifico. Sono l’equivalente delle regole di ingaggio militari, documenti che stabiliscono non come sparare, ma quando, perché e in quale contesto.

cyber operations
Runbook: manuale tattico, procedure d’azione, drill operativi

I runbook sono invece il braccio operativo: procedure dettagliate, passo dopo passo. «Il ransomware? Apro il runbook ransomware e c’è scritto: stacca il computer, fai login nella console, spegni tutti i servizi. Operazioni alla fine molto semplici, ma la cosa importante è che devono essere eseguite senza pensare».

È questo il punto cruciale: «La forza di questi sistemi vale nel momento in cui riesco a farli esercitare in maniera automatica. Ho un attacco? Automaticamente chi è disposto alla sicurezza deve aprire il runbook ed eseguirlo riga per riga senza pensare. È l’unico modo per andare a interagire e bloccare certi tipi di attacchi».

Il SOC non è un ufficio: la disciplina del processo

L’intervento ha dedicato ampio spazio ai Security Operation Center, il cui mercato in Italia è in forte crescita: da circa 1,1 miliardi di dollari nel 2024, si prevede raggiunga i 4,5 miliardi entro il 2035. Un trend trainato inizialmente dalle grandi imprese, ma che vedrà le PMI superarle numericamente nei prossimi anni.

cyber operations
Mercato SOC in Italia

«Quello che va capito è che il SOC non è un ufficio», ha precisato il relatore. «Non vi immaginate gente che va in ufficio alle otto. Stiamo parlando di un centro operativo che deve monitorare e controllare tutta una serie di segnali importanti». E ha aggiunto con forza: «La cosa più importante di un centro operativo non è la tecnologia. È la disciplina del processo».

cyber operations
SOC come unità tattica

Un monito chiaro per chi si affaccia a questo mercato: «Diffidate da chi vi vende il SOC come tecnologia. Il SOC non è tecnologia, il SOC è processi. La tecnologia serve a far sì che i processi possano operare più velocemente. Diffidate da chi vi dice: vi metto due o tre endpoint e poi vi controllo i log. Lì non avete un SOC, avete qualcuno che vi sta guardando la rete, e poi incrociate le dita».

Un modello italiano: l’esperienza Vianova-Cerbeyra

A conclusione dell’intervento, è stato presentato un esempio concreto di applicazione di questi principi. Cerbeyra, parte del gruppo Vianova — quarto operatore nazionale nel segmento business per servizi avanzati di telecomunicazione — opera con un’infrastruttura interamente italiana: reti, data center, software applicativi sviluppati e gestiti in Italia. Una scelta che risponde alle preoccupazioni sulla sovranità digitale emerse nella prima parte dell’intervento.

cyber operations
Metriche e disciplina del processo

I numeri presentati testimoniano l’efficacia dell’approccio basato sulla disciplina del processo: oltre il 96% di retention dei clienti nel 2024, e il 73% di incidenti intercettati prima ancora che il cliente se ne accorgesse. «Ci prendono per matti a volte perché ci apriamo il ticket da soli e poi avvertiamo il cliente», ha commentato con un sorriso l’esperto. «Eppure è così. Riusciamo a individuare le anomalie perché abbiamo il controllo dell’intera infrastruttura».

cyber operations
SOC Cerbeyra

Capire la minaccia prima che colpisca: dalla difesa passiva all’intelligence attiva

La chiusura dell’intervento ha offerto una riflessione che sintetizza l’intero messaggio: «La sicurezza non è ciò che impedisce l’attacco, ma è ciò che ci permette di comprendere la minaccia e bloccarla prima che si sviluppi appieno».

Un cambio di paradigma profondo, che trasforma la cybersecurity da presidio tecnico ad attività operativa permanente. Non più reagire agli eventi, ma interpretarli e, possibilmente, anticiparli. Non difendere un perimetro, ma operare in un dominio. Non installare tecnologie, ma orchestrare informazioni.

Come nella migliore tradizione militare, la prontezza non è un atto istantaneo ma un’abitudine. Non un riflesso casuale, ma un comportamento costruito giorno dopo giorno. Perché quando l’allarme suona — nel cyberspazio come nella caserma di un tempo — non c’è tempo per cercare gli scarponi: bisogna averli già ai piedi.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Progettista di sistemi esperti, software developer, network e system engineer, con oltre 30 anni di esperienza nell’ambito della sicurezza delle informazioni, Francesco Arruzzoli è il Resp. del Centro Studi Cyber Defense Cerbeyra, dove svolge attività di R&D, analisi delle cyber minacce e progettazione di nuove soluzioni per la cyber security di aziende ed enti governativi. Esperto di Cyber Threat Intelligence e contromisure digitali, autore di libri ed articoli sue riviste del settore, in passato ha lavorato per multinazionali, aziende della sanità italiana, collaborato con enti governativi e militari. In qualità di esperto cyber ha svolto inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cyber-operations-difesa/


Impianti hardware malevoli: la minaccia invisibile che compromette la supply chain

USBsamurai e l’Internet of Offensive Things: quando un cavo da 15 euro può paralizzare un impianto industriale

Al 23° Forum ICT Security di Roma, l’intervento intitolato “USBsamurai & the Internet of Offensive Things” ha sollevato il velo su una delle minacce più sofisticate e insidiose del panorama cybersecurity contemporaneo: gli impianti hardware malevoli che infiltrano la catena di approvvigionamento. Luca Bongiorni, Direttore del Cybersecurity Lab di ZTE Italia e fondatore del progetto WHID (We Hack In Disguise), ha condotto il pubblico attraverso un’analisi tecnica che parte dalle rivelazioni di Edward Snowden per arrivare alle più recenti evoluzioni degli hardware implants.

Con oltre 19 anni di esperienza in offensive security e una lunga carriera dedicata allo sviluppo di dispositivi hardware per operazioni di red teaming, lo speaker ha dimostrato come la sicurezza fisica dei componenti hardware rappresenti oggi un anello debole critico nelle strategie di difesa aziendale.

Il leak di Snowden e la nascita di una nuova era di minacce

“Nel 2013 Edward Snowden sparì, fece il giro del mondo portando con sé computer e flash drive contenenti documenti classificati top secret”, ha esordito il relatore, ricostruendo la genesi del suo percorso di ricerca. Tra i documenti trafugati dai server della NSA, particolare rilevanza aveva l’ANT Catalog (Advanced Network Technology), un catalogo classificato di 50 pagine che documentava le tecnologie offensive sviluppate dalla Tailored Access Operations Unit (TAO), considerata una delle unità di intelligence più avanzate al mondo per operazioni in ambienti ostili.

Il documento rivelava operazioni sistematiche di supply chain interdiction: componenti hardware venivano intercettati durante la spedizione dal produttore al cliente finale e compromessi con impianti malevoli prima di raggiungere la destinazione. Agenti della NSA aprivano i pacchi in transito, installavano beacon e impianti hardware, quindi sigillarono nuovamente le confezioni come se nulla fosse accaduto.

Supply chain interdiction – foto operative NSA

“Mi sono detto: interessante, se riescono a svilupparlo loro, perché non posso svilupparlo io?”, ha raccontato Bongiorni, descrivendo l’inizio di un percorso di ricerca e sviluppo decennale condotto insieme a una comunità internazionale di ricercatori di sicurezza. L’obiettivo era chiaro: democratizzare queste tecnologie offensive, renderle accessibili ai professionisti della sicurezza attraverso progetti open source a basso costo, permettendo così ai team di difesa di comprendere realmente le minacce che devono fronteggiare.

La gallery degli orrori: quando l’hardware diventa un’arma

L’intervento ha documentato un’ampia panoramica di impianti hardware malevoli già utilizzati in attacchi reali, con conseguenze documentate. Il relatore ha mostrato dispositivi sviluppati da cybercriminali per intercettare dati di carte di credito attraverso POS compromessi, cavi USB contenenti chip nascosti e miniaturizzati, e componenti per attacchi a sistemi industriali.

Cavi USB con chip nascosti e GSM bug

Gli impianti non si limitano alle classiche chiavette USB. Bongiorni ha illustrato come praticamente qualsiasi dispositivo che comunica tramite protocollo USB possa essere weaponizzato: dai cavi di ricarica ai mouse, dalle tastiere agli alimentatori, persino dispositivi apparentemente innocui come ventilatori USB o scaldatazze possono nascondere al loro interno microcomputer completi.

“Le porte USB sono dovunque”, ha sottolineato lo speaker. “Nei nostri laptop, nei dispositivi industriali, nei sistemi di controllo ICS, negli impianti nucleari, nei sistemi di trattamento acque. Qualsiasi cosa con una porta USB è potenzialmente vulnerabile a questo tipo di attacco.”

La minaccia concreta: attacchi documentati contro infrastrutture critiche

Il talk ha preso una piega ancora più seria quando il relatore ha iniziato a mostrare articoli di cronaca relativi a incidenti reali che hanno coinvolto impianti industriali compromessi attraverso dispositivi USB.

News su attacchi USB a impianti industriali

Tra i casi documentati: un impianto nucleare tedesco infettato da malware, centrali elettriche statunitensi compromesse tramite mouse USB contenenti ransomware, e il caso degli ATM Diebold Nixdorf, dove ricercatori di Positive Technologies hanno dimostrato la possibilità di installare firmware modificato attraverso la porta USB del dispenser, permettendo di bypassare la crittografia e prelevare denaro contante.

“Questi non sono scenari ipotetici”, ha sottolineato Bongiorni. “Sono attacchi reali, condotti da threat actor motivati economicamente o da attori statali, che hanno causato danni concreti e misurabili.”

Il pericoloso mito delle chiavette USB

Uno dei punti centrali dell’intervento ha riguardato un pericoloso misconception diffuso nei programmi di security awareness aziendale. “Tutti i nostri posti di lavoro fanno security awareness training in cui ci dicono: se trovate una chiavetta USB per terra, lasciatela lì”, ha osservato il relatore. “Ma questa narrazione crea un falso senso di sicurezza.”

Common Misconception: USB devices are NOT ONLY Flash Drives

La realtà è che le flash drive rappresentano solo una minuscola frazione del vettore di attacco USB. Qualsiasi dispositivo che si connette tramite USB – cavi di ricarica per smartphone, mouse, tastiere, hub, ventilatori, lampade USB, persino dispositivi medicali – può potenzialmente nascondere un impianto malevolo. E a differenza di una chiavetta USB sospetta trovata per terra, questi dispositivi vengono attivamente utilizzati quotidianamente senza destare alcun sospetto.

La democratizzazione degli offensive tools: il progetto open source

Quasi dieci anni fa, ispirato dai documenti di Snowden, Bongiorni ha iniziato a sviluppare – insieme a colleghi ricercatori in Europa – una serie di dispositivi hardware offensivi con una filosofia precisa: “L’idea era crearli, renderli open source e a basso costo, in maniera tale che altri colleghi esperti del settore potessero crearli, configurarli, flasharli, programmarli e utilizzarli durante le operazioni di penetration testing quotidiane”, ha spiegato.

Opensource Offensive Devices – WHID Injector e P4wnP1

Il progetto WHID Injector (2017) è stata la prima generazione: un dispositivo hardware open source multipiattaforma (Windows, Linux, macOS) con WiFi integrato, al costo di soli 11 euro. Seguito dal P4wnP1 di Marcus (2017), basato su Raspberry Pi Zero W, che introduceva capacità di emulazione USB keyboard e network, con funzionalità di autocall back al server di comando e controllo.

Nel corso degli anni, la community ha continuato a evolvere questi strumenti, miniaturizzandoli progressivamente fino a renderli completamente invisibili all’interno di cavi USB standard.

EvilCrow Cable e EvilCrow Keylogger

Cottonmouth: l’origine di tutto

Prima di introdurre USBsamurai, il relatore ha voluto rendere omaggio al dispositivo che ha ispirato tutta questa linea di ricerca.

COTTONMOUTH-I ANT Product Data e schema operativo

Cottonmouth era il nome in codice dell’impianto hardware sviluppato dalla NSA e documentato nell’ANT Catalog. Si trattava di un cavo USB modificato che permetteva a un operatore remoto, attraverso comunicazioni wireless via radio, di controllare e infettare un determinato target dall’esterno dell’edificio in cui il cavo era inserito. Il costo unitario era di circa 20.300 USD secondo i documenti leakati, e offriva capacità di bridging wireless in reti target, persistenza software e capacità di load/exploit su PC target.

“Cottonmouth aveva una caratteristica particolarmente interessante: la capacità di bypassare sistemi air-gapped”, ha sottolineato Bongiorni. “Un sistema air-gapped è per definizione isolato da reti esterne – non può essere raggiunto dall’esterno e non può raggiungere l’esterno. Cottonmouth aggirava questa protezione utilizzando quella rete wireless radio da remoto.”

La genesi di USBsamurai: dalla noia alla rivoluzione

“Nel maggio 2019, Marcus – noto come Mame82 – iniziò il reverse engineering dei dispositivi RF Logitech, scoprendo numerose vulnerabilità e rilasciando ad agosto 2019 due strumenti fondamentali: Munifying e LOGITacker”, ha raccontato il relatore, mostrando il tweet originale che documentava la nascita di USBsamurai.

“Durante l’ultima ora ero annoiato… quindi ho creato #USBsamurai! Un DIY [Do It Yourself] controllato remotamente e RF non rilevabile #BadUSB!”, recitava il tweet di aprile 2019. Quello che era iniziato come un esperimento durante un momento di noia si è trasformato in uno degli strumenti di offensive security più potenti e accessibili mai sviluppati.

“Avevamo fatto brainstorming e unito le due idee. Così sono state aggiunte funzionalità offensive. Il resto è storia: USBsamurai era nato!”, ha concluso, descrivendo la collaborazione che ha portato alla fusione delle due linee di ricerca in un unico strumento.

USBsamurai: anatomia di un impianto da 15 euro

La vera innovazione di USBsamurai risiede nella sua semplicità costruttiva e nel suo costo irrisorio. “Con 15 euro di componenti acquistabili su Amazon o eBay, chiunque abbia competenze elettroniche di base può costruirlo”, ha spiegato Bongiorni, mostrando il processo di assemblaggio.

Il cuore del sistema è un dongle USB Logitech standard (modello C-U0012 raccomandato), quello che normalmente si usa per connettere mouse e tastiere wireless. Questo viene modificato, inserito all’interno di un cavo USB e flashato con firmware personalizzato open source.

Ma è nelle capacità operative che USBsamurai rivela il suo vero potenziale:

Controllo remoto stealth: Il dispositivo può essere controllato da remoto – fino a 30-50 metri senza amplificatori, distanze significativamente maggiori con power amplifier e low noise amplifier – attraverso un protocollo wireless proprietario criptato AES-256 che opera sulla frequenza 2.4 GHz ma non utilizza il protocollo WiFi standard.

“Questa è la caratteristica chiave”, ha sottolineato il relatore. “Se utilizzassimo wireless Intrusion Detection System in azienda che fanno detection di fake Access Point o chiavette USB WiFi maliziose che fanno injection, non lo troverebbero. Utilizza la stessa frequenza del WiFi, ma non lo stesso protocollo, quindi fa blending e si mimetizza perfettamente nel rumore di fondo delle reti wireless circostanti.”

Il meccanismo tecnico è sofisticato: USBsamurai viene collegato alla macchina target, l’attaccante si connette remotamente al dispositivo attraverso LOGITacker (l’antenna di controllo), e invia comandi. LOGITacker trasmette frame RF HID++ invalidi con dati arbitrari (i comandi dell’attaccante) che USBsamurai relay all’host USB. Il software Logitech legittimo installato sul sistema li ignora, mentre l’agent malevolo iniettato da USBsamurai li riceve e li esegue. L’agent quindi esegue i comandi e invia l’output (STDOUT) attraverso il tunnel HID++ cifrato, che l’attaccante riceve remotamente.

La demo che replica Stuxnet: ingegneria sociale al contrario

La dimostrazione pratica ha mostrato uno scenario direttamente ispirato a Stuxnet, il celebre malware scoperto nel 2010 che compromise le centrifughe per l’arricchimento dell’uranio dell’impianto nucleare iraniano di Natanz.

Prima una demo preliminare: l’iniezione ed esecuzione di codice malevolo su un sistema standard. Una volta inserito il cavo USB compromesso nel computer target – che in questo caso mostrava una replica di interfaccia HMI di un impianto nucleare – l’attaccante, operando da remoto, ha inviato comandi attraverso LOGITacker.

“Per registrare questa demo ero lì vicino, ma il range operativo è di 30-40-50 metri senza amplificatori. Aggiungendo un power amplifier e un low noise amplifier, il range aumenta significativamente. Ho fatto demo negli anni in cui montavo l’antenna LOGITacker su un drone, lo controllavo da terra e lo facevo volare all’altezza del piano dove si trovava il target, all’esterno dell’edificio”, ha raccontato il relatore.

In pochi secondi, il sistema è stato compromesso con l’iniezione e l’esecuzione di un ransomware simulato (WannaCry), dimostrando quanto sia rapida e devastante questa tipologia di attacco.

L’attacco ICS: far esplodere un serbatoio senza lasciare traccia

La demo culminante ha replicato la logica di Stuxnet applicata a un impianto di trattamento tossine simulato.

USBsamurai Vs AirGap: schema della rete isolata

Il setup consisteva in due laptop connessi tramite un router LAN-only (senza accesso Internet, per simulare un ambiente air-gapped): uno fungeva da PLC Modbus Server, l’altro da HMI – Human Machine Interface – il dashboard di controllo che l’ingegnere di impianto monitora costantemente.

“L’obiettivo è far esplodere il tank, il serbatoio con le tossine, senza che l’ingegnere che guarda la HMI sia a conoscenza di quello che sta succedendo. E quando l’attacco verrà scoperto, il serbatoio sarà già esploso, quindi troppo tardi per rimediare”, ha spiegato Bongiorni.

Il malware iniettato tramite USBsamurai eseguiva una tripla manipolazione simultanea: manteneva attiva la pompa di alimentazione causando il riempimento continuo del serbatoio, bloccava la valvola di sfogo d’emergenza impedendo lo svuotamento automatico, e falsificava i valori mostrati sulla HMI facendo credere all’operatore che tutto procedesse normalmente.

Durante l’esecuzione dell’attacco, visibile nella parte sinistra dello schermo, il serbatoio si riempiva progressivamente di tossine rappresentate graficamente dal logo Umbrella Corporation. Il livello saliva oltre la soglia di sicurezza, la valvola di emergenza rimaneva bloccata, e le tossine iniziavano a fuoriuscire. Ma nel dashboard HMI che l’ingegnere sta monitorando, tutto appariva normale: “Tank Spilled Status: 1 Liters”, indicatori verdi, nessun alert.

“Come vedete, sul lato destro l’ingegnere nota solo un litro di spill, che potrebbe essere un glitch, un bug del sistema. Può assumere che tutto vada bene. Ma nella realtà, di quei puntini verdi ce ne sono molti di più”, ha commentato il relatore mentre la demo procedeva.

L’attacco durava circa 120 secondi. Quando il malware cessava la sua attività, i valori reali venivano improvvisamente mostrati sulla HMI.

“Da un litro di tossina persa, improvvisamente salta a 199 litri. Ma ormai è tardi. Il tempo che intercorre prima che qualcuno si accorga che il tank è esploso e le tossine sono già disperse nell’ambiente è il tempo in cui il danno è fatto e l’operazione è stata un successo”, ha concluso Bongiorni.

La demo dimostrava perfettamente il principio operativo di Stuxnet: “Il malware cosa faceva? Da un lato aumentava o diminuiva la frequenza di rotazione delle centrifughe a livello fisico, dall’altro diceva al sistema che tutto andava bene e la frequenza rimaneva stabile. Ci sono voluti mesi prima che gli ingegneri capissero cosa stesse succedendo, e nel frattempo le turbine si rompevano continuamente, costringendoli a spendere milioni per sostituirle mentre il programma di arricchimento dell’uranio veniva drasticamente rallentato.”

WHID Elite: l’evoluzione con connettività globale

L’ultima generazione degli strumenti sviluppati dalla community WHID porta le capacità offensive a un livello completamente diverso.

WHID Elite: GSM-enabled Open-Source Multi-Purpose Offensive Device

WHID Elite integra connettività GSM/2G che permette il controllo remoto letteralmente da qualsiasi parte del mondo, non più limitato al range di comunicazione radio. Le funzionalità includono remote HID injection, bypass di ambienti air-gapped, mousejacking attacks, radio hacking, embedded USB HUB per weaponizzare gadget esistenti, geo-location tracking e remote audio surveillance.

“Una volta che questo tipo di impianto viene inserito durante un attacco supply chain – per esempio, l’azienda ordina nuove tastiere e noi riusciamo a intercettare la spedizione – vi ritrovereste con tastiere compromesse dotate di batteria LiPo e connessione cellulare. Posso controllarle da remoto, letteralmente da un’altra nazione, senza mai dover essere fisicamente vicino al target”, ha spiegato il relatore.

Implicazioni per la sicurezza delle infrastrutture critiche

L’intervento si è concluso con una riflessione sulle implicazioni più ampie di questa ricerca. “Gli impianti hardware rappresentano una minaccia concreta che deve essere inclusa nella threat modeling di ogni organizzazione, specialmente quelle che gestiscono infrastrutture critiche”, ha sottolineato il relatore.

La facilità di realizzazione – componenti da 15 euro acquistabili su marketplace commerciali – unita alla difficoltà estrema di detection, rende questi attacchi accessibili non solo ad attori statali ma potenzialmente anche a gruppi criminali organizzati o insider malintenzionati.

“Supply chain attacks, sia lato software che lato hardware, sono un problema reale e concreto. È fondamentale tenere gli occhi aperti in tutti i casi”, ha concluso Bongiorni.

L’intervento ha lasciato il pubblico del Forum ICT Security con una consapevolezza amplificata: nell’era della supply chain globale e della proliferazione di dispositivi IoT e IIoT, la fiducia nei componenti hardware non può più essere data per scontata. Le misure di protezione devono estendersi ben oltre i tradizionali perimetri di difesa digitale, includendo vetting rigoroso dei fornitori, ispezioni fisiche dei dispositivi prima del deployment in ambienti critici, segmentazione di rete anche per sistemi air-gapped con controlli sugli accessi fisici, monitoring anomalo del traffico USB e dei pattern di comportamento dei dispositivi, e formazione del personale sulla reale portata delle minacce hardware.

La presentazione di USBsamurai non è stata solo una dimostrazione tecnica impressionante, ma un campanello d’allarme per un’intera industria: la minaccia hardware è reale, accessibile, devastante nelle sue conseguenze, e drammaticamente sottovalutata nei modelli di rischio tradizionali.

Guarda l’intervento completo:

[embedded content]
Profilo Autore

Luca Bongiorni attualmente ricopre il ruolo di Direttore del Cybersecurity Lab di ZTE Italia. Negli anni ha maturato un’esperienza professionale a livello internazionale nel ramo della Sicurezza Informatica. Specializzandosi perlopiù sul lato offensivo della materia. Luca ha anche contribuito al mondo InfoSec attraverso la divulgazione delle sue ricerce inerenti diverse tematiche presso le più importanti conferenze del settore (i.e. BlackHat, DEFCON, HackInParis, TROOPERS, OWASP Chapters, Hardwear.ioetc.). Al momento, oltre ad occuparsi quotidianamente di 5G Security, lavora a ricerce a-latere inerenti l’analisi forense di apparti IIoT, il bypass di sistemi di accesso a controllo biometrico ed allo sviluppo di device IoOT (Internet of Offensive Things).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/impianti-hardware-malevoli/


Machine Learning e cybersecurity: potenzialità e limiti nell’individuazione delle minacce

Intervento di Giorgio Giacinto al 23° Forum ICT Security – “Il Machine Learning aiuta a individuare i componenti malevoli di una minaccia?”

Il machine learning rappresenta oggi uno strumento imprescindibile nella lotta contro le minacce informatiche, ma la sua efficacia dipende da una progettazione accurata e dalla consapevolezza dei suoi limiti intrinseci. È questo il messaggio centrale emerso dall’intervento del Professor Giorgio Giacinto, ordinario di Ingegneria Informatica presso l’Università di Cagliari, durante il 23° Forum ICT Security tenutosi a Roma il 19 e 20 novembre 2025.

Lo speaker ha aperto la sua relazione contestualizzando il tema all’interno del panorama della ricerca italiana in cybersicurezza, citando il progetto SERICS (Security and Rights in the Cyberspace), un partenariato esteso finanziato dal PNRR che ha coinvolto l’intero sistema universitario nazionale. L’iniziativa, nata in seno al Cybersecurity National Lab del CINI, ha dato vita a 27 progetti di ricerca, cui si aggiungono altri 54 finanziati attraverso bandi a cascata, con l’assunzione di 134 nuovi ricercatori e un investimento complessivo di 113 milioni di euro.

Dall’interpretazione dei sensi umani alla cybersecurity

L’esperto ha ricordato come l’intelligenza artificiale abbia mosso i primi passi nell’interpretazione dei sensi umani: immagini, video, suoni. La sfida attuale consiste nel trasferire questa conoscenza, maturata in un contesto “umano”, verso un mondo completamente artificiale come quello informatico. I fattori chiave di questo sviluppo sono stati molteplici: modelli sempre più sofisticati capaci di simulare alcuni aspetti specifici del ragionamento umano, l’accumulo di enormi quantità di dati, le tecnologie IoT e la crescente disponibilità di risorse computazionali.

Applicando queste tecniche alla cybersecurity, il relatore ha evidenziato come gli attacchi stiano diventando sempre più sofisticati per diverse ragioni: sono realizzati con componenti diverse, ciascuna delle quali presa singolarmente non appare malevola; vengono eseguiti in più fasi; assomigliano sempre più ad attività legittime; sfruttano vulnerabilità del software non immediatamente emergenti. Ha citato come esempio recente le vulnerabilità scoperte in applicazioni come WhatsApp, dove un eseguibile malevolo era stato nascosto all’interno di un’immagine contenuta in un file zip.

L’analisi delle applicazioni Android: un caso di studio illuminante

Particolarmente interessante è stato l’approfondimento sulle tecniche di analisi del malware per applicazioni Android. L’approccio adottato dal gruppo di ricerca dell’Università di Cagliari non si è limitato a far apprendere al sistema l’applicazione nella sua interezza, ma ha proceduto scomponendola in componenti elementari: da un lato il codice, dall’altro le risorse associate, come le immagini potenzialmente utilizzate per nascondere contenuti malevoli.

Un esperimento particolarmente significativo ha riguardato la rappresentazione semplificata delle applicazioni attraverso la sequenza delle chiamate a funzioni critiche, ovvero quelle che il sistema Android stesso definisce come sensibili (accesso alla rete, al Bluetooth, alla localizzazione). L’obiettivo non era tanto dimostrare se un’applicazione fosse malevola o meno, quanto verificare la possibilità di spiegare all’esperto umano quali componenti rendessero sospetta un’applicazione.

machine learning
Capacità di rilevazione nelle Applicazioni Android

I risultati hanno messo in luce un fenomeno cruciale: nel 2018 si è verificato un crollo significativo nelle prestazioni del sistema di rilevamento. La causa? Android aveva modificato in modo sostanziale il paradigma di programmazione delle applicazioni, rendendo obsoleto l’addestramento precedente del modello. Questo episodio dimostra plasticamente come i sistemi di machine learning dipendano strettamente dai dati storici su cui sono stati addestrati.

machine learning
Individuazione componenti malevole nelle Applicazioni Android

L’aspetto più innovativo di questo approccio risiede nella capacità di fornire spiegazioni. Analizzando uno spyware, il sistema è stato in grado di indicare quali funzioni — legate ad esempio alla localizzazione GPS e alle connessioni WiFi — contribuissero maggiormente alla classificazione come malevolo. Confrontando questo risultato con l’analisi di un’applicazione legittima, dove tutte le caratteristiche puntavano verso la classificazione benigna, emerge il valore di questi strumenti per il professionista della sicurezza: non solo un verdetto, ma una spiegazione delle ragioni che lo sostengono.

I Large Language Model entrano in gioco

L’intervento ha poi esplorato le frontiere più recenti della ricerca, con l’utilizzo dei Large Language Model per l’analisi dinamica delle applicazioni. A differenza dell’analisi statica, che esamina il codice senza eseguirlo, l’analisi dinamica richiede di far funzionare l’applicazione in un ambiente controllato, simulando le interazioni di un utente reale.

machine learning
Analisi dinamica con LLM

Il sistema sviluppato combina un modello visuale (VLM), capace di interpretare ciò che appare sullo schermo, con un LLM che analizza il testo presente. Questa combinazione, integrata con l’analisi del codice dell’applicazione, permette di governare automaticamente una sequenza di interazioni — click, inserimenti, navigazione — che coprono in modo più completo i possibili comportamenti dell’applicazione, registrando le attività svolte per individuare eventuali comportamenti malevoli.

machine learning
LLM per Cyber Threat Intelligence

Un ulteriore ambito di applicazione riguarda la Cyber Threat Intelligence. I rapporti sulle minacce informatiche comprendono documenti di natura eterogenea: da quelli strutturati per la comunicazione machine-to-machine (indicatori di compromissione) a report testuali destinati agli esperti umani. L’idea del gruppo di ricerca è di suddividere questi documenti in piccole unità concettuali, più facilmente elaborabili dai motori di intelligenza artificiale, per sintetizzare le precondizioni che rendono possibile un attacco e le postcondizioni che ne segnalano l’avvenuta esecuzione. L’obiettivo finale è disporre di un sistema capace di simulare gli effetti di un attacco sulla propria infrastruttura aziendale, anticipandone le conseguenze.

L’IA come arma a doppio taglio

Lo speaker non ha mancato di sottolineare come l’intelligenza artificiale sia uno strumento nelle mani di entrambe le parti. Anche gli attaccanti la utilizzano per sviluppare i propri attacchi: non tanto per creare malware da zero — poiché l’IA si basa sulla conoscenza passata e non può inventare il futuro — quanto per accelerare significativamente la fase di sviluppo e test delle singole componenti. Esistono già rapporti, tra cui uno di Google, che documentano tentativi di utilizzare gli LLM per creare codice malevolo, aggirando le protezioni dei sistemi.

Ma la stessa strategia può essere impiegata a scopo difensivo: interrogare sistematicamente questi modelli per individuare possibili vettori di attacco e verificare costantemente la propria postura di sicurezza.

Le insidie dell’apprendimento automatico

Una parte sostanziale dell’intervento è stata dedicata alle vulnerabilità intrinseche dei sistemi di machine learning. Il relatore ha identificato tre snodi critici nella catena dell’apprendimento automatico: l’acquisizione dei dati, la loro rappresentazione e il meccanismo di ottimizzazione.

machine learning
Le insidie dell’IA

Sul primo aspetto, la domanda fondamentale riguarda l’affidabilità delle fonti e di chi “etichetta” i dati, distinguendo ciò che è malevolo da ciò che è legittimo. Se qualcuno manipola le etichette, l’intero sistema viene compromesso. Sulla rappresentazione, l’esperto ha ricordato che questi strumenti lavorano su dati numerici: è cruciale che la rappresentazione numerica rifletta fedelmente le somiglianze e le differenze del mondo reale. Infine, il meccanismo di ottimizzazione — la funzione matematica che separa “legittimo” e “malevolo” — dipende dalla definizione stessa di “ottimo”, che non è univoca.

Le domande che ogni professionista dovrebbe porsi sono dunque: il dataset di addestramento rappresenta uno scenario reale? Le etichette sono affidabili? Le correlazioni individuate dal sistema concordano con l’esperienza degli esperti? Quali metriche vengono utilizzate per valutare le prestazioni? Un falso senso di sicurezza può aprire la strada agli avversari.

Adversarial Machine Learning: quando l’IA viene attaccata

Il gruppo di ricerca dell’Università di Cagliari si occupa da oltre un decennio di Adversarial Machine Learning, ovvero lo studio delle debolezze dei sistemi di intelligenza artificiale inquadrate nella classica triade della cybersecurity: integrità, disponibilità e riservatezza.

machine learning
Adversarial Machine Learning

Gli attacchi più tipici sono di due tipi. Gli attacchi di evasione mirano a creare campioni malevoli che attraversano la superficie di decisione del sistema, apparendo come benigni. Ancora più insidiosi sono gli attacchi di poisoning (avvelenamento), che mirano a inquinare i dati di addestramento per deviare il processo di apprendimento e introdurre backdoor sfruttabili successivamente.

Il relatore ha fatto notare come la comunità scientifica, non disponendo di risorse infinite, e avendo necessità di produrre risultati replicabili, spesso utilizzi dataset condivisi gratuitamente. Proprio in questi archivi un attaccante potrebbe inserire dati manipolati che compromettono silenziosamente i modelli addestrati.

MITRE ha sistematizzato queste tipologie di attacco nella matrice ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems), mappando tecniche e tattiche nelle diverse fasi di un attacco: ricognizione, sviluppo delle risorse, accesso iniziale e così via.

AttackBench: uno strumento per la verifica della robustezza

Nell’ambito del progetto SERICS, il laboratorio dell’Università di Cagliari ha sviluppato AttackBench, uno strumento automatico che consente a chi sviluppa sistemi di intelligenza artificiale di verificarne la robustezza rispetto agli attacchi noti. Il sistema sottopone il modello a diverse tipologie di attacco e restituisce indicazioni sulla necessità di interventi correttivi.

machine learning
AttackBench – Valutare la robustezza di sistemi di IA

Conclusioni

L’intelligenza artificiale si conferma uno strumento potente, capace di elaborare rapidamente grandi quantità di dati eterogenei provenienti da sistemi diversi. Ma la stessa potenza è a disposizione degli attaccanti. L’efficacia della difesa, ha concluso il Professor Giacinto, dipende dalla conoscenza approfondita sia dei meccanismi di apprendimento automatico sia delle tecniche di attacco. Solo questa duplice competenza consente di sviluppare strumenti di difesa realmente efficaci e non soltanto apparentemente tali.

Guarda il video dell’intervento completo:

[embedded content]
Profilo Autore

Giorgio Giacinto è professore di Ingegneria Informatica presso l’Università di Cagliari, dove è coordinatore del corso di Laurea Magistrale in Computer Engineering, Cybersecurity and Artificial Intelligence. L’attività di ricerca, svolta nell’ambito di progetti finanziati a livello locale, nazionale e Europeo, è principalmente focalizzata su tecniche di machine learning per la cybersicurezza. E’ componente del collegio dei docenti del Dottorato in ingegneria Elettronica e Informatica dell’Università di Cagliari e del Dottorato di Interesse nazionale in Cybersicurezza, coordinato da IMT Lucca. Ha pubblicato circa 200 articoli in conferenze e riviste internazionali. All’interno del consorzio CINI è uno dei vice direttori del Cybersecurity National Lab e un componente del comitato di gestione dell’Artificial Intelligence & Intelligent Systems Lab. E’ componente della delegazione italiana del MUR nel Comitato di Programma di Horizon Europe, Cluster III “Civil Security for Society”. E’ guest professor presso la Lulea University of Technology, Svezia, all’interno del gruppo di ricerca Pervasive and Mobile Computing. E’ fellow della IAPR (International Association for Pattern Recognition) per le attività di ricerca in sicurezza informatica ed è senior member della IEEE Computer Society e dell’ACM.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/machine-learning-minacce/


Dal quantum computing alla crittografia del futuro: la roadmap verso la sicurezza post-quantum

La transizione verso nuovi standard crittografici è urgente: entro il 2030 le infrastrutture critiche dovranno essere protette dagli attacchi dei computer quantistici. Al Forum ICT Security 2025, Marco Baldi illustra stato dell’arte, sfide tecnologiche e il contributo della ricerca italiana agli algoritmi di nuova generazione

La corsa verso il quantum computing sta accelerando in modo esponenziale, e con essa l’urgenza di ripensare completamente la sicurezza delle nostre infrastrutture digitali. Al 23° Forum ICT Security, svoltosi a Roma il 19 e 20 novembre 2025, il professor Marco Baldi, docente di Telecomunicazioni presso il Dipartimento di Ingegneria dell’Informazione dell’Università Politecnica delle Marche, ha tracciato un quadro dettagliato e allarmante delle sfide che attendono il mondo della cybersecurity con il suo intervento “Tecnologie quantistiche per la sicurezza ICT e transizione alla crittografia post-quantum“.

I progressi della scienza dell’informazione quantistica stanno infatti rendendo possibili applicazioni che fino a pochi anni fa erano soltanto teoriche. Ma con queste opportunità arrivano anche nuovi, gravissimi rischi: un attaccante dotato di un computer quantistico sufficientemente potente sarà in grado di compromettere la maggior parte dei sistemi crittografici su cui oggi si basa la sicurezza di Internet, delle transazioni bancarie, delle comunicazioni governative e di tutte le nostre infrastrutture digitali.

Quantum Information Science – Schema divisione Quantum Computing vs Quantum Communications]

Due facce della rivoluzione quantistica

Il relatore ha esordito con una distinzione fondamentale, spesso confusa nel dibattito pubblico e mediatico. «È molto utile dividere le due grandi famiglie di tecnologie quantistiche che oggi abbiamo a disposizione, anche per evitare di cadere nel minestrone quantum in cui qualche volta ci ritroviamo», ha spiegato Baldi.

La prima famiglia è quella del quantum computing: computer che utilizzano fenomeni della meccanica quantistica, come la sovrapposizione quantistica, per eseguire calcoli. Il concetto chiave è il quantum bit, o qubit, che a differenza del bit classico può esistere in uno stato di sovrapposizione quantistica. Questo consente «una sorta di parallelismo intrinseco che accelera notevolmente alcuni calcoli», aprendo possibilità di calcolo impossibili per i computer tradizionali.

La seconda famiglia, molto distinta, è quella delle quantum communications: tecniche che utilizzano proprietà della meccanica quantistica per trasmettere informazioni con garanzie di sicurezza fisica. L’esempio più noto è la Quantum Key Distribution (QKD), che sfrutta il teorema di non clonazione: qualsiasi tentativo di intercettazione perturba il fenomeno quantistico stesso, rendendo l’attacco teoricamente rilevabile

Timeline “Verso il Quantum Computer” con evoluzione 2007-2025

L’escalation tecnologica: da D-Wave a IBM Nighthawk

Lo sviluppo dei computer quantistici è passato dalla teoria alla pratica con un’accelerazione impressionante negli ultimi due decenni. Nel 2007 l’azienda canadese D-Wave presentò il primo processore quantistico basato su quantum annealing, una tecnica che sfrutta fenomeni quantistici meno generali della sovrapposizione quantistica ma che ha comunque consentito di raggiungere migliaia di qubit basati su annealing.

Nel frattempo, IBM ha guidato la corsa verso processori basati su sovrapposizione quantistica, il fenomeno più generale, arrivando nel 2023 con il chip Condor a superare la soglia dei 1.000 qubit fisici. Ma l’esperto ha sottolineato un aspetto cruciale spesso trascurato: «Quei qubit sono qubit fisici e per realizzare un qubit logico servono addirittura centinaia di quei qubit fisici, per cui questo è un traguardo importante ma che purtroppo si presta male alla scalabilità».

Ed è proprio sulla scalabilità che si è concentrata la competizione dal 2023 in poi. Il problema fondamentale è la rumorosità dei qubit, che limita drasticamente la possibilità di aumentare il numero di qubit logici effettivamente utilizzabili. Google nel 2024 ha presentato il processore Willow con 105 qubit: apparentemente un passo indietro dai numeri di IBM, ma in realtà un salto in avanti qualitativo verso sistemi scalabili.

Il 2025 è stato definito dal relatore «un anno fantastico» per questa tecnologia. Microsoft ha introdotto Majorana One con apparentemente solo 8 qubit, ma organizzati in una struttura topologica innovativa che si presta alla scalabilità. Amazon è entrata in gioco con Ocelot, 9 qubit fault tolerant, cioè tolleranti agli errori e alla rumorosità.

Di pochi giorni fa, ha ricordato Baldi, l’annuncio di IBM che è tornata protagonista con due processori rivoluzionari: Nighthawk, con 120 qubit interconnessi tra loro in una struttura di distributed computing quantistico, e Loon, con 112 qubit che incorporano capacità di correzione degli errori. Entrambi progettati specificamente per la scalabilità.

«Quello che era un concetto teorico abbastanza lontano da noi sta diventando sempre più concreto e, come vedete, c’è un’accelerazione negli ultimi anni verso la costruzione di computer quantistici sempre più grandi e sempre più scalabili», ha avvertito il professore.

L’altra faccia: le comunicazioni quantistiche

Sul versante difensivo, le tecnologie di quantum communications offrono la possibilità di trasmissioni punto-punto con garanzie matematico-fisiche di confidenzialità. La Quantum Key Distribution esegue «la trasmissione punto-punto su link ottico in fibra o spazio libero di un’informazione segreta codificata in stati quantistici».

Il teorema di non clonazione garantisce che «se un attaccante tentasse di fare un’intercettazione, nell’eseguire la misura andrebbe a perturbare il fenomeno quantistico e quindi verrebbe deteriorata l’informazione stessa». Questo fornisce una garanzia matematico-fisica di non intercettabilità che va oltre la sicurezza computazionale tradizionale.

Quantum Computer e Quantum Communications: Applicazioni nel mondo ICT e Security

Le applicazioni: opportunità e minacce

Il quantum computer, ha spiegato l’esperto, avrà applicazioni generiche nel mondo ICT: accelererà la sintesi di molecole, l’addestramento di grandi reti neurali, la soluzione di problemi di ottimizzazione complessi. Le quantum communications aumenteranno la capacità trasmissiva delle reti, con prospettive verso un quantum Internet.

Ma è sul fronte della sicurezza che l’impatto sarà più drammatico. «Il quantum computer, ahimè, ha una forte applicazione in sicurezza dal punto di vista crittoanalitico», ha avvertito il relatore. «Un attaccante dotato di un quantum computer può sovvertire la sicurezza di molti degli algoritmi crittografici asimmetrici che noi oggi utilizziamo».

Le quantum communications, invece, hanno un’applicazione difensiva, garantendo confidenzialità delle comunicazioni punto-punto attraverso tecniche come la Quantum Key Distribution o le Quantum Secure Direct Communications.

Quantum Computer e Crittografia – Schema impatto su cifrari asimmetrici vs simmetrici

La bomba a orologeria: l’impatto sulla crittografia attuale

L’impatto del quantum computing sulla crittografia è profondamente asimmetrico. Il professor Baldi ha illustrato come sia necessario distinguere tra due grandi famiglie di cifrari:

I cifrari asimmetrici – quelli che utilizziamo per lo scambio automatico di chiavi, la cifratura asimmetrica, la firma digitale (RSA, ElGamal, DSA, ECDSA, Diffie-Hellman, curve ellittiche) – subiranno un impatto «drammatico». La complessità della soluzione dei problemi matematici su cui si basa la loro sicurezza viene ridotta da esponenziale a polinomiale nella lunghezza dell’input. In termini pratici: «Noi dobbiamo abbandonare gli attuali cifrari asimmetrici che sono vulnerabili al quantum computer».

I cifrari simmetrici – quelli usati per la bulk encryption con chiave precondivisa, come AES, ChaCha20, e le funzioni hash SHA-2, SHA-3 – subiscono un impatto «molto più contenuto». Il livello di sicurezza rimane esponenziale, pur subendo una riduzione quadratica. «Possiamo ancora utilizzare AES, ad esempio, oppure SHA-3, eventualmente adattando la lunghezza delle chiavi e la lunghezza dei digest», ha rassicurato l’esperto.

La risposta: la crittografia post-quantum

La soluzione esiste ed è già in fase avanzata di standardizzazione. La crittografia post-quantum (PQC) utilizza sistemi che non si basano più sui problemi matematici vulnerabili ai computer quantistici, ma su altri problemi: reticoli, codici correttori di errori, sistemi multivariati, isogenie, funzioni hash.

«Le tecniche crittografiche devono essere standardizzate attraverso processi competitivi internazionali», ha sottolineato Baldi. Il NIST (National Institute of Standards and Technology) americano coordina dal 2016 il più importante processo di standardizzazione di primitive crittografiche post-quantum.

Il percorso è stato rigoroso: nel 2017 furono presentati 69 candidati, ridotti a 26 nel 2019, 15 nel 2020, fino a quattro candidati standardizzati nel 2022. Nel frattempo, nel 2022 si decise di riaprire un ulteriore bando per aumentare la diversità negli algoritmi di firma digitale: 40 nuovi candidati raccolti nel 2023, ridotti a 14 nel 2024.

A marzo 2025 è stato aggiunto un algoritmo a quelli standardizzati, e per il 2026 si attende la conclusione del secondo processo di standardizzazione. Gli algoritmi finora standardizzati sono:

  • Due algoritmi per lo scambio di chiave (che sostituiranno Diffie-Hellman): ML-KEM e HQC-KEM (quest’ultimo aggiunto a marzo 2025)
  • Tre algoritmi per la firma digitale: ML-DSA, FN-DSA e SLH-DSA
LEDAcrypt, CROSS e LESS

Il contributo italiano: LEDAcrypt, CROSS e LESS

Con evidente orgoglio, il professor Baldi ha presentato tre algoritmi che vedono protagonista la ricerca italiana, tutti appartenenti alla famiglia dei sistemi post-quantum basati su codici correttori di errori.

LEDAcrypt (Low-dEnsity parity-check coDe-bAsed cryptographic systems) fornisce una famiglia di algoritmi per lo scambio di chiave e la cifratura asimmetrica. Si basa su un framework introdotto nel 1978 da Robert McEliece, «sostituendo le famiglie di codici con codici più moderni che si chiamano LDPC e MDPC, si ottengono sistemi molto compatti e molto veloci». Sebbene non sia stato standardizzato per questioni parametriche, «la versione 3 è sicura, compatta e veloce».

CROSS (Code and Restricted Object Signature Scheme) e LESS (Linear Equivalence Signature Scheme) sono due algoritmi di firma digitale tuttora in competizione, «gli unici due che sono stati ammessi al secondo round della gara attuale nella famiglia degli algoritmi basati su codici».

CROSS si basa sul problema di decodifica ristretta, «è molto veloce e ottiene delle firme ragionevolmente compatte». LESS si basa sul problema di equivalenza tra codici, «è ragionevolmente veloce ma le firme sono molto compatte».

«Spesso si parla di sovranità digitale, qualche volta in crittografia si parla anche del sospetto di backdoor», ha commentato Baldi. «Ecco, questi sono algoritmi il cui progetto è nato da spunto di ricercatori italiani».

Alternative alla PQC
Information-theoretic security

Il dibattito: PQC o QKD?

Una domanda legittima che il relatore ha affrontato: esistono alternative alla crittografia post-quantum? La risposta è articolata e richiede di comprendere due paradigmi distinti di sicurezza.

La crittografia post-quantum rientra nel paradigma della sicurezza computazionale (computational security): si richiede che la complessità di un attacco superi un certo valore (2^λ, dove λ è il livello di sicurezza in bit) anche per un attaccante dotato di quantum computer.

Esiste però un altro paradigma, quello della sicurezza information-theoretic, cui rispondono tecniche come il One-Time Pad (usato durante la Seconda Guerra Mondiale per le comunicazioni tra Roosevelt e Churchill), la Quantum Key Distribution e le Quantum Secure Direct Communications. In questo caso «la confidenzialità non dipende dalla capacità computazionale di un attaccante, perché si dimostra in modo matematico».

Il problema, ha spiegato l’esperto, è che questi due paradigmi offrono funzionalità diverse:

  • La PQC fornisce funzioni asimmetriche: cifratura asimmetrica, scambio automatico di chiavi, firma digitale
  • Le tecniche di sicurezza information-theoretic producono nativamente solo funzioni simmetriche basate su chiave precondivisa: cifratura simmetrica, distribuzione di chiave simmetrica

«Allora potremmo chiederci: usiamo information-theoretic security?», ha proseguito Baldi. «Da una parte è vero che offre una garanzia indipendente dalla capacità di calcolo dell’attaccante. Però i sistemi per information-theoretic security offrono solo funzioni simmetriche, che sono quelle meno impattate dal quantum computer, e richiedono delle chiavi precondivise manualmente».

Inoltre, alcuni sistemi come la QKD hanno limitazioni tecniche significative: breve distanza, limitato tasso di chiavi distribuite, mancanza di certificazioni. Il relatore ha citato position paper congiunti rilasciati dalle agenzie di sicurezza nazionali tedesca (BSI), francese (ANSSI), svedese e olandese che «descrivono molto dettagliatamente le limitazioni a cui va incontro la Quantum Key Distribution».

Si potrebbe pensare di adottare un approccio misto, mescolando QKD con PQC e funzioni hash per superare questi limiti e recuperare l’autenticazione automatica. «Però se noi facciamo così, ritorniamo nel paradigma della computational security, che è quello crittografico», ha obiettato il professore. «E allora non ha molto senso questo mescolamento, perché rimanendo nel paradigma crittografico, la sola crittografia post-quantum ci offre già tutte le funzioni necessarie senza limiti di fattibilità, con costi oltretutto notevolmente più bassi».

PQC vs QKD – Tabella applicabilità

PQC o QKD: applicabilità a confronto

La slide di confronto presentata dal relatore è stata inequivocabile. «Innanzitutto non è giusto contrapporli, perché PQC ci dà funzioni asimmetriche e QKD ci dà solo funzioni simmetriche», ha premesso.

Ma guardando all’applicabilità:

La PQC può essere applicata in tutti gli scenari in cui oggi usiamo crittografia:

  • Firma digitale
  • Navigazione web sicura
  • Reti private virtuali aziendali
  • Pagamenti elettronici
  • Sicurezza del cloud
  • Sicurezza wireless
  • Paradigmi futuri e avanzati come The Onion Routing (TOR), blockchain e criptovalute

Esistono già standard ed esistono certificazioni per la PQC.

La QKD, invece, è una tecnologia che «può essere di interesse perché ci dà una confidenzialità matematicamente dimostrabile, ma in alcuni casi di nicchia»:

  • Comunicazioni punto-punto su breve distanza
  • Con chiavi precondivise
  • Senza, per il momento, certificazioni di sicurezza e standard consolidati
Schema sfide della Transizione alla PQC

Le sfide della transizione: non basta lo standard

«Attrezziamoci per andare verso la transizione alla post-quantum cryptography», ha esortato Baldi. Ma ha anche avvertito che la standardizzazione degli algoritmi «è il primo passaggio fondamentale per avere una crittografia interoperabile, ma non è l’ultimo passaggio».

Le sfide sono molteplici:

1. Implementazioni sicure ed efficienti

Gli algoritmi devono essere implementati in hardware e software in modo non solo efficiente, ma anche sicuro. «Ci sono attacchi come i side-channel attacks che riguardano non tanto gli algoritmi ma le loro implementazioni», ha spiegato. «È necessario che le implementazioni hardware e software che noi andiamo a utilizzare siano sicure anche contro side-channel attacks, oltre che certificate».

2. Integrazione nei sistemi esistenti

Anche disponendo di algoritmi standard e implementazioni sicure, resta il problema di «prendere questi algoritmi e inserirli nei sistemi che utilizziamo». E qui emerge un problema concreto: le dimensioni delle chiavi e delle firme.

Il relatore ha mostrato una tabella di confronto tra sistemi di firma digitale che ha reso evidente la sfida: ECDSA (basato su curve ellittiche, quantum-vulnerable) ha chiavi e firme piccolissime. I sistemi post-quantum standardizzati – ML-DSA, FN-DSA, SLH-DSA – hanno chiavi pubbliche, chiavi private e firme con dimensioni «che non sono nemmeno lontanamente paragonabili» con quelle dei sistemi classici.

«Bisognerà andare a integrare e studiare come integrare queste nuove primitive crittografiche nei protocolli e nei sistemi che utilizziamo tutti i giorni per la sicurezza dei dati e delle reti», ha sottolineato.

3. L’urgenza: gli attacchi “store-now-decrypt-later”

L’aspetto forse più inquietante riguarda la dimensione temporale della minaccia. «Esistono attacchi di tipo store-now-decrypt-later», ha avvertito l’esperto. «I dati che io scambio oggi sulla mia rete potrebbero essere memorizzati oggi, con il cifrario che io sto usando oggi, per essere attaccati da un attaccante domani, quando l’attaccante avrà il quantum computer».

In altre parole, un attaccante può intercettare e archiviare oggi comunicazioni cifrate con algoritmi classici, in attesa di disporre domani di un quantum computer per decifrarle. Questo vale per dati sensibili, segreti industriali, comunicazioni governative, informazioni mediche: tutto ciò che deve rimanere confidenziale non solo oggi, ma anche tra 5, 10, 15 anni.

«Quindi non è una transizione che possiamo ritardare», ha ammonito Baldi.

La roadmap: dal 2016 al 2035

«Non a caso, sia a livello nazionale che internazionale si stanno delineando delle timeline per la transizione alla crittografia post-quantum», ha concluso il relatore presentando le scadenze che attendono governi, aziende e organizzazioni.

Standardizzazione della PQC, roadmap 2016 – 2026

La situazione di partenza è chiara: «Veniamo da un mondo in cui la crittografia è quantum-vulnerable. Quella che stiamo usando oggi per connetterci a Internet è quantum-vulnerable».

La roadmap delineata prevede:

  • 2016: il NIST inizia il processo di standardizzazione
  • 2022: primi algoritmi standardizzati
  • 2030: deadline per la transizione delle infrastrutture critiche. «È comunemente accettato che bisognerà essere riusciti a eseguire la transizione almeno delle infrastrutture critiche» entro questa data
  • 2035: completamento della transizione di tutte le infrastrutture digitali

L’obiettivo dichiarato è raggiungere entro il 2035 la cosiddetta quantum safety: «Essere resilienti anche nei confronti di attaccanti dotati di un quantum computer».

Il supporto della ricerca italiana

Prima di concludere, il professor Baldi ha voluto riconoscere il supporto di alcuni progetti di ricerca che sostengono l’attività italiana nella crittografia post-quantum:

  • Il programma PE SERICS (SEcurity and RIghts in the CyberSpace), finanziato dal Ministero dell’Università e della Ricerca nell’ambito del PNRR (Piano Nazionale di Ripresa e Resilienza) – Missione 4, componente 2, investimento 1.3 – finanziato dall’Unione Europea – NextGenerationEU
  • Il progetto QSAFEIT (Quantum-safe cryptographic tools for the protection of national data and information technology assets), finanziato dal Ministero dell’Università e della Ricerca nell’ambito del Fondo Italiano per le Scienze Applicate (FISA) 2022

Un segnale chiaro che l’Italia sta investendo nella ricerca di frontiera su tecnologie che saranno decisive per la sicurezza nazionale e la sovranità digitale nel prossimo decennio.

Conclusioni

La sfida è lanciata: la transizione alla crittografia post-quantum non è più un’opzione, ma una necessità urgente. Con computer quantistici sempre più potenti all’orizzonte e la minaccia concreta degli attacchi store-now-decrypt-later, governi, aziende e organizzazioni hanno meno di cinque anni per proteggere le proprie infrastrutture critiche. La ricerca italiana, con algoritmi come LEDAcrypt, CROSS e LESS, sta contribuendo attivamente a costruire le difese crittografiche del futuro. Ma come ha avvertito il professor Baldi: il tempo stringe, e ciò che proteggiamo oggi determinerà la sicurezza delle nostre informazioni per i decenni a venire.

Guarda il video dell’intervento completo:

[embedded content]
Profilo Autore

Marco Baldi è professore associato in Telecomunicazioni presso il Dipartimento di Ingegneria dell’Informazione dell’Università Politecnica delle Marche, dove partecipa al Centro di Ricerca e Servizio per la Privacy e la Cybersecurity (CRiSPY). È membro del comitato di gestione del Laboratorio Nazionale di Cybersecurity del CINI e ne coordina il nodo locale presso l’Università Politecnica delle Marche. È socio fondatore e membro del comitato scientifico dell’Associazione Nazionale di crittologia De Componendis Cifris. Svolge attività didattica, di ricerca e progettuale nell’area dell’affidabilità e della sicurezza delle comunicazioni, ed in particolare della crittografia post-quantum. È coautore di oltre 200 articoli scientifici apparsi in riviste, capitoli di libri e atti di conferenze internazionali, un libro e quattro brevetti. È membro di CINI, CNIT, GTTI, IEEE Communications Society, IEEE Information Theory Society e membro senior di IEEE. È stato vicepresidente per il periodo 2021-2023 ed è presidente per il periodo 2024-2025 del capitolo italiano della IEEE Information Theory Society. È coordinatore o membro dei gruppi di lavoro di progetti di ricerca nazionali ed internazionali commissionati da enti pubblici e privati. È co-organizzatore e membro del comitato tecnico di programma di conferenze e workshop internazionali nell’ambito dell’affidabilità e della sicurezza delle comunicazioni. Fa parte del gruppo proponente degli schemi crittografici LEDAcrypt, LESS e CROSS, che hanno partecipato o stanno partecipando al processo di standardizzazione internazionale di schemi crittografici post-quantum coordinato dal NIST. È membro del Quantum Technologies Coordination Group nominato dal Presidente del Consiglio dei Ministri su indicazione del Sottosegretario alla Presidenza del Consiglio con delega all’innovazione tecnologica.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-post-quantum/


Legge 132/2025 sull’Intelligenza Artificiale: dalla teoria alla pratica nelle aziende italiane

L’entrata in vigore della Legge 132/2025 rappresenta un punto di svolta per la governance dell’intelligenza artificiale in Italia, ma la distanza tra principi normativi e attuazione pratica rischia di amplificare un gap competitivo già preoccupante.

Mentre il tasso di adozione dell’IA nelle imprese italiane si attesta all’8,2% contro una media UE del 13,5% secondo i dati ISTAT 2024, le organizzazioni si trovano a fronteggiare un doppio onere: implementare sistemi di intelligenza artificiale per non perdere competitività, e simultaneamente garantirne la conformità a un quadro normativo che integra AI Act europeo e specificità nazionali. Questo contributo analizza le sfide operative concrete che Chief Information Security Officers, legal counsels specializzati in cyber law, digital forensics experts e compliance officers devono affrontare, identificando i gap critici nell’implementazione e proponendo metodologie pragmatiche per la transizione verso una AI governance sostenibile.

Il contesto normativo: architettura di un sistema binario

La Legge 23 settembre 2025, n. 132, pubblicata in Gazzetta Ufficiale il 25 settembre 2025 ed entrata in vigore il 10 ottobre, non sostituisce il Regolamento UE 2024/1689 (AI Act), ma lo integra con disposizioni nazionali che ne operazionalizzano i principi negli spazi lasciati alla discrezionalità degli Stati membri. Questa stratificazione normativa genera un’architettura binaria che richiede alle organizzazioni una capacità interpretativa sofisticata.

Il legislatore italiano ha adottato un approccio settoriale che definisce regole specifiche per ambiti critici: sanità (art. 9), giustizia (art. 10), lavoro (art. 11), professioni intellettuali (art. 13), pubblica amministrazione (art. 14). La scelta di non limitarsi a principi generali ma di disciplinare applicazioni concrete testimonia una volontà di indirizzo forte, ma introduce complessità implementative significative che molte organizzazioni stanno solo ora cominciando a comprendere nella loro portata effettiva.

L’elemento più dirompente per le imprese è l’impatto sui modelli organizzativi ex D.Lgs. 231/2001. L’articolo 21 della Legge 132/2025 introduce nuove fattispecie di reato connesse all’uso illecito dell’IA e aggravanti specifiche. Viene introdotto l’art. 612-quater c.p. che punisce la diffusione illecita di contenuti generati o alterati tramite IA (deepfake) con pena da uno a cinque anni, mentre l’art. 61 si arricchisce del nuovo n. 11-decies che prevede un’aggravante per l’impiego di sistemi IA quando costituiscano mezzo insidioso o ostacolino la difesa. Aggravanti analoghe vengono introdotte per reati contro diritti politici, aggiotaggio e manipolazione del mercato quando commessi mediante intelligenza artificiale.

Questa estensione del catalogo dei reati presupposto obbliga le organizzazioni a ripensare integralmente la mappatura dei rischi e i protocolli di controllo, inserendo l’IA come variabile trasversale nei processi decisionali. Non si tratta più di aggiungere un capitolo al Modello esistente, ma di ripensarne l’intera architettura alla luce di una tecnologia che permea trasversalmente l’organizzazione.

Il gap italiano: numeri di un ritardo strutturale

I dati del report ISTAT “Imprese e ICT 2024” fotografano una realtà preoccupante: nonostante una crescita sostenuta del mercato italiano dell’IA (+38,7% nel 2024, con proiezioni di 909 milioni di euro nel 2024 e 1,8 miliardi nel 2027 secondo il Rapporto Anitec-Assinform “Il Digitale in Italia 2025”), solo l’8,2% delle imprese italiane con almeno 10 addetti utilizza almeno una tecnologia di IA, contro una media UE del 13,5%.

Questo divario di 5,3 punti percentuali rispetto alla media europea (l’Italia adotta l’IA a un ritmo inferiore del 39% rispetto alla media UE) non è meramente quantitativo, ma qualitativo: la tecnologia resta concentrata nelle grandi aziende (32,5% di adozione) e nei settori avanzati, mentre le PMI, che rappresentano il 92% del tessuto produttivo italiano, faticano strutturalmente nell’adozione con solo il 7,7% che utilizza IA.

Parallelamente, gli investimenti in cybersecurity crescono con forza: da 2 miliardi di euro nel 2024 a una proiezione di 2,75 miliardi nel 2027 (tasso di crescita annuo del 10,6% fino al 2028), come emerge dal White Paper Anitec-Assinform “IA e Cybersecurity”, confermando l’urgenza di rafforzare le difese digitali. Come sottolineato da Anitec-Assinform nel comunicato stampa del 17 aprile 2025, oltre alla normativa, la vera sfida è aumentare il tasso di adozione e portare benefici concreti alle imprese e ai cittadini, attraverso investimenti in formazione, programmi di accompagnamento per le PMI e sviluppo di competenze diffuse.

Il gap si manifesta su dimensioni interconnesse che richiedono interventi sistemici. Sul fronte delle competenze, l’alfabetizzazione in materia di IA prevista dall’art. 4 dell’AI Act e richiamata dalla L. 132/2025 è ancora lontana dall’essere diffusa. Le organizzazioni mancano di figure ibride in grado di comprendere simultaneamente le implicazioni tecniche, legali, etiche e operative dell’IA. Il CISO tradizionale si trova a dover dialogare con data scientists, legal counsels, HR managers e compliance officers su temi che richiedono un metalinguaggio ancora in formazione. Questa lacuna di competenze trasversali rappresenta forse il vincolo più stringente all’adozione consapevole dell’IA.

Sul piano organizzativo, la governance dell’IA richiede strutture decisionali nuove che molte aziende italiane faticano a implementare. Il modello gerarchico tradizionale, in cui la decisione finale spetta a un singolo soggetto apicale, entra in crisi quando il sistema IA genera output che influenzano decisioni ad alto impatto. La L. 132/2025 impone il principio della supervisione umana significativa (art. 3), ma tradurlo operativamente significa ripensare workflow consolidati, definire ruoli e responsabilità inediti, implementare sistemi di tracciabilità delle decisioni. QQQCome evidenziato nell’analisi di Innovation Machine, questo richiede un assessment strutturato che valuti lo stato attuale del sistema di intelligenza artificiale, identifichi gap e rischi, e costruisca roadmap di adeguamento a breve, medio e lungo termine.

Il gap tecnologico-infrastrutturale completa il quadro critico. Molte PMI operano ancora con infrastrutture IT legacy, prive dei requisiti minimi per l’adozione sicura di sistemi IA. La questione non è solo di investimento economico, ma di cultura del dato: mappatura dei data flows, classificazione dei dataset, data quality management, data lineage sono pratiche ancora poco diffuse nel tessuto produttivo italiano. La L. 132/2025 richiede localizzazione dei dati strategici presso datacenter nazionali per le PA (art. 14), una disposizione che può rappresentare un vantaggio competitivo per le aziende italiane del settore, ma che solleva interrogativi più ampi sulla sovranità digitale e sulla capacità delle organizzazioni di gestire la territorialità dei dati in architetture cloud ibride sempre più complesse.

Implementazione pratica: dalla norma all’operatività

Fase zero: censimento e mappatura

Il primo step implementativo, spesso sottovalutato ma fondamentale, è il censimento sistematico dei sistemi IA già in uso. Molte organizzazioni scoprono con sorpresa che algoritmi di ranking, chatbot, sistemi di analisi predittiva, strumenti di OCR avanzato, tool di screening CV sono già operativi, magari adottati da singoli dipartimenti senza una governance centralizzata. Questa “IA shadow“ rappresenta un rischio compliance significativo che può emergere solo attraverso un’indagine sistematica condotta a livello enterprise.

La mappatura deve documentare per ciascun sistema identificato la finalità e il contesto d’uso, interrogandosi su quale processo aziendale sia funzionale il sistema, chi lo utilizzi effettivamente e con quale frequenza. È necessario procedere poi con la classificazione del rischio secondo la tassonomia dell’AI Act, distinguendo tra rischio inaccettabile, alto, limitato e minimo. Questa categorizzazione non è un esercizio accademico: determina gli obblighi applicabili e le misure di controllo richieste.

L’analisi deve proseguire identificando il fornitore e le caratteristiche tecniche del sistema: si tratta di un prodotto commerciale o di uno sviluppo interno? Quali dati utilizza per il proprio funzionamento? Come è stato addestrato il modello sottostante? La comprensione dei data flows risulta particolarmente critica: occorre tracciare quali dati personali o categorie particolari ex art. 9 GDPR vengono processati, da dove provengono questi dati, dove risiedono fisicamente, per quanto tempo sono conservati e secondo quali logiche di retention.

Le misure di sicurezza implementate completano il quadro: quali controlli tecnici e organizzativi sono attivi per proteggere il sistema? Esistono audit trail che consentano di ricostruire le decisioni? È garantita la reversibilità delle decisioni algoritmiche? Come sottolineato nell’analisi per la Pubblica Amministrazione, questo Registro degli utilizzi IA non è un mero adempimento formale, ma il fondamento della strategia di compliance. Senza una visione d’insieme accurata e costantemente aggiornata, ogni intervento successivo è destinato a essere parziale, inefficace e potenzialmente controproducente.

Valutazione del rischio: DPIA e oltre

La Data Protection Impact Assessment (DPIA) è obbligatoria quando i trattamenti mediante IA possono comportare rischi elevati per diritti e libertà degli interessati, come stabilito dall’art. 35 GDPR. L’European Data Protection Board ha chiarito che il concetto di “rischio elevato” non si limita alla sicurezza dei dati intesa come riservatezza, integrità e disponibilità, ma comprende l’impatto sui diritti fondamentali: libertà di parola, libertà di pensiero, divieto di discriminazione, diritto alla dignità. Questa interpretazione estensiva richiede un approccio alla DPIA radicalmente diverso rispetto alle valutazioni tradizionali focalizzate sui soli aspetti di data protection.

Nel contesto specifico dell’intelligenza artificiale, la DPIA deve valutare scenari che spesso risultano controintuitivi per chi proviene da una cultura di risk assessment tradizionale. La questione dei bias algoritmici, ad esempio, richiede di verificare se in fase di training e testing siano stati rilevati valori discriminatori incorporati nel codice stesso, e di documentare quali meccanismi di debiasing siano stati implementati per mitigarli. Occorre indicare le misure correttive previste nel caso in cui tale rischio si presentasse in fase di utilizzo del sistema.

L’explainability costituisce un altro nodo critico: il sistema è in grado di fornire spiegazioni comprensibili delle proprie decisioni? È possibile ricostruire il reasoning sottostante a un output specifico? Queste domande non hanno risposte binarie, ma richiedono una valutazione contestuale che tenga conto del livello di rischio dell’applicazione e delle aspettative ragionevoli degli interessati. La robustezza e resilienza del sistema devono essere analizzate verificando se il sistema rimane stabile di fronte a input avversariali, se è protetto contro data poisoning e model inversion attacks, se esistono meccanismi di monitoraggio che rilevino degradazione delle performance nel tempo.

La protezione della privacy richiede infine di documentare l’implementazione di tecniche di privacy-enhancing come federated learning, differential privacy o homomorphic encryption, valutandone l’efficacia nel contesto specifico. Come sottolineato dall’analisi tecnica di Marco Carbonelli su ICT Security Magazine, la DPIA non è un documento statico da archiviare dopo l’approvazione iniziale, ma un processo iterativo che accompagna l’intero ciclo di vita del sistema IA. Ogni modifica significativa, sia essa un aggiornamento del modello, l’introduzione di nuove tipologie di dati o l’estensione del perimetro d’uso, richiede una revisione della valutazione che documenti come il profilo di rischio sia variato e quali misure aggiuntive siano eventualmente necessarie.

Un elemento critico, spesso trascurato nella pratica quotidiana delle organizzazioni, è il coinvolgimento degli stakeholders rilevanti. L’art. 35 GDPR prevede espressamente la consultazione degli interessati “ove opportuno”: nel contesto IA, questa consultazione può assumere forme innovative che vanno oltre le tradizionali survey, includendo focus group strutturati, beta release con meccanismi di feedback, panel di utenti rappresentativi. Il coinvolgimento dei rappresentanti dei lavoratori quando l’IA impatta processi HR, la collaborazione costante con il DPO, l’interazione con responsabili IT security ed esperti di settore non sono opzioni ma necessità per una valutazione che abbia reale valore predittivo e non si risolva in un esercizio burocratico.

Aggiornamento dei Modelli 231: responsabilità amministrativa e IA

L’integrazione dell’IA nei Modelli di Organizzazione, Gestione e Controllo ex D.Lgs. 231/2001 rappresenta uno dei nodi più complessi dell’implementazione normativa. La L. 132/2025 introduce nuovi reati presupposto e aggravanti legate all’uso dell’IA, rendendo necessario un aggiornamento strutturale non solo della Parte Speciale del Modello, ma dell’intera filosofia di risk assessment aziendale.

Il primo passaggio operativo consiste nell’identificare con precisione i processi aziendali in cui l’IA è utilizzata o potrebbe essere utilizzata, valutandone l’esposizione ai nuovi rischi-reato. Le aree che emergono come particolarmente critiche includono il marketing e la comunicazione, dove la generazione di contenuti mediante IA generativa espone al rischio di produzione di deepfake o contenuti ingannevoli che potrebbero configurare i nuovi reati introdotti dalla legge. Le relazioni esterne e con la Pubblica Amministrazione costituiscono un’altra zona d’ombra: l’utilizzo di IA in processi che coinvolgono pubblici ufficiali può generare responsabilità se non adeguatamente governato.

La gestione delle risorse umane rappresenta forse l’ambito più delicato: i sistemi di screening CV, valutazione delle performance, previsione del turnover basati su algoritmi di machine learning espongono al rischio concreto di discriminazione algoritmica, con potenziali implicazioni sia sul fronte del diritto del lavoro sia su quello della responsabilità amministrativa. L’ambito della cybersecurity chiude il cerchio delle criticità: l’impiego di IA per finalità di attacco o difesa si muove su un confine labile tra security testing legittimo e attività potenzialmente illecite, richiedendo protocolli di controllo estremamente rigorosi.

Per ciascuna area sensibile identificata, il Modello deve prevedere protocolli di controllo specifici che vadano oltre le dichiarazioni di principio. La due diligence sui fornitori richiede l’implementazione di procedure strutturate di qualificazione dei provider di sistemi IA, con verifica documentale della conformità ad AI Act e L. 132/2025, valutazione delle certificazioni possedute, analisi dei contratti per individuare clausole critiche su responsabilità, accesso ai dati, diritti di audit. La formazione mirata deve articolarsi in programmi di alfabetizzazione specifici per ruoli esposti, distinguendo tra personale di marketing, HR, IT, con focus non generici ma calati su use case concreti: uso lecito degli strumenti, limiti operativi tassativi, procedure di escalation quando si manifestano dubbi interpretativi.

L’audit trail e logging assumono carattere obbligatorio: ogni decisione influenzata da IA deve essere tracciabile, con documentazione della supervisione umana che specifichi chi ha esaminato l’output algoritmico, con quali competenze, in quale lasso temporale. L’integrazione dell’intelligenza artificiale nei processi di valutazione dei rischi-reato rappresenta una frontiera che può potenziare l’efficacia dei controlli, ma richiede a sua volta governance rigorosa.

Gli incident response protocols per la gestione di eventi critici devono essere predisposti anticipatamente, non in emergenza: cosa fare se un sistema genera un output discriminatorio? Come gestire la scoperta di un deepfake prodotto internamente? Quali procedure attivare in caso di data breach originato da un sistema IA? Le risposte a queste domande non possono essere improvvisate, ma richiedono playbook dettagliati, responsabilità chiare, canali di comunicazione definiti.

Il ruolo dell’Organismo di Vigilanza subisce una trasformazione sostanziale. L’OdV deve acquisire competenze specifiche in materia di IA per svolgere efficacemente la propria funzione di controllo, il che può richiedere l’integrazione di nuove professionalità come data scientists o AI ethics experts, o il ricorso sistematico a consulenze tecniche esterne qualificate.

L’OdV non può limitarsi a verifiche formali sull’esistenza di documenti, ma deve entrare nel merito della sostanza: l’aggiornamento del registro sistemi IA è effettivo o cartolare? L’implementazione delle misure previste dal Modello è verificabile attraverso audit tecnici? La documentazione delle DPIA e delle decisioni di risk acceptance è completa e tracciabile? L’efficacia dei programmi di formazione è misurabile attraverso metriche oggettive? La gestione degli incident genera realmente learning organizzativo o si risolve in correzioni spot?

Trasparenza e informativa: l’obbligo comunicativo

Gli articoli 11 (lavoro), 13 (professioni intellettuali) e 14 (Pubblica Amministrazione) della L. 132/2025 introducono obblighi di informazione specifici che hanno generato reazioni contrastanti tra le categorie professionali coinvolte. Chi utilizza sistemi IA deve comunicarlo agli interessati in modo “chiaro, semplice ed esaustivo“. Questo principio, apparentemente banale, genera complessità operative significative che molte organizzazioni stanno sottovalutando.

La prima questione riguarda il “cosa comunicare”. L’informativa deve coprire l’esistenza stessa e le finalità del sistema IA utilizzato, specificando in quale fase del processo interviene e con quale impatto sulla decisione finale. Le tipologie di dati trattati devono essere elencate con precisione sufficiente a consentire all’interessato di comprendere l’estensione del trattamento. Le logiche algoritmiche sottostanti rappresentano il nodo più critico: occorre spiegare come funziona il sistema nella misura compatibile con la tutela di eventuali segreti industriali, un bilanciamento delicato che richiede competenze comunicative sofisticate.

L’impatto della decisione algoritmica sul risultato finale deve essere quantificato o quanto meno qualificato: il sistema fornisce una raccomandazione che l’operatore può liberamente disattendere? Genera un punteggio che vincola la decisione se supera determinate soglie? Preseleziona candidati eliminando automaticamente chi non soddisfa criteri prestabiliti? I meccanismi di supervisione umana attivi devono essere descritti con il necessario livello di dettaglio, specificando chi supervisiona, con quale frequenza, con quali strumenti di override. Infine, i diritti dell’interessato devono essere esplicitati: diritto di opposizione, rettifica, richiesta di human review delle decisioni algoritmiche.

Il “come comunicare” rappresenta forse la sfida più ardua. La trasparenza è il filo conduttore della normativa, ma renderla effettiva significa evitare sia il tecnicismo esoterico incomprensibile ai non addetti, sia la banalizzazione che svuota di significato l’informativa. Il layered approach, con informativa sintetica di primo livello integrata da approfondimenti tecnici disponibili on-demand, rappresenta una soluzione efficace: l’utente riceve immediatamente le informazioni essenziali, ma può accedere a livelli successivi di dettaglio se desidera approfondire.

La visual communication attraverso infografiche, flowcharts, video esplicativi può illustrare processi decisionali complessi in modo più accessibile rispetto a testi densi. Le FAQ strutturate e i casi d’uso concreti aiutano l’interessato a comprendere come il sistema opera in situazioni tipiche che può riconoscere come rilevanti per la propria esperienza. Un glossario accessibile diventa indispensabile quando termini tecnici come machine learning, neural network, training set risultano inevitabili: meglio spiegarli con linguaggio piano che dare per scontata una familiarità che spesso non c’è.

Il “quando comunicare” chiude il cerchio degli obblighi: l’informazione deve essere preventiva, non ex post. Nel contesto lavorativo, come specificato dall’art. 11 commentato dal Centro Studi CISL, ciò significa informare i dipendenti prima dell’implementazione di sistemi IA che impattano gestione, valutazione o selezione. Per le professioni intellettuali, l’obbligo scatta all’avvio della prestazione: il cliente deve sapere sin dall’inizio se e come l’IA supporta il professionista. Per la PA, deve essere garantita trasparenza ex ante attraverso pubblicazione sul sito istituzionale e informative specifiche nei procedimenti interessati.

Il mancato o inadeguato assolvimento di questi obblighi informativi espone l’organizzazione a rischi molteplici e convergenti. L’invalidità degli atti amministrativi per violazione del diritto di partecipazione e difesa rappresenta un rischio concreto per le PA. La responsabilità contrattuale può configurarsi nelle professioni intellettuali quando il cliente dimostri che avrebbe scelto diversamente se fosse stato adeguatamente informato. Le sanzioni GDPR possono raggiungere i 10 milioni di euro o il 2% del fatturato globale per violazione dell’art. 35, come documentato nel provvedimento del Garante. Il danno reputazionale, infine, può risultare più gravoso delle sanzioni formali, erodendo la fiducia di clienti, partner, investitori.

Human-in-the-loop: supervisione umana significativa

Il principio cardine della L. 132/2025 è che l’IA deve restare strumento di supporto, non decisore autonomo. L’art. 3 sancisce la “centralità della persona” e impone che ogni sistema di intelligenza artificiale debba essere sottoposto a forme di supervisione umana significativa. L’art. 14 specifica per la PA che l’utilizzo dell’intelligenza artificiale avviene in funzione strumentale e di supporto all’attività provvedimentale, nel rispetto dell’autonomia e del potere decisionale della persona che resta l’unica responsabile.

Tradurre operativamente il concetto di “supervisione umana significativa” è tutt’altro che scontato e richiede di superare la retorica che spesso accompagna questi temi. Non basta affermare che “la decisione finale spetta all’uomo” per adempiere all’obbligo: occorre progettare architetture decisionali che rendano questa supervisione effettiva, non formale. La letteratura tecnica identifica tre modelli principali di supervisione, ciascuno appropriato per diversi livelli di rischio.

Il modello Human-in-the-loop (HITL) prevede che l’umano sia coinvolto in ogni singola decisione: l’IA fornisce raccomandazioni che l’operatore può accettare o rigettare, con obbligo di motivazione esplicita in caso di disallineamento. Questo modello è mandatorio per sistemi ad alto rischio che impattano diritti fondamentali, salute o sicurezza delle persone. Il modello Human-on-the-loop (HOTL) consente all’IA di operare autonomamente entro parametri rigorosamente definiti, mentre l’umano monitora l’operatività e può intervenire quando emergono anomalie o su campioni predefiniti secondo logiche statistiche. Il modello Human-in-command (HIC) sposta la supervisione a livello strategico: l’umano definisce obiettivi e vincoli, l’IA esegue autonomamente ma l’umano mantiene il controllo strategico e può interrompere il sistema in qualsiasi momento.

La scelta del modello appropriato non può essere arbitraria ma deve discendere da un risk assessment rigoroso. Tuttavia, la supervisione efficace richiede prerequisiti che molte organizzazioni non garantiscono. Il supervisore deve possedere competenze sufficienti per comprendere il funzionamento del sistema, i suoi limiti intrinseci, i suoi bias potenziali: non può supervisionare efficacemente ciò che non comprende. L’autorità del supervisore deve essere effettiva, non nominale: deve avere il potere reale di overridare le raccomandazioni dell’IA senza subire conseguenze negative, pressioni implicite o esplicite verso il conformismo algoritmico.

Il tempo e le risorse rappresentano vincoli spesso sottovalutati: il supervisore deve disporre del tempo necessario per esaminare criticamente gli output, non essere pressato da vincoli di produttività incompatibili con una revisione accurata. Se il sistema genera 100 raccomandazioni al giorno e il supervisore dispone di 10 minuti totali per esaminarle, la supervisione è strutturalmente impossibile, non importa quanto competente sia l’operatore. L’indipendenza costituisce infine un requisito ideale spesso difficile da garantire: il supervisore non dovrebbe aver partecipato allo sviluppo del sistema per evitare bias di conferma, ma nelle organizzazioni piccole questa separazione può risultare impraticabile.

La documentazione di ogni decisione influenzata da IA diventa un obbligo non derogabile. Ogni caso deve essere tracciato specificando l’output fornito dal sistema IA, la valutazione del supervisore umano con indicazione delle verifiche effettuate, la decisione finale assunta e la motivazione di eventuali discostamenti dall’output algoritmico. Questa documentazione, per quanto onerosa, è essenziale non solo per dimostrare la compliance in caso di audit o contenziosi, ma anche per accumulare dati utili al miglioramento continuo del sistema: i casi in cui l’umano ha sistematicamente overridato l’IA possono rivelare bias o errori del modello che richiedono retraining o revisione delle logiche decisionali.

Gap analysis: criticità e opportunità

Gap normativi e implementativi

La L. 132/2025 si presenta dichiaratamente come legge “quadro“, rimandando a futuri decreti attuativi, da emanarsi entro 12 mesi, la definizione di aspetti cruciali quali procedure tecniche di valutazione, dettagli sanzionatori, articolazione precisa della governance nazionale tra AgID e ACN. Questa incompletezza, per quanto fisiologica in una normativa di questo tipo, genera incertezza operativa significativa: le organizzazioni devono implementare misure basandosi su principi generali, con il rischio concreto che i decreti attuativi introducano requisiti ulteriori o interpretazioni difformi che richiederanno costosi adeguamenti successivi.

Il coordinamento tra AI Act e L. 132/2025 crea ulteriori complessità interpretative che molti operatori sottovalutano. La sovrapposizione tra normativa europea e nazionale genera zone grigie in cui non è sempre chiaro quale disposizione prevalga o come si integrino requisiti apparentemente duplicati. L’AI Act classifica i sistemi in base al rischio e impone obblighi specifici ai providers e deployers. La L. 132/2025 introduce ulteriori obblighi settoriali che si stratificano su quelli europei. Le organizzazioni devono navigare due framework normativi che, pur coerenti nei principi ispiratori, differiscono nei dettagli operativi e nelle tempistiche applicative. La mancanza di linee guida consolidate da parte delle autorità competenti aumenta il rischio di interpretazioni difformi, con conseguente incertezza sulla compliance effettiva.

Il deficit di standard tecnici rappresenta forse la lacuna più critica dell’attuale panorama normativo. Molti requisiti normativi quali explainability, robustezza, fairness mancano di standard tecnici condivisi che consentano una valutazione oggettiva. Cosa significa concretamente “spiegazione comprensibile” per un modello di deep learning con milioni di parametri distribuiti su centinaia di layer? Quali metriche utilizzare per valutare il bias in contesti applicativi diversi? Quali threshold di accuratezza sono accettabili per un sistema di screening CV rispetto a uno di diagnosi medica assistita? L’assenza di reference standards condivisi, certificati da enti terzi riconosciuti, costringe le organizzazioni a scelte discrezionali, con conseguente frammentazione delle pratiche e difficoltà oggettive nei processi di audit e certificazione.

Gap di competenze e formazione

L’art. 4 dell’AI Act impone alle organizzazioni di garantire “un livello sufficiente di alfabetizzazione in materia di IA del loro personale“. La L. 132/2025 rafforza questo obbligo prevedendo “percorsi di formazione digitale” (art. 13) e “programmi di educazione e sensibilizzazione” (art. 8). Tuttavia, il mercato della formazione è ancora immaturo e caratterizzato da offerte di qualità molto disomogenea.

La carenza di formatori qualificati costituisce il primo vincolo strutturale: pochi professionisti combinano competenze tecniche in AI/ML, conoscenze legali approfondite di GDPR, AI Act e L. 132/2025, sensibilità etica su temi di bias e fairness, e competenze organizzative in risk management e compliance. Questa rarefazione di competenze ibride si riflette nell’offerta formativa: molti corsi propongono panoramiche superficiali su tutti i temi, senza declinazioni operative settoriali che consentano ai partecipanti di applicare i concetti al proprio contesto specifico. La difficoltà di misurazione dell’efficacia formativa completa il quadro critico: come valutare se la formazione ha realmente aumentato il livello di alfabetizzazione? Quali KPI adottare per monitorare il progresso? Come distinguere l’apprendimento dichiarativo superficiale dalla comprensione procedurale profonda?

Le organizzazioni che vogliono affrontare seriamente questo gap devono investire in formazione stratificata su più livelli. L’awareness generale per tutti i dipendenti deve coprire principi fondamentali, rischi connessi all’uso improprio dell’IA, obblighi informativi base, con un approccio divulgativo ma non banalizzante. La formazione tecnica per sviluppatori e data scientists richiede focus su privacy-by-design, tecniche di debiasing, metodologie di testing rigoroso, con esempi di codice e case study concreti.

La formazione specialistica per ruoli chiave quali DPO, CISO, legal counsels, compliance officers deve entrare nel dettaglio di governance frameworks, metodologie di risk assessment specifiche per IA, incident management, interpretazione normativa, con simulazioni e discussione di casi controversi. La formazione esecutiva per C-level e board deve concentrarsi su rischi strategici, responsabilità legali e reputazionali, opportunità competitive, con un taglio meno tecnico ma altrettanto rigoroso.

Gap organizzativo e culturale

L’adozione dell’IA non è un semplice aggiornamento tecnologico ma un cambiamento culturale profondo che investe i valori, i processi, le dinamiche di potere all’interno delle organizzazioni. Richiede anzitutto un mindset data-driven, un passaggio da decisioni basate su intuizione, esperienza personale, gerarchie consolidate a decisioni fondate su evidenze quantitative, analisi statistiche, pattern identificati algoritmicamente. Questo shift cognitivo genera resistenze, spesso implicite, in chi teme di vedere sminuito il valore della propria esperienza professionale.

La cultura dell’errore rappresenta un altro nodo critico: occorre accettare che i sistemi IA sbagliano, che l’accuratezza del 95% significa comunque 5 errori ogni 100 decisioni, che il machine learning richiede iterazioni, testing, fallimenti dai quali apprendere. Le organizzazioni italiane, tradizionalmente caratterizzate da bassa tolleranza all’errore e cultura della colpa, faticano a sviluppare questa capacità di learning from failures necessaria per governare tecnologie intrinsecamente probabilistiche.

La cross-functional collaboration diventa prerequisito non negoziabile: il superamento dei silos organizzativi, il dialogo costante tra IT, legal, business units, HR non sono opzioni ma necessità. L’IA è per definizione una tecnologia trasversale che tocca tutti i processi aziendali, e una governance efficace richiede meccanismi strutturati di coordinamento che molte organizzazioni gerarchiche tradizionali non possiedono. L’integrazione di etica applicata nei processi decisionali completa il quadro delle trasformazioni culturali necessarie: le considerazioni etiche non possono essere relegate a vincoli esterni imposti dalla compliance, ma devono diventare valori intrinseci che guidano le scelte tecnologiche.

Molte organizzazioni italiane, soprattutto PMI a carattere familiare, mantengono strutture gerarchiche rigide e culture profondamente avverse al rischio, poco compatibili con l’agilità e la sperimentazione controllata richieste dall’innovazione IA. Il cambiamento culturale è notoriamente lento, richiede leadership commitment visibile e continuativo, coerenza tra dichiarazioni e comportamenti effettivi, investimenti temporali che vanno ben oltre l’orizzonte del quarter finanziario.

Opportunità: compliance come vantaggio competitivo

La conformità alla L. 132/2025 e all’AI Act, tuttavia, non deve essere vista esclusivamente come onere ma anche come opportunità strategica che può generare vantaggi competitivi tangibili. La differenziazione reputazionale rappresenta il primo beneficio: le organizzazioni che dimostreranno standard elevati di AI governance, magari attraverso certificazioni di terza parte o audit indipendenti pubblicati, potranno valorizzare questa compliance in termini di brand equity e fiducia degli stakeholder. In un mercato dove i data breach e gli scandali algoritmici erodono rapidamente la fiducia, una reputazione solida di AI responsabile costituisce un asset strategico non facilmente replicabile.

L’accesso facilitato a incentivi pubblici costituisce un ulteriore vantaggio concreto. La L. 132/2025 prevede un fondo da 1 miliardo di euro per tecnologie emergenti e IA affidabile, con specifico sostegno a microimprese e PMI. Le organizzazioni che possono dimostrare compliance strutturata saranno favorite nell’accesso a bandi, contributi a fondo perduto, partnership pubblico-private che richiedono garanzie di solidità governance.

La mitigazione dei rischi legali assume rilevanza crescente in un contesto dove le sanzioni potenziali sono drammaticamente aumentate: fino a 35 milioni di euro o 7% del fatturato globale per pratiche vietate secondo l’AI Act. Investire in compliance preventiva significa ridurre drasticamente l’esposizione a queste sanzioni future, evitare contenziosi costosi, prevenire il danno reputazionale amplificato dai social media che può risultare più distruttivo delle multe stesse.

L’attraction e retention di talenti qualificati costituisce un beneficio spesso sottovalutato. I professionisti di alto livello, particolarmente nelle aree tecniche e legal, preferiscono lavorare per organizzazioni che dimostrano serietà nella governance tecnologica, che investono in formazione continua, che operano secondo standard etici elevati. In un mercato del lavoro sempre più competitivo per le competenze IA-related, la reputazione di AI responsabile può fare la differenza nel reclutamento.

Le sandbox regolamentari, infine, rappresentano opportunità preziose per PMI e startup. L’AI Act e la normativa nazionale prevedono spazi di sperimentazione controllata dove testare innovazioni IA con supervisione regolatoria, riducendo il rischio compliance durante le fasi di R&D. Accedere a questi programmi richiede però di dimostrare un approccio maturo alla governance, chiudendo il cerchio: la compliance apre porte che restano precluse a chi opera in zone grigie.

Metodologia operativa per l’implementazione: un percorso in cinque fasi

L’implementazione della Legge 132/2025 nelle aziende italiane richiede un approccio metodologico strutturato che bilanci rigore e pragmatismo, evitando sia la paralisi da analisi sia l’improvvisazione irresponsabile. La metodologia qui proposta si articola in cinque fasi temporalmente sovrapposte, con particolare attenzione all’interdipendenza tra gli interventi e alla necessità di quick wins che dimostrino valore nei primi mesi.

La prima fase di assessment e mappatura, che occupa tipicamente i primi due mesi del progetto, inizia con la costituzione di una task force multidisciplinare che coinvolga rappresentanti delle aree IT, legal, compliance, business e risorse umane. Questa eterogeneità non è un vezzo organizzativo ma una necessità: l’IA è per definizione trasversale e richiede competenze complementari per essere governata efficacemente. Il censimento dei sistemi IA esistenti, inclusa la cosiddetta “shadow AI” adottata dai dipartimenti senza autorizzazione formale, costituisce il primo deliverable concreto: un inventario esaustivo che documenti ogni applicazione, anche quelle apparentemente marginali.

La mappatura dei data flows procede in parallelo, identificando quali dati personali o categorie particolari vengano processati da ciascun sistema, con particolare attenzione alle origini dei dati e ai tempi di conservazione. La classificazione dei sistemi per livello di rischio secondo la tassonomia dell’AI Act consente di stabilire priorità razionali negli interventi successivi: un sistema ad alto rischio che processa dati sanitari sensibili richiede attenzione immediata, mentre un chatbot informativo a rischio minimo può essere affrontato con calma maggiore.

L’identificazione dei processi aziendali esposti ai nuovi reati presupposto del D.Lgs. 231/2001 chiude questa fase di analisi, producendo una gap analysis strutturata che confronta lo stato attuale con i requisiti normativi e definisce priorità di intervento basate su una matrice rischio per impatto.

La seconda fase di governance e policy, tipicamente collocata tra il terzo e il quarto mese, si concentra sulla definizione dell’architettura decisionale e dei documenti strategici. L’AI Governance Framework deve specificare ruoli e responsabilità con precisione chirurgica: chi approva l’adozione di nuovi sistemi IA? Chi ha autorità per interrompere un sistema che manifesta comportamenti anomali? Come si coordinano le diverse funzioni aziendali nelle decisioni che coinvolgono l’IA? La costituzione di un comitato multifunzionale per l’IA, che si riunisca con cadenza almeno mensile, fornisce la sede istituzionale per queste decisioni.

La redazione dell’AI Policy aziendale traduce i principi normativi in linee guida operative: quali casi d’uso sono ammessi, quali esplicitamente vietati, quali sottoposti ad approval workflow particolare? Un documento di policy efficace non si limita a enunciare principi astratti ma fornisce esempi concreti, distinguendo tra utilizzi legittimi e utilizzi problematici attraverso case study che i dipendenti possano riconoscere come rilevanti per il proprio lavoro quotidiano. L’aggiornamento del Modello 231 deve intervenire sia sulla Parte Generale, integrando i principi di AI governance, sia sulla Parte Speciale, introducendo protocolli specifici per le aree a rischio identificate nella prima fase.

La definizione di procedure per l’introduzione di nuovi sistemi IA costituisce forse il deliverable più importante di questa fase: un approval workflow che specifichi quali valutazioni siano necessarie prima dell’adozione, chi debba essere coinvolto, quali documenti prodotti, quali soglie di rischio richiedano escalation verso livelli decisionali superiori. La contrattualizzazione con i fornitori richiede attenzione particolare alle clausole su responsabilità, diritti di audit, data ownership, exit strategies: contratti standard pensati per software tradizionale spesso non coprono adeguatamente le specificità dell’IA.

La nomina di un AI Coordinator o AI Ethics Officer, se la dimensione aziendale lo giustifica, fornisce un punto di riferimento organizzativo visibile per tutte le questioni IA-related. L’integrazione dell’IA nell’Enterprise Risk Management chiude questa fase, assicurando che i rischi algoritmici siano trattati con lo stesso rigore dei rischi finanziari, operativi, reputazionali tradizionali.

La terza fase di compliance operativa, che si sviluppa tipicamente tra il quinto e il settimo mese con significative sovrapposizioni con la fase formativa, si concentra sull’implementazione concreta delle misure. L’esecuzione delle DPIA per sistemi ad alto rischio richiede competenze tecniche e legali avanzate, spesso imponendo il ricorso a consulenze esterne specializzate. L’implementazione di misure tecniche quali logging strutturato, audit trail immutabili, explainability tools integrati nei sistemi critici richiede collaborazione stretta tra team di compliance e team di sviluppo, spesso con necessità di refactoring di sistemi esistenti.

Le misure organizzative, quali segregation of duties e protocolli di human oversight, devono essere tradotte in procedure operative dettagliate che specifichino chi fa cosa, quando, con quali strumenti, secondo quali criteri. La redazione delle informative per lavoratori, clienti, utenti secondo il layered approach discusso precedentemente costituisce un deliverable che richiede iterazioni multiple: le prime versioni sono inevitabilmente troppo tecniche o troppo vaghe, e solo attraverso testing con utenti reali si raggiunge il bilanciamento ottimale tra completezza e comprensibilità.

La definizione di incident response plan specifici per IA anticipa scenari critici: discovery di bias discriminatorio in produzione, deep fake creato con strumenti aziendali, data breach originato da vulnerabilità in un modello di ML. Ogni scenario richiede playbook dettagliati con responsabilità, canali di comunicazione, criteri di escalation predefiniti. Il testing e la validazione dei meccanismi di supervisione umana attraverso simulazioni e penetration testing organizzativi verifica che i controlli progettati funzionino nella pratica, non solo sulla carta. La documentazione di compliance, che include registro dei trattamenti aggiornato, registro sistemi IA, DPIA, risk assessments settoriali, deve essere organizzata in modo che un auditor esterno possa ricostruire la logica decisionale dell’organizzazione senza necessità di interviste estensive.

La quarta fase di formazione e change management, che si sviluppa in parallelo alla fase di compliance operativa tra il sesto e l’ottavo mese, affronta la dimensione più critica e sottovalutata dell’implementazione: le persone. La progettazione del piano formativo stratificato deve differenziare contenuti, metodi e durata in funzione dei target: awareness generale per tutti i dipendenti con moduli e-learning di 2-3 ore, formazione tecnica per sviluppatori e data scientists con workshop pratici di 2-3 giorni, formazione specialistica per DPO, CISO, legal e compliance officers con masterclass di 5 giorni più follow-up periodici, formazione esecutiva per C-level e board con sessioni intensive di mezza giornata focalizzate su rischi e opportunità strategiche.

L’erogazione della formazione con metodologie blended che combinano e-learning asincrono, sessioni d’aula sincrone, workshop pratici su casi reali, simulazioni di incident response massimizza l’efficacia dell’apprendimento rispetto a formazioni puramente frontali. La valutazione dell’efficacia attraverso test di apprendimento, discussione di case studies, raccolta sistematica di feedback consente di iterare e migliorare i contenuti. Il programma di comunicazione interna attraverso newsletter periodiche, sezioni dedicate sull’intranet aziendale, town halls con il management crea awareness diffusa e dimostra commitment visibile della leadership.

Il coinvolgimento delle rappresentanze dei lavoratori, come richiesto dall’art. 11 della L. 132/2025, non deve essere formale ma sostanziale: presentazioni dedicate, consultazioni sui sistemi che impattano i lavoratori, canali di feedback strutturati. La creazione di un repository documentale accessibile che raccolga policy, procedure, FAQ, glossari, template per le valutazioni costituisce una risorsa permanente che riduce la dipendenza da singole persone e facilita l’onboarding di nuovi colleghi.

La quinta fase di monitoraggio e miglioramento continuo, che parte dall’ottavo-nono mese ma prosegue indefinitamente, trasforma la compliance da progetto a processo permanente. L’attivazione di KPI per monitorare la compliance attraverso metriche quali percentuale di sistemi IA censiti sul totale stimato, percentuale di DPIA completate per sistemi ad alto rischio, coverage della formazione per categoria di dipendenti, tempo medio di risposta agli incident fornisce visibilità oggettiva sullo stato dell’implementazione e consente correzioni di rotta tempestive.

Gli audit interni periodici, con cadenza almeno semestrale, verificano la conformità effettiva alle policy e procedure, non limitandosi a controllare l’esistenza di documenti ma testando l’operatività dei controlli attraverso sample testing e walkthrough. La revisione delle DPIA in caso di modifiche significative ai sistemi, nuovo training dei modelli, estensione dei casi d’uso, cambiamenti normativi assicura che le valutazioni restino attuali. Il monitoraggio dell’evoluzione normativa, con particolare attenzione ai decreti attuativi della L. 132/2025 attesi nei prossimi mesi e alle linee guida di AgID, ACN e EDPB richiede dedicare risorse specifiche al regulatory intelligence.

La raccolta e analisi sistematica degli incident IA, con root cause analysis, identificazione di lessons learned, aggiornamento conseguente delle procedure trasforma gli errori in opportunità di miglioramento. L’aggiornamento almeno annuale del Modello 231 basato sul risk assessment aggiornato mantiene allineamento tra governance formale e realtà operativa. Il reporting periodico al Consiglio di Amministrazione e all’Organismo di Vigilanza sullo stato della AI governance, con metriche quantitative e assessment qualitativo, assicura che il top management mantenga visibilità e ownership su un tema che rapidamente evolve da questione tecnica a rischio strategico d’impresa.

Conclusioni: oltre la compliance, verso l’AI trustworthy

L’implementazione della Legge 132/2025 nelle aziende italiane non può essere ridotta a un esercizio di compliance formale, un’ulteriore casella da spuntare nell’elenco già affollato degli adempimenti normativi. La posta in gioco è significativamente più alta: si tratta di costruire un ecosistema di intelligenza artificiale affidabile (trustworthy AI), in cui innovazione tecnologica e tutela dei diritti procedano in parallelo, in una tensione produttiva piuttosto che in un’opposizione sterile.

Il gap che separa l’Italia dalla media europea nell’adozione dell’IA, con quel divario del 61% che i dati Anitec-Assinform hanno impietosamente fotografato, è preoccupante e richiede interventi urgenti. Tuttavia, la normativa può trasformarsi da ostacolo percepito in catalizzatore effettivo se governata con approccio pragmatico e strategico. Le organizzazioni che sapranno integrare i requisiti normativi nei processi di sviluppo e deployment dell’IA fin dalle fasi iniziali, adottando un paradigma di AI governance by design piuttosto che di compliance retrofitted, costruiranno un vantaggio competitivo sostenibile che i competitor non potranno replicare rapidamente.

Tre fattori emergeranno come determinanti nei prossimi anni, distinguendo le organizzazioni che prospereranno in questo nuovo panorama da quelle che resteranno indietro. L’investimento sistematico in competenze ibride costituisce il primo elemento critico. La tecnologia evolve con ritmo esponenziale, la normativa la insegue con ritardi fisiologici inevitabili in democrazie pluraliste dove il processo legislativo richiede tempi di maturazione. Le organizzazioni non possono permettersi di affidarsi passivamente a checklist statiche elaborate da consulenti esterni: devono costruire capacità interne di interpretazione, anticipazione, adattamento.

Il ruolo tradizionale del Data Protection Officer sta già evolvendo verso quello di AI Ethics & Compliance Officer, una figura che integra competenze tecniche approfondite su machine learning e data science, conoscenze legali estese di GDPR, AI Act e normative settoriali, sensibilità etica maturata attraverso studio di casi controversi, capacità organizzative di gestire processi trasversali che coinvolgono tutta l’azienda.

La collaborazione multi-stakeholder rappresenta il secondo fattore critico che nessuna organizzazione può permettersi di trascurare. Nessuna impresa, per quanto grande e sofisticata, può affrontare da sola la complessità multidimensionale dell’IA governance. Servono piattaforme di confronto settoriali dove condividere esperienze, discutere interpretazioni normative controverse, sviluppare best practices validate sul campo. Le associazioni di categoria come Confindustria, Assinform e Anorc possono svolgere un ruolo prezioso di aggregazione, creando working group dedicati che producano linee guida operative, template riutilizzabili, case study anonimi che documentino successi e fallimenti. Le sandbox regolamentari previste da AI Act e L. 132/2025, rappresentano spazi preziosi per sperimentazione controllata dove testare soluzioni innovative sotto supervisione delle autorità, riducendo il rischio compliance durante le fasi critiche di R&D.

Il pragmatismo regolatorio costituisce il terzo elemento determinante, un fattore che esula dal controllo delle singole organizzazioni ma che condizionerà profondamente il successo dell’intero impianto normativo. L’efficacia della Legge 132/2025 dipenderà in misura cruciale dalla capacità delle autorità di controllo – AgID, ACN, Garante Privacy – di fornire guidance operative tempestive, proporzionali, evidence-based.

Un enforcement eccessivamente rigido nelle fasi iniziali, quando le organizzazioni stanno ancora sperimentando approcci e metodologie, rischia di paralizzare l’innovazione e generare un atteggiamento difensivo che privilegia la minimizzazione del rischio legale rispetto all’adozione di tecnologie potenzialmente transformative. Un approccio più graduale, come suggerito nell’analisi per la Pubblica Amministrazione, con focus su enforcement educativo prima che sanzionatorio, può favorire una compliance effettiva e sostanziale piuttosto che cartolare e formale.

Il percorso che si apre davanti alle organizzazioni italiane è appena iniziato, e presenta sfide formidabili ma non insormontabili. I prossimi dodici mesi, durante i quali verranno emanati i decreti attuativi della L. 132/2025, saranno cruciali per definire l’interpretazione operativa della normativa. Le organizzazioni che avranno già avviato il processo di adeguamento si troveranno in posizione di vantaggio, potendo influenzare l’evoluzione interpretativa della normativa attraverso il dialogo costruttivo con le autorità e la dimostrazione di soluzioni pratiche efficaci che bilanciano innovazione e protezione.

L’intelligenza artificiale è una rivoluzione tecnologica irreversibile che sta già ridisegnando settori interi dell’economia e della società. La sfida per l’Italia non è se adottare l’IA – questo treno è già partito e non si fermerà – ma come governarla in modo che massimizzi i benefici e minimizzi i rischi. La Legge 132/2025 fornisce gli strumenti normativi, creando un framework che, per quanto perfettibile e destinato a evolversi, rappresenta comunque un punto di riferimento chiaro. Alle organizzazioni spetta tradurli in pratica organizzativa quotidiana, investendo in competenze, processi, cultura. Alle autorità spetta garantire un ecosistema regolatorio che bilanci con saggezza innovazione e protezione, evitando sia il permissivismo che aprirebbe la strada ad abusi, sia il rigorismo che soffocherebbe la sperimentazione legittima.

Ai professionisti del diritto digitale, della cybersecurity, del digital forensics, della compliance spetta costruire le competenze ibride necessarie a navigare questa complessità, posizionandosi come bridge tra il mondo tecnologico e quello legale, traducendo in linguaggi reciprocamente comprensibili esigenze che troppo spesso parlano lingue inconciliabili. L’alternativa al governo consapevole e proattivo della trasformazione è l’irrilevanza competitiva progressiva, un declino magari lento ma inesorabile. Le aziende italiane, le istituzioni, i professionisti non possono permetterselo. Il momento di agire è ora, e gli strumenti normativi e metodologici per farlo efficacemente sono disponibili. Quello che serve è la volontà di investire, la capacità di collaborare, il coraggio di sperimentare.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/legge-132-2025/