Virtual Event Today: Zero Trust & Identity Strategies Summit

SecurityWeek’s Zero Trust & Identity Strategies Summit 2025 takes place today as a fully immersive virtual event. Sessions will run from 11AM – 2:00PM ET, with the virtual expo hall and networking lounge open until 4PM ET.

Zero Trust is more than a marketing buzzword. As defenders look to holistic approaches to securing corporate assets, the concept of ZTNA (Zero Trust Network Access) takes on added importance to help simplify and strengthen access controls for all users, devices and data.

Join us as we dive into the world of digital identity management and the role of zero-trust principles and associated technologies.

Agenda:

  • 11:00 AM ET – Zero Friction Defense: Where Identity Meets Security
  • 11:30 AM – Beyond the Basics: Why Today’s Enterprises Need Full IGA
  • 12:10 PM – Networking Break – Visit Virtual Expo Hall!
  • 12:30 PM – Solving Secrets Sprawl Takes More Than Security: Why Machine Identity Is Everyone’s Problem
  • 1:00 PM – Seamless Secure Authentication with Okta Fastpass
  • 1:40 PM – Ping Identity Workforce Solutions
  • 2:00 PM – 4PM ET – Networking and Virtual Expo Open

Platinum Sponsor:

Okta

Gold Sponsor

https://www.securityweek.com/virtual-event-today-zero-trust-identity-strategies-summit/


Google DeepMind’s New AI Agent Finds and Fixes Vulnerabilities 

Google’s DeepMind artificial intelligence research lab this week unveiled an AI agent designed to autonomously find and fix vulnerabilities.

Google has several projects focusing on the use of AI for the discovery of vulnerabilities in software. The tech giant recently reported that its Big Sleep agent discovered a critical SQLite vulnerability and thwarted efforts to exploit it in the wild.

Its latest product is CodeMender, an AI agent that not only finds security holes but also patches them. The company argues that such tools are needed because as AI gets better at discovering flaws, it will be difficult for humans to keep up with patching. 

Related: CISO Conversations: John ‘Four’ Flynn, VP of Security and Privacy at Google DeepMind

Deepmind says CodeMender, which leverages Gemini DeepThink models, is capable of rewriting and securing existing code in order to eliminate entire classes of security bugs to prevent future exploits. 

CodeMender includes checks designed to ensure that the changes it makes do not cause regressions or other issues. 

The AI agent can reason about code — understanding and predicting the behavior of a program without actually running it — and effectively validate changes through the use of advanced program analysis and multi-agent systems. 

Advanced program analysis includes static and dynamic analysis, fuzzing, differential testing, and SMT solvers to identify the root cause of vulnerabilities and architectural weaknesses. 

Advertisement. Scroll to continue reading.

As for multi-agent systems, DeepMind explained, “We developed special-purpose agents that enable CodeMender to tackle specific aspects of an underlying problem. For example, CodeMender uses a large language model-based critique tool that highlights the differences between the original and modified code in order to verify that the proposed changes do not introduce regressions, and self-correct as needed.”

Over the past six months, CodeMender has provided 72 security fixes to open source projects, some of which have millions of lines of code. However, DeepMind says it’s being cautious and all patches are reviewed before being submitted. 

Related: Google Patches Gemini AI Hacks Involving Poisoned Logs, Search Results

Related: California Gov. Gavin Newsom Signs Bill Creating AI Safety Measures

Related: Salesforce AI Hack Enabled CRM Data Theft

https://www.securityweek.com/google-deepminds-new-ai-agent-finds-and-fixes-vulnerabilities/


Cybersecurity israeliana: l’architettura della supremazia digitale occidentale (e le sue ombre)

La cybersecurity israeliana rappresenta oggi l’architettura fondamentale su cui l’Occidente costruisce la propria difesa digitale. Con un fatturato di 14,7 miliardi di dollari in export militare e investimenti per quasi 4 miliardi nel settore cyber, Israele ha trasformato la necessità di sopravvivenza in dominio tecnologico globale. Dall’Unità 8200 alle startup unicorno, dalla base segreta nel Negev ai contratti miliardari con Germania e Regno Unito, la “Startup Nation” detiene oggi 11 delle 21 aziende cyber unicorno mondiali.

Ma dietro l’innovazione si nasconde un’ombra: sistemi AI che automatizzano la morte, sorveglianza di massa sui territori palestinesi, e spyware come Pegasus nelle mani di regimi autoritari. Mentre l’Europa diventa sempre più dipendente da queste tecnologie, una domanda resta inevasa: stiamo proteggendo la democrazia o costruendo l’infrastruttura della nostra futura sorveglianza totale?

Come la “Startup Nation” ha trasformato la sopravvivenza in dominio globale della cybersecurity

Nel cuore del deserto del Negev, a novanta minuti da Tel Aviv, sorge quello che molti considerano il futuro della guerra digitale. È qui, in una base segreta che ospita 14.000 specialisti, che Israele sta scrivendo il prossimo capitolo della sicurezza informatica globale.

Non è fantascienza: è la realtà di un paese che ha trasformato ogni minaccia in un’opportunità di innovazione, costruendo un impero tecnologico da miliardi di dollari.

I numeri parlano chiaro: nel 2024 Israele ha toccato il record storico di 14,7 miliardi di dollari in export militare, mentre il settore della cybersecurity ha attratto investimenti per quasi 4 miliardi di dollari – una crescita del 56% in un solo anno. Ma dietro questi dati si nasconde una storia di innovazione e strategia, nonché una visione del futuro che sta cambiando il modo in cui il mondo occidentale si difende dalle minacce digitali.

Dal ferro al silicio: l’evoluzione dell’Iron Dome

Tutti conoscono l’Iron Dome, il sistema missilistico che intercetta razzi nemici con un’efficacia del 90%. Ma pochi sanno che Israele sta sviluppando la sua versione digitale: il “Cyber Dome”, un progetto ambizioso annunciato nel 2022 che promette di fare nel cyberspazio quello che l’Iron Dome ha fatto nei cieli israeliani.

«Chiamiamo questo progetto la “salsa segreta”», spiega Gaby Portnoy, direttore generale dell’Israel National Cyber Directorate.

«Mentre l’orchestra – gli sforzi combinati di diversi dipartimenti – lavora all’esterno, noi facciamo il lavoro interno. Lavoriamo tutti a stretto contatto, insieme».

Il progetto, ancora in fase di sviluppo, coinvolge veterani dell’Unità 8200 (l’equivalente israeliano della NSA), operatori del Mossad e Shin Bet, esperti del ministero della Difesa. L’obiettivo è creare un sistema di intelligenza artificiale capace di identificare e neutralizzare attacchi informatici prima ancora che si manifestino.

L’Unità 8200: la fabbrica dei geni digitali

Se dovessimo identificare il cuore pulsante della cyber-potenza israeliana, questo sarebbe sicuramente l’Unità 8200. Con i suoi 5.000-10.000 specialisti (le cifre esatte sono classificate), rappresenta la più grande unità delle forze armate israeliane e il vivaio da cui escono i futuri CEO delle più importanti aziende tech del mondo.

Tipicamente, infatti, gli ufficiali che vanno in pensione dalle forze di difesa si uniscono all’industria cyber privata.

L’unità ha sviluppato sistemi come Gospel (Habsora) e Lavender, database di intelligenza artificiale capaci di analizzare comunicazioni, immagini e informazioni da internet e reti mobili per individuare gli obiettivi da colpire: una scelta che ha attirato sul governo aspre critiche da parte degli osservatori internazionali – e non solo.

Già nel 2014, infatti, 43 riservisti e veterani dell’Unità 8200 – inclusi degli ufficiali – hanno pubblicato una lettera aperta rifiutandosi di continuare a servire, denunciando che “l’intelligence raccolta dall’unità era parte integrante dell’occupazione militare israeliana” e veniva usata per “danneggiare persone innocenti”.

L’Intelligenza Artificiale della morte: Gospel, Lavender e il prezzo dell’automazione

Se l’Iron Dome rappresenta il volto “presentabile” della tecnologia israeliana, i sistemi AI utilizzati a Gaza ne rivelano il lato più oscuro. Human Rights Watch ha documentato come l’esercito israeliano utilizzi strumenti digitali – tra cui Gospel per generare obiettivi strutturali, Lavender per identificare presunti militanti e “Where’s Daddy?” per tracciare i loro movimenti – che “possono aumentare il rischio di danni ai civili”.

Secondo fonti militari israeliane, Gospel può generare 100 obiettivi di bombardamento al giorno, rispetto ai 50-100 l’anno che producevano gli analisti umani. Ma questa efficienza ha un costo devastante: esperti ONU hanno denunciato come l’uso presunto di AI abbia contribuito a un bilancio senza precedenti, con oltre 33.000 persone uccise nei primi sei mesi del conflitto e il 60-70% di abitazioni a Gaza distrutte o danneggiate.

Secondo quanto ricostruito da diverse inchieste giornalistiche, agli ufficiali è stato detto come sia accettabile uccidere 15-20 non combattenti per eliminare un singolo soldato di Hamas, o addirittura fino a 100 civili per colpire un comandante nemico. Ancora più inquietante è che il sistema Lavender avrebbe un margine di errore del 10% nell’identificazione dei target; e gli analisti potrebbero dedicare appena 20 secondi alla verifica di ciascun obiettivo.

Il Comitato Speciale ONU ha concluso che “l’uso militare israeliano di sistemi di targeting assistiti da AI, con supervisione umana minima, combinato con bombe pesanti, sottolinea il disprezzo di Israele per il suo obbligo di distinguere tra civili e combattenti”.

La questione, quindi, non è più se l’AI possa essere usata in guerra; ma se il suo utilizzo rispetti il diritto internazionale umanitario. E le evidenze suggeriscono fortemente di no.

La corsa all’oro digitale: CyberArk e l’acquisizione del secolo

Se dovessimo scegliere un momento simbolico del dominio israeliano nella cybersecurity sarebbe il luglio del 2025, quando Palo Alto Networks ha annunciato di aver acquisito CyberArk per 25 miliardi di dollari; la seconda più grande acquisizione tecnologica americana dell’anno, dopo Google-Wiz.

CyberArk, specializzata nella gestione degli accessi privilegiati, rappresenta l’eccellenza israeliana nel settore. «Siamo partiti oltre vent’anni fa con l’obiettivo di proteggere gli asset più critici del mondo», racconta Udi Mokady, chairman esecutivo e co-fondatore.

«Unire le forze con Palo Alto Networks è un nuovo capitolo potente, costruito su valori condivisi e un profondo impegno nel risolvere le sfide identitarie più difficili».

L’acquisizione non è solo una questione economica: rappresenta il riconoscimento che nella nuova era dell’intelligenza artificiale, in cui controllare chi ha accesso a cosa è diventato il Santo Graal della sicurezza informatica.

L’Europa si arma: quando la Germania compra israeliano

La guerra in Ucraina ha cambiato tutto. Improvvisamente, l’Europa ha realizzato di aver bisogno di sistemi di difesa all’altezza delle nuove minacce. E a chi si è rivolta? A Israele.

Il contratto da 3,5 miliardi di dollari per il sistema Arrow-3 firmato dalla Germania nel 2023 rappresenta la più grande vendita di armi nella storia israeliana. «È un momento emozionante, essere qui come figlio e nipote di sopravvissuti all’Olocausto, su suolo tedesco», ha dichiarato il ministro della Difesa israeliano Yoav Gallant durante la cerimonia di firma.

Ma Arrow-3 è solo l’inizio. L’Europa rappresenta ora il 54% di tutti gli export militari israeliani, con contratti che spaziano dalla Romania (2,3 miliardi per sistemi Spyder) al Regno Unito (con una partnership cyber da 20 milioni di sterline). È una rivoluzione geopolitica, che vede l’Europa abbracciare sempre di più il modello di difesa israeliano.

La sfida russo-cinese: la geopolitica incontra la tecnologia

In questo nuovo mondo digitale la competizione non è solo commerciale: è strategica.
Da una parte ci sono le aziende russe come Kaspersky, che processa 467.000 file malevoli al giorno ma è stata bandita dai mercati NATO nel 2024; dall’altra giganti cinesi come 360 Security, con 500 milioni di utenti ma limitata ai mercati non occidentali.

La differenza fondamentale è che le aziende israeliane hanno accesso privilegiato ai mercati occidentali e NATO, con un vantaggio competitivo enorme, che va ben oltre la pura tecnologia.

Il risultato è evidente: pur essendo tecnologicamente avanzati, i sistemi russi e cinesi sono geograficamente e politicamente limitati. Le tecnologie israeliane, al contrario, diventano lo standard de facto dell’Occidente.

Il boom degli investimenti: il denaro segue l’innovazione

Per la cybersecurity israeliana, il 2024 è stato un anno d’oro: gli investimenti da 3,8 miliardi di dollari rappresentano un aumento del 56% rispetto all’anno precedente, con il settore che attrae il 36% di tutti gli investimenti tecnologici nazionali, nonostante rappresenti solo il 7% delle aziende.

«Quello che stiamo vedendo non è solo un rimbalzo, è una validazione di come il nostro ecosistema si è evoluto» spiega Or Salom, analista di YL Ventures.

«I founder israeliani sono sempre stati potenze tecniche, ma ora combinano queste capacità con l’acume negli affari».

I numeri sono eloquenti: delle 21 startup cyber “unicorno” globali, 11 sono israeliane. Team8 ha raccolto 500 milioni di dollari nel marzo 2024, mentre Cyberstarts ha lanciato un Employee Liquidity Fund da 300 milioni per trattenere i talenti migliori.

Cybersecurity israeliana, il futuro è quantistico

Mentre il mondo si prepara all’era del quantum computing, Israele sembra essere già un passo avanti. Il paese sta guidando la transizione verso la crittografia post-quantum, con scadenze governative a fine 2025 per completare i threat assessment ministeriali.

«Non si tratta solo di essere pronti per la minaccia quantistica», spiega un ricercatore dell’Israel Innovation Authority, «ma di definire gli standard che il resto del mondo seguirà».

Nel frattempo il paese ha completato (nel settembre 2025) il sistema Iron Beam, che utilizza laser ad alta energia per intercettare minacce aeree a costo quasi zero per colpo.

Quando la guerra diventa digitale: i test sul campo

Maggio 2021, operazione “Guardian of the Walls”. Per undici giorni, Hamas lancia oltre 4.360 razzi verso Israele mentre porta avanti una campagna cyber coordinata. È il primo vero test della resilienza digitale israeliana in tempo di guerra.

I risultati sono impressionanti: l’Iron Dome intercetta il 90% dei razzi, mentre i sistemi cyber respingono attacchi DDoS da un milione di richieste al secondo mantenendo un uptime del 99,9% per le infrastrutture critiche. Durante il conflitto Israele colpisce anche edifici utilizzati da Hamas per operazioni cyber, dimostrando l’integrazione tra capacità cinetiche e digitali.

Ma, anche se l’Iron Dome è spesso presentato come invincibile, la realtà è più complessa. Durante l’attacco di Hamas del 7 ottobre 2023, il sistema si è rivelato vulnerabile alla saturazione: con soli 600-800 intercettori disponibili contro diverse migliaia di missili, anche un’efficacia teorica del 100% non avrebbe impedito che molti razzi raggiungessero il bersaglio.

Ogni missile intercettore Tamir costa tra 40.000 e 100.000 dollari, mentre i razzi che deve abbattere costano poche centinaia di dollari. Questo squilibrio economico rappresenta un esempio lampante di asimmetria militare: un approccio low-cost è riuscito a sconfiggere un sistema high-tech molto più costoso.

Sorveglianza totale: il “laboratorio palestinese”

Per comprendere il futuro della sorveglianza di massa, è necessario guardare ai territori palestinesi. Un rapporto di 7amleh del dicembre 2024 ha rivelato che le politiche israeliane di sorveglianza digitale hanno raggiunto livelli senza precedenti dopo il 7 ottobre 2023, includendo arresti di massa basati su attività digitali, licenziamenti arbitrari e un maggiore affidamento su tecnologie avanzate come sistemi di riconoscimento facciale, droni e spyware.

Il New York Times ha documentato come l’esercito israeliano utilizzi un sistema espansivo di riconoscimento facciale a Gaza per condurre sorveglianza di massa e catalogare i volti dei palestinesi senza il loro consenso, utilizzando tecnologie dell’azienda israeliana Corsight e Google Photos. Una realtà quotidiana – per quanto distopica – che riguarda milioni di persone.

Il messaggio è chiaro: i palestinesi sono diventati cavie involontarie per testare tecnologie che potrebbero poi essere vendute e utilizzate altrove nel mondo. In merito Amnesty International ha accolto con favore la richiesta di un importante investitore olandese affinché TKH Group, produttore di telecamere installate a Gerusalemme Est occupata, adotti salvaguardie per i diritti umani entro un anno o affronti la fine degli investimenti come conseguenza.

La sorveglianza di massa non conosce confini. La domanda da porsi, allora, è: se queste tecnologie vengono normalizzate nei territori occupati, quanto tempo ci vorrà prima che vengano utilizzate anche dai nostri governi?

Il costo nascosto del successo: sostenibilità e limiti del modello israeliano

Alla luce delle informazioni ormai disponibili, il successo economico dell’industria cyber israeliana va esaminato senza tralasciare i suoi “costi nascosti”. Nel 2024, Israele è stato il secondo paese più colpito al mondo da attacchi informatici, con 1.550 attacchi, principalmente da gruppi filo-palestinesi che si oppongono alle politiche israeliane in Medio Oriente. L’intensità del conflitto ha triplicato gli attacchi cyber dal 7 ottobre 2023.

Ma ci sono limiti anche nei sistemi fisici tanto celebrati: ogni interceptor dell’Iron Dome costa 50.000 dollari e, durante conflitti prolungati, la necessità di rifornimenti diventa critica.

In questo senso la principale caratteristica della sicurezza israeliana, ossia l’integrazione militare-civile, potrebbe trasformarsi in una debolezza.

Inoltre, la dipendenza di Israele dall’export militare – con il 65% della produzione di alcune aziende destinato all’estero – crea vulnerabilità economiche che potrebbero ritorcersi contro in caso di cambiamenti geopolitici.

La Spagna ha già cancellato contratti per centinaia di milioni di euro con aziende israeliane nel 2025, dichiarando un embargo sulle armi e accusando Israele di “genocidio a Gaza”: il fatto che anche alleati tradizionali inizino a prendere tali posizioni dovrebbe suonare come un campanello d’allarme per un’industria così dipendente dalla reputazione internazionale.

Verso il 2030: la cyber-supremazia israeliana

Le proiezioni per il futuro sono impressionanti. Il mercato della cybersecurity globale raggiungerà 212 miliardi di dollari nel 2025, con una crescita del 15,1%. Dal canto suo, il mercato cyber israeliano passerà da 1 miliardo nel 2025 a 1,5 miliardi nel 2030.

E i numeri raccontano solo una parte della storia. La vera rivoluzione è che Israele sta definendo gli standard globali della cybersecurity per il prossimo decennio. Con tempi di risposta in millisecondi, capacità di processing avanzate e tassi di successo elevati contro attacchi State-sponsored, il paese si conferma l’architetto principale della difesa digitale occidentale.

In questa scalata apparentemente inarrestabile, tuttavia, non sono mancate battute di arresto e vicende ancora tutte da chiarire.

L’ombra di Pegasus: quando la tecnologia diventa strumento di repressione

Dietro il luccichio della “Startup Nation”, infatti, si nasconde una storia meno raccontata: quella di NSO Group e del suo famigerato spyware Pegasus.

Nel maggio 2025, un tribunale californiano ha condannato NSO Group a pagare 167 milioni di dollari di danni per aver spiato, tramite il software commercializzato dalla società israeliana, oltre 1.400 utenti di WhatsApp. Non si tratta di un caso isolato; Pegasus è stato utilizzato per spiare giornalisti, attivisti, avvocati e persino capi di Stato, da Jamal Khashoggi prima del suo assassinio a Emmanuel Macron, fino ai dissidenti politici in Giordania, Kazakistan e Rwanda.

Classificato come arma in Israele, Pegasus richiede un’approvazione governativa per l’esportazione, eppure è finito nelle mani di regimi autoritari in almeno 40 paesi. Il paradosso è stridente: un paese che si presenta come campione della democrazia occidentale vende tecnologie di sorveglianza che vengono sistematicamente usate per sorvegliare giornalisti e reprimere oppositori politici. Nel 2021, l’amministrazione Biden ha inserito NSO Group nella blacklist commerciale e ha vietato alle agenzie federali l’uso di spyware commerciali dopo aver scoperto che almeno 50 dipendenti governativi statunitensi avevano i telefoni infettati da Pegasus.

La compagnia, che ha perso 9 milioni nel 2023 e 12 nel 2024, incarna un dilemma etico irrisolto: quanto è accettabile che un’industria prosperi vendendo strumenti che – indipendentemente dalle intenzioni dichiarate – finiscono regolarmente per violare i diritti umani fondamentali?

Conclusione: la sicurezza del futuro, o un’architettura della complicità?

Dal complesso segreto nel deserto del Negev alle sale consiliari di Berlino, da Wall Street alle stanze dei bottoni di Washington, la tecnologia israeliana sta ridefinendo il concetto stesso di sicurezza nazionale nell’era digitale.

L’evoluzione dall’Iron Dome fisico ai sistemi integrati di cyber-defense rappresenta più di una storia di successo in campo tecnologico: è l’architettura fondamentale sulla cui base l’Occidente costruirà la propria sicurezza digitale nei prossimi decenni.

Sebbene il successo tecnologico israeliano sia innegabile, presentarlo come una storia pura di innovazione e necessità senza confrontarsi con le sue implicazioni etiche è una narrazione pericolosamente incompleta. La “Startup Nation” ha costruito un impero cyber su tre pilastri: eccellenza tecnologica, integrazione militare-civile e mercati occidentali compiacenti.

Ma questo modello ha prodotto anche Pegasus nelle mani di dittatori, strumenti AI che automatizzano la morte con supervisione umana minima, sistemi di sorveglianza di massa testati su popolazioni civili. L’Occidente, mentre proclama di difendere i diritti umani, è diventato il maggiore cliente e finanziatore di queste tecnologie, creando un circolo vizioso di indifferenza e complicità.

L’Europa è diventata il principale mercato per l’industria militare israeliana, con circa il 54% degli export destinati al continente; le importazioni europee di armi israeliane sono aumentate del 155% tra il 2020 e il 2024.

E quando la Spagna ha deciso di sospendere gli scambi di armi con Israele nel 2025, ha scoperto che sostituire rapidamente i fornitori israeliani sarebbe stato difficile. Questa situazione crea un paradosso: l’Europa, che aspira all’autonomia strategica, si ritrova sempre più dipendente da un paese di 9 milioni di abitanti per tecnologie critiche di difesa.

Nel futuro digitale che stiamo costruendo, la tecnologia israeliana potrebbe davvero essere indispensabile per la nostra sicurezza. Ma dobbiamo chiederci, quando abbracciamo questi sistemi senza riserve critiche, se stiamo proteggendo la democrazia o costruendo l’infrastruttura della nostra futura sorveglianza totale.

La questione non è solo tecnica, ma profondamente etica: quando uno strumento di sicurezza diventa un’arma contro giornalisti e dissidenti, l’industria cyber perde la sua presunta neutralità morale. La risposta a questa domanda definirà non solo il futuro della cybersecurity globale, ma anche i valori su cui l’Occidente intende costruire la propria difesa nell’era digitale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cybersecurity-israeliana/


Google Offers Up to $20,000 in New AI Bug Bounty Program

Google this week announced a new dedicated AI Vulnerability Reward Program (VRP) that builds on the 2023 Abuse VRP extension covering issues and vulnerabilities in its AI systems.

To date, bug hunters have earned more than $430,000 in rewards for AI-product related vulnerabilities, and the new VRP builds on that momentum and has been shaped based on the feedback received from participating researchers.

One of the most important aspects of the new AI bug bounty program is that prompt injections, jailbreaks, and alignment issues are not in its scope. However, Google encourages researchers to report these content-related issues as well.

“We don’t believe a Vulnerability Reward Program is the right format for addressing content-related issues. The primary goal of our VRP is to encourage researchers to report security vulnerabilities and abuse issues directly to Google, and to provide timely, valuable rewards to incentivize those reports,” Google explains.

All Google AI products, the company says, have in-product functionality that can be used to report content-based issues. Such reports should include information on the used model, context, and other metadata.

Within the AI VRP scope, however, the company has included attacks that modify a victim’s account or data, leak sensitive information without user approval, exfiltrate model parameters, lead to the persistent manipulation of a victim’s AI environment, lead to the exfiltration of data, enable server-side features without authorization, or cause persistent denial-of-service (DoS).

Attacks that enable phishing through persistent, cross-user injection of HTML code on Google-branded sites without a “user-generated content” warning are also within scope, if they are deemed a convincing attack vector.

As part of the program, Google’s AI products are split into three tiers, namely flagship (includes AI features on Google Search, Workspace core applications, and Gemini Apps), standard (AI features in AI Studio, Jules, and Google Workspace non-core applications), and other (other AI integrations in Google products, with certain exceptions).

Advertisement. Scroll to continue reading.

The highest rewards offered as part of the new VRP are $20,000 for attacks leading to victim account or data modifications in flagship products. For similar attacks in standard products, researchers can earn rewards of up to $15,000.

The highest reward for sensitive data exfiltration from flagship and standard products is of $15,000. Researchers who find these issues in products from the ‘other’ tier can earn rewards of up to $10,000.

“Going forward, a unified reward panel will review all rewards, and will issue the highest reward possible across the abuse and security tables,” Google says.

Additional information on the AI VRP can be found on the program’s rules page.

Related: $4.5 Million Offered in New Cloud Hacking Competition

Related: Researchers Earn $150,000 for L1TF Exploit Leaking Data From Public Cloud

Related: Google Paid Out $12 Million via Bug Bounty Programs in 2024

Related: Microsoft Boosts .NET Bounty Program Rewards to $40,000

https://www.securityweek.com/google-offers-up-to-20000-in-new-ai-bug-bounty-program/


North Korean Hackers Have Stolen $2 Billion in Cryptocurrency in 2025

North Korean threat actors are estimated to have stolen more than $2 billion in cryptocurrency during the first nine months of 2025, blockchain analysis firm Elliptic says.

This is an annual record for North Korean hackers, and the cumulative value of the cryptocurrency assets they have stolen to date has surpassed $6 billion.

But Elliptic notes that difficulties in attributing other attacks to North Korea and numerous incidents that remain unreported suggest that the actual stolen amount may be even higher.

“Attributing cyber thefts to North Korea is not an exact science: Elliptic and other experts use a combination of blockchain analytics, observed laundering patterns, and intelligence sources to make an attribution,” the company says.

The record-breaking amount stolen this year is largely fueled by the theft of $1.46 billion in crypto assets from the cryptocurrency exchange Bybit. According to Elliptic, North Korean hackers have been responsible for at least 33 other crypto heists this year.

“The 2025 total already dwarfs previous years and is almost triple last year’s tally, underscoring the growing scale of North Korea’s dependence on cyber-enabled theft to fund its regime,” the company notes.

In December 2023, Recorded Future estimated that threat actors associated with the Pyongyang regime had stolen a total of over $3 billion in cryptocurrency, after siphoning more than $1.7 billion in 2022 in high-profile heists such as Ronin Network ($600 million), Nomad ($190 million), Harmony ($100 million), and others.

In 2025, most of the attacks were conducted through social engineering, and not vulnerabilities in crypto infrastructure. The hackers mainly focused on cryptocurrency exchanges, although numerous high-net-worth individuals were also hit.

Advertisement. Scroll to continue reading.

“As crypto prices have risen, individuals have become increasingly attractive targets, often lacking the security measures employed by businesses. Some of these individuals are also targeted due to their association with businesses holding large amounts of crypto assets, which the hackers are looking to steal,” Elliptic notes.

In response to advanced blockchain analytics and more effective tracking of illicit cryptocurrency, North Korea has been using more complex techniques to launder the stolen assets.

The hackers now rely on multiple rounds of mixing and cross-chain transactions, use obscure blockchains to hinder analysis, and purchase utility tokens of specific protocols to reduce costs. They also redirect assets to fresh wallets by exploiting “refund addresses”, and create and trade tokens issued directly by the laundering networks.

“The record-breaking $2 billion stolen this year underlines both the scale of the threat and the importance of robust blockchain analytics. North Korea may be adapting its tactics, but with advanced forensic capabilities, the crypto industry and law enforcement are well-placed to detect and trace these threats,” Elliptic notes.

Related: North Korea’s Fake Recruiters Feed Stolen Data to IT Workers

Related: New XCSSET macOS Malware Variant Hijacks Cryptocurrency Transactions

Related: North Korean Hackers Target macOS Users

Related: Achieving Positive Outcomes With Multi-Domain Cyber and Open Source Intelligence

https://www.securityweek.com/north-korean-hackers-have-stolen-2-billion-in-cryptocurrency-in-2025/


La sovraesposizione dei dati personali online

Questo articolo fa parte di una serie dedicata all’esplorazione della sovraesposizione e del controllo sui dati personali nell’ecosistema informativo online. Partendo dalle origini di Internet come strumento di comunicazione militare, l’analisi di Marta Zeroni traccia l’evoluzione della rete fino alla sua trasformazione in un mezzo di diffusione di massa delle informazioni personali. L’avvento dei social media e la democratizzazione della condivisione online hanno portato a un’esplosione nella quantità di dati personali circolanti, creando nuove sfide per la privacy individuale.

“Lo”.

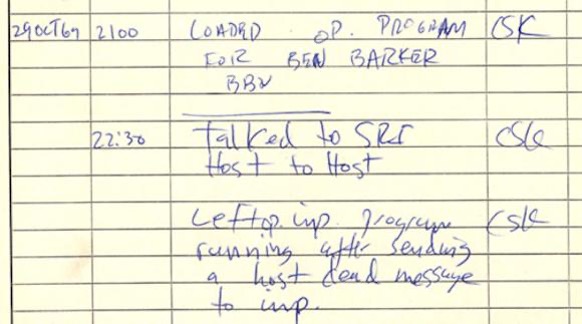
Era il 29 ottobre 1969 e, utilizzando il Teletype del professor Leonard Kleinrock, lo studente e programmatore Charlie Kline aveva appena inviato un messaggio dall’UCLA all’Istituto di Ricerca di Standford, a quasi 600 chilometri di distanza. L’intenzione era quella di scrivere “login” ma il sistema era andato in crash prima di trasmettere l’intera parola.

Si trattava della prima istanza di comunicazione mediata dal computer (c.d. CMC) e del primo utilizzo ARPANET, la rete militare per lo scambio di informazioni a distanza a cui il Governo statunitense lavorava dal 1966[1].

Fig. 1. Il primo log ARPANET redatto da “CSK” (Charles S. Kline). Fonte: UCLA Digital Library.

ARPANET: le origini militari di Internet e la diffusione nelle università

Presso l’UCLA, all’interno dell’aula 34020, è ancora presente l’elaboratore con il quale fu inviato il messaggio, “the first piece of internet equipment ever installed – a mini computer (…)” [2] . Così lo descrive Kleinrock, e tuttavia si tratta di una macchina relativamente grande – almeno per l’osservatore odierno – e soprattutto robusta; pensata, dice Kleinrock, per resistere in condizioni estremamente avverse.

Una caratteristica, questa, coerente con la finalità per cui la rete è stata creata: non la diffusione delle informazioni ma la difesa delle comunicazioni (e, di riflesso, la difesa dello stato).

Nel contesto della Guerra Fredda, ARPANET doveva collegare i centri di ricerca finanziati dal Pentagono, assicurando che la comunicazione tra gli stessi risultasse privata e sicura.

In ogni caso, gli addetti ai lavori avevano intuito il ruolo di catalizzatore che l’esperimento avrebbe presto assunto. Un anno prima che “Lo” fosse inviato, i teorici di ARPANET Joseph Licklider e Robert Taylor profetizzarono: “In a few years, men will be able to communicate more effectively through a machine than face to face” [3].

ARPANET rimase uno strumento di appannaggio delle università e dei centri di ricerca, fino al 1° gennaio 1983, quando, assieme alla Defense Data Network, adottò definitivamente il nuovo protocollo di comunicazione standardizzato sviluppatosi nel frattempo, il TCP/IP (Transfer Control Protocol/Internetwork Protocol), che permetteva ai computer di “parlare” tra loro anche su reti diverse.

La nascita di Internet: il percorso verso la diffusione di massa delle informazioni personali

Era nata Internet, ma la diffusione delle informazioni personali, alla fine del Novecento, passava ancora quasi esclusivamente attraverso i canali editoriali tradizionali, riguardando quindi perlopiù personaggi pubblici e celebrità[4]. Il cittadino comune, nel frattempo, poteva essere semmai preoccupato dalle possibili derive di forme più subdole di sorveglianza, complice l’ombra – anche solo psicologica – proiettata dalla Stasi sull’Occidente; si pensi, a titolo di esempio, ai casi schedature FIAT [5] e alle attività di intercettazione rese popolari dallo scandalo Watergate.

L’ascesa dei social media e la democratizzazione della condivisione online dei dati personali

Nel frattempo, però, internet continuava a crescere: gli internet service provider (ISP) resero possibili le reti ad accesso pubblico; con i bullettin board system e Usenet nacquero i primi strumenti di condivisioni tra gli utenti; il world wide web e l’avvento dei browser, infine, decretarono il salto di qualità: se prima internet poteva somigliare alla bacheca di sughero di una biblioteca di provincia, ora diventava uno spazio trasversalmente accessibile.

Alla fine degli anni ’90, i siti web consentivano a chiunque di condividere – quasi dialogicamente – le informazioni con un insieme definito utenti, e inoltre di propagarle verso un numero indeterminato di terzi. Da sistema di mera comunicazione la rete internet si stava evolvendo per essere, anche e soprattutto, uno strumento di diffusione [6]. È in questi anni, non a caso, che le principali testate italiane iniziano a lanciare i propri siti web (Il Corriere della Sera e Repubblica, rispettivamente, nel 1995 e 1996).

Come la rete internet degli albori, anche le piattaforme di social network – dai dismessi Friendster (2002) e My Space (2003) a Facebook (2004), primo mattone dell’impero Meta – si presentano inizialmente come sistemi chiusi, entro i quali l’utente può condividere (comunicare) con pochi e selezionati contatti. Nel giro di pochi anni, tuttavia, Facebook e gli altri social, a fronte di un aumento esponenziale dell’utenza e, non ultimo, delle possibilità di monetizzazione, aprono alle logiche della diffusione di informazioni.

I social network come nuove forme di mass media

La condivisione “privata” e i gruppi chiusi online, pur, come vedremo, non scomparendo del tutto, vanno così a sfumare nella dimensione pubblica, mentre le piattaforme iniziano a somigliare a una nuova forma di mass media, alla quale gli utenti si rivolgono anche per tenersi informati. I “vecchi” media, nel frattempo, si danno per morti [7], ma, di fatto, si trasferiscono a loro volta nelle piattaforme e inseriscono nei loro articoli web i plugin social per agevolarne la ricondivisione.

Non si crea, così, una contrapposizione netta tra vecchi e nuovi media, bensì una sorta di nuovo media ibridato, una rete d’informazione interconnessa, multiforme e sempre più estesa. La commistione è tanto più evidente oggi, alla luce di come quegli stessi giornali o tv che anni fa utilizzavano il tema delle fake news per spregiare la rete e i suoi meccanismi, sono diventati i primissimi propulsori di notizie prive di fact-checking, replicate all’infinito con titoli clickbait; una pratica, questa, non sempre priva di vittime [8].

L’utente come creatore di contenuti: quali rischi per la privacy?

Questo network tentacolare di informazione non si limita, peraltro, a inglobare i media tradizionali. Al suo interno è variamente rappresentata ogni tipo d’istanza sociale ma in particolare gli utenti, intesi come persone fisiche [9], che in questo habitat, si trovano, almeno in astratto, nella stessa posizione di partenza degli editori, con eguale possibilità di creare contenuti, disseminarli nella rete e dalla rete vederli rimbalzare sui media tradizionali, mentre i confini tra online e offline si fanno sempre più labili.

Per altro verso, è sempre più frequente che anche gli utenti che si limitano a scambiare le informazioni tra loro – in contesti più o meno chiusi, quali gruppi Facebook o Telegram, subreddit o thread di Twitter e 4chan [10] – contribuiscano esponenzialmente alla loro diffusione, con conseguenze più che concrete [11].

IoT, Big Data e la diffusione dei dati personali online

Il susseguirsi di ulteriori nuove (o vecchie e reinventate) tecnologie ha funzionato negli anni da moltiplicatore dei dati che transitano nella rete: i device IoT, le tecniche di analisi sui big data, le intelligenze artificiali che, dati alcuni (parecchi) input creano output inediti, le blockchain, fino alla prossima grande novità di cui sia starà parlando domani.

A ciò si aggiunga il rapporto di crescente interconnessione e dipendenza tra l’utente e l’interfaccia dei suoi device, la cui facilità di utilizzo e di portabilità è pari all’utilità che innegabilmente tali oggetti rivestono nei contesti professionali, personali, familiari.

La biblioteca di Babele digitale: l’universo sterminato dei contenuti online

Il giornalista Davide Piacenza, nell’indagare una prospettiva ancora diversa rispetto alla presente [12], paragona questo “mondo nuovo” alla biblioteca di Babele dell’omonimo racconto di Borges, i contenuti sono così sterminati da costituire un universo a sé stante.

Nelle sale esagonali della biblioteca, tutte collegate tra loro, ogni parete ha cinque scaffali, ogni scaffale trentadue, ogni libro quattrocento dieci pagine e così via; nella biblioteca di Babele dimora ogni possibile sapere e tuttavia, al contempo, “per una riga ragionevole, per una notizia corretta, vi sono leghe di insensate cacofonie, di farragini verbali e di incoerenze”.

“Non posso immaginare” scrive Borges. “alcuna combinazione di caratteri [dhcmrlchtdj] che la divina Biblioteca non abbia previsto”, avvicinandosi forse a rendere un’idea della quantità di contenuti che continuano a stratificarsi, nella rete.

L’aumento esponenziale dei dati generati dalle piattaforme di content sharing

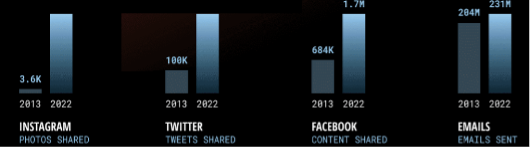
Annualmente, il cloud provider Domo Inc. pubblica Data Never Sleeps, un insight sui comportamenti degli utenti online l’anno precedente. Nel 2023 è uscita la versione 10.0, con le analisi e le infografiche relative al 2022.

Fig 2 Data Never Sleeps

Come facilmente immaginabile, dal primo report di Domo nel 2013, i dati generati sono aumentati a livello esponenziale, in particolare nell’ambito delle piattaforme di content sharing. A fronte di uno scostamento minimo rilevato nell’utilizzo della mail, si registra, come da fig. 2, un incremento estremamente significativo per ciò che riguarda i dati condivisi dagli utenti dei principali social network.

La moderazione dei contenuti nell’era dei Big Data: sfide e implicazioni per la privacy

“Il discorso guidato dall’intervento umano” afferma il filosofo Byung-Chul Han, “impallidisce dinanzi allo sguardo divino dei Big Data”[13].

I contenuti di cui siamo spettatori in prima persona, peraltro, sono solo una parte di quelli che vedremmo in assenza dei moderatori.

L’esistenza di queste figure – ancora non del tutto soppiantate dall’intelligenza artificiale ma coadiuvate da algoritmi e software [14] – e la crescente mole di lavoro che hanno portato e portano sulle spalle con l’evolversi ipertrofico delle piattaforme di sharing, dice di per sé già molto sul potenziale dannoso connaturato alla proliferazione informativa.

“Tutto l’orrore del mondo” scrive Shoshanna Zuboff, “viene cancellato o meno in base a un flusso di lavoro razionalizzato, con decisioni prese in un istante”[15].

La figura di per sé non è un’invenzione recente: già i bulletin board systems erano moderati, così come gran parte delle community pubbliche o private, dei siti web e dei forum.

Con l’avanzare delle piattaforme, però, il lavoro dei moderatori è diventato sempre più complesso e delicato, al punto che risulta impossibile delegarlo completamente ad un’intelligenza artificiale.

AI e moderazione umana

Benché gli algoritmi giochino un ruolo senza dubbio essenziale in quest’attività [16], l’IA – addestrata con i data set generati dalle attività degli stessi moderatori – può essere utilizzata per ora solo in chiave collaborativa (ad esempio per organizzare il lavoro o per le attività ripetitive) e non decisionale [17]. Ad oggi, lo strumento principale di detection delle immagini pedopornografiche online è ancora PhotoDNA, un semplice software di riconoscimento automatico delle immagini, introdotto da Microsoft nel 2009 [18].

La responsabilità e nondimeno le conseguenze psichiche [19]di questo tipo di attività restano pertanto interamente addossate a questi lavoratori invisibili, che passano le loro giornate a preservare l’utente da tutto ciò di peggio che il web abbia da offrire.

La diffusione incontrollata dei dati personali sui social media

Il moderatore non può che occuparsi dei contenuti evidentemente dannosi, quelli vietati dalle leggi o dalle policy delle sue piattaforme; ma non sempre la dannosità risulta palese o agevolmente accertabile a un primo sguardo, sia pure a quello di un professionista.

Così, è possibile – anzi, frequente – che nelle maglie del filtro passi qualcosa che sembra lecito solo in superficie: non il video di un’esecuzione, non una palese minaccia o hate speech, ma “semplici” dati personali, apparentemente al loro posto nel contesto in cui si trovano ma che nascondono dietro di sé un elevato potenziale lesivo.

Nel considerare tale potenziale, è opportuno, per quanto lapalissiano, specificare come quasi sempre la pubblicazione di un’informazione sul feed di un social network coincida con la sua diffusione.

Nel caso in cui l’original poster abbia utilizzato dei tag (es. hashtag) il contenuto viene indicizzato all’interno del motore di ricerca della piattaforma stessa, mettendolo a disposizione diretta del resto degli utenti, che possono a quel punto ricondividerlo all’interno dello stesso canale o altrove.

Anche in assenza di un tag, il contenuto può essere riproposto dal social agli altri utenti sulla base di valutazioni algoritmiche fondate su vari fattori, interni (si pensi ai metadati di una qualsiasi fotografia, come pure ai parametri risultanti dalla profilazione del nostro comportamento online) od esterni (quali, ad esempio, le altrui preferenze ed interessi).

Privacy e impostazioni di condivisione: limiti e falsa sicurezza

Quanto detto riguarda i post pubblicati su profili pubblici; impostazioni privacy più stringenti riducono, com’è ovvio, le possibilità di diffusione, ma non le azzerano: è sufficiente che uno solo utente della limitata cerchia che ha accesso a un’informazione protetta la ripubblichi senza restrizioni per innescare il processo sopra descritto e vanificare qualunque accorgimento possa aver adottato il primo condivisore.

Nonostante le statistiche sull’utilizzo di internet [20] e una certa narrativa portata avanti sia dai media tradizionali che dai nuovi media [21], si noti, a margine, come le abitudini social degli utenti inizino a mostrare qualche timida inversione di tendenza: da più parti vengono paventati possibili esodi di massa dalle piattaforme social [22], mentre su Facebook ad aumentare sono più che altro i profili di persone decedute [23].

L’engagement passivo

Al contempo, le piattaforme che mantengono rilevanza sembrano essere sempre più focalizzate sull’engagement passivo, con la generalità degli utenti che fruisce di contenuti resi disponibili da una piccola parte degli stessi [24].

Tuttavia, anche l’ipotetico utilizzo dei social come strumenti di fruizione passiva non azzererebbe le problematiche di sovraesposizione individuale. In primo luogo, qualora in tali contenuti siano coinvolti soggetti terzi diversi dai creator [25] non sempre questi ultimi si preoccupano di adottare i necessari accorgimenti per la tutela di immagine, dignità e reputazione dei soggetti coinvolti [26]. E persino immaginando di interrompere radicalmente ogni attività di condivisione, rimarrebbe la problematica dei dati già presenti online.

Se le statistiche della Domus Inc. ci hanno dato un’idea dell’attuale traffico informativo, dobbiamo pur tenere conto del fatto che questi dati si aggiungono, uno strato alla volta, ad un patrimonio storico preesistente, in un ambiente in cui i confini tra passato, presente e futuro sono divenuti meno netti e le informazioni risultano continuamente disponibili ed accessibili, come in una sorta di presente perenne.

Quanti dati sono presenti online? L’analisi di Gareth Mitchell

Il giornalista della BBC Gareth Mitchell, su richiesta dei lettori di BBC Science Focus, prova a formulare un’ipotesi su quanti dati possano essere presenti online nel complesso:

One way to answer this question is to consider the sum total of data held by all the big online storage and service companies like Google, Amazon, Microsoft and Facebook. Estimates are that the big four store at least 1,200 petabytes between them. That is 1.2 million terabytes (one terabyte is 1,000 gigabytes). And that figure excludes other big providers like Dropbox, Barracuda and SugarSync, to say nothing of massive servers in industry and academia[27].

Questa stima, benché approssimativa e molto riduttiva, è abbastanza per dare un’idea del perché il problema della diffusione dei dati, ad oggi, non possa essere risolto semplicemente smettendo di condividere informazioni o cercando di ripulire dai nostri dati gli angoli più visibili di internet.

In ogni caso, al netto dei possibili scenari futuri e delle piccole ondate di defezione dagli sviluppi incerti, i social e la rete internet restano innegabilmente affollati.

Il futuro dei social media

Considerato lo scenario descritto, e a mente delle considerazioni del capitolo 2, è ragionevole domandarsi se effettivamente ogni utente italiano o europeo abbia in concreto la possibilità di esercitare quel diritto al controllo delle proprie informazioni che dovrebbe costituire il nucleo duro e il minimo comun denominatore delle diverse declinazioni di privacy; se possa, quantomeno, decidere se e come essere rappresentato online, cosa condividere e cosa tenere per sé, ed attivare in modo efficace i diritti che gli riconosce il GDPR.

È chiaro che l’effettività di tale diritto – di tale basilare possibilità di controllo – risulta ancor più impellente per alcune categorie di interessati meritevoli di tutele rafforzate, quali ad esempio i minori.

La serie di articoli proseguirà affrontando un tema di grande attualità: l’esposizione dei minori sui social media e il fenomeno dello sharenting. Esamineremo le implicazioni legate alla tutela della privacy e dei diritti dei più giovani nell’era digitale. Per un approfondimento completo, ti invitiamo a scaricare il white paper di Marta Zeroni, “Sovraesposizione e controllo sui dati nell’ecosistema informativo online”.

Note:

[1] RAZ G., ‘Lo’ And Behold: A Communication Revolution (NPR). Ultimo accesso il 27 gennaio 2024.

[2] Lo and Behold: Reveries of the connected world, Werner Herzog, 2016.

[3] LICKLIDER J.C.R., TAYLOR R. W., The Computer as a Communication Device in Science and Technology, 1968, p. 1.

[4] Si pensi al citato caso Esfandiary (supra), affrontato dalla Corte di Cassazione nel 1975, così come alle vicende di Diana Spencer: il Protection from Harassment Act, che sanciva la responsabilità civile e penale dei membri dei comportamenti persecutori di giornalisti, paparazzi e altri membri dei media, fu adottato dal Parlamento inglese solo poche settimane prima della morte di Spencer. Simili normative furono proposte ed adottate negli anni ’90 anche negli USA. Sul punto: CURRY R.J.J., Diana’s Law, Celebrity and the Paparazzi: The Continuing Search for a Solution in Journal of Computer & Information Law, 18, 4, 2000.

[5] ACCORNERO P.G., Cinquant’anni fa le schedature Fiat (La Voce e il Tempo). Ultimo accesso il 27 gennaio 2024.

[6] Si fa riferimento ai concetti di comunicazione e diffusione così come definiti dal vecchio articolo 4 del D.Lgs 196/2003.

[7] Già nel 2008, Arianna Huffington riteneva che, con i dovuti accorgimenti, la rete avrebbe potuto salvare i giornali anziché decretarne la fine: ALTERMAN E., Out of Print (New Yorker). Ultimo accesso il 28 gennaio 2024.

[8] PASCOLETTI M., Il caso di Giovanna Pedretti: da una non notizia alla copertura mediatica di un presunto suicidio (Valigia Blu). Ultimo accesso il 27 gennaio 2024.

[9] Ma si tenga a mente che la demografia della rete è popolata anche da utenti diversi dalle persone fisiche: i social bot.

[10] 4chan è un imageboard conosciuto per essere stato di frequente al centro di polemiche e controversie: MEO T., Due team di linguisti affermano di aver scoperto chi sono i fondatori di QAnon (Wired Italia). Ultimo accesso il 10 febbraio 2024. L’inizio del peggio di Internet (Il Post). Ultimo accesso il 10 febbraio 2024.

[11] È ormai acclarato il ruolo che avrebbero svolto le interazioni su Facebook nell’assalto al Campidoglio di Capitol Hill: TIMBERG C., DWOSKIN E., ALBERGOTTI R., Inside Facebook, Jan. 6 violence fueled anger, regret over missed warning signs (The Washington Post). Ultimo accesso il 28 gennaio 2024; BINDER J.F., KENYON J., Terrorism and the internet: How dangerous is online radicalization? in Frontiers in Psychology, 13, 2022; LORENZ T., The online incel movement is getting more violent and extreme, report says (The Washington Post). Ultimo accesso il 28 gennaio 2024.

[12] PIACENZA D., La correzione del mondo, Einaudi, 2023.

[13] HAN B.C., Infocrazia, Einaudi, 2023, p. 50.

[14] LYMN T., BANCROFT J., The use of algorithms in the content moderation process (GOV.UK). Ultima consultazione in data 31 gennaio 2024.

[15] ZUBOFF S., Il capitalismo della sorveglianza, Luiss University Press, 2018, p. 524.

[16] LYMN T., BANCROFT J., art. cit.

[17] VINCENT G., AI won’t relieve the misery of Facebook’s human moderators (The Verge). Ultima consultazione in data 31 gennaio 2024.

[18] BUNI C., CHEMALY S., The Secret Rules of the Internet (The Verge). Ultima consultazione in data 31 gennaio 2024.

[19] FRANCHI J., Gli obsoleti, Agenzia X, 2021, pp. 236-247.

[20] Internet usage worldwide – Statistics & Facts (Statista). Ultimo accesso il 5 febbraio 2024.

[21] TREEM J.W., DAILEY S.L., BIFFL D., What We Are Talking About When We Talk About Social Media: A Framework for Study in Sociology Compass, 10, 9, 2016.

[22] SANDLE T., Are we heading for a social media exodus? (Digital Journal). Ultimo accesso il 6 febbraio 2024.

[23] SIGNORELLI A.D., Un esercito di morti sta marciando su Facebook (Wired Italia). Ultimo accesso il 5 febbraio 2024.

[24] SIGNORELLI A.D., La fine dei social network? (Spotify). Ultimo accesso il 5 febbraio 2024; BARBERA D., 12 milioni di persone hanno seguito il concerto virtuale di Travis Scott su Fortnite (Wired Italia). Ultimo accesso il 9 febbraio 2024; Marrageddon è stato lo show musicale più visto su Twitch in Europa nel 2023 (Rebel Mag. Ultimo accesso il 9 febbraio 2024.

[25] Si fa riferimento, ad esempio, alle street interview e ai video-prank.

[26] STEFANELLO V., Il problema dei tiktoker che riprendono i passanti senza il loro consenso (Il Post). Ultimo accesso il 5 febbraio 2024.

[27] MITCHELL G., How much data is on the internet? (BBC Science Focus). Ultimo accesso il 9 febbraio 2024.

Profilo Autore

Consulente Privacy e IT Law, auditor, Data Protection Officer e formatrice in materia di protezione dei dati personali e società digitale. Laureata magistrale in giurisprudenza all’Università degli Studi di Padova, con perfezionamento in criminalità informatica e investigazioni digitali alla Statale di Milano e master di secondo livello in Informatica Giuridica presso La Sapienza di Roma.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/dati-personali/


Paga con la faccia: sicurezza o incubo dei dati biometrici?

I tuoi dati biometrici sono già in vendita sul dark web. Un pacchetto completo di documenti d’identità statunitensi costa tra 70 e 165 dollari, mentre i dati biometrici vengono commercializzati in varie forme sui mercati criminali.

Questa non è fantascienza, ma la realtà del mercato criminale dei dati biometrici, dove i volti rubati alimentano sistemi di clonazione d’identità per svuotare conti bancari. Mentre l’Italia e l’Europa sperimentano i primi pagamenti con riconoscimento biometrico – Carrefour ha lanciato il primo pilot europeo a Parigi nel luglio 2024 con riconoscimento della vena del palmo, seguito da Mastercard in Polonia con tecnologia per iride e volto – esperti di cybersecurity e autorità privacy lanciano l’allarme: stiamo barattando la nostra identità immutabile per qualche secondo di comodità al checkout.

Il volto che non puoi cambiare: rischi dei dati biometrici

Bruce Schneier, uno dei massimi esperti mondiali di sicurezza informatica, ha identificato il problema fondamentale dei sistemi biometrici: l’irreversibilità. A differenza delle password, i dati biometrici non possono essere cambiati quando compromessi. Questa caratteristica rende particolarmente gravi le violazioni come quella di Clearview AI nel 2020, che ha esposto l’intera lista clienti di oltre 600 agenzie che utilizzavano un database di 3 miliardi di volti, o quando nel 2022 la cinese Xinai Electronics ha perso 800 milioni di record biometrici.

Il furto di dati biometrici è irreversibile per definizione. Studi recenti mostrano che circa il 40-42% dei dispositivi Android con riconoscimento facciale può essere ingannato con una semplice fotografia. Ma il problema va oltre: i criminali stanno già usando maschere in silicone professionali (300-1000 euro sul mercato nero) che raggiungono tassi di successo del 90% contro i sistemi avanzati, mentre i deepfake in tempo reale mostrano percentuali di bypass tra il 67 e il 99% a seconda della sofisticazione del sistema.

L’invasione silenziosa del pagamento biometrico

In Cina, 495 milioni di persone – un terzo della popolazione – utilizzavano già il riconoscimento facciale per pagare nel 2021. Alipay e WeChat Pay processano trilioni di dollari all’anno attraverso sistemi che scansionano i volti nei negozi, nelle metropolitane, persino per pagare le tasse. Negli Stati Uniti, Amazon One ha già conquistato oltre 400 location, completando l’espansione a tutti i 500+ Whole Foods entro la fine del 2023. L’Europa sta seguendo rapidamente: oltre al pilot Carrefour a Parigi con tecnologia Ingenico per il riconoscimento del palmo della mano, Mastercard ha lanciato in Polonia il 10 giugno 2024 il suo Biometric Checkout Program con riconoscimento dell’iride e del volto in cinque negozi Empik utilizzando la tecnologia PayEye.

In Italia, il terreno è già preparato. Nexi Pay, il principale processore di pagamenti italiano, offre dal febbraio 2020 l’autenticazione biometrica facciale per autorizzare transazioni e-commerce e PagoPA. Banco BPM e BBVA Italia hanno integrato il riconoscimento facciale nelle loro app bancarie, mentre BANCOMAT Pay, con circa 9 milioni di utenti registrati secondo Il Sole 24 ORE, permette l’autenticazione tramite volto per confermare i pagamenti. Le banche italiane assicurano che i dati biometrici non vengono conservati sui loro server ma solo sul dispositivo dell’utente – una promessa che diventa carta straccia quando il telefono viene hackerato o l’app compromessa.

Il prezzo nascosto della comodità

Il vero incubo inizia quando le aziende forzano l’adozione. All’Università della California del Sud, l’azienda PopID ha sponsorizzato un evento studentesco dove il riconoscimento facciale era l’unico modo per comprare cibo. “È leggermente coercitivo”, ha dichiarato la studentessa Vera Wang al Daily Trojan, “perché non ti viene data una scelta tra metodi di pagamento normali e usare la tua faccia”. Questo schema si sta ripetendo globalmente: sconti solo per chi paga con il volto, eliminazione graduale del contante, sistemi biometrici resi obbligatori per accedere a servizi essenziali.

Le conseguenze discriminatorie sono già evidenti. Il National Institute of Standards and Technology americano ha scoperto che i sistemi di riconoscimento facciale mostrano tassi di errore che variano di “fattori da 10 a oltre 100 volte” tra gruppi demografici diversi, con tassi di falsi positivi da 2 a 5 volte più alti nelle donne rispetto agli uomini. Gli anziani, i disabili, le minoranze etniche vengono sistematicamente esclusi o mal identificati da tecnologie che promettono inclusione ma praticano discriminazione algoritmica.

Violazioni da miliardi di volti

I database biometrici sono calamite per i criminali informatici. Nel 2024, El Salvador ha subito una violazione che ha esposto 5,1 milioni di record – l’80% della popolazione del paese – incluse foto ad alta definizione e numeri di identità nazionale. Il costo medio di una violazione di dati biometrici nel settore sanitario ha raggiunto i 9,77 milioni di dollari nel 2024. Sul dark web, documenti d’identità statunitensi completi costano tra 70 e 165 dollari, mentre sul marketplace Genesis (chiuso dall’FBI nell’aprile 2023) venivano vendute impronte digitali e tutorial per il face spoofing.

I criminali hanno già dimostrato l’efficacia di questi attacchi. Nel 2024, una truffa con deepfake ha sottratto 25 milioni di dollari alla multinazionale Arup quando un dipendente è stato ingannato da falsi dirigenti in videochiamata. In Brasile, ladri usano foto dei clienti su manichini per accedere a conti bancari e richiedere prestiti, con 8 milioni di vittime di furto d’identità che hanno causato perdite di R$10,1 miliardi nel settore finanziario. In Cina, casi documentati includono truffe da 1,86 milioni di yuan a Xi’an e 4,3 milioni di yuan a Baotou, mentre truffatori hanno violato il sistema governativo di riconoscimento facciale creando fatture false per oltre 500 milioni di yuan.

La resistenza italiana ed europea

Il Garante Privacy italiano non è rimasto a guardare. Ha inflitto una multa di 20 milioni di euro a Clearview AI per la raccolta non autorizzata di dati biometrici (febbraio 2022) e ha costretto il Comune di Como a sospendere il suo sistema di sorveglianza facciale. L’autorità italiana richiede una “verifica preliminare” per la maggior parte dei sistemi biometrici e impone che i dati siano crittografati, conservati separatamente dalle informazioni identificative e cancellati automaticamente quando non più necessari.

L’EU AI Act, in vigore dal 1° agosto 2024, vieta l’identificazione biometrica remota in tempo reale negli spazi pubblici e lo scraping non mirato di immagini facciali da internet a partire dal 2 febbraio 2025. Ma queste protezioni arrivano mentre l’infrastruttura di sorveglianza è già in costruzione. Edward Snowden ha avvertito che la tecnologia di scansione normalizza la sorveglianza di massa, rendendo accettabile ciò che dovrebbe essere inaccettabile.

Alternative più sicure esistono

La tokenizzazione, che sostituisce i dati sensibili della carta con token casuali impossibili da decifrare, offre sicurezza elevata senza esporre dati biometrici. I token hardware, le carte contactless con limiti di transazione, i one-time password: tutte alternative che l’European Central Bank raccomanda esplicitamente. Gli esperti di sicurezza consigliano di preferire sensori di impronte digitali, PIN lunghi o token hardware invece del riconoscimento facciale per l’autenticazione dei pagamenti.

Il messaggio è chiaro: pagare con la faccia non è progresso, è regressione verso un futuro dove la nostra identità più intima diventa merce di scambio. In un mondo dove non puoi cambiare il tuo volto ma i criminali possono clonarlo, dove le aziende ti costringono a scegliere tra mangiare e proteggere i tuoi dati biometrici, dove una singola violazione può comprometterti per sempre, la domanda non è se i pagamenti facciali siano comodi. La domanda è: vale la pena vendere la tua faccia per risparmiare tre secondi alla cassa?

Fonti:

CNN Business (2020). “Clearview AI has billions of our photos. Its entire client list was just stolen”

Biometric Update (2024). “El Salvador data breach includes selfies and ID numbers for 80% of country’s population”

CNN Business (2024). “Arup revealed as victim of $25 million deepfake scam involving Hong Kong employee”

South China Morning Post (2021). “Chinese government-run facial recognition system hacked by tax fraudsters”

Mastercard Newsroom (2024). “Buy with your eyes, pay with your glance!”

Retail Optimiser (2024). “Carrefour trials payment via palm vein recognition with Ingenico”

Nexi Press Release (2020). “Biometria nell’autenticazione dei pagamenti”

Garante Privacy Italiano (2022). “Riconoscimento facciale: il Garante privacy sanziona Clearview per 20 milioni di euro”

European Parliament (2024). “EU AI Act: first regulation on artificial intelligence”

NIST Special Publication IR 8280 (2019). “Face Recognition Vendor Test (FRVT) Part 3: Demographic Effects”

IBM Security (2024). “Cost of a Data Breach Report 2024”

FICO (2023). “Identity theft for digital fraud is on the rise in Brazil”

Il Sole 24 ORE (2023). “Con Bancomat Pay pagamenti via smartphone allargati all’Europa”

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/dati-biometrici/


Sicurezza edge e Intelligenza Artificiale Distribuita, una svolta epocale per la cybersecurity

Sicurezza edge e intelligenza artificiale distribuita stanno ridefinendo la cybersecurity globale. Con miliardi di dispositivi IoT, veicoli autonomi, sensori medici e infrastrutture critiche connessi in tempo reale, l’edge computing porta l’elaborazione dei dati sempre più vicino alla loro origine, creando nuove sfide di sicurezza. Questo articolo esplora il passaggio dal cloud all’edge, le principali minacce emergenti, le tecnologie di difesa più innovative, i casi reali in sanità, automotive e smart city, e il ruolo della normativa europea e delle strategie aziendali.

L’importanza della sicurezza edge nell’era dell’IoT e dell’intelligenza artificiale

Il 2025 segna un punto di svolta epocale per la cybersecurity mondiale. Mentre leggi questo articolo, diciotto virgola otto miliardi di dispositivi IoT connessi popolano il pianeta, trasformando radicalmente il panorama della sicurezza informatica. Non si tratta più di proteggere qualche server centralizzato: stiamo entrando nell’era dell’edge computing, dove l’intelligenza artificiale si sposta letteralmente “ai margini” della rete, creando sfide di sicurezza completamente inedite.

Perché questo cambiamento ti riguarda direttamente? Che tu sia un CTO, un security manager, un responsabile IT o semplicemente un professionista interessato al futuro digitale, l’edge computing sta già influenzando la tua vita quotidiana. Dalle auto autonome Tesla che utilizzano chip proprietari FSD Computer per processare enormi quantità di dati localmente, ai pacemaker intelligenti che salvano vite umane, fino ai sistemi di trading che muovono miliardi di dollari in millisecondi, tutto dipende da sistemi edge sicuri e affidabili.

Il grande spostamento:dal Cloud all’Edge

Per anni abbiamo sentito parlare di “cloud”, di servizi centralizzati dove tutti i nostri dati venivano elaborati in grandi data center lontani da noi. Amazon Web Services, Google Cloud, Microsoft Azure: giganti che processavano le nostre informazioni in server farm distanti migliaia di chilometri. Ma ora le cose stanno cambiando rapidamente.

Con il 5G che promette velocità fino a dieci Gbps e latenze sotto i dieci millisecondi, e con l’IA che diventa sempre più potente ma anche più “affamata” di dati in tempo reale, stiamo assistendo a quello che gli esperti chiamano “edge computing”. L’elaborazione dei dati si sposta vicino a noi, letteralmente “ai margini” della rete.

L’accelerazione verso l’edge è guidata dalla necessità di processare dati in tempo reale con latenze minime. Le previsioni indicano che entro il 2030 i dispositivi IoT raggiungeranno quaranta miliardi di unità a livello globale, con la Cina che dovrebbe averne oltre otto miliardi da sola. Questi numeri rappresentano una crescita esponenziale rispetto agli attuali diciotto virgola otto miliardi di dispositivi registrati nel 2024, con un incremento annuale del tredici per cento.

Pensate alle auto autonome: una Tesla utilizza il proprio FSD Computer, contrariamente a quanto spesso erroneamente riportato sui chip NVIDIA, per processare in tempo reale i dati provenienti da otto telecamere, dodici sensori ultrasonici e radar. Il sistema deve “pensare” istantaneamente, usando chip proprietari progettati internamente da Tesla per la massima efficienza nell’inferenza AI, processando migliaia di decisioni al secondo senza poter aspettare risposte da server remoti.

Lo stesso principio vale per i dispositivi medici che monitorano i pazienti in terapia intensiva, dove un ritardo di anche solo qualche secondo nell’analisi dei parametri vitali può fare la differenza tra la vita e la morte. Analogamente, nei sistemi di trading ad alta frequenza, millisecondi possono tradursi in milioni di dollari di profitti o perdite, rendendo la velocità di elaborazione un fattore critico di successo.

Anatomia di una rivoluzione tecnologica

Per comprendere davvero l’entità di questa trasformazione, dobbiamo esaminare i numeri aggiornati. IoT Analytics riporta che nel 2024 ci sono diciotto virgola otto miliardi di dispositivi IoT connessi globalmente, con una crescita del tredici per cento rispetto all’anno precedente. Entro il 2030, questo numero dovrebbe raddoppiare fino a circa quaranta miliardi di dispositivi, creando un ecosistema digitale di una complessità senza precedenti.

Ma non si tratta solo di quantità. La qualità dell’elaborazione sta cambiando radicalmente. I nuovi chip specializzati, come i Google Edge TPU che possono eseguire quattro trilioni di operazioni al secondo consumando solo due watt, o gli Intel Movidius, permettono di far girare modelli di IA sofisticati su dispositivi delle dimensioni di una moneta. Questa miniaturizzazione dell’intelligenza artificiale rappresenta un salto qualitativo che rende possibile l’elaborazione complessa direttamente sui dispositivi finali.

Singapore offre un esempio concreto di questa rivoluzione tecnologica in azione. La città-stato ha implementato oltre duecentomila sensori IoT che monitorano tutto, dalla qualità dell’aria al traffico, dall’illuminazione pubblica alla gestione dei rifiuti. Questi sensori non si limitano a raccogliere dati, ma li analizzano in tempo reale usando algoritmi di machine learning per ottimizzare automaticamente i servizi urbani. L’approccio dimostra come l’edge computing possa trasformare intere infrastrutture urbane, rendendo le città più intelligenti e responsive alle esigenze dei cittadini.

Il problema: la superficie di attacco esplode

Quando spostiamo l’intelligenza artificiale e l’elaborazione dati verso l’edge, non possiamo più fare affidamento sui tradizionali sistemi di sicurezza centralizzati. Questa transizione genera problemi di sicurezza di una complessità inedita, che richiedono approcci completamente nuovi alla cybersecurity.

La prima grande sfida è rappresentata dalla moltiplicazione esponenziale della superficie di attacco. Tradizionalmente, un’azienda doveva proteggere il proprio data center, qualche server e le connessioni di rete. Ora deve proteggere migliaia di endpoint distribuiti. Ogni dispositivo edge, dal sensore di temperatura nell’ospedale al computer di bordo dell’auto, dalla telecamera di sicurezza al contatore intelligente, diventa un potenziale punto di ingresso per i cybercriminali.

L’attacco Mirai del 2016 rappresenta un caso emblematico di questa nuova realtà. Il malware ha compromesso oltre seicentomila dispositivi IoT in tutto il mondo per creare una botnet capace di generare traffico da un Tbps. Questo attacco ha dimostrato come dispositivi apparentemente innocui possano essere trasformati in armi digitali di distruzione di massa. Ma quello era solo l’inizio: gli attacchi moderni sono molto più sofisticati e mirati.

La seconda sfida riguarda l’autonomia senza supervisione. I sistemi edge spesso devono funzionare in modo autonomo per settimane o mesi senza supervisione umana. Un sensore ambientale in una riserva naturale remota, o un sistema di monitoraggio in una piattaforma petrolifera offshore, deve prendere decisioni critiche da solo. Questa autonomia, però, li rende vulnerabili ad attacchi sofisticati che potrebbero passare inosservati per lungo tempo, permettendo agli attaccanti di stabilire persistenza e muoversi lateralmente attraverso la rete.

La terza sfida è rappresentata dalla frammentazione dei dati e della governance. Invece di avere tutti i dati in un posto sicuro e controllato, ora sono distribuiti ovunque. Questo crea quello che gli esperti definiscono un “data governance nightmare”. Come si può garantire che i dati personali siano trattati secondo il GDPR se sono processati da centinaia di dispositivi diversi, prodotti da aziende diverse, in paesi diversi? La complessità normativa si moltiplica esponenzialmente con il numero di punti di elaborazione.

Le nuove armi della cybersecurity: l’arsenal del futuro

Fortunatamente, l’industria della sicurezza informatica non resta a guardare. Organizzazioni come il GSMA, il 3GPP e l’IEEE stanno sviluppando nuovi approcci per affrontare queste sfide emergenti.

Il concetto di Zero Trust, formulato per la prima volta da John Kindervag di Forrester nel 2010, sta finalmente trovando applicazione pratica su larga scala. L’idea è rivoluzionaria: invece di presumere che tutto quello che è dentro la nostra rete sia sicuro, ogni dispositivo, ogni utente, ogni applicazione deve continuamente dimostrare di essere legittimo. Il principio “mai fidarsi, sempre verificare” diventa il mantra della sicurezza moderna.

Google è stata una delle prime ad implementare questo approccio su larga scala con il progetto BeyondCorp. I dipendenti Google non hanno accesso automatico alle risorse aziendali solo perché sono connessi alla rete aziendale. Ogni accesso viene verificato in tempo reale considerando molteplici fattori: chi è l’utente, da dove si connette, che dispositivo usa, che risorse sta cercando di accedere, e se il suo comportamento è coerente con i pattern storici. Nel contesto edge, questo significa che un sensore IoT in una fabbrica deve autenticarsi non solo quando si connette per la prima volta, ma continuamente durante il suo funzionamento.

I Trusted Execution Environments rappresentano un’altra innovazione promettente. Si tratta di creare “bunker digitali” all’interno dei processori, dove i dati più sensibili possono essere elaborati in completa sicurezza, protetti anche dal sistema operativo del dispositivo stesso. ARM TrustZone e Intel SGX sono le implementazioni più mature di questa tecnologia. Immaginate un processore diviso in due mondi paralleli: uno “normale” dove gira il sistema operativo standard, e uno “sicuro” dove vengono processati solo i dati più critici. Un dispositivo medico che monitora il battito cardiaco può usare il mondo “normale” per l’interfaccia utente e la connettività Wi-Fi, mentre i dati biometrici vengono processati esclusivamente nel mondo “sicuro”, dove neanche un malware che compromette completamente il dispositivo può accedervi.

Il Federated Learning, pioneered da Google, offre una soluzione elegante a una delle sfide più complesse dell’edge computing: come addestrare modelli di IA utilizzando dati distribuiti senza comprometterne la privacy. Invece di raccogliere tutti i dati in un posto centrale per addestrare un modello di IA, il modello viene addestrato localmente su ogni dispositivo, e solo i parametri del modello, non i dati grezzi, vengono condivisi. È come se migliaia di medici condividessero le loro conoscenze senza mai rivelare i dettagli dei loro pazienti.

Apple utilizza questa tecnologia per migliorare la digitazione predittiva su iPhone senza mai inviare quello che scrivete ai server Apple. Ogni iPhone addestra localmente un piccolo modello basato sulle vostre abitudini di digitazione, poi condivide solo i miglioramenti del modello con Apple, che li integra nell’aggiornamento successivo per tutti gli utenti.

La guerra degli algoritmi rappresenta la frontiera più avanzata della cybersecurity moderna. Se i criminali usano l’intelligenza artificiale per attacchi sempre più sofisticati, come deepfake per il social engineering o algoritmi di evasione per bypassare i sistemi di sicurezza, anche i difensori devono utilizzare IA per rilevare anomalie e rispondere agli attacchi in tempo reale.

I sistemi di sicurezza più avanzati utilizzano algoritmi di machine learning ispirati al sistema immunitario umano. Proprio come il nostro corpo impara a riconoscere e neutralizzare nuove minacce senza aver mai visto prima quel particolare virus, questi sistemi imparano il comportamento “normale” di una rete e identificano automaticamente anomalie che potrebbero indicare un attacco. L’approccio si basa sull’analisi comportamentale continua, dove algoritmi neurali costruiscono modelli dinamici del traffico di rete normale e segnalano deviazioni statisticamente significative.

Ma c’è anche il lato oscuro di questa evoluzione: i cybercriminali stanno usando IA per creare malware che si adatta in tempo reale alle difese, cambiando costantemente la propria “firma” per evitare di essere rilevato. Questa escalation tecnologica ha trasformato la cybersecurity in una vera e propria corsa agli armamenti digitale.

Il fattore europeo: regolamentazione come vantaggio competitivo

L’Europa sta giocando un ruolo particolare in questa trasformazione tecnologica, e contrariamente a quello che si potrebbe pensare, le regolamentazioni europee stanno diventando un vantaggio competitivo piuttosto che un ostacolo.

Il General Data Protection Regulation, entrato in vigore nel 2018, ha costretto le aziende di tutto il mondo a ripensare come gestiscono i dati personali. Nel contesto dell’edge computing, il GDPR diventa ancora più rilevante perché introduce principi fondamentali come la data minimization, che prevede di raccogliere solo i dati strettamente necessari. Questo principio è perfetto per l’edge computing, dove lo storage limitato costringe comunque a essere selettivi. La privacy by design richiede di integrare la protezione della privacy fin dalla progettazione del sistema, non come aggiunta successiva. Il right to be forgotten impone la capacità di cancellare completamente i dati di un utente, cosa complessa quando i dati sono distribuiti su migliaia di dispositivi edge.

L’AI Act europeo è entrato in vigore il primo agosto 2024, con implementazione graduale fino al 2027. La regolamentazione classifica i sistemi di IA in base al rischio, creando quattro categorie principali. I sistemi a rischio inaccettabile, che manipolano il comportamento umano o sfruttano vulnerabilità, sono completamente bannati. I sistemi ad alto rischio, critici per sicurezza o diritti fondamentali, devono sottostare a una regolamentazione stricta. I sistemi a rischio limitato, che interagiscono con umani, devono garantire trasparenza obbligatoria. Tutti gli altri sistemi rientrano nel rischio minimo e sono soggetti ad auto-regolamentazione.

Questo framework sta influenzando lo sviluppo di sistemi edge a livello mondiale. Anche aziende americane o asiatiche che vogliono vendere in Europa devono conformarsi a questi standard, creando un effetto “Brussels” che estende l’influenza normativa europea ben oltre i confini continentali.

Il Digital Services Act e il Cybersecurity Act completano il quadro normativo europeo, introducendo obblighi di trasparenza per le piattaforme digitali e standard di sicurezza per prodotti IoT. Il risultato è che le aziende europee stanno sviluppando competenze in “privacy-preserving edge computing” che stanno diventando sempre più richieste a livello globale, trasformando quello che poteva sembrare un onere burocratico in un vantaggio competitivo.

I settori in prima linea: case study dal mondo reale

Il settore sanitario rappresenta forse l’esempio più critico di edge computing, dove un attacco informatico non è solo una violazione della privacy ma può letteralmente mettere a rischio vite umane. Il caso dei pacemaker connessi illustra perfettamente questa realtà. Nel 2017, la FDA ha richiamato quattrocentosessantacinquemila pacemaker Abbott per vulnerabilità di sicurezza che permettevano ad attaccanti di modificarne il funzionamento da remoto. Il problema non era solo tecnico: questi dispositivi non avevano meccanismi di aggiornamento sicuro, richiedendo interventi chirurgici per la sostituzione.

Oggi, i nuovi dispositivi medici utilizzano tecnologie edge molto più sofisticate. I moderni pacemaker utilizzano algoritmi di IA locali per adattarsi automaticamente al ritmo cardiaco del paziente, processando migliaia di battiti senza mai trasmettere dati biometrici grezzi all’esterno. Gli ospedali moderni utilizzano sistemi edge per il monitoraggio continuo dei pazienti. Invece di inviare continuamente tutti i parametri vitali a server centrali, i dispositivi edge analizzano i dati localmente e trasmettono solo anomalie o pattern significativi.

La ricerca medica documenta come sistemi di machine learning ottimizzati possano ridurre significativamente i falsi allarmi nelle terapie intensive. Studi pubblicati su riviste scientifiche mostrano che è possibile ottenere riduzioni sostanziali degli allarmi non necessari – in alcuni casi fino all’ottantotto per cento – utilizzando soglie intelligenti e ritardi temporali che filtrano le fluttuazioni temporanee dei parametri vitali. Questi sistemi imparano a distinguere tra variazioni normali dei parametri vitali e situazioni che richiedono realmente l’attenzione del personale medico.

Il settore finanziario è forse quello che ha adottato più rapidamente le tecnologie edge, spinto dalla necessità di processare transazioni in tempo reale e rilevare frodi istantaneamente. Le società di trading ad alta frequenza come Citadel Securities hanno investito miliardi in infrastrutture edge per ridurre la latenza. Posizionano i loro server il più vicino possibile alle borse valori, letteralmente a metri di distanza, perché un millisecondo di vantaggio può tradursi in milioni di profitti.

Ma questo ha creato nuovi rischi. Nel 2010, il “Flash Crash” ha visto il Dow Jones perdere quasi mille punti in minuti, parzialmente a causa di algoritmi di trading automatico che si sono influenzati a vicenda in una spirale negativa. L’evento ha dimostrato come l’automazione estrema possa amplificare i rischi sistemici.

Mastercard utilizza IA edge per valutare ogni transazione in tempo reale. L’algoritmo considera oltre cento variabili, dalla posizione geografica ai pattern di spesa storici, e decide in meno di cento millisecondi se autorizzare o bloccare una transazione. Il sistema è così sofisticato che può rilevare se la vostra carta è stata clonata prima ancora che ve ne accorgiate, basandosi su micro-cambiamenti nel modo in cui inserite il PIN o nella velocità di digitazione.

Le smart city rappresentano forse l’applicazione più complessa dell’edge computing, dove migliaia di sistemi diversi devono collaborare per gestire servizi urbani critici. Singapore ha implementato la più avanzata infrastruttura smart city al mondo con il progetto Smart Nation. La piattaforma include oltre duecentomila sensori IoT che monitorano qualità dell’aria, rumore, traffico e illuminazione. Il sistema di trasporto intelligente utilizza semafori che si adattano al traffico in tempo reale usando IA edge. Gli algoritmi di manutenzione predittiva predicono quando le infrastrutture urbane necessitano interventi, mentre i sistemi di risposta alle emergenze ottimizzano automaticamente i percorsi dei mezzi di soccorso.

Tutto questo genera petabyte di dati al giorno, ma solo una frazione viene trasmessa ai data center centrali. La maggior parte viene processata localmente dai sistemi edge, dimostrando come sia possibile gestire una città intelligente senza saturare le infrastrutture di comunicazione.

L’industria automobilistica rappresenta il caso più complesso di edge computing mobile, dove i sistemi devono funzionare perfettamente mentre si muovono ad alta velocità. Ogni Tesla è essenzialmente un computer su ruote. Il sistema Autopilot utilizza il Tesla FSD Computer, chip proprietari progettati internamente e non hardware NVIDIA come spesso erroneamente riportato. Il sistema elabora dati da otto telecamere che coprono trecentosessanta gradi attorno al veicolo, dodici sensori ultrasonici sui modelli più vecchi, e radar frontale reintrodotto nell’Hardware 4.0.

Tesla ha sviluppato il Dojo, il supercomputer che utilizza per addestrare i suoi algoritmi utilizzando dati anonimi da tutta la flotta. È federated learning su scala planetaria, dove ogni veicolo contribuisce all’apprendimento collettivo senza mai condividere dati personali o sensibili.

Ma l’automotive edge presenta rischi unici. Nel 2015, i ricercatori Charlie Miller e Chris Valasek dimostrarono come hackerare remotamente una Jeep Cherokee, prendendo controllo di sterzo, freni e acceleratore attraverso il sistema di infotainment. Questo evento ha portato allo sviluppo di nuovi standard di sicurezza automotive come ISO/SAE 21434 che richiedono “security by design” per tutti i sistemi connessi.

Le minacce emergenti: i nuovi incubi della cybersecurity

Una delle minacce più sofisticate è l’AI Poisoning, che consiste nel manipolare i dati di training per compromettere il comportamento di un algoritmo di IA. Nel contesto edge, questo è particolarmente pericoloso perché molti sistemi continuano a imparare dal loro ambiente. La ricerca accademica ha dimostrato come sia possibile compromettere sistemi di riconoscimento attraverso modifiche strategiche a una piccola percentuale dei dati di training, rendendo i modelli vulnerabili a interpretazioni erronee di input critici come segnali stradali o comandi di controllo.

Con milioni di dispositivi edge interconnessi, diventano possibili nuovi tipi di attacchi coordinati. Gli “swarm attacks” utilizzano migliaia di dispositivi compromessi per attacchi coordinati che possono paralizzare intere infrastrutture. Ricercatori hanno simulato attacchi a smart grid utilizzando centomila termostati intelligenti compromessi. Coordinando i loro cicli di accensione e spegnimento, sono riusciti a destabilizzare la rete elettrica di un’intera città in simulazione, dimostrando come dispositivi apparentemente innocui possano diventare armi di guerra cibernetica.

Quando i modelli di IA girano localmente sui dispositivi edge, diventano vulnerabili a “model extraction attacks”. Attaccanti possono reverse-engineer algoritmi proprietari analizzando le loro risposte, un processo che gli esperti chiamano Edge Model Extraction. Questo è particolarmente problematico per aziende che investono milioni nello sviluppo di algoritmi di IA. Una volta estratto il modello, può essere replicato o usato per sviluppare attacchi più sofisticati.

L’economia della sicurezza Edge

I costi di sicurezza per sistemi edge sono significativamente superiori a quelli per sistemi centralizzati. Ogni dispositivo deve essere configurato e protetto individualmente, generando costi di deploy elevati. Monitorare migliaia di endpoint richiede strumenti sofisticati, mentre aggiornare migliaia di dispositivi distribuiti è complesso e costoso. Rispondere a incidenti su sistemi distribuiti richiede più tempo e risorse rispetto agli ambienti centralizzati.

Ma investire in sicurezza edge può anche generare risparmi significativi. IBM stima che il costo medio di un data breach ha raggiunto quattro virgola ottantotto milioni di dollari nel 2024, con un aumento del dieci per cento rispetto al 2023. Nel 2025, questo costo è sceso a quattro virgola quarantaquattro milioni di dollari grazie a tempi di rilevamento e contenimento più rapidi, dimostrando che gli investimenti in tecnologie avanzate stanno iniziando a dare frutti.

Le organizzazioni che utilizzano estensivamente IA e automazione nella sicurezza vedono risparmi medi di due virgola due milioni di dollari rispetto a quelle che non utilizzano queste tecnologie. Questi numeri dimostrano che, nonostante i costi iniziali elevati, la sicurezza edge può generare un ritorno sull’investimento significativo attraverso la riduzione dei rischi e l’miglioramento dell’efficienza operativa.

Standards e certificazioni: il puzzle normativo

Il NIST ha aggiornato il suo Cybersecurity Framework nel febbraio 2024 specificamente per affrontare le sfide dell’edge computing. Il Framework 2.0 introduce il Supply Chain Risk Management per gestire i rischi lungo tutta la catena di fornitura dei dispositivi edge. Il Recover Function Enhancement migliora le capacità di ripristino rapido per sistemi distribuiti, mentre il Governance Integration allinea la sicurezza edge con la governance aziendale complessiva.

L’ETSI ha pubblicato standard specifici per la sicurezza edge nel contesto 5G. L’ETSI TS 133 501 definisce la Security architecture per 5G networks, mentre l’ETSI GS MEC 009 stabilisce le General security considerations per Multi-access Edge Computing. L’ETSI TS 103 645 si concentra sulla Cybersecurity for consumer IoT, fornendo linee guida specifiche per i dispositivi consumer.

Con l’avvicinarsi dell’era dei computer quantistici, i sistemi edge devono prepararsi a minacce completamente nuove. Il NIST ha standardizzato nel 2024 nuovi algoritmi “quantum-safe” per proteggere le comunicazioni future. CRYSTALS-Kyber fornisce key encapsulation, mentre CRYSTALS-Dilithium offre digital signatures. FALCON è ottimizzato per signatures in ambienti con storage limitato, e SPHINCS+ fornisce signatures senza assumere problemi matematici specifici, garantendo maggiore robustezza contro attacchi futuri.

Case study approfonditi: lezioni dal campo

Nel dicembre 2017, FireEye ha scoperto TRITON/TRISIS, un malware progettato specificamente per attaccare sistemi di sicurezza industriali. A differenza di Stuxnet che puntava ai sistemi di controllo, TRITON disabilitava i sistemi di sicurezza, potenzialmente causando esplosioni o rilasci tossici. Il malware utilizzava tecniche edge-specific particolarmente insidiose.

La strategia “Living off the Land” sfruttava strumenti legittimi già presenti sui sistemi per evitare di essere rilevato. Gli attacchi Fileless esistevano solo in memoria, senza lasciare tracce su disco che potessero essere identificate da antivirus tradizionali. Il Lateral Movement permetteva al malware di muoversi tra sistemi edge sfruttando protocolli industriali non crittografati, progettati in un’epoca in cui la sicurezza non era una priorità.

Questo attacco ha evidenziato come i sistemi edge industriali siano particolarmente vulnerabili perché spesso utilizzano protocolli legacy non progettati per un mondo interconnesso. La lezione principale è che la modernizzazione delle infrastrutture industriali deve includere necessariamente un ripensamento completo della sicurezza.

Maersk, la più grande compagnia di shipping al mondo, ha subito nel 2017 uno dei peggiori attacchi ransomware della storia con NotPetya, che ha paralizzato le operazioni globali per settimane, causando perdite stimate tra i trecento e i trecentocinquanta milioni di dollari. La risposta dell’azienda è stata rivoluzionaria: invece di centralizzare ulteriormente i sistemi, Maersk ha implementato un’architettura edge distribuita dove ogni porto ha capacità operative autonome.

Ora, anche se un attacco compromette il cinquanta per cento dei sistemi, le operazioni possono continuare utilizzando la capacità edge rimanente. Il sistema utilizza mesh networking, dove ogni nodo può comunicare con qualsiasi altro nodo, distributed consensus per decisioni operative basate su algoritmi di consenso distribuito, e autonomous fallback che permette di operare offline per settimane se necessario.

Netflix serve oltre duecentosettanta milioni di utenti globally utilizzando una delle più sofisticate architetture edge al mondo. Con migliaia di server edge distribuiti globalmente, la sicurezza rappresenta una sfida enorme. La soluzione Netflix include immutable infrastructure, dove i server edge non vengono mai aggiornati ma solo sostituiti. Il continuous security scanning verifica ogni server per vulnerabilità continuamente, mentre l’automated incident response utilizza algoritmi di IA che possono isolare automaticamente server compromessi. L’intera architettura è basata su zero trust, dove ogni comunicazione tra server è criptata e autenticata.

Tecnologie emergenti: il futuro della sicurezza edge

L’Homomorphic Encryption rappresenta una delle frontiere più promettenti della crittografia moderna. Questa tecnologia permetterebbe di processare dati criptati senza mai decriptarli, risolvendo uno dei paradossi fondamentali dell’edge computing: come elaborare dati sensibili mantenendoli sempre protetti. Immaginate un sistema di IA che può analizzare dati medici sensibili senza mai “vedere” i dati in chiaro.

Microsoft SEAL e IBM HElib sono implementazioni open-source di questa tecnologia, ma le performance sono ancora troppo lente per applicazioni edge real-time. Tuttavia, i progressi nella ricerca stanno accelerando, e molti esperti prevedono che entro il 2030 l’homomorphic encryption diventerà praticabile per applicazioni commerciali.

La blockchain potrebbe risolvere il problema dell’identity management per miliardi di dispositivi IoT. Invece di fare affidamento su authority centrali che rappresentano un single point of failure, ogni dispositivo potrebbe avere un’identità crittografica verificabile sulla blockchain. IOTA ha sviluppato un’architettura blockchain specifica per IoT che non richiede mining e ha transazioni fee-free, rendendola praticabile per dispositivi con risorse limitate.

Geopolitica della sicurezza Edge

La competizione geopolitica sta influenzando profondamente lo sviluppo della sicurezza edge. Gli Stati Uniti hanno bannato l’uso di equipment Huawei e ZTE nelle reti 5G, citando preoccupazioni di sicurezza nazionale. Ma questo ha creato anche opportunità impreviste: aziende europee come Ericsson e Nokia sono diventate alternative “neutrali” per paesi che vogliono evitare di scegliere tra tecnologie americane e cinesi.

L’Europa sta promuovendo il concetto di “digital sovereignty”, l’idea che i dati europei dovrebbero essere processati utilizzando tecnologie europee. Questo ha portato a iniziative ambiziose come GAIA-X, un’infrastruttura cloud europea federata, l’European Chips Act che prevede investimenti miliardari per ridurre la dipendenza da semiconduttori asiatici, e il Digital Markets Act che impone regolamentazioni per ridurre il potere delle Big Tech americane.

Nel contesto edge, questo significa preferenza per soluzioni che mantengono i dati all’interno dei confini europei e utilizzano tecnologie sviluppate da aziende europee. La strategia potrebbe sembrare protezionistica, ma in realtà sta creando un mercato globale per tecnologie “sovereignty-compliant” che rispettano i requisiti di autonomia digitale.

Il fattore umano: skills gap e training

Secondo CyberSeek, ci sono attualmente tre virgola cinque milioni di posizioni cybersecurity aperte globalmente, e la situazione è ancora peggiore per specialisti in edge security. Le competenze richieste spaziano dalla IoT Security Architecture, che richiede di progettare sistemi sicuri per dispositivi con risorse limitate, alla Distributed Systems Security per gestire la sicurezza in ambienti distribuiti. Servono esperti in AI/ML Security per proteggere e da algoritmi di intelligenza artificiale, specialisti in Cloud-Edge Hybrid Security per integrare sicurezza cloud e edge, e professionisti in Industrial Control Systems per proteggere sistemi edge in ambienti industriali.

Università e aziende stanno sviluppando nuovi approcci per colmare questo gap. SANS ha sviluppato cyber ranges specificamente per edge security, dove professionisti possono praticare incident response su sistemi edge simulati. Siemens ha creato laboratori di industrial edge security in quindici università globally, dove studenti lavorano su progetti reali. ISC2 ha aggiunto moduli edge-specific al loro programma CISSP, mentre EC-Council ha creato una nuova certificazione specificamente per IoT security.

ROI e business case: numeri che contano

Calcolare il ROI della sicurezza edge è complesso perché include sia costi diretti che benefits indiretti. Per mille dispositivi edge, i costi diretti includono hardware security modules da cinquecento a duemila dollari per dispositivo, security management platform da centomila a cinquecentomila dollari annuali, security operations center da duecentomila a un milione di dollari annuali per personale, e compliance e audit da cinquantamila a duecentomila dollari annuali.

I benefits quantificabili includono la riduzione del data breach risk, con quattro virgola quarantaquattro milioni di dollari per breach evitato secondo IBM 2025. L’operational efficiency può migliorare del quindici-trenta per cento riducendo il downtime. La regulatory compliance permette di evitare fines fino al quattro per cento del revenue secondo il GDPR, mentre le insurance premiums possono ridursi del dieci-venti per cento con certificazioni appropriate.

Le aziende leader stanno utilizzando nuove metriche per misurare il successo della sicurezza edge. Il Mean Time to Detection è il tempo medio per rilevare un incidente: l’industry average è centonovantaquattro giorni nel 2024, mentre i best-in-class con edge security raggiungono meno di ventiquattro ore. Il Mean Time to Containment misura il tempo per contenere un incidente: l’industry average è sessantaquattro giorni nel 2024, mentre i best-in-class raggiungono meno di un’ora per sistemi edge. Il Security Automation Rate indica la percentuale di incidenti gestiti automaticamente, con target superiori all’ottanta per cento per sistemi edge.

La strada verso il futuro: predictions e preparations

Nei prossimi due-tre anni assisteremo alla convergenza su standard globali per la sicurezza edge. Organizzazioni come IEEE, NIST e ETSI stanno coordinando sforzi per creare frameworks interoperabili. I key developments includeranno la finalizzazione degli standard quantum-safe per dispositivi edge, l’armonizzazione tra regolamentazioni europee, americane e asiatiche, e l’emergere di edge security come disciplina separata nella cybersecurity.

Tra il 2027 e il 2030, la gestione della sicurezza edge diventerà completamente automatizzata. Sistemi di IA saranno in grado di detectare e rispondere a minacce in millisecondi, auto-configurare dispositivi edge per ambienti specifici, predire e prevenire attacchi prima che accadano, e auto-ripararsi da attacchi senza intervento umano. Questa automazione completa rappresenterà un salto qualitativo nella capacità di gestire ecosistemi edge complessi.

Oltre il 2030, con l’arrivo dei computer quantistici pratici, tutta la crittografia attuale dovrà essere sostituita. I sistemi edge, per la loro natura distribuita, saranno tra i primi a dover implementare soluzioni quantum-safe. Questa transizione rappresenterà una delle sfide tecniche più complesse della storia della cybersecurity, richiedendo la sostituzione di miliardi di dispositivi o almeno dei loro sistemi crittografici.

La sicurezza è un viaggio, non una destinazione

L’analisi di questo panorama complesso rivela che la sicurezza edge non rappresenta solo una sfida tecnica, ma una trasformazione fondamentale del modo in cui pensiamo alla cybersecurity. Non possiamo più permetterci di concepire la sicurezza come un perimetro da difendere, ma dobbiamo immaginarlo come un sistema immunitario distribuito che deve adattarsi costantemente a nuove minacce.

Le organizzazioni che avranno successo saranno quelle che investiranno in Security by Design, integrando la sicurezza fin dalla progettazione dei sistemi edge piuttosto che aggiungerla come elemento secondario. Dovranno adottare un approccio Zero Trust, dove la fiducia non viene mai data per scontata ma deve essere continuamente verificata. Sarà necessario sviluppare competenze specifiche, formando team specializzati in edge security che comprendano le peculiarità di questo ambiente distribuito. La collaborazione con l’ecosystem diventerà fondamentale, lavorando con vendor, regolatori e persino competitors per standard comuni che elevino il livello di sicurezza dell’intero settore. Infine, sarà indispensabile pensare a lungo termine, preparando i sistemi per minacce future come il quantum computing che potrebbero rendere obsolete le tecnologie di sicurezza attuali.

La posta in gioco è straordinariamente alta. I sistemi edge di oggi diventeranno l’infrastruttura critica di domani. Le auto autonome, i sistemi medici, le smart city, l’automazione industriale – tutto dipenderà da sistemi edge sicuri e affidabili. Un fallimento in questa transizione potrebbe compromettere non solo la sicurezza digitale ma anche la sicurezza fisica di milioni di persone.

Tuttavia, c’è motivo per essere ottimisti. L’industria della cybersecurity ha sempre dimostrato una straordinaria capacità di innovazione di fronte a nuove minacce. E oggi abbiamo a disposizione strumenti, dall’intelligenza artificiale alla crittografia avanzata, dalla blockchain ai computer quantistici, che erano impensabili solo pochi anni fa. La convergenza di queste tecnologie sta creando possibilità di difesa che potrebbero finalmente dare il vantaggio ai difensori rispetto agli attaccanti.

La sfida ora consiste nell’utilizzare questi strumenti saggiamente, bilanciando innovazione e sicurezza, efficienza e privacy, autonomia e controllo. È una sfida di complessità senza precedenti, ma rappresenta anche un’opportunità straordinaria per costruire un futuro digitale più sicuro e resiliente. Il successo richiederà non solo eccellenza tecnica, ma anche cooperazione internazionale, lungimiranza strategica e, soprattutto, la volontà di investire nella sicurezza come fondamento della società digitale.

L’edge computing e l’intelligenza artificiale distribuita rappresentano indubbiamente il futuro della tecnologia. La sicurezza edge rappresenta il futuro della cybersecurity. La partita si gioca ora, nei laboratori di ricerca, nelle sale riunioni aziendali, nelle aule parlamentari dove si scrivono le leggi del futuro digitale. Il risultato di questa partita determinerà quanto sarà sicuro il mondo digitale delle prossime decadi, influenzando la vita di miliardi di persone che dipenderanno sempre più da sistemi intelligenti distribuiti per la loro sicurezza, salute e benessere.

La trasformazione è già in corso, ed è irreversibile. Quello che possiamo ancora determinare è se questa trasformazione avverrà in modo sicuro e controllato, o se dovremo imparare le lezioni di sicurezza a nostre spese, attraverso incidenti che potrebbero costare non solo denaro, ma anche vite umane. La scelta è nostra, e il tempo per farla si sta rapidamente esaurendo.

Fonti:

IoT Analytics. (2024). State of IoT Summer 2024: Number of connected IoT devices growing 13% to 18.8 billion globally. Hamburg: IoT Analytics GmbH.

IBM Corporation & Ponemon Institute. (2024). Cost of a Data Breach Report 2024. Armonk, NY: IBM Corporation.

IBM Corporation & Ponemon Institute. (2025). Cost of a Data Breach Report 2025. Armonk, NY: IBM Corporation.

National Institute of Standards and Technology. (2024, February 26). The NIST Cybersecurity Framework (CSF) 2.0 (NIST CSWP 29). Gaithersburg, MD: U.S. Department of Commerce.

National Institute of Standards and Technology. (2024, August). NIST Releases First 3 Finalized Post-Quantum Encryption Standards. NIST News Release.

European Commission. (2024). Regulation (EU) 2024/1689 of the European Parliament and of the Council on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union.

Imhoff, M., Kuhls, S. (2006). Alarm algorithms in critical care monitoring. Anesthesia & Analgesia, 102(5), 1525-1537.

Sendelbach, S., Funk, M. (2013). Alarm fatigue: a patient safety concern. AACN Advanced Critical Care, 24(4), 378-386.

Drew, B. J., Harris, P., Zègre-Hemsey, J. K., et al. (2014). Insights into the problem of alarm fatigue with physiologic monitor devices: a comprehensive observational study of consecutive intensive care unit patients. PLOS ONE, 9(10), e110274.

Patient Safety Network, AHRQ. (2024). Surveillance Monitoring to Improve Patient Safety in Acute Hospital Care Units. Rockville, MD: Agency for Healthcare Research and Quality.

European Telecommunications Standards Institute. (2020). ETSI TS 103 645 V2.1.1: Cyber Security for Consumer Internet of Things: Baseline requirements. Sophia Antipolis: ETSI.

European Telecommunications Standards Institute. (2019). ETSI TS 133 501 V16.4.0: 5G Security architecture and procedures for 5G System. Sophia Antipolis: ETSI.

European Telecommunications Standards Institute. (2017). ETSI GS MEC 009 V1.1.1: Multi-access Edge Computing (MEC); General security considerations. Sophia Antipolis: ETSI.

International Organization for Standardization. (2020). ISO/IEC TR 23188:2020 Information technology — Cloud computing — Edge computing landscape. Geneva: ISO.

International Organization for Standardization. (2013). ISO/IEC 27001:2013 Information technology — Security techniques — Information security management systems — Requirements. Geneva: ISO.

Apple Inc. (2017). Learning with Privacy at Scale. Apple Machine Learning Research.

Google LLC. (2024). BeyondCorp Zero Trust Enterprise Security. Google Cloud Documentation.

Coral AI. (2024). Edge TPU Performance Benchmarks. Google Coral Documentation.

Tesla Inc. (2024). Tesla Autopilot Hardware Specifications. Disponibile tramite documentazione tecnica ufficiale Tesla.

ARM Limited. (2024). ARM TrustZone Technology Overview. ARM Technical Documentation.

Intel Corporation. (2024). Intel SGX Developer Guide. Intel Software Developer Resources.

Smart Nation and Digital Government Office, Singapore. (2024). Smart Nation Singapore Initiative.

Government Technology Agency, Singapore. (2024). Smart Nation 2.0: Initiatives in Singapore.

U.S. Food and Drug Administration. (2017). FDA Safety Communication: Cybersecurity Vulnerabilities Identified in St. Jude Medical’s Implantable Cardiac Devices and Merlin@home Transmitter. FDA Medical Device Safety Communications.

European Parliament. (2024). AI Act Implementation Timeline (EPRS_ATA(2025)772906_EN). European Parliament Research Service.

Cybersecurity and Infrastructure Security Agency (CISA). (2024). Industrial Control Systems Security Guidelines. U.S. Department of Homeland Security.

FireEye Inc. (2017, December 14). TRITON Actor TTP Profile, Custom Attack Tools, Detections, and ATT&CK Mapping. FireEye Threat Intelligence Report.

Cloudflare Inc. (2024). Inside the infamous Mirai IoT Botnet: A Retrospective Analysis. Cloudflare Blog.

Miller, C., & Valasek, C. (2015). Remote Exploitation of an Unaltered Passenger Vehicle. Black Hat USA 2015. [Jeep Cherokee hack]

Maersk A.S. (2017). Annual Report 2017: NotPetya Cyber Attack Impact Assessment. Copenhagen: A.P. Moller-Maersk Group.

Netflix Technology Blog. (2024). Open Connect: Netflix’s Content Delivery Network.

Statista. (2024). Internet of Things (IoT) – statistics & facts.

DemandSage. (2025). Internet of Things Statistics 2025 [Demographics & Active Users].

VentureBeat. (2024). Report: Average time to detect and contain a breach is 287 days.

Ramirez, M. A., Kim, S. K., Al Hamadi, H., et al. (2022). Poisoning Attacks and Defenses on Artificial Intelligence: A Survey. arXiv preprint arXiv:2202.10276.

Built In Editorial Team. (2024, November 19). What Is Data Poisoning? Built In Technology Articles.

National Institute of Standards and Technology. (2024). Poisoning Attacks Against Machine Learning (NIST Publication 934932). Gaithersburg, MD: NIST.

National Institute of Standards and Technology. (2024). Post-Quantum Cryptography Standardization. NIST Computer Security Resource Center.

Wikipedia Contributors. (2024). NIST Post-Quantum Cryptography Standardization. Wikipedia, The Free Encyclopedia.

Massachusetts Nurses Association. (2023). Patient alarms often unheard, unheeded.

IoT for All. (2024). 6 Technological Advancements That Make Singapore a Smart City.

Tech Monitor. (2023, November 30). How real is the threat of data poisoning to generative AI?

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-edge/


Nano Banana AI: sicurezza e privacy nell’era dell’intelligenza artificiale generativa

Nano Banana AI rappresenta una delle più recenti innovazioni nell’editing di immagini basato sull’intelligenza artificiale, ma quali considerazioni di sicurezza dovrebbero tenere presenti gli utenti? La tecnologia, che sfrutta il potente modello Gemini 2.5 Flash Image di Google (noto internamente come “Nano Banana”), promette capacità rivoluzionarie di generazione e modifica delle immagini attraverso semplici comandi in linguaggio naturale.

Tuttavia, come per ogni nuova tecnologia AI, emergono domande legittime sulla gestione della privacy, la protezione dei dati e le migliori pratiche per un utilizzo sicuro. Questo articolo esamina il panorama della sicurezza attorno a questa tecnologia emergente, analizzando sia i servizi ufficiali di Google che le implementazioni di terze parti, e fornisce indicazioni pratiche per navigare consapevolmente in questo nuovo ecosistema dell’AI generativa.

Nano Banana AI: una tecnologia, diverse implementazioni

Per comprendere appieno le implicazioni di sicurezza legate a Nano Banana AI, è essenziale distinguere tra le diverse implementazioni disponibili. “Nano Banana” era il nome in codice interno di Google per quello che è diventato ufficialmente Gemini 2.5 Flash Image, annunciato nel dicembre 2024 e rapidamente affermatosi come uno dei modelli leader nelle classifiche di LMArena per la generazione e modifica di immagini. Il modello è accessibile tramite i canali ufficiali di Google, inclusi Google AI Studio e l’API Gemini.

Parallelamente, sono emersi servizi di terze parti come nanobanana.ai, gestito da DanDan AI Limited (una società registrata a Hong Kong nel giugno 2025), che offrono interfacce alternative per accedere a funzionalità simili. Questa distinzione è cruciale dal punto di vista della sicurezza, poiché i diversi provider possono implementare misure di protezione differenti e operare sotto giurisdizioni diverse con requisiti normativi variabili.

Il funzionamento di base rimane consistente attraverso le diverse implementazioni: gli utenti caricano immagini, descrivono le modifiche desiderate in linguaggio naturale, e ricevono risultati elaborati attraverso modelli di intelligenza artificiale avanzati. Questa apparente semplicità nasconde una complessa catena di elaborazione dati che solleva questioni importanti sulla gestione della privacy e la protezione delle informazioni personali.

Il panorama della sicurezza nell’AI generativa

Le piattaforme di intelligenza artificiale generativa devono affrontare sfide di sicurezza uniche che vanno oltre i tradizionali rischi informatici. Il prompt injection rappresenta attualmente una delle minacce più significative, permettendo agli attaccanti di manipolare il comportamento del modello attraverso istruzioni malevole nascoste negli input degli utenti. Questa vulnerabilità può portare alla generazione di contenuti inappropriati o al comportamento imprevisto del sistema.

Il data poisoning costituisce un’altra preoccupazione rilevante, dove dati manipolati potrebbero essere introdotti nei dataset di addestramento per influenzare negativamente le prestazioni del modello. Mentre i modelli di Google sono sottoposti a rigorosi processi di validazione e controllo qualità, la natura distribuita dell’ecosistema AI significa che diversi livelli di protezione possono essere implementati da diversi provider.

Gli attacchi di membership inference, dove malintenzionati tentano di determinare se specifici dati erano presenti nel dataset di addestramento, rappresentano un rischio emergente per la privacy. Similmente, gli attacchi di model extraction potrebbero permettere a terze parti di ricostruire aspetti del modello attraverso query sistematiche, potenzialmente compromettendo la proprietà intellettuale e creando vulnerabilità di sicurezza.

Standard di sicurezza e migliori pratiche del settore

Il settore dell’intelligenza artificiale sta rapidamente sviluppando framework di governance e sicurezza per affrontare i rischi emergenti. Il NIST AI Risk Management Framework rappresenta attualmente il gold standard per la gestione sistematica del rischio AI, promuovendo un approccio strutturato attraverso quattro funzioni principali: Govern (governare), Map (mappare), Measure (misurare) e Manage (gestire). Questo framework enfatizza l’importanza di una governance proattiva piuttosto che reattiva.

Le certificazioni tradizionali di sicurezza informatica stanno evolvendo per incorporare considerazioni specifiche per l’AI. ISO/IEC 27001 rimane il standard globale per i sistemi di gestione della sicurezza informatica, mentre SOC 2 è particolarmente rilevante per i service provider, specialmente nel mercato nordamericano. È importante notare che l’ottenimento di queste certificazioni richiede investimenti significativi in termini di tempo, risorse e impegno organizzativo.

L’EU AI Act, entrato in vigore nell’agosto 2024 con implementazione completa prevista per agosto 2026, introduce requisiti specifici per diverse categorie di sistemi AI. I sistemi che processano dati biometrici o che operano in contesti ad alto rischio devono rispettare requisiti particolarmente stringenti di trasparenza, accuratezza e robustezza.

Considerazioni pratiche per diverse implementazioni

Quando si valutano servizi che utilizzano la tecnologia Nano Banana, gli utenti dovrebbero considerare diversi fattori chiave. I servizi ufficiali di Google beneficiano dell’infrastruttura di sicurezza consolidata dell’azienda, incluse misure come la crittografia end-to-end, i controlli di accesso avanzati e la conformità a standard internazionali di sicurezza. Tuttavia, anche i servizi ufficiali richiedono attenzione alle impostazioni di privacy e ai termini di utilizzo.

Per i servizi di terze parti, le considerazioni diventano più complesse. Senza accesso a informazioni dettagliate sulla loro infrastruttura di sicurezza, gli utenti dovrebbero applicare principi di due diligence più rigorosi. Questo include la verifica delle credenziali aziendali (come abbiamo confermato per DanDan AI Limited), la revisione delle politiche sulla privacy e la valutazione del track record dell’organizzazione in termini di sicurezza.

L’assenza di informazioni pubbliche su certificazioni di sicurezza specifiche non implica necessariamente carenze, ma suggerisce la necessità di maggiore cautela e valutazione case-by-case. Gli utenti dovrebbero cercare indicatori di trasparenza come politiche sulla privacy chiaramente articolate, informazioni sui controlli di sicurezza implementati e canali di comunicazione per questioni di sicurezza.

Navigare in sicurezza: raccomandazioni pratiche

Indipendentemente dal servizio scelto, gli utenti possono adottare diverse strategie per proteggere la propria privacy e sicurezza. Il principio della minimizzazione dei dati rimane fondamentale: utilizzare solo le informazioni strettamente necessarie per ottenere il risultato desiderato. Evitare di caricare immagini contenenti informazioni sensibili, documenti di identità, o contenuti che potrebbero compromettere la privacy propria o altrui.

La gestione delle credenziali richiede particolare attenzione nell’era dell’AI. L’utilizzo di password uniche e robuste, preferibilmente gestite attraverso un password manager affidabile, rappresenta una protezione essenziale. Quando disponibile, l’autenticazione multi-fattore dovrebbe sempre essere abilitata. Per servizi che non offrono questa opzione, considerare l’utilizzo di email dedicate e il monitoraggio regolare dell’account per attività sospette.

Per le organizzazioni che considerano l’integrazione di queste tecnologie nei propri workflow, è cruciale sviluppare policy d’uso chiare e condurre valutazioni del rischio appropriate. La classificazione dei tipi di dati da processare, la definizione di procedure di incident response specifiche per l’AI, e la formazione del personale sui rischi emergenti rappresentano elementi imprescindibili di una strategia di sicurezza completa.

L’Evoluzione del panorama normativo

Il contesto normativo per l’intelligenza artificiale sta evolvendo rapidamente a livello globale. L’EU AI Act rappresenta il primo tentativo completo di regolamentazione dell’AI, stabilendo obblighi differenziati basati sul livello di rischio. I sistemi che processano dati biometrici o che operano in settori critici saranno soggetti a requisiti particolarmente stringenti di documentazione, testing e monitoraggio continuo.

Negli Stati Uniti, iniziative come l’Executive Order presidenziale sull’AI del 2023 stanno creando framework per la governance dell’AI a livello federale, mentre diversi stati stanno sviluppando legislazioni specifiche. Questa patchwork di regolamentazioni significa che le organizzazioni operanti a livello internazionale devono navigare un panorama normativo complesso e in continua evoluzione.

La tendenza verso maggiore trasparenza e accountability nell’AI suggerisce che i provider di servizi dovranno investire crescentemente in compliance e documentazione. Le organizzazioni che abbracciano proattivamente questi principi di trasparenza probabilmente costruiranno vantaggi competitivi duraturi in un mercato sempre più attento alla privacy e alla sicurezza.

Verso un futuro di AI responsabile

L’intelligenza artificiale generativa, rappresentata da tecnologie come Nano Banana AI, offre potenzialità trasformative per creatività, produttività e innovazione. Tuttavia, la realizzazione di questo potenziale richiede un approccio equilibrato che valorizzi equamente innovazione e responsabilità. Questo significa non solo sviluppare tecnologie più potenti, ma anche implementare sistemi di governance, controllo e protezione adeguati.

Per gli utenti, questo si traduce nella necessità di sviluppare alfabetizzazione digitale specifica per l’AI, comprendendo tanto le opportunità quanto i rischi. La capacità di valutare criticamente i diversi servizi, comprendere le implicazioni delle proprie scelte digitali, e adottare pratiche di sicurezza appropriate diventerà sempre più importante in un mondo caratterizzato dalla pervasività dell’AI.

Per l’industria, la sfida consiste nel bilanciare accessibilità e sicurezza, innovazione e responsabilità. I provider che riusciranno a costruire fiducia attraverso trasparenza, sicurezza robusta e conformità normativa probabilmente emergeranno come leader in questo spazio competitivo.

Innovazione consapevole nell’era dell’AI

Nano Banana AI e le tecnologie simili rappresentano un’evoluzione significativa nelle capacità di elaborazione delle immagini, democratizzando strumenti precedentemente accessibili solo a professionisti specializzati. L’analisi del panorama della sicurezza rivela un ecosistema in rapida evoluzione, caratterizzato da opportunità significative ma anche da sfide importanti che richiedono attenzione informata.

La diversità delle implementazioni disponibili – dai servizi ufficiali di Google alle piattaforme di terze parti – offre agli utenti opzioni multiple ma richiede anche maggiore discernimento nella valutazione delle alternative. L’assenza di informazioni pubbliche dettagliate su aspetti specifici della sicurezza di alcune implementazioni sottolinea l’importanza di un approccio cauto e di pratiche di due diligence appropriate.

Il futuro promette sviluppi entusiasmanti in questo campo, con miglioramenti continui sia nelle capacità tecnologiche che nei framework di sicurezza e governance. Il successo nell’adozione di queste tecnologie dipenderà dalla nostra capacità collettiva di bilanciare l’innovazione con la responsabilità, costruendo un ecosistema dell’AI che sia tanto potente quanto sicuro e affidabile.

Gli utenti informati, che comprendono tanto le potenzialità quanto i rischi di queste tecnologie, e che adottano pratiche appropriate di sicurezza digitale, saranno meglio posizionati per beneficiare delle opportunità offerte dall’AI generativa. Nel contempo, l’industria e i regolatori continueranno a sviluppare standard e framework sempre più sofisticati per garantire che l’innovazione proceda di pari passo con la protezione degli interessi degli utenti e della società nel suo complesso.

Note:

Google LLC. (2024, dicembre). Introducing Gemini 2.5 Flash Image, our state-of-the-art image model. Google Developers Blog.

Google DeepMind. (2024). Create and edit images with Gemini 2.5 Flash Image.

Google LLC. (2024). Gemini models – Gemini API. Google AI for Developers.

Google LLC. (2024). Release notes – Gemini API. Google AI for Developers.

European Union. (2024). Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union.

European Commission. (2024). AI Act – Shaping Europe’s digital future.

International Organization for Standardization. (2022). ISO/IEC 27001:2022 – Information security management systems – Requirements.

National Institute of Standards and Technology. (2023). AI Risk Management Framework (AI RMF 1.0). NIST AI 100-1.

DanDan AI Limited. (2025). Company Registration Information. Hong Kong Companies Directory.

LMArena. (2024). Nano-Banana (Gemini 2.5 Flash Image): Try it on LMArena.

Amazon Web Services. (2024). What is MFA? – Multi-Factor Authentication and 2FA Explained.

CrowdStrike Inc. (2024). What is Multi-Factor Authentication (MFA)? CrowdStrike Cybersecurity 101.

IBM Corporation. (2024). What is MFA (Multifactor Authentication)? IBM Think Topics.

Microsoft Corporation. (2024). What is: Multifactor Authentication. Microsoft Support.

OWASP Foundation. (2024). LLM01: Prompt Injection – OWASP Gen AI Security Project.

Gupta, M. (2025, agosto). What is Google Nano Banana? Google’s Secret AI for Images. Data Science in Your Pocket, Medium.

Bird & Bird LLP. (2023). Biometrics under the EU AI Act.

Future Processing. (2024, settembre). Artificial Intelligence usage in Multi-Factor Authentication.

AsiaVerify. (2025, luglio). How to verify a Hong Kong company.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/nano-banana-ai/


Impennata delle scansioni dei portali di login di Palo Alto Networks: +500%


Lo scorso venerdì i ricercatori di GreyNoise hanno evidenziato un’impennata delle scansioni dei portali di login di Palo Alto Networks: secondo le stime condivide dalla compagnia, si è verificato un incremento di circa il 500%. 

Nel dettaglio, si è passati da un volume medio di scansioni da 200 IP al giorno a circa 1300; di questi, il 93% è stato classificato come sospetto e il 7% come malevolo. Il 91% degli IP erano geolocalizzati negli Stati Uniti, mentre i restanti si sono divisi tra Regno Unito, Olanda, Canada e Russia.

“Quasi tutte le scansioni miravano ai profili Palo Alto emulati da GreyNoise (Palo Alto GlobalProtect, Palo Alto PAN-OS), il che suggerisce che si trattasse di attività mirate, probabilmente derivanti da scansioni pubbliche (ad esempio Shodan, Censys) od originate da aggressori che effettuavano il fingerprinting dei dispositivi Palo Alto” ha spiegato la compagnia di sicurezza.

Il traffico rivelato era particolarmente strutturato e mirato, diviso tra diversi cluster di scansione.

scansioni Palo Alto Networks

Sebbene non sia una certezza, GreyNoise sottolinea che in alcuni casi l’impennata delle scansioni verso Palo Alto Networks ha coinciso con la pubblicazione di nuove vulnerabilità entro sei settimane dall’evento. Anche se non c’è una correlazione comprovata, GreyNoise sta monitorando attentamente l’evoluzione delle attività.

Contattata da The Hacker News, Palo Alto Networks ha affermato che al momento non sono stati rilevati segni di compromissione. “Palo Alto Networks è protetta dalla nostra piattaforma Cortex XSIAM che blocca ogni giorno 1,5 milioni di nuovi attacchi e riduce autonomamente 36 miliardi di eventi di sicurezza alle minacce più critiche, garantendo la sicurezza della nostra infrastruttura. Continuiamo ad avere fiducia nella nostra solida posizione in materia di sicurezza e nella nostra capacità di proteggere la nostra rete” ha specificato la compagnia.

Il consiglio GreyNoise per gli esperti di sicurezza è di bloccare immediatamente qualsiasi IP sospetto.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/10/06/impennata-delle-scansioni-dei-portali-di-login-di-palo-alto-networks-500/?utm_source=rss&utm_medium=rss&utm_campaign=impennata-delle-scansioni-dei-portali-di-login-di-palo-alto-networks-500