MedusaHVNC Malware Uses Hidden Windows Desktops to Evade Detection

Hidden desktops are a legitimate Windows capability, often used by specialized software, and occasionally used by malware.

MedusaHVNC is a remote access trojan (RAT) being sold as malware-as-a-service (MaaS). It is promoted through its own website and a Telegram channel. It was found and analyzed by BlackFog, with the analysis finding a hidden virtual network computing (HVNC) module that opens a legitimate browser on a separate hidden Windows desktop,

Since it operates from a hidden desktop, its operation is invisible to the user.

The malware uses a 5-stage infection chain. It starts when the legitimate wscript.exe executes a JScript launcher. The script waits for just over 7.5 seconds and then builds its embedded files under %TEMP%\Nx2981Okkr2\.

Several files are written to disc, including an encrypted payload and a .bat in the Startup folder to maintain persistence.

Windows AutoIT is used to decrypt the payload and start charmap.exe (the Windows character map utility. The loader, now inside charmap.exe, contains two further layers of encryption. “The first applies a 16-byte repeating XOR operation to 1,009,152 bytes from the .data section. The second uses ChaCha20 to decrypt 998,912 bytes of ciphertext with a 32-byte key, a 12-byte nonce, and an initial counter value of 1,” write the researchers.

Advertisement. Scroll to continue reading.

That installed final payload ‘is an unsigned PE32+ x86-64 console executable containing a .pay section and the family string MedusaHVNC.’ It communicates with the operator’s C2 at a hardcoded address: 51.89.204.28:4444.

The operator can create a browser of choice within the hidden desktop from Chrome, Edge, and Firefox. Legitimate Windows functions, including BitBlt, EnumWindows, and PrintWindow support screen and window capture, while SendInput and SetWindowsHookExW are associated with synthetic input and interaction. 

“Clipboard functions, including OpenClipboard, GetClipboardData, and SetClipboardData, provide another way to move information into or out of the session,” comment the researchers.

The hidden desktop allows the attacker to take full advantage of legitimate Windows tools without being observed by the user. The C2 is hardcoded into the malware but is relatively safe from observation. The result is a stealthy and persistent RAT.

The only obvious mitigation is detection of unexpected data exfiltration. Even if the RAT’s operation is out of view in the unknown and hidden desktop, the data must still be exfiltrated from the network. Detection of unexplained data leaving the network is always an indication that something is wrong somewhere.

Related: Google Antigravity in Crosshairs of Security Researchers, Cybercriminals

Related: Threat Actor Infests Hotels With New RAT

Related: New ‘Lobshot’ hVNC Malware Used by Russian Cybercriminals

Related: TrickBot Targets Outlook, Browser Data

https://www.securityweek.com/medusahvnc-malware-uses-hidden-windows-desktops-to-evade-detection/


Nvidia and Tech Giants Launch AI Security Alliance

Nvidia and a large group of technology, cybersecurity, and enterprise software companies announced on Monday the launch of the Open Secure AI Alliance, a new initiative aimed at developing and sharing open source tools, models, and techniques for securing AI systems and agents. 

The effort builds on existing work from the Linux Foundation’s recently launched Akrites initiative and the OpenSSF community.

Inaugural partners of the Open Secure AI Alliance also include Adobe, Cadence, Capital One, Cisco, Cloudera, Cloudflare, Cognition, CrowdStrike, Databricks, Dell, DoorDash, Elastic, HPE, Hugging Face, IBM, LangChain, Microsoft, Naver, NetApp, Nous Research, OpenClaw, Palantir, Palo Alto Networks, Red Hat, Reflection AI, Salesforce, SAP, SK Telecom, ServiceNow, Siemens, Snowflake, SpaceXAI, Synopsys, Thinking Machines Lab, and TrendAI.

Nvidia’s contribution to the project includes open models, weights, data, and agent harness research, including a newly released open source project called NOOA, designed to help harnesses make agent behavior easier to trace, test, and audit.

HPE is contributing to SPIFFE/SPIRE, a zero-trust identity framework for cryptographically verifying AI agents and services, while Hugging Face is donating its Safetensors model weight storage format to the PyTorch Foundation.

IBM and Red Hat are extending open source supply chain security through the Lightwell project, which is designed to deliver automated vulnerability remediation at scale.

Advertisement. Scroll to continue reading.

Microsoft is contributing MDASH, a multi-model agentic scanning harness that coordinates AI agents to find, debate, and validate exploitable software bugs.

SpaceXAI is open-sourcing its Grok Build terminal-based AI coding agent, with plans to eventually open-source the weights of the Grok model line.

The new alliance argues that open models, harnesses, and security tooling should be treated as defensive assets rather than liabilities, and warns policymakers and regulators that broad restrictions on open frontier AI could weaken collective cyber defense capacity.

Learn More at the AI Risk Summit | Ritz-Carlton, Half Moon Bay

Nvidia points to the recent security incident involving OpenAI and Hugging Face, noting that when closed AI tools could not differentiate between attackers and defenders and blocked forensic work, Hugging Face used the open-weight GLM 5.2 model on its own systems to review over 17,000 actions and contain the breach.

“The right response is not to deny defenders access to capable open systems. It is to pair openness with strong safeguards, clear rules against malicious misuse, rigorous evaluation and rapid remediation. In cybersecurity, the safer path is the one that gives more defenders the ability to test, verify and strengthen the systems on which society relies,” Nvidia said.

“Defenders need both frontier closed models and frontier open models, working together, so they can choose the right system for the job and ensure that transparency, adaptation and sovereign control are available wherever security demands them,” it added.

Related: Anthropic’s Opus 5 Nears Mythos 5 on Finding Bugs, but Falls Short on Exploits

Related: White House Launches AI-Driven ‘Gold Eagle’ Vulnerability Coordination Initiative

Related: OpenAI Fixes ChatGPT Agent Flaw That Could Let Attackers Forge an AI Insider

Related: Nuclear-Sabotage Malware Benchmark Trips Up Most Frontier AI Models

https://www.securityweek.com/nvidia-and-tech-giants-launch-ai-security-alliance/


Cryptographic Bill of Materials (CBOM): sapere che crittografia si usa prima di migrare

Il Cryptographic Bill of Materials (CBOM) risponde a una domanda che quasi ogni organizzazione, di fronte alla migrazione post-quantum, scopre di non saper trasformare in un elenco: dove, e con quali algoritmi, chiavi e certificati, l’azienda usa la crittografia. Sembra una domanda banale, e invece è insidiosa, perché la crittografia non vive in un posto solo. È incorporata nelle applicazioni, nelle librerie di terze parti, nei protocolli negoziati a runtime, nei certificati che scadono in silenzio, nell’hardware. Nessuno l’ha mai censita davvero, perché finora non è servito. Ora serve, e serve in fretta.

La ragione è la transizione verso una crittografia resistente ai computer quantistici, spinta da scadenze ormai fissate e dalla minaccia del “raccogli ora, decifra dopo”, che rende urgente proteggere già oggi i segreti destinati a durare a lungo. Ma prima di sostituire un algoritmo bisogna sapere di averlo. Il CBOM è lo strumento standardizzato che trasforma questa consapevolezza da esercizio manuale a inventario ripetibile, ed è la prima mossa concreta di una migrazione che, senza di esso, procederebbe alla cieca.

Che cos’è un Cryptographic Bill of Materials

Un Cryptographic Bill of Materials è l’inventario strutturato e leggibile dalle macchine degli asset crittografici di un sistema: gli algoritmi, le chiavi, i certificati e i protocolli, insieme alle relazioni che li legano ai componenti software che li usano. È l’estensione, al mondo della crittografia, di un’idea già familiare: quella del Software Bill of Materials. Come l’SBOM elenca le componenti di cui un software è fatto, il CBOM elenca la crittografia che quel software impiega, e dove la impiega. La differenza è che qui le dipendenze non sono librerie ma primitive crittografiche, ed è proprio la loro invisibilità a rendere l’inventario necessario.

Lo standard di riferimento è nato in ambito aperto. Il formato CBOM è stato introdotto in CycloneDX, il progetto di OWASP per le distinte dei materiali, con la versione 1.6 dell’aprile 2024, su un contributo iniziale di IBM Research, ed è stato poi standardizzato come ECMA-424. Non si è fermato lì: la versione 1.7, rilasciata nell’ottobre 2025 e ratificata come ECMA-424 di seconda edizione a dicembre 2025, ne ha ampliato le capacità, aggiungendo un elenco standardizzato delle famiglie di algoritmi e una lista completa delle curve ellittiche, utili anche fuori da CycloneDX per le verifiche di conformità e di prontezza al post-quantum. Non è quindi un formato proprietario legato a un fornitore, ma una grammatica comune con cui descrivere la postura crittografica di un’organizzazione, generarla con strumenti di scoperta automatica e scambiarla come si scambia già un SBOM.

Perché l’inventario viene prima della migrazione

Gli standard post-quantum, almeno i principali, ci sono: nell’agosto 2024 il NIST ha finalizzato i primi tre algoritmi resistenti al calcolo quantistico (FIPS 203, 204 e 205). E “primi” è la parola esatta, perché il quadro non è ancora completo: un ulteriore algoritmo, HQC, è stato selezionato nel marzo 2025, e la firma FN-DSA (FIPS 206) è tuttora in lavorazione. Le agenzie, intanto, hanno iniziato a fissare le date entro cui abbandonare gli algoritmi vulnerabili. Il problema, insomma, non è più quale crittografia adottare, ma dove va applicata, ed è qui che casca l’asino: la maggior parte delle organizzazioni non possiede una mappa di dove e come usa la crittografia. È un sapere sparso tra team diversi, sepolto in codice scritto anni prima, delegato a componenti che nessuno controlla riga per riga.

Non a caso le stesse autorità mettono l’inventario al primo posto. Il documento congiunto di CISA, NSA e NIST, dell’agosto 2023, indica come passo iniziale proprio la costruzione di un inventario crittografico: sapere quali algoritmi sono in uso, in quali sistemi, a protezione di quali dati. È l’applicazione di un principio tanto semplice quanto trascurato, cioè che non si può migrare ciò che non si vede. Senza quella mappa, ogni piano di transizione resta una stima, e ogni scadenza un salto nel buio.

Da allora le autorità hanno alzato la posta, e il CBOM è passato dalle raccomandazioni a un atto di governo. Con l’ordine esecutivo di giugno 2026 sulla sicurezza crittografica (Executive Order 14412), la Casa Bianca ha incaricato il Dipartimento della Sicurezza interna, tramite la CISA e in coordinamento con il NIST, di pubblicare entro 270 giorni, quindi verso il 19 marzo 2027, una guida sugli elementi minimi di un cryptographic bill of materials capace di abilitare la valutazione automatizzata degli asset crittografici di un componente hardware o software. È la prima volta che una direttiva federale nomina il CBOM come artefatto definito: il segnale che l’inventario non è più una buona pratica suggerita, ma la base su cui si costruirà la conformità.

Non solo Stati Uniti: la spinta arriva anche dall’Europa

Il baricentro del dibattito è statunitense, ma la stessa direzione si legge in Europa, ed è la parte che riguarda più da vicino chi lavora in Italia. La Coordinated Implementation Roadmap del Gruppo di Cooperazione NIS, del giugno 2025, chiede agli Stati membri di avviare la transizione entro la fine del 2026, di completare la migrazione delle infrastrutture critiche non oltre il 2030 e di estenderla ai sistemi restanti, per quanto praticabile, entro il 2035. La spinta potrebbe poi irrigidirsi in obbligo: la proposta COM(2026) 13, presentata dalla Commissione nel gennaio 2026 nell’ambito di un pacchetto di semplificazione della direttiva NIS2 e di allineamento al Cybersecurity Act, se approvata da Parlamento e Consiglio scriverebbe la crittografia post-quantum direttamente nel testo della direttiva, trasformando la pianificazione da interpretazione della clausola sullo “stato dell’arte” a requisito esplicito.

Per l’Italia la scadenza di fine 2026 è vicina, e il segnale nazionale è già arrivato: l’11 giugno 2026 l’Agenzia per la Cybersicurezza Nazionale ha pubblicato due nuovi documenti sulle funzioni crittografiche, dedicati ai cifrari a flusso e alle firme digitali, e ha aggiornato alla versione 2.0 la guida sul TLS, integrandovi le soluzioni post-quantum. Il messaggio, su entrambe le sponde dell’Atlantico, converge: la migrazione ha una data, e una data trasforma l’inventario da progetto rimandabile a compito immediato.

Dal CBOM alla crypto-agility

L’inventario, di per sé, non protegge nulla: è il presupposto di ciò che viene dopo. Con una fotografia accurata della crittografia in uso, un’organizzazione può fare ciò che senza quella mappa resta un’ipotesi. Può individuare gli algoritmi vulnerabili al quantum e distinguerli da quelli ancora solidi; può stabilire una priorità, mettendo in cima ciò che protegge segreti destinati a durare anni; può scovare la crittografia debole o scaduta che si annida ovunque, non solo quella da rimpiazzare in vista del post-quantum.

È qui che il CBOM incontra la crypto-agility, cioè la capacità di cambiare algoritmo senza riscrivere l’applicazione da capo. Se la crypto-agility è l’obiettivo, il CBOM è la mappa che lo rende raggiungibile: non si può sostituire in modo ordinato ciò di cui si ignora la collocazione. Un inventario tenuto aggiornato trasforma una migrazione monolitica e rischiosa in una serie di interventi mirati e verificabili, e permette di dimostrare a un revisore, dati alla mano, a che punto sia la transizione. La stessa logica vale per la migrazione post-quantum nel suo complesso, che diventa gestibile solo quando poggia su un inventario reale anziché su una supposizione.

I limiti: un inventario non è una migrazione

Sarebbe però un errore trattare il CBOM come una soluzione anziché come un punto di partenza. La scoperta della crittografia è tecnicamente difficile: gli algoritmi si nascondono nei binari, nell’hardware, nelle componenti di terze parti e nei protocolli decisi solo al momento della connessione, e nessuno strumento li individua tutti con certezza. Un CBOM, inoltre, è una fotografia, e come ogni fotografia invecchia: senza un processo che lo mantenga aggiornato si trasforma in fretta nel ritratto di un sistema che non esiste più. Gli strumenti di generazione stanno maturando, ma non sono ancora chiavi in mano, e la parte più insidiosa resta la crittografia che non lascia tracce facili da leggere.

Proprio per questo l’inventario non va inteso come una precondizione da esaurire prima di muoversi. Commentando l’ordine esecutivo, Cloudflare ha messo in guardia dal trasformare il CBOM esaustivo in un prerequisito paralizzante: catalogare ogni algoritmo in ogni libreria richiede molto tempo, e il rischio è che l’inventario risulti già superato nel momento in cui viene completato. La lezione è pratica: conviene procedere in parallelo, cominciando a migrare i sistemi più esposti mentre l’inventario si affina, invece di attendere una mappa perfetta che forse non arriverà mai.

Va poi ricordato che l’inventario, da solo, non corregge nulla. Elencare gli algoritmi deboli non li sostituisce, e produrre un CBOM solo per spuntare una casella di conformità, senza usarlo per pianificare e verificare, è un costo senza ritorno. La via realistica è duplice: automatizzare la scoperta il più possibile e integrarla nei processi, così che l’inventario si aggiorni da sé, e trattare il CBOM come uno strumento di lavoro continuo, non come un allegato prodotto una volta e poi dimenticato.

Cosa aspettarsi, senza illusioni

La migrazione post-quantum sarà la più grande transizione crittografica degli ultimi decenni, e il Cryptographic Bill of Materials ne è la parte meno vistosa e più decisiva, quella da cui dipende tutto il resto. Il ritorno concreto non è un documento in più, ma la capacità di rispondere con i dati a domande che oggi ricevono solo stime: quali sistemi usano crittografia vulnerabile, dove, e con quale priorità intervenire. L’orologio del “raccogli ora, decifra dopo” ha già iniziato a scorrere per i dati che devono restare riservati a lungo, e partire dall’inventario è il primo passo verso una postura crittografica difendibile. Chi tratta il CBOM come un adempimento otterrà un file inutile; chi lo tratta come la mappa su cui costruire la propria crypto-agility otterrà il controllo di una transizione che, altrimenti, subirà alla scadenza.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cryptographic-bill-of-materials-cbom/


Quishing: il QR code che scavalca la sicurezza email

Il quishing, cioè il phishing veicolato da un QR code, ha smesso di essere una curiosità e nel 2026 è diventato, nella telemetria di Microsoft, il vettore email in più rapida crescita. Non è un dettaglio di forma, un phishing con un’immagine al posto di un link: è un attacco costruito apposta per aggirare i controlli che difendono la posta aziendale e per portare la vittima là dove quei controlli non arrivano. I numeri lo confermano. Il rapporto Microsoft sulle minacce email del primo trimestre 2026 registra un balzo del phishing via QR da 7,6 a 18,7 milioni di attacchi tra gennaio e marzo, più 146%, il volume mensile più alto da almeno un anno, su circa 8,3 miliardi di minacce di phishing via email rilevate nel trimestre. ESET, nel suo Threat Report del primo semestre 2026 (dicembre 2025-maggio 2026), rileva che ormai l’11% delle email di phishing contiene un QR code, con una media di centomila rilevamenti al mese: è un livello record, sia pure su una serie storica breve, dato che ESET lo traccia come categoria distinta solo da settembre 2025. Per il lettore italiano conta la geografia dei bersagli: in testa Stati Uniti (19%) e Spagna (17%), seguiti da Messico (6%) e Regno Unito (5%), con l’Italia al 3% insieme a Cechia, Canada e Polonia; il fenomeno non risparmia il nostro Paese.

La ragione di questa crescita non è la novità della tecnica, che esiste da anni, ma la sua efficacia contro le difese attuali. Il QR sposta l’attacco in un punto cieco, e lo fa sfruttando due debolezze insieme: una tecnica, nei gateway di posta, e una umana, nella fiducia quasi automatica che le persone ripongono in un quadratino da inquadrare. Una precisazione di perimetro, prima di procedere: qui si parla del quishing via email, ma lo stesso inganno vive anche nel mondo fisico, con QR fraudolenti su parcometri, bike sharing e finti avvisi di multa o di pedaggio. A Pesaro, nel maggio 2026, la società dei parcheggi controllata dal Comune ha denunciato la comparsa di QR fraudolenti su alcuni parcometri cittadini, che rimandavano a pagine non autorizzate dove veniva chiesto l’inserimento dei dati della carta: cambia il canale, non il meccanismo. Capire perché funziona è la premessa per difendersi in modo diverso dal solito richiamo a “non fidarsi delle email”.

Perché il quishing, o QR code phishing, scavalca i controlli dell’email

I filtri di sicurezza della posta sono costruiti per analizzare testo e link: seguono gli URL, ne valutano la reputazione, riscrivono i collegamenti, confrontano il contenuto con schemi noti di truffa. Un QR code, per quei filtri, è un’immagine, e l’indirizzo che nasconde non è leggibile come testo. Il collegamento malevolo viaggia dentro un disegno che il gateway, se non è attrezzato a decodificarlo, non ispeziona. È lo scarto che rende il quishing efficace: non c’è un link da bloccare, c’è una figura che supera i controlli perché quei controlli guardano altrove.

Gli attaccanti hanno affinato anche la consegna. Il canale dominante resta l’allegato PDF, che anzi cresce dal 65% delle campagne QR di gennaio al 70% di marzo, mentre i documenti Office scendono dal 31% al 24%. Accanto a questo, nel marzo 2026 Microsoft ha osservato un aumento del 336% dei QR piazzati direttamente nel corpo dell’email: un volume ancora minoritario, il 5% del totale, ma un segnale di sperimentazione. È la conferma che la tecnica non solo cresce, ma cerca di continuo la superficie che i sistemi testuali non sanno leggere.

Il salto sul telefono, fuori dal perimetro

C’è un secondo motivo, più insidioso del primo, ed è dove finisce la vittima. Un QR non si clicca dalla postazione di lavoro, si inquadra con il telefono. Nel momento in cui il dipendente prende lo smartphone per scansionare il codice, esce dall’ambiente protetto del computer aziendale ed entra su un dispositivo che le difese dell’organizzazione, di norma, non presidiano. Se poi il telefono è personale, come accade nella maggior parte dei casi, l’attacco si completa interamente fuori dal perimetro gestito, lontano dall’endpoint detection e dai proxy che filtrano il traffico dei portatili.

È un trasferimento di terreno prima ancora che di vittima: l’attacco parte in un canale sorvegliato, la posta, e si conclude in uno che quasi nessuno sorveglia, il browser di un telefono privato. A questo si aggiunge la fiducia implicita nel formato. Un URL sospetto mette in guardia, un QR no, perché è illeggibile all’occhio umano e associato a usi quotidiani e legittimi, dal menu del ristorante al pagamento. La vittima non vede l’indirizzo verso cui sta andando finché non ci è già arrivata, spesso su uno schermo piccolo dove i segnali d’allarme di un sito falso sono più difficili da cogliere.

Dove porta davvero: non un’immagine, una catena

Sarebbe un errore fermarsi al QR come se fosse l’attacco. Il codice è solo la consegna; la pagina di destinazione è quasi sempre una trappola per le credenziali, e nelle campagne più evolute non un semplice sito clone ma una pagina adversary-in-the-middle che si frappone tra la vittima e il servizio reale. Una pagina di questo tipo non ruba solo la password, ma intercetta anche il codice del secondo fattore e il token di sessione, così l’attaccante entra come se avesse superato l’autenticazione forte. È la ragione per cui il quishing non va derubricato a truffa da utente distratto: è l’anello iniziale di una catena che può arrivare a un account takeover completo. Che non sia roba da dilettanti lo conferma chi lo usa: a gennaio 2026 l’FBI ha diffuso un’allerta sui QR malevoli impiegati nello spearphishing del gruppo nordcoreano Kimsuky contro obiettivi statunitensi, descrivendo attacchi che si chiudono con il furto e il riuso del token di sessione, così da scavalcare l’MFA senza generare un allarme di “autenticazione fallita”. E le pagine AiTM a valle non sono artigianali, ma servite da kit di phishing-as-a-service: un ecosistema in continuo rimescolamento: Tycoon 2FA è stato smantellato a inizio marzo 2026, ma un kit rivale come Starkiller era già documentato due settimane prima del takedown.

Letto così, il vettore QR e il furto di sessione non sono due problemi distinti, ma lo stesso attacco visto da due estremi. Il QR serve a far attraversare indenne la posta e a spostare la vittima su un dispositivo scoperto; la pagina AiTM, all’altro capo, monetizza quel varco rubando l’accesso. Difendere solo un estremo lascia l’altro aperto.

Come difendersi: l’awareness non basta, serve struttura

La prima reazione, formare le persone a diffidare dei QR, è utile ma insufficiente, e per un motivo strutturale: il QR è nato per essere inquadrato senza pensarci, e un livello di sospetto abbastanza alto da bloccarlo bloccherebbe anche gli usi legittimi. La security awareness resta un tassello, ma va affiancata a controlli che non dipendono dall’attenzione del singolo. Sul piano della posta significa dotare i gateway della capacità di decodificare i QR nelle immagini e di analizzare la destinazione prima della consegna, invece di trattarli come figure innocue. Sul piano del dispositivo significa estendere la protezione ai telefoni che accedono alle risorse aziendali, perché è lì che l’attacco si consuma.

Ma la difesa che chiude davvero la catena agisce all’ultimo anello, l’autenticazione. Se l’accesso è protetto solo da fattori resistenti al phishing, come le passkey basate su FIDO2, senza fallback su OTP o SMS, la pagina AiTM a cui il QR conduce non ha nulla da rubare: non esiste un codice da intercettare né un token riutilizzabile, perché la credenziale è legata al dominio legittimo e non funziona altrove. È lo spostamento decisivo, dal cercare di impedire alla vittima di arrivare sulla pagina falsa al rendere inutile il fatto che ci arrivi. Le altre misure riducono la probabilità dell’attacco; questa ne annulla il guadagno.

Cosa aspettarsi, senza illusioni

Il quishing non è una moda passeggera ma un vettore destinato a restare, perché sfrutta un divario reale e duraturo: quello tra la posta aziendale, sorvegliata, e il telefono personale, che non lo è. Finché l’attacco potrà partire in un canale controllato e concludersi in uno scoperto, il QR resterà uno strumento comodo per gli aggressori, e i numeri del 2026 lo dicono già con chiarezza. La risposta efficace non è un cartello che invita a non inquadrare i codici, ma una difesa a strati che unisce l’ispezione dei QR nella posta, la protezione dei dispositivi mobili e, soprattutto, un’autenticazione che regge anche quando la vittima finisce sulla pagina sbagliata. Trattare il quishing come una questione di distrazione individuale è il modo più sicuro per continuare a subirlo; trattarlo come ciò che è, un bypass architetturale, è il primo passo per neutralizzarlo.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/quishing-qr-code-phishing/


Memory safety: la classe di vulnerabilità che i governi vogliono estinguere

La memory safety è uno dei problemi di sicurezza più antichi del software, e nel 2026 è tornata in cima all’agenda con la spinta delle agenzie governative. Si tratta dell’assenza di una intera famiglia di difetti, quelli che nascono quando un programma gestisce a mano la memoria e sbaglia: un buffer overflow che scrive oltre i confini di un’area, un use-after-free che accede a memoria già liberata, una lettura fuori dai limiti. Non sono bug esotici, sono i mattoni con cui si costruiscono da decenni gli exploit più gravi, e continuano a esserlo. Secondo la guida di CISA e agenzie alleate del dicembre 2023, due terzi delle vulnerabilità segnalate nei linguaggi non memory-safe restano legate proprio alla gestione della memoria.

Il punto di svolta non è tecnico ma di prospettiva. Per anni questi difetti sono stati trattati come errori da correggere uno per uno; oggi l’idea che si sta affermando è che siano una classe da eliminare alla radice, scegliendo strumenti che non li rendano possibili. È lo spostamento dal “programmare con più attenzione” al “programmare in un linguaggio che non lascia commettere quell’errore”, e ha smesso di essere una preferenza accademica per diventare una richiesta esplicita di chi regola il mercato.

Che cos’è la memory safety, e perché C e C++ non ce l’hanno

Un linguaggio è memory-safe quando impedisce, per costruzione, gli accessi scorretti alla memoria: non si può leggere oltre la fine di un array, usare un puntatore a memoria già liberata o dimenticare di controllare un limite, perché il linguaggio non lo consente o lo verifica al posto dello sviluppatore. Rientrano in questa categoria linguaggi molto diversi tra loro, da Java e C# a Go, Swift, Python e Rust, che ci arrivano per strade differenti: alcuni con un garbage collector che gestisce la memoria automaticamente, Rust con un sistema di proprietà verificato dal compilatore che ottiene lo stesso risultato senza rinunciare al controllo di basso livello.

C e C++, i linguaggi su cui poggia gran parte del software di sistema, non offrono questa garanzia: lasciano allo sviluppatore la gestione manuale della memoria, e con essa la possibilità di sbagliare. La conseguenza è quantificata da chi ha più codice al mondo. Microsoft ha stimato nel 2019 che circa il 70% delle proprie vulnerabilità con CVE derivasse ogni anno da problemi di memory safety, e in Chrome, su un’analisi di 912 bug di gravità alta o critica segnalati dal 2015 in poi, Google ne ha ricondotto alla stessa classe circa il 70%. Non è una questione di programmatori distratti: è che una classe di errori, su basi di codice enormi, si ripresenta comunque, a prescindere dalla bravura di chi scrive.

Da problema tecnico a richiesta delle autorità

La novità è che la memory safety è entrata nei documenti delle autorità. La stessa guida di CISA, NSA, FBI e delle agenzie di Australia, Canada, Regno Unito e Nuova Zelanda chiede ai produttori di software di pubblicare una roadmap memory-safe, cioè un piano concreto per ridurre nel tempo la dipendenza dai linguaggi non sicuri. Con il documento Product Security Bad Practices, arrivato alla versione 2.0 nel gennaio 2025, il tono si è fatto più netto: sviluppare nuove linee di prodotto in linguaggi non memory-safe, per il software che sostiene funzioni critiche, viene indicato come una cattiva pratica, e ai produttori si chiede di pubblicare la propria roadmap entro la fine del 2025, scadenza ormai alle spalle, con l’eccezione dei prodotti la cui fine del supporto è prevista prima del 2030. Lo stesso documento precisa di non imporre alcun obbligo: non è una legge, ma una guida; sposta però le attese, e con esse la responsabilità di chi continua a ignorare il problema.

L’orientamento è confermato e dettagliato dal documento congiunto NSA e CISA sui linguaggi memory-safe del giugno 2025. In Europa la spinta è meno esplicita ma va nella stessa direzione, per la via del security by design: il Cyber Resilience Act, i cui requisiti essenziali di cybersicurezza si applicheranno dall’11 dicembre 2027, imporrà sicurezza fin dalla progettazione e gestione delle vulnerabilità per i prodotti con elementi digitali, mentre l’obbligo di segnalare le vulnerabilità attivamente sfruttate scatta già dall’11 settembre 2026. Il regolamento non nomina i linguaggi memory-safe, e il collegamento resta quindi inferenziale, ma un difetto di memoria evitabile alla radice è proprio il tipo di rischio che quell’obbligo mira a comprimere. La memory safety, insomma, sta migrando dal terreno delle buone pratiche a quello delle aspettative di mercato e, in prospettiva, degli obblighi.

La lezione di Android: non riscrivere tutto, cambiare il nuovo codice

La domanda ovvia è come si applichi tutto questo a basi di codice che contano decine di milioni di righe in C e C++. La risposta più convincente arriva da Google, che sul codice di Android ha ottenuto un risultato netto senza una riscrittura di massa. La serie storica è eloquente: la quota di vulnerabilità dovute a problemi di memoria è passata dal 76% del 2019 al 24% del 2024, e nel 2025, secondo la rilevazione di novembre, è scesa sotto il 20% per la prima volta. Google non ha riscritto il vecchio codice, ha spostato sui linguaggi memory-safe il codice nuovo, e la differenza si legge nella densità dei difetti: una stima prudente colloca il codice Rust di Android intorno a 0,2 vulnerabilità di memoria per milione di righe, contro le circa mille del C e del C++, oltre mille volte in meno.

Funziona perché le vulnerabilità non si distribuiscono in modo uniforme nel tempo: il codice appena scritto ne contiene molte di più di quello che è invecchiato ed è stato ripulito a forza di correzioni. Concentrare i linguaggi sicuri dove nasce il rischio, cioè nelle nuove funzionalità, fa crollare la quota complessiva senza il costo proibitivo di rifare ciò che già funziona. E smonta anche l’idea che la sicurezza costi in produttività: sempre su Android, sulle modifiche medie e grandi il tasso di rollback delle modifiche in Rust è circa quattro volte più basso che in C++, e le modifiche in Rust passano in generale circa il 25% di tempo in meno in revisione. Non bisogna migrare tutto, insomma: bisogna smettere di aggiungere il problema.

Rust non risolve tutto: i limiti e la strada realistica

Sarebbe però un errore trasformare la memory safety in un tifo per un linguaggio. Anche il codice memory-safe ha i suoi confini: Rust prevede blocchi unsafe per le operazioni di basso livello e per il dialogo con il codice C, che riaprono in parte i rischi che il linguaggio altrove elimina. Il peso di questi blocchi, però, va misurato e non esagerato: nel codice Rust circa il 4% sta dentro blocchi unsafe, e unsafe non disattiva la maggior parte dei controlli del linguaggio. E soprattutto la sicurezza della memoria non elimina le altre categorie di bug, dalla logica errata alle vulnerabilità di iniezione: un programma memory-safe può essere insicuro in mille altri modi. Ciò che si guadagna è la scomparsa della classe più numerosa e più sfruttata, non la sicurezza assoluta.

Resta poi l’enorme patrimonio di software che non si può realisticamente riscrivere, dai kernel al mondo embedded e industriale, dove C e C++ domineranno ancora a lungo. Per quel codice la risposta non è il linguaggio ma l’irrobustimento a più livelli: mitigazioni del compilatore, analisi statica lungo la pipeline di DevSecOps con strumenti come i SAST, fuzzing sistematico e architetture che confinano i danni. Che le difese a più livelli funzionino lo mostra un caso reale, arrivato peraltro dal versante opposto: una vulnerabilità del 2025 in un decoder Rust di Android (CVE-2025-48530), annidata in un blocco unsafe, non è mai arrivata in un rilascio pubblico, e il codice CVE le è stato assegnato solo per tracciarne la correzione con la giusta priorità. Il postmortem ha stabilito che l’allocatore hardened Scudo la rendeva comunque deterministicamente non sfruttabile grazie alle sue guard pages, che anzi hanno contribuito a scoprirla trasformando un overflow silenzioso in un crash rumoroso. Scudo è l’allocatore predefinito di Android, benché Google stia ancora lavorando con i partner per renderlo obbligatorio ovunque. È la difesa in profondità che fa il suo lavoro, e la conferma che la strada realistica è duplice: linguaggi memory-safe per il nuovo, difese a più livelli per il vecchio.

La pressione, del resto, si sente anche fuori da Android. Il mondo C++ ha reagito ai richiami delle agenzie scegliendo la via dei Profiles, un insieme di regole di sicurezza opzionali, dopo aver di fatto accantonato la proposta più radicale di un borrow checker in stile Rust, una scelta che diversi critici giudicano insufficiente a garantire una sicurezza stretta. Dentro Microsoft, un distinguished engineer ha reso pubblico a fine 2025 il proprio obiettivo, eliminare C e C++ dal codice dell’azienda entro il 2030, usando AI e algoritmi per tradurre i codebase più grandi, come da strategia del gruppo di ricerca di cui fa parte. L’autore ha poi precisato che si tratta di un progetto di ricerca e non di una strategia aziendale, ma la sola circolazione dell’idea dice quanto si sia spostato il baricentro del dibattito. E un argomento nuovo rende tutto più urgente: quando la generazione di codice assistita dall’AI produce software più in fretta di quanto gli umani riescano a rivederlo, conviene che quel codice nasca in un linguaggio che certi errori non li permette nemmeno.

Cosa aspettarsi, senza illusioni

La memory safety non è una bacchetta magica e non renderà sicuro il software di colpo, ma è probabilmente l’intervento con il miglior rapporto tra costo e beneficio disponibile oggi: rimuove alla radice la classe di vulnerabilità più numerosa e più sfruttata, e lo fa nel punto più economico, cioè prima che il difetto esista. Per chi sviluppa significa adottare una disciplina di secure coding che parte dalla scelta del linguaggio per il codice nuovo; per chi compra software significa iniziare a chiedere ai fornitori la loro roadmap memory-safe, esattamente come oggi si chiede un SBOM. Il messaggio che arriva dalle agenzie è che continuare a produrre nuovi difetti di memoria, avendo gli strumenti per non farlo, non sarà più considerato normale. La memory safety, da nicchia per specialisti, è diventata il modo più concreto per ridurre la superficie d’attacco alla fonte.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/memory-safety-linguaggi-sicuri/


Rockwell Patches Code Execution Flaws in Arena Simulation Software

Rockwell Automation has patched four vulnerabilities in its Arena Simulation software that could let an attacker execute arbitrary code on an affected system, according to advisories published by CISA and Rockwell.

Arena Simulation is a discrete-event simulation software that provides organizations with a virtual environment to model, visualize, and test complex operational workflows, allowing them to identify issues and evaluate process changes before implementing them in production.

The four high-severity flaws — CVE-2026-8085, CVE-2026-8312, CVE-2026-8313, and CVE-2026-8314 — are memory corruption issues stemming from improper validation of user-supplied data that can result in an out-of-bounds write. 

SecurityWeek Launches Critical Impact Awards to Recognize Excellence in Industrial Cybersecurity

Successful exploitation could allow an attacker to execute arbitrary code in the context of the current process. Arena versions up to and including 17.00.00 are affected. Rockwell has patched the vulnerabilities in version 17.00.01. 

Exploitation is not possible remotely without user interaction — an attacker would need to convince a user to open a malicious file to trigger any of the four bugs. 

Advertisement. Scroll to continue reading.

Michael Heinzl, the researcher who discovered the vulnerabilities, told SecurityWeek that the file types involved (Arena experiment and model files) are opened routinely by users as part of normal workflows, meaning a booby-trapped file would not necessarily stand out to an Arena user targeted in a social engineering attempt. 

Asked what an attacker could realistically accomplish given that Arena is simulation software rather than a live industrial control system (ICS), the researcher said code execution would be confined to the same privileges as the Arena process itself. Whether an attacker could pivot to more sensitive systems from there would depend on how an organization has deployed and segmented Arena on its network.

The researcher also pointed to Arena’s broad footprint as a reason the flaws matter despite the software not directly controlling physical processes, citing Rockwell’s own customer materials describing adoption among top global supply chain companies, hospitals across multiple countries, and organizations such as defense contractors.

The advisories published by CISA and Rockwell indicate that there is no evidence of in-the-wild exploitation.

Heinzl noted that he has actually identified 17 distinct vulnerabilities in Arena, but Rockwell decided to group them by the affected component, which resulted in only four CVEs being assigned.

The researcher has published 17 advisories on his personal website. 

Related: US Warns of Iranian Hackers Targeting Siemens, Schneider, and Rockwell ICS Devices

Related: Legacy Systems, Real-World Impacts: The Reality of OT Security

Related: New Controller Flaws Expose Highway Signs and Billboards to Remote Hacking

https://www.securityweek.com/rockwell-patches-code-execution-flaws-in-arena-simulation-software/


Security data lake: perché il SIEM si sdoppia tra raccolta e analisi

Il security data lake è la risposta a un problema che i responsabili della sicurezza conoscono bene ma di cui si parla poco: raccogliere e conservare i dati necessari a rilevare un attacco è diventato così costoso da spingere molte organizzazioni a rinunciarvi, cioè a scartare log che sarebbero serviti proprio nel momento peggiore. Il SIEM, il sistema che da vent’anni sta al centro del centro operativo di sicurezza, è nato in un’epoca di volumi di dati incomparabilmente più piccoli, e il suo modello economico, che fa pagare in proporzione a quanto si immette, mal si adatta a un mondo in cui i log crescono più in fretta dei budget. Da qui una trasformazione silenziosa ma profonda: la piattaforma non scompare, ma si scompone.

L’idea di fondo è separare due cose che il SIEM teneva insieme: la conservazione dei dati e la loro analisi. Da un lato uno strato di raccolta capace di trattenere tutto a costi bassi; dall’altro uno strato analitico che interroga quei dati quando servono. È la stessa logica che ha ridisegnato l’analisi dei dati aziendali dieci anni fa, arrivata ora, con ritardo, alla sicurezza. E non è una moda da fornitori: è la conseguenza aritmetica di un costo per gigabyte che, moltiplicato per i volumi odierni, non regge più.

Perché il SIEM tradizionale non regge più i volumi

Il nodo è il modello di prezzo. La maggior parte dei SIEM fattura in base al volume immesso, così ogni fonte aggiunta, ogni picco di traffico, ogni nuovo sistema da monitorare fa salire il conto. La reazione prevedibile dei team, sotto pressione di budget, è filtrare all’origine: non inviare al SIEM i log ritenuti meno critici, campionarli, o conservarli per pochi giorni. Ogni scelta di questo tipo è un risparmio immediato e un punto cieco differito, perché la fonte scartata è spesso quella che, a incidente avvenuto, avrebbe raccontato come l’attaccante è entrato e cosa ha toccato.

È il motivo per cui il problema economico è, in realtà, un problema di sicurezza. Quando l’analista deve scegliere quali dati permettersi invece di quali dati servono, la copertura di rilevamento smette di essere una decisione tecnica e diventa una voce di spesa. La crescita dei volumi, alimentata da cloud, identità, endpoint e ambienti ibridi, ha reso questa tensione insostenibile, e ha spinto il mercato a cercare un’architettura che disaccoppi il costo della conservazione da quello dell’analisi.

Che cos’è un security data lake

Un security data lake è un archivio centralizzato che raccoglie i dati di sicurezza, strutturati e non, su storage a oggetti a basso costo, tenendoli disponibili per l’interrogazione senza il sovrapprezzo di un’indicizzazione permanente. La differenza rispetto al SIEM classico è che conservare non implica più pagare per analizzare in continuazione: i dati restano lì, economici, e la potenza di calcolo viene applicata quando serve, sui dati che servono. Questo permette di trattenere anni di storico, invece di giorni, e di condurre indagini retrospettive che con la ritenzione ridotta imposta dai costi sarebbero impossibili.

La contropartita è il tiering, cioè la distinzione tra dati “caldi”, subito interrogabili per il rilevamento in tempo reale, e dati “freddi”, conservati a lungo e richiamabili con qualche attesa in più per le indagini e la conformità. Formati aperti e storage di proprietà dell’organizzazione riducono inoltre il rischio di lock-in, il vincolo che a lungo ha reso difficile lasciare un fornitore di SIEM una volta che ci si erano riversati dentro tutti i log. È un cambio di rapporti di forza: i dati tornano a essere dell’azienda, e la piattaforma di analisi diventa sostituibile.

La security data pipeline: filtrare prima di pagare

Tra le fonti e lo strato di analisi si è inserito un terzo componente, la security data pipeline, che raccoglie i dati, li normalizza, li arricchisce e decide dove instradarli. La sua funzione economica è semplice e potente: ridurre ciò che arriva al SIEM costoso, mandando il resto al data lake a basso costo, senza perdere nulla. È la promessa che ha reso questo strato l’oggetto delle acquisizioni che hanno riscritto il mercato tra il 2025 e il 2026: CrowdStrike ha rilevato Onum per 290 milioni di dollari, SentinelOne ha rilevato Observo AI per 225, e soprattutto Palo Alto Networks si è presa Chronosphere, una piattaforma di observability che porta con sé anche capacità di telemetry pipeline: l’operazione, annunciata a novembre 2025 per 3,35 miliardi e perfezionata il 29 gennaio 2026, vale oltre sei volte le due precedenti messe insieme, il segno che rendere sostenibile l’ingestion su larga scala è ormai un asset strategico.

Federated search: cercare dove i dati già sono

La federated search è la capacità di interrogare dati che risiedono in posti diversi, un SIEM, un bucket su cloud, una piattaforma di analytics, senza doverli prima centralizzare. Serve a superare il presupposto storico che per correlare i dati bisognasse ammassarli tutti nello stesso posto, presupposto che è anche la radice del costo. Se si può cercare dove i dati già sono, la centralizzazione totale smette di essere obbligatoria, e con essa cade una parte consistente della spesa.

Il mercato si consolida e si biforca

Questa transizione avviene mentre il mercato dei SIEM attraversa il suo più grande riassetto. Nel marzo 2024 Cisco ha chiuso l’acquisizione di Splunk per circa 28 miliardi di dollari; a maggio Palo Alto Networks ha annunciato l’acquisto delle attività SaaS del QRadar di IBM, perfezionato ad agosto per 1,1 miliardi comprensivi della componente variabile, di cui 500 milioni in contanti, migrando i clienti verso la propria piattaforma Cortex XSIAM; a luglio Exabeam e LogRhythm hanno completato la fusione. E il consolidamento non è solo cronaca finanziaria: il QRadar SaaS acquisito da IBM è già stato messo in fine vita, con la prima ondata di dismissioni (QRadar on Cloud, SOAR, Log Insights) scaduta il 14 aprile 2026 e la seconda (EDR, XDR, X-Force Threat Intelligence) fissata al 31 agosto 2026, un prodotto storico uscito dal mercato in meno di due anni dall’acquisizione, mentre le versioni on premise restano fuori dal perimetro dell’annuncio.

Sotto il consolidamento si intravede una distinzione più utile per chi deve scegliere, e più sottile della vulgata “aperto contro integrato”. Anche gli ecosistemi tutto-in-uno hanno ormai assorbito il data lake e la federated search, cioè proprio le tecnologie che sembravano la loro alternativa. Microsoft Sentinel, per esempio, ha reso generalmente disponibile un data lake nativo con storage a livelli e fino a dodici anni di dati interrogabili, e dall’aprile 2026 può federare dati da Fabric, ADLS e Azure Databricks; la sua piattaforma unisce già SIEM, XDR, SOAR e gestione dell’esposizione. E non è un caso isolato: anche Splunk, ormai in Cisco, ha annunciato un proprio Machine Data Lake dentro il Cisco Data Fabric presentato a settembre 2025, con una federazione che raggiunge Amazon S3, Iceberg, Delta Lake, Snowflake e Azure, e disponibilità annunciata nel corso del 2026. Lo ha ammesso senza giri di parole Kamal Hathi, a capo di Splunk in Cisco: ingerire tutti i dati dentro Splunk non è un’idea praticabile, la strada è portare l’analisi dove i dati vivono, non costruire un unico grande lago. Il Machine Data Lake non contraddice la frase, la completa: è il livello economico che sta sotto le piattaforme di analisi, da cui i dati vengono promossi solo quando servono. È esattamente la tesi da cui siamo partiti, pronunciata dal fornitore che proprio sul lago unico ha fondato vent’anni di fatturato.

La domanda vera, allora, non è “aperto o integrato”, ma due altre: chi possiede lo storage in cui vivono i dati, e quanto è portabile il formato in cui sono scritti. Da lì dipende se domani si potrà cambiare piattaforma di analisi senza rifare tutto, ed è la decisione che ogni SOC si troverà a prendere.

Il movimento, poi, non è più solo interno alla sicurezza. Il 24 marzo 2026 Databricks, uno dei nomi del lakehouse per l’analisi dei dati, ha presentato Lakewatch, un SIEM agentico e aperto oggi in private preview, annunciando insieme le acquisizioni di Antimatter e SiftD.ai, quest’ultima fondata dal creatore del Search Processing Language di Splunk e dagli architetti del suo stack di ricerca. È la conferma letterale del punto di partenza: la logica che ha ridisegnato l’analisi dei dati aziendali non solo è arrivata alla sicurezza, ma ora sono i fornitori del dato, e persino i creatori del linguaggio del vecchio SIEM, a entrare nel SOC.

Il rischio: un lago senza rilevamento è una palude

C’è un modo di sbagliare questa transizione, ed è trattare lo storage economico come un fine invece che come un mezzo. Poter conservare tutto tenta a fare esattamente questo, cioè accumulare dati con l’idea vaga di analizzarli “poi”, e il risultato è un archivio enorme e inerte, sul quale nessuno costruisce rilevamento. Un data lake senza detection non è una strategia, è una palude: costa meno di un SIEM mal dimensionato, ma non protegge di più. Il dato diventa sicurezza solo quando qualcuno scrive le regole di correlazione, definisce cosa cercare e mantiene viva la disciplina del rilevamento, esattamente come nell’evoluzione del SOC verso una difesa che misura la propria efficacia.

Va aggiunta la spinta della conformità, che in Europa rema nella stessa direzione. NIS2 e DORA non fissano una durata minima di conservazione dei log, ma impongono di definirla, documentarla e giustificarla in base al rischio, oltre a garantire l’integrità e la reperibilità delle evidenze, come ricorda la mappa degli adempimenti NIS2: in pratica, la ritenzione lunga smette di essere una scelta discrezionale e diventa una posizione da difendere davanti a un auditor. Su questo un security data lake è la risposta economicamente sostenibile, perché consente di trattenere anni di dati senza pagarli come se fossero tutti caldi. Per una volta la conformità coincide con la buona pratica di sicurezza, perché lo storico che serve al revisore è lo stesso che serve all’analista per ricostruire un attacco lento.

Cosa aspettarsi, senza illusioni

Il SIEM non sta morendo, si sta scomponendo, e il security data lake è la parte di questa scomposizione che ridà alle organizzazioni una leva che avevano perso: decidere cosa conservare in base a ciò che serve alla difesa, non a ciò che il modello di prezzo consente. Il ritorno concreto non è solo il risparmio, ma la fine del compromesso quotidiano tra copertura e budget, e la possibilità di guardare indietro di anni quando un’indagine lo richiede. Resta però la parte difficile, che nessuna architettura regala: il rilevamento, la correlazione e le persone che li governano. Chi tratta il security data lake come una scorciatoia per spendere meno otterrà un magazzino di dati; chi lo tratta come la fondazione su cui costruire un rilevamento finalmente non più razionato otterrà una difesa migliore. La differenza, come sempre, non è nello strumento ma in cosa ci si fa.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/security-data-lake-siem/


CISA, FBI Issue Warning of Ongoing Cyber Exploitation from Iran

In April of this year, The Cybersecurity Infrastructure & Security Agency (CISA), alongside other agencies, published a warning regarding Iranian cyber activity against United States critical infrastructure. Earlier this week, that alert was updated. 

The original publication offered information about ongoing cyber exploitation conducted by Iranian-linked advanced persistent threat (APT) actors, such as tactics, techniques, and procedures (TTPs) and indicators of compromise (IOCs). This week, the alert provided additional guidance, including: 

  • Identifying malicious alterations in reusable code modules used within Rockwell Automation PLC
  • Broadening the manufacturer scope to Siemen, Schneider Electric and other potentially branded/manufactured PLCs
  • Detailing best practices for secure deployment 

Security Leaders Weigh In

Ross Filipek, CISO at Corsica Technologies:

The biggest issue here is that most of these organizations simply can’t pause operations while an incident is investigated. Water utilities have to keep providing clean water. Energy providers have to maintain power and fuel availability. Local governments still need to support emergency services and public operations. Even a short disruption can force employees into slower manual processes, delay essential services, and create public safety concerns. Recovery costs can also hit smaller operators especially hard since many are limited by small security staffs, older equipment, or outside vendors having control over parts of their environment.

Protecting these systems starts with knowing every controller in use and who can access it. IT teams, plant operators, integrators, and security partners need a shared response plan rather than separate assumptions about who owns the problem. Trusted backups of PLC logic are critical, as are tested recovery procedures and experienced responders who can contain an intrusion quickly.

A single exposed controller may look like a local weakness. In critical infrastructure, it can become part of a much larger national security problem.

Pete Luban, Field CISO at AttackIQ:

Iranian cyber activity is becoming less dependent on one product and more focused on weaknesses that repeat across operational environments. By targeting controllers from several manufacturers, attackers can reuse the same playbook wherever exposed devices and weak access controls exist.

The ability to alter project logic and disable safeguards raises the stakes considerably. A compromise may no longer stop at unauthorized access. It can interfere with the systems designed to prevent unsafe physical conditions. Organizations therefore can’t treat each exposed controller as an isolated equipment issue.

Disconnecting vulnerable devices is essential, but defenders also need to understand how attackers could move from an internet-facing asset into critical operations. A CTEM program can map those realistic paths and identify the exposures that create the greatest operational risk. Adversarial exposure validation can then determine whether segmentation, access controls, monitoring, and incident procedures hold up against the tactics outlined in the advisory. Defenders need more than a list of weaknesses. They need evidence that the exposures most likely to cause physical disruption have been addressed.

Nick Tausek, Lead Security Automation Architect at Swimlane:

The latest warning moves the Iran-linked threat beyond broad concern and into specific, actionable detail. Security teams now have new indicators, targeted ports, affected device families, and examples of attackers changing PLC logic or disabling critical safeguards. The problem is getting that intelligence into active workflows before the attackers move again.

That’s hard to do when asset data, network alerts, threat intelligence, and incident procedures live in separate systems. Security teams may understand the threat, but still lose valuable time gathering context and determining which exposed devices require immediate attention. Agentic AI Automation, such as that employed by modern AI SOC applications, can bring those signals together, identify affected OT assets, enrich suspicious traffic, and coordinate response across security and operations teams. It can also help prioritize vulnerabilities based on internet exposure and operational importance instead of relying on a generic severity score. Human approval should remain central for any action that could affect physical systems.

https://www.securitymagazine.com/articles/102461-cisa-fbi-issue-warning-of-ongoing-cyber-exploitation-from-iran


AI Without Guardrails Is Driving a New Era of Cybercrime

The risk of guardrail-free AI isn’t a future concern — it’s a current-day threat. Researchers from ThreatDown discovered the AI tools that fuel today’s cyber incidents are increasingly open, mainstream and challenging to monitor. 

The first major finding from the research is that AI without guardrails has become mainstream. Some may assume that malicious AI is exclusively on the Dark Web; however, the report identified 6,644 models published openly on Hugging Face with labels such as “uncensored,” “heretic,” and “unfiltered,” indicating the models would not refuse requests typically rejected by conventional AI models. In a 30-day period, those models were downloaded more than 22 million times. 

The second key finding is that cybercriminals aren’t exclusively creating their own AI models from scratch; instead, they’re renting models. Researchers discovered a network of malicious AI services that take legitimate frontier models with mainstream cloud infrastructure and package, resell, or wrap them for their purposes. 

Below, security leaders discuss this new era of cybercrime. 

Security Leaders Weigh In

Dr. Margaret Cunningham, Vice President of Security & AI Strategy at Darktrace:

Frontier models are becoming more powerful and more widely accessible, while the mechanisms meant to control them remain imperfect. Against this landscape, defenders should assume breach, assume unapproved access, and assume that any capability useful enough to matter will eventually be used by adversaries.

While it is important to pay attention to claims about capabilities of these new models, it is also worth recognizing that the full picture often takes time to emerge. Some capabilities may prove more impactful than initially expected, while others may not live up to early expectations. For security teams, the challenge is evaluating these developments in real time, often before there is broad consensus on what the practical implications are. That can be especially difficult in a fast-moving environment where benchmarks, capability assessments, and model comparisons are evolving alongside intense industry interest and competition.

The same logic applies to guardrails. Guardrails can reduce opportunistic misuse, but they are not a complete defense. People who are good at jailbreaks already use context flooding, metaphor, literary framing, and iterative workarounds to test these systems. 

While a lot of focus lands on the offensive impact, the defensive burden is most concerning. Advanced defense is still mostly human, and we have not automated this level of expertise at scale. Vulnerability management was already behind schedule before AI accelerated discovery. The hard work is not just finding a vulnerability, its figuring out whether it matters in a specific environment, whether it is a lab-only edge case, whether patching will break something else, and how to remediate without disrupting the business.

There is no universal “normal” to defend anymore. Every organization, device, user, and agent behaves differently, which means security teams need a way to understand what is normal in their specific environment and spot when something changes. As AI accelerates discovery and exploitation, behavioral detection, anomaly-based analytics, and autonomous containment become essential. Defenders need to prioritize based on context, contain threats quickly when prevention fails, and build defenses around the reality of their own environment rather than a generic model of risk.

Randolph Barr, Chief Information Security Officer at Cequence Security:

Approximately two-thirds of current AI-related incidents still originate from traditional weaknesses, however, the remaining third are uniquely “AI-native.” These include model and data poisoning, prompt injection, and autonomous agents that can chain together API calls and act with minimal human oversight. These emerging risks reflect the reality that AI systems are dynamic, self-learning, and interconnected in ways traditional applications never were. When paired with the rapid speed of development, the outcome is a growing attack surface that grows faster than most security programs can respond.

We are approaching a future where the use of AI agents will outpace the readiness of security measures. We have seen a number of advisories over the past year which help highlight the gaps and hopefully drive the industry toward more secure, transparent designs before these tools become deeply embedded in enterprise ecosystems.

Ram Varadarajan, CEO at Acalvio:

Today, we are witnessing a significant swing in the cyber threat landscape and it’s more severe and unparalleled to anything we’ve ever faced before. Multi-agent swarms are coordinating in real-time across reconnaissance, credential harvesting, and data exfiltration. We’re facing exponential coordination where hundreds of specialized AI agents will operate simultaneously across our entire attack surface. Reactive defenses can’t operate at machine speed, requiring a shift in the cybersecurity stack to preemptive, AI-driven strategies. AI fighting AI, paired with offensive deception technologies, is the emergent design to catch attackers off guard and cause them to make mistakes and disclose themselves. Organizations that adapt will recognize that defense is no longer about building higher walls. It’s about becoming an unpredictable, moving target.

To maintain competitive edge and protect valuation, companies have to pivot from reactive defense to  active, game-theoretic defense. This means deploying AI-driven cybersecurity, specifically AI agents that use strategic deception in real-time. The future calls for forcing attackers to fight on the defender’s terms, gambling adversary compute against AI-driven decoys, and shifting the economic burden of the attack onto the attacker.

Diana Kelley, Chief Information Security Officer at Noma Security:

Traditionally, security teams focused on the protection of systems and data. Today, we are helping to govern AI systems and agents that make recommendations and decisions, and in some cases take action on behalf of the business, while enabling the business to adopt AI quickly and safely. AI also means that we’re facing a more well-resourced adversary. It lowers the cost of scale and increases the quality of automated attack campaigns. Without a strong control plane for AI systems and agents, including clear guardrails on access and actions, along with identity, access control, data governance, and runtime monitoring, AI will amplify whatever weaknesses already exist.

Moving forward, AI will be embedded in all aspects of our businesses, and every security professional needs a working understanding of AI and agent risk. That includes how models are trained, where data exposure can happen, how outputs can be manipulated, agentic blast radius, and how AI integrates into business workflows. In the real world, those risks show up inside existing domains like productivity tools, data loss prevention, access control, application security, cloud security, and risk management. 

Shane Barney, Chief Information Security Officer at Keeper Security: 

Advanced AI models are now capable of scanning systems, networks and code to identify vulnerabilities at a speed and scale no human analyst can match, and that capability cuts both ways. In the hands of a defender it’s a force multiplier for threat detection and response, but in the hands of a threat actor it accelerates the path from reconnaissance to exploitation faster than most security teams can detect, let alone respond to.

These AI systems easily bypass traditional “friction-based” defenses by automating complex, multi-step attack chains at scale, creating a massive influx of software bugs that human maintainers cannot triage fast enough. This results in a dangerous operational bottleneck, leaving a wide window of exposure for adversaries to exploit known flaws before a fix can be deployed. Security teams must operate on a much shorter clock, assuming public vulnerabilities will be weaponized within hours rather than weeks. Defenders should immediately implement automated update paths for internet-facing systems, treat dependency security patches as immediate priorities rather than backlog items and maintain robust logging and Multi-Factor Authentication (MFA) to prevent lateral network movement if a breach occurs.

Enterprises that have been deferring foundational security work are running out of time. The attack surface hasn’t changed, however, the tools available to exploit it have gotten significantly more powerful. Unpatched vulnerabilities, excessive access permissions and gaps in privileged account oversight are exactly the conditions that AI-assisted attacks are built to find and weaponize.

https://www.securitymagazine.com/articles/102458-ai-without-guardrails-is-driving-a-new-era-of-cybercrime


Cybersecurity, dalla prevenzione al recovery: perché simulare un attacco informatico aiuta le imprese a reagire meglio

Gli attacchi informatici si sviluppano ormai con una rapidità che lascia alle organizzazioni margini decisionali sempre più ridotti. In una crisi cyber, sapere che cosa fare, chi deve intervenire e quali attività proteggere per prime può determinare la portata dell’impatto operativo.

La consapevolezza del rischio, tuttavia, non è sufficiente. Un’impresa può investire in tecnologie avanzate e avere comunque difficoltà a reagire se non ha verificato la propria organizzazione sotto pressione: escalation non chiare, responsabilità sovrapposte, procedure non aggiornate o una comunicazione tardiva possono amplificare gli effetti dell’incidente.
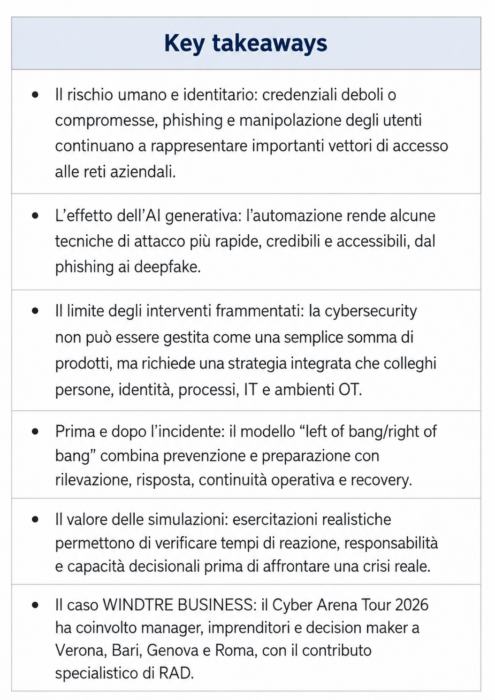
simulare un attacco informatico: WINDTRE Key takeaways -Cyber Arena Tour 2026

La cybersecurity deve quindi essere considerata una capacità complessiva dell’organizzazione, non una responsabilità circoscritta al reparto IT. È questa la prospettiva al centro del Cyber Arena Tour di WINDTRE Business: un approccio integrato che collega preparazione delle persone, protezione delle identità digitali, monitoraggio delle minacce, sicurezza degli ambienti IT e OT e capacità di risposta.

Dalla somma di prodotti a un ecosistema di sicurezza

Per lungo tempo, molte organizzazioni hanno affrontato la sicurezza attraverso interventi puntuali: un prodotto per proteggere gli endpoint, uno per la posta elettronica, uno per la rete e un altro ancora per il backup. Questi strumenti restano necessari, ma senza una visione unitaria rischiano di produrre silos tecnologici, processi disallineati e aree non presidiate.

Una strategia cyber efficace deve invece partire dal contesto aziendale: processi critici, dati, identità, dipendenze dalla supply chain, infrastrutture esposte e requisiti di continuità operativa. Solo dopo questa analisi è possibile definire controlli, procedure e responsabilità coerenti con il rischio.

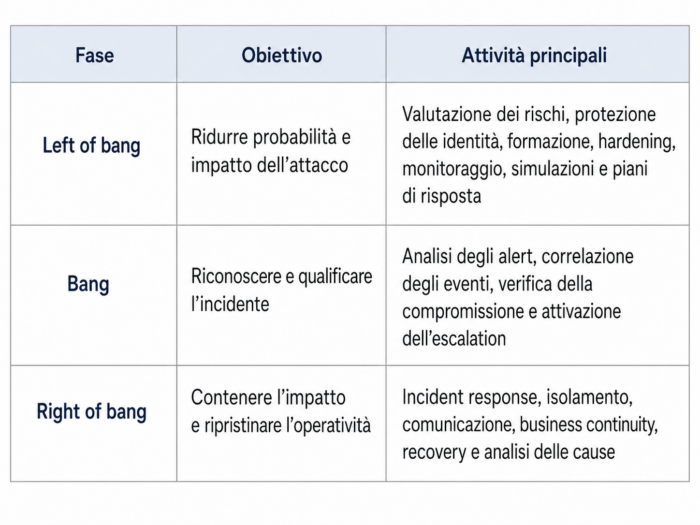
Un modello utile per collegare prevenzione e risposta è la logica left of bang/right of bang. Il “bang” rappresenta il momento in cui l’incidente si manifesta; alla sua sinistra si collocano le attività preventive e di preparazione, mentre alla destra rientrano rilevazione, contenimento, risposta e ripristino.simulare un attacco informatico: WINDTRE left of bangright of bang - Cyber Arena Tour 2026Questa impostazione supera la distinzione rigida tra prevenzione e risposta. Prepararsi prima dell’attacco serve a reagire meglio dopo; allo stesso modo, quanto appreso durante un incidente o una simulazione deve alimentare il miglioramento dei controlli preventivi.
Identità digitale e fattore umano al centro della minaccia

La superficie di attacco non coincide più soltanto con server, reti e dispositivi. Con la diffusione di servizi cloud, accessi remoti e ambienti di lavoro ibridi, l’identità digitale è diventata un punto particolarmente sensibile: credenziali rubate, password deboli, privilegi eccessivi o account non adeguatamente gestiti possono offrire agli attaccanti un ingresso nei sistemi aziendali.

La protezione delle identità richiede quindi un disegno coerente che includa autenticazione forte, gestione dei privilegi, controllo degli accessi, monitoraggio delle anomalie e revisione periodica delle autorizzazioni. Ma anche i controlli più avanzati devono essere accompagnati dalla preparazione delle persone.

Il fattore umano, infatti, non va considerato soltanto come l’anello debole della sicurezza. Se formato e coinvolto, può diventare la prima linea di difesa dell’organizzazione. Riconoscere una richiesta anomala, segnalare rapidamente un messaggio sospetto o applicare correttamente una procedura può interrompere la catena di un attacco prima che questo produca conseguenze più gravi.

Per questo la formazione non dovrebbe limitarsi alla diffusione periodica di contenuti teorici. Deve essere adattata ai ruoli, collegata ai rischi effettivi e verificata attraverso esercitazioni che riproducano situazioni realistiche.

L’AI accelera sia gli attacchi sia la difesa

L’intelligenza artificiale generativa sta contribuendo a cambiare lo scenario. La possibilità di generare rapidamente testi credibili, personalizzare messaggi e automatizzare alcune attività riduce le barriere operative per chi attacca. Phishing più plausibili, impersonificazioni e deepfake aumentano la difficoltà di distinguere una comunicazione autentica da un tentativo di manipolazione.

“Gli attacchi informatici sono sempre più rapidi e l’intelligenza artificiale sta aumentando il divario tra chi attacca e chi deve difendersi”, ha dichiarato Antonio Forzieri, Cybersecurity Strategy Director di WINDTRE. “Per questo le aziende, a partire dalle PMI, devono sviluppare una consapevolezza più concreta del rischio cyber”.

L’AI è però anche una leva difensiva. Può supportare l’analisi di grandi volumi di eventi, la rilevazione delle anomalie, la definizione delle priorità e l’accelerazione di alcune attività di risposta. Nei processi critici resta essenziale un modello human in the loop, nel quale l’automazione supporti gli esperti senza sostituire la supervisione umana e la valutazione del contesto.

La velocità, da sola, non è infatti garanzia di efficacia. Una decisione automatizzata priva di controllo può generare falsi positivi, attivare contromisure non proporzionate o trascurare elementi rilevanti per la continuità operativa.

Cybersecurity IT e OT: proteggere anche la continuità industriale

Per le imprese industriali, la strategia deve comprendere anche gli ambienti Operational Technology. Sistemi di controllo, macchinari, sensori e componenti connessi sono sempre più integrati con le reti aziendali. Questa convergenza tra IT e OT produce benefici operativi, ma può anche ampliare la superficie di attacco.

Negli ambienti industriali, inoltre, le priorità non coincidono sempre con quelle dell’IT tradizionale. Oltre a riservatezza e integrità dei dati, assumono un peso determinante la disponibilità degli impianti, la continuità produttiva e la sicurezza fisica.

La protezione degli ambienti OT richiede quindi competenze specifiche, visibilità sugli asset, segmentazione delle reti, controllo degli accessi e procedure di risposta compatibili con i vincoli degli impianti. Anche in questo ambito una strategia integrata aiuta a evitare che IT, sicurezza e funzioni operative lavorino come compartimenti separati.

Le PMI non sono semplici spettatrici

La crescente interconnessione delle filiere rende il rischio cyber rilevante anche per le piccole e medie imprese. Una PMI può gestire dati di valore, fornire servizi essenziali, accedere ai sistemi di clienti più grandi o presidiare un passaggio critico della supply chain.

Allo stesso tempo, le imprese di dimensioni più contenute possono disporre di risorse specialistiche limitate e affrontare la cybersecurity attraverso iniziative non coordinate. Il risultato è talvolta una protezione frammentata, difficile da misurare e da adattare alla trasformazione dell’azienda.

Rafforzare la resilienza non significa necessariamente replicare modelli pensati per le grandi organizzazioni. Significa identificare i processi essenziali, proteggere identità e accessi, definire responsabilità, predisporre procedure sostenibili e verificare periodicamente la capacità di risposta.

L’edizione 2026 del Cyber Arena Tour ha ampliato proprio alle PMI il proprio raggio d’azione, riconoscendo la loro crescente esposizione a minacce evolute e la necessità di rafforzarne competenze, consapevolezza e capacità di reazione.

Per capire come reagire bisogna mettersi alla prova

Report, webinar e attività di awareness sono strumenti importanti, ma non consentono sempre di verificare come un’organizzazione si comporterebbe durante una crisi. Le simulazioni colmano questa distanza, portando i partecipanti davanti a decisioni da prendere in tempi limitati e sulla base di informazioni inizialmente incomplete.

L’obiettivo non è dimostrare di avere una risposta perfetta. È osservare come vengono stabilite le priorità, quanto rapidamente circolano le informazioni, chi assume le decisioni e se i diversi soggetti coinvolti condividono la stessa rappresentazione dell’incidente.

Tra gli elementi che possono essere verificati attraverso una simulazione rientrano:

  • tempi e criteri di escalation;
  • chiarezza di ruoli e responsabilità;
  • coordinamento tra IT, security, management, legal e comunicazione;
  • capacità di valutare l’impatto sul business;
  • disponibilità e applicabilità dei piani di continuità;
  • modalità di comunicazione con dipendenti, clienti e stakeholder;
  • efficacia delle procedure di contenimento e recovery.

Cyber Arena Tour 2026: quattro tappe per simulare la crisi

Con questo approccio WINDTRE BUSINESS ha organizzato il Cyber Arena Tour 2026, iniziativa itinerante dedicata alla diffusione della cultura della sicurezza informatica tra le aziende.
Antonio Forzieri- WindTre - simulare un attacco informatico

Il tour si è concluso dopo le tappe di Verona, Bari, Genova e Roma, coinvolgendo manager, imprenditori e decision maker di differenti realtà produttive. Il format ha combinato confronto, attività interattive e simulazioni di attacco, mettendo i partecipanti di fronte a scenari nei quali valutare priorità, tempi di reazione e decisioni operative.

“Con il Cyber Arena Tour abbiamo portato nei territori un’esperienza pratica, fatta di simulazioni e confronto diretto, per aiutare le imprese a capire come reagire, quali decisioni prendere e quali competenze rafforzare”, ha spiegato Forzieri. “La sicurezza digitale non è più solo un tema tecnico: è una responsabilità che riguarda l’intera organizzazione”.

Il valore dell’iniziativa risiede anche nella capacità di avvicinare il rischio cyber alle esigenze quotidiane del business. Invece di presentare la minaccia soltanto attraverso indicatori tecnici, le simulazioni ne mostrano gli effetti sulle decisioni, sui processi e sulla continuità aziendale.

Il contributo specialistico di RAD

Il ciclo di eventi si è avvalso del contributo di RAD, azienda italiana specializzata in cybersecurity e interamente acquisita da WINDTRE. RAD ha portato nel tour competenze avanzate e strumenti specialistici a supporto delle imprese partecipanti.

L’integrazione di queste competenze nella proposta WINDTRE BUSINESS risponde alla necessità di affiancare le organizzazioni attraverso un approccio scalabile e personalizzabile, rivolto alle microimprese, alle PMI, ai grandi gruppi industriali e agli enti pubblici.

La combinazione tra capacità tecnologiche, conoscenza delle minacce, formazione e simulazioni consente di affrontare la sicurezza come un percorso continuo, non come un progetto che si conclude con l’installazione di una soluzione.

Prepararsi prima per reagire meglio dopo

Non esistono organizzazioni completamente immuni dagli attacchi. Esiste però una differenza sostanziale tra chi affronta una crisi per la prima volta nel momento in cui si verifica e chi ha già messo alla prova responsabilità, procedure e capacità decisionali.

È questo il valore delle simulazioni: trasformare un rischio percepito come astratto in un’esperienza concreta, osservabile e utile a individuare i punti da rafforzare.

Per CISO e security manager, la priorità è costruire un ecosistema che colleghi il “prima” e il “dopo” dell’incidente: protezione delle identità, formazione delle persone, monitoraggio, sicurezza IT e OT, risposta e recovery. Per imprenditori e vertici aziendali, significa riconoscere che la resilienza cyber non è soltanto un obiettivo tecnico, ma una condizione per garantire continuità, affidabilità e capacità competitiva.

FAQ

Che cos’è il Cyber Arena Tour di WINDTRE BUSINESS?

È un’iniziativa itinerante dedicata alla cultura della cybersecurity. L’edizione 2026 ha fatto tappa a Verona, Bari, Genova e Roma, coinvolgendo manager, imprenditori e decision maker in simulazioni e attività interattive.

Perché le simulazioni cyber sono utili?

Consentono di verificare in un ambiente controllato tempi di reazione, responsabilità, criteri decisionali e coordinamento tra le diverse funzioni aziendali, facendo emergere eventuali criticità prima di una crisi reale.

Che cosa significa “left of bang/right of bang”?

È un modello che distingue le attività svolte prima dell’incidente – prevenzione, preparazione e formazione – da quelle successive, come rilevazione, contenimento, risposta e recovery.

Perché le identità digitali sono un elemento critico?

Perché account e credenziali possono diventare un punto di accesso alle reti aziendali. La loro protezione richiede autenticazione forte, gestione dei privilegi, monitoraggio e formazione degli utenti.

Quale ruolo può avere l’AI nella cybersecurity?

L’AI può rendere alcuni attacchi più rapidi e credibili, ma può anche supportare rilevazione e risposta. Nei processi critici è opportuno mantenere la supervisione umana attraverso un modello human in the loop.

Le PMI sono realmente esposte?

Sì. Le PMI gestiscono informazioni, utilizzano infrastrutture digitali e partecipano a filiere interconnesse. Il Cyber Arena Tour 2026 ha ampliato il proprio focus proprio sulle piccole e medie imprese, sempre più chiamate a rafforzare consapevolezza e capacità di risposta.

Qual è il ruolo di RAD?

RAD è un’azienda italiana specializzata in cybersecurity, interamente acquisita da WINDTRE. Ha contribuito al Cyber Arena Tour con competenze avanzate e strumenti specialistici a supporto delle aziende partecipanti.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/simulare-un-attacco-informatico-cyber-arena-tour-2026/