Large enterprises scramble after supply-chain attack spills their secrets

Open source software used by more than 23,000 organizations, some of them in large enterprises, was compromised with credential-stealing code after attackers gained unauthorized access to a maintainer account, in the latest open source supply-chain attack to roil the Internet.

The corrupted package, tj-actions/changed-files, is part of tj-actions, a collection of files that’s used by more than 23,000 organizations. Tj-actions is one of many GitHub Actions, a form of platform for streamlining software available on the open source developer platform. Actions are a core means of implementing what’s known as CI/CD, short for Continuous Integration and Continuous Deployment (or Continuous Delivery).

Scraping server memory at scale

On Friday or earlier, the source code for all versions of tj-actions/changed-files received unauthorized updates that changed the “tags” developers use to reference specific code versions. The tags pointed to a publicly available file that copies the internal memory of severs running it, searches for credentials, and writes them to a log. In the aftermath, many publicly accessible repositories running tj-actions ended up displaying their most sensitive credentials in logs anyone could view.

“The scary part of actions is that they can often modify the source code of the repository that is using them and access any secret variables associated with a workflow,” HD Moore, founder and CEO of runZero and an expert in open source security, said in an interview. “The most paranoid use of actions is to audit all of the source code, then pin the specific commit hash instead of the tag into the … the workflow, but this is a hassle.”

https://arstechnica.com/information-technology/2025/03/supply-chain-attack-exposing-credentials-affects-23k-users-of-tj-actions/


Phishing: evoluzione del furto dell’identità e del rilevamento basato su Intelligenza Artificiale

Oltre 932.000 attacchi di phishing in un solo trimestre. La minaccia è in crescita costante e gli hacker ora utilizzano persino le immagini di Google Street View della tua casa per personalizzare le loro truffe. Scopri come l’intelligenza artificiale sta cambiando le regole del gioco nella protezione della tua identità digitale.

Il Fenomeno del Phishing nel Panorama della Cybersecurity

Nel contesto attuale della sicurezza informatica, il phishing rappresenta una delle minacce più insidiose e pervasive. Questa tecnica di attacco, che prende metaforicamente il nome dall’inglese “fishing” (pescare), consiste nell’indurre gli utenti a rivelare informazioni riservate attraverso comunicazioni fraudolente che imitano fonti attendibili. La crescente sofisticazione di questi attacchi ha reso necessario lo sviluppo di contromisure sempre più avanzate.

Gli attacchi di phishing hanno ormai trasceso la dimensione delle semplici truffe via email, evolvendosi in strategie complesse capaci di eludere anche sistemi di sicurezza sofisticati. Le conseguenze possono essere devastanti: dalle perdite economiche al furto d’identità, dai danni reputazionali alle responsabilità legali. Non è raro che questi attacchi costituiscano il primo anello di una catena più ampia di azioni malevole, inclusi data breach e infezioni ransomware.

L’Anatomia degli Attacchi di Phishing Moderni

Gli attacchi di phishing contemporanei si sono evoluti ben oltre le rudimentali email fraudolente. Oggi assistiamo a forme sofisticate come lo spear phishing (attacchi mirati a specifici individui o organizzazioni), il business email compromise (BEC) che prende di mira figure aziendali chiave, e il pharming che reindirizza il traffico web verso siti malevoli manipolando i sistemi DNS.

Particolarmente preoccupante è l’emergere del voice phishing (vishing) e del social media phishing, che sfruttano rispettivamente le comunicazioni vocali e le piattaforme social per ingannare le vittime. Secondo i dati dell’APWG, nel terzo trimestre del 2024 il vishing ha registrato un aumento di oltre il 28% rispetto al trimestre precedente, mentre lo smishing (phishing via SMS) è cresciuto del 22%. Questi vettori di attacco multipli richiedono approcci di difesa poliedrici e adattivi, capaci di riconoscere pattern sospetti attraverso diversi canali di comunicazione.

Un aspetto cruciale della sofisticazione degli attacchi moderni è l’utilizzo di tecniche di ingegneria sociale sempre più raffinate, basate su informazioni raccolte da fonti pubbliche e violazioni di dati precedenti. Nel terzo trimestre del 2024, l’APWG ha rilevato una nuova allarmante tendenza nelle email di estorsione: i criminali hanno iniziato a includere nei loro messaggi dati personali delle vittime, come numeri di telefono, indirizzi di casa e persino immagini di Google Street View delle abitazioni. Questo livello di personalizzazione è chiaramente progettato per spaventare le vittime e indurle a soddisfare le richieste degli aggressori.

Approcci di Machine Learning per il Rilevamento del Phishing

La ricerca nel campo della cybersecurity ha dimostrato come l’applicazione di tecniche di machine learning e deep learning offra risultati promettenti nel rilevamento del phishing. Numerosi studi concordano sul fatto che l’elemento chiave per l’efficacia di questi approcci risiede nella selezione intelligente delle caratteristiche (feature selection), che consente di ottenere prestazioni elevate con un sottoinsieme ottimizzato di parametri.

Le metodologie più efficaci seguono un percorso strutturato che comprende la raccolta dei dati, la pre-elaborazione, la selezione delle caratteristiche, l’addestramento dei modelli e la loro valutazione. È stato ampiamente dimostrato come non sia necessario utilizzare tutte le caratteristiche disponibili per ottenere risultati eccellenti: analisi comparative hanno evidenziato che spesso un sottoinsieme ben selezionato di caratteristiche può portare a prestazioni comparabili o addirittura superiori rispetto all’utilizzo dell’intero set, con il vantaggio di ridurre significativamente i costi computazionali.

Per la selezione delle caratteristiche, tecniche come l’analisi dell’importanza delle permutazioni hanno dimostrato particolare efficacia. Questo approccio valuta il contributo di ciascuna caratteristica misurando la diminuzione delle prestazioni del modello quando i valori di quella specifica caratteristica vengono casualmente permutati, consentendo di identificare gli elementi realmente determinanti per la classificazione.

Architetture di Deep Learning nel Contesto del Phishing

Nel campo del rilevamento del phishing, diverse architetture di deep learning hanno dimostrato la loro efficacia:

Reti Neurali Feedforward (FNN);

Queste reti hanno mostrato eccellente flessibilità nell’affrontare problemi di classificazione binaria come il rilevamento del phishing. La loro struttura, relativamente semplice ma potente, consente di elaborare le caratteristiche in modo sequenziale, estraendo pattern significativi attraverso strati nascosti con funzioni di attivazione non lineari. Diversi studi hanno evidenziato come le FNN possano raggiungere livelli di accuratezza superiori al 90% con un numero limitato di caratteristiche, rappresentando un eccellente compromesso tra efficacia e complessità computazionale.

Deep Neural Networks (DNN)

Le architetture DNN, caratterizzate da molteplici strati nascosti, hanno dimostrato la capacità di catturare pattern complessi e relazioni non lineari nei dati. L’applicazione di funzioni di attivazione come ReLU (Rectified Linear Unit) consente a queste reti di apprendere rappresentazioni gerarchiche dei dati, particolarmente utili quando le caratteristiche dei siti di phishing presentano interdipendenze complesse.

Modelli Wide and Deep

Combinando approcci di apprendimento superficiale e profondo, questi modelli sfruttano la complementarità delle due metodologie: la componente wide eccelle nella memorizzazione di dettagli specifici, mentre la componente deep cattura pattern complessi e generalizzazioni. Questa architettura ibrida si è dimostrata particolarmente efficace in contesti dove è necessario bilanciare la memorizzazione di caratteristiche specifiche del phishing con la capacità di generalizzare a nuove tipologie di attacco.

Architetture basate su Attenzione

Modelli che implementano meccanismi di attenzione, come TabNet, hanno mostrato risultati promettenti nell’analisi di dati strutturati come quelli utilizzati nel rilevamento del phishing. Questi approcci identificano e focalizzano l’elaborazione sulle caratteristiche più informative, migliorando l’interpretabilità dei modelli e consentendo di comprendere quali elementi influenzano maggiormente la classificazione.

Caratteristiche Determinanti per il Rilevamento

L’analisi delle caratteristiche più efficaci per il rilevamento del phishing ha evidenziato alcuni indicatori particolarmente significativi. La presenza di URL anomali, con domini creati recentemente o con nomi simili a brand noti ma con piccole variazioni (typosquatting), rappresenta un forte segnale di allarme. Anche la struttura dell’URL, inclusi lunghezza eccessiva, presenza di caratteri speciali o sottodomini sospetti, fornisce indizi preziosi.

Altri indicatori rilevanti includono la presenza di certificati SSL/TLS inadeguati o autofirmati, l’utilizzo di redirect multipli, la presenza di form di input per dati sensibili in contesti inusuali, e discrepanze tra il contenuto visualizzato e il codice HTML sottostante. Anche caratteristiche tecniche come l’età del dominio, il posizionamento geografico dei server, e anomalie nei record DNS si sono dimostrate utili nella classificazione.

L’integrazione di queste caratteristiche in modelli di machine learning consente di creare sistemi di rilevamento che vanno ben oltre le semplici blacklist, adattandosi continuamente all’evoluzione delle tecniche di phishing.

Metriche di Valutazione e Ottimizzazione

Un aspetto fondamentale nello sviluppo di sistemi efficaci di rilevamento del phishing è l’adozione di metriche di valutazione appropriate. Oltre all’accuratezza generale, è essenziale considerare il bilanciamento tra falsi positivi e falsi negativi, particolarmente critico in questo dominio: un falso positivo può generare frustrazione nell’utente legittimo, mentre un falso negativo può esporre l’utente a rischi significativi.

Per questo motivo, i ricercatori sviluppano metriche composite che considerano molteplici aspetti delle prestazioni, includendo non solo l’accuratezza ma anche tassi di falsi positivi, tassi di veri positivi e tempo di elaborazione. Quest’ultimo elemento è particolarmente rilevante nelle applicazioni real-time, dove la tempestività del rilevamento gioca un ruolo cruciale.

L’ottimizzazione degli iperparametri attraverso tecniche come la grid search ha dimostrato di poter migliorare significativamente le prestazioni dei modelli. Queste metodologie consentono di identificare la configurazione ottimale per ciascuna architettura, bilanciando efficacia ed efficienza. Numerosi studi hanno evidenziato come modelli adeguatamente ottimizzati possano mantenere elevate prestazioni anche quando applicati a nuovi dataset, dimostrando buone capacità di generalizzazione.

Rilevamento Comportamentale e Analisi Contestuale

Un approccio emergente nel contrasto al phishing è l’analisi comportamentale, che va oltre l’esame statico delle caratteristiche tecniche per considerare il comportamento dell’utente e il contesto dell’interazione. Questi sistemi monitorano pattern di comportamento anomali, come la richiesta inaspettata di credenziali da parte di siti raramente visitati, o interazioni inusuali con elementi dell’interfaccia.

L’analisi contestuale considera fattori come la relazione tra mittente e destinatario, la frequenza delle comunicazioni precedenti, il momento della giornata e il dispositivo utilizzato. Implementando modelli di machine learning che incorporano queste dimensioni comportamentali e contestuali, è possibile identificare attacchi di phishing sofisticati che potrebbero sfuggire all’analisi puramente tecnica.

Particolarmente promettenti sono gli approcci che integrano analisi comportamentale, rilevamento basato su anomalie e tecniche tradizionali di machine learning, creando sistemi di difesa multilivello capaci di adattarsi alle strategie di attacco in evoluzione.

Il Panorama Attuale degli Attacchi di Phishing

Secondo il rapporto dell’APWG (Anti-Phishing Working Group) relativo al terzo trimestre del 2024, sono stati osservati 932.923 attacchi di phishing, in aumento rispetto agli 877.536 del secondo trimestre. Il numero di attacchi mensili si è mantenuto tra 290.000 e 370.000 da giugno 2023. Le piattaforme di social media sono risultate il settore più frequentemente attaccato, rappresentando il 30,5% di tutti gli attacchi di phishing, seguite dai servizi SaaS/webmail (21,2%) e dalle istituzioni finanziarie (13%).

Le truffe basate su carte regalo sono state le più diffuse, costituendo il 40,4% del totale, seguite dalle frodi con pagamento anticipato (29,8%) e dalla diversione delle buste paga (6,6%). Particolarmente preoccupante è l’aumento delle truffe di estorsione che richiedono pagamenti in criptovaluta, passate dallo 0,6% al 2,7% rispetto al trimestre precedente.
Un dato significativo riguarda il Business Email Compromise (BEC), una tecnica di furto d’identità che ha causato perdite per 2,9 miliardi di dollari negli Stati Uniti nel 2023.

L’importo medio richiesto in questi attacchi nel terzo trimestre del 2024 è stato di 67.145 dollari, in calo del 25% rispetto al trimestre precedente. Il 70% degli attacchi BEC è stato lanciato utilizzando un dominio di webmail gratuito, con Gmail utilizzato nell’83,1% dei casi.

Applicazioni Pratiche e Tendenze Future

L’integrazione di tecniche avanzate di machine learning nei sistemi di sicurezza ha portato allo sviluppo di soluzioni pratiche per la protezione degli utenti. Estensioni per browser, filtri email e sistemi di monitoraggio del traffico di rete che implementano questi approcci hanno dimostrato efficacia nel contrastare il phishing in tempo reale, fornendo agli utenti avvisi tempestivi sui potenziali rischi.

Le tendenze future indicano un’evoluzione verso approcci sempre più integrati, che combinano il rilevamento del phishing con altre misure di cybersecurity. Particolare interesse è rivolto all’integrazione con sistemi di rilevamento delle intrusioni di rete (NIDS) e soluzioni di protezione degli endpoint, creando strategie di difesa multilivello. Queste integrazioni consentono di bloccare dinamicamente il traffico malevolo e di migliorare i meccanismi di protezione complessiva.

Un’altra direzione promettente è rappresentata dai sistemi di condivisione delle informazioni sulle minacce in tempo reale, che permettono di aggiornare rapidamente i modelli di rilevamento con informazioni sulle ultime tattiche di phishing, migliorando la capacità di risposta alle minacce emergenti.

La ricerca sta inoltre approfondendo l’impatto potenziale degli attacchi di machine learning avversariale sui sistemi di rilevamento del phishing. Comprendere le possibili vulnerabilità potrebbe portare allo sviluppo di algoritmi più robusti, capaci di mantenere la loro efficacia anche in condizioni avverse.

La Componente Umana: Educazione e Consapevolezza

Nonostante gli avanzamenti tecnologici, la componente umana rimane un elemento critico nella difesa contro il phishing. L’educazione degli utenti e la promozione di una cultura della sicurezza rappresentano complementi essenziali alle soluzioni tecniche. Programmi di formazione efficaci non si limitano a illustrare le caratteristiche generali del phishing, ma simulano attacchi reali per addestrare gli utenti a riconoscere i segnali di allarme in contesti autentici.

Le ricerche hanno dimostrato che approcci di apprendimento basati su microtraining periodici risultano più efficaci rispetto a sessioni formative intensive ma sporadiche. Inoltre, la personalizzazione dell’addestramento in base al ruolo e al livello di rischio dell’utente incrementa significativamente l’efficacia degli interventi formativi.

L’integrazione di feedback immediati nelle soluzioni anti-phishing, che spiegano all’utente perché un determinato contenuto è stato classificato come sospetto, contribuisce a un apprendimento continuo e migliora la consapevolezza generale degli utenti rispetto alle minacce emergenti.

Conclusioni

L’evoluzione delle tecniche di rilevamento del phishing basate su machine learning rappresenta un esempio significativo di come l’intelligenza artificiale possa contribuire concretamente alla cybersecurity. L’applicazione di approcci avanzati di selezione delle caratteristiche, combinata con architetture di deep learning ottimizzate, ha dimostrato di poter migliorare significativamente l’efficacia dei sistemi di protezione.

La capacità di ottenere prestazioni elevate con un sottoinsieme limitato di caratteristiche rappresenta un vantaggio significativo, consentendo implementazioni efficienti anche in contesti con risorse computazionali limitate. Questo aspetto è particolarmente rilevante per dispositivi mobili e embedded, dove i vincoli energetici e di elaborazione sono stringenti.
Di fronte all’evoluzione costante delle tecniche di phishing, evidenziata dai dati dell’APWG che mostrano quasi un milione di attacchi in un solo trimestre, lo sviluppo di approcci adattivi e l’integrazione di diverse tecnologie rappresentano elementi essenziali per una difesa efficace. La combinazione di intelligenza artificiale, analisi comportamentale e consapevolezza degli utenti costituisce la strategia più promettente per mitigare questa persistente minaccia alla sicurezza digitale.

La battaglia contro il phishing richiede un approccio olistico che unisca innovazione tecnologica, collaborazione tra esperti di sicurezza e un impegno continuo nell’educazione degli utenti. Solo attraverso questa sinergia sarà possibile costruire un ecosistema digitale più sicuro e resiliente di fronte alle sfide emergenti della cybersecurity, particolarmente in un contesto dove i criminali stanno adottando tecniche sempre più personalizzate e intimidatorie per colpire le loro vittime.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/phishing-furto-dellidentita/


Scoperto KoSpy, un nuovo spyware Android nord-coreano


I ricercatori di Lookout hanno individuato KoSpy, uno spyware Android attributo al gruppo nord-coreano APT37, noto anche come ScarCruft, attivo dal 2012.

KoSpy sfrutta finte applicazioni di utility come File Manager, Software Update Utility o tale “Kakao Security” per infettare i dispositivi Android coreani e di utenti di lingua anglosassone. Le prime due app presentano una tipica interfaccia per la gestione di file e dispositivo, mentre Kakao Security si limita a mostrare una finta finestra di sistema.

Una volta installata l’applicazione, lo spyware viene avviato. KoSpy recupera una configurazione cifrata da Firebase Firestore contenente uno switch “on/off” per permette agli attaccanti di controllare l’attività dello spyware e l’indirizzo del server C2.

KoSpy spyware

Questo meccanismo permette ai cybercriminali di abilitare o disabilitare KoSpy e modificare l’indirizzo del server di comunicazione nel caso venga individuato o bloccato. I ricercatori di Lookout hanno individuato cinque diversi progetti Firebase e altrettanti server C2 usati dagli attaccanti.

KoSpy è in grado di scaricare e installare plugin per espandere le proprie capacità di spionaggio. Tra le principali feature dello spyware ci sono la raccolta di SMS e del registro di chiamate, l’accesso a file e cartelle sullo storage locale, la registrazione di audio, la cattura di screenshot, l’uso della fotocamera e la registrazione dei tasti premuti.

Le applicazioni compromesse, presenti sul Play Store, sono state rimosse immediatamente dopo la segnalazione di Lookout. Stando a uno snapshot della pagina di download di File Manager, l’applicazione è rimasta online a lungo ed è stata scaricata da almeno una decina di utenti.

Secondo l’analisi di Lookout, l’infrastruttura dello spyware KoSpy coinciderebbe con quella usata da APT43, un altro gruppo nord-coreano. “I cyberattaccanti nord-coreani sono conosciuti per avere infrastrutture, obiettivi e TTP analoghi, il che rende difficile l’attribuzione [degli attacchi] a uno specifico gruppo“.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/03/14/scoperto-kospy-un-nuovo-spyware-android-nord-coreano/?utm_source=rss&utm_medium=rss&utm_campaign=scoperto-kospy-un-nuovo-spyware-android-nord-coreano


5G: Evoluzione, Architettura e Sicurezza delle Reti Mobili di Nuova Generazione

Questo articolo è il primo di una serie dedicata all’esplorazione approfondita della tecnologia 5G e del suo impatto sulla trasformazione digitale della società. In questo primo capitolo, analizziamo l’architettura hardware del 5G, i suoi componenti fondamentali e le innovazioni tecnologiche che promettono di rivoluzionare non solo le comunicazioni personali, ma interi settori industriali.

L’Evoluzione delle Reti Mobili e l’Avvento del 5G

L’Evoluzione delle Reti Mobili e l’Avvento del 5G L’evoluzione delle reti mobili ha seguito una progressione storica marcata da innovazioni tecnologiche significative che hanno trasformato il modo in cui comunichiamo e accediamo alle informazioni.

L’architettura hardware del 5G è progettata per supportare la trasmissione di dati ad alta velocità, una bassa latenza, e una maggiore capacità di connessione simultanea rispetto alle generazioni precedenti. Questa architettura è composta da diversi componenti chiave che lavorano insieme per garantire la funzionalità e le prestazioni della rete 5G.

Secondo l’Unione Internazionale delle Telecomunicazioni (ITU), l’introduzione del 5G, la quinta generazione di tecnologia cellulare, promette di rivoluzionare non solo le comunicazioni personali, ma interi settori industriali, offrendo velocità di trasmissione dati fino a 20 Gbps, latenza inferiore a 1 ms e una densità di connessione di 1 milione di dispositivi per km².

Architettura e Innovazioni Tecnologiche del 5G

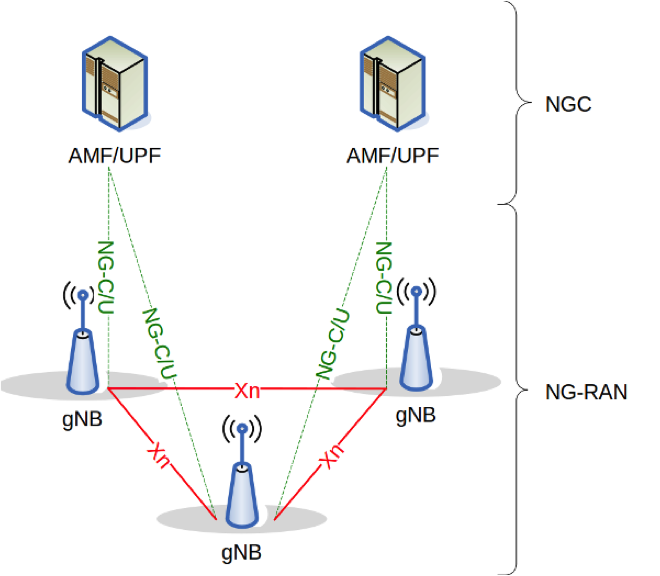
Figura 1. Architettura Rete 5G

Di seguito, descriviamo i principali componenti hardware e le loro funzioni:

1. Stazioni Base (Base Stations)

  • gNodeB (gNB): È la stazione base 5G che fornisce la connettività radio agli utenti. Sostituisce l’eNodeB della rete LTE e gestisce la comunicazione tra i dispositivi mobili e la rete centrale. La gNB è responsabile della gestione delle risorse radio, della codifica/decodifica dei segnali e dell’instradamento dei dati.
  • Small Cells: Sono stazioni base di dimensioni ridotte che coprono aree più piccole rispetto alle macro celle tradizionali. Vengono utilizzate per aumentare la capacità e la copertura in aree ad alta densità di traffico, come i centri urbani.

2. Antenne

  • Massive MIMO (Multiple Input Multiple Output): Utilizza un grande numero di antenne per trasmettere e ricevere più segnali simultaneamente. Questo migliora significativamente la capacità e l’efficienza spettrale della rete 5G.
  • Beamforming: Tecnica che consente di dirigere i segnali radio direttamente verso specifici dispositivi mobili, migliorando la qualità del segnale e riducendo le interferenze.

3. Core Network (Rete Centrale)

  • NG Core (Next Generation Core): È la rete centrale 5G, responsabile della gestione del traffico dati e delle connessioni. È composta da diversi componenti, tra cui:
  • AMF (Access and Mobility Management Function): Gestisce la registrazione degli utenti e la loro mobilità.
  • SMF (Session Management Function): Gestisce le sessioni dati e la loro qualità.
  • UPF (User Plane Function): Instrada i dati tra la rete e gli utenti finali.
  • NSSF (Network Slice Selection Function): Gestisce la selezione delle slice di rete, permettendo la creazione di reti virtuali personalizzate per diverse applicazioni.

4. Dispositivi Utente (User Equipment, UE)

  • Smartphone e Dispositivi Mobili: Dotati di modem 5G in grado di connettersi alla rete e supportare velocità di trasmissione elevate.
  • IoT Devices: Dispositivi connessi utilizzati in vari settori come l’automazione industriale, la smart home e la sanità.

Il 5G come Catalizzatore di un Futuro Interconnesso

L’avvento del 5G segna un punto di svolta nell’evoluzione delle tecnologie di comunicazione, promettendo di ridefinire il tessuto stesso della nostra società digitale. Mentre ci avventuriamo in questa nuova era, è evidente che il potenziale del 5G va ben oltre il mero incremento delle velocità di connessione.

Secondo un rapporto del MIT Technology Review Insights, il 5G fungerà da spina dorsale per l’Internet of Everything, facilitando l’integrazione seamless di tecnologie emergenti come l’intelligenza artificiale, la blockchain e l’edge computing.

Questa convergenza tecnologica non solo accelererà l’innovazione in settori critici come la sanità, i trasporti e l’energia, ma aprirà anche la strada a modelli di business rivoluzionari e a nuove forme di interazione uomo-macchina. Tuttavia, con queste opportunità senza precedenti emergono anche sfide complesse che richiederanno una collaborazione globale tra governi, industria e accademia.

La gestione responsabile di questa transizione tecnologica sarà cruciale per garantire che i benefici del 5G siano distribuiti equamente, minimizzando al contempo i rischi potenziali per la privacy e la sicurezza. In definitiva, il successo del 5G non sarà misurato solo in termini di prestazioni tecniche, ma anche dal suo impatto positivo sulla società, sull’economia e sull’ambiente, plasmando un futuro più connesso, efficiente e sostenibile per le generazioni a venire.

Verso un Ecosistema 5G Sicuro: Sfide e Strategie Emergenti

Mentre esploriamo le potenzialità rivoluzionarie del 5G, è imperativo affrontare le complesse sfide di sicurezza che questa tecnologia comporta. Il prossimo capitolo approfondirà le implicazioni critiche per la cybersecurity nell’era del 5G, analizzando le vulnerabilità uniche introdotte dall’architettura distribuita e dall’iperconnettività.

Esamineremo le strategie all’avanguardia sviluppate da esperti del settore e organizzazioni come il National Institute of Standards and Technology (NIST) per contrastare minacce emergenti. Dall’implementazione di protocolli di crittografia quantistica alla realizzazione di architetture Zero Trust, scopriremo come l’industria sta evolvendo per garantire l’integrità, la confidenzialità e la disponibilità dei dati in un ecosistema 5G.

Inoltre, esploreremo il ruolo cruciale dell’intelligenza artificiale e del machine learning nel rilevamento e nella mitigazione proattiva delle minacce, nonché le implicazioni geopolitiche della sicurezza delle infrastrutture 5G. Questo approfondimento fornirà agli stakeholder una comprensione essenziale delle misure necessarie per navigare in sicurezza nel panorama in rapida evoluzione del 5G, bilanciando innovazione e protezione in un mondo sempre più interconnesso.

In questo primo approfondimento dedicato al 5G, abbiamo esplorato l’architettura fondamentale e le innovazioni tecnologiche che stanno ridefinendo il panorama delle telecomunicazioni.

Dall’analisi dei componenti hardware alle promesse di una società più interconnessa, abbiamo gettato le basi per comprendere questa rivoluzionaria tecnologia. Nel prossimo articolo della serie, “8 Sfide Critiche per la Cybersecurity nelle Reti 5G”, esploreremo le complesse sfide di sicurezza che le organizzazioni devono affrontare nell’implementazione delle reti 5G. Non perdere l’opportunità di approfondire ulteriormente questi temi scaricando il white paper completo di Stefano Savo e Stefano Cangiano, che offre un’analisi dettagliata e approfondita delle sfide e delle opportunità nel panorama della cybersecurity 5G.

Profilo Autore

Dottore in Scienze e Tecnologie Informatiche presso l’Università di Roma “Tor Vergata”, ha esperienza decennale nel settore dell’Intelligence Militare e Privato. Ha svolto diverse operazioni come ausiliario di polizia giudiziaria. Ricopre ruolo di Security Specialist Consultant proponendo servizi mirati per la Security, Intelligence, Cyber Security & Digital Forensics. Esperto in attività di TSCM (Technical Surveillance Countermeasures) a supporto del controspionaggio industriale. Nel 2019 è CO-Founder della società ISK (isksecurity.it) partner strategico ed esterno per attività di TSCM, Cyber Security & Digital Forensics.

Profilo Autore

Titolare delle licenze EJPT e ECPPT (Professional Penetration Tester) della società eLearnSecurity. Svolge attività di Network Security in particolare Penetration Test & VA – Vulnerability Assessment.
Nel 2019 fonda la società ISK (www.isksecurity.it), partner strategico ed esterno per attività di Security specializzata. Svolge attività di bonifiche ambientali da microspie, attività di Security Assessment e Mobile Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/5g-architettura/


Enhance security posture: 4 key approaches to manage vulnerabilities

Cloud native application development is surging across businesses, along with the adoption of public cloud infrastructure and services. This progress has led to a growing set of challenges for security: as organizations expand their use of cloud native technologies, the complexity of these environments continues to grow, significantly increasing the attack surface. This added risk has not stopped the adoption but is making scaling and maintenance increasingly difficult, especially as teams have been moving more quickly to meet business demands — all while navigating a diverse and often fragmented cloud security landscape. Among the leading risk factors, vulnerabilities in open source components remain a top concern and demand a comprehensive strategy to minimize the risk, if not eliminate it altogether.

To gain control of the problem, security teams are tasked with maintaining an accurate asset inventory for vulnerability scanning, providing accurate scan results with actionable advice, and tracking remediation efforts for overall risk reduction. These tasks are difficult enough in a stable ecosystem, and they are especially challenging in the current reality of increasing findings and security advisories. The year 2024 broke the record, with more than 40,000 CVEs reported, highlighting this key issue. This surge in vulnerabilities is likely a result of several factors: the widespread use of open source, greater awareness and reporting, complexity of systems and regulatory requirements. 

While mitigating every single vulnerability is the ultimate goal, it is often unrealistic given the volume of findings in a modern set of container images, the limited development resources, and the time required to patch and fix them. In 2024, the National Vulnerability Database (NVD) struggled to analyze about half of the vulnerabilities published. This suggests that a significant portion of CVEs are still considered zero-day, meaning that they can be exploited in attacks while their risk is still studied and no fix is published.

Even with these challenges, organizations can still gain control over their vulnerability posture, with the right strategy and tools in place. Effective vulnerability management can help enhance security posture and significantly reduce risk. It’s all about choosing the right approach for the organization and building a robust vulnerability management program based on specific organizational needs and overall risk profile.

Structural and organizational constraints

No matter how skilled the security team is, efforts to manage vulnerabilities are often met with barriers that limit efficacy and increase risk. These roadblocks could include scalability of workloads to monitor, an increasing number of development teams that introduce vulnerabilities faster than they can be fixed, rapid deployment of updates and new features that can make timely patching and complexity in managing hybrid and multi-cloud environments.

Additionally, the division between development and security teams creates significant management challenges. Critical security information remains siloed within security departments, hindering developers who are under pressure to deliver features quickly. All of these factors make it difficult to efficiently address vulnerabilities accumulated over time and new ones that are being constantly introduced to the application stacks.

The thought of a simple process that includes scanning, handing over a list of vulnerabilities to be fixed, and waiting for developers to fix them is not working in today’s reality.

Four key approaches to handling vulnerabilities

While fixing a vulnerability by updating a component to a non-vulnerable version remains the main path to remediation, it is not the only approach. Waiting for a patch to be available, then waiting for developers to apply it, along with the testing required to release the application, could leave the exposure in place for too long. Organizations should consider expanding the toolbox to include removing non-essential components from container images, employing runtime defenses and accepting the risk associated with less critical vulnerabilities. When a vulnerability arises, it’s important to consider each approach so that the risk is effectively and quickly dealt with. 

1. Remove it

This approach involves eliminating the component affected by the vulnerability. Completely removing the vulnerable component, though ideal for eliminating risk, is often not considered the first approach due to its impact on the application and its dependencies. But short of removing components from an image, there is also the option of removing older images, ones where vulnerabilities still exist, from the registry. Cleaning up old images removes the risk of an outdated image finding its way to a production cluster, along with the added benefits of reduced storage. Removing old images is also the fastest way to reduce the overall vulnerability counts.

2. Fix it

Patching and updating vulnerable software brings the benefit of improved security and up-to-date components. However, the availability and nature of fixes can vary significantly depending on whether the software is sourced directly from an open source repository or through a downstream package. Security practitioners need to be aware of the work required to apply a fix, especially when it is packaged in a larger component requiring functionality retesting.

3. Mitigate it

This method involves implementing measures to reduce the impact or likelihood of exploitation. It can be a practical approach when immediate fixes aren’t possible or when the work to apply them is balanced against other priorities. Runtime security controls can be used to monitor and limit processes, files and network activity. These controls can target the underlying mechanisms of how vulnerabilities are exploited, effectively mitigating their risk. Common controls include preventing vulnerable processes from executing and implementing security measures such as drift prevention and blocking fileless execution, to prevent attackers from establishing a foothold in a vulnerable workload.

4. Accept the risk

With the understanding that vulnerabilities cannot be fully eliminated, acknowledging a vulnerability and accepting the associated risk could be a valid approach in cases where the vulnerability is low risk or other compensating controls are in place. This requires organizations to understand the cost/benefit of assuming the risk, document the reason for the exception, and limit its duration. It is also common to see a short grace period for fixing vulnerabilities, especially newly found ones.

Choosing the best approach to vulnerability management

Choosing the most optimal way to address a vulnerability requires evaluating a range of factors. While severity and score (measured as critical, high, or low, and often using CVSSv2, v3, or v4) are important, they are only a part of the picture, and more data points are needed to have a more holistic view. A thorough assessment should also consider the vulnerability’s context — its specific environment, including the nature of the application, the affected component, how it entered the environment, and its exploitation potential, including whether it’s remotely exploitable and if known exploits exist.  

To gain these deeper insights, organizations can leverage tools that provide comprehensive information about each vulnerability within its context, including maintainer score, temporal score, exploit details, and whether it exists in running workloads. Given the large volume of vulnerability findings, these tools are essential for prioritization and efficient management.

For example, a vulnerability scan returns results showing that CVE-2016-7098 is present. This is an older vulnerability associated with older versions of wget, but because it is present, the risk should be evaluated. In addition to its CVSS score of 8.3 (high risk), some factors that make this vulnerability dangerous are:

  1. It allows for remote execution.
  2. Code to exploit this vulnerability is widely available on the internet.
  3. The number of workloads running with this vulnerability.

Although the maintainer of the package has reclassified this as a minor issue, the other factors, along with the fact that a fix is readily available, indicate that the best approach in this scenario is to fix the vulnerability as soon as possible to the next minor version. Additionally, Dev teams might contemplate updating the resource or entire underlying operating system to the most recent major version for comprehensive security improvements, which might catch and remediate a number of other vulnerabilities.

As organizations increasingly rely on cloud-native technologies, they must take the security challenges of these complex environments into consideration. Effectively managing vulnerabilities is crucial for maintaining a strong security posture and mitigating risk. While the sheer volume of vulnerabilities can be daunting, a strategic approach to managing them is key. This involves understanding methods of handling vulnerabilities and carefully evaluating which approach is most appropriate for each specific instance. Moving beyond a simple focus on severity and score, organizations must consider the context of the vulnerability, its potential for exploitation, and leverage available tools to gain deeper insights. With a well-informed, comprehensive strategy, organizations can effectively navigate cloud-native security and reduce their vulnerability risk.

https://www.securitymagazine.com/articles/101463-enhance-security-posture-4-key-approaches-to-manage-vulnerabilities


Il ransomware Medusa ha colpito oltre 300 infrastrutture critiche


Il bilancio delle vittime del ransomware Medusa è tutt’altro che rassicurante: stando a un recente advisory pubblicato dalla CISA, il malware avrebbe colpito oltre 300 infrastrutture critiche statunitensi sin dall’inizio della sua attività nel 2021.

Inizialmente il ransomware era una variante “chiusa” e gestita da un unico gruppo; negli anni si è poi evoluto in un modello as-a-service dove gli sviluppatori originari si occupano di gestire il pagamento dei riscatti. Sia gli ideatori del ransomware Medusa che gli affiliati seguono un modello a doppia estorsione.

ransomware Medusa

La CISA ha rivelato che il gruppo dietro il ransomware recluta Initial Access Broker su forum e marketplace per ottenere l’accesso iniziale alle reti delle potenziali vittime. Agli affiliati viene chiesto di non collaborare con altri gruppi, dietro il pagamento di una somma che va dai 100 dollari a un milione di dollari.

Gli affiliati di Medusa si servono per lo più di campagne di phishing per sottrarre le credenziali degli account delle vittime, ma ricorrono anche allo sfruttamento di vulnerabilità software note. Dopo l’accesso iniziale, gli attaccanti usano tool legittimi come Advanced IP Scanner e SoftPerfect Network Scanner per la scansione e l’enumerazione di utenti, sistemi e reti.

Per eludere i controlli di sicurezza, gli attaccanti usano tool come Certutil e tecniche che fanno uso di PowerShell per nascondere le proprie tracce. A seguire, per la fase di spostamento laterali, i cybercriminali usano numerosi tool di accesso remoto come AnyDesk, Atera, ConnectWise, eHorus, N-able, PDQ Deploy, PDQ Inventory, SimpleHelp e Splashtop in combinazione con Remote Desktop Protocol e PsExec.

Infine gli affiliati installano Rclone sulle macchine compromesse per facilitare l’esfiltrazione di dati e ricorrono a PsExec, PDQ Deploy o BigFix per la cifratura dei file.

ransomware

Pixabay

Gli attaccanti chiedono di essere contattati per il pagamento del riscatto entro 48 ore dall’attacco, tramite una chat basata su browser Tor o Tox, un servizio di messaggistica con cifratura end-to-end. Nel caso la vittima non risponda alla richiesta, i cybercriminali provvedono a contattarla direttamente via telefono o email.

“Le indagini dell’FBI hanno rilevato che, dopo aver pagato il riscatto, una vittima è stata contattata da un altro attaccante di Medusa che ha affermato che il negoziatore aveva rubato l’importo del riscatto già pagato e ha chiesto di effettuare nuovamente metà del pagamento per fornire il “vero decryptor”, indicando potenzialmente uno schema di tripla estorsione” spiega la CISA.

L’attività di Medusa è tutt’altro che in calo: secondo quanto riportato dal Threat Hunter Team di Symantec, tra gennaio e febbraio gli attacchi del gruppo sono aumentati del doppio rispetto allo stesso periodo del 2024, e l’andamento continua a essere crescente.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/03/13/il-ransomware-medusa-ha-colpito-oltre-300-infrastrutture-critiche/?utm_source=rss&utm_medium=rss&utm_campaign=il-ransomware-medusa-ha-colpito-oltre-300-infrastrutture-critiche


The future of enterprise protection: Integrated data security platforms

Less than five years ago, one would have been hard-pressed to find information on Data Security Posture Management (DSPM). Today, it is a central pillar of modern cybersecurity strategies. The growth of DSPM from a relatively new technology to a must-have capability of the cybersecurity landscape reflects the growing need for organizations to protect and control their data in the face of increasing complexity in the cloud and the broadening use of AI in the enterprise.

DSPM morphs into cloud-native DSP

Artificial intelligence (AI) continues to advance at a breakneck pace, and it’s rapidly transforming the systems it relies on, including the cloud. But at its core, data and AI are intrinsically linked — AI models fundamentally rely on data (and much of it!) to function. This amplifies the urgency for data security tools to evolve and meet the complex demands of AI. In addition to DSPM, this includes technology like data discovery and classification, data access governance (DAG) and data detection and response (DDR). The integration of these technologies forms the foundation of a holistic new data security platform (DSP). And it must work well for data everywhere — in the cloud or on-premises.

While DSPM remains a critical element in addressing existing data security challenges, a more comprehensive integrated data security approach is needed to meet the dynamic, AI-driven needs of modern enterprises. The development of generative AI, the growth of the cloud, and the tightening of regulatory and governance requirements have created new challenges that DSPM alone cannot adequately address. What’s needed is more comprehensive data security.

Enter integrated, cloud-native DSPs. These are the next generation of platforms with additional security features like access governance, threat detection, and data loss prevention, all designed to work seamlessly and scale with the cloud. External forces driving the further need for DSP features include sophisticated cyber threats that aim at sensitive data and the complexity of regulatory compliance. 

The business case for a comprehensive DSP

Traditional disparate data security approaches lead to gaps in visibility and often don’t scale well. Cloud-native DSPs solve this by combining several data security functions into an ‘all-in-one’ platform that scales and is easier to manage. 

The shift to integrated platforms is not just technological; business needs are also driving it. DSPs meet the needs of modern enterprises who need to reduce operational complexity and associated cost, enhance the efficiency and effectiveness of their security team and ensure all policies are enforced uniformly across all data assets. Finally, they must continually ensure business innovation — the lifeblood of most organizations — is secure, particularly as they increasingly use AI.  

Next-generation DSP requirements

Enterprises considering implementing a DSP should look for three main capabilities in their next-generation data security platform:  

  1. First, they should provide context-aware data discovery and classification that uses AI to precisely understand what data exists and its business relevance and sensitivity. This awareness is the first step in making accurate risk assessments and policy implementations. A DSP must also prioritize scalability to handle growing data volumes and evolving business needs, ensuring consistent, efficient performance and adaptability as the organization expands.
  2. Second, a DSP should offer real-time threat detection and response capabilities that complement the conventional posture assessments and incorporate continuous monitoring and automated remediation of security threats. This mitigates risks more quickly before damages can occur.
  3. Third, a DSP should integrate seamlessly with the security ecosystems to enable coordinated security measures and consistent policy enforcement across all data assets. This means compatible labeling systems and easy customization to fit unique customer requirements.

Looking ahead: The future of data security

Data has become the lifeblood of nearly all businesses. Data-driven organizations, that realize the increasingly crucial role that data plays in their value creation, must take a new approach to secure and control  this most valuable asset.

With data democratization, rapid cloud adoption, and inter-connected supply chains, organizations should enhance their security strategy to protect data everywhere — no matter where it travels. This will empower their innovators to securely utilize data in new ways — to drive the business and improve customer outcomes — while adhering to the highest standards of data privacy and regulatory compliance.

Further, AI will continue to rise, bringing both new security risks and new protection solutions. Organizations will require platforms to secure AI training data while using AI in threat detection and response. Additionally, cross-cloud data governance will continue to grow as more organizations adopt multi-cloud strategies. Platforms will need to provide consistent visibility and control across all environments.

Finally, automation will play a more significant role in security operations; platforms will offer more sophisticated automated remediation capabilities and integrations to key security workflow tools to manage the growing complexity and burden of securing data.

As bright as the future can be, many are stuck with the past. For progressive organizations (the ones likely to prosper in the AI era!), this shift to comprehensive data security will become ingrained within their data architecture — and not be an added on afterthought.

Mastering data isn’t just a strategic advantage — it’s the foundation of survival in today’s competitive market. Data is the way to success and prosperity in an organization. Forward-thinking organizations use comprehensive DSPs to navigate this new era where speed, innovation and security can finally coexist.

https://www.securitymagazine.com/articles/101461-the-future-of-enterprise-protection-integrated-data-security-platforms


Machine Unlearning: Metodologie di Mitigazione

Il machine unlearning emerge come soluzione critica per affrontare le sfide della privacy e della sicurezza nei modelli di machine learning. Questo articolo esplora le metodologie di mitigazione, le tecniche implementative e i criteri di valutazione per rimuovere efficacemente dati specifici dai modelli addestrati, senza necessità di riaddestramento completo. Vengono analizzati gli scenari di applicazione, dalle normative sulla privacy come il GDPR alla mitigazione dei bias, evidenziando l’importanza di questo approccio nell’evoluzione dell’AI responsabile.

Stiamo assistendo ad una crescita esponenziale nell’utilizzo del machine learning per lo svolgimento di qualsiasi attività. I modelli di machine learning (ML) si stanno sempre di più integrando in molti prodotti e servizi di uso quotidiano. Tuttavia, la proliferazione della tecnologia di AI/ML solleva una serie di problemi in termini di violazione della privacy, di bias (pregiudizi) del modello e dell’uso non autorizzato dei dati utilizzati per il training dei modelli.

Questi ambiti evidenziano ancora una volta la necessità di adottare un controllo flessibile e reattivo sui dati con cui viene addestrato un modello. Il riaddestramento da zero di un modello di ML, per la rimozione di specifici dati, è poco pratico a causa degli elevati costi computazionali ed economici. Pertanto, è stata avviata la ricerca sul “machine unlearning” (MU), ovvero si sta cercando di sviluppare nuovi metodi in grado di rimuovere determinati dati da un modello addestrato in modo efficiente, efficace e, soprattutto, senza la necessità di realizzare un nuovo addestramento. Analizziamo le criticità del machine unlearning e le metodologie di valutazioni più efficaci.

Scenari di Mitigazione dei Rischi nel Machine Unlearning

Il machine unlearning (MU) rappresenta un tema rilevante, che non può essere sottovalutato, perché è in grado di affrontare una serie di problemi quali: la conformità alla privacy dei dati di training, la gestione dinamica dei dati, l’inclusione non autorizzata di dati tutelati dalla proprietà intellettuale o altre forme di tutela e, infine, l’uso di dati provenienti da data breaches.

Vediamo i principali use case del machine unlearning:

  • Protezione della privacy: il MU può svolgere un ruolo cruciale nell’applicazione dei diritti alla privacy e nel rispetto di normative come il GDPR dell’UE[1] (che include anche il diritto all’oblio). Consentirebbe di rimuovere i dati personali dai modelli addestrati, salvaguardando la privacy degli individui.
  • Incremento della sicurezza: il MU potrebbe migliorare la sicurezza dei modelli contro gli attacchi di “data poisoning” attraverso la rimozione dei dati c.d. tossici che mirano a manipolare il comportamento di un modello.
  • Miglioramento dell’adattabilità: il MU su larga scala potrebbe aiutare i modelli a rimanere pertinenti anche quando cambiano le distribuzioni dei dati nel tempo, ad esempio in base all’evoluzione delle preferenze dei clienti o delle tendenze di mercato.
  • Conformità normativa: nei settori fortemente regolamentati, il MU potrebbe essere fondamentale per mantenere la conformità alle leggi e ai regolamenti in continua evoluzione.

Mitigazione dei bias/pregiudizi: il MU potrebbe offrire un metodo per rimuovere i dati identificati dopo il training che creano distorsione, promuovendo così l’imparzialità e riducendo il rischio di risultati scorretti.

Tecniche di Mitigazione e Implementazione

La maggior parte delle implementazioni di machine unlearning suddividono il data set utilizzato per il training originario (“Dtrain”) in dati che devono essere conservati (“retain set” o Dr) e dati che devono essere dimenticati/rimossi (“forget set” o Df), come mostrato in Figura.

Il tipico training di un modello di ML (a) prevede l’utilizzo di tutti i dati di training per impostare i parametri del modello. I metodi di machine unlearning comportano la suddivisione dei dati di training (Dtrain) in retain set (Dr) e forget set (Df), quindi un utilizzo iterativo di questi set per modificare i parametri del modello (passaggi da b a d in maniera ciclica). La sezione gialla rappresenta i dati che sono stati dimenticati durante il processo.

Successivamente, i due set vengono utilizzati per modificare i parametri del modello sottoposto a training. Nel corso del tempo, i ricercatori hanno sviluppato diverse tecniche per migliorare questa fase di unlearning, analizziamole:

  • Ottimizzazione: la tecnica prevede che il modello sia ulteriormente addestrato sul retain set, consentendogli di adattarsi alla nuova distribuzione dei dati. Questa tecnica è semplice, ma può richiedere molta potenza di calcolo[2].
  • Etichettatura casuale: la tecnica prevede l’assegnazione di etichette errate casuali al forget set in grado di confondere il modello. In questo modo, il modello viene ottimizzato[3] [4].
  • Inversione del gradiente: questa tecnica prevede che, durante l’ottimizzazione del modello, sia invertito il segno dei gradienti di aggiornamento del peso per i dati del forget set. Questa tecnica contrasta il training precedente[5].
  • Riduzione selettiva dei parametri: questa tecnica prevede la riduzione selettiva dei parametri specificamente legati al forget set attraverso tecniche di analisi del peso e senza alcuna ottimizzazione[6].

Le scelte delle tecniche di unlearning riflettono i casi d’uso di unlearning. Ogni use case ha i propri requisiti che riguardano, in particolare, l’efficacia, l’efficienza e i problemi di privacy.

Valutazione e privacy e Sicurezza nel Machine Unlearning

Una delle principali difficoltà del machine unlearning consiste nel valutare se la tecnica di unlearning prescelta sia in grado di dimenticare i dati specificati e, contestualmente, mantenere le performance sui dati conservati e, inoltre, proteggere la privacy. Idealmente, un metodo di unlearning automatico dovrebbe produrre un modello che funzioni come se fosse stato addestrato da zero, quindi privo del set di dati da dimenticare.

I metodi di unlearning più utilizzati (come l’etichettatura casuale, l’inversione del gradiente e la riduzione selettiva dei parametri) provocano un degrado delle prestazioni del modello esattamente nei punti corrispondenti al dataset dei dati da dimenticare, mentre cercano di mantenere un alto grado di prestazioni del modello nei corrispondenti punti del dataset da mantenere.

Per semplicità, si potrebbe considerare un metodo di unlearning basato su due semplici obiettivi: ottenere prestazioni elevate sul set da conservare e scarse sul set dell’oblio. Questo approccio, tuttavia, rischierebbe di aprire un’altra superficie di attacco sul fronte della privacy: per esempio, se un modello unlearned funzionasse particolarmente male con un determinato input, ciò potrebbe far capire all’aggressore che in origine l’input fosse incluso nel set di dati utilizzati nel training originale e che sia stato rimosso successivamente.

Questo tipo di violazione della privacy, chiamato attacco di “membership inference” [7], è in grado di rivelare i dati importanti e sensibili di un determinato utente o su un set di dati specifico. Pertanto, durante la valutazione dei metodi di unlearning automatico, è importante testare la loro efficacia contro questa tipologia di attacco.

In questo contesto di analisi, i termini “stronger” e “weaker” si riferiscono alla complessità e all’efficacia dell’attacco:

Weaker attacks (Attacchi più deboli): si tratta di tentativi semplici e diretti per ricavare l’appartenenza inferenziale. Questi attacchi potrebbero fare affidamento su informazioni basilari, come i punteggi di confidenza del modello o la probabilità di un determinato output per un input definito. Spesso questi attacchi si basano su ipotesi semplificatrici del modello o sulla distribuzione dei dati, il che può fortunatamente limitarne l’efficacia.

Stronger attacks (Attacchi più forti): si tratta di attacchi sofisticati che utilizzano informazioni o tecniche più avanzate. In particolare, sono in grado di:

  • utilizzare più punti di query oppure input particolarmente elaborati,
  • sfruttare la conoscenza dell’architettura del modello o del processo di training,
  • utilizzare modelli ombra per comprendere il comportamento del modello target,
  • combinare più strategie di attacco,
  • adattarsi alle specifiche caratteristiche del modello target o del set di dati.

Generalmente, gli attacchi più forti sono più efficaci nell’inferenza di appartenenza e quindi sono più difficili da contrastare. Inoltre, rappresentano un modello di minaccia realistico, presente in molti scenari del mondo reale, in cui gli aggressori potrebbero disporre di importanti risorse e competenze.

Raccomandazioni

Il mondo della ricerca sta continuando a lavorare per lo sviluppo di nuove soluzioni di machine unlearning che siano aderenti agli ambienti di produzione e, inoltre, vengano sottoposti ad attacchi alla privacy o all’oblio dei dati più realistici. Uno studio recente offre una serie di raccomandazioni per migliorare la valutazione dell’unlearning basate sulla letteratura già esistente, in particolare vengono proposti nuovi benchmark e riprodotti diversi algoritmi di unlearning. In particolare, sono stati valutati gli algoritmi per misurare l’accuratezza sui dati conservati, la protezione della privacy dei dati dimenticati e la velocità di esecuzione del processo di unlearning[8].

I test hanno rivelato notevoli discrepanze tra gli algoritmi di unlearning, in molti casi sono state riscontrate difficoltà nel raggiungere il risultato in tutte le aree di valutazione. Sono stati testati tre metodi (Identity, Retrain e Finetune on retain) e cinque algoritmi (RandLabel[9], BadTeach[10], SCRUB+R [11] , Selective Synaptic Dampening [SSD][12] e una combinazione di SSD e finetuning).

Come evidenziato in figura, alcuni metodi riescono a difendersi bene dagli attacchi di inferenza debole, mentre sono completamente inefficaci contro gli attacchi più forti, evidenziando la necessità di effettuare il test del caso peggiore. Alla luce di questi risultati, è stata dimostrata l’importanza di dover effettuare la valutazione degli algoritmi in contesti iterativi, poiché alcuni algoritmi degradano la loro accuratezza complessiva durante le iterazioni di unlearning, mentre altri sono in grado di mantenere elevate prestazioni in maniera costante.

Sulla base di questi risultati, si suggerisce di adottare le seguenti raccomandazioni:

1)è necessario dare enfasi alle metriche del caso peggiore rispetto a quelle del caso medio e, inoltre, opportuno utilizzare attacchi avversari forti per la valutazione degli algoritmi. Gli utenti sono più preoccupati per gli scenari gravi, come l’esposizione di informazioni finanziarie personali, che non per gli scenari meno gravi. La valutazione delle metriche del caso peggiore fornisce un limite di alto livello sulla privacy.

2)è opportuno considerare tipi di attacchi specifici alla privacy, in cui l’aggressore ha l’accesso all’output da due versioni diverse dello stesso modello. In questi scenari, l’unlearning può portare a risultati peggiori perché stiamo fornendo all’aggressore maggiori informazioni. Se si verificasse un attacco di perdita di aggiornamento, il danno non dovrebbe essere maggiore di un attacco al modello di base.

3)è utile analizzare le prestazioni dell’algoritmo di unlearning su un numero ripetuto di applicazioni, ovvero il disapprendimento iterativo, per essere in grado di valutare il degrado delle prestazioni di accuratezza del test dei modelli. Poiché i modelli di unlearning automatico sono distribuiti in ambienti in continuo cambiamento, in cui le richieste di oblio, i dati dei nuovi utenti e i dati errati o avvelenati arrivano dinamicamente, è fondamentale essere in grado di poterli valutare in un ambiente online, cioè in un ambiente dove le richieste arrivano attraverso un flusso.

Poiché l’intelligenza artificiale sarà sempre più integrata nei vari aspetti della vita, molto probabilmente il machine unlearning automatico diventerà uno strumento essenziale e un complemento alla cura/manutenzione dei dati di training, e sarà in grado di bilanciare le capacità dell’intelligenza artificiale con le minacce relative alla privacy e alla sicurezza dei dati.

Questo aspetto aprirà nuove opportunità per migliorare la protezione della privacy e per lo sviluppo di sistemi di intelligenza artificiale adattabili, inoltre deve essere in grado di affrontare sfide significative, tra cui le limitazioni tecniche e l’elevato costo computazionale di alcuni metodi di unlearning. La ricerca e lo sviluppo stanno svolgendo un ruolo fondamentali per migliorare queste tecniche e garantire che le stesse possano essere efficacemente implementate in scenari reali.

Il machine unlearning si conferma come tecnologia essenziale per bilanciare le potenzialità dell’AI con la protezione della privacy e la sicurezza dei dati. Nonostante le sfide tecniche e computazionali, la ricerca continua a sviluppare soluzioni sempre più efficaci per scenari reali. Nel prossimo capitolo esploreremo le metodologie per misurare e garantire l’affidabilità dei sistemi di AI. Per un’analisi più completa, il white paper “Generative artificial intelligence rischi e contromisure” offre ulteriori approfondimenti sulle sfide e le soluzioni nel campo dell’IA Gen.

Note bibliografiche

[1]General Data Protection Regulation: https://en.wikipedia.org/wiki/General_Data_Protection_Regulation

[2] AA.VV., Machine unlearning through fine-grained model parameters perturbation: https://arxiv.org/abs/2401.04385, College of Computer Science and Electronic Engineering, 2024

[3] AA.VV., Random Relabeling for Efficient Machine Unlearning: https://arxiv.org/abs/2305.12320, Pennsylvania State University, 2023

[4] AA.VV., Amnesiac Machine Learning: https://arxiv.org/pdf/2010.10981, University of Waterloo, 2020

[5] AA.VV., Gone but Not Forgotten: Improved Benchmarks for Machine Unlearning: https://arxiv.org/pdf/2405.19211, Carnegie Mellon University, 2024

[6]AA.VV., Fast Machine Unlearning Without Retraining Through Selective Synaptic Dampening: https://arxiv.org/abs/2308.07707, University of Cambridge, 2023

[7]ML04:2023 Membership Inference Attack: https://owasp.org/www-project-machine-learning-security-top-10/docs/ML04_2023-Membership_Inference_Attack

[8] AA.VV., Gone But Not Forgotten: Improved Benchmarks for Machine Unlearning: https://arxiv.org/pdf/2405.19211, Carnegie Mellon University, 2024

[9] AA.VV., Amnesiac Machine Learning: https://arxiv.org/abs/2010.10981, University of Waterloo, 2020

[10] AA.VV., Can Bad Teaching Induce Forgetting? Unlearning in Deep Networks using an Incompetent Teacher: https://arxiv.org/abs/2205.08096, Mavvex Lab, 2023

[11] AA.VV., Towards Unbounded Machine Unlearning: https://arxiv.org/abs/2302.09880, University of Warwick, 2023

[12] AA.VV., Fast Machine Unlearning Without Retraining Through Selective Synaptic Dampening: https://arxiv.org/abs/2308.07707, University of Cambridge, 2023

Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/machine-unlearning/


Cyberattacks cited as top organizational threat

A recent Hiscox report revealed that seven in 10 (69%) U.S. companies report an increase in cyberattacks compared to the previous year. The report underscores that cyber threats now pose a greater risk to organizations than bankruptcy, according to the survey. 

According to the report, U.S. business leaders consider cyberattacks and data breaches (32%) to be a bigger threat to their organizations than skills shortages (30%) and bankruptcy (27%). With an average of 62 cyber incidents per business each year — or more than one attack or attempt per week — U.S. companies are facing threats as often as many receive company-wide communications from leadership or weekly newsletters. 

Suffering from ransomware (32%) or virus outbreaks (37%) proves to be the most common cyberattack outcome for businesses, with 56% also reporting financial losses due to payment diversion fraud and 36% citing loss of encrypted data. As a result, 72% of U.S. companies recognize the importance of cyber resilience as integral to their business strategy. 

Paying a ransom offers no assurance of full data recovery; in fact, only 7% of businesses who paid a ransom successfully retrieved all their data, and 10% experienced data leaks despite payment. After an attack, reputational challenges loom, with 43% of businesses struggling to attract new clients due to the damage caused. 

Phishing emails appear to still be the primary method of choice for cyber criminals, accounting for 57% of ransomware incidents. Among companies that have faced an increase in their cyber risk exposure, they credit a substantial lack of employee awareness (41%). 

Failing to decommission outdated systems was identified as the primary driver of rising cyber risk (47%), with legacy systems presenting greater vulnerabilities than employee personal device usage (39%). 

Businesses that opted to pay ransoms did so because 35% lacked adequate data backups and were unable to restore their data. 

Read the report.

https://www.securitymagazine.com/articles/101460-cyberattacks-cited-as-top-organizational-threat


API attacks surge due to rise in AI

According to a recent report by Kong, 25% of respondents have encountered AI-enhanced security threats related to APIs or LLMs, with 75% of respondents expressing serious concern about AI-enhanced attacks in the future. While 85% say they’re confident in their organization’s security capabilities, 55% of respondents cited they’ve experienced an API security incident in the past year, highlighting a notable disconnect. 

While 92% of respondents say they are taking measures to counter AI-enhanced attacks and 88% of respondents citing API security as a top priority, it is clear that many organizations lack the comprehensive security measures needed to protect their API infrastructure in the AI era. 

As might be expected 84% of respondents feel AI and LLMs will make securing APIs more difficult, but surprisingly, the research finds many basic API security tactics being left out of overall strategy. 

Thirty-five percent of organizations are adopting zero-trust architecture in order to mitigate API security risks and 3% of respondents cite shadow APIs as a significant security threat to their organization. With the convergence of APIs and AI, it is more important than ever to have a strong API security posture. 

The top three measures organizations are taking to secure APIs against AI-enhanced threats include increased monitoring and traffic analysis (66%), educating staff on AI-related threats (60%) and AI-driven threat detection systems (51%). 

The top three steps being taken to mitigate API security risks are API monitoring and anomaly detection tools (63%), API gateway solutions (61%), and API encryption and tokenization (58%). Forty-five percent of organizations have dedicated at least 20% of their cybersecurity budgets to API security. According to the report, 41% are unsure or doubtful that their organization’s investment is enough to cover API security risks. 

Read the report. 

https://www.securitymagazine.com/articles/101462-api-attacks-surge-due-to-rise-in-ai