Generative AI: Evoluzione, Funzionamento e Impatto sulla Trasformazione Digitale

Questo articolo fa parte di una serie dedicata all’esplorazione approfondita della Generative Artificial Intelligence (GenAI), una tecnologia rivoluzionaria che sta ridefinendo il panorama digitale. Attraverso un’analisi dettagliata, ripercorreremo la storia, esamineremo il funzionamento e valuteremo l’impatto di questa tecnologia che, secondo le previsioni di Gartner, sarà implementata dall’80% delle organizzazioni entro il 2026.

La Generative AI, talvolta chiamata GenAI, è un tipo di intelligenza artificiale (AI) in grado di creare contenuti originali, come testi, immagini, video, audio o codice software, in risposta al prompt o alla richiesta di un utente. Per rispondere a queste richieste, la GenAI utilizza sofisticati modelli di machine learning, chiamati modelli di deep learning, ovvero algoritmi in grado di simulare i processi di apprendimento e decisionale del cervello umano. Questi si basano sull’identificazione e la codifica di modelli e relazioni in enormi quantità di dati, che sono utilizzati per comprendere le richieste o le domande in linguaggio naturale degli utenti e rispondere con nuovi contenuti pertinenti.

L’AI ha rappresentato uno dei principali argomenti tecnologici degli ultimi dieci anni, ma l’AI generativa, e in particolare l’avvento di ChatGPT nel 2022, ha portato l’AI alla portata di tutti e ha lanciato un’ondata di innovazione senza precedenti. L’AI generativa offre enormi vantaggi in termini di produttività per tutti, individui e organizzazioni, e, sebbene presenti anche sfide e rischi sostanziali, la ricerca continua a esplorare i modi in cui questa tecnologia può migliorare i workflow, potenziare i prodotti e ottimizzare i servizi.

Secondo una ricerca realizzata nel 2023 da McKinsey, un terzo delle organizzazioni utilizza regolarmente l’AI generativa in almeno una funzione aziendale [1]. Gartner prevede che entro il 2026 oltre l’80% delle organizzazioni avrà implementato applicazioni di AI generativa oppure utilizzerà interfacce di programmazione delle applicazioni (API) di AI generativa [2].

Excursus Storico della Generative AI: Dall’Origine ai Moderni Foundation Model

Il termine Intelligenza Artificiale Generativa è divenuto popolare negli ultimi anni, ma l’intelligenza artificiale fa parte della quotidianità da decenni e la tecnologia di AI generativa di oggi si basa sulle scoperte dell’apprendimento automatico risalenti all’inizio del XX secolo. Cerchiamo di comprendere le tappe fondamentali:

  • 1964: Joseph Weizenbaum, ricercatore-informatico del MIT, sviluppa ELIZA, un’applicazione di elaborazione del linguaggio naturale basata su testo. ELIZA, è stato sostanzialmente il primo chatbot (all’epoca chiamato “chatterbot”) basato su uno script di pattern-matching in grado di rispondere agli input, forniti sottoforma di testo in linguaggio naturale, con risposte testuali empatiche.
  • 1999: Nvidia lancia GeoForce, la prima unità di elaborazione grafica. Originariamente sviluppata per fornire una grafica in movimento fluida per i videogiochi, le GPU sono diventate di fatto la piattaforma per lo sviluppo di modelli AI e il mining di criptovalute.
  • 2004: Google lancia la funzione di completamento automatico, che si attiva quando gli utenti inseriscono i termini di ricerca, in grado di generare potenziali parole o frasi successive. L’algoritmo è basato su una catena Markov, un modello matematico sviluppato nel 1906.
  • 2013: Compaiono i primi “Variational Autoencoders” (VAE), dei modelli di reti neurali che permettono di implementare un modello generativo.
  • 2014: Ian Goodfellow, ricercatore presso l’Università di Montreal, introduce le prime “Generative Adversarial Networks” (GAN) e i “Diffusion Models” [3], due architetture per addestrare un modello generativo di AI.
  • 2017: Un gruppo di ricerca formato da Ashish Vaswani, un team di Google Brain e un gruppo della University of Toronto pubblicano “Attention is All You Need [4]”, un documento che illustra i principi dei modelli di trasformazione (c.d. “Transformer”) in grado di abilitare i potenti “foundation model” e strumenti di AI generativa attuali.
  • 2019: OpenAI implementa i suoi modelli linguistici di grandi dimensioni GPT (Generative Pretrained Transformer), GPT-2 e GPT-3.
  • 2022: OpenAI presenta ChatGPT, un front-end di GPT-3 che genera frasi complesse, coerenti e contestualizzate, e contenuti in risposta ai prompt degli utenti finali.

La notorietà e la popolarità acquisite da ChatGPT ha dato il via ad una serie di progetti finalizzati allo sviluppo di altre AI generative e il rilascio di prodotti a un ritmo incalzante, fino a giungere alle attuali release di Google Bard (ora Gemini), Microsoft Copilot, Bedrock di Amazon, Ernie Bit di Baidu, Pangu-Σ di Huawei, Claude di Anthropic, xAI di Elon Musk, Jais in lingua araba, Poe di Quora, IBM watsonx.ai, e ai modelli linguistici di grandi dimensioni (LLM) open source come Llama-2, di Meta, o Dolly 2.0 di Databricks e OpenChat AI GitHub.

Come Opera la Generative AI: Architetture, Processi e Metodologie di Apprendimento

Normalmente il ciclo di vita della Generative AI si sviluppa in tre fasi:

  • Formazione: la fase in cui si crea un “foundation model” [5] che possa servire come base per più applicazioni di AI di nuova generazione.
  • Ottimizzazione: la fase in cui si adatta il foundation model a una specifica applicazione AI di nuova generazione.
  • Generazione, valutazione e improvement: la fase in cui si valutano i risultati dell’applicazione della GenAI per migliorarne la qualità e l’accuratezza.

Formazione

La GenAI si fonda su un foundation model, un modello di deep learning che funge da schema per diversi tipi di applicazioni di AI generativa. I foundation model più comuni sono i modelli linguistici di grandi dimensioni (LLM), sfruttati nelle applicazioni per generare testo, ma esistono foundation model per generare immagini, video, audio e musica, oltre a foundation model multimodali in grado di supportare simultaneamente diversi tipi di contenuti.

Per realizzare un foundation model occorre addestrare un algoritmo di deep learning su enormi volumi di dati grezzi, non strutturati e non etichettati, spesso raccolti dalla rete internet o da altre fonti di dati. Durante la fase di training, l’algoritmo esegue e valuta milioni di test c.d.”fill in the blank” (riempimento dello spazio), cercando di prevedere l’elemento successivo in una determinata sequenza, per esempio la parola successiva in una frase, l’elemento successivo in un’immagine, il comando successivo in una riga di codice, e, contestualmente, effettua un auto-tuning per ridurre al minimo la differenza tra le previsioni e i dati reali (o il risultato “corretto”).

Il risultato di questo ciclo di training è una rete neurale di parametri, ovvero una serie di rappresentazioni codificate di entità, pattern e relazioni nei dati, in grado di generare contenuti in modo autonomo in risposta agli input o ai prompt ricevuti.

Questo processo si caratterizza per l’alta intensità di calcolo, un elevato dispendio in termini di tempo e costi: infatti richiede la presenza di migliaia di unità di elaborazione grafica (GPU) sottoforma di cluster e settimane di elaborazione. Fortunatamente sono disponibili progetti di foundation model open source, come Llama-2 di Meta, che consentono agli sviluppatori di GenAI di saltare questo passaggio e i relativi costi.

Ottimizzazione

Un foundation model è generalista, ovvero sa molte cose su molti tipi di contenuti, ma spesso non è in grado di generare tipi specifici di output con la precisione o la qualità desiderate. Per questo motivo è opportuno che il modello debba essere ottimizzato seguendo un’attività di generazione dei contenuti specifica. Questo obiettivo può essere raggiunto in vari modi:

  • attraverso una messa a punto del modello. Questa metodologia comporta l’alimentazione del modello con dati specifici dell’applicazione di generazione di contenuti, cioè, deve comprendere le domande o i prompt che molto probabilmente l’applicazione riceverà e le corrispondenti risposte corrette nel formato desiderato. Per esempio, se un team di sviluppo sta tentando di creare un customer service chatbot, creerà centinaia o migliaia di documenti contenenti domande etichettate sul servizio clienti con le risposte corrette e li invierà al modello.
  • tramite un apprendimento di rinforzo con feedback umano (RLHF). La metodologia di RLHF (Reinforcement Learning from Human Feedback) prevede che gli utenti umani rispondano ai contenuti generati con valutazioni che, successivamente, il modello utilizza per aggiornare sé stesso e ottenere maggiore precisione o rilevanza.

Generazione, valutazione e improvement

Di norma, sia gli sviluppatori che gli utenti valutano continuamente i risultati delle app di GenAI che utilizzano e, di conseguenza, ottimizzano ulteriormente il modello per ottenere una maggiore precisione o pertinenza.

Esiste un’altra alternativa per ottimizzare le prestazioni di un’applicazione di AI: la “retrieval augmented generation” (RAG). La RAG è un framework in grado di estendere il foundation model al fine di utilizzare un set di fonti rilevanti, al di fuori dei dati utilizzati nel training, capaci di integrare e perfezionare i parametri o le rappresentazioni nel modello originale. A riguardo, la RAG garantisce che un’app di AI generativa abbia sempre accesso alle informazioni più aggiornate e contestualizzate. Inoltre, le fonti aggiuntive a cui si accede tramite RAG, a differenza dei dataset del foundation model originale, sono trasparenti e verificabili.

Architetture dei Modelli di Generative AI: Tecnologie che Abilitano la Creatività Artificiale

Dal 2013 abbiamo assistito allo sviluppo di modelli di AI veramente generativa, ovvero modelli di “deep learning” in grado di creare autonomamente contenuti su richiesta. Le principali architetture evolute durante questo periodo includono:

  • Variational Autoencoders (VAE): rappresentano modelli che hanno consentito di effettuare scoperte rivoluzionarie nel riconoscimento delle immagini, nell’elaborazione del linguaggio naturale e nel rilevamento delle anomalie.
  • Generative Adversarial Networks (GAN) & Diffusion Models: sono architetture che hanno migliorato l’accuratezza delle applicazioni precedenti e hanno reso possibile le prime applicazioni di AI per la generazione di immagini da foto reali.
  • Transformers: rappresentano l’architettura dei modelli di deep learning alla base dei principali foundation model e delle soluzioni di AI generativa di oggi.

Variational Autoencoder

Un “autoencoder” è un modello di deep learning composto da due reti neurali connesse tra loro: una che codifica (o comprime) un’enorme quantità di dati, non strutturati e non etichettati, in parametri per il training e un’altra che decodifica tali parametri per ricostruire il contenuto. Tecnicamente, gli autoencoder sono in grado di generare nuovi contenuti, ma sono utilizzati prevalentemente per la codifica, l’archiviazione o il trasferimento dei dati e, infine, per la decodifica degli stessi e la generazione di contenuti di alta qualità.

Nel 2013 sono stati introdotti i “Variational Autoencoder” (VAE) che, oltre a codificare i dati come un autoencoder, sono in grado di decodificare i dati in diverse varianti di contenuto. Questa peculiarità ha permesso di addestrare i VAE a generare varianti per raggiungere un particolare obiettivo e, al contempo, consentire di ottenere nel tempo contenuti più accurati e ad alta fedeltà. Le prime applicazioni dei VAE includevano il rilevamento delle anomalie (per esempio, nella diagnostica per immagini) e la generazione del linguaggio naturale.

Generative Adversarial Network

Anche le “Generative Adversarial Network” (GAN), introdotte nel 2014, comprendono due reti neurali: una denominata Generatore, adibita a generare nuovi contenuti, e una Discriminatore, destinata a valutare l’accuratezza e la qualità dei dati generati. Questi algoritmi antagonisti inducono il modello a generare output di qualità sempre più elevata.

Solitamente le GAN vengono utilizzate per generare immagini e video, ma sono in grado di originare contenuti realistici e di alta qualità anche in altri domini. Si sono dimostrate particolarmente efficaci in determinate attività, come il trasferimento di stile (per esempio la modifica dello stile di un’immagine: da una foto a uno schizzo a matita) e l’aumento dei dati (creazione di nuovi dati per aumentare le dimensioni e la diversità di un data set di training).

Diffusion Model

Un “Diffusion Model”, anch’essi introdotti nel 2014, funziona in maniera differente. Questo modello, prima di realizzare il training, aggiunge rumore ai dati per renderli casuali e irriconoscibili, successivamente, addestra l’algoritmo a disperdere iterativamente il rumore per rivelare l’output desiderato.

I Diffusion Models richiedono più tempo per l’addestramento rispetto ai VAE o alle GAN, ma offrono un controllo dell’output più preciso; infatti, sono particolarmente sfruttati negli strumenti di generazione di immagini di alta qualità. DALL-E, lo strumento di generazione di immagini di Open AI, è guidato da un diffusion model.

Transformer

I “Transformer”, documentati per la prima volta in un articolo del 2017 pubblicato da Ashish Vaswani e altri, trasformano il paradigma encoder-decoder per realizzarne un’evoluzione, da un lato, del modo in cui i foundation model vengono addestrati e, dall’altro, nella qualità e nella gamma di contenuti che possono produrre. Questi modelli sono alla base dei principali strumenti di AI generativa, tra cui ChatGPT e GPT-4, Copilot, BERT, Bard e Midjourney.

Per determinare quali dati, all’interno di una sequenza, sono più importanti e su quali occorre concentrarsi, i transformer utilizzano un concetto chiamato “attention” in grado di:

  • elaborare contemporaneamente intere sequenze di dati (ad es. frasi invece di parole singole);
  • acquisire il contesto dei dati all’interno della sequenza;
  • codificare i dati di training in incorporamenti (denominati anche iperparametri) che rappresentano i dati e il loro contesto.

Oltre a consentire un addestramento più rapido, i transformer sono performanti nel l’elaborazione del linguaggio naturale (“Natural Language Processing”, NLP) e nella sua comprensione (“Natural Language Understanding”, NLU) e sono in grado di generare sequenze di dati più lunghe (ad esempio, non solo risposte a domande, ma anche poesie, articoli o documenti) con maggiore precisione e qualità rispetto ad altri modelli di AI generativa. I modelli transformer possono essere addestrati o ottimizzati anche per l’uso di tools, ad esempio un’applicazione di fogli di calcolo, un programma di disegno, o per generare contenuti in un formato particolare.

Peculiarità della Generative AI

L’AI generativa può essere utilizzata per creare molti tipi di contenuti in domini diversi.

  • Testo: I modelli generativi, soprattutto quelli basati sui trasformer, possono generare testi coerenti e contestualmente rilevanti, come delle istruzioni, della documentazione, una brochure, un’e-mail, dei testi per siti web, blog, articoli, delle relazioni, dei documenti e, persino, contenuti creativi. Possono eseguire compiti di scrittura ripetitivi o noiosi (per esempio, la stesura di riassunti di documenti o meta descrizioni di pagine web), consentendo agli editor di dedicarsi a lavori più creativi e di maggior valore.
  • Immagini e video: La generazione di immagini, come DALL-E, Midjourney e Stable Diffusion, può realizzare immagini realistiche, oppure opere d’arte originali, ed eseguire il trasferimento di stili, la traduzione image-to-image e altre attività di modifica o miglioramento delle immagini. Gli strumenti GenAI video possono creare animazioni a partire da istruzioni di testo e possono applicare effetti speciali a video esistenti in maniera più rapida ed economica rispetto ai metodi tradizionali.
  • Suono, parole e musica: I modelli generativi possono sintetizzare contenuti vocali e audio per farli sembrare reali alle chatbot e agli assistenti digitali a comando vocale, consentire la narrazione degli audiolibri e di altre applicazioni basate sull’audio. La stessa tecnologia può generare musica originale in grado di imitare la struttura e l’audio delle composizioni professionali.
  • Codice software: La GenAI può generare codice di programmazione originale, effettuare il completamento automatico dei frammenti di codice, tradurre tra diversi linguaggi di programmazione e riassumere le funzionalità del codice. Consente di ottenere prototipi, eseguire rapidamente il debug delle applicazioni e realizzare sessioni di testing, offrendo al contempo un’interfaccia in linguaggio naturale.
  • Design e arte: I modelli di AI generativa possono generare opere d’arte digitali e di design uniche o assistere nella progettazione grafica. Le applicazioni includono la generazione dinamica di ambienti, personaggi o avatar ed effetti speciali per realizzare simulazioni virtuali e videogiochi.
  • Simulazioni e artefatti: I modelli di AI generativa possono essere addestrati per generare dati o strutture basate su dati reali o virtuali. Per esempio, l’AI generativa viene applicata nella scoperta di farmaci per generare strutture molecolari con le proprietà desiderate, contribuendo alla progettazione di nuovi composti farmaceutici.

Quali sono i Vantaggi?

Il principale beneficio, e forse quello più scontato, dell’AI generativa è la maggiore efficienza. La sua capacità di generare contenuti e risposte alle domande consente di accelerare o automatizzare le attività ad alta intensità di lavoro, ridurre i costi e guadagnare tempo da dedicare ad attività di maggior valore.

L’AI generativa offre ulteriori vantaggi in questi ambiti:

  • Creatività migliorata: Gli strumenti di Gen AI possono ispirare la creatività attraverso il brainstorming automatizzato, perché gli consente di generare più versioni inedite dei contenuti. Queste varianti possono servire come punti di partenza o riferimenti per superare il blocco creativo di scrittori, artisti, designer e altri tipi di creatori.
  • Processo decisionale migliorato (e più rapido): L’AI generativa è predominante nell’analisi di grandi insiemi di dati, nell’identificazione degli schemi e nell’estrazione di insight significativi, per poi generare ipotesi e suggerimenti basati su questi insight e supportare i dirigenti, gli analisti, i ricercatori e tutti gli altri professionisti, nel prendere decisioni più corrette e basate sui dati.
  • Personalizzazione dinamica: L’AI generativa può analizzare le preferenze e la cronologia degli utenti per creare contenuti personalizzati in tempo reale, rendendo l’esperienza dell’utente più personalizzata e coinvolgente.
  • Disponibilità continua: L’AI generativa funziona in maniera costante e fornisce una disponibilità continua per le attività come le chatbots utilizzate per erogare l’assistenza ai clienti e le risposte automatiche.

Casi d’uso

Di seguito sono riportati, solo a titolo esemplificativo, alcuni casi d’uso dell’AI nel settore business, per comprendere quali benefici possono portare nel breve periodo. In tal senso, man mano che le tecnologie si svilupperanno ulteriormente e le organizzazioni incorporeranno questi tools nei loro workflow, assisteremo alla scoperta di nuove e altrettante applicazioni.

  • User experience (UX): Il settore marketing delle aziende può trarre grossi benefici, in termini di tempo e quantità di contenuti, utilizzando strumenti di AI per redigere i testi dei blog, delle pagine web, della documentazione, dell’e-mail e altro ancora. Inoltre, le soluzioni di AI generativa sono in grado di produrre testi e immagini fortemente personalizzate e in tempo reale, in base a quando, dove e a chi deve essere erogato l’annuncio. Inoltre, può alimentare le chatbots e gli agent virtuali per fornire risposte personalizzate e, persino, avviare attività per conto del cliente. Tutto ciò rappresenta un avanzamento significativo rispetto alla precedente generazione di modelli di AI conversazionali formati su dati limitati e sfruttati per attività molto specifiche.
  • Sviluppo software e aggiornamento delle applicazioni: Gli strumenti per la generazione del codice basati sull’AI generativa sono in grado di automatizzare e accelerare il processo di scrittura di nuovo codice. Questa caratteristica può essere sfruttata anche per accelerare drasticamente l’aggiornamento delle applicazioni, perché consentirebbe di automatizzare gran parte della codifica ripetitiva necessaria per rinnovare le applicazioni legacy e distribuire in ambienti di cloud ibrido.
  • Attività digitale: L’AI generativa è in grado di redigere o rivedere rapidamente contratti, fatture, bollette e altri documenti digitali, in modo tale che i dipendenti, che la utilizzano o la gestiscono, possano concentrarsi su attività di concetto.
  • Scienza, ingegneria e ricerca: I modelli di AI possono aiutare i ricercatori e gli ingegneri a proporre nuove soluzioni per problemi complessi. Nel settore sanitario, ad esempio, i modelli generativi possono essere applicati per sintetizzare le nuove molecole o migliorare la lettura delle immagini degli esami.

Nel prossimo articolo della serie, approfondiremo un aspetto cruciale della Generative AI: la sicurezza e la protezione. Esploreremo le sfide, i rischi e le migliori pratiche per implementare soluzioni di GenAI in modo sicuro e responsabile, analizzando i protocolli di sicurezza e le strategie di protezione necessarie per un utilizzo consapevole di questa potente tecnologia. Per approfondire queste tematiche è possibile scaricare gratuitamente il white paper completo “Generative Artificial Intelligence: Punti di forza, rischi e contromisure”.

Note bibliografiche

[1] AA.VV., The state of AI in 2023: Generative AI’s breakout year, https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai-in-2023-generative-ais-breakout-year, McKinsey, 2023

[2] Gartner Says More Than 80% of Enterprises Will Have Used Generative AI APIs or Deployed Generative AI-Enabled Applications by 2026, https://www.gartner.com/en/newsroom/press-releases/2023-10-11-gartner-says-more-than-80-percent-of-enterprises-will-have-used-generative-ai-apis-or-deployed-generative-ai-enabled-applications-by-2026, Gartner, 2024

[3] AA.VV., Generative Adversarial Networks, https://arxiv.org/abs/1406.2661, Universite de Montreal, 2014

[4] AA.VV., Attention Is All You Need, https://arxiv.org/abs/1706.03762, Google, 2017

[5] Foundation model: Nell’ambito dell’Intelligenza Artificiale, il termine modello identifica un insieme strutturato di algoritmi e parametri che permettono di eseguire specifici compiti di apprendimento automatico. I modelli sono addestrati tramite l’analisi e l’elaborazione di dati, al fine di identificare e apprendere schemi o relazioni tra di essi.

Un foundation model rappresenta un tipo specifico e avanzato di modello di Intelligenza Artificiale. Mentre i modelli generici sono progettati e addestrati per svolgere compiti specifici e ben definiti e possono essere addestrati su set di dati di dimensioni variabili, a seconda del compito che dovranno svolgere; i foundation models, invece, sono addestrati su enormi quantità di dati e con moltissimi parametri. Ciò permette loro di svolgere una varietà di compiti più ampia rispetto ai modelli tradizionali.
Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/generative-ai/


7-Zip 0-day was exploited in Russia’s ongoing invasion of Ukraine

Researchers said they recently discovered a zero-day vulnerability in the 7-Zip archiving utility that was actively exploited as part of Russia’s ongoing invasion of Ukraine.

The vulnerability allowed a Russian cybercrime group to override a Windows protection designed to limit the execution of files downloaded from the Internet. The defense is commonly known as MotW, short for Mark of the Web. It works by placing a “Zone.Identifier” tag on all files downloaded from the Internet or from a networked share. This tag, a type of NTFS Alternate Data Stream and in the form of a ZoneID=3, subjects the file to additional scrutiny from Windows Defender SmartScreen and restrictions on how or when it can be executed.

There’s an archive in my archive

The 7-Zip vulnerability allowed the Russian cybercrime group to bypass those protections. Exploits worked by embedding an executable file within an archive and then embedding the archive into another archive. While the outer archive carried the MotW tag, the inner one did not. The vulnerability, tracked as CVE-2025-0411, was fixed with the release of version 24.09 in late November.

Tag attributes of outer archive showing the MotW. Credit: Trend Micro

Attributes of inner-archive showing MotW tag is missing. Credit: Trend Micro

“The root cause of CVE-2025-0411 is that prior to version 24.09, 7-Zip did not properly propagate MoTW protections to the content of double-encapsulated archives,” wrote Peter Girnus, a researcher at Trend Micro, the security firm that discovered the vulnerability. “This allows threat actors to craft archives containing malicious scripts or executables that will not receive MoTW protections, leaving Windows users vulnerable to attacks.”

https://arstechnica.com/security/2025/02/7-zip-0-day-was-exploited-in-russias-ongoing-invasion-of-ukraine/


850,000 individuals impacted by Globe Life ransomware incident

An estimated 850,000 individuals have been affected by a ransomware attack on Globe Life, an insurance company. In 2024, the organization reported a cybersecurity incident after receiving an extortion message from an unknown threat actor, seeking financial payment in exchange for not disclosing data held by the company. The company launched its incident response plan and investigation shortly thereafter.

According to the initial report, the company believed the data in question is associated with customers and customer leads connected to its subsidiary, American Income Life Insurance Company, and may have included:

At the time of the report, the company estimated 5,000 individuals were impacted. However, new reports estimate that the incident affected 850,000 individuals. 

Thomas Richards, Principal Consultant, Network and Red Team Practice Director at Black Duck, comments, “The uncertainty regarding the number of individuals affected and data accessed in this breach should be concerning, especially since this is a pretty substantial breach with almost one million policy holders affected. Without having this information, the affected individuals may not have clarity on the best ways to protect themselves and their personal information. Although it is fortunate that no financial information was accessed, financial information is often the easiest to change in this kind of scenario. However, one cannot change their health-related data, date of birth, or social security number so it’s imperative that the affected individuals are notified as soon as possible to begin taking the necessary steps to protect themselves and their data.”

https://www.securitymagazine.com/articles/101354-850-000-individuals-impacted-by-globe-life-ransomware-incident


Hacker russi fruttano un bug 0-day di 7-Zip per distribuire SmokeLoader


Il team di Threat Hunting della Zero Day Initiative di Trend Micro ha individuato una campagna malware che sfruttava un bug 0-day di 7-Zip per distribuire il malware SmokeLoader.

La vulnerabilità, tracciata come CVE-2025-0411, consente a un attaccante di eludere i controlli del Mark-of-The-Web (MoTW), un meccanismo di protezione di Windows che blocca l’esecuzione automatica di script e applicazioni non riconosciute.

Quando un utente scarica un file dal web, la feature lo identifica come sospetto per evitare che venga eseguito accidentalmente. Il bug di 7-Zip consente di eludere questi controlli semplicemente incapsulando un archivio dentro l’altro: il programma infatti non propaga correttamente i controlli di MoTW anche agli archivi interni, dove gli attaccanti possono inserire script ed eseguibili senza preoccuparsi che vengano bloccati.

bug 7-Zip

La campagna per distribuire SmokeLoader

Per distribuire SmokeLoader servendosi del bug di 7-Zip, gli attaccanti hanno inviato email di phishing a diversi funzionari e dipendenti di organizzazioni ucraine. I messaggi chiedevano agli utenti di aprire il materiale allegato con una certa urgenza, senza specificare a cosa si riferisse.

Gli allegati erano dei file .zip che contenevano a loro volta un archivio creato ad hoc; questo sfruttava la manipolazione tipografica per eseguire degli attacchi omografici, nei quali cioè vengono usati caratteri speciali  “mascherati” da quelli classici.

Nel caso della campagna in esame, i cybercriminali hanno usato il carattere cirillico “Es” per camuffare l’archivio interno da file .doc; in questo modo, gli utenti ignari aprivano il file e consentivano così l’esecuzione dei contenuti dell’archivio senza i controlli MoTW.

Nel dettaglio, l’apertura del file portava all’esecuzione di un file .URL presente nell’archivio che puntava a un server controllato dagli attaccanti; questo, a sua volta, scaricava un altro file .zip che conteneva l’eseguibile di SmokeLoader mascherato da file .pdf. 

A quel punto, dopo aver aperto il file .pdf appena scaricato, SmokeLoader veniva installato sul dispositivo. Il malware è in grado di sottrarre dati, eseguire attacchi DDoS e minare criptovalute, oltre a scaricare nuovi moduli per potenziare le proprie attività.

Le vittime del bug di 7-Zip

Dietro la campagna ci sono diversi gruppi cybercriminali russi. Gli attacchi hanno colpito organizzazioni governative e non in Ucraina per scopi di cyberspionaggio. Tra le vittime ci sono , tra le altre, il Ministro della Giustizia, alcune aziende manifatturiere, una farmacia, una compagnia assicurativa e l’azienda di trasporti pubblici della nazione.

I ricercatori sottolineano che gli attaccanti hanno preso di mira organizzazioni di dimensioni ridotte, più piccole rispetto agli organi governativi solitamente presi di mira; il motivo è che queste realtà, pur essendo sottoposte a una pressione cyber molto intensa, spesso dedicano abbastanza attenzione alla sicurezza o non possiedono le capacità necessarie per proteggersi. “Queste organizzazioni minori possono diventare dei validi punti cardine per gli attaccanti per infiltrarsi in organizzazioni governative più grandi“.

Alcuni degli account compromessi usati nella campagna potrebbero essere stati ottenuti da attacchi precedenti ed è possibile che i nuovi account colpiti vengano usati in operazioni future. 

Come proteggersi

Il team di Trend Micro ha scoperto il bug lo scorso settembre e ha immediatamente avvertito Igor Pavlov, il creatore di 7-Zip. La vulnerabilità è stata risolta nella versione 24.09 del software, rilasciata il 30 novembre.

Oltre ad aggiornare il software alla versione risolutiva, i ricercatori consigliano di implementare misure di sicurezza stringenti per il controllo delle email, con tecnologie di filtraggio e anti-spam avanzate, e di istruire i dipendenti a difendersi dagli attacchi di phishing.

È inoltre necessario sfruttare l’URL filtering per bloccare l’accesso a domini malevoli, disabilitare l’esecuzione automatica dei file con origini non riconosciute e configurare i sistemi in modo che richiedano sempre all’utente il permesso esplicito per eseguire uno script o un’applicazione.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/02/05/hacker-russi-fruttano-un-bug-0-day-di-7-zip-per-distribuire-smokeloader/?utm_source=rss&utm_medium=rss&utm_campaign=hacker-russi-fruttano-un-bug-0-day-di-7-zip-per-distribuire-smokeloader


Sicurezza dei Big Data: Protezione e Innovazione nell’Era della Trasformazione Digitale

Dopo aver esplorato il ruolo dei Big Data e l’importanza dei Fast Data in contesti aziendali, ci concentriamo ora sulla “Sicurezza dei Big Data”. Questa tematica è cruciale nell’era della trasformazione digitale, dove la protezione dei dati è fondamentale per le aziende moderne. Questo è il terzo articolo della serie estratta dal white paper “Big e Fast Data: tra sfida per la sicurezza e privacy”, il prossimo articolo si focalizzerà sui “Fast Data: velocità e sicurezza in tempo reale”, analizzando i meccanismi che permettono alle aziende di rispondere prontamente alle sfide odierne.

L’importanza della Sicurezza dei Big Data nella Trasformazione Digitale

La sicurezza informatica si basa sull’analisi in tempo reale, sull’identificazione e sui modelli di comportamento per mantenere le reti sicure. Tutte queste informazioni cruciali possono essere fornite da grandi volumi di dati. L’utilizzo di piattaforme di analisi dei dati e di sicurezza informatica offre agli utenti un’analisi approfondita di un set di dati per fornire le migliori soluzioni di sicurezza complete[1].

Sicurezza dei Big Data: Combattere le Minacce Informatiche

La sicurezza informatica dei Big Data è importante per combattere le potenziali minacce in evoluzione e prevenire l’accesso non autorizzato adottando strategie innovative e identificando modelli in grado di mitigare un attacco. Il framework adotta l’apprendimento automatico profondo, l’intelligenza artificiale e altri metodi per restringere le ricerche e segnalare le minacce più velocemente. L’utilizzo dell’analisi dei dati per migliorare la postura di sicurezza informatica garantirà una protezione efficiente, coerente e affidabile.

Sicurezza Informatica Basata sui Dati: Protezione in Tempo Reale

L’utilizzo di misure di sicurezza informatica basate sui dati protegge inoltre l’infrastruttura da minacce nuove e in evoluzione, creando al contempo informazioni su come combattere questi attacchi in tempo reale. I Big Data nella sicurezza informatica come Sangfor Endpoint Secure possono aiutare a identificare gli attacchi zero-day, gli attacchi interni e vari malware all’interno del sistema prima che possano essere causati danni. Ne sono un esempio il monitoraggio della rete, la sicurezza del cloud, la sicurezza degli endpoint, il rilevamento delle minacce e altro ancora.

Le Sfide nella Gestione della Sicurezza dei Big Data

Tuttavia, con una tale quantità di dati da setacciare, mantenere un’efficace sicurezza informatica utilizzando i Big Data può essere difficile. Questo è il motivo per cui il framework deve garantire informazioni più piccole e fruibili per fornire una sicurezza efficace. Esploriamo di più su come i Big Data forniscono informazioni utili che possono migliorare la sicurezza informatica.

Trasformazione Digitale e Industria 4.0

Per creare valore aggiunto ed essere sempre più competitive sul mercato, le aziende di oggi devono necessariamente trovare un punto di incontro con le nuove tecnologie emergenti. Per far sì che ciò accada è necessario sviluppare ed intraprendere un percorso di trasformazione dei processi produttivi basata sull’utilizzo e implementazione delle tecnologie abilitanti per consentire la transizione da modello tradizionale a modello di industria 4.0.

Questo è un passaggio necessario nella gestione delle nuove richieste e complessità: i nuovi processi logistici, manutentivi e produttivi devono sincronizzarsi per far fronte alla crescente domanda di prodotti personalizzati e all’esplosione dell’e-commerce.

Tecnologie Abilitanti (KETs) nella Digital Transformation

“Le tecnologie abilitanti o KETs (Key Enable Technologies) sono strumenti, dispositivi e risorse che interagiscono tra loro e grazie all’interazione con la rete internet, consentono alle imprese di migliorare i processi e creare il valore aggiunto necessario per generare vantaggio competitivo”[2].

Il loro ruolo è di particolare importanza nel processo legato alla digital trasformation: l’integrazione e l’analisi dei dati messi a disposizione da questi strumenti si traducono in una maggiore produttività e migliore qualità del prodotto finito.

Per quel che concerne le tecnologie abilitanti legate al tema Industria 4.0, sono stati effettuati diversi studi e sono stati individuati nove progressi tecnologici riassumibili come segue:

  • Internet of Things (IoT) – La connessione di dispositivi alla rete per raccogliere e scambiare dati.
  • Big Data e Analytics – L’analisi di grandi volumi di dati permette di supportare decisioni strategiche, migliorando efficienza e sicurezza.
  • Cloud Computing – Fornitura di risorse IT su richiesta attraverso internet, garantendo flessibilità e scalabilità.
  • Cybersecurity – Tecnologie e strategie per proteggere i dati e le infrastrutture digitali.
  • Intelligenza Artificiale e Machine Learning – Algoritmi che permettono alle macchine di apprendere e prendere decisioni autonome.
  • Realtà Aumentata (AR) – Utilizzo di informazioni digitali sovrapposte alla realtà fisica per migliorare i processi.
  • Robotica Avanzata – Utilizzo di robot per automatizzare compiti complessi nelle linee di produzione.
  • Additive Manufacturing (Stampa 3D) – Creazione di oggetti tridimensionali attraverso la stampa additiva.
  • Simulazione e Modellazione Digitale – Utilizzo di modelli digitali per simulare processi produttivi e ottimizzare le operazioni.

Internet of Things (IoT) e Big Data: Una Sinergia Potente

L’Internet of Things (IoT), si riferisce a un insieme di tecnologie che consentono la connessione ad Internet di dispositivi centralizzati tramite sistemi integrati che interagiscono e comunicano tra loro[3]. Lo scopo di questo tipo di soluzione è essenzialmente quello di monitorare, controllare, trasferire le informazioni e intraprendere le azioni conseguenti.

Questo concetto rappresenta una possibile evoluzione dell’uso di Internet. Gli oggetti (o “cose”) diventano “intelligenti”, acquisendo la capacità di trasferire dati su sé stessi o estrapolando informazioni da altri.

Per “cose” ci si riferisce a categorie come impianti, macchinari, dispostivi e processi che interagendo con la rete si contraddistinguono dagli antecedenti per alcune funzionalità come identificazione, localizzazione, possibilità di elaborazione dei dati e di interagire con l’ambiente esterno. Questa nuova tipologia di oggetti prende il nome di Smart Objects.

Applicazioni dell’IoT e il Ruolo dell’Intelligenza Artificiale

IoT prende così campo trovando applicazione in diversi campi e aree: la domotica in termini di ambiente domestico intelligente, smart building, smart mobility, treni controllati da IoT, macchine di monitoraggio e sensori di movimento[4].

Tuttavia, oltre alla versatilità di applicazione, lo sviluppo dell’Internet of Things è dovuto alla possibilità di fusione con tendenze più innovative, favorendo il processo di digital trasformation nei vari settori. L’interesse delle aziende per le start-up dell’IoT è cresciuto in modo esponenziale, alimentando un ciclo virtuoso di collaborazione e innovazione. A livello globale sono in aumento i finanziamenti ed investimenti per nuove iniziative imprenditoriali in diversi contesti applicativi quali: smart city, smart home, smart agricolture. Di particolare importanza e attualmente molto discusso nel binomio startup – IoT è il concetto di smart energy, con tutte le varie strategie e proposte sostenibili per implementare l’efficienza energetica di edifici e impianti industriali.

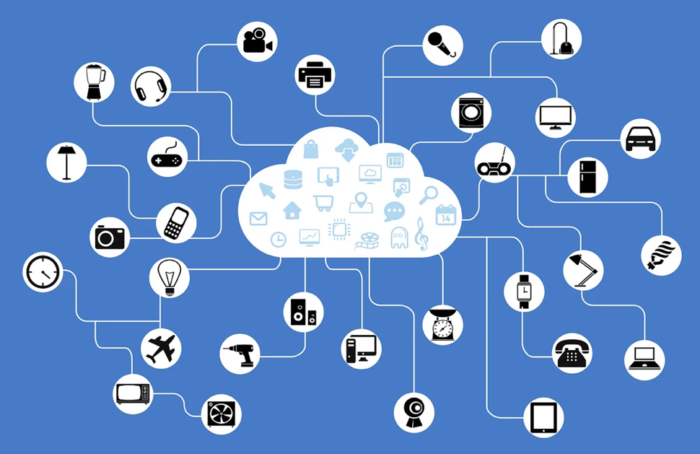
I dispositivi di Internet of Things (IoT), come precedentemente detto, sono utilizzati in molti settori (sanitario, edile, automobilistico, ferroviario, ecc.) e per tanti aspetti, rappresentano un movimento rivoluzionario in termini di potenzialità e servizi per gli utenti finali. dall’altra parte, il mondo dell’intelligenza artificiale è legato alla qualità dei dati utilizzati per “l’addestramento” di modelli e algoritmi: è necessario disporre di una fonte attendibile per intraprendere questo tipo di configurazione dei dati (figura 2).

Una soluzione possibile a questo problema potrebbe essere l’utilizzo congiunto di queste due tecnologie, consentendo a questi due mondi di trarre beneficio l’uno dall’altro, andando a creare una sinergia che andrà rappresentando il futuro dell’Innovation Technologies. Infatti, l’IoT implementa il valore dell’IA attraverso l’incremento della connessione e data Exchange, mentre l’IA aumenta il valore dell’IoT con l’apprendimento automatico (attraverso l’estrapolazione e traduzione dei dati da altri dispositivi in informazioni utili).

Convergenza tra IoT e Big Data: Opportunità di Crescita per le Aziende

Esiste una correlazione quasi naturale tra le tecnologie IoT e i Big Data. In effetti, i primi creano grandi quantità di dati grezzi, mentre i secondi forniscono le operazioni per analizzare, filtrare e ordinare quei dati al fine di estrarvi. Pertanto, la convergenza di IoT e Big Data è un potente strumento che le aziende possono utilizzare per diversi scopi. Ad esempio, nelle città intelligenti, i dati raccolti dai sensori distribuiti territorialmente sono un prezioso patrimonio da cui è possibile trarre tutti i tipi di informazioni, dalla congestione del traffico alla gestione dell’affluenza nei parcheggi.

La convergenza dell’Internet of Things e dei Big Data è senza dubbio parte integrante dell’Industria 4.0: gli oggetti connessi e installati nelle aziende trasmettono dati relativi alla loro stessa operatività e all’ambiente che li circonda, fornendo una vasta gamma di funzionalità che si propagano dal monitoraggio dei lavoratori al controllo stesso delle macchine[5].

Questa convergenza, pilastro sul quale si basa l’industria 4.0, viene definita anche Cyber-Physical Convergence, poiché nasce e si concretizza tramite un continuo scambio dati tra l’ambiente fisico e virtuale.

Valorizzare la Fusione di Tecnologie per un’Industria 4.0 Competitiva

Le aziende, stanno provvedendo a valorizzare questa fusione di tecnologie, ed oggi accade secondo 5 diverse modalità tra cui:

  • Ottimizzazione dei processi: metodo più intuitivo per valorizzare i dati raccolti all’interno di un’azienda. Apporta benefici in termine di riduzione dei costi e maggiore efficacia nel servizio al cliente.
  • Nuova generazione di prodotti e servizi: i dati raccolti contribuiscono allo sviluppo di nuove versioni, in modo da correggerne i difetti e migliorarne le funzionalità.
  • Personalizzazione di prodotti e servizi: sulla base di una grande quantità di dati raccolti, le aziende possono implementare i processi produttivi, avviando delle operazioni volte alla personalizzazione del prodotto, in modo da soddisfare sempre di più le esigenze del cliente.
  • Monetizzazione dei dati: i dati possono anche essere venduti a terzi in modo da creare nuovi fonti di guadagno e diversificare le entrate.
  • Pubblicità: grazie alla rete e alla profilazione di dati è possibili trasmettere annunci pubblicitari mirati sui device degli utenti.

Il Cloud Computing: Un Modello per la Sicurezza e l’Efficienza dei Dati

“Il cloud computing è un modello che, attraverso internet, permette di accedere convenientemente da qualsiasi posizione, su richiesta e in qualsiasi momento a un pool di risorse IT condivise e configurabili”[6].

Il cloud computing trasforma l’uso delle tecnologie informatiche in un “servizio” offerto.

Un fornitore terzo, responsabile della gestione dell’infrastruttura, lascia il cliente libero di utilizzare le funzionalità di cui è realmente interessato, imponendo un canone basato sull’effettivo consumo di tale tecnologia.

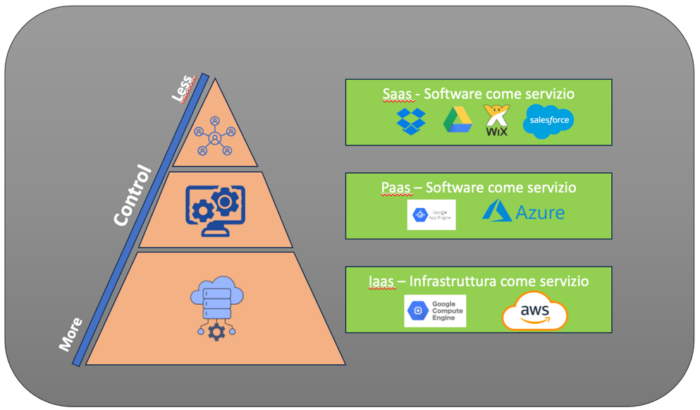
Esistono tre principali tipi di cloud computing[7] (figura 3):

  • Infrastructure as a Service (IaaS): è un servizio di cloud che garantisce agli utenti la massima autonomia. In questo caso l’utente può utilizzare le risorse di base messe a disposizione dal provider, come server e unità di archiviazione, che potrà poi personalizzare liberamente, modificando le componenti, in base alle necessità.
  • “Platform as a Service (Paas): è un servizio di cloud computing che fornisce agli utenti un ambiente cloud in cui possono sviluppare, gestire e distribuire applicazioni. Oltre allo storage e ad altre risorse informatiche, gli utenti possono utilizzare una serie di strumenti predefiniti per sviluppare, personalizzare e testare le proprie applicazioni”[8].
  • “Software as a Service (SaaS): Un servizio di cloud computing che fornisce agli utenti l’accesso al software cloud di un provider.”[9] Gli utenti non installano app sui propri dispositivi locali. L’applicazione risiede invece su una rete cloud remota a cui si accede tramite il Web. Con questa applicazione, gli utenti possono archiviare e analizzare i dati e collaborare ai progetti.

I Principali Vantaggi del Cloud Computing per le Aziende

I principali vantaggi derivati dall’utilizzo del Cloud sono:

  • Elasticità: il Cloud Computing offre elevati livelli di scalabilità (rapida espansione e contrazione dell’infrastruttura) e tariffe (Pay as you go) che permettono di pagare solo in base al consumo effettivo;
  • Risparmio sui costi: non necessita di investimenti da ammortizzare negli anni, ma solo di costi operativi d’esercizio;
  • Gestione del rischio integrata: il cloud provider diventa responsabile della sicurezza, protezione e ripristino dei dati che sono stati a lui affidati;
  • Device & Place Independence: possibilità di accesso ad applicazioni e dati indipendentemente dal dispositivo che si utilizza o dal luogo nel quale ci si trova[10].
Sicurezza dei Big Data: Ecosistema dell'Internet of Things
Figura 2. Ecosistema dell’Internet of Things
Sicurezza dei Big Data: Differenze tra Saas, Paas, Iaas nel Cloud Computer
Figura 3. Differenze tra Saas, Paas, Iaas nel Cloud Computer

Ti invitiamo a leggere il prossimo articolo della serie, che sarà dedicato ai “Fast Data: velocità e sicurezza in tempo reale”. Per approfondire ulteriormente questi temi, puoi scaricare liberamente e gratuitamente il documento completo intitolato “Big e Fast Data: tra sfida per la sicurezza e privacy“.

Note e Biografia:

[1] Hogan M. and A. Sokol. “NIST Cloud Computing Standards Roadmap Version 2.” NIST Cloud Computing Standards Roadmap Working Group, NIST Special Publications 500-291, NIST, Gaithersburg, MD, 2013, p.1-113

[2] Ransomtax. “Credito d’imposta formazione 4.0: le tecnologie abilitanti del piano”.

[3] Chen, Deyan, and Hong Zhao. “Data security and privacy protection issues in cloud computing.” 2012 international conference on computer science and electronics engineering. Vol. 1. IEEE, 2012.

[4] Alwi, Najwa Hayaati Mohd, and Ip-Shing Fan. “E-learning and information security management.” International Journal of Digital Society (IJDS) 1.2 (2010): 148-156.

[5] Li, Yuchong, and Qinghui Liu. “A comprehensive review study of cyber-attacks and cyber security; Emerging trends and recent developments.” Energy Reports 7 (2021): 8176-8186.

[6] Open Cloud Fastweb. “Open Cloud. Cos’è il Cloud Computing: 5 caratteristiche”. Open Cloud Fastweb Link in bibliografia.

[7] “Big Data: The Risks of the Concentration of Power Over Information and the Possible Remedies).” Diritto dell’informazione e dell’informatica (2012): 135.

[8] context.reverso.net | sviluppare e distribuire applicazioni – Traduzione in francese – esempi italiano | Reverso Context. Link in bibliografia.

[9] IBM. “Confronto tra IaaS, PaaS e SaaS – Italia”. IBM. Link in bibliografia

[10] Pagnanelli V. “Conservazione dei dati e sovranità digitale. Una rilettura della (big) data governance pubblica alla luce delle nuove sfide globali.” Rivista italiana di informatica e diritto 3.1 (2021): 11-26.

Profilo Autore

É un esperto di sicurezza informatica, con una formazione che combina conoscenze giuridiche e tecniche. Ha conseguito una laurea triennale in Operatore Giuridico di Impresa presso l’Università degli Studi de L’Aquila, seguita da una laurea magistrale in Giurisprudenza presso l’Università Telematica Pegaso. La sua formazione si arricchisce di quattro master: uno in Criminologia e Studi Forensi, uno in Programmazione e Sviluppo Backend e Frontend, un master in Cybersecurity presso l’Ethical Hacker Academy, e un master di II livello in Homeland Security presso l’Università Campus Bio-Medico di Roma.

Grazie a diverse certificazioni EIPASS, tra cui quella di Data Protection Officer (DPO/RDP), e licenze OPSWAT, ha acquisito competenze avanzate in sicurezza delle reti, protezione delle infrastrutture critiche e gestione dei dati. La sua passione per il mondo informatico e tecnologico e il costante aggiornamento professionale lo hanno reso un punto di riferimento nel settore, incluse aree emergenti come l’intelligenza artificiale.

È autore di due pubblicazioni scientifiche: “Contrasto al Terrorismo: La Normativa dell’Unione Europea” e “La Cyber Security: La Riforma Europea in Materia di Cybersicurezza ed il Cyber- Crime”, entrambe edite da Currenti Calamo.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-dei-big-data-2/


CISA’s communications guidance: A wake-up call for all industries

In late 2024, it became clear that the intensity of state sponsored attacks on the network infrastructure critical to both public and private organizations has reached unprecedented levels, with potentially extreme consequences. Earlier in the July, CrowdStrike exposed how even minor, innocent errors can lead to major disruption. So it is no real surprise that by the end of December, following the discovery of the Salt Typhoon compromise, that the then White House Deputy National Security Advisor for Cyber, Anne Neuberger, announced that the United States would follow the United Kingdom and Australia in implementing enhanced security and resilience regulations. These regulations recognize the critical role of the telecommunications sector, noting “the nation’s secrets and the nation’s economy” depend upon it.  

Throughout December and into January, the U.S. government agencies and Communications Service Providers (CSPs) were working urgently to address the Salt Typhoon attacks which compromised major telco networks. However, the threat extends beyond telcos to all organizations — and in many cases the groundwork may already be in place. Anne Neuberger underscored this urgency by naming the critical steps organizations must implement, including improving configuration management for network devices and enhancing vulnerability management. These measures are no longer optional — they are essential. 

Calls for urgent change: Defending against heightened threats

The stakes could not be higher. Volt and Salt Typhoon attacks date back as far as 2022, even though they were only recently discovered. This means state-sponsored threat groups have had the potential, at any time, to control Critical National Infrastructure networks and extract sensitive data, including information from health and financial sectors. As a result, for the first time in a decade, new rules for protecting healthcare data are also being introduced across the U.S.

Beyond this, Salt Typhoon highlights the deep threat of intellectual property theft affecting industries from aerospace to media and entertainment, along with the surge in ransomware and extortion threats that is impacting these sectors too.

Moving forward: Leveraging new guidance

In response to these escalating threats, the Cybersecurity and Infrastructure Security Agency (CISA), alongside the NSA, FBI and their Five Eyes counterparts has issued guidance for telecommunications infrastructure defenders. The guidance emphasizes five key areas: network visibility, access control, segmentation, change detection and configuration management. These principles are critical not just for CSPs but for any organization with on-premise enterprise equipment. 

Enhancing operational resilience: Four key practices

Aligned with CISA’s guidance, the following four actionable steps are foundational for strengthening defenses and building organizational resilience and recoverability. 

Segment networks to contain breaches

Network Segmentation — both macro and micro — is a proven strategy to prevent or delay attackers from moving laterally within a system. Begin by identifying critical systems and data, isolating them from enterprise IT networks using least privilege access. Enforce segmentation by monitoring all network and user change against approved whitelists and flagging anomalies in traffic. Effective segmentation can mean the difference between a manageable incident and a catastrophic failure.

Achieve full network visibility to identify anomalies

Without a comprehensive view of your network’s architecture, configurations, access controls and activity, defending it is nearly impossible. Continuous visibility allows organizations to establish baselines, differentiate between planned and unplanned changes, and quickly identify anomalies or indicators of compromise.

Assess risk exposure to known industry attacks

Organizations must understand and monitor their exposure to known attack vectors specific to their organization or industry. Continuously assess and prioritize vulnerabilities — whether configuration or software — based on their relevance to these attack vectors. Focus remediation efforts on the most critical risks to reduce the attack surface effectively.  Advanced risk exposure monitoring solutions are essential for achieving this. 

Maintain accurate CMDBs to aid business continuity and disaster recovery

Relying on network devices themselves as the ‘source of truth’ for their configurations introduces significant risk — especially in disaster recovery scenarios. Accurate, up-to-date Configuration Management Databases (CMDBs) are critical for roll-back and recovery, root cause analysis and business process improvement. Automating CMDB updates ensures all changes — planned or unauthorized — are documented, enabling swift recovery and preventing new exposure risks. 

Maintaining economic security and prosperity: Network readiness, resilience & recoverability

By implementing these practices, organizations can improve their network readiness, resilience and recoverability. These measures not only safeguard critical systems and data but also enable CSPs and other CNI providers to fulfil their role in maintaining national security and economic prosperity. 

https://www.securitymagazine.com/articles/101359-cisas-communications-guidance-a-wake-up-call-for-all-industries


Securing property in wildfire-prone areas: 5 ways to reduce risks

Wildfire

Malachi Brooks via Unsplash

By most accounts, the ferocious wildfires that devastated Southern California in January created hundreds of billions of dollars in damages. As residents and business owners throughout the region begin to recover, they will need to answer a crucial question: Is it worth it to rebuild in the same area?

For security professionals and the firms who employ them, a different question has emerged: How do they protect their businesses and employees when the next natural disaster strikes?

Fortunately, there are extra steps private security companies that conduct operations in disaster-prone areas can take to protect their employees and insulate their firms from potential damages.

Establish iron-clad contracts

Firm principals who operate in disaster-prone areas should consider regular consultations with their attorneys to assess potential liability for any losses or claims they cannot prevent. Wildfires and hurricanes are mostly considered acts of God by insurers. Even if a wildfire’s origin was intentional, the forces of nature — such as Santa Ana winds, in the case of the Los Angeles wildfires — contribute to the bulk of the spread and, therefore, the brunt of the damages.

For these reasons, it is nearly impossible for a security firm and its employees to prevent wildfire damage to an estate or business they are hired to protect. While firms are not likely to be held liable, firm principals can ask their attorney to review all contracts and add clear language that indemnifies the firm and employees from liability in the event of a natural disaster. 

Develop precise post orders — and stick to them

All firms should consider regular updates and maintenance to post orders. Such updates can include details on employees’ specific duties, including steps to take in the event of an emergency. Doing so will help prepare security professionals for any unexpected harsh weather conditions.

Just as important is ensuring guards are prepared for what might happen in the minutes and hours following a catastrophic weather event. In the days after a hurricane, for example, clients may be prone to take an all-hands-on-deck approach, asking security professionals to cut tree limbs, move heavy objects or make minor home repairs. While these actions may seem helpful in the moment, they are tasks that security guards are not properly trained to do, they may cause further damage and expose your firm to liability that you do not have insurance for and/or they may be injured themselves exposing your firm to workers’ compensation claims.

Keep your employees out of harms’ way

As many Los Angeles-area homeowners unfortunately learned in January, arson and looting are two despicable side effects that occur in the aftermath of a wildfire. Looting is also common after hurricanes. To protect their property from theft or additional damage in these critical hours, property owners may ask security guard professionals to secure their estate from intruders and malicious actors. Private security firms should consider instructing employees to avoid ad-hoc assignments at all costs. These activities put employees in danger and expose firms to potential workers’ compensation claims.

Secure your firm’s property

While clients hire your firm to protect their property, you also have first-party liability for any equipment your firm and its employees use in their day-to-day work. This may include a guard station or mobile office, any drones or surveillance systems, or security patrol vehicles. As such, your firm and employees are responsible for moving equipment out of the path of potential danger. Moving property to protect it can be as simple as moving patrol cars inland and off a barrier island in the event of an oncoming hurricane or boarding up guard stations to minimize potential damage.

Prepare your employees for what comes next

For property owners, the cleanup process following a natural disaster is long and hard, often filled with a cavalcade of emotions. Prepare your employees by providing training on how to maintain safety and order while simultaneously offering reassurance and responding to impacted property owners with empathy. Additionally, it is important to assess your staff’s mental and physical readiness to return to duty. An employee with asthma, for example, should not be tasked with securing property in or around a wildfire, especially considering that flare-ups can happen weeks, months or even longer after a major disaster. 

Rebuild and refocus

Whether or not your firm — or its guards — were impacted directly by the Southern California wildfires, all private security firms can use this most recent weather-related catastrophe as a learning lesson. It is vital to take proactive steps to strengthen contracts and protect employees. Working with the right professional, such as a specialty insurer or attorney can help identify gaps in contracts and post orders or pinpoint potential actions that will leave you liable. Such professionals can also make recommendations on how to word post orders to minimize risk and properly prepare your own property to mitigate first-party liability. Acting now can help you respond appropriately if and when a natural disaster occurs near your clients’ properties.

https://www.securitymagazine.com/blogs/14-security-blog/post/101356-securing-property-in-wildfire-prone-areas-5-ways-to-reduce-risks


39 cybercrime domains seized, linked to HeartSender cybercrime group

Law enforcement agencies from the United States and the Netherlands have dismantled 39 cybercrime domains and associated servers. These domains were a part of a Pakistan-based network of marketplaces selling tools to enable fraud and hacking. The network was operated by a group called Saim Raza, also known as HeartSender. 

The tools sold (such as phishing toolkits) enabled transnational organized crime groups to target numerous U.S. victims, primarily with business email compromise (BEC) attacks. 

Below, security leaders discuss the operation, the takedown, and its implications.

Security leaders weigh in 

J. Stephen Kowski, Field CTO at SlashNext Email Security+:

The takedown of HeartSender reveals how cybercrime has evolved into a sophisticated service industry, where even non-technical criminals can easily purchase and deploy advanced phishing tools to target businesses. While this operation marks a significant victory against BEC infrastructure, the $3 million in documented losses highlights only a fraction of the financial damage these automated phishing operations can inflict on organizations. Real-time detection and blocking of suspicious URLs, combined with AI-powered analysis of communication patterns, remains crucial as cybercriminals will inevitably attempt to fill the void left by this disrupted marketplace. The key to preventing future attacks lies in implementing advanced email security that can identify and stop social engineering attempts before they reach potential victims, especially since BEC attacks continue to evolve and become more sophisticated.

Darren Guccione, CEO and Co-Founder at Keeper Security:

Operation Heart Blocker highlights the ongoing threat of BEC phishing schemes and why proactive cybersecurity measures to protect organizations against social engineering attacks are essential. This takedown disrupted a network of fraud-enabling marketplace that provided phishing kits and credential-stealing tools, fueling large-scale BEC attacks since at least 2020 and causing millions in losses. The fact that these tools were readily available — complete with instructional videos — shows how cybercriminals are making it easier than ever to launch phishing attacks, even for non-technical threat actors.

BEC and other phishing attacks thrive on weak authentication and poor access controls. Organizations should enforce least privilege access and enable Multi-Factor Authentication (MFA) on all accounts that have it available. Implementing Privileged Access Management (PAM) allows organizations to monitor and secure their most sensitive, critical accounts. Cybercriminals exploit phishing, credential stuffing and malware to infiltrate systems, making real-time continuous monitoring another critical component to any cybersecurity defense. To stay ahead, organizations should leverage dark web monitoring to detect compromised credentials, enforce strict authentication policies and continuously update their security frameworks to combat BEC, phishing kits and other evolving cyber threats.

Heath Renfrow, CISO and Co-founder at Fenix24:

While I commend law enforcement and all involved in Operation Heart Blocker for their successful efforts in dismantling a key cybercriminal network, it will have minimal impact on slowing the larger cybercrime epidemic that continues to escalate. For every criminal group disrupted, multiple others remain active or emerge to take their place.

BEC remains one of the most widespread and financially devastating cyber threats, yet it garners far less public attention compared to ransomware. The reason? Unlike ransomware, which creates immediate operational disruptions that force victims to disclose incidents, BEC fraud is often quietly absorbed by organizations as a financial loss. Companies may be reluctant to report these crimes due to reputational concerns or because the stolen funds are often unrecoverable, leaving little incentive for public disclosure.

https://www.securitymagazine.com/articles/101352-39-cybercrime-domains-seized-linked-to-heartsender-cybercrime-group


54% of cyber leaders say budget constraints are a top challenge

Fortra has published its 2025 State of Cybersecurity survey, revealing insights into the biggest threats on cyber experts’ radars. More than 400 cybersecurity experts across industries were surveyed, including those from the United States, Canada, Europe, Asia, Latin America, the Middle East, the Caribbean, Australia, and New Zealand. 

Over the next six months, respondents predict the top cyber threats will be: 

  • Phishing (81%)
  • Ransomware and malware (76%)
  • Unintentional data loss (63%)
  • Social engineering (55%) 
  • Third-party risks (52%)

Other threats were listed, such as zero-day attacks (50%), talent shortage (39%), evolving technology (35%), digital risk (32%), and business email compromise (BEC) attacks (19%). 

The survey also reveals the top five cybersecurity initiatives for the year. These include minimizing outsider threats like malware or phishing (74%), identifying and closing security gaps (73%), improving security culture (66%), boosting cloud security (63%), and improving compliance (62%). These top five initiatives are followed by enhancing security skills (58%), minimizing insider threats (44%), improving supply chain security (36%), and consolidating tools (25%). 

Respondents identified the top three obstacles to their initiatives, citing budget constraints (54%), the constant evolution of threats (45%), and inadequate security skills (45%). 

https://www.securitymagazine.com/articles/101350-54-of-cyber-leaders-say-budget-constraints-are-a-top-challenge


Cyber Crime Conference 2025, partecipa il 16 e 17 aprile a Roma

Siamo lieti di annunciare la Cyber Crime Conference 2025, un evento d’eccellenza dedicato ai protagonisti della sicurezza informatica e ai decisori strategici, che si terrà il 16 e 17 aprile a Roma. Questa manifestazione rappresenta un’opportunità unica per esplorare in profondità le sfide e le innovazioni nel contrasto al cybercrime, con un approccio multidimensionale che integra prevenzione, investigazione e azione giudiziaria.

Cyber Crime Conference, un Palcoscenico per l’Eccellenza e l’Innovazione

Le due giornate di evento vedranno la partecipazione di personalità di spicco a livello internazionale e nazionale. Interverranno rappresentanti istituzionali, massimi rappresentanti del sistema giudiziario e leader della cybersecurity. Tra i momenti clou, la tavola rotonda “Il Modello Italiano di Contrasto al Cybercrime: dalla Prevenzione all’Azione Giudiziaria” offrirà una panoramica integrata delle strategie di difesa, con interventi di eminenti esperti tra cui Giovanni Melillo, Procuratore nazionale antimafia e antiterrorismo; Pasquale Stanzione, Garante per la protezione dei dati personali; Bruno Frattasi, Direttore dell’Agenzia per la Cybersicurezza Nazionale (ACN); Luigi Birritteri, Capo del Dipartimento per gli affari di Giustizia.

La conferenza si distingue per l’approfondimento di temi tecnici e strategici, dall’analisi delle architetture cognitive per la previsione delle minacce alla sicurezza degli ecosistemi IoT, fino a sofisticate metodologie di contrasto al cybercrime nella supply chain del software. Relatori di fama internazionale illustreranno anche le implicazioni emergenti legate a crittografia end-to-end, media sintetici e persino le vulnerabilità nei sistemi di distribuzione quantistica.

Percorsi Tematici all’Avanguardia durante la 13a Cyber Crime Conference

  • Architetture Cognitive e Threat Imagination: Un’analisi delle sinergie tra processi cognitivi e intelligenza artificiale per anticipare e neutralizzare le minacce.
  • Internet of Offensive Things: Approfondimenti sulle modalità con cui dispositivi smart possono essere sfruttati come armi in scenari di cyber attacco su larga scala.
  • Sovranità Digitale e Collaborazione Internazionale: Dibattiti sulle dinamiche tra autonomia nazionale e cooperazione transnazionale, essenziali per una difesa cyber integrata.
  • Innovazioni Tecnologiche e Normative: Esplorazione dei limiti e delle opportunità offerti dalla crittografia avanzata, dalla blockchain e dai nuovi paradigmi regolatori, come evidenziato dalla recente Legge 90/2024.

Networking e Opportunità di Business

Oltre ai momenti di confronto, la conferenza prevede spazi dedicati al networking e un’area espositiva dove le eccellenze del settore presenteranno soluzioni e tecnologie all’avanguardia. Business lunch e sessioni di interazione informale faciliteranno il dialogo tra top management, esperti di cybersecurity e rappresentanti istituzionali, creando un terreno fertile per collaborazioni e innovazioni future.

Invito alla Partecipazione

La Cyber Crime Conference 2025 è l’appuntamento imprescindibile per chi opera nel settore della cybersecurity e per il top management interessato a comprendere e anticipare le dinamiche del crimine informatico. La partecipazione a questo evento vi permetterà di confrontarvi direttamente con esperti di spicco e di acquisire strumenti e conoscenze strategiche per rafforzare la resilienza delle proprie organizzazioni in un contesto digitale sempre più complesso e interconnesso.

La partecipazione all’evento è gratuita, ISCRIVITI ORA per non perdere l’opportunità di essere parte di questo importante momento di innovazione e dialogo. Per informazioni dettagliate e modalità di registrazione, visita il sito web: https://www.ictsecuritymagazine.com/eventi/cybercrimeconference2025

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/cyber-crime-conference-2025/