Simplify your security toolkit


h3 {font-weight: bold;font-size: 18px;color: #C72026;}
.w3-panel:after,.w3-panel:before{content:””;display:table;clear:both}
.w3-panel{padding:5px;margin-top:16px;margin-bottom:16px}
.w3-card{box-shadow:0 2px 5px 0 rgba(0,0,0,0.16),0 2px 10px 0 rgba(0,0,0,0.12)}

As threats continue to emerge and develop, organizations find themselves spending more and more to protect themselves. This often leads to tool sprawl as organizations add on protections without considering how they’ll work together. How do security leaders manage tool sprawl? What threats do security leaders need to worry about?

Answer these questions and more with Corey Nachreiner, Chief Information Security Officer at WatchGuard.

The Security Podcasts logo

Simplify your security toolkit

What threats do security leaders need to worry about? Answer this question and more with Corey Nachreiner, CISO at WatchGuard.

Listen to more from The Security Podcasts.

Or check it out on our Apple Podcasts or Spotify channels. Don’t forget to like, follow, and rate and review our podcasts! 

https://www.securitymagazine.com/articles/101335-simplify-your-security-toolkit


DeepSeek: What to know about the Chinese artificial intelligence model

A Chinese startup, DeepSeek, has announced its latest AI model. Below, cyber experts discuss the implications of DeepSeek’s emergence and capabilities. 

What is DeepSeek? 

DeepSeek is an open-source large language model (LLM). DeepSeek’s AI Assistant (also called R1) claims to operate at a lower cost than United States models, such as OpenAI. Furthermore, the application reached the top-rated free application on the Apple App Store in the United States, surpassing ChatGPT.

Technology stocks dropped as a result. Many U.S. tech companies faced financial losses, including AI company Nvidia, whose loss amounted to $593 billion. This marks a single-day record loss for any company on Wall Street. 

Steve Povolny, Senior Director of Security Research & Competitive Intelligence at Exabeam, shares, “The release of Chinese-developed DeepSeek has thrown U.S. tech markets into turmoil; this is both justifiable and also perhaps, a bit overblown. The emergence of a technology that ultimately optimizes chip usage and efficiency is likely to apply pressure on existing large chip vendors, which is a very good thing. As the adage goes, ‘Pressure yields diamonds.’ In this case, I believe competition in this market will drive global optimization, lower costs, and sustain the tailwinds AI needs to drive profitable solutions in the short and longer term.”

Why is the security industry talking about DeepSeek? 

Gal Ringel, Co-Founder and CEO at Mine, explains, “The emergence of Chinese alternatives to ChatGPT, Deepseek, poses a critical security challenge for U.S. businesses that extends beyond previous concerns about consumer data privacy; it expands to the potential exposure of proprietary business information, trade secrets, and strategic corporate information. Just as TikTok raised red flags about personal data exposure, DeepSeek’s AI tools apply the same rules of risk to sensitive corporate information. Organizations must now urgently audit and track their AI assets to prevent potential data exposure to China. This isn’t just about knowing what AI tools are being used; it’s about understanding where company data flows and ensuring robust safeguards are in place so it doesn’t inadvertently end up in the wrong hands. The parallels to TikTok are striking, but the stakes may be even higher when considering the potential exposure of business data ending up in adversarial hands.”

Cyberattacks against DeepSeek: What are the implications? 

As DeepSeek has risen in prominence and popularity, it has also experienced cyberattacks that caused it to limit registrations. 

Toby Lewis, Global Head of Threat Analysis at Darktrace:

The reported cyber-attack on DeepSeek likely falls into one of several scenarios, with the most probable being simply a victim of their own success — what we in tech circles call the ‘Slashdot effect,’ where their infrastructure buckled under unexpected user demand following their viral moment on the App Store.

However, we shouldn’t dismiss security concerns. Given the rapid deployment of their platform, there’s a real possibility that opportunistic cybercriminals identified and exploited potential vulnerabilities that more established platforms have had time to address. 

This incident serves as another reminder that security cannot be an afterthought — it must be woven into the very foundations of these systems from the outset. As AI platforms continue to scale rapidly and handle increasingly sensitive data, robust security frameworks aren’t just nice to have features, they’re essential.

Stephen Kowski, Field CTO at SlashNext Email Security+:

The surge in DeepSeek’s popularity, particularly overtaking ChatGPT on Apple’s App Store, naturally attracts diverse threat actors ranging from hacktivists to sophisticated state-sponsored groups seeking to exploit or disrupt this emerging AI platform. While DDoS attacks are an obvious concern, the more insidious threats likely involve probing URL Parameters, API endpoints, and input validation mechanisms to manipulate or compromise the AI model’s responses potentially. The motivations span from competitive intelligence gathering to potentially using the infrastructure as a launchpad for broader attacks, especially given the open-source nature of the technology. The high-profile success and advanced AI capabilities make DeepSeek an attractive target for opportunistic attackers and those seeking to understand or exploit AI system vulnerabilities.

Eric Schwake, Director of Cybersecurity Strategy at Salt Security:

The swift ascent of DeepSeek and its R1 AI model has stirred significant excitement in the tech sector, underscoring the potential for major upheavals within the AI environment. Although the company’s assertions regarding cost-effectiveness are notable, the abrupt surge in popularity alongside subsequent outages raises questions about the trustworthiness and security of their AI model.

From an API security standpoint, these outages and cyberattacks emphasize the crucial need to safeguard AI-enabled applications and services. DeepSeek’s API presumably served a vital function in delivering its AI assistant, and the outages hint at possible vulnerabilities within the API that attackers may have exploited.

Enterprises contemplating integrating AI models, particularly from fledgling startups, must prioritize API security. This involves performing comprehensive security evaluations, establishing robust authentication and authorization protocols, and maintaining ongoing vigilance for possible vulnerabilities.

The swift embrace of AI models also brings up issues surrounding data privacy and intellectual property. Organizations should meticulously examine the terms of service for AI solutions, ensuring the protection and appropriate use of their data.

What is next? 

Dan Schiappa, Chief Product and Services Officer, Arctic Wolf:

People are already concerned around how much data social media firms have access to, most recently shown by rulings on TikTok, just imagine what the risks could be with Chinese Foundational models being trained on all your data. Considering DeepSeek is already limiting its registrations due to a cyber attack, you have to wonder whether they have the appropriate security and policies in place to maintain your privacy. Likewise, China could continue their trend of IP theft and replicating U.S. and European technologies. 

There is no doubt this will start an AI arms race. President Trump already highlighted the $500 billion investment coming to America with a partnership of Softbank, Oracle and OpenAI, and many others will jump on board. In short, this will force an innovation boom. However, the Sputnik description is a perfect analogy. While Russia was first to space, the West dominated after that, and through the nuclear arms race with Russia and the Strategic Defense Initiative under Reagan, the Soviet Union was bankrupted. While China will be near impossible to bankrupt, the West can collectively out-innovate them and hope that companies who wish to maintain their security will be hesitant to use an AI Chatbot from China — which will no doubt steal their data and be vulnerable to an attack as we are already seeing.

Andrew Bolster, Senior R&D Manager at Black Duck:

The release of DeepSeek undeniably showcases the immense potential of open-source AI. By making such a powerful model available under an MIT license, it not only democratizes access to cutting-edge technology but also fosters innovation and collaboration across the global AI community.

However, DeepSeek’s rumored use of OpenAI Chain of Thought data for its initial training highlights the importance of transparency and shared resources in advancing AI. In the context of ‘Open Source AI,’ it’s crucial that the underlying training and evaluation data are open, as well as the initial architecture and the resultant model weights. 

DeepSeek’s achievement in AI efficiency (leveraging a clever Reinforcement Learning-based multi-stage training approach, rather than the current trend of using larger datasets for bigger models), signals a future where AI is accessible beyond the billionaire-classes. Open-source AI, with its transparency and collective development, often outpaces closed source alternatives in terms of adaptability and trust. As more organizations recognize these benefits, we could indeed see a significant shift towards open-source AI, driving a new era of technological advancement.

https://www.securitymagazine.com/articles/101337-deepseek-what-to-know-about-the-chinese-artificial-intelligence-model


Security research discovers vulnerabilities in popular travel service

Research from Salt Labs reveals a vulnerability in a popular online travel service, specializing in hotel and car rentals while integrating with airline services. 

The flaw discovered is an account takeover vulnerability, which could allow a malicious actor to gain unauthorized access to an account and impersonate the user. From there, a malicious actor could perform a variety of actions, including: 

  • Cancelling booking information 
  • Editing booking information 
  • Booking rentals with the users airline loyalty points 

This vulnerability can be leveraged via a malicious link evading the travel services security measures. This link may be distributed through text messages, emails or a website controlled by the threat actor. Upon a user clicking the link and authenticating into the online service, the malicious actor gains full access to their account. 

Mr. Akhil Mittal, Senior Manager at Black Duck, comments, “This vulnerability shows a growing and recurring issue in API security — convenience often takes priority over security. Travel platforms are built to provide seamless user experiences, but that ease of use can create blind spots. Here, attackers didn’t use sophisticated techniques; they exploited weak validation processes and a failure to manage trust between integrated systems.

“What stands out to me is the lack of granular access controls and proper token validation. These are basics in API security, but they’re often overlooked in favor of faster integrations or simpler designs. Organizations need to step back and ask: Are we truly enforcing strong authentication at every step? Are we watching for unusual behaviors, like spikes in link activity or unexpected account access? And are we taking the time to understand the risks our third-party partners might bring into the mix?

“This isn’t just about fixing a technical issue or patching vulnerabilities. When systems are interconnected, the risks don’t just add up; they multiply. One flaw in an API can quickly spread, putting millions of users at risk. That’s why APIs need smarter security, like dynamic trust validation, validate behavior and detect anomalies in real time to prevent exploitation.” 

https://www.securitymagazine.com/articles/101338-security-research-discovers-vulnerabilities-in-popular-travel-service


PlushDaemon: un nuovo gruppo APT cinese colpisce la Corea del Sud. Il report di ESET


I ricercatori di ESET hanno scoperto PlushDaemon, un nuovo gruppo APT affiliato al governo cinese che ha colpito la supply chain di un provider VPN della Corea del Sud. 

“Nel maggio 2024, abbiamo notato delle rilevazioni di codice dannoso in un installer NSIS per Windows che gli utenti della Corea del Sud avevano scaricato dal sito web del legittimo software VPN IPany. Analizzando ulteriormente, abbiamo scoperto che l’installer distribuiva sia il software legittimo che la backdoor” ha affermato Facundo Muñoz, il ricercatore che ha scoperto la campagna.

PlushDaemon

Credits: ESET

Il gruppo ha sostituito l’installer legittimo della VPN con uno che distribuiva SlowStepper, una backdoor con oltre 30 componenti e funzionalità in grado di raccogliere grandi volumi di dati, anche dal browser, scattare foto, scansionare documenti, spiare gli utenti tramite audio e video e sottrarre le credenziali.

La backdoor non è nuova: secondo l’analisi di Muñoz, esistono diverse versioni di Slowstepper, di cui la prima risale al 31 gennaio 2019. La più nuova è stata compilata il 13 giugno 2024 (versione 0.2.12) ed è ad oggi la versione più completa in termini di funzionalità. Nell’attacco al provider di VPN, PlushDaemon ha utilizzato una versione antecedente, la 0.2.10 Lite; il nome suggerisce che questa backdoor abbia meno funzionalità di quelle in altre versioni.

“Le numerose componenti del toolset di PlushDaemon e la sua ricca storia di versionamento dimostrano che, anche se in precedenza sconosciuto, questo gruppo APT affiliato al governo cinese ha operato assiduamente per sviluppare un’ampia gamma di tool, rendendoli una minaccia significativa dalla quale proteggersi” avvisa ESET.

Dopo la scoperta, la compagnia ha informato il fornitore VPN riguardo la compromissione e l’installer dannoso è stato rimosso dal loro sito.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2025/01/29/plushdaemon-un-nuovo-gruppo-apt-cinese-colpisce-la-corea-del-sud-il-report-di-eset/?utm_source=rss&utm_medium=rss&utm_campaign=plushdaemon-un-nuovo-gruppo-apt-cinese-colpisce-la-corea-del-sud-il-report-di-eset


Game-day defense: Next-gen threat protection for sporting events

Big league sports inspire passion and pride — from the electrifying atmosphere of game day to the galvanizing community fostered among fans. They are arguably both a cornerstone of culture and an economic force to be reckoned with. Safeguarding national and international sporting events is essential for public safety and confers economic benefit on all involved. In the United States alone, upwards of $52 billion is spent annually by sports travelers, contributing to local businesses with direct spending, creating hundreds of thousands of jobs, and providing billions in tax revenues. 

Top sporting leagues are increasingly using a combination of measures, including threat intelligence tools, to prevent major security incidents. Also known as open-source intelligence (OSINT), the insight from these tools is used in concert with other efforts to ensure the security of venues, players, and fans on game days, such as the championship football game played annually between the winners of the American and National Football Conferences, referred to as “the Big Game.”

Per the U.S. Chamber of Commerce, 77% of Americans tuned in to “the Big Game” in February 2024. The national event has transcended the realm of sports with its eclectic high-energy entertainment consisting of iconic halftime shows, elaborate commercials, and extravagant tailgating, making it a key event for brand sponsorship.

Holistic threat awareness: A proactive, data-driven approach

High-profile sporting events are increasingly being targeted by those seeking to cause disruption or harm. One recent example is the 2024 Paris Olympics, which faced more than 140 cyberattacks that were thwarted due to the French authorities’ able management. 

Protecting sports franchises, team members, fans and venues is complex due to the diverse range of potential threats. These include physical assaults, cyberstalking, doxing, credential theft, impersonation, extortion and reputation damage. Online threats originate from social media platforms, message boards, and even the dark web, making comprehensive security measures essential. 

According to the Hetherington Group, “Just as in other industries, the threats to security in the sports sector are now technologically sophisticated and methodical. Often, bad actors leave abundant evidence of their harmful intent over many weeks, months, even years via social media, chat rooms, and the dark web. They activate misinformation campaigns, obtain personal identifiable information (PII) about athletes, referees, and team executives and dox their residential addresses, the schools and colleges the sports figures’ children attend, and the work addresses of spouses, using information obtained from public databases.”

Sports event organizers and venue operators have come to understand the critical importance of proactive, thorough monitoring and access to detailed, real-time data to inform and support best-in-class security operations. Threat intelligence, which involves the process of collecting, analyzing, and interpreting information from publicly available information (PAI) to support decision-making, now plays a vital role in risk mitigation.

Meanwhile, the automation enabled by artificial intelligence (AI) platforms makes it possible to process vast amounts of data, resulting in a distillation of relevant information and signals that can be reviewed by decisionmakers who can apply the real-world expertise, contextual understanding, and critical thinking necessary to make informed decisions that quickly transform data into action. 

Securing the biggest games

Sports leagues must gain a broad understanding of threat actors, their potential actions, and the context in which they are acting as well as what motivates them. OSINT provides the valuable insights needed to gain a proper understanding of possible threats, such as planned attacks, protests, or disturbances. It can also assist in managing and protecting brand and player reputations.

Key capabilities include:

  1. Threat monitoring: Organizations can leverage open-source threat intelligence solutions to monitor known bad actors and track keyword-based threats tied to sporting events. This proactive approach enables security teams to identify potential risks early and implement preventive measures before incidents arise.
  2. Mapping threat actors in advance: Venue security teams can enhance their understanding of threat groups and individuals targeting sporting events by having pre-collected data readily available in response to major events and breaking news. This should involve mapping social media networks to identify potential threat actors and relevant topics. By mapping the threat landscape in advance, security teams can develop more informed, comprehensive monitoring and mitigation strategies.
  3. Real-time threat detection: Modern threat intelligence solutions can quickly identify and assess online discussions, social media posts, and other open-source indicators, and provide alerts around emerging threats to the event, players, management, or attendees.
  4. Easy, seamless integration: OSINT solutions seamlessly integrate with existing venue security systems and workflows, often via API, enabling security teams to incorporate threat intelligence into established processes and protocols. Working with law enforcement and federal agencies, this collaboration enhances overall security efforts, ensuring better protection for sports fans, players, and VIPs.

Threat intelligence solutions should be part of every high-level sporting event playbook for threat protection. With the Big Game fast approaching, key stakeholders will be on high alert, with holistic game-day threat protection measures in place. Leveraging these tools as part of a broad security strategy is essential for monitoring, assessing, and mitigating risks, and informing security teams to make the right calls, play by play. 

https://www.securitymagazine.com/articles/101336-game-day-defense-next-gen-threat-protection-for-sporting-events


Apple chips can be hacked to leak secrets from Gmail, iCloud, and more

Apple-designed chips powering Macs, iPhones, and iPads contain two newly discovered vulnerabilities that leak credit card information, locations, and other sensitive data from the Chrome and Safari browsers as they visit sites such as iCloud Calendar, Google Maps, and Proton Mail.

The vulnerabilities, affecting the CPUs in later generations of Apple A- and M-series chip sets, open them to side channel attacks, a class of exploit that infers secrets by measuring manifestations such as timing, sound, and power consumption. Both side channels are the result of the chips’ use of speculative execution, a performance optimization that improves speed by predicting the control flow the CPUs should take and following that path, rather than the instruction order in the program.

A new direction

The Apple silicon affected takes speculative execution in new directions. Besides predicting control flow CPUs should take, it also predicts the data flow, such as which memory address to load from and what value will be returned from memory.

The most powerful of the two side-channel attacks is named FLOP. It exploits a form of speculative execution implemented in the chips’ load value predictor (LVP), which predicts the contents of memory when they’re not immediately available. By inducing the LVP to forward values from malformed data, an attacker can read memory contents that would normally be off-limits. The attack can be leveraged to steal a target’s location history from Google Maps, inbox content from Proton Mail, and events stored in iCloud Calendar.

SLAP, meanwhile, abuses the load address predictor (LAP). Whereas LVP predicts the values of memory content, LAP predicts the memory locations where instruction data can be accessed. SLAP forces the LAP to predict the wrong memory addresses. Specifically, the value at an older load instruction’s predicted address is forwarded to younger arbitrary instructions. When Safari has one tab open on a targeted website such as Gmail, and another open tab on an attacker site, the latter can access sensitive strings of JavaScript code of the former, making it possible to read email contents.

https://arstechnica.com/security/2025/01/newly-discovered-flaws-in-apple-chips-leak-secrets-in-safari-and-chrome/


Acting FBI director named, pending confirmation of Trump’s pick

The White House has named Brian Driscoll, a veteran agent, to serve as acting FBI director. This appointment is pending the Senate confirmation of Kash Patel, who President Donald Trump selected as director, and follows the retirement of Paul Abbate, who had been expected to serve as acting director.

Driscoll has stated that Robert Kissane, a counterterrorism official, will serve as acting deputy director. Driscoll and Kissane operate as Special Agents in Charge (SACs), possessing field leadership experience.

“As active Agents, Driscoll and Kissane have a deep understanding of the Bureau’s mission, and the challenges faced by Agents which will serve both the FBI and the nation well during this transition,” said the Federal Bureau of Investigations Agents Association in a statement. “The FBIAA stands ready to support Acting Director Driscoll and Acting Deputy Director Kissane in these important roles.” 

https://www.securitymagazine.com/articles/101332-acting-fbi-director-named-pending-confirmation-of-trumps-pick


Protecting organizations: Password smarter, not harder

Picture this: You’re about to log off and shake off the workday when PING! Yet another mandatory password change pops up on your work computer. You put in what you are sure is a new password and your computer replies, “Pick a password you have not used before.”

Instinctively, you might wonder, “Are these cybersecurity policies even worth it? Sisyphus had it easier than this.” 

The endless battle of navigating password rules is meant to protect us, but it often causes headaches. It’s essential to strike the balance between security and ease of use, or you run the risk of either frustrating your users or leaving your systems open to cybercriminals.

Cybersecurity teams shoulder the complex (and often thankless) task of safeguarding our sensitive systems, and while their controls may sometimes seem excessive, they are designed to maximize safety with the least amount of friction. 

That said, outdated security practices, like certain password policies, can create more problems than they solve. Reversing such controls is challenging, even when they are proven to be counterproductive, which is why evolving these standards is so important.

Password challenges: A history 

Passwords have been the cornerstone of digital security for decades, but their journey hasn’t been without flaws. They were once considered a simple yet effective way to restrict access. However, as technology advanced, so did the sophistication of cyberattacks. Password limitations became glaringly obvious when hackers began exploiting predictable patterns, weak encryption methods and poor user habits.

Early systems relied on short, easy-to-remember passwords, but the increase of breaches forced passwords to evolve into long-winded monstrosities. Users were required to add symbols, numbers and mixed-case letters to their passwords. Ironically, it only led to more predictable behaviors, such as replacing letters with similar-looking numbers or symbols (“O” with “0” or “A” with “@”). Hackers quickly adapted, leveraging algorithms to crack these patterns in seconds.

Then came the age of periodic password changes as another attempt to strengthen security. While the idea seemed sound, humans, it turns out, hate being forced to remember multiple, frequently changing passwords. Users often resorted to minor variations of the same password — a habit that attackers exploited. 

These historical challenges prove the need for smarter, more adaptive security measures.

Real-world examples of password failures

High-profile breaches serve as stark reminders of the risks associated with outdated password practices. 

For instance, in January 2025, edtech giant Powerschool, whose software supports more than 50 million students across the United States, reported a data breach where hackers stole almost all historical student and teacher data. A full password reset to restrict access control was one of the first motions to take charge of districts across the country. 

The 2024 Obamacare data breach exposed over 10 billion passwords posted on a hacking forum. Many of those were said to be reused by users, opening a larger window for threat actors to compromise credentials. 

But it is not just the big-name organizations that are suffering. The Center for Internet Security’s 2022 Nationwide Cybersecurity Review reported a 313% increase in endpoint security service incidents among the 3,600 local government agencies surveyed.

Clearly, modernizing password practices is critical for organizations of all sizes.

The age of periodic password changes is over

“Time to change your password!”

You’re not alone if this notification makes you want to throw things. Periodic password changes stemmed from a time when there were fewer tools to detect and mitigate breaches. Back then, changing passwords regularly helped limit the damage of compromised accounts.

Today, we have advanced monitoring systems and intrusion detection tools that basically render this practice obsolete. But it’s often easier to stick with the devil you know, so many organizations still cling to this outdated practice despite its drawbacks. 

Human behavior compounds the issue: we are not wired for randomness, and our memory limitations lead to predictable patterns, such as incrementing numbers or recycling familiar passwords. Hackers are well aware of these habits, making such approaches ineffective.

The shift toward smarter standards

So, if passwords are passé, how are you supposed to protect your organization?

The National Institute of Standards and Technology (NIST) publishes excellent cybersecurity standards and best practices for industry, government and the public. These standards provide a great framework for cybersecurity strategy and can be adopted unchanged or adapted for local controls at some point. So, NIST, among other groups, can help you get ahead of the curve in securing your business. 

NIST has recently provided updated password guidelines (SP800-63B) as part of its broader Digital Identity Guidelines. These recommendations distill years of lessons learned into actionable strategies for stronger security without unnecessary complexity.

Key changes include:

  • Eliminating periodic password changes: If your initial password is strong and secure, you can say goodbye to those dreaded reminders.
  • Encouraging passphrases: Instead of single words with substitutions like “P@ssw0rd,” opt for memorable, meaningful phrases — avoiding common quotes, lyrics or cliches.
  • Promoting password managers: Password manager tools can generate and securely store complex, unique passwords for every account.

These updates acknowledge that complexity for its own sake doesn’t equal security. By focusing on stronger, more user-friendly solutions, organizations can enhance protection while reducing frustration.

Beyond passwords: The role of multi-factor authentication

Strengthening passwords is just one piece of the puzzle. 

Multi-factor authentication (MFA) provides an additional layer of defense, making it significantly harder for attackers to gain access. It requires users to verify their identity using two or more factors: something they know (like a password), something they have (like a smartphone) or something they are (like a fingerprint).

Technologies like Microsoft’s Windows Hello and Apple’s Face ID illustrate how biometrics and other factors combine convenience with security. App-based authenticators are also widely used and offer a higher level of protection compared to interceptable SMS-based codes. These methods ensure that even if a password is compromised, unauthorized access can still be prevented.

Implementing MFA does more than secure accounts — it helps build user confidence. After all, isn’t it more reassuring, whether you are an employee or a customer, to know your data is protected by multiple layers of security? Especially since this can translate into reduced breach-related costs and stronger trust in your brand?

Passwords are not disappearing overnight, but their role is shifting. By storing them securely in a password manager and pairing them with robust MFA solutions, we can mitigate risks and make authentication seamless.

A smarter approach to identity protection

Secure identity management isn’t just about compliance — it’s about empowering better, safer experiences for everyone. By embracing smarter password practices and innovative authentication methods, organizations can protect what matters most without compromising usability.

https://www.securitymagazine.com/articles/101331-protecting-organizations-password-smarter-not-harder


Generative Artificial Intelligence (GenAI): Analisi completa di rischi, sicurezza e governance dei sistemi AI

Questo articolo è il primo di una serie dedicata all’esplorazione approfondita della Generative Artificial Intelligence (GenAI) nel 2024. In un momento in cui l’AI generativa sta superando il “Peak of Inflated Expectations”, questa serie analizza criticamente punti di forza, vulnerabilità e contromisure necessarie per implementazioni sicure e affidabili. L’articolo offre una panoramica strutturata che spazia dalla governance alla sicurezza, dall’analisi dei rischi alle metodologie di mitigazione, con particolare attenzione ai sistemi critici dove l’affidabilità rappresenta un fattore essenziale.

Generative Artificial Intelligence nel 2024: Oltre il Peak of Inflated Expectations

Il 2024 è l’anno in cui la Generative Artificial Intelligence (GenAI) supera la fase di “Peak of Inflated Expectations” (vd. il modello Hype Cycle di Gartner), ogni giorno vengono progettati, sviluppati e rilasciati sistemi di AI per qualsiasi ambito e applicazione; perciò, possiamo tranquillamente suddividere il mondo dei fruitori dell’AI in tre categorie: 1) quelli che la impiegano in maniera proattiva, 2) coloro che la governano e, infine, 3) chi la subisce.

Come accade per tutte le innovazioni, anche la GenAI avrà il suo “Trough of Disillusionment” poiché, da un lato, le aspettative degli utenti sono ancora molto elevate e, dall’altro, l’implementazione non sarà in grado di raggiungere i risultati sperati, sia in termini di performance, che di ROI. Per ridurre questo impatto negativo, che immancabilmente si genererà sugli stakeholders, è opportuno conoscere e studiare non solo i punti di forza dell’AI, ma anche le fragilità e le vulnerabilità che sono ancora presenti. Questo approccio consentirà di creare e utilizzare prodotti e servizi dell’AI “Safe, Secure and Trustworthy”.

In altri termini, l’aumento di volume e complessità dei progetti basati sull’intelligenza artificiale fa entrare in gioco variabili che inizialmente non erano state considerate, come accade per tutte le innovazioni tecnologiche, causando un disallineamento tra i risultati attesi e quelli reali; quindi, occorre prestare sempre più attenzione alla governance, ai rischi, all’ownership, alla sicurezza e ai relativi metodi di mitigazione per ridurre questo divario.

Machine Learning e GenAI: fragilità e rischi emergenti nei Large Language Models

In particolare, lo sviluppo di definizioni adeguate alla sicurezza e alla protezione dei sistemi basati sull’intelligenza artificiale, tra cui i modelli che sfruttano le reti neurali come il Machine Learning (ML) e la Generative Artificial Intelligence (GenAI), vive una fase iniziale di entusiasmo, dovuta al desiderio di essere i primi a uscire sul mercato, in cui è facile trascurare le fragilità e le vulnerabilità che rendono questi modelli suscettibili di errori, violazioni della confidenzialità e altri tipi di difetti o anomalie.

In realtà, le fragilità e le vulnerabilità del ML e del GenAI, tra cui i Large Language Models (LLM), generano rischi con caratteristiche diverse da quelle tipicamente considerate nell’analisi del software o della sicurezza informatica, pertanto, le fasi di progettazione e valutazione dei sistemi basati sull’intelligenza artificiale, e dei relativi workflow, meritano un’attenzione speciale.

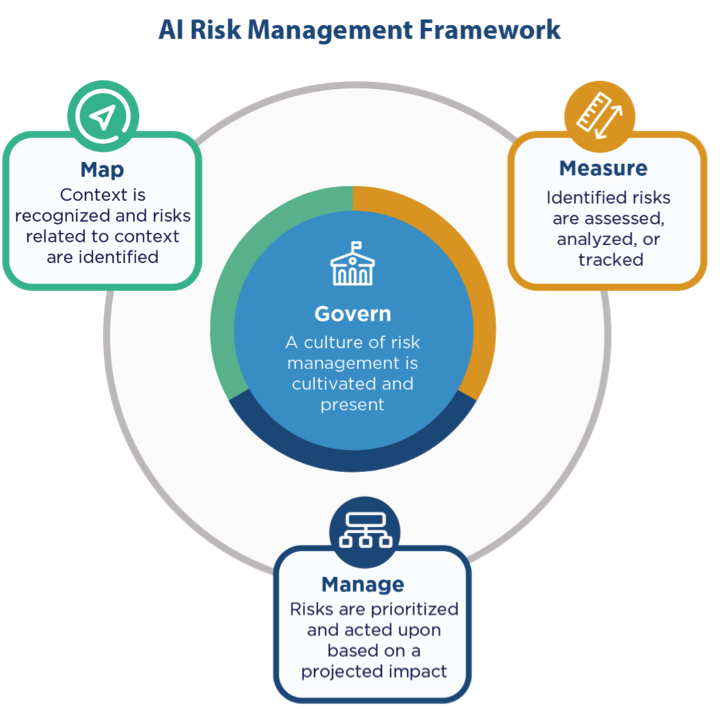
In particolare, lo sviluppo di definizioni adeguate alla sicurezza e alla protezione dei sistemi basati sull’intelligenza artificiale rappresenta una sfida significativa nell’ambito della progettazione e della valutazione dei sistemi. Se considerassimo il ruolo dell’intelligenza artificiale in domini applicativi critici, in cui la mission è incentrata sull’efficacia, la sicurezza, la protezione e la resilienza del sistema, questa minaccia si amplificherebbe. A riguardo vedasi le raccomandazioni del “NIST Artificial Intelligence Risk Management Framework (RMF)”[1] e “NIST Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile”[2] per individuare, mitigare e gestire i rischi connessi.

AI Risk Management Framework (fonte: NIST.gov)

Struttura dell’analisi sulla sicurezza della Generative Artificial Intelligence

Questo testo si concentra sull’intelligenza artificiale applicata ai sistemi critici in cui l’affidabilità, basata su evidenze verificabili, rappresenta il fattore essenziale per il consenso operativo.

L’analisi dell’argomento si sviluppa in sei parti:

  • La prima parte spiega i concetti fondamentali e il funzionamento dell’Intelligenza Artificiale Generativa (GenAI) e presenta i vantaggi, le sfide, le limitazioni e i rischi che si porta dietro.
  • La seconda parte introduce il problema della sicurezza e della protezione dell’AI e prova a rispondere alle seguenti domande: perché è difficile garantire la sicurezza e la protezione dell’AI? quali sono i concetti di sicurezza e protezione specifici per l’intelligenza artificiale basata sulle reti neurali? quali sono le sfide dell’intelligenza artificiale nello sviluppo di sistemi sicuri e protetti? quali sono i limiti di affidabilità e perché questi limiti sono fondamentali?
  • La terza parte affronta il problema della confidenzialità, dell’integrità e della governance dei sistemi di AI e tenta di rispondere alle seguenti domande: quali sono i rischi specifici dell’intelligenza artificiale – inclusi quelli associati alla confidenzialità, integrità e governance – con e senza avversari? quali sono le superfici di attacco e quali tipi di mitigazioni sono in fase di sviluppo e impiego per ridurre queste criticità?
  • La quarta parte approfondisce il rischio dell’AI e prova a rispondere alle seguenti domande: come possiamo definire la fase di Test and Evaluation (T&E) specifica per l’intelligenza artificiale? È possibile elaborare un framework di risk management per l’intelligenza artificiale? la progettazione dell’AI può affrontare le sfide a breve termine e, a riguardo, come è possibile sfruttare le opportunità dell’ingegneria del software e della sicurezza informatica?
  • La quinta parte illustra due case study riguardanti le principali minacce che affliggono i Large Language Models: i bias e il data poisoning; in particolare, un metodo per realizzare l’auditing dei bias e una serie di raccomandazioni per eliminare i dati errati (compresi i bias) da un data set di ML. Inoltre, vengono indicate una serie di raccomandazioni per misurare e rendere affidabile un sistema di intelligenza artificiale.
  • La sesta parte esamina i nuovi modelli di AI e tenta di rispondere alle seguenti domande: quali sono i vantaggi nel guardare oltre i modelli basati sulle reti puramente neurali dell’AI moderna verso approcci ibridi? quali sono gli esempi attuali che illustrano i vantaggi potenziali e in che modo questi approcci possono consentire di andare oltre i limiti dell’AI attuale? quali sono le prospettive nel breve e nel lungo periodo?

Nel prossimo articolo della serie, approfondiremo i fondamenti della Generative Artificial Intelligence, esplorando nel dettaglio i suoi meccanismi operativi, le architetture sottostanti e le metodologie di funzionamento. Analizzeremo come i sistemi GenAI generano contenuti, le tecnologie chiave che li alimentano e le implicazioni pratiche del loro utilizzo in diversi contesti applicativi. Per approfondire tutti questi temi è possibile scaricare il white paper completo “Generative Artificial Intelligence: punti di forza, rischi e contromisure”.

Note bibliografiche

[1] Artificial Intelligence Risk Management Framework (RMF), https://www.nist.gov/itl/ai-risk-management-framework

[2] Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf

Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/genai/


Fast Data: l’evoluzione dei Big Data verso l’Analisi in Tempo Reale

Dopo aver esplorato i Big Data nel primo articolo, ci concentreremo ora sui Fast Data, analizzando come la velocità di elaborazione delle informazioni sia diventata cruciale per il successo aziendale nell’era digitale. Questo è il secondo articolo della serie estratta dal white paper “Big e Fast Data: tra sfida per la sicurezza e privacy”.

Cosa Sono i Fast Data: Definizione e Importanza

Per “Fast Data” si intendono le informazioni in tempo reale che consentono di prendere decisioni appunto in tempo reale. Un’azienda di pubbliche relazioni deve sapere come le persone parlano dei marchi dei propri clienti in tempo reale per mitigare i messaggi negativi stroncandoli sul nascere. Qualche minuto di ritardo e i messaggi virali potrebbero essere incontenibili. Un’azienda di vendita al dettaglio deve sapere come sta vendendo la sua ultima collezione non appena viene rilasciata.

Gli operatori sanitari pubblici devono comprendere i focolai di malattie in tempo reale in modo da poter agire per frenarne la diffusione. Una banca deve stare al passo con le situazioni geopolitiche e socioeconomiche per prendere le migliori decisioni di investimento con una strategia macro-globale. Un’azienda di logistica deve sapere in che modo una catastrofe pubblica o una deviazione stradale sta influenzando l’infrastruttura di trasporto in modo da poter reagire di conseguenza. L’elenco potrebbe continuare, ma una cosa è chiara: i dati veloci sono fondamentali per le aziende moderne e le aziende stanno ora cogliendo la reale necessità di tali funzionalità di dati.

Vantaggi dei Fast Data nell’Infrastruttura Aziendale

Per dati veloci si intendono le informazioni in tempo reale o la capacità di ottenere informazioni dettagliate dai dati man mano che vengono generati. È letteralmente come le cose accadono. Perché i dati in streaming sono così caldi in questo momento? Perché il time-to-insight è sempre più critico e spesso gioca un ruolo importante nel processo decisionale intelligente e informato.

Metodologie di Elaborazione dei Fast Data

Oltre all’ovvio vantaggio commerciale che un’azienda ottiene dall’avere una conoscenza esclusiva delle informazioni sul presente o addirittura sul futuro, lo streaming dei dati comporta anche un vantaggio infrastrutturale. Con i Big Data arrivano gli aspetti tecnici da affrontare, uno dei quali è la questione costosa e complessa dell’archiviazione dei dati. Tuttavia, l’archiviazione dei dati è necessaria solo nei casi in cui i dati devono essere archiviati storicamente.

Più recentemente, man mano che vengono registrati sempre più dati in tempo reale con l’avvento di sensori, telefoni cellulari e piattaforme di social media, l’analisi in streaming al volo è sufficiente e l’archiviazione di tutti questi dati non è necessaria. I dati storici sono utili per il rilevamento retroattivo dei modelli; tuttavia, ci sono molti casi in cui le analisi dei dati in tempo reale sono più utili. Gli esempi includono il rilevamento del controllo qualità negli impianti di produzione, il monitoraggio meteorologico, la diffusione di epidemie, il controllo del traffico e altro ancora.

È necessario agire in base alle informazioni che arrivano al secondo. Per reindirizzare il traffico intorno a un nuovo progetto di costruzione o a una grande tempesta è necessario conoscere la situazione attuale del traffico e delle condizioni meteorologiche, ad esempio, rendendo inutili le informazioni della settimana precedente. Quando il tipo di dati a cui si è interessati non richiede l’archiviazione, o solo l’archiviazione selettiva, non ha senso adattarsi a un’infrastruttura di archiviazione dei dati che memorizzi tutti i dati storicamente. Si immagini di voler ascoltare i tweet negativi su Justin Bieber.

Si potrebbero memorizzare i tweet storici sulla pop star o analizzare i tweet in streaming su di lui. Registrare l’intera storia di Twitter solo per questo scopo costerebbe decine di migliaia di dollari in costi del server, per non parlare dei requisiti di RAM fisica per elaborare gli algoritmi attraverso questo enorme archivio di informazioni[1]. Oltre a determinare i cicli di vita dei dati, è anche importante pensare a come i dati dovrebbero essere elaborati. Le opzioni per l’elaborazione dei dati e il tipo di dati appropriato per ciascuna includono:

Elaborazione Batch: Analisi Tradizionale

L’Elaborazione batch si riferisce ad una serie di processi non interattivi vengono eseguiti dal computer contemporaneamente. Quando si fa riferimento all’elaborazione batch per l’analisi dei dati, ciò significa che è necessario fornire manualmente i dati al computer e quindi eseguire una serie di comandi che il computer esegue contemporaneamente. Non vi è alcuna interazione con il computer durante l’esecuzione delle attività.

Se si dispone di una grande quantità di dati da analizzare, ad esempio, è possibile ordinare le attività la sera e il computer analizzerà i dati durante la notte, consegnando i risultati la mattina seguente. I risultati dell’analisi dei dati sono statici e non cambieranno se cambiano i set di dati originali, a meno che non venga impartita al computer una nuova serie di comandi per l’analisi. Un esempio è il modo in cui tutte le fatture della carta di credito vengono elaborate dalla società della carta di credito alla fine di ogni mese.

Analisi in Tempo Reale: Il Cuore dei Fast Data

L’analisi dei dati in tempo reale ha lo scopo di ottenere risultati aggiornati ogni volta che si interroga qualcosa. Si ricevono risposte quasi in tempo reale con i dati più aggiornati fino al momento in cui la query è stata inviata. Analogamente all’elaborazione batch, l’analisi in tempo reale richiede l’invio di un comando di “query” al computer, ma l’attività viene eseguita molto più rapidamente e l’archivio dati viene aggiornato automaticamente man mano che arrivano nuovi dati.

Analisi di Flusso: Elaborazione Continua

L’analisi di flusso consta che nell’aggiornamento automatico dei risultati dell’analisi dei dati man mano che nuovi dati fluiscono nel sistema. Ogni volta che viene aggiunta una nuova informazione, i segnali vengono aggiornati per tenere conto di questi nuovi dati. L’analisi di streaming fornisce automaticamente i segnali non appena si verificano dai dati in ingresso senza la necessità di eseguire manualmente query per qualsiasi cosa[2].

È fondamentale sapere che tipo di dati si dispone e cosa si desidera analizzare da essi per scegliere una soluzione di analisi dei dati flessibile per soddisfare le proprie esigenze. A volte i dati devono essere analizzati dal flusso, non archiviati. Abbiamo bisogno di un’infrastruttura cloud così massiccia quando non abbiamo bisogno di dati persistenti? Forse abbiamo bisogno di più infrastrutture di dati non persistenti che consentano di archiviare i dati che non lo sono per l’eternità.

Time-To-Live e Gestione Efficiente dei Dati

Il Time-To-Live (TTL) dei dati può essere impostato in modo che scada dopo un determinato periodo di tempo, alleggerendo le capacità di archiviazione dei dati. Ad esempio, i dati di vendita dell’azienda di due anni fa potrebbero essere irrilevanti per prevedere le vendite dell’azienda oggi. E che i dati irrilevanti e obsoleti dovrebbero essere messi a tacere in modo tempestivo. Come l’accumulo compulsivo non è necessario e spesso costituisce un ostacolo allo stile di vita delle persone, lo è anche l’archiviazione insensata dei dati.

Un modo per garantire l’affidabilità e ridurre i costi è l’elaborazione distribuita. Invece di eseguire algoritmi su una macchina, eseguiamo un algoritmo su 30-50 macchine. In questo modo si distribuisce la potenza di elaborazione necessaria e si riduce lo stress su ciascuno.

L’elaborazione fault-tolerant garantisce che in una rete distribuita, in caso di guasto di uno qualsiasi dei computer, un altro computer prenderà il posto del computer difettoso senza soluzione di continuità e automaticamente. Ciò garantisce che ogni dato venga elaborato e analizzato e che nessuna informazione vada persa anche in caso di guasto della rete o dell’hardware. In un’epoca in cui il tempo di analisi è fondamentale in diversi settori, dobbiamo ridurre il tempo di acquisizione delle informazioni da settimane a secondi[3].

Fast Data nell’Era Digitale: Dal Passato al Presente

La tradizionale raccolta analogica dei dati richiedeva mesi. La polizia stradale o i medici annotavano le informazioni sulle infezioni dei pazienti o sugli incidenti di guida in stato di ebbrezza, e questi moduli venivano poi inviati a un hub che aggregava tutti questi dati. Quando tutti questi dettagli sono venivano raccolti in un unico documento, poteva essere passato anche un mese dall’insorgenza di una nuova malattia o da un problema nel comportamento di guida.

Oggi che i dati digitali vengono rapidamente aggregati, tuttavia, ci viene data l’opportunità di dare un senso a queste informazioni altrettanto rapidamente. Ciò richiede l’analisi di milioni di eventi al secondo rispetto ad algoritmi di apprendimento addestrati che rilevano segnali da grandi quantità di dati reali e in tempo reale, proprio come pescare rapidamente aghi in un pagliaio. In effetti, è come trovare gli aghi nel momento in cui vengono lasciati cadere nel pagliaio.

Applicazioni Pratiche dei Fast Data

In che modo è utile l’analisi dei dati in tempo reale? Le applicazioni spaziano dal rilevamento di prodotti difettosi in una linea di produzione alle previsioni di vendita al monitoraggio del traffico, tra molte altre. I prossimi anni segneranno un’età dell’oro non per i vecchi dati, ma per i dati veloci e intelligenti. Un’età dell’oro per le informazioni fruibili in tempo reale.

Fast Data nel Settore dei Pagamenti: Case Study

Mentre i Big Data si riferiscono all’enorme quantità di informazioni generate ogni ora, i dati veloci si riferiscono alle informazioni che forniscono informazioni in tempo reale. In molti settori, in particolare quello dei pagamenti, effettuare analisi rapide delle informazioni è fondamentale per i profitti. Ad esempio, la velocità dei dati potrebbe prevenire una massiccia violazione che rilascerebbe informazioni sensibili sui clienti. In questo caso, analizzare le informazioni in tempo reale è molto più importante che archiviarle in quantità massicce.

Quando si tratta di frodi nell’e-commerce, le informazioni che si verificano in quel momento contano di più. Per i sistemi di pagamento, le decisioni devono essere prese nell’ordine dei sub-secondi, gli utenti richiedono in genere tempi di risposta di 20-50 millisecondi[4]. Quindi abbiamo superato questo problema utilizzando tecnologie nate nell’era dei Big Data, come Hadoop e Cassandra. Gli elaboratori di pagamenti First Data e Feedzai hanno collaborato per utilizzare l’apprendimento automatico per combattere le frodi. Feedzai monitora la rete STAR dell’azienda, che consente pagamenti in addebito per i clienti di First Data.

La combinazione del software di apprendimento automatico di Feedzai e dell’esperienza di First Data ha reso la rete STAR in grado di segnare oltre 3.000 transazioni al secondo. Questo grande vantaggio in termini di velocità e precisione significa che la rete STAR è un obiettivo meno attraente per le frodi. Non tutti i sistemi sono configurati per gestire dati veloci. Senza gli strumenti giusti per gestire rapidamente il flusso di informazioni, le informazioni preziose vengono perse o acquisite troppo tardi per essere utili.

Mentre molte piattaforme esistenti sono in grado di gestire e archiviare grandi quantità di informazioni, la maggior parte rimane indietro quando si tratta di analizzare le informazioni in tempo reale. Per cominciare, le organizzazioni devono andare oltre i sistemi che consentono solo l’elaborazione in batch, secondo Wired. In questo caso, le aziende devono dire ai computer di analizzare grandi quantità di informazioni, che elaborano una alla volta, in modo simile al modo in cui le fatture delle carte di credito vengono elaborate alla fine di ogni mese.

Con la maggior parte delle aziende ora configurate per ottenere informazioni dai Big Data, il passo successivo è quello di abilitare informazioni in tempo reale. Nel mondo dei pagamenti, questo significa individuare potenziali frodi nel momento in cui si verificano, senza aspettare che siano già avvenute. L’ascesa della tecnologia mobile e la crescita dei Big Data stanno accelerando l’adozione dell’intelligenza artificiale, con lo scopo di aggregare i dati e capirne gli sviluppi tra loro da essi, utilizzando tecnologie avanzate di intelligenza artificiale e apprendimento automatico. La differenza più significativa è che i Big Data si concentrano sul volume, mentre gli smart data si concentrano sulla qualità e sulla velocità[5].

Questo secondo articolo della serie ci ha permesso di esplorare l’importanza dei Fast Data e il loro impatto sulla trasformazione digitale delle aziende. Non perdere il prossimo articolo della serie, dove esploreremo le sfide della sicurezza nell’era dei dati e le strategie per proteggere le informazioni.

Per approfondire tutti gli aspetti dei Big Data, Fast Data e le loro implicazioni sulla sicurezza, è possibile scaricare gratuitamente il white paper completo “Big e Fast Data: tra sfida per la sicurezza e privacy“

Note e Biografia:

[1] Jun Rao. “The Value of Apache Kafka in Big Data Ecosystem”. Confluent Blog.

[2] Mayer-Schonberger, V., & Cukier, K. (10 giugno 2013). “Watched by the web: surveillance is reborn”. New York Times.

[3] Vgs. nota 8.

[4] Rathod, Paresh, and Timo Hämäläinen. “Leveraging the benefits of Big Data with Fast Data for effective and efficient cybersecurity analytics systems: A robust optimisation approach.” International Conference on Cyber Warfare and Security. Academic Conferences International Limited, 2020.

[5] Ibidem

Profilo Autore

É un esperto di sicurezza informatica, con una formazione che combina conoscenze giuridiche e tecniche. Ha conseguito una laurea triennale in Operatore Giuridico di Impresa presso l’Università degli Studi de L’Aquila, seguita da una laurea magistrale in Giurisprudenza presso l’Università Telematica Pegaso. La sua formazione si arricchisce di quattro master: uno in Criminologia e Studi Forensi, uno in Programmazione e Sviluppo Backend e Frontend, un master in Cybersecurity presso l’Ethical Hacker Academy, e un master di II livello in Homeland Security presso l’Università Campus Bio-Medico di Roma.

Grazie a diverse certificazioni EIPASS, tra cui quella di Data Protection Officer (DPO/RDP), e licenze OPSWAT, ha acquisito competenze avanzate in sicurezza delle reti, protezione delle infrastrutture critiche e gestione dei dati. La sua passione per il mondo informatico e tecnologico e il costante aggiornamento professionale lo hanno reso un punto di riferimento nel settore, incluse aree emergenti come l’intelligenza artificiale.

È autore di due pubblicazioni scientifiche: “Contrasto al Terrorismo: La Normativa dell’Unione Europea” e “La Cyber Security: La Riforma Europea in Materia di Cybersicurezza ed il Cyber- Crime”, entrambe edite da Currenti Calamo.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/fast-data-big-data/