Pseudonimizzazione: linee guida, analisi e impatti sulla sicurezza dei dati personali

Il 17 gennaio 2025, il Comitato europeo per la protezione dei dati (EDPB) ha adottato nuove linee guida sulla pseudonimizzazione, aprendo una consultazione pubblica che si concluderà il 28 febbraio 2025. Come evidenziato dal vicepresidente dell’EDPB Zdravko Vukíc, questa iniziativa risponde all’evoluzione dei modelli aziendali e alla crescente centralità della protezione dei dati personali. Le linee guida forniscono importanti chiarimenti sulla definizione e l’applicabilità della pseudonimizzazione, confermando che i dati pseudonimizzati rimangono dati personali quando possono essere ricollegati a una persona fisica mediante l’uso di informazioni aggiuntive.

Il documento “Guidelines 01/2025 on Pseudonymisation” fornisce per la prima volta una definizione chiara e strutturata della pseudonimizzazione nel diritto dell’UE, rispondendo alle crescenti esigenze di chiarezza normativa in questo ambito. La pseudonimizzazione viene identificata come una misura di salvaguardia che può risultare appropriata ed efficace per l’adempimento di specifici obblighi di protezione dei dati, riducendo i rischi per gli interessati attraverso la prevenzione dell’attribuzione diretta dei dati personali alle persone fisiche durante il trattamento.

Il concetto di pseudonimizzazione e i suoi obiettivi

La pseudonimizzazione si configura come un processo che permette ai titolari del trattamento di mantenere la capacità di analizzare i dati e, opzionalmente, di unire diversi record relativi alla stessa persona, pur garantendo un livello elevato di protezione. Un aspetto fondamentale è che la pseudonimizzazione può essere configurata in modo da consentire il ripristino dei dati originali quando necessario. Questo significa che i titolari del trattamento possono elaborare i dati personali nella loro forma originale in alcune fasi del trattamento e in forma pseudonimizzata in altre, garantendo flessibilità e sicurezza.

Implementazione e sfide tecniche

L’implementazione della pseudonimizzazione richiede particolare attenzione agli aspetti tecnici e organizzativi. I titolari del trattamento devono stabilire e definire con precisione i rischi che intendono affrontare attraverso la pseudonimizzazione. La riduzione prevista di tali rischi costituisce l’obiettivo della pseudonimizzazione all’interno della specifica attività di trattamento. È fondamentale che i titolari modellino la pseudonimizzazione in modo da garantire che sia efficace nel raggiungimento di questo obiettivo.

Dominio di pseudonimizzazione e controllo dell’accesso

Un concetto innovativo introdotto dalle linee guida è quello del “dominio di pseudonimizzazione”, ovvero il contesto in cui la pseudonimizzazione deve impedire l’attribuzione dei dati a specifici interessati. L’efficacia della pseudonimizzazione nell’implementazione dei principi di protezione dei dati dipende fortemente dalla scelta del dominio di pseudonimizzazione e dal suo isolamento dalle informazioni aggiuntive che consentirebbero l’attribuzione dei dati pseudonimizzati a specifici individui.

Impatti sulla sicurezza e sulla protezione dei dati

La pseudonimizzazione si configura come una salvaguardia fondamentale che i titolari del trattamento devono implementare attraverso un’architettura di sicurezza stratificata. Il processo richiede l’adozione di tecniche crittografiche avanzate, tra cui l’utilizzo di algoritmi di cifratura simmetrica AES-256 in modalità GCM (Galois/Counter Mode) per garantire sia la confidenzialità che l’integrità dei dati. Per la generazione dei pseudonimi, è essenziale implementare funzioni di hash crittografiche robuste come SHA-3 o BLAKE3, combinate con salt casuali di lunghezza adeguata generati tramite CSPRNG (Cryptographically Secure Pseudo-Random Number Generator).

L’infrastruttura di sicurezza deve prevedere un sistema di key management basato su HSM (Hardware Security Module) per la protezione delle chiavi crittografiche, implementando procedure di key rotation automatica e backup sicuro delle chiavi. Il monitoraggio continuo dell’infrastruttura deve essere garantito attraverso sistemi SIEM (Security Information and Event Management) configurati per rilevare anomalie nei pattern di accesso e potenziali tentativi di de-pseudonimizzazione non autorizzata.

Considerazioni sulla trasferibilità dei dati

La trasmissione sicura dei dati pseudonimizzati a terze parti richiede l’implementazione di protocolli di comunicazione robusti basati su TLS 1.3 con perfect forward secrecy. È fondamentale stabilire canali di comunicazione dedicati attraverso VPN site-to-site con cifratura IPSec in modalità tunnel, utilizzando suite crittografiche moderne come AES-GCM con chiavi da 256 bit. Le politiche di data retention devono essere implementate attraverso sistemi di DLP (Data Loss Prevention) che monitorano e controllano il flusso dei dati pseudonimizzati.

Per garantire la segregazione dei dati, è necessario implementare un sistema di microsegmentazione della rete basato su tecnologie SDN (Software-Defined Networking), che permetta di isolare completamente l’ambiente di pseudonimizzazione. L’accesso ai dati da parte di terze parti deve essere regolato attraverso sistemi di Identity and Access Management (IAM) che implementino autenticazione multi-fattore e controlli basati sui ruoli (RBAC).

Implicazioni per i diritti degli interessati

La gestione dei diritti degli interessati richiede l’implementazione di un sistema di audit trail immutabile basato su tecnologie blockchain private, dove ogni operazione sui dati pseudonimizzati viene registrata con timestamp crittograficamente sicuri. È necessario implementare un sistema di gestione del consenso dinamico che permetta agli interessati di esercitare i propri diritti attraverso una piattaforma self-service protetta da autenticazione forte.

La piattaforma deve implementare meccanismi di verifica dell’identità basati su standard come FIDO2/WebAuthn, integrati con sistemi di gestione delle identità che supportino il principio di zero trust architecture. Per garantire la tracciabilità delle operazioni, è necessario implementare un sistema di logging centralizzato basato su tecnologie come ELK Stack (Elasticsearch, Logstash, Kibana) configurato secondo lo standard CEF (Common Event Format).

La protezione dei dati pseudonimizzati deve essere garantita anche a livello di storage, implementando sistemi di cifratura at-rest con algoritmi robusti e gestione separata delle chiavi di cifratura. È fondamentale implementare procedure di backup cifrate con recovery point objective (RPO) e recovery time objective (RTO) chiaramente definiti, utilizzando tecnologie di backup immutabile per prevenire modifiche non autorizzate ai dati di backup. Misure tecniche e organizzative

Le linee guida forniscono dettagliate indicazioni sulle misure tecniche e organizzative necessarie per una pseudonimizzazione efficace. Queste includono la protezione della trasformazione pseudonimizzante contro la reversione attraverso una progettazione adeguata e la garanzia di un livello appropriato di sicurezza per i segreti di pseudonimizzazione. È inoltre fondamentale gestire adeguatamente gli identificatori quasi-diretti e garantire che le ipotesi sulla portata del dominio di pseudonimizzazione siano rispettate.

Misure tecniche e organizzative

Le linee guida forniscono dettagliate indicazioni sulle misure tecniche e organizzative necessarie per una pseudonimizzazione efficace. Queste includono la protezione della trasformazione pseudonimizzante contro la reversione attraverso una progettazione adeguata e la garanzia di un livello appropriato di sicurezza per i segreti di pseudonimizzazione. È inoltre fondamentale gestire adeguatamente gli identificatori quasi-diretti e garantire che le ipotesi sulla portata del dominio di pseudonimizzazione siano rispettate.

Aspetti tecnici avanzati e implementazione operativa

Dettagli tecnici dell’implementazione operativa

L’implementazione di un sistema di pseudonimizzazione robusto richiede l’adozione di specifiche misure crittografiche e architetturali. Una delle tecniche più efficaci prevede l’utilizzo di funzioni crittografiche one-way come HMAC (Hash-based Message Authentication Code) con chiavi di almeno 256 bit, implementando l’algoritmo SHA-3 per la generazione degli hash. La struttura dell’architettura dovrebbe prevedere una separazione netta tra il layer di pseudonimizzazione e quello applicativo, utilizzando un sistema di key management distribuito basato su HSM (Hardware Security Module) per la gestione sicura delle chiavi crittografiche.

Per garantire la non reversibilità del processo, è consigliabile implementare un sistema di salt dinamico generato attraverso un CSPRNG (Cryptographically Secure Pseudo-Random Number Generator) come Fortuna o HMAC_DRBG. Nel contesto delle performance, l’utilizzo di tecniche di caching intelligente come il consistent hashing può ottimizzare significativamente le operazioni di lookup mantenendo al contempo l’integrità del sistema. Per quanto riguarda la gestione delle tabelle di mapping, è cruciale implementare un sistema di logging immutabile basato su tecnologie blockchain private, dove ogni operazione di pseudonimizzazione viene registrata con timestamp crittograficamente sicuri e firma digitale.

Il sistema dovrebbe inoltre prevedere procedure di key rotation automatizzate con periodi non superiori ai 90 giorni, implementando il principio di perfect forward secrecy attraverso l’utilizzo di chiavi effimere derivate mediante protocolli come HKDF (HMAC-based Key Derivation Function). Per la gestione degli accessi, è necessario implementare un sistema di autenticazione multi-fattore basato su standard come FIDO2/WebAuthn, integrato con un sistema di gestione delle identità che supporti il principio di zero trust architecture.

La protezione perimetrale dell’infrastruttura dovrebbe includere sistemi IDS/IPS con capacità di deep packet inspection e analisi comportamentale, configurati per rilevare specificamente tentativi di de-pseudonimizzazione non autorizzati attraverso tecniche di pattern matching avanzato e machine learning.

Architettura tecnica e best practices implementative

Un aspetto cruciale nell’implementazione di sistemi di pseudonimizzazione robusti riguarda la gestione delle sessioni e dei token. È fondamentale implementare un sistema di token management che utilizzi JWT (JSON Web Tokens) con firma EdDSA utilizzando curve ellittiche Ed25519, più efficienti e sicure rispetto alle tradizionali RSA.

La rotazione dei token dovrebbe essere gestita attraverso un sistema di refresh token con validità limitata, implementando meccanismi di revoca basati su distributed cache come Redis in configurazione cluster. Per la gestione del dato pseudonimizzato, è consigliabile implementare un sistema di storage dedicato utilizzando database column-oriented come Cassandra, che permettono una migliore gestione dei dati pseudonimizzati grazie alla loro struttura orientata alle colonne e alla possibilità di implementare sistemi di encryption at-rest nativi.

L’architettura dovrebbe prevedere anche l’implementazione di canary tokens all’interno del sistema di pseudonimizzazione, permettendo di rilevare tempestivamente eventuali accessi non autorizzati ai dati. Questi token dovrebbero essere gestiti attraverso un sistema di monitoring dedicato che utilizzi tecniche di anomaly detection basate su algoritmi di machine learning, in particolare ensemble methods come Random Forest o XGBoost, per identificare pattern sospetti di accesso o tentativi di de-pseudonimizzazione.

Per quanto riguarda la protezione della rete, è essenziale implementare un sistema di microsegmentazione basato su tecnologie SDN (Software Defined Networking) che permetta di isolare completamente l’ambiente di pseudonimizzazione dal resto dell’infrastruttura. Questo dovrebbe essere accompagnato da un sistema di Network Access Control (NAC) che implementi il principio di least privilege access attraverso policy dinamiche basate sul contesto di accesso. La comunicazione tra i vari componenti dell’architettura dovrebbe avvenire esclusivamente attraverso canali cifrati utilizzando TLS 1.3 con perfect forward secrecy e cipher suites moderne come TLS_AES_256_GCM_SHA384.

Dal punto di vista del monitoraggio e dell’auditing, è fondamentale implementare un sistema di log centralization basato su tecnologie come ELK Stack (Elasticsearch, Logstash, Kibana) configurato per gestire i log in formato strutturato secondo lo standard CEF (Common Event Format). Questo dovrebbe essere integrato con un sistema SIEM (Security Information and Event Management) che implementi regole di correlazione specifiche per identificare possibili violazioni della pseudonimizzazione. La retention dei log dovrebbe essere gestita secondo una policy di rotazione che preveda la conservazione dei log critici per almeno 12 mesi, con sistemi di compressione e archiviazione su storage immutabile.

Per garantire la business continuity, l’architettura dovrebbe prevedere un sistema di disaster recovery con RPO (Recovery Point Objective) non superiore ai 15 minuti e RTO (Recovery Time Objective) di massimo 1 ora. Questo può essere ottenuto attraverso l’implementazione di un sistema di replication asincrona con multiple availability zones, utilizzando tecnologie come PostgreSQL streaming replication con delayed standby per la protezione da corruzioni logiche dei dati.

Un aspetto spesso sottovalutato ma cruciale riguarda la gestione delle chiavi crittografiche utilizzate nel processo di pseudonimizzazione. È consigliabile implementare un sistema di key management gerarchico basato su tecnologie come HashiCorp Vault, con supporto per auto-unsealing e dynamic secrets. Le chiavi dovrebbero essere generate utilizzando generatori di numeri casuali hardware (HRNG) e gestite attraverso un sistema di envelope encryption che permetta la rotazione delle chiavi senza necessità di re-cifratura dei dati.

Infine, per garantire l’integrità del processo di pseudonimizzazione nel tempo, è necessario implementare un sistema di continuous compliance monitoring che verifichi costantemente l’aderenza delle configurazioni alle policy di sicurezza definite. Questo può essere realizzato attraverso l’utilizzo di tool di infrastructure as code come Terraform combinati con sistemi di policy enforcement come Open Policy Agent (OPA), che permettono di definire e verificare regole di compliance in modo dichiarativo e automatizzato.

Conclusioni e prospettive future

Le linee guida sulla pseudonimizzazione rappresentano un importante passo avanti nella definizione di standard chiari per la protezione dei dati personali. La loro implementazione richiederà un significativo impegno da parte dei titolari del trattamento, ma offre anche importanti vantaggi in termini di sicurezza e conformità normativa. La sfida per il futuro sarà quella di mantenere questi standard al passo con l’evoluzione tecnologica e le nuove minacce alla sicurezza dei dati, garantendo al contempo la praticabilità delle soluzioni proposte nel contesto delle operazioni aziendali quotidiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/pseudonimizzazione-linee-guida-analisi-e-impatti-sulla-sicurezza-dei-dati-personali/



Priorities and misconceptions: Improving security posture in 2025

Protecting enterprises from data breaches, patching vulnerabilities, and addressing phishing or zero day attacks is no easy feat. Chief Information Security Officers (CISOs) and their security teams must work 24/7/365 to ensure their organization’s networks and sensitive corporate data remain secure and out of the hands of nefarious actors.

CISOs’ priorities vary depending on the size of their organization and whether it operates in a highly regulated industry such as healthcare or finance, and the various data security and privacy laws to which they may be subject.

Regardless of the industry, though, there are many shared challenges. Despite differences in company size, industry and location, CISOs generally share the following four high-level priorities: 

  1. Managing cyber risk and tracking threat intelligence: CISOs and their security teams are responsible for identifying and managing risks to the organization’s information systems and data. This includes understanding the organization’s threat landscape, conducting risk assessments and implementing strategies to mitigate risks. This also includes staying ahead of emerging threats, such as the use of AI to create and launch more sophisticated and harder to detect cyberattacks. 
  2. Incident response & resilience: Another important part of security teams’ responsibilities is establishing and maintaining an effective incident response plan (IRP) and ensuring that the organization can quickly recover from a cyberattack or breach — an incident is inevitable, sooner or later, so this is critical.
  3. Compliance and regulatory requirements: Keeping up with the increasingly complex regulatory compliance ecosystem is a full-time job in itself. In an environment of increasing regulatory scrutiny, CISOs must ensure that their organizations comply with a growing number of industry-specific regulations and data protection laws. These may include GDPR, CCPA, HIPAA, SOC 2 and others.
  4. Building and fostering a strong security culture: In many respects, security breaches are still an “inside job” given the role of employees in most incidents, from poor security practices to critical mistakes. By creating a security-aware culture, often through continuous training programs and awareness campaigns for employees at all levels, CISOs can reduce the potential for human error and increase the organizations’ security posture.

Correcting two common misconceptions

Despite common obligations and priorities, security leaders should also be aware of two specific misconceptions pertaining to managing asset end-of-life, and their relevance to data security and environmental impact. The two common practices and misconceptions include:

Misconception #1: Decommissioned data center server drives 

There is a widespread belief that once decommissioned, data center server drives must be physically destroyed to protect the data left on them, 100% of the time. With a lifespan of just three to five years, according to some estimates, between 20 and 70 million very expensive HDDs reach end of life every year in the U.S., most of which are shredded and dumped into landfills — that’s a lot of scrap metal. However, destruction is not necessary, and there are alternatives available to make organizations’ data center decommissioning practices more secure and sustainable. Organizations can partner with an IT asset disposition company to have used HDDs securely sanitized, permanently removing any sensitive data and preparing the drives for a new life, either on the resale market or donating them to nonprofits in underserved countries or communities. 

Misconception #2: Applied data sanitization standards 

The most commonly applied data sanitization standard is NIST 800-88. Additionally, DoD 5220 is frequently mentioned. The latter is more than 15 years old and is recognized by experts as no longer the most effective way to sanitize data storage media. NIST 800-88, while still current, is at risk of falling behind newer storage technologies, as this standard was published in 2014. The emerging standard is IEEE 2883. Published in late 2022, this newer standard supersedes NIST 800-88 and DoD 5220 and outlines effective procedures for complete and irreversible data sanitization of the newest of storage media. Organizations should lean into using IEEE 2883 because it provides a standardized method for securely erasing data from storage devices, preventing unauthorized access to sensitive information when disposing of old hardware, enabling reuse and recycling of devices, and ultimately helping to comply with data protection and privacy regulations. It also minimizes environmental impact by enabling companies to confidently implement data sanitization (versus physical destruction) to prepare used IT assets for reuse while maintaining data secure

New year, new plan

As the year ahead brings new challenges and unforeseen threats, CISOs and their teams should evaluate the effectiveness of current security controls, aligning security initiatives with organizational goals, and prioritizing investments in key areas like cloud security, endpoint protection, and threat intelligence. Moving beyond commonly held misconceptions regarding asset end-of-life would allow CISOs to incorporate new best practices that don’t compromise data security and do support corporate sustainability objectives at the same time, and that’s a step in the right direction.

https://www.securitymagazine.com/articles/101317-priorities-and-misconceptions-improving-security-posture-in-2025


Trump admin fires security board investigating Chinese hack of large ISPs

“Effective immediately, the Department of Homeland Security will no longer tolerate any advisory committee[s] which push agendas that attempt to undermine its national security mission, the President’s agenda or Constitutional rights of Americans,” the DHS statement said.

The Cyber Safety Review Board operates under the DHS’s Cybersecurity and Infrastructure Security Agency (CISA), which has been criticized by Republican lawmakers for allegedly trying to “surveil and censor Americans’ speech on social media.”

Democrat: Board will be stacked with Trump loyalists

A Democratic lawmaker said that Trump appears ready to stack the Cyber Safety Review Board with “loyalists.” House Committee on Homeland Security Ranking Member Bennie Thompson (D-Miss.) made the criticism in his opening statement at a hearing today.

“Before I close, I would also like to express my concern regarding the dismissal of the non-government members of advisory committees inside the Department, including the Cyber Safety Review Board and the CISA Advisory Committee,” Thompson’s statement reads. “The CSRB is in the process of investigating the Salt Typhoon hack of nine major telecommunications companies, and it is a national security imperative that the investigation be completed expeditiously. I am troubled that the President’s attempt to stack the CSRB with loyalists may cause its important work on the Salt Typhoon campaign to be delayed.”

Thompson said Republicans have been trying to shut down CISA over “false allegations and conspiracy theories.” The conservative Heritage Foundation’s Project 2025 alleged that “CISA has devolved into an unconstitutional censoring and election engineering apparatus of the political Left.”

The DHS memo dismissing board members was published yesterday by freelance cybersecurity reporter Eric Geller, who quoted an anonymous source as saying the Cyber Safety Review Board’s review of Salt Typhoon is “dead.” Geller wrote that other advisory boards affected by the mass dismissal include the Artificial Intelligence Safety and Security Board, the Critical Infrastructure Partnership Advisory Council, the National Security Telecommunications Advisory Committee, the National Infrastructure Advisory Council, and the Secret Service’s Cyber Investigations Advisory Board.

“The CSRB was ‘less than halfway’ done with its Salt Typhoon investigation, according to a now-former member,” Geller wrote. The former member was also quoted as saying, “There are still professional staff for the CSRB and I hope they will continue some of the work in the interim.”

House Committee on Homeland Security Chairman Mark Green (R-Tenn.) told Nextgov/FCW that “President Trump’s new DHS leadership should have the opportunity to decide the future of the Board. This could include appointing new members, reviewing its structure, or deciding if the Board is the best way to examine cyber intrusions.”

https://arstechnica.com/tech-policy/2025/01/trump-admin-fires-homeland-security-advisory-boards-blaming-agendas/


US experiences 47% of global utilities cyberattacks

A report from Trustwave SpiderLabs indicates a rise in cyberattacks against the utilities sector. Since 2023, there has been an 80% increase in ransomware incidents against utilities. According to the report, 47% of global cyberattacks against the utilities sector target the United States. Additionally, electrical infrastructure in the U.S. is an average of 40 years old. 25% have surpassed 50 years. This outdated infrastructure plays a role in the rise in cyberattacks against U.S. utilities. 

Key findings from the report include:

  • $500,000 is the average financial impact of a data breach within the utilities sector.
  • Phishing is the most common and successful technique used by malicious actors, accounting for 84% of breaches.
  • 96% of malicious actors utilized remote services to move laterally.
  • 67% of credential access tactics were brute force.

The report also revealed ransomware groups increasingly targeting the utilities sector. Groups including Hunters International, Akira, Qilin, Conti and LockBit have been targeting utilities. Hunters International alone is responsible for 19% of attacks last year. 

https://www.securitymagazine.com/articles/101312-us-experiences-47-of-global-utilities-cyberattacks


The Internet is (once again) awash with IoT botnets delivering record DDoSes

We’re only three weeks into 2025, and it’s already shaping up to be the year of Internet of Things-driven DDoSes. Reports are rolling in of threat actors infecting thousands of home and office routers, web cameras, and other Internet-connected devices.

Here is a sampling of research released since the first of the year.

Lax security, ample bandwidth

A post on Tuesday from content-delivery network Cloudflare reported on a recent distributed denial-of-service attack that delivered 5.6 terabits per second of junk traffic—a new record for the largest DDoS ever reported. The deluge, directed at an unnamed Cloudflare customer, came from 13,000 IoT devices infected by a variant of Mirai, a potent piece of malware with a long history of delivering massive DDoSes of once-unimaginable sizes.

The same day, security company Qualys published research detailing a “large-scale, ongoing operation” dubbed the Murdoc Botnet. It exploits vulnerabilities to install a Mirai variant, primarily on AVTECH Cameras and Huawei HG532 routers. Late Tuesday afternoon, searches like this one indicated devices on more than 1,500 IP addresses were compromised, up from a figure of 1,300 reported a few hours earlier by Qualys. These devices are also waging DDoSes. It’s unknown if Cloudflare and Qualys are reporting on the same botnet.

Last week, security company Trend Micro said it also found an IoT botnet. The botnet, which is driven by variants of Mirai and a similar malware family known as Bashlite, has been delivering large-scale DDoSes since the end of last year, primarily to targets in Japan.

A report early last week from security firm Infoblox revealed a botnet comprising 13,000 devices—mostly routers manufactured by MikroTik—that researchers likened to “a large cannon, poised and ready to unleash a barrage of malicious activities.” The primary activity Infoblox has observed from this botnet is a flood of malicious spam emails that attempt to trick recipients into executing malicious file attachments.

https://arstechnica.com/security/2025/01/the-internet-is-once-again-awash-with-iot-botnets-delivering-record-ddoses/


Windsor port authority strengthens U.S.-Canada border waterway

Windsor Port Authority is one of 17 national ports created by the 1999 Canada Marine Act. Recently, Windsor Port Authority improved waterway safety and security across its jurisdiction on the U.S.-Canada border with cameras from Axis Communications. These cameras, combined with radar solutions from Accipiter Radar Technologies Inc., provide the port with the visibility needed to prevent collisions, better detect illegal activity, and save lives along the river.

Located on the Detroit River, the Windsor Port serves as the passageway between Lake Huron and Lake Erie, navigating between 6,000 and 9,000 cargo vessels annually. In addition to commercial ships, over 10,000 small fishing boats and other recreational watercraft make their way through the port each year. With so many vessels passing through, Windsor Port Authority realized that it needed better visibility into happenings along the river to be able to keep the waterway running safely and smoothly.

“Axis’ cameras, along with Accipiter’s radar technology, have been vital to keeping the port safe for all who pass through it,” said Peter Berry, Harbour Master and Vice President of Operations for Windsor Port Authority. “Without detailed knowledge of the traffic in these waters, the risk of severe accidents increases significantly, so having the ability to both detect and visually confirm incidents in real-time is invaluable. We’ve already been able to do some amazing things with the enhanced surveillance solution, like quickly rescuing drowning victims and helping to catch human smugglers, and we’re eager to see what the future holds as a result of this upgrade.”

While radar coverage from Accipiter has monitored river activity for years — offering wide-area, real-time detection and tracking to identify commercial vessels, small craft such as jet skiers, and even debris in the water — it lacked the visual detail needed to provide effective, remote observation. By integrating Axis’ bispectral cameras into Accipiter’s platform, the port now has a 360-degree surveillance system with both thermal detection and visual verification. With this enhanced system, the port can:

  • Broadcast real-time warnings about obstructions in the channel: In one instance, the U.S. Coast Guard notified the port that they’d spotted a boat stopped in the middle of the river. The vessel had caught fire, dropped anchor, and was dead in the water. The thermal camera and radar technology allowed for continuous monitoring of the fire onboard the ship — helping them to determine that it was contained to the engine room — while enabling the port to send out a navigational warning to other vessels on the river. While the darkness of the hour prevented them from seeing anything from shore, the technology also provided thermal visuals to monitor activity on the bridge and deck. Everyone was safely evacuated.
  • Safely navigate craft through high-risk construction projects: During construction of a new bridge, the port was concerned about potential disruptions to river traffic, but Axis cameras and integrated radars allowed them to effectively manage vessels passing underneath the site.
  • Deliver precise coordinates for faster rescue operations: When the port got a call from the U.S. Coast Guard that they had spotted a person treading water by the Ambassador Bridge, they were able to quickly identify the location of the person using a combination of radar and camera technology and execute a life-saving rescue.
  • Help to identify criminal activity: While using the camera-radar technology to view objects crossing from Canada to the U.S., the port identified suspicious activity from a boat that regularly sailed from Windsor to Detroit. The port turned the data and video over to the Canadian and U.S. authorities to investigate, which ultimately led to the arrest of two individuals running a human smuggling operation.

Read the full story for more details.

https://www.securitymagazine.com/articles/101313-windsor-port-authority-strengthens-us-canada-border-waterway


Eventi Cybersecurity 2025 – Il futuro della sicurezza digitale

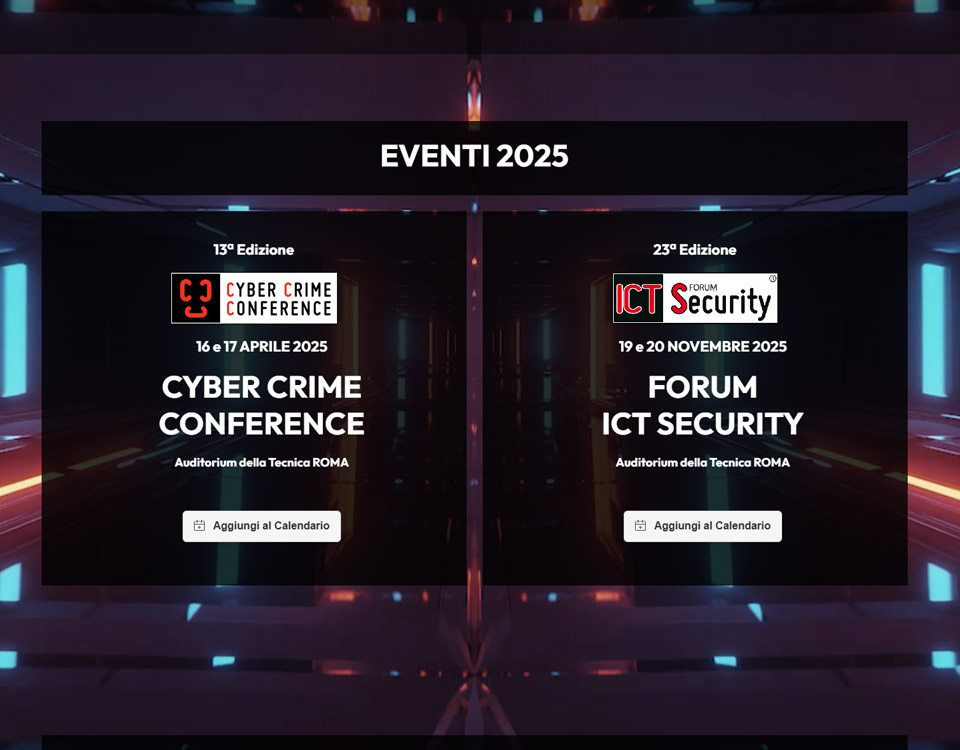
È con grande entusiasmo che annunciamo le date dei due eventi Cybersecurity 2025 più attesi nel panorama italiano: la 13a Edizione Cyber Crime Conference e il 23° Forum ICT Security.

Eventi Cybersecurity 2025: Il futuro della sicurezza digitale ti aspetta

Segna in agenda le seguenti date:

Cyber Crime Conference – “Oltre le minacce: plasmare la resilienza digitale”

16 e 17 aprile 2025, Roma – Auditorium della Tecnica, zona EUR

Preparatevi a due giorni intensi dedicati alle ultime frontiere del cybercrime e alle strategie di difesa più innovative. Quest’anno, la conferenza si focalizzerà sulle minacce emergenti nel panorama della sicurezza e sulle contromisure necessarie per proteggere aziende, organizzazioni e infrastrutture critiche.

Forum ICT Security – “Innovazione e Sicurezza: un binomio inscindibile”

19 e 20 novembre 2025, Roma – Auditorium della Tecnica, zona EUR

Il più importante evento italiano dedicato alla sicurezza informatica torna con un’edizione che promette di superare ogni aspettativa. Due giornate immersive dove innovazione tecnologica e sicurezza si fondono per delineare il futuro della protezione digitale.

Highlights degli eventi:

  • Keynote speech di esperti nazionali internazionali
  • Tavole rotonde dei CISO italiani
  • Case study di successo presentati dai protagonisti del settore
  • Networking con i maggiori esperti del settore
  • Area espositiva con le ultime soluzioni tecnologiche

Non perdete l’opportunità di partecipare a questi eventi fondamentali per tutti i professionisti della sicurezza informatica.

Per maggiori informazioni e aggiornamenti, iscriviti alla newsletter di ICT Security Magazine: https://www.ictsecuritymagazine.com/newsletter/

La sede di entrambi gli eventi sarà l’Auditorium della Tecnica, Viale Umberto Tupini, 65, 00144 Roma RM

La sicurezza digitale non è solo una sfida, è il nostro futuro. Ti aspettiamo!

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/eventi-cybersecurity-2025-il-futuro-della-sicurezza-digitale/


Anomaly Detection tramite Neural Networks: identificazione di pattern anomali e prevenzione dei cyber attacchi

Nel panorama attuale della sicurezza informatica, la rilevazione delle anomalie (anomaly detection) rappresenta una componente fondamentale per proteggere le infrastrutture digitali moderne. L’evoluzione delle minacce informatiche ha reso necessario lo sviluppo di sistemi sempre più sofisticati in grado di identificare comportamenti anomali e potenziali rischi per la sicurezza. In questo contesto, l’utilizzo di tecniche basate su neural networks ha dimostrato una notevole efficacia, offrendo soluzioni innovative e potenti per l’identificazione di pattern anomali e la prevenzione di attacchi.

Le principali Architetture di Reti Neurali

Nel campo dell’anomaly detection, diverse architetture di reti neurali hanno dimostrato la loro efficacia, ciascuna con caratteristiche e applicazioni specifiche. Le Deep Neural Networks (DNN) costituiscono l’architettura fondamentale per la rilevazione delle anomalie. Queste reti complesse sono organizzate in una struttura gerarchica che parte da un layer di input, deputato all’acquisizione dei dati grezzi, prosegue attraverso molteplici hidden layers che elaborano progressivamente l’informazione, e culmina in un layer di output che produce la classificazione finale. Il processo di addestramento delle DNN si concentra sull’apprendimento dei pattern normali del sistema, permettendo successivamente di identificare come anomalie le deviazioni significative da questi pattern durante la fase di inferenza.

Le Convolutional Neural Networks (CNN) rappresentano un’evoluzione specializzata particolarmente efficace nell’analisi di dati strutturati come i log di rete e le serie temporali. La loro architettura distintiva, basata su layer convolutivi, eccelle nell’estrazione di feature spaziali e temporali dai dati, nell’identificazione di pattern ricorrenti e nella riduzione intelligente della dimensionalità, preservando al contempo le informazioni cruciali per l’analisi.

Un’altra architettura fondamentale è rappresentata dalle Recurrent Neural Networks (RNN), insieme alle loro varianti evolute come le Long Short-Term Memory (LSTM) e le Gated Recurrent Units (GRU). Queste reti sono state specificamente progettate per l’analisi di sequenze temporali, caratteristica che le rende particolarmente adatte per l’analisi di log di sistema e traffico di rete. La loro capacità di mantenere una memoria interna permette di modellare efficacemente le dipendenze temporali nei dati, tracciando pattern complessi che si sviluppano nel tempo e identificando anomalie in sequenze di eventi correlati.

L’efficacia di queste architetture è ulteriormente potenziata dalla loro capacità di adattarsi a diversi contesti e tipologie di dati, rendendo possibile la creazione di sistemi di anomaly detection robusti e versatili. La scelta dell’architettura più appropriata dipende dalle specifiche esigenze del contesto applicativo, dalla natura dei dati da analizzare e dal tipo di anomalie da rilevare.

Approcci Metodologici nell’Anomaly Detection

Nel contesto dell’anomaly detection basata su neural networks, si sono sviluppati tre principali approcci metodologici, ciascuno con caratteristiche e applicazioni distintive che rispondono a diverse esigenze e scenari operativi.

Il supervised learning rappresenta l’approccio più tradizionale e strutturato, basandosi su dataset che contengono esempi esplicitamente etichettati di comportamenti sia normali che anomali. Questo metodo offre notevoli vantaggi in termini di accuratezza nella detection e nella capacità di identificare con precisione specifiche classi di anomalie. L’addestramento supervisionato permette infatti alla rete di apprendere caratteristiche distintive molto specifiche delle diverse tipologie di attacco. Tuttavia, questo approccio presenta alcune limitazioni significative: la necessità di disporre di dataset accuratamente etichettati, processo spesso costoso e time-consuming, e il rischio di overfitting sulle anomalie note, che può compromettere la capacità del sistema di rilevare nuove tipologie di attacchi.

L’unsupervised learning si pone come alternativa più flessibile, operando senza la necessità di esempi etichettati. Questo approccio si basa su tecniche sofisticate come gli autoencoders, che apprendono rappresentazioni compresse dei dati normali, e i modelli generativi come le Generative Adversarial Networks (GAN), che possono modellare la distribuzione dei dati normali. Le tecniche di clustering e outlier detection vengono impiegate per identificare pattern che deviano significativamente dal comportamento normale appreso. L’approccio non supervisionato offre il vantaggio significativo di poter operare su dati grezzi non etichettati, rendendolo particolarmente adatto per scenari reali dove l’etichettatura completa dei dati non è praticabile.

Il semi-supervised learning emerge come soluzione intermedia particolarmente promettente, combinando i punti di forza degli approcci precedenti. Questo metodo si basa principalmente sull’addestramento su dati normali etichettati, utilizzando poi questa conoscenza per identificare le anomalie come deviazioni significative dal comportamento normale appreso. L’approccio semi-supervisionato si è dimostrato particolarmente efficace nella capacità di generalizzare a nuove tipologie di attacco, mantenendo al contempo una buona robustezza nella detection. La sua flessibilità lo rende particolarmente adatto per sistemi di sicurezza che devono evolversi continuamente per far fronte a nuove minacce.

L’efficacia di questi approcci metodologici può essere ulteriormente potenziata attraverso tecniche di ensemble learning, che combinano multiple istanze di modelli per ottenere risultati più robusti e affidabili. Inoltre, l’integrazione di conoscenza di dominio specifica nel processo di addestramento può migliorare significativamente le prestazioni dei sistemi di anomaly detection, indipendentemente dall’approccio metodologico scelto.

Metriche di Valutazione nei Sistemi di Anomaly Detection

La valutazione dell’efficacia dei sistemi di anomaly detection basati su neural networks richiede un’analisi approfondita attraverso metriche specifiche che permettono di quantificare diversi aspetti delle prestazioni del sistema. Queste metriche sono fondamentali non solo per valutare l’efficacia complessiva del sistema, ma anche per confrontare diverse soluzioni e guidare il processo di ottimizzazione dei modelli.

La precision rappresenta una delle metriche fondamentali e misura l’accuratezza del sistema nella rilevazione delle vere anomalie. In termini pratici, indica la proporzione di anomalie correttamente identificate rispetto al totale delle segnalazioni generate dal sistema. Un’alta precision indica che il sistema è affidabile nelle sue segnalazioni, minimizzando i falsi allarmi che potrebbero sovraccaricare gli analisti di sicurezza.

Il recall, noto anche come sensitivity, valuta invece la capacità del sistema di identificare tutte le anomalie effettivamente presenti nei dati. Questa metrica è particolarmente critica in contesti di sicurezza, dove la mancata identificazione di un’anomalia potrebbe avere conseguenze gravi. Un elevato recall indica che il sistema è efficace nel rilevare la maggior parte delle minacce, minimizzando il rischio di lasciare vulnerabilità non identificate.

L’F1-score fornisce una misura bilanciata delle prestazioni del sistema, combinando precision e recall attraverso una media armonica. Questa metrica è particolarmente utile quando è necessario trovare un equilibrio ottimale tra la capacità di rilevare le anomalie e la minimizzazione dei falsi allarmi. L’F1-score risulta particolarmente significativo in scenari dove sia i falsi positivi che i falsi negativi hanno un impatto significativo sulle operazioni di sicurezza.

Il False Alarm Rate (FAR) misura la frequenza con cui il sistema genera falsi allarmi, ovvero segnala come anomalie comportamenti che in realtà sono normali. Questa metrica è cruciale per valutare l’usabilità pratica del sistema: un FAR troppo elevato può portare a quello che viene definito “alarm fatigue”, rendendo il sistema meno efficace nella pratica nonostante potenziali alte prestazioni in altre metriche.

Oltre a queste metriche principali, altri indicatori importanti includono il True Positive Rate (TPR), che misura la proporzione di anomalie correttamente identificate, e il True Negative Rate (TNR), che valuta la capacità del sistema di classificare correttamente i comportamenti normali. L’Area Under the Curve (AUC) della curva ROC (Receiver Operating Characteristic) fornisce invece una misura complessiva delle prestazioni del sistema attraverso diverse soglie di decisione.

La scelta delle metriche più appropriate per valutare un sistema di anomaly detection dipende fortemente dal contesto applicativo e dai requisiti specifici del sistema di sicurezza. In ambiti critici, potrebbe essere necessario privilegiare un alto recall anche a costo di un maggior numero di falsi positivi, mentre in altri contesti potrebbe essere più importante mantenere un basso FAR per garantire l’efficienza operativa del sistema.

L’analisi combinata di queste metriche permette di ottenere una comprensione approfondita delle prestazioni del sistema e di identificare aree di possibile miglioramento. È importante notare che queste metriche dovrebbero essere valutate su diversi set di dati e in diverse condizioni operative per garantire una valutazione robusta e affidabile delle prestazioni del sistema.

Sfide Aperte nell’Anomaly Detection

Nel campo dell’anomaly detection basata su neural networks, diverse sfide significative rimangono ancora aperte e rappresentano importanti aree di ricerca e sviluppo. Queste sfide richiedono un approccio multidisciplinare che combina competenze in machine learning, sicurezza informatica e analisi dei dati.

La riduzione dei falsi positivi rimane una delle sfide più critiche. Nonostante i significativi progressi nelle tecniche di deep learning, i sistemi di anomaly detection continuano a generare un numero significativo di falsi allarmi. Questo problema non è solo una questione tecnica, ma ha importanti implicazioni pratiche: un elevato tasso di falsi positivi può portare alla cosiddetta “alert fatigue“, riducendo l’efficacia complessiva del sistema di sicurezza. La ricerca si sta concentrando sullo sviluppo di nuovi algoritmi e architetture che possano migliorare la precisione della detection mantenendo al contempo un’alta sensibilità nella rilevazione delle vere anomalie.

La robustness rispetto al rumore nei dati rappresenta un’altra sfida fondamentale. I sistemi di anomaly detection devono operare in ambienti reali dove i dati sono spesso imperfetti, incompleti o disturbati. La capacità di mantenere prestazioni affidabili in presenza di rumore è cruciale per l’applicabilità pratica di questi sistemi. Le ricerche attuali si stanno concentrando sullo sviluppo di architetture più robuste e tecniche di pre-processing dei dati più efficaci.

La scalabilità rappresenta una sfida sempre più rilevante con l’aumento costante dei volumi di dati da analizzare. I sistemi di anomaly detection devono essere in grado di processare e analizzare grandi quantità di dati in tempo reale, mantenendo prestazioni efficienti e tempi di risposta rapidi. Questo richiede non solo ottimizzazioni algoritmiche, ma anche innovazioni nell’architettura dei sistemi e nelle tecniche di distribuzione del carico computazionale.

L’interpretabilità dei risultati è diventata una sfida cruciale, specialmente in contesti dove le decisioni del sistema possono avere impatti significativi sulla sicurezza. Gli utenti finali necessitano di comprendere il ragionamento dietro le segnalazioni di anomalie per poter prendere decisioni informate. La ricerca si sta muovendo verso lo sviluppo di tecniche di explainable AI specifiche per l’anomaly detection, che possano fornire spiegazioni chiare e actionable delle anomalie rilevate.

La detection di anomalie zero-day, ovvero la capacità di identificare minacce precedentemente sconosciute, rappresenta una delle sfide più complesse. I sistemi devono essere in grado di generalizzare dalle anomalie note per identificare nuovi tipi di attacchi mai visti prima. Questo richiede lo sviluppo di approcci innovativi che combinino apprendimento supervisionato e non supervisionato, insieme a tecniche di transfer learning e domain adaptation.

Un’ulteriore sfida emergente riguarda la privacy e la sicurezza dei dati utilizzati per l’addestramento dei modelli. Con l’aumentare delle normative sulla protezione dei dati, diventa cruciale sviluppare tecniche di anomaly detection che possano operare efficacemente pur rispettando i vincoli di privacy e conformità normativa.

La gestione degli adversarial attacks rappresenta un’altra area critica. I sistemi di anomaly detection devono essere resistenti a tentativi deliberati di elusione o manipolazione. Questo richiede lo sviluppo di tecniche di adversarial training e meccanismi di difesa specifici per i sistemi di detection delle anomalie.

Infine, l’integrazione efficace dei sistemi di anomaly detection nelle infrastrutture di sicurezza esistenti rimane una sfida significativa. È necessario sviluppare standard e protocolli che permettano una seamless integration con altri sistemi di sicurezza, garantendo al contempo performance ottimali e facilità di gestione.

Conclusioni

Nel panorama attuale della sicurezza informatica, le neural networks hanno dimostrato di essere uno strumento fondamentale per l’anomaly detection, offrendo soluzioni innovative ed efficaci per la protezione delle infrastrutture digitali. L’evoluzione continua delle tecniche di deep learning, unita alla crescente disponibilità di risorse computazionali, ha aperto nuove possibilità per lo sviluppo di sistemi sempre più sofisticati e performanti.

La ricerca nel campo dell’anomaly detection basata su neural networks sta progredendo rapidamente, con miglioramenti significativi in termini di accuratezza, robustness e scalabilità. L’integrazione di diverse architetture neurali, ciascuna con le proprie specificità e punti di forza, permette di affrontare in modo efficace la complessità e la varietà delle minacce informatiche moderne. Le Convolutional Neural Networks, le Recurrent Neural Networks e le loro varianti specializzate stanno dimostrando capacità sempre più raffinate nell’identificazione di pattern anomali e nella previsione di potenziali minacce.

Un aspetto particolarmente promettente è l’integrazione sinergica tra le tecniche di deep learning e la conoscenza di dominio specifica nel campo della sicurezza informatica. Questa combinazione permette di sviluppare sistemi che non solo apprendono dai dati, ma incorporano anche l’expertise umana e le best practice del settore. Il feature engineering guidato dalla conoscenza del dominio sta emergendo come componente cruciale per migliorare l’efficacia dei sistemi di detection, permettendo di focalizzare l’attenzione su caratteristiche particolarmente rilevanti per l’identificazione delle anomalie.

La continua evoluzione delle minacce informatiche richiede sistemi di anomaly detection sempre più adattivi e intelligenti. In questo contesto, l’approccio basato su neural networks si sta dimostrando particolarmente valido grazie alla sua capacità di apprendere e adattarsi a nuovi pattern di attacco. La ricerca futura si concentrerà probabilmente sullo sviluppo di architetture ancora più avanzate, capaci di bilanciare efficacemente la necessità di alta accuratezza nella detection con requisiti pratici come l’efficienza computazionale e la facilità di deployment.

L’importanza crescente della explainable AI nel contesto della sicurezza informatica sta guidando lo sviluppo di nuove metodologie che rendano più trasparente e interpretabile il processo decisionale delle neural networks. Questo aspetto è fondamentale per costruire la fiducia degli utenti nei sistemi automatizzati di anomaly detection e per facilitare l’integrazione di questi sistemi nei processi di sicurezza esistenti.

In conclusione, mentre le sfide nel campo dell’anomaly detection rimangono significative, l’approccio basato su neural networks continua a mostrare un potenziale straordinario. La combinazione di tecniche avanzate di deep learning, conoscenza di dominio e innovazioni nell’architettura dei sistemi sta aprendo la strada a soluzioni sempre più efficaci per la protezione delle infrastrutture informatiche. Il futuro di questo campo appare promettente, con nuove opportunità di ricerca e sviluppo che emergeranno dall’evoluzione continua sia delle tecnologie di machine learning che delle esigenze di sicurezza informatica.

Fonti:

Creating a deep learning neural network for anomaly detection on time-series data

Deep Learning for Anomaly Detection

A Review of Neural Networks for Anomaly Detection

Deep Learning for Anomaly Detection: A Review

Artificial neural networks based techniques for anomaly detection in Apache Spar

Anomaly Detection Using Deep Neural Network for IoT Architecture

A Deep Neural Network for Unsupervised Anomaly Detection and Diagnosis in Multivariate Time Series Data

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/anomaly-detection-sec/


Reducing the lifespan of digital certificates


h3 {font-weight: bold;font-size: 18px;color: #C72026;}
.w3-panel:after,.w3-panel:before{content:””;display:table;clear:both}
.w3-panel{padding:5px;margin-top:16px;margin-bottom:16px}
.w3-card{box-shadow:0 2px 5px 0 rgba(0,0,0,0.16),0 2px 10px 0 rgba(0,0,0,0.12)}

In this episode of The Security Podcasts featuring Tim Callan, Co-Chair at CA/Browser Forum and Chief Compliance Officer at Sectigo, we discuss the current state of digital certificate lifespans as well as the support for reducing them.

“If you look at SSL certificates, for example, once upon a time, there was no limit at all. You could get a 10 year certificate. That was first capped, and it was capped at three, and then it moved down to two, and then it moved down to one where it sits right now, and we are looking at a concrete proposal, that over the next several years, would bring the maximum turn down to 47 days.”

The Security Podcast logo

Reducing the lifespan of digital certificates

Tim Callan, Co-Chair at CA/Browser Forum and Chief Compliance Officer at Sectigo, discusses the current state of digital certificate lifespans and explains the support for reducing them.

Listen to more from The Security Podcasts.

Or check it out on our Apple Podcasts or Spotify channels. Don’t forget to like, follow, and rate and review our podcasts! 

https://www.securitymagazine.com/articles/101309-reducing-the-lifespan-of-digital-certificates


The end of digital transformation, the rise of AI transformation

The modern technology landscape is becoming increasingly advanced, and many enterprises are still trying to catch up. With the growing prominence of generative AI, organizational data is faced with new risks. 

Here, we talk with Steve Tait, Chief Technology Officer at Skyhigh Security, regarding the key areas of risk that generative AI can create. 

Security magazine: Tell us about your background and career.

Tait: I began my career as an engineer in the emerging mobile data space in the late 90s, and over time progressed through the traditional path of technical team management and leadership roles. One of my key early positions was Head of Engineering at Capita IT, where I covered a range of projects in financial services and government systems before finally ending as the Director of Software & Application Services for Capita’s Travel and Events business unit.

Later on in my career I joined BAE Systems as an engineering director, leading their global engineering workforce focused on the development of cyber and intelligence products along with complex system integration programs for government and enterprise systems. I was hired as the VP of Engineering at CALYX in 2018 where I focused on critical software solutions for the pharmaceutical industry before taking on my first Chief Technology Officer role at Snow Software. 

Today, I serve as Chief Technology Officer at Skyhigh Security, bringing my decades-long experience building, transforming, and leading highly scaled and distributed engineering teams, with a focus on delivering mission-critical security software to major enterprises, governments, and organizations across the globe.

Security magazine: What are the key areas of generative AI that create risk?

Tait: Generative AI presents numerous risks to the enterprise, including hallucinations, where the AI generates incorrect or misleading outputs, poisoning of its learning data, which could compromise the AI’s reliability, and malicious prompt injections designed to manipulate the system. Intellectual property (IP) risks also arise when data is shared with public AI services, leading to potential breaches of business confidentiality. 

However, in my opinion, the most pressing risk for enterprises lies in data protection within emerging AI-based productivity tools. There are two specific areas to look out for: copilots and AI-based low-code app development tools.

Security magazine: Why are these key areas risky?

Tait: It’s all about access to data. Copilots by their nature have access to an enormous amount of corporate data, which is very different when compared to the scope of access that an individual user has. While there are basic protections in place to protect users from unauthorized data access, there is no guarantee that the AI tool won’t inadvertently link unrelated datasets. This could significantly increase the potential for sensitive data exfiltration, either deliberately or completely by accident.

On the other hand, AI-supported development tools will explode the already steadily increasing output of “citizen developers” or non-technical individuals creating applications. These developers often lack the formal training of basic cyber development practices, such as scope management and the principle of least privilege. Consequently, applications can be built and distributed with minimal oversight.

While systems like Active Directory can manage some coarse-grained privileges, discrepancies arise when application-level access differs from user-level permissions. These horizontal privilege expansions can provide access to unauthorized data, making breaches extremely difficult to detect.

Security magazine: What are some best practices for organizations to keep data safe while incorporating AI?

Tait: Organizations need to invest significant time in understanding their level of data exposure. Where does your data reside? Web, cloud, email, private apps? Who has access to it — and should they?

They must also identify and train citizen developers, in addition to checking their applications for possible vulnerabilities.

When it comes to copilots, organizations must continuously review the outputs — don’t just put data in and forget about it. Additionally, don’t sleep on using cybersecurity tools and Data Loss Prevention (DLP) techniques. Many of these tools are already available and can safeguard your data, prevent threats and ensure compliance all while enabling organizations to embrace AI and innovation.

Security magazine: Anything else you’d like to add?

Tait: “Digital transformation” is over. In today’s technologically advanced landscape, few, if any, businesses would claim they are not already digitally transformed. This shift began two decades ago with the automation of manual tasks and reached its peak during the COVID-19 pandemic. Now, the fundamental challenge facing businesses is how to incorporate generative AI while keeping critical data secure.

AI usage will likely be a dominant priority for 2025 and beyond. This task is made complex not only by the emergence of new risks tied to large language models (LLMs), such as data poisoning and malicious prompt injection, but also by expanding threat vectors from shadow AI, private AI, and sanctioned applications. For instance, corporate copilots, which are deeply integrated with business assets and facilitate extensive “interrogation” of data, amplify these risks. Simultaneously, citizen developers — enabled by LLM-powered tools — create applications without necessarily understanding the principles of secure development, increasing the likelihood of vulnerabilities. As businesses integrate generative AI, securing critical data will remain paramount.

https://www.securitymagazine.com/articles/101311-the-end-of-digital-transformation-the-rise-of-ai-transformation