Bias nell’Intelligenza Artificiale: Strategie e Norme ISO per la Valutazione e il Controllo

I sistemi AI trovano ormai dilagante applicazione in ogni ambito della nostra vita e cultura attraverso, ad esempio, i modelli di Machine Learning (ML), ma, come molte volte accade, non si hanno informazioni chiare su come il modello abbia “imparato” e prodotto un determinato output.

Ecco, quindi, come un sistema di gestione dedicato all’AI può costituire un importante strumento a supporto di una corretta governance e controllo di tali modelli.

A tal proposito, la norma ISO 42001:2023 introduce molti di questi concetti, come nel caso della clausola 9.1, che individua proprio gli indicatori dedicati, o dei controlli previsti dall’Allegato A, che riportano la necessità di avere la contezza dei risultati: i controlli della classe A.6.2, da esempio, richiedono la verifica e la validazione delle misure.

Altro punto focale, sempre oggetto di richiamo quando si ragiona in punto di sistemi intelligenti, è quello che va a toccare i concetti di analisi dei rischi e di valutazione d’impatto.

A supporto dello standard ISO/IEC 42001:2023 Sistema di Gestione dell’AI ci sono altre norme che guidano ad una corretta analisi e implementazione dei controlli, quali

  • la norma ISO/IEC 42005 – Tecnologia dell’informazione — Intelligenza artificiale (AI) Valutazione d’impatto dei sistemi IA, e
  • la ISO/IEC 23894, Information technology — Artificial intelligence — Risk Management.

Con riferimento, specificamente, ai modelli di ML e alla loro verifica, possono venire in aiuto alcune norme dedicate, comprese quelle sulla qualità dei dati, come ad esempio:

  • ISO/IEC 4213 Information technology — Artificial intelligence — Assessment of machine learning classification performance,
  • ISO/IEC 6254 Information technology — Artificial intelligence — Objectives and approaches for explainability of ML models and AI systems,
  • ISO/IEC 23053 Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML), e
  • ISO/IEC 5259 1-5 Data quality for analytics and machine learning (ML) ISO/IEC 5339.

Dal momento che, come si è accennato ed è ormai noto, una delle problematiche intrinseche più rilevanti dei sistemi algoritmici è – a tutt’oggi – costituita dalla loro opacità e scarsa comprensibilità, è evidente come sia sempre più necessario affidarsi a specifiche metodologie al fine di meglio comprendere la correttezza del modello in uso.

Ancora di più se si pensa ad un ulteriore aspetto di complessità dell’AI, ossia quello che coinvolge la distorsione algoritmica o bias, intesa come forma di distorsione cognitiva causata dal pregiudizio in grado di influenzare ideologie, opinioni e comportamenti. Il bias è, per semplificare, un errore nel processo di apprendimento che deriva da assunzioni errate.

Con il precipuo scopo di indagare tale specifico aspetto è nata la ISO 24027:2021, che descrive metodologie e meccanismi per scoprire e trattare i bias nei sistemi di intelligenza artificiale, che vengono descritti, nelle definizioni, come:

  • “bias”, ossia una differenza sistematica nel trattamento[1] di determinati oggetti, persone o gruppi rispetto ad altri;
  • “bias cognitivo umano”[2], che si verifica quando gli esseri umani elaborano e interpretano le informazioni;
  • “bias di conferma”, quel tipo di bias cognitivo umano che favorisce le previsioni dei sistemi di intelligenza artificiale che confermano credenze o ipotesi preesistenti.

Nel documento si analizzano varie fonti di distorsioni indesiderate nei sistemi di AI, ricondotte a 3 categorie principali (distorsioni cognitive umane; distorsioni dei dati; distorsioni introdotte da decisioni ingegneristiche), così come il trattamento delle stesse durante i singoli stadi del ciclo di vita del sistema intelligente, a partire dalla raccolta dei dati, per passare alla progettazione, allo sviluppo, alle fasi di test e. arrivare al monitoraggio e alla validazione continui.

Sebbene si tenda ad attribuire al concetto di distorsione sempre un’accezione negativa, la norma in oggetto apre spiegando che, in realtà, gli effetti dei bias possono essere positivi, neutri o negativi, come si è cercato di sintetizzare nella tabella che segue:

Effetto positivo L’introduzione di errori/bias può servire a raggiungere un risultato equo. Ad esempio, l’introduzione di una distorsione nella fase decisionale di un processo di selezione di personale con date caratteristiche al fine di compensare “tare” nei data set dovute alla sottorappresentazione consolidata nel tempo di tali professionalità.
Effetto neutro La distorsione porta il sistema intelligente a classificare erroneamente un dato elemento, ma senza impatti particolari. Ad esempio, una vettura a guida autonoma riconosce come ostacolo un cassonetto, ma lo classifica erroneamente come idrante.
Effetto negativo Il bias porta con sé conseguenze indesiderate (etici o non ricadenti su profili etici) Ad esempio, può limitare le opportunità delle persone interessate (distorsioni che favoriscono candidati di un sesso piuttosto che di un altro) o incidere negativamente nella classificazione di qualcosa (es. una galassia)

Ciò premesso, resta tuttavia evidente come la perplessità prevalente relativa ai pregiudizi sia la facilità con cui gli stessi possono propagarsi in un sistema, a cui corrisponde – per contro – la difficoltà di riconoscerli e mitigarli. Tale aspetto va peggiorando tanto più il sistema è automatizzato (e tante più AI contribuiscono all’automazione), poiché in tal caso la supervisione umana diventa sempre meno efficace e, quindi, i bias negativi (anche involontari) trovano una facile via di sopravvivenza.

È bene evidenziare come mentre è decisamente probabile che in un sistema possano essere rintracciate più fonti di bias contemporaneamente, è, invece, assai improbabile che l’analisi di un sistema possa rilevarli tutti.

Alla luce di tutto quanto sopra descritto e in particolare con riferimento alle metodologie applicabili, si ritiene, quindi, di una certa utilità soffermarsi sulla cd. “matrice di confusione”, che costituisce uno strumento per analizzare gli errori compiuti da un modello di machine learning.

Nello specifico, come evidenzia la ISO 24027:2021, tale matrice riporta il numero di falsi positivi, falsi negativi, veri positivi e veri negativi e include ulteriori criteri di prestazione derivati da questi valori, come riportato nell’immagine seguente
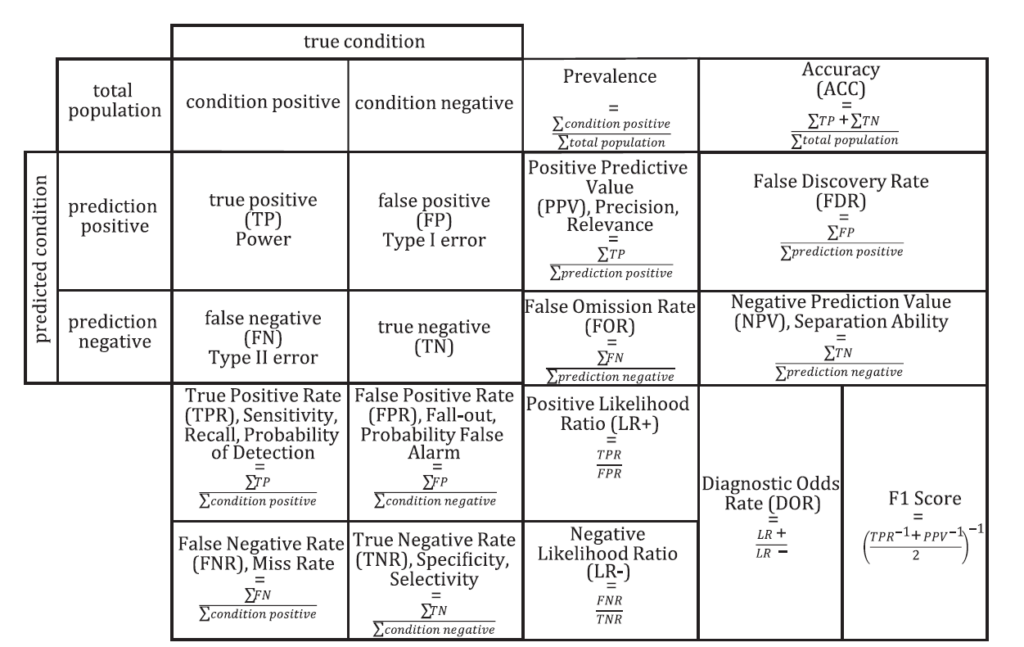
Poiché una matrice di confusione contiene e confronta più parametri, consente un’analisi dettagliata delle prestazioni di un classificatore ed è utile per aggirare o scoprire i punti deboli dei singoli parametri.

Consideriamo per semplicità un classificatore binario dove le classi si identificano con SI e NO.
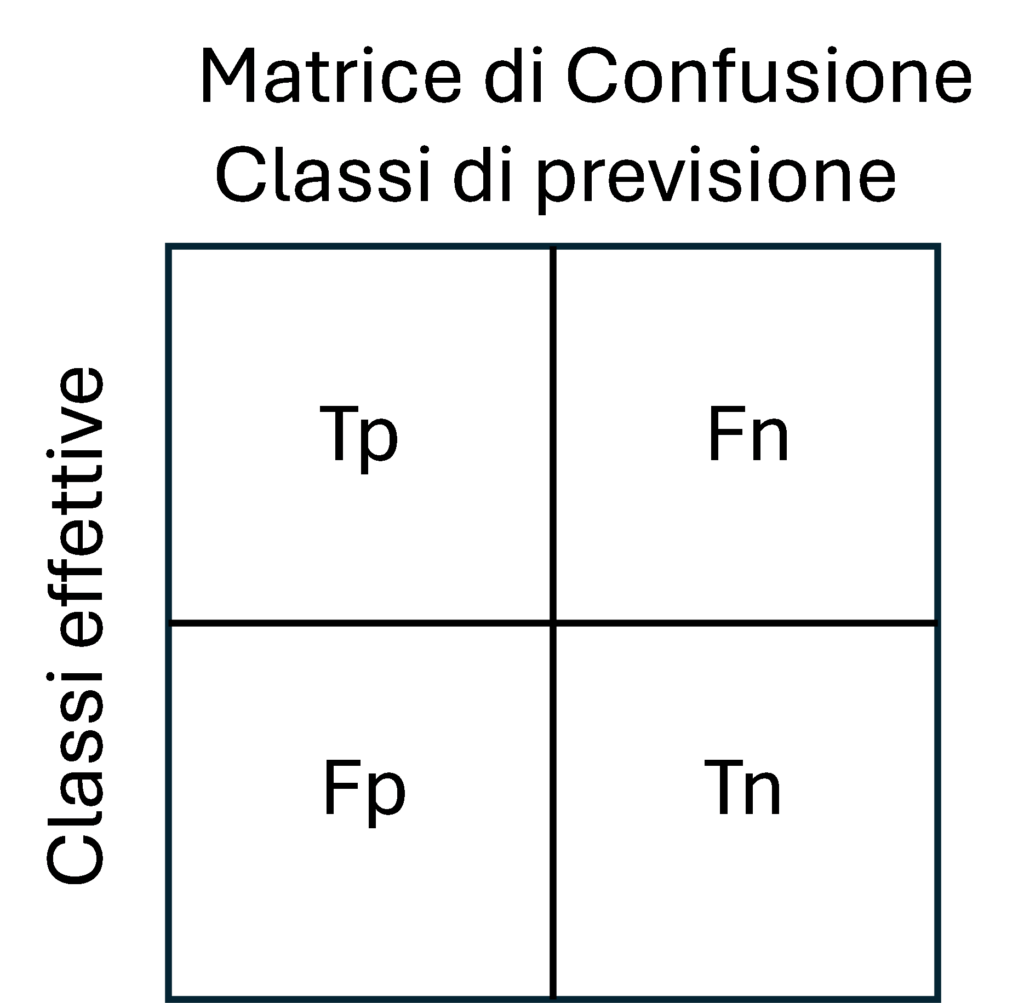
Figura 1: la matrice di confusione

Dove Tp = Veri Positivi, Fn = Falsi Negativi, Fp = Falsi Positivi e Tn = Veri Negativi.

Ad esempio, il modello analizza 100 risultati (identificazione di immagini di animali: cane e gatto) e le classifica come risultati veri o falsi. In 70 casi il modello classifica correttamente (cani) mentre in 30 sbaglia (gatti).
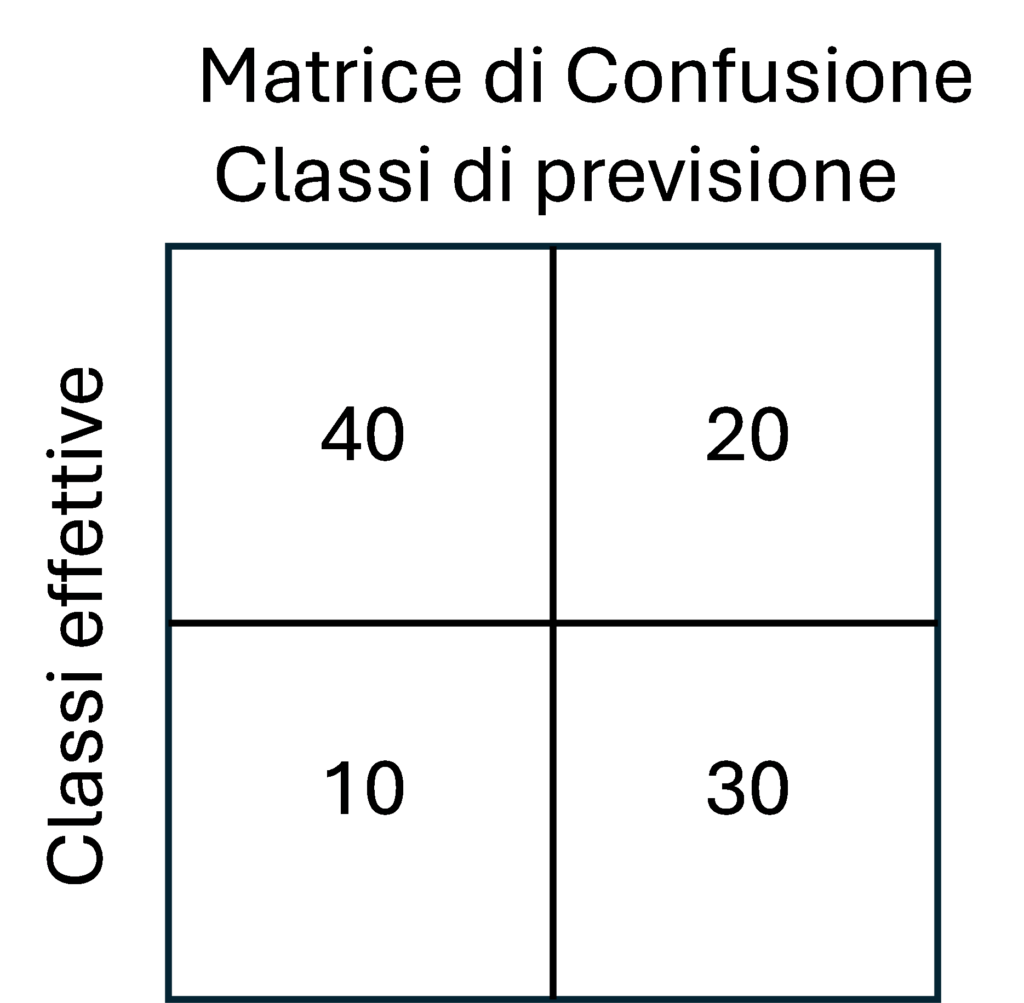
Figura 2: esempio di numerica nella matrice.

Come indicato nella figura 1, possono verificarsi quattro casi:

  • True positive (Tp)
    Se la classe prevista è SI nella prima riga e prima colonna ed è uguale alla classe effettiva il modello ha risposto correttamente SI.
  • True negative (Tn)
    Se la classe prevista è NO nella seconda riga e seconda colonna ed è uguale alla classe effettiva, il modello ha risposto correttamente NO.
  • False positive (Fp)
    Se la classe prevista è SI ma è diversa dalla classe effettiva, quindi nella seconda riga e prima colonna, il modello ha sbagliato a rispondere SI.
  • False negative (Fn)
    Se la classe prevista è NO ma è diversa dalla classe effettiva, cioè prima riga e seconda colonna, il modello ha sbagliato a rispondere NO.

Per soddisfare anche i controlli delle norme e le guide dalle norme ISO sopra citate è opportuno introdurre le metriche di una matrice di confusione.

  • Accuratezza: l’accuratezza complessiva del modello, definita come il rapporto tra le previsioni corrette e il numero totale di previsioni. Indica la proporzione di esempi che sono stati previsti correttamente.
  • Precisione: la precisione del modello, definita come il rapporto tra i veri positivi e il numero totale di esempi previsti come positivi. Indica la proporzione di esempi previsti come positivi e che sono effettivamente positivi.
  • Richiamo: il richiamo del modello, definito come il rapporto tra i veri positivi e il numero totale di esempi effettivamente positivi. Indica la proporzione di esempi positivi che sono stati previsti correttamente come positivi.
  • Punteggio F1: il punteggio F1 è una media ponderata della precisione e del richiamo ed è calcolato come. Fornisce un’unica metrica che bilancia sia la precisione che il richiamo.
  • Specificità (Specificity):La specificità rappresenta la proporzione di veri negativi rispetto al totale delle istanze negative effettive. Misura quanto il modello è bravo a identificare le istanze negative.
  • ROC Curve (Receiver Operating Characteristic Curve):La curva ROC è un grafico che mostra la relazione tra il tasso di veri positivi e il tasso di falsi positivi al variare della soglia di classificazione. A mano a mano che la soglia varia, i punti ROC vengono disegnati e collegati, e l’area sotto la curva ROC (AUC) può essere utilizzata come misura dell’efficacia del modello.

Accuratezza

L’accuratezza misura la percentuale delle previsioni esatte sul totale delle istanze. È l’inverso del tasso di errore. È compreso tra 0 (peggiore) e 1 (migliore). Essa indica quante volte il nostro modello ha correttamente classificato un item nel nostro dataset rispetto al totale.

Infatti, la formula per l’accuratezza è la divisione tra numero di risposte corrette e il totale delle risposte. Vale a dire che non ci permette di comprendere il contesto nel quale stiamo operando.

Deve essere sempre considerata nel contesto del modello. Ad esempio, è sconsigliato usare la accuratezza come metrica di valutazione quando operiamo con un dataset sbilanciato, dove le classi sono distribuite in maniera impari. Se la accuratezza non è altro che il rapporto tra risposte corrette sul totale, allora se una classe compone il 90% del nostro dataset e il nostro modello (erroneamente) classifica ogni esempio nel dataset con quella classe specifica, allora la sua accuratezza sarà del 90%.

Si potrebbe quindi pensare che il modello sia molto performante, quando in realtà è molto lontano dall’esserlo.

ACC = (Tp+Tn)/(Tp+Tn+Fp+Fn) = 1 – ERR (1)
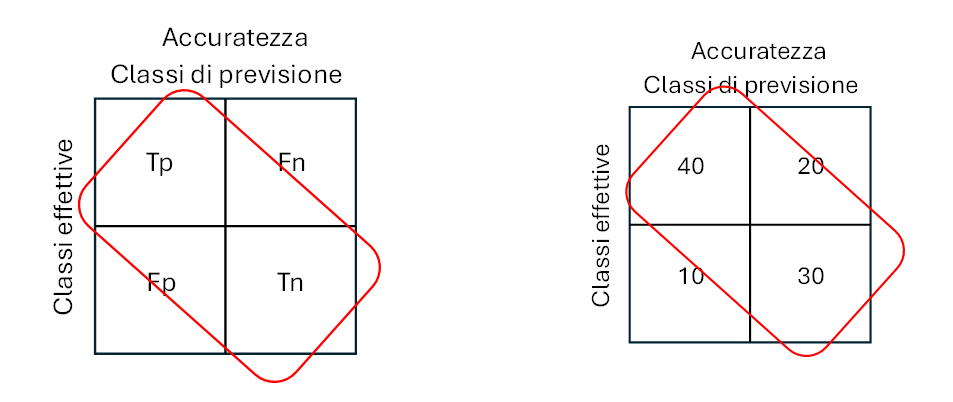
Figura 3: Accuratezza, nell’esempio Accuratezza = (40+30)/(40+20+10+30)= 70%

dove ERR è il tasso di errore, cioè, misura la percentuale di errore delle previsioni sul totale delle istanze. È compreso tra 0 (migliore) e 1 (peggiore).

ERR = (Fp+Fn)/(Tp+Tn+Fp+Fn) (2)
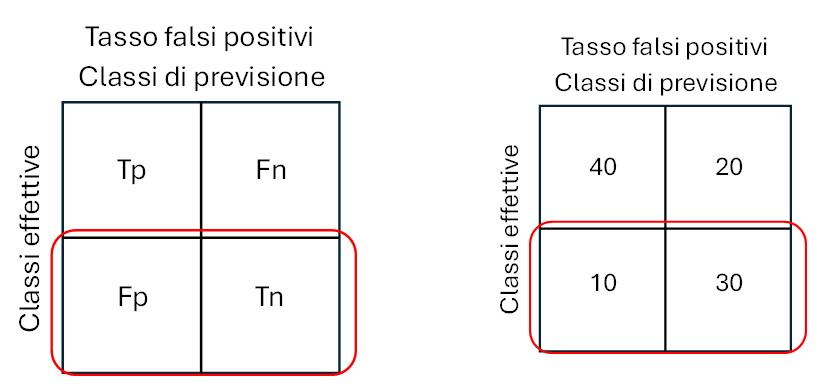
Figura 4: Tasso errore, nell’esempio, Tasso di errore = (20+10)/(40+20+10+30)= 30%

Precisione

La precisione è la percentuale delle previsioni positive corrette (Tp) sul totale delle previsioni positive del modello (giuste Tp o sbagliate Fp).

La precisione non è altro che l’accuratezza calcolata solo per classi positive. Essa è anche chiamata specificità positiva poiché definisce quanto sensibile è uno strumento quando c’è il segnale da riconoscere. Di fatto, la metrica ci informa quanto spesso siamo corretti quando classifichiamo una classe come positiva.

Un modello con alta precisione ci allerterà poche volte, ma quelle volte che lo farà possiamo essere abbastanza sicuri che si tratti veramente di un dato inteso come intruso.

Pr = Tp/(Tp+Fp) (3)
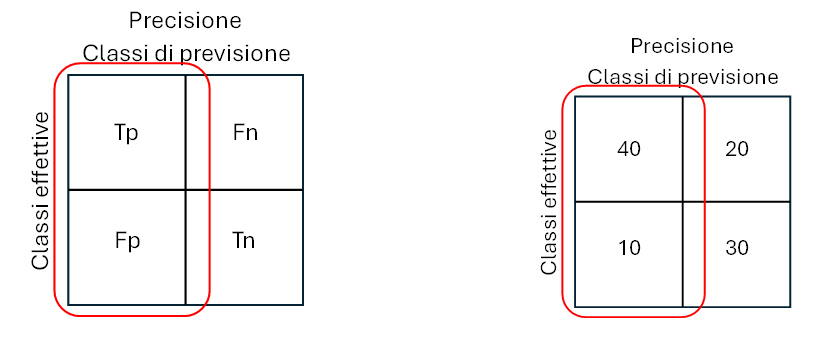
Figura 5: Precisione nell’esempio, Precisione = 40/(40+10) =80%

Richiamo o sensitività

Il richiamo o sensitività è la percentuale delle previsioni positive corrette (Tp) sul totale delle istanze positive. È compreso tra 0 (peggiore) e 1 (migliore). Se siamo interessati a riconoscere quanti più classi positive possibili, allora il nostro modello dovrà avere un richiamo alto.

In pratica significa che qui dobbiamo tener conto dei falsi negativi invece dei falsi positivi. Il richiamo viene anche chiamato sensibilità perché all’aumentare del richiamo, il nostro modello diventa sempre meno preciso e classifica anche classi negative come positive.

Un modello ad alta precisione è conservativo, ma introduce anche molto rumore di fondo.

Risulta quindi impossibile avere un modello con alta precisione e alto richiamo. Infatti, queste due metriche sono complementari: se aumentiamo una, l’altra deve diminuire. Si tratta del precision/recall trade-off.

Rec = Tp/(Tp+Fn) (4)
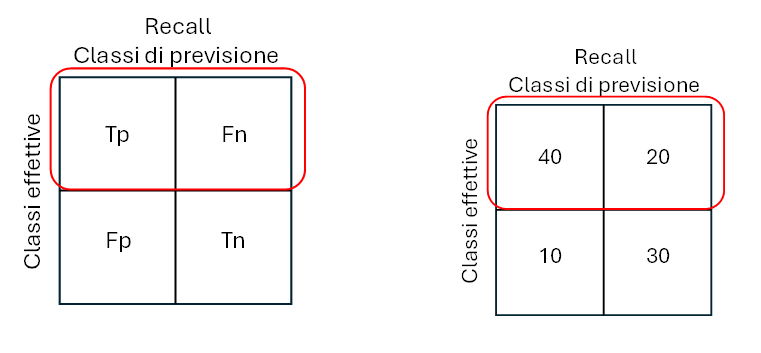
Figura 6: Richiamo nell’esempio, Recall = 40/(40+20) = 67%

Specificità

La specificità è la percentuale delle previsioni negative corrette (Tn) sul totale delle istanze negative. È compresa tra 0 (peggiore) e 1 (migliore).

Sp = Tn/(Tn+Fp) (5)
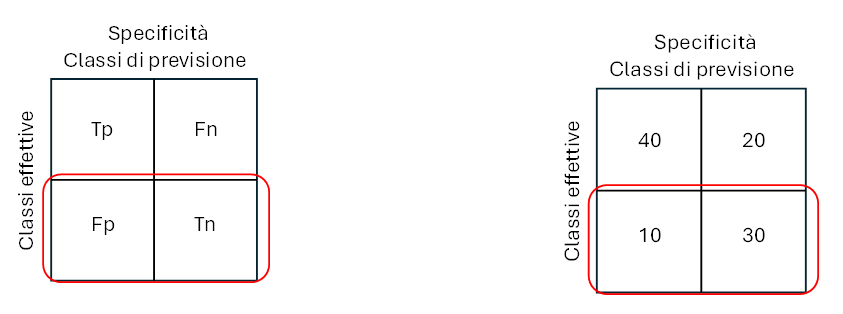
Figura 7: Specificità nell’esempio, Specificità = 30/(10+30) = 75%

Tasso dei falsi positivi

Il tasso dei falsi positivi (False Positive Rate) è la percentuale delle previsioni positive errate (Fp) sul totale delle istanze negative. Compreso tra 0 (migliore) e 1 (peggiore).

Fpr = Fp/(Tn+Fp) (6)
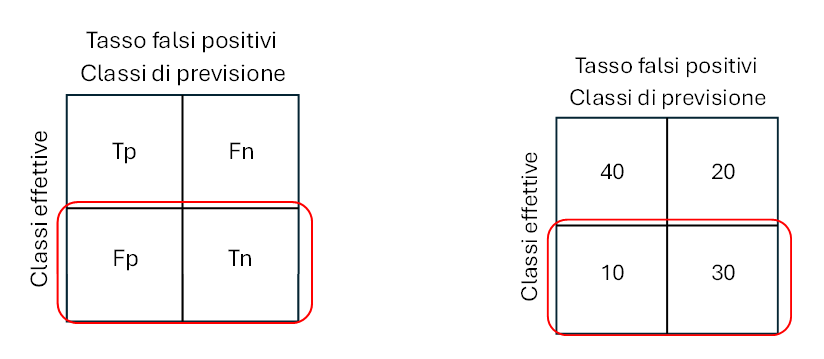
Figura 8: Tasso dei falsi positivi nell’esempio, Tasso falsi positivi = 10/(10+30) = 25%

Punteggio F

Il punteggio F (F-Score) è la media armonica delle metriche Precision e Recall. Varia da 0 (peggiore) a 1 (migliore).

A questo punto è chiaro che usare precisione o richiamo come metrica di valutazione è difficile perché possiamo solo usarne una a scapito dell’altra. Il punteggio F1 risolve proprio questo problema. Il punteggio F1 combina precisione e richiamo in una sola metrica. Questa è la media armonica di precisione e richiamo, ed è probabilmente la metrica più usata per valutare modelli di classificazione binaria. Se il punteggio F1 aumenta, vuol dire che il modello ha aumentato le performance per precisione, richiamo o per entrambi

F1 = (2* Rec*Pre)/Rec+Pre (7)

Nell’esempio: Punteggio F = (2*Recall*Precisione)/(Recall+Precisione) = 0.73 (8)

ROC-AUC

La metrica ROC-AUC si basa su una rappresentazione grafica della curva ROC (receiving operating characteristic curve).

“le curve ROC […] sono degli schemi grafici per un classificatore binario. Lungo i due assi si possono rappresentare la sensibilità e (1-specificità), rispettivamente rappresentati da True Positive Rate (TPR, frazione di veri positivi) e False Positive Rate (FPR, frazione di falsi positivi). In altre parole, si studiano i rapporti fra allarmi veri (hit rate) e falsi allarmi.” Tratto da Wikipedia
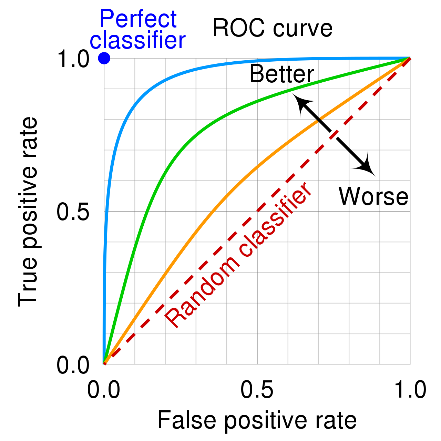
Figura 9: Curva ROC

AUC significa Area Under the Curve (area al di sotto della curva). Se poniamo l’attenzione sulla linea blu, vediamo che al di sotto di essa c’è di fatto una area più grande rispetto alle linee verde arancione. La linea tratteggiata indica una metrica di ROC-AUC del 50%.

Di conseguenza un buon modello avrà una ROC-AUC grande, mentre un modello scarso si posizionerà vicino alla linea tratteggiata, che non è altro che un modello che risponde in maniera casuale.

La metrica ROC-AUC è anche molto utile per confrontare diversi modelli uno contro l’altro.

Coefficiente di correlazione di Matthews (MCC)

Questo serve per valutare correttamente anche modelli addestrati su dataset non bilanciati.

La formula si comporta come un coefficiente di correlazione. Essa è compresa tra +1 e -1. Un valore che tende a +1 misura la qualità delle predizioni del nostro classificatore anche in contesti con classi sbilanciate nel dataset, poiché indica una correlazione tra valori reali osservati e previsioni fatte dal nostro modello.

MCC = [(Tp*Tn)-(Fp*Fn)]/ Ö[(Tp+Fp)*(Tp+Fn)*(Tn+Fp)*(Tn+Fn)] (9)

Ma possiamo fare un ulteriore passo avanti.

Possiamo introdurre, altri calcoli di verifica, coinvolgendo calcoli algebrici e la meccanica quantistica. In particolare, introduciamo il quadrato di un binomio

(a+b)2 = a2+ b2+2*a*b (10)

dove, i quadrati sono considerati la probabilità di accadimento e il doppio prodotto è l’interferenza.

Quindi possiamo estendere le formule sopra citate (recall, sensibilità, etc.) e considerando il rapporto tra il doppio prodotto e la somma dei quadrati

2ab/a2+b2 (11)

ottenendo:

Precisione:

InPr = (2*Tp*Fp)/(Tp2+Fp2), che nell’esempio assume il valore 0.47 (12)

Recall:

InRec = (2*Tp*Fn)/(Tp2+Fn2), che nell’esempio assume il valore 0.8 (13)

Specificità:

InSp = (2*Tn*Fp)/(Tn2+Fp2), che nell’esempio assume il valore 0.6 (14)

Queste formule forniscono il rapporto tra l’interferenza e la somma di probabilità.

Per concludere, dunque, per raggiungere una visione ed un controllo completi dei sistemi di intelligenza artificiale, pare imprescindibile puntare alla conoscenza tanto della parte umanistica, etica, psicologica e giuridica, quanto della componente più prettamente tecnica, che a sua volta non potrà prescindere dal supporto fornito dagli standard di settore, in parte qui analizzati.

Note

[1] Il trattamento è qualsiasi tipo di azione, inclusa la percezione, l’osservazione, la rappresentazione, la previsione o la decisione.

[2] i pregiudizi cognitivi umani influenzano il giudizio e il processo decisionale.

Articolo a cura di Stefano Gorla e Avv. Anna Capoluongo
Profilo Autore

Consulente e formatore in ambito governance AI, sicurezza e tutela dei dati e delle informazioni;
Membro commissione 533 UNINFO su AI; Comitato di Presidenza E.N.I.A.
Membro del Gruppo di Lavoro interassociativo sull’Intelligenza Artificiale di Assintel
Auditor certificato Aicq/Sicev ISO 42001, 27001, 9001, 22301, 20000-1, certificato ITILv4 e COBIT 5 ISACA, DPO Certificato Aicq/Sicev e FAC certifica, Certificato NIST Specialist FAC certifica,
Referente di schema Auditor ISO 42001 AicqSICEV.
Master EQFM. È autore di varie pubblicazioni sui temi di cui si occupa.
Relatore in numerosi convegni.
Profilo Autore

Avvocato Data Protection & ICT | Data Protection Officer UNI 11697 | membro dell’EDPB’s Support Pool of Experts | Membro Women For Security | Membro Osservatorio sulla Giustizia Civile Tribunale Milano (Gruppo sul danno da illecito trattamento dei dati personali) | Afferente B-ASC (Università Milano-Bicocca Applied Statistics Center) | Vicepresidente Institute for Research of Law Economical and Social Studies| Membro Gruppo di Lavoro sull’AI di ANORC | Docente a c. (Università di Padova, Sole24Ore Business School), Comitato di Presidenza E.N.I.A.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/bias-nellintelligenza-artificiale-strategie-e-norme-iso-per-la-valutazione-e-il-controllo/



Anatomia del data breach che ha colpito il MITRE


A partire dallo scorso gennaio e fino a metà marzo, MITRE è stata vittima di un attacco che ha sfruttato due vulnerabilità zero-day di Ivanti Connect Secure e ha permesso agli attaccanti di accedere al NERVE, una rete di ricerca e sviluppo dell’organizzazione, ed esfiltrare informazioni.

L’organizzazione aveva reso noto l’attacco a fine aprile, spiegando di essere riuscita a segmentare la rete per evitare che gli attaccanti riuscissero a muoversi ulteriormente all’interno del network. Il gruppo, sfruttando il session hijacking e una serie di backdoor e web shell sofisticate, è riuscito a mantenere la persistenza e ottenere le credenziali di diversi account.

In un recente articolo MITRE ha dettagliato le attività malevole spiegando che la prima intrusione, avvenuta il 31 dicembre 2023, è iniziata con ROOTROT, una web shell che ha sfruttato le vulnerabilità Ivanti per accedere al NERVE senza autorizzazione, eludendo l’autenticazione multi-fattore.

In seguito, dopo aver profilato l’ambiente NERVE, gli attaccanti sono riusciti a loggarsi a diversi account tramite RDP, sfruttando le credenziali per accedere ai preferiti e ai file condivisi dagli utenti. “Questa attività di scoperta, culminata con l’esfiltrazione di documenti, mirava a mappare la topologia della rete e a identificare obiettivi di alto valore per un futuro sfruttamento” ha affermato Lex Crumpton, principal cybersecurity engineer dell’organizzazione.

Pixabay

Il gruppo ha poi manipolato le macchine virtuali e stabilito il controllo sull’infrastruttura sfruttando credenziali di amministratore compromesso. Dopo l’accesso alle macchine virtuali, gli attaccanti hanno eseguito una serie di payload come la backdoor BRICKSTORM e una web shell chiamata BEEFLUSH: l’obiettivo era ottenere accesso persistente alla rete e riuscire ad eseguire comandi per raccogliere informazioni e comunicare col server C2.

Nel corso dell’analisi i ricercatori di sicurezza del MITRE hanno individuato anche WIREFIRE e BUSHWALK, altre due web shell che servivano a nascondere le comunicazioni e facilitare quindi il furto di dati.

Da febbraio e fino a metà marzo il gruppo è riuscito a mantenere la persistenza sui sistemi e ha cercato di muoversi al di fuori della rete NERVE per ottenere nuove risorse, ma senza successo.

L’organizzazione è riuscita a eliminare ogni traccia del gruppo, ma ha sottolineato l’importanza di rafforzare la propria sicurezza per scongiurare attacchi futuri. “Sebbene i nostri sforzi iniziali di risposta abbiano contribuito a mitigare l’impatto immediato dell’attacco informatico, riconosciamo la necessità di una continua vigilanza e adattamento” ha affermato Crumpton.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/05/10/anatomia-del-data-breach-che-ha-colpito-il-mitre/?utm_source=rss&utm_medium=rss&utm_campaign=anatomia-del-data-breach-che-ha-colpito-il-mitre


Need a new leadership style? Line up the contenders

.w3-panel:after,.w3-panel:before { content: “”; display: table; clear: both } .w3-panel { padding: 16px; margin-top: 16px; margin-bottom: 16px } .w3-leftbar { border-left: 6px solid #660066!important } .w3-color,.w3-hover-color:hover { color: #660066!important; background-color: #f9ecf2!important } .w3-large { font-size: 20px!important } .w3-sans-serif { Nunito Sans’,Arial,sans-serif } .w3-opacity,.w3-hover-opacity:hover { opacity: 0.60 }

Everything you know about leadership is wrong.

OK, not everything, but eventually something will displace the current leadership orthodoxy.

In the next few decades, if not years, a new theory is bound to upend our current notions of what makes a great leader and how one is developed.

What makes me so sure? Continuing research and reevaluation of every aspect of the universe, including the social sciences.

Isaac Newton discovered and described the laws that govern everything we know — the laws of motion and universal gravitation — until Einstein and others showed that those rules didn’t apply at the microscopic level. Now we live in a combo world of quantum and classical mechanics.

Every few years an archaeologist finds a fossil that rewrites what we thought about the development of humans and animals, pushing timelines forward or backwards thousands or millions of years. Since 2000 alone, new experiments, discoveries and theories have exploded what we knew about our hunter-gatherer past, the expansion of the universe, human consciousness, genetics and evolution, infant learning, life in the depths of the ocean, interbreeding among humans and Neanderthals, plant biology, cancer metabolism and dark matter.

Leadership theory doesn’t stand a chance of resisting a theoretical overhaul.

❝

In the next few decades, if not years, a new theory is bound to upend our current notions of what makes a great leader and how one is developed.”

Such a prediction isn’t an — excuse me — a quantum leap. In October 2022, this very column traced the evolution of leadership theory from the 1840s to today, spotlighting six different approaches that emerged and evolved over the years. Each approach lives on today in some way.

So what’s tomorrow’s new approach to leadership?

Since we are talking quantum, a philosophy called quantum leadership exists, and it can be traced all the way back to the late 1990s. According to the 2019 book Quantum Leadership: New Consciousness in Business, by Frederick Chavalit Tsao, that style involves changing someone’s consciousness to unlock “his or her leadership potential to create wealth and serve humankind.”

Rob Balmer’s 2020 Quantum Leadership: Igniting the Limitless Power of People in Disruptive Times (yes, there are multiple books on the subject) defines its subject matter as “supercharg[ing] many established approaches to organizational leadership and enabl[ing] leaders to excite a quantum leap in performance to match the seismic shifts confronting their organizations.”

Or will tomorrow’s dominant leadership style be AI-driven leadership, which was described back in 2018 in the MIT Sloan Management Review? The authors identify seven attributes of the AI-driven leader, including understanding the technologies, establishing clear business objectives and looking beyond pilots and proofs of concept. While AI-driven leadership seems more operational than philosophical, in a world of dominant AI, perhaps this style rises to the top.

Metaverse leadership could be another contender. Lessons in leading in the metaverse may evolve into a general approach to leadership. That style may, for instance, involve juggling leadership approaches between the real and virtual worlds.

Most likely, these contenders for the mantle of Next Great Leadership Paradigm are mere buzzword-specific pretenders — epiphenomenal offshoots of or blends of other leadership theories. The heir to the throne’s fate rests on the vicissitudes of business, academia, human resources and cultural shifts.

https://www.securitymagazine.com/articles/100642-need-a-new-leadership-style-line-up-the-contenders


Guarding the guardians: Importance of mental health for security personnel

No matter the industry — education, manufacturing, government, just to name a few — security professionals are tasked with safeguarding people, organizations and even nations from threats ranging from physical breaches to cyberattacks. Quite often this demanding field requires 27/7 vigilance, fast decision-making and resilience in the face of high-stakes situations.

With the focus often being on protecting others, the mental well-being of security professionals can be overlooked, and that can not only compromise the individual, but the overall effectiveness of security operations as well. That is why it is important for security leaders to foster a culture that promotes mental health awareness helping to prevent burnout among their security teams. And with May being Mental Health Awareness Month, there is no better time than the present to discuss this important topic. The topics of burnout and mental health are common topics at Security magazine. Here are what some security leaders have said:

“Organizational buy-in is imperative from the start. You must get stakeholders to commit to active shooter response plans at the beginning by having them provide the necessary resources and support,” says Mike Hasselbrink, Director of Physical Security at University of Alabama at Birmingham. “The right amount of effort on the front end will go a long way in providing the momentum needed to propel an active shooter program toward success. Success is everyone feeling and being safe and secure.”

“The thing that I always tell myself is, ‘It’s okay to feel burnt out. It’s okay to take breaks.’ There was a very long time in my career… where I was just go, go, go. It was, ‘How can I get to the next position? How can I get the next certification? How can I achieve the next thing, get accepted to speak at the next conference?’” says Meg West, X-Force Cybersecurity Incident Response Consultant at IBM. “Unfortunately, you get to this spot where you’re like, ‘Man, I don’t want to spend my time after work studying for a certification.’ And people feel ashamed or guilty about that, because unfortunately, there’s this air within cybersecurity that if you’re not constantly doing cybersecurity, then you’re not worthy of being in the field, or you’re not a good enough cybersecurity professional. And I’m here to tell you that that’s completely inaccurate. If you can’t sit down at your day job in the morning, put forth your best effort, and be curious, interested and passionate about helping out your company, then you’re probably too burnt out.”

“It’s so important to know why you’re getting into this field, because it’s not as glamorous as people may think it is,” Cadisha Miceli, Senior Security Coordinator, City of Toranto, says. “I’ve had some really interesting security details where I got to protect celebrities, got to meet famous athletes, but then there’s jobs where you’re dealing with some vulnerable communities, which could impact the mental health of any security professional. You need to be sure you’re in it for the right reasons.”

Mental health awareness and burnout prevention are critical to safeguarding the well-being of security professionals and by being aware of the unique challenges faced in these demanding careers, an organization can better ensure their security team’s resilience.

https://www.securitymagazine.com/articles/100643-guarding-the-guardians-importance-of-mental-health-for-security-personnel


Scoperta una campagna che sfrutta un bug di LiteSpeed Cache di WordPress


Le campagne sfruttano le vulnerabilità dei plugin di WordPress non finiscono mai: l’ultima, individuata dai ricercatori di WPScan, colpisce l’estensione LiteSpeed Cache.

LiteSpeed Cache è un plugin di accelerazione all-in-one che mette a disposizione cache server-level e una serie di feature di ottimizzazione il caching automatico delle pagine, cache privata per gli utenti loggati, supporto a WooCommerce e bbPress, crawler per il preload delle pagine e molte altre.

Gli attaccanti sfruttano la vulnerabilità CVE-2023-40000, un bug di Cross-Site Scripting, per iniettare script malevoli ed effettuare redirect, inserire pubblicità malevole sui siti o altri payload HTML che vengono eseguiti quando l’utente naviga sul sito. 

Prima di iniettare script, i cybercriminali elevano i propri privilegi a quelli di amministratore per avere il pieno controllo del sito, creando l’utente “wpsupp-user”. Se ci si è imbattuti in un utente con questo nome, allora il proprio sito WordPress è stato infettato e gli utenti sono a rischio.

La vulnerabilità è stata risolta nella versione 5.7 del plugin rilasciata lo scorso ottobre, ma ci sono ancora molti siti web che la utilizzano. Il plugin conta più di 5 milioni di installazioni attive e il 16,7% di esse sono versioni vulnerabili. Il consiglio è di aggiornare il prima possibile l’estensione all’ultima versione disponibile o perlomeno alla 5.7 o successive.

In generale, gli amministratori di siti WordPress dovrebbero effettuare review periodiche dei plugin installati e aggiornarli non appena sono disponibili nuove versioni; gli utenti dovrebbero invece fare molta attenzione a cliccare link sospetti presenti nei siti web ed evitare di scaricare e installare applicazioni sconosciute.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/05/09/scoperta-una-campagna-che-sfrutta-un-bug-di-litespeed-cache-di-wordpress/?utm_source=rss&utm_medium=rss&utm_campaign=scoperta-una-campagna-che-sfrutta-un-bug-di-litespeed-cache-di-wordpress


97% of organizations report difficulties with identity verification

Ping Identity released a report on the state of identity fraud, surveying 700 IT decision-makers worldwide between February and March of 2024, which found that 97% of organizations are experiences challenges with identity verification. Many respondents (49%) report that the fraud prevention strategies in place in their organization are somewhat or entirely ineffective, suggesting that many organizations do not have proper protections against identity fraud. Among those surveyed, only 45% use two-factor or multi-factor identification verification, and only 44% use biometrics to defend against fraud. 

The report highlights a concern among many respondents: defending against artificial intelligence (AI) threats. The key findings on the topic of AI include: 

  • 54% of respondents believe that AI will increase identity fraud. 
  • 41% predict that malicious actors will deploy AI to increase identity threats in the next year. 
  • 52% believe they could discern a deepfake of their CEO. 
  • 48% express low confidence that their organization has proper defenses to protect against AI attacks. 

Furthermore, the report also found that decentralized identity (DCI) is an underutilized resource for identity protection. 38% of respondents say that their organization has a strategy in place involving DCI to protect against fraud for employees and customers. According to the report, this represents a 25% increase from the previous year. For those who have not yet implemented DCI in their organization’s defense strategy, 60% cite accessibility as an obstacle while 52% cite integration issues. 

https://www.securitymagazine.com/articles/100645-97-of-organizations-report-difficulties-with-identity-verification


Aumentano gli attacchi con exploit contro gli utenti Linux


I sistemi Linux stanno diventando sempre più popolari e questa diffusione ha catturato l’attenzione degli attaccanti: secondo gli ultimi dati di Kaspersky Security Network, nel quarto trimestre del 2023 si è registrato un picco significativo di attacchi con exploit contro questi sistemi.

La tendenza alla crescita persiste anche nel 2024, con un aumento del 130% degli attacchi a utenti Linux a gennaio-marzo rispetto allo stesso periodo del 2023. I cybercriminali hanno sfruttato diverse vulnerabilità note, confezionando nuovi exploit efficaci.

“Questa tendenza spiega molto accuratamente l’aumento del panorama di minacce a cui assistiamo per Linux. In futuro, è probabile che il numero di exploit e attacchi cresca ulteriormente, sottolineando la necessità vitale di installare le patch e di disporre di una soluzione di sicurezza affidabile”,ha affermato Alexander Kolesnikov, esperto di sicurezza di Kaspersky. “Il maggior valore per gli sviluppatori di exploit risiede nelle vulnerabilità all’interno di software che garantiscono il controllo del sistema di un utente”.

Kaspersky ha evidenziato un aumento del 65% nel numero di CVE registrate negli ultimi quattro anni: si è passati da 15.000 nel 2019 a 25.000 nel 2023. Nell’ultimo anno, inoltre, ricercatori e aziende hanno individuato vulnerabilità critiche con una frequenza tre volte superiore alla media nel periodo di ricerca; nel dettaglio, nel 2019 le vulnerabilità critiche rappresentavano lo 0,19% del totale, mentre nel 2023 la percentuale è salita al 4,85%.

Vista l’evoluzione delle minacce, è essenziale che le aziende proteggano i propri asset e l’intera infrastruttura. Gli esperti di Kaspersky consigliano di implementare un processo di patch management per rilevare le vulnerabilità e installare tempestivamente le patch ed eseguire valutazioni periodiche di sicurezza per identificare e corregge i bug prima che diventino un punto di ingresso per gli attaccanti.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/05/09/aumentano-gli-attacchi-con-exploit-contro-gli-utenti-linux/?utm_source=rss&utm_medium=rss&utm_campaign=aumentano-gli-attacchi-con-exploit-contro-gli-utenti-linux


A.I. tra “nebbie” e “nuvole”: L’intelligenza artificiale per lo sviluppo del Fog e Cloud Continuum

Introduzione al Cloud Continuum e all’Intelligenza Artificiale

La relazione tra intelligenza artificiale e cloud continuum è sempre più importante e rilevante nel panorama tecnologico attuale. L’intelligenza artificiale si basa sull’elaborazione di enormi quantità di dati e sulla capacità di apprendere e adattarsi in modo autonomo, mentre il cloud continuum offre un unico ecosistema formato da una vasta gamma di risorse di calcolo e di archiviazione accessibili da ovunque. Potremmo definire il Cloud Continuum un’esperienza senza soluzione di continuità tra l’elaborazione centralizzata e quella distribuita, tra data center on premise, cloud pubblici e privati, strutture fog e di edge computing, un’evoluzione che va oltre il concetto tradizionale di cloud computing. Non si tratta solo di una tecnologia ma di una topologia in cui molte tecnologie cloud vengono integrate creandone una nuova che collega tutto. Un connubio perfetto tra una tecnologia “affamata” di informazioni come l’I.A. e un’altra abilitante a tutte le informazioni.

Evoluzione del Cloud Computing: Fog e Edge Computing

Il Cloud Continuum mira quindi ad integrare e rendere trasparenti 3 componenti fondamentali delle tecnologie cloud: il cloud computing che riporta i dati a un server centrale per l’archiviazione e l’analisi, il fog computing e l’edge computing che consentono di eseguire analisi e altre funzioni ai margini della rete, localmente, proprio alla fonte dei dati.

L’intelligenza artificiale, finora sviluppatasi prevalentemente nel cloud computing, in questa nuova visione architetturale (Fig.1) si espande ulteriormente anche al Fog Computing ed all’Edge Computing, ambito fino ad ora utilizzato principalmente in sistemi locali basati sull’Internet delle Cose (IoT), progettati con l’obiettivo di ridurre il traffico di dati verso il cloud analizzando parte dei dati localmente ed inviando solo informazioni “semilavorate”, in modo da poter essere utilizzati anche in ambienti con bassa latenza e larghezza di banda.

In particolare l’utilizzo dell’I.A. nel Fog Computing sta emergendo come una soluzione sempre più interessante al problema dell’elaborazione dei dati nell’IoT, che nel frattempo si sta trasformando in AIoT (Artificial Intelligence+IoT), amplificando potenza e velocità di analisi rispetto ai dispositivi finali, essendo questa la componente più vicina ai dispositivi IoT rispetto alle risorse cloud più potenti.

Fig 1

L’integrazione dell’IA nella gestione delle risorse Cloud

Con l’aumento dell’utilizzo dell’I.A. e del Machine Learning (ML), a tutti i vari livelli, i carichi di lavoro del cloud, fog e edge computing stanno diventando sempre più diversificati e dinamici. La convergenza tra fog computing ed intelligenza artificiale, richiede però l’uso di una gestione più intelligente delle risorse.

Nelle tradizionali piattaforme di cloud computing, la gestione delle risorse viene effettuata utilizzando approcci euristici tradizionali senza considerare carichi di lavoro diversi e dinamici. La maggior parte di questi metodi si basa su statiche euristiche configurate offline per determinati scenari di carico di lavoro, che non sono in grado di scalare le applicazioni in fase di esecuzione in base al modello e al comportamento del carico di lavoro.

L’intelligenza artificiale sta entrando anche nei meccanismi di gestione dinamica delle risorse tra i vari stack, l’utilizzo di tecniche I.A./ML per ottimizzare le politiche di gestione delle risorse e potrebbero essere utilizzate per modellare e prevedere metriche a livello di applicazione ed infrastruttura, alfine di ottimizzare l’orchestrazione delle attività e delle risorse migliorando la qualità delle decisioni di provisioning, fino a predirle.

Il Futuro del Cloud Continuum e l’IA

Lo sviluppo del Cloud Continuum riveste così un aspetto fondamentale per gestire le nuove sfide allo sviluppo della futura generazione di applicazioni e servizi, un futuro dove l’utilizzo del cloud non sarà on demand ma permanente e costante e non riguarderà una singola problematica, informazione o file ma il “contesto”.

Per garantire questa costante permanenza nella nostra quotidianità, il cloud continuum deve necessariamente diventare più pervasivo, dalla domotica, all’automotive, dai device mobili ai social network, i contesti per il monitoraggio delle nostre vite diventano sempre più ampi, e l’integrazione di un’I.A. connessa al cloud in tutti i nostri sistemi e processi, sembra essere l’obiettivo a breve e medio termine.

L’I.A. diventa così il “driver” principale per uno sviluppo simbiotico con il Cloud Continuum, che non punta solo a migliorare la produttività e la qualità della nostra vita ma a cambiare definitivamente anche il modo di interagire, sostituendo tastiera e mouse con i sistemi conversazionali dell’I.A. generativa (LLM).

Uno dei primi esempi di integrazione pervasiva è sicuramente il chat bot CoPilot di Microsoft che essendo radicato nel sistema operativo, elimina le catene della limitazione del contesto. L’intero computer, ogni file e ogni dato diventa il contesto.

Dal processo di analisi olistico alla risoluzione avanzata di problemi, l’intera dinamica dell’interazione tra utenti e macchine cambia radicalmente, il cloud continuum entra, a pieno titolo, grazie all’intelligenza artificiale, nel loop decisionale delle nostre scelte.

Considerazioni sulla Sicurezza e l’Etica nel Cloud Continuum

Tutto quello che finora avevamo capito sugli algoritmi di profilazione, a volte eticamente discutibili, che spesso ci suggeriscono e condizionano nelle scelte, sta per svilupparsi in un ambito completamente nuovo: il contesto, che eclisserà i parametri tradizionali degli attuali algoritmi, con il potere derivante da un’intelligenza artificiale in grado di comprende ed utilizzare “il contesto” dei nostri dati e del nostro comportamento.

Una potenzialità senza eguali se paragonata alle tecnologie passate e tutto questo in un mondo dove gli esseri umani sono sempre più connessi, a gennaio 2024 circa 5,54 miliardi di persone in tutto il mondo utilizzano Internet, costituendo il 70,4% della popolazione mondiale (Fonte: Worldometer).

Il cloud continuum potrà permettere di accedere istantaneamente ai tutti nostri dati in tempo reale e alle nostre applicazioni ovunque ci troviamo, senza la necessità di complessi processi di migrazione e integrazione, aumenterà esponenzialmente la produttività in modo sempre più distribuito, efficiente e flessibile, utilizzando la potenza ottimale di calcolo disponibile negli ambienti cloud e multi-cloud.

Fig 2

Il cloud continuum permetterà all’I.A. di interconnettere ed analizzare tutte le informazioni a noi associate, qualsiasi nostra traccia digitale prodotta potrà essere collegata e correlata al nostro contesto (Fig.2).

Il cloud continuum con la sua struttura permette all’I.A. di sfruttare al meglio la sua componente più rivoluzionaria: i modelli linguistici di grandi dimensioni (LLM).

Gli LLM sono reti neurali artificiali che hanno una notevole capacità nell’elaborazione del linguaggio naturale, la generazione di linguaggi generici e altri compiti.

Nello specifico, questi modelli sono in grado di analizzare dati non strutturati, esattamente gli stessi che utilizza l’essere umano per comunicare e apprendere: testi, immagini, video, etc..

Nel 2023 il volume dei dati analizzati dalle I.A. è stato di circa 120 Zettabyte, (per avere un’idea delle dimensioni, uno Zettabyte corrisponde a circa 36000 anni di un video in HD), numero questo in costante crescita nei prossimi anni.

Di tutti i dati analizzati solo il 20% sono dati strutturati, il rimanente 80% appartiene a dati non strutturati: dati presi dai siti web di informazione, dai video di Youtube, da documenti nei repository open source fino ai post dei social network.

L’uso del Continuum Cloud, potenzialmente, permetterà all’I.A. di accedere a qualsiasi “forma” di dato, analizzarla e correlarla ai relativi contesti.

Lo sviluppo del Cloud Continuum permetterà inoltre ai modelli I.A. di crescere ed elaborare sempre più informazioni personali direttamente supervisionate da noi, immaginate ad es. Copilot di Microsoft a cui chiedete di generare documenti di presentazione, leggere mail di lavoro o personali, classificarle e magari ad alcune, rispondere. L’integrazione di un chat bot all’interno di un sistema operativo che è presente nel browser, negli strumenti di produttività, nei sistemi di posta e comunicazione, ha l’enorme vantaggio di poter addestrare l’I.A. a comprendere meglio il nostro modo di essere, il nostro pensiero, su cosa è corretto e sbagliato relativamente al nostro contesto. Questa interazione, che sarà sempre più continuativa e quotidiana, permetterà all’I.A. di evolvere più velocemente nella “comprensione” delle informazioni, seguendo un processo di crowdsourcing. Grazie al crowdsourcing (“folla” dall’inglese crowd) un gran numero di persone può partecipare attivamente a risolvere processi complessi suddividendoli in micro task, nel nostro caso è addestrare l’I.A. a comprendere ciò che analizza.

Ogni richiesta che noi facciamo all’I.A., ogni correzione concettuale che gli diamo, stiamo di fatto facendo del micro training all’I.A., la quale imparerà e condividerà la singola esperienza fatta con ognuno di noi nella sua capacità globale di rispondere alle esigenze di tutti e il Cloud Continuum gli permetterà di avere un’esperienza “sensoriale” su tutto il dominio cibernetico, costante ed in tempo reale.

Una nuova e rivista schiera di agenti virtuali si sta affacciando nel nostro mondo, da versioni sempre più “intelligenti” di assistenti come Siri, Google e Alexa ad assistenti smart con tante funzionalità di I.A. che porteremo sempre in tasca con noi (come ad es. Rabbit R1 – https://www.rabbit.tech/).

E’ inutile dire che tutto ciò porta inevitabilmente a dubbi e perplessità sulla sicurezza dei sistemi e sulla riservatezza e privacy delle informazioni. Alcuni vedono il cloud continuum come l’ennesima enfasi sulla centralizzazione dei dati e delle risorse informatiche, rendendo le organizzazioni ancora più dipendenti dalle grandi corporations che detengono e gestiscono queste enormi infrastrutture e l’integrazione con l’I.A. amplifica queste preoccupazioni.

Un Continuum Cloud che potrebbe facilitare la migrazione verso l’ambiente digitale, potrebbe contestualmente aprire a nuove vulnerabilità e minacce, rendendo le nostre informazioni più sensibili ancora più vulnerabili agli attacchi informatici e alla violazione della privacy, ambienti gestiti da entità esterne di cui non si conosce veramente l’affidabilità e la sicurezza.

Se consideriamo le ingenti risorse necessarie allo sviluppo dei sistemi di I.A. e la capacità del Cloud Continuum di aggregare e gestire risorse eterogenee (pubbliche e private) in un unico ecosistema, le disponibilità economiche necessarie sono effettivamente appannaggio solo di poche e grandi corporations (che hanno fatturati simili al PIL di piccolo Stato) come mostrato nei grafici in figura 3 e 4 per l’anno 2023.

Fig. 3
Fig. 4

La democratizzazione di queste tecnologie e l’etica nell’uso delle risorse è un tema sicuramente vitale per lo sviluppo di applicazioni e servizi sempre più personalizzati, per migliorare, in sicurezza, la qualità della nostra vita. Il rapido sviluppo dell’intelligenza artificiale potrebbe però portare ad una maggiore dipendenza da sistemi automatizzati, rischiando di limitare la libertà individuale e la diversità delle scelte.

Bilanciamento tra Innovazione e Protezione dei Diritti Individuali

Si ripropone un tema ormai annoso, periodico e costante e cioè che è fondamentale trovare un equilibrio tra l’innovazione tecnologica, la protezione dei diritti e delle libertà individuali, per garantire che il progresso sia realmente benefico per la società nel suo complesso.

L’imprenditore miliardario hi-tech Bryan Johnson, proprietario della società di biohacking BionTech, considerato un guru della Silicon Valley, ha dato una rappresentazione del futuro dell’I.A. molto interessante, rappresentando rispetto alle attuali capacità umane, in quanta parte l’I.A. ci sostituirà in queste attività e quanto invece l’essere umano potrà fare grazie all’I.A. (Fig.5).

Fig.5

Immagine che parla da sé e alquanto suggestiva, un’opportunità incredibile e una nuova conoscenza ci aspettano, saremo in grado di gestirla?

Articolo a cura di Francesco Arruzzoli

Profilo Autore

Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/a-i-tra-nebbie-e-nuvole-lintelligenza-artificiale-per-lo-sviluppo-del-fog-e-cloud-continuum/


Online security job leads

Security job seekers have many ways to find job leads. Peer networks and social media are potential resources, especially for those who still think the best jobs are not in the public domain. For the sheer volume of apparently potential opportunities, though, it is hard to ignore job boards.

Job boards are predominantly generalist. This means you must weed through millions of listings unrelated to your security skill sets. Niche market boards exist, though. For instance, our friends at Security Jobs Network have been aggregating professional-level security jobs for more than 20 years.

SJN reports that, in addition to mid-level security roles, there is a marked increase in public listings of senior- and executive-level security and risk management positions. Salaries and comp packages for these jobs are routinely in the hundreds of thousands of dollars. What is diving this proliferation of security job listings?

One factor is organizations no longer need to pay high advertising fees to gain exposure to their target candidates. There are thousands of online listing sites open to global audiences, including the career sections of most company websites. Hiring and recruitment firms can generate responses for their openings this way, often at little to no cost.

Candidates can easily attach their profile or resume to a job on a board or company site instantly. This generates the large volume of applicants companies initially think they want. The number of responses might also be the statistic some talent acquisition (TA) practitioners are measured against.

It sounds great for both the hiring company and the job seeker. However, the resulting experience for both is often anything but great.

The top complaint we hear from security jobs seekers is not getting a response after applying to a job they believe they are the perfect match for. The top complaint we hear from companies looking to hire security professionals is they cannot find — or respond to — top talent given the deluge of applications they have received.

The chaotic nature of internet job posting has set up hiring challenges not readily clear to job seekers:

  • HR and/or TA staff have been reduced, but the volume of openings across organizations has increased. Recruiters often have multiple roles they manage and simply do not have the bandwidth to review every candidate. Additionally, they may not understand each of the organization’s functional areas and those roles they are recruiting for.
  • A company’s internal recruiting management system may be integrated into one of the major job boards as outsourced public posting. These are often complex set-ups and not necessarily configured with the candidate’s experience in mind. Knowledge about how these systems work is an ongoing challenge for companies, made more difficult if the organization has a high TA turnover rate.
  • A corporation’s internal policies may dictate positions are always listed publicly, even if the intent is to only consider internal candidates first.
  • Sometimes jobs are posted only for a day or two to enable a small number of previously sourced candidates to input their details into the company’s internal system. A variation of this is some intake systems either close a job or stop accepting new applicants after a certain number of applications. In either of these scenarios, not everyone who applies will be reviewed.
  • Corporate policy may be for recruiters to simply collect resumes and notify the hiring manager they are available for review on the company’s internal collection system. Many of these systems are not intuitive. As a practitioner, can you imagine how you would carve time from your day to review hundreds of applicant names? Some systems allow you to open only one record at a time to display limited information. From that snapshot, you will then have to decide if you want to open the related resume.
  • Social media sites and job boards often derive income from advertising. Many also troll and scape job listings from company career websites, recruiter sites and each other. Jobs get redated, reposted and reused. The goal is to drive user traffic, but the practice creates misinformation on a massive scale.

Well-prepared security job seekers invest time in self-assessment, resume development, branding and interview preparation. All while performing their day jobs. Their hope is to be fairly evaluated for the jobs they apply for. Unfortunately, that is often not the case, to the detriment of both the hiring company and the job seeker.

https://www.securitymagazine.com/articles/100641-online-security-job-leads


Navigating retail security challenges: A comprehensive approach

@import url(‘https://fonts.googleapis.com/css2?family=Nunito+Sans:ital,opsz,wght@0,6..12,400;0,6..12,500;0,6..12,600;0,6..12,700;1,6..12,400;1,6..12,500;1,6..12,600;1,6..12,700&family=Nunito:ital,wght@0,400;0,500;0,600;0,700;1,400;1,500;1,600;1,700&display=swap’); h3 { font-weight: bold; font-size: 18px; color: #C72026; } .w3-panel:after,.w3-panel:before { content: “”; display: table; clear: both } .w3-panel { padding: 16px; margin-top: 16px; margin-bottom: 16px } .w3-leftbar { border-left: 6px solid #660066!important } .w3-color,.w3-hover-color:hover { color: #660066!important; background-color: #f9ecf2!important } .w3-large { font-size: 20px!important } .w3-sans-serif { Nunito Sans’,Arial,sans-serif } .w3-opacity,.w3-hover-opacity:hover { opacity: 0.60 }

In the dynamic landscape of the retail industry, loss prevention professionals continually grapple with a diverse range of challenges that evolve with the times. From internal threats like employee theft and collusion with organized retail criminals to external challenges such as organized retail crime (ORC), flash mobs and smash-and-dash incidents, retailers face a complex security environment. This article investigates these complicated issues, highlighting the necessity for innovative solutions and an initiative-taking, technology-driven approach to enhance security measures.

Employee theft and collusion

Employee theft and collusion with organized criminal elements present significant risks to retailers. The National Retail Federation’s (NRF) 2023 National Retail Security Survey disclosed that approximately one third of retail theft losses were attributed to employee theft, including instances of collaboration with organized retail criminals.

Recent findings reported in a 2023 article in Security Magazine emphasize the urgent need for robust pre-employment screening. This article revealed that ORC leaders strategically recruit employees without criminal backgrounds and target disgruntled individuals within the workforce.

A promising solution gaining traction in the industry is the use of automated behavior assessment software, exemplified by tools that select out undesirable applicants. Traditional background checks, while valuable, have limitations in uncovering behaviors and characteristics indicating a potential for criminal activity. Automated behavior assessments offer a more comprehensive approach, utilizing advanced algorithms to analyze behavioral patterns, personality traits and risk indicators.

The power of automated behavior assessments

These assessments go beyond the scope of traditional background checks by evaluating an applicant’s ethical decision-making, honesty and propensity for risky or illegal activities. Scientifically validated methodologies are employed to assess responses to situational judgment scenarios and behavioral questionnaires. This objective measurement helps retailers make informed hiring decisions and identify potential red flags before an individual becomes part of the organization.

By incorporating automated behavior assessments into the pre-employment screening process, retailers can effectively address the issue of collusion with organized retail criminals. The statistic from the National Retail Federation, highlighting the substantial impact of employee theft, underscores the importance of identifying individuals susceptible to participating in such criminal acts.

Furthermore, automated assessments offer a standardized and objective evaluation method, reducing the potential for bias in the hiring process. Human judgment can be influenced by subjective factors, but tools like behavioral selection software provide an unbiased analysis of an applicant’s behavioral traits, ensuring fair treatment and consistent evaluations for all candidates.

Incorporating behavior assessment software into the pre-employment screening process serves as a deterrent to potential insider threats. The knowledge that their behavior will undergo thorough assessment may dissuade individuals with criminal intent from applying or attempting collusion. This sends a clear message that retailers prioritize security and are committed to preventing organized retail criminal acts.

It is essential to note that automated behavior assessments should not replace other screening measures but complement them. These assessments should be used in conjunction with thorough checks and interviews to form a comprehensive evaluation of an applicant’s suitability. They background investigations to provide an additional layer of information that enhances the overall decision-making process.

A landscape of challenges

Moving beyond internal threats, retailers grapple with a host of external challenges outlined in the NRF Loss Prevention Annual Survey. These challenges include the rise of organized retail crime, flash mobs and riots leading to retail burglaries, as well as smash-and-dash incidents.

Organized retail crime has witnessed a surge driven by various factors such as social unrest, an increase in felony theft limits and the ancillary fallout from the COVID-19 pandemic. ORC groups have become more violent, and political changes in power have added another layer of complexity to the situation.

❝

The retail industry is at a critical juncture where initiative-taking measures are essential to navigate the evolving landscape of security challenges.”

To combat external threats, retailers are adopting intelligence-gathering methods monitoring social media and implementing physical barriers like nylon mesh, crash-resistant window coverings, bollards and video analytics linked to point of sale with exception-based reporting. Additionally, retailer cooperative groups, such as the Organized Retail Crime Associations and the Coalition of Law Enforcement and Retailers, play a crucial role in information sharing and collaboration.

The rise of flash mobs and riots leading to retail burglaries presents a growing concern. Social media posts during such events attract young opportunists, necessitating well-defined response protocols, intelligence gathering and premises protection measures.

Defined as quick grab-and-go thefts, smash-and-dash incidents are increasing, with social media posts playing a role in attracting young opportunists. Effective investigative methods and premise protection, including the use of technology and physical barriers, are vital in addressing this challenge.

A layered approach

Comprehensive prevention programs are crucial for retailers to address these diverse challenges. Strategies include product placement, securing high-value items and leveraging technology like Electronic Article Surveillance (EAS), cables, drones and RFID. Video surveillance technology with analytics and facial recognition can identify watch list suspects, and GPS tracking on electronics can be activated or attached to deter theft.

Furthermore, it is essential to consider product placement strategies such as keeping high-cost and desirable items away from exits and securing them with proper hardware to slow theft. Displaying items on the floor while keeping stock in lockups and time-delay product safes can be an effective preventive measure.

While Electronic Article Surveillance (EAS), cables and RFID are effective for opportunistic theft, they may not suffice for combating organized retail crime and burglaries. In such cases, video surveillance technology with analytics and facial recognition becomes instrumental in identifying suspects on watch lists, information sharing, enabling immediate intervention or application.

GPS tracking on electronics, when activated or attached and enclosed in packaging, can provide an added layer of security. These measures, combined with a well-thought-out staffing strategy featuring appropriate levels with aggressive customer service skills, contribute to an effective prevention program. However, businesses must remain vigilant for decoys that could distract employees while others engage in shoplifting.

Partnerships between law enforcement and loss prevention through organized retail crime organizations, such as the Coalition of LE and Retailers (CLEAR), play a crucial role in information sharing and collaboration. Additionally, artificial intelligence (AI) can aid in finding intelligence providers capable of navigating the dark and deep web to gather information on scheduled protests and potential targets.

The retail industry is at a critical juncture where initiative-taking measures are essential to navigate the evolving landscape of security challenges. Internal threats like employee theft and collusion demand sophisticated solutions, and automated behavior assessments offer a robust approach to enhancing pre-employment screening. External threats, including organized retail crime and incidents stemming from social unrest, require a comprehensive strategy involving intelligence, collaboration and innovative technology.

In the pursuit of sustaining a safe environment for both employees and customers, the integration of innovative tools and methodologies is no longer a choice but a necessity. Retailers must not only stay abreast of the latest information but also embrace innovative technologies and cultivate collaborative efforts within the industry, law enforcement and legislative bodies. This initiative-taking stance enables retailers to effectively confront the numerous challenges posed by organized retail crime, flash mobs and smash-and-dash incidents. The path forward demands a comprehensive and initiative-taking approach to loss prevention, ensuring the perpetual safety and security of retail establishments in a dynamic and ever-changing environment.

Ultimately, mitigating all factors contributing to inventory shrinkage is imperative for retail establishments. The alternative, as observed in cities like Portland, Oregon, San Francisco, Seattle, and Chicago and others, may result in closures, leaving a void for honest, hardworking citizens who will then have to travel greater distances for their shopping needs.

https://www.securitymagazine.com/articles/100640-navigating-retail-security-challenges-a-comprehensive-approach