AT&T: Data breach affects 73 million or 51 million customers. No, we won’t explain.

AT&T: Data breach affects 73 million or 51 million customers. No, we won’t explain.
Getty Images

AT&T is notifying millions of current or former customers that their account data has been compromised and published last month on the dark web. Just how many millions, the company isn’t saying.

In a mandatory filing with the Maine Attorney General’s office, the telecommunications company said 51.2 million account holders were affected. On its corporate website, AT&T put the number at 73 million. In either event, compromised data included one or more of the following: full names, email addresses, mailing addresses, phone numbers, social security numbers, dates of birth, AT&T account numbers, and AT&T passcodes. Personal financial information and call history didn’t appear to be included, AT&T said, and data appeared to be from June 2019 or earlier.

The disclosure on the AT&T site said the 73 million affected customers comprised 7.6 million current customers and 65.4 million former customers. The notification said AT&T has reset the account PINs of all current customers and is notifying current and former customers by mail. AT&T representatives haven’t explained why the letter filed with the Maine AG lists 51.2 million affected and the disclosure on its site lists 73 million.

According to a March 30 article published by TechCrunch, a security researcher said the passcodes were stored in an encrypted format that could easily be decrypted. Bleeping Computer reported in 2021 that more than 70 million records containing AT&T customer data was put up for sale that year for $1 million. AT&T, at the time, told the news site that the amassed data didn’t belong to its customers and that the company’s systems had not been breached.

Last month, after the same data reappeared online, Bleeping Computer and TechCrunch confirmed that the data belonged to AT&T customers, and the company finally acknowledged the connection. AT&T has yet to say how the information was breached or why it took more than two years from the original date of publication to confirm that it belonged to its customers.

Given the length of time the data has been available, the damage that’s likely to result from the most recent publication is likely to be minimal. That said, anyone who is or was an AT&T customer should be on the lookout for scams that attempt to capitalize on the leaked data. AT&T is offering one year of free identity theft protection.

https://arstechnica.com/?p=2016342


Security leaders weigh in on the White House’s order regarding AI

The White House recently held a press call to announce a new order for federal agencies. All federal agencies must establish a chief artificial intelligence (AI) officer within the organization that will oversee the organization’s approach to AI. The goal of this established position will be to effectively manage the risks of evolving AI technology within each federal organization. The chief AI officer is expected to be experienced and knowledgeable in regard to emerging AI capabilities and security threats. 

Security leaders weigh in

Marcus Fowler, CEO of Darktrace Federal:

“While establishing AI leadership is an important step in ensuring the safe use of AI technologies– and there are existing frameworks around secure AI system development provided by CISA and the UK NCSC–  these efforts and resources are not the only thing organizations can do to adequately encourage the safe use of generative AI technologies.

“In order to ensure the safe and effective deployment of these tools in their workplaces, it is vital that AI officers and their associated teams have a firm understanding of “normal” behavior across their networks and IT environments and take part in a dedicated effort to educate their broader organizations with these findings. Through this approach, AI executives and their teams can ensure their broader organizations are equipped with a general understanding of the use cases and risks associated with leveraging AI tools, how these issues relate back to their roles and areas of business specifically, and best practices for mitigating business risk. 

“There are three areas of AI implementations that governments and companies should prioritize: data privacy, control and trust—but it’s vital that organizations remember that each of these areas require significant influence from leaders to remain effective. In addition to leveraging industry standards and appointing key leadership teams tasked with ensuring the effective use of these technologies, it’s critical that organizations also establish trust in these roles across their companies by highlighting the value that AI-focused roles bring to the broader organization. This will help to ensure that each and every team member is familiar and comfortable with the internal resources available to them – encouraging stronger collaboration between teams in tandem with the supervised use of these tools, ultimately strengthening an organization’s broader security posture.”

Gal Ringel, Co-Founder and CEO at Mine:

“These rules will be somewhat successful in safeguarding AI use, but it’s key to understand this only applies to the government, and thus, the public sector. The American private sector, from where much of the technological innovation of the past few decades has come, is still operating with mostly free rein when it comes to AI. Regarding the rules for government itself, internal assessments and oversight could provide a loophole for lax AI governance. While I understand the security concerns, independent third parties would be better suited for running AI-related assessments, which might necessitate the need to create a specific government agency to do just that.

“Utah just passed an AI law, which is opening Pandora’s Box since it paves the way for each state to pass its own AI law in the same way each state has sought to pass its own data privacy law. There needs to be a federal law that oversees the private sector, and while you don’t need to take the same risk-based approach the EU and UK have, meaningful legislation needs to come through to promote the same principles of transparency, harm reduction, and responsible usage echoed in today’s announcement.”

https://www.securitymagazine.com/articles/100557-security-leaders-weigh-in-on-the-white-houses-order-regarding-ai


Artificial intelligence (AI) e Sanità

La Commissione Europea ha di recente ricordato come “Artificial intelligence (AI) is not science fiction; it is already part of our everyday lives, from using a virtual personal assistant to organise our day, to having our phones suggest songs we might like”[1].

In tal senso, a fronte di una proliferazione spesso abusata del termine “intelligenza artificiale”, bisogna ricordare con sempre maggiore enfasi che la stessa necessita di un approccio cosciente e (in)formato per poter essere adeguatamente governata, anche a protezione dei diritti e delle libertà degli interessati.

L’applicazione di un agente/prodotto/sistema di AI richiede, anzitutto, che siano rispettati i seguenti principi:

  • Dignità e supervisione umana;
  • Robustezza e sicurezza;
  • Privacy e governance dei dati;
  • Trasparenza;
  • Diversità, non discriminazione ed equità;
  • Benessere sociale e ambientale;
  • Accountability.

Ma oltre ai principi è necessario considerare gli impatti che produce e, ancor di più, a quali rischi si va incontro facendone uso, ossia:

  • Generalità
  • Correttezza
  • Sicurezza
  • Safety
  • Tutela della privacy
  • Robustezza
  • Trasparenza e spiegabilità.

Nello specifico ambito sanitario, in tal senso possono essere di evidente aiuto – supportandoci nella comprensione di quanto sopra citato – alcuni documenti, quali ad esempio il report[2] dedicato all’AI in ambito sanitario emesso nel 2023 dalla World Health Organization, dove si precisa che:

“Questo documento fornisce una panoramica delle considerazioni normative sull’IA per la salute coprendo argomenti chiave quali: documentazione e trasparenza, gestione del rischio e ciclo di vita dello sviluppo dei sistemi di IA l’uso previsto e la convalida analitica e clinica, la qualità dei dati, la privacy e la protezione dei dati l’impegno e la collaborazione.

Questo documento vuole essere un elenco delle principali considerazioni normative e una risorsa che può essere considerata da tutti i portatori di interessi pertinenti negli ecosistemi dei dispositivi medici, compresi gli sviluppatori che stanno esplorando e sviluppando sistemi di IA, le autorità di regolamentazione che potrebbero essere in procinto di gestire e facilitare i sistemi di IA, i fabbricanti che progettano e sviluppano dispositivi medici integrati nell’IA, i professionisti che distribuiscono e utilizzano tali dispositivi medici e sistemi di IA e altri che lavorano in questi settori“.

In particolare, il documento, suddiviso in 6 aree, descrive gli impatti e i rischi ai quali è soggetta l’applicazione con riferimento alla salute delle persone.
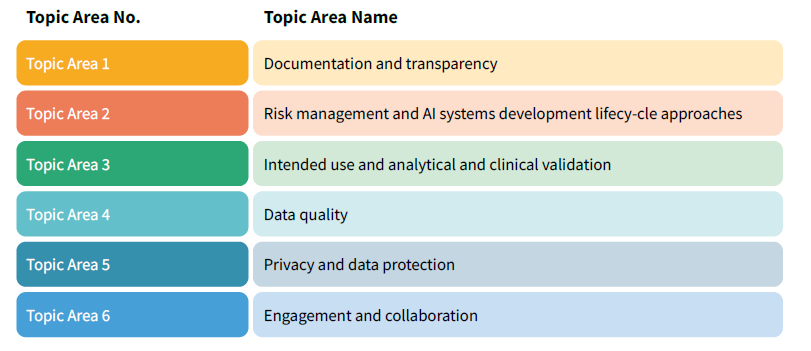
Queste aree descrivono, in maniera dettagliata, le problematiche che si possono incontrare, e così:

  1. Documentazione e trasparenza: pre-specificare e documentare lo scopo medico previsto nel processo di sviluppo, quali la selezione e l’uso di set di dati, norme di riferimento, parametri, metriche, deviazioni dai piani originali e aggiornamenti durante le fasi di sviluppo, dovrebbero essere in modo da consentire di tracciare le fasi di sviluppo, se del caso. Un approccio basato sul rischio dovrebbe essere preso in considerazione anche per il livello di documentazione e di conservazione dei dati sviluppo e validazione di sistemi di IA.
  2. Approcci al ciclo di vita della gestione del rischio e allo sviluppo di sistemi di IA: un ciclo di vita totale del prodotto dovrebbe essere preso in considerazione in tutte le fasi del ciclo di vita di un sistema di IA, vale a dire: gestione dello sviluppo, sorveglianza post-commercializzazione e gestione del cambiamento. Inoltre, è prendere in considerazione un approccio di gestione del rischio che affronti i rischi associati ai sistemi di IA, come le minacce e le vulnerabilità alla cibersicurezza, l’underfitting, i pregiudizi algoritmici, ecc.
  3. Destinazione d’uso e convalida analitica e clinica: Inizialmente, fornire una documentazione trasparente dell’uso previsto del sistema di IA. Dettagli della composizione del set di dati di training alla base di un sistema di IA, comprese le dimensioni, l’impostazione e la popolazione, i dati di input e output e composizione demografica – dovrebbero essere documentati in modo trasparente e forniti agli utenti.
    Inoltre è fondamentale prendere in considerazione la possibilità di dimostrare le prestazioni al di là dei dati di addestramento e test attraverso validazione analitica in un set di dati indipendente. Questo set di dati di convalida esterno deve essere rappresentativo della popolazione e dell’ambiente in cui si intende utilizzare il sistema di IA e dovrebbe essere indipendente del set di dati utilizzato per lo sviluppo del modello di IA durante l’addestramento e il test. Documentazione trasparente dell’insieme di dati esterno e delle metriche di prestazione. È importante prendere anche in considerazione una serie graduata di requisiti per la convalida clinica in base al rischio. Gli studi clinici randomizzati sono “gold standard” per la valutazione delle prestazioni cliniche comparative e potrebbe essere strumenti a più alto rischio o in cui è richiesto il più elevato livello di evidenza. In altre situazioni, le prospettive.
    La convalida può essere presa in considerazione in una prova di distribuzione e implementazione nel mondo reale che include un comparatore pertinente che utilizza gruppi accettati. Infine, un periodo di post-dispiegamento più intenso dovrebbe essere preso in considerazione attraverso la sorveglianza post-commercializzazione e la vigilanza del mercato per i sistemi IA.
  4. Qualità dei dati: gli sviluppatori dovrebbero valutare se i dati disponibili sono di qualità sufficiente per supportare lo sviluppo del sistema di IA per raggiungere lo scopo previsto. Inoltre, gli sviluppatori dovrebbero prendere in considerazione l’implementazione di rigorose valutazioni pre-rilascio per i sistemi di IA per garantire che non si amplifichino dei problemi, come distorsioni ed errori. Progettazione accurata o la risoluzione tempestiva dei problemi può aiutare a identificare tempestivamente i problemi di qualità dei dati e può prevenire o mitigare possibili danni che ne derivino. I portatori di interessi dovrebbero inoltre prendere in considerazione la possibilità di attenuare i problemi di qualità dei dati e rischi che emergono nei dati sanitari, nonché continuare a lavorare per creare ecosistemi di dati per facilitare la condivisione di fonti di dati di buona qualità.
  5. Privacy e protezione dei dati: la privacy e la protezione dei dati dovrebbero essere considerate durante la progettazione e la diffusione dei sistemi di IA. All’inizio del processo di sviluppo, gli sviluppatori dovrebbero prendere in considerazione l’acquisizione di una buona comprensione delle normative applicabili in materia di protezione dei dati e delle leggi sulla privacy e che il processo di sviluppo soddisfi o superi tali requisiti legali. È inoltre importante prendere in considerazione l’attuazione di un programma di conformità che affronti i rischi e garantisca che la tutela della Privacy. Le pratiche di cybersicurezza tengono conto dei potenziali danni e del contesto di applicazione.
  6. Coinvolgimento e collaborazione: durante lo sviluppo della tabella di marcia per l’innovazione e la diffusione dell’IA.

È necessario considerare lo sviluppo di piattaforme accessibili e informative che facilitino l’impegno e la collaborazione tra le principali parti interessate, ove applicabile e appropriato, così come è fondamentale prendere in considerazione la razionalizzazione del processo di sorveglianza per la regolamentazione dell’IA e la collaborazione al fine di accelerare i progressi che cambiano la pratica nell’IA.

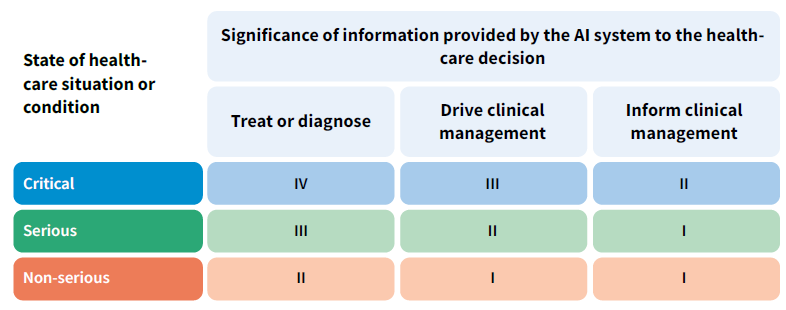
Il documento analizza anche i rischi in ambito sanitario dell’AI classificandoli come da immagine che segue:
Sempre sul tema è di certo interesse guardare all’Artificial intelligence in healthcare Applications, risks, and ethical and societal impacts[3] dell’EPRS (European Parliamentary Research Service), che riporta i 7 rischi che emergono in un sistema/agente di AI indicandone anche le misure di remediation (cui si rimanda):

  1. Danni al paziente dovuti a errori di intelligenza artificiale;
  2. Uso improprio degli strumenti di IA medica;
  3. Rischio di bias nell’IA medica e perpetuazione delle disuguaglianze;
  4. Mancanza di trasparenza;
  5. Problemi di privacy e sicurezza;
  6. Lacune nella responsabilità dell’IA;
  7. Ostacoli all’implementazione nell’assistenza sanitaria nel mondo reale.

L’analisi dei rischi dovuti all’AI viene, poi, affrontata anche dal RMF (Risk Management Framework) del NIST [https://www.nist.gov/itl/ai-risk-management-framework] che riporta, per le funzioni, le sottocategorie alle quali è necessario rispondere per avere una valutazione del sistema:
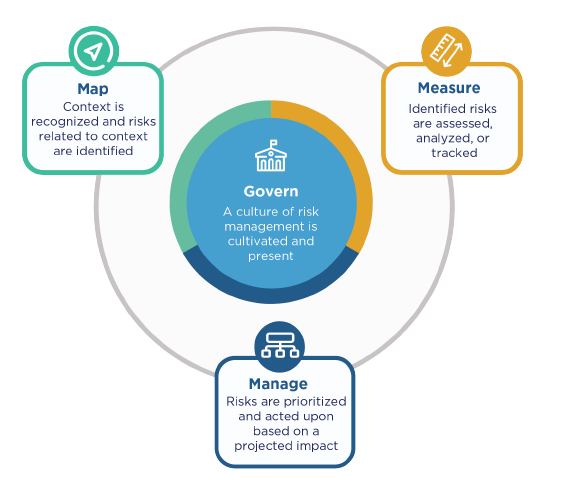
  • la funzione GOVERN è suddivisa in 6 categorie e 13 sottocategorie. Questa coltiva e implementa una cultura della gestione del rischio all’interno delle organizzazioni che progettano, sviluppano, implementano, valutano o acquisiscono sistemi di intelligenza artificiale; delinea i processi, i documenti e gli schemi organizzativi che anticipano, identificano e gestiscono i rischi che un sistema può comportare, incorpora processi per valutare gli impatti potenziali; fornisce una struttura in base alla quale le funzioni di gestione del rischio dell’IA possono allinearsi ai principi, alle politiche e alle priorità strategiche dell’organizzazione; collega gli aspetti tecnici della progettazione e dello sviluppo dei sistemi di AI ai valori e ai principi dell’organizzazione e consente pratiche e competenze organizzative per le persone coinvolte nell’acquisizione, nella formazione, nell’implementazione e nel monitoraggio di tali sistemi; e affronta l’intero ciclo di vita del prodotto e i processi associati, comprese le questioni legali e di altro tipo relative all’uso di sistemi e dati software o hardware di terze parti;
  • la funzione MAP è suddivisa in 5 categorie e 18 sottocategorie. La MAP stabilisce il contesto per inquadrare i rischi relativi a un sistema di IA. L’IA Il ciclo di vita è costituito da molte attività interdipendenti che coinvolgono un insieme diversificato di attori. In pratica, gli attori dell’IA responsabili di una parte del processo spesso non dispongono di visibilità o controllo su altre parti e sui loro contesti associati;
  • la funzione MEASURE, invece, è composta da 4 categorie e 22 sottocategorie. Questa impiega strumenti, tecniche e metodologie quantitative, qualitative o miste per analizzare, valutare, confrontare e monitorare il rischio dell’IA e i relativi impatti. Utilizza le conoscenze relative ai rischi dell’IA identificati nella funzione MAP e informa la funzione MANAGE. I sistemi di IA dovrebbero essere testati prima della loro diffusione e regolarmente durante il funzionamento. Le misurazioni del rischio dell’IA includono la documentazione degli aspetti della funzionalità e dell’affidabilità dei sistemi;
  • la funzione MANAGE, infine, è suddivisa in 4 categorie e 13 sottocategorie e comporta l’allocazione delle risorse di rischio a rischi mappati e misurati su base regolare e come definito dalla funzione GOVERN. Il trattamento del rischio comprende piani per rispondere, riprendersi e comunicare in merito a incidenti o eventi.

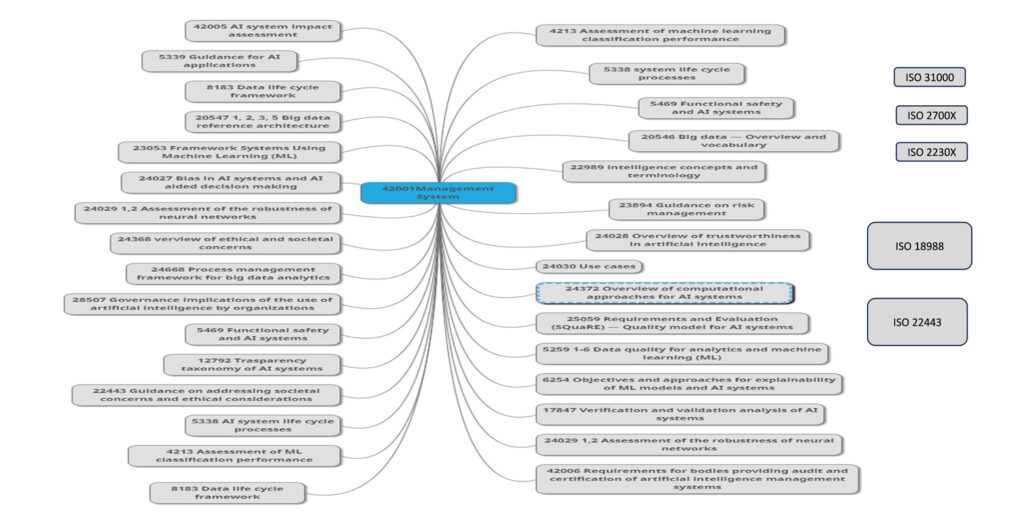
Senza dimenticare che, oltre ai documenti già citati, possono venire in aiuto anche le norme ISO dedicate all’AI, in primis quella relativa ad un sistema di gestione dell’AI – la norma(con i relativi controlli) -, e come supporto tutte le norme di contorno a partire dalla ISO 42005 relativa alla valutazione d’impatto, la ISO 23894 dedicata ai rischi, le norme ISO della serie 250XX dedicata alla qualità dei dati e del software oppure quelle relative alla gestione e validazione degli algoritmi di Machine Learning e le norme ISO 18988 (Applicazione delle tecnologie AI all’informatica sanitaria) e ISO 22443 (Guida su come affrontare le preoccupazioni sociali e le considerazioni etiche) che sono in fase di pubblicazione. Altre norme che possono aiutare a comprendere il sistema, i rischi e gli impatti sono la ISO 27001 sulla sicurezza delle informazioni, ISO 27005 sui rischi relativi alla sicurezza delle informazioni, ISO 31000 sulla gestione dei rischi e ISO 22301 sulla continuità operativa.
In ultimo, anche il Regolamento “AI Act” – caratterizzato da un risk-based approach – concentra buona parte dei propri sforzi sulla parte relativa ai rischi, considerando di “alto livello” quelli trattati nel presente contributo, e così:

“Articolo 6

Regole di classificazione per i sistemi di IA ad alto rischio

  1. Indipendentemente dal fatto che un sistema di IA sia immesso sul mercato o messo in servizio indipendentemente dai prodotti di cui alle lettere a) e b), tale sistema di IA è considerato ad alto rischio se sono soddisfatte entrambe le seguenti condizioni:
  2. a) il sistema di IA è destinato a essere utilizzato come componente di sicurezza di un prodotto, o il sistema di IA è esso stesso un prodotto disciplinato dalla normativa di armonizzazione dell’Unione elencata nell’allegato II;
  3. b) il prodotto il cui componente di sicurezza a norma della lettera a) è il sistema di IA, o il sistema di IA stesso in quanto prodotto, è tenuto a sottoporsi a una valutazione della conformità da parte di terzi, ai fini dell’immissione sul mercato o della messa in servizio di tale prodotto a norma della normativa di armonizzazione dell’Unione elencata nell’allegato II.
  4. Oltre ai sistemi di IA ad alto rischio di cui al paragrafo 1, anche i sistemi di IA di cui all’allegato III sono considerati ad alto rischio”.

In particolare l’allegato III cita:

“5. Accesso e godimento dei servizi privati essenziali e dei servizi e delle prestazioni pubbliche essenziali:
a) sistemi di IA destinati a essere utilizzati dalle autorità pubbliche o per conto delle autorità pubbliche per valutare l’ammissibilità delle persone fisiche a prestazioni e servizi essenziali di assistenza pubblica, compresi i servizi sanitari, nonché per concedere, ridurre, revocare o richiedere tali prestazioni e servizi”.

L’AI Act, oltre ai servizi, considera anche i prodotti e i dispositivi medici come indicato dal Regolamento UE 2017/745 del 5 aprile 2017 relativo ai dispositivi medici, i quali sono considerati oggetti ad alto rischio.

Nell’ambito sanitario, dove è importantissimo l’impatto sulla persona diventa fondamentale la conoscenza dei processi di Machine Learning, dalla qualità e correttezza dei dati, agli algoritmi utilizzati, alle metodologie e ai controlli.

Ad esempio:
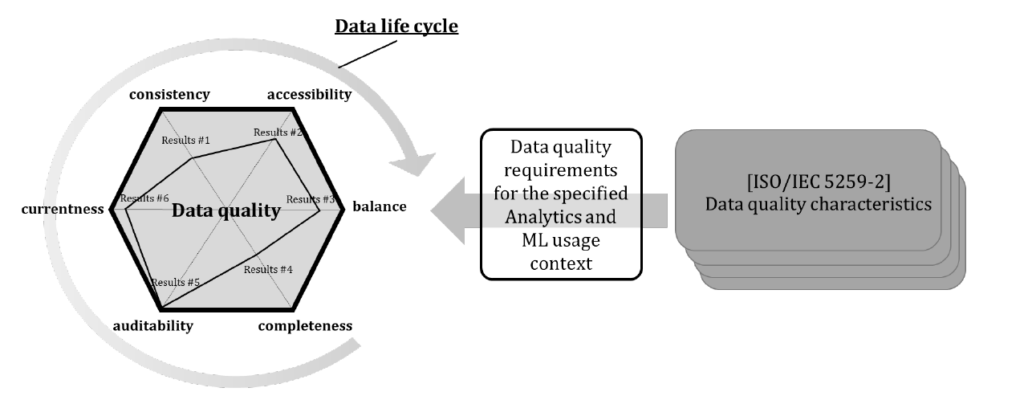
  • la qualità dei dati,

  • i tipi di ML utilizzati: Supervisionato, non supervisionato e rinforzato (ISO 2053),
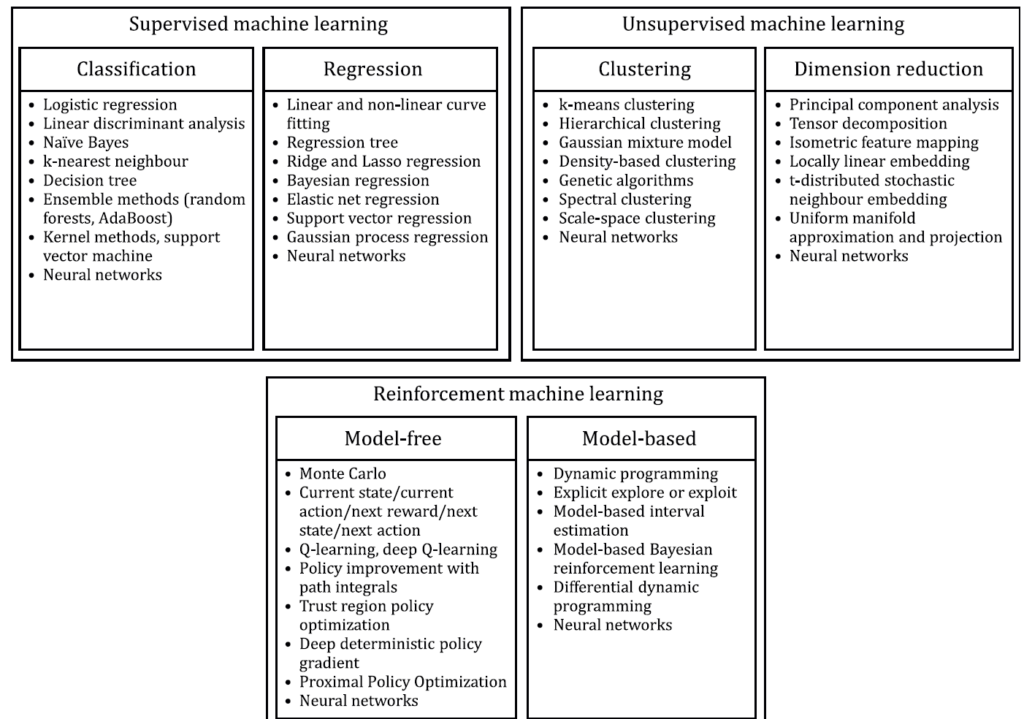
che risultano importanti per:

  • Diagnosi della malattia
  • Medicina personalizzata
  • Produzione di farmaci
  • Svolgimento dei test clinici
  • Radioterapia e radiologia
  • Raccolta elettronica dei dati
  • Previsione delle epidemie

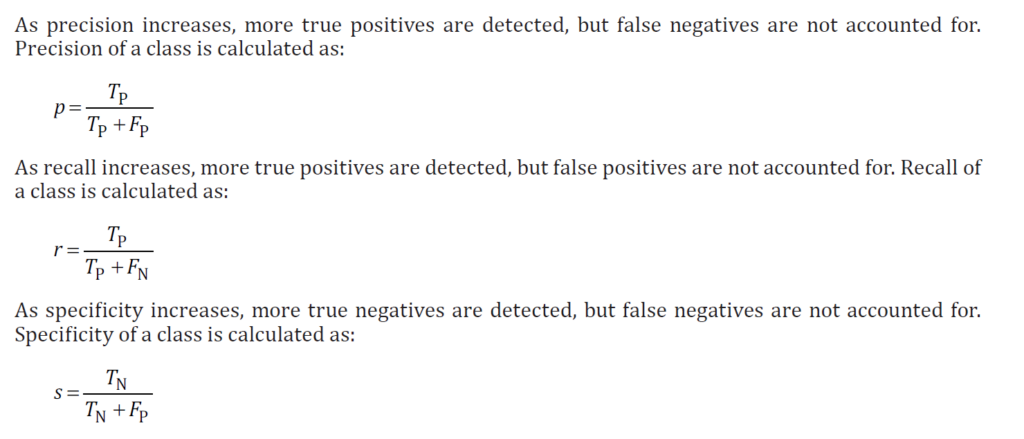
e i suoi controlli (dove T=vero, F=falso, P=positivo e N=negativo) come riportato dalla ISO TS 4213:
  • oppure i tipi di AI:
    • Intelligenza artificiale stretta (ANI), che ha una gamma ristretta di abilità, definita anche come debole o stretta;
    • Intelligenza generale artificiale (AGI), che è alla pari con le capacità umane, definita anche come AI forte o profonda;
    • Super intelligenza artificiale (ASI), che risulta più capace di un essere umano.

Allora, l’analisi e la riduzione dei rischi, dato l’elevato impatto sulle persone, diventa un’attività fondamentale e necessaria per una corretta applicazione e gestione dei sistemi AI.

Volendo, infine, scendere più nel concreto con riferimento all’applicazione pratica di Ai nell’ambito sanitario, è d’obbligo citare – seppur in estrema sintesi – il recente (marzo 2024) “Compendio sul trattamento dei dati personali effettuato attraverso piattaforme volte a mettere in contatto i pazienti con i professionisti sanitari accessibili via web e app” del Garante italiano per la protezione dei dati personali. Nello specifico, si tratta di un documento che fornisce indicazioni su come devono essere trattati i dati nei casi in cui il contatto tra medico e paziente avvenga attraverso una piattaforma o una app, ossia mediante strumenti innovativi che contengono sistemi di AI.

Il decalogo dei punti cui prestare particolare attenzione può essere riassunto come segue:

  1. finalità del trattamento,
  2. coordinamento con la disciplina vigente,
  3. basi giuridiche,
  4. divieto di diffusione dei dati e comunicazione di dati a terzi,
  5. valutazione d’impatto,
  6. ruoli privacy, adempimenti e responsabilità,
  7. principio di correttezza e trasparenza e informativa,
  8. trattamenti transfrontalieri,
  9. Privacy by Design,
  10. sicurezza del trattamento.

Per quanto qui d’interesse, si rileva che:

  • con riferimento al punto 5, il trattamento rientra tra quelli ad alto rischio che richiedono obbligatoriamente la preventiva valutazione d’impatto ex 35 GDPR[4] e delle Linee Guida del Gruppo di Lavoro Articolo 29[5], al fine di comprovare l’idoneità delle misure di sicurezza applicate, tenuto anche conto degli specifici rischi connessi al trattamento effettuato,
  • ex punto 9, i titolari del trattamento sono tenuti a trattare i dati personali solo utilizzando sistemi e tecnologie che integrano by design e by default i principi di protezione dei dati (cfr. considerando 78 del Regolamento e punto 94 delle citate Linee guida),
  • ai sensi del punto 10, il gestore della piattaforma dovrebbe implementare misure di sicurezza adeguate e così, ad esempio:
    • tecniche crittografiche durante la trasmissione dei dati su internet
    • un protocollo di rete che garantisca la riservatezza e l’integrità dei dati scambiati tra il browser dell’utente e il server che ospita i servizi delle predette piattaforme, consentendo inoltre agli utenti di verificare l’autenticità del sito web visualizzato.
    • una procedura di adesione alla piattaforma da parte dello specialista che preveda la verifica del possesso della qualifica professionale (es. invio di un codice OTP all’indirizzo PEC -censito su INI-PEC- del medesimo professionista);
    • una procedura di verifica/convalida del dato di contatto scelto dall’utente (es. indirizzo di posta elettronica, numero di cellulare);
    • misure volte alla riduzione degli errori di omonimia/omocodia;
    • una procedura di autenticazione informatica a più fattori;
    • meccanismi di blocco dell’app in caso di inattività o di chiusura della medesima;
    • sistemi di monitoraggio, anche automatici, per rilevare accessi non autorizzati o anomali alla piattaforma.

Note

Articolo a cura di Stefano Gorla e Anna Capoluongo

Profilo Autore

Consulente e formatore in ambito governance AI, sicurezza e tutela dei dati e delle informazioni;
Membro commissione 533 UNINFO su AI; Comitato di Presidenza E.N.I.A.
Membro del Gruppo di Lavoro interassociativo sull’Intelligenza Artificiale di Assintel
Auditor certificato Aicq/Sicev ISO 42001, 27001, 9001, 22301, 20000-1, certificato ITILv4 e COBIT 5 ISACA, DPO Certificato Aicq/Sicev e FAC certifica, Certificato NIST Specialist FAC certifica,
Referente di schema Auditor ISO 42001 AicqSICEV.
Master EQFM. È autore di varie pubblicazioni sui temi di cui si occupa.
Relatore in numerosi convegni.

Profilo Autore

Avvocato Data Protection & ICT | Data Protection Officer UNI 11697 | membro dell’EDPB’s Support Pool of Experts | Membro Women For Security | Membro Osservatorio sulla Giustizia Civile Tribunale Milano (Gruppo sul danno da illecito trattamento dei dati personali) | Afferente B-ASC (Università Milano-Bicocca Applied Statistics Center) | Vicepresidente Institute for Research of Law Economical and Social Studies| Membro Gruppo di Lavoro sull’AI di ANORC | Docente a c. (Università di Padova, Sole24Ore Business School), Comitato di Presidenza E.N.I.A.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/artificial-intelligence-ai-e-sanita/


Credential phishing accounted for 91% of active threat reports

Email is an essential part of everyday life. It is often the primary form of communication between employees, meaning company information is constantly shared within it. Because of this, threat actors often look to email when designating attack methods. According to a recent report by Cofense, 90% of data breaches begin with phishing.

The report found that healthcare and finance are the top targeted industries, likely due to the sensitive information those organizations hold. Healthcare data, bank account information and personally identifiable information (PII) are all desirable targets for threat actors looking for large ransomware payouts.

Even with increased security measures, organizations still found their emails subject to cyberattacks. The report found a 104.5% increase in malicious emails bypassing secure email gateways (SEGs) and users received a malicious email every minute. The report found a 67% increase in credential phishing. Credential phishing was the cause of 91% of published active threat reports.

There was a 331% increase in QR code active threat reports in 2023, according to the report. Security leaders should warn employees not to scan any QR codes of unknown sources, especially on company devices. This could include codes at events, parking meters or anything with an unclear destination.

When considering email security, security leaders should encourage employees to utilize two-factor authentication and change their passwords regularly. Leaders should also discourage employees from sending sensitive information over email, especially to someone outside of the organization.

Find out more here.

https://www.securitymagazine.com/articles/100569-credential-phishing-accounted-for-91-of-active-threat-reports


There was a 72% increase in cloud infrastructure incidents in 2023

According to an Expel report, identity threats accounted for 64% of all investigated incidents and increased in volume by 144% from 2022. Of those incidents, 60% were unauthorized email logins and 40% were authentications to identity platforms, like Microsoft Entra ID, Okta, Ping and Duo.

The report found that 35% of organizations experienced more than one incident (up from 24% in 2022). Organizations saw an average of eight identity-based incidents over the year, according to the report.

The report found a 72% increase in cloud infrastructure incidents, roughly consistent with 2022. Exposed credentials (or secrets) were the leading root cause of cloud infrastructure incidents (42%), according to the report. Publicly exposed or stolen credentials allow attackers to maintain persistent access to the cloud environment with the permissions tied to that identity or role.

Hospitality, technology and financial services also made the list of top industries where we identified the most high-risk malware and identity incidents.

The report found that while malware as a percentage of overall incidents decreased by 25% in 2023, the potential impact of both high-risk and latent-risk malware should not be discounted. Phishing incidents tripled from 2% in 2022 to 6% in 2023, according to the report. The percentage of authorized penetration tests and red teams investigated decreased 43%.

Find out more here.

https://www.securitymagazine.com/articles/100570-there-was-a-72-increase-in-cloud-infrastructure-incidents-in-2023


Thousands of LG TVs are vulnerable to takeover—here’s how to ensure yours isn’t one

Thousands of LG TVs are vulnerable to takeover—here’s how to ensure yours isn’t one
Getty Images

As many as 91,000 LG TVs face the risk of being commandeered unless they receive a just-released security update patching four critical vulnerabilities discovered late last year.

The vulnerabilities are found in four LG TV models that collectively comprise slightly more than 88,000 units around the world, according to results returned by the Shodan search engine for Internet-connected devices. The vast majority of those units are located in South Korea, followed by Hong Kong, the US, Sweden, and Finland. The models are:

  • LG43UM7000PLA running webOS 4.9.7 – 5.30.40
  • OLED55CXPUA running webOS 5.5.0 – 04.50.51
  • OLED48C1PUB running webOS 6.3.3-442 (kisscurl-kinglake) – 03.36.50
  • OLED55A23LA running webOS 7.3.1-43 (mullet-mebin) – 03.33.85

Starting Wednesday, updates are available through these devices’ settings menu.

Got root?

According to Bitdefender—the security firm that discovered the vulnerabilities—malicious hackers can exploit them to gain root access to the devices and inject commands that run at the OS level. The vulnerabilities, which affect internal services that allow users to control their sets using their phones, make it possible for attackers to bypass authentication measures designed to ensure only authorized devices can make use of the capabilities.

“These vulnerabilities let us gain root access on the TV after bypassing the authorization mechanism,” Bitdefender researchers wrote Tuesday. “Although the vulnerable service is intended for LAN access only, Shodan, the search engine for Internet-connected devices, identified over 91,000 devices that expose this service to the Internet.”

The key vulnerability making these threats possible resides in a service that allows TVs to be controlled using LG’s ThinkQ smartphone app when it’s connected to the same local network. The service is designed to require the user to enter a PIN code to prove authorization, but an error allows someone to skip this verification step and become a privileged user. This vulnerability is tracked as CVE-2023-6317.

Once attackers have gained this level of control, they can go on to exploit three other vulnerabilities, specifically:

  • CVE-2023-6318, which allows the attackers to elevate their access to root
  • CVE-2023-6319, which allows for the injection of OS commands by manipulating a library for showing music lyrics
  • CVE-2023-6320, which lets an attacker inject authenticated commands by manipulating the com.webos.service.connectionmanager/tv/setVlanStaticAddress application interface.

https://arstechnica.com/?p=2015865


51% of check fraud victims had been targeted two or more times

Americans and small businesses are suffering from check fraud, according to a recent Abrigo report. Forty-five percent of respondents report being a victim of financial fraud, and 17% of that group report experiencing check fraud in particular — potentially more than 20 million people.

According to the report, 51% of check fraud victims had been targeted two or more times. The survey also found that small business owners more often were victims of financial fraud than others, with 57% reporting they’ve been targeted. They also dealt with more check fraud too: 60% of small businesses experiencing check fraud reported two or more instances.

While a majority (53%) of respondents believed credit card theft is the most common type of financial fraud and a plurality (43%) said it’s what they fear most, check fraud is actually the bigger liability for banks. This year, check fraud is projected to reach $24 billion globally.

Almost a third of Americans surveyed (31%) also admitted to either not following best practices to avoid check fraud or being unsure whether they do so. And more than half (54%) didn’t know whether their banks used advanced check fraud technologies or said their banks did not use such technologies. Seventy-eight percent wanted to be involved in the validation process, stating that being involved improves their customer experience.

The survey revealed that small businesses have a greater awareness of check fraud technology (66%) than the general population. Small businesses (50%) are also more proactive than the general population (13%) about signing up for educational sessions or workshops offered by financial institutions to raise awareness about check fraud prevention.

Despite technological shifts, using checks persists in America. In addition to 61% of Americans still writing checks each year, 57% send or receive one or more payments by check per month. Respondents used a variety of methods to deposit checks when receiving them, including:

  • 44% depositing checks at a physical bank branch
  • 37% using a mobile banking app to deposit checks remotely
  • 14% depositing checks through an ATM

Read the full report here.

https://www.securitymagazine.com/articles/100582-51-of-check-fraud-victims-had-been-targeted-two-or-more-times


Decine di canali YouTube distribuivano malware tramite video di software piratati


I ricercatori di Proofpoint hanno individuato numerosi canali YouTube che distribuivano malware pubblicizzando il download di videogiochi craccati e piratati.

I video incriminati spiegavano agli utenti come scaricare e installare il gioco, ma i link presenti in descrizione scaricavano in realtà information stealer, tra i quali Vidar, StealC e Lumma Stealer. Molti account che avevano caricato i video sono stati compromessi o acquistati da utenti legittimi, ma ci sono anche casi in cui gli account erano stati creati esclusivamente per distribuire i malware e sono rimasti attivi per poche ore.

Questo metodo di distribuzione dei malware non è nuovo, ma i ricercatori sottolineano che in questo caso gli attaccanti hanno scelto di colpire utenti molto giovani condividendo link per scaricare giochi molto popolari tra i più piccoli, in alcuni casi anche bambini, quindi gruppi di persone che fanno più fatica a identificare contenuti sospetti.

Gli account malevoli hanno insospettito i ricercatori perché gli ultimi video pubblicati erano molto diversi dai precedenti, sia per la lingua usata, che per il contenuto e la descrizione. In alcuni casi gli account erano verificati, ma non pubblicavano video sulla piattaforma da molto tempo.

In un caso specifico, la maggior parte dei video dell’account erano stati pubblicati oltre un anno fa ed erano tutti in thailandese, mentre gli ultimi video (12) erano stati caricati tutti nell’arco di 24 ore e si riferivano a crack per videogiochi e software popolari.

YouTube malware

Uno dei canali individuati dai ricercatori di Proofpoint. Credits: Proofpoint

Nella descrizione di uno dei video c’era un link MediaFire che portava al download di un archivio .rar con un eseguibile che, una volta eseguito, installava il malware Vidar Stealer. In altri casi i link rimandavano a dei canali Telegram o Discord con le istruzioni per scaricare il presunto gioco.

I video che diffondevano link malevoli hanno in media più di 1.000 visualizzazioni l’uno, anche se i ricercatori ritengono che il numero sia stato aumentato facendo uso di bot.

“Al momento Proofpoint non ha visibilità su come gli account YouTube identificati possano essere stati compromessi e YouTube è stato rapido nel rimuovere gli account segnalati dal team di ricerca” hanno spiegato i ricercatori.

Di recente, lo scorso gennaio, i ricercatori di FortiGuard Labs avevano individuato una campagna simile che sfruttava i video di YouTube per distribuire una variante dello stealer Lumma. Come sempre, per proteggersi da questi attacchi è consigliato non scaricare software e altri contenuti da fonti non ufficiali. 

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/04/09/canali-youtube-malware-software-piratati/?utm_source=rss&utm_medium=rss&utm_campaign=canali-youtube-malware-software-piratati


Programma Cyber Crime Conference 2024

Di seguito il programma della Cyber Crime Conference 2024, che avrà luogo a Roma nei giorni 17 e 18 aprile 2024 presso l’Auditorium della Tecnica.

17 Aprile

08:00

WELCOME COFFEE AND NETWORKING – EXPO AREA

Il bar offrirà servizio gratuito a tutti i visitatori fino alle ore 12:20

09:00

SALUTO DI APERTURA

MATTIA SICILIANO

Presidente Commissione Studi Cyber Threat Intelligence e Cyber Warfare, SOCINT

MATTEO LUCCHETTI

Direttore, Cyber 4.0 – National Cyber Security Competence Center

09:10

THE LEGISLATIVE SCENARIO ON CYBERCRIME AND ELECTRONIC EVIDENCE: EXISTING NORMS AND FUTURE PERSPECTIVES

JÁNOS DRIENYOVSZKI

Legal and Policy Officer – E-evidence and Cybercrime; European Commission; Directorate-General for Migration and Home Affairs (DG HOME), Unit for the Security in the Digital Age
Abstract

09:30

ARTIFICIAL INTELLIGENCE AND THE CHALLENGES POSED BY CYBERCRIME: THE COLLECTIVE EFFORT TO SET AN INTERNATIONAL STANDARD

KRISTIAN BARTHOLIN

Secretary to the Committee on Artificial Intelligence, Head of Digital Development Unit, Council of Europe
Abstract

09:50

FROM RAGNAR LOCKER TO LOCKBIT, ONE YEAR OF OPERATIONS SUPPORTED BY EUROPOL AGAINST RANSOMWARES

EMMANUEL KESSLER

Head of Head of Prevention & Outreach at EC3, Cybercrime Centre, EUROPOL
Abstract

10:10 – Tavola Rotonda

SICUREZZA CIBERNETICA DELLA SOCIETÀ DIGITALE: APPROCCI INTEGRATI PER LA PREVENZIONE E IL CONTRASTO DELLE MINACCE INFORMATICHE

NUNZIA CIARDI

Vice Direttore Generale dell’Agenzia per la cybersicurezza nazionale

GEN.D. PAOLO ACETO

Capo del III° Reparto del Comando Generale dell’Arma dei Carabinieri

IVANO GABRIELLI

Direttore della Polizia Postale e delle Comunicazioni

AGOSTINO GHIGLIA

Componente Autorità Garante per la Protezione dei Dati Personali

Moderatore:
PIERLUIGI PAGANINI

Member ENISA Ad-Hoc Working Group on Cyber Threat Landscapes
Abstract

11:00

THE ITALIAN JOB: CYBER ATTACCHI IN LINGUA ITALIANA

DAVIDE MAIORCA

Assistant Professor Pattern Recognition and Applications Lab Department of Electrical and Electronic Engineering University of Cagliari
Abstract

11:20

NIS2 E REGOLAMENTO CLOUD: TANTE AZIENDE, POCHE COMPETENZE. UNA RISPOSTA CONCRETA ALL’EMERGENZA DI CONFORMITÀ

CLAUDIO DE PAOLI

Head of BIP CyberSec
Abstract

11:40

NETWORKING AND COFFEE BREAK

12:20

L’IMPREVEDIBILE CERTEZZA DELLE MINACCE INFORMATICHE: COME ESSERE UN PASSO AVANTI AL CYBERCRIME

ROBERTO VINCENZO VECA

Head of Cybersecurity presso CYBEROO S.p.A.
Abstract

12:40

REMOTEGRANT: LA CHIAVE PER LA CYBER SECURITY NEL SETTORE MANIFATTURIERO

VALERIO PASTORE

CEO e fondatore di Cyber Grant
Abstract

13:00

MIGLIORARE LA RESILIENZA INFORMATICA CON L’AUTOMAZIONE IT

LUCAS BALACLAV

Product Specialist, NinjaOne
Abstract

13:20

BUSINESS LUNCH

14:20

LA CYBERSECURITY NELL’ERA DELL’AI GENERATIVA: UNA ‘CHIACCHIERATA’ TRA LLAMA2 E CHATGPT PER LA CREAZIONE AUTOMATIZZATA DI EXPLOIT

SIMON PIETRO ROMANO

Professore Ordinario di Network Security alla Federico II
Abstract

14:40

AI COME STRUMENTO PER IL MALWARE DEVELOPEMENT

NICOLAS FASOLO

Security Researcher | Incident Responder
Abstract

15:00 – Tavola Rotonda

SISTEMI DI INTELLIGENZA ARTIFICIALE E MACHINE LEARNING: RISCHI, VULNERABILITÀ E STRATEGIE DI DIFESA

STEFANO BISTARELLI

Professor of Computer Science at the Department of Mathematics and Computer Science at the University of Perugia

GIAN LUCA FORESTI

Professore di Cybersecurity e Computer Vision, Direttore del Master in Intelligence and Emerging Technologies, Università di Udine

MARCO MELLIA

Professore presso il Dipartimento di Automatica e Informatica, Politecnico di Torino (DAUIN)

ANGELO SPOGNARDI

Professore associato presso il Dipartimento di Informatica dell’Università Sapienza di Roma

Moderatrice:
VALERIA LAZZAROLI

Chief Risk Officer e Chairperson dell’Enia, Ente nazionale per l’intelligenza artificiale
Abstract

16:00

SALUTI FINALI E CHIUSURA DEI LAVORI

18 Aprile

08:00

WELCOME COFFEE AND NETWORKING – EXPO AREA

Il bar offrirà servizio gratuito a tutti i visitatori fino alle ore 12:20

09:00

SALUTO DI APERTURA

MATTIA SICILIANO

Presidente Commissione Studi Cyber Threat Intelligence e Cyber Warfare, SOCINT

MATTEO LUCCHETTI

Direttore, Cyber 4.0 – National Cyber Security Competence Center

9:10 – Tavola Rotonda in Inglese

INTERNATIONAL COOPERATION ON CYBERCRIME AND ELECTRONIC EVIDENCE: TOOLS AND GOOD PRACTICES

H.E. CLAUDIO PEGUERO CASTILLO

Cyber Ambassador of the Dominican Republic and Vice Chair of the UN Ad-Hoc Committee on Cybercrime

CLAUDIA PINA

European Judicial Cybercrime Network Support Team Coordinator, EuroJust

VINCENT DANJEAN

Head of the Cyberspace and New Technologies Laboratory – INTERPOL Innovation Centre

Moderatore:
MATTEO LUCCHETTI

Direttore di Cyber 4.0 – National Cyber Security Competence Center
Abstract

10:00 – Tavola Rotonda

AFFRONTARE I RISCHI INFORMATICI NEL PUBBLICO: NORMATIVE, RIVOLUZIONI E STRATEGIE DI MITIGAZIONE

GIOVANNI CIMINARI

Head of Cybersecurity in Sogei

THOMAS MASCIOLI COLAVECCHI

Chief Information Security Officer presso Polo Strategico Nazionale

ALBERTO MANFREDI

Country Leader e Presidente Cloud Security Alliance (CSA) Italy

Moderatore:
CLAUDIO DE PAOLI

Head of BIP CyberSec
Abstract

10:40

BLOCKCHAIN: ANALISI PER IL TRACCIAMENTO E LA DEANONIMIZZAZIONE DI PAGAMENTI IN CRIPTOVALUTE

LAURA RICCI

Professor at Department of Computer Science, University of Pisa, Italy
Abstract

11:00

VULNERABILITÀ NEI PROCESSI DI CREAZIONE DI IDENTITÀ DIGITALI SPID: COME UN CRIMINALE POTREBBE OPERARE A TUO NOME

STEFANO FRATEPIETRO

Cyber Security Strategic Consultant
Abstract

11:20

COME CREARE UN MALWARE DI SUCCESSO E COME DIFENDERSI IN MANIERA EFFICACE CON IL MODELLO ZERO TRUST

CRISTIANO GUERRIERI

Solution’s Engineer at Threatlocker
Abstract

11:40

NETWORKING AND COFFEE BREAK

12:20

CYBERCRIME AND MISINFORMATION: EVOLUZIONI E TREND

ANTONIO TETI

Responsabile del Settore Sistemi Informativi di Ateneo, Innovazione Tecnologica e Sicurezza Informatica e docente di Cyber Intelligence, IT Governance e Big Data dell’Università di Chieti-Pescara. Componente del Comitato di Coordinamento per la Strategia Nazionale sull’Intelligenza Artificiale
Abstract

12:40

HI-TECH CRIME, AI E CYBERWARFARE: QUALI SONO LE SFIDE DEL 2024

GIULIO VADA

Regional Sales Director – Italy & Iberia, Group-IB
Abstract

13:00

IL LATO OSCURO DELL’INTELLIGENZA ARTIFICIALE: APPROCCIO DELLA THREAT INTELLIGENCE ALLE NUOVE TIPOLOGIE DI VULNERABILITÀ E MINACCE DEL CYBERCRIME

FRANCESCO ARRUZZOLI

Sr. Cyber Security Threat Intelligence Architect
Abstract

13:20

BUSINESS LUNCH

14:20

CLOUD COMPUTING FORENSICS: PECULIARITÀ E INDICAZIONI METODOLOGICHE

VINCENZO CALABRÒ

Funzionario alla Sicurezza CIS (Ministero dell’Interno) e Digital Forensics Analyst
Abstract

14:40

DIGFORASP: EXPLAINABLE AI NELLA DIGITAL FORENSICS

RAFFAELE OLIVIERI

Esperto in Digital Forensics, ex appartenente dei Carabinieri
Abstract

15:00 – Tavola Rotonda

L’IMPATTO DELL’INTELLIGENZA ARTIFICIALE SU FORZE DELL’ORDINE E GIUSTIZIA

GEN.B. ANTONIO MANCAZZO

Comandante del Nucleo Speciale Tutela Privacy e Frodi Tecnologiche, Guardia di Finanza

SEBASTIANO BATTIATO

Professore presso il Dipartimento di Matematica e Informatica dell’Università di Catania

DONATELLA CURTOTTI

Direttore del Dipartimento di Giurisprudenza e Professore ordinario di Diritto processuale penale presso l’Università di Foggia

RANIERI RAZZANTE

Componente del Comitato strategico per l’AI presso la Presidenza del Consiglio

Moderatore:
ARIJE ANTINORI

Professore di Criminology nel Corso di Laurea Magistrale internazionale in Cognitive Forensic Sciences del Dipartimento di Psicologia – Sapienza Università di Roma
Abstract

16:00

SALUTI FINALI E CHIUSURA DEI LAVORI

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/programma-cyber-crime-conference-2024/


Più di 92.000 NAS D-Link sono vulnerabili a backdoor e command injection


Sul web ci sono più di 92.000 NAS D-Link vulnerabili ad attacchi di command injection e backdoor. Netsecfish, il ricercatore che ha scoperto la vulnerabilità, spiega che un attaccante può eseguire comandi arbitrari per accedere a informazioni sensibili, modificare le configurazioni di sistema e provocare un’interruzione di servizio.

Il bug colpisce lo script nas_sharing.cgi e consente a un attaccante di inviare una specifica richiesta HTTP per prendere il controllo del sistema. Includendo il parametro per lo username (user=messagebus) e lasciando il campo password vuoto (passwd=), l’attaccante può accedere a un account sul dispositivo senza passare per l’autenticazione.

La vulnerabilità consente inoltre di sfruttare il parametro system per specificare una stringa base64 che, una volta decodificata, esegue un comando sul sistema.

Pixabay

I dispositivi colpiti sono il DNS-320L versioni 1.11, 1.03.0904.2013 e 1.01.0702.2013, il DNS-325 versione 1.01, il DNS-327L versioni 1.09 e 1.00.0409.2013 e il DNS-340L versione 1.08.

Contattata dal ricercatore, D-Link ha specificato che i NAS vulnerabili sono tutti prodotti arrivati al termine del loro ciclo di vita e non sono quindi previsti degli aggiornamenti per risolvere il bug.

“Questo exploit riguarda i prodotti D-Link legacy e tutte le revisioni hardware che hanno raggiunto il loro ciclo di vita EOL (“End of Life”)/End of Service Life (“EOS”). I prodotti che hanno raggiunto l’EOL/EOS non ricevono più gli aggiornamenti del software del dispositivo e le patch di sicurezza e non sono più supportati da D-Link” si legge nell’advisory ufficiale. D-Link ha invitato gli utenti a sostituire il prima possibile i dispositivi obsoleti con quelli più nuovi.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/04/09/piu-di-92-000-nas-d-link-sono-vulnerabili-a-backdoor-e-command-injection/?utm_source=rss&utm_medium=rss&utm_campaign=piu-di-92-000-nas-d-link-sono-vulnerabili-a-backdoor-e-command-injection