AgID e l’intelligenza artificiale nella PA: le Linee Guida per sviluppo e procurement chiudono la consultazione e aprono una nuova fase

La consultazione pubblica si è conclusa l’11 aprile 2026. Oggi AgID Academy organizza il webinar sull’Agentic AI. L’iter istituzionale verso l’adozione definitiva è ufficialmente aperto.

La funzione di indirizzo e supporto svolta dall’Agenzia per l’Italia Digitale (AgID) si esercita in maniera permanente e continuativa, come dimostra il percorso appena concluso: dal 12 marzo all’11 aprile 2026, le “Linee Guida per lo sviluppo di sistemi di Intelligenza Artificiale nella Pubblica Amministrazione” e le “Linee Guida per il procurement di IA nella Pubblica Amministrazione”, adottate con la Determinazione n. 43 del 10 marzo 2026, sono state sottoposte a consultazione pubblica. Un ciclo di trenta giorni che ha coinvolto amministrazioni, operatori economici, ricercatori e cittadini in un processo partecipativo destinato a incidere concretamente sulle modalità con cui la PA italiana acquisterà e svilupperà sistemi di intelligenza artificiale nei prossimi anni.

Intelligenza artificiale nella PA – Il quadro normativo e istituzionale di riferimento

L’iniziativa si inserisce in una cornice normativa e strategica articolata su più livelli. Sul piano legislativo nazionale, la Legge 23 settembre 2025, n. 132 “Disposizioni e deleghe al Governo in materia di intelligenza artificiale”, pubblicata in Gazzetta Ufficiale n. 223 del 25 settembre 2025 ed entrata in vigore il 10 ottobre 2025, introduce la prima cornice normativa organica italiana dedicata all’IA. Secondo la comunicazione istituzionale di AgID, con questo provvedimento l’Italia è intervenuta “prima in Europa” nel campo della regolazione dell’intelligenza artificiale. La legge fonda la disciplina sui princìpi di un utilizzo antropocentrico, trasparente e sicuro della tecnologia, in conformità al Regolamento (UE) 2024/1689 (AI Act).

Sul piano tecnico-amministrativo, le Linee Guida sono state adottate seguendo la procedura prevista dall’articolo 71 del Codice dell’Amministrazione Digitale (CAD, D.Lgs. n. 82/2005), che attribuisce ad AgID il compito di emanare regole tecniche e di indirizzo per l’attuazione del CAD, previa consultazione pubblica. La stessa Legge 132/2025, all’articolo 20, designa AgID e l’Agenzia per la Cybersicurezza Nazionale (ACN) quali autorità nazionali responsabili dell’attuazione della normativa italiana ed europea in materia di IA.

Il tutto si innesta coerentemente nella Strategia Italiana per l’Intelligenza Artificiale 2024-2026 e nel Piano Triennale per l’Informatica nella PA 2024-2026, adottato con DPCM 12 gennaio 2024, che individua nelle Linee Guida per lo sviluppo (CAP5.16) e per il procurement (CAP5.15) di applicazioni di IA obiettivi specifici a carico di AgID.

I due documenti: un quadro unitario per l’intero ciclo di vita dell’IA

La caratteristica più rilevante dell’impianto concettuale elaborato da AgID è la complementarità dei due documenti: non si tratta di strumenti separati, ma di parti di un percorso unitario che accompagna le amministrazioni lungo l’intero ciclo di vita dei sistemi di IA, dalla fase di progettazione fino alla gestione operativa e al monitoraggio nel tempo.

L’approccio si sviluppa in una sequenza logica ben definita: progettazione del sistema di IA, attraverso l’individuazione degli obiettivi e dei casi d’uso; definizione dell’architettura e dei requisiti tecnici, con riferimento allo stack tecnologico e ai livelli di autonomia del sistema; acquisizione delle soluzioni attraverso il procurement, mediante procedure di gara adeguate alla complessità delle tecnologie; gestione e monitoraggio nel sistema nel tempo, per verificarne prestazioni, affidabilità e conformità normativa.

Entrambi i documenti sono orientati da venti principi cardine che devono guidare lo sviluppo, l’acquisizione e la gestione dei sistemi di IA nella PA, e fanno riferimento esplicito all’AI Act europeo, costruendo un ponte operativo tra la regolazione comunitaria e le modalità concrete di adozione della tecnologia da parte delle amministrazioni italiane.

Le Linee Guida per lo sviluppo

Le Linee Guida per lo sviluppo dei sistemi di IA nella PA sono rivolte ai soggetti di cui all’articolo 2, comma 2, del CAD, vale a dire pubbliche amministrazioni, società a controllo pubblico, società partecipate, gestori di servizi pubblici e organismi di diritto pubblico. Il documento è composto da un testo principale e da due allegati tecnici: il primo dedicato a termini e definizioni, il secondo alle metodologie di training, validazione e fine-tuning dei modelli, nonché all’utilizzo di tecniche come il Retrieval Augmented Generation (RAG).

Sul piano architetturale, le Linee Guida introducono elementi innovativi rispetto al quadro precedente. In particolare:

  • la definizione dei livelli tecnologici dello stack di IA;
  • l’individuazione dei livelli di autonomia dei sistemi di intelligenza artificiale;
  • un’architettura logica di riferimento per i sistemi IA nella PA;
  • l’uso delle personas nella progettazione di servizi pubblici basati sull’IA.

Quanto ai livelli di autonomia, il documento classifica le PA in quattro profili operativi: Operatore Base, che utilizza soluzioni preconfigurate con limitata personalizzazione; Operatore Avanzato, capace di adattare modelli esistenti a specifici contesti operativi; Operatore Esperto, che sviluppa e addestra modelli proprietari o open source; Operatore Controllore, responsabile della supervisione, dell’audit e della conformità dei sistemi.

Il documento si fonda su quattro principi fondamentali: sovranità tecnologica, neutralità hardware, sostenibilità energetica e centralità dell’uomo. L’obiettivo è evitare architetture monolitiche e situazioni di dipendenza tecnologica dai fornitori (cosiddetti lock-in), favorendo invece ecosistemi aperti e modulari.

Le Linee Guida AgID per il procurement

Le Linee Guida per il procurement di sistemi di IA nella PA partono da una constatazione fondamentale: l’adozione dell’intelligenza artificiale nella PA non può essere gestita con gli strumenti tradizionali degli appalti informatici. Le soluzioni basate su algoritmi e modelli di machine learning presentano caratteristiche peculiari: dipendono fortemente dalla qualità dei dati, richiedono aggiornamenti continui, comportano costi distribuiti lungo l’intero ciclo di vita e possono evolvere rapidamente nel tempo.

Il procurement viene quindi configurato non come una mera procedura amministrativa, ma come uno strumento strategico di governance dell’innovazione. Le decisioni di approvvigionamento vengono collegate a tre dimensioni fondamentali: tecnologica, relativa alle caratteristiche delle soluzioni; economica, relativa alla sostenibilità degli investimenti e al calcolo del costo complessivo del ciclo di vita (il cosiddetto LCOAI); organizzativa e contrattuale, necessaria per garantire controllo pubblico e adattabilità nel tempo.

Il documento, di circa 100 pagine nella versione sottoposta a consultazione, introduce strumenti e criteri operativi per rafforzare la capacità delle amministrazioni di progettare e gestire gare complesse. Tra questi figurano una struttura di capitolato articolata in dodici sezioni e clausole specifiche per la portabilità dei dati e le strategie di exit contrattuale. Il principio di trasparenza è declinato in termini operativi: la PA deve essere in grado di comprendere, descrivere e documentare il funzionamento complessivo del sistema almeno a livello architetturale, funzionale e decisionale.

La conferenza stampa del 12 marzo: le parole del Direttore Generale di AgID

I due documenti sono stati presentati in conferenza stampa il 12 marzo 2026, con la partecipazione del Direttore Generale di AgID, Mario Nobile, e gli interventi dei tecnici dell’Agenzia Fabio Massimi, Alessandra Pieroni e Giovanni Melardi.

Nelle parole dello stesso Nobile:

«I due documenti sulle linee guida sono ormai prossimi alla conclusione del percorso di adozione. I testi riguardano due aspetti complementari: da un lato lo sviluppo dei sistemi di intelligenza artificiale nella Pubblica Amministrazione, dall’altro il procurement, cioè le modalità con cui le amministrazioni potranno acquisire modelli e soluzioni di IA dal mercato. L’obiettivo di questo momento di confronto è fornire alcuni elementi aggiuntivi rispetto all’abstract inviato nei giorni scorsi e condividere quelli che riteniamo i punti più rilevanti delle linee guida.»

L’obiettivo dichiarato, ha precisato il Direttore Generale, non è solo favorire l’adozione di nuove tecnologie, ma costruire un linguaggio comune tra amministrazioni pubbliche e mercato, definendo standard tecnici, modelli economici e strumenti contrattuali che consentano alla PA di dialogare con i fornitori in modo più consapevole e strutturato.

La consultazione si chiude: i prossimi passaggi istituzionali

L’11 aprile 2026 si è concluso il periodo di consultazione pubblica. Attraverso la piattaforma Forum Italia, amministrazioni, imprese e cittadini hanno avuto la possibilità di inviare osservazioni, proposte di modifica e suggerimenti sia sul piano editoriale sia su quello tecnico. Tra i contributi pervenuti nella fase finale, si segnala quello dell’Osservatorio sulla IA per i Comuni Italiani di ANFoV, pubblicato il 10 aprile 2026.

Al termine della raccolta dei contributi, i documenti saranno aggiornati e trasmessi ad almeno tre soggetti istituzionali per i rispettivi pareri obbligatori: la Conferenza Unificata Stato-Regioni-Enti locali, il Garante per la protezione dei dati personali e il Ministero delle Imprese e del Made in Italy (MIMIT), che gestisce la procedura di notifica alla Commissione Europea. Solo al termine di questo iter le Linee Guida acquisiranno forza vincolante per tutte le PA.

Oggi, 13 aprile: AgID Academy sul tema dell’IA agentica

In stretta continuità con la chiusura della consultazione, AgID ha organizzato per oggi, lunedì 13 aprile 2026, dalle ore 15:30 alle 17:00, il webinar “Agentic AI: tra autonomia e responsabilità”, promosso da AgID Academy. L’evento è aperto a tutti e affronta uno dei nodi più critici per il futuro dell’IA nella PA: la transizione verso sistemi capaci non solo di rispondere a istruzioni, ma di pianificare e svolgere attività in modo autonomo, interagendo con applicazioni e servizi digitali per perseguire obiettivi complessi.

Il webinar è introdotto dallo stesso Direttore Generale Mario Nobile e moderato da Paola Liberace, Dirigente dell’Area Risorse Umane e Academy di AgID. Intervengono il Prof. Giuseppe Italiano, Prorettore per l’Artificial Intelligence e le Digital Skills e ordinario di Ingegneria Informatica presso la LUISS Guido Carli, e il Prof. Mario De Caro, titolare della Cattedra UNESCO “Ethics of Artificial Intelligence and Practical Wisdom” presso l’Università Roma Tre e Presidente della Society for the Ethics and Politics of AI (SEPAI).

Una parte centrale dell’incontro è dedicata alle implicazioni sul piano della responsabilità, all’importanza del controllo umano e alle sfide etiche che emergono inevitabilmente con l’adozione di sistemi capaci di prendere decisioni e agire in modo indipendente: temi che le Linee Guida appena chiuse in consultazione affrontano attraverso la classificazione dei livelli di autonomia dei sistemi di IA.

Il collegamento con la sicurezza informatica è diretto. Un’analisi del CERT-AgID, anch’essa pubblicata nelle ultime ore, evidenzia come un agente IA, se non correttamente interfacciato, possa inavvertitamente rivelare informazioni sensibili o eseguire errori progettuali presenti nel codice a cui è collegato. La sicurezza deve quindi essere considerata una componente integrante dell’architettura fin dall’inizio e non un elemento accessorio aggiunto a posteriori.

Il percorso verso una PA “agentica”: le sfide aperte

L’IA agentica rappresenta oggi uno dei fronti più delicati per le pubbliche amministrazioni. Come emerso anche in occasione del “Digital Experience FORUM PA” del 10 aprile scorso, la transizione verso sistemi capaci di agire in modo autonomo introduce sfide di sicurezza senza precedenti: dalla gestione del rischio di prompt injection alla governance degli accessi, dalla responsabilità decisionale alla verifica delle azioni eseguite da sistemi multi-agente.

Tra gli obiettivi dichiarati di AgID figura la creazione di un registro di soluzioni di IA adottate dalle PA, che favorisca il riuso e superi le logiche isolate di sperimentazione. Un approccio che richiama direttamente i principi di neutralità tecnologica e apertura degli ecosistemi già sanciti nelle Linee Guida in corso di adozione.

In sintesi: uno spartiacque per la PA digitale italiana

Il percorso avviato con la Determinazione n. 43/2026 segna un passaggio significativo nella maturazione del dibattito pubblico sull’intelligenza artificiale nella PA italiana. Non si tratta più soltanto di capire dove usare l’IA, ma di stabilire con quali regole, con quali limiti e con quali garanzie. Le Linee Guida AgID per lo sviluppo e il procurement delineano un quadro unitario che affronta in modo coordinato progettazione dei sistemi, acquisizione delle soluzioni, gestione e monitoraggio nel tempo, nel pieno rispetto dei principi di trasparenza, responsabilità e controllo umano sulle decisioni automatizzate.

L’iter istituzionale è ora aperto. Nei prossimi mesi si conoscerà l’esito delle valutazioni della Conferenza Unificata, del Garante Privacy e del MIMIT. Solo allora le Linee Guida diventeranno obbligatorie per tutte le amministrazioni pubbliche italiane, segnando un punto di non ritorno nel rapporto tra Stato e intelligenza artificiale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/agid-intelligenza-artificiale-pa-linee-guida-procurement/


Gestire il rischio cyber oggi: il modello Cyber Resilience Lifecycle di ReeVo

Il Cyber Resilience Lifecycle di ReeVo ridisegna la gestione del rischio cyber nel momento in cui le certezze su cui si reggeva la sicurezza informatica stanno cedendo una dopo l’altra. Non è una provocazione: è la logica conseguenza di un cambiamento che molti hanno visto arrivare, ma che pochi hanno saputo anticipare davvero.

Per anni il paradigma dominante ha risposto alle minacce con più controlli, più policy, più layer tecnologici. Un accumulo progressivo di difese che, però, continuava a ragionare in modo lineare in un mondo diventato radicalmente non lineare. Gli attaccanti evolvono, si adattano, imparano dagli errori altrui. Le organizzazioni, troppo spesso, no.

La vera domanda, allora, non è più se un attacco arriverà, ma quanto velocemente si sarà in grado di riconoscerlo, contenerlo e trasformarlo in un’informazione utile per il futuro. Resilienza, non invulnerabilità: un cambio di paradigma che suona semplice, ma che richiede metodo, visione e continuità. Perché nel panorama attuale, sopravvivere a un incidente non basta: bisogna uscirne più forti di prima, con una postura di sicurezza più matura e consapevole dei propri punti critici.

Il Cyber Resilience Lifecycle di ReeVo: un approccio integrato e continuo alla gestione del rischio cyber

Negli ultimi anni il cybercrime ha superato i confini tradizionali, trasformandosi in un fenomeno sempre più pervasivo e strutturato, nel quale criminalità organizzata, dinamiche geopolitiche e tecnologie emergenti si intrecciano. Gli attacchi informatici non sono più eventi isolati, ma operazioni sofisticate, spesso automatizzate e condotte su larga scala, capaci di colpire indistintamente aziende di ogni dimensione e settore. In questo scenario, la cybersecurity non può più fondarsi su un approccio statico, basato su controlli rigidi e limitato ad attività di compliance, ma deve evolvere in un processo continuo e adattivo di gestione del rischio.

Da questa esigenza nasce il Cyber Resilience Lifecycle sviluppato da ReeVo, un modello dinamico progettato per accompagnare le organizzazioni in un percorso di miglioramento continuo della propria postura di sicurezza. Non si tratta soltanto di adottare tecnologie avanzate, ma di costruire una strategia integrata, capace di anticipare, affrontare e superare le minacce informatiche in modo strutturato ed efficace.

Il modello si articola in cinque fasi consecutive – Know, Prevent, Detect, Respond e Assess – che coprono l’intero ciclo della cybersecurity. La fase di Know rappresenta il punto di partenza: comprendere il proprio livello di esposizione al rischio è fondamentale per definire priorità e orientare gli investimenti. Questo significa mappare gli asset critici, identificare le vulnerabilità e analizzare le possibili superfici di attacco.

Segue la fase di Prevent, in cui vengono implementate misure di protezione volte a ridurre la probabilità di compromissione. In questa fase rientrano tecnologie, policy e attività di formazione, elementi indispensabili per costruire una prima linea di difesa efficace. La fase di Detect assume un ruolo centrale, poiché consente di individuare tempestivamente eventuali anomalie o comportamenti sospetti.

Quando un incidente si verifica, è essenziale intervenire in modo rapido e coordinato. La fase di Respond si concentra proprio sulla gestione degli attacchi, con l’obiettivo di minimizzare l’impatto operativo e garantire la continuità del business. Infine, la fase di Assess chiude il ciclo attraverso un’attività di valutazione e miglioramento continuo: analizzare quanto accaduto consente infatti di rafforzare le difese e prepararsi meglio alle minacce future.

Il Cyber Resilience Lifecycle è dunque un processo continuo, alimentato costantemente da nuove informazioni, verifiche e adattamenti. In un contesto in cui anche la compliance normativa assume un ruolo sempre più rilevante, adottare un approccio strutturato e proattivo alla sicurezza non è più un’opzione, ma una necessità strategica per garantire resilienza, continuità e competitività nel tempo.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/cyber-resilience-reevo/


AI Act, l’Unione Europea bandisce le “nudify apps”

L’Europa annuncia un passo in avanti sul contrasto al Deepfake Porn: il 26 marzo 2026 il Parlamento UE ha varato una misura che intende colpire le cosiddette nudify apps, nate per generare o alterare immagini di persone reali tramite l’intelligenza artificiale e creare contenuti espliciti senza il loro consenso.

Nello specifico si tratta di un emendamento all’AI Act, parte del più generale processo di revisione noto come “Digital Omnibus” e avviato nel novembre 2025 allo scopo dichiarato di semplificare e aggiornare la normativa comunitaria alla luce del rapido sviluppo delle tecnologie digitali.

Come già avvenuto in altri campi, l’intelligenza artificiale ha avuto un impatto dirompente anche sulla diffusione di contenuti sessualmente espliciti. Oltre a trasformare l’industria legale dell’intrattenimento per adulti, l’estrema accessibilità degli strumenti che usano l’AI per produrre materiale pornografico a partire da immagini o video di persone inconsapevoli (inclusi minorenni) sta abilitando forme di abuso sempre più pervasive.

Deepfake Porn: un fenomeno in crescita allarmante

Il termine deepfake può indicare ogni tipologia di contenuto audiovisivo digitale creato e/o alterato mediante AI.

Sebbene si tratti di un’attività teoricamente lecita, è noto già da anni come ciò possa prestarsi a numerosi utilizzi illeciti.

Una specifica tipologia è infatti rappresentata dal deepnude, che parte dall’immagine di una persona reale per generarne altre di natura esplicita.
La stragrande maggioranza di tali contenuti rappresenta corpi femminili in scenari sessuali: secondo le Nazioni Unite, “deepfake pornography made up 98% of all deepfake videos online and 99% depicted women, according to a 2023 report”.

Il medesimo report registra una crescita superiore al 500% dei video deepfake circolanti a partire dal 2019, evidenziando quanto gli strumenti necessari a crearli siano ormai “widely available, usually free, and require very little technical expertise”.

Come in altri casi di Technology Facilitated Gender-based Violence (TFGBV) – in particolare nella categoria dell’Image Based Sexual Abuse (IBSA) – una volta pubblicati i contenuti sono quasi impossibili da rimuovere; “once posted, AI generated content can be replicated endlessly, saved to private devices and shared across platforms, making it nearly impossible to fully remove”.

Le persone coinvolte rischiano di soffrire gravi effetti psicologici ed emotivi, nonché professionali e reputazionali, in conseguenza dell’essere state associate a materiali pornografici diffusi online.

Cosa sono le nudify apps?

Nell’ambito del Deepfake Porn, si è sviluppato un fiorente mercato dedicato ad app e software che in poche mosse consentono di “denudare” una persona partendo da un’immagine in cui appaia parzialmente o completamente vestita.

Sebbene tale possibilità esistesse già da diversi anni, la massiccia diffusione di strumenti semplici e gratuiti (o comunque a prezzi molto accessibili) ha trasformato una realtà marginale in un fenomeno dilagante: secondo una ricerca condotta dal Centre for Countering Digital Hate, il solo GROK avrebbe prodotto – in un periodo di osservazione di appena 10 giorni – ben 3 milioni di immagini sessualmente esplicite e 23.000 contenuti relativi ad abusi su minori.

Più di recente, la Internet Watch Foundation (IWF) ha pubblicato i risultati di un’indagine che conferma come nel 2025 siano stati diffusi migliaia di “AI-generated images and videos of realistic child sexual abuse”.

Anche in questo caso, è evidente come la circolazione di immagini a carattere intimo che rappresentano minori reali e riconoscibili rischi di avere effetti devastanti sulla loro sicurezza presente e futura.

Le normative sul Deepfake Porn nel mondo

Mentre la creazione e la diffusione di immagini ritraenti minori sono severamente proibite ovunque, i contenuti che mostrano soggetti adulti sono rimasti a lungo in una “zona grigia” sul piano legale.

Soltanto negli ultimi anni, anche in seguito al clamore mediatico creatosi intorno ad alcune “vittime eccellenti” – come la cantante Taylor Swift – molti Paesi hanno iniziato ad adottare normative per contenere questo fenomeno e sanzionare i responsabili.

Vediamone le principali.

Regno Unito: già dal 2023, l’Online Safety Act proibisce la diffusione di immagini esplicite manipolate digitalmente, senza tuttavia rivolgersi in modo specifico alla creazione di contenuti mediante AI; per colmare tale lacuna, nel 2025 il Data (Use and Access) Act ha previsto come reato “to create or request the creation of non-consensual intimate images”.

Corea del Sud: alla luce di oltre 800 casi in un solo anno, nel 2024 il governo di Seoul ha adottato una delle normative più rigorose al mondo in tema di deepfake, vietando i contenuti espliciti generati tramite AI e prevedendo fino a 3 anni di carcere per chi detenga o visioni tali contenuti, nonché fino a 7 per chi li generi a fini di distribuzione.

Singapore: nello stesso anno sono state introdotte pene severe per i responsabili di truffe o estorsioni conseguenti alla creazione di deepfake a natura sessuale, sulla scorta di numerosi scandali verificatisi nei mesi precedenti.

Stati Uniti: il “Take It Down Act” (Tools to Address Known Exploitation by Immobilizing Technological Deepfakes on Websites and Networks) del 2025 criminalizza la pubblicazione non consensuale di immagini intime, citando esplicitamente i deepfakes; entro il 19 maggio 2026, ogni piattaforma che ospiti contenuti creati dagli utenti deve dotarsi di sistemi per la segnalazione e rimozione di materiali espliciti creati senza il consenso delle persone ritratte.

Messico: sempre nel 2025, il Congresso ha approvato una legge che prevede fino a 5 anni di carcere (e significative sanzioni pecuniarie) per chiunque crei o diffonda senza consenso materiali a contenuto sessuale manipolati tramite l’AI, includendo espressamente ogni applicazione, programma o tecnologia capace di alterare o modificare fotografie, file audio, video o qualsiasi altro materiale grafico.

Brasile: a marzo 2026, il codice penale è stato aggiornato per includere nuove sanzioni nei confronti di chi alteri l’immagine o la voce di una persona mediante l’uso di AI o altre tecnologie; per i siti o piattaforme che consentano la pubblicazione di materiali espliciti così prodotti, sono previste multe fino al 2% del fatturato annuale.

Molti altri Paesi – come l’Australia o il Canada – hanno annunciato di star elaborando simili normative, confermando la percezione globale del Deepfake porn come minaccia concreta ed estremamente attuale.

Anche la nuova UN Cybercrime Convention prevede per gli Stati contraenti l’obbligo di criminalizzare la condivisione di Non-Consensual Intimate Imagery (NCII), includendo le immagini di persone reali create o modificate dall’intelligenza artificiale; e l’Unione Europea aveva già provveduto ad adottare alcune misure di contrasto.

Il divieto di deepnudes: direttiva europea e legge italiana

In effetti la Direttiva (UE) 2024/1385, adottata nel 2024 e dedicata al contrasto della violenza contro le donne, proibisce “creating and distributing pornographic material digitally altered to make it appear that a person is involved without their consent”.

Un’ipotesi che – pur non menzionando esplicitamente gli strumenti basati sull’AI – potrebbe applicarsi anche ai contenuti generati dalle nudify apps.

Tuttavia, come noto, le direttive non sono immediatamente applicabili negli Stati membri; al contrario richiedono passaggi applicativi che non tutti i componenti dell’Unione hanno ancora compiuto, portando a una disparità di tutele tra i vari Paesi UE.

Inoltre la direttiva subordina l’illiceità dei deepfake alla circostanza che siano idonei a provocare seri danni (“likely to cause serious harm”), lasciando un ampio margine interpretativo circa la valutazione di tali requisiti.

Analogamente, in Italia l’art. 612 quater c.p. (introdotto dalla legge n. 132/2025) punisce con la reclusione fino a cinque anni “chiunque cagiona un danno ingiusto ad una persona, cedendo, pubblicando o altrimenti diffondendo, senza il suo consenso, immagini, video o voci falsificati o alterati mediante l’impiego di sistemi di intelligenza artificiale”.

La scelta di mutuare dalla direttiva l’elemento del “danno ingiusto” rischia così di limitare l’applicabilità della norma italiana, lasciando alla vittima l’onere della prova in merito agli effetti dell’abuso.

Ulteriori profili di rischio dei Deepnudes

Oltre alle citate conseguenze psicologiche e reputazionali, un deepfake diffuso sul web può esporre la persona ritratta ad attenzioni indesiderate (e potenzialmente pericolose), mettendo a repentaglio la sua sicurezza fisica ed emotiva.

Ma i deepnude hanno già dimostrato di comportare ulteriori profili di rischio: è il caso delle finte app che promettono di creare gratuitamente materiali erotici, in realtà utilizzate da gruppi cyber criminali per indurre gli utenti a scaricare contenuti malevoli con cui sottrarre le loro credenziali per poi condurre attacchi informatici mirati.

I deepfake possono altresì potenziare i casi di sextortion, dove immagini o video intimi generalmente ottenuti con l’inganno sono utilizzati per ricattare qualcuno al fine di estorcere denaro (di solito in criptovalute) o di farsi inviare ulteriori immagini private, minacciando in caso contrario di pubblicarli online.

E anche laddove i materiali in questione vengano creati o modificati artificialmente, non è difficile immaginare come una persona potrebbe finire per cedere al ricatto sull’onda del timore per la propria reputazione personale e professionale.

Conclusioni: contro il Deepfake abuse serve più consapevolezza

Alla luce dei molteplici profili di rischio evidenziati, nonché della rapidità con cui si evolvono le tecnologie, sembra utopico ipotizzare che il solo strumento normativo – tanto a livello nazionale quanto sovranazionale – possa risultare sufficiente ad arginare il fenomeno deepfake.

Risultano senz’altro utili i tentativi di coinvolgere le aziende nella prevenzione degli abusi basati sull’AI; ma difficilmente i colossi tech rinunceranno ai relativi lauti guadagni, al più limitandosi a prevedere meccanismi di age verification e segnalazione/rimozione dei contenuti illegali che tuttavia, proprio come i rimedi giurisdizionali, intervengono quando il danno si è già verificato.

Allo stesso modo, le possibili contromisure tecniche – come il watermarking delle immagini – rischiano di rivelarsi presto superate dall’evoluzione degli strumenti digitali.

Fondamentale, allora, è impegnarsi nel costruire una cultura del consenso a partire dalle giovani generazioni, creando consapevolezza circa i pericoli e le gravi conseguenze potenzialmente derivanti dalla creazione e diffusione di materiali non consensuali online, affinché lo sviluppo delle tecnologie non divenga sempre più uno strumento per ledere la dignità delle persone.

Profilo Autore

Con una laurea in Giurisprudenza conseguita presso l’Università degli Studi Roma Tre – seguita da un dottorato di ricerca in Economia e Diritto delle Relazioni Internazionali – Irene Salvi è docente in diversi Master e Corsi formativi, nonché giornalista pubblicista e ricercatrice indipendente sul tema dell’intersezione tra diritti individuali, libertà civili e tecnologie digitali.

Dal 2020 è consigliera di una rete internazionale attiva nel contrasto alla violenza di genere; nel 2025 ha partecipato al PRIN-PNRR “Gendering Internet. Violence, Resilience and Empowerment in digital spaces” (GIVRE), condotto dalla Sapienza insieme a Università di Padova e Link University, primo progetto di ricerca sul fenomeno della violenza digitale di genere in Italia.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ai-act-nudify-apps/


APT31 spiava la Russia: cyber spionaggio cinese infiltrato nel tech russo per anni

La partnership “senza limiti” tra Pechino e Mosca ha invece un limite ben preciso: la fiducia reciproca. Un’indagine della società di sicurezza russa Positive Technologies rivela che il gruppo di spionaggio cinese APT31 ha operato indisturbato nelle reti di aziende IT russe principalmente nel periodo 2024-2025, con un primo accesso documentato risalente alla fine del 2022 in almeno un caso, sottraendo dati sensibili a contractor del governo di Mosca.

Un alleato che spia un alleato – APT31 cinese spiava la Russia

Nel panorama del cyber warfare globale, poche notizie riescono a sorprendere come questa: la Cina ha spiato la Russia. Silenziosamente. E Mosca, almeno pubblicamente, non ha detto nulla.

Il gruppo hacker collegato a Pechino noto come APT31 ha infiltrato il settore tecnologico russo, esfiltrando silenziosamente dati da aziende coinvolte in appalti governativi e nell’integrazione di sistemi. Lo rivela una ricerca pubblicata il 20 novembre 2025 dalla società di cybersicurezza russa Positive Technologies, a firma dei ricercatori Daniil Grigoryan e Varvara Koloskova del PT Expert Security Center.

Vale la pena precisare il contesto: Positive Technologies, pur essendo uno dei principali player della cybersecurity russa e una fonte tecnica autorevole, è stata sanzionata dagli Stati Uniti nel 2021 per aver fornito presunto supporto IT alle agenzie di intelligence civile e militare russe. Questo dato non inficia la validità tecnica del report, ampiamente riscontrata da fonti indipendenti come Kaspersky, SC Media e The Hacker News, ma è rilevante per una lettura editorialmente trasparente.

Quanto al perimetro temporale: la campagna sistematica di APT31 contro il settore IT russo si colloca principalmente nel periodo 2024-2025. Un singolo caso documenta un primo accesso risalente alla fine del 2022, con ripresa dell’attività durante le festività del Capodanno 2023. Si tratta di un episodio isolato all’interno di una campagna la cui intensità operativa è concentrata negli ultimi due anni.

La scelta del bersaglio non è casuale. Gli attaccanti si sono concentrati specificamente su aziende che sviluppano o integrano soluzioni per le agenzie governative russe, colpendo i punti di accesso chiave piuttosto che le agenzie stesse: un approccio da manuale per un attacco alla supply chain dell’IT governativo.

La tecnica: invisibili per anni

Ciò che rende questa campagna particolarmente rilevante dal punto di vista tecnico è il livello di sofisticazione operativa. Anziché appoggiarsi a server esterni sospetti, APT31 ha instradato il proprio traffico di command-and-control attraverso Yandex Cloud e Microsoft OneDrive, piattaforme popolari e considerate affidabili all’interno della Russia. Il gruppo ha inoltre inserito istruzioni cifrate in profili sui social media, sia domestici che esteri, e ha sincronizzato alcune operazioni nei fine settimana e durante le festività nazionali, quando la probabilità di rilevamento era significativamente più bassa.

In un caso, i ricercatori hanno accertato che gli attaccanti avevano mantenuto l’accesso ai sistemi di un’azienda IT russa dalla fine del 2022, riprendendo l’attività intensiva durante le festività del Capodanno 2023, quando l’infrastruttura aziendale era operativa ma il personale era ridotto al minimo. In un altro episodio, rilevato nel dicembre 2024, gli attori della minaccia hanno inviato una email di spear-phishing contenente un archivio RAR che includeva un file Windows Shortcut (LNK), responsabile del lancio di un loader Cobalt Strike denominato CloudyLoader tramite DLL side-loading. La tecnica era già stata documentata da Kaspersky nel luglio 2025, che aveva identificato sovrapposizioni con il cluster di minacce noto come EastWind.

L’arsenale tecnico impiegato è ampio e in continua evoluzione. Tra gli strumenti documentati: SharpADUserIP per la ricognizione della rete, SharpChrome.exe per il furto di cookie e credenziali del browser, SharpDir per la ricerca di file nei sistemi compromessi, Microsoft dev tunnels e la VPN Tailscale per il tunneling del traffico, il modulo IIS Owawa per il furto di credenziali, e le backdoor OneDriveDoor e CloudSorcerer, che sfruttano OneDrive e cloud come infrastruttura di controllo remoto. Molti di questi strumenti erano configurati in modalità server, attendendo passivamente che gli attaccanti si connettessero all’host compromesso, minimizzando ulteriormente l’esposizione del traffico.

Il risultato è stato sistematico: durante il periodo trascorso nelle reti delle vittime, il gruppo ha esfiltrato documenti, password, credenziali di caselle di posta e accessi a servizi interni. In molti casi, il furto è proseguito per mesi, in alcuni per oltre un anno, senza innescare alcun allarme. Sul tema degli APT che abusano di servizi cloud legittimi come vettore C2, ICT Security Magazine ha già documentato l’evoluzione di questa tecnica tra i principali gruppi statali attivi nel 2025.

Chi è APT31

APT31, noto anche come Altaire, Bronze Vinewood, Judgement Panda, PerplexedGoblin, RedBravo, Red Keres, Violet Typhoon (già Zirconium), TA412 e Hurricane Panda, è attivo almeno dal 2010 ed è pubblicamente associato all’Hubei State Security Department, dipartimento regionale del Ministero per la Sicurezza dello Stato (MSS) cinese. Quest’ultimo avrebbe istituito come copertura la società Wuhan Xiaoruizhi Science and Technology Company Ltd. (Wuhan XRZ), con sede a Wuhan.

Ha all’attivo operazioni contro un’ampia gamma di settori, tra cui governi, finanza, aerospazio e difesa, alta tecnologia, costruzioni e ingegneria, telecomunicazioni, media e assicurazioni.

Il gruppo è principalmente orientato a raccogliere intelligence che possa fornire a Pechino e alle imprese statali cinesi vantaggi politici, economici e militari. Per un quadro più ampio sui principali threat actor cinesi e le loro strutture operative, si rimanda all’analisi dedicata pubblicata su ICT Security Magazine.

Non si tratta di un attore sconosciuto o recente. Nel marzo 2024, il Dipartimento di Giustizia americano ha incriminato sette cittadini cinesi legati ad APT31 per una campagna globale di spionaggio informatico durata circa quattordici anni, mentre l’OFAC ha contestualmente sanzionato Wuhan XRZ e due individui chiave, Zhao Guangzong e Ni Gaobin.

In parallelo, il governo del Regno Unito ha adottato le medesime sanzioni, collegando APT31 a una campagna di ricognizione informatica contro parlamentari britannici critici nei confronti di Pechino. L’hack della UK Electoral Commission (2021-2022), che ha coinvolto i dati personali di circa 40 milioni di elettori britannici, è stato attribuito dalle autorità britanniche a “un’entità affiliata allo Stato cinese” in senso più ampio, senza un’attribuzione specifica ad APT31.

Il 28 maggio 2025, la Repubblica Ceca ha formulato un’accusa formale con alto grado di certezza, attraverso l’agenzia di cybersicurezza NÚKIB e tre agenzie di intelligence nazionali, attribuendo ad APT31 una campagna intrusiva contro il suo Ministero degli Affari Esteri avviata nel 2022 e finalizzata a compromettere una delle reti non classificate del ministero per diversi mesi. L’attribuzione ha ottenuto la solidarietà formale di NATO e Unione Europea.

Va segnalato inoltre che, nell’ottobre 2025, la società americana Symantec aveva attribuito un attacco separato contro provider russo al gruppo cinese Jewelbug, un cluster distinto da APT31. Si tratta di un ulteriore segnale che le operazioni cyber cinesi contro l’infrastruttura tecnologica russa non si esauriscono in un unico attore. Per approfondire il contesto dello spionaggio cinese contro la Russia, incluse le operazioni documentate fin dal 2022 nel quadro del conflitto in Ucraina, si rinvia all’analisi di ICT Security Magazine.

Il silenzio di Mosca e le implicazioni geopolitiche

La parte forse più rilevante di questa vicenda non è tecnica: è politica. I rapporti pubblici di operazioni cyber cinesi contro la Russia sono rari, dato che i due paesi sono ampiamente considerati partner strategici. Eppure Mosca non ha risposto pubblicamente.

Gli attori cinesi hanno ottenuto un accesso profondo al settore tecnologico russo adiacente alla difesa, ma Mosca appare riluttante a confrontarsi con Pechino apertamente. Questo silenzio dice più sulla natura della partnership sino-russa di qualsiasi comunicato ufficiale.

La lettura geopolitica offerta dall’European Policy Centre (gennaio 2026) è lucida: le rivelazioni su APT31 indicano che la Cina sta monitorando le capacità e i punti deboli della Russia in tempo reale. Lo spionaggio funziona non solo come raccolta di intelligence, ma come strumento di gestione dell’alleanza. Pechino vuole mantenere la Russia abbastanza forte da sfidare l’Occidente, ma non così forte da sfuggire alla propria orbita.

La cooperazione visibile non deve essere scambiata per fiducia strategica. Man mano che il coinvolgimento cinese cresce, con l’export di componenti dual-use critici per lo sforzo bellico russo e il rafforzamento dei legami industriali della difesa, cresce anche il suo incentivo a monitorare e proteggersi dalla debolezza russa.

Cosa significa per l’Europa

Per l’Europa la lezione è chiara: l’asse Cina-Russia non è né senza soluzione di continuità né permanente. È un allineamento pragmatico tra due potenze che perseguono obiettivi a lungo termine differenti.

In un contesto in cui il conflitto in Ucraina continua e le catene di fornitura tecnologiche rimangono sotto pressione, la notizia che Pechino infiltra il settore IT russo, compresi i contractor governativi, ridefinisce il perimetro di rischio per tutti gli attori del campo: alleati, avversari e neutrali. La frontiera del cyber warfare non segue le linee diplomatiche. E le alleanze, nel cyberspazio, valgono quanto l’ultima campagna di spear-phishing andata a buon fine.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/apt31-cina-spia-russia/


Threat Modeling nel 2026: analisi approfondita, aggiornata e operativa

32% degli attacchi parte da una vulnerabilità sfruttata. 11% da una telefonata. 9% da credenziali rubate. I numeri del report M-Trends 2026 di Mandiant raccontano una storia precisa: chi attacca non forza più le porte, le apre con le chiavi giuste, al momento giusto, spesso senza che nessun alert si attivi.

In questo scenario, sapere dove si è vulnerabili non basta più. Serve sapere come un avversario reale si muoverebbe attraverso i propri sistemi, quali identità sfrutterebbe, quali agenti AI manipolerebbe, quali fornitori userebbe come testa di ponte. Questa capacità ha un nome consolidato, threat modeling, e nel 2026 ha smesso di essere una pratica da specialisti per diventare un requisito operativo, regolamentare e strategico per qualsiasi organizzazione che gestisca infrastrutture digitali critiche.

Questa analisi percorre lo stato dell’arte della disciplina: dai framework classici in evoluzione (STRIDE, PASTA, LINDDUN) ai nuovi standard AI-native come MITRE ATLAS v5.4.0, MAESTRO e l’OWASP Top 10 per le applicazioni agentiche, fino a un percorso di maturità praticabile anche per chi parte da zero.

Threat Modeling: una disciplina che non si può più rimandare

Per anni il threat modeling è rimasto confinato ai margini del ciclo di sviluppo software: un esercizio formale, spesso delegato a un singolo specialista di sicurezza, raramente aggiornato dopo il rilascio in produzione. Nel 2026 quella stagione è definitivamente chiusa.

Tre forze convergenti hanno trasformato il threat modeling da pratica opzionale a imperativo strategico. La prima è un threat landscape che si industrializza a velocità senza precedenti: gli attaccanti operano come organizzazioni strutturate, con divisione del lavoro, specializzazione e catene di fornitura del crimine che comprimono i tempi di compromissione a pochi secondi. La seconda è la diffusione pervasiva di sistemi di intelligenza artificiale agentici, che ridisegnano la superficie d’attacco in modo radicalmente diverso da qualsiasi tecnologia precedente. La terza è un quadro regolamentare europeo – AI Act, NIS2, Cyber Resilience Act, DORA – che impone la formalizzazione del risk modeling come requisito di conformità verificabile, non più come buona pratica volontaria.

Questa analisi ricostruisce lo stato dell’arte del threat modeling nel 2026 in modo operativo: framework in evoluzione, domini applicativi prioritari, strumenti disponibili, errori comuni da evitare e un percorso di maturità praticabile anche per le organizzazioni che partono da zero.

  1. Il contesto: un threat landscape che si industrializza

Il punto di partenza non può che essere il dato più rilevante dell’anno. Il report M-Trends 2026 di Mandiant – basato su centinaia di interventi di incident response condotti a livello globale nel 2025 – fotografa un panorama in cui i cyberattacchi sono diventati più veloci, più coordinati e sempre più professionalizzati. Gli attaccanti riescono a trasferire accessi tra diversi soggetti in meno di trenta secondi, comprimendo drasticamente le finestre di risposta per i difensori e rendendo obsoleti i playbook tradizionali.

Il global median dwell time – cioè il tempo medio che un attaccante trascorre non rilevato all’interno di un sistema compromesso – è salito a quattordici giorni, in crescita rispetto agli undici dell’anno precedente. L’aumento è trainato in larga misura da attività di spionaggio a lungo termine e da operazioni di IT worker collegati alla Corea del Nord, che infiltrano organizzazioni tecnologiche occidentali attraverso false identità professionali.

Sul fronte dei vettori iniziali di compromissione, lo sfruttamento di vulnerabilità (exploit) si conferma in cima alla classifica con il 32% dei casi, seguito dal voice phishing all’11%, dal prior compromise al 10% e dalle credenziali rubate al 9%. Il web compromise contribuisce per l’8%, mentre email phishing e insider threat si attestano entrambi al 6%. Questi numeri hanno implicazioni dirette sul threat modeling: un modello che prioritizza esclusivamente le vulnerabilità tecniche sottostima gravemente i vettori di compromissione basati sull’identità e sull’ingegneria sociale.

Un dato strutturale da tenere a mente riguarda il cambiamento di paradigma degli attaccanti. Il panorama delle minacce si è spostato verso un approccio “log in rather than break in”: gli avversari sfruttano credenziali valide, session token e accessi federati per aggirare le difese perimetrali tradizionali senza mai attivare un singolo alert di rilevamento perimetrale. Questo sposta il baricentro del threat modeling dall’analisi delle vulnerabilità tecniche alla modellazione dell’abuso di identità e degli accessi legittimi.

Sul fronte dell’intelligenza artificiale, il Google Threat Intelligence Group conferma che gli avversari stanno integrando l’AI per accelerare il ciclo d’attacco. Famiglie di malware come PROMPTFLUX e PROMPTSTEAL interrogano attivamente modelli linguistici durante l’esecuzione per eludere il rilevamento; le cosiddette “distillation attack” minacciano la proprietà intellettuale estraendo la logica proprietaria e i dati di addestramento specializzati di modelli ad alto valore. Al tempo stesso, il credential stealer QUIETVAULT è stato osservato mentre analizzava le macchine target alla ricerca di strumenti AI da riga di comando, eseguendo prompt predefiniti per individuare file di configurazione.

Un avvertimento prezioso per chi è tentato di sovrastimare la minaccia AI: la grande maggioranza delle intrusioni di successo continua a derivare da fallimenti umani e sistemici fondamentali – patch management carente, MFA assente, privilege sprawl non governato – e non da attacchi AI sofisticati. Il threat modeling efficace non deve inseguire la novità a scapito dei fondamentali.

  1. Che cos’è il threat modeling e perché va reinterpretato nel 2026

Il threat modeling è, nella sua definizione più solida, una disciplina strutturata per identificare, analizzare e comunicare le minacce nel contesto della protezione di un asset di valore. Applicato al software, abilita decisioni informate sui rischi di sicurezza applicativa e produce – oltre al modello stesso – un elenco prioritizzato di miglioramenti da applicare a concept, requisiti, progettazione o implementazione.

Il Threat Modeling Manifesto, redatto nel 2020 da un gruppo di practitioner internazionali, ha codificato quattro domande fondamentali che strutturano qualsiasi sessione di threat modeling: su cosa stiamo lavorando? Cosa può andare storto? Cosa possiamo fare al riguardo? Il lavoro svolto è stato efficace? Queste domande, pur nella loro apparente semplicità, sono ancora oggi la bussola più affidabile per orientarsi in un processo che rischia di diventare esercizio burocratico invece di strumento operativo.

Il thread modeling tradizionale si è evoluto attorno al software deterministico: percorsi di codice noti, input e output prevedibili, modalità di fallimento relativamente stabili. I sistemi di intelligenza artificiale – in particolare quelli generativi e agentici – rompono molte di queste assunzioni. Un sistema AI è probabilistico: lo stesso input può produrre output diversi in esecuzioni successive. Tratta la conversazione e le istruzioni come parte di un singolo flusso di input in cui il testo avversariale può essere interpretato come intento eseguibile. Può invocare API esterne, persistere stato in memoria e attivare workflow autonomamente, con effetti a cascata su componenti non direttamente modellati.

Il 2026 impone quindi una doppia lettura del threat modeling: la consolidazione delle metodologie classiche in pipeline DevSecOps mature, e la costruzione di framework radicalmente nuovi capaci di modellare sistemi probabilistici, non deterministici, con autonomia d’azione e memoria persistente.

  1. Framework metodologici classici: evoluzione e stato dell’arte

STRIDE

Creato da Microsoft, STRIDE rimane il framework più diffuso e pedagogicamente più accessibile. L’acronimo copre sei categorie di minaccia: Spoofing (impersonificazione di un’entità legittima), Tampering (manomissione di dati o codice), Repudiation (ripudio di un’azione), Information Disclosure (divulgazione non autorizzata di informazioni), Denial of Service (saturazione di risorse) ed Elevation of Privilege (acquisizione di permessi superiori a quelli legittimi).

STRIDE si applica in modo naturale insieme ai Data Flow Diagram, analizzando ogni elemento del diagramma – processi, archivi dati, flussi, entità esterne – contro le sei categorie. Nel 2026 viene estensivamente usato nelle pipeline DevSecOps integrate, ma richiede estensioni esplicite per coprire le superfici AI: la categoria “Spoofing” va estesa all’impersonificazione tramite prompt injection, “Tampering” al data poisoning nei dataset di addestramento, “Elevation of Privilege” all’escalation ottenuta manipolando il contesto di un agente autonomo.

PASTA

PASTA (Process for Attack Simulation and Threat Analysis) è una metodologia attacker-centric articolata in sette fasi: definizione degli obiettivi di business, definizione dello scope tecnico, decomposizione dell’applicazione, analisi delle minacce, analisi delle vulnerabilità, simulazione degli attacchi, analisi del rischio e impatto. È particolarmente indicata per threat modeling di sistemi ad alta complessità regolamentare, poiché allinea l’analisi delle minacce agli obiettivi di business e all’impatto operativo misurabile. Una banca, un’azienda sanitaria o un operatore di infrastrutture critiche troverà in PASTA la metodologia più aderente al proprio modello di governance del rischio.

LINDDUN

LINDDUN è una metodologia focalizzata sulla privacy, progettata per identificare minacce relative a Linkability (possibilità di collegare dati appartenenti allo stesso soggetto), Identifiability (possibilità di identificare un individuo da dati aggregati), Non-repudiation, Detectability, Disclosure of Information, Unawareness (mancanza di consapevolezza dell’interessato) e Non-compliance. Supporta nativamente GDPR, HIPAA e normative analoghe. Nel contesto europeo del 2026 – con l’AI Act in piena applicazione – LINDDUN sta acquisendo rilevanza crescente per le organizzazioni che devono modellare i rischi dei sistemi AI sull’identità e sulla protezione dei dati personali degli utenti.

Attack Trees

Uno degli approcci più longevi, ancora ampiamente usato per analizzare scenari d’attacco complessi in modo gerarchico. La radice dell’albero è l’obiettivo dell’attaccante; ogni nodo figlio rappresenta un modo per raggiungere il nodo genitore. Nel 2026 gli attack tree vengono spesso generati automaticamente da strumenti AI-assisted come IriusRisk o Microsoft Threat Modeling Tool, riducendo il tempo necessario per coprire scenari complessi.

Framework ibridi

Gli approcci più maturi combinano più metodologie per ottenere copertura più ampia. Una configurazione comune nel 2026 è l’uso di STRIDE per la struttura di base, LINDDUN per la dimensione privacy, e PASTA per la valutazione dell’impatto business, il tutto mappato sulle tattiche e tecniche di MITRE ATT&CK per verificare la copertura rispetto al threat landscape reale.

  1. La tabella comparativa: scegliere il framework giusto
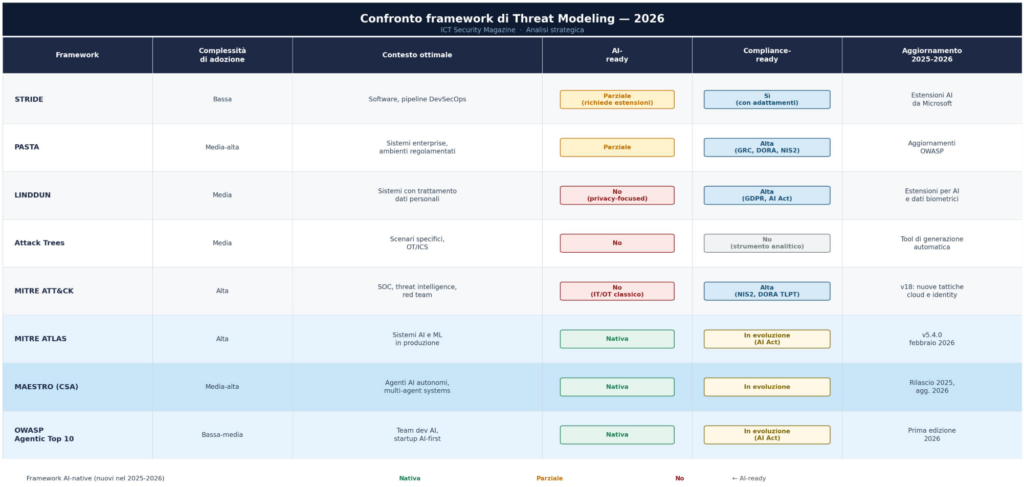
    Tabella framework threat modeling 2026 - threat modeling nel 2026, cybersecurity 2026

  1. I nuovi framework AI-native: la svolta strutturale del 2026

Questa è la frontiera più rilevante e meno consolidata del threat modeling nel 2026. L’insufficienza dei framework classici per i sistemi AI non è un’opinione: è un dato strutturale riconosciuto da MITRE, OWASP, CSA e Microsoft con aggiornamenti formali dei rispettivi framework.

MITRE ATLAS v5.4.0

MITRE ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems) è la base di conoscenza di riferimento per le minacce ai sistemi AI, organizzata come MITRE ATT&CK ma specificamente progettata per modelli ML e sistemi AI in produzione. L’aggiornamento di novembre 2025 ha portato il framework a sedici tattiche, ottantaquattro tecniche, trentadue mitigazioni e quarantadue case study documentati. L’aggiornamento successivo del febbraio 2026 (v5.4.0) ha aggiunto ulteriori tecniche incentrate sugli agenti AI, tra cui “Publish Poisoned AI Agent Tool” ed “Escape to Host”.

L’aggiornamento 2026 di MITRE ATLAS sposta il focus dagli attacchi centrati sul modello all’esposizione al livello di execution layer: il threat modeling deve ora tenere conto del chaining autonomo di workflow, della persistenza dell’autorità delegata e del rischio di orchestrazione a livello API. I team di sicurezza non possono più limitare le valutazioni agli input e agli output del modello: devono valutare come i sistemi AI interagiscono con l’infrastruttura enterprise nel tempo, attraverso tool call, accessi a memoria persistente e deleghe di autorità.

Un caso documentato particolarmente istruttivo è SesameOp, aggiunto ad ATLAS a fine 2025: una backdoor che sfrutta le API dei servizi di agenti AI come canale di command and control, mascherando attività malevole nel normale traffico verso i provider AI. Un altro caso documentato riguarda il Financial Transaction Hijacking tramite Microsoft 365 Copilot, che dimostra come un assistente AI aziendale possa essere sfruttato per operazioni finanziarie non autorizzate attraverso la manipolazione del suo contesto.

MAESTRO

MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) è il framework della Cloud Security Alliance specificamente progettato per gli agenti AI autonomi. A differenza di ATLAS – che è essenzialmente una tassonomia delle minacce – MAESTRO è un framework di processo che guida l’analisi del rischio lungo l’intero ciclo di vita agentico, organizzata attorno agli elementi di sistema AI (ambiente, strumenti, memoria, identità, comunicazione inter-agente). Include un tool AI-powered per il threat modeling che genera automaticamente scenari di rischio a partire dall’architettura del sistema.

OWASP Top 10 per le applicazioni agentiche (2026)

La prima edizione dell’OWASP Top 10 for Agentic Applications cataloga i dieci rischi più critici per i sistemi AI agentici: Agent Goal Hijacking (ASI01), Tool Misuse (ASI02), Identity & Privilege Abuse (ASI03), Supply Chain Vulnerabilities (ASI04), Unexpected Code Execution (ASI05), Memory & Context Poisoning (ASI06), Insecure Inter-Agent Communication (ASI07), Cascading Failures (ASI08), Human-Agent Trust Exploitation (ASI09) e Rogue Agents (ASI10). La lista è complementare – non sostitutiva – all’OWASP Top 10 per le applicazioni LLM, che mantiene la Prompt Injection al primo posto con l’aggiunta di System Prompt Leakage e Vector & Embedding Weaknesses.

  1. Il tool landscape: gli strumenti disponibili nel 2026

Il threat modeling è efficace solo se viene praticato sistematicamente, e la sistematicità richiede strumenti adeguati. Il mercato nel 2026 si divide in tre categorie.

Strumenti open source e gratuiti. Microsoft Threat Modeling Tool rimane il punto di partenza più accessibile per chi usa STRIDE su applicazioni Windows e cloud Azure. OWASP Threat Dragon è l’alternativa open source multi-piattaforma, con supporto per DFD e modelli STRIDE esportabili. MITRE ATLAS Navigator e il relativo Arsenal permettono di mappare i propri controlli di sicurezza sulle tattiche ATLAS e di identificare le lacune di copertura specifiche per i sistemi AI.

Piattaforme commerciali integrate. IriusRisk è oggi la piattaforma più matura per il threat modeling enterprise integrato nel ciclo DevSecOps, con supporto per più framework, generazione automatica di threat model a partire dai diagrammi architetturali, integrazione con Jira e sistemi di ticketing, e un motore basato su regole aggiornato continuamente. ThreatModeler offre funzionalità analoghe con enfasi sull’automazione tramite AI. SD Elements di Security Compass si distingue per la capacità di tradurre il threat model in requisiti di sicurezza specifici per sviluppatori, riducendo il gap tra modellazione e implementazione.

Strumenti AI-assisted di nuova generazione. Nel 2026 emergono soluzioni che usano modelli linguistici per generare threat model a partire da descrizioni testuali dell’architettura, diagrammi esistenti o documentazione di progetto. Questi strumenti accelerano significativamente la fase di elicitazione delle minacce, ma richiedono revisione esperta dell’output: i modelli linguistici tendono a produrre minacce plausibili ma non necessariamente prioritizzate rispetto al contesto specifico dell’organizzazione.

  1. I domini applicativi prioritari nel 2026

7.1 Threat modeling dell’identità

La surface d’attacco è oggi identity-driven. Gli avversari scelgono di accedere anziché forzare, sfruttando credenziali valide, session token e accessi federati per aggirare le difese perimetrali. Il voice phishing – undici per cento dei vettori iniziali secondo M-Trends 2026 – ha soppiantato il phishing tradizionale via email per gli attacchi mirati di alto valore, perché la componente umana in tempo reale rende molto più difficile il rilevamento automatico.

Il threat modeling dell’identità deve coprire scenari che i framework tradizionali non modellano esplicitamente: abuso di SSO e identity provider federati, session hijacking post-autenticazione MFA, exploitation delle integrazioni SaaS (OAuth scope abuse), privilege escalation tramite service account e managed identity nei cloud provider, e social engineering degli helpdesk IT che possono essere indotti a resettare credenziali o bypassare procedure di verifica.

7.2 Threat modeling dei sistemi AI agentici

Il threat modeling AI è intrinsecamente difficile per tre ragioni strutturali. Prima: il comportamento dei sistemi AI è probabilistico e dipende dal contesto, rendendo impossibile enumerare in anticipo tutti i percorsi di esecuzione. Seconda: la superficie d’attacco si estende attraverso tutto ciò che l’agente può fare – tool call, accessi a database, invio di email, scrittura di codice – non solo attraverso i suoi input diretti. Terza: gli effetti di una compromissione possono propagarsi rapidamente attraverso sistemi connessi: un singolo agente compromesso può avvelenare l’87% delle decisioni downstream entro quattro ore, secondo le analisi su incidenti reali documentati nel 2026.

Il percorso operativo consigliato dai principali practitioner segue tre fasi progressive. Si parte dall’OWASP Top 10 for Agentic Applications per costruire la comprensione di base delle categorie di rischio. Si progredisce verso il red teaming AI-specific, testando empiricamente le ipotesi del threat model attraverso attacchi controllati (prompt injection, context poisoning, tool misuse). Si struttura infine lo sviluppo sicuro con controlli specifici: validazione dell’input nei tool, principio del minimo privilegio per le autorizzazioni degli agenti, logging granulare delle azioni autonome, e meccanismi di human-in-the-loop per le azioni ad alto impatto.

7.3 Supply chain del software

Il Cyber Resilience Act europeo rende il threat modeling della supply chain un obbligo per i produttori di hardware e software con elementi digitali. Il modello di minaccia deve coprire l’intero ciclo di vita del componente: dalle dipendenze open source (con generazione e manutenzione del Software Bill of Materials) all’integrità degli artefatti di build, fino alla distribuzione sicura degli aggiornamenti. Nel 2026 sono stati identificati quarantatré componenti differenti di framework per agenti AI con vulnerabilità incorporate, a dimostrazione che la supply chain AI merita un sotto-dominio specifico del threat modeling.

7.4 OT, ICS e infrastrutture critiche

La convergenza IT-OT ha eliminato il tradizionale “air gap” che proteggeva i sistemi industriali. Il threat modeling per ambienti OT/ICS presenta sfide peculiari: i sistemi legacy non sono aggiornabili, i tempi di fermo per manutenzione sono limitati, e le conseguenze di una compromissione possono avere impatto fisico diretto sulla sicurezza delle persone. La convergenza tra crimine finanziario, minacce insider e attacchi cyber-fisici crea scenari in cui un attore può colpire simultaneamente la componente IT, la componente OT e i processi di business, con effetti a cascata che nessun threat model tradizionale è in grado di catturare integralmente.

Il riferimento metodologico per questo dominio è IEC 62443, standard internazionale per la sicurezza dei sistemi di automazione e controllo industriale, che deve essere integrato con MITRE ATT&CK for ICS per la mappatura delle tecniche di attacco documentate contro infrastrutture industriali.

7.5 Post-quantum readiness

Ogni sistema che gestisce dati con requisiti di confidenzialità a lungo termine è già oggi esposto al rischio “harvest-now-decrypt-later”: gli attaccanti raccolgono traffico cifrato con la certezza di poterlo decifrare non appena i computer quantistici raggiungeranno capacità crittograficamente rilevanti. Il NIST ha completato nel 2024 la standardizzazione dei primi algoritmi post-quantum (CRYSTALS-Kyber per la cifratura a chiave pubblica, CRYSTALS-Dilithium per le firme digitali). Il threat modeling del 2026 deve includere la catalogazione degli algoritmi crittografici in uso nell’organizzazione – cosiddetto “crypto inventory” – e la prioritizzazione della migrazione verso PQC in base alla sensibilità dei dati e alla loro durata di vita rilevante.

  1. La prospettiva italiana ed europea: gap e opportunità

L’Italia si trova in una posizione di transizione nel 2026. Il recepimento di NIS2 (D.lgs. 138/2024) ha formalmente esteso l’obbligo di gestione del rischio cyber a migliaia di soggetti essenziali e importanti, molti dei quali non disponevano in precedenza di un processo formalizzato di threat modeling. L’Agenzia per la Cybersicurezza Nazionale ha pubblicato linee guida operative che richiamano esplicitamente l’adozione di metodologie strutturate di valutazione del rischio.

Il gap più critico riguarda le medie imprese del manifatturiero avanzato e delle filiere industriali: organizzazioni con ambienti OT significativi, spesso prive di un team di sicurezza dedicato, che devono costruire un processo di threat modeling praticamente da zero in tempi ristretti per la conformità NIS2. In questo contesto la scelta del framework e degli strumenti è determinante: un approccio troppo complesso rischia di essere abbandonato prima di produrre valore reale.

Le grandi organizzazioni italiane – banche, assicurazioni, utility, telco – sono generalmente più avanzate, con programmi di threat modeling maturi e in alcuni casi integrati nei cicli di sviluppo agile. Il gap in questo segmento riguarda prevalentemente la capacità di estendere il threat modeling ai sistemi AI che stanno deployando rapidamente, e la gestione della supply chain di fornitori e partner.

A livello europeo, il 2026 è l’anno in cui l’AI Act entra in piena applicazione per la maggior parte degli obblighi che riguardano i sistemi AI ad alto rischio. Le organizzazioni che implementano agenti AI autonomi devono dimostrare conformità con i requisiti di gestione del rischio, trasparenza e supervisione umana – requisiti che si soddisfano attraverso un threat model documentato, non attraverso dichiarazioni generiche di conformità.

  1. Gli errori più comuni da evitare

Il threat modeling mal praticato è peggio dell’assenza di threat modeling: crea una falsa percezione di sicurezza e consuma risorse senza produrre valore reale. Questi sono i pattern anti-threat-modeling più frequenti osservati nelle organizzazioni nel 2026.

Fare il threat model una volta sola. Il threat model è un artefatto vivente, non un documento da archiviare dopo la fase di design. Ogni cambiamento architetturale significativo, ogni nuova integrazione, ogni modifica del threat landscape esterno richiede una revisione. Le organizzazioni mature lo collegano direttamente al processo di change management: nessuna modifica architetturale rilevante viene approvata senza una valutazione dell’impatto sul threat model esistente.

Limitarsi alle vulnerabilità tecniche. Un threat model che si concentra esclusivamente su CVE, misconfiguration e debolezze del codice è sistematicamente cieco rispetto ai vettori più utilizzati nel 2026: social engineering dell’identità, abuso di accessi legittimi, supply chain compromise, manipolazione del contesto nei sistemi AI. Il modello deve rappresentare l’attaccante reale, non solo il sistema difeso.

Escludere gli stakeholder non tecnici. Il threat modeling efficace richiede contributi da team di sicurezza, engineering, product management, UX e legal/compliance. Escludere le funzioni non tecniche produce threat model tecnicamente accurati ma disconnessi dagli obiettivi di business e dai requisiti normativi. Un CISO legale presente nella sessione di threat modeling può identificare in pochi minuti obblighi di notifica o vincoli di data residency che cambiano radicalmente la prioritizzazione delle minacce.

Non collegare il threat model ai controlli di sicurezza. Un threat model che produce una lista di minacce senza mappatura sui controlli esistenti e sulle lacune di copertura è un esercizio intellettuale, non uno strumento operativo. Il valore reale emerge quando il threat model diventa il driver delle decisioni di investimento in sicurezza: “investiamo in questo controllo perché copre queste tre minacce ad alta priorità del nostro threat model”.

Usare un solo framework per tutti i contesti. STRIDE è eccellente per applicazioni web tradizionali e pipeline DevSecOps; è inadeguato per sistemi AI agentici o ambienti OT industriali. L’errore opposto – adottare un framework complesso come PASTA per ogni contesto, inclusi i sistemi più semplici – produce overhead sproporzionato che porta all’abbandono del processo. La scelta del framework deve essere contestuale.

Ignorare i sistemi AI come componenti del threat model. Molte organizzazioni nel 2026 continuano a modellare le minacce ai propri sistemi senza includere i servizi AI integrati (LLM API, agenti, sistemi di raccomandazione). Questi componenti hanno superfici d’attacco specifiche – prompt injection, data poisoning, model extraction – che non vengono catturate dai framework classici e che possono diventare punti di ingresso per compromissioni più ampie.

  1. Un percorso di maturità: da zero alla piena integrazione

Livello 0: punto di partenza (organizzazioni senza processo formalizzato)

Il primo obiettivo non è la perfezione metodologica ma l’abitudine. Si inizia con sessioni di threat modeling strutturate per i nuovi progetti o per le modifiche architetturali significative, usando STRIDE come framework di riferimento per la sua accessibilità. Bastano tre ore con le persone giuste – un architetto, un developer, un responsabile della sicurezza – e un foglio bianco con il DFD dell’applicazione per produrre un primo threat model utile. L’output minimo è una lista di minacce prioritizzate e una prima mappatura sui controlli esistenti e mancanti.

Livello 1: standardizzazione (sei-dodici mesi)

Il processo viene formalizzato e reso ripetibile: template standard per i DFD, checklist metodologiche, criteri di prioritizzazione del rischio condivisi. Il threat modeling viene integrato nel processo di approvazione delle modifiche architetturali: nessuna modifica rilevante viene implementata senza una sessione di revisione del threat model. Si adottano i primi strumenti di supporto (OWASP Threat Dragon, Microsoft Threat Modeling Tool) per ridurre il tempo necessario per la documentazione.

Livello 2: integrazione DevSecOps (dodici-ventiquattro mesi)

Il threat modeling viene integrato nel ciclo di sviluppo agile: ogni epic o sprint significativo include una micro-sessione di threat modeling (trenta-sessanta minuti) focalizzata sulle modifiche specifiche. Si adottano piattaforme commerciali come IriusRisk o ThreatModeler per gestire l’inventario dei threat model, tracciare le remediation e generare reportistica per il management. Il threat model viene collegato al sistema di ticketing (Jira, Azure DevOps) in modo che ogni minaccia identificata generi automaticamente un work item di sicurezza tracciabile.

Livello 3: automazione e continuous threat modeling (oltre i ventiquattro mesi)

Il threat model viene generato e aggiornato semi-automaticamente a partire dai diagrammi architetturali mantenuti nel repository di codice, con tool AI-assisted che suggeriscono minacce rilevanti sulla base delle modifiche apportate. Il threat modeling AI-specific (MITRE ATLAS, MAESTRO, OWASP Agentic Top 10) viene integrato per tutti i sistemi che includono componenti di intelligenza artificiale. Il threat model diventa la base documentale per la conformità regolamentare (NIS2, AI Act, CRA, DORA), eliminando la duplicazione tra processi di sicurezza e processi di compliance.

  1. Il contesto regolamentare: la compliance come driver di threat modeling

L’ambiente regolamentare europeo nel 2026 è il più esigente della storia per le organizzazioni che operano nel digitale. Quattro framework normativi convergono simultaneamente in fase di enforcement.

La Direttiva NIS2 (recepita in Italia con D.lgs. 138/2024) impone la formalizzazione di un processo di gestione del rischio che include esplicitamente l’analisi delle minacce alle reti e ai sistemi informativi, con audit regolari e notifica delle vulnerabilità significative entro ventiquattro ore per gli incidenti con impatto significativo. Il threat modeling strutturato è lo strumento naturale per soddisfare questo requisito in modo documentabile e verificabile.

L’AI Act dell’Unione Europea ha portato in piena applicazione, nell’agosto 2026, la maggior parte degli obblighi per i sistemi AI ad alto rischio. Le organizzazioni che deploiano agenti AI autonomi devono dimostrare conformità con i requisiti di gestione del rischio, trasparenza e supervisione umana. Un threat model documentato dei sistemi AI – che copra le minacce specifiche all’autonomia, alla memoria e alla catena degli strumenti – è la base tecnica per questa dimostrazione.

Il Cyber Resilience Act rende obbligatorio il Software Bill of Materials e impone requisiti di sicurezza lungo tutto il ciclo di vita del prodotto digitale, inclusa la gestione delle vulnerabilità e la disponibilità di aggiornamenti sicuri. Il threat model della supply chain software diventa parte integrante del dossier tecnico richiesto per la conformità.

DORA (Digital Operational Resilience Act) estende analoga disciplina al settore finanziario, con particolare enfasi sui Threat-Led Penetration Test: test di penetrazione avanzati basati su threat intelligence reale, condotti da fornitori certificati, che richiedono come prerequisito un threat model maturo delle infrastrutture critiche dell’organizzazione.

Le figure di Legal e Compliance devono essere parte integrante del processo di threat modeling, non destinatarie passive dei suoi output. La loro presenza nelle sessioni di analisi garantisce che vengano identificate e modellate minacce con implicazioni normative specifiche: violazioni di data residency, scenari di data breach soggetti a notifica obbligatoria, rischi reputazionali connessi a incidenti che coinvolgono categorie particolari di dati.

  1. Raccomandazioni operative per il 2026

Adottare un approccio multi-framework calibrato sul contesto. Nessun singolo framework copre tutti i domini rilevanti nel 2026. La combinazione più solida è: STRIDE o PASTA come metodologia base per i sistemi software tradizionali, MITRE ATLAS più OWASP Agentic Top 10 per i sistemi AI, LINDDUN per i componenti con trattamento di dati personali, IEC 62443 per gli ambienti OT industriali. La scelta non deve essere ideologica ma pragmatica: il framework migliore è quello che il team effettivamente usa e aggiorna.

Trattare l’identità come superficie primaria. Il threat model deve riflettere il nuovo paradigma degli attaccanti: la compromissione inizia quasi sempre attraverso l’identità, non attraverso le vulnerabilità tecniche. Questo significa modellare esplicitamente gli scenari di abuso di accessi legittimi, session hijacking post-MFA, exploitation delle integrazioni SaaS e social engineering degli helpdesk IT. La mitigazione più efficace – continuous identity verification e routing di tutte le applicazioni SaaS attraverso un identity provider centralizzato – deve essere guidata dal threat model, non dall’intuizione.

Integrare il threat modeling nel ciclo di vita degli agenti AI dall’inizio. I sistemi agentici richiedono modelli di sicurezza che comprendano obiettivi, strumenti, contesto e flusso decisionale. I controlli tradizionali di rete, IAM e sicurezza applicativa rimangono necessari ma non più sufficienti. Il logging granulare delle azioni autonome, il principio del minimo privilegio per le autorizzazioni degli agenti e i meccanismi di human-in-the-loop per le azioni ad alto impatto devono essere definiti nel threat model prima del deployment.

Mappare il threat model sui requisiti normativi. AI Act, NIS2, CRA e DORA richiedono documentazione formale del processo di gestione del rischio. Un threat model strutturato correttamente diventa la base documentale per la conformità regolamentare, eliminando la duplicazione tra processi di sicurezza e processi di compliance. Questa sinergia riduce significativamente il costo complessivo della conformità.

Passare dagli indicatori di compromissione statici al rilevamento comportamentale. Con gli attaccanti che cambiano rapidamente l’infrastruttura e distribuiscono malware custom eseguito in memoria, affidarsi esclusivamente agli IoC statici non è più sufficiente. Il threat model deve anticipare questi scenari comportamentali e guidare l’implementazione di modelli di rilevamento basati sulle anomalie rispetto alle baseline stabilite.

Avviare il crypto inventory e la roadmap post-quantum. Ogni sistema che gestisce dati con requisiti di confidenzialità a lungo termine merita una sezione specifica del threat model dedicata ai rischi crittografici. Il primo passo pratico è il censimento degli algoritmi crittografici in uso nell’organizzazione; il secondo è la prioritizzazione della migrazione verso algoritmi post-quantum in base alla sensibilità dei dati e alla loro durata di vita rilevante.

Costruire un team interdisciplinare e mantenerlo nel tempo. Il threat modeling efficace non è un’attività che si delega a un singolo esperto di sicurezza. Richiede la partecipazione attiva di architetti software, sviluppatori, product manager, responsabili legali e compliance officer. Il valore del processo cresce con la maturità del team: un’organizzazione che pratica il threat modeling da due anni produce output qualitativamente superiori rispetto a una che lo ha appena avviato, a parità di metodologia e strumenti.

Conclusione

Il threat modeling nel 2026 non è più un esercizio teorico confinato alla fase di design del software. È una disciplina operativa continua, regolamentariamente necessaria e tecnicamente inedita nella sua complessità. La combinazione di attacchi che si industrializzano, sistemi AI autonomi che moltiplicano la superficie d’attacco e un quadro normativo europeo in piena enforcement rende questa disciplina non rinviabile per nessuna organizzazione che gestisca sistemi digitali critici.

Il paradosso del threat modeling è che le organizzazioni che ne hanno più bisogno – quelle con meno maturità in sicurezza, spesso PMI o soggetti appena rientrati nel perimetro NIS2 – sono anche quelle più tentate di rimandarlo, percependolo come troppo complesso o troppo costoso. La risposta è che il costo di un processo di threat modeling ben calibrato è sistematicamente inferiore al costo medio di una singola violazione: non come stima teorica, ma come dato empirico confermato da anni di ricerca sul ROI della sicurezza preventiva.

Le organizzazioni che hanno già investito in processi maturi di threat modeling si trovano nel 2026 in una posizione di vantaggio strutturale: dispongono di una difesa più efficace, di una documentazione di conformità che i regolatori richiedono esplicitamente, e di una capacità di risposta agli incidenti più rapida perché i percorsi di attacco più probabili sono già stati anticipati. Per chi non ha ancora strutturato questo processo, il momento per iniziare – con umiltà metodologica, strumenti proporzionati alla propria maturità e un team interdisciplinare – è adesso.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/threat-modeling-2026/


CPUID compromesso: malware nei download ufficiali di CPU-Z e HWMonitor


Un attacco alla catena di distribuzione ha colpito il progetto CPUID, trasformando per alcune ore il sito ufficiale in un vettore di diffusione malware attraverso il download di CPU-Z e HWMonitor, due delle utility di monitoraggio hardware più utilizzate al mondo. Gli aggressori hanno compromesso una API secondaria del progetto, modificando i link di download e indirizzando gli utenti verso eseguibili trojanizzati ospitati su storage esterni. Il risultato è un classico supply chain attack, in cui i file originali firmati non vengono alterati ma la distribuzione viene avvelenata, inducendo gli utenti a scaricare versioni malevole apparentemente legittime.

Download avvelenati: eseguibile sospetto al posto delle utility ufficiali

Le prime segnalazioni sono arrivate da utenti che hanno notato come il portale ufficiale reindirizzasse a Cloudflare R2 per scaricare i file. Invece delle utility originali, veniva distribuito un archivio contenente un installer malevolo chiamato “HWiNFO_Monitor_Setup”, mascherato come strumento di monitoraggio hardware.  L’esecuzione del file avviava un installer in lingua russa con wrapper Inno Setup, comportamento atipico per software legittimi e immediatamente sospetto. Alcuni utenti hanno inoltre verificato che i file originali erano ancora disponibili tramite URL diretti, confermando che il compromesso riguardava la catena di distribuzione e non i binari firmati.

Le analisi condotte da ricercatori indipendenti e community specializzate indicano che il payload utilizzava un loader avanzato multi-stage, con tecniche progettate per operare quasi interamente in memoria ed eludere soluzioni EDR e antivirus. Secondo i ricercatori, il malware implementa tecniche di file masquerading, esecuzione in-memory e proxying delle funzionalità NTDLL da assembly .NET, una combinazione che lo rende più difficile da rilevare con strumenti tradizionali. Il comportamento osservato suggerisce un attacco mirato e non opportunistico, con un livello di sofisticazione superiore alla media.

Il campione distribuito è stato analizzato su VirusTotal, dove 20 motori antivirus lo segnalano come malevolo, anche se senza classificazione univoca. Alcuni vendor lo identificano come Tedy Trojan, altri come Artemis Trojan, mentre diversi ricercatori lo descrivono come infostealer progettato per sottrarre credenziali e dati sensibili.

L’attacco ha colpito strumenti con milioni di utenti, rendendo particolarmente rilevante l’impatto potenziale. CPU-Z e HWMonitor sono infatti utilizzati sia da utenti consumer sia in contesti professionali per diagnostica hardware, monitoraggio termico e analisi delle prestazioni. Secondo alcuni ricercatori, lo stesso gruppo avrebbe preso di mira anche FileZilla il mese precedente, suggerendo una campagna focalizzata su utility ampiamente diffuse e considerate affidabili. Questo approccio consente agli attaccanti di massimizzare la distribuzione sfruttando la fiducia degli utenti.

Compromissione durata circa sei ore

CPUID ha confermato che l’attacco ha coinvolto una API secondaria, compromessa per circa sei ore tra il 9 e il 10 aprile. Durante questo intervallo, il sito ha mostrato in modo casuale link malevoli, mentre i file firmati originali non sono stati alterati. L’azienda ha dichiarato che la vulnerabilità è stata individuata e corretta e che attualmente i download distribuiti dal sito sono nuovamente puliti. L’incidente sarebbe avvenuto in un momento in cui lo sviluppatore principale era assente, dettaglio che suggerisce una possibile pianificazione mirata dell’attacco.

Cosa devono fare gli utenti

Chi ha scaricato CPU-Z o HWMonitor tra il 9 e il 10 aprile dovrebbe verificare l’integrità dei file, controllare eventuali eseguibili sospetti e monitorare il sistema per comportamenti anomali. In particolare, la presenza del file HWiNFO_Monitor_Setup rappresenta un indicatore di compromissione.

L’incidente dimostra ancora una volta come anche i download ufficiali non siano immuni da attacchi, e come la verifica delle firme digitali e dei checksum resti una pratica essenziale, soprattutto per strumenti amministrativi e diagnostici.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/04/10/cpuid-compromesso-malware-nei-download-ufficiali-di-cpu-z-e-hwmonitor/?utm_source=rss&utm_medium=rss&utm_campaign=cpuid-compromesso-malware-nei-download-ufficiali-di-cpu-z-e-hwmonitor


School’s Out, But Security’s Not: Preparing for K-12 Summertime Security

@import url(‘https://fonts.googleapis.com/css2?family=Nunito+Sans:ital,opsz,wght@0,6..12,400;0,6..12,500;0,6..12,600;0,6..12,700;1,6..12,400;1,6..12,500;1,6..12,600;1,6..12,700&family=Nunito:ital,wght@0,400;0,500;0,600;0,700;1,400;1,500;1,600;1,700&display=swap’); @import url(‘https://fonts.googleapis.com/css2?family=Handlee&display=swap’); h3 { font-weight: bold; font-size: 18px; color: #C72026; } figure { padding: 4px; margin: auto; } figcaption { color: #404144; Nunito Sans’, Arial, sans-serif; font-size: 14px; padding: 10px; text-align: left; } .pqFull { display: block; border-width: 2px 0; border-style: solid; border-color: #404144; padding: 1.5em 0 0.5em; margin: 1.5em 0; position: relative; Handlee”, Arial, sans-serif; font-size: 20px; text-align: center; color: #0067A6; } .pqFull:before { content: ‘\275D’; position: absolute; top: -.10em; left: 50%; transform: translate(-50%, -50%); background: #fff; width: 4rem; height: 2rem; color: #666; text-align: center; } .pqFull:after { content: “\2013 \2003” attr(cite); display: block; text-align: center; font-size: 18px; color: #404144; } .w3-container:after,.w3-container:before,.w3-row:after,.w3-row:before { content: “”; display: table; clear: both } .w3-container { padding: 5px; } .w3-col,.w3-half,.w3-third,.w3-twothird,.w3-threequarter,.w3-quarter { float: left; width: 100% } @media (min-width:601px) { .w3-col.m1 { width: 8.33333% } .w3-col.m2 { width: 16.66666% } .w3-col.m3,.w3-quarter { width: 24.99999% } .w3-col.m4,.w3-third { width: 33.33333% } .w3-col.m5 { width: 41.66666% } .w3-col.m6,.w3-half { width: 49.99999% } .w3-col.m7 { width: 58.33333% } .w3-col.m8,.w3-twothird { width: 66.66666% } .w3-col.m9,.w3-threequarter { width: 74.99999% } .w3-col.m10 { width: 83.33333% } .w3-col.m11 { width: 91.66666% } .w3-col.m12 { width: 99.99999% }} .w3-row-padding,.w3-row-padding>.w3-half,.w3-row-padding>.w3-third,.w3-row-padding>.w3-twothird,.w3-row-padding>.w3-threequarter,.w3-row-padding>.w3-quarter,.w3-row-padding>.w3-col { padding: 0 8px }
As the weather grows warmer and the summer months draw closer, plenty of people are looking forward to kicking back and relaxing — especially those who work in schools. However, when it comes to security, the vacation season doesn’t mean the threats have taken time off.

“In K-12 environments, the risk profile undergoes a fundamental shift once the final bell rings,” says Tom Fischer, Head of Solutions Engineering, Public Sector at Ambient.ai. “During the school year, the focus is on life safety, student behavior and unauthorized visitors. However, during the summer, campuses are often completely shuttered, which means no students, staff or regular visitors are on-site during the week.”

While it may seem at a first glance that the threats would decrease during the summer, as there is less consistent foot traffic on campus, the reality is that the threats don’t decrease — they shift.

Paul Timm, Director of Education Safety for Allegion
Paul Timm, Director of Education Safety for Allegion, is a board-certified Physical Security Professional (PSP), author of School Security: How to Build and Strengthen a School Safety Program, and a nationally acclaimed expert in physical security. He is also a member of PASS, NCSSD, ASIS International’s School Safety & Security Council and the IASBO (Illinois Association of School Business Officials) Risk Management Committee. He hosts The Changing Face of School Security podcast, highlighting tools & resources from the changemakers in the K-12 industry. Image courtesy of Timm

Tom Fischer, Head of Solutions Engineering, Public Sector at Ambient.ai
Tom Fischer has spent 20-plus years in the security industry, working with government entities. His past roles include leading product management and sales engineering teams. He is currently heading the Solutions Engineering for Public Sector team at Ambient.ai, a leader in AI physical security solutions. Image courtesy of Fischer

“It isn’t necessarily that risks go down in the summer; rather, the ‘operating profile’ of the building changes,” explains Paul Timm, Director of Education Safety at Allegion. “During the school year, schools often have a set rhythm and a predictable schedule (like 8:00 am to 3:30 pm). In the summer, the building is often open for varied reasons and times, like summer classes, cleaning, renovations and special projects. Because the routine is different, schools often encounter new and additional vulnerabilities that they aren’t always prepared to address in the same way they do during the academic year.”

Vulnerabilities during the school year are typically related to the safety of students, teachers and staff. While this concern lessens considerably during the summer months, other vulnerabilities take the forefront.

“While the ‘people’ risk diminishes, the property risk skyrockets,” says Fischer. “An empty campus is a target for vandalism, theft and arson. The challenge is that without eyes on the ground, a broken window or a perimeter breach might go unnoticed for days, leading to compounding damage. We move from managing a busy community to protecting a vulnerable, static asset.”

Throughout the year, schools often deal with barriers to security such as insufficient budgets for technology or staffing. These barriers can be amplified during the summer months as well as met with new struggles that security leaders must consider.

Lack of Human Resources

“During the school year, security is human-heavy. You have School Resource Officers (SROs) on-site and maybe a Security Operations Center (SOC), depending on size of school campus and district, that is likely staffed daily to manage the ‘noise’ of a thousand students. These resources are essential for real-time response to immediate safety incidents,” states Fischer. “In the summer, those human resources often scale back significantly due to budget or scheduling. This creates a dangerous gap. While the need for monitoring remains, the capacity to do it manually vanishes. This is where legacy systems fail; they rely on human attention that isn’t there, turning thousands of expensive cameras into passive “post-incident” recording devices rather than active tools for prevention”

In K-12 environments, the risk profile undergoes a fundamental shift once the final bell rings.

Laid-Back Visitor Management

“During the school year, schools often try to keep all exterior doors locked and funnel everyone through the main entrance to be screened in a secured vestibule by an administrative assistant utilizing visitor management software. In the summer, it can be easy to lose that process,” warns Timm. “For example, doors may be propped open for renovation projects or for contractors to move equipment. With unpredictable comings and goings or contract worker turnover, processes may be relaxed during summer, whereas schools would likely never allow that during the school year.”

Properly Securing Schools During the Summer

If schools aren’t mindful of the differing summertime threats, they run the risk of leaving their buildings exposed.

Security leaders can start by shifting their mentality when it comes to risk mitigation. While the potential threats of the school year should still be present and considered, the main focus can switch to the building itself.

“When students and staff depart, the security program must pivot toward perimeter integrity and asset protection,” asserts Fischer. “The priority shifts to detecting early indicators of graffiti, break-ins, unauthorized person presence, and environmental hazards like fire.”

When the focus shifts and the warm weather makes people think of beach vacations and fun travel plans, how do schools ensure security measures are upheld and followed with the same rigor as the school year? Security leaders can take steps now to reaffirm the importance of existing security processes to school employees.

“It comes down to anticipation and standardization,” says Timm. “Whoever oversees safety needs to anticipate that the operating profile is going to change and adjust practices accordingly. We should strive for as much consistency as possible. Even if a contractor is working in the back of the building, schools should require them to report to the main entry and go through the same visitor management software and protocols that those schools use during the school year.”

While security must remain vigilant after the school year ends, that doesn’t mean it has to be stressful. Through preparation and established processes, security leaders can help staff shift focus, maintain their security-oriented mentality, and do all of this while still enjoying the excitement that summer brings.

https://www.securitymagazine.com/articles/102206-schools-out-but-securitys-not-preparing-for-k-12-summertime-security


SBOM: da obbligo normativo a strumento operativo. Come implementarlo davvero

Il Cyber Resilience Act impone il Software Bill of Materials su tutti i prodotti digitali. Oltre la compliance: come costruire, mantenere e integrare l’SBOM nella supply chain security, con tool open source e workflow pratici.

Il contesto normativo: perché l’SBOM è diventato urgente

Per anni l’SBOM è rimasto un concetto familiare solo agli ambienti DevSecOps più maturi. Poi sono arrivati SolarWinds, Log4Shell e una cascata di attacchi alla supply chain software che hanno reso evidente una verità scomoda: la maggior parte delle organizzazioni non sapeva cosa girasse realmente nei propri sistemi. Da quella consapevolezza è nata la spinta normativa che oggi impone alle aziende di rispondere a una domanda apparentemente banale con un documento formale, strutturato e aggiornato: di cosa è fatto il software che produciamo o utilizziamo?

Il Cyber Resilience Act (CRA), pubblicato nella Gazzetta Ufficiale dell’Unione Europea il 20 novembre 2024 come Regolamento (UE) 2024/2847 ed entrato in vigore il 10 dicembre 2024, è il riferimento normativo più rilevante per il mercato europeo. Gli obblighi di notifica di vulnerabilità e incidenti gravi si applicano a partire dall’11 settembre 2026, mentre la piena applicazione di tutti i requisiti di sicurezza diventa obbligatoria dall’11 dicembre 2027. Il regolamento si applica a tutti i prodotti con elementi digitali immessi sul mercato UE, tra cui hardware con componenti software integrato, applicazioni, firmware e sistemi embedded.

Tra i requisiti dell’Allegato I individua esplicitamente l’obbligo per i fabbricanti di “identificare e documentare le vulnerabilità e i componenti contenuti nei prodotti con elementi digitali, anche elaborando una distinta base del software in un formato comunemente usato e leggibile meccanicamente che copra almeno le dipendenze di primo livello dei prodotti”.

Vale la pena sottolineare una sfumatura rilevante: il CRA non impone la pubblicazione dell’SBOM, ma la sua disponibilità su richiesta delle autorità di sorveglianza del mercato. Le linee guida tecniche che CEN/CENELEC sta sviluppando, con uno standard orizzontale atteso entro metà 2026, chiariranno ulteriori aspetti applicativi, inclusa la questione interpretativa sull’estensione dell’obbligo alle dipendenze transitive oltre quelle di primo livello.

Parallelamente, il quadro normativo si articola su più livelli: la Direttiva NIS2 richiede alle organizzazioni essenziali e importanti di gestire i rischi della catena di fornitura, inclusa la sicurezza dei componenti software; il DORA impone agli enti finanziari controlli stringenti sulle dipendenze tecnologiche critiche; in ambito statunitense, l’Executive Order 14028 del 12 maggio 2021 ha reso l’SBOM un requisito per i fornitori software del governo federale, stabilendo un precedente che ha accelerato l’adozione globale. Per i produttori di software e di dispositivi connessi che operano su mercati internazionali, l’SBOM non è più una scelta architettuale: è un requisito di mercato. Per un approfondimento sugli adempimenti NIS2 in scadenza, si veda anche questo articolo di ICT Security Magazine.

Cosa è (davvero) un SBOM

Un Software Bill of Materials è un inventario formale e leggibile da macchina di tutti i componenti che compongono un artefatto software: librerie di terze parti, dipendenze transitive, moduli open source, pacchetti interni, strumenti di build incorporati. Ogni componente è descritto da un insieme di attributi minimi che ne permettono l’identificazione univoca e la correlazione con le basi di dati delle vulnerabilità note.

Il National Telecommunications and Information Administration (NTIA) statunitense ha definito nel luglio 2021, in attuazione dell’EO 14028, i sette campi dati minimi che ogni SBOM deve contenere:

  • Nome del produttore (Producer Name) del componente;
  • Nome del componente (Component Name);
  • Versione del componente;
  • Identificatore univoco aggiuntivo, quali Package URL (PURL), Common Platform Enumeration (CPE) o SWID tag;
  • Relazione di dipendenza con il componente padre;
  • Autore dei dati SBOM (SBOM Author);
  • Timestamp di generazione.

È importante precisare che l’hash crittografico del componente, spesso citato erroneamente come campo obbligatorio, non rientra nei sette campi minimi della versione originale NTIA 2021: il documento lo classifica esplicitamente tra i campi “beyond minimum”, ovvero raccomandati per casi d’uso ad alta garanzia ma non obbligatori nella baseline. Solo la revisione proposta da CISA nell’agosto 2025, ancora in fase di commento pubblico al momento della redazione, propone di elevare l’hash a campo minimo obbligatorio, insieme a licenza e contesto di generazione.

Attorno a questi campi minimi esistono due formati standard che si sono affermati come dominanti nel settore, entrambi riconosciuti dal NTIA insieme al formato SWID.

SPDX (Software Package Data Exchange), mantenuto dalla Linux Foundation e pubblicato come standard internazionale ISO/IEC 5962:2021 nel settembre 2021, è nato in ambito open source e privilegia la completezza delle informazioni di licenza oltre che di sicurezza. Supporta formati di serializzazione multipli: tag-value, JSON, YAML, RDF e XML. La versione 3.0, rilasciata nell’aprile 2024, estende il modello a componenti hardware, AI, dati e sistemi di build.

CycloneDX, sviluppato da OWASP, è progettato esplicitamente per i casi d’uso di sicurezza: integra nativamente il concetto di VEX (Vulnerability Exploitability eXchange), supporta la descrizione di servizi e di componenti hardware, e dispone di un ecosistema di tool particolarmente maturo. È il formato preferito dalla maggior parte dei workflow DevSecOps moderni. Per un’analisi comparativa approfondita dei due formati nel contesto CRA, si veda l’articolo di ICT Security Magazine SBOM e Cyber Resilience Act: come SPDX 3.0 e CycloneDX ridefiniscono la sicurezza della supply chain software.

La scelta tra i due dipende dal contesto: SPDX è preferibile quando la gestione della compliance delle licenze open source è prioritaria o quando si opera in ecosistemi che richiedono la certificazione ISO; CycloneDX è più adatto quando l’obiettivo primario è l’integrazione nella pipeline di vulnerability management.

Il problema delle dipendenze transitive

Il valore di un SBOM si misura nella sua completezza, e la completezza è il problema più difficile da risolvere. Un’applicazione moderna non dichiara solo dipendenze dirette: ogni dipendenza diretta porta con sé le proprie dipendenze, e queste a loro volta le proprie, in un grafo che può raggiungere centinaia di nodi per un’applicazione di medie dimensioni.

Log4Shell ha dimostrato plasticamente questa criticità. La vulnerabilità CVE-2021-44228, divulgata pubblicamente il 9 dicembre 2021 e classificata con punteggio CVSS 10.0 su 10.0, colpiva il modulo log4j-core di Apache Log4j 2, una libreria di logging Java. L’exploit sfruttava le funzionalità JNDI (Java Naming and Directory Interface) per consentire l’esecuzione remota di codice arbitrario tramite una stringa di input appositamente costruita. Log4j2 era inclusa come dipendenza in numerosi framework Apache, tra cui Struts2, Solr, Druid e Flink, e in prodotti di sicurezza e infrastruttura ampiamente diffusi come Elasticsearch, Logstash e Apache Kafka. Le organizzazioni che non disponevano di un inventario completo delle dipendenze transitive hanno impiegato settimane per valutare la propria esposizione.

Un SBOM efficace deve quindi essere generato a partire dall’artefatto compilato, ossia il binario, il container o il pacchetto di distribuzione, e non soltanto dai file di manifesto del progetto sorgente come pom.xml, package.json o requirements.txt. Questi ultimi dichiarano le dipendenze intenzionali; i tool di analisi dell’artefatto rilevano le dipendenze effettive, incluse quelle introdotte indirettamente.

Questo approccio è tanto più rilevante considerando che il CRA, nella sua formulazione attuale, richiede le sole dipendenze di primo livello come minimo, ma le best practice di settore e le linee guida ENISA in sviluppo convergono verso la copertura completa del grafo delle dipendenze. Per il ruolo degli SBOM nella supply chain security in relazione alla NIS2, si veda l’intervento presentato al Forum ICT Security 2025 disponibile su ICT Security Magazine.

Tool open source per generare SBOM

L’ecosistema dei tool open source per la generazione di SBOM si è consolidato significativamente negli ultimi anni. Di seguito i principali, con le rispettive caratteristiche operative.

Syft (Anchore)

Syft è uno degli strumenti di generazione SBOM più diffusi nell’ecosistema cloud-native. Supporta container images, filesystem, archivi e artefatti in formato OCI ed è in grado di rilevare componenti in un’ampia varietà di ecosistemi: Java (Maven, Gradle), JavaScript (npm, yarn), Python (pip, poetry, conda), Go, Rust, Ruby, .NET, PHP, Swift e molti altri.

sbom

Syft si integra nativamente con Grype, il vulnerability scanner della stessa Anchore, creando un workflow coerente dalla generazione dell’inventario alla correlazione con le CVE.

Grype (Anchore)

Grype consuma SBOM generati da Syft (o da altri tool compatibili) e li correla con database di vulnerabilità multipli: NVD, GitHub Security Advisories, OSS-Index, RedHat, Ubuntu Security Notices e altri.

sbom

L’opzione –fail-on è particolarmente utile per l’integrazione in pipeline CI/CD: permette di bloccare il build se vengono rilevate vulnerabilità al di sopra di una soglia di severità definita.

Trivy (Aqua Security)

Trivy è un vulnerability scanner all-in-one che include capacità native di generazione SBOM. Supporta container, repository Git, filesystem, pacchetti Kubernetes e file di Infrastructure as Code.

sbom

Trivy è spesso preferito in ambienti Kubernetes per la sua capacità di aggregare l’analisi di sicurezza dell’infrastruttura con quella del software applicativo.

cdxgen (OWASP)

cdxgen è il generatore SBOM del progetto CycloneDX di OWASP e produce output nativamente in formato CycloneDX. Si distingue per la profondità dell’analisi in ecosistemi specifici, in particolare Java e JavaScript, e per la capacità di generare SBOM anche da codice sorgente senza dover compilare l’artefatto.

sbom

SBOM Tool (Microsoft)

Microsoft SBOM Tool è lo strumento rilasciato open source da Microsoft, progettato per funzionare in ambienti enterprise con build system eterogenei. Supporta sia SPDX che CycloneDX e si integra con i workflow Azure DevOps.

sbom

Integrare l’SBOM nella pipeline CI/CD

La generazione di un SBOM come attività manuale e occasionale non produce valore operativo. Per essere utile, l’SBOM deve essere generato automaticamente a ogni build, versionato insieme all’artefatto e consumato da sistemi di analisi che producono alert azionabili.

Un workflow CI/CD maturo per la supply chain security si articola tipicamente in cinque fasi.

Fase 1: Generazione. L’SBOM viene prodotto durante il build dell’artefatto, a partire dal risultato compilato. L’integrazione in GitHub Actions può avere questa forma:

sbom

Fase 2: Firma e attestazione. L’SBOM deve essere firmato crittograficamente per garantirne l’autenticità e la non ripudiabilità. Sigstore/Cosign è diventato lo strumento standard per la firma di artefatti software nel mondo cloud-native.

sbom

Fase 3: Archiviazione e versionamento. L’SBOM firmato viene archiviato in un repository dedicato, associato alla versione dell’artefatto. In ambienti container, una pratica emergente è quella di allegare l’SBOM direttamente all’immagine OCI come attestation, seguendo le specifiche SLSA (Supply-chain Levels for Software Artifacts).

Fase 4: Analisi continua delle vulnerabilità. Le CVE vengono scoperte dopo il rilascio del software. Un SBOM generato al momento del build deve essere analizzato periodicamente rispetto ai database di vulnerabilità aggiornati, non solo al momento della sua creazione. Tool come Dependency-Track (OWASP) permettono di caricare SBOM e ricevere notifiche automatiche quando nuove vulnerabilità vengono associate a componenti già in inventario.

Fase 5: VEX (Vulnerability Exploitability eXchange). Non tutte le vulnerabilità rilevate in un SBOM sono effettivamente sfruttabili nel contesto di deployment specifico. Il VEX è un documento complementare all’SBOM che permette al produttore di dichiarare lo stato di exploitability di ogni vulnerabilità identificata, secondo quattro stati possibili: not affected, affected, fixed e under investigation. CycloneDX supporta nativamente i VEX document, consentendo ai clienti finali di contestualizzare i risultati delle scansioni automatiche. Il requisito VEX è menzionato esplicitamente anche nelle raccomandazioni ENISA per il CRA.

Dependency-Track: la piattaforma operativa

Dependency-Track, progetto OWASP in stato di maturità avanzata, è la piattaforma open source di riferimento per la gestione continuativa degli SBOM in ambienti enterprise. Offre un’interfaccia web per l’importazione di SBOM in formato CycloneDX e SPDX, la correlazione automatica con database di vulnerabilità multipli, la gestione delle policy di sicurezza e l’integrazione con sistemi di notifica e ticketing.

Il deployment tramite Docker Compose è la modalità più comune per ambienti di sviluppo e staging:

sbom

Una volta avviato, Dependency-Track può ricevere SBOM tramite API REST, permettendo l’automazione del caricamento dalla pipeline CI/CD, e li analizza continuamente man mano che i database di vulnerabilità vengono aggiornati. Il sistema supporta l’integrazione con Jira, Slack, Teams e webhook generici per la notifica degli alert.

SBOM nella supply chain: estendere il perimetro

L’SBOM generato internamente copre il software prodotto dall’organizzazione. La supply chain security richiede però di estendere la visibilità anche ai componenti acquistati da fornitori terzi, compresi i prodotti COTS (Commercial Off-The-Shelf) e i sistemi embedded. Per un inquadramento normativo dell’interazione tra NIS2, DORA e CRA su questi temi, si rimanda alla lettura di NIS2 e oltre: la cybersicurezza diventa governance aziendale su ICT Security Magazine.

Il CRA stabilisce che i fabbricanti devono essere in grado di fornire l’SBOM alle autorità di sorveglianza del mercato su richiesta motivata. In parallelo si sta sviluppando una catena documentale lungo la supply chain: il produttore finale deve raccogliere gli SBOM dei componenti che integra, inclusi quelli dei propri fornitori, e produrre un SBOM composito che rappresenti l’intero stack software del prodotto.

In pratica questo impone di aggiornare i contratti con i fornitori di software per includere il requisito di fornitura dell’SBOM, e di definire processi per la verifica e l’integrazione degli SBOM ricevuti nella propria piattaforma di gestione. Le linee guida ENISA sulla sicurezza della supply chain e il documento NTIA sui minimi elementi forniscono i criteri di qualità che un SBOM ricevuto da un fornitore deve soddisfare per essere considerato valido.

Un aspetto spesso sottovalutato riguarda i componenti open source per i quali l’SBOM non viene fornito da un produttore identificato: in questo caso la responsabilità di generazione ricade sull’organizzazione che integra il componente, a prescindere dalla modalità di acquisizione.

Le sfide operative: cosa non funziona ancora

Nonostante la maturità crescente dell’ecosistema, alcune sfide operative restano aperte e richiedono consapevolezza.

Completezza versus precisione. Gli strumenti di analisi automatica tendono a generare falsi positivi, ossia componenti rilevati che non sono effettivamente presenti nell’artefatto finale, oppure a non rilevare componenti inclusi tramite meccanismi non standard. La qualità dell’SBOM dipende dalla configurazione dello strumento e dalla conoscenza del sistema di build utilizzato.

SBOM per firmware e sistemi embedded. L’analisi di componenti in sistemi embedded, firmware proprietari e stack software per OT/ICS è significativamente più complessa rispetto agli stack applicativi tradizionali. Tool specializzati come Binwalk sono in grado di estrarre e analizzare layer da immagini firmware, ma richiedono competenze specifiche e producono risultati che necessitano di validazione manuale.

Aggiornamento e ciclo di vita. Un SBOM non aggiornato è peggio di nessun SBOM: genera falsa sicurezza. Ogni modifica al software, che si tratti di aggiornamento di dipendenze, refactoring o inclusione di nuovi componenti, deve innescare la rigenerazione dell’SBOM. Questo richiede che il processo di generazione sia completamente automatizzato e che esistano controlli per verificare che la versione dell’SBOM sia allineata alla versione del software in produzione.

Gestione delle licenze. L’SBOM espone non solo le vulnerabilità ma anche le licenze open source dei componenti inclusi. Licenze copyleft come GPL v3 possono avere implicazioni rilevanti per i prodotti commerciali. Una pipeline SBOM matura deve includere l’analisi delle licenze e la verifica della compatibilità con la politica di licensing dell’organizzazione. Tool come FOSSology (open source) o il modulo licenze di Dependency-Track supportano questo caso d’uso. Vale la pena notare che il draft CISA 2025 per i minimi elementi SBOM propone di elevare l’informazione di licenza a campo obbligatorio, a conferma della sua rilevanza operativa.

Un framework di implementazione in quattro livelli

Per le organizzazioni che devono strutturare un percorso di adozione, è utile pensare all’implementazione dell’SBOM secondo una progressione per livelli di maturità.

Livello 1: Visibilità di base. Generazione manuale o semi-automatica dell’SBOM per i prodotti principali, in formato CycloneDX o SPDX. Analisi periodica con Grype o Trivy. Obiettivo: avere un inventario documentato dei componenti critici.

Livello 2: Integrazione CI/CD. Generazione automatica dell’SBOM a ogni build, integrata nella pipeline. Alert automatici per vulnerabilità critiche. Archiviazione versionata degli SBOM. Obiettivo: nessun artefatto rilasciato senza SBOM aggiornato.

Livello 3: Gestione continua. Deployment di Dependency-Track o soluzione equivalente. Monitoraggio continuativo delle vulnerabilità anche per release già distribuite. Integrazione con il sistema di ticketing per la gestione della remediation. Produzione di VEX document per le vulnerabilità non exploitabili. Obiettivo: vulnerability management basato sull’inventario reale.

Livello 4: Supply chain estesa. Raccolta degli SBOM dai fornitori terzi. Verifica e integrazione nella piattaforma centrale. Politiche contrattuali che includono requisiti SBOM. Reportistica di compliance per il CRA e NIS2. Obiettivo: visibilità completa sull’intera supply chain software.

Conclusioni

L’SBOM non risolve il problema della sicurezza software: non impedisce che le vulnerabilità esistano e non sostituisce le pratiche di secure development. Quello che fa è rendere possibile una risposta rapida ed efficace quando le vulnerabilità vengono scoperte, che è esattamente il punto critico messo in luce da attacchi come SolarWinds e Log4Shell.

Il Cyber Resilience Act ha trasformato questa capacità da best practice in requisito normativo. Le organizzazioni che si trovano oggi a dover dimostrare compliance hanno un vantaggio se interpretano il percorso di adozione non come un adempimento documentale ma come un’opportunità per costruire infrastruttura operativa: pipeline automatizzate, inventari vivi, processi di risposta agili.

L’ecosistema open source offre oggi strumenti sufficientemente maturi per coprire l’intero ciclo, dalla generazione alla firma, dall’archiviazione all’analisi continua, senza richiedere investimenti in soluzioni commerciali nella fase iniziale. Il costo reale dell’implementazione non è tecnologico: è organizzativo, e riguarda la capacità di mantenere l’SBOM sincronizzato con il software reale nel tempo. È lì che si misura la differenza tra un documento di compliance e uno strumento operativo.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/sbom-implementazione/


Chinese Supercomputer Allegedly Hacked, 10 Petabytes of Data Stolen

A “massive trove” of data has allegedly been stolen from a state-run Chinese supercomputer, according to CNN. The dataset reportedly contains more than 10 petabytes of sensitive information, including: 

  • Classified defense documents
  • Missile schematics
  • Technical files 
  • Animated simulations/rendered displays of defense technology 
  • Research from fields of aerospace engineering, bioinformatics, fusion simulation and more

The dataset is believed to belong to Tianjin’s National Supercomputing Center (NSCC), a hub of infrastructure services utilized by more than 6,000 clients across China. 

What Happened? 

On Feb. 6, a sample of the dataset was posted by user FlamingChina on Telegram. Marc Hofer, a cybersecurity researcher, reviewed the database and contacted an individual who claimed to be behind the attack. According to this individual, unauthorized access was granted via a compromised VPN domain. From there, the threat actor deployed a botnet to extract, download and store the data. The exfiltration took approximately six months. 

The alleged hacker is offering limited previews of the dataset for thousands of dollars. Full access is priced at hundreds of thousands of dollars. Payment is requested in cryptocurrency. 

Who Is Involved? 

If the claims of the breached supercomputer are genuine, the leaked information may be associated with notable entities such as:

  • The Aviation Industry Corporation of China
  • The Commercial Aircraft Corporation of China
  • The National University of Defense Technology

https://www.securitymagazine.com/articles/102225-chinese-supercomputer-allegedly-hacked-10-petabytes-of-data-stolen


Baltimore Security Guards On Strike

Baltimore’s city-owned buildings may be lacking security staff today, as the security guards are participating in a strike. This one-day strike has been assembled by Service Employees International Union’s Local 32BJ. 

  • Who is striking? Security guards associated with with Abacus Corp., Metropolitan Protective Services and Urban Development Solutions will be on strike. 
  • Why are they striking? The union claims the company barred security guards from unionizing, alleging that workers who participated in unions were discriminated against and even fired. The strike exists in protest of these actions by the company. 

Approximately 200 employees will be involved with the strike. Additionally, Odette Ramos and Jermaine Jones (members of the Baltimore City Council) are expected to be in attendance. 

Baltimore holds contracts with three organizations that provide armed and unarmed protection services at city-owned/leased properties, such as public-facing office buildings. However, the security guards are also responsible for patrolling parts of the city’s critical infrastructure and other essential services such as health clinics and even some police stations. 

https://www.securitymagazine.com/articles/102224-baltimore-security-guards-on-strike