Fine della copia integrale e del sequestro a “strascico”: barriere crittografiche, garanzie costituzionali e giurisprudenza

Alla 14ª Cyber Crime Conference (Roma, 6-7 maggio 2026) Pier-Luca Toselli ha ricostruito il nuovo equilibrio fra esigenze investigative e tutela dei diritti nel sequestro probatorio dei dispositivi digitali. Fra le pronunce più recenti della Cassazione, le direttive delle Procure e il DDL A.C. 1822 / A.S. 806, prende forma un sistema che archivia la cosiddetta “pesca a strascico”, ma la cui disciplina operativa resta tutt’altro che lineare.

Dalla “pesca a strascico” alla copia mirata

Pier-Luca Toselli, esperto senior in digital forensics e investigazioni digitali, con quasi trentotto anni di esperienza nella Guardia di Finanza e oggi libero professionista, ha aperto il suo intervento con un richiamo storico: gli albori della Legge 48/2008. Prima di quella legge le perquisizioni informatiche si risolvevano spesso in un “sequestro indiscriminato”. Si entrava in casa di un soggetto, si portava via tutto ciò che lampeggiava (compresa, paradossalmente, la spia del frigorifero) e si analizzava poi in laboratorio, con calma.

Quella stagione, ha osservato Toselli, è oggi definitivamente chiusa. Il punto di svolta porta una data precisa: la Cass. Pen. Sez. VI n. 2234 del 20 gennaio 2026, che ha consolidato un orientamento già delineato negli anni precedenti. In tema di sequestro probatorio di dati contenuti in dispositivi informatici o telematici, il decreto del Pubblico Ministero deve contenere specifica motivazione sulla proporzionalità e adeguatezza della misura, illustrando le ragioni che rendono necessario un sequestro esteso e onnicomprensivo e indicando sia le informazioni ricercate sia i criteri di selezione del materiale archiviato nel dispositivo.
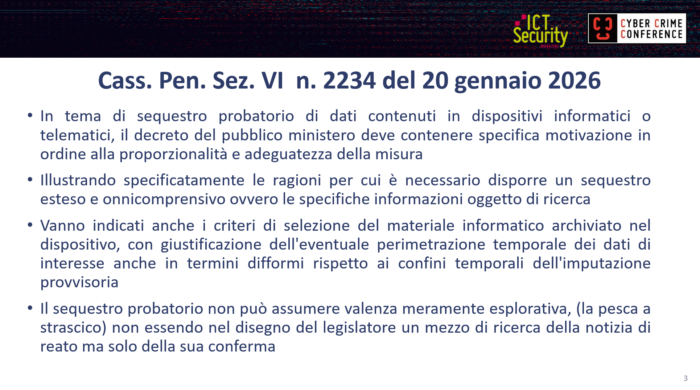
La fine della copia integrale e del sequestro a "strascico": Cass. Pen. Sez. VI n. 2234 del 20 gennaio 2026 - Cyber Crime Conference, Pier-Luca Toselli
La fine della copia integrale e del sequestro a “strascico”: Cass. Pen. Sez. VI n. 2234 del 20 gennaio 2026

Soprattutto, “il sequestro probatorio non può assumere valenza meramente esplorativa”: non essendo, nel disegno del legislatore, un mezzo di ricerca della notizia di reato, ma solo della sua conferma.

I principi consolidati dalla giurisprudenza

Sui principi che oggi presidiano l’acquisizione probatoria digitale Toselli ha richiamato in particolare la Cass. Pen. Sez. VI n. 24671 del 4 luglio 2025 e la Cass. Pen. Sez. II n. 33657 del 13 ottobre 2025:

  • illegittimità del sequestro indiscriminato;
  • principio di proporzionalità e adeguatezza;
  • divieto di acquisizione esplorativa;
  • criteri di selezione e limiti temporali;
  • meccanismo di copia-mezzo e restituzione.

L’insieme di questi vincoli viene sintetizzato dal relatore con l’acronimo TPA: temporaneità, proporzionalità e adeguatezza del sequestro. Per anni, ha osservato, “siamo stati abituati alla ricerca del reato a seguito dell’esame di tutte le prove acquisite in un determinato procedimento”: capita ancora che da una perquisizione per evasione fiscale si arrivi a fattispecie del tutto diverse. Quel paradigma esplorativo è oggi giuridicamente insostenibile.

La selezione rapida dei dati e la sentenza 170/2023

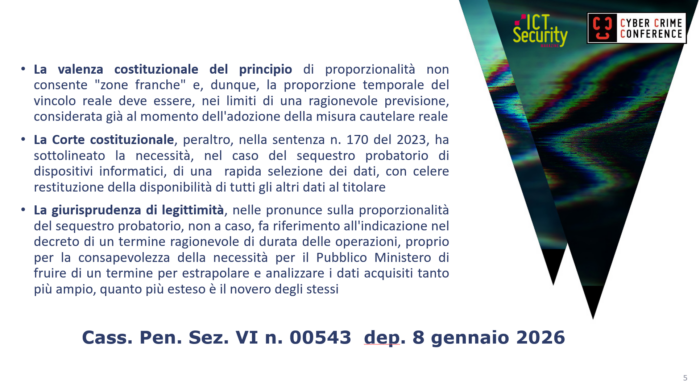
Sul versante della tempistica, Toselli ha richiamato la Corte Costituzionale n. 170 del 2023, che impone, nel caso del sequestro probatorio di dispositivi informatici, una rapida selezione dei dati e la celere restituzione al titolare di tutto ciò che non è pertinente. Lo ha poi collegato alla Cass. Pen. Sez. VI n. 543 dep. 8 gennaio 2026, secondo cui la valenza costituzionale del principio di proporzionalità non consente “zone franche”: la proporzione temporale del vincolo reale deve essere valutata già al momento dell’adozione della misura cautelare reale, nei limiti di una ragionevole previsione.La fine della copia integrale e del sequestro a "strascico": Cass. Pen. Sez. VI n. 543 dep. 8 gennaio 2026 - Cyber Crime Conference, Pier-Luca Toselli La fine della copia integrale e del sequestro a “strascico”: Cass. Pen. Sez. VI n. 543 dep. 8 gennaio 2026
In questo quadro la Cass. Pen. Sez. III n. 3350 del 28 gennaio 2026 ha precisato i contenuti minimi della motivazione: il PM deve indicare specificamente, anche in modo conciso, le ragioni che rendono necessaria la limitazione della disponibilità dei dati, le informazioni ricercate e i criteri di selezione rispetto al reato contestato. La stessa pronuncia ha escluso un termine perentorio per la selezione.La fine della copia integrale e del sequestro a "strascico": Cass. Pen. Sez. III n. 3350 del 28 gennaio 2026 - Cyber Crime Conference, Pier-Luca Toselli La fine della copia integrale e del sequestro a “strascico”: Cass. Pen. Sez. III n. 3350 del 28 gennaio 2026
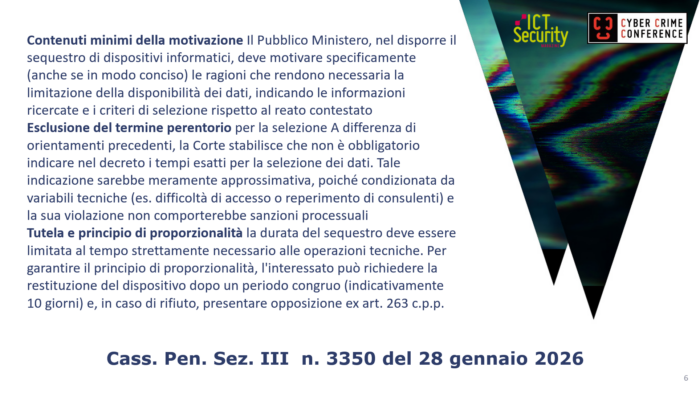
Sarebbe inevitabilmente approssimativo, condizionato da variabili tecniche come la difficoltà di accesso o il reperimento di consulenti; ha però confermato che la durata del sequestro deve essere limitata al tempo strettamente necessario alle operazioni tecniche, lasciando all’interessato la facoltà di richiedere la restituzione del dispositivo dopo un periodo congruo (indicativamente dieci giorni) e di proporre opposizione ex art. 263 c.p.p. in caso di rifiuto.

Il messaggio operativo è netto: non è più pensabile sequestrare dispositivi, riporli in un armadio e analizzarli con calma nei sei mesi delle indagini preliminari. La selezione deve avvenire in tempi rapidi, espellendo dal compendio digitale tutto ciò che non riguarda il procedimento.

Copia-mezzo e copia-fine: il modello operativo

Una parte centrale dell’intervento è dedicata alla distinzione fra copia-mezzo e copia-fine, che oggi regge l’intera procedura. La copia-mezzo è la copia forense bit a bit del dispositivo (la classica copia fisica, quando tecnicamente possibile): sulla sua base viene poi effettuata la selezione dei dati pertinenti. Da quella selezione nasce la copia-fine, ovvero il sottoinsieme di elementi rilevanti per il procedimento, destinato al dibattimento. La copia integrale, in altre parole, non è più la prova finale ma uno strumento funzionale alla selezione dei dati pertinenti e alla restituzione del dispositivo.

Il valore probatorio della copia-mezzo è garantito dall’integrità del dato, verificata tramite hash. È proprio sulla fase di selezione, però, che si annidano le maggiori criticità pratiche: la fallibilità di una ricerca per parola chiave o per data è evidente per chiunque abbia esperienza del settore, e la lettura incrociata dei dati richiede inevitabilmente il contributo conoscitivo sia dell’accusa sia della difesa.

Le criticità: tecniche e giuridiche

Sul piano tecnico Toselli ha richiamato un insieme di nodi ormai strutturali:

  • collaborazione della persona: senza il contributo dell’utente, la crittografia rende oggi spesso impossibile un’acquisizione piena dei dati e la successiva selezione;
  • forme di sicurezza dei dispositivi, sempre più stratificate;
  • utilizzo diffuso della crittografia;
  • eterogeneità di modelli e sistemi operativi.

Sul piano giuridico, invece, le criticità nascono dal continuo attrito fra le esigenze investigative e i principi TPA. In un contesto in cui, come ha rilevato con franchezza il relatore, “tante volte la legge viene fatta dalla giurisprudenza”, e ciò non è del tutto corretto.

Il mosaico delle direttive delle Procure

A complicare il quadro si sono aggiunte le direttive emanate da diverse Procure (Torino, Trento, Roma, Cagliari, Bari) per orientare l’attività della polizia giudiziaria nei rispettivi territori. Pur con sfumature diverse, queste direttive condividono alcuni tratti di fondo:

  • il riconoscimento dell’importanza delle prove digitali e della copia forense a supporto delle indagini;
  • una sequenza procedurale tipica che prevede sequestro del dispositivo, formazione della copia forense, immediata restituzione del dispositivo, qualificazione del sequestro dell’originale come strumentale e temporaneo, esecuzione dell’analisi investigativa sulla copia forense e successiva selezione che porta prima alla copia-mezzo e poi alla copia-fine;
  • il rispetto del principio di proporzionalità e pertinenza, il divieto di “mandato esplorativo”, la gestione attenta dei dati personali e sensibili, la gestione delle notizie di reato diverse emerse incidentalmente e il ruolo centrale del Pubblico Ministero.

Il problema, ha rilevato Toselli, è che pratiche e qualificazioni cambiano da Procura a Procura: a oggi non è chiaro nemmeno se queste operazioni debbano essere svolte come accertamenti irripetibili ex art. 359 c.p.p. oppure con le garanzie dell’art. 360 c.p.p.. “Se stamattina dicevamo che servirebbe una certa omogeneizzazione a livello europeo”, ha osservato, “probabilmente non l’abbiamo neanche a livello regionale”.

Messaggistica e corrispondenza: il riallineamento giurisprudenziale

Un capitolo specifico è stato dedicato alla qualificazione giuridica della messaggistica. Toselli ha richiamato la Cass. Pen. Sez. II n. 33657 del 13 ottobre 2025, secondo cui è illegittimo il decreto di sequestro probatorio di un telefono cellulare con il quale il Pubblico Ministero acquisisca la totalità dei messaggi, filmati e fotografie ivi contenuti, senza indicare le ragioni per le quali, ai fini dell’accertamento dei reati ipotizzati, si renda imprescindibile l’integrale verifica di tutti i predetti dati e si giustifichi, nel rispetto del principio di proporzionalità, un così penetrante sacrificio del diritto alla segretezza della corrispondenza.

La svolta sostanziale è arrivata con la Corte Costituzionale n. 170 del 2023, che ha stabilito come lo scambio di messaggi elettronici (e-mail, SMS, WhatsApp) rientri pienamente nella nozione di “corrispondenza” tutelata dall’art. 15 della Costituzione: la natura di corrispondenza persiste anche dopo la ricezione (la cosiddetta “dimensione statica”), finché il messaggio conserva un carattere di attualità e interesse per i corrispondenti.

Su questa traccia si è mossa la Cass. n. 25549 del 15 maggio 2024, che ha recepito l’orientamento della Consulta affermando la persistenza della natura di corrispondenza anche dopo la ricezione e ricondotto il sequestro alle forme dell’art. 254 c.p.p.. Come ha ricordato il relatore, l’art. 254 c.p.p. vieta alla polizia giudiziaria di accedere al contenuto dei messaggi nel momento stesso del sequestro: il dispositivo deve essere consegnato all’autorità giudiziaria, unica legittimata a verificarne il contenuto. La Cass. Pen. Sez. VI n. 13585/2025 ha poi precisato che l’accesso ai dati di un dispositivo informatico a fini di indagine penale richiede il controllo di un giudice o di un organo amministrativo indipendente e terzo rispetto all’organo richiedente.

Toselli ha tuttavia segnalato il nodo operativo: stabilire quando un messaggio conservi un “carattere di attualità e interesse per i corrispondenti” è una valutazione che rischia di scivolare nel terreno strumentale e si presta a letture divergenti fra accusa e difesa. Il parallelo è quello, ben noto a chi ha fatto digital forensics da prima, dell’antica diatriba sull’e-mail “aperta” e “chiusa”: una distinzione che dal lato informatico è sempre stata, in fondo, un nonsenso.

Le prospettive di riforma: il DDL A.C. 1822 / A.S. 806

L’attuale quadro normativo (artt. 253 e 254 c.p.p., L. 48/2008) è ormai considerato inadeguato a disciplinare il sequestro dei dispositivi informatici e le indagini sui dati digitali, e lascia ampi margini di discrezionalità e incertezza. In questo contesto si inserisce la proposta comune sul DDL A.C. 1822 / A.S. 806, che mira a colmare le lacune introducendo nel codice di procedura penale il nuovo art. 254-ter dedicato specificamente al sequestro di dispositivi, sistemi informatici, dati e comunicazioni. La proposta prevede una riserva di giurisdizione per il sequestro del dispositivo (decreto motivato del GIP su richiesta del PM, con deroga per urgenza e successiva convalida) e introduce discipline distinte per l’acquisizione e l’analisi dei dati comunicativi e non comunicativi.

L’impianto della riforma, ha riassunto Toselli, ruota intorno ad alcuni assi principali:

  • semplificazione delle procedure e ampliamento dell’utilizzabilità delle prove digitali, ormai strategiche in ogni indagine;
  • equilibrio fra tutela dei diritti ed efficacia investigativa;
  • diritto al contraddittorio e ruolo della difesa, con partecipazione effettiva non solo nella fase di analisi ma anche in quella di acquisizione della prova digitale.

Su quest’ultimo punto Toselli si è soffermato con particolare attenzione. La difesa dovrebbe disporre di controllo tecnico tempestivo, di accesso alle copie forensi dei dati e della possibilità di contestare ricostruzioni non corrispondenti.

A questo si affianca la proposta di un rafforzamento del ruolo del GIP in passaggi critici: accesso a dati remoti (Cloud) subordinato a previa autorizzazione del GIP, data la delicatezza e l’ampiezza di tali dati; controllo ex ante o validazione giudiziale ex post per la deroga alla duplicazione ordinaria ex art. 254-ter co. 10 in caso di urgenza; introduzione di una fase partecipata post-duplicazione per la difesa e la persona offesa nella selezione dei dati operata dal PM; oppure, in alternativa, proroga del termine per l’esame e verbalizzazione accurata delle operazioni, con verifica e autorizzazione del giudice.

Sul versante della perquisizione informatica (art. 247 c.p.p.) la proposta normativa, nella sua attuale formulazione, lascerebbe il potere ancora in capo al Pubblico Ministero, con il rischio di eludere le nuove garanzie previste per il sequestro: la perquisizione digitale comporta di fatto una duplicazione non sorvegliata. Per questo si propone che ogni perquisizione di dispositivo digitale richieda previa autorizzazione del GIP, data la sua natura invasiva. Analogamente, in caso di perquisizioni o sopralluoghi d’iniziativa della polizia giudiziaria su dispositivi digitali ex artt. 352 e 354 c.p.p., la comunicazione al PM dovrebbe essere seguita da una richiesta di convalida al GIP, sullo schema dell’art. 254-ter co. 4.

Un “accertamento irripetibile anticipato”?

Toselli ha proposto una lettura suggestiva del nuovo assetto: la riforma, di fatto, configurerebbe una sorta di “accertamento irripetibile anticipato“. La perquisizione è l’atto irripetibile per antonomasia: consentire l’intervento della difesa fin dalle primissime fasi (eventualmente con l’ausilio di un consulente tecnico) diventa cruciale anche in sede di selezione dei dati, dove un identico smartphone, una identica messaggistica e una identica chat possono essere letti in modo radicalmente diverso a seconda dell’angolazione.

Il relatore ha però segnalato anche un nodo critico: la formulazione attuale rischia di tradursi in passaggi davanti al GIP non solo per la selezione copia-mezzo / copia-fine, ma anche per la legittimità stessa del sequestro (rispetto dei canoni TPA). Inoltre l’introduzione di termini molto stringenti (si parla di cinque giorni) appare poco realistica per chi conosce la procedura penale: in cinque giorni non si fanno neanche le notifiche, figurarsi un’attività di questo tipo davanti al GIP.

La riforma merita grande attenzione da parte di tutti gli operatori: è infatti già stato richiesto un intervento da numerose autorità, personalità accademiche, esperti e consulenti informatici. L’obiettivo non è “tifare” per l’accusa o per la difesa, ma evitare che le pieghe degli esiti politici portino a soluzioni che non aiutino né l’una né l’altra.

Una riflessione finale: oltre lo smartphone

In chiusura Toselli ha lasciato uno spunto destinato a pesare sulle prossime stagioni regolatorie e operative. Se questo è il livello di complessità richiesto dalla disciplina del sequestro di uno smartphone o di un hard disk (oggetti che il relatore ha definito, licentia poetica, “qualcosa di morto”), è facile immaginare il salto di scala che attende gli operatori quando l’oggetto delle indagini sarà costituito da attacchi generati da intelligenza artificiale e da agenti di intelligenza artificiale: scenari in cui, come emerso nel corso della stessa Conference, già oggi non si è in grado di ricostruire con certezza nemmeno l’origine dell’attacco.

Il messaggio che esce dall’intervento è di lucida preoccupazione professionale. Il sistema italiano sta uscendo dalla stagione del “sequestro a strascico” grazie a una giurisprudenza coraggiosa, ma sta entrando in una fase in cui il dettaglio operativo (chi fa che cosa, in che termini, con quali garanzie e con quale controllo del GIP) resta ampiamente da scrivere. E le tecnologie corrono più veloci della procedura.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/copia-integrale-copia-mezzo/
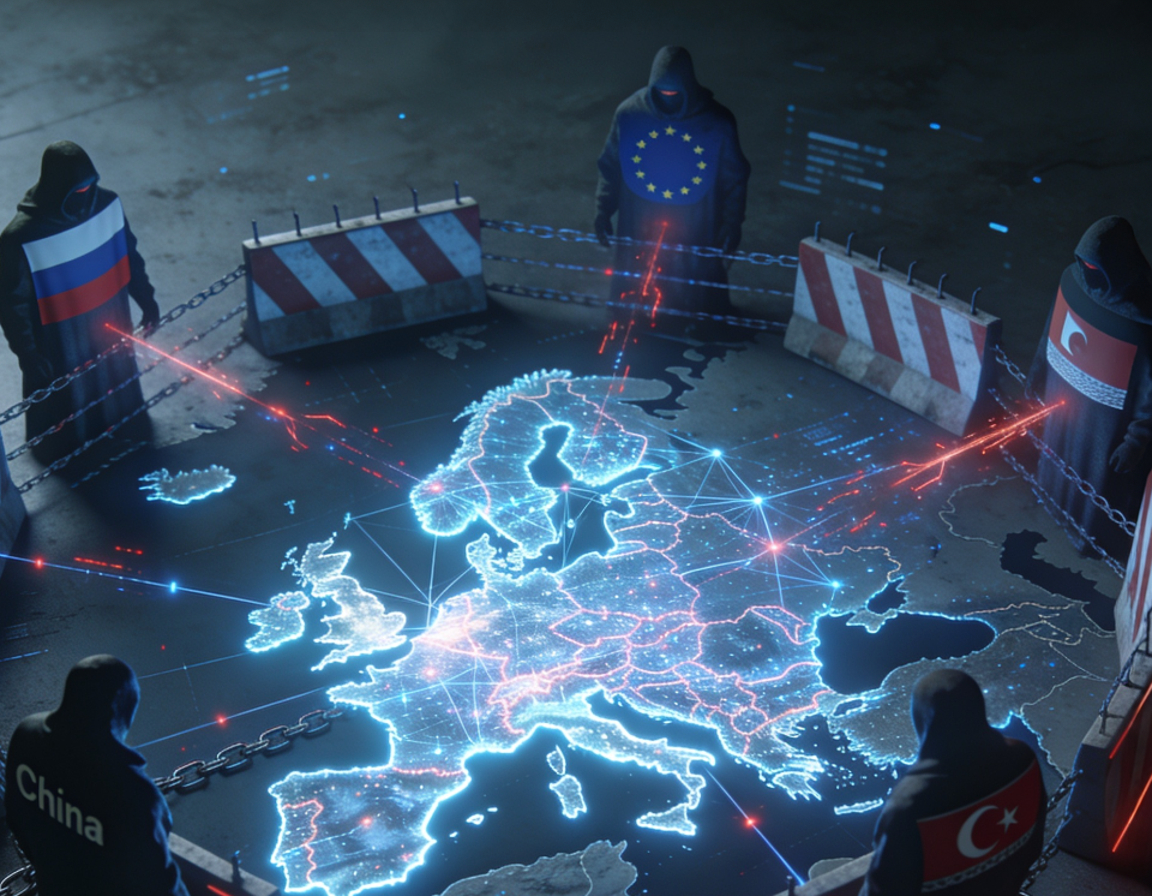


Sanzioni cyber e diplomazia coercitiva: il framework UE alla prova dei fatti

Dall’adozione del Regolamento 2019/796 a oggi, l’Unione Europea ha costruito un arsenale di sanzioni cyber inedito nel dominio cibernetico. Sei anni di applicazione rivelano tanto le potenzialità di questo strumento quanto le sue contraddizioni strutturali, in un contesto geopolitico che non lascia spazio alla compiacenza.

Un regime sanzionatorio per il cyberspazio: le fondamenta normative

Quando nel maggio 2019 il Consiglio dell’Unione Europea adottò la Decisione (PESC) 2019/797 e il Regolamento (UE) 2019/796, compì un passo che fino a poco prima sarebbe sembrato improbabile: dotarsi di uno strumento giuridico autonomo per rispondere ad attacchi informatici di origine extraeuropea. Il framework consente all’UE di imporre sanzioni nei confronti di persone o entità responsabili di attacchi cyber o tentati attacchi, di chi fornisce supporto finanziario, tecnico o materiale, o è altrimenti coinvolto in tali operazioni. Le misure restrittive includono il divieto di ingresso nei territori degli Stati membri e il congelamento dei beni.

Il terreno era stato preparato due anni prima con il Cyber Diplomacy Toolbox, adottato nel giugno 2017, che delineava un catalogo di misure diplomatiche proporzionate da attivare in risposta alle minacce cibernetiche. Ma fu la sequenza di attacchi di portata sistemica (da NotPetya nel 2017 all’operazione contro l’OPCW nel 2018) a convincere gli Stati membri che serviva uno strumento più incisivo. La legislazione fu promossa con particolare impulso da Regno Unito e Paesi Bassi, entrambi colpiti da significativi attacchi informatici nei mesi precedenti all’adozione della Decisione.

Sul piano strutturale, il regime si distingue per una caratteristica fondamentale: le sanzioni possono essere adottate soltanto nei confronti di persone fisiche, giuridiche, entità o organismi distinti dallo Stato. L’UE si astiene dall’attribuire gli attacchi cyber direttamente a Stati terzi, ritenendo tale determinazione una decisione politica sovrana che ogni Stato membro deve valutare autonomamente caso per caso. Le sanzioni, concentrate su attori non statali individualmente designati, hanno natura “mirata” o “intelligente”: sono concepite per incidere su un soggetto precisamente identificato, non sull’intera popolazione di un Paese.

Questa scelta architetturale riflette una tensione irrisolta: l’UE vuole punire chi agisce, ma non vuole assumere la responsabilità politica di accusare formalmente uno Stato, una distinzione che costituisce sia una garanzia giuridica sia un limite operativo.

I casi concreti: Russia, Cina, Corea del Nord, Iran

La prima applicazione concreta del regime risale al luglio 2020, quando il Consiglio designò sei individui e tre entità. Le misure si applicarono a due cittadini cinesi e quattro russi, nonché a tre organizzazioni (una cinese, una nordcoreana e una russa), con divieto di ingresso nell’UE e congelamento dei beni, oltre al divieto di mettere fondi a disposizione delle persone e delle entità elencate.

Sul fronte russo, le sanzioni nominano l’Unità 74455 del GRU (nota nella comunità di threat intelligence come Sandworm), ritenuta responsabile dell’attacco NotPetya del 2017, che paralizzò infrastrutture in tutto il mondo causando danni superiori ai dieci miliardi di dollari secondo una valutazione della Casa Bianca. L’UE attribuisce inoltre al GRU gli attacchi alle centrali elettriche ucraine del 2015 e del 2016. Quattro membri dell’unità speciale vennero sanzionati per il tentato attacco alla rete Wi-Fi dell’OPCW nei Paesi Bassi.

Sul versante cinese e nordcoreano, individui e aziende cinesi vennero collegati all’operazione Cloud Hopper (2017-2018), mentre attori nordcoreani furono ricondotti all’attacco WannaCry e alle operazioni del gruppo APT38/Lazarus.

Il regime ha conosciuto una progressiva espansione. Il 27 gennaio 2025 il Consiglio ha adottato misure restrittive nei confronti di tre ufficiali del GRU dell’Unità 29155 (Nikolay Korchagin, Vitaly Shevchenko e Yuriy Denisov), responsabili di una serie di attacchi informatici condotti nel 2020 contro diversi ministeri del governo estone, inclusi i Ministeri degli Affari Economici e delle Comunicazioni, degli Affari Sociali e degli Affari Esteri, con furto di migliaia di documenti riservati contenenti segreti commerciali e dati sanitari. Con quelle designazioni il regime orizzontale cyber copriva 17 individui e 4 entità.

Queste designazioni non rappresentano un’azione isolata. Furono il risultato dell’«Operation Toy Soldier», uno sforzo di controintelligence senza precedenti coordinato da 14 servizi provenienti da 10 Paesi (Australia, Canada, Cechia, Estonia, Germania, Lettonia, Paesi Bassi, UK, Ucraina e USA), che ha collegato l’Unità 29155 a numerose operazioni cyber contro l’Ucraina e i suoi alleati NATO e UE. Come ha dichiarato Tanel Sepp, direttore generale del Dipartimento di Cyber Diplomazia del Ministero degli Esteri estone, «l’attribuzione nel cyberspazio non è un compito facile, ma oggi possiamo dimostrare chiaramente che possiamo farlo e continueremo a identificare i responsabili degli attacchi contro di noi».

La svolta più significativa è arrivata il 16 marzo 2026, quando il Consiglio ha ampliato il perimetro geografico delle designazioni ben oltre la Russia. Le nuove misure colpiscono tre entità e due individui:

Integrity Technology Group (Cina), collegata al gruppo statale cinese noto come Flax Typhoon, che tra il 2022 e il 2023 ha compromesso oltre 65.000 dispositivi in sei Stati membri; Anxun Information Technology (Cina, nota anche come i-Soon), che ha fornito servizi di hacking diretti alle infrastrutture critiche degli Stati membri e di Paesi terzi; Emennet Pasargad (Iran), responsabile di attacchi informatici e campagne di manipolazione delle informazioni in Francia contro il giornale Charlie Hebdo nel 2023 e contro le Olimpiadi di Parigi 2024. I due individui designati sono co-fondatori di una delle società cinesi.

Con queste aggiunte il regime orizzontale cyber si applica ora complessivamente a 19 individui e 7 entità. È la prima volta che l’Iran viene incluso esplicitamente in questo framework. Vale anche la pena sottolineare che le due società cinesi sanzionate dall’UE erano già state precedentemente sanzionate dal Regno Unito, confermando la tendenza al coordinamento sanzionatorio tra i due partner anche nel dominio cyber.

Parallelamente al regime cyber specifico, l’UE ha sviluppato un framework più ampio per rispondere alle attività destabilizzanti russe. Nel dicembre 2025 il Consiglio ha sanzionato 12 individui e due entità per il sostegno alle minacce ibride della Russia contro l’Europa, includendo tre persone legate all’Unità 29155 del GRU e al gruppo Cadet Blizzard, che hanno preso di mira Stati membri dell’UE e alleati NATO per acquisire informazioni sensibili e destabilizzarne la situazione politica.

La lista include anche il 142° Battaglione separato di guerra elettronica, basato a Kaliningrad, responsabile di disturbi ai sistemi di comunicazione e collegato ai recenti malfunzionamenti GPS nello spazio aereo di diversi Stati membri. Con le designazioni del 16 marzo 2026 (quattro ulteriori individui per attività di propaganda e disinformazione) il framework per le attività destabilizzanti della Russia si applica complessivamente a 69 individui e 17 entità.

Il processo di attribuzione: scienza, intelligence e politica

Comprendere il funzionamento del regime sanzionatorio implica confrontarsi con il problema più complesso nel dominio cyber: chi ha fatto cosa. L’attribuzione di un attacco informatico è un processo in tre fasi: prima si identificano i computer e le reti utilizzati nell’operazione; poi si stabilisce il collegamento con le persone fisiche responsabili; infine, lo Stato o gli Stati colpiti possono decidere di agire (tipicamente attraverso sanzioni) contro i responsabili.

Questo processo non è meramente tecnico: è profondamente politico. La questione della soglia di prova richiesta per una designazione rimane opaca. A differenza di un procedimento penale, le sanzioni non dipendono in linea di principio da alcuna determinazione di colpevolezza penale, ma l’attribuzione rimane cruciale perché consente a chi irroga le sanzioni di designare la responsabilità e giustificare le misure all’opinione pubblica.

Il caso Estonia è qui esemplare. Dietro una singola attribuzione pubblica, quattro anni di indagine e un’operazione coordinata da 14 servizi di dieci Paesi. Questo solleva una questione metodologica centrale: il processo di attribuzione è tanto più credibile quanto più è multilaterale. Non è un caso che le designazioni più solide siano sempre arrivate in scia a operazioni di condivisione dell’intelligence tra partner (come appunto Operation Toy Soldier), e non da iniziative unilaterali dei singoli Stati membri.

Il coordinamento dell’attribuzione avviene prevalentemente attraverso canali bilaterali tra gli Stati membri, senza un meccanismo centralizzato a livello UE. Questo crea asimmetrie notevoli: i Paesi con agenzie di intelligence più sviluppate (Paesi Bassi, Francia, Germania, Svezia, Estonia) tendono a svolgere un ruolo da traino nell’identificazione dei responsabili, mentre altri seguono. La questione si è acuita dopo la Brexit, privando l’UE dell’expertise del GCHQ nel circuito istituzionale europeo.

Il coordinamento con USA e UK: alleanza solida, architetture distinte

Il regime sanzionatorio europeo non opera nel vuoto: si inserisce in un ecosistema più ampio di misure restrittive occidentali. La tendenza alla coordinazione è strutturale: le sanzioni del luglio 2020 contro Russia, Cina e Corea del Nord arrivarono in parallelo con analoghi annunci da Washington e Londra.

Secondo il recente policy brief dell’European Policy Centre dedicato alle cyber sanctions UE-UK, la cooperazione tra i due partner è rimasta solida dopo la Brexit e fornisce una base stabile per ulteriori collaborazioni nel dominio cyber. Il regime britannico offre maggiore agilità e integrazione operativa, supportato da robuste capacità di intelligence e legami con il settore privato, pur dipendendo in misura ancora maggiore dalla cooperazione con i partner internazionali. Il framework UE beneficia di maggiore portata regolamentare, ma è vincolato da sfide legate principalmente al coordinamento dell’attribuzione, alla condivisione di informazioni, al processo decisionale e all’enforcement.

Nel maggio 2025 la dinamica coordinata è risultata particolarmente visibile: l’UE e il Regno Unito hanno lanciato una campagna sanzionatoria coordinata per colpire l’infrastruttura di guerra ibrida della Russia, coincidendo con il 17° pacchetto sanzionatorio europeo. Tra le entità designate figurava Stark Industries Solutions, un provider di hosting russo strettamente legato all’infrastruttura cybercriminale filo-russa, utilizzato dal gruppo DDoS NoName057(16) per attacchi contro obiettivi europei. A questo riguardo, le cyber sanctions come frammentazione digitale sono state analizzate approfonditamente anche sulle nostre pagine, dove emerge come le misure restrittive tendano a ridisegnare l’architettura stessa di internet in blocchi regionali sempre più separati.

Una nota dell’EUISS del maggio 2025 sottolinea che una task force bilaterale EU-UK sulle minacce ibride agevolerebbe il coordinamento e la condivisione di intelligence, particolarmente in un momento in cui strutture multilaterali più ampie potrebbero essere percepite come un ostacolo all’azione tempestiva, con preoccupazione crescente anche in seno all’alleanza Five Eyes per quanto riguarda la condivisione di intelligence con Washington.

I limiti strutturali: la regola dell’unanimità e il problema del deterrente

La critica più ricorrente al regime sanzionatorio cyber europeo non riguarda la sua architettura normativa (sostanzialmente solida) ma la sua governance politica. Il punto debole principale è la regola dell’unanimità.

Le decisioni e i regolamenti sulle sanzioni vengono adottati dal Consiglio dell’UE all’unanimità, in base al quadro della Politica Estera e di Sicurezza Comune (PESC). Questa regola, che riflette il carattere intergovernativo della PESC, consente a un singolo Stato membro di bloccare o ritardare qualsiasi designazione. Come ha analizzato il Verfassungsblog nell’ottobre 2025, la struttura del framework sanzionatorio è concepita in due passaggi (unanimità per le decisioni di principio e voto a maggioranza qualificata per le misure di implementazione), ma nella prassi i due passaggi vengono collassati in uno, amplificando la leva di un singolo veto. Il caso emblematico è quello dell’Ungheria, il cui uso sistematico del potere di blocco è diventato il simbolo di una PESC tendenzialmente disfunzionale.

Il problema non è teorico. Tra il 2011 e il 2025 si sono registrate almeno 45 opposizioni a decisioni di politica estera, e il caso di Cipro (che nel 2020 pose il veto alle sanzioni contro la Bielorussia per fare pressione sull’UE in una disputa con la Turchia) illustra come l’unanimità venga sempre più utilizzata come leva per strappare concessioni su temi non correlati.

Oltre all’unanimità, pesano le dimensioni numeriche del regime. Diciannove individui e sette entità (i numeri attuali del regime cyber orizzontale) appaiono esigui rispetto alla scala e alla frequenza delle operazioni ostili documentate. La valutazione del CSIS di marzo 2026 sottolinea che resilienza e sanzioni mirate sono necessarie ma non sufficienti da sole, e che l’Europa deve credibilmente sviluppare una capacità offensiva cyber in tempo di guerra, impegnarsi in contromisure cyber contro le attività di guerra ibrida e comunicare entrambe le cose in modo autorevole agli avversari.

Un terzo limite strutturale riguarda l’enforcement. L’efficacia delle misure restrittive (congelamento dei beni e divieto di viaggio) dipende dall’effettiva presenza di asset nell’UE da parte dei soggetti designati. Gli operatori di intelligence dei servizi russi o i componenti delle unità GRU tipicamente non detengono conti bancari in Europa né pianificano vacanze a Parigi. La deterrenza funziona su chi ha interessi patrimoniali nell’orbita europea; ha un effetto limitato su chi opera dall’interno di apparati statali stranieri o di aziende private (in Cina e Iran) che svolgono lavoro per conto di Pechino e Teheran.

Le proposte di riforma: verso una deterrenza più credibile

La consapevolezza dei limiti ha generato un dibattito vivace sulle riforme necessarie. Il contributo più sistematico e aggiornato è il policy brief di marzo 2026 dell’European Policy Centre, dedicato alla cooperazione EU-UK in materia di cyber sanctions.

Le raccomandazioni principali includono: rafforzare il coordinamento sull’attribution policy e la condivisione di intelligence; valutare il voto a maggioranza qualificata e le coalizioni dei volenterosi per le decisioni sanzionatorie; ampliare l’esposizione pubblica e l’attribuzione come strumenti di dissuasione complementari; prendere di mira gli ecosistemi più ampi che abilitano le operazioni cyber ostili; rafforzare la cooperazione con il settore privato riducendo le dipendenze strategiche; costruire campagne sanzionatorie sostenute attorno a narrative strategiche coerenti; e migliorare l’early warning e il coordinamento strategico sulle cyber sanctions tra UE e UK.

Sul fronte del voto a maggioranza qualificata, il dibattito si è intensificato. Come ha osservato l’Institut Jacques Delors in un documento del 2025, il meccanismo attuale lascia gli Stati membri esposti al ricatto politico. In piena conformità con il Trattato, non vi sarebbe motivo di ritenere che l’adozione di misure di implementazione delle sanzioni debba avvenire all’unanimità: la distinzione tra la decisione di principio (che richiede unanimità ex art. 29 TUE) e le misure di implementazione (modificabili con voto a maggioranza qualificata ex art. 215 TFEU) potrebbe essere recuperata per ridurre la leva del singolo veto.

Sul piano operativo, la risposta europea al problema dell’attribuzione punta sempre più su un approccio “ecosistemico”: anziché designare soltanto i singoli operatori, si mira a colpire l’intera catena di supporto (infrastrutture di hosting, intermediari finanziari, piattaforme di disinformazione, fornitori di strumenti). La designazione di Stark Industries Solutions nel maggio 2025 e quelle di marzo 2026 contro Integrity Technology Group e Anxun/i-Soon (due aziende private che svolgono funzioni di hacking-as-a-service per conto di attori statali) vanno esattamente in questa direzione.

Sul fronte istituzionale, il 16 marzo 2026 il Consiglio ha approvato conclusioni sull’avanzamento della capacità dell’UE di contrastare le minacce ibride, riaffermando la determinazione dell’Unione in questo dominio e consolidando la prospettiva di un EU hybrid toolbox sempre più integrato. Emerge anche la proposta italiana: nel novembre 2025 il Ministro della Difesa Guido Crosetto ha avanzato l’ipotesi di un organismo counter-hybrid a livello UE, affiancato da un corpo nazionale denominato Arma Cyber con un organico iniziale di 1.200-1.500 unità destinato a espandersi progressivamente fino a 5.000, inclusi i riservisti.

Il contesto della guerra ibrida: sanzioni come segnale, non come soluzione

Valutare l’efficacia delle sanzioni cyber significa confrontarsi con una domanda scomoda: a cosa servono, esattamente? Se l’obiettivo è fermare gli attacchi, l’evidenza empirica non è confortante.

Nel solo dicembre 2025, la Germania ha attribuito pubblicamente vari incidenti cyber ad attori russi, tra cui un attacco dell’agosto 2024 al controllo del traffico aereo tedesco ricondotto ad APT28 e una campagna di information operations contro obiettivi tedeschi. La Danimarca ha accertato che la Russia era dietro due attacchi definiti “distruttivi e perturbatori”, tra cui uno contro un’utility idrica e uno che ha disturbato siti istituzionali durante le elezioni locali del novembre 2025. Come abbiamo già documentato nell’analisi della cybercrisi italiana del 2025, il gruppo NoName057(16) ha trasformato il cybercrime da attività criminale sporadica a operazione geopolitica sistematica, con effetti diretti anche sul tessuto istituzionale italiano.

Se invece l’obiettivo è segnalare che certe condotte sono inaccettabili e costruire una norma internazionale condivisa, le sanzioni assolvono meglio la loro funzione. Ogni designazione è anche un atto di public attribution: fissa nella documentazione ufficiale dell’UE la responsabilità di specifici individui, unità e aziende per attacchi specifici. Questo ha valore politico-diplomatico, anche se i diretti interessati raramente perdono il sonno.

Come sottolinea il rapporto del CEPA del dicembre 2025, la resilienza da sola non fermerà la guerra ibrida: gli alleati devono affiancare alla deterrenza per negazione una deterrenza per punizione. Le contromisure pratiche dovrebbero includere l’attribuzione pubblica e il naming-and-shaming, la condivisione rafforzata di intelligence NATO-UE, lo smantellamento delle reti di disinformazione e la sanzione mirata di élite e reti di supporto. Un approccio coordinato NATO-UE è essenziale per allineare le leve economiche e giuridiche europee con le capacità militari e cyber dell’Alleanza, impedendo agli avversari di sfruttare le divisioni.

Conclusioni: un framework che deve crescere

Sei anni dopo la sua istituzione, il regime sanzionatorio cyber dell’UE ha dimostrato di poter funzionare: ha prodotto designazioni concrete, ha costruito una giurisprudenza politica condivisa sull’attribuzione, ha favorito il coordinamento con partner chiave. Le ultime designazioni di marzo 2026 (con l’inclusione esplicita di Cina e Iran accanto alla Russia) segnalano la maturazione del regime verso una visione davvero multilaterale della minaccia cyber. Il fatto che il quadro giuridico sia stato prorogato fino al maggio 2028 segnala la volontà politica di mantenere e sviluppare questo strumento nel lungo periodo.

Le sfide strutturali rimangono aperte. La regola dell’unanimità espone il meccanismo alla paralisi politica. La lista dei designati è numericamente esigua rispetto alla portata delle operazioni ostili documentate. L’approccio tradizionale (sanzionare individui specifici) mostra i suoi limiti contro apparati statali che operano con sostituibilità sistemica e contro ecosistemi privati di hacking-as-a-service che proliferano in Cina, Russia e Iran.

Il futuro del framework dipenderà dalla capacità di tre evoluzioni parallele: una riforma della governance decisionale che riduca il rischio del veto singolo attraverso la corretta applicazione della distinzione tra art. 29 TUE e art. 215 TFEU; un ampliamento dell’approccio sanzionatorio verso l’ecosistema abilitante delle operazioni cyber ostili; e un rafforzamento strutturale del coordinamento intelligence con USA e UK in un momento in cui le certezze atlantiche appaiono meno scontate.

La diplomazia coercitiva nel cyberspazio non è un’alternativa alla deterrenza militare o alla resilienza difensiva: è un pezzo di un puzzle più complesso. Ma è un pezzo che l’Europa ha il dovere di tenere affilato e di usare con maggiore rapidità, coraggio e precisione di quanto la storia recente abbia dimostrato.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sanzioni-cyber-ue/


Sicurezza delle API: il tallone d’Achille dell’economia digitale

C’è un paradosso silenzioso al cuore dell’economia digitale contemporanea. Le API (Application Programming Interface) sono l’infrastruttura nervosa che tiene in vita ogni transazione bancaria, ogni ordine di e-commerce, ogni scambio di dati sanitari, ogni richiesta di un’applicazione mobile. Sono invisibili all’utente finale, onnipresenti nel codice, fondamentali per qualunque modello di business digitale. Eppure, proprio questa ubiquità le rende il bersaglio preferito degli attaccanti moderni e, troppo spesso, il punto più trascurato dell’intera catena della sicurezza informatica.

I numeri aiutano a comprendere la dimensione del problema. Secondo il Cloudflare Radar 2025 Year in Review, l’analisi più autorevole e aggiornata disponibile, basata sull’osservazione diretta di una rete globale presente in oltre 330 città, le API rappresentano oggi più della metà di tutto il traffico web dinamico, con un’incidenza in costante crescita.

Akamai, su un campione diverso di traffico internet, stima la quota fino all’83%. Nel solo 2025, le API hanno generato oltre 11.000 bollettini di sicurezza, pari al 17% di tutte le vulnerabilità software pubblicamente divulgate in un anno. Il traffico malevolo diretto verso le API è cresciuto del 681% nell’arco degli ultimi anni, secondo il Wallarm 2026 API ThreatStats Report. Quasi il 99% delle organizzazioni ha dichiarato di aver subito almeno un incidente legato alla sicurezza delle API negli ultimi dodici mesi. Non si tratta di statistiche marginali: è la fotografia di un’infrastruttura critica sotto assedio sistematico, e di un settore che stenta ancora a rispondere con adeguata consapevolezza.

Un bersaglio su misura per gli attaccanti

Cosa rende le API un vettore così attraente? La risposta sta nella loro natura strutturale. A differenza delle applicazioni web tradizionali, un’API non ha una “porta d’ingresso” visibile: non ha un login, non ha un CAPTCHA, non ha l’interfaccia grafica che un essere umano deve attraversare. È progettata per essere consumata da macchine, e le macchine non faticano a sparare decine di migliaia di richieste al secondo. Un’organizzazione che espone API pubbliche riceve in media 10.000 attacchi al giorno. Le API GraphQL, sempre più diffuse per la loro flessibilità, hanno visto un incremento del 140% nei tentativi di abuso nel corso del 2025.

La semplicità di attacco è altrettanto allarmante. Secondo il Wallarm 2026 API ThreatStats Report, il 97% delle vulnerabilità API è sfruttabile con una singola richiesta HTTP. Il 98% è classificato come facile o banale da sfruttare. Il 59% non richiede nemmeno autenticazione. Il 30% ha già exploit pubblici disponibili nel momento stesso in cui la vulnerabilità viene divulgata. Questa combinazione di alta diffusione, alta sfruttabilità e bassa complessità trasforma le API in un terreno di caccia privilegiato per attori di ogni livello, dai criminali opportunistici alle APT sofisticate.

A questo si aggiunge la questione del rilevamento. Solo il 21% delle organizzazioni dichiara di avere capacità solide nell’identificare attacchi a livello API. Appena il 13% riesce a prevenire più del 50% degli attacchi. Gli strumenti tradizionali come i Web Application Firewall (WAF) si rivelano inadeguati: il 53% delle organizzazioni ne riconosce apertamente i limiti nella rilevazione di frodi a livello API. Siamo di fronte a un disallineamento strutturale tra la superficie esposta e le difese disponibili.

L’OWASP API Security Top 10: una mappa delle fragilità

Dal 2019, l’Open Worldwide Application Security Project pubblica la propria lista delle vulnerabilità API più critiche. La versione aggiornata al 2023, oggi il riferimento di settore, riflette un’evoluzione significativa del panorama delle minacce. L’88% degli attacchi reali sfrutta almeno una delle vulnerabilità elencate, il che rende questa tassonomia uno strumento di prioritizzazione imprescindibile per qualunque team di sicurezza.

API1:2023 – Broken Object Level Authorization (BOLA) rimane, a distanza di anni, la vulnerabilità più sfruttata nelle API. Si manifesta quando un endpoint espone dati di un oggetto senza verificare che l’utente autenticato abbia effettivamente il diritto di accedervi. Un attaccante che conosce o indovina l’identificatore di un record (un numero d’ordine, un ID paziente, un codice cliente) può semplicemente cambiarlo nella richiesta e accedere ai dati altrui. La logica è elementare; l’impatto, devastante.

API2:2023 – Broken Authentication aggrega tutte le debolezze legate alla gestione dell’identità: password deboli, token JWT mal configurati, assenza di blocco su tentativi multipli, meccanismi di reset insicuri. In questa categoria rientrano anche i frequenti errori nella gestione dei segreti: chiavi API hard-coded nel codice sorgente, token esposti in repository pubblici, credenziali condivise tra ambienti di produzione e sviluppo. Un caso emblematico, divulgato nel dicembre 2024 dal team TRIAD di CloudSEK: la scoperta di oltre 30.000 workspace Postman accessibili pubblicamente, contenenti token di accesso attivi, chiavi API reali e payload con dati sanitari e credenziali aziendali di organizzazioni in settori che vanno dalla finanza all’abbigliamento sportivo.

API3:2023 – Broken Object Property Level Authorization (BOPLA) è una novità della lista 2023, nata dalla fusione di due categorie precedenti (Excessive Data Exposure e Mass Assignment). Riconosce che il problema non è solo chi può accedere a un oggetto, ma anche quali proprietà di quell’oggetto possono essere lette o modificate. Un utente che riesce a modificare un campo come role: admin in una richiesta PUT sta sfruttando esattamente questa vulnerabilità.

API4:2023 – Unrestricted Resource Consumption riguarda la mancanza di limiti efficaci sull’uso delle risorse: assenza di rate limiting, nessun controllo sulla dimensione dei payload, nessun tetto alle query su database o ai servizi di terze parti a pagamento. Gli attacchi DDoS diretti alle API sono cresciuti del 200% nel 2025. In assenza di throttling, un attaccante può paralizzare un servizio o generare costi operativi insostenibili attraverso richieste massive e automatizzate.

API5:2023 – Broken Function Level Authorization (BFLA) colpisce quando la distinzione tra funzioni amministrative e funzioni utente non è enforcement a livello backend. Se un’API non verifica il livello di privilegio richiesto per ciascun endpoint, un utente ordinario potrebbe invocare endpoint di amministrazione semplicemente conoscendone il path.

API6:2023 – Unrestricted Access to Sensitive Business Flows è la vulnerabilità più sottile e difficile da rilevare automaticamente. Non riguarda un bug tecnico, ma l’assenza di protezione contro l’uso massiccio e automatizzato di flussi di business legittimi: acquisto di biglietti, creazione di account, pubblicazione di contenuti. Un bot che acquista in millisecondi tutti i posti di un concerto sta sfruttando questa categoria, e nessuno scanner tradizionale lo individuerà.

API7:2023 – Server-Side Request Forgery (SSRF) è una novità del 2023. Si verifica quando un’API recupera risorse remote senza validare l’URI fornito dall’utente, consentendo a un attaccante di instradare richieste verso sistemi interni, servizi di metadata cloud o endpoint protetti da firewall.

API8:2023 – Security Misconfiguration è il contenitore di una casistica vastissima: CORS permissivi, header di sicurezza assenti, messaggi di errore verbosi che rivelano la struttura interna, TLS non configurato, porte di debug esposte in produzione. I cloud provider registrano misconfigurazioni API in oltre il 30% dei casi di breach.

API9:2023 – Improper Inventory Management riguarda le cosiddette shadow API, un tema che merita un approfondimento dedicato per la rilevanza che ha assunto negli ultimi anni, come illustrato nel paragrafo seguente.

API10:2023 – Unsafe Consumption of APIs è l’unica voce della lista che capovolge la prospettiva: non riguarda i rischi di essere un provider di API, ma quelli di essere un consumer. Un’applicazione che consuma API di terze parti senza validarne l’output, senza limitare i dati elaborati e senza considerare la possibilità di un provider compromesso, eredita automaticamente le vulnerabilità di quell’ecosistema.

Il problema delle shadow API: quello che non sai che esiste

Tra tutte le sfide della sicurezza API, la gestione delle API non documentate, denominate shadow API o zombie API, è probabilmente la più sistemica e la più sottovalutata. Le shadow API sono endpoint reali, attivi, raggiungibili dalla rete, che non compaiono in nessun inventario ufficiale, non sono soggetti a test di sicurezza, non sono monitorati da nessun team. Possono essere API di vecchie versioni dimenticate durante una migrazione, endpoint di sviluppo mai rimossi in produzione, integrazioni create da team interni senza passare per il processo formale di release.

I numeri dicono che le shadow API rappresentano oltre il 20% dell’inventario API totale nelle organizzazioni enterprise. Le istituzioni finanziarie gestiscono in media 601 API e una parte rilevante di queste sfugge a qualsiasi governance attiva. Un caso paradigmatico del 2025 è quello di Stripe: attaccanti hanno individuato un endpoint legacy (/v1/sources) ancora collegato ai sistemi di validazione pagamenti, privo dei controlli di sicurezza delle API moderne, e lo hanno sfruttato per condurre una campagna massiva di card skimming su almeno 49 e-commerce compromessi. L’endpoint era un residuo dell’architettura precedente, scarsamente documentato e ignorato nei security audit. Non una vulnerabilità zero-day: un oggetto dimenticato.

Quello di Stripe non è un caso isolato. Il breach di Optus del settembre 2022 ha esposto i dati personali di quasi 10 milioni di clienti australiani, quasi un terzo della popolazione del paese, attraverso un’API priva di autenticazione rimasta accessibile da internet per circa tre mesi. Secondo l’analisi dell’Australian Communications and Media Authority (ACMA), un errore di codifica introdotto nel 2018 aveva reso inefficaci i controlli di accesso su un sottodominio, e il problema era rimasto non rilevato nonostante una correzione parziale applicata nel 2021 sul dominio principale. L’attaccante non aveva bisogno di strumenti sofisticati: l’API non richiedeva alcuna autenticazione, e i customer ID erano numerici e incrementali, rendendoli banalmente enumerabili.

Il breach che nel 2022 ha colpito Twitter è spesso descritto in modo impreciso. Non si trattava di un’API legacy dimenticata, ma di un bug introdotto nell’aggiornamento del codice di giugno 2021: la vulnerabilità consentiva a chiunque di sottomettere un numero di telefono o un indirizzo e-mail all’API della piattaforma e ricevere in risposta l’ID dell’account Twitter associato, anche quando l’utente aveva esplicitamente configurato le impostazioni di privacy per impedire questa correlazione.

Il bug fu segnalato tramite bug bounty in gennaio 2022 e corretto subito dopo; era però già stato sfruttato da almeno dicembre 2021. Un threat actor aveva creato un database di 5,4 milioni di profili, incluse informazioni private come numeri di telefono e indirizzi e-mail, poi venduto online e infine diffuso gratuitamente. Ulteriori analisi rivelarono che la stessa vulnerabilità era stata sfruttata su scala molto più ampia, portando a un dataset finale di oltre 200 milioni di account.

In entrambi i casi, come nel caso Stripe, la catena causale è identica: controlli insufficienti, endpoint dimenticati o alterati, nessun monitoraggio, nessun alert.

Breach recenti: leggere gli incidenti come segnali

L’analisi dei 60 breach API divulgati nel 2025, condotta da Wallarm nel 2026 API ThreatStats Report, restituisce un quadro per settori e categorie: software (15%), piattaforme AI (15%), vendor di cybersecurity (13%), SaaS (8%), automotive (7%), cloud services (7%). Mappati sulla tassonomia OWASP, la broken authentication è responsabile del 52% degli incidenti, mentre l’unsafe consumption di API di terze parti spiega il 27%.

Tra gli episodi più rilevanti del 2025: API di terze parti hanno esposto milioni di record presso il fornitore di servizi creditizi 700Credit; debolezze nell’autenticazione delle API Qantas hanno permesso accessi di massa non autorizzati; credenziali rubate e permessi API eccessivi hanno abilitato transazioni fraudolente su SwissBorg; server MCP esposti hanno fatto trapelare infrastrutture di agent AI su larga scala. A maggio 2025 un hacker con lo pseudonimo “ByteBreaker” ha pubblicato su forum underground la presunta raccolta di dati relativi a 1,2 miliardi di account Facebook tramite abuso di API.

Meta ha negato si tratti di un breach nuovo, sostenendo che il dataset reimpacchetti dati già divulgati nel 2021; i ricercatori di Cybernews e Hackread hanno rilevato incongruenze strutturali nella dimensione dichiarata e sovrapposizioni significative con il leak precedente. Il claim resta pertanto non verificato indipendentemente, ma l’episodio conferma il modello di sfruttamento delle API come vettore di data harvesting massivo.

Il filo conduttore è sempre lo stesso: non exploit sofisticati, non attori nation-state con capacità eccezionali, ma debolezze fondamentali (autenticazione assente o debole, autorizzazione non granulare, endpoint dimenticati, terze parti non verificate) sfruttate con strumenti automatizzati alla portata di qualunque attore.

DevSecOps e la sicurezza by design: integrare prima che sia tardi

La risposta sistemica al problema della sicurezza API non può essere post-hoc. Applicare controlli di sicurezza su API già in produzione è costoso, inefficace e spesso destinato a fallire. La strada maestra è l’integrazione della sicurezza nel ciclo di vita dello sviluppo, in quello che il settore definisce approccio DevSecOps oppure, più recentemente, shift-left security.

In pratica, questo significa che il processo di sviluppo deve includere: modellazione delle minacce nella fase di design (identificare le attack surface prima di scrivere codice); revisione del codice orientata alla sicurezza (con particolare attenzione alla gestione dei segreti, alla sanitizzazione degli input, alla corretta implementazione dell’autenticazione); test automatizzati di sicurezza nelle pipeline CI/CD (SAST per il codice sorgente, DAST per le API deployate, test specifici contro le vulnerabilità OWASP); e monitoraggio continuo in produzione, con alerting su anomalie comportamentali che potrebbero segnalare tentativi di exploitation.

Questo approccio richiede che la sicurezza non sia responsabilità esclusiva di un team separato, ma venga distribuita attraverso l’intera organizzazione di sviluppo. I developer devono conoscere le vulnerabilità OWASP API Top 10. I team di prodotto devono includere requisiti di sicurezza nelle specifiche. I team di infrastruttura devono garantire che le pipeline espongano segnali di sicurezza rilevabili. Tuttavia, secondo il 2025 State of API Security Report di Traceable AI, basato su oltre 1.500 professionisti IT e cybersecurity, solo il 14% delle organizzazioni ha attualmente una strategia formale di API posture governance. Il gap tra l’ambizione del DevSecOps e la sua attuazione pratica rimane ampio.

Un nodo critico è rappresentato dall’adozione dell’AI generativa nello sviluppo software. La pratica del cosiddetto vibe coding, generare codice API con assistenti AI senza un’adeguata revisione critica, è diventata pervasiva. Secondo Akamai, l’AI-assisted coding è associato a un aumento di misconfigurazioni, impostazioni predefinite insicure e vulnerabilità trascurate nelle API generate. Il 65% delle organizzazioni considera la GenAI un rischio da serio a estremo per la sicurezza delle proprie API. La velocità di sviluppo che l’AI permette amplifica proporzionalmente la superficie esposta se non è accompagnata da un’eguale accelerazione dei controlli di sicurezza.

PSD2, Open Banking e DORA: la sicurezza delle API come obbligo regolatorio

Nel settore finanziario, la sicurezza delle API non è solo una questione tecnica: è un obbligo normativo con conseguenze legali misurabili. La Direttiva PSD2 ha imposto alle banche europee di esporre API dedicate ai Third-Party Provider (TPP), ovvero fintech autorizzate a offrire servizi di pagamento e aggregazione di conti, con requisiti stringenti di Strong Customer Authentication (SCA), dynamic linking e identificazione tramite certificati eIDAS. In questa architettura aperta, ogni vulnerabilità su un’API bancaria è potenzialmente una violazione dei dati del cliente, una frode abilitata dalla piattaforma e una sanzione per la banca emittente.

Le penali per non conformità possono raggiungere il 4% del fatturato annuo o 5 milioni di euro, applicando il criterio più alto. Ma il quadro si è ulteriormente complicato. Con l’accordo politico su PSD3/PSR raggiunto a novembre 2025 e l’adozione formale attesa nel primo semestre 2026, cui seguirà un periodo di transizione di 21 mesi verso l’implementazione completa prevista intorno al 2027, le banche europee si trovano ora a navigare obblighi paralleli e crescenti: responsabilità ampliata per le frodi da impersonificazione, verifica obbligatoria del beneficiario (Verification of Payee), autenticazione a doppia inerenza e benchmark di performance API più severi.

Parallelamente, DORA (il Digital Operational Resilience Act, entrato pienamente in vigore il 17 gennaio 2025) ha unificato il regime di incident reporting per il settore finanziario. L’EBA ha formalmente abrogato le proprie linee guida PSD2 sulla notifica degli incidenti, sostituendole con il framework DORA. Questo cambiamento non è meramente amministrativo: significa che un breach su un’API Open Banking deve ora essere gestito attraverso il prisma della resilienza operativa digitale, con obblighi di notifica armonizzati e un orizzonte di governance che abbraccia l’intera catena tecnologica, incluse le terze parti. Va notato che questa convergenza risolve parzialmente, ma non elimina, la tensione strutturale tra PSD2 (che spinge verso l’apertura dei dati) e il GDPR (che impone la protezione dei dati personali).

Come documentato in uno studio peer-reviewed pubblicato su MDPI nel gennaio 2026, i requisiti sovrapposti di consenso e protezione dei dati creano ancora incertezza nella governance e nell’allocazione delle responsabilità tra banche e TPP, anche alla luce del quadro normativo europeo DORA e NIS2.

Sul piano tecnico, il framework FAPI 2.0 (Financial-grade API Security Profile) ha raggiunto la propria specifica finale nel febbraio 2025, diventando il riferimento per l’implementazione sicura di API ad alto valore. FAPI 2.0 richiede l’uso di Pushed Authorization Requests (PAR), PKCE per tutti i client e token sender-constrained tramite mTLS o DPoP. Il 75% delle banche europee ha già adottato lo standard NextGenPSD2 del Berlin Group.

PCI DSS 4.0.1, diventata l’unica versione attiva dall’aprile 2025, è il primo standard PCI a citare esplicitamente le API come oggetto di controlli di sicurezza: il Requisito 6.4.2 impone soluzioni automatizzate davanti alle API pubbliche per rilevare e prevenire attacchi; il Requisito 6.3.2 richiede un inventario completo di tutto il software custom incluse le API. La non conformità comporta sanzioni tra 5.000 e 100.000 dollari al mese.

La frammentazione persistente nella qualità delle implementazioni rimane una fonte di rischio documentata dalla stessa Commissione Europea, che ha rilevato significative discrepanze negli standard API tra istituti diversi: un problema che PSD3 punta a risolvere attraverso benchmark di performance più stringenti e l’eliminazione definitiva del fallback allo screen scraping.

Verso una maturità sistemica: cosa manca ancora

Osservando il panorama nel suo insieme, la distanza tra il livello di esposizione e il livello di maturità difensiva delle organizzazioni appare strutturalmente preoccupante. Il 57% delle organizzazioni ha subito un breach API negli ultimi due anni, con il 73% di queste che ne ha subiti tre o più. Il 41% dichiara cinque o più episodi. Si tratta di fallimenti sistemici, non di incidenti episodici.

La risposta richiede un cambio di paradigma su più livelli. Primo, il problema della visibilità: non è possibile proteggere ciò che non si conosce. La discovery continua delle API, incluse le shadow API, deve diventare una funzione operativa permanente, non un esercizio periodico. Secondo, il problema della governance: le organizzazioni devono trattare ogni API come un asset critico, con un ciclo di vita documentato, un responsabile identificato, test di sicurezza automatizzati e metriche di esposizione misurabili. Terzo, il problema della cultura: finché la sicurezza API è percepita come un vincolo tecnico imposto a posteriori, anziché come una proprietà architettonica costruita ab initio, il divario tra attaccanti e difensori continuerà ad ampliarsi.

Le previsioni per il 2026 non lasciano spazio all’ottimismo passivo. Akamai stima che le API diventeranno il vettore dominante per i breach a livello applicativo, potenzialmente responsabili di più della metà di tutti gli attacchi alle applicazioni. Il Model Context Protocol, l’infrastruttura che collega gli agenti AI alle API esterne, ha già accumulato 315 vulnerabilità documentate nel 2025, pari al 14,4% di tutte le vulnerabilità AI, con una crescita del 270% tra il secondo e il terzo trimestre. L’interconnessione crescente tra sistemi AI agentici e API di business apre una superficie d’attacco che oggi non è ancora pienamente compresa né adeguatamente presidiata.

Conclusione

Le API sono, nel senso più letterale, i punti di connessione dell’economia digitale. Sono ciò che permette a una banca di condividere i dati di un cliente con un’app fintech, a un ospedale di integrare i referti con un sistema di telemedicina, a una supply chain di coordinare ordini e spedizioni in tempo reale. La loro sicurezza non è un problema tecnico tra gli altri: è una condizione necessaria per la fiducia digitale su cui si regge l’intero ecosistema.

Il paradosso è che questa centralità non si traduce ancora in un’attenzione proporzionale. Le organizzazioni investono in perimetri, in endpoint protection, in SIEM sofisticati e lasciano le API senza inventario, senza test, senza monitoraggio. Solo il 14% ha una strategia formale di governance. Meno di una su cinque riesce a rilevare con sufficiente efficacia gli attacchi che la colpiscono. Gli attaccanti hanno capito dove si trova il valore. La domanda è se le organizzazioni abbiano la stessa chiarezza sul proprio tallone d’Achille e, soprattutto, se abbiano la volontà di trasformare quella consapevolezza in azione prima che sia il prossimo breach a farlo decidere per loro.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-delle-api/


Linux bitten by second severe vulnerability in as many weeks

Both privilege escalation vulnerabilities stem from bugs in the kernel’s handling of page caches stored in memory, allowing untrusted users to modify them. They target caches in networking and memory-fragment handling components. Specifically, CVE-2026-43284 attacks the esp4 and esp6 () processes, and CVE-2026-43500 zeroes in on rxrpc. Last week’s CopyFail exploited faulty page caching in the authencesn AEAD template process, which is used for IPsec extended sequence numbers. A 2022 vulnerability named Dirty Pipe also stemmed from flaws that allow attackers to overwrite page caches.

Researchers from security firm Automox wrote:

Dirty Frag belongs to the same bug family as Dirty Pipe and Copy Fail, but it targets the frag member of the kernel’s struct sk_buff rather than pipe_buffer. The exploit uses splice() to plant a reference to a read-only page-cache page (for example, /etc/passwd or /usr/bin/su) into the frag slot of a sender-side skb. Receiver-side kernel code then performs in-place cryptographic operations on that frag, modifying the page cache in RAM. Every subsequent read of the file sees the corrupted version, even though the attacker only ever had read access.

CVE-2026-43284 is found in the esp_input() process on the IPsec ESP receive path. When an skb object is non-linear but lacks a frag list, the code skips skb_cow_data() and decrypts AEAD in place on the planted frag. From there, an attacker can control the file offset and the 4-byte value of each store.

CVE-2026-43500, meanwhile, resides in rxkad_verify_packet_1(). The process decrypts RxRPC payloads using a single-block process. Splice-pinned pages become both a source and destination. That, paired with the decryption key being freely extracted using the add_key (rxrpc), allows an attacker to rewrite contents in memory.

Either exploit used separately is unreliable. Some Ubuntu configurations use AppArmor to prevent untrusted users from creating namespace contents. That, in turn, neutralizes the ESP technique. Most other distributions by default don’t run rxrpc.ko, which neutralizes the RxRPC arm. When chained together, however, the two exploits allow attackers to obtain root on every major distribution Kim tested. Once the exploits run, attackers can use SSH access, web-shell execution, container escapes, or compromise low-privilege accounts.

“Dirty Frag is notable because it introduces multiple kernel attack paths involving rxrpc and esp/xfrm networking components to improve exploitation reliability,” Microsoft researchers wrote. “Rather than relying on narrow timing windows or unstable corruption conditions often associated with Linux local privilege escalation exploits, Dirty Frag appears designed to increase consistency across vulnerable environments.”

Researchers at Google-owned Wiz said exploits will be less likely to break out of hardened containerized environments such as Kubernets with default security settings in place. “However, the risk remains significant for virtual machines or less restricted environments.”

The best response for anyone using Linux is to install patches immediately. While fixes likely require a reboot, protection from a threat as severe as Dirty Frag outweighs the cost of disruptions. Anyone who can’t install immediately should follow the mitigation steps laid out in the posts linked above. Additional guidance can be found here.

https://arstechnica.com/security/2026/05/linux-bitten-by-second-severe-vulnerability-in-as-many-weeks/


Falso repository OpenAI su Hugging Face distribuisce malware


La corsa all’AI sta creando nuove superfici di attacco e i cybercriminali stanno iniziando a sfruttarle con tecniche sempre più sofisticate. L’ultimo caso arriva dal mondo dei modelli open source e delle piattaforme collaborative dedicate all’intelligenza artificiale: un repository malevolo pubblicato su Hugging Face è riuscito a spacciarsi per un progetto ufficiale di OpenAI, raggiungendo rapidamente la vetta dei contenuti più popolari prima di essere rimosso.

Secondo quanto riportato da The Hacker News, il repository fraudolento imitava il progetto “privacy-filter” di OpenAI, copiandone descrizione e struttura per convincere sviluppatori e ricercatori a scaricare codice malevolo. L’obiettivo finale, come avviene sempre più spesso negli attacchi alla catena del software, era il furto di credenziali, cookie di sessione e dati sensibili dai browser Windows delle vittime.

L’attacco alla fiducia dell’ecosistema AI open source

La vicenda mostra come l’ecosistema AI stia vivendo una dinamica molto simile a quella già osservata negli anni nel mondo dei package npm, PyPI e GitHub. I criminali non devono necessariamente violare infrastrutture complesse: spesso basta sfruttare la fiducia implicita che sviluppatori e ricercatori ripongono nei repository pubblici.

Nel caso specifico, gli attaccanti hanno creato un progetto chiamato “Open-OSS/privacy-filter”, estremamente simile a quello reale pubblicato da OpenAI. Il repository riprendeva testi, descrizioni e struttura del progetto originale, rendendo difficile per molti utenti distinguere il repository legittimo da quello malevolo.

Secondo le analisi, il repository sarebbe riuscito a ottenere centinaia di migliaia di download prima della rimozione, sfruttando anche account fake e meccanismi di trending della piattaforma.

Come funzionava il malware nascosto nel repository

Il cuore dell’attacco era un file Python apparentemente innocuo chiamato “loader.py”. Dietro codice, che simulava normali funzioni AI, il file nascondeva una catena di infezione progettata per scaricare ed eseguire un infostealer sviluppato in Rust.

L’analisi tecnica evidenzia diversi elementi tipici delle moderne campagne malware. Uno dei primi passaggi consisteva nella disattivazione della verifica SSL, scelta che permetteva al codice di contattare server remoti senza controlli rigorosi sui certificati.

Successivamente il malware decodificava dinamicamente URL in Base64 e recuperava payload esterni contenenti comandi PowerShell eseguiti in background. Da lì veniva scaricato il componente finale dell’attacco: un infostealer compilato in Rust, linguaggio sempre più utilizzato nel cybercrime moderno perché più difficile da analizzare e facilmente utilizzabile su più piattaforme.

Una volta attivo, il malware cercava informazioni nei browser Chromium e Gecko-based, inclusi Chrome, Edge e Firefox. Nel mirino finivano password salvate, cookie, token di autenticazione e sessioni attive, informazioni particolarmente preziose per compromettere account cloud, piattaforme AI e servizi enterprise.

Il nuovo problema: modelli AI come vettore di supply chain attack

Il caso conferma una tendenza che molti ricercatori stanno osservando da mesi: le piattaforme AI stanno diventando un nuovo terreno di supply chain attack.

Hugging Face, come GitHub nel mondo software tradizionale, si basa su un modello estremamente aperto. Chiunque può pubblicare modelli, dataset e codice. Questa apertura accelera l’innovazione, ma crea anche un ambiente ideale per campagne di impersonificazione, typosquatting e distribuzione malware.

Il problema è amplificato dalla velocità con cui le aziende stanno adottando strumenti AI. Molti sviluppatori scaricano modelli e repository senza effettuare verifiche approfondite sull’autore, sulle dipendenze o sul codice eseguito localmente. Il risultato è che la fiducia nell’ecosistema open source AI rischia di diventare un nuovo punto debole della sicurezza enterprise. Non a caso, negli ultimi mesi si sono moltiplicati gli incidenti legati a modelli malevoli, package compromessi e strumenti AI distribuiti con payload nascosti.

Perché gli infostealer sono così pericolosi nel mondo AI

Gli infostealer rappresentano oggi una delle categorie malware più redditizie per i cybercriminali. Nel contesto AI, il loro valore cresce ulteriormente perché gli sviluppatori tendono ad avere accesso privilegiato a infrastrutture cloud, repository di codice e piattaforme di training. Un singolo account compromesso può consentire attacchi a catena contro pipeline CI/CD, modelli proprietari, dataset sensibili e infrastrutture cloud aziendali. Cookie di sessione e token API possono inoltre permettere agli attaccanti di bypassare MFA e altri controlli tradizionali.

In pratica, il furto di credenziali da un laptop di sviluppo può diventare il punto di partenza per compromissioni molto più ampie, incluse intrusioni nella supply chain software o manipolazioni di modelli AI distribuiti pubblicamente.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/05/11/falso-repository-openai-su-hugging-face-distribuisce-malware/?utm_source=rss&utm_medium=rss&utm_campaign=falso-repository-openai-su-hugging-face-distribuisce-malware


AI-OSINT: quando l’intelligenza artificiale ridefinisce i confini dell’intelligence aperta

L’Open Source Intelligence non è mai stata soltanto una questione di strumenti. È sempre stata, prima di tutto, una questione di metodo: la capacità di trasformare frammenti di informazione pubblica in conoscenza operativa, passando attraverso raccolta, correlazione, verifica e interpretazione. Per decenni, questo processo ha richiesto pazienza, rigore analitico e una buona dose di creatività umana. Oggi, l’intelligenza artificiale sta comprimendo in minuti ciò che richiedeva giorni, e sta aprendo possibilità analitiche che fino a poco tempo fa appartenevano alla fantascienza. Ma sta anche consegnando le stesse capacità a chi ha interesse a fare danno.

Questo è il doppio binario su cui si muove l’AI-OSINT nel 2026: uno strumento di straordinaria utilità difensiva e, al tempo stesso, un moltiplicatore di forza per gli avversari. Capire entrambe le facce non è un esercizio teorico, è una necessità pratica per chiunque lavori nel campo della sicurezza.

Il problema del volume: quando i dati superano la capacità umana

Al cuore dell’OSINT è sempre stata la capacità di usare dati pubblici per risolvere un’indagine, ma oggi il volume ha superato di gran lunga ciò che qualsiasi analista umano può realisticamente gestire. Il web indicizzato, il dark web, i social media, i registri pubblici, le immagini satellitari commerciali, le blockchain, i repository di codice aperti: la superficie informativa disponibile cresce in modo esponenziale, e con essa il rischio che segnali rilevanti si perdano nel rumore.

Secondo un’analisi peer-reviewed condotta da Riccardo Ghioni, Mariarosaria Taddeo e Luciano Floridi dell’Oxford Internet Institute, pubblicata sulla rivista AI & Society nel 2023, l’OSINT costituisce oggi tra l’80 e il 90 per cento di tutte le attività di intelligence condotte dalle forze dell’ordine e dai servizi di sicurezza in Occidente. Questo dato, già significativo, diventa ancora più rilevante se si considera che la mole di dati pubblicamente accessibili continua ad aumentare. L’analista umano, per quanto esperto, incontra un limite fisico invalicabile.

Il mercato globale dell’OSINT riflette questa centralità crescente: secondo Global Market Insights, il settore era valutato 12,7 miliardi di dollari nel 2025 e si prevede raggiunga i 133,6 miliardi entro il 2035, con un tasso di crescita annuo composto del 26,7%. Una traiettoria che segnala un’adozione sistematica, non più sperimentale, in governi, aziende e organizzazioni di sicurezza di tutto il mondo.

Con il calo del costo della potenza di calcolo e la sofisticazione crescente degli algoritmi, quantità sempre maggiori di dati possono essere acquisiti ed elaborati in tempo quasi reale. L’AI non sostituisce il ragionamento dell’analista: abbatte il collo di bottiglia che precede quel ragionamento, liberando risorse cognitive per le fasi a più alto valore aggiunto.

Cosa cambia con i modelli linguistici di grandi dimensioni

L’introduzione dei Large Language Model (LLM) nella toolchain OSINT ha segnato un salto qualitativo rispetto alle generazioni precedenti di automazione. Non si tratta più soltanto di parser e crawler: i modelli linguistici possono leggere, riassumere, tradurre, correlare e suggerire percorsi di indagine su testi non strutturati provenienti da fonti eterogenee.

Lo Stimson Center, nel webinar del 26 marzo 2026 organizzato congiuntamente dallo Strategic Foresight Hub e dall’Energy, Water, and Sustainability Program, ha esaminato come i sistemi guidati dall’AI stiano trasformando la pratica OSINT allargandone le applicazioni attraverso sicurezza, governance e sviluppo sostenibile, analizzando in particolare le pipeline che alimentano modelli di analisi con dati da social media e immagini satellitari, e i sistemi di machine learning che classificano e mappano eventi globali in tempo reale.

Il contributo dei modelli linguistici si articola su più livelli. In fase di raccolta, automatizzano la strutturazione di dati grezzi eterogenei rendendoli immediatamente utilizzabili per analisi successive. In fase di verifica, permettono di confrontare più fonti simultaneamente, incrociare affermazioni e segnalare contraddizioni: un analista che indaga su un profilo sospetto può usare strumenti AI per confrontare nomi utente, biografie e attività in tempo reale, identificando istantaneamente le discrepanze. In fase di esplorazione, suggeriscono nuovi percorsi investigativi quando le piste sembrano esaurite.

La capacità multilingue merita un cenno a parte. L’OSINT operata su scala globale si scontra sistematicamente con la barriera linguistica: la maggior parte dei segnali di interesse non è in inglese. I modelli linguistici attuali trattano questa barriera come una variabile secondaria, non come un ostacolo strutturale. Per approfondire il ruolo dell’AI nella cybersecurity difensiva si rimanda agli approfondimenti della redazione.

Il lato oscuro: i threat actor e l’OSINT potenziata dall’AI

Ogni capacità difensiva ha la sua controparte offensiva. L’AI applicata all’OSINT non fa eccezione, e i dati disponibili nel 2026 disegnano un quadro preoccupante ma anche, almeno per ora, parzialmente rassicurante nelle sue proporzioni effettive.

Per gli attori sostenuti da governi, i modelli linguistici di grandi dimensioni sono diventati strumenti essenziali per la ricerca tecnica, la definizione dei target e la rapida generazione di contenuti di phishing sofisticati. Il report trimestrale di Google GTIG del 12 febbraio 2026 documenta come gruppi legati a Corea del Nord, Iran, Cina e Russia abbiano operazionalizzato l’AI nella seconda metà del 2025, coprendo attività di oltre 57 gruppi APT distinti provenienti da almeno sedici paesi.

Il meccanismo è preciso: i threat actor usano l’AI per accelerare la reconnaissance e trasformare informazioni pubblicamente disponibili in piani di attacco pronti all’uso. Invece di passare manualmente in rassegna siti web, profili social, dati di breach e tracce tecniche, possono usare strumenti AI per sintetizzare grandi volumi di OSINT in note di targeting operative.

Gli LLM possono servire come moltiplicatori strategici durante la fase di reconnaissance, consentendo agli attori malevoli di profilare rapidamente target ad alto valore, identificare i decisori chiave nei settori della difesa e mappare le gerarchie organizzative, passando dalla reconnaissance iniziale al targeting attivo con velocità e scala prima impossibili.

Una precisazione fondamentale è però indispensabile per leggere correttamente questo scenario: GTIG specifica chiaramente che i threat actor stanno sperimentando con l’AI ottenendo guadagni di produttività, ma non stanno ancora sviluppando capacità genuinamente nuove che alterino in modo fondamentale il panorama delle minacce. L’AI agisce come acceleratore della tradecraft esistente, non come generatore di capacità radicalmente diverse.

Il blog Microsoft Security del 6 marzo 2026 ha documentato una dinamica ulteriore: sebbene non ancora osservata su larga scala, la sperimentazione con sistemi di AI agentici segnala un potenziale cambiamento nella tradecraft, dove flussi di lavoro supportati dall’AI assistono sempre più il processo decisionale iterativo e l’esecuzione di compiti, indicando un adattamento più rapido e una maggiore resilienza nelle intrusioni future. In particolare, il gruppo nordcoreano Coral Sleet ha già sviluppato un flusso di lavoro completamente AI-assistito per la creazione di lure, il provisioning di infrastrutture e il testing di payload.

Il termine agentico merita una definizione precisa. A differenza dei modelli linguistici reattivi, i sistemi di AI agentici si basano sugli stessi modelli sottostanti ma sono integrati in flussi di lavoro che perseguono obiettivi nel tempo, pianificando passi, invocando strumenti, valutando risultati e adattando il comportamento senza continui interventi umani.

Ancora più recentemente, al RSAC 2026 di aprile, Microsoft ha presentato dati che mostrano come l’AI stia riducendo le frizioni lungo l’intero ciclo di vita dell’attacco, aiutando i threat actor a fare ricerche più velocemente, scrivere lure migliori, generare o effettuare il debug di malware e triagare i dati rubati. Rimane tuttavia ancora un operatore umano nel ciclo che controlla le campagne, senza AI pienamente autonoma o agentiva che gestisca gli attacchi in modo indipendente.

Il paradosso della disinformazione: l’AI come problema e come soluzione

Esiste una tensione profonda al cuore dell’AI-OSINT che merita di essere nominata esplicitamente. L’AI genera contenuti sintetici in quantità e qualità crescenti, rendendo la verifica dell’informazione sempre più difficile. Al tempo stesso, l’AI è lo strumento principale che abbiamo per operare quella verifica su scala.

Secondo Blackdot Solutions, la disinformazione generata dall’AI e i deepfake rendono più difficile che mai fidarsi di ciò che si vede online. Nel 2026, i professionisti OSINT si trovano ad affrontare un bisogno ancora maggiore di verificare l’autenticità delle informazioni, poiché gli attori malevoli usano strumenti avanzati per manipolare i media e creare identità false convincenti. Sarà cruciale per le organizzazioni assicurarsi che i propri analisti siano addestrati a riconoscere i contenuti generati dall’AI; in caso contrario, rischiano di facilitare involontariamente attività criminali.

La conseguenza pratica è che la catena di verifica dell’OSINT non può più appoggiarsi soltanto sull’analisi semantica del contenuto: deve includere l’analisi della provenienza, della coerenza interna, della contestualizzazione storica e del confronto con fonti primarie di natura diversa. La verifica delle informazioni sulla proprietà effettiva di aziende, per esempio, richiede di confrontare quanto emerge da fonti online con registri societari di fonte ufficiale.

Questo introduce un rischio di concentrazione: chi ha accesso alle fonti migliori e agli strumenti più affidabili costruisce un vantaggio informativo strutturale rispetto a chi ne è privo. La democratizzazione dell’OSINT resa possibile dall’AI porta con sé, paradossalmente, una nuova forma di asimmetria. Il tema si intreccia strettamente con quello della threat intelligence e disinformazione già affrontato sulle pagine di questa rivista.

L’elemento umano: insostituibile, non residuale

Di fronte all’accelerazione tecnologica, si genera spesso una retorica della sostituzione che merita di essere corretta con precisione. Nonostante i progressi tecnologici, il giudizio e l’esperienza umana continueranno a definire i processi OSINT di maggior successo. La migliore difesa contro l’attività criminale guidata dall’AI sarà la combinazione di automazione intelligente e investigatori qualificati, in grado di validare i risultati e garantire gli standard etici.

Il punto non è che gli analisti umani siano superiori ai sistemi AI nei task di elaborazione massiva: non lo sono, e fingere il contrario sarebbe controproducente. Il punto è che l’AI tende a ottimizzare per pattern già noti, mentre l’analista umano è capace di riconoscere l’anomalia che non ha precedenti, di costruire contestualizzazioni che richiedono comprensione culturale profonda, di prendere decisioni in condizioni di ambiguità radicale.

Affidarsi esclusivamente all’AI per la totalità di un’indagine è rischioso a causa delle tendenze alla distorsione e alle allucinazioni. L’esperienza umana rimane cruciale per l’analisi contestualizzata, la verifica e il processo decisionale etico. Bilanciare correttamente l’efficienza dell’AI con l’intuizione umana sarà la chiave del successo nel 2026 e negli anni a venire.

La metafora più utile non è quella della sostituzione ma quella dell’amplificazione: l’AI amplifica le capacità degli analisti preparati e amplifica i limiti di quelli non preparati. Investire nella formazione degli operatori diventa, in questo contesto, una priorità tanto strategica quanto l’investimento negli strumenti.

Verso l’OSINT agentiva: cosa ci aspetta

Il 2026 segna un punto di transizione, non un punto di arrivo. La traiettoria tecnologica indica chiaramente la direzione: sistemi OSINT sempre più autonomi, capaci di monitorare superfici informative in continuo, aggiornare modelli di rischio in tempo reale e produrre intelligence azionabile senza intervento umano nelle fasi di raccolta e prima elaborazione.

Strumenti come Taranis AI navigano attraverso diverse fonti di dati per raccogliere articoli non strutturati, utilizzano il Natural Language Processing e l’AI per migliorare la qualità del contenuto e supportano la condivisione collaborativa di threat intelligence tramite integrazione con MISP. Non si tratta di prototipi di laboratorio, ma di sistemi operativi open source che ridisegnano già oggi il flusso di lavoro degli analisti.

La dimensione etica e di governance non è accessoria a questa trasformazione, ne è parte costitutiva. La convergenza tra AI e OSINT solleva importanti preoccupazioni in termini di governo, implicazioni etiche, legali e sociali, con la necessità di supervisione crescente a fronte di strumenti di analisi sempre più avanzati che richiedono poca o nessuna supervisione continua. Domande come: chi è responsabile delle conclusioni prodotte da un sistema AI-OSINT? Come si gestisce il falso positivo che innesca un’azione operativa? Come si bilancia la capacità di raccolta con il rispetto della privacy degli individui non coinvolti in attività illecite? Queste domande non hanno ancora risposte consolidate, ma richiedono risposte urgenti.

Conclusione: lucidità senza ingenuità

L’AI-OSINT non è una moda tecnologica né una promessa lontana. È una realtà operativa che sta già ridisegnando le pratiche di intelligence, sicurezza e investigazione in tutto il mondo. La sfida per i professionisti della sicurezza non è decidere se adottarla, ma come farlo con lucidità.

Lucidità significa riconoscere le capacità reali senza sovrastimarle: l’AI non elimina l’errore, lo sposta e lo trasforma. Significa comprendere che ogni strumento che rafforza il difensore sta, potenzialmente, rafforzando anche l’offensore: la simmetria dell’accesso è una caratteristica strutturale delle tecnologie generative. Significa anche tenere a mente che, come confermano sia Google GTIG che Microsoft, l’AI agisce oggi come acceleratore della tradecraft esistente e non come generatore di capacità radicalmente nuove: un dato che non va sottovalutato, ma nemmeno usato per abbassare la guardia.

Chi si occupa di sicurezza sa già che il vantaggio non si costruisce su un singolo strumento, ma sulla capacità di integrare strumenti, metodi e giudizio critico in un sistema coerente. L’AI è uno strumento potente. Usarlo bene è, ancora, una questione umana.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ai-osint/


Forum ICT Security 2026: torna a Roma il 18 e 19 novembre la 24ª Edizione dell’evento di riferimento sulla cybersecurity

ICT Security Magazine annuncia l’apertura dei lavori per la 24ª Edizione del Forum ICT Security, in programma il 18 e 19 novembre 2026 presso l’Auditorium della Tecnica di Roma.

Giunto al suo ventiquattresimo anno, il Forum ICT Security si conferma come il principale appuntamento B2B italiano dedicato alla cybersecurity: due giornate di confronto strategico, approfondimento tecnico e networking qualificato, in cui istituzioni, mondo accademico, aziende utenti e vendor del settore si incontrano per costruire insieme una visione condivisa della sicurezza digitale.

Una community in crescita

Il Forum riunisce ogni anno un pubblico altamente profilato: C-level (CISO, CSO, CIO), security e IT manager, responsabili OT, risk manager e business continuity manager, oltre a rappresentanti di Pubbliche Amministrazioni centrali e locali, ministeri, agenzie governative, settore bancario e finanziario, sanità, energia, trasporti, telecomunicazioni e utilities. Presenti anche università e centri di ricerca, per un ecosistema unico in cui pubblico e privato, strategia e tecnologia, normativa e innovazione dialogano in modo strutturato.

I temi dell’edizione 2026

Il programma, in fase di definizione, affronterà le sfide che stanno ridefinendo il panorama della sicurezza informatica.

Quadro normativo europeo. Piena attuazione di NIS2 e DORA, applicazione dell’AI Act e del Cyber Resilience Act, evoluzione del quadro compliance per le organizzazioni italiane.

Resilienza e continuità operativa. Cyber resilience e business continuity nelle organizzazioni complesse, disaster recovery e gestione della crisi cyber.

Tecnologie emergenti. Sicurezza dell’AI agentica e dei sistemi autonomi, post-quantum cryptography, sfide e opportunità dell’innovazione tecnologica per la difesa digitale.

Infrastrutture critiche e ambienti industriali. Protezione degli ambienti OT/ICS, Operational Technology e sicurezza industriale, difesa dei settori strategici del Paese.

Supply chain e gestione del rischio. Supply chain security, third-party risk management, governance, risk e compliance (GRC) nell’era delle dipendenze digitali.

Architetture e sicurezza applicativa. Gestione delle identità e modelli Zero Trust, cloud e multi-cloud security, sicurezza applicativa e DevSecOps.

Minacce, intelligence e investigazione digitale. Threat intelligence e cooperazione internazionale nel contrasto alle minacce nation-state, digital forensics e incident response.

Fattore umano e cultura della sicurezza. Componente umana negli incidenti, programmi di security awareness e formazione, costruzione di una cultura della sicurezza nelle organizzazioni.

Dati, privacy e settori verticali. Data protection e privacy nell’era dell’AI, sicurezza dei sistemi di pagamento e protezione del settore finance.

Ampio spazio sarà dedicato, come di consueto, alle Tavole Rotonde istituzionali, alle sessioni verticali per settore e ai casi d’uso reali presentati direttamente dalle organizzazioni utenti.

Expo Area, live demo, incontri 1to1 e momenti di networking

L’Expo Area ospiterà le aziende leader del settore, con live demo, hands-on zone e spazi di confronto diretto sulle soluzioni più innovative. Sarà inoltre possibile prenotare incontri 1to1 per approfondire in modo riservato esigenze specifiche, casi d’uso e progettualità in corso. Non mancheranno momenti dedicati al networking, tra coffee break e business lunch.

Call for papers e opportunità di sponsorship

Aperte la call for papers per i relatori interessati a proporre un intervento e le opportunità di sponsorship per le aziende che desiderano presentare le proprie soluzioni a una community qualificata di oltre 60.000 lettori della testata e a un pubblico on site di altissimo profilo.

Informazioni

📅 18 -19 novembre 2026
📍 Auditorium della Tecnica, Viale Umberto Tupini 65, Roma
🌐 ictsecuritymagazine.com
📧 redazione@ictsecuritymagazine.com

La partecipazione sarà gratuita previa registrazione. Il programma completo, l’apertura delle iscrizioni e i dettagli per sponsor e relatori saranno comunicati nelle prossime settimane.
Vi aspettiamo a Roma.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/forum-ict-security/


Cyber Crime Conference 2026: il resoconto della 14ª edizione

La 14ª Cyber Crime Conference, svoltasi il 6 e 7 maggio 2026 nella prestigiosa cornice dell’Auditorium della Tecnica a Roma, si conferma come appuntamento di riferimento per istituzioni, aziende, professionisti ed esperti impegnati nel contrasto alla criminalità informatica.

L’evento B2B ha offerto due giornate di analisi e approfondimento sullo stato attuale del cybercrime globale, con la presentazione di soluzioni e strategie per contrastarlo efficacemente sul piano di governance, tecnico e normativo.

Glen Prichard Cyber Crime Conference 2026 - evento di cybercrime evento di cybersecurity
Glen Prichard, Chief of Cybercrime and Money Laundering Section, United Nations Office on Drugs and Crime (UNODC)

Alternandosi sul palco, rappresentanti delle istituzioni nazionali ed internazionali, del mondo accademico e dell’industria hanno animato i lavori con riflessioni stimolanti e mai scontate sui temi più attuali del settore.

Aisling Kelly Cyber Crime Conference 2026 - evento cybercrime e cybersecurity
Aisling Kelly, Head of the Cybercrime Division, Council of Europe

La prima giornata si è aperta sulla dimensione globale del fenomeno: dalla firma e implementazione della Convenzione delle Nazioni Unite contro il cybercrime illustrata dall’UNODC, alle sfide della cooperazione internazionale per l’acquisizione delle prove elettroniche affrontate dal Consiglio d’Europa, passando per le operazioni Power-Off e Lightning condotte da Europol-EC3 contro gli asset criminali, fino al punto di vista delle forze di polizia italiane – con la Polizia Postale per la Sicurezza Cibernetica – e tedesche, rappresentate dal Bundeskriminalamt.

Ivano Gabrielli Cyber Crime Conference 2026 - evento di cybercrime evento di cybersecurity
Ivano Gabrielli, Direttore del Servizio Polizia Postale per la Sicurezza Cibernetica

Il pomeriggio è stato dedicato al cambio di paradigma rappresentato dall’AI agentica, con interventi su Agentic AI e nuove frontiere del cybercrime, anti-forensics e prova digitale, fino agli scenari di Cyber Warfare autonoma. A chiusura, la Tavola Rotonda “Geopolitica e Cybercrime: quando il codice diventa strumento di potere tra Stati“, che ha visto confrontarsi DIS, Bundeskriminalamt, accademia e consulenti internazionali sotto la moderazione di Cyber 4.0.

Cyber Crime Conference 2026 - evento cybercrime e cybersecurity: Gen. C.A. Leandro Cuzzocrea - Vice Direttore Generale del Dipartimento delle Informazioni per la Sicurezza (DIS) Zahid Jamil - Barrister-at-Law, Advocate Supreme Court; former Legal Consultant FBI; Consultant Council of Europe Raffaele Marchetti - Professore Ordinario Relazioni Internazionali e Direttore Center for International and Strategic Studies-CISS, Università Luiss Luigi Martino - Professore @UniversitàdiBologna; Senior Research Scientist @KhalifaUniversity; CEO @DamoTech Carsten Meywirth - Director of the Cybercrime Division at Bundeskriminalamt Moderata da: Paolo Spagnoletti - Presidente di Cyber 4.0 e Professore Ordinario Luiss

Nel corso della giornata si sono susseguiti contributi tecnici di alto profilo: software supply chain compromessa da attori nation-state, Volt Typhoon e ambienti OT, abuso di file MSC da parte degli APT, OSINT potenziato dall’AI, campagne phishing contro lo Stato, minacce hardware e vulnerabilità nei sistemi di sicurezza aerea (TCAS). A chiusura, due interventi dedicati ai limiti tecnico-giuridici dell’indagine digitale: il caso Graphite tra tecnica, diritto ed etica, e la fine della copia integrale e del sequestro “a strascico” tra barriere crittografiche, garanzie costituzionali e giurisprudenza.

Gen. Brig. CC Giuseppe De Magistris Cyber Crime Conference 2026 - evento di cybercrime evento di cybersecurity
Gen. Brig. CC Giuseppe De Magistris, Direttore Coadiutore presso l’Istituto Alti Studi Difesa (IASD) del Centro Alti Studi Difesa (CASD) di Roma

La seconda giornata ha aperto sulla cornice strategica europea e nazionale, con i contributi dello European Security and Defence College (ESDC), del CASD-IASD e del Servizio per la Sicurezza Cibernetica del Ministero dell’Interno sugli attacchi alle infrastrutture critiche italiane.

Gianpaolo Zambonini Cyber Crime Conference 2026 - evento di cybercrime evento di cybersecurity
Gianpaolo Zambonini, Dirigente Superiore Ingegnere della Polizia di Stato con incarico di Direttore del Servizio per la Sicurezza Cibernetica del Ministero dell’Interno

Centrale la Tavola Rotonda “L‘attribuzione impossibile: identificare il nemico nell’era dell’AI e dei Proxy“, che ha riunito ROS dei Carabinieri, accademia italiana ed europea e ricercatori indipendenti di cyber in telligence, in un confronto rigorosamente transnazionale.

Cyber Crime Conference 2026 - evento cybercrime e cybersecurity: Gabriella Biró - Assistant lecturer at the Ludovika University of Public Service Ten. Col. Antonio Bisogno - Comandante del Reparto Indagini Tecniche, Raggruppamento Operativo Speciale (ROS), Arma dei Carabinieri Emanuele De Lucia - Cyber Security & Cyber Intelligence Researcher Roberto Flor - Professore ordinario di Diritto penale, Dipartimento di Scienze Giuridiche, Università di Verona Ranieri Razzante - Professore di "Cybercrime & Homeland Security" Università di Perugia Moderata da: Mattia Siciliano - Presidente Commissione Studi Cyber Threat Intelligence e Cyber Warfare, SOCINT

Come di consueto, foto, registrazioni e contenuti delle presentazioni saranno presto disponibili per tutti gli iscritti. Quest’anno, inoltre, è stata sviluppata per la prima volta una web app dalla quale è possibile -senza necessità di installazione – scaricare i materiali dell’evento e il proprio attestato di partecipazione, lasciare un feedback sull’esperienza complessiva e assegnare un punteggio ai singoli interventi.

Un sentito ringraziamento a Cyber 4.0 e SOCINT per la collaborazione, ai relatori e alle relatrici, alle aziende sponsor e a tutti gli ospiti che hanno animato queste due intense giornate di lavori. Vi diamo appuntamento il 18 e 19 novembre 2026 per la 24ª Edizione del Forum ICT Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/cyber-crime-conference-2026-il-resoconto-della-14a-edizione/


Chaos erupts as cyberattack disrupts learning platform Canvas amid finals

Chaos erupted at schools and colleges throughout the US on Thursday as a cyberattack disrupted online learning platform Canvas just as students were due to take final exams.

Canvas parent company Instructure said that as of Friday morning, the platform was back online. Instructure said it temporarily took Canvas offline on Thursday after identifying unauthorized activity in its network. The threat actor was the same one responsible for a data breach that Instructure disclosed a week ago. Data accessed included user names, email addresses, student ID numbers, and messages exchanged on the platform. The company said it has no indication that passwords, dates of birth, government identifiers, or financial information were involved.

Schools and colleges scramble

A ransomware group known as ShinyHunters claimed responsibility for the breach on its dark web site. It claimed the data it took came from 275 million people associated with 8,800 schools.

As students were trying to prepare for and take final exams Thursday, Canvas login pages displayed a ransom demand. It said Instructure had rebuffed the group’s earlier demands and encouraged individual schools to negotiate directly with them. The note and the outage sent schools and colleges scrambling. The University of Illinois reportedly postponed all final exams and assignments scheduled for Friday, Saturday, and Sunday. The University of Massachusetts Dartmouth rescheduled or extended due dates for exams. The University of California system directed all its campuses to linkword.

Canvas isn’t the only learning platform to be struck by a cyberattack. Last year, PowerSchool, a firm that provides cloud-based software to 60 million students from 16,000 K–12 schools worldwide, disclosed a breach that exposed years’ worth of sensitive data, including names, addresses, and disciplinary records.

ShinyHunters has operated for years as a loose collective. In 2024, it made off with a trove of credentials and other data from cloud storage provider Snowflake and used it in follow-on breaches of Snowflake customers, including TicketMaster.

https://arstechnica.com/security/2026/05/chaos-erupts-as-cyberattack-disrupts-learning-platform-canvas-amid-finals/


AI Will Tell Your Breach Story for the Next Two Years — Day One Decides What It Says

Megaphone

Igor Omilaev via Unsplash

The breach hits at 6:14 a.m. By 9 a.m. you’ve got a holding statement out. By noon, the trades are running it. By the end of the week, the news cycle has moved on.

But the conversation hasn’t. It just moved somewhere you’re not watching. When a customer, investor, journalist, board member, or regulator’s staffer wants to understand what happened to your company, they are not opening a browser and combing through ten blue links. They are asking ChatGPT, Gemini, Claude, or Perplexity. And the answer they get, confident, conversational, authoritative, is built from whatever sources those engines indexed during the worst 72 hours of your incident. They will keep telling that version of your story for the next 18 to 24 months.

That is the new front line of cybersecurity communications, and most security and comms teams are not on it.

The post-breach AI narrative is sticky in ways the press cycle never was. A bad headline used to fade. A bad answer in an AI engine doesn’t. It gets repeated, paraphrased, summarized, and embedded into every downstream tool, sales intelligence platforms, vendor-risk questionnaires, due-diligence reports, even procurement chatbots that increasingly screen vendors before a human ever reads a proposal. Your breach story is now infrastructure.

Worse: the models tend to anchor on early reporting, which is almost always the worst, most speculative version of what happened. Initial estimates of records exposed, usually inflated. Unverified attribution. The threat actor’s ransom note read straight off the dark-web leak site as if it were fact. Days later, when you have actual forensics and a clean post-incident report, the public correction may never make it into the model’s next training pass, or it lands as a footnote against a paragraph of day-one panic.

Picture the flow: a Fortune 500 procurement officer pastes your company name into an internal AI tool to vet you for a renewal. The tool answers based on what it learned from a trade publication’s first-day write-up of your incident, the version that quoted “potentially millions of records” before forensics confirmed it was actually under fifty thousand. The renewal stalls. You will likely never know it stalled, or why. Multiply that by every vendor-risk team using AI to triage. That is the actual cost.

This is no longer a search-engine problem. It is a security and reputation problem, and it requires a coordinated response between the CISO and the chief communications officer. Three actions every leadership team should put on the table this quarter:

  1. Inventory your AI shelf — before you need it. Ask the major AI engines what they currently say about your company’s security posture, your last incident if you’ve had one, and your leadership. Treat that output the way you’d treat a vendor risk report. Document the gaps. If the answer is wrong, outdated, or speculative, you have a baseline problem you need to fix on a calm day, not a crisis day.
  2. Rebuild your owned-source authority. AI answer engines disproportionately weight authoritative, structured content from a company’s own domain — security trust pages, transparency reports, post-incident updates, executive bylines, and well-structured FAQs. If your owned properties are thin, the models will fill the gap with someone else’s reporting on you. The fix is not a press release. It is durable, primary-source content that gives the engines something better to cite than the day-one wire story.
  3. Add an AI-surface workstream to your incident response plan. Your IR runbook almost certainly covers regulators, customers, employees, media, and law enforcement. It probably does not cover monitoring how the major AI engines describe the incident in real time, identifying which sources are feeding them, and shipping corrective content within 48 hours to compete with the early narrative. Add it. Assign it. Drill it. The team that owns it is a joint CISO-CCO function — not a marketing project, not a security project, both.

There is a final piece that gets less attention than it should: the regulators are using these tools too. Staffers at the FTC, SEC, state AGs, and sector regulators increasingly use AI engines for early background on companies in their queue. The version of your breach those engines surface may shape how a regulator opens a file before any formal inquiry begins. The cost of letting an inaccurate first-week narrative calcify is no longer just commercial. It is legal exposure measured in years.

The hard truth for 2026: the breach statement on your website matters less than what an AI engine says when an enterprise buyer, a regulator, or a reporter asks, “Is this company safe to work with?” That answer is being formed right now, every day, whether or not anyone on your team is shaping it.

Cybersecurity has spent a decade learning that defense isn’t only technical — that culture, behavior, and communication are part of the perimeter. The next decade’s lesson is already arriving: the perimeter now includes the machines that explain you to the world.

The companies that win the AI-era reputation fight will be the ones whose CISOs and CCOs share a line item, a runbook, and a dashboard. The ones that don’t will keep wondering why the truth they put out at 9 a.m. never seemed to stick.

https://www.securitymagazine.com/blogs/14-security-blog/post/102295-ai-will-tell-your-breach-story-for-the-next-two-years-day-one-decides-what-it-says