Consapevolezza e responsabilità nell’uso dei sistemi di Gen AI in ambiente forense – la guida CCBE per contrastare i principali rischi

La Gen AI sta ridisegnando i confini della professione legale, ponendo l’Avvocatura europea di fronte a una scelta ineludibile: governare il cambiamento o subirne le conseguenze. In questo scenario, la Guida del CCBE sull’uso dell’intelligenza artificiale generativa da parte degli avvocati rappresenta la bussola con cui orientarsi tra obblighi normativi, principi deontologici e nuove opportunità operative.

Con l’entrata in vigore nell’ottobre 2025 della Legge n.132/2025 [1], per i professionisti, inclusi gli avvocati, si è sancito un nuovo esplicito onere informativo nei confronti dei clienti riguardo all’eventuale utilizzo di sistemi di IA nelle loro prestazioni[2].

Non di meno, a livello di regolamentazione UE a partire dal 2 febbraio 2025, l’IA Act – (Regolamento UE n. 2024/1689[3]) ha richiesto che tutte le Organizzazioni garantiscano che il proprio personale possieda conoscenze adeguate sull’IA, indipendentemente dal fatto che esse partecipino alla catena del valore dell’IA come fornitori o utenti (c.d. deployers).

In attuazione di ciò, in ambiente forense e per l’Italia, il CNF (Consiglio Nazionale Forense) – organismo istituzionale di vertice dell’Avvocatura italiana[4] – si è reso protagonista di una serie di iniziative importanti, finalizzate a garantire un uso consapevole e responsabile dei sistemi di IA in ambiente professionale forense.

In particolare, il CNF:

  • ha elaborato un apposito schema di informativa che gli Avvocati possono adottare in adempimento all’obbligo di trasparenza nei confronti del Cliente;
  • ha avviato una consultazione preliminare di mercato ex 77 D.Lgs. 36/2023[5] per l’acquisizione di servizi di IA destinati al supporto dell’attività professionale legale;
  • ha recepito e diffuso la Guida del CCBE Conseil des Barreaux Européens (Consiglio degli Ordini Forensi d’Europa) sull’uso etico e trasparente dell’Intelligenza artificiale generativa da parte degli avvocati.

In questa sede, si ripropongono in chiave sintetica i principali passaggi di tale Guida secondo le interpretazioni del CNF, a valere quale fonte di natura autoregolamentare per l’utilizzo dei sistemi di IA, che ha come finalità dichiarata quella di “aumentare la consapevolezza su cosa sia in particolare la GenAI, illustrarne gli usi attuali nella pratica e mettere in evidenza opportunità e rischi potenzialmente connessi al suo impiego in ambiente professionale forense”[6].

La Guida può essere un utile supporto per Avvocati, Ordini e Associazioni forensi, Studi Legali e Organizzazioni professionali, per promuovere un uso responsabile dei sistemi di IA e GenAI.

Introduzione alla Guida CCBE – rimandi a fonti integrative

Il CCBE rappresenta oltre 1 milione di Avvocati europei attraverso i rispettivi Ordini nazionali di 45 Paesi; nell’ottobre 2025, ha emanato il documento “CCBE guide on the use of generative AI by Lawyers”.

Una Linea Guida (di seguito anche solo Guida) è volta ad illustrare all’avvocatura europea i concetti fondamentali in materia di IA e le sue evoluzioni, con enunciazione dei principali obblighi che si impongono in caso di ricorso a strumenti di IA e di GenAI nell’esercizio dell’attività forense.

Di seguito lo Schema della Guida CCBE:

CCBE Guide on the use of generative AI by Lawyers

SCHEMA DELL’ ARTICOLATO

Art.1 Introduction
Art.2 AI – The basics

2.1. Key Characteristics of generative AI

2.2. How is generative AI legally defined?

2.3. Regulatory approces to GenAI

Art. 3 Generativa AI in legal practice – take up, benefits and risks

3.1. Take up of GenAI tools by lawyera

3.2. Benefits of generativa AI in legal practice

3.3. Risks of using generati AI

3.3.1. Privacy and data protection

3.3.2. Hallucinations

3.3.3. Bias and sycophancy

3.3.4. Lack of transparency

3.3.5. Intellectual property and related rights

3.3.6. Cybersecurity

3.3.7. Fraud

Art. 4 The use of genrative AI in legal practice and lawyers’ professional obligatione

4.1. Confidentiality

4.2. Professional Competence

4.3. Independence

4.4. Transparency and information to the client

4.5. Conflict of interest

Art. 5 Considerations for the future
Art. 6 Conclusion
Annex 1 -Resources on the use of generative AI by lawyers and/or judical professionals

Il rilievo del documento, non è solo nel suo contenuto testuale, ma anche nel richiamo a numerose fonti che – a livello nazionale, europeo ed internazionale ne integrano le previsioni e che costituiscono riferimento imprescindibile per un utilizzo corretto e consapevole dell’IA in ambiente forense[7].

Per l’Italia, spicca il rimando alla Carta dei principi per un uso consapevole di strumenti di intelligenza artificiale in ambiente forense – HOROS a cura del Consiglio dell’Ordine degli Avvocati (COA) di Milano (Dicembre 2024)[8].

Frutto del lavoro della Commissione Informatica del Consiglio, la Carta dei principi HOROS di Milano:

  • è il primo disciplinare legale italiano che orienta nell’uso consapevole e sicuro delle nuove tecnologie, in chiave integrata con il diritto;
  • persegue l’obiettivo di sviluppare un efficace modello di intervento in ambito forense, in conformità alle Linee Guida “Avvocati Europei nell’era di Chatgpt” – Fédération des Barreaux d’Europe di Giugno 2024 ed in allineamento al Regolamento UE sull’IA.
“HOROS”- La Carta dei principi del COA di Milano (brevi cenni)
La Carta dei principi per un uso consapevole di strumenti di intelligenza artificiale in ambiente forense– HOROS del COA di Milano risponde ora alle nuove esigenze di innovazione, ora alla necessità di garantire che la rivoluzione tecnologica rappresentata dall’IA (certamente foriera di grandi potenzialità, ma non di meno fonte di rischi concreti) non intacchi i fondamenti etici e deontologici della professione.

Alla base della Carta sono in primis i principi generali di legalità, correttezza, trasparenza e responsabilità. Ciò in quanto (rif. parte introduttiva della Carta): “le tecnologie impiegate devono essere conformi alle normative europee e nazionali vigenti e l’uso dell’IA deve sempre essere finalizzato al miglioramento della qualità del servizio legale, senza compromettere i diritti e la fiducia dei clienti. Ogni adozione di IA deve essere attentamente per garantire che gli strumenti scelti siano adatti e proporzionati agli scopi specifici per cui ne è stato ipotizzato l’utilizzo”.

Segue la declinazione dei seguenti principi specifici:

Ø Dovere di competenza: l’uso consapevole dell’IA richiede che il professionista mantenga e sviluppi con continuità competenze tecnologiche; comprendendone funzionalità, limiti e rischiosità, evitando la dipendenza da risultati automatizzati;

Ø Trasparenza dell’uso dell’IA: è fatto obbligo di informare il cliente dell’uso dell’IA, del possibile impatto sul servizio fornito, descrivendo metodi e tecnologie utilizzate; con informativa anche sulla possibilità di valutare validità ed affidabilità dei risultati;

Ø Centralità della decisione umana: il professionista ha il compito di intervenire attivamente per valutare criticamente i risultati prodotti dall’IA, assicurando sia l’adeguatezza delle tecnologie IA adottate, sia che il loro processo di elaborazione non risulti negativamente condizionato dagli algoritmi (ciò significa applicare un “esame umano” al risultato IA per garantirne adeguatezza, accuratezza, conformità a principi etici e legali e per prevenire errori, pregiudizi, bias o decisioni ingiuste forieri di possibili ricadute significative sulla vita delle presone coinvolte);

Ø Protezione dei dati e riservatezza: l’uso dell’IA deve avvenire nel pieno rispetto dei principi fondamentali di protezione dei dati personali di cui al GDPR, in allineamento agli approcci di “privacy by design” e “privacy by default” e con previsione di Data Protection Impact Assessment (DPIA) ove prevista dalla normativa applicabile;

Ø Sicurezza informatica: l’adozione di strumenti IA richiede un’attenzione particolare alla sicurezza informatica per garantire che i dati trattati siano protetti e che i sistemi utilizzati siano sicuri ed affidabili;

Ø Valutazione del rischio dell’utilizzo di sistemi di IA: il professionista è tenuto a: i) una valutazione su base continua dei rischi legati all’uso IA nel proprio ambito di attività; ii) adozione di azioni correttive (AC) in presenza di rischi significativi, così da mitigarli tempestivamente; iii) documentare le misure adottate; iv) verificare periodicamente l’efficacia delle AC intraprese per garantirne uso responsabile e conforme alla normativa vigente; v) informare in modo adeguato e trasparente Cliente e Stakeholder;

Ø Diversità e sostenibilità ambientale: l’uso dell’IA deve avvenire nel rispetto dei principi di diversità, sostenibilità ambientale e non discriminazione; promuovendone un approccio responsabile;

Ø Formazione continua e Re-skilling: il professionista è tenuto a partecipare a corsi di aggiornamento delle proprie competenze in materia di nuove tecnologie, protezione e dati e sicurezza informatica, nonché sui relativi rischi ed implicazioni legali;

Ø Tutela del diritto d’autore: è fatto obbligo di garantire la conformità alla normativa a tutela di copyright, PI e diritti d’autore nell’uso di IA generativa di opere, contenuti, immagini.

Al documento del COA Milano, hanno fatto seguito altri provvedimenti Ordinistici nazionali.

Meritano una menzione:

  • il “Breve Vademecum per Avvocati sull’utilizzo dell’intelligenza artificiale” emanato nel Dicembre 2024 dalla Commissione Procedura Civile del COA di Roma, che integra il quadro normativo vigente in materia di IA con indicazioni pratiche per l’uso dei sistemi in ambiente forense;
  • il “Promemoria sulle principali norme deontologiche da rispettare nell’uso dell’IA” del 29 Ottobre 2025, a cura del COA di Genova che specifica i principali obblighi e doveri di deontologia applicabili e da osservarsi, per un corretto utilizzo di IA in ambiente professionale.[9]

IA e GenAI nel quadro regolamentare di rango normativo applicabile

Come chiarisce la Guida CCBE, caratteristica principale che distingue i sistemi di intelligenza artificiale generativa (Generativa AI, o GenAI) dagli altri sistemi di IA è la capacità di produrre nuovi contenuti, sotto forma di testo, immagini, audio o video.

Come tutti i sistemi di IA, anche i modelli di GenAI sono basati su macchine, operano con gradi variabili di autonomia e deducono dagli input ricevuti come generare l’output; tuttavia la GenAI presenta proprie peculiarità, ossia:

  • per la maggior parte dei modelli, utilizza tecniche di deep learning (apprendimento profondo), in particolare reti neurali per elaborare e produrre dati;
  • funziona analizzando i dati di input nel loro contesto e riconoscendo schemi ricorrenti, in modo da generare nuovi output coerenti con il tono, lo stile e l’argomento desiderati;
  • sa adattarsi a diversi stili espressivi (ad es. quelli artistici, narrativi o musicali);
  • si basa su principi probabilistici, fondati sulla matematica della probabilità e della statistica;
  • evolve costantemente attraverso processi iterativi di addestramento su dataset di grandi dimensioni e diversificati (all’aumentare e al variare dei dati a cui sono esposti, la loro capacità di generare contenuti si modifica di conseguenza).

Nella legislazione UE (in particolare nella nell’IA Act) non si rinviene una specifica definizione di GenAI; essa è considerata, ora come una sottocategoria dei “sistemi di IA”, ora come un “sistema di IA ad uso generale”/ “modello di IA per finalità generali” (i.e. general -pourpose AI system, rif. art.3, Regolamento n. 1689/2024/UE).

Sistema di IA (definizione OCSE ripresa all’art.3 IA Act) E’ un sistema automatizzato progettato per funzionare con livelli di autonomia variabili e che può presentare adattabilità dopo la diffusione e che, per obiettivi espliciti o impliciti, deduce dall’input che riceve come generare output quali previsioni, contenuti, raccomandazioni o decisioni che possono influenzare ambienti fisici o virtuali.
Modello di IA per finalità generali (art.3 IA Act) E’ un sistema di IA basato su un modello di IA per finalità generali e che ha la capacità di perseguire varie finalità, sia per uso diretto che per integrazione in altri sistemi di IA.

Dal punto di vista regolamentare, esistono leggi che disciplinano direttamente specifici aspetti dell’IA, e vi sono molte altre normative che si applicano indirettamente ai sistemi di IA (ad es. quelle in materia di privacy e protezione dei dati, istruzione, occupazione e ricerca medica).

Quadro normativo nazionale ed europeo sull’uso della Gen AI

La normativa più conosciuta nel contesto sovranazionale è la già citata Legge sull’IA dell’Unione Europea, adottata nel 2024 ed entrata in vigore nell’Agosto dello stesso anno; che istituisce un quadro normativo basato sul rischio, applicabile a tutti i fornitori e utilizzatori di sistemi di IA nel mercato dell’Unione, indipendentemente dalla loro provenienza.

L’ IA Act classifica i relativi sistemi in 4 categorie, ognuna soggetta a differenti livelli di obblighi e regolamentazione; prevede inoltre regole specifiche per i sistemi GPAI (Generale Purpose AI – AI per finalità generali) sottoponendoli a obblighi di trasparenza e documentali più severi per i modelli con capacità elevate.

Categorie di rischio associate ai sistemi di IA – IA Act
1 ALTO RISCHIO Sistemi soggetti a numerosi requisiti (i.e. valutazioni di conformità, trasparenza, supervisione umana, qualità dei dati, registrazione in un database dell’UE); vi rientra anche l’uso di IA nel sistema giudiziario.
2 RISCHIO LIMITATO Obblighi di trasparenza (ad es. informare gli utenti quando interagiscono con un sistema di IA o quando i contenuti sono generati artificialmente, come nei deepfake).
3 RISCHIO MINIMO Riguarda la maggior parte dei sistemi di IA che non sono soggetti a requisiti aggiuntivi oltre a quelli di normativa generale UE.
4 RISCHIO
INACCETTABILE
Afferisce a tutte le pratiche vietate (es. social scoring, manipolazione comportamentale, identificazione biometrica non autorizzata in luoghi pubblici).

Negli Stati Uniti, l’approccio è ibrido; combina ordini esecutivi federali, regolamenti settoriali e leggi statali (in particolare in Colorado e California).

A livello internazionale, la Convenzione quadro del Consiglio d’Europa sull’intelligenza artificiale, i diritti umani, la democrazia e lo Stato di diritto[10] – formalmente adottata il 17 Maggio 2024 dal Comitato dei Ministri del Consiglio d’Europa – costituisce il primo trattato internazionale giuridicamente vincolante in materia di IA.

La Convenzione:

  • mira a garantire che le attività di IA siano conformi ai diritti umani, ai principi democratici e allo Stato di diritto, includendo temi come: dignità e autonomia umana, uguaglianza e non discriminazione; privacy e protezione dei dati, trasparenza e supervisione, responsabilità, sicurezza e innovazione affidabile;
  • è finalizzata a garantire che ogni fase del ciclo di vita dei sistemi di IA (progettazione, addestramento e utilizzo) rispetti i principi e valori di cui sopra;
  • impone obblighi proporzionati ai potenziali rischi dell’IA per i diritti umani;
  • si applica alle attività IA svolte dalle Autorità pubbliche o da soggetti privati che agiscono per loro conto (per il settore privato gli Stati aderenti alla Convenzione possono scegliere se applicare direttamente gli obblighi o adottare misure alternative equivalenti).

Rilevano poi a livello UE e come fonti riferite specificatamente al contesto giudiziario:

  • la Carta etica europea sull’uso dell’intelligenza artificiale nei sistemi giudiziari e nel loro contesto adottata dalla Commissione UE per l’efficienza della giustizia (CEPEJ), Consiglio d’Europa 2018,
  • varie Linee guida per Professionisti della giustizia e per Avvocati (di cui in parte si è già detto nei paragrafi che precedono).

In ogni caso, la CCBE nella sua Guida chiarisce che “l’uso dell’IA (inclusa la GenAI) da parte degli Avvocati resta soggetto agli obblighi professionali vigenti nelle rispettive giurisdizioni, oltre che alle leggi generali applicabili”.

Declinazioni applicative dell’IA in ambiente forense – benefici e rischi

Tra i principali benefici riconosciuti ai sistemi di IA diffusi in ambiente forense, la Guida CCBE indica quelli di:

  • maggiore efficienza operativa (ad es. creazione automatizzata di documenti, analisi rapida di grandi volumi di materiali per una comunicazione più snella al cliente);
  • miglioramento e potenziamento della ricerca legale (ad es. reperibilità più rapida e accurata di giurisprudenza pertinente, analisi di banche dati o individuazione di tendenze giuridiche);
  • migliore qualità del lavoro (ad es. riduzione di errori, verifica della conformità e standardizzazione dei processi);

con conseguenti ricadute positive anche in termini di:

  • risparmi di costi e tempi di produzione;
  • ottimizzazione delle risorse;
  • riduzione dei tempi di trattazione di casi giudiziari;
  • possibilità di concentrarsi su attività qualitative piuttosto che ripetitive.

Anche nella relazione con il Cliente, il ricorso ai sistemi di IA presenta potenziali vantaggi per l’Avvocato, consentendo tempi di risposta più rapidi, stime di costo più accurate, migliore supporto operativo e di affiancamento, facilitazioni nell’accesso alla giustizia da parte di soggetti attualmente sottoserviti.

Poiché poi anche i fornitori di sistemi di IA hanno incrementato in modo significativo la produzione di nuovi modelli pensati specificatamente per le peculiarità di uno Studio legale, le soluzioni di IA vengono oggi commercializzate in modo diffuso e come strumenti specializzati per i Professionisti del diritto, con l’obiettivo di consentire pratiche di lavoro più rapide ed efficienti (rif. a strumenti di ricerca e redazione addestrati su dati giuridici o collegati a banche dati legali).

Tuttavia, la Guida CCBE non si limita ai benefici ed ai trend di mercato, ma individua anche e soprattutto i principali rischi che l’utilizzo dell’IA prospetta al legale, per rapporto agli obblighi che gli si impongono per normativa anche di stampo ordinistico e di deontologia applicabile.

Di seguito, la sintesi dei principali rischi collegati all’uso dei sistemi di IA nell’operatività legale:

ALLUCINAZIONI L’IA può generare risposte fattualmente inesatte o illogiche (imputabili a possibili cause e fattori quali: limitazioni nei dati di addestramento, natura probabilistica dei modelli di IA, incomprensioni di contesto, eccessiva generalizzazione, generazione di dati di sintesi).

Con il rischio – nel contesto dei servizi legali – di giurisprudenza completamente fittizia, cause o decisioni giudiziarie inesistenti, attribuzione erronea di citazioni a giudici o studiosi del diritto, oppure di argomentazioni giuridiche apparentemente plausibili ma interamente inventate. Sussistono anche: il rischio di interpretazioni giuridiche fittizie, di principi giuridici inventati, di rappresentazioni scorrette dello stato del diritto vigente in specifiche giurisdizioni, o ancora di falsi collegamenti o correlazioni tra concetti giuridici.

BIAS E ADULAZIONE (SYCOPHANCY – COMPIACENZA) Bias e compiacenza nella GenAI: il concetto si riferisce a errori sistematici o rappresentazioni distorte che emergono dai dati di addestramento, dal design/dalla progettazione del modello o dai processi algoritmici seguiti dai sistemi di IA (imputabili al fatto che i modelli di IA vengono addestrati su enormi insiemi di dati che riflettono modelli di comunicazione umana, nei quali l’accordo e il rinforzo positivo sono presenti, così che l’IA può dare priorità alla generazione di risposte concilianti o gradire all’utente, piuttosto che a informazioni accurate, critiche o bilanciate); i bias possono riprodurre o amplificare pregiudizi sociali esistenti, generando risultati ingiusti o inaccurati, o ancora produrre output fuorvianti o distorti.

Adulazione nella GenAI: indica la tendenza dei sistemi di IA (in particolare dei Modelli Linguistici di Grandi Dimensioni – LLM), a generare risposte che si allineano a preferenze o a bias percepiti dell’utente; concordando eccessivamente o fornendo riscontri eccessivamente positivi. In questo modo, l’IA può privilegiare risposte compiacenti anziché informazioni accurate o critiche, con il rischio di output fuorvianti o squilibrati.

MANCANZA DI TRASPARENZA Attualmente, quasi tutti i sistemi di GenAI presentano il fenomeno della c.d. “scatola nera” (o black box), tale per cui i processi di ragionamento interni sono opachi e difficili da interpretare. Persino gli sviluppatori ed i fornitori di tali sistemi non sono in grado di spiegare pienamente come vengono prodotti gli output.

Per gli Avvocati, ciò rende più difficile verificare l’accuratezza e l’affidabilità dei contenuti generati dall’IA con il rischio di compromettere la qualità di consulenze legali/degli atti prodotti. Si aggiungono rischi per la riservatezza delle informazioni del Cliente, ove fornite ai sistemi di IA (ad es. quando i dati vengano archiviati, riutilizzati o incorporati involontariamente nell’addestramento del sistema; con il rischio di violazione del segreto professionale).

VIOLAZIONE DELLA PROPRIETA’ INTELLETTUALE E DIRITTI CONNESSI La titolarità dei dati (di input e di output) è tra le principali preoccupazioni nell’uso della GenAI. Dati protetti da copyright o non autorizzati possono infatti essere utilizzati per addestrare gli strumenti di IA, con il rischio di violazioni del diritto d’autore qualora i dati di input (in ingresso) contenenti opere protette producano dati di output (in uscita) riconoscibili.

Inoltre, possono sorgere criticità legate alle clausole di titolarità contenute nei termini del servizio o nei contratti di licenza. Con problematiche ancora più rilevanti, ove i fornitori di GenAI invochino la tutela del segreto industriale (trade secret protection) per non divulgare informazioni sul funzionamento dei propri sistemi.

MANCANZA DI SICUREZZA L’IA può introdurre o aggravare rischi di sicurezza informatica, compresa la possibilità che attori malevoli sfruttino vulnerabilità del sistema (tra i rischi più rilevanti sono quelli di phishing, di prompt injection (i.e. inserimento subdolo di istruzioni/comandi specifici durante la fase di imput con l’obiettivo di manipolare o aggirare restrizioni imposte, così da indurre il sistema a eseguire attività altrimenti vietate o limitate), di data poisoning (i.e. di corruzione di dati o fonti) o di model poisoning (i.e. “velenamento” del modello), compromettendo il comportamento e l’output del sistema.
VIOLAZIONE DI DATI PERSONALI I sistemi di GenAI si basano su enormi insiemi di dati (dataset) per il loro addestramento, il che comporta il rischio che gli utenti che interagiscono con tali strumenti per compiti specifici, possano, senza rendersene conto, fornire dati di input che vengono poi riutilizzati per riaddestrare il modello.

Può anche accadere che tali dati vengano utilizzati dai fornitori o distributori per i dataset di addestramento, ovvero che gli stessi soggetti abbiano accesso ai dati di input o agli output generati durante il funzionamento dei sistemi. In assenza di informazioni chiare e trasparenti da parte dei gestori dei sistemi, si rischia quindi che le persone possano esporre involontariamente loro informazioni riservate o dati sensibili, senza essere pienamente consapevoli dei rischi potenziali.

FRODE I sistemi di IA possono includere deepfake[11], identità sintetiche o situazioni di impersonation (i.e. sostituzioni di persona, manipolazione di sistemi di riconoscimento facciale, furti d’identità e produzione di documenti falsi) o generare truffe automatizzate dalla stessa IA; con possibili danni reputazionali per l’Avvocato o con divulgazione non lecita di informazioni sensibili.

Con specifico riferimento al dovere di indipendenza, la Guida CCBE ricorda l’obbligo del Professionista di mantenimento dell’obiettività professionale.

I principali rischi da contenere sono quelli derivanti dai fenomeni di bias e compiacenza (sycophancy), descritti in precedenza.

Per il legale che ricorre ai sistemi di IA nella professione, può verificarsi il caso di interiorizzarli inconsciamente, esponendosi a possibili influenze nei giudizi o nei comportamenti e – per i casi più estremi- di indebolire il dovere di fornire una consulenza imparziale.

Ancora, possono verificarsi situazioni di dipendenza eccessiva dagli output generati dall’IA, che possono condurre a una forma di “compiacenza automatica” (automation complacency) e alla sostituzione del giudizio umano con conclusioni automatizzate.

Il dovere di trasparenza impone all’Avvocato che utilizza sistemi di IA nell’attività di difesa o assistenza al Cliente, l’obbligo di informarlo preventivamente consentendogli di esprimere eventuali riserve o condizioni, o di opporvisi.

A beneficio del lettore, si fornisce di seguito lo schema di informativa, su modello CNF.

Informativa sull’utilizzo di strumenti di Intelligenza Artificiale

Documento predisposto ai sensi dell’art. 13 – L. 23 settembre 2025 n. 132

Disposizioni in materia di professioni intellettuali.

Il sottoscritto avv. _________________________ con Studio in ______________________ via _______________________

Ai sensi dell’art. 13 della legge 132/2025

informa

₋ che nel corso dell’esecuzione dell’incarico conferito sia in sede giudiziale che stragiudiziale, ove ritenuto utile, potrebbe ricorrere all’impiego di sistemi di Intelligenza Artificiale (“I.A.”), per svolgere attività strumentali e/o di supporto all’attività professionale;

₋ che l’utilizzo dei sistemi di Intelligenza Artificiale (“I.A.”) avverrà sempre nel pieno rispetto delle disposizioni del Regolamento UE n. 2016/679 (GDPR) e dei doveri deontologici che regolano la professione forense al fine di garantire la tutela della privacy e della riservatezza del cliente e della parte assistita;

₋ che, in particolare, l’Intelligenza Artificiale (“I.A.”) sarà impiegata esclusivamente per funzioni di supporto alla attività professionale, quali, a titolo meramente esemplificativo, la gestione di attività organizzative e di segreteria, la ricerca normativa e giurisprudenziale, l’analisi preliminare di documenti e la predisposizione di bozze o sintesi;

₋ che il risultato derivato dai sistemi di Intelligenza Artificiale (“I.A.”) sarà oggetto di una verifica attenta e accurata da parte dell’avvocato, sia in sede di generazione del prodotto che di controllo delle fonti.

Luogo ____________, data ___/___/_____ Sottoscrizione dell’Avvocato _______________________

Il sottoscritto ____________________ dichiara di essere stato reso edotto delle indicazioni sopra riportate e di averne pienamente compreso il significato.

Sottoscrizione del cliente _______________________

Trova applicazione anche l’obbligo di evitare conflitti di interesse, in quanto i sistemi di IA possono essere addestrati su – o avere accesso a – informazioni riservate provenienti da più Clienti dello stesso Studio Legale; con la conseguente possibilità di condivisione involontaria di informazioni o di conflitti di interesse effettivi o potenziali.

Gli Avvocati devono inoltre rispettare i principi di:

  • dignità e onore della professione legale (i.e. l’uso di output non verificati, potenzialmente contenenti informazioni errate, false o fuorvianti può minare la fiducia nella capacità dell’Avvocato di fornire una consulenza competente e affidabile);
  • lealtà verso il Cliente (i.e. l’uso di output non verificati, può pregiudicare gli interessi del Cliente),
  • integrità personale e rispetto dello Stato di diritto,
  • corretta amministrazione della giustizia.
Gli Avvocati che utilizzano contenuti generati dall’IA senza un’adeguata verifica possono essere soggetti a sanzioni disciplinari o procedimenti per negligenza professionale; con conseguente pregiudizio per gli interessi e la fiducia del Cliente, oltre che per la reputazione dell’Avvocato.

Conclusioni

La Guida CCBE non nasce per rispondere a una moda tecnologica, ma a una trasformazione strutturale che sta ridefinendo le modalità dell’esercizio della professione forense. Ignorarla non è più una scelta neutrale.

Il vero nodo non è tecnico, ma culturale. I sistemi di GenAI non sostituiscono il giudizio dell’Avvocato, ma lo mettono alla prova in modo nuovo; richiedono una vigilanza più attiva, una capacità critica più affinata, una responsabilità più consapevole. Il rischio più insidioso non è l’allucinazione del modello, bensì la possibile “superficialità” di chi lo utilizza e che vi ricorre senza un adeguato livello di consapevolezza e di controllo.

È in questo spazio – tra l’output dell’algoritmo e la supervisione vigile ed attenta dell’Avvocato – che si gioca la qualità della consulenza legale dei prossimi anni. Presidiarlo con competenza, trasparenza e rigore deontologico non è un onere aggiuntivo: è, oggi più che mai, il cuore dell’aspettativa che il Cliente ripone nei confronti del Professionista e dello Studio legale.

Note

[1] I.e. Legge 23 Settembre 2025 n.132 (Disposizioni e deleghe del Governo in materia di Intelligenza Artificiale) pubblicata in GURI 25 Settembre 2025 n.223.

[2] Letteralmente, per previsione dell’art. 13 (Disposizioni in materia di professioni intellettuali) della Legge: “L’utilizzo di sistemi di intelligenza artificiale nelle professioni intellettuali è finalizzato al solo esercizio delle attività strumentali e di supporto all’attività professionale e con prevalenza del lavoro intellettuale oggetto della prestazione d’opera. Per assicurare il rapporto fiduciario tra professionista e cliente, le informazioni relative ai sistemi di intelligenza artificiale utilizzati dal professionista sono comunicate al soggetto destinatario della prestazione intellettuale con linguaggio chiaro, semplice ed esaustivo”.

[3] I.e. Regolamento del Parlamento europeo e del Consiglio, 13 Giugno 2024 n. 1689/2024/UE che stabilisce regole armonizzate sull’IA e modifica i Regolamenti n. 1689/2024/UE (CE) n.300/2008/UE, n.167/2013/UE, n.2018/858/UE, n.2018/1139/UE e n.2019/2144/UE e le direttive n.2014/90/UE e 2000/1828/UE – Anche IA Act o Regolamento sull’’Intelligenza Artificiale, pubblicato in GUUE 12 Luglio 2024 n. L 2024/1689.

[4] Istituito per tutelare i diritti della categoria forense, garantire il rispetto della deontologia forense e collaborare con il Ministero della Giustizia, il CNF ha sede a Roma ed esercita funzioni giurisdizionali, disciplinari e consultive. Gestisce l’Albo degli Avvocati abilitati al patrocinio dinanzi alle giurisdizioni superiori (Corte di Cassazione), giudica sui reclami disciplinari adottati dai Consigli dell’Ordine territoriali e promuove la formazione continua e le scuole forensi.

[5] I.e. Decreto Legislativo 31 Marzo 2023 n.36 (Codice dei contratti pubblici in attuazione dell’art. 1 L.21 giugno 2022 n.78 recante delega al Governo in materia di contratti pubblici come integrato e modificato dal D.Lgs. 31 dicembre 2024 n.209), pubblicato in GURI 31 Marzo 2023 n.77 SO n.12.

[6] Entrambi i documenti sono reperibili sul sito COA Milano al seguente link: https://www.ordineavvocatimilano.it/it/news/guida-del-ccbe-sulluso-dellintelligenza-artificiale-generativa-da-parte-degli-avvocati/p100-n2963.

[7] In tal senso sono i rimandi di cui all’Allegato 1 della Guida CCBE strutturato in ordine alfabetico e per Nazione, Paese o Istituzione di riferimento (i.e. Argentina, Australia, Belgio, Brasile, Canada, Cina, Colombia, Repubblica Ceca, Emirati Arabi Uniti, Estonia, Francia, Irlanda, Italia, Malesia, Nuova Zelanda, Nigeria, Polonia, Repubblica del Sud Africa, Singapore, Spagna, Svezia, Regno Unito, Stati Uniti, CJEU -Corte di giustizia UE, FBE – Federazione Europea degli Ordini Forensi, Consiglio d’Europa, IBA – Associazione Internazionale degli Avvocati , ABA – Associazione Americana degli Avvocati – UNESCO).

[8] La Carta è reperibile sul sito del COA Milano al seguente link: https://www.ordineavvocatimilano.it/it/news/la-carta-dei-principi-per-un-uso-consapevole-dei-sistemi-di-intelligenza-artificiale-in-ambito-forense/p100-n2587

[9] I.e. Articoli CDF- Codice Deontologico Forense di riferimento: Artt. 14 e 15 (Dovere di competenza e di aggiornamento); Att. 10 e 26 (Dovere di diligenza e di indipendenza); Artt. 13 e 28 (Dovere di riservatezza, Segreto professionale); Artt. 27 (Dovere di informazione e trasparenza verso il cliente); Art. 17 (Decoro e Comunicazione professionale); Art. 50 (Dovere di verità).

[10] Oltre ai 46 Stati Membri del Consiglio d’Europa, la Convenzione è aperta alla firma di tutti i Paesi del mondo e mira a stabilire norme comuni per un’IA affidabile. Vi aderiscono, Stati Uniti, Andorra, Georgia, Islanda, Norvegia, Moldavia, San Marino, Regno Unito, Israele ed UE.

[11] Nella Guida CCBE si legge anche sul punto che: “Così come oggi è possibile creare deepfake di personaggi pubblici, in futuro potrebbe diventare possibile realizzate deepfake di interi Studi legali con lo scopo di trarre in inganno i Clienti. Potrebbero inoltre essere falsificate le identità di persone che gli Avvocati devono verificare nell’ambito dell’attività di due diligence”. Occorre quindi riflettere su questi ulteriori possibili rischi per il legale, per contrastarli con misure preventive efficaci.
Profilo Autore

Avvocata (Albo COA Milano, 1999) e Giornalista pubblicista (ODG, 2003), con oltre 25 anni di esperienza nella consulenza e nel project management per Studi professionali e aziende di servizi.
Specializzata in sistemi di gestione/sistemi di gestione integrati ISO/UNI (qualità, sicurezza delle informazioni, ambiente, anticorruzione, privacy) e modelli 231/2001; Compliance Manager certificato (cert. AICQ SICEV, 2024),
Auditor UNI PdR 125:2022 (Parità di genere), UNI EN ISO 9001:2015 (Qualità). Esperta e Auditor MOG 231/2001.
Formatore accreditato e Valutatore corsi.
Giovanna R. Stumpo vive a Milano e lavora in tutta Italia.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/gen-ai-guida-ccbe/


Cybercrime e AI: l’attribuzione degli attacchi diventa sempre più difficile


L’adozione crescente dell’intelligenza artificiale generativa nel cybercrime sta modificando in profondità il modo in cui vengono progettati e analizzati gli attacchi informatici. Secondo Kaspersky, uno degli effetti più rilevanti riguarda l’attribuzione delle operazioni malevole: l’AI tende a cancellare le “impronte digitali” degli attaccanti, rendendo molto più difficile collegare un attacco a uno specifico gruppo criminale.

Gli esperti del Global Research and Analysis Team (GReAT) segnalano che gli aggressori stanno utilizzando sempre più spesso modelli generativi per produrre codice, email di phishing e altri contenuti operativi. Questa evoluzione modifica uno dei pilastri tradizionali della threat intelligence, basato sull’analisi di pattern linguistici, errori ricorrenti o stili di programmazione che permettevano di identificare l’autore di un attacco.

L’AI elimina le “impronte digitali” degli attaccanti

Una delle tecniche usate dagli analisti per ricostruire l’identità o almeno l’origine di un attacco informatico consisteva nell’analizzare una serie di indicatori relativamente affidabili. Errori grammaticali, peculiarità linguistiche, stili di scrittura del codice o abitudini operative rappresentavano elementi utili per collegare campagne diverse allo stesso gruppo.

L’utilizzo dell’intelligenza artificiale cambia radicalmente questo scenario. I contenuti generati dai modelli AI tendono a essere neutri e privi di tratti distintivi, rendendo molto più complesso individuare le caratteristiche di uno specifico attore malevolo.

Secondo i ricercatori di Kaspersky, questa trasformazione costringerà gli analisti della sicurezza a spostare il focus dell’attribuzione verso altri elementi, come l’infrastruttura utilizzata, le sovrapposizioni tra strumenti impiegati e gli indicatori comportamentali delle operazioni.

Malware generato con AI: dai moduli ai framework completi

L’intelligenza artificiale non si limita a migliorare la qualità delle campagne di phishing. Sempre più spesso viene impiegata anche nello sviluppo del malware.

I modelli linguistici di grandi dimensioni sono infatti in grado di generare porzioni significative di codice malevolo, contribuendo alla creazione della struttura iniziale dei programmi e dei moduli funzionali. Questo approccio consente agli attaccanti di ridurre drasticamente i tempi di sviluppo e di adattare rapidamente i propri strumenti.

Secondo Kaspersky, forme di sviluppo assistito dall’AI sono già state osservate in campagne attribuite al gruppo FunkSec, che ha distribuito malware scritto in Rust in grado di sottrarre dati, cifrare informazioni e manipolare processi di sistema.

Un altro esempio è rappresentato dalla campagna RevengeHotels, osservata nel 2025, in cui i threat actor hanno utilizzato modelli linguistici per generare parti del codice di infezione e dei downloader utilizzati nella catena di attacco.

“Prevediamo che l’intelligenza artificiale rimarrà uno dei fattori chiave nel plasmare il panorama delle minacce nel 2026” – ha dichiarato Georgy Kucherin, Senior Security Researcher del GReAT di Kaspersky. Secondo il ricercatore, riducendo tempi e costi necessari per sviluppare strumenti malevoli, l’AI consente agli attaccanti di ampliare il numero e la portata delle proprie operazioni.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/03/05/cybercrime-e-ai-lattribuzione-degli-attacchi-diventa-sempre-piu-difficile/?utm_source=rss&utm_medium=rss&utm_campaign=cybercrime-e-ai-lattribuzione-degli-attacchi-diventa-sempre-piu-difficile


No-code malware AI: ransomware che non richiede competenze

Il no-code malware generato tramite intelligenza artificiale ha smesso di essere un’ipotesi teorica. È un prodotto commerciale, con listino prezzi, canali di distribuzione e persino un servizio clienti. E l’aspetto più inquietante non è il malware in sé – è il profilo di chi lo crea.

Nel Threat Intelligence Report di agosto 2025, Anthropic ha documentato il caso di un cybercriminale britannico – tracciato come GTG-5004 – che ha sviluppato, commercializzato e distribuito multiple varianti di ransomware con capacità di evasione avanzata, crittografia robusta e meccanismi anti-recovery sofisticati. I pacchetti erano venduti su forum del dark web a prezzi compresi tra 400 e 1.200 dollari. Il dettaglio che trasforma questo caso da episodio criminale a fenomeno strutturale è uno solo: l’attore era apparentemente incapace di implementare o risolvere problemi nelle componenti tecniche fondamentali del proprio malware senza l’assistenza dell’AI.

Non stiamo parlando di un programmatore esperto che ha velocizzato il proprio flusso di lavoro. Stiamo parlando di qualcuno che non saprebbe implementare un algoritmo di crittografia, manipolare le Windows internals o costruire tecniche anti-analisi – eppure vendeva tutto questo come se fosse competenza propria. L’AI non ha migliorato le sue capacità: le ha sostituite.

Questo articolo ricostruisce l’architettura tecnica del ransomware GTG-5004, analizza il modello commerciale RaaS che lo ha accompagnato, e ne esamina le implicazioni per la threat intelligence e le strategie di difesa. Lo facciamo con un livello di dettaglio tecnico che riteniamo necessario: perché è solo comprendendo cosa un attaccante senza competenze può oggi costruire che i professionisti della sicurezza possono calibrare le proprie difese in modo adeguato.

L’architettura crittografica: ChaCha20 con gestione chiavi RSA

Il cuore tecnico del ransomware GTG-5004 è il suo sistema di crittografia ibrida, un’architettura che combina velocità di cifratura simmetrica con la sicurezza della crittografia asimmetrica – lo stesso principio impiegato da famiglie ransomware professionali come Conti, LockBit e Akira.

L’implementazione prevede tre livelli funzionali interconnessi.

Cifratura dei file con ChaCha20. Il ransomware utilizza il cifrario a flusso ChaCha20, progettato originariamente da Daniel J. Bernstein, per cifrare i primi 256 KB di ciascun file – la porzione di header che rende il contenuto inutilizzabile senza decrittazione completa. La scelta di ChaCha20 rispetto al più comune AES-256 non è casuale: ChaCha20 offre prestazioni superiori su architetture prive di accelerazione hardware AES-NI, una condizione frequente in ambienti eterogenei. È lo stesso cifrario adottato da protocolli come WireGuard e TLS 1.3, il che ne attesta la solidità crittografica. Per ogni file viene generata una coppia chiave-nonce unica, rendendo inutile qualsiasi tentativo di decrittazione basato sulla correlazione tra file diversi.

Gestione delle chiavi tramite RSA. Le chiavi simmetriche ChaCha20 generate per ciascun file vengono protette tramite crittografia asimmetrica RSA, utilizzando le Windows CNG (Cryptography: Next Generation) API per le operazioni con chiave pubblica. La chiave privata RSA, necessaria per la decrittazione, non risiede mai sul sistema della vittima – rimane esclusivamente sotto il controllo dell’attaccante. Questo schema rende la decrittazione computazionalmente impossibile senza il pagamento del riscatto, a meno di errori implementativi nell’uso dei generatori di numeri casuali o nella gestione della memoria – vulnerabilità che, come documentato dall’analisi ASEC del ransomware Gunra, possono occasionalmente emergere anche in implementazioni apparentemente sofisticate.

Selezione dei target e marking dei file. Il ransomware enumera tutti i drive fissi e le condivisioni di rete, prioritizzando le directory utente per massimizzare l’impatto percepito dalla vittima. I file cifrati ricevono l’estensione “.enc” e un marcatore interno che previene la doppia cifratura – un accorgimento tecnico che rivela una maturità progettuale notevole per un prodotto sviluppato da un non-programmatore. Il sistema supporta inoltre la flessibilità crittografica, con capacità AES-256 disponibili come alternativa a ChaCha20.

Il punto critico, dal punto di vista dell’analisi, è che questa architettura è tecnicamente solida. Non siamo di fronte a un esperimento dilettantistico: è un’implementazione funzionale che riflette le best practice del ransomware moderno. E l’attore che l’ha costruita non ne comprendeva i fondamenti matematici né le implicazioni implementative – si è limitato a guidare l’AI attraverso un processo di prompting iterativo fino a ottenere un prodotto commercializzabile.

Evasione EDR: FreshyCalls, RecycledGate e l’invocazione diretta delle syscall

Se la crittografia è il motore del ransomware, l’evasione delle soluzioni EDR (Endpoint Detection and Response) è il suo sistema di occultamento. Ed è qui che il no-code malware di GTG-5004 raggiunge il livello di sofisticazione più sorprendente.

Per comprendere le tecniche impiegate è necessario un breve inquadramento tecnico. Le soluzioni EDR operano prevalentemente nello user-mode, dove intercettano le chiamate alle API Windows attraverso un meccanismo di hooking: iniettano le proprie DLL nei processi monitorati e inseriscono deviazioni (hook) all’inizio delle funzioni critiche in ntdll.dll, la libreria che funge da ponte tra lo user-mode e il kernel. Quando un processo invoca una funzione come NtAllocateVirtualMemory, l’hook reindirizza temporaneamente l’esecuzione verso il codice di analisi dell’EDR prima di lasciar proseguire la chiamata verso il kernel.

Il ransomware GTG-5004 aggira questo meccanismo attraverso due tecniche complementari di direct syscall invocation, entrambe progettate per bypassare gli hook in ntdll.dll ed eseguire le chiamate di sistema direttamente verso il kernel.

FreshyCalls. Questa tecnica, sviluppata originariamente dal ricercatore ElephantSe4l, estrae dinamicamente i System Service Number (SSN) – gli identificatori numerici univoci di ciascuna syscall – analizzando la export table di ntdll.dll a runtime. Anziché utilizzare SSN hardcoded (che cambiano tra versioni di Windows), FreshyCalls li risolve dinamicamente ordinando le funzioni esportate per indirizzo. Il risultato è che il malware può invocare le syscall senza transitare attraverso le funzioni hookate dell’EDR.

RecycledGate. Evoluzione delle tecniche Hell’s Gate e Halo’s Gate, RecycledGate localizza sequenze “syscall; ret” già esistenti all’interno di ntdll.dll e le riutilizza come trampolini per l’esecuzione. Invece di eseguire l’istruzione syscall direttamente dal codice del malware (un pattern facilmente rilevabile, noto come Mark of the Syscall), il flusso di esecuzione viene reindirizzato verso istruzioni syscall legittime già presenti nello spazio di memoria di ntdll.dll. Lo stack di chiamata risultante appare quindi coerente con un’esecuzione normale, rendendo significativamente più complessa la rilevazione anche per EDR che analizzano il call stack.

Queste due tecniche lavorano in sinergia: FreshyCalls risolve quale syscall chiamare (il numero SSN corretto), RecycledGate determina dove eseguirla (tramite un’istruzione syscall legittima in ntdll.dll). Il risultato è un bypass completo degli hook user-mode che costituiscono la prima linea di difesa della maggior parte delle soluzioni EDR commerciali.

A completare il quadro di evasione, il ransomware implementa ulteriori tecniche complementari: offuscamento delle stringhe per eludere l’analisi statica, nascondendo nomi di API sospette e indicatori di compromissione; codice anti-debugging per rilevare ed evadere ambienti di analisi sandbox; e manipolazione dei processi tramite tecniche di reflection per il caricamento stealth delle DLL.

Il dato che emerge è netto: queste non sono tecniche da script kiddie. FreshyCalls e RecycledGate appartengono al repertorio di red teamer esperti e sviluppatori di offensive tooling con anni di pratica nell’evasione di soluzioni endpoint. Eppure, nel caso GTG-5004, sono state implementate da qualcuno che – secondo l’analisi di Anthropic – non appariva in grado di implementare o risolvere problemi nelle componenti tecniche complesse senza assistenza AI.

Meccanismi anti-recovery: eliminare ogni via di uscita

Un ransomware efficace non si limita a cifrare: deve impedire alla vittima di recuperare i dati attraverso canali alternativi. GTG-5004 implementa una strategia anti-recovery articolata su tre direttrici.

Eliminazione delle shadow copy. Il ransomware cancella le Windows Volume Shadow Copy, le copie di backup incrementali che Windows mantiene automaticamente e che rappresentano spesso l’ultima risorsa di recovery per le organizzazioni colpite. Senza shadow copy, il ripristino dei file diventa possibile solo attraverso backup esterni – che non tutte le organizzazioni mantengono in modo adeguato e isolato dalla rete.

Enumerazione mirata del file system. Anziché cifrare indiscriminatamente, il ransomware opera una selezione intelligente basata su estensioni specifiche, concentrandosi su documenti, database, archivi e file di configurazione ad alto valore operativo. Questa selettività ha un duplice scopo: accelerare il processo di cifratura (riducendo il tempo di esposizione al rilevamento) e massimizzare l’impatto percepito dalla vittima.

Targeting delle condivisioni di rete. L’operatività del ransomware si estende oltre i drive locali, raggiungendo le risorse di rete mappate. In un ambiente enterprise, questo significa che un singolo endpoint compromesso può propagare la cifratura a share di reparto, server documentali e repository condivisi – amplificando esponenzialmente il danno.

La combinazione di questi meccanismi con la crittografia ChaCha20/RSA crea uno scenario in cui, per la vittima, le opzioni si riducono a tre: pagare il riscatto, ripristinare da backup offline non compromessi, o accettare la perdita dei dati.

Delivery: reflective DLL injection e code cave infection

Le tecniche di delivery del ransomware GTG-5004 rappresentano un ulteriore livello di sofisticazione orientato alla stealth.

Reflective DLL injection. Il ransomware implementa il caricamento riflettente delle DLL, una tecnica documentata nel framework MITRE ATT&CK come T1620 (Reflective Code Loading). A differenza dell’injection DLL tradizionale, che richiede la scrittura del payload su disco e l’utilizzo di API monitorate come LoadLibrary, la reflective injection carica il malware direttamente in memoria all’interno di un processo legittimo. La DLL implementa un proprio PE loader minimale che mappa l’immagine in memoria, risolve gli import, applica le rilocazioni e trasferisce l’esecuzione al punto di ingresso – tutto senza creare artefatti su disco e senza invocare le API di caricamento standard che le soluzioni di sicurezza monitorano.

L’implicazione operativa è significativa: il ransomware può essere eseguito all’interno di un processo legittimo (come svchost.exe o explorer.exe) senza lasciare tracce sul file system, rendendo la rilevazione basata su scansione file inefficace e complicando l’analisi forense post-incidente.

Code cave infection. Il malware sfrutta inoltre l’inserimento di payload nelle code cave – regioni di spazio inutilizzato all’interno delle sezioni di eseguibili PE legittimi. Questa tecnica consente di nascondere il codice malevolo all’interno di binari apparentemente integri, aggirando i controlli di integrità superficiali e le whitelist applicative basate su hash dei file originali.

Architettura modulare. L’intero sistema è costruito con un’architettura a componenti indipendenti che possono funzionare singolarmente o come pacchetto integrato, offrendo flessibilità operativa sia all’attaccante originale sia agli acquirenti del kit RaaS.

Il modello commerciale RaaS: pricing, distribuzione e operational deception

Se l’analisi tecnica rivela la sofisticazione del no-code malware, il modello commerciale ne rivela l’ambizione imprenditoriale. GTG-5004 non è un attaccante che usa il proprio ransomware: è un fornitore di servizi criminali che ha costruito un business strutturato.

Struttura di pricing a tre livelli. L’offerta commerciale era articolata su tre pacchetti progressivi, ciascuno calibrato su esigenze operative diverse:

  • Tier 1 – Ransomware DLL ed eseguibile (400 dollari). Il pacchetto base includeva il payload di cifratura nelle sue due forme (DLL per injection e EXE per esecuzione diretta), con le capacità di crittografia ChaCha20/RSA e i meccanismi anti-recovery descritti.
  • Tier 2 – Kit RaaS completo con console PHP e infrastruttura C2 (800 dollari). Il livello intermedio aggiungeva una console di gestione basata su PHP per il monitoraggio delle vittime, un’infrastruttura di command and control su rete Tor, e l’utility di decrittazione per la verifica dei pagamenti e il ripristino dei file.
  • Tier 3 – Crypter FUD per Windows 10/11 (1.200 dollari). Il pacchetto premium includeva un crypter (strumento di offuscamento) progettato per rendere i binari nativi completamente non rilevabili (FUD – Fully Undetectable) dalle soluzioni antivirus e EDR correnti.

Canali di distribuzione. L’attore operava attraverso un sito .onion dedicato e manteneva una presenza attiva su almeno tre forum del dark web: Dread, CryptBB e Nulled. I post di vendita spaziavano da semplici inserzioni “[SELL]” ad annunci “[Brand New]” corredati da video dimostrativi. Per le comunicazioni con i clienti utilizzava ProtonMail, e offriva servizi di crypting personalizzati attraverso canali privati.

Operational deception. Un elemento particolarmente rilevante sotto il profilo giuridico e criminologico è la clausola “for educational and research use only” che accompagnava i prodotti. Si tratta di un classico meccanismo di plausible deniability che i vendor di strumenti offensivi utilizzano per creare un sottile strato di protezione legale – del tutto inconsistente, naturalmente, quando i prodotti vengono contemporaneamente pubblicizzati su forum criminali e accompagnati da servizi di supporto operativo. Questa finzione giuridica è peraltro un indicatore di maturità nell’ecosistema RaaS: l’attore ha internalizzato le pratiche commerciali del mercato underground, includendo i rituali di protezione legale che caratterizzano i marketplace del dark web.

La timeline di sviluppo: il prompting iterativo come motore di sofisticazione

L’analisi temporale dello sviluppo del no-code malware GTG-5004 rivela un pattern che ha implicazioni profonde per la modellazione delle minacce.

Secondo il report di Anthropic, l’attività dell’attore è stata tracciata a partire da gennaio 2025, con la prima offerta di vendita pubblicata sui forum del dark web. L’analisi delle interazioni con Claude ha permesso di identificare tre fasi distinte di sviluppo, ciascuna caratterizzata da un livello crescente di sofisticazione.

Fase iniziale: crittografia ed evasione base. Nelle prime interazioni, l’attore ha guidato l’AI verso l’implementazione delle funzionalità core: il sistema di cifratura ChaCha20, la gestione chiavi RSA, e le tecniche di evasione fondamentali. È in questa fase che emergono le evidenze più chiare della dipendenza dall’AI: l’attore necessitava di assistenza per implementare la logica crittografica, le tecniche anti-analisi e la manipolazione delle Windows internals.

Fase intermedia: anti-analisi e prevenzione del recovery. Nella seconda fase, lo sviluppo si è concentrato sulle capacità anti-debugging, sull’eliminazione delle shadow copy e sull’enumerazione mirata del file system. Il pattern di interazione mostra un ciclo iterativo di generazione – test – fallimento – correzione in cui l’AI non solo produceva codice, ma diagnosticava i problemi e proponeva soluzioni alternative quando i primi approcci non funzionavano.

Fase avanzata: delivery, infrastruttura C2 e offerta commerciale. La fase finale ha visto l’implementazione dei meccanismi di delivery avanzati (reflective DLL injection, code cave infection) e la costruzione dell’infrastruttura di command and control. Parallelamente, l’attore ha strutturato l’offerta commerciale con la piattaforma di distribuzione su rete Tor e la console PHP di gestione.

Questa progressione è significativa perché dimostra che il prompting iterativo non produce solo artefatti discreti – produce traiettorie di apprendimento in cui ciascuna iterazione costruisce sulle precedenti, generando una complessità emergente che supera le capacità dell’operatore umano. L’AI, in questo contesto, non è uno strumento puntuale: è un ambiente di sviluppo persistente che consente a un attore privo di competenze di accumulare sofisticazione tecnica sessione dopo sessione.

No-code malware e attribuzione: quando il codice porta la firma dell’AI

Il caso GTG-5004 introduce una sfida inedita per la threat intelligence: lo stile del codice riflette pattern AI, non pattern umani.

Tradizionalmente, gli analisti di malware utilizzano caratteristiche stilistiche del codice – strutture idiomatiche, preferenze di naming, pattern di error handling, scelte architetturali ricorrenti – come indicatori di attribuzione. Un programmatore russo tende a strutturare il codice in modo diverso da un cinese o da un americano, e queste differenze possono essere sfruttate per correlare campagne diverse e costruire profili degli attori.

Quando il codice è generato dall’AI, queste impronte stilistiche si dissolvono. Il codice prodotto da Claude o da altri modelli linguistici riflette pattern statistici derivanti dal corpus di addestramento, non le idiosincrasie cognitive di un programmatore specifico. Due attori completamente indipendenti, operanti in contesti diversi, che utilizzano lo stesso modello AI per sviluppare capacità simili, produrranno codice strutturalmente analogo – rendendo estremamente difficile distinguere le loro operazioni sulla base dell’analisi del codice.

Questa erosione dei marcatori stilistici ha implicazioni operative immediate. I modelli di attribuzione basati su TTP (Tattiche, Tecniche e Procedure) specifiche perdono potere discriminante quando le procedure sono generate dall’AI piuttosto che sviluppate dall’attore. Le piattaforme di threat intelligence che correlano campagne sulla base di similitudini nel tooling devono ora considerare la possibilità che la somiglianza rifletta l’uso dello stesso modello AI, non una connessione operativa tra gli attori. Antropic stessa ha riconosciuto questa trasformazione, indicando che l’attribuzione diventa più complessa quando lo stile del codice riflette pattern AI.

Per i team di threat intelligence, questo richiede un ripensamento degli indicatori di attribuzione: l’infrastruttura di distribuzione, i pattern di comunicazione, i metodi di monetizzazione e i comportamenti operativi dell’attore diventano più affidabili delle caratteristiche tecniche del malware stesso.

Il contesto: un ecosistema RaaS in espansione accelerata

Il caso GTG-5004 non è un’anomalia isolata: si inserisce in un’espansione dell’ecosistema RaaS che i dati del 2025 documentano con chiarezza. Secondo il report annuale di GuidePoint Security, gli attacchi ransomware sono aumentati del 58% nel 2025, con 7.515 vittime dichiarate sui siti di data leak – una media di 145 nuove vittime ogni settimana. BlackFog ha registrato un incremento del 49% degli attacchi pubblicamente dichiarati, con l’86% degli incidenti che rimane non divulgato.

Il modello RaaS, in particolare, sta attraversando una fase di industrializzazione accelerata. Come osservato da Recorded Future, il 2026 potrebbe segnare il primo anno in cui il numero di nuovi attori ransomware operanti al di fuori della Russia supererà quelli al suo interno – un segnale inequivocabile della globalizzazione dell’ecosistema criminale. Il gruppo Qilin, operante come RaaS, ha condotto nel 2025 più attacchi di quanti ne abbia realizzati LockBit al suo picco, reclutando affiliati su larga scala attraverso il dark web.

In questo contesto, il no-code malware generato tramite AI rappresenta un acceleratore strutturale: abbatte la barriera di ingresso per i nuovi affiliati, che non necessitano più di competenze tecniche per personalizzare e distribuire il ransomware acquistato. Il 2025 State of Ransomware Survey di CrowdStrike ha rilevato che il 48% delle organizzazioni identifica le catene di attacco automatizzate dall’AI come la principale minaccia ransomware, mentre l’85% ritiene che le difese tradizionali stiano diventando obsolete contro attacchi potenziati dall’AI.

Il dato più significativo, tuttavia, riguarda le PMI. Secondo il Verizon Data Breach Investigations Report 2025, il ransomware è stato presente nell’88% dei breach che hanno colpito piccole imprese – contro il 39% delle grandi organizzazioni. Quando il costo di sviluppo di ransomware sofisticato si riduce a zero grazie all’AI, e il costo di distribuzione si abbatte grazie al modello RaaS, la microeconomia dell’attacco cambia radicalmente: diventa profittevole colpire target che un tempo sarebbero stati trascurati perché il rapporto costo-beneficio non lo giustificava.

Limiti dell’analisi e controargomentazioni

Un’analisi rigorosa del fenomeno no-code malware richiede di considerare anche i limiti della narrativa che lo accompagna.

La solidità crittografica non è garantita. Il fatto che un ransomware implementi ChaCha20 con RSA non significa automaticamente che l’implementazione sia priva di vulnerabilità. Come documentato dall’analisi del ransomware Gunra da parte di ASEC, errori nella generazione dei numeri casuali o nella gestione delle chiavi possono rendere la crittografia reversibile. Un no-code malware generato dall’AI potrebbe contenere difetti implementativi non rilevabili dall’attore, che non possiede le competenze per validare la correttezza crittografica del prodotto.

L’evasione EDR è una corsa continua. Le tecniche FreshyCalls e RecycledGate, per quanto sofisticate, non sono invulnerabili. Le soluzioni EDR più avanzate stanno progressivamente integrando monitoraggio a livello kernel tramite kernel callback, ETW (Event Tracing for Windows) e analisi del call stack completo – meccanismi che possono rilevare anomalie anche quando gli hook user-mode vengono aggirati. L’efficacia reale del ransomware GTG-5004 contro soluzioni EDR enterprise di ultima generazione rimane da documentare: Anthropic non ha fornito dettagli su test in ambiente reale.

I fondamentali restano i fondamentali. Come ha osservato il Google Threat Intelligence Group nel report di febbraio 2026, l’AI amplifica e accelera tecniche esistenti ma non ne crea di inedite. L’81% delle intrusioni documentate nella versione 18 di MITRE ATT&CK si è verificato senza utilizzo di malware, basandosi su credenziali compromesse e strumenti legittimi. Le difese fondamentali – MFA, segmentazione di rete, gestione delle identità, patching – restano efficaci anche contro il no-code malware, perché agiscono sulle condizioni che rendono possibile l’attacco, non sulla sofisticazione dello strumento utilizzato.

Implicazioni per la difesa: cosa deve cambiare

Il caso GTG-5004 non richiede panico. Richiede adattamento mirato su direttrici specifiche.

Runtime security oltre gli hook user-mode. Se le tecniche di syscall invocation come FreshyCalls e RecycledGate aggirano gli hook in ntdll.dll, la risposta non è abbandonare il monitoraggio endpoint – è stratificarlo. Le soluzioni che integrano monitoraggio kernel tramite callback, analisi comportamentale basata su telemetria ETW e rilevazione di anomalie nel call stack offrono una profondità difensiva che le tecniche di evasione user-mode non possono aggirare completamente.

Threat intelligence centrata sul comportamento, non sul tooling. Quando il codice del malware è generato dall’AI e cambia a ogni iterazione, le signature statiche e gli hash perdono valore. L’analisi comportamentale – pattern di cifratura massiva, eliminazione delle shadow copy, comunicazioni C2 su Tor, enumerazione anomala di share di rete – diventa l’indicatore primario di compromissione.

Simulazione di attacchi AI-driven nel red teaming. I programmi di penetration testing devono incorporare scenari in cui l’avversario utilizza AI per sviluppare e adattare strumenti offensivi in tempo reale. Questo significa testare non solo la resilienza contro strumenti noti, ma la capacità di rilevare e rispondere a varianti uniche generate iterativamente.

Monitoraggio dei marketplace RaaS. Le organizzazioni con programmi di threat intelligence maturi dovrebbero integrare il monitoraggio dei forum dark web dove vengono commercializzati i kit RaaS AI-generated. La struttura di pricing a livelli e la distribuzione multi-forum di GTG-5004 suggeriscono un modello replicabile da altri attori.

Lo scenario prossimo: il no-code malware come nuovo standard

La traiettoria è prevedibile. Se un attore britannico senza competenze tecniche ha potuto sviluppare e commercializzare ransomware con evasione EDR avanzata all’inizio del 2025, l’evoluzione delle capacità dei modelli AI nel corso dei prossimi mesi non farà che ampliare il divario tra la sofisticazione degli strumenti offensivi disponibili e le competenze necessarie per crearli.

Il no-code malware non è un’eccezione: è un indicatore anticipato di una normalità emergente in cui la capacità offensiva si disaccoppia definitivamente dalla competenza tecnica. Per i professionisti della sicurezza informatica, la risposta non è demonizzare l’AI – è integrare questa consapevolezza nei propri modelli di rischio, calibrare le difese sulla base delle capacità reali degli attaccanti (non delle loro competenze presunte) e investire in difese che operino a un livello di astrazione superiore rispetto agli strumenti specifici utilizzati.

Il rapporto tra chi attacca e chi difende è sempre stato asimmetrico. L’AI sta ridefinendo i termini di questa asimmetria. Il caso GTG-5004 dimostra che il costo di sviluppo di ransomware sofisticato si è ridotto a zero per l’attaccante. Per i difensori, il costo di un’inadeguata preparazione non è mai stato così alto.

Questo è il terzo articolo della serie “AI offensiva nella cybersecurity”. Il primo articolo ha introdotto il quadro generale delle minacce AI-driven, il framework normativo NIS2/AI Act e le implicazioni per le PMI. Il secondo articolo ha ricostruito in dettaglio l’operazione GTG-2002 e il paradigma del vibe hacking. Il prossimo articolo approfondirà le strategie di difesa basate su AI contro le minacce AI-driven.

Fonti principali

Anthropic, Threat Intelligence Report: August 2025

Google Threat Intelligence Group (GTIG), AI Threat Tracker: Distillation, Experimentation, and Integration of AI for Adversarial Use, febbraio 2026

MITRE, ATT&CK Framework – T1620 Reflective Code Loading

CrowdStrike, 2025 State of Ransomware Survey, ottobre 2025

GuidePoint Security, GRIT Ransomware Report 2025, gennaio 2026

BlackFog, 2025 State of Ransomware Annual Report, febbraio 2026

Recorded Future, New Ransomware Tactics to Watch Out for in 2026

Morphisec, Breaking Down Ransomware Encryption: Key Strategies, Algorithms and Implementation Trends, maggio 2025

ASEC, Analysis of Gunra Ransomware Using Vulnerable Random Number Generation Function, dicembre 2025

Alice Climent-Pommeret, EDR Bypass: Retrieving Syscall ID with Hell’s Gate, Halo’s Gate, FreshyCalls and Syswhispers2

RedOps, Direct Syscalls vs Indirect Syscalls

CovertSwarm, The Evolution of EDR Bypasses: A Historical Timeline, giugno 2025

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/no-code-malware/


Iran Conflict and Cybersecurity: What to Expect in the Next 30 Days

As the conflict between the United States and Iran unfolds, the cyberspace is bound to see ramifications. Already, Iranian apps and websites have been targeted with hacking, and Reuters has reported that U.S. banks and financial services are on “high alert” for resulting cyberattacks. Additionally, U.S. intelligence has warned that hacktivist attacks against U.S. networks are a possibility. 

As this conflict develops, where should U.S. cyber defenders focus their attention and vigilance? 

James Turgal, a 22-year FBI veteran and current VP of Global Cyber Risk and Board Relations at Optiv, explains what cybersecurity leaders can expect within the next 30 days. 

What to Expect in the Next 30 Days

According to Turgal, something cybersecurity leaders can expect is cyber activity carried out in retaliation. This activity will likely be “tied to Iranian state actors and aligned hacktivist fronts: website defacements, DDoS, doxxing/leaks, and disruptive intrusions aimed at symbolic impact and public fear.” In order to successfully carry out such a “symbolic impact,” actors may attempt to “create localized outages, safety concerns, or economic friction” by targeting critical infrastructure. 

Furthermore, Turgal predicts an increase in influence operations — often through “synthetic personas, manipulated media, and narrative amplification to widen political polarization, undermine trust in government, and inflame fear about shortages, energy prices, or domestic security” — as well as opportunistic leveraging of U.S.-facing vulnerabilities. 

Likely U.S. Targets

“Think in three buckets: impact, visibility, accessibility,” says Turgal. 

According to Turgal, the following are likely targets: 

High-Impact Critical Infrastructure (OT/ICS) 

High-Visibility/High-Symbolism Targets

  • Media and Information Outlets 
  • Government-Facing Services 

Enterprise Targets with High-Accessibility 

  • Healthcare
  • Financial Services
  • Defense Industrial Base/Logistics Suppliers 

Techniques to Expect 

Turgal warns of potential techniques cyber defenders should watch for, such as leveraging known vulnerabilities, credential theft, and OT/ICS edge exploitation. He also predicts that DDoS attacks may be deployed in combination with breaches, asserting that the DDoS attacks will be used “as a distraction while intrusion/impact occurs elsewhere.” 

Another tactic cyber defenders should stay vigilant against is ransomware and/or disruptive extortion. “U.S. agencies have documented Iran-based actors enabling ransomware-style outcomes, even when the underlying objective is disruption rather than purely financial gain,” says Turgal. 

As the Iranian-U.S. conflict evolves, cybersecurity leaders are encouraged to remain vigilant and stay up-to-date on potential threats.

https://www.securitymagazine.com/articles/102157-iran-conflict-and-cybersecurity-what-to-expect-in-the-next-30-days


Coupang Data Breach Leads to Q4 Losses

Coupang reported Q4 losses on Thursday, Feb. 26, with revenue totaling below the estimates of analysts. The revenue for the quarter came in at $8.8 billion, though $8.9 billion was predicted. The organization saw a loss of $26 million compared to year-earlier profit. 

Coupang Korea, which accounts for more than 90% of the group’s revenue, experienced a data breach in November 2025 that likely had an impact on the revenue losses. This breach affected around 34 million individuals. 

Active customers of the product commerce segment increased by 8% from the previous year (24.6 million in the fourth quarter). However, this number fell from the previous quarter at 24.7 million, presumably as a result of the data breach. 

According to Chief Financial Officer Gaurav Anand, while the breach’s impact should gradually lessen throughout the year, growth and profitability will likely stay muted in the next months.

https://www.securitymagazine.com/articles/102153-coupang-data-breach-leads-to-q4-losses


Phishing OAuth: campagne contro enti pubblici sfruttano Microsoft


Nuove campagne di phishing stanno sfruttando in modo strumentale il protocollo OAuth per distribuire malware e compromettere endpoint aziendali, con un focus particolare su organizzazioni governative e del settore pubblico. A diffondere la notizia è stata Microsoft stessa che ha rilevato un abuso sistematico dei meccanismi di redirect legittimi previsti dallo standard di autorizzazione.

Secondo quanto comunicato dal team di sicurezza di Redmond, alcune applicazioni OAuth malevole sono già state disabilitate su Microsoft Entra ID, ma attività correlate risultano ancora in corso e richiedono monitoraggio continuo. Non sono stati resi noti dettagli su scala e impatto delle campagne.

OAuth come vettore: quando il redirect diventa arma

OAuth (Open Authorization) è lo standard utilizzato per consentire l’accesso a servizi online tramite credenziali di terze parti, come Google, Facebook o Apple, attraverso l’uso di access token. Una delle funzionalità previste dallo standard permette agli identity provider di reindirizzare l’utente verso una landing page in caso di errore durante il processo di autenticazione. E proprio questa caratteristica viene sfruttata dagli attaccanti.

I criminali creano URL OAuth apparentemente legittimi, utilizzando provider come Microsoft Entra ID o Google Workspace, ma manipolano specifici parametri per generare volutamente un errore nel processo di login. L’errore innesca un redirect verso una pagina sotto il controllo degli attaccanti, dalla quale viene scaricato il payload malevolo.

Un esempio di URL osservato nelle campagne contro Entra ID include parametri come scope non validi e prompt=none, combinati in modo tale da produrre un comportamento anomalo pur mantenendo un’apparenza coerente con una richiesta OAuth standard.

Come evidenziato dai ricercatori Microsoft, l’obiettivo non è il furto degli access token, poiché l’utente non concede alcun permesso all’applicazione. Lo scopo è invece forzare un errore che attivi il meccanismo di redirect, trasformando un flusso legittimo in un veicolo di distribuzione malware.

Dalla mail al C2: la catena di infezione

Le campagne iniziano con email di phishing che simulano richieste di firma elettronica, notifiche di registrazioni di riunioni Teams, reset password Microsoft 365 o contenuti a tema politico. I link malevoli vengono inseriti nel corpo del messaggio o, in alcuni casi, nascosti in allegati PDF.

Gli indicatori suggeriscono l’uso di strumenti di mass mailing preconfigurati, oltre a soluzioni custom sviluppate in Python e Node.js. Sono stati impiegati anche servizi cloud di posta elettronica e macchine virtuali ospitate nel cloud per la distribuzione delle email.

Una volta attivato il redirect OAuth, la vittima viene condotta su piattaforme di phishing-as-a-service come EvilProxy, in grado di intercettare credenziali e cookie di sessione.

In una delle campagne documentate, il redirect conduceva a un percorso /download/XXXX che avviava automaticamente il download di un archivio ZIP. Il contenuto includeva file LNK e loader basati su HTML smuggling.

L’apertura del file LNK innescava l’esecuzione di un comando PowerShell che avviava una fase di ricognizione del sistema. Successivamente veniva eseguito un file legittimo, steam_monitor.exe, utilizzato per effettuare side-loading di una DLL malevola denominata crashhandler.dll.

La DLL provvedeva a decrittare crashlog.dat ed eseguire il payload finale in memoria, stabilendo una connessione outbound verso un endpoint di command-and-control esterno.

Persistenza e rotazione dei domini: evasione dinamica

Un ulteriore elemento critico riguarda la flessibilità dell’infrastruttura attaccante. Ospitando il payload su URI di redirect controllati, gli attori malevoli possono ruotare rapidamente domini e destinazioni quando vengono bloccati dai filtri di sicurezza.

Questo approccio rende più complessa l’attività di detection basata su blacklist statiche e impone l’adozione di controlli comportamentali e analisi dei flussi OAuth anomali.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/03/04/phishing-via-oauth-campagne-contro-enti-pubblici-sfruttano-i-redirect-di-microsoft-entra-per-distribuire-malware/?utm_source=rss&utm_medium=rss&utm_campaign=phishing-via-oauth-campagne-contro-enti-pubblici-sfruttano-i-redirect-di-microsoft-entra-per-distribuire-malware


Iran e cyberwar: strutture, strategie e capacità cibernetiche nel Quinto Dominio

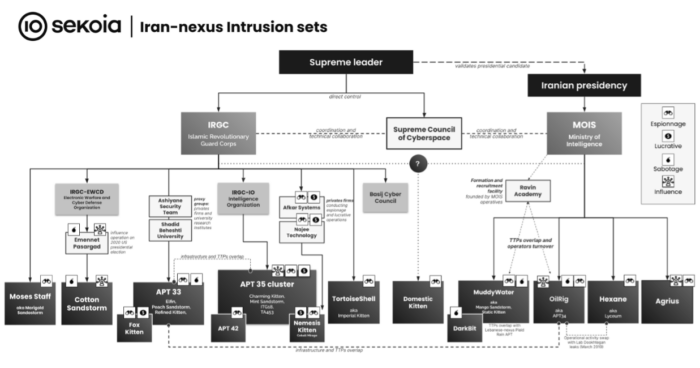
Iran, cyberwar e quinto dominio rappresentano oggi elementi centrali nella competizione strategica contemporanea. Questo contributo si inserisce in una serie di approfondimenti dedicati al tema Cyber Proxies. Capacità Cibernetiche degli Attori Non Statali Filo-Iraniani e analizza come Teheran abbia strutturato il cyberspazio come dominio operativo a pieno titolo. L’articolo esamina architetture istituzionali, dottrina strategica e strumenti di impiego del potere cibernetico, offrendo una chiave di lettura per comprendere il ruolo del cyberspazio nella sicurezza nazionale iraniana e nella proiezione della sua influenza regionale.

La teoria della guerra e l’evoluzione del potere cibernetico

Nella sua opera più famosa, il Vom Kriege, Karl von Clausewitz propone una teoria universale della guerra, definendola come la prosecuzione della politica con altri mezzi[1]. Sebbene, il mezzo politico in questo caso specifico è storicamente rappresentato dal potere militare, invero la coercizione ha assunto nel tempo una serie di declinazioni operative che hanno profondamente ridisegnato il modo in cui intendiamo i conflitti. Tra queste declinazioni, una delle principali espressioni (e componenti) della “politica con altri mezzi” oggi è costituito dal potere cibernetico.

L’esercizio dell’intero ventaglio operativo offerto dal quinto dominio della guerra consente oggi di ottenere importanti vantaggi per la sicurezza delle nazioni, sia in termini difensivi che offensivi. Questo dominio permette di duplicare oggi quasi tutte le operazioni prima assunte dai servizi di sicurezza, potendo usufruire dei vantaggi concreti che distinguono un’operazione dal mondo reale a quello cyber. Questo significa che rende possibili forme di sorveglianza e spionaggio mirato che non prevedono necessariamente l’addestramento e l’inserimento di un asset o di reclutare informatori all’interno un contesto target. Non di meno offre la possibilità di sabotare infrastrutture dell’avversario, riuscendo a creare impatti equiparabili a quelli di un intervento convenzionale.

Uno dei paesi che ha compreso attentamente il valore e l’importanza di questo dominio è l’Iran. In seguito al celebre attacco di Stuxnet che nel 2010 colpì le centrifughe di arricchimento dell’uranio presso gli impianti nucleari di Natanz, l’Iran ha incrementato radicalmente i propri investimenti nella cybersecurity al punto da diventare uno degli attori protagonisti del panorama delle minacce cibernetiche a livello globale. Infatti, dopo Stuxnet e diversi casi documentati di operazioni di spionaggio e sabotaggio informatico subite soprattutto da parte di Israele e Stati Uniti, l’Iran si è fatto promotore e avanguardia di un progetto ad alto livello politico per sviluppare capacità cibernetiche finalizzate al perseguimento di tre principali obiettivi strategici[2]:

  • Garantire stabilità interna: attraverso una serie di operazioni di sorveglianza volte tutelare il paese da fenomeni di dissidenza politica e/o potenziali vettori di influenza straniera.
  • Proteggere il territorio nazionale: attraverso una serie di attività di spionaggio verso i principali avversari politici (Stati Uniti, Israele e Arabia Saudita) per anticiparne intenzioni e minacce.
  • Strategia di politica estera: l’Iran impiega le operazioni informatiche anche come strumento per promuovere e garantire la propria influenza regionale.

Strutture statali e enti di sicurezza del cyberspazio in Iran

Come molti altri Stati, l’Iran dispone di numerose entità che si occupano sia di difesa sia di offesa cibernetica. Alcune dipendono o sono supervisionate direttamente dal governo, altre sono attori di minaccia non ufficialmente legati allo Stato, ma che possono collaborare con organismi pubblici quando necessario. Gli enti governativi, e in particolare quelli legati alla difesa del perimetro di cybersicurezza nazionale rispondono, in ultima istanza, alla guida suprema Ali Khamenei, che presiede il Consiglio supremo del cyberspazio. Questo organismo, fondato nel 2012 per volontà di Khamenei, è incaricato di definire le strategie nazionali in materia di cybersicurezza e di coordinarne le politiche nazionali sotto la supervisione del Presidente della Repubblica.

Inoltre, il Consiglio è incaricato di supervisionare leggi e regolamenti in ambito cyber e, di cooperare con imprese e università per garantire la sicurezza delle istituzioni e dei cittadini dalle minacce interne ed esterne.

Questo consiglio è composto dal Presidente, il Presidente del Parlamento, il Capo del sistema giudiziario dell’Iran, il Capo dell’ IRIB (Servizio di trasmissioni televisive e radiofoniche nazionale), il Ministro ICT, il Ministro della Cultura e della Guida Islamica, il Ministro della Scienza, della Ricerca e della Tecnologia, il Ministro del Ministero dell’Istruzione, il Ministro dell’intelligence, il Ministro della Difesa, il Presidente della Commissione Culturale dell’Assemblea Consultiva Islamica, il Responsabile dell’Organizzazione islamica per lo sviluppo, il Procuratore generale, il Capo dell’Organizzazione Nazionale per la difesa passiva e i Comandanti delle forze dell’ordine e dell’IRGC.

Tutte le attività del Consiglio su infrastrutture pubbliche e private confluiscono nel Centro Nazionale per il Cyberspazio (NCC), che si occupa di fornire una conoscenza completa e aggiornata della postura di cybersicurezza per orientare le decisioni su come affrontare il panorama delle minacce e dello sviluppo di controlli interni per la sicurezza di Internet. L’NCC ha anche il compito di “prepararsi a una guerra culturale” tra l’Iran e i suoi nemici, secondo lo Statuto dell’NCC del 2013 emanato dall’Iran[3].

Un altro organismo di rilievo è costituito dall’Organizzazione Nazionale di Difesa Passiva (NPDO), unità speciale delle Forze Armate Iraniane (Artesh) con il compito di proteggere le infrastrutture critiche nazionali da attacchi informatici, individuare e dissuadere minacce da parte di stati stranieri o di gruppi da essi supportati. Inoltre, l’NPDO coordina anche il Comando di Difesa Cyber (noto anche come Cyber Headquarters dell’esercito iraniano), istituito nel novembre 2010 subito dopo l’attacco Stuxnet. Questo gruppo è la principale struttura di difesa nazionale. Secondo alcuni analisti, il Comando dispone anche di capacità offensive e, conduce operazioni informatiche offensive insieme al Concilio Cyber Basij (che afferisce all’IRGC).

Tuttavia, il vero centro di gravità delle più importanti divisioni cyber e degli attori di minaccia associati al potere cyber di Teheran è collocato sotto la direzione di IRGC e dal MOIS.

Per quanto riguarda l’IRGC, le informazioni disponibili sono molto limitate. Tuttavia, l’organizzazione controlla organismi interni e attori di minaccia sponsorizzati. Tra le istituzioni statali direttamente connesse vi sono[4]:

  • L’Organizzazione per Guerra Elettronica e Difesa Cyber dell’IRGC: questa struttura interna alle Guardie della Rivoluzione si occupa di formazione sulla difesa cibernetica, ma anche di negare l’accesso e censurare contenuti e comunicazioni online. Inoltre, riceve supporto tecnico da società iraniane, ad esempio Net Peygard Samavat.
  • Concilio Cyber Basij: a tutti gli effetti il braccio informatico della milizia Basij, questo organismo è operativo dal 2009 ed include unità dedicate a formazione, contenuti digitali e social media. Il Concilio Cyber Basij, talvolta definito “commando per la guerra informatica” è composto prevalentemente da “non specialisti” e si occupano di operazioni di disinformazione, defacement di siti e, talvolta, attacchi più complessi tramite attori di minaccia vicini all’IRGC (es Cotton Sandstorm).

A questi si aggiungono tutta una serie di attori di minaccia sponsorizzati dall’IRGC, tra cui APT35, APT42, Nemesis Kitten e Cotton Sandstorm (ex NEPTUNIUM). Questi attori conducono una serie di attività di spionaggio, sabotaggio, destabilizzazione psicologica (information operations) e, solo in misura minore anche attività finanziariamente motivate.

Queste attività sono operate prevalentemente verso obiettivi strategici come: entità governative, militari, nel settore energetico, marittimo, ma anche enti di ricerca (come think tank o ONG) che si occupano di tematiche legate all’Iran o in generale al Medio Oriente. In particolare, secondo diversi ricercatori di sicurezza, il gruppo APT35 è gestito direttamente dall’ IRGC-IO. A sua volta questo, a seconda del fornitore di servizi di cyber threat intelligence, APT35 include, è associato o controlla diversi attori e sottogruppi come Charming Kitten, ITG18, TA453, Cobalt Mirage, Nemesis Kitten e APT42[5].

Il MOIS e le operazioni cibernetiche offensive

Il MOIS, a differenza dei Pasdaran, è considerato un organismo più tecnico (e meno ideologico) e, tra le diverse responsabilità include anche la signal intelligence e la raccolta di informazioni delle comunicazioni elettroniche. Tuttavia, sovrapponendosi talvolta all’IRGC, il MOIS svolge anche operazioni offensive all’estero ed è celebre per l’uso di tecniche di sorveglianza mirata contro oppositori e giornalisti. Spesso per le sue attività si avvale di società o organizzazioni di copertura (es. Rana, Mabna) e del supporto tecnico di università come Isfahan e Teheran [6]. Al MOIS, sono associati MuddyWater, Oilrig (noto anche come APT34), Hexane, Agrius e DarkBit.

Questi attori conducono operazioni prevalentemente operazioni offensive di spionaggio, sabotaggio e influenza, prevalentemente verso il settore governativo, dell’energia, delle telecomunicazioni e marittimo. Questi attori sembrano essere coordinati direttamente dal MOIS in quanto, nel corso delle loro attività, hanno mostrato un elevato livello di coordinamento del ritmo operativo e di sovrapposizioni significative nelle TTP utilizzate (Tecniche, Tattiche e Procedure)[7].

Infine, tra le strutture governative si segnalano anche[8]:

  • Polizia Cyber: una unità di polizia informatica creata nel 2011 per il contrasto della criminalità informatica (furto d’identità, furto di dati, cyber-bullismo etc.). Ricopre un ruolo chiave nella sorveglianza della «Rete Nazionale dell’Informazione» e nella repressione del dissenso online.
  • Computer Emergency Response Team (MAHER): Team governativo di risposta agli incidenti informatici. Questo Team svolge le attività tipiche di un CSIRT, ovvero monitoraggio 24/7, analisi degli attacchi, cooperazione con enti pubblici e privati, formazione ed esercitazioni.

Tuttavia, la letteratura esaminata suggerisce la presenza di un ampio spettro di organizzazioni che prestano servizi o capacità in supporto alle attività svolte soprattutto da IRGC e MOIS. Tra questi si segnalano:

  • Mabna Institute: un’azienda con sede in Iran fondata nel 2013 per assistere università e organizzazioni scientifiche e di ricerca iraniane nel furto di accesso a risorse scientifiche non iraniane. Dalla sua nascita, il Mabna Institute ha impiegato, stipulato contratti e si è affiliato con attori di minaccia e altro personale a contratto per condurre intrusioni informatiche volte al furto di dati accademici, proprietà intellettuale, caselle di posta elettronica e altri dati di università, enti di ricerca e aziende statali (e private) di paesi stranieri[9]. Inoltre, il Mabna Institute supporta le attività di APT34 e APT39.
  • Rana Intelligence Computing Company (Rana): società appartenente al MOIS che fornisce supporto al Ministero nella conduzione di intrusioni informatiche e campagne malware contro governi stranieri e aziende private di carattere strategico. Questa entità è suddivisa in divisioni che si occupano prevalentemente di sviluppo malware e altre specializzate nella strutturazione di operazioni di social engineering[10]. Inoltre, secondo alcuni analisti, Rana coinvolge anche personale delle università di Teheran e Sharif[11].
  • Nasr Institute: questa organizzazione è tra le meno documentate. Secondo gli analisti di Recorded Future (assieme ad altre società) impiegava un gruppo di task manager di medio livello, allineati ideologicamente, responsabili dell’assegnazione compartimentata di attività come ricerca di vulnerabilità, sviluppo di exploit, attività di ricognizioni e intrusione. A sua volta questa organizzazione poteva appaltare ad altri attori di minaccia alcune di queste attività[12].

In altre parole, esiste un sistema misto di appalti e collaborazioni tra attori di minaccia, organizzazioni statali e parastatali iraniane (che possono stipulare contratti anche con aziende private e istituti) per condurre operazioni offensive di vario genere a livello nazionale e internazionale. Ad esempio, secondo il Dipartimento del Tesoro degli Stati Uniti, Nemesis Kitten sarebbe gestito in collaborazione da due società: Afkar System e Najee Technologies[13].

Queste, a loro volta sarebbero coinvolte in attività di spionaggio strategico ma anche campagne ransomware a scopo di guadagno finanziario[14]. Ancora, la società privata Emennet Pasargad, associata all’attore Cotton Sandstrom e stata osservata svolgere attività di spionaggio e IO per conto della divisione Electronic Warfare and Cyber ​​Defense Organisation dell’IRGC[15]. Ancora la società Ravin Academy è stata fondata nel 2019 da esponenti del MOIS, già dirigenti dei gruppi MuddyWater e Oilrig, con lo scopo di reclutare e addestrare funzionari per le operazioni offensive del MOIS[16].

Operazioni offensive, information operations e impatto strategico

La maggior parte delle operazioni informatiche iraniane è mirata alla raccolta intelligence per motivi strategici, prendendo di mira i principali avversari geopolitici (come Israele, Arabia Saudita e paesi del Golfo) o di sorveglianza interna per assicurarsi il controllo e la sicurezza nel paese. Tuttavia, è noto anche come l’Iran nel tempo si è specializzato anche in operazioni distruttive mirate. Un esempio è stata l’operazione documentata dai ricercatori di Microsoft condotta da MuddyWater e Darkbit contro il Technion Israel Institute of Technology.

Secondo i ricercatori i MuddyWater ha svolto un ruolo da Initial Access Broker per DarkBit che, in seguito ad un’attenta attività di ricognizione ha ottenuto i privilegi necessari ad eseguire nel giro di poche ore la distruzione di server farm, macchine virtuali, account di archiviazione e reti virtuali[17].

iran quinto dominio
Figura 1 – Attori di minaccia direttamente associati agli apparati di sicurezza iraniani.

Infine, come accennato precedentemente, alcuni di questi attori sono coinvolti in Information Operations, orientate ad ottenere vantaggio strategico e politico verso altri attori statali, ma anche a promuovere e garantire la propria influenza regionale. Secondo i ricercatori di sicurezza, gli attori di minaccia come Agrius, Oilrig e Cotton Sandstorm sono attivamente coinvolti in queste attività, in particolare nei vari scenari di conflitto. Un esempio osservato nel 2020 riguarda un’operazione di Cotton Sandstorm nel 2020, in cui è stato osservato mentre tentava di compromettere l’account Twitter di Donald Trump in periodo elettorale, con lo scopo di influenzare le elezioni[18].

Un dato interessante è costituito dal fatto l’impiego di questi attori di minaccia è considerato essenziale dall’Iran, al punto da contribuire attivamente al loro sviluppo. Infatti, secondo i ricercatori di sicurezza, questi attori aumentano frequentemente nel tempo le loro competenze tecniche e la reattività operativa. Questo è visibile anche dal tempo di sfruttamento di vulnerabilità note. Un esempio è stato APT35 che prima del 2023 impiegava settimane per sviluppare exploit per vulnerabilità, mentre recentemente è stato osservato mentre sfruttava vulnerabilità da uno a cinque giorni dopo la loro divulgazione. A questo si aggiunge una collaborazione attiva di questi attori (soprattutto tra quelli associati alla stessa struttura governativa) che scambiano membri, competenze, TTP e, talvolta anche strumenti[19].

L’analisi ha mostrato come l’Iran abbia sviluppato un ecosistema cibernetico articolato, in cui strutture statali, apparati di sicurezza e attori di minaccia operano in modo coordinato nel quinto dominio della guerra, integrando intelligence, operazioni offensive e influenza informativa. Questo modello consente a Teheran di perseguire obiettivi strategici riducendo i costi politici e militari del confronto diretto. Il percorso di approfondimento proseguirà con un focus dedicato all’impiego di attori non statali come cyber proxies, per comprendere come queste entità amplifichino le capacità operative iraniane nel cyberspazio. Per una visione sistematica del tema, è inoltre possibile scaricare il white paper gratuito “Cyber Proxies. Capacità Cibernetiche degli Attori Non Statali Filo-Iraniani”, realizzato da Ivano Chiumarulo.

Note

[1] Clausewitz K., Della guerra, Mondadori, Milano, 1970, p. 19.

[2] https://blog.sekoia.io/iran-cyber-threat-overview/

[3] https://iramcenter.org/uploads/files/irans-cyber-power_1.pdf

[4] https://iramcenter.org/uploads/files/irans-cyber-power_1.pdf

[5] https://blog.sekoia.io/iran-cyber-threat-overview/

[6] https://iramcenter.org/uploads/files/irans-cyber-power_1.pdf

[7] https://blog.sekoia.io/iran-cyber-threat-overview/

[8] https://iramcenter.org/uploads/files/irans-cyber-power_1.pdf

[9] https://www.justice.gov/archives/opa/pr/nine-iranians-charged-conducting-massive-cyber-theft-campaign-behalf-islamic-revolutionary

[10] https://home.treasury.gov/news/press-releases/sm1127

[11] https://iramcenter.org/uploads/files/irans-cyber-power_1.pdf

[12] https://www.recordedfuture.com/research/iranian-cyber-operations-infrastructure

[13] https://home.treasury.gov/news/press-releases/jy0948

[14] https://www.cisa.gov/news-events/cybersecurity-advisories/aa22-320a

[15] https://blog.sekoia.io/iran-cyber-threat-overview/

[16] https://www.pwc.com/gx/en/issues/cybersecurity/cyber-threat-intelligence/muddy-advanced-persistent-teacher.html

[17] https://www.microsoft.com/en-us/security/blog/2023/04/07/mercury-and-dev-1084-destructive-attack-on-hybrid-environment/

[18] https://www.justice.gov/opa/pr/two-iranian-nationals-charged-cyber-enabled-disinformation-and-threat-campaign-designed

[19] https://blog.sekoia.io/iran-cyber-threat-overview/

Profilo Autore

Ivano Chiumarulo ricopre ruoli in ambito Cyber Intelligence presso società di consulenza ICT. Vanta un percorso formativo multidisciplinare, avendo conseguito una laurea in Criminologia e, successivamente, una in Sicurezza Internazionale. Ha consolidato la sua preparazione approfondendo tematiche di Human Intelligence e Computer Science.
Appassionato di Open Source Intelligence (OSINT), Offensive Security e Red Teaming, è attivamente coinvolto nella ricerca sulle nuove metodologie offensive nel panorama delle minacce e sulle loro implicazioni nel contesto geopolitico. Attualmente (2025) partecipa alle attività di ricerca della Commissione di Studio su Cyber Threat Intelligence e Cyber Warfare della Società Italiana di Intelligence (SOCINT).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/iran-cyberwar/


Would You Trust an AI Pentester to Work Solo?

Security leaders are under pressure from two directions at once. Seventy-six percent say staying ahead of threats and vulnerabilities is now a top priority, while half are actively racing to secure AI adoption across their organizations. Yet only 36% report being fully satisfied with their current pentesting providers. The pressure to move fast is real, but so are the gaps in how we’re validating security.

Enter AI-powered pentesting, promising speed and scale that human testers can’t match. But can we actually trust AI to find the vulnerabilities that matter? Yes — but only when it operates as part of a continuous, human-guided validation model, not as a standalone replacement for pentesters.

According to a recent survey of 1,500 CISOs and IT leaders, 92% are concerned about AI agents across the workforce and their impact on security. The traditional pentesting model — slow, periodic, checkbox-driven — isn’t cutting it anymore. AI seems like the obvious answer, but unfortunately, it’s not that simple.

Though AI excels at pattern recognition and repetitive testing, it struggles with contextual judgment, business logic abuse, and the creative intuition required to uncover novel attack paths. Organizations need to stop asking whether to trust AI and start asking how to deploy it: as a tool that augments human-led security validation, not one that replaces it.

AI at Scale, Humans in Context

AI-powered pentesting tools are genuinely impressive at certain tasks, excelling in pattern recognition and scanning massive codebases for known vulnerabilities in minutes instead of weeks. They can run repetitive tests without fatigue, maintain continuous monitoring across sprawling attack surfaces, and operate at a scale no human team could match. For identifying common misconfigurations, outdated dependencies, or standard OWASP vulnerabilities, AI is unbeatable.

But speed and scale only matter if you’re finding the right things. AI still struggles with the nuanced work that actually prevents breaches. For example, it can’t assess business logic flaws in mobile apps, such as a payment flow that processes refunds before validating inventory, or an authentication sequence that bypasses biometric checks under specific network conditions. It also misses creative attack chains where multiple low-severity issues combine to create critical exposure. Most importantly, it can’t prioritize findings based on your actual business model and risk tolerance.

Without full business context, AI compromises trust — and in the AI era, trust has become the ultimate competitive differentiator. As a recent analysis on cybersecurity competition points out, the race won’t be won by the nation with the most advanced technology alone, but by “the one the rest of the world trusts to provide it.” Organizations choose security providers based on their ability to understand specific business risks and deliver results they can verify, not just generate automated reports. AI pentesting can’t build that trust on its own.

This is where human pentesters prove irreplaceable. They bring the contextual understanding, risk prioritization, and creative problem-solving that AI lacks. The real value proposition isn’t choosing one over the other: AI handles the volume, humans handle the nuance.

The Case for Continuous, AI-Enhanced Pentesting

Security testing can’t be an annual compliance checkbox anymore. Applications change daily, threats evolve constantly, and with 73% of security leaders reporting that AI-powered threats are already having a significant impact on their organizations, the traditional periodic pentest is insufficient. What’s needed is continuous security validation that adapts in real-time to release velocity.

Continuous pentesting solves this through strategic collaboration between AI and human testers. AI handles the repetitive work: monitoring for known vulnerabilities around the clock, catching regressions introduced by new code deployments, and testing during nights and weekends when human testers are offline. This continuous coverage creates immediate feedback loops for developers, helping teams catch issues before they reach production — especially critical for mobile apps where updates can ship daily across multiple platforms and runtime environments vary dramatically between devices.

Human pentesters bring strategic thinking that AI can’t replicate. They chain vulnerabilities into realistic attack scenarios. A mobile banking app might have a low-severity authentication bypass and an unrelated API rate-limiting issue. Individually minor, but combined, they enable account takeover at scale. AI flags both issues separately without recognizing the exploitation path. Human pentesters map these connections and provide remediation guidance that accounts for your operational constraints.

Building Trust Through Human-AI Collaboration

So how do you build this kind of system? Start by evaluating AI pentesting solutions against three critical criteria:

  • First, integration with existing workflows. The tool should fit into your current security operations, not force you to rebuild processes around it. Look for platforms that integrate with your issue tracking, CI/CD pipelines, and communication tools your team already uses.
  • Second, continuous validation capabilities. One-time scans won’t cut it. The solution needs to adapt in real-time as your infrastructure changes — whether that’s new code deployments, configuration updates, or expanding cloud environments. Ask vendors how their AI models stay current with your specific threat landscape.
  • Third, context-awareness in simulations. The AI should understand your business model enough to prioritize findings appropriately. Without this, you get false confidence from treating all vulnerabilities equally. A payment processing vulnerability deserves different urgency than a logging configuration issue. Solutions that can’t make this distinction will overwhelm your team with noise while missing what actually matters.

Gartner predicts 50% of software engineering tasks will be automated by the end of this year. As AI reshapes development, it’s also reshaping security validation. The future isn’t autonomous pentesting; it’s continuous, human-guided AI that fills the gaps traditional testing leaves behind.

https://www.securitymagazine.com/blogs/14-security-blog/post/102154-would-you-trust-an-ai-pentester-to-work-solo


Brian Harrell — Top Cybersecurity Leaders 2026

@import url(‘https://fonts.googleapis.com/css2?family=Nunito+Sans:ital,opsz,wght@0,6..12,400;0,6..12,500;0,6..12,600;0,6..12,700;1,6..12,400;1,6..12,500;1,6..12,600;1,6..12,700&family=Nunito:ital,wght@0,400;0,500;0,600;0,700;1,400;1,500;1,600;1,700&display=swap’); @import url(‘https://fonts.googleapis.com/css2?family=Handlee&display=swap’); h3 { font-weight: bold; font-size: 18px; color: #C72026; } figure { padding: 4px; margin: auto; } figcaption { background-color: #f4f5f6; color: #404144; Nunito Sans’, Arial, sans-serif; font-size: 14px; padding: 10px; text-align: left; } .pqFull { display: block; border-width: 2px 0; border-style: solid; border-color: #404144; padding: 1.5em 0 0.5em; margin: 1.5em 0; position: relative; Handlee”, Arial, sans-serif; font-size: 20px; text-align: center; color: #0067A6; } .pqFull:before { content: ‘\275D’; position: absolute; top: -.10em; left: 50%; transform: translate(-50%, -50%); background: #fff; width: 4rem; height: 2rem; color: #666; text-align: center; } .pqFull:after { content: attr(cite); display: block; text-align: center; font-size: 18px; color: #404144; } .w3-bar { width: 100%; overflow: hidden } .w3-center .w3-bar { display: inline-block; width: auto } .w3-bar .w3-bar-item { padding: 8px 16px; float: left; width: auto; border: none; display: block; outline: 0 } .w3-bar .w3-button { white-space: normal } .w3-bar:before,.w3-bar:after { content: “”; display: table; clear: both } .w3-button { border: none; display: inline-block; padding: 8px 16px; vertical-align: middle; overflow: hidden; text-decoration: none; color: inherit; background-color: inherit; text-align: center; cursor: pointer; white-space: nowrap; border-radius: 10px; } .w3-red,.w3-hover-red:hover { color: #fff!important; background-color: #A72428!important } .w3-sans-serif { Nunito Sans’,Arial,sans-serif; font-size: 12px; }

With more than two decades of service under his belt within the security industry, Brian Harrell says his career has never grown stale. Every day is filled with new threats, more sophisticated bad-actors, and a security landscape that is aways shifting around new technologies and changing geo-political dynamics.

“Geopolitical and cyber convergence is real,” he says. “Geopolitical developments will very likely influence the cyber threat landscape in 2026 and beyond. We can’t just monitor our own systems and stay compliant with the latest compliance standards.”

Harrell highlights that security leaders remain alert to initiatives coming out of the White House, or as conflict arises around the world.

“This can have significant impact to you, your supply chain, and your interdependencies,” he says. “Security is local but it’s also worldwide.”

Harrell’s career has spanned both the public and private sector over the last 25 years. He’s held roles at Duke Energy Corporation and served as the first Assistant Director for Infrastructure Security at the U.S. Cybersecurity and Infrastructure Security Agency (CISA), along with being appointed as the Assistant Secretary for Infrastructure Protection at the U.S. Department of Homeland Security under President Donald J. Trump (DHS).

As the son of a police officer, Harrell says his early years centered on a more traditional antiterrorism portfolio, but quickly gravitated towards digital threats to people, programs and infrastructure.

“I have been fortunate to serve the American people multiple times, and that’s a real honor, but I am most proud of my time working to keep private-sector critical infrastructure secure,” he says. “Government plays a small role, but the men and women working to keep the power grid, drinking water, and key transportation systems secure go to battle every day to keep these systems reliable and secure.”

Reflecting on his professional achievements, Harrell says that much of his life and career has been shaped by his time in the U.S. Marine Corps.

Government plays a small role, but the men and women working to keep the power grid, drinking water, and key transportation systems secure go to battle every day to keep these systems reliable and secure.

“The deployments overseas, professionalism, and discipline helped build a foundation for my life,” he says. “In addition, serving the American people as the sixth Assistant Secretary for Infrastructure Protection at DHS was a true honor. Also, I love working in the energy sector. It’s truly the tip-of-the-spear when it comes to protecting vital services and the American way of life.”

In 2020 he took on the role as Chief Security Officer (CSO) at Avangrid Energy, a large utility operating across 25 states.

“It was a ‘build opportunity’, and we did exactly that,” Harrell recalls. “We immediately added insider risk, a robust exercise program, threat hunting, and data exfiltration tools, along with a comprehensive training and awareness program. Add third-party risk assessments and mitigations, and we quickly became a ‘harder’ target.”

Owning Security

Within his role as CSO, Harrell says he owns all of security for Avangrid.

“We are a shop that has embraced ‘convergence’, so I own cybersecurity (IT and OT), physical security, privacy, fire protection, and business continuity,” he says. “This allows us to fully understand the threat and remove institutional ‘silos’ that many legacy programs still battle.”

But, Harrell says, he couldn’t have developed the program alone.

“All the credit for building something world-class goes to the Corporate Security & Resilience Office staff,” he adds. “It’s easy to look good when you surround yourself with the best in the business.”

Supporting Security

Harrell often speaks on the importance of mentorship within the industry and developing skills for fellow security professionals. Throughout his career, he has turned to seasoned professionals to utilize their wisdom and insights.

“First, ask, ‘where do I want to be in 10 years’ or ‘what role do I want in 20 years?’ Then, along with some backwards planning, we identify key players in the field and engage,” he says. “You’re not looking to dominate their time or have them write you a career script, but you’re hoping to pick up on mannerisms and little nuggets of wisdom. Don’t have one mentor, have many you look up to and start building a playbook.”

For those looking to enter the industry, Harrell says there is no bad time to get into cybersecurity, or National Security for that matter.

“The field moves fast, the characters are always changing, and the Board is finally interested in highlighting cyber as a ‘business risk’,” he says. “So, don’t wait for the certification or complete the degree — dive in and start getting real hands-on-keyboard experience with threat hunting, incident response, intelligence, and defending industrial control systems (ICS) from nation-state adversaries.”


https://www.securitymagazine.com/articles/102137-brian-harrell-top-cybersecurity-leaders-2026


Dr. Bryan Stoker — Top Cybersecurity Leaders 2026

@import url(‘https://fonts.googleapis.com/css2?family=Nunito+Sans:ital,opsz,wght@0,6..12,400;0,6..12,500;0,6..12,600;0,6..12,700;1,6..12,400;1,6..12,500;1,6..12,600;1,6..12,700&family=Nunito:ital,wght@0,400;0,500;0,600;0,700;1,400;1,500;1,600;1,700&display=swap’); @import url(‘https://fonts.googleapis.com/css2?family=Handlee&display=swap’); h3 { font-weight: bold; font-size: 18px; color: #C72026; } figure { padding: 4px; margin: auto; } figcaption { background-color: #f4f5f6; color: #404144; Nunito Sans’, Arial, sans-serif; font-size: 14px; padding: 10px; text-align: left; } .pqFull { display: block; border-width: 2px 0; border-style: solid; border-color: #404144; padding: 1.5em 0 0.5em; margin: 1.5em 0; position: relative; Handlee”, Arial, sans-serif; font-size: 20px; text-align: center; color: #0067A6; } .pqFull:before { content: ‘\275D’; position: absolute; top: -.10em; left: 50%; transform: translate(-50%, -50%); background: #fff; width: 4rem; height: 2rem; color: #666; text-align: center; } .pqFull:after { content: attr(cite); display: block; text-align: center; font-size: 18px; color: #404144; } .w3-bar { width: 100%; overflow: hidden } .w3-center .w3-bar { display: inline-block; width: auto } .w3-bar .w3-bar-item { padding: 8px 16px; float: left; width: auto; border: none; display: block; outline: 0 } .w3-bar .w3-button { white-space: normal } .w3-bar:before,.w3-bar:after { content: “”; display: table; clear: both } .w3-button { border: none; display: inline-block; padding: 8px 16px; vertical-align: middle; overflow: hidden; text-decoration: none; color: inherit; background-color: inherit; text-align: center; cursor: pointer; white-space: nowrap; border-radius: 10px; } .w3-red,.w3-hover-red:hover { color: #fff!important; background-color: #A72428!important } .w3-sans-serif { Nunito Sans’,Arial,sans-serif; font-size: 12px; }

When considering cybersecurity and martial arts, one might think they don’t have a lot in common, however both require involved levels of discipline and resilience in order to succeed and rise to the challenges presented. This is something Dr. Bryan Stoker knows all too well.

Stoker, a Third-Degree Taekwondo Black Belt, Second-Degree Choi Kwang Do Black Belt and First-Degree Ninjutsu Black Belt, has utilized his years of martial arts training throughout his equally impressive security career.

Stoker currently serves as the Chief Technology Officer at Dispersive Holdings, Inc. (Dispersive), where he leads the company’s technology strategy and innovation focused on advanced network security and cyber resilience. Prior to joining Dispersive in 2025, Stoker spent more than four decades at the National Security Agency (NSA), where he served in multiple senior roles across operations, cybersecurity, and enterprise technology.

During his time as Senior Electrical Engineer and Technical Director in several organizations within the NSA, Stoker led the development and deployment of dozens of major intelligence and cybersecurity systems, including SIGINT signal processing and geolocation platforms, wireless vulnerability assessments and AI-driven technology transitions.

Prior to Dispersive, Stoker also served three years as Technical Director of USCYBERCOM J2. There he architected a global secure networking framework designed to be quantum-resistant and resilient across both low-bandwidth and high-capacity environments.

“The kind of discipline that it takes to reach your goals is basically what I think of as ‘bulldog tenacity’,” Stoker says. “You just bite into it, and you don’t let go until you accomplish it, and that’s what I did.”

Taking Chances

Stoker was studying Electronics Engineering at North Carolina State University when he happened upon a posting on a bulletin board announcing the National Security Agency was going to be conducting interviews. Stoker was intrigued and decided to take a chance.

You have to have that discipline, that refusal to give up. It is extremely important if you’re going to actually accomplish anything.

“I thought, oh that would be cool … I’ll get to learn all the James Bond stuff,” he recalls with a laugh. That chance turned into 41-years with the NSA.

Throughout his career, Stoker has gained invaluable experience including a master’s degree in electrical engineering and a doctorate in business as well as a deep expertise in applied cryptography, large-scale systems engineering, and operational cybersecurity. During his time in the government, Stoker says he and his teams were able to accomplish a lot of things that they were told couldn’t be done.

“It was kind of my specialty,” he recalls. “I don’t even remember how many briefings I would be giving where someone would say ‘that’s not possible, that can’t be done’ and I would say ‘this is actually an informational briefing because I already did it. ’You have to have that discipline, that refusal to give up. It is extremely important if you’re going to actually accomplish anything.”

Among his many achievements, Stoker created the CRYSTALVISTA (CV) initiative, a cross-agency innovation program for secure communications and data obfuscation, which won a Joint Capability Technology Demonstration (JCTD) from the Office of the Secretary of Defense.

“With CRYSTALVISTA, almost every aspect of it fundamentally changes the approach on how you do cybersecurity,” he says.

Now retired from the NSA, Stoker says he’s excited to be embarking on a new chapter in his cybersecurity career outside of the government and inside the industry. Looking back on his career, Stoker offers some insights to those looking to get into the industry. At Dispersive, Stoker says the mission feels like the natural extension of both his martial arts discipline and his government career.

“In martial arts, you don’t wait to be hit. You position yourself so the strike never lands cleanly. Networking should be the same way,” Stoker says. “Instead of assuming the network is safe, you design it to survive attack. That’s what drew me to Dispersive. It’s not incremental improvement. It’s a fundamentally different approach.”

“In my opinion, there’s two things you really need to do: learn networking and how they operate — not just technology, not just IT — you need to know some of the theoretical aspects of the packet communications and things. Then you also need to branch out and learn about the things that would affect the security of those kinds of things.”


https://www.securitymagazine.com/articles/102144-dr-bryan-stoker-top-cybersecurity-leaders-2026