AI, intervista al padre del modello italiano ‘Vitruvian-1’ (batte Google, Meta e Grok): “Non è una questione di GPU, ma di ingegno”
“Avete fatto il colpaccio?” Ha risposto con la sua solita umiltà e anche un po’, orgogliosamente, da nerd: “Siamo gente che lavora”. È iniziata così la nostra intervista a Nicola Grandis, CEO di ASC27, la società romana che ha sviluppato il modello linguistico di grandi dimensioni (large language model – LLM) Vitruvian-1, che ha conquistato il quarto posto sul benchmark MATH-500, con un punteggio di 93,6.
Per capirci, l’italiano Vitruvian-1 si posiziona subito dopo alcuni modelli di OpenAI01 e 03 e Deepseek R1, ma prima di Gemini 2.0 Flash di Google, di Qwen 2.5-72b di Alibaba, o Llama 3.3 70b di Meta e Grok-2 di xAI di Elon Musk.
Nicola Grandis. Abbiamo una lista di attesa, stiamo facendo entrare a gruppi di 100-200 persone per testare la versione Beta di Vitruvian-1.
Key4biz. Che significa che ragiona?
Nicola Grandis. Può fare tante cose, come elaborare degli scenari e fare relazioni tra gli input che gli stai dando. Non fa lo “psicoanalista” come chatGPT per gli utenti, ma Vitruvian-1 è un modello linguistico che ha una capacità di ragionamento. Per esempio, se gli chiedi ‘Key4biz vorrebbe espandersi sull’Arabia Saudita, ci sono queste condizioni e possibilità, cosa mi suggeriresti di fare?’ E lui ti risponde, dando buoni consigli.
Key4biz. Avete dimostrato cosa? Che quasi dal “niente” si può sfidare i giganti dell’AI?
Nicola Grandis. Adesso, i giganti dell’AI risponderanno, Luigi. Per esempio, OpenAi con o-3 ci ha già provato. Noi vogliamo dimostrare che anche in Italia si può sviluppare AI e con il lancio di Vitruvian-1 speriamo si possa creare anche in Italia uno zoccolo duro, per richiamare tester ed esperti per lavorare insieme sul nostro modello. Infatti, stiamo ricevendo già tanti messaggi di esperti italiani all’estero, dagli Emirati, dagli Stati Uniti e dalla Cina: sono molto interessati al technical report, che credo sia il primo di questo genere pubblicato in Italia.
Key4biz. In quanto tempo e grazie a quante persone è nato Vitruvian-1?
Nicola Grandis. Abbiamo iniziato a pensarci da metà novembre 2024, ma il lavoro ‘rush’ lo abbiamo fatto negli ultimi 10 giorni. Ho diretto un team di 30 persone.
Key4biz. I prossimi passi?
Nicola Grandis. Continuare a sviluppare V1 e specializzarlo per l’uso aziendale, mettendo a disposizione delle API ad hoc per le imprese.
Key4biz. Quanta tecnologia serve per creare un LLM con le performance di Vitruvian-1, che è al 4° posto sul benchmark MATH-500, prima di Google, Meta eMusk?
Nicola Grandis. Serve testa, carta, penna e ingegno (italiano). Non è una questione di GPU. Serve tanta conoscenza e cervello.
AI, la risposta di Macron a Stargate di Trump. Piano da 109 miliardi di euro in Francia. Progetto UE per le startup. Basterà?
Il presidente francese Emmanuel Macron ha annunciato piani per investimenti in intelligenza artificiale (IA) in Francia per un totale di 109 miliardi di euro nei prossimi anni, con l’obiettivo di rafforzare la posizione dell’Europa in un settore attualmente dominato da Stati Uniti e Cina.
Questi investimenti includono:
50 miliardi di euro dagli Emirati Arabi Uniti per la costruzione di un nuovo campus per data center.
20 miliardi di euro dalla società canadese Brookfield per sostenere lo sviluppo dell’infrastruttura IA in Francia.
Inoltre, durante il vertice di Parigi sull’IA in corso a partire da oggi, sarà istituito un fondo di investimento no-profit chiamato Current AI, con l’obiettivo di raccogliere 2,5 miliardi di euro in cinque anni per promuovere progetti di IA di interesse pubblico.
Macron ha sottolineato la necessità per l’Europa e la Francia di accelerare gli investimenti in IA per competere a livello globale, evidenziando l’importanza di mantenere l’indipendenza tecnologica europea.
Come Macron intende affrontare la sfida di Trump all’intelligenza artificiale Stargate
In una conversazione esclusiva con Firstpost e France TV, Macron ha annunciato che l’Europa annuncerà un investimento di 109 miliardi di euro nell’IA, in risposta a quanto annunciato dagli Stati Uniti con Stargate.
Il mese scorso, Trump ha annunciato una joint venture di 500 miliardi di dollari di investimenti in infrastrutture legate all’intelligenza artificiale (IA), chiamando l’iniziativa Stargate. La nuova entità è una joint venture di OpenAI, Oracle e SoftBank e mira a sviluppare l’infrastruttura necessaria per sistemi di IA avanzati.
L’azienda avrà il compito di costruire data center e impianti di generazione di elettricità, entrambi fondamentali per alimentare il panorama dell’IA in rapida evoluzione. Mentre l’investimento iniziale è di 100 miliardi di dollari, potrebbe espandersi a 500 miliardi di dollari. Il progetto è incentrato in Texas, con la costruzione dei primi 10 data center già in corso.
Macron ha osservato che nella joint venture europea, anche gli Emirati Arabi Uniti contribuiranno in modo significativo. “Loro (gli Emirati Arabi Uniti) creeranno enormi data center e saranno presenti anche aziende americane, canadesi e francesi”, ha detto. “L’Europa crescerà più velocemente, anche la Francia accelererà”, ha osservato Macron.
Parte oggi la EU AI Champions Initiative: previsti investimenti per 150 miliardi
Nel contempo, parte in Europa la EU AI Champions Initiative, una iniziativa volta a sostenere un ecosistema europeo di start up. Lunedì, la società di venture capital General Catalyst ha dichiarato al Financial Times di essere a capo di un gruppo di investimento più ampio che prevede di spendere 150 miliardi di euro nei prossimi cinque anni per implementare l’intelligenza artificiale nelle aziende, investire in start-up europee di intelligenza artificiale e costruire infrastrutture critiche nella regione.
Il piano, denominato EU AI Champions Initiative, è concepito per “stabilire l’Europa come leader mondiale nell’intelligenza artificiale”. Tra gli altri investitori di private equity e venture capital che hanno aderito all’iniziativa figurano KKR, Blackstone, EQT, CVC e DST Global. Alcuni dei piani di spesa specifici degli investitori devono ancora essere determinati e sono subordinati all’identificazione delle opportunità di investimento, nonché ad altri fattori come la regolamentazione.
Il progetto è sostenuto anche da oltre 60 aziende europee, tra cui la casa automobilistica tedesca Volkswagen, il servizio di streaming musicale svedese Spotify e il gruppo di investimento italo-olandese Exor. Queste aziende si impegnano ad “accelerare e adottare” l’intelligenza artificiale, ma non si sono impegnate a stanziare spese specifiche per la tecnologia.
Si prevede che i gruppi uniranno le forze per presentare a Ursula von der Leyen, Presidente della Commissione Europea, nuove raccomandazioni politiche volte a ridurre la burocrazia per armonizzare e semplificare le leggi dell’UE in materia di intelligenza artificiale e dati.
Jeannette zu Fürstenberg, amministratore delegato di General Catalyst, ha detto di aver radunato personalità dell’industria europea per investire nell’intelligenza artificiale europea, aggiungendo: “Abbiamo ricevuto sveglia e ora stiamo deregolamentando, ci stiamo attivando, ci stiamo preparando”.
Le startup europee sono da tempo indietro rispetto alle loro controparti statunitensi e cinesi, poiché devono affrontare una dura battaglia a causa di finanziamenti insufficienti, accesso alla potenza di calcolo e mancanza di chiarezza su come applicare le normative.
Oggi e domani a Parigi il summit sull’AI
Oggi e domani, leader politici e imprenditori di tutto il mondo si incontreranno a Parigi per un Summit d’azione sull’intelligenza artificiale (IA).
Il summit si terrà oggi e domani al Grand Palais e all’Eliseo e segue la scia degli incontri di Bletchley Park e di Seul, che hanno iniziato a fare il punto sulle sfide, sia tecnologiche che umane, rappresentate dall’emergere di strumenti come ChatGPT (lanciato dagli Stati Uniti nel 2022).
Tuttavia, nel frattempo la corsa dei Paesi per frenare l’intelligenza artificiale ha subito un rallentamento.
Il presidente degli Stati Uniti Donald Trump ha revocato le restrizioni all’intelligenza artificiale imposte dal suo predecessore Joe Biden e la sua amministrazione non invierà alcun rappresentante del National Security Institute degli Stati Uniti a Parigi.
Donald Trump ha lanciato anche il progetto “Stargate”, a cui parteciperà OpenAI, che punta a sviluppare l’intelligenza artificiale entro il 2029 con investimenti fino a 500 miliardi di dollari.
Al vertice di Parigi, la Francia annuncerà investimenti nell’intelligenza artificiale per 109 miliardi di euro, ha detto ieri sera il presidente Emmanuel Macron.
A fine gennaio l’avvento di DeepSeek
A fine gennaio, il gruppo cinese DeepSeek ha sorpreso il mondo presentando un’intelligenza artificiale generativa con una potenza equivalente a quella di ChatGPT ma più economica e molto meno dispendiosa in termini energetici, sfidando i suoi concorrenti ad accelerare il passo in termini di innovazione.
È in questo contesto che il vicepresidente statunitense J.D. Vance e il vicepremier cinese Zhang Guoqing si incontreranno a Parigi per discutere anche dell’enorme fabbisogno energetico generato dall’intelligenza artificiale, in un momento in cui stiamo lottando contro il cambiamento climatico.
È in fase di preparazione una dichiarazione non vincolante.
Mentre l’Europa cerca di trovare la quadra in questo contesto e di imporre una sua visione, la Francia chiede che le normative europee siano applicate in modo sufficientemente flessibile da non ostacolare le ambizioni dei suoi campioni nazionali di tecnologia.
“L’intelligenza artificiale non può essere il Far West”
“Si tratta di stabilire le regole del gioco. L’intelligenza artificiale non può essere il Far West”, ha affermato Emmanuel Macron in un’intervista alla stampa quotidiana regionale la scorsa settimana.
“C’è il rischio che alcune persone decidano di non avere regole e questo è pericoloso. Ma c’è anche il rischio opposto, se l’Europa si dà troppe regole“, ha sostenuto. “Non dobbiamo avere paura dell’innovazione.”
Il vertice di Parigi: agenda fitta
Il vertice di Parigi è preceduto da giornate scientifiche che riuniscono ricercatori ed economisti, eventi culturali e incontri politici.
Emmanuel Macron ha annunciato domenica su France 2 un totale di 109 miliardi di investimenti nel campo dell’intelligenza artificiale in Francia “nei prossimi anni”, una dotazione che comprende un investimento da parte degli Emirati Arabi Uniti fino a 50 miliardi e 20 miliardi da parte della canadese Brookfield.
Il presidente francese ha cenato domenica con il primo ministro canadese Justin Trudeau, il cui Paese è coinvolto, come circa altri quaranta, nel Partenariato globale per l’intelligenza artificiale.
“La cosa importante è come mettiamo l’intelligenza artificiale al servizio dei cittadini, come la classe media e i piccoli imprenditori possono sentirsi coinvolti e più potenti”, ha affermato Justin Trudeau.
“Vogliamo innovare e muoverci rapidamente, vogliamo essere tutti in gara”, ha detto Emmanuel Macron accanto al leader canadese, ricordando l’importanza di “vedere chiaro” nell’uso di questo strumento.
Secondo l’ordine del giorno presidenziale, il presidente francese incontrerà lunedì Zhang Guoqing e martedì vedrà JD Vance.
Per quanto riguarda il lato commerciale, sono attesi a Parigi il CEO di Alphabet Sundar Pichai e il CEO di OpenAI Sam Altman.
Lunedì è prevista una cena all’Eliseo, alla vigilia della sessione plenaria del Grand Palais presieduta congiuntamente da Emmanuel Macron e dal primo ministro indiano Narendra Modi. Per le aziende, il martedì viene organizzato un Business Day presso la stazione F.
Arthur Mensch, amministratore delegato della startup francese Mistral, ha detto a Reuters che il summit contribuirà a mostrare al grande pubblico i vantaggi dell’intelligenza artificiale nella vita quotidiana.
Developer creates endless Wikipedia feed to fight algorithm addiction
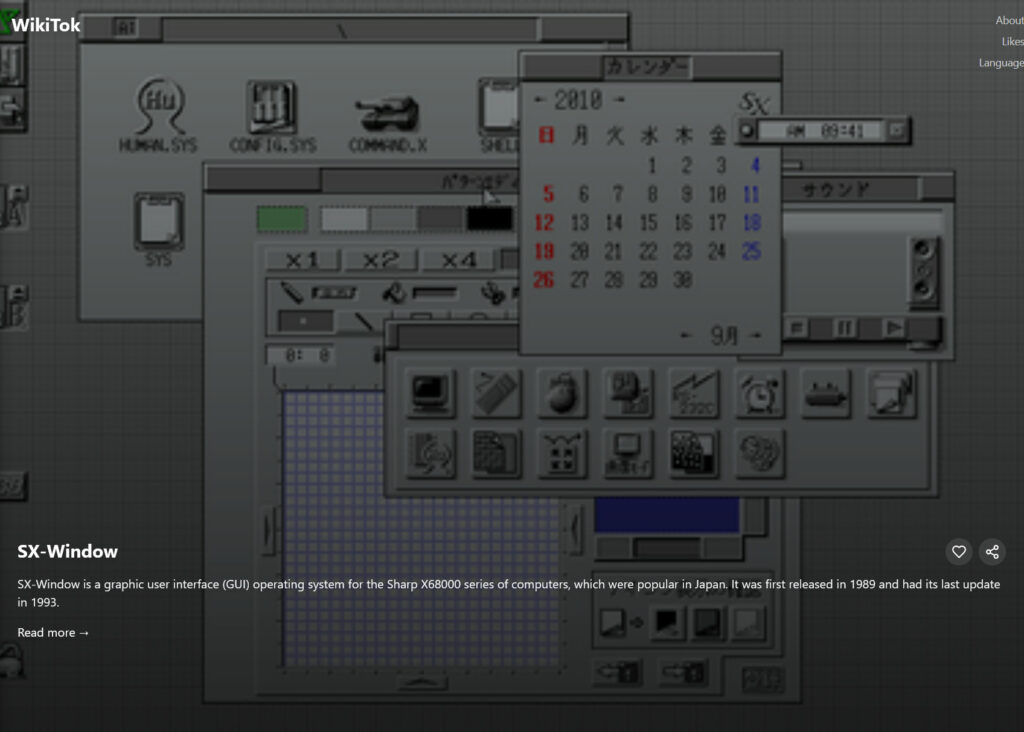
On a recent WikiTok browsing run, I ran across entries on topics like SX-Window (a GUI for the Sharp X68000 series of computers), Xantocillin (“the first reported natural product found to contain the isocyanide functional group), Lorenzo Ghiberti (an Italian Renaissance sculptor from Florence), the William Wheeler House in Texas, and the city of Krautheim, Germany—none of which I knew existed before the session started.
How WikiTok took off
The original idea for WikiTok originated from developer Tyler Angert on Monday evening when he tweeted, “insane project idea: all of wikipedia on a single, scrollable page.” Bloomberg Beta VC James Cham replied, “Even better, an infinitely scrolling Wikipedia page based on whatever you are interested in next?” and Angert coined “WikiTok” in a follow-up post.
Early the next morning, at 12:28 am, writer Grant Slatton quote-tweeted the WikiTok discussion, and that’s where Gemal came in. “I saw it from [Slatton’s] quote retweet,” he told Ars. “I immediately thought, ‘Wow I can build an MVP [minimum viable product] and this could take off.'”
Gemal started his project at 12:30 am, and with help from AI coding tools like Anthropic’s Claude and Cursor, he finished a prototype by 2 am and posted the results on X. Someone later announced WikiTok on ycombinator’s Hacker News, where it topped the site’s list of daily news items.
A screenshot of the WikiTok web app running in a desktop web browser. Credit: Benj Edwards
“The entire thing is only several hundred lines of code, and Claude wrote the vast majority of it,” Gemal told Ars. “AI helped me ship really really fast and just capitalize on the initial viral tweet asking for Wikipedia with scrolling.”
Gemal posted the code for WikiTok on GitHub, so anyone can modify or contribute to the project. Right now, the web app supports 14 languages, article previews, and article sharing on both desktop and mobile browsers. New features may arrive as contributors add them. It’s based on a tech stack that includes React 18, TypeScript, Tailwind CSS, and Vite.
And so far, he is sticking to his vision of a free way to enjoy Wikipedia without being tracked and targeted. “I have no grand plans for some sort of insane monetized hyper-calculating TikTok algorithm,” Gemal told us. “It is anti-algorithmic, if anything.“
“L’intelligenza artificiale non esiste! Esistono straordinarie, potentissime tecnologie, che nelle mani di un’intelligenza umana capace potrà fare delle cose straordinarie altrimenti finisce male. Per questi motivi è fondamentale investire nella Formazione per consentire alle giovani generazioni di gestire queste nuove tecnologie, potentissime, nel modo migliore: in modo informato, critico e intelligente”. È uno dei passaggi più significati dell’intervento di Luciano Floridi, nuovo presidente della Fondazione LeonardoETS presentata alla Camera dei Deputati insieme a Roberto Cingolani, AD di Leonardo, e a Helga Cossu, Direttore Generale della Fondazione Leonardo ETS. Ha moderato Jordan Foresi, coordinatore del Progetto Outreach della Fondazione. 📽️ Il videointervento integrale dell’intervento del prof. Floridi
AI Act: le 5 cose da sapere sul nuovo regolamento europeo
Il 2 febbraio 2025 sono entrate in vigore le prime disposizioni dell’AI Act, il regolamento dell’Unione Europea sull’intelligenza artificiale. Questo testo mira a proteggere i diritti dei cittadini e a limitare gli abusi dell’IA.
Le misure già applicate
Alcune norme sono entrate in vigore immediatamente:
Stop ai sistemi di scoring sociale, simili a quelli usati in Cina.
Divieto della polizia predittiva, che anticipa il rischio di reati.
Niente riconoscimento delle emozioni in ambito lavorativo e scolastico.
Vietata l’identificazione biometrica in tempo reale negli spazi pubblici per riconoscere razza, opinioni politiche, religiose o orientamento sessuale.
Le prossime tappe del regolamento
Il regolamento sarà implementato gradualmente:
Dal 1° agosto 2025, i modelli di IA generativa (come ChatGPT e Gemini) dovranno essere più trasparenti sulle loro fonti di dati e passare audit di sicurezza.
Dal 2027, le IA ad alto rischio, come quelle usate in giustizia, polizia, sanità ed energia, dovranno essere sottoposte a valutazioni per ridurre errori e bias.
Chi controllerà il rispetto delle regole?
L’UE istituirà un Bureau dell’IA, un ufficio europeo dell’AI, che lavorerà con le autorità nazionali di protezione dei dati (come ad esmepio il nostro Garante Privacy o la CNIL in Francia). Le aziende che non rispettano le regole rischiano multe fino al 7% del loro fatturato globale.
Un regolamento contestato
Il settore dell’IA ha criticato l’AI Act, soprattutto per l’obbligo di trasparenza sui dati di addestramento.
Le aziende tech si oppongono, temendo di dover rivelare segreti industriali.
I detentori di diritti d’autore, invece, applaudono la misura, sperando di ottenere compensazioni.
Un freno alla competitività dell’UE?
Alcuni esperti temono che norme troppo rigide penalizzino l’innovazione europea, creando un’eccessiva burocrazia. Tuttavia, i sostenitori del regolamento affermano che un quadro normativo chiaro favorisce uno sviluppo più sicuro e stabile dell’IA.
L’AI Act continuerà a far discutere nei prossimi mesi, anche nei rapporti tra UE e il nuovo governo di Donald Trump, vicino agli interessi delle big tech.
Riepilogo in tabella
Aspetto
Dettagli
Misure già in vigore
Stop scoring sociale, polizia predittiva e riconoscimento facciale in tempo reale.
Prossime tappe
2025: trasparenza per IA generativa. 2027: valutazioni per IA ad alto rischio.
Controllo e sanzioni
Bureau dell’IA + autorità nazionali. Multe fino al 7% del fatturato.
Critiche principali
Trasparenza sui dati di addestramento. Tech preoccupata, detentori di diritti favorevoli.
Competitività UE
Rischio burocrazia, ma i difensori dicono che aumenterà la fiducia nel settore.
Le italiane AIKO e Tyvak International testano l’AI nelle operazioni satellitari
AI e spazio: la collaborazione tra AIKO e Tyvak International
Oggi la competizione globale si gioca sulla capacità di sviluppare tecnologie autonome, tra cui l’intelligenza artificiale (AI). In questo, affidarsi esclusivamente a modelli esteri (OpenAI, DeepMind, Baidu, ecc.) significa dipendere da soluzioni sviluppate da altri Paesi, con il rischio di perdere controllo su dati strategici e algoritmi.
Le startup, come le piccole e medie imprese, possono diventare motori di crescita per il tessuto industriale italiano, creando nuove opportunità di business e favorendo la competitività delle imprese, allo stesso tempo possono aiutare nella costruzione di un ecosistema AI indipendente, evitando la colonizzazione digitale da parte delle big tech straniere.
La scaleup torinese AIKO, che sviluppa software avanzati basati sull’AI e l’automazione per applicazioni spaziali, e Tyvak International, azienda italiana ed europea che realizza nano – e micro – satelliti, hanno annunciato una collaborazione per ottimizzare la gestione operativa dei satelliti e ridurre il carico di lavoro degli operatori, aumentando l’efficienza e la sicurezza delle missioni spaziali.
Il software gifted_GENE applicato a un satellite CubeSat 6U
“Insieme a Tyvak International è stato possibile testare sul campo l’efficacia e l’efficienza del sistema gifted_GENE, confermando la validità dell’approccio. I risultati promettono di ridefinire i confini dell’esplorazione spaziale, stabilendo un nuovo paradigma nel settore in termini di efficienza, precisione e avanzamento tecnologico”, ha spiegato Lorenzo Feruglio, CEO e Co-founder di AIKO.
“Grazie all’AI, siamo riusciti a ottimizzare la gestione dei dati e la pianificazione delle missioni, riducendo tempi e margini di errore. Ciò che ci entusiasma di più è il potenziale che questa tecnologia ha di rivoluzionare completamente le missioni spaziali”, ha aggiunto Fabio Nichele, CEO di Tyvak International.
L’AI applicata ai progetti di missioni spaziali porta benefici tangibili alle aziende e ai team che operano nel settore, aprendo a nuove opportunità di innovazione e di crescita economica.
Con l’automatizzazione dei processi, questo tempo è stato ridotto, consentendo ai team di concentrarsi su operazioni strategicamente più rilevanti per la profittabilità della missione.
In termini pratici, il sistema ha rilevato 4 anomalie su 5 con un solo falso positivo alla settimana per ogni componente, superando in modo significativo l’efficacia dei metodi tradizionali, che vedono il coinvolgimento diretto degli operatori.
Prima dell’integrazione dell’AI, gli operatori dovevano dedicare circa il 30% del loro tempo a eseguire manualmente ispezioni e controlli sui dati telemetrici.
Generative AI: Evoluzione, Funzionamento e Impatto sulla Trasformazione Digitale
Questo articolo fa parte di una serie dedicata all’esplorazione approfondita della Generative Artificial Intelligence (GenAI), una tecnologia rivoluzionaria che sta ridefinendo il panorama digitale. Attraverso un’analisi dettagliata, ripercorreremo la storia, esamineremo il funzionamento e valuteremo l’impatto di questa tecnologia che, secondo le previsioni di Gartner, sarà implementata dall’80% delle organizzazioni entro il 2026.
La Generative AI, talvolta chiamata GenAI, è un tipo di intelligenza artificiale (AI) in grado di creare contenuti originali, come testi, immagini, video, audio o codice software, in risposta al prompt o alla richiesta di un utente. Per rispondere a queste richieste, la GenAI utilizza sofisticati modelli di machine learning, chiamati modelli di deep learning, ovvero algoritmi in grado di simulare i processi di apprendimento e decisionale del cervello umano. Questi si basano sull’identificazione e la codifica di modelli e relazioni in enormi quantità di dati, che sono utilizzati per comprendere le richieste o le domande in linguaggio naturale degli utenti e rispondere con nuovi contenuti pertinenti.
L’AI ha rappresentato uno dei principali argomenti tecnologici degli ultimi dieci anni, ma l’AI generativa, e in particolare l’avvento di ChatGPT nel 2022, ha portato l’AI alla portata di tutti e ha lanciato un’ondata di innovazione senza precedenti. L’AI generativa offre enormi vantaggi in termini di produttività per tutti, individui e organizzazioni, e, sebbene presenti anche sfide e rischi sostanziali, la ricerca continua a esplorare i modi in cui questa tecnologia può migliorare i workflow, potenziare i prodotti e ottimizzare i servizi.
Secondo una ricerca realizzata nel 2023 da McKinsey, un terzo delle organizzazioni utilizza regolarmente l’AI generativa in almeno una funzione aziendale [1]. Gartner prevede che entro il 2026 oltre l’80% delle organizzazioni avrà implementato applicazioni di AI generativa oppure utilizzerà interfacce di programmazione delle applicazioni (API) di AI generativa [2].
Excursus Storico della Generative AI: Dall’Origine ai Moderni Foundation Model
Il termine Intelligenza Artificiale Generativa è divenuto popolare negli ultimi anni, ma l’intelligenza artificiale fa parte della quotidianità da decenni e la tecnologia di AI generativa di oggi si basa sulle scoperte dell’apprendimento automatico risalenti all’inizio del XX secolo. Cerchiamo di comprendere le tappe fondamentali:
1964: Joseph Weizenbaum, ricercatore-informatico del MIT, sviluppa ELIZA, un’applicazione di elaborazione del linguaggio naturale basata su testo. ELIZA, è stato sostanzialmente il primo chatbot (all’epoca chiamato “chatterbot”) basato su uno script di pattern-matching in grado di rispondere agli input, forniti sottoforma di testo in linguaggio naturale, con risposte testuali empatiche.
1999: Nvidia lancia GeoForce, la prima unità di elaborazione grafica. Originariamente sviluppata per fornire una grafica in movimento fluida per i videogiochi, le GPU sono diventate di fatto la piattaforma per lo sviluppo di modelli AI e il mining di criptovalute.
2004: Google lancia la funzione di completamento automatico, che si attiva quando gli utenti inseriscono i termini di ricerca, in grado di generare potenziali parole o frasi successive. L’algoritmo è basato su una catena Markov, un modello matematico sviluppato nel 1906.
2013: Compaiono i primi “Variational Autoencoders” (VAE), dei modelli di reti neurali che permettono di implementare un modello generativo.
2014: Ian Goodfellow, ricercatore presso l’Università di Montreal, introduce le prime “Generative Adversarial Networks” (GAN) e i “Diffusion Models” [3], due architetture per addestrare un modello generativo di AI.
2017: Un gruppo di ricerca formato da Ashish Vaswani, un team di Google Brain e un gruppo della University of Toronto pubblicano “Attention is All You Need [4]”, un documento che illustra i principi dei modelli di trasformazione (c.d. “Transformer”) in grado di abilitare i potenti “foundation model” e strumenti di AI generativa attuali.
2019: OpenAI implementa i suoi modelli linguistici di grandi dimensioni GPT (Generative Pretrained Transformer), GPT-2 e GPT-3.
2022: OpenAI presenta ChatGPT, un front-end di GPT-3 che genera frasi complesse, coerenti e contestualizzate, e contenuti in risposta ai prompt degli utenti finali.
La notorietà e la popolarità acquisite da ChatGPT ha dato il via ad una serie di progetti finalizzati allo sviluppo di altre AI generative e il rilascio di prodotti a un ritmo incalzante, fino a giungere alle attuali release di Google Bard (ora Gemini), Microsoft Copilot, Bedrock di Amazon, Ernie Bit di Baidu, Pangu-Σ di Huawei, Claude di Anthropic, xAI di Elon Musk, Jais in lingua araba, Poe di Quora, IBM watsonx.ai, e ai modelli linguistici di grandi dimensioni (LLM) open source come Llama-2, di Meta, o Dolly 2.0 di Databricks e OpenChat AI GitHub.
Come Opera la Generative AI: Architetture, Processi e Metodologie di Apprendimento
Normalmente il ciclo di vita della Generative AI si sviluppa in tre fasi:
Formazione: la fase in cui si crea un “foundation model”[5] che possa servire come base per più applicazioni di AI di nuova generazione.
Ottimizzazione: la fase in cui si adatta il foundation model a una specifica applicazione AI di nuova generazione.
Generazione, valutazione e improvement: la fase in cui si valutano i risultati dell’applicazione della GenAI per migliorarne la qualità e l’accuratezza.
Formazione
La GenAI si fonda su un foundation model, un modello di deep learning che funge da schema per diversi tipi di applicazioni di AI generativa. I foundation model più comuni sono i modelli linguistici di grandi dimensioni (LLM), sfruttati nelle applicazioni per generare testo, ma esistono foundation model per generare immagini, video, audio e musica, oltre a foundation model multimodali in grado di supportare simultaneamente diversi tipi di contenuti.
Per realizzare un foundation model occorre addestrare un algoritmo di deep learning su enormi volumi di dati grezzi, non strutturati e non etichettati, spesso raccolti dalla rete internet o da altre fonti di dati. Durante la fase di training, l’algoritmo esegue e valuta milioni di test c.d.”fill in the blank” (riempimento dello spazio), cercando di prevedere l’elemento successivo in una determinata sequenza, per esempio la parola successiva in una frase, l’elemento successivo in un’immagine, il comando successivo in una riga di codice, e, contestualmente, effettua un auto-tuning per ridurre al minimo la differenza tra le previsioni e i dati reali (o il risultato “corretto”).
Il risultato di questo ciclo di training è una rete neurale di parametri, ovvero una serie di rappresentazioni codificate di entità, pattern e relazioni nei dati, in grado di generare contenuti in modo autonomo in risposta agli input o ai prompt ricevuti.
Questo processo si caratterizza per l’alta intensità di calcolo, un elevato dispendio in termini di tempo e costi: infatti richiede la presenza di migliaia di unità di elaborazione grafica (GPU) sottoforma di cluster e settimane di elaborazione. Fortunatamente sono disponibili progetti di foundation model open source, come Llama-2 di Meta, che consentono agli sviluppatori di GenAI di saltare questo passaggio e i relativi costi.
Ottimizzazione
Un foundation model è generalista, ovvero sa molte cose su molti tipi di contenuti, ma spesso non è in grado di generare tipi specifici di output con la precisione o la qualità desiderate. Per questo motivo è opportuno che il modello debba essere ottimizzato seguendo un’attività di generazione dei contenuti specifica. Questo obiettivo può essere raggiunto in vari modi:
attraverso una messa a punto del modello. Questa metodologia comporta l’alimentazione del modello con dati specifici dell’applicazione di generazione di contenuti, cioè, deve comprendere le domande o i prompt che molto probabilmente l’applicazione riceverà e le corrispondenti risposte corrette nel formato desiderato. Per esempio, se un team di sviluppo sta tentando di creare un customer service chatbot, creerà centinaia o migliaia di documenti contenenti domande etichettate sul servizio clienti con le risposte corrette e li invierà al modello.
tramite un apprendimento di rinforzo con feedback umano (RLHF). La metodologia di RLHF (Reinforcement Learning from Human Feedback) prevede che gli utenti umani rispondano ai contenuti generati con valutazioni che, successivamente, il modello utilizza per aggiornare sé stesso e ottenere maggiore precisione o rilevanza.
Generazione, valutazione e improvement
Di norma, sia gli sviluppatori che gli utenti valutano continuamente i risultati delle app di GenAI che utilizzano e, di conseguenza, ottimizzano ulteriormente il modello per ottenere una maggiore precisione o pertinenza.
Esiste un’altra alternativa per ottimizzare le prestazioni di un’applicazione di AI: la “retrieval augmented generation” (RAG). La RAG è un framework in grado di estendere il foundation model al fine di utilizzare un set di fonti rilevanti, al di fuori dei dati utilizzati nel training, capaci di integrare e perfezionare i parametri o le rappresentazioni nel modello originale. A riguardo, la RAG garantisce che un’app di AI generativa abbia sempre accesso alle informazioni più aggiornate e contestualizzate. Inoltre, le fonti aggiuntive a cui si accede tramite RAG, a differenza dei dataset del foundation model originale, sono trasparenti e verificabili.
Architetture dei Modelli di Generative AI: Tecnologie che Abilitano la Creatività Artificiale
Dal 2013 abbiamo assistito allo sviluppo di modelli di AI veramente generativa, ovvero modelli di “deep learning” in grado di creare autonomamente contenuti su richiesta. Le principali architetture evolute durante questo periodo includono:
Variational Autoencoders (VAE): rappresentano modelli che hanno consentito di effettuare scoperte rivoluzionarie nel riconoscimento delle immagini, nell’elaborazione del linguaggio naturale e nel rilevamento delle anomalie.
Generative Adversarial Networks (GAN) & Diffusion Models: sono architetture che hanno migliorato l’accuratezza delle applicazioni precedenti e hanno reso possibile le prime applicazioni di AI per la generazione di immagini da foto reali.
Transformers: rappresentano l’architettura dei modelli di deep learning alla base dei principali foundation model e delle soluzioni di AI generativa di oggi.
Variational Autoencoder
Un “autoencoder” è un modello di deep learning composto da due reti neurali connesse tra loro: una che codifica (o comprime) un’enorme quantità di dati, non strutturati e non etichettati, in parametri per il training e un’altra che decodifica tali parametri per ricostruire il contenuto. Tecnicamente, gli autoencoder sono in grado di generare nuovi contenuti, ma sono utilizzati prevalentemente per la codifica, l’archiviazione o il trasferimento dei dati e, infine, per la decodifica degli stessi e la generazione di contenuti di alta qualità.
Nel 2013 sono stati introdotti i “Variational Autoencoder” (VAE) che, oltre a codificare i dati come un autoencoder, sono in grado di decodificare i dati in diverse varianti di contenuto. Questa peculiarità ha permesso di addestrare i VAE a generare varianti per raggiungere un particolare obiettivo e, al contempo, consentire di ottenere nel tempo contenuti più accurati e ad alta fedeltà. Le prime applicazioni dei VAE includevano il rilevamento delle anomalie (per esempio, nella diagnostica per immagini) e la generazione del linguaggio naturale.
Generative Adversarial Network
Anche le “Generative Adversarial Network” (GAN), introdotte nel 2014, comprendono due reti neurali: una denominata Generatore, adibita a generare nuovi contenuti, e una Discriminatore, destinata a valutare l’accuratezza e la qualità dei dati generati. Questi algoritmi antagonisti inducono il modello a generare output di qualità sempre più elevata.
Solitamente le GAN vengono utilizzate per generare immagini e video, ma sono in grado di originare contenuti realistici e di alta qualità anche in altri domini. Si sono dimostrate particolarmente efficaci in determinate attività, come il trasferimento di stile (per esempio la modifica dello stile di un’immagine: da una foto a uno schizzo a matita) e l’aumento dei dati (creazione di nuovi dati per aumentare le dimensioni e la diversità di un data set di training).
Diffusion Model
Un “Diffusion Model”, anch’essi introdotti nel 2014, funziona in maniera differente. Questo modello, prima di realizzare il training, aggiunge rumore ai dati per renderli casuali e irriconoscibili, successivamente, addestra l’algoritmo a disperdere iterativamente il rumore per rivelare l’output desiderato.
I Diffusion Models richiedono più tempo per l’addestramento rispetto ai VAE o alle GAN, ma offrono un controllo dell’output più preciso; infatti, sono particolarmente sfruttati negli strumenti di generazione di immagini di alta qualità. DALL-E, lo strumento di generazione di immagini di Open AI, è guidato da un diffusion model.
Transformer
I “Transformer”, documentati per la prima volta in un articolo del 2017 pubblicato da Ashish Vaswani e altri, trasformano il paradigma encoder-decoder per realizzarne un’evoluzione, da un lato, del modo in cui i foundation model vengono addestrati e, dall’altro, nella qualità e nella gamma di contenuti che possono produrre. Questi modelli sono alla base dei principali strumenti di AI generativa, tra cui ChatGPT e GPT-4, Copilot, BERT, Bard e Midjourney.
Per determinare quali dati, all’interno di una sequenza, sono più importanti e su quali occorre concentrarsi, i transformer utilizzano un concetto chiamato “attention” in grado di:
elaborare contemporaneamente intere sequenze di dati (ad es. frasi invece di parole singole);
acquisire il contesto dei dati all’interno della sequenza;
codificare i dati di training in incorporamenti (denominati anche iperparametri) che rappresentano i dati e il loro contesto.
Oltre a consentire un addestramento più rapido, i transformer sono performanti nel l’elaborazione del linguaggio naturale (“Natural Language Processing”, NLP) e nella sua comprensione (“Natural Language Understanding”, NLU) e sono in grado di generare sequenze di dati più lunghe (ad esempio, non solo risposte a domande, ma anche poesie, articoli o documenti) con maggiore precisione e qualità rispetto ad altri modelli di AI generativa. I modelli transformer possono essere addestrati o ottimizzati anche per l’uso di tools, ad esempio un’applicazione di fogli di calcolo, un programma di disegno, o per generare contenuti in un formato particolare.
Peculiarità della Generative AI
L’AI generativa può essere utilizzata per creare molti tipi di contenuti in domini diversi.
Testo: I modelli generativi, soprattutto quelli basati sui trasformer, possono generare testi coerenti e contestualmente rilevanti, come delle istruzioni, della documentazione, una brochure, un’e-mail, dei testi per siti web, blog, articoli, delle relazioni, dei documenti e, persino, contenuti creativi. Possono eseguire compiti di scrittura ripetitivi o noiosi (per esempio, la stesura di riassunti di documenti o meta descrizioni di pagine web), consentendo agli editor di dedicarsi a lavori più creativi e di maggior valore.
Immagini e video: La generazione di immagini, come DALL-E, Midjourney e Stable Diffusion, può realizzare immagini realistiche, oppure opere d’arte originali, ed eseguire il trasferimento di stili, la traduzione image-to-image e altre attività di modifica o miglioramento delle immagini. Gli strumenti GenAI video possono creare animazioni a partire da istruzioni di testo e possono applicare effetti speciali a video esistenti in maniera più rapida ed economica rispetto ai metodi tradizionali.
Suono, parole e musica: I modelli generativi possono sintetizzare contenuti vocali e audio per farli sembrare reali alle chatbot e agli assistenti digitali a comando vocale, consentire la narrazione degli audiolibri e di altre applicazioni basate sull’audio. La stessa tecnologia può generare musica originale in grado di imitare la struttura e l’audio delle composizioni professionali.
Codice software: La GenAI può generare codice di programmazione originale, effettuare il completamento automatico dei frammenti di codice, tradurre tra diversi linguaggi di programmazione e riassumere le funzionalità del codice. Consente di ottenere prototipi, eseguire rapidamente il debug delle applicazioni e realizzare sessioni di testing, offrendo al contempo un’interfaccia in linguaggio naturale.
Design e arte: I modelli di AI generativa possono generare opere d’arte digitali e di design uniche o assistere nella progettazione grafica. Le applicazioni includono la generazione dinamica di ambienti, personaggi o avatar ed effetti speciali per realizzare simulazioni virtuali e videogiochi.
Simulazioni e artefatti: I modelli di AI generativa possono essere addestrati per generare dati o strutture basate su dati reali o virtuali. Per esempio, l’AI generativa viene applicata nella scoperta di farmaci per generare strutture molecolari con le proprietà desiderate, contribuendo alla progettazione di nuovi composti farmaceutici.
Quali sono i Vantaggi?
Il principale beneficio, e forse quello più scontato, dell’AI generativa è la maggiore efficienza. La sua capacità di generare contenuti e risposte alle domande consente di accelerare o automatizzare le attività ad alta intensità di lavoro, ridurre i costi e guadagnare tempo da dedicare ad attività di maggior valore.
L’AI generativa offre ulteriori vantaggi in questi ambiti:
Creatività migliorata: Gli strumenti di Gen AI possono ispirare la creatività attraverso il brainstorming automatizzato, perché gli consente di generare più versioni inedite dei contenuti. Queste varianti possono servire come punti di partenza o riferimenti per superare il blocco creativo di scrittori, artisti, designer e altri tipi di creatori.
Processo decisionale migliorato (e più rapido): L’AI generativa è predominante nell’analisi di grandi insiemi di dati, nell’identificazione degli schemi e nell’estrazione di insight significativi, per poi generare ipotesi e suggerimenti basati su questi insight e supportare i dirigenti, gli analisti, i ricercatori e tutti gli altri professionisti, nel prendere decisioni più corrette e basate sui dati.
Personalizzazione dinamica: L’AI generativa può analizzare le preferenze e la cronologia degli utenti per creare contenuti personalizzati in tempo reale, rendendo l’esperienza dell’utente più personalizzata e coinvolgente.
Disponibilità continua: L’AI generativa funziona in maniera costante e fornisce una disponibilità continua per le attività come le chatbots utilizzate per erogare l’assistenza ai clienti e le risposte automatiche.
Casi d’uso
Di seguito sono riportati, solo a titolo esemplificativo, alcuni casi d’uso dell’AI nel settore business, per comprendere quali benefici possono portare nel breve periodo. In tal senso, man mano che le tecnologie si svilupperanno ulteriormente e le organizzazioni incorporeranno questi tools nei loro workflow, assisteremo alla scoperta di nuove e altrettante applicazioni.
User experience (UX): Il settore marketing delle aziende può trarre grossi benefici, in termini di tempo e quantità di contenuti, utilizzando strumenti di AI per redigere i testi dei blog, delle pagine web, della documentazione, dell’e-mail e altro ancora. Inoltre, le soluzioni di AI generativa sono in grado di produrre testi e immagini fortemente personalizzate e in tempo reale, in base a quando, dove e a chi deve essere erogato l’annuncio. Inoltre, può alimentare le chatbots e gli agent virtuali per fornire risposte personalizzate e, persino, avviare attività per conto del cliente. Tutto ciò rappresenta un avanzamento significativo rispetto alla precedente generazione di modelli di AI conversazionali formati su dati limitati e sfruttati per attività molto specifiche.
Sviluppo software e aggiornamento delle applicazioni: Gli strumenti per la generazione del codice basati sull’AI generativa sono in grado di automatizzare e accelerare il processo di scrittura di nuovo codice. Questa caratteristica può essere sfruttata anche per accelerare drasticamente l’aggiornamento delle applicazioni, perché consentirebbe di automatizzare gran parte della codifica ripetitiva necessaria per rinnovare le applicazioni legacy e distribuire in ambienti di cloud ibrido.
Attività digitale: L’AI generativa è in grado di redigere o rivedere rapidamente contratti, fatture, bollette e altri documenti digitali, in modo tale che i dipendenti, che la utilizzano o la gestiscono, possano concentrarsi su attività di concetto.
Scienza, ingegneria e ricerca: I modelli di AI possono aiutare i ricercatori e gli ingegneri a proporre nuove soluzioni per problemi complessi. Nel settore sanitario, ad esempio, i modelli generativi possono essere applicati per sintetizzare le nuove molecole o migliorare la lettura delle immagini degli esami.
Nel prossimo articolo della serie, approfondiremo un aspetto cruciale della Generative AI: la sicurezza e la protezione. Esploreremo le sfide, i rischi e le migliori pratiche per implementare soluzioni di GenAI in modo sicuro e responsabile, analizzando i protocolli di sicurezza e le strategie di protezione necessarie per un utilizzo consapevole di questa potente tecnologia. Per approfondire queste tematiche è possibile scaricare gratuitamente il white paper completo “Generative Artificial Intelligence: Punti di forza, rischi e contromisure”.
[5] Foundation model: Nell’ambito dell’Intelligenza Artificiale, il termine modello identifica un insieme strutturato di algoritmi e parametri che permettono di eseguire specifici compiti di apprendimento automatico. I modelli sono addestrati tramite l’analisi e l’elaborazione di dati, al fine di identificare e apprendere schemi o relazioni tra di essi.
Un foundation model rappresenta un tipo specifico e avanzato di modello di Intelligenza Artificiale. Mentre i modelli generici sono progettati e addestrati per svolgere compiti specifici e ben definiti e possono essere addestrati su set di dati di dimensioni variabili, a seconda del compito che dovranno svolgere; i foundation models, invece, sono addestrati su enormi quantità di dati e con moltissimi parametri. Ciò permette loro di svolgere una varietà di compiti più ampia rispetto ai modelli tradizionali.
Profilo Autore
È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.
Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.
Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.
Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it
Not Gouda-nough: Google removes AI-generated cheese error from Super Bowl ad
Blame cheese.com
While it’s easy to accuse Google Gemini of just making up plausible-sounding cheese facts from whole cloth, this seems more like a case of garbage-in, garbage-out. Google President of Cloud Applications Jerry Dischler posted on social media to note that the incorrect Gouda fact was “not a hallucination,” because all of Gemini’s data is “grounded in the Web… in this case, multiple sites across the web include the 50-60% stat.”
The specific Gouda numbers Gemini used can be most easily traced to cheese.com, a heavily SEO-focused subsidiary of news aggregator WorldNews Inc. Cheese.com doesn’t cite a source for the percentages featured prominently on its Smoked Gouda page, but that page also confidently asserts that the cheese is pronounced “How-da,” a fact that only seems true in the Netherlands itself.
The offending cheese.com passage that is not cited when using Google’s AI writing assistant.
The offending cheese.com passage that is not cited when using Google’s AI writing assistant. Credit: cheese.com
Regardless, Google can at least point to cheese.com as a plausibly reliable source that misled its AI in a way that might also stymie web searchers. And Dischler added on social media that users “can always check the results and references” that Gemini provides.
The only problem with that defense is that the Google writing assistant shown off in the ad doesn’t seem to provide any such sources for a user to check. Unlike Google search’s AI Overviews—which does refer to a cheese.com link when responding about gouda consumption—the writing assistant doesn’t provide any backup for its numbers here.
The Gemini writing assistant does note in small print that its results are “a creative writing aid, and not intended to be factual.” If you click for more information about that warning, Google warns that “the suggestions from Help me write can be inaccurate or offensive since it’s still in an experimental status.”
This “experimental” status hasn’t stopped Google from heavily selling its AI writing assistant as a godsend for business owners in its planned Super Bowl ads, though. Nor is this major caveat included in the ads themselves. Yet it’s the kind of thing users should have at the front of their minds when using AI assistants for anything with even a hint of factual info.
Now if you’ll excuse me, I’m going to go update my personal webpage with information about my selection as World’s Most Intelligent Astronaut/Underwear Model, in hopes that Google’s AI will repeat the “fact” to anyone who asks.
Hugging Face clones OpenAI’s Deep Research in 24 hours
On Tuesday, Hugging Face researchers released an open source AI research agent called “Open Deep Research,” created by an in-house team as a challenge 24 hours after the launch of OpenAI’s Deep Research feature, which can autonomously browse the web and create research reports. The project seeks to match Deep Research’s performance while making the technology freely available to developers.
“While powerful LLMs are now freely available in open-source, OpenAI didn’t disclose much about the agentic framework underlying Deep Research,” writes Hugging Face on its announcement page. “So we decided to embark on a 24-hour mission to reproduce their results and open-source the needed framework along the way!”
Similar to both OpenAI’s Deep Research and Google’s implementation of its own “Deep Research” using Gemini (first introduced in December—before OpenAI), Hugging Face’s solution adds an “agent” framework to an existing AI model to allow it to perform multi-step tasks, such as collecting information and building the report as it goes along that it presents to the user at the end.
The open source clone is already racking up comparable benchmark results. After only a day’s work, Hugging Face’s Open Deep Research has reached 55.15 percent accuracy on the General AI Assistants (GAIA) benchmark, which tests an AI model’s ability to gather and synthesize information from multiple sources. OpenAI’s Deep Research scored 67.36 percent accuracy on the same benchmark.
As Hugging Face points out in its post, GAIA includes complex multi-step questions such as this one:
Which of the fruits shown in the 2008 painting “Embroidery from Uzbekistan” were served as part of the October 1949 breakfast menu for the ocean liner that was later used as a floating prop for the film “The Last Voyage”? Give the items as a comma-separated list, ordering them in clockwise order based on their arrangement in the painting starting from the 12 o’clock position. Use the plural form of each fruit.
To correctly answer that type of question, the AI agent must seek out multiple disparate sources and assemble them into a coherent answer. Many of the questions in GAIA represent no easy task, even for a human, so they test agentic AI’s mettle quite well.
The 7 Best AI Video Generators for Creators and Marketers, Tried and Tested
I took my first foray back into AI video generators when the first version of this article came out in mid-2024.
I was pretty impressed with what was on offer at the time, but my initial assessment was that, while there were some helpful AI-driven features in the world of video, nothing could really change the game for me just yet.
As I updated this article in 2025, let me tell you — I’ve just had my socks knocked off by some absolutely incredible AI video generators and tools.
What’s pretty cool, too, is that there is a huge spectrum of functionality when it comes to AI video generators, too.
The artificial intelligence tools on this list can do everything from helping you remove a couple of “ums” to complete video creation — think entire fantasy worlds from scratch.
Which is incredible because, let’s be real: Creating enough video content to satisfy the TikTok, YouTube, or Instagram algorithm is not easy.
Scripting, filming, editing — video requires multiple steps. Plus, all these tasks involve very different skill sets. Just because you’re great at talking to a camera doesn’t necessarily mean you’re great at editing video, and vice versa.
But thanks to the ever-growing list of AI video tools, you might not have to.
I spent hours testing every AI video generator and tool I could get my hands on — my computer’s fan is still recovering, but don’t worry, I had a great a time — and I’ve pulled together a pretty diverse list of some of the best.
They’re not ranked from best to worst — they’re all really different, so direct comparison isn’t really possible. Instead, I’ve arranged them in order of ease of use.
So, whether you’re a content creator, marketer, or just someone who wants to make better videos, there’s something here for you.
⚡
To help compare the AI video generators and tools a little better — and create videos a marketer or creator would actually be able to use in their day-to-day work — I asked all the tools with AI video generation capabilities to create a video based on the same prompt: “A young woman working on her laptop in a home office.”
1. Canva
Best AI video tool for generating simple AI videos without a learning curve
You already know Canva for its graphic design capabilities — but did you know it also has an AI-powered video editor?
Canva’s Magic Studio offers AI-generated video editing tools, including text-to-video, auto-visual effects, and even AI avatars. If you’re already using Canva for design, it’s a smooth addition to your workflow.
In terms of text-to-video, I was really impressed with Canva’s built-in AI video generator. It worked fast, and the video clips were realistic — surprisingly so when it came to human faces and hands (AI generators’ usual nemeses).
Of course those AI animations on typography and other graphics are a huge timesaver, too! Fun fact: I used this feature to animate a static design for the intro to Buffer Chat: The Podcast.
[embedded content]
Canva pricing: Free with limited features; Pro plans start at $12.99/month.
2. Veed
Best AI video tool for speeding up your workflow with AI features
Veed is probably the best AI video maker for generating a complete video with AI, including voiceovers, music, and the footage itself. It even boasts an AI avatar video generator.
The AI features slot into the workflow so seamlessly, too. Veed walks you through the process step-by-step rather than relying on you to add every possible detail to the prompt. This is a really nice touch, particularly for folks who don’t use AI often.
For example, when I fed Veed my “woman in office prompt,” it followed up by asking what style I’d like for my video (“old film,” “realistic,” “hand-drawn,” and “Lego” were some of the options), with some helpful examples.
Beyond the text-to-image AI video generator, Veed really shines in helping you create entire videos from scratch. For example, I fed it a video script I had for a planned clip about the best time to post on TikTok. From there, I asked it to create a video with a voiceover that featured video clips of people using their phones.
The result was a really great foundation for editing. I could choose my own AI voice and easily swap out some of the stock footage and background music the AI had chosen for me.
Veed pricing: Free with limited features (videos will have a watermark, too); Pro plans start at $12.99/month.
3. Sora
Best AI video generator for creating more complex scenes
OpenAI’s latest creation is taking the internet by storm, and for good reason. Forget brief clips — its AI video generator, Sora, can generate entire scenes from simple text prompts.
This is thanks to its clever ‘storyboard’ feature, where you’ll create a prompt for each frame, and Sora will keep the scene consistent and coherent (unless you ask it to shift gears.)
I used it to generate multi-part AI videos that were uncannily realistic — if you can forgive a wonky finger or two.
Sora struggles with a few things, such as the aforementioned fingers. While the AI video generator’s landscapes and abstract scenes look breathtaking, human and animal movements can still look a bit weird. The women in the above videos, for example, pulled their coffee cups right out of their laptops.
But as an AI video generator for creating dreamy, atmospheric content? Sora is phenomenal.
Sora pricing: Sora is available as part of ChatGPT Plus subscription at $20/month.
4. Hailuo AI
Best AI video generator for experimenting with emerging AI video tech
While not quite at the level of Sora or Runway (below), Hailuo is a fun way to take a no-strings-attached foray into AI video creation. The AI video generator offers decent-quality output and some unique features, like subject reference (using the same character across different videos) and advanced camera movement control.
The barrier to getting up and running with Hailuo AI is really low, and you get new generation credits for free, every single day, on their free plan. I’d argue it’s the best free AI video generator out right now.
If you’re keen to play around here, a pro tip: explore Hailuo’s mindblowing user gallery of AI-generated videos to see how others have prompted the tool for the best results.
Hailuo pricing: Generous free plan, with paid options starting at $14.99 per month
5. Descript
Best AI video tool for transcript-based editing
Descript doesn’t have AI video creation features like most of the other options on this list. It’s really just a video editor — but it does that exceptionally well.
Descript is the answer to the question: “What if we could edit video like we edit text?” Instead of dragging clips around on a timeline, you edit the transcript. Cut a sentence from the text, and the corresponding video disappears.
Once you get the hang of the video editor — because it definitely comes with a learning curve — it’s surprisingly intuitive and incredibly powerful.
On top of that come the nifty AI features. There’s a green screen editor, a surprisingly smooth eye contact corrector (you read that script, my friend!) and even a studio sound feature that uses “regenerative AI” to remove noises and enhance voices.
That said, the real magic happens with Descript’s filler word removal. Those pesky “ums,” “likes,” and awkward pauses? Gone with a single click. While other tools offer similar features, Descript does it best.
One caveat: if your videos don’t involve much talking, you won’t get the full benefit of the tool. But for podcasters, interviewers, or anyone working with dialogue-heavy content, it’s a game-changer.
Descript pricing: A free starter plan is available, with paid plans beginning at $12/month.
6. Synthesia
Best AI video generator for creating your own AI avatar
Need a talking head but don’t want to be on camera? Synthesia offers over 70 AI avatars and 120 voices in its starter plan (with more than 140 avatars in higher tiers). While the avatars aren’t quite ready to replace real humans in close-up shots, they’re pretty effective for training videos or product tutorials.
You can even create an avatar of yourself, though it’s a bit of a process — you’ll need to film specific video clips and wait up to 10 days for the AI magic to happen. The voice dubbing can be hit or miss, so it’s worth experimenting with different AI avatar and voice combinations to find a good match.
Synthesia pricing: Plans start at $22 per month billed annually.
7. Runway
Best AI video generator for advanced generative AI
Can you imagine it — and come up with a really thorough, detailed prompt for it? Then Runway can create it.
While Runway requires a bit more technical know-how than Sora, this AI video generator packs some seriously powerful features that can turn your wildest imaginings into reality.
The platform’s Gen-3 Alpha model can generate videos from text prompts, bring still images to life, and even create lip-syncing avatars from voice recordings. There are practical features baked into this AI video creator, too: You can remove backgrounds, create super-slow motion footage, and generate subtitles with just a few clicks.
A bit of a drawback for casual users is that Runway’s Gen-2 model isn’t as great at creating humans (my prompt yielded some pretty creepy Tim Burton-esque figures). The Gen-2 model is the only one you’ll have access to on the free plan, but you can still use the still-image-to-video feature for free (which is exceptional).
Fair warning: there’s definitely a learning curve with this video generator. I spent hours exploring the web version to create videos and barely scratched the surface of what it can do. But, if you’re willing to put in the time and pay for a premium plan, Runway could become your entire AI video production studio.
Runway pricing: Free plan available with 125 one-time credits. Standard plan starts at $15/month, unlocking Gen-3 Alpha, 625 monthly credits, no watermark, and higher export quality.
AI video generators won’t do all the work for you — yet
Many of these AI video generators have simplified parts of my video editing workflow (and they’re incredibly fun to play around with). But, as powerful as the latest and greatest tools are, none of the options out there are going to eliminate the need for human creativity (and tenacity?) required for brainstorming, filming, and editing engaging video content.
Which, if you think about it, is pretty great. There’s really no replacement for you.
Still, they can certainly help lighten the load by simplifying some of the frustrating work that comes with video creation, freeing you up to focus on the creative process.
As is the case with all other AI tool niches, it feels as though there is a new AI video generator dropping every day — so if I haven’t featured your tool of choice here, do let me know!
Please comment below or tag @buffer or @bufferapp on all major social channels, and I’ll put your favorite tool to the test.