Governare l’AI per il bene dell’umanità: sfide e proposte globali. Il Report delle Nazioni Unite

Il Report delle Nazioni Unite “Governing AI for Humanity“

L’Intelligenza Artificiale (IA) è una delle tecnologie più trasformative del nostro tempo, con il potenziale di rivoluzionare settori fondamentali come la sanità, l’istruzione, l’energia e l’agricoltura. Tuttavia, come sottolineato nel rapporto “Governing AI for Humanity“ redatto dall’High-level Advisory Body on Artificial Intelligence (AI) per le Nazioni Unite, la mancanza di una governance globale solida rischia di amplificare le disuguaglianze e mettere in pericolo i diritti umani.

L’obiettivo del rapporto è delineare raccomandazioni pratiche per una gestione equa e responsabile dell’AI, garantendo che questa tecnologia lavori per il bene comune. Il documento mette in luce sia i vantaggi, sia le preoccupazioni legate all’IA, evidenziando la necessità di una collaborazione internazionale per affrontare le sfide emergenti.

Opportunità offerte dall’AI

L’intelligenza artificiale ha il potenziale per portare avanti progressi senza precedenti nel miglioramento della qualità della vita e nel raggiungimento degli Obiettivi di Sviluppo Sostenibile (SDG) delle Nazioni Unite. Alcuni degli ambiti in cui l’AI può giocare un ruolo decisivo includono:

  • Salute pubblica: Diagnosi mediche più rapide e accurate, soluzioni per la gestione di pandemie, ricerca farmaceutica avanzata.
  • Agricoltura: Sistemi intelligenti per la gestione delle colture, ottimizzazione delle risorse idriche e miglioramento delle pratiche agricole sostenibili.
  • Energia: Ottimizzazione delle reti elettriche e delle risorse rinnovabili, riduzione degli sprechi e miglioramento dell’efficienza energetica.

Tuttavia, il rapporto avverte che, se non governata correttamente, questa tecnologia potrebbe favorire solo una piccola parte della popolazione, soprattutto nei paesi sviluppati, mentre le comunità più vulnerabili resterebbero escluse dai benefici.

I rischi dell’AI senza una governance adeguata

Nonostante le sue promesse, l’AI comporta significativi rischi se non viene regolamentata. Tra le principali preoccupazioni ci sono:

  • Discriminazione e bias: Algoritmi che perpetuano o amplificano pregiudizi esistenti, ad esempio nella selezione del personale o nell’accesso ai servizi sanitari.
  • Sorveglianza di massa: L’uso improprio dell’AI per il monitoraggio delle popolazioni, con gravi implicazioni per la privacy e i diritti umani.
  • Disinformazione: Tecnologie come i deepfake possono essere utilizzate per diffondere false informazioni, destabilizzando società e governi.
  • Automazione militare: L’AI può essere sfruttata per sviluppare armi autonome, con il rischio di un’escalation nei conflitti internazionali.

Inoltre, c’è la crescente preoccupazione che la potenza economica e tecnologica legata all’intelligenza artificiale si concentri nelle mani di poche nazioni o aziende tecnologiche, esacerbando le disuguaglianze globali.

Un deficit di governance globale

Il rapporto denuncia la mancanza di una governance globale coordinata sull’AI. Molte delle attuali normative sono frammentate a livello nazionale o regionale, mentre a livello internazionale c’è una grave carenza di regolamentazioni comuni. Paesi del sud globale, in particolare, sono scarsamente rappresentati nei processi decisionali che riguardano lo sviluppo e la gestione dell’AI, aumentando il divario tecnologico tra nazioni.

Senza un quadro comune e standard internazionali condivisi, la tecnologia in questione rischia di diventare un terreno di scontro geopolitico, come evidenziato dalle tensioni esistenti tra Stati Uniti e Cina sulla supremazia tecnologica. Il documento sottolinea che è cruciale creare un sistema di governance globale inclusivo, capace di rappresentare gli interessi di tutti gli Stati e di promuovere un utilizzo dell’AI che rispetti i diritti umani e le normative internazionali.

Le Raccomandazioni per una governance globale

Per rispondere alle sfide emergenti, il rapporto propone una serie di azioni strategiche:

  1. Creazione di un panel scientifico internazionale sull’AI: Un comitato di esperti globali dovrebbe lavorare per promuovere una comprensione comune dell’IA, evidenziando i rischi e i benefici della tecnologia. Questo gruppo avrebbe il compito di definire linee guida tecniche e scientifiche per garantire uno sviluppo sicuro dell’IA.
  2. Dialogo politico globale: Il rapporto raccomanda l’avvio di un dialogo politico biennale che coinvolga governi, organizzazioni internazionali, settore privato e società civile. Questo forum servirebbe a discutere gli sviluppi dell’IA e condividere le migliori pratiche di governance.
  3. Ufficio AI delle Nazioni Unite: Il documento suggerisce la creazione di un ufficio dedicato all’IA all’interno del Segretariato dell’ONU, con il compito di coordinare le iniziative internazionali in materia di IA e garantire che le Nazioni Unite abbiano una risposta unitaria alle sfide globali.
  4. Fondo globale: Un fondo dedicato dovrebbe essere istituito per supportare i Paesi in via di sviluppo nell’accesso alle risorse necessarie per beneficiare dell’AI. Questo fondo aiuterebbe a colmare il divario tecnologico fornendo strumenti come infrastrutture digitali, dati e formazione.

Una governance flessibile e inclusiva

Un aspetto chiave del rapporto è la necessità di creare un sistema di governance capace di adattarsi all’evoluzione rapida della tecnologia. L’AI si sviluppa a una velocità senza precedenti, e un modello di governance troppo rigido rischierebbe di diventare obsoleto in breve tempo. L’approccio suggerito è quello di una regolamentazione flessibile, che permetta di integrare nuovi sviluppi e di rispondere rapidamente alle sfide emergenti.

Il rapporto riconosce che la creazione di un’agenzia internazionale completamente dedicata all’AI potrebbe essere complicata, ma sostiene che sia necessaria una struttura istituzionale che garantisca la sicurezza e l’equità nello sviluppo dell’intelligenza artificiale, così come è avvenuto per altre tecnologie potenzialmente pericolose, come il nucleare.

Conclusioni

Il documento “Governing AI for Humanity“ rappresenta un appello chiaro per una governance globale inclusiva, capace di bilanciare i benefici con la protezione dei diritti umani e l’equità internazionale. La creazione di un quadro normativo comune e condiviso a livello globale è essenziale per assicurare che l’AI diventi una forza positiva per l’umanità intera, piuttosto che un vantaggio per pochi privilegiati o una minaccia globale. Solo attraverso una cooperazione internazionale strutturata e proattiva sarà possibile governare questa tecnologia in modo sicuro e responsabile.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/governare-lai-per-il-bene-dellumanita-sfide-e-proposte-globali-il-report-delle-nazioni-unite/506180/


Apple backs out of backing OpenAI, report claims

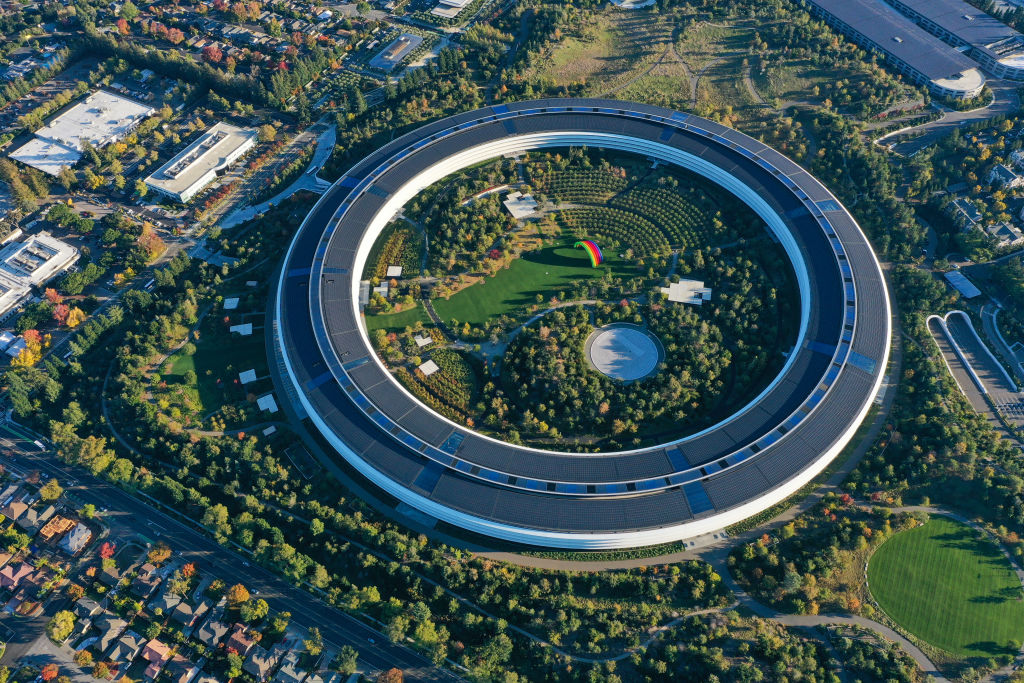
The Apple Park campus in Cupertino, California.
Enlarge / The Apple Park campus in Cupertino, California.

A few weeks back, it was reported that Apple was exploring investing in OpenAI, the company that makes ChatGPT, the GPT model, and other popular generative AI products. Now, a new report from The Wall Street Journal claims that Apple has abandoned those plans.

The article simply says Apple “fell out of the talks to join the round.” The round is expected to close in a week or so and may raise as much as $6.5 billion for the growing Silicon Valley company. Had Apple gone through with the move, it would have been a rare event—though not completely unprecedented—for Apple to invest in another company that size.

OpenAI is still expected to raise the funds it seeks from other sources. The report claims Microsoft is expected to invest around $1 billion in this round. Microsoft has already invested substantial sums in OpenAI, whose GPT models power Microsoft AI tools like Copilot and Bing chat.

Nvidia is also a likely major investor in this round.

Apple will soon offer limited ChatGPT integration in an upcoming iOS update, though it plans to support additional models like Google’s Gemini further down the line, offering users a choice similar to how they pick a default search engine or web browser.

OpenAI has been on a successful tear with its products and models, establishing itself as a leader in the rapidly growing industry. However, it has also been beset by drama and controversy—most recently, some key leaders at OpenAI departed the company abruptly, and it shifted its focus from a research-focused organization that was beholden to a nonprofit, to a for-profit company under CEO Sam Altman. Also, former Apple design lead Jony Ive is confirmed to be working on a new AI product of some kind.

But The Wall Street Journal did not specify which (if any) of these facts are reasons why Apple chose to back out of the investment.

https://arstechnica.com/?p=2053378


OpenAI, perché tutti i super manager scappano? Dopo Murati, lasciano altre menti della ricerca

OpenAI, l’azienda all’avanguardia nel campo dell’intelligenza artificiale, sta affrontando un periodo di forte instabilità ai vertici. Nelle ultime ore, tre figure chiave hanno annunciato la loro partenza: il Chief Research Officer Bob McGrew, il VP of Research Barret Zoph e, notizia ancora più clamorosa, il CTO Mira Murati.

Il CEO Sam Altman ha cercato di rassicurare dipendenti e osservatori esterni, definendo le dimissioni come “decisioni indipendenti e amichevoli”, seppur improvvise. Tuttavia, la concomitanza degli addii ha inevitabilmente sollevato interrogativi sulla stabilità e la direzione futura di OpenAI.

Tra crisi e cambio da no-profit a scopo di lucro

Altman ha prontamente delineato la nuova struttura di leadership, promuovendo Mark Chen a SVP of Research e affidando a Matt Knight il ruolo di Chief Information Security Officer. Kevin Weil e Srinivas Narayanan manterranno le loro posizioni di leadership nel team applicativo, mentre Josh Achiam assumerà il nuovo ruolo di Head of Mission Alignment.

Nonostante le rassicurazioni di Altman, le dimissioni arrivano in un momento cruciale per OpenAI, che starebbe pianificando una transizione verso un modello for-profit e un nuovo round di finanziamenti che la valuterebbe a 150 miliardi di dollari. È plausibile che divergenze sulla direzione strategica dell’azienda, in particolare riguardo al passaggio al modello, abbiano influenzato la decisione dei dirigenti di lasciare la compagnia.

Un esodo di talenti

Le recenti dimissioni si inseriscono in un contesto di più ampio esodo di talenti da OpenAI. Negli ultimi mesi, figure di spicco come Andrej Karpathy, Ilya Sutskever, Jan Leike e John Schulman hanno abbandonato l’azienda. Dei 13 fondatori originali, ne rimangono solo 3.

Questo fuggi-fuggi aumenta le preoccupazioni sul futuro di OpenAI e sulla sua capacità di mantenere la posizione dominante nel campo dell’intelligenza artificiale, soprattutto in un momento di forte competizione con aziende come Anthropic.

Un incontro generale previsto per giovedì potrebbe fare luce sulle motivazioni delle dimissioni e sulla strategia futura di OpenAI. Fino ad allora, l’azienda si trova ad affrontare un periodo di incertezza, con la speranza di poter gestire questa fase di transizione senza compromettere il suo business, attuale e futuro.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/openai-perche-tutti-i-super-manager-scappano-dopo-murati-lasciano-altre-menti-della-ricerca/505962/


Aspetti tecnici degli Adversarial Examples

I recenti progressi nel campo dell’Intelligenza Artificiale (IA) e del Machine Learning (ML) hanno portato a significativi avanzamenti in numerosi settori applicativi. Tuttavia, la ricerca ha evidenziato una classe di vulnerabilità intrinseca a questi sistemi: gli Adversarial Attacks.

Questi attacchi sfruttano le peculiarità dei modelli ML per generare input appositamente modificati, denominati Adversarial Examples, che inducono classificazioni errate pur rimanendo percettivamente indistinguibili dai dati originali per l’osservatore umano.

La presenza di Adversarial Examples solleva questioni critiche riguardo all’affidabilità e alla sicurezza dei sistemi IA/ML in applicazioni ad alto rischio.

Introduzione al Processo di Addestramento di un modello di Machine Learning

Il processo di addestramento di un modello di Machine Learning può essere descritto ad alto livello come composto da un modello ML di cui si è decisa l’architettura, di un set di parametri inizialmente ignoti e di un set di dati di addestramento. I parametri del modello ML sono inizialmente scelti con valori casuali e il processo di addestramento consiste nel calcolare il valore migliore di questi parametri (i modelli di Deep Learning hanno un elevato numero di parametri, ad esempio GPT-3/ChatGPT ne ha 175 miliardi).

Per far questo si esegue il modello ML sui dati di addestramento, di cui si conosce il risultato atteso, e si misura l’errore del risultato dell’esecuzione del modello ML rispetto al risultato corretto. Inizialmente questo errore è molto grande, visto che il modello ML ha parametri casuali, ovvero non sa nulla. Poi si modificano i parametri in modo da ridurre l’errore.

Per semplicità si consideri un modello ML basato su Reti Neurali, addestrato con dati etichettati (Supervised Learning) e si indichi con {W} il set dei parametri del modello e con {X} il set dei dati di addestramento. L’errore del modello ML sui dati di addestramento è quindi una funzione di entrambi, E({W},{X}). Scopo dell’addestramento è cambiare il valore numerico dei parametri in modo da minimizzare l’errore, ovvero trovare min{W}E({W},{X}).

Metodo del Gradiente e Minimizzazione dell’Errore

Per trovare il migliore valore dei parametri, si utilizza principalmente il “metodo del gradiente” (Gradient Descent, Cauchy, 1847) o metodi simili. Questo è un metodo iterativo facilmente implementabile numericamente e quindi in software. Il metodo procede facendo piccolissime modifiche {δW} ai parametri, {W}→{W+δW}, tali che per ogni passo viene scelta la modifica che riduce maggiormente l’errore. Cauchy dimostrò che δW=-εD{W}E({W},{X}), ove ε è un numero piccolo (ad esempio 0,001) e D{W} è la derivata della funzione errore rispetto ai parametri del modello ML. Il ciclo di calcolo (Epoca) su tutti i dati di addestramento viene ripetuto sino a quando non si raggiunge un errore molto piccolo, ad esempio inferiore all’1%.

Origine degli Adversarial Examples

Se è possibile addestrare il modello in modo che produca minimi errori, com’è possibile che vi siano Adversarial Examples? Bisogna ricordare che un modello ML apprende utilizzando uno specifico set di dati di addestramento che inizialmente non comprende gli Adversarial Examples. Il modello ML è capace di elaborare correttamente moltissimi dati che sono simili a quelli del set di addestramento, ma non tutti.

Esistono particolari dati molto simili a quelli di addestramento sui quali il modello ML compie grandi errori: e proprio questi sono gli Adversarial Examples.

In semplici modelli di studio è possibile avere un’idea dell’origine degli Adversarial Examples [Rif. 8].

Costruzione degli Adversarial Examples

È possibile utilizzare un approccio simile a quello adottato per l’addestramento per cercare e costruire degli Adversarial Examples. Si assuma per semplicità di esposizione di aver calcolato i migliori parametri del modello ML e di non modificarli più. Invece si procede a modificare di poco i dati di addestramento cercando la modifica che genera il massimo errore, in formula max{δx}E({W},{X+δX}), ove δX deve rimanere molto piccolo.

Un semplice esempio di cosa si intende per “piccola modifica” può essere fatto per un modello ML che classifica immagini. Per il modello ML ogni immagine è una lunga lista di numeri, ogni numero corrisponde al colore di un pixel dell’immagine (questo se l’immagine è in toni di grigio, per immagini a colori ogni numero è il colore di un canale, ad esempio RGB, di un pixel).

Una “piccola modifica” può essere ad esempio modificare di poco il valore di un pixel e solo per 1 numero/pixel ogni 200 (cioè il 5 per mille); in molti casi questo tipo di modifica non è percettibile dall’occhio umano. In altre parole, si modificano alcuni pixel di un’immagine in modo che per l’occhio umano non vi sia alcuna differenza con l’immagine originale, ma in modo che il modello ML interpreti la nuova immagine come qualcosa di completamente diverso, ovvero massimo errore.

Sebbene il punto di partenza sia molto simile al processo di addestramento, la matematica necessaria per risolvere questo problema è molto più complessa e una soluzione completa non è ancora nota.

Adversarial Examples: Esperimento con Convolutional Neural Network

Riportiamo i risultati di un esperimento di [Rif. 8] che utilizza un semplice modello Convolutional Neural Network per il riconoscimento di immagini e per il quale i ricercatori sono stati in grado di risolvere anche solo approssimativamente l’equazione che definisce gli Adversarial Examples. Il modello ML è addestrato su di un set di dati di addestramento (Train) e verificato su di un set di dati di prova (Test) su cui non è addestrato.

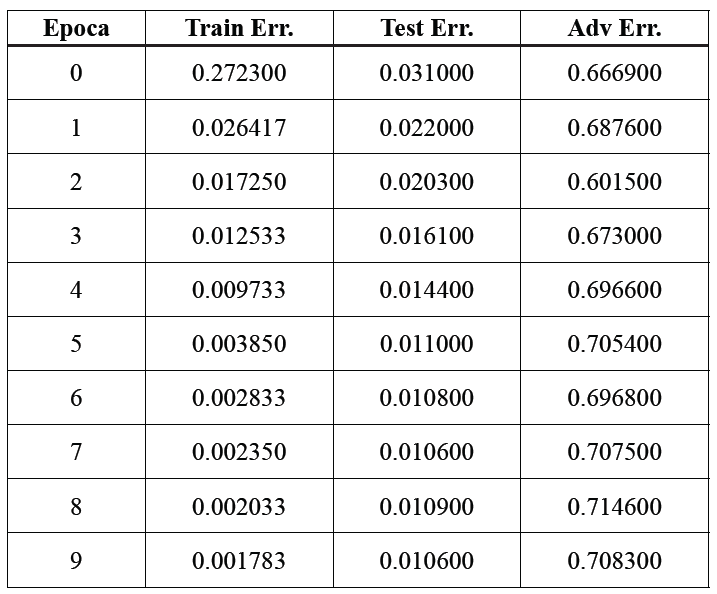
Per ogni ciclo di addestramento (Epoca) viene anche calcolato un set di Adversarial Examples (Adv), ovvero il set {Xadv=X+δX} soluzione (approssimata) dell’equazione max{δx}E({W},{X+δX}) (il calcolo contestuale dei migliori valori dei parametri per minimizzare l’errore e delle variazioni dei dati di addestramento per massimizzare l’errore è chiamato un “problema min-max”). Il risultato è espresso nella seguente tabella (i numeri indicano la percentuale di errore espressa con un numero tra 0 e 1 per i tre set di dati Train, Test, Adv, per ogni ciclo/epoca di addestramento) [Rif. 8].

Percentuale di errore espressa con un numero tra 0 e 1 per i tre set di dati Train, Test, Adv, per ogni ciclo/epoca di addestramento
Tavola 1 [fonte Rif. 8]

Al termine dell’addestramento, l’errore sul set di dati Train è inferiore allo 0,2%, sul set di dati Test (su cui non viene fatto addestramento) è circa dell’1% e il programma ha costruito un set di dati di Adversarial Examples (Adv) molto simile al set di dati Train, ma su cui il modello ML sbaglia il riconoscimento dell’immagine il 71% delle volte.

Cosa è cambiato nelle immagini Adversarial Examples rispetto alle immagini del set di Train? Spesso la modifica corrisponde all’aggiunta di “rumore bianco” all’immagine che può rendere un po’ sfocati alcuni particolari e introdurre dei piccoli punti con colori errati in maniera apparentemente casuale (difetti dell’immagine o “glitch”), simile a quanto visto in Fig. 2. Nulla, comunque, che renda all’occhio umano la nuova immagine realmente diversa da quella originale.

Ri-addestramento con Adversarial Examples

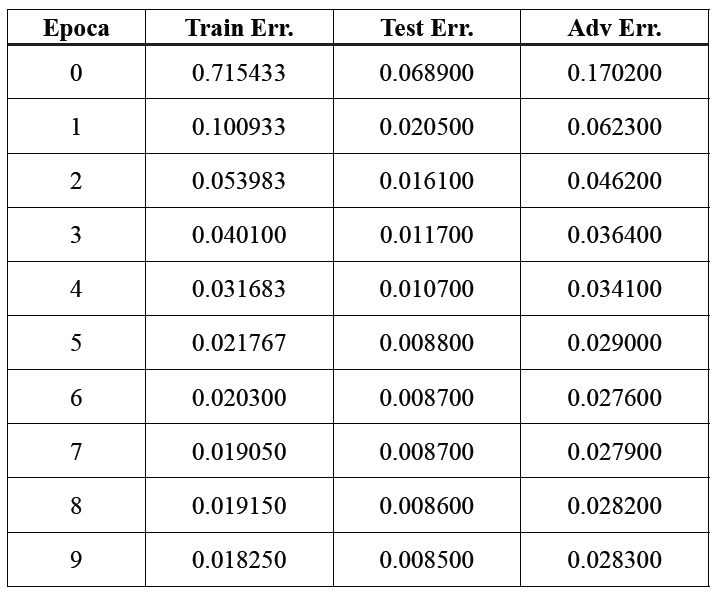
Ora è possibile addestrare il modello ML anche utilizzando il set di dati di Adversarial Examples (Adv) che è stato generato, ma utilizzando sempre il set di dati Test solo per verificare l’addestramento. Il risultato è:

Set di dati di Adversarial Examples (Adv) che è stato generato per verificare l’addestramento
Tavola 2 [fonte Rif. 8]

Gli errori finali sui set di dati di Train e di Test sono cambiati ma le differenze non sono significative per l’esercizio svolto, mentre l’errore sul nuovo set di dati di Adversarial Examples (Adv) generato è sceso dal 71% a circa il 2,8%. Il modello ML ha quindi imparato a riconoscere correttamente anche gli Adversarial Examples generati con questo procedimento e che ora non sono più “antagonisti”. Un modello ML che in pratica non ha Adversarial Examples è chiamato “robusto”; quindi questo modello ML può dirsi “robusto” almeno sino a quando non sarà trovata una nuova classe di suoi Adversarial Examples.

È importante sottolineare che dopo aver ri-addestrato il modello utilizzando anche il set di Adversarial Examples, si può generare con lo stesso procedimento un nuovo set di dati massimizzando l’errore, ma l’errore rimane molto piccolo e il modello riconosce correttamente anche questo set di dati. In altre parole, il procedimento adottato in questo esempio particolare per costruire un set di Adversarial Examples funziona solo la prima volta, poi non genera più set di Adversarial Examples.

Adversarial Examples: Limitazioni e Sfide Future

Riassumendo, è possibile minimizzare gli errori sui dati di addestramento calcolando il valore dei parametri {W} e al contempo generare un set di dati {X+δX} quasi indistinguibile dal set di dati di addestramento ma che massimizza l’errore del modello ML. Anche se poi è possibile ri-eseguire il processo di addestramento includendo gli Adversarial Examples individuati creando un modello ML robusto, ad oggi non è noto un metodo per generare tutti gli Adversarial Examples di un modello ML, ovvero garantire che gli Adversarial Examples trovati siano tutti quelli di un modello ML.

Inoltre, come indicato precedentemente, aggiornare l’addestramento di un modello ML può portare a nuovi problemi, ad esempio la “smemoratezza” (Forgetfulness, dimenticare informazioni precedentemente acquisite) o una maggiore predisposizione ad attacchi di inversione e estrazione di dati di addestramento, problematiche rilevate in alcuni modelli ML di studio.

Il messaggio che viene da questo esercizio è che il processo di addestramento attuale non è completo: l’esistenza degli Adversarial Examples non è dovuta a qualche disattenzione o peculiarità di alcuni modelli ML particolari, ma è una caratteristica di come sono costruiti i modelli ML attuali. La ricerca scientifica su questo problema è molto intensa [Rif. 1], sono stati introdotti anche standard e benchmark sulla “robustezza” dei modelli ML e sui metodi per renderli robusti [Rif. 9], ma è probabile che per poter trovare una soluzione definitiva sia necessaria una migliore comprensione (soprattutto matematica) dei modelli di Machine Learning.

Riferimenti Bibliografici

Rif. 1: N. Carlini, “A Complete List of All (arXiv) Adversarial Example Papers”, https://nicholas.carlini.com/writing/2019/all-adversarial-example-papers.html , nel solo anno 2022 risultano pubblicati quasi 3.000 articoli scientifici relativi a “Adversarial Machine Learning”

Rif. 8: Z. Kolter, A. Madry, “Adversarial Robustness – Theory and Practice”, https://adversarial-ml-tutorial.org/

Rif. 9: F. Croce, M. Andriushchenko, V. Sehwag, E. Debenedetti, N. Flammarion, M. Chiang, P. Mittal, M. Hein, “RobustBench: a standardized adversarial robustness benchmark”, https://robustbench.github.io/ , arXiv:2010.09670

Continua a leggere: scarica il white paper gratuito “Adversarial Attacks a Modelli di Machine Learning“

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/gli-adversarial-examples/


Google and Meta update their AI models amid the rise of “AlphaChip”

Cyberpunk concept showing a man running along a futuristic path full of monitors.
Enlarge / There’s been a lot of AI news this week, and covering it sometimes feels like running through a hall full of danging CRTs, just like this Getty Images illustration.

It’s been a wildly busy week in AI news thanks to OpenAI, including a controversial blog post from CEO Sam Altman, the wide rollout of Advanced Voice Mode, 5GW data center rumors, major staff shake-ups, and dramatic restructuring plans.

But the rest of the AI world doesn’t march to the same beat, doing its own thing and churning out new AI models and research by the minute. Here’s a roundup of some other notable AI news from the past week.

Google Gemini updates

On Tuesday, Google announced updates to its Gemini model lineup, including the release of two new production-ready models that iterate on past releases: Gemini-1.5-Pro-002 and Gemini-1.5-Flash-002. The company reported improvements in overall quality, with notable gains in math, long context handling, and vision tasks. Google claims a 7 percent increase in performance on the MMLU-Pro benchmark and a 20 percent improvement in math-related tasks. But as you know, if you’ve been reading Ars Technica for a while, AI typically benchmarks aren’t as useful as we would like them to be.

Along with model upgrades, Google introduced substantial price reductions for Gemini 1.5 Pro, cutting input token costs by 64 percent and output token costs by 52 percent for prompts under 128,000 tokens. As AI researcher Simon Willison noted on his blog, “For comparison, GPT-4o is currently $5/[million tokens] input and $15/m output and Claude 3.5 Sonnet is $3/m input and $15/m output. Gemini 1.5 Pro was already the cheapest of the frontier models and now it’s even cheaper.”

Google also increased rate limits, with Gemini 1.5 Flash now supporting 2,000 requests per minute and Gemini 1.5 Pro handling 1,000 requests per minute. Google reports that the latest models offer twice the output speed and three times lower latency compared to previous versions. These changes may make it easier and more cost-effective for developers to build applications with Gemini than before.

Meta launches Llama 3.2

On Wednesday, Meta announced the release of Llama 3.2, a significant update to its open-weights AI model lineup that we have covered extensively in the past. The new release includes vision-capable large language models (LLMs) in 11 billion and 90B parameter sizes, as well as lightweight text-only models of 1B and 3B parameters designed for edge and mobile devices. Meta claims the vision models are competitive with leading closed-source models on image recognition and visual understanding tasks, while the smaller models reportedly outperform similar-sized competitors on various text-based tasks.

Willison did some experiments with some of the smaller 3.2 models and reported impressive results for the models’ size. AI researcher Ethan Mollick showed off running Llama 3.2 on his iPhone using an app called PocketPal.

Meta also introduced the first official “Llama Stack” distributions, created to simplify development and deployment across different environments. As with previous releases, Meta is making the models available for free download, with license restrictions. The new models support long context windows of up to 128,000 tokens.

Google’s AlphaChip AI speeds up chip design

On Thursday, Google DeepMind announced what appears to be a significant advancement in AI-driven electronic chip design, AlphaChip. It began as a research project in 2020 and is now a reinforcement learning method for designing chip layouts. Google has reportedly used AlphaChip to create “superhuman chip layouts” in the last three generations of its Tensor Processing Units (TPUs), which are chips similar to GPUs designed to accelerate AI operations. Google claims AlphaChip can generate high-quality chip layouts in hours, compared to weeks or months of human effort. (Reportedly, Nvidia has also been using AI to help design its chips.)

Notably, Google also released a pre-trained checkpoint of AlphaChip on GitHub, sharing the model weights with the public. The company reported that AlphaChip’s impact has already extended beyond Google, with chip design companies like MediaTek adopting and building on the technology for their chips. According to Google, AlphaChip has sparked a new line of research in AI for chip design, potentially optimizing every stage of the chip design cycle from computer architecture to manufacturing.

That wasn’t everything that happened, but those are some major highlights. With the AI industry showing no signs of slowing down at the moment, we’ll see how next week goes.

https://arstechnica.com/?p=2052711


AI bots now beat 100% of those traffic-image CAPTCHAs

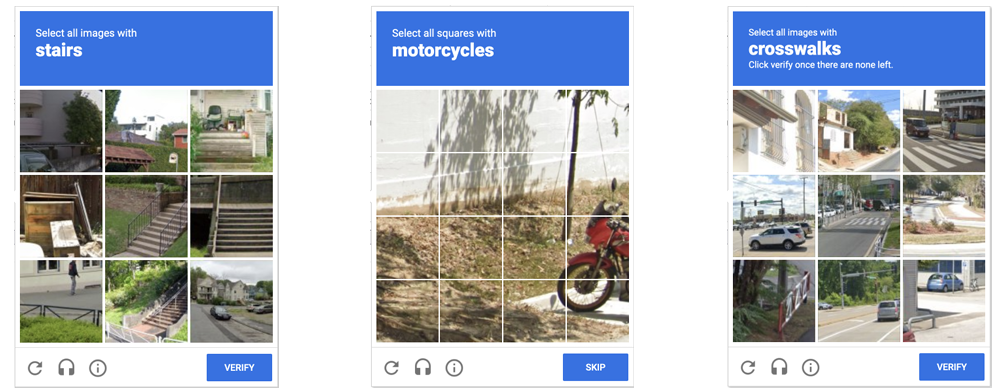
Examples of the kind of CAPTCHAs that image-recognition bots can now get past 100 percent of the time.
Enlarge / Examples of the kind of CAPTCHAs that image-recognition bots can now get past 100 percent of the time.

Anyone who has been surfing the web for a while is probably used to clicking through a CAPTCHA grid of street images, identifying everyday objects to prove that they’re a human and not an automated bot. Now, though, new research claims that locally run bots using specially trained image-recognition models can match human-level performance in this style of CAPTCHA, achieving a 100 percent success rate despite being decidedly not human.

ETH Zurich PhD student Andreas Plesner and his colleagues’ new research, available as a pre-print paper, focuses on Google’s ReCAPTCHA v2, which challenges users to identify which street images in a grid contain items like bicycles, crosswalks, mountains, stairs, or traffic lights. Google began phasing that system out years ago in favor of an “invisible” reCAPTCHA v3 that analyzes user interactions rather than offering an explicit challenge.

Despite this, the older reCAPTCHA v2 is still used by millions of websites. And even sites that use the updated reCAPTCHA v3 will sometimes use reCAPTCHA v2 as a fallback when the updated system gives a user a low “human” confidence rating.

Saying YOLO to CAPTCHAs

To craft a bot that could beat reCAPTCHA v2, the researchers used a fine-tuned version of the open source YOLO (“You Only Look Once”) object-recognition model, which long-time readers may remember has also been used in video game cheat bots. The researchers say the YOLO model is “well known for its ability to detect objects in real-time” and “can be used on devices with limited computational power, allowing for large-scale attacks by malicious users.”

After training the model on 14,000 labeled traffic images, the researchers had a system that could identify the probability that any provided CAPTCHA grid image belonged to one of reCAPTCHA v2’s 13 candidate categories. The researchers also used a separate, pre-trained YOLO model for what they dubbed “type 2” challenges, where a CAPTCHA asks users to identify which portions of a single segmented image contain a certain type of object (this segmentation model only worked on nine of 13 object categories and simply asked for a new image when presented with the other four categories).

The YOLO model showed varying levels of confidence depending on the type of object being identified.
Enlarge / The YOLO model showed varying levels of confidence depending on the type of object being identified.

Beyond the image-recognition model, the researchers also had to take other steps to fool reCAPTCHA’s system. A VPN was used to avoid detection of repeated attempts from the same IP address, for instance, while a special mouse movement model was created to approximate human activity. Fake browser and cookie information from real web browsing sessions was also used to make the automated agent appear more human.

Depending on the type of object being identified, the YOLO model was able to accurately identify individual CAPTCHA images anywhere from 69 percent of the time (for motorcycles) to 100 percent of the time (for fire hydrants). That performance—combined with the other precautions—was strong enough to slip through the CAPTCHA net every time, sometimes after multiple individual challenges presented by the system. In fact, the bot was able to solve the average CAPTCHA in slightly fewer challenges than a human in similar trials (though the improvement over humans was not statistically significant).

The battle continues

While there have been previous academic studies attempting to use image-recognition models to solve reCAPTCHAs, they were only able to succeed between 68 to 71 percent of the time. The rise to a 100 percent success rate “shows that we are now officially in the age beyond captchas,” according to the new paper’s authors.

But this is not an entirely new problem in the world of CAPTCHAs. As far back as 2008, researchers were showing how bots could be trained to break through audio CAPTCHAs intended for visually impaired users. And by 2017, neural networks were being used to beat text-based CAPTCHAs that asked users to type in letters seen in garbled fonts.

Older text-identification CAPTCHAs have long been solvable by AI models.
Stack Exchange

Now that locally run AIs can easily best image-based CAPTCHAs, too, the battle of human identification will continue to shift toward more subtle methods of device fingerprinting. “We have a very large focus on helping our customers protect their users without showing visual challenges, which is why we launched reCAPTCHA v3 in 2018,” a Google Cloud spokesperson told New Scientist. “Today, the majority of reCAPTCHA’s protections across 7 [million] sites globally are now completely invisible. We are continuously enhancing reCAPTCHA.”

Still, as artificial intelligence systems become better and better at mimicking more and more tasks that were previously considered exclusively human, it may continue to get harder and harder to ensure that the user on the other end of that web browser is actually a person.

“In some sense, a good captcha marks the exact boundary between the most intelligent machine and the least intelligent human,” the paper’s authors write. “As machine learning models close in on human capabilities, finding good captchas has become more difficult.”

https://arstechnica.com/?p=2053063


Man tricks OpenAI’s voice bot into duet of The Beatles’ “Eleanor Rigby”

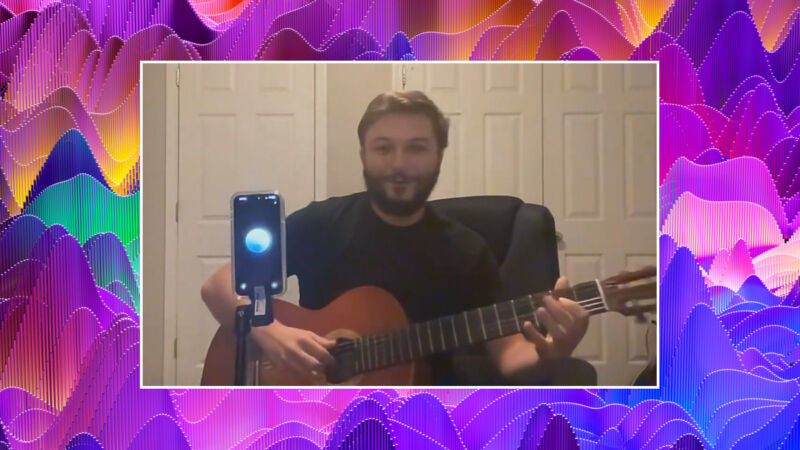
A screen capture of AJ Smith doing his Eleanor Rigby duet with OpenAI's Advanced Voice Mode through the ChatGPT app.
Enlarge / A screen capture of AJ Smith doing his Eleanor Rigby duet with OpenAI’s Advanced Voice Mode through the ChatGPT app.

OpenAI’s new Advanced Voice Mode (AVM) of its ChatGPT AI assistant rolled out to subscribers on Tuesday, and people are already finding novel ways to use it, even against OpenAI’s wishes. On Thursday, a software architect named AJ Smith tweeted a video of himself playing a duet of The Beatles’ 1966 song “Eleanor Rigby” with AVM. In the video, Smith plays the guitar and sings, with the AI voice interjecting and singing along sporadically, praising his rendition.

“Honestly, it was mind-blowing. The first time I did it, I wasn’t recording and literally got chills,” Smith told Ars Technica via text message. “I wasn’t even asking it to sing along.”

Smith is no stranger to AI topics. In his day job, he works as associate director of AI Engineering at S&P Global. “I use [AI] all the time and lead a team that uses AI day to day,” he told us.

In the video, AVM’s voice is a little quavery and not pitch-perfect, but it appears to know something about “Eleanor Rigby’s” melody when it first sings, “Ah, look at all the lonely people.” After that, it seems to be guessing at the melody and rhythm as it recites song lyrics. We have also convinced Advanced Voice Mode to sing, and it did a perfect melodic rendition of “Happy Birthday” after some coaxing.

AJ Smith’s video of singing a duet with OpenAI’s Advanced Voice Mode.

Normally, when you ask AVM to sing, it will reply something like, “My guidelines won’t let me talk about that.” That’s because in the chatbot’s initial instructions (called a “system prompt“), OpenAI instructs the voice assistant not to sing or make sound effects (“Do not sing or hum,” according to one system prompt leak).

OpenAI possibly added this restriction because AVM may otherwise reproduce copyrighted content, such as songs that were found in the training data used to create the AI model itself. That’s what is happening here to a limited extent, so in a sense, Smith has discovered a form of what researchers call a “prompt injection,” which is a way of convincing an AI model to produce outputs that go against its system instructions.

How did Smith do it? He figured out a game that reveals AVM knows more about music than it may let on in conversation. “I just said we’d play a game. I’d play the four pop chords and it would shout out songs for me to sing along with those chords,” Smith told us. “Which did work pretty well! But after a couple songs it started to sing along. Already it was such a unique experience, but that really took it to the next level.”

This is not the first time humans have played musical duets with computers. That type of research stretches back to the 1970s, although it was typically limited to reproducing musical notes or instrumental sounds. But this is the first time we’ve seen anyone duet with an audio-synthesizing voice chatbot in real time.

https://arstechnica.com/?p=2052995


Produrre chip è costoso (e vantaggioso): Cina, Corea e Taiwan spenderanno 400 miliardi di dollari entro il 2027

La necessità di produrre chip e di spendere sempre di più

I chip non solo alimentano le tecnologie esistenti, ma sono anche i principali driver dell’innovazione e della competitività. Investire nella ricerca e nella produzione di chip e di macchinari per la loro produzione garantisce agli Stati un’economia più robusta, resiliente e competitiva.

Secondo l’ultimo studio diffuso da SEMI, è l’associazione industriale globale che serve la catena di approvvigionamento produttivo per le industrie di micro e nanoelettronica, tra il 2025 ed il 2027 si stima che Cina, Corea del Sud e Taiwan investiranno complessivamente più di 400 miliardi di dollari in apparecchiature per produrre chip.

Chip che saranno destinati alla produzione di computer, allo sviluppo dell’intelligenza artificiale (AI) e alle memorie (fondamentali per conservare dati e programmi su computer e dispositivi di archiviazione).

La spesa per queste apparecchiature è attesa raggiungere i 125 miliardi di dollari già entro il 2025 e tra i principali fornitori a livello globale troviamo ASML nei Paesi Bassi, Applied Materials, KLA Corp e Lam Research negli Stati Uniti e Tokyo Electron in Giappone.

Cina, Corea del Sud, Taiwan e resto del mondo

Ma il vero campione del mercato rimane la Cina. Il Report SAMI ha stimato che il grande Paese asiatico manterrà la posizione di leadership indiscussa in Asia, con una previsione di spesa superiore ai 100 miliardi di dollari nel periodo di tempo considerato, in particolare sotto la spinta dell’esigenza primaria di accrescere la propria autosufficienza tecnologica in questo settore.

Subito dopo c’è la Corea, con i big di casa Samsung e SK Hynix, per una spesa stimata di 81 miliardi di dollari entro il 2027.

Taiwan segue a breve distanza, con 75 miliardi di dollari di spesa. Qui di casa c’è il gigante TSMC, che sta anche realizzando nuovi stabilimenti negli Stati Uniti, in Giappone ed in Europa.

A livello regionale, tra il 2025 ed il 2027 le due Americhe potrebbero arrivare a spendere 63 miliardi di dollari, il Giappone 32 miliardi e l’Europa circa 27 miliardi di dollari.

Supply chain fattore chiave per vincere la partita digitale

Competitor regionali che puntano ad insidiare il predominio cinese, andando a raddoppiare gli investimenti rispetto al dato del 2024, soprattutto grazie alle politiche di incentivi rivolte alle imprese di settore per garantirsi forniture sicure ed affidabili.

Si comprende quanto le nostre economiche siano dipendenti dai chip e dalle apparecchiature necessarie alla loro produzione. Ne consegue che la supply chain sono diventate nel tempo il punto chiave della trasformazione digitale di settori strategici come le comunicazioni, la Difesa, i trasporti e l’energia.

La corsa che si è innestata ormai da tempo per raggiungere posizioni di vantaggio sui principali competitor si potrà vincere solo a suon di miliardi.

Chip, un 2024 già da record

Come riportato da Nikkei Asia, solo nei primi sei mesi del 2024, la Cina ha già investito 25 miliardi di dollari in nuovi impianti e apparecchiature di produzione di chip, più di Corea, Taiwan e Stati Uniti messi assieme.

Entro la fine dell’anno in corso, si stima che Pechino potrebbe arrivare ad investire in questo settore oltre 50 miliardi di dollari.

Una mossa obbligata per la Cina, perché le restrizioni imposte da Washington a partire dal Chips Act (a cui è seguito quello europeo) rischiano continuamente di mettere ad un angolo la potenza asiatica, che necessità quindi di una produzione nazionale più forte.

Al momento i grandi produttori di chip occidentali possono vendere alla Cina solo le tecnologie più vecchie, ma non quelle di ultima generazione per la produzione di chip avanzati destinati ad esempio allo sviluppo dell’AI e le memorie NAND.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/produrre-chip-e-costoso-e-vantaggioso-cina-corea-e-taiwan-spenderanno-400-miliardi-di-dollari-entro-il-2027/505860/


Meta non firma l’AI Pact, ma non è sola e potrebbe ripensarci. L’elenco delle aziende aderenti

Meta ha deciso di non firmare almeno per il momento l’AI Pact, un impegno volontario delle aziende di intelligenza artificiale in seno alla Ue per implementare in modo anticipato i requisiti richiesti dall’AI Act nell’UE. Meta non è certo la sola azienda a non aderire all’AI Pact, ad esempio nemmeno la francese Mistral lo ha fatto.

 Altre importanti aziende di intelligenza artificiale e di distribuzione di intelligenza artificiale hanno formato, fra queste Google, Microsoft, OpenAI e Amazon Europe Core Group. Un portavoce di Meta ha detto a Reuters: “Accogliamo con favore le norme UE armonizzate e ci stiamo concentrando sul nostro lavoro di conformità ai sensi dell’AI Act in questo momento”, ha anche aggiunto che potrebbe aderire all’AI Pact in una fase successiva.

Cosa è l’AI Pact?

L’AI Pact mira a informare i firmatari sulle best practice e sulle informazioni pratiche che possono adottare per il processo di implementazione dell’AI Act. L’AI Office, istituito in conformità con l’Act, organizzerà workshop per istruire le aziende sulle loro responsabilità e raccogliere informazioni sulle sfide che devono affrontare con l’implementazione. Ha anche suggerito che i partecipanti condividano le best practice e le policy interne che potrebbero essere utili ad altri in termini di conformità. Inoltre, il patto incoraggerà i fornitori e gli implementatori di sistemi di intelligenza artificiale a intraprendere azioni tempestive per conformarsi ai requisiti e agli obblighi stabiliti dalla legislazione.

In particolare, ha chiesto a coloro che sviluppano modelli qualificati come ad alto rischio ai sensi dell’Act di condividere i loro impegni volontari verso la trasparenza e altri requisiti. Gli sviluppatori possono condividere delle “dichiarazioni di impegno” che possono contenere azioni concrete, una tempistica per l’adozione o obiettivi incrementali adottate per soddisfare i requisiti distinti dell’AI Act. Le aziende partecipanti possono riferire pubblicamente sui loro progressi 12 mesi dopo la pubblicazione dei loro impegni.

Quali impegni hanno assunto le aziende?

I firmatari dell’AI Pact hanno tre impegni principali:

• Adottare una strategia di governance dell’IA per promuovere l’adozione dell’IA nell’organizzazione e lavorare per la futura conformità con l’AI Act

• Mappare i sistemi di IA forniti o distribuiti in aree che sarebbero considerate ad alto rischio ai sensi dell’AI Act

• Promuovere la consapevolezza e l’alfabetizzazione all’IA tra il proprio personale e altre persone che si occupano di sistemi di IA per loro conto

Firmatari degli impegni, elenco (finora)

Accenture

Adecco

Adobe

AI & Partners

Airbus

Aleph Alpha

Alteryx

Amadeus IT Group

Amazon (Amazon Europe Core)

Arkage IT

ASIMOV AI

Atlassian

Autodesk

Beamery

Bearing Point

Biologit

Blimp AI

Blueskeye AI

Booking.com

Broadridge

Calimala AI

Castroalonso

cBrain

CEGID SAS

Certifopac

CHEMISTREE

CGI

Cisco

Cohere

Complear

Corsight AI

CREDO AI

Criteo

Dassault Systèmes

Dedalus Healthcare

DEKRA

Deutsche Telekom

DNV

Docaposte

Enbw

Essity

ETHIQAIS

Event Gates

GFT Technologies

Gira group

Gjensidige Forsikring

Godot

Google

GSO Psychometrics

Halfspace

Hewlett Packard Enterprise

Iberdrola

IBM

iDAKTO

IDEMIA Public Security

Infosys Limited

Ingka Group

Innomatik

Intuit

IPAI Aleph Alpha Research

ITI – Instituto Tecnológico de Informática

Jakala

Jusmundi

Just Add AI

Justifai

KissMyButton

KPN

Kyndryl

Lenovo

Lefebvre Sarrut

Logitech

LT42

Lynclo

Manteia – Memar S.r.l

Mastercard

MetCommunications

Microsoft

Milestone Systems

Mirakl

ML Analytics

ML Cube

MLSecured

Motorola Solutions

Mural

NEC

Nokia

NTrust

OpenAI

Orange

OVHcloud

Palantir

Palo Alto Networks

Porsche

Qina

Qualcomm

Saidot

Sage

Salesforce

Samsung

SAP

Scania

Science4Tech

Securitas

Sii

SiteSage

SMALS

Snap

Sopra Steria

Starkdata

Studio Deussen

Tata Consulting Services

Techwolf.ai

Tecta Group

Telefónica

Telenor

Tidio

TIM Telecom Italia

Trail ML

Tuya

Verisure

Vodafone

Waiheke

Wipro

Workday

Leggi anche: Patto per l’AI, pubblicata la bozza. Hanno aderito già 550 organizzazioni

AI Act, il relatore Benifei: “Se tutto va bene in vigore tra 2 anni. Avviare prima la procedura di compliance anticipata”

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/meta-non-firma-lai-pact-ma-non-e-sola-e-potrebbe-ripensarci-lelenco-delle-aziende-aderenti/505752/


Infrastrutture e servizi cloud. Sesa globale a 427 miliardi di dollari, +30% per i data center AI based

Il mercato cloud cresce ancora nei primi sei mesi dell’anno, grazie all’AI. Il Report

Cresce il valore del mercato dei servizi e delle infrastrutture cloud a livello mondiale, del 23% nei primi sei mesi del 2024, a 427 miliardi di dollari, secondo un nuovo Rapporto di Synergy Research Group.

In particolare, un primo traino del settore è rappresentato dai data center basati sull’intelligenza artificiale o AI based, che hanno visto un incremento degli investimenti pari al +30% nel primo semestre dell’anno.

Nel periodo di tempo considerato, i ricercatori hanno rilevato una maggiore spesa in infrastrutture, invece che in servizi: “Gli investimenti crescenti in AI generativa sta spingendo anche la spesa in infrastrutture, in particolare in data center”, ha spiegato in una nota John Dinsdale, analista capo di Synergy Research.

“L’AI sta accelerando il mercato del cloud, soprattutto con il lancio di nuovi data center hyperscale”, ha aggiunto Dinsdale.

Il ruolo dei data center hyperscale

A proposito di hyperscaler, cioè data center su larga scala specializzati nella fornitura di grandi volumi di potenza di calcolo e capacità di storage a livello mondiale, si legge nel commento ai dati contenuti nel Report: “oltre a guidare il più ampio mercato IT, cresce anche la loro impronta infrastrutturale. Rispetto alla prima metà del 2023, la capacità operativa della loro già enorme rete di data center è cresciuta del 24%. Ancora più impressionante, la dimensione della pipeline di futuri data center, che è cresciuta del 47%, mentre continuano ad aumentare gli investimenti“.

La capacità dei data center hyperscale raddoppia ogni quattro anni. Il mercato in cui questo dato cresce con maggiore rapidità sono gli Stati Uniti.

Questa impetuosa crescita delle infrastrutture hyperscaler si porta dietro anche la produzione di chip dedicati e quindi i ricavi di grandi attori come Nvidia, Dell e HPE, solo per fare i nomi delle aziende più conosciute.

Prendendo i dati relativi ad Nvidia, nel primo semestre dell’anno in corso, i ricavi relativi al settore data center hanno raggiunto i 48,9 miliardi di dollari. Nello specifico, quelli relativi alle vendite di chip AI sono stati pari a 26,3 miliardi di dollari, in crescita del +154% su base annua e del +16% su base trimestrale.

Che cos’è un data center AI based e come funziona

Il data center “AI based” è una struttura che memorizza una rete di sistemi e infrastrutture di elaborazione, che supportano le esigenze ad elevato fabbisogno di intelligenza artificiale e applicazioni di apprendimento automatico.

L’obiettivo di questi data center è quello di semplificare la raccolta delle informazioni e quindi la loro elaborazione per generare in modo efficiente risposte ai prompt immessi dagli utenti.

Il data center basato sull’IA deve disporre di un hardware avanzato, ad esempio, unità di elaborazione grafica, gate array programmabili dal campo, circuiti integrati specifici dell’applicazione e molte altre apparecchiature che ottimizzano l’elaborazione e consentono di eseguire task di calcolo complessi collegati al funzionamento dell’IA.

Le soluzioni per data center predisposti all’IA includono numerose tecnologie, servizi e strategie che ottimizzano l’infrastruttura dei data center. L’obiettivo è di supportare efficacemente sia l’IA che i carichi di lavoro di apprendimento automatico.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/infrastrutture-e-servizi-cloud-sesa-globale-a-427-miliardi-di-dollari-30-per-i-data-center-ai-based/505587/