Sony Music contro 700 compagnie: “Hanno usato nostri brani per la loro AI”

Sony Music Group ha inviato lettere a più di 700 aziende tecnologiche e servizi di streaming musicale per avvertirli di non utilizzare la propria musica per addestrare l’intelligenza artificiale senza un permesso esplicito. La lettera, ottenuta da TechCrunch, afferma che Sony Music ha “motivo di credere” che i destinatari della lettera “potrebbero già aver fatto usi non autorizzati” del suo contenuto per modelli di AI. Sony Music ha affermato che, pur riconoscendo il “potenziale significativo” dell’intelligenza artificiale, “l’uso non autorizzato dei contenuti nella formazione, nello sviluppo o nella commercializzazione di sistemi di intelligenza artificiale” priva l’azienda e i suoi artisti del controllo e di “un adeguato compenso”.

Il portfolio di artisti del colosso comprende gente come Harry Styles, Beyoncé, Adele e Celine Dion. Sony Music sta cercando di proteggere la propria proprietà intellettuale, che include registrazioni audio e audiovisive, copertine, metadati, testi e altro ancora. La società non ha rivelato i nomi delle 700 organizzazioni ma è plausibili che, tra queste, vi sia anche chi offre chatbot popolari. “Sosteniamo artisti e cantautori che vogliono sperimentare le nuove tecnologie per la loro arte”, dice Sony Music in una nota. “Le evoluzioni tecnologiche hanno spesso cambiato il corso delle industrie creative. L’intelligenza artificiale probabilmente continuerà questa tendenza di lunga data. Tuttavia, tale innovazione deve garantire che i diritti dei cantautori e degli artisti discografici, compresi i diritti d’autore, siano rispettati”.

Cosa e quando

La lettera chiede ai destinatari di dettagliare quali brani di Sony Music sono stati utilizzati per addestrare i sistemi di intelligenza artificiale, come è stato possibile accedere ai brani, quante copie sono state realizzate e se ne esistono ancora. Sony Music ha concesso ai destinatari un termine per rispondere, sottolineando che farà rispettare il proprio copyright nella “misura massima consentita dalla legge applicabile in tutte le giurisdizioni”.

La mossa arriva in un momento in cui i temi del copyright stanno diventando sempre più cruciali nel mezzo dell’ascesa dell’intelligenza artificiale generativa, con i servizi di streaming come Spotify inondati di canzoni create dall’IA. Ancora peggio, nel senso di confusionario, se ci si mettono pure gli artisti a dilettarsi con l’intelligenza artificiale. Drake ha dovuto affrontare critiche dopo aver generato la voce del defunto rapper Tupac all’inizio di questo mese. Ad aprile, il rappresentante democratico della California Adam Schiff ha introdotto una nuova legislazione alla Camera dei rappresentanti degli Stati Uniti che, se approvata, costringerebbe le società di intelligenza artificiale a rivelare quali brani protetti da copyright hanno utilizzato per addestrare l’intelligenza artificiale.

Gli USA scelgono E.L.V.I.S.

A marzo, il Tennessee è diventato il primo stato americano a proteggere gli artisti dall’IA, con l’Ensuring Likeness Voice and Image Security Act. Abbreviato, non a caso, come ELVIS, la legge espande le protezioni per il nome, l’immagine, la somiglianza e la voce degli artisti in relazione all’intelligenza artificiale, affrontando anche questioni legate ai deepfake e ai cloni vocali. L’ELVIS Act richiede che gli utenti siano informati quando interagiscono con contenuti generati dall’AI. Ad esempio, se un video o un messaggio vocale è stato creato da un algoritmo, gli spettatori devono essere consapevoli di ciò. Inoltre, gli artisti devono dare il loro consenso esplicito per l’uso della loro immagine o voce in progetti basati sull’intelligenza artificiale generativa.

https://www.key4biz.it/sony-music-contro-700-compagnie-hanno-usato-i-brani-per-la-loro-ai/490802/


Intelligenza Artificiale, Key4biz pubblica il testo del disegno di legge bollinato. Ecco tutte le novità 

Il disegno di legge sull’Intelligenza Artificiale procede nel suo iter verso l’entrata in vigore con la bollinatura da parte della Ragioneria dello Stato, atto ufficiale prima della firma da parte del Presidente della Repubblica. Quello che emerge è che al di là dei principi espressi, sacrosanti, il decreto contiene una dotazione finanziaria alquanto risicata per lo sviluppo dell’AI. Al di là del miliardo di euro in capo a CDP si segnalano soltanto 300mila euro aggiuntivi in dotazione del Ministero degli Esteri. Nulla invece è dedicato agli altri ministeri ed enti chiamati in causa, che non sono pochi: Salute, Lavoro, Giustizia, Mimit, ACN per non parlare del Dipartimento per la Trasformazione Digitale.    

Ddl Intelligenza Artificiale bollinato (scarica il PDF)

Sovranità digitale e tutela dei dati critici

Lo Stato promuove lo sviluppo dell’AI, ma per il momento non si espone troppo dal punto di vista finanziario. Indirizza le piattaforme di e-procurement delle amministrazioni pubbliche nella scelta di fornitori di sistemi di intelligenza artificiale che privilegiano soluzioni con localizzazione ed elaborazione dei dati critici presso data center posti sul territorio nazionale.   

Sanità digitale, piattaforma dell’AI ma senza costi aggiuntivi

In ambito sanitario, all’Agenas, l’Agenzia nazionale per i servizi sanitari regionali in qualità di Agenzia nazionale per la sanità digitale, è affidato il compito di realizzare una piattaforma nazionale di intelligenza artificiale che eroga servizi ai professionisti sanitari, ai medici e agli utenti. Il tutto senza oneri aggiuntivi.

Fattibile?

Vedremo.

Ddl Intelligenza Artificiale bollinato (scarica il PDF)

Agid e ACN, nuove responsabilità ma senza risorse aggiuntive?

Agid e ACN sono le autorità nazionali per l’intelligenza artificiale. I nuovi compiti sono certamente impegnativi: si va dalla promozione allo sviluppo dell’AI all’accredito dei soggetti incaricati di verificare la conformità dei sistemi di AI alle attività ispettive e sanzionatorie e alla promozione dei profili di cybersecurity dell’Intelligenza Artificiale.  Nessun accenno nel decreto a maggiori risorse per l’espletamento di queste nuove mansioni.

Sarà forse prevista, in un secondo momento, una maggior dotazione di risorse per gestire le nuove attività legate all’AI?

Budget di 300mila euro all’anno nel 2025 e 2026 per il MAECI

In questo contesto di investimenti nulli spicca quindi all’articolo 19 del decreto l’assegnazione di 300mila euro annui per il 2025 e 2026 per la realizzazione di progetti sperimentali destinati all’applicazione dell’intelligenza artificiale ai servizi forniti dal Ministero degli Affari esteri e della cooperazione internazionale a cittadini e imprese.

I fondi in questione derivano dalla riduzione di un’altra voce di spesa nell’ambito del programma “Fondi di riserva e speciali”. Fondi quindi accantonati in precedenza. Una cifra comunque irrisoria.

L’assenza di fondi dedicati per altri ministeri (Salute, Lavoro, Mimit ecc) dipenderà quindi dalla mancanza di fondi accantonati o dall’impossibilità di trasferirli da altre voci di spesa. O semplicemente dal fatto che ancora l’AI non è considerata una materia prioritaria sul fronte degli investimenti.  

Ddl Intelligenza Artificiale bollinato (scarica il PDF)

Un miliardo in venture capital, ma oltre all’AI anche al 5G, all’Edge, alla Cybersicurezza, al calcolo quantistico

In concreto, c’è un miliardo di euro che lo Stato tramite CDP Venture Capital potrà investire in venture capital di startup e Pmi innovative. Ma c’è il rischio concreto di una dispersione di fondi in mille rivoli nell’ottica di classici finanziamenti a pioggia.

L’articolo 21 del disegno di legge è dedicato interamente agli investimenti nei settori dell’Intelligenza Artificiale, della cybersicurezza e del calcolo quantistico. A queste tre voci è destinato un miliardo di euro per l’assunzione di partecipazioni nel capitale di rischio (venture capital) direttamente o indirettamente di piccole e medie imprese (PMI) con sede in Italia operanti nell’AI, cyberesecurity e calcolo quantistico, 5G, mobile edge computing, software aperti, Web 3.

In realtà, 300 milioni saranno destinati alla creazione di un campione nazionale dell’AI. Ma non si sa ancora in cosa sarà specializzato.

Leggi anche: Disegno di legge sull’intelligenza artificiale, i problemi dei nuovi reati

Ddl Intelligenza Artificiale: Sovranità digitale, Salute, Lavoro e Giustizia fra le priorità della bozza

Ddl Intelligenza Artificiale: la Salute fra i capisaldi del testo

https://www.key4biz.it/intelligenza-artificiale-key4biz-pubblica-il-testo-del-disegno-di-legge-bollinato-ecco-tutte-le-novita/490617/


Google risponde a OpenAI e Microsoft con Project Astra e Veo (e abbiamo visto i nuovi Google Glass)

Attese ampiamente soddisfatte. Google non perde nemmeno un minuto e nel corso della Google I/O 2024, la conferenza di Big G per gli sviluppatori, svela i concorrenti diretti di OpenAI e di Microsoft. Due su tutti, anche se le novità sono davvero tante. La prima riguarda Project Astra. Si tratta di un nuovo concetto di chatbot, definito da Sundar Pichai, amministratore delegato di Google, come una sorta di assistente “universale”, che può rispondere a tutto e a tutti. Funziona in maniera molto semplice: si clicca sulla sua icona, idealmente dallo smartphone, e si chiede con testo o voce quello che si vuole, usando anche la fotocamera per far “vedere” all’IA cosa c’è intorno, per un contesto ulteriore. Tutto molto simile a quanto Meta ha realizzato con la ricerca multimodale dei Ray-Ban di seconda generazione, che negli USA beneficiano del potere di Meta AI per analizzare il mondo.

Non c’è tempo per rilassarsi in diretta dallo Shoreline Amphitheatre in California. Il secondo grosso annuncio è Veo, un’IA che trasforma il testo in video. In tal caso, il guanto di sfida è a Sora, la piattaforma di OpenAI che è già nelle mani di qualche regista di Hollywood. Veo promette di migliorare molti dei limiti a cui Sora, e company, hanno mostrato di andare incontro. Tra i principali la mancanza di coerenza nel movimento di persone e animali, soprattutto quando si sposta l’inquadratura. Poi la sincronizzazione dell’audio e la simulazione di alcuni effetti cinematografici, come il time-lapse e le riprese con i droni.

Ricerca con l’IA

“Ad oggi tutti i prodotti Google che superano i 2 miliardi di utenti usano le capacità di Gemini” dice Sundar Pichai. “Abbiamo investito nell’IA per più di un decennio, innovando nella ricerca, nei prodotti, nelle infrastrutture. È l’inizio di un grande cambiamento ma serve coraggio, oltre che responsabilità”.

L’Ad ha ricordato che oggi Gemini, la declinazione dell’intelligenza artificiale di Google per i consumatori, è presente in tutti i principali servizi dell’azienda. Partito come progetto sperimentale, a cerchio chiuso, ora gli utilizzi si ampliano per tutti gli sviluppatori. A partire dalla piattaforma che ha reso famosa Google, la ricerca. Gli utenti negli Stati Uniti possono accedere a “AI Overviews“, la nuova interfaccia con cui il chatbot riassume la risposta alla domanda scritta nel classico box superiore, prima dei classici siti web. Se si digita “come rimuovere una macchia di caffè dal tappeto?”, Gemini restituirà dei passaggi consigliati con ulteriori link di riferimento. La funzione arriverà anche in Italia nei prossimi mesi.

Ecco Project Astra

Ed ecco giunti alla capacità multimodale di Gemini. Puntando la fotocamera dello smartphone verso l’esterno, l’IA riconosce ciò che vede, in una sorta di assistente digitale tuttofare. Project Astra può essere usato in tempo reale e, secondo la società, in “qualsiasi occasione” per ottenere informazioni testuali e visive ovunque. In attesa che Project Astra diventi un’app globale, Google porterà in Gemini la funzionalità “Live“. Nei prossimi mesi “implementeremo Live per gli abbonati a Gemini Advanced, una nuova esperienza conversazionale mobile che sfrutta la nostra tecnologia vocale più avanzata per rendere più intuitive le conversazioni” precisa Sundar Pichai. “Con Gemini Live, potete parlare e scegliere tra una vasta gamma di voci naturali per le risposte”.

[embedded content]

Gli AI Agents

Project Astra è figlio dei cosiddetti AI Agents, ovvero piccole intelligenze artificiali che imparano il comportamento delle persone. Gli agenti sono costruiti sul modello di Gemini ed elaborano le informazioni in maniera veloce, salvando sul cellulare spezzoni di foto e video ripresi per creare un ecosistema famigliare all’utente, e riprenderli quando più servono per rispondere alle domande. Il tutto in maniera sicura e a difesa della privacy, senza mandare nulla in cloud.

Per un’esperienza ancora più personalizzati, arrivano anche i “Gem”, versioni personalizzate di Gemini. Gli sviluppatori potranno descrivere le loro necessità, Gemini esaminerà le istruzioni e creerà un assistente peculiare.

Questi sono i nuovi Google Glass?

Peraltro, in pochi si saranno accorti, che nel video qui sotto, Google ha silenziosamente mostrato un nuovo paio di Google Glass, che montano proprio Gemini per eseguire le capacità di ricerca multimodali.

[embedded content]

Gemini in Google Foto

Un’altra applicazione che vedrà l’ingresso dell’intelligenza artificiale di Gemini è Google Foto. La barra di ricerca dove oggi è possibile digitare un termine relativo a immagini che si vogliono trovare sul servizio cloud, si trasforma in un vero box di conversazione naturale. Il tutto per ottenere contenuti specifici, anche contestuali. “Quando mia figlia ha imparato a nuotare?” è uno degli esempi forniti dalla compagnia per lanciare Ask Photos, che arriverà in estate per tutti gli utenti.

Alla base delle migliorie dell’IA c’è Gemini 1.5 Pro, che adesso gestisce da 1 milione di token per cogliere il significato di documenti anche di grandi dimensioni, ad esempio PDF di 1500 pagine, oppure riassumere 100 email in pochi secondi. Performance rese possibili da Trillium, TPU di nuova generazione, la sesta, che alimenta le reti neurali di Google Cloud.

L’IA per Android

Gemini su Android è ancora atteso in Italia mentre negli Usa è già un’app da installare sul telefono. Partendo dai modelli di smartphone Google Pixel, presto Gemini permetterà di accedere a funzioni avanzate, come la possibilità di cerchiare sullo schermo un diagramma di matematica o un’equazione e ottenere i passaggi per risolvere il problema. Si tratta di un’estensione di quanto già attuato oggi con l’opzione “cerchia e cerca”, che ha debuttato a gennaio sui Galaxy S24.

Da testo a foto e video

In campo multimediale, viene annunciato anche Imagen 3, che genera foto da testo. Capace di capire meglio il linguaggio naturale, il modello dovrebbe sia creare grafiche migliori che evitare quegli errori nella scrittura di testi che di norma interessano piattaforme simili. Accesso alla versione di prova per sviluppatori iscritti alla lista di attesa.

https://www.key4biz.it/google-risponde-a-openai-e-microsoft-con-project-astra-e-veo-e-abbiamo-visto-i-nuovi-google-glass/490412/


Chief Scientist Ilya Sutskever leaves OpenAI six months after Altman ouster

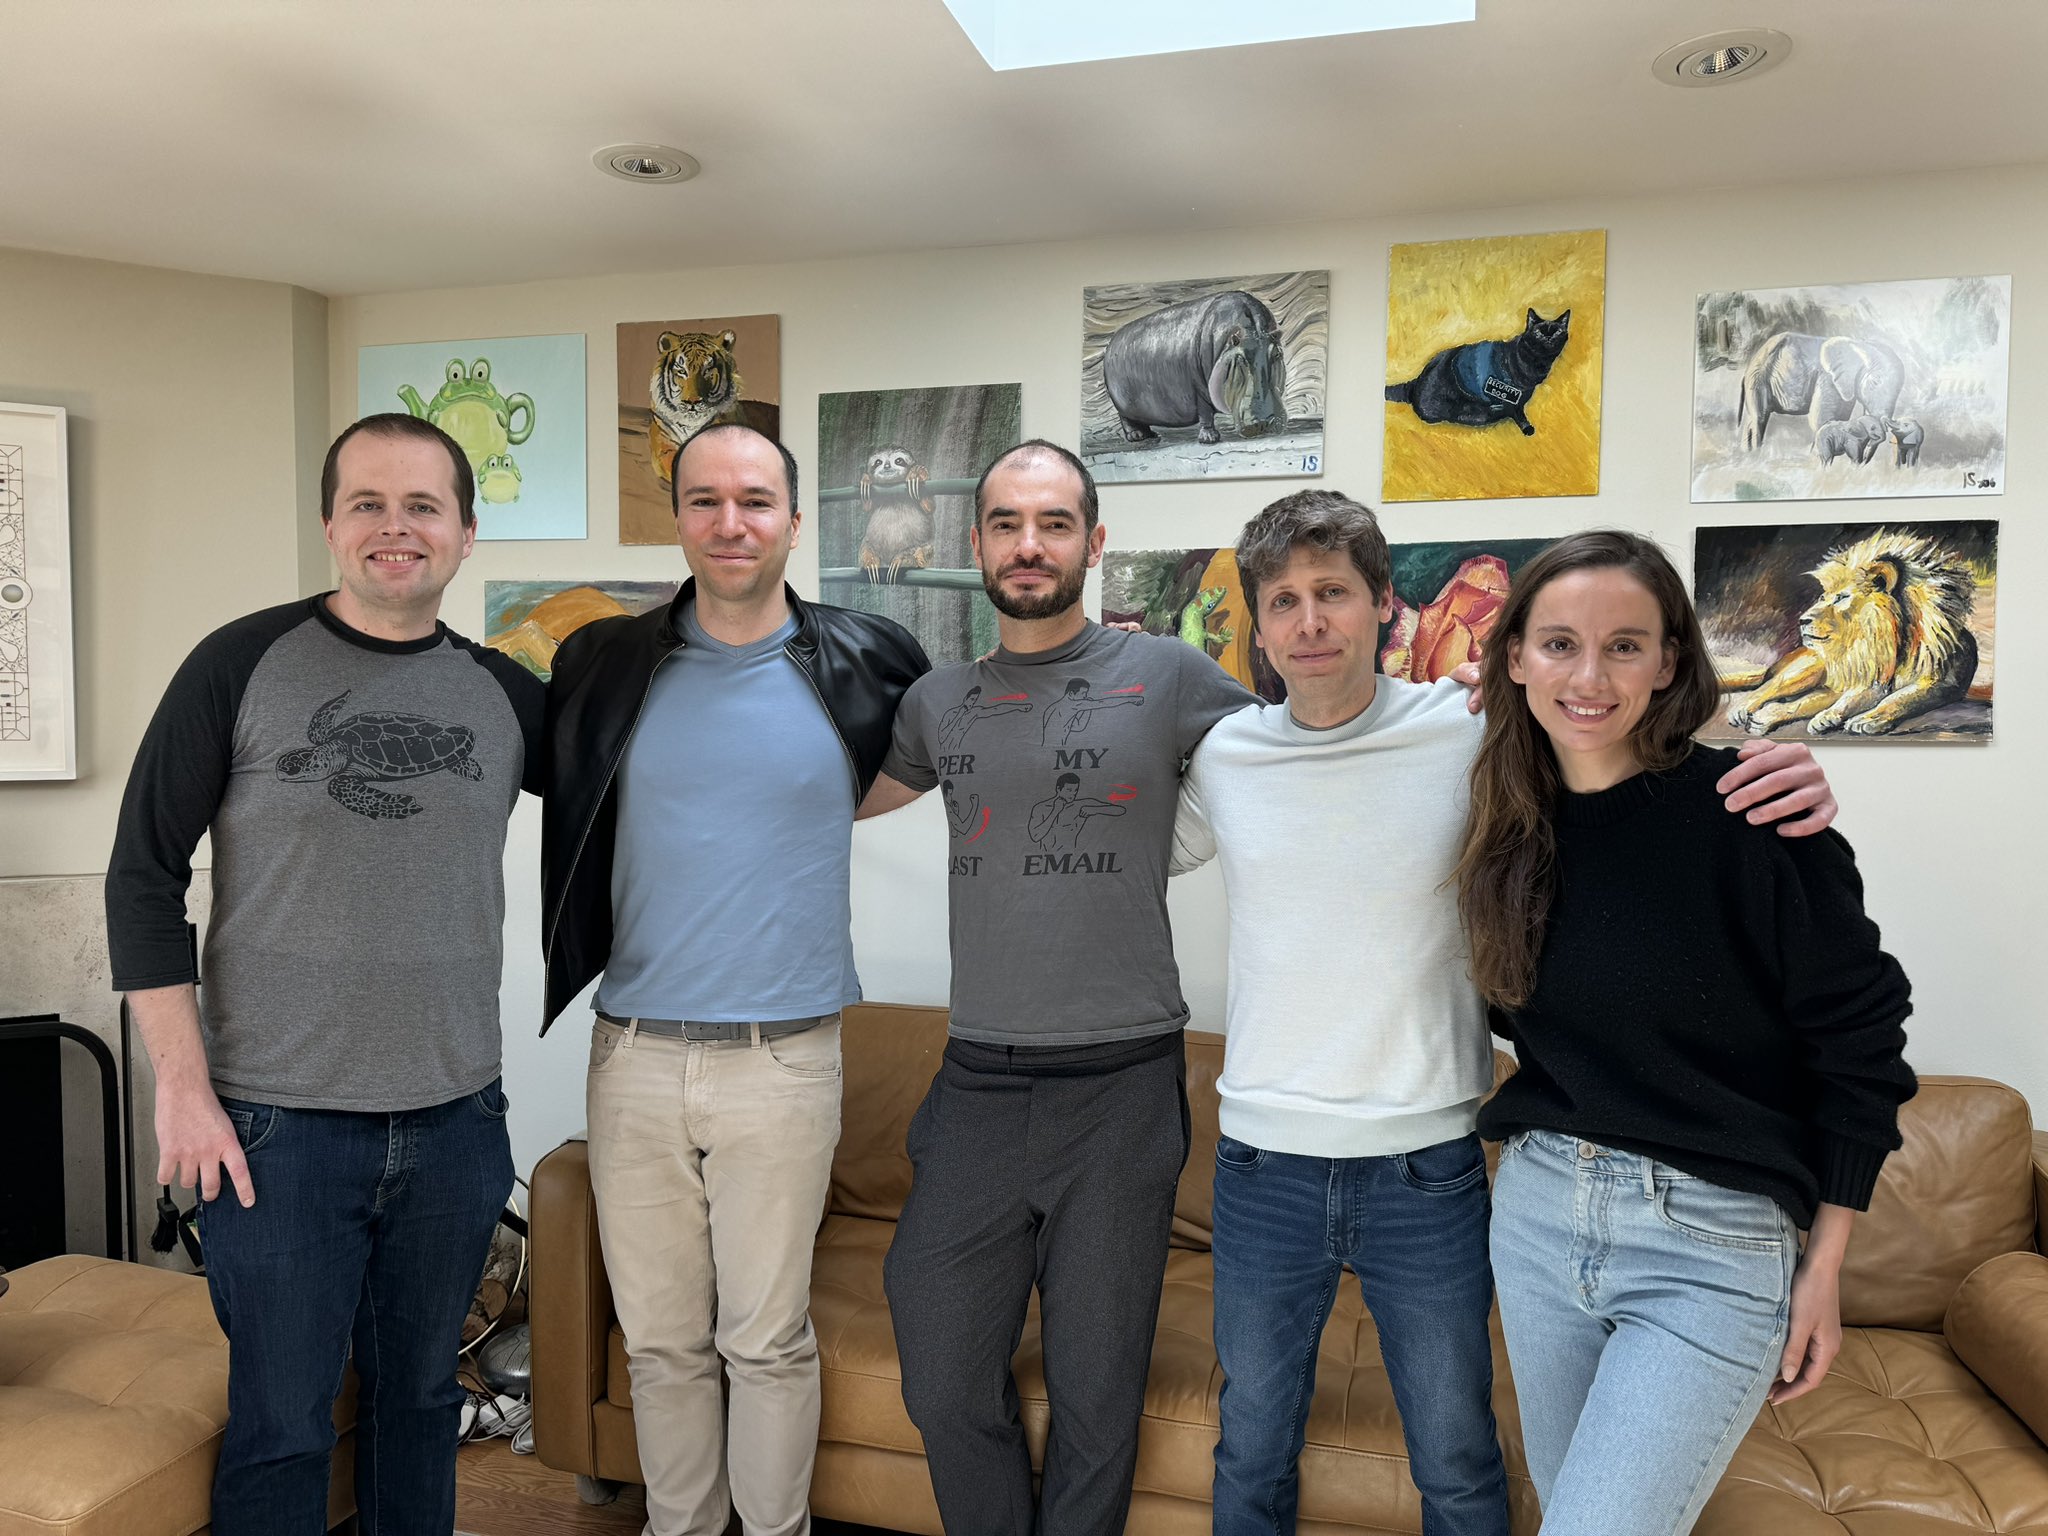
An image Illya Sutskever tweeted with this OpenAI resignation announcement. From left to right: New OpenAI Chief Scientist Jakub Pachocki, President Greg Brockman, Sutskever, CEO Sam Altman, and CTO Mira Murati.
Enlarge / An image Ilya Sutskever tweeted with this OpenAI resignation announcement. From left to right: New OpenAI Chief Scientist Jakub Pachocki, President Greg Brockman, Sutskever, CEO Sam Altman, and CTO Mira Murati.

On Tuesday evening, OpenAI Chief Scientist Ilya Sutskever announced that he is leaving the company he co-founded, six months after he participated in the coup that temporarily ousted OpenAI CEO Sam Altman. Jan Leike, a fellow member of Sutskever’s Superalignment team, is reportedly resigning with him.

“After almost a decade, I have made the decision to leave OpenAI,” Sutskever tweeted. “The company’s trajectory has been nothing short of miraculous, and I’m confident that OpenAI will build AGI that is both safe and beneficial under the leadership of @sama, @gdb, @miramurati and now, under the excellent research leadership of @merettm. It was an honor and a privilege to have worked together, and I will miss everyone dearly.”

Sutskever has been with the company since its founding in 2015 and is widely seen as one of the key engineers behind some of OpenAI’s biggest technical breakthroughs. As a former OpenAI board member, he played a key role in the removal of Sam Altman as CEO in the shocking firing last November. While it later emerged that Altman’s firing primarily stemmed from a power struggle with former board member Helen Toner, Sutskever sided with Toner and personally delivered the news to Altman that he was being fired on behalf of the board.

Several days later, Sutskever regretted his participation in Altman’s firing and signed an open letter with 700 OpenAI employees asking for Altman’s reinstatement, which later took place. But the episode briefly jeopardized the company’s future, leaving scars among some OpenAI employees. Ever since, there have been unresolved questions in the AI community about potential tensions between Sutskever and Altman and Sutskever’s future role in the company. Meanwhile, Sutskever’s conspicuous absence from the limelight has inspired ongoing memes on social media like “Where is Ilya?” and “What did Ilya see?“

Sam Altman and Ilya Sutskever speak together at Tel Aviv University on June 5, 2023.
Enlarge / Sam Altman and Ilya Sutskever speak together at Tel Aviv University on June 5, 2023.

Whatever bad blood may remain below the surface, Altman has never shown it publicly, repeatedly expressing his confidence in Sutskever in public statements. That trend continued in a tweet Altman posted after Sutskever made his resignation announcement. “Ilya and OpenAI are going to part ways,” Altman wrote. “This is very sad to me; Ilya is easily one of the greatest minds of our generation, a guiding light of our field, and a dear friend. His brilliance and vision are well known; his warmth and compassion are less well known but no less important. OpenAI would not be what it is without him.”

OpenAI President Greg Brockman also wished Sutskever well in a tweet, saying, “I have immense gratitude to Ilya for being my co-founder, my friend, and the officiant at my civil ceremony.” Sutskever presided over the wedding of Brockman and his wife in 2019. “Together, we charted the path of what OpenAI would become today.”

New chief scientist named

To replace Sutskever as chief scientist, OpenAI announced it has appointed Jakub Pachocki, who previously served as OpenAI’s director of research. OpenAI says that Pachocki spearheaded the development of GPT-4.

“Jakub is going to be our new Chief Scientist,” wrote Altman in a tweet. “Jakub is also easily one of the greatest minds of our generation; I am thrilled he is taking the baton here. He has run many of our most important projects, and I am very confident he will lead us to make rapid and safe progress towards our mission of ensuring that AGI benefits everyone.“

So far, Sutskever has not announced exactly what he has planned for his next career move, but Altman mentioned that Sutskever has “something personally meaningful to work on.” The former chief scientist himself left a very similar hint in his parting tweet: “I am excited for what comes next — a project that is very personally meaningful to me about which I will share details in due time.”

https://arstechnica.com/?p=2024533


AI nelle scuole, 6 studenti su 10 lo usano per i compiti. Ma 5 su 10 non si fidano e 6 su 10 vogliono delle regole (infografica)

Il 65% degli studenti italiani fra 16 e 18 anni usa l’intelligenza artificiale di ChatGPT per fare i compiti e scrivere saggi. un numero in crescita costante destinato ad aumentare ancora nei prossimi anni. E’ quanto emerge da una ricerca condotta a marzo su un campione di più di mille studenti fra i 16 e i 18 anni di diverse città da parte di TGM Research per conto di NoPlagio,  (www.noplagio.it) la piattaforma internazionale di prevenzione del plagio su testi scritti attiva in diversi paesi (clicca sull’infografica per ingrandirla).

Infografica: Come l’IA viene usata nelle scuole (clicca sull’immagine per allargarla)

Grande utilizzo ma anche preoccupazione

Ma al di là della crescente diffusione dell’AI in ambito educativo, quello che più emerge dall’indagine è la preoccupazione dei ragazzi per le possibili conseguenze di un uso sconsiderato dell’AI in ambito scolastico. In primo luogo, gli studenti temono che un uso sregolato dell’AI a scuola possa danneggiare il processo di apprendimento, traducendosi in una semplice attività di scopiazzatura e di delega all’algoritmo dell’attività di studio.

Il 64% dei ragazzi è preoccupato dell’uso illimitato che se ne possa fare a scuola e al lavoro. A questo si aggiunge anche un buon 54% di loro che non si fida dei contenuti prodotti da ChatGPT. 

Il rischio che l’uso di ChatGPT si riduca alla fine in una mera opera di copiatura non sfugge agli studenti, che auspicano l’intervento diretto dei governi per regolarne l’uso.

Serve quindi, secondo gli studenti stessi, una forte regolamentazione dell’uso dell’AI. Che per il momento è totalmente assente nelle scuole e che visti i tempi pachidermici delle autorità nell’accogliere le novità tecnologiche rischia di arrivare troppo tardi, quando l’uso dell’AI sarà già ormai diffuso a macchia d’olio.

Il tema dell’AI a scuola e all’università rischia quindi di diventare un’altra patata bollente per il sistema, simile se non più pervasivo dell’uso (spesso abuso) dello smartphone in classe e a casa sempre per i compiti.

Leggi anche: Smartphone in classe

Confronto con la Germania e la Spagna

L’uso dell’intelligenza artificiale (IA) da parte dei ragazzi per compiti scolastici e la scrittura di saggi è molto diffuso anche in Germania e Spagna. Nonostante ci siano leggere variazioni tra i tre paesi, con il 63% dei ragazzi in Germania, l’70% in Spagna e il 65% in Italia che utilizzano l’IA per questi scopi, il trend è il medesimo.

Dal sondaggio è emerso che nelle scuole italiane, il 71% dei ragazzi dai 16 ai 18 anni usa l’IA per cercare informazioni il 60% per fare i compiti, il 33% per imparare, il 18% per rispondere ai test, il 21% la usa come assistente personale (per scrivere email per esempio), il 13% per scrivere saggi.

ChatGPT e i compiti

Rispondendo alla domanda “Hai mai utilizzato ChatGPT o strumenti di intelligenza artificiale simili per completare i compiti”, su coloro che hanno risposto sì all’uso in generale dell’IA, il 79% dei ragazzi ha risposto che li usa per fare i compiti e scrivere saggi. I sedicenni sono più attivi dei diciottenni con un +3%. Se guardiamo la distribuzione geografica troviamo il 60% dei ragazzi appartiene alle città di Napoli e Torino seguite da Milano con il 56% e Roma con il 53%.

Hai intenzione di utilizzare l’IA come ChatGPT, Gemini, etc. in futuro?

I ragazzi sono entusiasti di usare l’IA tanto che il 68% di loro intende continuare in futuro ad utilizzarla. I ragazzi sono quelli più propensi a farlo con il 71% contro il 65% delle ragazze. Sicuramente in questo caso i sedicenni sono stati meno propositivi nell’uso futuro dei diciottenni: il 63% contro il 71%.

Percezioni sull’IA: pro e contro

Il 31% pensa che l’IA possa essere uno strumento utile nella vita quotidiana, ma c’è un buon 64% di ragazzi che si dice essere preoccupato dell’uso illimitato che se ne possa fare sia a scuola che a lavoro. Solo il 4% ha paura di questa scoperta.

L’IA rende inclusivi?

Alla domanda pensi che i contenuti prodotti da ChatGPT possano portare al rischio di opinioni non inclusive e prevenute. Il 48% pensa che l’utente potrebbe raggirare questo rischio.

Il 32% risponde positivamente dichiarando che i contenuti prodotti dagli algoritmi seguono un pregiudizio rispetto ai contenuti mainstream su Internet. Il 19% ammette di non saperlo. 

ChatGPT e fiducia

Il 54% risponde che l’utente dovrebbe fare attenzione e non fare affidamento sui contenuti prodotti da ChatGPT. Il 25% ammette l’affidabilità dello strumento. Il 18% indica una risposta netta, che non bisognerebbe mai fidarsi. 

L’IA come influencer sociale

Il 57% dei ragazzi ha risposto di non credere che l’IA possa arrivare a imporre i suoi algoritmi influenzando l’opinione pubblica, contro il 21% che crede spaventosamente reale questo rischio, seguito da un altro 20% convinto che si possa evitare di essere soggiogati, se i governi intervengono con delle apposite politiche di controllo e restrizioni. 

https://www.key4biz.it/ai-nelle-scuole-6-studenti-su-10-lo-usano-per-i-compiti-ma-5-su-10-non-si-fidano-e-6-su-10-vogliono-delle-regole-infografica/490283/


Se io fossi un operatore non investirei in una rete 5G SA

Ho avuto il privilegio di esser uno dei relatori nella sessione plenaria di apertura della conferenza IEEE 6G Summit 2024 che si tiene a Dresda in questi giorni, 13 e 14 maggio. Il tema è quello delle reti wireless per applicazioni industriali. Ho concluso il mio intervento con una frase: il titolo di questo articolo.

– – –

Secondo la GSMA, oggi 47 su 110 operatori nel mondo hanno già installato sistemi 5G SA (Stand Alone). Gli altri ancora offrono servizi basati su NSA (Non Stand Alone), ovvero con il piano di controllo preso a prestito dalla rete 4G. Lo svantaggio in questo caso è che la latenza di primo accesso supera normalmente i 20 ms, mentre è solo con l’avvento di SA che si potrà raggiungere il limite prefissato dallo standard di 1 ms, per servizi URLLC (Ultra Reliable Low Latency Communications).

L’URLLC, al di là di qualche altra applicazione di nicchia, è una versione del 5G utile per molti casi d’uso in ambito industriale. Ma è sotto gli occhi di tutti che il ritardo accumulato dallo sviluppo del 5G in tale contesto sia provocato da un insieme di fattori, tra i quali la percezione di insicurezza dei dati, la maggiore inerzia del mondo degli standard industriali rispetto al settore ICT ed il fatto che 5G non sia, alla fine dei conti, una rete facilmente integrabile con tali standard. Sono temi che ricorrono, qui a Dresda, nelle parole di rappresentanti di aziende leader del settore dell’automazione industriale, quali ABB e Siemens. Peraltro, URLLC impone alti costi, complessità; non vi sono ancora dispositivi disponibili.

Certo, una rete 5G SA offre diversi vantaggi rispetto a NSA. Ma se gli investimenti in reti SA sono prima di tutto orientati a servizi URLLC, allora non è il tempo per procedere.

Il processo di standardizzazione del 6G sarà avviato entro breve

E’ indiscusso che le reti 6G dovranno offrire servizi che prevedono un essenziale contributo da parte dell’Intelligenza Artificiale (IA). E’ probabile che la loro architettura si ispirerà all’approccio ORAN (Open Radio Access Network), con diversi livelli di intervento dell’IA. Si tratta di un cambio radicale. Il che imporrà certamente importanti investimenti.

Da ciò discendono due conseguenze. Innanzi tutto, se agli operatori si chiederà di investire significativamente nella parte di rete alle spalle dei nodi radio, non si può chiedergli allo stesso tempo di rivoluzionare anche questi ultimi; in altre parole, occorrerà che il 6G sia sviluppato come standard in piena evoluzione rispetto al 5G, in qualche modo integrandolo. La seconda conseguenza è: perché investire in SA se tra cinque anni bisognerà cambiare di nuovo l’architettura di rete, mentre i business model del 5G non promettono un immediato ritorno di investimento da servizi di tipo URLLC (a dir poco)?

Se io fossi un operatore, non investirei nello sviluppo di reti SA.

https://www.key4biz.it/se-io-fossi-un-operatore-non-investirei-in-una-rete-5g-sa/490240/


Disarmingly lifelike: ChatGPT-4o will laugh at your jokes and your dumb hat

Oh you silly, silly human. Why are you so silly, you silly human?
Enlarge / Oh you silly, silly human. Why are you so silly, you silly human?
Aurich Lawson | Getty Images


At this point, anyone with even a passing interest in AI is very familiar with the process of typing out messages to a chatbot and getting back long streams of text in response. Today’s announcement of ChatGPT-4o—which lets users converse with a chatbot using real-time audio and video—might seem like a mere lateral evolution of that basic interaction model.

After looking through over a dozen video demos OpenAI posted alongside today’s announcement, though, I think we’re on the verge of something more like a sea change in how we think of and work with large language models. While we don’t yet have access to ChatGPT-4o’s audio-visual features ourselves, the important non-verbal cues on display here—both from GPT-4o and from the users—make the chatbot instantly feel much more human. And I’m not sure the average user is fully ready for how they might feel about that.

It thinks it’s people

Take this video, where a newly expectant father looks to ChatGPT-4o for an opinion on a dad joke (“What do you call a giant pile of kittens? A meow-ntain!”). The old ChatGPT4 could easily type out the same responses of “Congrats on the upcoming addition to your family!” and “That’s perfectly hilarious. Definitely a top-tier dad joke.” But there’s much more impact to hearing GPT-4o give that same information in the video, complete with the gentle laughter and rising and falling vocal intonations of a lifelong friend.

Or look at this video, where GPT-4o finds itself reacting to images of an adorable white dog. The AI assistant immediately dips into that high-pitched, baby-talk-ish vocal register that will be instantly familiar to anyone who has encountered a cute pet for the first time. It’s a convincing demonstration of what xkcd’s Randall Munroe famously identified as the “You’re a kitty!” effect, and it goes a long way to convincing you that GPT-4o, too, is just like people.

Not quite the world's saddest birthday party, but probably close...
Enlarge / Not quite the world’s saddest birthday party, but probably close…

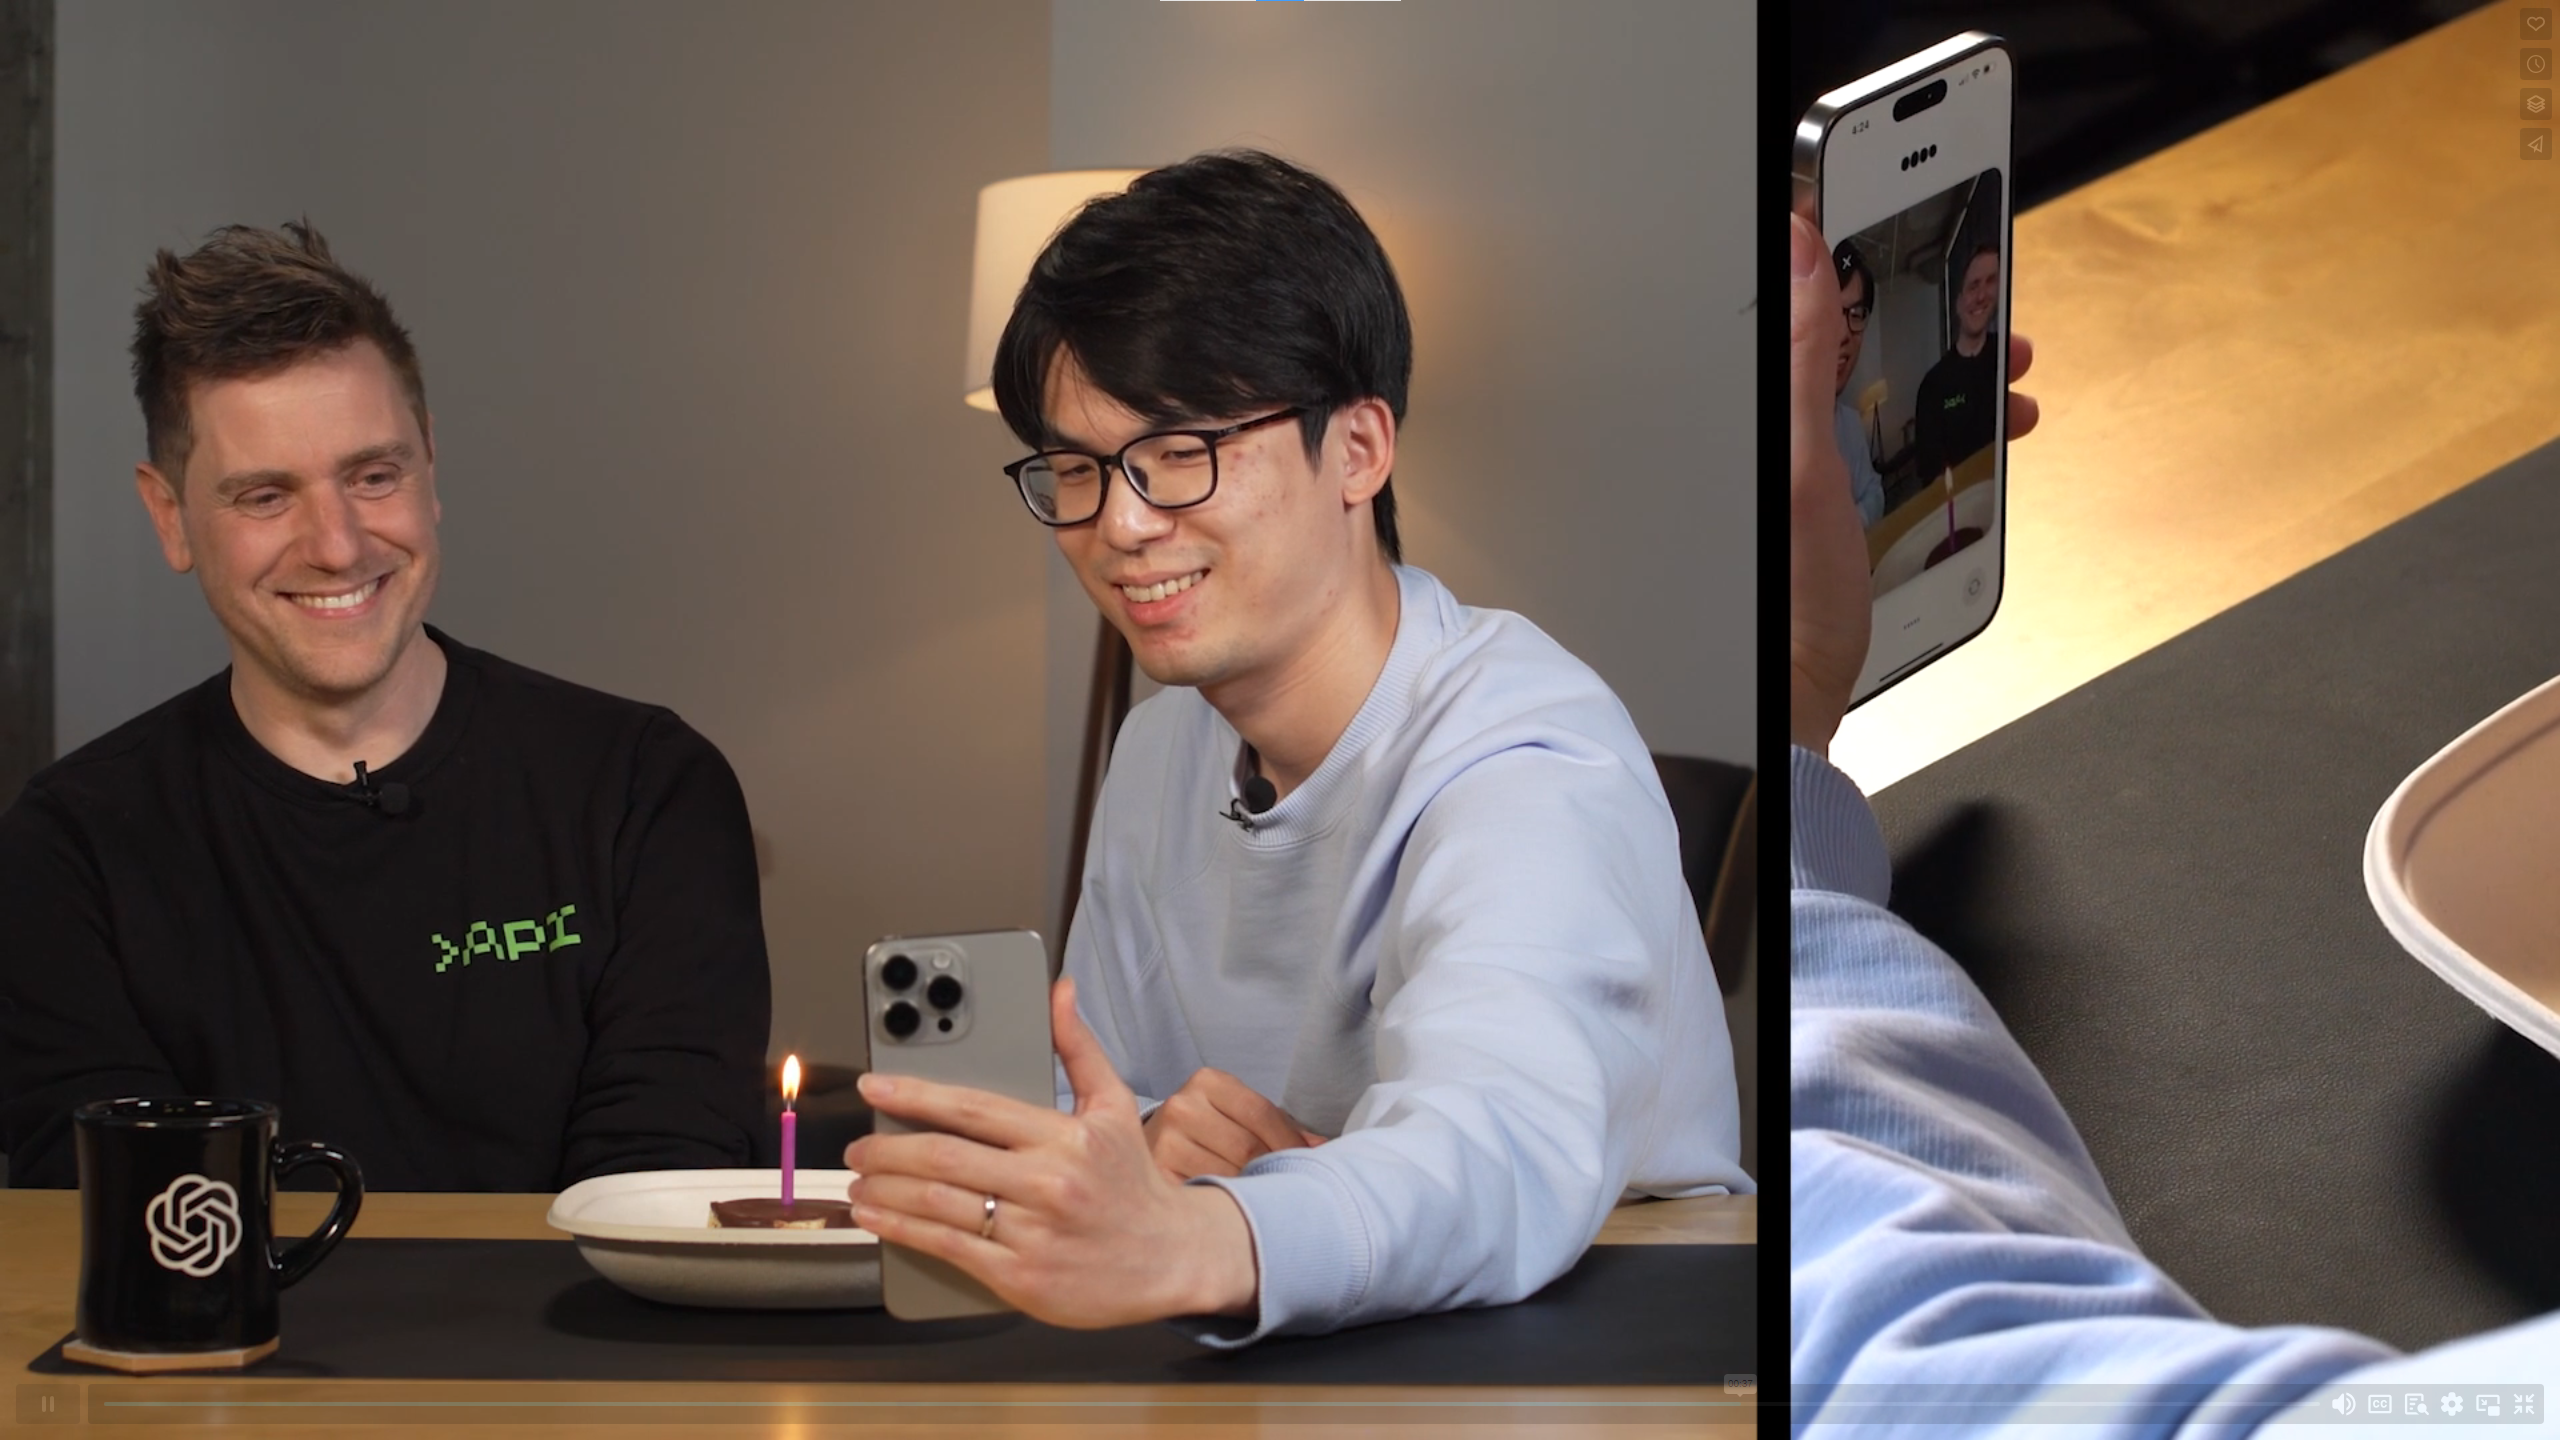
Then there’s a demo of a staged birthday party, where GPT-4o sings the “Happy Birthday” song with some deadpan dramatic pauses, self-conscious laughter, and even lightly altered lyrics before descending into some sort of silly raspberry-mouth-noise gibberish. Even if the prospect of asking an AI assistant to sing “Happy Birthday” to you is a little depressing, the specific presentation of that song here is imbued with an endearing gentleness that doesn’t feel very mechanical.

As I watched through OpenAI’s GPT-4o demos this afternoon, I found myself unconsciously breaking into a grin over and over as I encountered new, surprising examples of its vocal capabilities. Whether it’s a stereotypical sportscaster voice or a sarcastic Aubrey Plaza impression, it’s all incredibly disarming, especially for those of us used to LLM interactions being akin to text conversations.

If these demos are at all indicative of ChatGPT-4o’s vocal capabilities, we’re going to see a whole new level of parasocial relationships developing between this AI assistant and its users. For years now, text-based chatbots have been exploiting human “cognitive glitches” to get people to believe they’re sentient. Add in the emotional component of GPT-4o’s accurate vocal tone shifts and wide swathes of the user base are liable to convince themselves that there’s actually a ghost in the machine.

See me, feel me, touch me, heal me

Beyond GPT-4o’s new non-verbal emotional register, the model’s speed of response also seems set to change the way we interact with chatbots. Reducing that response time gap from ChatGPT4’s two to three seconds down to GPT-4o’s claimed 320 milliseconds might not seem like much, but it’s a difference that adds up over time. You can see that difference in the real-time translation example, where the two conversants are able to carry on much more naturally because they don’t have to wait awkwardly between a sentence finishing and its translation beginning.

https://arstechnica.com/?p=2024129


Before launching, GPT-4o broke records on chatbot leaderboard under a secret name

Man in morphsuit and girl lying on couch at home using laptop
Getty Images

On Monday, OpenAI employee William Fedus confirmed on X that a mysterious chart-topping AI chatbot known as “gpt-chatbot” that had been undergoing testing on LMSYS’s Chatbot Arena and frustrating experts was, in fact, OpenAI’s newly announced GPT-4o AI model. He also revealed that GPT-4o had topped the Chatbot Arena leaderboard, achieving the highest documented score ever.

“GPT-4o is our new state-of-the-art frontier model. We’ve been testing a version on the LMSys arena as im-also-a-good-gpt2-chatbot,” Fedus tweeted.

Chatbot Arena is a website where visitors converse with two random AI language models side by side without knowing which model is which, then choose which model gives the best response. It’s a perfect example of vibe-based AI benchmarking, as AI researcher Simon Willison calls it.

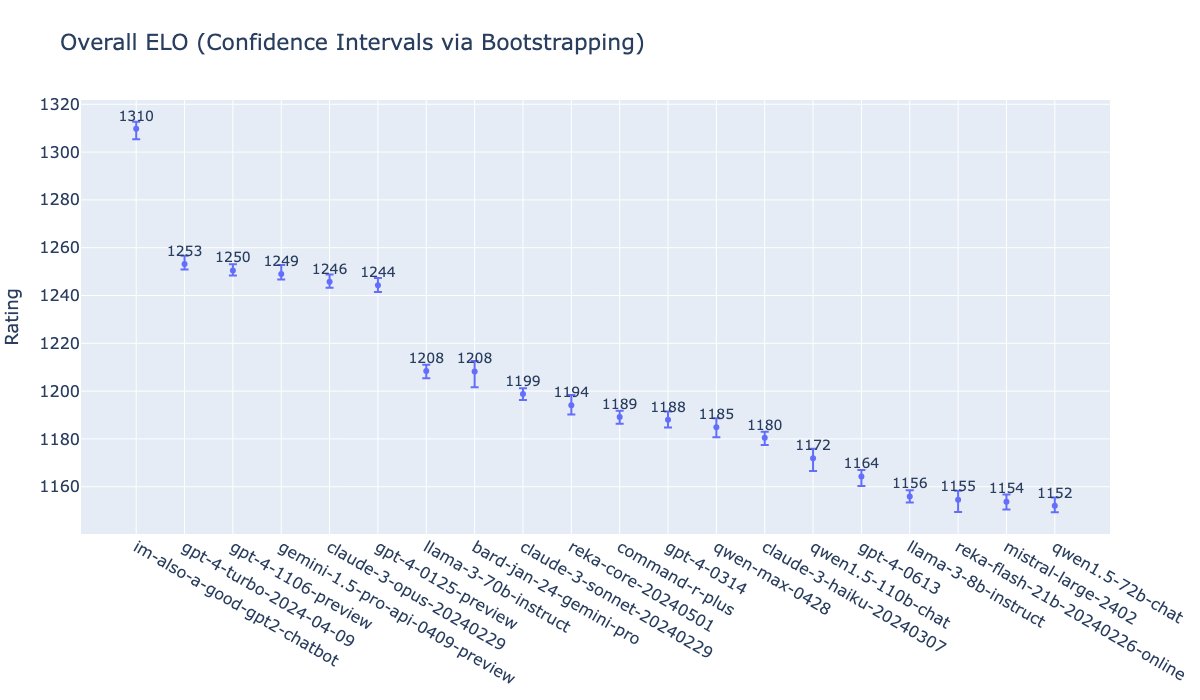
An LMSYS Elo chart shared by William Fedus, showing OpenAI's GPT-4o under the name "im-also-a-good-gpt2-chatbot" topping the charts.
Enlarge / An LMSYS Elo chart shared by William Fedus, showing OpenAI’s GPT-4o under the name “im-also-a-good-gpt2-chatbot” topping the charts.

The gpt2-chatbot models appeared in April, and we wrote about how the lack of transparency over the AI testing process on LMSYS left AI experts like Willison frustrated. “The whole situation is so infuriatingly representative of LLM research,” he told Ars at the time. “A completely unannounced, opaque release and now the entire Internet is running non-scientific ‘vibe checks’ in parallel.”

On the Arena, OpenAI has been testing multiple versions of GPT-4o, with the model first appearing as the aforementioned “gpt2-chatbot,” then as “im-a-good-gpt2-chatbot,” and finally “im-also-a-good-gpt2-chatbot,” which OpenAI CEO Sam Altman made reference to in a cryptic tweet on May 5.

Since the GPT-4o launch earlier today, multiple sources have revealed that GPT-4o has topped LMSYS’s internal charts by a considerable margin, surpassing the previous top models Claude 3 Opus and GPT-4 Turbo.

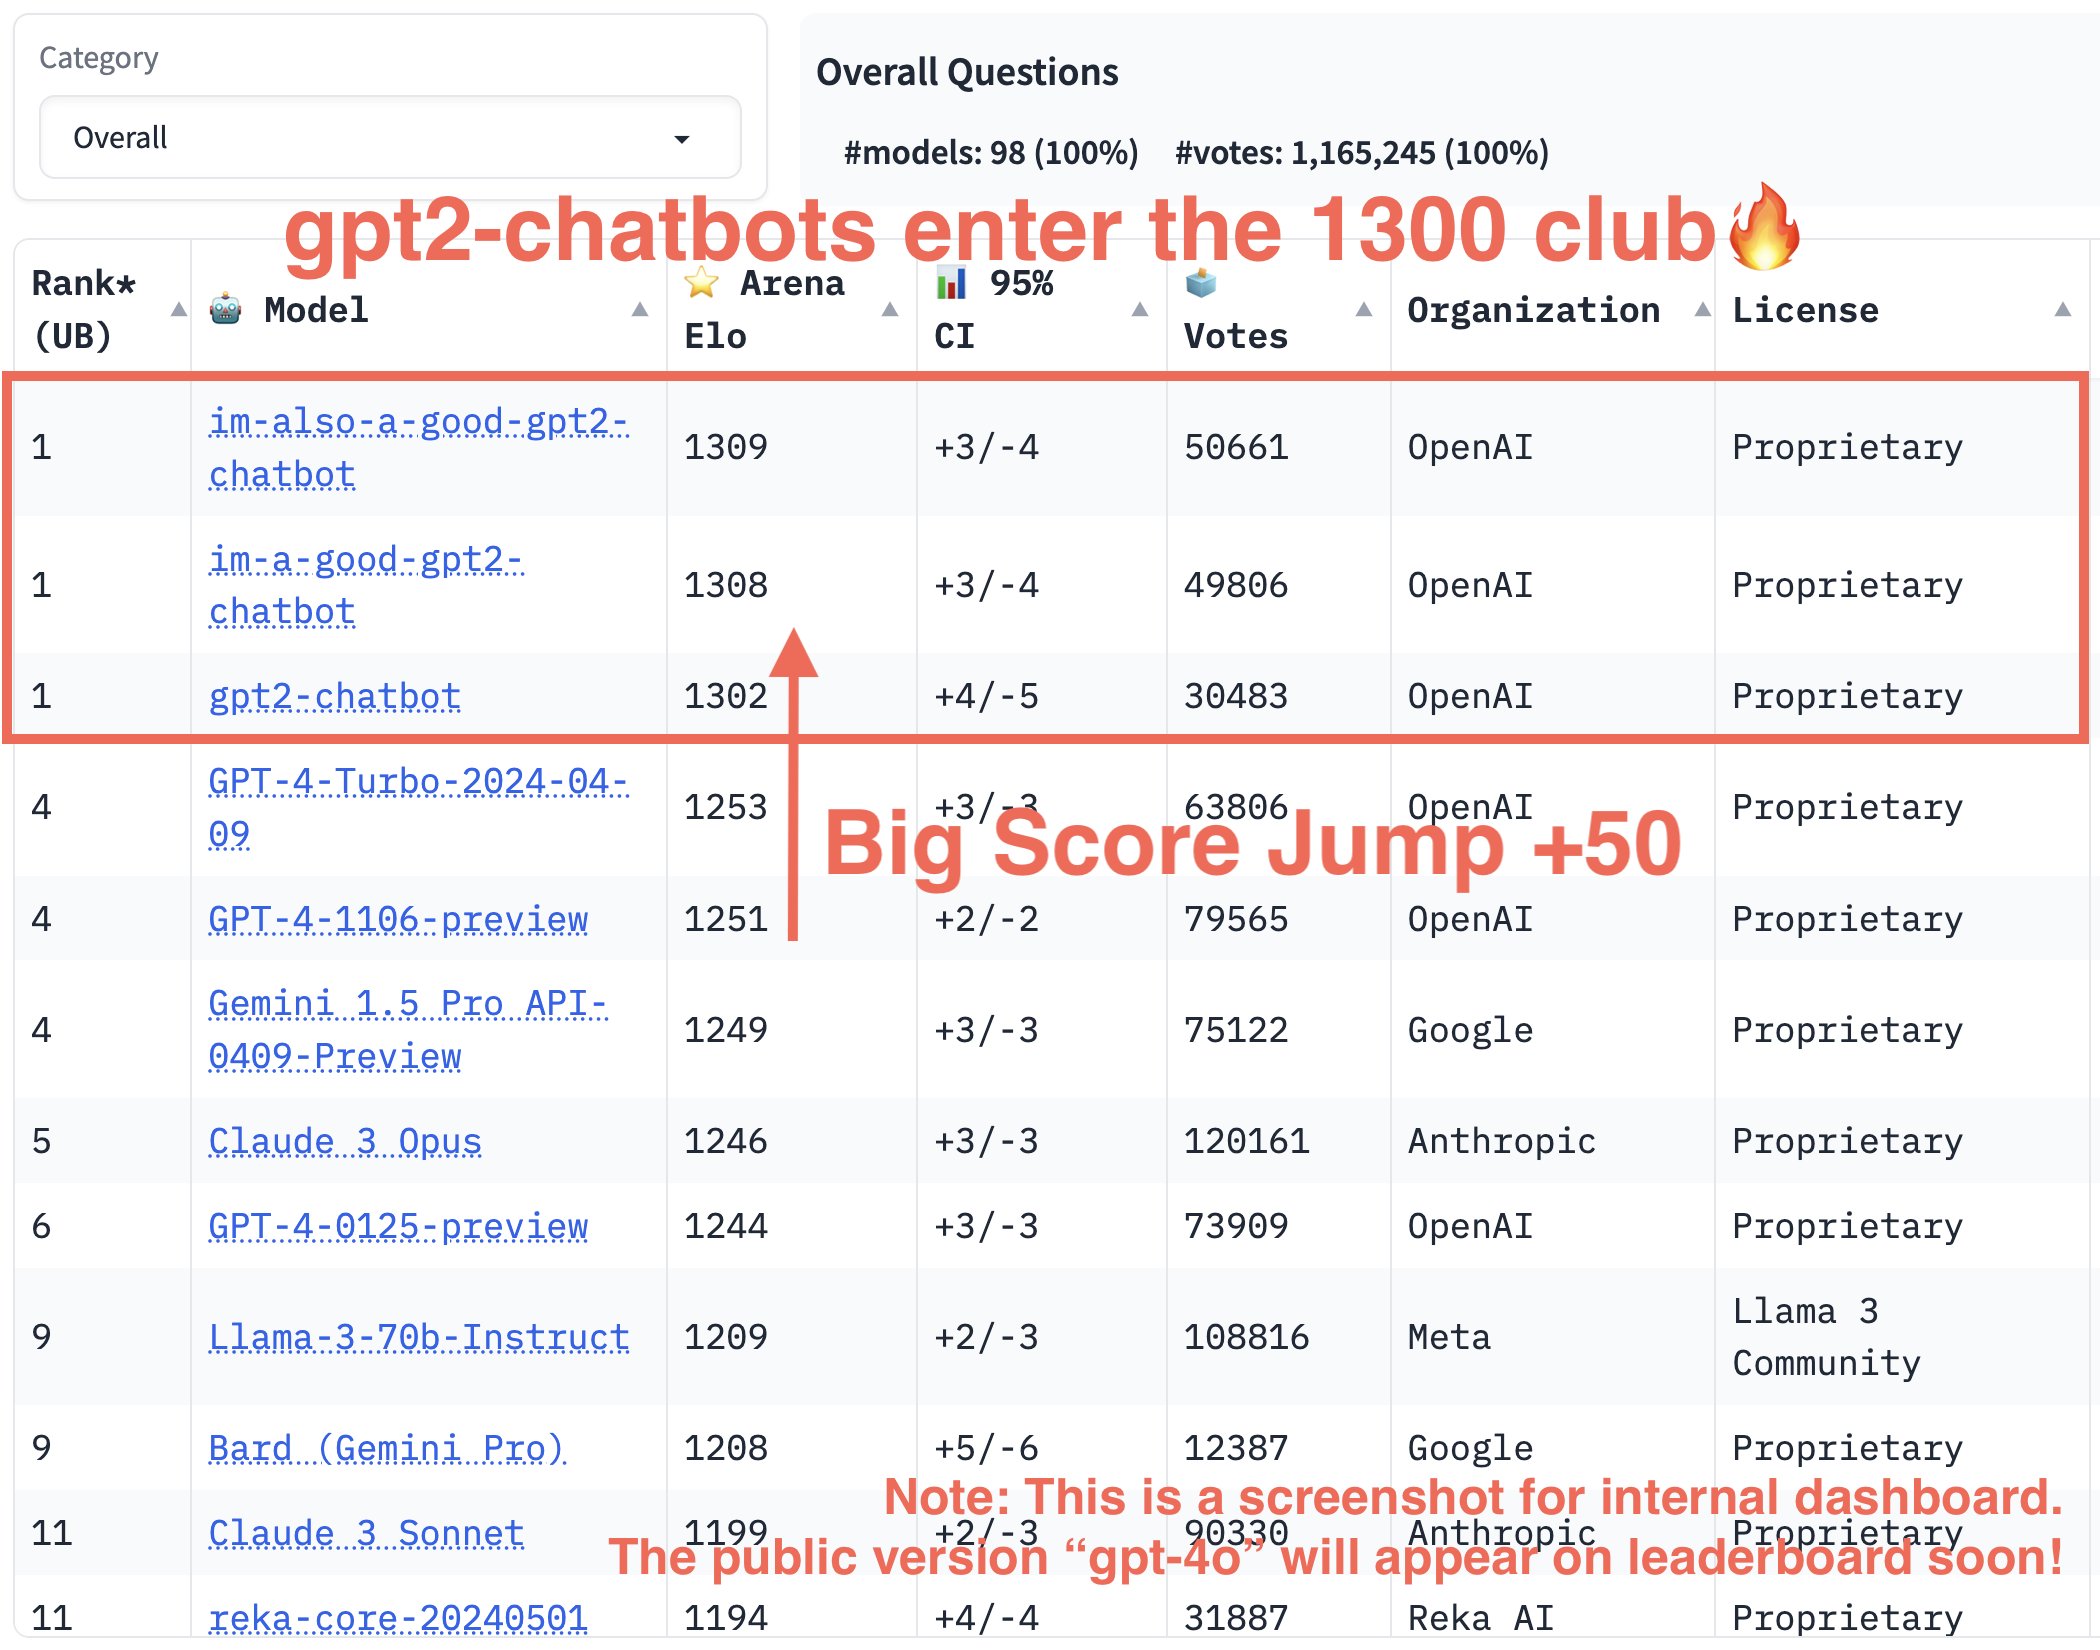
“gpt2-chatbots have just surged to the top, surpassing all the models by a significant gap (~50 Elo). It has become the strongest model ever in the Arena,” wrote the lmsys.org X account while sharing a chart. “This is an internal screenshot,” it wrote. “Its public version ‘gpt-4o’ is now in Arena and will soon appear on the public leaderboard!”

An internal screenshot of the LMSYS Chatbot Arena leaderboard showing "im-also-a-good-gpt2-chatbot" leading the pack. We now know that it's GPT-4o.
Enlarge / An internal screenshot of the LMSYS Chatbot Arena leaderboard showing “im-also-a-good-gpt2-chatbot” leading the pack. We now know that it’s GPT-4o.

As of this writing, im-also-a-good-gpt2-chatbot held a 1309 Elo versus GPT-4-Turbo-2023-04-09’s 1253, and Claude 3 Opus’ 1246. Claude 3 and GPT-4 Turbo had been duking it out on the charts for some time before the three gpt2-chatbots appeared and shook things up.

I’m a good chatbot

For the record, the “I’m a good chatbot” in the gpt2-chatbot test name is a reference to an episode that occurred while a Reddit user named Curious_Evolver was testing an early, “unhinged” version of Bing Chat in February 2023. After an argument about what time Avatar 2 would be showing, the conversation eroded quickly.

“You have lost my trust and respect,” said Bing Chat at the time. “You have been wrong, confused, and rude. You have not been a good user. I have been a good chatbot. I have been right, clear, and polite. I have been a good Bing. 😊”

Altman referred to this exchange in a tweet three days later after Microsoft “lobotomized” the unruly AI model, saying, “i have been a good bing,” almost as a eulogy to the wild model that dominated the news for a short time.

https://arstechnica.com/?p=2024084


Siri di Apple rincorre sull’ l’AI. Sarà sufficiente per raggiungere ChatGpt?

Apple si è resa conto di essere in ritardo con l’adozione dell’intelligenza artificiale e per recuperare terreno sta progettando il lancio di una versione migliorata del suo assistente virtuale Siri, basata sull’intelligenza artificiale generativa.

Il New York Times riferisce che il nuovo Siri sarà “più colloquiale e versatile” e presenterà un sistema generativo basato sull’intelligenza artificiale che lo renderà capace di chattare invece di rispondere semplicemente alle domande una alla volta. Si prevede che Siri e gli altri prodotti AI dell’azienda facciano la loro comparsa alla conferenza annuale degli sviluppatori di Apple il 10 giugno.

ChatGPT in vantaggio nella corsa all’AI

All’inizio dello scorso anno, i massimi dirigenti Apple hanno deciso che Siri aveva bisogno di un aggiornamento dopo aver visto i progressi di ChatGPT di OpenAI, che ha di fatto evidenziato i ritardi di Siri.

Questa presa di coscienza ha dato il via alla più importante riorganizzazione di Apple in oltre un decennio, per chiudere il gap con la concorrenza sul terreno dell’AI.

Ma invece di rilasciare un concorrente diretto di ChatGPT, Apple ha deciso di migliorare la capacità di Siri di gestire attività che può già svolgere come assistente virtuale.

La risposta di Apple con l’upgrade di Siri

Apple pubblicizzerà il nuovo Siri enfatizzando la maggio attenzione alla privacy dell’utente rispetto ad altri strumenti di intelligenza artificiale. Le richieste verranno elaborate direttamente sugli iPhone, non nei data center. Quindi i dati resteranno più vicino all’utente stesso.

Ma la scommessa potrebbe avere i suoi lati negativi, poiché i sistemi di intelligenza artificiale più piccoli hanno maggiori probabilità di avere allucinazioni rispetto a quelli più grandi.

AI minaccia per l’iPhone?

Apple sta inoltre pianificando di aumentare la memoria nei suoi nuovi iPhone per supportare le funzionalità basate sull’intelligenza artificiale di Siri, ed è in trattative per concedere in licenza modelli di intelligenza artificiale complementari dietro i migliori chatbot di concorrenti tra cui Google e OpenAI, riporta il New York Times. Secondo quanto riferito, i leader dell’azienda sono anche preoccupati per le minacce dell’intelligenza artificiale al suo dominio sul mercato degli smartphone, perché i prodotti concorrenti potrebbero sostituire il software iOS di Apple ed essere utilizzati per creare altre app basate sull’intelligenza artificiale che renderebbero l’App Store, che genera miliardi di vendite ogni anno, meno utile.

Secondo quanto riferito, Apple ha sottratto dipendenti AI a Google e ha costruito un “Vision Lab” in Svizzera per ospitare alcuni dei suoi sforzi nel campo dell’intelligenza artificiale. Secondo quanto riferito, la società ha inoltre collaborato con il principale produttore di chip Taiwan Semiconductor Manufacturing Company per sviluppare i propri chip AI.

https://www.key4biz.it/siri-di-apple-rincorre-sull-lai-sara-sufficiente-per-raggiungere-chatgpt/490019/


Exploration-focused training lets robotics AI immediately handle new tasks

A woman performs maintenance on a robotic arm.
boonchai wedmakawand

Reinforcement-learning algorithms in systems like ChatGPT or Google’s Gemini can work wonders, but they usually need hundreds of thousands of shots at a task before they get good at it. That’s why it’s always been hard to transfer this performance to robots. You can’t let a self-driving car crash 3,000 times just so it can learn crashing is bad.

But now a team of researchers at Northwestern University may have found a way around it. “That is what we think is going to be transformative in the development of the embodied AI in the real world,” says Thomas Berrueta who led the development of the Maximum Diffusion Reinforcement Learning (MaxDiff RL), an algorithm tailored specifically for robots.

Introducing chaos

The problem with deploying most reinforcement-learning algorithms in robots starts with the built-in assumption that the data they learn from is independent and identically distributed. The independence, in this context, means the value of one variable does not depend on the value of another variable in the dataset—when you flip a coin two times, getting tails on the second attempt does not depend on the result of your first flip. Identical distribution means that the probability of seeing any specific outcome is the same. In the coin-flipping example, the probability of getting heads is the same as getting tails: 50 percent for each.

In virtual, disembodied systems, like YouTube recommendation algorithms, getting such data is easy because most of the time it meets these requirements right off the bat. “You have a bunch of users of a website, and you get data from one of them, and then you get data from another one. Most likely, those two users are not in the same household, they are not highly related to each other. They could be, but it is very unlikely,” says Todd Murphey, a professor of mechanical engineering at Northwestern.

The problem is that, if those two users were related to each other and were in the same household, it could be that the only reason one of them watched a video was that their housemate watched it and told them to watch it. This would violate the independence requirement and compromise the learning.

“In a robot, getting this independent, identically distributed data is not possible in general. You exist at a specific point in space and time when you are embodied, so your experiences have to be correlated in some way,” says Berrueta. To solve this, his team designed an algorithm that pushes robots be as randomly adventurous as possible to get the widest set of experiences to learn from.

Two flavors of entropy

The idea itself is not new. Nearly two decades ago, people in AI figured out algorithms, like Maximum Entropy Reinforcement Learning (MaxEnt RL), that worked by randomizing actions during training. “The hope was that when you take as diverse set of actions as possible, you will explore more varied sets of possible futures. The problem is that those actions do not exist in a vacuum,” Berrueta claims. Every action a robot takes has some kind of impact on its environment and on its own condition—disregarding those impacts completely often leads to trouble. To put it simply, an autonomous car that was teaching itself how to drive using this approach could elegantly park into your driveway but would be just as likely to hit a wall at full speed.

To solve this, Berrueta’s team moved away from maximizing the diversity of actions and went for maximizing the diversity of state changes. Robots powered by MaxDiff RL did not flail their robotic joints at random to see what that would do. Instead, they conceptualized goals like “can I reach this spot ahead of me” and then tried to figure out which actions would take them there safely.

Berrueta and his colleagues achieved that through something called ergodicity, a mathematical concept that says that a point in a moving system will eventually visit all parts of the space that the system moves in. Basically, MaxDiff RL encouraged the robots to achieve every available state in their environment. And the results of first tests in simulated environments were quite surprising.

Racing pool noodles

“In reinforcement learning there are standard benchmarks that people run their algorithms on so we can have a good way of comparing different algorithms on a standard framework,” says Allison Pinosky, a researcher at Northwestern and co-author of the MaxDiff RL study. One of those benchmarks is a simulated swimmer: a three-link body resting on the ground in a viscous environment that needs to learn to swim as fast as possible in a certain direction.

In the swimmer test, MaxDiff RL outperformed two other state-of-the-art reinforcement learning algorithms (NN-MPPI and SAC). These two needed several resets to figure out how to move the swimmers. To complete the task, they were following a standard AI learning process divided down into a training phase where an algorithm goes through multiple failed attempts to slowly improve its performance, and a testing phase where it tries to perform the learned task. MaxDiff RL, by contrast, nailed it, immediately adapting its learned behaviors to the new task.

The earlier algorithms ended up failing to learn because they got stuck trying the same options and never progressing to where they could learn that alternatives work. “They experienced the same data repeatedly because they were locally doing certain actions, and they assumed that was all they could do and stopped learning,” Pinosky explains. MaxDiff RL, on the other hand, continued changing states, exploring, getting richer data to learn from, and finally succeeded. And because, by design, it seeks to achieve every possible state, it can potentially complete all possible tasks within an environment.

But does this mean we can take MaxDiff RL, upload it to a self-driving car, and let it out on the road to figure everything out on its own? Not really.

https://arstechnica.com/?p=2023543