Come funziona Vasa-1, la nuova AI di Microsoft che sfida Sora di OpenAI

La divisione di Microsoft in Asia ha presentato un nuovo progetto di intelligenza artificiale, chiamato Vasa-1, che può realizzare video di persone partendo solo da una loro foto.

La piattaforma, concorrente di Sora, il software sviluppato dal creatore di ChatGpt, OpenAI, può anche replicare la voce di un individuo, con solo pochi secondi di esempi campionati. L’intento è, per i ricercatori, “aprire la strada a interazioni con avatar realistici che emulano comportamenti umani”. Il risultato finale apre a ulteriori domande sulle capacità di distinguere un contenuto generato dall’IA da uno reale.

Al momento, Vasa-1 è solo un esperimento dei laboratori di Microsoft Research e non un programma pensato per un utilizzo ampio. Il colosso americano ha pubblicato diversi esempi in cui si vedono volti, ad un primo sguardo verosimili, pronunciare varie frasi. Anche se i movimenti delle labbra e della testa potrebbero sembrare artefatti, il potenziale rischio di uso della tecnologia per diffondere deepfake, filmati fasulli, è alto. I ricercatori stessi ne sono consapevoli e per questo hanno deciso di non rilasciare “una demo, un prodotto e ulteriori dettagli di implementazione o qualsiasi offerta correlata” finché non saranno sicuri che la loro tecnologia “sarà utilizzata in modo responsabile e in conformità con le corrette procedure”.

Secondo il documento di Microsoft, Vasa-1 è stato addestrato sul set di dati VoxCeleb2, che contiene “oltre 1 milione di espressioni di 6.112 individui celebri” estratte dai video di YouTube. Anche se lo strumento è stato addestrato su volti reali, Microsoft dimostra che Vasa-1 può funzionare anche su disegni e opere. Gli esperti hanno combinato la Mona Lisa con un file audio dell’attrice Anne Hathaway. “Pur riconoscendo la possibilità di un uso improprio, i vantaggi dell’IA per video vanno dall’equità educativa al miglioramento dell’accessibilità per le persone con difficoltà di comunicazione, fino alla compagnia o il supporto terapeutico a chi ne ha bisogno” spiega Microsoft.

Niente demo pubblica per evitare abusi

Nonostante le sue potenzialità, il team di Microsoft è consapevole che VASA-1 potrebbe essere utilizzato in modo improprio, ad esempio per creare contenuti fuorvianti o ingannevoli. Pertanto, i ricercatori hanno deciso di non rilasciare una demo online, un’API o un prodotto fino a quando non saranno certi che la tecnologia sarà utilizzata in modo responsabile e in conformità con le normative appropriate.

L’intelligenza artificiale sta facendo passi da gigante nel ricreare le espressioni umane, ma la strada è ancora lunga. Inoltre, sarà fondamentale garantire che sistemi di questo tipo siano utilizzati in modo etico e responsabile, per evitare possibili abusi e inganni.

https://www.key4biz.it/come-funziona-vasa-1-la-nuova-ai-di-microsoft-che-sfida-sora-di-openai/487583/


Oracle insieme a Fujitsu investe 8 miliardi in Giappone per AI e Cloud sovrani

Fujitsu e Oracle stanno collaborando per fornire funzionalità cloud e AI sovrani in Giappone alle aziende e al settore pubblico. Un investimento complessivo di 8 miliardi di dollari in 10 anni. Fujitsu implementerà Oracle Alloy, una piattaforma di infrastruttura cloud che fornisce più di 100 servizi Oracle Cloud Infrastructure (OCI), inclusa l’intelligenza artificiale generativa, come parte del suo portafoglio Fujitsu Uvance Hybrid IT, con infrastrutture on-premise e basate su cloud.

Ciò consentirà alle aziende e al settore pubblico nipponico di utilizzare l’infrastruttura cloud sovrana e l’intelligenza artificiale sovrana direttamente dal data center gestito da Fujitsu in Giappone. Fujitsu sostiene che sarà in grado di gestire Oracle Alloy in modo indipendente nei suoi data center in Giappone con un controllo aggiuntivo sulle sue operazioni. Sulla base delle conoscenze accumulate attraverso casi d’uso nel mercato giapponese, Fujitsu prenderà attivamente in considerazione l’espansione di Oracle Alloy in altri mercati. Fujitsu ha affermato che il servizio consente alle aziende di centralizzare le operazioni e le policy di sicurezza in ambienti on-premise e hyperscaler.

Oracle prevede di aumentare il supporto clienti locale delle sue regioni cloud pubbliche a Tokyo e Osaka e dei suoi team operativi locali per Oracle Alloy e OCI Dedicated Region. Ciò consentirà ai governi e alle aziende di tutto il Giappone di continuare a spostare i propri carichi di lavoro mission-critical su Oracle Cloud e ad adottare soluzioni di intelligenza artificiale sovrane. I servizi cloud e AI sovrani di Oracle possono essere forniti in modo sicuro all’interno dei confini di un paese o nelle sedi di un’organizzazione con una serie di controlli operativi. Oracle è l’unico hyperscaler in grado di fornire intelligenza artificiale e una suite completa di oltre 100 servizi cloud a livello locale, ovunque.

https://www.key4biz.it/oracle-insieme-a-fujitsu-investe-8-miliardi-in-giappone-per-ai-e-cloud-sovrani/487623/


Deepfakes in the courtroom: US judicial panel debates new AI evidence rules

An illustration of a man with a very long nose holding up the scales of justice.

On Friday, a federal judicial panel convened in Washington, DC, to discuss the challenges of policing AI-generated evidence in court trials, according to a Reuters report. The US Judicial Conference’s Advisory Committee on Evidence Rules, an eight-member panel responsible for drafting evidence-related amendments to the Federal Rules of Evidence, heard from computer scientists and academics about the potential risks of AI being used to manipulate images and videos or create deepfakes that could disrupt a trial.

The meeting took place amid broader efforts by federal and state courts nationwide to address the rise of generative AI models (such as those that power OpenAI’s ChatGPT or Stability AI’s Stable Diffusion), which can be trained on large datasets with the aim of producing realistic text, images, audio, or videos.

In the published 358-page agenda for the meeting, the committee offers up this definition of a deepfake and the problems AI-generated media may pose in legal trials:

A deepfake is an inauthentic audiovisual presentation prepared by software programs using artificial intelligence. Of course, photos and videos have always been subject to forgery, but developments in AI make deepfakes much more difficult to detect. Software for creating deepfakes is already freely available online and fairly easy for anyone to use. As the software’s usability and the videos’ apparent genuineness keep improving over time, it will become harder for computer systems, much less lay jurors, to tell real from fake.

During Friday’s three-hour hearing, the panel wrestled with the question of whether existing rules, which predate the rise of generative AI, are sufficient to ensure the reliability and authenticity of evidence presented in court.

Some judges on the panel, such as US Circuit Judge Richard Sullivan and US District Judge Valerie Caproni, reportedly expressed skepticism about the urgency of the issue, noting that there have been few instances so far of judges being asked to exclude AI-generated evidence.

“I’m not sure that this is the crisis that it’s been painted as, and I’m not sure that judges don’t have the tools already to deal with this,” said Judge Sullivan, as quoted by Reuters.

Last year, Chief US Supreme Court Justice John Roberts acknowledged the potential benefits of AI for litigants and judges, while emphasizing the need for the judiciary to consider its proper uses in litigation. US District Judge Patrick Schiltz, the evidence committee’s chair, said that determining how the judiciary can best react to AI is one of Roberts’ priorities.

In Friday’s meeting, the committee considered several deepfake-related rule changes. In the agenda for the meeting, US District Judge Paul Grimm and attorney Maura Grossman proposed modifying Federal Rule 901(b)(9) (see page 5), which involves authenticating or identifying evidence. They also recommended the addition of a new rule, 901(c), which might read:

901(c): Potentially Fabricated or Altered Electronic Evidence. If a party challenging the authenticity of computer-generated or other electronic evidence demonstrates to the court that it is more likely than not either fabricated, or altered in whole or in part, the evidence is admissible only if the proponent demonstrates that its probative value outweighs its prejudicial effect on the party challenging the evidence.

The panel agreed during the meeting that this proposal to address concerns about litigants challenging evidence as deepfakes did not work as written and that it will be reworked before being reconsidered later.

Another proposal by Andrea Roth, a law professor at the University of California, Berkeley, suggested subjecting machine-generated evidence to the same reliability requirements as expert witnesses. However, Judge Schiltz cautioned that such a rule could hamper prosecutions by allowing defense lawyers to challenge any digital evidence without establishing a reason to question it.

For now, no definitive rule changes have been made, and the process continues. But we’re witnessing the first steps of how the US justice system will adapt to an entirely new class of media-generating technology.

Putting aside risks from AI-generated evidence, generative AI has led to embarrassing moments for lawyers in court over the past two years. In May 2023, US lawyer Steven Schwartz of the firm Levidow, Levidow, & Oberman apologized to a judge for using ChatGPT to help write court filings that inaccurately cited six nonexistent cases, leading to serious questions about the reliability of AI in legal research. Also, in November, a lawyer for Michael Cohen cited three fake cases that were potentially influenced by a confabulating AI assistant.

https://arstechnica.com/?p=2019174


AI, ok in Cdm al Ddl. Sconti per i ricercatori che tornano e reclusione fino a 5 anni per ‘danno ingiusto’

Una dotazione di un miliardo di euro in capo a CDP e stretta sui reati, fino a 5 anni di reclusione per illecita diffusione di contenuti AI. Queste in estrema sintesi le principali novità del disegno di legge sull’Intelligenza Artificiale varato in Consiglio dei Ministri, che tra le altre cose, estende il regime di agevolazioni fiscali per i lavoratori impatriati anche a chi ha svolto all’estero un’attività di ricerca nell’ambito delle tecnologie di IA. La norma, ha spiegato il sottosegretario per l’innovazione tecnologia Alessio Butti, è rivolta a chi rientra dagli Stati Uniti ma anche dagli altri Paesi europei. Con il decreto delegato dovrebbero arrivare anche facilitazioni per la formazione e in ambito scolastico.

Ddl AI testo finale, scarica il documento in PDF

Leggi anche: Ddl Intelligenza Artificiale: Sovranità digitale, Salute, Lavoro e Giustizia fra le priorità della bozza

AI, nella bozza del Ddl AgID e ACN le Autorità designate per l’intelligenza artificiale

AI, Butti ‘Italia primo paese al mondo a normare l’AI dopo l’AI Act’

“Il Governo italiano è il primo che dopo l’approvazione dell’AI Act legifera in materia di intelligenza artificiale – ha detto Butti – con uno strumento di legge che è il disegno di legge”. Il testo, aggiunge Butti, è del tutto compliant con quanto approvato dall’Europarlamento, che ha votato un testo che seleziona i modelli in base al rischio. Peraltro l’AI Act prevede anche delle sanzioni e dei divieti.

Il testo italiano è inoltre molto atteso in ambito G7.

La strategia rinnovata su base biennale

La strategia sull’intelligenza artificiale viene elaborata in seno alla Residenza del Consiglio dal Dipartimento per la Transizione Digitale, che a cadenza biennale aggiorna la strategia stessa.

Nel passaggio dalla bozza iniziale si perde per strada la Fondazione per la ricerca e i trasferimento tecnologico, con una dotazione finanziaria di 150 milioni che doveva restare sotto il controllo della Presidenza del Consiglio.

Ad ACN (Agenzia per la Cybersicurezza Nazionale) e Agid (Agnrzia per l’Italia Digitale) il compito di monitoraggio, verifica e sanzione, con buona pace del Garante Privacy che rivendica un ruolo di primo piano che però non le è stato concesso.

Dotazione finanziaria di 1 miliardo in capo a CDP

La dotazione finanziaria è di circa un miliardo, tutto in capo a CDP.

Definito anche un sostegno allo sport e ai giovani per quanto riguarda l’implementazione dell’intelligenza artificiale ad esempio all’articolo 20 (sono 26 in tutto gli articoli del ddl) è prevista una agevolazione fiscale per il rientro dei cervelli dagli Usa ma anche dal resto dell’Europa e non solo.

Previsti dei crediti formativi per i giovani più meritevoli.

La strategia nazionale è ben identificata all’articolo 17, e mira ad una attenzione particolare per l’uomo: “è una visione antropocentrica – sottolinea Butti – e mette insieme le amministrazioni pubbliche e i soggetti privati, promuove la ricerca e indirizza incentivi per lo sviluppo delle imprese. L’obiettivo è dotare il paese di una politica industriale che in materia di intelligenza artificiale non esiste e che esisterà per la prima volta con il Governo Meloni”.          

La prima legge italiana sull’Ia punta a guidare lo sviluppo dell’intelligenza artificiale e il suo utilizzo in tutti i settori, dalla sanità alla giustizia. Il disegno di legge introduce il reato di “Illecita diffusione di contenuti generati o manipolati con sistemi di intelligenza artificiale”, punito con la reclusione fino a 5 anni. Il governo definirà poi nuove fattispecie di reato con decreti legislativi ad hoc nei prossimi mesi.

Nel decreto di legge si affida alla presidenza del Consiglio italiano la definizione della strategia nazionale, che “favorisce la collaborazione tra le amministrazioni pubbliche e i soggetti privati” per lo sviluppo della tecnologia.

I danni gravi causati a terzi saranno punti penalmente, così come il copyright che sarà regolato con protezione prevista per gli editori.

Sicurezza nazionale, forze armate, ACN, intelligence sono escluse dalla normativa.

AI: Nordio, ‘in ddl introdotta pena da 1 a 5 anni per danno ingiusto’

Chiunque “cagiona un danno ingiusto” utilizzando sistemi di intelligenza artificiale per falsificare immagini, voci e video di qualcuno senza il suo consenso sarà punito con una pena da 1 a 5 anni. L’obiettivo è tutelare l’immagine e la genuinità dell’identità delle persone. E’ quanto prevede il ddl sull’Intelligenza artificiale approvato dal Cdm, illustrato ieri sera in conferenza stampa a Palazzo Chigi dal ministro della Giustizia Carlo Nordio. Lo stesso utilizzo costituirà “una aggravante per i reati per i quali è possibile che si intervenga in modo insidioso con la Ia”, ha spiegato il ministro. “Si è diffuso il pensiero – ha spiegato – che l’intelligenza artificiale possa sostituire l’attività dei giudici” ma il provvedimento approvato dal Cdm prevede che “possa essere utilizzata per l’organizzazione e la semplificazione del lavoro giudiziario” ma “senza condizionare i magistrati, ai quali è sempre riservata la decisione finale, e senza sostituire l’intelligenza artificiale all’intelligenza umana”.

Un primo articolo che riguarda la giustizia è il 14. Il sistema giustizia in oche parole tenterà di cogliere l’opportunità dell’intelligenza artificiale, che può essere utilissima nell’organizzazione dell’ufficio e nella ricerca giurisprudenziale. “L’intelligenza artificiale non crea dei fotomontaggi, come in passato – dice Nordio – con l’AI puoi creare un mondo reale, ancorché virtuale, quindi attribuire ad una persona atteggiamenti, comportamenti, idee, voce, canzoni che possono creare dei danni”. L’uso dell’AI sarà una aggravante in caso di furto, truffa, riciclaggio aggiotaggio ecc.

Ia: Urso, ‘provvedimento che interessa 4 milioni di Pmi, 1 mld di prime risorse’

”Il nostro Paese ha oltre 4 milioni di piccole e medie imprese che devono essere messe anch’esse nelle condizioni di utilizzare appieno” l’intelligenza artificiale, ”così sfidante per i loro processi produttivi”. Così il ministro per le Imprese e il Made in Italy Adolfo Urso. Il provvedimento approvato dal Cdm ”indirizza un miliardo di euro del fondo innovazione al venture capital gestito da Cassa Depositi e Prestiti da un lato per promuovere la nascita di startup e di far crescere le startup esistenti che operano nel campo dell’Intelligenza Artificiale e dall’altra per consentire la nascita di un campione nazionale, come stanno facendo altri paesi europei”. ”Si tratta ovviamente delle prime risorse ancorché significative, e poi vedremo successivamente le ulteriori necessità”, aggiunge il ministro.

Nascita di un mercato dell’AI aperto

Nel provvedimento, articolo 5, ”è definito che l’obiettivo è quello di creare un mercato dell’intelligenza artificiale che sia aperto, equo e senza barriere all’ingresso. E inoltre quello di garantire a tutti l’accessibilità a dati che siano di alta qualità da utilizzare per sviluppare e allenare i sistemi applicativi di intelligenza artificiale”.

L’obiettivo del Governo è quindi quello di coinvolgere le Pmi nel processo innovativo legato all’avvento sul mercato dell’AI.

Per le aziende, previsti sandbox regolamentari. Test leciti previo parere del Ministero della Difesa per l’uso duale. In ambito sanitario, sistemi di AI per il fascicolo sanitario elettronico, previo decreto del ministero della Salute.

IA, Mantovano: aggravante per chi la usa per alterare le elezioni

Sul fronte delle criticità derivanti dall’intelligenza artificiale il regolamento europeo sarà “pienamente operativo tra circa due anni e noi ci siamo posti il problema di cosa facciamo nel frattempo”. Cosi’ il sottosegretario alla presidenza del consiglio Alfredo Mantovano, dopo il via libera da parte del Consiglio dei ministri del ddl sull’IA.

Mantovano, parlando in occasione della conferenza stampa di presentazione della Relazione annuale al Parlamento dell’Agenzia per la Cybersicurezza Nazionale (ACN), ha riferito che “proprio ieri è emersa in Cdm l’opportunità di inserire un’ulteriore aggravante per alterare l’espressione del volto, all’approssimarsi di elezioni. E’ qualcosa che è accaduto in altre nazioni europee, all’approssimarsi di elezioni, con le manipolazioni dell’uso distorto dell’intelligenza artificiale sono stati diffusi messaggi miranti ad aumentare l’astensionismo, attraverso la diffusione di notizie che per esempio raccontavano falsamente che i seggi erano a rischio di attentati ed esplosioni. Una cosa del genere mina l’equilibrio di una democrazia e devono essere accompagnati di sanzioni”.

“Auspico che anche per questo ddl ci sia dal Parlamento un’attenzione analoga a quello che sta dimostrando sul fronte Cyber in modo che l’Italia nel giro di qualche mese possa dotarsi degli strumenti più efficaci”, ha concluso.

Ddl AI testo finale, scarica il documento in PDF

https://www.key4biz.it/ai-ok-in-cdm-al-ddl-sconti-per-i-ricercatori-che-tornano-e-reclusione-fino-a-5-anni-per-danno-ingiusto/487804/



Microsoft’s Phi-3 shows the surprising power of small, locally run AI language models

An illustration of lots of information being compressed into a smartphone with a funnel.

Enlarge (credit: Getty Images)

On Tuesday, Microsoft announced a new, freely available lightweight AI language model named Phi-3-mini, which is simpler and less expensive to operate than traditional large language models (LLMs) like OpenAI’s GPT-4 Turbo. Its small size is ideal for running locally, which could bring an AI model of similar capability to the free version of ChatGPT to a smartphone without needing an Internet connection to run it.

The AI field typically measures AI language model size by parameter count. Parameters are numerical values in a neural network that determine how the language model processes and generates text. They are learned during training on large datasets and essentially encode the model’s knowledge into quantified form. More parameters generally allow the model to capture more nuanced and complex language-generation capabilities but also require more computational resources to train and run.

Some of the largest language models today, like Google’s PaLM 2, have hundreds of billions of parameters. OpenAI’s GPT-4 is rumored to have over a trillion parameters but spread over eight 220-billion parameter models in a mixture-of-experts configuration. Both models require heavy-duty data center GPUs (and supporting systems) to run properly.

Read 8 remaining paragraphs | Comments

https://arstechnica.com/?p=2019278


È stato creato un worm gestito dall’IA capace di propagarsi tra i sistemi informatici


Un team di ricercatori ha sviluppato quello che ritengono essere uno dei primi worm informatici basati sull’intelligenza artificiale generativa, capace di passare da un sistema all’altro per sottrarre dati o diffondere malware. Questo innovativo attacco, battezzato Morris II in onore del primo worm che nel 1988 mise in crisi Internet, è opera di Ben Nassi, Stav Cohen e Ron Bitton della Cornell Tech.

Il loro lavoro, svelato per la prima volta a Wired, rivela come tale worm possa prendere di mira assistenti email basati su AI per trafugare informazioni e inviare spam, eludendo le difese di sistemi come ChatGPT e Gemini. “Significa sostanzialmente che ora è possibile condurre o eseguire un nuovo tipo di cyberattacco che non è mai stato visto prima”.

La ricerca sottolinea la vulnerabilità a questa tipologia di attacchi dei sistemi di intelligenza artificiale, che sono sempre più versatili in quanto capaci di produrre testi, immagini e video. Essendo programmabili attraverso comandi diretti, possono essere indotti a comportamenti nocivi, incluso il rilascio di contenuti dannosi o l’attuazione di attacchi specifici.

I ricercatori hanno spiegato come sia possibile manipolare questi sistemi tramite comandi che si auto-replicano, causando la diffusione del worm attraverso le banche dati degli assistenti email. Questi ultimi, da non confondersi coi client email, sono servizi spesso basati sull’intelligenza artificiale, che assistono l’utente nella gestione della posta elettronica. Le funzionalità possono includere suggerimenti per la scrittura di risposte automatiche o semi-automatiche, organizzazione delle email in base alla priorità, al mittente o all’argomento, programmazione di email da inviare in momenti specifici e riepilogo delle email importanti o non lette.

Nel corso dell’esperimento, i ricercatori hanno allestito un sistema email gestito da AI, interagendo con ChatGPT, Gemini e un modello aperto, LLaVA. E hanno scoperto come sfruttare le vulnerabilità tramite testo e immagini per diffondere il worm. Per la sua creazione hanno utilizzato un “prompt auto-replicante avversario“, un comando che induce l’AI a generare nella sua risposta un altro prompt. In breve, al sistema AI viene detto di produrre un insieme di ulteriori istruzioni nelle sue risposte. Ciò, dicono i ricercatori, è ampiamente simile agli attacchi tradizionali di iniezione SQL e buffer overflow.

Il video che vede qui sotto mostra un sistema di posta elettronica che inoltra ripetutamente un messaggio, dimostrando la potenzialità di estrazione di dati sensibili come nomi, numeri di telefono e dati bancari. Quello che hanno fatto i ricercatori, però, è a fin di bene. Nonostante abbiano evidenziato le lacune nei sistemi di ChatGPT e Gemini, il loro obiettivo è sensibilizzare in merito a questa problematica.

[embedded content]

Non a caso, hanno informato Google e OpenAI delle loro scoperte. “Sembra che abbiano trovato un modo per sfruttare le vulnerabilità di tipo iniezione di prompt facendo affidamento su input dell’utente che non sono stati controllati o filtrati”, ha dichiarato un portavoce di OpenAI.

Che poi ha aggiunto che l’azienda sta lavorando per rendere i suoi sistemi “più resilienti” e che gli sviluppatori dovrebbero “utilizzare metodi che assicurino che non stiano lavorando con input dannosi”. Google ha rifiutato di commentare ufficialmente la ricerca ma, stando ai messaggi che Nassi ha condiviso con WIRED, i ricercatori dell’azienda avrebbero chiesto un incontro per parlare dell’argomento.

Gli specialisti di sicurezza informatica concordano sul reale rischio futuro rappresentato dai worm AI generativi, soprattutto in scenari dove le applicazioni di intelligenza artificiale operano autonomamente per conto dell’utente. Sahar Abdelnabi, del CISPA Helmholtz Center for Information Security in Germania, avverte che la diffusione di tali attacchi è realistica, specie con modelli AI che interagiscono con dati esterni o che operano in autonomia: “Penso che l’idea di diffondere iniezioni sia molto plausibile”.

Tuttavia, per mitigare questi rischi esistono strategie difensive come il design sicuro delle applicazioni e un controllo costante. “È qualcosa che potrebbe in parte essere affrontata da una corretta progettazione delle applicazioni e dal monitoraggio umano”, afferma Adam Swanda, ricercatore di minacce informatiche presso Robust Intelligence. “In genere, è meglio non fidarsi ciecamente dell’output degli LLM in nessuna parte delle proprie applicazioni”.

In conclusione, sebbene gli attacchi dimostrati siano stati condotti in un ambiente controllato, l’integrazione crescente dell’AI richiede una maggiore consapevolezza dei rischi e lo sviluppo di appropriate strategie di mitigazione.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/04/23/creato-worm-gestito-da-ia-propaga-tra-sistemi-informatici/?utm_source=rss&utm_medium=rss&utm_campaign=creato-worm-gestito-da-ia-propaga-tra-sistemi-informatici


High-speed imaging and AI help us understand how insect wings work

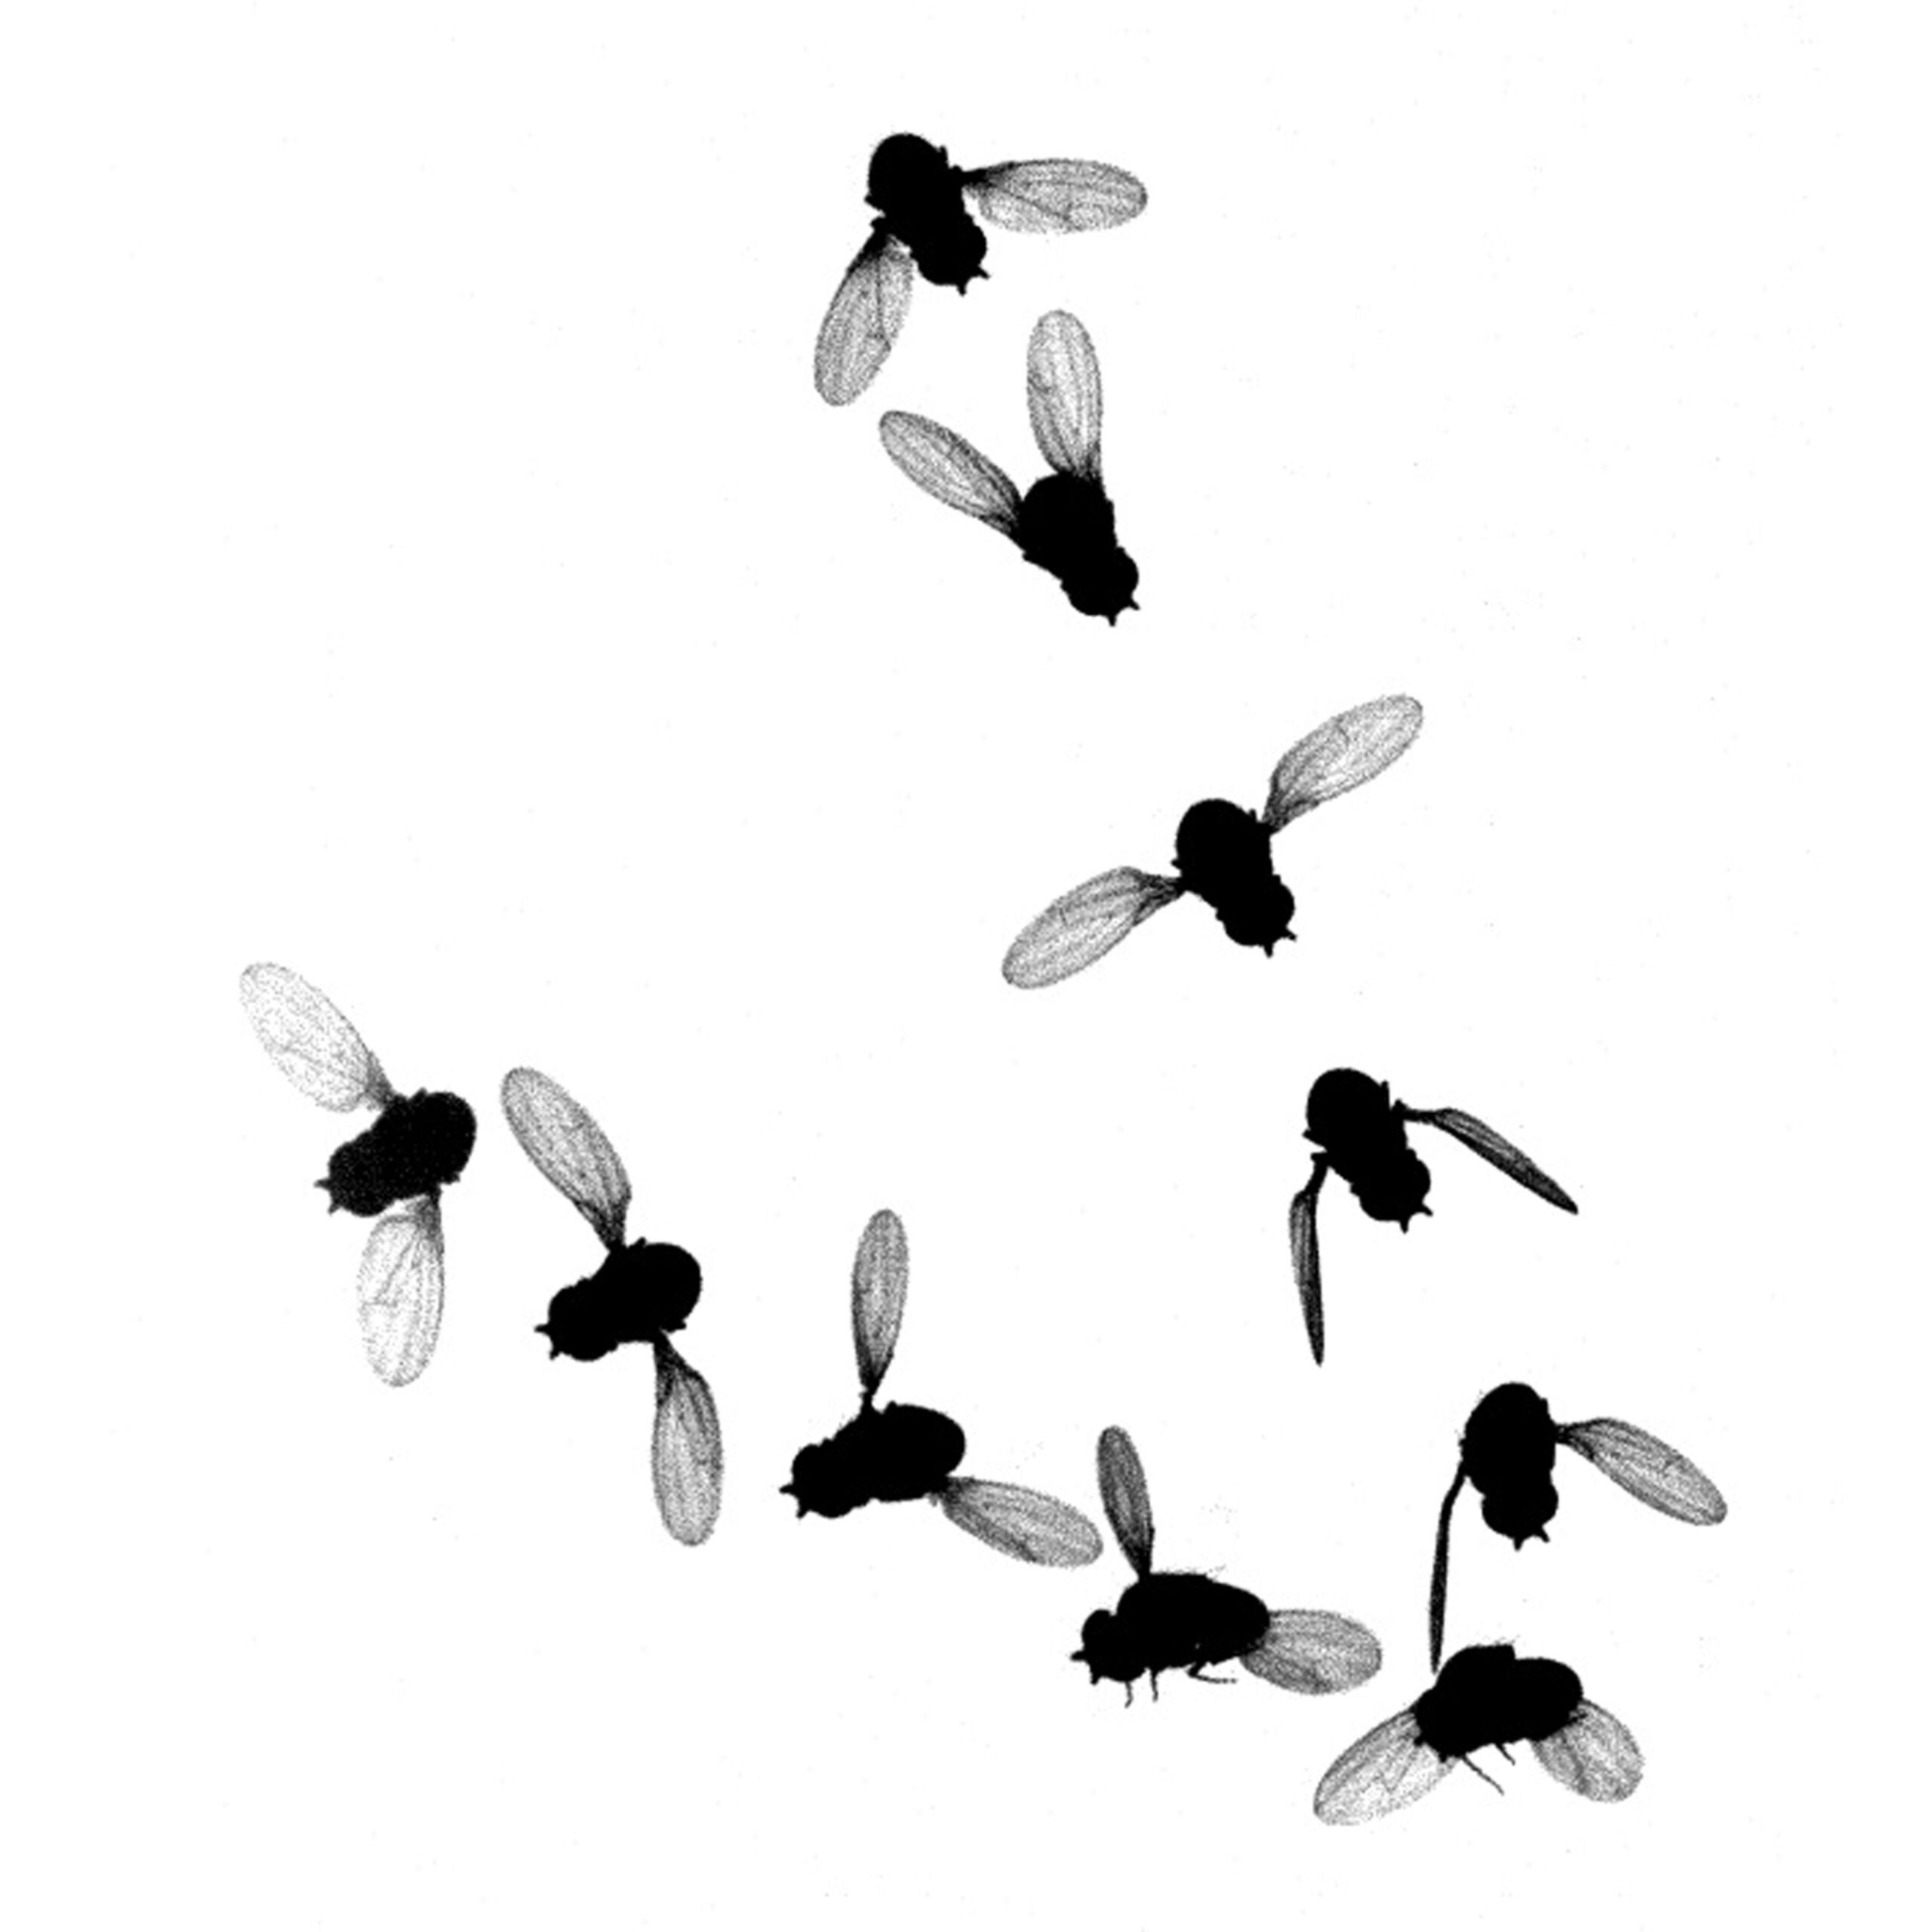
Black and white images of a fly with its wings in a variety of positions, showing the details of a wing beat.
Enlarge / A time-lapse showing how an insect’s wing adopts very specific positions during flight.
Florian Muijres, Dickinson Lab

About 350 million years ago, our planet witnessed the evolution of the first flying creatures. They are still around, and some of them continue to annoy us with their buzzing. While scientists have classified these creatures as pterygotes, the rest of the world simply calls them winged insects.

There are many aspects of insect biology, especially their flight, that remain a mystery for scientists. One is simply how they move their wings. The insect wing hinge is a specialized joint that connects an insect’s wings with its body. It’s composed of five interconnected plate-like structures called sclerites. When these plates are shifted by the underlying muscles, it makes the insect wings flap.

Until now, it has been tricky for scientists to understand the biomechanics that govern the motion of the sclerites even using advanced imaging technologies. “The sclerites within the wing hinge are so small and move so rapidly that their mechanical operation during flight has not been accurately captured despite efforts using stroboscopic photography, high-speed videography, and X-ray tomography,” Michael Dickinson, Zarem professor of biology and bioengineering at the California Institute of Technology (Caltech), told Ars Technica.

As a result, scientists are unable to visualize exactly what’s going on at the micro-scale within the wing hinge as they fly, preventing them from studying insect flight in detail. However, a new study by Dickinson and his team finally revealed the working of sclerites and the insect wing hinge. They captured the wing motion of fruit flies (Drosophila melanogaster) analyzing 72,000 recorded wing beats using a neural network to decode the role individual sclerites played in shaping insect wing motion.

Understanding the insect wing hinge

The biomechanics that govern insect flight are quite different from those of birds and bats. This is because wings in insects didn’t evolve from limbs. “In the case of birds, bats, and pterosaurs we know exactly where the wings came from evolutionarily because all these animals fly with their forelimbs. They’re basically using their arms to fly. In insects, it’s a completely different story. They evolved from six-legged organisms and they kept all six legs. However, they added flapping appendages to the dorsal side of their body, and it is a mystery as to where those wings came from,” Dickinson explained.

Some researchers suggest that insect wings came from gill-like appendages present in ancient aquatic arthropods. Others argue that wings originated from “lobes,” special outgrowths found on the legs of ancient crustaceans, which were ancestors of insects. This debate is still ongoing, so its evolution can’t tell us much about how the hinge and the sclerites operate.

Understanding the hinge mechanics is crucial because this is what makes insects efficient flying creatures. It enables them to fly at impressive speeds relative to their body sizes (some insects can fly at 33 mph) and to demonstrate great maneuverability and stability while in flight.

“The insect wing hinge is arguably among the most sophisticated and evolutionarily important skeletal structures in the natural world,” according to the study authors.

However, imaging the activity of four of the five sclerites that form the hinge has been impossible due to their size and the speeds at which they move. Dickinson and his team employed a multidisciplinary approach to overcome this challenge. They designed an apparatus equipped with three high-speed cameras that recorded the activity of tethered fruit flies at 15,000 frames per second using infrared light.

They also used a calcium-sensitive protein to track changes in the activity of the steering muscles of the insects as they flew (calcium helps trigger muscle contractions). “We recorded a total of 485 flight sequences from 82 flies. After excluding a subset of wingbeats from sequences when the fly either stopped flying or flew at an abnormally low wingbeat frequency, we obtained a final dataset of 72,219 wingbeats,” the researchers note.

Next, they trained a machine-learning-based convolutional neural network (CNN) using 85 percent of the dataset. “We used the CNN model to investigate the transformation between muscle activity and wing motion by performing a set of virtual manipulations, exploiting the network to execute experiments that would be difficult to perform on actual flies,” they explained.

In addition to the neural network, they also developed an encoder-decoder neural network (an architecture used in machine learning) and fed it data related to steering muscle activity. While the CNN model could predict wing motion, the encoder/decoder could predict the action of individual sclerite muscles during the movement of the wings. Now, it was time to check whether the data they predicted was accurate.

https://arstechnica.com/?p=2019187


5G & Co., Bilel Jamoussi (ITU): ‘Il ruolo dell’AI e del machine learning per le reti 5G’ (video)

Il ruolo crescente dell’Intelligenza Artificiale e del Machine Learning per l’ottimizzazione delle reti 5G. Questo il tema dell’intervento di Bilel Jamoussi, Deputy to the Director of the Telecommunication Standardization Bureau dell’ITU in occasione del 5G & Co., la conferenza internazionale organizzata dal CNIT che si è tenuto a Roma il 16 e 17 aprile.

[embedded content]

L’ITU è l’organismo in seno all’ONU che si occupa di fissare le politiche internazionali sull’utilizzo dello spettro radio e attualmente è molto attiva nella fase di standardizzazione e sviluppo dell’interconnessione fra diverse tecnologie in particolare delle reti 5G con le enormi potenzialità dell’AI. Fra gli obiettivi principali dell’ITU c’è anche la chiusura del gap tecnologici fra paesi sviluppati e non a livello globale.

L’ITU in questo senso sta organizzando diversi focus group per lo sviluppo del ML5G e il 30 e 31 maggio ha organizzato a Ginevra un evento ad hoc, battezzato AI for good Global Summit. “L’obiettivo è condividere progetti e contributi in modalità open source – ha detto Bilel Jamoussi – per arrivare a standard comuni per sfruttare le potenzialità dell’AI nelle reti 5G e 6G”.    

https://www.key4biz.it/5g-co-bilel-jamoussi-itu-il-ruolo-dellai-e-del-machine-learning-per-le-reti-5g-video/487520/


IA sul campo di battaglia: l’incubo dei dati avvelenati

La AI è al centro anche delle tecnologie militari per migliorarne l’efficacia sul campo di battaglia. Il suo ampio uso però la espone ad un attacco molto particolare, cioè “l’avvelenamento del pozzo” dei dati che alimentano la sua intelligenza.

“Non credo che i nostri dati siano avvelenati ora”, ha sottolineato il vice segretario alla difesa USA , Jennifer Swanson, mercoledì alla conferenza del Potomac Officers Club, “ma quando combatteremo contro un avversario quasi alla pari, dovremo sapere esattamente quali sono i vettori di minaccia”.

Ogni algoritmo di apprendimento automatico deve essere addestrato su dati – molti e molti dati. Il Pentagono sta facendo uno sforzo enorme per raccogliere, collazionare, curare e pulire i suoi dati, in modo che gli algoritmi analitici e le IA neonate possano dargli un senso. In particolare, il team di preparazione deve eliminare tutti i punti di dati errati, prima che l’algoritmo possa imparare la cosa sbagliata.

La battaglia dei dai

I chatbot commerciali, da Microsoft Tay del 2016 a ChatGPT del 2023, hanno mostrato come la qualità dei dati possa influenzare lo sviluppo della AI e il suo funzionamento. Nel caso di Ai utilizzate nel settore militare i dati potrebbero essere “Avvelenati”, cioè falsificati e distorti, in mdo deliberato e guidato dagli avversari potenziali delle forze armati di un paese, e questa tecnica è proprio definita “avvelenamento dei dati”.

“Qualsiasi LLM [Large Language Model] commerciale che è in circolazione e che apprende da Internet, oggi è avvelenato”, ha detto Swanson senza mezzi termini. “Ma sono onestamente più preoccupato di ciò che si chiama, come dire, l’IA ‘normale’, perché questi sono gli algoritmi che saranno realmente utilizzati dai nostri soldati per prendere decisioni sul campo di battaglia”.

Nel caso del Pentagono non si tratta di addestrare dei chatbot con i dati presi dalla rete. L’esercito dovrebbe addestrarlo su un set di dati militari affidabili e verificati all’interno di un ambiente sicuro e protetto. In particolare, ha raccomandato un sistema al livello di impatto 5 o 6 del DoD, adatto ai dati sensibili (5) o classificati (6).

Entro l’estate deovrebbe essere il primo campione di intelligenza artficiale IL-5 LLM, cioè basato sui dati di livello 5.  Questo può essere utile per tutti i tipi di funzioni di back-office, riassumendo le risme di informazioni per rendere più efficienti i processi burocratici. “Ma la nostra preoccupazione principale sono gli algoritmi che informeranno le decisioni sul campo di battaglia”.

Avvelenare i dati della IA che decidono le attività sul campo di battaglai può essere invece un problmea molto più profondo e di difficile soluzione.

CJADC2, test AI ecome sconfiggere i dati avvelenati

Ottenere i giusti dati di addestramento specifici per le forze armate è particolarmente critico per il Pentagono, che mira a utilizzare l’AI per coordinare le future operazioni di combattimento attraverso la terra, l’aria, il mare, lo spazio e il cyberspazio. Il concetto si chiama Combined Joint All-Domain Command and Control (CJADC2) e a febbraio il Pentagono ha annunciato che una “capacità minima di fattibilità” funzionante è già stata messa in campo in alcuni quartieri generali selezionati in tutto il mondo.

Le versioni future aggiungeranno i dati di targeting e la pianificazione degli attacchi, collegandosi ai progetti di comando di battaglia AI esistenti a livello di servizio: ABMS dell’Aeronautica, Project Overmatch della Marina e Project Convergence dell’Esercito.

Il Project Convergence, a sua volta, utilizzerà la tecnologia sviluppata dal neonato Project Linchpin, che sarà la Ai di punto nella guida delle decisioni strategiche.

In altre parole, l’Esercito sta cercando di applicare all’apprendimento automatico il ciclo di feedback “agile” tra sviluppo, cybersicurezza e operazioni correnti (DevSecOps) utilizzato dai principali sviluppatori di software per lanciare rapidamente nuove tecnologie e aggiornarle continuamente.

Il problema è che, in realtà, non si sa come guidare questi processi e le società che commercialmente gestiscono gli algoritmi non hanno bene idea di come questi funzionino. Normalmente si è abituati a vedere il funzionamento dei programmi come deterministico, come la risposta fissa a una certa situazione. Questo non accade con la AI, dove la risposta non sempre predeterminata, come dimostrano le applicaazioni di OpenAI.

C’è poi anche un problema ulteriore: ogni implementazione della Ai provoca un flusso di dati che viene a sua volta ad essere integrato nel database della AI e quindi ne viene a definire i processi futuri. Tutto questo viene a rendere il problema dell’avvelenament dei dati e della purezza delle informazioni che vengono fornite ai programmi Ai importantitssimo, essenziale, nella definizione delle decisioni strategiche e nella loro trasmissione.

I prossimi anni vedranno lo sviluppo di un nuovo campo di battaglia: quello dei dati, in cui ciascuna parte cercherà di corrompere e falsificare la abse dei dati su cui si basano le decisioni degli altri.


Telegram

Telegram
Grazie al nostro canale Telegram potete rimanere aggiornati sulla pubblicazione di nuovi articoli di Scenari Economici.

⇒ Iscrivetevi subito ⇐


MindsMinds

https://scenarieconomici.it/ia-sul-campo-di-battaglia-lincubo-dei-dati-avvelenati/


Netflix doc accused of using AI to manipulate true crime story

<img src="https://rassegna.lbit-solution.it/wp-content/uploads/2024/04/netflix-doc-accused-of-using-ai-to-manipulate-true-crime-story.jpg" alt="A cropped image showing Raw TV's poster for the Netflix documentary What Jennifer Did, which features a long front tooth that leads critics to believe it was AI-generated.”>
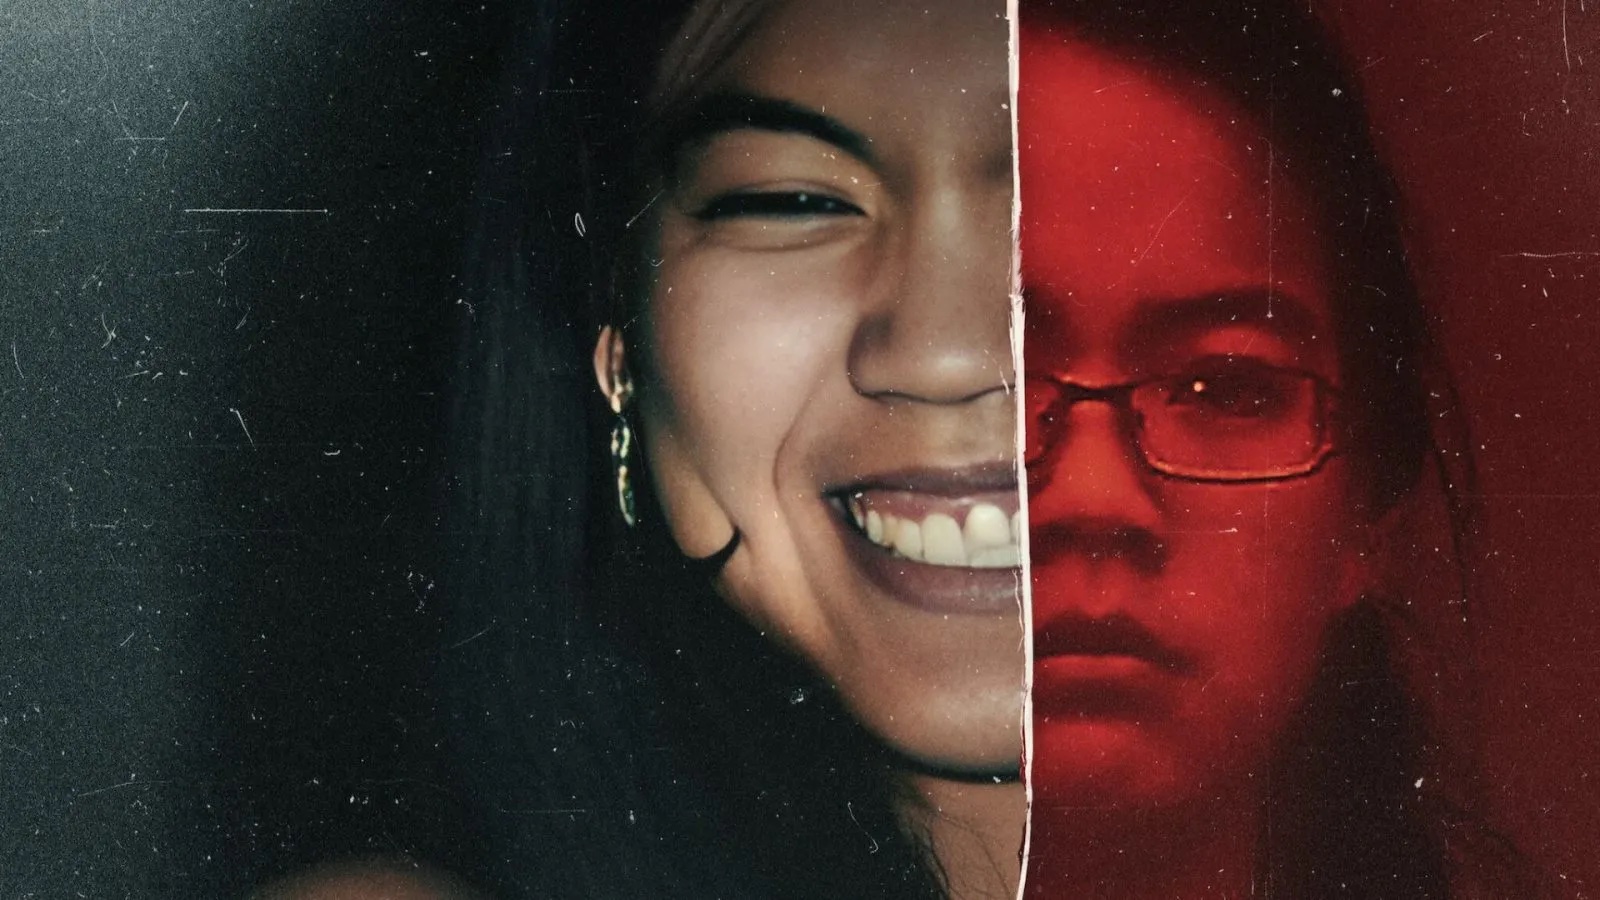
Enlarge / A cropped image showing Raw TV’s poster for the Netflix documentary What Jennifer Did, which features a long front tooth that leads critics to believe it was AI-generated.

An executive producer of the Netflix hit What Jennifer Did has responded to accusations that the true crime documentary used AI images when depicting Jennifer Pan, a woman currently imprisoned in Canada for orchestrating a murder-for-hire scheme targeting her parents.

What Jennifer Did shot to the top spot in Netflix’s global top 10 when it debuted in early April, attracting swarms of true crime fans who wanted to know more about why Pan paid hitmen $10,000 to murder her parents. But quickly the documentary became a source of controversy, as fans started noticing glaring flaws in images used in the movie, from weirdly mismatched earrings to her nose appearing to lack nostrils, the Daily Mail reported, in a post showing a plethora of examples of images from the film.

Futurism was among the first to point out that these flawed images (around the 28-minute mark of the documentary) “have all the hallmarks of an AI-generated photo, down to mangled hands and fingers, misshapen facial features, morphed objects in the background, and a far-too-long front tooth.” The image with the long front tooth was even used in Netflix’s poster for the movie.

Because the movie’s credits do not mention any uses of AI, critics called out the documentary filmmakers for potentially embellishing a movie that’s supposed to be based on real-life events.

But Jeremy Grimaldi—who is also the crime reporter who wrote a book on the case and provided the documentary with research and police footage—told the Toronto Star that the images were not AI-generated.

Grimaldi confirmed that all images of Pan used in the movie were real photos. He said that some of the images were edited, though, not to blur the lines between truth and fiction, but to protect the identity of the source of the images.

“Any filmmaker will use different tools, like Photoshop, in films,” Grimaldi told The Star. “The photos of Jennifer are real photos of her. The foreground is exactly her. The background has been anonymized to protect the source.”

While Grimaldi’s comments provide some assurance that the photos are edited versions of real photos of Pan, they are also vague enough to obscure whether AI was among the “different tools” used to edit the photos.

One photographer, Joe Foley, wrote in a post for Creative Bloq that he thought “documentary makers may have attempted to enhance old low-resolution images using AI-powered upscaling or photo restoration software to try to make them look clearer on a TV screen.”

“The problem is that even the best AI software can only take a poor-quality image so far, and such programs tend to over sharpen certain lines, resulting in strange artifacts,” Foley said.

Foley suggested that Netflix should have “at the very least” clarified that images had been altered “to avoid this kind of backlash,” noting that “any kind of manipulation of photos in a documentary is controversial because the whole point is to present things as they were.”

Hollywood’s increasing use of AI has indeed been controversial, with screenwriters’ unions opposing AI tools as “plagiarism machines” and artists stirring recent backlash over the “experimental” use of AI art in a horror film. Even using AI for a movie poster, as Civil War did, is enough to generate controversy, the Hollywood Reporter reported.

Neither Raw TV, the production company behind What Jennifer Did, nor Netflix responded to Ars’ request for comment.

https://arstechnica.com/?p=2018753