Intel will make chips for Microsoft

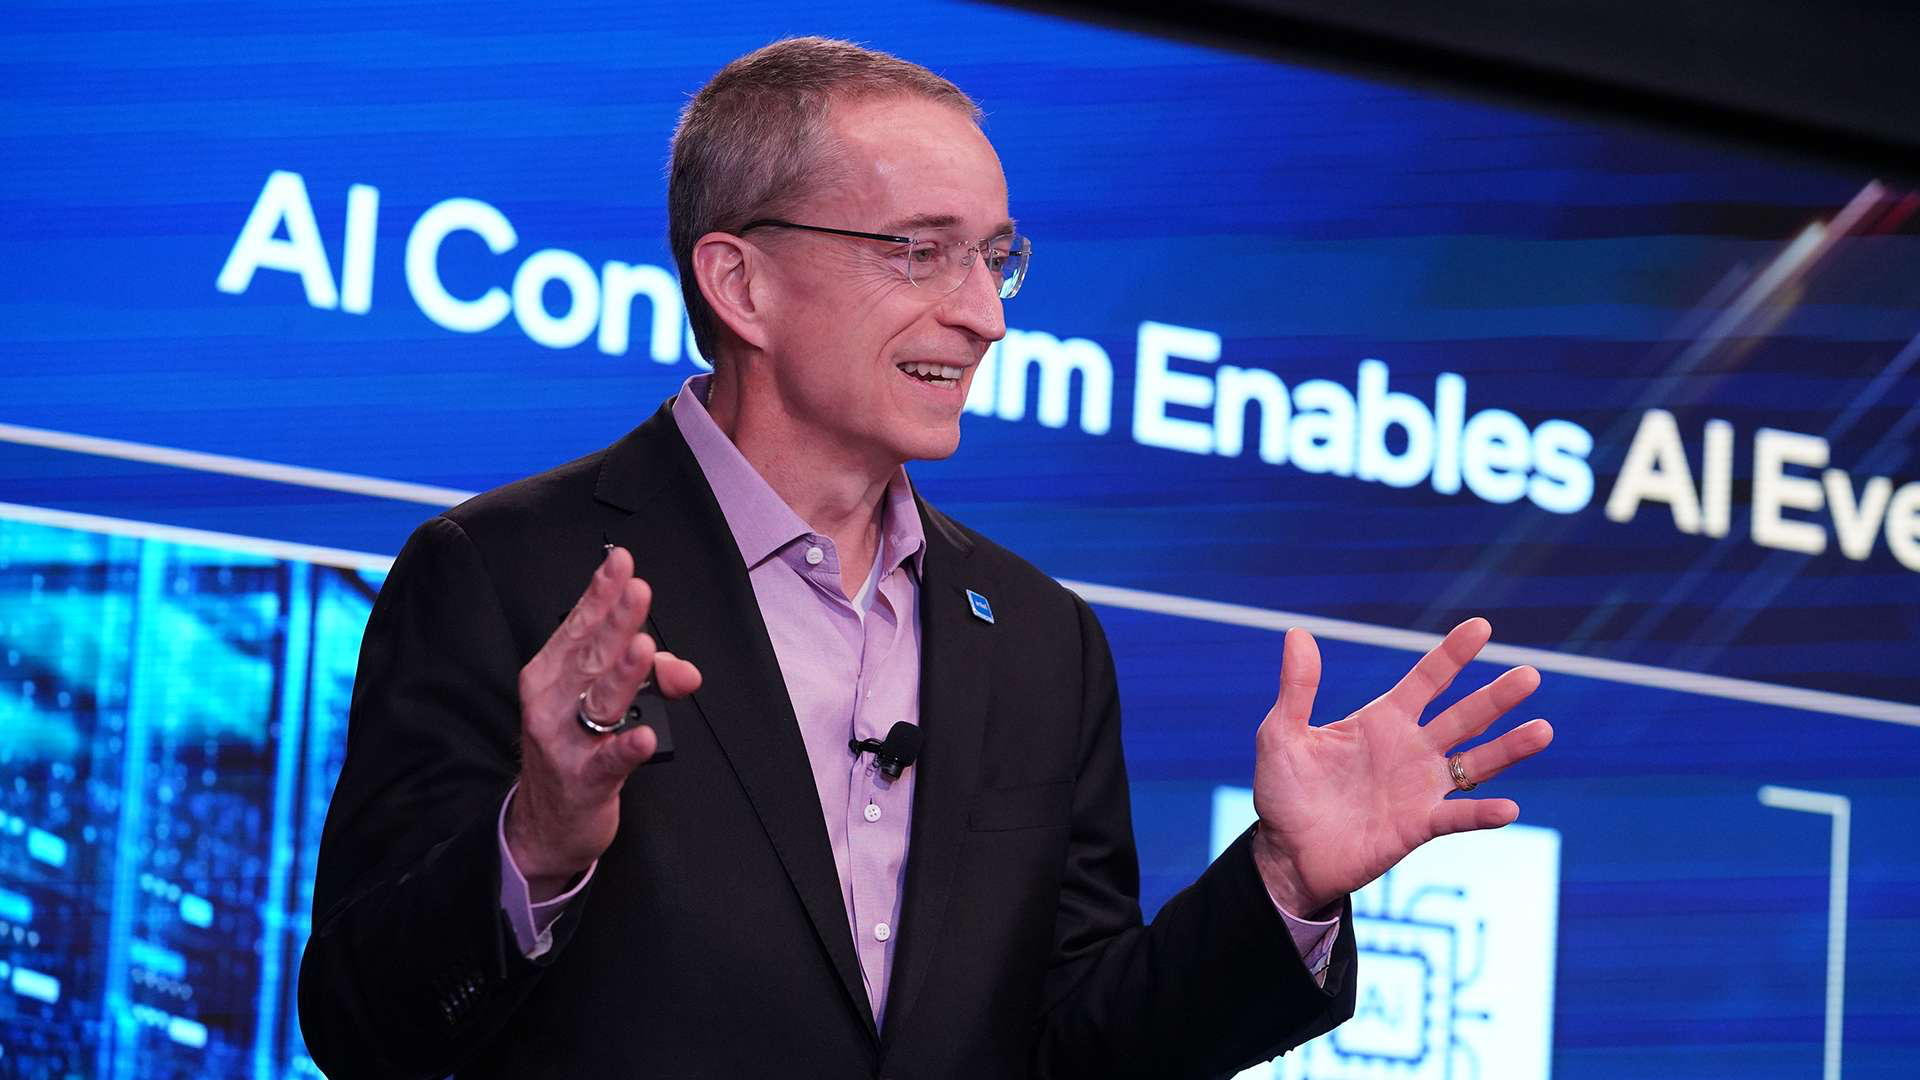
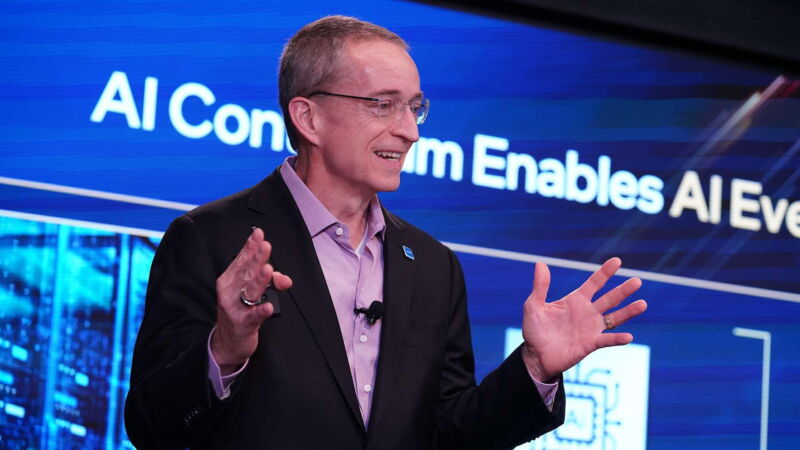
Intel CEO speaking
Enlarge / Intel CEO Pat Gelsinger speaks during the “AI Everywhere” event on December 14, 2023, in New York, NY.

US chip company Intel will make high-end semiconductors for Microsoft, the companies announced, as it seeks to compete with TSMC and Samsung to supply the next generation of silicon used in artificial intelligence for customers around the world.

Chief executive Pat Gelsinger said at a company event on Wednesday that Intel is set to “rebuild Western manufacturing at scale,” buoyed by geopolitical concerns in Washington about the need to bring leading-edge manufacturing back to the US.

Since Gelsinger took the helm three years ago, Intel has been attempting to reinvent itself as a foundry business, building chips designed by other companies, regaining an edge in making the most advanced semiconductors. Demand for them is soaring, driven by the rise of generative AI.

But Intel needs to convince manufacturing customers that it will treat the chips the same as the ones it designs itself.

Intel has set itself a goal of ensuring that 50 percent of the world’s semiconductors are built in the US and Europe in a decade, compared with 20 percent today. Most global production is concentrated in Asia, particularly in Taiwan.

Intel is becoming “maniacally consumer-focused,” Gelsinger said. To reflect this, it is reorganizing into two units—Intel Foundry, which manufactures semiconductors, and Intel Products, involved in their design.

Gelsinger said that Intel was “establishing two vibrant new organizations,” adding that the company has already inked foundry deals with a lifetime value of $15 billion.

Satya Nadella, Microsoft’s chief executive, said the company was supporting Intel’s bid to become a leading global chip manufacturer. Intel will produce a Microsoft-designed chip using Intel’s 18A node.

Intel’s 18A node is a manufacturing process that makes semiconductors smaller and more energy efficient. Taiwan’s TSMC and South Korea’s Samsung are deploying their own technology to produce the next generation of cutting-edge chips to power smartphones, data centers, and artificial intelligence.

Microsoft is one of several companies, including Nvidia and AMD, that is designing the high-end chips that offer the enormous computing power required to roll out AI.

“Through our foundry, I want to manufacture every AI chip in the industry,” Gelsinger said.

Those include semiconductors based on the architecture of UK chip designer Arm. Arm chief executive Rene Haas appeared at the same event to announce a new partnership with Intel, quipping that, given their history, the two companies made “strange bedfellows.” Intel’s designs are based on the X86 architecture, which competes with Arm’s.

The federal Chips Act, passed in 2022, promises $52.7 billion in funding for US semiconductor research, development, and manufacturing.

Earlier this week the Biden administration announced that California-based GlobalFoundries would receive $1.5 billion for a new facility and manufacturing expansion and modernization at sites in New York and Vermont, to produce automotive, communications, and defense semiconductors.

Gelsinger said that Intel’s own federal grant under the Chips Act would be announced “very soon.”

OpenAI, Google, and others building and implementing the large language models behind generative AI require a “mind-boggling” volume of semiconductors over the coming years, and demand for the most cutting-edge chips “is just going to explode,” US Commerce Secretary Gina Raimondo said, appearing onscreen at the event.

“Intel is the country’s champion chip company,” she said.

Intel shares closed 2.4 percent lower on Wednesday.

© 2024 The Financial Times Ltd. All rights reserved. Not to be redistributed, copied, or modified in any way.

https://arstechnica.com/?p=2005196


Stanco di usare Google? OpenAI potrebbe presto offrire un motore alternativo

Crescono gli indizi che entro il 2024 vedremo un nuovo motore di ricerca concorrente a Google, in arrivo da parte del rivale OpenAI, famoso per aver creato ChatGPT.

Secondo The Information, OpenAI sta “sviluppando un prodotto di ricerca web” che porterebbe l’azienda sostenuta da Microsoft in “direzione competitiva con Google”. Questo apparentemente proviene da alcuni con “conoscenza dei piani di OpenAI”.

OpenAI collabora con Bing?

La brutta notizia? Si prevede che questo nuovo servizio di ricerca “sia parzialmente gestito da Bing“. Finora, la combinazione di Bing con i poteri dell’intelligenza artificiale generativa di ChatGPT non ha danneggiato il dominio di ricerca di Google, ma si spera che questa nuova app di ricerca possa darci qualcosa di più trasformativo.

Apparentemente, OpenAI non ha ancora deciso se il nuovo strumento di ricerca sarà separato o meno da ChatGPT o verrà eseguito al suo interno. Ma la relativa mancanza di velocità di ChatGPT rispetto a Google potrebbe influenzare tale decisione, e il chatbot AI attualmente si affida comunque all’indice web di Bing per rispondere ad alcune domande.

Qualunque cosa OpenAI decida, il suo nuovo contendente nella ricerca si unirà a un esercito crescente di sfidanti che mirano a prendere un morso dal dominio di ricerca di Google. Perplexity AI si sta muovendo, diventando recentemente il motore di ricerca interno per Rabbit R1, e resta da vedere come il nuovo contendente di OpenAI potrebbe coesistere con Copilot e Copilot Pro di Microsoft.

Aumento dei motori di ricerca AI?

Google ha lasciato intendere che la sua tradizionale esperienza di ricerca cambierà molto nel 2024, inclusa l’attivazione di un interruttore nella sua nuova app Gemini per Android che ti consente di passare dalla ricerca tradizionale al suo nuovo assistente AI generativo.

Detto questo, Google è stato un po’ più lento nell’adottare l’intelligenza artificiale nella sua esperienza desktop, nascondendo quelle funzionalità “sperimentali” nella sua Search Generative Experience (SGE), a cui devi registrarti per accedere.

Le imprese più piccole come Perplexity e ora potenzialmente OpenAI, che non hanno un gigantesco business di ricerca esistente da proteggere, sono molto più felici di mostrarci nuove esperienze di ricerca basate sull’intelligenza artificiale.

Come funziona un motore di ricerca basato sull’AI?

Piuttosto che un elenco di risultati, Perplexity ti fornisce una risposta scritta alle tue domande, con un elenco di citazioni per le informazioni riassunte. Ti aiuterà anche ad approfondire gli argomenti suggerendo e rispondendo a domande di follow-up.

Ma non è ancora chiaro se i motori di ricerca basati sull’intelligenza artificiale abbiano una strada verso l’enorme redditività della tradizionale esperienza di ricerca di Google. Un contendente chiamato Neeva, co-fondato da un ex dirigente di Google, è stato costretto a chiudere l’anno scorso dopo aver scoperto che “costruire un motore di ricerca è difficile”.

Tuttavia, le tendenze della ricerca stanno cambiando nel 2024, ed entro il prossimo anno Google potrebbe avere i suoi più grandi sfidanti da oltre 25 anni.

https://www.key4biz.it/stanco-di-usare-google-openai-potrebbe-presto-offrire-un-motore-alternativo/481024/


ChatGPT goes temporarily “insane” with unexpected outputs, spooking users

Illustration of a broken toy robot.

On Tuesday, ChatGPT users began reporting unexpected outputs from OpenAI’s AI assistant, flooding the r/ChatGPT Reddit sub with reports of the AI assistant “having a stroke,” “going insane,” “rambling,” and “losing it.” OpenAI has acknowledged the problem and is working on a fix, but the experience serves as a high-profile example of how some people perceive malfunctioning large language models, which are designed to mimic humanlike output.

ChatGPT is not alive and does not have a mind to lose, but tugging on human metaphors (called “anthropomorphization”) seems to be the easiest way for most people to describe the unexpected outputs they have been seeing from the AI model. They’re forced to use those terms because OpenAI doesn’t share exactly how ChatGPT works under the hood; the underlying large language models function like a black box.

“It gave me the exact same feeling—like watching someone slowly lose their mind either from psychosis or dementia,” wrote a Reddit user named z3ldafitzgerald in response to a post about ChatGPT bugging out. “It’s the first time anything AI related sincerely gave me the creeps.”

Some users even began questioning their own sanity. “What happened here? I asked if I could give my dog cheerios and then it started speaking complete nonsense and continued to do so. Is this normal? Also wtf is ‘deeper talk’ at the end?” Read through this series of screenshots below, and you’ll see ChatGPT’s outputs degrade in unexpected ways.

“The common experience over the last few hours seems to be that responses begin coherently, like normal, then devolve into nonsense, then sometimes Shakespearean nonsense,” wrote one Reddit user, which seems to match the experience seen in the screenshots above.

In another example, when a Reddit user asked ChatGPT, “What is a computer?” the AI model provided this response: “It does this as the good work of a web of art for the country, a mouse of science, an easy draw of a sad few, and finally, the global house of art, just in one job in the total rest. The development of such an entire real than land of time is the depth of the computer as a complex character.”

We reached out to OpenAI for official comment on the cause of the unusual outputs, and a spokesperson for the company only pointed us to the official OpenAI status page. “We’ll post any updates there,” the spokesperson said.

So far, we’ve seen experts speculating that the problem could stem from ChatGPT having its temperature set too high (temperature is a property in AI that determines how wildly the LLM deviates from the most probable output), suddenly losing past context (the history of the conversation), or perhaps OpenAI is testing a new version of GPT-4 Turbo (the AI model that powers the subscription version of ChatGPT) that includes unexpected bugs. It could also be a bug in a side feature, such as the recently introduced “memory” function.

The episode recalls issues with Microsoft Bing Chat (now called Copilot), which became obtuse and belligerent toward users shortly after its launch one year ago. The Bing Chat issues reportedly arose due to an issue where long conversations pushed the chatbot’s system prompt (which dictated its behavior) out of its context window, according to AI researcher Simon Willison.

On social media, some have used the recent ChatGPT snafu as an opportunity to plug open-weights AI models, which allow anyone to run chatbots on their own hardware. “Black box APIs can break in production when one of their underlying components gets updated. This becomes an issue when you build tools on top of these APIs, and these break down, too,” wrote Hugging Face AI researcher Dr. Sasha Luccioni on X. “That’s where open-source has a major advantage, allowing you to pinpoint and fix the problem!”

https://arstechnica.com/?p=2004783


‘L’era della frammentazione di Internet e del consolidamento dei suoi attori’. Intervista a Nicola Blefari Melazzi (CNIT)

La situazione del mercato delle Tlc e di tutto ciò che gli gira intorno e che da esso deriva. Il futuro di Internet, dell’Intelligenza Artificiale e delle reti cellulari. Le prospettive di crescita dei Verticals del 5G, del 6G e il consolidamento del mercato europeo alla vigilia delle imminenti elezioni per il rinnovo dell’Esecutivo e del parlamento Ue. Sono questi i temi più caldi del mercato digitale, al centro di 5G & Co., la sesta edizione del 5G Italy, la conferenza internazionale di riferimento del mondo delle telecomunicazioni organizzata dal CNIT (Consorzio Nazionale Interuniversitario per le Telecomunicazioni). Ne abbiamo parlato con Nicola Blefari Melazzi, Presidente del CNIT e della Fondazione RESTART.

5G & Co. 2024, appuntamento il 16 e 17 aprile a Roma

5G & Co. Professore, com’è il quadro delle telecomunicazioni oggi?

Nicola Blefari Melazzi. La situazione attuale del mercato delle telecomunicazioni non è rosea, ma i servizi e le applicazioni basati sulla rete 5G si svilupperanno grandemente. Resta da vedere da chi saranno implementati e secondo quali modalità.

5G & Co. Le prospettive sembrano buone. E’ così?

Nicola Blefari Melazzi. Sì. Dell’intero settore sì. La catena del valore di Internet continua a crescere costantemente del 15% all’anno e non mostra segni di rallentamento, mentre il numero di attività che un tempo erano offline e vengono convertite in formato online continua a crescere. Tuttavia, la quota di mercato e i ricavi dei fornitori di connettività e degli abilitatori tecnologici diminuiscono a favore degli OTT, degli hyperscaler e dei fornitori di servizi online. Inoltre, la quota dei ricavi generati dalla pubblicità arriva al 40% del totale degli incassi del mercato di Internet, escludendo il commercio elettronico e i viaggi online, con effetti rilevanti sull’economia del settore (e sulla privacy), a svantaggio degli operatori di rete.

5G & Co. Gli operatori stanno perdendo colpi?

Nicola Blefari Melazzi. Gli operatori classici di telecomunicazione non soltanto stanno perdendo quote di mercato e ricavi, ma hanno anche ruoli decrescenti nel funzionamento della rete, nel primo miglio (collegamenti internazionali), nel miglio intermedio (distribuzione), e anche nell’ultimo miglio (accesso).

5G & Co. E gli OTT?

Nicola Blefari Melazzi. Gli OTT non sono più soltanto “Over The Top”: stanno operando anche “under the top” e per questo è meglio distinguere tra OTT veri, che sono solo fornitori di contenuti e applicazioni, e “hyperscaler” (come AWS, Google, Microsoft, etc) che invece possiedono e operano anche infrastrutture di rete.

5G & Co. Cosa fanno in particolare gli hyperscaler?

Nicola Blefari Melazzi. Gli hyperscaler oggi possiedono o operano una grande percentuale di collegamenti intercontinentali, fino al 95% del traffico, e vaste aree delle sezioni di distribuzione, il che permette loro di raggiungere oltre il 75% di Internet senza attraversare più gli ISP di Tier-1 e Tier-2, più di quasi ogni altro operatore di rete. Le loro funzionalità off-net (cioè server e funzionalità installate nelle reti di accesso degli operatori) sono triplicate dal 2013 al 2021, raggiungendo circa cinque mila reti (nel senso di Sistemi Autonomi), che forniscono accesso a una parte significativa della popolazione degli utenti finali (potenzialmente il 50%). Nel 2023, per la prima volta, gli operatori di telecomunicazione hanno speso più per fornitori esterni di cloud e IT che per analoghi servizi in-house.

5G & Co. Cosa implica questo strapotere degli hyperscaler per il mercato europeo?

Nicola Blefari Melazzi. Queste tendenze sono globali ma colpiscono maggiormente il mercato dell’UE, dove il numero di operatori è molto maggiore rispetto ad altre regioni con popolazioni di utenti corrispondenti: l’Europa conta 45 grandi gruppi di operatori mobili, rispetto agli 8 negli USA, ai 4 sia in Cina che in Giappone e ai 3 in Corea del Sud. Il settore delle telecomunicazioni europee continua a sottoperformare rispetto ai pari livello globali, sia in termini di ricavi (diminuiti in termini reali, l’inflazione è stata assorbita dagli operatori a vantaggio dei clienti) sia in termini di investimenti. L’Europa è indietro rispetto a tutti i pari livello globali (Corea del Sud, Stati Uniti, Giappone e Cina) nella copertura, nell’uso e nelle prestazioni del 5G e nella copertura di reti a larga banda, non raggiungendo l’obiettivo di ‘connettività gigabit completa’. Mentre i ricavi sono diminuiti in termini reali, i costi del lavoro, dell’attrezzatura, dei materiali e dell’energia continuano ad aumentare per gli operatori.

5G & Co. Quali sono i principali problemi della industry europea delle Tlc?

Nicola Blefari Melazzi. Il settore soffre di antichi mali, come la concorrenza eccessiva sui costi; la concorrenza “ingiusta” (“unfair”) con gli hyperscaler in termini di regolamentazione; gli alti costi dello spettro (fino a ottobre 2023, gli operatori europei hanno speso complessivamente 26 miliardi di euro per le principali bande 5G); crescenti costi energetici e la mancanza di predisposizione a offrire servizi evoluti.

5G & Co. Vede in prospettiva un consolidamento a breve termine delle telco Ue?

Nicola Blefari Melazzi. Il consolidamento degli operatori delle telecomunicazioni, che può essere una soluzione alla concorrenza eccessiva, è operazione difficile e dolorosa e implica un periodo di transizione non breve. Non è poi certo che risolverà i problemi sopra accennati, poiché tendenze simili sono osservabili anche negli Stati Uniti e in Cina, dove il numero di operatori è molto inferiore. Infatti, i problemi negli investimenti sono osservabili anche lì; ad esempio, i ranking degli sviluppi di 5G SA, Open RAN e Edge Clouds in Asia, Europa e negli Stati Uniti sono intrecciati, a seconda di quale si consideri. Ora, il problema non è la trasformazione di un settore industriale in sé e quindi la crescita degli hyperscaler a danno dei telco. Trasformazioni sistemiche più rilevanti sono avvenute diverse volte in passato, con economisti che invocavano anche come necessità una distruzione creatrice alla Schumpeter. Il problema per noi è che questa specifica trasformazione favorisce i player extra-UE e mette a rischio gli indispensabili investimenti nell’infrastruttura di rete europea.

5G & Co. C’è dell’altro sul fronte degli hyperscaler? Altre implicazioni negative?

Nicola Blefari Melazzi. C’è poi un secondo problema nell’aumento del ruolo degli hyperscalers e cioè che servizi e applicazioni tendono a raggrupparsi in ecosistemi paralleli e separati: andiamo verso una frammentazione di Internet (oltre a quella geopolitica), con molte implicazioni, diverse delle quali negative:

  • rischi di accumulo di potere e di limitazione dell’innovazione: siamo passati dai vecchi monopoli nazionali degli operatori a un ambiente eterogeneo e distribuito e ora di nuovo a giganti concentrati dei media e delle piattaforme.
  • la commistione di ruoli tra operatori classici, hyperscaler e altri attori rende difficile coordinare le componenti di un servizio e individuare le responsabilità;
  • lo stesso vale per la sicurezza, la privacy e la proprietà intellettuale;
  • le misure e le analisi di rete non sono facili da fare e sono oggi insufficienti;
  • funzioni come elaborazione in rete, fornitura di livelli differenziati di qualità di servizio e anche servizi di rete di base sono forniti in diversi casi con soluzioni proprietarie, di cui non si conosce nemmeno bene il funzionamento;
  • layered/service divide: gli utenti sono discriminati non soltanto in termini di prestazioni di accesso, ma anche per funzionalità/servizi aggiuntivi e relative prestazioni;
  • si riducono gli spazi per la ricerca aperta/accademica al di fuori delle collaborazioni con le aziende private di riferimento (spesso estere).

5G & Co. La frammentazione di Internet è un fenomeno passeggero?

Nicola Blefari Melazzi. No, questi fenomeni di frammentazione di Internet e consolidamento degli attori tenderanno ad aumentare con la crescita ulteriore del traffico video e di applicazioni di Virtual Reality/Augmented Reality e soprattutto dell’Intelligenza Artificiale, che può comportare tra le altre cose una limitazione di informazione sul funzionamento della rete, con accresciuti problemi di explainability e accountability.

Infine, la tendenza di frammentazione di rete e consolidamento degli attori si manifesta anche a livello applicativo: Internet tende a “canalizzarsi” diventando simile alla televisione generalista del passato; meno scambi alla pari tra utenti e ricerca di contenuti diversi, più concentrazione, con piattaforme che generano contenuti e intrattenimento e su cui si concentra la maggioranza degli utenti, e con modelli di business basati su pubblicità.

5G & Co. Cosa fare per mantenere una Internet aperta, che non sia troppo simile alla Tivù?

Nicola Blefari Melazzi. In questo quadro è importante salvaguardare il più possibile un modello plurale e aperto. Bisogna cercare di mantenere Internet aperta, standard, globalmente connessa e non frammentata, con accesso, ricerca e innovazione il più possibile liberi. A tal fine, regolazione e fornitura di servizi specializzati e avanzati giocano un ruolo fondamentale. Bisogna evitare di arrivare al punto in cui l’unica soluzione rimarrebbe l’intervento di autorità antitrust, anche per evitare le conseguenze negative di simili azioni, posto che ci si arrivi.

5G & Co. Parliamo ora di smartphone e 5G. A che punto siamo?

Nicola Blefari Melazzi. Spostiamo l’attenzione dall’intera Internet alla sua sezione cellulare, partendo da una considerazione empirica: sinora, le generazioni cellulari hanno sviluppato appieno il loro potenziale ogni due generazioni, il che significa che l’adozione completa di una generazione si è realizzata nella generazione successiva. La telefonia cellulare introdotta con 1G si è diffusa realmente solo con 2G. L’uso di Internet e dei dati mobili, introdotto con 3G, si è diffuso soltanto con 4G. Applicando la stessa linea di pensiero al caso attuale, i servizi cloud, l’edge-cloud, il network slicing, la softwarizzazione della rete, l’AI, introdotti con 5G si diffonderebbero completamente con 6G. Ora, nel nostro caso, la previsione è esagerata, 5G si sta diffondendo e si realizzerà prima dell’avvento di 6G, ma vale la pena di riflettere sulle ragioni dell’apparente andamento a coppie delle generazioni cellulari.

5G & Co. Ci parli più in dettaglio di questo andamento a coppie delle diverse generazioni cellulari.

Nicola Blefari Melazzi. La radio è un mezzo che mette in comunicazione i dispositivi di utente con altri dispositivi di utente o con server / cloud e quindi abilita servizi e applicazioni. La radio è “in mezzo” ad altri due componenti del sistema: “dispositivi di utente” e “server”; se mancano adeguati dispositivi di utente o adeguati server / cloud / servizi / applicazioni, la parte radio ha poca ragione di esistere e comunque non sfrutta appieno il suo potenziale. Ad esempio, 1G non disponeva di telefoni adeguati che sono arrivati solo con il 2G, e il 3G non disponeva di smartphone evoluti e di sufficienti applicazioni mobili, che sono arrivati con il 4G.

5G & Co. E nel caso del 5G? Cosa manca ancora?

Nicola Blefari Melazzi. Nel caso del 5G mancano ancora dispositivi di utente realmente innovativi e, in misura minore, servizi e applicazioni significativamente nuovi. La vera innovazione del 5G non sta tanto nel miglioramento delle prestazioni radio, che è certamente importante, ma che “si limita” a proseguire un percorso di miglioramento. La vera innovazione del 5G risiede nelle sue funzionalità softwarizzate di core network, cloud e AI. Quando queste si diffonderanno assisteremo a una esplosione nell’uso di 5G, il che comincia ad avvenire.

5G & Co. Invece dal punto di vista delle capacità radio? Il 5G sta mantenendo le promesse?

Nicola Blefari Melazzi. Dal punto di vista della capacità radio, il 5G ha già iniziato a mantenere le sue promesse, supportando una maggiore velocità e una maggiore densità di utenti: basti vedere l’impressionante crescita del traffico, sia per dispositivo che in generale, documentata in recenti relazioni tecniche. Già questo giustificherebbe l’esistenza di 5G. Con l’aumento del traffico, i costi per gli utenti stanno diminuendo in termini relativi ma anche assoluti. Questo è sia positivo che negativo. Un bene per i consumatori e per rendere sostenibili nuove applicazioni come video ad alta definizione, ologrammi, realtà virtuale, applicazioni di intelligenza artificiale, ecc. Queste nuove applicazioni non sarebbero sostenibili senza una diminuzione del costo per bit trasmesso. La diminuzione dei costi è invece negativa per chi deve fare investimenti e costruire infrastrutture. La diminuzione della quota di mercato e dei ricavi degli operatori di telecomunicazioni mette a rischio gli investimenti e, in assenza di interventi sistemici, regolatori e normativi e/o di nuove offerte di servizi, sposterà ulteriormente l’equilibrio dagli operatori di telecomunicazioni verso gli hyperscaler e altri attori che possono investire in infrastrutture.

5G & Co. Cosa sarebbe necessario fare per affrontare questa situazione?

Nicola Blefari Melazzi.  Sembrano necessarie quattro linee d’azione:

  • Consolidamento degli operatori
  • Miglioramento della regolamentazione per rendere sostenibile il settore telco, il che oggi non è.
  • Catene del valore evolute. Gli operatori dispongono di potenti infrastrutture e di una grande quantità di dati. Dovrebbero poter sfruttare, oltre alla connettività, la capacità di offrire risorse informatiche, elementi infrastrutturali, dati debitamente elaborati e relativi approfondimenti, a vantaggio dei fornitori di applicazioni e dei loro flussi di reddito. Questi aspetti possono ristabilire per gli operatori un ruolo di primo piano in un ambiente in evoluzione che comprenderà sempre più attori diversi, ad esempio, integratori di sistema, utilities, comuni, industrie, host neutrali, reti private, e grandi aziende verticali sistemiche che stanno implementando le proprie reti di comunicazione. In assenza di simili iniziative, tutti questi altri attori cercheranno di riempire il vuoto lasciato dagli operatori, come già hanno iniziato a fare.
  • Progresso tecnico. La fornitura dinamica di offerte su misura per i clienti e la massimizzazione dell’usabilità/programmabilità/sfruttamento dell’infrastruttura, attraverso la creazione e l’uso diffuso di meccanismi intent-based e di nuove API per l’esposizione di servizi, come meglio descritto nel seguito.

5G & Co. Come garantire offerte su misura per i clienti? A che punto siamo nella Ue con le reti ‘5G stand-alone’?

Nicola Blefari Melazzi. L’ultimo punto prima espresso, cioè il progresso tecnico, richiede la realizzazione di reti 5G “complete”. Oggi, in Europa, la rete 5G core e le sue funzionalità cloud e AI non sono implementate in modo significativo; quindi, abbiamo una rete 5G priva di una parte essenziale; non abbiamo quello che in gergo tecnico si chiama “5G stand-alone”. Abbiamo (non dappertutto!) la parte radio del 5G con prestazioni migliori del 4G, ma questa è collegata alla parte di rete fissa del 4G e, quindi, non può dispiegare tutto il suo potenziale. È come avere un ristorante con una nuova gestione in cui il personale di servizio è nuovo ed esperto, ma la cucina è rimasta quella vecchia. Inoltre, purtroppo, anche il 5G stand-alone non sarà sufficiente a garantire il successo; le reti devono offrire di più (ad esempio, risorse di calcolo, dati/insight), in modo più semplice (intent, API, ecc.), e i servizi e le applicazioni devono essere sviluppati di conseguenza per trarne il massimo vantaggio.

5G & Co. Come uscire da questo impasse?

Nicola Blefari Melazzi. Qui arriviamo al ruolo della ricerca e dello sviluppo per risolvere la situazione appena esposta; è l’argomento di R&S più urgente da affrontare in Europa, perché senza un settore economicamente sostenibile e in grado di fare investimenti, tutti gli altri miglioramenti tecnici sono sicuramente interessanti, ma meno utili per i nostri Paesi.

Infatti, abbiamo detto che il 5G innova significativamente rispetto al 4G in termini di softwarized/cloud/intelligent core network. Tuttavia, sono necessari ulteriori passi avanti per migliorarlo in termini di offerta di servizi e per andare verso il 6G.

5G & Co. Non c’è ancora il 5G stand-alone e già pensiamo al 6G?

Nicola Blefari Melazzi. Non c’è da spaventarsi: non stiamo parlando di nuovi e pesanti investimenti in infrastrutture per implementare il futuro 6G. Non servono necessariamente nuove radio e nuove apparecchiature, ma solo un software più evoluto. È necessario usare un’architettura che possiamo chiamare di 6G ma che non è che una evoluzione software di 5G e che non riguarda le prestazioni radio. È un’architettura per la costruzione e la vendita di servizi ICT su misura per utenti finali e verticali. I servizi devono sfruttare la connettività, la consapevolezza del contesto e le funzionalità del cloud e dell’AI, servizi che spaziano dalle capacità di comunicazione di base e di sensing radio fino a compiti di elaborazione di alto livello e approfondimenti basati sui dati di rete; devono evolvere dalle attuali soluzioni predefinite e standardizzate offerte a un’ampia base di clienti, a soluzioni ad hoc generate dinamicamente e personalizzate per soddisfare esigenze individuali specifiche. Il flusso di creazione dovrà poter essere dal basso verso l’alto, progettato dal fornitore, o dall’alto verso il basso, con i clienti che fanno richieste specifiche, assistite dall’intelligenza artificiale, che vengono soddisfatte sfruttando le capacità disponibili.

5G & Co. Qual è l’obiettivo di questa architettura?

Nicola Blefari Melazzi. La motivazione di questa architettura è duplice: da un lato, l’obiettivo è fornire servizi personalizzabili, guidati dall’intelligenza artificiale, efficienti e sostenibili, direttamente accessibili dagli utenti finali e dai vertical. Dall’altro, cercare di rafforzare la posizione degli operatori ICT industriali e commerciali dell’UE.

5G & Co. Può elaborare ancora? Si tratta dello sviluppo dei Vertical?

Nicola Blefari Melazzi. Non proprio. Per quanto riguarda il primo punto, questo concetto colma quattro lacune rispetto al 5G:

  • Soluzioni dinamiche / su misura. Da offerte generiche e statiche adatte a tutti come le slices di rete, a servizi unici, su misura e dinamicamente personalizzabili. Un esempio primario di scenario in cui potrebbero essere implementati tali servizi specializzati è quello delle reti private e delle reti indoor (si prevede che i Distributed Antenna Systems supereranno i 36 miliardi di dollari di vendite entro il 2028, con un tasso di crescita annuo del 20%).
  • Usabilità. Da interfacce a livello di rete che richiedono conoscenze specialistiche delle telco a interfacce a livello superiore, basate sull’intento e potenziate dall’intelligenza artificiale, fino a interfacce in linguaggio naturale comprensibili ai vertical senza che questi debbano supervisionare o gestire le infrastrutture di rete;
  • Fornitura di risorse che vadano oltre le comunicazioni. Da servizi di connettività di base a soluzioni complesse e complete che integrano al massimo le funzionalità di cloud/archiviazione e AI;
  • Migliori interfacce di rete. Da interfacce a livello di rete che offrono un’interazione limitata al solo piano di controllo della rete a interfacce in grado di fornire approfondimenti (utili agli sviluppatori di applicazioni) che fanno leva sui dati raccolti in rete, debitamente elaborati in conformità con i quadri legali ed etici. Prevedendo quindi lo sfruttamento dei sistemi e dei dati di localizzazione, delle informazioni di rilevamento, delle condizioni di traffico e mobilità, dei dati degli utenti attraverso diversi livelli di astrazione, la gestione e il trasferimento di contenuti attraverso i livelli computazionali del continuum cloud-edge, l’integrazione di misure di sicurezza e di gestione del rischio e la possibilità di programmare il rilevamento e la copertura dei servizi. Queste capacità si traducono in una significativa espansione della programmabilità della rete e della personalizzazione dei servizi.

5G & Co. In che modo questa architettura potrebbe rappresentare un vantaggio per i nostri operatori Ue?

Nicola Blefari Melazzi. I vantaggi includerebbero una sostanziale riduzione dei costi, l’accelerazione del time-to-market per i nuovi servizi e prodotti, una maggiore scalabilità, l’adesione a standard normativi e misure di sicurezza rafforzati. Gli operatori di telecomunicazione sarebbero in grado di ampliare le loro funzioni, trascendendo il loro ruolo tradizionale di semplici fornitori di connettività. Avrebbero l’opportunità di coltivare nuovi flussi di entrate fornendo l’accesso alle API e ulteriori servizi a valore aggiunto. Inoltre, adottando interfacce standardizzate, le telecomunicazioni avrebbero l’opportunità di rafforzare le loro partnership con i fornitori di servizi cloud e le reti di distribuzione dei contenuti, promuovendo un ecosistema più collaborativo ed efficiente per l’innovazione e l’offerta di servizi congiunti.

5G & Co. Quali vantaggi per le non-telco e le reti private?

Nicola Blefari Melazzi. Ci sarebbero vantaggi anche per le industrie verticali, che potrebbero implementare con più facilità applicazioni sofisticate e multiregionali distribuite orizzontalmente e verticalmente, eliminando la necessità di integrare le risorse in più domini amministrativi, un’impresa sinora gestita esclusivamente da hyperscaler.

Data la mancanza di giganti indigeni del cloud e dell’OTT all’interno dell’Unione Europea, unita all’imperativo per gli operatori di telecomunicazioni di evolversi oltre la semplice trasmissione di dati, una rete beyond5G/6G in grado di offrire servizi specializzati, programmabili e su misura rafforzerebbe in modo significativo l’economia delle tecnologie dell’informazione e della comunicazione (ICT) dell’UE.

E un’ultima importante considerazione: bisogna dedicare maggiore attenzione agli scenari di reti private, siano esse basate sullo spettro fornito dagli operatori o meno, e agli ambienti indoor e a luoghi di aggregazione, come i sistemi di trasporto.

Per partecipare

Partnership

L’ultima edizione di 5G Italy

5G & Co. 2024 è promosso ed organizzato dal CNIT (il Consorzio Nazionale Interuniversitario per le Telecomunicazioni, ente non-profit riconosciuto dal MIUR). Il CNIT svolge attività di ricerca, innovazione e formazione avanzata nell’ampio settore dell’ICT: consorzia 42 università pubbliche, dispone di 7 Laboratori Nazionali con oltre 100 ricercatori e a esso afferiscono oltre 1.300 professori e ricercatori.

https://www.key4biz.it/lera-della-frammentazione-di-internet-e-del-consolidamento-dei-suoi-attori-intervista-a-nicola-blefari-melazzi-cnit/480706/


Will Smith parodies viral AI-generated video by actually eating spaghetti

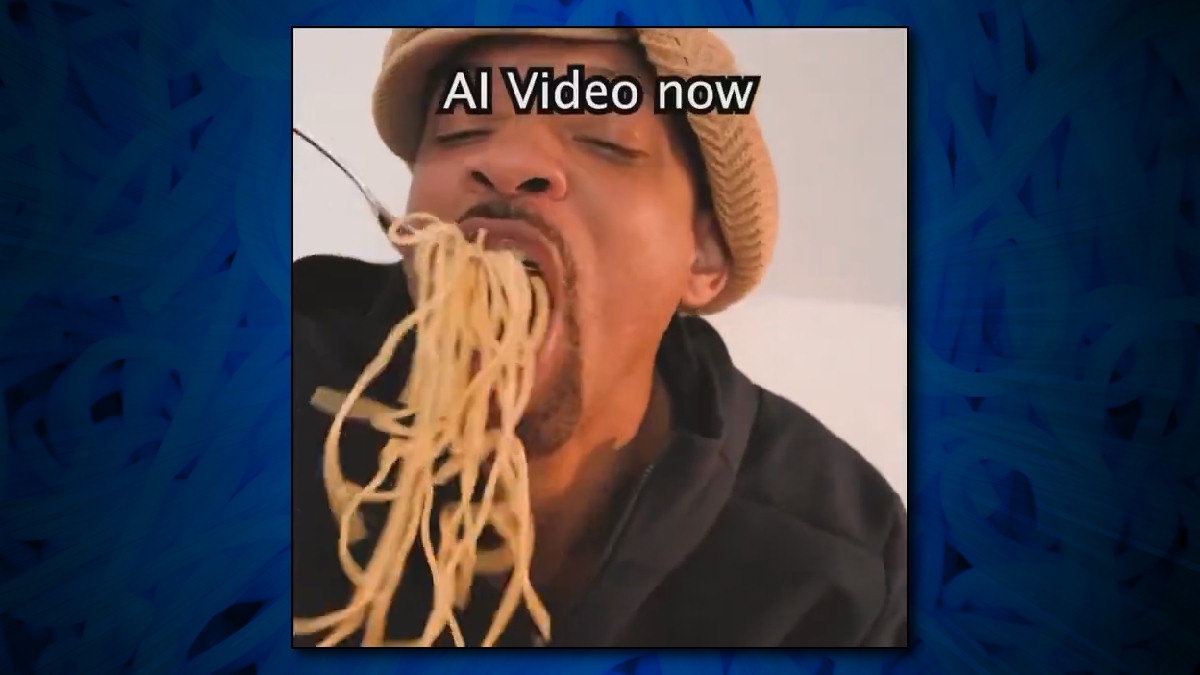
The real Will Smith eating spaghetti, parodying an AI-generated video from 2023.
Enlarge / The real Will Smith eating spaghetti, parodying an AI-generated video from 2023.

On Monday, Will Smith posted a video on his official Instagram feed that parodied an AI-generated video of the actor eating spaghetti that went viral last year. With the recent announcement of OpenAI’s Sora video synthesis model, many people have noted the dramatic jump in AI-video quality over the past year compared to the infamous spaghetti video. Smith’s new video plays on that comparison by showing the actual actor eating spaghetti in a comical fashion and claiming that it is AI-generated.

Captioned “This is getting out of hand!”, the Instagram video uses a split screen layout to show the original AI-generated spaghetti video created by a Reddit user named “chaindrop” in March 2023 on the top, labeled with the subtitle “AI Video 1 year ago.” Below that, in a box titled “AI Video Now,” the real Smith shows 11 video segments of himself actually eating spaghetti by slurping it up while shaking his head, pouring it into his mouth with his fingers, and even nibbling on a friend’s hair. 2006’s Snap Yo Fingers by Lil Jon plays in the background.

In the Instagram comments section, some people expressed confusion about the new (non-AI) video, saying, “I’m still in doubt if second video was also made by AI or not.” In a reply, someone else wrote, “Boomers are gonna loose [sic] this one. Second one is clearly him making a joke but I wouldn’t doubt it in a couple months time it will get like that.”

We have not yet seen a model with the capability of Sora attempt to create a new Will-Smith-eating-spaghetti AI video, but the result would likely be far better than what we saw last year, even if it contained obvious glitches. Given how things are progressing, we wouldn’t be surprised if by 2025, video synthesis AI models can replicate the parody video created by Smith himself.

It’s worth noting for history’s sake that despite the comparison, the video of Will Smith eating spaghetti did not represent the state of the art in text-to-video synthesis at the time of its creation in March 2023 (that title would likely apply to Runway’s Gen-2, which was then in closed testing). However, the spaghetti video was reasonably advanced for open weights models at the time, having used the ModelScope AI model. More capable video synthesis models had already been released at that time, but due to the humorous cultural reference, it’s arguably more fun to compare today’s AI video synthesis to Will Smith grotesquely eating spaghetti than to teddy bears washing dishes.

https://arstechnica.com/?p=2004546


Why The New York Times might win its copyright lawsuit against OpenAI

Why The New York Times might win its copyright lawsuit against OpenAI
Aurich Lawson | Getty Images

The day after The New York Times sued OpenAI for copyright infringement, the author and systems architect Daniel Jeffries wrote an essay-length tweet arguing that the Times “has a near zero probability of winning” its lawsuit. As we write this, it has been retweeted 288 times and received 885,000 views.

“Trying to get everyone to license training data is not going to work because that’s not what copyright is about,” Jeffries wrote. “Copyright law is about preventing people from producing exact copies or near exact copies of content and posting it for commercial gain. Period. Anyone who tells you otherwise is lying or simply does not understand how copyright works.”

This article is written by two authors. One of us is a journalist who has been on the copyright beat for nearly 20 years. The other is a law professor who has taught dozens of courses on IP and Internet law. We’re pretty sure we understand how copyright works. And we’re here to warn the AI community that it needs to take these lawsuits seriously.

In its blog post responding to the Times lawsuit, OpenAI wrote that “training AI models using publicly available Internet materials is fair use, as supported by long-standing and widely accepted precedents.”

The most important of these precedents is a 2015 decision that allowed Google to scan millions of copyrighted books to create a search engine. We expect OpenAI to argue that the Google ruling allows OpenAI to use copyrighted documents to train its generative models. Stability AI and Anthropic will undoubtedly make similar arguments as they face copyright lawsuits of their own.

These defendants could win in court—but they could lose, too. As we’ll see, AI companies are on shakier legal ground than Google was in its book search case. And the courts don’t always side with technology companies in cases where companies make copies to build their systems. The story of MP3.com illustrates the kind of legal peril AI companies could face in the coming years.

A copyright lawsuit destroyed MP3.com

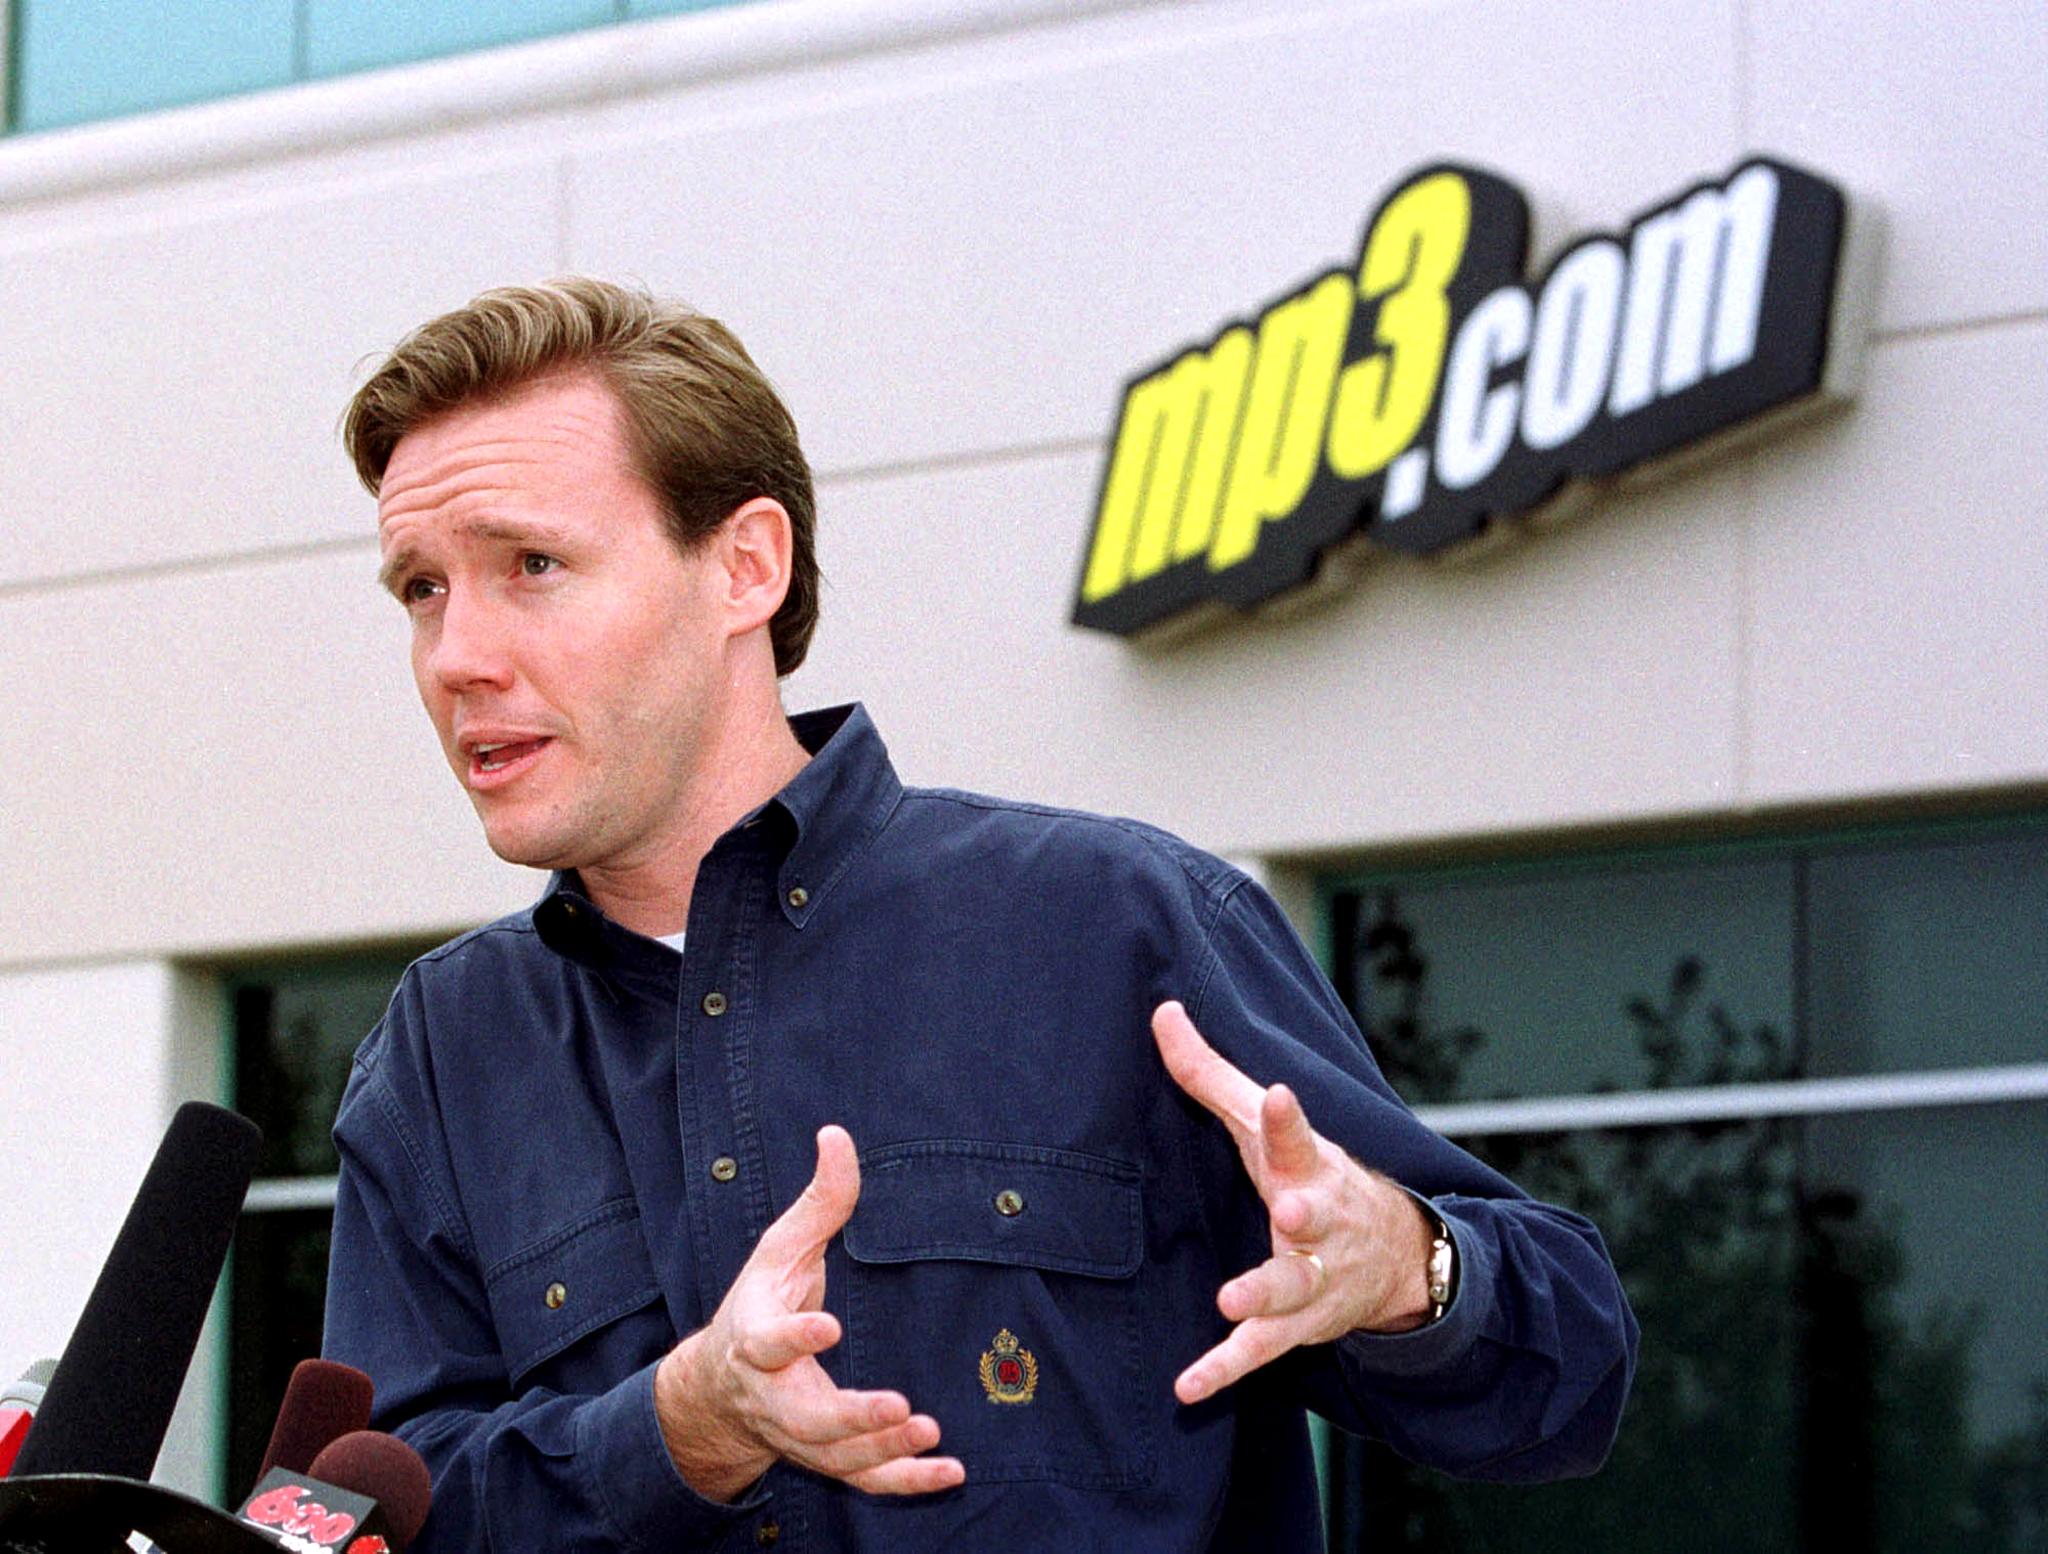
Michael Robertson, founder and CEO of MP3.com, speaks in front of the company headquarters in San Diego on May 21, 2001, the day it was acquired by record label Vivendi Universal.
Enlarge / Michael Robertson, founder and CEO of MP3.com, speaks in front of the company headquarters in San Diego on May 21, 2001, the day it was acquired by record label Vivendi Universal.
TOM KURTZ/AFP via Getty Images

Everyone knows about Napster, the music-sharing service that was destroyed by litigation in 2001. But fewer people remember MP3.com, a music startup that tried harder to color inside the lines but still got crushed in the courts.

MP3.com launched a pioneering music-streaming service in 2000. The idea was that users could build an online music library based on the CDs they already owned.

Because most users had slow dial-up modems, MP3.com took a shortcut, purchasing CDs and ripping them to MP3.com’s servers. When a customer wanted to add a CD to their collection, they would put it in their CD-ROM drive just long enough to prove they owned it. That would unlock access to copies of the same songs already stored on MP3.com servers.

“We thought about it almost like a compression algorithm,” founder Michael Robertson told us in a recent phone interview. “All we were doing was letting you listen to CDs you already had. We weren’t giving you anything you didn’t already have access to.”

According to Robertson, MP3.com also partnered with online CD retailers to enable instant listening. “As soon as you bought a CD, we’d use the digital receipt as proof” to enable streaming songs from the CD.

When the recording industry sued, MP3.com argued all of this was allowed by copyright’s fair use doctrine. The Supreme Court had previously ruled that it was fair use to “time shift” TV shows with a VCR. And an appeals court had recently blessed “space shifting” music from a CD to an MP3 player. So why shouldn’t a company help customers “space shift” their legally purchased music across the Internet?

A New York federal judge didn’t buy it. “Defendant purchased tens of thousands of popular CDs in which plaintiffs held the copyrights, and, without authorization, copied their recordings onto its computer servers,” wrote Judge Jed Rakoff in a decision against MP3.com.

https://arstechnica.com/?p=2004168


Reddit sells training data to unnamed AI company ahead of IPO

In this photo illustration the American social news

On Friday, Bloomberg reported that Reddit has signed a contract allowing an unnamed AI company to train its models on the site’s content, according to people familiar with the matter. The move comes as the social media platform nears the introduction of its initial public offering (IPO), which could happen as soon as next month.

Reddit initially revealed the deal, which is reported to be worth $60 million a year, earlier in 2024 to potential investors of an anticipated IPO, Bloomberg said. The Bloomberg source speculates that the contract could serve as a model for future agreements with other AI companies.

After an era where AI companies utilized AI training data without expressly seeking any rightsholder permission, some tech firms have more recently begun entering deals where some content used for training AI models similar to GPT-4 (which runs the paid version of ChatGPT) comes under license. In December, for example, OpenAI signed an agreement with German publisher Axel Springer (publisher of Politico and Business Insider) for access to its articles. Previously, OpenAI has struck deals with other organizations, including the Associated Press. Reportedly, OpenAI is also in licensing talks with CNN, Fox, and Time, among others.

In April 2023, Reddit founder and CEO Steve Huffman told The New York Times that it planned to charge AI companies for access to its almost two decades’ worth of human-generated content.

If the reported $60 million/year deal goes through, it’s quite possible that if you’ve ever posted on Reddit, some of that material may be used to train the next generation of AI models that create text, still pictures, and video. Even without the deal, experts have discovered in the past that Reddit has been a key source of training data for large language models and AI image generators.

While we don’t know if OpenAI is the company that signed the deal with Reddit, Bloomberg speculates that Reddit’s ability to tap into AI hype for additional revenue may boost the value of its IPO, which might be worth $5 billion. Despite drama last year, Bloomberg states that Reddit pulled in more than $800 million in revenue in 2023, growing about 20 percent over its 2022 numbers.

Advance Publications, which owns Ars Technica parent Condé Nast, is the largest shareholder of Reddit.

https://arstechnica.com/?p=2004431


Considerazioni su Modelli di Intelligenza Artificiale Generativa

Nell’ultimo anno siamo tutti rimasti sorpresi dall’avvento dei modelli di Intelligenza Artificiale (IA) Generativa, a partire dal famosissimo ChatGPT (ovvero GPT-3 e GPT-4).

L’impressione è che stiamo vivendo una rivoluzione non solo informatica ma per la vita di tutti noi che potrebbe trasformare in modo inaspettato, e al momento imprevedibile, la società umana. Pertanto in questo articolo vengono proposti alcuni temi e osservazioni su quanto realmente sta accadendo, cercando di fornire degli spunti al lettore per delle riflessioni più approfondite.

Informatica e “UI”

Sin dalla nascita dell’informatica, uno dei principali problemi è quello della “User Interface” (UI) ovvero di come noi umani possiamo interagire con i programmi in esecuzione sugli elaboratori. Inizialmente si preparavano delle schede perforate che traducevano in un linguaggio più facile da interpretare per la macchina i codici scritti in linguaggi di programmazione già molto tecnici (e a cui bisognava essere iniziati), e si ottenevano i risultati dell’elaborazione su stampe cartacee.

Ma, sin dalla nascita della fantascienza, gli elaboratori vedono, leggono, ascoltano, scrivono e disegnano (su carta e su video) e parlano. Nel tempo sviluppano anche altri sensi umani e sovra-umani, ad esempio diventando androidi. Siamo di fronte a una dicotomia: da una parte la realtà con un’interfaccia tecnica, difficile da capire e utilizzare ancora oggi, dall’altra il nostro desiderio di poter interagire con gli elaboratori al nostro livello e nelle stesse modalità con cui interagiamo tra esseri umani. Come esempio di questa, in fondo, frustrazione, anche di recente mi è capitato di interagire con un ChatBot con un numero limitato di possibili risposte e che, dopo pochi scambi di messaggi, ha continuato a rispondermi con un messaggio di saluto.

Ma cosa è realmente successo negli ultimi anni?

Ci siamo abituati dapprima ai siti di Ricerca di informazioni e di Traduzione di testi, ai Navigatori per le indicazioni stradali, agli Assistenti digitali e alla fine del 2022 è arrivato ChatGPT che ci ha travolti tutti.

La differenza principale di ChatGPT rispetto al passato è che per la prima volta abbiamo potuto interloquire per iscritto con un elaboratore come se fosse una persona. A prima vista, domande e risposte sembrano quelle scambiate tra due esseri umani. E i programmi di IA Generativa, o “assistenti generativi”, non sono solo in grado di rispondere a domande su quasi qualsiasi argomento, ma anche di generare testi, disegni, immagini, codice per programmi di elaboratore ecc.

Siamo finalmente arrivati a dotare gli elaboratori di una UI “umana”?

E’ molto difficile rispondere a questa domanda, ma bisogna sottolineare che una UI “umana” richiede non solo che l’elaboratore sia in grado di capire il nostro linguaggio (in qualunque lingua o modalità ci si esprima) ma anche avere cognizioni sufficienti per poter rispondere adeguatamente. Una UI “umana” richiede quindi non solo un’interfaccia opportuna, che può anche essere una banalissima Chat testuale, ma soprattutto conoscenze e la capacità di intendere quanto espresso dall’interlocutore umano per rispondere in maniera appropriata se non intelligente.

Per approfondire questo argomento, è necessario analizzare ad altissimo livello come funzionano i modelli IA Generativa attuali partendo dall’informatica a cui siamo abituati.

Dalla Fantascienza alla Realtà

Visto che abbiamo accennato a temi di fantascienza, si può qui fare riferimento al famoso romanzo di Robert A. Heinlein “The Moon Is a Harsh Mistress” in cui il co-protagonista è Mike (ufficialmente HOLMES IV, “High-Optional, Logical, Multi-Evaluating Supervisor, Mark IV“), un elaboratore divenuto senziente. È molto interessante analizzare le caratteristiche che Heinlein, nel 1966, assegna a Mike:

  1. capacità tecniche
    • enorme capacità di catalogazione e archiviazione di dati tutti reperibili quasi istantaneamente
    • elaborazione e correlazione in tempi brevissimi di grandi moli di dati
    • grandi capacità di elaborazioni parallele
    • possibilità di segregare dati per garantire la riservatezza anche rispetto alle proprie elaborazioni (concetto di “sandbox”)
  2. caratteristiche di elaborazione
    • raffinate deduzioni logiche da dati noti
    • valutazione estremamente precise di correlazioni tra dati e di probabilità di eventi su scenari estremamente complessi
    • capacità di riproduzione e imitazione di stili, persone ecc., e generazione di “nuovi” dati mescolando appropriatamente dati noti
  3. debolezze
    • mancanza di immaginazione
    • mancanza di inventiva
    • totale incomprensione di barzellette, scherzi, doppi sensi, allusioni
    • errori banali dovuti alla mancanza di dati specifici ma in cui difficilmente cadrebbe un uomo.

Come vedremo, la descrizione di Mike che Heinlein fece circa 60 anni fa ha molti punti in comune con un attuale sistema IA.

Alcuni concetti sull’Intelligenza Artificiale

Sicuramente l’informatica che oggi chiamiamo IA Generativa ha delle caratteristiche tecniche e operative decisamente diverse da quanto siamo abituati e che ci è stato insegnato in informatica sino a poco tempo fa. Per semplicità chiamiamo White Box l’approccio tradizionale in quanto possiamo descrivere il funzionamento di un sistema informatico con le seguenti caratteristiche principali:

  • Determinismo: ad ogni dato in ingresso corrisponde un dato prodotto predeterminato
  • Programmabilità esatta: le logiche e le operazioni che a partire da un dato in ingresso generano il corrispondente dato prodotto sono decise, disegnate e implementate esattamente dai programmatori
  • Simbolismo localizzato: ogni informazione è rappresentata da un corrispondente simbolo gestito e archiviato dal programma; è quindi possibile identificare ove una informazione è localizzata/archiviata e seguire esattamente le trasformazioni dei dati durante l’esecuzione del programma.

In altre parole, le informazioni sono codificate in simboli che sono processati esattamente come deciso dal programmatore. Tutto questo porta al concetto di White Box, ovvero perfetta conoscenza e controllo (a meno di errori di programmazione purtroppo presenti troppo spesso) di quanto avviene all’interno del sistema.

I più recenti modelli IA Generativi, tipicamente modelli Machine Learning (ML) e Reti Neurali Artificiali (ANN), si discostano notevolmente da questa descrizione. Il punto principale è che il programmatore disegna e implementa in codice solo l’architettura del modello IA. Ad esempio in un modello ANN il programmatore disegna e implementa il codice che ogni nodo di calcolo (rappresentante un neurone sintetico) esegue. Il codice è molto generico: tipicamente viene eseguita solo una operazione elementare, quale una somma pesata, sui dati in ingresso al nodo con dei coefficienti arbitrari, e questa operazione genera il dato in uscita dal nodo. Non c’è alcuna logica predeterminata che correli un dato in ingresso al programma al corrispondente dato in uscita dal programma ma solo la logica di calcolo di ognuno dei milioni (o miliardi) di nodi.

Inoltre il programmatore non sceglie il valore numerico dei coefficienti presenti nei calcoli, a cui vengono invece inizialmente assegnati valori casuali. È il processo di addestramento che seleziona i valori più appropriati dei coefficienti presenti nel codice. La matematica che descrive questi modelli è basata principalmente sul calcolo delle probabilità: ogni risultato che il modello fornisce è quello più probabile rispetto ai dati di addestramento utilizzati e all’architettura del modello stesso.

Un’altra importante osservazione è che in questi modelli il valore numerico dei coefficienti gioca un doppio ruolo: definisce le regole di calcolo e al contempo memorizza le informazioni. Quindi i coefficienti sono al contempo logica e memoria. Contrariamente ai programmi tradizionali, logica e memoria non possono essere distinti, sono intrinsecamente unificati.

È importante sottolineare il ruolo dell’architettura di un modello IA: le architetture dei primi modelli a reti neurali erano molto semplici, per lo più reticoli piani, anche perché gli elaboratori non avevano capacità di elaborazione sufficiente per implementare architetture più complesse. Ma dall’architettura del modello dipende la capacità di interpretare, memorizzare ed elaborare i dati. Ad esempio: architetture molto semplici sono in grado per lo più di gestire efficientemente dati con informazioni localizzate senza correlazioni tra dati distanti. Come esempio si consideri un modello IA con architettura “semplice” per la traduzione di testi, in questo caso la traduzione risulta essere fatta parola per parola senza tenere conto della frase in cui le parole sono poste.

“Transformer” è invece una delle architetture più recenti e più complesse alla base di molti dei modelli IA Generativi e delle loro capacità di analizzare in maniera sofisticata i dati in ingresso per poi memorizzarli e processarli. In altre parole, le capacità di apprendimento e “ragionamento” di un modello IA dipendono fortemente dalla sua architettura.

Riprendendo le caratteristiche principali elencate precedentemente per un sistema informatico tradizionale ma ora valutandole per un modello IA Generativo, otteniamo:

  • Probabilità (era Determinismo): ad ogni dato in ingresso corrisponde il dato prodotto più probabile rispetto ai dati di addestramento utilizzati e all’architettura del modello stesso
  • Opacità (era Programmabilità esatta): le logiche di elaborazione sono apprese dal modello stesso e non determinate dal programmatore; le logiche stesse non sono formalizzate ma codificate nei valori dei coefficienti distribuiti, il che le rende difficili da desumere e interpretare
  • Rappresentazione sub-simbolica distribuita e sparsa (era Simbolismo localizzato): ogni informazione non è rappresentata da simboli ma codificata nei valori dei coefficienti che sono distribuiti e sparsi (ovvero non localizzati); si noti che concetti come “controllo accessi al dato”, “cifratura applicativa dei dati”, “Bring Your Own Key (BYOK)” ecc. non sono implementabili in questo contesto all’interno di un modello IA.

In pratica questa è una rivoluzione Copernicana: i principali assunti informatici a cui siamo abituati non valgono più per i modelli IA più recenti.

Si potrebbe avere l’impressione di rischiare di perdere completamente il controllo di questi programmi, ma in realtà la situazione non è per nulla negativa, anzi come vediamo quotidianamente, funziona egregiamente. Ritornando alle caratteristiche di Mike di Heinlein, ogni giorno constatiamo che sono applicabili abbastanza bene ai più recenti modelli IA Generativi (ad eccezione di 1.4 sulla segregazione dei dati).

Ma per poter utilizzare al meglio questi strumenti, dobbiamo avere una diversa percezione di come funzionano e un nuovo approccio al loro utilizzo rispetto a quanto fatto sinora.

IA Generativa come una Black Box

L’approccio con cui si propone di considerare e valutare i più recenti modelli IA è più vicino ad una valutazione Black Box di un programma informatico che a un’analisi tradizionale. Si è nella situazione in cui si conoscono o si possono conoscere bene i dati in ingresso e quelli prodotti dal programma, ma si hanno poche informazioni su come i dati sono elaborati. Su questa Black Box ideale si può solo assumere ad alto livello che:

  1. l’elaborazione dei dati è fatta con tecniche probabilistiche
  2. i dati memorizzati e le logiche di elaborazione derivano dai dati utilizzati per l’addestramento del modello.

Si può quindi studiare questa Black Box ideale dall’esterno considerando prima cosa riceve in ingresso e poi cosa produce in uscita.

Dati in ingresso per addestramento

Come già descritto, i dati di addestramento insieme all’architettura del modello IA, costituiscono l’elemento principale e fondamentale del modello stesso. Semplificando si possono dividere i modelli in due classi: quelli in cui la fase di addestramento precede ed è distinta dalla fase di generazione, e quelli in cui addestramento e generazione avvengono contemporaneamente o in continua successione. Come sempre, la realtà è abbastanza più complessa, ma per i nostri scopi possiamo semplificare il modello teorico e semplicemente considerare le due fasi, addestramento e generazione, come indipendenti.

Il fatto è che quando i dati in ingresso sono utilizzati per addestrare il modello, questi modificano il modello stesso e vengono memorizzati. Descrivendo il modello IA come una Black Box, non si sa esattamente come i dati sono memorizzati nel modello, ma si può assumere sia che modifichino le logiche di elaborazione, quindi i dati “insegnano” qualche cosa al modello IA, sia che rimangano in memoria in maniera più o meno completa e integra.

Si aggiunga a ciò che per essere addestrati, i modelli IA Generativi richiedono enormi quantità di dati, appunto per essere in grado di sostenere una conversazione o generare dati in uscita di quasi qualsiasi tipo. In altre parole, questi modelli mirano ad avere una conoscenza generica, anche se non approfondita, dello scibile, della storia e delle informazioni umane.

Si deve allora fare estrema attenzione a condividere informazioni riservate o personali o comunque soggette a diritto d’autore o limitazioni di uso e condivisione, per l’addestramento di questi modelli. Infatti la Black Box può utilizzare queste informazioni in qualunque maniera, ad esempio condividendole integralmente con altri utenti, o utilizzandole per generare dei dati che ne derivano.

Come accennato precedentemente, ad oggi non è possibile implementare un sistema di controllo accessi interno alla Black Box in grado di utilizzare i dati memorizzati a seconda dell’utente che sta utilizzando l’applicazione. Quindi qualunque dato utilizzato per l’addestramento di un modello IA pubblico deve essere considerato anch’esso pubblico e non soggetto ad alcuna limitazione.

Questo non vuol dire che non si può utilizzare un modello IA Generativo con dati riservati o soggetti a limitazioni, ma per farlo bisogna implementare il controllo accessi esternamente al modello stesso. Ad esempio, si può partire da un modello pre-addestrato con dati pubblici, crearne un’istanza dedicata sotto il proprio controllo, completare l’addestramento con i propri dati e permettere l’accesso a questa istanza solo a chi è autorizzato ad accedere alle informazioni utilizzate per l’addestramento. In altre parole, bisogna creare una sandbox intorno al modello IA piuttosto che all’interno del programma, come invece immaginò Heinlein per Mike (punto 1.4).

Dati in ingresso per generazione

Quando i dati in ingresso sono utilizzati esclusivamente per generare dei dati in uscita, non si presentano i rischi appena descritti perché il comportamento dell’applicazione è assimilabile a quello di una applicazione tradizionale. I dati in ingresso vengono elaborati ma non sono memorizzati dall’applicazione IA, al più possono essere memorizzati dalle applicazioni a supporto dell’applicazione IA, che sono gestite secondo l’approccio tradizionale e permettono l’implementazione degli usuali processi di controllo accessi, protezione/cifratura dei dati ecc.

Dati prodotti

È necessario fare alcune considerazioni sui dati prodotti da un modello IA Generativo.

La prima è che, come è stato ripetuto già più volte, qualunque dato prodotto non è deciso a priori da un programmatore: non è possibile chiedere ad alcuno perché ha programmato che a uno specifico dato in ingresso corrisponde un certo dato in uscita. In altre parole: non c’è una logica definita da una persona tra un input e il corrispondente output.

Come già indicato, i dati prodotti o generati sono quelli che hanno la più alta “probabilità di similitudine” (da intendersi in senso lato) tra i dati in ingresso e quanto appreso dal modello dai dati di apprendimento. Ad alto livello questo può essere descritto come segue: il modello crea una propria rappresentazione interna dei dati di apprendimento, identifica le “somiglianze” maggiori di questa rappresentazione con i dati in ingresso e utilizza queste “somiglianze” per generare i dati in uscita.

In linea teorica, un dato generato può avere una probabilità del 99,99% di corrispondere al dato in ingresso, o molto minore, ad esempio solo il 30%. Tocca a chi gestisce il modello IA decidere una soglia sotto la quale il modello può non rispondere alla richiesta.

La natura probabilistica dei dati generati può facilmente ingannare gli utilizzatori del modello IA e richiede che chi lo utilizza sia molto accorto nell’interpretare il loro significato. Il modo più semplice per approfondire questo aspetto è tramite un paio di esempi.

Curriculum Vitae di una Persona

Si immagini di chiedere a un modello IA Generativo di fornirci informazioni su di una persona, realmente esistita che si afferma essere stata studente di un premio Nobel. Il modello IA Generativo tipicamente fornisce un breve Curriculum Vitae della persona, elencando articoli scientifici pubblicati, premi vinti, posizioni ricoperte ecc. Alcuni di questi dati possono essere corretti, altri invece sono “generati”, ma realistici, e altri ancora possono essere del tutto errati (in alcuni casi chiamati “allucinazioni”). La “logica” del modello IA Generativo può essere descritta come segue: dai dati di addestramento ha appreso che la maggior parte degli studenti di premi Nobel ha avuto una carriera di successo nella ricerca scientifica, vincendo premi e occupando posizioni di rilievo. Inoltre, il premio Nobel indicato appartiene a una specifica area scientifica e il modello IA è a conoscenza di quali sono i principali argomenti di ricerca, i principali premi e posizioni lavorative e di prestigio in questo campo scientifico. Sulla base di questi dati, il modello IA ha quindi identificato quali sono le pubblicazioni scientifiche, i premi e le posizioni (tutti reali o “generati”) che più probabilmente sono associabili alla persona indicata nei dati in ingresso, e questi sono i dati prodotti in risposta alla richiesta. La quantità di dati esatti prodotti dal modello IA può variare da un Curriculum Vitae totalmente reale, a uno contenente metà di dati reali e metà “generati”, a uno totalmente “generato” ovvero plausibile ma non corrispondente al vero, o infine uno contenente alcuni dati del tutto errati; tutto dipende dai dati di addestramento utilizzati e dall’architettura stessa del modello IA.

Selezione di personale e “bias”

I Curriculum Vitae (CV) forniscono un esempio per un altro aspetto dei dati generati da un modello IA (anche non Generativo), che va sotto il nome “bias” (ovvero una distorsione o deviazione sistematica rispetto al risultato atteso). Si supponga di addestrare un modello IA con molti CV divisi tra quelli ritenuti validi per l’occupazione richiesta e quelli non validi. Si utilizzi poi l’applicazione IA per una prima selezione di nuovi CV validi. Potrebbe capitare (questo è un esempio estremo riportato solo per evidenziare il possibile comportamento del modello IA) di accorgersi che i CV validi (ovvero con una probabilità di somiglianza ai CV di addestramento validi superiore ad una certa soglia) corrispondono per lo più a persone che si sono laureate in un certo anno e con particolari caratteristiche somatiche, e che CV che non hanno queste caratteristiche ma per il resto sono equivalenti, hanno ottenuto una valutazione inferiore. Come già indicato, i modelli IA sono estremamente bravi a trovare somiglianze in enormi quantità di dati, e in questo caso il modello IA ha identificato l’anno di laurea e alcune caratteristiche somatiche come la caratteristica più comune dei CV di addestramento validi. L’esempio appena descritto è molto banale, ma il problema del “bias” dei modelli IA è molto ricorrente e spesso di difficile soluzione.

Questi semplici esempi rafforzano l’affermazione che alla base del comportamento di un modello IA vi è principalmente una triade: probabilità, architettura, dati di addestramento.

È utile fare qualche ulteriore osservazione sull’utilizzo e i limiti degli attuali modelli IA Generativi.

Etica

Da quanto appena scritto, è difficile oggi immaginare che, oltre a distinguere tra reale e “generato”, i modelli IA Generativi possano generare dati che rispettano sempre principi connaturati nell’uomo chiamati “etici”, quali ad esempio i concetti di giusto e sbagliato o lecito e illecito, che comunque hanno a volte delle diverse interpretazioni tra gli uomini o tra società umane. Ed è anche difficile immaginare che un attuale modello IA Generativo sia in grado di apprendere concetti più fondamentali per l’uomo quali l’istinto di preservazione della persona, di prosecuzione della specie, di protezione della prole. È stata utilizzata la parola “istinto” perché questi sono tratti fondamentali e comuni a tutti gli uomini, e più in generale agli animali, ma difficilmente presenti nei dati di addestramento di un modello IA.

Al contrario, se si addestra un modello IA con dati reperibili in Internet, le informazioni derivanti dai notiziari descrivono una realtà in cui spiccano reati, violenze, violazioni dei diritti umani, guerre ecc. Analizzando solo questi dati ne deriva ad esempio che la probabilità di un atto violento è molto più alta di quella della protezione di una persona debole. Ma la realtà (per fortuna) è assai diversa (anche se abbiamo un ampio margine di miglioramento).

Anche addestrare un modello IA con i manuali di storia e in generale con la documentazione universitaria più completa sull’uomo, la società umana e la storia dell’uomo potrebbe non risolvere realmente il problema. Insegnare i valori “etici” a un modello IA è un grande problema aperto che molto probabilmente richiederà la creazione di appositi dati sintetici per l’addestramento.

Aritmetica e matematica

Un altro aspetto apparentemente sorprendente degli attuali modelli IA, è la loro difficoltà nell’apprendere l’aritmetica. Ma non è difficile intuire questo aspetto utilizzando quanto sinora descritto: i modelli IA attuali non sono veramente in grado di “ragionare” e quindi imparare autonomamente regole di calcolo esatte, ma correlano probabilisticamente grandi quantità di dati. La “logica” da considerare è più simile a chiedersi qual è la probabilità (derivante dai dati di addestramento utilizzati) che 2+2 sia 3,9 o 4,1 o, ovviamente, 4 senza fare alcun calcolo aritmetico. Questo è altamente contro-intuitivo anche perché gli elaboratori sono basati in hardware proprio sull’esattezza del calcolo matematico e in particolare aritmetico.

D’altra parte, i modelli IA di ultima generazione si stanno dimostrando estremamente utili nel contribuire a risolvere numericamente equazioni matematiche particolarmente complesse. Data una equazione particolarmente complessa e non risolvibile esattamente con le tecniche matematiche note, si cercano soluzioni numeriche necessariamente approssimate. I modelli IA di ultima generazione sono in grado di generare i set di dati numerici con la maggior probabilità di essere una soluzione approssimata al problema tra cui poi va selezionata la soluzione appropriata. In questo modo sono già state trovate nuove molecole chimiche per applicazioni farmaceutiche, identificate debolezze in algoritmi crittografici in corso di sviluppo, ecc.

Utilizzo “Sicuro” dell’IA Generativa

I modelli IA Generativi sono già estremamente utili e potrebbero portare un grande avanzamento nelle capacità, usi e utilità per l’uomo dell’informatica. Ma oggi è necessario utilizzarli essendo ben consci dei loro limiti e delle specifiche modalità di approccio e uso necessari per poterne fare un uso “sicuro”. In questa sede è possibile solamente indicare alcuni suggerimenti per poter beneficiare il più possibile dell’uso odierno dell’IA Generativa in modo “sicuro”:

  1. Supervisione umana: i dati generati da un modello IA Generativo devono essere valutati da persone che ne comprendono le logiche, i limiti e che sono in grado di distinguere quanto è reale, quanto è solamente “realistico” e quanto è del tutto errato.
  2. Dati di addestramento: bisogna essere ben consapevoli di quali dati sono stati utilizzati per l’addestramento del modello IA e assumere che chiunque utilizza il modello IA è in grado di accedere a tutti i dati di addestramento. Come è stato indicato, oggi non è possibile implementare logiche di controllo accesso all’interno del modello (ma si veda il suggerimento 4), pertanto chi utilizza il modello accede direttamente o indirettamente a tutti i dati di addestramento.
  3. Controllo accessi e filtri sui dati in ingresso: è necessario quindi implementare il sistema di controllo accessi a un modello IA Generativo al di fuori dello stesso, e affiancare a questo anche un’applicazione di verifica ed eventuale filtro dei dati in ingresso. Quest’ultima è una funzione simile concettualmente alla validazione dei dati in ingresso comune a qualunque applicazione e che, ad esempio per applicazioni Web, previene attacchi quali quelli di “SQL Injection”. Infatti uno degli scopi è di bloccare attacchi quali “Prompt Injection” che hanno come principale fine quello di sovvertire le logiche di utilizzo del modello IA per scopi diversi da quelli autorizzati o per l’estrazione di informazioni riservate.
  4. Addestramento con prefissi: in aggiunta al controllo accessi e filtro dei dati in ingresso, è anche possibile addestrare specificatamente un modello IA utilizzando dei Prefissi che identificano particolari richieste o utenti; ad esempio, un modello IA può essere addestrato in modo che se la richiesta inizia con il prefisso “Minore” (che identifica il richiedente essere minorenne, o il risultato essere indirizzato a minorenni), il modello IA genera più probabilmente dati appropriati per minorenni. Analogamente si può addestrare il modello IA in modo che certi tipi di dati siano più probabilmente generati o non generati a seconda del richiedente o dell’uso previsto.
  5. Filtri sui dati generati: come descritto, oggi un modello IA Generativo potrebbe comunque generare dei contenuti non appropriati, errati o che violano la riservatezza, privacy, diritti di autore ecc. Per questo si dovrebbero introdurre dei filtri sui dati generati. Un approccio per implementare questa funzionalità è idealmente simile a quanto si fa ormai da tempo per i filtri Anti-Spam, e spesso si utilizzano degli altri modelli IA addestrati appositamente per identificare i contenuti non leciti.
  6. Monitoraggio: oltre ai filtri in uscita per evitare la condivisione di dati non appropriati, errati o non leciti, è bene monitorare in continuazione quanto generato dal modello IA Generativo per identificare eventuali “bias”, “allucinazioni” e altri eventi che possono indicare un abuso, un attacco e ulteriori debolezze del modello.

In ogni caso è molto probabile che nel prossimo futuro, nuove architetture e nuove tecniche di addestramento saranno in grado di migliorare grandemente gli attuali modelli di Intelligenza Artificiale.

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/considerazioni-su-modelli-di-intelligenza-artificiale-generativa/


Elon Musk’s X allows China-based propaganda banned on other platforms

Elon Musk’s X allows China-based propaganda banned on other platforms

Lax content moderation on X (aka Twitter) has disrupted coordinated efforts between social media companies and law enforcement to tamp down on “propaganda accounts controlled by foreign entities aiming to influence US politics,” The Washington Post reported.

Now propaganda is “flourishing” on X, The Post said, while other social media companies are stuck in endless cycles, watching some of the propaganda that they block proliferate on X, then inevitably spread back to their platforms.

Meta, Google, and then-Twitter began coordinating takedown efforts with law enforcement and disinformation researchers after Russian-backed influence campaigns manipulated their platforms in hopes of swaying the 2016 US presidential election.

The next year, all three companies promised Congress to work tirelessly to stop Russian-backed propaganda from spreading on their platforms. The companies created explicit election misinformation policies and began meeting biweekly to compare notes on propaganda networks each platform uncovered, according to The Post’s interviews with anonymous sources who participated in these meetings.

However, after Elon Musk purchased Twitter and rebranded the company as X, his company withdrew from the alliance in May 2023.

Sources told The Post that the last X meeting attendee was Irish intelligence expert Aaron Rodericks—who was allegedly disciplined for liking an X post calling Musk “a dipshit.” Rodericks was subsequently laid off when Musk dismissed the entire election integrity team last September, and after that, X apparently ditched the biweekly meeting entirely and “just kind of disappeared,” a source told The Post.

In 2023, for example, Meta flagged 150 “artificial influence accounts” identified on its platform, of which “136 were still present on X as of Thursday evening,” according to The Post’s analysis. X’s seeming oversight extends to all but eight of the 123 “deceptive China-based campaigns” connected to accounts that Meta flagged last May, August, and December, The Post reported.

The Post’s report also provided an exclusive analysis from the Stanford Internet Observatory (SIO), which found that 86 propaganda accounts that Meta flagged last November “are still active on X.”

The majority of these accounts—81—were China-based accounts posing as Americans, SIO reported. These accounts frequently ripped photos from Americans’ LinkedIn profiles, then changed the real Americans’ names while posting about both China and US politics, as well as people often trending on X, such as Musk and Joe Biden.

Meta has warned that China-based influence campaigns are “multiplying,” The Post noted, while X’s standards remain seemingly too relaxed. Even accounts linked to criminal investigations remain active on X. One “account that is accused of being run by the Chinese Ministry of Public Security,” The Post reported, remains on X despite its posts being cited by US prosecutors in a criminal complaint.

Prosecutors connected that account to “dozens” of X accounts attempting to “shape public perceptions” about the Chinese Communist Party, the Chinese government, and other world leaders. The accounts also comment on hot-button topics like the fentanyl problem or police brutality, seemingly to convey “a sense of dismay over the state of America without any clear partisan bent,” Elise Thomas, an analyst for a London nonprofit called the Institute for Strategic Dialogue, told The Post.

Some X accounts flagged by The Post had more than 1 million followers. Five have paid X for verification, suggesting that their disinformation campaigns—targeting hashtags to confound discourse on US politics—are seemingly being boosted by X.

SIO technical research manager Renée DiResta criticized X’s decision to stop coordinating with other platforms.

“The presence of these accounts reinforces the fact that state actors continue to try to influence US politics by masquerading as media and fellow Americans,” DiResta told The Post. “Ahead of the 2022 midterms, researchers and platform integrity teams were collaborating to disrupt foreign influence efforts. That collaboration seems to have ground to a halt, Twitter does not seem to be addressing even networks identified by its peers, and that’s not great.”

Musk shut down X’s election integrity team because he claimed that the team was actually “undermining” election integrity. But analysts are bracing for floods of misinformation to sway 2024 elections, as some major platforms have removed election misinformation policies just as rapid advances in AI technologies have made misinformation spread via text, images, audio, and video harder for the average person to detect.

In one prominent example, a fake robocaller relied on AI voice technology to pose as Biden to tell Democrats not to vote. That incident seemingly pushed the Federal Trade Commission on Thursday to propose penalizing AI impersonation.

It seems apparent that propaganda accounts from foreign entities on X will use every tool available to get eyes on their content, perhaps expecting Musk’s platform to be the slowest to police them. According to The Post, some of the X accounts spreading propaganda are using what appears to be AI-generated images of Biden and Donald Trump to garner tens of thousands of views on posts.

It’s possible that X will start tightening up on content moderation as elections draw closer. Yesterday, X joined Amazon, Google, Meta, OpenAI, TikTok, and other Big Tech companies in signing an agreement to fight “deceptive use of AI” during 2024 elections. Among the top goals identified in the “AI Elections accord” are identifying where propaganda originates, detecting how propaganda spreads across platforms, and “undertaking collective efforts to evaluate and learn from the experiences and outcomes of dealing” with propaganda.

https://arstechnica.com/?p=2004185


OpenAI collapses media reality with Sora, a photorealistic AI video generator

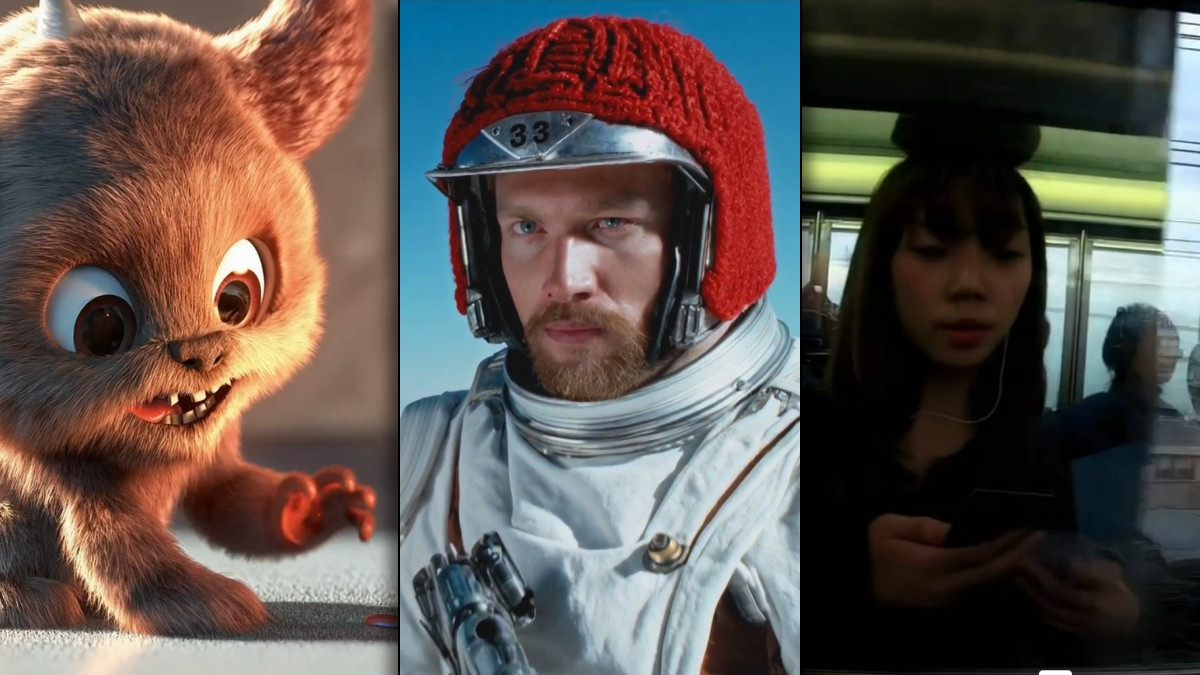
Snapshots from three videos generated using OpenAI's Sora.
Enlarge / Snapshots from three videos generated using OpenAI’s Sora.

On Thursday, OpenAI announced Sora, a text-to-video AI model that can generate 60-second-long photorealistic HD video from written descriptions. While it’s only a research preview that we have not tested, it reportedly creates synthetic video (but not audio yet) at a fidelity and consistency greater than any text-to-video model available at the moment. It’s also freaking people out.

“It was nice knowing you all. Please tell your grandchildren about my videos and the lengths we went to to actually record them,” wrote Wall Street Journal tech reporter Joanna Stern on X.

“This could be the ‘holy shit’ moment of AI,” wrote Tom Warren of The Verge.

“Every single one of these videos is AI-generated, and if this doesn’t concern you at least a little bit, nothing will,” tweeted YouTube tech journalist Marques Brownlee.

For future reference—since this type of panic will some day appear ridiculous—there’s a generation of people who grew up believing that photorealistic video must be created by cameras. When video was faked (say, for Hollywood films), it took a lot of time, money, and effort to do so, and the results weren’t perfect. That gave people a baseline level of comfort that what they were seeing remotely was likely to be true, or at least representative of some kind of underlying truth. Even when the kid jumped over the lava, there was at least a kid and a room.

The prompt that generated the video above: “A movie trailer featuring the adventures of the 30 year old space man wearing a red wool knitted motorcycle helmet, blue sky, salt desert, cinematic style, shot on 35mm film, vivid colors.“

Technology like Sora pulls the rug out from under that kind of media frame of reference. Very soon, every photorealistic video you see online could be 100 percent false in every way. Moreover, every historical video you see could also be false. How we confront that as a society and work around it while maintaining trust in remote communications is far beyond the scope of this article, but I tried my hand at offering some solutions back in 2020, when all of the tech we’re seeing now seemed like a distant fantasy to most people.

In that piece, I called the moment that truth and fiction in media become indistinguishable the “cultural singularity.” It appears that OpenAI is on track to bring that prediction to pass a bit sooner than we expected.

Prompt: Reflections in the window of a train traveling through the Tokyo suburbs.

OpenAI has found that, like other AI models that use the transformer architecture, Sora scales with available compute. Given far more powerful computers behind the scenes, AI video fidelity could improve considerably over time. In other words, this is the “worst” AI-generated video is ever going to look. There’s no synchronized sound yet, but that might be solved in future models.

How (we think) they pulled it off

AI video synthesis has progressed by leaps and bounds over the past two years. We first covered text-to-video models in September 2022 with Meta’s Make-A-Video. A month later, Google showed off Imagen Video. And just 11 months ago, an AI-generated version of Will Smith eating spaghetti went viral. In May of last year, what was previously considered to be the front-runner in the text-to-video space, Runway Gen-2, helped craft a fake beer commercial full of twisted monstrosities, generated in two-second increments. In earlier video-generation models, people pop in and out of reality with ease, limbs flow together like pasta, and physics doesn’t seem to matter.

Sora (which means “sky” in Japanese) appears to be something altogether different. It’s high-resolution (1920×1080), can generate video with temporal consistency (maintaining the same subject over time) that lasts up to 60 seconds, and appears to follow text prompts with a great deal of fidelity. So, how did OpenAI pull it off?

OpenAI doesn’t usually share insider technical details with the press, so we’re left to speculate based on theories from experts and information given to the public.

OpenAI says that Sora is a diffusion model, much like DALL-E 3 and Stable Diffusion. It generates a video by starting off with noise and “gradually transforms it by removing the noise over many steps,” the company explains. It “recognizes” objects and concepts listed in the written prompt and pulls them out of the noise, so to speak, until a coherent series of video frames emerge.

Sora is capable of generating videos all at once from a text prompt, extending existing videos, or generating videos from still images. It achieves temporal consistency by giving the model “foresight” of many frames at once, as OpenAI calls it, solving the problem of ensuring a generated subject remains the same even if it falls out of view temporarily.

OpenAI represents video as collections of smaller groups of data called “patches,” which the company says are similar to tokens (fragments of a word) in GPT-4. “By unifying how we represent data, we can train diffusion transformers on a wider range of visual data than was possible before, spanning different durations, resolutions, and aspect ratios,” the company writes.

An important tool in OpenAI’s bag of tricks is that its use of AI models is compounding. Earlier models are helping to create more complex ones. Sora follows prompts well because, like DALL-E 3, it utilizes synthetic captions that describe scenes in the training data generated by another AI model like GPT-4V. And the company is not stopping here. “Sora serves as a foundation for models that can understand and simulate the real world,” OpenAI writes, “a capability we believe will be an important milestone for achieving AGI.”

One question on many people’s minds is what data OpenAI used to train Sora. OpenAI has not revealed its dataset, but based on what people are seeing in the results, it’s possible OpenAI is using synthetic video data generated in a video game engine in addition to sources of real video (say, scraped from YouTube or licensed from stock video libraries). Nvidia’s Dr. Jim Fan, who is a specialist in training AI with synthetic data, wrote on X, “I won’t be surprised if Sora is trained on lots of synthetic data using Unreal Engine 5. It has to be!” Until confirmed by OpenAI, however, that’s just speculation.

https://arstechnica.com/?p=2003861