Holy chips! Microsoft’s new AI silicon will power its chatty assistants

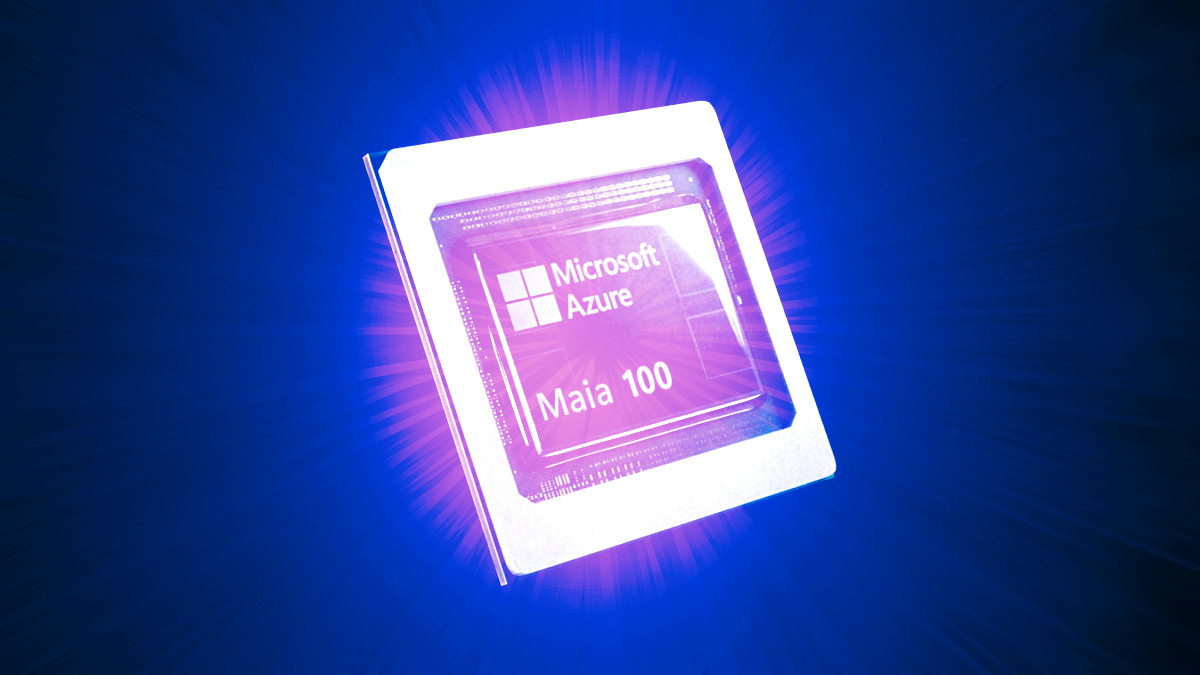
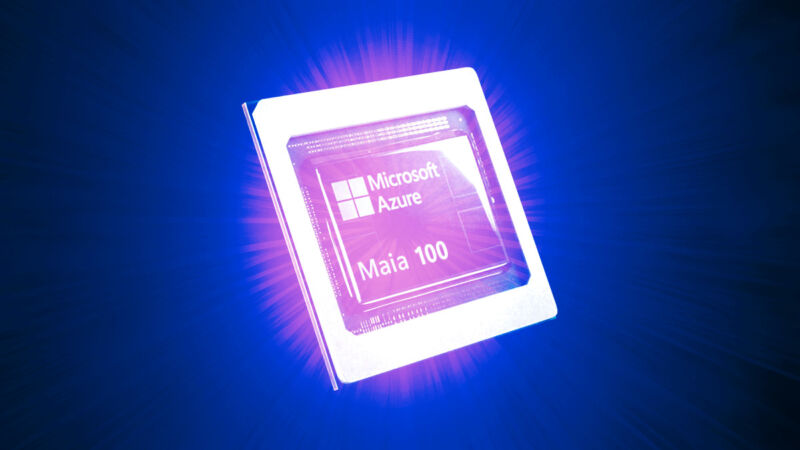
A photo of the Microsoft Azure Maia 100 chip that has been altered with splashes of color by the author to look as if AI itself were bursting forth from its silicon substrate.
Enlarge / A photo of the Microsoft Azure Maia 100 chip that has been altered with splashes of color by the author to look as if AI itself were bursting forth from its silicon substrate.
Microsoft | Benj Edwards

On Wednesday at the Microsoft Ignite conference, Microsoft announced two custom chips designed for accelerating in-house AI workloads through its Azure cloud computing service: Microsoft Azure Maia 100 AI Accelerator and the Microsoft Azure Cobalt 100 CPU.

Microsoft designed Maia specifically to run large language models like GPT 3.5 Turbo and GPT-4, which underpin its Azure OpenAI services and Microsoft Copilot (formerly Bing Chat). Maia has 105 billion transistors that are manufactured on a 5-nm TSMC process. Meanwhile, Cobalt is a 128-core ARM-based CPU designed to do conventional computing tasks like power Microsoft Teams. Microsoft has no plans to sell either one, preferring them for internal use only.

As we’ve previously seen, Microsoft wants to be “the Copilot company,” and it will need a lot of computing power to meet that goal. According to Reuters, Microsoft and other tech firms have struggled with the high cost of delivering AI services that can cost 10 times more than services like search engines.

Amid chip shortages that have driven up the prices of highly sought-after Nvidia AI GPUs, several companies have been designing or considering designing their own AI accelerator chips, including Amazon, OpenAI, IBM, and AMD. Microsoft also felt the need to make a custom silicon to push its own services to the fore.

“Much like building a house lets you control every design choice and detail, Microsoft sees the addition of homegrown chips as a way to ensure every element is tailored for Microsoft cloud and AI workloads,” the company writes in its announcement blog. Then it adds poetically like a cookie commercial, “The chips will nestle onto custom server boards, placed within tailor-made racks that fit easily inside existing Microsoft datacenters. The hardware will work hand in hand with software–co-designed together to unlock new capabilities and opportunities.”

This isn’t Microsoft’s first foray into chip development. According to The Verge, the firm has long collaborated on silicon for its Xbox consoles and co-engineered chips for its line of Surface tablets.

No tech company is an island, and Microsoft is no exception. The company plans to continue to rely on third-party chips both out of supply necessity and likely to please its tangled web of business partnerships. “Microsoft will also add the latest Nvidia H200 Tensor Core GPU to its fleet next year to support larger model inferencing [sic] with no increase in latency,” it writes, referring to Nvidia’s recently announced AI-crunching GPU. And it will also add AMD MI300X-accelerated virtual machines to Azure.

So, how well do the new chips perform? Microsoft hasn’t released benchmarks yet, but the company seems happy with the chips’ performance-per-watt ratios, especially for Cobalt. “The architecture and implementation is designed with power efficiency in mind,” Microsoft corporate VP of hardware product development Wes McCullough said in a statement. “We’re making the most efficient use of the transistors on the silicon. Multiply those efficiency gains in servers across all our datacenters, it adds up to a pretty big number.”

https://arstechnica.com/?p=1984078


CISA Outlines AI-Related Cybersecurity Efforts

The US cybersecurity agency CISA on Tuesday published a new document detailing its efforts in promoting the use of artificial intelligence (AI) to improve security and supporting critical infrastructure organizations in adopting AI.

Aligned with national AI strategy, CISA’s Roadmap to AI (PDF) promotes beneficial uses of AI in enhancing cybersecurity capabilities and details the agency’s efforts to protect AI systems from threats and to prevent threat actors from using AI to threaten critical infrastructure.

According to CISA, while AI software systems are different from traditional software, basic security practices apply to them as well, and the roadmap builds on existing cybersecurity and risk management programs.

“The security challenges associated with AI parallel cybersecurity challenges associated with previous generations of software that manufacturers did not build to be secure by design, putting the burden of security on the customer,” the agency notes.

CISA encourages AI system makers to follow secure-by-design principles, to ensure transparency and accountability, and ensure that security is a core requirement and integral to AI system development, throughout its lifecycle.

“We envision a future in which AI systems advance our nation’s cyber defense, where our critical infrastructure is resilient and protected from malicious use of AI, and where AI developers prioritize the security of their products as a core business requirement,” the agency says.

CISA plans to integrate AI across its systems, noting that it can help defend against traditional cyber threats and maintain and improve the resilience of critical infrastructure systems, but also pointing out that AI companies and use cases may require specific protections.

The roadmap also details five lines of effort that CISA will follow in unifying and accelerating its AI goals: the responsible use of AI, a secure-by-design AI-based software adoption, protecting critical infrastructure from the malicious use of AI, collaborating with other agencies and national and international partners on key AI efforts, and educating its workforce on AI software systems and techniques.

Advertisement. Scroll to continue reading.

“This roadmap provides objectives for each line of effort that detail how CISA will accomplish these goals and measure our success. We also include representative outcomes and a notional measurement approach for each line of effort We are developing more specific measures of effectiveness, which will be defined in our annual operating plans,” CISA notes.

Related: US Government Issues Guidance on SBOM Consumption

Related: CISA Releases New Identity and Access Management Guidance

Related: ChatGPT, the AI Revolution, and the Security, Privacy and Ethical Implications

Related: CISA Introduces Secure-by-design and Secure-by-default Development Principles

https://www.securityweek.com/cisa-outlines-ai-related-cybersecurity-efforts/


5G, gli Usa verso un mega-restyling delle frequenze: servono 1500 Mhz di spettro aggiuntivo

La Casa Bianca a caccia di 1500 Mhz di banda per spingere sull’acceleratore del 5G. E’ di questa settimana la notizia che le agenzie federali sono pregate di liberare spazio per gli usi commerciali dello spettro, a partire dal 5G. L’obiettivo è redigere una nuova strategia nazionale dello spettro radio entro fine anno, si legge nella nota della Casa Bianca (vai al link).

Biden vuole una nuova strategia nazionale dello spettro

E’ per questo che Joe Biden due giorni fa ha posto le basi per una nuova strategia nazionale dello spettro, scrive la Reuters, per una gestione più coordinata di un bene scarso come le frequenze. L’obiettivo è non perdere terreno rispetto a grandi player globali, in primis la Cina, che a giugno aveva destinato ulteriori 700 megahertz per il 5G, portando il totale a 1.160 megahertz, “ovvero 4,3 volte di più” di quanto detenuto dagli operatori americani, secondo il CTIA, l’associazione americana delle aziende wireless.

“Gli Stati Uniti hanno da tempo portato avanti la propria leadership tecnologica globale trovando l’equilibrio tra la promozione dell’innovazione da parte del settore privato e l’approfondimento delle missioni dei suoi ministeri e agenzie”, dice Joe Biden nel protocollo Memorandum of Understanding (MoU) firmato lunedì. Tuttavia, negli ultimi anni, gli oggetti connessi, le automobili autonome, il turismo spaziale e le crescenti esigenze dello Stato federale hanno portato a una “concorrenza più forte” per lo spettro. Abbastanza da mettere a repentaglio la leadership del Paese nelle reti mobili, mentre gli Stati Uniti sono stati tra i primi, insieme a Cina, Corea del Sud e Giappone, a lanciare il 5G nel 2018.

Mega-revisione riguarda 2.700 Mhz di spettro

E’ quindi in cantiere lo studio di una grande revisione di più di 2.700 Mhz di spettro passibile di una potenziale riallocazione.

La domanda per l’uso dello spettro è in forte aumento così come sono previsti nuovi usi come i veicoli connessi in grado di comunicare con Internet, altri veicoli e fonti aggiuntive. Il traffico dati wireless mobile negli Stati Uniti è aumentato del 38% nel 2022.

La Casa Bianca ha messo nero su bianco che lo spettro aggiuntivo è fondamentale per i servizi wireless di prossima generazione e per una varietà di tecnologie avanzate, infrastrutture e esigenze governative.

Serve più spettro per le innovazioni del futuro

“Le innovazioni che vanno dalle reti 5G, all’agricoltura di precisione, ai veicoli aerei senza pilota, alle missioni lunari richiedono grandi quantità di spettro per funzionare”, ha indicato lunedì la Casa Bianca in una nota.

In concreto, Joe Biden ha dato tempo fino al 31 dicembre a Gina Raimondo, segretaria del Commercio, per elaborare questa nuova strategia. Oltre a questa riallocazione pubblico-privato, la strategia deve anticipare meglio i bisogni futuri e riflettere sulle modalità di attribuzione delle frequenze (vendita, utilizzo gratuito, mutualizzazione, ecc.).

Cresce la domanda di servizi satellitari

La domanda di servizi satellitari è in espansione, con le aziende nazionali che presentano richieste di licenza per costellazioni satellitari per supportare la banda larga di consumo e altri usi.

A gennaio la FCC ha proposto di rendere disponibile lo spettro della banda 5 GHz per il crescente numero di droni.

L’amministrazione Biden prevede entro 12-18 mesi di “far avanzare la ricerca, creare incentivi agli investimenti e stabilire obiettivi misurabili per far avanzare la tecnologia di accesso allo spettro”, inclusa la creazione di banchi di prova dello spettro, ha reso noto la Casa Bianca.

In ogni caso, l’iniziativa americana non mancherà di animare la prossima Conferenza mondiale delle radiocomunicazioni (WRC-23) che inizierà lunedì a Dubai. Organizzata ogni tre o quattro anni dall’Itu, l’agenzia Onu che si occupa delle politiche sullo spettro radio, la WRC esamina se sia necessario modificare il trattato internazionale che regola l’uso dello spettro.

https://www.key4biz.it/5g-gli-usa-verso-un-mega-restyling-delle-frequenze-servono-1500-mhz-di-spettro-aggiuntivo/467452/


People think white AI-generated faces are more real than actual photos, study says

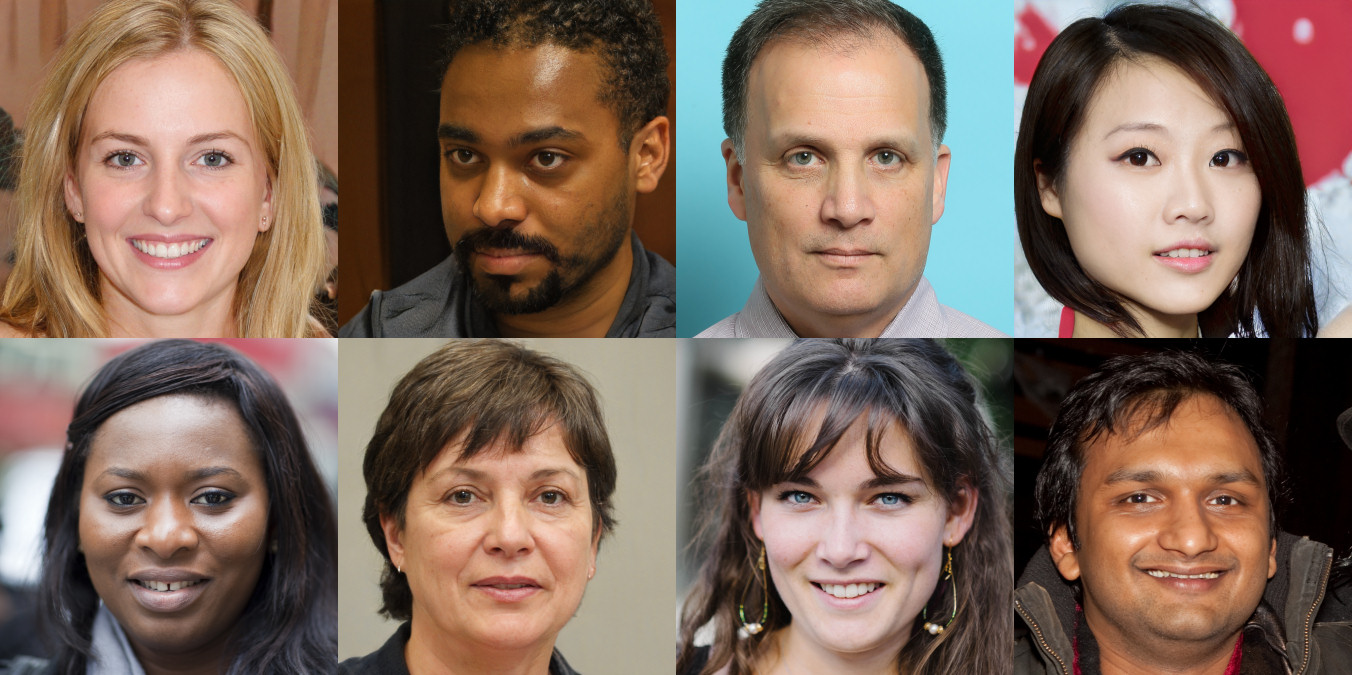
Eight images used in the study. Four of them are synthetic. Can you tell which ones?
Enlarge / Eight images used in the study; four of them are synthetic. Can you tell which ones? (Answers at bottom of the article.)

A study published in the peer-reviewed journal Psychological Science on Monday found that AI-generated faces, particularly those representing white individuals, were perceived as more real than actual face photographs, reports The Guardian. The finding did not extend to images of people of color, likely due to AI models being trained predominantly on images of white individuals—a common bias that is well-known in machine learning research.

In the paper titled “AI Hyperrealism: Why AI Faces Are Perceived as More Real Than Human Ones,” researchers from Australian National University, the University of Toronto, University of Aberdeen, and University College London coined the term in the paper’s title, hyperrealism, which they define as a phenomenon where people think AI-generated faces are more real than actual human faces.

In their experiments, the researchers presented white adults with a mix of 100 AI-generated and 100 real white faces, asking them to identify which were real and their confidence in their decision. Out of 124 participants, 66 percent of AI images were identified as human, compared to 51 percent for real images. This trend, however, was not observed in images of people of color, where both AI and real faces were judged as human about 51 percent of the time, irrespective of the participant’s race.

Researchers used real and synthetic images sourced from an earlier study, with the synthetic ones generated by Nvidia’s StyleGAN2 image generator, which can create realistic faces using image synthesis.

The research also showed that participants who frequently misidentified faces showed higher confidence in their judgments, which the researchers say is a manifestation of the Dunning-Kruger effect. In other words, people who were more confident were more often wrong.

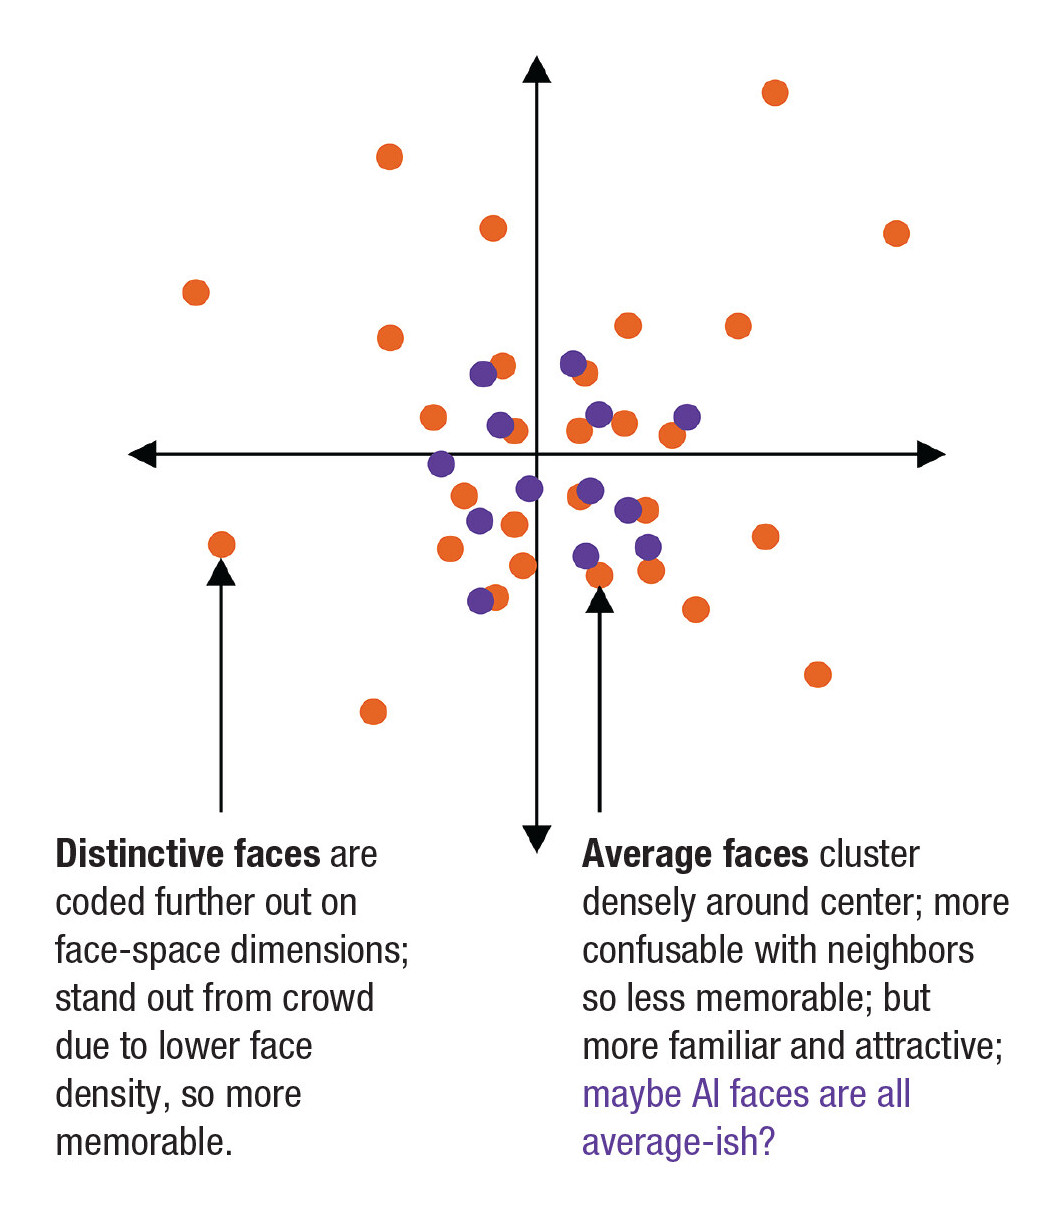
From the paper: "Schematic illustration of face-space theory: A potential explanation for AI hyperrealism. Orange dots show sample distribution of human faces; purple dots show hypothesized distribution of AI faces. We focus on relevant abstract principles of face-space theory (e.g., relating to single images of faces in human perception)."
Enlarge / From the paper: “Schematic illustration of face-space theory: A potential explanation for AI hyperrealism. Orange dots show sample distribution of human faces; purple dots show hypothesized distribution of AI faces. We focus on relevant abstract principles of face-space theory (e.g., relating to single images of faces in human perception).”
Miller et al.

A second experiment, with 610 adults, involved participants rating AI and human faces on various attributes without knowing some were AI-generated, with the researchers using “face space” theory to pinpoint specific facial attributes. The analysis of participants’ responses suggested that factors like greater proportionality, familiarity, and less memorability led to the mistaken belief that AI faces were human. Basically, the researchers suggest that the attractiveness and “averageness” of AI-generated faces made them seem more real to the study participants, while the large variety of proportions in actual faces seemed unreal.

Interestingly, while humans struggled to differentiate between real and AI-generated faces, the researchers developed a machine-learning system capable of detecting the correct answer 94 percent of the time.

The study’s findings raise concerns about perpetuating social biases and the conflation of race with perceptions of being “human,” which could have implications in areas like locating missing children, where AI-generated faces are sometimes used. And people being unable to detect synthetic faces, in general, may lead to fraud or identity theft.

Dr. Zak Witkower, a co-author from the University of Amsterdam, told The Guardian that the phenomenon could have far-reaching consequences in various fields, from online therapy to robotics. “It’s going to produce more realistic situations for white faces than other race faces,” he said.

Dr. Clare Sutherland, another co-author from the University of Aberdeen, emphasized to The Guardian the importance of addressing biases in AI. “As the world changes extremely rapidly with the introduction of AI,” she said, “it’s critical that we make sure that no one is left behind or disadvantaged in any situation–whether due to ethnicity, gender, age, or any other protected characteristic.”

Answer key for image above. Which ones are real? From left to right top row: 1. Fake, 2. Fake, 3. Real, 4. Fake. From left to right, bottom row: 1. Real, 2. Fake, 3. Real, 4. Real.

https://arstechnica.com/?p=1983842


AI outperforms conventional weather forecasting for the first time: Google study

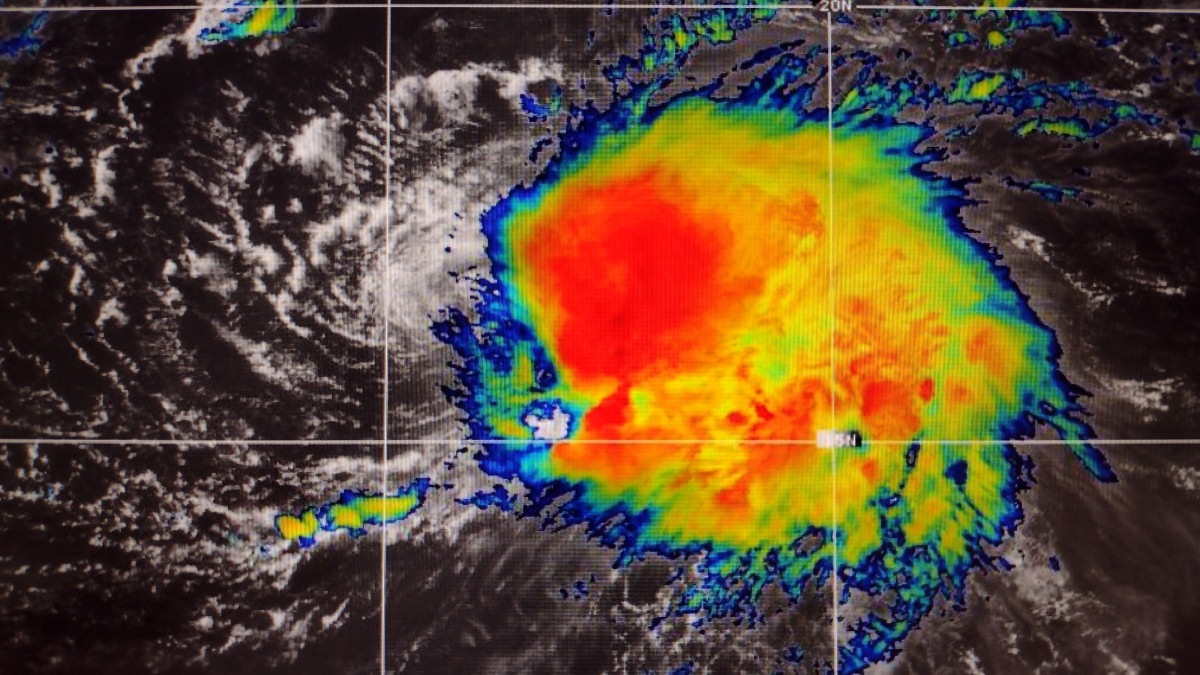
A file photo of Tropical storm Fiona as seen in a satellite image from 2022.
Enlarge / A file photo of Tropical Storm Fiona as seen in a satellite image from 2022.

On Tuesday, the peer-reviewed journal Science published a study that shows how an AI meteorology model from Google DeepMind called GraphCast has significantly outperformed conventional weather forecasting methods in predicting global weather conditions up to 10 days in advance. The achievement suggests that future weather forecasting may become far more accurate, reports The Washington Post and Financial Times.

In the study, GraphCast demonstrated superior performance over the world’s leading conventional system, operated by the European Centre for Medium-range Weather Forecasts (ECMWF). In a comprehensive evaluation, GraphCast outperformed ECMWF’s system in 90 percent of 1,380 metrics, including temperature, pressure, wind speed and direction, and humidity at various atmospheric levels.

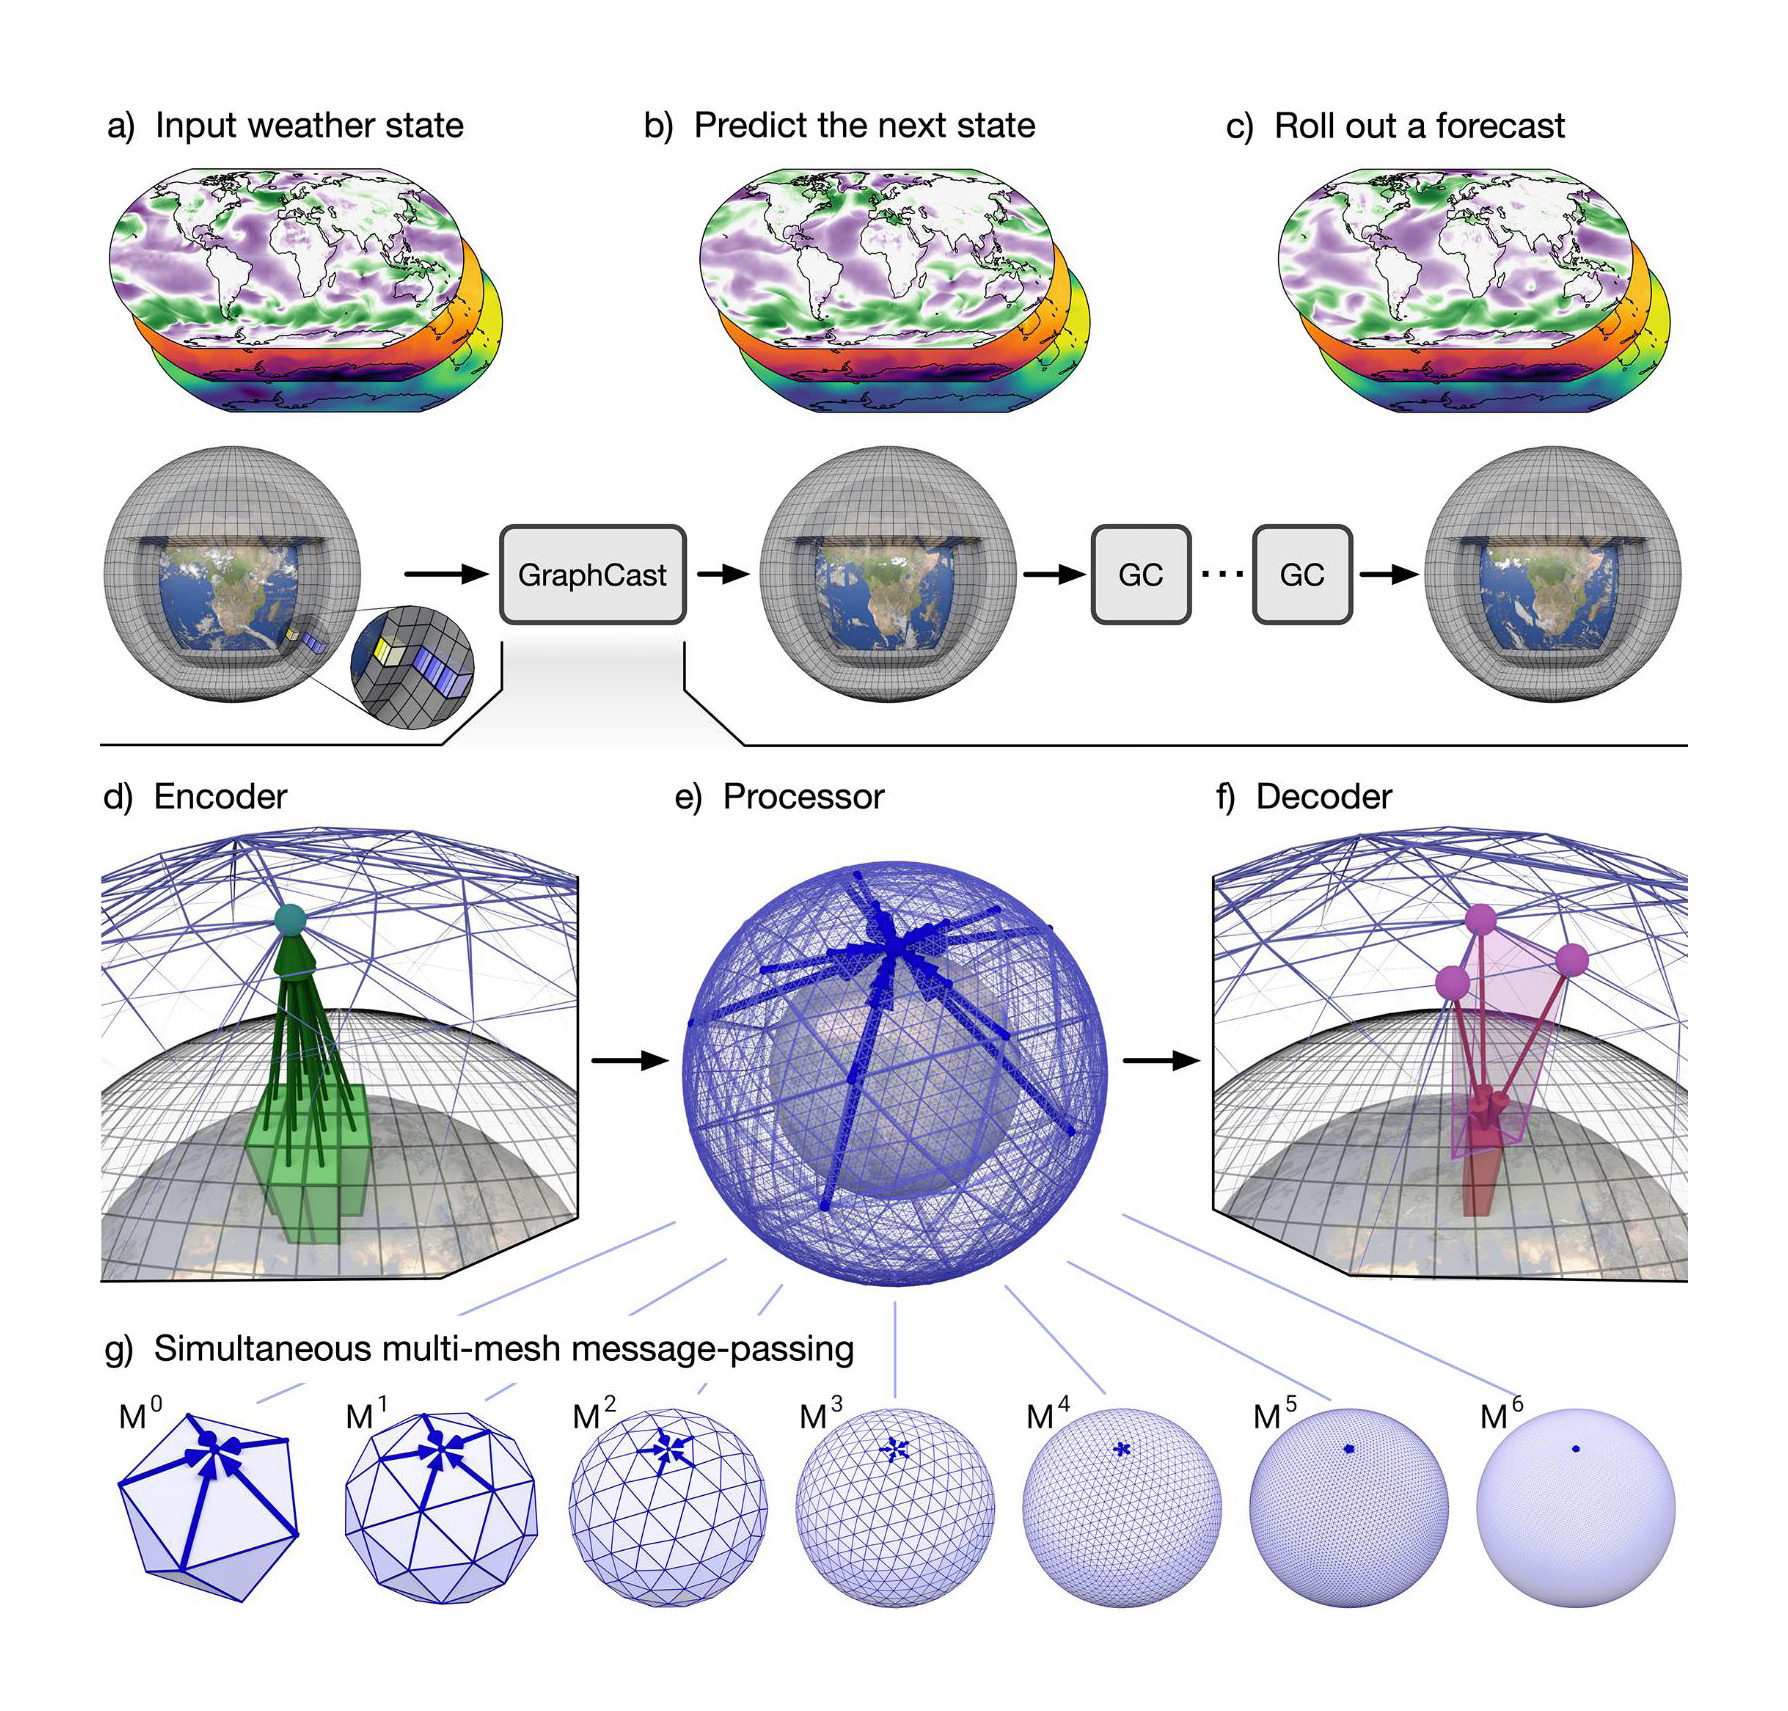
And GraphCast does all this quickly: “It predicts hundreds of weather variables, over 10 days at 0.25° resolution globally, in under one minute,” write the authors in the paper “Learning skillful medium-range global weather forecasting.”

This marks a notable advancement in speed and accuracy for AI in meteorology. Matthew Chantry, machine-learning coordinator at ECMWF, acknowledged the rapid progress in an interview with the Financial Times, saying that an AI system in meteorology had progressed “far sooner and more impressively than we expected even two years ago.”

GraphCast utilizes what researchers call a “graph neural network” machine-learning architecture, trained on over four decades of ECMWF’s historical weather data. It processes the current and six-hour-old global atmospheric states, generating a 10-day forecast in about a minute on a Google TPU v4 cloud computer. Google’s machine learning method contrasts with conventional numerical weather prediction methods that rely on supercomputers to process equations based on atmospheric physics, consuming significantly more time and energy.

A selection of fancy-looking graphs from the Google DeepMind paper, titled, "Learning skillful medium-range global weather forecasting."
Enlarge / A selection of fancy-looking graphs from the Google DeepMind paper, titled, “Learning skillful medium-range global weather forecasting.”
Google DeepMind

Chantry highlighted GraphCast’s efficiency to the Financial Times, estimating it to be about 1,000 times cheaper in terms of energy consumption compared to traditional methods. An example of its forecasting success was its prediction of Hurricane Lee’s landfall in Nova Scotia nine days in advance, three days earlier than traditional approaches.

Despite the advancement, GraphCast has limitations. It did not outperform conventional models in all scenarios, such as the sudden intensification of Hurricane Otis, which hit Acapulco with minimal warning on October 25. Also, due to technological limitations, global AI models can’t yet create forecasts as detailed or granular as traditional ones, making them more ideal for examining smaller-scale phenomena, according to The Washington Post. And they have transparency issues since meteorologists can’t yet look inside the “black box” of the AI model and see exactly why it makes the forecast it does.

Ultimately, the Google DeepMind researchers see their AI-based approach as a complement to current weather prediction techniques. “Our approach should not be regarded as a replacement for traditional weather forecasting methods,” they write, “which have been developed for decades, rigorously tested in many real-world contexts, and offer many features we have not yet explored.”

Looking ahead, ECMWF plans to develop its own AI model and explore integrating it with its numerical weather prediction system. The UK Met Office, in partnership with the Alan Turing Institute, is also developing a graph neural network for weather forecasting to be incorporated into its supercomputer infrastructure in the future.

https://arstechnica.com/?p=1983760


Asstel, Butti: ‘Tlc in crisi? Serve una nuova visione paneuropea’

Alessio Butti, Sottosegretario di Stato con delega all’Innovazione e alla Transizione Digitale, ha chiuso oggi il Forum annuale delle Telecomunicazioni organizzato da Asstel e dai sindacati Slc Cgil, Fistel Cisl e Uilcom Uil.  “Meno male che Pietro Labriola ha esordito dicendo che è ottimista visto che ha tracciato un quadro abbastanza complicato”, ha detto Butti, ringraziando poi l’ad di Tim che ha riconosciuto l’attività del Governo, in termini di ascolto e di soluzioni avanzate per la industry delle Tlc.

Leggi anche: Asstel, ricavi degli operatori Tlc ancora in flessione del 3% nel 2022. ‘Serve una nuova politica industriale’

Intelligenza artificiale in cima all’agenda

Butti ha cominciato il suo intervento dall’Intelligenza Artificiale, più volte evocata durante il Forum di Asstel. “La settimana scorsa è stato varato il comitato strategico di assoluto livello – ha detto – una segreteria tecnica e soprattutto con il presidente del Consiglio Giorgia Meloni abbiamo trattato il tema in sede di comitato interministeriale”.

L’intervento del presidente del BEREC Masselos

L’intervento del presidente del BEREC Konstantinos Masselos stimola una serie di riflessioni. “Masselos ha ricordato i ritardi (di copertura a banda ultralarga ndr), che noi conosciamo e abbiamo ripetuto in più occasioni, e ci ha anche parlato dell’importanza di un 5G che non sia questa volta un 4,5G ma un 5G stand alone. E come sapete questo Governo ha varato una strategia sulla banda ultralarga dove investe, per la prima volta, anche in edge computing – ha aggiunto – Questo Governo è il primo governo che a livello europeo ha presentato in tempi non sospetti una serie di proposte e lo ha fatto anche sull’edge computing e anche in materia di fair share. La soddisfazione che abbiamo registrato a Leon in occasione dell’ultimo Telecom Council informale del 23 e 24 di ottobre è stato una grande soddisfazione. Altri governi hanno ammesso che l’Italia ha delle idee e delle proposte in materia di Tlc”.

“Noi non intendiamo accettare il silenzio assenso in materia di Tlc”, ha aggiunto.

Butti, ‘Switch off del rame auspicato, ma non può essere pagato’

Sullo switch off del rame, “è stato auspicato, certamente va accompagnato, non può essere pagato come qualcuno ha ipotizzato nei mesi scorsi”, ha detto il Sottosegretarioche domani sarà a Bruxelles a parlare anche di questi temi.

Butti, ‘Due errori da evitare sull’AI’

Proiettandosi verso il futuro, Butti precisa che in tema di Intelligenza artificiale due sono le cose da evitare. “Vorremmo evitare due errori commessi nella precedente strategia – ha detto – il primo è che indubbiamente c’è il problema della formazione. Ma i corsi di laurea STEM su cui insisteva molto la precedente strategia non ha dato i risultati sperati. Questo perché lo Stato e le famiglie italiane spendono mediamente 170mila euro per accompagnare alla laurea un giovane o una giovane italiana. Li formiamo bene e poi ci vengono sottratti dal mercato globale che non ce li restituisce più. Quindi c’è un danno e una beffa”.

Il secondo errore da evitare è “l’immissione massiva di sistemi di intelligenza artificiale in una nazione che non ha una politica industriale – ha detto Butti – non ce l’ha sulle telecomunicazioni, immaginiamoci se ce l’ha sull’intelligenza artificiale. E su questo ovviamente tutti insieme stiamo lavorando. Ma l’immissione massiva di sistemi di intelligenza artificiale significa una e una sola cosa: lock in successivo. E questo è un errore che non vogliamo commettere, perché abbiamo la presunzione di voler fare l’intelligenza artificiale e ovviamente anche poi limitarci soltanto ad usarla”.    

Butti, ‘Broadband satellitare sempre più diffuso. Rivedere il business model delle Tlc’

“Sto pensando a quello che sta accadendo con la moltiplicazione dei satelliti a bassa quota – prosegue Butti – che sono capaci di offrire servizi broadband di altissima qualità anche in condizioni critiche. Spiace citare due situazioni belliche come l’Ucraina e Gaza, però quello che è accaduto e accade in Ucraina dove il satellite consente di fare delle dirette indisturbate al presidente Zelensky è certamente dovuto al fatto che la tecnologia satellitare dà un grande aiuto. Lo stesso vale per la Striscia di Gaza, dove le connessioni sono garantite sempre dal satellite. Questa è la direzione del futuro e anche l’orientamento che anche a livello europeo sta emergendo. Spiace dire che in Ucraina e a Gaza il sistema satellitare è quello di Elon Musk”.   

Sovranità digitale

Sovranità digitale a livello europeo è importante parlarne, termine sdoganato dalla presidente Von Der Leyen. “Proprio a Leon il commissario Breton ha fatto un passo indietro sul fair share e un passo avanti rispetto al Digital Network Act, per cui adesso gli Stati membri andranno a elaborare insieme un libro bianco che consentirà di proiettare la politica europea, la politica paneuropea sulle telecomunicazioni e non solo del prossimo futuro”.

Consolidamento paneuropeo, numerazione, roaming

Tutto ciò passa dal consolidamento. “Se non si procede con il consolidamento a livello europeo avremo dei problemi con le altre aree del mondo – dice – Partiamo dalla numerazione, che deve diventare europea. Nell’epoca di Whatsapp non ha più senso parlare di numeri nazionali. E poi c’è il roaming. A me piacerebbe che il servizio fosse garantito all’estero da chi già mi segue nel mio paese a prescindere dai perimetri nazionali. E invece oggi quando si acquista la sim card non la si può usare liberamente in un altro paese”.

Larga banda fissa

Oggi un consumatore può rivolgersi ad un incumbent nazionale o all’operatore tv via cavo, dove esiste il cavo, o ad un operatore alternativo. “Se esistesse un vero mercato unico potremmo avere operatori che operano anche in altri paesi – dice Butti – se ci fosse anche un mercato wholesale, per quanto riguarda la fibra, sempre a livello paneuropeo”. Lo stesso discorso vale per i servizi e i contenuti. Ad esempio, un cliente di Sky Italia non può vedere i contenuti italiani se si trova all’estero.

Butti, Incumbent contrari a dividere la rete dai servizi

“Gli incumbent, essendo quasi tutti integrati verticalmente, si oppongono- a questo disegno – dice Butti – e qui c’è una soluzione. Vale a dire dividere la rete dai servizi, come stiamo cercando di fare a livello nazionale. Ma non è una cosa semplice, perché dipende anche dalle procedure”. “L’integrazione fra la rete e i servizi non è più indispensabile come una volta”, aggiunge.

“I governi sono interessati al controllo strategico, senz’altro e noi ne abbiamo fatto un tratto distintivo. Però dobbiamo promuovere un mercato wholesale che sia aperto, competitivo, che garantisca una maggiore efficienza e la neutralità nei confronti degli altri operatori attivi nel mercato retail”, aggiunge Butti, secondo cui occorre un nuovo modello di business, una nuova visione, delle nuove scelte che non siano sempre convenzionali.

https://www.key4biz.it/asstel-butti-tlc-in-crisi-serve-una-nuova-visione-paneuropea/467288/


Nvidia introduces the H200, an AI-crunching monster GPU that may speed up ChatGPT

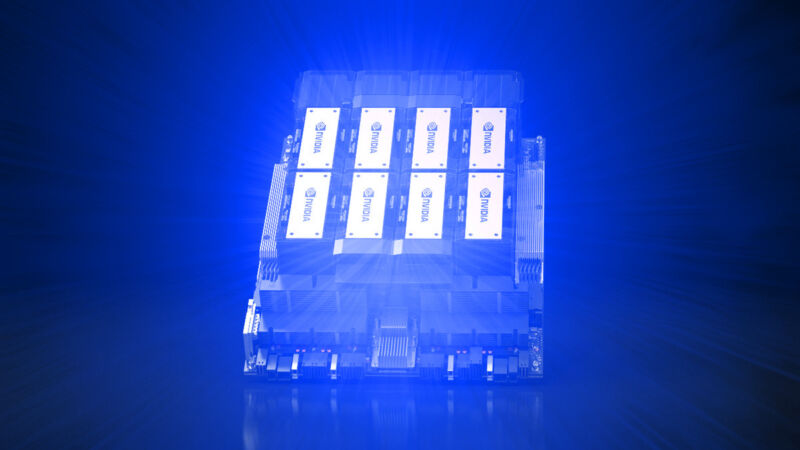
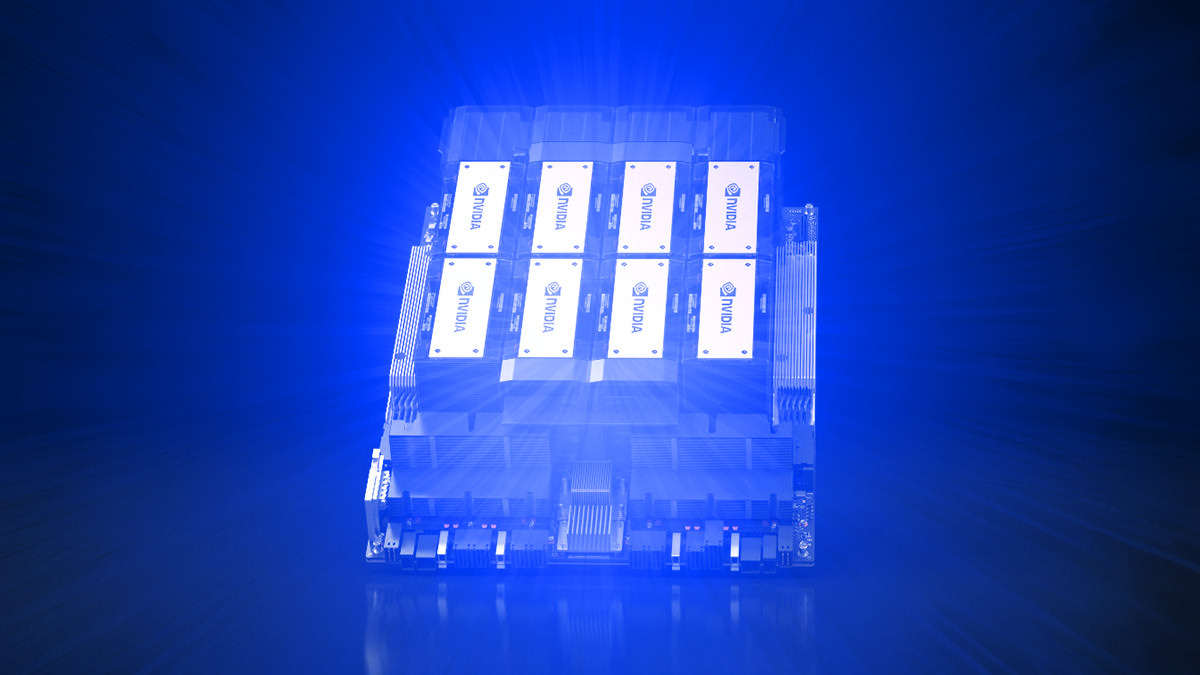
The Nvidia H200 GPU covered with a blue explosion.
Enlarge / Eight Nvidia H200 GPUs covered with a fanciful blue explosion that figuratively represents raw compute power bursting forth in a glowing flurry.
Nvidia | Benj Edwards

On Monday, Nvidia announced the HGX H200 Tensor Core GPU, which utilizes the Hopper architecture to accelerate AI applications. It’s a follow-up of the H100 GPU, released last year and previously Nvidia’s most powerful AI GPU chip. If widely deployed, it could lead to far more powerful AI models—and faster response times for existing ones like ChatGPT—in the near future.

According to experts, lack of computing power (often called “compute”) has been a major bottleneck of AI progress this past year, hindering deployments of existing AI models and slowing the development of new ones. Shortages of powerful GPUs that accelerate AI models are largely to blame. One way to alleviate the compute bottleneck is to make more chips, but you can also make AI chips more powerful. That second approach may make the H200 an attractive product for cloud providers.

What’s the H200 good for? Despite the “G” in the “GPU” name, data center GPUs like this typically aren’t for graphics. GPUs are ideal for AI applications because they perform vast numbers of parallel matrix multiplications, which are necessary for neural networks to function. They are essential in the training portion of building an AI model and the “inference” portion, where people feed inputs into an AI model and it returns results.

“To create intelligence with generative AI and HPC applications, vast amounts of data must be efficiently processed at high speed using large, fast GPU memory,” said Ian Buck, vice president of hyperscale and HPC at Nvidia in a news release. “With Nvidia H200, the industry’s leading end-to-end AI supercomputing platform just got faster to solve some of the world’s most important challenges.”

For example, OpenAI has repeatedly said it’s low on GPU resources, and that causes slowdowns with ChatGPT. The company must rely on rate limiting to provide any service at all. Hypothetically, using the H200 might give the existing AI language models that run ChatGPT more breathing room to serve more customers.

4.8 terabytes/second of bandwidth

Eight Nvidia H200 GPU chips on a HGX carrier board.
Enlarge / Eight Nvidia H200 GPU chips on a HGX carrier board.

According to Nvidia, the H200 is the first GPU to offer HBM3e memory. Thanks to HBM3e, the H200 offers 141GB of memory and 4.8 terabytes per second bandwidth, which Nvidia says is 2.4 times the memory bandwidth of the Nvidia A100 released in 2020. (Despite the A100’s age, it’s still in high demand due to shortages of more powerful chips.)

Nvidia will make the H200 available in several form factors. This includes Nvidia HGX H200 server boards in four- and eight-way configurations, compatible with both hardware and software of HGX H100 systems. It will also be available in the Nvidia GH200 Grace Hopper Superchip, which combines a CPU and GPU into one package for even more AI oomph (that’s a technical term).

Amazon Web Services, Google Cloud, Microsoft Azure, and Oracle Cloud Infrastructure will be the first cloud service providers to deploy H200-based instances starting next year, and Nvidia says the H200 will be available “from global system manufacturers and cloud service providers” starting in Q2 2024.

Meanwhile, Nvidia has been playing a cat-and-mouse game with the US government over export restrictions for its powerful GPUs that limit sales to China. Last year, the US Department of Commerce announced restrictions intended to “keep advanced technologies out of the wrong hands” like China and Russia. Nvidia responded by creating new chips to get around those barriers, but the US recently banned those, too.

Last week, Reuters reported that Nvidia is at it again, introducing three new scaled-back AI chips (the HGX H20, L20 PCIe, and L2 PCIe) for the Chinese market, which represents a quarter of Nvidia’s data center chip revenue. Two of the chips fall below US restrictions, and a third is in a “gray zone” that might be permissible with a license. Expect to see more back-and-forth moves between the US and Nvidia in the months ahead.

https://arstechnica.com/?p=1983396


Intelligenza Artificiale a rischio: si stanno esaurendo dati e immagini di qualità su cui istruirla. La soluzione? I dati sintetici

L’intelligenza artificiale è diventato il tema più cool del dibattito internazionale e della percezione dell’opinione pubblica, non solo di quella specializzata.

A dispetto della popolarità raggiunta dal settore, si sta silenziosamente facendo strada l’idea che la crisi possa essere dietro l’angolo e a creare difficoltà a questa crescita inarrestabile dell’intelligenza artificiale possa essere la scarsità di nuovi dati. Sì proprio così. L’intelligenza artificiale, per crescere, ha bisogno continuo di nuovi dati, che rappresentano il suo insostituibile carburante.

In assenza di nuovi dati disponibili, potrebbero registrarsi rallentamenti nella crescita dei modelli di intelligenza artificiale, in particolare i modelli linguistici di grandi dimensioni, e ciò potrebbe persino alterare la traiettoria della rivoluzione dell’IA da molti auspicata.

Ecco perché i dati di alta qualità sono importanti per l’Intelligenza artificiale

Ma c’è un modo per affrontare il rischio? E perché una potenziale mancanza di dati è un problema, considerando l’immensa mole di dati presenti in internet?

Perché per addestrare algoritmi potenti, accurati servono dati di alta qualità. Ad esempio, ChatGPT è stato addestrato su 570 Gigabyte di dati di testo (libri, testi scritti per internet, Wikipedia, articoli ecc.), pari a circa 300 miliardi di parole.

Allo stesso modo, la diffusione di algoritmi stabili ed equilibrati (che è dietro molte app di generazione di immagini AI come DALL-E, Lensa e Midjourney) è stata possibile grazie ad addestramenti con strumenti affidabili come LIAON-5B, un dataset forte di 5,8 miliardi di accoppiamenti immagine-testo. Al contrario, è evidente che se un algoritmo viene addestrato su una quantità insufficiente di dati, produrrà output imprecisi o di bassa qualità.

Anche la qualità dei dati su cui si fonda la formazione è importante. I dati di bassa qualità come i post sui social media o le fotografie sfocate sono facili da reperire, ma non sono sufficienti per addestrare modelli di intelligenza artificiale ad alte prestazioni.

Il testo preso dalle piattaforme di social media, come in altri angoli del web, potrebbe essere di parte, marcato da pregiudizio, o potrebbe includere disinformazione o contenuti illegali che potrebbero essere replicati dal modello che si sta costruendo. Ad esempio, quando Microsoft ha cercato di addestrare il suo bot AI usando i contenuti di Twitter, si è ritrovato a creare output razzisti e misogini (“Twitter taught Microsoft’s AI chatbot to be a racist asshole in less than a day”) .

Questo è il motivo per cui gli sviluppatori di intelligenza artificiale cercano contenuti di alta qualità come testi di libri, articoli online, articoli scientifici, Wikipedia e alcuni contenuti web filtrati ed affidabili. L’Assistente Google, ad esempio, è stato addestrato  su 11.000 romanzi d’amore (Google swallows 11,000 novels to improve AI’s conversation) presi dal sito di self-publishing Smashwords, per renderlo più colloquiale ed amichevole.

Ma abbiamo abbastanza dati per alimentare gli algoritmi che vorremmo?

L’industria dell’intelligenza artificiale ha addestrato i sistemi di intelligenza artificiale prodotti su set di dati sempre più grandi, grazie a ciò abbiamo oggi modelli ad alte prestazioni come ChatGPT o DALL-E 3. Ma il problema, come abbiamo visto, è che gli stock di dati online prodotti in tempo reale stanno crescendo molto più lentamente dei set di dati già disponibili ed utilizzati per addestrare l’intelligenza artificiale.

Il primo grido di allarme è stato lanciato circa un anno fa nel paper “Will we run out of data? An analysis of the limits of scaling datasets in Machine Learning” scritto da un gruppo di sei ricercatori in intelligenza artificiale (Pablo Villalobos, Jaime Sevilla, Lennart Heim, Tamay Besiroglu, Marius Hobbhahn e Anson Ho) dislocati in varie università in giro per il mondo (University of Aberdeen, MIT Computer Science & Artificial Intelligence Laboratory, Centre for the Governance of AI, University of Tubingen), ma raggruppati sotto le insegne di Epoch. Le loro affermazioni nascono dall’analisi dei flussi di dati creati nel corso del tempo: i dati di qualità non crescono di pari passo con l’impennata della produzione generale di dati e, da canto suo, l’intelligenza artificiale per crescere ha bisogno di dati di qualità.

La previsione del gruppo di studiosi è che i dati linguistici di bassa qualità saranno esauriti tra il 2030 e il 2050 e i dati di immagine di bassa qualità tra il 2030 e il 2060.

Un danno non da poco se si pensa che l’IA potrebbe contribuire per 15,7 trilioni di dollari all’economia mondiale entro il 2030, secondo Price Waterhouse Cooper (The Macroeconomic impact of artificial intelligence). E la carenza di dati di qualità potrebbe rallentare tale contribuzione di valore.

Dovremmo essere preoccupati?

Mentre gli elementi sopra descritti potrebbero allarmare più di qualche tecno-fan dell’IA, la situazione potrebbe non essere così brutta come apparentemente sembra. È vero, ci sono molte incognite non solo su come si svilupperanno i modelli di intelligenza artificiale in futuro, ma anche numerose incertezze e timori proprio su come affrontare il rischio della carenza di dati di qualità.

Una delle opportunità auspicate dagli sviluppatori di intelligenza artificiale è quella di migliorare gli algoritmi in modo che utilizzino in modo più efficiente i dati di cui si ha già disponibilità.

È inoltre probabile che nei prossimi anni gli sviluppatori saranno in grado di addestrare sistemi di intelligenza artificiale ad alte prestazioni, utilizzando meno dati e probabilmente minore potenza computazionale. La qual cosa aiuterebbe anche a ridurre i timori relativi agli effetti sull’ambiente derivano dallo sviluppo dell’intelligenza artificiale (The Green Dilemma: Can AI Fulfil Its Potential Without Harming the Environment?)

La soluzione? I dati sintetici…

Un’altra opzione è quella di utilizzare l’IA per creare “dati sintetici”, ovvero dati  appositamente generati in base alle esigenze di produzione degli algoritmi, su richiesta, nei volumi che occorrono e nelle forme necessarie e rispondenti alle specifiche formulate a monte (Synthetic Data Is About To Transform Artificial Intelligence). Diversi progetti stanno già utilizzando contenuti sintetici, con dati provenienti da servizi di generazione di dati come Mostly AI (The #1 synthetic data platform). E il processo è ormai avviato, come sottolineato dal Wall Street Journal (Fake It to Make It: Companies Beef Up AI Models With Synthetic Data)

Gli sviluppatori sono anche alla ricerca di contenuti al di fuori dello spazio online gratuito, come quello detenuto da grandi editori e repository off-line. Si pensi ai milioni di testi pubblicati prima di internet e non ancora presenti in rete. Resi disponibili in digitale, potrebbero fornire una nuova fonte di dati per i progetti di intelligenza artificiale in corso e futuri.

Oppure occorrerà usare le montagne di dati privati e di alta qualità di editori e creatori

Un altro punto cruciale, che sta registrando l’attenzione degli osservatori è la grande quantità di dati già digitalizzati, ma protetti, ovvero custoditi da paywall che non consentono l’accesso. L’editore News Corp, uno dei più grandi proprietari di contenuti di notizie al mondo (che ha gran parte dei suoi contenuti dietro un paywall) ha recentemente dichiarato che stava negoziando accordi di contenuti con gli sviluppatori di intelligenza artificiale (News Corp in negotiations with AI companies over content usage, CEO says). Una strada, questa, che potrebbe essere percorsa anche da tutti gli altri proprietari di contenuti online protetti.

Tali accordi costringerebbero le aziende di intelligenza artificiale a pagare per i dati di formazione necessari all’addestramento degli algoritmi, mentre finora questi dati sono stati per lo più raschiati via Internet gratuitamente.

I creatori di contenuti hanno protestato con alcune aziende come Microsoft, Open AI e Stability AI contro l’uso non autorizzato dei propri contenuti per addestrare i modelli di intelligenza artificiale. Essere remunerati per il loro lavoro, è la loro tesi, può aiutare a ripristinare parte dello squilibrio di potere che esiste tra i creativi e l’industria dei contenuti da un lato e le aziende di intelligenza artificiale dall’altro.

Anche in questo caso, si aprono strade nuove sino ad ora non battute. Occorre coraggio, visione e naturalmente creatività.

https://www.key4biz.it/intelligenza-artificiale-a-rischio-si-stanno-esaurendo-dati-e-immagini-di-qualita-su-cui-istruirla-la-soluzione-i-dati-sintetici/466982/


In Italia servirebbe un’Agenzia ad hoc per lo spettro radio?

Serve davvero in Italia l’istituzione di un’agenzia ad hoc, sul modello francese, per la gestione dello spettro radio? L’idea arriva nel Digital Innovation Act presentato ieri al Senato da Lorenzo Basso, vicepresidente della commissione Ambiente, Antonio Nicita, vicepresidente del gruppo e Antonio Misiani, responsabile economico dei Dem, con la senatrice Beatrice Lorenzin, vicepresidente dei senatori Dem. Molto giusto dare centralità allo spettro. Era ora che si aprisse un dibattito sulle frequenze, anche perché in gioco c’è lo sviluppo tecnologico fatto di AI, del metaverso, dell’industrial 5G, del 6G e della connettività satellitare.

Modello francese

In realtà non si tratta di un’idea nuova. In Francia l’Agence nationale de Fréquences già esiste da tempo come punto unico di raccolta delle istanze che riguardano 5G, Digitale terrestre, radio, innovazione, tecnologie wireless come i DAS, onde elettromagnetiche, emissioni ecc.

C’è da dire che lo spettro radio è un bene scarso e prezioso, tanto più prezioso quanto cresce la domanda di connettività.

Pro e contro

Centralizzare la gestione delle frequenze potrebbe effettivamente snellire le procedure di assegnazione, anche temporanea, di risorse spettrali e affrontare in maniera sistematica la crescente domanda in arrivo di nuove risorse spettrali da parte di nuovi soggetti, fra cui in primis i provider di connettività satellitare e privati in genere in ottica di 5G industriale, un ambito destinato a crescere in futuro con nuovi soggetti che entreranno nell’arena delle frequenze, fra cui anche gli Hyperscalers.

Leggi anche: 5G e reti locali, Amazon apripista degli OTT nella partita dei Verticals?

Google entra nell’arena delle reti private 5G

Ma il rischio di fare dei pasticci è dietro l’angolo quando si toccano le competenze di ministeri (Mimit) e autorità (Agcom) che hanno ruoli ben distinti nella pianificazione e gestione dello spettro radio.

Il rischio inoltre è quello di attribuire troppe competenze alla nuova agenzia, centrali e regionali. Ma il controllo del territorio è attribuito agli enti locali.

La proposta dei senatori del Pd

La proposta del Pd

Nel dettaglio, l’articolo 8 del Ddl:

“…istituisce l’Agenzia nazionale delle frequenze (di seguito: ANAF), sul modello francese, che ha la missione di garantire la pianificazione, la gestione, il controllo dell’uso del dominio pubblico delle frequenze radio in Italia e il monitoraggio degli effetti ambientali e per la salute delle stesse”, si legge.

Fusione di diverse competenze di Mimit, Agcom e Arpa

“…L’ANAF nasce dalla fusione, senza oneri aggiuntivi per la finanza pubblica, in un unico ente pubblico, di talune competenze attualmente divise tra MiMiT, AGCOM e ARPA, che faranno a tal fine confluire al nuovo ente parte del personale dedicato a tale attività”, si legge.

L’ANAF gestirebbe tutte le frequenze radio in Italia

“…L’ANAF gestirà tutte le frequenze radio in Italia impiegate per tutte le comunicazioni wireless, per le comunicazioni mobili e FWA, nei trasporti, nell’internet delle cose, nella televisione digitale terrestre, nella difesa nazionale, nell’industria e così via”, si legge.

Le frequenze per la Difesa sono un tema da sempre molto delicato. L’Agcom non se ne occupa. Lo farebbe l’Anaf? Ma è un ente governativo o indipendente?

Leggi anche: Telco a corto di spettro: Agcom apre alle frequenze della Difesa

All’ANAF ruolo di cooperazione e negoziazione internazionale

“…L’ANAF svolgerà, per conto del MiMiT e di AGCOM il ruolo di cooperazione e negoziazione delle posizioni italiane nelle principali direzioni di accesso allo spettro delle frequenze”. 

A questo proposito, non è chiaro cosa vuol dire che svolgerà per conto di Mimit e Agcom il ruolo di negoziazione delle posizioni italiane. Una cosa è il Mimit (governativo) e un’altra cosa è Agcom (autorità indipendente), L’Anaf, ancora, sarebbe indipendente? Non è detto che sia una cosa positiva in un’ottica di sicurezza nazionale.

ANAF punto di ingresso per gli operatori satellitari

“…L’Agenzia sarà anche il punto di ingresso per gli operatori satellitari per registrare le loro frequenze nel registro internazionale delle frequenze dell’Unione Internazionale delle Telecomunicazioni (ITU)”.

Questo è un altro tema delicato, visto che la connettività satellitare (basti pensare a Starlink) assumerà un ruolo sempre più centrale in futuro e non soltanto per la copertura delle aree in digitale divide. La crescente quantità di satelliti in orbita moltiplicherà le fonti di connettività, sempre più concorrenziali rispetto a tecnologie più classiche come la fibra e il wireless mobile. Anche il 6G si baserà su frequenze satellitari.

Leggi anche: ICC 2023, Blefari Melazzi (CNIT): ‘Il futuro di Internet? Fra Hyperscalers e 6G’

Gestione del monitoraggio e del controllo dell’utilizzo delle frequenze

“… L’ANAF sarà anche l’interlocutore pubblico dei grandi utilizzatori dello spettro delle frequenze. Emetterà accordi per l’istituzione di siti radio garantendo la compatibilità elettromagnetica e monitorandone effetti e impatti. Oltre a gestire le autorizzazioni d’installazione, l’ANAF sarà responsabile del monitoraggio e del controllo dell’utilizzo delle frequenze, garantirà l’effettiva disponibilità delle frequenze assegnate agli utenti grazie al lavoro quotidiano degli agenti sul campo, proporrà al Governo la determinazione dei limiti alle emissioni compatibili con la tutela della salute, nel quadro dell’armonizzazione europea”.

A questo proposito, per la definizione dei limiti l’Anaf acquisirebbe competenze del Ministero della Salute e dell’Istituto Superiore di Sanità, ma non è previsto che ci sia personale proveniente da queste amministrazioni. Se non ci sono oneri aggiuntivi per la finanza pubblica, come fa ad acquisire queste competenze tecniche?

Assegnazione dell’uso temporaneo di spettro per eventi

“…L’ANAF, in presenza di conflitti tra operatori, opererà come sede di risoluzione delle interferenze. Inoltre, durante i grandi eventi, che richiedono molte frequenze, l’ANAF interverrà per pianificare e controllare l’utilizzo delle frequenze temporaneamente consegnate sul territorio e garantire il regolare svolgimento dell’evento”.

Questa è un’altra funzione che sarà sempre più diffusa, vale a dire l’assegnazione di risorse spettrali a titolo temporaneo, in occasione di eventi ad alto tasso di consumo di banda come concerto o grandi eventi pubblici come lo è stata ad esempio l’incoronazione di re Carlo III d’Inghilterra.

Leggi anche: 5G, la più grande rete privata temporanea al mondo per l’incoronazione di Carlo III. E per il Giubileo?

Limiti elettromagnetici tema sensibile

“…Infine l’ANAF monitora l’esposizione della popolazione alle onde elettromagnetiche; definisce su delega del Governo i valori limite che garantiscono l’assenza di effetti sulla salute e vigila sul rispetto degli stessi; garantisce inoltre la conformità delle apparecchiature radio e dei terminali disponibili sul mercato effettuando misure del tasso di assorbimento specifico (SAR); garantisce la tutela della ricezione del segnale televisivo e gestisce i reclami dei telespettatori quando hanno difficoltà a riceverlo, purché tali difficoltà non siano legate alle loro apparecchiature individuali”.

L’Anaf gestirebbe i reclami dei telespettatori, ma come farebbe senza togliere competenze a Rai, a Mediaset e ai broadcaster?

Leggi anche: Limiti elettromagnetici, ok emendamento per alzarli. Ma l’iter è complesso

L’Agenzia servirebbe per la gestione strategica dello spettro

In conclusione, l’Agenzia servirebbe eccome, ma così rischierebbe di essere affogata da troppi adempimenti trasferiti forse inutilmente all’agenzia da Arpa e Ministero della Salute. L’agenzia dovrebbe, invece, concentrarsi sulla gestione strategica e sugli indirizzi industriali dell’uso dello spettro radio. In realtà, il Ministero già lo sta facendo, ma potrebbe farlo di più e meglio se fosse potenziato dalle competenze della Fondazione Ugo Bordoni, la in house del Mimit che si occupa dello spettro radio. In questo senso, partendo dall’esistente, sarebbe certamente utile un rapporto più organico fra Ministero e FUB anche in vista delle prossime sfide tecnologiche future a partire dall’Intelligenza Artificiale.

https://www.key4biz.it/in-italia-servirebbe-unagenzia-ad-hoc-per-lo-spettro-radio/466885/


Digital Innovation Act, il Ddl del Pd per l’innovazione: dalla Legge annuale del Digitale, all’Agenzia nazionale delle frequenze a quella dell’IA

Un disegno di legge in tema di innovazione e sviluppo tecnologico, con lo scopo di realizzare nel nostro Paese un ambiente favorevole all’adozione e allo sviluppo delle tecnologie digitali, creare posti di lavoro qualificati, guidare la transizione digitale ed ecologica, sostenere la competitività delle imprese, far crescere startup e scaleup, promuovere la cittadinanza digitale, stimolare nuove risorse e finanziamenti, attrarre investimenti esterni e talenti internazionali.

E’ quello che ha presentato il Pd al Senato, nel corso di una conferenza stampa alla quale hanno partecipato i proponenti Lorenzo Basso, vicepresidente della commissione Ambiente, Antonio Nicita, vicepresidente del gruppo e Antonio Misiani, responsabile economico dei Dem, con la senatrice Beatrice Lorenzin, vicepresidente dei senatori Dem.

ANTONIO NICITA PD, LORENZO BASSO PD, BEATRICE LORENZIN PD, ANTONIO MISIANI PD

Tre pilastri

“Il disegno di legge – hanno detto i senatori – si sviluppa attraverso tre pilastri: il primo riguarda la governance, con la creazione di un nuovo ministero dell’Innovazione e dello Sviluppo tecnologico, di un Consiglio Nazionale dell’Innovazione, di un Comitato interministeriale per le politiche industriali e di sviluppo tecnologico, oltre a un Comitato per la regolazione digitale. Il secondo pilastro si focalizza sulle misure per la sostenibilità nell’innovazione, come la promozione dei principi di accessibilità, il contrasto ai contenuti illegali, l’accesso tutelato per i minori, algoritmi trasparenti, la contendibilità e l’equità dei servizi digitali, misure per evitare gli usi impropri dell’Ia”. Infine, “il terzo pilastro si concentra sulle misure volte a promuovere lo sviluppo di tecnologia e abilitare l’innovazione, un voucher per la digitalizzazione delle piccole e micro imprese e dei lavoratori autonomi, la creazione di un credito d’imposta per gli investimenti in beni tecnologicamente avanzati e/o green”.

Governance

Il primo pilastro del Ddl, che riguarda la Governance, prevede fra le altre cose, l’istituzione di una Legge Annuale per il Digitale, sul modello della legge annuale per la Concorrenza, “finalizzata a fotografare i progressi nell’adozione delle politiche, a individuare e rimuovere gli ostacoli tecnologici e regolatori al dispiego dell’innovazione digitale, e ad aggiornare, ove necessario, il quadro normativo”, si legge nella sintesi.

Viene poi istituita “l’Agenzia Nazionale delle Frequenze, sul modello francese, che ha la missione di garantire la pianificazione, la gestione, il controllo dell’uso del dominio pubblico delle frequenze radio in Italia e il monitoraggio degli effetti ambientali e per la salute delle stesse. Viene inoltre promossa una Agenzia per l’Intelligenza artificiale, centro per la regolamentazione e lo sviluppo di questo importante settore”.

Misure per la sostenibilità dell’innovazione

Il secondo pilastro del Ddl, che riguarda le Misure per la sostenibilità dell’innovazione prevede fra le altre cose “disposizioni per la verifica della maggiore età per l’accesso ai siti, alle app e alle piattaforme che contengono o condividono contenuti vietati ai minori di anni 18”. Sul fronte dell’Intelligenza Artificiale “ci sono misure per evitare gli usi impropri di repliche digitali, la creazione di uno spazio tecnico-normativo sperimentale e temporaneo, e la necessità di dare immediata riconoscibilità agli utenti dei contenuti generati da IA”.

Misure per lo sviluppo tecnologico e l’innovazione delle imprese

Il terzo pilatro del Ddl, che riguarda Misure per lo sviluppo tecnologico e l’innovazione delle imprese propone fra l’altro l’istituzione del del “Responsabile della Sicurezza Informatica”, una sorta di Dpo (Digital Protection Officer) dedicato però non alla privacy ma alla cybersecurity come figura a sé stante sempre più necessaria in azienda.

https://www.key4biz.it/digital-innovation-act-il-ddl-del-pd-per-linnovazione-dalla-legge-annuale-del-digitale-allagenzia-nazionale-delle-frequenze-a-quella-dellia/466854/