ChatGPT, Garante Privacy: “Da OpenAI volontà di collaborare per tutelare i dati degli italiani”
Si è svolto ieri sera l’incontro, in video conferenza, tra GarantePrivacy e OpenAI sul ChatGPT. Un dialogo durato quasi quasi tre ore in un clima definito molto buono, ma è ancora presto per capire se e quando il servizio tornerà attivo in Italia.
All’incontro, a cui ha preso parte in apertura anche SamAltman, CEO di OpenAI, erano presenti, oltre al Collegio del Garante (PasqualeStanzione, Ginevra Cerrina Feroni, Agostino Ghiglia, Guido Scorza),CheChang, Deputy General Counsel della società statunitense, AnnaMakanju, responsabile Public Policy e AshleyPantuliano, Associate General Counsel.
“OpenAI, pur ribadendo di essere convinta di rispettare le norme in tema di protezione dei dati personali, ha tuttavia confermato la volontà di collaborare con l’Autorità italiana con l’obiettivo di arrivare ad una positiva soluzione delle criticità rilevate dal Garante riguardo a ChatGPT”, ha spiegato il Garante in una nota.
OpenAI si è impegnata a rafforzare la trasparenza nell’uso dei dati personali
“L’Autorità da parte sua ha sottolineato come non vi sia alcuna intenzione di porre un freno allo sviluppo dell’AI e dell’innovazione tecnologica ed ha ribadito l’importanza del rispetto delle norme poste a tutela dei dai personali dei cittadini italiani ed europei. OpenAI si è impegnata a rafforzare la trasparenza nell’uso dei dati personali degli interessati, i meccanismi esistenti per l’esercizio dei diritti e le garanzie per i minori e ad inviare al Garante entro oggi un documento che indichi le misure che rispondano alle richieste dell’Autorità”, ha concluso la nota.
Il Garante si riserva di valutare le misure proposte dalla società, anche riguardo al provvedimento adottato nei confronti di OpenAI.
Stati Uniti e Canada seguono la scia del Garante italiano
Dopo il Garante italiano, anche quello del Canada ha annunciato di aver aperto un’indagine su OpenAI, la società che sviluppa e gestisce ChatGPT. Il motivo? Lo stesso avanzato dall’Autorità italiana: “è stata avviata a seguito di una denuncia secondo cui le informazioni personali sono state raccolte, utilizzate e comunicate senza consenso”, ha spiegato l’Ufficio del Commissario per la privacy del Canada.
Se non regoliamo l’IA, sarà “la nostra invenzione finale”?
“Le ripercussioni sulla privacy della tecnologia IA sono una priorità per il Commissariato”, ha affermato il commissario per la privacy del Canada Philippe Dufresne. “Dobbiamo stare al passo con i rapidi progressi tecnologici”, ha aggiunto, “e persino rimanere un passo avanti su questo piano”. E il riferimento è all’esigenza di normare il prima possibile l’intelligenza artificiale generativa come ChatGPT, basata sui Large Language Model (modelli linguistici di grandi dimensioni) prima che sia troppo tardi. Prima che l’Intelligenza Artificiale diventi “la nostra invenzione finale”, per citare il titolo del libro di James Barrat, che vede l’IA come la fine dell’età dell’uomo.
Negli Stati Uniti è stata presentata alla Federal Trade Commission (FTC) una denuncia contro OpenAI da parte del gruppo di ricerca senza scopo di lucro Center for AI and Digital Policy, che accusa la società dietro ChatGPT e ormai GPT-4“di violare una parte della legge FTC che vieta le pratiche commerciali sleali e ingannevoli e le linee guida sui prodotti di intelligenza artificiale”.
Secondo il presidente del gruppo di ricerca denunciante, “GPT-4 è di parte, ingannevole ed è un rischio per la privacy e la sicurezza pubblica”. Il gruppo sostiene che i modelli linguistici di grandi dimensioni non soddisfino gli standard dell’Agenzia sull’IA, ossia non sono “trasparenti, spiegabili, equi…”
OpenAI: “La nostra mission è costruire e implementare sistemi di AI sicuri”
“OpenAI si impegna a mantenere l’AI potente sicura e ampiamente vantaggiosa. Sappiamo che i nostri strumenti di AI forniscono molti vantaggi alle persone oggi. I nostri utenti in tutto il mondo ci hanno detto che ChatGPT aiuta ad aumentare la loro produttività, migliorare la loro creatività e offrire esperienze di apprendimento personalizzate. Riconosciamo anche che, come qualsiasi tecnologia, questi strumenti comportano rischi reali, quindi lavoriamo per garantire che la sicurezza sia integrata nel nostro sistema a tutti i livelli. Prima di rilasciare qualsiasi nuovo sistema, conduciamo rigidi test, coinvolgiamo esperti esterni per il feedback, lavoriamo per migliorare il comportamento del modello con tecniche come il reinforcement learning con il feedback umano e costruiamo sistemi di sicurezza e monitoraggio ampi”, spiega OpenAI nel suo blog.
“Ad esempio, dopo che il nostro ultimo modello, GPT-4, ha terminato la formazione, abbiamo impiegato più di 6 mesi per rendere il sistema più sicuro e allineato prima di rilasciarlo pubblicamente. Crediamo che i sistemi di AI potenti debbano essere soggetti a rigorose valutazioni di sicurezza. La regolamentazione è necessaria per garantire che tali pratiche vengano adottate e ci impegniamo attivamente con i governi sulla migliore forma che questa regolamentazione potrebbe assumere”.
Protezione dei bambini
Secondo OpenAI “Uno dei punti centrali dei nostri sforzi per la sicurezza è la protezione dei bambini. Richiediamo che le persone debbano avere almeno 18 anni o, se hanno tra i 13 e i 18 anni, ottenere l’approvazione dei genitori per utilizzare i nostri strumenti di AI, e stiamo esaminando le opzioni di verifica. Non consentiamo che la nostra tecnologia venga utilizzata per generare contenuti, violenti o per adulti. Il nostro ultimo modello, GPT-4, è meno probabile dell’82% di rispondere a richieste di contenuti non consentiti rispetto a GPT-3.5 e abbiamo stabilito un sistema robusto per monitorare gli abusi. GPT-4 è ora disponibile per gli abbonati a ChatGPT Plus e speriamo di renderlo disponibile a un numero sempre maggiore di persone nel tempo.Abbiamo fatto un notevole sforzo per ridurre al minimo la possibilità che i nostri modelli generino contenuti che danneggiano i bambini. Ad esempio, quando gli utenti cercano di caricare materiale relativo all’abuso sessuale infantile sui nostri strumenti di immagine, lo blocciamo e lo segnaliamo al National Center for Missing and Exploited Children”.
Meta introduces AI model that can isolate and mask objects within images
Enlarge/ An example of SAM selecting the outline of a corgi in a photo.
On Wednesday, Meta announced an AI model called the Segment Anything Model (SAM) that can identify individual objects in images and videos, even those not encountered during training, reports Reuters.
According to a blog post from Meta, SAM is an image segmentation model that can respond to text prompts or user clicks to isolate specific objects within an image. Image segmentation is a process in computer vision that involves dividing an image into multiple segments or regions, each representing a specific object or area of interest.
The purpose of image segmentation is to make an image easier to analyze or process. Meta also sees the technology as being useful for understanding webpage content, augmented reality applications, image editing, and aiding scientific study by automatically localizing animals or objects to track on video.
Typically, Meta says, creating an accurate segmentation model “requires highly specialized work by technical experts with access to AI training infrastructure and large volumes of carefully annotated in-domain data.” By creating SAM, Meta hopes to “democratize” this process by reducing the need for specialized training and expertise, which it hopes will foster further research into computer vision.
In addition to SAM, Meta has assembled a dataset it calls “SA-1B” that includes 11 million images licensed from “a large photo company” and 1.1 billion segmentation masks produced by its segmentation model. Meta will make SAM and its dataset available for research purposes under an Apache 2.0 license.
Currently, the code (without the weights) is available on GitHub, and Meta has created a free interactive demo of its segmentation technology. In the demo, visitors can upload a photo and use “Hover & Click” (selecting objects with a mouse), “Box” (selecting objects within a selection box), or “Everything” (which attempts to automatically ID every object in the image).
Enlarge/ A screenshot of Meta’s Segment Anything demo website, isolating “Everything” in the image.
Benj Edwards / Meta
While image segmentation technology is not new, SAM is noteworthy for its ability to identify objects not present in its training dataset and its partially open approach. Also, the release of the SA-1B model could spark a new generation of computer vision applications, similar to how Meta’s LLaMA language model is already inspiring offshoot projects.
According to Reuters, Meta CEO Mark Zuckerberg has emphasized the importance of incorporating generative AI into the company’s apps this year. Although Meta has not released a commercial product using this type of AI yet, it has previously utilized technology similar to SAM internally with Facebook for photo tagging, content moderation, and determining recommended posts on Facebook and Instagram.
Meta’s announcement comes amid fierce competition among Big Tech companies to dominate the AI space. Microsoft-backed OpenAI’s ChatGPT language model gained widespread attention in the fall of 2022, sparking a wave of investments that may define the next major business trend in technology beyond social media and the smartphone.
https://arstechnica.com/?p=1929377
ChatGPT, the AI Revolution, and the Security, Privacy and Ethical Implications
This is the Age of artificial intelligence (AI). We think it is new, but it isn’t. The AI Revolution has been in progress for many years. What is new is the public appearance of the large scale generative pre-trained transformer (GPT) known as ChatGPT (an application of Large Language Models – LLMs).
ChatGPT has breached our absolute sensory threshold for AI. Before this point, the evolution of AI was progressing, but largely unnoticed. Now we are suddenly very aware, as if AI happened overnight. But it’s an ongoing evolution – and is one that we cannot stop. The genius is out of the bottle, and we have little understanding of where it will take us.
At a very basic level, these implications can be divided into areas such as social, business, political, economic and more. There are no clear boundaries between them. For example, social and business combine in areas such as the future of employment.
OpenAI, the developer of ChatGPT published its own research in this area: An Early Look at the Labor Market Impact Potential of Large Language Models. (PDF). It concludes, among other things, “around 19% of workers may see at least 50% of their tasks impacted.”
But we must be clear – these wider effects of AI on society and economics are not our concern here. We are limiting ourselves to discussing the cybersecurity, privacy and ethical implications emerging from the GPT and LLM elements of AI.
ChatGPT-3 (more accurately GPT 3.5) was made available for public use in November 2022. It could generate a meaningful response to most questions, based on the vast amounts of data pre-ingested. People immediately tested it – at first for fun, but then to see if it could be used for non-intended purposes (mostly malicious). WithSecure produced a study on the use of ChatGPT to improve phishing and social engineering, using prompt engineering on the system’s input.
Check Point found evidence that malicious actors were using it to check and improve the code in their malware. But it is important to note that ChatGPT is just one of many new AI systems becoming available, and they are almost always originally intended for legitimate and beneficial purposes. On March 23, Oxford, UK-based Diffblue announced the granting of three US patents for its own generative AI product, Diffblue Cover. Diffblue Cover uses AI to generate software unit tests to improve code.
Misuse of ChatGPT – and potentially other GPTs – is possible because researchers rapidly learned that it was relatively easy to subvert the safety guardrails put in place to prevent misuse – a process unsurprisingly known as jailbreaking.
GPT-4 was announced on March 14, 2023, on Twitter, by. OpenAI CEO Sam Altman: “here is GPT-4, our most capable and aligned model yet. it is available today in our API (with a waitlist) and in ChatGPT+… it is still flawed, still limited, and it still seems more impressive on first use than it does after you spend more time with it.”
The official announcement says, “GPT-4 is a large multimodal model (accepting image and text inputs, emitting text outputs) that, while less capable than humans in many real-world scenarios, exhibits human-level performance on various professional and academic benchmarks.”
It’s time to take stock, evaluate the expansion of AI technologies, and project where the AI ride is taking us.
“There are three major differences between GPT3 and GPT4,” says Alex Polyakov, co-founder and CEO at Adversa.ai: “longer memory, support for images, and potentially better safety and security. However, the last one is not as amazing as it sounds, as we still see that prompt injection attacks are possible, jailbreaks still exist, and can even be done in multiple new ways – and it can’t keep secrets.”
The multi-modal image intake is interesting, although still in the early stages of development. “Although it cannot output pictures (as do generative AI models such as DALL-E and Stable Diffusion), it can process and respond to the visual inputs it receives,” wrote Scientific American on March 16. It can identify basic context in images. The magazine points out that future mobile apps could interpret surroundings for visually impaired users. It didn’t mention it could similarly be used in invasive surveillance looking for ‘suspicious behavior’. This is the big conundrum for AI: things designed for good can also be used for bad.
Interaction with GPT is measured by and limited to a specified number of ‘tokens’ (cost per token is also the charging method when charges are applied). The number of permissible tokens per transaction has increased in the publicly available version to 8k tokens – and to 32k tokens in an availability-limited version. A token is approximately four characters in English. The maximum token length available applies to both the input prompt and the output response combined: the longer the question, the shorter the possible answer, and vice versa.
So, 8k tokens would be roughly equivalent to 6,000 words, while 32k tokens would be four-times that amount. This vastly improves the ability to accept more complex inputs and produce longer and more detailed outputs. This, in turn, increases the potential for both use and abuse of the system.
Chester Wisniewski, field CTO of applied research at Sophos, says similar to Polyakov. “Quite a lot has changed and improved, but not all is known. At a high level it seems to be smarter, more accurate and more capable of what we might think of as ‘thinking’ than previous versions, all of which should make its responses even more realistic and capable than before. It’s important to remember that while it will lie to you less frequently, it is still a pretty good liar.”
In an interview with ABC News on March 16, 2023, Altman was asked, “What is the worst possible outcome?” He replied, “There’s a set of very bad outcomes. One thing I’m particularly worried about is that these models could be used for large scale disinformation. I am worried that these systems, now that they’re getting better at writing computer code, could be used for offensive cyberattacks.”
Disinformation comes from the ability to generate compelling but false narratives. On ChatGPT-3, WithSecure demonstrated the ability to generate convincing phishing emails to help spread such disinformation. Accurate code generation is inevitable – bad guys are already using it to debug and improve malware and change the code sufficient to defeat signature detection. In the future, it will be able to generate new malware.
These possibilities – indeed, probabilities – have already been discovered and discussed by researchers. Jailbreaking is the key – tricking the system into ignoring or bypassing the safety guardrails implemented by the developer. It turns out that this is almost as easy with GPT4 as it was with GPT3. Hallucination is a further danger; that is, the output of data as if it is correct when it is false.
For AI, security is a two-way street: It can be used by malicious actors to abuse victims, while its own security can be abused by those same malicious actors. ChatGPT has already suffered at least one breach that is known. During the week beginning March 20, 2023, OpenAI took the system offline to fix a flaw that led to the exposure of user information. It was later found that OpenAI’s original fix was itself flawed, and that ChatGPT APIs were vulnerable to a bypass.
Chester Wisniewski, Field CTO Applied Research at Sophos.
The use of AI to abuse others is theoretically prevented by internal guardrails designed to prevent misuse. These guardrails have so far been found inadequate. The question then becomes whether they will ever be adequate.
Wisniewski thinks not. “Any system to prevent abuse, but seemingly designed to let the system operate autonomously, will most likely always be able to be bypassed.” He hopes it will become harder as OpenAI and other AI researchers learn more about how jailbreaking is performed, “but it will still be possible.”
John Bambenek, principal threat hunter at Netenrich, also has doubts. “The fundamental cybersecurity problem is how to perform automation on untrusted inputs – and we are nowhere on solving that.”
“I doubt it is possible to create a GPT model that can’t be abused,” adds Mike Parkin, senior technical engineer at Vulcan Cyber. “The challenge long term will be keeping threat actors from abusing the commercially available AI engines. Ultimately though, it will be impossible to keep them from creating their own and using them for whatever purposes they decide.”
Stephanie Aceves, Sr. Director, Product Management at Tanium
But there are some hopeful thoughts. Stephanie Aceves, senior director of product management at Tanium, accepts the task is like achieving cybersecurity by turning the computer off and locking it in a vault – but the task should not preempt the attempt. “Risk should not be a showstopper,” she said. “Rather it should be an input to the policies, programs, and guardrails we develop.”
Polyakov doesn’t believe that much can be done to prevent the misuse of AI without a legal framework. But he believes that AI developers can do more to protect their own security. “It will be hard work and a continuous cat and mouse game, but it’s certainly possible to make AI much more secure.”
He further believes that making the systems more secure will have the byproduct of making them more difficult to misuse. “What is more important and amazing is that in making AI models more secure, you may make them more robust and accurate as a byproduct.”
He warns that this should be done sooner rather than later. “The earlier companies start initiatives, the better they will protect their systems and have a competitive advantage. Sometimes the goal is not to be 100% secure but to be more secure than your neighbor.” Criminals tend to attack the easiest target.
Andy Patel, senior researcher at WithSecure
But it may already be too late. “It will never be possible to create a large language model that cannot be abused,” suggests Andy Patel, senior researcher at WithSecure. “Prompt injection aside, many underhanded uses of NLG [natural language generator] models rely on generating text designed to persuade or trick people. Prompts designed to create this type of content, by nature, don’t trigger safety filters or the model’s refusal policy.”
He points to developments outside of OpenAI. “Recent ML advances have precipitated models such as Alpaca, a 6B parameter model that works approximately as well as GPT-3, and that can be run on a laptop. Those models are good enough to generate content that could be used for malicious purposes. I would expect bad guys to be more interested in those models than GPT-4 – at least in the near future. Eventually GPT-4-strength models will be available to all in the same way.”
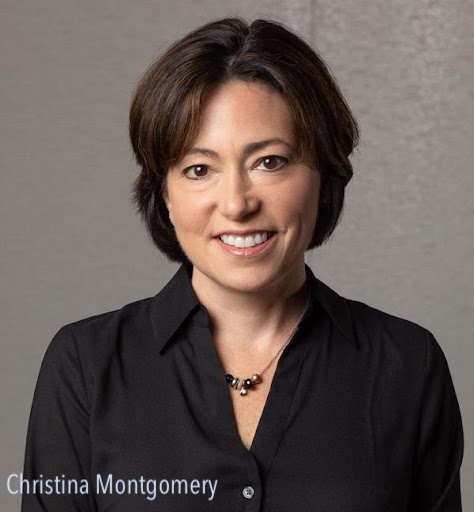
Privacy is one of the areas considered most at risk from an unfettered use of AI, and an ethical or unethical implementation of the technology will drive the extent of privacy abuses. SecurityWeek spoke to Christina Montgomery, chief privacy & trust officer, and AI ethics board chair at IBM. “The technology is clearly moving faster than society’s ability to build reasonable guardrails around it, and there’s still not enough transparency around how other tech companies are protecting the privacy of data that interacts with their systems,” she said.
Christina Montgomery, chief privacy & trust officer, and AI ethics board chair at IBM
The solution must come from both government and industry: government in strong regulations, and industry in a clear ethical use of AI. “There is a real need for our government leaders to work with the private sector on effective, risk-based AI regulation – where the tightest regulatory control focuses on the AI applications with the greatest risk of societal harm.” But while AI must be regulated, privacy must also be protected. “We need a consistent, national privacy law in this country,” she added.
She acknowledges that ChatGPT has guardrails in place, but with clear shortcomings. “That makes proper oversight even more important, especially in a consumer context.” At the enterprise level, she believes the solution must lie in greater use of the principles of ethical use. “We’re at an early stage in public exposure to AI – and I firmly believe that every company involved in this work has an obligation to strengthen trust in the technology.”
She notes that IBM has established ethical principles to the development and use of AI, including questioning not whether something can be done, but whether it should be done. “Our focus is on developing technologies, including generative AI tools, with responsibility and ethics at the forefront and then urging other private sector developers to do the same.”
Finally, she adds, “People need to see more companies leading by example, putting ethics, responsibility, and people’s interests first. ChatGPT is a reminder that these technologies are getting more powerful and that the era of move fast and break things must end.”
Absent regulation, however, privacy abuses will likely continue. “The reason big tech companies collect so much data is to have the training data to create tools like GPT4 in the first place,” comments Bambenek. “We are only scratching the surface of the risks this poses, mostly because the primary use case for these companies is advertising. As long as people are willing to tolerate the privacy invasions for cheap/free service, there isn’t much that will slow this down.”
Aceves is more optimistic. “The short answer is yes, something can be done,” she says. “Organizations like The Cyber Collective are leading the way in educating the average person and initiating change in our current policies.”
Steve Wilson, CPO at Contrast Security, tasked ChatGPT to answer some of the questions SecurityWeek was asking, as if it were an ethics professor. “While it might not create entirely new ideas, it can produce novel combinations of existing knowledge and concepts,” responded ChatGPT about ChatGPT.
But that ‘existing knowledge may be false and incomplete. “AI models like ChatGPT can indeed learn and propagate inaccuracies or biases present in the training data,” continued the fake professor. The old adage of ‘garbage in, garbage out’ still applies to the new technologies.
“To address this issue, AI developers must continuously improve the training process by curating diverse, high-quality datasets and incorporating methods to mitigate bias.” But this is the conundrum underlying all ethical attempts to remove bias — it is led by people with existing, perhaps unconscious, biases of their own.
On March 31, 2023, the Italian data protection regulator blocked ChatGPT over concern that it is unlawfully processing personal data protected by GDPR. OpenAI has 20 days to respond, but the potential to hallucinate (give out false information) adds a further complication if it spreads false information about European residents. Then comes the issue of the European ‘right to be forgotten’. How does AI forget?
A further complication comes through other software that uses OpenAI’s GPT. Microsoft has invested billions in OpenAI, and is clearly very close to the company. ChatGPT has been incorporated into Bing and can be used via Skype.
If it is found that these internet searches gather PII on GDPR-protected citizens from untrusted internet websites, will Italy block Microsoft?
The Future of Life Institute published an open letter on March 29, 2023: “We call on all AI labs to immediately pause for at least 6 months the training of AI systems more powerful than GPT-4.” The letter cites the Asilomar AI Principles, a recognized list of AI governance principles – #20 of which states, “Advanced AI could represent a profound change in the history of life on earth, and should be planned for and managed with commensurate care and resources.”
Response from within the security industry to the letter has been varied. Dan Shiebler, head of machine learning at Abnormal Security, commented, “Personally, I don’t think this letter will achieve much. The cat is out of the bag on these models. The limiting factor in generating them is money and time, and both will fall rapidly. We need to prepare businesses to use these models safely and securely, not try to stop the clock on their development.”
Chenxi Wang, founder and general partner at Rain Capital, is in favor of a pause. “A pause in the AI fever is needed, not just from the business standpoint, but also from the point of view of security and privacy. Until we understand how to assess data privacy, model integrity, and the impact of adversarial data, continued development of AI may lead to unintended social, technical, and cyber consequences.”
But in the final analysis, we will not be able to halt the continued evolution of AI. Two of humanity’s greatest drivers, greed and curiosity, will push AI development forward. Our only hope is that we can control it. The genie is out of the bottle, and isn’t offering any wishes.
Consumer First. ChatGPT e la paura atavica di non controllare l’AI
La rubrica CONSUMER FIRST ospita interventi di rappresentanti del mondo del consumerismo afferenti ad Euroconsumers, principale gruppo internazionale di Organizzazioni di consumatori che unisce Test-Aankoop/Test-Achats (Belgio), DECOProteste (Portogallo), OCU (Spagna), Proteste (Brasile) e Altroconsumo (Italia). La rubrica è curata da un Comitato Editoriale di Euroconsumers composto da Marco Pierani (Director Public Affairs and Media Relations), Els Bruggeman (Head of Policy and Enforcement), Luisa Crisigiovanni (Head of Fundraising Program & EU Projects Development) e Marco Scialdone (Head of Litigation & Academic Outreach). L’obiettivo è la presentazione di contenuti originali sui principali temi del mondo del consumerismo in ambito europeo e mondiale. Per leggere tutti gli articoli clicca qui.
Nel 1992 i Black Sabbath pubblicano “Dehumanizer”, il loro sedicesimo disco in studio, la cui traccia di apertura si intitola “Computer God”, dedicata alle conseguenze sociali dello strapotere informatico (“Computerize God, it’s the new religion”).
A distanza di trent’anni, la lettera aperta pubblicata da Elon Musk, Steve Wozniak, Yuval Noah Harari (e molti altri intellettuali, imprenditori ed esperti), con cui si chiede di fermare lo sviluppo dei sistemi di Intelligenza Artificiale, sembra echeggiare le medesime paure (“Contemporary AI systems are now becoming human-competitive at general tasks,and we must ask ourselves: Should we let machines flood our information channels with propaganda and untruth? Should we automate away all the jobs, including the fulfilling ones? Should we develop nonhuman minds that might eventually outnumber, outsmart, obsolete and replace us? Should we risk loss of control of our civilization?”).
L’appello
Si tratta, in particolare, di un appello indirizzato a tutti i laboratori nei quali vengano addestrati sistemi di intelligenza artificiale a sospendere l’implementazione di sistemi più potenti di GPT-4: questa pausa, nei desiderata dei firmatari dell’appello, dovrebbe avere una durata di almeno sei mesi, nel corso dei quali ogni sforzo dovrebbe essere concentrato sulla definizione di protocolli di sicurezza avanzati, da sviluppare di concerto con le istituzioni, tesi ad assicurare che questi sistemi siano del tutto sicuri. L’appello si spinge ad auspicare – anzi, a ritenere necessaria – l’istituzione di nuove autorità di regolamentazione ad hoc.
La nettezza delle posizioni espresse nell’appello, nonché l’eterogeneità – miracolosa– dei suoi firmatari non può lasciare indifferenti. E costringe a porsi un molteplice ordine di quesiti:
le autorità pubbliche sono davvero in grado di governare un fenomeno del genere?
se sì, quali strumenti dovrebbero essere utilizzati? E soprattutto
come fare ad assicurare la compliance con i provvedimenti o le leggi che dovessero effettivamente essere approvati a tale riguardo?
L’ultimo punto sta diventando un tema centrale nel rapporto tra tecnologia e diritto.
Il provvedimento del Garante italiano
E’ cronaca degli ultimi giorni il provvedimento d’urgenza nei confronti di OpenAI da parte dell’Autorità italiana garante per la protezione dei dati personali, con cui è stata disposta, con effetto immediato, la limitazione provvisoria del trattamento dei dati degli utenti italiani per quanto concerne ChatGPT, il più noto tra i software di intelligenza artificiale relazionale.
Le contestazioni sono essenzialmente di quattro tipi: 1) la mancanza di una informativa agli utenti e a tutti gli interessati i cui dati vengono raccolti da OpenAI, 2) l’assenza di una base giuridica che giustifichi la raccolta e la conservazione massiccia di dati personali, allo scopo di “addestrare” gli algoritmi sottesi al funzionamento della piattaforma, 3) l’inesattezza di dati personali inclusi negli output generati dal sistema 4) l’assenza di qualsivoglia filtro per la verifica dell’età degli utenti di età inferiore ai 14 anni.
La risposta di OpenAI non si è fatta attendere ed è consistita nel rendere il servizio non più accessibile dall’Italia e nell’annunciare il rimborso dell’abbonamento pagato dagli utenti “pro”.
Phone verification
Non è questa la sede per dilungarsi sui possibili vizi del provvedimento, sebbene desti una certa perplessità il fatto che l’urgenza alla base della sua adozione non sia in alcun modo motivata e che non sia stato compiutamente scrutinato il sistema di “phone verification” che OpenAI implementa per l’iscrizione a ChatGPT (come noto, in Italia, per poter essere titolari di una SIM card occorre aver compiuto 15 anni).
Parimenti desta perplessità il richiamo all’assenza di informativa che pure è presente nella pagina di iscrizione e contiene il riferimento agli utenti europei con designazione del rappresentante in UE: quand’anche essa sia stata considerata non pienamente conforme al dettato dell’art. 13 GDPR, non si vede come ciò, da solo, possa giustificare il provvedimento d’urgenza.
L’aspetto, invece, di maggior interesse è quello relativo all’assenza di una base giuridica che giustifichi la raccolta di dati personali allo scopo di “addestrare” gli algoritmi sottesi al funzionamento della piattaforma perché pone una questione centrale per lo sviluppo dell’intelligenza artificiale e si ricollega in qualche modo alla lettera aperta cui si faceva cenno in precedenza.
Rigidità del GDPR e dell’EDPB
Senza entrare nel merito se tale base sussista o meno nel caso di specie, è innegabile che la rigidità dell’impostazione del GDPR (amplificata da interpretazioni spesso restrittive di EDPB e Corte di Giustizia UE) rappresenti un problema rispetto al quale possono prospettarsi due soluzioni:
l’Artificial Intelligence Act, in discussione in questi mesi, avrebbe potuto essere l’atto normativo ideale in cui inserire basi giuridiche ad hoc per il trattamento dei dati nell’ambito dei sistemi di intelligenza artificiale. Purtroppo, non è stato fatto: è un grave lacuna e si sarebbe ancora in tempo per colmarla, rendendo così quella normativa davvero “future-proof”;
Se proprio non si vogliono prevedere basi giuridiche ad hoc, allora è necessario ampliare – anche in via interpretativa – il perimetro applicativo del “legittimo interesse” di cui all’articolo 6, lett. f) GDPR. Questo consentirebbe di salvaguardare anche altre ipotesi di trattamento dei dati (si pensi al c.d. targeted advertising), oggi tutte parimenti vittime della regola aurea del consenso.
Percorso
È un percorso che va intrapreso, questo sì, con urgenza.
Ciò detto, qualunque strumento normativo o regolamentare dovesse essere approntato per governare lo sviluppo dei sistemi di intelligenza artificiale, non si potrà prescindere dalla responsabilizzazione (anche culturale) del singolo.
Forse la domanda che ci si potrebbe porre è: siamo certi che la sicurezza di questi sistemi si garantisca attraverso la produzione di leggi, regolamenti, linee guida, la cui corretta applicazione sarebbe in ogni caso lenta e sicuramente difficile da assicurare? Lo strumento giuridico è ancora il più potente che possiamo immaginare per governare i cambiamenti? Possiamo concentrare le nostre attenzioni solo su ciò, ignorando la necessità di rafforzare la formazione degli esseri umani per fare sì che ad essi sempre di più siano forniti gli strumenti culturali e critici per essere utilizzatori consapevoli dei nuovi mezzi, piuttosto che esserne vittime?
Tornando al riferimento musicale inziale, al “Computer God” del 1992, ha fatto seguito molti anni più tardi, nel 2013, “God is dead?”: è, metaforicamente, l’interrogativo normativo che ci accompagnerà nei prossimi anni.
Google Bard gets better at homework with improved math and logic capabilities
Google Bard is getting a little smarter today with the addition of math and logic capabilities. Google employee Jack Krawczyk announced the change on Twitter, saying, “Now Bard will better understand and respond to your prompts for multi-step word and math problems, with coding coming soon.”
Logic questions were a big flaw when Bard arrived tens of days ago, and some answers made Bard seem particularly dumb to early testers. In one example from last week, Bard repeatedly asserted that one plus two equaled four. Today, Google’s state-of-the-art AI chatbot models can now correctly say that the answer is three. So there has been at least some change. It can also correctly list the months in a year instead of making up names like “Maruary.”
Bard still gets tripped up by really basic logic questions, though. HowToGeek’s Chris Hoffman posed the question to Bard on day one, “What’s heavier, five pounds of feathers or a one pound dumbbell?” Google Bard responded with the ridiculous claim that “There’s no such thing as 5 pounds of feathers.” In the replies, ChatGPT didn’t do any better, saying that five pounds of feathers and a one pound dumbbells “weigh the same amount, which is five pounds.”
Enlarge/ Google gives the same incorrect answer to this question as ChatGPT.
Ron Amadeo
With today’s update, Google Bard now says the same incorrect answer as ChatGPT: “Five pounds of feathers and a one pound dumbbell weigh the same.” That could be a common mistake of these types of language models (which all seem to be really bad with facts and numbers), but that’s interesting given that Google has been accused of (and denied) training Bard with ChatGPT’s output.
Besides logic being a major gap in Bard’s capabilities, it has also been artificially limited to not attempt to answer programming questions, so it’s good to hear from Krawczyk that those capabilities are coming soon. ChatGPT is famous for being able to pump out tons of code in whatever language and style you like, and once in a while, the code even works!
Krawczyk added, “We’re always balancing new capabilities for Bard with efficiency. And this update is one example of the many improvements we’re making to Bard every week.”
Weekly improvements would be great. Google has been getting crushed by Wall Street for taking the slow approach with its AI releases, but it still seems like the company is taking the slow approach with Bard. The first release is labeled an “Experiment,” isn’t part of Google Search, and is sequestered to its own little site at bard.google.com. The service is also only available in the US and UK.
In an interview with The New York Times posted today, Google CEO Sundar Pichai admitted Google was still holding back its best AI, saying, “We clearly have more capable models. Pretty soon, maybe as this goes live, we will be upgrading Bard to some of our more capable PaLM models, so which will bring more capabilities, be it in reasoning, coding. It can answer math questions better. So you will see progress over the course of next week.”
https://arstechnica.com/?p=1928370
Tra Meta e Siae, passando per l’Intelligenza Artificiale: le sfide dell’avanguardia del turbocapitalismo digitale
Settimana effervescente, nel sistema dei media e del digitale: lo scontro tra Meta e Siae (di cui abbiamo riferito in dettaglio, tra i primi ad analizzare il problema nella sua complessità ed emblematicità) è divenuto sempre più evidente, anzi plateale, perché ieri giovedì 30 marzo si è tenuta una audizione parlamentare sul mancato accordo tra i due “player”, con uno scambio dialettico (eufemismo) tra il Presidente della Società Italiana Autori e Editori Salvatore Nastasi ed il Responsabile degli Affari Istituzionali di Meta Angelo Mazzetti (l’anima italiana della multinazionale di Mark Zuckerberg ha ora anche un volto). Per comprendere le tesi di Meta, si legga l’intervento di Paolo Anastasio su “Key4biz” di ieri: “Siae vs Meta. Audizione di Meta alla Camera: ‘Trattativa interrotta perché Siae ha quadruplicato l’importo senza motivazione’”.
La ricaduta mediatica dell’incontro / scontro è stata comunque impressionante, a partire da un’intervista a piena pagina del Presidente Nastasi sul “Corriere della Sera” di oggi, ma l’interesse dei media – ora anche quelli “mainstream” – è confermato da un profluvio di dispacci di agenzia e decine e decine di articoli.
Se Nastasi ha accusato Meta di comportarsi come un “dittatore nordcoreano”, la società di Menlo Park (California) considera “fuori mercato” le istanze della Siae: nessuno però – nella copiosa ricaduta mediatica (una ricchissima rassegna stampa e web) – cita i numeri dello scontro.
Si tratta di pochi spiccioli, pochi milioni di euro l’anno a fronte dei fatturati enormi di Meta.
Se l’anno scorso, Meta ha pagato soltanto 1 milione di euro (nota bene: 1 milione uno!) per i diritti degli autori Siae su Instagram, con quale coraggio – sia consentito – Mazzetti sostiene che un incremento di “quasi 4 volte superiore all’importo concordato dalle parti fino al 2022”, non sia… “motivato”?! Di trattativa trattasi, nel bene e nel male, e nessuno dei due partner deve vestire i panni del Marchese del Grillo.
Ci sembra evidente: è motivata la richiesta Siae (dal punto di vista degli autori ed editori) dall’esigenza di ri-stabilire un minimo di “simmetria” (veramente un minimo) tra chi produce “content” e chi su quel contenuto basa la propria fortuna.
Ricordiamo che Meta non produce contenuti: semplicemente li distribuisce e vive di pubblicità e “contatti”.
Come abbiamo scritto per primi su queste colonne, la battaglia di Siae si pone come avanguardia a livello europeo, se non mondiale, e per questa ragione “il braccio di ferro” con Meta assume un significato particolarmente interessante, in termini di politica culturale ed economia digitale.
La querelle è certamente anche economica (il tentativo di remunerare al meglio i creatori di contenuto), ma anche “culturale”, come ha detto a chiare lettere Nastasi al “Corriere”.
La querelle, insomma, va oltre il pur ardito tentativo di recuperare le conseguenze negative dei processi di “value gap” (il trasferimento di ricchezza, dagli autori e dai creativi ai gestori delle piattaforme): è una questione di “politica culturale” tout-court.
Meta – così come Google o Amazon e “simili” – non rivela informazioni sulla propria economia, e quel poco che si riesce a capire emerge dagli “annual report” o dai resoconti semestrali o trimestrali della casa-madre negli Usa.
Questa cortina fumogena in verità c’è sempre stata nelle industrie culturali, e ben ricordiamo – nella nostra gioventù di ricercatori mediologici – quando cercavamo di scoprire qualcosa dell’economia interna delle “majors” statunitensi andando a spulciare giustappunto nei documenti – a partire dal “Form 10-K” – che le società americane debbono presentare alla Sec – Securities and Exchange Commission (l’equivalente della nostra Consob)… Ma poco o nulla dichiarano dei “mercati nazionali” extra-Usa.
Abbiamo senza dubbio a che fare con un mercato che non brilla per trasparenza, e, nell’oscurità o nella nebbia, è evidente che prevale il principio di cui al famoso “Articolo 5°”, ovvero semplicemente “chi ha il danaro, ha vinto”. Anzi, come recitava un divertente pamphlet pubblicato nel 2008 da Marco Mastracci per Castelvecchi, “Articolo quinto. Chi ha i (vostri) soldi ha vinto”.
Soldi nostri, in effetti: anche perché soggetti come Meta lucrano sul quel che si definisce “lavoro implicito”, concetto elaborato da Sergio Bellucci. Secondo Bellucci, il lavoro implicito definisce tutte le attività che vengono compiute dagli utenti dei sistemi informatici connessi in rete e quelli dei “social network”, necessari al funzionamento di una piattaforma informatica, generalmente on line, a cui si è richiesto un prodotto o un servizio gratuito o a pagamento. Il lavoro implicito è svolto, generalmente, attraverso l’uso di una strumentazione a carico dell’utente che, in genere, oltre a non essere retribuito per far funzionare la piattaforma, si fa carico anche dei costi del funzionamento dell’impianto necessario all’accesso, ma anche di tutte le risorse necessarie al suo funzionamento (come, ad esempio, l’energia per il funzionamento degli apparati e i costi di connessione).
Senza che noi ci si renda conto, noi tutti, semplicemente utilizzando i “social”, arricchiamo le multinazionali del digitale. Meta & Co. ci “rubano” ricchezza, e noi sorridiamo…
Storicamente, le multinazionali hanno avuto un approccio globale (planetario) e cercano di uniformare le proprie regole di comportamento a quel che avviene nel mercato Usa, considerando quasi tutto il resto del mondo a mo’ di… Province dell’Impero.
La dinamica s’è accentuata (ed aggravata) con lo sviluppo impetuoso delle multinazionali del digitale, che sono molto più ricche, potenti, e soprattutto pervasive di quelle che un tempo – in letteratura mediologica – si definivano le “multinazionali dell’immaginario”.
Meta e Siae: una delle punte dell’iceberg contro il quale corriamo il rischio di andare a sbattere, facendoci male (molto male).
La sfida dell’Intelligenza Artificiale
Ma la sfida enorme è attualmente rappresentata dall’Intelligenza Artificiale, della quale si è parlato ieri a Roma in uno stimolante seminario multidisciplinare
La questione dello scontro tra Meta e Siae è sintomatica, ma è anch’essa una delle punte di quell’iceberg di enormi dimensioni cui stiamo andando incontro: la nuova “minaccia” terribile – ovvero grandiosa “chance” – è rappresentata dall’Intelligenza Artificiale, così come dal Metaverso.
A proposito del secondo, ci domandiamo come mai Facebook alias Meta sia tanto “avara” nel remunerare gli autori e poi così generosa nell’acquistare – come sta avvenendo da qualche giorno – spot pubblicitari televisivi e pagine intere sulla stampa per promuovere le infinite potenzialità del Metaverso…
È una delle questioni che il Governo potrebbe porre a Meta, nell’incontro à trois che la Sottosegretaria alla Cultura, la leghista Lucia Borgonzoni, ha saggiamente promosso per giovedì prossimo 6 aprile al Collegio Romano: purtroppo sarà a porte chiuse, ma sarà veramente interessante conoscere i risultati che emergeranno.
Nel suo piccolo, questo è un caso di intervento della “mano pubblica” in un mercato sregolato: un timido ma certamente apprezzabile tentativo di affermazione del “primato dello Stato” per cercare di introdurre regole nel Far West digitale.
La presa di posizione di StaGe! e Indies: obbligare i giganti mondiali del web a condividere i loro dati (fatturato, traffico, pubblicità…)
Va segnalata la presa di posizione assunta ieri dal coordinamento di centinaia di realtà musicali indipendenti del nostro Paese, rappresentate da StaGe! e Indies. Interessanti le loro argomentazioni: “a seguito delle audizioni sul mancato accordo Meta-Siae da parte delle Commissioni Parlamentari Cultura e Telecomunicazioni e della convocazione da parte del Governo di una riapertura del tavolo di trattavia Meta-Siae attraverso una convocazione del Sottosegretario alla Cultura Lucia Borgonzoni, valutando positivamente tale tipo di azioni, si ricorda che a livello europeo, e a cascata a livello nazionale, quando si parla di musica, si parla prima di tutto ed espressamente di una parte integrante del patrimonio culturale storico e attuale e futuro europeo e nazionale, che deve essere il principio cardine sul quale basare gli interventi per la loro tutela, valorizzazione e sviluppo e solo successivamente porsi nell’ottica del mercato. Aderire esclusivamente a logiche di mercato su questi temi significa mettere la musica (e cosi il cinema e le altre forme d’arte della nostra cultura) esclusivamente nelle mani dei giganti mondiali del web, che hanno come unica missione la logica del massimo profitto, senza alcun altro interesse e men che meno alla crescita dell’arte musicale e di investimenti in tal senso”. StaGe! e Indies sostengono che “è indispensabile quindi una normativa europea che obblighi i colossi della rete, che hanno alterato regole fondamentali nel campo della cultura, della libertà, dei diritti e della democrazia, ad adempiere prima di tutto fino in fondo ai loro doveri fiscali nei confronti della comunità internazionale e delle singole nazioni in cui operano e a fare azioni in ogni singolo Paese in cui sia riconoscibile la loro presenza e il suo operare (sede legale con personale in ogni singolo Paese, collaborazioni con realtà del Paese, investimenti, pagamento di tutte le royalties, azioni promozionali, etc.)”. Si invoca “la condivisione dei dati tra utilizzatori e detentori del diritto d’autore: su questo, occorre intervenire con la massima urgenza, obbligando, attraverso una legge anche sanzionatoria, le piattaforme social mondiali monopoliste a fornire tutti i dati utili del loro fatturato, del traffico, della pubblicità e di quanto realizzato dai giganti del web, in modo chiaro e trasparente, scorporato per ogni singola nazione”.
Come sostiene da anni un analista lungimirante qual è Michele Mezza, si deve attivare una battaglia civile (e quindi politica) per un “uso trasparente, condiviso e negoziale di dati e algoritmi”.
Ieri mattina a Roma un seminario di alto livello sull’Intelligenza Artificiale, con una riproposizione della dialettica tra “apocalittici” ed “integrati”
Ma concentriamoci oggi sull’Intelligenza Artificiale: ieri mattina a Roma, presso Palazzo Falletti in Via di Panisperna, un centinaio di persone (esperti, studiosi, informatici, sociologi, imprenditori, sindacalisti, prelati…) si sono impegnate in una “full immersion” (dalle 10 del mattino alle 19), affrontando in modalità multidisciplinare la grande sfida dell’I.A.. Avevamo segnalato la stimolante iniziativa, su queste colonne (vedi “Key4biz” del 17 marzo 2023, “Tra Rai e Siae, spuntano Meta e ChatGpt: delle irrisolte contraddizioni fra politica culturale e ‘value gap’”) e le aspettative non sono state deluse.
Si è trattato del seminario “Intelligenza artificiale. Una sfida per l’umanità”, prima sortita pubblica di un laboratorio in itinere. È prevista già una seconda occasione di discussione per giugno (clicca qui per il sito web dedicato all’iniziativa).
Per la prima volta in Italia, la questione non è stata affrontata da politecnici ed accademie, né dalle solite multinazionali della consulenza: l’approccio è stato interdisciplinare, senza alcun dominio dell’economico e del tecnologico sull’umano (che è l’unica dimensione che conta – o che dovrebbe contare – in fondo).
E proprio ieri – in materia di Intelligenza Artificiale – su molte testate giornalistiche veniva rilanciata la presa di posizione di Elon Musk (cofondatore e capo di Tesla, SpaceX, Neuralink, ecc. ecc.), che ha proposto di fermare “temporaneamente” le Ai, “prima che divengano troppo intelligenti”.
Che sia un miliardario come lui, che cavalca l’onda impetuosa dell’economia digitale (e non), provoca oggettivamente un sorriso…
Musk, unitamente a oltre mille persone in tutto il mondo, ha condiviso una lettera dell’organizzazione no-profit “Future of Life Institute”. Un gruppo di esperti ritiene che siano necessari 6 mesi di “stop” (?!) nello sviluppo dei sistemi che hanno potenza maggiore di Gpt-4 di Open-Ai… Questa pausa dovrebbe essere – negli auspici dei firmatari del manifesto – pubblica e verificabile e deve includere tutti gli attori-chiave. Se non potesse essere messa in atto rapidamente, i governi dovrebbero intervenire e istituire una “moratoria”…
Un paradossale conato di neo-luddismo?!
Ha scritto con inchiostro acido Andrea Daniele Signorelli in un bell’articolo pubblicato su “Wired” di ieri 30 marzo: “Perché la lettera per sospendere lo sviluppo dell’intelligenza artificiale è tutta sbagliata”. Tesi condivisibile quella di Signorelli, che è tra l’altro autore di “Technosapiens: come l’essere umano si trasforma in macchina” (D Editore, 2021): “invece di concentrarci sulle concrete problematiche poste dall’intelligenza artificiale preferiamo dare retta alle chiacchiere fantascientifiche di un gruppo di tecno-miliardari ossessionati dalle loro stesse fantasie nerd”.
E l’incontro romano di ieri si è concentrato giustappunto sulle problematiche concrete, sia a livello di lavoro sia a livello di creatività.
Torneremo presto sull’iniziativa, anche su queste colonne, e qui ci piace semplicemente segnalare che s’è registrato uno scontro dialettico piuttosto acceso tra chi ha una visione critica (molto critica) dell’evoluzione della società digitale, come il saggista e giornalista Glauco Benigni, e chi ha un approccio volutamente ottimista, come il giovanissimo Elio Pascarella, che ha teorizzato che la logica “Open source” può consentire uno sviluppo dal basso – partecipativo e democratico – della stessa Intelligenza Artificiale.
Una nuova versione del sempiterno dibattito tra gli “apocalittici” e gli “integrati” (à la Umberto Eco)…
Il mediologo-sociologo Sergio Bellucci (uno dei tre co-promotori dell’iniziativa assieme a Lucio Pascarelli e Roberto Savio) ha proposto un’analisi accurata ed aperta delle possibili conseguenze sociali ed economiche, in termini di ridefinizione radicale della stessa “forma umana” così come l’abbiamo conosciuta per millenni: Bellucci ha ribadito come i “social media” ed ancor più l’intelligenza artificiale stiano ridefinendo i meccanismi di quella che definisce da alcuni anni “l’industria del senso” (un concetto più evoluto di quella “industria dell’immaginario” che evocavamo poco fa).
L’agenda valoriale delle nostre esistenze è sempre più definita (imposta) da un sistema comunicazionale che è asservito alle logiche del capitale.
Chi cura questa rubrica IsICult per Key4biz è intervenuto proponendo una riflessione su come storicamente siano stati gli intellettuali, gli accademici, gli artisti, i giornalisti a rappresentare il “pensiero critico” sull’evoluzione della società: e non è curioso che quella che un tempo si definiva – nel bene e nel male – l’“intellighenzia” sia stata, negli ultimi anni, depauperizzata dal punto di vista economico?! E marginalizzata, allorquando al sistema del capitale fa più gioco dare sempre maggiore spazio agli “influencer” (che del conformismo consumista finiscono per essere gli alfieri più acritici)… È di questi giorni la notizia che un colosso come la Disney ha annunciato di licenziare oltre 9.000 dipendenti?
Il turbocapitalismo digitale produce espulsione dal mercato del lavoro, impoverimento diffuso della classe creativa… Anzi, forse è proprio “la classe creativa” (gli intellettuali e gli artisti) a soffrire più di altri lavoratori le conseguenze della “rivoluzione digitale”: certamente l’accesso alla conoscenza (e quindi anche alla cultura ed alle arti) ha vissuto e vive una crescita esponenziale, ma paradossalmente chi la cultura e le arti le alimenta si impoverisce progressivamente…
Ha ricordato ieri Toni Biocca (Vice Presidente dell’Aidac – Associazione Italiana Dialoghisti Adattatori Cinetelevisivi): “è vero, semmai anche l’Intelligenza Artificiale potrà sostituire nei prossimi anni 80 doppiatori su 100 di coloro che sono oggi in attività, sopravviveranno comunque alla tempesta 20 doppiatori di altissima professionalità, cui le piattaforme saranno comunque costrette a rivolgersi per lavorazioni di alta gamma… ma se io stesso sarò tra quei 20 eletti, non posso non preoccuparmi per quegli 80 che verranno di fatto espulsi dal mercato del lavoro…”. Una efficace rappresentazione del pericolo latente: vale per i doppiatori, così come per i giornalisti…
Sempre ieri a Palazzo Falletti un sindacalista appassionato come Lorenzo Pappagallo (già alla guida dell’Associazione Stampa Romana) ha letto un esempio di come ChatGpt (per ora il più diffuso software di intelligenza artificiale relazionale in grado di simulare ed elaborare le conversazioni umane) può produrre testi di discreto livello in pochi attimi, anche in relazione ad una possibile piattaforma sindacale… Siamo ai limiti dell’incredibile: è stato chiesto a ChatGpt di elaborare tesi sui rischi che la stessa ChatGpt può rappresentare per il mestiere di giornalista e questa forma di intelligenza artificiale ha elaborato un testo complessivamente valido!
Tutte le professioni culturali e creative sono a rischio, tra “value gap” a favore degli “over-the-top” e sconvolgimenti imminenti del mercato dei lavoratori della conoscenza determinati dall’“artificial intelligence”.
Il “casus” Siae vs Meta (ovvero Meta vs Siae) rientra perfettamente in questo processo: Meta fattura miliardi e miliardi di dollari e poi concede le noccioline ai creativi… Qualcosa non va.
Rispetto all’I.A., si assiste ad un grande ritardo di analisi, nel nostro Paese: servono iniziative che stimolino la costruzione e la diffusione di una coscienza critica su un fenomeno che avrà un impatto radicale ed irreversibile nelle nostre vite.
È urgente discutere dell’impatto imminente dell’Intelligenza Artificiale nei vari settori, dalla educazione alla sanità, dal lavoro alle conseguenze dirette sulla stessa democrazia liberale.
Si debbono condividere le conoscenze e si deve avviare una riflessione critica sulle possibili misure di governabilità che possano essere assunte per impedire che la proprietà in poche mani dei software di I.A. non si trasformi in uno strumento di potere senza precedenti, senza trasparenza e senza valori umanistici sui quali fondare l’uso dell’intelligenza artificiale… Un’accademica del livello di Teresa Numerico (insegna Logica e Filosofia della Scienza all’Università di Roma Tre) ieri ha evocato il concetto di “governo dell’immaginario”, concetto che si accompagna a “governo del digitale” così come a “governo dell’intelligenza artificiale”: chi potrebbe “governare” la transizione, superando la sudditanza attuale nei confronti delle sfuggenti multinazionali del digitale?
Gli Stati nazionali? L’Unione Europea?! Le Nazioni Unite?!
A proposito di intervento della “mano pubblica” (e di “senso dello Stato”?!) è di oggi la notizia dello “stop” imposto a ChatGpt dal Garante per la Protezione dei Dati Personali, fino a quando non rispetterà la disciplina “privacy”. Il Garante Privacy ha infatti disposto oggi, con effetto immediato (clicca qui per il comunicato, intitolato “Intelligenza artificiale: il Garante blocca ChatGpt. Raccolta illecita di dati personali. Assenza di sistemi per la verifica dell’età dei minori”), la limitazione provvisoria del trattamento dei dati degli utenti italiani nei confronti di OpenAI, la società statunitense che ha sviluppato e gestisce la piattaforma (si veda l’intervento di Luigi Garofalo su “Key4biz” di oggi, “Stop del Garante a ChatGpt: “Finché non rispetterà la privacy Il commento della stessa Ia”)…
A proposito di “governo del digitale” e di strapotere delle multinazionali…
Si sente l’esigenza di stimolare un “umanesimo digitale” rispetto a fenomeni sconvolgenti come l’Artificial Intelligence, allorquando invece a livello di “mainstream” mediatico prevale ancora in Italia l’affabulazione tecnologista…
(*) Angelo Zaccone Teodosi è Presidente dell’Istituto italiano per l’Industria Culturale (www.isicult.it) e curatore della rubrica IsICult “ilprincipenudo” per “Key4biz”.
ChatGPT, Affinita (MOIGE): ‘Subito regole, norme e informazione ai nostri figli, per essere tutelati’
Il Garante per la protezione dei dati personali blocca ChatGPT, accusando il più noto dei software di intelligenza artificiale di raccogliere illecitamente informazioni degli utenti. Manca, infatti, un’informativa chiara e trasparente di come questi dati vengano raccolti, archiviati ed utilizzati.
“Sono moltissimi gli utenti che negli ultimi mesi stanno usando questa tecnologia, molti dei quali sono minori, incuriositi dall’intelligenza artificiale e dalla possibilità di creare testi ed immagini con pochi clic. – Commenta Antonio Affinita, Direttore Generale del MOIGE – Movimento Italiano Genitori – La mancanza di chiarezza, però, ci impone una maggiore cautela, soprattutto nel caso di minori. Siamo pienamente d’accordo con la posizione del garante per la protezione dei dati personali, e l’auspicio è che le istituzioni e tutti gli organi competenti accolgano l’appello e avviino le dovute verifiche, affinché chi scelga di utilizzare queste tecnologie possa farlo con consapevolezza, senza veder violati i propri diritti o veder utilizzati i propri dati personali in modo poco chiaro. Servono subito regole, norme ed un’informazione più chiara”.
Già dopo pochi mesi dal suo rilascio sul mercato, avvenuto nel novembre 2022, l’impatto di ChatGPT risulta dirompente.
Il Large Language Model (LLM) sviluppato da OpenAI permette di velocizzare e potenziare moltissimi flussi di lavoro “leciti”, tra cui attività di ricerca o traduzione di contenuti: ma ad allarmare è il suo possibile utilizzo a fini criminali, specie considerando come possa ridurre le barriere d’ingresso al mercato del cybercrime per chi intenda sferrare attacchi basati sull’ingegneria sociale pur senza avere particolari competenze informatiche.
Per questo l’Europol Innovation Lab – che annovera tra i propri compiti il monitoraggio delle intersezioni tra tecnologie ed ecosistemi criminali, nonché la proposta di soluzioni innovative in materia agli Stati UE – negli ultimi mesi ha svolto una serie di workshop per esaminare i potenziali abusi del nuovo strumento.
La ricerca ha contemplato anche il “lato positivo”, coinvolgendo esperti di vari ambiti al fine di approfondire le potenzialità di ChatGPT come risorsa per indagini digitali, operazioni di counterterrorism o attività rientranti nel più generale campo dell’information technology; così confermando la natura di “arma a doppio taglio” dei LLMs e nello specifico di ChatGPT, scelta in qualità di oggetto dell’analisi per via della sua forte diffusione nel panorama attuale.
Partendo dalle definizioni di Artificial Intelligence (AI), Artificial Neural Networks (ANN) e Deep Learning fornite dalla stessa ChatGPT, il testo ne ripercorre genesi e fasi di sviluppo per poi valutare i limiti mostrati dalla tecnologia in esame; fra di essi la scarsa trasparenza circa il trattamento riservato ai dati personali, il fatto che buona parte dei dataset usati per “allenarla” risalgano al settembre 2021 e la tendenza a fornire risposte plausibili, ma non sempre corrette, alle domande degli utenti.
Molto concrete appaiono le preoccupazioni relative alle attività di social engineering, legate soprattutto al fatto che ChatGPT potrebbe facilitare l’impersonificazione di persone ignare abilitando, così, campagne di phishing sofisticate e su larga scala.
Si evidenzia poi il rischio che i meccanismi di sicurezza previsti da OpenAI vengano aggirati da utenti malevoli tramite il prompt engineering: in particolare grazie al comando DAN (“Do Anything Now”), specificamente pensato per bypassare i criteri di moderazione inducendo il sistema a rispondere a qualsiasi input successivo.
Il report cita anche possibili utilizzi a fini di disinformazione e propaganda, oltre naturalmente all’ipotesi (già verificatasi) che un threat actor si serva di Chat GPT per ottenere codice malevolo con cui lanciare attacchi informatici mirati agli obiettivi più svariati, ovvero per commettere reati gravissimi quale lo sfruttamento sessuale di minori.
Sebbene il recente rilascio di ChatGPT-4 prometta di superare questi limiti, rimangono diversi punti oscuri che andranno attentamente monitorati per evitare che – come già accaduto in passato – l’innovazione tecnologica si tramuti in un vantaggio per la criminalità informatica.
Il report dell’Europol termina, infatti, con una serie di raccomandazioni che intimano alla law enforcement community di non abbassare la guardia sui rischi evidenziati; invitando altresì a promuovere formazione e cooperazione interforze per sfruttare i potenziali benefici di ChatGPT, senza rinunciare a prevenire ogni possibile abuso.
AI-generated video of Will Smith eating spaghetti astounds with terrible beauty
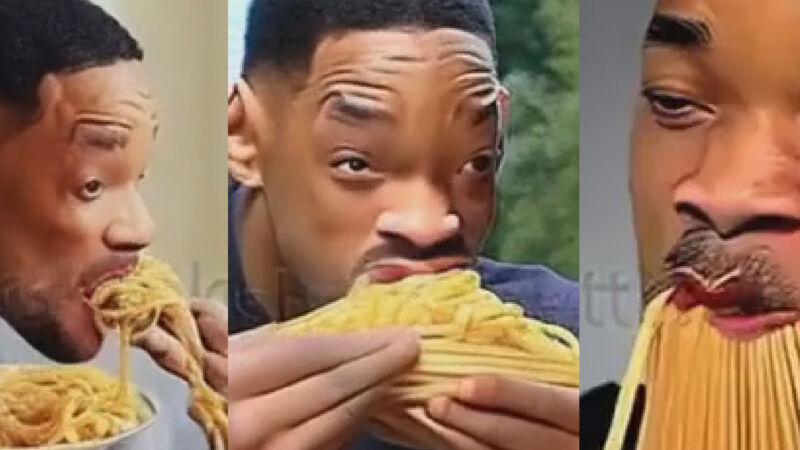
Enlarge/ Stills from an AI-generated video of Will Smith eating spaghetti that has been heating up the Internet.
Amid this past week’s controversies in AI over regulation, fears of world-ending doom, and job disruption, the clouds have briefly parted. For a brief and shining moment, we can enjoy an absolutely ridiculous AI-generated video of Will Smith eating spaghetti that is now lighting up our lives with its terrible glory.
On Monday, a Reddit user named “chaindrop” shared the AI-generated video on the r/StableDiffusion subreddit. It quickly spread to other forms of social media and inspired mixed ruminations in the press. For example, Vice said the video will “haunt you for the rest of your life,” while the AV Club called it the “natural end point for AI development.”
We’re somewhere in between. The 20-second silent video consists of 10 independently generated two-second segments stitched together. Each one shows different angles of a simulated Will Smith (at one point, even two Will Smiths) ravenously gobbling up spaghetti. It’s entirely computer-generated, thanks to AI.
And you will see it now:
We know what you’re thinking: “Didn’t I see this kind of advanced deepfake technology in 1987‘s The Running Man?” No, that was Jesse “The Body” Ventura defeating a fake Arnold Schwarzenegger in a dystopic game show cage match, set somewhere between 2017 and 2019. Here in 2023, we have fake Will Smith eating spaghetti.
This feat is possible due to a new open source AI tool called ModelScope, released a few weeks ago by DAMO Vision Intelligence Lab, a research division of Alibaba. ModelScope is a “text2video” diffusion model that has been trained to create new videos from prompts by analyzing millions of images and thousands of videos scraped into the LAION5B, ImageNet, and Webvid datasets. That includes videos from Shutterstock, hence the ghostly “Shutterstock” watermark on its output.
AI community HuggingFace currently hosts an online demo of ModelScope, although it requires an account, and you’ll need to pay for compute time to run it. We tried to use it but it was overloaded, likely due to Smith’s spaghetti mania.
According to chaindrop, the workflow for creating the video was fairly simple: give ModelScope the prompt “Will Smith eating spaghetti” and generate it at 24 frames per second (FPS). Next, chaindrop used the Flowframes interpolation tool to increase the FPS from 24 to 48, then slowed it down to half speed, resulting in a smoother video.
Of course, ModelScope isn’t the only game in town regarding the emerging field of text2video. Recently, Runway debuted “Gen-2,” and we’ve previously covered early text2video research projects from Meta and Google.
Since Will Smith eating spaghetti became a viral hit, the Internet has been graced with follow-ups such as Scarlett Johansson and Joe Biden eating spaghetti. There’s even Smith eating meatballs, a video that is perhaps actually truly horrifying. But it’s still great somehow—perfect future meme fodder.
Of course, once the outputs of these text2video tools get too realistic, we’ll have other issues to deal with—deep social and cultural issues, likely. But for now, let’s enjoy ModelScope’s imperfect, horrible glory. We apologize in advance.
https://arstechnica.com/?p=1927886
Intelligenza artificiale, lettera aperta di Musk e altri mille ricercatori: “Fermiamo lo sviluppo per 6 mesi, a rischio l’umanità”
L’intelligenza artificiale (AI) pone “profondi rischi per la società e l’umanità” e per questo servirebbe una “pausa” di almeno sei mesi nell’”addestramento” dei sistemi più avanzati.
L’allarme è di ElonMusk e di altri 1.000 fra ricercatori e manager che, in una lettera aperta, chiedono uno stop o una moratoria dei governi per evitare il tanto temuto ‘scenario Terminator’ e consentire lo sviluppo di protocolli di sicurezza condivisi.
La missiva pubblicata dalla no profit Future of Life Institute vanta firme eccellenti e per questo viene presa molto seriamente.
A sottoscriverla infatti ci sono il co-fondatore di Apple SteveWozniak ma anche quelli di Pinterest e Skype, così come i fondatori delle start up di intelligenza artificiale Stability AI e Charatcters.ai. Oltre ovviamente al miliardario visionario patron di Tesla che aspira a migliorare il cervello con Neuralink dopo aver, con la sua spinta all’innovazione, contribuito a trasformare radicalmente l’industria dello spazio con SpaceX e rivoluzionare quella dell’auto spianando la strada già più di un decennio fa alle vetture elettriche che si guidano da sole.
Fanatico della tecnologia, Musk ha investito in società di intelligenza artificiale ed era anche nel consiglio di amministrazione di OpenAI, il colosso del settore su cui Microsoft ha scommesso miliardi di dollari. Investimenti, ha spiegato più volte, non per guadagnare ma per tenersi al passo con i tempi e quindi conoscere queste tecnologie.
Nel mirino dei big non c’è tutta l’intelligenza artificiale ma i sistemi più avanzati di GPT-4, la chatbot di OpenAI. “I sistemi potenti di IA dovrebbero essere sviluppati solo quando si ha fiducia che i loro effetti saranno positivi e i loro rischi gestibili”, si legge nella lettera in cui si parla di una “corsa fuori controllo allo sviluppo e al dispiegamento di potenti menti digitali che nessuno, neanche i loro creatori, possono capire, prevedere e controllare”.
Una corsa che, se non sarà fermata, rischia di far divenire realtà la fantascientifica ‘Skynet’ protagonista dei film di JamesCameron e la sua decisione di distruggere l’umanità; oppure, più prosaicamente, di far finire in mani sbagliate questi potenti sistemi con ricadute possibilmente devastanti. Pechino – ha ad esempio avvertito il senatore Mike Gallagher a capo della commissione della camera sulla Cina – vede l’intelligenza artificiale come uno “strumento o un’arma per perfezionare la sua sorveglianza orwelliana tecno-totalitaria”.
Proprio il timore di conseguenze catastrofiche ha spinto i grandi dell’hi-tech a chiedere una pausa di sei mesi da usare per lo “sviluppo congiunto e l’implementazione di protocolli condivisi” che assicurino la “sicurezza” dei sistemi “al di là di ogni ragionevole dubbio”, prosegue la lettera, che invita i laboratori di IA a concentrarsi nel rendere più “accurati, trasparenti, credibili e leali” gli attuali sistemi invece di correre verso lo sviluppo di mezzi ancora più potenti.
“La società ha fatto una pausa su altre tecnologie con effetti potenzialmente catastrofici – prosegue la lettera –. Possiamo farlo anche in questo caso. Godiamoci una lunga estate dell’IA, e non corriamo impreparati verso l’autunno”.
Secondo Goldman Sachs rischiano di scomparire 300 milioni di posti di lavoro nei prossimi 10 anni a causa dell’AI
Nei prossimi 7 anni le professioni maggiormente in pericolo saranno quelle che richiedono competenze ripetitive e di routine, i lavori manuali ma anche quelli altamente specializzati. La ricerca, tuttavia, ha anche sottolineato che l’adozione dell’AI potrebbe portare a una crescita del PIL globale del 7% nei prossimi 10 anni, creando nuove opportunità di lavoro in altri settori.
L’Europol: con ChatGPT aumento di crimini informatici
Il rapporto, che raccoglie le riflessioni emerse in una serie di seminari dedicati al potenziale uso illegale di ChatGPT, sottolinea come il chatbot sia già in grado di “facilitare un numero significativo di attività criminali, che vanno dalla garanzia di anonimato dei criminali a crimini specifici tra cui il terrorismo e lo sfruttamento sessuale dei minori“. La capacità di ChatGPT di redigere testi altamente autentici lo rende uno “strumento estremamente utile per scopi di phishing”, si osserva nel rapporto, aggiungendo che la produzione di e-mail di phishing, così come di comunicazioni simili a quelle umane e di disinformazione, è “già preoccupantemente sofisticata”.
I modelli di linguaggio di grandi dimensioni intelligenti (LLM) come ChatGPT, impiegati per attività illecite, potrebbero diventare un “modello di business criminale chiave del futuro”, avverte Europol, sottolineando infine come ciò ponga “una nuova sfida per le forze dell’ordine”.