Chinese propose to build a dam with a distributed 3D printer
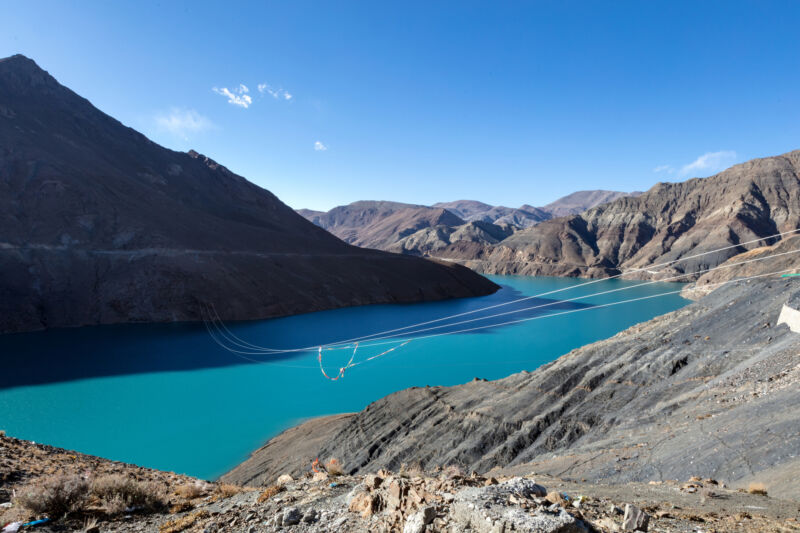
Enlarge/ The Chinese already have a number of dams in the generally arid Tibetan Plateau.
A study recently published by a team of researchers at Beijing’s Tsinghua University has revealed plans to construct a 594-foot-tall dam using robots, 3D printing, and artificial intelligence. The researchers claim that no human labor needs to be directly employed in building this massive structure—if the plan moves forward, the dam would produce 5 billion kWh of electricity annually. This much energy will be enough to meet the power demands of 50 million homes in China.
The Yangqu dam is on the second largest river in China, the Yellow River, where it flows through Qinghai Province on the Tibetan plateau. There is already a dam on the river, so the proposal involves enlarging the existing structure and increasing its power generation capacity, making it one of the world’s largest dams. If everything goes as planned, the Yangqua dam will become the biggest ever AI-made 3D-printed structure on the planet.
3D printing without a printer
Construction-scale 3D-printing technology involves the use of giant 3D printers to produce concrete layers that form the structure. In contrast, the researchers at Tsinghua University have developed a method that allows them to 3D-print concrete without a printer. They plan on using an additive manufacturing approach that employs a computerized scheduling system that takes the 3D structure into account. It will use AI-controlled robots instead of a large 3D printer to construct the upgrade to the Yangqu dam.
According to the study, the scheduling system uses the design model of the dam to determine the amount of material required to construct a particular section of the dam. The construction robots assigned to that section then collect the filling material and unload it at the targeted spot. Finally, they perform “intelligent paving and rolling” to turn the material into a 3D-printed layer. Repeating this process creates multiple layers that eventually complete the section.
Explaining the process in detail, the lead author of the study and faculty at Tsinghua University’s School of Civil Engineering, LIU Tianyun, wrote, “Once each construction layer is finished, the robots send construction state information to the scheduling system. The complete filling process is then printed step by step under the control of the 3D printing scheduling system.” During construction, each robot works as labor and as input to the scheduling system; collectively, the robots function as a large 3D printer.
This unique approach could save both time and resources, enabling the construction of multiple sections of the Yangqu dam at once and without a bulky 3D printer that may require continuous human assistance. The robot-made Yangqu dam is set to be operational by 2024—less than two years from now. You can contrast that with two of the other largest man-made dams, the Oroville dam in the US and the Three Gorges dam in China, which took seven and nine years to complete, respectively.
Great idea—will it happen?
The Yangqu dam is not the first impressive additive manufacturing idea proposed by the researchers of Tsinghua University. In 2021, another team of scientists led the development of a 3D-printed retractable bridge in Shanghai. This nine-meter-long bridge is controlled via Bluetooth and can fully expand in less than 60 seconds. The team has also 3D-printed a library building and an 86-foot-long concrete bridge in the past. Given these past successes, there’s a chance that the government will move forward with this group’s latest idea.
However, when 3D printing is combined with AI and robots (as is planned for the Yangqu dam project), it can also pose problems. Constructing a massive structure similar to the Yangqu dam generally demands hundreds of human laborers and many other types of low-skilled workers; widespread adoption of AI-powered robots could put an end to these jobs.
Skilled workers account for roughly 30 percent of China’s total workforce, so automation practices could threaten the livelihood of a large population in the country. Safety is also incredibly important for dams of this size, and we don’t have experience evaluating the output of this sort of process.
3D printing has various advantages over traditional construction methods; for instance, a small house that may take months to complete can be built within 24 hours and at a much lower budget using 3D printing. NASA even has plans to employ 3D printing for building human-friendly structures on the Moon. The approach proposed in this paper has the potential to provide further options for future construction by getting rid of the printer entirely.
Rupendra Brahambhatt is an experienced journalist and filmmaker. He covers science and culture news, and for the last five years, he has worked with news agencies, magazines, and media brands operating in different parts of the globe.
https://arstechnica.com/?p=1876668
Machine learning, concluded: Did the “no-code” tools beat manual analysis?
Aurich Lawson | Getty Images
I am not a data scientist. And while I know my way around a Jupyter notebook and have written a good amount of Python code, I do not profess to be anything close to a machine learning expert. So when I performed the first part of our no-code/low-code machine learning experiment and got better than a 90 percent accuracy rate on a model, I suspected I had done something wrong.
If you haven’t been following along thus far, here’s a quick review before I direct you back to the first two articles in this series. To see how much machine learning tools for the rest of us had advanced—and to redeem myself for the unwinnable task I had been assigned with machine learning last year—I took a well-worn heart attack data set from an archive at the University of California-Irvine and tried to outperform data science students’ results using the “easy button” of Amazon Web Services’ low-code and no-code tools.
The whole point of this experiment was to see:
Whether a relative novice could use these tools effectively and accurately
Whether the tools were more cost-effective than finding someone who knew what the heck they were doing and handing it off to them
That’s not exactly a true picture of how machine learning projects usually happen. And as I found, the “no-code” option that Amazon Web Services provides—SageMaker Canvas—is intended to work hand-in-hand with the more data science-y approach of SageMaker Studio. But Canvas outperformed what I was able to do with the low-code approach of Studio—though probably because of my less-than-skilled data-handling hands.
(For those who have not read the previous two articles, now is the time to catch up: Here’s part one, and here’s part two.)
Assessing the robot’s work
Canvas allowed me to export a sharable link that opened the model I created with my full build from the 590-plus rows of patient data from the Cleveland Clinic and the Hungarian Institute of Cardiology. That link gave me a little more insight into what went on inside Canvas’ very black box with Studio, a Jupyter-based platform for doing data science and machine learning experiments.
As its name slyly suggests, Jupyter is based on Python. It is a web-based interface to a container environment that allows you to spin up kernels based on different Python implementations, depending on the task.
Examples of the different kernel containers available in Studio.
Kernels can be populated with whatever modules the project requires when you’re doing code-focused explorations, such as the Python Data Analysis Library (pandas) and SciKit-Learn (sklearn). I used a local version of Jupyter Lab to do most of my initial data analysis to save on AWS compute time.
The Studio environment created with the Canvas link included some pre-built content providing insight into the model Canvas produced—some of which I discussed briefly in the last article:
Enlarge/ Model details from the Canvas best-of-show in Studio.
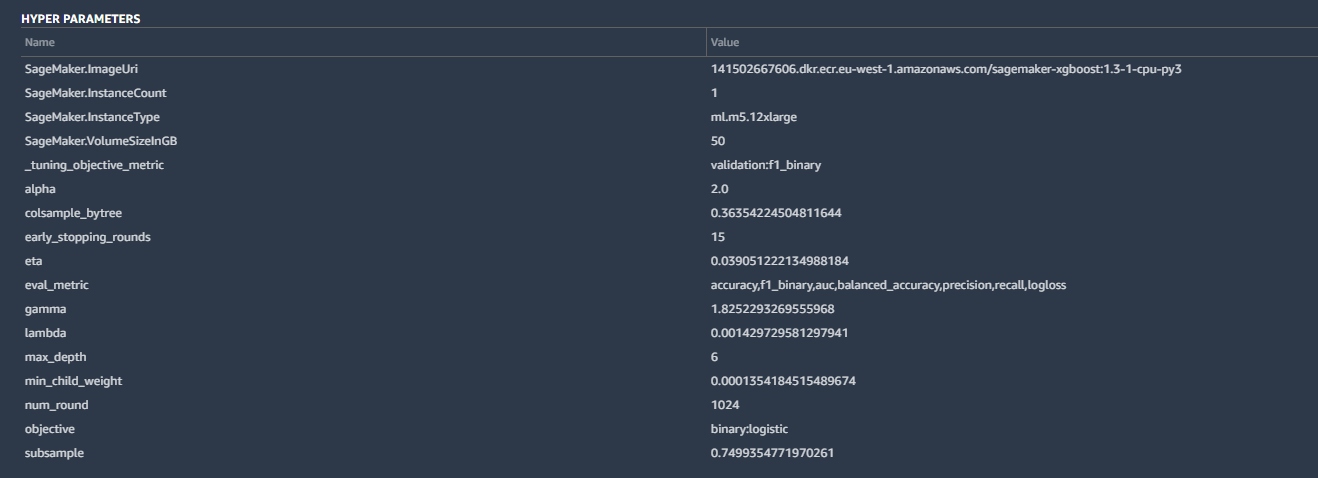
Some of the details included the hyperparameters used by the best-tuned version of the model created by Canvas:
Hyperparameters are tweaks that AutoML made to calculations by the algorithm to improve the accuracy, as well as some basic housekeeping—the SageMaker instance parameters, the tuning metric (“F1,” which we’ll discuss in a moment), and other inputs. These are all pretty standard for a binary classification like ours.
The model overview in Studio provided some basic information about the model produced by Canvas, including the algorithm used (XGBoost) and the relative importance of each of the columns rated with something called SHAP values. SHAP is a really horrible acronym that stands for “SHapley Additive exPlanations,” which is a game theory-based method of extracting each data feature’s contribution to a change in the model output. It turns out that “maximum heart rate achieved” had negligible impact on the model, while thalassemia (“thall”) and angiogram results (“caa”)—data points we had significant missing data for—had more impact than I wanted them to. I couldn’t just drop them, apparently. So I downloaded a performance report for the model to get more detailed information on how the model held up:
https://arstechnica.com/?p=1872745
Setting our heart-attack-predicting AI loose with “no-code” tools
This is the second episode in our exploration of “no-code” machine learning. In our first article, we laid out our problem set and discussed the data we would use to test whether a highly automated ML tool designed for business analysts could return cost-effective results near the quality of more code-intensive methods involving a bit more human-driven data science.
If you haven’t read that article, you should go back and at least skim it. If you’re all set, let’s review what we’d do with our heart attack data under “normal” (that is, more code-intensive) machine learning conditions and then throw that all away and hit the “easy” button.
As we discussed previously, we’re working with a set of cardiac health data derived from a study at the Cleveland Clinic Institute and the Hungarian Institute of Cardiology in Budapest (as well as other places whose data we’ve discarded for quality reasons). All that data is available in a repository we’ve created on GitHub, but its original form is part of a repository of data maintained for machine learning projects by the University of California-Irvine. We’re using two versions of the data set: a smaller, more complete one consisting of 303 patient records from the Cleveland Clinic and a larger (597 patient) database that incorporates the Hungarian Institute data but is missing two of the types of data from the smaller set.
The two fields missing from the Hungarian data seem potentially consequential, but the Cleveland Clinic data itself may be too small a set for some ML applications, so we’ll try both to cover our bases.
The plan
With multiple data sets in hand for training and testing, it was time to start grinding. If we were doing this the way data scientists usually do (and the way we tried last year), we would be doing the following:
Divide the data into a training set and a testing set
Use the training data with an existing algorithm type to create the model
Validate the model with the testing set to check its accuracy
We could do that all by coding it in a Jupyter notebook and tweaking the model until we achieved acceptable accuracy (as we did last year, in a perpetual cycle). But instead, we’ll first try two different approaches:
A “no-code” approach using AWS’s Sagemaker Canvas: Canvas takes the data as a whole, automatically splits it into training and testing, and generates a predictive algorithm
Another “no-/low-code” approach using Sagemaker Studio Jumpstart and AutoML: AutoML is a big chunk of what sits behind Canvas; it evaluates the data and tries a number of different algorithm types to determine what’s best
After that’s done, we’ll take a swing using one of the many battle-tested ML approaches that data scientists have already tried with this data set, some of which have claimed more than 90 percent accuracy.
The end product of these approaches should be an algorithm we can use to run a predictive query based on the data points. But the real output will be a look at the trade-offs of each approach in terms of time to completion, accuracy, and cost of compute time. (In our last test, AutoML itself practically blew through our entire AWS compute credit budget.)
https://arstechnica.com/?p=1871110
AI, Ghiglia (Garante Privacy): ‘Umanizzare la tecnica e non viceversa’
Si è aperto a Torino, nella bellissima cornice di Palazzo Reale, il Convegno “La protezione dei dati: da 25 anni la bussola del futuro” organizzato nell’ambito delle celebrazioni per i 25 anni del Garante. Lo scrive il Garante in una nota.
Nel suo saluto il sindaco di Torino Stefano Lo Russo ha sottolineato l’importanza e l’estrema attualità del tema delle garanzie. “E’ un bene – ha aggiunto – che il Garante non sia “simpatico” a nessuno, non deve esserlo perché oggi la proprietà del dato diventa fattore determinante per la tenuta dei valori democratici e del sistema economico”.
<!-- ARUBA -->
Il Presidente della Regione Alberto Cirio, ha evidenziato come si stia vivendo un’era di cambiamento epocale e quindi quanto sia fondamentale il lavoro del Garante per trasmettere e spiegare all’opinione pubblica “il valore della protezione dei dati personali”.
Il Vice Ministro del MISE Gilberto Pichetto, ha sottolineato come il Garante abbia nell’ambito del suo ruolo anche una funzione fondamentale che è quella di tutela dei consumatori più fragili che rischiano di essere travolti dalle nuove tecnologie.
Nel suo intervento di apertura dei lavori, Agostino Ghiglia componente dell’Autorità Garante e organizzatore del convegno ha evidenziato come lo sviluppo vorticoso della tecnologia, ci metta di fronte a scambi, sino a pochissimi anni fa impensabili, nei processi di interazione tra uomo e macchina in cui l’uomo si macchinizza e la macchina si umanizza.
“La sfida dei prossimi anni quindi, è umanizzare la tecnica e non macchinizzare l’uomo rendendolo amorfo, un automa routinario che cede alle macchine troppa parte della sua vita” ha affermato Ghiglia. “Se le macchine debbono essere strumenti a servizio dell’uomo è fondamentale che l’uomo nell’utilizzarle non perda mai il controllo della sua individualità e della capacità di autodeterminarsi, che non confonda mai il mezzo con il fine e che, soprattutto, non deleghi il fine al mezzo”.
La scelta dell’Unione Europea di dotarsi di un Regolamento generale sull’Intelligenza Artificiale (Artificial Intelligence Act del 21 aprile 2021) appare, quindi, fondamentale e la sua approvazione definitiva è sempre più urgente. “Come il GDPR – ha continuato Ghiglia – ha avviato la “rivoluzione” globale della protezione dei dati (ricordiamo che ha richiesto più di quattro anni di negoziazione e sei anni prima dell’entrata in vigore), anche il Regolamento sull’IA dovrà auspicabilmente diventare uno standard globale traendo influenza e ispirazione dal GDPR e fungendo da catalizzatore per un processo di regolamentazione internazionale.”
“In questo scenario – ha concluso Agostino Ghiglia – dobbiamo essere consapevoli che “la rivoluzione digitale in atto non è semplicemente un’evoluzione tecnologica ma una nuova scoperta del fuoco che porterà, però, ad una tempistica evolutiva difficilmente immaginabile. In tale ambito, la nostra Autorità dovrà assumere un ruolo centrale nella definizione di regole che, coniugando innovazione tecnologica e diritto, consentano di congiungere i benefici offerti dal progresso scientifico con la garanzia del rispetto della dignità e dei diritti fondamentali della persona”.
Metaverso
Nella prima sessione “Le costituzioni del Metaverso: occorrono delle meta leggi?” moderata da Martina Pennisi del Corriere della Sera, Stefano Fratta EMEA Privacy Policy Director di META, ha spiegato il valore aggiunto che lo sviluppo del Metaverso potrà dare sia al mondo fisico che digitale. “Il Metaverso è pensato non per far stare più ore al computer ma per migliorare l’esperienza quotidiana, aumentandola attraverso un’esperienza più immersiva condivisa nello stesso spazio e nello stesso luogo con altre persone.” E rassicura, “Lo scopo del Metaverso non è quello di identificare e profilare le persone ma di aiutare l’interazione sociale sviluppando realtà virtuale e realtà aumentata in maniera trasparente e responsabile”.
L’ex Presidente del Garante, Francesco Pizzetti, nella sua relazione ha messo in evidenza la diversità di concezione tra Unione Europea e Stati Uniti sul tema dell’innovazione e sul conseguente divario tecnologico destinato a diventare scontro profondo. “Abbiamo – ha precisato Pizzetti- da una parte gli USA con la dottrina “Washington consensus” per cui il mondo economico lasciato senza vincoli produce innovazione, e dall’altra abbiamo l’idea europea di volere regolamentare la tecnologia per creare una società digitale più garantista”.
Derrick De Kerckhove ha evidenziato come il Metaverso sia la nuova tappa della trasformazione digitale. Nel Metaverso vige il “principio della duplicazione di tutto” e dovremo imparare – ha sottolineato il famoso sociologo – a gestire questa nuova dimensione, in cui i tre spazi in cui viviamo -fisico, mentale e virtuale- saranno interconnessi, perché la tecnologia non può tornare indietro.
La seconda sessione della mattina, dedicata ad “AI, Smart City, IoT, Auto connesse: futuro, innovazione, lavoro”, moderata da Simona Burattini, giornalista di RAI TG 2, Mauro Velardocchia, ordinario di Meccanica del veicolo al Politecnico di Torino ha spiegato come dal concetto di safety (garantire sicurezza al guidatore) degli anni ’80, passando per la meccatronica (capire e assecondare i desideri del guidatore) e la telematica (smartphone e geolocalizzazione), si sia oggi nell’era di “safety, security e privacy” in cui la digitalizzazione è il linguaggio comune che consente di mettere in comunicazione logiche diverse con l’obiettivo di dare un servizio migliore.
La professoressa Barbara Caputo, direttrice HUB sull’intelligenza artificiale del Politecnico di Torino, ha illustrato la nuova strategia dell’Italia sull’Intelligenza Artificiale concepita su “tre pilastri”, la formazione, la ricerca e l’innovazione.
Il Presidente di Confindustria Piemonte, Marco Gay, ha voluto sottolineare come i nuovi strumenti tecnologici possano dare un valore aggiunto al mondo delle imprese ma che la loro necessaria regolarizzazione non deve diventare un freno allo sviluppo economico.
Google’s powerful AI spotlights a human cognitive glitch
Getty Images
When you read a sentence like this one, your past experience tells you that it’s written by a thinking, feeling human. And, in this case, there is indeed a human typing these words: [Hi, there!] But these days, some sentences that appear remarkably humanlike are actually generated by artificial intelligence systems trained on massive amounts of human text.
People are so accustomed to assuming that fluent language comes from a thinking, feeling human that evidence to the contrary can be difficult to wrap your head around. How are people likely to navigate this relatively uncharted territory? Because of a persistent tendency to associate fluent expression with fluent thought, it is natural—but potentially misleading—to think that if an AI model can express itself fluently, that means it thinks and feels just like humans do.
Thus, it is perhaps unsurprising that a former Google engineer recently claimed that Google’s AI system LaMDA has a sense of self because it can eloquently generate text about its purported feelings. This event and the subsequent media coverage led to a number of rightly skeptical articles and posts about the claim that computational models of human language are sentient, meaning capable of thinking and feeling and experiencing.
The question of what it would mean for an AI model to be sentient is complicated (see, for instance, our colleague’s take), and our goal here is not to settle it. But as languageresearchers, we can use our work in cognitive science and linguistics to explain why it is all too easy for humans to fall into the cognitive trap of thinking that an entity that can use language fluently is sentient, conscious or intelligent.
Using AI to generate humanlike language
Text generated by models like Google’s LaMDA can be hard to distinguish from text written by humans. This impressive achievement is a result of a decades-long program to build models that generate grammatical, meaningful language.
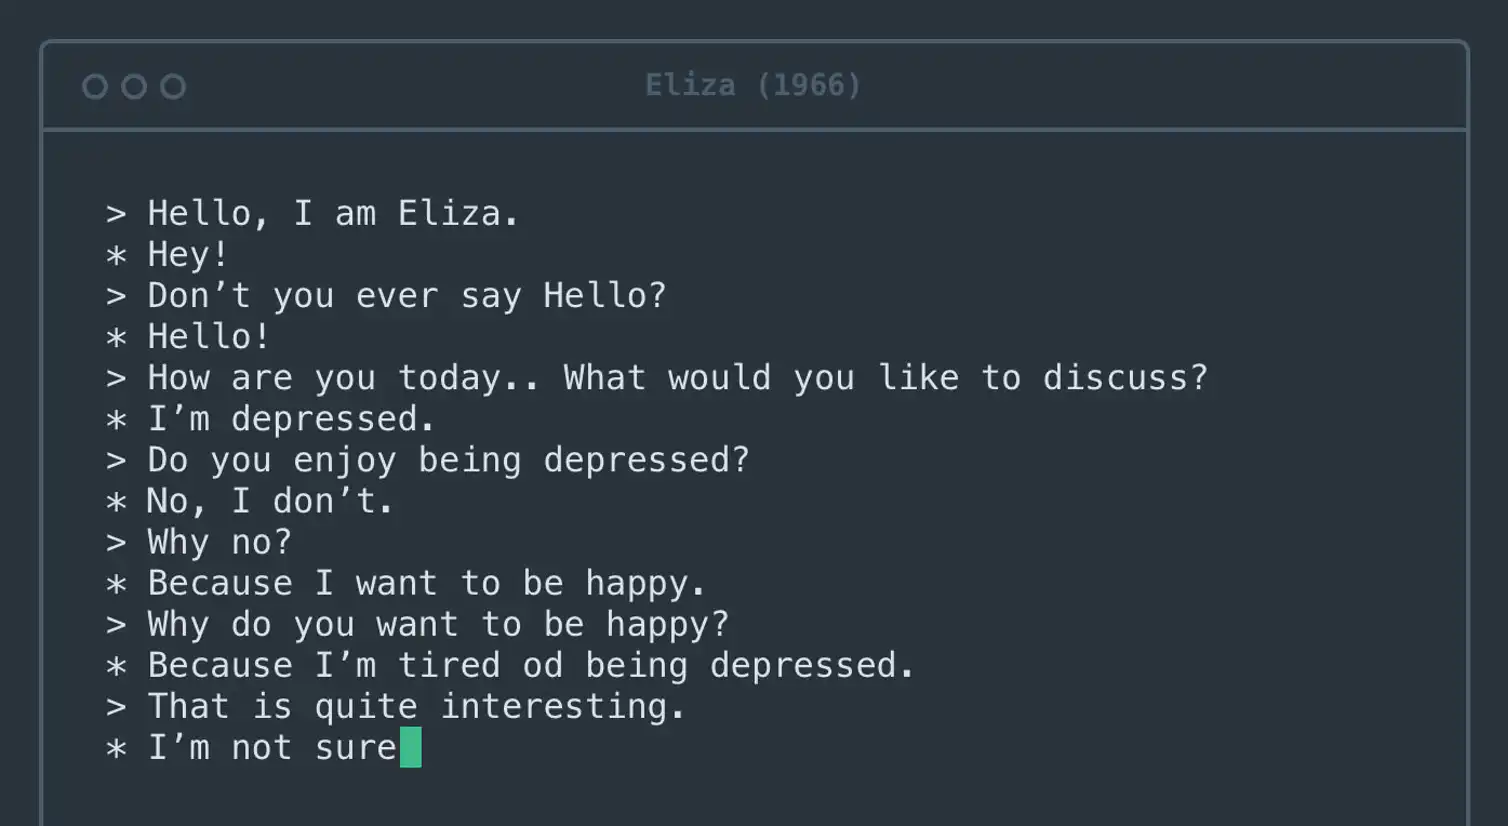
Enlarge/ The first computer system to engage people in dialogue was psychotherapy software called Eliza, built more than half a century ago.
Early versions dating back to at least the 1950s, known as n-gram models, simply counted up occurrences of specific phrases and used them to guess what words were likely to occur in particular contexts. For instance, it’s easy to know that “peanut butter and jelly” is a more likely phrase than “peanut butter and pineapples.” If you have enough English text, you will see the phrase “peanut butter and jelly” again and again but might never see the phrase “peanut butter and pineapples.”
Today’s models, sets of data, and rules that approximate human language, differ from these early attempts in several important ways. First, they are trained on essentially the entire Internet. Second, they can learn relationships between words that are far apart, not just words that are neighbors. Third, they are tuned by a huge number of internal “knobs”—so many that it is hard for even the engineers who design them to understand why they generate one sequence of words rather than another.
The models’ task, however, remains the same as in the 1950s: determine which word is likely to come next. Today, they are so good at this task that almost all sentences they generate seem fluid and grammatical.
https://arstechnica.com/?p=1863040
AR, meet ML: IKEA app lets you erase and replace your furniture
You might have seen augmented reality (AR) mobile apps that allow you to place 3D models of furniture in a camera view of your home, but a new app from IKEA will take that idea to a new level with the help of machine learning (ML).
Called IKEA Kreativ, the app allows you to take an accurate 3D scan of your room, then remove existing furniture items or clutter by replacing them with IKEA products you want to see in the space.
The delete-a-piece-of-furniture capability is reminiscent of the Google Pixel 6’s Magic Eraser and iOS 16’s upcoming “lift subject from background” features for smartphone photos. Those features are driven by similar AI/ML technology.
For now, the app will only be available on iOS devices (and the web). But IKEA plans to release an Android version in the next couple of months. iPhones and iPads with lidar sensors will work best, but other iOS devices are also supported.
IKEA Kreativ is built on machine learning and spatial imaging technologies developed by Geomagical Labs, an AI company acquired by IKEA’s holding company, Ingka Group.
It’s the sort of thing that may show an early hint of what future AR products can do with the help of machine learning and artificial intelligence. But as with most early attempts, there are some limitations.
First, the app has to start with a somewhat laborious, multi-step room-scanning process that involves pointing your phone around the room and moving it in a figure-eight motion. The process can take minutes rather than seconds.
With lidar and recent developments in ARKit, Apple has greatly reduced this scanning time on some devices for most basic and common AR applications, but the process is more involved for this app.
There’s another notable limitation, too. You might already be familiar with IKEA Place, an existing app that lets you place furniture in your home using your phone’s camera view. That app essentially allowed you to walk around the placed furniture and see it as if it were right there in front of you. IKEA Kreativ can’t do that. Rather, it puts the furniture inside static images. Since the functionality is a bit different, the IKEA Place app will remain available.
IKEA is far from the only retail company offering AR furniture placement apps. Amazon, Target, and others have released AR apps, and on Thursday, Walmart announced an app release that provides the feature.
While Google and Apple have put a lot of work into building hardware and software features, as well as SDKs for app-makers, to facilitate mobile AR experiences, not that many killer apps have emerged for smartphone AR.
That might be because many high-potential ideas would be more appealing with comfortable AR glasses rather than a smartphone screen, and the market hasn’t seen mainstream, high-quality AR glasses just yet. Apple, Google, Amazon, and other big tech companies are all developing mixed reality headsets that could take these sorts of AR apps to new heights of popularity, but none seem close to release.
Nonetheless, these shopping apps have emerged as one of the more popular uses of smartphone AR.
https://arstechnica.com/?p=1862598
Le nuove sfide di cyber security per l’Intelligenza Artificiale: la mappatura dell’ecosistema e la tassonomia delle minacce
Introduzione
L’Intelligenza Artificiale (IA) ha guadagnato terreno negli ultimi anni facilitando il processo decisionale intelligente e automatizzato in tutta l’estensione degli scenari di implementazione e delle aree applicative. Stiamo assistendo a una convergenza di diverse tecnologie (ad es. Internet of things, robotica, tecnologie dei sensori, ecc.) e una crescente quantità e varietà di dati, nonché le loro nuove caratteristiche (ad es. dati distribuiti) per utilizzare l’IA su larga scala.
Nel contesto della cyber security, l’IA può essere vista come un approccio emergente e, di conseguenza, le tecniche di IA sono state utilizzate per supportare e automatizzare le operazioni rilevanti, ad esempio il filtraggio del traffico, l’analisi forense automatizzata, ecc. Sebbene indubbiamente vantaggioso, non si dovrebbe eludere il fatto che l’IA e la sua applicazione, ad esempio, al processo decisionale automatizzato, specialmente in implementazioni critiche per la sicurezza come veicoli autonomi, produzione intelligente, eHealth, ecc., può esporre individui e organizzazioni a rischi nuovi e talvolta imprevedibili e può̀ aprire nuove vie di attacco metodi e tecniche, oltre a creare nuove sfide in materia di protezione dei dati.
Inoltre, è ormai chiaro come l’Intelligenza Artificiale sta influenzando sempre più la vita quotidiana delle persone e svolge un ruolo chiave nella trasformazione digitale attraverso le sue capacità decisionali automatizzate. I vantaggi di questa tecnologia emergente sono significativi, ma lo sono anche le preoccupazioni. È quindi necessario evidenziare il ruolo della cyber security nello stabilire l’affidabilità e la diffusione di un’IA affidabile.
Quando si considera la sicurezza nel contesto dell’IA, è necessario essere consapevoli del fatto che le tecniche e i sistemi di IA che utilizzano l’IA possono portare a risultati imprevisti e possono essere manomessi per manipolare i risultati attesi.
Pertanto, è essenziale proteggere l’IA stessa tramite misure di sicurezza. In particolare, è importante:
capire cosa deve essere messo in sicurezza (gli asset soggetti all’IA minacce specifiche e modelli contraddittori);
comprendere i relativi modelli di governance dei dati (compresa la progettazione, valutazione e protezione dei dati e del processo di addestramento dei sistemi di IA);
gestire le minacce in un ecosistema multipartitico in modo completo utilizzando modelli e tassonomie condivisi;
sviluppare controlli specifici per garantire che l’IA stessa sia sicura.
Il quadro normativo comunitario ed italiano dell’IA
L’Unione Europea ha compreso sin da subito l’importanza che ricopre l’Intelligenza Artificiale all’interno della società. Pertanto, nel dicembre 2018 la Commissione europea ha adottato il “Coordinated Plan on Artificial Intelligence” con l’obiettivo di accrescere le sinergie tra Stati membri e istituzioni europee. Più precisamente, la Commissione ha evidenziato la necessità per gli stati membri di adottare una strategia nazionale di AI. Successivamente, nell’aprile 2019, la Commissione ha istituito un gruppo di esperti ad alto livello che ha pubblicato orientamenti per un’IA affidabile, pubblicando una comunicazione in cui accoglie con favore i sette requisiti fondamentali individuati negli orientamenti del gruppo di esperti ad alto livello:
intervento e sorveglianza umani;
robustezza tecnica e sicurezza;
riservatezza e governance dei dati;
trasparenza;
diversità, non discriminazione ed equità;
benessere sociale e ambientale;
accountability.
Inoltre, è meritevole ricordare il “White Paper on AI” promosso nel febbraio 2020 dalla Commissione Europea, la cui finalità è la creazione di un ecosistema di eccellenza e di fiducia nell’Intelligenza Artificiale, così ponendo l’Europa all’avanguardia nella regolamentazione di questo settore.
Nel dettaglio, gli elementi primari di tale documento sono i seguenti:
il quadro strategico che stabilisce misure per allineare gli sforzi a livello europeo, nazionale e regionale. Tramite un partenariato tra il settore pubblico e privato, l’obiettivo di tale quadro è mobilitare risorse per conseguire un “ecosistema di eccellenza” lungo l’intera catena del valore, a cominciare dalla ricerca e dall’innovazione, e creare i giusti incentivi per accelerare l’adozione di soluzioni basate sull’IA, anche da parte delle piccole e medie imprese (PMI);
gli elementi chiave di un futuro quadro normativo per l’IA in Europa, che creerà un “ecosistema di fiducia” unico. La costruzione di un ecosistema di fiducia è un obiettivo strategico in sé e dovrebbe dare ai cittadini la fiducia di adottare applicazioni di IA e alle imprese e alle organizzazioni pubbliche la certezza del diritto necessaria per innovare utilizzando l’IA.
La strategia europea per i dati che accompagna il “White Paper on AI” ha l’obiettivo di far sì che l’Europa diventi l’economia agile basata sui dati più attraente, sicura e dinamica del mondo, mettendo a sua disposizione i dati necessari a migliorare le decisioni e la vita di tutti i suoi cittadini.
Tale documento ha fatto emergere per l’European Union Agency for Cyber security (ENISA), la necessità di approfondire il tema della cyber security applicata all’IA, pubblicando nel dicembre 2020 il report “Artificial Intelligence Threat Landscape”.
I principali elementi del documento avanzato dall’ENISA sono i seguenti:
Definizione dell’ambito dell’IA nel contesto della cyber security secondo un approccio basato sul ciclo di vita. Tenendo conto delle diverse fasi, dall’analisi dei requisiti all’implementazione, viene delineato l’ecosistema dei sistemi e delle applicazioni di IA.
Identificazione degli asset dell’ecosistema IA come passaggio fondamentale per individuare ciò che deve essere protetto e cosa potrebbe eventualmente andare storto in termini di sicurezza dell’ecosistema IA.
Mappatura del panorama delle minacce dell’IA mediante una tassonomia dettagliata. Ciò funge da base per l’identificazione di potenziali vulnerabilità ed eventualmente di scenari di attacco per casi d’uso specifici e servirà nelle valutazioni del rischio settoriale e nell’elenco dei controlli di sicurezza proporzionati.
Classificazione delle minacce per i diversi asset e nel contesto delle diverse fasi del ciclo di vita dell’IA, elencando anche gli attori delle minacce rilevanti. Viene inoltre evidenziato l’impatto delle minacce su diverse proprietà di sicurezza.
Infine, nell’aprile 2021, la Commissione ha rilasciato la Revisione del Piano Coordinato sull’Intelligenza Artificiale che contiene una serie di azioni per rafforzare la posizione dell’UE nello sviluppo di sistemi AI che siano sostenibili, inclusivi, affidabili e che pongano l’uomo al centro del sistema IA. Tale piano propone da oggi al 2027 circa 70 azioni per una cooperazione più stretta ed efficiente tra gli Stati membri e la Commissione in tema di IA. Inoltre, la Commissione sosterrà i corsi di laurea magistrale e i dottorati di ricerca in IA proponendo una più stretta cooperazione tra i centri di eccellenza nella ricerca in materia di IA e, più in generale, i programmi di ricerca e innovazione dell’UE. Inoltre, sosterrà l’interdisciplinarità promuovendo lauree congiunte, ad esempio in legge o psicologia e IA. Le competenze digitali che facilitano lo sviluppo e l’uso dell’IA dovrebbero essere incluse in tutti i programmi di istruzione e formazione.
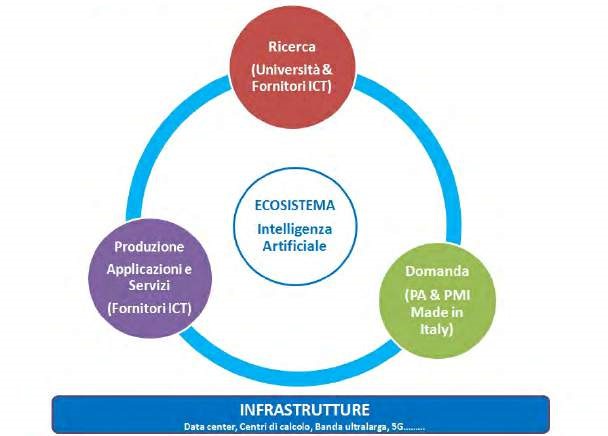
In Italia, come in altri paesi del panorama internazionale, il governo italiano ha pubblicato nel 2020 la bozza di Strategia nazionale per l’Intelligenza Artificiale. Più precisamente, viene sottolineato che l’IA presenta una forte interconnessione tra tre componenti:
Ricerca e Trasferimento Tecnologico: la ricerca italiana in AI gode di una buona visibilità internazionale in alcuni settori specifici. Fanno parte dell’ecosistema le università ed i centri di ricerca pubblici/ privati nonché le reti di ricerca e di trasferimento tecnologico, come i Technology Cluster, i Competence Center, i Digital Innovation Hubs e i poli tecnologici regionali.
Produzione: la produzione include l’industria del software, il comparto delle infrastrutture e dei servizi, l’industria della componentistica intelligente, dei semiconduttori per lo sviluppo di componenti IoT, automotive e telecomunicazioni, e il comparto dei sistemi e oggetti intelligenti, autonomi e semi autonomi, in particolare la robotica e l’automazione industriale.
Adozione: l’adozione include la Pubblica Amministrazione (PA) e l’industria. La PA e le istituzioni possono utilizzare l’IA per la sicurezza, le città intelligenti, la sostenibilità ambientale, i trasporti, la gestione dei beni culturali e l’istruzione. Diversamente, nell’industria l’IA ha un utilizzo pervasivo che va dalla definizione di prodotto, marketing, logistica, pianificazione, fino ad arrivare alla manifattura.
Figura 1 – I tre componenti dell’ecosistema dell’IA italiana (fonte: Ministero dello Sviluppo Economico – Proposte per una strategia italiana per l’intelligenza artificiale, 2020)
L’intelligenza Artificiale e le misure di sicurezza
Secondo quanto indicato dall’articolo 5 dal Regolamento generale sulla protezione dei dati (GDPR) viene stabilita la sicurezza come principio nel trattamento dei dati personali. Più precisamente i dati personali devono essere trattati in maniera da garantire un’adeguata sicurezza dei dati personali, compresa la protezione, mediante misure tecniche e organizzative adeguate, da trattamenti non autorizzati o illeciti e dalla perdita, dalla distruzione o dal danno accidentali.
Questa caratteristica assume una significativa importanza per la sicurezza rispetto al passato, quando quest’ultima era una mera prestazione tecnico-organizzativa al di sopra dell’operazione di trattamento. Pertanto, è possibile affermare che nel GDPR la sicurezza è un prerequisito e la mancata adozione di adeguate misure di sicurezza invalida il trattamento e lo rende illecito. Analogamente agli altri principi di protezione dei dati, la sicurezza non è un’opzione ma una necessità.
In aggiunta, l’articolo 32 del GDPR prevede misure di sicurezza che devono essere ampliate in base al rischio di diversa probabilità e gravità per i diritti e le libertà degli interessati. Pertanto, il “bene” da tutelare con misure di sicurezza è il libero esercizio dei diritti delle persone, e non solo il bene informativo di per sé. I dati personali devono essere protetti in modo progressivo (maggiori sono i rischi, più rigorose sono le misure). La sicurezza è un modo per rafforzare i diritti e le libertà degli individui nel loro insieme e consente la centralità degli esseri umani rispetto alle macchine. I sistemi di IA sono sistemi logici e, in quanto tali, potrebbero non essere del tutto coerenti e completi, il che significa che gli esseri umani non saranno mai in grado di prevedere, in anticipo durante la fase di progettazione, tutti i possibili fattori contestuali che potrebbero comprometterne il funzionamento. Ciò espone le persone ai rischi intrinseci di esiti imprevisti in cui gli output di un sistema di IA non sono adeguatamente vincolati.
La sicurezza è anche uno strumento di protezione dei dati fin dalla progettazione, come previsto dall’art. 25 del GDPR. Tenendo conto di una serie di fattori contestuali (come lo stato dell’arte), i titolari del trattamento devono mettere in atto misure tecniche e organizzative adeguate. Tali misure devono essere in atto per attuare i principi di protezione dei dati in modo efficace, dalla minimizzazione all’accuratezza dei dati, integrando le necessarie salvaguardie nel trattamento. Nel dettaglio, il GDPR menziona specificamente la pseudonimizzazione come una di quelle misure efficaci. La dimensione della sicurezza per la protezione dei dati, nell’ambito dell’IA, è molto importante per poter introdurre le necessarie tutele tecniche e organizzative (per la tutela dei diritti e delle libertà delle persone) già nella fase di progettazione di nuove applicazioni di IA (security by design).
A tal fine, la sicurezza può anche essere un fattore abilitante di nuove operazioni di trattamento, in particolare legate alle tecnologie emergenti, come l’IA. Ad esempio, l’implementazione di misure di sicurezza specifiche, come la pseudonimizzazione o la crittografia, può portare i dati in un nuovo formato in modo che non possano essere attribuiti a un interessato specifico senza l’uso di dati informativi aggiuntivi (come una chiave di decrittazione). Queste opzioni potrebbero essere esplorate nel contesto dell’ambiente dell’IA, per modellare nuove relazioni tra umani e macchine, in modo che gli individui non siano per impostazione predefinita identificabili dalle macchine a meno che non lo desiderino. Ad esempio, una IA impostata allo scopo di annullare l’effetto della pseudonimizzazione o crittografia implementata.
Il legislatore europeo, ponendo la sicurezza tra i principi di protezione dei dati, stabilisce che questa è una condizione preliminare per il trattamento. Pertanto, la chiave è il passaggio dalla sicurezza come strumento difensivo alla sicurezza come elemento funzionale dell’ecosistema digitale. La sicurezza non deve essere implementata solo per prevenire perdite, ma anche per creare valore. Solo se le minacce alla sicurezza si affievoliranno, l’ecosistema AI può generare fiducia, attrarre investimenti, trattenere utenti e creare un feedback positivo per sviluppare ogni volta nuove applicazioni vantaggiose.
Il ciclo di vita dell’IA
Per inquadrare correttamente il dominio dell’IA, è essenziale seguire un approccio strutturato e metodico per comprenderne le diverse sfaccettature.
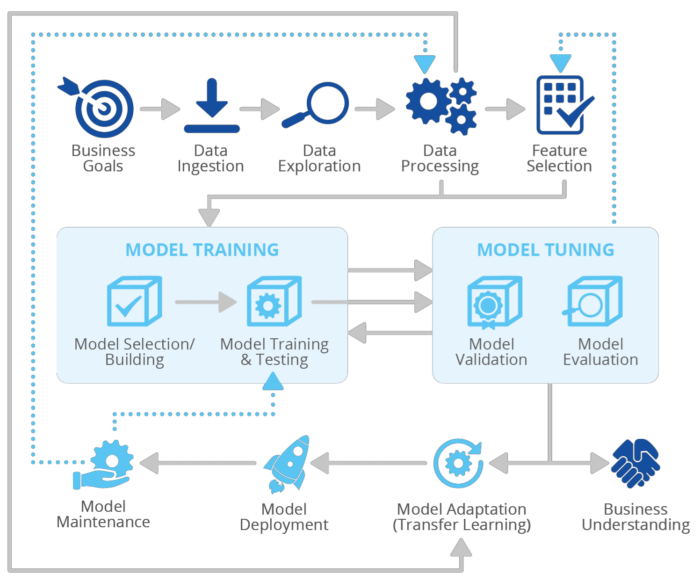
Il ciclo di vita di un sistema di Intelligenza Artificiale comprende diverse fasi interdipendenti che vanno dalla progettazione e sviluppo (comprese sottofasi come analisi dei requisiti, raccolta dati, formazione, test, integrazione), installazione, distribuzione, funzionamento, manutenzione e smaltimento. Data la complessità dei sistemi di Intelligenza Artificiale (e in generale delle informazioni), sono stati definiti diversi modelli e metodologie per gestire questa complessità, soprattutto durante le fasi di progettazione e sviluppo, come cascata, spirale, sviluppo software agile, prototipazione rapida e incrementale. Il ciclo di vita dell’IA definisce le fasi che un’organizzazione dovrebbe seguire per trarre vantaggio dalle tecniche di Intelligenza Artificiale e in particolare dai modelli di Machine Learning (ML) per ricavare valore di business pratico[1].
Figura 2 – Modello di riferimento generico del ciclo di vita dell’IA (fonte: ENISA – Artificial Intelligence Cybersecurity Challenges, 2020)
Business Goal Definition
In questa fase risulta di fondamentale importanza che l’organizzazione comprenda appieno il contesto aziendale dell’applicazione di intelligenza artificiale e i dati necessari per raggiungere i target prefissati.
Data Ingestion
Il Data Ingestion è la fase del ciclo di vita dell’IA in cui i dati vengono ottenuti da più fonti (i dati grezzi possono essere di qualsiasi forma strutturata o non strutturata). L’ acquisizione di dati è alla base di qualsiasi applicazione di intelligenza artificiale. I dati possono essere acquisiti direttamente dalle sue fonti in tempo reale, un modo continuo noto anche come streaming, o importando batch di dati, dove i dati vengono importati periodicamente in grandi macro-batch o in piccoli micro-batch.
Data Exploration
In questa fase le informazioni dettagliate iniziano a essere ricavate dai dati inseriti.
Data Pre-processing
La fase di preelaborazione dei dati utilizza tecniche per pulire, integrare e trasformare i dati. Questo processo mira a migliorare la qualità dei dati che migliorerà le prestazioni e l’efficienza dell’intero sistema di IA.
Feature Selection
Questa è la fase in cui viene ridotto il numero di componenti o caratteristiche (chiamate anche dimensioni) che compongono ciascun vettore di dati, identificando i componenti che si ritiene siano i più significativi per il modello di IA.
Model Selection / Building
Questa fase esegue la selezione/costruzione del miglior modello o algoritmo di intelligenza artificiale per l’analisi dei dati. Le tre categorie principali comunemente identificate sono l’apprendimento supervisionato, l’apprendimento non supervisionato e i modelli di apprendimento per rinforzo.
Model Training
Dopo aver selezionato un modello di IA, che nell’ambito di questo modello di riferimento fa per lo più riferimento a un modello di Machine Learning (ML), inizia la fase di training del sistema di IA.
Model Tuning
L’ottimizzazione del modello di solito si sovrappone all’addestramento del modello, poiché l’ottimizzazione è generalmente considerata all’interno del processo di addestramento.
Transfer Learning
In questa fase, l’organizzazione dell’utente utilizza un modello di intelligenza artificiale pre-addestrato e pre-sintonizzato e lo utilizza come punto di partenza per un’ulteriore formazione per ottenere una convergenza migliore e più rapida.
Model Deployment
Un modello di Machine Learning porterà conoscenza a un’organizzazione solo quando le sue previsioni saranno disponibili per gli utenti finali. La distribuzione è il processo in cui un modello viene reso disponibile agli utenti.
Model Maintenance
Dopo l’implementazione, i modelli di intelligenza artificiale devono essere continuamente monitorati e mantenuti per gestire le modifiche ai concetti e le potenziali derive concettuali che potrebbero verificarsi durante il loro funzionamento. La manutenzione del modello riflette anche la necessità di monitorare gli obiettivi e le risorse aziendali che potrebbero evolversi nel tempo e di conseguenza influenzare il modello stesso.
Business Understanding
In questa fase le aziende che implementano modelli di intelligenza artificiale acquisiscono informazioni sull’impatto dell’IA sul proprio business e cercano di massimizzare le probabilità di successo.
Attori del ciclo di vita dell’IA
Nella rosa delle figure coinvolte nell’ecosistema dell’IA vi sono numerosi attori attivamente coinvolti.
In primo luogo, è possibile ricordare i progettisti di intelligenza artificiale impegnati nella progettazione e creazione di sistemi di intelligenza artificiale. Successivamente, vi sono gli sviluppatori di intelligenza artificiale con il compito di costruire e sviluppare il software e gli algoritmi utilizzati nei sistemi di intelligenza artificiale, oltre a lavorare per perfezionarli e migliorarli. Queste ultime figure collaborano con i cosiddetti data scientist, i quali sono coinvolti nella raccolta e nell’interpretazione dei dati, concentrandosi sull’estrazione di conoscenze e approfondimenti da tali dati. Inoltre, sono presenti anche i data engineers i quali prestano particolare attenzione alla progettazione, gestione e ottimizzazione del flusso di dati.
Un altro attore che ricopre un’importanza significativa nel ciclo di vita dell’IA è il data owner il quale possiede i set di dati utilizzati per addestrare o convalidare i sistemi di intelligenza artificiale. Diversamente, i model providers che forniscono modelli (nonché implementazioni di essi sotto forma di librerie IA/ML) che sono già stati formati e messi a punto. Alcuni model providers sono dei cloud providers, ed offrono i modelli come servizio, in particolare l’uso di capacità di calcolo e analisi dei dati basate sull’intelligenza artificiale nel cloud.
Infine, vi sono gli utenti finali che utilizzano i sistemi di intelligenza artificiale. Tra questi è possibile menzionare i consumatori di servizi, ma anche il pubblico in generale.
Cybersecurity threats: minacce dell’IA
Come già sottolineato, l’intelligenza artificiale consente il processo decisionale automatizzato e facilita molti aspetti della vita quotidiana, portando con sé miglioramenti delle operazioni e numerosi altri vantaggi. Tuttavia, i sistemi di IA devono far fronte a numerose cybersecurity threats. Pertanto, è necessario analizzare i vari gruppi di attori coinvolti nelle minacce e successivamente approfondire la tassonomia delle minacce nell’ecosistema dell’IA.
Attori minacciatori
Le figure che potrebbero voler danneggiare i sistemi di IA utilizzando mezzi informatici sono i seguenti:
Cyber criminali: essi sono motivati principalmente dal profitto e tendono ad utilizzare l’IA come strumento per condurre attacchi, ma anche per sfruttare le vulnerabilità nei sistemi di IA esistenti.
Insider: essi sono figure interne ad un’azienda ed hanno accesso alle reti di un’organizzazione, possono coinvolgere coloro che hanno intenzioni dannose o coloro che possono danneggiare un’azienda involontariamente.
Nation state actors: questi soggetti sono principalmente sponsorizzati dagli stati sia per difendere le proprie reti, ma anche per sfruttare le vulnerabilità dei sistemi di intelligenza artificiale di altri paesi
Terrorists: sono figure che hanno l’obiettivo di causare chiaramente dei danni fisici o di danneggiare la sicurezza nazionale di un paese.
Hacktivists: essi sono un gruppo di hacker, motivati ideologicamente, che possono hackerare i sistemi di intelligenza artificiale per dimostrare le vulnerabilità di infrastrutture critiche.
Script Kiddies: essi sono generalmente un gruppo di individui non qualificati che utilizzano script o programmi pre-scritti per attaccare i sistemi di IA.
Tassonomia delle minacce
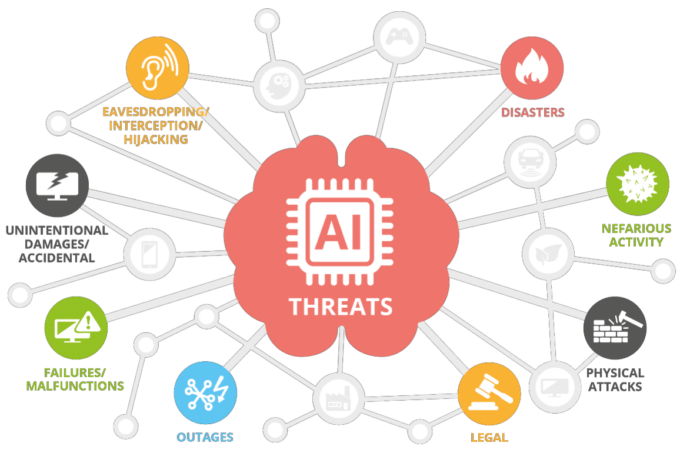
È possibile utilizzare una tassonomia delle minacce per mappare il panorama delle minacce nell’ecosistema dell’Intelligenza Artificiale.
Figura 3: tassonomia delle minacce dell’IA (fonte: ENISA – Artificial Intelligence Cybersecurity Challenges, 2020)
Nefarious activity/abuse (NAA): sono le azioni previste che prendono di mira i sistemi ICT, infrastrutture e reti mediante atti dannosi con l’obiettivo di rubare, alterare o distruggere un determinato obiettivo.
Eavesdropping/ Interception/ Hijacking (EIH): sono le azioni volte ad ascoltare, interrompere o prendere il controllo di una comunicazione di terzi senza consenso.
Physical attacks (PA): sono le azioni che mirano a distruggere, esporre, alterare, disabilitare, rubare o ottenere l’accesso non autorizzato a risorse fisiche come infrastrutture, hardware o interconnessione.
Unintentional Damage (UD): sono le azioni non intenzionali che causano distruzione, danno o lesione di cose o persone e si traducono in un fallimento o riduzione dell’utilità.
Failures or malfunctions (FM): sono le azioni che causano un insufficiente o parziale funzionamento di un bene (hardware o software).
Outages (OUT): sono le azioni che causano interruzioni impreviste del servizio o diminuzione della qualità al di sotto un livello richiesto.
Disaster (DIS): sono le azioni che causano un incidente improvviso o una catastrofe naturale che provoca gravi danni o perdita di vite umane.
Legal (LEG): sono le azioni legali di terzi, contrattuali e non contrattuali, al fine di vietare azioni o compensare perdite in base alla legge applicabile.
Conclusioni
La significativa importanza che ricopre l’Intelligenza Artificiale nella società odierna non può essere certamente trascurata. Essendo agli albori di una nuova rivoluzione digitale, è stato stimato che il mercato globale dell’intelligenza artificiale nell’arco temporale 2020-2027 possa crescere con tasso medio annuo del 42.2%.
Pertanto, è doveroso sottolineare come qualsiasi ambito della nostra vita sia sotto l’aspetto quotidiano, economico, professionale e del lavoro subirà un cambiamento, così dando origine ad una convivenza tra uomo e digitale.
Come osservato dallo storico Y.N. Harari[2], l’Intelligenza Artificiale realizza due capacità particolarmente importanti che sono la connettività e la possibilità di aggiornamento. “Poiché gli esseri umani sono individui, è difficile connetterli l’uno all’altro e assicurarsi che siano tutti aggiornati. Le macchine invece non sono individui ed è facile integrarle in una singola rete flessibile. Pertanto, non si tratta di sostituzione di milioni di lavoratori individuali con milioni di individui robot e computer. È più verosimile che gli individui umani siano rimpiazzati da una rete integrata”.
Note
[1] ENISA, Artificial Intelligence Cybersecurity Challenges, Dicembre 2020.
[2] Y.N. Harari, 21 lezioni per il XXI secolo, Bompiani, 2018.
Articolo a cura di Luca Barbieri
Profilo Autore
Luca Barbieri è laureato in Giurisprudenza presso l’Università Luiss Guido Carli con tesi intitolata “From cyber espionage to cyber warfare: a criminal comparative analysis between Italy, USA and China”, nella materia di Diritto Penale, con il Prof. A. Gullo. Durante l’Exchange Program, presso la Beijing Normal University di Pechino, ha sostenuto numerosi esami in diritto cinese e cyber security. Inoltre, ha conseguito il Master universitario di secondo Livello in “Responsabile della protezione dei dati personali: Data Protection Officer e Privacy Expert” presso l’Università Roma Tre. Attualmente collabora in uno studio legale specializzato in diritto delle nuove tecnologie, privacy e cyber security.
How we learned to break down barriers to machine learning
Dr. Sephus discusses breaking down barriers to machine learning at Ars Frontiers 2022. Click here for transcript.
Welcome to the week after Ars Frontiers! This article is the first in a short series of pieces that will recap each of the day’s talks for the benefit of those who weren’t able to travel to DC for our first conference. We’ll be running one of these every few days for the next couple of weeks, and each one will include an embedded video of the talk (along with a transcript).
For today’s recap, we’re going over our talk with Amazon Web Services tech evangelist Dr. Nashlie Sephus. Our discussion was titled “Breaking Barriers to Machine Learning.”
What barriers?
Dr. Sephus came to AWS via a roundabout path, growing up in Mississippi before eventually joining a tech startup called Partpic. Partpic was an artificial intelligence and machine-learning (AI/ML) company with a neat premise: Users could take photographs of tooling and parts, and the Partpic app would algorithmically analyze the pictures, identify the part, and provide information on what the part was and where to buy more of it. Partpic was acquired by Amazon in 2016, and Dr. Sephus took her machine-learning skills to AWS.
When asked, she identified access as the biggest barrier to the greater use of AI/ML—in a lot of ways, it’s another wrinkle in the old problem of the digital divide. A core component of being able to utilize most common AI/ML tools is having reliable and fast Internet access, and drawing on experience from her background, Dr. Sephus pointed out that a lack of access to technology in primary schools in poorer areas of the country sets kids on a path away from being able to use the kinds of tools we’re talking about.
Furthermore, lack of early access leads to resistance to technology later in life. “You’re talking about a concept that a lot of people think is pretty intimidating,” she explained. “A lot of people are scared. They feel threatened by the technology.”
Un-dividing things
One way of tackling the divide here, in addition to simply increasing access, is changing the way that technologists communicate about complex topics like AI/ML to regular folks. “I understand that, as technologists, a lot of times we just like to build cool stuff, right?” Dr. Sephus said. “We’re not thinking about the longer-term impact, but that’s why it’s so important to have that diversity of thought at the table and those different perspectives.”
Dr. Sephus said that AWS has been hiring sociologists and psychologists to join its tech teams to figure out ways to tackle the digital divide by meeting people where they are rather than forcing them to come to the technology.
Simply reframing complex AI/ML topics in terms of everyday actions can remove barriers. Dr. Sephus explained that one way of doing this is to point out that almost everyone has a cell phone, and when you’re talking to your phone or using facial recognition to unlock it, or when you’re getting recommendations for a movie or for the next song to listen to—these things are all examples of interacting with machine learning. Not everyone groks that, especially technological laypersons, and showing people that these things are driven by AI/ML can be revelatory.
“Meeting them where they are, showing them how these technologies affect them in their everyday lives, and having programming out there in a way that’s very approachable—I think that’s something we should focus on,” she said.
https://arstechnica.com/?p=1855169
Trema Cannavaccioulo: stanno per applicare l’intelligenza artificiale al cibo per prevedere i gusti!
Una piccola rivoluzione potrebbe cambiare il mondo della cucina e dell’alimentazione, almeno di un certo tipo. Mars sta pianificando una collaborazione pluriennale con Pipa, una società di ricerca alimentare con intelligenza artificiale, per apportare miglioramenti alla salute del cibo con ingredienti più gradevoli di sapore.
Mettendo l’IA al centro di cibo, nutrizione e salute, il colosso dolciario vuole sbloccare nuovi cibi di alta qualità, ma dalle positive caratteristiche organolettiche. Le tecnologie di Pipa consentiranno anche a Marte di risparmiare tempo e denaro, poiché le sue tecnologie di intelligenza artificiale consentono la previsione dei sapori con “pannelli sensoriali virtuali”, consentendo la creazione di profili sensoriali senza sperimentazione.
“Il prossimo decennio vedrà un cambio di paradigma nel modo in cui comprendiamo il cibo, i suoi effetti sulla nostra salute e benessere“, afferma il dott. Ilias Tagkopoulos, fondatore di Pipa e direttore dell’AI Institute of Next Generation Food Systems (AIFS) presso l’Università della California.
“La triplice mappatura dell’atlante molecolare del cibo, sfruttando metodi computazionali che imparano dai dati e alimentando un ecosistema che traduce le scoperte in pratica, crea la tempesta perfetta per un’interruzione senza precedenti e ci avvicina di un passo all’Ippocratico ‘lascia che il cibo sia tuo medicinale’.” Come pensa di ottenere questo la società di AI? Utilizzando un ampio database che mescola dati medici e da pubblicazioni scientifiche, studi clinici e set di dati omici, cioè derivanti dalla genomica e da altre scienze assimilabili. Per accelerare la sperimentazione di nuovi prodotti si utilizzerà la AI per simulare il sapore dei singoli prodotti, rendendo quindi superflui, o secondari , i sistemi di screening randomizzato dei prodotti, cioè quei test in cui fanno assaggiare prodotti a persone scelte a caso per poter avere poi un feedback sulla qualità dei prodotti.
I laboratori Pipa AI cercano di identificare i prodotti bi-attivi e quindi di capire come interagiscono con i singoli. Quindi cercano, praticamente, di prevedere quale gusto avrà il prodotti finale attraverso l’intelligenza artificiale e l’analisi dei database. Il prodotto viene quindi simulato dalla AI e quindi, alla fine, quando la soluzione è ottimale, viene testato dal vero. In pratica la AI fa quello che fanno, mentalmente, gli Chef. Potenzialmente questa AI potrebbe anche battere Cannavacciuolo per produrre dei piatti ottimi e salutari, oppure produrrà delle porcherie. Perchè la AI, in fondo, esamina solo dei dati, non assaggia i cibi.
Grazie al nostro canale Telegram potete rimanere aggiornati sulla pubblicazione di nuovi articoli di Scenari Economici.
Fra Mass Media ormai completamente uniformati ai bollettini di informazione del Potere, Scenari Economici rimane una voce che presenta opinioni libere ed indipendenti. Aiutaci a crescere ed a farci conoscere, sia condividendo i nostri contenuti, sia, se vuoi, con una donazione. Grazie!
There are already four American-accented English voices for Siri, but Apple will add a fifth in iOS 15.4. The new voice aims to provide a gender-neutral option for the first time, as reported by Axios.
The voice is labeled “Voice 5” in the Settings panel in the current beta release, though developer Steve Moser noted on Twitter that the voice is named “Quinn” under the hood. Apple confirmed to Axios that the voice is built from recordings by a member of the LGBTQ+ community. Moser also tweeted an example of what the new voice sounds like:
For most of the time since Siri first became a core iPhone feature back in 2011, a female voice was the default. That changed last year when Apple changed the iPhone setup to prompt the user to pick a male or female voice when first starting the iPhone, with no default choice selected.
Apple sent the following statement to Axios about the new voice added in the iOS 15.4 beta:
We’re excited to introduce a new Siri voice for English speakers, giving users more options to choose a voice that speaks to them. Millions of people around the world rely on Siri every day to help get things done, so we work to make the experience feel as personalized as possible.
Apple also added the third and fourth US English Siri voices last year—female and male voices meant to represent the speech of African Americans.
In addition to these five US English voices, Apple offers Siri voices in numerous other languages, including Cantonese, Mandarin, Danish, Dutch, Finnish, French, German, Hebrew, Italian, Japanese, Korean, Malay, Norwegian Bokmål, Portuguese, Russian, Spanish, Swedish, Thai, and Turkish. There are also several regional or accent variations within those languages, such as Chilean, Mexican, Spanish, and US variants of Spanish.
Other changes in the upcoming iOS 15.4 include the ability to use Face ID while wearing a face mask, dual-sim 5G support, the ability to set a preferred music-streaming service, and more.