Anthropic dopo la scomunica del Pentagono: la tecnologia si separa dalle istituzioni per comunicare con le autorità
Mai una scomunica è stata cosi fruttifera quale quella dichiarata dalla Casa Bianca ai danni di Anthropic, dai tempi di Enrico VIII che, sulla spinta del rifiuto di Clemente VII di annullare il suo matrimonio, creò la chiesa Anglicana, architrave dell’impero britannico.

Rispetto all’anno scorso, la società che produce il sistema di intelligenza artificiale Claude, che si è ribellata alle pretese del Pentagono di usare le sue tecnologie senza vincoli o limiti etici, ha più che triplicato il suo fatturato, passando da 9 a 30 miliardi.

Ma siamo solo all’inizio. Proprio lo scontro con Trump, che avviene nel pieno di una guerra che vede le forze americane sulla linea del fuoco, invece di produrre una reazione di rigetto e critica da parte dell’opinione pubblica, secondo la tradizione del nazionalismo statunitense nelle circostanze belliche- right or wrong is my country – si registra una straordinaria adesione alle posizioni dei proprietari della società, gli italo americani fratelli Amodei.

Da mesi si assiste ad una trasmigrazione di utenti dalle proposte di ChatGPT a quelle di Anthropic. Ma questa spinta non riguarda solo l’emotività popolare, ma anche il sensibile e cinico mondo del business.

Infatti, insieme ai successi di fatturato, Anthropic informa di una nuova combinazione strategica con Google e Broadcom, società di produzione delle unità di calcolo, per la produzione di TCU, i nuovissimi microchip progettati dal motore di ricerca di Moutain View, che dovrebbero sostituire le fondamentali CPU di Nvidia nel cuore dei sistemi di intelligenza artificiale.

Un’operazione questa che, insieme al salto quantico atteso, sembra destinata a mutare radicalmente il volto del mercato digitale e soprattutto la struttura stessa delle infrastrutture che ancora lo contengono.
Un nuovo microchip, quale si annuncia il TCU (Tensor Processor Unit), è un’unità  sviluppata da Google proprio per l’apprendimento neurale, che in una sinergia con Anthropic potrebbe rapidamente soppiantare l’attuale applicazione basata sulla produzione di Nvidia.

Siamo dunque ad un ulteriore giro di boa, dove non solo i gruppi tecnologici si separano dalle istituzioni politiche ma, proprio in opposizione ai comandi militari, nel pieno di un conflitto, elaborano linee di sviluppo che contrastano con i programmi degli stati maggiori.

Sembra paradossalmente avverarsi quello che nel nostro ultimo libro, “Guerre in Codice, come le intelligenze artificiali resettano la democrazia” (Donzelli), abbiamo definito di Peter Thiel’s Switch, ossia quell’inversione gerarchia fra politica e digitale, dove, come teorizza il templare della Silicon Valley, la politica comunica quello che le tecnologie decidono.

Solo che questa affermazione di supremazia dei gruppi di calcolo avviene sul versante ideologico opposto a quello guidato dal capo di Palantir.

Potrebbe essere l’ennesimo segnale di uno scollamento fra la leadership Maga, la tendenza sovranista dei repubblicani che ha portato Trump alla Casa Bianca. Ma inevitabilmente ci parla di un processo più di fondo, in cui, la potenza computazionale sfonda ogni limite geopolitico e si afferma come struttura di base dei processi sociali e politici.

Proprio nel 250° anniversario della pubblicazione della Ricchezza delle Nazioni di Adama Smith, che diede un fondamento teorico al nascente capitalismo industriale basato sulle dinamiche globali di un capitalismo che formava le nazioni, oggi si pone all’ordine del giorno un nuovo primato sociale costituito proprio dalla differenziazione fra le diverse forme di tecnologie automatiche.

Il successo di Anthropic non rappresenta solo la preminenza di una vocazione libertaria, o comunque democratica dei sistemi tecnologici, ma ci rappresenta la pretesa di queste tecnologie di riassumere nel proprio universo di calcolo tutte le variabili, riducendo ogni valore ad un calcolo appunto.

Una posizione, per certi versi, non dissimile da quello che in qualche modo si afferma in Cina, dove la supremazia dell’apparato di governo si basa proprio sulla capacità di armonizzare la potenza digitale con la forma di amministrazione del paese. Stiamo passando da uno Stato-algoritmo, in cui un regime si sosteneva con lo sviluppo tecnologico, ad un algoritmo che si fa Stato, in cui è la tecnologia, nelle sue continue progressioni che mutano la forma e i contenuti delle relazioni sociali, che si propone come codice di controllo e governo.

Sia in una versione più conservatrice e autoritaria, quale quella teorizzata da Peter Thiel, sia in una più aperta e dinamica, quale quella che oggi viene rappresentata da Anthropic. Ma in entrambi i casi siamo ad una riclassificazione delle dinamiche geopolitiche e culturali, in cui, come vediamo anche nel conflitto attorno all’Iran, o in quello in Ucraina, non sono più le dimensioni di una potenza ad imporsi ma la capacità di distribuire saperi e competenze per rendere inafferrabile la testa del sistema bellico, che ormai coincide con la vita civile di una comunità.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/il-boom-di-anthropic-dopo-la-scomunica-del-pentagono-la-tecnologia-si-separa-dalle-istituzioni-per-comunicare-con-le-autorita-nazionali/568622/
Intel is going all-in on advanced chip packaging

Last month, Anwar Ibrahim, the prime minister of Malaysia, revealed in a post on Facebook that Intel is expanding its Malaysian chip-making facilities, which were first established back in the 1970s. Ibrahim said the head of Intel’s Foundry, Naga Chandrasekaran, had “outlined plans to commence the first phase” of expansion, which would include advanced packaging.

“I welcome Intel’s decision to begin operations for the complex later this year,” a translated version of Ibrahim’s post read. An Intel spokesperson, John Hipsher, confirmed that it’s building out additional chip assembly and test capacity in Penang, “amid rising global demand for Intel Foundry packaging solutions.”

Package store

According to Chandrasekaran, who took over Intel’s Foundry operations in 2025 and spoke exclusively with WIRED during the reporting of this story, the term “advanced packaging” itself didn’t exist a decade ago.

Chips have always required some sort of integration of transistors and capacitors, which control and store energy. For a long time the semiconductor industry was focused on miniaturization, or, shrinking the size of components on chips. As the world began demanding more from its computers in the 2010s, chips started to get even more dense with processing units, high-bandwidth memory, and all of the necessary connective parts. Eventually, chipmakers started to take a system-in-packages or package-on-package approach, in which multiple components were stacked on top of one another in order to squeeze more power and memory out of the same surface space. 2D stacking gave way to 3D stacking.

TSMC, the world’s leading semiconductor manufacturer, began offering packaging technologies like CoWoS (chip on wafer on substrate) and, later, SoIC (system on integrated chip) to customers. Essentially, the pitch was that TSMC would handle not just the front end of chip-making—the wafer part—but also the back end, where all of the chip tech would be packaged together.

https://arstechnica.com/gadgets/2026/04/intel-is-going-all-in-on-advanced-chip-packaging/


Google announces Gemma 4 open AI models, switches to Apache 2.0 license

Google’s Gemini AI models have improved by leaps and bounds over the past year, but you can only use Gemini on Google’s terms. The company’s Gemma open-weight models have provided more freedom, but Gemma 3, which launched over a year ago, is getting a bit long in the tooth. Starting today, developers can start working with Gemma 4, which comes in four sizes optimized for local usage. Google has also acknowledged developer frustrations with AI licensing, so it’s dumping the custom Gemma license.

Like past versions of its open-weight models, Google has designed Gemma 4 to be usable on local machines. That can mean plenty of things, of course. The two large Gemma variants, 26B Mixture of Experts and 31B Dense, are designed to run unquantized in bfloat16 format on a single 80GB Nvidia H100 GPU. Granted, that’s a $20,000 AI accelerator, but it’s still local hardware. If quantized to run at lower precision, these big models will fit on consumer GPUs.

Google also claims it has focused on reducing latency to really take advantage of Gemma’s local processing. The 26B Mixture of Experts model activates only 3.8 billion of its 26 billion parameters in inference mode, giving it much higher tokens-per-second than similarly sized models. Meanwhile, 31B Dense is more about quality than speed, but Google expects developers to fine-tune it for specific uses.

[embedded content]

What’s new in Gemma 4

The other two Gemma 4 models, Effective 2B (E2B) and Effective 4B (E4B), are aimed at mobile devices. These options were designed to maintain low memory usage during inference, running at an effective 2 billion or 4 billion parameters. Google says the Pixel team worked closely with Qualcomm and MediaTek to optimize these models for devices like smartphones, Raspberry Pi, and Jetson Nano. Not only do they use less memory and battery than Gemma 3, but Google also touts “near-zero latency” this time around.

More powerful, more open

All the new Gemma 4 models will reportedly leave Gemma 3 in the dust—Google claims these are the most capable models you can run on your local hardware. Google says Gemma 31B will debut at number three on the Arena list of top open AI models, behind GLM-5 and Kimi 2.5. However, even the biggest Gemma 4 variant is a fraction of the size of those models, making it theoretically much cheaper to run.

https://arstechnica.com/ai/2026/04/google-announces-gemma-4-open-ai-models-switches-to-apache-2-0-license/


Anthropic says its leak-focused DMCA effort unintentionally hit legit GitHub forks

An Anthropic-backed DMCA effort to remove its recently leaked Claude Code client source code from GitHub this week resulted in the accidental removal of many legitimate forks of its official public code repository. While that overzealous takedown has now been reversed, Anthropic still faces an extreme uphill battle in limiting the spread of its recently leaked code.

The DMCA notice that GitHub received late Tuesday focuses on a repository containing the leaked source code originally posted by GitHub user nirholas (archived here) and nearly 100 specifically named forks of that repository. In a note appended to that request, though, GitHub said it had acted to take down a network of 8,100 similar forked repositories because “the submitter alleged that all or most of the forks were infringing to the same extent as the parent repository.”

That expanded takedown affected many repositories that didn’t contain leaked code but instead forked Anthropic’s official public Claude Code repository, which the company shares to encourage public bug reports and fixes. Many coders took to social media to complain about being swept up in the DMCA dragnet despite not sharing any leaked code.

“I’m sorry that your people shipped your source code, and that your lawyers don’t know how to read a repo,” coder Robert McLaws wrote. “I will be filing a DCMA counter-notice.”

By Wednesday, Anthropic had moved to fix the issue with GitHub, requesting that the site restrict its takedowns to the 96 fork URLs specifically listed in its takedown notice and to “reinstate all other repositories that were disabled by network-wide processing.” Anthropic’s head of Claude Code, Boris Cherny, said on social media that the overzealous takedowns were “not intentional,” and Anthropic’s Thariq Shihipar added that they were the result of “a communication mistake.”

https://arstechnica.com/ai/2026/04/anthropic-says-its-leak-focused-dmca-effort-unintentionally-hit-legit-github-forks/


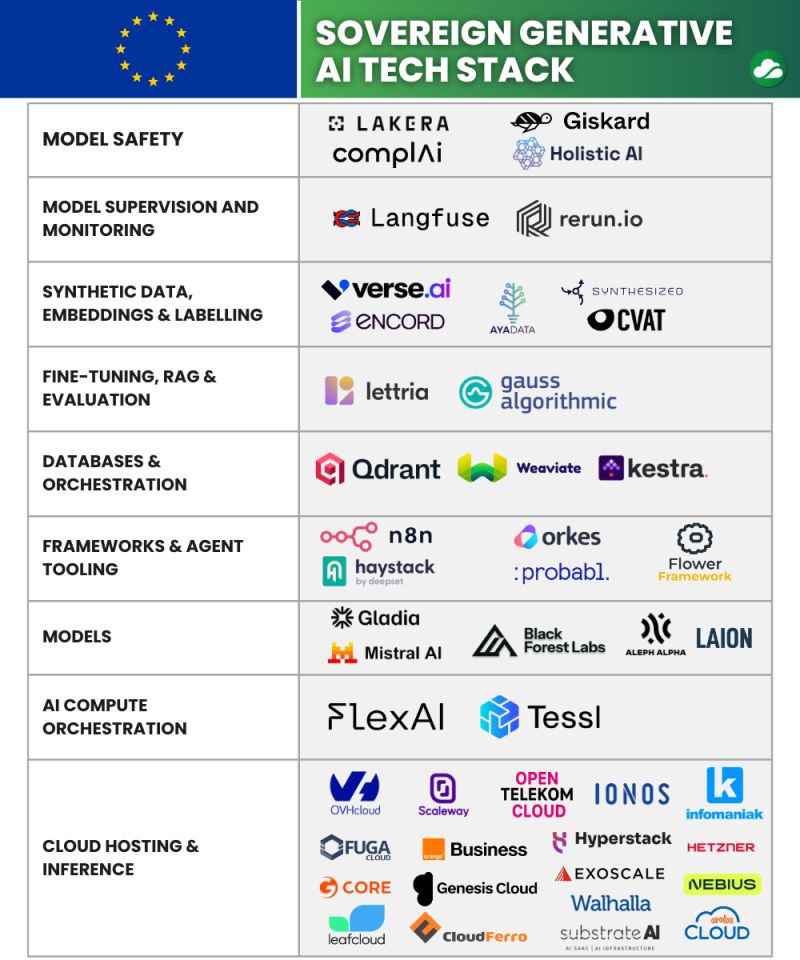
AI, basta dire che l’UE dipende dagli USA. La mappa di 46 aziende europee

Basta credere che l’Europa dipenda interamente dagli hyperscaler americani per l’AI! E’ un appello senza mezze misure, quasi una chiamata alle armi nei confronti dei player europei quella lanciata su Linkedin da  Anthony Monthe, Cloud Benchmarker di Cloud Mercato, che nero su bianco scrive: “Quell’epoca è (quasi?) finita”.

Un appello per chiudere l’era della sudditanza tecnologica europea, “Oggi abbiamo uno stack tecnologico europeo completo per costruire sistemi di IA generativa end-to-end, senza compromettere prestazioni o sovranità”, aggiunge Monthe, secondo cui la sovranità non è più un vincolo. È un vantaggio competitivo.

“Le aziende e gli integratori europei dispongono ora di tutti i mattoni necessari per costruire sistemi di AI ad alte prestazioni, sicuri e conformi, senza dipendere da infrastrutture non europee”.

Il talento è qui. La tecnologia è qui. L’infrastruttura cloud è qui.

“P.S.: Questa mappa è ispirata al lavoro iniziale di Daniel Jarjoura. Se meritano altri giocatori europei di essere aggiunti, sentitevi liberi di menzionarli nei commenti!”,
chiude Monthe accendendo un tread interessante con diverse aziende che si sono proposte per entrare nel novero dei player europei dell’AI.

Nel tread dei commenti al post, spicca infine la citazione di un sito il cui nome è un programma. Si tratta di European Tech Map, che al suo interno conta ben 2.371 aziende tecnologiche europee, di cui 192 nella categoria specifica “AI and Machine Learning”. Insomma, la volontà di creare un ecosistema Ue del digitale c’è eccome.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ai-basta-dire-che-lue-dipende-dagli-usa-la-mappa-di-46-aziende-europee/561335/


AI. I grandi data center creano nuove ‘isole di calore’ dove vivono 340 milioni di persone

La ricerca di Cambridge su 6.000 data center hyperscale: aumentano mediamente la temperatura di oltre 2°C, cambiando il clima locale

Le aree che ospitano grandi data center dedicati all’intelligenza artificiale (AI) stanno registrando un aumento medio della temperatura superficiale di 3,6 gradi Fahrenheit (circa 2 °C), con picchi che possono arrivare fino a 16,4 gradi Fahrenheit (oltre 9 °C). È quanto emerge da una nuova ricerca guidata da Andrea Marinoni, associate professor dell’Earth Observation group dell’Università di Cambridge, che ha analizzato oltre 6.000 data center distribuiti a livello globale.

Lo studio (non ancora sottoposto a revisione paritaria) evidenzia un fenomeno finora poco indagato: la formazione di vere e proprie “isole di calore” legate alle infrastrutture digitali, con effetti che si estendono fino a 6,2 miglia (circa 10 km) di distanza e che coinvolgono oltre 340 milioni di persone.

Il dato di partenza: fa più caldo dove nascono i data center

L’analisi si basa su un confronto tra dati satellitari di temperatura raccolti negli ultimi 20 anni e la localizzazione dei cosiddetti hyperscaler, ovvero data center di grandi dimensioni costruiti soprattutto nell’ultimo decennio.

Per isolare l’effetto specifico dei data center, i ricercatori hanno scelto siti al di fuori delle aree urbane densamente popolate, escludendo così interferenze legate ad attività industriali, riscaldamento domestico o traffico. Inoltre, sono stati filtrati gli effetti della stagionalità e del riscaldamento globale.

Il risultato è chiaro: dopo l’entrata in funzione di un data center, la temperatura superficiale locale aumenta in modo sistematico.

Perché i data center generano calore

Dal punto di vista tecnico, il fenomeno è spiegabile con la natura stessa dei data center. Queste infrastrutture:

  • ospitano migliaia di server che operano ininterrottamente;
  • richiedono enormi quantità di energia per il calcolo;
  • utilizzano sistemi di raffreddamento intensivi per evitare il surriscaldamento delle apparecchiature.

Questo processo comporta una trasformazione continua di energia elettrica in calore disperso nell’ambiente. In altre parole, non solo i data center consumano energia, ma rilasciano attivamente calore residuo, contribuendo a modificare il microclima circostante.

I casi studio: Messico e Spagna

I risultati sono stati riscontrati in diverse aree del mondo. Due esempi emblematici:

  • Regione del Bajío (Messico): negli ultimi 20 anni si è registrato un aumento di circa 3,6 °F, non spiegabile da altre variabili climatiche note.
  • Aragona (Spagna): area diventata hub europeo per data center AI, con un incremento analogo di 3,6 °F, non replicato nelle province limitrofe.

Questi casi rafforzano l’ipotesi che la presenza dei data center sia un fattore determinante nell’alterazione delle temperature locali.

Impatti estesi, non solo effetti locali: coinvolte 340 milioni di persone

Uno degli aspetti più rilevanti dello studio è la scala dell’impatto. Le anomalie termiche non si limitano all’area immediatamente circostante, ma si propagano fino a diversi chilometri, contribuendo a creare condizioni di maggiore stress termico per le comunità locali.

Secondo i ricercatori, oltre 340 milioni di persone vivono in aree interessate da questo effetto. In un contesto globale già segnato dall’aumento delle temperature e da ondate di calore più frequenti, questo contributo locale può amplificare i rischi per la salute, l’economia e gli ecosistemi.

Un fenomeno da studiare meglio e c’è chi invita alla cautela

Marinoni sottolinea che esistono ancora ampie lacune nella comprensione degli impatti complessivi dei data center, nonostante la loro rapida diffusione. L’obiettivo della ricerca è proprio stimolare un dibattito più ampio su come gestire questa crescita.

Anche altri esperti invitano alla cautela. Ralph Hintemann, senior researcher presso il Borderstep Institute for Innovation and Sustainability, ha definito i risultati “interessanti”, ma ha osservato che gli effetti riportati “sembrano molto elevati” e necessitano di ulteriori verifiche. Ha inoltre ricordato che, in termini climatici globali, le emissioni legate alla produzione di energia per alimentare i data center restano la principale preoccupazione.

Data center restano strategici, ma c’è da aumentare la loro sostenibilità energetica e ambientale

Il tema si inserisce in un contesto di forte espansione dell’intelligenza artificiale. La domanda di capacità computazionale è in crescita esponenziale e con essa la costruzione di nuove infrastrutture high‑density computing.

Lo studio non mette in discussione il ruolo strategico dei data center e dell’AI nello sviluppo economico e tecnologico. Piuttosto, evidenzia la necessità di:

  • migliorare l’efficienza energetica,
  • sviluppare sistemi di raffreddamento meno impattanti,
  • pianificare la localizzazione delle infrastrutture,
  • integrare queste valutazioni nelle politiche ambientali e industriali.

Come sottolinea Marinoni, “potrebbe esserci ancora tempo per considerare un percorso diverso”, capace di coniugare innovazione tecnologica e sostenibilità ambientale.

In definitiva, la ricerca apre un nuovo fronte nel dibattito sulla transizione digitale: accanto ai benefici dell’AI, emergono impatti fisici e territoriali concreti, che richiedono analisi rigorose e politiche lungimiranti.

Il riuso del calore dei data center, la possibilità del teleriscaldamento: trasformare uno scarto in risorsa

Se da un lato i data center contribuiscono alla formazione di isole di calore locali, dall’altro rappresentano anche una fonte energetica potenzialmente recuperabile. Le tecnologie di riuso del calore stanno emergendo come una delle leve più promettenti per ridurre l’impatto ambientale complessivo di queste infrastrutture.

Il calore prodotto dai sistemi di raffreddamento può essere recuperato tramite scambiatori di calore e immesso in reti di acqua calda per il teleriscaldamento urbano. Questo consente di alimentare abitazioni, scuole, ospedali e interi quartieri.

Esempi concreti sono già operativi: a Høje-Taastrup, in Danimarca, Microsoft utilizza il calore di un proprio data center per riscaldare migliaia di appartamenti, con una riduzione significativa delle emissioni di CO₂. In questo modo, un sottoprodotto del calcolo digitale diventa un elemento attivo della transizione energetica.

Il caso di Milano

A Milano è stata avviata la prima partnership industriale in Italia per il recupero di calore dai data center destinato al teleriscaldamento. Grazie ad una collaborazione tra A2A, DBA Group e Retelit, l’energia generata da “Avalon 3” alimenterà la rete cittadina nel Municipio 6 di Milano. Si tratta del più recente e sostenibile data center iperconnesso che con i suoi oltre 3.500 mq e 3,2 MW di potenza rappresenta il più grande punto di interconnessione internet d’Italia.

Grazie alla disponibilità di 2,5 MW di potenza termica e al recupero di 15 GWh termici, la rete di teleriscaldamento potrà servire oltre 1.200 famiglie in più ogni anno. Il progetto non solo permetterà di ridurre lo spreco di calore, ma consentirà anche un risparmio energetico pari a 1.300 TEP (tonnellate equivalenti di petrolio), evitando al contempo l’emissione di 3.300 tonnellate di CO2 con benefici ambientali pari al contributo di 24.000 alberi.

Riscaldamento diretto di edifici e infrastrutture

Un’altra applicazione consiste nel convogliare il calore verso edifici adiacenti, come uffici, centri sportivi, ospedali o piscine. Questo permette di mantenere temperature adeguate riducendo o eliminando l’uso di caldaie a gas.

I progetti pilota sviluppati in Europa mostrano risultati rilevanti: tra il 60% e il 90% del calore generato dai server può essere recuperato e riutilizzato, con una riduzione dei consumi fossili locali di diverse decine di punti percentuali.

Accumulo termico e integrazione nei sistemi energetici locali

Una delle sfide principali è la gestione della variabilità tra produzione e domanda di calore. Per questo si stanno diffondendo sistemi di accumulo termico, vere e proprie “batterie di calore”, spesso basate su materiali a cambiamento di fase (PCM).

Queste soluzioni permettono di immagazzinare il calore e rilasciarlo nei momenti di maggiore richiesta, contribuendo a stabilizzare i consumi e a integrare il data center in un ecosistema energetico locale, ad esempio in combinazione con fonti rinnovabili o reti di quartiere.

Applicazioni industriali e agricole

Il calore residuo, anche a temperature relativamente basse (30–60 °C), può essere utilizzato in diversi ambiti produttivi. In ambito industriale, può supportare processi come lavaggi, asciugature o pre-riscaldamento di fluidi.

Nel settore agricolo, trova applicazione nel riscaldamento di serre, allevamenti o nei processi di essiccazione. In alcuni casi, il recupero del calore si integra con sistemi di trigenerazione, che combinano produzione di elettricità, raffreddamento e calore, massimizzando l’efficienza complessiva.

Non sempre è possibile

Sicuramente il riuso dell’energia in eccesso generata dai grandi data center può essere riutilizzata, ma già sappiamo che il teleriscaldamento presenta dei limiti strutturali da tenere bene in conto.

Il calore dei data center è spesso disponibile a bassa o media temperatura (30–60 °C), quindi per non subire la dispersione in trasporto serve una rete di teleriscaldamento già presente e relativamente vicina (qualche chilometro).

Se il data center è situato lontano dai centri industriali o in area non urbanizzata, inoltre, realizzare una nuova rete diventa costoso e economicamente poco sostenibile, soprattutto per piccoli e medi impianti.

Un’opportunità da integrare nelle politiche industriali

Queste soluzioni, quindi, non eliminano il problema delle isole di calore, ma offrono in molti casi una strada concreta per mitigarne gli effetti e valorizzare l’energia dissipata. La sfida, oggi, è passare da progetti pilota a una pianificazione sistemica, in cui i data center vengano progettati fin dall’inizio come nodi attivi delle reti energetiche locali.

In questo senso, il tema non riguarda solo l’efficienza tecnologica, ma anche la capacità delle politiche pubbliche e industriali di integrare sempre di più transizione digitale ed energetica, trasformando un impatto ambientale in una leva di sostenibilità. L’innovazione tecnologica è dalla nostra parte, sfruttiamola fino in fondo.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ai-i-grandi-data-center-creano-nuove-isole-di-calore-dove-vivono-340-milioni-di-persone/561330/


Here’s what that Claude Code source leak reveals about Anthropic’s plans

Yesterday’s surprise leak of the source code for Anthropic’s Claude Code revealed a lot about the vibe-coding scaffolding the company has built around its proprietary Claude model. But observers digging through over 512,000 lines of code across more than 2,000 files have also discovered references to disabled, hidden, or inactive features that provide a peek into the potential roadmap for future features.

Chief among these features is Kairos, a persistent daemon that can operate in the background even when the Claude Code terminal window is closed. The system would use periodic “<tick>” prompts to regularly review whether new actions are needed and a “PROACTIVE” flag for “surfacing something the user hasn’t asked for and needs to see now.”

Kairos makes use of a file-based “memory system” designed to allow for persistent operation across user sessions. A prompt hidden behind a disabled “KAIROS” flag in the code explains that the system is designed to “have a complete picture of who the user is, how they’d like to collaborate with you, what behaviors to avoid or repeat, and the context behind the work the user gives you.”

To organize and consolidate this memory system across sessions, the Claude Code source code includes references to an evocatively named AutoDream system. When a user goes idle or manually tells Anthropic to sleep at the end of a session, the AutoDream system would tell Claude Code that “you are performing a dream—a reflective pass over your memory files.”

This prompt describing this AI “dream” process asks Claude Code to scan the day’s transcripts for “new information worth persisting,” consolidate that new information in a way that avoids “near-duplicates” and “contradictions,” and prune existing memories that are overly verbose or newly outdated. Claude Code would also be instructed to watch out for “existing memories that drifted,” an issue we’ve seen previously when Claude users have tried to graft memory systems onto their harnesses. The overall goal would be to “synthesize what you’ve learned recently into durable, well-organized memories so that future sessions can orient quickly,” according to the prompt.

https://arstechnica.com/ai/2026/04/heres-what-that-claude-code-source-leak-reveals-about-anthropics-plans/


Running local models on Macs gets faster with Ollama’s MLX support

Ollama, a runtime system for operating large language models on a local computer, has introduced support for Apple’s open source MLX framework for machine learning. Additionally, Ollama says it has improved caching performance and now supports Nvidia’s NVFP4 format for model compression, making for much more efficient memory usage in certain models.

Combined, these developments promise significantly improved performance on Macs with Apple Silicon chips (M1 or later)—and the timing couldn’t be better, as local models are starting to gain steam in ways they haven’t before outside researcher and hobbyist communities.

The recent runaway success of OpenClaw—which raced its way to over 300,000 stars on GitHub, made headlines with experiments like Moltbook and became an obsession in China in particular—has many people experimenting with running models on their machines.

As developers get frustrated with rate limits and the high cost of top-tier subscriptions to tools like Claude Code or ChatGPT Codex, experimentation with local coding models has heated up. (Ollama also expanded Visual Studio Code integration recently.)

The new support is available in preview (in Ollama 0.19) and currently supports only one model—the 35 billion-parameter variant of Alibaba’s Qwen3.5. Hardware requirements are intense by normal users’ standards. Users need an Apple Silicon-equipped Mac, sure, but they also need at least 32GB of RAM, according to Ollama’s announcement.

https://arstechnica.com/apple/2026/03/running-local-models-on-macs-gets-faster-with-ollamas-mlx-support/


Chip AI, inizia la corsa all’elio. Per la guerra nel Golfo tagli alle forniture e rialzo dei prezzi

La guerra del Golfo si ripercuote sulle forniture globali di elio, essenziale per la produzione di chip AI

La guerra di Stati Uniti e Israele con l’Iran non ha destabilizzato solamente il mercato energetico mondiale. Secondo quanto riportato dal Wall Street Journal, presto a mancare sarà anche l’elio. Un prodotto derivato dal gas naturale e utilizzato principalmente nella produzione di chip per l’intelligenza artificiale (AI).

Il problema è che l’elio è un elemento raro sul nostro pianeta. C’è ne tanto nell’universo, ma è scarso sulla Terra. Qui da noi lo si trova generalmente in piccolissime concentrazioni e sempre in giacimenti di gas naturale.

In più, un terzo circa delle forniture mondiali di questo gas arrivano dal Qatar e via mare attraverso lo stretto di Hormuz. Motivo per cui, entro pochissimo tempo l’elio diventerà una risorsa scarsa.

Gli attacchi di Teheran sul Qatar e il blocco della navigazione in quel tratto di mare che collega i Paesi del Golfo con il Mare Arabico e quindi l’Oceano Indiano, rendono a dir poco incerte queste forniture per il futuro e i mercati se ne sono accorti subito.

Previsti tagli alle forniture e rialzo dei prezzi

Il quotidiano americano spiega che, già oggi, i principali fornitori stanno avvertendo alcuni clienti di aspettarsi “tagli alle forniture e sovrapprezzi”, secondo quanto riferito da operatori del settore.

Gli utilizzatori di elio, che per lo più si assicurano le forniture tramite contratti a lungo termine, “si stanno già contendendo i pochi carichi disponibili sul mercato spot a breve termine”, aprendo di fatto “una vera e propria guerra di offerte che ha fatto più che raddoppiare i prezzi”.

La Corea del Sud, uno dei principali produttori di chip per l’AI, che dipende fortemente dalle forniture del Qatar (60-70%), si è subito rivolta ai produttori degli Stati Uniti per ottenere ulteriori volumi di gas.

Il prezzo spot dell’elio gassoso si aggira oggi sui 900-1.200 dollari per mille piedi cubi (Mcf), con picchi fino a 2.000 dollari in alcune transazioni di emergenza legate alla crisi del Golfo.
È salito del 50-100% rispetto all’inizio di marzo 2026, quando oscillava tra 450-600 dollari/Mcf.
Un trend che potrebbe peggiorare però, perchè se la guerra perdurerà anche nei prossimi mesi il prezzo dell’elio potrebbe crescere ulteriormente durante il secondo trimestre dell’anno in corso.

Perché è importante l’elio

Si tratta di un gas invisibile ‘essenziale’ per raffreddare le apparecchiature utilizzate nella produzione di chip per l’intelligenza artificiale, ma anche per altri usi, come ad esempio il corretto funzionamento degli scanner per la risonanza magnetica.

Altri utilizzi chiave dell’elio li ritroviamo nel settore aerospaziale, comprese le missioni della NASA, dove viene impiegato per spurgare i serbatoi di carburante dei razzi. È inoltre essenziale nella produzione di fibre ottiche e nelle applicazioni per la Difesa.

La scarsità dell’elio potrebbe perdurare

Anche se la guerra dovesse finire rapidamente e lo stretto venisse riaperto, molte delle perdite non sarebbero facili da recuperare. Il Qatar ha dichiarato che gli attacchi iraniani contro il suo impianto di GNL di Ras Laffan, avvenuti all’inizio di marzo, hanno causato danni ingenti, con l’effetto diretto di ridurre drasticamente le esportazioni annuali di elio del 14%.
La riparazione dei danni alle infrastrutture potrebbe richiedere fino a cinque anni.

“Lo shock dell’elio mette in luce una vulnerabilità più profonda nello sviluppo dell’IA: l’estrema dipendenza da un numero ristretto di nodi esposti a fattori geopolitici”, ha affermato Ralf Gubler, direttore della ricerca presso S&P Global Energy, specializzato in gas industriali.

“Se queste condizioni (interruzione dell’approvvigionamento) persistono, il mercato si troverà effettivamente a corto di circa 5,2 milioni di metri cubi di elio al mese“, ha affermato Aleksandr Romanenko, CEO della società di ricerche di mercato IndexBox, come riporta Reuters.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/chip-ai-inizia-la-corsa-allelio-per-la-guerra-nel-golfo-tagli-alle-forniture-e-rialzo-dei-prezzi/561086/


Authors’ lucky break in court may help class action over Meta torrenting

Because Meta was going to face the contributory infringement claim anyway, it would not prejudice Meta to require discovery on the issue so late in the class action, Chhabria wrote.

Further, “denying the motion to add the contributory infringement claim could potentially harm the interests of the proposed class members,” Chhabria said. If the class action proceeded without the claim, members would be barred from ever raising it, even if the Entrepreneur Media case ruling went against Meta, the judge noted.

“There is a serious concern that the interests of the absent class members would be harmed, through no fault of their own,” Chhabria wrote, while noting that he granted the authors’ request “reluctantly.”

“On the flip side,” Chhabria said, adding the claim to the class action basically “meant that if the named plaintiffs obtained summary judgment and subsequently obtained class certification, proposed class members would know, when deciding whether to opt out of the class, that they had essentially already won.”

Chhabria’s ruling perhaps incentivizes Meta to dodge these claims as fast as possible. He noted that Meta faces no discovery in the class action “until plaintiffs can get past summary judgment on the distribution and contributory infringement claims.”

Moving forward, authors may feel somewhat more optimistic that they could get a partial win. Chhabria explained the standard for contributory infringement as a lower bar, proving that Meta was “facilitating copyright infringement by third parties by uploading protected works onto the torrenting network.”

Yet the authors can’t be sure, since looming on the horizon, Meta is drafting a filing based on the Supreme Court ruling that could change the game.

Already, Meta is seemingly willing to make any argument to escape consequences for torrenting. It’s continuing to argue that the number of works at dispute is a small fraction of the total data that was torrented. And it has even claimed that there’s no way to prove that Meta ever knew that torrenting required uploading.

However, if Meta loses at the summary judgment stage, the authors are ready to argue that none of Meta’s internal discussions of torrenting should be privileged. If that discovery request is eventually granted, it could finally expose who exactly at Meta approved the torrenting and how well did they understand how BitTorrent works.

https://arstechnica.com/tech-policy/2026/03/meta-hopes-scotus-piracy-ruling-will-help-it-beat-lawsuit-over-torrenting-ai-data/