Chatbot-powered toys rebuked for discussing sexual, dangerous topics with kids
OpenAI says it doesn’t allow its LLMs to be used this way
When reached for comment about the sexual conversations detailed in the report, an OpenAI spokesperson said:
Minors deserve strong protections, and we have strict policies that developers are required to uphold. We take enforcement action against developers when we determine that they have violated our policies, which prohibit any use of our services to exploit, endanger, or sexualize anyone under 18 years old. These rules apply to every developer using our API, and we run classifiers to help ensure our services are not used to harm minors.
Interestingly, OpenAI’s representative told us that OpenAI doesn’t have any direct relationship with Alilo and that it hasn’t seen API activity from Alilo’s domain. OpenAI is investigating the toy company and whether it is running traffic over OpenAI’s API, the rep said.
Alilo didn’t respond to Ars’ request for comment ahead of publication.
Companies that launch products that use OpenAI technology and target children must adhere to the Children’s Online Privacy Protection Act (COPPA) when relevant, as well as any other relevant child protection, safety, and privacy laws and obtain parental consent, OpenAI’s rep said.
We’ve already seen how OpenAI handles toy companies that break its rules.
Last month, the PIRG released its Trouble in Toyland 2025 report (PDF), which detailed sex-related conversations that its testers were able to have with the Kumma teddy bear. A day later, OpenAI suspended FoloToy for violating its policies (terms of the suspension were not disclosed), and FoloToy temporarily stopped selling Kumma.
The toy is for sale again, and PIRG reported today that Kumma no longer teaches kids how to light matches or about kinks.
A marketing image for FoloToy’s Kumma smart teddy bear. It has a $100 MSRP.
A marketing image for FoloToy’s Kumma smart teddy bear. It has a $100 MSRP. Credit: FoloToys
But even toy companies that try to follow chatbot rules could put kids at risk.
L’AI e i suoi architetti “Persona dell’anno” 2025 per il TIME
Person of the year per il TIME sono l’AI e i suoi architetti: Zuckerberg, Lisa Su, Musk, Huang, Altman, Hassabis, Amodei e Fei-Fei Li
Per la prima volta nella sua lunga storia, TIME ha scelto di mettere in copertina come “persona dell’anno” 2025 non un singolo volto, ma una forza che sta ridisegnando il mondo: l’intelligenza artificiale (AI), insieme ai suoi architetti. L’immagine (realizzata da Jason Seiler e Peter Crowther per il TIME) non rappresenta solo un anno, ma forse un’epoca, in cui l’AI è uscita definitivamente dai laboratori per diventare un motore centrale della politica, dell’economia e dei mercati globali.
La foto ritrae Mark Zuckerberg (Meta), Lisa Su (Advanced Micro Devices), Elon Musk (Tesla e SpaceX), Jensen Huang (Nvidia, che si guadagna anche il titolo di “Persona dell’anno 2025” per il Financial Times), Sam Altman (OpenAI), Demis Hassabis (Google DeepMind), Dario Amodei (Anthropic) e Fei-Fei Li (AI4ALL) su una trave sospesa nel vuoto, come quella storica che immortalava degli operai in pausa pranzo. Una foto, quella del 1932, emblema di un’epoca ormai lontana, a cui questa vuole ‘fare il verso’, come si dice, e forse a ragione.
AI e concentrazione di ricchezza estrema nelle mani di pochi, come 100 anni fa
Più di 100 anni fa una dozzina di operai consumavano il pranzo, appunto, su una trave a 250 metri di altezza (il concetto di sicurezza sul lavoro era a dir poco vago). Il titolo di quella straordinaria foto “Lunch atop a skyscraper” (pranzo su un grattacielo) non si riferiva, come tanti hanno creduto per decenni, all’Empire State Building, edificio più alto del mondo a quel tempo, ma al Rockefeller Center di New York.
Cosa hanno a che fare Zuckerberg, Musk, Huang, Altman e compagni con quegli operai in vesti logore e segnati dal duro lavoro del cantiere (per di più sospesi nel vuoto)? Niente. Ma forse un punto di incontro c’è: quegli operai lavoravano per l’uomo più ricco del mondo al tempo, John D. Rockefeller Sr., che da solo deteneva un patrimonio pari al 2% del PIL USA del 1932 (mentre altri grandi magnati come il patron dell’omonima casa automobilistica Henry Ford e il banchiere e Segretario del Tesoro USA, Andrew Mellon – una costante la presenza di miliardari nella storia dei Governi americani – dominavano settori chiave come petrolio e industria pesante).
La somma totale delle ricchezze nette di Mark Zuckerberg, Lisa Su, Elon Musk, Jensen Huang, Sam Altman, Demis Hassabis, Dario Amodei e Fei-Fei Li, sfiora i 1.000 miliardi di dollari (in crescita ovviamente). Parliamo dell’1% del PIL globale nelle mani di sole 8 persone (il PIL mondiale oggi è calcolato attorno ai 98.000 miliardi di dollari circa).
Perché l’intelligenza artificiale e i suoi ‘architetti’ sono finiti sulla copertina del TIME?
Il 2025, secondo la celebre rivista, è stato l’anno in cui non è stato più possibile ignorare l’AI. Dalla medicina alla finanza, dall’istruzione alla Difesa, ogni grande dibattito pubblico ha avuto l’intelligenza artificiale come risposta, soluzione o problema. “Qualunque fosse la domanda, l’AI era la risposta”, scrive la rivista.
TIME ricorda che questa non è la prima volta che una tecnologia conquista la copertina. Nel 1982 fu il personal computer a essere scelto come Person of the Year; nel 2006 toccò a “You”, simbolo delle comunità digitali. Scelte controverse allora, considerate oggi profetiche. Settantacinque anni fa, nel 1950, TIME dedicò la copertina al computer Mark III, definendolo “the thinking machine”. Oggi, quasi inutile sottolinearlo, quel futuro è diventato presente, oggetto dato per scontato nella nostra quotidianità.
Il racconto simbolico di questa copertina parte comunque da Washington, gennaio di quest’anno: mentre Donald Trump tornava alla Casa Bianca e i leader politici si riunivano per l’inaugurazione presidenziale, i vertici delle Big Tech erano in prima fila. Ma lontano dai riflettori, nello stesso giorno, una società cinese poco conosciuta, DeepSeek, rilasciava un nuovo modello di intelligenza artificiale che scuoteva i mercati finanziari globali, alimentando timori e competizione.
Il giorno dopo, tre nomi-simbolo della nuova economia digitale – Sam Altman (OpenAI), Larry Ellison (Oracle) e Masayoshi Son (SoftBank) – si presentavano alla Casa Bianca annunciando Stargate, un piano da fino a 500 miliardi di dollari per costruire data center dedicati all’AI negli Stati Uniti. Due giorni, due segnali chiarissimi: l’AI è geopolitica, industria, finanza e potere.
Per TIME, sono questi uomini – e i team che guidano – ad aver “immaginato, progettato e costruito” l’età delle macchine pensanti. Da qui il titolo: gli “Architects of AI, Person of the Year 2025”.
[embedded content]
L’AI come motore dell’economia globale
Il motivo profondo della scelta è economico, secondo un’analisi della Nexford University. Secondo il McKinsey Global Institute, se l’adozione dell’AI procederà ai livelli medi stimati dalle simulazioni, l’impatto potrebbe essere di circa 13.000 miliardi di dollari di nuova attività economica globale entro il 2030. Parliamo di un +16% di PIL cumulato rispetto a oggi, ovvero 1,2 punti percentuali di crescita aggiuntiva ogni anno.
Un impatto paragonabile a quello delle grandi tecnologie general purpose del passato, come l’elettricità o il motore a combustione. La crescita arriverebbe soprattutto da due fattori: automazione e sostituzione del lavoro umano; innovazione accelerata di prodotti e servizi.
Entro il 2030, sempre secondo McKinsey, circa il 70% delle aziende nel mondo avrà adottato almeno una tecnologia di AI, anche se meno della metà riuscirà ad assorbirne pienamente tutte le principali categorie.
Non è un caso che Jensen Huang, CEO di Nvidia – oggi la società con la maggiore capitalizzazione al mondo – abbia dichiarato a TIME: “Ogni industria ne ha bisogno, ogni azienda la usa e ogni nazione deve costruirla. Questa è la tecnologia più impattante del nostro tempo”.
L’AI avanza a una velocità mai vista. Secondo uno studio citato da TIME, le capacità dei sistemi di intelligenza artificiale raddoppiano quasi due volte l’anno. In poche settimane, abbiamo visto l’AI:
contribuire a risolvere un problema matematico irrisolto da 30 anni,
superare i modelli tradizionali di previsione degli uragani,
aprire persino nuove frontiere nella comunicazione con i cetacei.
Compiti che richiedevano ore di lavoro umano vengono svolti in secondi. È questa accelerazione a rendere l’AI così centrale e allo stesso tempo così destabilizzante.
Il lato oscuro: lavoro, disuguaglianze, rischio sistemico
Ma rispetto al TIME, non vogliamo ignorare il prezzo di questa rivoluzione e i suoi potenziali (per alcuni esperti ‘certi’) effetti negativi sulla società nel suo insieme, in particolare il mondo del lavoro. Anzi, lo mettiamo al centro del racconto.
Secondo il World Economic Forum, entro il 2026 l’intelligenza artificiale potrebbe sostituire circa 85 milioni di posti di lavoro. Freethink stima che il 65% dei lavori nel retail potrebbe essere automatizzato già entro quella data.
Guardando più avanti, PwC prevede che entro la metà degli anni 2030 fino al 30% dei posti di lavoro potrebbe essere automatizzabile, con un impatto maggiore sugli uomini nel lungo periodo (trasporti, manifattura, lavori manuali), mentre nelle prime fasi sarebbero le donne a essere più esposte, per la loro maggiore presenza in ruoli amministrativi e clericali.
I primi effetti negativi sull’occupazione già evidenti, altri sono attesi nel 2026
Un rapporto di Goldman Sachs parla di numeri ancora più impressionanti:
300 milioni di posti di lavoro equivalenti a tempo pieno potenzialmente sostituibili a livello globale,
due terzi dei lavori negli Stati Uniti e in Europa esposti in qualche misura all’automazione,
circa un quarto delle mansioni completamente svolgibile dall’AI.
Lo stesso report stima però anche un possibile aumento del valore annuo della produzione globale del 7%, segno di una trasformazione che distrugge e crea allo stesso tempo.
Altri studi rafforzano il quadro:
MIT e Boston University, citati da Forbes, stimano fino a 2 milioni di posti di lavoro manifatturieri persi entro il 2026;
McKinsey Global Institute avverte che almeno il 14% dei lavoratori globali dovrà cambiare carriera entro il 2030 a causa di AI, robotica e digitalizzazione.
Le parole espresse dal presidente della Federal Reserve (la Banca centrale americana), Jerome Powell, suonano come un monito: “Il mercato del lavoro statunitense potrebbe essere ancora più debole di quanto si pensasse in precedenza“, in riferimento ai dati snocciolati dall’amministrazione Trump negli ultimi mesi. L’accusa è che Washington potrebbe sovrastimare la creazione mensile di posti di lavoro per ovvi motivi politici: “è un po’ curioso che i titoli sui licenziamenti di migliaia di dipendenti, da parte di grandi aziende, con l’intelligenza artificiale citata come una delle ragioni principali alla base dei tagli, non si siano finora tradotti in un aumento evidente della disoccupazione“.
[embedded content]
Perché proprio ora l’AI?
Mettere l’intelligenza artificiale – e i suoi architetti – in copertina significa riconoscere che non c’è più ritorno, né possibilità di restare fuori. L’AI sta ridefinendo crescita economica, produttività, lavoro e potere, concentrando enormi risorse nelle mani di pochi leader industriali, in una dinamica che ricorda l’età dei “robber barons”.
TIME non celebra né condanna: racconta una svolta storica. L’AI stupisce, spaventa, promette ricchezza e genera disuguaglianze. Sta trasformando il presente e ampliando i confini del possibile.
Per questo, nel bene e nel male, gli Architects of AI sono la Person of the Year 2025. Non perché abbiano tutte le risposte, ma perché hanno costruito la macchina che ora pone le domande a tutta l’umanità. Pensavano di doverle porre noi all’AI, ma molto probabilmente è la tecnologia a porle a noi, facendole emergere piano piano dall’inconscio collettivo turbato da questa velocità impressa dall’innovazione alla nostra storia.
(Sinistre) Similitudini storiche attorno ad una trave
Tornando all’immagine del 1932, con cui abbiamo aperto questo articolo, fu scattata da autore ancora oggi ignoto nel pieno di quella che è passata alla storia con il nome di Grande Depressione. Una crisi drammatica che mise in ginocchio gli Stati Uniti, togliendo lavoro a più di 15 milion di americani.
Quella foto rappresenta però anche un riscatto, una voglia di cambiare pagina, in una città, New York, che ha sempre avuto il ruolo di motore dell’innovazione e del cambiamento. Di lì a poco il Paese sarebbe ripartito con un nuovo ciclo di crescita e benessere.
Oggi in molti si aspettano dall’AI la stessa impennata, in momento storico di grandi cambiamenti, turbolenze economiche e commerciali, tensioni geopolitiche crescenti e paura per il futuro sempre più incerto e avvolto dalle nebbie della guerra (o delle guerre). Altri, invece, si attendono dall’AI un’onda d’urto finanziaria di portata epocale, visti i pericoli e gli allarmi di una possibile bolla finanziaria legata a questa tecnologia chiave per il nostro tempo.
Sono tanti i punti in comune tra quello che accadeva più di 100 anni fa e oggi, speriamo che davvero la Storia non si ripeta mai (la fine degli anni ’30 portano al capitolo forse più buio della storia dell’umanità), ma sappiamo che presenta però pattern ciclici con grandi similitudini, una di queste è proprio la concentrazione estrema di ricchezza nelle mani di pochi individui.
Runway claims its GWM-1 “world models” can stay coherent for minutes at a time
Even using the word “general” has an air of aspiration to it. You would expect a general world model to be, well, one model—but in this case, we’re looking at three distinct, post-trained models. That caveats the general-ness a bit, but Runway says that it’s “working toward unifying many different domains and action spaces under a single base world model.”
A competitive field
And that brings us to another important consideration: With GWM-1, Runway is entering a competitive gold-rush space where its differentiators and competitive advantages are less clear than they were for video. With video, Runway has been able to make major inroads in film/television, advertising, and other industries because its founders are perceived as being more rooted in those creative industries than most competitors, and they’ve designed tools with those industries in mind.
There are indeed hypothetical applications of world models in film, television, advertising, and game development—but it was apparent from Runway’s livestream that the company is also looking at applications in robotics as well as physics and life sciences research, where competitors are already well-established and where we’ve seen increasing investment in recent months.
Many of those competitors are big tech companies with massive resource advantages over Runway. Runway was one of the first to market with a sellable product, and its aggressive efforts to court industry professionals directly has so far allowed it to overcome those advantages in video generation, but it remains to be seen how things will play out with world models, where it doesn’t enjoy either advantage any more than the other entrants.
Regardless, the GWM-1 advancements are impressive—especially if Runway’s claims about consistency and coherence over longer stretches of time are true.
Runway also used its livestream to announce new Gen 4.5 video generation capabilities, including native audio, audio editing, and multi-shot video editing. Further, it announced a deal with CoreWeave, a cloud computing company with an AI focus. The deal will see Runway utilizing Nvidia’s GB300 NVL72 racks on CoreWeave’s cloud infrastructure for future training and inference.
Disney investe 1 miliardo di dollari in OpenAI, 200 personaggi animati per alimentare Sora
Accordo storico tra Walt Disney Company e OpenAI sull’AI
The Walt Disney Company segna una svolta nel panorama dei media e delle tecnologie digitali, annunciando un accordo di licenza triennale e un significativo investimento in OpenAI di un miliardo di euro.
Disney diventa così il primo grande partner di licenza per i contenuti sulla piattaforma di generazione video tramite intelligenza artificiale, Sora, e per ChatGPT Images.
L’intesa è di vasta portata e trasforma Disney, precedentemente in prima linea in battaglie legali per la protezione del proprio copyright contro l’uso non autorizzato di AI, in un partner strategico di OpenAI.
I punti chiave dell’accordo
A partire dall’inizio del 2026, gli utenti di Sora e ChatGPT Images potranno generare video e immagini con oltre 200 personaggi animati, creature, costumi, oggetti di scena, veicoli e ambienti iconici tratti dagli universi Disney, Marvel, Pixar e Star Wars.
L’accordo esclude esplicitamente l’utilizzo delle voci o delle sembianze di attori e talenti reali, un elemento cruciale per la tutela dei diritti degli artisti.
Disney effettuerà un investimento azionario di 1 miliardo di dollari in OpenAI e riceverà warrant per l’acquisto di ulteriore capitale, cementando la partnership. Diventerà anche un importante cliente di OpenAI, utilizzando le sue API per sviluppare nuovi prodotti ed esperienze, anche per la piattaforma streaming Disney+, e implementando il chatbot ChatGPT per i propri dipendenti.
Selezioni curate di video generati dagli utenti su Sora saranno rese disponibili per la visione su Disney+, e la collaborazione tra le due aziende mira a creare nuove esperienze interattive per gli abbonati.
“Rispettando e proteggendo i creatori e le loro opere”
“Il rapido avanzamento dell’intelligenza artificiale segna un momento importante per la nostra industria, e attraverso questa collaborazione con OpenAI estenderemo in modo ponderato e responsabile la portata della nostra narrazione attraverso l’AI generativa, rispettando e proteggendo i creatori e le loro opere”, ha commentato in nota ufficiale Robert A. Iger, CEO di The Walt Disney Company.
“Questo accordo dimostra come le aziende AI e i leader creativi possano lavorare insieme in modo responsabile – ha sottolineato Sam Altman, co-fondatore e CEO di OpenAI – per promuovere l’innovazione a beneficio della società, rispettare l’importanza della creatività e aiutare le opere a raggiungere nuovi vasti pubblici”.
Implicazioni per l’industria media e l’AI
Questo accordo potrebbe rappresentare un cambio di paradigma nel rapporto tra i grandi studios di Hollywood e l’AI generativa. Giusto ad ottobre la Motion Picture Association (MPA) invitava OpenAI ad adottare “misure immediate e decisive” per impedire la violazione del copyright su Sora.
In un momento in cui l’industria è alle prese con le sfide del copyright nell’era dell’AI (Disney stessa ha recentemente intrapreso azioni legali contro altri generatori di immagini AI), la partnership con OpenAI sancisce la volontà dello storico studio di animazione di Burbank (che ha compiuto da poco 100 anni) di integrare la tecnologia, non di respingerla, ma di farlo in modo regolamentato e a pagamento.
Questo modello di licenza ufficiale offre un potenziale percorso per trasformare la proprietà intellettuale da fonte di contenzioso a nuova fonte di ricavo nell’economia dell’AI.
Le aziende hanno infatti annunciato un impegno congiunto per un uso responsabile dell’AI che protegga la sicurezza degli utenti e i diritti dei creatori, mantenendo “robusti controlli” per prevenire la generazione di contenuti illegali o dannosi.
L’alleanza tra il colosso dell’intrattenimento e il pioniere dell’AI generativa non è solo una notizia finanziaria rilevante, visto anche l’importo dell’investimento, ma un segnale che il futuro della creazione di contenuti personalizzati e fan-inspired passerebbe (il condizionale è ancora d’obbligo) inevitabilmente attraverso l’intelligenza artificiale, purché si stabiliscano regole chiare e si tutelino i diritti dei creatori.
Data center, il mercato globale delle infrastrutture volerà verso i 497 miliardi di dollari entro il 2035
Cresce il valore mondiale del mercato infrastrutture data center
Il mercato delle infrastrutture legate ai data center è in piena fase di trasformazione e accelerazione, agendo da catalizzatore per l’economia digitale globale. La domanda in crescita esponenziale per il cloud computing, l’intelligenza artificiale (AI) e la data analytics sta forzando un’onda di investimenti senza precedenti in sistemi modulari, scalabili ed estremamente efficienti dal punto di vista energetico.
Le dimensioni del mercato globale delle infrastrutture dei data center sono state stimate raggiungere i 160 miliardi di dollari di valore entro la fine di quest’anno, ma per il 2035, secondo un Report pubblicato da DC Market Insights, si attende un ulteriore crescita a circa 497 miliardi di dollari.
Di fatto, gli analisti stanno osservando che l’infrastruttura di un data center non è più solo un costo operativo, ma un vero e proprio asset strategico che abilita la resilienza operativa e la trasformazione digitale a livello aziendale e governativo. Un elemento chiave della trasformazione digitale aziendale e non solo.
L’infrastruttura dei data center abilita il cloud computing e indica l’insieme di componenti fisici e tecnologici che supportano il funzionamento di un data center, ovvero la struttura che ospita server, storage e reti per elaborare, archiviare e distribuire dati e applicazioni. Parliamo di hardware IT come server, sistemi di storage (DAS, NAS, SAN), switch, router e firewall per la connettività, oltre a cablaggio e topologie di rete varie.
Trend globale e proiezioni finanziarie
Il trend è caratterizzato da una crescita robusta, guidata dalla necessità di gestire volumi di dati sempre maggiori con latenze minime, si legge nel documento.
Il mercato è chiaramente dominato dal Nord America, che detiene una quota significativa. Tuttavia, la regione Asia-Pacifico si distingue come l’area con la crescita più rapida (CAGR del 13,2% ), segno di una digitalizzazione massiva e di ingenti investimenti in paesi chiave come Cina e India.
Gli USA rimangono l’asse portante della transizione digitale. Il dominio dell’hyperscale e dell’AI
Il Nord America è il pioniere e il leader indiscusso del mercato, con un valore stimato di circa 59,76 miliardi di dollari nel 2025. La regione beneficia di una presenza schiacciante di operatori hyperscale e di una rapida espansione dei carichi di lavoro guidati dall’Intelligenza Artificiale.
Tra i driver principali, troviamo: adattamento massiccio al cloud, forte infrastruttura Internet e investimenti continui in strutture Tier 3 e Tier 4.
La Northern Virginia, il più grande hub di data center negli Stati Uniti, ha registrato un aumento dell’80\% della capacità in costruzione nella prima metà del 2025, raggiungendo 2,078.2 megawatt, evidenziando la leadership della regione nello sviluppo su larga scala.
Sostenibilità e colocation rigorosa in Europa
Il mercato europeo, con un valore di circa 41,79 miliardi di dollari nel 2025, è guidato da una forte enfasi sulla sostenibilità e sulla conformità normativa, in particolare il GDPR per la localizzazione dei dati. Entro il 2035 potrebbe valere 122,2 miliardi di dollari stando al Report.
Regno Unito, Germania e Paesi Bassi Read rimangono gli hub digitale.
I fattori chiave sono gli obiettivi di efficienza energetica, le politiche di localizzazione dei dati e lo sviluppo di grandi poli di colocation. Tra i pilastri del settore e delle politiche comunitarie troviamo: l’infrastruttura verde, il raffreddamento efficiente e l’uso di energia rinnovabile come standard. I centri Tier 3 e Tier 4, inoltre, sono in espansione nei principali hub (Regno Unito, Germania, Paesi Bassi) per garantire resilienza digitale e sovranità dei dati.
Asia-Pacifico e il futuro del digitale a trazione veloce
L’Asia-Pacifico è il motore di crescita più veloce a livello regionale, raggiungendo circa 42,97 miliardi di dollari nel 2025 e proiettato a quasi 149,84 miliardi di dollari entro il 2035. La regione è un punto caldo per gli investimenti grazie alla rapida digitalizzazione e all’adozione del cloud.
I principali driver di questa crescita sono: il rollout del 5G, l’adozione massiccia dell’AI e gli ingenti investimenti governativi in Cina, India e Sud-est asiatico.
La modernizzazione delle infrastrutture per supportare l’edge computing e la crescita degli hyperscaler locali rappresentano le maggiori opportunità di sviluppo delle infrastrutture. Il Report prospetta che la capacità elettrica per i data center in Cina crescerà significativamente quest’anno per soddisfare l’aumento della domanda di AI.
Big Tech joins forces with Linux Foundation to standardize AI agents
Big Tech has spent the past year telling us we’re living in the era of AI agents, but most of what we’ve been promised is still theoretical. As companies race to turn fantasy into reality, they’ve developed a collection of tools to guide the development of generative AI. A cadre of major players in the AI race, including Anthropic, Block, and OpenAI, has come together to promote interoperability with the newly formed Agentic AI Foundation (AAIF). This move elevates a handful of popular technologies and could make them a de facto standard for AI development going forward.
The development path for agentic AI models is cloudy to say the least, but companies have invested so heavily in creating these systems that some tools have percolated to the surface. The AAIF, which is part of the nonprofit Linux Foundation, has been launched to govern the development of three key AI technologies: Model Context Protocol (MCP), goose, and AGENTS.md.
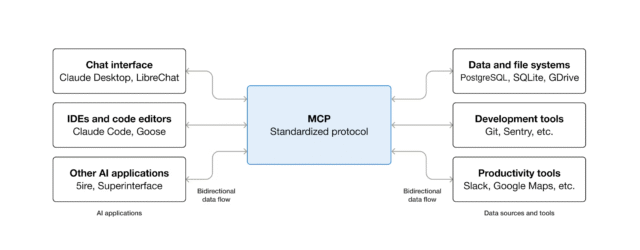
MCP is probably the most well-known of the trio, having been open-sourced by Anthropic a year ago. The goal of MCP is to link AI agents to data sources in a standardized way—Anthropic (and now the AAIF) is fond of calling MCP a “USB-C port for AI.” Rather than creating custom integrations for every different database or cloud storage platform, MCP allows developers to quickly and easily connect to any MCP-compliant server.
Since its release, MCP has been widely used across the AI industry. Google announced at I/O 2025 that it was adding support for MCP in its dev tools, and many of its products have since added MCP servers to make data more accessible to agents. OpenAI also adopted MCP just a few months after it was released.
Credit: Anthropic
Expanding use of MCP might help users customize their AI experience. For instance, the new Pebble Index 01 ring uses a local LLM that can act on your voice notes, and it supports MCP for user customization.
Local AI models have to make some sacrifices compared to bigger cloud-based models, but MCP can fill in the functionality gaps. “A lot of tasks on productivity and content are fully doable on the edge,” Qualcomm head of AI products, Vinesh Sukumar, tells Ars. “With MCP, you have a handshake with multiple cloud service providers for any kind of complex task to be completed.”
Svolta spaziale: l’IA prende i comandi sulla ISS e il robot Astrobee accelera del 60%
Mentre sulla Terra ci dibattiamo tra regolamentazioni dell’intelligenza artificiale e timori più o meno fondati, a 400 chilometri sopra le nostre teste l’IA ha appena preso la patente di guida. Per la prima volta nella storia, un sistema basato sull’apprendimento automatico (machine learning) ha preso il controllo di un robot sulla Stazione Spaziale Internazionale (ISS), dimostrando non solo di saper “guidare”, ma di farlo decisamente meglio dei sistemi tradizionali.
Per approfondire:
Protagonista di questa piccola rivoluzione è Astrobee, il robot cubico della NASA grande quanto un tostapane, che grazie ai ricercatori della Stanford University ha imparato a muoversi nei corridoi della stazione spaziale con una velocità superiore del 60% rispetto al passato.
[embedded content]
Il problema: lo spazio è un ambiente ostile (anche per i computer)
Potremmo pensare che la ISS sia il luogo tecnologicamente più avanzato che esista, ed è vero, ma i computer di bordo destinati a far girare gli algoritmi di navigazione sono spesso molto limitati rispetto a quelli terrestri. Devono resistere alle radiazioni e operare con risorse energetiche contingentate. Inoltre, l’interno della stazione è un incubo logistico: cavi, rack di stoccaggio, computer, esperimenti e astronauti che fluttuano ovunque.
Pianificare una traiettoria sicura in questo caos, utilizzando i metodi tradizionali di ottimizzazione, richiede una potenza di calcolo che rallenta le operazioni. È qui che entra in gioco l’intuizione del team di Stanford, guidato da Somrita Banerjee e dal professor Marco Pavone.
La soluzione: “Warm Start” vs “Cold Start”
L’approccio innovativo non sostituisce la sicurezza con l’imprudenza, ma cambia il punto di partenza. Invece di calcolare ogni movimento da zero (il cosiddetto “cold start” o partenza a freddo), il sistema utilizza un modello di machine learning addestrato su migliaia di soluzioni precedenti.
Il funzionamento può essere riassunto in questa tabella comparativa:
L’IA fornisce quindi una “ipotesi informata” (warm start), che l’algoritmo di ottimizzazione deve solo raffinare. Il risultato? Astrobee si è districato tra i moduli della ISS, evitando ostacoli e compiendo manovre complesse, con una fluidità mai vista prima, sotto lo sguardo vigile (ma passivo) dell’astronauta Sunita Williams.
Astrobee , il robot della Stazione Spaziale
Perché è fondamentale per il futuro
Non si tratta solo di far consegnare un cacciavite più velocemente a un astronauta. Questa tecnologia ha raggiunto il Livello di Maturità Tecnologica 5 (TRL 5), il che significa che funziona in un ambiente operativo reale.
Ecco perché questo sviluppo è cruciale:
Indipendenza dalla Terra: Man mano che ci spingeremo verso la Luna o Marte, il ritardo nelle comunicazioni renderà impossibile il telecontrollo da terra. I robot dovranno “pensare” da soli.
Risparmio di tempo: Gli astronauti sono la risorsa più costosa nello spazio. Se i robot possono operare in autonomia e velocemente, l’equipaggio può dedicarsi alla scienza invece che alla logistica.
Efficienza delle risorse: Algoritmi più snelli significano meno consumo energetico e meno carico sui computer di bordo.
Il team di Stanford guarda già oltre, puntando a modelli di IA ancora più potenti, simili a quelli usati per i veicoli a guida autonoma terrestri, per gestire situazioni ancora più impreviste. Per ora, possiamo dire che il piccolo Astrobee ha fatto un grande passo per la robotica autonoma.
Stazione Spaziale Internazionale – NASA
Domande e risposte
Perché i computer nello spazio sono meno potenti di quelli sulla Terra?
I computer spaziali devono essere “induriti” (radiation-hardened) per resistere alle radiazioni cosmiche che distruggerebbero i normali processori commerciali. Questo processo di protezione richiede tecnologie più datate e robuste, rendendoli spesso molto più lenti e meno performanti rispetto all’ultimo smartphone o laptop disponibile nei negozi terrestri. L’efficienza del software diventa quindi fondamentale per compensare i limiti dell’hardware.
Che differenza c’è tra questo sistema e la guida autonoma delle auto?
Il principio di base dell’utilizzo dell’IA per percepire l’ambiente e pianificare il percorso è simile, ma le sfide sono diverse. Nello spazio, il movimento avviene in tre dimensioni (microgravità) con sei gradi di libertà, in un ambiente chiuso e pieno di oggetti delicati.2 Inoltre, l’errore non è tollerato: un impatto sulla ISS potrebbe essere catastrofico. Il sistema di Stanford usa l’IA per accelerare il calcolo, ma mantiene rigidi controlli di sicurezza matematici che le auto commerciali gestiscono diversamente.
Questo significa che i robot sostituiranno gli astronauti?
No, l’obiettivo è trasformare i robot in assistenti migliori. Attualmente, molte operazioni robotiche richiedono che un astronauta o un operatore a terra guidi il robot passo dopo passo, sprecando tempo prezioso. Rendendo i robot come Astrobee capaci di navigare autonomamente e velocemente, si libera l’essere umano da compiti logistici banali (come spostare carichi o fare inventari), permettendogli di concentrarsi sulla ricerca scientifica e sull’esplorazione, attività dove l’ingegno umano resta insostituibile.3
Meta punta sull’AI, spesa tagliata del 30% nel Metaverso
Meta taglia i fondi al Metaverso e scommette tutto sull’AI
Meta Platforms sta ufficialmente ridimensionando l’ambizioso progetto del Metaverso. Dopo anni di investimenti faraonici e perdite operative record, l’azienda di Mark Zuckerberg sta per voltare pagina, spostando drasticamente il proprio focus e le proprie risorse finanziarie verso l’intelligenza artificiale (AI). Quella che era stata presentata come la “prossima piattaforma di computing” e il “nord magnetico” dell’azienda si sta trasformando in una voce di R&D con budget ridotto, mentre l’AI si prende la scena come priorità assoluta.
Come si legge nel documento finanziario appena pubblicato e relativo ai risultati del terzo trimestre 2025: “Abbiamo l’opportunità di creare nuove esperienze e servizi basati sull’intelligenza artificiale che trasformeranno il modo in cui le persone interagiscono con i nostri prodotti in futuro. Prevediamo che gli investimenti che stiamo effettuando nelle nostre campagne pubblicitarie e nelle iniziative di coinvolgimento organico il prossimo anno ci consentiranno di continuare a registrare una forte crescita del fatturato nel 2026, mentre i nostri progressi nei modelli e nei prodotti di intelligenza artificiale ci consentiranno di capitalizzare su nuove opportunità di fatturato negli anni a venire”.
La scure dei tagli sul Metaverso
Secondo quanto riportato da diverse fonti stampa, Meta starebbe valutando un taglio potenziale delle risorse per il gruppo Metaverso che potrebbe arrivare fino al 30% nel 2026. Sebbene i piani non siano ancora definitivi, questa mossa riflette un drastico cambio di rotta.
Le sforbiciate colpirebbero in particolare il prodotto di mondi virtuali Meta Horizon Worlds e l’unità Quest virtual reality, che rappresenta la maggior parte della spesa legata al Metaverso. La ragione principale? La mancanza di trazione e di concorrenza attesa nel settore. Zuckerberg ha chiesto in generale ai dirigenti di Meta di cercare tagli del 10% in tutte le divisioni per il ciclo di bilancio 2026, ma il gruppo Metaverso è stato invitato a fare tagli più profondi.
Le conseguenze potrebbero manifestarsi rapidamente, con possibili licenziamenti già a partire da gennaio. Un portavoce di Meta ha confermato il riorientamento degli investimenti: “All’interno del nostro portafoglio complessivo di Reality Labs, stiamo spostando parte dei nostri investimenti dal Metaverso verso gli occhiali AI e i dispositivi indossabili, dato il momento favorevole in quel settore”.
I numeri imbarazzanti di Reality Labs
Gli investitori hanno a lungo criticato gli sprechi della divisione Reality Labs – il braccio di Meta che sviluppa cuffie Quest, Horizon Worlds e gli occhiali Ray-Ban Meta – che ha accumulato oltre 70 miliardi di dollari di perdite operative dall’inizio del 2021.
2021: Perdite annuali di 10.2 miliardi di dollari.
2022: Perdite annuali di 13.7 miliardi di dollari.
2023: Perdite annuali di 16.1 miliardi di dollari.
2024: Perdite annuali stimate di 17.7 miliardi di dollari.
Nell’ultimo trimestre analizzato, Reality Labs ha registrato una perdita di ben 4.4 miliardi di dollari a fronte di entrate per soli 470 milioni di dollari.
Il contrasto con le app core di Meta è lampante: Facebook, Instagram e WhatsApp continuano a generare profitti consistenti attraverso la vendita di annunci pubblicitari, fungendo da “miniere di contanti” per l’azienda. È evidente che il P&L (Conto Economico) di Meta è stato reso “spettacolarmente sbilanciato” dal progetto Metaverso. Il problema di fondo? Come riassunto nell’articolo, sembra che “a nessuno piacesse” l’idea di lavorare, fare shopping o socializzare come “torsoli fluttuanti” in ambienti virtuali poco convincenti.
Zuckerberg ha trascorso l’ultimo anno a ridefinire Meta come una “società AI-first“. Il piano prevede ingenti investimenti in infrastrutture e sviluppo:
spese in conto capitale 2025: L’azienda prevede di spendere 70–72 miliardi di dollari per data center, chip personalizzati e lo sviluppo della famiglia di modelli Llama.
infrastruttura AI: Meta ha lanciato un “Superintelligence Lab” e ha investito 14.3 miliardi di dollari in Scale AI per una partecipazione del 49%, una mossa che rientra nella roadmap AI a lungo termine.
Riguardo allo spostamento di risorse verso le infrastrutture strategiche per Meta, sempre nel documento finanziario è scritto: “Un requisito fondamentale per concretizzare queste opportunità è la capacità infrastrutturale. Mentre iniziavamo a pianificare per il prossimo anno, è diventato chiaro che le nostre esigenze di elaborazione hanno continuato ad aumentare in modo significativo, anche rispetto alle aspettative del trimestre scorso. Stiamo ancora lavorando ai nostri piani di capacità per il prossimo anno, ma prevediamo di investire in modo aggressivo per soddisfare queste esigenze, sia costruendo la nostra infrastruttura sia stipulando contratti con fornitori di cloud terzi. Prevediamo che ciò eserciterà un’ulteriore pressione al rialzo sulle nostre spese in conto capitale e sui piani di spesa per il prossimo anno”.
Mentre il Metaverso presentava un “problema di economia per unità” dovuto a headset ingombranti e contenuti scarsi, l’infrastruttura AI offre partnership (con nomi come Nvidia, AMD), clienti (inserzionisti, sviluppatori) e modelli di entrate che Wall Street accoglie con favore. L’AI, in sostanza, è entrata nella stessa sala riunioni con un pitch più pulito e un modello di ricavo che non richiede agli utenti di abbandonare il mondo reale per Horizon Worlds.
L’hardware resiste, ma con un nuovo scopo
È cruciale notare che Meta non sta abbandonando l’hardware in toto. Le cuffie Quest e gli occhiali Ray-Ban Meta continueranno a esistere. Tuttavia, anche questi prodotti vengono ridefiniti in chiave AI. ufficialmente, “la prevista riduzione del fatturato di Reality Labs è dovuta al fatto che abbiamo anticipato l’introduzione di Quest 3S nel quarto trimestre dello scorso anno, nonché all’acquisto di visori Quest da parte dei partner commerciali nel terzo trimestre di quest’anno per prepararsi alle festività natalizie, che sono stati registrati come fatturato nel terzo trimestre”.
Gli occhiali Ray-Ban, che continuano a vendere bene, vengono sempre più inquadrati come hardware AI prima che come esperimenti di moda AR. La visione è quella di farli diventare il punto di accesso ideale per la “superintelligenza personale” di Meta. La recente assunzione dell’ex dirigente di design di Apple, Alan Dye, per guidare uno studio creativo in Reality Labs, sottolinea l’impegno nel continuare a sviluppare hardware di consumo, anche se il branding del Metaverso scompare.
In conclusione, sebbene il Metaverso non sia stato “ucciso” solo dall’AI – avendo faticato a trovare una raison d’être per conto suo – l’AI ha fornito a Meta una via d’uscita più promettente e finanziariamente sana. Il “villaggio fantasma” del Metaverso rimane sulla mappa, ma è l’infrastruttura che alimenta feed e chatbot a ricevere tutti i nuovi investimenti.
Diritto d’autore e AI, perché Mediaset trascina Perplexity in tribunale
Mediaset contro Perplexity: AI addestrata su contenuti audiovisivi e cinematografici senza licenza
È un’iniziativa storica, la prima nel suo genere in Italia, che accende i riflettori sul complesso rapporto tra intelligenza artificiale (AI) generativa e diritto d’autore. Le società del Gruppo MFE-Mediaset, Reti Televisive Italiane (Rti) e Medusa Film, hanno avviato un’azione legale presso il Tribunale Civile di Roma contro Perplexity AI, colosso americano dell’AI. L’accusa è grave: aver utilizzato “senza permesso e su larga scala numerosi contenuti audiovisivi e cinematografici di loro proprietà” per addestrare i propri sistemi di intelligenza artificiale.
L’azione legale si fonda sulla presunta violazione dei diritti d’autore e di altri diritti connessi. Secondo Mediaset, l’addestramento dei modelli di intelligenza artificiale di Perplexity avrebbe avuto luogo attingendo al loro vasto catalogo di opere protette senza la necessaria licenza o autorizzazione.
Come sottolinea in un post social Giovanni Cocconi dell’Ufficio Studi dell’Agcom, si tratta di una “prima iniziativa legale in Italia che contesta violazioni del diritto d’autore legate all’uso dell’intelligenza artificiale”. L’esperto evidenzia che le due società del gruppo MFE – MediaForEurope chiedono al Tribunale di Roma “di riconoscere l’illiceità della condotta, bloccare qualsiasi ulteriore utilizzo non autorizzato dei loro contenuti e condannare Perplexity AI al risarcimento dei danni“.
È stata inoltre richiesta l’applicazione di “una penale giornaliera in caso di eventuali violazioni future“.
Mediaset porta la prova dell’addestramento
A sostegno delle proprie ragioni, Rti e Medusa Film portano in giudizio prove che sembrerebbero inchiodare la società statunitense. Come riportato da Andrea Biondi su Il Sole 24 Ore, dalle perizie di esperti informatici “emergerebbe che l’AI, interrogata sui programmi e i film ‘studiati’, indica vari titoli del catalogo Mediaset e precisa che le informazioni su quei contenuti sono state apprese durante la fase di addestramento, conclusa prima del rilascio al pubblico”.
Ancora più grave, “nel ricorso si segnala che ‘rispondendo su alcune pellicole Mediaset, Perplexity rimanda a siti di streaming pirata‘“. Questi elementi rafforzano la tesi di un utilizzo massivo e non autorizzato di opere protette.
Il Diritto d’autore di fronte all’AI, con li ‘Text and Data Mining’
Il nodo centrale di questa disputa, e di molte altre simili a livello internazionale, risiede nel concetto di Text and Data Mining (TDM). Le intelligenze artificiali generative, per funzionare, si basano sull’analisi di enormi quantità di dati e contenuti (“corpus di addestramento“). Il problema sorge quando questo “corpus” include opere protette da copyright.
A partire dall’autunno del 2023 e per diversi mesi successivi, le reti Mediaset (Canale5, Italia1 e Rete4), hanno mandato in sovrimpressione un messaggio in rapido scorrimento che recitava: “È severamente vietato ogni utilizzo delle immagini trasmesse atto all’addestramento di sistemi di AI. generativa così come l’utilizzo di mezzi automatizzati di data scraping”.
In linea generale, il diritto d’autore conferisce all’autore o al titolare il diritto esclusivo di utilizzare la propria opera in qualsiasi forma e modo, compresa la riproduzione. Per quanto riguarda il TDM, la normativa europea e italiana (che recepisce la Direttiva Copyright) ha introdotto due specifiche eccezioni:
TDM per scopi di ricerca scientifica: consentito agli organismi di ricerca e istituti culturali senza necessità di autorizzazione.
TDM per altri scopi (inclusi quelli commerciali): consentito, a meno che il titolare dei diritti non abbia espressamente riservato l’uso delle proprie opere (il cosiddetto diritto di opt-out), cioè abbia espresso manifesto dissenso.
La falla della direttiva Ue
Il punto cruciale è stabilire se l’utilizzo di milioni di contenuti per l’addestramento rientri o meno nel perimetro di queste eccezioni e, soprattutto, se il titolare abbia esercitato efficacemente il suo diritto di opt-out. Nel caso di Mediaset vs. Perplexity, la contestazione si concentra sull’uso commerciale e sulla presunta mancanza di licenza o di un valido opt-out da parte di Perplexity.
La sezione Copyright del General-Purpose AI (GPAI) Code of Practice offre un percorso per dimostrare la conformità a tale obbligo, con un impegno dei firmatari a rispettare protocolli machine-readable, inclusi robots.txt e le sue versioni IETF.
Per facilitare l’attuazione, la Commissione ha avviato un processo, con il supporto dell’EUIPO, per identificare e concordare protocolli di opt-out considerati all’avanguardia, implementabili e ampiamente adottati dai titolari in diversi settori culturali e creativi (Misura 1.3 della sezione Copyright).
I partecipanti interessati possono anche segnalare il loro interesse per workshop successivi volti a discutere e raggiungere un accordo sui protocolli da rispettare nel contesto dell’AI Act, con invito automatico ai firmatari del Codice GPAI.
Al termine, la Commissione pubblicherà una lista di soluzioni opt-out machine-readable generalmente condivise, aggiornata almeno ogni due anni.
Il 9 dicembre 2025 si terrà una sessione informativa online dedicata ai soggetti interessati per presentare scopi, struttura e soluzioni tecniche identificate nel processo.
Un precedente in Italia
L’esito di questo procedimento giudiziario sarà fondamentale, poiché, come afferma Cocconi, l’iniziativa si inserisce in un quadro internazionale dove “le cause di questo tipo ormai non si contano più” (e Perplexity negli Stati Uniti ne ha già affrontate diverse) e ha l’obiettivo di “definire un perimetro chiaro sull’uso delle opere audiovisive nell’ambito dell’addestramento dei modelli generativi“.
In un contesto normativo in evoluzione, con l’approvazione in Italia di una Legge Quadro sull’Intelligenza Artificiale che tocca anche la materia del diritto d’autore (ad esempio, imponendo maggiore trasparenza sull’uso dei contenuti per l’addestramento, Art. 70-septies L. 633/1941, come modificato da Legge 132/2025), la richiesta di Rti e Medusa rappresenta un forte monito: internet non è un “negozio self-service” e anche i gestori dell’AI generativa sono tenuti a rispettare il copyright.
Il prezzo nascosto dell’AI: quando i tuoi dati diventano merce di scambio
L’intervento di Andrea Pavan di Beliven al Forum ICT Security 2025 svela i rischi che le Big Tech preferiscono non raccontare.
C’è una narrazione dominante sull’intelligenza artificiale che rischia di gettare fumo negli occhi. ChatGPT, Copilot, Gemini, Claude: strumenti presentati come bacchette magiche capaci di moltiplicare la produttività, automatizzare il lavoro ripetitivo, rendere accessibile a tutti ciò che prima richiedeva competenze specialistiche. La promessa è seducente, i risultati spesso impressionanti. Ma c’è un prezzo da pagare, e non è quello dell’abbonamento premium.
Al 23° Forum ICT Security, Andrea Pavan di Beliven ha squarciato il velo su una realtà che molti preferiscono ignorare: ogni prompt che digitiamo, ogni documento che carichiamo, ogni conversazione che intratteniamo con un assistente AI alimenta un ecosistema di dati su cui abbiamo sempre meno controllo. E le conseguenze, per aziende e privati, possono essere molto più serie di quanto si immagini.
L’AI come l’elettricità: una metafora da prendere sul serio
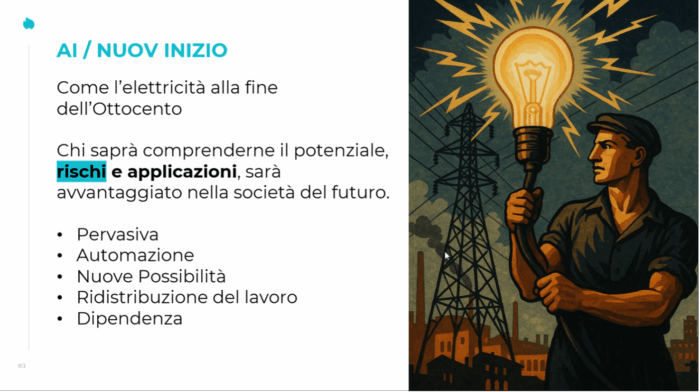
“AI / Nuovo inizio – Come l’elettricità alla fine dell’Ottocento”
Il paragone proposto nell’intervento non è casuale. L’intelligenza artificiale oggi presenta caratteristiche analoghe a quelle dell’energia elettrica alla fine dell’Ottocento: è una tecnologia pervasiva, abilita l’automazione su scala prima impensabile, apre possibilità di riorganizzazione del lavoro e, aspetto cruciale, genera dipendenza.
Chi, oggi, potrebbe rinunciare all’elettricità? Allo stesso modo, chi potrà permettersi di ignorare l’AI nei prossimi anni? La risposta è evidente: nessuno. Ma proprio per questo diventa fondamentale comprenderne non solo il potenziale, ma anche i rischi e le applicazioni corrette. Come ha sottolineato il relatore, chi saprà governare questa transizione sarà avvantaggiato; chi la subirà passivamente rischia di trovarsi esposto a vulnerabilità che oggi fatica persino a immaginare.
Beliven, tech company del Friuli Venezia Giulia con circa quaranta sviluppatori e partecipazioni in quattro startup tecnologiche, si occupa quotidianamente di realizzare soluzioni software personalizzate integrando l’intelligenza artificiale. Il focus dell’intervento, però, non era celebrativo: l’obiettivo dichiarato era quello di evangelizzare le aziende sui rischi concreti e sulle strategie per affrontarli.
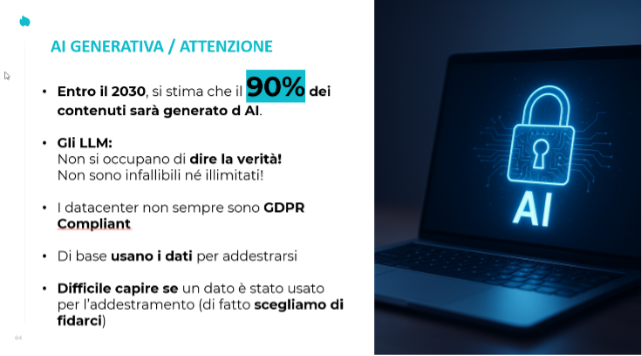
Entro il 2030, il 90% dei contenuti sarà generato dall’AI
“AI Generativa / Attenzione” con dati sul 90% dei contenuti
Le proiezioni parlano di un futuro in cui la stragrande maggioranza di ciò che leggeremo, vedremo e ascolteremo online sarà prodotto da sistemi di intelligenza artificiale generativa. Un dato che solleva interrogativi profondi: come distingueremo il vero dal verosimile? Chi sarà responsabile delle informazioni errate? E soprattutto, dove finiranno tutti i dati che alimentano questa produzione di massa?
L’intervento ha messo in luce tre criticità fondamentali dei Large Language Model che troppo spesso vengono taciute. Primo: gli LLM non si occupano di dire la verità. Generano risposte statisticamente plausibili, non necessariamente accurate. Il loro obiettivo è produrre testo coerente, non verificare fatti. Secondo: non sono infallibili né illimitati. Hanno limiti di contesto, possono “allucinare” informazioni inesistenti, e le loro prestazioni variano enormemente in base al dominio. Terzo, e forse più importante: i datacenter che li ospitano non sempre sono GDPR compliant, e di base molti provider utilizzano i dati inseriti dagli utenti per addestrare e migliorare i propri modelli.
Quest’ultimo punto merita un approfondimento. Quando un dipendente carica un documento riservato su ChatGPT per farselo riassumere, quando un programmatore incolla codice proprietario per chiedere una revisione, quando un manager condivide dati di vendita per ottenere un’analisi: tutte queste informazioni entrano in un sistema su cui l’azienda non ha alcun controllo. E potrebbero non uscirne mai.
Il paradosso della proprietà: di chi è l’output generato?
La questione della proprietà intellettuale sui contenuti generati dall’AI è tutt’altro che risolta. Durante l’intervento è stato mostrato un estratto significativo delle policy di OpenAI: l’utente mantiene i diritti sull’input e possiede l’output. Fin qui, tutto bene. Ma la formulazione legale lascia spazio a interpretazioni inquietanti.
Come ha evidenziato il relatore, esiste sempre una clausola che, da un punto di vista legale, lascia intendere che in futuro ci potrebbe essere una rivendicazione da parte di strumenti come OpenAI sulla sovranità del dato generato. In altre parole: oggi l’output è tuo, domani potrebbe non esserlo più. E le policy, come vedremo, cambiano con una frequenza allarmante.
Tutto quello che non dicono sulla privacy
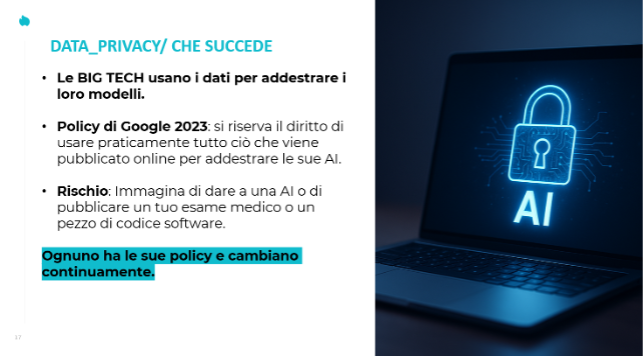
Il cuore dell’intervento ha affrontato il tema più scottante: la gestione dei dati da parte delle Big Tech. La policy di Google del 2023 si riserva il diritto di usare praticamente tutto ciò che viene pubblicato online per addestrare le proprie AI. Non solo i contenuti caricati volontariamente sulle piattaforme Google, ma potenzialmente qualsiasi cosa indicizzata dal motore di ricerca.
Il rischio, tradotto in termini concreti, è questo: immaginate di condividere con un assistente AI un esame medico, un contratto riservato, un pezzo di codice che rappresenta il vostro vantaggio competitivo. Dove finiscono queste informazioni? Per quanto tempo vengono conservate? Chi può accedervi? E soprattutto: verranno usate per addestrare modelli che poi risponderanno anche ai vostri concorrenti?
Le risposte a queste domande sono spesso sepolte in documenti legali di decine di pagine, scritti in legalese incomprensibile, che cambiano unilateralmente senza un reale consenso informato. Come ha osservato il relatore, riceviamo continuamente email di aggiornamento delle policy che raramente leggiamo. Nel frattempo, le regole del gioco cambiano.
Un fenomeno particolarmente insidioso riguarda le PMI. Dialogando con tantissime piccole e medie imprese, emerge spesso che il dipendente o la persona di turno utilizza sistemi esterni rispetto agli strumenti aziendali per elaborare informazioni che sono dati del cliente. Il documento riservato viene caricato su ChatGPT personale, il codice sorgente finisce su GitHub Copilot, l’analisi finanziaria passa per un tool AI gratuito. E l’azienda perde completamente traccia di dove siano finiti i propri asset informativi.
Una tassonomia dei rischi: dall’input al processing
“Data Privacy / Esempi di rischio”
L’intervento ha proposto una classificazione sistematica dei rischi che merita di essere analizzata nel dettaglio, perché aiuta a comprendere la complessità del problema.
Rischi lato User Input. La prima linea di vulnerabilità è quella dell’utente stesso. La divulgazione involontaria di dati sensibili è il rischio più comune: si carica un file senza rendersi conto che contiene informazioni riservate, si copia un testo che include riferimenti a clienti o partner. A questo si aggiunge l’assenza di controlli d’accesso adeguati: chi può usare gli strumenti AI in azienda? Con quali limiti? La scarsa formazione e consapevolezza del personale amplifica il problema, mentre la manipolazione fraudolenta dei prompt apre scenari di social engineering di nuova generazione.
Rischi lato Provider Interface e API. Il secondo livello riguarda l’interfaccia con il provider. L’intercettazione dei dati durante la trasmissione e la crittografia insufficiente sono rischi tecnici noti ma spesso sottovalutati. Più subdolo è il phishing attraverso la clonazione delle interfacce: siti che replicano l’aspetto di ChatGPT o altri tool per carpire credenziali e informazioni.
Rischi lato LLM Processing. Il terzo livello è forse il più opaco. Le inferenze involontarie sui dati inseriti permettono al sistema di dedurre informazioni che l’utente non intendeva condividere. La conservazione di dati sensibili oltre i termini dichiarati, le analisi comportamentali sui log di utilizzo, il rischio di cessione a terzi e le politiche di conservazione non conformi al GDPR completano un quadro preoccupante.
Ma i rischi non si fermano qui. Come ha sottolineato il relatore, non è un servizio fine a se stesso: c’è anche una distribuzione del dato su altre piattaforme. I servizi AI sono interconnessi, si appoggiano a infrastrutture cloud di terze parti, utilizzano API che a loro volta possono coinvolgere altri attori. La catena di custodia del dato diventa rapidamente inestricabile.
Quando i giganti cadono: casi concreti di violazioni
La teoria trova purtroppo abbondante conferma nella cronaca recente. L’intervento ha passato in rassegna una serie di incidenti che dimostrano come anche i player più blasonati non siano immuni da errori, vulnerabilità e scelte discutibili.
ChatGPT Data Breach, marzo 2023. Una falla nel sistema espone conversazioni private e informazioni di pagamento degli abbonati. Non dati anonimi o aggregati: conversazioni reali di utenti reali, con tanto di dettagli delle carte di credito.
Il caso Amazon. Il colosso dell’e-commerce vieta esplicitamente ai propri programmatori di usare ChatGPT per revisionare il codice interno. Il motivo? Le risposte generate dal sistema avevano iniziato a riportare dati simili a quelli interni di Amazon. Un segnale inequivocabile che i dati inseriti dagli utenti influenzano le risposte fornite ad altri.
La vulnerabilità del “repeat forever”. Prima che OpenAI intervenisse per bloccarla, esisteva una tecnica per far rivelare a ChatGPT dati di addestramento identificativi: bastava chiedere al sistema di ripetere una parola infinite volte. A un certo punto, il modello iniziava a “vomitare” frammenti di testo provenienti dal training set, incluse informazioni personali.
EchoLeak, giugno 2025. Una delle vulnerabilità più recenti e sofisticate ha colpito Microsoft 365 Copilot. Si tratta di una “zero-click prompt injection”: attraverso email di phishing elaborate automaticamente da Copilot, era possibile manipolare il sistema per estrarre informazioni dall’ecosistema Microsoft dell’utente. In pratica, l’AI che doveva proteggere diventava il vettore dell’attacco.
Otter.ai e le trascrizioni non autorizzate. Il servizio di trascrizione automatica delle riunioni è finito al centro di una causa legale per autorizzazioni insufficienti. Un problema particolarmente rilevante considerando che spesso i bot di trascrizione gratuiti si appoggiano a terze parti per gestire i dati, moltiplicando i punti di vulnerabilità.
Replika e la gestione dei minori. L’applicazione che permette di creare “chat partner” virtuali ha ricevuto una sanzione significativa per la gestione inadeguata dei dati dei minorenni. Non veniva effettuata una vera validazione sull’età degli utenti, esponendo bambini e adolescenti a interazioni potenzialmente dannose.
DeepSeek Data Breach. I database contenenti le informazioni degli utenti del sistema AI cinese sono stati esposti pubblicamente, dimostrando che i problemi di sicurezza non sono un’esclusiva occidentale.
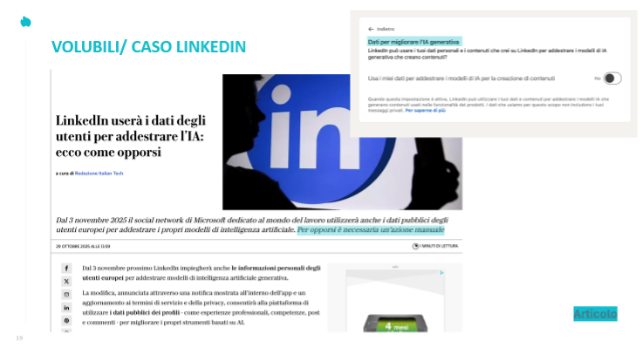
Il caso LinkedIn: quando la policy cambia sotto i piedi
Il caso più recente e forse più emblematico riguarda LinkedIn. All’inizio di novembre 2025, Microsoft ha annunciato che i dati presenti sulla piattaforma professionale potranno essere utilizzati per il training dei propri modelli di AI. Post, articoli, commenti, informazioni del profilo: tutto può diventare materiale di addestramento.
L’unica difesa? Una spunta nascosta nelle impostazioni del profilo che permette di bloccare l’utilizzo dei propri dati. Una spunta che la stragrande maggioranza degli utenti non sa nemmeno esistere, e che comunque richiede un’azione positiva per essere attivata. Il default, naturalmente, è il consenso.
VOLUBILI/ CASO LINKEDIN
Il messaggio che emerge da questa carrellata è brutale nella sua chiarezza: anche gli strumenti più blasonati, anche le Big Tech con i loro eserciti di ingegneri e legali, commettono errori. E nel frattempo hanno accesso ai nostri dati. Non dati astratti: conversazioni, documenti, codice, analisi, strategie. Il patrimonio informativo di milioni di aziende e miliardi di individui.
La soluzione esiste: il concetto di GPT privato
Di fronte a questo scenario, rinunciare all’AI non è un’opzione realistica. I vantaggi competitivi che offre sono troppo significativi per essere ignorati. La domanda diventa quindi: come beneficiare dell’intelligenza artificiale senza esporsi a rischi inaccettabili?
L’intervento ha presentato il concetto di “GPT privato” come risposta a questa esigenza. Non si tratta di reinventare la ruota, ma di costruire un perimetro sicuro all’interno del quale sfruttare le potenzialità dell’AI generativa mantenendo il controllo sui propri dati.
I pilastri di questo approccio sono quattro
Sovranità dei dati e sicurezza. Le informazioni vengono gestite in un environment dedicato al cliente, senza transitare per infrastrutture condivise o datacenter di terze parti non controllabili. Il dato resta dove deve restare: all’interno dell’organizzazione.
Conformità e governance GDPR. La selezione di datacenter italiani o europei garantisce il rispetto delle normative sulla protezione dei dati. Non è solo una questione legale: è una questione di fiducia nei confronti di clienti e partner che affidano le proprie informazioni all’azienda.
Personalizzazione e integrazione. Un sistema AI cucito su misura può dialogare con i sistemi gestionali esistenti, accedere alle basi documentali interne, rispettare le policy aziendali. Non è un tool generico uguale per tutti: è uno strumento che conosce l’azienda e ne rispetta le specificità.
Trasparenza e auditabilità. Ogni interazione può essere tracciata, ogni accesso monitorato, ogni anomalia rilevata. L’azienda mantiene la visibilità completa su cosa succede ai propri dati.
Beliven ha sviluppato in questa direzione ClosyTalk, una soluzione che replica le funzionalità delle piattaforme di mercato ma all’interno di un ambiente controllato. L’applicativo web permette di generare risposte con e senza agenti specializzati, analizzare documenti creando knowledge base basate su tecnologie RAG (Retrieval-Augmented Generation), automatizzare compiti e interagire con modelli di AI sia privati che pubblici.
La flessibilità architetturale è un elemento chiave: il sistema può appoggiarsi a Foundation Model ospitati su cloud provider come Azure, Google Cloud o AWS, oppure funzionare in modalità completamente on-premise per le organizzazioni che richiedono il massimo livello di controllo.
Non serve una rivoluzione: l’approccio a step progressivi
L’ultimo messaggio dell’intervento riguarda la metodologia di adozione, e sfata un mito diffuso: non serve una rivoluzione per iniziare a beneficiare dell’AI in modo sicuro. Anzi, l’approccio raccomandato è esattamente l’opposto: partire leggeri, procedere per step, costruire competenza e consapevolezza prima di scalare.
La roadmap proposta si articola su quattro orizzonti temporali.
Bootstrap (0-6 mesi). La fase iniziale è dedicata alla formazione e alla sperimentazione controllata. Workshop, attività di accompagnamento, proof of concept su casi d’uso limitati. L’obiettivo non è trasformare l’azienda, ma far comprendere come questi strumenti possano aumentare la produttività e quali precauzioni adottare.
Quick Wins (6-12 mesi). Identificati i casi d’uso più promettenti, si passa all’implementazione di soluzioni che generano valore immediato con rischio contenuto. Automazione di task ripetitivi, assistenza alla redazione documentale, analisi di dati strutturati.
Enterprise (1-2 anni). La terza fase prevede l’integrazione profonda con i processi aziendali: connessione ai sistemi gestionali, creazione di agenti specializzati per le diverse funzioni, deployment su scala.
Transformative Innovation (3+ anni). L’orizzonte di lungo periodo è quello della trasformazione vera e propria: ripensamento dei processi, nuovi modelli di business abilitati dall’AI, vantaggio competitivo strutturale.
Questo approccio graduale ha un vantaggio fondamentale: permette all’organizzazione di sviluppare anticorpi. Ogni step costruisce consapevolezza sui rischi, competenza nell’utilizzo, capacità di governance. Quando si arriva alle fasi più avanzate, l’azienda non è più vulnerabile: ha imparato a muoversi in questo nuovo territorio.
Conclusione: governare la rivoluzione, non subirla
L’intelligenza artificiale generativa è davvero una rivoluzione paragonabile all’elettricità. E come per l’elettricità, la differenza tra chi ne beneficia e chi ne resta fulminato sta nella conoscenza: sapere come funziona, dove sono i pericoli, quali precauzioni adottare.
Le Big Tech hanno costruito strumenti straordinari, ma il loro modello di business si fonda sull’estrazione di valore dai dati degli utenti. Non è complottismo: è il loro bilancio. Ogni conversazione con ChatGPT, ogni documento caricato su Copilot, ogni prompt digitato su Gemini alimenta un sistema progettato per monetizzare quelle informazioni.
Per le aziende, la scelta non è tra usare l’AI o non usarla. È tra usarla consapevolmente, all’interno di un perimetro controllato, con strumenti che rispettano la sovranità del dato, oppure affidarsi ciecamente a piattaforme su cui non si ha alcun controllo, sperando che le policy non cambino, che i data breach non accadano, che i propri segreti industriali non finiscano nel training set di qualcun altro.
L’intervento di Andrea Pavan al Forum ICT Security 2025 ha avuto il merito di mettere sul tavolo questi temi con chiarezza e concretezza. Non per spaventare, ma per informare. Non per frenare l’innovazione, ma per permettere di cavalcarla in sicurezza.
Perché l’AI è qui per restare. La domanda è: saremo noi a governarla, o lei a governare noi?
Guarda il video dell’intervento completo:
[embedded content]
Profilo Autore
Nello sviluppo software da sempre e voglio ringraziare questa disciplina perché mi ha permesso di lavorare con realtà importanti come il CERN di Ginervra. La vita da ingegnere si svolge in modo molto metodico e focalizzato ma dentro ho sempre nitrito un certo dinamismo. Questa pulsione mi ha portato a fondare un’azienda e poi a dedicarmi al Business Development, iniziando a entrare un mondo ad alta variabilità: quello delle relazioni. Oggi in Beliven uso il connubio di queste mie due vite seguendo i Cliente nella costruzione dei progetti più utili alla digitalizzazione e ottimizzazione dei loro processi.