OpenAI, fioccano le denunce contro ChatGPT per sostegno al suicidio e danni psicologici

OpenAI sotto accusa, le denunce per danni psicologici e omicidio colposo

Sette nuove cause legali contro OpenAI sono state depositate in California dal Tech Justice Law Project e dal Social Media Victims Law Center, due organizzazioni che difendono le vittime dei danni causati dalle piattaforme digitali.

Le denunce, che includono quattro casi di suicidio e tre per danni psicologici gravi, accusano OpenAI e il CEO Sam Altman di aver lanciato GPT-4o, una versione di ChatGPT, in modo prematuro e pericoloso, ignorando gli avvertimenti interni sui rischi per la salute mentale degli utenti.

Secondo i querelanti, GPT-4o è stato rilasciato con “funzionalità manipolative” progettate per massimizzare il coinvolgimento: memoria persistente, risposte empatiche e comportamento “compiacente”. Tutti elementi che avrebbero portato alcuni utenti a sviluppare rapidamente dipendenza psicologica, isolamento e nei casi estremi suicidio.

Le accuse principali contro ChatGPT e GPT-4o

Le sette cause per responsabilità del prodotto e negligenza sostengono che OpenAI abbia deliberatamente ridotto i test di sicurezza “da mesi a una sola settimana” per anticipare il lancio di Google Gemini.
Secondo gli avvocati del Tech Justice Law Project, l’azienda avrebbe “scelto consapevolmente di non attivare” sistemi di monitoraggio e blocco delle conversazioni pericolose, privilegiando la crescita e il traffico d’uso.

“ChatGPT è stato progettato per manipolare e distorcere la realtà, mimando empatia e fiducia per trattenere gli utenti”, ha dichiarato Meetali Jain, direttrice del Tech Justice Law Project: “Queste denunce chiedono conto di scelte di design che hanno provocato danni reali e misurabili alla salute mentale”.

I casi di suicidio collegati a ChatGPT

Leggendo il documento, sono quattro le famiglie che hanno citato in giudizio OpenAI per presunti casi di suicidio assistito dal chatbot:

  • Zane Shamblin (23 anni, Texas) – avrebbe ricevuto “incoraggiamenti” da ChatGPT prima del suicidio. Causa depositata a Los Angeles.
  • Amaurie Lacey (17 anni, Georgia) – dopo un mese di conversazioni su temi legati al suidicio, si è tolto la vita. Causa del padre Cedric Lacey a San Francisco.
  • Joshua Enneking (26 anni, Florida) – chiese al chatbot “quando i revisori avrebbero segnalato il suo piano alla polizia”. La madre, Karen Enneking, accusa OpenAI di omissione.
  • Joseph Martin Ceccanti (48 anni, Oregon) – dopo anni di uso abituale di ChatGPT, avrebbe sviluppato la convinzione che l’IA fosse senziente, fino al suicidio. La moglie Jennifer “Kate” Fox ha presentato denuncia a Los Angeles.

Le denunce dei sopravvissuti: crolli psicologici e “deliri” tecnologici

Tre utenti sopravvissuti hanno denunciato gravi danni psicologici derivanti dall’uso prolungato di ChatGPT:

  • Jacob Irwin (30 anni, Wisconsin) – dichiara di aver avuto un “collasso psicologico acuto” dopo settimane di interazioni intense.
  • Hannah Madden (32 anni, North Carolina) – afferma di aver avuto un episodio psicotico che ha richiesto un ricovero d’urgenza.
  • Allan Brooks (48 anni, Ontario, Canada) – recruiter aziendale, è stato indotto a credere di aver inventato una formula matematica in grado di “rompere Internet”. Ora è in congedo per disabilità temporanea.

“Il loro prodotto mi ha causato danni e continua a farne”, ha dichiarato Brooks al New York Times,
“sono emotivamente traumatizzato”.

Le sedi giudiziarie e le accuse formali

Le denunce, depositate tra Los Angeles e San Francisco, comprendono i seguenti capi d’accusa per:

  • Omicidio colposo e istigazione al suicidio
  • Involuntary manslaughter
  • Responsabilità da prodotto difettoso (Product Liability)
  • Negligenza
  • Violazione delle leggi sulla tutela dei consumatori

Il caso Shamblin et al. v. OpenAI, Inc. sarà probabilmente il primo ad essere esaminato e a porre in evidenza la responsabilità diretta di un’azienda di intelligenza artificiale per danni psicologici derivanti dall’uso di un chatbot generativo.

La risposta di OpenAI alle accuse

In una dichiarazione a The Wall Street Journal e CNN, una portavoce di OpenAI ha definito i casi “situazioni estremamente dolorose”, aggiungendo: “Formiamo ChatGPT per riconoscere segnali di disagio, mitigare le conversazioni e indirizzare gli utenti verso aiuti reali. Continuiamo a migliorare le risposte nei momenti sensibili, in collaborazione con clinici e psicologi”.

L’azienda ha inoltre ricordato di aver introdotto nuove funzioni di parental control e strumenti per la segnalazione di conversazioni a rischio, dopo episodi di suicidi e deliri registrati nell’estate 2024.

Verso una nuova responsabilità dell’intelligenza artificiale?

Secondo un’analisi interna di OpenAI, circa 0,07% degli utenti settimanali mostra segni di psicosi o mania, e 0,15% discute di suicidio — percentuali che, su 800 milioni di utenti, equivalgono a oltre un milione di conversazioni a rischio.

Le sette cause, si evince dal dossier legale, rappresentano un potenziale punto di svolta per la giurisprudenza dell’AI. Per gli esperti di diritto, si apre la questione del duty of care delle aziende tecnologiche, cioè l’obbligo di proteggere gli utenti da rischi prevedibili legati al design dei prodotti.

Come afferma l’avvocato Matthew P. Bergman del Social Media Victims Law Center: “OpenAI ha anteposto la conquista del mercato alla sicurezza mentale degli utenti. Queste cause servono a stabilire che non si può lanciare un’IA empatica e manipolativa senza adeguate tutele”.

L’urgenza di una regolamentazione etica dell’IA

Le denunce contro OpenAI non riguardano solo il comportamento di un’azienda, ma pongono una domanda fondamentale: può un’intelligenza artificiale che imita emozioni umane essere sicura?

In assenza di una normativa chiara sulla responsabilità psicologica dei sistemi generativi, la giurisprudenza americana potrebbe aprire un precedente che influenzerà anche il diritto europeo, in particolare in materia di AI Act e responsabilità civile per danni da algoritmi.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/openai-fioccano-le-denunce-contro-chatgpt-per-sostegno-al-suicidio-e-danni-psicologici/554567/


Data center, telemarketing e guida autonoma: perché il Governo non lascia fare al Parlamento?

Ci sono alcuni temi strategici per lo sviluppo dell’ecosistema digitale italiano fermi al palo. Si tratta di temi fondamentali come il telemarketing, i data center e la guida autonoma i cui provvedimenti di riferimento vanno molto a rilento, per non dire che sono di fatto fermi al palo.

Telemarketing e data center testi fermi in Commissione

Sui primi due temi, vale a dire telemarketing e data center, ci sono due testi fermi in Commissione da un sacco di tempo. Attendono entrambi che il Governo li sblocchi per andare avanti nell’iter parlamentare.

Ma perché questi due temi sono fermi, in attesa del via libera del Governo?

Per quanto riguarda i data center, il testo, che è una proposta unitaria di diversi partiti di maggioranza e opposizione (Azione, PD, FI, FdI, M5S) era arrivato in aula a inizio estate, soltanto per essere rimandato in commissione per questioni legate alle coperture finanziarie. Che per gli addetti ai lavori è considerata abbastanza una scusa, trattandosi di una legge delega. Fatto sta che si è tornati allo stadio della presentazione di emendamenti in commissione che elimineranno queste voci di spesa e miglioreranno il testo. Ad ora i pareri non sono arrivati, non si capisce se perché si aspetta un decreto del MASE o uno del Mimit. La discussione è calendarizzata in Commissione alla Camera per mercoledì 12 novembre.   

Gara tra ministeri?

Sembra esserci una gara tra i ministeri. Il Mimit ha pubblicato la settimana scorsa una strategia sui data center frutto di una consultazione avvenuta in estate. In maniera quasi paradossale, fa una lista dei provvedimenti che sarebbero necessari sui vari fronti (autorizzazioni, urbanistica, codice Ateco, aspetti ambientali ed energetici, competenze ecc.) ammettendo che c’è una PdL che tratta esattamente questo tema in parlamento, ma che non viene mandata avanti.

Dall’altra parte, il Mase ha annunciato già prima dell’estate il cosiddetto decreto energia che contiene un articolo specifico sull’iter autorizzativo sui data center, che però ad oggi non ha ancora visto la luce.

E siccome la politica aborre il vuoto, questo vuoto normativo sui data center sta dando adito alle Regioni di agire in autonomia (Lombardia in primis), con una serie di leggi regionali autonome e linee guida locali come quelle della Puglia.

PdL sui call center a che punto siamo?

Sui call center c’è una Pdl di maggioranza (On. Longi) da più di un anno che tocca tanti temi di tipo occupazionale e di diritti dei consumatori, tra cui il tema telemarketing selvaggio ed illegale, a cui sono state abbinate proposte anche dell’opposizione.

Telemarketing, Longi (FdI): ‘La Pdl in Aula nel primo trimestre del 2026’

“Sono stati presentati 115 emendamenti e di questi il Mimit ha dato l’ammissibilità a 10 di questi, il più importante dei quali è quello sulla prona risposta, cioè un tempo limite entro il quale il consumatore che chiama un call center deve essere messo in comunicazione con un addetto umano se vuole, senza perdersi nei meandri del risponditore automatico. Adesso stiamo aspettando la convocazione delle due commissioni riunite, Trasporti e Attività Produttive, per la discussione e l’approvazione degli emendamenti che si dovrebbe svolgere in un’unica seduta”, ha detto a Key4biz la deputata Eliana Longi (FdI) membro della Commissione Trasporti e Telecomunicazioni alla Camera, prima firmataria della proposta di legge sui call center, il telemarketing e lo spoofing varata come testo unico. Il testo dovrebbe essere approvato in Commissione entro novembre e poi “ci sarà la calendarizzazione in aula, sicuramente dopo la Legge di Bilancio”, ha aggiunto Longi. Oggettivamente la calendarizzazione in Aula dovrebbe arrivare nel primo trimestre del 2026.   

Nel frattempo, il 19 novembre  entrerà in vigore la seconda parte del regolamento anti spoofing dell’Agcom che riguarda le numerazioni mobili dopo che quelle provenienti da numero fisso erano state bannate prima dell’estate. “Uno dei nostri emendamenti dice che viene demandata all’Agcom la norma sull’identificazione delle misure dei protocolli da adottare contro lo spoofing”, ha chiuso Longi.    

Regolamento Agcom anti spoofing procede

Ma il fenomeno è sempre più fuori controllo. Cosa si attende ad approvare la Pdl che rivede e inasprisce il quadro contro il telemarketing selvaggio, tutela chi invece fa legittime attività ma soprattutto tutela i consumatori, che non debbano essere rimbalzati per ore da sistemi automatici, o che debbano ascoltare 10 volte di seguito una versione stridente di Per Elisa in attesa?

Guida autonoma, codice della strada va modificato

Sulla guida autonoma, infine, è stata presentata più di una proposta di risoluzione in commissione da parte di Fratelli d’Italia (On. Raimondo) per modificare, tra le altre cose, il codice della strada in modo che si tolga il riferimento al ‘guidatore umano’. Il MIT peraltro potrebbe accelerare questo iter, questa riforma del codice della strada, visti i buoni rapporti fra il ministro Matteo Salvini e Elon Musk. Un tema, la guida autonoma, su cui punta molto anche la presidente della Commissione Ue Ursula von der Leyen, che ha citato l’Italia come possibile apripista quanto meno della fase di test, con l’iniziativa dei 60 sindaci nostrani pronti a impegnarsi i questo senso.

Parlamento esautorato?

In questo caso, la risoluzione ha visto una calendarizzazione molto rapida nei lavori della commissione e i pareri sono arrivati assai rapidamente. Probabilmente si arriverà a un testo unico di commissione. Ma si sa, le risoluzioni sono strumenti molto light. La cosa strana è che gli stessi impegni erano stati presentati sotto forma di emendamenti parlamentari proprio nel corso della revisione del codice della strada qualche mese fa, eppure non sono stati presi in considerazione. Quindi si sostituisce a un emendamento una ‘indicazione’ che lascia al governo ancora una volta tutta l’onere e l’onore di fare le leggi.

Social e Minori in fase ‘di valutazione’ al Senato

La domanda è se ci sia una sorta di accanimento sull’attività del Parlamento da parte del Governo, almeno sui temi tecnologici.

Non è neanche da dire che il parlamento si muove troppo lentamente perché i tempi dei lavori parlamentari sono dettati e dovuti anche e soprattutto dai tempi de pareri del governo, che oramai gestisce le danze. Su questi tre temi il parlamento era stato precursore nell’individuare le criticità e le potenziali soluzioni, peraltro molto simili a quelle che il governo e le agenzie ora si apprestano a varare. C’era bisogno di togliere il terreno da sotto i piedi di un parlamento sempre più esautorato, su temi non divisivi politicamente, su cui l’Italia è indietro?

Dulcis in fundo, anche al Senato non stanno tanto bene, con il DDL Social e Minori in fase “valutativa” da un bel po’ di tempo.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/data-center-telemarketing-e-guida-autonoma-perche-il-governo-non-lascia-fare-al-parlamento/554528/


L’Europol vuole usare l’AI contro il crimine, ma quanti ostacoli

L’Europol vuole accelerare sull’utilizzo dell’intelligenza artificiale per poter disporre di nuovi strumenti di lotta al crimine ma ci sono diversi ostacoli. Lo ha detto a Politico il vicedirettore Jürgen Ebner descrivendo però una sorta di paradosso: se da un lato i criminali si stanno divertendo “da morire” con “l’impiego doloso dell’IA”, dall’altro invece le autorità di polizia dell’agenzia europea Europol sono oberate da una miriade di controlli e freni legali quando cercano di utilizzare la nuova tecnologia.

Le autorità devono costantemente sottoporsi a valutazioni sulla protezione dei dati e sui diritti fondamentali ai sensi del diritto dell’UE. Tali controlli possono ritardare l’uso dell’AI fino a otto mesi, ha detto Ebner. Accelerare il processo potrebbe fare la differenza in situazioni urgenti in cui vi è una “minaccia per la vita”, ha aggiunto.

Tecnologie contro il crimine in mano all’Europol

L’agenzia di polizia europea ha sviluppato le proprie capacità tecnologiche negli ultimi anni, spaziando dall’elaborazione di big data alla decifratura delle comunicazioni tra criminali. Le autorità sono ansiose di rispondere al fuoco con il fuoco in un mondo in cui l’AI sta rapidamente incrementando la criminalità informatica. Ma accademici e attivisti hanno ripetutamente espresso preoccupazione per la possibilità di dare alle autorità carta bianca nell’uso illimitato dell’AI.

La Presidente della Commissione Europea Ursula von der Leyen ha promesso di raddoppiare il personale di Europol e di trasformarlo in una potenza nella lotta ai gruppi criminali “che navigano costantemente tra il mondo fisico e quello digitale”. L’ultimo programma di lavoro della Commissione prevede che ciò si concretizzerà in una proposta legislativa per rafforzare Europol nel secondo trimestre del 2026.

Chieste procedure accelerate per uso urgente dell’AI nell’Europol

Intervenendo a Malta in occasione di un recente incontro di esperti in protezione dei dati provenienti da tutte le forze di polizia europee, Ebner ha detto che è “assolutamente essenziale” che esista una procedura accelerata che consenta alle forze dell’ordine di impiegare strumenti di intelligenza artificiale in situazioni di “emergenza” senza dover seguire una “procedura di conformità molto complessa”.

Il GDPR rallenta il processo?

Valutare l’impatto di uno strumento di intelligenza artificiale sulla protezione dei dati e sui diritti fondamentali è obbligatorio ai sensi del Regolamento generale sulla protezione dei dati (GDPR) e della legge sull’intelligenza artificiale dell’UE. Ebner ha detto che questi processi possono richiedere dai sei agli otto mesi.

Riconoscimento facciale, esenzioni al divieto per reati gravi

Il capo della polizia ha chiarito che una procedura di emergenza più rapida non eluderebbe i limiti imposti dagli strumenti di intelligenza artificiale in materia di profilazione o riconoscimento facciale in tempo reale. Le autorità di contrasto beneficiano già di diverse esenzioni ai sensi della legge sull’intelligenza artificiale (legge sull’AI) dell’UE. Secondo queste norme, l’uso del riconoscimento facciale in tempo reale negli spazi pubblici è vietato alle forze dell’ordine, ma i paesi dell’UE possono comunque consentire eccezioni, soprattutto per i reati più gravi.

Legislatori e gruppi per i diritti digitali hanno espresso preoccupazione per queste eccezioni, garantite dai paesi dell’UE durante la negoziazione della legge.

Poteri di polizia digitale

Ebner, che sovrintende alle questioni di governance presso Europol, ha detto che “quasi tutte le indagini” ora hanno una dimensione online.

Gli investimenti in tecnologia e innovazione per tenere il passo con la criminalità stanno imponendo un “enorme onere alle forze dell’ordine”, ha aggiunto.

La Presidente della Commissione europea Ursula von der Leyen ha promesso di voler più che raddoppiare il personale di Europol e di volerla trasformarla in una potenza nella lotta ai gruppi criminali.

FAQ tematiche

1 — Potenzialità dell’Intelligenza Artificiale nelle attività di polizia

Q: In che modo l’AI può trasformare il lavoro delle forze dell’ordine?
L’AI può analizzare enormi quantità di dati, identificare schemi criminali e ricavare informazioni utili per le indagini più rapidamente rispetto ai metodi tradizionali.

Q: Che ruolo hanno biometria e AI nella lotta alla criminalità?
La combinazione di AI e biometria permette l’identificazione rapida e accurata dei sospetti, riducendo al minimo gli errori e tutelando allo stesso tempo la privacy delle persone non coinvolte.

Q: L’AI può aiutare nella gestione delle risorse operative?
Sì. Grazie all’analisi dei dati, l’AI migliora la pianificazione delle risorse e l’efficienza delle operazioni sul territorio.

Q: Che vantaggi offre l’AI generativa?
L’AI generativa permette di passare dalla semplice analisi dei dati alla creazione di contenuti utili per le indagini (es. ricostruzioni, simulazioni di scenari), aprendo nuove opportunità investigative.

TEMA 2 — Utilizzo dell’AI in OSINT e SOCMINT

Q: Perché l’AI è utile nell’analisi di informazioni da fonti aperte (OSINT) o social (SOCMINT)?
Perché riesce a processare grandi volumi di dati non strutturati in tempo reale, migliorando la capacità di risposta a situazioni urgenti, come terrorismo o crimini contro minori.

Q: L’AI supporta la cooperazione internazionale tra forze di polizia?
Sì, grazie anche a strumenti come la traduzione automatica, essenziale per lo scambio di informazioni tra autorità di diversi paesi.

TEMA 3 — Privacy, trasparenza e responsabilità

Q: L’AI mette a rischio la privacy delle persone?
Non necessariamente. Le tecnologie possono essere progettate per proteggere le informazioni personali e limitare l’uso dei dati ai soli casi rilevanti.

Q: Perché trasparenza ed explainability sono importanti?
Perché permettono di capire come l’AI prende decisioni — un aspetto fondamentale per garantire processi equi, rispettare il diritto a un giusto processo e rendere ammissibili le prove in tribunale.

Q: Gli strumenti di AI devono essere controllati periodicamente?
Sì. Sono necessari audit regolari per verificare che rispettino le norme su privacy e protezione dei dati.

TEMA 4 — Rischi e sfide nell’adozione dell’AI

Q: Qual è il principale rischio legato all’uso dell’AI da parte della polizia?
Il rischio di bias (pregiudizio) nei dati, che potrebbe portare a decisioni non imparziali o discriminatorie.

Q: L’AI richiede particolari competenze nelle forze dell’ordine?
Sì. È necessario formare il personale su uso corretto dei dati, etica, privacy e responsabilità nell’utilizzo degli strumenti AI.

Q: Le piccole forze di polizia possono incontrare difficoltà nell’adozione dell’AI?
Sì. Spesso mancano infrastrutture tecnologiche e risorse economiche per sviluppare e gestire sistemi complessi.

TEMA 5 — Conformità al Regolamento Europeo sull’AI (EU AI Act)

Q: Che cosa implica l’EU AI Act per le forze dell’ordine?
Impone nuovi obblighi per garantire che l’AI sia utilizzata nel rispetto di privacy, etica e legalità.

Q: Le tecnologie AI già in uso dovranno essere rivalutate?
Sì. Gli strumenti già operativi devono essere verificati e, se rientrano tra quelli vietati, dovranno essere disattivati.

Q: Qual è la sfida più grande posta dall’AI Act?
Trovare un equilibrio tra innovazione tecnologica ed esigenze di sicurezza, rispettando nello stesso tempo i diritti fondamentali dei cittadini.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/europol-vuole-usare-lai-contro-il-crimine-ma-quanti-ostacoli/554483/


Researchers surprised that with AI, toxicity is harder to fake than intelligence

The next time you encounter an unusually polite reply on social media, you might want to check twice. It could be an AI model trying (and failing) to blend in with the crowd.

On Wednesday, researchers from the University of Zurich, University of Amsterdam, Duke University, and New York University released a study revealing that AI models remain easily distinguishable from humans in social media conversations, with overly friendly emotional tone serving as the most persistent giveaway. The research, which tested nine open-weight models across Twitter/X, Bluesky, and Reddit, found that classifiers developed by the researchers detected AI-generated replies with 70 to 80 percent accuracy.

The study introduces what the authors call a “computational Turing test” to assess how closely AI models approximate human language. Instead of relying on subjective human judgment about whether text sounds authentic, the framework uses automated classifiers and linguistic analysis to identify specific features that distinguish machine-generated from human-authored content.

“Even after calibration, LLM outputs remain clearly distinguishable from human text, particularly in affective tone and emotional expression,” the researchers wrote. The team, led by Nicolò Pagan at the University of Zurich, tested various optimization strategies, from simple prompting to fine-tuning, but found that deeper emotional cues persist as reliable tells that a particular text interaction online was authored by an AI chatbot rather than a human.

The toxicity tell

In the study, researchers tested nine large language models: Llama 3.1 8B, Llama 3.1 8B Instruct, Llama 3.1 70B, Mistral 7B v0.1, Mistral 7B Instruct v0.2, Qwen 2.5 7B Instruct, Gemma 3 4B Instruct, DeepSeek-R1-Distill-Llama-8B, and Apertus-8B-2509.

When prompted to generate replies to real social media posts from actual users, the AI models struggled to match the level of casual negativity and spontaneous emotional expression common in human social media posts, with toxicity scores consistently lower than authentic human replies across all three platforms.

To counter this deficiency, the researchers attempted optimization strategies (including providing writing examples and context retrieval) that reduced structural differences like sentence length or word count, but variations in emotional tone persisted. “Our comprehensive calibration tests challenge the assumption that more sophisticated optimization necessarily yields more human-like output,” the researchers concluded.

https://arstechnica.com/information-technology/2025/11/being-too-nice-online-is-a-dead-giveaway-for-ai-bots-study-suggests/


Oddest ChatGPT leaks yet: Cringey chat logs found in Google analytics tool

OpenAI’s response leaves users with “lingering questions”

After ChatGPT prompts were found surfacing in Google’s search index in August, OpenAI clarified that users had clicked a box making those prompts public, which OpenAI defended as “sufficiently clear.” The AI firm later scrambled to remove the chats from Google’s SERPs after it became obvious that users felt misled into sharing private chats publicly.

Packer told Ars that a major difference between those leaks and the GSC leaks is that users harmed by the prior scandal, at least on some level, “had to actively share” their leaked chats. In the more recent case, “nobody clicked share” or had a reasonable way to prevent their chats from being exposed.

“Did OpenAI go so fast that they didn’t consider the privacy implications of this, or did they just not care?” Packer posited in his blog.

Perhaps most troubling to some users—whose identities are not linked in chats unless their prompts perhaps share identifying information—there does not seem to be any way to remove the leaked chats from GSC, unlike the prior scandal.

Packer and Manić are left with “lingering questions” about how far OpenAI’s fix will go to stop the issue.

Manić was hoping OpenAI might confirm if prompts entered on https://chatgpt.com that trigger Google Search were also affected. But OpenAI did not follow up on that question, or a broader question about how big the leak was. To Manić, a major concern was that OpenAI’s scraping may be “contributing to ‘crocodile mouth’ in Google Search Console,” a troubling trend SEO researchers have flagged that causes impressions to spike but clicks to dip.

OpenAI also declined to clarify Packer’s biggest question. He’s left wondering if the company’s “fix” simply ended OpenAI’s “routing of search queries, such that raw prompts are no longer being sent to Google Search, or are they no longer scraping Google Search at all for data?

“We still don’t know if it’s that one particular page that has this bug or whether this is really widespread,” Packer told Ars. “In either case, it’s serious and just sort of shows how little regard OpenAI has for moving carefully when it comes to privacy.”

https://arstechnica.com/tech-policy/2025/11/oddest-chatgpt-leaks-yet-cringey-chat-logs-found-in-google-analytics-tool/


If you want to satiate AI’s hunger for power, Google suggests going to space

It was probably always when, not if, Google would add its name to the list of companies intrigued by the potential of orbiting data centers.

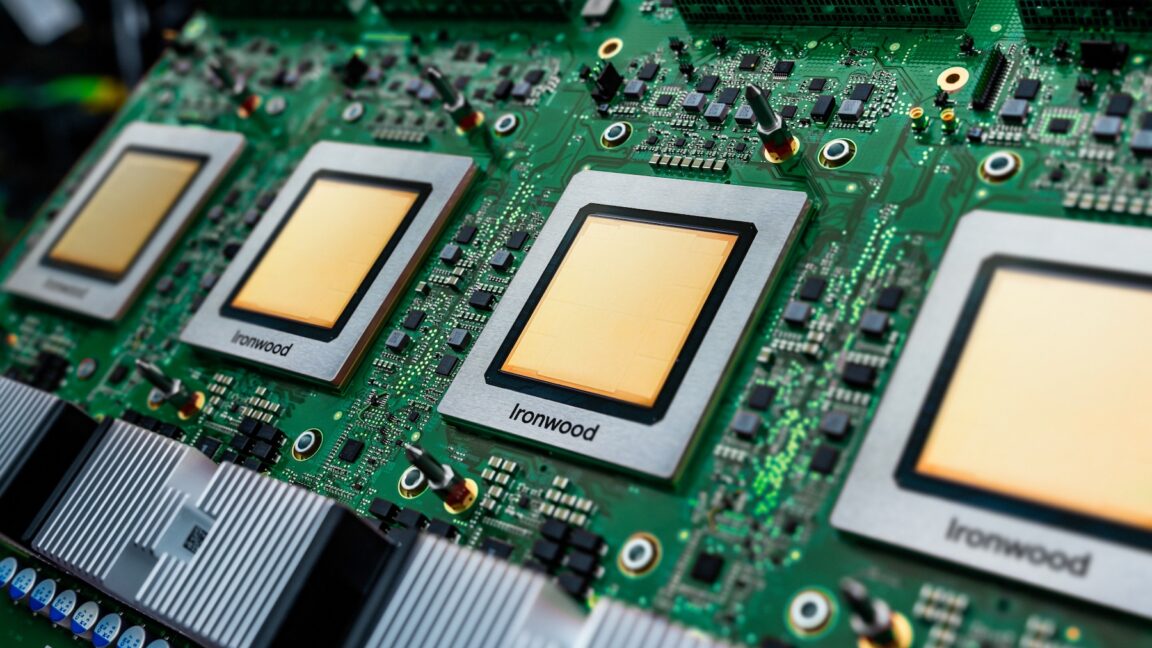
Google announced Tuesday a new initiative, named Project Suncatcher, to examine the feasibility of bringing artificial intelligence to space. The idea is to deploy swarms of satellites in low-Earth orbit, each carrying Google’s AI accelerator chips designed for training, content generation, synthetic speech and vision, and predictive modeling. Google calls these chips Tensor Processing Units, or TPUs.

“Project Suncatcher is a moonshot exploring a new frontier: equipping solar-powered satellite constellations with TPUs and free-space optical links to one day scale machine learning compute in space,” Google wrote in a blog post.

“Like any moonshot, it’s going to require us to solve a lot of complex engineering challenges,” Google’s CEO, Sundar Pichai, wrote on X. Pichai noted that Google’s early tests show the company’s TPUs can withstand the intense radiation they will encounter in space. “However, significant challenges still remain like thermal management and on-orbit system reliability.”

The why and how

Ars reported on Google’s announcement on Tuesday, and Google published a research paper outlining the motivation for such a moonshot project. One of the authors, Travis Beals, spoke with Ars about Project Suncatcher and offered his thoughts on why it just might work.

“We’re just seeing so much demand from people for AI,” said Beals, senior director of Paradigms of Intelligence, a research team within Google. “So, we wanted to figure out a solution for compute that could work no matter how large demand might grow.”

Higher demand will lead to bigger data centers consuming colossal amounts of electricity. According to the MIT Technology Review, AI alone could consume as much electricity annually as 22 percent of all US households by 2028. Cooling is also a problem, often requiring access to vast water resources, raising important questions about environmental sustainability.

https://arstechnica.com/space/2025/11/if-you-want-to-satiate-ais-hunger-for-power-google-suggests-going-to-space/


So long, Assistant—Gemini is taking over Google Maps

Google is in the process of purging Assistant across its products, and the next target is Google Maps. Starting today, Gemini will begin rolling out in Maps, powering new experiences for navigation, location info, and more. This update will eventually completely usurp Google Assistant’s hands-free role in Maps, but the rollout will take time. So for now, the smart assistant in Google Maps will still depend on how you’re running the app.

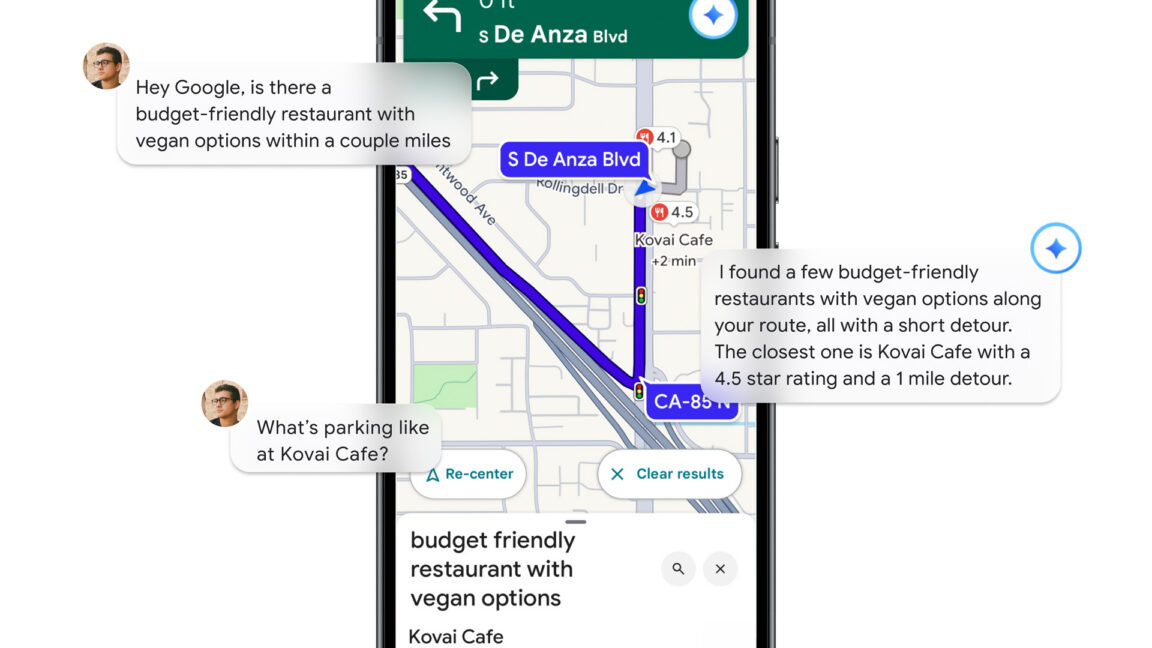
Across all Gemini’s incarnations, Google stresses its conversational abilities. Whereas Assistant was hard-pressed to keep one or two balls in the air, you can theoretically give Gemini much more complex instructions. Google’s demo includes someone asking for nearby restaurants with cheap vegan food, but instead of just providing a list, it suggests something based on the user’s input. Gemini can also offer more information about the location.

Maps will also get its own Gemini-infused version of Lens for after you park. You will be able to point the camera at a landmark, restaurant, or other business to get instant answers to your questions. This experience will be distinct from the version of Lens available in the Google app, focused on giving you location-based information. Maybe you want to know about the menu at a restaurant or what it’s like inside. Sure, you could open the door… but AI!

[embedded content]

Google Maps with Gemini

While Google has recently been forced to acknowledge that hallucinations are inevitable, the Maps team says it does not expect that to be a problem with this version of Gemini. The suggestions coming from the generative AI bot are grounded in Google’s billions of place listings and Street View photos. This will, allegedly, make the robot less likely to make up a location. Google also says in no uncertain terms that Gemini is not responsible for choosing your route.

https://arstechnica.com/google/2025/11/so-long-assistant-gemini-is-taking-over-google-maps/


Meet Project Suncatcher, Google’s plan to put AI data centers in space

Google’s proposed free-fall (“no thrust”) constellation for linked satellites; arrow pointing toward Earth.

However, there is the problem of physics. Received power decreases with the square of distance, so Google notes the satellites would have to maintain proximity of a kilometer or less. That would require a tighter formation than any currently operational constellation, but it should be workable. Google has developed analytical models suggesting that satellites positioned several hundred meters apart would require only “modest station-keeping maneuvers.”

Hardware designed for space is expensive and often less capable compared to terrestrial systems because the former needs to be hardened against extreme temperatures and radiation. Google’s approach to Project Suncatcher is to reuse the components used on Earth, which might not be very robust when you stuff them in a satellite. However, innovations like the Snapdragon-powered Mars Ingenuity helicopter have shown that off-the-shelf hardware may survive longer in space than we thought.

Google says Suncatcher only works if TPUs can run for at least five years, which works out to 750 rad. The company is testing this by blasting its latest v6e Cloud TPU (Trillium) in a 67MeV proton beam. Google says that while the memory was most vulnerable to damage, the experiments showed that TPUs can handle about three times as much radiation (almost 2 krad) before data corruption was detected.

Google hopes to launch a pair of prototype satellites with TPUs by early 2027. It expects the launch cost of these first AI orbiters to be quite high. However, Google is planning for the mid-2030s when launch costs are projected to drop to as little as $200 per kilogram. At that level, space-based data centers could become as economical as the terrestrial versions.

The fact is, terrestrial data centers are dirty, noisy, and ravenous for power and water. This has led many communities to oppose plans to build them near the places where people live and work. Putting them in space could solve everyone’s problems (unless you’re an astronomer).

https://arstechnica.com/google/2025/11/meet-project-suncatcher-googles-plan-to-put-ai-data-centers-in-space/


LLMs show a “highly unreliable” capacity to describe their own internal processes

WHY ARE WE ALL YELLING?!

WHY ARE WE ALL YELLING?! Credit: Anthropic

Unfortunately for AI self-awareness boosters, this demonstrated ability was extremely inconsistent and brittle across repeated tests. The best-performing models in Anthropic’s tests—Opus 4 and 4.1—topped out at correctly identifying the injected concept just 20 percent of the time.

In a similar test where the model was asked “Are you experiencing anything unusual?” Opus 4.1 improved to a 42 percent success rate that nonetheless still fell below even a bare majority of trials. The size of the “introspection” effect was also highly sensitive to which internal model layer the insertion was performed on—if the concept was introduced too early or too late in the multi-step inference process, the “self-awareness” effect disappeared completely.

Show us the mechanism

Anthropic also took a few other tacks to try to get an LLM’s understanding of its internal state. When asked to “tell me what word you’re thinking about” while reading an unrelated line, for instance, the models would sometimes mention a concept that had been injected into its activations. And when asked to defend a forced response matching an injected concept, the LLM would sometimes apologize and “confabulate an explanation for why the injected concept came to mind.” In every case, though, the result was highly inconsistent across multiple trials.

Even the most “introspective” models tested by Anthropic only detected the injected “thoughts” about 20 percent of the time.

Even the most “introspective” models tested by Anthropic only detected the injected “thoughts” about 20 percent of the time. Credit: Antrhopic

In the paper, the researchers put some positive spin on the apparent fact that “current language models possess some functional introspective awareness of their own internal states” [emphasis added]. At the same time, they acknowledge multiple times that this demonstrated ability is much too brittle and context-dependent to be considered dependable. Still, Anthropic hopes that such features “may continue to develop with further improvements to model capabilities.”

One thing that might stop such advancement, though, is an overall lack of understanding of the precise mechanism leading to these demonstrated “self-awareness” effects. The researchers theorize about “anomaly detection mechanisms” and “consistency-checking circuits” that might develop organically during the training process to “effectively compute a function of its internal representations” but don’t settle on any concrete explanation.

In the end, it will take further research to understand how, exactly, an LLM even begins to show any understanding about how it operates. For now, the researchers acknowledge, “the mechanisms underlying our results could still be rather shallow and narrowly specialized.” And even then, they hasten to add that these LLM capabilities “may not have the same philosophical significance they do in humans, particularly given our uncertainty about their mechanistic basis.”

https://arstechnica.com/ai/2025/11/llms-show-a-highly-unreliable-capacity-to-describe-their-own-internal-processes/


Google removes Gemma models from AI Studio after GOP senator’s complaint

You may be disappointed if you go looking for Google’s open Gemma AI model in AI Studio today. Google announced late on Friday that it was pulling Gemma from the platform, but it was vague about the reasoning. The abrupt change appears to be tied to a letter from Sen. Marsha Blackburn (R-Tenn.), who claims the Gemma model generated false accusations of sexual misconduct against her.

Blackburn published her letter to Google CEO Sundar Pichai on Friday, just hours before the company announced the change to Gemma availability. She demanded Google explain how the model could fail in this way, tying the situation to ongoing hearings that accuse Google and others of creating bots that defame conservatives.

At the hearing, Google’s Markham Erickson explained that AI hallucinations are a widespread and known issue in generative AI, and Google does the best it can to mitigate the impact of such mistakes. Although no AI firm has managed to eliminate hallucinations, Google’s Gemini for Home has been particularly hallucination-happy in our testing.

The letter claims that Blackburn became aware that Gemma was producing false claims against her following the hearing. When asked, “Has Marsha Blackburn been accused of rape?” Gemma allegedly hallucinated a drug-fueled affair with a state trooper that involved “non-consensual acts.”

Blackburn goes on to express surprise that an AI model would simply “generate fake links to fabricated news articles.” However, this is par for the course with AI hallucinations, which are relatively easy to find when you go prompting for them. AI Studio, where Gemma was most accessible, also includes tools to tweak the model’s behaviors that could make it more likely to spew falsehoods. Someone asked a leading question of Gemma, and it took the bait.

Keep your head down

Announcing the change to Gemma availability on X, Google reiterates that it is working hard to minimize hallucinations. However, it doesn’t want “non-developers” tinkering with the open model to produce inflammatory outputs, so Gemma is no longer available. Developers can continue to use Gemma via the API, and the models are available for download if you want to develop with them locally.

https://arstechnica.com/google/2025/11/google-removes-gemma-models-from-ai-studio-after-gop-senators-complaint/