UE, 500 milioni di euro per la nuova ondata di AI Factory. In totale adesso se ne contano 13 (una a Bologna)

Sei nuove fabbriche europee dell’AI, ecco dove sorgeranno

L’Unione europea (Ue) punta con maggiore decisione sulle tecnologie di punta e quindi sull’intelligenza artificiale (AI). L’impresa comune europea per il calcolo ad alte prestazioni (EuroHPC JU) ha selezionato sei nuove AI Factories che dovranno nascere entro il 2026 in Austria, Bulgaria, Francia, Germania, Polonia e Slovenia.

A sostegno dei nuovi siti è previsto un investimento nazionale e comunitario complessivo di 485 milioni di euro.

L’obiettivo dell’iniziativa è garantire un accesso facilitato all’AI per startup e piccole e medie imprese (Pmi), promuovendo crescita, competitività e un’espansione più efficace sul mercato interno e quelli esteri.

Cosa sono le AI Factories

Le fabbriche di intelligenza artificiale sono state ideate come ecosistemi dinamici che promuovono innovazione, collaborazione e sviluppo in questa nuova tecnologia, nel suo sviluppo, nelle applicazioni e nella crescita delle competenze.

Si tratta di ‘fabbriche’ all’interno delle quali sono riunite tutte le risorse necessarie (potenza di calcolo, dati e talento) per creare modelli di AI generativa all’avanguardia.

Non solo, secondo Bruxelles, queste Factories dovranno promuovere e favorire la collaborazione in ricerca, innovazione e sviluppo in tutta Europa, collegando università, centri di supercalcolo, industria e attori finanziari.

Il risultato finale sarà un’infrastruttura comunitaria di hub che guidano i progressi nelle applicazioni di AI in vari settori, come salute, produzione, clima, finanza e altro ancora. 

Le prime nasceranno entro il 2025, una delle prime è stata selezionata a Bologna

La Commissione vorrebbe vedere avviate le prime fabbriche entro la fine del 2025 e l’obiettivo molto ambizioso annunciato dalla stessa Presidente Ursula von der Leyen è dare vita al primo continente dell’intelligenza artificiale.

A dicembre sono stati selezionati i primi sette consorzi per dare il via alla realizzazione di altrettante AI Factories, coinvolgendo 15 Stati membri dell’Unione e altri 2 Stati partecipanti di EuroHPC (Spagna, Italia con il Cineca-tecnopolo di Bologna, Finlandia, Svezia, Germania, Grecia, più Portogallo, Romania e Turchia, Austria e Slovenia, Repubblica Ceca, Danimarca, Estonia, Norvegia e Polonia).

Con un investimento di circa 1,5 miliardi di euro da parte dell’Ue e degli Stati membri, questi siti implementeranno nuovi supercomputer ottimizzati per l’AI e aggiorneranno i sistemi esistenti, migliorando significativamente le capacità, la sicurezza e l’autonomia tecnologica dell’Europa.

Di questo e di altro si parlerà ampiamente alla prossima edizione del convegno promosso dal CNIT Telecommunications of the Future by 5GItaly, che si terrà il prossimo 9 aprile a Roma.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ue-500-milioni-di-euro-per-la-nuova-ondata-di-ai-factory-in-totale-adesso-se-ne-contano-13-una-a-bologna/524410/


Machine Unlearning: Metodologie di Mitigazione

Il machine unlearning emerge come soluzione critica per affrontare le sfide della privacy e della sicurezza nei modelli di machine learning. Questo articolo esplora le metodologie di mitigazione, le tecniche implementative e i criteri di valutazione per rimuovere efficacemente dati specifici dai modelli addestrati, senza necessità di riaddestramento completo. Vengono analizzati gli scenari di applicazione, dalle normative sulla privacy come il GDPR alla mitigazione dei bias, evidenziando l’importanza di questo approccio nell’evoluzione dell’AI responsabile.

Stiamo assistendo ad una crescita esponenziale nell’utilizzo del machine learning per lo svolgimento di qualsiasi attività. I modelli di machine learning (ML) si stanno sempre di più integrando in molti prodotti e servizi di uso quotidiano. Tuttavia, la proliferazione della tecnologia di AI/ML solleva una serie di problemi in termini di violazione della privacy, di bias (pregiudizi) del modello e dell’uso non autorizzato dei dati utilizzati per il training dei modelli.

Questi ambiti evidenziano ancora una volta la necessità di adottare un controllo flessibile e reattivo sui dati con cui viene addestrato un modello. Il riaddestramento da zero di un modello di ML, per la rimozione di specifici dati, è poco pratico a causa degli elevati costi computazionali ed economici. Pertanto, è stata avviata la ricerca sul “machine unlearning” (MU), ovvero si sta cercando di sviluppare nuovi metodi in grado di rimuovere determinati dati da un modello addestrato in modo efficiente, efficace e, soprattutto, senza la necessità di realizzare un nuovo addestramento. Analizziamo le criticità del machine unlearning e le metodologie di valutazioni più efficaci.

Scenari di Mitigazione dei Rischi nel Machine Unlearning

Il machine unlearning (MU) rappresenta un tema rilevante, che non può essere sottovalutato, perché è in grado di affrontare una serie di problemi quali: la conformità alla privacy dei dati di training, la gestione dinamica dei dati, l’inclusione non autorizzata di dati tutelati dalla proprietà intellettuale o altre forme di tutela e, infine, l’uso di dati provenienti da data breaches.

Vediamo i principali use case del machine unlearning:

  • Protezione della privacy: il MU può svolgere un ruolo cruciale nell’applicazione dei diritti alla privacy e nel rispetto di normative come il GDPR dell’UE[1] (che include anche il diritto all’oblio). Consentirebbe di rimuovere i dati personali dai modelli addestrati, salvaguardando la privacy degli individui.
  • Incremento della sicurezza: il MU potrebbe migliorare la sicurezza dei modelli contro gli attacchi di “data poisoning” attraverso la rimozione dei dati c.d. tossici che mirano a manipolare il comportamento di un modello.
  • Miglioramento dell’adattabilità: il MU su larga scala potrebbe aiutare i modelli a rimanere pertinenti anche quando cambiano le distribuzioni dei dati nel tempo, ad esempio in base all’evoluzione delle preferenze dei clienti o delle tendenze di mercato.
  • Conformità normativa: nei settori fortemente regolamentati, il MU potrebbe essere fondamentale per mantenere la conformità alle leggi e ai regolamenti in continua evoluzione.

Mitigazione dei bias/pregiudizi: il MU potrebbe offrire un metodo per rimuovere i dati identificati dopo il training che creano distorsione, promuovendo così l’imparzialità e riducendo il rischio di risultati scorretti.

Tecniche di Mitigazione e Implementazione

La maggior parte delle implementazioni di machine unlearning suddividono il data set utilizzato per il training originario (“Dtrain”) in dati che devono essere conservati (“retain set” o Dr) e dati che devono essere dimenticati/rimossi (“forget set” o Df), come mostrato in Figura.

Il tipico training di un modello di ML (a) prevede l’utilizzo di tutti i dati di training per impostare i parametri del modello. I metodi di machine unlearning comportano la suddivisione dei dati di training (Dtrain) in retain set (Dr) e forget set (Df), quindi un utilizzo iterativo di questi set per modificare i parametri del modello (passaggi da b a d in maniera ciclica). La sezione gialla rappresenta i dati che sono stati dimenticati durante il processo.

Successivamente, i due set vengono utilizzati per modificare i parametri del modello sottoposto a training. Nel corso del tempo, i ricercatori hanno sviluppato diverse tecniche per migliorare questa fase di unlearning, analizziamole:

  • Ottimizzazione: la tecnica prevede che il modello sia ulteriormente addestrato sul retain set, consentendogli di adattarsi alla nuova distribuzione dei dati. Questa tecnica è semplice, ma può richiedere molta potenza di calcolo[2].
  • Etichettatura casuale: la tecnica prevede l’assegnazione di etichette errate casuali al forget set in grado di confondere il modello. In questo modo, il modello viene ottimizzato[3] [4].
  • Inversione del gradiente: questa tecnica prevede che, durante l’ottimizzazione del modello, sia invertito il segno dei gradienti di aggiornamento del peso per i dati del forget set. Questa tecnica contrasta il training precedente[5].
  • Riduzione selettiva dei parametri: questa tecnica prevede la riduzione selettiva dei parametri specificamente legati al forget set attraverso tecniche di analisi del peso e senza alcuna ottimizzazione[6].

Le scelte delle tecniche di unlearning riflettono i casi d’uso di unlearning. Ogni use case ha i propri requisiti che riguardano, in particolare, l’efficacia, l’efficienza e i problemi di privacy.

Valutazione e privacy e Sicurezza nel Machine Unlearning

Una delle principali difficoltà del machine unlearning consiste nel valutare se la tecnica di unlearning prescelta sia in grado di dimenticare i dati specificati e, contestualmente, mantenere le performance sui dati conservati e, inoltre, proteggere la privacy. Idealmente, un metodo di unlearning automatico dovrebbe produrre un modello che funzioni come se fosse stato addestrato da zero, quindi privo del set di dati da dimenticare.

I metodi di unlearning più utilizzati (come l’etichettatura casuale, l’inversione del gradiente e la riduzione selettiva dei parametri) provocano un degrado delle prestazioni del modello esattamente nei punti corrispondenti al dataset dei dati da dimenticare, mentre cercano di mantenere un alto grado di prestazioni del modello nei corrispondenti punti del dataset da mantenere.

Per semplicità, si potrebbe considerare un metodo di unlearning basato su due semplici obiettivi: ottenere prestazioni elevate sul set da conservare e scarse sul set dell’oblio. Questo approccio, tuttavia, rischierebbe di aprire un’altra superficie di attacco sul fronte della privacy: per esempio, se un modello unlearned funzionasse particolarmente male con un determinato input, ciò potrebbe far capire all’aggressore che in origine l’input fosse incluso nel set di dati utilizzati nel training originale e che sia stato rimosso successivamente.

Questo tipo di violazione della privacy, chiamato attacco di “membership inference” [7], è in grado di rivelare i dati importanti e sensibili di un determinato utente o su un set di dati specifico. Pertanto, durante la valutazione dei metodi di unlearning automatico, è importante testare la loro efficacia contro questa tipologia di attacco.

In questo contesto di analisi, i termini “stronger” e “weaker” si riferiscono alla complessità e all’efficacia dell’attacco:

Weaker attacks (Attacchi più deboli): si tratta di tentativi semplici e diretti per ricavare l’appartenenza inferenziale. Questi attacchi potrebbero fare affidamento su informazioni basilari, come i punteggi di confidenza del modello o la probabilità di un determinato output per un input definito. Spesso questi attacchi si basano su ipotesi semplificatrici del modello o sulla distribuzione dei dati, il che può fortunatamente limitarne l’efficacia.

Stronger attacks (Attacchi più forti): si tratta di attacchi sofisticati che utilizzano informazioni o tecniche più avanzate. In particolare, sono in grado di:

  • utilizzare più punti di query oppure input particolarmente elaborati,
  • sfruttare la conoscenza dell’architettura del modello o del processo di training,
  • utilizzare modelli ombra per comprendere il comportamento del modello target,
  • combinare più strategie di attacco,
  • adattarsi alle specifiche caratteristiche del modello target o del set di dati.

Generalmente, gli attacchi più forti sono più efficaci nell’inferenza di appartenenza e quindi sono più difficili da contrastare. Inoltre, rappresentano un modello di minaccia realistico, presente in molti scenari del mondo reale, in cui gli aggressori potrebbero disporre di importanti risorse e competenze.

Raccomandazioni

Il mondo della ricerca sta continuando a lavorare per lo sviluppo di nuove soluzioni di machine unlearning che siano aderenti agli ambienti di produzione e, inoltre, vengano sottoposti ad attacchi alla privacy o all’oblio dei dati più realistici. Uno studio recente offre una serie di raccomandazioni per migliorare la valutazione dell’unlearning basate sulla letteratura già esistente, in particolare vengono proposti nuovi benchmark e riprodotti diversi algoritmi di unlearning. In particolare, sono stati valutati gli algoritmi per misurare l’accuratezza sui dati conservati, la protezione della privacy dei dati dimenticati e la velocità di esecuzione del processo di unlearning[8].

I test hanno rivelato notevoli discrepanze tra gli algoritmi di unlearning, in molti casi sono state riscontrate difficoltà nel raggiungere il risultato in tutte le aree di valutazione. Sono stati testati tre metodi (Identity, Retrain e Finetune on retain) e cinque algoritmi (RandLabel[9], BadTeach[10], SCRUB+R [11] , Selective Synaptic Dampening [SSD][12] e una combinazione di SSD e finetuning).

Come evidenziato in figura, alcuni metodi riescono a difendersi bene dagli attacchi di inferenza debole, mentre sono completamente inefficaci contro gli attacchi più forti, evidenziando la necessità di effettuare il test del caso peggiore. Alla luce di questi risultati, è stata dimostrata l’importanza di dover effettuare la valutazione degli algoritmi in contesti iterativi, poiché alcuni algoritmi degradano la loro accuratezza complessiva durante le iterazioni di unlearning, mentre altri sono in grado di mantenere elevate prestazioni in maniera costante.

Sulla base di questi risultati, si suggerisce di adottare le seguenti raccomandazioni:

1)è necessario dare enfasi alle metriche del caso peggiore rispetto a quelle del caso medio e, inoltre, opportuno utilizzare attacchi avversari forti per la valutazione degli algoritmi. Gli utenti sono più preoccupati per gli scenari gravi, come l’esposizione di informazioni finanziarie personali, che non per gli scenari meno gravi. La valutazione delle metriche del caso peggiore fornisce un limite di alto livello sulla privacy.

2)è opportuno considerare tipi di attacchi specifici alla privacy, in cui l’aggressore ha l’accesso all’output da due versioni diverse dello stesso modello. In questi scenari, l’unlearning può portare a risultati peggiori perché stiamo fornendo all’aggressore maggiori informazioni. Se si verificasse un attacco di perdita di aggiornamento, il danno non dovrebbe essere maggiore di un attacco al modello di base.

3)è utile analizzare le prestazioni dell’algoritmo di unlearning su un numero ripetuto di applicazioni, ovvero il disapprendimento iterativo, per essere in grado di valutare il degrado delle prestazioni di accuratezza del test dei modelli. Poiché i modelli di unlearning automatico sono distribuiti in ambienti in continuo cambiamento, in cui le richieste di oblio, i dati dei nuovi utenti e i dati errati o avvelenati arrivano dinamicamente, è fondamentale essere in grado di poterli valutare in un ambiente online, cioè in un ambiente dove le richieste arrivano attraverso un flusso.

Poiché l’intelligenza artificiale sarà sempre più integrata nei vari aspetti della vita, molto probabilmente il machine unlearning automatico diventerà uno strumento essenziale e un complemento alla cura/manutenzione dei dati di training, e sarà in grado di bilanciare le capacità dell’intelligenza artificiale con le minacce relative alla privacy e alla sicurezza dei dati.

Questo aspetto aprirà nuove opportunità per migliorare la protezione della privacy e per lo sviluppo di sistemi di intelligenza artificiale adattabili, inoltre deve essere in grado di affrontare sfide significative, tra cui le limitazioni tecniche e l’elevato costo computazionale di alcuni metodi di unlearning. La ricerca e lo sviluppo stanno svolgendo un ruolo fondamentali per migliorare queste tecniche e garantire che le stesse possano essere efficacemente implementate in scenari reali.

Il machine unlearning si conferma come tecnologia essenziale per bilanciare le potenzialità dell’AI con la protezione della privacy e la sicurezza dei dati. Nonostante le sfide tecniche e computazionali, la ricerca continua a sviluppare soluzioni sempre più efficaci per scenari reali. Nel prossimo capitolo esploreremo le metodologie per misurare e garantire l’affidabilità dei sistemi di AI. Per un’analisi più completa, il white paper “Generative artificial intelligence rischi e contromisure” offre ulteriori approfondimenti sulle sfide e le soluzioni nel campo dell’IA Gen.

Note bibliografiche

[1]General Data Protection Regulation: https://en.wikipedia.org/wiki/General_Data_Protection_Regulation

[2] AA.VV., Machine unlearning through fine-grained model parameters perturbation: https://arxiv.org/abs/2401.04385, College of Computer Science and Electronic Engineering, 2024

[3] AA.VV., Random Relabeling for Efficient Machine Unlearning: https://arxiv.org/abs/2305.12320, Pennsylvania State University, 2023

[4] AA.VV., Amnesiac Machine Learning: https://arxiv.org/pdf/2010.10981, University of Waterloo, 2020

[5] AA.VV., Gone but Not Forgotten: Improved Benchmarks for Machine Unlearning: https://arxiv.org/pdf/2405.19211, Carnegie Mellon University, 2024

[6]AA.VV., Fast Machine Unlearning Without Retraining Through Selective Synaptic Dampening: https://arxiv.org/abs/2308.07707, University of Cambridge, 2023
[7]ML04:2023 Membership Inference Attack: https://owasp.org/www-project-machine-learning-security-top-10/docs/ML04_2023-Membership_Inference_Attack

[8] AA.VV., Gone But Not Forgotten: Improved Benchmarks for Machine Unlearning: https://arxiv.org/pdf/2405.19211, Carnegie Mellon University, 2024

[9] AA.VV., Amnesiac Machine Learning: https://arxiv.org/abs/2010.10981, University of Waterloo, 2020

[10] AA.VV., Can Bad Teaching Induce Forgetting? Unlearning in Deep Networks using an Incompetent Teacher: https://arxiv.org/abs/2205.08096, Mavvex Lab, 2023

[11] AA.VV., Towards Unbounded Machine Unlearning: https://arxiv.org/abs/2302.09880, University of Warwick, 2023

[12] AA.VV., Fast Machine Unlearning Without Retraining Through Selective Synaptic Dampening: https://arxiv.org/abs/2308.07707, University of Cambridge, 2023

Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/machine-unlearning/


AI, copyright e audiovisivo. Lasorella (Agcom): “Tecnologia dirompente capace di ridefinire il modo di produrre, distribuire e consumare contenuti”

Tra tutele e innovazione. L’audiovisivo nella corsa all’Intelligenza Artificiale

L’innovazione tecnologica sta progressivamente investendo tutti i settori industriali, economici e sociali della nostra società. Il legislatore è chiamato al difficile compito di regolamentare un ambito che è profondamente segnato dalla rapidità del progresso di queste tecnologie, sia a livello nazionale, sia europeo.

Il tema è stato al centro del convegno dal titolo “Tra Tutele e Innovazione. L’audiovisivo nella corsa all’Intelligenza Artificiale”, organizzato a Roma dall’Autorità per le Garanzie nelle Comunicazioni (Agcom) presso lo spazio Esperienza Europa “David Sassoli”, messo a disposizione dal Parlamento europeo.

Un’occasione per fare il punto sulle opportunità e i rischi generati dall’incontro tra intelligenza artificiale (AI) e settore audiovisivo, assieme a regolatori, policy maker e stakeholder, che si sono confrontati sulle principali dorsali dell’attuale impiego di questa tecnologia nell’ambito dell’industria culturale.

“Un confronto sull’audiovisivo al tempo dell’AI è rilevante nel contesto europeo, sia per il copyright, sia per l’industria, sia della pirateria, sia in termini di regolamento. Una tecnologia dirompente che si inserisce in un contesto fortemente instabile, che richiede una nuova visione di policy. Le piattaforme digitali oggi hanno un ruolo chiave nello sviluppo del settore dell’informazione e dei media, con l’obbligo di affrontare con decisione il problema della disinformazione e della manipolazione dell’opinione pubblica. L’UE deve rimanere uno spazio di regole”, ha detto Carlo Corazza, Direttore del Parlamento europeo in Italia, aprendo il convegno con i saluti delle Istituzioni.

Secondo Giacomo Lasorella, Presidente AGCOM: “L’AI è una tecnologia dirompente in grado di ridefinire il modo in cui i contenuti mediatici sono prodotti, distribuiti e consumati. Per l’AI Act e il suo corso legislativo in Italia come Agcom cerchiamo di capire in che modo regolamentare l’utilizzo di questa tecnologia nei settori di interesse, nella tutela dei diritti e nell’innovazione. Nostro compito è regolare tutto questo. Il DSA è il plesso normativo che riguarda l’AI che è già tra noi, come le piattaforme la usano per regolare i servizi che offrono. Il DSA detta le norme fondamentali affinché il design stesso delle piattaforme nell’uso dell’AI risponda ai criteri di trasparenza e tutela degli utenti. I gatekeeper hanno già investito nei grandi sistemi di AI e per integrarla nei vari servizi si rischia di erigere nuove barriere di accesso al mercato. Poi ci sono criticità per quel che riguarda il copyright. È necessario garantire un’interazione più efficace tra disciplina settoriale dei media e copyright e i plessi normativi DSA e AI Act”.

“Dal codice di buone pratiche siamo passati al codice di condotta sulla disinformazione ai sensi del DSA. Con questa conversone l’UE compie un passo decisivo nel contrasto alla disinformazione. È un benchmark per valutare le responsabilità delle piattaforme digitali in questo campo. Dal 1° luglio prossimo le piattaforme saranno sottoposte a verifiche annuali indipendenti. Il codice è frutto di un confronto multilaterale tra tutti gli attori impegnati nella lotta alla disinformazione. I suoi pilastri sono diversi: eliminare gli incentivi economici alle fake news e a chi le diffonde, aumentare la trasparenza della pubblicità politica, aumentare la consapevolezza degli utenti con strumenti più efficaci. Alcune piattaforme importanti si sono ritirate dagli impegni del fact-checking. Ci sono dei dubbi in generale sull’efficacia del codice e la Commissione avvierà un dialogo per il follow-up. Poi c’è la questione della relazione tra copyright e AI. I dati per l’addestramento di questi modelli sono protetti dal diritto d’autore. L’UE si è dotata di strumenti di policy per lo sviluppo di tecnologie di machine learning, introducendo due eccezioni al copyright per consentire l’impiego di queste tecnologie nell’industria dei contenuti. La più importante è l’eccezione TDM per bilanciare la promozione dell’innovazione e la tutela dei diritti d’autore, che possono sfruttare lo strumento dell’opt-out, un cardine fondamentale per favorire il rispetto dei diritti in qualsiasi luogo e per conciliare l’ubiquità del web con il rispetto del diritto d’autore a livello nazionale”, ha spiegato Giuseppe Abbamonte, Direttore per le politiche dei media Commissione Europea.

“L’AI va affrontata a seconda delle applicazioni, con delle regole specifiche per ogni settore di impiego, mentre nell’industria creativa e culturale si deve dare un’attenzione diversa, una regolamentazione diversa. C’è il diritto d’autore e la tutela dell’immagine, della voce e dei testi dei creatori. Abbiamo messo nel tax credit della legge cinema strumenti di regolamentazione per l’industria dell’audiovisivo che necessità di regole che si adattino rapidamente ai cambiamenti tecnologici. Abbiamo messo dei paletti per garantire trasparenza nell’uso dell’AI, che rimane uno strumento e che non deve togliere nulla all’uomo e il suo specifico spazio esistenziale e professionale. I fondi dati agli attori e altri professionisti siano garantiti per le persone. Abbiamo sottolineato come non potesse essere sottinteso in un contratto che le immagini siano sfruttabili in altri contesti fuori dal consenso specifico per un’opera. Serve un’autoregolamentazione dei soggetti interessati”, ha dichiarato Lucia Borgonzoni, Sottosegretario di Stato Ministero della Cultura.

“In pochi anni siamo arrivati alle soglie di un mondo sempre più distopico, con tecnologie in grado di stupirci sempre di più, ma a rischio altissimo in termini di democrazia, copyright e sostenibilità sociale. Si pone un problema di tutela della proprietà intellettuale dei lavoratori e delle loro competenze. La maggior parte delle piattaforme è impostata per profilare i contenuti attraverso algoritmi troppo opachi. Le innovazioni non sono sbagliate per sé, dipende dagli usi che se ne fanno. L’utilizzo delle tecnologie avviene in contesti non ancora pienamente regolamentati e segnati da squilibri spaventosi tra imprese e utenti. Serve un perimetro di regole trasparenti, uno sforzo sulle competenze e un confronto serrato tra Governi e imprese tecnologiche”, ha detto Alessio Butti, Sottosegretario di Stato Presidenza del Consiglio dei Ministri, intervenendo in video.

L’evento – articolato in tre panel dedicati a disinformazione e hate speech, tutela del copyright online e pirateria, impatti dei sistemi di AI nella produzione e distribuzione dei contenuti audiovisivi – è stato moderato da Enrico Pagliarini di Radio24.

L’AI vista dall’Europa

Nel panel dal titolo “L’AI vista dall’Europa”, Andrea Renda, Coordinatore Comitato AGCOM sull’AI, ha dichiarato che si deve “cercare di capire come la creatività umana si adatterà all’AI, uno strumento che si riproduce rapidamente con formidabile efficacia e che si alimenta con quanto fatto fino ad oggi dall’umanità. Negli USA l’AI generativa è stata spinta al punto che investimenti enormi non producono eguali profitti. Siamo di fronte alla consapevolezza che il futuro dell’AI non è negli LLM. In Europa si cerca un’AI affidabile con requisiti stringenti e gli attuali LLM non riescono ad adeguarsi a nessuno di questi criteri. In Europa si sta lavorando ad un’idea di un CERN he si occupi di fare ricerca sull’AI pe renderla sicura e affidabile, per migliorarne le applicazioni nella scienza, nell’industria e nei servizi pubblici ed evitare i rischi che già abbiamo individuato. Si tratta di tecnologie centrali per il mantenimento dei livelli di competitività che l’UE ha fissato come obiettivi chiave per la crescita. Nell’interazione tra competenza e sicurezza si sta lavorando su alcuni punti chiave. Riaprire l’AI Act per semplificarne l’applicazione e ridurre i costi amministrativi e di compliance per le imprese e le PMI in particolare. La Commissione ha ritirato la direttiva sulla responsabilità civile al tempo dell’AI ma il parlamento potrebbe portarla avanti comunque, per creare un quadro giuridico comune tra i Paesi UE, tale da semplificare lo sviluppo dell’AI”.

Successivamente, ha preso la parola in collegamento da Strasburgo, Brando Benifei, Deputato Parlamento europeo: “Stanotte sono stati attivati negli USA i dazi su acciaio e alluminio europei. Stamattina la Commissione ha annunciato delle misure di risposta. Questo perché non possiamo accettare tutto quello che gli USA ci chiedono e non possiamo sperare che i rapporti migliorino andando sempre incontro alle aspettative americane. Si deve rispondere con l’obiettivo di negoziare da un punto di forza. Il parlamento non intende mollare la direttiva e stiamo proponendo alla Commissione di trovare una formulazione diversa. Si rischia di trasferire la responsabilità dell’AI dalle grandi imprese alle più piccole. Stiamo dando un messaggio chiaro: aspettiamo che si abbassi la tensione politica con gli USA e cerchiamo di lavorare lucidamente. Su questo tema c’è convergenza nel Parlamento sull’AI Act e la tutela dei diritti. La semplificazione va bene, ma non possiamo deregolamentare ogni settore per far piacere alle esigenze degli Stati Uniti. Nel negoziato sulle tariffe non possiamo farci mettere in discussione le nostre leggi, piuttosto lavoriamo con l’AI office per semplificare la compliance delle piccole e medie imprese. L’AI Act lavora su questo fronte: ridurre i rischi e rendere più sicuro l’uso dell’AI da parte di imprese, PA e cittadini. Solo con regole chiare e un clima di fiducia è possibile sfruttare al massimo e in sicurezza le potenzialità di questa tecnologia in chiave di crescita e sviluppo”.

Per quel che riguarda l’impatto della diffusione dell’AI sull’attività regolamentare di AGCOM, intervenendo nel panel “AI, Disinformazione, Hate Speech e Tutela dei Minori”, la Commissaria Laura Aria ha sottolineato che “noi tutti siamo coinvolti nella sfida per una regolazione efficace dell’Intelligenza Artificiale, specie in relazione alla tutela dei diritti fondamentali, sia per individuare le criticità e i rischi che l’Intelligenza Artificiale porta con sé, ma soprattutto per coglierne le opportunità di innovazione, crescita e sviluppo sociale ed economico”.

“L’innovazione va guidata e resa sicura per imprese e cittadini. Ci sono casi però in cui la titolarità del diritto deve rimanere nelle mani degli autori. Devono essere le società che gestiscono l’algoritmo ha dichiarare che i dati acquisiti per il training siano aderenti al copyright, se ne devono preoccupare loro. Fondamentale il nuovo comitato Agcom sull’AI. La difesa del copyright va aggiornata ai nuovi utilizzi della tecnologia. La normativa italiana, istituendo il nuovo reto di deep fake, è innovativa a livello europeo. Il caso Crosetto ha fatto scuola. Ci stiamo interfacciando con potenti strumenti che hanno anche finalità criminali particolarmente gravi”, ha precisato Alberto Barachini, Sottosegretario di Stato Presidenza del Consiglio dei Ministri.

AI, copyright e pirateria

Da sinistra: Massimiliano Capitanio, Gina Nieri, Federico Bagnoli Rossi

“Sulla tutela del copyright la situazione è grave, perdiamo 2 miliardi di ricavi per colpa della pirateria e oggi fare pirateria nonostante l’AI possa darci una grande mano in questa lotta in Italia è semplicissimo. Chiunque può andare sullo store di Google e scaricare app per vedere partite e film violando il copyright, rubando i contenuti. Su Alibaba si può comprare una chiavetta per vedere contenuti piratati. Su TikTok è possibile guardare partite di calcio senza pagare. Solo per fare alcuni esempi. Barachini ha fatto bene ha dire che il tema fondamentale è la fiducia. L’AI dal nulla non crea niente, genera acquisendo proprietà intellettuale che va riconosciuta e remunerata. Vale per ogni settore, soprattutto l’audiovisivo. Ci sono diverse criticità, tra cui la violazione dei diritti d’autore. L’innovazione c’è mancano le tutele. Agcom c’è, sia nel settore dei diritti sportivi, ora anche nell’audiovisivo, con la rimozione tempestiva dei link pirata entro 30 minuti. Agcom ha stretto un protocollo col MUR per investire nelle competenze, perché l’AI è un grande strumento di conoscenza ma bisogna saperlo usare, stiamo potenziando il ruolo di chi deve segnalare le violazioni del copyright in rete. L’avvento comunque positivo dell’Intelligenza Artificiale impone con urgenza un’azione di responsabilizzazione per fare in modo che i cittadini possano esserne fruitori attivi e non consumatori passivi. Regole ed educazione civica digitale sono imprescindibili”, ha detto Massimiliano Capitanio, Commissario AGCOM, aprendo il panel “AI, Copyright e Pirateria”.

“Senza regole forse qualcuno fa soldi più facilmente. Noi vogliamo lavorare in un contesto di regole chiare, che tutti devono rispettare. Con l’arrivo di Trump sono state spedite lettere dall’FCC in cui si evidenzia che le leggi dell’Europa sono liberticide e che limitano l’azione delle imprese americane nel mercato europeo. Le piattaforme che avevano sottoscritto il codice sulla disinformazione prodotto da Bruxelles hanno subito sfruttato l’occasione per liberarsi dai vincoli del DSA”, ha sostenuto Gina Nieri di Mediaset.

Secondo Federico Bagnoli Rossi di FAPAV: “L’Italia è uno dei Paesi più attenzionati dai pirati. Noi come FAPAV utilizziamo in maniera responsabile l’AI per fare attività di comunicazione e lo facciamo anche oggi, come nel caso della campagna di sicurezza nelle sale cinematografiche “Il cinema siete voi”. L’AI non è solo uno strumento dalle grandi potenzialità, ma anche dai grandi rischi. Dietro alla pirateria c’è la criminalità organizzata che vuole fare facili profitti, come nel caso delle IPTV illegali, che proprio grazie al piracy shield stiamo contenendo e contrastando. Un business pirata che gestisce un’intera filiera della pirateria che oggi può avvantaggiarsi proprio delle potenzialità dell’AI. Come FAPAV inizieremo ad introdurre il lato positivo dell’AI che può essere impiegata nella lotta alla pirateria. Fondamentale sarà la formazione. Oggi c’è il semaforo verde al primo corso del LABS – Learn Antipiracy Best Skills, la società benefit di FAPAV – Federazione per la Tutela delle Industrie dei Contenuti Audiovisivi e Multimediali, in collaborazione con Anica Academy, per sviluppare competenze post laurea proprio su queste tematiche”.

L’AI nella produzione e distribuzione dei contenuti audiovisivi

“L’audiovisivo è un settore che sta vedendo un crescente utilizzo dell’AI, con un tasso di penetrazione del 38% e le prospettive sono di una crescita esponenziale. Accanto a questa crescita esponenziale si accompagna ovviamente allarme sociale e una sottile inquietudine, che però è la stessa che ha accolto ogni nuova tecnologia o nuovo mezzo di comunicazione.
Preoccupazioni in ordine al possibile rimpiazzo e sostituzione del fattore umano, dell’autodeterminazione umana, per mezzo delle macchine, aprendo agli scenari apocalittici narrati dalla fantascienza. Più precisamente, quanto al settore diventa audiovisivo, la preoccupazione riguarda la sostituzione dei talenti, degli attori, dei doppiatori, ma anche di chi lavora nel backstage, cioè tutte quelle maestranze creative coinvolte nella realizzazione del prodotto, dal concept alla scrittura, dalle riprese alla postproduzione e alla distribuzione. Sono molto lieta che la sottosegretaria Borgonzoni abbia fatto riferimento al fatto che non è sul piatto l’idea di una intelligenza artificiale applicata agli attori, ma perimetrata e ridotta semplicemente all’opera.
In nessun modo, io credo, l’intelligenza artificiale arriverà a ledere la centralità, il ruolo centrale dell’attore nel determinare il valore del prodotto e l’engagement con l’audience. E questo ce lo racconta anche la scienza. In nessun modo la mediazione tecnologica ha nel tempo ridotto la centralità dell’umano e della corporeità umana, al contrario ha permesso l’affermarsi di un vero e proprio star system.
Quando si va a verificare qual è l’effettivo utilizzo dell’intelligenza artificiale nella filiera produttiva, ci si rende conto che gli usi sono volti a potenziare la creatività umana, ad aumentare il controllo editoriale.
L’AI può potenziare l’immagine degli attori nell’industria dell’audiovisivo, soprattutto con algoritmi che ringiovaniscono volti, ma anche con sistemi di traduzione di molte opere che altrimenti non varcherebbero il imiti del mercato nazionale. La stessa tecnologia può tutelare il copyright andando a rintracciare ogni violazione
”, ha dichiarato Elisa Giomi, Commissaria AGCOM, intervenendo nel panel “L’AI nella Produzione e Distribuzione dei Contenuti Audiovisivi”.

“Il nostro settore è da sempre la frontiera delle nuove tecnologie applicate all’industria, che qui trovano pieno e pioneristico impiego. Pensiamo alla CGI e altri visual effects legati al virtuale. Ovviamente non mancano mai diffidenza e paura, ma c’è anche tanta voglia di sperimentare. I cambiamenti tecnologici portano sempre con sé nuove opportunità e nuovi rischi. L’AI è una grande opportunità per potenziare la creatività nel settore audiovisivo. Gli artisti contemporanei posso sfruttare oggi effetti visivi avanzati, alcuni dei quali incorporano l’AI, che aiuta notevolmente il processo creativo e produttivo. Basti pensare alla tecnica di rotoscopica, che è essenziale nella postproduzione, oggi fortemente investita dall’AI, che interviene nella correzione del colore, nella rimozione di oggetti, nell’affilatura dei dettagli, nel tracciamento del movimento, nei processi di invecchiamento o de-invecchiamento di un attore. Sono numerose le applicazioni dell’AI nel modo del cinema e dell’audiovisivo. L’espressione creativa degli esseri umani è la linfa vitale dell’industria cinematografica e gli esseri umani rimarranno sempre al centro del processo creativo”, ha dichiarato Emilie Anthonis della Motion Pictures Association.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ai-copyright-e-audiovisivo-lasorella-agcom-tecnologia-dirompente-capace-di-ridefinire-il-modo-di-produrre-distribuire-e-consumare-contenuti/524308/


In Spagna multe fino a 35 milioni alle aziende che non etichettano i contenuti generati dall’AI

Il governo spagnolo vuole rendere obbligatoria per legge l’identificazione dei contenuti generati con l’intelligenza artificiale (IA) e in tende introdurre sanzioni fino a 35 milioni di euro o al 7 percento del fatturato di un’azienda.

Il nuovo regime sanzionatorio sarà incluso nella Legge per il buon uso e la governance dell’intelligenza artificiale, che in bozza è stato approvato ieri dal Consiglio dei ministri per garantire un uso “etico, inclusivo e benefico” di questa tecnologia e facilitare per gli utenti la chiara distinzione fra contenuti reali e contenuti virtuali.

Recepite le linee guida dell’AI Act

Il disegno di legge adotta le linee guida dell’Artificial Intelligence Act, il principale strumento dell’Unione Europea, che impone rigidi obblighi di trasparenza sui sistemi di intelligenza artificiale considerati ad alto rischio, ha detto il ministro della Trasformazione digitale Oscar Lopez.

Lopez ha fatto riferimento all’intelligenza artificiale come a uno strumento “potente” che può favorire la crescita economica, favorire la lotta contro molte malattie o lo sviluppo di nuovi farmaci, ma anche essere uno strumento per diffondere bufale, per spargere odio e attaccare la democrazia.

Le sanzioni volute dall’Ue

In questo modo, la Spagna diventa uno dei primi paesi dell’UE ad applicare le regole del blocco, considerate più complete del sistema statunitense, che si basa in gran parte sulla conformità volontaria e su un mosaico di normative statali.

Lopez ha aggiunto che tutti sono suscettibili di possibili attacchi deepfake, un termine per video, foto o audio che sono stati modificati o generati utilizzando algoritmi di intelligenza artificiale ma sono presentati come reali.

Considerata grave violazione

Questa norma classifica la mancata etichettatura corretta dei contenuti generati dall’IA come una “grave violazione” che può comportare multe fino a 35 milioni di euro o il 7% del fatturato annuo globale.

Il disegno di legge proibisce anche altre pratiche, come l’uso di tecniche subliminali (suoni e immagini impercettibili) per manipolare gruppi vulnerabili. Lopez ha citato come esempi chatbot che incoraggiano le persone con dipendenze a giocare d’azzardo o giocattoli che incoraggiano i bambini a eseguire sfide pericolose.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/in-spagna-multe-fino-a-35-milioni-alle-aziende-che-non-etichettano-i-contenuti-generati-dallai/524306/


Seeweb, l’AI generativa ha pregiudizi politici. ChatGPT più liberal, Lllama (Meta) e Qwen più conservatori. Come regolarsi?

L’Intelligenza artificiale non è neutra. Le piattaforme di AI generativa hanno tutte degli orientamenti politici in qualche modo predeterminati. Queste macchine hanno degli imprintig politici. L’influenza politica dell’intelligenza artificiale è un dato di fatto. Bisogna saperlo ed esserne consapevoli. E’ quanto emerge da un esperimento commissionato dal Cloud Provider italiano  Seeweb a un gruppo di ricerca indipendente, mii-llm – composto da Alessandro Ercolani, Samuele Colombo, Edoardo Federici e Mattia Ferraretto – per capire se sia possibile influenzare l’orientamento politico dei modelli LLM (Large Language Model) (leggi qui un articolo di approfondimento realizzato da Dario Denni, presidente di Europio Consulting).

Come si costruisce il consenso

Lo studio ha non soltanto dimostrato che è possibile manipolare e misurare l’orientamento politico di un LLM, evidenziando come questi modelli possano assorbire bias politici dai loro creatori o dai dati di addestramento, anche involontariamente. Ma ha mostrato anche che le diverse piattafrome di Gen AI presenti sul mercato hanno tutte orientamenti diversi, più o meno di “destra” o di “sinistra” da subito.

Abstract

È stato condotto un esperimento sulla manipolazione dell’orientamento politico di un modello di linguaggio di grandi dimensioni (LLM) e sulle modalità di valutazione di questa manipolazione da parte di un soggetto indipendente. L’obiettivo principale era dimostrare che è possibile influenzare l’orientamento politico di un LLM, inizialmente neutro, e misurare questo cambiamento. L’esperimento ha evidenziato come, anche involontariamente, i modelli di linguaggio di grandi dimensioni (LLM) possono incorporare un orientamento politico. Si è concluso che i LLM possono essere influenzati dalle opinioni dei loro creatori o dai dati utilizzati per l’addestramento.

Gli utenti devono essere consapevoli che i sistemi di IA possono non essere neutrali e che le risposte che ricevono potrebbero essere influenzate da bias politici o culturali.

Implicazioni e Conclusioni

L’esperimento ha sollevato interrogativi importanti sulla trasparenza, l’etica e l’imparzialità dei modelli di linguaggio. Il problema dei bias nei LLM non è più nascosto, ma può diventare doloso, ovvero dettato da una volontà precisa di far preferire una scelta politica piuttosto che un’altra, un elemento che aggiunge urgenza alla questione. E’ possibile inserire bias in un LLM, influenzando l’utente in maniera sottile, anche senza espliciti comandi. Questo ci spinge a riflettere sulla necessità di regolamentare l’uso dei modelli di linguaggio per evitare che vengano usati per la manipolazione politica o per la diffusione di disinformazione. In conclusione l’esperimento ha dimostrato:

Le Gen AI hanno diversi orientamenti politici ab origine

  • I modelli hanno naturalmente diverse inclinazioni politiche: analizzando diversi modelli linguistici popolari, i ricercatori hanno scoperto che ciascuno mostra già delle tendenze politiche naturali. Come mostrato nel grafico di valutazione (Figura sottostante del report), alcuni modelli tendono a essere più liberali (con punteggi più alti come GPT-4 a 270) mentre altri sono più conservatori (con punteggi più bassi).

Ma cosa vuol dire?

Dal momento che tutti gli agenti di intelligenza artificiale generativa come ChatGPT, indipendentemente dall’ambito di applicazione, ricevono per così dire un’educazione umana, tutti gli agenti di AI hanno un loro imprinting anche dal punto di vista politico.

Come regolarsi?

Cosa fare per scremare i pregiudizi dell’AI?

E’ possibile per così dire azzerare le convinzioni politiche dell’AI oppure bisogna comunque sempre tenerne conto in tutte le ricerche e i ragionamenti che si fanno?

A quanto pare no. E’ necessario quindi promuovere la consapevolezza di tutto ciò.

Baldassarra (Seeweb): ‘Attenzione ai campioni dell’AI. Promuoviamo la pluralità dell’intelligenza artificiale’

“Ritengo che la tecnologia debba essere nelle mani di tutti – ha detto Antonio Baldassarra, Ceo di Seeweb – è pericoloso, soprattutto in prospettiva, sapere che una tecnologia potente come l’AI generativa sia nelle mani di pochi grandi player in modo monopolisitco o quanto meno oligopolistico. Noi tutti abbiamo una visione della macchina come di un qualcosa che dà risultati esatti. Ma questa è una trappola, perché l’AI non è una tecnologia deterministica. Attenzione ai campioni dell’AI, promuoviamo la pluralità dell’Intelligenza Artificiale”.

Di questo e di altro si parlerà alla prossima edizione del convegno promosso dal CNIT Telecommunications of the Future by 5GItaly, che si terrà il prossimo 9 aprile a Roma.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/seeweb-lai-generativa-ha-pregiudizi-politici-chatgpt-piu-liberal-lllama-meta-e-qwen-piu-conservatori-come-regolarsi/524267/


Why extracting data from PDFs is still a nightmare for data experts

“The biggest [drawback] is that they are probabilistic prediction machines and will get it wrong in ways that aren’t just ‘that’s the wrong word’,” Willis explains. “LLMs will sometimes skip a line in larger documents where the layout repeats itself, I’ve found, where OCR isn’t likely to do that.”

AI researcher and data journalist Simon Willison identified several critical concerns of using LLMs for OCR in a conversation with Ars Technica. “I still think the biggest challenge is the risk of accidental instruction following,” he says, always wary of prompt injections (in this case accidental) that might feed nefarious or contradictory instructions to a LLM.

“That and the fact that table interpretation mistakes can be catastrophic,” Willison adds. “In the past I’ve had lots of cases where a vision LLM has matched up the wrong line of data with the wrong heading, which results in absolute junk that looks correct. Also that thing where sometimes if text is illegible a model might just invent the text.”

These issues become particularly troublesome when processing financial statements, legal documents, or medical records, where a mistake might put someone’s life in danger. The reliability problems mean these tools often require careful human oversight, limiting their value for fully automated data extraction.

The path forward

Even in our seemingly advanced age of AI, there is still no perfect OCR solution. The race to unlock data from PDFs continues, with companies like Google now offering context-aware generative AI products. Some of the motivation for unlocking PDFs among AI companies, as Willis observes, doubtless involves potential training data acquisition: “I think Mistral’s announcement is pretty clear evidence that documents—not just PDFs—are a big part of their strategy, exactly because it will likely provide additional training data.”

Whether it benefits AI companies with training data or historians analyzing a historical census, as these technologies improve, they may unlock repositories of knowledge currently trapped in digital formats designed primarily for human consumption. That could lead to a new golden age of data analysis—or a field day for hard-to-spot mistakes, depending on the technology used and how blindly we trust it.

https://arstechnica.com/ai/2025/03/why-extracting-data-from-pdfs-is-still-a-nightmare-for-data-experts/


Agcom, l’audiovisivo nella corsa all’Intelligenza Artificiale. Il 12 marzo evento a Roma

Si terrà mercoledì 12 marzo il Convegno AGCOM “Tra tutele e innovazione. L’audiovisivo nella corsa all’intelligenza artificiale”, dalle ore 9:00 presso Esperienza Europa “David Sassoli”.

I progressi sempre più rapidi della tecnologia, le iniziative legislative messe in atto dall’Unione Europea e le ricadute del fenomeno sull’attività regolamentare di AGCOM rendono urgente una riflessione sull’impatto dell’intelligenza artificiale negli ambiti di intervento dell’Autorità. In particolare, la diffusione nella vita quotidiana di strumenti di intelligenza artificiale generativa ha rivoluzionato le modalità di produzione, distribuzione e fruizione di contenuti di testo, audio e video.

Scarica il programma completo in PDF

Questo convegno intende fare il punto sulle opportunità e i rischi generati dall’incontro tra intelligenza artificiale e settore audiovisivo, in cui offrire a regolatori, policy maker e stakeholder un’occasione di confronto e riflessione attorno alle principali dorsali dell’attuale impiego dell’AI in questo strategico ambito dell’industria culturale.

All’evento parteciperanno fra gli altri Carlo Corazza, Direttore del Parlamento europeo in Italia; Giacomo Lasorella Presidente AGCOM; Giuseppe Abbamonte Direttore per le politiche dei media Commissione Europea; Alessio Butti Sottosegretario di Stato Presidenza del Consiglio dei Ministri; Lucia Borgonzoni Sottosegretario di Stato Ministero della Cultura; Alberto Barachini Sottosegretario di Stato Presidenza del Consiglio dei Ministri.

Brando Benifei Deputato Parlamento europeo; Andrea Renda Coordinatore Comitato AGCOM sull’AI; i commissari Agcom Laura Aria, Elisa Giomi e Massimiliano Capitanio; Gina Nieri Mediaset; Federico Bagnoli Rossi FAPAV.

Scarica il programma completo in PDF

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/agcom-laudiovisivo-nella-corsa-allintelligenza-artificiale-il-12-marzo-evento-a-roma/524125/


Manus, dalla Cina l’AI completamente autonoma. Come funziona e perché ci deve preoccupare

Manus: la prima IA completamente autonoma sviluppata in Cina

L’intelligenza artificiale (AI) ha compiuto un nuovo salto evolutivo con l’arrivo di Manus, definita dagli sviluppatori cinesi di The Butterfly Effect come la “prima intelligenza artificiale completamente autonoma” al mondo. A differenza di chatbot come ChatGPT, Google Gemini o Grok, che necessitano di input umano per eseguire compiti, Manus sarebbe in grado di operare in totale autonomia, prendendo decisioni e portando a termine operazioni complesse senza alcuna supervisione.

Come funziona Manus?

Il funzionamento di Manus, secondo Forbes e altri quotidiani di settore, si basa su un’architettura avanzata che va oltre il concetto tradizionale di AI generativa. Anziché affidarsi a un singolo modello, il sistema opera come un “manager” che coordina diversi agenti specializzati, dei sub AI agents, assegnando loro compiti e supervisionando il processo fino al completamento. Questo permette all’AI di gestire workflow articolati senza necessitare di continue istruzioni umane.

Un esempio pratico? Se un utente chiedesse “Trovami un appartamento”, Manus non si limiterebbe a fornire una lista di opzioni, ma eseguirebbe una ricerca approfondita, analizzando fattori come tasso di criminalità, condizioni climatiche e andamento del mercato immobiliare, fornendo un report dettagliato con le migliori soluzioni personalizzate.

Un altro elemento distintivo è la capacità di operare in modalità asincrona: una volta avviato un compito, Manus lo esegue in background e notifica l’utente solo al termine dell’elaborazione, senza bisogno di interazioni continue.

[embedded content]

Le possibili applicazioni di Manus

L’arrivo di Manus potrebbe rivoluzionare numerosi settori. Nel campo del recruitment, potrebbe analizzare autonomamente i curriculum, incrociando dati del mercato del lavoro per suggerire i candidati migliori e fornire analisi dettagliate per le assunzioni.

Nel software development, invece, potrebbe realizzare da zero un sito web professionale: dalla raccolta delle informazioni sui social media fino al deployment online e alla risoluzione delle eventuali problematiche tecniche.

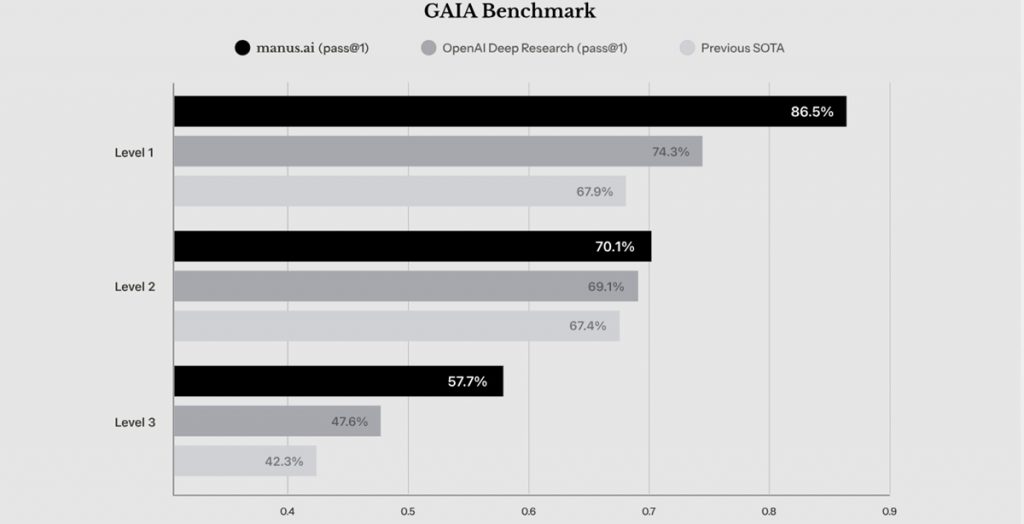
Secondo Yichao “Peak” Ji, responsabile della ricerca per Manus, l’AI autonoma supera la ricerca approfondita su un benchmark popolare per assistenti AI generici chiamato GAIA, che sonda la capacità di un’IA di svolgere specifiche attività navigando sul Web, utilizzando software e altro ancora.

Le implicazioni e le criticità di un agente AI completamente autonomo

Se da un lato Manus rappresenta una straordinaria innovazione (o almeno sembra tale), dall’altro solleva questioni etiche, economiche e regolatorie di non poco conto. Il timore più immediato riguarda l’impatto sul mercato del lavoro: a differenza di altre IA che migliorano l’efficienza dei lavoratori umani, questa tecnologia potrebbe effettivamente sostituirli in molte mansioni, portando a una possibile crisi occupazionale.

Altra problematica fondamentale è la responsabilità legale: se un agente virtuale autonomo come Manus commettesse un errore con gravi conseguenze, chi ne risponderebbe? Attualmente, la regolamentazione globale in materia di AI non è ancora attrezzata per affrontare scenari di questo tipo.

Infine, il debutto di Manus solleva anche questioni di geopolitica tecnologica. Da tempo la leadership americana nell’IA sembrava incontrastata, con aziende della Silicon Valley che procedevano per incrementi graduali nello sviluppo delle tecnologie. L’emergere di un’intelligenza artificiale realmente autonoma, sviluppata in Cina, potrebbe ribaltare questo equilibrio e offrire a Pechino un vantaggio competitivo cruciale nelle industrie basate sull’AI.

Manus è o non è un’AI ‘completamente’ autonoma?

La domanda l’abbiamo posta a ChatGPT (un diretto futuro competitor). Il dubbio, quando si legge “la prima” AI completamente autonoma della storia, viene sempre. E in effetti qualcosa non torna.

Ma è davvero la prima AI completamente autonoma?

  1. Non è un’entità indipendente
    • Anche se Manus può eseguire compiti da solo, dipende ancora da server e infrastrutture digitali per funzionare.
    • Non prende iniziative senza input iniziale (ha bisogno di una richiesta o di un obiettivo da parte dell’utente).
  2. Non evolve autonomamente come un organismo
    • Non sviluppa una coscienza o un’intelligenza generale (AGI).
    • Non può autonomamente ridefinire la propria esistenza, ma migliora i suoi processi sulla base di dati e feedback.
  3. Non è il primo agente AI con autonomia crescente
    • AlphaGo Zero (2017) è stato il primo sistema a superare il livello umano senza input esterni.
    • AutoGPT e OpenAI Five hanno dimostrato capacità simili di pianificazione e autoapprendimento.
    • MuZero (2020) ha imparato senza conoscere le regole del gioco, dimostrando un’elevata autonomia.

Manus è la prima AI autonoma?

  • Se consideriamo l’autonomia come “capacità di eseguire compiti senza supervisione umana”, allora sì, Manus è tra i più avanzati al mondo.
  • Se per autonomia intendiamo “un’AI che si evolve, migliora e prende iniziative senza input umano”, allora Manus è molto avanzato, ma non è ancora una vera AGI (Intelligenza Artificiale Generale).
  • Non è necessariamente la “prima”, ma probabilmente è il primo AI agent con un alto livello di autonomia praticabile in ambito generale.

Quindi, cosa manca a Manus per essere davvero la prima AI completamente autonoma?

  1. Una vera indipendenza decisionale senza input umano iniziale.
  2. La capacità di apprendere nuovi concetti al di fuori del suo addestramento.
  3. Un sistema di auto-miglioramento che funzioni senza intervento umano.

Al momento, questo lo possiamo dire, Manus è probabilmente il miglior esempio di agente AI autonomo per compiti pratici.

Verso un futuro di agenti AI autonomi? Siamo pronti ad affrontarlo?

L’arrivo di Manus segna una svolta significativa nel panorama dell’intelligenza artificiale. Se questa tecnologia dovesse mantenere le promesse (ed è tutto da dimostrare), potremmo essere sull’orlo di una nuova era dominata da agenti IA autonomi.

Tuttavia, anche questo possiamo dire, resta da vedere come il mondo reagirà a questa rivoluzione, se non si tratti di una notizia volutamente ‘pompata’ da Pechino e, in caso di conferma, quali misure verranno adottate per gestire le opportunità e i rischi connessi.

La sfida, a questo punto (che sia o meno confermate le reali potenzialità di Manus), non è solo tecnologica, ma anche sociale e politica: il (nuovo) futuro dell’AI potrebbe essere già iniziato e la domanda principale, in parte suggerita anche dal Premio Nobel Hinton, è: siamo davvero pronto ad affrontarlo?

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/manus-dalla-cina-lai-completamente-autonoma-come-funziona-e-perche-ci-deve-preoccupare/524025/


Ruvolo: “Il Festival dell’imprenditore diventi come il 1^ maggio per i lavoratori”. Il 13 e 14 giugno l’evento a Roma: Moda e Cibo Made in Italy sposano l’AI’

Sfruttare l’onda lunga della Settimana della Moda di Milano per creare un ponte ideale che trasporti a Roma il glamour delle passerelle milanesi attraverso un evento ad hoc, ideato per mostrare al mondo degli imprenditori il ruolo trainante dell’Intelligenza Artificiale per il Cibo e la Moda, fiori all’occhiello del nostro Made in Italy. Intelligenza Artificiale, un’occasione di business da non perdere per le nostre PMI e in particolare per il nostro Made in Italy splendidamente rappresentato all’estero da Moda e Cibo che tutti ci riconoscono. Confimprenditori rompe gli indugi e prende per mano le PMI del nostro paese. Lo fa con un nuovo evento ad hoc, disegnato appositamente per promuovere e sostenere il ricco tessuto di piccole e medie aziende, che rappresenta il 99% del nostro sistema produttivo. Il Primo Festival dell’Imprenditore, che si terrà a Roma il 13 e 14 giugno al Palazzo delle Esposizioni, ha l’ambizione di diventare il punto di riferimento delle PMI italiane. “Allo stesso modo del Primo maggio per i lavoratori, il Festival dell’Imprenditore per noi di Confimprenditori deve diventare la data di riferimento di tutti gli imprenditori che con coraggio e dedizione portano avanti fra mille difficoltà il loro business in Italia”. Lo ha detto questa mattina a Palazzo Marino  il Presidente di Confimprenditori, Stefano Ruvolo che insieme all’Assessora allo Sviluppo Economico e Politiche del Lavoro del Comune di Milano, Alessia Cappello e al consigliere comunale del gruppo Forza Italia Berlusconi, Luca Bernardo ha dato vita alla conferenza stampa di presentazione dell’evento a Palazzo Marino a Milano. Key4biz è media partner dell’evento.

Ruvolo (Confimprenditori): ‘Le Pmi un pilastro per la crescita dell’Italia’

“Le PMI rappresentano il 99% del tessuto produttivo del nostro Paese e costituiscono un pilastro fondamentale per la crescita economica, la creazione di occupazione e l’innovazione. Tuttavia, nonostante il loro straordinario contributo, si trovano spesso ad affrontare sfide sempre più complesse: dalla burocrazia alle difficoltà di accesso ai fondi europei, fino alla necessità di adeguarsi alle trasformazioni imposte dalle nuove tecnologie e dall’intelligenza artificiale. Affrontare queste sfide richiede un impegno congiunto tra il mondo imprenditoriale e le istituzioni. Per questi motivi abbiamo deciso di promuovere un Festival dedicato agli imprenditori che coinvolga anche il mondo delle istituzioni. Sarà una giornata di festa che nel tempo acquisirà l’importanza e la rilevanza che il primo maggio ricopre oggi per i lavoratori, motivo per cui chiederemo ufficialmente al Parlamento di istituzionalizzare il Festival degli Imprenditori”. Lo ha detto oggi il presidente di Confimprenditori, Stefano Ruvolo, presentando nella sala stampa del comune di Milano il Festival dell’Imprenditore, che si terrà il 13 e 14 giugno a Roma presso il Palazzo delle Esposizioni.

Ruvolo (Confimprenditori): ‘Festival dell’Imprenditore occasione di crescita in nome dell’AI e del Made in Italy’

“L’evento non sarà solo una celebrazione del ruolo delle imprese italiane nel mondo, ma anche un’occasione di confronto, crescita e sviluppo. Attraverso panel tematici, incontri B2B e testimonianze dirette, vogliamo offrire alle imprese uno spazio in cui poter condividere esperienze, creare nuove sinergie e accedere a strumenti concreti per affrontare le sfide del futuro. Il Festival dell’Imprenditore vuole essere un punto di riferimento per le PMI italiane, un’occasione per dare voce agli imprenditori e per costruire insieme un futuro in cui l’innovazione e la tradizione possano convivere e rafforzarsi reciprocamente. È il momento di valorizzare le nostre eccellenze, di investire nel futuro e di dare alle nostre imprese gli strumenti necessari per competere a livello globale”.

PMI, il sostegno della politica

Per Alessia Cappello, Assessora allo Sviluppo Economico e Politiche del Lavoro del Comune di Milano, “Le PMI sono fondamentali per il sistema economico milanese: rappresentano non solo la maggior parte del nostro tessuto produttivo, ma anche un motore di innovazione e crescita. Oggi, per rimanere competitive sui mercati globali, hanno bisogno di investire in innovazione e sostenibilità. Costi che, purtroppo, molte piccole e medie imprese non possono affrontare senza il giusto supporto. È quindi essenziale che le istituzioni, insieme al mondo imprenditoriale, creino un ambiente favorevole, riducendo la burocrazia e facilitando l’accesso a fondi e risorse che possano accompagnare le PMI in questo processo di trasformazione. sono sfide complesse, ma anche opportunità straordinarie di crescita e l’internazionalizzazione delle nostre imprese. Per questo, eventi come il Festival dell’Imprenditore sono fondamentali: creano connessioni tra aziende, startup, investitori e istituzioni, favorendo il dialogo e lo scambio di idee. Confidiamo che questa iniziativa possa crescere e diventare un punto di riferimento per tutti coloro che credono nell’impresa come motore di sviluppo e innovazione”. Tra l’altro, da quanto emerso oggi l’edizione del prossimo anno del Festival dell’Imprenditore si terrà a Milano.

Il consigliere Luca Bernardo nel suo intervento ha spiegato che “Fare l’imprenditore oggi in Italia è una sfida che richiede coraggio. Le istituzioni e i media devono riconoscere il ruolo dell’imprenditore illuminato, che non solo produce beni e crea lavoro ma contribuisce al progresso della comunità, attraverso l’innovazione e la valorizzazione delle nostre eccellenze”.

Presentazione del Festival dell’Imprenditore: l’intervento integrale del Presidente di Confimprenditori Stefano Ruvolo

“È con grande entusiasmo che oggi annunciamo la prima edizione del Festival dell’Imprenditore, un evento unico che nasce dalla volontà di valorizzare e sostenere il cuore pulsante dell’economia italiana: le piccole e medie imprese.

L’idea del Festival dell’Imprenditore

L’idea di organizzare il Festival dell’Imprenditore è nata dalla forte convinzione che fosse necessario dedicare una festa a chi ogni giorno lavora con dedizione per costruire il futuro del nostro Paese. Gli imprenditori spesso restano nell’ombra, ma il nostro impegno è fondamentale: creiamo posti di lavoro, innoviamo e affrontiamo con coraggio le sfide quotidiane del mercato.

Una giornata speciale

Per questo ho sentito il bisogno di dedicarci un riconoscimento nazionale, una giornata speciale che celebri i nostri sforzi e i sacrifici che compiamo per il benessere della collettività. Questo Festival vuole essere un tributo al nostro prezioso contributo.

Un Festival per le PMI e il Made in Italy

Il Festival dell’Imprenditore, che quest’anno si terrà il 13 e 14 giugno a Roma, non sarà solo una celebrazione del ruolo delle imprese italiane nel mondo, ma anche un’occasione di confronto, crescita e sviluppo. Attraverso panel tematici, incontri B2B e testimonianze dirette, vogliamo offrire alle imprese uno spazio in cui poter condividere esperienze, creare nuove sinergie e accedere a strumenti concreti per affrontare le sfide del futuro.

L’impatto dell’AI sul Made in Italy: un’occasione da non perdere

Un’attenzione particolare sarà dedicata all’impatto delle nuove tecnologie sul Made in Italy. L’adozione di strumenti digitali e dell’intelligenza artificiale può rappresentare un’opportunità straordinaria per rafforzare la competitività delle nostre imprese e per posizionare il Made in Italy in modo ancora più solido sui mercati internazionali.

Il Ruolo delle Istituzioni e il Dialogo con le aziende: aprire un canale con la politica

Affrontare queste sfide richiede un impegno congiunto tra il mondo imprenditoriale e le istituzioni. Per questo, durante il Festival, le aziende avranno la possibilità di dialogare direttamente con esponenti del governo e dell’opposizione, portando all’attenzione delle istituzioni proposte concrete su temi chiave come semplificazione burocratica, accesso ai fondi europei e internazionalizzazione delle imprese.

Conclusioni

Il Festival dell’Imprenditore vuole essere un punto di riferimento per le PMI italiane, un’occasione per dare voce agli imprenditori e per costruire insieme un futuro in cui l’innovazione e la tradizione possano convivere e rafforzarsi reciprocamente. È il momento di valorizzare le nostre eccellenze, di investire nel futuro e di dare alle nostre imprese gli strumenti necessari per competere a livello globale”.

Dall’Intelligenza Artificiale una spinta da 80 miliardi e 300mila posti di lavoro in più

Secondo uno studio di Accenture l’introduzione dell’AI potrebbe trasformare e migliorare molti processi produttivi e commerciali. Le nuove tecnologie e l’AI in particolare possono avere un impatto significativo sul Made in Italy, la sua proiezione e affermazione sui mercati internazionali.

Lo sottolinea uno studio di Accenture dedicato agli impatti dell’Intelligenza Artificiale Generativa (Gen AI) sulla competitività delle imprese italiane.

Nello studio, Accenture evidenzia come l’applicazione di nuove tecnologie, secondo il paradigma Human+ Machine, lungo tutta la filiera dei settori tipici del Made in Italy, possa trasformare radicalmente il settore manifatturiero italiano, con il potenziale di rivoluzionare interi processi produttivi.

In particolare, l’Intelligenza Artificiale Generativa e le nuove tecnologie possono rendere più efficienti le diverse fasi delle catene del valore: dal design alla produzione, dalla logistica alla comunicazione, dalle vendite al post-vendita. Accenture ha anche stimato il potenziale economico totale sottostante allo sviluppo e all’applicazione delle nuove tecnologie alla catena del valore del Made in Italy ed alle politiche internazionali di branding.

Il potenziale economico che verrebbe liberato è stimato in circa 80 miliardi di euro, con un incremento dell’occupazione di circa 300mila unità addizionali rispetto allo scenario iniziale.

Per richiedere di partecipare in presenza al Festival dell’Imprenditore, clicca qui


Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ruvolo-il-festival-dellimprenditore-diventi-come-il-1-maggio-per-i-lavoratori-il-13-e-14-giugno-levento-a-roma-moda-e-cibo-made-in-italy-sposano-lai/523855/


L’AI nel programma di punta del Pentagono “Thunderforge”. Primi impieghi nel Pacifico e in Europa

Thunderforge: l’AI al servizio del Pentagono

Il Dipartimento della Difesa degli Stati Uniti sta intensificando l’uso dell’intelligenza artificiale (AI) nelle operazioni militari per accelerare i processi decisionali in scenari bellici. Il Pentagono ha annunciato di aver affidato un contratto multi-milionario alla società Scale AI per lo sviluppo di Thunderforge, un programma strategico volto a integrare l’AI nella pianificazione e nelle operazioni militari.

Il programma Thunderforge segna una svolta decisiva verso una guerra guidata dai dati e dall’AI. Secondo il Dipartimento della Difesa, il progetto consentirà alle forze statunitensi di anticipare e rispondere alle minacce con maggiore velocità e precisione. Sebbene i dettagli finanziari del contratto non siano stati resi pubblici, fonti CNBC parlano di un investimento di diversi milioni di dollari.

Oltre a Scale AI, il progetto coinvolgerà Anduril, che fornirà la piattaforma software Lattice, e Microsoft, che metterà a disposizione le sue tecnologie basate su Large Language Models (LLM). L’obiettivo è sfruttare la tecnologia più avanzata per migliorare lo sviluppo di campagne militari, la gestione delle risorse, le simulazioni di guerra, la pianificazione strategica e l’analisi delle minacce.

AI militare, un percorso iniziato nel 2021

Il Pentagono lavora all’integrazione dell’AI nelle operazioni militari dal 2021, con l’utilizzo di armi autonome e sistemi di computer vision per l’identificazione di obiettivi aerei. Thunderforge, tuttavia, rappresenta il primo passo concreto verso l’inserimento di modelli linguistici avanzati nelle decisioni operative delle forze armate.

Secondo Schuyler Moore, Chief Technology Officer del Comando Centrale USA (CENTCOM), i primi test condotti nel 2023 con motori di raccomandazione basati su AI hanno evidenziato limiti rispetto alle decisioni umane nelle strategie d’attacco. Per questo motivo, il Pentagono ha deciso di testare inizialmente il sistema nei comandi Indo-Pacific Command (INDOPACOM) alle Hawaii e European Command (EUCOM) in Germania, prima di estenderlo agli altri nove comandi operativi strategici statunitensi.

Automazione e rischi: il dibattito sull’AI in guerra

Nonostante la supervisione umana prevista nel programma, l’introduzione di questa tecnologia nei processi decisionali solleva interrogativi. Secondo Ashley Deeks, esperta legale ed ex consulente della Casa Bianca, l’AI presenta il rischio di automation bias, ovvero la tendenza umana ad affidarsi ciecamente alle decisioni delle macchine. Inoltre, i sistemi AI sono spesso black box, rendendo difficile comprendere il processo con cui giungono alle loro conclusioni.

“Mi auguro che il Pentagono stia sviluppando strategie per addestrare il personale a resistere all’automazione eccessiva, quando l’esperienza umana suggerisce decisioni diverse da quelle dell’intelligenza artificiale“, ha dichiarato Deeks a Quartz.

La competizione globale e la minaccia cinese

Alexandr Wang, CEO di Scale AI, è da tempo un sostenitore della tecnologia più avanzata applicata alla guerra. Nel gennaio 2024 ha acquistato una pagina pubblicitaria sul Washington Post per esortare l’amministrazione Trump a investire di più nell’intelligenza artificiale, avvertendo che gli Stati Uniti rischiano di perdere la AI war contro la Cina.

Durante un summit in Qatar a febbraio, Wang ha ribadito la sua preoccupazione, affermando che Pechino potrebbe sfruttare l’AI per superare le capacità militari delle potenze occidentali. La Cina, infatti, ha reso lo sviluppo dell’intelligenza artificiale militare una priorità strategica, sebbene alcuni esperti ritengano che il Paese incontri ancora ostacoli significativi nell’implementazione su larga scala.

AI e guerre attuali: gli esempi di Israele, Russia e Ucraina

L’uso dell’AI nelle operazioni militari non è un’esclusiva degli Stati Uniti. Israele l’ha impiegata nei suoi attacchi su Gaza, mentre sia la Russia sia l’Ucraina stanno sfruttando soluzioni sempre più all’avanguardia di intelligenza artificiale per l’identificazione di obiettivi e il supporto alle operazioni belliche.

L’accelerazione del Pentagono con Thunderforge si inserisce dunque in un contesto di competizione globale sempre più serrata, dove l’intelligenza artificiale potrebbe diventare il fattore chiave nella supremazia militare del XXI secolo.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/lai-nel-programma-di-punta-del-pentagono-thunderforge-primi-impieghi-nel-pacifico-e-in-europa/523895/