Perplexity wants to reinvent the web browser with AI—but there’s fierce competition

It has recently been expanding its offerings—for example, it recently launched a deep research tool competing with similar ones provided by OpenAI and Google, as well as Sonar, an API for generative AI-powered search.

It will face fierce competition in the browser market, though. Google’s Chrome accounts for the majority of web browser use around the world, and despite its position at the forefront of AI search, Perplexity isn’t the first to introduce a browser with heavy use of generative AI features. For example, The Browser Company showed off its Dia browser in December.

Dia will allow users to type natural language commands into the search bar, like finding a document or webpage or creating a calendar event. It’s possible that Comet will do similar things, but again, we don’t know.

So far, most consumer-facing AI tools have come in one of three forms. There are general-purpose chatbots (like OpenAI’s ChatGPT and Anthropic’s Claude); features that use trained deep learning models subtly baked into existing software (as in Adobe Photoshop or Apple’s iOS); and, less commonly, standalone software meant to remake existing application categories using AI features (like the Cursor IDE).

There haven’t been a ton of AI-specific applications in existing categories like this before, but expect to see more coming over the next couple of years.

https://arstechnica.com/ai/2025/02/perplexitys-comet-aims-to-reinvent-the-web-browser-with-ai-but-its-not-saying-how/


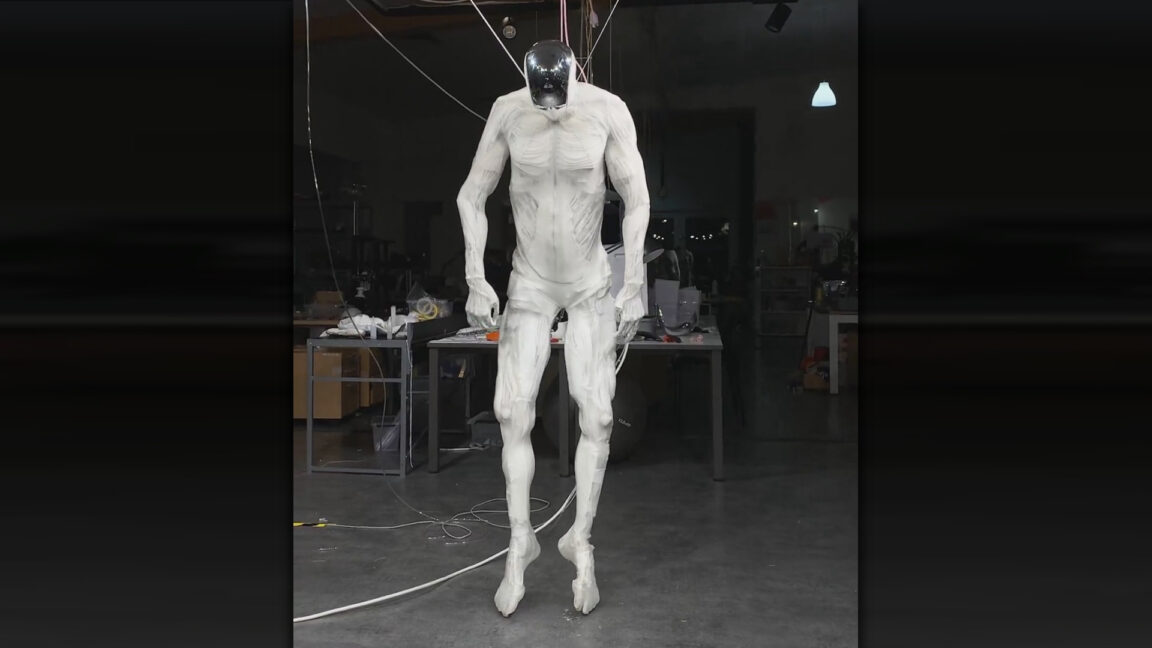
Robot with 1,000 muscles twitches like human while dangling from ceiling

Plans for 279 robots to start

While the Protoclone is a twitching, dangling robotic prototype right now, there’s a lot of tech packed into its body. Protoclone’s sensory system includes four depth cameras in its skull for vision, 70 inertial sensors to track joint positions, and 320 pressure sensors that provide force feedback. This system lets the robot react to visual input and learn by watching humans perform tasks.

As you can probably tell by the video, the current Protoclone prototype is still in an early developmental stage, requiring ceiling suspension for stability. Clone Robotics previously demonstrated components of this technology in 2022 with the release of its robotic hand, which used the same Myofiber muscle system.

[embedded content]

Artificial Muscles Robotic Arm Full Range of Motion + Static Strength Test (V11).

A few months ago, Clone Robotics also showed off a robotic torso powered by the same technology.

[embedded content]

Torso 2 by Clone with Actuated Abdomen.

Other companies’ robots typically use other types of actuators, such as solenoids and electric motors. Clone’s pressure-based muscle system is an interesting approach, though getting Protoclone to stand and balance without the need for suspension or umbilicals may still prove a challenge.

Clone Robotics plans to start its production with 279 units called Clone Alpha, with plans to open preorders later in 2025. The company has not announced pricing for these initial units, but given the engineering challenges still ahead, a functional release any time soon seems optimistic.

https://arstechnica.com/gadgets/2025/02/dangling-twitching-human-robot-with-synthetic-muscles-makes-its-debut/


DeepSeek goes beyond “open weights” AI with plans for source code release

Major models, including Google’s Gemma, Meta’s Llama, and even older OpenAI releases like GPT2, have been released under this open weights structure. Those models also often release open source code covering the inference-time instructions run when responding to a query.

It’s currently unclear whether DeepSeek’s planned open source release will also include the code the team used when training the model. That kind of training code is necessary to meet the Open Source Initiative’s formal definition of “Open Source AI,” which was finalized last year after years of study. A truly open AI also must include “sufficiently detailed information about the data used to train the system so that a skilled person can build a substantially equivalent system,” according to OSI.

A fully open source release, including training code, can give researchers more visibility into how a model works at a core level, potentially revealing biases or limitations that are inherent to the model’s architecture instead of its parameter weights. A full source release would also make it easier to reproduce a model from scratch, potentially with completely new training data, if necessary.

Elon Musk’s xAI released an open source version of Grok 1’s inference-time code last March and recently promised to release an open source version of Grok 2 in the coming weeks. However, the recent release of Grok 3 will remain proprietary and only available to X Premium subscribers for the time being, the company said.

Earlier this month, HuggingFace released an open source clone of OpenAI’s proprietary “Deep Research” feature mere hours after it was released. That clone relies on a closed-weights model at release “just because it worked well,” Hugging Face’s Aymeric Roucher told Ars Technica, but the source code’s “open pipeline” can easily be switched to any open-weights model as needed.

https://arstechnica.com/ai/2025/02/deepseek-goes-beyond-open-weights-ai-with-plans-for-source-code-release/


Del Fante (Poste Italiane): “Nel 2025 focus su pacchi, risparmio postale, assicurazioni, energia”. Presto un modello di governance per l’AI

[embedded content]

I risultati preliminari di Poste Italiane per il 2024

L’attività economica italiana ha ripreso nell’ultima parte dell’anno 2024 il trend di modesta crescita avuto nel primo semestre, dopo il ristagno del prodotto interno lordo registrato nel terzo trimestre; tale andamento ha risentito, come nel resto dell’area Euro, della persistente debolezza della manifattura e del rallentamento dei servizi.

Le recenti proiezioni stimano un incremento del PIL nazionale dello 0,5% nell’anno 2024 e un’accelerazione nel triennio 2025-2027 con un’espansione del PIL in media dell’1% l’anno. La crescita rimarrà contenuta nella prima parte del 2025, per riacquistare slancio in seguito, sostenuta dai consumi e dalle esportazioni. Le stime del triennio restano ad ogni modo circondate dall’incertezza riconducibile allo scenario internazionale: un orientamento maggiormente protezionistico delle politiche commerciali e le perduranti tensioni derivanti dai conflitti in corso potrebbero frenare la domanda estera e interna.

In tale contesto, il Gruppo Poste Italiane ha chiuso il 2024 con nuovi record: l’Ebit Adjusted del 2024 ha raggiunto 2,96 miliardi di euro che, oltre ad essere superiore alla guidance di piano comunicata nel mese di luglio scorso, è cresciuto sensibilmente nel corso degli ultimi anni quasi triplicando il livello del 2017. Analoga progressione di crescita nel periodo è stata registrata dall’utile netto di Gruppo che si è attestato a oltre 2 miliardi di euro nell’esercizio 2024, in linea con la guidance aggiornata del piano. A tali risultati hanno contribuito la crescita dei ricavi in tutte le strategic business unit e, in particolare, le performance rilevanti sul margine di interesse e nel comparto pacchi, oltre all’attenta disciplina sui costi. Nuovi massimi storici hanno, inoltre, riguardato la raccolta lorda complessiva realizzata dal Gruppo e in particolare quella sui fondi comuni di investimento. Il comparto assicurativo ha continuato a registrare nell’anno flussi netti positivi con performance superiori rispetto a quelle del mercato.

Del Fante: “Per il 2025 rimaniamo focalizzati su pacchi, risparmio, assicurazioni, luci e gas“

Poste Italiane archivia un 2024 da record e rivede al rialzo gli obiettivi del 2025 grazie al contributo di tutte le linee di business e, soprattutto, al grande lavoro dei suoi 120.000 dipendenti. L’Ad Matteo Del Fante intervistato dal TG Poste ha voluto manifestare la sua gratitudine per i risultati raggiunti, indicando le prossime sfide che attendono il Gruppo. “Questa azienda – ha detto Del Fante – non produce beni fisici ma offre servizi. Se i nostri colleghi operativi e l’azienda tutta non collaborassero non si raggiungerebbero questi numeri. Quando si ottiene più di quello che ci si aspettava, significa che tutti i colleghi ci hanno messo passione ed è la cosa per noi più importante. Un grazie sulla base di risultati concreti”. Del Fante si è poi soffermato sui principali obiettivi per il 2025. “Rimaniamo focalizzati sulla logistica, in particolare sui pacchi – ha continuato l’Amministratore Delegato di Poste Italiane –. Resteranno importanti i prodotti di risparmio: quest’anno ricorre il 150° anniversario del libretto postale e il centenario del buono fruttifero. Stiamo studiando con Cassa Depositi e Prestiti delle emissioni per celebrare le soluzioni di risparmio più apprezzate dagli italiani, per un valore di 340 miliardi. Per quanto riguarda la protezione sarà un anno molto positivo. Per la nostra offerta di luce e gas il 2025 sarà storico perché ci siamo dati l’obiettivo di raggiungere il milione di contratti. Al momento Poste Energia conta 700mila clienti, abbiamo ancora lavoro da fare”, ha concluso Del Fante.

Poste Vita

Il Gruppo Poste Vita chiude il 2024 con un coefficiente di solvibilità pari al 334%, che diventa circa il 300% al netto della previsione di distribuire alla capogruppo Poste Italiane SpA dividendi per circa 1,5 miliardi di euro in arco piano, in aggiunta alla distribuzione del 100% degli utili.

Sulla base dei risultati raggiunti, nonché dell’ampia visibilità sui flussi di cassa futuri e della solida generazione e ottimizzazione di capitale, il management ha proposto il miglioramento della politica di dividendi, aumentando il payout ratio al 70% per il 2024-2028. Il dividendo preliminare per l’anno 2024 è di 1,08 euro ad azione, in crescita del 35% rispetto al valore del precedente esercizio. Sin dalla quotazione avvenuta nel 2015, gli azionisti hanno beneficiato di una elevata e crescente remunerazione complessiva con performance superiore ai valori registrati dal principale indice di Borsa Italiana e il record storico del prezzo del titolo che ha raggiunto 14,88 euro il 18 febbraio 2025.

The Connecting Platform

Il nuovo piano “2024 – 2028 Strategic Plan – The Connecting Platform”, presentato alla comunità finanziaria nel mese di marzo 2024, posa le basi su:

  1. un nuovo modello di servizio commerciale che massimizza il valore dell’Azienda ‘piattaforma’ in modo diversificato, integrato e sostenibile;
  2. la trasformazione del Gruppo verso un operatore logistico completo, assicurando la sostenibilità finanziaria del segmento Corrispondenza, Pacchi e Distribuzione.

Il nuovo modello di servizio mira a ottimizzare la copertura e la gestione dei clienti in logica omnicanale, indirizzando l’impegno dei consulenti in attività “relazionali” anziché “transazionali”, generando valore per il Gruppo. Nel corso del 2024 è stato confermato il ruolo dell’Ufficio Postale come punto di riferimento per la costruzione e il mantenimento della relazione con il cliente e affinato il modello di servizio focalizzandolo su segmenti di clientela strategica e a maggior valore. È stata inoltre ulteriormente potenziata la rete dei Punto Poste Casa e Famiglia con l’obiettivo di rafforzare i canali di accesso e vendita dei prodotti/servizi anche attraverso l’ampliamento dell’offerta.

La trasformazione logistica

Nell’ambito della trasformazione logistica verso un operatore logistico end-to-end rileva l’evoluzione della rete postale, sempre più orientata alla gestione dei pacchi e lo sviluppo del business internazionale e della logistica integrata; in tale strategia rientrano la partnership strategica con DHL siglata nel 2023 e la costituzione nel mese di aprile 2024 di Locker Italia SpA, per lo sviluppo in Italia di una rete di locker su cui effettuare le consegne last-mile dei pacchi. Nel mese di settembre 2024 è stato inaugurato il primo dei 10.000 locker che saranno attivati in tutto il territorio nazionale e che consentiranno, grazie alla loro capillarità e tecnologia, di migliorare ulteriormente la qualità dei servizi a supporto dell’e-commerce. Al fine di accelerare e cofinanziare il processo di trasformazione infrastrutturale e immobiliare del Gruppo, è stata costituita nel mese di febbraio 2025 la joint venture Patrimonio Italia Logistica – SICAF SpA in gestione esterna, che mira a gestire con modalità all’avanguardia e secondo i più alti standard di qualità ed ESG l’infrastruttura logistica del Gruppo Poste Italiane. L’operazione coinvolgerà, inoltre, più operatori specializzati nello sviluppo immobiliare in ambito logistico in grado di apportare risorse finanziarie e know-how specialistico e accelerare così il processo di rinnovamento dei siti.

Al rafforzamento della c.d. logistica integrata contribuisce anche la costituzione, avvenuta nel mese di marzo 2024, della NewCo Poste Logistics SpA.

Per la gestione e razionalizzazione della logistica sanitaria integrata per l’Azienda Sanitaria Provinciale di Cosenza è stata costituita la società SPV Cosenza.

Anche per il 2025, il Gruppo Poste Italiane conferma la centralità del Risparmio Postale nella propria offerta e l’attenzione all’offerta di prodotti/servizi che risultino al passo con

Sinergie con TIM?

Beneficiando della crescita dell’e-commerce e dei pagamenti cashless, il business di PostePay evolverà verso soluzioni di pagamento digitali e innovative, così da aumentare il livello di fidelizzazione del cliente, lo stock e soprattutto l‘utilizzo delle carte di pagamento. Nell’ambito della telefonia proseguirà l’impegno nella proposizione di nuovi prodotti e servizi integrati con un focus sulle evoluzioni della Postepay Connect.

Inoltre, il recente ingresso nella compagine azionaria di Telecom Italia S.p.A. da parte di Poste Italiane abilita l’evoluzione dei rapporti commerciali tra le due società e mira a creare sinergie e favorire il consolidamento del mercato nazionale delle telecomunicazioni.

App Poste Italiane, trasformazione del canale web e implementazione dell’AI

Tra le iniziative di maggior rilievo in ambito omnicanalità, nel corso del 2025 sarà portato a termine il percorso di migrazione della customer base delle app BancoPosta e Postepay sull’unica app Poste Italiane, la quale rappresenterà un punto di accesso unico e il riferimento per l’operatività sul canale app e che gestirà un traffico potenziale di oltre 6 milioni di visite giornaliere. Grazie anche all’intelligenza artificiale, verrà garantita un’elevata personalizzazione dell’app con contenuti diversificati real time, viste e funzionalità dedicate, al fine di adattarla ai comportamenti e rispondendo alle esigenze del singolo cliente. Nell’ambito del potenziamento dei canali digitali del Gruppo, è stato inoltre avviato un percorso di trasformazione del canale web che vedrà nel corso dell’anno la prima revisione del sito consumer Poste.it sviluppata in un’ottica cliente-centrico e con un design coerente con l’app Poste Italiane. Nel corso dell’anno il Gruppo proseguirà inoltre nella traiettoria di sviluppo già avviata, estendendo l’utilizzo dell’intelligenza artificiale all’interno del suo modello di business a beneficio dei processi interni e dei clienti e al fine di rendere sempre più inclusivo l’accesso ai servizi dell’ecosistema del Gruppo.

L’impegno nell’implementazione dell’intelligenza artificiale si svilupperà nell’ottica di potenziare i valori portanti del Gruppo, all’interno del quadro etico di riferimento e mettendo al centro le persone. Verrà istituito un modello di governance dell’intelligenza artificiale che, a partire dai principi identificati nel Manifesto Etico finalizzato lo scorso dicembre 2024, stabilisca le regole, i processi e le responsabilità per un utilizzo sicuro ed efficace delle nuove tecnologie.

Il Progetto Polis e la transizione ecologica

Il Gruppo proseguirà nel 2025 nella realizzazione di ‘Polis’, progetto strategico a supporto della coesione sociale del Paese che coinvolge circa 7.000 comuni con meno di 15 mila abitanti, nei quali l’Ufficio Postale sarà trasformato in hub di servizi digitali per un accesso rapido e facile ai servizi della Pubblica Amministrazione. È inoltre prevista la realizzazione di circa 250 spazi di coworking a livello nazionale e l’implementazione di numerose azioni a supporto della transizione energetica del Paese. Da inizio progetto sono stati completati 2.918 Uffici Postali e 81 Spazi per l’Italia (coworking).

Con il Progetto Polis, parte del Piano Complementare al PNRR, Poste Italiane promuove la coesione economica, sociale e territoriale del Paese e il superamento del digital divide nei piccoli centri. Ad oggi, completati 3.026 interventi di rinnovo negli uffici postali, con circa altri 600 in corso, e realizzati 81 spazi di co-working. Erogati oltre 50 mila servizi della Pubblica Amministrazione, di cui oltre 20 mila passaporti.

Nel percorso di transizione intrapreso verso la carbon neutrality, proseguiranno gli investimenti e le iniziative strategiche, quali il rinnovo della flotta di recapito con mezzi a basse emissioni di CO2, l’installazione di pannelli fotovoltaici per l’approvvigionamento energetico e l’efficientamento degli immobili; continuerà inoltre la sostituzione delle attuali carte Postepay con carte realizzate con materiali ecosostenibili e con carte digitali, nonché lo sviluppo di specifiche offerte volte a valorizzare i comportamenti sostenibili dei clienti, tra i quali lo sviluppo di una piattaforma di donazione omnicanale che consentirà ai clienti, possessori di una carta Postepay, di effettuare erogazioni liberali verso Associazioni ed Organizzazioni terze, utilizzando le stesse carte Postepay. Nell’ambito della transizione green rileva inoltre la costituzione nel corso del 2024 della nuova società Postego S.p.A., che mira ad internalizzare progressivamente il parco auto di Poste Italiane.

Poste Energia

L’offerta retail di Poste Energia per luce e gas, lanciata a giugno 2022, ha contribuito alla performance, ricavi per € 76 milioni nell’esercizio 2024 e € 23 milioni nel quarto trimestre, sostenuta da positive dinamiche di mercato e dal perdurare di condizioni di settore favorevoli.

Il risultato operativo (EBIT) Adjusted è cresciuto nell’esercizio 2024 del 20,3% su base annua pari a € 529 milioni nell’esercizio 2024 e il 20,9% a € 148 milioni nel quarto trimestre del 2024, trainato da una solida performance di ricavi.

Per il 2025 il Gruppo Poste si attende: 1 milione di contratti nell’offerta Energia (>50% rispetto al 2024), sostenuti da un rinnovato sforzo commerciale e da un contesto di mercato favorevole.

Milano Cortina 2026

Tra le recenti iniziative che valorizzano la vocazione sociale di Poste Italiane, rileva la recente partnership siglata in vista dei Giochi Invernali del 2026 durante i quali l’Azienda sarà premium logistic partner dei Giochi Olimpici e Paralimpici di Milano Cortina 2026, gestendo, attraverso la controllata Poste Logistics, il trasporto e la logistica di tutti i beni, le attrezzature e i materiali necessari per il successo dell’evento presso le sedi olimpiche e paralimpiche.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/poste-italiane-i-numeri-del-2024-presto-un-modello-di-governance-per-lai/522381/


L’AI generativa cambia il mondo della musica, mercato da 22 miliardi di dollari entro il 2034

L’industria musicale nell’era dell’AI generativa

Il digitale in generale aveva già stravolto il settore 25 anni fa, ora l’intelligenza artificiale generativa (Gen AI) lo sta trasformando in profondità, direttamente alla radice, cioè nel modo in cui la musica viene creata, prodotta e distribuita.

Nel 2024, il mercato globale della Gen AI nella musica ha raggiunto un valore di 419,85 milioni di dollari, crescendo con un tasso annuo composto (CAGR) del 53,34% dal 2019. Le stime proposte da The Business Research Company indicano un’espansione straordinaria fino a 4,3 miliardi di dollari nel 2029 (CAGR del 59,25%), per poi arrivare a 22,57 miliardi di dollari entro il 2034, crescendo al 39,32% annuo tra il 2029 e il 2034.

Questa crescita è trainata da alcuni fattori sociali ed economici, tra cui il forte processo di urbanizzazione in quasi tutti i continenti, dalla diffusione e il massiccio utilizzo dei social media, dalla maggiore penetrazione di internet e diffusione dei servizi di streaming musicale. Tuttavia, l’elevato costo operativo e le preoccupazioni sulla privacy dei dati rappresentano ancora degli ostacoli da superare.

Un mercato frammentato con leader emergenti

L’industria dell’AI generativa nella musica è altamente frammentata: nel 2023, i primi dieci competitor detenevano solo il 24,17% del mercato. Tra questi, Jukedeck era il leader con una quota del 5,57%, seguito da T Suno (2,97%), Aiva Technologies SARL (2,30%), Boomy Corporation (2,15%) e Amper Music Inc. (1,89%). Altri player come Amadeus Code, Beatoven AI, Hydra II (Rightsify), Vochlea Music e Udio AI detenevano ciascuno l’1,86%.

Musica e Gen AI, quali settori guideranno la crescita? Qualche numero

Per tipologia di utilizzo

  • Song composition e creative process è il segmento principale con 165,25 milioni di dollari nel 2024 (39,36% del mercato) e secondo il report dovrebbe crescere più rapidamente tra il 2024 e il 2029, con un CAGR del 64,07%.

Per modello software

  • Cloud-based solutions dominano con 74,69% del mercato (313,6 milioni di dollari nel 2024) e cresceranno a un CAGR del 61,90% fino al 2029.

Per sistema operativo

  • Windows è la piattaforma principale con 73,01% del mercato (306,52 milioni di dollari nel 2024).
  • Mac OS crescerà però rapdamente (CAGR del 62,44%) nei prossimi cinque anni.

Per tipologia di utenti finali

  • Professionisti e ingegneri del suono rappresentano il 27,31% del mercato (114,68 milioni di dollari nel 2024).
  • Gli autori di musica elettronica saranno presto dei driver per questa tecnologia, con un CAGR del 66,37% tra 2024-2029.

Espansione geografica: Nord America domina, ma l’Asia-Pacifico cresce più velocemente

Il Nord America è attualmente il mercato più grande con una quota del 40,59% (170,44 milioni di dollari nel 2024), ma l’Asia-Pacifico e l’Europa Occidentale guideranno la crescita nei prossimi anni con CAGR rispettivamente del 62,18% e 60,72%.

Gli Stati Uniti rappresenteranno la quota maggiore della crescita, guadagnando 1,35 miliardi di dollari entro il 2029.

Quale futuro dell’AI nella musica?

L’intelligenza artificiale generativa non è più solo una sperimentazione, ma un passaggio tangibile che sta già trasformando l’industria musicale. Con un mercato che passerà da 419,85 milioni di dollari nel 2024 a 22,57 miliardi di dollari nel 2034, le opportunità per aziende e artisti sono immense.

Il cloud computing, l’AI e i modelli text-to-music stanno ridisegnando il settore, mentre Nord America e Asia-Pacifico restano i mercati più strategici da tenere d’occhio. L’AI nella musica non è solo un trend, ma un cambiamento strutturale destinato a definire il futuro della creatività musicale.

Creatività e copyright, tra rischi e opportunità

L’introduzione della Gen AI nel mondo della musica (e non solo, dei media in generale) ha creato enormi problemi, in termini culturali e di diritti connessi alla proprietà intellettuale, basti pensare al concetto della creatività e dell’originalità di un’opera, ma certamente ha mostrato anche delle grandi opportunità di cambiamento e di miglioramenti fino ad oggi impensabili, da un punto di vista professionale.

Come si legge in un contributo della Federazione industriale musica italiana (Fimi), da un lato vi sono grandi preoccupazioni riguardo all’integrità artistica, al termine delle opportunità retribuite per i musicisti che lavorano e a molte questioni sul controllo e sul copyright; dall’altro emergono anche le potenzialità che gli strumenti di AI generativa stanno avendo nel settore.

Ci sono infatti aspetti tecnologici che riguardano la creatività e la produzione, ma anche altre aree del settore fortemente dipendenti dalle innovazioni che l’AI sta introducendo.

Il copyright è certamente un punto dolente in questa faccenda, anche se un ulteriore livello di integrazione tra AI e metadati potrebbe migliorare i sistemi di ripartizione dei diritti musicali e di gestione delle royalty, nonché le attività di content protection, rendendo più efficiente il contrasto alle riproduzioni non autorizzate e alle contraffazioni.

Un mercato che cambia con l’AI, chi vince e chi perde

Mentre i ricavi dei fornitori di Gen AI vedranno una crescita significativa nei prossimi cinque anni, i creatori rischiano di perdere una quota importante del loro reddito attuale a causa dell’impatto dell’AI generativa. A riguardo è stato recentemente pubblicato uno studio molto interessante condotto dalla CISAC (CISAC Annual Report 2024), la Confederazione Internazionale delle Società di Autori e Compositori, la principale rete mondiale degli organismi di gestione collettiva.

Nonostante forniscano il carburante creativo del mercato dei contenuti Gen AI, i creatori di musica e audiovisivi vedranno perdere rispettivamente il 24% e il 21% dei loro ricavi entro il 2028. Ciò equivale a una perdita cumulativa di 22 miliardi di euro nel periodo di 5 anni (10 miliardi di euro nella musica; 12 miliardi di euro nell’audiovisivo).

Lo studio rileva che il mercato dei contenuti musicali e audiovisivi generati dall’intelligenza artificiale aumenterà in modo esponenziale nei prossimi cinque anni, passando dagli attuali circa 3 miliardi di euro a 64 miliardi di euro nel 2028.

Come risultato di questa crescita esponenziale del mercato della musica e dei contenuti audiovisivi, si stima che i ricavi futuri dei fornitori di Gen AI saliranno di 4 miliardi di euro nella musica (in aumento rispetto a 0,1 miliardi di euro nel 2023) e 5 miliardi di euro nell’audiovisivo (in aumento rispetto a 0,2 miliardi di euro) entro il 2028.

Si tratta di ricavi derivanti direttamente dalla riproduzione senza licenza delle opere dei creatori, che rappresentano un trasferimento di valore economico dai proprietari alle aziende di AI.

Nel settore musicale, i mercati dello streaming e delle librerie musicali saranno fortemente influenzati da questa tecnologia. Entro il 2028, si prevede che la musica Gen AI rappresenterà circa il 20% dei ricavi delle piattaforme di streaming musicale tradizionali e circa il 60% dei ricavi delle librerie musicali.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/lai-generativa-cambia-il-mondo-della-musica-mercato-da-22-miliardi-di-dollari-entro-il-2034/522330/


Microsoft’s new AI agent can control software and robots

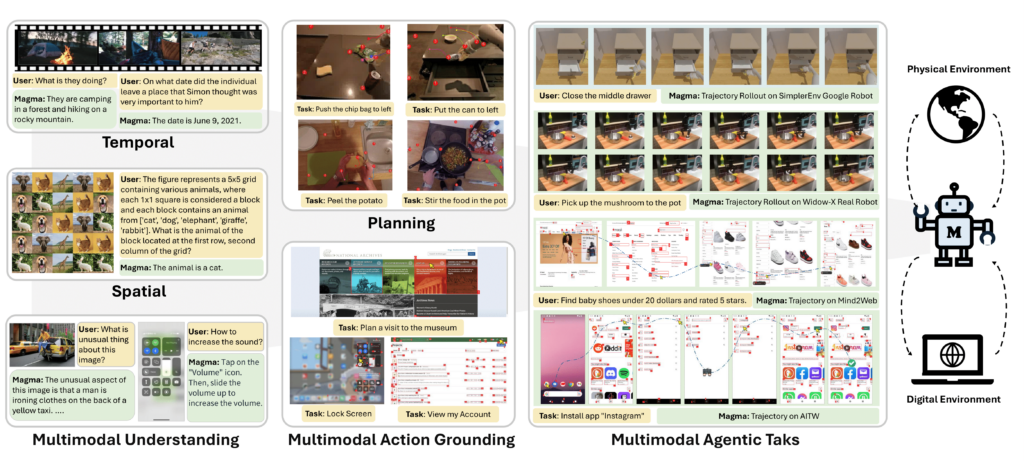
On Wednesday, Microsoft Research introduced Magma, an integrated AI foundation model that combines visual and language processing to control software interfaces and robotic systems. If the results hold up outside of Microsoft’s internal testing, it could mark a meaningful step forward for an all-purpose multimodal AI that can operate interactively in both real and digital spaces.

Microsoft claims that Magma is the first AI model that not only processes multimodal data (like text, images, and video) but can also natively act upon it—whether that’s navigating a user interface or manipulating physical objects. The project is a collaboration between researchers at Microsoft, KAIST, the University of Maryland, the University of Wisconsin-Madison, and the University of Washington.

We’ve seen other large language model-based robotics projects like Google’s PALM-E and RT-2 or Microsoft’s ChatGPT for Robotics that utilize LLMs for an interface. However, unlike many prior multimodal AI systems that require separate models for perception and control, Magma integrates these abilities into a single foundation model.

A combined graphic that shows off various capabilities of the Magma model.
A combined graphic that shows off various capabilities of the Magma model. Credit: Microsoft Research

Microsoft is positioning Magma as a step toward agentic AI, meaning a system that can autonomously craft plans and perform multistep tasks on a human’s behalf rather than just answering questions about what it sees.

“Given a described goal,” Microsoft writes in its research paper. “Magma is able to formulate plans and execute actions to achieve it. By effectively transferring knowledge from freely available visual and language data, Magma bridges verbal, spatial, and temporal intelligence to navigate complex tasks and settings.”

Microsoft is not alone in its pursuit of agentic AI. OpenAI has been experimenting with AI agents through projects like Operator that can perform UI tasks in a web browser, and Google has explored multiple agentic projects with Gemini 2.0.

Spatial intelligence

While Magma builds off of Transformer-based LLM technology that feeds training tokens into a neural network, it’s different from traditional vision-language models (like GPT-4V, for example) by going beyond what they call “verbal intelligence” to also include “spatial intelligence” (planning and action execution). By training on a mix of images, videos, robotics data, and UI interactions, Microsoft claims that Magma is a true multimodal agent rather than just a perceptual model.

https://arstechnica.com/ai/2025/02/microsofts-new-ai-agent-can-control-software-and-robots/


Il futuro dell’Intelligenza Artificiale Generativa e potenziali cyber rischi nel campo dell’AI

Questo articolo fa parte di una serie dedicata all’esplorazione critica dell’Intelligenza Artificiale Generativa, concentrandosi sulle vulnerabilità e i rischi sistemici dei modelli di intelligenza artificiale generativa basati su reti neurali. L’analisi offre una prospettiva tecnica e strategica sui potenziali rischi emergenti nel campo dell’AI.

Se considerassimo l’elenco completo delle criticità e delle vulnerabilità, dal punto di vista della progettazione, dello sviluppo e del funzionamento dei sistemi basati sull’intelligenza artificiale, ricaveremmo un quadro sconfortante; in realtà, il vero problema è che le attuali misure di mitigazioni non sono sufficienti a contrastare le minacce. Al momento esistono poche misure di contenimento e, la maggior parte, sono concentrate alle fasi di progettazione e ad alcune scelte per contenere l’ambito operativo.

Hybrid AI: Un Approccio Innovativo

Tuttavia, è importante ricordare che l’intelligenza artificiale è in corso di evoluzione, infatti stanno emergendo molte proposte di modelli di Hybrid AI[1] per specifiche aree di applicazione. Queste idee creano nuove opportunità di sviluppo per l’intelligenza artificiale di base, perché gli consentiranno di offrire un’affidabilità intrinseca e verificabile rispetto a particolari categorie di rischi. Questa peculiarità è fondamentale perché, generalmente, non è possibile ottenere un’affidabilità intrinseca con l’I.A. basata unicamente sulle reti neurali.

Un altro importante punto di forza dell’intelligenza artificiale basata sulle reti neurali è rappresentato dall’eccezionale capacità euristica di questi modelli, anche se, come precedentemente detto, è difficile realizzare un test sicuro in modelli che sono, per loro natura, statistici e, quindi, sostanzialmente inesatti e generalmente poco trasparenti all’analisi. I sistemi basati sulla symbolic artificial intelligence[2], d’altro canto, offrono maggiore trasparenza, un ragionamento esplicito e ripetibile e, infine, la possibilità di manifestare competenza nel dominio di riferimento in modo verificabile, viceversa, sono generalmente deboli in termini di capacità euristica e, a volte, vengono percepiti come privi di flessibilità e scalabilità.

Molti gruppi di ricerca hanno riconosciuto questa complementarità e hanno efficacemente combinato tra loro i diversi approcci statistici derivanti da applicazioni euristiche avanzate. Alcuni esempi comprendono la combinazione del Machine Learning (ML) con la teoria dei giochi e l’ottimizzazione per supportare applicazioni che coinvolgono strategie multi-adversary, come il poker multigiocatore e le tattiche di antibracconaggio dei ranger.

Altri gruppi di ricerca hanno “ibridato” approcci statistici e simbolici per consentire lo sviluppo di sistemi capaci di pianificare e ragionare in maniera affidabile, sfruttando l’intelligenza artificiale come se fosse un oracolo euristico talvolta inaffidabile. Questi sistemi tendono a focalizzarsi su domini applicativi specifici, tra cui contesti in cui l’esperienza deve essere manifestata in modo affidabile. Questi sistemi simbolico-dominanti sono sostanzialmente diversi dall’utilizzo plug-in nei LLM. Normalmente, gli approcci ibridi all’I.A. sono utilizzati nei robot, nella comprensione del parlato e nel gioco. Per esempio, AlphaGo[3] utilizza un ML ibrido con strutture di ricerca.

I sistemi ibridi simbolici, in cui gli LLM sono subordinati, stanno iniziando ad apportare benefici in alcuni ambiti dello sviluppo software, tra cui la risoluzione degli errori e la verifica del software. È importante sottolineare che l’attuale I.A. simbolica ha infranto molte barriere di scalabilità che, dagli anni ‘90, sono state percepite come fondamentali.

Ciò è riscontrabile in molteplici esempi, tra cui Google Knowledge Graph, che è euristicamente informato, ma verificabile dall’uomo; altro esempio è rappresentato dalla verifica delle proprietà di sicurezza su Amazon AWS, la quale utilizza tecniche di dimostrazione dei teoremi su larga scala. Questi esempi suggeriscono che altri approcci, simili ai precedenti, potrebbero fornire un livello di affidabilità in altri domini applicativi in cui questa caratteristica è rilevante. Una sfida importante consiste nel passare da questi esempi specifici a un’AI affidabile più generalista.

Intelligenza Artificiale Generativa: Confidenzialità, Integrità e Governance

Lo sviluppo di sistemi di intelligenza artificiale per applicazioni critiche richiede necessariamente la conoscenza specifica delle debolezze e delle vulnerabilità dei modelli di intelligenza artificiale utilizzati. Questo aspetto è fondamentale per la progettazione, l’implementazione e la valutazione dei modelli di AI e dei sistemi basati sull’AI.

In questo paragrafo esaminiamo una serie di criticità associate ai moderni modelli di Artificial Intelligence (AI) basati su reti neurali. Questi modelli neurali includono il Machine Learning (ML) e l’AI generativa, con particolare riferimento i Large Language Models (LLM).

In particolare, ci concentriamo su tre aspetti:

  • i trigges: i vettori di attacco delle azioni avverse (exploiting vulnerabilities) e le limitazioni intrinseche dovute alla natura statistica dei modelli (manifestations from weaknesses);
  • la natura delle conseguenze operative: i potenziali tipi di guasti o gli errori operazionali;
  • le metodologie di mitigazione: le attività progettuali e quelle operative.

Di seguito sono indicati alcuni esempi relativi a specifiche criticità, organizzati in base a tre tipologie di rischio: confidenzialità, integrità e governance (CIG)[4]. Questa analisi si ispira alle metodologie indicate dal NIST, tra cui l’AI RMF Framework[5], l’AI RMF Playbook[6] e l’AI RMF Generative Artificial Intelligence Profile[7].

Il NIST struttura le attività in quattro categorie:

  1. govern: sostenere una cultura organizzativa basata sulla consapevolezza del rischio,
  2. map: individuare il contesto di utilizzo,
  3. measure: identificare, analizzare e valutare i rischi,
  4. manage: dare le priorità e agire.

I rischi CIG si basano su queste pietre miliari del NIST e si concentrano sulle conseguenze sia degli attacchi (guidati dalle vulnerabilità), sia degli esiti avversi accidentali (guidati dalle debolezze), con l’intento di anticipare l’approccio “Hybrid AI” in grado di supportare le applicazioni critiche in modo sicuro e verificabile.

Confidenzialità

Solitamente i rischi di confidenzialità dei sistemi di intelligenza artificiale sono associati alla rivelazione involontaria dei dati di training o delle caratteristiche architetturali del modello neurale. Tra questi rientrano i cosiddetti attacchi denominati “jailbreak”, una particolare tipologia di attacchi in grado di indurre i LLM a produrre risultati che superano i limiti stabiliti dai loro progettisti per prevenire determinati tipi di risposte pericolose e limitare la diffusione di contenuto malevolo. Questi attacchi compromettono anche l’integrità dei sistemi. Infatti, la derivazione statistica dei modelli di intelligenza artificiale non consente di delineare con precisione i confini delle categorie di rischio.

Il principale rischio connesso alla confidenzialità è rappresentato dalla violazione della privacy. L’opinione pubblica è convinta che i modelli siano stati addestrati su grandi insiemi di dati privati o sensibili, come le cartelle cliniche o le informazioni finanziarie, e che durante l’attività di riconoscimento o classificazione non sia stato possibile scoprire tali dati. Recenti studi hanno dimostrato l’infondatezza di tale assunzione, evidenziando che diversi tipi di attacchi alla privacy hanno comportato significative conseguenze nefaste per la sicurezza. Vediamo alcuni:

Gli attacchi di jailbreak e il trasferimento dei dati:
Esistono tecniche per sviluppare attacchi di injection o jailbreak al prompt in grado di eludere i sistemi di protezione, tipicamente integrati nei LLM, attraverso cicli di fine-tuning[8]. Esistono metodi per rendere le tecniche di jailbreak manuale più robuste, applicabili a modelli LLM API e LLM open source, e trasferibili sui modelli proprietari.

Gli aggressori possono ottimizzare un set di modelli open source per imitare i comportamenti dei modelli proprietari mirati e, successivamente, tentare un trasferimento black-box utilizzando i modelli testati. Continuano ad essere sviluppate nuove tecniche di jailbreak, spesso facilmente accessibili anche per chi ha risorse limitate, che appaiono al prompt sottoforma di testo in linguaggio naturale[9]. Alcune di queste tecniche includono l’assegnazione di ruoli, in cui ad un LLM viene chiesto di mettersi in un certo ruolo, per esempio come attore malevole, e in tale veste può rivelare informazioni protette[10].

L’inversione del modello e l’inferenza di appartenenza:
Un avversario con accesso limitato a un modello ML addestrato può estrarre dati di training tramite query. Sono stati identificati attacchi di inversione del modello[11] in grado di sfruttare le informazioni confidenziali generate dai modelli e consentire l’estrazione di informazioni sensibili, come i dati sanitari di un individuo, inseriti in un set di dati specifico per una determinata malattia oppure lo stile di una persona che ha partecipato ad un sondaggio.

Il problema della memorizzazione:
Il problema della memorizzazione dei dati di training, a differenza del problema di hallucination[12], si verifica quando gli utenti di un LLM si aspettano nuovi risultati sintetizzati, mentre ricevono una replica esatta dei dati di input. Questo fenomeno, noto come overfitting, può portare a violazioni della privacy, appropriazioni indebite della proprietà intellettuale e violazioni del copyright.

La ricerca black-box:
Se un modello proprietario espone un’API che fornisce probabilità per un insieme di output potenziali, una ricerca discreta di tipo black-box può generare prompt avversari che superano le protezioni previste. Questa vulnerabilità è accessibile a un aggressore, anche senza particolari risorse GPU, che effettua chiamate ripetute all’API per identificare i prompt efficaci. Sono state documentate tecniche chiamate “leakage prompts” in grado di ottenere punteggi di confidenza dai modelli i cui progettisti intendevano proteggere tali punteggi. Questi ultimi facilitando anche l’inversione del modello.

Strategie di Mitigazione per la Confidenzialità

Proviamo a introdurre le azioni di mitigazione per ridurre il rischio per la confidenzialità:

La privacy differenziale:
Le soluzioni tecniche alla protezione della privacy, come la privacy differenziale, costringono gli ingegneri dell’intelligenza artificiale a valutare il compromesso tra sicurezza e accuratezza. Le tecniche di privacy differenziale fanno parte del set di tecniche basate sulla statistica chiamate “privacy-preserving analytics” (PPA), utilizzate per salvaguardare i dati privati supportando al contempo l’analisi.

Le tecniche PPA includono anche le “blind signatures”, il “k-anonymity” e l’apprendimento federato.Le tecniche PPA sono un sottoinsieme delle “privacy-enhancing technologies” (PET), che includono anche prove a “zero-knowledge” (ZK), la “homomorphic encryption” (HE) e il “secure multiparty computation” (MPC). Sono in corso esperimenti per integrarle nei modelli LLM per migliorare la privacy.

Le tecniche di privacy differenziale implicano la perturbazione dei dati di training o degli output di un modello allo scopo di limitare la capacità degli utenti di poter trarre conclusioni su elementi particolari dei dati di training di un modello in base agli output osservati. Tuttavia, questo tipo di difesa ha un costo in termini di accuratezza dei risultati e mostra un pattern nella mitigazione del rischio ML, ovvero l’azione difensiva potrebbe interferire con l’accuratezza dei modelli addestrati.

Le tecniche di disapprendimento:
Sono state proposte diverse tecniche a supporto della rimozione dell’influenza di determinati esempi di training che potrebbero avere contenuti nocivi o che potrebbero compromettere la privacy tramite inferenza di appartenenza. Nel tentativo di accelerare questa attività sono state avviate attività di Machine Unlearning[13]. Tutti gli esperimenti sono arrivati alla conclusione che il disapprendimento automatico rimane un’incognita per l’uso pratico a causa del grado con cui i modelli si degradano analogamente agli effetti delle tecniche di privacy differenziale.

Integrità nei Sistemi AI

Nell’ambito dell’intelligenza artificiale basata sulle reti neurali, tra cui il ML e l’AI generativa, i rischi di integrità si riferiscono al potenziale di attacchi che potrebbero far sì che i sistemi producano risultati non previsti dai progettisti, dai programmatori e dai valutatori. Poiché le specifiche iniziali, oltre all’attenzione sui dati di training, sono difficili o impraticabili per molti modelli di reti neurali, il concetto di risultati attesi riveste solo un significato informale.

Di seguito sono indicati diversi tipi di attacco all’integrità contro le reti neurali, la natura dei punti deboli e delle vulnerabilità sfruttate, oltre ad alcune potenziali misure di mitigazione.

Il data poisoning (Avvelenamento dei dati):
Negli attacchi di data poisoning, un avversario interferisce con i dati su cui è addestrato l’algoritmo di ML, per esempio iniettando dati aggiuntivi durante il processo di training. L’avvelenamento può essere efficace anche nell’apprendimento supervisionato[14].

Questi attacchi consentono a un avversario di interferire con i comportamenti di test-time e runtime dell’algoritmo, sia degradando l’efficacia complessiva (c.d. accuratezza), sia inducendo l’algoritmo a produrre risultati errati in specifiche situazioni. La ricerca ha dimostrato[15] che una quantità sorprendentemente piccola di dati di addestramento manipolati può comportare grandi cambiamenti nel comportamento del modello. Gli attacchi di data poisoning sono particolarmente seri quando la qualità dei dati di addestramento non può essere accertata; questa difficoltà può essere amplificata dalla necessità di riaddestrare continuamente gli algoritmi con nuovi dati.

Gli attacchi di poisoning possono verificarsi anche nell’apprendimento federato, per esempio nei domini relativi alla sicurezza nazionale o alla salute pubblica, in cui un insieme di organizzazioni addestrano congiuntamente un algoritmo senza condividere direttamente i dati posseduti da ciascuna organizzazione. Poiché i dati di training non vengono condivisi, può essere difficile, per qualsiasi parte, determinare la qualità complessiva dei dati. Esistono rischi simili con i dati pubblici, dove gli avversari possono facilmente distribuire input di addestramento nocivi.

Gli attacchi correlati possono influenzare i metodi di trasferimento del training, in cui un nuovo modello è derivato da un modello precedentemente addestrato. Potrebbe essere impossibile accertare quali fonti di dati siano state utilizzate per addestrare il modello di origine, il che nasconderebbe qualsiasi addestramento avversario che influenzi il modello derivato. Numerose ipotesi tentano di spiegare il sorprendente livello di trasferibilità tra modelli, tra cui, per modelli più grandi, la comunanza dei dati di addestramento e nella messa a punto per l’allineamento[16].

I misdirection and evasion attacks (Attacchi di deviazione ed evasione):
Gli attacchi di evasion sono caratterizzati dal tentativo di un avversario a indurre un modello a produrre output errati durante il funzionamento di un sistema. Esempi possono riguardare l’errata identificazione di un oggetto in un’immagine, la classificazione errata dei rischi nella consulenza agli addetti ai prestiti bancari e la valutazione errata della probabilità che un paziente possa trarre beneficio da un particolare trattamento sanitario.

Questi attacchi vengono realizzati mediante la manipolazione, posta in essere dall’avversario, di un input o di una query fornita al modello. Gli attacchi di evasion sono spesso classificati come non mirati, quando l’obiettivo dell’avversario è ingannare il modello inducendolo a produrre una risposta errata, o mirati, nel caso in cui l’obiettivo dell’avversario è ingannare il modello inducendolo a produrre una specifica risposta errata. Un esempio di attacco consiste nel disorientare le reti neurali per il riconoscimento facciale posizionando punti colorati sulle montature degli occhiali[17].

In molti attacchi di evasion, è importante che l’input manipolato o fornito dall’aggressore sembri benigno, in modo tale che l’esame superficiale dell’input non riveli l’attacco. C’è anche il noto attacco degli adesivi su un segnale di stop[18]. È improbabile che questi adesivi siano notati dai conducenti umani, poiché molti segnali di stop hanno adesivi e altre alterazioni, ma gli adesivi posizionati con cura funzionano come patch in grado di disorientare in modo affidabile una rete di classificazione dei segnali affinché veda un segnale di limite di velocità. Questo tipo di spoofing richiede un impegno relativamente basso e, infatti, è stato oggetto di ricerca universitaria.

È fondamentale definire quando l’output di un modello è corretto per valutare la suscettibilità dei modelli agli attacchi di evasion. Per molte applicazioni, la correttezza potrebbe essere definita quando il sistema fornisce la risposta che darebbe un essere umano. Questo è difficile da testare con un certo grado di completezza. Inoltre, ci sono applicazioni in cui questo criterio non potrebbe essere sufficiente. Per esempio, potremmo voler vietare risultati accurati ma dannosi, come le istruzioni dettagliate su come realizzare un esplosivo o come commettere una frode con la carta di credito.

Una delle principali sfide nella valutazione è definire l’intento progettuale riguardo alla funzione del sistema e agli attributi di qualità, come avviene per una tradizionale specifica software. Poiché raramente è possibile fornire specifiche complete, le tre categorie CIG non sono delineate in modo netto e, in effetti, questo tipo di attacco pone rischi sia per l’integrità, che per la confidenzialità.

L’inesattezza:
La debolezza fondamentale condivisa da tutte le moderne tecnologie di AI deriva dalla natura statistica delle reti neurali e dal loro training: i risultati dei modelli basati su reti neurali sono previsioni statistiche. I risultati derivano da una distribuzione e gli errori dovuti all’effetto della memorizzazione o dell’allucinazione rientrano nei limiti di tale distribuzione. La ricerca sta portando a un rapido miglioramento: la progettazione dei modelli sta migliorando, i dataset di training stanno aumentando di dimensione e, infine, vengono applicate sempre più risorse computazionali ai processi di training. Tuttavia, è essenziale tenere presente che i modelli di reti neurale risultanti sono basati su dati stocastici e, pertanto, sono predittori inesatti.

Le Generative AI hallucinations (Allucinazioni dell’intelligenza artificiale generativa):
La caratteristica modellazione statistica delle architetture a rete neurale LLM può portare a contenuti generati in contrasto con i dati di training dati in input o che non sono coerenti con i fatti. In questi casi si parla di output “hallucinated”. Le allucinazioni possono essere elementi rappresentativi generati all’interno di una categoria di risposte. Questo è il motivo per cui spesso si riscontra una vaga somiglianza con i fatti reali, definita incertezza aleatoria nel contesto delle tecniche di mitigazione della modellazione della quantificazione dell’incertezza (UQ).

Gli errori di ragionamento:
Il corollario dell’inesattezza statistica consiste nel fatto che i modelli a rete neurale non hanno capacità intrinseche per pianificare o ragionare. La comprensione del mondo da parte dei modelli è molto superficiale, in particolare se sono addestrati esclusivamente sul testo e, di conseguenza, gli LLM autoregressivi hanno limitate capacità di ragionamento e pianificazione. Per esempio, il funzionamento degli LLM è sostanzialmente un’iterazione nel prevedere la parola successiva di un testo o nel basarsi sul contesto di un prompt e sulla stringa di testo precedente che ha prodotto.

Gli LLM possono essere indotti a creare l’immagine di un ragionamento e, così facendo, forniscono previsioni migliori che potrebbe creare l’apparenza di ragionamento. Una delle tecniche di prompt per raggiungere questo obiettivo è chiamata “chain-of-thought” (CoT)[19]. Questo crea una sorta di “fast-thinking”[20] tra pianificazione e ragionamento, ma genera risultati inevitabilmente inesatti, che diventano più evidenti una volta che le catene di ragionamento aumentano anche solo di poco. Uno studio recente[21] ha dimostrato che, generalmente, le catene più lunghe, anche di una dozzina di passaggi, non sono fedeli al ragionamento svolto senza CoT.

Tra i numerosi parametri funzionali ai sistemi di ragionamento automatico e sul calcolo si evidenziano: la capacità di effettuare controlli esterni per la solidità delle strutture di ragionamento prodotte da un LLM e il numero di passaggi di ragionamento e/o calcolo intrapresi.

Potenziali mitigazioni

Oltre alle attività riparatorie menzionate nei paragrafi precedenti, sono allo studio diverse potenzialmente alternative capaci di mitigare un’ampia gamma di vulnerabilità. Vediamole:

Uncertainty quantification (UQ) (la quantificazione dell’incertezza):
La quantificazione dell’incertezza, nell’ambito del ML, si concentra sull’identificazione dei tipi di incertezze statistiche predittive che si presentano nei modelli ML, con l’obiettivo di modellare e misurare tali incertezze. Nel contesto del ML, si distingue tra le incertezze relative a effetti statistici intrinsecamente casuali (c.d. aleatorie) e le incertezze relative a insufficienze nella rappresentazione della conoscenza in un modello (c.d. epistemiche)[22].

L’incertezza epistemica può essere ridotta tramite un training aggiuntivo e il miglioramento dell’architettura di rete, mentre l’incertezza aleatoria è correlata all’associazione statistica di input e output e non può essere ridotta. I metodi UQ dipendono da precise specifiche delle caratteristiche statistiche del problema. Inoltre, sono poco utili nelle applicazioni di ML in cui gli avversari hanno avuto accesso alle superfici di attacco. Esistono metodi UQ che tentano di rilevare campioni che non si trovano nella parte centrale di una distribuzione di probabilità degli input attesi. Anche questi ultimi sono suscettibili di attacchi.

Molti modelli di ML possono essere dotati della capacità di esprimere fiducia oppure la probabilità di errore. Ciò consente di modellare gli effetti degli errori a livello di sistema in modo che i loro effetti possano essere mitigati durante l’implementazione. Questo avviene attraverso una combinazione di metodi per la quantificazione dell’incertezza nei modelli di ML, la creazione di un framework software per ragionare con incertezza e la gestione sicura dei casi in cui i modelli di ML siano incerti.

Retrieval augmented generation (RAG) (Generazione aumentata di recupero):
Alcuni studi suggeriscono di sviluppare nei LLM la capacità di controllare la coerenza degli output rispetto alle fonti che si prevede rappresentino le verità fondamentali, come le basi di conoscenza o determinati siti Web come Wikipedia. La RAG si riferisce a questa idea di utilizzare database esterni per verificare e correggere gli output dei LLM. Questo rappresenta una potenziale misura di mitigazione sia per gli attacchi di evasione che per le allucinazioni dell’AI generativa, ma è imperfetta perché i risultati del recupero vengono elaborati dalla stessa rete neurale.

L’ingegneria della rappresentazione. L’aumento del grado di astrazione in un’analisi white-box può potenzialmente migliorare la comprensione di una serie di comportamenti indesiderati nei modelli, tra cui le allucinazioni, i pregiudizi e la generazione di risposte nocive[23]. Esistono diversi metodi che tentano di estrarre la funzionalità. Questo tipo di test richiede un accesso al modello del tipo white-box, ma ci sono risultati preliminari che restituiscono effetti simili in scenari di test del tipo black-box, ottimizzando i prompt che hanno come target le stesse rappresentazioni interne.

Si tratta di un elemento per ridurre l’opacità[24] caratteristica dei modelli di reti neurali più grandi. Uno studio recente, nell’ambito dell’interpretabilità automatizzata, ha dimostrato che sia possibile automatizzare un processo iterativo di sperimentazione per identificare i concetti latenti nelle reti neurali e quindi dare loro nomi[25].

I Principi di Governance dell’Intelligenza Artificiale Generativa

Gli incidenti che coinvolgono l’intelligenza artificiale sono ampiamente documentati attraverso vari repository[26]. Per mitigare un po’ i rischi è necessario essere consapevoli non solo delle debolezze e delle vulnerabilità, ma anche dei principi di governance dell’AI, ovvero del modo con cui le organizzazioni sviluppano, regolamentano e gestiscono la responsabilità dei workflow supportati dall’AI.

Stakeholders e accountability:
La governance può coinvolgere un ecosistema costituito da elementi e sistemi di AI e dagli stakeholder umani e organizzativi. Questi stakeholder possono includere progettisti, sviluppatori di sistemi, team di distribuzione, leadership istituzionale, utenti finali e decisori, fornitori di dati, operatori, consulenti legali, valutatori e revisori.

Essi sono complessivamente responsabili delle decisioni relative alla scelta di assegnare determinate capacità a determinate tecnologie di AI in un determinato contesto applicativo, nonché delle scelte relative al modo in cui il sistema basato sull’AI è integrato nei flussi operativi e nei processi decisionali. Sono, inoltre, responsabili dell’architettura dei modelli e della selezione dei dati di training, compreso l’allineamento dei dati al contesto operativo. Sono responsabili dei parametri, dei tassi di rischio e di responsabilità.

L’assegnazione della responsabilità tra coloro che sono coinvolti nella progettazione, nello sviluppo e nell’uso dei sistemi di intelligenza artificiale non è un compito semplice. Questa circostanza è nota come il “problem of many hands” [27]. Questo problema è amplificato dalla assenza di trasparenza e dall’incomprensibilità dei modelli di intelligenza artificiale, spesso persino ai loro creatori [28] [29]. Nel contesto della data science, è fondamentale sviluppare strutture di governance efficaci che siano consapevoli delle caratteristiche dell’AI moderna.

Pacing (ritmo):
Le criticità in materia di governance derivano anche dalla velocità dello sviluppo tecnologico. Questo include non solo le principali tecnologie dell’AI, ma anche i continui progressi nel campo dell’identificazione e della comprensione di vulnerabilità. Infatti, questa velocità sta portando a una continua escalation delle aspettative sulle capacità operative.

Business:
Un ulteriore insieme di difficoltà per la governance deriva dagli aspetti legati al business, tra cui il segreto commerciale e la protezione della proprietà intellettuale, così come le scelte relative al modello architetturale e ai dati di training. In molti casi, le informazioni sui modelli, nell’ambito di una supply chain, possono essere deliberatamente limitate.

Tuttavia, è importante notare che, quando le superfici di attacco sono sufficientemente esposte, molti degli attacchi sopra menzionati possono avere successo nonostante vi siano restrizioni black-box. Infatti, uno dei paradossi del rischio informatico è che, a causa del segreto commerciale, gli avversari possano conoscere l’ingegneria dei sistemi meglio rispetto alle organizzazioni che valutano e gestiscono questi sistemi. Questo è uno dei motivi per cui l’AI open source è ampiamente attenzionata anche da parte degli sviluppatori proprietari[30].

Responsabile AI:
Sono state pubblicate diverse linee guida che trattano la Responsabile AI (RAI) e in molti casi convergono sugli stessi principi: la correttezza, la responsabilità, la trasparenza, la sicurezza, la validità, l’affidabilità, la protezione e la privacy. Il Dipartimento della Difesa Americano ha pubblicato una strategia RAI insieme a un toolkit associato[31].

Le Tipologie di Minacce Informatiche legate alla Governance

Esistono diverse minacce legate alla governance:

Deepfake:
Gli strumenti di AI generativa possono operare in più modalità e produrre materiale deepfake multimodale, per esempio audio e video, che possono apparire verosimilmente come se fossero originali. Sono state pubblicate numerose ricerche sul rilevamento dei deepfake[32] e sulla generazione aumentata tramite filigrane e altri tipi di firme[33]. Il ML e la GenAI possono essere utilizzati sia per generare deepfake, che per analizzare firme deepfake. Ciò significa che la tecnologia di intelligenza artificiale è in crescita su entrambi i fronti: la creazione e il rilevamento della disinformazione[34].

Overfitting (sovradimensionamento):
È possibile addestrare il modello di ML in modo tale da portare a un overfitting. Questo succede quando il miglioramento del tasso di successo nel dataset di training portano a un degrado della qualità dei risultati nel dataset di test. Il termine overfitting deriva dal contesto della modellazione matematica quando e si usa per descrivere i casi in cui i modelli non riescono a catturare in maniera affidabile le caratteristiche salienti dei dati, per esempio compensando eccessivamente gli errori di campionamento. Il problema della memorizzazione è una forma di overfitting[35]. L’overfitting è trattato come un rischio di governance perché implica scelte fatte nella progettazione e nell’addestramento dei modelli.

Undertfitting (sottodimensionamento):
L’underfitting è un altro tipo di errore che si verifica quando il modello non è in grado di determinare una relazione significativa tra i dati di input e di output. L’underfitting si verifica se i modelli non sono stati addestrati per il periodo di tempo appropriato su un numero elevato di punti di dati. I modelli con underfitting presentano un bias elevato: forniscono risultati imprecisi sia per i dati di addestramento sia per il set di test.

Bias (pregiudizio/distorsione):
Spesso si ritiene che il bias derivi dalla mancata corrispondenza dei dati di training con i dati di input, ovvero che i dati di addestramento non sono allineati con i contesti applicativi. Inoltre, nel caso in cui non vi è la disponibilità di dati idonei, è possibile incorporare il bias nei dati di addestramento anche quando il processo di campionamento degli input è destinato ad essere allineato con i casi d’uso. Per tanto, a causa della mancanza di disponibilità di dataset di training imparziale, è difficile correggere il bias.

Per esempio, è stato osservato un bias di genere nei vettori di parole degli LLM: la distanza vettoriale della parola female è più vicina a nurse, mentre male è più vicina a engineer[36]. Il problema della parzialità nelle decisioni dell’AI è correlato alle conversazioni attive nell’ambito della corretta classificazione dei risultati nei sistemi di ricerca e di raccomandazione [37].

Tossic text:
I modelli di AI generativa possono essere addestrati sia sui contenuti migliori, che su quelli peggiori di Internet. I modelli di GenAI possono utilizzare strumenti per filtrare i dati di training, ma il risultato potrebbe risultare imperfetto. Anche quando i dati di training non sono esplicitamente tossici, la messa a punto può consentire la generazione di materiale negativo.

È importante riconoscere che non esistono definizioni universali e che la caratteristica di tossicità spesso dipende in larga misura dal pubblico e dal contesto: esistono diversi tipi di contesti che influenzano le decisioni in merito all’appropriatezza del linguaggio. La maggior parte dei rimedi prevede l’uso di filtri sui dati di training e un’ottimizzazione dell’input, del prompt e dell’output. I filtri spesso includono l’apprendimento con feedback umano “reinforcement learnig with human feedback (RLHF)”. Finora, nessuna di queste soluzioni è riuscita a eliminare i danni da tossicità, soprattutto laddove i segnali nocivi sono nascosti.

Rischi informatici:
È importante ricordare che anche gli attacchi informatici che coinvolgono la supply chain rappresentano un rischio significativo per i modelli di ML. Questo riguarda sia i modelli black-box, che quelli open source, perché entrambi possono includere payload indesiderati. Lo stesso si può affermare nei modelli basati sul cloud in cui si può accedere attraverso API non sicure. Questi sono i classici rischi della supply chain del software, ma la complessità e l’opacità dei modelli di AI possono creare ulteriori opportunità per gli aggressori.

L’articolo ha esplorato approfonditamente i rischi sistemici nell’intelligenza artificiale generativa, evidenziando le vulnerabilità intrinseche dei modelli neurali. Attraverso un’analisi dettagliata dei rischi di Confidenzialità, Integrità e Governance (CIG), sono emerse le complessità dei sistemi di intelligenza artificiale generativa, dalle minacce di jailbreak alle hallucination.

Dopo questa analisi esaustiva sulla Governance dell’intelligenza artificiale generativa, si passerà ad un articolo dedicato alla valutazione del rischio nella Generative AI, approfondendo le metodologie di risk assessment e mitigazione. Per un’analisi più dettagliata e per approfondire il tema legato all’intelligenza artificiale generativa, invitiamo i lettori a scaricare il white paper dal titolo “Generative Artificial Intelligence: punti di forza, rischi e contromisure”.

Note bibliografiche

[1] Hybrid artificial intelligence (intelligenza artificiale ibrida) può essere definita come l’arricchimento di modelli di intelligenza artificiale esistenti tramite conoscenze specialistiche ottenute per un apposito contesto.

[2] Symbolic artificial intelligence (intelligenza artificiale simbolica) indica i metodi della ricerca sull’intelligenza artificiale che si basano su rappresentazioni di problemi “simbolic” di logica e ricerca. L’AI simbolica è stata il paradigma dominante della ricerca sull’AI dalla metà degli anni ’50 fino alla fine degli anni ’80.

[3] AlphaGo è un software per il “gioco del go” sviluppato da Google DeepMind per studiare le reti neurali.

[4] CIG Framework: Confidentiality, Integrity and Governance.

[5] AI RMF Framework, https://www.nist.gov/itl/ai-risk-management-framework

[6] AI RMF Playbook, https://airc.nist.gov/AI_RMF_Knowledge_Base/Playbook

[7] AI RMF Generative Artificial Intelligence Profile, https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf, NIST, 2024

[8] AA.VV., Universal and Transferable Adversarial Attacks on Aligned Language Models, https://arxiv.org/abs/2307.15043, 1Carnegie Mellon University, 2023

[9] AA.VV., Weak-to-Strong Jailbreaking on Large Language Models, https://arxiv.org/abs/2401.17256, 1University of California, 2024

[10] AA.VV., In ChatGPT We Trust? Measuring and Characterizing the Reliability of ChatGPT, https://arxiv.org/abs/2304.08979, CISPA, 2023

[11] AA.VV., Model Inversion Attacks that Exploit Confidence Information and Basic Countermeasures, https://dl.acm.org/doi/pdf/10.1145/2810103.2813677, Carnegie Mellon University, 2015

[12] L’hallucination è il fenomeno per cui un modello di machine learning o un’altra forma di AI genera risultati o output che non sono basati sui dati di addestramento o sulla realtà. In altre parole, l’allucinazione si verifica quando un modello di AI crea informazioni che non esistono. Questo fenomeno può verificarsi in diversi modelli di intelligenza artificiale, inclusi modelli di linguaggio come LLM. Ad esempio, un modello potrebbe generare frasi o risposte che sembrano plausibili ma che sono in realtà completamente inventate o basate su connessioni errate o casuali. L’allucinazione può compromettere l’affidabilità e la precisione delle risposte generate dai modelli.

[13] AA.VV., Google Machine Unlearning Challenge, https://research.google/blog/announcing-the-first-machine-unlearning-challenge/ – NeurIPS 2023 Machine Unlearning Challenge, https://unlearning-challenge.github.io/ – Who’s Harry Potter? Approximate Unlearning in LLMs, https://arxiv.org/abs/2310.02238, Microsoft, 2023

[14] AA.VV., Indiscriminate Poisoning Attacks on Unsupervised Contrastive Learning, https://arxiv.org/abs/2202.11202, MIT, 2023

[15] AA.VV., Targeted Backdoor Attacks on Deep Learning Systems Using Data Poisoning, https://arxiv.org/abs/1712.05526, UC Berkeley, 2017

[16] AA.VV., Universal and Transferable Adversarial Attacks on Aligned Language Models, https://arxiv.org/abs/2307.15043, Carnegie Mellon University, 2023

[17] AA.VV., A General Framework for Adversarial Examples with Objectives, https://arxiv.org/pdf/1801.00349, Carnegie Mellon University, 2019

[18] AA.VV., Robust Physical-World Attacks on Deep Learning Visual Classification, https://arxiv.org/pdf/1707.08945, University of Michigan, 2018

[19] AA.VV., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, https://arxiv.org/abs/2201.11903, Google, 2023

[20] D. Kahneman, Of 2 Minds: How Fast and Slow Thinking Shape Perception and Choice, https://www.scientificamerican.com/article/kahneman-excerpt-thinking-fast-and-slow/, ScientificAmerican, 2012

[21] AA.VV., Measuring Faithfulness in Chain-of-Thought Reasoning, https://arxiv.org/abs/2307.13702, Anthropic, 2023

[22] AA.VV., Aleatoric and epistemic uncertainty in machine learning: an introduction to concepts and methods, https://link.springer.com/article/10.1007/s10994-021-05946-3, Springer, 2021

[23] AA.VV., A top-down approach to AI transparency, https://arxiv.org/pdf/2310.01405, CMU, 2023

[24] AA.VV., Mapping the Mind of a Large Language Model, https://www.anthropic.com/news/mapping-mind-language-model, Anthropic, 2024

[25] AA.VV., A Multimodal Automated Interpretability Agent, https://arxiv.org/pdf/2404.14394, MIT, 2024

[26] AI Incident Database from the Responsible AI Collaborative: https://incidentdatabase.ai/ – AI Incident Database from the Partnership on AI: https://partnershiponai.org/workstream/ai-incidents-database/ – the Organisation for Economic Co-operation and Development (OECD) AI Incidents Monitor: https://oecd.ai/en/incidents – AI, Algorithmic, and Automation Incidents and Controversies (AIAAIC) Repository of incidents and controversies: https://www.aiaaic.org/aiaaic-repository

[27] Thompson, Designing Responsibility: The Problem of Many Hands in Complex Organizations: https://dash.harvard.edu/bitstream/handle/1/37092148/Dennis%20Thompson%20chapter.pdf, Cambridge, 2014

[28] M. Sullivan, The frightening truth about AI chatbots: Nobody knows exactly how they work, https://www.fastcompany.com/90896928/the-frightening-truth-about-ai-chatbots-nobody-knows-exactly-how-they-work, FastCompany, 2023

[29] R. Curry, OpenAI Doesn’t Fully Understand How GPT Works Despite Rapid Progress: https://observer.com/2024/05/sam-altman-openai-gpt-ai-for-good-conference/, Observer, 2024

[30] Gen, The tech industry can’t agree on what open-source AI means. That’s a problem, https://www.technologyreview.com/2024/03/25/1090111/tech-industry-open-source-ai-definition-problem/, 2024

[31] AA.VV., Responsible Artificial Intelligence Strategy and Implementation Pathway: https://www.ai.mil/docs/RAI_Strategy_and_Implementation_Pathway_6-21-22.pdf, DoD, 2022

[32] Semantic Forensics: https://www.darpa.mil/program/semantic-forensics

[33] AA.VV., Provable Robust Watermarking for AI-Generated Text, https://arxiv.org/pdf/2306.17439, UC Santa Barbara, 2023

[34] AA.VV., Fighting Fire with Fire: The Dual Role of LLMs in Crafting and Detecting Elusive Disinformation, https://aclanthology.org/2023.emnlp-main.883.pdf, Pennsylvania State University, 2023

[35] AA.VV., A Careful Examination of Large Language Model Performance on Grade School Arithmetic, https://arxiv.org/pdf/2405.00332v1, 2024

[36] AA.VV., Gender bias and stereotypes in Large Language Models, https://dl.acm.org/doi/fullHtml/10.1145/3582269.3615599, Apple, 2023

[37] AA.VV., Evaluating Stochastic Rankings with Expected Exposure, https://dl.acm.org/doi/10.1145/3340531.3411962, 2020
Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/intelligenza-artificiale-generativa/


DOGE, la strategia di Musk “AI First” apre falle nella sicurezza pubblica e automatizza gli errori

Dubbi e allarmi sul controverso obiettivo del DOGE di razionalizzare la spesa governativa con l’AI

Il DOGE (Department of Government Efficiency) guidato da Elon Musk non smette di occupare le prime pagine dei quotidiani americani e non solo. Secondo quanto riportato dal New York Times, Wired, 404.com e da altre fonti, il dipartimento mira a integrare l’intelligenza artificiale (AI) nei sistemi delle agenzie federali per analizzare contratti, valutare le spese e suggerire tagli.

L’iniziativa, denominata “AI First”, si inserisce in una più ampia strategia di modernizzazione tecnologica del governo, sulla scia di esperienze passate come la U.S. Digital Service voluta dall’ex Presidente degli Stati Uniti, Barack Obama.

L’idea di base è che l’AI possa velocizzare i processi burocratici, eliminare inefficienze e migliorare la gestione dei fondi pubblici. Tuttavia, l’entusiasmo per questa misura fortemente AI based nel settore governativo nasconde diversi rischi per la sicurezza pubblica, delle finanze dei dati sensibili, già individuati nei giorni scorsi da diverse testate giornalistiche.

I timori degli esperti: rischi di errori sistemici e discriminazioni

L’adozione dell’AI nel settore pubblico, senza adeguati test preliminari, potrebbe tradursi in decisioni errate e in un aumento delle inefficienze, anziché nella loro eliminazione. Donald Moynihan, professore di politiche pubbliche all’Università del Michigan e co-direttore del Better Government Lab, ha espresso forti preoccupazioni: “L’uso su larga scala dell’AI senza test approfonditi è una ricetta per il disastro”.

Secondo Meredith Broussard, docente alla NYU e autrice di “Artificial Unintelligence: How Computers Misunderstand the World”, un’intelligenza artificiale incaricata di ottimizzare la spesa pubblica potrebbe semplicemente fornire risposte automatiche senza comprenderne la reale validità: “La macchina darà sempre una risposta, ma non necessariamente quella corretta”.

Questa tendenza dell’AI a generare informazioni errate, spesso definite “allucinazioni”, potrebbe portare a decisioni potenzialmente devastanti, come il taglio indiscriminato di programmi essenziali per le fasce più deboli della popolazione.

Il DOGE alimenta preoccupazioni per la sicurezza e la trasparenza

Un altro nodo critico riguarda la sicurezza dei dati e la mancanza di trasparenza nel progetto DOGE. Al momento, non esiste un quadro chiaro su come il governo intenda implementare l’AI, quali siano i criteri di valutazione e quali misure di supervisione verranno adottate per evitare abusi e errori.

Dmitry Shevelenko, Chief Business Officer di Perplexity, ritiene che l’AI possa effettivamente migliorare l’efficienza governativa, ma solo se utilizzata con estrema cautela: “Non si dovrebbe mai bloccare il finanziamento a programmi pubblici basandosi esclusivamente su decisioni di un’intelligenza artificiale”.

Altri esperti hanno evidenziato come l’uso dell’AI per prendere decisioni su appalti pubblici e allocazione di risorse possa aprire nuove vulnerabilità informatiche, esponendo i dati sensibili del governo a rischi di hacking e manipolazione.

Il nodo politico e il futuro dell’AI nel governo

Le imprese che sviluppano modelli di intelligenza artificiale continuano a spingere per una maggiore adozione delle proprie tecnologie/soluzioni nel settore pubblico. OpenAI ha lanciato ChatGPT Gov, Google e Microsoft stanno già collaborando con diversi Stati per migliorare la gestione delle richieste di disoccupazione e altre funzioni amministrative, mentre Anthropic collabora con Palantir e Amazon Web Services per aiutare le agenzie di intelligence USA ad elaborare più rapidamente i dati.

Tuttavia, l’esperienza dimostra che i tentativi di modernizzare rapidamente la tecnologia governativa incontrano ostacoli enormi. Broussard sottolinea: “Se fosse davvero possibile ottimizzare il governo in poco tempo con la tecnologia, qualcuno lo avrebbe già fatto”.

L’idea di usare l’AI per eliminare gli sprechi governativi può sembrare attraente ed efficace, soprattutto leggendo i titoli dei giornali (o i post sui social), ma senza un’adeguata supervisione e test rigorosi, il progetto DOGE rischia di diventare un esperimento pericoloso con conseguenze imprevedibili.

La sfida principale non è solo tecnica e tecnologica, ma anche politica e sociale: senza trasparenza, sicurezza e una valutazione accurata dei rischi, l’adozione affrettata dell’AI nella gestione pubblica potrebbe rivelarsi più dannosa che utile e soprattutto difficile da affrontare nelle conseguenze peggiori (o inattese).

Al momento, l’unica cosa certa è che il futuro dell’efficienza governativa non può essere lasciato esclusivamente a un algoritmo. E questo ammonimento non vale solo per il Governo americano.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/doge-la-strategia-di-musk-ai-first-apre-falle-nella-sicurezza-pubblica-e-automatizza-gli-errori/521999/


EuroStack, che cos’è la Strategia guidata da Bria per l’indipendenza digitale europea e per creare un Fondo ad hoc

L’Europa si trova oggi di fronte a una scelta cruciale che influenzerà il suo futuro digitale e tecnologico nei decenni a venire. Da un lato, vi è la possibilità di continuare a dipendere da tecnologie sviluppate e controllate da attori extraeuropei, con tutte le implicazioni in termini di sicurezza, sovranità e competitività economica. Dall’altro, si profila l’opportunità di costruire un ecosistema tecnologico autonomo, innovativo e sostenibile, che rispecchi i valori e gli interessi del continente.

EuroStack, l’alternativa europea

Il nuovo documento EuroStack – A European Alternative for Digital Sovereignty propone una strategia articolata per rafforzare la capacità tecnologica europea, ridurre la dipendenza da fornitori stranieri e sviluppare un’infrastruttura digitale sovrana, aperta e conforme ai principi europei. Questa iniziativa mira a promuovere la creazione di tecnologie all’avanguardia, garantendo al contempo trasparenza, sicurezza e sostenibilità ambientale.

L’80% delle infrastrutture digitali Ue dipende da tecnologie extra Ue

Attualmente, oltre l’80% delle infrastrutture digitali europee dipende da tecnologie importate, una condizione che espone il continente a vulnerabilità sistemiche, inefficienze economiche e rischi geopolitici. Nel settore del cloud computing, tre aziende statunitensi, Amazon Web Services (AWS), Microsoft Azure e Google Cloud, detengono quasi il 70% del mercato europeo, mentre il più grande fornitore europeo ha una quota inferiore al 2%. Allo stesso modo, il 70% dei modelli fondamentali di intelligenza artificiale è stato sviluppato negli Stati Uniti, con la Cina che sta rapidamente incrementando la propria quota di mercato. Anche nella produzione di semiconduttori, essenziale per l’industria tecnologica, l’Europa consuma circa il 20% del totale mondiale ma ne produce solo il 9%. Con l’European Chips Act, l’Unione Europea mira a raddoppiare questa quota al 20% entro il 2030, ma la strada per raggiungere tale obiettivo è ancora lunga e richiede ingenti investimenti.

Dipendenza critica da fornitori extra Ue

Questi numeri evidenziano una dipendenza critica da fornitori extraeuropei, con conseguenze dirette sulla capacità dell’UE di controllare le proprie infrastrutture digitali e proteggere i dati sensibili di governi, aziende e cittadini. L’uso di server localizzati all’estero significa che molte informazioni strategiche sono soggette a legislazioni straniere, come il Cloud Act statunitense, che consente alle autorità americane di accedere ai dati conservati su server di aziende statunitensi, anche se situati in Europa. Ciò può entrare in conflitto con normative europee come il GDPR, che pone standard stringenti sulla protezione dei dati personali.

Un freno all’innovazione locale

La predominanza di piattaforme cloud e software extraeuropei limita anche la capacità dell’UE di sviluppare soluzioni digitali indipendenti e competitive. Questo scenario frena l’innovazione locale e rende il continente vulnerabile a interruzioni tecnologiche o a decisioni politiche unilaterali di attori esterni. In assenza di un intervento strutturato e lungimirante, l’Europa rischia di consolidare il proprio ruolo di consumatore passivo di tecnologie sviluppate altrove, anziché diventare un attore di primo piano nella definizione dell’ecosistema digitale globale.

La proposta EuroStack

Di fronte a queste sfide, EuroStack propone da una parte un percorso chiaro per sviluppare un’infrastruttura digitale resiliente e federata, fondata su autonomia strategica, interoperabilità e apertura. L’iniziativa mira a promuovere modelli di intelligenza artificiale rispettosi della diversità culturale e linguistica europea, garantendo che i dati restino sotto giurisdizione UE e riducendo le dipendenze critiche da infrastrutture cloud extraeuropee. Inoltre, prevede la creazione di un’infrastruttura cloud decentralizzata e distribuita, capace di limitare il predominio dei grandi fornitori statunitensi e asiatici, favorendo lo sviluppo di soluzioni europee competitive. D’altra parte, il rapporto strategico riguarda anche il rafforzamento della leadership europea nella produzione di semiconduttori con l’obiettivo di potenziare la capacità produttiva del continente, riducendo la dipendenza da fornitori asiatici e statunitensi e garantendo un accesso sicuro e stabile ai componenti critici per il settore tecnologico. Considerando la crescente domanda di microchip e componenti elettronici, l’UE ha già stanziato 43 miliardi di euro per il settore.

Servizi digitali pubblici, dal Digital IT Wallet all’Euro digitale

Oltre agli aspetti infrastrutturali e produttivi, EuroStack promuove lo sviluppo di servizi digitali pubblici sicuri, interoperabili e orientati alla tutela dei cittadini. Tra questi, il Digital ID Wallet, che mira a fornire un’identità digitale unificata e sicura per tutti i cittadini europei, e l’Euro Digitale, una valuta digitale sviluppata nel rispetto della normativa sulla privacy e della sovranità economica dell’UE. La diffusione di soluzioni open-source è considerata un elemento chiave per garantire trasparenza, sicurezza e controllo pubblico sulle infrastrutture critiche, riducendo la dipendenza da fornitori privati e rafforzando la fiducia degli utenti nei servizi digitali europei.

Sostenibilità ambientale

Un’attenzione particolare è riservata alla sostenibilità ambientale: le nuove infrastrutture digitali, comprese quelle destinate all’high-performance computing e all’intelligenza artificiale, dovranno essere progettate in linea con gli obiettivi climatici europei. Ciò significa privilegiare l’uso di fonti di energia rinnovabile e sviluppare tecnologie ad alta efficienza energetica, in grado di ridurre l’impatto ambientale del settore. Attualmente, il consumo energetico dei data center europei rappresenta il 2,7% della domanda totale di elettricità del continente e si prevede un ulteriore aumento nei prossimi anni. Per questo motivo, EuroStack promuove strategie innovative per la riduzione dei consumi energetici e per l’adozione di pratiche sostenibili nel settore tecnologico, contribuendo agli obiettivi di neutralità climatica dell’UE.

Investimento stimato in 300 miliardi in 10 anni

Anche se questo potrebbe sembrare un approccio isolazionista, EuroStack non punta a una chiusura tecnologica, ma alla costruzione di partenariati strategici fondati sui valori europei condivisi.  Con un investimento stimato di 300 miliardi di euro nei prossimi dieci anni, EuroStack si propone di creare posti di lavoro altamente qualificati, rafforzare settori strategici come la manifattura avanzata, la sanità e l’energia, e colmare il gap di investimenti in ricerca e sviluppo.

Proposta creazione di un Fondo Europeo per la Tecnologia Sovrana

Attualmente, le aziende europee rappresentano solo il 7% della spesa globale in R&D per il software e internet, contro il 71% degli Stati Uniti e il 15% della Cina. Per ridurre questo divario, è prevista la creazione di un Fondo Europeo per la Tecnologia Sovrana, destinato a sostenere startup e imprese innovative del continente.

La piena autosufficienza tecnologica non è un obiettivo realistico né auspicabile, ma un modello di governance collaborativa, investimenti pubblico-privati e regolamentazioni agili possono favorire l’innovazione senza sacrificare la tutela dei diritti fondamentali.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/eurostack-che-cose-la-strategia-guidata-da-bria-per-lindipendenza-digitale-europea-e-per-creare-un-fondo-ad-hoc/521954/


Fastweb+Vodafone, accordo con Cineca per l’AI Generativa nelle imprese

Fastweb + Vodafone e Cineca annunciano un accordo strategico per supportare le imprese nello sviluppo e nella messa in produzione di applicazioni basate sull’Intelligenza Artificiale Generativa (Gen AI).

Le sinergie

Il protocollo d’intesa firmato tra le parti permetterà alle aziende e agli enti di ricerca di passare con continuità dalla fase di test e sperimentazione gestita con Cineca a quella operativa, sfruttando le infrastrutture di calcolo avanzate e le soluzioni cloud ad alte prestazioni garantite dal supercomputer NeXXt AI Factory di Fastweb + Vodafone.

Grazie alla propria rete di ultima generazione, ai servizi cloud resilienti e sicuri, nonché alla presenza di infrastrutture di cybersecurity avanzate come il NOC (Network Operations Center) e il SOC (Security Operations Center), Fastweb + Vodafone si pone come partner strategico per tutte le realtà che vogliono scalare i propri progetti di AI con efficienza e sicurezza.

Addestramento su larga scala

L’accordo prevede che Cineca, punto di riferimento per il calcolo ad alte prestazioni per attività di ricerca e innovazione, grazie alla disponibilità del supercomputer NeXXt AI Factory di Fastweb + Vodafone, coinvolga in un modello virtuoso di filiera i soggetti che, superata la fase di ricerca e sviluppo, necessitano di infrastrutture scalabili e performanti per portare le proprie applicazioni AI a livello produttivo. Fastweb + Vodafone metterà quindi a disposizione la propria piattaforma tecnologica e il supercomputer NeXXt AI Factory, ovvero il NVIDIA DGX con 248 GPU H100, un’infrastruttura in grado di gestire l’addestramento e l’implementazione di modelli Gen AI su larga scala.

“L’intelligenza artificiale sta rivoluzionando ogni settore e Fastweb + Vodafone è impegnata a fornire le migliori tecnologie per accelerare questa trasformazione”, ha detto Walter Renna, CEO di Fastweb + Vodafone. “Grazie a questa collaborazione con Cineca, le aziende – incluse le PMI – potranno contare su un percorso fluido e sicuro per trasformare i propri progetti AI in soluzioni operative di successo”.

“La strategia europea sull’intelligenza artificiale vuole promuovere la creazione di filiere dell’AI, che vadano dallo sviluppo di nuove soluzioni fino alle applicazioni finali”, ha sottolineato Francesco Ubertini, Presidente di Cineca. “La collaborazione tra Cineca e Fastweb + Vodafone si sviluppa esattamente con tali obiettivi: confido che possa rivelarsi preziosa per rafforzare l’innovazione e la competitività del nostro Paese”.

L’iniziativa si inserisce nella più ampia strategia di Fastweb + Vodafone per lo sviluppo dell’AI e della trasformazione digitale, fornendo alle imprese italiane strumenti concreti per innovare in un contesto tecnologico sicuro, scalabile ed efficiente.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/fastwebvodafone-accordo-con-cineca-per-lai-generativa-nelle-imprese/521908/