La trappola di Tucidide e l’Europa nell’era dell’intelligenza artificiale

Dalla Lega di Delo al caso Fable 5 e Mythos 5: perché la trappola di Tucidide aiuta a leggere la dipendenza tecnologica dell’Unione Europea

La trappola di Tucidide offre una chiave di lettura insolita per la dipendenza europea dall’intelligenza artificiale. La propone Aniello Gentile nel volume «L’Europa nella Trappola di Tucidide ai tempi dell’Intelligenza Artificiale» (agosto 2026), che parte da un episodio recente e risale al V secolo a.C. Il quesito di fondo è che cosa l’Europa possa imparare da Atene e dagli alleati finiti sotto il suo controllo.

Il 12 giugno 2026: da un blocco tecnologico a una lezione di storia

Il libro si apre con una data. Il 12 giugno 2026, tre giorni dopo il rilascio pubblico dei modelli Claude Fable 5 e Claude Mythos 5, Anthropic ha ricevuto dal governo statunitense una direttiva di export control. Secondo la ricostruzione del volume, la misura imponeva di sospendere l’accesso per i cittadini stranieri, ovunque si trovassero. Non esisteva un meccanismo per applicarla in modo selettivo, e i modelli sono stati disattivati per tutti gli utenti «nel giro di poche ore».

Il testo presenta il fatto come privo di precedenti: la decisione di politica estera di un solo paese ha bloccato all’istante un servizio usato su scala globale. Il volume, chiuso ad agosto, non racconta l’epilogo. Anthropic ha comunicato che il Dipartimento del Commercio ha revocato i controlli il 30 giugno e che l’accesso è stato ripristinato il 1° luglio.

Che cos’è la trappola di Tucidide

Per leggere l’episodio, il libro adotta un metodo dichiarato. Richiama Giambattista Vico e la sua teoria dei corsi e ricorsi, intesa come «un ritorno strutturale, non la ripetizione pedissequa degli stessi fatti». Le analogie storiche, avverte, sono strumenti euristici e non leggi predittive.

La causa profonda della guerra del Peloponneso

Tucidide distingue le cause profonde dai pretesti. La ragione più vera del conflitto fu la crescita della potenza ateniese e il timore che suscitò a Sparta, mentre le crisi locali di Epidamno, Corcira e Potidea furono soltanto occasioni. Su questa intuizione il politologo Graham Allison ha coniato la formula oggi nota come trappola di Tucidide, applicata soprattutto ai rapporti tra Stati Uniti e Cina. Lo studio di Allison, riferito nel volume, esamina sedici casi in cinquecento anni: dodici si sono chiusi con una guerra.

La Lega di Delo: come nasce una dipendenza

Il cuore storico dell’opera è la Lega di Delo. Nata nel 478 a.C. come alleanza difensiva tra pari contro la minaccia persiana, nel giro di pochi decenni diventa uno strumento di egemonia. Tre passaggi segnano la svolta. Le città che versavano un tributo in denaro invece di fornire navi smisero di mantenere una flotta propria, e Atene rimase l’unica garante della sicurezza collettiva. Nel 454 a.C. il tesoro comune passò da Delo all’Acropoli e divenne di fatto patrimonio ateniese. Infine Atene favorì, e a volte impose, governi democratici nelle città alleate, aggiungendo al controllo militare ed economico un controllo politico.

Nasso, Taso, Mitilene e Melo

Quattro episodi disegnano un percorso progressivo. Con Nasso, che tentò di uscire dalla Lega, Atene stabilì che dall’alleanza non si esce. Con Taso, punita per aver difeso i propri interessi commerciali in Tracia, affermò che quelli degli alleati sono subordinati ai suoi. Con Mitilene mostrò che neppure l’alleato più autonomo sfugge al controllo centrale. Con Melo, infine, rese chiaro che basta la neutralità per essere puniti.

Al dialogo dei Meli è affidata la citazione che apre il libro. Nella traduzione proposta, gli Ateniesi sostengono che «i forti fanno ciò che è in loro potere, mentre i deboli accettano ciò che devono accettare» (Tucidide, V, 89).

Gli equivalenti moderni della flotta ateniese

Il passaggio dalla storia all’attualità parte da una domanda: che cosa rendeva la flotta lo strumento di egemonia per eccellenza? Era insieme un mezzo di proiezione della forza, una garanzia per i commerci e un meccanismo che generava dipendenza. Il volume cerca gli equivalenti di questi tratti nel mondo contemporaneo e ne individua sei.

Il primo è il dollaro, erede del tesoro di Delo, che trasforma il sistema dei pagamenti in una leva geopolitica. Il secondo è la rete di basi militari statunitensi, flotta fisica che offre sicurezza ma crea dipendenza. Vengono poi le infrastrutture digitali, con cavi, satelliti e data center che fanno da rotte marittime, e i semiconduttori avanzati, concentrati in pochi punti della filiera e soggetti a controllo all’esportazione. Il quinto pilastro è il peso della lingua e degli standard tecnici, un vantaggio che non richiede l’uso diretto della forza. Il sesto è l’intelligenza artificiale, definita «il meta-strumento che potenzia e condiziona tutti gli altri».

Una differenza rispetto ad Atene rende la sfida più complessa ma anche più governabile. Il dominio ateniese poggiava su un solo strumento e crollò quando la flotta fu distrutta in Sicilia. L’egemonia tecnologica odierna si regge su sei pilastri parzialmente indipendenti, e questo offre all’Europa più punti di intervento.

Fable 5 e Mythos 5: un «momento Sputnik» per l’Europa

L’espressione «momento Sputnik» indica un evento che rende visibile e indiscutibile un rischio già noto agli esperti. Il satellite sovietico del 1957 non rivelò una capacità sconosciuta, ma la rese tangibile per l’opinione pubblica. Allo stesso modo la sospensione di giugno ha trasformato in realtà l’ipotesi che l’accesso all’IA di frontiera venga interrotto da una decisione di politica interna di un solo Stato.

Secondo il volume, si tratta di un precedente per tre ragioni. Il criterio applicato è la cittadinanza di chi invia la richiesta e non la posizione del server, quindi un’azienda europea che usa infrastrutture cloud in Europa non è per questo al riparo: è un controllo extraterritoriale per costruzione. Manca poi ogni gradualità, a differenza dei controlli sui semiconduttori, che prevedono soglie, classificazioni ed esenzioni. Infine un problema di conformità è diventato un problema operativo, perché lo spegnimento totale era l’unica opzione compatibile con i tempi imposti.

Ne nasce una variabile nuova per le imprese europee, chiamata «access surface» del modello. Accanto a intelligenza, costo e latenza, occorre chiedersi chi può usare il modello, da quale giurisdizione e quanto la continuità del servizio dipenda da decisioni che il cliente non può influenzare né prevedere.

La risposta europea alla dipendenza tecnologica

Digital Omnibus on AI

Il libro inserisce la reazione dell’Unione in una strategia di più lungo periodo. Il primo atto è il Digital Omnibus on AI, approvato in via definitiva dal Parlamento europeo il 16 giugno 2026. Nasce per razionalizzare un quadro normativo stratificato e viene letto come un’operazione preparatoria: alleggerire il carico regolatorio interno per liberare risorse da destinare a un’infrastruttura propria.

Technological Sovereignty Package e CADA

Il secondo atto è il Technological Sovereignty Package, presentato il 3 giugno 2026, dieci giorni prima della sospensione. Comprende il Chips Act 2.0, il Cloud and AI Development Act (CADA), una strategia open source e una roadmap per digitalizzazione e IA nell’energia. Il CADA riceve l’attenzione maggiore: introduce quattro livelli di assicurazione per gli appalti pubblici, dal minimo basato su autocertificazione fino al più esigente, che richiede proprietà e controllo europei e personale con cittadinanza dell’Unione.

La tesi è che questa architettura risponda al problema emerso a giugno. Se il criterio statunitense è la cittadinanza, la sola residenza dei dati in Europa non basta. Serve il controllo dell’intera catena: proprietà, governance, personale, hardware e software. Il volume riporta anche la diagnosi di partenza del pacchetto, secondo cui la quota di mercato dei fornitori cloud europei sarebbe scesa dal 29% del 2017 al 15% del 2022. È l’equivalente di un tributo digitale versato senza costruire una flotta propria.

Il Piano d’Azione 2026 sulla cybersicurezza

Il terzo atto è il Piano d’Azione 2026 sulla Cybersicurezza e l’Intelligenza Artificiale, pubblicato il 7 luglio 2026 (COM(2026) 577). Se il pacchetto sulla sovranità costruisce la flotta, il Piano deve difenderla. La prima linea d’azione prevede una capacità europea di valutazione dei modelli prima del rilascio e un «European Blueprint» con misure di emergenza per i casi in cui l’accesso a modelli di guida straniera venga limitato o revocato bruscamente. È il primo tentativo istituzionale di rispondere proprio al tipo di evento accaduto a giugno.

Che cosa possono fare le aziende europee

Il volume non invita a rinunciare agli strumenti di frontiera, ma ad adottarli con piani di contingenza espliciti. Per le imprese soggette a NIS2, Cyber Resilience Act e DORA, un’architettura che dipende da un solo modello di un solo fornitore extra-UE non soddisfa i requisiti di resilienza richiesti per i fornitori critici. Le aziende dovrebbero quindi diversificare i fornitori, progettare architetture portabili tra più modelli, includere il rischio di accesso nelle valutazioni dei fornitori e investire, dove possibile, in soluzioni europee. Non è una risposta completa, ma è «la risposta praticabile oggi».

Conclusione: il rischio Mitilene

Il libro si chiude con una cautela. L’Unione Europea del 2026 non è una città-stato greca, e le analogie non sono previsioni. Resta valida l’intuizione di fondo: le dipendenze strutturali per capacità tecnologiche critiche possono trasformarsi in grandi vulnerabilità nei momenti di tensione politica.

Il richiamo più forte è a Mitilene, che aveva il diritto formale di recedere dall’alleanza ma non la forza per esercitarlo. È il rischio che corre l’Europa se il quadro normativo resta «un’architettura elegante priva dell’edificio che dovrebbe sostenere». Da qui l’attenzione al bilancio europeo 2028-2034, chiamato a dare sostanza industriale alle regole. L’auspicio finale di Aniello Gentile affida allo studio del passato il compito di evitare errori e tragedie già viste, e la trappola di Tucidide resta, in questa lettura, un monito più che una profezia.

Fonti

https://www.ictsecuritymagazine.com/articoli/trappola-di-tucidide-intelligenza-artificiale/


CVD, 615-ter e il coraggio di chiedere aiuto

L’Agenzia per la Cybersicurezza Nazionale introduce una procedura per la divulgazione coordinata delle vulnerabilità, ma l’articolo 615-ter del Codice penale resta applicabile. Tra anonimato, obblighi di segnalazione e assenza di un safe harbor legislativo, emergono interrogativi sulla posizione dei ricercatori di sicurezza. Un’analisi del quadro italiano e delle soluzioni adottate negli altri Paesi europei.

CVD e hacker etici: la nuova politica ACN sulle zero day e i limiti delle tutele penali

A pagina 9 della Politica nazionale di divulgazione coordinata delle vulnerabilità (CVD) c’è un riquadro che ogni ricercatore italiano dovrebbe leggere due volte. Dice che le attività di ricerca delle zero day «non devono integrare alcuna fattispecie criminosa», e tra le norme richiamate mette l’accesso abusivo dell’articolo 615-ter del Codice penale. Poi ricorda che il personale del CSIRT Italia è pubblico ufficiale e, se ha notizia di un reato perseguibile d’ufficio, deve informare l’autorità giudiziaria.

La Politica è stata comunicata da ACN il 7 ottobre 2026. Crea una procedura di segnalazione, anche anonima. Non crea nessuna tutela penale. Vediamo cosa dice il testo, cosa dice la legge e cosa fanno gli altri Paesi europei.

CVD: cosa prevede la politica nazionale di divulgazione delle vulnerabilità

Le basi sono europee e nazionali. L’articolo 12 della direttiva NIS2 (UE 2022/2555, pubblicata in Gazzetta ufficiale dell’Unione europea il 27 dicembre 2022) chiede a ogni Stato membro di designare un CSIRT come coordinatore della divulgazione coordinata delle vulnerabilità. L’Italia ha recepito la direttiva con il D.Lgs. 138/2024, in vigore dal 16 ottobre 2024. L’articolo 16 designa il CSIRT Italia e, al comma 4, affida all’autorità NIS l’adozione della politica nazionale. L’articolo 40, comma 5, lettera d), prevede che avvenga «d’intesa con il Ministero della giustizia».

Secondo il comunicato di ACN, la Politica è stata adottata con determina del Direttore generale Andrea Quacivi. La determina, firmata digitalmente il 6 ottobre 2026, richiama l’intesa del Ministero della giustizia (comunicazione del 31 ottobre 2025) e il parere del Tavolo NIS (riunione del 18 dicembre 2025). Il processo descritto dalla Politica ha tre fasi: segnalazione, validazione e cooperazione, divulgazione. Il CSIRT Italia verifica la segnalazione, contatta il fabbricante e chiede il CVE ID. Il workaround va individuato entro 7 giorni solari dalla validazione, la patch entro 90, salvo complessità. Il testo vale solo per le vulnerabilità zero day.

Il segnalante assume degli obblighi. Deve segnalare «non appena ne abbia preso consapevolezza» e non può condividere con terzi, senza autorizzazione del CSIRT, alcun dettaglio, comprese le tecnologie usate per trovare o sfruttare la falla. Il canale indicato è segnalazioni.acn.gov.it. Un portale di segnalazione esisteva già: le FAQ del CSIRT Italia lo descrivono, anche per vulnerabilità non note. La novità è una procedura con fasi e tempi.

CVD e anonimato: quali tutele per gli hacker etici?

Il segnalante può chiedere l’anonimato. A pagina 12 ACN promette di tutelare le informazioni identificative ricavabili dal mezzo di segnalazione, come IP, e-mail e numero di telefono. Aggiunge però che potrà essere tenuta a comunicare le informazioni alle autorità competenti, in particolare se ravvisa una notizia di reato. L’anonimato protegge l’identità durante il processo, non nei confronti dell’autorità giudiziaria.

A mio avviso l’intesa con il Ministero della giustizia, richiamata nella determina, va letta con prudenza. Riguarda l’adozione di un atto amministrativo. In materia penale vale la riserva di legge (articolo 25, secondo comma, della Costituzione), quindi una determina non può introdurre una causa di non punibilità. La Relazione annuale ACN 2025 (riquadro Focus, pagina 16 del documento, 17 del PDF) conferma la lettura: la Politica, elaborata a legislazione vigente, «non reca una disciplina in materia di tutela dei segnalanti delle vulnerabilità sotto i profili della responsabilità civile e penale».

Articolo 615-ter: i rischi penali per gli hacker etici

L’articolo 615-ter punisce chi si introduce abusivamente in un sistema protetto da misure di sicurezza, o vi si mantiene contro la volontà espressa o tacita del titolare. Non richiede un’autorizzazione scritta. L’ipotesi base è a querela. Le ipotesi aggravate si procedono d’ufficio, come già prima della L. 90/2024. Quella legge ha alzato le pene per i sistemi di interesse pubblico (comma 3) a 3-10 anni, e a 4-12 se ricorre anche un’aggravante del comma 2. Il tetto di 12 anni non è automatico.

Sulle intenzioni la giurisprudenza è netta. Le Sezioni Unite Casani (n. 4694/2012) hanno stabilito che per chi è abilitato conta il rispetto delle condizioni poste dal titolare, mentre sono irrilevanti «gli scopi e le finalità» che hanno motivato l’ingresso. Le Sezioni Unite Savarese (n. 41210/2017) riguardano i pubblici ufficiali, e l’estensione ai ricercatori è un’interpretazione. Per chi non ha alcuna abilitazione il problema, a mio avviso, sta ancora più a monte: manca il consenso del titolare.

Esiste un precedente favorevole, ma isolato: il decreto di archiviazione del GIP di Catania del 15 luglio 2019, che ha ricondotto la condotta alla divulgazione responsabile. Non è vincolante. Il valore pratico dell’autorizzazione scritta è una mia valutazione di prudenza: la legge non la richiede, ma senza di essa è difficile provare il consenso.

Safe harbor per gli hacker etici: le proposte legislative in Italia

Il DDL S. 1441 (sen. Basso), comunicato alla Presidenza il 3 aprile 2025, è una delega al Governo sulla strategia contro il ransomware. La lettera q) dell’articolo 1, comma 1, prevede un «safe harbor» per chi segnala in buona fede vulnerabilità informatiche rilevanti. Secondo il fascicolo del Senato risulta assegnato e non ancora esaminato. È un criterio di delega di una riga e parla di chi segnala, non di chi ricerca. Nelle verifiche svolte non ho trovato altre proposte pendenti con una scriminante specifica.

CVD in Europa: le tutele per i ricercatori negli altri Paesi

Il Belgio ha scritto l’esenzione nella legge. Introdotta nel 2022 dalla norma sul whistleblowing, oggi è negli articoli 22 e 23 della legge NIS2 del 26 aprile 2024, in vigore dal 18 ottobre 2024. Secondo il Centre for Cybersecurity Belgium la protezione richiede azioni necessarie e proporzionate, assenza di intento fraudolento, notifica al CCB e al titolare, e nessuna divulgazione pubblica senza il consenso del CCB.

I Paesi Bassi non hanno un’immunità formale. Hanno la guida del Nationaal Cyber Security Centrum, pubblicata nel 2013 e aggiornata nel 2018, e una lettera di politica della Procura del 14 dicembre 2020 che sostituisce quella del 2013. Secondo la sintesi dell’OM, in assenza di una policy la denuncia non basta a trattare l’hacker etico come sospettato.

La Germania ci sta lavorando. Nel novembre 2024 il Ministero della giustizia ha elaborato un Referentenentwurf, una bozza ministeriale e non un disegno di legge, che modificava il § 202a StGB per escludere l’accesso finalizzato a segnalare una vulnerabilità. Il progetto non è stato approvato prima della fine anticipata della legislatura. Il contratto di coalizione CDU/CSU-SPD del 2025 promette certezza giuridica per la ricerca, e il Governo ha ribadito l’impegno in una risposta parlamentare del 16 aprile 2026. Non ho trovato una nuova bozza.

La Francia offre una protezione solo procedurale: l’articolo L2321-4 del Code de la défense disapplica l’obbligo di denuncia dell’articolo 40 del codice di procedura penale nei confronti di chi, in buona fede, trasmette l’informazione alla sola autorità nazionale (l’ANSSI), e tutela la riservatezza della sua identità. È in vigore dal 9 ottobre 2016. Uno studio sul Journal of Cybersecurity del 2026, che esamina anche l’Italia, chiede safe harbour giuridici e tecnici a livello europeo perché le politiche di divulgazione siano «legally accessible and safe for the researchers».

Il caso FreeHour: quando l’hacking etico diventa un procedimento penale

A Malta la mancanza di tutele ha avuto un volto. Secondo MaltaToday, nell’ottobre 2022 tre studenti individuarono una vulnerabilità nell’app FreeHour e scrissero al fondatore, che informò la polizia. Gli arresti sono di novembre 2022. Il docente che aveva riletto la mail fu accusato di concorso. Le cronache riportano che gli studenti chiesero una ricompensa e che uno di loro modificò temporaneamente l’app, poi ripristinata (Newsbook).

L’imputazione formale è arrivata nella prima settimana di marzo 2025. Nella settimana successiva il Cabinet ha raccomandato la grazia, concessa dal presidente il 1° luglio 2025. Il premier Robert Abela, secondo la stampa maltese (Malta Daily), ha riconosciuto la responsabilità dello Stato di aggiornare le leggi alla realtà tecnologica. È una parafrasi giornalistica, non una citazione. A mio avviso il caso mostra che, senza una tutela espressa, la decisione di procedere resta a titolare, procura e giudice.

CVD e segnalazione delle vulnerabilità: cosa fare in pratica

Questo è il mio parere. Chi trova una vulnerabilità senza accedere a sistemi altrui, per esempio analizzando firmware acquistato o software proprio, ha ora un canale con tempi definiti, e il rischio penale è basso. Chi ha già acceduto a un sistema in produzione è nella posizione più delicata: la Politica chiede di segnalare subito, il CSIRT può informare l’autorità giudiziaria e l’anonimato non copre quel passaggio. Il divieto di condividere dettagli con terzi incide anche sul confronto con la community.

Lo strumento più solido resta il consenso documentato del titolare, con un contratto di pentest o un bug bounty con regole di ingaggio. Le clausole di safe harbor dei programmi privati vincolano le parti, non il pubblico ministero. Aziende e PA, dal canto loro, possono pubblicare una Vulnerability Disclosure Policy con l’impegno a non sporgere querela contro i ricercatori in buona fede. Funziona per l’ipotesi base del 615-ter, che è a querela, non per le aggravate.

Il mio commento

Quasi quattro anni dopo la direttiva e due dopo l’entrata in vigore del decreto, l’Italia ha il suo canale CVD. Va riconosciuto, ed è un passo utile. Ma guardate come è scritto. La Politica chiede di segnalare «non appena» si ha consapevolezza della vulnerabilità, vieta di parlarne con terzi e avverte che l’accesso abusivo è reato.

A chi ha trovato una zero day entrando dove non doveva dice di farsi avanti. Nello stesso riquadro ricorda che chi riceve la segnalazione è un pubblico ufficiale con obbligo di informare i magistrati. La Giustizia ha dato l’intesa a ottobre 2025 e il Tavolo NIS ha espresso il parere a dicembre. Alla firma, a ottobre 2026, il testo non contiene una riga di tutela.

Il Belgio ha scritto l’esenzione nella legge, con condizioni precise. L’Italia ha scritto un avviso e lo ha chiamato politica. Un ricercatore in buona fede esce da questa lettura con una certezza sola: segnalare conviene a tutti, tranne a lui. Si può discutere se sia un difetto di progettazione o il compromesso obbligato da un codice penale che non cambia. Ma finché il 615-ter resta com’è, la domanda di ogni hacker etico non è se segnalare. È come ha trovato quello che segnala, e se può dimostrarlo.

https://www.ictsecuritymagazine.com/articoli/cvd-hacker-etici-615-ter/


Polizze D&O e NIS2: responsabilità degli amministratori e nuove sfide per la governance cyber

La cybersecurity entra sempre più direttamente nelle responsabilità del Consiglio di Amministrazione. Tra obblighi di supervisione, gestione del rischio informatico e coperture assicurative, la NIS2 impone un cambio di prospettiva: non basta adottare misure di sicurezza, occorre dimostrare che siano state effettivamente applicate, monitorate e supervisionate. Quale ruolo assumono le polizze D&O nella tutela degli amministratori?

Dal rischio IT al rischio di governance

Il rischio cyber è migrato definitivamente dai server del reparto IT ai tavoli del Consiglio di Amministrazione. Non si tratta più soltanto di una minaccia tecnica da affidare alle funzioni informatiche. È un rischio di impresa, che incide sulla continuità operativa, sulla protezione degli asset informativi, sulla reputazione aziendale, sui rapporti contrattuali e, sempre più chiaramente, sulla responsabilità degli organi sociali.

La trasformazione digitale, la crescente dipendenza da infrastrutture tecnologiche e l’aumento degli attacchi informatici hanno reso evidente una cosa: le conseguenze di un incidente cyber vanno ben oltre il perimetro tecnico. Interruzioni dell’attività, contenziosi contrattuali, sanzioni regolatorie, richieste risarcitorie di clienti o partner e danni reputazionali incidono sul valore dell’impresa e sulle scelte del management.

In questo contesto si inserisce la Direttiva (UE) 2022/2555 (NIS2), recepita in Italia con il d.lgs. 4 settembre 2024, n. 138, che segna un cambio di paradigma: la cybersicurezza non è più considerata soltanto una questione tecnologica, ma diviene parte integrante del sistema di governo dei rischi aziendali. Gli organi di amministrazione e direttivi assumono un ruolo diretto nella supervisione delle misure di sicurezza e nella gestione del rischio cyber. È una logica che richiama da vicino un dovere già scritto nel codice civile. L’articolo 2086, secondo comma, impone all’imprenditore che operi in forma societaria o collettiva di istituire un assetto organizzativo, amministrativo e contabile adeguato alla natura e alle dimensioni dell’impresa[1].

Il tema assume particolare rilevanza anche sotto il profilo della responsabilità degli amministratori. La disciplina nazionale delinea una responsabilità personale e diretta degli organi apicali, che trova la propria origine negli obblighi di governo e supervisione fissati dall’articolo 23, comma 1, del decreto NIS.

La norma affida agli organi di amministrazione e direttivi tre compiti: approvare le misure di gestione dei rischi, sovrintendere alla loro implementazione, rispondere delle violazioni. Sul piano sanzionatorio, l’articolo 38, comma 5, aggiunge che la persona fisica responsabile di un soggetto essenziale, o che ne sia rappresentante legale, può essere ritenuta responsabile dell’inadempimento quando il soggetto rappresentato violi il decreto. Il comma 6 prevede poi la sanzione amministrativa accessoria dell’incapacità a svolgere funzioni dirigenziali all’interno del medesimo soggetto. Non si affianca automaticamente alle sanzioni pecuniarie: può essere disposta soltanto se il soggetto non adempie, nei termini stabiliti, alla diffida di cui all’articolo 37, commi 6 e 7.

All’esito di un incidente informatico la questione non sarà stabilire se il rischio potesse essere eliminato, obiettivo evidentemente irrealistico. Sarà verificare se l’impresa avesse predisposto assetti adeguati alla natura e alle dimensioni dell’attività svolta, e se quel rischio fosse stato identificato, valutato, monitorato e gestito. È in questa prospettiva che il dialogo tra cybersicurezza, governance e coperture D&O assume oggi una rilevanza centrale.

NIS2 e D&O: il nuovo ruolo del Consiglio di Amministrazione

La NIS2 attribuisce agli organi amministrativi una responsabilità che va oltre la mera presa d’atto delle attività svolte dalle funzioni tecniche. Il decreto di recepimento individua, infatti, tra gli obblighi principali dei soggetti NIS l’adozione di misure di gestione del rischio cyber, la supervisione della loro implementazione e la responsabilizzazione degli organi di amministrazione e direttivi[2].

Dalla fine del 2025 quegli obblighi hanno anche un contenuto puntuale. Le misure di sicurezza di base sono fissate dalla determinazione ACN n. 379907 del 19 dicembre 2025, applicabile dal 15 gennaio 2026. Per adeguarsi, i soggetti dispongono di diciotto mesi dalla comunicazione di inserimento nell’elenco dei soggetti NIS: per chi vi è stato inserito nel 2025 la scadenza cade a ottobre 2026. Per i soggetti inseriti per la prima volta nel 2026, la determinazione n. 127434 del 13 aprile 2026 porta il termine al 31 luglio 2027.

La cybersicurezza diventa così una componente della governance societaria. Il Consiglio di Amministrazione non può limitarsi a ricevere informazioni occasionali dal responsabile IT o dal CISO. Deve essere posto nelle condizioni di comprendere il livello di esposizione dell’organizzazione, valutare le priorità di intervento, allocare risorse adeguate e verificare che i presidi predisposti siano coerenti con il profilo di rischio aziendale.

Le FAQ pubblicate e aggiornate dall’Agenzia per la Cybersicurezza Nazionale il 14 luglio 2026 contribuiscono a chiarire un aspetto particolarmente delicato: la distinzione tra livello strategico e livello operativo. Secondo i chiarimenti dell’ACN, gli organi di amministrazione devono approvare gli indirizzi e la pianificazione strategica delle misure di sicurezza. La documentazione tecnica e operativa, invece, può essere predisposta, aggiornata e gestita dalle funzioni competenti senza una nuova approvazione degli organi di governo, salvo che la richiedano il modello organizzativo adottato o specifiche scelte interne[3].

Tale impostazione consente di evitare due errori speculari. Il primo è l’eccessiva tecnicizzazione del ruolo degli amministratori, che non possono essere chiamati a validare ogni procedura o controllo operativo. Il secondo è la tentazione di delegare del tutto la gestione del rischio cyber alle funzioni specialistiche, senza un’effettiva supervisione. La governance richiesta dalla NIS2 si colloca proprio tra questi due estremi: il management definisce gli indirizzi, valuta il rischio e supervisiona l’attuazione; le strutture tecniche implementano concretamente le misure necessarie.

A conferma della centralità del vertice, le stesse FAQ ACN precisano che l’approvazione dei documenti previsti dall’articolo 23 costituisce competenza esclusiva dell’organo collegiale o, ove previsto, monocratico, e non è delegabile[4].

Ne deriva che la responsabilità degli amministratori non dipende dalla loro capacità di comprendere i dettagli tecnici di una vulnerabilità o di un attacco. Dipende dalla capacità di assicurare che l’organizzazione disponga di processi decisionali, ruoli, controlli e flussi informativi adeguati a governare il rischio. In altri termini, la questione centrale non è se il board sappia gestire un incidente cyber, ma se abbia creato le condizioni per consentire all’organizzazione di farlo efficacemente.

La governance difendibile: quando la compliance deve essere dimostrata

Nel contesto post-NIS2 la semplice esistenza di policy, procedure o manuali non è più sufficiente. La vera sfida è dimostrare che tali strumenti siano stati approvati, applicati, aggiornati, testati e monitorati nel tempo. La differenza tra compliance formale e governance effettiva si misura sempre più sul piano della prova[5].

Dopo un incidente informatico, autorità, assicuratori, soci o controparti contrattuali cercheranno di ricostruire il percorso decisionale che ha preceduto l’evento. Sarà quindi necessario dimostrare quali rischi fossero stati identificati, quali valutazioni fossero state svolte, quali misure fossero state adottate, quali risorse fossero state stanziate e quali controlli fossero stati effettuati per verificarne l’efficacia[6].

In questa prospettiva acquisisce particolare rilevanza il concetto di audit trail. Esso non coincide soltanto con la registrazione tecnica degli eventi informatici. Comprende l’insieme delle evidenze che consentono di ricostruire l’intero ciclo decisionale. Vi rientrano i verbali del Consiglio di Amministrazione, i report periodici e i registri degli incidenti. Contano inoltre i risultati di vulnerability assessment e penetration test, i piani di continuità operativa, la documentazione sulla formazione del personale e le attività di audit interno[7].

Molte di queste evidenze sono operative e di controllo: non richiedono necessariamente l’approvazione degli organi apicali, ma documentano l’attuazione, il monitoraggio e il riesame delle misure. Per i soli documenti che quell’approvazione la richiedono, la guida alla lettura delle specifiche di base ACN dedica un’apposita sezione, l’appendice C. Vi sono elencati undici documenti da sottoporre agli organi di amministrazione e direttivi, dall’organizzazione per la sicurezza informatica al piano di gestione degli incidenti.

Particolare attenzione merita il flusso informativo verso il Consiglio di Amministrazione. Una governance realmente difendibile presuppone che gli amministratori ricevano periodicamente informazioni comprensibili e orientate al rischio aziendale, non esclusivamente dati di natura tecnica. Minacce emergenti, vulnerabilità critiche, stato di attuazione dei piani di remediation, incidenti rilevanti, rischi derivanti dai fornitori strategici e adeguatezza delle coperture assicurative dovrebbero costituire parte integrante dell’informativa direzionale[8].

La vera domanda che verrà posta dopo un incidente non sarà dunque se l’organizzazione disponesse formalmente di una procedura, ma se tale procedura fosse effettivamente conosciuta, applicata, verificata e supervisionata. È qui che si colloca il concetto di “governance difendibile”: la capacità dell’impresa di dimostrare, ex post, la ragionevolezza e la proporzionalità delle scelte adottate ex ante.

Tre incidenti, una sola domanda

La varietà degli incidenti cyber che possono colpire un’organizzazione è estremamente ampia. Tuttavia, nella prospettiva della responsabilità degli amministratori, le domande che verranno poste ex post sono spesso le medesime.

Il primo scenario è rappresentato dal ransomware con fermo operativo e minaccia di esfiltrazione dei dati. In queste situazioni vengono messi alla prova i processi di gestione della crisi, la capacità di ripristino dei sistemi e la disponibilità di backup efficaci. E, soprattutto, le procedure di escalation e la qualità delle decisioni assunte nelle prime ore successive all’evento[9].

Il secondo scenario riguarda il data breach derivante da errore umano, come l’ipotesi ricorrente dell’invio di una comunicazione utilizzando il campo “CC” anziché “CCN”. Si tratta di eventi apparentemente banali ma spesso significativi sotto il profilo organizzativo, poiché consentono di verificare l’effettività della formazione del personale, l’esistenza di procedure di gestione delle violazioni e la capacità dell’organizzazione di documentare le valutazioni svolte e le decisioni assunte[10].

Il terzo scenario è rappresentato dalla compromissione di un fornitore ICT o di un cloud provider. In un ecosistema digitale sempre più interconnesso, la cybersicurezza dipende anche dalla sicurezza della filiera digitale. Diventano quindi rilevanti la mappatura dei fornitori critici, le attività di due diligence, le clausole contrattuali di sicurezza e il monitoraggio continuativo dei soggetti terzi da cui l’organizzazione dipende per l’erogazione di servizi essenziali[11].

Gli incidenti sono diversi per natura, impatto e modalità di gestione. Tuttavia, il criterio di valutazione rimane sostanzialmente identico: il rischio era stato identificato? Era stato portato all’attenzione degli organi competenti? Erano state adottate misure adeguate? Le decisioni erano state documentate? È intorno a queste domande che si giocherà sempre più frequentemente la valutazione della diligenza degli amministratori e del management.

Polizze D&O e cyber insurance: la necessità di un approccio coordinato

L’evoluzione della governance cyber impone una riflessione anche sul programma assicurativo aziendale. Le polizze cyber e le polizze D&O rispondono infatti a esigenze diverse ma tra loro strettamente connesse.

La polizza cyber tende a coprire i costi direttamente collegati all’incidente informatico, quali attività di forensic analysis, ripristino dei sistemi, business interruption, consulenza specialistica, gestione della crisi e responsabilità verso terzi. La polizza D&O interviene invece quando amministratori o dirigenti siano destinatari di contestazioni fondate su presunti errori gestionali, omissioni o carenze nell’attività di supervisione[12].

Dopo un incidente significativo, le due coperture possono interagire e talvolta sovrapporsi. Conviene quindi verificare in anticipo la coerenza fra il sistema di gestione del rischio cyber e il programma assicurativo. Vanno guardati da vicino gli obblighi di notifica, i requisiti minimi di sicurezza, le condizioni di assicurabilità e i rischi legati a fornitori terzi e servizi cloud[13].

La copertura assicurativa non può tuttavia sostituire una governance efficace. Al contrario, quanto più la cybersicurezza diventa elemento strutturale degli assetti organizzativi, tanto più il programma assicurativo deve essere letto come parte integrante del sistema di gestione del rischio.

Conclusioni: dalla conformità alla capacità di provarla

La traiettoria tracciata dalla NIS2 conduce a una conclusione chiara: la cybersicurezza non può più essere considerata un mero adempimento tecnico o regolatorio. Essa è oggi una componente essenziale della governance aziendale e, come tale, incide direttamente sulla posizione degli amministratori, del top management e delle funzioni di controllo[14].

La conformità normativa rimane certamente necessaria, ma non è più sufficiente. Dopo un incidente cyber non rileverà soltanto l’esistenza di policy, procedure o piani di continuità operativa. Rileverà la capacità dell’organizzazione di dimostrare che quegli strumenti erano conosciuti, applicati, aggiornati e supervisionati nel tempo[15].

Il passaggio dalla compliance alla prova rappresenta quindi il vero cambiamento introdotto dalla nuova stagione normativa europea. Per gli amministratori la migliore linea di difesa non consiste nel poter affermare che l’impresa disponeva di una procedura. Consiste nel dimostrare che quella procedura era parte di un sistema vivo: verificato, insegnato, monitorato e migliorato nel tempo.

Nel contesto post-NIS2, il vero interrogativo per il board non è più soltanto:
«Siamo conformi?», ma piuttosto: «Siamo in grado di provarlo?».

Biografia e Note:

[1] Direttiva (UE) 2022/2555 (NIS2); d.lgs. 4 settembre 2024, n. 138, di recepimento della Direttiva NIS2 in Italia, pubblicato in G.U. Serie Generale n. 230 del 1° ottobre 2024, in vigore dal 16 ottobre 2024 e applicabile dal 18 ottobre 2024 per espressa previsione dell’articolo 41, comma 1. La responsabilità personale degli organi apicali è disciplinata dall’articolo 23, comma 1, e dall’articolo 38, commi 5 e 6, del decreto. Il dovere di assetti adeguati richiamato nel testo è quello dell’articolo 2086, secondo comma, del codice civile, introdotto dall’articolo 375 del d.lgs. 12 gennaio 2019, n. 14.

[2] D.lgs. 4 settembre 2024, n. 138, artt. 23 e 24; FAQ ACN sui profili generali degli obblighi NIS.

[3] FAQ ACN ODA.10, ODA.11 e ODA.12, di nuova introduzione, e FAQ ODA.8 e ODA.9, integrate, aggiornate il 14 luglio 2026, relative agli obblighi degli organi di amministrazione e direttivi e alla distinzione tra documentazione strategica e documentazione operativa.

[4] FAQ ACN ODA.8 e ODA.9, aggiornate il 14 luglio 2026: l’approvazione dei documenti di cui all’articolo 23 del decreto NIS è competenza esclusiva dell’organo di amministrazione, collegiale o monocratico, e non è delegabile.

[5] Direttiva (UE) 2022/2555, artt. 20 e 21; d.lgs. n. 138/2024, artt. 23 e 24.

[6] ACN, determinazione n. 379907 del 19 dicembre 2025, modalità e specifiche di base; ACN, Linee Guida NIS. Specifiche di base. Guida alla lettura, versione 2.1, aprile 2026.

[7] ACN, Linee Guida NIS. Specifiche di base. Guida alla lettura, versione 2.1, aprile 2026, con particolare riferimento alle evidenze documentali, all’approccio basato sul rischio e all’appendice C, che elenca gli undici documenti soggetti ad approvazione degli organi di amministrazione e direttivi.

[8] Regolamento (UE) 2022/2554 (DORA), artt. 5, 6, 11 e 13; ACN, Linee Guida NIS. Specifiche di base. Guida alla lettura, versione 2.1, aprile 2026.

[9] CSIRT Italia, Ransomware. Misure di protezione e organizzazione dei dati per un ripristino efficace, agosto 2021; ENISA, Threat Landscape 2025, 1° ottobre 2025.

[10] European Data Protection Board, Guidelines 9/2022 on Personal Data Breach Notification under GDPR, versione 2.0, adottate il 28 marzo 2023; Regolamento (UE) 2016/679, artt. 33 e 34.

[11] Direttiva (UE) 2022/2555, art. 21, par. 2, lett. d), e considerando 85 e 86; d.lgs. n. 138/2024, art. 24; ACN, determinazione n. 379907 del 19 dicembre 2025, modalità e specifiche di base.

[12] Per le sole coperture cyber, IVASS, Indagine sulle polizze a copertura del cyber risk, ottobre 2023, che ha per oggetto cinquanta polizze in commercio al 30 luglio 2023, ventisei rivolte alle piccole e medie imprese e ventiquattro a individui e famiglie. L’indagine non riguarda le polizze D&O né i programmi assicurativi delle grandi imprese: il perimetro va tenuto presente.

[13] IVASS, Indagine sulle polizze a copertura del cyber risk, ottobre 2023 (in particolare par. 3.1.2 sulle condizioni di assicurabilità e 3.1.4 sull’esclusione dei danni derivanti da infrastrutture esterne non sotto il controllo dell’assicurato); Regolamento (UE) 2022/2554 (DORA).

[14] Direttiva (UE) 2022/2555; d.lgs. n. 138/2024; Regolamento (UE) 2022/2554 (DORA).

[15] ACN, determinazione n. 379907 del 19 dicembre 2025, modalità e specifiche di base; ACN, Linee Guida NIS. Specifiche di base. Guida alla lettura, versione 2.1, aprile 2026; EDPB, Guidelines 9/2022 on Personal Data Breach Notification under GDPR, versione 2.0.

https://www.ictsecuritymagazine.com/articoli/do-nis2-responsabilita-governance-cyber/


Cybersecurity awareness, vulnerabilità e phishing: limiti metodologici e implicazioni dello studio

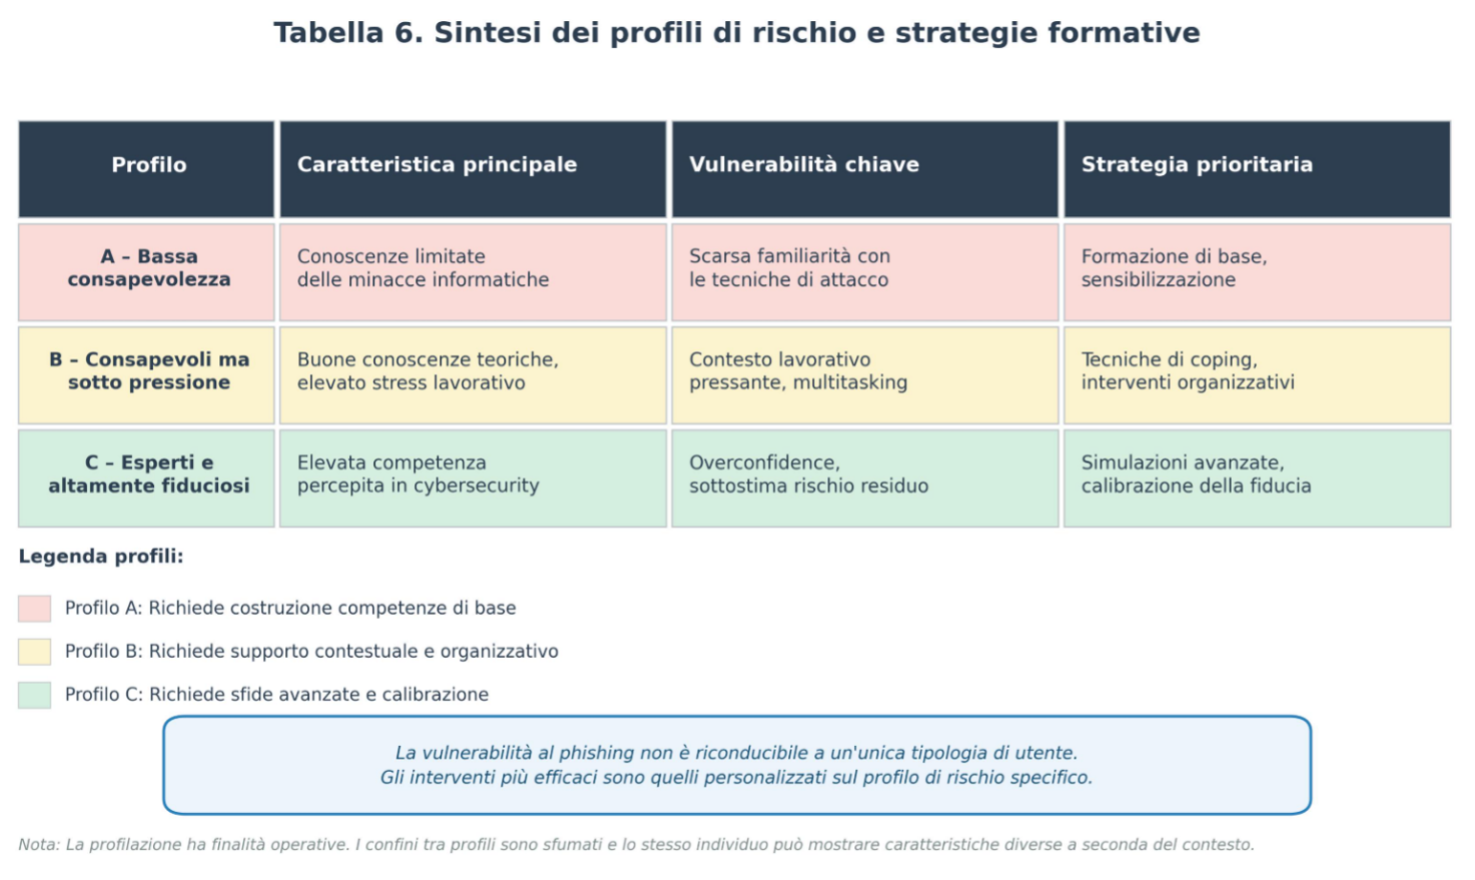
Questo articolo conclude la serie di approfondimenti dedicati all’analisi di una survey di cybersecurity awareness condotta su 65 dipendenti di un’azienda IT, tutti caduti in una simulazione di phishing aziendale nel 2025. Nell’approfondimento precedente sono stati analizzati i fattori emotivi, cognitivi e situazionali che favoriscono il click, ricostruendo la sequenza temporale che va dagli stati emotivi alla ricezione dell’email sospetta (sicurezza, ansia, curiosità, indifferenza), alle leve motivazionali sfruttate dagli attacchi (curiosità, urgenza, senso di responsabilità), fino ai fattori contestuali (fretta, stanchezza, pressione temporale, sovraccarico) che facilitano l’errore. Su questa base era stata inoltre proposta una segmentazione del campione in tre profili di rischio, utile a orientare interventi formativi differenziati.

Il presente articolo discute i limiti dello studio  relativi al campione, alla metodologia e alla generalizzabilità dei risultati e presenta le conclusioni finali, riepilogando le risposte alle domande di ricerca e i contributi alla letteratura. Vengono quindi proposte raccomandazioni operative concrete, organizzate per area di intervento: riprogettazione della formazione in chiave continua ed esperienziale, potenziamento delle simulazioni, gamification, interventi sul contesto organizzativo, contrasto all’overconfidence e monitoraggio dinamico nel tempo. L’articolo si chiude con una riflessione complessiva sulla centralità del fattore umano nella cybersecurity e sulla necessità di un approccio sistemico, personalizzato e continuativo.

Limitazioni dello studio

Ogni ricerca presenta limiti metodologici che è necessario esplicitare per consentire una corretta interpretazione dei risultati e orientare gli sviluppi futuri. Il presente studio non fa eccezione, e questa sezione discute le principali limitazioni che ne circoscrivono la portata e la generalizzabilità.

Limiti relativi al campione

Dimensione e rappresentatività. Il campione analizzato (n=65) rappresenta una frazione limitata dei dipendenti esposti alla simulazione (2.286), con un tasso di risposta del 2,8%. Sebbene questa numerosità sia sufficiente per analisi descrittive e per l’identificazione di tendenze, limita la potenza statistica delle analisi inferenziali e la possibilità di rilevare effetti di piccola entità. Inoltre, il basso tasso di risposta solleva interrogativi sulla rappresentatività: i dipendenti che hanno scelto di compilare il questionario potrebbero differire sistematicamente da coloro che non hanno partecipato, introducendo potenziali bias di auto-selezione.

Caratteristiche del campione. I partecipanti provengono da un’unica organizzazione del settore IT, con caratteristiche specifiche in termini di cultura aziendale, livello di digitalizzazione e esposizione pregressa a tematiche di cybersecurity. L’elevata percentuale di soggetti con formazione pregressa (86%) e titolo di studio universitario (66%) configura un campione con competenze superiori alla media della popolazione lavorativa generale. I risultati potrebbero quindi non essere direttamente trasferibili ad altri settori, organizzazioni di diversa dimensione o contesti con minore maturità digitale.

Assenza di gruppo di controllo. Lo studio ha analizzato esclusivamente i dipendenti che hanno cliccato sul link di phishing. L’assenza di un gruppo di confronto (coloro che non hanno cliccato) impedisce di identificare con certezza i fattori che discriminano tra comportamento vulnerabile e comportamento resiliente. Le caratteristiche emerse potrebbero essere comuni anche a chi non è caduto nella simulazione, limitando la capacità di isolare i predittori specifici della vulnerabilità.

Limiti metodologici

Self-report e desiderabilità sociale. I dati sono stati raccolti attraverso questionari auto-compilati, con i noti limiti associati a questa metodologia. I partecipanti potrebbero aver fornito risposte influenzate dalla desiderabilità sociale – ad esempio, sovrastimando le proprie abitudini di sicurezza o sottostimando i comportamenti a rischio – specialmente in un contesto in cui l’errore era già stato commesso. La tendenza a presentarsi in modo favorevole potrebbe aver attenuato alcune delle criticità emerse.

Distorsioni della memoria retrospettiva. Il questionario è stato somministrato dopo la simulazione, chiedendo ai partecipanti di ricostruire retrospettivamente stati emotivi, motivazioni e processi decisionali. La memoria autobiografica è soggetta a ricostruzioni e razionalizzazioni post-hoc, e le risposte potrebbero riflettere più le teorie implicite dei partecipanti sul proprio comportamento che i processi effettivamente occorsi nel momento del click.

Disegno cross-sectional. Lo studio ha natura trasversale, rilevando le variabili in un singolo momento temporale. Questo disegno non consente di stabilire relazioni causali tra le variabili osservate, ma solo associazioni. Ad esempio, non è possibile determinare se l’elevata fiducia nelle proprie capacità causi una minore attivazione dei controlli, o se entrambe le variabili siano effetto di un terzo fattore non misurato.

Singola simulazione di phishing. I risultati si riferiscono a una specifica simulazione, caratterizzata da un particolare contenuto (benefici sanitari), formato e tempistica. La vulnerabilità osservata potrebbe essere in parte specifica di questa tipologia di attacco e non generalizzabile ad altre tecniche di phishing (es. spear phishing personalizzato, attacchi basati su urgenza finanziaria, whaling verso dirigenti).

Strumento non validato. Il questionario è stato sviluppato ad hoc per gli obiettivi dello studio e non è stato sottoposto a procedure formali di validazione psicometrica. Sebbene le domande siano state costruite sulla base della letteratura esistente, l’affidabilità e la validità di costrutto delle scale utilizzate non sono state verificate empiricamente.

Limiti di generalizzabilità

Specificità settoriale. Il settore IT presenta caratteristiche peculiari in termini di familiarità con le tecnologie, esposizione a minacce informatiche e cultura della sicurezza. I risultati potrebbero non essere trasferibili a settori meno digitalizzati o con diversi profili di rischio (es. sanità, pubblica amministrazione, manifattura).

Contesto culturale e geografico. Lo studio è stato condotto in un contesto italiano. Differenze culturali nella percezione del rischio, negli stili comunicativi e nelle dinamiche organizzative potrebbero limitare la generalizzabilità dei risultati ad altri paesi o contesti culturali.

Specificità dell’esca. L’utilizzo di un’esca relativa a benefici sanitari – tema di elevato interesse personale – potrebbe aver amplificato la vulnerabilità rispetto ad altre tipologie di contenuto. La replicabilità dei risultati con esche diverse rimane da verificare.

Implicazioni delle limitazioni

Nonostante i limiti descritti, lo studio offre contributi significativi alla comprensione della vulnerabilità al phishing in contesti aziendali. Le limitazioni non invalidano i risultati, ma ne circoscrivono l’ambito di applicabilità e suggeriscono cautela nelle generalizzazioni.

In particolare, i risultati sono da considerarsi indicativi di tendenze e pattern che meritano ulteriore approfondimento con metodologie complementari (studi sperimentali, analisi comportamentali in tempo reale, campioni più ampi e diversificati). Le raccomandazioni operative che seguono tengono conto di questi limiti, privilegiando indicazioni di carattere generale supportate dalla convergenza con la letteratura esistente.

Conclusioni

Sintesi dei risultati principali

Il presente studio ha analizzato le cause comportamentali, cognitive ed emotive della vulnerabilità al phishing in un campione di 65 dipendenti di un’azienda IT, tutti caduti in una simulazione di attacco. I risultati offrono una risposta articolata alle domande di ricerca iniziali.

RQ1: Quali fattori emotivi e cognitivi contribuiscono alla vulnerabilità in dipendenti già formati?

L’analisi ha identificato molteplici fattori che, interagendo tra loro, determinano la vulnerabilità anche in soggetti con formazione pregressa:

  • Fattori emotivi: curiosità, senso di urgenza, ansia, senso di responsabilità e paura delle conseguenze negative emergono come le principali leve che gli attacchi di phishing sfruttano per superare le difese cognitive.
  • Fattori cognitivi: fretta, distrazione, multitasking, stanchezza mentale e sovraccarico informativo riducono le risorse disponibili per l’elaborazione sistematica, favorendo risposte automatiche ed euristiche.
  • Fattori contestuali: la pressione temporale, le urgenze lavorative e la cultura organizzativa che privilegia la rapidità sulla prudenza creano le condizioni ambientali in cui l’errore diventa più probabile.

RQ2: Che relazione esiste tra fiducia percepita e comportamento effettivo?

I dati hanno rivelato un paradosso significativo: tutti i partecipanti che si erano dichiarati “completamente sicuri” (5/5) della propria capacità di riconoscere minacce sono caduti nella simulazione. L’overconfidence emerge come un fattore di rischio critico, associato a una minore attivazione dei comportamenti di verifica e a una ridotta consapevolezza dei propri limiti. La correlazione negativa tra sicurezza percepita e ammissione di fattori di rischio (r = -0,33; p < 0,01) conferma che chi si sente più competente tende a sottostimare la propria vulnerabilità.

RQ3: È possibile identificare profili comportamentali distinti?

L’analisi ha permesso di delineare tre profili di rischio – utenti con bassa consapevolezza, utenti consapevoli ma sotto pressione, utenti esperti e fiduciosi – ciascuno caratterizzato da vulnerabilità specifiche e bisogni formativi differenziati. Questa segmentazione offre una base operativa per la personalizzazione degli interventi.

Contributo alla letteratura

Lo studio offre diversi contributi alla ricerca sulla vulnerabilità al phishing e sulla cybersecurity awareness:

Conferma della dissonanza formazione-comportamento. I risultati confermano e approfondiscono quanto suggerito dalla letteratura precedente (Bada et al., 2019; Kumaraguru et al., 2010): la formazione tradizionale, pur aumentando le conoscenze dichiarate, non garantisce protezione in condizioni operative reali. L’86% dei partecipanti aveva ricevuto formazione, eppure tutti sono risultati vulnerabili.

Quantificazione del paradosso dell’overconfidence. Lo studio fornisce evidenze empiriche dirette del ruolo dell’eccesso di fiducia come fattore di rischio, contribuendo a un filone di ricerca ancora relativamente poco sviluppato nel contesto specifico del phishing aziendale.

Integrazione di framework teorici. L’analisi ha dimostrato l’utilità di integrare modelli provenienti da diverse discipline – psicologia cognitiva (HSM, IBLT), psicologia sociale (dissonanza cognitiva), criminologia (RAT) – per comprendere un fenomeno intrinsecamente multidimensionale.

Profilazione operativa. La segmentazione in profili di rischio rappresenta un contributo pratico che può orientare la progettazione di interventi differenziati, superando l’approccio one-size-fits-all tipico di molti programmi di awareness.

Implicazioni pratiche

I risultati hanno importanti implicazioni per le organizzazioni che intendono rafforzare la propria resilienza al phishing:

  1. La formazione è necessaria ma non sufficiente. I programmi di awareness devono essere integrati con interventi sui fattori contestuali (riduzione della pressione temporale, gestione del sovraccarico) e con rinforzi continui nel tempo.
  2. Attenzione all’overconfidence. Gli utenti più esperti e fiduciosi rappresentano un target critico che richiede interventi specifici: simulazioni sofisticate, feedback calibrato, esercizi di metacognizione.
  3. Personalizzazione degli interventi. Non tutti i dipendenti sono vulnerabili allo stesso modo o per le stesse ragioni. La profilazione consente di allocare le risorse formative in modo più efficiente ed efficace.
  4. Gestione costruttiva dell’errore. Le reazioni emotive post-click (vergogna, rabbia, ansia) possono essere trasformate in opportunità di apprendimento attraverso debrief non colpevolizzanti e supporto organizzativo.
  5. Interventi multilivello. La vulnerabilità emerge dall’interazione tra individuo e contesto. Gli interventi più efficaci agiscono simultaneamente su conoscenze, emozioni, comportamenti e ambiente organizzativo.

Direzioni per la ricerca futura

I limiti dello studio e le questioni rimaste aperte suggeriscono diverse direzioni per la ricerca futura:

  • Studi longitudinali che seguano l’evoluzione della vulnerabilità nel tempo e misurino l’efficacia a lungo termine degli interventi formativi;
  • Confronto tra clicker e non-clicker per identificare i fattori che discriminano tra comportamento vulnerabile e resiliente;
  • Studi sperimentali con manipolazione controllata delle variabili contestuali (pressione temporale, carico cognitivo) per stabilire relazioni causali;
  • Replicazione in altri settori e contesti culturali per verificare la generalizzabilità dei risultati;
  • Sviluppo e validazione di strumenti per la misurazione standardizzata della vulnerabilità al phishing e dei suoi predittori;
  • Valutazione di interventi innovativi basati su nudging, gamification e tecniche comportamentali.

Cybersecurity awareness efficace: raccomandazioni operative per ridurre la vulnerabilità al phishing

Lo studio ha dimostrato come anche gli individui che si sentono più sicuri e che hanno già ricevuto formazione possano cadere vittime di attacchi di phishing. Sulla base dei risultati emersi e del framework teorico adottato, si propongono le seguenti raccomandazioni operative, organizzate per area di intervento.

Riprogettare la formazione

Implementare sessioni di formazione continua e modulare. Abbandonare il modello della formazione one-shot a favore di percorsi continuativi che mantengano alta l’attenzione nel tempo. Privilegiare contenuti smart – video pillole di 3-5 minuti, infografiche, quiz rapidi – erogati con cadenza regolare (settimanale o bisettimanale) piuttosto che sessioni lunghe e sporadiche. La ripetizione spaziata (spaced repetition) favorisce il consolidamento in memoria a lungo termine.

Privilegiare approcci pratici ed esperienziali. Coerentemente con la teoria IBLT, la formazione dovrebbe creare “istanze” memorizzabili attraverso esercitazioni pratiche: riconoscimento di email reali vs. phishing, analisi di casi studio, simulazioni interattive. L’apprendimento esperienziale è più efficace della trasmissione passiva di nozioni.

Personalizzare i contenuti sul profilo di rischio. Utilizzare la profilazione per calibrare gli interventi: formazione di base per chi ha bassa consapevolezza; tecniche di gestione dello stress per chi è esposto alla pressione; contenuti avanzati e sfidanti per gli esperti a rischio di overconfidence.

Potenziare le simulazioni

Aumentare frequenza e varietà delle simulazioni. Le simulazioni periodiche di phishing rappresentano lo strumento più efficace per creare memoria esperienziale e mantenere alta la vigilanza. Variare le tipologie di attacco (urgenza, autorità, curiosità, paura), i canali (email, SMS, messaggistica) e i livelli di sofisticazione per evitare l’assuefazione.

Graduare la difficoltà. Prevedere simulazioni di diversa complessità: attacchi “facili” per i meno esperti, che consentano di sperimentare il successo nel riconoscimento; attacchi sofisticati per gli esperti, che sfidino l’overconfidence e dimostrino che nessuno è immune.

Garantire sempre un debriefing costruttivo. Ogni simulazione deve essere seguita da un feedback tempestivo, non colpevolizzante e orientato all’apprendimento. Spiegare quali erano gli indicatori di phishing, normalizzare l’errore (“può capitare a chiunque”), fornire strumenti concreti per migliorare. Il debrief è il momento in cui l’esperienza si trasforma in apprendimento.

Introdurre elementi di gamification

Utilizzare quiz, sfide e competizioni. La gamification aumenta l’engagement e facilita l’apprendimento. Introdurre quiz periodici con classifiche (anonime o di team), badge per il completamento di percorsi formativi, sfide di riconoscimento con punteggi. La competizione amichevole può motivare anche i più resistenti alla formazione tradizionale.

Premiare i comportamenti virtuosi. Riconoscere pubblicamente chi segnala email sospette, chi completa i percorsi formativi, chi dimostra miglioramenti nelle simulazioni. Il rinforzo positivo è più efficace della punizione nel promuovere il cambiamento comportamentale.

Intervenire sul contesto organizzativo

Focus sul “fattore tempo”. Integrare nelle policy aziendali il principio che verificare è più importante della rapidità. Istruire i manager a non richiedere sempre risposte immediate e a concedere il tempo necessario per le verifiche. Creare una cultura in cui “ho preferito controllare prima di rispondere” sia valorizzato, non stigmatizzato come lentezza.

Supporto contro stress e sovraccarico. Collaborare con HR per identificare e mitigare le situazioni di sovraccarico cronico che aumentano la vulnerabilità. Promuovere pause strategiche, gestione sostenibile dei carichi di lavoro, attenzione ai segnali di burnout. La sicurezza informatica è anche una questione di benessere organizzativo.

Semplificare i processi di segnalazione. Rendere facile e veloce la segnalazione di email sospette: pulsante dedicato nel client di posta, canale diretto con il team di sicurezza, feedback rapido sull’esito della segnalazione. Ridurre le barriere alla segnalazione aumenta la probabilità che avvenga.

Contrastare l’overconfidence

Sfidare gli “esperti”. Progettare simulazioni specificamente mirate a chi ha elevata formazione e fiducia nelle proprie capacità. Dimostrare attraverso l’esperienza diretta che anche i più preparati possono essere ingannati. L’umiltà epistemica si costruisce con l’evidenza, non con le esortazioni.

Promuovere la metacognizione. Inserire nei percorsi formativi momenti di riflessione sui propri limiti e bias cognitivi. Esercizi come “quando sono più vulnerabile?”, “quali situazioni abbassano la mia guardia?”, “come posso proteggermi nei momenti di debolezza?” sviluppano la consapevolezza che previene l’eccesso di fiducia.

Condividere casi di esperti caduti. Raccontare storie (anonimizzate) di professionisti della sicurezza, manager, esperti IT che sono caduti vittime di phishing. La normalizzazione dell’errore riduce la vergogna e l’overconfidence simultaneamente.

Monitorare e personalizzare nel tempo

Tracciare i progressi individuali e di gruppo. Utilizzare i dati delle simulazioni e delle attività formative per costruire profili di rischio dinamici, che si aggiornano nel tempo. Identificare chi migliora, chi rimane vulnerabile, chi regredisce.

Adattare le strategie sulla base dei dati. La formazione efficace è un processo iterativo. Analizzare regolarmente i risultati, identificare i pattern di vulnerabilità emergenti, adeguare contenuti e modalità in risposta ai dati raccolti.

Considerare le differenze demografiche. Come emerso dall’analisi, età e genere possono associarsi a vulnerabilità diverse. Calibrare i messaggi e le modalità formative tenendo conto di queste differenze, senza stereotipare ma riconoscendo la diversità dei bisogni.

Sintesi: un approccio integrato

Le raccomandazioni presentate convergono verso un principio unificante: la cybersecurity efficace richiede un approccio integrato che agisca simultaneamente su conoscenze, emozioni, comportamenti e contesto organizzativo.

La formazione tradizionale, da sola, non basta. Come sintetizza efficacemente un principio consolidato della sicurezza informatica: “la miglior difesa è la consapevolezza, ma la consapevolezza deve tradursi in comportamento, e il comportamento dipende dal contesto in cui si opera”.

cybersecurity awareness
Tabella 7. Sintesi delle raccomandazioni operative

Considerazioni conclusive

Il phishing rimane una delle minacce più insidiose per le organizzazioni non perché sia tecnicamente sofisticato, ma perché sfrutta vulnerabilità profondamente umane: la fretta, la fiducia, la curiosità, il desiderio di essere collaborativi, la difficoltà di mantenere l’attenzione in contesti sovraccarichi.

I risultati di questo studio confermano che la vulnerabilità non è una questione di ignoranza o negligenza, ma emerge dall’interazione complessa tra fattori individuali, emotivi e contestuali. Anche i dipendenti più formati e consapevoli possono cadere, e paradossalmente proprio chi si sente più sicuro può essere più esposto.

Questa consapevolezza non deve generare rassegnazione, ma orientare verso strategie più sofisticate e realistiche. La sicurezza informatica non si costruisce solo con la tecnologia o con la formazione, ma con un approccio sistemico che riconosca la centralità del fattore umano e intervenga su tutte le leve disponibili: cognitive, emotive, comportamentali e organizzative.

Come emerge dalla profilazione proposta, non esiste un “utente tipo” vulnerabile al phishing: la vulnerabilità attraversa trasversalmente l’organizzazione, manifestandosi in forme diverse. Gli interventi più efficaci saranno quindi quelli capaci di riconoscere questa diversità e di rispondere con strategie personalizzate, continue e integrate nel tessuto organizzativo.

La cybersecurity, in ultima analisi, non è solo questione di conoscere le minacce, ma di gestire emozioni e abitudini di fronte ad esse. E questa è una sfida che riguarda non solo i singoli individui, ma le organizzazioni nel loro complesso.

Per un approfondimento completo dello studio, si rimanda al paper originale: “Phishing aziendale: perché i dipendenti formati cliccano comunque?”, a cura di Riccardo Laurenti, Veronica Vacchi e Ilenia Mercuri del team Cybersecurity di Dinova, che presenta l’analisi completa della vulnerabilità al phishing basata sulla survey condotta su 65 dipendenti di un’azienda italiana del settore IT, tutti caduti in una simulazione realizzata nel primo trimestre 2025.

Fonti:

Bada, M., Sasse, A. M., & Nurse, J. R. (2019). Cyber security awareness campaigns: Why do they fail to change behaviour? arXiv preprint arXiv:1901.02672. https://arxiv.org/abs/1901.02672

Kumaraguru, P., Sheng, S., Acquisti, A., Cranor, L. F., & Hong, J. (2010). Teaching Johnny not to fall for phish. ACM Transactions on Internet Technology, 10(2), 1-31. https://doi.org/10.1145/1754393.1754396

https://www.ictsecuritymagazine.com/articoli/cybersecurity-awareness/


Sottostazioni elettriche digitali: come applicare lo Zero Trust con MATRIX

Dalla teoria all’impianto: lo scenario NovaGrid mostra come applicare MATRIX a sottostazioni elettriche digitali in cui SCADA moderni convivono con IED e sistemi legacy.

Le parti precedenti della serie hanno descritto le sei fasi di MATRIX e la matrice di allocazione. Resta da vedere come il metodo funziona su un impianto.

Questa quinta parte apre la sezione di validazione con uno scenario illustrativo: NovaGrid, un operatore di distribuzione ipotetico ma verosimile. Qui un sistema SCADA moderno convive con apparati legacy che governano un centinaio di sottostazioni secondarie. Seguirlo fase per fase è il modo più diretto per capire il framework.

Validazione di MATRIX nelle sottostazioni elettriche digitali

Lo scenario NovaGrid mostra come applicare MATRIX a un’infrastruttura elettrica con SCADA moderni, IED e apparati legacy.

La validazione del framework adotta un approccio multi metodo articolato su tre componenti complementari: una validazione di copertura rispetto agli standard di riferimento, una validazione comparativa rispetto agli schemi esistenti e una validazione retrospettiva condotta su un incidente reale e documentato. Lo scenario illustrativo delle sottostazioni digitali, descritto nel seguito, fornisce il sostrato a cui le tre componenti fanno riferimento.

Sottostazioni elettriche digitali: lo scenario NovaGrid

Per mostrare il framework all’opera consideriamo uno scenario applicativo relativo a un ipotetico operatore di distribuzione, qui denominato NovaGrid, che gestisce un parco di sottostazioni elettriche digitali. Una sottostazione svolge la funzione di abbassare i livelli di alta tensione provenienti dalla rete di trasmissione per alimentare i circuiti di distribuzione locale, regolando la fornitura in risposta alla domanda di abitazioni e piccole utenze. I sistemi di automazione di NovaGrid comunicano con IED, relè e altri apparati; un’interfaccia uomo-macchina di tipo web supporta gli operatori nel monitoraggio e nel comando locale e remoto, mentre un sistema SCADA fornisce la vista d’insieme sulla stabilità della rete e sulle manovre.

L’infrastruttura è il risultato di una stratificazione storica: accanto a un sistema SCADA moderno convivono apparati legacy che governano un centinaio di sottostazioni secondarie tramite protocolli proprietari non integrabili con il sistema di monitoraggio centrale, e la cui sostituzione integrale non è, allo stato, una priorità sostenibile per ragioni di costo e di affidabilità. Lo scenario è volutamente analogo, nelle sue caratteristiche tecniche, ai casi discussi nella letteratura recente sul tema,[1] ma i dettagli e le scelte qui presentati sono originali e funzionali alla sola illustrazione del metodo.

Applicando la fase M, NovaGrid ricostruisce i propri mission thread attorno alla trasformazione, regolazione e distribuzione dell’energia, identificando come DAAS critici i segnali di comando verso i dispositivi di protezione, i dati di telemetria del sistema SCADA e i servizi di automazione delle manovre. La caratterizzazione evidenzia che la conseguenza più grave non è la perdita di riservatezza dei dati, ma la perdita di integrità o disponibilità del comando: un’alterazione dei segnali inviati ai relè potrebbe compromettere la protezione del sistema e la continuità della fornitura.

Nella fase A, NovaGrid profila le proprie classi di asset. Le HMI su piattaforma Windows e i server SCADA mostrano un’idoneità elevata e uniforme, compatibile con controlli on-device. Gli IED moderni nelle sottostazioni primarie presentano un’idoneità intermedia. Gli apparati legacy delle sottostazioni secondarie, privi di gestione dell’identità e di controlli di accesso granulari, esibiscono un’idoneità minima e dovranno affidarsi a meccanismi esterni di enforcement.

La fase T conduce alla mappatura della superficie d’attacco. NovaGrid riconosce di essere esposta soprattutto a tre delle categorie di minaccia canoniche: la minaccia interna, le vulnerabilità della supply chain e gli attori di tipo nation-state, con il ransomware come minaccia trasversale ad alto impatto, aggravata dalle fragilità dell’infrastruttura legacy. La mappatura individua punti di ingresso che vanno dall’accesso remoto dei fornitori agli aggiornamenti firmware, dai supporti rimovibili collegati alle workstation ai dispositivi legacy che costituiscono altrettanti blind spot. Particolare attenzione è riservata al rischio di manomissione in transito degli apparati – relè e controllori – durante la consegna dai fornitori, dove la discontinuità di visibilità nella logistica dell’ultimo miglio apre un varco di fiducia sfruttabile.

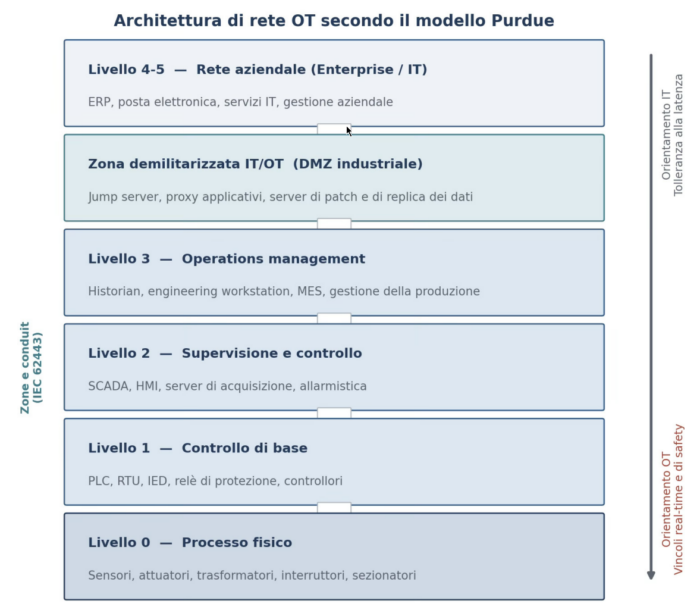
Nella fase R, NovaGrid pondera i controlli candidati rispetto ai vincoli operativi. La verifica riguarda, ad esempio, se l’introduzione di software antimalware o di scansioni in tempo reale interferisca con i processi critici dell’automazione, e se i controlli granulari desiderati – tali da impedire che un dispositivo compromesso di Livello 2 possa interagire con un controllore di Livello 1 senza superare verifiche di identità e autorizzazione in tempo reale – siano sostenibili sui diversi apparati. L’analisi conferma che ciò che è praticabile sulle sottostazioni primarie non lo è sulle secondarie, dove i protocolli legacy non supportano controlli di accesso granulari né gestione dell’identità.

La fase I consolida queste valutazioni nella matrice di allocazione (cfr. Tabella 1). Per HMI e server SCADA, NovaGrid prevede l’applicazione nativa dell’autenticazione a più fattori, della verifica della postura e del monitoraggio; tra apparati di pari livello impone confini logici e controlli di accesso stringenti per ostacolare il movimento laterale; per le connessioni remote di terze parti adotta una gestione centralizzata e sicura, valutando ogni tentativo di autenticazione al SCADA rispetto al policy engine. Per gli IED legacy, l’enforcement è delegato a un layer intermediario che offre un’interfaccia standardizzata verso i diversi protocolli e dispositivi, assicurando l’interoperabilità in attesa del dispiegamento della segnalazione digitale moderna nelle sottostazioni secondarie e della loro integrazione nell’architettura zero trust.

Infine, nella fase X, NovaGrid colloca questi interventi lungo una roadmap di maturità (cfr. Figura 5), partendo dalla messa in sicurezza degli asset a più alto rischio – engineering workstation, workstation operatore, historian – con controlli on-device, e procedendo per stadi successivi. L’organizzazione valuta che l’onere amministrativo e la complessità tecnica introdotti rientrino in soglie di rischio operativo accettabili, e riconosce esplicitamente che alcune sottostazioni secondarie potrebbero non essere adeguabili nel breve periodo, contabilizzandone il rischio residuo. Il risultato non è un impianto a prova di attacco, ma un sistema in cui la superficie d’attacco è ridotta, il movimento laterale è ostacolato, gli accessi critici sono verificati con continuità e ciò che resta scoperto è noto e monitorato.

Dallo scenario NovaGrid alla validazione di MATRIX

Lo scenario NovaGrid ha valore illustrativo. Nella sesta parte della serie l’autore sottopone MATRIX a tre verifiche più stringenti: la copertura rispetto agli standard, il confronto con i metodi esistenti e la rilettura dell’attacco alla rete elettrica ucraina del 2015. Il paper integrale «Zero Trust selettivo negli ambienti OT» è disponibile per il download.

zero trust ot, OT security, OT cybersecurity, sicurezza OT

Fonti:

[1] R. Brown, “Implementing Zero Trust in Operational Technology: A Practical Case Study,” SEI Insights (blog), Software Engineering Institute, Carnegie Mellon University, 16 giugno 2026.

https://www.ictsecuritymagazine.com/articoli/zero-trust-sottostazioni-elettriche-novagrid/


Vulnerabilità al phishing: urgenza, curiosità e distrazione come fattori emotivi e cognitivi che favoriscono il click

La vulnerabilità al phishing rappresenta oggi uno dei principali fattori critici nella sicurezza informatica aziendale, poiché emerge dall’interazione tra emozioni, processi cognitivi e contesto operativo. In questa prospettiva, comprendere i meccanismi del comportamento umano è essenziale per ridurre il rischio di errore.

Questo articolo fa parte di una serie di approfondimenti su una survey di cybersecurity awareness condotta su 65 dipendenti di un’azienda IT, tutti caduti in una simulazione di phishing nel 2025. Nell’approfondimento precedente è stato analizzato il paradosso dell’efficacia formativa: nonostante l’86% del campione possedesse formazione pregressa e ne valutasse l’utilità molto positivamente (59% punteggio massimo), tutti i partecipanti sono risultati comunque vulnerabili all’attacco simulato.

Il presente articolo ricostruisce l’”anatomia del click”, analizzando in sequenza gli stati emotivi alla ricezione dell’email sospetta (sicurezza/overconfidence, ansia, curiosità, indifferenza), le leve emotive più efficaci (curiosità e urgenza su tutte) e i fattori cognitivi e situazionali (fretta, stanchezza mentale, pressione temporale, sovraccarico email) che facilitano l’errore. Sulla base di questi elementi, vengono identificati tre profili di rischio (bassa consapevolezza digitale, consapevoli ma esposti alla pressione, esperti e altamente fiduciosi), ciascuno associato a strategie formative differenziate.

L’analisi delle risposte al questionario ha permesso di esplorare in profondità i fattori emotivi, cognitivi e situazionali che hanno contribuito alla vulnerabilità dei partecipanti. Questa sezione presenta i risultati organizzati secondo una sequenza temporale: dalle emozioni provate alla ricezione dell’email sospetta, alle motivazioni che hanno spinto al click, fino ai fattori contestuali che hanno facilitato l’errore.

Emozioni all’arrivo di un’email sospetta

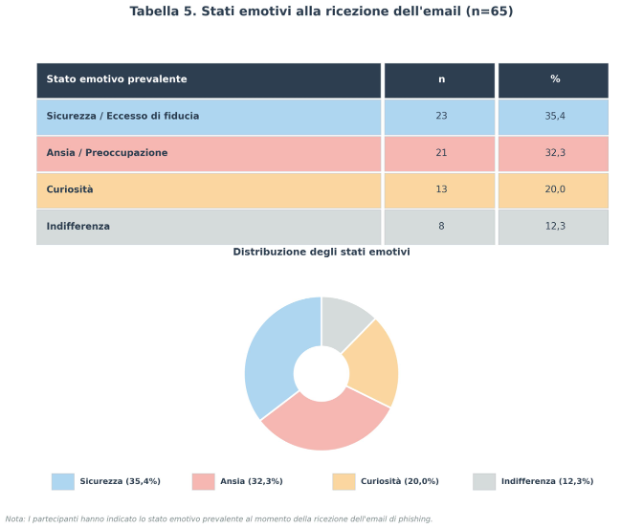
Alla ricezione di un’email percepita come potenzialmente sospetta, i partecipanti riportano quattro stati emotivi prevalenti, distribuiti in modo relativamente omogeneo nel campione.

Sicurezza o eccesso di fiducia (35%). Oltre un terzo del campione dichiara di sentirsi sicuro o comunque non particolarmente allarmato di fronte a email inattese. Questo dato suggerisce una sottovalutazione iniziale del rischio, coerente con il fenomeno dell’overconfidence discusso nei capitoli precedenti. Chi si sente sicuro tende a processare il messaggio in modalità euristica, senza attivare i controlli sistematici che potrebbero rivelare gli indicatori di phishing.

Ansia o preoccupazione (32%). Quasi un terzo dei partecipanti riferisce stati di ansia alla ricezione di email inaspettate, soprattutto quando queste evocano conseguenze negative o richiedono azioni urgenti. L’ansia può avere effetti ambivalenti sulla sicurezza: da un lato, può favorire un atteggiamento più prudente e attento; dall’altro, può spingere verso decisioni impulsive finalizzate a ridurre rapidamente lo stato di disagio. Come documentato da Lerner e Keltner (2001), l’ansia tende ad amplificare la percezione del rischio ma può anche compromettere la qualità del ragionamento.

Curiosità (20%). Un quinto del campione riporta curiosità come emozione prevalente. La curiosità rappresenta un fattore di rischio significativo perché spinge all’interazione anche in presenza di segnali ambigui. Il desiderio di sapere “cosa succede se clicco” o “di cosa si tratta” può prevalere sulla prudenza, soprattutto quando il contenuto dell’email tocca temi di interesse personale – come nel caso della simulazione, che faceva riferimento a benefici sanitari.

Indifferenza (13%). Una quota minore dichiara indifferenza, processando l’email in modo automatico senza particolare coinvolgimento emotivo. Questo stato può derivare dall’abitudine a gestire grandi volumi di comunicazioni o da una percezione di routine che abbassa la soglia di attenzione.

vulnerabilità al phishing
Tabella 5. Stati emotivi alla ricezione dell’email (n=65)

Interpretazione. La distribuzione degli stati emotivi conferma che non esiste un unico profilo di vulnerabilità. Sia chi si sente troppo sicuro sia chi è ansioso può cadere vittima di phishing, sebbene attraverso meccanismi diversi: nel primo caso, per insufficiente attivazione dei controlli; nel secondo, per decisioni affrettate finalizzate a ridurre l’ansia. Gli interventi formativi dovrebbero quindi differenziarsi in base al profilo emotivo prevalente.

Motivazioni emotive al click

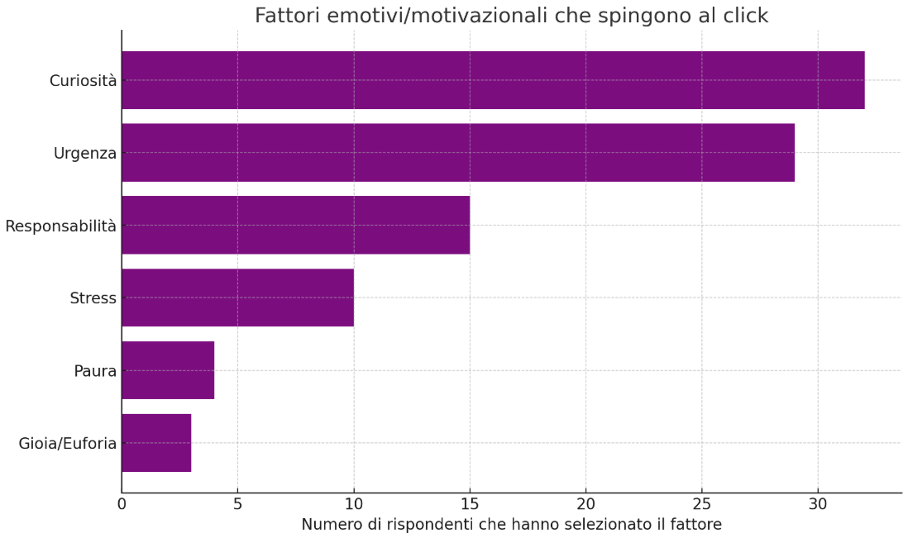
Oltre a rilevare lo stato emotivo iniziale, il questionario ha esplorato le leve emotive che i partecipanti riconoscono come efficaci nel superare le proprie difese cognitive. È stato chiesto quali caratteristiche di un messaggio li rendessero più propensi a interagire senza verifiche approfondite.

Curiosità e urgenza (49%). Quasi la metà del campione riconosce che messaggi in grado di suscitare curiosità o senso di urgenza costituiscono la leva più efficace per indurre il click. Questo dato è coerente con le tecniche di social engineering documentate in letteratura: la creazione di uno stato di attivazione emotiva – sia essa curiosità (“scopri subito”) o urgenza (“agisci entro 24 ore”) – riduce la propensione all’analisi critica e favorisce risposte automatiche (Stajano & Wilson, 2011).

Senso di responsabilità (22%). Oltre un quinto dei partecipanti indica il senso di responsabilità come fattore motivante. Email che sembrano provenire da superiori, che richiedono azioni per conto dell’azienda o che fanno appello al ruolo professionale del destinatario attivano il desiderio di essere collaborativi e affidabili. L’amicalità come tratto di personalità, discussa nel framework teorico, facilita questo tipo di manipolazione.

Stress e stanchezza (18%). Una quota significativa riconosce che condizioni di stress e affaticamento riducono la capacità di valutazione critica. In questi stati, il click diventa la via di minor resistenza cognitiva – una risposta che richiede meno sforzo rispetto alla verifica attenta del messaggio.

Paura di conseguenze negative (11%). Una minoranza indica la paura come leva efficace. Email che minacciano la sospensione di account, sanzioni o perdite economiche possono indurre azioni impulsive finalizzate a evitare l’esito temuto.

vulnerabilità al phishing
Figura 1. Leve emotive riconosciute come efficaci per indurre il click

Fattori cognitivi e attentivi di vulnerabilità

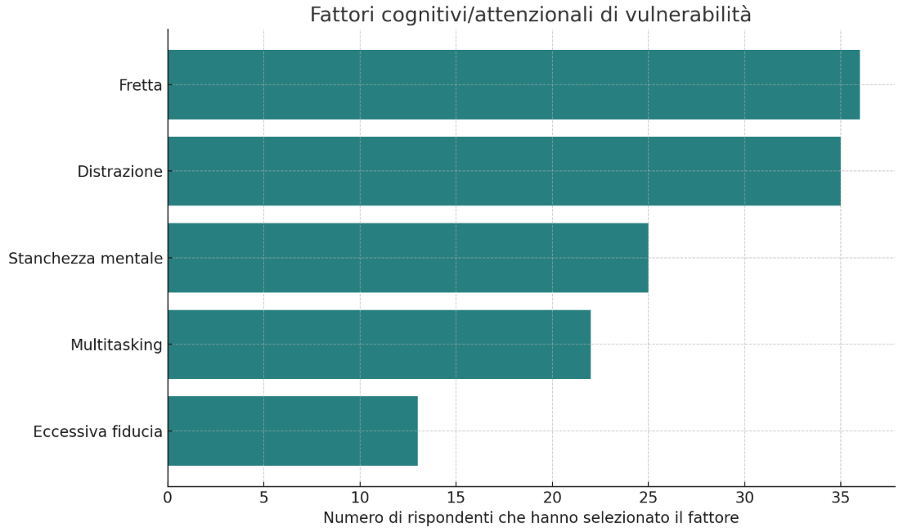
Oltre alle leve emotive, l’analisi ha esplorato i fattori cognitivi e situazionali che i partecipanti percepiscono come facilitanti l’errore. È stato chiesto di indicare le condizioni in cui si sentono più vulnerabili agli attacchi.

Fretta e distrazione (67%). Due terzi del campione identifica la fretta e la distrazione – spesso associate al multitasking – come le principali condizioni che aumentano la probabilità di errore. Quando l’attenzione è divisa tra più compiti, la capacità di elaborazione sistematica si riduce drasticamente, lasciando spazio alle risposte automatiche e alle euristiche. Questo dato è coerente con la ricerca sulla “cecità attenzionale” (inattentional blindness): in condizioni di sovraccarico, anche stimoli evidenti possono passare inosservati (Simons & Chabris, 1999).

Stanchezza mentale (52%). Oltre metà dei partecipanti indica la stanchezza mentale – associata a burnout, fine giornata lavorativa o sovraccarico prolungato – come fattore di vulnerabilità. L’affaticamento cognitivo riduce le risorse disponibili per l’elaborazione controllata, favorendo il ricorso a scorciatoie decisionali. Non a caso, molti attacchi di phishing vengono programmati per raggiungere i destinatari nelle fasce orarie di maggiore stanchezza (tardo pomeriggio, fine settimana lavorativa).

Pressione temporale (48%). Quasi la metà dei rispondenti riconosce che le scadenze imminenti e le urgenze lavorative compromettono la capacità di verifica. La pressione temporale attiva quella che Kahneman (2011) definisce “Sistema 1” – il pensiero rapido, automatico e intuitivo – a scapito del “Sistema 2” – il pensiero lento, deliberato e analitico.

Sovraccarico di email (34%). Un terzo del campione indica il volume elevato di comunicazioni come fattore di rischio. Quando si gestiscono decine o centinaia di email al giorno, ogni messaggio riceve inevitabilmente meno attenzione, e i comportamenti diventano più automatici e meno riflessivi.

Come evidenziato da PhishEnterprise e confermato dai dati del presente studio, queste condizioni sono frequenti nelle normali giornate lavorative. La vulnerabilità al phishing non emerge solo da carenze individuali, ma è inscritta nelle dinamiche organizzative contemporanee: ritmi serrati, multitasking costante, comunicazioni incessanti. Non sempre l’utente riesce a compensare con maggiore attenzione ciò che il contesto sottrae in termini di risorse cognitive.

Figura 2. Fattori cognitivi e situazionali di vulnerabilità

Percezione del rischio e decisioni sotto stress

L’analisi ha esplorato anche la percezione soggettiva del rischio informatico e la consapevolezza dell’impatto dello stress sulle proprie decisioni.

Percezione della rilevanza delle minacce cyber. La percezione del rischio informatico risulta eterogenea nel campione. Il 60% dei partecipanti considera le minacce cyber come rilevanti nella propria vita quotidiana e professionale, riconoscendo la possibilità concreta di esserne colpiti. Il restante 40%, tuttavia, percepisce tali minacce come marginali, distanti o comunque poco probabili nel proprio contesto specifico.

Questa percezione attenuata del rischio rappresenta di per sé un fattore di vulnerabilità. La letteratura sulla risk perception documenta come la sottostima della probabilità di eventi negativi – fenomeno noto come “ottimismo irrealistico” (unrealistic optimism) – riduca l’adozione di comportamenti preventivi (Weinstein, 1980). Chi non si percepisce come potenziale bersaglio è meno motivato a investire attenzione nella verifica delle comunicazioni.

Consapevolezza dell’impatto dello stress. Il 67% dei partecipanti concorda sul fatto che la pressione temporale e le urgenze lavorative aumentino la propria probabilità di commettere errori. Questo dato indica una buona consapevolezza metacognitiva: la maggioranza riconosce che lo stress compromette la qualità delle proprie decisioni.

Tuttavia, emerge un paradosso significativo: chi riconosce di essere vulnerabile allo stress risulta, nei fatti, ugualmente esposto a comportamenti impulsivi. La consapevolezza del rischio non si traduce automaticamente in capacità di mitigazione. Sapere che “sotto stress sbaglio” non impedisce di sbagliare quando si è effettivamente sotto stress. Questo gap tra consapevolezza e comportamento rappresenta una delle sfide centrali per la progettazione di interventi efficaci.

Implicazioni. I dati suggeriscono che gli interventi formativi non possono limitarsi ad aumentare la consapevolezza dei rischi – che nel campione è già relativamente elevata – ma devono fornire strumenti pratici e automatizzabili per gestire le situazioni di pressione. Strategie possibili includono:

  • Procedure semplificate di verifica che richiedano minimo sforzo cognitivo;
  • Sistemi di nudging che rallentino le risposte automatiche;
  • Interventi organizzativi sulla gestione dei tempi e delle urgenze;
  • Tecniche di mindfulness applicata alla sicurezza digitale.

Sintesi: l’anatomia del click

I dati presentati in questa sezione permettono di ricostruire l’”anatomia” del click su un link di phishing, intesa come la sequenza di fattori che convergono nel determinare l’errore.

Fase 1 – Ricezione. L’email arriva in un momento in cui il destinatario può trovarsi in diversi stati emotivi (sicurezza, ansia, curiosità, indifferenza), ciascuno dei quali comporta vulnerabilità specifiche.

Fase 2 – Valutazione iniziale. Il messaggio viene processato in modo più o meno approfondito a seconda delle risorse cognitive disponibili. Condizioni di fretta, distrazione, stanchezza o sovraccarico favoriscono un’elaborazione superficiale (euristica).

Fase 3 – Attivazione emotiva. Il contenuto del messaggio attiva leve emotive – curiosità, urgenza, senso di responsabilità, paura – che spingono verso l’azione.

Fase 4 – Decisione. In assenza di “freni” sufficienti (tempo per riflettere, procedure di verifica automatiche, dubbi espliciti), il click avviene come risposta di default.

Fase 5 – Realizzazione (eventuale). Solo dopo il click – e spesso solo a seguito di segnali esterni (landing page anomala, comunicazione dell’azienda) – emerge la consapevolezza dell’errore, con le conseguenti reazioni emotive.

Questa ricostruzione evidenzia come la vulnerabilità sia il prodotto di un sistema di fattori interagenti, non di un singolo deficit. Intervenire efficacemente richiede quindi un approccio multilivello che agisca su più punti della catena.

Tre profili di rischio phishing: come segmentare i dipendenti per una formazione mirata

L’analisi integrata dei dati raccolti – caratteristiche demografiche, abitudini di sicurezza, conoscenze pregresse, fattori emotivi e cognitivi – ha permesso di identificare tre profili comportamentali distinti all’interno del campione. Questa segmentazione ha l’obiettivo di orientare la progettazione di interventi formativi differenziati, calibrati sulle specifiche vulnerabilità di ciascun gruppo.

Profilo A: Utenti con bassa consapevolezza digitale

Caratteristiche. Questo profilo include dipendenti con conoscenza limitata delle minacce informatiche e abitudini di sicurezza deboli o inconsistenti. Spesso non hanno partecipato a corsi di formazione specifici, oppure la formazione ricevuta non ha prodotto cambiamenti comportamentali significativi. Mostrano difficoltà nel riconoscere gli indicatori tecnici di phishing (es. spoofing dell’indirizzo mittente) e tendono a fidarsi delle comunicazioni che sembrano provenire da fonti legittime.

Fattori di vulnerabilità prevalenti:

  • Scarsa familiarità con le tecniche di attacco;
  • Assenza di routine di verifica consolidate;
  • Percezione attenuata del rischio personale;
  • Tendenza a seguire le istruzioni senza verifiche.

Strategia formativa consigliata. Per questo gruppo è prioritaria una formazione di base e sensibilizzazione che costruisca awareness a partire dai fondamentali:

  • Introduzione alle tipologie di minacce e alle tecniche di social engineering;
  • Addestramento pratico al riconoscimento degli indicatori di phishing;
  • Creazione di routine di verifica semplici e memorizzabili;
  • Utilizzo di esempi concreti e casi reali per aumentare la percezione del rischio;
  • Gamification per mantenere l’engagement e facilitare l’apprendimento.

Profilo B: Utenti consapevoli ma esposti alla pressione

Caratteristiche. Questo profilo include dipendenti con buona conoscenza teorica delle minacce informatiche e un forte senso di responsabilità professionale. Hanno generalmente partecipato a corsi di formazione e sanno cosa cercare in un’email sospetta. Tuttavia, la loro vulnerabilità emerge in condizioni di stress, urgenza o sovraccarico lavorativo. Quando le pressioni contestuali aumentano, le conoscenze acquisite non vengono attivate e prevalgono le risposte automatiche.

Fattori di vulnerabilità prevalenti:

  • Elevata pressione temporale e scadenze frequenti;
  • Multitasking e frammentazione dell’attenzione;
  • Senso di responsabilità che spinge ad agire rapidamente;
  • Difficoltà a “rallentare” anche quando sarebbe opportuno;
  • Stanchezza cronica e rischio di burnout.

Strategia formativa consigliata. Per questo gruppo sono prioritarie soluzioni organizzative e tecniche di gestione dello stress:

  • Training su tecniche di coping e gestione della pressione;
  • Esercizi di riconoscimento dei propri segnali di sovraccarico;
  • Promozione di pause strategiche anche nei momenti di picco;
  • Semplificazione delle procedure di verifica per ridurre il costo cognitivo;
  • Interventi a livello organizzativo: revisione delle policy sulle urgenze, coinvolgimento dei manager nel promuovere una cultura della verifica;
  • Strumenti tecnologici di supporto (es. warning automatici, delay prima dell’invio di credenziali).

Profilo C: Utenti esperti e altamente fiduciosi

Caratteristiche. Questo profilo include dipendenti con elevata formazione in cybersecurity, spesso con background tecnico o esperienza diretta nel settore. Mostrano buone abitudini di sicurezza nella maggior parte delle situazioni e si percepiscono come altamente competenti nel riconoscere le minacce. Paradossalmente, proprio questa elevata fiducia nelle proprie capacità può tradursi in una ridotta attivazione dei comportamenti di verifica, rendendoli vulnerabili ad attacchi sofisticati o inattesi.

Fattori di vulnerabilità prevalenti:

  • Overconfidence e sottostima del rischio residuo;
  • Tendenza a non riconoscere i propri limiti;
  • Minore attivazione dei controlli (“tanto lo riconoscerei”);
  • Reazioni emotive intense in caso di errore (vergogna, dissonanza cognitiva);
  • Possibile resistenza a formazioni percepite come “basiche”.

Strategia formativa consigliata. Per questo gruppo sono prioritari interventi sfidanti che calibrino la fiducia:

  • Simulazioni sofisticate e personalizzate che mettano alla prova anche i più esperti;
  • Feedback approfondito che evidenzi le vulnerabilità residue senza colpevolizzare;
  • Contenuti avanzati su tecniche di attacco emergenti (es. AI-powered phishing);
  • Esercizi di metacognizione sui propri limiti e bias cognitivi;
  • Coinvolgimento come “ambasciatori” della sicurezza per valorizzare le competenze;
  • Condivisione di casi in cui anche esperti sono caduti vittime di attacchi.

Considerazioni trasversali

La profilazione presentata ha finalità operative e non pretende di essere esaustiva. Nella realtà, i confini tra i profili sono sfumati e lo stesso individuo può mostrare caratteristiche di profili diversi a seconda del contesto e del momento.

Inoltre, la vulnerabilità al phishing non è un tratto stabile della persona, ma emerge dall’interazione dinamica tra caratteristiche individuali (conoscenze, tratti di personalità, abitudini), fattori situazionali (stress, fretta, stanchezza) e caratteristiche dell’attacco (sofisticazione, personalizzazione, leve emotive utilizzate).

Nel complesso, la profilazione evidenzia come la vulnerabilità al phishing non sia riconducibile a un’unica tipologia di utente, ma attraversi trasversalmente il campione, manifestandosi in forme diverse a seconda del profilo. Gli interventi più efficaci saranno quindi quelli capaci di:

  • Riconoscere la diversità dei profili di rischio;
  • Personalizzare contenuti e modalità formative;
  • Integrare interventi individuali e organizzativi;
  • Agire simultaneamente su conoscenze, emozioni e contesto.
vulnerabilità al phishing
Tabella 6. Sintesi dei profili di rischio e strategie formative

Il prossimo approfondimento presenterà le conclusioni finali, con la sintesi dei risultati rispetto alle domande di ricerca, il contributo alla letteratura, le implicazioni pratiche per le organizzazioni e le direzioni per la ricerca futura.

Per approfondire, si rimanda all’Empirical Research Paper “Phishing aziendale: perché i dipendenti formati cliccano comunque?” di Riccardo Laurenti, Veronica Vacchi e Ilenia Mercuri del team Cybersecurity di Dinova, che analizza in modo empirico le dinamiche della vulnerabilità al phishing nei contesti aziendali e i fattori emotivi e cognitivi che influenzano il comportamento degli utenti.

Fonti:

Articoli accademici:

Kahneman, D. (2011). Thinking, fast and slow. Farrar, Straus and Giroux.

Lerner, J. S., & Keltner, D. (2001). Fear, anger, and risk. Journal of Personality and Social Psychology, 81(1), 146-159. https://doi.org/10.1037/0022-3514.81.1.146

Simons, D. J., & Chabris, C. F. (1999). Gorillas in our midst: Sustained inattentional blindness for dynamic events. Perception, 28(9), 1059-1074. https://doi.org/10.1068/p281059

Stajano, F., & Wilson, P. (2011). Understanding scam victims: Seven principles for systems security. Communications of the ACM, 54(3), 70-75. https://doi.org/10.1145/1897852.1897872

Weinstein, N. D. (1980). Unrealistic optimism about future life events. Journal of Personality and Social Psychology, 39(5), 806-820. https://doi.org/10.1037/0022-3514.39.5.806

https://www.ictsecuritymagazine.com/articoli/vulnerabilita-al-phishing-fattori-emotivi/


Zero trust e modello Purdue: perché i controlli IT non bastano nell’OT

Il modello Purdue aiuta a comprendere perché latenza, disponibilità continua, sistemi legacy e requisiti di safety rendono inefficace il trasferimento diretto dei controlli IT agli ambienti OT.

Nella prima parte della serie Vincenzo Calabrò ha spiegato perché la fine dell’air gap impone di ripensare la sicurezza degli impianti industriali, e perché lo zero trust non può essere applicato all’OT in modo uniforme.

Questa seconda parte fornisce gli strumenti per orientarsi: i principi della NIST SP 800-207, l’organizzazione degli impianti secondo il modello Purdue e le ragioni tecniche per cui i controlli IT non si trasferiscono. Il paragrafo 2.3 merita attenzione particolare: introduce i cinque attributi di idoneità che torneranno in tutto il framework.

Modello Purdue e Zero Trust negli ambienti OT

Fondamenti dello Zero Trust, anatomia degli ambienti OT e limiti del trasferimento diretto dei controlli EIT.

Zero Trust: dai perimetri alle identità

Lo zero trust non è un prodotto o una tecnologia specifica, ma una strategia di sicurezza basata su un insieme di principi. La NIST SP 800-207 ne enuncia i principi fondamentali:

  • tutte le risorse di dati e di calcolo sono trattate come tali, indipendentemente dalla loro posizione;
  • ogni comunicazione è protetta, a prescindere dalla rete su cui transita;
  • l’accesso alle singole risorse è concesso per sessione, sulla base del principio del privilegio minimo;
  • le decisioni di accesso sono determinate da una policy dinamica che considera l’identità del richiedente, lo stato del dispositivo e altri attributi comportamentali e ambientali;
  • l’organizzazione monitora e misura costantemente l’integrità e la postura di sicurezza dei propri asset, applica e rivaluta in modo continuo l’autenticazione e l’autorizzazione e raccoglie quante più informazioni possibili sullo stato corrente, al fine di migliorare nel tempo la propria postura.[1]

Sul piano logico, questi principi si traducono in un’architettura in cui il piano di controllo e il piano dei dati sono nettamente separati. Il policy engine, il cuore decisionale del sistema, esegue un algoritmo di fiducia per concedere, negare o revocare l’accesso; il policy administrator instaura o interrompe il canale di comunicazione in base alla decisione presa; il policy enforcement point, collocato lungo il percorso tra il soggetto e la risorsa, applica materialmente l’esito.[2]

Il passaggio concettuale più rilevante consiste nello spostare il baricentro dei controlli dalla segmentazione basata su parametri di rete quali indirizzi, sottoreti e perimetri, verso l’identità di utenti, dispositivi e servizi, con politiche di autorizzazione costruite attorno ad attributi anziché a topologie.[3]

La letteratura ha contribuito a sistematizzare il campo: la rassegna di Syed et al. offre una tassonomia esaustiva delle architetture e delle componenti zero trust,[4] mentre Fernandez e Brazhuk ne propongono un’analisi critica, mettendo in luce le ambiguità definitorie e nodi irrisolti nella traduzione dei principi in pratica.[5] Bertino, da parte sua, invita a una valutazione misurata dei benefici effettivi, ricordando che lo zero trust non è una panacea ma una strategia il cui valore dipende dalla qualità dell’implementazione.[6]

Modello Purdue: come sono organizzati gli ambienti OT

Per comprendere perché lo zero trust non può essere trasferito senza adattamenti nell’ambito OT, è necessario osservare la struttura tipica di un ambiente OT. Il modello architetturale dominante è il modello Purdue, derivato dalla Purdue Enterprise Reference Architecture, elaborata all’inizio degli anni Novanta da Williams e dal consorzio universitario sul Computer Integrated Manufacturing.[7] Concepito originariamente per razionalizzare i flussi informativi negli impianti automatizzati, il modello è stato adottato dalla comunità della sicurezza, in quanto la gerarchia funzionale che descrive si presta a delimitare confini difensivi naturali.

La serie di standard ISA/IEC 62443 ha adottato questa stratificazione traducendola nei concetti di zone e conduits: raggruppamenti di sistemi con requisiti di sicurezza omogenei e canali di comunicazione controllati che li collegano e ciascuno associato a un livello di sicurezza target commisurato al rischio.[8] La Figura 1 riassume questa organizzazione.

L’architettura di rete OT secondo il modello Purdue prevedei livelli funzionali, la zona demilitarizzata IT/OT e l’intensificarsi dei vincoli di tempo reale verso il processo fisico.
Figura 1. L’architettura di rete OT secondo il modello Purdue prevede i livelli funzionali, la zona demilitarizzata IT/OT e l’intensificarsi dei vincoli di tempo reale verso il processo fisico.

Ai livelli inferiori si trova il processo fisico (Livello 0), con i suoi sensori e attuatori, governato dai dispositivi di controllo di base (Livello 1), quali i controllori logici programmabili (PLC), le unità terminali remote (RTU), i dispositivi elettronici intelligenti (IED) e i relè di protezione. Il livello di supervisione (Livello 2) ospita i sistemi SCADA e le interfacce uomo-macchina (HMI), che consentono il monitoraggio e il comando, mentre il livello di operations management (Livello 3) raccoglie gli historian, le workstation per l’ingegneria e i sistemi di gestione della produzione.

Tra il dominio OT e la rete aziendale (livelli 4 e 5) si interpone, nelle architetture mature, una zona demilitarizzata industriale che media ogni scambio. Come evidenziato sul lato destro della figura, una caratteristica fondamentale è che i requisiti di tempo reale e di sicurezza aumentano scendendo verso il processo, mentre l’affinità con le tecnologie IT e, di conseguenza, la possibilità di riutilizzare i relativi controlli di sicurezza, aumenta risalendo verso l’alto.

Perché i controlli IT non si trasferiscono direttamente nell’OT

Le ragioni dell’incompatibilità sono molteplici e si rafforzano a vicenda. In primo luogo, l’eterogeneità: un impianto OT è costituito da apparecchiature di generazioni e fornitori diversi, spesso governate da protocolli proprietari che non prevedono autenticazione e controlli di integrità. In secondo luogo, la disponibilità continua: molti processi non tollerano interruzioni e le finestre di manutenzione per aggiornamenti o riconfigurazioni sono rare e costose. Infine, la sensibilità alla latenza: l’introduzione di un controllo che aggiunga ritardo alla catena di comando può compromettere la funzione, pertanto ogni meccanismo zero trust deve dimostrare di non interferire con i vincoli temporali del processo.[9]

A questi si aggiungono i limiti di calcolo, memoria ed energia dei dispositivi più datati che non dispongono del margine necessario per ospitare agenti software o funzioni crittografiche. Un filone di ricerca del Software Engineering Institute, sviluppato originariamente per i sistemi di difesa con OT embedded ma di valenza generale, ha condensato questi fattori in un insieme di attributi utili a valutare l’idoneità di un sistema ad accogliere le capacità zero trust: la configurabilità dinamica, la flessibilità di progettazione o retrofit, i vincoli di dimensione, peso e potenza (size, weight and power, SWaP), la tolleranza alla latenza e il grado di centralità IT rispetto a OT.[10]

Riprenderemo questi attributi nella sezione successiva come base per la fase di profilazione.

Standard e architetture per la sicurezza degli ambienti OT

Sul fronte normativo e istituzionale, oltre alle già citate NIST SP 800-207 e 800-82r3, meritano attenzione alcuni documenti per il loro approccio metodologico. La guida della Cloud Security Alliance per le infrastrutture critiche suddivide l’adozione dello zero trust in cinque fasi: definire la superficie da proteggere in termini di dati, applicazioni, asset e servizi; mappare i flussi delle transazioni; costruire l’architettura zero trust; formulare le relative politiche; monitorare e mantenere la rete.[11]

A livello europeo, l’ENISA (Agenzia dell’Unione europea per la cybersicurezza) ha pubblicato una guida tecnica che traduce le misure di gestione del rischio della NIS2 in indicazioni operative, esempi di documentazione e mappature verso standard internazionali quali ISO/IEC 27001, il NIST Cybersecurity Framework e la serie IEC 62443, offrendo un riferimento direttamente utilizzabile dalle organizzazioni dell’Unione.[12]

La ricerca accademica ha affrontato il problema da angolazioni complementari. Feng e Hu propongono un’architettura zero trust per i sistemi cyber-fisici industriali, mostrando come i principi possano essere riformulati tenendo conto dell’accoppiamento tra computazione e processo fisico.[13] Zanasi, Russo e Colajanni hanno elaborato un’architettura zero trust flessibile per le infrastrutture industriali basate su Industrial IoT, con l’obiettivo esplicito di adattare l’applicazione delle regole alla diversità dei dispositivi.[14] Federici, Martintoni e Senni si concentrano in particolare sull’accesso remoto alle infrastrutture IIoT, proponendo un’architettura a due livelli di controllo conforme al modello zero trust.[15] Per quanto riguarda la transizione, Phiayura e Teerakanok delineano un framework di migrazione verso lo zero trust, sebbene orientato principalmente ai contesti IT.[16]

Da questa analisi emerge un quadro coerente, ma incompleto. Le linee guida istituzionali forniscono processi di alto livello validi, ma volutamente generici, mentre i contributi accademici offrono architetture e meccanismi puntuali, spesso validati su scenari circoscritti o su sistemi relativamente moderni. Resta scoperto lo spazio intermedio: una metodologia che, a partire da una comprensione mission-centrica dell’ambiente, conduca in modo tracciabile alla selezione dei controlli effettivamente sostenibili per ogni classe di asset, integri esplicitamente l’analisi dei compromessi tra sicurezza e continuità operativa e gestisca il rischio residuo dei componenti non adeguabili. È questo lo spazio che MATRIX intende occupare, non in alternativa, ma in complemento agli schemi esistenti, dei quali assume e perfeziona i passaggi.

VINCOLI OT: Latenza stringente, disponibilità continua, eterogeneità dei protocolli, margini di calcolo e memoria ridotti (SWaP) e requisiti di safety restringono lo spazio dei controlli applicabili.

Nella prossima parte: dal modello Purdue al framework MATRIX

La rassegna si chiude su uno spazio scoperto, tra linee guida istituzionali generiche e architetture accademiche puntuali. Nella terza parte della serie l’autore presenta il framework MATRIX e le sue prime tre fasi: missione, idoneità degli asset e superficie d’attacco. Il paper integrale «Zero Trust selettivo negli ambienti OT» è disponibile per il download.

zero trust ot, OT security, OT cybersecurity, sicurezza OT

Fonti:

[1] S. Rose, O. Borchert, S. Mitchell e S. Connelly, Zero Trust Architecture, NIST Special Publication 800-207. Gaithersburg, MD, USA: National Institute of Standards and Technology, 2020, doi: 10.6028/NIST.SP.800-207.

[2] S. Rose, O. Borchert, S. Mitchell e S. Connelly, Zero Trust Architecture, NIST Special Publication 800-207. Gaithersburg, MD, USA: National Institute of Standards and Technology, 2020, doi: 10.6028/NIST.SP.800-207.

[3] S. Rose, O. Borchert, S. Mitchell e S. Connelly, Zero Trust Architecture, NIST Special Publication 800-207. Gaithersburg, MD, USA: National Institute of Standards and Technology, 2020, doi: 10.6028/NIST.SP.800-207.

[4] N. F. Syed, S. W. Shah, A. Shaghaghi, A. Anwar, Z. Baig e R. Doss, “Zero trust architecture (ZTA): A comprehensive survey,” IEEE Access, vol. 10, pp. 57143–57179, 2022.

[5] E. B. Fernandez e A. Brazhuk, “A critical analysis of zero trust architecture (ZTA),” Computer Standards & Interfaces, vol. 89, art. 103832, 2024.

[6] E. Bertino, “Zero trust architecture: Does it help?,” IEEE Security & Privacy, vol. 19, n. 5, pp. 95–96, 2021.

[7] T. J. Williams, “The Purdue enterprise reference architecture,” Computers in Industry, vol. 24, n. 2-3, pp. 141–158, 1994.

[8] International Electrotechnical Commission, IEC 62443: Security for Industrial Automation and Control Systems (serie). Ginevra, Svizzera: IEC.

[9] K. Stouffer, M. Pease, C. Tang, T. Zimmerman, V. Pillitteri, S. Lightman, A. Hahn, S. Saravia, A. Sherule e M. Thompson, Guide to Operational Technology (OT) Security, NIST Special Publication 800-82r3. Gaithersburg, MD, USA: National Institute of Standards and Technology, 2023, doi: 10.6028/NIST.SP.800-82r3.

[10] C. J. Alberts, T. Morrow, R. Brown e C. M. Wallen, Tailoring Security and Zero Trust Principles to Weapon System Environments, Special Report. Pittsburgh, PA, USA: Software Engineering Institute, Carnegie Mellon University, 2025.

[11] Cloud Security Alliance, Zero Trust Guidance for Critical Infrastructure. Seattle, WA, USA: CSA Zero Trust Working Group, ott. 2024.

[12] Agenzia dell’Unione europea per la cibersicurezza (ENISA), Technical Implementation Guidance on Cybersecurity Risk Management Measures, v1.0. Atene, Grecia: ENISA, giugno 2025.

[13] X. Feng e S. Hu, “Cyber-physical zero trust architecture for industrial cyber-physical systems,” IEEE Transactions on Industrial Cyber-Physical Systems, vol. 1, pp. 394–405, 2023.

[14] C. Zanasi, S. Russo e M. Colajanni, “Flexible zero trust architecture for the cybersecurity of industrial IoT infrastructures,” Ad Hoc Networks, vol. 156, art. 103414, 2024, doi: 10.1016/j.adhoc.2024.103414.

[15] F. Federici, D. Martintoni e V. Senni, “A zero-trust architecture for remote access in industrial IoT infrastructures,” Electronics, vol. 12, n. 3, art. 566, 2023, doi: 10.3390/electronics12030566.

[16] P. Phiayura e S. Teerakanok, “A comprehensive framework for migrating to zero trust architecture,” IEEE Access, vol. 11, pp. 19487–19511, 2023.

https://www.ictsecuritymagazine.com/articoli/zero-trust-modello-purdue-ot/


Sicurezza digitale e vulnerabilità al phishing: profilo demografico e abitudini

La sicurezza digitale rappresenta il punto di partenza di questo progetto di ricerca, che analizza la vulnerabilità al phishing in contesto aziendale attraverso lo studio di un caso reale: una survey di cybersecurity awareness somministrata a 65 dipendenti di un’azienda IT, tutti caduti in una simulazione di phishing condotta nel 2025 su un campione complessivo di 2.286 destinatari.

Il primo articolo della serie ha presentato il profilo demografico del campione e le sue abitudini di sicurezza digitale, evidenziando un dato apparentemente paradossale: l’86% dei partecipanti possedeva già una formazione pregressa in cybersecurity, eppure il 100% è risultato vulnerabile alla simulazione. L’analisi ha messo in luce come fattori emotivi e cognitivi giochino un ruolo determinante nel determinare questa dissonanza tra conoscenza dichiarata e comportamento effettivo, mostrando inoltre differenze interessanti (e talvolta controintuitive) legate a genere ed età nella percezione del rischio e nelle esperienze pregresse con tentativi di phishing.

Caratteristiche del campione

Il campione analizzato è costituito dai dipendenti che hanno cliccato sul link della simulazione di phishing, effettuata nel corso del 2025, e che hanno aderito volontariamente alla survey in forma anonima. Come descritto nella sezione metodologica, la simulazione ha coinvolto complessivamente 2.286 dipendenti di un’azienda operante nel settore della tecnologia informatica.

Il questionario è stato compilato da 65 partecipanti, equamente distribuiti per genere (32 uomini, 32 donne, un partecipante non dichiarante). La fascia di età maggiormente rappresentata è quella compresa tra i 35 e i 44 anni (circa il 32%), seguita dalla fascia 45-54 anni (circa il 29%). Sono presenti anche partecipanti più giovani (18-24 anni, 5%) e over 55 (circa il 18%). Circa due terzi del campione possiede un titolo di studio universitario.

Un dato rilevante è rappresentato dall’elevata esposizione formativa: l’86% dei rispondenti dichiara di aver già partecipato a corsi di cybersecurity o di avere esperienza nel settore. Tuttavia, tutti i partecipanti sono risultati vulnerabili alla simulazione di phishing, evidenziando una possibile dissonanza tra formazione ricevuta e comportamento effettivo. Questo paradosso costituisce uno dei nodi centrali dell’analisi che segue.

Differenze di genere nella suscettibilità al phishing

Il genere è un fattore ampiamente studiato in relazione alla vulnerabilità alle truffe online, in particolare agli attacchi di phishing, sebbene i risultati in letteratura siano spesso contrastanti.

Suscettibilità generale. Diversi studi hanno riscontrato che le donne tendono a essere più suscettibili al phishing rispetto agli uomini. Halevi et al. (2015) hanno rilevato che il 40% delle donne è caduto in uno schema di phishing a due fasi, rispetto al 27% degli uomini. Questa maggiore suscettibilità femminile potrebbe essere mediata da fattori quali una minore motivazione o opportunità di apprendere sugli attacchi informatici, una maggiore familiarità con la comunicazione digitale quotidiana, o una tendenza a seguire le istruzioni più prontamente. Tuttavia, altri studi non hanno riscontrato differenze significative tra i generi (Sheng et al., 2010), suggerendo che il contesto e la tipologia di attacco possano giocare un ruolo moderatore.

Tratti di personalità e genere. I tratti della personalità secondo il modello Big Five mostrano correlazioni diverse con la vulnerabilità in base al genere. Nelle donne, il nevroticismo è correlato positivamente alla suscettibilità: livelli elevati di ansia e instabilità emotiva possono portare a decisioni affrettate di fronte a messaggi che evocano urgenza o minaccia (Eftimie et al., 2022). L’amicalità, tratto mediamente più presente nelle donne secondo la letteratura psicologica (Costa & McCrae, 1992), è un forte predittore di suscettibilità poiché facilita la manipolazione attraverso la fiducia e la conformità sociale. Gli individui con elevata amicalità tendono infatti a dare il beneficio del dubbio e a rispondere positivamente alle richieste altrui, caratteristiche che gli attaccanti sfruttano sistematicamente (Frauenstein & Flowerday, 2020).

Comportamenti online e competenze tecniche. Gli uomini tendono a comportamenti online più rischiosi in generale – come la visita di siti non sicuri o il download di software da fonti non verificate – mentre le donne, pur meno propense al rischio generico, risultano vulnerabili a esche specifiche come offerte di vantaggi immediati, coupon o promozioni (Halevi et al., 2013). Emerge inoltre un divario nelle competenze tecniche auto-percepite: le donne riportano mediamente una minore familiarità con gli aspetti tecnici della sicurezza informatica, e l’educazione anti-phishing non sempre si traduce in una riduzione effettiva della vittimizzazione per questo gruppo (Sheng et al., 2010). Questo suggerisce la necessità di approcci formativi differenziati che tengano conto delle diverse vulnerabilità.

Età e vulnerabilità al phishing

L’età rappresenta un altro fattore demografico frequentemente indagato, con risultati che sfidano alcune assunzioni di senso comune.

Adulti più anziani. L’età è positivamente correlata ai tempi di risposta e alla cautela dichiarata. Gli adulti più anziani tendono a classificare le email più lentamente e con maggiore attenzione, e sono più propensi a ignorare o eliminare le email di phishing piuttosto che interagire con esse (Sarno et al., 2023). Questo comportamento più prudente potrebbe derivare da una minore pressione temporale percepita o da una maggiore diffidenza verso le comunicazioni digitali. Tuttavia, quando decidono di interagire, gli anziani possono essere più vulnerabili a causa di una minore familiarità con gli indicatori tecnici di frode (Gavett et al., 2017).

Giovani adulti. I giovani, al contrario, sono più propensi a seguire le richieste contenute nelle email di phishing. Questa maggiore vulnerabilità può essere attribuita a diversi fattori: una maggiore velocità di elaborazione che si traduce in minore riflessione, un’esposizione più intensa al flusso di comunicazioni digitali che genera habituation, e una percezione di invulnerabilità tipica delle fasce d’età più giovani (Kumaraguru et al., 2009). I millennial e la Generazione Z, pur essendo “nativi digitali”, non mostrano necessariamente una maggiore capacità di riconoscere le minacce – anzi, la familiarità con il mezzo può generare un falso senso di sicurezza.

Implicazioni per la formazione. Questi dati suggeriscono che gli interventi formativi dovrebbero essere calibrati sull’età dei destinatari: per i più giovani, enfatizzando l’importanza di rallentare e verificare; per i più anziani, fornendo strumenti pratici per riconoscere gli indicatori tecnici di phishing.

Abitudini di sicurezza digitale dichiarate

Per quanto riguarda le abitudini dichiarate nella gestione delle email, la maggioranza dei partecipanti riferisce di adottare comportamenti prudenti. Circa il 75% afferma di controllare spesso o sempre un’email inaspettata prima di agire, mentre oltre l’80% dichiara di verificare frequentemente l’indirizzo del mittente.

Tuttavia, un’analisi più approfondita rivela criticità significative. Solo una minoranza (30%) dichiara di adottare queste precauzioni in modo sistematico e costante, mentre la quota rimanente ammette comportamenti discontinui, condizionati dal contesto, dal carico di lavoro e dallo stato emotivo del momento. Questa variabilità suggerisce l’esistenza di “finestre di vulnerabilità” – momenti di riduzione dell’attenzione che possono essere sfruttati da attacchi di phishing ben progettati e tempestivamente orchestrati.

Gestione delle password. Un’area di particolare criticità emerge nella gestione delle credenziali. Quasi la metà dei partecipanti (49%) dichiara di aggiornare le password esclusivamente quando obbligato da policy aziendali o scadenze di sistema, mentre il 43% lo fa con cadenza trimestrale. L’uso sistematico di password uniche per ciascun servizio non risulta consolidato: il punteggio medio su una scala da 1 a 5 è pari a 3,4, e solo il 23% dichiara di adottare sempre credenziali differenti.

Questo aspetto riflette un trend generale osservato anche in contesti più ampi. Secondo l’indagine globale di Proofpoint (2024), il 71% degli utenti ammette di compiere azioni digitali rischiose pur essendo consapevole dei pericoli, spesso in nome della praticità, del sovraccarico cognitivo o di una percezione attenuata del rischio. La comodità, in altre parole, tende a prevalere sulla sicurezza quando quest’ultima richiede uno sforzo aggiuntivo.

Profilo emergente. Il quadro che emerge è quello di un campione mediamente istruito e formato, con una buona consapevolezza teorica dei rischi informatici, ma con comportamenti di sicurezza non sempre coerenti e sistematici. La presenza di abitudini discontinue, unite a un’elevata fiducia nelle proprie capacità, costituisce un contesto favorevole all’insorgenza di errori, specialmente in condizioni di pressione, urgenza o distrazione. È proprio in questi momenti che la formazione teorica mostra i suoi limiti e la vulnerabilità si manifesta.

Percezione del rischio ed esperienze pregresse

Esperienze passate con link sospetti

Le risposte relative alle esperienze pregresse mostrano una percezione eterogenea del rischio e della propria vulnerabilità. Il 46% dei rispondenti dichiara di non aver mai cliccato su link sospetti in passato, mentre il 38% ammette almeno un episodio precedente e il 15% si dichiara incerto.

Questa distribuzione merita attenzione. La quota di incerti (15%) e la possibile sottostima degli incidenti passati suggeriscono che molti click su contenuti malevoli potrebbero non essere stati riconosciuti come tali, oppure che meccanismi di rimozione o imbarazzo influenzino l’ammissione dell’errore. La vulnerabilità reale potrebbe quindi essere superiore a quella auto-riferita, un fenomeno noto in letteratura come underreporting (Wash & Cooper, 2018).

Differenze di genere nelle esperienze pregresse

L’analisi per genere evidenzia differenze interessanti e apparentemente controintuitive. Le donne riportano meno episodi pregressi di click su link sospetti rispetto agli uomini: solo il 31% delle partecipanti ha dichiarato “Sì, mi è capitato”, contro il 44% degli uomini. Tuttavia, le donne si attribuiscono mediamente un livello di sicurezza inferiore nella capacità di riconoscere le minacce.

Questo dato suggerisce una possibile relazione inversa tra fiducia soggettiva e comportamento prudente: chi si percepisce meno competente potrebbe adottare maggiori precauzioni, mentre chi si sente sicuro tende a esporsi con maggiore disinvoltura. Una dinamica che richiama il fenomeno dell’overconfidence, approfondito nelle sezioni successive.

La letteratura sul tema mostra risultati contrastanti: alcuni studi trovano le donne più suscettibili al phishing (Halevi et al., 2015), altri non rilevano differenze significative tra generi (Ribeiro et al., 2024). I risultati della presente survey si collocano in questa zona di ambiguità, confermando che il genere, di per sé, non è un predittore univoco della vulnerabilità.

Competenza percepita nel riconoscimento dello spoofing

Oltre metà del campione (57%) dichiara di saper distinguere un indirizzo email legittimo da uno falsificato (spoofing), mentre il restante 43% si dichiara incerto o incapace. Questo dato, apparentemente rassicurante, rivela però un paradosso centrale: anche i soggetti che si attribuiscono tale competenza sono caduti nella simulazione.

Il fenomeno evidenzia come la conoscenza tecnica, se non supportata da attenzione costante e consapevolezza situazionale, non sia di per sé sufficiente a prevenire l’errore. Sapere cosa cercare non garantisce che lo si cerchi effettivamente, soprattutto in condizioni di fretta, distrazione o multitasking.

Il paradosso dell’overconfidence

Questo fenomeno prende il nome di overconfidence ed è ben documentato nella letteratura sulla presa di decisione in condizioni di incertezza (Moore & Healy, 2008). L’eccessiva fiducia nelle proprie capacità riduce la propensione ad adottare comportamenti di verifica e attenzione, creando un falso senso di sicurezza che gli attaccanti possono sfruttare.

Nel contesto del phishing, l’overconfidence opera come un fattore di rischio paradossale: proprio chi si sente più preparato può abbassare la guardia, convinto di essere in grado di riconoscere qualsiasi minaccia. Come mostreremo nell’analisi delle correlazioni, tutti i partecipanti che si erano dichiarati “completamente sicuri” (5 su 5) della propria capacità di riconoscere link malevoli sono caduti nella simulazione – un dato che rappresenta un monito inequivocabile sul pericolo di questa distorsione cognitiva.

Vishwanath et al. (2011) hanno dimostrato che la fiducia auto-riferita nella capacità di rilevare il phishing ha una correlazione negativa con l’effettiva capacità di rilevazione: in altre parole, chi si sente più sicuro tende a performare peggio nei test reali. Questo paradosso ha importanti implicazioni per la progettazione dei programmi formativi, che dovrebbero mirare non solo a trasmettere conoscenze, ma anche a calibrare realisticamente la percezione delle proprie competenze.

Il prossimo approfondimento sposterà l’attenzione dal piano descrittivo a quello interpretativo, introducendo il framework teorico che guiderà la lettura dei risultati empirici. Verranno presentati modelli psicologici, sociali e criminologici utili a comprendere perché individui formati e consapevoli continuino a cadere vittime di attacchi di social engineering ben congegnati.

Il presente contributo introduce i principali risultati dell’analisi; per un approfondimento completo del disegno metodologico, dei modelli interpretativi adottati e delle evidenze empiriche, si rimanda alla lettura dell’Empirical Research Paper “Phishing aziendale: perché i dipendenti formati cliccano comunque?”, a cura di Riccardo Laurenti, Veronica Vacchi e Ilenia Mercuri del team Cybersecurity di Dinova.

Fonti:

Articoli accademici:

  • Costa, P. T., & McCrae, R. R. (1992). Revised NEO Personality Inventory (NEO-PI-R) and NEO Five-Factor Inventory (NEO-FFI) professional manual. Psychological Assessment Resources.
  • Gavett, B. E., Zhao, R., John, S. E., Bussell, C. A., Roberts, J. R., & Yue, C. (2017). Phishing suspiciousness in older and younger adults: The role of executive functioning. PLOS ONE, 12(2), e0171620. https://doi.org/10.1371/journal.pone.0171620
  • Kumaraguru, P., Cranshaw, J., Acquisti, A., Cranor, L., Hong, J., Blair, M. A., & Pham, T. (2009). School of phish: A real-world evaluation of anti-phishing training. Proceedings of the 5th Symposium on Usable Privacy and Security (SOUPS ’09), 1-12.
  • Moore, D. A., & Healy, P. J. (2008). The trouble with overconfidence. Psychological Review, 115(2), 502-517. https://doi.org/10.1037/0033-295X.115.2.502
  • Sheng, S., Holbrook, M., Kumaraguru, P., Cranor, L. F., & Downs, J. (2010). Who falls for phish? A demographic analysis of phishing susceptibility and effectiveness of interventions. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 373-382.
  • Vishwanath, A., Herath, T., Chen, R., Wang, J., & Rao, H. R. (2011). Why do people get phished? Testing individual differences in phishing vulnerability within an integrated, information processing model. Decision Support Systems, 51(3), 576-586. https://doi.org/10.1016/j.dss.2011.03.002
  • Wash, R., & Cooper, M. M. (2018). Who provides phishing training? Facts, stories, and people like me. Proceedings of the 2018 CHI Conference on Human Factors in Computing Systems, 1-12.

https://www.ictsecuritymagazine.com/articoli/vulnerabilita-al-phishing/


Responsabilità e rischio nei sistemi di IA: il ruolo del contratto tra AI Act e NIS2

Nel percorso di analisi dedicato alla governance giuridica dell’Intelligenza Artificiale e alla progressiva costruzione del quadro regolatorio europeo, si è evidenziato come il diritto sia chiamato a confrontarsi con una crescente complessità tecnologica e con nuove forme di distribuzione del rischio. In questo contesto, emerge con particolare evidenza un nodo ancora solo parzialmente esplorato dalla dottrina e dalla regolazione.

Questo approfondimento, che conclude la serie di contributi, si concentra proprio su tale asimmetria: da un lato, l’AI Act, la direttiva NIS2 e la nuova disciplina sulla responsabilità da prodotto rafforzano in modo significativo gli strumenti di prevenzione, sicurezza e gestione del rischio; dall’altro, resta meno definita la concreta allocazione delle responsabilità quando i sistemi di Intelligenza Artificiale producono errori, danni o risultati inattesi.

Il risultato è un impianto normativo fortemente orientato alla prevenzione, ma ancora parzialmente incompleto sul piano della responsabilità ex post. È in questo spazio che si inserisce l’analisi che segue, dedicata al ruolo del contratto come strumento di governo e distribuzione del rischio nei sistemi di IA.

Sistemi di IA e non prevedibilità degli output come problema giuridico di partenza

Dall’analisi sin qui svolta emerge, dunque, la rilevanza della non prevedibilità degli output come elemento determinante per un’analisi giuridica dell’utilizzo dei modelli di IA.

Si è già notato come tale caratteristica costituisca un tratto strutturale di svariati modelli di IA contemporanei, in particolare di quelli basati su tecniche di apprendimento automatico e, più specificamente, sui modelli di deep learning.

Questa dimensione probabilistica implica che, pur in presenza di input identici o molto simili, il sistema possa produrre risultati differenti o non completamente prevedibili. L’output non è quindi rigidamente predeterminato dal programmatore, ma emerge dal funzionamento del modello addestrato su grandi quantità di dati. Ne deriva una parziale perdita di controllo ex ante sul comportamento del sistema, che rende più complessa l’attribuzione delle responsabilità giuridiche in caso di errore, malfunzionamento o danno.

A tale problematica si aggiunge un ulteriore elemento di complessità rappresentato dalla limitata trasparenza di molti modelli di IA avanzati.

In particolare, nei sistemi basati su modelli di apprendimento profondo e su grandi modelli linguistici (Large Language Models)[1], il funzionamento interno del sistema risulta spesso difficilmente comprensibile anche per gli stessi sviluppatori.

La mancanza di trasparenza costituisce una delle principali criticità da affrontare nella diffusione di tali tecnologie: da un lato rende più difficile per gli utenti comprendere i meccanismi decisionali dei sistemi di IA, alimentando talvolta diffidenza e resistenza alla loro adozione; dall’altro lato può ostacolare l’identificazione e la correzione di eventuali bias presenti nei modelli, proprio a causa della difficoltà di analizzare in modo diretto i processi decisionali sottostanti[2].

La trasparenza assume inoltre rilievo anche sotto il profilo dell’adeguamento normativo e della supervisione. Quando i processi decisionali dei sistemi risultano opachi, diventa più complesso verificare se essi rispettino effettivamente gli standard previsti da leggi, regolamenti e linee guida. Ciò può rendere più difficile per autorità di controllo, organizzazioni e utilizzatori accertare la conformità dei sistemi di IA ai requisiti imposti dal diritto europeo.

In questo contesto si inserisce il noto problema della “black box”, divenuta emblematica delle sfide poste dai sistemi basati su reti neurali profonde che producono decisioni attraverso processi computazionali la cui logica interna risulta in larga misura opaca. Tale opacità non rappresenta semplicemente un limite tecnico contingente, ma costituisce spesso una caratteristica intrinseca di determinate architetture algoritmiche. Come evidenziato nel quadro metodologico elaborato dal National Institute of Standards and Technology nel proprio AI Risk Management Framework (NIST)[3], esiste infatti una relazione strutturale tra capacità predittiva dei modelli e loro interpretabilità: sistemi caratterizzati da elevata complessità e performance tendono a risultare meno facilmente spiegabili.

Si delinea così quello che è definito un vero e proprio “paradosso della trasparenza”: i sistemi di Intelligenza Artificiale più avanzati e performanti, proprio perché fondati su architetture algoritmiche altamente complesse, risultano spesso anche i meno interpretabili sotto il profilo del loro funzionamento interno[4]. Questa tensione tra efficacia tecnologica ed esigenza di comprensibilità rappresenta uno dei nodi centrali del dibattito giuridico e regolatorio sull’IA.

Tale lettura non è tuttavia priva di obiezioni nella letteratura tecnica più recente. Una parte autorevole della scienza dei dati ha contestato la natura ineluttabile del trade-off fra accuratezza e interpretabilità, sostenendo che, per i contesti decisionali ad alto impatto, sia preferibile progettare modelli intrinsecamente interpretabili piuttosto che sviluppare metodi post hoc di spiegazione di modelli opachi (cfr. C. Rudin, Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Instead, in Nature Machine Intelligence, vol. 1, 2019, 206 ss.).

La distinzione assume rilievo anche sul piano regolatorio, poiché incide direttamente sulla qualità dell’adempimento degli obblighi di trasparenza imposti dall’AI Act: una documentazione tecnica chiara e una governance basata su modelli interpretabili in origine offrono garanzie sostanziali più robuste rispetto a tecniche di Explainable AI applicate a sistemi black box già addestrati.

Queste caratteristiche pongono un problema giuridico di fondo: il modello tradizionale di imputazione della responsabilità, costruito attorno all’idea di controllo e prevedibilità di un comportamento, pur conciliato con gli obblighi di prevenzione introdotti dalla legislazione europea e nazionale, risulta in ogni caso parzialmente inadeguato e insufficiente quando applicato ai sistemi di IA.

Se il comportamento del sistema non è completamente governabile e prevedibile ex ante e se i processi decisionali risultano in parte opachi, diventa più complesso stabilire quando un determinato risultato sia imputabile a un difetto del sistema, a un errore nell’addestramento, a un uso improprio da parte dell’utente o a fattori esterni non controllabili.

In questo senso, il limite della norma non deriva soltanto da una eventuale lacuna del Legislatore, ma trova la propria ragione nella natura stessa della tecnologia regolata.

L’IA introduce infatti una dimensione di incertezza strutturale che difficilmente può essere eliminata attraverso un incremento degli obblighi normativi o mediante una regolazione più dettagliata. Anche un sistema regolatorio particolarmente articolato non sarebbe in grado di prevedere tutte le possibili configurazioni di rischio derivanti dall’interazione tra modelli di IA, utenti e contesti applicativi.

Di conseguenza, il problema giuridico non può essere affrontato esclusivamente attraverso l’imposizione di nuovi obblighi legislativi. Piuttosto, appare necessario affiancare alla regolazione pubblica strumenti giuridici più flessibili, capaci di adattarsi alle specificità dei singoli rapporti tra i soggetti coinvolti nello sviluppo, nella distribuzione e nell’utilizzo dei sistemi di Intelligenza Artificiale, alla luce delle caratteristiche proprie del singolo rapporto.

In questa prospettiva, il contratto assume un ruolo centrale, quale strumento idoneo a disciplinare in modo puntuale e preciso la ripartizione dei rischi e delle responsabilità tra le parti, in relazione al singolo caso.

La contrattualizzazione della responsabilità come risposta funzionale

Attraverso specifiche clausole contrattuali, le parti possono definire ex ante i limiti di utilizzo del sistema oggetto di negoziazione, le garanzie offerte dal fornitore, le responsabilità dell’utilizzatore e i meccanismi di gestione degli eventuali incidenti o malfunzionamenti.

In questo modo, il diritto non cerca tanto di eliminare l’incertezza intrinseca della tecnologia, quanto piuttosto di governarla e distribuirne i rischi in modo consapevole.

Un’applicazione di tale logica si rinviene nel segmento del legal-tech, ambito in cui si è progressivamente affermata una pluralità di piattaforme di IA dedicate al supporto della ricerca giuridica, dell’analisi documentale e della redazione di atti, fra le quali, a livello internazionale, Harvey AI, CoCounsel (Casetext, oggi Thomson Reuters) e Lexis+ AI di LexisNexis. A titolo esemplificativo si può considerare, nel contesto italiano, Lexroom AI[5], piattaforma di Intelligenza Artificiale progettata per supportare avvocati e team legali nella ricerca giuridica, nell’analisi documentale e nella redazione di atti.

Secondo le informazioni pubbliche e le condizioni contrattuali della piattaforma (Lexroom Terms and Conditions)[6], i risultati generati dall’IA sono accompagnati da fonti normative e giurisprudenziali verificabili, consentendo agli utenti di controllare la correttezza delle informazioni prodotte. Tale approccio riduce il rischio di affidamento cieco sull’IA e assegna all’utente professionale la responsabilità finale della revisione e dell’utilizzo dell’output.

Inoltre, il modello contrattuale di Lexroom prevede che il servizio sia destinato esclusivamente a professionisti qualificati, come avvocati o dipartimenti legali aziendali, che dispongano delle competenze necessarie per interpretare e verificare le informazioni generate. Gli output sono concepiti come strumenti di supporto o bozze preliminari, che richiedono una revisione da parte dell’utente prima dell’utilizzo. Tali accorgimenti non eliminano l’incertezza intrinseca del sistema, ma contribuiscono a renderla gestibile attraverso una combinazione di misure tecnologiche, organizzative e contrattuali.

Dal punto di vista giuridico, l’esperienza di Lexroom evidenzia come la responsabilità per l’uso dei sistemi di IA venga ripartita tra fornitore e utente in modo coerente con le rispettive sfere di controllo e con lo scopo di utilizzo: il fornitore si impegna a garantire il corretto funzionamento della piattaforma e la qualità delle fonti integrate nel sistema, mentre l’utente mantiene la responsabilità della verifica finale dei contenuti e della loro applicazione nel contesto professionale.

In questa prospettiva, il contratto assume una funzione di integrazione della disciplina normativa, consentendo di adattare la gestione del rischio alle specificità del singolo rapporto contrattuale.

Questa esigenza emerge con particolare evidenza anche nella gestione dei rapporti lungo l’intera supply chain dei sistemi di Intelligenza Artificiale.

In tale contesto, la negoziazione contrattuale assume un ruolo centrale attraverso clausole relative a dichiarazioni e garanzie, manleve, obblighi di collaborazione e assistenza, nonché meccanismi di gestione degli incidenti e di condivisione delle informazioni, nel rispetto dei limiti normativi[7].

Accanto a tali profili, particolare rilievo assume anche l’individuazione del soggetto che debba assumere il ruolo di “fornitore” ai sensi dell’AI Act, con i relativi obblighi lui attribuiti. In contesti caratterizzati da una pluralità di attori, come nel caso di sistemi sviluppati da una software house su incarico di un’impresa committente, la determinazione della qualifica di fornitore può richiedere una valutazione più articolata, che tenga conto delle concrete modalità di sviluppo, distribuzione e utilizzo del sistema[8].

Proprio per questo motivo, il contratto assume una funzione particolarmente rilevante nel chiarire e specificare la ripartizione delle responsabilità tra i diversi soggetti coinvolti.

Un ulteriore elemento che conferma il ruolo integrativo del contratto emerge dall’art. 25, par. 1, lett. a), dell’AI Act, secondo cui il deployer che apponga il proprio nome o marchio a un sistema di AI assume la qualifica di fornitore, “fatti salvi accordi contrattuali che prevedano una diversa ripartizione degli obblighi”: tale previsione riconosce espressamente lo spazio della negoziazione contrattuale come strumento idoneo a modulare la distribuzione delle responsabilità tra i soggetti coinvolti, nel rispetto del quadro normativo europeo.

In questa prospettiva, la contrattualizzazione non rappresenta un elemento di tensione rispetto al quadro normativo europeo, ma piuttosto uno strumento ausiliario e complementare alla disciplina previste dall’AI Act, NIS2 e, in generale, alle politiche europee di gestione del rischio tecnologico, che consente di tradurre nella pratica operativa i principi di gestione del rischio, trasparenza e responsabilità promossi dalle normative.

La dimensione negoziale diventa così il luogo in cui le indicazioni generali della normativa vengono adattate alle specificità dei singoli rapporti economici e tecnologici, contribuendo a rendere effettiva e concretamente applicabile la governance dei sistemi di Intelligenza Artificiale.

Clausole contrattuali potenzialmente orientate alla gestione dell’imprevedibilità

Dall’analisi precedente si è visto come, generalmente, nei contratti relativi a servizi basati su Intelligenza Artificiale si riscontrino disposizioni che limitano la responsabilità del fornitore in relazione a risultati inesatti o incompleti generati dal sistema, nonché clausole che escludono garanzie implicite circa l’assoluta correttezza degli output. Tali pattuizioni, purché non si traducano in un grave squilibrio tra i contraenti, non risultano in contrasto con l’impianto dell’AI Act, il quale non pretende di garantire l’infallibilità dei sistemi, ma piuttosto impone obblighi di gestione del rischio, trasparenza e accountability.

In questo senso, il contratto deve consentire di tradurre tali obblighi in una disciplina operativa dei rapporti tra le parti, prevenendo situazioni di incertezza e potenziali contenziosi derivanti dall’utilizzo improprio o non conforme dei sistemi di IA.

Un ulteriore profilo rilevante riguarda la verificabilità delle informazioni e delle fonti utilizzate dal sistema. Alcune piattaforme di Intelligenza Artificiale progettate per ambiti professionali specifici adottano soluzioni che consentono agli utenti di controllare direttamente le fonti su cui si basano gli output generati.

Su questa linea si collocano, secondo quanto dichiarato dalle stesse imprese fornitrici, anche le piattaforme già richiamate nel legal-tech – fra cui, in Italia, Lexroom AI – che presentano l’affidabilità e la trasparenza delle risposte prodotte dal sistema come elementi qualificanti del proprio posizionamento di mercato.

In particolare, l’output generato dal sistema è accompagnato da riferimenti normativi e giurisprudenziali verificabili, che l’utente può consultare per accertare la correttezza delle informazioni. Il sistema non fornisce quindi soltanto una risposta, ma rende accessibili anche le basi giuridiche su cui tale risposta è costruita.

La promessa di risultati “verificati, citabili e trasparenti”, evidenziata nelle informazioni pubbliche della piattaforma, non può e non deve tuttavia essere interpretata come una garanzia assoluta di correttezza dell’output.

Piuttosto, essa rappresenta il risultato di una serie di strategie tecniche e organizzative finalizzate a ridurre il rischio di errore. Tra queste rientrano l’utilizzo di dataset giuridici specializzati, l’integrazione con banche dati normative e giurisprudenziali e la possibilità per l’utente di verificare direttamente le fonti citate dal sistema. Tali soluzioni consentono di mitigare, senza pretendere di eliminarla completamente, l’incertezza intrinseca dei modelli di Intelligenza Artificiale generativa, prevedendo contrattualmente una verifica “umana” dell’output da parte dell’utilizzatore.

Ne deriva che anche nel caso di sistemi verticali e altamente specializzati, come quelli sviluppati nel settore legal tech, permane una dimensione di rischio legata alla natura probabilistica del funzionamento dei modelli che la regolazione normativa, da sola, difficilmente può controllare, rendendo necessario il ricorso a strumenti negoziali di gestione del rischio.

Una simile impostazione, tra l’altro, traduce sul piano contrattuale e operativo i principi di trasparenza e tracciabilità promossi dall’AI Act e contribuisce, in linea con la logica preventiva della direttiva NIS2, a rafforzare la gestione del rischio nell’impiego dei sistemi digitali.

Tale approccio, ben specificato nelle condizioni contrattuali, valorizza l’utilizzo del sistema di IA come strumento di supporto decisionale e non di sostituzione, mantenendo centrale il ruolo del professionista nella valutazione finale delle informazioni prodotte.

Di conseguenza, ciò diviene rilevante anche per la gestione dei rapporti lungo la supply chain. In questo contesto, il contratto può svolgere, infatti, una funzione essenziale nel disciplinare i rapporti tra i diversi attori della filiera, prevedendo, ad esempio, dichiarazioni e garanzie relative alla qualità dei dati utilizzati per l’addestramento, obblighi di collaborazione e assistenza tecnica, nonché meccanismi di manleva o di ripartizione delle responsabilità in caso di malfunzionamenti o incidenti.

Accanto a tali disposizioni, i contratti possono prevedere dichiarazioni e garanzie rese dall’utilizzatore, attraverso le quali quest’ultimo attesti di possedere le competenze tecniche e organizzative necessarie per utilizzare il sistema nel rispetto delle istruzioni fornite. Tali dichiarazioni possono riguardare, ad esempio, il livello di alfabetizzazione digitale dell’utente, la disponibilità di adeguati sistemi di controllo interno o, appunto, la capacità di verificare gli output generati dall’Intelligenza Artificiale prima del loro utilizzo. L’obiettivo di tali clausole non è tanto quello di trasferire integralmente il rischio sull’utilizzatore, quanto piuttosto quello di garantire che il sistema venga impiegato in condizioni coerenti con le finalità e i limiti per cui è stato progettato.

Un ulteriore ambito di rilievo riguarda le clausole relative alla manutenzione, agli aggiornamenti e alla sicurezza dei sistemi. In particolare, i contratti possono prevedere obblighi specifici in capo al fornitore relativi alla manutenzione della piattaforma, alla correzione di eventuali vulnerabilità e all’aggiornamento periodico dei modelli e delle basi dati utilizzate dal sistema.

Tali disposizioni risultano coerenti non solo con la logica preventiva dell’AI Act, ma anche con le prescrizioni della Direttiva NIS2 in materia di gestione del rischio informatico e di sicurezza delle infrastrutture digitali. In questo ambito, il contratto può disciplinare aspetti quali gli standard di sicurezza adottati (es. crittografia AES-256, certificazioni ISO 27001, ISO 22301), le procedure di backup e disaster recovery, nonché i tempi di notifica in caso di incidenti o violazioni dei dati[9].

Particolare attenzione può essere dedicata anche alla disciplina della proprietà intellettuale, dell’utilizzo dei dati e degli eventuali indennizzi derivanti da violazioni contrattuali. La definizione chiara ed esaustiva di tali profili dei diritti tutelati contribuisce indubbiamente a ridurre l’incertezza giuridica connessa all’utilizzo di sistemi di IA e a prevenire possibili controversie tra le parti, rafforzando al contempo i principi di responsabilizzazione e prevenzione che caratterizzano la regolazione europea del settore.

Accanto a questi strumenti contrattuali, un ulteriore meccanismo di gestione del rischio può essere rappresentato dall’inserimento di una polizza assicurativa accessoria al contratto, destinata a coprire i danni eventualmente derivanti da malfunzionamenti del sistema, da errori negli output generati dall’IA o da violazioni involontarie di obblighi normativi.

La polizza può prevedere specifici massimali di indennizzo, eventuali franchigie o esclusioni e condizioni per l’attivazione della copertura, contribuendo a distribuire in modo più equilibrato il rischio tra i diversi soggetti coinvolti nel rapporto contrattuale.

Negli ultimi anni, numerose imprese stanno infatti valutando, insieme ai propri broker assicurativi, se i rischi derivanti dall’utilizzo dei sistemi di Intelligenza Artificiale possano essere ricompresi nelle coperture assicurative già esistenti – quali le polizze di responsabilità civile professionale o le assicurazioni cyber – oppure se sia necessario sviluppare nuovi strumenti assicurativi specificamente dedicati a tali tecnologie.

La valutazione del rischio rappresenta, del resto, un elemento centrale nel contratto di assicurazione: affinché un rischio possa essere assicurato, è necessario che esso sia almeno in parte prevedibile e valutabile in termini di frequenza e gravità. Nel caso dell’Intelligenza Artificiale, tuttavia, la natura evolutiva dei sistemi e la rapida trasformazione delle tecnologie potrebbero rendere la valutazione del rischio particolarmente complessa, imponendo un continuo adattamento delle soluzioni assicurative disponibili[10].

Le prime soluzioni attualmente presenti sul mercato tendono quindi ad adattare le coperture assicurative esistenti alle nuove sfide, ad esempio attraverso l’introduzione di specifiche esclusioni, franchigie dedicate o limiti di copertura mirati. In prospettiva, è possibile che il progressivo sviluppo di queste tecnologie e una maggiore conoscenza dei rischi associati al loro utilizzo consentano di elaborare strumenti assicurativi sempre più adeguati alle esigenze degli operatori.

Per rendere più concreto il quadro sinora delineato, è utile riportare a titolo esemplificativo un’ipotesi di clausola contrattuale che mostra come gli obblighi di conformità e di sicurezza previsti dall’AI Act e dalla direttiva NIS2 possano essere tradotti in disposizioni operative.

Il contratto potrebbe ad esempio contenere la dicitura: “Le Parti riconoscono che il Sistema di Intelligenza Artificiale oggetto del presente contratto opera sulla base di modelli di apprendimento automatico caratterizzati da componenti probabilistiche e, pertanto, può generare output non integralmente prevedibili né riproducibili.

Tale caratteristica non costituisce, di per sé, vizio o difetto del servizio, purché il Fornitore mantenga un sistema di controllo, aggiornamento e logging conforme agli standard tecnici applicabili, al Regolamento (UE) 2024/1689 (AI Act) e, in particolare, agli articoli 9, 17 e 19 dello stesso.

L’Utente si impegna a utilizzare gli output generati esclusivamente come supporto decisionale, garantendo che ogni decisione finale sia oggetto di validazione da parte di un soggetto umano dotato delle competenze necessarie per interpretare e verificare i risultati prodotti.

Il Fornitore, da parte sua, si impegna a rendere disponibili le informazioni tecniche essenziali sul funzionamento del sistema e sui rischi d’impiego, in modo da consentire tale supervisione.

Il Fornitore si impegna altresì a rispettare gli obblighi di sicurezza della supply chain previsti dalla Direttiva (UE) 2022/2555 (NIS2) ed eventuali normative di ricevimento, assicurando che i propri subfornitori adottino misure di cybersicurezza equivalenti e siano soggetti a verifiche periodiche. 

L’Utente si obbliga a utilizzare il Sistema in conformità alle istruzioni d’uso, garantendo supervisione umana qualificata e qualità dei dati di input, nonché a sospendere immediatamente l’utilizzo in caso di rischio per la salute, la sicurezza o i diritti fondamentali. 

In caso di incidente di sicurezza o malfunzionamento, il Fornitore dovrà notificare tempestivamente l’Utente e le autorità competenti (CSIRT/ACN), collaborando alla gestione dell’incidente. 

Le Parti concordano che: 

– i danni derivanti da difetti di progettazione, addestramento o conformità normativa del Sistema saranno imputabili al Fornitore; 

– i danni derivanti da uso improprio, mancata supervisione o alterazioni sostanziali del Sistema saranno imputabili all’Utente, che assumerà la qualifica di Fornitore ai sensi dell’art. 25 AI Act. 

Resta inteso che eventuali violazioni degli obblighi di sicurezza della supply chain (NIS2) da parte di subfornitori saranno imputabili al Fornitore, salvo che l’Utente abbia selezionato direttamente tali soggetti.

Le Parti cooperano nella tracciabilità e nella documentazione degli eventi, ai fini di eventuali indennizzi o coperture assicurative.

Le Parti convengono che il rischio residuo legato a eventi imprevedibili e non imputabili a violazione contrattuale sia coperto da apposita polizza assicurativa, il cui massimale e condizioni sono indicati nell’Allegato tecnico al presente contratto”.

Nel complesso, l’insieme delle clausole contrattuali dimostra come il contratto possa svolgere una funzione essenziale di traduzione operativa dei principi stabiliti dalla normativa europea.

I limiti della contrattualizzazione: clausole vessatorie, squilibrio negoziale e necessità di standard minimi

L’analisi delle clausole virtuose svolta nel paragrafo precedente non può prescindere da una constatazione già emersa nel Capitolo II: la prassi contrattuale dei principali fornitori di servizi di IA si discosta sensibilmente dal modello di equilibrio negoziale che la regolazione europea presuppone. I contratti dei big tech, predisposti unilateralmente e proposti in via prevalentemente standardizzata, concentrano sull’utente finale una quota molto significativa del rischio decisionale, applicativo e risarcitorio.

Vi concorre una combinazione ricorrente di esclusioni di garanzia, limitazioni quantitative della responsabilità, manleve a senso unico, clausole di modifica unilaterale e facoltà di sospensione del servizio in capo al fornitore.

La «contrattualizzazione» rischia, in tale contesto, di tradursi non in una distribuzione condivisa della responsabilità, ma in una traslazione integrale verso il contraente debole.

Il quadro così delineato solleva interrogativi rilevanti sotto il profilo della disciplina delle clausole vessatorie. Nei rapporti business-to-consumer si applica la Direttiva 93/13/CEE[11], recepita in Italia agli artt. 33 ss. del Codice del consumo (D.Lgs. 6 settembre 2005, n. 206) [12], che presume vessatorie le clausole le quali, malgrado la buona fede, determinino un significativo squilibrio dei diritti e degli obblighi derivanti dal contratto.

Più nel dettaglio, l’art. 33, comma 2, qualifica come presuntivamente vessatorie, fra le altre, le pattuizioni che escludono o limitano la responsabilità del professionista in caso di morte o danno alla persona derivante da un suo fatto o da una sua omissione (lett. a), che limitano le azioni in caso di inadempimento totale o parziale (lett. b), che riservano al solo professionista la facoltà di recedere o di modificare unilateralmente le condizioni contrattuali (lett. e ed m) e che limitano la responsabilità per inadempimento delle obbligazioni accessorie. Tali clausole, ai sensi dell’art. 36 Cod. cons., sono nulle quando non abbiano formato oggetto di trattativa individuale; la nullità opera anche di ufficio nell’interesse esclusivo del consumatore.

Diverse pattuizioni rinvenibili nei Termini di OpenAI, Microsoft e Google, esaminate nel Capitolo II, presentano profili di tensione con tale disciplina. La formula «as is and as available», unita a tetti risarcitori molto contenuti (frequentemente parametrati al corrispettivo versato negli ultimi dodici mesi) e all’esclusione integrale dei danni indiretti, consequenziali, reputazionali e di lucro cessante, si colloca al limite estremo dello spazio negoziale consentito al professionista. Analoghe perplessità destano le clausole di modifica unilaterale dei termini, le facoltà di sospensione del servizio ad nutum e le manleve generali a carico dell’utente, che in concreto possono integrare ipotesi di vessatorietà presunta.

La piena valutazione della loro validità andrà condotta caso per caso, alla luce dell’effettiva trattativa individuale (di norma assente nei piani consumer) e della giurisprudenza europea di legittimità in materia di squilibrio significativo.

A rafforzare la cornice di tutela intervengono le Direttive (UE) 2019/770 e 2019/771[13], in materia rispettivamente di contratti di fornitura di contenuti e servizi digitali e di vendita di beni con elementi digitali. Le due fonti, recepite nel Codice del consumo agli artt. 135-octies ss. e 128 ss., introducono garanzie di conformità soggettiva e oggettiva, obblighi di aggiornamento e specifici rimedi a tutela del consumatore digitale. La disciplina si applica anche ai servizi di IA generativa erogati in modalità SaaS, e con essa le clausole standard analizzate non sempre risultano pienamente compatibili.

Nei rapporti business-to-business l’apparato di tutela è meno strutturato ma non assente. Vengono in rilievo, in particolare, il divieto di abuso di dipendenza economica di cui all’art. 9 della legge 18 giugno 1998, n. 192, applicabile per estensione giurisprudenziale ai rapporti di fornitura digitale segnati da forte asimmetria contrattuale, e il Regolamento (UE) 2022/1925 (Digital Markets Act)[14], che nei confronti dei gatekeeper impone obblighi di equità nelle condizioni d’uso.

A livello europeo è inoltre in corso una riflessione sull’opportunità di introdurre una disciplina armonizzata delle clausole abusive nei contratti B2B nel mercato dei servizi digitali, sull’esempio di quanto già previsto dal Regolamento (UE) 2019/1150 in materia di servizi di intermediazione online.

In tale prospettiva, la funzione integrativa del contratto rispetto al quadro AI Act-NIS2 non può essere accolta acriticamente. Nei rapporti caratterizzati da forte squilibrio l’autonomia negoziale rischia di ridursi a mera adesione a condizioni predisposte, con effetti potenzialmente regressivi rispetto agli obiettivi di responsabilizzazione e tutela perseguiti dal Legislatore europeo.

La «contrattualizzazione virtuosa» descritta nei paragrafi precedenti presuppone, infatti, una capacità negoziale effettiva tra le parti, di norma riscontrabile soltanto nei contratti enterprise o nei rapporti negoziati individualmente, ben difficilmente nei piani consumer o nelle micro e piccole imprese.

Si profila dunque, sul piano sistematico, l’esigenza di affiancare alla libera negoziazione strumenti di standardizzazione e di riequilibrio idonei a tradurre i principi di gestione del rischio in clausole minime non derogabili. In tale direzione si possono ipotizzare quattro soluzioni concorrenti.

La prima è il ricorso ai codici di condotta volontari previsti dall’art. 95 dell’AI Act, che possono includere modelli di clausole per la traslazione equilibrata del rischio.

La seconda è l’elaborazione, da parte di autorità nazionali ed europee, di clausole contrattuali tipo, sull’esempio delle Standard Contractual Clauses adottate dalla Commissione europea ai sensi dell’art. 46 del Regolamento (UE) 2016/679 per i trasferimenti internazionali di dati, e di quelle predisposte dall’Unione europea per gli appalti pubblici di soluzioni di IA (EU Model Contractual AI Clauses, 2023).

La terza consiste nell’adozione di linee guida AgID e di modelli operativi per la Pubblica Amministrazione, idonei a fissare uno standard contrattuale di riferimento nei rapporti con i fornitori tecnologici. La quarta, infine, prevede un intervento legislativo settoriale, di matrice nazionale o europea, volto a tipizzare alcune clausole abusive nei contratti di fornitura di servizi di IA, in coerenza con la ratio di protezione del contraente debole già accolta dal Codice del consumo.

In un assetto così rinnovato il contratto manterrebbe la propria funzione di adattamento operativo ai singoli contesti, ma all’interno di un perimetro di standard minimi inderogabili. Solo a queste condizioni potrà evitarsi che, nei rapporti tra fornitori di IA e utenti, la prassi negoziale riproponga logiche di traslazione integrale del rischio incompatibili con il quadro europeo di responsabilizzazione multilivello.

Prospettive evolutive e considerazioni conclusive

L’analisi svolta nei paragrafi precedenti evidenzia come la disciplina dei sistemi di Intelligenza Artificiale si collochi all’interno di un contesto normativo in rapida evoluzione, nel quale il Legislatore europeo ha progressivamente cercato di sviluppare strumenti volti a garantire un elevato livello di sicurezza, trasparenza e responsabilità nell’utilizzo delle nuove tecnologie. Come si è visto, l’AI Act rappresenta il primo tentativo organico di regolamentare l’Intelligenza Artificiale secondo un approccio basato sul rischio, mentre la direttiva NIS2 rafforza il quadro di sicurezza delle infrastrutture digitali e dei servizi essenziali.

Tuttavia, si è constatato che la complessità tecnica dei sistemi di IA e la pluralità di soggetti coinvolti nella loro progettazione, sviluppo e utilizzo rendono difficile per la sola normativa pubblica disciplinare in modo esaustivo tutte le possibili configurazioni operative di tali tecnologie. I modelli di IA, si caratterizzano per un funzionamento dinamico ed evolutivo, che può generare risultati non pienamente prevedibili e che si inserisce spesso all’interno di ecosistemi tecnologici articolati, composti da diversi attori e livelli della supply chain.

In questo scenario, dall’analisi svolta è emerso con chiarezza che il ruolo del diritto non può limitarsi alla definizione di obblighi generali e di principi regolatori, ma deve necessariamente confrontarsi con l’esigenza di garantire strumenti applicativi in grado di adattarsi alla varietà dei contesti operativi in cui i sistemi di IA vengono impiegati.

È in questa prospettiva che emerge la funzione integrativa del contratto, quale strumento capace di tradurre i principi della regolazione europea in soluzioni operative calibrate sulle specifiche caratteristiche dei rapporti tra gli operatori economici.

La contrattualizzazione consente di adattare la distribuzione delle responsabilità alle concrete modalità di sviluppo, distribuzione e utilizzo dei sistemi di Intelligenza Artificiale, tenendo conto delle diverse posizioni dei soggetti coinvolti nella filiera tecnologica. In questo modo, il contratto contribuisce a rendere effettiva la governance del rischio prevista dal Legislatore europeo, permettendo di coordinare obblighi, controlli e meccanismi di cooperazione tra i diversi attori del sistema.

Da questa prospettiva, la relazione tra normativa pubblica e autonomia negoziale non deve essere interpretata in termini di contrapposizione, ma piuttosto come un rapporto di complementarità. Mentre la regolazione europea stabilisce gli standard minimi di sicurezza, trasparenza e responsabilità cui devono conformarsi i sistemi di IA, il contratto consente di declinare tali principi in modo flessibile e adattabile alle specificità delle diverse applicazioni tecnologiche e dei contesti organizzativi in cui esse vengono implementate.

Guardando alle possibili evoluzioni future, è verosimile che il ruolo della contrattualizzazione nella disciplina dei sistemi di Intelligenza Artificiale sia destinato a rafforzarsi ulteriormente. La crescente diffusione di modelli di IA in settori strategici dell’economia e della Pubblica Amministrazione comporterà infatti un progressivo consolidamento di prassi contrattuali specializzate, capaci di affrontare in modo sempre più sofisticato le questioni relative alla gestione del rischio tecnologico, alla sicurezza dei sistemi e alla ripartizione delle responsabilità lungo la filiera digitale.

Parallelamente, anche il quadro normativo europeo potrebbe evolversi verso forme sempre più integrate di governance tecnologica, nelle quali la regolazione pubblica continui a definire principi e standard di riferimento, lasciando tuttavia spazio a strumenti flessibili di attuazione, tra cui la contrattazione tra gli operatori economici e l’adozione di modelli organizzativi e di compliance interni alle imprese.

In questa prospettiva, la normativa potrebbe progressivamente orientarsi non tanto verso una disciplina rigida e dettagliata delle singole clausole contrattuali, quanto piuttosto verso la definizione di principi guida e requisiti minimi relativi alla gestione del rischio, alla trasparenza e alla ripartizione delle responsabilità nei rapporti contrattuali relativi ai sistemi di IA, improntati al rispetto della disciplina consumeristica e all’equilibrio tra i contraenti.

Un simile approccio consentirebbe di valorizzare il ruolo dell’autonomia negoziale senza irrigidire eccessivamente una materia caratterizzata da una forte evoluzione tecnologica.

Il Legislatore potrebbe, ad esempio, individuare alcune aree nelle quali favorire la standardizzazione di prassi contrattuali o la predisposizione di modelli di riferimento e, parallelamente, quelle che invece necessitano di maggiore flessibilità negli accordi, lasciando alle parti un margine di adattamento alle specificità dei singoli contesti applicativi e delle diverse filiere tecnologiche. Oppure, ancora, paventare l’ipotesi di istituire una polizza assicurativa obbligatoria per i sistemi maggiormente complessi, come misura a tutela del rischio imprevedibile.

In conclusione, l’analisi dei modelli normativi e contrattuali applicabili ai sistemi di IA evidenzia come la gestione dei rischi connessi a tali tecnologie non possa certamente essere affidata esclusivamente alla regolazione legislativa. Piuttosto, essa richiede un approccio su più piani, nel quale norme pubbliche, strumenti contrattuali e misure organizzative cooperino nel costruire un sistema di governance capace di coniugare innovazione tecnologica e tutela degli interessi giuridici coinvolti.

L’analisi evidenzia come la crescente diffusione dei sistemi di Intelligenza Artificiale metta in crisi i tradizionali modelli di imputazione della responsabilità giuridica, a causa della non prevedibilità degli output e della natura opaca di molti sistemi avanzati. Il quadro europeo, articolato tra AI Act, NIS2 e disciplina sulla responsabilità da prodotto, rafforza gli strumenti di prevenzione e gestione del rischio, ma non sempre consente una chiara allocazione ex post delle responsabilità.

In questo spazio di incertezza si colloca il ruolo del contratto, inteso come strumento flessibile di distribuzione del rischio e di integrazione della regolazione pubblica lungo la filiera dell’IA. Il contributo costituisce la base di riflessione del white paper “Contrattualizzazione e allocazione delle responsabilità nei modelli di IA: AI Act, NIS2 e profili critici” di Chiara De Filippo, al quale si rinvia per un approfondimento sistematico.

Fonti:

[1] Longo A., Masi G., LLM, cosa sono: tutto ciò che bisogna sapere sui large language models, in Agenda Digitale, 2025: “I Large language models sono modelli di deep learning estremamente complessi, basati su reti neurali con miliardi di parametri, progettati per comprendere, interpretare e generare linguaggio naturale in forma scritta. Il loro funzionamento si basa sull’addestramento su vastissimi corpora di testi eterogenei – libri, articoli accademici, siti web, contenuti social, conversazioni online – che consente di cogliere e modellare con efficacia le strutture sintattiche, semantiche, lessicali e pragmatiche della lingua umana in tutte le sue sfumature”, consultabile al sito: https://www.agendadigitale.eu.

[2] Lusardi G., Assicurare l’imprevedibile: le polizze per il rischio di IA, in Diritto al Digitale, 20 maggio 2024, consultabile al sito: https://dirittoaldigitale.com.

[3] https://www.nist.gov/itl/ai-risk-management-framework.

[4]Responsabilità dei sistemi AI e decisioni automatizzate: il nuovo paradigma giuridico dell’era algoritmica, in ICT Security Magazine, 27 gennaio 2026, consultabile al sito: https://www.ictsecuritymagazine.com.

[5] https://lexroom.ai.

[6] https://lexroom.ai/terms-and-conditions.

[7] Franchi A., Riflessioni sulla manleva, in Contratto e impresa, 1, 2017, 155.

[8] Fedi A., Tre osservazioni sull’AI Act e il suo rapporto con il diritto dei contratti, in MediaLaws, 3/2024, 284 ss.

[9] Contratti SaaS: guida legale a SLA, dati e aggiornamenti (2025), op. cit.

[10] Lusardi G., op.cit.

[11] Direttiva 93/13/CEE del Consiglio, del 5 aprile 1993, concernente le clausole abusive nei contratti stipulati con i consumatori. Consultabile al sito: https://eur-lex.europa.eu/legal-content/IT/ALL/?uri=celex%3A31993L0013.

[12] Codice del consumo, D.Lgs. 6 settembre 2005, n. 206, artt. 33-37 e 128 ss.

[13] Direttiva (UE) 2019/770 del Parlamento europeo e del Consiglio, del 20 maggio 2019. Consultabile al sito: https://eur-lex.europa.eu/legal-content/it/ALL/?uri=CELEX%3A32019L0770.

[14] Regolamento (UE) 2022/1925 (Digital Markets Act), consultabile al sito: https://eur-lex.europa.eu/eli/reg/2022/1925/oj/eng.

https://www.ictsecuritymagazine.com/articoli/sistemi-di-ia/
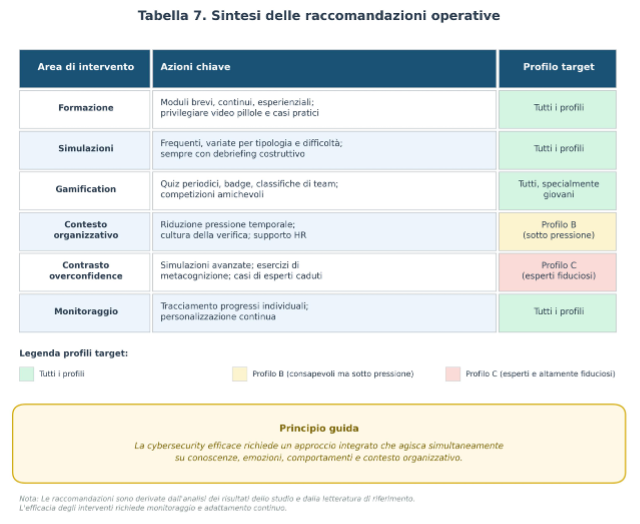


Star Blizzard passa alla tecnica RedFlick: oltre 100 organizzazioni prese di mira con finti inviti a eventi

Microsoft Threat Intelligence ha pubblicato il 29 settembre 2026 l’analisi delle campagne condotte tra gennaio e agosto da Star Blizzard, attore russo che otto agenzie di cinque paesi ritengono subordinato al Centro 18 dell’FSB. L’attività ha interessato oltre 100 organizzazioni, in prevalenza negli Stati Uniti e nel Regno Unito, con almeno 13 campagne di phishing su larga scala oltre al consueto spear phishing mirato. Il numero delle organizzazioni effettivamente compromesse non è stato divulgato. La novità tecnica è RedFlick: una catena che si affida ad attività pianificate travestite da componenti di rete per installare CosmicPulse, backdoor in Python, e che secondo Microsoft richiede una sola interazione dell’utente. Nuovo anche il canale di invio: account creati su siti WordPress e cPanel compromessi.

Il report è pubblicato sul Microsoft Security Blog e dichiara di notificare direttamente le organizzazioni prese di mira o compromesse.

Chi è Star Blizzard

Star Blizzard è un attore attivo da anni contro obiettivi diplomatici, accademici, giornalistici e della società civile. È tracciato anche come SEABORGIUM, Callisto Group, TA446 e COLDRIVER. Microsoft osserva che il gruppo riscrive periodicamente le proprie tecniche in risposta all’esposizione pubblica delle campagne precedenti. È esattamente ciò che si vede nel 2026.

L’attribuzione al Centro 18 dell’FSB

Microsoft riporta l’attribuzione di CISA, che colloca Star Blizzard come subordinato al Centro 18 dell’FSB, il servizio di sicurezza federale russo. L’attribuzione risale all’advisory congiunto del 7 dicembre 2023, firmato da otto enti di cinque paesi: NCSC britannico, CISA, FBI, NSA e Cyber National Mission Force per gli Stati Uniti, ACSC australiano, CCCS canadese e NCSC neozelandese. Il testo afferma che il gruppo è “almost certainly subordinate” a quel centro.

Vale la pena essere precisi sul linguaggio, perché per un lettore giuridico la differenza conta. “Almost certainly” è una espressione di probabilità nelle scale usate dalle agenzie di intelligence, non una dichiarazione di livello di confidenza analitica, e non è in alcun modo un accertamento giudiziario. La convergenza di otto enti e la stabilità della valutazione nel tempo la rendono però solida quanto può esserlo un giudizio di questo genere. È la distanza fra valutazione di intelligence e prova processuale il punto in cui la cronaca sbaglia più spesso, come sa chi lavora con i modelli di analisi degli attori.

Il cambio di modello: dallo spear phishing mirato alle campagne di massa

Il mutamento più significativo non è tecnico ma operativo. “In 2026, Microsoft observed Star Blizzard shift from exclusively targeted spear-phishing operations to also conducting larger-scale phishing campaigns“, scrive l’azienda nel passaggio ripreso anche da CyberScoop. Si parla di campagne da decine a centinaia di messaggi ciascuna, a un volume mai osservato prima per questo attore. Microsoft valuta che il gruppo abbia adottato una piattaforma di invio massivo per automatizzare l’esecuzione e allargare il bacino iniziale di bersagli. Le campagne su larga scala contate da gennaio sono almeno 13.

Per una struttura di intelligence è una scelta controintuitiva, perché il volume aumenta la probabilità di essere individuati. Ha senso solo se il bacino di organizzazioni con difese deboli è abbastanza ampio da compensare il rumore. Microsoft aggiunge un’ipotesi sulla sequenza geografica, e la formula al condizionale: le prime campagne, a gennaio e febbraio, hanno raggiunto utenti del provider ucraino Ukr.net, e il successivo passaggio ai bersagli globali “could indicate Star Blizzard initially targeted Ukraine to test their new capabilities“.

Siti WordPress e cPanel compromessi come infrastruttura di invio

Da marzo il gruppo ha cambiato anche il canale. In precedenza creava account su servizi di posta gratuiti, soprattutto Proton e account consumer Microsoft, per impersonare figure note al bersaglio. Nelle campagne di massa usa invece account creati su siti ospitati su cPanel e WordPress, con lo stesso nome utente replicato su più domini. Microsoft Threat Intelligence valuta con alta confidenza che quei siti siano stati compromessi dal gruppo per questo scopo.

È il dettaglio che sposta il problema oltre la platea dei bersagli. Un sito vetrina trascurato, con un CMS non aggiornato, non è soltanto un rischio per chi lo possiede. Può diventare l’infrastruttura di invio di una operazione di spionaggio statuale, con le conseguenze reputazionali e di responsabilità che ne derivano.

Anatomia della catena RedFlick

La conversazione prima dell’allegato

Il primo messaggio, scrive Microsoft, di norma non contiene allegati: serve ad aprire una conversazione. Se il destinatario risponde, arriva un secondo messaggio con un archivio RAR o ZIP protetto da password. La password compare come immagine nel corpo del testo. Quelle documentate negli indicatori pubblicati sono del tipo LiveCrown8142, LiteRaspberry9415 e BirdMouseCrab.

Field Effect descrive con chiarezza la funzione difensiva dello schema. Il primo messaggio non offre nulla da rilevare. L’archivio cifrato impedisce l’ispezione dei contenuti ai prodotti che non sanno decifrarlo. E poiché l’allegato arriva dentro uno scambio già avviato, il destinatario è più propenso a leggerlo come normale condivisione di documenti. Secondo la stessa analisi, la conversazione funziona anche da filtro: seleziona i bersagli reattivi prima di spendere il malware.

Gennaio: il disco virtuale VHDX

Nella prima variante l’archivio contiene un disco virtuale VHDX. Questo porta un file LNK camuffato da PDF insieme a una cartella nascosta con uno script BAT e un PDF esca legittimo. Aperto il collegamento, conhost.exe parte con finestra nascosta e avvia cmd.exe, che esegue lo script. Lo script apre il PDF esca, per non insospettire la vittima, e richiama SSH.exe con l’opzione PermitLocalCommand abilitata, uso improprio di un binario legittimo, per scaricare ed eseguire un installatore MSI remoto. L’MSI crea una attività pianificata che usa control.exe per scaricare ed eseguire un downloader travestito da applet del Pannello di controllo.

È a questo passaggio che si riferisce la sintesi di Microsoft sul salto di qualità: “The shift from interactive user execution to remote execution and masquerading as a CPL item highlights an evolution in both persistence and defense evasion techniques”.

Aprile: tre attività pianificate travestite da componenti di rete

A gennaio l’MSI creava una sola attività pianificata. Ad aprile diventano tre, con nomi scelti per confondersi con funzioni di sistema:

  • Internet Quality Test Connection, che trasmette al server di comando e controllo nome di rete o del computer e nome utente, codificati in UTF-16 e Base64, e consente l’esecuzione remota di una DLL controllata dall’attaccante richiamando Control_RunDLL da Shell32.dll. Microsoft non è riuscita a recuperare una variante di questo payload.
  • Network Configuration Manager, attività di supporto che predispone il client WebDAV di Windows.
  • System Health Monitor, che usa control.exe per accedere a un percorso remoto sul server di comando e controllo ed eseguire lo stadio successivo.

L’uso di WebDAV è la parte più elegante. Consente di trattare un percorso UNC come risorsa di rete recuperandola su HTTP invece che su SMB, protocollo quest’ultimo che molte reti filtrano in uscita.

Microsoft segnala sovrapposizioni con la campagna di giugno documentata dal Digital Security Lab Ukraine, costruita su finti inviti alla Ukraine Recovery Conference. Quella campagna colpiva organizzazioni della società civile ucraine ma anche funzionari governativi, giornalisti ed economisti, partiva da un account Proton e non da siti compromessi, e creava quattro attività pianificate. Il laboratorio non ha attribuito la campagna a un attore e non ha recuperato il carico finale. La sovrapposizione, quindi, è di tecniche, non di attore.

Luglio: il payload nascosto in un PDF

A luglio la catena si allunga. L’archivio RAR protetto da password è annidato in uno ZIP. Il collegamento estratto usa conhost.exe e curl per scaricare un PDF da un server dell’attaccante. Un secondo payload PowerShell cerca dentro il PDF l’intestazione cAB, estrae i 208 byte di dati Base64 che seguono ed esegue il comando decodificato, che scarica un ulteriore MSI. Questo, scrive Microsoft, tenta di creare due attività pianificate: una di supporto e una che prova di nuovo a scaricare ed eseguire un applet del Pannello di controllo.

Ad agosto si aggiungono due accorgimenti: la steganografia per occultare identificatori e l’invio di un archivio ZIP diverso per ciascun bersaglio. Il secondo merita attenzione operativa, perché rende inutile il blocco basato sugli hash dei file.

CosmicPulse e il ginepraio dei nomi

L’applet del Pannello di controllo è un downloader con un solo scopo: scaricare, rendere persistente ed eseguire CosmicPulse. Scarica due archivi ZIP e scrive una chiave AES cifrata nella chiave di registro HKEY_CURRENT_USER\Software\Classes\.mollis. Il primo archivio contiene un pacchetto dell’interprete Python 3.8 a 64 bit e un bootstrapper. Questo legge la chiave dal registro, la recupera con una chiave incorporata in modalità AES-ECB e con essa decodifica il payload contenuto nel secondo archivio. CosmicPulse è quindi una backdoor scritta in Python e distribuita insieme al proprio interprete. Dal gennaio 2026 ha subito piccole modifiche continue per aggirare le firme, mantenendo capacità e finalità invariate.

Sui nomi serve una precisazione, perché la confusione è già circolata. NOROBOT, introdotto dal Google Threat Intelligence Group nell’ottobre 2025, e BAITSWITCH, introdotto da Zscaler nel settembre dello stesso anno, indicano il downloader, non la backdoor. Il payload finale, CosmicPulse, corrisponde secondo Microsoft a YESROBOT, la backdoor Python che GTIG aveva visto impiegare due sole volte a fine maggio 2025 prima dell’abbandono in favore della backdoor PowerShell MAYBEROBOT. Va aggiunto che COLDCOPY, che Microsoft definisce “malware”, per GTIG è l’esca ClickFix a finto CAPTCHA e non un malware. Tre vendor, cinque nomi, due o tre componenti: nel citare questa famiglia conviene sempre indicare chi ha coniato il nome usato. Microsoft, per parte sua, presenta il proprio lavoro come continuazione dei blog aziendali del 2023 e del 2025, usando il report GTIG come riferimento temporale.

Perché un solo clic conta

Nel 2025 il gruppo distribuiva il malware con finte pagine CAPTCHA secondo lo schema ClickFix, che induceva la vittima a copiare ed eseguire comandi di propria mano. Microsoft è esplicita sul confronto: le catene ClickFix “required victims to complete multiple actions before CosmicPulse could be installed”, mentre “the RedFlick infection flow only requires a single user interaction, reducing friction in the compromise process”.

Da qui una conseguenza pratica sulla formazione del personale. Le campagne di sensibilizzazione costruite sul messaggio “non eseguire comandi che ti vengono dettati” sono efficaci contro ClickFix, ma non intercettano RedFlick. Il gesto rischioso torna a essere l’apertura di un file che si presenta come un documento, cioè l’azione che chiunque compie ogni giorno per lavoro. C’è un limite in più da conoscere: Microsoft avverte che Attack Simulator, lo strumento di simulazione di Defender for Office 365, al momento supporta solo email di phishing con collegamenti. Le esche ad archivio cifrato usate in queste campagne non sono quindi riproducibili in esercitazione. Restano decisive l’igiene sugli attacchi veicolati via posta elettronica e la capacità di riconoscere i documenti infetti nello spear phishing.

La parentesi iOS: il caso DarkSword

Una campagna di marzo, costruita su un invito a tema Atlantic Council, ha seguito una strada diversa. A chi rispondeva non arrivava l’archivio per Windows ma un collegamento all’installazione di DarkSword, che Microsoft definisce backdoor per iOS.

Trellix lo descrive in modo più preciso: un exploit a catena completa per browser su iOS, basato su sei CVE, cioè due di esecuzione remota in WebKit e JavaScriptCore, una di bypass del PAC, una di evasione dalla sandbox e due di elevazione di privilegi. Il bersaglio sono le versioni da iOS 18.4 a 18.7; le correzioni sono state completate in iOS 26.3 e nei backport per le versioni precedenti. Dopo la compromissione una backdoor JavaScript esfiltra messaggi, credenziali, contatti, posizione e file. GTIG ne ha documentato l’uso presso più attori di area russa, quindi DarkSword non è uno strumento esclusivo di Star Blizzard.

Le due descrizioni non vanno però fuse. Trellix analizza quattro email nominative del 26 marzo, che impersonano Frederick Kempe, presidente dell’Atlantic Council, e che contengono già il collegamento nel messaggio. Microsoft descrive una campagna di primo contatto, in cui il collegamento arriva solo a chi risponde. Possono essere ondate diverse della stessa operazione. Tra i destinatari individuati da Trellix ci sono l’ufficio di una presidenza centroeuropea, un ministero degli esteri europeo, un’agenzia federale statunitense e il responsabile di un programma in una grande azienda aerospaziale europea.

Per l’Italia è il passaggio da leggere con più attenzione. La sorveglianza dei dispositivi mobili di giornalisti, attivisti e figure politiche è un tema già aperto nel paese, come mostra la vicenda dello spyware Graphite. L’indicazione di Trellix è puntuale: aggiornare a iOS 26.3 o versione successiva e attivare la modalità di isolamento dove l’aggiornamento non sia ancora possibile. Secondo The Hacker News, che riprende una segnalazione di Proofpoint su X, a marzo il gruppo ha anche fatto registrare un forte aumento del volume di posta inviata: è al momento una fonte secondaria unica.

Il profilo dei bersagli

Le campagne RedFlick hanno preso di mira individui e istituzioni ucraine, ONG internazionali, think tank, governi e istituti finanziari che hanno sostenuto l’Ucraina sul piano politico o finanziario. Microsoft ha osservato l’attività su oltre 100 organizzazioni, in prevalenza negli Stati Uniti e nel Regno Unito, in linea con le priorità storiche del gruppo.

La cronologia delle esche mostra un perimetro più ampio di quanto la sintesi “finti inviti a eventi” suggerisca. A gennaio e febbraio sono notifiche di accertamento fiscale e di addebito di una multa, inviate a utenti ucraini. Da marzo arrivano gli inviti: tavole rotonde su sicurezza europea, tecnologia, allocazione globale dei capitali e operazioni di pace. A giugno un vertice sulla crisi ucraina rivolto a personale diplomatico in carica o in pensione, e la London Conference di Chatham House verso think tank, ONG e parlamentari. A luglio un avviso di interruzione dell’erogazione idrica indirizzato ad alberghi di Kyiv. Ad agosto una comunicazione di pagamento ai dipendenti di un’organizzazione finanziaria internazionale.

Il materiale cercato sembra essere quello che precede le decisioni politiche: bozze di posizione, corrispondenza fra analisti e decisori, contatti, calendari di incontri. Le campagne rivolte al settore tecnologico e alle organizzazioni finanziarie suggeriscono però che il perimetro non sia solo quello della policy. È in ogni caso la fisionomia delle operazioni di cyber spionaggio nel conflitto russo-ucraino, e conferma quanto si osserva sull’evoluzione degli APT sostenuti da governi.

Le organizzazioni impersonate

Meritano attenzione anche i soggetti usati come maschera: IISS, Atlantic Council, Chatham House, il Future of Peace Operations Forum, l’USUBC. Impersonare quelle istituzioni funziona perché un loro invito è plausibile e atteso nella casella di un analista di politica internazionale. Negli inviti a eventi l’esca non fa leva su urgenza o paura, ma sull’aspettativa professionale; nelle esche fiscali e nei falsi avvisi di pagamento o di interruzione del servizio la leva è invece quella classica dell’urgenza. In molti casi le email sono scritte per sembrare comunicazioni interne all’organizzazione bersaglio. Come scrive Microsoft, “Star Blizzard’s success relies on sophisticated, targeted phishing lures that trick users into engaging with the actor by impersonating trusted contacts”. Il ricorso a finti inviti a conferenze non è nuovo: l’advisory congiunto dell’NCSC lo documentava già nel dicembre 2023. Nuovo è ciò che segue il clic.

Il segnale sul mittente

Microsoft indica un controllo che non richiede competenze tecniche ed è il più utile per un lettore non specialista. Negli indirizzi usati dal gruppo il nome della persona e dell’organizzazione reale compare nella parte locale dell’indirizzo, quella che precede la chiocciola, e non nel dominio registrato. È un segnale di inautenticità sufficiente a fermarsi. Nel dubbio, la raccomandazione è contattare il presunto mittente attraverso un canale già noto, un numero di telefono o un indirizzo verificato in precedenza.

Il rischio per il tessuto italiano

Nel report non compaiono organizzazioni italiane e l’Europa è citata in termini generali. Sarebbe però un errore leggere l’assenza come esenzione. Il profilo di bersaglio descritto esiste anche in Italia: centri studi di politica internazionale, fondazioni, redazioni specializzate, studi professionali e consulenti che lavorano su dossier ucraini, sanzioni e controllo delle esportazioni. Vi si aggiunge il settore tecnologico, già toccato dalla campagna di marzo.

Il perimetro NIS2 non coincide con l’esposizione

Sono strutture con rilevanza informativa alta, dimensione organizzativa piccola e risorse di sicurezza limitate. Sul piano normativo la posizione va verificata caso per caso: l’allegato II della NIS2 comprende il settore della ricerca, quindi alcuni organismi di ricerca e centri studi possono rientrare nel perimetro se superano le soglie dimensionali. Molti altri restano fuori, perché il perimetro degli adempimenti NIS2 si costruisce su settori e dimensioni, non sull’esposizione geopolitica.

È un disallineamento strutturale: la normativa protegge chi eroga servizi essenziali, l’intelligence avversaria punta a chi produce conoscenza. Per i soggetti che restano fuori, le indicazioni pensate per le strategie antiphishing nelle piccole organizzazioni sono più utili di qualsiasi riferimento normativo.

E i siti italiani come infrastruttura

C’è poi il versante rovesciato, di cui in Italia si parla poco: i siti su WordPress e cPanel usati per creare gli account di invio. Non servono dati sensibili per essere coinvolti in una campagna di questo tipo: basta un sito dimenticato. Vale la pena incrociare questa evidenza con i dati periodici del CSIRT Italia, come quelli dell’Operational Summary ACN, sulla numerosità dei CMS compromessi nel perimetro nazionale.

Misure difensive verificabili

Le raccomandazioni di Microsoft hanno il pregio di essere verificabili, non generiche, e si rivolgono in primo luogo a enti pubblici, ONG e think tank vicini alle politiche di sostegno all’Ucraina.

Autenticazione e posta

La prima misura è l’adozione di metodi di autenticazione resistenti al phishing, accompagnata da criteri di accesso condizionale. Il report del 2026 segnala che il gruppo continua a usare Evilginx nelle operazioni di spear phishing. Che quello strumento consenta di sottrarre anche i cookie di sessione, e quindi di aggirare il secondo fattore, è documentato nell’advisory congiunto del dicembre 2023. È la dinamica degli attacchi adversary in the middle, contro cui un autenticatore legato all’origine regge e un codice temporaneo no. Per chi parte da zero, la migrazione a FIDO2 e alle passkey è l’intervento con il miglior rapporto tra costo e riduzione del rischio.

Sul fronte posta Microsoft indica le protezioni di Defender for Office 365 su collegamenti e allegati, la riverifica dei collegamenti al momento del clic e la quarantena retroattiva dei messaggi già consegnati. Resta il limite strutturale di questa campagna: un archivio cifrato con password fornita come immagine è costruito per sottrarsi all’analisi automatica. Field Effect suggerisce per questo un controllo mirato. Si tratta di cercare nella telemetria di posta gli archivi RAR o ZIP protetti da password arrivati dopo un primo messaggio senza allegati, in particolare quando il mittente dichiara che l’allegato era stato dimenticato. Gli archivi cifrati non ispezionabili vanno poi indirizzati a revisione manuale.

Endpoint, attività pianificate e SSH in uscita

Sull’endpoint Microsoft raccomanda EDR in modalità di blocco, protezione in tempo reale, protezione di rete e le regole di riduzione della superficie di attacco che bloccano gli script potenzialmente offuscati e gli eseguibili non diffusi, recenti o non attendibili. Le firme utili per una verifica immediata sono Trojan:Script/RedFlick, Backdoor:Script/CosmicPulse e Backdoor:Python/CosmicPulse.

Due controlli meritano una segnalazione separata, perché costano poco e non richiedono un SOC. Il primo è l’inventario periodico delle attività pianificate sui sistemi client, confrontato con una linea di base approvata: intercetta la persistenza anche quando i nomi cambiano. Il secondo lo indica Microsoft stessa ed è insolito trovarlo in un elenco di raccomandazioni: limitare o impedire, con il firewall, le connessioni SSH in uscita verso reti esterne non necessarie all’attività. La variante di gennaio usava proprio SSH per scaricare l’installatore, e in molte organizzazioni non tecniche il traffico SSH in uscita non ha ragione di esistere.

Indicatori e caccia: i limiti da conoscere

Il report è utilizzabile anche da chi non dispone di una piattaforma commerciale di threat intelligence. Microsoft pubblica cinque hash SHA-256, sedici domini e sei indirizzi IPv4 di comando e controllo, tre query KQL per Microsoft Defender XDR e due query basate su ASIM per Microsoft Sentinel, su sessioni di rete e sessioni web. Le tre query KQL cercano conhost.exe che invoca curl, l’uso di SSH con PermitLocalCommand=yes, e i nomi delle tre attività pianificate, quest’ultima unendo tabelle di processo, eventi e registro.

Le query valgono più della lista di indicatori, perché descrivono catene di esecuzione mentre domini e indirizzi cambiano nel giro di giorni: è il limite noto degli indicatori di compromissione. Microsoft associa il dominio secure-dns-hub[.]com alle campagne “da luglio 2026 a quelle in corso”, e The Hacker News ne deduce che fosse ancora in uso alla data di pubblicazione del report. La stessa testata segnala un confronto utile: due indicatori, l’indirizzo 103.160.59[.]97 e lo stesso dominio, compaiono anche nel report di giugno del Digital Security Lab Ukraine, il che non dimostra da solo che sia lo stesso gruppo a condurre entrambe le campagne.

Un indirizzo fuori tabella

Chi imposta una ricerca dovrebbe sapere che nel report compare un settimo indirizzo, 103.245.213[.]217, citato nella didascalia della figura sull’attività System Health Monitor come server di comando e controllo cablato nel comando. Quell’indirizzo non è nella tabella degli indicatori né nelle query Sentinel. Data la vicinanza con i due 103.245.231[.]x presenti in tabella, potrebbe trattarsi di un indicatore aggiuntivo oppure di un errore di battitura nella didascalia. In entrambi i casi conviene includerlo nella verifica.

La finestra di sette giorni

Un avvertimento pratico che il report non evidenzia e che The Hacker News mette bene a fuoco: le tre query KQL pubblicate guardano indietro solo sette giorni. La caccia avanzata di Defender conserva al massimo trenta giorni di dati grezzi, quindi una verifica retrospettiva fino a gennaio richiede registri conservati più a lungo, per esempio in Sentinel. Anche le due query ASIM vanno adeguate: il parametro lookback è impostato su trenta giorni e va ampliato. Chi non ha quella profondità di archiviazione può soltanto verificare il presente. In quel caso impostare una ipotesi di ricerca a partire dalle tecniche osservate, secondo l’approccio del threat hunting guidato da ipotesi, rende più della ricerca cieca sugli indicatori.

La catena non è una firma

Un ultimo avvertimento metodologico, che vale per chi dovrà interpretare un ritrovamento. La catena descritta non identifica Star Blizzard. Nello stesso report di settembre, Trellix documenta una campagna di giugno 2026 attribuita a Bitter APT che usa la medesima sequenza: archivio ZIP, disco VHDX, file LNK travestito da PDF, conhost --headless, persistenza tramite attività pianificata e installatore MSI, con un payload diverso. Trovare quella catena in una rete indica una tecnica in circolazione, non un attore.

Che cosa resta aperto

Microsoft non indica quante delle oltre 100 organizzazioni siano state effettivamente compromesse. Scrive di aver osservato, “in almeno un incidente”, la prima o la terza attività pianificata installare CosmicPulse sulla macchina infetta. Manca anche una mappatura formale su MITRE ATT&CK, pur essendo descritte tecniche riconducibili ad accesso iniziale, esecuzione tramite attività pianificate, mascheramento e comando e controllo. Il report non elenca infine procedure di bonifica per una macchina su cui le attività pianificate vengano trovate, rimandando i clienti Defender XDR ai propri rapporti di analisi. E non risultano organizzazioni italiane tra quelle citate: se ne emergessero, sarebbe l’elemento che trasforma questa analisi in un caso nazionale.

https://www.ictsecuritymagazine.com/geopolitica-cyberspazio/star-blizzard-redflick-cosmicpulse/