Assessment di sicurezza su Ecosistemi IoT

IoT è un neologismo riferito all’estensione di Internet al mondo degli oggetti e dei luoghi concreti introdotto da Kevin Ashton, cofondatore e direttore esecutivo di Auto-ID Center (consorzio di ricerca con sede al MIT) durante una presentazione presso Procter & Gamble nel 1999.

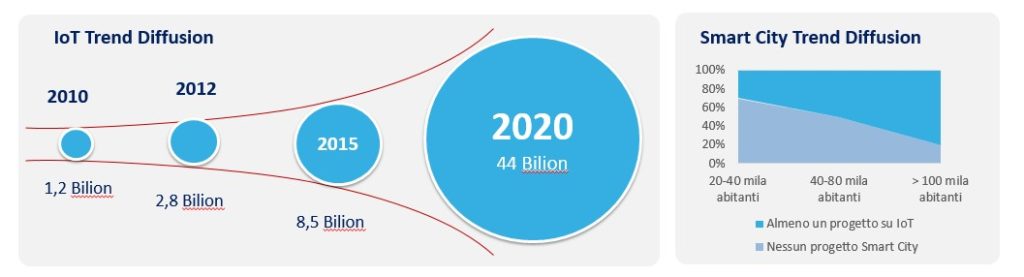
Già, dal 1999 sembra passata un’era geologica e stiamo assistendo nell’ultimo periodo (ma già annunciato da diverso tempo) ad un aumento dei servizi basati su IoT andando verso una logica di Smart City dove un ecosistema di sensori registra, processa e immagazzina dati localmente e interagisce in modo autonomo tramite internet e protocolli in radio frequenza.

L‘internet delle cose è in forte espansione (ad esempio oggi non esiste un comune che non ha almeno un progetto IoT avviato) e a livello di verifiche di sicurezza siamo molto indietro, occorre quindi un approccio metodologico di ICT Risk management completamente differente rispetto alle classiche infrastrutture ICT e definire nuovi modelli di Assessment con un approccio a servizio e non su applicazioni monolitiche come fatto in passato.
Evoluzione tecnologica

I sistemi nel tempo si sono evoluti passando da tecnologie Mainframe a Client-server per abbracciare infrastrutture / ecosistemi distribuiti sempre più complessi. La Terza Piattaforma è un nuovo paradigma tecnologico costituito da ecosistemi di risorse e applicazioni che includono servizi cloud, infrastrutture mobili, Big Data, IoT, social media e altro ancora con un aumento vertiginoso degli utenti e dei dati e (di nostro particolare interesse) della superfici di rischio.
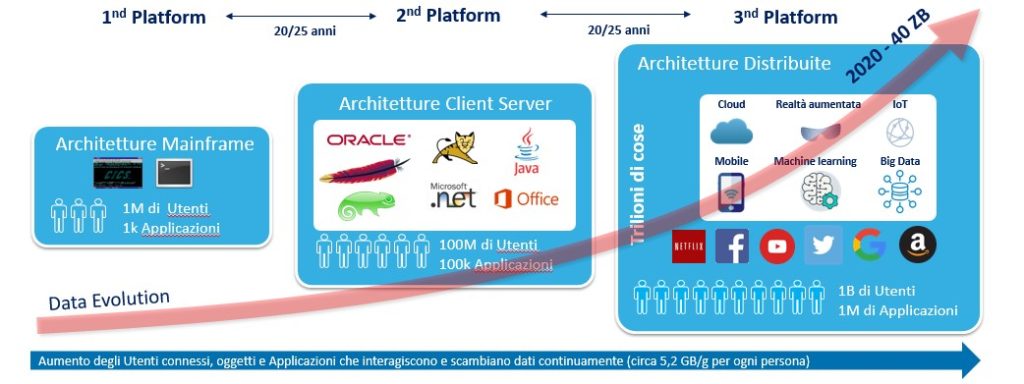
Senza entrare nel teorico (ma fatemelo fare), ogni azienda deve applicare rigidamente il I requisito del NIST e del framework nazionale di sicurezza che stabilisce l’esigenza di inventory e catalogazione delle componenti ICT, che occorre un’impalcatura di norme a supporto della sicurezza, che occorrono campagne di awareness periodiche e mirate, che occorre limitare il numero di sistemi, ecc & ecc… in piena trasformazione, stiamo assistendo ad un forte cambiamento nello stile di vita quotidiano.

Viviamo una digital-experience sempre più connessa alla rete; basta pensare quanto tempo un italiano medio passa guardando il proprio telefono o i social network / chat sul proprio smartphone.
Uno studio parla di 4,5 ore online delle quali 2,5 sui social, una percentuale significativa del nostro tempo che ci porta a lasciare tracce “consistenti” sui nostri comportamenti, sulle nostre abitudini, sulle nostre preferenze e molto altro ancora.

Questi dati oggi sono di interesse strategico per molte forme di business (un esempio il caso Cambridge Analytica) e stiamo assistendo ad un inversione del paradigma sull’appetibilità dei dati passando da un paradigma “Business & Data Centric” in 1st & 2nd platform a “User Centric” in 3rd platform (come vediamo nella figura in calce) con nuovi tipi di sistemi e servizi.
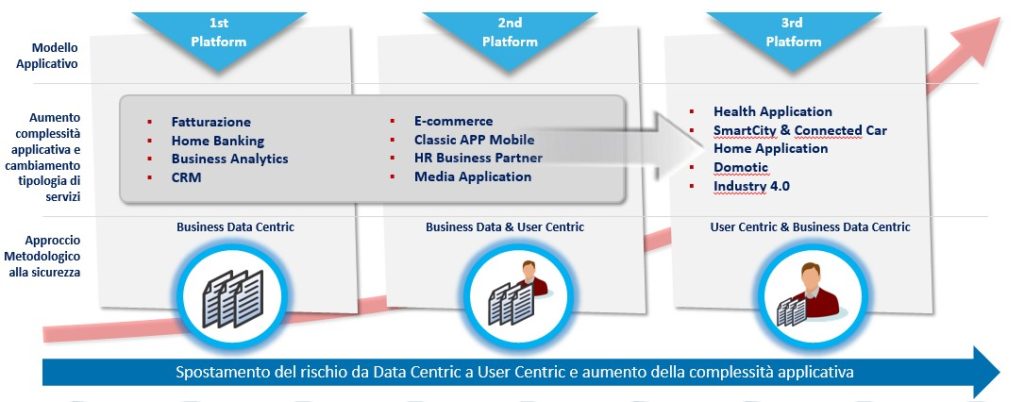
Rischio e Minacce

Mentre stiamo progettando i nostri sistemi IoT, cominciamo a diffondersi dai giornali le prime notizie sui sistemi violati e non sono molto rassicuranti:

  • Akamai Finds Longtime Security Flaw in 2 Million Devices
  • Hackers Remotely Kill a Jeep on the Highway
  • TalkTalk Hack Data Was Unencrypted.
  • Hacker Can Send Fatal Dose to Hospital Drug Pumps
  • DDOS Botnet Mirai

Nuove forme di impatti si cominciano ad intravedere che vedono sempre più l’utente al centro contornato da una moltitudine di ecosistemi complessi, queste minacce fanno intravedere nuovi rischi fino ad oggi mai valutati.
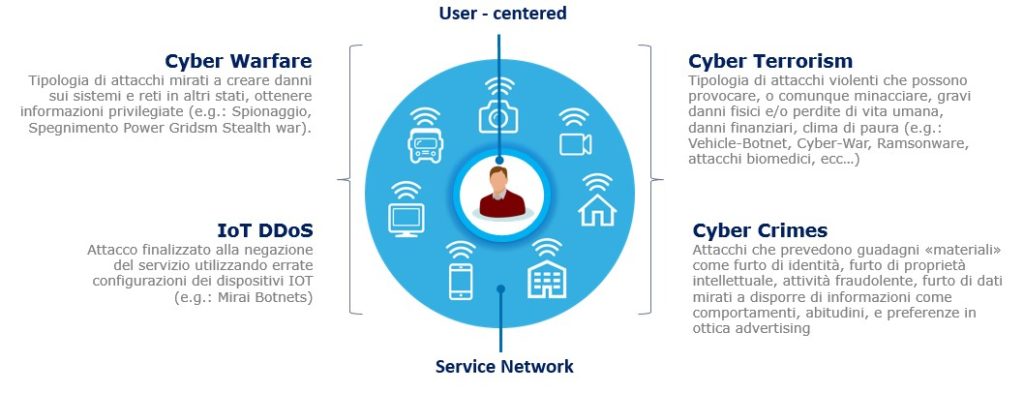
Sappiamo inoltre che la sicurezza è una grandezza «inversamente proporzionale» alla complessità applicativa e mentre i sistemi cominciano ad essere sempre più complessi il Livello Massimo di confidenza (LMC) nelle attività di Assessment risulta in costante diminuzione oltre ad un aumento della richiesta di controllo e tempistiche sempre più stringenti anche in virtù delle nuove normative in atto (ad esempio il GDPR).

Possiamo quindi asserire che il rischio cambia forma e aspetto.

L’internet mobile oramai è storia passata (il nostro smartphone è diventato una protesi strutturale della nostra persona e ne siamo tutti consapevoli) ma altre nuove “utility” cominciano ad affacciarsi nel nostro mondo, ma tutto questo ottimismo, questa “esaltazione” rende le nostre cose e le nostre vite più al sicuro? Una SmartCar a guida autonoma, quanto ci fa paura?

Occorre quindi coniugare nuove grandezze fino ad oggi mai pensate perché oltre al rischio privacy (sulla quale abbiamo costruito la Riservatezza, Integrità e Disponibilità del dato e misurato il rischio da diversi anni a questa parte) non basta più…
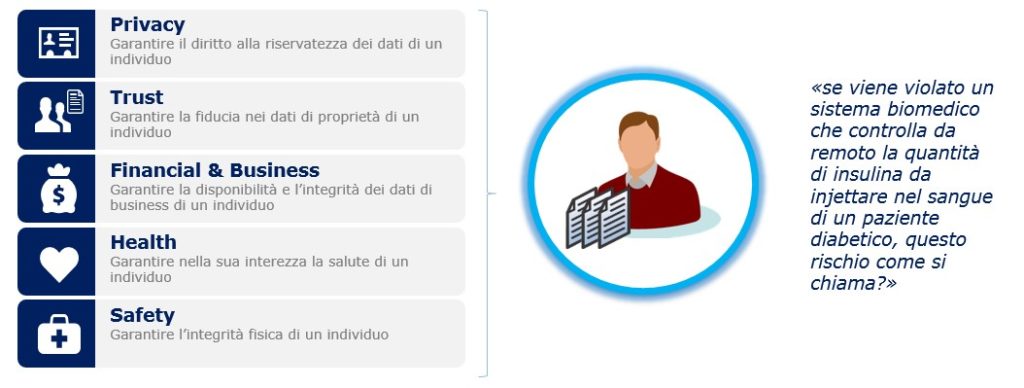
Ecosystem Security Assessment

L’approccio nelle attività di Assessment dovrà cambiare verificando l’ecosistema nel suo complesso (il servizio) e non effettuare più controlli monolitici su una singola Applicazione (ad es. solo sull’APP Mobile).

Ecco l’avvento degli Ecosystem Security Assessment (ESA) che consentono di misurare il livello di rischio su un ecosistema complesso composto da apparati Classic-ICT, Reti Zegbee, WiFi Network, App Mobile e web application e backand misti on-premise/Cloud per poi misurare gli impatti sull’utente finale.
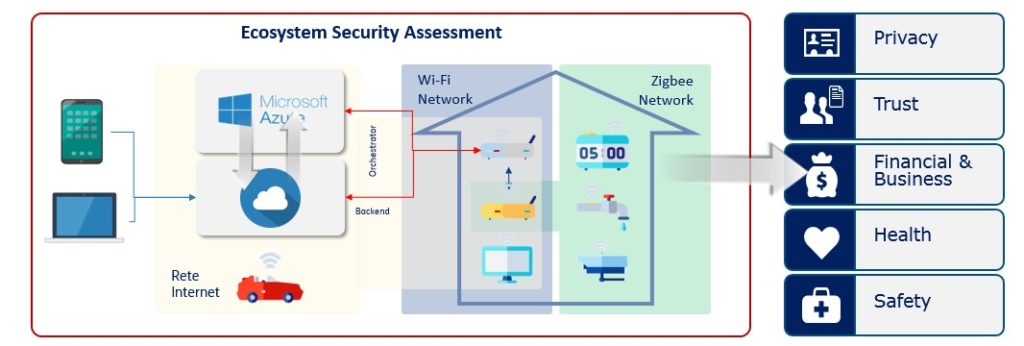
Modello di Verifica

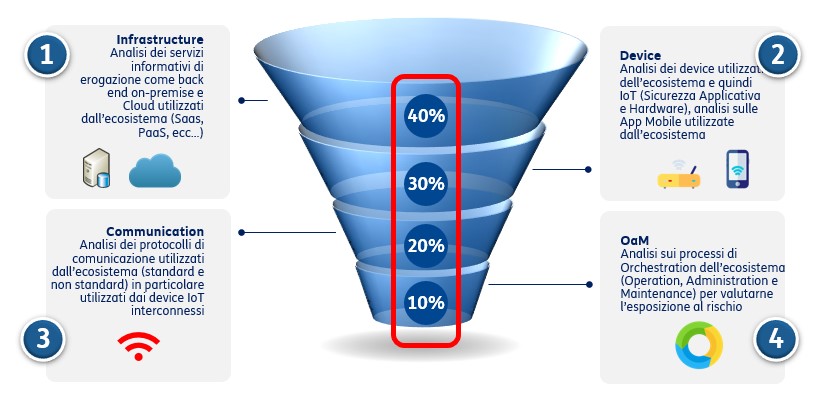
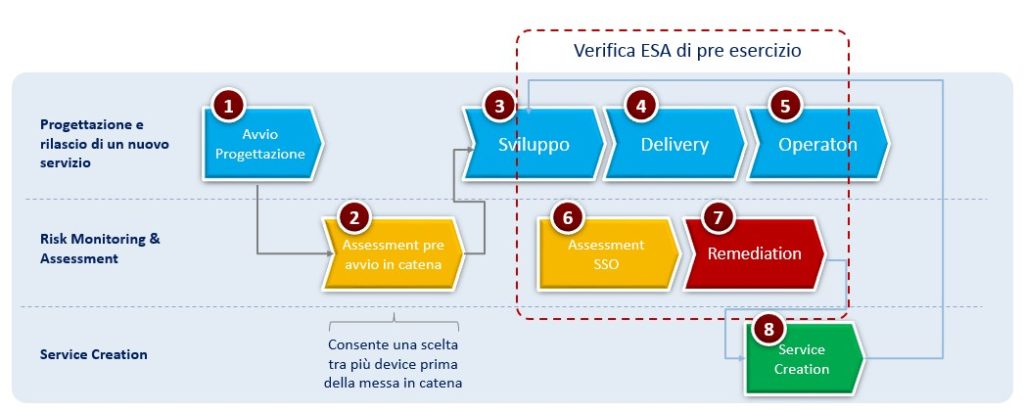
In una logica ESA, l’approccio metodologico all’Assessment cambia completamente approccio anche in relazione al sistema stesso, ai device interconnessi definendo 4 direttrici di verifica che vengono sintetizzate in calce.
Viste le tempistiche limitate di verifica, l’information gathering garantirà di individuare con buoni margini di confidenza le corrette direttrici / percentuali di verifica da dedicare ad ogni “strato” in quanto ogni sistema è differente e non esiste una metodologia standard, ma deve essere definita di volta in volta.
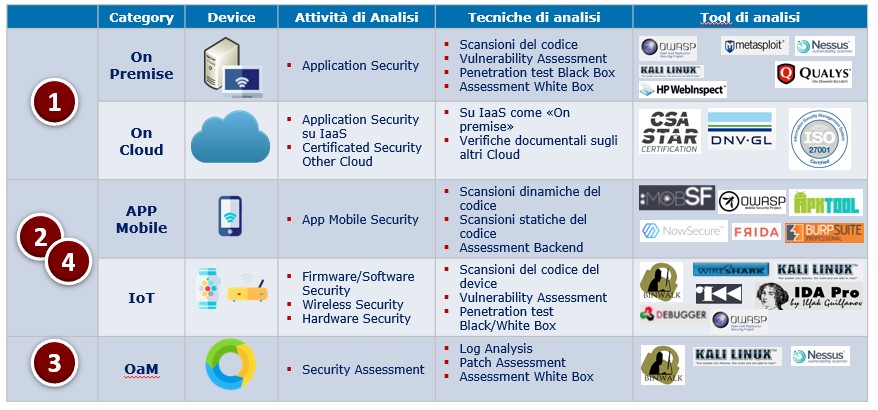
Si evolvono quindi anche le tecniche disponibili introducendo oltre al classico penetration test anche verifiche documentali sugli standard Cloud (dove non è possibile praticare una verifica in campo) e soprattutto vede la luce una nuova forma di verifica quale l’Hardware Security e gli assessment di Orchestration Application Management di gestione dei device.
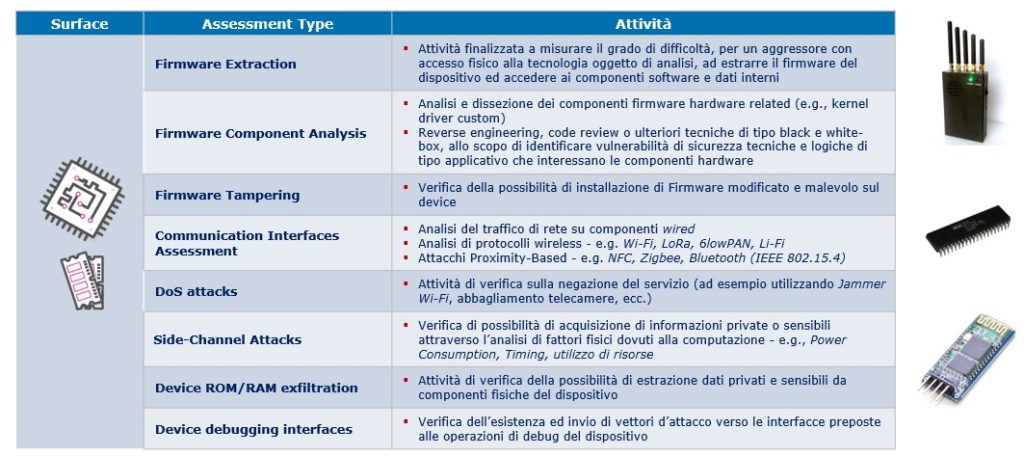
In Hardware Security infatti non basta più verificare il software degli apparati perché un utente malintenzionato può avere accesso “fisico” al device e condurre attacchi mirati. Occorre quindi valutare Firmware, reti wifi (ad es. protocollo Zigbee), Component Analysis ecc… tecniche fino ad oggi mai utilizzate sui sistemi “Classic ICT” e nasce l’esigenza di disporre di un laboratorio per queste particolari tecniche.

Da tener in considerazione che in ambiente IoT esiste molta meno “consapevolezza” al rischio (soprattutto su soluzioni off the shelf), infatti non è difficile trovare in Hardware Security problematiche di chiavi condivise tra device o password predicibili banali (principale direttrice di attacco della botnet MIRAI).
Security By Design

Sempre di rilevanza strategica rimane la «Security By Design» ovvero quella fase nella quale identificare i requisiti di sicurezza da implementare in maniera nativa e quindi scegliere il giusto device prima della messa in catena. Tale verifica consentirà di identificare il device a minor rischio in modo da poter sviluppare su questo il nostro ecosistema evitando di procedere ad effettuare tale verifica in fase di roll-out.
Conclusioni

Per chi si occupa di sistemi occorre una vera riflessione su come la sicurezza in passato veniva implementata (valore accessorio) e quanto la sicurezza diventa oggi un elemento “abilitante” che non può essere più sottovalutato. La sicurezza nasce dalla Progettazione di un sistema e dal suo sviluppo, errori fatti in queste fasi (molto prima dell’avvio in produzione di un servizio) possono compromettere completamente la sicurezza di un ecosistema, questi aspetti non possono essere più sottovalutati da chi si occupa di progettazione dei sistemi in 3rd platform.

Chi produce applicazioni di 3rd platform deve prevedere all’interno dei team esperti di sicurezza che valutino le architetture, seguano il programma e gli sviluppi, forniscano linee guida per il collaudo e l’esercizio del sistema. Tutto questo per applicare la “Security By Design” che non è l’headline di un prodotto di bellezza, ma è la chiave di volta per realizzare sistemi sicuri.

Purtroppo in ambito IoT vale ancor di più il concetto che la sicurezza se non applicata è una tassa non pagata. Dopo cinque anni può andare in prescrizione, ma se contestata occorre pagare more e more rimpiangendo di non averci pensato a suo tempo

A cura di: Massimiliano Brolli

L’articolo Assessment di sicurezza su Ecosistemi IoT proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/assessment-di-sicurezza-su-ecosistemi-iot/


Unità di crisi informatica: le basi per gestire al meglio l’emergenza

La tecnologia ormai ci circonda. In ogni istante, se ci pensiamo bene, una quantità ingente di informazioni circola nella grande ragnatela di Internet, un’immensa rete di computer interconnessi tra loro. La rapida evoluzione degli attacchi alla sicurezza delle infrastrutture dei sistemi informativi e tecnologici rende evidente che tale fenomeno sia divenuto una seria e reale minaccia da combattere attraverso adeguate misure di prevenzione.

In questo scenario, in particolar modo con l’avvio del processo di dematerializzazione documentale e della digitalizzazione dei servizi, in cui le aziende pubbliche e private sono divenute sempre più bersaglio del cyber crime, l’istituzione di una squadra di soccorso informatico è una necessità indispensabile, da precostituire in una fase antecedente l’emergenza.

In tal senso le figure di ruolo con le competenze necessarie per la composizione di un CSIRT (Computer Security Incident Response Team) possono essere trovate all’interno dell’organizzazione, o all’esterno valutando opportunamente in termini di costi la convenienza di colmare le eventuali carenze.

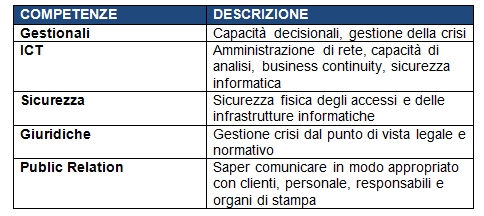
Le principali competenze da ricercare utili al caso possono essere:

  • Capacità di gestione della crisi e incidenti di sicurezza;
  • Competenze decisionali;
  • Competenze di sicurezza informatica e di amministrazione di rete;
  • Competenze legali e forensi;
  • Competenze di Public Relation.

È chiaro come sia fondamentale che ogni azienda

  • prenda consapevolezza di tale esigenza ed intraprenda ogni utile iniziativa per l’istituzione di un organo di controllo interno;
  • provveda alla stesura di un adeguato piano di gestione degli incidenti informatici che scaturisca da un’esaustiva analisi dei rischi specifici;
  • tenga conto del grado di esposizione aziendale, del tipo di rete di distribuzione e della criticità dei dati.

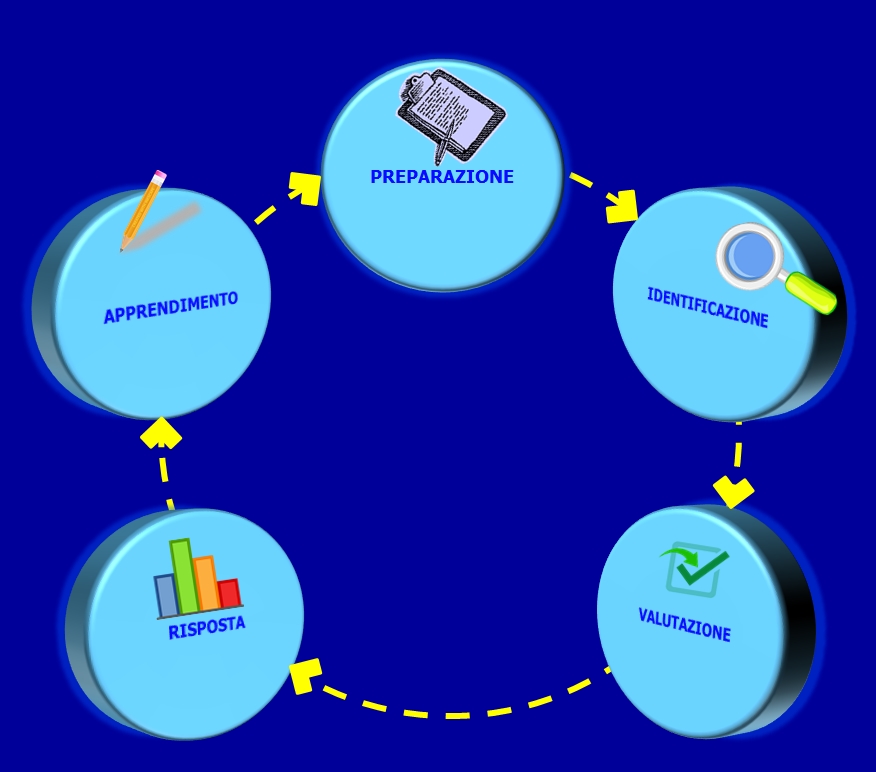
Lo standard che delinea le regole base del processo di gestione dei rischi in ambito informatico è il modello ISO / IEC 27035 il quale prevede cinque fasi principali:

  1. La fase di Preparazione per la gestione degli incidenti;
  2. La fase di Identificazione attraverso il monitoraggio e la segnalazione;
  3. La fase di Valutazione per determinare come attenuare il rischio;
  4. La fase di Risposta all’incidente contenendo, mitigando o risolvendo il problema;
  5. La fase di Apprendimento da documentare per trarre insegnamenti per il futuro.

Ognuno di questi stati è propedeutico a quello successivo secondo un ordine ciclico e continuo.

Di seguito tratterò i vari step dal punto di vista dell’esperto ICT chiamato ad intervenire, il quale dovrà anche interagire e collaborare con tutte le altre figure componenti il team CSIRT.

LA PREPARAZIONE

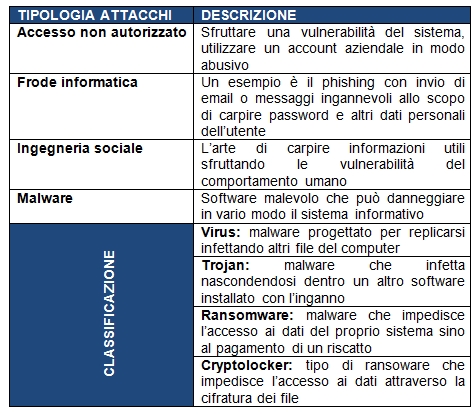
Un incidente informatico è un qualsiasi tipo di anomalia che altera il normale funzionamento di un sistema informativo e può manifestarsi come

  • un malfunzionamento hardware/software accidentale;
  • un vero attacco informatico.

Per fronteggiare un evento del genere, in ogni caso, è strategicamente rilevante per limitare i danni, ridurre i costi e i tempi di recupero creare un piano operativo di soccorso per tempo e non durante l’emergenza. Ma tutto questo può non bastare se non accompagnato da un continuo aggiornamento procedurale avvalendosi, soprattutto, dei preziosi insegnamenti forniti dallo storico degli eventi passati. Agire in modo improvvisato senza un preordinato e pianificato modus operandi porterebbe al sicuro fallimento di tutte le operazioni del caso.

Occorre implementare regole ed azioni per un protocollo di gestione che:

  • identifichi le risorse da preservare, le vulnerabilità e le potenziali minacce;
  • valuti la necessità di stipulare una polizza assicurativa;
  • individui i livelli di allerta in base alla gravità dell’incidente;
  • individui le priorità delle azioni da intraprendere per il ripristino;
  • censisca l’architettura di rete, le attrezzature, i servizi e i documenti, gli accessi autorizzati del personale;
  • pianifichi una strategia di comunicazione con gli organi di stampa e tutte le figure di riferimento coinvolte;
  • definisca le condizioni per le quali un evento qualsiasi può trasformarsi in un incidente di sicurezza informatica;
  • individui gli incidenti che possono avere un impatto negativo sulle attività dell’organizzazione;
  • cataloghi le tipologie degli incidenti;
  • individui le metodologie d’identificazione.

L’IDENTIFICAZIONE

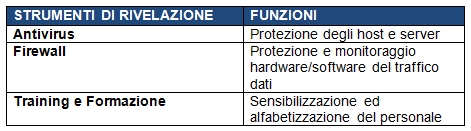
La protezione e il monitoraggio di tutti i dispositivi connessi nella rete di una azienda in quanto potenziali punti di guasto e/o di accesso per i criminali informatici, devono essere accompagnati da azioni che puntino alla sensibilizzazione dei dipendenti, rendendoli consapevoli del ruolo fondamentale che possono avere nella fase di rilevazione. Instaurare una sinergia tra tecnologia, servizi e personale è un punto chiave di fondamentale importanza.

LA VALUTAZIONE

Importante è la corretta valutazione dell’incidente. Dopo averlo individuato, è fondamentale raccogliere tutte le informazioni disponibili. I dati archiviati nei vari file di log, registri di sistema e registri di audit consentono a colui che è stato incaricato all’analisi dell’evento, di esaminare le proporzioni e la gravità dell’accadimento ed individuare, sia nei casi di attacchi informatici che in quelli di fatti accidentali, la strategia difensiva da seguire nella fase di risposta.

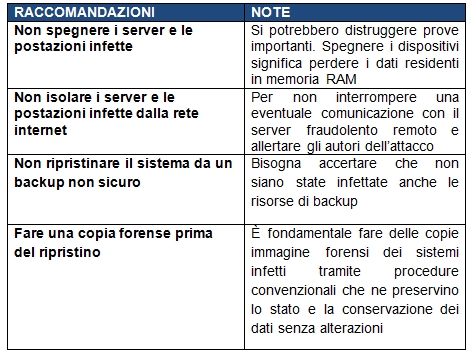
Il primo passo che bisogna intraprendere per impedire un effetto domino che interessi ulteriori sistemi e dispositivi interni all’organizzazione è quello di riuscire ad arginare gli effetti, impiegando il massimo sforzo per il suo contenimento con l’obiettivo, non sempre possibile, di ripristinare lo status quo.

Nei casi più gravi, prima che l’incidente venga risolto occorre raccogliere tutte le prove forensi secondo quanto previsto dalla normativa vigente, rivolgendosi se necessario, anche ad esperti esterni.

LA RISPOSTA

Una volta che la valutazione e/o l’indagine sono state concluse, si passa alla fase di rimozione e ripristino dell’operatività. È necessario, in caso di attacco informatico, solo dopo essere sicuri di avere la situazione sotto controllo, rimuovere tutti i codici e dati nocivi lasciati dall’attaccante e sanare le vulnerabilità riscontrate. Il risultato ottenuto costituirà il risultato finale dell’intervento e dovrà essere in ogni caso documentato per lo storico degli eventi, operazione utile per l’apprendimento.

L’APPRENDIMENTO E LA RACCOLTA DOCUMENTALE

È molto importante fare tesoro dell’esperienza acquisita, per valutare nel suo complesso il piano di emergenza adottato e quali miglioramenti futuri eventualmente prevedere. Un’analisi di valutazione accurata può aiutare in modo significativo ad individuare carenze nella politica di gestione dell’emergenza.

La documentazione di tutti gli incidenti e lo storico delle azioni intraprese risulteranno sicuramente utili per il futuro training periodico. Un report documentale sull’evento, sulle azioni e sui risultati andrebbe consegnato anche alla dirigenza aziendale coinvolgendola in modo rilevante.

OSSERVAZIONI FINALI

La cultura digitale, la condivisone delle informazioni, l’implementazione di regole di buona pratica e di tecniche di protezione sono tutti argomenti da tenere in considerazione nella pianificazione di una politica di gestione dell’emergenza.

Per ovvi motivi, non è possibile garantire la piena protezione da tutti i rischi d’incidente, ma possiamo cercare di mitigarne l’impatto assicurando la continuità operativa durante e dopo ogni evento dannoso. Proprio per questo motivo, per garantire sempre e comunque la fruibilità dei servizi, occorre una costante analisi del nostro sistema informativo per ciò che riguarda la capacità di resistenza di fronte a tutte le possibili minacce e di adattamento alle nuove eventuali condizioni.

Ogni qualvolta che siamo chiamati ad intervenire, bisogna operare con tenacia e senza presunzione, mettendo in campo competenza e professionalità, e ricavando da ogni caso, a prescindere dal risultato conseguito, indispensabili insegnamenti.

In tal senso ci viene bene incontro il prezioso consiglio di Sun Tzu nell’Arte della Guerra:

Se conosci il nemico e te stesso, la tua vittoria è sicura. Se conosci te stesso ma non il nemico, le tue probabilità di vincere e perdere sono uguali. Se non conosci il nemico e nemmeno te stesso, soccomberai in ogni battaglia.

SITOGRAFIA


A cura di: Salvatore Lombardo

L’articolo Unità di crisi informatica: le basi per gestire al meglio l’emergenza proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/unita-di-crisi-informatica-le-basi-per-gestire-al-meglio-lemergenza/


Il Cyberstalking: le trame illegali delle rete

Il telefono che squilla incessantemente, messaggi dal contenuto aggressivo e minaccioso, lettere anonime, spamming informatico e continui tentativi di contatto attraverso i social network: sono solo alcuni degli eventi che scandiscono la vita di coloro che sono vittime di stalking.

La parola stalking, derivante dal verbo inglese to stalk (letteralmente fare la posta), usata in questa accezione, identifica una condotta persecutoria ripetuta ed intrusiva perpetrata da un soggetto nei confronti di un altro. Detto comportamento pone la vittima in una condizione di sudditanza psicologica nei confronti del reo, tale da indurla a modificare sensibilmente il proprio stile di vita e le proprie abitudini.

In Italia, il reato di stalking è stato introdotto dalla Legge n. 38 del 2009, la quale all’articolo 612 bis prevede, infatti, il reato di “atti persecutori” a cui possono essere ricondotti una serie di condotte che in passato venivano punite con l’applicazione di disposizioni concernenti, ad esempio, la violenza privata.

Il corpus normativo entrato in vigore nel 2009 ha riconosciuto l’esistenza di un tipo di condotta penalmente rilevante, lesiva della libertà morale e della capacità di autodeterminazione dell’individuo. A tal proposito, appare di estremo interesse l’interpretazione ermeneutica secondo la quale, ai fini della configurazione del reato in oggetto, è sufficiente l’effettivo mutamento delle abitudini di vita della persona lesa. Mutamento accompagnato e motivato dal persistere di uno stato di ansia e paura per la propria incolumità personale o per quella di un proprio congiunto.

La normazione del reato di stalking è dovuta, come già accennato, al riconoscimento dell’esistenza di condotte che presentano un maggior grado di complessità rispetto alla semplice minaccia o violenza psicologica. Lo stalker cerca in ogni modo di controllare la propria vittima attraverso atti intimidatori realizzati con l’ausilio di strumenti leciti e di comune utilizzo.

Molti di questi sono rappresentati dalle reti telematiche. All’inizio dell’anno 2000, quando il web non era ancora all’apice della sua diffusione, le condotte che avrebbero successivamente integrato gli estremi del reato di stalking si basavano su continui contatti telefonici, costante invio di sms a carattere intimidatorio o persecutorio. Questi comportamenti, col passare del tempo, sono stati trasferiti prima sulla rete internet e successivamente sui social network così da divenire, nell’arco di poco più di un decennio, estremamente pericolosi per la vita di relazione di ciascun soggetto offeso.

Impulso decisivo si ebbe, poi, nel momento in cui ci si rese conto che i programmi di messaggistica istantanea e di condivisione sociale costituivano delle vere e proprie finestre aperte sulla vita degli utilizzatori e che tali spazi venivano abilmente sfruttati dagli stalkers per controllare movimenti, abitudini e relazioni delle loro vittime.

Nasceva il Cyberstalking, vale a dire lo stalking perpetrato attraverso internet. Quest’ultimo, pur essendo incentrato sui medesimi elementi costitutivi del reato di stalking, ne configura una forma aggravata poiché presenta delle significative differenze quali:

  • la molestia istantanea della vittima;
  • la lontananza fisica e psicologica dalla vittima;
  • maggior facilità nel mantenere l’anonimato;
  • possibilità di impersonare la vittima a scopi diffamatori;
  • possibilità di incoraggiare (se non costringere) persone terze a perpetrare violenze nei confronti della vittima.

Ma, se la consapevolezza della pericolosità della fattispecie criminosa in questione non tardò a manifestarsi, altrettanto non avvenne riguardo ai metodi di prevenzione e di contrasto.

In questo senso, l’intuizione dello psichiatra Paul Mullen lo portò, nel 1999, a classificare gli stalkers in base alle loro tipologie comportamentali. Tale metodo era incentrato su tre aree ben definite cosiddette assi. Dette aree tenevano in considerazione la tipologia del molestatore, la motivazione di quest’ultimo, il contesto, il rapporto con la vittima e l’esistenza o meno di disturbi psichiatrici a carico del reo.

Partendo dagli “assi” Mullen addivenne alla seguente classificazione:

– Rifiutati: coloro che in seguito alla conclusione non desiderata di una relazione sentimentale attuano comportamenti persecutori finalizzati alla riconciliazione.

– Cercatori di intimità: coloro che vogliono stabilire una relazione intima con uno sconosciuto o con un conoscente e tendono, così, a voler risolvere i problemi della loro esistenza, spesso oberata da costante solitudine e dalla mancanza di una relazione stabile con un’altra persona, o ancor peggio, dalla mancanza di qualsivoglia relazione.

– Rancorosi: coloro che rispondono ad una presunta offesa che sarebbe stata loro arrecata dalla vittima. Perseguono la vendetta e la rivendicazione spasmodica delle proprie ragioni. Attuano condotte punitive dalle quali ricavano sensazioni di potere e di controllo.

– Predatori: coloro che tendono all’appagamento sessuale ed al controllo sulla vittima, con la quale vogliono sempre avere un rapporto intimo ed esclusivo. Sono soggetti fortemente orientati alla pedofilia, alla pedopornografia ed al feticismo.

– Incompetenti: coloro che sono desiderosi di corteggiare un possibile partner ma che, a causa della loro ignoranza per i rituali del corteggiamento, sfociano in comportamenti oppressivi ed insistenti.

A queste cinque tipologie basate sul primo asse, se ne possono aggiungere altre catalogate per il tramite dei due assi successivi. Fra queste si distinguono, ad esempio, i precedenti partner, i colleghi di lavoro, i personaggi famosi, gli stalker psicotici (affetti da schizofrenia e deliri) e non psicotici (affetti da disturbi della personalità).

La classificazione di Mullen, seppur fondamentale ai fini dell’inquadramento penalistico del reato e dell’applicazione di alcune circostanze aggravanti ad esso collegate, non forniva una concreta difesa alle vittime di cyberstalking le quali, sempre più spesso, venivano prese di mira da soggetti che utilizzavano la rete come luogo di occultamento della propria identità e personalità. L’abilità di mimesi degli stalkers si sviluppò progressivamente ed in linea con le potenzialità del web. Detta abilità si fondava sull’utilizzo di software di occultamento, sulla creazione di falsi profili social, sulla navigazione in anonimato e sullo sfruttamento di siti legali facilmente penetrabili ed adattabili a scopi illeciti.

Le modalità di azione appena menzionate, oltre ad essere state ostacolate dalla polizia postale attraverso software di tracciamento degli indirizzi informatici, hanno trovato un mezzo di contrasto efficace nell’ammonimento del questore. Tale strumento permette alla vittima degli atti persecutori di denunciare il fatto criminoso al questore, che provvederà ad ammonire verbalmente lo stalker intimandogli di porre in essere una condotta conforme alla legge. Le statistiche hanno dimostrato l’assoluta efficacia di tale misura, la quale, però dipende prevalentemente o, per meglio dire, unicamente, dalla prontezza di attivazione del soggetto leso.

Lo stesso grado di consapevolezza non può rinvenirsi in soggetti che per caratteristiche anagrafiche o sociali si trovino in condizioni di estrema vulnerabilità. Si parla, in questi casi, dei cosiddetti soggetti deboli, come ad esempio i minori.

Ed è proprio per tutelare quest’ultima categoria che, nel corso del 2016, è stato ampliato il concetto di cyberstalking mediante il riconoscimento del fenomeno del cyberbullismo. Quest’ultimo, largamente diffuso negli ambienti scolastici e giovanili, non presenta i medesimi profili psicologici dello stalking e neanche le medesime modalità di esplicazione. La vittima, infatti, viene perseguitata per fini futili o addirittura infantili. Inoltre, chi pratica il cyberbullismo non mira a nascondersi nella rete ma a fare del web uno strumento di vanto con la pubblicazione di immagini o video che lo ritraggono in situazioni di superiorità o di potere rispetto ai coetanei.

Recentemente, le denunce di cyberstalking e cyberbullismo sono state oggetto di maggiori attenzioni anche da parte della magistratura ordinaria. Quest’ultima ha iniziato ad adottare dei provvedimenti rilevanti e differenziati a seconda dei comportamenti del reo e della sua condizione psicologica. A tal proposito, nell’ottobre del 2017, il Tribunale Penale di Milano ha sottoposto uno stalker ad “ingiunzione terapeutica” al fine di proteggere l’ex compagna risultata vittima di gravi comportamenti persecutori. Il provvedimento del Tribunale, in modo del tutto inusuale ed innovativo rispetto al passato, ha previsto che il reo seguisse un piano di trattamento terapeutico che lo potesse condurre, attraverso indicazioni specifiche degli esperti incaricati, a prendere coscienza del forte disvalore delle sue condotte violente con il fine di imparare a contenere le sue pulsioni e di dare un senso critico a quanto compiuto.

Stalking, Cyberstalking e Cyberbullismo rappresentano manifestazioni comportamentali deviate integranti profili criminosi, talvolta di rilevante entità. Anch’esse, come molte altre criticità sociali e valoriali, sono il prodotto dell’informatizzazione selvaggia unita ad una modernizzazione dei sistemi di comunicazione le quali, lungi dall’apportare miglioramenti alla vita di relazione, trascurano le debolezze dei soggetti più esposti e consentono a chi delinque di rimanere più facilmente nell’ombra.

BIBLIOGRAFIA:

  • GIOVANNI FIANDACA/ENZO MUSCO, Diritto Penale. Parte generale, Zanichelli Editore, 2014
  • BRUNO FIAMMELLA, Atti persecutori on line: dalla molestia e minaccia al «cyber stalking», Altalex Editore, 2015
  • BRUNO FIAMMELLA/ROSA MARIA STRATI, Cyber stalking e nuove tecnologie, Altalex Editore, 2016
  • GIUSEPPE CASSANO, Stalking, atti persecutori, cyberbullismo e tutela dell’oblio, Ipsoa Editore, 2017

SITOGRAFIA:


A cura di: Matteo Cappelletti


L’articolo Il Cyberstalking: le trame illegali delle rete proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/il-cyberstalking-le-trame-illegali-delle-rete/


Peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche. L’individuazione.

Vorrei dare inizio alla redazione di una serie di articoli dedicati alle peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche. Anche se molti tratti le accomunano a quelle tradizionali quelle cosiddette informatiche presentano diverse caratteristiche di cui l’operatore dovrebbe tener conto o che quantomeno dovrebbero costituire un momento di particolare attenzione e valutazione nella predisposizione ed esecuzione dell’incombente.

Nonostante le modifiche apportate dalla legge 48/2008[1], che ha introdotto importanti modifiche nel campo dell’informatica forense, le peculiarità e caratteristiche di questa tipologia di perquisizioni, appaiono tutt’altro che ben definite e risolte, tanto da farmi ritenere che un singolo articolo non avrebbe avuto sufficiente spazio per i necessari approfondimenti e le opportune riflessioni.

Per ragioni di sintesi, nel prosieguo parlerò in genere di “perquisizioni” ricomprendendovi sia quelle operate ai sensi e per gli effetti dell’art. 247 e seguenti c.p.p. sia quelle previste dallo stesso codice all’art. 352. Ossia le perquisizioni cd. “delegate” e quelle cd. “d’iniziativa”.

Non è mia intenzione procedere ad un analisi giuridica circa le loro finalità, oggetto e modalità di esecuzione, ma comprendendo entrambi gli “istituti” vorrei, appunto, tracciare un elenco delle peculiarità che contraddistinguo particolarmente, quelle dirette alla ricerca di evidenze informatiche, comunemente chiamate “perquisizioni informatiche[2]”, dalle altre.

Prima di addentrarmi in quelle che a mio parere sono le peculiarità di spicco, un rapido, ma doveroso accenno, alle modifiche apportate dalla L. 48/2008 ai due articoli summenzionati:

art. 247

… omissis

1 -bis. Quando vi è fondato motivo di ritenere che dati, informazioni, programmi informatici o tracce comunque pertinenti al reato si trovino in un sistema informatico o telematico, ancorché protetto da misure di sicurezza, ne è disposta la perquisizione, adottando misure tecniche dirette ad assicurare la conservazione dei dati originali e ad impedirne l’alterazione.

… omissis …

art. 352

…omissis…

1-bis. Nella flagranza del reato, ovvero nei casi di cui al comma 2 quando sussistono i presupposti e le altre condizioni ivi previsti, gli ufficiali di polizia giudiziaria, adottando misure tecniche dirette ad assicurare la conservazione dei dati originali e ad impedirne l’alterazione, procedono altresì alla perquisizione di sistemi informatici o telematici, ancorché protetti da misure di sicurezza, quando hanno fondato motivo di ritenere che in questi si trovino occultati dati, informazioni, programmi informatici o tracce comunque pertinenti al reato che possono essere cancellati o dispersi. (1).

… omissis

L’individuazione

Uno dei primi problemi che si devono affrontare all’atto di una perquisizione è l’individuazione dei “target” ovvero (mi sia concessa la sintesi) dei dispositivi da sottoporre a controllo; o ancora gli apparati da “attenzionare” e che saranno oggetto di particolari attività di esame e ricerca. L’operazione tutt’altro che facile e sovente sottovalutata si risolve purtroppo, spesso, nel concentrare vicino alla persona deputata ad eseguirvi “tecnicamente” la perquisizione, tutti i potenziali “target”, tralasciando (fattore di determinante e strategica importanza) una minuziosa ed attenta descrizione del luogo preciso di rinvenimento dello stesso. Il luogo di rinvenimento, accompagnato da un “analisi ambientale” capace anche se solo in via prognostica di attribuire l’utilizzo del dispositivo ad una o più persone presenti in loco, o meglio capace di identificarne anche solo in via presuntiva l’utilizzatore, è un elemento importantissimo, soprattutto nella considerazione che chi procede alla perquisizione potrebbe poi non essere la persona deputata alla successiva analisi dello stesso “target”.

Volendo dire meglio, potremo porre l’attenzione sul fatto che chi procede poi all’analisi forense del “target” (personale specializzato, consulente della Procura, etc.) non sempre ha la possibilità di partecipare materialmente ed in prima persona alla perquisizione. In tal caso la mancanza di un indicazione e descrizione precisa del luogo di rinvenimento, accompagnata da una prognosi sui potenziali utilizzatori sono elementi che se non indicati all’atto della perquisizione in apposito verbale, da chi vi ha partecipato, potrebbero poi impedire una serie di presunzioni, considerazioni e valutazioni, conseguenti all’analisi forense.

Tali carenze nei casi più complessi possono costituire una grave lacuna oggetto di specifica osservazione e lamentela in sede dibattimentale, a cura delle parti interessate.  Mi permetto a tal proposito di rammentare che la responsabilità penale nel nostro ordinamento è personale! E pertanto è importante all’atto dell’individuazione procedere, laddove possibile, anche alla determinazione dei potenziali utilizzatori/autori della condotta incriminata.[3]

L’indicazione dell’esatta collocazione del target permetterà anche di valutarne l’accessibilità ad una o più persone ed ancora l’effettuazione di rilievi fotografici potrà poi aiutare il personale cui verrà demandata “l’analisi dei dati” di apprendere ulteriori elementi, spesso strategici, per le sorti dell’indagine e sottovalutati al momento dell’effettuazione dell’operazione di polizia giudiziaria. Si pensi in particolare a quei casi in cui il “target” non risulta protetto da password o da altre tutele anche fisiche (per esempio un pc chiuso a chiave in una stanza a cui hanno accesso solo determinate persone,  o pc in un luogo in cui vengono monitorati gli accessi fisici anche con altri sistemi quali telecamere a CC ) ed ancora all’importanza degli elementi presenti nei rilievi fotografici relativi alla posizione ed elementi di contorno al “target” nella costituzione di una “libreria” di termini per un eventuale attacco bruteforce-password. Le foto del “target” permettono di apprendere la presenza di elementi libri, poster, gadget che possono aiutare a creare una libreria di password circoscritta agli interessi del soggetto, desumibili da questi “oggetti”.  O ancora per determinarne le abitudini e caratteristiche dell’utilizzatore (es. posizione/collocazione del mouse nelle determinazione se l’utilizzatore è destro o mancino), insieme ad altri rilievi antropometrici che possono rivelarsi utili per l’individuazione del responsabile.

Altro problema che attiene l’individuazione del target è rappresentato dall’attuale “proliferazione” di dispositivi digitali e quindi di potenziali “bersagli” da attenzionare attraverso la perquisizione. L’accenno è al cosiddetto IoT (Internet of Things) pur non costituendone l’unica causa. Oggi assistiamo ad una continua proliferazione di dispositivi digitali, che in maniera più o meno diretta e facile permettono la scrittura, trasmissione, cancellazione e conservazione di dati digitali. Molti autori tentano elencazioni più o meno aggiornate dei dispositivi digitali presenti sul mercato, ma per far comprendere l’entità del problema preferisco affidarmi all’attenzione di ciascuno di noi, fermiamoci a riflettere per un attimo su ciò che ci circonda. Ora, se tutti abbiamo ben presente che la perquisizione informatica interesserà PC-Desktop, NAS, Notebook, Netbook, Tablet, Smartphone, Hard-Disk, Pen Drive, etc., non altrettanto consideriamo che molti di noi oggi possiedono (mi si perdoni la generalizzazione ma non ho trovato altre sintesi “suggestive”) auto-intelligenti, elettrodomestici-intelligenti, giocattoli-intelligenti, accessori-intelligenti e etc-intelligenti; dove “intelligenti” spesso se non sempre, fa riferimento a qualcosa di digitale e, di conseguenza, potenziale oggetto di una perquisizione informatica. In sintesi oggi si sono moltiplicate a dismisura le possibilità di nascondere dati digitali.  In tale contesto, pur senza considerare (mi si riperdoni la sintesi ma so di essere letto da addetti alla materia) il mondo del “cloud”, al quale andrà dedicato uno specifico articolo, appare evidente come l’operatore di polizia giudiziaria oggi si trovi più che mai alla ricerca dell’ago nel pagliaio, formula di sintesi antica, ma che a mio modo di vedere esprime bene l’attuale contesto[4]!

In tale contesto il primo problema allora è rappresentato da un’attenta individuazione di tutti quei dispositivi che potrebbero contenere elementi oggetto della nostra ricerca. L’operazione è tutt’altro che agevole e semplice e ciò, essenzialmente, per le seguenti ragioni:

1) l’inarrestabile proliferazione digitale vede ormai l’affacciarsi pressoché quotidiano di nuovi dispositivi quasi sempre accompagnati da elevati ed affinati sistemi di sicurezza che se da un lato assicurano un’efficace tutela dei dati, dall’altra rendono sempre più complicato, il lavoro degli investigatori;

2) vi è poi la constatazione che il continuo affacciarsi di nuovi dispositivi non è sempre accompagnato da immediate soluzioni tecnico-informatiche capaci di approcciarsi efficacemente e nel rispetto delle norme, ovvero “best pratices” ai dati contenuti negli stessi. In sintesi le soluzioni tecnico-informatiche capaci di svolgere una “perquisizione” sul dispositivo segnano il passo rispetto la loro genesi ed evoluzione.  Si considerino le crescenti difficoltà legate all’effettuazione delle più elementari operazioni legate all’effettuazione di una perquisizione informatica (preview, e individuazione del dato; di estrazione e copia ne parlerò prossimamente!), rispetto l’introduzione dei più recenti dispositivi (su tutti … gli smartphone, ma senza dimenticare l’IoT. e la miriade di gadget- intelligenti);

3) non ultimo, siamo ormai circondati da decine e decine di dispositivi digitali più o meno personali che riempiono le nostre abitazioni, uffici e luoghi in cui viviamo, questo comporta oggi la necessità di una scelta da parte dell’operatore circa i dispositivi da perquisire. Per esprimere questo concetto mi sia permesso un parallelo con le perquisizioni tradizionali. In quest’ultime talvolta vi è la necessità di sfondare muri, abbattere pareti, smontare mobili, elettrodomestici etc. ed ancora procedere a ricerche attraverso apparecchiature particolari (body scanner, sonde, etc.); tuttavia tali necessità non rappresentano certo l’ordinarietà, dove la perquisizione a seconda dell’oggetto ricercato, si limita a più elementari ricerche ed operazioni che non richiedono i precedenti approfondimenti.

Oggi data la proliferazione dei dispositivi l’ovvia conseguenza, nella considerazione che tutti “possono” contenere dati digitali, consiglierebbe di procedere ad una perquisizione di tutti quelli che vengono rinvenuti sul luogo delle operazioni, senza escluderne alcuno (fate il gioco del divano … nota 4 a piè di pagina). Tuttavia ciò appare improbo sia per motivi di tempo, sia per motivi legati all’impossibilità di procedervi nell’immediatezza, ed anche il sequestro, riservando ad altro momento una più approfondita perquisizione, non è sempre possibile. Per un approfondimento su questi aspetti rimando per chi non lo avesse già letto ad un altro mio articolo di approfondimento e riflessione[5].

Ne consegue che solo l’esperienza e le tecniche patrimonio di ciascun investigatore possono permettere, attraverso una “analisi di contesto” di restringere il campo dei possibili target solo a quei dispositivi che per il particolare “contesto d’indagine” risultano più probabilmente contenere i dati digitali ricercandi.

A conforto di questa tesi vi è che il medesimo dato digitale anche in virtù di un’elevata “proliferazione di dispositivi digitali” oggi si trova spesso contemporaneamente su più dispositivi, si pensi ai backup degli smartphone che oltre in “Cloud” vengono talvolta conservati anche su PC e Notebook, spesso anche all’insaputa dello stesso utente o ancora alla posta elettronica ove anche la cd. Webmail, attraverso i client viene a trovarsi scaricata anche su altri dispositivi; ed ancora alle nostre abitudini che oggi ci portano a fare copie di copie di files nel timore di perderli, facendoci spesso perdere “il conto” di quante copie ne abbiamo in giro.

Di contro, nulla vieta che un singolo ed unico dato digitale venga conservato in un singolo dispositivo abilmente occultato e questo è l’elemento che “sconforta” la tesi!

Cosa potrebbe aiutarci a soluzione del problema?

Ritengo che una buona “analisi di contesto”[6] azione purtroppo non da tutti adeguatamente apprezzata e valutata, al pari del “profiling” utilizzato per restringere la cerchia dei sospetti, possa aiutare non poco ad uscire da questo problema. Un adeguato “breafing operativo” nel corso del quale indicare con precisione l’oggetto della ricerca, abitudini e conoscenze informatiche del soggetto (se note o apprendibili magari attraverso un buon OSINT), unitamente ad ogni altro dato o notizia spesso dai più sottovalutato ma che per l’investigatore informatico possono invece essere talvolta strategiche, per esempio: ha un Iphone; ha un Android; in azienda usano BlackBerry; il condominio ha la “fibra”; non usa le mail ma Telegram! Etc.etc.; potrebbe mitigare il problema indirizzando gli investigatori verso quei dispositivi ritenuti di maggior interesse per svariati motivi che qui non si possono sintetizzare né tipizzare, atteso che si parla di “analisi di contesto” ed ogni contesto lo è a sé.

Tuttavia appare sempre più necessaria un’analisi di tal specie. Viceversa come già detto la proliferazione dei dispositivi oggi rende “pleonastico” parlare di perquisizione informatica anche solo dei dispositivi informatici mediamente presenti in una abitazione.

Di qui non nasce lo sconforto, per l’operatore di polizia, ma un rinnovato “modus operandi” di approcciare nel corso delle perquisizioni informatiche i dispositivi digitali. Solo una continua formazione (ribadisco continua … ed è già in ritardo…) può informare gli operatori circa le più recenti novità in materia di dispositivi digitali e loro caratteristiche, permettendo così a ciascun operatore al di là delle proprie capacità e passioni di saper riconoscere dopo un’adeguata “analisi di contesto” e “profilo” del soggetto, quali di questi dispositivi possono costituire il contenitore privilegiato dei dati ricercandi, ovvero quel dispositivo e quei dispositivi che devono essere particolarmente attenzionati  nel corso della perquisizione.

Sarà un sogno di “mezza estate”! Ma taluni modus operandi efficaci in un recente passato (prendete tutto!) oggi segnano il passo dinanzi a dispositivi digitali, sempre più sicuri, piccoli, complicati e purtroppo sempre più spesso con capacità di “storage” dei dati ormai inarrestabili.

La speranza quindi è quella di affiancare a tecniche informatiche e strumenti di ricerca sempre più evoluti anche sane e mai trascurate tecniche tradizionali d’indagine, che se un tempo si traducevano in un successo, grazie all’affinamento, esperienza e preparazione dell’operatore, ancora oggi possono dire la loro, quantomeno per quanto concerne quella delicata ed importante fase operativa che è l’individuazione dei target.

NOTE

  • [1] http://www.csigbologna.it/referenze/giurisprudenza/la-legge-48-2008-a-dieci-anni-dalla-pubblicazione/
  • [2] https://www.bit4law.com/glossario-informatica-forense/perquisizione-informatica/
  • [3] Si pensi ai casi di pedopornografia, che vedono coinvolto un PC utilizzato in modo promiscuo da più da persone e privo di idonee misure di sicurezza. Ed ancora ai numerosi casi di reati perpetrati attraverso le cd. BOTNET all’insaputa dell’utente utilizzatore del cd. ZOMBIE; ed anche quei reati informatici che richiedono l’individuazione di un IP ferme restando le difficoltà legate a VPN, PROXY, rete TOR etc. etc.
  • [4] Mi cimento spesso in questo esercizio, mi siedo in salotto e mi guardo intorno cercando di fare un censimento di tutti i potenziali luoghi in cui potrei occultare files, poco dopo mi addormento! E ad oggi non ho ancora esaurito l’elenco. Sono arrivato a : TV SMART, Tablet Android da divano, WII (sono antico non ho la PlayStation), Cornice Digitale con le foto del matrimonio, Stick TV ANDROID, l’HD portable con le foto di famiglia, …e non solo! Etc. Etc ….sono certo che mi avete capito e forse avete anche riso.
  • [5] https://www.ictsecuritymagazine.com/articoli/bit-stream-image-dellintero-supporto-digitale-ieri-oggi-domani/
  • [6] In tale definizione vi si ricomprende ogni utile valutazione preliminare all’intervento che permetta attraverso un analisi e studio del contesto operativo di riferimento (reato, mezzi utilizzati, personalità del potenziale autore, ambiente, probabili dispositivi digitali coinvolti nella condotta, tipologia di rete, conoscenze informatiche del potenziale autore ed ogni altro elemento conosciuto) di pervenire ad una “selezione” dei dispositivi meritevoli di particolare attenzione ovvero che dovranno essere sottoposti con maggior precisione e cura ad una approfondita perquisizione.


A cura di: Pier Luca Toselli

L’articolo Peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche. L’individuazione. proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/peculiarita-delle-perquisizioni-dirette-alla-ricerca-di-evidenze-informatiche-lindividuazione/


25 giugno 2018: ad un mese dal GDPR Start Day la PA è ancora ai blocchi di partenza?

E così dal fatidico GDPR START DAY (25 maggio 2018) è trascorso già un mese. Sia chiaro, si tratta di un lasso temporale troppo breve, anzi al limite del “ridicolo” per poter effettuare una qualsivoglia considerazione o valutazione sul “nuovo”, sui “cambiamenti”, sul “dopo” dall’entrata in vigore del nuovo Regolamento per la Protezione dei Dati Personali (Reg. UE – GDPR 2016/679), ma non è detto che in questo breve arco temporale qualcosa non sia effettivamente “cambiato”.

Nei mesi trascorsi dalla data di emanazione del GDPR (e parliamo dell’anno 2016), in quasi tutti i settori abbiamo assistito all’alternarsi di momenti di sconforto contrapposti a periodi di euforia, momenti di profonda frustrazione, di disfatta contrapposti a momenti di (quasi) certezza che “in Italia non cambierà nulla”, “tanto faranno la proroga” […], ma alla fine dei conti, trascorsi i 24 mesi concessi per gli adeguamenti ora bisogna guardare in faccia la realtà e guardarsi (tutti) allo specchio chiedendosi cosa è stato fatto, cosa andava, invece, realmente fatto e come dare un’accelerata su quello che ancora c’è da fare.

Il settore che, probabilmente, ha sofferto e continua a “soffrire” maggiormente per l’avvento della nuova normativa è, nel nostro bel paese, la Pubblica Amministrazione (nell’accezione più ampia possibile – amministrazioni centrali, locali, enti economici, aziende pubbliche, sanità …). Sulle motivazioni molto (forse anche troppo) è stato detto nel corso di questi mesi e, infatti, la PA è stata (nuovamente) oggetto di particolari attenzioni da parte di esperti, addetti ai lavori, osservatori, commissioni ecc… che, alla fine, hanno concordato nel riscontrare una serie di cause o concause responsabili della situazione in cui la PA italiana versa (come anche in passato versava) anche in ambito di Protezione dati Personali (e-Privacy):

  • Mancanza di risorse finanziarie;
  • Problematiche legate all’età e alla non specializzazione/preparazione del personale (legato al blocco del turn-over [ma non solo – ndr -])
  • Scarsa (e a volte del tutto mancante) cultura nelle materie specifiche.

Va ricordato, non solo per dovere di cronaca, che la PA rientra fra quelle “categorie” di soggetti obbligati all’applicazione della nuova normativa, sui quali ricadono un numero maggiore di obblighi/adempimenti da effettuare proprio per le funzioni in essa incardinate.

Citiamo a titolo di esempio( non esaustivo) alcuni degli obblighi cui la PA deve comunque adempiere:  l’art. 30 – Registi delle attività di trattamento – , l’art. 35 (e considerando 84 – 89 – 93 – 95) – Valutazione d’impatto sulla protezione dei dati -, l’art. 37 ( e considerando 97) – Designazione del responsabile della protezione dei dati ; mentre per le aziende una serie di valutazioni preliminari in merito ai precedenti punti vanno fatte, per la PA non necessitano in quanto la stessa è OBBLIGATA ad adempiervi  in toto.

A supporto va anche riportato quanto indicato dall’Autorità Garante per la Protezione Dati Personali nazionale quando, proprio in tema di GDPR e PA, ha indicato i tre punti fondamentali ai quali ogni PA doveva essere, quantomeno, conforme alla data del 25 maggio 2018 data la “consapevolezza” dell’Autorità di vigilanza e controllo delle “reali condizioni della PA italiana”:

  1. Istituzione dei registri di trattamento;
  2. Nomina del responsabile della protezione dei dati personali;
  3. Procedura per la notifica in caso di violazione dei dati personali;

NB: Per il punto c) noto anche come “DATA BREACH” (art. 33) richiede anche per la PA una valutazione preliminare al fine di valutare la necessità di informare o meno gli interessati dell’avvenuta violazione così come previsto dall’art. 34 c. 1.

Trascorso un mese, come dicevano, dalla fatidica data del 25 maggio si è cercato di verificare se, e come, all’interno della PA (sia a livello centrale che locale) il cambiamento fosse percepibile o, quantomeno, se questo processo si sia almeno innescato.

Partendo dalle tre priorità fissate dall’autorità garante nazionale, senza dubbio, quella più facilmente verificabile risulta essere proprio la nomina del DPO (Data Protection Officer)/ RPD (Responsabile della Protezione dei Dati)  in virtù di quanto previsto all’Art. 37 c. 7 [il titolare del trattamento o il responsabile del trattamento pubblica i dati di contatto del responsabile della protezione dei dati e li comunica all’autorità di controllo] e in previsione di quanto indicato al c. 4 dell’Art. 38 [gli interessati possono contattare il responsabile della protezione dei dati per tutte le questioni relative al trattamento dei loro dati personali e l’esercizio dei loro diritti derivanti dal presente regolamento].

Muovendosi nel web fra siti istituzionali di ministeri, dipartimenti, agenzie si ha effettivamente la sensazione del cambiamento, rispetto ad alcuni mesi fa in quanto è possibile rinvenire i “dati di contatto” del DPO (in molti casi), oppure (addirittura) i dati completi del DPO e dei suoi contatti con anche copia del provvedimento di nomina dello stesso.

A questo punto, però, nascono delle domande, forse ovvie, ma necessarie (a parere di chi scrive):

  • Può bastare come “dati di contatto del DPO” esclusivamente una casella di posta elettronica al limite “dell’anonimato” (es. amministrazione@amministrazione.it)?
  • Perché non seguire le indicazioni dell’Autorità Garante Nazionale che nelle FAQ in merito al DPO in ambito pubblico consigliava la pubblicazione del nominativo del DPO sul sito web del soggetto pubblico, nonché l’inserimento di tutti i dati all’interno della sezione “Amministrazione Trasparente” e non solo in quella “Privacy”(se esistente)?
  • E’ sufficiente indicare esclusivamente una “mail generica” di riferimento al DPO all’interno dell’informativa privacy del sito web?

E ancora …

  • Come è possibile che all’interno di diversi siti web di amministrazioni centrali, dipartimenti, agenzie, non vi sia traccia alcuna non solo dei dati del DPO, ma anche di modifiche all’interno dell’informativa privacy del sito web?

Scendendo ancora di più in profondità e tenendo conto di quanto recita il c. 6 dell’Art. 38 [il responsabile della protezione dei dati può svolgere altri compiti e funzioni. Il titolare del trattamento o il responsabile del trattamento si assicura che tali compiti e funzioni non diano adito a conflitto di interessi] sarebbe interessante conoscere il parere dell’autorità di controllo in merito al rilascio, in sede di nomina, da parte di alcuni nominandi DPO di “autodichiarazioni” di assenza di conflitto di interessi in merito ad altre/i funzioni/incarichi ricoperti,  fatto salvo poi verificare che gli stessi ricoprono incarichi in una certa rilevanza all’interno dell’Amministrazione/ente (es. dirigenti area personale, dirigenti area controlli amministrativi, segretari generali, dirigenti uffici legali..).

Una menzione a parte va fatta per il settore Istruzione Pubblica e Enti/Amministrazioni locali che, nonostante la sempre più cronica mancanza di risorse finanziarie, a causa della non reperibilità di figure “interne” con adeguato profilo professionale fra i dipendenti, si stanno, in maniera sempre maggiore, rivolgendo al “mercato” per reperire soggetti preparati/professionisti che possano ricoprire l’incarico di DPO.

In questi casi i sistemi più utilizzati sono quelli delle “reti di scuole” o del bando unico per unioni di comuni. Anche in questi casi, però, è possibile riscontrare delle “storture” che possono essere riassunte col famoso detto del “cane che si morde la coda” (requisiti richiesti non proprio “in linea” con la normativa), remunerazione per l’incarico che sfiora il paradossale, offerte economiche (in diversi casi) al massimo ribasso (che solitamente non collima con la richiesta di elevata professionalità – ndr -), fermo restando i casi in cui a causa della mancanza di candidati, pur di “adempiere” sempre e comunque alla nomina (spesso nel lasso di tempo che va dal 24 a 26 maggio [!!!]) la scelta è ricaduta su personale interno all’ente/organizzazione privo di requisiti (necessari oltre che obbligatori) o addirittura nell’autonomina da parte dei vertici delle strutture (dirigenti scolastici, segretari comunali, dirigenti sanitari/amministrativi di aziende sanitarie ecc).

In merito alle altre priorità indicate dall’Autorità garante, ma anche a riguardo di tutti gli altri punti inseriti nella normativa, risulta difficile avere contezza del reale stato dell’arte o quantomeno entrare in possesso di un crono programma che possa fornire dati certi sul cammino del processo di adeguamento,quando, al contrario, sarebbe auspicabile mettere a disposizione di Amministrazioni/Enti maggiormente in ritardo  procedure e best practies già disponibili e rodate ( vedasi ad es. Ministero dell’Economia e Finanze).

Questo piccolo spaccato non vuole, ovviamente, “buttare alle ortiche” tutto il buon lavoro e le buone prassi che sono state messe in campo da una buona parte del settore pubblico (seppur con ritardo, con mille difficoltà  e con responsabilità che andrebbero imputati ad altri e temporalmente spostate su altri periodi “storici”), ma si propone solamente (ahimè) di evidenziare paure e timori che già da tempo serpeggiavano fra i tavoli degli addetti ai lavori, esperti, studiosi della materia, pienamente consapevoli delle difficoltà che la PA italiana avrebbe dovuto affrontare nel rapporto con la nuova normativa europea.

Sarebbe auspicabile, proprio per “correggere il tiro” il prima possibile che si innescasse una inversione di tendenza magari grazie ad una spinta congiunta fra Autorità Garante Nazionale, e Amministrazioni centrali, Associazione dei Comuni italiani affinché quantomeno in questa prima fase di piena operatività la “BASE” su cui si poggerà tutta la macchina della protezione dati personali sia costruita a regola d’arte e non (ancora una volta) “ad occhio”.

SITOGRAFIA


A cura di: Leonardo Scalera

L’articolo 25 giugno 2018: ad un mese dal GDPR Start Day la PA è ancora ai blocchi di partenza? proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/25-giugno-2018-ad-un-mese-dal-gdpr-start-day-la-pa-e-ancora-ai-blocchi-di-partenza/


Cyber Hygiene: gli ingredienti di base per un programma di cyber protection

Sebbene la cultura della sicurezza del Cyber Spazio si stia (fortunatamente) diffondendo, spesso nelle discussioni tra gli  addetti ai lavori a prendere il sopravvento sono tematiche assai evolute: Advanced Persistent Threat, Spear Phishing, Targeted Attack, nation-state cyber weapons, etc. Più raramente vengono presi nella dovuta considerazione gli effetti di attacchi che si basano sullo sfruttamento di vulnerabilità molto diffuse, datate e scontate: tali attacchi sono di gran lunga i più frequenti, con esiti altrettanto disastrosi rispetto ai meccanismi più sofisticati. Prendendo in considerazione il danno di immagine o gli impatti per la violazione di un regolamento vigente (ad esempio il General Data Protecion Regulation, GDPR), non è difficile immaginare come l’essere oggetto di un incidente a causa di una vulnerabilità molto banale (ad esempio la mancata applicazione di una patch di Windows o l’utilizzo di credenziali deboli sul proprio sito di e-commerce) possa essere molto più deleterio.

Non a caso, il recente rapporto del National Cyber Security Center “The cyber threat to UK business “2017-2018, stigmatizza l’alta diffusione di software non patchato nel sistema pubblico e privato in UK: “highlighting the importance of basic security practices”.

Potremmo dire che un programma completo di cyber security può essere rappresentato come una costruzione con delle fondamenta (pratiche di base di security e di corretta gestione degli asset) e con un piano rialzato composto dalle soluzioni tecnologicamente più evolute (IPS, WAF, NAC, anti APT, EDR, Risk Based authentication,…): la solidità del piano dipende dalle sue fondamenta.

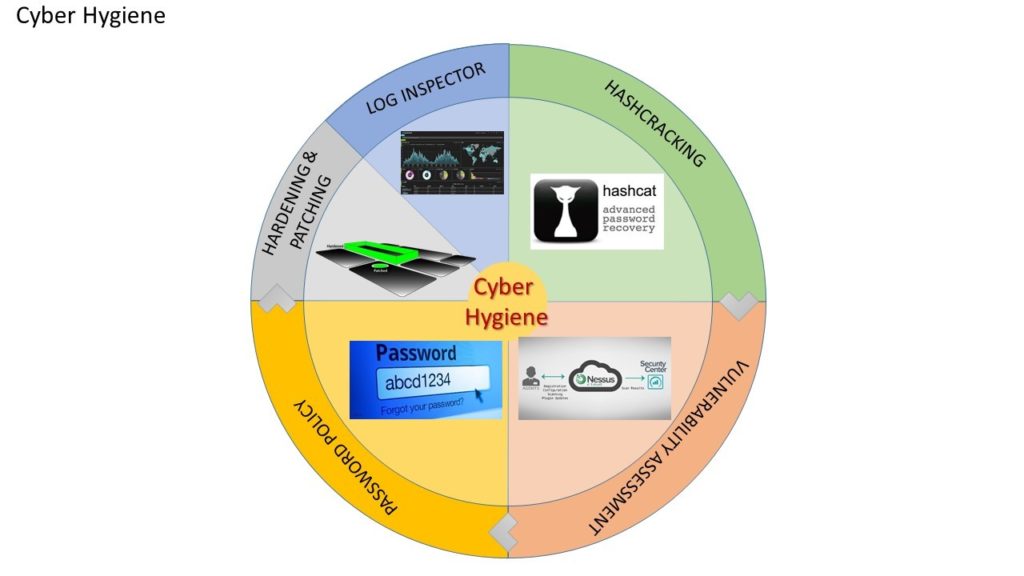
Fanno parte delle pratiche di base: le tecniche di Hardening, il Patching, la segmentazione della Rete, la sicurezza dei protocolli e la sicurezza delle credenziali di autenticazione. Tali elementi vengono comunemente racchiusi nel concetto di Cyber Hygiene.

Nello specifico:

  • le tecniche di Hardening contribuiscono a mantenere una elevata sicurezza di base delle apparecchiature, da cui vengono rimossi i comandi e i servizi non indispensabili e più soggetti ad un utilizzo malevolo;
  • una politica periodica di Patching garantisce di avere a disposizione sempre la versione più aggiornata del software (contenente quindi tutte le fix di sicurezza) per la versione di prodotto che si utilizza;
  • la segmentazione della Rete contribuisce ad isolare le apparecchiature rivolte verso il mondo esterno (Internet) dai legacy aziendali, le applicazioni aziendalmente più critiche da quelle che lo sono meno, riducendo quindi l’esposizione di infrastrutture e dati al minimo necessario;
  • è una doverosa pratica di sicurezza non solo l’adozione di protocolli di comunicazione sicuri, autenticati e cifrati(anche nelle comunicazioni tra apparecchiature interne all’azienda) ma anche l’adozione di credenziali di autenticazione che si adattino al contesto di utilizzo che può richiedere una semplice password (in questo caso verificando che le regole di composizione e sostituzione periodica siano in linea con le policy aziendali o con le best practice in materia) fino a eventuali meccanismi basati sul riconoscimento biometrico.

Se ci fosse bisogno di rimarcare l’importanza di queste pratiche, basterebbe ricordare come la minaccia che ha avuto la maggiore risonanza nel 2017 in tutto il mondo, Wannacry, non sia altro che una questione di Cyber Hygiene: le aziende più efficaci nelle pratiche di patching del proprio sistema informativo, che avevano installato il software che correggeva la vulnerabilità descritta nel CVE-2017-0144, non hanno subito alcun impatto sul proprio business.

Cyber Hygiene

Per Cyber-Hygiene si intende quindi una serie di principi, semplici ma efficaci, che devono essere osservati quotidianamente per minimizzare, e se possibile azzerare, il livello di rischio residuo delle applicazioni aziendali. La questione rilevante è che, pur essendo i principi di base semplici, molto spesso non è tale la loro applicazione in sistemi informativi complessi.

La disciplina del Cyber Hygiene si articola in tre fasi: planning, execution e check.

Nella fase di planning è essenziale:

  • determinare l’insieme degli asset che compongono il sistema informativo,
  • identificare le regole di hardening ed un processo per il loro aggiornamento,
  • identificare il processo di verifica del patching (frequenza, prodotti interessati, possibili impatti),
  • definire un modello di segmentazione (nord/sud, est/ovest) in base ai principi di analisi del rischio adottati,
  • stilare la lista dei protocolli classificati come sicuri e le loro caratteristiche (es. mutua autenticazione), i metodi di autenticazione ammessi e i criteri di accettazione delle credenziali (es. dizionario dei termini da escludere).

Nella fase di execution gli elementi rilevanti riguardano soprattutto patching e hardening, che possono impattare sui sistemi in produzione: le normali precauzioni in questo caso prevedono di operare dapprima in ambiente di pre-produzione per gestire in sicurezza eventuali incompatibilità.

Nella fase di check è importante essere in grado di verificare in maniera oggettiva e aggiornabile il corretto stato di Cyber Hygiene. In tal senso, operare in maniera automatizzata garantisce sia la riproducibilità che la possibilità di eseguire verifiche molto frequenti lasciando quindi una finestra di esposizione al rischio ridotta rispetto all’insorgere di una nuova vulnerabilità.

In aziende di medio-grandi dimensioni implementare e mantenere un processo che garantisca un adeguato livello di Cyber Hygiene è estremamente sfidante: nel caso di centinaia o migliaia di server i controlli da dover implementare potrebbero essere migliaia e con decine di varianti e peculiarità (considerando che i requisiti da applicare variano a seconda degli strati software quali sistema operativo, middleware e applicazioni).

Per questo motivo è auspicabile poter contare su una piattaforma specializzata in grado di automatizzare sia la fase di planning che quella di check. Per la fase di execution sono le piattaforme commerciali di System & Network management a poter fornire un valido aiuto.

Cyber Hygiene “automatizzata”

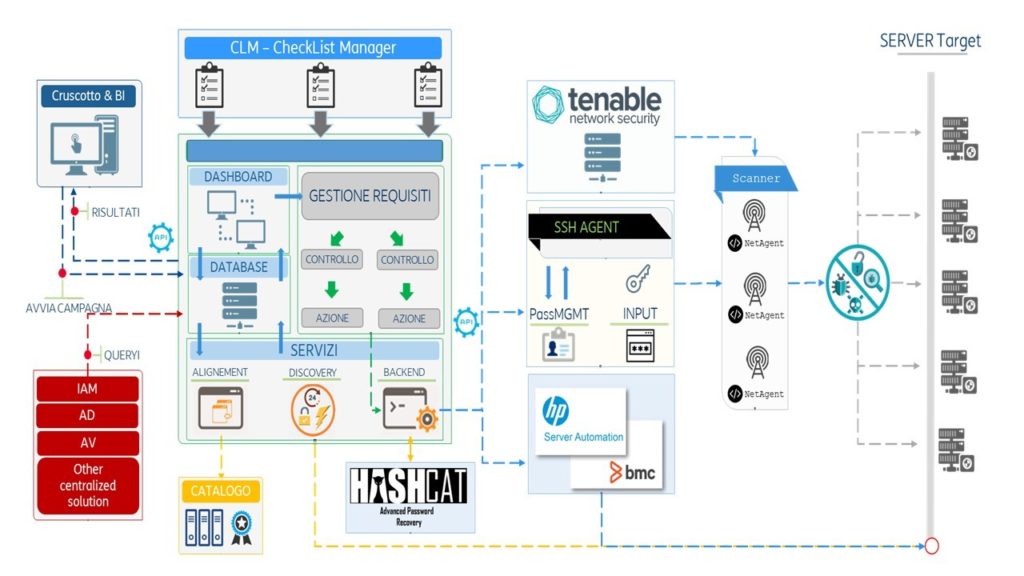
Dall’esperienza di una grande realtà industriale come TIM, è nata una piattaforma di supporto al processo di mantenimento della Cyber Hygiene. Tale piattaforma, composta da vari moduli, prevede il supporto sia alla fase di planning (mediante un cruscotto) che alla fase di check mediante alcuni strumenti di verifica verso i sistemi target.

Il cruscotto si alimenta con i dati delle applicazioni sulle quali viene preventivamente effettuata un’analisi di sicurezza che, in base al livello di criticità assegnato, guida la definizione dei requisiti di sicurezza da applicare. Il problema, ora è verificare l’effettiva adozione di tali requisiti.

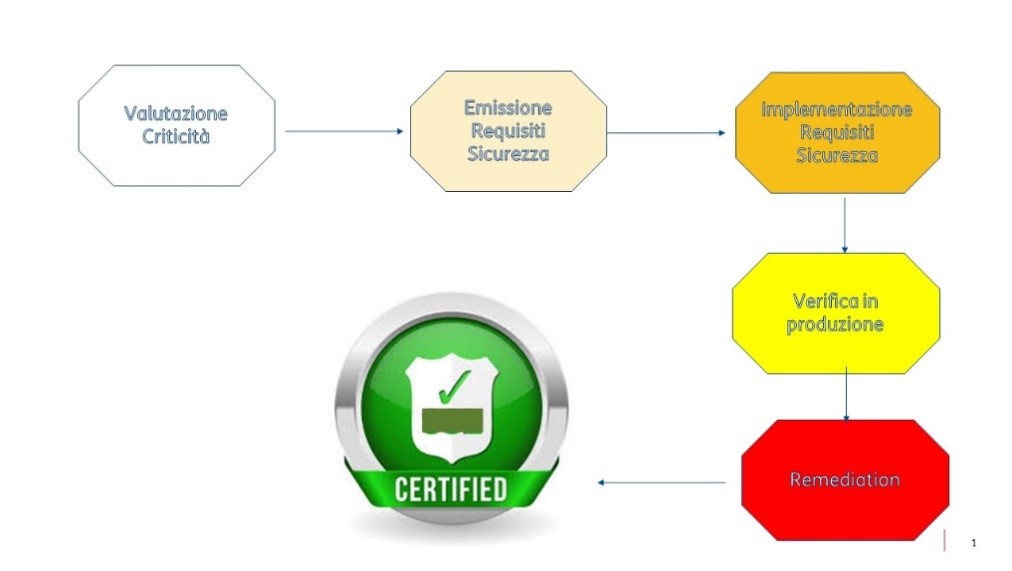
Il processo che dalla definizione dei requisiti alla certificazione dell’implementazione sostiene la Cyber Hygiene

Tutte le informazioni relative alla Cyber-Hygiene confluiscono in un cruscotto manageriale integrato con uno strumento di Business Intelligence che consente di avere in un unico colpo d’occhio la situazione sullo stato del processo. Navigando fra le diverse applicazioni o sulle vulnerabilità è possibile approfondire l’analisi fino ad arrivare ad evidenziare l’elenco delle vulnerabilità di un unico host oppure l’elenco degli host affetti da una unica vulnerabilità. Mediante lo strumento vengono effettuate analisi temporali in modo da valutare i KPI (Key Performance Indicator) stabiliti, quali ad esempio il numero di non conformità rispetto alla numerosità degli asset.

Il processo di analisi delle vulnerabilità delle applicazioni è per sua natura ricorsivo: lo strumento arricchendosi periodicamente con i dati delle scansioni più recenti è in grado di mostrare la serie storica delle vulnerabilità ed è possibile visualizzare il “percorso” di sicurizzazione compiuto su una o più applicazioni aziendali a seguito degli interventi di ‘remediation’ eseguiti.

Alcune tipologie di requisiti possono essere indirizzati attraverso soluzioni aziendali centralizzate (ad es. AAA-Autenticazione, Autorizzazione ed Accounting). Altri requisiti, come ad es. l’Hardening ed il Patching, rispondono a delle linee guida che devono essere applicate a cura dell’owner (gestore) dell’applicazione.

La fase di check può quindi seguire diversi percorsi, dalla verifica sul sistema di CMDB (Configuration Management Data Base), all’interrogazione delle soluzioni di sicurezza aziendali (es. IAM, Active Directory, …) laddove la verifica di una effettiva integrazione corrisponde al superamento del requisito, all’accesso diretto alle applicazioni sia dall’esterno che dall’interno (scansioni non autenticate e scansioni autenticate). Purtroppo non tutti i controlli che assicurano una corretta Cyber Hygiene sono automatizzabili: una percentuale non trascurabile richiede l’intervento di una analista che con il proprio know-how sia in grado di stabilire che il requisito sia correttamente e quindi efficacemente implementato.

Vediamo di seguito una rassegna dei controlli automatizzati.

Patching check

Un meccanismo alternativo all’utilizzo del CMDB per identificare l’aggiornamento o meno del software è l’utilizzo di uno strumento di Vulnerability Assessment (ad es. Nessus). Questo meccanismo consente di effettuare verifiche su qualunque tipologia di server, indipendentemente dal sistema operativo, ed è sufficiente definire un elenco di “plugin”, racchiusi in una policy di scansione, per ricercare l’elenco dei prodotti vulnerabili installati, indicandone la vulnerabilità e la contromisura di sicurezza raccomandata.

Tali verifiche raggiungono il massimo grado di affidabilità se vengono effettuate in modalità “white-box”, utilizzando un account con adeguato livello di privilegi già presente sul server. In modalità black-box invece, quando la scansione viene effettuata senza accedere al server, vengono effettuati dei tentativi di rilevazione dei software installati, ad es. dai banner di accesso o verificando le porte standard dei protocolli più comuni.

Hardening check

Le linee guida di hardening vengono definite e applicate sui sistemi su indicazione dell’owner dell’applicazione, che deve armonizzare tali linee guida preservando il corretto funzionamento senza intaccarne la validità in termini di security.

L’applicazione viene quindi sottoposta periodicamente alla verifica di implementazione dell’hardening, mediante strumenti automatici che si connettono direttamente ai server e verificano i singoli item attestandone l’effettiva applicazione.

Password check

Le credenziali di accesso predicibili rappresentano un fattore di rischio molto elevato per cui è necessario adottare password policy stringenti e verificarne l’effettiva adozione. Uno dei metodi più efficaci per effettuare questa verifica è “Hashcracking”.

Tale tecnica enumera gli account presenti in un determinato contesto (ad es. gli utenti di sistema operativo), estrae l’hash della password e lo confronta con un dizionario di password deboli composto da decine di milioni di termini, al fine di evidenziare eventuali password predicibili.

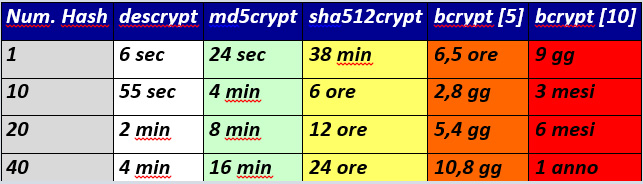
Specchietto esemplificativo sui tempi di decodifica di alcune tecniche di hashing (Scenario: 4 GPU Nvidia, 62mln di entry, password non crackata):

Il tempo richiesto dal processo di Hashcracking è funzione dell’algoritmo di hash utilizzato e della potenza elaborativa a disposizione. Per aumentare quest’ultima grandezza vengono utilizzati dei supporti hardware basati su GPU (Graphics Processing Unit) in grado di garantire un alto parallelismo di calcolo.

Log Inspector

L’analisi automatica e a posteriori dei log di accesso ai sistemi ed alle applicazioni, c.d. Log Inspecting, è una efficace tecnica di Cyber-Hygiene perché, incrociando i dati degli accessi rilevati dai log con gli elenchi degli utenti autorizzati e le matrici dei profili ad essi associati, consente di verificare che i meccanismi di sicurezza degli accessi siano correttamente configurati e funzionanti e di rilevare eventuali accessi non consentiti.

Una analisi massiva (non personalizzata) e continua dei dati relativi ai dati di tracciamento, eventualmente analizzata con tecniche di Machine Learning, consente di rilevare eventuali scostamenti, nei volumi e nei contenuti, che possono fornire una indicazione di variazione (ad es. una applicazione che non invia più dati di tracciamento oppure che ha variato il formato) su cui avviare i necessari approfondimenti.

Architettura di riferimento per l’automazione dei controlli di Cyber Hygiene

Estensione del perimetro agli apparati di rete

In un contesto quale quello di un operatore di telecomunicazioni, inoltre, è essenziale poter estendere i principi della Cyber Hygiene anche agli apparati di rete. Con lo stesso cruscotto con cui si analizza il sistema informativo, potranno quindi essere raccolti i dati sulla corretta configurazione di migliaia di CPE (Customer Premises Equipment) per verificare la loro corretta configurazione (eliminazione servizi inutili, raggiungibilità da internet, corretta attivazione del servizio di AAA), l’adeguatezza della versione di hardware e software.

Conclusioni

Implementare un processo che garantisca un corretto percorso di Cyber Hygiene è certamente un obiettivo basilare di un efficace strategia di protezione aziendale.

In realtà complesse, garantire la Cyber Hygiene significa pianificare e verificare decine di migliaia di controlli. L’adozione di strumenti automatici e di una vera e propria piattaforma di gestione consente di:

  • rendere riproducibili ed esenti da errori operativi i risultati
  • ridurre i costi e i tempi di esecuzione
  • capitalizzare il know-how del personale specialistico in un momento di significativa carenza di skill tecnici, in particolare di Cyber Security
  • poter disporre di informazioni sullo stato di salute del proprio ambiente IT in tempi brevissimi, con dati oggettivi e monitorabili nel tempo (trend storici) mediante la definizione di opportuni KPI.

Come riportato nell’articolo, la Cyber Hygiene è un processo continuativo e quindi sempre migliorabile lungo le direttrici di una sempre maggiore copertura, automatizzazione ed efficacia del singolo controllo.


A cura di: Giovanni Ciminari e Angelo De Spagnolis

L’articolo Cyber Hygiene: gli ingredienti di base per un programma di cyber protection proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/cyber-hygiene-gli-ingredienti-di-base-per-un-programma-di-cyber-protection/


Ruoli, responsabilità e adempimenti utili e inutili

Negli ultimi mesi, anche con l’approssimarsi della “scadenza GDPR” si è molto parlato di “nomine” e “designazioni”. Il 25 maggio è stato il “privacy spam day” per l’enorme numero di informative e nomine inviate spesso senza ragione da tante aziende, anche di primaria importanza (che avrebbero dovuto essere più attente, oltre che evitare di ridursi all’ultimo momento e fare le cose in modo spesso sciatto).

Allora approfittiamo per ripassare i ruoli emersi negli ultimi anni in virtù di norme e standard e il loro reale impatto sulle organizzazioni. Ci si limita qui ad alcuni ruoli collegati alla sicurezza informatica.

Responsabile qualità

Il Responsabile qualità era inizialmente la persona addetta ai controlli dei semilavorati e del prodotto finito nelle aziende manifatturiere.

Con la diffusione della ISO 9001 (soprattutto dal 1999), il suo ruolo ha assunto caratteristiche diverse, orientato a mantenere i “documenti della qualità”, solitamente numerosi, prolissi e complessi, più utili a far contenti gli auditor che assicurare l’effettiva qualità del prodotto finito o dei servizi erogati.

Il Responsabile qualità, anche quando molto competente, ha quindi perso la sua caratteristica tecnica e si è ritrovato con il ruolo di mantenere documenti e di intrattenere gli auditor perdendo autorevolezza e potere per migliorare i processi. Spesso questo ruolo è assunto direttamente dalla Direzione, ma raramente con l’attenzione nei confronti della qualità.

Poche organizzazioni hanno saputo valorizzare la visione complessiva dei processi e delle attività e la capacità di coordinarne i progetti di miglioramento.

Gli standard della serie ISO 9000 richiedevano fosse nominato un “Rappresentante della Direzione per la qualità” (non un “Responsabile qualità”). Spesso però il vero rappresentante non era un membro della Direzione. Nell’ultima versione della norma, questa figura è scomparsa, forse auspicando una maggiore responsabilizzazione della Direzione.

Responsabile della sicurezza (delle informazioni)

La qualità di un prodotto è solitamente facilmente identificabile dai suoi stessi produttori. Molto più difficile quando si tratta di un servizio erogato, viste le sue molte caratteristiche intangibili (provate a dire ad un impiegato che non ha svolto correttamente il suo lavoro!). Ancora più arduo è stabilire il proprio livello di sicurezza.

Proprio per l’intangibilità della materia, la sicurezza delle informazioni richiede la presenza di persone altamente specializzate e dedicate all’argomento, che devono trovare soluzioni per bilanciare le esigenze di flessibilità con quelle di sicurezza.

Molti criteri adottati per dimostrare l’approccio di un’organizzazione alla sicurezza (standard ISO/IEC 27xxx, linee guida NIST CFS, normativa eIDAS, eccetera) sono controllati dagli auditor attraverso molti documenti spesso inutili nella pratica e di cui deve occuparsi il “Responsabile della sicurezza”.

Similmente a quanto è successo per la qualità, un ruolo importante e in alcuni contesti molto utile sta perdendo di autorevolezza.

Questo non succede solo a causa di consulenti ed “esperti” con la capacità di proporre modi per complicare un’organizzazione, ma anche perché molti dirigenti sono più motivati a raggiungere obiettivi (e bonus) a breve termine che assicurare la sostenibilità dell’organizzazione. Questo è stato ben dimostrato dai recenti casi di cronaca come quello relativo a Equifax.

Responsabile esterno del trattamento

Con la normativa privacy, dal 1996 molti fornitori sono stati “nominati” o “designati” responsabili esterni del trattamento. Il GDPR non richiede alcuna nomina (anche perché stonerebbe con il ruolo di “processor”, malamente tradotto con “responsabile”), ma un contratto con specifiche caratteristiche.

In molti non hanno colto l’importante cambiamento normativo e il 25 maggio (il privacy spam day) hanno inondato i propri clienti e fornitori con nomine assolutamente generiche, in molti casi inadeguate al contesto (per esempio, a singoli consulenti è stato chiesto di avere un DPO). In più alcuni hanno accompagnato le nomine a questionari inutili.

Ancora una volta si sta imponendo un modello basato su tanti documenti prolissi, complicati, con prescrizioni inattuabili e difficili da mantenere. Purtroppo la massa di carta (digitale) prodotta ha tolto energie per capire veramente a chi sono trasferiti i dati e quali misure chiedergli.

Responsabile interno del trattamento

Negli ultimi mesi è stato detto e ripetuto che il “responsabile interno” non è oggetto del GDPR. Ovviamente ogni organizzazione può, e deve, specificare al proprio interno le responsabilità come meglio ritiene necessario (un po’ ridicoli quelli che auspicano che questo logico adempimento venga ribadito dalla normativa).

In passato e in alcune organizzazioni, la nomina di pochi “responsabili interni” ha permesso agli altri di ritenersi esentati dal prestare attenzione alla privacy.

Il GDPR avrebbe dovuto rimettere al centro il principio per cui ciascuno, dall’ultimo impiegato all’Amministratore delegato, è responsabile, per la propria parte, del trattamento dei dati personali.

Purtroppo, ancora una volta, in molti hanno imboccato la strada della burocrazia inutile e hanno rinnovato le “nomine interne” (scritte spesso anche male).

Auditor interno

Molti standard e regolamenti richiedono che vengano condotti audit interni e che gli auditor siano indipendenti dalle attività oggetto di audit.

L’auditor, se specializzato in una certa materia, è una figura molto importante perché garantisce il presidio di certe competenze, oltre che il controllo di certi adempimenti.

Purtroppo alcuni hanno spinto gli auditor interni a chiudersi in una torre d’avorio, permettendo loro di scendere qualche volta per condurre gli audit, scrivere rapporti e elencare tante raccomandazioni.

Questo ha fatto perdere autorevolezza anche a questo ruolo, dopo aver unito la burocrazia (rapporti prolissi e troppe raccomandazioni) con la torre d’avorio (raccomandazioni non aderenti al contesto, senza alcun aiuto per trattarle, commenti astratti e tardivi alle procedure da applicare).

Da diversi anni alcuni auditor partecipano direttamente alla redazione delle procedure e ai riesami di progetto (indicando sin dall’inizio alcune misure da prevedere e alcuni rischi da considerare) e alle discussioni per rispondere alle loro stesse raccomandazioni.

Questo non è contrario all’indipendenza degli auditor (devono infatti verificare come sono attuate le procedure dall’organizzazione, non evitare di progettarle) e assicura una maggiore significatività ai loro contributi.

Responsabile della protezione dei dati (DPO)

Ed infine poche parole sulla figura che negli ultimi 3 o 4 anni è stata al centro dell’attenzione: il DPO.

Il ruolo richiede elevate competenze e sarebbe importante fornire suggerimenti e indicazioni, organizzare e condurre, non necessariamente in prima persona, gli audit interni e mantenere i rapporto con le entità esterne quando si parla di privacy.

Purtroppo si sta cercando di rovinarlo burocratizzandolo e spingendolo verso la torre d’avorio (alcuni DPO si sono rifiutati di partecipare alle discussioni per impostare le procedure e le misure di sicurezza), esattamente come è successo agli auditor interni.

Le premesse non sono incoraggianti, ma è necessario lavorare perché questi ruoli riconquistino reale utilità e autorevolezza.


A cura di: Cesare Gallotti

L’articolo Ruoli, responsabilità e adempimenti utili e inutili proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/ruoli-responsabilita-e-adempimenti-utili-e-inutili/


Smartphone Modulari: Vivi, Morti o X?

Prefazione

Quanto sarebbe bello poter sostituire i componenti del vostro smartphone che ritenete più obsoleti, senza dover sostituire l’intero dispositivo?

Incrementare la RAM, potenziare la CPU, aggiungere l’n-esima fotocamera (Huawei P20 vi dice qualcosa?).

Ebbene, quanto descritto non è pura fantascienza: partendo dall’ambizioso progetto “fai da te” di Orange-PI, passando per l’abortito Project ARA di Google e concludendo con il prototipo Fairphone 2, possiamo affermare che dal 2011 questo scenario è più attuale che mai.

Orange-Pi 4G IoT

È favoloso pensare che su youtube vi siano istruzioni su come creare il proprio smartphone artigianale. L’idea di base è molto semplice: basta uno schermo LCD ed un single-board computer della famiglia Pi.

L’Orange Pi è mosso da un processore ARM. Integra le connettività Wi-Fi e Bluetooth e, come suggerisce il nome completo, un modulo 2-3 o 4G a seconda del modello della single-board. Il piccolo dispositivo dispone di uno slot di espansione per micro SD, di alcune porte USB per collegare ulteriori periferiche, di un microfono, di un altoparlante, di un connettore LCD e di un header da 40 PIN.

In teoria è possibile alimentare l’Orange-Pi tramite powerbank o batteria, collegabile al connettore presente sulla scheda.

Infine, un altro aspetto interessante proposto dall’Orange-Pi è la possibilità di installare sul dispositivo non solo Android (a partire da 4.4 KitKat), ma molti altri sistemi operativi elencati sul sito ufficiale.

Fairphone 2

Fairphone è uno smartphone Android modulare, costruito seguendo un progetto etico di un’azienda olandese nata nel 2009. La filosofia adottata mette in primo piano i diritti dei lavoratori e l’estrazione consapevole delle materie prime. Il dispositivo viene assemblato in fabbriche che garantiscono diritti sindacali ai loro operai, ed usa materiali ricavati da miniere congolesi gestite da organizzazioni non governative, fuori dai conflitti militari della zona.

La prima versione del dispositivo, spinta dal crowdfunding, è stata distribuita nel 2014; la seconda 2016.

Fairphone 2 è quindi il primo smartphone modulare realmente sul mercato. È progettato per essere assemblato e smontato con un semplice cacciavite in molti dei suoi componenti, così da poter essere riparato o migliorato dagli utenti più smanettoni, a costi contenuti.

Pannello LCD, modulo camera, microUSB, vibrazione, microfono ed anche la stessa scheda madre, con CPU e memorie, possono essere sostituiti.

Vi è inoltre un connettore libero sul retro del dispositivo col quale è possibile collegare moduli esterni come il supporto NFC, cover con ricarica wireless, pannello solare o altro.

Il Fairphone è comunque un progetto un work in progress. Acquistarlo significa accettare questo spirito geek e mettersi in tasca un telefono bizzarro, bello a modo suo ma indubbiamente unico.

Il motto di Fairphone è “buy a phone, start a movement” ed il fine è quello di sensibilizzare il mercato sulle ripercussioni ambientali ed etiche della tecnologia. Anche da questo punto di vista, le attività di Fairphone sono in divenire e proseguono sia al fine di migliorare le condizioni di lavoro dei dipendenti dei suoi fornitori certificati, sia dal punto di vista ambientale e di approvvigionamento delle materie prime con cui il telefono è costruito.

Project ARA

Project Ara è il nome in codice di una iniziativa abortita da parte di Google, che mirava a sviluppare un hardware libero basato su Android per la creazione di Smartphone modulari.

La piattaforma prevedeva un telaio strutturale contenente i moduli dello smartphone da applicare a scelta del proprietario, come ad esempio un display, una tastiera, una batteria supplementare, una fotocamera, speaker e così via. Il capo del progetto Ara aveva inoltre annunciato che gli utenti avrebbero potuto scambiare parti del telefono modulare anche da acceso.

Le cose sembravano quindi andare davvero per il verso giusto per il progetto: con il kit di sviluppo aggiornato ed ormai pronto per gli sviluppatori già a fine 2016, si pensava che fosse solo una questione di tempo prima di vedere i primi prototipi dello smartphone modulare funzionare a dovere con componenti quali radio, fotocamera, display, display, ecc.

Invece, le prime complicanze sono sorte a causa del design risultante poco accattivante (dispositivo con eccessiva preminenza di bordi e spessore), problema tuttavia secondario viste le potenzialità del progetto.

Sfortunatamente, a livello tecnico i problemi da risolvere sono stati molti e il gruppo Ara ha cercato in diversi modi di risolverli. Uno di questi era la modalità di gestione del trasferimento dati dai moduli al corpo di base, con interconnessioni capacitive e altri connettori. La piattaforma Android avrebbe avuto bisogno radicali “cambiamenti” per supportare tale modularità.

Il 2017 sarebbe dovuto essere l’anno del debutto sul mercato del dispositivo modulare di Google, purtroppo già da settembre 2016 arrivò la notizia che il progetto era stato cancellato.

Considerazioni

Orange-Pi è una bella idea per i più smanettoni, sicuramente non è una soluzione commercialmente percorribile vista l’ingombro delle componenti in gioco.

Project ARA si è rivelata una sfida troppo rivoluzionaria persino per un gigante pieno di risorse come Google, che si è dovuto arrendere di fronte all’evidenza delle difficoltà oggettive.

I difetti insormontabili del concetto base volto a dividere un telefono in componenti intercambiabili hanno comportato un rallentamento della comunicazione tra gli stessi, influenzando drasticamente anche la durata della batteria.

Fairphone 2 è l’unico progetto realmente commercializzato, frutto di un’ottima programmazione e con l’idea di essere ambientalmente sostenibile. È un compromesso tra Orange-Pi ed ARA, poiché i moduli installabili sono limitati e realizzati unicamente dal produttore stesso.

Conclusioni

La sicurezza rimane, come affermato nei precedenti articoli (qui e qui), il punto cruciale di ogni dispositivo. Analizzando le soluzioni presentate possiamo desumere che:

  • Orange-Pi è sì aggiornato ad Android 8.1 Oreo, ma la cadenza della patch di sicurezza non è sicuramente sufficiente a garantire la salvaguardia dell’utenza. Le fasi di sviluppo e la correzione di errori/bug sono in larga parte demandati all’impegno volontario dei membri della community;
  • Fairphone 2 attualmente è al lavoro per garantire l’installazione del vecchio Android 7.1.2 Nougat in estate. Non si parla in alcun modo di Android 8 Oreo. Anche in questo la community è il punto di riferimento principale per la risoluzione della maggior parte dei problemi riscontrati dagli utenti.
  • Project Ara è stato abortito proprio per i problemi legati alla sicurezza: garantire un sistema veloce, compatto ma soprattutto sicuro si è rivelato impossibile. Ogni connettore di aggancio dei moduli avrebbe potuto presentare un facile punto di ingresso per un utente malevolo. Senza contare le vulnerabilità introdotte dai moduli sviluppati da terze parti, passibili di bug e/o codice infetto volontariamente impiantato.

In tal senso, la mancanza di specifiche di sviluppo stringenti hanno decretato l’aborto prematuro di un progetto ambizioso.

Nonostante gli innumerevoli vantaggi ambientali derivanti dall’implementazione di una filosofia basata sullo sviluppo etico dei dispositivi modulari, è purtroppo ragionevole dedurre che in assenza del serio impegno di un gigante della tecnologia in grado di definire solide specifiche hardware, tecniche, architetturali e di sicurezza, tali dispositivi non avranno mai la possibilità di avere un significativo impatto commerciale su larga scala.

A cura di: Daniele Rigitano


L’articolo Smartphone Modulari: Vivi, Morti o X? proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/smartphone-modulari-vivi-morti-o-x/


Security Operations Center: il cuore della protezione dell’Informazione

Non c’è sicurezza in questo mondo, ci sono solo opportunità

Douglas MacArthur

Cos’è un SOC ?

Il Security Operations Center (SOC) è un’entità organizzativa che si caratterizza, principalmente, per le capacità difensive in contrasto ad attività non autorizzate condotte contro gli asset oggetto di protezione. Tra le prerogative del SOC, usando come riferimento il Cyber Security Framework del NIST[1], rientrano capacità di identificazione (Identify), protezione (Protect), rilevazione (Detect), risposta (Respond) e recupero (Recover). Un SOC è composto da un gruppo di professionisti – analisti e architetti di sicurezza – organizzati per rilevare, analizzare, rispondere, fare rapporti e prevenire incidenti di cyber-security ed erogare servizi verso la propria constituency, che consiste in un insieme di utenti, siti, asset IT, reti e organizzazioni. I Managed Security Services Provider (MSSP), operati da player di mercato, offrono servizi di sicurezza gestita tipici di un SOC ai propri clienti secondo una logica di esternalizzazione.

Uno dei principali obiettivi di alto livello del SOC è promuovere la Situational Awareness[2] dell’organizzazione consolidando flussi di dati tramite aggregazione, associazione e contestualizzazione e presentazione di una visione olistica e costante della security posture. Altri obiettivi sono la riduzione del rischio e dei disservizi, il controllo e la prevenzione delle minacce cyber, la riduzione dei costi amministrativi, la capacità di investigare in maniera appropriata gli incidenti di sicurezza e il supporto nelle attività di audit e di compliance a leggi, norme, standard e best practice di settore.

Per raggiungere i propri obiettivi il SOC deve essere in grado di effettuare determinate azioni – organizzate in domini funzionali – che comprendono, come minimo, funzioni quali gestione dei log (collezione, conservazione e analisi), monitoraggio e correlazione degli eventi di sicurezza, gestione degli incidenti, identificazione e reazione alle minacce e attività di reporting.

L’azione del SOC è possibile tramite la combinazione di elementi quali tecnologia, persone e processi; è importante sottolineare che il termine stesso “SOC” non è inequivocabile ed è figlio delle evoluzioni del mercato della sicurezza delle informazioni. Esistono altre parole per identificare forme organizzative le cui funzioni, capability e obiettivi sono identici a quelli di un SOC, quali ad esempio i Computer Emergency Response Team (CERT) e i Computer Security Incident Response Team (CSIRT).

Il SOC utilizza numerose tecnologie, quali ad esempio sistemi di Security Information Event Management (SIEM), Database Activity Monitoring (DAM), Intrusion Detection/Prevention System (IDS/IPS), Next-Generation Firewall, Malware Protection, Sandbox, etc. Data la natura estremamente dinamica del panorama delle minacce cyber, è naturale per il SOC avvalersi costantemente delle tecnologie di sicurezza allo stato dell’arte, ampliando continuamente il novero delle capacità tecniche a disposizione e aggiornando di conseguenza le proprie capacità operative. Le persone sono il fattore centrale e distintivo del SOC e di solito esiste una struttura multilivello all’interno dell’organizzazione per svolgere azioni diverse e complementari. Ogni livello (tier) ha compiti e responsabilità ben identificate e si relaziona con gli altri secondo procedure chiare. La matrice degli skill delle persone che compongono un SOC comprende sia hard skill (conoscenza di protocolli di rete, tecnologie di sicurezza specifiche, sistemi e reti IT, etc) sia soft skill (capacità di operare sotto stress, attitudine alla comunicazione, capacità di gestire le relazioni con colleghi e clienti, etc). Per la natura specifica delle minacce che deve fronteggiare, il SOC è operativo 24 ore al giorno per tutto l’anno: gli attacchi informatici (automatici e manuali) sono sferrati continuamente e da qualsiasi parte del pianeta in modalità follow-the-sun. Al fine di garantire adeguati livelli di efficienza ed efficacia, il SOC opera secondo processi divisi in quattro categorie: di business, tecnologici, operativi e analitici.

Figura 1 – Modello di SOC

Il SOC soddisfa le esigenze della propria constituency erogando un insieme di servizi, altrimenti noti come capability, che possono essere raggruppate in cinque generazioni[3] e che verranno successivamente illustrate.

Figura 2 – Esempio di servizi SOC

Le dimensioni, l’ampiezza delle capability e del catalogo servizi, le competenze e la forma organizzativa dei SOC variano in funzione del valore che l’asset “informazione” riveste per la constituency.

Dal punto di vista del mercato esistono diverse tipologie di SOC[4]:

Tipo di SOC Struttura dedicata Team dedicato Modalità In house Outsourced
Virtuale No No (part time) Reattivo No Si
Dedicato Si Si Proattivo Si No
Distribuito No Si Proattivo Si Si
Command Si Si Proattivo focalizzato su Threat Intelligence Si Si
Multifunzione (SOC/NOC) Si Si (svolge operazioni di rete e di sicurezza) Reattivo Si Si

Capability e livelli di maturità

Uno dei problemi legati alla valutazione dell’efficacia e dell’efficienza di un SOC nel perseguimento dei propri obiettivi è la possibilità di misurarne le performance (tramite appositi indicatori prestazionali o KPI) e la qualità della governance. La misura della maturità delle capability è un metodo usato in molte aree, interne ed esterne al dominio IT, per determinare l’andamento dei processi e dei vari elementi all’interno di un’organizzazione. I risultati di tali assessment periodici evidenziano aree di forza e di debolezza, aiutando a indirizzare eventuali gap tramite interventi mirati e piani di rientro in accordo al paradigma del continuous improvement[5]. Un modello autorevole e universalmente riconosciuto è il Capability Maturity Model Integration (CMMI) della Carnegie Mellon University[6] , che identifica livelli di maturità crescenti e codificati in valori numerici (da 0, che indica l’assenza del processo, a 5, che indica l’esistenza di un processo ottimizzato). La misurazione dei livelli di maturità delle capability di un SOC avviene tramite scomposizione del dominio di analisi in diverse dimensioni di indagine; un ottimo riferimento è rappresentato da SOC-CMM[7], che fornisce sia una metodologia sia gli strumenti di lavoro per effettuare il Maturity Assessment misurando 5 ambiti di analisi (Business, Persone, Processi, Tecnologia, Servizi).

Figura 3 – Modello SOC-CMM

Storia dei SOC

La breve storia dei SOC che segue è tratta dal Business White Paper “5G/SOC: SOC Generations” rilasciato da Hewlett Packard Enterprise ed è un tentativo di correlare i principali eventi storici di sicurezza alle forme che i vari SOC hanno adottato nel corso del tempo.

SOC di prima generazione – Dagli anni 70 al 1995

I SOC di prima generazione si sono sviluppati per quasi 25 anni e sono nati insieme a Internet. Durante questo periodo le connessioni Internet non erano ubiquitarie come lo sono oggi e molti business non erano nemmeno connessi alla rete. Gli attacchi erano tipicamente programmi seccanti che comportavano un impatto minimo sulla capacità delle varie organizzazioni di erogare i propri servizi core. Verso la fine di questa generazione, ambienti governativi e militari iniziarono a stabilire i Computer Emergency Response Team (CERT) ponendo le fondamenta di ciò che oggi chiamiamo Security Operations Center. Inoltre, cominciano ad apparire tecnologie di sicurezza quali gli anti-virus e gli Intrusion Detection System (IDS).

  • 1972      Introduzione del primo modem full duplex a veocità di 1.200 baud per second
  • 1974      Sviluppo della tecnologia Ethernet
  • 1979      Kevin Mitnick – tramite social engineering – ottiene accesso a sistemi DEC[8]
  • 1981      Lo SmartModem Hayes (14.4kbs) diventa popolare nel circuito delle BBS
  • 1983      Esce il film “War Games”
  • 1986      Negli Stati Uniti, il Computer Fraud and Abuse Act and the Electronic Communications Privacy Act rende l’accesso informatico non autorizzato un reato
  • 1987      Christmas Tree Exec, primo software auto-replicante, si diffonde in maniera dirompente[9]
  • 1987      Viene creato il tool tcpdump
  • 1987      McAfee & Associates crea il primo software antivirus[10]
  • 1992      Viene lanciato sul mercato DEC SEAL, primo firewall commerciale[11]
  • 1993      Viene rilasciato Windows 3.11 con funzionalità di rete peer to peer
  • 1993      USAF crea il 67th Air Intelligence Wing (AFCERT) foclizzato sulla Cyber Intelligence
  • 1995      Wheelgroup lancia il primo Intrusion Detection System: NetRanger[12]

SOC di seconda generazione – 1996 – 2001: Esplosione del malware e sviluppo degli IDS

I SOC di seconda generazione sono nati verso la fine del ventesimo secolo. Questa generazione ha visto la nascita dei Managed Security Service Provider (MSSP) e l’introduzione di risorse preziose per la sicurezza delle informazioni quali la mailing list di Packet Storm, il SANS Institute Internet Storm Center e il database delle Common Vulnerabilities and Exposure (CVE). La propagazione di worm e virus inizia ad avere un impatto crescente e piattaforme di tipo SIEM (Security Information Event Management) come ArcSight e netForensics si affacciano sul mercato.

  • 1996      Managed Security Service Provider iniziano a offrire servizi di gestione Firewall e IDS[13]
  • 1998      Viene creato SNORT[14]
  • 1999      Mitre crea il repository CVE[15]
  • 1999      SANS crea il precursore dell’Internet Storm Center
  • 1999      Viene lanciata la mailing list PacketStorm
  • 1999      Il virus “Happy99” colpisce Outlook Express, il worm “Melissa” attacca Microsoft Word
  • 2000     Diffusione del virus “ILOVEYOU” (LoveBug)
  • 2001      Il worm “Sadmind” attacca Sun Solaris[16], i worm“Code Red” e “Code Red II” attaccano MS IIS, si diffonde il worm “Nimda”
  • 2001      I prodotti SIEM (Security Information Event Management) sono introdotti sul mercato

SOC di terza generazione – 2002 – 2005: Botnet, Cybercrime, Intrusion Prevention, Compliance

La terza generazione dei SOC è esistita tra il 2002 e il 2005. Botnet controllate centralmente e requisiti di compliance proliferano e molte grandi aziende costituiscono i propri SOC.

  • 2002      Il Sarbanes Oxley Act prescrive controlli di sicurezza IT e introduce responsabilità individuali per le figure apicali all’interno delle organizzazioni
  • 2003      Si diffondo i worm “SQL Slammer”, “Blaster”, “Nachi”, “Sobig” e “Sober”
  • 2003      HD Moore crea il framework Metasploit[17]
  • 2003      Viene creato lo US-CERT[18]
  • 2003      La legge della California SB 1386 obbliga la notifica al consumatore nel caso in cui le proprie informazioni personali (PII) siano rivelate a terze parti: è considerata la prima legge che obbliga a notificare il data breach
  • 2004      Viene formato il PCI council
  • 2004      Si diffondo i worm “Bagle” e “MyDoom”
  • 2004      Primo attacco rilevato tramite l’utilizzo di entry di tipo wildcard sul DNS[19]
  • 2004      Primo malware per piattaforme mobile (“Cabir”, scritto per Symbian OS)
  • 2004      Operazione Titan Rain (attacco cinese contro sistemi governativi e militari degli Stati Uniti)[20]
  • 2005      Diffusione del worm “Zotob”

SOC di quarta generazione – 2006 – 2012: Cyberwar, Hacktivisim, APT, data exfiltration

I SOC di quarta generazione coprono un periodo che va dal 2006 al 2012 circa. I temi principali sono relativi all’Hacktivism, alle minacce interne (insider threat), all’ingresso nell’arena degli Stati Nazione e al furto di proprietà intellettuale.

  • 2007      Zeus Trojan/Botnet
  • 2007      Data breach della TJX[21]
  • 2007      La Russia attacca l’Estonia nella prima cyberwar pubblicamente conosciuta[22]
  • 2007      Il gruppo Anonymous guadagna le prime attenzioni mediatiche
  • 2008      Diffusione del worm Conficker e delle relative Botnet
  • 2008      Data breach della Hannaford Bros[23]
  • 2009-2010     Operazione Aurora – attacchi Cinesi contro aziende quali Google, Adobe Systems, Juniper Networks, Yahoo, Symantec, Northrop Grumman, Morgan Stanley e Dow Chemical[24]
  • 2010-2011      WikiLeaks pubblica il Baghdad Air Strike video e numerosi dispacci diplomatici[25]
  • 2010      Il trojan Stuxnet attacca sistemi SCADA Iraniani[26]
  • 2011      Data breach subito da RSA[27]

SOC di quinta generazione – 2012 – oggi: Automazione, Analytics, Big Data, Information Sharing, Machine Learning, Threat Management & Intelligence, Predictive Analysis

I SOC di quinta generazione sono ancora in evoluzione. Il panorama delle minacce cyber si sta evolvendo ad un ritmo senza precedenti e i mercati chiedono e offrono prodotti e servizi sempre più avanzati. I SOC di quinta generazione riconoscono il cambiamento del panorama delle minacce e approcciano la sfida in maniera olistica: addestrando gli analisti in ambiti quali counter-intelligence di sicurezza, sorveglianza, psicologia criminale e pensiero analitico. Gli sforzi di standardizzazione e conformità hanno facilitato l’adozione diffusa di prodotti e pratiche di sicurezza.

  • 2012      Attacco contro Foxconn, Linkedin subisce il furto di 6.5 milioni di credenziali
  • 2012      Saudi Aramco subisce per mesi un attacco cyber tramite malware Shamoon, che distrugge 35.000 computer della compagnia[28]
  • 2013      Edward Snowden divulga i programmi di sorveglianza di massa delle maggiori intelligence occidentali[29]
  • 2014      Data Leak ai danni della Sony[30]
  • 2017      Attacco del ransomware Wannacry[31]
  • 2017      Attacco cyber di Petya[32] e data breach alla Equifax[33]

Conclusione

I rapporti sociali di produzione attuali si fondano su un fattore determinante: l’Informazione. La Digital Transformation espone l’Informazione a rischi direttamente proporzionali alla dinamica di crescente centralità delle ICT ed è sempre più urgente attivare adeguate capacità di difesa contro attacchi e minacce. Il SOC è l’eccellenza operativa di tali capacità e i servizi che lo caratterizzano rappresentano la frontiera mobile entro cui proteggere l’Informazione nelle dimensioni di sicurezza che le sono proprie: Riservatezza, Integrità e Disponibilità.

NOTE


A cura di: Andrea Boggio

L’articolo Security Operations Center: il cuore della protezione dell’Informazione proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/security-operations-center-il-cuore-della-protezione-dellinformazione/


A case history: come ho risolto un WanaCrypt0r 2.0 Attack

Lo scorso 11 Maggio 2017 questo worm colpì più di 75mila macchine in 99 paesi di tutto il mondo, fra ministeri, università, banche, sanità, case automobilistiche, ferrovie, compagnie telefoniche e logistiche. L’Italia grazie alla sua “ridotta interconnessione informatica tra le divere strutture” (come la definì allora un giornalista1) per non dire di peggio, limitò almeno la virulenza di questo ransomware in sporadici focolai isolati.

Solitamente i non addetti ai lavori, credono che il punto forte di questo worm sia la parte di criptazione dei file, con la relativa schermata: “Ooops, your important files are encrypted”. Ma come molti di voi ormai sapranno, il pezzo forte è l’Exploitation del Bug conosciuto con il suo nome più famoso: EternalBlue (CVE-2017-0144, ID MS17-010)2. Funzionava (e funziona ancora se non sono state prese le misure di sicurezza adeguate) su tutte le versioni di Windows comprese quelle Server, con particolare successo su Windows 8 che permette la condivisione IPC$ attraverso una null-session. Vale a dire che è possibile effettuare la connessione via anonima abilitando la null session di default. Una volta abilitata tale connessione è possibile inviare differenti comandi al server d’interrogazione. In poche parole è come se la multinazionale example.com avesse previsto una sala d’attesa per chi scarica e carica merci all’interno del proprio magazzino centrale, accessibile in maniera anonima.

La National Security Agency (NSA) ai tempi aveva creato il suo apposito strumento di deploy conosciuto come FuzzBunch (somiglia molto al famoso Metasploit2.5). Il framework permetteva di settare l’IP della vittima, i thread da dedicare al processo di exploitation, il servizio di aggancio e molto altro: prendeva la mira e boom sparava sul bersaglio. Ora, l’EternalBlue sfrutta 3 bugs: Wrong Casting Bug (WCB), Wrong Parsing Function Bug (WPFB) e Non-paged Pool Allocation Bug (Non-paged PAB).

Senza scendere eccessivamente nel dettaglio dell’analisi:

WCB: permette lo sfruttamento del processo di conversione File Extended Attributes (FEA). Dalla struttura Os2 a quella NT è possibile eseguire un buffer overflow in una sessione non-paged del kernel sfruttando il protocollo Server Message Block (SMB) di Windows (driver srv.sys). Nel momento in cui la parte SMB_FEA del nostro pacchetto SMB eccede la memory size, invece di ricalcolare lo shrink della memoria sulle dimensioni del pacchetto, viene dato temporaneamente a disposizione uno spazio di memoria molto più grande. In quel momento avviene l’injection della nostra payload. In questa stanza comune dove scarichiamo e carichiamo merci per la nostra multinazionale example.com, arriva un bel giorno un carico che eccede il volume della stanza, la multinazionale mette a disposizione altro spazio per farci stare tutta quella merce, peccato che nel nostro carico c’era anche un martello pneumatico che ci permetterà di aprirci un buco all’interno del nuovo spazio messoci a disposizioni sprovvisto di telecamere e misure di controllo.

WPFB: sfrutta lo stesso bug appena descritto e lo fa inviando dati al protocollo SMB SMB_COM_TRANSACTION2 e SMB_COM_NT_TRANSACT che eccedono la grandezza massima del buffer. A questo punto la connessione di scambio richiama dei comandi secondari che a loro volta chiamano altri sub comandi e questa situazione porta ad un’analisi errata dei dati dando all’attaccante l’opportunità di sfruttare il bug WCB.

Non-paged PAB: in breve questo bug consente di allocare un codice avente dimensione preassegnata in una pagina del kernel diversa da quella assegnatagli. Questo significa, che come già avvenuto per i precedenti bug, viene causato un buffer overflow eccedendo nel blocco di memoria successivo.

Così, se all’alba di una calda mattinata primaverile fui svegliato dal rumore del campanello della porta, lo devo a questi tre bug e di conseguenza al successo che l’EternalBlue ebbe su decine di migliaia di macchine.

<<Vestiti. Abbiamo un ICR-T:R qui nel nord Italia>> Esordì il mio socio dopo avermi frettolosamente salutato. Incident Case categoria Red di Tipologia: Ransomware (Ovviamente era superfluo specificare di quale si trattasse).

<<Hanno dei backup? Altrimenti torno a dormire>> risposi ancora frastornato dal sonno.

<<Parziali…Vogliono che tu dia un’occhiata>>

Parziali equivale a No, solitamente.

Era stato colpito un server di produzione di un importante studio d’elaborazione dati, che gestiva servizi di criticità elevata per molteplici clienti e conteneva altrettante informazioni sensibili. L’attacco era avvenuto durante la notte e la criptazione del database (DB) era durata svariate ore. Il server di backup (erroneamente configurato) aveva eseguito una copia completa e i successi due incrementali salvando le varie versioni criptate dell’immagine del server. La più recente immagine ripristinabile, senza il worm quindi, non era sufficientemente completa. Mancavano infatti alcuni file importanti che erano stati inseriti nel DB durante la notte, alcuni nel momento dell’attacco stesso e che dovevano ancora essere rielaborati dal sistema e integrati sotto forma di record nel DB.

Fui accolto dal responsabile (uno dei Soci Amministratori) che mi fece strada sin nel cuore dell’azienda che a quell’ora era deserta. Le uniche voci provenivano dal reparto IT, svegliato d’urgenza per l’occasione.

Di solito, un semplice ransomware si diffonde sfruttando tecniche di social engineering (ad esempio convincendo la vittima designata a cliccare su di un link; oppure aprendo il relativo allegato) ma questo worm era diverso. Diviso in più parti, il dropper del WannaCry era costituito da un software che cercava in altri computer interconnessi a quello infettato la vulnerabilità CVE-2017-0145 (SMB Remote Code execution, descritta prima). Per questo avevo chiesto espressamente durante il viaggio in macchina, che il server oggetto dell’attacco fosse spento ed isolato. Ovviamente ogni minuto in cui la macchina rimaneva offline si traduceva in soldi persi per l’azienda.

L’Amministratore tralasciò i convenevoli e disse al suo gruppo IT che avevo carta bianca.

Chiesi di segmentare3 un’area della rete nella struttura virtuale e di ripristinare il backup più recente. L’ IT Architect mi mise in contatto con una famosa società italiana di hosting dove il cliente aveva allocata la sua struttura e chiesi di cominciare a preparare una virtual machine (VM)4 con l’ultima versione di Windows Server scaricata dal loro repository Microsoft e di procedere all’aggiornamento e configurazione. Sarebbe stata la futura macchina che avrebbe hostato l’applicazione, qualora fossi riuscito ad estrarre il DB ed i file necessari.

Come c’era da aspettarsi i backup e gli snapshot erano completamente criptati. L’unica mia vera possibilità restava il “famoso” backup “Parziale”, che sulla linea temporale dell’infezione si collocava fra la fase di exploitation e quella di dropping del worm.

Cominciai a lavorare su questa immagine. Una volta che l’infezione è ad uno stato avanzato, il worm, nella fase di avvio crea un “servizio” Windows che ha lo scopo di attivare l’exploit della vulnerabilità in altri operation systems (OS) analoghi. Il cuore vero e proprio si trova in un file .zip criptato e a sua volta protetto da password.

Purtroppo intervenire in questa fase è solitamente troppo tardi. L’unica possibilità che avevo era intervenire prima della fase di avvio del ransomware e cioè nella fase di “Kill Switch”. La fase di Kill Switch ha limitato e rallentato l’infezione di questo worm5. Tale fase assolveva la duplice funzione di “interruttore” o semplicemente di controllo, al fine di testare se il worm si trovasse in una sandbox o in un sistema operativo vero e proprio. Il funzionamento è alquanto intuitivo: se il dato dominio preinserito nel malware è raggiungibile attraverso la funzione InternetOpenUrl(), allora l’infezione si blocca, altrimenti no. Vale a dire che se il sito è raggiungibile, la criptazione non avviene.

In pratica nel codice del worm esisteva la seguente condizione “if”:

memcpy=(&sxUrl, “http://www.dominio-non-registrato.com , 0x21u);  //dominio-non-registrato da verificare ….. ….. vX = InternetOpenA( 0, 1u , 0, 0,0); vX+1 = InternetOpenUrlA(v4, &szUrl …. )  //esegui la richiesta http al precedente dominio-non-registrato If (vX+1)                               //il dominio-non-registrato esiste? La richiesta ha avuto successo allora Esci { InternetCloseHandle(vX); InternetCloseHandle(vX+1); result = 0; } else   //il dominio-non-registrato non esiste? La richiesta non ha avuto successo: esecuzione del payload { InternetCloseHandle(vX); InternetCloseHandle(0); detonate(); result = 0; }

Il mio piano era quindi tentare di bloccare la criptazione utilizzando la funzione di Kill Switch.

La prima cosa che avrei dovuto fare sarebbe stata quella di analizzare il traffico in uscita dal server infetto al fine di capire quale fosse il dominio di riferimento che permetteva di attivare la funzione e quindi di “spegnere” il worm (il dominio-non-registrato). Con le credenziali di accesso che mi ero fatto lasciare dal gruppo IT, installai sulla loro infrastruttura virtuale6 (precisamente nel segmento di rete che avevamo isolato) una distribuzione di Kali Linux scaricata dalla rete e già predisposta per l’ambiente VM7. Modificai il file nella directory etc/network/interfaces in modo da configurare manualmente gli IP e da raggiungere il server infetto. A questo punto avviai il restore dal backup “Parziale” del server e rimasi in ascolto sulla macchina Kali analizzando il traffico in uscita con il programma WireShark. Quando il backup ripristinato ed ancora infettato con il worm nello stato embrionale riprese il suo decorso, la prima cosa che eseguì fu il check sul dominio di Kill Switch.

Sul mio WireShark in ascolto apparve il record che stavo cercando:

Source: 192.168.150.serverinfetto Protocol: DNS Lunghezza: 109 Info: Standard query 0x4ec1 A www.kjasndkjansdkjasndkjsandsakmkcnjaiuewhdoeawpopwmfw.com

Nel frattempo non essendo la condizione di Kill Switch verificata, il worm eseguì ancora una volta il resto del suo codice.

Chiamai ancora una volta IT Architect e chiesi di ricontattare la società di hosting al fine di ripristinare il backup “Parziale” del server e di freezzarlo nel momento del boot.

Ora avevo una possibilità, tentare di utilizzare il dominio che avevo reperito tramite sniffing del traffico con WireShark, azionando il meccanismo di Kill Switch del WannaCry sul server infetto.

Il tempo fuori si era annuvolato ed era quasi ora di pranzo, la voce si era già sparsa nell’azienda e nell’ufficio del gruppo IT c’era stato un via vai di persone per tutta la mattinata, scandito da continue chiamate.

Se fossi riuscito a verificare la condizione della Kill Switch come vera e cioè il dominio www.kjasndkjansdkjasndkjsandsakmkcnjaiuewhdoeawpopwmfw.com avesse risposto, sarei riuscito a fermare il worm e a rimettere la macchina in rete, per salvare le ultime modifiche al DB ed eseguire un dump completo.

Quindi escogitai un piano, riavviai la macchina infetta utilizzando una bootable key di una versione di Linux che avevo sotto mano e aprii il file hosts contenuto nella directory C:\Windows\System32\Drivers\etc\hosts di Windows Server 2008 R2.

Prima di consultare un server DNS, la macchina cerca se il valore dominio.example è presente nel file hosts della macchina locale. Se il record è presente, il computer cercherà di collegarsi all’indirizzo IP specificato sulla stessa riga, in caso contrario tenterà di risolverlo tramite DNS.

Ciò che feci fu mappare nel file hosts del server infetto il percorso del dominio facendolo puntare alla mia distro Linux che avevo messo in ascolto sulla porta 80 e 8080, avviando inoltre il servizio di apache2.

Aprii il file hosts e introdussi il seguente record:

192.168.150.miamacchinalinux www.kjasndkjansdkjasndkjsandsakmkcnjaiuewhdoeawpopwmfw.com

Riavviai il server ed incrociai le dita, nel momento in cui il dropper fu rilanciato la condizione della Kill Switch fu verificata ed il processo di esecuzione del WannaCry arrestato.

Mi precipitai nell’ufficio dell’IT e dissi di rimettere il server in comunicazioni con gli altri nodi in modo da terminare il processo di scrittura dei diversi record nel DB e successivamente eseguire un dump di tutta la struttura esportandolo sulla nuova macchina.

<<Ma il Virus?>> esordì il responsabile…

<<Per ora non è più un problema.>>

Referenze:

A cura di: Vincenzo Digilio


L’articolo A case history: come ho risolto un WanaCrypt0r 2.0 Attack proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/a-case-history-come-ho-risolto-un-wanacrypt0r-2-0-attack/