Quale protezione per gli open data?

Cosa sono gli open data

Quando, nel lontano 2003, l’Unione Europea si è accorta che la Pubblica Amministrazione, in tutti i paesi membri, era una miniera di dati ancora non si parlava di big data e della possibilità di elaborarli per favorire le attività economiche. In quell’anno l’intuizione, tradotta in una apposita direttiva, fu quella di mettere a disposizione dei cittadini i dati in possesso delle pubbliche amministrazioni, affinché potessero fare da volano per iniziative di studio, di ricerca e, eventualmente, di avvio di attività economiche.

L’esempio più classico è l’elenco dei ristoranti autorizzati ad operare in una zona a potenziale vocazione turistica: da questo dato un operatore economico lungimirante avrebbe potuto verificare la proficuità di un investimento in quella zona scegliendo di avviare un’attività di ristorazione (se il numero di ristoranti fosse stato ancora basso) oppure di realizzare un parco giochi per bambini (se la zona fosse stata già piena di ristoranti).

L’idea di base era quella di indurre le pubbliche amministrazioni, centrali e locali, a condividere dati con le seguenti caratteristiche:

  • i dati dovevano essere pubblici ovvero conoscibili da chiunque;
  • i dati dovevano essere in formato aperto ovvero utilizzabili da chiunque.

La compresenza di questi due elementi caratterizza quelli che vengono comunemente definiti open data e che, quindi, la Pubblica Amministrazione può mettere a disposizione tramite lo strumento di diffusione più efficace: il proprio sito web.

La normativa di riferimento

Dal punto di vista normativo, tutto nasce, come già detto, con la direttiva europea n. 98 del 2003[i] che è stata applicata, in Italia, dal decreto legislativo n. 36 del 2006[ii]. L’oggetto di questo provvedimento è il “riutilizzo dell’informazione del settore pubblico” ovvero l’uso dei dati, anche a fini commerciali, di cui è titolare una pubblica amministrazione per scopi diversi dallo scopo iniziale per il quale quel dato (documento, dice la norma) era stato prodotto.

Quindi, per esempio, l’elenco degli acquisti di un comune, aggregati per categoria merceologica, rientra nell’ambito di applicazione del decreto perché lo scopo iniziale dell’acquisto è dotare il comune dei mezzi e degli strumenti utili al suo funzionamento ma gli operatori commerciali possono utilizzare l’elenco per capire, insieme ad altri dati, se esiste un “mercato da esplorare”.

Nel 2013, l’Unione Europea è tornata sulla materia con la direttiva n. 37[iii] che ha definito con maggior precisione alcuni elementi tecnici ed ha specificato meglio quali dati (documenti, insiste la norma) non rientravano nell’applicazione della direttiva. Parallelamente, in Italia, il decreto legislativo n. 102[iv] del 2015 ha modificato il decreto legislativo n. 36 del 2006, tutt’ora vigente.

In particolare, tra le novità introdotte, vi è l’esclusione dall’ambito di applicazione della norma di documenti che contengono dati personali il cui riuso è incompatibile con gli scopi originari del trattamento da parte della Pubblica Amministrazione. Questo vuol dire che i dati personali, di fatto, non possono essere considerati open data a meno che:

  • esista una norma che preveda espressamente la facoltà o l’obbligo di pubblicarli;
  • sia stato acquisito il consenso per la loro diffusione, da realizzare tramite canali tradizione o sul sito web istituzionale.

Proprio a seguito di queste modifiche l’Agenzia per l’Italia Digitale introduce, nelle “Linee Guida Nazionali per la Valorizzazione del Patrimonio Informativo Pubblico” del 2016[v], una check‑list d’ausilio alle pubbliche amministrazioni per verificare gli aspetti giuridici che avrebbero potuto incidere sulla possibilità di considerare “open” alcuni data set. Nella check‑list, confermata nella versione del 2018 delle stesse Linee Guida[vi], l’Agid si concentra soprattutto sulla riservatezza dei dati personali attraverso le seguenti domande:

  • i dati sono liberi da ogni informazione personale che possa identificare in modo diretto l’individuo (nome, cognome, indirizzo, codice fiscale, patente, telefono, email, foto, descrizione fisica, ecc.)? In caso negativo queste informazioni sono autorizzate per legge?
  • i dati sono liberi da ogni informazione indiretta che possa identificare l’individuo (caratteristiche personali che possono identificare facilmente il soggetto)? In caso negativo queste informazioni sono autorizzate per legge?
  • i dati sono liberi da ogni informazione sensibile riconducibile all’individuo? In caso negativo queste informazioni sono autorizzate per legge?
  • i dati sono liberi da ogni informazione relativa al soggetto che incrociata con dati comunemente reperibili nel web (e.g. google maps, linked data, ecc.) possa identificare l’individuo? In caso negativo queste informazioni sono autorizzate per legge?
  • i dati sono liberi da ogni riferimento a profughi, protetti di giustizia, vittime di violenze o in ogni caso categorie protette?
  • hai considerato il rischio di de-anonimizzazione del tuo dataset prima di pubblicarlo?

L’Agid, insomma, si preoccupa di verificare che non siano resi pubblici dati che potrebbero essere ricondotti a persone fisiche e che, quindi, potrebbero ledere i loro diritti e le loro libertà.

Le previsioni del Regolamento Europeo 679/2016

Tuttavia, il Regolamento UE n. 679/2016[vii] (GDPR), oltre a ribadire l’attenzione alla riservatezza, tra i principi cardine specifica (come d’altra parte faceva già il decreto legislativo n. 196/2003) che i dati personali devono essere “esatti e, se necessario aggiornati; devono essere adottate tutte le misure ragionevoli per cancellare o rettificare i dati inesatti rispetto alle finalità per le quali sono trattati (“esattezza”)”.

Questo vuol dire che la check-list dell’Agid ha bisogno di un’integrazione che induca le pubbliche amministrazioni a manutenere i data set che pubblicano come open data.

Sappiamo, inoltre, che le pubbliche amministrazioni sono obbligate, dall’art. 37 del GDPR, a designare un Data Protection Officer (DPO) con il compito di sorvegliare sull’osservanza del regolamento e di altre norme nazionali ed europee in materia di trattamento dei dati personali. Il DPO, quindi, dovrà verificare che gli open data messi a disposizione dalla pubblica amministrazione che lo ha designato siano pubblicati osservando i principi del GDPR: liceità, riservatezza ma anche esattezza. Insomma, deve vigilare affinché i dati non siano pubblicati e, poi, abbandonati a se stessi.

La situazione attuale

La situazione in Italia, per quanto riguarda gli open data, è piuttosto confusa. Non esiste un obbligo di pubblicazione in un unico hub e nemmeno di centralizzazione della catalogazione: ogni pubblica amministrazione può pubblicare gli open data utilizzando il proprio sito web con l’unico vincolo di renderli in formato “aperto” ovvero utilizzabile da chiunque con i comuni software di automazione d’ufficio.

Le pubbliche amministrazioni più solerti si sono avvalse dell’opportunità di aderire alla federazione di cataloghi messa a disposizione dall’Agid[viii]. Parliamo di 42 amministrazioni che hanno messo a disposizione circa 20.000 data set: possono sembrare numeri importanti ma, di fatto, sono poca cosa rispetto alle potenzialità pubbliche. Colpisce, inoltre, che il Comune di Albano Laziale pubblichi 1.189 data set a fronte della Regione Campania che ne pubblica solo 36.

Una sbirciatina al contenuto dei singoli data set sorprende ancora di più. Si può scoprire, infatti, che:

  • le domande dell’Agid vengono spesso ignorate se sono stati pubblicati data set di artigiani con una colonna dedicata ai collaboratori dove si possono trovare diciture del tipo “Sig. Caio Tizio (Fratello)” oppure “Sempronia Mevia (moglie) dal 02.07.2012” (i veri nomi sono presenti nel data set);
  • molti data set contengono dati personali (il cui consenso alla diffusione si suppone acquisito a monte) che sono riferiti ad anni precedenti e che sembrano abbandonati senza alcuna sistematica attività di aggiornamento; per esempio il data set direttoretecnico.csv (il cui ultimo aggiornamento è del 16/6/2017) messo a disposizione dalla Città Metropolitana di Roma sembra, addirittura, fornire informazioni sullo stato di occupazione lavorativa dei soggetti interessati.

Bella trovata gli open data! Ma anche un lavoro aggiuntivo (e non così piacevole) al quale i Data Protection Officer, forse, non avevano pensato.


A cura di: Francesco Maldera

L’articolo Quale protezione per gli open data? proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/quale-protezione-per-gli-open-data/


Penetration Test: Punti di forza e di debolezza ed una possibile soluzione

Questo contributo cerca di illustrare alcuni punti di debolezza della valutazione della robustezza di un sistema basato su penetration test. Il nostro focus è ovviamente su debolezze strutturali del metodo di valutazione che, proprio perché strutturali, sono indipendenti dalle competenze e conoscenze dei team coinvolti nel test. Il penetration test è uno dei metodi più popolari per la valutazione della robustezza di un sistema rispetto alle intrusioni. L’idea di base è molto semplice: prendiamo qualcuno che sia, o dichiari di essere, un esperto di intrusioni e paghiamo questo tester per attaccare il nostro sistema, o meglio per ripetere le attività di un attaccante contro il nostro sistema. Se l’intrusione ha successo, il tester ci indicherà i difetti che ha sfruttato e noi potremo rimediare. In altre parole, il penetration test non è altro che il primo passo di una soluzione “penetrate and patch”, trova i difetti per eliminali. Chiaro, semplice efficace. Come tutte le soluzioni semplici e risolutive, il diavolo sta nei dettagli. Avevamo già sollevato qualche dubbio in passato sulla complessità di scegliere le contromisure, si veda ICT Security del settembre 2015, che ora generalizzeremo.

Il principale punto di forza di un penetration test è la sua generalità, infatti esso può essere realizzato su un qualunque sistema dopo il suo deployment. Un qualunque sistema che può essere attaccato può essere il target di un penetration test. E’ovvio che si ricorre ad un penetration test in tutti quei casi in cui si ritiene sia impossibile misurare in modo “ripetibile” e “condiviso” la cyber security di un sistema. Con ripetibile intendiamo che la valutazione possa essere ripetuta da persone diverse in modo da verificarne i risultati. La ripetibilità richiede che il processo sia adeguatamente formalizzato definendo delle regole che indichino come gestire le possibili ambiguità che si possono incontrare durante l’attività. Con valutazione condivisa intendiamo che le caratteristiche del sistema da valutare e la scala di valutazione vengono concordati anticipatamente tra chi valuta e chi viene valutato. Quando non si conoscono metodi con queste proprietà ci si rivolge a prassi come il penetration test che permettono di avere comunque risultati in qualche modo utilizzabili. Nel seguito ci concentreremo su un black box penetration test, uno in cui l’attaccante non ha a propria disposizione informazioni sul sistema da attaccare ma deve scoprire tali informazioni durante il test. Questo è a nostro giudizio il caso più significativo perche rispetto ad altri tipi di penetration test abbiamo la massima similitudine con un attacco reale. Raramente infatti un attaccante ha a disposizione informazioni sul sistema come avviene in un white box penetration test.

Il primo problema da risolvere per definire un penetration test è quello di trovare un esperto di attacchi informatici. Non ci sono molte certificazioni disponibili e mai come in questo caso il curriculum è fondamentale. Sfortunatamente il primo requisito per eseguire un penetration test è un dettagliato NDA che vieta di parlare di quanto fatto e dei risultati ottenuti. Superato questo problema, ad esempio ingaggiando un team con un currriculum significativo, dovremo cercare non un generico esperto ma un esperto con conoscenze e competenze adeguate per il nostro sistema. E’ovvio che utilizzare un esperto di Linux per attaccare sistemi Windows non sia una buona idea.  La ricerca del penetration tester deve quindi comunicare all’esterno un numero di informazioni non banali sul nostro sistema.

Altri problemi sono il social engineering ed il phishing. Sono leciti o non lo sono? Il penetration tester può telefonare fingendo di essere la segretaria dell’amministratore delegato e dicendo che l’amministratore ha perso la password? Può mandare un interessante link che invogli a cliccare oppure no?

Una volta scelto il team e definite le regole del gioco, occorre decidere anche gli obiettivi dell’attaccante ovvero quali componenti, fisici o virtuali, deve controllare o quali informazioni deve esfiltrare o manipolare. A questo punto il penetration test, cioè l’attacco, può iniziare. Durante il penetration test, il sistema continua il suo normale funzionamento e gli strumenti di monitoraggio e difesa operano come al solito per supportare la normale gestione del sistema. Infine, i difensori, i.e. i gestori e gli amministratori del sistema non sono informati del test in modo da riprodurre con la maggior accuratezza possibile lo scenario dalla prospettiva sia dell’attaccante che del difensore.

Per continuare la nostra discussione, assumiamo che il sistema da penetrare sia di una ragionevole complessità e che quindi l’attaccante debba necessariamente costruire ed eseguire una catena di attacchi. Per costruire tale catena ogni black box penetration test deve comprende due tipi di attività che, per semplicità, indichiamo rispettivamente come collect ed exploit. L’obiettivo delle attività di collect è quello di raccogliere le informazioni sul sistema da attaccare. Infatti, visto che il test deve ripetere le attività di un attaccante, il penetration tester dovrà anche investire del tempo per raccogliere informazioni sui nodi del sistema target, le applicazioni che eseguono e le connessioni logiche e fisiche. Queste informazioni sono fondamentali per scoprire le vulnerabilità del sistema e quindi gli attacchi che possono essere efficaci. I meccanismi di base delle attività di collect sono il network scanning per scoprire i nodi di un sistema ed il vulnerability scanning per scoprire le loro vulnerabilità.

Le attività di exploit sono quelle che eseguono gli attacchi permessi dalle vulnerabilità scoperte dalle attività di collect. Metaforicamente, possiamo vedere le attività di collect come quelle che permettono all’attaccante di ricostruire una mappa dei vari componenti del nostro sistema e delle loro relazioni. Le attività di exploit sono quelle che utilizzano le informazioni raccolte per attaccare alcuni componenti, controllarli ed eventualmente usarli in altre attività di collect. L’attaccante sta esplorando un ambiente sconosciuto in cui deve attaccare alcuni elementi per usarli e raccogliere ulteriori informazioni per raggiungere il suo obiettivo.

Le due attività si alternano durante un test perché, ad esempio, è possibile scoprire i collegamenti di un certo componente solo dopo averlo attaccato con successo. Ad esempio, un attaccante può scoprire il sottosistema protetto da un firewall solo dopo aver attaccato con successo il firewall stesso. Nel penetration test di un sistema non banale, la percentuale di tempo necessaria per raccogliere informazioni non è assolutamente trascurabile e contribuisce significativamente al tempo necessario all’attaccante per raggiungere gli obiettivi concordati.

Ogni penetration tester deve, prima o poi nel suo attacco, risolvere quello che è stato chiamato il dilemma collect or exploit. Questo dilemma nasce quando l’attaccante può eseguire alcuni attacchi ma nessuno di loro permette di raggiungere l’obiettivo perché la mappa costruita fino a questo punto non permette di capire come raggiungere l’obiettivo. A questo punto l’attaccante può o eseguire uno degli attacchi possibili, sperando che i diritti acquisiti permettano di estendere la mappa e capire come raggiungere l’obiettivo oppure può raccogliere altre informazioni grazie alle quali estendere la mappa. La scelta ha ripercussioni non banali perché l’esecuzione di un attacco aumenta la probabilità che i difensori scoprano l’attaccante poichè la raccolta di informazioni richiede un tempo non banale e può generare un elevato carico di comunicazioni che, nuovamente, può permettere la scoperta dell’attacco. A conferma della complessità del dilemma possiamo ricordare come esista una letteratura con una grande quantità di proposte, teoriche e pratiche, per risolvere il dilemma, nessuna delle quali è però risolutiva.

Risolto l’amletico dilemma collect or exploit, l’attaccante sceglie un attacco in base ad un proprio insieme di preferenze e priorità e lo esegue. Solo se tale esecuzione ha successo, la costruzione della catena di attacco può proseguire. Altrimenti l’attaccante deve decidere come gestire il fallimento dell’attacco. Le soluzioni possibili sono la scelta di un altro attacco o la ripetizione dell’attacco fallito. Se non esiste un altro attacco, il penetration test può raccogliere altre informazioni, ad esempio mediante ulteriori vulnerability scanning per scoprire nuove vulnerabilità e quindi nuovi attacchi oppure dichiarare il fallimento del test.

La nostra breve descrizione evidenzia come ogni attaccante abbia una propria strategia che possiamo riassumere come la soluzione di tre dilemmi del penetration test:

  1. Collect or exploit
  2. Scelta di uno dei possibili attacchi
  3. Gestione del fallimento di un attacco

Ovviamente, le singole soluzioni utilizzate e la loro fusione in una strategia complessiva hanno effetti significativi sul risultato del test ed anche sul tempo necessario all’attaccante per raggiungere gli obiettivi prefissati. Questo punto è di particolare rilevanza se il test fallisce. Infatti, a questo punto nasce un ulteriore e più importante dilemma ovvero “un attaccante con una diversa strategia avrebbe avuto successo?”. Rispondere a questo ulteriore dilemma è l’unico modo di capire se il nostro sistema è davvero robusto oppure se non lo è ed ha resistito solo perché la strategia dell’attaccante è sbagliata. Sappiamo bene che ancora peggiore della mancanza di robustezza e sicurezza è la falsa sensazione di sicurezza e robustezza, quindi capire cosa sarebbe successo con un’altra strategia è davvero fondamentale per valutare la robustezza.

Raccogliere dati per risolvere il dilemma sulla strategia dell’attaccante è però possibile solo se il penetration tester ripete il test con una strategia diversa. Ma questo non è possibile perché per ripeter il test innanzitutto il tester dovrebbe dimenticarsi tutto quanto ha già scoperto sul nostro sistema come pure ripetere la telefonata in cui impersona la segretaria dell’amministratore delegato. Quindi possiamo rispondere alla domanda solo utilizzando un altro penetration tester che utilizzi una strategia diversa. Una prima deduzione è quindi che un penetration test possa essere ripetuto solo utilizzando non solo strategie diverse ma anche “tester” diversi. Anche in questo caso, un ulteriore fallimento resta comunque di difficile spiegazione perché non sapremo mai se attribuirlo a proprietà strutturali del sistema o ad eventuali carenze anche nella strategia del nuovo attaccante. In altri termini, possiamo cosi generalizzare il dilemma “dopo quanti fallimenti di “penetration tester” diversi potremo affermare che il sistema è robusto?”. Sottolineiamo che se, in passato, la probabilità di fallimento di un penetration test era molto bassa, il focus sugli aspetti di cybersecurity, i vincoli legislativi e gli investimenti previsti renderanno il fallimento del test un evento sempre più probabile. Quindi, in futuro, si incontreranno sempre più fallimenti e diventerà sempre più importante interpretarli e spiegarli. In termini statistici, la soluzione del dilemma sui fallimenti è un problema di confidenza che può essere cosi formulato “quale è il livello di confidenza sulla robustezza del sistema dopo k fallimenti di un penetration test”. La statistica ci dice anche che l’unico modo di rispondere alla domanda sul livello di confidenza e poter interpretare i fallimenti del test è quello di ripetere più volte il penetration test, garantendo l’indipendenza di ogni esecuzione, cioè ristabilendo ogni volta le condizioni iniziali. In questo modo possiamo attribuire il fallimento a debolezze del sistema o dell’attacco. Una ripetizione indipendente può essere ottenuta solo automatizzando il test ovvero implementandolo mediante un programma. Ciò richiede una formalizzazione delle varie attività ancora più rigorosa ed estesa di quella precedente, in modo che essa possa essere affidata ad un programma. Il ripristino delle condizioni iniziali è in questo caso semplice, immediato e facilmente verificabile. Le strategie da applicare per risolvere i vari dilemmi possono essere modificate in fase di configurazione del programma. Se si dispone di questo strumento di attacco, che tipicamente utilizzerà meccanismi e politiche tipiche dell’intelligenza artificiale, è possibile ripetere più volte un test. Le ripetizioni utilizzano lo strumento nella stessa configurazione per valutare come eventi probabilistici influenzano il risultato del test. Ad esempio, ripetendo più volte il test possiamo analizzare la correlazione tra la probabilità di successo di uno specifico attacco ed il risultato finale del test. Invece, per scoprire come una specifica strategia influenzi i risultati del test, è necessario ripetere il test dopo aver modificato la configurazione dello strumento, e quindi la strategia dell’attaccante.

Una conferma indiretta sulla prospettiva della completa automatizzazione del penetration ci viene dai significativi investimenti che il DOD USA sta facendo sulla automatizzazione del processo che va dalla scoperta di una vulnerabilità all’attacco di un sistema. E’ chiaro che se il sistema è complesso, l’attacco è in realtà una catena d’attacco la cui costruzione richiede l’adozione di una strategia che risolva i tre dilemmi del penetration tester prima delineati. Sempre più nel futuro il penetration sarà automatizzato e se, da un lato, questo permetterà di ripetere più volte il test, dall’altro pone il problema delle competenze necessarie non per attaccare un sistema ma per costruire, configurare e programmare un sistema che lo faccia in modo automatico. Ovviamente, i due insiemi di competenze hanno delle intersezioni ma sono fortemente diversi.

Tutto quanto detto fino ad ora, non risolve due ulteriori debolezze del penetration test, entrambe generate dal fatto che il test opera su un sistema esistente. Il primo problema di operare su un sistema esistente è il disturbo che il test genera. Per quanto il tester sia accorto e prudente, attività anche con un impatto relativamente basso come uno scanning possono spesso avere effetti non prevedibili su un sistema. Non è raro ad esempio che uno scanning di un sistema di controllo industriale possa rallentare in modo significativo il funzionamento del sistema con effetti a catena sul processo industriale che viene controllato. L’impossibilità di garantire l’assenza di tali effetti dovrebbe comunque sconsigliare l’adozione di questa soluzione in sistemi critici per la sicurezza dell’ambiente e delle persone come, ad esempio, sistemi di controllo del traffico o di impianti chimici potenzialmente inquinanti.

La seconda debolezza, a nostro giudizio la più significativa, è la possibilità di condurre il test solo dopo il deployment del sistema ovvero quando il sistema è stato progettato, installato e configurato. Ovviamente, ciò implica l’impossibilità di ottenere una “cyber security by design” e cioè di avere una qualche certezza sul sistema prima del suo utilizzo e, vero problema critico, riduce fortemente il numero di contromisure con un costo accettabile e proporzionato a disposizione dei difensori. Infatti, il costo di modificare strutturalmente il sistema in fase di progetto è di alcuni ordini di grandezza inferiore a quello di una modifica su un sistema già operativo. Questo problema non può essere risolto nemmeno automatizzando il penetration test ed affidandolo ad uno strumento. L’unica soluzione a questo problema è l’adozione di una tecnica di model based simulation in cui l’attacco viene condotto operando non sul sistema reale ma su un modello del sistema reale. Tale modello deve poter essere costruito sia quando il sistema è già esistente, analizzando i componenti utlizzati sia quando il sistema è ancora in fase di progetto, utilizzando le specifiche dei componenti che si prevede di utilizzare. Un ulteriore vantaggio di una soluzione model based è la possibilità di condurre valutazioni con gradi di accuratezza e costi diversi. Ciò è possibile modificando il livello di astrazione del modello utilizzato per il test. Una valutazione quick and dirty può utilizzare un modello molto semplice, una più accurata utilizzerà invece modello molto più fedele e dettagliato del sistema target.

Riassumendo, solo automatizzando il penetration test ed eseguendolo su un modello del sistema si possono superare i punti di debolezza prima evidenziati. Questa soluzione è in grado di offrire valutazioni accurate della robustezza di un sistema in tutta la sua vita, dalla progettazione al suo utilizzo in campo, fornendo inoltre informazioni statisticamente attendibili sulla resilienza del sistema, ad esempio dopo quanto tempo, quanti attacchi e con quale probabilità/livello di confidenza il sistema cominci a collassare. Se condotta in modo formale e ripetibile, questa valutazione può fornire inoltre informazioni fondamentali per la gestione dinamica del rischio ICT, la risposta ad attacchi e la gestione degli incidenti. Azzardando una previsione sul futuro, quella più difficile, possiamo dire che il futuro appartiene a chi sa automatizzare i penetration test.

A cura di: F.Baiardi, J.Lipilini, M.Montecucco, F.Tonelli
Università di Pisa e Haruspex srl

L’articolo Penetration Test: Punti di forza e di debolezza ed una possibile soluzione proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/penetration-test-punti-di-forza-e-di-debolezza-ed-una-possibile-soluzione/


Telegram Messenger Forensics – 1 parte

In questo articolo continuo la carrellata iniziata con WhatsApp occupandomi di Telegram Messenger, forse la più veloce applicazione di messaggistica sul mercato. La prima parte sarà dedicata a iOS.

Telegram Messenger LLP è stata fondata da Pavel Durov, Nikolai Durov e Axel Neff. L’app Telegram per iOS è stata rilasciata il 14 Agosto 2013 dai fratelli Nikolai e Pavel Durov, i fondatori del social network russo VK[1].

I client ufficiali di Telegram Messenger sono open source[2]. Il codice sorgente relativo al lato server invece non è stato reso pubblico.

A marzo 2018 Telegramma aveva raggiunto i 200 milioni di utenti mensili attivi.[3]

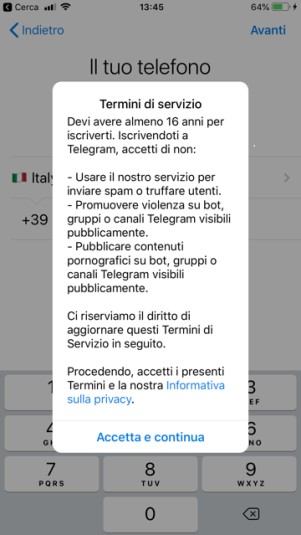
Con la versione 4.8.2 – ultima release attualmente scaricabile da App store – arrivano su Telegram Messenger nuovi sticker con la relativa ricerca, la possibilità di scattare ed inviare foto multiple e la modalità notte automatica; viene aggiornato il processo di registrazione con l’aggiunta del limite minimo di età per poter utilizzare l’app in EU ed UK (cfr. Fig.1):

Fig.1

Telegram è prima di tutto un’applicazione di messaggistica istantanea sicura. Ha il vantaggio di essere disponibile su iOS, Android e Windows Phone, ma anche in una versione Web; vi sono applicazioni anche per MacOS, Windows e Linux. Quindi è possibile utilizzare Telegram comodamente su quasi tutte le piattaforme possibili e immaginabili.

Diversamente da WhatsApp, Telegram è un servizio di messaggistica basato su cloud con sincronizzazione istantanea. Ciò consente l’accesso ai messaggi da diversi dispositivi contemporaneamente, inclusi tablet e computer, condividendo un numero illimitato di foto,video, file (doc, zip, mp3, etc.) con dimensioni fino a 1,5 GB per ogni documento.

Di conseguenza, gli utenti di Telegram possono godere di una sincronizzazione perfetta su telefoni, tablet e computer, della disponibilità immediata sui nuovi dispositivi connessi e della possibilità di riprendere da dove hanno lasciato (progetti di cloud) nelle loro Cloud Chat.

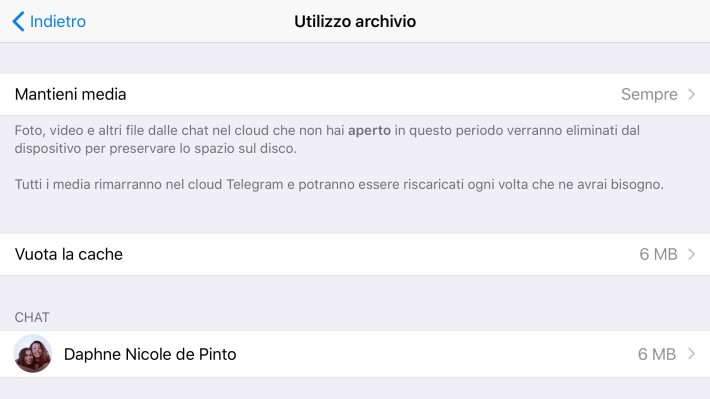
Infatti, a differenza della maggior parte delle app di messagistica istantanea, Telegram Messenger può occupare pochissimo spazio sul dispositivo. La rimozione dei dati presenti nella cache locale non comporta quindi un rimozione fisica dato che gli stessi verranno mantenuti nel cloud per tutto il tempo necessario, praticamente senza limitazioni.

Utilizzando l’impostazione “Mantieni media”, è possibile controllare per quanto tempo i file multimediali e altri file delle chat possano permanere sul dispositivo. Se non si accede a un file per il periodo di tempo specificato, questo viene automaticamente eliminato dalla cache. Naturalmente, i dati verranno immediatamente ricaricati dal cloud nel momento in cui si accede nuovamente.

Su iOS è anche possibile cancellare i file della cache in chat.

Una delle caratteristiche particolari dell’app riguarda i cosiddetti “super gruppi”: ogni singolo creato può contenere fino a 100.000 persone.

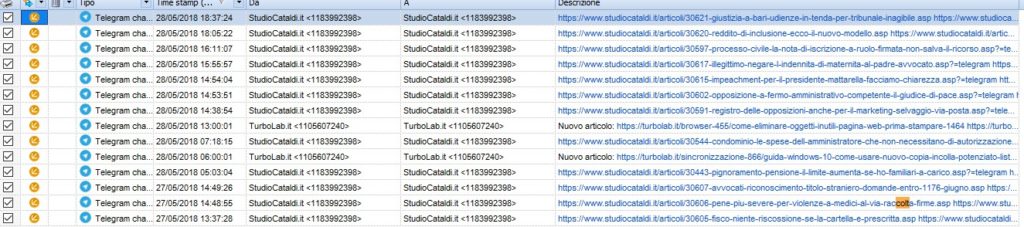
Altra caratteristica peculiare dell’applicazione sono i “canali”, forum di discussione dove chiunque può abbonarsi per ricevere notizie in tempo reale dai suoi “informatori” preferiti. Siti di informazione giuridica come www.studiocataldi.it o siti di notizie relative al mondo informatico come http://www.Turbolab.it utilizzano già da tempo questa caratteristica.

Telegram è inoltra fornita di ‘chat segreta’, che non è abilitata di default. I messaggi vengono distrutti dopo un limite di tempo impostato dall’utente e non dovrebbero essere recuperati – in seguito vedremo che non è così -.  Le stesse vengono escluse dai backup, il che consente agli utenti il pieno controllo dei dati che considerano sensibili e risiedono sul dispositivo dell’utente.

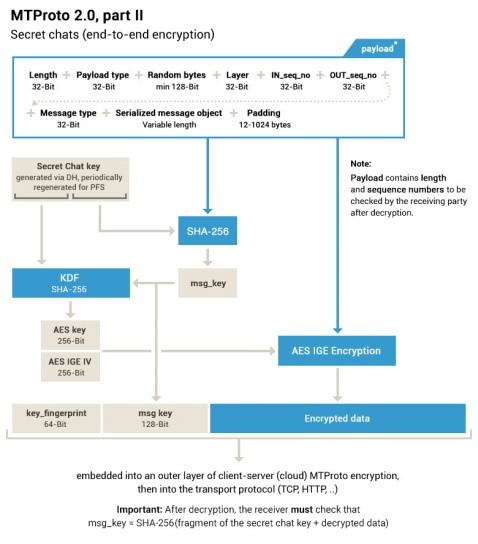
I messaggi tra gli utenti e il server vengono passati secondo il protocollo di messaggistica Telegram, scritto in casa e denominato MTProto[4] – dalla release 4.6, i principali client Telegram utilizzano MTProto 2.0 e la versione 1.0 è ormai divenuta obsoleta -:

Gli utenti utilizzano uno scambio di chiavi Diffie-Hellman[5] per generare una chiave comune che viene quindi utilizzata per lo scambio dei messaggi.  Essi comunicano con il server utilizzando la chiave RSA pubblica del server, che è “hard-coded” nei client Telegram e cambia raramente.

Le chat segrete sono legate a dispositivi specifici ed è impossibile continuare una conversazione su un dispositivo diverso da quello dove la chat è iniziata. Gli utenti devono creare e autenticare i loro account usando un codice di autenticazione ricevuto a mezzo SMS sul dispositivo in uso.

Telegram è fornito inoltre di un meccanismo di verifica in due passaggi per il quale l’utente, una volta configurata una password aggiuntiva, deve inserirla ogni volta che accede all’applicazione – nel caso, chiaramente, di logout -.

Telegram mette a disposizione, gratuitamente, due tipi di API[6] per gli sviluppatori. Le API per la creazione di Bot – abbreviazione di robot che consente di automatizzare un servizio e di dialogare con utenti reali, tramite chat, senza che dall’altro lato ci sia un essere umano – e le API di Telegram, le quali consentono la creazione di propri client Telegram personalizzati.

Che dire, lo scenario che si pone davanti all’informatico forense non è certo idilliaco.

Oltre all’applicazione client Telegram Messenger, vi sono molte probabilità di trovare client Telegram personalizzati con funzioni non note e interazioni non conosciute.

Un rapido cenno merita anche “Telegram X”, nettamente più veloce ed efficiente, in passato conosciuto come “Telegram HD”.

Telegram X per iOS è interamente scritto in Swift[7] ed è significativamente più leggero, più veloce e più efficiente di Telegram Messenger, realizzata con Objective C[8].

Riepilogando, quindi:

Tutti i dati sono crittografati. Le chat segrete utilizzano la crittografia end-to-end (EE2E), le chat cloud utilizzano la crittografia client–server /server-client e sono ovviamente crittografate anche nello storage.

Per proteggere i dati che non sono coperti dalla crittografia end-to-end, Telegram utilizza un’infrastruttura distribuita che è unica tra le app di IM. I dati di Cloud Chat vengono memorizzati in modo crittografato in diversi data center in tutto il mondo controllati da diverse entità legali distribuite in diverse giurisdizioni.

Le relative chiavi di decrittazione sono suddivise in parti e non vengono mai conservate nello stesso luogo dei dati che proteggono.

Questa soluzione ibrida è stata lanciata da Telegram nel 2013 e da allora è stata emulata da Kakao (2014), Line (2015), Google Allo (2016) e Facebook Messenger (2016). Tutti questi servizi hanno introdotto le proprie versioni di chat crittografate end-to-end oltre alla messaggistica di base basata su cloud.

Per quanto è a mia conoscenza, non vi sono ad oggi lavori pubblicati che affrontino l’analisi forense dei dati gestiti da Telegram Messenger e che forniscano una metodologia per ottenerli e consentire, nel contempo, la ricostruzione degli eventi relativi all’indagato e la validazione dei risultati prodotti.

Vi sono alcuni software forensi in grado di decifrare le evidenze archiviate da Telegram – Cellebrite Ufed, Oxygen Forensics Detective, Magnet Axiom, Belkasoft Evidence Center solo per citarne alcuni -, ma gli stessi non forniscono alcuna spiegazione su come questa decodifica venga eseguita, né tantomeno alcun ausilio su come utilizzare i vari elementi estratti al fine di ricostruire completamente le attività dell’utente.

Pertanto, alla luce di quanto sopra, è praticamente impossibile valutare la completezza e la correttezza dei risultati generati.

Identica problematica – quale la mancanza di informazione e chiarezza – si riscontra a seguito dell’acquisizione delle evidenze dai dispositivi da analizzare: alcuni software, utilizzando a seconda dei casi le varie tipologie a disposizione (direct/logica/filesystem/fisica), effettuano operazioni sui dati da estrarre impostando password e configurazioni senza fornire alcuna spiegazione.

Ad esempio:

Oxygen Forensics Detective[9] cifra i backup di iTunes senza alcun avviso e senza richiederne il consenso all’investigatore, assegnando al backup la password “Oxygen”. E’ noto che la codifica dei backup di iTunes viene adoperata per aggiungere ulteriori informazioni non presenti nei backup non codificati: password salvate, cronologia dei siti web, impostazioni Wi-Fi e dati inerenti la salute.

Altri, invece, si comportano da veri “gentiluomini”:

  1. Msab Xry[10] chiede invece all’investigatore il consenso a poter codificare il backup, ricevuto il quale procede alla codifica assegnando la password “1234” e mettendone al corrente l’operatore.
  2. Magnet Axiom, invece, dopo averne illustrato le motivazioni, chiede all’investigatore l’introduzione della password da adoperare per cifrare il backup.

Telegram è noto come l’instant messenger più sicuro, ma non crittografa i file di database pertinenti memorizzati sul dispositivo. Pertanto, l’analisi forense di Telegram Messenger sul dispositivo, ammesso sia possibile recuperare i file di database in dipendenza della versione di iOs installata, può effettuarsi senza grandi problemi.

Il database principale di Telegram Messenger è tgdata.db che si trova nella directory /private/var/mobile/Containers/Shared/AppGroup/9C8C5F63-4EF3-4D6C-9F7F-C71B9A0970A/Documents. Il file di database non è crittografato, consentendo una visualizzazione intuitiva dei dati memorizzati nel database.

Le tabelle di particolare interesse investigativo sono le seguenti:

  • users_v29: contiene informazioni dettagliate sugli utenti, tra cui ID utente, nome, numero di telefono, etc .;
  • contacts_v29: contiene la lista di tutti gli ID dell’utente; una join tra uid di contacts_v29 e uid di users_v29 consente l’ottenimento di informazioni più dettagliate;
  • convesations_v29: contiene l’elenco delle conversazioni attive così come sono riportate nelle schermate di chat dell’app, nonché l’ultimo messaggio scambiato; se trattasi di una sessione di gruppo, un resoconto dettagliato del nome del gruppo, il numero dei membri del gruppo e l’elenco dei membri del gruppo; una chicca: la “r” nel nome della tabella non è un refuso ma manca davvero!;
  • messages_v29: contiene l’elenco di tutti i messaggi scambiati, identificati come mittente/destinatario nonché un ID conversazione (CID), in modo da facilitare il raggruppamento dei messaggi appartenenti alla stessa conversazione; gli stessi messaggi scambiati in “chat segrete” sono anch’essi memorizzati in questa tabella; i contenuti multimediali sono memorizzati in un campo di tipo BLOB[11].;
  • encrypted_cids_v29: contiene gli ID di conversazione delle chat segrete. Tutti
    i CID di 10 bit relativi alle chat segrete iniziano con il simbolo – (meno). La differenza tra la sessione ordinaria di chat e la segreta è proprio l’identificativo “- (meno)” posto all’inizio del CID. Mettendoli in correlazione con la tabella dei messaggi, è possibile riprodurli per intero.

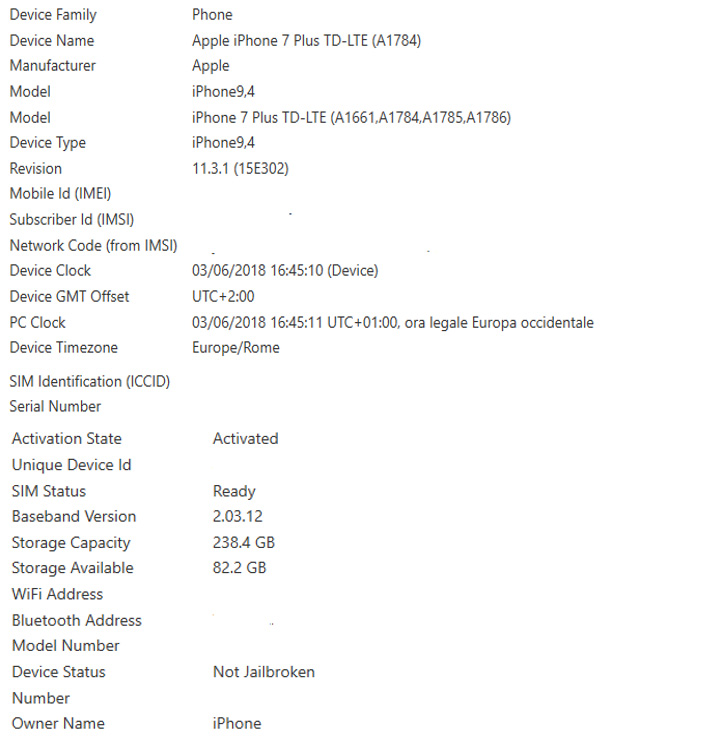
Dai test effettuati in laboratorio con l’ausilio di vari software forensi (Oxygen detective rel. 10.2.1.2, Msab Xry rel.7.7.1 e Magnet Axiom rel. 2.1.0.927) su di un dispositivo aventi le caratteristiche indicate in fig.2 – iOS 11.3 -, gli stessi non sono stati in grado di estrarre nulla in riferimento ai db utilizzati dall’applicazione, di seguito elencati:

  1. Tgdata.db;
  2. Tgdata.db-journal;
  3. Tgdata_index.db;
  4. Tgdata_index.db-journal.

L’acquisizione logica – l’unica attuabile – ha consentito unicamente di estrarre solo poche informazioni, quali immagini identificative attribuite ai profili della lista contatti, allegati di chat, file di configurazione dell’app. Chiaramente ben poca cosa rispetto al bisogno dell’investigatore.

Fig.2

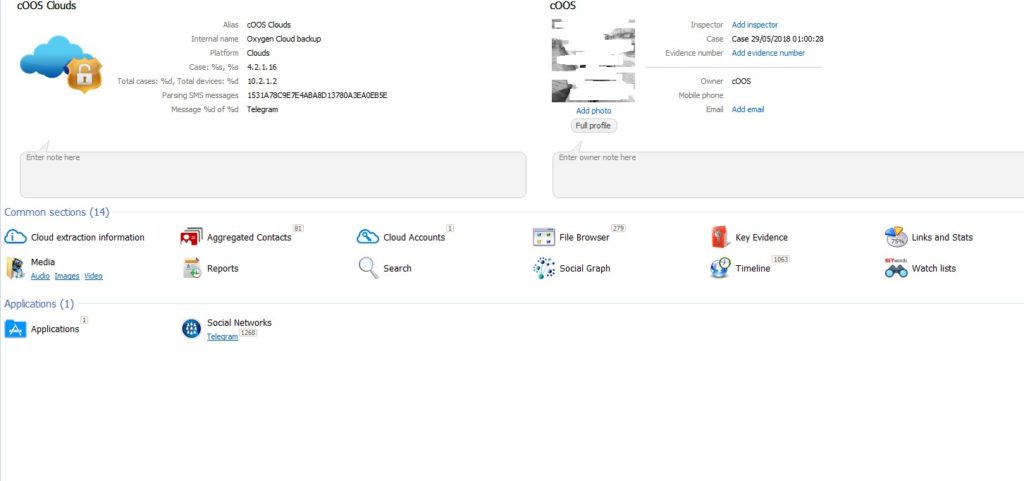
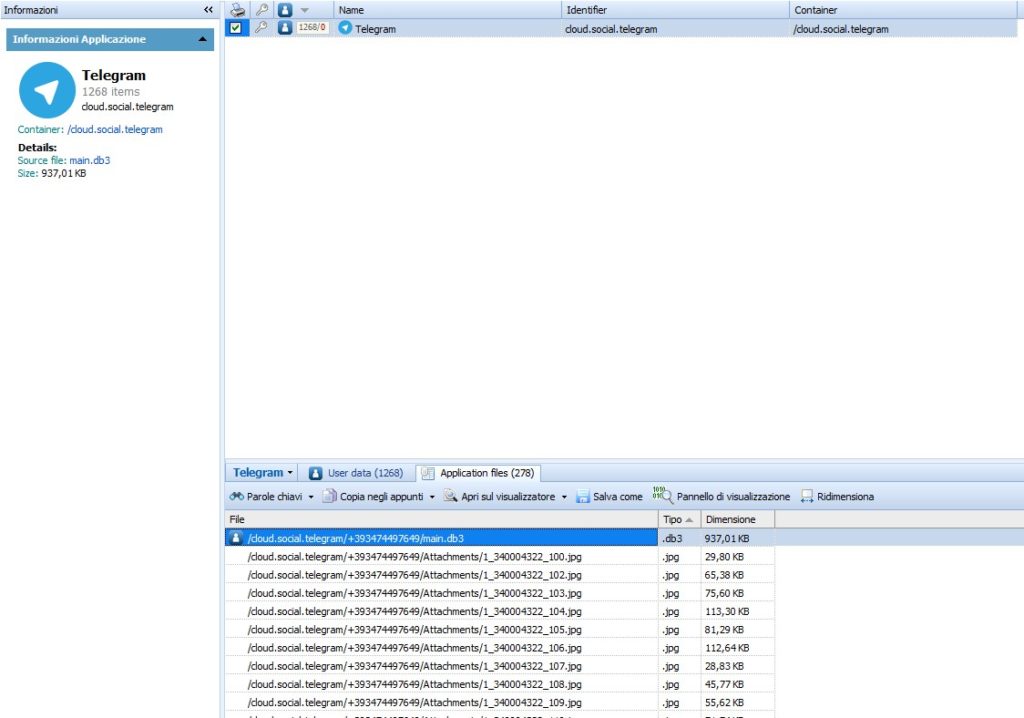
Il ricorso invece a Oxygen Cloud Backup ha consentito, invece, – fornendo il solo numero telefonico e il codice di autorizzazione pervenuto a mezzo SMS – l’estrazione delle informazioni direttamente dal cloud, come evidenziato in calce:

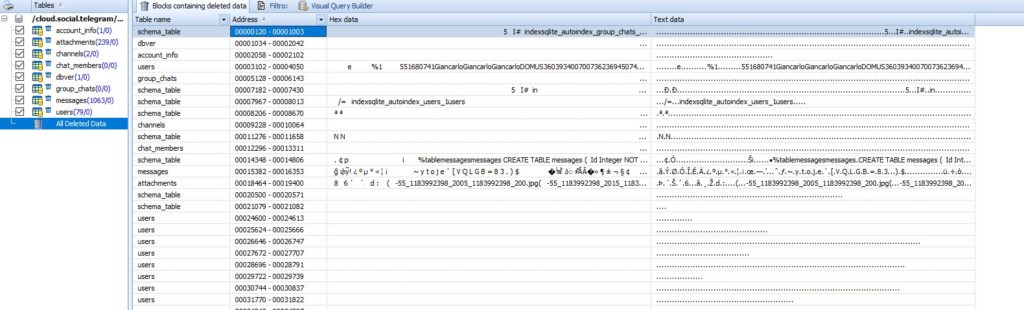
Le evidenze estratte hanno permesso dunque la ricostruzione degli eventi (timeline, contatti, chat, file multimediali e aggregazioni al bisogno) e consentito l’analisi di ogni singolo artefatto. Dal database estrapolato, Oxygen effettuava anche un carving dei record eventualmente cancellati (cfr. Fig. 3).

Fig.3

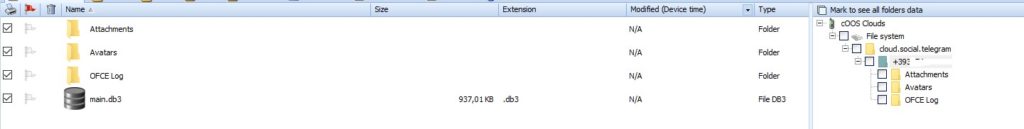
La struttura del file system è evidenziata in calce:

Nella directory Attachments vi si trovano i file multimediali relativi alle chat e ai profili:

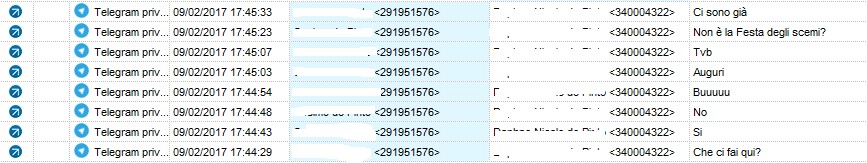
La timeline ricostruita dal software presentava tutti i messaggi in ordine cronologico:

E le chat, tutti i dati indispensabili per lo studio delle conversazioni e degli interlocutori:

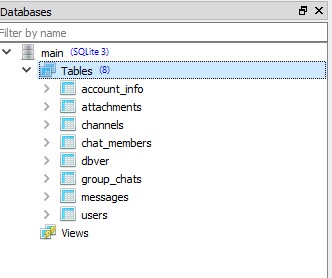
Il database estratto è composto da 8 tabelle autoesplicative:

Quelle di interesse investigativo, users, attachments, chat members, group_chats e messages possono essere messe in relazione tra loro con semplici query sql e ricostruire la cronologia delle chat.

In conclusione:

Ci affidiamo a dispositivi mobile per archiviare le nostre risorse digitali e consentirci di accedervi. I nostri telefoni sono sempre con noi e sono diventati una forma principale di comunicazione vocale, video e di messaggistica.

Questo rende i nostri dispositivi mobile obiettivi di grande valore per gli inquirenti.

Ormai quasi tutti gli strumenti commerciali tentano di supportare l’estrazione delle applicazioni fornite da terze parti. Purtroppo le app vengono aggiornate frequentemente ed è possibile che gli strumenti utilizzati in ambito forense possano perdersi qualcosa. Uno studio accurato sul funzionamento delle app, su come vengono memorizzati i dati e sul loro funzionamento è parte integrale del bagaglio di esperienza di un informatico forense.

Il mio consiglio è quello di testare sempre e accuratamente gli strumenti con cui si approcciano le acquisizioni e le analisi in ambito forense.

Un report ben costruito non è automatico, ma è frutto di una mediazione implicita tra mente umana e strumento.

A volte è proprio questo che fa la differenza.

Penso che la coscienza collettiva abbia ormai compreso che il lavoro di un informatico forense esperto non può essere sostituito da alcuno strumento, ma solo coadiuvato.

Stay Tuned.

NOTE


A cura di: Cosimo de Pinto

L’articolo Telegram Messenger Forensics – 1 parte proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/telegram-messenger-forensics-1-parte/


Phishing: consigli utili per attenuare il rischio di adescamento

Nonostante siano passati molti anni, il fenomeno del phishing continua a mietere vittime. I criminali utilizzano sempre le stesse tecniche cambiando le modalità di azione. Il recente caso della truffa architettata attraverso la posta elettronica certificata ne è un’ulteriore esempio e testimonia come il problema non sia la mancanza di strumenti tecnici e normativi per la gestione della sicurezza informatica ma la scarsa consapevolezza del rischio di adescamento. Difatti ad essere stata violata non è stata la sicurezza dei sistemi di gestione della PEC, come puntualizzato da due importanti autorità di certificazione nazionali Infocamere e Assocertificatori [1], ma la buona fede degli ignari clienti che, confidando nell’identità del mittente, hanno commesso il solito errore: fornire credenziali, pin dispositivi ed altri dati personali tramite canali non convenzionalmente utilizzati dai servizi di home banking e simili. Purtroppo questo tipo di attività illegale continua inesorabilmente ad essere attuale cambiando ciclicamente i propri strumenti d’azione.

Per difendersi occorre una buona protezione e la massima prudenza e diffidenza senza abbassare mai la guardia. Per assimilare questi concetti è necessaria una formazione ed una educazione digitale che coinvolga le nuove e le vecchie generazioni. Bisogna prendere coscienza che gli atti criminosi possono concretizzarsi anche attraverso gli strumenti informatici.

Nel presente articolo che concludo con un esempio pratico, rispondo ad alcune domande sull’argomento che più frequentemente mi vengono poste:

  • Come si sviluppa un attacco di tipo phishing?
  • Come è possibile creare delle mail truffa e clonare dei siti?
  • Come interpretare la struttura della nomenclatura dei file?
  • Come interpretare la struttura di un indirizzo WEB?
  • Come interpretare la struttura di un indirizzo mail?

Come si sviluppa un attacco di tipo phishing?

Possiamo schematicamente suddividere quattro fasi principali.

  1. Preparazione: per portare a compimento l’attacco è necessario, preventivamente, costruire un database di indirizzi mail bersaglio cui spedire in modo massivo i messaggi per l’adescamento. Ciò è possibile avvalendosi di algoritmi basati sull’uso di dizionari elettronici, scansione di siti e furti di dati sensibili;
  2. Invio: con l’invio di messaggi contenenti informazioni e loghi aziendali attendibili, l’utente di solito viene allarmato ed invitato a eseguire delle operazioni per correggere delle verosimili problematiche: scadenza della password, rinnovo carte di credito, problemi di accreditamento etc.
  3. Adescamento: Qualora l’ignaro utente seguisse la procedura consigliata nel messaggio fraudolento ad esempio cliccare su un collegamento o aprire l’allegato per fornire le informazioni necessarie alla risoluzione della problematica esposta, gli artefici della trappola possono mettere in opera il loro piano.
  4. Azione: l’atto criminale viene messo in atto con tutte le conseguenze del caso.

A tal proposito è consigliabile che nel dubbio ciascuno segua delle regole di buon senso:

  • Leggere attentamente i dettagli dell’intestazione della mail verificando la veridicità dell’identità del mittente;
  • controllare la grammatica e l’ortografia nel testo e nell’oggetto della mail. Gli errori di scrittura possono essere un campanello d’allarme;
  • Imparare a saper interpretare gli indirizzi web;
  • Non aprire allegati la cui natura non è chiara. L’allegato potrebbe essere un veicolo per l’installazione di malware adeguatamente architettato allo scopo.
  • Prestare attenzione a catene di Sant’Antonio ed mail spazzatura (spam).

In ogni caso si consiglia di integrare queste regole di buona pratica con le seguenti ulteriori raccomandazioni:

  • Installare e aggiornare periodicamente l’antivirus sui propri dispositivi;
  • segnalare eventuali anomalie al proprio gestore e nei casi più gravi alle autorità;
  • aggiornarsi periodicamente sulle notizie al riguardo consultando lo sportello per la sicurezza degli utenti del web a cura della Polizia Postale e delle Comunicazioni [2].

Come è possibile creare delle mail truffa e clonare dei siti?

Partiamo dal presupposto che nulla è impossibile. Esistono tecniche per far sì che una email sembri inviata da un indirizzo piuttosto che da un altro. È anche possibile creare dei collegamenti a siti apparentemente legittimi e dei file di documenti che in realtà nascondono un software nocivo. Esistono altresì abili tecniche di persuasione. Si parla in questi casi di spoofing, scraping, binding ed ingegneria sociale.

  • Spoofing: tipo di attacco che falsifica l’identità di indirizzi di posta elettronica, di siti internet e di altri applicazioni web.
  • Scraping: è una tecnica di estrazione di dati da un sito web per mezzo di programmi ad hoc per la clonazione.
  • Binding: con questa tecnica è possibile annidare un algoritmo malevolo all’interno di un comune file di tipo noto in modo da superare i test di controllo antivirus e una volta attivato, all’insaputa dell’utente, eseguire le operazioni per le quali è stato implementato.
  • Ingegneria sociale: tecnica che fa leva sulle ben note vulnerabilità del fattore umano e che si materializza attraverso delle azioni di persuasione ingannevole.

Come interpretare la struttura della nomenclatura dei file?

Il formato del nome di un file è un altro aspetto da considerare molto bene. È comunemente indicato attraverso una estensione che è una serie di tre lettere unita al nome del file vero è proprio. Ad esempio, “articolo.txt” è un file da interpretare come testo, mentre “tabella.jpg” è un file da interpretare come immagine. Ciò che gli attaccanti fanno è quello di sfruttare la proprietà dei sistemi Windows di nascondere di default l’estensione dei file più comuni.

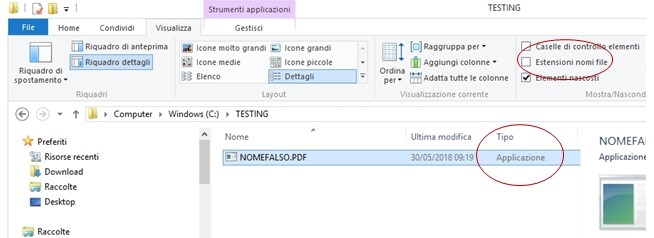
Supponiamo di avere a che fare con il file nomefalso.pdf.exe. Dal momento che il sistema operativo conosce l’estensione .exe, per impostazione predefinita non la visualizza. Ecco, quindi, cosa vede l’utente nel caso del file in esame:

L’utente potrebbe essere indotto ad aprire il file ritenendolo un documento pdf. Invece, dovrebbe subito allertarsi notando che l’indicazione del tipo lo classifica come Applicazione piuttosto che come Adobe Acrobat Document. Per evitare questi tipi di trappole è consigliabile abilitare la casella Estensione nomi file e prestare attenzione anche al logo che il sistema operativo assegna al file.

Di seguito le estensioni più comuni a cui fare attenzione:

  • Estensioni eseguibili: EXE, COM, BAT
  • Estensioni per documenti: PDF, DOC, XLS, PPT
  • Estensioni file di sistema: DLL, CPL, MSC, CMD
  • Estensioni per installatori e file compressi: MSI, ZIP, CAB, RAR
  • doppia estensione: PDF.EXE

Come interpretare la struttura di un indirizzo WEB?

L’indirizzo web che noi digitiamo sulla barra degli indirizzi del nostro browser è il cosiddetto URL ovvero l’acronimo di Uniform Resource Locator ed altro non è che un indirizzo costituito da più elementi.

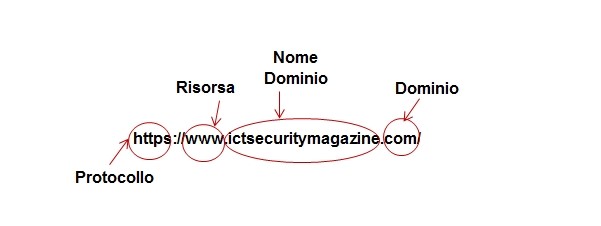
A titolo di esempio consideriamo l’indirizzo del nostro magazine e vediamo di individuare le varie componenti che lo compongono.

Il protocollo determina il tipo di servizio offerto dal server. In questo caso https (Hypertext Transfer Protocol with Privacy) stabilisce una connessione http sicura con crittografia SSL (Secure Sockets Layer).

La risorsa specifica il tipo di contenuto del server: WWW sta per World Wide Web ed indica una pagina html.

Il nome di dominio è il nome del sito vero e proprio che viene scelto dal proprietario e assegnato da gestori adibiti al servizio (ictsecuritymagazine).

Il tipo di dominio viene assegnato da organizzazioni nazionali e/o internazionali ed identifica il tipo di attività. In questo caso .com sta ad indicare una attività commerciale.

Alcuni dei tipi di dominio più comuni sono:

  • it: dominio italiano;
  • com: dominio per attività commerciali;
  • org: dominio per attività senza fini di lucro;
  • net: dominio per attività legate a internet;
  • eu: dominio per attività europee

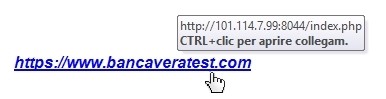
Uno dei metodi più frequentemente usati dai cyber criminali è quello di falsificare i collegamenti a questi URL. Anche se vale sempre la regola di controllare che l’indirizzo di un sito web utilizzi il protocollo sicuro “https”, una buona pratica è quella di non fare mai click sui link, ma di passarci sopra con il puntatore del mouse per verificare prima quale sia l’indirizzo reale. Nella figura di esempio si può vedere come il collegamento punti in realtà ad un indirizzo anomalo (l’indirizzo IP indicato è fittizio).

Come interpretare la struttura di un indirizzo mail?

Osserviamo il seguente indirizzo di posta elettronica e analizziamo i vari elementi

mariorossi@vi.home.it

il simbolo @ (chiamato chiocciola o at) separa il nome dell’intestatario dall’indirizzo della casella postale.

In particolare l’interpretazione corretta è la seguente: “mariorossi” ha la propria casella postale nel “@” pc “vi” gestito dal server “home” appartenente al dominio italiano “it”.

Un consiglio utile pertanto può essere quello di prestare attenzione ai dettagli del mittente di una mail, non soffermandoci semplicemente al nome distintivo che ci viene proposto.

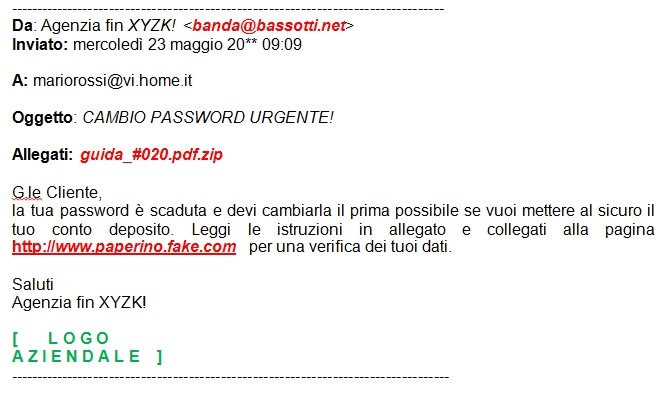
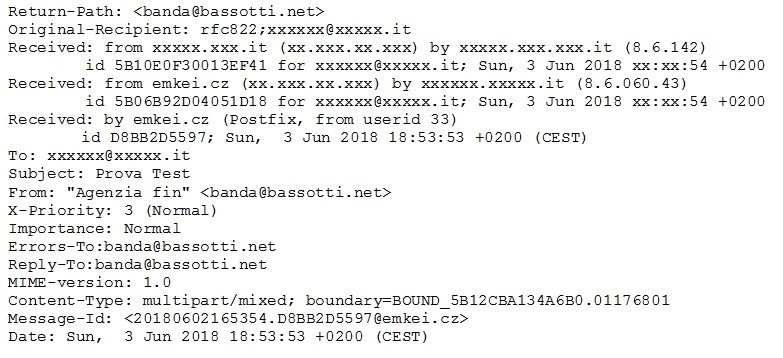
Di seguito riporto un esempio di messaggio di posta elettronica palesemente taroccato a scopo educativo.

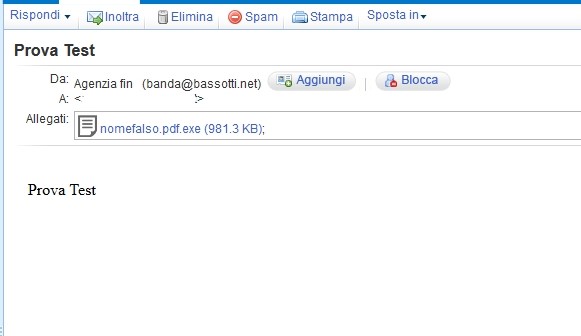
I punti essenziali da controllare sono evidenziati in rosso: a scrivere la mail non è stata l’Agenzia fin ma la banda bassotti, il link è sospetto e l’allegato un falso pdf.

Un esempio pratico di phishing tramite mail

  • Generazione di un Cavallo di Troia
  • Preparazione ed invio di una mail contraffatta
  • Risultati

L’esempio che propongo è a scopo esclusivamente informativo e didattico.

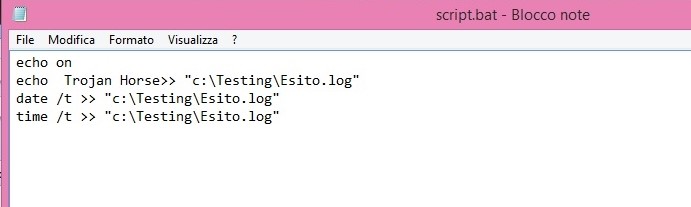
Per annidare dentro un file pdf un semplice script di scrittura log che si attivi in background all’apertura del pdf stesso, ho utilizzato il ben noto programma mFileBinder.exe [3].

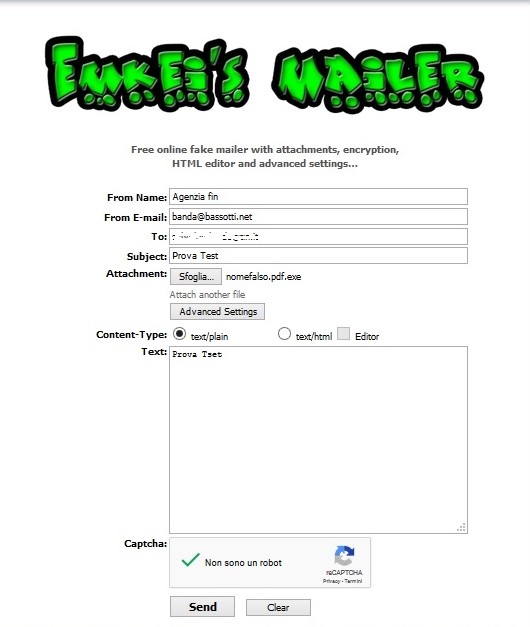
Per inviare a me stesso il malware come allegato di una “fake mail” ho invece utilizzato uno dei tanti servizi on line offerti da terze parti ovvero Emkei’s Mailer [4].

Generazione di un Cavallo di Troia

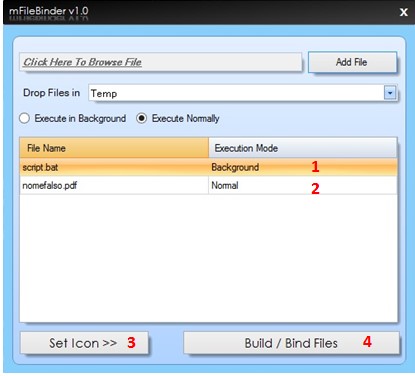
Una volta mandato in esecuzione mFileBinder.exe ho seguito i seguenti semplici e intuitivi passi:

  1. ho caricato il file script.bat in modalità di esecuzione in background;
  2. ho caricato il file nominato nomefalso.pdf in modalità di esecuzione normale;
  3. ho scelto di assegnare un’icona adeguata per il formato pdf;
  4. ho eseguito il binding di questi due file generando il Cavallo di Troia nomefalso.pdf.exe

Preparazione ed invio di una mail contraffatta

Come riportato in figura l’home page del servizio web scelto propone, per l’allestimento della mail, di compilare opportunamente i vari campi di un form (mittente, destinatario, oggetto, allegato e corpo del messaggio). Infine una volta inserito il codice captcha e premuto il tasto send la mail così confezionata è stata inviata.

Risultati

1.  La mail è arrivata a destinazione: il filtro antispam della mia casella postale è evidentemente incorso in un errore di valutazione generando un falso negativo. Riporto di seguito un’anteprima e i dettagli dell’header della mail ricevuta.

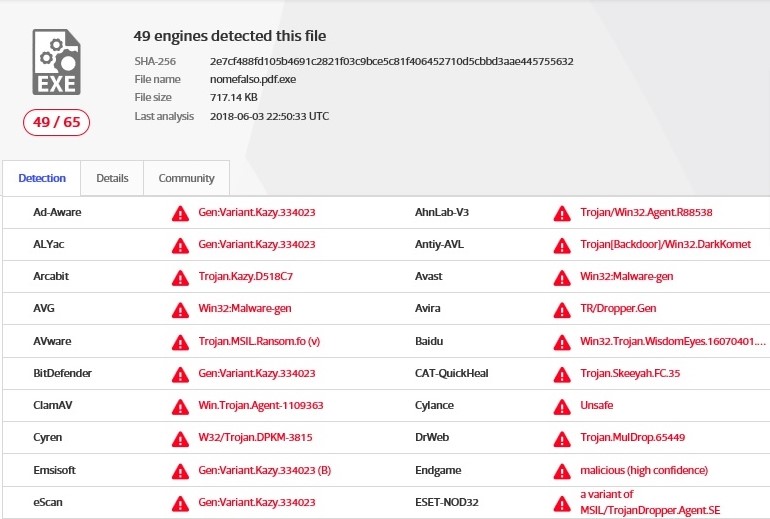
2.  ho proceduto ad analizzare il file nomefalso.pdf.exe attraverso il noto servizio online VirusTotal [5] ottenendo l’esito seguente: solo 49 su 65 antivirus (il 75%) hanno rilevato il codice malevolo. Questo risultato anche se accettabile dal punto di vista probabilistico non può esserlo per quello della sicurezza. Una zona d’ombra del 25% mette in chiaro che il rischio di una infezione informatica non è irrilevante e che non possiamo ritenerci immuni nemmeno da una infezione malware datata e ben nota.

Considerazioni finali

È indiscutibile che la sicurezza antivirus da sola non basta. Occorre che tutti i cibernauti prendano piena coscienza delle gravi conseguenze che una sottovalutazione del rischio informatico può comportare e che è possibile attenuarne l’esposizione adoperando, a supporto degli strumenti di protezione necessari, la regola di sicurezza che amo definire delle tre C: Consapevolezza, Cautela e Controllo.

Note

Sitografia


A cura di: Salvatore Lombardo

L’articolo Phishing: consigli utili per attenuare il rischio di adescamento proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/phishing-consigli-utili-per-attenuare-il-rischio-di-adescamento/


Google e la tutela dei minori tra Regolamento privacy europeo e parental control

Durante l’EMEA Child Safety Summit, tenutosi a Dublino il 18 e 19 aprile, si è parlato molto di Google e YouTube in merito agli strumenti di tutela per i minori, tanto che gli aggiornamenti attesi con più curiosità sono stati pubblicati proprio a margine del Summit, con riferimento al Regolamento privacy europeo (GDPR) e a Family Link.

Nel precedente articolo (https://www.ictsecuritymagazine.com/articoli/minori-e-social-network-alle-soglie-del-regolamento-privacy-europeo-i-nuovi-strumenti-di-facebook-per-la-verifica-del-consenso-genitoriale/) si è parlato di come Facebook abbia implementato il GDPR con riferimento all’età del consenso dei minori e all’intervento genitoriale. Per integrare quanto detto – e fugare i tanti dubbi emersi nel corso delle precedenti settimane – è bene specificare che WhatsApp, pur essendo di proprietà di Facebook, ha impostato in tutta Europa a 16 anni l’età minima per utilizzare questa applicazione, a prescindere da quale età minima indicherà poi la legge nazionale.

Google, invece, sulla linea di Facebook e Instagram, ha introdotto numerose innovazioni, con riferimento al controllo dei minori online, non solo su YouTube.

C’è da dire, infatti, che come per Facebook, anche il piano di implementazione del GDPR da parte di Google si affianca a un maggiore impegno per una migliore trasparenza dei dati sull’applicazione delle Linee guida della community di YouTube (consultabili qui: https://www.youtube.com/intl/it/yt/about/policies/#community-guidelines), incluso l’aspetto relativo alla sicurezza dei bambini. In effetti, il 24 aprile è stato pubblicato il primo Rapporto sull’applicazione delle norme sulla community di YouTube (https://transparencyreport.google.com/youtube-policy/overview), che include dati mai condivisi prima sull’applicazione delle norme relative ai contenuti della piattaforma, mostrando in che modo la tecnologia e le persone vengano impiegate per dare attuazione alle regole di Big G in modo responsabile e su vasta scala. Per offrire un costante impegno, il rapporto verrà pubblicato trimestralmente e, entro la fine dell’anno, verrà implementato con ulteriori dati sui commenti, sulla velocità di rimozione e sui motivi/criteri di rimozione.

Con riferimento ai contenuti, il dato interessante del primo Rapporto (relativo al periodo ottobre-dicembre 2017) è che su 9.321.943 di segnalazioni, pur rimanendo imbattibile la percentuale di contenuti segnalati dagli utenti perché giudicati a sfondo sessuale (30,1%), ben il 5,2% è stato segnalato perché relativo all’abuso su minore. Trattandosi di segnalazioni umane, ovviamente è ammissibile un margine di scollamento tra violazione reale e percezione del contenuto – in effetti, i video poi effettivamente rimossi a seguito della segnalazione degli utenti sono stati “solo” 1.598.308. Ma per questa ragione, YouTube ha sviluppato sistemi automatici che aiutano a rilevare contenuti che potrebbero violare le norme della comunità. Questi sistemi automatizzati si concentrano sulle forme più eclatanti di abuso, come lo sfruttamento dei minori o l’estremismo violento. Una volta che il contenuto potenzialmente problematico viene contrassegnato dai sistemi automatici, entra poi in gioco la revisione umana per verificare che il video vìoli effettivamente le policy di YouTube – il che ha portato alla rimozione di altri 6.685.731 video. La parte interessante di questo strumento è che il contenuto dannoso rimosso viene poi utilizzato per “addestrare” le macchine a una migliore analisi preventiva per il futuro.

Ma cosa accade con riferimento all’iscrizione degli utenti e quindi, alla presenza degli under 18 tra gli utenti di Google? Ricordiamo brevemente che l’art. 8.1 del Regolamento privacy europeo ha introdotto la regola generale per cui il cd. “consenso digitale” applicato alla fornitura di servizi online per ragazzi sotto i 18 anni sarà lecito solo laddove il minore “abbia almeno 16 anni”. Nel caso in cui, invece, l’interessato abbia un’età inferiore, il trattamento dei dati verrà considerato lecito “soltanto se e nella misura in cui tale consenso è prestato o autorizzato dal titolare della responsabilità genitoriale”, ferma restando la possibilità degli Stati membri di stabilire con legge nazionale (in Italia ancora non è stata adottata) “un’età inferiore a tali fini purché non inferiore ai 13 anni”. In sostanza, se la legge nazionale dovesse fissare il limite a 15 anni, tutti i minori tra i 13 anni e i 15 anni meno un giorno, dovranno ottenere il consenso del genitore per iscriversi ai social o ad altre piattaforme digitali. Questo consenso genitoriale, peraltro, dovrà essere verificato attivamente dal titolare del trattamento (il social network, ad esempio) “in ogni modo ragionevole”. Qui è disponibile l’elenco degli attuali limiti di età per prestare il consenso online in ciascun paese – si ricorda che attualmente in Italia il limite è fissato a 16 anni, almeno fino all’entrata in vigore di una legge nazionale che riduca l’età minima per il consenso digitale: https://support.google.com/accounts/answer/1350409?p=families_aoc&visit_id=1-636609008982616341-1926987227&rd=1

In linea con quanto sopra, l’11 maggio Google ha rilasciato una serie di aggiornamenti relativi a ragazzi e genitori che vanno a implementare il GDPR all’interno delle regole delle sue piattaforme. In particolare, per gli under 16, è stata lanciata la app Family Link (https://families.google.com/familylink/) che consente ai genitori di creare un account Google (quello che comunemente conosciamo come Gmail) appositamente per i ragazzi e stabilire alcune regole digitali di base per la navigazione. In particolare, la app permette di:

  • Gestire le applicazioni che il figlio può utilizzare, approvando o bloccando le app che vuole scaricare dal Google Play Store sul suo dispositivo;
  • Tenere sotto controllo il tempo di utilizzo dei dispositivi, sia con riferimento all’uso delle app, sia per quanto riguarda l’uso del PC, telefono o tablet in sé. Sono disponibili rapporti settimanali o mensili sulle attività e si possono impostare limiti giornalieri per il tempo di utilizzo dei dispositivi.
  • Impostare l’ora di dormire, bloccando il dispositivo del ragazzo da remoto quando è ora di andare a dormire o di fare una pausa.
  • Impostare i filtri per alcune app Google, come Ricerca e Chrome, filtrando i risultati troppo espliciti restituiti dal motore di ricerca (https://support.google.com/websearch/answer/510?source=gsearch).
  • Modificare o eliminare le informazioni sull’account Google dei propri figli (foto, nome, data di nascita, sesso ecc…).
  • Reimpostare la password dell’account del minore anche se, ovviamente, nel momento in cui il genitore cambia la password del figlio, quest’ultimo verrà disconnesso dal suo dispositivo e tutte le impostazioni di supervisione che il genitore aveva attivato con Family Link non funzioneranno fino a quando il ragazzo non eseguirà di nuovo l’accesso.

Attualmente, queste funzionalità possono essere gestite dall’adulto sia tramite Apple che Android, però il dispositivo del minore dovrà essere un necessariamente Android per poter essere sottoposto ai meccanismi di parental control di cui sopra.

Quanto detto per Family Link è valido anche con riferimento a YouTube. Infatti, per accedere a YouTube, è necessario creare un account Google che per un minore di 16 anni, essendo creato con Family Link, sarà sottoposto alla vigilanza del genitore. Per evitare che i ragazzi utilizzino un altro account, sfuggendo alla sorveglianza del genitore, il dispositivo Android impedirà l’inserimento di più account – evitando, ad esempio, che il bambino passi a un profilo non collegato a Family Link per scaricare app da Google Play senza l’approvazione di un genitore. In tal modo, l’adulto potrà applicare a YouTube la modalità con restrizioni, che consente di escludere contenuti potenzialmente inappropriati per i minori.

Inoltre, gli annunci pubblicitari sui servizi Google proposti agli account di minori creati con Family Link, sono sottoposti a un processo di revisione per contribuire ad assicurare che siano adatti alle famiglie e non saranno in alcun modo personalizzati, cioè non saranno basati su informazioni derivate dal profilo del minore.

Per confermare che il genitore sta dando il suo consenso in qualità di titolare della potestà genitoriale, al momento della creazione dell’account Google del figlio, gli verrà chiesto di verificare la carta di credito. Per ogni account creato (quindi per ogni figlio) verrà addebitato un importo pari a 1 centesimo che costituisce solo un’autorizzazione temporanea sulla carta per verificarne la validità – solitamente le autorizzazioni temporanee vengono rimosse dal conto entro 48 ore.

Una volta che il ragazzo avrà compiuto 16 anni, potrà passare a un account Google normale. Prima che ciò avvenga, i genitori riceveranno una e-mail che li informerà che, il giorno del suo compleanno, il figlio diventerà idoneo a gestire il proprio account autonomamente e spetterà a lui scegliere come utilizzarlo – o eventualmente decidere che i genitori continuino a monitorarlo.

L’unica pecca di un sistema che sembra piuttosto ben funzionante, risiede nella impossibilità di utilizzare Family Link per gestire account Google già esistenti, creati dagli under 16 prima dell’applicazione del GDPR (25 maggio 2018). Molte persone hanno espresso questa esigenza e Google sta certamente lavorando per fare in modo di soddisfarla… Speriamo solo che nel frattempo l’età minima del consenso venga riportata a una soglia accettabile (qui per approfondire: https://www.ictsecuritymagazine.com/articoli/eta-del-consenso-digitale-delicato-rapporto-minori-sicurezza-online/).

A cura di: Camilla Bistolfi

L’articolo Google e la tutela dei minori tra Regolamento privacy europeo e parental control proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/google-e-la-tutela-dei-minori-tra-regolamento-privacy-europeo-e-parental-control/


La Cyber Intelligence a protezione del sistema Paese

In un mondo in cui la rete internet lega indissolubilmente aziende, cittadini e governi, non si può pensare di affrontare la protezione di una nazione senza coinvolgere gli organismi militari, le infrastrutture critiche e la pubblica amministrazione. Ogni singolo attore, facendo la sua parte, aiuta a innalzare la sicurezza del sistema paese ma per farlo ogni attore deve disporre di tutte, o almeno di parte, delle informazioni a lui utili per proteggersi al meglio.

Queste informazioni provengono dall’ormai nota area della Cyber Intelligence e vengono veicolate tramite la condivisione dell’informazione, o parte di essa – “Information Sharing”.

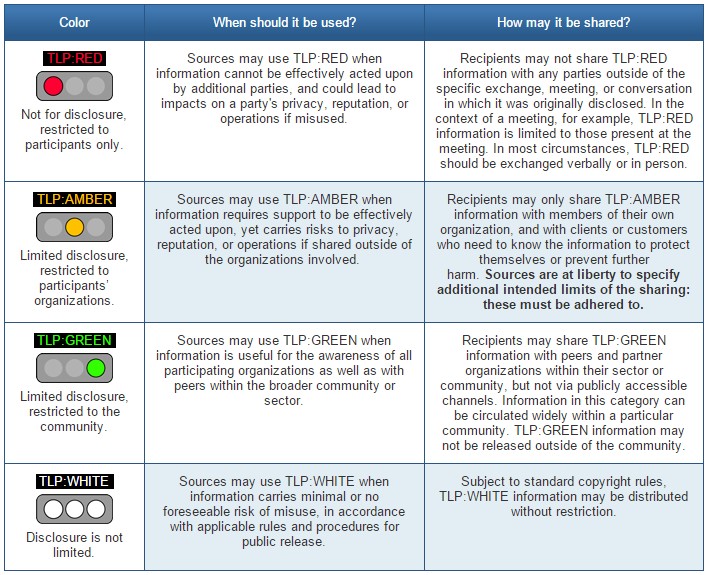
Per facilitare la condivisione delle informazioni, il FIRST[1] ha creato un protocollo definito TLP (Traffic Light Protocol)[2]. Il TLP è basato su uno schema semplice e intuitivo che, utilizzando quattro colori (RED, AMBER, GREEN, WHTE), garantisce che le informazioni sensibili siano condivise con il pubblico appropriato. Esso fornisce uno schema semplice e intuitivo per indicare quando e in che modo le informazioni sensibili possono essere condivise, facilitando una collaborazione più frequente ed efficace.

Ad oggi, se si vuole realizzare un piano valido di Sicurezza Nazionale, bisogna vincere una sfida senza precedenti, cioè riuscire a consentire “l’Information Sharing” tra le infrastrutture critiche, i principali attori del settore tecnologico e l’intelligence militare. Per certo non è un compito semplice; non tutte le informazioni d’intelligence provenienti dall’area militare possono essere condivise, quindi bisogna attuare un piano strategico e ben orchestrato che permetta di condividere almeno parte di queste informazioni, privandole di dati sensibili e/o riservati. Questa è la chiave di volta per un approccio corretto in termini di Cyber Security a protezione del sistema, definita anche “CyberSecurity Nazionale”.

Verso la tematica di Sicurezza Nazionale si sono mossi vari attori, in primis la NATO, con il National Cyber Security Framework Manual[3], l’Unione Europea con la riforma della cyber security[4] e anche lo stato italiano con il piano di sicurezza nazionale.

Ma andiamo per ordine. La NATO, come pubblicato nella pagina dedicata alla Cyber Defence[5], ha preso atto che gli attacchi cyber fanno parte di quella che viene definita “guerra ibrida”. Ogni alleato deve avere difese cibernetiche forti e resilienti per adempiere ai principali compiti previsti dell’alleanza, tra le quali difesa collettiva, gestione delle crisi e sicurezza cooperativa.

La Cyber Defence è stata integrata con l’iniziativa di Smart Defence per consentire ad ogni nazione una facile cooperazione al fine di sviluppare e mantenere capacità cyber di alto livello.  Attraverso il “National Cyber Security Framework Manual” la NATO fornisce agli alleati informazioni sui vari aspetti della sicurezza informatica nazionale; inoltre, per far fronte alle nuove e sempre più insidiose minacce del mondo cyber, è stata istituita una struttura per rispondere tempestivamente agli incidenti di natura cyber “NATO Computer Incident Response Capability (NCIRC)”, al fine di protegge le reti della NATO, fornendo un supporto di difesa cibernetica centralizzato.

Tornando alla questione dell’information sharing, il settore privato è stato individuato dalla NATO come attore chiave per portare all’interno del cyberspazio innovazioni tecnologiche e competenze utili a tutti gli alleati in termini di Cyber Defence. Con quest’obiettivo, attraverso la NATO Industry Cyber ​​Partnership (NICP), sono state rafforzate le relazioni con l’industria privata agevolando le attività di formazione, information sharing, esercitazioni, ecc.

Anche l’UE ha capito che ha bisogno di strutture più solide e più efficaci per garantire una forte resilienza alle minacce cyber, promuovere la cyber security e rispondere agli attacchi cyber rivolti agli Stati membri, istituzioni, agenzie e agli organismi dell’UE.  Pertanto, il 20 dicembre 2017, le istituzioni dell’UE hanno compiuto un passo importante per rafforzare la cooperazione contro gli attacchi cyber, attraverso la “Riforma della Cyber Security”. Questa mira a creare misure atte a sviluppare una strategia di cyber security sulla base della direttiva Europea NIS -Network and Information Security. Inoltre, grazie ad un accordo inter-istituzionale, è stato istituito il CERT-UE – Computer Emergency Response Team, con il compito di difendere le istituzioni, gli organi e le agenzie dell’UE, cooperando con i CERT nazionali di ogni stato membro e con la controparte NATO, NATO Computer Incident Response Capability (NCIRC).

Jean-Claude Juncker, presidente della Commissione europea, ha dichiarato: “Gli attacchi informatici possono essere molto pericolosi per la stabilità delle democrazie e delle economie rispetto alle armi convenzionali. Gli attacchi informatici non conoscono confini e nessuno è immune. Per questo motivo, la Commissione propone nuovi strumenti, tra cui un’Agenzia europea per la sicurezza informatica, per difenderci da tali attacchi”.

La Commissione Europea ha pertanto deciso di rafforzare la resilienza, la deterrenza e la risposta agli attacchi cyber attraverso:

  • La creazione della “European Union Cybersecurity Agency”, parte dell’ENISA – The European Union Agency for Network and Information Security, centro di competenza che supporta gli Stati membri nel rafforzamento della sicurezza informatica[6];
  • La realizzazione dello “EU-wide cybersecurity certification scheme”, schema di certificazione della sicurezza informatica a livello UE, che aumenti la cybersecurity di prodotti e servizi nel mondo digitale;
  • La creazione di una Blueprint, piano per rispondere rapidamente e operativamente in caso di attacco cyber su larga scala;
  • Una rete di “European Cybersecurity Research and Competence Centre”, che contribuirà a sviluppare gli strumenti e la tecnologia necessari a costruire una difesa più forte possibile contro delle nuove minacce;
  • Una nuova direttiva per la lotta contro le frodi tramite i mezzi di pagamento elettronici;
  • Un Framework per una risposta diplomatica comune dell’UE alle attività informatiche dannose e per un consolidamento della cooperazione internazionale sulla cybersecurity, compreso l’approfondimento della cooperazione tra l’UE e la NATO;
  • Lo sviluppo di competenze di alto livello per i professionisti civili e militari.

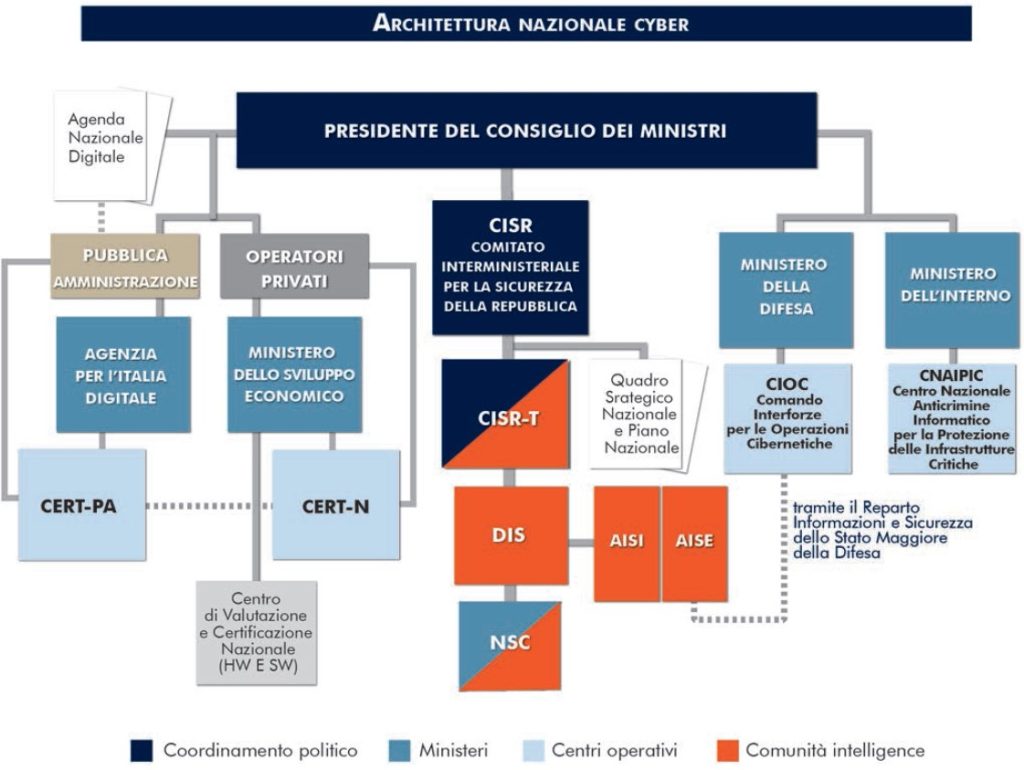
Anche l’Italia si è mossa in tal senso sviluppando un piano di sicurezza nazionale[7] suddiviso in 3 parti.

La prima parte, definita “QUADRO STRATEGICO NAZIONALE (QSN)”, mira a sviluppare gli indirizzi strategici, tra i quali:

  • Il potenziamento delle capacità di difesa delle infrastrutture critiche nazionali e degli attori di rilevanza strategica per il sistema Paese;
  • Il miglioramento delle capacità tecnologiche, operative e di analisi degli attori istituzionali interessati;
  • L’incentivazione della cooperazione tra istituzioni ed imprese nazionali;
  • La promozione e la diffusione della cultura della sicurezza cibernetica,
  • Il rafforzamento della cooperazione internazionale in materia di sicurezza cibernetica, e infine, il rafforzamento delle capacità di contrasto alle attività e ai contenuti illegali on-line.

La seconda parte, definita “PIANO NAZIONALE (PN)” mira a sviluppare gli indirizzi operativi, tra i quali:

  • Potenziamento della capacità di intelligence, di polizia e di difesa civile e militare;
  • Potenziamento dell’organizzazione e delle modalità di coordinamento e di interazione a livello nazionale tra soggetti pubblici e privati;
  • Promozione e diffusione della cultura della sicurezza informatica;
  • Cooperazione internazionale, formazione ed esercitazioni;
  • Operatività delle strutture nazionali di incident prevention, response e remediation;
  • Interventi legislativi e compliance con obblighi internazionali;
  • Compliance a standard e protocolli di sicurezza;
  • Supporto allo sviluppo industriale e tecnologico;
  • Comunicazione strategica e operativa;
  • Implementazione di un sistema di cyber risk management nazionale.

La terza parte, definita “PIANO D’AZIONE” mira a:

  • Revisionare il Nucleo per la Sicurezza Cibernetica;
  • Accorciare la catena di comando per la gestione delle crisi cibernetiche;
  • Ridurre la complessità dell’architettura nazionale;
  • Unificare i CERT-N e CERT-PA per costituire il CSIRT[8];
  • Istituire un centro di valutazione e certificazione nazionale ICT;
  • Creare una fondazione o fondo di venture capital;
  • Istituire un Centro nazionale di ricerca e sviluppo sulla cybersecurity;
  • Costituire un Centro nazionale di crittografia;

Sono anche previste iniziative volte a realizzare il “Centro nazionale di Ricerca e Sviluppo in Cybersecurity” e il “Centro nazionale di crittografia”.

Il settore privato è stato visto come un attore chiave e necessario in materia di cyber security per poter organizzare un robusto e funzionale piano di sicurezza nazionale. Pertanto l’alleanza tra pubblico e privato è stata ampliata e nuovi operatori critici e strategici hanno sottoscritto convenzioni con il Dipartimento delle informazioni per la sicurezza della Repubblica – DIS[9].

NOTE


A cura di: Giuseppe Brando

L’articolo La Cyber Intelligence a protezione del sistema Paese proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-cyber-intelligence-a-protezione-del-sistema-paese/


La Perizia Antropometrica, aspetti scientifici e utilizzi tipici

Antropometria: tecniche di analisi e valutazione

L’antropologia è la scienza che più di tutte contiene le potenzialità per svolgere accertamenti tecnici specifici capaci di immettere nel processo dati e ricostruzioni idonei all’identificazione. Questa operazione deve essere predisposta seguendo e confrontando diversi metodi, al fine di avere un grado di attendibilità più elevato possibile:

  1. Fisionomico e metrico;
  2. Morfologico;
  3. Sovrapposizione 2D-2D e 2D-3D attraverso immagini digitali.

L’antropometria gioca un ruolo fondamentale in quanto offre gli strumenti scientifici e tecnici necessari per effettuare analisi riducendo al minimo gli errori derivanti dal processo comparativo.

Per antropometria si intende l’investigazione statistica dei caratteri dei gruppi umani, siano essi misurabili (“quantitativi” come il peso, la statura, le dimensioni della testa, la frequenza del respiro, la durata della vita, ecc.) o classificabili (“qualitativi” come il colore degli occhi, la forma dei capelli, le proprietà biochimiche del sangue, ecc.) allo scopo di conoscerne le intensità o le modalità, quando è possibile i loro nessi, ed eventualmente risalire alle cause da cui quelle e questi dipendono.

Lo strumento utilizzato, quindi, è la biometria che permette sia di definire e classificare i parametri discriminatori del corpo umano, come caratteristiche e proporzione del volto, lunghezza degli arti, altezza dell’individuo, sia di stabilire le regole per le analisi e l’interpretazione dei risultati. Ottenuti i dati questi ultimi devono essere interpretati e analizzati, operazioni che possono essere condotte richiedendo l’intervento del tecnico operatore, in modo completamente automatico, mediante l’utilizzo di hardware e software opportuni e ovviamente unendo entrambe le visioni.

Vengono quindi utilizzate codifiche standardizzate riconosciute dalla comunità scientifica, in modo che l’interpretazione sia il meno possibile soggettiva. Questi parametri sono raggruppati all’interno di tabelle di confronto tramite le quali è possibile assegnare agli individui da confrontare un grado di differenza o somiglianza. Fotografie segnaletiche e filmati di videosorveglianza per loro natura sono spesso utilizzati come base di lavoro per effettuare comparazioni descritte all’interno di perizie antropometriche che spesso sono scritte da esperti di informatica forense.

Un’importante tappa storica nell’ambito dell’identificazione avviene alla fine del XIX secolo quando l’antropologo francese Alphonse Bertillon introdusse un metodo scientifico di segnalamento descrittivo per scopi identificativi. Egli definì il ritratto parlato in cui erano descritte la fronte, il naso, l’occhio destro, i capelli, la barba e l’orecchio, nonché note particolari come per esempio cicatrici e tatuaggi. Veniva così introdotta per la prima volta la codifica degli aspetti fisionomici facciali.

Il riconoscimento dei volti

Il confronto del volto di due soggetti, al fine di asserirne l’eventuale identità, si basa sulla definizione di parametri discriminatori che possono essere sia fisionomici sia metrici, come sopra spiegato. Poiché il punto iniziale del processo di identificazione consiste generalmente nella comparazione delle immagini estratte dai dispositivi elettronici con quelle acquisite all’atto dell’accertamento, occorre sottolineare come la natura del fotogramma estratto influisca notevolmente sul procedimento di identificazione. Quando le immagini sono di alta qualità, nitide, ricche di dettagli, raffiguranti soggetti senza alcuna forma di mimetismo con l’ambiente circondante risultano essere assolutamente adatte al processo di confronto, mentre in caso opposto è necessario valutarne la compatibilità strutturale. Esistono però alcuni parametri che risultano essere oggettivamente validi come ad esempio deturpazioni, cicatrici, espressioni facciali, tatuaggi.

Per effettuare la comparazione di due volti è necessario svolgere due tipologie di interventi: analisi fisionomica e analisi metrica.

L’analisi fisionomica ha come base gli elementi morfologici fondamentali che devono essere il più possibile indipendenti da variazioni ponderali e dall’età del soggetto al termine della fase dello sviluppo. Gli elementi che vengono presi in considerazione sono i seguenti:

  • Forma generale del volto (può essere ad esempio ellittica, ovale, rotonda, quadrata, rombica, pentagonoide, ecc.);
  • Forma della testa (può essere carenata, ad occipite appiattito, insellata, con occipite sporgente, ecc.);
  • Morfologia dell’attaccatura dei capelli (può essere ad esempio curvilinea, rettilinea, ecc);
  • Profilo del volto (ad esempio rettilineo, piramidale, semilunare, ecc.);
  • Profilo fronto-nasale (può essere continuo, parallelo, angoloso, ondulato, ecc.);
  • Profilo naso-buccale (può essere ad esempio mandibolare totale, nasale, ecc.);
  • Profilo della fronte (concava, convessa, prominente, sfuggente, ecc.);
  • Piramide nasale possiede un elevato grado di discriminazione e si possono identificare quattro aree che lo compongono: dorso, radice, punta e base;
  • Mento (può essere piatto, a punta, quadrangolare, prominente, ecc.);
  • Sopracciglia (ad esempio curve, rette, ondulate, oblique interne);

Due strutture anatomiche di notevole valore discriminatorio sono la regione naso-boccale e in particolare il padiglione auricolare, in quanto si parla di impronta auricolare.

Questo particolare organo presenta diversi punti che sono estremamente variabili da un individuo all’altro, particolari che sono descritti nell’immagine sotto proposta:

Figura 1 Padiglione auricolare


L’analisi metrica consiste nell’estrapolare grandezze geometriche di spazio pluridimensionale sufficientemente caratterizzate per effettuare operazioni di confronto. Il rilievo delle misurazioni e il successivo confronto, le posture assunte dagli individui in esame devono essere appropriate per generare sul piano bidimensionale immagini tali che i segmenti biologici presentino aspetti e forme confrontabili. Scegliendo ad esempio la punta del mento, i lobi delle orecchie e le orbite oculari si ottiene un pentagono che inscrive la parte inferiore del volto. Questa figura non è altamente discriminante, quindi è sempre meglio procedere alla sua scomposizione in triangoli i quali invece offrono informazioni più utili e dettagliate. La comparazione dei fattori di forma dei triangoli permette di avvalorare oppure non l’ipotesi di identità.

Incrociando i risultati ottenuti dalle due analisi è quindi possibile stabilire il grado di somiglianza, anche se il problema posto è tutt’altro che semplice, occorre quindi adattare le metodologie di indagine ai particolari casi in esame, in quanto non è sempre possibile usare sequenze standard di operazioni predefinite.

Perizie antropometriche

Le perizie antropometriche sono principalmente commissionate per verificare se un determinato soggetto noto corrispondente ad un secondo soggetto non noto. Il processo di identificazione si pone lo scopo di definire il grado di coincidenza delle caratteristiche biometriche in particolare del volto, rilevabili in un individuo, messe a confronto con quelle di altro soggetto.

In occasione di indagini penali sempre più frequentemente viene effettuata la valutazione probatoria delle immagini che sono state acquisite da videocamere di sorveglianza, che possono essere registrate casualmente da sistemi preinstallati (ad esempio telecamere di negozi, bar, banche, uffici pubblici, ecc.) oppure intenzionalmente in concomitanza di pedinamenti, appostamenti e intercettazioni ambientali. Le perizie antropometriche, oltre a valutare gli elementi del viso, possono riguardare anche il resto del corpo, prendendo come punti di raffronto la larghezza delle spalle, l’altezza, la dimensione delle mani e dei piedi e nel caso in cui la qualità del video sia sufficientemente alta, anche la postura, la camminata e il colore della pelle.

Questa tipologia di analisi e relative relazioni tecniche vengono spesso commissionate per identificare soggetti che hanno commesso reati quali rapine, atti violenti come aggressioni ed omicidi, abusi sessuali ed anche reati ai danni dell’ambiente.

Si tratta di una disciplina estremamente complessa e articolata, è quindi indispensabile conoscere approfonditamente la materia e la scienza sulla quale si basa. Fondamentale è focalizzare e delimitare l’oggetto della perizia in modo da dosare i parametri antropometrici di riferimento. Compito delle Forze dell’Ordine e degli Organi di Giustizia è quello di informare e guidare il consulente nelle proprie scelte, formulando un quesito il più possibile preciso senza fraintendimenti, al fine di generare un lavoro preciso e affidabile.

Suggerimenti bibliografici

[1] http://www.professionisti.it/enciclopedia/voce/603/Perizia-antropometrica

[2] L’identificazione basata sul volto: metodi fisionomici e metrici scritto da Nello Balossino e Simona Siracusa

[3] http://www.avvocatocastellaneta.it/articoli/difendersi-investigando/identificazione-di-vivi-nel-processo-penale-criteri-e-metodi


A cura di: Michele Vitiello

L’articolo La Perizia Antropometrica, aspetti scientifici e utilizzi tipici proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-perizia-antropometrica-aspetti-scientifici-e-utilizzi-tipici/


Penetration Testing tra le nuvole con Amazon Web Service e Kali Linux

La tecnologia Cloud ha portato sicuramente innumerevoli vantaggi al mondo dell’Information Tecnology, permettendo alle aziende e ai privati di disporre di spazio di storage, potenza di calcolo, servizi di elaborazione e analisi dei dati, servizi di database relazionali e molto altro, sostenendo costi sicuramente inferiori rispetto al disporre di tale tecnologia in proprio presso la propria struttura e permettendo al contempo di poterne usufruire in qualunque luogo ci si trovi.

Disporre di un laboratorio con varie macchine dove potersi esercitare e studiare, oppure altre per eseguire dei Vulnerability Assessment o veri e propri Penetration Testing, senza disporre fisicamente di tali macchine, è quindi una realtà che grazie ai servizi Cloud oggi è possibile. Molti sono i Provider che offrono completi e potenti servizi Cloud (Google Cloud Platform, Microsoft Azure, Amazon Web Service, …) e tutti offrono un periodo di prova gratuito. Quello che vi illustrerò oggi è Amazon Web Service (AWS) che offre ben un anno di prova dei suoi molti servizi, ovviamente con delle limitazioni che per il nostro scopo vanno comunque benissimo. Possiamo vederle collegandoci al sito https://aws.amazon.com/it/free. Su questa pagina potremmo esplorare le limitazioni del piano gratuito ma conoscere anche tutti i servizi messi a disposizione da AWS come si vede nell’immagine che segue.

Quello che faremo sarà quindi creare una macchina Kali Linux attraverso il servizio EC2, “un servizio Web che fornisce capacità di elaborazione sicura e scalabile nel cloud” di Amazon. Come prima cosa dobbiamo registrarci e creare appunto un piano gratuito. Lo faremo andando nella relativa pagina di registrazione e inserendo tutti i dati necessari. A quel punto, dopo esserci autenticati nella Console di Gestione AWS con le nostre credenziali, ci troveremo di fronte la finestra che segue.

Da questa maschera la funzione utile per il nostro scopo è “Launch a virtual machine”. Non avendone ancora la procedura ce ne farà creare una portandoci sulla maschera “Step 1: Choose an Amazon Machine Image (AMI)”, il luogo dove si potranno scegliere moltissime Macchine virtuali che AWS mette a disposizione e offerte dai relativi produttori. Cliccando sul menù a sinistra “AWS Marketplace” ci troveremo nell’archivio dei prodotti software disponibili, per non sfogliarli tutti possiamo direttamente inserire nel campo di ricerca “Kali” e premere invio. Ci verrà quindi proposto Kali Linux come si vede nell’immagine che segue.

Come possiamo notare sotto l’icona c’è la dicitura “Free tier eligible” che significa appunto che possiamo utilizzarla senza dover pagare. Vedremo più avanti che tale Sistema Operativo sarà sempre gratuito, non sarà però la stessa cosa per le risorse hardware sulle quali installare tale sistema. Scegliamo a questo punto “Select” sulla destra dello schermo. A quel punto troveremo davanti a noi tutti i vari prezzi che si potrebbero sostenere con questo servizio e come vediamo, appunto, sono divisi in Software, il quale sarà sempre gratis, mentre il costo dell’hardware dipenderà dalla macchina che si sceglierà. Ad ogni modo avendo scelto il piano gratuito per un anno non pagheremo nemmeno quello ma saremo obbligati a scegliere una sola determinata macchina. Premiamo quindi “Continue” e ci troveremo davanti la seguente maschera.

Appena entrati sulla maschera “Step 2: Choose an Instance Type” di default sarà selezionata la macchina t2.medium che dispone di 2 vCPUs a 2.3 GHz, Intel Broadwell E5-2686v4 e 4 GB di memoria RAM, ma noi invece per mantenere il piano gratuito dobbiamo accertarci di selezionare la t2.micro (come nella figura in alto) che dispone invece di 1 vCPUs a 2.5 GHz, Intel Xeon Family e 1 GB di memoria RAM. Facciamo attenzione a scegliere proprio questa, che è l’unica disponibile per il piano gratuito, perché se non lo facciamo violiamo i limiti e pagheremo. Così pagheremo se violeremo qualsiasi altra limitazione imposta.

A questo punto selezioniamo in basso a destra “Next: Configure Instance Details” trovandoci di fronte la seguente videata che fa parte dello “Step 3: Configure Instance Details”.

In questa maschera dobbiamo scegliere la rete e le sotto-reti sulle quali la macchina si troverà ad operare. Per la precisione dovremmo impostare un VPC, ossia il nostro Virtual Private Cloud. Potremmo utilizzare quello di default ed una relativa subnet, ma per ordine e soprattutto per scegliere in autonomia i parametri, decidiamo di creare tutto nuovo. Sulla riga Network premiamo a destra “Create new VPC” e poi sulla maschera seguente il bottone grande in alto “Create VPC”.

Sulla maschera di creazione di una nuova VPC inseriamo un nome (io ho usato Pen_Test_AWS) e il relativo blocco di indirizzi IPV4. Come dicono le istruzioni non possiamo creare un blocco più grande di /16 ma giusto /16 si, potendo avere così a disposizione 65.534 indirizzi IP disponibili da poter suddividere. Io non ho particolari esigenze e 254 indirizzi mi vanno bene quindi creo una rete /24 (10.0.0.0/24). Gli altri parametri li possiamo lasciare così. A quel punto premiamo “Yes, Create” e chiudiamo la scheda sulla quale eravamo tornando così alla maschera di prima “Step 3: Configure Instance Details”. A quel punto premendo il simbolo della freccia che ruota vicino al bottone “Create new VPC possiamo impostare alla riga Network il VPC creato da noi. A quel punto comparirà il messaggio che non esistono subnet per quel VPC come da immagine sotto.

Dovremmo a questo punto indicare la, o le, subnet che fanno capo alla nostra rete, ossia al nostro VPC. Premiamo quindi il bottone “Create new subnet”. Si aprirà un’altra scheda del browser dove vedremo le altre subnet già presenti e dove premendo il bottone blu in alto a sinistra “Create Subnet” creeremo la nostra subnet da abbinare alla rete (VPC) creata prima.

Nella finestra che appare (immagine in alto) inseriamo il nome della subnet, scegliamo il nostro VPC creato prima e ci verrà mostrato il suo blocco di IP da suddividere. Inseriremo in basso le subnet (una per volta) che costituiranno la nostra rete. Nel mio caso ho creato una sola subnet, la 10.0.0.0/24, quindi premiamo il bottone “Yes, Create”. Ci troveremo nuovamente nella scheda del browser VPC Dashboard. Questa volta non chiuderemo questa scheda, perché prima di procedere sistemiamo alcuni parametri di rete. Alla VPC Dashboard potremo sempre tornare andando qui https://console.aws.amazon.com/vpc/

Avendo creato un nuovo VPC e una nuova Subnet, e non avendo utilizzato quelle di default, dobbiamo indicare a questo punto quale dev’essere il Gateway (Virtual Router) che la nostra nuova rete deve utilizzare per navigare. Spostiamoci pertanto nella sezione “Internet Gateway”, cliccando il relativo tasto sulla barra dei menu di sinistra. Ci troveremo di fronte la maschera seguente.

Come possiamo osservare nell’immagine in alto l’unico Internet Gateway (Router) presente, quello di default, è “attached” al VPC di default e non al VPC creato nuovo da noi. Se lasciassimo così non ci sarebbe permesso navigare con la nostra macchina Kali e di conseguenza non potremmo nemmeno raggiungerla per utilizzarla. A questo punto abbiamo due strade, o creiamo un nuovo “Interne Gateway” a cui fare l’“attach” del nostro VPC oppure possiamo tenere il Gateway di default e attaccare il nostro VPC al posto di quello di default. Scelgo questa seconda via e quindi in alto seleziono “Actions” e poi “Detach from VPC” come vediamo nell’immagine in basso.

Sulla finestra che appare confermo l’operazione premendo “Detach”, quindi poi faccio l’operazione inversa premendo nuovamente “Actions” ma questa volta “Attach to VPC” e inserendo a quel punto, sulla nuova maschera che compare, il mio nuovo VPC e tornando infine nuovamente sulla VPC Dashboard.

Successivamente dobbiamo inserire la route affinchè la macchina Kali e tutte quelle eventuali della nostra rete sappiano che Gateway utilizzare per andare in internet. Premiamo a sinistra la sezione “Route Tables” e poi la tab “Routes” in basso. Dovrebbe apparire una situazione come questa.

Come si vede selezionando in alto la riga relativa al nostro VPC, in basso nella tab “Routes” esiste una sola rotta. Quella che si riferisce alla rete locale. Non c’è quella che permette alle macchine della rete e quindi alla nostra Kali di andare in internet ed essere raggiunta da noi. Procediamo cliccando “edit” nella sezione “Routes” in modo da poter aggiungere la route e quindi premiamo il bottone “Add another route” che sarà comparso più sotto. A quel punto aggiungiamo la route 0.0.0.0/0 e semplicemente passando sopra la colonna target comparirà il gateway. A quel punto premiamo “Save” per confermare l’aggiunta della route che permetterà al nostro Kali di navigare in internet e raggiungere qualsiasi indirizzo. Dovrà comparire una situazione come l’immagine sotto.

A questo punto possiamo chiudere la scheda del browser relativa alla VPC Dashboard e tornare su quella dove eravamo rimasti negli step di creazione dell’Istanza di Kali ed esattamente allo “Step 3: Configure Instance Details” nel punto dove inserire la Subnet che abbiamo creato. Premiamo sempre la freccia rotante in modo da aggiornare la network e comparirà quindi la subnet che abbiamo creato, nel mio caso indica anche che ho 251 indirizzi disponibili. Procediamo abilitando il campo “Auto-assign Public IP” in modo che la nostra macchina abbia l’indirizzo pubblico assegnato automaticamente e poter essere raggiungibile, come vediamo nell’immagine sotto. Ci troveremo quindi una situazione come quella della seguente immagine. Possiamo a quel punto lasciare tutti gli altri parametri così come sono e premere il bottone in basso “Next: Add Storage” per aggiungere il disco fisso alla macchina che stiamo creando.

Ci troveremo quindi allo step “Step 4: Add Storage” nel quale aggiungere il disco fisso sul quale far girare la nostra istanza di Kali Linux.

Come ci ricordano le istruzioni presenti sulla maschera, per restare nel nostro piano gratuito possiamo indicare un disco grande al massimo 30 GB e di tipologia SSD o Magnetico. Nel mio caso, come vediamo nell’immagine in alto, ho confermato quello che la procedura mi proponeva e cioè un disco di 25 GB del tipo “General Purpose SSD (GP2)”. A quel punto possiamo premere il bottone in basso “Next: Add Tags” per trovarci appunto nella mashera “Step 5: Add Tags” che vediamo di seguito.

Qualora si abbiano varie istanze (macchine), Amazon EC2 rende più facile la loro gestione attraverso l’utilizzo dei “tags”, ossia coppie di valori case-sensitive da poter assegnare ad ogni istanza.

Per saperne di più è possibile consultare la documentazione ufficiale di AWS al seguente indirizzo https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/Using_Tags.html?icmpid=docs_ec2_console.

In questo caso non ho intenzione di assegnare tags alla mia unica istanza e quindi premo il bottone in basso “Next: Configure Security Group”. Questa sarà una sezione molto importante in quanto è qui che creiamo le prime regole del firewall per accedere in remoto alla nostra Kali Linux e comandarla. Ci troviamo quindi di fronte alla seguente maschera.

Eccoci arrivati allo “Step 6: Configure Security Group”. Creiamo il nostro “Security Group” lasciando il pallino su “Create a new security group” e scrivendo il nome che desideriamo dargli nella riga “Security group name:”. Nell’immagine in alto vediamo il nome che ho attribuito io. Gli altri parametri possiamo lasciarli così ma possiamo anche modificarli o aggiungerne di nostri a piacere. Di default AWS per Kali Linux lascia aperta una porta SSH (porta 22) raggiungibile da chiunque (vediamo l’indirizzo 0.0.0.0/0). La procedura ci avvisa di come sia pericoloso lasciare la porta aperta per tutti gli indirizzi, quindi se ci collegheremo sempre dallo stesso indirizzo IP possiamo impostare invece un unico indirizzo restringendo moltissimo la possibilità di tentativi di attacco da terzi. Ricordiamoci che la nostra macchina si trova a tutti gli effetti in internet e quindi eventuali vulnerabilità sarebbero facilmente individuabili e sfruttabili.

Volendo aggiungere altre porte e servizi alla nostra istanza basterà premere il bottone “Add Rule” e indicare le informazioni volute. Al momento lascio solo la porta 22 raggiungibile in SSH e premo il bottone “Review and Launch” per mandare finalmente in esecuzione la mia macchina. Si apre la maschera dello “Step 7: Review Instance Launch” che ci mostra il riepilogo di tutte le impostazioni. Si prosegue premendo il bottone “Launch”.

A questo punto comparirà la maschera, che si vede nell’immagine sopra, che ci permetterà di creare una coppia di chiavi (una pubblica che rimane ad AWS e una privata che scaricheremo) grazie alle quali potremmo collegarci da remoto in maniera sicura alla nostra istanza senza necessità di digitare utente e password.

Scegliamo nella prima casella di selezione “Create a new key pair” e quindi sotto digitiamo il nome della chiave da scaricare. A quel punto scarichiamo la chiave con il bottone “Download key pair” e una volta scaricata la custodiamo in un luogo sicuro e la teniamo nella macchina dal quale ci collegheremo al nostro Kali. A quel punto finalmente lanciamo l’istanza premendo “Launch Instances”. Comparirà una maschera con varie istruzioni, sia sul funzionamento sia per il collegamento. Quindi in basso premendo “View Instances” andremo direttamente alla nostra istanza che sarà stata avviata come da immagine più sotto.

Nell’immagine vediamo la nostra istanza in stato “running” e più in basso i dettagli del tipo di istanza, la zona di riferimento, il Security Group e soprattutto l’indirizzo IP pubblico che ci servirà per raggiungere la nostra macchina. A questo punto tutto è pronto per poterci collegare e disporre di una macchina Kali sulle nuvole.

Come dicevano le istruzioni, è importante come prima cosa aggiornare la macchina, e poi farlo spesso, per poter disporre degli ultimi pacchetti e risolvere eventuali bug dei software e del Sistema Operativo. Le istruzioni ci avvisavano inoltre che qualora si volesse eseguire attività di Penetration Testing occorre fare riferimento alla sezione apposita della documentazione di AWS, cosa che vedremo tra poco.

Nel frattempo per poterci collegare alla macchina abbiamo vari sistemi. Da Windows con Putty o ancora meglio installando Git per Windows. Ad ogni modo esiste un’ottima documentazione per l’avvio di macchine Linux che comprende anche come collegarsi https://aws.amazon.com/it/getting-started/tutorials/launch-a-virtual-machine/  e qui invece qualora ci fossero problemi di collegamento utilizzando SSH https://aws.amazon.com/it/premiumsupport/knowledge-center/ec2-linux-ssh-troubleshooting/?icmpid=support_rt_kc_articles

Da Linux è molto più semplice collegarsi perché SSH è già presente nelle varie distribuzioni. Utilizzando ad esempio un’altra Kali Linux basterà aprire un terminale e, avendo ben a mente dove risiede il file della chiave privata che abbiamo scaricato, digitare il seguente comando:

# ssh -i {percorso completo al file .pem} ec2-user@{indirizzo IP pubblico dell’istanza}.

dove ec2-user è l’utente e l’IP pubblico è quello che abbiamo visto assegnata all’istanza prima.

Nell’immagine sopra vediamo il comando digitato per collegarci sapendo che la chiave privata era sulla Scrivania. A quel punto il collegamento avviene e siamo dentro la nostra macchina Kali. Giusto per conferma lancio qualche comando, tra cui quello per vedere lo spazio disponibile accorgendomi che sul disco di 25 Gb mi rimangono ora 16 Gb liberi a mia disposizione.

Avendo ora il controllo di una macchina Kali Linux potrei decidere di creare delle macchine target e costruirmi così un piccolo laboratorio sul clound, utilizzabile pertanto da qualsiasi luogo semplicemente avendo un computer e una connessione internet a disposizione. Oppure potrei utilizzare questa unica macchina Kali per eseguire attività di Vulnerability Assessment o Penetration Testing qualora un amico o un cliente me lo commissioni. Attenzione però, oltre la ovvia autorizzazione necessaria del cliente/amico, in questo caso utilizzando risorse e indirizzi pubblici di Amazon, occorre chiedere autorizzazione anche a questa attraverso un apposito modulo di richiesta. Risposta che avverrà in media dopo 2 giorni. Esiste una documentazione specifica messa a disposizione da AWS qualora siano proprio quelle le attività che vogliamo eseguire con la nostra macchina. E si trova qui https://aws.amazon.com/it/security/penetration-testing/

Abbiamo visto quanto sia facile poter disporre di una macchina d’attacco nel cloud, comandabile da qualsiasi computer collegato ad internet. Chiudo questo pezzo con uno spunto di riflessione. E se comandassimo la nostra macchina sulle nuvole semplicemente con lo smartphone? Potremmo disporne davvero in ogni dove e in ogni quando. Potrebbe essere l’argomento di un prossimo articolo, ma intanto date sfogo alle vostre conoscenze informatiche.

A cura di: Antonio Sagliocca

L’articolo Penetration Testing tra le nuvole con Amazon Web Service e Kali Linux proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/penetration-testing-tra-le-nuvole-con-amazon-web-service-e-kali-linux/


Trade-off tra Privacy e Security

Prima di analizzare il rapporto vicendevolmente funzionale che lega privacy e security, occorre darne una definizione concettuale.

Il concetto di privacy è stato evocato, nel 1890, da Samuel Warren e Louis Brandeis i quali pubblicarono un articolo sulla rivista Harvard Law Review, [1] contenente la prima definizione del cosiddetto “diritto di essere lasciato da solo” (right to be let alone).

I due giuristi statunitensi rivendicavano l’esigenza che nei rapporti privati vi fosse un limite all’ingerenza nella vita altrui rappresentato dalla presenza di un interesse pubblico che legittimi la pubblicazione di una notizia. L’aspetto più problematico nell’esperienza americana è stato, quindi, sin da subito quello di trovare un equilibrio tra riservatezza e informazione, tema più che mai attuale dato l’elevato grado di commistione tra tecnologie e aspetti della vita privata. Ancora oggi, a distanza di più un secolo, l’obiettivo rimane quello di individuare dei criteri per stabilire quando, nel bilanciamento tra interesse del singolo e della collettività, quest’ultimo debba prevalere. Questo per dire che le preoccupazioni sorte più di 100 anni fa non hanno ancora ricevuto una chiara risposta.

Nell’esperienza europea, a seguito dell’avvento degli stati totalitari che utilizzavano le informazioni sui loro cittadini per eliminare ogni dissenso politico, il diritto alla riservatezza nasce, invece, come un diritto di personalità connaturato all’idea giuridica di persona fisica e, in quanto tale, trova il suo fondamento nel valore supremo della dignità umana.

Non a caso, infatti, i primi riconoscimenti internazionali del diritto alla Privacy si rinvengono proprio nella Dichiarazione Universale dei Diritti dell’Uomo del 1948 che all’art. 12 condanna le interferenze arbitrarie nella vita privata e nella Convenzione Europea dei Diritti dell’Uomo e del cittadino, che all’art. 8 impone il rispetto della vita privata e familiare.

Con il rapido sviluppo delle tecnologie e con la crescente esigenza di “iperconnettività” (accesso a informazioni fruibili in qualsiasi momento e da qualsiasi piattaforma), il rischio di ingerenza altrui nella propria sfera personale cresce in via esponenziale e si manifesta la necessità di porre dei limiti alla raccolta e all’uso delle informazioni personali. In tale contesto, quindi, il diritto alla riservatezza si arricchisce, cosicchè alla privacy di cui sin ora abbiamo parlato si affianca il diritto alla protezione dei dati personali. Esso è strettamente connesso alla tecnologia digitale, in quanto finalizzato a tutelare gli individui dai rischi derivanti da sistemi di diffusione dei dati personali sempre più veloci e dalle tecniche sempre più sofisticate di utilizzo degli stessi per le finalità più disparate (big data, data mining, marketing, profilazione, fidelizzazione, controllo sociale, influenza dell’opinione pubblica) [2].

Ed è qui che entra in gioco il concetto di security, definito come l’insieme di processi, risorse e tecnologie tesi alla protezione dei sistemi e degli asset informativi in termini di riservatezza, integrità e disponibilità.

A causa della crescente informatizzazione della società e dei servizi (pubblici e privati) in termini di asset e sistemi informatici e della parallela diffusione e specializzazione degli attaccanti, l’interesse per la sicurezza informatica è dunque cresciuto in maniera esponenziale negli ultimi anni.

Nella sicurezza informatica sono coinvolti elementi umani, tecnici, organizzativi e giuridici finalizzati ad individuare le minacce, le vulnerabilità e i rischi associati agli asset informatici, per proteggerli da possibili attacchi sia interni che esterni, i quali potrebbero provocare danni diretti o indiretti di impatto superiore a una determinata soglia di tollerabilità (es. impatto economico, politico-sociale, di reputazione, ecc.).

L’elaborazione massiva e sistematica di dati personali, su cui si basa il trend dei nuovi servizi informatici presenti sul mercato (Internet of Things, Big Data, Machine learning), accresce il ruolo strategico ricoperto dalle tematiche di protezione e sicurezza di tali informazioni.

Uno dei più recenti fattori di crescita del settore dell’information security legato alla protezione dei dati, è considerato il nuovo General Data Protection Regulation (GDPR – Regolamento UE 2016/679) che, come noto, è entrato pienamente in applicazione lo scorso 25 maggio in tutti gli Stati dell’Unione Europea.

La centralità del principio di sicurezza del trattamento dei dati personali emerge, fra l’altro, anche dal considerando n. 83 dello stesso GDPR secondo cui:

“Per mantenere la sicurezza e prevenire trattamenti in violazione al presente regolamento, il titolare del trattamento o il responsabile del trattamento dovrebbe valutare i rischi inerenti al trattamento e attuare misure per limitare tali rischi, quali la cifratura. Tali misure dovrebbero assicurare un adeguato livello di sicurezza, inclusa la riservatezza, tenuto conto dello stato dell’arte e dei costi di attuazione rispetto ai rischi che presentano i trattamenti e alla natura dei dati personali da proteggere. Nella valutazione del rischio per la sicurezza dei dati è opportuno tenere in considerazione i rischi presentati dal trattamento dei dati personali, come la distruzione accidentale o illegale, la perdita, la modifica, la rivelazione o l’accesso non autorizzati a dati personali trasmessi, conservati o comunque elaborati, che potrebbero cagionare in particolare un danno fisico, materiale o immateriale” [3].

Occorre, dunque, porre l’attenzione sui seguenti concetti:

  • adeguato livello di sicurezza che per essere determinato in maniera corretta richiede capacità analitiche approfondite e conoscenze dei processi di analisi dei rischi e delle tecnologie in uso;
  • migliore tecnologia disponibile che richiede specifiche conoscenze del mercato e delle tecnologie, nonché budget (notoriamente limitato) da allocare sulle soluzioni ritenute più idonee.

Tali principi di sicurezza vengono inoltre cristallizzati nell’art. 32 del GDPR in base al quale il Titolare del trattamento e il Responsabile del trattamento – tenuto conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, come anche del rischio di varia probabilità e gravità per i diritti e le libertà delle persone fisiche – mettono in atto misure tecniche e organizzative adeguate per garantire un livello di sicurezza adeguato al rischio, che comprendono, tra le altre cose:

  • la protezione del dato attraverso tecniche di cifratura e similari;
  • una continua verifica dell’efficacia dei presidi di sicurezza atti a garantire riservatezza, integrità e disponibilità dei sistemi
  • garantire la resilienza dei sistemi informativi per mezzo dell’implementazione dei principi di business continuity e disaster recovery
  • un approccio fattuale legato all’esecuzione test di sicurezza (ad es. code review, penetration test e vulnerability assessment applicativi e sistemistici su base periodica) che forniscono dati oggettivi circa l’effettivo livello di sicurezza implementato e gli eventuali piani di mitigazione da adottare.

Il vasto e complesso tema della tutela della protezione dei dati, nella sua accezione più estesa, non si esaurisce di certo con la sicurezza del dato.

Internet of Things, Intelligenza artificiale, Big Data e Social Network, costituiscono solo una parte delle nuove tecnologie che quotidianamente rischiano di “minare” la fiducia degli utenti, violandone la libertà.

Fra le tante novità del nuovo Regolamento – Data Protection Impact Assessment, Data Protection Officer, Diritto all’oblio, Diritto alla portabilità dei dati, Registro dei trattamenti e il robusto apparato sanzionatorio solo per citarne alcune – si segnala l’art. 25 relativo alla c.d. Privacy by Design e c.d. Privacy by Default.

In particolare, per Privacy by Design si intende la necessità di progettare i sistemi informativi in modo da garantire la tutela del dato durante tutto il suo ciclo di vita (data at rest, data in transit). Questo implica la messa in atto di determinati meccanismi in base ai processi, alle tecnologie disponibili e alle tipologie di flussi informatici che caratterizzano quel dato trattamento.

Il concetto di Privacy by Default, invece, prevede che il titolare del trattamento metta in atto misure tecniche e organizzative adeguate per garantire che siano trattati, per impostazione predefinita, solo i dati personali necessari per ogni specifica finalità del trattamento. Tale obbligo vale per la quantità dei dati personali raccolti, la portata del trattamento, il periodo di conservazione e l’accessibilità.

Tali principi, previsti dall’art. 25 del GDPR, introducono concetti di processo ingegneristici atti a garantire la necessità di tutelare il dato sin dalla progettazione di sistemi informatici che ne prevedano l’utilizzo. Precisamente tale norma stabilisce che il Titolare del trattamento – tenuto conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, come anche dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche costituiti dal trattamento, sia al momento di determinare i mezzi del trattamento sia all’atto del trattamento stesso – mette in atto misure tecniche e organizzative adeguate, quali la pseudonimizzazione, volte ad attuare in modo efficace i principi di protezione dei dati, quali la minimizzazione, e a integrare nel trattamento le necessarie garanzie al fine di soddisfare i requisiti del presente regolamento e tutelare i diritti degli interessati.

Già l’attuale Codice della Privacy fa espresso riferimento alla definizione delle PET – Privacy enabling technologies – che del concetto di “privacy by design” costituiscono il fondamento.

Secondo l’art. 3 del D.Lgs. 196/2003 infatti “i sistemi informativi e i programmi informatici sono configurati riducendo al minimo l’utilizzazione di dati personali e di dati identificativi, in modo da escluderne il trattamento quando le finalità perseguite nei singoli casi possono essere realizzate mediante, rispettivamente, dati anonimi od opportune modalità che permettano di identificare l’interessato solo in caso di necessità“.

Il tema della Privacy by Design rafforza questo approccio costituendone di fatto il futuro. Secondo il Regolamento europeo, infatti, qualsiasi progetto (sia esso strutturale o concettuale) è necessario che venga realizzato considerando sin dalle fasi di project design, ovvero dalla fase di progettazione, la riservatezza e la protezione dei dati personali coinvolti nello stesso.

È auspicabile, dunque, pensare ai concetti di privacy e security non come ambiti distinti e separati ma come due facce della stessa medaglia, concorrenti – ognuno per la propria parte – al raggiungimento di un unico obiettivo.


BIBLIOGRAFIA

[1] Samuel D. Warren, Louis D. Brandeis, The Right to Privacy, Harvard Law Review, 15 dicembre 1890

[2] Diritto alla protezione dei dati personali – Data Protection Law | Privacy e protezione dati personali, in Data Protection Law | Privacy e protezione dati personali

[3] Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio del 27 aprile 2016 relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati (Regolamento generale sulla protezione dei dati).


A cura di: Roberto De Sortis e Anastasia Ambesi

L’articolo Trade-off tra Privacy e Security proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/trade-off-tra-privacy-e-security/


Il Business Continuity Manager: un professionista al servizio della resilienza organizzativa

Il mondo in cui si muovono le nostre organizzazioni è sempre più complesso: interconnessioni con svariati gruppi d’interesse: enti pubblici, agenzie, altre organizzazioni; innumerevoli minacce di varia origine: eventi atmosferici, attacchi cyber, instabilità politica, interruzioni di servizi essenziali quali l’energia o le telecomunicazioni; una costante velocizzazione delle attività e dei processi interni e esterni all’organizzazione, dove un’interruzione di poche ore può risultare fatale.

Questa complessità può mettere a rischio l’operatività e la sopravvivenza stessa di qualsiasi organizzazione, a prescindere dalle dimensioni e dal settore in cui opera. Per questo – e per essere del tutto resilienti ai rischi – è fondamentale che ognuna di esse adotti la business continuity, mettendo in atto una serie di analisi e procedure per mitigare gli impatti delle minacce e continuare a operare a fronte di emergenze o eventi critici.

Lo standard internazionale ISO 22301 definisce infatti la business continuity come “la capacità di continuare a erogare prodotti o servizi in seguito a un incidente a livelli predefiniti accettabili.”

Chiaramente, un aspetto così essenziale di un’organizzazione non può prescindere dalla presenza di un responsabile. E non uno qualsiasi; il business continuity manager deve essere una figura di riferimento per l’intera organizzazione.

È sua la responsabilità dell’intero sistema di gestione della continuità operativa. Per adempiere con efficacia al suo ruolo, deve fare parte dei livelli più alti dell’organizzazione.

Ci sono principalmente due vie con cui un professionista può acquisire competenza nel ruolo. Tramite l’esperienza, con anni di pratica del mestiere. E con lo studio approfondito delle best practice internazionali di continuità e resilienza organizzativa.

Entrambe le componenti sono essenziali. Coloro che si sono avvicinati allo studio delle linee guida e degli international standard dopo anni di pratica (come me) sanno di cosa sto parlando. È stato infatti necessario correggere e aggiornare molti aspetti della metodologia che avevo usato fino ad allora per adeguarli alle best practice, in un’ottica di miglioramento continuo.

Un passo importante in questa direzione è senza dubbio l’acquisizione di una certificazione riconosciuta a livello internazionale. Una certificazione in business continuity può avere diversi benefici per un professionista della materia. In primo luogo, fornisce una conoscenza completa e aggiornata dei principi fondamentali e delle best practice della disciplina. In più, garantisce l’ingresso all’interno di un network di professionisti specializzati, con tutte le possibilità di scambio di informazioni e competenze che ne conseguono. Per finire, una certificazione riconosciuta a livello internazionale garantisce al professionista una credibilità maggiore con gli interlocutori interni ed esterni all’organizzazione. I principali enti erogatori al mondo sono il Business Continuity Institute – BCI, e il Disaster Recovery Institute – DRI.

Ma la continuità operativa è una materia olistica, che di fatto comprende e coinvolge tutti gli ambiti di un’organizzazione. Per questo, a parte la formazione specialistica, il business continuity manager deve avere una conoscenza adeguata di tutto il contesto operativo e una predisposizione a interloquire agevolmente con tutti gli stakeholder dell’organizzazione.

Si tratta di un ruolo difficile e ricco di sfide. Porta però con sé anche un grande carico di entusiasmo e gratificazione professionale, una volta raggiunti gli obiettivi. Il professionista di business continuity gioca infatti un ruolo chiave nel miglioramento di tutta l’organizzazione ed è in grado di misurare e vedere coi propri occhi i risultati del proprio lavoro. Tra le caratteristiche che contraddistinguono il ruolo ci sono:

Collaborazione e coinvolgimento: il business continuity manager deve essere un professionista riconosciuto come credibile e autorevole da tutti i colleghi. Per questa ragione, è consigliabile che sia una persona con una rilevante seniority. Deve riportare direttamente al vertice dell’organizzazione, che a sua volta deve dare evidenza di allineamento con i suoi obiettivi. Tuttavia, se si decide di collocare tale figura all’interno di una funzione dell’organizzazione, è importante che venga comunque riconosciuta al manager la trasversalità dei suoi compiti e la possibilità (necessaria per svolgere il proprio lavoro) di interagire direttamente con i vertici dell’organizzazione.

Mandato chiaro e endorsement da parte del top management: per svolgere al meglio il proprio ruolo, il business continuity manager deve avere il pieno supporto da parte dei vertici dell’organizzazione, che devono essere essi stessi costantemente aggiornati sulle attività di continuità operativa. Deve anche avere la capacità di interagire con tutti i livelli dell’organizzazione, dall’esecutivo al middle management, fino ai livelli operativi. Tale continuo esercizio di relazione permetterà al business continuity manager di trasmettere i problemi operativi al top management e nel contempo interpretare le decisioni prese dall’alto verso il basso, nonché di condividere i problemi delle varie unità in maniera trasversale. In tal modo, le informazioni fluttueranno dall’alto verso il basso e viceversa, oltre che tra le varie sezioni di business e di supporto, per aumentare il coinvolgimento sulle problematiche comuni e la conoscenza delle best practice.

Divulgazione e promozione: attraverso opportune tecniche di comunicazione, il business continuity manager ha il compito di promuovere continuamente i principi di buona gestione della continuità operativa con il resto dell’organizzazione. Gli strumenti che ha a disposizione possono essere blog, newsletter, articoli di cronaca, partecipazione a convegni e conferenze sul tema, workshop e sessioni di sensibilizzazione (in aula o in modalità e-learning), esempi di crisi altrui o lezioni apprese da crisi interne. Dovrà anche assistere i vertici a promuovere regolarmente tali principi, comunicando quanto essi facciano parte degli obiettivi strategici dell’organizzazione.

Hands-off: il business continuity manager NON ha un ruolo operativo. Incontro spesso business continuity manager che fanno tutto per tutti. Mi dicono che è l’unico modo per ottenere qualche risultato nella continuità operativa. All’apparenza encomiabile, tale approccio procura invece un danno. È un errore grave cercare di fare per conto terzi qualcosa di cui non si è titolare.

Il professionista della business continuity è una figura di coordinamento delle varie fasi del sistema di gestione della continuità operativa. Avendo una buona esperienza delle tecniche di analisi di impatto e una conoscenza approfondita del contesto in cui l’organizzazione opera, il business continuity manager facilita la riflessione per identificare prodotti, servizi, processi e attività prioritarie dell’organizzazione, e stimola l’analisi di quali sarebbero gli impatti nel caso si verificassero delle interruzioni a queste priorità.

Project management: il business continuity manager deve proporre il disegno di modelli operativi per l’analisi di impatto e per il piano di continuità operativa. Grazie alla sua esperienza, può anche stimare le soglie di tollerabilità di un’interruzione (la classificazione del Massimo Periodo Tollerabile dell’Interruzione – MTPD, e degli Obiettivi di Tempo di Recupero – RTO), che saranno poi sottoposte al vaglio e all’approvazione dei vertici dell’organizzazione. Inoltre, assiste i vari titolari di prodotti, servizi, processi o attività nella programmazione dei propri compiti di continuità.

Responsabilità nella supervisione: il business continuity manager è responsabile della supervisione dell’intero sistema di gestione della continuità operativa. Non compila, non sviluppa, non completa e non analizza per conto dei titolari, ma li assiste, ove necessario, nella realizzazione di tali attività. In più, ha il compito di monitorare l’aggiornamento continuo e puntuale di tutta la documentazione relativa al sistema di gestione. A tal proposito sarà necessario prevedere che tutti i piani, i progetti, i registri di formazione, la pianificazione dei test, le analisi d’impatto e qualunque procedura relativa alla continuità operativa, siano centralizzati in un database sotto il controllo diretto del business continuity manager. In tal modo, il professionista di continuità sarà nella posizione di allertare l’organizzazione su eventuali ritardi nella revisione pianificata, dati obsoleti o scadenze non rispettate. In pratica, il business continuity manager è responsabile della qualità del sistema di gestione della continuità operativa. Dati tutti gli strumenti di cui sopra, avrà la possibilità di dimostrarne anche il miglioramento continuo.

Facilitazione: uno dei compiti fondamentali del business continuity manager è anche quello di indicare la via per il miglioramento continuo del sistema di gestione della continuità operativa. Il professionista deve semplificare le procedure e renderle accessibili a tutti i manager. Deve inoltre assistere i vari titolari dei processi a espletare i propri compiti relativi alla continuità dell’organizzazione. A titolo di esempio, dovrà verificare che la funzione di HR progetti un programma di formazione e sensibilizzazione annuale, indicando le figure di riferimento che devono partecipare. Così come dovrà supervisionare che ICT, logistica e tutti i titolari di piani di continuità operativa si siano dotati di una puntuale programmazione dei test. Stimolerà infine la riflessione in tutti i soggetti competenti per trovare le soluzioni più idonee e aggiornate per mitigare l’impatto di eventuali interruzioni.

Consulenza nella gestione della crisi: il ruolo del business continuity manager sarà prezioso in caso di evento critico. Di conseguenza, sarà opportuno includerlo sempre nel team di gestione della crisi. In queste occasioni agirà da consulente al business incoraggiando i vertici organizzativi a prendere decisioni rapide sull’invocazione del disaster recovery plan e della business continuity. Ricorderà a tutti le soluzioni progettate e documentate nei piani e potrà coordinare la registrazione delle decisioni fatte e delle azioni intraprese durante l’evento.

Conoscenza di Linee Guida, Norme e Standard internazionali: per finire, il business continuity manager deve conoscere gli standard internazionali in materia di continuità operativa. Gli standard e le linee guida molto spesso contengono tutti gli elementi.  Di seguito una lista (non esaustiva) delle principali norme, standard e best practice internazionali in materia:

  • ISO 22301:2012
    Societal security — Business continuity management systems – Requirements
  • ISO 22313:2012
    Societal security — Business continuity management systems – Guidance
  • ISO/TS 22316:2017
    Security and resilience – Organizational resilience – Principles and attributes
  • ISO/TS 22317:2015
    Societal security — Business continuity management systems — Guidelines for business impact analysis
  • ISO/TS 22318:2015
    Societal security — Business continuity management systems — Guidelines for supply chain continuity
  • ISO 22398:2013
    Security and resilience — Guidelines for exercises
  • ISO/IEC 27031:2011
    Information technology — Security techniques — Guidelines for information and communication technology readiness for business continuity
  • ISO 31000:2009
    Risk management – Principles and guidelines
  • ISO/IEC 31010:2009
    Risk management — Risk assessment techniques
  • Good Practice Guidelines (GPG) 2018
    Linee Guida di Buona Pratica del Business Continuity Institute
  • DRI Professional Practices
    Le Pratiche Professionali del Disaster Recovery Institute
  • BS 11200:2014
    Crisis management. Guidance and good practice


A cura di: Gianna Detoni

L’articolo Il Business Continuity Manager: un professionista al servizio della resilienza organizzativa proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/il-business-continuity-manager-un-professionista-al-servizio-della-resilienza-organizzativa/