Sicurezza dei dispositivi mobili e BYOD

Questo articolo prosegue la serie dedicata a temi su cui ci sono i maggiori dubbi e perplessità sulle norme della serie ISO/IEC 27000.

La ISO/IEC 27001 ha un controllo specifico per i dispositivi mobili, ma solo relativo alle regole sul loro uso. Non fa esplicito riferimento alle tecnologie disponibili per controllare le impostazioni di sicurezza di questi strumenti, né al fenomeno del BYOD.

Questo ci permette di parlare, come conclusione, anche dei rischi che si vogliono nascondere.

Regole per i dispositivi mobili

Le organizzazioni devono specificare le regole (policies, in inglese) per l’uso dei dispositivi mobili (tra cui cellulari, tablet e pc portatili).

Alcune regole sono tipiche di ogni dispositivo informatico:

  • controllo degli accessi con user-id e password (o altri meccanismi di identificazione e autenticazione);
  • blocco quando non utilizzato;
  • installazione e aggiornamento di antivirus;
  • divieto di installare software (app per dispositivi mobili) non autorizzato.

Altre regole riguardano i dispositivi portatili nello specifico:

  • evitare di visualizzare dati riservati in luoghi pubblici e quando sono facilmente leggibili da persone non autorizzate (in caso di cellulari, evitare di discutere di argomenti riservati in luoghi pubblici);
  • evitare di farli usare ad altri;
  • impostare la cancellazione remota dei dati in caso di furto o perdita;
  • cifrare i dati.

Per i dispositivi messi a disposizione dell’organizzazione (i cosiddetti “cellulari aziendali”), anche se non richiamati dalla ISO/IEC 27001, sono oggi a disposizione degli strumenti di mobile device management o MDM, che permettono di stabilire centralmente le configurazioni dei dispositivi, esattamente come per i pc in rete. È importante ricordare quanto questi strumenti siano oggi fondamentali, visto che spesso tutte le informazioni dell’organizzazione (incluse le email con i loro allegati) sono archiviate in questi dispositivi e non solo sui pc (fissi o portatili).

Visto che la ISO/IEC 27001 non menziona esplicitamente questi strumenti, alcuni prevedono di aggiungere un controllo alla propria Dichiarazione di applicabilità; altri preferiscono vederli come casi particolare del già esistente controllo “A.06.02.01 Politica per i dispositivi portatili”.

Bring your own device (BYOD)

Il termine BYOD indica un fenomeno degli ultimi 10 anni, esploso soprattutto con la diffusione degli smartphone e dei tablet: le persone usano sempre più i propri dispositivi personali per accedere ai dati di lavoro. Configurano il proprio dispositivo per ricevere e visualizzare le email aziendali e i loro allegati e per interagire con i colleghi, i clienti o i fornitori con strumenti di instant messaging.

In questi casi i dati devono avere lo stesso livello di sicurezza di quando sono trattati con strumenti messi a disposizione dall’organizzazione. Pertanto gli utenti devono configurare i propri dispositivi personali nello stesso modo e devono ricevere opportune istruzioni (in breve, un regolamento interno può elencare le misure di sicurezza da configurare sui propri dispositivi se usati per trattare dati dell’organizzazione).

Per inciso, consentire il BYOD con strumenti non adeguatamente protetti può avere come conseguenze la perdita o diffusione non autorizzata di dati personali, sanzionabile come previsto dal GDPR.

Inutile nasconderlo: poche persone, nella realtà, configureranno i propri dispositivi personali con misure di sicurezza sufficientemente robuste. In alcuni casi, addirittura, aprono ulteriori vulnerabilità, per esempio sincronizzando l’email aziendale con quella personale su servizi cloud pubblici (e spesso offerti da società negli USA).

Una soluzione drastica è quella di vietare il BYOD. Questo implica anche il blocco di strumenti quali webmail e di file sharing, oltre ai sempre più diffusi strumenti di office automation sul cloud (i più celebri sono quelli di Google). Infatti, fornire agli utenti strumenti cui si può accedere da qualsiasi dispositivo equivale a consentire il BYOD.

Un’altra soluzione è l’adozione di un Cloud based security broker, strumento che permette di controllare i dispositivi personali che possono accedere ai dati dell’organizzazione. Maggiori dettagli nell’articolo https://www.ictsecuritymagazine.com/articoli/mitigare-rischi-sicurezza-nel-cloud-pubblico-cloud-access-security-brokers-casb/.

In parole molto povere, gli utenti devono “collegare” il proprio smartphone o tablet o pc al CASB dell’organizzazione per cui lavorano. In molti però fanno resistenza (curiosamente sono più propensi a fornire tutti i propri dati a OTT come Google, Amazon, Facebook e Apple che permettere al proprio datore di lavoro un controllo limitato del proprio dispositivo personale) e per questo è necessario pianificare attentamente l’introduzione degli strumenti CASB.

Le ISO/IEC 27001:2013 e ISO/IEC 27002:2013 non trattano del BYOD, anche se nel 2013 il fenomeno stava sempre più diffondendosi. È quindi necessario fare riferimento ad altre pratiche come per esempio le pubblicazioni SP 800-46 “Guide to Enterprise Telework, Remote Access, and Bring Your Own Device (BYOD) Security” e SP 800-114 “User’s Guide to Telework and Bring Your Own Device (BYOD) Security” del NIST, anche se sono eccessivamente prolisse, o le linee guida del CESG, anche se complicate dalla suddivisione in più documenti.

Per chi vuole adottare la ISO/IEC 27001, come sopra suggerito è possibile aggiungere un controllo alla Dichiarazione di applicabilità o vedere il BYOD come caso particolare del già esistente controllo “A.06.02.01 Politica per i dispositivi portatili”.

Riflessioni finali

Le organizzazioni solitamente si nascondono le difficoltà nel controllare il BYOD. Infatti sono ben contente di aumentare la reperibilità del proprio personale, e di introdurre lo smart working a costi limitati. Quindi promuovono sempre più l’uso di strumenti cloud, anche se spesso si può accedere a questi con strumenti insicuri.

Ma oggi è anche necessaria una maggiore sicurezza e questo richiede di controllare in qualche modo la flessibilità e la libertà introdotta dalle nuove tecnologie.

Tali questioni non devono essere nascoste sotto il tappeto e vanno affrontate valutando correttamente tutti i rischi, tra i quali: le vulnerabilità introdotte, la possibilità di essere sanzionati per carenza di misure di sicurezza, personale meno connesso nel caso venga vietato il BYOD, persone scontente (o non sempre connesse ai sistemi dell’organizzazione) nel caso vengano introdotti strumenti CASB, maggiori costi per fornire al personale strumenti controllati dall’organizzazione.

A cura di: Cesare Gallotti

L’articolo Sicurezza dei dispositivi mobili e BYOD proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sicurezza-dei-dispositivi-mobili-e-byod/


ePrivacy, l’integrazione del GDPR

Il GDPR, una norma da integrare

25 maggio 2018: ecco il GDPR, il nuovo regolamento europeo sulla protezione dei dati personali. In realtà, i regolamenti che dovevano nascere quel giorno, nelle intenzioni del legislatore europeo, erano due: gemelli eterozigoti. Diversi ma uguali nelle finalità, l’uno più corpulento, l’altro più acuto ma bisognoso di essere sostenuto. Alla fine, è nato solo quello più corpulento, l’altro è rimasto nelle pieghe delle procedure legislative dell’UE. E, così, prima o poi nascerà il “Regolamento relativo al rispetto della vita privata ed alla tutela dei dati personali nelle comunicazioni elettroniche”, il cosiddetto regolamento ePrivacy. Per ora, è fermo come proposta[i] ma esprime già tutta la sua portata.

Il regolamento ePrivacy nasce dall’esigenza di:

  • far evolvere le previsioni contenute nella direttiva 2002/58/EC[ii], così come modificata dalla direttiva 2009/136/EC[iii];
  • uniformare, rendendole direttamente applicabili, le norme di tutela delle comunicazioni elettroniche nei paesi membri.

Il testo ePrivacy si muove in uno specifico contesto di trattamento di dati personali (comunicazioni elettroniche) e, per questo motivo, è sostenuto da tutto quello che è previsto dal GDPR (definizioni, principi, autorità di controllo, ecc.). Infatti, l’articolo 1 sottolinea che il regolamento tende a “precisare e ad integrare” quanto stabilito dal regolamento europeo 679/2016.

L’attualità della proposta di ePrivacy discende da un recente parere fornito dal Comitato Europeo per la Protezione dei Dati Personali[iv] che commenteremo a conclusione di una sintesi dei contenuti del regolamento in bozza.

Le somiglianze

Analogamente al GDPR, ePrivacy si disinteressa del luogo in cui ha la sede legale il fornitore di reti o servizi di comunicazione elettronica (il titolare del trattamento, nel lessico del GDPR) e si dichiara applicabile a tutti i cittadini dell’Unione Europea. Questo vuol dire che l’impiego da parte di un utente italiano di un servizio di posta elettronica fornito da una società statunitense richiede che il servizio sia fornito conformemente alle norme UE.

Inoltre, sempre in sintonia con il GDPR, ePrivacy si applica a prescindere dal pagamento di un corrispettivo da parte dell’utente.

Anche il meccanismo dei controlli e delle sanzioni è simile al GDPR. Infatti, le autorità di controllo (per l’Italia il Garante per la Protezione dei Dati Personali) che devono garantire la tutela dei dati personali potranno esercitare i loro poteri anche in materia di tutela delle comunicazioni elettroniche. In caso di sanzioni, vale lo stesso meccanismo che prevede la doppia marcia con escalation: fino a 10.000.000 di euro per le violazioni meno gravi (elevabili al 2% del fatturato) e fino a 20.000.000 di euro per le violazioni più gravi (elevabili al 4% del fatturato).

Alcune differenze

La differenza più evidente riguarda l’ambito soggettivo di tutela. Il GDPR tutela i dati personali riferiti alle sole persone fisiche mentre l’ePrivacy tutela le comunicazioni relative a persone fisiche e persone giuridiche. Questo è chiarito bene nel capitolo 2 della relazione di accompagnamento della proposta di regolamento il quale specifica che la sua finalità ultima è quella di rendere effettivo il diritto al rispetto della vita privata e familiare previsto dall’art. 7 della Carta dei Diritti Fondamentali dell’Unione Europea[v]. Questo diritto, secondo specifiche sentenze della Corte di Giustizia dell’Unione Europea[vi] e della Corte Europea dei Diritti dell’Uomo[vii] (ricordiamo che l’art. 8 della Convenzione Europea dei Diritti dell’Uomo[viii] è il gemello del predetto articolo 7), è rivendicabile, per quanto riguarda la riservatezza delle comunicazioni, anche dalle persone giuridiche oltre che dalle persone fisiche.

Un’altra differenza rilevante riguarda la distinzione tra i contenuti delle comunicazioni elettroniche ed i relativi metadati. I contenuti sono la voce, i video, i testi che viaggiano da un mittente ad uno o più destinatari mentre i metadati sono i dati che accompagnano i contenuti ma che sono funzionali a consentire che la comunicazione possa avvenire con successo (data, ora, luogo, tipo di messaggio, ecc.). La differenza è precisata in relazione alla base giuridica che ne consente il trattamento (sempre con l’obbligo di minimizzarne la conservazione). Per i metadati, il trattamento è consentito:

  • se c’è il consenso dell’interessato a patto che le finalità non siano raggiungibili anonimizzando i dati;
  • se è necessario per garantire la qualità del servizio (prevista dall’atteso codice europeo per le comunicazioni elettroniche[ix], anch’esso non ancora approvato);
  • se è necessario per scopi di fatturazione o rilevazione di usi fraudolenti.

Per i contenuti, invece, le basi di liceità sono ridotti a:

  • consenso dell’interessato rispetto ad un servizio che non potrebbe essere fornito senza il trattamento dei contenuti;
  • consenso di tutti gli interessati per uno o più fini specifici previa consultazione dell’autorità di controllo conformemente all’art. 36 del GDPR.

Il consenso, come è ovvio, può essere revocato in qualsiasi momento ma ePrivacy offre un’ulteriore tutela, imponendo al fornitore di servizi di comunicazione elettronica di ricordare all’utente questo diritto con una frequenza pari a sei mesi.

Infine, diversamente dal GDPR, l’ePrivacy impone la cancellazione o all’anonimizzazione immediata dei contenuti e dei metadati non appena il destinatario abbia ricevuto la comunicazione, salvo che l’interessato non abbia acconsentito diversamente. Solo i metadati utili a scopo di fatturazione possono essere conservati fino alla scadenza del periodo, previsto dalla legge nazionale, utile alla contestazione delle fatture.

Le intrusioni nella vita privata

L’ePrivacy, oltre ad integrare il GDPR sul fronte riservatezza, estende il proprio campo d’azione all’invadenza derivante dalle comunicazioni (prevalentemente telefoniche e email) cui, in Italia, ha tentato di dare una prima risposta la legge n. 5/2018 (legge sul telemarketing).

Le comunicazioni che prevedono una chiamata tramite numero identificativo dovranno essere filtrabili dall’utente chiamato che sarà messo in grado, dal suo fornitore di servizi di comunicazione, di configurare il rifiuto delle chiamate sconosciute oltre che quelle provenienti da determinati numeri o prefissi.

Sulle email pubblicitarie, infine, non cambia molto rispetto all’attuale disciplina prevista dal nostro Codice della Privacy. È previsto, infatti, che il mittente debba ottenere il consenso del destinatario a meno che non si verifichino tutte le seguenti condizioni allo stesso tempo:

  • il destinatario deve essere già cliente del mittente;
  • l’email contenga pubblicità di merci o servizi analoghi a quelli già venduti;
  • il destinatario sia messo in grado di opporsi, gratuitamente ed agevolmente, alle email pubblicitarie.

Il parere dell’EDPB

Le tante novità contenute nella proposta ePrivacy non hanno pienamente convinto il Comitato Europeo per la Protezione dei Dati Personali (EDPB) che, il 28 maggio scorso, ha adottato un parere per sollecitare alcune riflessioni da parte della Commissione Europea, del Parlamento Europeo e del Consiglio Europeo. In particolare, dopo aver chiesto di chiudere rapidamente l’iter legislativo, ha ribadito l’importanza di includere nel provvedimento:

  • uno specifico divieto nell’applicazione del legittimo interesse o del generico riferimento al contratto quali basi giuridiche per il trattamento;
  • una precisa e sistematica disciplina per l’acquisizione del consenso via web o tramite app affinché l’interessato sia guidato in maniera efficace all’espressione di un consenso libero, specifico, informato ed inequivocabile;
  • un’apposita proibizione dei cosiddetti cookie wall cioè della tecnica che impedisce la fruizione di un servizio senza l’accettazione dell’installazione di cookie sul proprio terminale.

Note


A cura di: Francesco Maldera

L’articolo ePrivacy, l’integrazione del GDPR proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/eprivacy-lintegrazione-del-gdpr/


Permessi in Android

In Android, un permesso è una stringa di testo che consente di eseguire specifiche operazioni. Operazioni che possono riguardare l’hardware (come ad esempio la videocamera, il bluetooth, ecc.), oppure servizi messi a disposizione da un’altra applicazione o dal sistema, o la connettività ad Internet, o ancora l’accesso a determinati dati.

Poiché le applicazioni vengono eseguite in una sandbox, di per sé non hanno molta libertà di movimento: possono solo accedere ai propri file, a tutte quelle risorse che sono comunemente accessibili e a un insieme molto limitato di servizi. Una simile applicazione, dal punto di vista delle funzionalità, rischia di non essere molto interessante e utile, da qui il bisogno di interagire direttamente con altre risorse.

Un’applicazione, per poter interagire con l’hardware, con il sistema o con un’altra applicazione ha bisogno di particolari permessi, in modo che sia in grado di eseguire operazioni su risorse non controllate direttamente. A questo scopo, Android ha introdotto i permessi, per garantire e controllare l’accesso delle applicazioni a risorse terze e permettere una più ampia varietà di funzionalità.

Il sistema operativo Android viene distribuito con un insieme di permessi predefiniti che un’applicazione può richiedere. Cosa importante, i permessi necessari all’applicazione devono essere richiesti al momento dell’installazione e non possono essere più cambiati, salvo delle eccezioni che vedremo in seguito.

Richiesta dei permessi

I permessi, necessari all’applicazione per eseguire alcune sue funzionalità, vanno richiesti nel file AndroidManifest.xml (Figura 1).

Figura 1

In AndroidManifest.xml i permessi vengono richiesti attraverso il tag <uses-permission> che prende due attributi principali: – android:name: rappresenta il nome del permesso da richiedere; – android:maxSdkVersion: rappresenta la maggiore versione dell’SDK che garantisce la concessione del permesso associato.

Alcuni permessi possono essere concessi solo alle applicazioni di sistema e vengono sistematicamente rifiutati se a richiederli è una normale app.

Come detto, i permessi possono essere assegnati all’applicazione che li richiede solo al momento dell’installazione. Il package manager (pm), che si occupa di concedere i permessi, tiene traccia nel file /data/system/packages.xml (aggiornato ogni volta che un applicazione viene installata, disinstallata o aggiornata) di tutte le informazioni relative ad un pacchetto, ad esempio path, versione, permessi concessi.

Definizione di un nuovo permesso

Le applicazioni di terze parti possono definire dei permessi personalizzati utilizzando gli stessi attributi di un permesso di sistema. La definizione avviene attraverso il tag <permission>, sempre nel manifesto dell’applicazione, nel seguente modo:

<permission android:description="string resource" android:icon="drawable resource" android:label="string resource" android:name="string" android:permissionGroup="string" android:protectionLevel=["normal" | "dangerous" | "signature" | ...] />

I campi interessanti sono name, che rappresenta il nome del permesso da creare, e protectionLevel, che vedremo in dettaglio dopo.

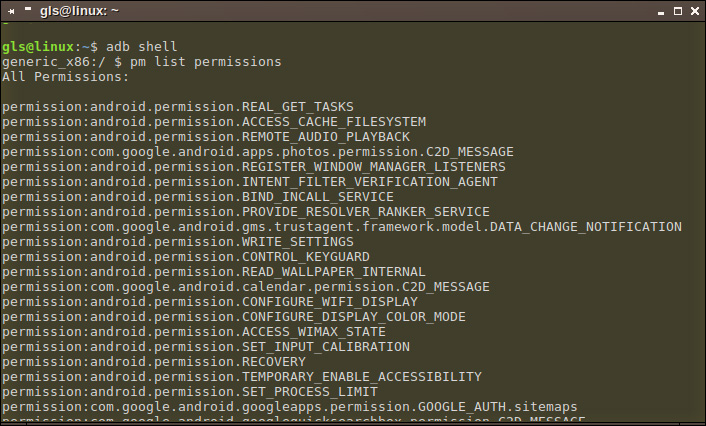
Per vedere una lista di possibili permessi, occorre lanciare, una volta eseguito adb shell, il comando pm list permissions sul device o nell’emulatore (Figura 2).

Figura 2

Come funziona

Al momento dell’installazione, Android controlla i permessi richiesti e decide quali concedere automaticamente, quali dopo consenso dell’utente e quali non concedere. Una volta concessi, i permessi non possono essere revocati, tranne in casi particolari, e sono disponibili all’app senza ulteriori passaggi. Il comportamento di un permesso è determinato dal livello di protezione associato, ad esempio alcuni permessi richiedono un consenso esplicito da parte dell’utente, anche se all’applicazione è stato concesso già il permesso relativo. Vediamo ora in dettaglio proprio i livelli di protezione disponibili.

Livelli di protezione

Android associa ad ogni permesso un livello di protezione basato sulla natura delle risorse al quale il permesso dà accesso. La concessione o meno di un permesso ad una applicazione dipende dal livello di protezione associato allo specifico permesso richiesto. I possibili valori sono:

  • normal: è il valore che, se non indicato nessun livello di protezione, viene impostato di default. Viene usato per tutti quei permessi che non servono a svolgere operazioni critiche sulle risorse. Questi permessi vengono automaticamente concessi all’applicazione, e non richiedono una esplicita conferma da parte dell’utente.
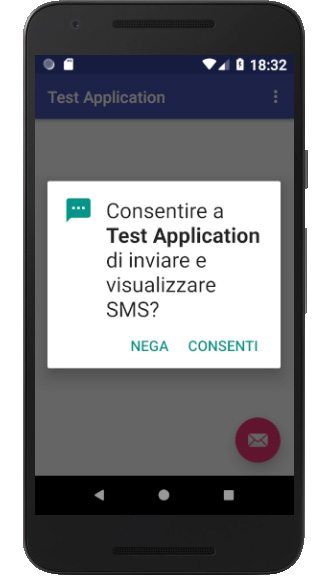
  • dangerous: i permessi con livello dangerous permettono, generalmente, di controllare in qualche modo il dispositivo o i dati presenti in esso. A differenza degli altri permessi, questi non vengono concessi automaticamente all’app che li richiede. Se un’applicazione dichiara che ha bisogno di un permesso indicato come dangerous, l’utente deve esplicitamente concedere il permesso all’app. Per poter utilizzare questi permessi, l’app deve mostrare, a runtime, un avviso all’utente, che può o meno accettare (Figura 3). Inoltre, un’app deve controllare i permessi ogni volta che vuole usarli, e, dalla versione 23 delle API (Android 6.0), l’utente può revocare, in qualsiasi momento, i permessi precedentemente concessi all’applicazione.
  • signature: se il livello è signature, il permesso viene concesso solo a quelle applicazioni firmate con la stessa chiave dell’applicazione che definisce i permessi.

Figura 3

I livelli di protezione dei permessi built-in sono definiti nel manifesto del file /system/framework/framework-res.apk, dove per ogni permesso definito dal sistema è indicato il relativo livello, ad esempio:

android:protectionLevel=”dangerous”

Inoltre, è possibile anche indicare, nello stesso campo, dei flag che specificano l’azione, ad esempio:

android:protectionLevel=”dangerous|privileged”

I principali flag sono:

  • privileged: nelle API level 23 e precedenti, questo flag si chiamava system. I permessi con questo flag richiedono, per essere concessi, che l’applicazione sia un’app privilegiata installata nell’immagine di sistema, ovvero che risieda sulla partizione, a sola lettura, del sistema (/system/priv-app).
  • development: usualmente, Android non consente di richiedere o revocare i permessi dopo l’installazione; se invece il flag è impostato come development, il permesso in esame diventa parte dei development permissions, che vengono gestiti in modo differente dal sistema: sarà possibile da parte dell’applicazione richiedere o revocare il permesso anche dopo l’installazione.

Concessione effettiva dei permessi

Ad ogni applicazione sono assegnati, al momento dell’esecuzione, un UID e un GID, e, in base ai permessi richiesti, uno o più GID supplementari. Android usa questi ID per decidere se una specifica risorsa deve essere concessa all’applicazione.

Il sistema tiene traccia dei permessi necessari ad accedere ad ogni risorsa e, quando un’applicazione vuole accedere ad essa, prima di permetterlo, controlla che il permesso richiesto sia stato concesso.

Conclusioni

Abbiamo visto come vengono richiesti ed usati i permessi da parte di un’applicazione e come vengono concessi e gestiti da parte del sistema. Informazioni utili soprattutto in fase di assessment ed analisi di un’app.

A cura di: Gianluigi Spagnuolo

L’articolo Permessi in Android proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/permessi-in-android/


GDPR tra novità e falsi miti

Man mano che la scadenza del GDPR si avvicinava erano sempre di più le “leggende” che si consolidavano in ordine alla sua applicazione, e si diffondevano a macchia d’olio le interpretazioni più varie, il più delle volte instillando dubbi e timori francamente infondati, a volte proponendo letture decisamente pericolose.

Il Regolamento generale sulla protezione dei dati è una normativa complessa, che si colloca al crocevia con diverse altre fonti che ne intersecano e lambiscono l’ambito di applicazione; non sempre è semplice comprendere come questi ambiti possano essere regolati, e il legislatore nazionale, che avrebbe dovuto dettare le regole di coordinamento sul piano nazionale non è stato in grado di intervenire tempestivamente.

D’altra parte il Regolamento lascia ampi spazi di deroga al legislatore nazionale, e l’auspicio è che gli Stati membri se ne avvalgano il meno possibile, in modo da poter mantenere il quadro europeo quanto più uniforme.

In alcuni casi, tuttavia, è necessario che il legislatore intervenga: ad esempio in tema di consenso prestato dal minore per quanto riguarda l’offerta di servizi della società dell’informazione loro diretti; in questo caso il GDPR fissa un range (una età variabile tra i 13 e i 16 anni) e ogni Stato membro, autonomamente, dovrà stabilire l’età che ritiene più consona. L’Italia, nel momento in cui scrivo, non ha ancora pubblicato questa norma.

Questo articolo si propone di fare chiarezza su alcune interpretazioni fuorvianti che si stanno coagulando attorno alla lettera del Regolamento soprattutto tra chi non ha consuetudine con la normativa sulla protezione dei dati personali, in modo da scongiurare letture “pericolose”: come, ad esempio, pericolose possono rivelarsi per chi ha poca dimestichezza con la normativa,  le fantasiose interpretazioni relative al numero di dipendenti: taluni ritengono che l’obbligo di nominare il data protection officer riguardi solo le imprese con più di 250 dipendenti, altri addirittura che il Regolamento stesso trovi applicazione solo per le imprese con più di 250 dipendenti. Si tratta di interpretazioni di pura fantasia, il GDPR non commisura gli adempimenti a questo limite dimensionale e l’unico caso in cui si fa riferimento ai 250 dipendenti, nel testo, è relativamente all’obbligo di tenuta del registro delle attività di trattamento. Tuttavia anche in questo caso non è il numero dei dipendenti ad essere di per sé decisivo, ma l’occasionalità o il rischio del trattamento operato.

Preciso, infine, che questa analisi muove dalla mia personalissima esperienza, senza alcuna pretesa di completezza o sistematicità.

Obbligo o verità

L’articolato del Regolamento europeo è differente da quello delle norme nazionali: agli articoli veri e propri sono premesse alcune formulazioni (173, per la precisione) che sono indicate da un numero tra parentesi: si tratta dei “considerando”.

I “considerando” sono la spiegazione del senso che il legislatore europeo voleva imprimere alla norma: per quello tendenzialmente non vengono utilizzati tempi verbali che indicano un precetto, ma viene usato per lo più il condizionale.

Il precetto vero e proprio è contenuto solo negli articoli. Avventurarsi in spiegazioni contorte sul perché una norma sarebbe o meno vincolante attaccandosi al testo del considerando (come ho visto fare in alcune discussioni sui social) è pericoloso: i considerando sono principalmente rivolti ai Giudici della Corte di Giustizia, che hanno una approfondita conoscenza del diritto europeo e dell’ordinamento in cui il GDPR si inquadra.

La lettura dei considerando può essere utile, soprattutto per gli esempi che riportano: ma è sconsigliabile appellarsi ai cavilli che si crede di reperire nel testo; infatti, questi possono essere estremamente fuorvianti. Inoltre prima di avventurarsi in interpretazioni poggiate sulla lettera della legge, occorre tener presente che il Regolamento è una norma europea, e a differenza delle leggi italiane non è scritto in una lingua sola, ma in 24 lingue. In genere, se sorge un problema legato all’interpretazione letterale, va risolto nel senso prevalente che la norma ha nella maggioranza delle versioni ufficiali. L’inglese non è la versione predominante, e anche se a volte la versione in inglese appare più chiara di quella italiana e può essere di aiuto, non è di per sé dirimente.

Consensi, consensi ovunque

Il consenso è una delle basi giuridiche del trattamento elencate dall’articolo 6 del GDPR, non è prioritaria o prevalente rispetto ad altre. Questa impostazione, già seguita in Europa dai tempi della direttiva 95/46/CE, era stata ribaltata in Italia, dove il sistema era stato costruito attorno al consenso, elencando i casi tassativi in cui era possibile operare in via di eccezione al consenso stesso.

In estrema sintesi, il GDPR non obbliga ad avere il consenso per tutti i trattamenti, anzi: sono più i trattamenti che non impongono la richiesta di consenso che quelli che la impongono.

Se i dati che mi vengono forniti (conferiti, come si dice tecnicamente) al momento della stipula di un contratto mi serviranno per eseguire il contratto, non dovrò chiedere il consenso (ma attenzione: dovrò sempre rendere l’informativa), e non mi servirà il consenso fintanto che utilizzerò i dati per eseguire il contratto e assolvere gli obblighi di legge connessi.

Attenzione anche al legittimo interesse, che è una diversa base giuridica: è una base che taluni considerano “pericolosa” o “rischiosa” e cercano di ricorrere al consenso invece che al legittimo interesse: ma consenso e legittimo interesse non sono due basi intercambiabili; il legittimo interessa opera spesso proprio dove il consenso non potrebbe essere validamente acquisito: infatti, il consenso che non è liberamente prestato non è valido, e il consenso non è valido perché non è libero ogni volta che è condizionato (dalla necessità di ricevere una prestazione o dal particolare rapporto che lega le parti, ad esempio).

Alcuni dei presupposti di invalidità del consenso (ad esempio la necessità di “coartarlo” per poter effettuare il trattamento connesso, o il particolare rapporto in essere tra le parti) sono proprio i presupposti su cui si fonda il legittimo interesse: si tratta di basi giuridiche alternative, nel senso che una esclude l’altra, nella maggioranza dei casi.

Resta il problema che il legittimo interesse non basta individuarlo: per impiegarlo validamente si deve anche fare il bilanciamento degli interessi (per iscritto, in ossequio al principio di accountability). Tuttavia se non sono in grado di ottenere un bilanciamento favorevole non posso limitarmi a inserire un modulo di consenso per superare il problema, devo valutare se in quel caso il consenso sarà valido o invece, invalido, perché condizionato. Ad esempio, nei rapporti di lavoro, il consenso, data la sperequazione nelle posizioni di forza di datore di lavoro e lavoratore non può essere impiegato se non in rari, marginalissimi, casi: il più delle volte il trattamento si baserà necessariamente sul legittimo interesse (cfr. WP opinion 2/2017).

Mi permetto anche una annotazione sinteticissima in ordine all’informativa: è vero che la fortuna ha voluto che fosse sempre disciplinata dal medesimo articolo (il 13) nei due testi normativi, ma non basta sostituire la formula normativa per rendere una informativa conforme al GDPR: non solo perché è necessario rivedere il “tono” (il GDPR richiede un linguaggio semplice e chiaro, non legalese) e la forma (è preferibile dare un’informativa su più livelli) ma perché è diverso il contenuto. L’articolo 13 del GDPR richiede elementi prima non previsti, come l’indicazione della base giuridica, e sono elementi tassativi, non si possono omettere a piacimento. Scrivere “informativa resa ai sensi dell’articolo 13 del Regolamento UE 679/2016” su un testo risalente all’informativa “resa ai sensi dell’articolo 13 del D. Lgs. 196/03” è efficace come il nascondiglio dei bambini che credono di non essere visti se si coprono gli occhi coi palmi delle mani.

Le parole sono importanti

Come anticipato più sopra, il consenso può essere prestato da parte dei minori solo se essi hanno raggiunto il limite di età fissato dalle varie legislazioni nazionali.

Attenzione però perché la norma non tocca la capacità di agire del minore, che resta fissata dalle regole civilistiche, tocca solo i trattamenti la cui base giuridica è il consenso.

L’articolo 8 del Regolamento recita: “Qualora si applichi l’articolo 6, paragrafo 1, lettera a), per quanto riguarda l’offerta diretta di servizi della società dell’informazione ai minori, il trattamento di dati personali del minore è lecito ove il minore abbia almeno 16 anni.

Ove il minore abbia un’età inferiore ai 16 anni, tale trattamento è lecito soltanto se e nella misura in cui tale consenso è prestato o autorizzato dal titolare della responsabilità genitoriale.

Gli Stati membri possono stabilire per legge un’età inferiore a tali fini purché non inferiore ai 13 anni.” La norma va letta così: Qualora il trattamento sia basato sul consenso, per quanto riguarda l’offerta diretta di servizi della società dell’informazione ai minori, il trattamento di dati personali del minore è lecito ove il minore abbia almeno 16 anni.

Eliminare il riferimento all’articolo 6 paragrafo 1 lettera a), e riportare solo l’inciso seguente: “per quanto riguarda l’offerta diretta di servizi della società dell’informazione ai minori, il trattamento di dati personali del minore è lecito ove il minore abbia almeno 16 anni” scompagina completamente il senso della norma, perché rivela una portata generale, che apparentemente incide anche sulla capacità di agire e che il legislatore non solo non si prefiggeva, ma proprio non ha scritto. “Le parole sono importanti” per dirla con Nanni Moretti, e negli articoli di legge sono imprescindibili anche quando sono hanno scarso appeal come “Qualora si applichi l’articolo 6, paragrafo 1, lettera a)”.

Cookie monster

Le interpretazioni più improbabili e gli adempimenti più strampalati si addensano come nubi attorno soprattutto al nodo del rapporto tra “cookie law” (qualunque cosa con questa espressione si intenda indicare) e GDPR.

La “cookie law”non abroga/ modifica o è abrogata/ modificata  dal GDPR, come si paventa da più parti.

Innanzi tutto bisogna chiarire cosa sia la famigerata “cookie law”, dato che, a mio avviso, il punto critico è proprio la confusione intorno alla fonte normativa da cui discendono gli obblighi in ordine ai cookie (e non solo: sono obblighi che riguardano anche altri strumenti di remarketing).  Parafrasando Goya, la confusione sulla “cookie law” genera mostri.

Innanzi tutto, generalmente quando parliamo di “cookie law” spesso facciamo riferimento a più norme, che sgorgano a cascata dalla Direttiva e-privacy (Direttiva 2002/58/CE e s.m.i.).

Trattandosi di una direttiva, a differenza del Regolamento – che trova immediata applicazione nei singoli Stati -, la e-privacy aveva bisogno di essere attuata dalla normativa nazionale.

La parte che riguarda i cookie nella nostra normativa ha trovato compimento nell’articolo 122 del Codice della Privacy, il quale alla rubrica “Informazioni raccolte nei riguardi del contraente o dell’utente” dispone che “1. L‘archiviazione delle informazioni nell’apparecchio terminale di un contraente o di un utente o l’accesso a informazioni già archiviate sono consentiti unicamente a condizione che il contraente o l’utente abbia espresso il proprio consenso dopo essere stato informato con le modalità semplificate di cui all’articolo 13, comma 3. Ciò non vieta l’eventuale archiviazione tecnica o l’accesso alle informazioni già archiviate se finalizzati unicamente ad effettuare la trasmissione di una comunicazione su una rete di comunicazione elettronica, o nella misura strettamente necessaria al fornitore di un servizio della società dell’informazione esplicitamente richiesto dal contraente o dall’utente a erogare tale servizio. Ai fini della determinazione delle modalità semplificate di cui al primo periodo il Garante tiene anche conto delle proposte formulate dalle associazioni maggiormente rappresentative a livello nazionale dei consumatori e delle categorie economiche coinvolte, anche allo scopo di garantire l’utilizzo di metodologie che assicurino l’effettiva consapevolezza del contraente o dell’utente. Ai fini dell’espressione del consenso di cui al comma 1, possono essere utilizzate specifiche configurazioni di programmi informatici o di dispositivi che siano di facile e chiara utilizzabilità per il contraente o l’utente (omissis)”

In ragione del potere attribuito da questo articolo, il Garante, nel 2014, emetteva il noto provvedimento “Individuazione delle modalità semplificate per l’informativa e l’acquisizione del consenso per l’uso dei cookie – 8 maggio 2014 [3118884]”.

Discendono da questo provvedimento (che ha solo in parte valore prescrittivo generale) indicazioni sui cookie profilanti quali: usare il banner, inserire un testo idoneo nel banner e il link alla informativa estesa, bloccare il rilascio dei cookie da parte del sito sino a che il consenso non sia stato prestato, dare la possibilità di rifiutare l’uso dei cookie, anche attraverso le impostazioni di programmi, ovvero del browser. Non si tratta pertanto di obblighi che discendono dal GDPR, ma di indicazioni che consentono di non violare il dettato dell’articolo 122 del Codice Privacy che dispone che non si possono registrare cookie sul terminale dell’utente prima che questi abbia prestato il consenso informato.

Senza addentrarci in spiegazioni troppo complesse, ché non è lo scopo di questo scritto, mi limito a osservare che ciò che non discendente dalla direttiva madre (la 95/46/CE) abrogata dal Regolamento, non viene abrogato: quindi restano in piedi sia la direttiva e-privacy sia buona parte dell’articolo 122 del Codice privacy [indipendentemente dalla tecnica normativa che userà il legislatore, sia che abroghi il codice riproponendo (in pratica copiando e incollando)  le norme “superstiti” in un nuovo decreto, sia che scriva un nuovo decreto solo per indicare le norme – o le parti di norme – del Codice privacy che dovranno essere abrogate (la comprensione di ciò che rimarrà vigente è più tortuosa, ma il risultato è identico)].

Il punto di intersezione tra la direttiva e-privacy e la direttiva madre (95/46/CE) verranno presidiati dal Regolamento generale sulla protezione dei dati: ciò che cambia in ordine all’informativa (oltre al linguaggio chiaro e ai contenuti), è che ora il titolare può scegliere le modalità semplificate per rendere l’informativa e quindi può continuare a fare ciò che faceva prima indipendentemente dalla sopravvivenza del provvedimento del Garante (peraltro l’uso del banner era indicato come linea guida).

A ben guardare, la direttiva e-privacy aveva previsto un sistema in cui offrire la possibilità di rifiutare i cookie, richiamando espressamente la direttiva madre (e quindi, ora, il Regolamento), solo in ordine all’informativa: “Gli Stati membri assicurano che l’uso di reti di comunicazione elettronica per archiviare informazioni o per avere accesso a informazioni archiviate nell’apparecchio terminale di un abbonato o di un utente sia consentito unicamente a condizione che l’abbonato o l’utente interessato sia stato informato in modo chiaro e completo, tra l’altro, sugli scopi del trattamento in conformità della direttiva 95/46/CE e che gli sia offerta la possibilità di rifiutare tale trattamento da parte del responsabile del trattamento. Ciò non impedisce l’eventuale memorizzazione tecnica o l’accesso al solo fine di effettuare o facilitare la trasmissione di una comunicazione su una rete di comunicazione elettronica, o nella misura strettamente necessaria a fornire un servizio della società dell’informazione esplicitamente richiesto dall’abbonato o dall’utente”.

Nel considerando connesso all’articolo 5 sopra riportato, si precisava che “Tuttavia, tali dispositivi, per esempio i cosiddetti marcatori (“cookies”), possono rappresentare uno strumento legittimo e utile, per esempio per l’analisi dell’efficacia della progettazione di siti web e della pubblicità, nonché per verificare l’identità di utenti che effettuano transazioni “on-line”. Allorché tali dispositivi, ad esempio i marcatori (“cookies”), sono destinati a scopi legittimi, come facilitare la fornitura di servizi della società dell’informazione, il loro uso dovrebbe essere consentito purché siano fornite agli utenti informazioni chiare e precise, a norma della direttiva 95/46/CE, sugli scopi dei marcatori o di dispositivi analoghi per assicurare che gli utenti siano a conoscenza delle informazioni registrate sull’apparecchiatura terminale che stanno utilizzando. Gli utenti dovrebbero avere la possibilità di rifiutare che un marcatore o un dispositivo analogo sia installato nella loro apparecchiatura terminale. Ciò riveste particolare importanza qualora utenti diversi dall’utente originario abbiano accesso alle apparecchiature terminali e quindi a dati contenenti informazioni sensibili in relazione alla vita privata che sono contenuti in tali apparecchiature. L’offerta di informazioni e del diritto di opporsi può essere fornita una sola volta per l’uso dei vari dispositivi da installare sull’attrezzatura terminale dell’utente durante la stessa connessione e applicarsi anche a tutti gli usi successivi, che possono essere fatti, di tali dispositivi durante successive connessioni. Le modalità di comunicazione delle informazioni, dell’offerta del diritto al rifiuto o della richiesta del consenso dovrebbero essere il più possibile chiare e comprensibili. L’accesso al contenuto di un sito Internet specifico può tuttavia continuare ad essere subordinato all’accettazione in conoscenza di causa di un marcatore o di un dispositivo analogo, se utilizzato per scopi legittimi.”

Il nostro legislatore ha preferito ricorrere al consenso, piuttosto che ricorrere alla “possibilità di sottrarsi”; ad avviso di chi scrive, occorrerà fare maggiore attenzione alla prestazione del consenso che non deve essere meramente formalistica: occorre che il consenso si sostanzi in una azione positiva dell’utente, come ricordava anche il Garante nel già citato provvedimento: “il superamento della presenza del banner al video deve essere possibile solo mediante un intervento attivo dell’utente (appunto attraverso la selezione di un elemento contenuto nella pagina sottostante il banner stesso)”.

C’è da domandarsi se, in assenza di un espresso richiamo, la manifestazione di volontà che impone sia la direttiva e-privacy, sia il medesimo consenso disciplinato dal GDPR. Chi scrive propende per una risposta affermativa, in linea con l’orientamento espresso dal WP29 nelle linee guida sul consenso “With regard to the existing e-Privacy Directive, WP29 notes that references to the repealed Directive 95/46/EC shall be construed as references to the GDPR. This also applies to references to consent in the current Directive 2002/58/EC”

“According to Article 95 GDPR, additional obligations in relation to processing in connection with the provision of publicly available electronic communications services in public communication networks shall not be imposed insofar the e-Privacy Directive imposes specific obligations with the same objective. WP29 notes that the requirements for consent under the GDPR are not considered to be an ‘additional obligation’, but rather as preconditions for lawful processing. Therefore, the GDPR conditions for obtaining valid consent are applicable in situations falling within the scope of the e-Privacy Directive”.

Secondo tale lettura è possibile procedere a fornire le informazioni su più livelli ma occorrerà fare attenzione se si utilizzano cookie profilanti che possono rivelare l’orientamento sessuale o lo stato di salute o le convinzioni politiche o filosofiche (o altri dati appartenenti alle particolari categorie individuate all’articolo 9 del GDPR): in questi casi (come peraltro anche secondo la Direttiva 95/46/CE) il consenso dovrà essere “esplicito” ovvero manifestato attraverso una dichiarazione espressa e non può essere “implicito”.

Inoltre: quanti consensi andranno chiesti? Il GDPR ribadisce che il consenso deve essere granulare e non omnicomprensivo: sta a significare che viene ribadito il principio “un consenso / una finalità” e la finalità per cui si domanda il consenso per i cookie di profilazione è, come efficacemente sintetizzato dal Garante nel fac simile di banner che aveva proposto: “inviarti pubblicità in linea con le tue preferenze”.

Comunque, in sintesi, il GDPR non pone nuove regole in tema di cookie, gli obblighi in ordine ai cookie nascevano da un’altra fonte che sopravvive al GDPR e il provvedimento del Garante mirava a facilitare alcuni adempimenti, lasciando per lo più il titolare libero di trovarne di diversi purché sostanzialmente equivalenti.

La direttiva e-privacy è comunque al momento in fase di revisione e presto sarà sostituita anch’essa da un Regolamento, il Regolamento e-privacy. Solo quando diverrà applicabile il regolamento e-privacy potremo attenderci modifiche significative anche alla “cookie law”.

Non fatevi prendere dal panico

“In molte delle civiltà meno formaliste dell’Orlo Esterno Est della Galassia, la Guida galattica per gli autostoppisti ha già soppiantato la grande Enciclopedia galattica, diventando la depositaria di tutto il sapere e di tutta la scienza, perché nonostante presenti alcune lacune e contenga molte notizie spurie, o se non altro alquanto imprecise, ha due importanti vantaggi rispetto alla più vecchia e più accademica Enciclopedia.

Uno, costa un po’ meno; due, ha stampate in copertina, a grandi caratteri che ispirano fiducia, le parole non fatevi prendere dal panico.” (Douglas Adams, Guida galattica per autostoppisti)

Dal 25 maggio 2018 il Regolamento è diventato applicabile. Nel momento in cui scrivo alla fatidica data manca ancora qualche giorno, e se state leggendo dopo il 25 maggio vuol dire che il mondo non è finito… Cosa è successo dal 25 maggio 2018? In soldoni, che il GDPR ha preso il posto della Direttiva 95/46/CE e della normativa nazionale che la attuava: nel nostro caso buona parte del Codice privacy.

Non è successo nulla di irreparabile il 25 maggio 2018: è una data che ha segnato un inizio, e se non siete ancora pronti, state  tranquilli che siete in ottima e numerosa compagnia: il GDPR, in vigore ormai da due anni, giunto al momento della sua attuazione non ha trovato pronto nessuno, neppure il Working Party (che non ha ancora finalizzato tutte le linee guida promesse) né la Commissione (che non ha ancora pubblicato né le clausole standard per gli accordi sul trattamento, né le icone standardizzate per rendere le informative), né il legislatore nazionale, che, alla vigilia del 25 maggio, ancora lotta contro il tempo per riscrivere la normativa interna di coordinamento.

Il GDPR, dicevo, segna un nuovo inizio, un nuovo modo di approcciare la materia della protezione dei dati, più in linea con l’evoluzione tecnologica che ha reso obsoleta la direttiva che lo ha preceduto.

Per non farsi presto superare dalla tecnologia, il GDPR impone al titolare obblighi di documentazione che riflettono il suo potere discrezionale: il titolare stesso decide buona parte degli adempimenti in autonomia valutando i rischi e implementando le misure tecniche e organizzative che ritiene più idonee a proteggere i dati che tratta.

Il GDPR è pensato per evolversi al progredire della tecnica, e chi, meglio del titolare, conosce i trattamenti che opera e può proteggere i dati? Per quello occorre documentare le scelte che si fanno e non ci sono obblighi identici per tutti.

La corsa all’adempimento dell’ultimo minuto è un approccio fallimentare: il GDPR necessita di essere compreso, non a caso tanti autorevoli voci (primo tra tutti l’ICO) insistono sulla “consapevolezza”, perché solo la consapevolezza in ordine alla gestione dei dati e alle esigenze di protezione che ne discendono consentirà al titolare e ai responsabili di essere davvero “in regola”.

Il nuovo sistema è vero che prevede alte sanzioni, ma proprio perché è incentrato sulla valorizzazione della consapevolezza, considera la sanzione una extrema ratio e nessuno ha bussato alla nostra porta il 26 maggio 2018 per controllare a che punto fossimo con l’adeguamento. D’altra parte, è vero che questo non deve spingerci a restare inerti: buona parte del controllo passerà anche dal lato privatistico, prevedendosi sia il ristoro dei danni con connotazioni afflittive in caso di violazione della normativa, sia la class action.

Dire: “non mi interessa come funziona, voglio solo i documenti per mettermi a posto ed evitare le multe” è la spia di un approccio sbagliato; significa credere che l’adeguamento sia un adempimento una tantum e non un modo diverso di organizzarsi, e persino di pensare, che inizia ora. Nel corso del tempo abbiamo imparato molte cose che non interessavano a chi ci ha preceduto e che prima si pensava che non servissero: leggere e scrivere, usare i computer, leggere i valori nutrizionali sulle confezioni di cibo, le regole del codice della strada. Anche se non abbiamo la patente sappiamo che dobbiamo attraversare sulle strisce e camminare da una parte.

Non significa che dovranno tutti trasformarsi in legali o che tutti dovremo diventare esperti di informatica o ingegneri gestionali. Significa che dobbiamo però capire quello che stiamo facendo, e imparare a riconoscere e gestire le criticità.

Il GDPR ha un approccio molto meno burocratico del Codice della privacy, e anche se ci vorrà un po’ di tempo per scrollarci di dosso la polvere del sistema al quale siamo abituati, presto ci renderemo conto che molte cose sono più semplici di come le avevamo immaginate.

Meglio farsi trovare in alto mare con l’adeguamento adottando un approccio consapevole, che sentirsi adeguati perché ci si è muniti di documentazione precompilata, destinata a restare chiusa in un cassetto (anche se il cassetto è una cartella elettronica) e che non ci servirà a nulla quando dovremo selezionare il fornitore di un servizio in outsourcing o dare riscontro a un interessato o valutare i rischi di un nuovo trattamento.

Come l’Enciclopedia Galattica, il nostro sistema concentrava “tutto il sapere e tutta la scienza” in tema di protezione dei dati personali nelle mani del Garante: ora con il GDPR il sistema muta, e il “sapere” e la “scienza” in fatto di protezione dei dati tornano nelle nostre mani; il Garante ci servirà come riferimento, ma non ci detterà più gli adempimenti in modo così dettagliato, come eravamo abituati. Come la guida Galattica, il GDPR ci pare avere lacune e notizie spurie, ma sul lungo termine, imponendo una seria riflessione su misure di sicurezza (informatiche, organizzative e persino contrattuali) imprescindibili in un mondo che evolve (con rischi che si evolvono e che le misure minime non potevano più presidiare) ci costerà meno del sistema precedente.

Il GDPR è la nostra Guida Galattica alla protezione dei dati personali: “non fatevi prendere dal panico”!

Bibliografia

  1. F. di Resta, La nuova privacy europea – I principali adempimenti del Regolamento UE 2016/679 e profili risarcitori Torino, Giappichelli, 2018
  2. Edoardo Pusillo, Divergenze linguistiche ed interpretazione uniforme delle norme europee http://www.farum.it/publifarum/ezine_articles.php?art_id=388
  3. Gruppo di lavoro Articolo 29, WP 249 opinion 2/2017 on data processing at work
  4. Garante Privacy – Individuazione delle modalità semplificate per l’informativa e l’acquisizione del consenso per l’uso dei cookie – 8 maggio 2014 [3118884]
  5. Gruppo di lavoro Articolo 29, wp259rev.01 Guidelines on consent under Regulation 2016/679
  6. ICO Good and bad examples of privacy notices https://ico.org.uk/media/for-organisations/documents/1625136/good-and-bad-examples-of-privacy-notices.pdf


A cura di: Cristina Vicarelli

L’articolo GDPR tra novità e falsi miti proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/gdpr-tra-novita-e-falsi-miti/


Strumenti digitali e standard ISO 37001 nella lotta degli Stati alla corruzione

Il contrasto alla corruzione rappresenta uno degli obiettivi strategici della politica governativa degli Stati dell’economia moderna e vede coinvolti, accanto ai Governi di tutto il mondo, Enti, organizzazioni e associazioni no profit nel comune intento di arginare la diffusione di quello che viene considerato uno dei mali più insidiosi della società attuale.

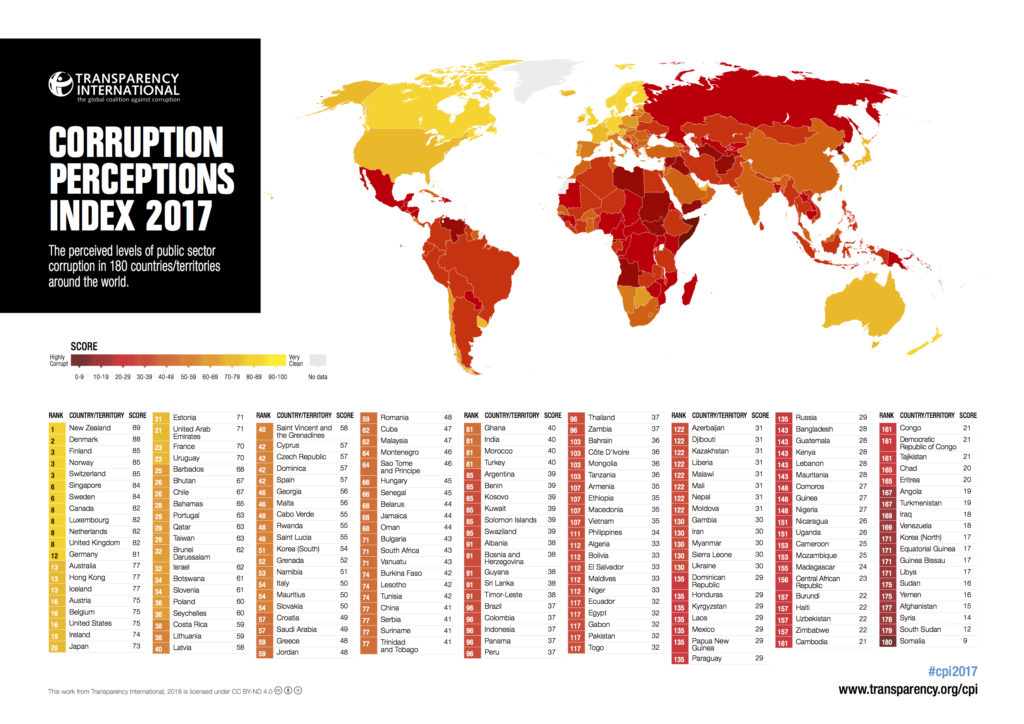
L’ultimo rapporto di Transparency International[1] sulla percezione della corruzione, che ogni anno classifica i Paesi analizzati in base ad un indice che misura il livello di corruzione percepito nel settore pubblico e nella politica, vede, con riferimento all’anno 2017, la Danimarca e la Nuova Zelanda come i Paesi più virtuosi[2] su 180 Stati analizzati.

Nel corso degli ultimi decenni diverse sono state le iniziative da parte degli Stati di tutto il mondo per contrastare la diffusione della corruzione sia a livello nazionale che internazionale, talmente numerose che sarebbe arduo ripercorrerle tutte in queste breve contributo. E’ tuttavia doveroso ricordare che gli Stati Uniti d’America sono stati tra i primi ad introdurre norme anticorruzione nell’ordinamento giuridico: nel 1977 viene infatti approvato il Foreign Corrupt Practices Act (FCPA), un insieme di disposizioni normative finalizzate a contrastare la corruzione da parte di società statunitensi verso funzionari stranieri in veste di pubblici ufficiali. Ancora prima, nel 1966, vede la luce negli Stati Uniti un altro importante atto, del quale abbiamo sentito diffusamente parlare negli ultimi anni, ovvero il Freedom of Information Act (FOIA) che, affermando il diritto al libero accesso ai documenti della pubblica amministrazione non sottoposti a riservatezza, garantisce ai cittadini statunitensi[3] la trasparenza dell’operato del governo federale.

Il Consiglio d’Europa[4], la principale organizzazione internazionale in materia di difesa dei diritti umani, impegnata fin dagli anni 90 in una serie di iniziative finalizzate all’intercettazione e alla prevenzione delle dinamiche corruttive, istituisce nel 1999 il Gruppo di Stati contro la Corruzione (noto come GRECO,[5] dal francese Groupe d’États contre la corruption), che conta attualmente 49 Stati aderenti[6] nel mondo e le cui finalità si sostanziano, da un lato, nel rafforzamento delle capacità di contrastare la corruzione attraverso riforme in ambito legislativo e istituzionale e, dall’altro, nel monitoraggio dell’osservanza degli standard anticorruzione del Consiglio d’Europa da parte degli Stati[7] membri.

Transparency Internationl – Indice di Percezione della Corruzione (CPI) 2017 – Mappa globale[8]

La stessa Unione Europea è da anni impegnata in una serie di iniziative volte ad osteggiare i fenomeni corruttivi[9]; l’impatto dei costi della corruzione sull’economia dei paesi UE raggiunge livelli di inimmaginabile grandezza: secondo quanto riportato nello studio del marzo 2016 dell’European Parliamentary Research Service – ‘The Cost of Non-Europe in the area of Organised Crime and Corruption In-Depth Analysis’, il costo stimato dalla stessa Commissione Europea in 120 miliardi di euro l’anno[10] oscilla in realtà tra i 179 e 990 miliardi di euro all’anno in termini di PIL, in quanto la Commissione ha incluso nel calcolo delle sue stime solo le entrate fiscali e gli investimenti persi senza considerare ulteriori componenti dei costi indiretti.

Nel suddetto studio vengono presi a riferimento tre diversi possibili metodi nella stima del costo della corruzione che ricade sulla Comunità europea:

  • il metodo magnificent seven (magnifici sette) calcola la perdita in termini economici rapportandola al numero di Paesi nei quali il livello di corruzione non raggiunge quello dei sette Stati membri che hanno conseguito i migliori risultati (perdita economica stimata: da 870 a 990 miliardi di euro);
  • il metodo catch me if you can (prendimi se puoi) calcola la perdita in termini economici rapportandola al numero di Paesi che non raggiungono il livello medio di corruzione dell’UE (perdita economica stimata: da 179 a 256 miliardi di euro);
  • il metodo goodfellas (dei bravi ragazzi), ritenuto il più praticabile, divide gli Stati membri in quattro gruppi diversi con caratteristiche istituzionali e livelli di corruzione simili. Il metodo determina quanti Paesi contribuiscono alla perdita in termini economici non raggiungendo il livello del miglior rendimento all’interno del corrispondente gruppo di Paesi con simili caratteristiche (perdita economica stimata: da 218 a 282 miliardi di euro).

Al di là di ogni considerazione sulla quantificazione dei costi in termini meramente economici, occorre tener presente che la corruzione genera una serie di costi politici e sociali che gravano sulla comunità: il fenomeno corruttivo è infatti inscindibilmente legato a disuguaglianza, criminalità organizzata, indebolimento dello stato di diritto, riduzione dell’affluenza alle urne, minore fiducia nelle istituzioni.

Fermo restando quanto regolamentato da ciascuno Stato a livello di legislazione nazionale, l’UE e i suoi Stati membri possono trarre comuni benefici affinando sempre più i metodi e le politiche contro la criminalità organizzata e la corruzione; tali benefici possono essere conseguiti migliorando il recepimento e l’applicazione delle norme europee e internazionali e colmando le lacune legislative ancora in sospeso: proprio nelle ultime settimane la Commissione Europea ha pubblicato la proposta di una direttiva comunitaria in difesa del whistleblower[11], uno degli istituti più efficaci nella lotta al contrasto alla corruzione. Questa proposta rappresenta un decisivo passo in avanti verso la tutela a livello comunitario dei diritti di chi segnala episodi o dinamiche di corruzione, dato che la tutela giuridica in tale ambito nei Paesi EU risulta essere ancora eterogenea e frammentata.

La proposta di direttiva comunitaria intende tutelare il soggetto che responsabilmente effettua una segnalazione a salvaguardia del pubblico interesse per violazioni al diritto dell’UE nei seguenti ambiti:

  • appalti pubblici, servizi finanziari, riciclaggio di denaro e finanziamento del terrorismo
  • sicurezza dei prodotti, sicurezza dei trasporti
  • tutela ambientale, sicurezza nucleare, sicurezza degli alimenti, salute e benessere degli animali, salute pubblica, protezione dei consumatori, tutela della concorrenza
  • tutela della vita privata, protezione dei dati e sicurezza delle reti e dei sistemi informativi
  • norme in materia di imposta sulle società e interessi finanziari dell’UE

La Commissione invita gli Stati membri ad espandere l’interesse alla protezione del whistleblower oltre queste norme minime e delinea meccanismi e precisi obblighi per i datori di lavoro. La proposta prevede infatti l’obbligo, per tutte le imprese con più di 50 dipendenti o con un fatturato annuo superiore ai 10 milioni di Euro, di adottare una procedura interna per gestire le segnalazioni, nonché l’applicazione della nuova normativa a tutte le amministrazioni statali e regionali e a tutti i comuni con più di 10 000 abitanti[12].

Lo standard ISO 37001 per la lotta alla corruzione

I valori di trasparenza ed integrità dovrebbero contraddistinguere ogni organizzazione pubblica o privata di cui è composto il tessuto economico internazionale; il raggiungimento e il mantenimento di tali valori favorisce la buona reputazione e la prosperità delle stesse organizzazioni e si traduce in modelli organizzativi che contribuiscono a sviluppare, oltre ad un solido approccio etico orientato al contrasto dei fenomeni corruttivi, una concreta impronta di efficienza e di efficacia.

La norma ISO 37001 ‘Anti-bribery management systems’ (in italiano ‘Sistemi di gestione anticorruzione’), identifica uno standard internazionale di gestione aziendale di recente pubblicazione finalizzato ad agevolare il contrasto alla corruzione e a favorire una cultura della trasparenza e dell’integrità all’interno di organizzazioni di qualsiasi Stato, dimensione e assetto giuridico. Rappresenta senza dubbio una best practice per l’adozione di sistemi di prevenzione della corruzione, non si contrappone ad altri modelli organizzativi regolamentati dalle legislazioni nazionali dei singoli Stati e può presa come riferimento in ambito pubblico, privato, no profit.

Gli elementi caratterizzanti del Sistema di Gestione Anticorruzione contemplato nello standard ISO si possono riassumere nei seguenti punti:

  • analisi e comprensione dell’organizzazione e del suo contesto
  • comprensione dei bisogni e delle aspettative degli stakeholders rilevanti per il sistema di gestione anticorruzione
  • individuazione e valutazione del rischio di corruzione
  • approvazione e implementazione della politica anticorruzione
  • supervisione dell’efficacia del sistema di gestione anticorruzione da parte del management
  • promozione di un’adeguata cultura anticorruzione all’interno dell’organizzazione
  • adeguata fornitura di risorse necessarie per l’istituzione, l’implementazione, la manutenzione e il miglioramento continuo del sistema di gestione anticorruzione
  • creazione e aggiornamento di informazioni documentate a supporto del sistema di gestione
  • attuazione di procedure finalizzate a segnalare dinamiche e condotte sospette o di effettiva corruzione
  • impedimento di ritorsioni e garanzia di tutela verso coloro che effettuano segnalazioni in buona fede o sulla base di una ragionevole convinzione
  • implementazione di procedure per impedire l’offerta, la fornitura o l’accettazione di regali, ospitalità, donazioni e benefici simili laddove l’offerta, la fornitura o l’accettazione siano o possano essere ragionevolmente percepite come tangenti
  • conduzione di audit interni ad intervalli pianificati per fornire informazioni sul sistema di gestione anticorruzione e apportare eventuali azioni correttive
  • miglioramento continuo dell’adeguatezza e dell’efficacia del sistema di gestione anticorruzione

Preme sottolineare che l’investimento in misure volte al contrasto della corruzione e al mantenimento di strategie aziendali orientate alla trasparenza si traduce per le organizzazioni in importanti e tangibili benefici, come la riduzione dei costi e dei rischi e la fidelizzazione di clienti, utenti e collaboratori, attratti da una reputazione aziendale pulita e rassicurante. In diversi Paesi la legislazione nazionale riconosce significative riduzioni, sospensioni o inapplicabilità di sanzioni nei confronti delle organizzazioni che dimostrano di aver adottato idonee pratiche, modelli organizzativi e codici di condotta volti a contrastare dinamiche e condotte corruttive; l’adozione di programmi anticorruzione abbatte la probabilità di subire l’effetto negativo della corruzione in termini di perdita di opportunità di business, reputazione aziendale, risorse economiche a causa dell’impatto delle sanzioni pecuniarie.

Strumenti digitali per il contrasto alla corruzione

L’informatizzazione dei processi e la digitalizzazione dei documenti rappresentano fattori determinanti per un’efficace politica anticorruzione all’interno delle organizzazioni. Attraverso l’informatizzazione e la digitalizzazione è possibile tracciare le attività, ridurre il rischio di flussi informativi non controllati, agevolare la circolarità delle informazioni e intercettare eventuali dinamiche corruttive, nonché effettuare un efficiente monitoraggio del rispetto dei termini procedurali e contrattuali laddove previsti.

Al di là delle riflessioni sull’opportunità di orientarsi verso l’adozione di queste misure trasversali, risulta opportuno fare qualche considerazione sugli strumenti digitali che possono nel concreto aiutare un’organizzazione pubblica o privata nel contrasto alla corruzione, anche in riferimento al modello organizzativo scelto.

Una possibilità di contrasto alla corruzione su larga scala può senz’altro essere rappresentata dalla diffusione capillare di piattaforme web dedicate e applicazioni per dispositivi mobili a ciò finalizzate nel rispetto della riservatezza e della protezione dei dati, dando la possibilità a cittadini e utenti di avere un riscontro tempestivo e agevole rispetto a eventuali dinamiche anomale o da sottoporre a verifica nell’ambito dei rapporti che intercorrono con  PA, istituzioni, istituti bancari e altre organizzazioni.

Anche nell’ambito della Digital Forensics è possibile contare su ottimi metodi e strumenti per l’intercettazione di pratiche fraudolente e dinamiche corruttive; in casi particolarmente complessi e delicati l’analisi forense dei dati e dei dispositivi rappresenta la strada per l’individuazione di anomalie, operazioni sospette e transazioni illecite. Per prevenire le pratiche fraudolente, gli strumenti di analisi dei dati sono in grado di indagare sistematicamente sulle transazioni dei sistemi di pagamento e di approvvigionamento, di intercettare eventuali anomalie e identificare rapidamente flussi finanziari sospetti. L’automazione di quei processi critici per i quali il rischio di corruzione è particolarmente alto (ad es. quello della gestione degli appalti) può ridurre sensibilmente il rischio di corruzione derivanti da condotte fraudolente dei funzionari o del management.

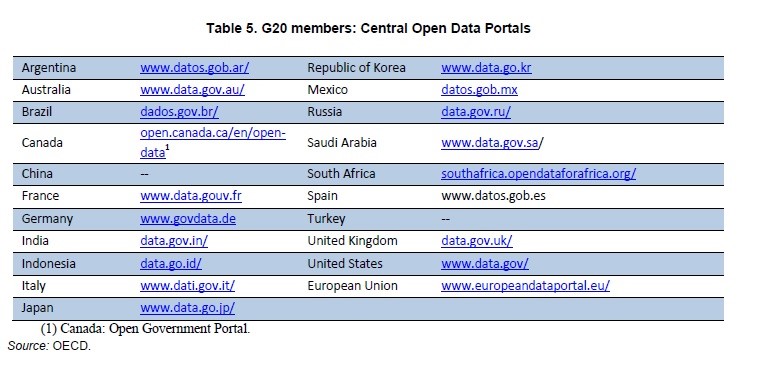
A livello globale, la condivisione delle informazioni tra Stati attraverso strumenti come gli open data, e soprattutto una efficiente gestione e analisi dei dati, possono senz’altro contribuire ad affrontare i problemi, identificare lacune critiche, aumentare la collaborazione e creare un incentivo nel comune intento di contrastare la corruzione e il malaffare.

Come ben argomentato nello studio dell’OECD[13] – ‘Compendium of good practices on the publication and reuse of open data for Anti-corruption across G20 countries: Towards data-driven public sector integrity and civic auditing’[14] – i dati aperti possono agevolare la prevenzione e il contrasto della corruzione responsabilizzando gli Stati e facendo luce sulle attività dei Governi, sulle decisioni e sulle spese  sostenute, consentendo ai cittadini di monitorare il flusso e l’uso del denaro pubblico all’interno dei Paesi di appartenenza e consentendo il confronto dei dati con quello di altri Paesi.

Sintetizzando, gli open data offrono la possibilità di:

  • dimostrare come e dove viene speso il denaro pubblico
  • rendere le informazioni esistenti più facili da analizzare, elaborare e combinare, consentendo un nuovo livello di monitoraggio pubblico
  • consentire la ricerca avanzata, l’analisi e la comprensione dei processi che riguardano gli appalti pubblici
  • individuare gli ambienti inclini alla corruzione all’interno del settore pubblico
  • consentire la collaborazione intersettoriale tra Governi, cittadini, società civile e organizzazioni impegnate nella definizione di politiche finalizzate alla prevenzione e al contrasto della corruzione

Conclusioni

Partendo dalla considerazione che non esiste Stato al mondo totalmente immune dagli episodi di corruzione, al di là del grado di percezione del fenomeno e da studi e ricerche che lo analizzano e lo monitorizzano, tanto si è fatto e tanto ancora si può fare per arginare la diffusione delle dinamiche corruttive nel comune interesse di una comunità mondiale che può unire le sue energie e collaborare per diminuire la diffusione di questo male.

Occorre dunque continuare con convinzione sul percorso già intrapreso, moltiplicare le iniziative, fare forza sulla diffusione della cultura della legalità ad ogni livello della società civile a partire dalle scuole, rafforzare la cooperazione tra pubblico e privato sia all’interno che all’esterno dei propri confini, coinvolgere organizzazioni e  associazioni no profit, condividere le best practices, rendere omogenea la legislazione degli Stati finalizzata alla prevenzione e alla repressione del fenomeno, adottare modelli organizzativi improntati alla legalità, condividere le esperienze, i dati e le informazioni che possono contribuire, attraverso l’uso opportuno della tecnologia, ad una proficua sinergia tra Governi, istituzioni, forze dell’ordine, imprese e comuni cittadini.

NOTE

[1] Transparency International  è un’organizzazione internazionale non governativa  con sede centrale a Berlino, diffusa in oltre 100 Paesi del mondo, che si occupa di prevenire e contrastare la corruzione collaborando con Governi, aziende e società civile

[2] Si veda https://www.transparency.org/

[3] Nel 1996 la legge è stata integrata con norme relative all’accesso ai documenti elettronici. L’emendamento ha preso il nome di Electronic Freedom of Information Act(E-FOIA).

[4] Il Consiglio d’Europa (da non confondersi con il Consiglio dell’Unione Europea) è la principale organizzazione internazionale di difesa dei diritti umani e comprende 47 Stati membri, 28 dei quali fanno anche parte dell’Unione Europea. Obiettivi dell’organizzazione sono quelli della promozione dei diritti dell’uomo e della democrazia, il contrasto alla criminalità organizzata, al terrorismo e al traffico di esseri umani, la cooperazione con altre organizzazioni internazionali.  Tutti gli Stati membri del Consiglio d’Europa sono firmatari della Convenzione Europea dei Diritti dell’Uomo. La Corte europea dei diritti dell’uomo supervisiona l’attuazione della Convenzione negli Stati membri

[5] Originariamente composto da 17 Stati (Belgio, Bulgaria, Cipro, Estonia, Finlandia, Francia, Germania, Grecia, Islanda, Irlanda, Lituania, Lussemburgo, Romania, Slovacchia, Slovenia, Spagna e Svezia), il numero degli stati membri è costantemente cresciuto nel tempo, fino a comprendere tutti i 47 Stati del Consiglio d’Europa, la Bielorussia e gli Stati Uniti, per un totale ad oggi di 49 Stati. Per approfondimenti consultare il sito https://www.coe.int/en/web/greco

[6] Albania, Andorra, Armenia, Austria, Azerbaijan, Belgio, Bielorussia, Bosnia-Herzegovina, Bulgaria, Cipro, Croazia, , Danimarca, Estonia, Georgia,  Federazione Russa, Finlandia, Francia, Germania, Grecia, Ungheria, Irlanda, Islanda, Italia, Lettonia, Lituania, Liechtenstein, Lussemburgo, Malta, Moldavia, Montenegro, Norvegia, Paesi Bassi, Polonia, Portogallo, Principato di Monaco, Repubblica Ceca, Repubblica di Macedonia, Regno Unito, Romania,  San Marino, Serbia, Slovacchia, Slovenia, Spagna, Svezia, Svizzera, Stati Uniti d’America, Turchia e Ucraina

[7] Standard anticorruzione e fonti legali del Consiglio d’Europa:

  • – Convenzione Penale sulla Corruzione (ETS 173)
  • – Convenzione Civile sulla Corruzione (ETS 174)
  • – Protocollo Addizionale alla Convenzione Penale sulla Corruzione (ETS 191)
  • – Venti Principi Guida contro la Corruzione (Risoluzione (97)24)
  • – Raccomandazione sul Codice di Condotta per i funzionari pubblici (Raccomandazione No. R (2000)10)
  • – Raccomandazione sulle regole comuni sulla Corruzione nel finanziamento ai partiti e nelle campagne elettorali (Raccomandazione Rec. (2003)4)

[8] https://www.transparency.org/news/feature/corruption_perceptions_index_2017

[9] Per approfondimenti si vedano gli atti del pacchetto anticorruzione dell’Unione Europea del giugno 2011 http://europa.eu/rapid/press-release_IP-11-678_it.htm

[10] Per approfondimenti si veda la prima relazione di analisi della corruzione negli Stati membri dell’UE presentata dalla Commissione europea nel febbraio 2014 https://ec.europa.eu/home-affairs/sites/homeaffairs/files/e-library/documents/policies/organized-crime-and-human-trafficking/corruption/docs/acr_2014_it.pdf

[11] Whistleblower (letteralmente ‘soffiatore nel fischietto’) è il termine inglese che identifica il dipendente che, dall’interno del proprio ente di appartenenza (pubblico o privato), segnala condotte illecite nell’interesse pubblico

[12] Per approfondimenti si veda il comunicato stampa della Commissione europea del 23 aprile 2018 http://europa.eu/rapid/press-release_IP-18-3441_it.htm

[13] L’Organizzazione per la cooperazione e lo sviluppo economico (OCSE) – in inglese Organisation for Economic Co-operation and Development (OECD) – è un’organizzazione internazionale di studi economici per i Paesi membri, Paesi sviluppati aventi in comune un’economia di mercato. L’organizzazione svolge prevalentemente un ruolo di assemblea consultiva che consente un’occasione di confronto delle esperienze politiche, per la risoluzione dei problemi comuni, l’identificazione di pratiche commerciali e il coordinamento delle politiche locali e internazionali dei Paesi membri. L’OCSE conta 35 paesi membri e ha sede a Parigi (fonte: wikipedia)

[14] Per approfondimenti si veda https://www.oecd.org/gov/digital-government/g20-oecd-compendium.pdf


A cura di: Anna Cardetta

L’articolo Strumenti digitali e standard ISO 37001 nella lotta degli Stati alla corruzione proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/strumenti-digitali-e-standard-iso-37001-nella-lotta-degli-stati-alla-corruzione/


Sicurezza informatica: ottenere il livello ottimale con una politica di gestione che punti sull’utente

La messa in pratica di una strategia tale da garantire la sicurezza informatica di un sistema informativo si complica quanto più estesa risulta la rete aziendale. Per questo motivo è necessario definire un’adeguata gestione della sicurezza ICT (Information and Communication Technologies), che individui il rischio e le vulnerabilità del sistema, e che definisca le contromisure da adottare in caso di manifestazione di un evento di pericolo.

In tal senso, non si può prescindere dal non ricorrere ad un approccio basato sull’analisi del rischio, secondo quanto stabilito dallo standard ISO/IEC 27001.

Questa norma internazionale definisce i requisiti per impostare e gestire un Sistema di Gestione della Sicurezza delle Informazioni (SGSI) e consente di analizzare la problematica sotto i punti di vista della sicurezza logica (protezione dei dati e delle informazioni), fisica (protezione delle persone e delle risorse) e organizzativa (politica del Personale).

Di seguito tratterò alcuni aspetti.

  1. Il ruolo dell’Amministratore di rete e la cultura della sicurezza informatica
  2. Il livello di sicurezza informatica ottimale
  3. La continuità operativa dei servizi

Il ruolo dell’Amministratore di rete e la cultura della sicurezza informatica

La politica di sicurezza, riguardando tutti gli utenti del sistema, deve essere elaborata partendo dalla direzione dell’organizzazione interessata. Poiché i responsabili dirigenziali, in genere, non hanno competenze tecniche, l’amministratore di rete deve essere l’intermediario della comunicazione tra la dirigenza e gli utenti ed il punto di riferimento riguardo ai problemi e alle raccomandazioni della sicurezza ICT.

Il ruolo dell’Amministratore è quello di assicurare che le risorse informatiche e i permessi di accesso siano coerenti con la politica di sicurezza definita, di mettere a conoscenza la dirigenza sulle informazioni riguardo alla sicurezza, e di consigliarla sulle strategie da attuare.

Il segreto principale per il successo di una politica di sicurezza è quello di riuscire a fornire agli impiegati, in quanto utenti del sistema informativo dell’organizzazione, una buona conoscenza delle regole attraverso delle azioni di sensibilizzazione e spesso anche di alfabetizzazione.

Gli ultimi fatti di cronaca riguardanti gli attacchi informatici rilevano infatti che la prima fonte di incidenti relativi alla sicurezza informatica è rappresentata dalla scarsa consapevolezza del rischio da parte delle vittime che cadono nelle trappole appositamente allestiste dai cyber criminali.

Risulta quindi di fondamentale importanza che le strutture amministrative diffondano al proprio interno una vera e propria cultura della sicurezza informatica, aiutando i centri di elaborazione dati nell’azione di prevenzione e difesa dalle potenziali minacce.

In quest’ottica sarebbe buona norma fornire consigli utili per la salvaguardia e la riservatezza delle informazioni sensibili. L’applicazione delle buone regole comportamentali in tema di sicurezza informatica può infatti diminuire le vulnerabilità ed essere d’ausilio a quelle tecniche convenzionalmente utilizzate per la protezione hardware/software (antivirus, firewall etc.).

Il livello di sicurezza informatica ottimale

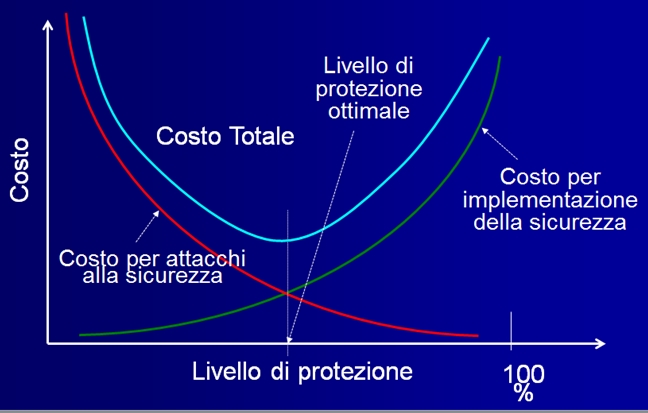
Nelle fasi preliminari dello studio di un piano di sicurezza, un aspetto indispensabile, al fine di ottenere il massimo rendimento possibile con il minor costo, è la determinazione del livello ottimale del livello di sicurezza. Esso corrisponde al costo minimo totale, necessario a garantire un compromesso tra il costo per l’implementazione di un dispositivo di sicurezza efficiente e il costo relativo alle conseguenze di un attacco informatico.

Quanto detto è verificabile dal diagramma cartesiano costo-livello di protezione di figura, che di seguito si commenta.

Il costo per l’implementazione della sicurezza aumenta all’aumentare del livello di protezione (curva verde), mentre diminuisce di pari passo quello relativo alle conseguenze degli attacchi alla sicurezza (curva rossa). Il costo totale è rappresentato dalla curva superiore (curva celeste), ottenuta dalla somma punto per punto delle due curve precedenti. Nel punto più basso della curva somma si ottiene il minor costo possibile, a fronte di un livello ottimale di sicurezza. Per una corretta valutazione è di fondamentale importanza che le curve per ogni tipologia di costo si calcolino tracciando sul diagramma costo – livello di protezione l’insieme dei punti dati dalla serie storica dei dati disponibili. Maggiore sarà il numero di punti a disposizione, maggiore sarà l’attendibilità della curva del costo totale dato dalla somma dei due andamenti.

La continuità operativa dei servizi

Il piano di continuità operativa è il documento guida principale per le azioni da intraprendere nelle condizioni d’emergenza al fine di garantire la continuità dei servizi di una infrastruttura informatica, la cui stesura deve valutare opportunamente i costi e i rischi che un fermo attività può comportare.

Gli eventi che potenzialmente pregiudicano l’operatività dei servizi possono essere sommariamente raggruppati nel modo seguente:

  • guasti elettrici, allagamenti, incendi;
  • danneggiamento di strumenti hw/sw;
  • errore umano;
  • interruzione di servizi causa virus, introduzione involontaria di codice malevolo etc.

Pertanto, sarebbe auspicabile che tale piano venisse:

  • recepito da tutto il personale;
  • aggiornato periodicamente in funzione anche della continua evoluzione del settore ICT;
  • adattato ad ogni possibile variazione subita dalla politica di sicurezza dell’amministrazione.

In ogni caso occorre tenere in considerazione per ridurre al minimo i danni causati dall’interruzione di un servizio, sia il tempo necessario per il ripristino dell’infrastruttura informativa che la distanza temporale che intercorre tra lo stato in cui il sistema si trovava prima del blocco e lo stato in cui viene ripristinato.

Quest’ultima prerogativa può essere garantita migliorando la ridondanza dei dati residenti su quei sistemi di riserva, solitamente remoti, pronti al subentro in caso di blocco del sistema principale. C’è da precisare che, in concomitanza con la fase di realizzazione della continuità operativa, deve essere studiata anche un’adeguata procedura di collaudo, per la verifica della validità delle soluzioni adottate. I risultati così ottenuti potranno dare un prezioso contributo per delineare una politica ottimale di Business Continuity.

Considerazioni finali

Purtroppo, per ovvi motivi, come per la sicurezza fisica nella vita reale, non è possibile garantire una sicurezza informatica assoluta, ma possiamo almeno, adottando anche delle regole di buona pratica, attenuare il rischio di esposizione alle minacce informatiche.

Penso che per raggiungere questo obiettivo sia fondamentale la collaborazione di tutti.

A tal proposito mi piace citare lo scrittore statunitense Robert Orben: Errare è umano e dare la colpa al computer lo è anche di più. Con questo intendo dire che nella gestione della sicurezza informatica l’approccio dell’uomo riveste un ruolo fondamentale.

Il compito di noi addetti ai lavori e di coloro che conoscono le tecnologie ed i rischi connessi al loro uso per incrementare in maniera sensibile il livello di sicurezza dovrebbe essere quello di mettere le nostre competenze al servizio della collettività ponendo gli utenti al centro del processo di prevenzione ed attenuazione del rischio.

Tutti gli accorgimenti e le soluzioni hardware e/o software sono necessari ma non sufficienti a garantire da soli la totale protezione dei sistemi informativi. Bisogna puntare sul continuo aggiornamento riguardo alle vulnerabilità degli strumenti di comunicazione telematica, alle nuove tecniche di attacco e alle possibili contromisure da adottare, allo scopo di diffondere una cultura digitale che consideri l’utente non finale ma punto centrale.

Sitografia


A cura di: Salvatore Lombardo

L’articolo Sicurezza informatica: ottenere il livello ottimale con una politica di gestione che punti sull’utente proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sicurezza-informatica-ottenere-il-livello-ottimale-con-una-politica-di-gestione-che-punti-sullutente/


Attacco ad una rete pubblica WiFi

Chissà quante volte ci è capitato di vedere affissi – presso esercizi commerciali, locali o parchi pubblici – cartelli che segnalano la presenza di reti WiFi gratuite o accessibili attraverso un semplice “like” su Facebook. Con buona probabilità, ognuno di noi ha utilizzato tali servizi almeno una volta, vuoi per necessità o semplicemente per quella che oggigiorno è una naturale attitudine a rimanere connessi a internet.

Come mai allora queste reti non godono di una buona reputazione? E in che modo vengono sfruttate da utenti malintenzionati? Nel prosieguo dell’articolo analizzeremo e creeremo un tipico potenziale scenario con lo scopo di intercettare le informazioni sensibili inserite dall’ignaro utente (la classica combinazione username/password, insomma).

Dal momento che le possibilità di intercettare traffico e dati interessanti in chiaro – dunque non crittografati dal ben noto protocollo HTTPS – mediante sniffer di rete (come wireshark, xplico, ferret) sono piuttosto scarse per via delle policy sempre più stringenti in fatto di sicurezza adottate da browser e sistemi operativi, ci industrieremo in un ben più efficace tentativo di phishing: d’altra parte è risaputo, l’anello debole di un sistema informatico si trova sempre davanti allo schermo!

Ancora una volta, precisiamo che effettuare le pratiche mostrate qui di seguito al di fuori di ambienti simulati o nei confronti di soggetti non consenzienti, può significare incorrere nelle prescrizioni di cui agli articoli 616, 615-ter, 615-quater, 617-sexies, 640-ter del nostro Codice Penale.

Cominciamo configurando sulla nostra distribuzione Linux uno dei framework più famosi nell’ambito degli attacchi wireless, ovvero il progetto wifiphisher:

git clone https://github.com/wifiphisher/wifiphisher.git cd wifiphisher sudo python setup.py install

Troviamo lo strumento già preinstallato in WifiSlax, un ottimo sistema operativo di origini catalane dedicato per l’appunto al pentesting di applicazioni WiFi. Dobbiamo poi munire il nostro sistema (anche come macchina virtuale) di almeno una seconda scheda di rete WiFi che consenta l’iniezione di pacchetti e il monitor mode. Se stiamo utilizzando VirtualBox come piattaforma di virtualizzazione, ci basterà cliccare sull’apposito menù e spuntare il device:

Lanciamo il programma nel suo utilizzo base con il comando:

sudo wifiphisher

Una prima modalità prevede la possibilità di clonare un Access point – e creare il cosiddetto Evil twin – inviando pacchetti di modo da deautenticare tutti i client connessi in quel momento per poi forzarli a riconnettersi all’AP creato dal nostro script. Dopo aver modificato l’indirizzo MAC della scheda di rete attaccante per garantirci un minimo di anonimato, selezioniamo la rete target da clonare tra quelle proposte nel menù:

Vengono messi a disposizione quattro possibili scenari con cui adescare il client vittima; nella fattispecie, selezioniamo il numero 4 – OAuth login Page:

Un aspetto interessante di questa modalità di attacco, è che il tutto avviene in maniera automatica e piuttosto sbrigativa: la vittima vedrà apparire una finestra del proprio browser – sia desktop che mobile – la quale richiede l’inserimento di credenziali per poter proseguire nella navigazione (in questo caso quelle di Facebook):

Ed ecco come il terminale del programma ci restituirà indirizzo mail e password della vittima:

Se volessimo essere ancor più diabolici e aumentare le probabilità di successo, potremmo modificare a nostro piacimento i tag HTML della pagina web, magari inserendo un titolo più accattivante e in lingua italiana oppure rendere ancora più credibile l’URL generato dal server web. Troviamo le cartelle delle pagine HTML del server al percorso:

wifiphisher/data/phishing-pages

Una seconda modalità molto efficace del framework, prevede invece la creazione ex novo di un hotspot WiFi aperto da lasciare attivo in attesa di un malcapitato utente alla ricerca di una connessione internet. La community di wifiphisher, inoltre, si è adoperata per ampliare il numero di scenari di quest’ultima tipologia di attacco, mettendo a disposizione il seguente materiale:

https://github.com/wifiphisher/extra-phishing-pages

Copiamo le cartelle scaricate al percorso indicato poc’anzi e rilanciamo lo script iniziale di installazione per avere anche questi add-on operativi. Eseguiamo dunque il programma con la seguente sintassi, specificando il nome della rete da usare come trappola e quello della pagina web dello scenario desiderato (parametro -p):

sudo wifiphisher --noextensions --essid "FREE WIFI ICT SECURITY MAGAZINE" -p oauth-login -kB

La vittima rileverà dal proprio device una nuova rete: come è possibile vedere dagli screenshot successivi, la finta maschera di login appare in primo piano anche con dispositivi Android:


Dopo aver visto ciò che può mettere in atto un potenziale attaccante, ci chiediamo quello che possiamo fare da internauti consapevoli per non incappare in brutte sorprese. Il mondo del software in questo caso ci dà solo parzialmente una mano: è possibile che qualche antivirus metta genericamente in allerta della pericolosità di una nuova rete rilevata ma di certo non fermerà l’utente in fase di inserimento delle credenziali. Nemmeno una VPN ci mette al riparo dalla malevola intercettazione: l’incapsulamento del traffico internet avverrà solo successivamente alla connessione all’Access point, e dunque quando avremmo già inserito i nostri preziosi dati.

E’ invece sicuramente utile tenere aggiornati i propri browser e prestare attenzione alla compilazione automatica che spesso propongono innanzi a nuovi form: URL e pop-up vari devono essere sempre esaminati con la dovuta perizia, premendo invio solo quando siamo certi di inviare i nostri dati al legittimo destinatario. Infine, per i siti più sensibili è consigliabile implementare il meccanismo di doppia autenticazione tramite SMS o token monouso a sei cifre generato da applicazioni per smartphone.

A cura di: Milo Caranti

L’articolo Attacco ad una rete pubblica WiFi proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/attacco-ad-una-rete-pubblica-wifi/


WhatsApp Forensics

Chi non conosce WhatsApp Messenger, l’applicazione di messaggistica istantanea multipiattaforma fondata da Jan Koum nel 2009 e più usata al mondo?

Sicuramente pochi, semmai ve ne siano. WhatsApp ha sicuramente rivoluzionato la cultura della comunicazione.

Dal 16 febbraio del 2014 fa parte del gruppo Facebook inc. ed è attualmente disponibile per IOS, Android e Windows Phone.

Il 1 febbraio del 2016 fu annunciato il raggiungimento di 1 miliardo di utenze.

Grazie alla sua stragrande popolarità, WhatsApp divenne rapidamente un bersaglio per spammer, truffatori e semplici criminali di tutti i tipi.

Il fatto stesso che l’app di messaggistica sia stata progettata per utilizzare comunicazioni end-to-end sicure, rende difficile per le forze dell’ordine indagare su casi che riguardano la messaggistica istantanea di WhatsApp.

WhatsApp è anche più sicuro degli SMS. A differenza del sistema di messaggi di testo e degli MMS messi a disposizione dal gestore di telefonia mobile, le comunicazioni di WhatsApp non possono essere intercettate o richieste al gestore stesso. A differenza di Apple iMessage, WhatsApp non è legato a una singola piattaforma, fungendo da perfetto sostituto di iMessage per le comunicazioni Android e iOS.

Dunque, non essendo memorizzato alcun dato dal gestore di telefonia mobile, non è possibile richiederne il dettaglio delle comunicazioni. L’unico modo per acquisire i dati di WhatsApp è quindi la copia forense dei dispositivi in possesso degli indagati oppure l’estrazione dei dati da backup locali o cloud. I backup su cloud sono comunque cifrati e quindi la loro acquisizione è tutt’altro che banale.

Infatti, tutte le versioni recenti di WhatsApp per Android cifrano i loro backup con una chiave unica per ogni account WhatsApp. Senza l’accesso a quella chiave, gli unici dati che potrebbero essere estratti dall’account Google dell’utente – per la precisione da Google Drive – si limiterebbero ai soli contatti e file multimediali inviati e ricevuti, dato che non vengono cifrati.

La cronologia delle comunicazioni principali è cifrata in modo sicuro con AES-256. Per rendere le cose ancora più complicate, le diverse build di WhatsApp utilizzavano diversi algoritmi di crittografia, rendendo complicato costruire un strumento univoco necessario alla decifrazione. La tecnologia peer-to-peer di scambio di messaggi cifrati, rende irrealizzabile anche l’attacco man-in-the-middle[1].

WhatsApp, come già detto, non conserva copia di quei messaggi sui propri server; il che esclude l’acquisizione diretta del cloud.

La chiave di cifratura viene generata dai server WhatsApp la prima volta che l’utente esegue un backup. La chiave non viene mai memorizzata nel cloud; è presente solo sul dispositivo dell’utente. La possibilità o meno di estrarre la chiave dal dispositivo dipende dalla versione di Android e dallo stato del dispositivo (permessi di root); tuttavia, è possibile generare quella chiave in base all’ID WhatsApp dell’utente (il loro numero di telefono). La chiave di cifratura così generata corrisponderà esattamente alla chiave utilizzata e renderà tutti i precedenti backup presenti sull’account Google decifrabili e leggibili. La stessa key verrà utilizzata per decifrare anche i futuri backup creati nell’account Google dell’utente.

In altre parole, è sufficiente generare una volta la chiave e utilizzarla a tempo indeterminato per decifrare i backup passati, presenti e futuri.

Uno strumento adatto allo scopo è costituito da un software sviluppato da Elcomsoft: Explorer per Whatsapp[2], il quale, tentando di registrarsi come un’applicazione WhatsApp, è in grado di inviare una richiesta di autenticazione al server ed ottenere il codice di verifica sul numero di telefono dell’utente registrato. Il codice ricevuto via SMS andrà inserito nell’applicazione Explorer per WhatsApp, consentendo così la generazione della key che rimarrà valida anche dopo nuova autenticazione su un dispositivo diverso, a condizione che vengano utilizzati lo stesso numero telefonico e lo stesso account Google.

Per quanto concerne iOS, tranne alcune differenze, valgono le considerazioni su esposte.

Nel dicembre 2016 WhatsApp veniva aggiornato alla versione 2.16.17. In questa build, la società iniziava a cifrare i backup archiviati in iCloud Drive, rendendo immediatamente inefficaci i metodi di estrazione esistenti. Prima della modifica era possibile, utilizzando degli opportuni software forensi, accedere correttamente agli archivi WhatsApp effettuando l’accesso all’account iCloud dell’utente e utilizzando le credenziali di autenticazione valide (login e password o i token di autenticazione binaria estratti dai computer dell’utente). La cifratura di WhatsApp poneva indubbiamente un significativo ostacolo all’estrazione, consentendola solo dai backup del sistema iOS (basati su iCloud e locali).

Dal 2016, quindi, sia i backup manuali che quelli giornalieri archiviati da WhatsApp in iCloud Drive vengono automaticamente crittografati. La chiave di cifratura, generata da WhatsApp quando l’utente effettua il backup per la prima volta, è univoca per ogni combinazione ID Apple e numero di telefono e ne vengono generate diverse qualora vi siano molteplici numeri di telefono afferenti allo stesso ID Apple.

Le chiavi vengono create e archiviate lato server da WhatsApp stesso; non vengono mai memorizzate in

iCloud e non possono essere estratte dal dispositivo.

Lo strumento già menzionato in precedenza è di ausilio anche in questo caso: Elcomsoft Explorer per WhatsApp è in grado di generare le chiavi di cifratura per i backup iCloud di WhatsApp, con lo stesso metodo descritto per Android; unica differenza è il necessario possesso delle credenziali utente (ID Apple e password, oppure il token di autenticazione binaria) per poter poi accedere al backup stesso.

WhatsApp è ormai un’applicazione universalmente utilizzata e implica che le persone, coinvolte in casi giudiziari, presentino i messaggi come prova per dimostrare come una conversazione possa aver avuto luogo, in termini concreti, tra alcuni interlocutori.

La Suprema Corte di Cassazione Penale, con sentenza n. 49016 del 25/10/2017 sez. V, ha analizzato con particolare attenzione la problematica attualissima inerente il valore probatorio delle comunicazioni svoltesi tramite WhatsApp che, come noto, è divenuto un elemento rilevante nel corso delle indagini giudiziarie.

Difatti, contrariamente a quanto ritenuto nel recente passato, la prova informatica prodotta in sede processuale dovrà indi possedere alcune imprescindibili caratteristiche; particolare rilevanza è rivestita dall’integrità.

Gli accorgimenti che dovranno essere adottati riguardano principalmente le fasi della raccolta e della loro conservazione e l’adozione di un sistema idoneo a garantirne l’integrità e la non alterabilità della prova stessa.

E’ appena il caso di ricordare che detti principi non sono nuovi ma rientrano nell’ambito del fondamento normativo della Digital Forensics espresso dall’art.8 della legge 48/2008.

Sempre la V sezione della Cassazione Penale, con sentenza n. 1822 del 16/01/2018 ha poi stabilito la natura documentale dei dati e dei messaggi acquisiti dai dispositivi informatici così come disposto dall’art. 234 del c.p.p e di conseguenza utilizzabili a tutti gli effetti in un giudizio di cognizione.

Perché gli artefatti di WhatsApp sono così importanti nell’ambito delle indagini sui dispositivi mobile?

Proprio come le altre applicazioni di chat installate su mobile, i contatti, i messaggi e gli allegati di WhatsApp possono essere preziosi per gli investigatori che cercano di recuperare le prove utilizzabili in una grande varietà di tipologia di indagini differenti.

Infatti questi artefatti possono contenere informazioni preziose e potrebbero essere determinanti alla risoluzione di molti casi giudiziari (stalking, violenza sessuale, estorsione, appropriazione indebita, pedofilia, etc.)

In questo articolo vedremo come individuare tra i dati già estratti da un dispositivo mobile quelli di interesse investigativo e come trattare le evidenze riscontrate nei due sistemi operativi più diffusi in ambito mobile: Android e IOS.

Un breve panoramica sul funzionamento dell’app di messaggistica istantanea più usata al mondo è d’obbligo ed è schematizzata in modo egregio nella figura in calce.

Architettura
Immagine gentilmente concessa da Fingent[3]

Dal punto di vista architetturale – inteso come aggregato delle sue parti costituenti e delle relazioni esistenti tra loro –  WhatsApp utilizza lo stack LYME / LYCE[4].

I co-fondatori, Jan Koum and Brian Acton, hanno optato per FreeBSD su Linux, data la loro personale esperienza del sistema che già conoscevano e apprezzavano sia per le intrinseche qualità di robustezza che per la sicurezza, e che avevano già avuto modo di utilizzare nella loro precedente attività quali dipendenti della Yahoo Inc..

In calce l’architettura di base dell’app:

Sistema operativo: FreeBSD[5]
Linguaggio di programmazione: Erlang[6]
Macchina virtuale (per eseguire Erlang): BEAM[7]
Server: Ejabberd[8], YAWS[9]
Database: Mnesia[10]
Database locale: SQLite[11]

Erlang è il linguaggio di programmazione principale di WhatsApp, molto apprezzato per le sue prestazioni.

I principali vantaggi sono rappresentati dalla velocità e dalla scalabilità, oltre alla possibilità di aggiornare il codice “on fly”.

Ma ovviamente, Erlang non è l’unica opzione.

Altre app di chat, come Telegram o Kik, utilizzano Node.js, la scelta numero uno per le applicazioni che devono elaborare un volume elevato di messaggi brevi che richiedono una bassa latenza.

Le app di questo tipo, ovvero le applicazioni in tempo reale (RTA[12]), includono strumenti collaborativi come Slack[13], Trello[14] o Google Docs. La tecnologia è particolarmente apprezzata dagli sviluppatori di app live-chat e di messaggistica istantanea presentando dei vantaggi non indifferenti.

WhatsApp si avvale di Ejabberd, un server di messaggistica istantanea Jabber/XMPP open source scritto in Erlang. Adopera il protocollo XMPP (eXtensible Messaging and Presence Protocol) che gestisce un sistema di consegna dei messaggi.

Il server Ejabberd si basa su una serie di moduli collegabili (plugin) che abilitano funzioni come:

  1. Invio di messaggi “one to one”;
  2. Memorizza e inoltra (messaggi offline);
  3. Elenco contatti e presenza on line;
  4. Chat di gruppo – Multi User Chat (MUC);
  5. Gestione archivio messaggi (MAM);
  6. Protocollo evento personale (PEP);
  7. Impostazioni della privacy.

La società ha personalizzato la maggior parte di Ejabberd, passando da XMPP a un protocollo sviluppato internamente, ristrutturando il codice di base e riprogettando alcuni componenti principali, apportando molte modifiche importanti alla macchina virtuale Erlang per ottimizzare le prestazioni del server. WhatsApp memorizza i file multimediali di notevole dimensione sul server web YAWS.

Il server è una struttura determinante per le app di messaggistica istantanea: permette di conservare i messaggi destinati a utenti temporaneamente off-line in modo da poterli inoltrare successivamente.

Per tale scopo, si utilizza, infatti, una connessione asincrona. Il ridimensionamento orizzontale (che significa aggiungere più macchine, non più memoria) aiuta a far fronte ai picchi di traffico.

Esistono due modi per archiviare i messaggi: è possibile conservarli per sempre sui server oppure eliminarli non appena vengono consegnati per essere archiviati localmente – WhatsApp utilizza il motore di database SQLite per farlo -.

In tal caso, i messaggi vengono temporaneamente accodati sui server fino a quando il destinatario non è nuovamente on-line: il messaggio viene quindi consegnato e la coda cancellata.

Allo stesso modo, i riconoscimenti dei messaggi inviati, consegnati o letti verranno messi in coda sui server sotto forma di un particolare “ID message”. L’integrità della coda, – mantenendo pochi messaggi nella stessa -, verrà salvaguardata e i picchi di traffico, – ad esempio eventi legati a calamità naturali -, verranno gestiti con server aggiuntivi.

Come è facilmente deducibile, Ejabberd rappresenta un’ottima scelta per il supporto di applicazioni audio e video e il trasferimento di dati multimediali (i file di notevoli dimensione, come già accennato, vengono memorizzati su YAWS).

Analizzeremo ora le evidenze digitali rilevanti ai fini investigativi.

Android

WhatsApp memorizza tutti i dati in un database SQLite. Poiché si tratta di un’app multipiattaforma per dispositivi mobili, la posizione del database varia a seconda del sistema operativo in cui è installato.
Questa è la struttura della specifica cartella Android utilizzata per l’installazione dell’app[15]:
Di seguito la struttura della directory presente sulla SD:
I file di interesse investigativo – versione 2.17.79 -:

Contenuto Directory File
Database dei contatti /data/data/com.whatsapp/databases wa.db (SqLite)
Database dei Messaggi /data/data/com.whatsapp/databases msgstore.db (SqlLite)
Contiene i contatti (numero di telefono) con cui sono state effettuate le conversazioni /data/data/com.whatsapp/databases Axolotl.db (SqLite)
Backup dei database messaggi /SDCard/Whatsapp/Databases msgstore-db.crypt*

msgstore-(data).1.db.crypt*

Avatars dei contatti /data/data/com.whatsapp/files/Avatars UID@s.whatsapp.net.j dove UID è l’identificativo del contatto
Numero di telefono associato all’account /data/data/com.whatsapp/files/ me
File di log dell’applicazione /data/data/com.whatsapp/files/Logs


whatsapp.log,

whatsapp-<date>.log


Recupero ulteriore del numero telefonico associato all’account /data/data/com.whatsapp/shared_prefs/ registration.RegisterPhone.xml
Mostra la data di verifica dell’account registrato e il primo utilizzo dell’applicazione. /data/data/com.whatsapp/shared_prefs/ registration.VerifySMS.xml. Esempio:

<long name=”com.whatsapp.registration.VerifySms.call_countdown_end_time” value=”1488996158375″ />

mercoledì, 8 marzo 2017 19:02:38.375 GMT+01:00

Vari tipi di file multimediali /SDCard/Whatsapp/Media La scheda SD è una miniera di informazioni e dati WhatsApp.  Contiene una cartella per ogni tipo di file multimediale (audio, documenti, immagini, video e note vocali). Tutti gli allegati ricevuti sono memorizzati, a seconda del tipo, nella root delle apposite cartelle. Tutti i file inviati sono contenuti invece in sottocartelle denominate “sent” e situate in ogni cartella menzionata.

La directory dei database è una fonte di informazioni ancora più grande. WhatsApp fa un backup di
msgstore.db periodicamente e memorizza i backup /SDCard/Whatsapp/Databases.

Ciò consente di analizzare i dati storici memorizzati in date diverse.

L’unico problema è che questi backup sono crittografati!

Msgstore.db è un database SQLite formato da 14 tabelle – versione 2.17.79 di WhatsApp -, come evidenziato in calce:
La tabella dei messaggi contiene un elenco di tutte le comunicazioni inviate o ricevute dai suoi contatti.

WhatsApp utilizza il numero di telefono dell’utente come identificativo univoco sia per l’utente che per i suoi contatti. Questa tabella includerà il numero di telefono del contatto, il contenuto dei messaggi, lo stato dei messaggi, i timestamp e tutti i dettagli relativi agli allegati inclusi nel messaggio.

Gli allegati inviati tramite WhatsApp hanno una propria voce di tabella e il contenuto del messaggio conterrà una voce nulla con una miniatura e un collegamento alla foto/immagine condivisa. Gli allegati vengono referenziati in appositi campi della tabella messages – illustrati in seguito – contenuta nel db msgstore.db.

Inoltre, la tabella può contenere le coordinate di latitudine e longitudine per i messaggi inviati, consentendo all’investigatore di poter disporre di ulteriori evidenze da poter utilizzare nel corso delle indagini.

Tabella messages – Contiene tutti i messaggi (sia di gruppo che individuali):
Campo “status”.

Indica i valori dello stato del messaggio:

  • 0 – messaggio ricevuto;
  • 13 – messaggio inviato visualizzato (segno di spunta blu);
  • 5 – messaggio inviato non visualizzato (doppio segno di spunta ma segno di spunta blu);
  • 4 – inviato un messaggio al server Whatsapp, ma non ricevuto nell’app Whatsapp del destinatario (spunta singola);
  • 6 – chiamate inviate / ricevute (il campo key_from_me specifica se la chiamata è inviata o ricevuta); può assumere i valori 0 o 1:
    Valore 0 – dai contatti.
    Valore 1 – dall’utente corrente di WhatsApp.

Campo “destinatario_count”.

Può assumere 2 valori:

  • 0 per le singole chat oppure il numero dei membri che compongono il gruppo se il messaggio fa parte di un gruppo.

Campo “read_device_timestamp”.

Non contiene alcun valore se il messaggio non è stato letto da tutti nel gruppo.

Campo “media_name”.

Contiene il nome del file inviato e memorizzato nelle apposite cartelle WhatsApp a seconda della tipologia dello stesso e contenuta nel campo “media_mime_type”.

Campo “media_caption”.

Contiene la didascalia del file multimediale che abbiamo fornito durante l’invio.

Campo “media_url”.

Fornisce la posizione del file nel server WhatsApp. Es: https://mme.whatsapp.net/d/9w-Bu3sFaxMzaF6NIBkbuleaVIU/Asj6Kh-dOXv9tidYk-uBwe0Z78_lpmTC5Nm3U_ZmYbKg.enc.

Tabella chat_list –  Contiene tutti i contatti (se il campo subject è vuoto) e i gruppi (se lo stesso campo subject assume un valore) con cui sono state effettuate tutte le comunicazioni inviate e ricevute (ma non esaustivo):
Nel caso di gruppo il campo “creation” mostra la data di creazione.

Il valore contenuto nel campo “message_table_id” corrisponde al valori del campo “docid“ della tabella “messages_fts_content “(contiene tutti i messaggi), ed indica l’ultimo messaggio inviato e/o ricevuto.
Il database denominato wa.db, contiene tutte le informazioni relative ai contatti dell’utente, è anch’esso un database SQLite formato da 7 tabelle – versione 2.17.79 di WhatsApp -, come evidenziato in calce:
Tabella wa_contacts – Contiene i nomi dei contatti, i numeri di telefono e il loro stato:
 

WhatsApp memorizza l’immagine del profilo nella posizione /data/data/com.whatsapp/files/Avatars con estensione [.j]. Questi file, estratti e rinominati con estensione [.jpg], potranno essere visualizzati quali immagini. I file sono identificati con i numeri telefonici relativi.
 

E’ chiaro che l’accesso a questi file è permesso solo dopo aver eseguito il rooting del dispositivo o effettuato un’acquisizione fisica con un software forense.

WhatsApp può memorizzare, inoltre, – in dipendenza dalla configurazione effettuata dall’utente – una copia di msgstore.db sulla scheda SD, che viene normalmente utilizzata per i backup e può essere rinvenuta nella directory:

/SDCard/WhatsApp/Databases/msgstore.db.crypt*

Come già evidenziato precedentemente, i file di backup presenti sono cifrati.

WhatsApp utilizza diversi tipi di crittografia a seconda della versione utilizzata e denomina i database con estensioni diverse (crypt5, crypt8,crypt12).

Questi possono essere decifrati solo con la key archiviata nella cartella /data/data/com.whatsapp/files.
Solitamente per estrarre la chiave di crittografia un informatico forense deve eseguire un’estrazione fisica dal dispositivo. Ma ciò non è sempre possibile a causa di problemi software e hardware di alcuni dispositivi mobili. Naturalmente, ci sono metodi di estrazione della chiave di crittografia da dispositivi “non-rooted”, ma queste tecniche possono essere applicate a un numero limitato di dispositivi.

Oggi esistono in commercio varie soluzioni che consentono, già durante l’estrazione, la decriptazione dei database di whatsapp: Cellebrite Ufed, Belkasoft Evidence Center, Magnet Axiom solo per citarne alcuni.

Recuperare i contatti, i messaggi e gli allegati di WhatsApp su Android è relativamente semplice una volta che hai accesso ai database appropriati.

Il processo è simile in iOS con alcune piccole differenze.

iOS

Anche qui, una breve premessa è d’obbligo.

A partire dalla versione 8 di iOS, i dati delle applicazioni sono stati separati dai loro bundle e la struttura della directory corrente è ora la seguente:

/private/var/mobile/Containers/Bundle/Application/, dove sono archiviati i componenti dell’applicazione;

/private/var/mobile/Containers/Data/Application/, dove è archiviata la maggior parte dei dati inerenti l’applicazione;

/private/var/mobile/Containers/Shared/AppGroup/, in cui le applicazioni possono memorizzare dati da condividere con altre app o estensioni.

Whatsapp memorizza i dati nella directory condivisa menzionata in precedenza in una sottocartella denominata 332A098D-368C-4378-A503-91BF33284D4B; il percorso completo

private/var/mobile/Containers/Shared/AppGroup/332A098D-368C-4378-A503-91BF33284D4B contiene

quanto riportato in calce:

  • Axolotl.sqlite
  • ChatSearch.sqlite
  • ChatStorage.sqlite
  • Contacts.sqlite.

ChatStorage.sqlite è il database che contiene le conversazioni di WhatsApp in iOS. Le tabelle di interesse per la raccolta di elementi probatori interessanti sono:

ZWAMESSAGE,ZWACHATSESSION, ZWAGROUPMEMBER, ZWAGROUPINFO and ZWAMEDIAITEM.

La più importante è ZWAMESSAGE, che contiene, tra l’altro, i messaggi scambiati, i timestamp e il nome dell’utente coinvolto nella chat.
 

Le altre tabelle che meritano di essere analizzate correlate tra loro sono: ZWACHATSESSION, ZWAGROUPMEMBER, ZWAGROUPINFO e ZWAMEDIAITEM, che memorizza i riferimenti ai file multimediali scambiati, l’indicazione degli utenti coinvolti, i timestamp e il percorso in cui è stato archiviato il file.

J. Zdziarski[16] evidenziò, a suo tempo, un’interessante “caratteristica” di Whatsapp: le chat cancellate non vengono effettivamente eliminate dal database.

Ciò è dovuto alla gestione che SQLite fa dei record cancellati; infatti, quando un record è cancellato, per motivi di prestazioni esso non viene in realtà eliminato dal database immediatamente, ma solo contrassegnato come libero ed eventualmente sovrascritto in seguito, se e quando lo spazio di archiviazione sarà necessario.

Pertanto, utilizzando semplicemente uno strumento come SQLite-parser[17][18] sarà possibile risalire ai record cancellati nel database di WhatsApp.

Oggi la condivisione della conoscenza che si ottiene attraverso l’apprendimento e l’esperienza è fondamentale per affrontare le sfide che ogni giorno un informatico forense si trova a fronteggiare.

Con poco sapere, ma di buona qualità, si produce di più che con moltissimo sapere di cattiva qualità.

Arthur Schopenhauer

Note


A cura di: Cosimo de Pinto

L’articolo WhatsApp Forensics proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/whatsapp-forensics/
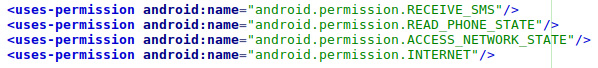


I servizi cloud alla prova del GDPR

I servizi cloud sono, ormai, molto diffusi nelle imprese italiane che, in questo modo, ottengono diversi vantaggi:

  • non immobilizzano risorse in infrastrutture ICT;
  • rendono flessibile la disponibilità di risorse;
  • accedono alle informazioni “anytime” e “anywhere”;
  • risparmiano i costi di manutenzione delle infrastrutture ICT.

Le soluzioni cloud, nei diversi paradigmi che possono caratterizzarle, sono, dunque, molto convenienti soprattutto per le piccole e medie imprese. Tuttavia, il Regolamento Europeo sulla Protezione dei Dati Personali n. 679/2016 (GDPR) richiede un supplemento di attenzione, con riferimento agli articoli 28 (Responsabile del trattamento) e 40 (Codici di condotta) ed all’intero Capo V che disciplina il trasferimento di dati personali verso Paesi terzi e organizzazioni internazionali.

Il rapporto titolare-responsabile

L’articolo 28 disciplina il rapporto tra il titolare del trattamento dei dati personali ed il responsabile del trattamento che è, per definizione, la persona fisica o giuridica che tratta i dati personali per conto dello stesso titolare. È il soggetto, dunque, che in concreto opera sui dati personali ed effettua su di essi tutte o alcune delle operazioni (registrazione, organizzazione, conservazione, ecc.). Non c’è dubbio che tra l’impresa ed il Cloud Service Provider (CSP) esista un rapporto del tipo titolare‑responsabile. Questo significa che l’impresa, quando tratta dati personali, ha alcuni obblighi nella scelta del CSP:

  • verificare che presentino garanzie sufficienti per mettere in atto misure tecniche e organizzative compliant rispetto al GDPR;
  • fornire autorizzazioni scritte sulla possibilità di avvalersi di sub‑responsabili (p.e. altri CSP);
  • stipulare l’accordo tramite forme contrattuali tipiche o tramite altri atti con validità giuridica;
  • fornire al responsabile apposite istruzioni per il trattamento;
  • specificare, nell’accordo, la durata del trattamento, la natura e la finalità, il tipo di dati personali, le categorie di interessati;
  • definire con precisione gli obblighi delle parti rispetto alle previsioni normative, europee e nazionali, in materia di trattamento dei dati personali (costituzione ed aggiornamento dei registri, DPIA, gestione delle violazioni, ecc.);
  • definire le “modalità di chiusura” del contratto in termini di restituzione/cancellazione al termine del rapporto contrattuale.

È necessario, dunque, trovare una soluzione agile a queste attività che possono risultare piuttosto onerose e richiedere skill non sempre presenti in azienda.

Dove sono i dati

Inoltre, il primo degli obblighi richiede una verifica preliminare di aspetti organizzativi e tecnici e, tra questi, una specifica analisi rispetto alla materiale collocazione dei dati. Un servizio cloud, sotto questo aspetto, può presentare particolari criticità perché strutturalmente basato sulla “trasparenza” rispetto all’utente del posto dove sono memorizzati ed elaborati i dati.

Il Capo V del GDPR, invece, prevede regole stringenti sul trasferimento di dati presso paesi estranei all’Unione Europea (paese terzo). Questo vuol dire che l’impresa, nello scegliere il proprio CSP, deve verificare che i dati personali siano collocati in server fisicamente situati in paesi che offrano un livello di protezione adeguato. L’adeguatezza del livello di protezione per un paese terzo è, di norma, stabilito dalla Commissione Europea con una decisione di adeguatezza basata sui seguenti criteri di valutazione:

  • caratteristiche dell’ordinamento giuridico con particolare riferimento al riconoscimento dei diritti e delle libertà delle persone;
  • effettività della possibilità di difesa in giudizio rispetto al trattamento dei dati personali;
  • esistenza di autorità indipendenti di controllo sulla protezione dei dati personali;
  • impegni internazionali assunti per la protezione dei dati personali.

È necessario, dunque, che il CSP sia trasparente rispetto alla collocazione dei dati affinché non ci siano spiacevoli sorprese per il cliente con le conseguenti e pesanti sanzioni. D’altra parte, è onere del titolare, cioè dell’impresa, rispettare il principio di accountability (tradotto in responsabilizzazione) ovvero riuscire a dimostrare che ha avuto un comportamento diligente (e proattivo) rispetto a questo specifico obbligo.

Il codice di condotta

Il principio di responsabilizzazione e gli altri obblighi del GDPR possono trovare, nel caso del cloud, un valido aiuto nel Codice di Condotta (CoC) per i Fornitori di Servizi Cloud in materia di Protezione dei Dati Personali. L’iniziativa è partita dal Cloud Select Industry Group cioè da un gruppo di CSP leader, riconosciuto dalla Direzione Generale per le Comunicazioni in Rete, i Contenuti e la Tecnologia della Commissione Europea, quando il quadro normativo europeo era basato sulla Direttiva 95/46 successivamente superata dall’entrata il vigore del GDPR. Il percorso, non breve, ha superato anche il parere richiesto al Gruppo dei Garanti Europei (WP29) del quale sono stati accolti tutti i suggerimenti fino ad arrivare alla versione definitiva che è di maggio 2017 e, quindi, recepisce in pieno le previsioni del nuovo regolamento così come espresse dall’articolo 40.

Il Cloud CoC è un elemento di fiducia di cui l’impresa può avvalersi nella scelta del CSP. Infatti, prima di sedersi al tavolo per la definizione dei dettagli tecnici, il cliente può verificare se il CSP candidato contraente è aderente al CoC e, quindi, procedere con maggiore tranquillità rispetto agli obblighi previsti dal GDPR.

Il CoC, naturalmente, non sostituisce il contratto essendo un codice di comportamento che il CSP si impegna a rispettare nel corso della fornitura. Gli impegni di rilievo previsti dal CoC per i CSP aderenti sono:

  • la dislocazione dei dati personali in paesi che offrono le garanzie previste dal Capo V del GDPR;
  • l’aggiornamento continuo della lista di collocazioni fisiche dei dati personali e la possibilità di consultazione, in qualsiasi momento, da parte del cliente e delle autorità di controllo;
  • la possibilità, per il cliente, di svolgere, in proprio o avvalendosi di un ente terzo, attività di audit finalizzate alla verifica del rispetto del GDPR;
  • la restituzione, al termine del contratto, dei dati personali all’azienda cliente secondo i formati concordati e la cancellazione secondo il cronoprogramma previsto in sede di contratto e, comunque, entro un anno dalla fine del rapporto contrattuale.

Infine, un cenno alla governance del CoC è, certamente, un ulteriore elemento di fiducia per i clienti giacché è stato adottato un modello a tre livelli:

  1. gestione del framework ovvero governo degli organi e dei flussi consultivi, decisionali ed operativi;
  2. gestione dei CSP aderenti ovvero governo delle richieste di adesione da parte dei CSP e del mantenimento dei requisiti previsti;
  3. gestione dello stesso CoC ovvero aggiornamento del Codice rispetto alle evoluzioni normative o tecnologiche.

A cura di: Francesco Maldera

L’articolo I servizi cloud alla prova del GDPR proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/i-servizi-cloud-alla-prova-del-gdpr/


Rischi dell’accesso fisico non autorizzato

Prefazione

Come reagireste se affermassi che i tre maggiori Sistemi Operativi (SO) in commercio – Windows, Linux e MacOSX – contengono al loro interno una falla che permette, in pochi e semplici passi, il pieno accesso ai dati archiviati nei vostri Personal Computer (PC)?

Se aggiungessi che non importa quanto è complessa la vostra passphrase di accesso, poiché chiunque abbia la possibilità di “mettere le mani” sul vostro PC può bypassarla, o resettarla, a proprio piacimento?

Infine, ultimo ma non meno importante, se affermassi che i suddetti produttori di SO sono da lungo tempo a conoscenza di queste falle. Anzi, che alcune di esse non fossero considerate “falle”, ma vere e proprie “feature” dei loro SO?

Seguitemi e vi illustrerò alcuni metodi con i quali un’utente malevolo, sfruttando tali feature, può prendere il pieno controllo del dispositivo reimpostando le password utente e/o creando account di tipo amministratore.

Microsoft Windows

Il SO di casa Redmond, da Windows XP in poi, mette a disposizione nella schermata di Logon un utility per l’“accessibilità”. Questa dovrebbe consentire di facilitare l’uso del computer ad ipovedenti e non udenti, tramite le funzionalità: assistente vocale, lente di ingrandimento e contrasto elevato. Ma la cosa, come vedremo, nasconde anche alcune insidie.

La procedura per reimpostare la password, infatti, si basa proprio su questa utility e fa capo all’eseguibile utilman.exe.

Windows 7 Windows 8/8.1 Windows 10

Per effettuare un cambio password o la creazione di un’utenza amministrativa, pertanto, abbiamo la necessità di poter accedere al Prompt dei Comandi, quindi all’eseguibile cmd.exe.

L’idea è quella di sovrascrivere utilman.exe con cmd.exe, in modo da poter avviare il prompt, invece di utilman. In questo modo si avrebbe la possibilità di eseguire i comandi necessari per ottenere quanto detto in precedenza dalla schermata di Logon.

Ma per far questo dobbiamo modificare i rispettivi file eseguibili, dal momento che sono entrambi file di sistema, senza però avere alcun tipo di utenza sul dispositivo.

L’operazione, proposta in tre semplici passi, è tanto semplice quanto disarmante; occorre:

  1. munirsi di un disco/pendrive di avvio di Windows;
  2. avviare la modalità di “Ripristino del Computer” dal disco di avvio;
  3. selezionare l’opzione di ripristino tramite Prompt dei Comandi, per ottenere una shell con privilegi amministrativi sulla macchina vittima.

Successivamente basta eseguire la sequenza di comandi di seguito elencata per sostituire utilman.exe con cmd.exe.

move C:\Windows\System32\Utilman.exe c:\Windows\System32\Utilman.exe.bak copy C:\Windows\System32\cmd.exe c:\Windows\System32\Utilman.exe

Fatto ciò, non rimane che riavviare e, appena possibile, selezionare l’icona di accessibilità per ottenere un prompt dei comandi in modalità amministratore.

A questo punto è possibile digitare quanto segue per creare un’utenza amministrativa.

net user <username> /add net localgroup administrators <username> /add

Infine, per non lasciare tracce di quanto effettuato, ripristiniamo l’utility utilman originale.

del C:\Windows\System32\Utilman.exe ren C:\Windows\System32\Utilman.exe.bak Utilman.exe

Al termine dell’azione “malevola” si può inoltre, ove possibile, riportare il sistema ad un punto di ripristino precedente, in modo da non destare alcun sospetto verso gli utilizzatori della macchina.

Linux

Anche il SO targato Torvalds & Stallman prevede semplici metodologie di recupero password.

Prendiamo in esame una delle distribuzioni più usata dagli utenti Linux: Ubuntu.

Durante la fase di boot tenendo premuto il tasto “shift”, si accede alla schermata del bootloader grub 2 che permette di selezionare la modalità di ripristino del SO tramite l’opzione “Advanced options for Ubuntu”.

Dalla console di ripristino è possibile selezionare l’opzione che consente l’avvio di una shell di root:

A questo punto, resettare una qualsiasi password utente diventa molto semplice.

Per prima cosa è necessario garantirsi i permessi di accesso sulla partizione di root:

mount -rw -o remount /

Questa operazione abilita la possibilità di resettare la password di un qualsivoglia utente:

passwd <username> exit

Infine, a seguito del comando exit, si torna al menu della modalità di ripristino, dalla quale è possibile selezionare l’opzione per riprendere il normale avvio del SO.

MacOsX

Anche la casa di Cupertino permette di ripristinare una password utente tramite console di ripristino.

Per fare ciò, occorre avviare il Macintosh facendo pressione contemporaneamente sui tasti
accensione + Command + R.

Dopo qualche minuto si accederà alla console di ripristino: dalla barra del menù occorre selezionare
Utilità à Terminale.

Il comando da digitare è resetpassword: dopo qualche attimo comparirà la schermata che consente di selezionare l’utente per il quale si intende resettare la password.

A questo punto non ci resta che digitare semplicemente i caratteri della nuova passphrase negli appositi campi, cliccare su avanti ed infine riavviare.

Conclusioni

Quanto esposto nei paragrafi precedenti, a primo impatto, potrebbe essere giudicato inammissibile. In realtà per quanto riguarda Linux e MacOsX, tali funzionalità sono perfettamente previste dalle procedure di ripristino dei propri SO.

Più delicato è l’ambito Microsoft. In questo caso la procedura che sfrutta il componente utilman.exe è stata inizialmente considerata un possibile bug di sviluppo tant’è che qualcuno, tra gli altri anche lo scrivente, ha deciso di contattare il supporto Microsoft per chiedere lumi e sciogliere le riserve a riguardo.

In risposta, il supporto Microsoft ha giudicato la propria schermata di Logon totalmente sicura. Aggiungendo che, a loro avviso, la reale vulnerabilità insiste nella possibilità di accedere fisicamente al sistema. In parole povere secondo Microsoft, se un utente malevolo ha la possibilità di “mettere le mani” fisicamente su un dispositivo, quest’ultimo è da considerarsi intrinsecamente vulnerabile e, pertanto, assoggettabile a qualsiasi tipo di manomissione e/o compromissione.

A questo punto, almeno due domande nascono spontanee:

  1. a cosa servono le certificazioni dei SO che, secondo l’Orange Book, sono valutabili in base a quattro classi di “fiducia”: da D (meno sicuro) ad A (più sicuro)?
    1. Nello specifico poiché Windows è certificato EAL4+, posizionabile tra TCSEC B1 e B2, come si giustifica questa carenza in sicurezza fisica rispetto a quanto richiesto da tale livello di sicurezza?
  2. cosa dovrebbe quindi fare uno sventurato utente che vede la sicurezza fisica del suo dispositivo compromessa?

Non si possono di certo inibire le periferiche CD/DVD/USB tramite BIOS, sarebbe una grave perdita di usabilità, né tantomeno eliminare le funzionalità previste dalle procedure di ripristino.

Ed allora, cosa fare? Di seguito qualche consiglio:

Tralasciando soluzioni esotiche quali mettere sotto chiave il proprio PC o installare costosissimi impianti di sicurezza audio/video, la soluzione è molto semplice: la crittografia.

Abilitando rispettivamente Bitlocker, Ubuntu Encrypted Custom Install e FileVault, quanto esposto nei paragrafi precedenti risulta non attuabile a meno che non si conosca l’apposita chiave di cifratura, poiché il sistema cifra l’intera partizione di avvio.

A cura di: Daniele Rigitano

L’articolo Rischi dell’accesso fisico non autorizzato proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/rischi-dellaccesso-fisico-non-autorizzato/