L’accountability oltre il registro dei trattamenti

L’accountability (ovvero il principio di responsabilizzazione  nella terminologia adottata nella traduzione italiana del Regolamento generale sulla protezione dei dati) è, probabilmente, l’innovazione maggiore che la norma europea ha apportato nell’ambito della protezione dei dati personali per il nostro Paese.

Il principio di responsabilizzazione, infatti, sposta il timone della protezione dei dati dalle mani del Garante a quelle del titolare del trattamento (e in certa parte, del responsabile del trattamento, inteso come soggetto terzo rispetto all’organizzazione del titolare) imponendogli non solo di garantire il rispetto dei principi che presiedono al trattamento dei dati, ma anche di comprovare il suo operato: il regolamento, spesso, si limita a fissare i parametri entro i quali dovranno prendere forma le scelte del titolare, e solo in pochi casi pone direttamente gli adempimenti ai quali il titolare dovrà attenersi.

Quindi, da una parte, si lascia al titolare un certo margine di scelta: è chiaro che il principio di accountability va letto in armonia con l’approccio basato sul rischio, che non prescinde dal contesto in cui opera il titolare; imprese di dimensioni diverse, che operano trattamenti diversi, non saranno costrette a prendere le stesse misure di protezione (sia che si tratti di misure di sicurezza, sia che si tratti di misure organizzative). D’altra parte consente al titolare anche, per così dire, di precostituire le prove che saranno destinate a comprovare il suo diligente operato, e la congruità delle scelte effettuate. Si tratta di un vantaggio non da poco, che però, per essere colto appieno necessita di un radicale cambio di mentalità: non ci saranno adempimenti da burocratizzare al solo scopo di evitare sanzioni, ma occorre operare proattivamente scelte congrue e bilanciate, e imparare a comprovarle.

Insomma, una volta tanto, bisogna abbandonare la strada vecchia per la nuova, azione che sappiamo tutti essere sconsigliata dal vecchio adagio popolare e che probabilmente è endemicamente vissuta come incauta dal nostro subconscio sociale, tanto che anche il legislatore nazionale è stato indotto, nel tentativo di mantenere il più possibile in vita il vecchio impianto ben più familiare, a discutibili interventi mirati a riportare la misura della discrezionalità nelle mani dell’Autorità (mi riferisco, in particolare al tentativo di azzerare la valutazione del titolare in tema di legittimo interesse, o alla pervicace riproposizione dei ruoli interni).

E’ fondamentale, però, in un sistema fondato sull’accountability, non scambiare la documentabilità delle scelte operate con un onere di burocratizzazione che si risolve in una inutile proliferazione di scartoffie (in senso lato, anche digitali quindi).

Cosa occorrerà documentare dunque?

Il registro dei trattamenti

Quando si parla di accountability si pensa subito ai registri delle attività di trattamento, probabilmente anche in ragione di una certa somiglianza che pare avere, di primo acchito, con il documento programmatico sulla sicurezza, croce e delizia (a seconda dell’approccio più o meno passivo) dei titolari italiani fino al 2011.

Sarebbe però un errore appiattire l’accountability solo sul registro: e ancora più da evitare sarebbe l’errore di appiattire la funzione del registro a mero onere compilativo, come molti fecero al tempo del DPS: esattamente come avveniva per il DPS, il registro delle attività di trattamento ha il compito di fotografare i trattamenti operati, in modo da costituire un ausilio e non un intralcio alle attività di monitoraggio o controllo che deve operare il titolare (o chi per lui).

Il contenuto tassativo del registro delle attività di trattamento è contenuto nell’articolo 30 del regolamento generale sulla protezione dei dati, e molte autorità nazionali hanno pensato di fornire modelli per aiutare titolari e responsabili nella sua tenuta: i più noti, probabilmente sono quelli forniti dalla CNIL e dall’autorità belga.

Anche l’ICO, l’autorità che presiede alla protezione dei dati nel Regno Unito, ha fornito un suo modello; chi scrive lo ha trovato oltremodo interessante, e nel prosieguo si tenterà di fornire alcuni elementi suggeriti nel modello che, probabilmente, meritano attenzione anche in Italia.

Anche perché, se abbiamo difficoltà anche solo a tradurla l’accountability, forse è meglio trarre ispirazione da chi, invece, questo istituto lo conosce bene.

L’ICO fornisce due versioni del registro: una per il titolare e una per il responsabile. Quella del responsabile, da utilizzare per i trattamenti che egli effettua per conto di altri è molto snella, adatta per chi deve tenere traccia di una molteplicità di trattamenti effettuati per altrettanti clienti. E’ importante sottolineare che, qualora si volesse impiegare il modello fornito da un’autorità straniera, questo andrebbe tradotto in italiano prima di essere impiegato. Le autorità che procederanno al controllo, infatti, opereranno nella nostra lingua e non è consigliabile mantenere i modelli in lingua straniera, anche se poi venissero  compilati in italiano: così come è sconsigliabile usare termini stranieri nella documentazione o nelle comunicazioni ufficiali: ad esempio, sarà bene non individuare il responsabile della protezione dei dati con l’acronimo DPO o con il corrispondente “data protection officer” anche se, per comodità e per non ingenerare confusione con altri termini simili o anche solo per abitudine, a volte, informalmente, si preferisce optare per la definizione anglofona (la traduzione del RGPD non è delle più felici, il lettore italiano deve destreggiarsi tra responsabilità, responsabilizzazione, responsabile del trattamento e responsabile della protezione, rispetto a termini come accountability, liability, processor e data protection officer che risultano, dal punto di vista linguistico, marcatamente distanti).

Tornando ai modelli di registro forniti dall’ICO, la struttura suggerita per il titolare è più complessa e si compone di due parti: una parte obbligatoria, e una facoltativa, dettata da ragioni di opportunità, proprio in ragione del controllo sui trattamenti che il registro dovrebbe garantire ai titolari.

Inoltre l’ICO distingue le annotazioni che occorre effettuare in ottemperanza al regolamento europeo da quelle che occorre effettuare per adempiere alla sua normativa nazionale (ovvero il Data Protection Act, che, comunque potrebbe essere foriero di qualche spunto anche per l’Italia, come si vedrà nel prosieguo).

In ogni sezione l’ICO indica l’adempimento che pone alla base dell’onere di documentazione e consiglia di utilizzare documenti elettronici in modo che sia possibile collegarli tra loro e aggiornarli con facilità. E’ chiaro, che si tratta di un ottimo consiglio, ma  qui, per gli italiani, si innesta anche la normativa sulla conservazione digitale dei documenti, e quindi, ove si tratti di documenti informatici che debbono essere conservati a norma anche per altri fini (penso, ad esempio ai contratti e agli accordi sul trattamento) sarà bene domandarsi se non occorra anche valutare l’adozione di un sistema  di conservazione. Chiaramente analogo problema si pone anche per la valida sottoscrizione degli accordi in forma digitale.

Ove non si disponesse di strumenti che consentano di sottoscrivere validamente gli accordi (ad esempio) e di conservarli digitalmente nel tempo, i campi del registro in cui l’ICO indichi che vanno linkati i relativi documenti potranno essere compilati indicando semplicemente ove quel documento sia stato archiviato (e si potrà anche eventualmente digitalizzarne una mera copia, per comodità).

Già da quanto detto sin qui si comprende che sebbene l’ICO ponga il registro al centro della documentazione da predisporre al fine di dimostrare la propria conformità alla normativa, egli non lo considera affatto l’unico documento richiesto ai fini dell’accountability, anzi.

L’informativa come linea guida per l’accountability

Ai titolari che si domandino  quali adempimenti vadano documentati, l’ICO risponde di guardare l’informativa (che è essa stessa rilevante al fine di dimostrare la conformità al GDPR): infatti, mutando la prospettiva, nell’informativa il titolare dà atto di molte delle scelte che ha operato e che vanno, appunto comprovate, ossia “documentate”.

Ad esempio: l’informativa impone di evidenziare agli interessati la base giuridica dei trattamenti; per i trattamenti basati sul legittimo interesse potrebbe essere opportuno[1] anche dare atto, sinteticamente, del bilanciamento operato e del perché di è ritenuto prevalente l’interesse del titolare.

Tale sintetica indicazione dovrà essere corredata da una valutazione scritta (che non viene inserita nell’informativa), che lasci agli atti e renda palese, in caso di controlli o di istanze, il bilanciamento degli interessi operato dal titolare. Quindi: l’annotazione sintetica che si dà nell’informativa non esaurisce gli obblighi ai quali è tenuto il titolare in ottemperanza al principio di responsabilizzazione.

Muovendo dall’informativa, quindi, e dagli elementi che dovrà fornire agli interessati e dei quali e bene, quindi, che tenga traccia de:

  • la base giuridica dei trattamenti;
  • il legittimo interesse (e il bilanciamento operato[2]);
  • i correlati diritti dell’interessato (non sempre l’interessato gode di tutti i diritti: ad esempio, la portabilità dei dati è un diritto riconosciuto solo in caso di trattamenti basati su consenso o contratto; sarà bene che i diritti dell’interessato siano specificati a seconda della base giuridica su cui poggia il trattamento). E’ bene predisporre documentazione che agevoli l’esercizio dei diritti dell’interessato e procedure interne per poter tempestivamente fornirgli riscontro.
  • L’esistenza di decisioni automatizzate, inclusa la profilazione;
  • la fonte dei dati personali (le informazioni da dare agli interessati (e i tempi in cui darle) variano, infatti, a seconda che i dati siano stati raccolti presso l’interessato stesso o presso terzi e in questo secondo caso deve essere informato della fonte di raccolta) .

Una volta che il titolare abbia fissato questi aspetti, egli potrà procedere a predisporre ulteriore documentazione,che può evincersi dagli adempimenti che il Regolamento impone al titolare in ordine a:

  • registrazione dei consensi (si dovrà infatti poter provare, per i trattamenti basati sul consenso, che il consenso è stato validamente acquisito)
  • accordi sul trattamento (tra contitolari, ma anche tra titolare e responsabile del trattamento)
  • “dove” i dati sono trattati (non in riferimento a trasferimenti in Paesi terzi -elemento che è comunque richiesto dall’articolo 30 del GDPR -ma in riferimento ai sistemi informatici in cui sono trattati, ad esempio gestionali interni, servizi cloud, ecc: questo aspetto è fondamentale per garantire agli interessati l’esercizio dei loro diritti, ma anche per poter creare delle policy interne che consentano di autorizzare dipendenti e collaboratori in ordine ai diversi profili di trattamento)
  • documentazione relativa a violazioni di dati (che impone non solo di dotarsi di efficaci procedure interne e modulistica per poter far fronte tempestivamente agli obblighi di comunicazione eventualmente previsti, ma anche di conservare la documentazione relativa alle violazioni subite, a prescindere dal fatto che la comunicazione sia stata effettuata o meno).
  • valutazione di impatto sulla protezione dei dati: quando necessaria l’ICO consiglia non solo di tener traccia della DPIA effettuata, ma anche di tener traccia del suo stato di progressione, mentre la si effettua.

Alcuni di questi oneri “documentali” (che come si vede possono avere la forma più varia, spesso sostanziandosi in policy interne) sono imposti direttamente dal GDPR, altri invece sono opportuni per consentire al titolare un monitoraggio più efficace. Ad esempio, tenere traccia di “dove” i dati sono trattati potrebbe aiutare il titolare ad individuare trasferimenti all’estero dei quali non si è reso conto (operati magari inconsapevolmente attraverso l’uso di un sistema cloud), e incrociare tutte queste informazioni può ridurre la possibilità di omissioni o dimenticanze in ordine all’individuazione dei responsabili del trattamento; infine, una documentazione puntuale dei trattamenti ha indubbio vantaggio nella gestione delle istanze provenienti dagli interessati.

Non solo: la documentazione predisposta dal titolare, accompagnata ad audit e revisione delle procedure interne e della contrattualistica può aiutare il titolare  a monitorare la corretta applicazione della normativa.

E’ ovvio che il modello di registro dell’ICO dedica anche spazio alla  sintetica indicazione delle misure di sicurezza adottate, in modo che sia sempre facile procedere a revisione a seconda del trattamento operato, ma si tratta di uno degli elementi imposti dall’articolo 30 del Regolamento: mi permetto di aggiungere che tener traccia anche della valutazione operata al momento della scelta e dell’adozione delle misure, potrebbe aiutare il titolare a rivedere più rapidamente, anche a distanza di tempo, se la valutazione può ancora considerarsi congrua, e potrebbe facilitarlo in caso di controlli. Mi permetto anche di aggiungere di non dimenticare le “misure di sicurezza” contrattuali: vincolare dipendenti e collaboratori ad un accordo di riservatezza destinato a perdurare anche oltre la cessazione del rapporto di lavoro o collaborazione è una misura ben più efficace della “nomina a incaricato” alla quale eravamo abituati, e può permettere, per certi versi, di raccordare la tutela dei dati personali con quella accordata alle informazioni commerciali (cfr. Trade Secret Directive).

Data retention policy

L’ICO, in applicazione della propria normativa interna, suggerisce anche di documentare le politiche aziendali sulla conservazione e sulla cancellazione dei dati: sebbene tali procedure non siano imposte dal GDPR è chiara l’utilità che possono avere per dimostrare la conformità del titolare al Regolamento, soprattutto in riferimento ad adempimenti, quali la cancellazione, che, in mancanza, sarebbero piuttosto difficili da provare.

L’intervento del WP29

L’ICO ricorda come il WP29 voglia alleggerire gli oneri documentali delle piccole e medie imprese, che quindi potrebbero, in futuro, ricevere qualche “sconto”: tuttavia il WP29 non ha ancora provveduto sul punto (e peraltro se è vero che la documentazione aiuta a dimostrare la compliance al GDPR forse, anche in caso di “sconti,” sarà bene valutare cosa conviene comunque conservare).

Ci si permette di notare, tuttavia, che sino ad oggi il WP29 in realtà ha aggiunto più che togliere: ad esempio, in tema di data protection officer ha suggerito ai titolari e ai responsabili che versassero in stato di incertezza in ordine all’obbligo di designare il DPO, di procedere a una congrua valutazione scritta ove ritenessero di non dover procedere alla designazione, in modo da lasciarla a disposizione dell’autorità competente in caso di futuri controlli: e ciò proprio in ragione del principio di responsabilizzazione.

Sempre in tema di Data protection officer il WP29 ha consigliato di creare policy interne volte a precisare:

  • tempistiche e modalità di coinvolgimento del DPO nelle decisioni riguardanti la protezione dei dati;
  • determinazione più precisa delle ipotesi di conflitto di interesse;
  • determinazione delle modalità e tempistiche di intervento del DPO nelle valutazioni di impatto sulla protezione dei dati

Non solo: è evidente come anche la contrattualistica con il data protection officer consentirà di valutare l’efficacia della sua azione, anche i termini di autonomia e indipendenza, e come anche questa vada ad aggiungersi alle misure di accountability.

Conclusioni

E’ chiaro che la “documentazione” delle attività descritta sin qui è parte dell’accountability, ma non la esaurisce: restano esclusi da questa breve disamina, ad esempio, i principi di privacy by design e by default,  le indicazioni in ordine al contenuto della contrattualista che aiuta il titolare a mantenere il controllo sui dati personali in outsourcing, o a regolare i suoi rapporti con il data protection officer, o sulla metodologia con cui condurre una DPIA, o ancora, i criteri con i quali procedere alla valutazione del bilanciamento degli interessi in caso di trattamenti basati su di esso (banalmente: se verrà meno – come chi scrive ritiene probabile- il provvedimento generale del Garante privacy in tema di videosorveglianza, occorrerà che ogni titolare proceda da sè al bilanciamento che il Garante aveva operato nel provvedimento generale dell’8 aprile 2010, sulla base del legittimo interesse).

Qui ci si è limitati, sulla scorta dei suggerimenti dell’ICO a individuare la documentabilità di scelte, compiute dal titolare, che potrebbe non apparire immediata, o a suggerire di integrare la documentazione obbligatoria con elementi che possono essere utili al titolare e che non gli sono, magari, immediatamente percepibili.

L’ICO a titolo esemplificativo consiglia inoltre, in estrema sintesi ai titolari e ai responsabili di munirsi (secondo le rispettive necessità) di politiche interne sulla riservatezza dei dati, sulla protezione dei dati, sulla sicurezza, sull’utilizzo dei sistemi ( e qui, per noi, si aprirebbe anche tutto un capitolo in ordine all’utilizzo di sistemi aziendali, BYOD e controllo del lavoratore), sulla conservazione  e sugli accordi di contitolarità e  di accordi sul trattamento con i responsabili del trattamento.

L’ICO rammenta come documentare le attività di trattamento sia importante non solo perché è richiesto dalla normativa, ma anche perché è utile al titolare nella gestione dei dati e può aiutarlo a dimostrare la conformità ad altri aspetti del GDPR: insomma, la documentazione non ha valore in sé e per sé, come onere burocratico per scongiurare la sanzione, ma ha valore perché è di concreto ausilio al titolare nella sua attività di gestione dei dati e controllo sulla correttezza dei trattamenti, e perché lo aiuta a dimostrare la compliance agli obiettivi fissati dal GDPR.

Si tratta di un approccio, ad avviso di chi scrive, molto simile a quello già efficacemente descritto su queste pagine, ma guardato dalla prospettiva dell’accountability.

A dimostrazione che i vari obblighi che discendono dal GDPR, ove gestiti con accortezza, non sono destinati a sovrapporsi, ma ad integrarsi tra loro, e ad integrarsi con la gestione aziendale in misura maggiore e probabilmente più efficace di quanto avvenisse con la precedente normativa nazionale, specie ove ci si fosse rassegnati supinamente a un approccio smaccatamente burocratico e non aderente alla realtà nella quale si fosse preteso di calarlo.

Note

  1. Si vedano in proposito le linee guida (non ancora definitive) del Gruppo di lavoro articolo 29 in tema di trasparenza, ove è consigliato come buona pratica l’inserimento nelle informative di un sintetico accenno al bilanciamento operato: [adopted, but still to be finalized] Guidelines on Transparency under Regulation 2016/679 (wp260);
  2. Per agevolare i titolari nel bilanciamento degli interessi l’ICO ha recentemente pubblicato anche un modello di valutazione in formato word (“sample LIA template”) e una guida dettagliata (tutto in lingua inglese) reperibili all’indirizzo https://ico.org.uk/for-organisations/guide-to-the-general-data-protection-regulation-gdpr/legitimate-interests/

Bibliografia

 A cura di: Cesare Gallotti
Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/laccountability-oltre-il-registro-dei-trattamenti/


Il Cybercrime: un reato in continua Evoluzione

Lo sviluppo di tecnologie telematiche ed informatiche, sempre più sofisticate ed efficienti, ha favorito l’insorgere di nuove forme d’illecito diffuse nella nostra società attraverso l’impiego di strumenti di comune utilizzo quali computer, pc, tablet e cellulari.

I comportamenti illegali, di cui in questa sede si esamineranno gli aspetti e le criticità principali, vengono generalmente definiti reati informatici.

Si è in presenza di un cybercrime sia quando la condotta o l’oggetto materiale del crimine è correlato ad un sistema informatico o telematico, sia quando l’illecito è perpetrato sfruttando o colpendo il sistema.

Nel primo caso si fa riferimento alla categoria dei reati informatici impropri (cd. computer as a tool), disciplinati espressamente dal codice penale e dalla legislazione speciale, quali diffamazione a mezzo di posta elettronica, chat o siti internet; molestie perpetrate attraverso lo spamming o sui social network; istigazione a delinquere; riciclaggio; pedopornografia; etc.

Nel secondo caso, invece, si parla di reati informatici propri (cd. computer as a target) il cui scopo consiste unicamente nell’offendere il sistema informatico.

Tali fattispecie sono state introdotte nel nostro ordinamento dalla Legge n. 547/1993 e dalla Legge n. 48/2008, applicata in Italia a seguito di quanto richiesto con la Convezione sulla criminalità informatica del Consiglio d’Europa di Budapest del 23 novembre 2001. Tra i più diffusi vi sono: il danneggiamento dei dati, dei programmi e dei sistemi; la frode informatica; l’accesso abusivo; la detenzione e la diffusione dei codici d’accesso; la falsificazione di documenti informatici; l’interferenza illecita nelle comunicazioni; l’emissione di dispositivi o programmi informatici finalizzati ad interrompere o danneggiare un sistema informatico o telematico, etc.

Ciò premesso, appare utile evidenziare che affinché la condotta del soggetto possa essere qualificata come crimine informatico è necessario verificare l’esistenza di caratteristiche precise.

Si parla, quindi, di veri e propri elementi costitutivi che consentono di classificare ed inquadrare agevolmente il comportamento criminale.

I requisiti richiesti dal nostro ordinamento giuridico constano, in primo luogo, nella firma dell’autore del crimine (lasciata consciamente o inconsciamente) che può essere rinvenuta sulla scena del delitto o essere riconducibile al sospettato. Essa non varia in ragione della reiterazione della condotta illecita, diversamente dal modus operandi, e si estrinseca attraverso l’utilizzo di elementi univoci e ripetuti come ad esempio dettagli linguistici o grafici.

L’identificazione del colpevole può avvenire, altresì, analizzando le caratteristiche della vittima, soggetto passivo dell’illecito informatico.

Per quanto attiene, poi, alle modalità operative queste possono essere influenzate da variazioni temporali connesse agli aggiornamenti tecnologici o dovuti al miglioramento della propria esperienza nel settore, pur conservando al contempo un ruolo sostanziale nella correlazione di casi ed individui.

In tema di condotta e modalità operative, assume particolare importanza il fenomeno dello stanging che si verifica quando il criminale o le persone legate al reato commesso alterano completamente o parzialmente la scena del crimine o gli elementi ad essa collegati.

I fattori di rischio propri del cybercrime, inoltre, possono collimare con il risultato ottenuto a seguito della valutazione psicologica espletata durante la fase vittimologica o coincidere con il diverso livello di gravità dei fattori di rischio cui si espone il reo nell’agire illecitamente e da valutare caso per caso.

Da ultimo, ma non per questo meno importante, è il riscontro dell’esistenza di una motivazione, fondamento ed espressione chiara degli elementi psicologici, economici, politici o sociali che spingono l’individuo a delinquere.

In particolare, appare auspicabile porre l’accento sull’aspetto psicologico del reo onde poter individuare le caratteristiche che consentono di distinguere i vari profili del cybercriminale.

Precisamente, i crimini informatici scaturiscono da dinamiche psicologiche complesse che assumono senza alcun dubbio un ruolo di centralità nell’individuazione della personalità del delinquente informatico, che risulta essere ben diversa da quella propria dei soggetti che commettono reati che potremmo definire semplicemente tradizionali.

Il cybercriminale, infatti, appare come una persona tendenzialmente non violenta e solitaria, dotata di una grande capacità di pianificazione del comportamento che intende porre in essere al fine di sfruttare le proprie conoscenze informatiche, ma con scarse abilità di contenimento dell’ansia cagionata dall’impossibilità di avere un qualsiasi contatto sia con la scena del crimine che con la vittima.

L’aspetto senza alcun dubbio interessante è quello che concerne l’incapacità dell’individuo di prendere coscienza dell’illiceità del proprio operato.

In altre parole, lo sviluppo del settore informatico genera in alcuni soggetti delle alterazioni nella percezione del crimine, inducendoli così ad attuare comportamenti criminali che difficilmente realizzerebbero al di fuori del cyberspazio, come ad esempio: pedofili che non avrebbero mai il coraggio di adescare un bambino per strada; terroristi psicologicamente non adatti ad azioni militari; truffatori che non affronterebbero mai il face-to-face; impiegati che non avrebbero l’ardire di compiere azioni di sabotaggio a discapito della azienda di cui sono dipendenti; etc.

Pertanto, la classificazione basata sulla presenza di una motivazione corroborata dalla componente psicologica, ci consente di riscontrare l’esistenza di delinquenti informatici così definiti:

  1. attaccanti casuali (casual hackers): organizzano il proprio attacco per lo più spinti dalla curiosità e da motivi di natura emotiva, al punto da sentirsi già gratificati dal semplice utilizzo delle sottoscrizioni altrui su siti a pagamento;
  2. attaccanti politici (political hackers): militano a favore di una causa specifica basando le loro azioni sulle proprie conoscenze ed esperienze. Operano emotivamente e razionalmente per rendere pubblico l’ideale cui hanno aderito;
  3. crimine organizzato (organized crime): composto da attaccanti professionisti ed esperti del settore che agiscono con cura, prevalentemente per motivi di natura economica. Ogni progetto ha quale ultimo fine il profitto;
  4. squatters: agiscono in modo impersonale con obiettivi che non hanno alcun legame con il destinatario e l’identità del proprietario del sistema colpito. L’intento è quello di ottenere l’accesso ai database contenenti informazioni riservate, password, materiale video, musicale o immagini per motivi ludici e con scopi di natura privata non necessariamente criminali;
  5. insiders e intruders: gli attacchi riconducibili a questa tipologia possono essere portati a termine sia dall’interno ovvero dagli operatori o utenti interni ad un’organizzazione o ad un sistema informatico (insiders) che dall’esterno ovvero da attaccanti esterni che si introducono illegalmente all’interno di un’organizzazione (intruders).

Altro aspetto importante, oltre alla componente psicologica, è quello che concerne le capacità e le conoscenze del cybercriminale.

Quando si parla di intrusione nelle reti informatiche, vi è la convinzione che per porre in essere la condotta illegale siano necessarie una conoscenza ed un’abilità tecnica superiore alla media.

Una simile premessa, alla luce di quanto accade ogni giorno, risulta essere non solo errata ma, altresì, frutto di una sostanziale inconsapevolezza. Esistono, invero, diversi modi per introdursi all’interno di un sistema informatico.

Alcuni soggetti optano per la combinazione di maggiori capacità con le tecnologie più moderne, altri per azioni a distanza ed altri ancora per violazioni effettuate a stretto contatto con la lesione del bene giuridico tutelato, come accade frequentemente, ad esempio, nel caso di intrusioni all’interno dei sistemi aziendali.

Secondo una prima classificazione basata sul livello di abilità, risalente al 1987, gli autori degli illeciti devono essere distinti in:

  1. crackers: dotati di elevate competenze, conoscenza approfondita e comprovata esperienza, la cui attività di ricerca delle informazioni è gestita in modo ossessivo compulsivo;
  2. hackers: detentori di conoscenze di medio livello ed in grado di riconoscere alle informazioni ottenute la medesima importanza che gli attribuiscono i legittimi proprietari;
  3. rodents: competenze scarse e basso profilo.

Di guisa che, appare evidente che con simili presupposti è assai difficile circoscrivere l’ampio genus di illeciti realizzati dal delinquente informatico.

Ancora oggi, definiamo genericamente cybercriminale colui che attua una condotta che si estrinseca attraverso la violazione delle reti telematiche e dei sistemi informatici ed è accompagnata sovente da finalità meramente ludiche che con il tempo possono mutare, trasformandosi in comportamenti posti in essere per scopo di lucro sfruttando i dati ottenuti o inserendo programmi dannosi all’interno del sistema.

Nello specifico, l’hacking può manifestarsi in due forme o per meglio dire essere di tipo benevolo (cd. ethical hacking) perché commesso da individui che non desiderano danneggiare qualcuno o qualcosa nel momento in cui violano il sistema – come accade frequentemente nelle aziende nel momento in cui è necessario testare le misure di sicurezza – o malevolo perché perpetrato da individui che intendono danneggiare o sottrarre le informazioni contenute nei sistemi.

L’approccio con la delinquenza informatica, infine, può essere di natura criminologica, qualora si esamini il reato da un punto di vista squisitamente fenomenologico – scindendo dalle categorie giuridiche i comportamenti illeciti individuati e descritti -, civilistica, quando la problematica viene analizzata esclusivamente nell’ottica del danno arrecato ai singoli e ai mezzi di riparazione o penalistica nel momento in cui è necessario analizzare le componenti delle singole condotte per poter individuare le norme incriminatrici esistenti nell’ordinamento ed eventualmente applicabili al caso concreto.

Brevi cenni sulla sicurezza in rete

L’incessante sviluppo della rete e la mutevolezza dei sistemi di informazione celano il delicato problema della sicurezza, vale a dire la capacità delle reti di resistere alle violazioni o ad eventi imprevisti in grado di compromettere le componenti dei sistemi operativi di cui disponiamo.

Le proprietà fondamentali della sicurezza in rete sono:

  1. la disponibilità, l’autenticazione, l’integrità e la riservatezza dei dati, dei servizi forniti o fruibili attraverso l’accessibilità dei dati e dei servizi (anche in caso di interruzioni dovute ad eventi imprevisti o ad attacchi di pirateria informatica);
  2. l’autenticazione ovvero la conferma dell’identità dichiarata da un organismo o da un utente (anche se in alcuni casi è necessario preservare la possibilità per quest’ultimo di mantenere l’anonimato qualora non sia necessaria la conoscenza del profilo anagrafico);
  3. l’integrità, ossia il mantenimento dei dati trasmessi esattamente come sono, senza tagli o modifiche;
  4. la riservatezza, orientata alla protezione dei dati e fondamentale in caso di trasferimento di dati sensibili riguardanti le informazioni relative alla vita privata degli utenti.

In una simile situazione di precarietà, l’unico modo per tutelare la nostra privacy consiste nell’adottare pochi semplici accorgimenti quali ad esempio: l’utilizzo di password di non facile reperibilità e con codici alfanumerici; evitare la diffusione della propria password; l’installazione e la configurazione di firewall e di antivirus tenendoli costantemente aggiornati; servirsi di antispyware in grado di ripulire efficacemente il sistema; prestare attenzione ai cookies; non aprire allegati di e-mail provenienti da utenti sconosciuti o sospetti per non incorrere nel fenomeno del cosiddetto phishing; configurare il livello della privacy del browser almeno a livello medio; leggere attentamente le licenze e le disposizioni riguardo alla privacy prima di installare un qualsiasi software; utilizzare efficacemente il browser con il sistema di anti tracciamento.

Conclusioni

La continua evoluzione delle tecnologie informatiche unita al dilagare dei crimini ad essa connessi impone una riflessione sul punto.

Con il trascorrere del tempo le scoperte tecnologiche, frutto di studi approfonditi e di ricerche all’avanguardia, aumentano di giorno in giorno fornendo a ciascun individuo migliorie di ogni genere che entrano a far parte della quotidianità e della vita sociale, culturale, economica ed amministrativa dei Paesi.

La centralità del ruolo acquisito dall’informatizzazione ha apportato indiscutibilmente dei benefici nella nostra società, ma al contempo ci ha resi più vulnerabili.

La privacy di ognuno di noi è messa costantemente a dura prova. Le aziende e le pubbliche amministrazioni di tutto il mondo investono ingenti fondi per tentare invano di arginare uno dei più grandi e dilaganti problemi degli ultimi tempi.

Nostro malgrado, assistiamo al proliferare dei reati perpetrati attraverso i dispositivi informatici e sul Web da soggetti privi di inibizioni e che si macchiano, a volte, di alcuni tra i crimini peggiori esistenti, come nel caso della pedopornografia, del furto di identità o della frode informatica. Per non parlare dei dati sensibili o coperti da segreto sottratti alle loro fonti di provenienza.

Si manifestano a volte come crimini nuovi, strettamente legati all’utilizzo dei sistemi o come crimini tradizionali che trovano nelle tecnologie innovative ulteriori prospettive di azione.

Ed è proprio in funzione di queste criticità che l’aggiornamento tecnologico necessita di una produzione normativa ingente che sia al passo con la mutevolezza di questo mondo così vasto onde poter arginare i sempre più numerosi ed imprevedibili reati informatici.

Da un punto di vista meramente tecnico ciò non appare certamente agevole.

Tuttavia, negli ultimi anni, l’attenzione è stata focalizzata sulla politica dell’informazione per la sicurezza – con conseguente impiego e dispendio di energie, anche economiche, di notevole entità – per cercare di colmare le lacune prodotte dal lungo e farraginoso processo di emanazione delle norme giuridiche vigenti nell’ordinamento italiano.

I progressi e i risultati ottenuti sono rilevanti, ma molto altro deve ancora essere fatto, sia a causa delle lacune dell’ordinamento sia in ragione della costante incertezza interpretativa che caratterizza quella parte della giurisprudenza che disciplina i cybercrimes. A ciò si aggiunge l’inconsapevolezza dei fruitori dei sistemi informatici.

Ebbene, le sofisticate forme criminali di fronte alle quali siamo posti di certo non rendono più agevole l’amaro compito che lo Stato è chiamato a svolgere: rispettare la sottile linea di confine che intercorre fra la tutela delle informazioni e la tutela della libertà personale.

Invero, siamo in presenza di ambiti particolarmente delicati che necessitano dell’adozione di provvedimenti che non implichino una lesione dei diritti fondamentali e che contestualmente siano efficaci in termini di protezione dei sistemi.

Equilibri non facili da creare e quasi impossibili da mantenere in una società che si muove ad una velocità elevata.

BIBLIOGRAFIA:

  • S. AMORE, V. STANCA, S. STARO, I crimini informatici. Dottrina, giurisprudenza ed aspetti tecnici delle investigazioni, Halley, 2006.
  • F. ANTOLISEI, Manuale di diritto penale. Leggi complementari 2: Reati fallimentari, reati ed illeciti amministrativi in materia tributaria, di lavoro, ambientale ed urbanistica, responsabilità degli enti, Giuffré, Milano, 2014.
  • S. ATERNO, Digital Forensics (investigazioni informatiche), in Digesto delle discipline penalistiche, UTET, Torino, 2014.
  • M. BETZU, Regolare Internet. La libertà di informazione e di comunicazione nell’era digitale, GIAPPICHELLI, Torino, 2012.
  • C. CREMONESI, G. MARTELLA, I crimini informatici: storia, tecniche e difese, MONDADORI, Milano, 1990.
  • F. DELFINI, G. FINOCCHIARO, Diritto dell’informatica, UTET, Torino, 2014.
  • G. FIANDACA, E. MUSCO, Diritto penale. Parte speciale. Vol. II, ZANICHELLI, Bologna, 1996.
  • G. FIANDACA, E. MUSCO, Diritto penale. Parte speciale. 2.1: I delitti contro la persona, ZANICHELLI, Bologna, 2013.
  • https://www.treccani.it/enciclopedia/cybercrime_%28Lessico-del-XXI-Secolo%29/
  • https://www.interno.gov.it/it/speciali/campo-contro-cybercrime
  • https://www.theguardian.com/technology/cybercrime
  • https://www.interpol.int/Crime-areas/Cybercrime

A cura di: Valentina Bartolucci

Ha conseguito la Laurea magistrale in Giurisprudenza nell’anno accademico 2010/2011 con una tesi in Diritto penale e si è diplomata nel 2013 presso la Scuola di Specializzazione per le Professioni Legali della LUISS Guido Carli.

Dal 2011 collabora con alcune delle più importanti riviste giuridiche italiane.

Dall’ottobre 2012 al giugno 2013 ha effettuato il tirocinio presso il Tribunale Civile di Roma, Diritto del Mercato (XI sezione – Diritto societario e del libero mercato).

Dal 2013 è tutor d’aula per i corsi di formazione continua degli Avvocati – sede di Roma.

Nel 2014 ha conseguito il Master in Diritto e contenzioso bancario e finanziario.

Dal 2014 è consulente legale in materia di diritto civile, penale ed amministrativo, con particolare attenzione alle cause collettive ed alla malpractice medica.

Dal 2015 è iscritta all’Ordine degli Avvocati di Roma.

Dal 2016 è titolare dello Studio legale Cappelletti-Bartolucci, con sede in Roma e in Arezzo.

Nel 2017 ha conseguito il Master in contrattualistica internazionale.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-cybercrime-un-reato-in-continua-evoluzione/


Sorveglianza e profitto: qual è il giusto prezzo di ciò che è gratuito?

“E la Yakuza stava stendendo la sua rete occulta sulle banche dati della città, cercando pallide immagini di me stesso riflesse su numeri di conto corrente, assicurazioni, bollette. Siamo un’economia fondata sull’informazione. Lo insegnano a scuola. Quello che non dicono è che è impossibile muoversi, vivere, operare a qualunque livello senza lasciare tracce, segni, frammenti di informazione apparentemente privi di significato. Frammenti che possono essere recuperati e amplificati…”

William Gibson, “Johnny Mnemonic”, 1981

Lo scandalo Facebook-Cambridge Analytica

A metà 2014 Cambridge Analytica (azienda che accumula dati personali per creare profili psicologici per campagne di comunicazione e che opera secondo un sistema di microtargeting[1] comportamentale) commissionò a Aleksander Kogan, docente di psicologia all’università di Cambridge, la raccolta di alcune informazioni relative a profili di utenti Facebook. Kogan creò l’app “This is your digital life”, essenzialmente un quiz sulla personalità, riuscendo a somministrarlo anche tramite l’utilizzo di piattaforme quali Mechanical Turk di Amazon, uno dei servizi più controversi della cosiddetta gig economy[2] il cui motto recita “Intelligenza Umana tramite API – Accesso a una forza lavoro globale, su richiesta e 24×7”.

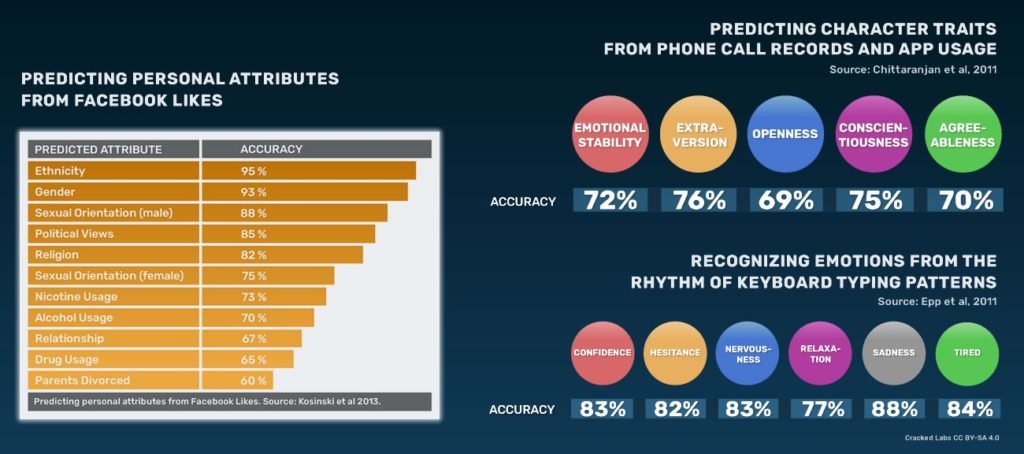
Kogan riuscì a far eseguire il quiz a poco meno di 300.000 utenti Facebook (dietro pagamento di pochi centesimi a ciascuno di essi) e a raccogliere informazioni non solamente su di loro, ma anche sui loro amici (nel caso in cui i settaggi della privacy lo consentissero), ampliando il perimetro di collezione dei dati ad un numero di utenti sconosciuto ma oscillante tra 50 e 90 milioni. Kogan, in realtà, prima di sviluppare la propria app cercò invano di convincere Michal Kosinski, uno dei principali studiosi dell’intersezione tra psicometria[3] e big data, a fargli utilizzare i dati raccolti tramite analoghe app che quest’ultimo aveva realizzato per scopi di ricerca. Kosinski aveva dimostrato nel 2013 la possibilità di predire tratti e attributi personali da una varietà di informazioni che generiamo quotidianamente durante l’utilizzo delle piattaforme di social network o di altri servizi Web: ad esempio, analizzando i Like su Facebook è possibile dedure con buona accuratezza diverse informazioni personali[4]. Kosinski si è sempre detto preoccupato per l’elevato rischio di perdita della privacy connaturato a pratiche sconsiderate di raccolta e analisi dei dati.

Normalmente Facebook ha sempre consentito agli sviluppatori che realizzano app all’interno del proprio ecosistema questo genere di raccolta dei dati, ma solamente per scopi di ricerca accademica e non per utilizzo commerciale. Facebook accusa Kogan di aver venduto i dati ricavati tramite la propria app a Cambridge Analytica, violando le regole e le policy aziendali. Facebook ha anche sospeso improvvisamente Cambridge Analytica dalla propria piattaforma: a quanto pare sapeva del problema da un paio d’anni ma non era stato realizzato alcun intervento risolutivo, come sostenuto dall’immancabile whistleblower (ce n’è sempre uno in ogni scandalo che si rispetti) Christopher Wylie, ex dipendente di Cambridge Analytica.

Non siamo quindi in presenza di alcuna violazione di sicurezza o Data Breach, ma di un utilizzo dei dati considerato illegittimo da parte di Facebook.

Dati per analisi

Non solo Facebook, anche Google. Microsoft, Amazon, Alibaba e tante altre aziende fanno business tramite la condivisione e la compravendita di profili digitali. Molti aspetti relativi alla personalità possono essere dedotti dalle ricerche che effettuiamo quotidianamente sul web, dall’history del nostro browser, da come guardiamo i video, dalle attività che facciamo sui social network e dagli acquisti che operiamo. Attributi personali sensibili quali etnia, appartenenza religiosa o politica, stato civile, orientamento sessuale, utilizzo di droghe, alcool o sigarette possono essere ricavate dai Like di Facebook. Stessi risultati sono ottenibili tramite l’analisi delle app e del traffico telefonico così come dagli schemi di digitazione sulla tastiera[5]:

Figura 1 – Analisi dei Like di Facebook, dei dati telefonici e degli schemi di digitazione

I metodi attuali di data mining e analytics poggiano su correlazioni statistiche con determinati livelli di probabilità e nonostante il miglioramento generalizzato delle capacità predittive degli algoritmi ci sono ancora margini di miglioramento in termini di accuratezza. Questi metodi sono utilizzati per ordinare, categorizzare, etichettare, sistemare, valutare e classificare le persone non solo per finalità di marketing, ma anche in contesti decisionali quali le operazioni finanziarie, assicurative, sanitarie o per influenzare scenari politici. Alcuni use case tipici riguardano la valutazione del merito di credito tramite dati di comportamento digitale o la previsione sulla salute in base ai dati dei consumatori.

Data Broker

La raccolta dei dati personali digitali avviene su scala globale: Facebook detiene i profili digitali di circa 2 miliardi di utenti della propria piattaforma, oltre a quelli di Whatsapp e Instagram. Google ha i profili di oltre 2 miliardi di utenti di dispositivi Android, oltre a quelli di Gmail e Youtube. Apple possiede i profili di circa 1 miliardo di proprietari di dispositivi con a bordo iOS. I profili digitali di Facebook usano circa 52.000 attributi per identificare l’identità dei propri utenti e categorizzarli: tutto ciò è possibile tramite l’analisi di post, Like, commenti, condivisioni, amici, foto, video, check-in di localizzazione geografica e così via. Cosa di notevole interesse, sono aziende come Facebook a comprare altra informazione da broker di dati come Acxiom per aumentare il perimetro di analisi e migliorare l’accuratezza dei propri profili digitali.

I broker di dati sono al centro dell’industria dei dati personali e si occupano di aggregare, combinare e scambiare commercialmente enormi quantità di informazioni, collezionate da sorgenti disparate sia online sia offline. Di solito i dati provengono da fonti diverse dagli individui e spesso, soprattutto nel cyberspazio, sono collezionati senza consenso. I broker analizzano i dati, fanno deduzioni e applicano inferenze, ordinano i profili in categorie e forniscono migliaia di attributi individuali ai propri clienti. I profili che i broker hanno sugli individui includono informazioni relative a educazione, lavoro, figli, religione, etnia, schieramento politico, attività, interessi, utilizzo dei media, ma anche comportamenti online quali, ad esempio, le ricerche effettuate sul web. I broker collezionano dati relativi agli acquisti, all’utilizzo delle carte di credito, al reddito e ai prestiti, alle posizioni bancarie e assicurative, alla proprietà di veicoli e immobili e a una varietà di altre tipologie di dato. I broker calcolano punteggi in grado di predire il possibile comportamento futuro di un individuo, con attenzione, ad esempio, alla stabilità economica o ai piani di fare un figlio o cambiare lavoro.

La sorveglianza dei consumatori è molto più vecchia di Internet: prima esistevano quattro principali filoni. Il primo, relativo alle aziende che tracciano le abitudini dei propri clienti, ha portato all’utilizzo di sistemi CRM. Il secondo era il marketing diretto tramite posta cartacea, basato su informazioni demografiche. Il terzo proveniva dagli istituti di credito, che collezionavano dettagli sui propri clienti per vendere le informazioni alle banche per scopi finanziari. Il quarto era relativo al governo e consisteva di diverse informazioni pubbliche: certificati di nascita e di morte, patenti di guida, permessi e licenze, schede elettorali e cosi via. Gli istituti di credito e le aziende di marketing diretto hanno combinato i quattro filoni per diventare i moderni data broker, come Acxiom.

Più dati produciamo, più i data broker li collezionano e sono in condizione di profilarci con maggior accuratezza.

Metadati

Un metadato è un’informazione che descrive un insieme di dati[6], tipicamente utile all’elaborazione di una macchina. I dati sono il contenuto, i metadati sono il contesto: possono rivelare molto più dei dati stessi, soprattutto se aggregati e proiettati su vasta scala.

Come ha detto il General Counsel dell’NSA Stewart Baker, “i metadati ti dicono tutto sulla vita di una persona. Se hai abbastanza metadati, non hai proprio bisogno del contenuto dell’informazione”; il Generale Michael Hayden, ex direttore dell’NSA e della CIA, si è spinto oltre, asserendo che “uccidiamo le persone sulla base dei metadati[7]”.

I tratti caratteristici della personalità possono essere dedotti dalle informazioni relative ai siti web acceduti, così come dall’analisi dei flussi delle chiamate telefoniche e dai dati relativi all’utilizzo delle applicazioni sugli smartphone: i metadati concorrono in maniera determinante alla sorveglianza e al monitoraggio dei comportamenti digitali su Internet.

Il Peccato Originale di Internet

In un famoso articolo pubblicato su Atlantic nel 2014[8], Ethan Zuckerman, direttore del «Center for Civic Media» del MIT, fece pubblica ammenda su quello che chiamò il “Peccato Originale di Internet”. Tale peccato consiste nell’aver contribuito attivamente (Zuckerman è l’ideatore del pop up[9]) al fatto che l’unico modello di business sostenibile di Internet fosse, ed è ancora oggi, la pubblicità. Siamo stati educati così: per poter usare gratis un servizio Internet (che comporta costi notevoli per poter essere erogato) cediamo dati personali e forniamo informazioni di vario tipo. Siamo spesso ben disposti a cedere dati in cambio di servizi, anche se spesso non si tratta di un processo bilanciato e chiaro. Ne consegue che è materialmente impossibile immaginare un modello di pubblicità on-line che non comporti una forma di sorveglianza degli utenti: più ci apriamo alla sorveglianza, più gli strumenti e i contenuti che vogliamo rimarranno gratuiti. Secondo Zuckerman ormai l’unico modo per sovvertire l’attuale modello di business è iniziare a pagare i servizi che riteniamo importanti: “è ora di iniziare a pagare per proteggere la nostra privacy, sostenendo i servizi che amiamo e abbandonando quelli che sono completamente gratuiti ma guadagnano solo vendendo le preferenze e le scelte dei loro utenti”[10]. Il modello di business di Internet si fonda quindi sul monitoraggio continuo del comportamento dei propri utenti, altrimenti noto come sorveglianza.

Capitalismo della Sorveglianza e Privacy

Il Capitalismo della Sorveglianza[11] è profondamente innestato nella nostra società sempre più computerizzata e il suo principale obiettivo, semplicemente, è monetizzare i dati acquisiti tramite la sorveglianza. Questo genere di capitalismo[12] porta lo scenario finora analizzato a un livello superiore avvalendosi della manipolazione psicologica nella forma di pubblicità personalizzate per persuaderci a comprare qualcosa o a fare qualcosa (nel caso di Cambridge Analytica, votare per un candidato). I servizi web che usiamo quotidianamente sono gratuiti perché in cambio cediamo i nostri dati e da questo modello di business ne consegue una proporzionalità diretta tra quantità di dati raccolti e qualità dei servizi erogati: tanto maggiore la pervasività della sorveglianza, tanto migliore l’efficacia dei servizi offerti e della pubblicità associata. In questo scenario lo smartphone è probabilmente il dispositivo tecnologico di sorveglianza più intimo mai realizzato: traccia costantemente la nostra posizione geografica, sa dove viviamo, dove lavoriamo e dove spendiamo il nostro tempo, è la prima e ultima cosa che controlliamo ogni giorno, quindi sa quando ci svegliamo e quando andiamo a dormire. Tutti ne abbiamo almeno uno, quindi sa anche con chi dormiamo.

Nel 2016 l’Unione Europea ha approvato il General Data Protection Regulation (GDPR): il regolamento è ampio e complesso ma alcune prescrizioni sono relative al trattamento dei dati personali dei cittadini dell’Unione Europea, che possono essere collezionati e conservati solamente per “scopi specifici, espliciti e legittimi” e solamente con l’esplicito consenso dell’utente. Il consenso non può essere seppellito all’interno delle clausole contrattuali dei Termini e delle Condizioni di Utilizzo o espresso in “legalese”; nemmeno può essere dato per scontato fino a quando l’utente non lo esprime esplicitamente. In vista dell’entrata in vigore del GDPR, PayPal ha pubblicato una lista di 600 aziende con cui potrebbe condividere i dati personali dei clienti[13]: che cosa succederà quando ogni azienda dovrà pubblicare questo tipo di informazioni e spiegare esplicitamente come le sta utilizzando?[14] Le risposte collettive riguardano le regole, a livello individuale è possibile prendere decisioni “drastiche” (#DeleteFacebook[15]) e/o adottare una serie di comportamenti online per limitare la raccolta indiscriminata dei propri dati (ci sono numerose guide in merito[16],[17]).

NOTE

A cura di:  Andrea Boggio

Andrea Boggio è Business Development Manager in Fastweb dal 2014 ed è coinvolto in attività di prevendita e progettazione di servizi di Cyber e ICT Security, con particolare attenzione al settore della Pubblica Amministrazione. In precedenza ha lavorato presso multinazionali (HP, NTT Data) e presso aziende italiane focalizzate sulla sicurezza informatica.
Andrea lavora da oltre 15 anni nell’Information Security Arena e si occupa di diverse aree tematiche quali: Governance, Risk & Compliance, SIEM e SOC, Mobile Protection, Threat e Vulnerability Management, Network Security e Cyber Security.
Andrea detiene le certificazioni professionali ISO/IEC 27001:2013 Lead Auditor, CISA, CISM, CGEIT, CRISC, ITIL e diverse altre legate a specifici vendor di sicurezza, è membro del capitolo italiano di ISACA e ha partecipato al Cloud Security and Resilience Expert Group di ENISA.

Download PDF

https://www.ictsecuritymagazine.com/articoli/sorveglianza-e-profitto-qual-e-il-giusto-prezzo-di-cio-che-e-gratuito/


Net Neutrality: Regole e Sicurezza

Ho sempre pensato che le regole debbano essere uno strumento di equilibrio e non di sopraffazione delle libertà altrui. Tuttavia la storia ci insegna che gli eccessi di libertà confinano con l’intolleranza, come l’eccesso di leggi confinano con l’autoritarismo.

Un aforisma attribuito a Voltaire recita: “La mia libertà finisce dove inizia la tua”, e ancora più famosa: “Non sono d’accordo con quello che dite, ma mi batterò fino alla morte affinché possiate dirlo”. Frasi che esprimevano un concetto di tolleranza. Tolleranza sempre più in crisi nella nostra epoca dove vale il principio del più forte, e il denaro, quale strumento del più forte, è sempre più l’unico strumento regolatore del mercato e delle condizioni di vita delle persone.

In un mondo dove le diseguaglianze sociali sono in netto aumento, è il denaro a determinare quanto vale la libertà di una persona, quale istruzione può permettersi, quale assistenza sanitaria può ricevere, in quale luogo può vivere o sopravvivere. E tutto ciò in netta antitesi con il concetto di civiltà dove non è il denaro lo strumento regolatore ma le regole condivise, nella fattispecie le leggi.

Quindi quando pensiamo alle regole non dobbiamo pensare ad uno strumento di oppressione, come non pensiamo sia uno strumento di oppressione quando stabiliamo delle regole per i nostri figli, anzi, pensiamo sia educativo perché così facendo cresciamo dei buoni figli e dei futuri cittadini liberi e responsabili. Allora possiamo affermare che non c’è libertà senza responsabilità, come non c’è civiltà senza libertà responsabili. Di conseguenza si può dedurre quindi che non c’è libertà in rete senza la Net Neutrality quale strumento giuridico di regolamentazione.

Cos’è la ‘NET NEUTRALITY’

La Net Neutrality come principio giuridico a tutela della neutralità della rete è nato in Europa e normato con il regolamento europeo 2015/2120 applicato in via definitiva anche in Italia con la supervisione di AGCOM. Negli USA, invece, è stata normato con legge federale nel 2015 sotto la presidenza di Obama e controllata dalla Federal Communications Commission (FCC).

Nella fattispecie, la ‘Net Neutrality’ o “neutralità della rete” è un principio giuridico, riferito alle reti residenziali a banda larga che forniscono accesso a internet, dove il traffico delle informazioni, quali messaggi, video, foto, file musicali o accesso a pagine private o istituzionali, usufruiscono della stessa velocità di rete.

In particolare, allo stato attuale, a nessun fornitore di servizi come Spotify, Youtube e Netflix può essere garantita una velocità maggiore per arrivare all’utente finale. Infatti internet è nata con principi democratici legati all’originalità delle idee e dei contenuti, e non come idea di business.

Stato attuale della ‘NET NEUTRALITY’

Sulla ‘Net Neutrality’ abbiamo due punti di vista diversi: il primo, che potremmo definire di civiltà, è il luogo delle idee e dei contenuti in un’ottica di condivisione dei saperi e senza privilegi sul vettore di rete, ed è quello che ha portato poi ad una regolamentazione di internet; il secondo, invece, ha come obbiettivo primario il luogo dove fare business in un ambito di globalizzazione, ed è quello che ha portato il 14 dicembre 2017 alla decisione dell’autority statunitense, FCC, di liberalizzare il mercato dei servizi di rete: velocità della rete direttamente proporzionale alla quantità di denaro che si è disposti a spendere. In altri termini, per semplificare il concetto, possiamo paragonare la liberalizzazione dei servizi di rete ad un’autostrada con corsie preferenziali ad alta velocità, che avranno un costo maggiore, e ad una corsia lenta che avrà costi minori e servizi scadenti.

In particolare, i grandi provider americani, fornitori delle connessioni internet (essenzialmente Verizon, ComCast ed At&T) non dovranno più rispettare l’obbligo di non discriminazione, come previsto dalla ‘Net neutrality’, rispetto al contenuto della loro fornitura. In altri termini, l’offerta di pacchetti riguardanti la sola navigazione vengono superati da offerte diversificate legate a quali contenuti gli utenti possono avere accesso e a quali velocità possono navigare. Ed è chiaro a questo punto chi deve guadagnare e chi deve pagare: i fornitori di vettori come Verizon, ComCast ed AT&T guadagneranno e i fornitori di contenuti come i social, youtube e Netflix dovranno sborsare più soldi per offrire i loro servizi su linee a velocità adeguate.

Ovviamente i costi di quest’ultimi si riverseranno sugli utenti ricchi e poveri, ma è ai primi che toccherà il privilegio di avere servizi con buona velocità di traffico, agli altri toccherà avere servizi su linee lente e affollate. Ora qualcuno potrà anche obbiettare che si può anche fare a meno del sollazzo destinato solo ai ricchi e benestanti, tuttavia, le ripercussioni di queste diseguaglianze possono avere serie conseguenze sociali.

Regole e Sicurezza

Per meglio comprendere l’importanza della ‘Net Neutrality’, occorre sapere cosa sono le regole e cos’è la sicurezza. In qualsiasi campo, dall’economia al sociale e alla scienza, le regole servono a prevenire errori, eventi non desiderati per la buona riuscita di un obbiettivo o di un progetto. Applichiamo tuttavia regole anche quando sviluppiamo un algoritmo o scriviamo un codice per un software di sicurezza.

Sono altresì sinonimo di regole: norma, legge, dettame, principio, precetto, direttiva, metodo, metodologia, regolamento, prammatica disciplina, ordinamento, statuto, normativa, regolamentazione e sono contrari invece: irregolarità, eccezione, indisciplina, disordine e improvvisazione.

Non è un caso, quindi, che regole e sicurezza, non eccedenti, siano presupposti l’uno dell’altra. E che ogni buona regola, venga spesso sovvertita, ce lo ricorda anche Umberto Eco che da buon semiologo nel suo romanzo capolavoro il “Nome della rosa” ci invita a leggere i segni del cambiamento quando in occasione della partenza dall’abbazia Guglielmo da Baskerville rivolge queste parole al giovane Adso da Melk: “Tu hai vissuto in questi giorni, povero ragazzo, una serie di avvenimenti in cui ogni retta regola sembrava essersi sciolta. Ma l’anticristo può nascere dalla stessa pietà, dall’eccessivo amor di Dio o della verità, come l’eretico nasce dal santo e l’indemoniato dal veggente; e la verità si manifesta a tratti anche negli errori del mondo, cosicché dobbiamo decifrarne i segni, anche là dove ci appaiono oscuri e intessuti di una volontà del tutto intesa al male”

Tuttavia la scelta statunitense sull’annullamento della ‘Net Neutrality’ ha tutti i segni dell’aumento delle diseguaglianze sociali e il sovvertimento di buone regole mette in evidenza problemi di sicurezza sociale e un futuro incerto per quella che doveva essere la rete di tutti. D’ora in avanti molti cittadini americani saranno penalizzati da scelte che metteranno in discussione lo sviluppo di quella economia basata sull’internet delle cose (IoT) in cui un vettore potrà avere costi proibitivi per chi fa ricerca e sviluppo. E costi proibitivi si ripercuoteranno anche in quei settori applicativi ormai così diffusi della telemedicina e della logistica.

Riguardo la situazione europea e quella italiana in particolare, la ‘Net Neutrality’ al momento resiste nonostante la pressione delle lobby delle telecomunicazioni. Tuttavia la ‘Net neutrality’ è un tema di pertinenza politica, prima che tecnica. Infatti in Europa viene legiferato da organismi politici, e cioè dal Parlamento Europeo e dal Consiglio, non dalla Commissione, che è organo puramente tecnico e il cui ruolo principale è quello di revisore. Negli USA al contrario, la questione è stata demandata ad un organo tecnico, la FCC, che l’ha decisa con una stretta maggioranza dei suoi membri: 3 a 2. Tuttavia una flebile speranza anima il ricorso dei procuratori di 23 stati americani il cui responso è atteso per il 23 aprile.

Bibliografia

  • Agrillo, A., (2015), Net Neutrality: Una rete senza discriminazioni, Torino, MiT Press;
  • Fachechi, A., (2015), Net Neutrality e discriminazioni arbitrarie. Edizioni Scientifiche Italiane
  • Orofino, M., Federalismi.it (2016) La declinazione della net-neutrality nel Regolamento europeo 2015/2120. Un primo passo per garantire un’internet aperta?
  • Cencetti C., (2014), Cybersecurity: Unione europea e Italia: Prospettive a confronto, Roma, Ed. Nuova Cultura

A cura di: Agostino Agrillo

Download PDF

https://www.ictsecuritymagazine.com/articoli/net-neutrality-regole-e-sicurezza/


I Meccanismi di Non Ripudiabilità del documento informatico

Introduzione

L’economia moderna è caratterizzata da un’incessante evoluzione dei modelli di comunicazione, dalla nascita di innovative forme di business, dal sorgere dei mercati virtuali e globali, dalla dematerializzazione dei processi gestionali e burocratici. L’intensificarsi della dinamica dei processi economici, per effetto di un nuovo sistema informativo, introdotto con l’uso degli strumenti di ICT, ridisegna i processi organizzativi in termini di digital trasformation, per la semplificazione e deburocratizzazione dell’organizzazione pubblica e privata.

In questo scenario, si è reso necessario un nuovo quadro normativo, che regoli la trasformazione dei sistemi di document management, e possa guidare verso la completa trasformazione e automazione dei processi e delle procedure, attraverso l’adozione di strumenti quali il protocollo informatico, sistemi di classificazione e fascicolazione elettronica degli archivi digitali, sistemi per il passaggio dal cartaceo al digitale, soluzioni per la creazione di documenti nativi digitali, per la firma digitale e la fatturazione elettronica.

Questo cambiamento ha portato ad una graduale sostituzione dei supporti tradizionali della documentazione amministrativa in favore del “documento informatico”, a cui viene attribuito pieno valore giuridico, grazie alla definizione degli standard sulle tecnologie e procedure da impiegare.

Non ripudiabilità del documento informatico

Il problema fondamentale che il legislatore è stato chiamato a risolvere, è quello inerente alle caratteristiche fondamentali che il documento informatico deve rispettare per avere pieno valore legale, con l’obiettivo di poter garantire la cosiddetta non ripudiabilità del messaggio.

A tal fine era stato emanato il D.P.R. 445 del 28 dicembre 2000, recante «disposizioni legislative in materia di documentazione amministrativa» che, dopo aver definito il documento informatico come «la rappresentazione informatica di atti, fatti o dati giuridicamente rilevanti», dispone che lo stesso «da chiunque formato, (nonché) la registrazione su supporto informatico e la trasmissione con strumenti telematici, sono validi e rilevanti a tutti gli effetti di legge, se conformi alle disposizioni del presente testo unico».

A garantire la non ripudiabilità del documento digitale, abbiamo la firma digitale, considerata come equivalente informatico della tradizionale firma su carta. La tecnologia della firma digitale permette di verificare la provenienza, l’integrità e l’immodificabilità del documento in formato elettronico.

In conclusione, la legge italiana equipara la firma digitale a quella autografa, il documento informatico al documento cartaceo, la spedizione telematica alla spedizione tradizionale, il contratto stipulato via internet a quello tradizionale.

Gestione Documentale Digitale Avanzata

La gestione elettronica dei documenti rappresenta oggi una componente importante dei sistemi informativi di un’amministrazione o dell’azienda privata, in quanto, implementa, sul piano procedurale ed informatico, le regole tecniche normative del documento informatico e della firma digitale, e introduce:

  • La gestione dei documenti cartacei, tramite soluzioni di Intelligent Data Capturing (ormai molto performanti) che trasformano semi-automaticamente documenti destrutturati in ingresso in dati strutturati, da incanalare nel flusso digitale;
  • Funzioni di archiviazione, trattamento, gestione, accessibilità e circolazione dei documenti in formato elettronico con piena validità legale;
  • Gestione a norma della fatturazione elettronica PA e B2B;
  • Integrazione di sistemi di Business Intelligence;
  • Gestione dei sistemi di Conservazione Sostitutiva e Digitale dei documenti in modo conforme all’attuale normativa.

Inoltre, per una corretta gestione dei dati sensibili gestiti tramite sistemi informatizzati, è necessario assicurare la riservatezza dei dati scambiati sia in conformità alla normativa vigente (prima il Decreto Legislativo n. 196/2003, conosciuto come Codice per la protezione dei dati personali, successivamente la nuova legislazione in materia di protezione dei dati introdotta nel 2015 con il General Data Protection Regulation, in sostituzione alla direttiva sulla protezione dei dati del 1995 le aziende che gestiscono i dati personali dei cittadini europei dovranno sottostare a nuovi obblighi e responsabilità.)

I meccanismi di non riputiabilità

I meccanismi di non repudiabilità sono messi in opera attraverso algoritmi e protocolli di firma digitale, di calcolo di condensati, di marcatempo. La messa in opera meccanismi di non repudiabilità necessita la partecipazione di servizi infrastrutturali (per esempio, infrastrutture a chiave pubblica, autorità di certificazione, servizi marcatempo certificati).

Panoramica del mercato

Il Gartner Group, ha affermato che “ci troviamo nel bel mezzo di una epidemia di una perdita di dati”. Basti citare il recentissimo caso di Facebook sulla protezione dei dati. Questo presuppone l’implementazione di avanzati sistemi di sicurezza volti a fare in modo che i dati non possano essere in qualche modo persi, corrotti e soprattutto ripudiati dalle parti coinvolte in una transazione via rete garantendo la privacy.

Impatti sulle Aziende

La crescente informatizzazione delle aziende, della pubblica amministrazione e della società in generale, inevitabilmente comporterà l’introduzione di processi documentali digitali, supportati dalla firma digitale e dai sistemi di non ripudiabilità a tutti i livelli e in tutti gli ambiti.  In particolare, stiamo andando verso una gestione delle informazioni in maniera digitale per tutti i settori: dal settore bancario a quello del commercio, dal settore pubblico al privato. Questo cambiamento sarà accompagnato da nuove applicazioni pratiche che vanno dal diritto d’autore al commercio elettronico, dalla sicurezza informatica alla corrispondenza (e-mail) protetta e sicura.

Applicazioni pratiche della firma digitale e meccanismi non ripudiabilità

  • Stipula di contratti (conclusione e firma degli accordi);
  • Adempimenti fiscali e burocratici;
  • Diritto d’autore;
  • Commercio elettronico;
  • Sicurezza informatica;
  • Corrispondenza (e-mail) protetta e sicura.

Considerazioni

La soluzione ai problemi di identificazione, autenticazione e privacy nei sistemi informatici può essere trovata nell’ambito della crittografia.

Grazie ad algoritmi di cifratura è possibile garantire la confidenzialità, l’integrità e la non ripudiabilità dei documenti e dei dati trattati e scambiati. Le soluzioni finalizzate a tale problematica sono molteplici, per garantirsi la non ripudiabilità, è utile disporre di un’infrastruttura condivisa con i propri interlocutori che supporti workflow documentali a norma, integrati con sistemi di firma digitale.

Utilizzando certificati digitali, è possibile scambiare email criptate e firmate: raggiungendo un elevatissimo grado di confidenzialità, nonché la sicurezza relativa all’autenticità del mittente.

Le soluzioni attualmente presenti nel mercato sono molteplici, un approccio condiviso è l’impiego di strumenti omogenei che siano in grado di garantire una governance completa del processo di cifratura tramite soluzioni preconfezionate o sviluppate ad hoc.

Il processo di digitalizzazione delle aziende permetterà di costruire un percorso di crescita professionale e di prodotto, costante e all’avanguardia, senza perdere di vista le norme che regolano il settore, con la sfida di fornire strumenti orientati alla massima usabilità, per semplificare le procedure orientate al rispetto della norma stessa, che permetta alle aziende un reale abbassamento dei costi e dei tempi di gestione, conservazione dei documenti, con soluzioni fruibili su tutti i dispositivi Desktop e Mobile.

A cura di: Cristian Rei

Download PDF

https://www.ictsecuritymagazine.com/articoli/i-meccanismi-di-non-ripudiabilita-del-documento-informatico/


BYOD Quando l’ufficio è nello zaino

La tecnologia ci offre vantaggi sconfinati: ci permette di vedere un film mentre siamo in treno o di fotografare un airone che si libra all’improvviso mentre siamo in riva al lago. La maggior parte delle nostre attività possono svolgersi utilizzando un solo dispositivo che, peraltro, possiamo comodamente conservare nelle nostre tasche o nel nostro zaino.

È questo il punto di partenza del Bring Your Own Device (BYOD) che, in italiano, si traduce in Porta Il Tuo Apparato. È un fenomeno associato al rapporto di lavoro ed alla possibilità, per il lavoratore, di utilizzare i dispositivi elettronici di sua proprietà per l’attività lavorativa.

Quindi, un principio apparentemente semplice per il quale, tuttavia, occorre qualche riflessione sugli aspetti critici che accompagnano questa scelta organizzativa.

Facoltà o obbligo?

L’utilizzo dei dispositivi di proprietà del lavoratore può derivare da una facoltà, esercitata dal lavoratore, o da un obbligo, imposto contrattualmente dal datore di lavoro.

I dispositivi personali fanno parte della nostra vita e, di fatto, ogni lavoratore ha almeno uno smartphone che porta sempre con sé: perché non utilizzarlo anche per il lavoro? Perché non chiedere al datore di lavoro di realizzare un’app da installare sul proprio telefonino? In questi casi, il vantaggio è reciproco:

  • il lavoratore non è costretto a tenere ulteriori dispositivi dedicati all’attività lavorativa;
  • il datore di lavoro non deve acquistare dispositivi ulteriori né deve pagare relativi costi di connessione alla rete visto che, con le tariffe attuali, quasi tutti i lavoratori sono dotati di una propria linea fonia/dati flat o, comunque, abbondante.

Stessi vantaggi ma visione capovolta se l’iniziativa parte dal datore di lavoro. Il BYOD si avvia come un obbligo contrattuale ed il lavoratore, soprattutto se neoassunto, deve dotarsi di un dispositivo adeguato alle caratteristiche previste dal datore di lavoro.

Sul luogo di lavoro o all’esterno?

Il dispositivo personale può essere utilizzato all’interno dei luoghi di lavoro o, più frequentemente, all’esterno.

Un caso di utilizzo interno, può essere la necessità di misurare costantemente l’altezza dal suolo di un lavoratore e, quindi, attivare un alert per l’obbligo di utilizzare appositi dispositivi di protezione individuale contro il rischio di cadute dall’alto.

Nei casi di utilizzo interno, di solito, la connessione del dispositivo avviene tramite rete WIFI aziendale e, quindi, diventa più intenso il flusso di dati (p.e. localizzazione) nella disponibilità del datore di lavoro con la conseguente possibilità (teorica) di effettuare un controllo sull’attività del lavoratore.

Più frequente è il caso di utilizzo all’esterno. Pensiamo ad un addetto alle vendite che può, tramite un’app, comunicare un ordine dal suo smartphone. In questi casi, la disponibilità di dati sul lavoratore si riduce, se il software è sviluppato con la dovuta sensibilità, ai momenti in cui lo stesso lavoratore attiva l’app.

Gli aspetti tecnologici

Gli aspetti tecnologici del BYOD riguardano, principalmente, la compatibilità dei dispositivi personali sia con riguardo alla loro possibilità di integrare funzioni lavorative sia rispetto alle policy di sicurezza aziendali.

Se focalizziamo la nostra attenzione a smartphone e tablet, gli standard sono ormai delineati. Le statistiche più recenti, infatti, raccontano che Android e iOS, in Italia, sono utilizzati nel 98% di smarthpone e tablet in circolazione.

Questo vuol dire che la realizzazione di una app adeguata agli standard funzionali e di sicurezza dipende solo dalle capacità tecnologiche degli sviluppatori. Non si vuole, con ciò, sottovalutare l’impegno richiesto per lo sviluppo ma, semplicemente, sottolineare che si tratta di mondi ben noti e consolidati, ancorché in evoluzione soprattutto relativamente alle vulnerabilità che, via via, possono emergere. In ogni caso, specifici meccanismi di sicurezza sono individuati dal WP29, come si vedrà più avanti, per il trasferimento di dati personali.

Un ulteriore aspetto tecnologico può essere legato alle funzioni di connettività dei dispositivi personali. Le capacità di connessione su rete mobile non dipende dalla app ma dalle caratteristiche hardware dell’apparato e dal grado di copertura del luogo dove il dispositivo viene utilizzato. Per evitare sorprese, potrebbe essere utile effettuare preventivamente test specifici che verifichino l’effettiva capacità di comunicazione del singolo dispositivo nei luoghi dove, in prevalenza, verrà utilizzato.

La tutela dei lavoratori tra diritto nazionale e GDPR

L’aspetto più delicato del BYOD è, tuttavia, il bilanciamento tra il diritto del datore di lavoro a proteggere i dati trattati con i dispositivi personali ed i diritti e le libertà dei lavoratori.

Non dimentichiamo che il nostro ordinamento è ispirato ai principi costituzionali oltre che a quelli stabiliti dalla Convenzione Europea dei Diritti Umani[i]. Quindi, occorre una particolare attenzione sia alle norme del diritto nazionale sia a quelle di derivazione UE:

  • legge 300/1970[ii] altrimenti conosciuta come Statuto dei Lavoratori;
  • legge 81/2017[iii] altrimenti conosciuta come legge sul Lavoro Agile;
  • regolamento UE 679/2016[iv] altrimenti conosciuto come Regolamento Europeo per la Protezione dei Dati Personali (o GDPR).

Lo Statuto dei Lavoratori ha visto una revisione, tra gli altri, dell’art. 4 che è così riformulato

  1. Gli impianti audiovisivi e gli altri strumenti dai quali derivi anche la possibilità di controllo a distanza dell’attività dei lavoratori possono essere impiegati esclusivamente per esigenze organizzative e produttive, per la sicurezza del lavoro e per la tutela del patrimonio aziendale e possono essere installati previo accordo collettivo stipulato dalla rappresentanza sindacale unitaria o dalle rappresentanze sindacali aziendali. In alternativa, nel caso di imprese con unità produttive ubicate in diverse province della stessa regione ovvero in più regioni, tale accordo può essere stipulato dalle associazioni sindacali comparativamente più rappresentative sul piano nazionale. In mancanza di accordo gli impianti e gli strumenti di cui al periodo precedente possono essere installati previa autorizzazione della Direzione territoriale del lavoro o, in alternativa, nel caso di imprese con unità produttive dislocate negli ambiti di competenza di più Direzioni territoriali del lavoro, del Ministero del Lavoro e delle Politiche sociali.
  2. La disposizione di cui al comma 1 non si applica agli strumenti utilizzati dal lavoratore per rendere la prestazione lavorativa e agli strumenti di registrazione degli accessi e delle presenze.
  3. Le informazioni raccolte ai sensi dei commi 1 e 2 sono utilizzabili a tutti i fini connessi al rapporto di lavoro a condizione che sia data al lavoratore adeguata informazione delle modalità d’uso degli strumenti e di effettuazione dei controlli e nel rispetto di quanto disposto dal Dlgs. n. 196/03.

La nuova formulazione, oltre ad eliminare concettualmente (ma non sostanzialmente) il divieto di installazione di impianti per il controllo dell’attività lavorativa, consente al datore di lavoro di introdurre strumenti tecnologici finalizzati a rendere la prestazione lavorativa (senza specificare se di proprietà aziendale o del lavoratore) purché i dati provenienti da queste apparecchiature siano trattati in conformità al Codice della Privacy.

Il quadro giuridico si arricchisce con gli articoli 19 e 21 della legge sul Lavoro Agile che, in concreto, è la norma che più frequentemente dovrà essere applicata in caso di BYOD. E, mentre l’art. 21 è un rimando all’art. 4 dello Statuto del Lavoratori, l’art. 19 introduce un vero e proprio diritto alla disconnessione per il lavoratore. Questo si traduce, nel dovere, da parte del datore di lavoro, di stabilire meccanismi che possano consentire al lavoratore di determinare quando e come “staccare” il proprio dispositivo dalle funzionalità aziendali.

Il quadro normativo è completato dal GDPR e, in particolare, dagli approfondimenti contenuti nel parere n. 2 dell’8 giugno 2017[v] fornito dal gruppo dei Garanti Europei (WP29). Il documento affronta alcune fattispecie particolarmente delicate rispetto all’uso dei dispositivi personali per attività lavorative:

  • l’uso di strumenti di scanning dell’apparato, per esempio per rilevare malaware, deve essere calibrato in modo che non possa accedere alle zone di memoria che contengono esclusivamente dati personali (foto, messaggi di testo, ecc.);
  • l’uso di software di geolocalizzazione o di monitoraggio del traffico, sebbene giustificato dal legittimo interesse del datore di lavoro a proteggere i dati trattati nella sua qualità di titolare del trattamento dei dati, può essere applicato solo in presenza di adeguate misure che distinguano l’utilizzo privato del dispositivo da quello per attività lavorative;
  • il trasferimento di dati dal dispositivo del lavoratore al data center aziendale deve avvenire attraverso una connessione sicura cioè, preferibilmente, attraverso una VPN specificatamente realizzata; inoltre, è preferibile che i dati da trasferire siano contenuti in sandbox appositamente realizzate sui dispositivi personali.

In ogni contesto, quindi, appare opportuno applicare il BYOD senza trascurarne gli aspetti di tutela ed i relativi riflessi tecnologici ed organizzativi.

Note:

[i] https://www.echr.coe.int/Documents/Convention_ITA.pdf

[ii] http://www.normattiva.it/

[iii] http://www.normattiva.it/

[iv] https://eur-lex.europa.eu/legal-content/IT/TXT/PDF/?uri=CELEX:32016R0679&from=IT

[v] https://ec.europa.eu/newsroom/document.cfm?doc_id=45631

A cura di: Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/byod-quando-lufficio-e-nello-zaino/


Viaggio nei malware Android: l’incubo Ransomware (Parte 3)

(Parte 3)

Introduzione

Nel primo articolo di questa serie dedicata ai ransomware, abbiamo fornito una descrizione generale delle famiglie più comuni legate a questo tipo di attacco.

Nel secondo articolo ci siamo concentrati su un attacco di esempio, descrivendone le caratteristiche generali e gli elementi principali del file AndroidManifest.xml.

In quest’ultima parte, ci concentreremo sull’analisi più approfondita del file classes.dex, (che rappresenta anche la parte più tecnica e complessa di un’applicazione), fornendo un piccolo esempio tratto proprio dalla applicazione analizzata nel precedente articolo.

Si premette che questa è un’analisi tecnica che richiede delle competenze di base di programmazione ad oggetti. L’analisi qui contenuta è lungi dall’essere esaustiva, e deve solamente essere considerata come punto di partenza per analisi più approfondite.

Inizieremo la descrizione fornendo una panoramica delle caratteristiche del classes.dex (ed in particolare del bytecode Dalvik), e proseguiremo concentrandoci sull’esempio che abbiamo iniziato ad esplorare nel precedente articolo.

Caratteristiche Classes.dex

Il classes.dex è un file che contiene il codice relativo a tutte le classi, metodi ed attributi implementati dall’utente. Le istruzioni sono scritte in Dalvik bytecode, una rappresentazione intermedia fra linguaggio macchina (Assembly ARM) e codice sorgente (Java). Le istruzioni in Dalvik bytecode operano su registri virtuali, che non coincidono ovviamente con il numero di registri del processore ARM (in Dalvik è possibile infatti usarne un numero molto maggiore), ma che vengono utilizzati per garantire una maggiore flessibilità e velocità rispetto al bytecode Java (che preferisce l’utilizzo di una architettura a stack, priva di registri). Ogni registro inizia con una “v”, susseguita da un numero.

Di seguito, riportiamo le istruzioni principali utilizzate nell’analisi del classes.dex. Per un approfondimento (praticamente obbligato) si consiglia di riferirsi alla documentazione ufficiale [1]. Come regola generale, queste istruzioni utilizzano la notazione:

[Istruzione][Registri][Parametri]

  • get/put: Sono istruzioni che consistono nell’inserimento del valore di un campo nel registro di destinazione (get), o viceversa (put). Le istruzioni possono essere riferite ad attributi statici (sget/sput) o di istanza (iget/iput). Notare come il nome delle istruzioni possa essere esteso a seconda del tipo di oggetto trattato. Ad esempio, se viene trattato un tipo fondamentale char, allora l’istruzione iget diventerà iget-char. Per oggetti di tipi non fondamentali si utilizzerà invece l’estensione object (es. iget-object).

Esempio:

sget-object v4, MyClass.foo

Inserisce il contenuto di MyClass.foo nel registro v4 (e foo è di un tipo non fondamentale).

  • new-instance: Inizializza una nuova istanza di classe (in maniera molto simile a quella che viene fatta col comando new in Java).

Esempio:

new-instance v4, MyFoo: definisce una nuova istanza della classe MyFoo.

  • const-string: definisce una stringa costante da inserire in un registro.

 Esempio:

const-string v4, “bla”: inserisce la stringa “bla” nel registro V4

Un discorso a parte meritano le invocazioni. Sono forse il tipo di istruzione Dalvik più difficile da gestire, perché sono molto più lunghe e complesse da leggere. La formulazione generale di tale istruzioni può essere così rappresentata:

Invoke-[Virtual/Direct/Static/Interface] {registry parametri}, L{Nome_Classe}->{Metodi}(Nomi Parametri){Tipo di Ritorno}

Ogni invocazione inizia sempre col nome Invoke, susseguito dal tipo di invocazione (se è Static si tratta di un metodo statico, se è Virtual di un metodo di istanza, etc.), dai registri che corrispondono ai parametri (uno o più per parametro), dalla classe del metodo invocato (sempre introdotta dalla lettera L), dal nome del metodo, dal nome dei parametri (nello stesso ordine dei registri) ed infine dal tipo di ritorno.

Qui vanno sottolineati due aspetti importanti. Il primo riguarda il numero dei parametri. Nella maggior parte dei casi, il numero dei parametri è sempre più grande di uno rispetto al numero dei parametri nominali. Questo perché il primo parametro corrisponde all’istanza della classe o alla classe stessa (sostanzialmente l’equivalente del this in Java).

Il secondo aspetto concerne la rappresentazione dei tipi di ritorno. Per i tipi fondamentali, si utilizza una notazione abbreviata ad una sola lettera. Ad esempio, int corrisponde a I, void a V, e boolean a Z. Non è scopo di questo articolo descrivere tutti i tipi, i quali possono essere facilmente individuati dalla documentazione Dalvik ufficiale [1].

Infine, è bene ricordare che le istruzioni invoke sono solitamente susseguite da una istruzione move-result (anche questa espandibile, ad esempio con object), in quanto il risultato dell’invocazione deve essere inserito dentro un registro.

A titolo di esempio, si consideri la seguente invocazione:

invoke-virtual{v0,v1}, LMyClass->foo(I)V

Il metodo chiamato è foo, appartenente alla classe MyClass. Il metodo prende in ingresso un intero (rappresentato dalla lettera I), corrispondente a v1. v0 è l’oggetto this, relativo a MyClass. Notate quindi come il numero di registri usato sia più grande di uno rispetto al numero di parametri. Il metodo non ritorna alcun valore, quindi il tipo di ritorno è void (V).

Analisi Ransomware

Veniamo ora all’analisi del ransomware vero e proprio (che abbiamo iniziato ad analizzare nel precedente articolo). Come osservazione preliminare, è importante osservare che questo campione ha una complessità tecnica abbastanza elevata. Pertanto, in questo articolo si daranno solo degli spunti di base per capire come procedere ad un’analisi poi più approfondita.

ApkTool crea dei file in formato .smali, che consente una lettura semplificata del bytecode. In particolare, dentro la cartella “smali” verrà creata una struttura di cartelle che riflette quella dei package. Ad esempio, se il package ha il nome “foo.bar”, dentro la cartella “smali” vi sarà una sottocartella “foo”, che conterrà a sua volta “bar”. All’interno di queste cartelle, ApkTool cercherà di creare un file .smali per classe, in maniera simile a quello che succede con il codice sorgente Java.

Di norma, si inizia l’analisi del campione partendo dall’attività con intent-filter MAIN/LAUNCHER (vedi il precedente articolo). Nel nostro caso, tale attività corrisponde a com.zynga.FarmVilleTropicEscape.FarmVilleTropicEscape.

Andiamo a cercare quindi il corrispondente file FarmVilleTropicEscape.smali nella cartella com/zynga/FarmVilleTropicEscape (Nota bene: verranno create anche cartelle con altri package, che però non sono di nostro interesse, essendo associate a pacchetti di sistema). Il primo metodo da cercare è onCreate, che rappresenta ciò che viene immediatamente eseguito al caricamento dell’attività.

L’idea generale è quella di ricostruire il grafo dei metodi implementati dall’utente partendo dal metodo sopra citato, in modo da poter seguire un primo percorso di analisi. In questa prima fase, si presta meno attenzione ai metodi di sistema, ovvero quei metodi utilizzati nella documentazione principale di Android. Una volta determinato il grafo, si esplora metodo per metodo più nel dettaglio alla ricerca di chiamate sospette (ovviamente non bisogna solo guardare il tipo di invocazione, ma anche e soprattutto dove queste agiscono, quindi i loro parametri). La cosa più importante in assoluto è che non è necessario analizzare ogni singola riga di codice per avere una idea sommaria sulle azioni svolte dall’applicazione. Una volta sviluppata la giusta “sensibilità”, ci si può soffermare sugli aspetti che risaltano maggiormente: stringhe legate all’invio di sms, siti web da contattare, e via discorrendo.

Naturalmente, in questa sede verrà proposta solo una piccola parte di tale grafo e di tale analisi.

Dal metodo onCreate è possibile individuare otto invocazioni. Di queste otto, ci concentriamo sulle istruzioni di tipo virtual, che rappresentano metodi di istanza per l’oggetto che viene creato. Sono presenti quattro metodi di questa tipologia, e noi ne analizzeremo, per ragioni di spazio, solo due:

  • FarmVilleTavropicEscape;->concates(Ljava/lang/String;)Ljava/lang/String
  • FarmVilleTropicEscape;>startService(Landroid/content/Intent;)Landroid/content/ComponentName

Il primo metodo è sicuramente uno dei più sospetti. Infatti, il nome farebbe pensare alla funzione concat, il cui ruolo è quello di concatenare due stringhe. Tuttavia, il parametro in ingresso della funzione, definito dall’istruzione const-string v1, “1f26b9af2f3340212eb8d1d1b1fbba3d”, è molto strano. Da notare anche il nome della classe dell’oggetto: FarmVilleTavropicEscape. Ovviamente, il nome è utilizzato per confondere l’analista. Andiamo quindi nel file FarmVilleTavropicEscape.smali e cerchiamo il metodo concates. Il metodo è notevolmente complesso, ma è possibile notare alcuni aspetti “generali”. In questa sede ne indicheremo due:

  1. Sono presenti diversi riferimenti alle funzioni della classe crypto, tipicamente usata per funzioni di crittografia. Questa famiglia di funzioni è notevolmente usata dai ransomware per criptare i dati o per nascondere delle informazioni all’occhio dell’analista.
  2. All’interno di questo metodo, è possibile trovare due const-string che si susseguono: const-string v1, “getIn” e const-string v2, “stance”. Viene poi chiamata la funzione concat sulle due stringhe (da non confondere con concates). Dopodiché, il suo risultato verrà usato come parametro per il metodo getMethod relativo alla famiglia lang.reflect. Questo significa che un metodo di nome “getInstance” verrà chiamato attraverso la reflection. La reflection è una tecnica che consente di accedere ad un metodo o ad un attributo indirettamente, semplicemente specificandone il nome come stringa e dandolo come parametro ad una funzione della famiglia java.lang.reflection. Ovviamente, tale strategia non avrebbe senso rispetto ad una chiamata diretta perché è ovviamente molto più lenta dal punto di vista computazionale, ma aumenta la difficoltà di lettura del metodo stesso.

Metodi come concates sono ricchi di complessità e non è possibile, in un’analisi come quella proposta qui, fornire troppi dettagli tecnici. La primissima conclusione che è possibile trarre, però, è che l’analisi statica non sarà sufficiente a comprendere a fondo il funzionamento del malware, in quanto le strategie di encryption sono spesso “decodificate” a runtime. Allo stesso tempo, però, da una primissima analisi è già possibile intuire che il programma presenta delle “anomalie” che vanno sicuramente approfondite, e che la presenza di routine di criptazione potrebbe essere (ma non necessariamente) associata ad un ransomware. Quindi, anche con un’analisi manuale “abbozzata”, è subito possibile individuare degli aspetti sospetti.

Veniamo ora al secondo metodo. È abbastanza evidente che questo metodo si propone di inizializzare ed eseguire un servizio. Per capire quale viene inizializzato, basta osservare le istruzioni antecedenti:

new-instance v0, Landroid/content/Intent;

invoke-virtual {p0}, Lcom/zynga/FarmVilleTropicEscape/FarmVilleTropicEscape;->getApplicationContext()Landroid/content/Context;

move-result-object v1

const-class v2, Lcom/zynga/FarmVilleTropicEscape/FarmVvailleTropicEscape;

invoke-direct {v0, v1, v2}, Landroid/content/Intent;-><init>(Landroid/content/Context;Ljava/lang/Class;)V

Queste quattro istruzioni si possono leggere così: inizializza un nuovo Intent (un massaggio da mandare ad un altro componente) su v0, prepara la sorgente del messaggio su v1 (ovvero la nostra classe attuale), inizializza la nuova classe FarmVvailleTropicEscape (notare anche il nome leggermente distorto) su v2 e inizializza l’intent, che verrà tradotto nella richiesta da parte dell’attività attuale di avviare il servizio.

L’analisi dei due metodi sopra descritti mostra quali sono le prossime classi da esplorare a fondo: FarmVilleTavropicEscape e FarmVvailleTropicEscape. Ripetendo il procedimento sopra descritto, è possibile analizzare in maniera approfondita il file classes.dex.

Ovviamente, in molti casi (e anche in questo) non basta l’analisi manuale per avere un quadro completo del funzionamento dell’applicazione, ma è possibile comunque ricorrere a diverse tecniche automatiche di analisi statica e dinamica per semplificare l’analisi. Una panoramica degli strumenti utilizzabili è disponibile su [2]. L’analisi manuale è comunque importante, dato che aiuta l’analista a comprendere più facilmente le zone “critiche” dell’applicazione su cui concentrare la propria analisi.

In conclusione, questo articolo, assieme ai due precedenti, ha voluto riportare solo un “assaggio” della complessità dei ransomware e della disciplina del reverse engineering su Android. Questo mostra anche come la rilevazione di tali attacchi possa essere complessa e ricca di insidie. Per ulteriori approfondimenti, è caldamente consigliato lo studio approfondito della documentazione ufficiale di Android e degli internals Dalvik [1].

Riferimenti:

[1] Dalvik Bytecode. https://source.android.com/devices/tech/dalvik/dalvik-bytecode

[2] Mobile Security Wiki. https://mobilesecuritywiki.com/

A cura di: Davide Maiorca

L’Ing. Davide Maiorca (http://pralab.diee.unica.it/it/DavideMaiorca) ha conseguito presso l’Università degli Studi di Cagliari la Laurea Specialistica in Ingegneria Elettronica (con punti 110/110 e lode) nel 2012, ed il Dottorato (PhD) in Ingegneria Elettronica ed Informatica nel 2016.  Nel 2017, la sua tesi di dottorato è stata annoverata dal CLUSIT (Associazione Italiana per la Sicurezza Informatica) fra i migliori lavori a livello nazionale nel campo della sicurezza informatica. Lavora per il Pattern Recognition and Applications Lab (PRALab – Dipartimento di Ingegneria Elettrica ed Elettronica, Università degli Studi di Cagliari – Diretto dal prof. Fabio Roli) dal 2012, dove attualmente ricopre il ruolo di post-doc. I suoi campi di ricerca includono l’analisi di malware all’interno di documenti e applicazioni multimediali (PDF, Microsoft Office, Flash), l’analisi di malware Android, e l’Adversarial Machine Learning.  Da novembre 2013 ad aprile 2014 è stato Visiting Student presso la Ruhr-Universität Bochum, nel gruppo System Security guidato dal Prof. Dr. Thorsten Holz, dove ha lavorato a tecniche di reverse engineering per applicazioni Android. Dal 2016, è docente del seminario “Mobile Forensics” presso il Dipartimento di Ingegneria Elettrica ed Elettronica, Università degli Studi di Cagliari. È autore di numerose pubblicazioni su conferenze e riviste internazionali, e fa parte di diversi comitati scientifici internazionali. Svolge, inoltre, attività di consulenza tecnica in ambito legale.

Download PDF

https://www.ictsecuritymagazine.com/articoli/viaggio-nei-malware-android-lincubo-ransomware-parte-3/


Introduzione alla Cyber Intelligence

L’intelligence ha uno scopo predittivo, cioè, sulla base della raccolta delle notizie e a seguito di una loro analisi, cerca di estrarre informazioni utili al fine di fornire supporto su decisioni strategiche o operative.

Le principali modalità di raccolta delle informazioni sono[1]:

  • Intelligence umana (HUMINT)
  • Intelligence delle immagini (IMINT)
  • Intelligence dei segnali (SIGINT)
  • Intelligence delle misurazioni (MASINT)
  • Intelligence tecnica (TECHINT)
  • Intelligence delle fonti libere (Open Source) (OSINT)

Ogni fonte deve essere valutata e per fare questo si usa un codice che va dalla lettera “A” (affidabile) alla lettera “F” (non classificabile). Tale attività si definisce “classificazione dell’informazione”.

Come le fonti, anche le informazioni vanno valutate e in questo caso si usa un valore che va da “1” (confermato) a 6 (Non classificabile). Questo processo si definisce “Classificazione dei contenuti informativi”.

Quindi l’informazione avrà un valore dato dall’affidabilità della fonte più l’attendibilità dell’informazione. Ad esempio un’informazione potrebbe essere classificata come A-3, cioè la fonte si reputa “affidabile” ma non si ha certezza che la notizia sia veritiera.

Calando l’intelligence in un contesto Cyber, questa diventa di non semplice definizione. Tra tutte le definizioni di Cyber Intelligence cito con piacere quella trovata in un libro che ho letto qualche tempo fa:

“Complesso di attività programmate e applicate per identificare, seguire, misurare e monitorare informazioni sulle minacce digitali, nonché dati sulle intenzioni e attività di entità avversarie…”[2]

È facile intuire che in questa scienza convivono sia la parte informatica sia le logiche dell’intelligence classica. C’è infatti la necessità di analizzare i dati raccolti con logiche ben specifiche derivanti dall’intelligence classica, che usa l’intelligenza umana per fare appropriate valutazioni e/o previsioni; dall’altra parte c’è la necessità dell’intelligence classica di avvalersi delle più innovative tecnologie al fine di raccogliere quanti più dati possibili per permettere di fare una valutazione a tutto tondo.

Con il passare del tempo la Cyber Intelligence ha acquisito nel mondo aziendale un’importanza sempre più rilevante, divenendo parte integrante delle strategie di cyber security. In questo contesto è molto importante collezionare e acquisire le tecniche, le tattiche e le procedure (TTP) usate da ogni attore criminale durante tutte le fasi degli attacchi perpetrati.

La capacità di avere informazioni precise e dettagliate in merito al contesto e agli avversari è uno dei grandi benefici offerto della Cyber Intelligence, permettendo in tal modo di avere una conoscenza approfondita del modus operandi degli avversari. Tali informazioni consentono di effettuare interventi e controlli preventivi per evitare e prevenire attacchi informatici, consentendo di evitare anche i danni economici, reputazionali e legali che ne possono derivare.

I criminali informatici hanno diversi vantaggi nei confronti delle aziende; tra i più importanti c’è il fattore tempo. Questi possono dedicare mesi interi a:

  • studiare le difese di un azienda;
  • individuare possibili vulnerabilità;
  • individuare i soggetti più facili da colpire con email di Phishing mirate;
  • sviluppare risorse e strumenti necessari per l’attacco;
  • progettare un attacco mirato in ogni minimo dettaglio;

Pertanto la Cyber Intelligence deve essere usata nel modo opportuno al fine di implementare delle strategie di sicurezza “attiva” che permettano una difesa efficace.

Tra tutte le modalità di raccolta delle informazioni la più usata nel campo della cyber intelligence è l’OSINT – Open Source Intelligence, che prevede l’analisi, la raccolta e la categorizzazione di tutte quelle fonti definite “aperte” o anche di “pubblico accesso”. Questa ha diverse declinazioni, alcune delle quali sono:

  • IMagery Intelligence – IMINT, che prevede la raccolta e l’analisi di immagini e dei metadati in esse contenuti
  • SOCial Media Intelligence – SOCINT, che prevedere l’analisi e la raccolta di informazioni presenti all’interno dei social media e dei social network.

Tra le fonti più usate nell’Open Source Intelligence troviamo:

  • Mezzi di comunicazione: giornali, riviste, televisione, radio e siti web;
  • Piani finanziari;
  • Conferenze stampa;
  • Discorsi;
  • Fotografie;
  • Conferenze;
  • Pubblicazioni scientifiche;
  • Social Network;
  • Ecc.

Possiamo pertanto definire la Cyber Intelligence come un processo che colleziona le informazioni raccolte da fonti diverse; quindi quelle pertinenti ad una specifica tematica d’interesse vengono valutate e analizzate per produrre una stima o una previsione di un fenomeno criminale che potenzialmente si potrebbe verificare. Le risultanze di questo processo possono anche essere integrate con le risultanze di un’investigazione a seguito di un evento criminoso. Il quadro generale permette di creare una conoscenza significativa e affidabile sulla quale basare decisioni immediate o future.

La Cyber Intelligence affonda le sue radici nell’ambito militare dove ha importanza strategica per prevedere e/o anticipare le mosse degli avversari. Usando in modo strategico le informazioni raccolte si può acquisire un enorme vantaggio, infatti avendo l’opportunità di conoscere le intenzioni e le capacità dell’avversario, diventa possibile pianificare e attuare le migliori strategie di difesa, attacco o contrattacco.

Oggi più che mai i conflitti tra Stati si stanno spostando dal campo di battaglia alla rete internet e le cyber armi stanno assumendo un ruolo predominate e critico nei conflitti; proprio per questo motivo si sta cercando di regolamentarne il loro uso. Mentre prima si bombardavano i punti strategici del nemico, ora si cerca di colpire a livello informatico le infrastrutture critiche di un paese per metterlo in crisi prima di intraprendere qualsiasi altra forma di azione militare. Ogni anno, nel mese di gennaio si tiene a Davos, Svizzera, il World Economic Forum – WEF, incontro annuale tra esponenti di spicco della politica, dell’economia e intellettuali di tutto il mondo al fine di discutere delle questioni più urgenti che il mondo si trova ad affrontare. Prima di questo evento viene solitamente rilasciata l’analisi “The Global Risks Report” [3]; in quello del 2018 è stato ipotizzato di vietare in futuro l’utilizzo delle “cyber armi” durante i conflitti, alla stregua delle armi nucleari, chimiche e biologiche.

Da notare che il “rischio cyber” da diversi anni è ormai presente nella classifica dei “TOP risk” stilata dal World Economic Forum – WEF.

Note:

A cura di: Giuseppe Brando

Dottore in Ingegneria Informatica, ha trasformato la passione per la sicurezza informatica nella sua attività professionale.

Durante il periodo universitario ha costruito forti competenze nello sviluppo software. Ha ampliato la sua conoscenza e le sue competenze lavorando in aziende di primaria importanza e svolgendo attività di Incident Response, sistemista in ambito Security, Penetration Test, Source Code Review, Malware Analysis e Code Reverse Engineering.

Esperto in attività di Open Source Intelligence (OSINT), attualmente si occupa di Cyber Threat Intelligence con l’obbiettivo di individuare preventivamente le minacce, studiare le tattiche, le tecniche e le procedure (TTP) usate durante gli attacchi e il modus operandi dei Cyber criminali.

Collabora a programmi di Bug Bounty tramite i quali ha ricevuto diversi riconoscimenti per le vulnerabilità individuate e conduce inoltre attività di formazione sulle tematiche legate alla Cyber Security e investigazione su eventi Cyber.

Download PDF

https://www.ictsecuritymagazine.com/articoli/introduzione-alla-cyber-intelligence/


Individuare gli utenti malintenzionati con l’User Behavior Analytics

I controlli di sicurezza convenzionali non sono efficaci contro alcuni tipi di minacce, e precisamente nei confronti del comportamento di alcuni utenti. Le anomalie nel comportamento degli utenti possono essere individuate soltanto con un approccio che prevede l’utilizzo dei big data e di algoritmi di machine learning.

L’User Behavior Analytics (UBA) può definire, se ben progettato, un modello di comportamento tipico di gruppi di utenti.

Principalmente il bersaglio di attacchi del genere sono i dati non strutturati (ad esempio email, pagine web etc.) poiché non sono facilmente controllabili. La media, tra la compromissione di dati e la sua individuazione, è di 146 giorni (fonte: FireEye), e di questo problema l’User Behavior Analytics può rappresentare una soluzione. Soluzione che è poco utilizzata nonostante l’evidenza: l’anello debole è rappresentato dal fattore umano. La maggior parte dei fondi destinati alla sicurezza è ancora impiegata in software tradizionali.

Cos’è l’User Behavior Analytics

Alla base dell’User Behavior Analytics c’è la distinzione tra tutto ciò che sembra normale attività dell’utente e quello che sembra non comune. Non a caso si è usato il termine sembra perché fin qui si tratta solo di sospetto comportamento non conforme; poi tocca all’apposito team investigare su quell’utente e su quel comportamento specifico.

Ricapitolando, l’UBA si basa sulla capacità di analizzare grandi quantità di dati, creare modelli e di identificare comportamenti non simili a quelli previsti.

User Behavior Analytics in dettaglio

L’User Behavior Analytics raccoglie dati, sia strutturati che non strutturati, da diversi punti dell’intera infrastruttura. Da questi dati definisce cosa rappresenta un comportamento normale tenendo conto dei diversi contesti. Dopodiché continua a raccogliere dati cercando comportamenti non conformi a quanto definito in precedenza. I modelli di comportamento definiti, ovviamente, si adattano a nuove situazioni e nuovi ambienti previsti nell’infrastruttura.

Come dicevamo prima un’anomalia non è considerata ancora un rischio per la sicurezza ma solo un sospetto. Va dunque valutato l’impatto di tale comportamento. A tale scopo si può usare la classica equazione (Figura 1):

Rischio = Probabilità x Impatto

Dove, in questo caso, probabilità indica che il comportamento dell’utente è da ritenersi anomalo mentre impatto indica l’effetto e la criticità dell’eventuale accesso alle informazioni in esame.

Come tutti i sistemi basati sulla raccolta di dati si possono individuare per l’User Behavior Analytics tre elementi:

  • Data Analytics: vengono raccolti i dati da più fonti.
  • Integrazione dei dati: vengono integrati diversi tipi di dati disponibili e creati dei profili, per uno o più individui, sulla base di questi. Identificando i modelli di comportamenti leciti risulta poi immediato identificare le eventuali anomalie. Tali dati opportunamente trattati sono inviati ad un esistente sistema di sicurezza che si occupa della loro gestione.
  • Presentazione e Visualizzazione: infine i dati raccolti e trattati vengono presentati a diversi attori che si occuperanno delle azioni successive.

A cosa serve

L’importanza di uno strumento come l’User Behavior Analytics sta nel fatto che esso tiene conto di dati molto disomogenei come ad esempio la provenienza geografica dei dati, informazioni sugli utenti provenienti dall’infrastruttura di rete (accessi, permessi, etc.), dati sugli utenti provenienti dalle risorse umane, dati provenienti dai sistemi di sicurezza, etc.

Sono valutate anche informazioni che generalmente vengono ignorate dai tradizionali sistemi di sicurezza. Inoltre vengono presi in considerazione sia dati passati che dati attuali in modo da avere un quadro esaustivo della situazione.

Il fattore chiave degli strumenti dei sistemi di UBA è il tempo; attraverso delle operazioni di machine learning svolgono compiti in maniera molto rapida prendendo in considerazione anche più fonti e maggiori dettagli. In questo modo è possibile individuare comportamenti non conformi pressoché in tempo reale; ed è proprio questa caratteristica che ne fa uno strumento indispensabile in ogni organizzazione che si occupa della sicurezza in maniera proattiva.

L’User Behavior Analytics risulta utile anche durante la fase di valutazione dei rischi dove le regole precedentemente create possono essere utilizzate per identificare dei potenziali rischi di un’organizzazione legati al comportamento dei singoli utenti. Poiché comprendendo come gli utenti agiscono e isolando un comportamento lecito è possibile individuare gli utenti che potrebbero portare ad un problema di sicurezza.

Individuazione e protezione

Come detto, l’User Behavior Analytics si occupa della raccolta, dell’analisi e della gestione dei dati utenti, tutte operazioni noiose che vengono svolte da chi gestisce la sicurezza ed essendo ripetitive rischiano di generare errori. Permette, ad esempio, di determinare se un account è stato compromesso e se il traffico generato da questo account è lecito oppure necessita di maggiori investigazioni.

La piattaforma che si occupa dell’UBA può eseguire sia azioni indirette per un’ulteriore analisi (come ad esempio l’invio di email e alert vari, l’aggiornamento di dashboard etc.) sia azioni dirette (come ad esempio l’aggiornamento delle regole di un firewall o di un IPS, la disattivazione di un account etc.).

Mentre la maggior parte dei dati non è significativa, bastano poche informazioni che combinate tra loro contribuiscono ad identificare una minaccia. Qui sta la capacità nell’identificare un comportamento potenzialmente malevolo partendo da informazioni apparentemente insignificanti e non correlate. Comportamento non identificabile in breve tempo se non utilizzando appositi algoritmi per l’analisi dei dati. Inoltre bisogna considerare la natura di alcuni attacchi che prevedono un’escalation di privilegi, quindi niente è come sembra.

Consigli per l’implementazione

Ecco infine alcuni consigli utili in fase di implementazione di una soluzione che prevede un sistema di UBA:

  • vanno raccolte tutte le informazioni possibili anche se appaiono insignificanti;
  • va usato un tool “serio” di machine learning in modo da ridurre al minimo i falsi positivi;
  • quando si scrivono nuove regole vanno prese in considerazione sia le minacce interne sia quelle esterne;
  • e le regole vanno sempre aggiornate in modo da tenere in considerazione i nuovi attacchi;
  • non bisogna considerare nessun account innocuo (anche i più insignificanti dal punto di vista dei permessi);
  • dopo aver implementato la soluzione UBA è necessario definire delle regole di base che all’inizio hanno il compito di definire cosa viene trattato come comportamento lecito;
  • dopo l’implementazione e la definizione del comportamento di base è necessario un periodo di test utile per affinare le regole e adattare la soluzione all’ambiente.

Conclusioni

L’User Behavior Analytics si occupa quindi di collezionare, correlare e analizzare sia fonti interne sia fonti esterne come ad esempio informazioni di terze parti su possibili minacce al fine di creare modelli attendibili di comportamento.

Non solo gli algoritmi utilizzati nell’User Behavior Analytics permettono di creare modelli comportamentali riducendo al minimo la possibilità di falsi positivi ma permettono anche di valutare i possibili rischi e i processi di sicurezza in generale alla luce dei dati raccolti.

A cura di: Gianluigi Spagnuolo

Si interessa di sicurezza informatica, reti di sensori e ingegneria del sotware.

Attualmente si occupa pricipalmente dell’analisi dei dati.

Collabora con diverse riviste del settore scrivendo di programmazione e sicurezza

Download PDF

https://www.ictsecuritymagazine.com/articoli/individuare-gli-utenti-malintenzionati-con-luser-behavior-analytics/


DOMAIN SPOOFING

In termini generali, con l’espressione domain spoofing ci si riferisce all’azione di creare un sito web contraffatto a partire da un dominio originale (e dunque legittimo) con l’intento di ingannare il visitatore e potenzialmente intercettarne informazioni sensibili inserite nei campi dell’applicazione web. Normalmente il sito ricreato presenta stessa grafica e nome dominio molto simile al sito web di partenza.

La questione del domain spoofing è particolarmente sentita nell’industria dell’advertisement: un marketer paga per un’ad da collocare all’interno del sito di una determinata società e, nel caso di campagne in programmatic e dunque automatizzate, riceve conferma dell’avvenuta transazione. A seguito di tale conferma, nessun dubbio sorge in capo all’inserzionista circa la genuinità della procedura; in realtà lo spazio pubblicitario viene dirottato su un altro dominio – generalmente di proprietà sconosciuta – che si spaccia per l’originale. Tra le vittime illustri di questa pratica troviamo anche il Financial Times, che nel 2017 ha stimato l’ammontare della frode in atto in 1.3 milioni di dollari/mese.

Tutto ciò danneggia sia gli advertiser, il cui budget investito per la campagna viene sperperato per un sito dagli scarsi contenuti, sia l’organizzazione che concede lo spazio pubblicitario, che viene privata di ingenti entrate derivanti da tale campagna.

Sempre in riferimento al domain spoofing, vi sono poi applicazioni del fenomeno più mirate che prevedono invece la creazione di una shadow copy del sito web oggetto di spoofing, al fine di dirottare tutto il traffico dell’utente/vittima attraverso la macchina attaccante. Nel prosieguo dell’articolo, vedremo come realizzare questo tipo di scenario e indurre l’utente a inserire le proprie credenziali in una web application furbescamente spoofata.

Avviamo la nostra distribuzione dedicata alla sicurezza e creiamo un file di testo denominato hosts.txt con il comando:

touch hosts.txt

Con un editor di testo, inseriamo come parametri l’indirizzo della macchina attaccante e il dominio che si desidera mostrare nella barra del browser della vittima al momento in cui aprirà l’URL responsabile di innescare lo spoofing. Dal momento che l’intento è raggirare l’utente che naviga, è facile intuire come un semplice dettaglio come quello accennato poc’anzi possa risultare determinante per la buona riuscita dell’attacco.

Abilitiamo il kernel del nostro sistema operativo all’IP forwarding, di modo da inoltrare il traffico di rete verso un destinatario prefissato (diventando una sorta di router, insomma):

echo 1 > /proc/sys/net/ipv4/ip_forward

Nel caso si utilizzassero distribuzioni Linux che a differenza di Kali non utilizzano di default l’utenza root (cfr. Parrotsec, Backbox), modificare il precedente comando come segue:

sudo sh -c 'echo 1 > /proc/sys/net/ipv4/ip_forward'

Verifichiamo poi che quest’ultima operazione sia andata a buon fine:

more /proc/sys/net/ipv4/ip_forward

Ai fini dell’inganno, è necessario che la macchina attaccante assuma il ruolo del server web richiesto dall’utente/vittima durante la normale navigazione e che il server ci veda come un vero client.

Per fare ciò, in due terminali separati e come super utenti, lanciamo in sequenza i seguenti comandi di ARP spoofing:

sudo arpspoof -i ​INTERFACCIARETE​ -t IPVITTIMA​ IPGATEWAY
sudo arpspoof -i INTERFACCIARETE​ -t IPGATEWAY IPVITTIMA

A questo proposito ricordiamo che i comandi ifconfig e route -n da terminale UNIX, visualizzano gli indirizzi IP di cui abbiamo bisogno:

In una nuova console eseguiamo l’istruzione che genera lo spoofing del dominio desiderato, richiamando il file di testo creato nei primi passaggi:

sudo dnsspoof -i INTERFACCIADIRETE​ -f hosts.txt

Per velocizzare la procedura richiamiamo setoolkit, lo strumento di ingegneria sociale per eccellenza; dal menu a scelta numerica impostiamo la sequenza:

1) Social-Engineering Attacks
2) Website Attack Vectors
3) Credential Harvester Attack Method
2) Site cloner

Indichiamo indirizzo IP della macchina attaccante per il reverse e l’URL che SET deve clonare (facebook.com per l’esempio in questione):

A questo punto ci occorre qualche manovra di ingegneria sociale per far aprire alla vittima l’URL che abbiamo indicato nel file hosts.txt. Sempre a proposito di spoofing – sebbene occorra una trattazione a parte decisamente più ampia – possiamo qui accennare che il classico copia/incolla del link all’interno di una comunicazione ufficiale (vedasi mail, canali chat di piattaforme social e così via), rimane statisticamente uno dei metodi più efficaci. È possibile ricreare una mail dal tono formale da inviare alla vittima spoofando il mittente di un’organizzazione autorevole (per esempio il supporto di facebook) oppure segnalare un finto evento – magari di interesse della vittima – al quale unirsi cliccando sul link in calce. Ecco alcuni validi progetti che è possibile trovare sulla community GitHub:

Coloro che non avessero tempo di cimentarsi a tal riguardo, possono fare un rapido tentativo con un servizio online dedicato (anche se è bene ricordare che le probabilità che la mail venga confinata nella spam sono piuttosto alte):

Ricordiamo a questo proposito che per avere la certezza che una mail inviata provenga effettivamente dal dominio mostrato, occorre esaminare (se presenti) le stringhe SPF, DKIM, DMARC del codice sorgente del messaggio originale; in caso affermativo, viene indicata la dicitura ‘pass’. Vediamo un esempio da Gmail:

Ad ogni modo, ecco cosa si presenterà alla vittima cliccando sul collegamento incriminato:

Come possiamo vedere all’immagine successiva, le credenziali inserite sono visibili in tempo reale nel terminale di SET; possono essere successivamente consultate in formato HTML accedendo al percorso:

/root/.set/reports

Coloro che avessero confidenza con ettercap, possono realizzare lo stesso attacco modificando il file /etc/ettercap/etter.dns con le seguenti entry:

E avvalersi sempre di SET per il clone dell’URL e relativo listener. Lo spoof invece viene innescato dall’istruzione:

ettercap -Tqi ​INTERFACCIADIRETE​ -P dns_spoof -M arp
/​ IPVITTIMA​ // /​ IPGATEWAY​ //

A cura di: Milo Caranti

Download PDF

https://www.ictsecuritymagazine.com/articoli/domain-spoofing/