Il fattore umano nella sicurezza di una rete: Trasformare una minaccia in una risorsa

Introduzione

Nell’ultimo decennio si è assistito ad un cambiamento nella quantità e nella tipologia di attacchi informatici, soprattutto per quanto riguarda gli attacchi zero day.

Un attacco zero day è un attacco che sfrutta una vulnerabilità non ancora risolta. La finestra di esposizione è il periodo che va da quando viene registrato l’attacco per la prima volta a quando viene rilasciata la patch di sicurezza.

Attacchi di questo tipo si diffondono rapidamente infettando moltissimi dispositivi in poco tempo.

Gli attacchi zero day passeranno da una media di uno a settimana nel 2015 ad una media di uno al giorno nel 2021.  [1] [2]

Gli attacchi zero day colpiscono chiunque in modo indiscriminato; la maggior parte dei danni li subiscono i liberi professionisti e le piccole imprese, che non sono preparati a fronteggiare la minaccia informatica.

Questo nuovo scenario preoccupa non solo gli utenti, ma anche le aziende che vendono prodotti o servizi di sicurezza informatica.

La velocità con cui gli attacchi informatici si modificano è molto più elevata rispetto alla capacità di trovare soluzioni adeguate.

“L’imprevedibilità e la rapidità con cui si diffondono i nuovi attacchi informatici apre la sfida nel trovare nuovi modi di pensare la sicurezza informatica che siano altrettanto rapidi e capaci di mutare.”

Gli investimenti in sicurezza informatica sono indispensabili per mitigare i rischi, ma alla luce dell’incertezza sulla previsione di attacchi zero-day, non si può non prendere in considerazione il fallimento degli strumenti di rilevazione della minaccia.

Nel caso in cui Antivirus, firewall, IDS…etc., non siano in grado di bloccare automaticamente la minaccia, l’ultimo (e unico) strumento per mitigare l’attacco è l’azione tempestiva dell’uomo.

L’intento dell’articolo è quello di argomentare l’utilità di un nuovo approccio nella risoluzione di attacchi zero day per liberi professionisti e PMI.

La domanda che ci dobbiamo porre è: “Se l’utente finale fosse opportunamente allertato all’inizio di un attacco zero-day, metterebbe in atto le misure necessarie a mitigare l’attacco?”

 Alla luce di questa domanda e delle considerazioni fatte sugli attacchi zero day si potrebbe valutare l’utilità di un canale di comunicazione dedicato alla sicurezza informatica e diretto all’utilizzatore finale.
In particolare per la comunicazione all’utente servirebbe la notifica di allerta in caso di attacco zero day. All’utente finale sarebbero inoltre fornite le istruzioni per verificare la presenza della vulnerabilità, le informazioni sui rischi e le opzioni che può mettere in atto per prevenire e/o mitigare l’attacco.

La soluzione proposta è solo la punta dell’iceberg di un diverso paradigma di sicurezza informatica che considera l’uomo come strumento di difesa.

Quale lezione abbiamo imparato da WannaCry?

Nel maggio del 2017 il ransomware WannaCry ha infettato oltre 230.000 computer in 150 paesi, con richieste di riscatto in BitCoin in 28 lingue differenti sfruttando la vulnerabilità EthernalBlue esposta in un leak della NSA. [3] La minaccia si diffuse in tutto il mondo molto rapidamente e la maggior parte dei software antivirus non furono in grado di bloccare la minaccia.

Nel caso di WannaCry una comunicazione tempestiva all’inizio dell’attacco avrebbe ridotto il numero di dispositivi colpiti.

Ad esempio avremmo potuto avvertire gli utenti così:
“Attenzione, è in corso in queste ore un attacco ai sistemi operativi Windows xx che provoca il malfunzionamento del computer e la perdita di tutti i dati.

Per risolvere il problema si può aggiornare il sistema operativo oppure seguire le istruzioni per disabilitare un modulo chiamato SMB [..] L’attacco si diffonde automaticamente da un computer all’altro all’interno della stessa rete. Puoi diminuire le probabilità di essere colpito disabilitando la ricezione di pacchetti detti ping. Per farlo devi…”

Il lettore potrebbe pensare che questo tipo di informazione esista già. E’ vero. Infatti queste informazioni si trovano su internet nelle ore immediatamente successive all’attacco.

Tuttavia l’attuale paradigma di sicurezza informatica non prevede di allertare l’utente finale all’inizio dell’attacco zero day.

La comunicazione dell’attacco all’utente finale è un punto chiave del nuovo paradigma.

La comunicazione dell’attacco zero-day

Consideriamo la sicurezza (security + safety) in settori diversi da quello informatico.

In autostrada in caso di incidente o coda i cartelloni luminosi avvertono gli automobilisti del pericolo imminente.

In alcuni comuni quando un fiume è a livello di guardia la popolazione nella zona colpita viene avvertita tramite sms.

Quando i ladri mettono a segno uno o più colpi in uno stesso paese il passa parola tra compaesani mette in guardia le persone.

Il comportamento che si ripete in questi esempi è quello di avvertire le persone dello stato di allarme tramite una comunicazione mirata al fine di prevenire ulteriori incidenti.

Questo modo di agire non è in uso per la sicurezza informatica.

La comunicazione rivolta alle persone in sicurezza informatica è solo incentrata sulle best practice.

In caso di zero day attack la comunicazione avviene solo agli esperti del settore tramite bollettini, detti CVE.

A questo punto il lettore potrebbe pensare che se l’utente seguisse tutte le best practice non ci sarebbe bisogno di comunicare lo stato di allarme.

Tuttavia sarebbe ipocrita pensare che le persone seguano le best practice H24.

Conclusione

Quando l’utente acquista un prodotto/servizio di protezione dai virus informatici si fida del brand e indirettamente della macchina (software o hardware). L’attuale paradigma di sicurezza informatica è basato su due pilastri; il rilevamente della minaccia da parte della macchina e l’attuazione delle best practice da parte dell’uomo.

In un attacco zero day è molto probabile che entrambi questi pilastri vengano a mancare.

Nell’articolo è stata discussa l’ipotesi di valutare la risorsa umana come strumento di prevenzione dell’attacco.

A questo punto ci si potrebbe domandare come integrare la risorsa umana nell’attuale paradigma.

Possiamo immaginare che all’acquisto di un antivirus venga associato un servizio gratuito che avverta l’utente finale del fallimento del sistema di protezione in seguito ad un attacco zero day.  All’inizio dell’attacco l’azienda che ha venduto il prodotto all’utente invierà un sms di allerta e farà in modo di attivare un servizio di assistenza che l’utente potrà chiamare per avere maggiori informazioni.

L’utente verrà guidato nel mettere in atto le misure necessarie a prevenire e/o mitigare l’attacco in corso.

Una soluzione di questo tipo è indipendente dalla natura dell’attacco, rapida e infallibile.

Note

[1] http://investor.symantec.com/About/Investors/press-releases/press-release-details/2016/One-New-Zero-Day-Discovered-on-Average-Every-Week-in-2015-Twice-the-Rate-of-a-Year-Ago-as-Advanced-Attackers-Exploit-Stockpile-and-Resell-High-Value-Vulnerabilities/default.aspx

[2] https://cybersecurityventures.com/zero-day-vulnerabilities-attacks-exploits-report-2017/

[3] https://it.wikipedia.org/wiki/Ransomware

A cura di: Francesco Ermini

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-fattore-umano-nella-sicurezza-di-una-rete-trasformare-una-minaccia-in-una-risorsa/


La resilienza di una rete di telecomunicazioni ad attacchi di tipo DDoS

Negli ultimi anni, gli attacchi Distribuited Denial of Service (DDoS) hanno guadagnato grande visibilità non solo sulle testate del settore ICT ma anche sui media generalisti in virtù della loro crescente numerosità e della rilevanza degli impatti che hanno comportato. Le motivazioni sono le più varie: portare a termine un’estorsione; attuare un diversivo atto a coprire altre attività illecite volte al furto di informazioni; attuare una protesta digitale (“hacktivism”); distorcere i processi competitivi impedendo a qualcuno di erogare i propri servizi online.

La parte numericamente più rilevante degli attacchi DDoS è costituita dagli attacchi volumetrici che hanno come obiettivo la saturazione delle risorse di connettività; i DDoS, però, possono anche puntare ad esaurire risorse diverse dalla banda disponibile come, ad esempio, il numero di sessioni contemporanee gestibili da un firewall o la memoria dedicata ai processi di comunicazione su un server che ospita un portale. Qualsiasi azienda che basi, anche solo in parte, il suo business su Internet è esposta a questa minaccia.

Un ISP per sua natura ha una rete “aperta” e “neutrale” che deve avere delle caratteristiche e delle contromisure in grado di fronteggiare un attacco di tipo DDoS verso le proprie infrastrutture (Data Center, DNS, router, etc…) o verso la rete di un proprio cliente. L’ISP è, nei fatti, il partner di elezione del cliente per la protezione da attacchi DDoS nella consapevolezza che, anche la migliore soluzione di network security da utilizzare on-premise (WAF, IPS, Firewall, etc…), nulla potrebbe contro un evento di dimensioni tali da saturare la capacità del suo accesso ad Internet.

Chiunque si occupi di Information Technology avrà dedicato attenzione ad eventi come l’attacco di Settembre 2016 da 620 Gbps verso il blog di Brian Krebs, noto esperto di sicurezza, o quello verso l’azienda francese di web hosting OVH, con un picco che ha superato 1 Tbps, nonché all’attacco dell’Ottobre 2016 verso Dyn, colosso nell’erogazione di servizi DNS, che ha comportato in tutti gli Stati Uniti orientali un degrado nella fruizione di Twitter, Amazon, Tumblr, Reddit, Spotify e Netflix. Nel 2018, poi, è arrivata la conferma della continua crescita del trend dei volumi degli attacchi DDoS con picchi mai raggiunti in passato: 1,35 Tbps verso Github, utilizzatissima piattaforma per lo sviluppo collaborativo di software e ben 1,7 Tbps osservati in un attacco avvenuto negli USA (grafico da https://www.arbornetworks.com/blog/asert/netscout-arbor-confirms-1-7-tbps-ddos-attack-terabit-attack-era-upon-us/).

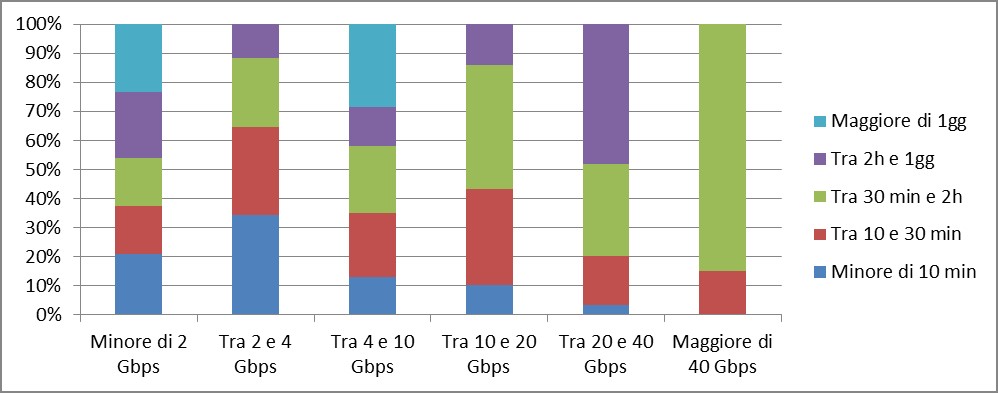
Il SOC di TIM, nel corso del 2017 ha analizzato e gestito poco meno di 8000 attacchi; quello con il volume maggiore ha sfiorato i 160 Gbps. Il trend è in costante crescita con +19% nel 2016 rispetto al 2015 ed un +27% nel 2017 rispetto al 2016. La distribuzione degli attacchi volumi/durate è descritta in Figura. Il 2% degli attacchi hanno come target l’infrastruttura TIM mentre il 98% ha come target risorse IP dei clienti.

Distribuzione volumi/durate degli attacchi DDoS, TIM 2017

Attacchi con questi volumi vengono lanciati da chi è in grado di controllare una botnet, cioè un insieme di computer e dispositivi che sono stati “compromessi” attraverso la diffusione di malware o sfruttando vulnerabilità nei loro software; questi eserciti di macchine zombie arrivano a poter contare centinaia di migliaia o milioni di unità.

BOTNET E “REFLECTION&AMPLIFICATION” ATTACK

Le botnet vengono efficacemente impiegate nella generazione di attacchi DDoS in più modalità; i bot possono produrre grandi volumi di traffico di specifiche tipologie diretti verso un target oppure possono essere sfruttati in modo diverso, facendo leva su due fattori: i meccanismi di reflection and amplification e l’applicazione solo parziale da parte degli ISP di politiche di anti-spoofing, cioè che impediscano ai loro clienti di generare traffico con un indirizzo IP sorgente che non è a loro assegnato.

L’effetto di reflection and amplification si ottiene grazie al comportamento di alcuni servizi, presenti su un grande numero di host (server, PC, modem/router, dispositivi IoT, etc..), non opportunamente configurati. C’è una continua ricerca, sia da parte di “white hat” che di “black hat”, di servizi che abbiano potenzialità di reflection and amplification. Negli ultimi anni ne sono stati identificati un discreto numero; tra questi possiamo ricordare Network Time Protocol (NTP), Character Generator Protocol (CharGEN) e Simple Service Discovery Protocol (SSDP), solo per citare alcuni dei più noti, fino ad arrivare al recente “Memcache” che garantisce fattori di amplificazione altissimi e che è prepotentemente balzato all’onore delle cronache perché utilizzato negli attacchi record del 2018.

Per lanciare un attacco DDoS i bot, tramite un meccanismo di controllo, vengono indotti a generare un traffico opportunamente forgiato e diretto verso gli host che espongono il servizio cha garantisce l’effetto di reflection and amplification. Questo traffico viene generato fingendo di essere il target, ovvero usando come indirizzo IP sorgente quello del target, comportamento consentito solo dove mancano misure di anti-spoofing. Tutto il traffico generato dalla botnet viene quindi riflesso ed amplificato verso il target, con il vantaggio ulteriore per l’attaccante di nascondere all’attaccato i reali IP della botnet.

L’avvento della Internet of Things (IoT) da questo punto di vista ha complicato lo scenario: ha incrementato ed incrementa con continuità in rete il numero di devices equipaggiati con software minimali, nei quali l’attenzione agli aspetti di sicurezza è ridotta al minimo; ciò facilità il compito di chi vuole comprometterli prendendone il controllo. Sono state infatti individuate botnet composte quasi completamente da dispositivi IoT: quella denominata Mirai, che è stata protagonista nell’attacco a Dyn, ne è l’esempio più noto.

La costruzione e la crescita di un vero e proprio business basato sulla capacità di lanciare attacchi DDoS, secondo il paradigma “DDoS as a Service”, rende disponibile questa arma a una platea di potenziali utilizzatori sempre più ampia, contribuendo alla crescita del numero degli attacchi oltre che aumentando la capacità dei “black hat” di investire risorse economiche nella ricerca di tecniche di attacco nuove e sempre più sofisticate.

LA GESTIONE DI UNA ATTACCO DI TIPO DDOS

Il macroprocesso di gestione di un attacco DDoS, è diviso in due fasi:

  • Detection: si concretizza nella rilevazione di un attacco DDoS, e di anomalie di traffico in genere, che viene effettuata attraverso la correlazione di eventi generati da più strumenti; l’elemento centrale è una piattaforma che elabora informazioni sintetiche sul traffico prodotte dai nodi di rete. Questi descrittori arrivano al livello 4 dello stack ISO/OSI, senza quindi guardare al payload dei pacchetti, e vengono esportati con un certo passo di campionamento, pur restando assolutamente efficaci ai fini della rilevazione: l’introduzione di strumenti dedicati all’analisi di questi dati, e non della totalità del traffico, è stata la grande innovazione che, oramai più di 15 anni fa, ha consentito di venire incontro all’esigenza di monitorare in tempo reale, alla ricerca di DDoS, grandissime quantità di traffico.
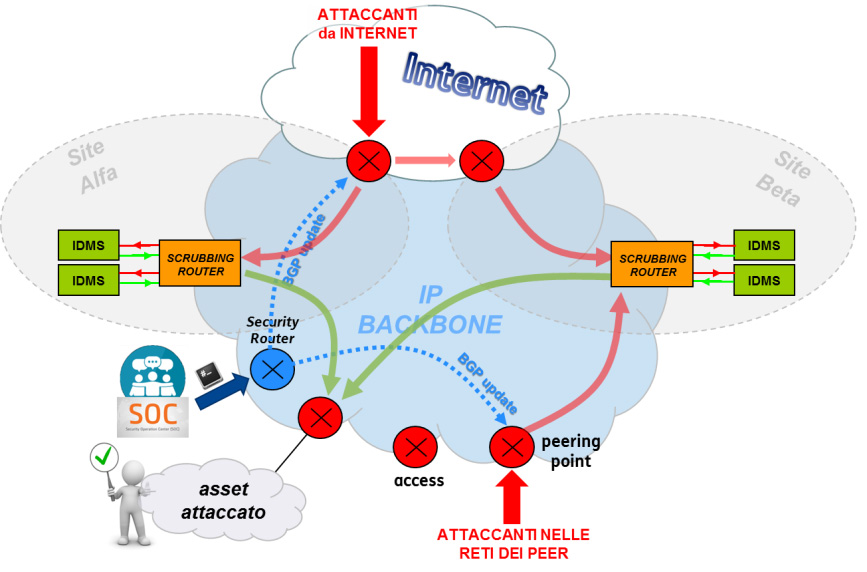
  • Reaction: prevede che, a seguito della rilevazione, vengono attivate le opportune contromisure volte a bloccare i flussi di traffico non leciti ed a contenere tutti gli impatti; le tecnologie di Intelligent DDoS Mitigation System (IDMS) che si occupano del traffic cleaning, ovvero di analizzare il traffico ed eliminare solo parte malevola, svolgono un ruolo principale e devono essere dimensionate in coerenza con i volumi degli attacchi a cui si ritiene di dover rispondere (tipicamente centinaia di Gbps).

In ragione della rapidità con cui si manifestano gli impatti c’è un impegno costante nella ricerca di soluzioni tecniche volte a rendere più rapida la rilevazione, diminuendo il mean time to detect (MTTD), e ad automatizzare la reazione e l’implementazione delle contromisure al fine di minimizzare il mean time to respond (MTTR), mantenendo un approccio conservativo per evitare di incorrere in falsi positivi.

Per l’impiego degli IDMS le soluzioni architetturali possibili sono differenti, ciascuna con pro e contro: l’ideale per gestire il traffico malevolo proveniente dall’esterno della rete dell’ISP sarebbe collocare le risorse di traffic cleaning in prossimità di tutti i possibili punti di ingresso. Questo però significa ‘frammentare’ la capacità di cleaning e aumentare i costi. In alternativa si individuano dei punti topologicamente appropriati nella rete dell’ISP per inserire delle scrubbing farm dove centralizzare tutta la capacità di cleaning, con il contro di dover trasportare il traffico di attacco dal punto di ingresso fino a questa infrastruttura; questo approccio è oggi quello più utilizzato. In base alla scelta fatta per il posizionamento degli IDMS vanno poi previste delle opportune configurazioni che consentano di realizzare al momento opportuno la traffic diversion, per portare tutto il traffico destinato al target verso le risorse di cleaning, e la traffic reinjection, per consegnare la parte lecita del traffico al target dell’attacco. La traffic diversion può essere realizzata sia mediante modifiche sul piano di routing, che agendo sui DNS che risolvono il nome logico del servizio da proteggere: questa modalità è tecnicamente più agile, ma la protezione così realizzata può essere bypassata in modo abbastanza semplice da azioni che puntino direttamente all’IP della risorsa target.

Non va trascurata, infine, l’esistenza di scenari nei quali soluzioni di traffic cleaning posizionate in prossimità del target, anche on customer premise e costantemente in line sul traffico, concorrono alla due fasi di detection e reaction, al fine di migliorare la reattività e la sensibilità della contromisura.

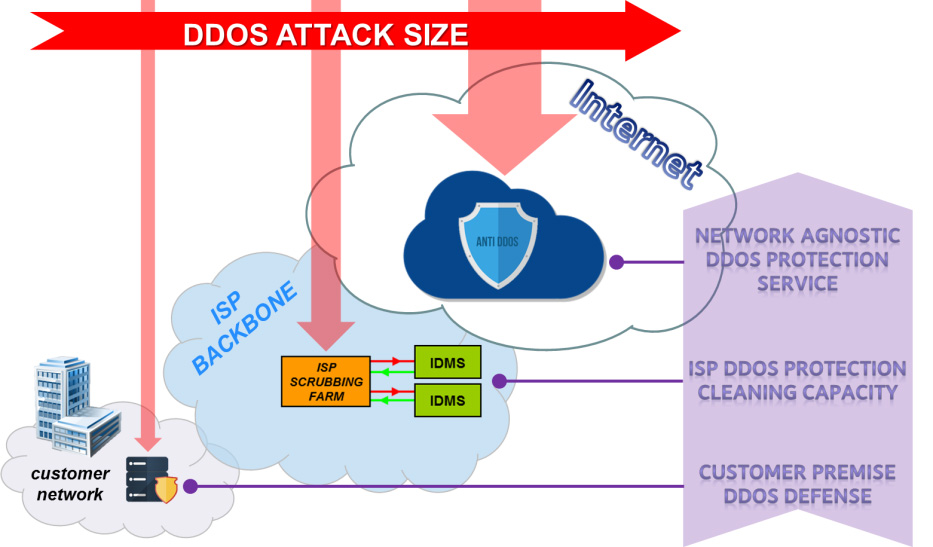
Un’azienda (e quindi anche un ISP) oggi ha anche la possibilità di stringere accordi commerciali per avere la collaborazione di player che operano a livello mondiale offrendo servizi di protezione network agnostic e con capacità di cleaning estremamente elevate e distribuite nel mondo. Nel caso dei servizi network agnostic va osservato che agiscono, dal punto di vista della traffic diversion basata sul routing, in maniera meno chirurgica (almeno una subnet /24 ossia 256 indirizzi IP) di quanto si possa fare localmente alla rete dell’ISP (dove si può modificare il routing per singolo indirizzo IP).

Allo scopo di contenere la minaccia rappresentata dai DDoS, si può delineare un approccio layered, su più livelli: un primo livello basato su una componente customer premise, in grado di gestire flussi di attacco che non superino in volume la capacità di banda del collegamento che vede il target, un secondo livello erogato dall’ISP che si occupi di attacchi gestibili con la cleaning capacity installata (dall’ISP), ed un terzo livello gestito tramite accordi con i player che offrono protezione network agnostic.

In considerazione dell’incremento della dimensione degli attacchi, nell’ambito di una ottimizzazione degli investimenti in soluzioni di protezione, una significativa novità è rappresentata dall’introduzione di BGP Flowspec. Questa funzionalità consente di utilizzare il protocollo BGP, solitamente destinato a trasportare informazioni sulla raggiungibilità delle subnet, per distribuire azioni applicabili a flussi di traffico identificabili specificando un rilevante numeri di parametri. I technology vendor, nonostante la prima specifica di BGP Flowspec risalga a quasi 10 anni fa (RFC5575, Agosto 2009), solo di recente hanno iniziato ad introdurre sui nodi di rete carrier class il supporto alle possibili azioni che mediante BGP Flowspec possono essere indicate. In questo scenario la fase di reaction, limitatamente ad alcune contromisure (es. rate limiting, drop del traffico), viene effettuata direttamente dagli apparati di rete, cosa che verrà ancora di più accelerata dall’evoluzione che alcuni dei vendor di tecnologia di rete (parliamo quindi di apparati la cui capacità si misura in decine di terabit al secondo) iniziano a proporre mediante hardware in grado di rendere disponibili una parte delle capacità proprie degli IDMS a bordo dei router. Un’evoluzione di questo tipo, in potenza, consentirà agli ISP di gestire direttamente sui nodi di frontiera della loro rete un gran numero di attacchi aprendo nuove possibilità, con un conseguente adeguamento delle soluzioni oggi impiegate a beneficio proprio e dei clienti.

La big picture tecnologica tratteggiata non può prescindere da competenze e processi, che sono componenti indispensabili nella gestione operativa della sicurezza. Solo l’acquisizione del know how ed un’analisi continua degli scenari di rischio portano all’implementazioni di contromisure puntuali ed efficaci. Un esempio in tal senso è il contenimento di attacchi di refletcion and amplification basati sul protocollo NTP, oggi realizzato grazie ad una azione di filtraggio implementata sui nodi di rete, mediante access-list (ACL), che è stata identificata a valle di un lavoro di analisi sul traffico di attacco.

A cura di: Giovanni Ciminari e Giuseppe Giannini

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-resilienza-di-una-rete-di-telecomunicazioni-ad-attacchi-di-tipo-ddos/


Il sostegno della protezione dei dati extra UE tra codici di condotta e certificazioni

I progetti finanziati dalla Commissione Europea nell’ambito del programma Horizon2020 hanno il merito di trasformare le materie più complesse in output accessibili anche ai non addetti ai lavori, ai cittadini che non hanno dimestichezza con il settore ICT. Anche quando i tool sviluppati non sono progettati per un impiego d’uso quotidiano, però, il loro merito è quello di sostenere i diritti fondamentali a partire dall’operatività delle aziende.

In particolare, il progetto Privacy Flag [1], che si avvia alla conclusione della sua ricerca iniziata nell’aprile 2015, intende sviluppare una struttura di protezione della privacy collettiva che consenta ai cittadini di controllare e proteggere meglio i propri dati personali. Oltre a una serie di strumenti e soluzioni che consentono agli interessati di valutare collettivamente e controllare il livello di rischio per la loro privacy nel contesto di applicazioni web, app per smartphone e Internet of Things, Privacy Flag fornisce anche un meccanismo volontario di compliance, ma legalmente vincolante, messo a disposizione per le aziende situate al di fuori dell’Europa.

L’obiettivo è quello di consentire a imprese cinesi, giapponesi, sud coreane e americane di allinearsi e rispettare gli standard europei in termini di protezione dei dati personali. Il Voluntary Compliance Commitment tool (di seguito, “VCT”) si basa su un accordo unilaterale che, attraverso la sottoscrizione volontaria della società mediante firma elettronica, rende questo impegno all’osservanza del GDPR efficace, fornendo una base giuridica che consenta a terzi di farvi riferimento in caso di non conformità.

Nel corso dei mesi, considerato che il tool è nato nella vigenza della Direttiva 95/46/CE ed è stato poi riadattato all’adozione del GDPR, si è osservato come tale meccanismo possa costituire una valida alternativa per sostenere e dimostrare un livello adeguato di protezione dei dati fornito dai titolari del trattamento al fine di rispettare il celebre principio dell’accountability introdotto proprio dal GDPR, apportando peraltro, ulteriori benefici che aumenteranno la fiducia degli utenti nelle attività delle imprese extra UE.

Ma andiamo con ordine.

Innanzitutto, l’adozione formale di questo “strumento di impegno volontario alla conformità” consente di sottoporre le imprese situate a distanza geografica e culturale a un insieme comune di norme allineate alla regolamentazione europea sulla protezione dei dati personali.

L’accordo unilaterale si basa su una fee proporzionata alle dimensioni dell’azienda ed è strutturato sulla base di clausole contrattuali standard per trasferimenti da titolari/responsabili a titolari/responsabili stabiliti al di fuori dell’UE (cfr. Model clauses della Commissione Europea [2]). Inoltre, considerando la possibilità per le società straniere di stabilire una controllata all’interno dell’UE, il VCT è stato definito seguendo il modello BCR (Binding Corporate Rules), inteso come soluzione per le società multinazionali che esportano dati personali dallo Spazio economico europeo ad altre entità del gruppo situate in paesi terzi che non garantiscono un livello adeguato di protezione.

Lo scopo del VCT è quello di vincolare il titolare del trattamento dei dati (la Società che sottoscrive il contratto) a una serie di obblighi che si applicano a favore degli interessati. Infatti, le clausole dell’accordo unilaterale riprendono tutti i principi di base della legislazione europea sulla protezione dei dati personali quali il principio di liceità del trattamento, di minimizzazione, di limitazione delle finalità, dell’esattezza, dell’integrità, della riservatezza nonché l’obbligo del titolare di fornire le informazioni, la notifica della violazione dei dati, ecc.

Ciò che rende il tool effettivamente molto semplice da utilizzare, il fatto di essere stato reso disponibile come piattaforma contrattuale online all’indirizzo www.privacypact.com. La stessa piattaforma mette a disposizione un elenco pubblico contenente i dettagli delle organizzazioni che hanno deciso di sottoscrivere l’accordo, al fine di renderli conoscibile agli interessati.

Una volta effettuata la registrazione dell’azienda da parte di un soggetto interno autorizzato, si firmerà digitalmente il contratto che avrà una validità di dodici mesi. Al termine di tale periodo, l’accordo potrà essere rinnovato dietro pagamento di una piccola tassa di rinnovo, ammettendo comunque la revoca del contratto in qualsiasi momento da parte dell’azienda – in tal caso, conseguentemente rimossa dalla lista pubblica.

A beneficio dei sottoscrittori, inoltre, firmando il contratto, Privacy Flag rilascia un sigillo apponibile sui siti web dell’azienda, che dimostra l’impegno volontario della società a rispettare i principi cardine della protezione dei dati.

Non volendosi sostituire in alcun modo alle autorità nazionali per la protezione dei dati, Privacy Flag non è responsabile per la risoluzione delle controversie tra data subject e aziende firmatarie. Tuttavia, il sito permette agli utenti di effettuare segnalazioni documentando la decisione di un’Autorità per la protezione dei dati che identifica una delle società pubblicate nella lista come non conforme alle norme sulla privacy dell’UE. Qualora tale decisione sia stata presa, vi è la cessazione automatica dell’accordo con la società, cui consegue anche la rimozione del sigillo di partecipazione.

Ma perché sottoscrivere il VCT se il GDPR “si applica al trattamento dei dati personali di interessati che si trovano nell’Unione, effettuato da un titolare del trattamento o da un responsabile del trattamento che non è stabilito nell’Unione, quando le attività di trattamento riguardano: a) l’offerta di beni o la prestazione di servizi ai suddetti interessati nell’Unione, indipendentemente dall’obbligatorietà di un pagamento dell’interessato; oppure b) il monitoraggio del loro comportamento nella misura in cui tale comportamento ha luogo all’interno dell’Unione” (Art. 3(2)?

Ebbene, il VCT rappresenta un prezioso strumento aggiuntivo volto a garantire il rispetto delle norme sulla protezione dei dati personali da parte di tutte le entità situate al di fuori dell’UE in tre diversi casi:

  • se non offrono beni e servizi ai cittadini dell’UE o non controllano ancora il loro comportamento, ma attraverso la sottoscrizione volontaria si impegnano a rispettare le norme europee sulla protezione dei dati personali in previsione dell’offerta di beni e servizi o del monitoraggio del comportamento;
  • se trattano dati personali di persone fisiche che non sono nell’UE (ma potrebbero essere cittadini dell’UE) offrendo beni e servizi o svolgendo attività di monitoraggio sul comportamento, anche se il comportamento non si svolge all’interno dell’Unione;
  • se desiderano offrire beni e servizi ai cittadini dell’UE o monitorarne il comportamento e sono alla ricerca di uno strumento di responsabilizzazione per offrire anche visivamente (con il sigillo) garanzie in relazione alla tutela della vita privata, dei diritti e delle libertà fondamentali e l’esercizio dei diritti correlati.

Per inquadrare il contesto normativo in cui il VCT opera è bene ricordare che il GDPR consente esplicitamente la possibilità per “responsabili del trattamento o incaricati del trattamento che non sono soggetti al presente regolamento a norma dell’articolo 3 al fine di fornire garanzie adeguate nell’ambito dei trasferimenti di dati personali verso paesi terzi o organizzazioni internazionali” a “rendere impegni esecutivi, tramite strumenti contrattuali o altri strumenti giuridicamente vincolanti, per l’applicazione di tali garanzie adeguate anche in relazione ai diritti degli interessati ” (articolo 40.3).

Inoltre, al fine di migliorare la trasparenza e l’osservanza del GDPR, il legislatore europeo ha incoraggiato l’istituzione di meccanismi di certificazione della protezione dei dati e di sigilli e marchi di protezione dei dati, in particolare per consentire ai dati di valutare rapidamente il livello di protezione dei dati dei prodotti pertinenti e servizi.

Questo è il motivo per cui, conformemente all’articolo 42 del GDPR ed esattamente come per i codici di condotta, “i responsabili del trattamento o i trasformatori che non sono soggetti al presente regolamento a norma dell’articolo 3 nell’ambito dei trasferimenti di dati personali verso paesi terzi o organizzazioni internazionali” possono “assumere impegni vincolanti e esecutivi, tramite strumenti contrattuali o altri strumenti giuridicamente vincolanti, per applicare tali garanzie appropriate, anche in relazione ai diritti degli interessati“.

Grazie a questo nuovo background legale, dunque, il progetto Privacy Flag ha dato vita a un vero e proprio meccanismo aggiuntivo di protezione dei dati, in conformità con gli articoli 40(3) e 42(2) del GDPR. Così, pur non costituendo il VCT una certificazione (articolo 42) o un codice di condotta (articolo 40), esso rappresenta a tutti gli effetti uno strumento valido per il supporto e la dimostrazione del principio di accountability ex art. 5(2), GDPR.

Il VCT può essere visto, allora, come un ibrido tra un codice di condotta – dal momento che contiene una serie di principi e obblighi per il responsabile del trattamento dei dati che ne fa parte – e una certificazione, poiché garantisce anche l’identificazione positiva delle aziende aderenti con un elenco pubblico e attraverso un sigillo che la Società può ottenere dopo la conclusione del contratto. Ecco che H2020 ha dato origine a una “certificazione di condotta”.

Bibliografia

A cura di: Camilla Bistolfi

Specializzata cum laude in Scienze di governo e della comunicazione pubblica alla LUISS Guido Carli. Dopo un tirocinio presso il Garante Privacy (Dipartimento attivià ispettive e sanzioni), ha ottenuto nel 2014 l’incarico di Research Fellow dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati – di cui è diventata nel 2017 componente del Consiglio di Amministrazione e per il quale, dal 2015, segue il progetto di ricerca e innovazione Horizon 2020 “Privacy Flag”, finanziato dalla Commissione Europea.

È direttrice del Centro Nazionale Anti-Cyberbullismo (CNAC) nato in seno a IIP.

È coautrice nella raccolta “Privacy Technologies and Policies” (Springer, 2016) di uno studio in tema di IoT e 3D privacy e di una pubblicazione su pseudonimizzazione, privacy e Big Data sulla Computer Law & Security Review. Ha scritto, in questi anni, anche di social network, identità digitali e portabilità dei dati.

E’ autrice con Luca Bolognini e Enrico Pelino del volume “Il Regolamento Privacy Europeo”, il primo commentario italiano sulla materia pubblicato nel 2016 da Giuffrè.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-sostegno-della-protezione-dei-dati-extra-ue-tra-codici-di-condotta-e-certificazioni/


Internet of Things: protocolli e criticità nella sicurezza di rete (Prima parte)

Sommario

Chi mai avrebbe pensato nel 1969, partendo da un debutto in sordina con la rete ARPANET (Advanced Research Projects Agency Network), in cui erano interconnessi solo pochi siti, di prevedere entro il 2020 un numero di 50 miliardi di oggetti interconnessi grazie a Internet. Le connessioni globali di Internet rendono possibili la navigazione sul web, l’accesso ai social media e l’uso dei dispositivi mobili intelligenti. Internet of Things nasce in questo contesto. Nella prima parte di quest’articolo analizziamo l’ambiente tecnologico di partenza, concentrandoci sugli aspetti generali architetturali, mentre nella seconda vediamo quali sono gli avanzamenti e quali sono i tentativi per implementare la sicurezza in una tecnologia che, in alcuni casi, potrebbe avere dei risvolti pericolosi per la vita degli esseri umani.

Introduzione

Internet of Things (IoT), un termine coniato da Kevin Ashton, un pioniere della tecnologia britannica, durante il suo studio sull’identificazione a radio frequenza (RFID), che teorizzava un sistema di sensori universale e che doveva collegare il mondo fisico a Internet, oggi si sta diffondendo nelle Smart Cities, le città intelligenti altamente tecnologiche e nell’Industria 4.0, che sono industrie sempre più digitalizzate, automatizzate ed interconnesse. Stiamo infatti assistendo alla cosiddetta “Quarta Rivoluzione Industriale” [a] [b]. Le cose (i dispositivi), Internet e la connettività sono le tre componenti di base dell’Internet of Things. Con la nascita dell’IoT ci troviamo a dover risolvere due grossi problemi: i Big Data e la Security. La grande quantità di dati originati dalle reti di sensori, la relativa trasmissione e conservazione sono oggi i nuovi problemi dell’industria IT. Termostati, dispositivi di videosorveglianza, rilevatori di luminosità, orologi, dispositivi indossabili, sensori ambientali e spaziali generano grandi set di dati che devono essere gestiti dalle reti [c]. La banda larga e la congestione della rete sono ancora problemi presenti, sebbene oggi ogni casa italiana sia stata raggiunta dalla fibra ottica, eliminando il collo di bottiglia che si era creato alla fine degli anni ’90 nel cosiddetto “ultimo miglio”. In quegli anni il collegamento telefonico tra abitazione e centrale telefonica del gestore di telecomunicazioni non era altro che un imbuto dove il flusso di dati veniva rallentato, a causa del quale la velocità interna della rete LAN di casa era 100 volte più grande rispetto alla velocità dell’interconnessione con l’ISP (Internet Service Provider). Inoltre, nonostante siano stati implementati complessi e sofisticati algoritmi di instradamento dei dati (routing), i nodi della rete geografica del gestore sono tutt’oggi spesso ancora congestionati da situazioni temporanee, di difficile soluzione, che rallentano la rete, anche se limitate in aree geografiche ben circoscritte.

Dall’altra parte, aumentando la connettività, diminuisce la sicurezza della rete, pertanto la net-security sta diventando un problema enorme e richiede una soluzione immediata. Il cybercrime è un settore emergente del crimine. I cyber criminali stanno sfruttando Internet per impegnare una vasta gamma di attività che non conoscono confini. Un attacco informatico criminale alla rete di sensori del traffico urbano che gestisce i semafori di un incrocio cittadino metterebbe in serio rischio la vita degli automobilisti. È ovvio che la minaccia principale è la diffusione sempre crescente di malware.

Con l’obiettivo di supportare l’IoT, nel contesto delle comunicazioni wireless e, più specificamente, nel wireless a corto raggio, è stato definito dall’IEEE (Institute of Electrical and Electronic Engineers) uno standard chiamato 802.15.4, approvato nel 2003 [d] [e]. È un protocollo nato per permettere la comunicazione via radio di piccoli dispositivi, che hanno poca energia in alimentazione in quanto spesso sono alimentati da batterie. Il principale problema di questo standard, nel momento in cui fu progettato, fu la sua carenza dal punto di vista della sicurezza di rete. Vediamo in cosa consiste lo standard e come è stato affrontato il problema della security.

Lo standard IEEE 802.15.4

Questo standard è stato ideato per comunicazioni wireless a basso costo, bassa velocità e basso consumo energetico. È adatto per reti WPAN (Wireless Personal Area Network) di piccola portata ed è spesso costituito da dispositivi alimentati a batterie che, non possono essere sostituite e devono essere ricaricate molto velocemente da sistemi di energia alternativi.

Le caratteristiche principali di questa tecnologia sono:

  • poche decine di metri di area di copertura con un bit-rate massimo di 250 Kbps;
  • bassa potenza di trasmissione;
  • basso assorbimento di alimentazione;
  • supporto del routing agli strati superiori;
  • possibilità di utilizzare acknowledgement per ritrasmettere i dati in caso di mancata ricezione o errori di trasmissione.

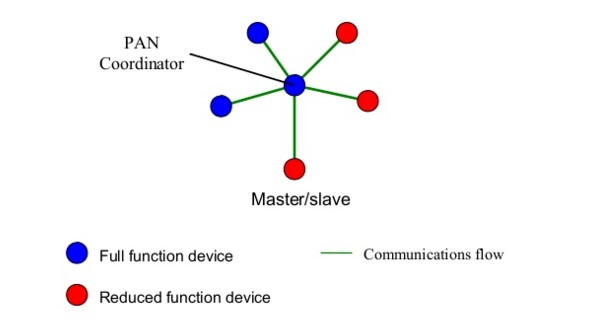
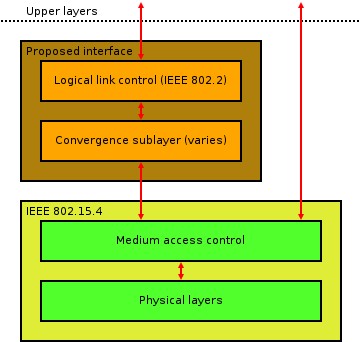
Lo standard 802.15.4 definisce un livello 1 (livello fisico) e un livello 2 (livello MAC, Medium Access Control) [d]. I dispositivi che utilizzano lo standard IEEE 802.15.4 possono avere due diverse modalità: dispositivo a funzione ridotta (RFD: Reduced Function Device) e dispositivo a funzione completa (FFD: Full Function Device).

Il dispositivo FFD ha una funzione di coordinamento, è compatibile con ogni tipo di rete e gestisce le connessioni con altri dispositivi. L’RFD invece viene utilizzato solo nelle reti con topologia a stella, non ha una funzione di coordinamento e può comunicare solo con gli FFD (Fig.1). Il protocollo supporta la connessione tra dispositivi adiacenti, fornisce una gestione delle reti molto complesse ed estese.

Fig. 1 Reduced Function Device (RFD) e  Full Function Device (FFD) in una rete a topologia a stella (Joe Dvorak, Motorola)

Lo Strato fisico: il livello 1

Il livello fisico abilita/disabilita il modulo radio per risparmiare energia ed effettua anche la scelta del miglior canale di comunicazione, calcolando il rapporto segnale/rumore (SNR), in modo tale da ridurre la probabilità di errore durante la trasmissione. Infine modula e demodula i segnali nel ricetrasmettitore (Fig.2).

Lo strato fisico opera nella banda ISM (Industrial, Scientific and Medical) utilizzando tre possibili bande libere:

  • 868-868,6 MHz: la banda utilizzata nella maggior parte dei paesi europei con una velocità di 20kbps e l’utilizzo di un singolo canale;
  • 902-928 MHz: la banda utilizzata nel continente oceanico e americano, che offre una velocità di trasmissione dati di 40 kbps e 10 canali disponibili;
  • 2400-2483,5: la banda utilizzata quasi in tutto il mondo con una velocità di trasmissione dati fino a 250 Kbps e 16 canali disponibili.

Il sistema di modulazione più diffuso è il DSSS (Direct Sequence Spread Spectrum) che utilizza le tecniche di BPSK (Binary Phase Shift Keying), QPSK (Quadrature Phase Shift Keying) e PSSK (Phase Silence Shift Keying).

La PDU (Protocol Data Unit, la struttura di dati) a livello fisico, come mostrato, è formato da una serie di campi:

  • un preambolo formato di 32 bit, che ha lo scopo di sincronizzare il nodo destinatario;
  • un ottetto (11100101) che funziona come delimitatore del frame iniziale;
  • un campo che indica la lunghezza del payload (Physical Service Data Units) che può avere una lunghezza massima di 127 byte.


Fig. 2 I livelli dello standard IEEE 802.15.4 layers (By Rob Blanco (Own work), via Wikimedia Commons

Il livello MAC (Medium Access Control): il livello 2

Il secondo livello (MAC) (Fig.2) offre servizi che supportano la creazione di una rete PAN (Personal Area Network), la gestione del beacon (un tipo di messaggio) e l’accesso al canale tramite il protocollo CSMA/CA (Carrier Sense Multiple Access/Collision Avoidance) [f]. Questo livello supporta algoritmi di crittografia basati su AES-128 per la sicurezza dei dati, gestisce la negoziazione e gli acknowledgement per la ritrasmissione dei dati in caso di errore ed infine calcola e verifica l’integrità della PDU. Può supportare reti con un massimo di 65.536 nodi utilizzando un indirizzamento fino a 16 bit. Al livello MAC esiste una struttura di dati chiamata superframe. Tale struttura è creata da un FFD ed è contenuta tra due messaggi chiamati beacon. I beacon contengono informazioni che possono essere utilizzate per la sincronizzazione dei dispositivi, per l’identificazione della rete, per descrivere la struttura del superframe e la frequenza ciclica della loro trasmissione. Il superframe è diviso in 16 intervalli di tempo (time-slots) di medesima dimensione e il frame del beacon viene trasmesso all’inizio e alla fine di ogni time-slot.

Esistono due tipi di superframe:

  • senza GTS (Guaranteed Time Slot, Time Slot Garantito);
  • con GTS.

Quando inviamo un superframe senza GTS, l’accesso al canale è regolarizzato dal protocollo CSMA/CA in cui ogni dispositivo deve competere con gli altri per assicurarsi l’accesso a un time-slot. Il momento della contesa per appropriarsi dello slot è chiamato CAP (Contention Access Period). Nelle applicazioni in cui è necessario assicurarsi che ogni nodo possa trasmettere, si utilizzano i superframes con GTS, in cui ogni nodo ha a disposizione fino a un massimo di sette time-slots. Questo periodo è chiamato CFP (Contention-FreePeriod). In questo periodo i nodi predeterminati possono solo trasmettere e accedere al canale, senza utilizzare il protocollo CSMA/CA [f].

Modalità di trasferimento dei dati

La trasmissione dei dati può avvenire in tre modi diversi, a seconda del dispositivo che invia i dati. La prima modalità si riferisce al trasferimento dei dati da RFD a FFD, il secondo da FFD a RFD e il terzo tra due RFD. Le prime due modalità possono essere utilizzate solo in una rete a topologia a stella, mentre tutte le modalità possono essere utilizzate per reti di topologia mesh (topologia a maglia).

Possiamo utilizzare due diversi meccanismi per la trasmissione dei dati:

  • Beacon-Enable: trasmissione basata su beacon;
  • Beacon-Disable: trasmissione non basata su beacon.

In una rete basata sui beacon, quando un RFD deve trasmettere i dati ad un FFD, attende il beacon e si sincronizza con il superframe. L’RFD trasmette i dati all’FFD che, opzionalmente, dopo averli ricevuti, invia un ACK di avvenuta consegna al dispositivo.

In una rete non basata sui beacon, quando un RFD deve trasmettere i dati all’FFD, semplicemente trasmette sul canale utilizzando il protocollo CSMA/CA [f]. In questo tipo di trasmissione, l’FFD può facoltativamente trasmettere un ACK dopo la ricezione dei dati. La trasmissione diventa più complessa quando un FFD deve comunicare con una RFD.

In caso di trasmissione con beacon, l’FFD indica la sua volontà di trasmettere verso l’RFD, il quale risponde attraverso una PDU chiamata MAC command, che è una conferma di ricezione dati. L’FFD, dopo aver ricevuto il MAC command, invia un ACK PDU e poi trasmette i dati. Al termine degli scambi di dati, l’RFD trasmette una conferma di fine trasmissione.

Se la rete non è basata su beacon, il trasferimento dei dati da FFD e RFD avviene nello stesso modo con l’eccezione che l’FFD memorizza i dati finché l’RFD non ha instaurato la connessione. In questa modalità ogni accesso alla rete è realizzato tramite il protocollo CSMA/CA [f].

Struttura dei frame al livello MAC

L’IEEE 802.15.4 definisce quattro tipi di frame generici:

  • Beacon Frame: utilizzato per definire un superframe e coordinare la sincronizzazione tra RFD e FFD;
  • Data Frame: con un payload massimo di 104 byte, trasporta i dati e fornisce altri servizi di packet-tracing ed il controllo dell’integrità della PDU.
  • Frame ACK: fornisce una conferma della ricezione del pacchetto di dati;
  • MAC Command Frame: consente meccanismi per il controllo e la configurazione dei dispositivi.

Riferimenti

  • [a] Evans D. The Internet of things, how the next evolution of the Internet is changing everything, 2011. Cisco Internet Business Solutions Group (IBSG). White paper.
  • [b] Xu LD, He W, Li S. Internet of things in industries: a sur- vey. IEEE Transactions on Industrial Informatics 2014; 10(4): 2233–2243.
  • [c] Ericsson. More than 50 billion connected devices, 2011. Ericsson White Paper.
  • [d] http://standards.ieee.org/getieee802/download/802.15.4-2015.pdf
  • [e] 802.15.4-2011: IEEE standard for local and metropolitan area networks—Part 15.4: low-rate wireless personal area networks (LR-WPANs), IEEE Std., 16 June 2011.
  • [f] http://standards.ieee.org/about/get/802/802.11.html

A cura di: Crescenzio Gallo, Michele Perilli, Michelangelo De Bonis
Università di Foggia

Il dott. Crescenzio Gallo ha conseguito la laurea in Scienze dell’Informazione presso l’Università di Bari (1978) e la laurea specialistica in Scienze e Tecnologie Informatiche presso l’Università di Milano (2007).

Negli anni 1978–1980 ha svolto attività di ricerca in Sistemi Informativi presso l’Istituto di Informatica dell’Università di Bari ed è stato consulente tecnico-scientifico della società Telespazio SpA di Roma per i progetti satellitari TERRA-Landsat della NASA e dell’Agenzia Spaziale Europea (ESA).

Dal 1992 al 2003 è stato docente a contratto presso le Università di Bari e Foggia, e dal 2004 al 2007 è stato ricercatore di ruolo in Matematica Applicata presso l’Università di Foggia.

Dal 2007 è Professore Aggregato di Informatica e Sistemi di Elaborazione delle Informazioni, ed attualmente svolge la sua attività di ricerca e docenza presso il Dipartimento di Medicina Clinica e Sperimentale dell’Università di Foggia.

I suoi interessi scientifici primari includono l’analisi dei dati e il machine learning applicati alla bioinformatica, e l’analisi delle problematiche di sicurezza delle reti.

L’Ing. Michele Perilli è nato a Foggia, nel 1962. Si è laureato in Informatica presso l’Università degli Studi di Bari nel 1987, e in Scienze e Tecnologie dell’ Informazione (2005) e Tecnologie dell’Informazione e della Comunicazione (2006) presso l’Università di Milano.

Nel periodo 1988-2000 ha lavorato in Telecom Italia SpA con compiti di direzione tecnica. È docente di ruolo di Informatica dal 2001, professore a contratto presso l’Università di Foggia dal 2007. È membro IEEE e istruttore certificato Cisco Systems.

Il suo principale interesse nella ricerca riguarda il networking, i protocolli e il routing delle reti.

Download PDF

https://www.ictsecuritymagazine.com/articoli/internet-of-things-protocolli-e-criticita-nella-sicurezza-di-rete-prima-parte/


Il repertamento informatico dopo un decennio di applicazione della Legge 18 marzo 2008 n.48

Abbiamo festeggiato da poco il decimo compleanno della Legge 18 marzo 2008, n. 48 ed in un precedente articolo senza pretesa di completezza ho tentato di tratteggiare brevemente cosa è cambiato dalla sua entrata in vigore. In particolare ho cercato di far comprendere come sia sempre più avvertita e necessaria un’imponente e capillare diffusione di istruzione e cultura giuridico-informatica forense, diretta a tutti i protagonisti coinvolti e capace di preparare ufficiali ed agenti di polizia giudiziaria, consulenti, giudici e pubblici ministeri ad affrontare nell’ambito delle rispettive competenze con professionalità, efficienza ed attualità le sfide future della Digital Forensics. Dopo 10 anni di applicazione della norma, speravo, che si fosse sgomberato il campo da quel “si è sempre fatto così”, che in un mondo digitale in continua evoluzione e trasformazione, mal si adatta e concilia a scenari sempre nuovi e diversi tra loro.

E’ evidente come approcci, tecniche, soluzioni e strumenti qualche anno fa moderni ed efficienti oggi segnano il passo, mal si conciliano ed adattano, alla gestione dei “casi” che si prospettano quotidianamente alla platea sopra delineata.

Vorrei allora, in occasione di questa ricorrenza, tornare sul repertamento dei supporti informatici e lungi dal voler dare consigli, vorrei invece, che questa fosse l’occasione per rinverdire quell’azione (il repertamento) che mi piace definire la “genesi” di ogni indagine forense. Già perché senza un buon ed efficace repertamento la Chain of custody o catena di custodia parte con un anello debole, quasi spezzato e destinato a rompersi in occasione di quella delicata fase processuale che è il dibattimento.

Anzi ritengo che senza un buon repertamento, di fatto, la tanto decantata e giustamente valorizzata catena di custodia (chain of custody) non abbia neanche il suo inizio!

L’articolo pertanto non vuole insegnare niente a nessuno, ma vuole essere un momento di riflessione da parte di tutti al fine di rivalorizzare un momento della digital forensics spesso dato … ahimè … a torto per scontato. Vorrei davvero che la lettura servisse a far riflettere ciascuno, su abitudini, prassi, consuetudini e procedure e l’amara realtà dei fatti, sollecitando quindi tutti a porre maggior attenzione a questa importante fase.

Penso sia stata esperienza di molti l’aver affrontato in dibattimento problematiche legate al repertamento e alla catena di custodia spesso (quanto meno il primo) quasi mai dipendente dal consulente o esperto chiamato ad analizzare gli stessi, ma strettamente legato all’esperienza e preparazione di coloro che nella primissima fase si sono occupati del sequestro e repertazione dei supporti informatici, quasi sempre ufficiali ed agenti di polizia giudiziaria che pur affidandosi al buon senso ed esperienza non sempre sono riusciti a forgiare un primo e robusto anello di quella catena.

Accade purtroppo ancora spesso che arrivino nei laboratori e quindi nelle mani di esperti e consulenti, reperti:

A) privi di un dossier fotografico

Oggi tutti abbiamo in tasca un smartphone o per dirla in altre parole una macchina fotografica digitale, quando va male, oggi da 12 megapixel (viene un eccellente stampa in A3), tuttavia arrivano ancora sequestri non accompagnati da un dossier fotografico,  che al di là delle spesso infelici descrizioni, come vedremo nel prosieguo,  possa aiutare il consulente/esperto ad associare compiutamente la descrizione messa a verbale con il corrispondente reperto. Capita ancora molto spesso specie nei sequestri effettuati in ambito aziendale dove si trovano più reperti della spesse marca e modello, che la sola descrizione a verbale se non accompagnata da altri elementi rende difficile l’identificazione del reperto da parte del consulente. Oltre che alla carenza di informazioni ciò può dipendere anche da errori di trascrizione, dettatura e ortografia compiuti da verbalizzanti. La fotografia del reperto nel suo complesso e quando presenti dei suoi dati identificativi “esterni” targhette, marca e modello etc. possono aiutare molto nel risolvere detta problematica, anche se è preferibile etichettare i reperti con targhette adesive (fogli con intestazione del reparto operante) o con scotch carta attribuire loro un numero o lettera e poi fotografarli, per avere una “repertazione” più efficace ed immediata.

Tempo fa un consulente mi ha insegnato (questo è il termine esatto) ad usare quando presente una normale fotocopiatrice, per stampare già su un foglio A4 l’immagine del reperto, cosa che direte banale (e che viene difficile con server e “case” di PC) ma non ci avevo mai pensato, e fa risparmiare un sacco di tempo, cavi e stampa, soprattutto quando si tratta di semplici hard-disk, pen drive, cd-rom, DVD e altri piccoli oggetti che possono stare comodamente sul “vetro” della stampante.

Qualora si opti per il report fotografico sarà bene in termine alle operazioni comprimere tutte le foto in una cartella .zip, .rar etc. e calcolarne l’algoritmo di hash che andrà messo nel verbale si eviteranno così modifiche al dossier/report fotografico.

Si potrebbe pensare di poter filmare tutti i reperti ed anche le azioni effettuate sugli stessi. Qui tuttavia mi sento di richiamare ad un’attenta riflessione:

– sulla qualità di un video rispetto a foto che possono essere ingrandite molto di più permettendo di visualizzare elementi non sempre apprendibili da un video (seriali scritti molto in piccolo, in posizioni poco illuminate, etc.);

– sulle difficoltà ad avere “operatori” impegnati solo in detta operazione e capaci di non essere distratti da elementi che poi non andranno a costituire reperto, ovvero capaci di realizzare un video che non dovrà essere modificato, cancellato o tagliato in quanto contenente elementi estranei alla repertazione.

B) privi delle necessarie indicazioni utili ad identificarli.

Tornando alla descrizione dei reperti, nei verbali non è più possibile scrivere un PC, un portatile, una chiavetta, un telefono o altre indicazioni generiche che posso significare tante cose.  E’ necessario istruire gli addetti ai lavori su quel minimo di indicazioni che devono essere fornite per una completa e precisa identificazione del reperto.

In via indicativa ma non esaustiva, vorrei evidenziare la necessità di indicare almeno:

– una descrizione sommaria del reperto (forma, colore, tipologia di dispositivo[1])accompagnata ove rinvenibile da un numero di seriale, facendo attenzione come accade spesso a non indicare il product key che indica il prodotto o altri seriali “generici” e non univoci  (è come se si indicasse “FIAT 500” senza il numero di targa) o altri codici che potrebbero ingenerare confusione, anziché chiarezza, capita talvolta che i seriali siano mal interpretati (zero per O e viceversa) o vengano letti e dettati con errori. Soprattutto in ambito aziendali le forniture sono solitamente in serie e confondere una lettere o una cifra, può avere conseguenze, nella migliore delle ipotesi, imbarazzanti. Qualora poi si tratti di prodotti assemblati spesso privi di segni identificativi univoci , ci si dovrà necessariamente affidare ad una “repertazione” fotografica accompagnata da un supporto (foglio, post-it, scotch carta)  che attribuisca al reperto un numero o lettera identificativa che dovrà anche essere “autenticata” dalla parte attraverso la sottoscrizione dell’apposito verbale.

Un mondo a parte è rappresentato dagli smartphone. In rete si trovano validi supporti per giungere ad una sufficiente identificazione di marca e modello e per poterne rilevare l’IMEI, consiglio una volta individuata marca e modello di fare una “Googleata”, ricordando che non è sempre buona cosa digitare, togliere la batteria etc se non si sa bene cosa si stia facendo e perché. All’argomento andrebbero dedicati ampi spazi, soprattutto oggi che lo spegnimento di un dispositivo di tal tipo può essere “fatale” al prosieguo di un indagine;

– dove è stato precisamente rinvenuto il reperto e da chi viene solitamente utilizzato. Non sono indicazioni banali in quanto spesso risultano determinanti anche per le sorti processuali. Al di là degli “User” rinvenibili dal sistema (per capirci) occorre anche attraverso altri elementi ed indizi ricondurre l’utilizzo del reperto ad una o più persone nella maniera più precisa possibile. Non va poi sottovalutato come meglio sottolineato nel seguito che fotografare “lo stato delle cose” (posizione delle cose e loro stato) prima di procedere al repertamento e sequestro dei dispositivi, può risultare se non determinante, spesso, strategico. Ricordo che l’art. 357 c.p.p. lettera f) indica tra la documentazione della polizia giudiziaria: “atti, che descrivono fatti e situazioni, eventualmente compiuti sino a che il pubblico ministero non ha impartito le direttive per lo svolgimento delle indagini” (con espresso riferimento all’art. 348 c.p.p. – Assicurazione delle fonti di prova. Ritengo che il combinato disposto testé evidenziato permetta alla polizia giudiziaria di redigere un vero e proprio verbale dal quale emergano nel migliore dei modi tutti quegli elementi che possano a posteriori introdurre nel dibattimento una descrizione quanto mai precisa dello stato, posizione, caratteristiche ed utilizzatori dei reperti.

– lo stato del dispositivo (acceso/spento/non so) è un elemento fondamentale, oltre, a quanto appena segnalato, lo stato del dispositivo serve a “corroborare” le scelte effettuate sul posto dagli ufficiali/agenti di P.G., nel rispetto delle linee guida fissate dalla L.48/2008. Invero servirà di volta in volta attraverso lo “stato del dispositivo corroborare/giustificare le azioni tecniche intraprese, non esistendo per fortuna una regola generale che imponga lo spegnimento di un dispositivo o la sua accensione durante le operazioni di P.G. L’eventuale presenza di password invece, oltre ad essere indicata nel verbale, dovrebbe costituire elemento di attenzione e sollecitazione per gli investigatori che dovrebbero cercare di ottenerle ognuno secondo le proprie tecniche. Si vuole qui evidenziare che le molteplici tecniche finalizzate all’ottenimento delle password e credenziali fanno parte dell’esperienza e capacità dell’investigatore al pari delle capacità necessarie a condurre un interrogatorio. Il problema è che spesso presi da altre priorità non si pensa a quanto invece sia determinante e strategico soprattutto oggi, ottenere le necessarie credenziali in maniera rapida e diretta. Si fa molto, forse troppo affidamento sulla tecnologia (crack password, e direi anche sulla filmografia dove in pochi secondi si vede ottenere la password segreta), tralasciando forse troppo le tradizionali tecniche di indagine che comunque devono essere patrimonio del investigatore 4.0, soprattutto oggi dove la riservatezza e la privacy spingono i produttori ad adottare tecniche sofisticate a tutela di detti principi. Tutele che non sempre riescono ad essere superate se non dopo diverso tempo e studio dalla loro introduzione. Ecco perché allora come già sopra indicato un buon report fotografico (al di là del post-it sul monitor) ha aiutato molto se non nell’individuazione diretta delle password a tracciare un profilo del soggetto, predisponendo magari “librerie” di password ad hoc da tentare attraverso tecniche di “brute force” (titoli dei libri letti, frasi apparentemente senza senso appuntate qui e là, poster di film, squadre del cuore, foto di cani e gatti. etc. etc., fotografate sulla “crime scene” possono aiutare). Quest’ultimo aspetto è molto importante ed assume sempre maggior rilevanza oggi che i dispositivi risultano, dico meglio, protetti da sistemi difficilmente by-passabili o che a cagione degli algoritmi utilizzati per esempio AES256 richiederebbero tempi biblici per un crack- password[2]. Tale ultimo problema è talmente avvertito che l’interconnessione dei dispositivi consiglia oggi di acquisire tutti i dispositivi presenti, in particolari situazioni, al fine di tentare almeno attraverso uno di questi, di ottenere spunti, indizi o le vere e proprie password magari utili a sbloccarne altri.

– una descrizione analitica del reperto (eventuali danni, abrasioni, etc.) nonché degli eventuali accessori che lo accompagnano (cavi, alimentatori, trasformatori etc.) in tale ultimo caso è utile procedere anche ad una vera e propria “etichettatura”, degli stessi al fine di ricondurli al rispettivo reperto. Ricordo che collegare un dispositivo ad un alimentatore, trasformatore non suo può provocare seri danni. E che per taluni dispositivi non è così facile reperire accessori compatibili. Inoltre ma non ultimo i reperti vengono spesso consegnati “imballati” e sigillati al consulente o esperto e questi talvolta non ha modo di verificarne in dettaglio il contenuto, ritrovandosi solo dopo l’apertura del plico dinanzi a reperti danneggiati, abrasi, rotti senza che ciò sia stato fatto risultare al momento del repertamento.  Quest’ultimo punto che interesserà maggiormente la fase del cosiddetto “dissequestro” e restituzione dei reperti all’avente diritto, pur emergendo successivamente può essere talvolta momento di grande imbarazzo e di conseguenze anche gravi (richieste di risarcimento danni per danni provocati ai dispositivi).

C) impacchettati e trasportati senza idonee cautele.

– …. sono cose delicate! Seguite le indicazioni riportate alla lettera precedente, non va dimenticato che si tratta di cose delicate e particolari.  Delicate perché un hard disk a discapito dell’aspetto non è un blocco di ferro, una pen drive si può danneggiare irrimediabilmente soprattutto quelle che hanno l’aspetto di accattivanti gadget (vedi quelle a forma di carta credito o con connettori morbidi), un pc desktop all in one va trattato con più cura rispetto ad un case di un pc desktop tradizionale senza il relativo monitor, un tablet non è un tagliere per cetrioli, i dvd, cd, blue ray etc, sono fragili.

Particolari, perché alcuni dispositivi (su tutti gli smartphone e tablet in genere) richiedono specifiche  accortezze prima di essere repertati, l’argomento in questione è vasto e richiederebbe  uno spazio dedicato, qui mi limito a ricordare che qualora necessario se il dispositivo deve essere lasciato acceso andrà cautelato con apposite gabbie di Faraday che lo isolino da eventuali violazioni esterne o in assenza delle apposite scatole o gabbie posto in modalità “aereo” al fine di isolarlo dalla rete (sull’utilizzo della carta stagnola per pollo arrosto, non entro nel merito, sembrerebbe tuttavia che l’isolamento sia proporzionale agli strati, per cui attendo che arrivi qualche smartphone ben ..impacchettato.. in ogni caso per chi volesse approfondire il tema (http://www.gravita-zero.org/2013/06/snowden-mette-veramente-i-cellulari-in.html);

– anche allorquando si realizza una bit stream image del supporto “target” è bene adottare le dovute cautele anche nei confronti di dischi di destinanzione che contengono  quest’ultima. Accade spesso che incautamente la realizzazione della bit- stream image tenda a “sollevare” gli operatori da tutte quelle cautele, attenzioni e cure riservate ai reperti “originali”. Invero anche i supporti contenenti la bit-stream image assurgono a reperti veri e propri e sarebbe bene che gli stessi venissero custoditi, trasportati ed inseriti in una apposita chain of custody come qualsiasi altro reperto, al di là della loro “assunta” immodificabilità, identicità, autenticità garantite dal match dell’algoritmo di hash tra “sorgente” (reperto origine) e “destinazione” (disco contenente l’immagine forense .dd, .eo1, etc. del sorgente).

– spesso arrivano reperti impacchettati alla meno peggio con scatole di fortuna e spesso privi di imballo, un consiglio può essere quello di utilizzare quando rinvenibili, gli imballi originali o in loro assenza affidarsi a scatole corredate di idonee imbottiture, quando non si ha nulla a disposizione vanno bene anche le palle fatte con fogli di giornali, ma lasciando a ciascuno le proprie scelte e preferenze è importante che il reperto non “balli” troppo all’interno della scatola. Per gli hard disk a pochi centesimi è possibile acquistare apposite scatole in plastica che possono efficacemente proteggerli e possono anche essere facilmente sigillate e cautelate. Altro ottimo consiglio per quanto attiene le cautele da apporre al plico o scatola sta nel riporre la scatola o plico all’interno di sacchi di plastica capienti, quali quelli della spazzatura neri cd. da condominio che in assenza di altro materiale più idoneo e specifico permettono di racchiudere in un robusto sacco la scatola e cautelarla più facilmente magari attraverso appositi sigilli, posti all’apertura del sacco. Ad ogni buon conto al di là delle tecniche e materiali utilizzati è sempre importante ricordare e dare adeguata importanza all’apposizione dei sigilli, poiché soprattutto in caso di accertamenti differiti (es. sequestro di apparati sui quali si effettueranno accertamenti irripetibili ex art. 360 c.p.p., non essendo possibile sul posto e nell’immediatezza provvedervi), l’apposizione del suggello o sigillo costituirà per le parti interessate (anche la P.G.) un elemento fondamentale in quanto andrà ad attestare che dal sequestro alla data di effettuazione dell’accertamento il reperto non è stato nella disponibilità di alcuno. Sono cauto nell’uso dei termini non sbilanciandomi nel definire che il sigillo abbia impedito “modifiche” al reperto (lo so è una provocazione ma serve a riflettere). Dico meglio l’apposizione del sigillo certificherà che il reperto da allora è rimasto nella busta o scatola che sia, tuttavia non potrà certificare che lo stesso non abbia subito modifiche da quella data … (purtroppo riporto a titolo di esempio: smartphone sequestrati accesi ed in modalità “on line” (non aereo !) … per non parlare di reperti lasciati per lungo tempo in luoghi umidi e risultati all’apertura dei plichi, ossidati (soprattutto quelli che sono alimentati con pile, e tanti altri “aneddoti” sperando che siano rimasti tali, che lascio a ciascuno ricordare.)

E’ evidente come quelle sopra evidenziate siano solo alcune delle problematiche che possono frapporsi ad una adeguata e sufficiente gestione del reperto informatico. Ritengo che ognuno di noi possa portare oltre a quelle da me in sintesi tratteggiate le proprie esperienze ed i propri aneddoti (del resto chi non ne ha su questo tema?), vorrei tuttavia aggiungere a questa mia panoramica due auspici:

1) mi auspico che dopo 10 anni di applicazione della L. 48/2008 tutti gli attori coinvolti si sentano chiamati ad una maggiore responsabilità nell’affrontare le inarrestabili innovazioni tecnologiche che quotidianamente si presentano sulla scena della digital forensics. Sistemi, tecniche, consigli, trucchi adottati un tempo ed idonei per reperti come dischi fissi e PC desktop non solo segnano il passo ma possono risultare inefficaci nella repertazione di nuovi dispositivi (cito a mero titolo di esempio l’ IoT soprattutto per quanto concerne il mondo delle autovetture, quindi navigatori integrati, sistemi di rilevamento o ancora l’ IoT domestico allarmi, sistemi di rilevamento fumi, gas , lavatrici intelligenti, etc.). La soluzione non può che essere in un continuo aggiornamento da parte degli operatori (l’U.P.G. 4.0) volto quantomeno a colmare le elementari lacune che ancora oggi portano, purtroppo, alcuni a confondere la natura di alcuni reperti o a non saperli descrivere adeguatamente o a credere ancora che un “server” possa essere sequestrato con la facilità con cui ci si porta un PC desktop.

2) Auspico e spero che via sia sempre più una maggior interazione tra gli attori coinvolti volta a definire “insieme” tecniche ed elementi minimi del repertamento. Pur trovando spazio in tutti i libri dedicati alla digital forensics l’argomento viene spesso considerato patrimonio della sola polizia giudiziaria e degli avvocati (ovviamente ciascuno per la parte di rispettiva competenza…), mentre dovrebbe essere un tema trasversale a tutti dalla polizia giudiziaria fino agli organi giudicanti di un processo attraverso appunto tutti gli attori coinvolti. La speranza è quindi quella di vedere il “repertamento informatico” quale materia non solo dedicata a pochi e specializzati corpi o sezioni di polizia giudiziaria, ma esteso a tutti coloro che anche in ipotesi remota ma probabile possano venire a contatto con dispositivi informatici.

In sintesi è giunto il momento di leggere le modifiche apportate dalla L. 48/2008 nel loro pieno significato, ovvero che non si fa nessun riferimento nelle modifiche al codice penale e di procedura penale a reparti, corpi, personale specializzato o qualificato, quelle norme tracciate dal legislatore, in materia di perquisizione, ispezione e sequestro, quant’anche si sostanziano in linee guida devono essere patrimonio e cultura di ogni U.P.G., 4.0 o 0.0. che sia, così come lo deve essere il repertamento degli stessi che non può più essere affidato,  al solo buon senso degli operatori.

[1] Quanto alla tipologia di dispositivo consiglio di “googleare” come sappiamo tante cose utili attraverso “Google” consiglio di utilizzarlo anche per indicare marca e modello di un dispositivo in modo corretto. Inoltre dai motori di ricerca è possibile apprendere anche caratteristiche intrinseche del prodotto che potrebbero consigliare approfondimenti investigativi ( es. pensavo fosse un HD ma invece è un NAS,  non è una pen-drive ma un dongle .. etc.).

[2] Il riferimento è a tecnologie quali FileVault,  Bitlocker, Intel Identity Protection, HdLock Toshiba etc. etc. ovvero le varie tecnologie (hardware/software) che permettono la crittografia/criptazione/cifratura dei dischi.

A cura di: Pier Luca Toselli

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-repertamento-informatico-dopo-un-decennio-di-applicazione-della-legge-18-marzo-2008-n-48/

Valutazione contestuale della criticità di una vulnerabilità

Un problema che i gestori di un sistema devono spesso affrontare è quello di determinare il rischio associato ad una vulnerabilità di un componente, ovvero la probabilità che tale vulnerabilità sia sfruttata da una minaccia ed il danno conseguente. Nel caso di più vulnerabilità presenti simultaneamente, valutare in modo consistente il rischio di ognuna può essere troppo complesso. In questo caso, si utilizza spesso un ordinamento, o ranking, delle vulnerabilità che valuta in modo relativo il rischio che ognuna di esse genera. Se consideriamo il numero di vulnerabilità a cui rimediare in un sistema ICT anche di media complessità, il ranking di queste vulnerabilità è un input fondamentale di ogni strategia, poiché chi applica le contromisure deve intervenire in modo prioritario partendo dalle vulnerabilità più rischiose per il sistema che deve essere protetto.

Una qualunque strategia di ranking deve, quindi, valutare il rischio integrando contemporaneamente due aspetti: le caratteristiche intrinseche della vulnerabilità e come essa va ad impattare sul sistema che utilizza i componenti affetti dalle vulnerabilità.

Una valutazione integrata è fondamentale perché, ovviamente, non si possono trascurare né le caratteristiche intrinseche della vulnerabilità, ad esempio quanto è facile eseguire l’attacco che la sfrutta, né il ruolo dei componenti attaccati nel sistema complessivo.

Per illustrare i problemi che una valutazione integrata pone, consideriamo una delle più note strategie di ranking: il Common Vulnerability Scoring System (CVSS). Nel caso del CVSS è più corretto parlare di metrica e non di strategia di ranking, visto che esso associa ad ogni vulnerabilità un valore numerico e proporzionale al rischio che la vulnerabilità genera. L’ordinamento tra vulnerabilità considera unicamente il valore associato che va da 0 a 10. La metrica CVSS assume, innanzitutto, che l’attaccante conosca già tutte le vulnerabilità da ordinare ed è definita componendo tre metriche più semplici: la metrica di base, quella temporale e quella ambientale. In maniera ricorsiva, ognuna di tali metriche è definita in base a metriche più semplici. Al di là della apparente complessità, tutto il procedimento è estremamente semplice una volta definite le proprietà di interesse di una vulnerabilità. La metrica di base del CVSS considera le caratteristiche intrinseche di una vulnerabilità, quelle che non cambiano con il tempo e che non dipendono dal sistema considerato. Queste caratteristiche vengono valutate a partire da tre sotto-metriche: Exploitability, Authorization Scope ed Impact. E(V), l’exploitability di una vulnerabilità V valuta la facilità di implementare un attacco che sfrutti V e gli strumenti disponibili per eseguire questo attacco. E(V) dipende non solo da V, ma anche dal componente che è affetto da V, perché questo componente contribuisce a definire quali sono gli attacchi possibili ed i meccanismi per realizzarlo. Questi meccanismi appartengono ad un range che comprende parametri di procedure e funzione, protocolli di rete, form web o query su un database. La metrica considera non tanto le proprietà della vulnerabilità ma dell’attacco che essa abilita. In particolare, E(V) considera queste proprietà dell’attacco che V abilita:

  1. il tipo di accesso richiesto per l’esecuzione;
  2. la complessità dell’esecuzione;
  3. i privilegi necessari per eseguire l’attacco;
  4. la necessità di un’interazione con l’utente legittimo.

Per ogni proprietà vengono introdotti alcuni possibili casi; ad ogni caso corrisponde un valore numerico che poi verrà utilizzato come input della formula per il calcolo del rischio associato. I valori sono tanto più vicini ad 1 quanto più è semplice eseguire l’attacco ed il valore della metrica risultante è il prodotto dei valori.

Il tipo di accesso considera quattro casi possibili che vanno dalla necessità di disporre di un accesso fisico alla macchina, rischio minimo, a quello di poter trasmettere un pacchetto TCP alla macchina, rischio massimo.

La complessità dell’esecuzione dipende dalla capacità dell’attaccante di creare le condizioni necessarie per lanciare l’attacco. In particolare, il rischio diminuisce se l’attacco richiede delle condizioni particolari che l’attaccante non può produrre autonomamente mentre aumenta e si avvicina ad 1 se l’attacco non richiede condizioni particolari, o se comunque l’attaccante è in grado di riprodurle facilmente.

I privilegi richiesti possono andare dall’insieme vuoto a quello dei privilegi utenti o di amministrazione. Più grande è l’insieme di privilegi, minore è il rischio. Infine, il rischio si riduce se l’attacco richiede che l’utente legittimo del sistema esegua delle specifiche azioni. È evidente che la focalizzazione sulle azioni che l’attacco richiede permetta di trascurare le correlazioni con il sistema target.

La metrica Authorization Scope, introdotta nella versione 3, valuta la capacità di V di coinvolgere autorità diverse nell’attacco. Un esempio possibile è quello di vulnerabilità che permettano di violare una macchina virtuale o una sandbox. In questo caso, l’attacco coinvolge, ad esempio, sia l’amministratore della macchina virtuale che quello della macchina fisica che esegue la virtuale. Si compie un primo passo per la contestualizzazione del singolo componente affetto da V nel sistema in cui tale componente è immerso.

I(V), la metrica Impact della vulnerabilità V, valuta l’impatto degli attacchi abilitati da V, cioè i danni per chi controlla il sistema ICT, dovuti al successo di uno di tali attacchi. In generale, il componente affetto da V può essere un modulo o una libreria software. Notabili eccezioni sono state di recente le vulnerabilità Spectre e Meltdown. I componenti che generano l’impatto I(V) possono essere sia hardware che software ed anche collezioni di dati. La metrica di I(V) fa riferimento alla classica triade di disponibilità, confidenzialità ed integrità distinguendo tra perdita bassa, media ed alta di ognuna delle tre proprietà. Anche questa metrica introduce valori numerici, nell’intervallo 0..1, per la stima delle perdite possibili ed il suo valore è uguale al prodotto dei valori numerici, ma la metrica non aiuta in nessun modo la scelta del valore da utilizzare. Se in molti casi è quasi ovvio decidere se un attacco che sfrutti V risulti in una perdita in uno o più delle tre proprietà, in altri la definizione dell’impatto globale è molto più complessa. Consideriamo, ad esempio, una vulnerabilità come Meltdown o Spectre che può provocare una perdita di confidenzialità. Gli effetti di tale perdita sono quasi totalmente dipendenti dal ruolo nel sistema del componente affetto da V. Se, ad esempio, nel sistema questo componente ha compiti di autenticazione, è ovvio che la perdita di confidenzialità permetta all’attaccante di accedere al sistema e di eseguire altri attacchi che magari richiedono l’account di un utente o di un amministratore. In altri termini, la perdita di confidenzialità, dovuta ad un componente, semplifica l’esecuzione di altri attacchi, ovvero cambia il valore di E(V’) per una vulnerabilità V’ diversa da V. Questa relazione tra due vulnerabilità in componenti diversi evidenzia come ogni metodologia che voglia definire un ranking delle vulnerabilità non possa trascurare le catene di attacco. Infatti, un attaccante sfrutta raramente un solo attacco per raggiungere il suo obiettivo. Molto più frequente è il caso in cui l’attaccante compone sequenzialmente i suoi attacchi, cioè costruisca una catena di attacchi, sfruttando i diritti ottenuti dagli attacchi precedenti per poter eseguire quelli successivi. Quale catene siano possibili e quali l’attaccante scelga è un problema di sistema, poiché ogni catena può comprendere attacchi contro componenti diversi del sistema.

CVSS raffina il punteggio che le tre metriche precedenti assegnano a V mediante altre due metriche opzionali, quella temporale e quella ambientale. Come suggerito dal suo nome, il valore che la metrica temporale assegna a V cambia nel tempo, poiché questa metrica ingloba tutti quegli aspetti che possono cambiare con il trascorrere del tempo. In particolare, la metrica temporale considera:

  1. la disponibilità di un exploit affidabile;
  2. la disponibilità di una contromisura per gli attacchi che V abilita;
  3. il livello di credibilità delle informazioni su V e sulle sue caratteristiche.

Anche questa metrica definisce i valori possibili per ogni attributo ed il corrispondente parametro numerico. Ad esempio, la metrica introduce tre diversi livelli di credibilità che vanno da “presenza confermata con report affidabili” a “report di fonte sconosciuta e senza dettagli”. Inoltre, la metrica utilizza quattro valori per stimare il rischio dovuto all’esistenza di un exploit pubblico che vanno da “codice funzionante e disponibile” a “codice inesistente”. Un ranking può non applicare una o più di queste metriche nel caso non sia interessato alla metrica o non disponga di notizie affidabili sui valori di interesse.

L’ultima metrica, quella ambientale, compone due metriche. La prima valuta quanto una perdita di confidenzialità, integrità e disponibilità del sistema considerato va ad impattare sui processi aziendali. In altri termini, valuta quanto i parametri di sicurezza del sistema target in esame influenzino la sicurezza complessiva degli utilizzatori finali del sistema. La seconda metrica tiene conto del livello di personalizzazione del sistema, ovvero degli interventi sul sistema target che hanno differenziato i vari moduli rispetto a quelli standard. Questa metrica vuole valutare come le modifiche apportate a componenti standard possano ostacolare l’attaccante.

Al di là delle specifiche valutazioni della metrica CVSS complessiva è evidente che l’oggettività e la ripetibilità delle valutazioni dei singoli attributi diminuiscono per le metriche diverse da quelle di base. Inoltre, non esiste nessuno strumento di supporto alla valutazione.

È necessario dire che, attualmente, esistono metodologie alternative che vogliono produrre un ranking più accurato e che meglio tenga conto del contesto del componente affetto dalla singola vulnerabilità V. Queste metodologie definiscono la posizione del ranking della vulnerabilità V e considerano le catene di attacco in cui gli attacchi abilitati da V appaiono piuttosto che gli attacchi che V abilita in maniera isolata. È possibile, ad esempio, che V abiliti degli attacchi estremamente pericolosi, e che quindi abbiano un valore elevato delle metriche di base CVSS, ma che V non ponga nessun rischio per il sistema. Questo accade, ad esempio, quando l’attaccante non può ottenere i diritti necessari per eseguire tale attacco. In altre parole, non esiste una catena di attacchi che permetta di acquisire i diritti necessari per eseguire l’attacco abilitato da V. In maniera simile, un attacco non particolarmente critico può divenire tale se rappresenta l’anello mancante di una catena di attacco. Ovvero, due sequenze di attacchi, che erano singolarmente ininfluenti, possono essere fuse, grazie alla vulnerabilità considerata in un’unica catena che permette all’attaccante di raggiungere un obiettivo con un impatto elevato. Questi casi possono essere scoperti solo ragionando sulle catene. Ragionare sulle catene è utile anche per scegliere le contromisure da applicare. Se un attacco appare in alcune catene, possiamo renderlo ininfluente bloccando almeno un attacco in ogni catena. In questo caso, privilegeremo, ovviamente, gli attacchi condivisi, che appaiono cioè in più catene. Per ovvie ragioni di convenienza privilegeremo le contromisure che garantisco all’attaccante una probabilità di successo più elevata o che possono provocare un danno più elevato.

Per scoprire le possibili catene, si possono applicare metodologie e strumenti diversi, ma che hanno un forte elemento di similitudine. Infatti, tutte queste metodologie utilizzano strutture di tipo grafo, che sono rappresentazioni alternative di una stessa struttura logica, l’attack graph. Ogni cammino su questo grafo rappresenta una diversa catena di attacco, mentre i vari attacchi sono, ad esempio, gli archi di un cammino. Ovviamente, siamo interessati ad un sottoinsieme dei cammini; quelli che partono dai diritti che ogni attaccante può legalmente acquisire e quelli che terminano con il controllo dei “gioielli della corona”, cioè le risorse di valore del sistema ICT bersaglio. Il numero di questi cammini è percentualmente trascurabile rispetto a quello di tutti i cammini. Quello in cui le varie metodologie esistenti differiscono fortemente è il numero di cammini che ognuna deve generare per scoprire le catene di interesse. Questo numero è cosi diverso che la bontà di ogni metodologia può essere misurata in base al numero di cammini inutili, che essa genera, per poter scoprire tutti i cammini utili. Un altro parametro fondamentale, per valutare la bontà di una metodologia, è la capacità di valutare la probabilità che ogni catena abbia successo e che l’attaccante la scelga. Questi problemi sono complessi e di non banale soluzione, ma che è una condizione fondamentale per definire un ranking, anche approssimato, ma consistente e che non alteri in maniera significativa il rischio associato ad ogni vulnerabilità. Tanto maggiore è l’accuratezza della stima del rischio e tanto più accurato può essere il piano per l’adozione delle contromisure e più elevato il ritorno dell’investimento in sicurezza.

A cura di: F.Baiardi, F.Tonelli

Laureato in Scienze dell’Informazione all’Università di Pisa.

E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca sy ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Ha partecipato a numerosi assessment di sistemi ICT con particolare interesse per quelli con componenti SCADA.

Attualmente è responsabile scientifico del progetto Haruspex che ha prodotto una suite integrata di strumenti per analisi e gestione del rischio.

Una lista aggiornata delle pubblicazioni scientifiche sul progetto Haruspex e dei premi ricevuti si può trovare alla pagina http://www.di.unipi.it/~tonelli/securityteam/publications.php

F. Baiardi è stato presidente della laurea in Informatica Applicata e della laurea magistrale in Sicurezza Informatica dell’Università di Pisa.

E’ stato coinvolto in vari progetti nazionali ed europei sulla valutazione della qualità dei corsi di studio e di formazione superiore. Inoltre è valutatore di progetti di innovazione tecnologica per enti pubblici e fondazioni private nazionali ed europei.

Download PDF

https://www.ictsecuritymagazine.com/articoli/valutazione-contestuale-della-criticita-di-una-vulnerabilita/


Sicurezza degli Smartphone e i rischi dell’obsolescenza precoce

Prefazione

Diciamocelo, aggiornare i nostri dispositivi è una vera seccatura!

Immaginiamo la giornata tipo di un utente:

  • La mattina, all’accensione del cellulare:
    • notifiche di aggiornamento app
    • notifica di aggiornamento del sistema operativo
  • Subito dopo, alla propria scrivania di lavoro:
    • quantità indefinita di aggiornamenti del SO
    • notifica di mancato aggiornamento dell’antivirus
  • Nel pomeriggio, sul tapis roulant in palestra:
    • notifica di aggiornamento firmware della FitBand/SmartWatch
  • La sera, prima di cena:
    • richiesta di supporto da parte della moglie, per similitudine, sui punti precedenti
    • ibidem, in caso di figli
    • ibidem, in caso di animali domestici aventi collare smart!

Stressante.

Tuttavia, l’utente in questione può ritenersi molto fortunato.

Di seguito vedremo il perché, ponendo l’attenzione ai soli dispositivi smartphone.

Le vulnerabilità

Quanto detto in precedenza, seppur in tono ironico, fa realmente parte del vissuto di quasi ognuno di noi.

Spesso si ignora che una notifica di aggiornamento, applicativa o di sistema, non comporta solamente un abbellimento dell’interfaccia utente o l’aggiunta di ludiche funzionalità. In molti casi questi aggiornamenti volgono su tematiche di sicurezza.

Nonostante i singoli individui non siano tenuti a conoscere le principali minacce relative ai propri dispositivi, il contesto informativo attuale è comunque sufficiente a sensibilizzare l’utente riguardo questa tematica.

Di seguito una carrellata delle maggiori vulnerabilità da un anno a questa parte.

BlueBorne

Scoperta da Armis (Palo Alto), BlueBorne rende miliardi di device potenzialmente attaccabili nel raggio di 10 metri, sfruttando una vulnerabilità presente nella connettività Bluetooth (se attivo).

Si tratta di una remote code execution su Bluez, un componente del kernel che fornisce le funzionalità relative alla gestione di periferiche BT. La vulnerabilità, insita nell’implementazione del livello L2CAP dello stack, è causata dalla copia di un buffer senza previo controllo della dimensione (buffer overflow).

BlueBorne può servire qualsiasi obiettivo malevolo: cyber-spionaggio, furto di dati, diffusione di ransomware o creazione di botnet composte da dispositivi IoT.

Vulnerabili: Google Android < 7.1.2 e Windows Mobile < 10
Risolto: iPhone >= 5S

KRACK

Scoperta da due ricercatori belgi Mathy Vanhoef e Frank Piessens, è una vulnerabilità del protocollo di crittografia WPA2 che protegge la trasmissione dati sulle reti Wi-Fi.

Il metodo non tenta di decrittare il traffico Wi-Fi. Il Key Reinstallation AttaCK prende di mira il meccanismo che si viene a stabilire tra il supplicant (device) e l’authenticator (router): l’attaccante si intromette con un “man in the middle” nell’interscambio di messaggi, forzando l’authenticator a generare una chiave più semplice (composta di soli zero) di quella originaria. Tutto all’insaputa dell’utente. È chiaro quindi che con una simile chiave decrittare i dati è molto semplice.

Volendo semplificare, è come se un ladro decidesse che è inutile tentare di scovare la combinazione di una cassaforte, quando è più facile spiare chi la conosce e la sta utilizzando. Anzi, in questo caso è come se il ladro avesse il potere di convincere il malcapitato a reimpostare la combinazione con una sequenza di zeri.

Vulnerabili: Google Android < 7.1.1 e Windows Mobile < 10
Risolto: iPhone >= 5S

Meltdown e Spectre

Sono due vulnerabilità scoperte dai ricercatori di Google Project Zero.

Immaginiamo che tutti i dispositivi siano vulnerabili ad esfiltrazione di dati da parte di malintenzionati. Aggiungiamo che l’exploit non sia rilevabile dai software antivirus poiché sfrutta il normale funzionamento delle CPU, consentendo l’accesso non autorizzato ai registri di memoria dei processori.

Infatti, tutto parte dai dati: una CPU carica le informazioni, richieste da un processo, dalla RAM. Nel contempo verifica che tali dati non siano prerogativa del kernel, approvando o negando l’operazione.

Il problema nasce dal meccanismo di esecuzione speculativa: i core delle CPU usano pipeline multiple per processare le istruzioni parallelamente. In caso di branch (diramazione) di un’istruzione, si genera uno stallo che porta la pipeline a passare da una sequenza di istruzioni ad un’altra, causando una perdita di tempo in termini di cicli di clock, in attesa di nuovi dati dalla RAM.

Per evitare che ciò avvenga, ad ogni branch, un’unità di predizione prova a indovinare la sequenza di istruzioni di cui il processore avrà bisogno in seguito. Il problema risiede qui: nel modo in cui il sistema gestisce l’accesso alla memoria cache durante queste esecuzioni speculative.

I normali controlli di sicurezza che separano lo spazio utente e la memoria kernel non si compiono con la necessaria rapidità. Di conseguenza il processore può momentaneamente recuperare, ed eseguire, dati dalla memoria cache a cui di norma non dovrebbe avere accesso.

Vulnerabili: Google Android < 8.1 e Windows Mobile < 10
Risolto: iPhone >= 5S

chaiOS

Il bug è stato reso noto da Abraham Masri tramite twitter.

In sostanza è stato scoperto che se si inserisce una gran quantità di caratteri nei metadati di una pagina Web Safari va in crash, portandosi dietro tutto il SO con il conseguente blocco del dispositivo.

Ciò deriva da un mancato controllo del buffer utilizzato per creare il preview delle pagine all’interno delle app (buffer overflow).

Risolto: iPhone >= 5S

Carattere indiano

La vulnerabilità riguarda un carattere della lingua Telugu. Se visualizzato in una qualsiasi app di messaggistica su iOS ne provoca un crash, bloccando quest’ultima fino a quando non avviene l’eliminazione dello stesso dal messaggio che lo contiene.

Peggio ancora, se iOS tentasse di mostrare il carattere in un messaggio di notifica, il crash potrebbe coinvolgere l’intera Springboard[1]. In questo caso iOS entrerebbe in uno stato di bootloop, rendendo inutilizzabile il dispositivo fino ad un successivo reset in modalità DFU[2], causando la perdita di tutti i dati memorizzati.

Risolto: iPhone >= 5S

Cloak & Dagger

Scoperta da un team di ricercatori della University of California e del Georgia Institute of Technology, la vulnerabilità colpisce il SO Android.

Questa si basa sull’autorizzazione “draw on top” (“disegna sopra altre applicazioni”) che viene concessa come impostazione predefinita alle app scaricate da Google Play. In questo scenario, un’app malevola può sfruttare questa autorizzazione per indurre l’utente ad abilitare l’autorizzazione “a11y” (contrazione di “Accessibility”) mediante clickjacking (cattura dei clic sfruttando elementi di interfaccia ingannevoli).

Se condotti con successo, gli attacchi consentono ad un’app di interferire nell’interazione con l’interfaccia utente ed ottenere il controllo completo del dispositivo all’insaputa del proprietario.

Vulnerabili: Google Android < 8.0

Google Play

In conclusione, non si possono non menzionare le problematiche legate al Play Store di Google.

Una ricerca condotta dalla Princeton University mette in evidenza un gigantesco sistema di sorveglianza che sfrutta una serie di JavaScript inseriti nelle app, volti a registrare tutto quello che facciamo: dai dati inseriti ai tocchi sullo schermo fino ai clic sulla pagine.

Senza contare che tali app, spesso inserite sullo Store da sviluppatori di origine sconosciuta, possono contenere non solo codice malevolo, ma anche pericolosi bug.

In tal senso, poniamo l’attenzione su app critiche come quelle sviluppate per i sistemi SCADA[3]. Da un recente report, si evince come tali app sul Play Store si siano rivelate un vero colabrodo in quanto a sicurezza.

L’obsolescenza precoce

Le vulnerabilità descritte in precedenza sono tempestivamente risolte dagli sviluppatori nel caso in cui i bug riguardino le app. Viceversa, la questione è più complicata se tali criticità riguardano i SO.

Quanto detto nell’articolo riguardante la memorizzazione dei dati è estendibile agli aggiornamenti del SO: analizziamo ora gli approcci dei maggiori produttori.

Allo stato dell’arte, per quanto riguarda iOS, possiamo constatare che device fino all’iPhone 5S, commercializzato nel 2013, continuano a ricevere aggiornamenti di sistema e di sicurezza con l’ultima versione di iOS (11). Abbiamo quindi circa 5 anni di finestra di supporto al device.

Per quanto riguarda Android, i dispositivi marcati Google (Pixel) hanno una finestra di supporto al device di circa 3 anni; per i produttori di terze parti, tale finestra non supera mediamente i due anni dalla data di uscita del dispositivo.

A conferma, in questo articolo sono riportati i dispositivi che continueranno ad essere supportati tramite l’ultimo SO Android. Una rapida occhiata rivela come dispositivi quali Sony Xperia Z5 o Huawei P9, con caratteristiche HW degne di nota, non compaiano in tale lista.

Di conseguenza, dispositivi con simili caratteristiche non riceveranno mai gli ultimi aggiornamenti di sicurezza, rimanendo esposti a gran parte delle vulnerabilità scoperte nel recente passato.

È inutile, anche in questo caso, approfondire la scena Windows Phone, poiché il progetto è stato dichiarato concluso.

Conclusioni

In base a quanto detto sarebbe buona prassi, nel momento in cui si sceglie uno smartphone, aver cura di valutare non solo gli attributi puramente quantitativi (CPU, RAM, GB di memoria, megapixel, ergonomia, ecc.), ma anche gli attributi qualitativi relativi alla sicurezza ed alla longevità del progetto.

È totalmente sconsigliato farsi trarre in inganno da dispositivi “simulacri” delle marche più blasonate. Di solito questi ultimi sono progettati in paesi dell’est ed hanno caratteristiche hardware apparentemente di livello. In realtà, un occhio ben attento e un pizzico di esperienza, possono portare in risalto l’arretratezza (o peggio, considerando quanto riportato qui) del SO installato e la totale mancanza di supporto ed aggiornamenti di sicurezza da parte della casa produttrice.

In concreto, si vuole solamente sottolineare cosa vi è dietro al prezzo di un dispositivo certificato dalle aziende più blasonate: ingenuamente considerati “apparecchi che fanno le stesse cose che fanno gli altri”, in realtà questi ultimi sono il risultato di una serie di studi, accortezze, qualità del supporto, che altri competitor non garantiscono.

Acquistare un dispositivo che rientra in quest’ultima casistica, riduce notevolmente il rischio di ritrovarsi tra le mani un prodotto precocemente obsoleto e di essere esposti ad un elevato numero di vulnerabilità che non saranno mai risolte.

Note

[1] La SpringBoard è l’applicazione che gestisce la schermata Home di iOS.
[2] DFU, Device Firmware Update
[3] Sistemi Scada: https://it.wikipedia.org/wiki/SCADA

A cura di: Daniele Rigitano

Download PDF

https://www.ictsecuritymagazine.com/articoli/sicurezza-degli-smartphone-e-i-rischi-dellobsolescenza-precoce/