Chat Control 2.0: il punto di non ritorno della sorveglianza digitale europea

Chat Control 2.0 rappresenta il più ambizioso progetto di sorveglianza digitale mai proposto in Europa: un regolamento che autorizzerebbe la scansione automatica di messaggi, email e contenuti privati di centinaia di milioni di cittadini. L’obiettivo dichiarato è contrastare la pedopornografia online, ma il prezzo da pagare potrebbe essere la fine della segretezza delle comunicazioni. Con l’avvio dei triloghi a dicembre 2025, l’UE si trova a un bivio tra sicurezza e libertà fondamentali.

Perché l’astensione dell’Italia potrebbe trasformarsi in un diniego costituzionale al regolamento

Chat Control è una proposta della Commissione Europea che prevede l’introduzione di sistemi automatizzati in grado di scansionare messaggi, immagini e video privati alla ricerca di contenuti illegali relativi allo sfruttamento dei minori. La misura si applicherebbe potenzialmente a:

  • chat private (WhatsApp, Signal, Telegram, Messenger, ecc.);
  • email;
  • servizi cloud;
  • piattaforme di gaming con messaggistica integrata;
  • strumenti di comunicazione interna nelle aziende;
  • backup personali.

Una delle caratteristiche più criticate della proposta è che la scansione avverrebbe anche in assenza di un sospetto, configurando una forma di sorveglianza generalizzata e preventiva, senza distinzione tra cittadini innocenti e criminali.

L’obiettivo dichiarato è nobile e incontestabile: contrastare la pedopornografia online, un fenomeno odioso e in crescita. Tuttavia, la strada scelta dall’Unione Europea apre scenari delicatissimi per la privacy, la sicurezza digitale e, in ultima analisi, la tenuta democratica del continente.

La fase finale dei negoziati tra Parlamento Europeo, Commissione e Consiglio (trilogo) è iniziata il 9 dicembre 2025. Se non ci saranno impedimenti, Chat Control potrebbe diventare effettivo tra marzo e aprile 2026.
L’avvio del trilogo rappresenta molto più della fase conclusiva di un iter legislativo: è il momento in cui l’UE decide se costruire o meno la più grande infrastruttura di sorveglianza preventiva della storia democratica europea.

L’astensione dell’Italia, insieme a quella della Germania, non è un dettaglio politico. È un segnale d’allerta: molti elementi del regolamento appaiono in contrasto con i principi costituzionali degli Stati membri, in particolare con l’articolo 15 della Costituzione italiana, che garantisce l’inviolabilità della libertà e della segretezza delle comunicazioni. Non è un tecnicismo giuridico, ma il cuore del rapporto tra individuo e potere pubblico.

Il paradosso strutturale di Chat Control 2.0: una sorveglianza preventiva, non reattiva

Il regolamento nasce per contrastare gli abusi sessuali sui minori online, obiettivo che nessuno contesta. Ma la modalità scelta rappresenta un cambio di paradigma: dalla sorveglianza mirata, basata su indizi concreti e autorizzata da un giudice, alla sorveglianza preventiva, generalizzata e algoritmica su tutta la popolazione.
Una svolta che ricorda il passaggio dal “controllo su indizi” al “profiling predittivo” tipico dell’intelligence, applicato però al cuore della vita digitale: le comunicazioni private.

Il falso mito della “volontarietà” e il meccanismo di pressione normativa

La prima bozza (bocciata il 9 ottobre 2025) prevedeva esplicitamente la scansione generalizzata dei contenuti delle chat, comprese quelle protette da crittografia end-to-end. Non sorprende che le critiche siano arrivate da EDPS, Garanti nazionali, esperti di sicurezza, giuristi e attivisti per i diritti digitali, che la consideravano una forma di sorveglianza di massa incompatibile con i principi europei.

La versione riscritta dalla Danimarca modifica l’impianto originario. Secondo il mandato negoziale approvato dal Consiglio, la rilevazione diventa formalmente volontaria: i gestori dei servizi possono scegliere se applicarla o meno. Il nuovo impianto prevede che:

  • i provider possano scegliere se attivare la scansione;
  • debbano comunque effettuare una valutazione obbligatoria del rischio;
  • se risultano “ad alto rischio”, le autorità possano imporre misure correttive;
  • sul piano economico e reputazionale, la scelta più sicura diventa attivare la scansione.

È un classico caso di compliance indotta: la legge non ordina esplicitamente, ma rende troppo rischioso non conformarsi. Per questo gli analisti definiscono la scansione “volontaria” solo sulla carta ma coercitiva nella sostanza.

La scelta non spetta agli utenti, ma ai provider: sono loro a decidere se i nostri messaggi saranno analizzati.

C’è poi un ulteriore incentivo: più comunicazioni vengono scansionate, più dati possono essere usati per addestrare modelli di intelligenza artificiale. Un vantaggio economico e tecnologico che può spingere verso una sorveglianza permanente.

La storia recente suggerisce che la distinzione tra obbligo formale e pressione informale è spesso teorica, durante la pandemia, molte piattaforme hanno rimosso o penalizzato contenuti su pressioni politiche, come rivelato dai Twitter Files e dalle dichiarazioni di Mark Zuckerberg al Congresso USA, il risultato è stato un ecosistema di censura di fatto su contenuti perfettamente leciti, etichettati come disinformazione o “lawful but awful”, tecnicamente legali ma politicamente scomodi. Ciò che era “volontario” si è trasformato in uno standard di fatto. Applicata a Chat Control, la dinamica diventa particolarmente pericolosa.

Una tensione giuridica irrisolta: privacy e sicurezza in conflitto strutturale

Il regolamento promette che la crittografia end-to-end non verrà indebolita. Ma per rilevare contenuti illeciti in una comunicazione cifrata, l’unico punto di intervento è il dispositivo dell’utente, prima della cifratura, cioè il client-side scanning, tecnicamente equivalente ad una intercettazione generalizzata.

La vera spia di allarme rosso su cui riflettere, è nell’articolo 85(1a) della bozza di regolamento, che incarica la Commissione di valutare periodicamente tecnologie di rilevazione per servizi con crittografia E2EE. Oggi non possono imporre il client-side scanning, ma si riservano il diritto di riprovarci.

La domanda diventa inevitabile: se ogni messaggio può essere analizzato prima di essere cifrato, la comunicazione è ancora “segreta” ai sensi dell’articolo 15 della Costituzione? Molti giuristi rispondono NO.

Da qui la possibile trasformazione dell’astensione italiana in un diniego costituzionale: l’ordinamento non può approvare una norma che svuota di fatto la segretezza delle comunicazioni per 60 milioni di cittadini.

Function creep: un’infrastruttura pronta per usi futuri

Il regolamento delinea un apparato completo:

  • un EU Centre con database, indicatori e metriche;
  • comitati tecnici incaricati di sviluppare ulteriormente tecnologie di mitigazione;
  • obblighi per i provider di integrare strumenti di rilevazione quando richiesto.

Oggi il focus è il CSAM. Domani potrebbe essere terrorismo, hate speech, disinformazione, opposizione politica “radicale”. Una volta costruita l’infrastruttura, ampliarne lo scopo sarà una decisione politica, non tecnica. È il rischio classico di function creep, che in un contesto democratico dovrebbe essere considerato inaccettabile.

L’EU Centre: un nuovo potere sovranazionale con capacità operative ibride

L’EU Centre on Child Sexual Abuse:

  • riceve segnalazioni da provider e piattaforme
    • le valida con algoritmi e revisori umani
    • coopera direttamente con le forze dell’ordine
    • può influenzare tecnologie e standard europei sulle comunicazioni private

Nasce così una struttura sovranazionale, non eletta, con poteri operativi, tecnici e normativi. È esattamente il contesto in cui il function creep diventa più probabile: una volta installato un sistema di sorveglianza generalizzata, impedirne l’estensione è quasi impossibile.

Il rischio strategico: la normalizzazione della sorveglianza algoritmica in Europa

La tecnologia raramente rimane confinata allo scopo originario.
Se esiste un’infrastruttura capace di analizzare contenuti, identificare pattern, coordinare polizie, profilare rischi, la tentazione di estenderla sarà inevitabile.
Storicamente, il passaggio dall’abuso sui minori al dissenso politico è il più documentato nello sviluppo dei sistemi di sorveglianza.

Proporzionalità e necessità: due principi europei ignorati

La Corte di Giustizia dell’UE ha stabilito in più sentenze (Digital Rights Ireland, Tele2 Sverige, La Quadrature du Net) che:

  • la sorveglianza generalizzata delle comunicazioni non è mai proporzionale;
  • è ammessa solo su individui o gruppi specifici;
  • la raccolta preventiva e indiscriminata viola la Carta dei Diritti Fondamentali.

Chat Control 2.0 entra pienamente in questo schema vietato. Come potrà superare il vaglio della Corte una volta approvato?

La vulnerabilità sistemica della società digitale europea

Creare un meccanismo di scansione centralizzato significa:

  • aumentare la superficie d’attacco per spionaggio e cybercrime;
  • introdurre backdoor potenziali nelle piattaforme;
  • facilitare abusi interni;
  • indebolire l’ecosistema della crittografia.

Qualsiasi infrastruttura progettata per “controllare tutto” diventa un bersaglio irresistibile per Stati ostili e cybercriminali. Una vulnerabilità in un tale sistema comporta rischi sistemici per milioni di cittadini.

L’effettività: il regolamento colpisce davvero i criminali?

Gli abusi reali vengono spesso scambiati:

  • in darknet chiuse;
  • su reti P2P cifrate;
  • tramite strumenti decentralizzati;
  • in circoli privati offline;
  • in contesti che il regolamento non può raggiungere.

Chat Control rischia dunque di colpire soprattutto i cittadini comuni, lasciando intatti i criminali più organizzati, producendo falsi positivi e sovraccaricando le indagini.

Falsi positivi e “danno collaterale digitale”

Il regolamento riconosce formalmente l’esistenza degli errori, citando falsi positivi, falsi negativi, oversight umano e metriche di errore.
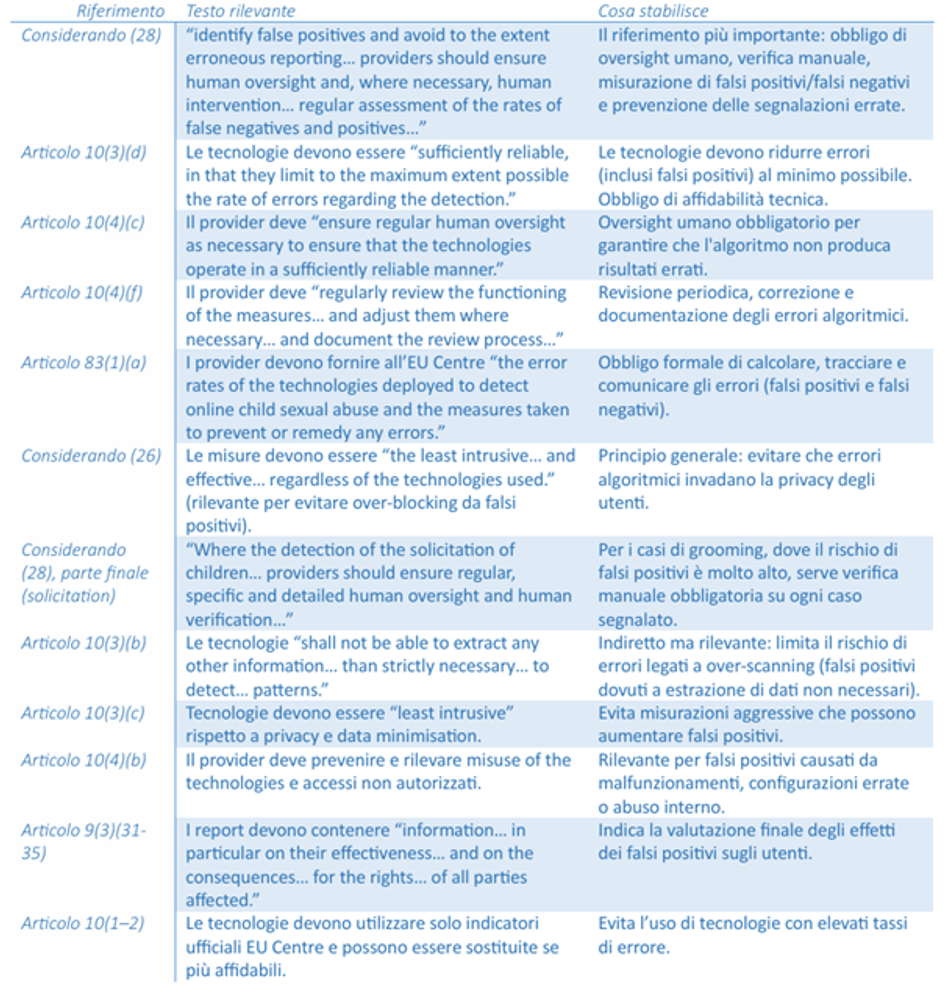
Chat Control 2.0 e sorveglianza digitale europea: Falsi positivi e danno collaterale digitale
Tabella 1

Dalla Tabella 1 emergono elementi strutturali inquietanti :

Gli errori sono considerati inevitabili

Il testo richiede tecnologie “sufficientemente affidabili”, invita a “limitare al massimo possibile il tasso di errori” e prevede valutazioni periodiche, ma:

  • non esistono soglie minime di accuratezza;
  • non esistono limiti oltre i quali la tecnologia è vietata;
  • non esistono criteri chiari per definire l’accettabilità dell’errore.

L’errore, però, non è neutrale: significa cittadini innocenti che finiscono in database, sotto indagine o con account sospesi.

“Limitare al massimo possibile”: una formula vaga

Chi decide qual è “il massimo possibile”? Quali benchmark? Con quali sanzioni in caso di imprecisione?
Il rischio è che la formula diventi un paracadute retorico per giustificare sistemi con numerosi falsi positivi.

Oversight umano: paracadute o illusione?

Il regolamento insiste su “oversight umano regolare”, ma nella pratica:

i volumi saranno altissimi;
il lavoro è psicologicamente gravoso;
la pressione regolatoria spinge al “meglio segnalare troppo”.

Il controllo umano può trasformarsi in un clic routinario.

Metriche per le autorità, opacità per gli utenti

L’articolo 83 impone metriche ai provider, ma:

  • solo EU Centre e autorità vedono i dati;
  • gli utenti non hanno accesso a statistiche dettagliate;
  • manca trasparenza granulare.

Lo Stato può normalizzare statisticamente l’errore; chi vi finisce dentro lo vive come una violazione gravissima.

Incentivo all’over-reporting

Segnalare troppo poco comporta rischi; segnalare troppo non comporta costi. Il sistema è strutturalmente orientato all’eccesso di segnalazione.

Tutela ex post, danno ex ante

Il regolamento prevede:

  • reclami;
  • ricorsi;
  • rappresentanza tramite enti.

Ma quando l’utente agisce:

  • il contenuto è già stato rimosso:
  • l’account può essere sospeso;
  • la segnalazione è già arrivata alle autorità;
  • un’indagine può essere iniziata.

Anche in caso di archiviazione restano log, copie, danni emotivi e reputazionali. È un modello “ti proteggo dopo averti colpito”. Nel complesso, il regolamento appare costruito per accettare l’errore come costo sistemico, confidando che metriche e oversight lo mantengano gestibile.

Asimmetria informativa e crisi di fiducia

Le autorità vedono tutto in macro; i provider controllano l’infrastruttura; i cittadini vedono solo gli effetti sul proprio account. Questo si inserisce in un contesto europeo già segnato dal crollo di fiducia verso istituzioni, media e organismi sovranazionali.

In tale scenario, Chat Control può essere percepito:

  • come strumento di ordine in un mondo instabile;
  • come strumento di sorveglianza contro dissidenti, giornalisti e oppositori.

Più la fiducia cala, più cresce la tentazione dei governi di usare il controllo al posto del consenso.
E più cresce il controllo, più la fiducia cala: un circolo vizioso.

Guerra, intelligence e libertà: un equilibrio fragile

L’Europa si sta riarmando come non accadeva da decenni, in un contesto di confronto ibrido con la Russia e di instabilità globale. In scenari del genere, la privacy tende a diventare un ostacolo operativo.
La storia lo dimostra: dopo l’11 settembre, il Patriot Act ha compresso diritti che, vent’anni dopo, sono ancora lì. Il rischio è che Chat Control diventi il primo pezzo di un’architettura permanente di sorveglianza digitale, giustificata dalla protezione dei minori ma pronta a espandersi ad altre emergenze future.

Perché l’Italia potrebbe dire definitivamente “no”: l’argomento costituzionale

Nessuna legge, nemmeno europea, può introdurre un sistema generalizzato di controllo delle comunicazioni in contrasto con l’articolo 15 della Costituzione.
L’unica eccezione ammessa richiede:

  • un’indagine specifica;
  • un atto motivato dell’autorità giudiziaria;
  • destinatari determinati.

Chat Control 2.0 viola tutti e tre questi criteri. L’Italia deve quindi scegliere tra approvare un regolamento anticostituzionale o porre un diniego formale, avviando un conflitto giuridico con Bruxelles. L’astensione è un messaggio: l’Italia non può accettare un regolamento che viola un diritto “inviolabile”.

La questione politica più ampia: quale modello di società digitale vuole l’Europa?

Chat Control 2.0 non è solo un tema tecnico. È una scelta di civiltà.
Si delineano due modelli:

  • Sicurezza preventiva attraverso sorveglianza pervasiva
    Simile ai modelli cinesi, russi o a quelli post-11 settembre.
  • Tutela dei diritti fondamentali come limite al potere
    Tradizione europea basata su proporzionalità, necessità, segretezza delle comunicazioni, warrant giudiziario, presunzione di innocenza.

Con Chat Control l’UE rischia di abbandonare gradualmente il secondo modello per avvicinarsi al primo.

Una società che rinuncia alla privacy rinuncia alla democrazia

La privacy non è un lusso: è la condizione che consente a giornalisti, attivisti, dissidenti e cittadini di operare senza paura. La sorveglianza preventiva produce autocensura sistemica e modifica i comportamenti umani prima ancora dell’intervento repressivo.

Chat Control 2.0 è una scelta antropologica, non tecnica

La questione è semplice, radicale, si basa su queste domande: Siamo disposti ad accettare una società in cui ogni comunicazione può essere analizzata da algoritmi? Siamo pronti a sacrificare la segretezza delle comunicazioni sulla promessa di tecnologie che generano errori elevati? Siamo consapevoli che i criminali continueranno a operare su canali invisibili mentre il controllo ricadrà sui cittadini comuni?

L’Italia, con il suo quadro costituzionale, ha la responsabilità di sollevare queste domande. Una volta costruita un’infrastruttura di sorveglianza generalizzata, smantellarla sarà quasi impossibile. Il 9 dicembre 2025 rischia di essere ricordato non come il giorno in cui l’Europa ha difeso i minori, ma come il giorno in cui ha aperto la porta alla più grande infrastruttura di sorveglianza mai approvata in tempo di pace. Per chi si occupa di democrazia, diritto e cybersicurezza, la posta in gioco è altissima: superata la linea della segretezza delle comunicazioni, tornare indietro sarà quasi impossibile.
Profilo Autore

Progettista di sistemi esperti, software developer, network e system engineer, con oltre 30 anni di esperienza nell’ambito della sicurezza delle informazioni, Francesco Arruzzoli è il Resp. del Centro Studi Cyber Defense Cerbeyra, dove svolge attività di R&D, analisi delle cyber minacce e progettazione di nuove soluzioni per la cyber security di aziende ed enti governativi. Esperto di Cyber Threat Intelligence e contromisure digitali, autore di libri ed articoli sue riviste del settore, in passato ha lavorato per multinazionali, aziende della sanità italiana, collaborato con enti governativi e militari. In qualità di esperto cyber ha svolto inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/chat-control-2-0-sorveglianza/


LIME e SHAP: intelligenza artificiale spiegabile per la security intelligence

L’implementazione di LIME e SHAP nella cybersecurity rappresenta oggi uno spartiacque nella relazione tra analisti di sicurezza e sistemi di intelligenza artificiale. Quando un sistema di machine learning classifica un file come malware, blocca una transazione sospetta o identifica un’anomalia nel traffico di rete, comprendere il processo decisionale sottostante non è più una curiosità tecnica ma un requisito operativo, normativo e strategico fondamentale.

Il paradosso della complessità algoritmica nella cybersecurity

Il settore della sicurezza informatica si trova oggi di fronte a un dilemma crescente: quanto più sofisticati diventano i modelli predittivi basati su intelligenza artificiale, tanto più opaca risulta la loro logica decisionale. In un contesto dove ogni decisione automatizzata può avere conseguenze legali, operative e reputazionali significative, questa opacità non è più sostenibile.

LIME (Local Interpretable Model-agnostic Explanations) e SHAP (SHapley Additive exPlanations) rappresentano due approcci matematicamente fondati per decostruire le predizioni dei modelli complessi, trasformando l’AI da oracolo imperscrutabile a collaboratore intelligibile.

LIME: spiegazioni locali per decisioni globali

LIME, proposto nel 2016 da Marco Tulio Ribeiro, Sameer Singh e Carlos Guestrin, affronta il problema dell’interpretabilità con un’intuizione elegante: invece di tentare di comprendere l’intera complessità di un modello globale, si concentra su spiegazioni locali, specifiche per ogni singola predizione.

Quando un sistema di threat detection identifica un comportamento anomalo, LIME costruisce un modello semplificato che approssima il comportamento del classificatore complesso solo nell’intorno di quella specifica istanza. La forza di questo approccio risiede nella sua agnosticità rispetto al modello: funziona indipendentemente dall’architettura sottostante, che si tratti di random forest, reti neurali profonde o ensemble complessi.

Per un team di security operations, questo significa poter interrogare qualsiasi sistema di rilevamento, indipendentemente dalla sua complessità interna, ottenendo risposte comprensibili sulle feature che hanno contribuito a una specifica allerta. L’integrazione di LIME nei sistemi di intrusion detection permette agli analisti di validare le decisioni del modello e identificare potenziali falsi positivi in tempo reale.

SHAP: la matematica della responsabilità algoritmica

SHAP, sviluppato da Scott Lundberg e Su-In Lee nel 2017, porta l’interpretabilità a un livello superiore ancorandosi a una base teorica rigorosa: la teoria dei giochi cooperativi e i valori di Shapley. L’approccio calcola il contributo di ogni feature considerando tutte le possibili combinazioni con le altre variabili, garantendo proprietà matematiche fondamentali come coerenza e additività.

Quando un sistema SIEM basato su machine learning genera un alert di alta priorità, SHAP può quantificare esattamente quanto ogni indicatore di compromissione ha pesato nella decisione. Questa granularità diventa cruciale per discriminare tra falsi positivi e minacce reali, permettendo agli analisti di concentrare l’attenzione sui fattori veramente determinanti.

Le applicazioni pratiche di SHAP nella cybersecurity includono:

  • Intrusion Detection Systems: identificazione delle feature di rete più rilevanti per la classificazione delle minacce
  • Malware Analysis: comprensione dei comportamenti che determinano la classificazione malevola
  • Fraud Detection: quantificazione del peso di ciascun pattern anomalo nelle transazioni
  • Behavioral Analytics: spiegazione delle deviazioni comportamentali degli utenti

GDPR, AI Act e interpretabilità: il contesto normativo europeo

L’aspetto più rilevante di questi framework emerge nell’intersezione con il panorama normativo europeo. Il GDPR (Regolamento UE 2016/679), attraverso l’articolo 22, stabilisce il diritto dell’interessato a non essere sottoposto a decisioni basate unicamente su trattamenti automatizzati che producano effetti giuridici significativi. Sebbene il regolamento non utilizzi esplicitamente l’espressione “diritto alla spiegazione”, gli articoli 13, 14 e 15 impongono obblighi di trasparenza che richiedono di fornire “informazioni significative sulla logica utilizzata” nei processi decisionali automatizzati.

L’AI Act (Regolamento UE 2024/1689), entrato in vigore nell’agosto 2024 con applicazione graduale, estende e rafforza questi requisiti. Per i sistemi di IA ad alto rischio, l’articolo 13 prescrive che i sistemi siano progettati e sviluppati “in modo da garantire che il loro funzionamento sia sufficientemente trasparente” per consentire ai deployer di “interpretare l’output del sistema e utilizzarlo adeguatamente”.

Trasparenza algoritmica e compliance normativa

LIME e SHAP offrono un linguaggio tecnico per rispondere a questi requisiti normativi, traducendo il funzionamento interno dei modelli in termini comprensibili. Tuttavia, è fondamentale distinguere tra spiegabilità tecnica e giustificazione legale: una spiegazione generata automaticamente non costituisce necessariamente una giustificazione valida dal punto di vista giuridico se il modello identifica correlazioni spurie o bias nascosti nei dati di addestramento.

Le organizzazioni che implementano sistemi di IA nella cybersecurity devono quindi:

  1. Documentare i processi decisionali automatizzati con spiegazioni LIME/SHAP
  2. Validare che le correlazioni identificate siano significative dal punto di vista della security
  3. Monitorare continuamente i modelli per identificare drift o bias emergenti
  4. Garantire la supervisione umana nelle decisioni critiche

Digital Forensics e catene di custodia cognitive

Nel campo della digital forensics, l’utilizzo di modelli di machine learning per l’analisi di grandi volumi di dati è ormai consolidato. Dalla classificazione automatica di file sequestrati all’identificazione di pattern di comunicazione sospetti, dall’analisi di timeline complesse al riconoscimento di tecniche di data exfiltration, l’IA è diventata uno strumento investigativo essenziale.

Ma ogni volta che un modello ML contribuisce a un’indagine, si pone il problema della sua ammissibilità probatoria. Un giudice, un perito di parte o un collegio difensivo devono poter comprendere non solo il risultato di un’analisi, ma il percorso logico che ha condotto a quella conclusione.

LIME e SHAP trasformano il modello da strumento opaco a componente documentabile di una catena investigativa. Quando un algoritmo identifica un cluster di documenti come rilevanti per un caso di sottrazione di informazioni riservate, SHAP può mostrare quali caratteristiche linguistiche, metadati temporali o pattern di accesso hanno determinato quella classificazione.

Questa tracciabilità rappresenta una garanzia epistemologica che permette di identificare quando un modello sta “ragionando” in modo sensato rispetto al contesto investigativo e quando invece sta seguendo correlazioni artefatte dai dati.

I limiti intrinseci dell’interpretabilità post-hoc

Sarebbe ingenuo considerare LIME e SHAP come soluzioni definitive al problema dell’opacità algoritmica. Entrambi i framework presentano limitazioni intrinseche che è fondamentale riconoscere:

Limitazioni di LIME:

  • Fornisce spiegazioni approssimate: il modello semplificato locale non cattura necessariamente la vera complessità del sistema originale
  • Instabilità: piccole perturbazioni nei dati possono produrre spiegazioni diverse
  • Selezione del vicinato: la definizione dell’intorno locale per dati tabulari rimane una questione irrisolta

Limitazioni di SHAP:

  • Complessità computazionale: i requisiti crescono esponenzialmente con il numero di feature, rendendolo impraticabile per modelli con centinaia o migliaia di variabili
  • Assunzione di indipendenza: assume implicitamente l’indipendenza tra feature, che raramente si verifica nella realtà
  • Tempo di calcolo: per applicazioni real-time può risultare troppo lento

In cybersecurity, dove il panorama delle minacce evolve continuamente e gli attaccanti adattano le proprie tecniche per eludere i sistemi di rilevamento, queste distinzioni sono cruciali. La ricerca sull’interpretabilità automatizzata sta esplorando nuove frontiere per superare queste limitazioni.

Implementazione pratica nei Security Operations Center

L’adozione di LIME e SHAP nei Security Operations Center (SOC) richiede un approccio strutturato che bilanci esigenze operative, requisiti normativi e vincoli computazionali.

Framework di implementazione

  1. Assessment iniziale:
    • Identificare i modelli ML critici che richiedono interpretabilità
    • Valutare i requisiti normativi specifici (GDPR, AI Act, NIS2)
    • Determinare i vincoli di latency accettabili
  2. Integrazione tecnica:
    • Implementare SHAP per analisi offline e validazione dei modelli
    • Utilizzare LIME per spiegazioni real-time sugli alert critici
    • Sviluppare dashboard di visualizzazione per gli analisti
  3. Formazione e change management:
    • Formare gli analisti sull’interpretazione delle spiegazioni
    • Integrare l’XAI nei processi decisionali esistenti
    • Creare procedure per l’escalation dei casi ambigui
  4. Monitoraggio e validazione continua:
    • Verificare la coerenza delle spiegazioni nel tempo
    • Identificare drift nei modelli attraverso l’analisi delle spiegazioni
    • Documentare le decisioni per audit e compliance

Verso una Security Intelligence trasparente e responsabile

Il vero valore di LIME e SHAP risiede non tanto nella loro capacità di rendere ogni decisione algoritmica completamente trasparente, quanto nel modo in cui ridefiniscono il rapporto tra intelligenza artificiale ed expertise umano nel dominio della security. Questi strumenti non sostituiscono il giudizio dell’analista, ma lo potenziano, fornendo insight azionabili che permettono di validare, contestare o raffinare le predizioni automatiche.

In un settore dove la velocità di risposta è determinante ma l’errore può avere conseguenze devastanti, questa sinergia tra automazione e interpretabilità rappresenta l’unico percorso sostenibile. Non si tratta di rinunciare alla potenza predittiva dei modelli complessi in nome di una trasparenza assoluta, né di accettare ciecamente le decisioni algoritmiche in nome dell’efficienza.

Si tratta di costruire sistemi che siano tanto potenti quanto interrogabili, tanto sofisticati quanto responsabili. L’adozione diffusa di framework come LIME e SHAP nei security operations center, nei sistemi di threat intelligence e negli strumenti di digital forensics non è quindi solo una questione tecnica o una risposta a obblighi normativi.

È un passo necessario verso una concezione più matura dell’intelligenza artificiale in cybersecurity, dove la capacità di spiegare è considerata non meno importante della capacità di predire. L’integrazione di approcci ibridi e neuro-simbolici promette di superare le attuali limitazioni, mantenendo l’interpretabilità come proprietà intrinseca dei sistemi.

In un dominio dove le decisioni hanno conseguenze reali su persone, organizzazioni e infrastrutture critiche, l’opacità non è più un prezzo accettabile da pagare per l’innovazione. La convergenza tra requisiti normativi europei e necessità operative sta spingendo l’intera industria della cybersecurity verso standard più elevati di trasparenza e accountability.

Fonti:

Ribeiro, M.T., Singh, S., Guestrin, C. (2016). “Why Should I Trust You?”: Explaining the Predictions of Any Classifier. KDD 2016.

Lundberg, S.M., Lee, S.I. (2017). A Unified Approach to Interpreting Model Predictions. NIPS 2017.

Regolamento (UE) 2016/679 (GDPR) – Testo ufficiale

Regolamento (UE) 2024/1689 (AI Act) – Testo ufficiale

LIME – GitHub Repository

SHAP – GitHub Repository

SHAP Documentation

Frontiers in Artificial Intelligence (2025). A systematic review on the integration of explainable artificial intelligence in intrusion detection systems.

IEEE (2024). Explainable AI for Intrusion Detection Systems: LIME and SHAP Applicability on Multi-Layer Perceptron.

PLOS ONE (2025). Advancing malware imagery classification with explainable deep learning using SHAP, LIME and Grad-CAM.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/lime-e-shap/


L’AI Factory italiana per l’autonomia digitale europea: la strategia di ACN presentata al Forum ICT Security 2025

Durante la 23a edizione del Forum ICT Security, tenutosi a Roma il 19 e 20 novembre 2025, Luca Nicoletti, direttore del servizio programmi industriali, tecnologici e di ricerca dell’Agenzia per la Cybersicurezza Nazionale (ACN), ha presentato un intervento di grande rilevanza strategica dal titolo “The Italian AI Factory for the European Digital Autonomy: securing AI development and deployment”.

Al centro della presentazione: IT4LIA, l’infrastruttura che rappresenta il cuore della strategia italiana per conquistare autonomia tecnologica nel campo dell’intelligenza artificiale e della cybersicurezza, in un contesto geopolitico sempre più complesso e imprevedibile.

La strategia nazionale: un percorso già tracciato

ai technologies
AI technologies: the strategic priorities

Luca Nicoletti ha aperto il proprio intervento ripercorrendo brevemente il cammino strategico intrapreso dall’Italia negli ultimi anni. Una strada segnata da tappe fondamentali:

  • Giugno 2021: promulgazione della Legge 82/2021 che istituisce ACN e definisce le prime linee guida sulla cybersicurezza nazionale
  • Maggio 2022: pubblicazione della Strategia 2022-2026 e del Piano di Implementazione, documenti che traducono in azioni concrete la visione strategica
  • Marzo 2023: definizione dell’Agenda Strategica del Centro Europeo di Competenza in Cybersicurezza
  • Giugno 2023: pubblicazione dell’Agenda Ricerca e Innovazione di ACN
  • Luglio 2024: approvazione dell’AI Act europeo (Regolamento UE 1689/2024)
  • Settembre 2025: trasposizione italiana con la Legge n. 132/2025, che designa ACN come autorità di vigilanza del mercato

Con l’AI Act, l’Agenzia ha assunto responsabilità ancora maggiori, moltiplicando i propri compiti «in uno scenario che è assolutamente critico per lo sviluppo della nostra economia», come ha sottolineato il direttore.

Il nuovo ruolo di ACN nell’ecosistema dell’intelligenza artificiale

Con l’entrata in vigore della normativa europea e italiana sull’intelligenza artificiale, ACN ha assunto un ruolo centrale e multifunzionale:

  • Autorità di vigilanza del mercato: responsabile della sorveglianza sui prodotti AI, delle azioni correttive e dei poteri investigativi e sanzionatori
  • Punto di contatto unico con le istituzioni dell’Unione Europea
  • Rappresentante italiano nell’AI Board europeo, l’organismo composto da rappresentanti di tutti gli Stati membri
  • Autorità di certificazione per i sistemi di intelligenza artificiale
  • Promotore dello sviluppo tecnologico: sviluppo, trasferimento e miglioramento delle tecnologie AI in ambito cybersicurezza

L’Italia, come precisato nell’intervento, promuove un approccio centrato sull’essere umano (human-centered approach) all’intelligenza artificiale, con particolare enfasi sulla valorizzazione dei benefici e sulla gestione attenta dei rischi, salvaguardando i diritti fondamentali.

ai factory
AI ACT and ACN role

AGID (Agenzia per l’Italia Digitale), invece, è stata designata come autorità di notifica, insieme ad altre entità che compongono l’ecosistema nazionale dell’innovazione digitale.

IT4LIA: il cuore pulsante dell’autonomia digitale italiana

Il fulcro dell’intervento si è concentrato sull’AI Factory italiana, denominata IT4LIA, un’infrastruttura strategica in fase di sviluppo a Bologna che rappresenta uno dei pilastri della strategia nazionale per l’indipendenza tecnologica.

«Riteniamo in ACN che il tema dell’intelligenza artificiale sia assolutamente centrale. Già oggi, ancora di più lo sarà nei prossimi anni», ha dichiarato Nicoletti, evidenziando come l’AI stia rapidamente diventando un autentico game changer – un elemento di svolta radicale – per l’economia, i servizi pubblici, lo sviluppo di prodotti competitivi sul mercato e, più in generale, per la qualità della vita del sistema Paese.

L’esperto ha tenuto a precisare che il discorso non è «beceramente economico»: si tratta piuttosto di una questione che riguarda la qualità della vita complessiva e la resilienza del sistema Paese in un contesto geopolitico sempre più complesso e imprevedibile.

L’importanza strategica dell’autonomia infrastrutturale

«Abbiamo assolutamente bisogno di sviluppare maggiormente le nostre infrastrutture perché non possiamo dipendere, soprattutto in un contesto geopolitico che sta cambiando con una velocità impressionante, da infrastrutture proprietarie di infrastrutture che siano collocate all’interno dell’Unione europea», ha affermato con forza il relatore.

Il punto è cruciale: oggi le tecnologie e le infrastrutture digitali sono sviluppate ed erogate principalmente da grandi multinazionali americane. Questa dipendenza rappresenta un rischio strategico inaccettabile, soprattutto considerando i rapidi e imprevedibili stravolgimenti dello scenario geopolitico globale a cui assistiamo quotidianamente.

ai factory
IT4LIA: focus on key priorities

Le quattro priorità verticali di IT4LIA

L’AI Factory italiana si concentra su quattro settori strategici fondamentali per l’economia e la sicurezza nazionale:

  1. Cybersecurity
    Lo sviluppo di soluzioni avanzate per rilevare e mitigare minacce digitali rappresenta naturalmente la priorità principale, considerando il ruolo di ACN come principale finanziatore dell’iniziativa. L’obiettivo è creare sistemi di intelligenza artificiale specificamente progettati per la sicurezza informatica, capaci di identificare pattern anomali, prevenire attacchi e rispondere rapidamente alle minacce emergenti.
  2. Agritech e Agrifood
    Il settore agroalimentare italiano è un’eccellenza riconosciuta a livello mondiale. L’applicazione dell’AI può supportare lo sviluppo di un’agricoltura più sostenibile e efficiente, ottimizzare le produzioni agroalimentari e garantire tracciabilità e qualità. «Potete immaginare facilmente quante applicazioni si possono fare delle tecnologie di intelligenza artificiale al campo dell’agrifood», ha commentato il direttore.
  3. Earth
    L’analisi di dati ambientali e la modellazione predittiva sono essenziali per affrontare le sfide climatiche. «È immediatamente immaginabile da un lato sicuramente sistemi di previsione della situazione meteorologica, ma anche relativa all’inquinamento, relativo al tema del riscaldamento globale e così via», ha spiegato Nicoletti, evidenziando le molteplici applicazioni possibili in questo ambito.
  4. Manufacturing
    L’Italia è un Paese la cui economia è fondata prevalentemente sulla manifattura. «Fondamentale, se vogliamo di nuovo competere sul mercato globale, poter ricorrere alle tecnologie più importanti» per ottimizzare i processi industriali, ridurre gli sprechi, migliorare la qualità produttiva e aumentare la competitività internazionale.

Una strategia integrata: i quattro pilastri dell’innovazione

ai factory
National cybersecurity strategy towards European Digital Autonomy

La strategia di ACN, già incorporata nella legge istitutiva del 2021 e formalizzata nel documento pubblicato nel 2022, si articola su quattro pilastri fondamentali strettamente interconnessi tra loro, che coprono l’intero ciclo dell’innovazione: dalla ricerca di base fino alla messa a terra di infrastrutture nazionali operative.

1. Ricerca e innovazione: la base della piramide

«La ricerca è fondamentale per creare nuove opportunità, per creare nuova tecnologia», ha affermato il relatore. ACN sta attualmente finanziando circa 60 borse di dottorato, con l’obiettivo di arrivare a circa 90 borse attive a regime. La maggior parte di queste borse è dedicata a temi legati all’intelligenza artificiale.

Nei prossimi mesi e semestri verranno lanciate anche iniziative verticali sui gruppi di ricerca, specificatamente orientate verso il trasferimento tecnologico. Un punto importante sottolineato dall’esperto: «La nostra ricerca deve essere ricerca volta verso il trasferimento tecnologico». Pur riconoscendo l’importanza della ricerca di base, ACN concentra i propri finanziamenti su progetti che abbiano una chiara prospettiva di applicazione pratica e di sviluppo industriale.

2. Iniziative per le startup: colmare il divario critico

«Il link in questo momento è il punto più debole del nostro ecosistema italiano», ha dichiarato con franchezza il direttore, riferendosi al collegamento tra ricerca e impresa. «Il gap che c’è tra chi fa ricerca e chi fa impresa tutt’oggi è troppo ampio».

Questo divario ha cause molteplici e complesse:

  • Difficoltà di accesso al mercato per le giovani imprese innovative
  • Difficoltà di accesso al venture capital, che in Italia e in Europa non è ancora sufficientemente maturo
  • Carenza di competenze specifiche nel capitale di rischio tecnologico

Come ha spiegato Nicoletti, «il venture capital in questo ambito deve avere due caratteristiche fondamentali: la competenza e la velocità nel rispondere agli stimoli che vengono appunto dai nostri gruppi di ricerca, e non sempre questo purtroppo è completamente presente».

Per questo motivo, ACN sta sostenendo una serie di iniziative dedicate specificamente alle startup, fornendo non solo supporto finanziario ma anche servizi di accompagnamento e mentoring per facilitare il percorso verso il mercato.

3. Networking: costruire ponti tra innovazione e sistema produttivo

«Una volta che abbiamo queste startup bisogna metterle in grado di poter lavorare con i grandi gruppi, con le grandi pubbliche amministrazioni», ha sottolineato l’esperto. Questo è un altro tema sul quale, onestamente, «dobbiamo lavorare parecchio ancora in Italia».

Lo sviluppo di un efficace sistema di networking è fondamentale per creare un ecosistema maturo e funzionale. Questo tema viene sviluppato anche a livello europeo attraverso il National Coordination Centre (NCC), che rappresenta la componente italiana del Centro Europeo di Competenza in Cybersicurezza.

Il NCC facilita la collaborazione tra ricerca, industria e pubblica amministrazione, promuove eventi di matchmaking tra domanda e offerta di innovazione, e lavora all’analisi continua dell’ecosistema per identificare opportunità e criticità.

4. Infrastrutture nazionali: il tassello strategico finale

«Ultimo ma non ultimo», come ha precisato il relatore, si arriva al tema delle infrastrutture nazionali, elemento su cui si è concentrata la parte finale e più sostanziale dell’intervento.

Oltre all’AI Factory IT4LIA, ACN sta sviluppando un intero ecosistema di infrastrutture strategiche:

  • ENSOC (National Cyber Hub): iniziativa che rientra nell’ambito del Cyber Solidarity Act europeo, rappresenta un centro di concentrazione di tutte le informazioni di natura cyber raccolte nell’ecosistema nazionale. «Non necessariamente incidenti, noi vogliamo collezionare proprio eventi che poi in qualche modo, dopo una opportuna elaborazione, possano rivelare comportamenti o fenomeni in qualche maniera effettivamente malevoli», ha precisato.
  • Sandbox regolatorie: «Un altro strumento fondamentale per le nostre imprese, per comprendere come muoversi all’interno di uno scenario complesso, molto complesso, come è quello dell’AI», soggetto a numerose regolamentazioni sovrapposte: AI Act, Cyber Resilience Act, direttiva NIS2, direttiva CER, regolamento DORA in ambito finanziario. «C’è una enorme sovrapposizione di norme che non sempre è immediato comprendere e collocare correttamente».
  • Megaride: infrastruttura di high performance computing per la cybersicurezza nazionale, già installata a Napoli.
  • AI Gigafactory: il passo successivo, di scala ancora maggiore rispetto all’AI Factory, di cui si è accennato ma che non è stato oggetto di approfondimento specifico.
  • Cable Labs: ulteriore strumento per il monitoraggio delle infrastrutture critiche, non soltanto di comunicazione ma anche di approvvigionamento e distribuzione energetica.

Il mercato europeo della cybersicurezza: numeri e opportunità

ai factory
The European cybersecurity market context

«Questa è l’unica slide di numeri che vi faccio vedere», ha premesso il relatore prima di illustrare alcuni dati particolarmente significativi relativi al 2024 (in attesa di quelli del 2025, previsti in crescita di circa il 10%).

Un mercato da quasi 200 miliardi di euro

Il mercato globale della cybersicurezza vale circa 200 miliardi di dollari, di cui circa la metà (91 miliardi) sviluppati in Europa, seguita dagli Stati Uniti (184 miliardi) e dal resto del mondo (48 miliardi).

«Siamo una grande economia, siamo probabilmente uno dei posti principali, insieme agli Stati Uniti, dove fare impresa e dove sviluppare tecnologia», ha affermato con orgoglio Nicoletti, ribadendo un concetto fondamentale: «Questo discorso non deve essere visto in maniera sterile. Il tema – purtroppo o per fortuna viviamo in un’economia di mercato – della capacità, della possibilità di mettere a terra e di sviluppare economia è fondamentale per il nostro continente e per lo stile di vita che abbiamo noi in Europa».

L’Italia: terza potenza europea

L’Italia si posiziona come terzo Paese nell’Unione Europea per quota di mercato della cybersicurezza, preceduta solo da Germania e Francia. Un risultato significativo che testimonia la solidità dell’ecosistema italiano in questo settore strategico.

Una crescita superiore a USA e Israele

Il mercato europeo sta crescendo a un ritmo del 8,9% annuo (periodo 2022-2024), superando la crescita di Israele (6,4%) e allineandosi agli Stati Uniti (8,8%). Un segnale che l’Europa sta recuperando terreno e che gli investimenti in questo settore stanno dando frutti concreti.

Le acquisizioni: un ecosistema che si rafforza

Un dato particolarmente interessante emerso dall’analisi riguarda le acquisizioni di aziende europee di cybersicurezza. Nel 2024, 134 aziende europee del settore sono state acquisite da altre aziende o fondi di private equity, con un incremento del 13% rispetto al 2023.

Il dato più rilevante è che oltre due terzi delle acquisizioni (72%) sono state condotte da investitori europei, mentre solo il 25% da investitori statunitensi e il restante 4% dal resto del mondo. Questo rappresenta un segnale molto positivo: indica che l’ecosistema continentale si sta consolidando e rafforzando internamente, riducendo la dipendenza da capitali esterni.

Una doppia vittoria strategica

«La cyber security, lo sviluppo di questo tipo di tecnologia è una doppia vittoria», ha spiegato efficacemente il relatore. «Nel momento in cui riusciamo veramente a mettere a terra queste cose che stiamo provando a fare, da un lato ci garantiremo un ecosistema più sicuro, quindi più attrattivo per le persone che possono venire a lavorare in Europa. Dall’altra parte abbiamo la possibilità di creare economia, di creare posti di lavoro, di creare ricchezza e in definitiva di stare meglio complessivamente a livello europeo».

Un approccio integrato ai servizi dell’AI Factory

ai factory
IT4LIA: an Integrated Services Approach to AI

IT4LIA non è semplicemente un’infrastruttura di calcolo: è una piattaforma integrata di servizi che copre l’intera filiera dell’intelligenza artificiale, dalla gestione dei dati fino alla formazione delle competenze.

I quattro cluster di servizi

1. Servizi relativi ai dati (Data-related services)

Comprendono accesso, trasferimento, gestione e generazione di dati. «Come si accede, come si trasferisce, come si gestisce, come si prepara un dataset ben fatto per applicazione di intelligenza artificiale», ha elencato il direttore. La qualità e la corretta preparazione dei dati sono infatti fondamentali per ottenere risultati affidabili dai sistemi di AI.

2. Servizi orizzontali (Horizontal services)

Coprono tutti gli aspetti trasversali dello sviluppo AI: setup iniziale, sviluppo vero e proprio, verifica del trust (affidabilità) dei sistemi, testing, integrazione in rete. «Come si fa il setup, come si sviluppa, come si fa a verificare il trust in questi sistemi, come si fa a testarli, come si fa a metterli in una rete e così via», ha sintetizzato.

3. Servizi verticali (Vertical services)

Servizi specializzati nei quattro ambiti prioritari: agrifood, cybersicurezza, earth e manufacturing. Ogni settore richiede competenze specifiche e soluzioni dedicate che tengano conto delle peculiarità del dominio applicativo.

4. AI Skill

«Anzi dal mio punto di vista è quello più importante», ha sottolineato con particolare enfasi il relatore, introducendo il tema cruciale delle competenze.

La carenza di competenze: l’emergenza silenziosa

Il tema delle competenze (skill) è stato identificato come prioritario e urgente. «Soffriamo una carenza di skill gigantesca in tutti i campi tecnologici», ha dichiarato senza mezzi termini lo speaker.

Il sistema universitario: eccellenza ma inerzia strutturale

«Purtroppo il sistema universitario ha una certa inerzia, non si può pensare che dall’oggi al domani triplichiamo il numero di laureati STEM che siamo in grado di produrre», ha spiegato realisticamente Nicoletti, che però ha tenuto a precisare: «Dobbiamo essere fieri del nostro sistema universitario, perché tutt’ora, con tutte le difficoltà nel quale si dibatte, produce laureati di ottima qualità».

La fuga dei cervelli: un’emorragia continua

Il problema è che questi laureati di ottima qualità «molto spesso ci vengono rapiti all’estero». La cosiddetta “fuga dei cervelli” (brain drain) rappresenta una perdita secca per il Paese, che investe nella formazione ma poi vede i propri talenti migliori attratti da opportunità all’estero, principalmente negli Stati Uniti e in altri Paesi europei più competitivi.

L’AI Factory come palestra per i talenti

«Uno degli scopi di queste grandi infrastrutture è proprio di mettere a disposizione delle palestre sulle quali i nostri talenti si possano esercitare, le nostre startup possano lavorare», ha spiegato il direttore. Questo diventa un elemento fondamentale, una condizione chiaramente necessaria, non sufficiente, ma necessaria per trattenere questi talenti nel nostro Paese.

L’idea è creare un ambiente stimolante, dotato di tecnologie all’avanguardia, dove giovani ricercatori, data scientist e sviluppatori possano lavorare su progetti sfidanti e di frontiera senza dover necessariamente emigrare all’estero.

IT4LIA offrirà quindi servizi di training, capacity building, up-skilling e re-skilling, creando percorsi formativi continui che permettano ai professionisti di rimanere aggiornati in un settore che evolve con rapidità esponenziale.

EUSAiR: le sandbox regolatorie per accelerare l’innovazione

ai factory
THE EUSAiR Project

Un’iniziativa particolarmente innovativa menzionata nell’intervento è il progetto EUSAiR (EU Regulatory Sandboxes for AI), dedicato allo sviluppo di sandbox regolatorie per l’intelligenza artificiale.

Cosa sono le sandbox regolatorie

Le AI Regulatory Sandboxes (AIRS) sono ambienti controllati dove le imprese, in particolare PMI e startup, possono sviluppare e testare sistemi di intelligenza artificiale innovativi prima dell’ingresso sul mercato, verificando la conformità con l’AI Act e le altre normative europee e nazionali.

Come previsto dall’articolo 57 dell’AI Act e dall’articolo 20, comma 1, lettera c della Legge italiana 132/2025, ogni Stato membro dell’UE deve istituire almeno una sandbox per:

  • Supportare l’innovazione e lo sviluppo responsabile dell’AI
  • Garantire la conformità legale e la gestione dei rischi
  • Fornire chiarezza normativa e facilitare l’apprendimento regolatorio
  • Migliorare la cooperazione tra autorità e stakeholder
  • Facilitare l’accesso al mercato, in particolare per PMI e startup

Un progetto multidisciplinare coordinato da giuristi

«È interessante notare che è un progetto, una volta tanto, pur essendo in ambito AI, pur essendo in ambito quindi molto tecnologico, coordinato dal dipartimento di giurisprudenza dell’Università di Bologna», ha evidenziato con soddisfazione il relatore.

«Quindi è interessante che c’è il professore di giurisprudenza che coordina questo tipo di progetto. Questo anche per far capire quanto poi l’ambito sia sempre di più diventando multidisciplinare e aperto a diversi tipi di competenze che sono necessarie».

Un segnale importante: l’intelligenza artificiale non è solo una questione tecnica, ma richiede l’integrazione di competenze giuridiche, etiche, economiche e sociali per uno sviluppo veramente responsabile e sostenibile.

La sinergia tra IT4LIA e EUSAiR

La Commissione europea sta utilizzando il progetto EUSAiR come riferimento per definire le regole di costruzione delle sandbox regolatorie in tutta Europa. Questo rappresenta un riconoscimento importante per l’Italia e per l’approccio metodologico adottato.

La collaborazione tra IT4LIA e EUSAiR crea un percorso bidirezionale virtuoso:

  • Le imprese possono accedere ai servizi AI Trust di IT4LIA per ricevere orientamento regolatorio prima di sviluppare modelli o sistemi AI, e poi testarli nelle sandbox
  • Oppure possono accedere prima alle sandbox per ricevere consulenza sulla conformità normativa, e poi sviluppare concretamente i sistemi AI nell’infrastruttura della Factory

«IT4LIA può preparare i fornitori di AI per una sperimentazione regolatoria nelle sandbox. EUSAiR beneficerà dell’insieme di servizi AI Trust erogati dalla Factory. Le sinergie aiuteranno a costruire un ecosistema AI coerente che supporta la sperimentazione, la conformità e un accesso più rapido al mercato», si legge nelle slide presentate.

L’obiettivo finale è ridurre i costi di conformità per le imprese e migliorare il time-to-market, fattori cruciali soprattutto per le piccole e medie imprese e le startup che non dispongono di risorse legali interne paragonabili a quelle delle grandi multinazionali.

L’adozione sicura dell’AI: un approccio a 360 gradi

ai factory
Safe Adoption of AI: An Integrated Services Approach

Un’intera sezione delle slide è dedicata all’adozione sicura dell’intelligenza artificiale, un tema centrale per ACN in quanto autorità di vigilanza.

Servizi orizzontali e AI Trust

L’implementazione di servizi volti a garantire che i sistemi AI siano affidabili, etici, trasparenti e conformi alle normative applicabili include:

  • Analisi delle implicazioni di cybersicurezza (es. NIS2 e CRA – Cyber Resilience Act)
  • AI e protezione dei dati (es. GDPR e Codice Privacy italiano)
  • Legal Triage: una guida alla conformità regolatoria AI (es. AI Act, Legge n. 132/2025, Strategia Nazionale AI)

Servizi verticali per la cybersicurezza

Nel settore della cybersicurezza, IT4LIA svilupperà:

  • Identificazione e selezione di dataset AI-ready nei domini verticali (agrifood, osservazione della Terra, cybersicurezza, manifatturiero)
  • Preparazione e standardizzazione dei dati per i modelli AI in questi settori verticali
  • Selezione e caratterizzazione di modelli AI specifici per dominio
  • Sviluppo di modelli AI per supportare applicazioni di cybersicurezza data-driven, che serviranno come fondamento per soluzioni specializzate all’interno della Factory

L’approccio multidisciplinare di EUSAiR

Le sandbox regolatorie adottano un approccio multidisciplinare che integra:

  • Aspetti regolatori e di policy
  • Accesso a infrastrutture di supercalcolo
  • Casi d’uso del tessuto produttivo europeo

Questo permette di testare in condizioni realistiche la conformità dei sistemi AI, identificando eventuali criticità prima del lancio sul mercato e riducendo significativamente i rischi legali ed economici per le imprese.

Il contesto europeo: 16 AI Factory per l’autonomia continentale

Quello che sta accadendo in Italia non è un caso isolato, ma si inserisce in una strategia europea coordinata e ambiziosa. Come ha rivelato il relatore, «oltre alla AI Factory italiana ne sono state finanziate altre 15 in Europa».

L’anno prossimo, ha proseguito, «saranno finanziate probabilmente quattro o cinque Gigafactory che saranno addirittura di ordine di grandezza ancora più grande». Un ecosistema continentale di infrastrutture AI che mira a ridurre progressivamente la dipendenza dalle piattaforme americane e cinesi.

«L’obiettivo è creare tecnologia, ma anche semplicemente avere a disposizione l’infrastruttura è già un fattore di autonomia», ha spiegato lucidamente Nicoletti. «Perché anche se utilizzassimo software non necessariamente prodotti in Italia o in Europa, però almeno lo faremo girare su infrastrutture nostre».

Un punto fondamentale: l’autonomia strategica non significa necessariamente autarchia tecnologica totale. Anche solo disporre delle infrastrutture fisiche su suolo europeo, pur utilizzando eventualmente software sviluppati altrove, rappresenta già un livello base ma essenziale di autonomia, che protegge dalla volatilità geopolitica e dalle pressioni politiche esterne.

Quantum computing: l’urgenza di una preparazione immediata

Nel corso dell’intervento, il relatore ha anche affrontato il tema del quantum computing, già ampiamente discusso durante la giornata del Forum. Diversamente da chi mantiene un approccio più cauto sulle tempistiche, Nicoletti si è dichiarato decisamente meno ottimista riguardo all’arrivo di computer quantistici capaci di compromettere gli algoritmi di crittografia classici attualmente in uso.

«Secondo me siamo veramente a pochi anni da quando succederà e non siamo per niente preparati», ha affermato con una nota di preoccupazione che ha sottolineato l’urgenza della situazione. Il rischio è concreto: quando i computer quantistici raggiungeranno la potenza necessaria per violare gli standard crittografici attuali, l’intero ecosistema digitale potrebbe trovarsi vulnerabile.

Proprio per questa ragione, ACN ha recentemente inaugurato un servizio specifico dedicato alla crittografia, che nei prossimi mesi inizierà operativamente a seguire questa componente cruciale della strategia di sicurezza nazionale. Un passo necessario per non farsi trovare impreparati di fronte a una rivoluzione tecnologica ormai alle porte.

Non ripetere con il quantum gli errori commessi con l’AI

Nella parte conclusiva del suo intervento, il direttore è tornato con ancora maggiore enfasi sul tema del quantum computing, legandolo strettamente alla lezione appresa con l’intelligenza artificiale.

«L’altra rivoluzione che sta arrivando è quella del quantum. L’auspicio che noi stiamo facendo è di non farci trovare anche in quel caso impreparati, come abbiamo fatto con l’intelligenza artificiale, trovandoci poi costretti a rincorrere», ha dichiarato con tono preoccupato ma determinato.

L’Italia ha le competenze necessarie

Sul quantum computing, l’Italia non parte da zero. «Ci sono una serie di iniziative che sta mettendo in campo sia la Commissione» europea, ha ricordato Nicoletti. «Pochi mesi fa è stata anche rilasciata la Strategia Quantum Nazionale».

E soprattutto: «Anche in quel caso dobbiamo puntare a produrre tecnologia. In Europa abbiamo tutte le competenze, in Italia in particolare le abbiamo assolutamente le competenze sul quantum».

Ammettere i ritardi senza perdere la speranza

Il relatore non ha nascosto le responsabilità: «È vero, è verissimo quello che diceva il professore nell’intervento precedente, che siamo rimasti fermi troppo a lungo».

Ma ha voluto chiudere con una nota di ottimismo costruttivo: «Però di nuovo, anche in questo caso vorrei essere ottimista e dire che ci sono tutti i presupposti per riuscire. E ci sono anche dei privati che stanno facendo investimenti importanti, vediamo un pochettino dove arriveremo».

Il nuovo servizio ACN sulla crittografia

«Noi come ACN – e qua mi fermo perché ho finito il tempo – abbiamo anche da pochissimo inaugurato proprio un servizio specifico che è dedicato alla crittografia e che nei prossimi mesi comincerà a lavorare e seguire anche questa parte della strategia che necessariamente va seguita per ottenere questa autonomia della quale abbiamo assolutamente bisogno», ha concluso il direttore, collegando idealmente il tema del quantum a quello della crittografia post-quantistica, un ambito di ricerca cruciale per preparare le difese dell’ecosistema digitale all’era dei computer quantistici.

Conclusioni: un ottimismo consapevole per il futuro digitale italiano ed europeo

L’intervento di Luca Nicoletti si è concluso con un messaggio di ottimismo consapevole e ragionato, lontano tanto dall’euforia acritica quanto dal pessimismo paralizzante.

«Abbiamo di fronte delle sfide gigantesche», ha riconosciuto apertamente. Due rivoluzioni tecnologiche in particolare: una già in corso (l’intelligenza artificiale), l’altra imminente (il quantum computing).

L’Europa si è svegliata, anche se in ritardo

Sull’intelligenza artificiale, ha ammesso con franchezza: «Chiaramente siamo molto indietro». L’Europa «si sta muovendo, si sta muovendo in ritardo, si sta muovendo a volte in maniera un po’ disordinata».

Tuttavia, ha voluto sottolineare un aspetto positivo: «Io ho sempre un animo molto ottimista e dico anche che comunque in qualche maniera ci siamo, tra virgolette, svegliati. Queste spinte esogene che ci vengono sia dagli Stati Uniti che dalla Cina hanno messo in moto comunque una reazione lato europeo».

Le infrastrutture come fondamento dell’autonomia

«La possibilità di disporre però di grandi infrastrutture in Europa è fondamentale», ha ribadito con forza. Anche nell’ipotesi – non auspicabile ma realistica – di continuare a utilizzare software non europei, «almeno lo faremo girare su infrastrutture nostre».

Un livello minimo ma essenziale di sovranità digitale, che protegge da interruzioni improvvise del servizio dovute a decisioni politiche esterne, garantisce il rispetto delle normative europee sulla privacy e sui dati, e crea le basi per uno sviluppo autonomo futuro.

Un impegno concreto verso l’autonomia strategica

L’AI Factory IT4LIA, insieme alle altre 15 factory europee e alle future Gigafactory, rappresenta quindi non solo un’infrastruttura tecnologica, ma un tassello fondamentale di una strategia complessiva che punta a:

  • Ridurre la dipendenza tecnologica da attori extra-europei
  • Sviluppare competenze locali attraverso formazione continua e trattenimento dei talenti
  • Creare opportunità economiche per startup e PMI innovative
  • Garantire sicurezza e autonomia digitale in un contesto geopolitico sempre più imprevedibile
  • Proteggere i diritti fondamentali dei cittadini europei attraverso un’AI etica e trasparente

Il percorso è lungo e complesso, le sfide sono effettivamente «gigantesche», come ha ammesso il relatore. Ma la direzione è tracciata, le risorse (anche se non sufficienti) cominciano ad essere allocate, e soprattutto – forse per la prima volta – c’è una consapevolezza diffusa della natura strategica e urgente di queste scelte.

Come ha efficacemente sintetizzato Nicoletti chiudendo il suo intervento: l’obiettivo è garantire «questa autonomia della quale abbiamo assolutamente bisogno» per preservare non solo la competitività economica, ma lo stesso modello di società aperta e democratica che caratterizza l’Europa.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Luca Nicoletti è nato a Roma nel 1970, si è laureato in Fisica presso l’Università degli Studi di Roma “La Sapienza” nel 1996 con il punteggio di 110/110. Dopo aver svolto il servizio Militare come Ufficiale di Marina, dal 1997 lavora in ambito informatico, interessandosi fin dall’inizio di sistemi distribuiti e tecnologie Web.

I suoi campi di interesse principali sono le Architetture Orientate ai Servizi, virtualizzazione di sistemi e applicazioni, Cloud Computing, sistemi di Identity & Access management, temi sui quali ha prodotto articoli ed è stato chiamato a svolgere seminari.

Tra il 1998 e il 2000 si è occupato di sistemi di Controllo di Gestione per importanti aziende Italiane di Telecomunicazioni ed Energetica. Tra il 2000 ed il 2013 lavora in Consip, prima nell’area “Architetture Tecnologiche” quindi nell’area “System Solution”. Nel 2013 si trasferisce in Sogei S.p.A. nell’area “Architetture e Servizi Tecnologici” e dal 2018 fino a tutto il 2019 è stato responsabile del gruppo di Demand Management Tecnologico.

Prima In Consip, poi in Sogei, ha inoltre partecipato a numerosi progetti europei nell’ambito del settimo programma quadro (FP7) e del programma Horizon 2020. Dal 2015 al 2018, in rappresentanza del MEF, è stato il Technical Leader del progetto H2020 “Sunfish” e dal 2018 del progetto H2020 “Poseidon”.

Dal 2019 al 2021 ha lavorato in Presidenza del Consiglio dei Ministri, ricoprendo incarichi di responsabile dei servizi IT Dipartimentali e coordinando numerosi gruppi di lavoro, tra i quali quello per la scrittura dei DPCM attuativi del Perimetro di Sicurezza Cibernetica, quello che ha elaborato la componente 5 della Missione 1 del PNRR relativa alla Cybersecurity, quello che ha elaborato la Strategia Cloud Italia e quello relativo alla Strategia Nazionale di Cybersicurezza. Ha partecipato inoltre al gruppo di lavoro che ha elaborato il DL 82/2021 tramite il quale è stata creata l’Agenzia Nazionale per la Cybersicurezza.

Nel corso degli anni ha sviluppato approfondita conoscenze del codice degli appalti pubblici e procedure di gara, nonché nell’esecuzione di contratti complessi.

Attualmente è responsabile del Servizio Programmi Industriali, Tecnologici e di ricerca presso l’Agenzia Nazionale per la Cybersicurezza dove si occupa dell’attuazione della componente Cybersecurity del PNRR e dello sviluppo di nuove capacità industriali e tecnologiche nel settore della sicurezza cibernetica. Con provvedimento a firma del Presidente del Consiglio del 28 febbraio 2022, è stato nominato membro italiano del board del Centro Europeo di Competenza in Cybersecurity (ECCC) di cui al regolamento (UE) 2021/887 del Parlamento europeo e del Consiglio del 20 maggio 2021.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ai-factory-italiana/


Resilienza IT/OT per la NIS2: dall’esperienza nel settore militare alla protezione delle infrastrutture critiche civili dalla vita reale alla cyber resilience

L’intervento “Autonomia operativa in ambienti critici: Resilienza IT/OT per la NIS2” di Nicola Mugnato, CTO e Co-Founder di Gyala, al 23° Forum ICT Security ha illustrato come le lezioni apprese dalla difesa militare possano trasformare l’approccio alla cybersecurity delle infrastrutture critiche.

La Direttiva NIS2 rappresenta oggi una sfida impellente per le aziende italiane. Ma quali sono le implicazioni operative concrete per chi gestisce infrastrutture critiche, specialmente quando la complessità dei sistemi OT si aggiunge a quella tradizionale dell’IT? Nicola Mugnato, CTO e Co-Founder di Gyala, ha affrontato questa questione durante il 23° Forum ICT Security tenutosi a Roma, offrendo un punto di vista originale che nasce dall’esperienza maturata nel contesto della difesa militare.

L’evoluzione dalla NIS1 alla NIS2: uniformare la resilienza europea

L’intervento ha preso le mosse dall’analisi degli obiettivi che hanno portato l’Europa a modificare la precedente direttiva. Come ha spiegato il relatore, la NIS1 era stata concepita per garantire una capacità abbastanza uniforme di resilienza a livello europeo e favorire lo scambio di informazioni sulle minacce tra le diverse nazioni. Tuttavia, ogni Stato membro l’aveva interpretata in modo leggermente diverso, sia nella definizione delle organizzazioni dei servizi essenziali, sia soprattutto nell’imposizione di requisiti di cybersecurity che variavano significativamente da paese a paese.

Questa disomogeneità nell’implementazione ha spinto il legislatore europeo a intervenire con la NIS2, che introduce categorie molto precise di servizi critici ed estremamente critici, e soprattutto definisce obblighi puntuali per le singole nazioni. Un elemento centrale della nuova direttiva, come sottolineato durante la presentazione, è l’approccio multirischio: non si tratta più di valutare soltanto l’aspetto strettamente cyber, ma anche quello operativo che le infrastrutture devono garantire.

resilienza it
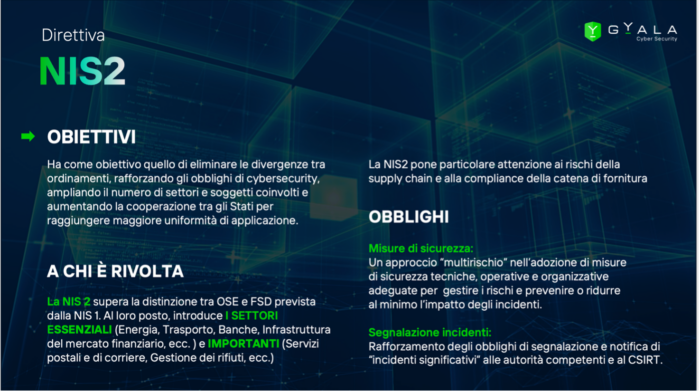
“Direttiva NIS2: Obiettivi, Obblighi, A chi è rivolta”

Il Decreto Legislativo 138 del settembre 2024 ha recepito la direttiva in Italia, suddividendo i soggetti interessati in quattro allegati: i primi due definiscono i settori ad alta criticità (energia, trasporti, banche, sanità, acqua potabile) e i settori critici (servizi postali, gestione rifiuti, produzione alimentare). Gli altri due allegati riguardano la pubblica amministrazione, con le amministrazioni centrali e regionali considerate essenziali, mentre comuni sotto i 100.000 abitanti e altri enti rientrano tra i soggetti importanti.

Due scenari a confronto: la PA centrale e la centrale elettrica

Per illustrare concretamente gli impatti della direttiva, Mugnato ha proposto un’analisi comparativa tra due tipologie di infrastrutture: una pubblica amministrazione centrale – usando come esempio un ente che gestisce dati contributivi e pensionistici – e un impianto di produzione di energia elettrica.

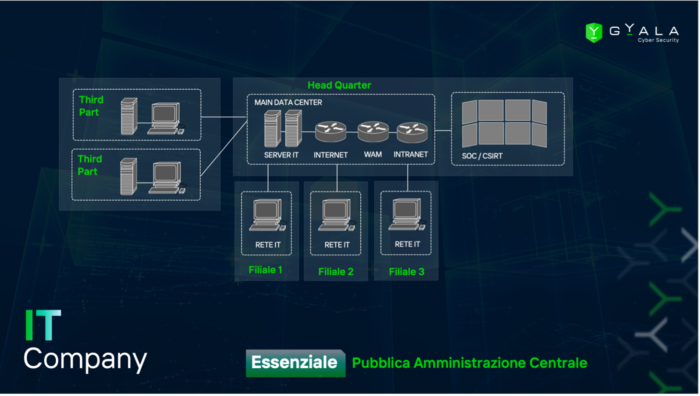
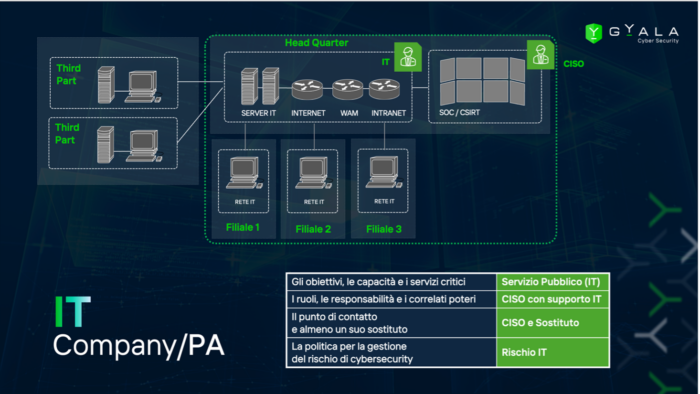
Nel primo caso, l’infrastruttura risulta relativamente centralizzata: un headquarter con data center centrali, eventualmente filiali periferiche, e sistemi IT che devono principalmente gestire dati; considerando anche Le terze parti che supportano l’esercizio di questi servizi e che sono tipicamente collegate alle infrastrutture centralizzate.

resilienza it
Infrastruttura IT Company – Pubblica Amministrazione Centrale

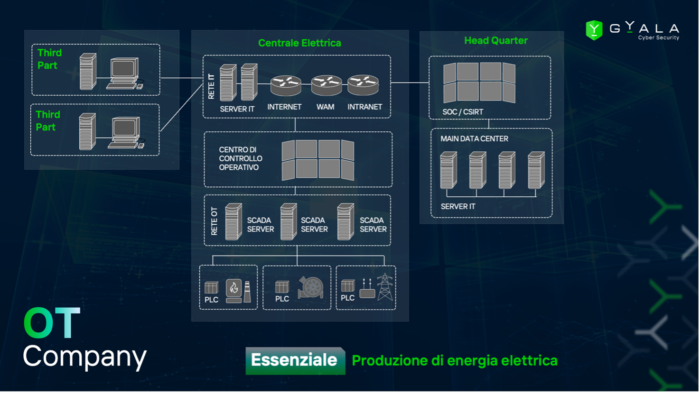
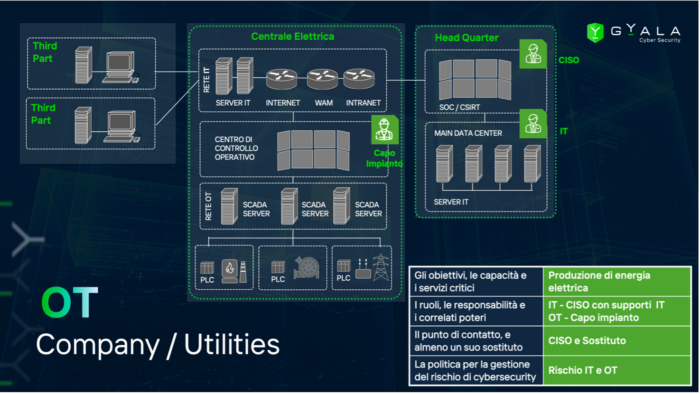
La situazione si complica notevolmente quando si passa a considerare un’azienda che produce energia elettrica. Qui, oltre alla componente IT per la gestione amministrativa, la fatturazione e i rapporti con i clienti, esistono numerose infrastrutture OT indipendenti distribuite sul territorio che devono garantire la produzione effettiva. All’interno di ciascun impianto, la parte operativa deve gestire una serie di sottosistemi quasi indipendenti: dalla produzione del vapore o dei gas che alimentano le turbine, alla gestione della turbina stessa, fino al controllo dell’alta tensione.

resilienza it
Infrastruttura OT Company – Centrale Elettrica

Un aspetto cruciale evidenziato durante l’intervento riguarda le terze parti. Nel mondo IT, è leggermente più semplice imporre requisiti alla propria supply chain, se sono piccole aziende. Mentre in caso di multinazionali e particolarmente nel mondo OT, invece, ci si confronta con aziende che gestiscono centinaia di impianti nel mondo e impongono le proprie policy e procedure di accesso. Come ha osservato il relatore: “Andare a dire al fornitore ‘tu per entrare nel nostro impianto usi il mio firewall con la mia autenticazione’ è impossibile”. C’è da dire che queste grandi aziende applicano normalmente policy di sicurezza efficaci e paradossalmente, il rischio maggiore spesso proviene dalle terze parti IT più piccole e meno strutturate.

La governance distribuita: il ruolo del capo impianto

La determinazione del Direttore Generale dell’Agenzia per la Cybersicurezza Nazionale del 14 aprile 2025 ha fornito le disposizioni di dettaglio per l’implementazione della NIS2, selezionando i requisiti del framework di cybersecurity nazionale applicabili come requisiti minimi.

Nel contesto IT, l’applicazione risulta lineare: il CISO è il punto di contatto con l’ACN, responsabile della definizione delle politiche interne e, in caso di incidente, della gestione e comunicazione verso l’Autorità.

resilienza it
Governance IT

Ma quando ci si sposta nel mondo OT di una centrale elettrica, i ruoli si sdoppiano.

resilienza it
Governance OT

Come ha efficacemente spiegato Mugnato, il capo impianto diventa “il comandante della nave”: è lui che decide cosa si fa, come si interviene, quali sono le azioni di ripristino sugli incidenti cyber o non cyber.

L’ownership della gestione operativa resta in capo a questa figura, mentre il CISO mantiene il coordinamento generale e le comunicazioni verso le autorità. Le politiche di sicurezza devono quindi considerare sia i rischi IT che quelli OT, e la formazione deve raggiungere entrambi gli ambiti.

Questa dicotomia si riflette anche nella fase di risposta agli incidenti. Nel mondo IT esistono metodologie consolidate per backup, disaster recovery e business continuity. Nel mondo OT la situazione è più complessa: l’infrastruttura gode di una certa indipendenza operativa ma dipende fortemente dalle terze parti specializzate per la manutenzione e la gestione dei problemi. I piani di ripristino sono molto più articolati e la loro esecuzione resta in capo ai singoli capi impianto, non al governo centralizzato.

Dal contesto militare alle infrastrutture critiche civili

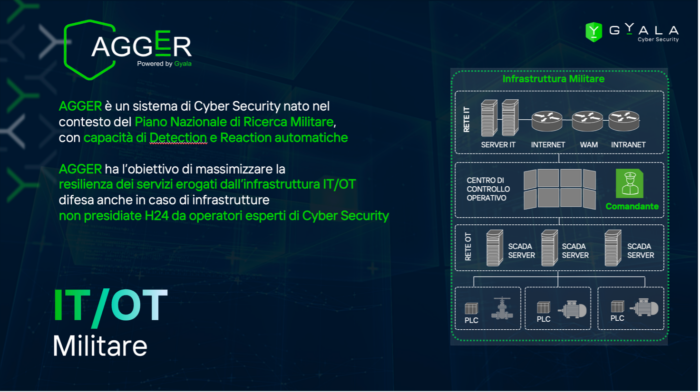
L’intervento ha poi illustrato come questi problemi si amplifichino ulteriormente nel contesto militare, dove le infrastrutture IT/OT sono impegnate in operazioni e non possono sempre essere connesse a Security Operation Center o CSIRT remoti. Gli operatori in campo non hanno esperienza cyber, sono esperti della missione che devono compiere e la tecnologia a supporto deve essere resiliente. Il governo dell’infrastruttura è interamente in capo al comandante della postazione.

resilienza it
Origine militare di Agger

È proprio da questo scenario militare che è nato nel 2016 Agger, la soluzione di cybersecurity sviluppata da Gyala nel contesto del Piano Nazionale di Ricerca Militare inizialmente con Marina Militare ed Esercito.
Oggi la soluzione protegge anche il mercato civile ed è estesa a centrali elettriche, acquedotti, strutture sanitarie e altre tipologie di infrastrutture critiche. L’idea fondante è dotare le infrastrutture di capacità di autodifesa che non solo siano in grado di identificare e bloccare potenziali incidenti, ma che possano ripristinare autonomamente i servizi IT/OT, garantendo al comandante della nave – o al capo impianto nel caso del contesto civile – che l’infrastruttura compia esattamente le operazioni richieste e senza mettere a repentaglio la safety locale.

Un sistema di resilienza automatizzata

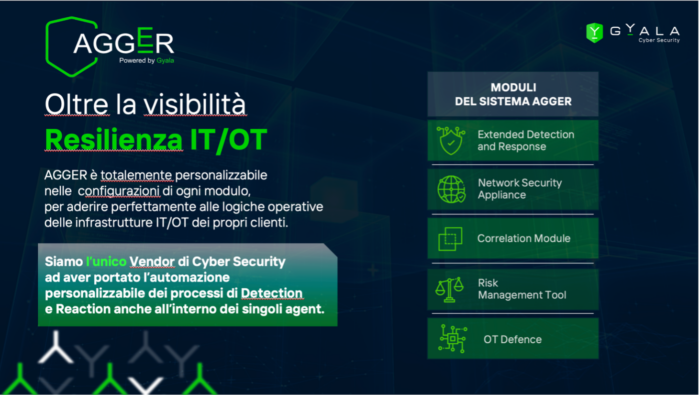
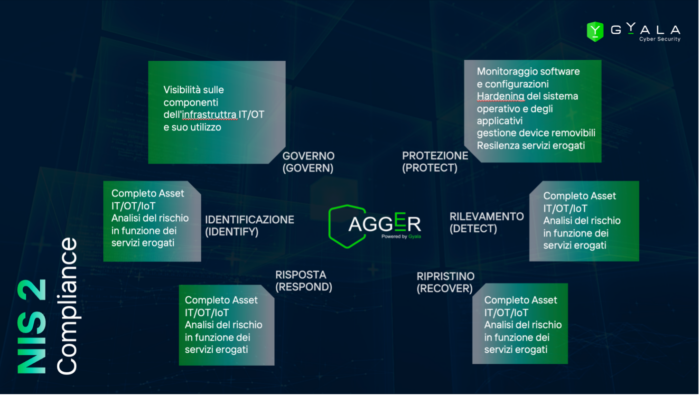
Il sistema, interamente sviluppato in Italia, si articola in diversi moduli complementari. Gli agent installati sui computer analizzano i processi in esecuzione e possono bloccarli o ripristinarli secondo regole di detection e di reaction personalizzabili. Le sonde di rete rilevano anomalie di comunicazione, mentre interrogazioni dirette verificano lo stato degli apparati OT su cui non è possibile installare software. Un sistema di coordinamento centrale con regole totalmente personalizzabili garantisce non solo la capacità di identificare anomalie rispetto al comportamento normale, ma soprattutto di reagire in maniera opportuna.

resilienza it
Moduli del sistema Agger

Come ha sottolineato il relatore, Gyala è l’unico vendor di cybersecurity ad aver portato l’automazione personalizzabile dei processi di detection e reaction anche all’interno dei singoli agent. Questo approccio risponde a una necessità concreta: trasferire logiche operative all’interno di ogni singola macchina.

Nel contesto aziendale IT, gli agent coprono tutti i computer con sistemi operativi Windows e Linux – inclusi sistemi legacy come XP, ancora diffusi nel mondo dell’automazione industriale – mentre le sonde analizzano il traffico di rete. Nel mondo OT, ogni impianto mantiene una propria autonomia con visione e gestione locale della console per la gestione degli incidenti, mentre i dati vengono comunque remotizzati verso i SOC/CSIRT dove il CISO mantiene una visione d’insieme a livello aziendale.

resilienza it
NIS 2 Compliance

Una risposta nata sul campo

La conclusione dell’intervento ha evidenziato come un prodotto nato per rispondere alle esigenze di resilienza dei sistemi militari si sia rivelato capace di soddisfare tutti i requisiti che oggi la NIS2 e l’ACN richiedono alle infrastrutture critiche italiane. Non si tratta di una coincidenza: le sfide della cybersecurity operativa in contesti disconnessi, con operatori non specializzati e necessità di continuità assoluta, anticipano e amplificano quelle che oggi le aziende civili si trovano ad affrontare nell’implementazione della nuova direttiva europea.

L’approccio proposto suggerisce che la vera resilienza non può dipendere esclusivamente da un SOC remoto o da interventi centralizzati, ma deve essere incorporata nell’infrastruttura stessa, con capacità di autodifesa, auto-rilevamento e auto-ripristino che possano operare anche in condizioni di isolamento o quando il personale presente non dispone di competenze cyber specialistiche.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Nel 2000, Nicola Mugnato ha fondato una società con l’obiettivo di supportare tecnicamente le attività operative delle forze dell’ordine nazionali e internazionali, sviluppando sonde per l’intercettazione di comunicazioni internet e software Trojan.

Dopo aver ceduto l’azienda al Gruppo Finmeccanica nel 2007, diventa Head of Finmeccanica Group Cybers Security, con la responsabilità di definire ed implementare l’intero sistema di sicurezza informatica per tutte le aziende Finmeccanica worldwide.

Nel 2015 ha fondato Gyala, una società di sicurezza informatica che sviluppa soluzioni avanzate di sicurezza informatica per il mercato civile e militare.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/resilienza-it-ot/


Human-in-the-loop security: l’equilibrio strategico tra automazione e giudizio umano nella cybersecurity

L’intelligenza artificiale sta ridefinendo i confini della cybersecurity, promettendo di individuare minacce in millisecondi, automatizzare risposte e alleggerire i team di sicurezza da compiti ripetitivi. Eppure, proprio mentre celebriamo questi progressi tecnologici, emerge una consapevolezza critica: i sistemi completamente autonomi eccellono nell’identificazione di pattern, ma falliscono quando serve interpretare il contesto, valutare sfumature o assumere decisioni che impattano persone e organizzazioni in modi complessi.

Da questa tensione nasce l’approccio Human-in-the-Loop (HITL), che non rappresenta un regresso rispetto all’automazione, ma la sua evoluzione più matura. Come evidenziato da ricerche specializzate sulla sicurezza cognitiva, non si tratta di mantenere l’elemento umano “nel circuito” per nostalgia o diffidenza verso le macchine, ma perché determinate decisioni di sicurezza richiedono capacità che restano prerogativa della cognizione umana: intuizione strategica, esperienza contestuale, giudizio etico e la capacità di valutare rischi in scenari inediti.

La problematica dell’automazione totale nella security

Negli ultimi anni, l’industria della cybersecurity ha inseguito con determinazione la promessa dell’automazione integrale. Le piattaforme Security Orchestration, Automation and Response (SOAR) hanno proliferato rapidamente – secondo analisi di mercato specializzate, il concetto è stato coniato da Gartner nel 2015 –, i sistemi Extended Detection and Response (XDR) promettono correlazione automatica tra domini multipli, e gli algoritmi di machine learning vengono presentati come soluzione definitiva al problema del sovraccarico di alert che affligge i Security Operations Center.

Questo paradigma ignora una realtà fondamentale: la sicurezza informatica non è esclusivamente un problema tecnico, ma anche profondamente umano e organizzativo. Un alert di potenziale data exfiltration può indicare un attacco sofisticato o semplicemente un dipendente che trasferisce file legittimamente per lavorare in remoto. Un comportamento anomalo su un endpoint può segnalare malware o un utente che ha modificato le proprie abitudini lavorative. La differenza non risiede nei bit, ma nel contesto.

L’alert fatigue e i suoi costi reali

Secondo uno studio pubblicato su ACM Computing Surveys, i team dei SOC affrontano quotidianamente volumi, velocità e varietà di alert che generano un carico cognitivo insostenibile. Una ricerca di Trend Micro condotta nel 2021 ha rivelato che il 70% dei professionisti dei SOC si sente emotivamente sopraffatto dal volume di alert di sicurezza, con conseguenze che si estendono anche alla vita personale.

I numeri sono impressionanti e documentati: i team gestiscono in media 3.832 alert al giorno, con il 62% di questi che vengono ignorati. Uno studio condotto da IDC ha rivelato che le aziende con 500-1.499 dipendenti ignorano o non investigano il 27% di tutti gli alert, percentuale che sale al 30% per organizzazioni con 1.500-4.999 dipendenti. Ancora più preoccupante: il 55% dei team di sicurezza ammette di perdere alert critici, con il 41% che dichiara che questo accade settimanalmente e il 22% quotidianamente.

Le conseguenze degli errori nei sistemi automatizzati possono essere gravi. Un sistema che blocca automaticamente un account per attività sospette può fermare un dirigente durante una negoziazione critica. Una risposta automatica a un presunto ransomware può eliminare file legittimi crittografati per ragioni di compliance. Il caso emblematico del data breach di Target nel 2013 illustra perfettamente questo problema: FireEye aveva sollevato l’allarme almeno cinque volte dopo aver rilevato malware sulla rete di Target, ma il team di sicurezza della società aveva ignorato gli alert.

Il paradosso dell’automazione: più strumenti, più complessità

Uno studio ESG ha rivelato che il 44% degli alert non vengono investigati a causa di una combinazione di scarsità di talenti e molteplicità di soluzioni di sicurezza che generano volumi enormi di alert. Il Ponemon Institute ha documentato che il SOC medio utilizza dozzine di strumenti per proteggere dati e sistemi, e questi strumenti generano un numero stordente di alert.

La ricerca di Computer Weekly su 427 leader IT ha scoperto che il 70% ha visto il volume di alert di sicurezza più che raddoppiare dal 2015, mentre il 99% ha affermato che gli alti volumi di alert causano problemi ai team di sicurezza e l’83% ha dichiarato che il proprio personale soffre di alert fatigue.

Il valore strategico del giudizio umano nell’approccio human-in-the-loop

Il punto di forza dell’approccio Human-in-the-Loop non sta nel rallentare i processi, ma nel posizionare l’intelligenza umana dove questa apporta massimo valore. Come evidenziato da analisi approfondite sui sistemi HITL, l’expertise umana viene integrata nei processi automatizzati per migliorare l’accuratezza del rilevamento delle minacce, la precisione della risposta e il decision-making strategico.

Un analista esperto apporta elementi che nessun algoritmo può replicare: la conoscenza approfondita del business, la memoria di incidenti passati simili ma non identici, la capacità di percepire quando qualcosa non quadra anche in assenza di indicatori tecnici evidenti. Michael Noory, Lead Threat Hunter di CYDEF, ha sottolineato: “Per quanto comoda possa sembrare la sicurezza al 100% guidata dall’AI a un team IT, questi sistemi non sono ancora al punto in cui possono rilevare in modo affidabile tutte le minacce”.

Human-in-the-loop vs human-on-the-loop: differenze critiche

È fondamentale distinguere l’approccio Human-in-the-Loop da modelli alternativi. Nel modello Human-on-the-Loop (HOTL), gli esseri umani progettano, configurano e distribuiscono sistemi automatizzati ma non sono direttamente coinvolti nelle decisioni quotidiane o nella supervisione. Il sistema opera indipendentemente fino a quando non è necessaria una revisione importante o un aggiornamento.

Nel Human-over-the-Loop, la supervisione umana si concentra sulla governance complessiva e sulla supervisione umana di un intero sistema AI, garantendo che non causi danni o “impazzisca”. Come spiegato da Marsh nella loro analisi sui rischi AI, il primo è definito dalla governance e dalla supervisione umana su un sistema AI complessivo, mentre il secondo si concentra sulla fase operativa dove esiste un forte desiderio di mitigare i rischi di autonomia o di decisioni automatiche del sistema AI.

L’Human-in-the-Loop, invece, mantiene le persone strettamente coinvolte nel decision-making attivo. Nella cybersecurity, dove il contesto può cambiare rapidamente e il costo di una decisione errata può essere elevato, HITL offre un approccio più bilanciato.

Human-in-the-loop e advanced persistent threats

Consideriamo il caso delle Advanced Persistent Threats (APT). Gli indicatori tecnici possono risultare ambigui, le tecniche possono simulare comportamenti legittimi, e la vera natura dell’attacco emerge solo correlando elementi apparentemente scollegati nel corso di giorni o settimane. Come documentato da IBM nella loro analisi XDR, le minacce avanzate possono nascondersi per mesi prima di essere rilevate, preparando attacchi su larga scala o breach.

È in questo contesto che l’intuizione dell’analista, alimentata da anni di esperienza, diventa insostituibile. L’automazione può presentare i frammenti del puzzle, ma serve una mente umana per visualizzare l’immagine complessiva. Gli analisti umani eccellono nel decision-making strategico, nella valutazione dell’impatto potenziale delle minacce e nella prioritizzazione delle azioni basate sulla criticità del business. L’intuizione umana e la capacità di collegare punti apparentemente non correlati sono inestimabili per scoprire attacchi sofisticati e multi-stadio che potrebbero eludere il rilevamento automatico.

Dimensione etica e legale delle decisioni di security

Ancora più critico è il ruolo umano nelle decisioni con implicazioni etiche o legali. Quando un sistema rileva che un dipendente sta potenzialmente sottraendo proprietà intellettuale, la decisione su come procedere non può essere delegata a un algoritmo. Entrano in gioco considerazioni su privacy, diritti del lavoratore, normative come il GDPR o l’HIPAA, potenziali danni reputazionali.

Come evidenziato nell’analisi di Medium sullo sfruttamento dell’expertise umana, gli esseri umani possono interpretare le intuizioni generate dall’AI, considerando fattori che le macchine potrebbero non comprendere pienamente, come sfumature organizzative, dinamiche geopolitiche e attori di minacce emergenti. Gli incidenti di sicurezza tipicamente coinvolgono informazioni personali, e i SOC devono affrontare framework legali complessi. I fattori legali sono essenziali durante un incidente, e per questo gli analisti umani possono analizzare questi aspetti e garantire che le azioni intraprese durante un incidente siano conformi alle normative.

Progettare sistemi human-in-the-loop efficaci

La sfida non è decidere se includere l’elemento umano nel processo, ma determinare dove, come e quando. Un approccio Human-in-the-Loop ben progettato non significa semplicemente aggiungere un pulsante di approvazione manuale a ogni processo automatizzato. Significa ripensare il workflow della sicurezza per massimizzare i punti di forza sia dell’automazione che dell’intelligenza umana.

Stratificazione intelligente delle decisioni

In pratica, questo si traduce in una stratificazione intelligente delle decisioni che rispetta la natura e il rischio di ogni tipo di intervento:

Automazione completa per azioni a basso rischio: Bloccare indirizzi IP riconosciuti come malevoli, applicare patch critiche, isolare endpoint compromessi basandosi su Indicators of Compromise (IoC) ben definiti. In questi casi l’automazione eccelle e l’intervento umano costituirebbe solo un collo di bottiglia. Come documentato nelle linee guida Microsoft per la riduzione dell’alert fatigue, i team con alti livelli di automazione risolvono la maggior parte degli alert di sicurezza lo stesso giorno (66%), rispetto al 34% dei team con bassi livelli di automazione.

Approccio semi-automatico per decisioni di medio livello: L’automazione esegue analisi preliminari e prepara raccomandazioni, ma l’analista mantiene la decisione finale. Il sistema effettua il lavoro oneroso di correlazione e analisi, presenta le opzioni con relativi pro e contro, ma l’ultima parola spetta all’umano. Questo modello funziona efficacemente per situazioni dove il contesto è rilevante ma il tempo di risposta resta un fattore critico.

Centralità umana per decisioni ad alto impatto: Per le decisioni ad alto impatto o elevata incertezza, il ruolo umano diventa centrale fin dall’inizio. L’automazione supporta fornendo dati, visualizzazioni e analisi, ma strategia, valutazione del rischio e decisione finale restano saldamente nelle mani di professionisti esperti. È qui che si gioca la partita più importante: quando un CISO deve decidere se dichiarare pubblicamente un breach, quando serve valutare se un incidente è parte di un attacco coordinato più ampio, quando bisogna bilanciare sicurezza e continuità operativa.

Architetture operative dei sistemi HITL

Dal punto di vista architetturale, i sistemi Human-in-the-Loop per l’automazione dei SOC integrano la velocità dell’automazione con la conoscenza dell’analista. Utilizzando HITL, i SOC possono analizzare ed elaborare numerosi alert, identificare minacce nuove ed esotiche, e scegliere la migliore linea d’azione quando si affronta un incidente.

Un’architettura efficace prevede:

Livello di raccolta dati: Integrazione con SIEM, EDR, NDR, fonti di threat intelligence e altri strumenti di sicurezza per aggregare telemetria completa.

Livello di analisi automatizzata: Algoritmi di machine learning che eseguono correlazione iniziale, identificazione di anomalie, arricchimento contestuale degli alert e classificazione preliminare della gravità.

Livello di decisione umana: Interfaccia che presenta agli analisti solo gli alert che richiedono giudizio umano, con contesto completo, opzioni di risposta preconfigurate e raccomandazioni basate su playbook.

Livello di risposta orchestrata: Esecuzione automatica delle azioni approvate dall’analista attraverso integrazioni con strumenti di sicurezza, con capacità di rollback e audit completo.

Metriche e KPI per sistemi HITL efficaci

Per valutare l’efficacia di un sistema Human-in-the-Loop, le organizzazioni dovrebbero monitorare metriche specifiche:

Tasso di override umano: Percentuale di volte in cui gli analisti sovrascrivono le raccomandazioni dell’AI. Un tasso troppo alto indica che il sistema non è ben calibrato; troppo basso può indicare automation bias.

Tempo medio di decisione: Quanto tempo impiegano gli analisti per prendere decisioni sui casi escalati. Questo dovrebbe diminuire nel tempo man mano che il sistema impara.

Precisione delle raccomandazioni AI: Percentuale di raccomandazioni AI che gli analisti confermano come corrette.

Riduzione dei falsi positivi: Confronto tra il tasso di falsi positivi prima e dopo l’implementazione HITL. Secondo ricerche documentate, tra il 20% e il 40% degli alert sono falsi positivi.

Carico cognitivo degli analisti: Misurato attraverso sondaggi sulla soddisfazione lavorativa e sul burnout.

Mean Time to Detect (MTTD) e Mean Time to Respond (MTTR): Le piattaforme SOAR ben implementate possono ridurre significativamente questi tempi grazie all’integrazione intelligente tra automazione e supervisione umana.

Le sfide dell’implementazione human-in-the-loop

Implementare efficacemente un approccio Human-in-the-Loop presenta complessità significative che richiedono attenzione strategica e pianificazione accurata.

Il rischio di alert fatigue 2.0

La prima insidia è quella che potremmo definire “alert fatigue 2.0″: se ogni azione automatizzata richiede approvazione umana, il risultato è un diluvio di richieste che desensibilizza gli analisti, portandoli ad approvare meccanicamente senza reale valutazione. È il paradosso del loop mal progettato: invece di sfruttare il giudizio umano, lo erode.

Come documentato da Splunk nella loro guida sui sistemi HITL, incorporare gli esseri umani nel ciclo dell’AI offre vantaggi significativi ma presenta anche sfide: miglioramento dell’accuratezza attraverso la supervisione umana che può correggere errori e affinare le prestazioni del modello, ma anche il rischio che la qualità dei giudizi umani degradi sotto pressione cognitiva.

La soluzione sta nel progettare soglie intelligenti: solo gli alert che superano determinate soglie di incertezza o criticità dovrebbero essere escalati agli umani. Il sistema deve essere abbastanza intelligente da riconoscere quando è “confuso” e ha bisogno di aiuto, piuttosto che chiedere costantemente conferma.

Competenze e formazione nei sistemi HITL

La seconda sfida riguarda formazione e competenze. Gli analisti devono essere in grado non solo di comprendere cosa sta eseguendo l’automazione, ma anche di valutare quando fidarsi delle sue raccomandazioni e quando sovrascriverle. Serve una nuova generazione di professionisti fluenti sia nel linguaggio della security che in quello del machine learning, capaci di interpretare le decisioni degli algoritmi e riconoscerne i limiti.

Come evidenziato nell’analisi pubblicata su Medium riguardo l’expertise umana nella cybersecurity, garantire che i team di sicurezza posseggano le competenze necessarie per comprendere e lavorare efficacemente con i sistemi AI è fondamentale. Esiste un divario di competenze significativo nella cybersecurity, e integrare l’AI richiede ulteriori competenze specializzate.

Le organizzazioni dovrebbero investire in:

Programmi di formazione continua: Su AI/ML nella cybersecurity, interpretazione degli output algoritmici, riconoscimento dei bias nei modelli.

Certificazioni specializzate: Che combinano competenze tradizionali di security con conoscenza dei sistemi AI.

Simulazioni e tabletop exercises: Che testano come gli analisti interagiscono con i sistemi HITL in scenari di crisi.

Accountability e responsabilità nei sistemi ibridi

Esiste poi il problema della responsabilità. Quando un sistema automatizzato suggerisce un’azione e un umano la approva, chi è responsabile se le cose vanno male? Se la risposta è sempre “l’umano”, allora il loop diventa una foglia di fico per scaricare la responsabilità. Se è “il sistema”, allora l’umano diventa un timbro di gomma.

Come discusso nell’analisi di Marsh sulla gestione del rischio AI, richiedere la supervisione umana per i sistemi AI non è di per sé una panacea per mitigare i rischi dell’AI e può, nel migliore dei casi, portare a un falso senso di sicurezza e, nel peggiore dei casi, aggravare i rischi. Risolvere i rischi dell’AI con HITL richiede: definire chiaramente il loop applicabile, specificare chiaramente i principi sottostanti per guidare la supervisione in modo che l’essere umano appropriato possa essere assegnato al ruolo, e dove possibile, avere metriche appropriate per valutare i risultati abilitati dall’AI per tenere conto dei bias intrinseci e della fallibilità del giudizio umano e delle limitazioni tecnologiche.

Serve chiarezza sui ruoli e sulle responsabilità, con framework decisionali che specifichino:

Livelli di autorità: Chi può approvare quali tipi di decisioni e in quali circostanze.

Protocolli di escalation: Quando una decisione deve essere elevata a un livello superiore di autorità.

Audit trail completi: Registrazione di ogni decisione, chi l’ha presa, su quale base e con quale risultato.

Revisione post-incidente: Analisi sistematica delle decisioni HITL per identificare pattern di errore o miglioramento.

Bias cognitivi e automazione

Un rischio sottile ma significativo è quello dell’automation bias: la tendenza umana a favorire i suggerimenti provenienti da sistemi automatizzati, anche quando contraddicono informazioni corrette da fonti non automatizzate. Come documentato in letteratura sulla fatica da alert, se gli esseri umani che sono nel loop hanno bias propri, il Reinforcement Learning from Human Feedback (RLHF) potrebbe peggiorare le cose anziché migliorarle.

Per mitigare questo rischio:

Presentazione di informazioni contrarie: Il sistema dovrebbe attivamente presentare prove che contraddicono la propria raccomandazione.

Rotazione degli analisti: Evitare che gli stessi analisti approvino sempre lo stesso tipo di decisioni.

Revisione periodica randomizzata: Un campione di decisioni approvate dovrebbe essere rivisto da un secondo analista.

Metriche di diversità decisionale: Monitorare se gli analisti stanno effettivamente usando il loro giudizio o semplicemente approvando automaticamente.

Casi d’uso e applicazioni pratiche dell’human-in-the-loop

Risposta automatizzata al phishing con supervisione umana

Un’applicazione classica dell’HITL è la gestione del phishing. Quando gli utenti segnalano email sospette, un sistema automatizzato può estrarre indicatori (URL, indirizzi IP, domini), interrogare feed di threat intelligence per determinare reputazione o malevolenza nota, e quarantenare automaticamente l’email dalle caselle di posta degli utenti.

Tuttavia, gli agenti AI nella cybersecurity possono generare falsi positivi, specialmente con email legittime da partner nuovi o messaggi che utilizzano servizi di abbreviazione URL. L’HITL interviene quando:

Email ambigue: L’AI non è sicura della classificazione (punteggio di confidenza medio).

Email da mittenti VIP: Messaggi da dirigenti o clienti importanti richiedono revisione umana prima della quarantena.

Campagne nuove: Quando viene rilevato un nuovo pattern di phishing mai visto prima.

L’analista umano può esaminare il contesto completo – cronologia del mittente, contenuto del messaggio, tempistica – e decidere se confermare la quarantena o rilasciare l’email come falso positivo. Nel frattempo, il sistema apprende da questa decisione per migliorare le classificazioni future.

Gestione delle vulnerabilità e patch management

Nel vulnerability management, l’automazione può identificare vulnerabilità attraverso scansioni continue, valutare la gravità tecnica (CVSS scores), e persino applicare patch automaticamente in ambienti non critici.

L’intervento umano diventa cruciale per:

Valutazione del rischio contestuale: Una vulnerabilità critica su un sistema esposto a Internet richiede azione immediata, ma la stessa vulnerabilità su un sistema isolato in una rete di sviluppo può aspettare. L’analista considera l’architettura di rete, i controlli compensativi esistenti, la criticità del business.

Decisioni di patch in produzione: Applicare una patch può causare interruzioni o incompatibilità. L’analista deve bilanciare il rischio della vulnerabilità contro il rischio dell’interruzione del servizio.

Eccezioni temporanee: In alcuni casi, un sistema non può essere patchato immediatamente a causa di dipendenze applicative. L’analista approva eccezioni temporanee con controlli compensativi.

Threat hunting guidato dall’AI

Il threat hunting proattivo beneficia enormemente dall’approccio HITL. Gli algoritmi di machine learning possono analizzare enormi volumi di dati di rete, log di sistema e telemetria endpoint per identificare anomalie comportamentali che potrebbero indicare minacce latenti.

Il sistema AI potrebbe notare:

  • Connessioni di rete insolite a orari anomali
  • Pattern di accesso ai dati che deviano dalle baseline
  • Sequenze di eventi che, pur essendo individualmente innocue, insieme potrebbero indicare lateral movement

L’hunter umano utilizza questi lead generati dall’AI come punto di partenza, ma poi applica intuizione e creatività:

Formulazione di ipotesi: “Se questo fosse un attacco APT, quali altri indicatori dovrei cercare?”

Investigazione contestuale: Correlazione con eventi di business (fusioni, licenziamenti, progetti sensibili).

Identificazione di TTPs: Collegamento dei comportamenti osservati a Tactics, Techniques, and Procedures note di gruppi APT specifici.

Il risultato è un processo di hunting che combina la scala e velocità dell’AI con l’intuizione investigativa umana.

Gestione degli incidenti di sicurezza complessi

Durante un incidente di sicurezza significativo, le piattaforme SOAR possono automatizzare molte azioni di risposta iniziali: isolamento degli endpoint compromessi, raccolta di forensics, notifiche alle parti interessate. Tuttavia, come analizzato nelle best practice di automazione della security, l’expertise umana rimane indispensabile.

Gli Incident Responder umani devono:

Valutare la portata completa: L’automazione può identificare sistemi direttamente compromessi, ma gli umani devono ipotizzare quali altri sistemi potrebbero essere stati toccati.

Prendere decisioni di contenimento: Isolare completamente una rete potrebbe fermare l’attacco ma anche paralizzare il business. Serve giudizio per bilanciare sicurezza e operatività.

Comunicazione strategica: Decidere quando e come comunicare l’incidente agli stakeholder interni, ai clienti, alle autorità regolatorie e potenzialmente ai media.

Analisi delle cause radice: Identificare non solo come l’attacco è avvenuto, ma perché i controlli esistenti hanno fallito.

Il futuro: loop adattivi e contestuali

Guardando al futuro, l’evoluzione dell’Human-in-the-Loop Security sarà probabilmente verso loop sempre più adattivi e contestuali. I sistemi futuri non avranno un punto fisso dove interviene l’umano, ma sapranno dinamicamente decidere quando richiedere input umano basandosi sulla fiducia nelle proprie analisi, sulla criticità della situazione e sulla disponibilità di esperti.

AI generativa e human-in-the-loop

Come evidenziato in recenti analisi sull’intelligenza artificiale e cybersecurity nel 2025, l’AI generativa potrebbe giocare un ruolo trasformativo in questo contesto, non per prendere decisioni, ma per amplificare le capacità analitiche umane.

Le applicazioni emergenti includono:

Generazione di scenari what-if: L’AI generativa può creare simulazioni di come un attacco potrebbe evolvere sotto diverse strategie di risposta, permettendo agli analisti di valutare le opzioni prima di agire.

Sintesi automatica di intelligence: Trasformazione di centinaia di pagine di threat intelligence in riassunti concisi e actionable.

Supporto alla documentazione: Generazione automatica di report di incidente basati sulle azioni intraprese, riducendo il carico amministrativo sugli analisti.

Assistenza nella threat modeling: Aiuto agli analisti nell’identificazione di potenziali vettori di attacco che potrebbero non aver considerato.

Tuttavia, come sottolineato dal World Economic Forum nel Global Cybersecurity Outlook 2025, gli attacchi informatici sono in forte crescita. Negli ultimi quattro anni, il loro numero medio settimanale è più che raddoppiato: da 818 per organizzazione nel secondo trimestre del 2021 a 1.984 nell’ultimo trimestre del 2024. Questo rende ancora più critico l’equilibrio tra capacità AI e supervisione umana.

Sistemi HITL adattivi basati su reinforcement learning

Immaginiamo sistemi che, dopo aver osservato migliaia di decisioni di un team di security, imparano non solo a replicare quelle decisioni, ma anche a riconoscere quando la situazione esce dai pattern noti e serve l’intervento di un esperto specifico.

Questi sistemi potrebbero:

Apprendimento delle preferenze del team: Ogni team di security ha una propria “firma” di risk tolerance e priorità. Il sistema apprende questi pattern e si adatta.

Riconoscimento dell’incertezza: Invece di forzare una classificazione, il sistema riconosce quando i dati sono insufficienti o ambigui e chiede aiuto.

Escalation intelligente: Non solo “passare all’umano”, ma identificare quale specifico esperto nel team è più qualificato per quel particolare tipo di decisione.

Apprendimento continuo: Ogni decisione umana diventa un nuovo punto dati per affinare i modelli, in un ciclo virtuoso di miglioramento.

Integrazione con architetture zero trust

L’evoluzione verso architetture Zero Trust richiede decisioni continue di autorizzazione basate su molteplici fattori contestuali. L’HITL in questo contesto significa:

Validazione di accessi anomali: Un utente che accede da una nuova località geografica potrebbe essere legittimo (viaggio d’affari) o indicare compromissione delle credenziali. L’AI può bloccare temporaneamente e richiedere autenticazione aggiuntiva, ma un analista può valutare il contesto più ampio.

Definizione dinamica di policy: Gli analisti umani definiscono le policy di Zero Trust a livello strategico, ma l’AI le applica e adatta tatticamente basandosi sui pattern di comportamento osservati.

Gestione delle eccezioni: In situazioni di emergenza business, potrebbe essere necessario concedere eccezioni temporanee ai principi Zero Trust. Questa è una decisione che richiede giudizio umano senior.

Best practices per l’implementazione human-in-the-loop

Iniziare con un approccio incrementale

Non tentare di implementare HITL su tutti i processi di sicurezza contemporaneamente. Iniziare con un caso d’uso ben definito, dimostrarne il valore, e poi espandere gradualmente.

Fase 1 – Pilota su singolo caso d’uso: Scegliere un processo con alto volume ma bassa complessità (es. phishing response).

Fase 2 – Misurazione e ottimizzazione: Raccogliere metriche per 3-6 mesi, ottimizzare le soglie di escalation.

Fase 3 – Espansione controllata: Estendere a 2-3 casi d’uso aggiuntivi, mantenendo il focus sulla qualità.

Fase 4 – Integrazione enterprise: Solo dopo aver dimostrato ROI chiaro, espandere all’intero stack di sicurezza.

Investire nell’interfaccia analista

Il successo dell’HITL dipende criticamente dalla qualità dell’interfaccia attraverso cui gli analisti interagiscono con il sistema. Come evidenziato nell’analisi su Medium riguardo la collaborazione umano-AI, progettare interfacce intuitive, visualizzazioni chiare e workflow semplificati che facilitino l’interazione e la condivisione di informazioni tra analisti umani e sistemi AI è cruciale.

Un’interfaccia efficace dovrebbe:

Minimizzare il carico cognitivo: Presentare solo le informazioni essenziali per la decisione, non sovraccaricare con dati non rilevanti.

Fornire contesto ricco: Cronologia dell’entità, comportamento baseline, decisioni precedenti su casi simili.

Offrire opzioni chiare: Non “approva/rifiuta” generico, ma opzioni di risposta specifiche con conseguenze previste.

Supportare il feedback rapido: L’analista può fornire feedback sulla qualità della raccomandazione con un clic, alimentando il miglioramento continuo.

Visualizzazione dell’incertezza: Mostrare chiaramente il livello di confidenza dell’AI e quali fattori contribuiscono all’incertezza.

Costruire una cultura di fiducia calibrata

Un rischio è che gli analisti sviluppino o troppa fiducia (approvando ciecamente) o troppo poca fiducia (ignorando raccomandazioni valide) nel sistema AI. Serve una “fiducia calibrata”.

Trasparenza algoritmica: Gli analisti devono capire, almeno a livello concettuale, come il sistema arriva alle sue raccomandazioni.

Validazione continua: Pubblicare regolarmente metriche sull’accuratezza del sistema, confrontate con le decisioni umane.

Cultura dell’errore produttivo: Quando il sistema sbaglia, trattarlo come opportunità di apprendimento, non di colpa.

Empowerment degli analisti: Gli analisti devono sentirsi autorizzati a sovrascrivere il sistema quando il loro giudizio lo richiede, senza timore di ritorsioni.

Pianificazione per la governance e compliance

Le normative emergenti come l’AI Act europeo richiedono accountability nei sistemi AI utilizzati per decisioni ad alto impatto. L’implementazione HITL può supportare la compliance:

Audit trail completi: Registrazione di ogni decisione AI, revisione umana e outcome.

Explainability delle decisioni: Capacità di spiegare perché il sistema ha fatto una particolare raccomandazione.

Meccanismi di ricorso: Processo per contestare decisioni automatizzate e ottenere revisione umana.

Valutazioni di impatto: Documentazione di come il sistema HITL impatta i diritti degli individui e la sicurezza dell’organizzazione.

Oltre la tecnologia: una questione di governance

In ultima analisi, l’Human-in-the-Loop Security ci ricorda che la sicurezza informatica non è solo questione di tecnologia, ma di persone, processi e giudizio. In un’era dove l’automazione è spesso presentata come soluzione a ogni problema, questo approccio riconosce con onestà intellettuale che esistono dimensioni della sicurezza dove l’intelligenza umana resta insostituibile.

Non è un rifiuto del progresso tecnologico, ma un’affermazione che il progresso autentico sta nel creare sistemi che amplificano le capacità umane piuttosto che tentare inutilmente di rimpiazzarle. È il riconoscimento che le decisioni migliori nascono quando macchine e umani lavorano insieme, ciascuno portando i propri punti di forza complementari.

Come sottolineato dal Dr. Victoria Baines, ricercatrice di cybersecurity: “Siamo abituati a descrivere la cybersecurity in termini di persone, processi e tecnologia. Troppo spesso, però, le persone sono ritratte come una vulnerabilità piuttosto che come una risorsa, e le difese tecniche sono prioritizzate rispetto alla resilienza umana. È giunto il momento di rinnovare il nostro investimento nelle nostre risorse di sicurezza umane”.

Per i CISO e i team di security, questo significa ripensare non solo quali strumenti adottare, ma come progettare i workflow, quali competenze sviluppare nei team e come costruire una cultura che valorizzi tanto l’efficienza dell’automazione quanto la saggezza dell’esperienza umana. È una sfida complessa, ma forse è proprio questa complessità il segno che stiamo finalmente ponendo le domande giuste sul futuro della cybersecurity.

L’Human-in-the-Loop non è una soluzione temporanea fino a quando l’AI diventerà “abbastanza buona” da operare autonomamente. È piuttosto un principio fondamentale per lo sviluppo di sistemi di sicurezza robusti, affidabili e responsabili, capaci di navigare la complessità del mondo reale e garantire che le decisioni critiche riflettano valori umani, considerazioni etiche e comprensione contestuale che nessuna macchina, per quanto avanzata, può pienamente replicare.

Fonti:

Rapid7, “Human-in-the-Loop in Cybersecurity”

ACM Computing Surveys, “Alert Fatigue in Security Operations Centres”

Trend Micro, “70% Of SOC Teams Emotionally Overwhelmed”

IBM, “What is SOAR?”

Microsoft Security Blog, “6 strategies to reduce alert fatigue”

CYDEF, “What is Human-in-the-Loop Cybersecurity?”

Splunk, “Human in the Loop in Practice”

Medium, “Leveraging Human Expertise in Cybersecurity”

Marsh, “Human in the Loop in AI Risk Management”

IBM, “What is XDR?”

Expel, “Alert fatigue, burnout, turnover”

XenonStack, “Human-in-the-loop in SOC Automation”

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/human-in-the-loop/


Governance AI e protezione dati: la roadmap EDPS tra accountability e complessità algoritmica

L’11 novembre 2025 segna una svolta nell’approccio europeo alla governance AI e alla protezione dei dati: il Garante europeo della protezione dei dati (EDPS) ha pubblicato una guida operativa per il risk management che, per la prima volta, traduce i principi del GDPR in misure tecniche concrete per i sistemi di intelligenza artificiale. Non si tratta dell’ennesimo documento teorico, ma di un framework operativo basato sulla metodologia ISO 31000:2018 per la gestione dei rischi che affronta una delle contraddizioni più complesse della trasformazione digitale: come garantire i diritti fondamentali quando i sistemi che elaborano dati personali sono, per loro natura, opachi e probabilistici.

La guida si inserisce in un momento cruciale. Mentre il Regolamento UE 2024/1689 del 13 giugno 2024 definisce il perimetro normativo dell’intelligenza artificiale in Europa, rimane aperta la questione su come le organizzazioni possano effettivamente implementare controlli che rispettino il Regolamento 2018/1725 (EUDPR), equivalente del GDPR per le istituzioni UE. La distanza tra requisiti legali e fattibilità tecnica non è mai stata così evidente come nell’ambito dell’AI, dove concetti come “rettifica” o “cancellazione” dei dati personali si scontrano con l’architettura stessa delle reti neurali profonde.

L’illusione della neutralità algoritmica e la tassonomia dei bias

Il documento dell’EDPS parte da un presupposto raramente esplicitato con questa chiarezza: l’AI non è neutra. I sistemi di machine learning tendono ad amplificare i bias esistenti, incorporando nei loro parametri le distorsioni presenti nei dataset di addestramento. La guida va oltre questa constatazione, proponendo una tassonomia articolata delle fonti di bias che spazia dalla qualità dei dati (data quality bias) alla rappresentatività del campione (sampling bias), dall’architettura algoritmica (algorithmic bias) alle distorsioni interpretative degli analisti umani (interpretation bias).

L’approccio è pragmatico e richiede un sistema di gestione che garantisca applicazione e conformità: l’EDPS non chiede l’impossibile – l’eliminazione totale del bias – ma richiede alle istituzioni di identificarlo, misurarlo e documentare gli sforzi di mitigazione. È un cambio di paradigma rispetto alla compliance formale: non basta dimostrare di aver scelto il fornitore “giusto” o di aver inserito clausole contrattuali appropriate. Serve una comprensione tecnica profonda di come il sistema funziona, quali sono i suoi failure mode, dove si annidano i rischi per i diritti delle persone.

La tensione tra performance e data minimisation nel machine learning

Una delle questioni più delicate riguarda il principio di minimizzazione dei dati nel contesto della governance AI e della protezione dati. I modelli di machine learning, per loro natura, traggono beneficio da grandi quantità di dati: più esempi vedono durante l’addestramento, migliore è – in teoria – la loro capacità di generalizzazione. Ma il GDPR impone di processare solo dati adeguati e pertinenti, limitati a quanto necessario. Come si conciliano queste esigenze?

La guida suggerisce diverse strategie: dal data sampling (selezionare sottoinsiemi rappresentativi invece di utilizzare l’intero dataset) all’uso di dati sintetici, dall’anonimizzazione alla pseudonimizzazione. Ma ogni tecnica porta con sé trade-off complessi. I dati sintetici, per esempio, possono preservare la privacy ma rischiano di introdurre nuovi bias o di non catturare pattern marginali ma significativi. L’anonimizzazione, se mal implementata, può essere vulnerabile ad attacchi di re-identificazione, specialmente quando i modelli sono esposti tramite API pubbliche.

Emerge qui una delle tensioni fondamentali della governance AI e della protezione dati: la protezione dei dati non può essere un vincolo esterno aggiunto a posteriori, ma deve essere embedded nella progettazione stessa del sistema. Il concetto di privacy by design trova nell’AI la sua massima espressione – e la sua massima sfida operativa.

Explainability e interpretability: i prerequisiti dimenticati nella governance AI

Il documento dedica un’intera sezione a interpretability ed explainability, definendole come sine qua non – prerequisiti essenziali per qualsiasi altra forma di compliance. È una scelta significativa, in linea con gli strumenti di valutazione d’impatto dell’AI che permettono di identificare, analizzare e mitigare i rischi associati ai sistemi automatizzati.

Troppo spesso, la discussione sull’AI si concentra su metriche di performance (accuracy, precision, recall) trascurando la comprensibilità del sistema. Ma senza explainability, come può un’organizzazione verificare che il modello rispetti il principio di fairness? Come può identificare e correggere errori sistematici? Come può rispondere alle richieste dei data subject di comprendere le decisioni automatizzate che li riguardano?

La distinzione operata tra interpretability (la capacità di comprendere il funzionamento interno del modello) ed explainability (la capacità di spiegare specifiche decisioni) è particolarmente utile. Un modello può non essere interpretabile nella sua totalità – pensiamo ai transformer con miliardi di parametri – ma deve comunque essere possibile spiegare perché ha prodotto un determinato output per un determinato input. Tecniche come LIME per spiegazioni locali interpretabili o SHAP basato sui valori di Shapley vengono citate come esempi, ma il documento non nasconde che si tratta di approssimazioni, non di spiegazioni complete.

Il problema del machine unlearning e i diritti dei data subject

Tra i passaggi più interessanti della guida c’è quello dedicato ai diritti dei data subject, in particolare al diritto di rettifica e cancellazione. Come si “dimentica” un dato che è stato incorporato nei pesi di una rete neurale addestrata su milioni di esempi? Il documento introduce il concetto di machine unlearning – la capacità di rimuovere selettivamente l’influenza di specifici punti dati dal modello.

Ma la guida non nasconde le difficoltà: l’unlearning “esatto” richiederebbe di riaddestrare il modello da zero escludendo i dati da rimuovere, un processo computazionalmente proibitivo per modelli di grandi dimensioni. L’unlearning “approssimato”, invece, introduce incertezze sulla completezza della rimozione. È un’area di ricerca attiva, ma con soluzioni ancora immature per il deployment in produzione.

In alternativa, viene suggerito l’output filtering: intercettare e bloccare in tempo reale le risposte del modello che potrebbero contenere dati personali. È una soluzione più praticabile, ma che sposta il problema: richiede sistemi di rilevamento affidabili e introduce latenza nelle risposte. Inoltre, non risolve il problema alla radice: i dati restano nel modello, semplicemente vengono oscurati nell’output.

La supply chain dell’AI e il procurement consapevole nella governance AI e protezione dati

Un aspetto spesso sottovalutato, ma al quale la guida dedica attenzione significativa, è la fase di procurement. La maggior parte delle organizzazioni non sviluppa i propri modelli di AI da zero, ma integra soluzioni di terze parti, spesso tramite API. Questo crea una catena di responsabilità complessa dove il data controller (l’istituzione UE) ha visibilità limitata su come i dati vengono effettivamente processati.

La guida propone una checklist dettagliata di informazioni da richiedere ai fornitori: non solo specifiche funzionali, ma documentazione completa sui dataset di addestramento, sulle metriche di fairness e accuracy misurate su diverse demographic, sui processi di quality assurance, sulle misure di sicurezza implementate. È un approccio esigente, che potrebbe incontrare resistenze da parte di fornitori abituati a considerare questi aspetti come “segreti commerciali”.

Ma è proprio qui che si gioca la partita della governance AI e della protezione dati: senza trasparenza sulla supply chain, il principio di accountability rimane una dichiarazione d’intenti. L’EDPS sta sostanzialmente dicendo alle istituzioni UE: non potete delegare la compliance, anche quando procurate tecnologie sviluppate altrove. Un principio rafforzato anche dalla recente Legge 132/2025 che disciplina sviluppo e uso dell’AI, entrata in vigore il 10 ottobre 2025, che ha introdotto obblighi specifici per l’uso dell’AI nel contesto nazionale.

Oltre la checklist: verso una cultura della risk literacy

Ciò che distingue questo documento da molte altre linee guida è il rifiuto della compliance meccanica. Non si tratta di spuntare caselle, ma di sviluppare una capacità organizzativa di risk assessment specifica per l’AI. Il framework ISO 31000 viene adottato come base metodologica, ma viene esplicitato che ogni organizzazione dovrà adattarlo al proprio contesto, alle proprie use case, ai propri risk appetite.

Le metriche proposte negli annex – da BLEU e ROUGE per il NLP, a ImageNet e COCO per la computer vision, fino a MMLU per la comprensione multimodale del linguaggio – non sono prescrittive ma esemplificative. L’invito è a sviluppare una “risk literacy” che permetta di navigare la complessità dell’AI senza cadere né nell’entusiasmo acritico né nel rifiuto preconcetto.

L’approccio europeo si distingue per il tentativo di bilanciare innovazione e protezione attraverso un framework basato sul rischio che potrebbe influenzare gli standard globali, sebbene evidenze preliminari del 2025 mostrino un’adozione internazionale più limitata del previsto rispetto all’atteso “Effetto Bruxelles”.

Zone d’ombra e domande aperte nella governance AI

Nonostante il rigore e la completezza, il documento lascia inevitabilmente alcune questioni in sospeso. La prima riguarda l’enforcement: quali saranno le conseguenze per le istituzioni che non riusciranno a implementare questi controlli? Il GDPR prevede sanzioni significative, ma applicarle in un contesto dove la “conformità perfetta” è probabilmente irraggiungibile richiede una dose di pragmatismo che deve ancora essere calibrata.

La seconda questione riguarda l’evoluzione tecnologica: il documento è datato novembre 2025, ma i sistemi di AI si evolvono con una velocità che rende qualsiasi framework rapidamente obsoleto. Come mantenere rilevante questa guida quando emergeranno nuove architetture, nuove modalità di addestramento, nuovi vettori di attacco? La sfida è creare framework sufficientemente robusti attraverso norme ISO specifiche che resistano al cambiamento tecnologico ma rimangano abbastanza flessibili da adattarsi all’innovazione.

Infine, c’è la questione della competenza: implementare questi controlli richiede team interdisciplinari con competenze profonde sia in machine learning che in data protection law. Quante organizzazioni dispongono realmente di queste risorse? Il rischio è che la guida diventi un documento aspirazionale, consultato ma non implementato, o implementato in modo superficiale per pura facciata.

Un cambio di paradigma necessario per la governance AI e la protezione dati

Nonostante questi interrogativi, la guida dell’EDPS rappresenta un passo avanti significativo. Per la prima volta, un’autorità di controllo europea tenta di colmare il gap tra principi legali e implementazione tecnica nell’ambito dell’AI, senza rifugiarsi in astrazioni né in tecnicismi inaccessibili.

Il messaggio di fondo è chiaro: l’adozione dell’AI nelle istituzioni pubbliche europee non può essere guidata solo da considerazioni di efficienza o innovazione. Deve essere un processo consapevole, dove ogni scelta tecnologica viene valutata anche – e soprattutto – in termini di impatto sui diritti fondamentali delle persone. Non è una posizione luddista o anti-tecnologica, ma una riaffermazione dei valori che dovrebbero caratterizzare l’azione pubblica in una democrazia liberale.

Resta da vedere se questo approccio rigoroso alla governance AI e alla protezione dei dati diventerà lo standard anche al di fuori delle istituzioni UE, influenzando il mercato più ampio dell’AI. Le dinamiche competitive potrebbero spingere le organizzazioni a privilegiare velocità e performance rispetto alla compliance approfondita. Ma forse è proprio questo il test decisivo: riuscirà l’Europa a dimostrare che è possibile sviluppare e utilizzare l’AI in modo potente ed efficace senza sacrificare la protezione dei dati personali?

La risposta a questa domanda definirà non solo il futuro della governance tecnologica, ma l’identità stessa del progetto europeo nell’era digitale. Come evidenziato nell’analisi sulla ridefinizione del concetto di sicurezza nazionale nell’era AI, la sfida principale consiste nel mantenere un controllo razionale e democratico su uno sviluppo tecnologico di portata epocale, preservando i valori fondamentali delle società libere attraverso una governance multilivello che bilanci innovazione e protezione.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/governance-ai/


Responsabilità penale degli amministratori per data breach: quando la violazione dei dati diventa reato

Quando un’organizzazione subisce una violazione massiva di dati personali, l’attenzione si concentra immediatamente sulle sanzioni amministrative del Garante, che possono raggiungere i 20 milioni di euro o il 4% del fatturato mondiale annuo. Raramente, invece, ci si interroga sulla più insidiosa questione della responsabilità penale individuale degli amministratori che siedono nei consigli di amministrazione delle società coinvolte.

Eppure, è proprio su questo crinale che si gioca una partita fondamentale: quella tra accountability aziendale e personalità della responsabilità penale, tra obblighi preventivi e punizione degli illeciti, tra cultura della compliance e logiche sanzionatorie che possono portare, nei casi più gravi, a pene detentive fino a sei anni di reclusione.

La giurisprudenza italiana del biennio 2024-2025 offre un quadro tutt’altro che lineare, frammentato tra reati informatici, violazioni del Codice della privacy e applicazione del D.lgs. 231/2001. La sostanziale assenza di pronunce specificamente dedicate alla responsabilità penale per data breach in senso stretto crea una zona grigia che genera incertezza operativa per CISO, DPO, responsabili della sicurezza informatica e, soprattutto, per gli amministratori che devono comprendere i confini esatti della loro esposizione al rischio penale.

Il quadro normativo italiano: un sistema stratificato tra GDPR e codice penale

Il Regolamento (UE) 2016/679 (GDPR), nella sua complessa architettura sanzionatoria, ha volutamente privilegiato la responsabilità amministrativa, costruendo un sistema binario di sanzioni pecuniarie che distingue tra violazioni “minori” (fino a 10 milioni di euro o 2% del fatturato) e violazioni “gravi” (fino a 20 milioni o 4% del fatturato).

Tuttavia, il Considerando 149 del GDPR stabilisce espressamente che “gli Stati membri dovrebbero poter stabilire disposizioni relative a sanzioni penali per le violazioni del presente regolamento”, lasciando agli ordinamenti nazionali la facoltà – non l’obbligo – di introdurre fattispecie penali complementari.

La scelta italiana: mantenere le fattispecie penali del codice privacy

L’Italia ha scelto una strada peculiare: mantenere in vigore gli articoli 167, 167-bis e 167-ter del Codice della privacy (D.lgs. 196/2003, come modificato sostanzialmente dal D.lgs. 101/2018 in seguito all’entrata in vigore del GDPR), che puniscono il trattamento illecito di dati personali con pene detentive significative.

Questa scelta ha generato un sistema a “doppio binario” che molti esperti di diritto penale considerano problematico: da un lato la responsabilità amministrativa comminata dal Garante per la protezione dei dati personali, dall’altro la possibile responsabilità penale individuale per fattispecie che, in molti casi, presentano elementi costitutivi parzialmente sovrapponibili.

L’articolo 167 del codice privacy: elementi costitutivi del reato

L’art. 167, comma 1 del Codice privacy stabilisce testualmente: “Salvo che il fatto costituisca più grave reato, chiunque, al fine di trarre per sé o per altri profitto ovvero di arrecare danno all’interessato, operando in violazione di quanto disposto dagli articoli 123, 126 e 130 o dal provvedimento di cui all’articolo 129 arreca nocumento all’interessato, è punito con la reclusione da sei mesi a un anno e sei mesi”.

Questa norma presenta caratteristiche tecniche che ne limitano significativamente l’applicabilità pratica ai casi di data breach:

  1. Clausola di riserva: “Salvo che il fatto costituisca più grave reato” significa che l’art. 167 opera in via sussidiaria rispetto ad altre fattispecie penali più gravi (es. estorsione mediante ransomware, accesso abusivo a sistema informatico ex art. 615-ter c.p.)
  2. Dolo specifico alternativo: è richiesto il “fine di trarre profitto” oppure il “fine di arrecare danno”. Non è sufficiente la mera violazione colposa degli obblighi di sicurezza
  3. Nocumento effettivo: oltre al dolo specifico, è necessario che si verifichi un “nocumento” concreto all’interessato, non meramente ipotetico o potenziale
  4. Violazione di specifiche norme: il rinvio agli artt. 123, 126, 130 e 129 del Codice circoscrive le condotte rilevanti

La Cassazione penale, con la fondamentale sentenza n. 13102 del 14 marzo 2023 (depositata il 29 marzo 2023), ha precisato che l’art. 167 configura un reato comune, che può essere commesso da “chiunque” e non solo da soggetti qualificati come titolari o responsabili del trattamento. Questo amplia potenzialmente la platea dei soggetti perseguibili, ma al contempo la Corte ha ribadito che il nocumento deve essere “giuridicamente rilevante”, escludendo disagio o fastidio di lieve entità.

L’articolo 167-bis: la comunicazione illecita su larga scala

L’art. 167-bis, introdotto dal D.lgs. 101/2018, rappresenta un inasprimento significativo della tutela penale: “Salvo che il fatto costituisca più grave reato, chiunque comunica o diffonde al fine di trarre profitto per sé o altri ovvero al fine di arrecare danno, un archivio automatizzato o una parte sostanziale di esso contenente dati personali oggetto di trattamento su larga scala, in violazione degli articoli 2-ter, 2-sexies e 2-octies, è punito con la reclusione da uno a sei anni”.

Questa norma è stata pensata per colpire casi di massive data breach con successiva divulgazione intenzionale dei dati (tipicamente, la pubblicazione sul dark web di database sottratti). La pena edittale elevata (fino a 6 anni) riflette la gravità sociale di condotte che espongono milioni di persone a rischi concreti di furto d’identità, frodi finanziarie e altri crimini derivati.

Tuttavia, anche qui permane il requisito del dolo specifico: deve essere dimostrato il fine di profitto o di danno. Un data breach causato da negligenza nella gestione della sicurezza informatica – per quanto grave sul piano della compliance GDPR – difficilmente può essere ricondotto a questa fattispecie.

La posizione di garanzia degli amministratori: quando l’omissione diventa reato

Il vero nodo interpretativo per la responsabilità degli amministratori societari nel contesto dei data breach non riguarda tanto la commissione attiva del reato quanto la responsabilità omissiva: può un amministratore rispondere penalmente per non aver impedito una violazione dei dati causata da terzi o da inadeguatezza delle misure di sicurezza?

Il principio costituzionale della personalità della responsabilità penale

L’art. 27, comma 1, della Costituzione italiana stabilisce che “la responsabilità penale è personale”. Questo principio, apparentemente semplice, ha implicazioni profonde: non è possibile punire qualcuno per il solo fatto di ricoprire una determinata carica (responsabilità di posizione), ma è necessario dimostrare un contributo causale personale, attivo od omissivo, alla realizzazione dell’evento criminoso.

La giurisprudenza consolidata della Cassazione ha tradotto questo principio in regole operative stringenti, particolarmente rilevanti per gli amministratori:

  1. La posizione formale non basta: essere registrati come amministratore presso il Registro Imprese non è sufficiente per fondare una condanna
  2. Serve la prova del contributo causale: deve essere dimostrato cosa l’amministratore ha fatto o omesso di fare
  3. È necessario l’elemento psicologico: oltre al nesso causale, deve essere provato il dolo o, nei reati colposi, la negligenza, imprudenza o imperizia

La dottrina della posizione di garanzia nel diritto penale societario

La posizione di garanzia è un istituto del diritto penale (disciplinato dall’art. 40, comma 2, c.p.) secondo cui “non impedire un evento che si ha l’obbligo giuridico di impedire equivale a cagionarlo”. In altre parole, chi ha il dovere giuridico di evitare che si verifichi un determinato evento dannoso risponde penalmente se, potendo impedirlo, non interviene.

Gli amministratori di società sono tradizionalmente considerati garanti del patrimonio sociale e dell’integrità dell’organizzazione. Ma questa posizione di garanzia si estende anche alla protezione dei dati personali trattati dall’azienda?

La risposta è articolata:

  • Sul piano civilistico e amministrativo: sì, senza dubbio. Gli artt. 2381 e 2392 c.c. impongono agli amministratori doveri di diligente gestione, e il GDPR (art. 24) attribuisce al titolare del trattamento l’obbligo di implementare misure tecniche e organizzative adeguate
  • Sul piano penale: la questione è controversa. La dottrina prevalente ritiene che la posizione di garanzia penalmente rilevante debba essere fondata su una norma espressa, non su generici obblighi di vigilanza

Le sentenze della cassazione 2024: la svolta sulla consapevolezza effettiva

Il 2024 ha visto pronunce significative che ridefiniscono i confini della responsabilità penale degli amministratori. Due sentenze in particolare meritano un’analisi approfondita.

Cassazione n. 11968 del 26 gennaio 2024 – Il caso dell’amministratore “testa di legno”

Questa sentenza ha esaminato il caso di un amministratore unico di S.r.l., in carica dal 2013 al fallimento nel 2016, accusato di bancarotta fraudolenta documentale e patrimoniale. L’imputato sosteneva di essere un mero prestanome, senza effettivi poteri gestionali.

La Corte di Cassazione ha annullato la condanna con rinvio a nuovo giudizio, stabilendo un principio fondamentale: “Per affermare la responsabilità penale dell’amministratore di diritto non è sufficiente la sua posizione formale, ma occorre provare la sua effettiva e concreta consapevolezza delle condotte illecite poste in essere dagli amministratori di fatto o, comunque, il suo contributo causale alla realizzazione del reato”.

La motivazione è particolarmente significativa: “La posizione di garanzia che deriva dalla carica di amministratore non può trasformarsi in una presunzione di responsabilità penale che inverte l’onere della prova, imponendo all’imputato di dimostrare la propria estraneità ai fatti. Al contrario, è l’accusa che deve fornire la prova positiva del coinvolgimento, della consapevolezza e dell’elemento soggettivo del reato”.

Trasponendo questo principio ai data breach: un amministratore non può essere ritenuto penalmente responsabile per la sola circostanza che, durante il suo mandato, si sia verificata una violazione dei dati. Deve essere dimostrato che:

  • Era a conoscenza di vulnerabilità specifiche non risolte
  • Aveva ricevuto segnalazioni formali (es. dal DPO, dal CISO, dall’OdV) rimaste inascoltate
  • Aveva deliberatamente rifiutato stanziamenti di budget per investimenti in sicurezza ritenuti essenziali
  • Era stato informato di precedenti incidenti minori che avrebbero dovuto allertarlo

Cassazione n. 13620/2024 – La responsabilità nella gestione collegiale

Questa pronuncia ha affrontato il caso di una S.r.l. con tre amministratori, tutti condannati per bancarotta fraudolenta nonostante solo uno fosse il gestore di fatto. Gli altri due si difendevano sostenendo di essere stati esclusi dalla gestione.

La Cassazione ha confermato le condanne, ma con una motivazione che introduce elementi rilevanti: “L’amministratore non operativo è esente da responsabilità penale solo se dimostra di aver effettivamente vigilato sull’operato degli altri amministratori e di essersi attivato per impedire le condotte illecite, ad esempio formalizzando il proprio dissenso, convocando assemblee dei soci o, nei casi più gravi, rassegnando le dimissioni”.

Il principio chiave è quello della vigilanza attiva: non basta non partecipare alle decisioni illegittime; occorre attivarsi concretamente per contrastarle o, quantomeno, documentare il proprio dissenso.

Applicazione pratica ai data breach: in un CdA con più amministratori, se il CEO o l’amministratore delegato rifiuta di implementare raccomandazioni di sicurezza critiche, gli altri amministratori hanno l’obbligo di:

  1. Formalizzare il proprio dissenso in sede di consiglio
  2. Richiedere pareri tecnici esterni (consulenti, auditor)
  3. Nei casi più gravi, informare il collegio sindacale o rassegnare le dimissioni

La mera “non partecipazione” passiva alle decisioni insufficienti in materia di cybersecurity potrebbe non essere sufficiente a escludere la responsabilità.

Il decreto legislativo 231/2001: la responsabilità dell’ente come sistema di imputazione parallelo

L’art. 24-bis del D.lgs. 231/2001 ha introdotto nel 2008 (con la Legge 48/2008 di ratifica della Convenzione di Budapest sul cybercrime) i delitti informatici e il trattamento illecito di dati tra i reati presupposto della responsabilità amministrativa degli enti.

Questo meccanismo introduce un livello di complessità ulteriore nella gestione del rischio penale connesso ai data breach.

Come funziona la responsabilità ex 231: il meccanismo dell’imputazione “per ricochet”

Il sistema 231 si basa su un principio apparentemente paradossale: l’ente (società, associazione, fondazione) risponde “penalmente” (anche se tecnicamente si tratta di responsabilità amministrativa) per reati commessi da persone fisiche. È una deroga al principio societas delinquere non potest.

Il meccanismo funziona così:

  1. Un soggetto “apicale” (amministratore, direttore, dirigente con funzioni di rappresentanza) o un soggetto “sottoposto” (dipendente, collaboratore) commette uno dei reati presupposto elencati nel D.lgs. 231
  2. Il reato è commesso nell’interesse o a vantaggio dell’ente (non a vantaggio esclusivo personale dell’autore)
  3. L’ente non ha adottato un Modello di Organizzazione, Gestione e Controllo (MOG) idoneo a prevenire quel tipo di reato, oppure il modello è stato fraudolentemente eluso
  4. L’Organismo di Vigilanza (OdV) non ha vigilato efficacemente sul rispetto del modello

Se questi elementi ricorrono, l’ente può essere condannato a sanzioni pecuniarie (da 25.900 a 1.549.000 euro, calcolate a quote) e, nei casi più gravi, a sanzioni interdittive:

  • Interdizione dall’esercizio dell’attività
  • Sospensione o revoca di autorizzazioni, licenze o concessioni
  • Divieto di contrattare con la pubblica amministrazione
  • Esclusione da finanziamenti, contributi o sussidi
  • Divieto di pubblicizzare beni o servizi

Queste sanzioni interdittive possono essere devastanti per un’azienda, comportando di fatto la cessazione dell’attività economica.

I reati informatici rilevanti per i data breach

L’art. 24-bis include diverse fattispecie:

  • Art. 615-ter c.p. (Accesso abusivo a sistema informatico): pena per l’ente da 100 a 500 quote, se il reato è commesso da un dipendente che supera i propri privilegi di accesso
  • Art. 615-quater c.p. (Detenzione e diffusione abusiva di codici di accesso): rilevante quando vengono sottratte credenziali per accedere ai database
  • Art. 615-quinquies c.p. (Diffusione di programmi diretti a danneggiare o interrompere un sistema informatico): ransomware sviluppati internamente
  • Art. 617-quater c.p. (Intercettazione, impedimento o interruzione illecita di comunicazioni informatiche)
  • Art. 617-quinquies c.p. (Installazione di apparecchiature per intercettare comunicazioni)
  • Art. 635-bis c.p. (Danneggiamento di informazioni, dati e programmi informatici)
  • Art. 635-ter, quater, quinquies c.p. (Danneggiamento di sistemi informatici)
  • Art. 640-ter c.p. (Frode informatica)

Inoltre, sono inclusi gli artt. 167 e 167-bis del Codice privacy già analizzati.

Il paradosso del modello 231: scudo o amplificatore di responsabilità?

L’adozione di un Modello di Organizzazione, Gestione e Controllo efficace dovrebbe costituire una causa di esonero dalla responsabilità dell’ente ex art. 6 del D.lgs. 231/2001. In teoria, quindi, rappresenta uno “scudo” contro le sanzioni.

Tuttavia, nella pratica forense emerge un paradosso che pochi commentatori hanno evidenziato:

Scenario 1 – Ente senza MOG 231:

  • Si verifica un data breach
  • Un dipendente ha commesso un reato informatico (es. accesso abusivo, art. 615-ter)
  • L’ente non ha un modello 231
  • Conseguenza: l’ente risponde ex 231, ma è difficile imputare agli amministratori una responsabilità penale personale, perché l’assenza del modello è al massimo una violazione di obblighi civilistici

Scenario 2 – Ente con MOG 231 dettagliato:

  • Si verifica un data breach
  • L’ente ha un modello 231 che contiene protocolli specifici sulla cybersecurity
  • Nei verbali del CdA risulta che l’amministratore ha approvato procedure anti-ransomware, policy di gestione accessi, etc.
  • Conseguenza: è più facile per l’accusa sostenere che l’amministratore era pienamente consapevole dei rischi cyber e ha comunque omesso di vigilare adeguatamente

In altre parole, il MOG 231 può trasformarsi in un’arma a doppio taglio: da un lato protegge l’ente (se è stato efficacemente implementato), dall’altro cristallizza la consapevolezza dell’amministratore, rendendo più difficile sostenere di non essere a conoscenza dei rischi.

Il ruolo dell’organismo di vigilanza: sentinella della consapevolezza

L’Organismo di Vigilanza (OdV) è un organo interno dell’ente con funzioni di controllo sull’applicazione e l’efficacia del Modello 231. Può essere monocratico o collegiale, e deve possedere requisiti di autonomia, indipendenza, professionalità e continuità d’azione.

Il Parere del Garante del 27 gennaio 2020 (doc. web 9347842) ha chiarito la qualificazione privacy dell’OdV: non è né titolare autonomo né responsabile del trattamento, ma è parte integrante dell’ente. Tratta dati personali nell’ambito delle sue funzioni di vigilanza, ma la responsabilità per eventuali violazioni ricade sull’ente stesso.

Tuttavia, sul piano della dinamica della responsabilità penale degli amministratori, l’OdV svolge un ruolo cruciale come produttore di evidenze documentali. Le relazioni periodiche dell’OdV, le segnalazioni di criticità, le raccomandazioni non implementate sono tutti elementi che possono:

  1. Dimostrare la consapevolezza dell’amministratore: se l’OdV ha segnalato vulnerabilità di sicurezza e l’amministratore non ha stanziato i fondi necessari per risolverle, questo può integrare l’elemento soggettivo del reato
  2. Provare l’inadeguatezza del modello: un OdV che segnala ripetutamente le stesse criticità senza che vengano risolte dimostra che il modello non è “efficacemente attuato” ai sensi dell’art. 6 del D.lgs. 231
  3. Escludere la buona fede dell’amministratore: è più difficile sostenere di aver agito con la diligenza del “buon padre di famiglia” quando esistono segnalazioni formali ignorate

Analisi delle più recenti pronunce: insegnamenti dal diritto societario applicabili alla cybersecurity

In assenza di un corpus giurisprudenziale consolidato specificamente dedicato alla responsabilità penale per data breach, è necessario guardare alle pronunce in materia di reati societari, fallimentari e tributari che hanno affrontato la questione della responsabilità degli amministratori. Molti dei principi elaborati sono direttamente trasponibili al contesto della protezione dei dati.

Cassazione n. 35031 del maggio 2025: la consapevolezza della “macroscopica illegalità”

Questa sentenza, che ha confermato la condanna di un amministratore di diritto per reati tributari, introduce un concetto particolarmente rilevante: quello della “macroscopica illegalità”.

Il caso riguardava un soggetto che formalmente rivestiva la carica di amministratore, ma sosteneva di essere un mero prestanome, senza alcuna partecipazione alla gestione. La difesa aveva argomentato che, non essendo a conoscenza dei dettagli delle singole operazioni fiscalmente illecite, non poteva essere ritenuto responsabile.

La Cassazione ha respinto questa tesi con una motivazione articolata:

“In tema di reati tributari, la prova del dolo specifico dei delitti in capo all’amministratore di diritto di una società, che funge da mero prestanome, può essere desunta dal complesso dei rapporti tra questi e l’amministratore di fatto, nell’ambito dei quali assumono decisiva valenza la macroscopica illegalità dell’attività svolta e la consapevolezza di tale illegalità”.

Il concetto di “macroscopica illegalità” indica situazioni in cui l’illiceità è così evidente che non si può credibilmente sostenere di non essersene accorti. Esempi:

  • Fatturazioni per importi spropositati rispetto al fatturato reale
  • Movimenti bancari anomali e sistematici
  • Assenza totale di documentazione contabile
  • Utilizzo di società cartiere o soggetti fittizi

Trasposizione al contesto cyber: potrebbero configurare “macroscopica illegalità” in materia di protezione dati situazioni come:

  • Assenza totale di misure di sicurezza informatica (nessun firewall, nessun antivirus, nessuna gestione degli accessi)
  • Trattamento di dati sensibili (sanitari, giudiziari) senza alcuna crittografia
  • Violazione sistematica dei principi di minimizzazione e limitazione della conservazione (conservare dati per decenni senza alcuna ragione)
  • Database pubblicamente accessibili su internet senza protezione
  • Vendita deliberata di dati personali sul mercato nero

In questi casi estremi, un amministratore difficilmente potrebbe sostenere credibilmente di non essere a conoscenza della situazione.

Cassazione n. 2499 del 2024: l’inversione dell’onere della prova in caso di distrazioni

Questa sentenza, relativa a bancarotta fraudolenta, introduce un principio processuale rilevante: l’inversione dell’onere della prova in caso di mancata rendicontazione.

Il caso riguardava un amministratore di fatto (gestore effettivo pur senza carica formale) accusato di aver distratto beni aziendali. La difesa sosteneva che non vi era prova dell’effettiva distrazione, essendo possibile che i beni fossero stati utilizzati per finalità aziendali legittime.

La Cassazione ha stabilito: “La responsabilità dell’imprenditore in merito alla destinazione dei beni dell’impresa per la conservazione della garanzia patrimoniale verso i creditori giustifica l’apparente inversione dell’onere della prova a carico dell’amministratore della società fallita, in caso di mancato rinvenimento degli stessi o del loro ricavato, la cui violazione comporta responsabilità penale”.

In altre parole: se i beni aziendali mancano, spetta all’amministratore dimostrare dove sono finiti e che sono stati utilizzati correttamente. Non è l’accusa che deve provare la distrazione, ma è l’amministratore che deve giustificare l’assenza.

Applicazione ai data breach: questo principio potrebbe essere trasferito in contesti come:

  • Perdita di backup: se i backup dei dati sono scomparsi o non più accessibili, potrebbe spettare all’amministratore dimostrare che esisteva un’adeguata policy di backup e che è stata rispettata
  • Log mancanti: se non esistono log di accesso ai sistemi che avrebbero dovuto essere conservati per finalità di sicurezza, l’amministratore potrebbe dover giustificare questa assenza
  • Documentazione compliance: se non esiste documentazione sull’adozione di misure di sicurezza (DPIA, valutazioni del rischio, audit), l’onere di dimostrare che comunque le misure erano state prese potrebbe gravare sull’amministratore

Cassazione n. 13200 del 2024: la necessaria delimitazione temporale della responsabilità

Questa pronuncia affronta il caso di due amministratori che si erano succeduti nella gestione di una S.r.l. poi fallita. Entrambi erano stati condannati “in blocco” per le stesse condotte distrattive, senza che i giudici di merito avessero distinto quali atti fossero stati compiuti durante il mandato di ciascuno.

La Cassazione ha annullato la sentenza stabilendo un principio fondamentale: “Per affermare la responsabilità penale per bancarotta fraudolenta, non è sufficiente constatare l’esistenza di un danno per i creditori. È indispensabile dimostrare, al di là di ogni ragionevole dubbio, che una specifica condotta illecita, posta in essere da un determinato soggetto, abbia causato quel danno”.

La Corte ha quindi indicato che il giudice deve:

  1. Identificare temporalmente le singole condotte distrattive
  2. Collegare ciascuna condotta al periodo di gestione dell’amministratore in carica
  3. Motivare specificamente l’eventuale responsabilità per fatti avvenuti fuori dal mandato (es. accordo fraudolento con successore)

Trasposizione ai data breach: questo principio è cruciale quando:

  • Si succedono più amministratori: se un data breach emerge durante il mandato dell’amministratore B, ma deriva da vulnerabilità non risolte dall’amministratore A, occorre verificare: quando è stata segnalata la vulnerabilità? A chi? Chi aveva l’obbligo di risolverla? Chi aveva il budget?
  • Sistemi legacy: molti data breach derivano da vulnerabilità in sistemi informatici obsoleti ereditati da gestioni precedenti. L’amministratore attuale può essere responsabile solo se aveva conoscenza del rischio e disponibilità dei mezzi per porvi rimedio
  • Processi di M&A: in caso di fusioni o acquisizioni, occorre distinguere tra responsabilità per sistemi ereditati dalla società incorporata e responsabilità per mancata due diligence in fase pre-acquisizione

Scenari applicativi e casistica operativa: quando si configura il rischio penale concreto

Dopo aver analizzato il framework normativo e giurisprudenziale, è necessario calare questi principi nella pratica operativa, esaminando scenari reali che potrebbero configurare responsabilità penale per gli amministratori.

Scenario 1 – Attacco ransomware con exfiltration e pubblicazione dati

Fatto: Un’azienda sanitaria privata subisce un attacco ransomware. Gli attaccanti criptano i server, rendendo inaccessibili le cartelle cliniche di 50.000 pazienti. Contestualmente, exfiltrano 200 GB di dati sanitari (diagnosi, terapie, referti) che successivamente pubblicano sul dark web dopo il rifiuto di pagare il riscatto di 500.000 euro.

Profili di responsabilità amministrativa (Garante):

  • Violazione art. 32 GDPR (misure di sicurezza inadeguate)
  • Violazione art. 33 GDPR se la notifica non avviene entro 72 ore
  • Sanzioni potenziali: fino a 20 milioni o 4% fatturato (trattandosi di dati sanitari, categoria particolare ex art. 9 GDPR)

Profili di responsabilità penale dell’amministratore:

  1. Art. 167 Codice privacy: difficilmente applicabile, perché l’amministratore non ha “trattato illecitamente” i dati. Sono stati gli attaccanti a farlo. La mera omissione di adeguate misure di sicurezza non integra il reato commissivo dell’art. 167
  2. Art. 615-ter c.p. (accesso abusivo): l’amministratore non ha commesso personalmente l’accesso. Potrebbe rispondere solo se fosse dimostrato che ha agevolato l’accesso (es. fornendo credenziali, disabilitando sistemi di sicurezza dietro compenso)
  3. Responsabilità omissiva ex art. 40 cpv c.p.: potrebbe essere configurabile se si dimostra che:
    • L’amministratore aveva ricevuto audit di sicurezza che segnalavano vulnerabilità critiche non risolte
    • Il CISO o il DPO avevano formalmente raccomandato investimenti in sicurezza (es. implementazione di backup offline, segmentazione della rete)
    • L’amministratore aveva deliberatamente negato i fondi necessari o rimandato gli interventi nonostante la consapevolezza del rischio

Elemento discriminante: la documentazione della consapevolezza. Se esistono:

  • Email del CISO all’amministratore con alert su vulnerabilità
  • Verbali del CdA in cui si discute di investimenti in cybersecurity non approvati
  • Relazioni dell’OdV 231 che segnalano carenze nei protocolli di sicurezza
  • Report di penetration test non seguiti da interventi correttivi

…allora il rischio penale per l’amministratore diventa concreto, non tanto per l’art. 167, quanto per una possibile imputazione colposa ex art. 40 cpv (omesso impedimento di evento che si aveva l’obbligo di impedire).

Scenario 2 – Accessi abusivi sistematici da parte di dipendenti

Fatto: In una banca, emerge che 15 dipendenti di varie filiali hanno effettuato nel corso di 3 anni oltre 5.000 accessi abusivi ai conti correnti di clienti VIP, politici, personaggi dello spettacolo, per mera curiosità (cd. “snooping”). I dati sono stati in alcuni casi condivisi informalmente con amici e conoscenti.

Profili di responsabilità amministrativa:

  • Violazione art. 32 GDPR (mancanza di controlli tecnici sugli accessi)
  • Violazione principio di integrità e riservatezza
  • Sanzioni Garante: già comminate in casi simili tra 500.000 e 1.000.000 euro

Profili di responsabilità penale:

  1. Dei dipendenti: sicuramente configurabile l’art. 615-ter c.p. (accesso abusivo a sistema informatico). La recente Cass. n. 28887 del 1° novembre 2025 ha confermato condanne per dipendenti che accedevano a dati al di fuori delle proprie mansioni. Inoltre, è applicabile l’art. 167 Codice privacy se gli accessi hanno causato nocumento (es. diffusione di informazioni riservate che hanno danneggiato la reputazione degli interessati)
  2. Dell’amministratore delegato: potrebbe rispondere se:
    • Era stato informato di precedenti casi di snooping e non ha implementato controlli (es. sistemi di log, alert automatici per accessi anomali, audit periodici)
    • Non ha disposto formazione adeguata del personale sulle policy aziendali di accesso ai dati
    • Non ha previsto sanzioni disciplinari efficaci nei regolamenti interni

La Cassazione n. 28887/2025 è particolarmente rilevante: ha confermato il licenziamento di una dipendente di una ASL che aveva effettuato 30 accessi illeciti a fascicoli sanitari di vicini di casa con cui aveva controversie in corso. La Corte ha sottolineato che “la responsabilità dell’agente si configura anche per la forzatura dei limiti dell’autorizzazione concessa dal titolare del domicilio informatico”.

Elemento chiave: la prevenzione e la reazione. Se l’amministratore:

  • Ha implementato sistemi tecnici di monitoraggio (SIEM, log analysis, Data Loss Prevention)
  • Ha disposto audit periodici sugli accessi
  • Ha formato il personale con percorsi obbligatori e tracciabili
  • Ha sanzionato tempestivamente i primi casi emersi

…allora ha dimostrato la diligenza richiesta e difficilmente potrà essere chiamato a rispondere penalmente.

Al contrario, se i casi di snooping erano emersi in passato e nulla è stato fatto, la responsabilità omissiva diventa plausibile.

Scenario 3 – Omessa notifica al Garante e agli interessati

Fatto: Una piattaforma e-commerce subisce un data breach che compromette email, password (hasgate con algoritmo debole MD5) e dati di carte di credito di 800.000 clienti. Il breach viene scoperto dal team IT dopo 3 settimane. L’amministratore delegato, per timore di danni reputazionali e crollo delle vendite, decide di non notificare né al Garante né agli interessati. Mesi dopo, i dati vengono messi in vendita sul dark web e la violazione diventa pubblica.

Profili di responsabilità amministrativa:

  • Violazione art. 33 GDPR (obbligo di notifica entro 72 ore): sanzione fino a 10 milioni o 2% fatturato
  • Violazione art. 34 GDPR (obbligo di comunicazione agli interessati): stessa sanzione
  • Aggravanti: durata dell’omissione, numero di interessati, tipologia di dati (includono dati di pagamento)

Profili di responsabilità penale dell’amministratore:

  1. Art. 167 Codice privacy: potrebbe essere configurabile? La questione è controversa:
    • Tesi positiva: l’omessa notifica ha aggravato il nocumento, perché gli interessati non sono stati posti in condizione di proteggersi (es. cambiare password, bloccare carte). Il “fine di trarre profitto” potrebbe essere individuato nel vantaggio economico derivante dal non perdere clienti
    • Tesi negativa (prevalente): l’art. 167 punisce il trattamento illecito di dati, non l’omessa notifica. Quest’ultima è un obbligo procedimentale, la cui violazione è sanzionata sul piano amministrativo ma non configura autonomo reato
  2. Responsabilità per il reato continuato: se l’omessa notifica si protrae per mesi, con decisioni reiterate di non comunicare, potrebbe configurarsi una condotta unitaria aggravata
  3. Rilevanza processuale: la mancata notifica può costituire elemento di prova del dolo o della consapevolezza in altri reati. Il fatto che l’amministratore abbia deciso di nascondere la violazione dimostra che ne era pienamente consapevole e ne comprendeva la gravità

Elemento critico: la decisione deliberata di occultare. Se l’amministratore:

  • Ha convocato riunioni per decidere di non notificare
  • Ha dato istruzioni al personale di mantenere il silenzio
  • Ha occultato prove o distrutto log

…allora si configura una condotta dolosa che può aggravare ogni profilo di responsabilità e può integrare, in concorso con altri reati (es. truffa verso i clienti che continuano ad affidargli dati), fattispecie più gravi.

Scenario 4 – Data breach causato da fornitore cloud inadeguato

Fatto: Un’azienda affida i propri database a un fornitore cloud low-cost, senza adeguata due diligence. Il fornitore non implementa nemmeno le misure di sicurezza basilari. Si verifica un massiccio data breach. L’azienda sostiene di non essere responsabile perché “il fornitore era il responsabile del trattamento ex art. 28 GDPR”.

Profili di responsabilità:

  1. Dell’azienda (titolare): art. 32 GDPR prevede che il titolare debba assicurarsi che anche il responsabile implementi misure adeguate. Il titolare risponde in solido con il responsabile per danni causati dal trattamento (art. 82 GDPR)
  2. Del fornitore cloud (responsabile): violazione obblighi art. 28 e 32 GDPR
  3. Dell’amministratore dell’azienda: potrebbe rispondere se:
    • Ha scelto il fornitore solo sul prezzo, ignorando segnalazioni di inadeguatezza tecnica
    • Non ha verificato le certificazioni del fornitore (es. ISO 27001, SOC 2)
    • Non ha previsto clausole contrattuali adeguate ex art. 28 GDPR
    • Non ha effettuato audit periodici sul fornitore come richiesto dal GDPR

Un caso emblematico è il Provvedimento Garante dell’8 febbraio 2024 n. 66 contro una società informatica responsabile del trattamento per una banca. Il fornitore:

  • Aveva comunicato il data breach alla banca con grave ritardo
  • Aveva subappaltato attività a terzi senza autorizzazione preventiva del titolare
  • Non aveva implementato misure di sicurezza adeguate

Il Garante ha sanzionato sia la banca (provvedimento n. 65) che il fornitore (provvedimento n. 66), evidenziando che la responsabilità è solidale e che il titolare non può “scaricare” le proprie responsabilità sul responsabile.

Implicazioni penali: se l’amministratore ha deliberatamente scelto un fornitore inadeguato pur essendo consapevole dei rischi (es. per risparmiare costi), e se questo ha causato un data breach con conseguente danno agli interessati, potrebbe configurarsi una responsabilità colposa aggravata.

La compliance integrata GDPR-231: costruire un sistema difensivo efficace

Alla luce della complessità del quadro normativo e giurisprudenziale, emerge con chiarezza che la protezione dell’amministratore dalla responsabilità penale non può fondarsi sull’ignoranza o sulla speranza che “non succeda nulla”, ma deve basarsi su un sistema di compliance integrato, documentato e sostanziale.

I pilastri della compliance efficace

Un sistema di compliance che minimizzi il rischio penale per gli amministratori deve poggiare su sei pilastri fondamentali:

  1. Governance formale e sostanziale

Non basta nominare un DPO e un CISO. Occorre:

  • Definire chiaramente ruoli, responsabilità e linee di reporting
  • Prevedere budget dedicati e adeguati per la cybersecurity (percentuale del fatturato IT tipicamente 8-12% nelle aziende mature)
  • Stabilire KPI misurabili per valutare l’efficacia delle misure di sicurezza
  • Inserire la cybersecurity come punto fisso all’ordine del giorno dei CdA
  1. Documentazione sistematica e tracciabilità

Ogni decisione rilevante deve essere:

  • Verbalizzata nei CdA con dettaglio delle motivazioni
  • Supportata da analisi tecniche (DPIA, risk assessment, penetration test)
  • Archiviata in modo da poter essere recuperata in sede processuale

Questa documentazione svolge una doppia funzione:

  • Prova della diligenza: dimostra che l’amministratore si è attivato, ha valutato i rischi, ha preso decisioni informate
  • Prova dei vincoli: se l’amministratore ha proposto investimenti in sicurezza bocciati dall’assemblea dei soci, il verbale lo scagiona
  1. Integrazione tra GDPR e Modello 231

I due sistemi devono dialogare:

  • Il MOG 231 deve contenere una sezione specifica sui “reati informatici e trattamento illecito di dati”
  • Le procedure 231 per la prevenzione dei reati cyber devono essere coerenti con le misure tecniche e organizzative GDPR
  • L’OdV deve ricevere flussi informativi dal DPO su data breach e near miss
  • Il DPO deve essere coinvolto nell’aggiornamento del MOG 231 per la parte cyber
  1. Formazione e consapevolezza diffusa

La formazione non deve essere un adempimento formale (corso online da 30 minuti con test a risposta multipla), ma un processo strutturato:

  • Formazione base obbligatoria per tutti i dipendenti (almeno annuale)
  • Formazione avanzata per ruoli critici (IT, HR, amministrazione)
  • Formazione specifica per amministratori e OdV su responsabilità e rischi penali
  • Simulazioni periodiche (phishing test, tabletop exercise su incident response)
  1. Incident Response Plan e gestione delle crisi

Un piano di risposta agli incidenti deve prevedere:

  • Fase 1 – Detection: come si rileva un data breach (SIEM, alert, segnalazioni)
  • Fase 2 – Assessment: chi valuta la gravità, con quali criteri, in quanto tempo
  • Fase 3 – Containment: procedure immediate per limitare il danno
  • Fase 4 – Notification: chi decide se notificare al Garante e agli interessati, con quali tempistiche
  • Fase 5 – Remediation: come si ripristinano i sistemi e si risolvono le vulnerabilità
  • Fase 6 – Lessons learned: analisi post-incidente e aggiornamento procedure

Cruciale: il piano deve essere testato con esercitazioni periodiche, non rimanere un documento sulla carta.

  1. Audit indipendenti e certificazioni

Affidarsi a valutazioni di terzi indipendenti:

  • Audit annuali ISO 27001 sulla sicurezza delle informazioni
  • Penetration test periodici (almeno annuali) condotti da società specializzate
  • DPIA affidate a consulenti esterni per i trattamenti più rischiosi
  • Certificazioni di settore (es. PCI-DSS per chi tratta dati di pagamento)

Questi elementi costituiscono prova oggettiva della diligenza dell’amministratore: “ho fatto tutto ciò che era ragionevolmente possibile nelle condizioni date”.

Il caso Postel: lezioni pratiche da un provvedimento del Garante

Il Provvedimento del Garante del 4 luglio 2024 contro Postel S.p.A. (doc. web 10063782) è particolarmente istruttivo. Postel, società che gestisce servizi di gestione documentale e comunicazione per enti pubblici e privati, ha subito un attacco ransomware nell’agosto 2023.

I fatti:

  • Vulnerabilità nota (CVE pubblicata) nei sistemi Postel era stata segnalata dai loro stessi sistemi di monitoraggio
  • Postel non aveva applicato la patch di sicurezza disponibile
  • Gli attaccanti hanno sfruttato proprio quella vulnerabilità
  • Si è verificato un data breach massivo con blocco dei server e sottrazione dati

La sanzione: 900.000 euro (ridotta da 1.200.000 per attenuanti)

Le motivazioni del Garante (rilevanti per la responsabilità degli amministratori):

  1. “La società non era intervenuta su una vulnerabilità già nota e segnalata dai propri sistemi”
  2. “Le misure di sicurezza erano inadeguate rispetto al rischio e al volume di dati trattati”
  3. “Non risulta implementato un adeguato sistema di gestione della sicurezza delle informazioni”

Implicazioni penali (ipotetiche, perché il Garante non esercita azione penale):

  • Gli amministratori di Postel avevano ricevuto report interni sulla vulnerabilità?
  • Era stato stanziato budget per l’aggiornamento dei sistemi?
  • Esisteva un processo formalizzato di patch management?

Se la risposta a queste domande fosse negativa, la consapevolezza del rischio e l’omissione di interventi potrebbero configurare l’elemento soggettivo di una responsabilità penale.

Conclusioni: navigare la zona grigia tra prevenzione e punizione

La responsabilità penale degli amministratori per data breach nell’ordinamento italiano rappresenta una frontiera giuridica ancora in via di definizione. La giurisprudenza penale specifica è scarsa, frammentata, costruita per accumulazione di principi elaborati in altri ambiti del diritto penale societario.

Tuttavia, alcune certezze emergono con chiarezza dall’analisi condotta:

  1. La posizione formale non è sufficiente per una condanna: la giurisprudenza costituzionale e di legittimità è fermissima nel richiedere la prova del contributo causale consapevole. Un amministratore non può essere il “parafulmine” automatico di ogni violazione dei dati.
  2. La consapevolezza è l’elemento discriminante: tra una violazione GDPR sanzionabile amministrativamente e un reato penalmente rilevante corre la linea della consapevolezza dell’amministratore. Le segnalazioni ricevute e ignorate, i report di audit disattesi, le raccomandazioni di DPO e CISO rimaste senza seguito sono gli elementi che possono trasformare una colpa amministrativa in dolo penale.
  3. La documentazione è protezione: un sistema di compliance ben strutturato, tracciabile, sostanziale (non meramente formale) costituisce la migliore difesa dell’amministratore. Non garantisce l’immunità, ma dimostra la diligenza e può spostare l’imputazione dall’individuo all’organizzazione.
  4. L’integrazione GDPR-231 non è opzionale: nelle aziende di dimensioni medio-grandi, la convergenza tra sistema di protezione dei dati e modello organizzativo 231 è necessaria sia per l’efficacia della prevenzione sia per la costruzione di un sistema di evidenze difensive.
  5. La latenza giurisprudenziale non deve generare falsa sicurezza: il fatto che ad oggi manchino sentenze penali di condanna di amministratori specificamente per data breach non significa che il rischio sia inesistente. Le Procure stanno acquisendo competenze cyber, gli strumenti di digital forensics si affinano, e i casi di domani potrebbero derivare dalle negligenze di oggi.

In ultima analisi, per amministratori, CISO, DPO e tutti i professionisti della security, emerge un imperativo operativo: la consapevolezza ignorata è più grave dell’ignoranza stessa.

Nel contesto della cybersecurity aziendale, come la Cassazione ha ribadito in materia societaria, non si può invocare la non conoscenza quando esistono sistemi di allerta, segnalazioni formalizzate, audit che evidenziano criticità. La colpa cosciente – sapere del rischio e scegliere di non agire – è ciò che trasforma una violazione amministrativa in possibile reato penale.

La responsabilità penale per data breach in Italia resta più un’ipotesi che una pratica consolidata. Ma questa condizione può cambiare rapidamente, con il primo caso eclatante che verrà portato all’attenzione della magistratura penale. Meglio costruire oggi il sistema di prevenzione e documentazione che domani potrebbe fare la differenza tra una sanzione amministrativa all’ente e un procedimento penale a carico delle persone fisiche.

Normativa di riferimento essenziale

Norme europee

Norme nazionali – Codice privacy

  • D.lgs. 196/2003 come modificato da D.lgs. 101/2018
  • Art. 167 – Trattamento illecito di dati (reclusione 6 mesi – 1,5 anni)
  • Art. 167-bis – Comunicazione illecita su larga scala (reclusione 1-6 anni)
  • Art. 167-ter – Acquisizione fraudolenta di dati

Norme nazionali – Reati informatici

  • Art. 615-ter c.p. – Accesso abusivo a sistema informatico
  • Art. 615-quater c.p. – Detenzione abusiva codici accesso
  • Art. 617-quater c.p. – Intercettazione comunicazioni informatiche
  • Art. 635-bis c.p. – Danneggiamento di dati e programmi
  • Art. 640-ter c.p. – Frode informatica

Responsabilità degli enti

  • D.lgs. 231/2001 – Art. 24-bis (delitti informatici)
  • Art. 5 – Soggetti in posizione apicale
  • Art. 6 – Modelli di organizzazione e Organismo di Vigilanza

Riferimenti giurisprudenziali citati

  • Cass. pen. n. 13102/2023 – Natura comune reato art. 167
  • Cass. pen. n. 11968/2024 – Responsabilità amministratore di diritto
  • Cass. pen. n. 13620/2024 – Vigilanza attiva in organi collegiali
  • Cass. pen. n. 13200/2024 – Delimitazione temporale responsabilità
  • Cass. pen. n. 35031/2025 – Macroscopica illegalità
  • Cass. pen. n. 28887/2025 – Accesso abusivo dipendenti
  • Cass. pen. n. 2499/2024 – Onere della prova distrazioni

Provvedimenti Garante Privacy

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/responsabilita-penale-degli-amministratori-per-data-breach/


Supply chain resilienti e sostenibili: il ruolo strategico dell’economia circolare

Uno studio empirico sulle imprese italiane rivela come le pratiche circolari possano rafforzare la capacità di risposta alle disruption

Le catene di approvvigionamento globali si trovano oggi ad affrontare sfide senza precedenti. La crescente complessità delle filiere produttive, unita a un contesto geopolitico ed economico sempre più instabile, ha reso le imprese particolarmente vulnerabili a eventi dirompenti capaci di compromettere l’intera continuità operativa. A questa realtà si aggiunge una pressione crescente verso modelli di produzione e consumo più sostenibili, che impongono alle aziende di ripensare radicalmente le proprie strategie.

Di questi temi ha parlato Roberta Pellegrino, docente di Risk management e Controllo di gestione al Politecnico di Bari, nel corso del suo intervento al 23° Forum ICT Security, intitolato “La resilienza delle catene di approvvigionamento e il ruolo dell’economia circolare nella gestione delle supply chain disruptions“. L’esperta ha presentato i risultati di due indagini empiriche condotte su imprese italiane tra il 2021 e il 2023, offrendo una prospettiva inedita sul rapporto tra sostenibilità e capacità di recupero delle filiere produttive.

Le supply chain moderne sono divenute strutture sempre più globali e complesse, esposte a tipologie di rischio eterogenee i cui impatti si propagano sia a monte (upstream) sia a valle (downstream) della catena del valore. La natura di questi impatti varia significativamente in funzione del settore industriale, della configurazione del network, delle tecnologie impiegate e della tipologia di prodotto.

“La risposta a questo tipo di eventi richiede oggi più che mai non soltanto la capacità di ridurre gli effetti delle disruption e incrementare la resilienza, ma di farlo in maniera sostenibile, nel rispetto delle componenti ambientali e sociali”

Proprio da questa esigenza nasce l’interesse della ricercatrice verso il paradigma dell’economia circolare come possibile driver di resilienza. La letteratura scientifica, pur avendo ampiamente studiato il tema della supply chain resilience, ha dedicato finora scarsa attenzione all’intersezione tra resilienza e sostenibilità, lasciando aperta una domanda cruciale: possono le pratiche di economia circolare rappresentare una risposta efficace alle crisi che colpiscono le filiere produttive?

La prima ricerca, condotta tra il 2021 e il 2022, ha analizzato come le imprese italiane abbiano risposto alla disruption pandemica, una delle più severe mai affrontate dal sistema economico globale. L’obiettivo era comprendere quali capability – ovvero capacità strategiche – le aziende abbiano effettivamente messo in campo per fronteggiare gli impatti e raggiungere la resilienza, e quale ruolo abbiano giocato le tecnologie digitali in questo processo.

Il gruppo di ricerca ha sviluppato un framework concettuale che mette in relazione gli impatti delle disruption con la resilienza della supply chain, mediata da quattro capability fondamentali: flessibilità, agilità, reattività ed efficienza. A queste si aggiunge il ruolo delle risorse tecnologiche digitali, ipotizzate come fattore sia diretto sia indiretto di resilienza.

Una metodologia rigorosa

L’indagine si è basata su un questionario strutturato, somministrato a un campione di 1.250 piccole e medie imprese italiane. Le 164 risposte valide raccolte – pari a un tasso di risposta del 13%, statisticamente significativo – hanno coperto settori diversi, prevalentemente manifatturieri, e aziende di differenti dimensioni. I dati sono stati analizzati mediante tecniche di statistica descrittiva e modelli di equazioni strutturali (PLS-SEM).

supply chain
Structural Model Results

Gli impatti percepiti e le strategie di risposta

I risultati hanno evidenziato che gli impatti più severi percepiti dalle imprese sono stati: l’aumento dei prezzi delle materie prime, i ritardi nelle consegne, le variazioni imprevedibili della domanda e, sul fronte finanziario, l’incremento dei costi operativi e la contrazione dei margini di profitto. Di fronte a queste sfide, le aziende hanno adottato un portafoglio diversificato di strategie, combinando approcci di flessibilità nella gestione dei fornitori, agilità operativa, reattività e controllo dei costi.

Tuttavia, l’analisi statistica ha rivelato risultati in parte sorprendenti. Non tutte le capability impiegate si sono dimostrate ugualmente efficaci nel favorire la resilienza. Nel campione analizzato, sono state le strategie di efficienza – quelle più orientate al contenimento dei costi nel breve periodo – a mostrare un impatto positivo significativo sulla capacità di recupero delle imprese.

“Agilità e reattività sono state ampiamente utilizzate dalle imprese, ma non vengono percepite come strategie in grado di accrescerne la resilienza. Probabilmente, di fronte a una disruption così rapida, le aziende hanno privilegiato azioni di breve termine piuttosto che avere il tempo di percepire il mercato e reagire di conseguenza”

supply chain
Risultati in sintesi

Il ruolo delle tecnologie digitali: un effetto indiretto

Un altro risultato degno di nota riguarda il ruolo della digitalizzazione. Contrariamente a quanto si potrebbe ipotizzare, le risorse tecnologiche non mostrano un impatto diretto sulla resilienza delle imprese. Le aziende non percepiscono le tecnologie digitali come capaci, da sole, di accrescere la capacità di risposta alle crisi.

L’effetto delle tecnologie diventa invece significativo quando è mediato dagli investimenti in altre capability. In altre parole, la digitalizzazione funziona come fattore abilitante: potenzia l’efficacia delle strategie aziendali, ma non le sostituisce. Questo suggerisce che gli investimenti tecnologici, per essere realmente efficaci in termini di resilienza, devono essere accompagnati da un parallelo sviluppo delle capacità organizzative e strategiche.

La seconda ricerca, condotta tra settembre e dicembre 2023, ha spostato il focus sull’economia circolare, indagando se l’adozione di pratiche sostenibili – come riciclo, recupero, riutilizzo e ri-manifattura – possa effettivamente contribuire alla resilienza delle imprese e al miglioramento delle loro performance.

Il modello concettuale sviluppato dal team di ricerca ipotizza che l’economia circolare possa avere un impatto positivo su tre dimensioni delle performance aziendali – di business, ambientali e finanziarie – oltre che sulla resilienza della supply chain. In questo quadro, il rischio di approvvigionamento (supply risk) agisce come moderatore: quanto maggiore e l’esposizione ai rischi di fornitura, tanto più forte dovrebbe essere l’effetto positivo delle pratiche circolari sulla resilienza.

supply chain
Background della ricerca e ipotesi (modello CE)

I risultati: conferme e sorprese

Il questionario è stato somministrato a circa 1.000 imprese italiane impegnate in pratiche di economia circolare, raccogliendo 125 risposte valide (tasso di risposta del 12%). I risultati confermano alcune ipotesi e ne smentiscono altre, offrendo un quadro articolato e ricco di implicazioni per il management.

In primo luogo, le imprese intervistate percepiscono un impatto positivo degli investimenti in economia circolare sulla resilienza. Questo effetto risulta tanto più marcato quanto maggiore è l’esposizione dell’azienda ai rischi di approvvigionamento: in contesti caratterizzati da elevata vulnerabilità delle forniture, le pratiche circolari si rivelano particolarmente efficaci nel rafforzare la capacità di risposta alle crisi.

Sul fronte delle performance, l’economia circolare mostra un effetto diretto significativo solo sulle performance di business – misurate attraverso indicatori come crescita delle vendite, reputazione aziendale e soddisfazione del cliente. Non emerge invece un effetto diretto sulle performance finanziarie, probabilmente perché l’economia circolare richiede investimenti iniziali che ne attenuano l’impatto economico immediato. Tuttavia, la resilienza agisce come meccanismo di mediazione: le imprese che investono in pratiche circolari e contemporaneamente sviluppano capacità di resilienza riescono a tradurre questi investimenti in vantaggi finanziari.

supply chain
Risultati in sintesi (economia circolare)

L’assenza di effetto sulle performance ambientali: l’effetto rebound

Un risultato apparentemente controintuitivo riguarda l’assenza di una relazione significativa tra economia circolare e performance ambientali. Ci si aspetterebbe che le pratiche circolari, per loro natura orientate alla sostenibilità, producano benefici ambientali diretti. I dati raccolti non confermano questa aspettativa.

La spiegazione proposta dalla ricercatrice chiama in causa il cosiddetto effetto rebound: quando le imprese investono in pratiche di economia circolare a “basso R” – ovvero quelle che non comportano una completa sostituzione della materia prima vergine – si possono generare dinamiche controproducenti. L’incremento delle vendite e dei consumi associato ai prodotti “circolari” può compensare o addirittura annullare i benefici ambientali attesi, un fenomeno già documentato nella letteratura scientifica.

“Le pratiche di economia circolare, soprattutto quelle a basso R, potrebbero generare un effetto rebound che si manifesta nell’aumento delle vendite e dei consumi, con conseguenze potenzialmente negative sulle performance ambientali”

I risultati delle due indagini offrono indicazioni concrete per il management delle imprese. In primo luogo, confermano che la resilienza non si costruisce con un’unica strategia, ma richiede un approccio integrato che combini diverse capability. In secondo luogo, evidenziano come l’economia circolare possa rappresentare una leva strategica non solo per la sostenibilità, ma anche per la competitività e la capacità di fronteggiare le crisi.

Il team di ricerca sta attualmente conducendo uno studio longitudinale per verificare se, a distanza di alcuni anni, la percezione delle imprese sia mutata. L’economia circolare è un investimento di medio-lungo periodo, e le sue ricadute potrebbero manifestarsi in modo diverso nel tempo. La relatrice ha invitato i partecipanti al Forum a contribuire alla ricerca, condividendo il questionario con i supply chain manager delle proprie organizzazioni.

Come ha sottolineato in chiusura del suo intervento: “Si tratta di un’indagine che merita ulteriore approfondimento. I modelli statistici ci permettono di capire quali relazioni esistono tra i diversi fenomeni, ma il perché e il come di certe dinamiche può essere compreso solo attraverso casi studio e analisi qualitative più puntuali”.

Guarda il video completo dell’intervento:

[embedded content]
References

Gaudenzi, B., Pellegrino, R., & Confente, I. (2023). Achieving supply chain resilience in an era of disruptions: a configuration approach of capacities and strategies. Supply Chain Management: An International Journal, 28(7), 97-111.

Pellegrino, R., & Gaudenzi, B. (2025). Supply chain resilience as a viable way to cope with disruptions: an empirical analysis of Italian firms. Review of Managerial Science, 1-31.

Pellegrino, R., Gaudenzi, B., Fraccascia, L., Genovese, A., & Basile, L. J. (2025). Can the adoption of circular economy practices foster supply chain resilience and performance improvements?. Business Strategy and the Environment.

Profilo Autore

Roberta Pellegrino è Professore Associato di Ingegneria Economico-Gestionale presso il Politecnico di Bari (Italia), dove insegna Risk Management e Controllo di Gestione. E’ coordinatore Erasmus per Ingegneria Gestionale. I suoi principali interessi di ricerca riguardano la gestione del rischio nelle supply chain, il partenariato pubblico-privato / Project Financing, e la teoria delle opzioni reali. È autrice o coautrice di numerose pubblicazioni su riviste e libri internazionali e nazionali, e di diversi articoli presentati a convegni internazionali.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/supply-chain-resilienti/


Network Detection and Response: la visione di Corelight per proteggere le reti moderne

La piattaforma Open NDR al centro della sicurezza informatica secondo Jean-Pierre Carlin di Corelight

Nel contesto del 23° Forum ICT Security, Jean-Pierre Carlin, Regional Sales Manager Southern Europe di Corelight, ha presentato una panoramica approfondita sul ruolo strategico del Network Detection and Response (NDR) nella sicurezza informatica contemporanea. L’intervento, dal titolo “Dati più intelligenti, rilevamenti più accurati, risposte più rapide: proteggere le reti moderne con Corelight Open NDR”, ha evidenziato come questa tecnologia rappresenti oggi un elemento imprescindibile per i Security Operations Center che si trovano ad affrontare minacce sempre più sofisticate.

“What is NDR?”

Cos’è l’NDR e perché è fondamentale

“NDR significa Network Detection and Response ed è una tecnologia che scansiona l’intera rete per individuare ogni tipo di evidenza”, ha spiegato il relatore nell’apertura del suo intervento. La soluzione analizza i dati per presentare agli analisti tutto ciò che riguarda violazioni, attacchi o comportamenti anomali all’interno del sistema IT, inviando tutte le informazioni al SIEM per essere elaborate automaticamente, eventualmente attraverso un SOAR.

L’esperto ha chiarito un punto fondamentale: “L’NDR non può essere autonomo di per sé, ma fa parte di una sicurezza globale, quella che chiamiamo triad”. Questa triade comprende l’EDR (Endpoint Detection and Response), che protegge server e endpoint, il SIEM che raccoglie log e dati per individuare correlazioni e attacchi, e appunto l’NDR che monitora il traffico di rete.

“Why NDR? – Integrated SOC Triad”

Il limite della sicurezza perimetrale

Carlin ha posto l’accento su una criticità spesso sottovalutata: “Se avete un EDR che protegge tutto il perimetro, potreste pensare di essere al sicuro perché il perimetro è protetto. Ma, come si può leggere sui giornali, quasi ogni settimana una importante azienda subisce una violazione. Anche se avete la sicurezza sul perimetro, gli hacker possono sempre entrare nel vostro sistema informativo”.

Ed è qui che entra in gioco l’NDR: “L’NDR è l’unico modo per scoprire cosa sta accadendo all’interno del vostro IT. Perché tutto ciò che gli hacker faranno passerà attraverso la rete in un modo o nell’altro. E l’NDR rileverà tutti questi movimenti nel vostro sistema IT”, ha sottolineato lo speaker.

Corelight: 15 anni di esperienza nella sicurezza di rete

Corelight è un’azienda americana specializzata in NDR, presente sul mercato da 15 anni con una gamma completa di capacità di rilevamento basate su firme, analisi comportamentale e molteplici tecnologie integrate. “In un unico appliance, che può essere virtuale o fisico, integriamo IDS, PCAP, NSM, YARA Host e tutti questi layer saranno in grado di rilevare specifici tipi di attacchi”, ha illustrato Carlin.

“Corelight is an Enterprise Class NDR”

Il DNA open source: Zeek

Un elemento distintivo di Corelight risiede nelle sue origini. L’azienda è stata fondata dalle stesse persone che, 25-30 anni fa, hanno creato Zeek (originariamente chiamato Bro), una tecnologia che trasforma qualsiasi flusso di rete in log. “Forse non conoscete Zeek perché il nome non è del tutto noto, ma probabilmente la maggior parte degli analisti usa Zeek anche quando non sanno che è Zeek”, ha rivelato il relatore.

Zeek è diventato uno standard de facto nel settore: “È open source e aziende come Microsoft, CrowdStrike e Splunk utilizzano Zeek. Abbiamo un linguaggio comune, una grammatica comune, che ci permette di comunicare tra noi e di interpretare e correlare tutti questi eventi”, ha spiegato l’esperto. Negli Stati Uniti, Zeek è ampiamente adottato dalle amministrazioni pubbliche e dal Dipartimento della Difesa, mentre Corelight protegge numerose istituzioni finanziarie e infrastrutture critiche nei settori dell’energia e dei trasporti.

Partnership strategiche per l’integrazione

Il modello di business di Corelight si basa su partnership strategiche particolarmente forti. “Abbiamo relazioni molto strette con aziende come CrowdStrike. CrowdStrike è un investitore di Corelight e parla il nostro stesso linguaggio, integrando anch’essa Zeek”, ha evidenziato Carlin.

Lo stesso vale per Cisco, Splunk e Mandiant. Un aspetto particolarmente interessante riguarda l’integrazione operativa: “CrowdStrike o Splunk possono acquisire i nostri dati e potete evitare di utilizzare la nostra interfaccia per gestire la soluzione – potete gestire Corelight direttamente da CrowdStrike o da Splunk. Questo vi evita di avere un ulteriore pannello di controllo per monitorare cosa sta accadendo nella rete”.

“Corelight Open NDR – SaaS Platform”

L’architettura della piattaforma

La piattaforma Corelight raccoglie dati da qualsiasi tipo di rete – fisica, cloud o OT – attraverso diversi sensori che normalizzano i dati in formato Zeek e altri standard, generando alert, log, file e packet capture. Questi dati possono essere inviati sia a un SIEM (come Splunk, Microsoft, Elastic o CrowdStrike) sia alla piattaforma proprietaria di Corelight.

“La nostra piattaforma esegue il triage degli alert, utilizza l’intelligenza artificiale per interpretarli e trasforma un alert espresso in termini tecnici in inglese, francese, italiano o qualsiasi altra lingua utilizziate, per renderlo facilmente comprensibile a tutti”, ha spiegato il relatore. Questa elaborazione assistita dall’AI fornisce una visione d’insieme degli alert e delle tendenze in corso.

I motori di rilevamento multipli

La piattaforma integra motori multipli per rilevamento, analisi dei file, NSM (Network Security Monitoring) e packet capture. Per quanto riguarda il rilevamento, Corelight analizza tutte le corrispondenze tra MITRE ATT&CK e i protocolli tecnici utilizzati dagli hacker, operando sia su base signature che comportamentale.

“Possiamo rilevare un cambiamento di comportamento sulla rete. Effettuiamo anche correlazioni con la threat intelligence, e tutta questa parte è integrata nel prodotto stesso”, ha dichiarato Carlin. Quando ci sono file nella rete, questi vengono analizzati con le regole YARA per individuare minacce attraverso queste tecniche.

Per l’analisi di rete, Corelight utilizza Zeek e dispone di un set completo di log standard utilizzati dal SIEM e correlati con l’EDR. “Possiamo anche ottenere informazioni dal traffico cifrato e dalle VPN. Naturalmente, non decifriamo il traffico, ma solo l’header ci fornisce molte informazioni che ci permettono di capire cosa sta succedendo ed eventualmente allertare quando c’è un attacco specifico”, ha precisato lo speaker.

Smart PCAP: l’ottimizzazione intelligente

Una funzionalità particolarmente innovativa è lo “Smart PCAP”, una cattura pacchetti intelligente. “Non inviamo ogni packet capture, che sarebbe piuttosto pesante per il SIEM e costerebbe molto denaro se inviassimo tutti i dati al SIEM”, ha spiegato Carlin. “Lo chiamiamo Smart PCAP perché inviamo solo la parte interessante di queste informazioni. E se l’informazione è ridondante, non inviamo gli stessi dati più e più volte – diciamo semplicemente che ci sono state X occorrenze dello stesso packet capture”.

“Multi-layered detection strategy”

Un approccio multilivello al rilevamento

Il relatore ha illustrato come ogni attacco abbia la propria tecnica o modo di procedere, e ogni approccio può essere rilevato con una tecnica diversa: comportamentale, signature-based, machine learning, rilevamento delle anomalie e altro ancora. “Invece di avere strumenti diversi per rilevare i diversi tipi di attacchi, tutto è integrato nei vostri sensori e nella vostra soluzione. Qualunque sia l’attacco, lo rileveremo perché abbiamo i diversi motori in grado di individuare questi diversi attacchi”, ha affermato con sicurezza.

Ma c’è di più: Corelight rileva anche la progressione di un attacco. “Rileveremo come l’attacco si sta muovendo e forniremo all’analista tutti i pattern dell’attacco stesso e il modo in cui sta evolvendo. E naturalmente forniremo informazioni su come fermare quell’attacco e quali sono i diversi modi per bloccarlo”, ha aggiunto Carlin.

“SOC Challenge – Pain points across the kill chain”

I problemi che Corelight risolve

L’intervento ha quindi affrontato le problematiche concrete che affliggono i Security Operations Center moderni:

1. Visibilità incompleta

“La maggior parte delle volte, quando avete un sistema informativo, sapete cosa sta succedendo sui bordi del vostro sistema, ma avete un punto cieco quando si tratta dell’interno”, ha osservato il relatore. La soluzione Corelight aiuta ad avere visibilità su ciò che accade all’interno della rete, compresi i movimenti laterali e gli spostamenti Est-Ovest.

2. Consolidamento degli strumenti

“Con una sola soluzione non avete bisogno di avere strumenti diversi per rilevare questo tipo di attacco e quell’altro tipo di attacco. Tutto è nella stessa soluzione, che rileverà qualsiasi tipo di attacco che possa essere individuato all’interno della rete”, ha sottolineato l’esperto.

3. Ottimizzazione dei costi

L’ottimizzazione dei log forniti al SIEM riduce i costi di utilizzo del SIEM stesso. “Dato che tutti i nostri strumenti sono integrati e inviano lo stesso tipo di alert, avremo un rilevamento coerente e alert consistenti in tutto il vostro sistema di sicurezza”, ha evidenziato Carlin.

4. Integrazione nativa

“Il fatto che possiamo dialogare molto strettamente con un SIEM come Splunk o con un EDR come Microsoft o CrowdStrike crea un sistema di allerta globale e coerente”, ha concluso il relatore.

“How can Corelight help you?”

Visibilità cloud e architetture ibride

Un aspetto particolarmente rilevante nell’era della trasformazione digitale riguarda la sicurezza cloud. “Quando ci si sposta da una rete on-site a una rete cloud o ibrida, si hanno altri punti ciechi relativi a cosa sta succedendo nel cloud e se è possibile ottenere informazioni dal cloud”, ha osservato Carlin. Corelight dispone di sensori che funzionano anche nel cloud, permettendo di estendere la copertura dell’intero sistema informativo.

Conclusioni

L’intervento di Jean-Pierre Carlin ha delineato un quadro chiaro del valore strategico dell’NDR nel panorama della cybersecurity moderna. In un contesto in cui le minacce evolvono costantemente e gli attacchi diventano sempre più sofisticati, avere una visibilità completa del traffico di rete – sia on-premise che in cloud – rappresenta non più un’opzione ma una necessità.

Corelight si posiziona come una soluzione enterprise-class che, grazie alle sue radici open source con Zeek, all’integrazione nativa con i principali player del settore e alle capacità di rilevamento multilivello assistite dall’intelligenza artificiale, offre ai team di sicurezza gli strumenti per identificare, comprendere e rispondere rapidamente alle minacce informatiche.

Come ha concluso il relatore invitando i partecipanti al Forum ICT Security a visitare lo stand per demo tecniche e discussioni approfondite, la vera forza di Corelight risiede nella combinazione di dati di altissima qualità, architettura flessibile e workflow intelligenti che accelerano il rilevamento delle minacce e la risposta agli incidenti.

Profilo Autore

Jean-Pierre Carlin ha oltre 25 anni di esperienza nel settore della sicurezza IT. Nel corso della sua carriera, Jean-Pierre ha avuto l’opportunità di lanciare e sviluppare commercialmente diverse filiali start-up nell’Europa meridionale. Prima di entrare a far parte di Corelight, Jean-Pierre ha avviato le attività di Swimlane, Recorded Future, Venafi, LogRhythm, A10 Networks, Proofpoint, Aventail/SonicWall, Netscreen e Netscout. Jean-Pierre si è laureato presso l’E.S.I.E.E. di Parigi come ingegnere di rete e telecomunicazioni.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/network-detection-and-response/


Explainable Security: dalle fiabe alla cybersecurity – quando Cenerentola insegna l’autenticazione multifattore

Al 23° Forum ICT Security, il Professor Luca Viganò del King’s College di Londra ha proposto un approccio rivoluzionario alla comunicazione della sicurezza informatica: utilizzare le narrazioni universali per rendere comprensibili concetti tecnici complessi.

La sicurezza informatica è difficile. È difficile da ottenere, da analizzare, da capire e, soprattutto, da spiegare. Se non fosse così, ha esordito Luca Viganò aprendo il suo intervento al Forum ICT Security 2025, “non saremmo qui. Probabilmente ci occuperemmo di altre cose perché avremmo risolto il problema.”

Il Professor Viganò, che dirige il Cybersecurity Group presso il Department of Informatics del King’s College di Londra, lavora all’intersezione tra sicurezza informatica, ingegneria del software, intelligenza artificiale e logica. Da questa posizione privilegiata ha sviluppato un approccio innovativo denominato Explainable Security (XSec), che affronta una questione tanto semplice quanto fondamentale: come comunicare efficacemente i concetti di sicurezza a pubblici diversi?

Il paradosso della colpa condivisa

Uno studio IBM citato dal Professor Viganò rivela un dato impressionante: il 95% delle vulnerabilità informatiche deriva da errori umani. Questa statistica ha alimentato per decenni la narrazione secondo cui gli esseri umani rappresentano “l’anello più debole della catena” (the weakest link). Ma il relatore invita a una riflessione più profonda: di chi è davvero la colpa?

explainable security

“Se noi chiediamo al sistema, il sistema dirà: è stato un errore umano”, ha spiegato. “Ma se chiediamo all’utente, molto spesso l’utente non è nemmeno conscio di questa cosa, giustamente. E dirà: è stato un errore tecnico, un technical glitch.”

explainable security

Questa dissonanza rivela due problemi interconnessi che la Explainable Security si propone di affrontare. Il primo riguarda gli utenti che non comprendono la sicurezza, spesso per una combinazione di ignoranza (nel senso letterale di non conoscere, non sapere), incomprensioni e comportamenti involontari. Il secondo, forse meno ovvio, riguarda gli esperti che non comprendono gli utenti.

Il mondo non è in bianco e nero

Il professore ha illustrato questo secondo problema attingendo alla propria esperienza di ricercatore specializzato in analisi formale. Nel modellare sistemi di sicurezza, gli esperti tendono a dividere il mondo in due categorie nette: da un lato gli attaccanti, dall’altro gli agenti onesti che si comportano esattamente come il programmatore aveva previsto.

“Questa divisione è molto utile perché ci consente di ottenere dei risultati”, ha ammesso. “Il problema è che gli esseri umani non sono neri, perché tipicamente non hanno le capacità di un attaccante, ma non sono nemmeno bianchi, perché magari non sanno nemmeno che cosa aveva in testa il programmatore.”

Con una punta di ironia, il professore ha ricordato l’evoluzione dei telefoni cellulari: “Sono vecchio a sufficienza da ricordarmi quando sono usciti i primi cellulari, che erano spessi diverse dita e arrivavano con un manuale spesso altrettanto. Oggigiorno i cellulari sono sottilissimi e non c’è il manuale.” Come può dunque un utente sapere esattamente come comportarsi?

La risposta dell’Explainable Security

Il framework dell’Explainable Security, sviluppato da Viganò insieme al collega Daniele Magazzini (oggi dirigente per JP Morgan), adotta un approccio sistematico basato sulle classiche sei domande del giornalismo: chi, cosa, come, dove, quando e perché.

explainable security

Chi fornisce le spiegazioni e chi le riceve? Cosa viene spiegato: un attacco, una strategia di difesa, un processo di recovery? Dove e quando si colloca la spiegazione nel ciclo di vita del software o nell’utilizzo di un sistema? E, naturalmente, perché abbiamo bisogno di questa spiegabilità e come possiamo realizzarla?

explainable security

Il cuore della proposta di Viganò sta nel passaggio da un approccio puramente tecnico a uno socio-tecnico. “La soluzione è molto semplice”, ha affermato: “invece di considerare un sistema tecnico, dobbiamo considerare un sistema socio-tecnico, ovvero includere esplicitamente gli esseri umani all’interno delle nostre analisi e delle nostre difese.”

Ma c’è un elemento in più, che il relatore chiama provocatoriamente Human Learning. “Parliamo tanto di machine learning”, ha osservato, “però non dobbiamo dimenticarci che dobbiamo fare in modo che siano anche gli utenti ad apprendere, non solamente le macchine e gli algoritmi.”

Cenerentola e l’autenticazione a due fattori

Come rendere concreto questo cambiamento culturale? La risposta di Viganò è tanto inaspettata quanto affascinante: attraverso le fiabe.

“Sono trent’anni che mi occupo di cybersecurity, sono trent’anni che sento Humans are the weakest link“, ha dichiarato. “E questo vuol dire che non abbiamo risolto il problema ancora, quindi forse è perché non abbiamo usato le parole giuste.”

In un articolo intitolato The Cybersecurity of Fairy Tales, il professore ha mappato 16 fiabe tradizionali su molteplici concetti di sicurezza informatica: dal controllo degli accessi all’anonimità, dall’autenticazione agli attacchi di tipo replay.

L’esempio più illuminante è quello di Cenerentola, una storia che esiste in circa 700 versioni diverse in tutto il mondo. Quando il principe cerca di identificare la misteriosa fanciulla del ballo usando la scarpetta di cristallo, sta essenzialmente implementando un protocollo di autenticazione. La scarpetta rappresenta un fattore biometrico: qualcosa che Cenerentola è (la dimensione del suo piede).

Ma il protocollo ha una vulnerabilità. Nella versione dei fratelli Grimm, le sorellastre tentano un attacco di impersonificazione, arrivando a mutilarsi i piedi per farli entrare nella scarpetta. L’attacco viene sventato solo grazie a quello che potremmo definire un runtime monitor: un soldato che nota il sangue.

La vera lezione arriva nel finale. Quando i soldati trovano finalmente Cenerentola, lei non si limita a calzare la scarpetta: estrae dalla tasca la seconda. “Cenerentola è una fiaba sull’autenticazione multifattore”, ha concluso Viganò. “Su qualcosa che Cenerentola è, un fattore biometrico, ovvero la dimensione del suo piede, e su un fattore di possesso, ovvero qualcosa che Cenerentola ha: la seconda scarpetta.”

Nella versione Disney, questo principio viene ulteriormente enfatizzato: quando la matrigna rompe la prima scarpetta, è il secondo fattore a salvare la situazione.

Da Ulisse a Pinocchio: un patrimonio nascosto

Ma Cenerentola non è un caso isolato. Il relatore ha dimostrato come l’autenticazione multifattore fosse già presente nell’Odissea. Quando Ulisse torna a Itaca dopo vent’anni di assenza, nessuno lo riconosce immediatamente. L’identificazione avviene attraverso tre fattori distinti: il cane Argo lo riconosce dall’odore (qualcosa che è), la nutrice Euriclea lo identifica da una cicatrice d’infanzia (qualcosa che ha sul corpo), e infine dimostra la propria identità tendendo l’arco che nessun altro può usare e scoccando una freccia attraverso dodici asce (qualcosa che sa fare). Esiste perfino un quarto fattore: la conoscenza del segreto del letto nuziale, costruito sopra un albero.

Alì Babà e i Quaranta Ladroni, dal canto suo, offre un vero catalogo di vulnerabilità: dalla password intercettata (“Apriti Sesamo”) alla coercizione, dalla password dimenticata all’anonimità compromessa.

E Pinocchio? L’episodio del Gatto e la Volpe nel Campo dei Miracoli rappresenta, secondo Viganò, l’archetipo della truffa nota come Nigerian Prince email scam. “Che cosa dicono il Gatto e la Volpe? Dicono: Pinocchio, ti faremo ricco. L’unica cosa, ci devi dare un po’ di monete d’oro prima, che le seppelliamo nel campo sotto l’albero e poi crescerà l’albero di monete.” È esattamente la struttura dello Spanish Prisoner e delle moderne truffe via email.

L’evidenza scientifica

Ma funziona davvero? Viganò non si è accontentato dell’intuizione: ha condotto studi empirici rigorosi per verificare l’efficacia di questo approccio. I risultati confermano che l’utilizzo di film, fiabe e altre forme artistiche migliora effettivamente la comprensione della sicurezza informatica da parte degli utenti.

“Il risultato è sì, anche se non sempre”, ha precisato con onestà scientifica. Per comprendere meglio questi limiti, ha collaborato con l’artista inglese Alistair Gentry, che si traveste da automa e interagisce con le persone interrogandole sulla sicurezza informatica.

Gli studi, sia quantitativi che qualitativi, hanno rivelato che l’approccio narrativo funziona, ma talvolta richiede moderazione: in alcuni casi l’efficacia è diretta, in altri serve un facilitatore che guidi la comprensione. Questo non diminuisce il valore dell’approccio, ma ne chiarisce le condizioni ottimali di applicazione.

Verso una nuova narrativa

L’intervento rappresenta un invito a ripensare radicalmente il modo in cui comunichiamo la sicurezza informatica. Non si tratta semplicemente di “semplificare” concetti complessi, ma di attingere a un patrimonio narrativo universale che contiene già, in forma implicita, le strutture logiche della sicurezza.

Il professore ha concluso menzionando The First, un cortometraggio di cui ha scritto la sceneggiatura, dedicato all’intelligenza artificiale, al test di Turing e “alla difficoltà di essere umani in un mondo autonomo”. Un progetto che testimonia come la contaminazione tra discipline scientifiche e umanistiche possa produrre nuove forme di comprensione.

Figlio di un’informatica e di un critico cinematografico, Viganò incarna questa sintesi. E la sua proposta ci ricorda che, forse, per affrontare le sfide più tecniche del nostro tempo, abbiamo bisogno di riscoprire le storie più antiche.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Luca Viganò is Professor at the Department of Informatics of King’s College London, UK, where he heads the Cybersecurity Group. His research focuses on formal analysis of socio-technical cybersecurity and on explainable cybersecurity, where, in addition to more formal approaches, he has been investigating how different kinds of storytelling can be used to explain cybersecurity.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/explainable-security/