Legge 132/2025 sull’Intelligenza Artificiale: dalla teoria alla pratica nelle aziende italiane
L’entrata in vigore della Legge 132/2025 rappresenta un punto di svolta per la governance dell’intelligenza artificiale in Italia, ma la distanza tra principi normativi e attuazione pratica rischia di amplificare un gap competitivo già preoccupante.

Mentre il tasso di adozione dell’IA nelle imprese italiane si attesta all’8,2% contro una media UE del 13,5% secondo i dati ISTAT 2024, le organizzazioni si trovano a fronteggiare un doppio onere: implementare sistemi di intelligenza artificiale per non perdere competitività, e simultaneamente garantirne la conformità a un quadro normativo che integra AI Act europeo e specificità nazionali. Questo contributo analizza le sfide operative concrete che Chief Information Security Officers, legal counsels specializzati in cyber law, digital forensics experts e compliance officers devono affrontare, identificando i gap critici nell’implementazione e proponendo metodologie pragmatiche per la transizione verso una AI governance sostenibile.

Il contesto normativo: architettura di un sistema binario

La Legge 23 settembre 2025, n. 132, pubblicata in Gazzetta Ufficiale il 25 settembre 2025 ed entrata in vigore il 10 ottobre, non sostituisce il Regolamento UE 2024/1689 (AI Act), ma lo integra con disposizioni nazionali che ne operazionalizzano i principi negli spazi lasciati alla discrezionalità degli Stati membri. Questa stratificazione normativa genera un’architettura binaria che richiede alle organizzazioni una capacità interpretativa sofisticata.

Il legislatore italiano ha adottato un approccio settoriale che definisce regole specifiche per ambiti critici: sanità (art. 9), giustizia (art. 10), lavoro (art. 11), professioni intellettuali (art. 13), pubblica amministrazione (art. 14). La scelta di non limitarsi a principi generali ma di disciplinare applicazioni concrete testimonia una volontà di indirizzo forte, ma introduce complessità implementative significative che molte organizzazioni stanno solo ora cominciando a comprendere nella loro portata effettiva.

L’elemento più dirompente per le imprese è l’impatto sui modelli organizzativi ex D.Lgs. 231/2001. L’articolo 21 della Legge 132/2025 introduce nuove fattispecie di reato connesse all’uso illecito dell’IA e aggravanti specifiche. Viene introdotto l’art. 612-quater c.p. che punisce la diffusione illecita di contenuti generati o alterati tramite IA (deepfake) con pena da uno a cinque anni, mentre l’art. 61 si arricchisce del nuovo n. 11-decies che prevede un’aggravante per l’impiego di sistemi IA quando costituiscano mezzo insidioso o ostacolino la difesa. Aggravanti analoghe vengono introdotte per reati contro diritti politici, aggiotaggio e manipolazione del mercato quando commessi mediante intelligenza artificiale.

Questa estensione del catalogo dei reati presupposto obbliga le organizzazioni a ripensare integralmente la mappatura dei rischi e i protocolli di controllo, inserendo l’IA come variabile trasversale nei processi decisionali. Non si tratta più di aggiungere un capitolo al Modello esistente, ma di ripensarne l’intera architettura alla luce di una tecnologia che permea trasversalmente l’organizzazione.

Il gap italiano: numeri di un ritardo strutturale

I dati del report ISTAT “Imprese e ICT 2024” fotografano una realtà preoccupante: nonostante una crescita sostenuta del mercato italiano dell’IA (+38,7% nel 2024, con proiezioni di 909 milioni di euro nel 2024 e 1,8 miliardi nel 2027 secondo il Rapporto Anitec-Assinform “Il Digitale in Italia 2025”), solo l’8,2% delle imprese italiane con almeno 10 addetti utilizza almeno una tecnologia di IA, contro una media UE del 13,5%.

Questo divario di 5,3 punti percentuali rispetto alla media europea (l’Italia adotta l’IA a un ritmo inferiore del 39% rispetto alla media UE) non è meramente quantitativo, ma qualitativo: la tecnologia resta concentrata nelle grandi aziende (32,5% di adozione) e nei settori avanzati, mentre le PMI, che rappresentano il 92% del tessuto produttivo italiano, faticano strutturalmente nell’adozione con solo il 7,7% che utilizza IA.

Parallelamente, gli investimenti in cybersecurity crescono con forza: da 2 miliardi di euro nel 2024 a una proiezione di 2,75 miliardi nel 2027 (tasso di crescita annuo del 10,6% fino al 2028), come emerge dal White Paper Anitec-Assinform “IA e Cybersecurity”, confermando l’urgenza di rafforzare le difese digitali. Come sottolineato da Anitec-Assinform nel comunicato stampa del 17 aprile 2025, oltre alla normativa, la vera sfida è aumentare il tasso di adozione e portare benefici concreti alle imprese e ai cittadini, attraverso investimenti in formazione, programmi di accompagnamento per le PMI e sviluppo di competenze diffuse.

Il gap si manifesta su dimensioni interconnesse che richiedono interventi sistemici. Sul fronte delle competenze, l’alfabetizzazione in materia di IA prevista dall’art. 4 dell’AI Act e richiamata dalla L. 132/2025 è ancora lontana dall’essere diffusa. Le organizzazioni mancano di figure ibride in grado di comprendere simultaneamente le implicazioni tecniche, legali, etiche e operative dell’IA. Il CISO tradizionale si trova a dover dialogare con data scientists, legal counsels, HR managers e compliance officers su temi che richiedono un metalinguaggio ancora in formazione. Questa lacuna di competenze trasversali rappresenta forse il vincolo più stringente all’adozione consapevole dell’IA.

Sul piano organizzativo, la governance dell’IA richiede strutture decisionali nuove che molte aziende italiane faticano a implementare. Il modello gerarchico tradizionale, in cui la decisione finale spetta a un singolo soggetto apicale, entra in crisi quando il sistema IA genera output che influenzano decisioni ad alto impatto. La L. 132/2025 impone il principio della supervisione umana significativa (art. 3), ma tradurlo operativamente significa ripensare workflow consolidati, definire ruoli e responsabilità inediti, implementare sistemi di tracciabilità delle decisioni. QQQCome evidenziato nell’analisi di Innovation Machine, questo richiede un assessment strutturato che valuti lo stato attuale del sistema di intelligenza artificiale, identifichi gap e rischi, e costruisca roadmap di adeguamento a breve, medio e lungo termine.

Il gap tecnologico-infrastrutturale completa il quadro critico. Molte PMI operano ancora con infrastrutture IT legacy, prive dei requisiti minimi per l’adozione sicura di sistemi IA. La questione non è solo di investimento economico, ma di cultura del dato: mappatura dei data flows, classificazione dei dataset, data quality management, data lineage sono pratiche ancora poco diffuse nel tessuto produttivo italiano. La L. 132/2025 richiede localizzazione dei dati strategici presso datacenter nazionali per le PA (art. 14), una disposizione che può rappresentare un vantaggio competitivo per le aziende italiane del settore, ma che solleva interrogativi più ampi sulla sovranità digitale e sulla capacità delle organizzazioni di gestire la territorialità dei dati in architetture cloud ibride sempre più complesse.

Implementazione pratica: dalla norma all’operatività

Fase zero: censimento e mappatura

Il primo step implementativo, spesso sottovalutato ma fondamentale, è il censimento sistematico dei sistemi IA già in uso. Molte organizzazioni scoprono con sorpresa che algoritmi di ranking, chatbot, sistemi di analisi predittiva, strumenti di OCR avanzato, tool di screening CV sono già operativi, magari adottati da singoli dipartimenti senza una governance centralizzata. Questa “IA shadow“ rappresenta un rischio compliance significativo che può emergere solo attraverso un’indagine sistematica condotta a livello enterprise.

La mappatura deve documentare per ciascun sistema identificato la finalità e il contesto d’uso, interrogandosi su quale processo aziendale sia funzionale il sistema, chi lo utilizzi effettivamente e con quale frequenza. È necessario procedere poi con la classificazione del rischio secondo la tassonomia dell’AI Act, distinguendo tra rischio inaccettabile, alto, limitato e minimo. Questa categorizzazione non è un esercizio accademico: determina gli obblighi applicabili e le misure di controllo richieste.

L’analisi deve proseguire identificando il fornitore e le caratteristiche tecniche del sistema: si tratta di un prodotto commerciale o di uno sviluppo interno? Quali dati utilizza per il proprio funzionamento? Come è stato addestrato il modello sottostante? La comprensione dei data flows risulta particolarmente critica: occorre tracciare quali dati personali o categorie particolari ex art. 9 GDPR vengono processati, da dove provengono questi dati, dove risiedono fisicamente, per quanto tempo sono conservati e secondo quali logiche di retention.

Le misure di sicurezza implementate completano il quadro: quali controlli tecnici e organizzativi sono attivi per proteggere il sistema? Esistono audit trail che consentano di ricostruire le decisioni? È garantita la reversibilità delle decisioni algoritmiche? Come sottolineato nell’analisi per la Pubblica Amministrazione, questo Registro degli utilizzi IA non è un mero adempimento formale, ma il fondamento della strategia di compliance. Senza una visione d’insieme accurata e costantemente aggiornata, ogni intervento successivo è destinato a essere parziale, inefficace e potenzialmente controproducente.

Valutazione del rischio: DPIA e oltre

La Data Protection Impact Assessment (DPIA) è obbligatoria quando i trattamenti mediante IA possono comportare rischi elevati per diritti e libertà degli interessati, come stabilito dall’art. 35 GDPR. L’European Data Protection Board ha chiarito che il concetto di “rischio elevato” non si limita alla sicurezza dei dati intesa come riservatezza, integrità e disponibilità, ma comprende l’impatto sui diritti fondamentali: libertà di parola, libertà di pensiero, divieto di discriminazione, diritto alla dignità. Questa interpretazione estensiva richiede un approccio alla DPIA radicalmente diverso rispetto alle valutazioni tradizionali focalizzate sui soli aspetti di data protection.

Nel contesto specifico dell’intelligenza artificiale, la DPIA deve valutare scenari che spesso risultano controintuitivi per chi proviene da una cultura di risk assessment tradizionale. La questione dei bias algoritmici, ad esempio, richiede di verificare se in fase di training e testing siano stati rilevati valori discriminatori incorporati nel codice stesso, e di documentare quali meccanismi di debiasing siano stati implementati per mitigarli. Occorre indicare le misure correttive previste nel caso in cui tale rischio si presentasse in fase di utilizzo del sistema.

L’explainability costituisce un altro nodo critico: il sistema è in grado di fornire spiegazioni comprensibili delle proprie decisioni? È possibile ricostruire il reasoning sottostante a un output specifico? Queste domande non hanno risposte binarie, ma richiedono una valutazione contestuale che tenga conto del livello di rischio dell’applicazione e delle aspettative ragionevoli degli interessati. La robustezza e resilienza del sistema devono essere analizzate verificando se il sistema rimane stabile di fronte a input avversariali, se è protetto contro data poisoning e model inversion attacks, se esistono meccanismi di monitoraggio che rilevino degradazione delle performance nel tempo.

La protezione della privacy richiede infine di documentare l’implementazione di tecniche di privacy-enhancing come federated learning, differential privacy o homomorphic encryption, valutandone l’efficacia nel contesto specifico. Come sottolineato dall’analisi tecnica di Marco Carbonelli su ICT Security Magazine, la DPIA non è un documento statico da archiviare dopo l’approvazione iniziale, ma un processo iterativo che accompagna l’intero ciclo di vita del sistema IA. Ogni modifica significativa, sia essa un aggiornamento del modello, l’introduzione di nuove tipologie di dati o l’estensione del perimetro d’uso, richiede una revisione della valutazione che documenti come il profilo di rischio sia variato e quali misure aggiuntive siano eventualmente necessarie.

Un elemento critico, spesso trascurato nella pratica quotidiana delle organizzazioni, è il coinvolgimento degli stakeholders rilevanti. L’art. 35 GDPR prevede espressamente la consultazione degli interessati “ove opportuno”: nel contesto IA, questa consultazione può assumere forme innovative che vanno oltre le tradizionali survey, includendo focus group strutturati, beta release con meccanismi di feedback, panel di utenti rappresentativi. Il coinvolgimento dei rappresentanti dei lavoratori quando l’IA impatta processi HR, la collaborazione costante con il DPO, l’interazione con responsabili IT security ed esperti di settore non sono opzioni ma necessità per una valutazione che abbia reale valore predittivo e non si risolva in un esercizio burocratico.

Aggiornamento dei Modelli 231: responsabilità amministrativa e IA

L’integrazione dell’IA nei Modelli di Organizzazione, Gestione e Controllo ex D.Lgs. 231/2001 rappresenta uno dei nodi più complessi dell’implementazione normativa. La L. 132/2025 introduce nuovi reati presupposto e aggravanti legate all’uso dell’IA, rendendo necessario un aggiornamento strutturale non solo della Parte Speciale del Modello, ma dell’intera filosofia di risk assessment aziendale.

Il primo passaggio operativo consiste nell’identificare con precisione i processi aziendali in cui l’IA è utilizzata o potrebbe essere utilizzata, valutandone l’esposizione ai nuovi rischi-reato. Le aree che emergono come particolarmente critiche includono il marketing e la comunicazione, dove la generazione di contenuti mediante IA generativa espone al rischio di produzione di deepfake o contenuti ingannevoli che potrebbero configurare i nuovi reati introdotti dalla legge. Le relazioni esterne e con la Pubblica Amministrazione costituiscono un’altra zona d’ombra: l’utilizzo di IA in processi che coinvolgono pubblici ufficiali può generare responsabilità se non adeguatamente governato.

La gestione delle risorse umane rappresenta forse l’ambito più delicato: i sistemi di screening CV, valutazione delle performance, previsione del turnover basati su algoritmi di machine learning espongono al rischio concreto di discriminazione algoritmica, con potenziali implicazioni sia sul fronte del diritto del lavoro sia su quello della responsabilità amministrativa. L’ambito della cybersecurity chiude il cerchio delle criticità: l’impiego di IA per finalità di attacco o difesa si muove su un confine labile tra security testing legittimo e attività potenzialmente illecite, richiedendo protocolli di controllo estremamente rigorosi.

Per ciascuna area sensibile identificata, il Modello deve prevedere protocolli di controllo specifici che vadano oltre le dichiarazioni di principio. La due diligence sui fornitori richiede l’implementazione di procedure strutturate di qualificazione dei provider di sistemi IA, con verifica documentale della conformità ad AI Act e L. 132/2025, valutazione delle certificazioni possedute, analisi dei contratti per individuare clausole critiche su responsabilità, accesso ai dati, diritti di audit. La formazione mirata deve articolarsi in programmi di alfabetizzazione specifici per ruoli esposti, distinguendo tra personale di marketing, HR, IT, con focus non generici ma calati su use case concreti: uso lecito degli strumenti, limiti operativi tassativi, procedure di escalation quando si manifestano dubbi interpretativi.

L’audit trail e logging assumono carattere obbligatorio: ogni decisione influenzata da IA deve essere tracciabile, con documentazione della supervisione umana che specifichi chi ha esaminato l’output algoritmico, con quali competenze, in quale lasso temporale. L’integrazione dell’intelligenza artificiale nei processi di valutazione dei rischi-reato rappresenta una frontiera che può potenziare l’efficacia dei controlli, ma richiede a sua volta governance rigorosa.

Gli incident response protocols per la gestione di eventi critici devono essere predisposti anticipatamente, non in emergenza: cosa fare se un sistema genera un output discriminatorio? Come gestire la scoperta di un deepfake prodotto internamente? Quali procedure attivare in caso di data breach originato da un sistema IA? Le risposte a queste domande non possono essere improvvisate, ma richiedono playbook dettagliati, responsabilità chiare, canali di comunicazione definiti.

Il ruolo dell’Organismo di Vigilanza subisce una trasformazione sostanziale. L’OdV deve acquisire competenze specifiche in materia di IA per svolgere efficacemente la propria funzione di controllo, il che può richiedere l’integrazione di nuove professionalità come data scientists o AI ethics experts, o il ricorso sistematico a consulenze tecniche esterne qualificate.

L’OdV non può limitarsi a verifiche formali sull’esistenza di documenti, ma deve entrare nel merito della sostanza: l’aggiornamento del registro sistemi IA è effettivo o cartolare? L’implementazione delle misure previste dal Modello è verificabile attraverso audit tecnici? La documentazione delle DPIA e delle decisioni di risk acceptance è completa e tracciabile? L’efficacia dei programmi di formazione è misurabile attraverso metriche oggettive? La gestione degli incident genera realmente learning organizzativo o si risolve in correzioni spot?

Trasparenza e informativa: l’obbligo comunicativo

Gli articoli 11 (lavoro), 13 (professioni intellettuali) e 14 (Pubblica Amministrazione) della L. 132/2025 introducono obblighi di informazione specifici che hanno generato reazioni contrastanti tra le categorie professionali coinvolte. Chi utilizza sistemi IA deve comunicarlo agli interessati in modo “chiaro, semplice ed esaustivo“. Questo principio, apparentemente banale, genera complessità operative significative che molte organizzazioni stanno sottovalutando.

La prima questione riguarda il “cosa comunicare”. L’informativa deve coprire l’esistenza stessa e le finalità del sistema IA utilizzato, specificando in quale fase del processo interviene e con quale impatto sulla decisione finale. Le tipologie di dati trattati devono essere elencate con precisione sufficiente a consentire all’interessato di comprendere l’estensione del trattamento. Le logiche algoritmiche sottostanti rappresentano il nodo più critico: occorre spiegare come funziona il sistema nella misura compatibile con la tutela di eventuali segreti industriali, un bilanciamento delicato che richiede competenze comunicative sofisticate.

L’impatto della decisione algoritmica sul risultato finale deve essere quantificato o quanto meno qualificato: il sistema fornisce una raccomandazione che l’operatore può liberamente disattendere? Genera un punteggio che vincola la decisione se supera determinate soglie? Preseleziona candidati eliminando automaticamente chi non soddisfa criteri prestabiliti? I meccanismi di supervisione umana attivi devono essere descritti con il necessario livello di dettaglio, specificando chi supervisiona, con quale frequenza, con quali strumenti di override. Infine, i diritti dell’interessato devono essere esplicitati: diritto di opposizione, rettifica, richiesta di human review delle decisioni algoritmiche.

Il “come comunicare” rappresenta forse la sfida più ardua. La trasparenza è il filo conduttore della normativa, ma renderla effettiva significa evitare sia il tecnicismo esoterico incomprensibile ai non addetti, sia la banalizzazione che svuota di significato l’informativa. Il layered approach, con informativa sintetica di primo livello integrata da approfondimenti tecnici disponibili on-demand, rappresenta una soluzione efficace: l’utente riceve immediatamente le informazioni essenziali, ma può accedere a livelli successivi di dettaglio se desidera approfondire.

La visual communication attraverso infografiche, flowcharts, video esplicativi può illustrare processi decisionali complessi in modo più accessibile rispetto a testi densi. Le FAQ strutturate e i casi d’uso concreti aiutano l’interessato a comprendere come il sistema opera in situazioni tipiche che può riconoscere come rilevanti per la propria esperienza. Un glossario accessibile diventa indispensabile quando termini tecnici come machine learning, neural network, training set risultano inevitabili: meglio spiegarli con linguaggio piano che dare per scontata una familiarità che spesso non c’è.

Il “quando comunicare” chiude il cerchio degli obblighi: l’informazione deve essere preventiva, non ex post. Nel contesto lavorativo, come specificato dall’art. 11 commentato dal Centro Studi CISL, ciò significa informare i dipendenti prima dell’implementazione di sistemi IA che impattano gestione, valutazione o selezione. Per le professioni intellettuali, l’obbligo scatta all’avvio della prestazione: il cliente deve sapere sin dall’inizio se e come l’IA supporta il professionista. Per la PA, deve essere garantita trasparenza ex ante attraverso pubblicazione sul sito istituzionale e informative specifiche nei procedimenti interessati.

Il mancato o inadeguato assolvimento di questi obblighi informativi espone l’organizzazione a rischi molteplici e convergenti. L’invalidità degli atti amministrativi per violazione del diritto di partecipazione e difesa rappresenta un rischio concreto per le PA. La responsabilità contrattuale può configurarsi nelle professioni intellettuali quando il cliente dimostri che avrebbe scelto diversamente se fosse stato adeguatamente informato. Le sanzioni GDPR possono raggiungere i 10 milioni di euro o il 2% del fatturato globale per violazione dell’art. 35, come documentato nel provvedimento del Garante. Il danno reputazionale, infine, può risultare più gravoso delle sanzioni formali, erodendo la fiducia di clienti, partner, investitori.

Human-in-the-loop: supervisione umana significativa

Il principio cardine della L. 132/2025 è che l’IA deve restare strumento di supporto, non decisore autonomo. L’art. 3 sancisce la “centralità della persona” e impone che ogni sistema di intelligenza artificiale debba essere sottoposto a forme di supervisione umana significativa. L’art. 14 specifica per la PA che l’utilizzo dell’intelligenza artificiale avviene in funzione strumentale e di supporto all’attività provvedimentale, nel rispetto dell’autonomia e del potere decisionale della persona che resta l’unica responsabile.

Tradurre operativamente il concetto di “supervisione umana significativa” è tutt’altro che scontato e richiede di superare la retorica che spesso accompagna questi temi. Non basta affermare che “la decisione finale spetta all’uomo” per adempiere all’obbligo: occorre progettare architetture decisionali che rendano questa supervisione effettiva, non formale. La letteratura tecnica identifica tre modelli principali di supervisione, ciascuno appropriato per diversi livelli di rischio.

Il modello Human-in-the-loop (HITL) prevede che l’umano sia coinvolto in ogni singola decisione: l’IA fornisce raccomandazioni che l’operatore può accettare o rigettare, con obbligo di motivazione esplicita in caso di disallineamento. Questo modello è mandatorio per sistemi ad alto rischio che impattano diritti fondamentali, salute o sicurezza delle persone. Il modello Human-on-the-loop (HOTL) consente all’IA di operare autonomamente entro parametri rigorosamente definiti, mentre l’umano monitora l’operatività e può intervenire quando emergono anomalie o su campioni predefiniti secondo logiche statistiche. Il modello Human-in-command (HIC) sposta la supervisione a livello strategico: l’umano definisce obiettivi e vincoli, l’IA esegue autonomamente ma l’umano mantiene il controllo strategico e può interrompere il sistema in qualsiasi momento.

La scelta del modello appropriato non può essere arbitraria ma deve discendere da un risk assessment rigoroso. Tuttavia, la supervisione efficace richiede prerequisiti che molte organizzazioni non garantiscono. Il supervisore deve possedere competenze sufficienti per comprendere il funzionamento del sistema, i suoi limiti intrinseci, i suoi bias potenziali: non può supervisionare efficacemente ciò che non comprende. L’autorità del supervisore deve essere effettiva, non nominale: deve avere il potere reale di overridare le raccomandazioni dell’IA senza subire conseguenze negative, pressioni implicite o esplicite verso il conformismo algoritmico.

Il tempo e le risorse rappresentano vincoli spesso sottovalutati: il supervisore deve disporre del tempo necessario per esaminare criticamente gli output, non essere pressato da vincoli di produttività incompatibili con una revisione accurata. Se il sistema genera 100 raccomandazioni al giorno e il supervisore dispone di 10 minuti totali per esaminarle, la supervisione è strutturalmente impossibile, non importa quanto competente sia l’operatore. L’indipendenza costituisce infine un requisito ideale spesso difficile da garantire: il supervisore non dovrebbe aver partecipato allo sviluppo del sistema per evitare bias di conferma, ma nelle organizzazioni piccole questa separazione può risultare impraticabile.

La documentazione di ogni decisione influenzata da IA diventa un obbligo non derogabile. Ogni caso deve essere tracciato specificando l’output fornito dal sistema IA, la valutazione del supervisore umano con indicazione delle verifiche effettuate, la decisione finale assunta e la motivazione di eventuali discostamenti dall’output algoritmico. Questa documentazione, per quanto onerosa, è essenziale non solo per dimostrare la compliance in caso di audit o contenziosi, ma anche per accumulare dati utili al miglioramento continuo del sistema: i casi in cui l’umano ha sistematicamente overridato l’IA possono rivelare bias o errori del modello che richiedono retraining o revisione delle logiche decisionali.

Gap analysis: criticità e opportunità

Gap normativi e implementativi

La L. 132/2025 si presenta dichiaratamente come legge “quadro“, rimandando a futuri decreti attuativi, da emanarsi entro 12 mesi, la definizione di aspetti cruciali quali procedure tecniche di valutazione, dettagli sanzionatori, articolazione precisa della governance nazionale tra AgID e ACN. Questa incompletezza, per quanto fisiologica in una normativa di questo tipo, genera incertezza operativa significativa: le organizzazioni devono implementare misure basandosi su principi generali, con il rischio concreto che i decreti attuativi introducano requisiti ulteriori o interpretazioni difformi che richiederanno costosi adeguamenti successivi.

Il coordinamento tra AI Act e L. 132/2025 crea ulteriori complessità interpretative che molti operatori sottovalutano. La sovrapposizione tra normativa europea e nazionale genera zone grigie in cui non è sempre chiaro quale disposizione prevalga o come si integrino requisiti apparentemente duplicati. L’AI Act classifica i sistemi in base al rischio e impone obblighi specifici ai providers e deployers. La L. 132/2025 introduce ulteriori obblighi settoriali che si stratificano su quelli europei. Le organizzazioni devono navigare due framework normativi che, pur coerenti nei principi ispiratori, differiscono nei dettagli operativi e nelle tempistiche applicative. La mancanza di linee guida consolidate da parte delle autorità competenti aumenta il rischio di interpretazioni difformi, con conseguente incertezza sulla compliance effettiva.

Il deficit di standard tecnici rappresenta forse la lacuna più critica dell’attuale panorama normativo. Molti requisiti normativi quali explainability, robustezza, fairness mancano di standard tecnici condivisi che consentano una valutazione oggettiva. Cosa significa concretamente “spiegazione comprensibile” per un modello di deep learning con milioni di parametri distribuiti su centinaia di layer? Quali metriche utilizzare per valutare il bias in contesti applicativi diversi? Quali threshold di accuratezza sono accettabili per un sistema di screening CV rispetto a uno di diagnosi medica assistita? L’assenza di reference standards condivisi, certificati da enti terzi riconosciuti, costringe le organizzazioni a scelte discrezionali, con conseguente frammentazione delle pratiche e difficoltà oggettive nei processi di audit e certificazione.

Gap di competenze e formazione

L’art. 4 dell’AI Act impone alle organizzazioni di garantire “un livello sufficiente di alfabetizzazione in materia di IA del loro personale“. La L. 132/2025 rafforza questo obbligo prevedendo “percorsi di formazione digitale” (art. 13) e “programmi di educazione e sensibilizzazione” (art. 8). Tuttavia, il mercato della formazione è ancora immaturo e caratterizzato da offerte di qualità molto disomogenea.

La carenza di formatori qualificati costituisce il primo vincolo strutturale: pochi professionisti combinano competenze tecniche in AI/ML, conoscenze legali approfondite di GDPR, AI Act e L. 132/2025, sensibilità etica su temi di bias e fairness, e competenze organizzative in risk management e compliance. Questa rarefazione di competenze ibride si riflette nell’offerta formativa: molti corsi propongono panoramiche superficiali su tutti i temi, senza declinazioni operative settoriali che consentano ai partecipanti di applicare i concetti al proprio contesto specifico. La difficoltà di misurazione dell’efficacia formativa completa il quadro critico: come valutare se la formazione ha realmente aumentato il livello di alfabetizzazione? Quali KPI adottare per monitorare il progresso? Come distinguere l’apprendimento dichiarativo superficiale dalla comprensione procedurale profonda?

Le organizzazioni che vogliono affrontare seriamente questo gap devono investire in formazione stratificata su più livelli. L’awareness generale per tutti i dipendenti deve coprire principi fondamentali, rischi connessi all’uso improprio dell’IA, obblighi informativi base, con un approccio divulgativo ma non banalizzante. La formazione tecnica per sviluppatori e data scientists richiede focus su privacy-by-design, tecniche di debiasing, metodologie di testing rigoroso, con esempi di codice e case study concreti.

La formazione specialistica per ruoli chiave quali DPO, CISO, legal counsels, compliance officers deve entrare nel dettaglio di governance frameworks, metodologie di risk assessment specifiche per IA, incident management, interpretazione normativa, con simulazioni e discussione di casi controversi. La formazione esecutiva per C-level e board deve concentrarsi su rischi strategici, responsabilità legali e reputazionali, opportunità competitive, con un taglio meno tecnico ma altrettanto rigoroso.

Gap organizzativo e culturale

L’adozione dell’IA non è un semplice aggiornamento tecnologico ma un cambiamento culturale profondo che investe i valori, i processi, le dinamiche di potere all’interno delle organizzazioni. Richiede anzitutto un mindset data-driven, un passaggio da decisioni basate su intuizione, esperienza personale, gerarchie consolidate a decisioni fondate su evidenze quantitative, analisi statistiche, pattern identificati algoritmicamente. Questo shift cognitivo genera resistenze, spesso implicite, in chi teme di vedere sminuito il valore della propria esperienza professionale.

La cultura dell’errore rappresenta un altro nodo critico: occorre accettare che i sistemi IA sbagliano, che l’accuratezza del 95% significa comunque 5 errori ogni 100 decisioni, che il machine learning richiede iterazioni, testing, fallimenti dai quali apprendere. Le organizzazioni italiane, tradizionalmente caratterizzate da bassa tolleranza all’errore e cultura della colpa, faticano a sviluppare questa capacità di learning from failures necessaria per governare tecnologie intrinsecamente probabilistiche.

La cross-functional collaboration diventa prerequisito non negoziabile: il superamento dei silos organizzativi, il dialogo costante tra IT, legal, business units, HR non sono opzioni ma necessità. L’IA è per definizione una tecnologia trasversale che tocca tutti i processi aziendali, e una governance efficace richiede meccanismi strutturati di coordinamento che molte organizzazioni gerarchiche tradizionali non possiedono. L’integrazione di etica applicata nei processi decisionali completa il quadro delle trasformazioni culturali necessarie: le considerazioni etiche non possono essere relegate a vincoli esterni imposti dalla compliance, ma devono diventare valori intrinseci che guidano le scelte tecnologiche.

Molte organizzazioni italiane, soprattutto PMI a carattere familiare, mantengono strutture gerarchiche rigide e culture profondamente avverse al rischio, poco compatibili con l’agilità e la sperimentazione controllata richieste dall’innovazione IA. Il cambiamento culturale è notoriamente lento, richiede leadership commitment visibile e continuativo, coerenza tra dichiarazioni e comportamenti effettivi, investimenti temporali che vanno ben oltre l’orizzonte del quarter finanziario.

Opportunità: compliance come vantaggio competitivo

La conformità alla L. 132/2025 e all’AI Act, tuttavia, non deve essere vista esclusivamente come onere ma anche come opportunità strategica che può generare vantaggi competitivi tangibili. La differenziazione reputazionale rappresenta il primo beneficio: le organizzazioni che dimostreranno standard elevati di AI governance, magari attraverso certificazioni di terza parte o audit indipendenti pubblicati, potranno valorizzare questa compliance in termini di brand equity e fiducia degli stakeholder. In un mercato dove i data breach e gli scandali algoritmici erodono rapidamente la fiducia, una reputazione solida di AI responsabile costituisce un asset strategico non facilmente replicabile.

L’accesso facilitato a incentivi pubblici costituisce un ulteriore vantaggio concreto. La L. 132/2025 prevede un fondo da 1 miliardo di euro per tecnologie emergenti e IA affidabile, con specifico sostegno a microimprese e PMI. Le organizzazioni che possono dimostrare compliance strutturata saranno favorite nell’accesso a bandi, contributi a fondo perduto, partnership pubblico-private che richiedono garanzie di solidità governance.

La mitigazione dei rischi legali assume rilevanza crescente in un contesto dove le sanzioni potenziali sono drammaticamente aumentate: fino a 35 milioni di euro o 7% del fatturato globale per pratiche vietate secondo l’AI Act. Investire in compliance preventiva significa ridurre drasticamente l’esposizione a queste sanzioni future, evitare contenziosi costosi, prevenire il danno reputazionale amplificato dai social media che può risultare più distruttivo delle multe stesse.

L’attraction e retention di talenti qualificati costituisce un beneficio spesso sottovalutato. I professionisti di alto livello, particolarmente nelle aree tecniche e legal, preferiscono lavorare per organizzazioni che dimostrano serietà nella governance tecnologica, che investono in formazione continua, che operano secondo standard etici elevati. In un mercato del lavoro sempre più competitivo per le competenze IA-related, la reputazione di AI responsabile può fare la differenza nel reclutamento.

Le sandbox regolamentari, infine, rappresentano opportunità preziose per PMI e startup. L’AI Act e la normativa nazionale prevedono spazi di sperimentazione controllata dove testare innovazioni IA con supervisione regolatoria, riducendo il rischio compliance durante le fasi di R&D. Accedere a questi programmi richiede però di dimostrare un approccio maturo alla governance, chiudendo il cerchio: la compliance apre porte che restano precluse a chi opera in zone grigie.

Metodologia operativa per l’implementazione: un percorso in cinque fasi

L’implementazione della Legge 132/2025 nelle aziende italiane richiede un approccio metodologico strutturato che bilanci rigore e pragmatismo, evitando sia la paralisi da analisi sia l’improvvisazione irresponsabile. La metodologia qui proposta si articola in cinque fasi temporalmente sovrapposte, con particolare attenzione all’interdipendenza tra gli interventi e alla necessità di quick wins che dimostrino valore nei primi mesi.

La prima fase di assessment e mappatura, che occupa tipicamente i primi due mesi del progetto, inizia con la costituzione di una task force multidisciplinare che coinvolga rappresentanti delle aree IT, legal, compliance, business e risorse umane. Questa eterogeneità non è un vezzo organizzativo ma una necessità: l’IA è per definizione trasversale e richiede competenze complementari per essere governata efficacemente. Il censimento dei sistemi IA esistenti, inclusa la cosiddetta “shadow AI” adottata dai dipartimenti senza autorizzazione formale, costituisce il primo deliverable concreto: un inventario esaustivo che documenti ogni applicazione, anche quelle apparentemente marginali.

La mappatura dei data flows procede in parallelo, identificando quali dati personali o categorie particolari vengano processati da ciascun sistema, con particolare attenzione alle origini dei dati e ai tempi di conservazione. La classificazione dei sistemi per livello di rischio secondo la tassonomia dell’AI Act consente di stabilire priorità razionali negli interventi successivi: un sistema ad alto rischio che processa dati sanitari sensibili richiede attenzione immediata, mentre un chatbot informativo a rischio minimo può essere affrontato con calma maggiore.

L’identificazione dei processi aziendali esposti ai nuovi reati presupposto del D.Lgs. 231/2001 chiude questa fase di analisi, producendo una gap analysis strutturata che confronta lo stato attuale con i requisiti normativi e definisce priorità di intervento basate su una matrice rischio per impatto.

La seconda fase di governance e policy, tipicamente collocata tra il terzo e il quarto mese, si concentra sulla definizione dell’architettura decisionale e dei documenti strategici. L’AI Governance Framework deve specificare ruoli e responsabilità con precisione chirurgica: chi approva l’adozione di nuovi sistemi IA? Chi ha autorità per interrompere un sistema che manifesta comportamenti anomali? Come si coordinano le diverse funzioni aziendali nelle decisioni che coinvolgono l’IA? La costituzione di un comitato multifunzionale per l’IA, che si riunisca con cadenza almeno mensile, fornisce la sede istituzionale per queste decisioni.

La redazione dell’AI Policy aziendale traduce i principi normativi in linee guida operative: quali casi d’uso sono ammessi, quali esplicitamente vietati, quali sottoposti ad approval workflow particolare? Un documento di policy efficace non si limita a enunciare principi astratti ma fornisce esempi concreti, distinguendo tra utilizzi legittimi e utilizzi problematici attraverso case study che i dipendenti possano riconoscere come rilevanti per il proprio lavoro quotidiano. L’aggiornamento del Modello 231 deve intervenire sia sulla Parte Generale, integrando i principi di AI governance, sia sulla Parte Speciale, introducendo protocolli specifici per le aree a rischio identificate nella prima fase.

La definizione di procedure per l’introduzione di nuovi sistemi IA costituisce forse il deliverable più importante di questa fase: un approval workflow che specifichi quali valutazioni siano necessarie prima dell’adozione, chi debba essere coinvolto, quali documenti prodotti, quali soglie di rischio richiedano escalation verso livelli decisionali superiori. La contrattualizzazione con i fornitori richiede attenzione particolare alle clausole su responsabilità, diritti di audit, data ownership, exit strategies: contratti standard pensati per software tradizionale spesso non coprono adeguatamente le specificità dell’IA.

La nomina di un AI Coordinator o AI Ethics Officer, se la dimensione aziendale lo giustifica, fornisce un punto di riferimento organizzativo visibile per tutte le questioni IA-related. L’integrazione dell’IA nell’Enterprise Risk Management chiude questa fase, assicurando che i rischi algoritmici siano trattati con lo stesso rigore dei rischi finanziari, operativi, reputazionali tradizionali.

La terza fase di compliance operativa, che si sviluppa tipicamente tra il quinto e il settimo mese con significative sovrapposizioni con la fase formativa, si concentra sull’implementazione concreta delle misure. L’esecuzione delle DPIA per sistemi ad alto rischio richiede competenze tecniche e legali avanzate, spesso imponendo il ricorso a consulenze esterne specializzate. L’implementazione di misure tecniche quali logging strutturato, audit trail immutabili, explainability tools integrati nei sistemi critici richiede collaborazione stretta tra team di compliance e team di sviluppo, spesso con necessità di refactoring di sistemi esistenti.

Le misure organizzative, quali segregation of duties e protocolli di human oversight, devono essere tradotte in procedure operative dettagliate che specifichino chi fa cosa, quando, con quali strumenti, secondo quali criteri. La redazione delle informative per lavoratori, clienti, utenti secondo il layered approach discusso precedentemente costituisce un deliverable che richiede iterazioni multiple: le prime versioni sono inevitabilmente troppo tecniche o troppo vaghe, e solo attraverso testing con utenti reali si raggiunge il bilanciamento ottimale tra completezza e comprensibilità.

La definizione di incident response plan specifici per IA anticipa scenari critici: discovery di bias discriminatorio in produzione, deep fake creato con strumenti aziendali, data breach originato da vulnerabilità in un modello di ML. Ogni scenario richiede playbook dettagliati con responsabilità, canali di comunicazione, criteri di escalation predefiniti. Il testing e la validazione dei meccanismi di supervisione umana attraverso simulazioni e penetration testing organizzativi verifica che i controlli progettati funzionino nella pratica, non solo sulla carta. La documentazione di compliance, che include registro dei trattamenti aggiornato, registro sistemi IA, DPIA, risk assessments settoriali, deve essere organizzata in modo che un auditor esterno possa ricostruire la logica decisionale dell’organizzazione senza necessità di interviste estensive.

La quarta fase di formazione e change management, che si sviluppa in parallelo alla fase di compliance operativa tra il sesto e l’ottavo mese, affronta la dimensione più critica e sottovalutata dell’implementazione: le persone. La progettazione del piano formativo stratificato deve differenziare contenuti, metodi e durata in funzione dei target: awareness generale per tutti i dipendenti con moduli e-learning di 2-3 ore, formazione tecnica per sviluppatori e data scientists con workshop pratici di 2-3 giorni, formazione specialistica per DPO, CISO, legal e compliance officers con masterclass di 5 giorni più follow-up periodici, formazione esecutiva per C-level e board con sessioni intensive di mezza giornata focalizzate su rischi e opportunità strategiche.

L’erogazione della formazione con metodologie blended che combinano e-learning asincrono, sessioni d’aula sincrone, workshop pratici su casi reali, simulazioni di incident response massimizza l’efficacia dell’apprendimento rispetto a formazioni puramente frontali. La valutazione dell’efficacia attraverso test di apprendimento, discussione di case studies, raccolta sistematica di feedback consente di iterare e migliorare i contenuti. Il programma di comunicazione interna attraverso newsletter periodiche, sezioni dedicate sull’intranet aziendale, town halls con il management crea awareness diffusa e dimostra commitment visibile della leadership.

Il coinvolgimento delle rappresentanze dei lavoratori, come richiesto dall’art. 11 della L. 132/2025, non deve essere formale ma sostanziale: presentazioni dedicate, consultazioni sui sistemi che impattano i lavoratori, canali di feedback strutturati. La creazione di un repository documentale accessibile che raccolga policy, procedure, FAQ, glossari, template per le valutazioni costituisce una risorsa permanente che riduce la dipendenza da singole persone e facilita l’onboarding di nuovi colleghi.

La quinta fase di monitoraggio e miglioramento continuo, che parte dall’ottavo-nono mese ma prosegue indefinitamente, trasforma la compliance da progetto a processo permanente. L’attivazione di KPI per monitorare la compliance attraverso metriche quali percentuale di sistemi IA censiti sul totale stimato, percentuale di DPIA completate per sistemi ad alto rischio, coverage della formazione per categoria di dipendenti, tempo medio di risposta agli incident fornisce visibilità oggettiva sullo stato dell’implementazione e consente correzioni di rotta tempestive.

Gli audit interni periodici, con cadenza almeno semestrale, verificano la conformità effettiva alle policy e procedure, non limitandosi a controllare l’esistenza di documenti ma testando l’operatività dei controlli attraverso sample testing e walkthrough. La revisione delle DPIA in caso di modifiche significative ai sistemi, nuovo training dei modelli, estensione dei casi d’uso, cambiamenti normativi assicura che le valutazioni restino attuali. Il monitoraggio dell’evoluzione normativa, con particolare attenzione ai decreti attuativi della L. 132/2025 attesi nei prossimi mesi e alle linee guida di AgID, ACN e EDPB richiede dedicare risorse specifiche al regulatory intelligence.

La raccolta e analisi sistematica degli incident IA, con root cause analysis, identificazione di lessons learned, aggiornamento conseguente delle procedure trasforma gli errori in opportunità di miglioramento. L’aggiornamento almeno annuale del Modello 231 basato sul risk assessment aggiornato mantiene allineamento tra governance formale e realtà operativa. Il reporting periodico al Consiglio di Amministrazione e all’Organismo di Vigilanza sullo stato della AI governance, con metriche quantitative e assessment qualitativo, assicura che il top management mantenga visibilità e ownership su un tema che rapidamente evolve da questione tecnica a rischio strategico d’impresa.

Conclusioni: oltre la compliance, verso l’AI trustworthy

L’implementazione della Legge 132/2025 nelle aziende italiane non può essere ridotta a un esercizio di compliance formale, un’ulteriore casella da spuntare nell’elenco già affollato degli adempimenti normativi. La posta in gioco è significativamente più alta: si tratta di costruire un ecosistema di intelligenza artificiale affidabile (trustworthy AI), in cui innovazione tecnologica e tutela dei diritti procedano in parallelo, in una tensione produttiva piuttosto che in un’opposizione sterile.

Il gap che separa l’Italia dalla media europea nell’adozione dell’IA, con quel divario del 61% che i dati Anitec-Assinform hanno impietosamente fotografato, è preoccupante e richiede interventi urgenti. Tuttavia, la normativa può trasformarsi da ostacolo percepito in catalizzatore effettivo se governata con approccio pragmatico e strategico. Le organizzazioni che sapranno integrare i requisiti normativi nei processi di sviluppo e deployment dell’IA fin dalle fasi iniziali, adottando un paradigma di AI governance by design piuttosto che di compliance retrofitted, costruiranno un vantaggio competitivo sostenibile che i competitor non potranno replicare rapidamente.

Tre fattori emergeranno come determinanti nei prossimi anni, distinguendo le organizzazioni che prospereranno in questo nuovo panorama da quelle che resteranno indietro. L’investimento sistematico in competenze ibride costituisce il primo elemento critico. La tecnologia evolve con ritmo esponenziale, la normativa la insegue con ritardi fisiologici inevitabili in democrazie pluraliste dove il processo legislativo richiede tempi di maturazione. Le organizzazioni non possono permettersi di affidarsi passivamente a checklist statiche elaborate da consulenti esterni: devono costruire capacità interne di interpretazione, anticipazione, adattamento.

Il ruolo tradizionale del Data Protection Officer sta già evolvendo verso quello di AI Ethics & Compliance Officer, una figura che integra competenze tecniche approfondite su machine learning e data science, conoscenze legali estese di GDPR, AI Act e normative settoriali, sensibilità etica maturata attraverso studio di casi controversi, capacità organizzative di gestire processi trasversali che coinvolgono tutta l’azienda.

La collaborazione multi-stakeholder rappresenta il secondo fattore critico che nessuna organizzazione può permettersi di trascurare. Nessuna impresa, per quanto grande e sofisticata, può affrontare da sola la complessità multidimensionale dell’IA governance. Servono piattaforme di confronto settoriali dove condividere esperienze, discutere interpretazioni normative controverse, sviluppare best practices validate sul campo. Le associazioni di categoria come Confindustria, Assinform e Anorc possono svolgere un ruolo prezioso di aggregazione, creando working group dedicati che producano linee guida operative, template riutilizzabili, case study anonimi che documentino successi e fallimenti. Le sandbox regolamentari previste da AI Act e L. 132/2025, rappresentano spazi preziosi per sperimentazione controllata dove testare soluzioni innovative sotto supervisione delle autorità, riducendo il rischio compliance durante le fasi critiche di R&D.

Il pragmatismo regolatorio costituisce il terzo elemento determinante, un fattore che esula dal controllo delle singole organizzazioni ma che condizionerà profondamente il successo dell’intero impianto normativo. L’efficacia della Legge 132/2025 dipenderà in misura cruciale dalla capacità delle autorità di controllo – AgID, ACN, Garante Privacy – di fornire guidance operative tempestive, proporzionali, evidence-based.

Un enforcement eccessivamente rigido nelle fasi iniziali, quando le organizzazioni stanno ancora sperimentando approcci e metodologie, rischia di paralizzare l’innovazione e generare un atteggiamento difensivo che privilegia la minimizzazione del rischio legale rispetto all’adozione di tecnologie potenzialmente transformative. Un approccio più graduale, come suggerito nell’analisi per la Pubblica Amministrazione, con focus su enforcement educativo prima che sanzionatorio, può favorire una compliance effettiva e sostanziale piuttosto che cartolare e formale.

Il percorso che si apre davanti alle organizzazioni italiane è appena iniziato, e presenta sfide formidabili ma non insormontabili. I prossimi dodici mesi, durante i quali verranno emanati i decreti attuativi della L. 132/2025, saranno cruciali per definire l’interpretazione operativa della normativa. Le organizzazioni che avranno già avviato il processo di adeguamento si troveranno in posizione di vantaggio, potendo influenzare l’evoluzione interpretativa della normativa attraverso il dialogo costruttivo con le autorità e la dimostrazione di soluzioni pratiche efficaci che bilanciano innovazione e protezione.

L’intelligenza artificiale è una rivoluzione tecnologica irreversibile che sta già ridisegnando settori interi dell’economia e della società. La sfida per l’Italia non è se adottare l’IA – questo treno è già partito e non si fermerà – ma come governarla in modo che massimizzi i benefici e minimizzi i rischi. La Legge 132/2025 fornisce gli strumenti normativi, creando un framework che, per quanto perfettibile e destinato a evolversi, rappresenta comunque un punto di riferimento chiaro. Alle organizzazioni spetta tradurli in pratica organizzativa quotidiana, investendo in competenze, processi, cultura. Alle autorità spetta garantire un ecosistema regolatorio che bilanci con saggezza innovazione e protezione, evitando sia il permissivismo che aprirebbe la strada ad abusi, sia il rigorismo che soffocherebbe la sperimentazione legittima.

Ai professionisti del diritto digitale, della cybersecurity, del digital forensics, della compliance spetta costruire le competenze ibride necessarie a navigare questa complessità, posizionandosi come bridge tra il mondo tecnologico e quello legale, traducendo in linguaggi reciprocamente comprensibili esigenze che troppo spesso parlano lingue inconciliabili. L’alternativa al governo consapevole e proattivo della trasformazione è l’irrilevanza competitiva progressiva, un declino magari lento ma inesorabile. Le aziende italiane, le istituzioni, i professionisti non possono permetterselo. Il momento di agire è ora, e gli strumenti normativi e metodologici per farlo efficacemente sono disponibili. Quello che serve è la volontà di investire, la capacità di collaborare, il coraggio di sperimentare.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/legge-132-2025/


Il prezzo nascosto dell’AI: quando i tuoi dati diventano merce di scambio

L’intervento di Andrea Pavan di Beliven al Forum ICT Security 2025 svela i rischi che le Big Tech preferiscono non raccontare.

C’è una narrazione dominante sull’intelligenza artificiale che rischia di gettare fumo negli occhi. ChatGPT, Copilot, Gemini, Claude: strumenti presentati come bacchette magiche capaci di moltiplicare la produttività, automatizzare il lavoro ripetitivo, rendere accessibile a tutti ciò che prima richiedeva competenze specialistiche. La promessa è seducente, i risultati spesso impressionanti. Ma c’è un prezzo da pagare, e non è quello dell’abbonamento premium.

Al 23° Forum ICT Security, Andrea Pavan di Beliven ha squarciato il velo su una realtà che molti preferiscono ignorare: ogni prompt che digitiamo, ogni documento che carichiamo, ogni conversazione che intratteniamo con un assistente AI alimenta un ecosistema di dati su cui abbiamo sempre meno controllo. E le conseguenze, per aziende e privati, possono essere molto più serie di quanto si immagini.

L’AI come l’elettricità: una metafora da prendere sul serio

“AI / Nuovo inizio – Come l’elettricità alla fine dell’Ottocento”
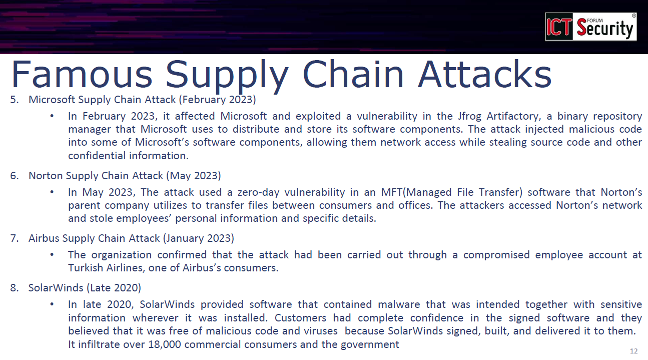
Il paragone proposto nell’intervento non è casuale. L’intelligenza artificiale oggi presenta caratteristiche analoghe a quelle dell’energia elettrica alla fine dell’Ottocento: è una tecnologia pervasiva, abilita l’automazione su scala prima impensabile, apre possibilità di riorganizzazione del lavoro e, aspetto cruciale, genera dipendenza.

Chi, oggi, potrebbe rinunciare all’elettricità? Allo stesso modo, chi potrà permettersi di ignorare l’AI nei prossimi anni? La risposta è evidente: nessuno. Ma proprio per questo diventa fondamentale comprenderne non solo il potenziale, ma anche i rischi e le applicazioni corrette. Come ha sottolineato il relatore, chi saprà governare questa transizione sarà avvantaggiato; chi la subirà passivamente rischia di trovarsi esposto a vulnerabilità che oggi fatica persino a immaginare.

Beliven, tech company del Friuli Venezia Giulia con circa quaranta sviluppatori e partecipazioni in quattro startup tecnologiche, si occupa quotidianamente di realizzare soluzioni software personalizzate integrando l’intelligenza artificiale. Il focus dell’intervento, però, non era celebrativo: l’obiettivo dichiarato era quello di evangelizzare le aziende sui rischi concreti e sulle strategie per affrontarli.

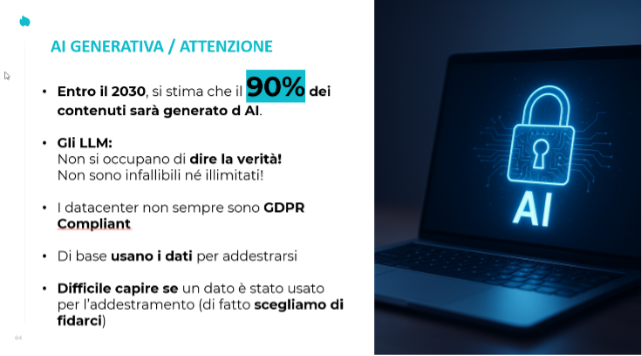
Entro il 2030, il 90% dei contenuti sarà generato dall’AI

“AI Generativa / Attenzione” con dati sul 90% dei contenuti

Le proiezioni parlano di un futuro in cui la stragrande maggioranza di ciò che leggeremo, vedremo e ascolteremo online sarà prodotto da sistemi di intelligenza artificiale generativa. Un dato che solleva interrogativi profondi: come distingueremo il vero dal verosimile? Chi sarà responsabile delle informazioni errate? E soprattutto, dove finiranno tutti i dati che alimentano questa produzione di massa?

L’intervento ha messo in luce tre criticità fondamentali dei Large Language Model che troppo spesso vengono taciute. Primo: gli LLM non si occupano di dire la verità. Generano risposte statisticamente plausibili, non necessariamente accurate. Il loro obiettivo è produrre testo coerente, non verificare fatti. Secondo: non sono infallibili né illimitati. Hanno limiti di contesto, possono “allucinare” informazioni inesistenti, e le loro prestazioni variano enormemente in base al dominio. Terzo, e forse più importante: i datacenter che li ospitano non sempre sono GDPR compliant, e di base molti provider utilizzano i dati inseriti dagli utenti per addestrare e migliorare i propri modelli.

Quest’ultimo punto merita un approfondimento. Quando un dipendente carica un documento riservato su ChatGPT per farselo riassumere, quando un programmatore incolla codice proprietario per chiedere una revisione, quando un manager condivide dati di vendita per ottenere un’analisi: tutte queste informazioni entrano in un sistema su cui l’azienda non ha alcun controllo. E potrebbero non uscirne mai.

Il paradosso della proprietà: di chi è l’output generato?

La questione della proprietà intellettuale sui contenuti generati dall’AI è tutt’altro che risolta. Durante l’intervento è stato mostrato un estratto significativo delle policy di OpenAI: l’utente mantiene i diritti sull’input e possiede l’output. Fin qui, tutto bene. Ma la formulazione legale lascia spazio a interpretazioni inquietanti.

Come ha evidenziato il relatore, esiste sempre una clausola che, da un punto di vista legale, lascia intendere che in futuro ci potrebbe essere una rivendicazione da parte di strumenti come OpenAI sulla sovranità del dato generato. In altre parole: oggi l’output è tuo, domani potrebbe non esserlo più. E le policy, come vedremo, cambiano con una frequenza allarmante.

Tutto quello che non dicono sulla privacy

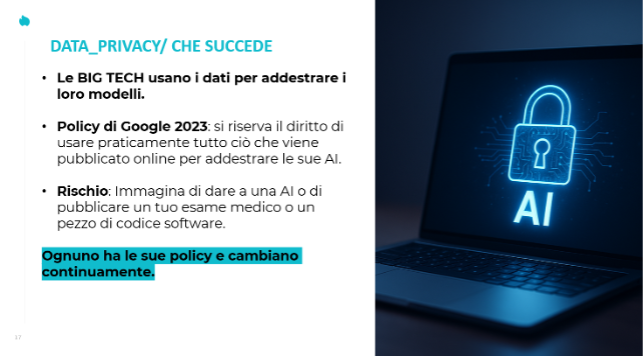
Il cuore dell’intervento ha affrontato il tema più scottante: la gestione dei dati da parte delle Big Tech. La policy di Google del 2023 si riserva il diritto di usare praticamente tutto ciò che viene pubblicato online per addestrare le proprie AI. Non solo i contenuti caricati volontariamente sulle piattaforme Google, ma potenzialmente qualsiasi cosa indicizzata dal motore di ricerca.

Il rischio, tradotto in termini concreti, è questo: immaginate di condividere con un assistente AI un esame medico, un contratto riservato, un pezzo di codice che rappresenta il vostro vantaggio competitivo. Dove finiscono queste informazioni? Per quanto tempo vengono conservate? Chi può accedervi? E soprattutto: verranno usate per addestrare modelli che poi risponderanno anche ai vostri concorrenti?

Le risposte a queste domande sono spesso sepolte in documenti legali di decine di pagine, scritti in legalese incomprensibile, che cambiano unilateralmente senza un reale consenso informato. Come ha osservato il relatore, riceviamo continuamente email di aggiornamento delle policy che raramente leggiamo. Nel frattempo, le regole del gioco cambiano.

Un fenomeno particolarmente insidioso riguarda le PMI. Dialogando con tantissime piccole e medie imprese, emerge spesso che il dipendente o la persona di turno utilizza sistemi esterni rispetto agli strumenti aziendali per elaborare informazioni che sono dati del cliente. Il documento riservato viene caricato su ChatGPT personale, il codice sorgente finisce su GitHub Copilot, l’analisi finanziaria passa per un tool AI gratuito. E l’azienda perde completamente traccia di dove siano finiti i propri asset informativi.

Una tassonomia dei rischi: dall’input al processing

“Data Privacy / Esempi di rischio”

L’intervento ha proposto una classificazione sistematica dei rischi che merita di essere analizzata nel dettaglio, perché aiuta a comprendere la complessità del problema.

Rischi lato User Input. La prima linea di vulnerabilità è quella dell’utente stesso. La divulgazione involontaria di dati sensibili è il rischio più comune: si carica un file senza rendersi conto che contiene informazioni riservate, si copia un testo che include riferimenti a clienti o partner. A questo si aggiunge l’assenza di controlli d’accesso adeguati: chi può usare gli strumenti AI in azienda? Con quali limiti? La scarsa formazione e consapevolezza del personale amplifica il problema, mentre la manipolazione fraudolenta dei prompt apre scenari di social engineering di nuova generazione.

Rischi lato Provider Interface e API. Il secondo livello riguarda l’interfaccia con il provider. L’intercettazione dei dati durante la trasmissione e la crittografia insufficiente sono rischi tecnici noti ma spesso sottovalutati. Più subdolo è il phishing attraverso la clonazione delle interfacce: siti che replicano l’aspetto di ChatGPT o altri tool per carpire credenziali e informazioni.

Rischi lato LLM Processing. Il terzo livello è forse il più opaco. Le inferenze involontarie sui dati inseriti permettono al sistema di dedurre informazioni che l’utente non intendeva condividere. La conservazione di dati sensibili oltre i termini dichiarati, le analisi comportamentali sui log di utilizzo, il rischio di cessione a terzi e le politiche di conservazione non conformi al GDPR completano un quadro preoccupante.

Ma i rischi non si fermano qui. Come ha sottolineato il relatore, non è un servizio fine a se stesso: c’è anche una distribuzione del dato su altre piattaforme. I servizi AI sono interconnessi, si appoggiano a infrastrutture cloud di terze parti, utilizzano API che a loro volta possono coinvolgere altri attori. La catena di custodia del dato diventa rapidamente inestricabile.

Quando i giganti cadono: casi concreti di violazioni

La teoria trova purtroppo abbondante conferma nella cronaca recente. L’intervento ha passato in rassegna una serie di incidenti che dimostrano come anche i player più blasonati non siano immuni da errori, vulnerabilità e scelte discutibili.

ChatGPT Data Breach, marzo 2023. Una falla nel sistema espone conversazioni private e informazioni di pagamento degli abbonati. Non dati anonimi o aggregati: conversazioni reali di utenti reali, con tanto di dettagli delle carte di credito.

Il caso Amazon. Il colosso dell’e-commerce vieta esplicitamente ai propri programmatori di usare ChatGPT per revisionare il codice interno. Il motivo? Le risposte generate dal sistema avevano iniziato a riportare dati simili a quelli interni di Amazon. Un segnale inequivocabile che i dati inseriti dagli utenti influenzano le risposte fornite ad altri.

La vulnerabilità del “repeat forever”. Prima che OpenAI intervenisse per bloccarla, esisteva una tecnica per far rivelare a ChatGPT dati di addestramento identificativi: bastava chiedere al sistema di ripetere una parola infinite volte. A un certo punto, il modello iniziava a “vomitare” frammenti di testo provenienti dal training set, incluse informazioni personali.

EchoLeak, giugno 2025. Una delle vulnerabilità più recenti e sofisticate ha colpito Microsoft 365 Copilot. Si tratta di una “zero-click prompt injection”: attraverso email di phishing elaborate automaticamente da Copilot, era possibile manipolare il sistema per estrarre informazioni dall’ecosistema Microsoft dell’utente. In pratica, l’AI che doveva proteggere diventava il vettore dell’attacco.

Otter.ai e le trascrizioni non autorizzate. Il servizio di trascrizione automatica delle riunioni è finito al centro di una causa legale per autorizzazioni insufficienti. Un problema particolarmente rilevante considerando che spesso i bot di trascrizione gratuiti si appoggiano a terze parti per gestire i dati, moltiplicando i punti di vulnerabilità.

Replika e la gestione dei minori. L’applicazione che permette di creare “chat partner” virtuali ha ricevuto una sanzione significativa per la gestione inadeguata dei dati dei minorenni. Non veniva effettuata una vera validazione sull’età degli utenti, esponendo bambini e adolescenti a interazioni potenzialmente dannose.

DeepSeek Data Breach. I database contenenti le informazioni degli utenti del sistema AI cinese sono stati esposti pubblicamente, dimostrando che i problemi di sicurezza non sono un’esclusiva occidentale.

Il caso LinkedIn: quando la policy cambia sotto i piedi

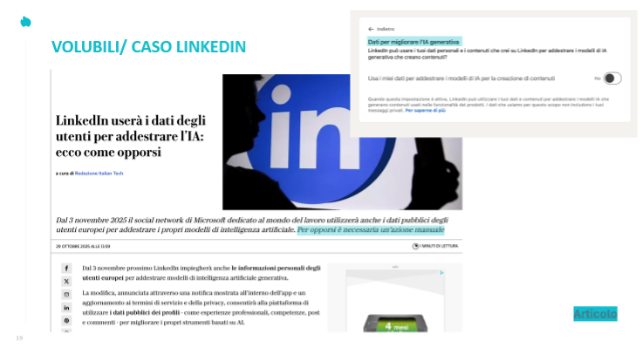
Il caso più recente e forse più emblematico riguarda LinkedIn. All’inizio di novembre 2025, Microsoft ha annunciato che i dati presenti sulla piattaforma professionale potranno essere utilizzati per il training dei propri modelli di AI. Post, articoli, commenti, informazioni del profilo: tutto può diventare materiale di addestramento.

L’unica difesa? Una spunta nascosta nelle impostazioni del profilo che permette di bloccare l’utilizzo dei propri dati. Una spunta che la stragrande maggioranza degli utenti non sa nemmeno esistere, e che comunque richiede un’azione positiva per essere attivata. Il default, naturalmente, è il consenso.

VOLUBILI/ CASO LINKEDIN

Il messaggio che emerge da questa carrellata è brutale nella sua chiarezza: anche gli strumenti più blasonati, anche le Big Tech con i loro eserciti di ingegneri e legali, commettono errori. E nel frattempo hanno accesso ai nostri dati. Non dati astratti: conversazioni, documenti, codice, analisi, strategie. Il patrimonio informativo di milioni di aziende e miliardi di individui.

La soluzione esiste: il concetto di GPT privato

Di fronte a questo scenario, rinunciare all’AI non è un’opzione realistica. I vantaggi competitivi che offre sono troppo significativi per essere ignorati. La domanda diventa quindi: come beneficiare dell’intelligenza artificiale senza esporsi a rischi inaccettabili?

L’intervento ha presentato il concetto di “GPT privato” come risposta a questa esigenza. Non si tratta di reinventare la ruota, ma di costruire un perimetro sicuro all’interno del quale sfruttare le potenzialità dell’AI generativa mantenendo il controllo sui propri dati.

I pilastri di questo approccio sono quattro

Sovranità dei dati e sicurezza. Le informazioni vengono gestite in un environment dedicato al cliente, senza transitare per infrastrutture condivise o datacenter di terze parti non controllabili. Il dato resta dove deve restare: all’interno dell’organizzazione.

Conformità e governance GDPR. La selezione di datacenter italiani o europei garantisce il rispetto delle normative sulla protezione dei dati. Non è solo una questione legale: è una questione di fiducia nei confronti di clienti e partner che affidano le proprie informazioni all’azienda.

Personalizzazione e integrazione. Un sistema AI cucito su misura può dialogare con i sistemi gestionali esistenti, accedere alle basi documentali interne, rispettare le policy aziendali. Non è un tool generico uguale per tutti: è uno strumento che conosce l’azienda e ne rispetta le specificità.

Trasparenza e auditabilità. Ogni interazione può essere tracciata, ogni accesso monitorato, ogni anomalia rilevata. L’azienda mantiene la visibilità completa su cosa succede ai propri dati.

Beliven ha sviluppato in questa direzione ClosyTalk, una soluzione che replica le funzionalità delle piattaforme di mercato ma all’interno di un ambiente controllato. L’applicativo web permette di generare risposte con e senza agenti specializzati, analizzare documenti creando knowledge base basate su tecnologie RAG (Retrieval-Augmented Generation), automatizzare compiti e interagire con modelli di AI sia privati che pubblici.

La flessibilità architetturale è un elemento chiave: il sistema può appoggiarsi a Foundation Model ospitati su cloud provider come Azure, Google Cloud o AWS, oppure funzionare in modalità completamente on-premise per le organizzazioni che richiedono il massimo livello di controllo.

Non serve una rivoluzione: l’approccio a step progressivi

L’ultimo messaggio dell’intervento riguarda la metodologia di adozione, e sfata un mito diffuso: non serve una rivoluzione per iniziare a beneficiare dell’AI in modo sicuro. Anzi, l’approccio raccomandato è esattamente l’opposto: partire leggeri, procedere per step, costruire competenza e consapevolezza prima di scalare.

La roadmap proposta si articola su quattro orizzonti temporali.

Bootstrap (0-6 mesi). La fase iniziale è dedicata alla formazione e alla sperimentazione controllata. Workshop, attività di accompagnamento, proof of concept su casi d’uso limitati. L’obiettivo non è trasformare l’azienda, ma far comprendere come questi strumenti possano aumentare la produttività e quali precauzioni adottare.

Quick Wins (6-12 mesi). Identificati i casi d’uso più promettenti, si passa all’implementazione di soluzioni che generano valore immediato con rischio contenuto. Automazione di task ripetitivi, assistenza alla redazione documentale, analisi di dati strutturati.

Enterprise (1-2 anni). La terza fase prevede l’integrazione profonda con i processi aziendali: connessione ai sistemi gestionali, creazione di agenti specializzati per le diverse funzioni, deployment su scala.

Transformative Innovation (3+ anni). L’orizzonte di lungo periodo è quello della trasformazione vera e propria: ripensamento dei processi, nuovi modelli di business abilitati dall’AI, vantaggio competitivo strutturale.

Questo approccio graduale ha un vantaggio fondamentale: permette all’organizzazione di sviluppare anticorpi. Ogni step costruisce consapevolezza sui rischi, competenza nell’utilizzo, capacità di governance. Quando si arriva alle fasi più avanzate, l’azienda non è più vulnerabile: ha imparato a muoversi in questo nuovo territorio.

Conclusione: governare la rivoluzione, non subirla

L’intelligenza artificiale generativa è davvero una rivoluzione paragonabile all’elettricità. E come per l’elettricità, la differenza tra chi ne beneficia e chi ne resta fulminato sta nella conoscenza: sapere come funziona, dove sono i pericoli, quali precauzioni adottare.

Le Big Tech hanno costruito strumenti straordinari, ma il loro modello di business si fonda sull’estrazione di valore dai dati degli utenti. Non è complottismo: è il loro bilancio. Ogni conversazione con ChatGPT, ogni documento caricato su Copilot, ogni prompt digitato su Gemini alimenta un sistema progettato per monetizzare quelle informazioni.

Per le aziende, la scelta non è tra usare l’AI o non usarla. È tra usarla consapevolmente, all’interno di un perimetro controllato, con strumenti che rispettano la sovranità del dato, oppure affidarsi ciecamente a piattaforme su cui non si ha alcun controllo, sperando che le policy non cambino, che i data breach non accadano, che i propri segreti industriali non finiscano nel training set di qualcun altro.

L’intervento di Andrea Pavan al Forum ICT Security 2025 ha avuto il merito di mettere sul tavolo questi temi con chiarezza e concretezza. Non per spaventare, ma per informare. Non per frenare l’innovazione, ma per permettere di cavalcarla in sicurezza.

Perché l’AI è qui per restare. La domanda è: saremo noi a governarla, o lei a governare noi?

Guarda il video dell’intervento completo:

[embedded content]
Profilo Autore

Nello sviluppo software da sempre e voglio ringraziare questa disciplina perché mi ha permesso di lavorare con realtà importanti come il CERN di Ginervra. La vita da ingegnere si svolge in modo molto metodico e focalizzato ma dentro ho sempre nitrito un certo dinamismo.
Questa pulsione mi ha portato a fondare un’azienda e poi a dedicarmi al Business Development, iniziando a entrare un mondo ad alta variabilità: quello delle relazioni.
Oggi in Beliven uso il connubio di queste mie due vite seguendo i Cliente nella costruzione dei progetti più utili alla digitalizzazione e ottimizzazione dei loro processi.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/il-prezzo-nascosto-dell-ai/


NIS2 e oltre: la cybersicurezza diventa governance aziendale

Al 23° Forum ICT Security ACN, aziende e studi legali a confronto sulla nuova responsabilità dei board, la convergenza normativa europea e il passaggio dalla compliance alla resilienza

La direttiva NIS2 non è un semplice adempimento normativo: segna un cambio di paradigma che porta la cybersecurity al centro della governance aziendale, coinvolgendo direttamente i consigli di amministrazione e ridefinendo il concetto stesso di responsabilità.

È quanto emerge dalla tavola rotonda “NIS2 & Beyond: governance della cybersicurezza nell’era della convergenza normativa europea“, che ha riunito al 23° Forum ICT Security autorevoli voci del mondo istituzionale, legale e aziendale.

A confrontarsi sul tema sono stati Nicolò Rivetti di Val Cervo, Capo Divisione NIS presso l’Agenzia per la Cybersicurezza Nazionale; Daniela Mazzarone, Vice President e Head of Cybersecurity Strategy & Governance di NTT DATA; Elsa Catalano, Group Compliance Director e DPO di Engineering; Ilaria Curti, partner di Portolano Cavallo, dove si occupa di diritto penale e 231. A moderare Laura Liguori, partner dello stesso studio legale con focus in data protection e cybersecurity, che in apertura del dibattito ha ricordato come l’attuale complessità normativa ponga sfide significative per le organizzazioni.

Nicolò Rivetti ha aperto il dibattito spiegando l’evoluzione che ha portato dalla NIS1 alla NIS2. Se in passato le normative sulla cybersicurezza, dalla prima direttiva NIS al Perimetro di sicurezza nazionale cibernetica, si concentravano su pochi soggetti – «qualche centinaio a livello nazionale, in quanto considerati infrastrutture critiche» – oggi lo scenario è radicalmente mutato.

NIS2 e oltre: la cybersicurezza diventa governance aziendale: Nicolò Rivetti di Val Cervo, Capo Divisione NIS presso l'Agenzia per la Cybersicurezza Nazionale al Forum ICT Security 2025
Nicolò Rivetti di Val Cervo, Capo Divisione NIS presso l’Agenzia per la Cybersicurezza Nazionale – Forum ICT Security 2025

Oggi, infatti, «la minaccia cibernetica (tranne forse quella di carattere statuale), è molto più interessata a soggetti più piccoli, che hanno meno risorse per mettere in piedi difese adeguate». La NIS2 va dunque intesa come un accompagnamento per questi soggetti meno maturi: «È come mettere l’antifurto su una macchina: non basta a garantire che non la rubino, ma abbassa le probabilità. Si cerca di gestire il rischio», ha sintetizzato il relatore.

C’è un altro elemento cruciale: la sicurezza informatica non può più essere pensata come questione della singola organizzazione. Un’azienda può essere colpita perché un proprio partner tecnologico o commerciale non si è messo in sicurezza. «Il concetto di filiera», ha sottolineato Rivetti, «in Italia è particolarmente importante».

Il punto di svolta del d.lgs. 138/2024 con cui è stata recepita la NIS2 riguarda il ruolo del consiglio di amministrazione. Ilaria Curti lo ha sintetizzato in modo netto: «La NIS2 porta la cybersecurity all’interno del board».

NIS2 e oltre: la cybersicurezza diventa governance aziendale: Ilaria Curti, partner di Portolano Cavallo al Forum ICT Security 2025
Ilaria Curti, partner di Portolano Cavallo al Forum ICT Security 2025

Il CdA non deve più limitarsi a essere informato o a prendere atto. Deve approvare le misure di sicurezza, supervisionarne l’attuazione ed essere formato per capire cosa gli venga proposto; «prima di tutto, quindi, il cambiamento sta nella competenza del board, che oggi deve essere in grado di entrare nella gestione cyber dell’azienda».

E alla competenza si associa la responsabilità. Come ha ricordato la relatrice, i membri del consiglio di amministrazione rispondono con una misura interdittiva dalla funzione in caso di violazioni. Ma alcuni passaggi del testo normativo hanno generato preoccupazione: si può pensare che i consiglieri rispondano personalmente anche delle sanzioni pecuniarie comminate alla società? Secondo Curti, questa lettura sarebbe sproporzionata: vista la potenziale entità, una sanzione parametrata al fatturato aziendale applicata a una persona fisica equivarrebbe di fatto a una sanzione penale, il che non ha senso in un’ottica sistematica.

Rimangono tuttavia aperte altre forme di responsabilità: quella civile per mala gestio, qualora il board non abbia adempiuto ai propri obblighi e la società venga sanzionata; e potenzialmente quella penale per omissione in presenza di una posizione di garanzia e al ricorrere degli elementi costitutivi del reato. Il parallelo con la normativa in tema di salute e sicurezza sul lavoro – che include responsabilità penali per obblighi di protezione non esercitati in caso di incidenti – suggerisce che questo modello potrebbe applicarsi anche in caso in cui reati siano commessi in presenza di violazioni degli obblighi di sicurezza previsti dal d.lgs. 138/2024, pur rimanendo alcuni dubbi che solo l’applicazione in concreto della direttiva permetterà di chiarire.

Daniela Mazzarone ha offerto una chiave di lettura che ribalta la percezione comune: la NIS2 non è una direttiva tecnica, ma una direttiva di governance. «Ha finalmente sottratto il tema della cybersecurity dalla sua usuale connotazione di componente tecnica a cui di solito era relegata, portandola al centro del business aziendale. È un cambio culturale importantissimo».

NIS2 e oltre: la cybersicurezza diventa governance aziendale: Daniela Mazzarone, Vice President e Head of Cybersecurity Strategy & Governance di NTT DATA al Forum ICT Security 2025
Daniela Mazzarone, Vice President e Head of Cybersecurity Strategy & Governance di NTT DATA al Forum ICT Security 2025

Per le organizzazioni meno mature, che si avvicinano per la prima volta a questi temi, la NIS2 rappresenta un accompagnamento. Ma il board deve dotarsi di tre capacità fondamentali: visibilità, competenza e collaborazione.

Sul tema della visibilità, la relatrice ha evidenziato un problema strutturale: le funzioni tecniche dispongono di una mole infinita di dati – alert, vulnerabilità, configurazioni – che però non arrivano al consiglio di amministrazione, perché non vengono “tradotti” in un linguaggio comprensibile. Come ha sintetizzato Mazzarone, il board deve poter rispondere a quattro domande essenziali: a quali minacce è esposta l’organizzazione, quale impatto avrebbero se si verificassero, quali sono le vulnerabilità maggiori (includendo l’intera filiera) e in quali tempi l’organizzazione è in grado di rispondere.

Il board deve avere competenze adeguate, come richiesto dalla normativa NIS2. Non si chiede al board di diventare un esperto tecnico; ma è necessaria la competenza per governare, da alimentare con formazione mirata.

Come ultimo elemento, il board deve poter contare su una collaborazione interfunzionale: CISO, Risk, Legal, Procurement, Operations, HR, Comunicazione devono lavorare su dati condivisi e priorità comuni. Garantire e costruire questa collaborazione è parte della governance e il board deve promuoverla attivamente, ad esempio istituendo comitati cyber, richiedendo simulazioni di crisi che coinvolgano tutte le funzioni e lo stesso CdA, definendo processi decisionali chiari.

«Si passa da un board che di solito chiedeva “quanto siamo conformi alla normativa”, “quanto ci discostiamo”, o “paghiamo la sanzione?” a un board che invece dice “quanto siamo pronti a reagire?”», con un cambio di prospettiva radicale nelle logiche gestionali delle organizzazioni.

Elsa Catalano ha spostato l’attenzione sul principale fattore che da sempre muove le aziende: il business. La domanda che arriva dal top management non riguarda solo la velocità di reazione a una minaccia, ma cosa si rischia di perdere in seguito a un incidente. E la risposta non è il denaro: «È la reputazione che si fa molta fatica a ricostruire».

NIS2 e oltre: la cybersicurezza diventa governance aziendale: Elsa Catalano, Group Compliance Director e DPO di Engineering al Forum ICT Security 2025
Elsa Catalano, Group Compliance Director e DPO di Engineering al Forum ICT Security 2025

La sfida è allora trasformare lo sforzo di compliance – l’aggiunta di regole, la traduzione di norme in comportamenti, gli adeguamenti tecnologici imposti da NIS2, DORA, CRA – in un investimento e una leva competitiva: «la possibilità di stare sul mercato in modo più solido, garantendo al cliente trasparenza, tracciabilità e fiducia».

Poiché questo vale per tutta la supply chain, la responsabilità degli operatori è creare un ecosistema in cui ciò che si garantisce al cliente possa riflettersi verso il fornitore. Spesso le aziende più piccole non hanno né la sensibilità né le risorse per investire in sicurezza: il supporto può consistere nell’aiutarle a definire congiuntamente un livello minimo di sicurezza che garantisca la governance dell’intera filiera.

«Non parlerei più di governance della singola azienda», ha concluso Catalano; «considerato qual è il mood della NIS2, stiamo parlando di sistema Paese. Dobbiamo fare da traino alle realtà più piccole».

Laura Liguori ha richiamato l’attenzione sul Digital Omnibus, il pacchetto di semplificazione normativa pubblicato dalla Commissione europea proprio il giorno precedente al panel, che mira a facilitare l’integrazione tra le diverse normative europee.

NIS2 e oltre: la cybersicurezza diventa governance aziendale: Laura Liguori, partner dello stesso studio legale con focus in data protection e cybersecurity al Forum ICT Security 2025
Laura Liguori, partner dello stesso studio legale con focus in data protection e cybersecurity al Forum ICT Security 2025

In merito, Rivetti ha invitato alla cautela: «È evidente che bisogna essere cauti, perché spesso le intenzioni di chi scrive la norma sono buone ma gli effetti pratici, poi, non così tanto…»

Un caso tipico è il rapporto tra DORA e NIS: sebbene l’impostazione iniziale prevedesse due “silo” distinti, concretamente emergono sovrapposizioni che generano complessità aggiuntiva o potenziali vuoti normativi. L’Agenzia sta lavorando per uniformare il catalogo dei requisiti e fornire indicazioni sulle equivalenze, laddove la legislazione lo consenta.

Portando un esempio concreto, il relatore ha ricordato che il settore portuale e dell’aviazione civile sono entrambi oggetto di preesistenti normative sovranazionali; e l’ACN può indicare quali obblighi NIS siano automaticamente soddisfatti dalle regole già in vigore.

Un altro fronte aperto riguarda il rapporto tra cybersecurity e data protection. È stato avviato un confronto con il Garante Privacy sulla questione della log retention, uno dei temi in cui sicurezza informatica e protezione dei dati presentano visioni apparentemente divergenti. Con la platea NIS che si è enormemente allargata, la preoccupazione è cresciuta e si stanno cercando soluzioni condivise.

Ilaria Curti ha individuato un punto di contatto importante tra la NIS2 e una normativa che le aziende italiane conoscono da oltre vent’anni: il decreto legislativo 231/2001 sulla responsabilità amministrativa degli enti. «Le organizzazioni (anche le più piccole) hanno ormai familiarizzato con i concetti di governance, processi, flussi informativi, strutturazione dei processi e consapevolezza».

A norma del decreto del 2001, tra i reati che comportano la responsabilità dell’ente figurano i reati informatici, incluso l’accesso abusivo a sistema informatico: la categoria generale in cui rientra ogni cyber attack. Le società che hanno già strutturato un “modello 231” con attenzione ai reati informatici dispongono quindi di una solida base su cui costruire, con risk assessment già effettuati, flussi informativi consolidati verso l’organismo di vigilanza e procedure documentate.

Il consiglio della relatrice è partire da una gap analysis per verificare cosa manchi rispetto agli obblighi NIS2: il risultato può essere quello che Liguori ha definito un «modello organizzativo 2.0», integrato e capace di coprire sia i requisiti previsti dal d.lgs. 231 sia le nuove richieste della NIS2.

Alla domanda se il CISO fosse il suo migliore amico o il peggior nemico, Elsa Catalano ha risposto senza esitazioni: «È il mio migliore amico. È venuto ad ascoltarmi».

Tuttavia, ha sottolineato come questa collaborazione non sia scontata: richiede un approccio culturale diverso e soprattutto una percezione più ampia dell’impatto che un rischio cyber può avere su un’organizzazione complessa, con riflessi su molteplici piani normativi.

La visione è quella di una compliance integrata: NIS, DORA, decreto 231, privacy, cybersecurity, ma anche proprietà intellettuale e segreti commerciali. In particolare per le aziende del mondo ICT, essere vulnerabili significa esporsi anche al rischio di perdere competitività, mettendo sulla pubblica piazza strategie e tecnologie riservate.

L’obiettivo è ottimizzare i controlli senza duplicarli: prevenire audit diversi sulle stesse cose, evitare che le funzioni di compliance vengano percepite come un blocco al business. «Dovremmo essere dei facilitatori», ha osservato Catalano; e la chiave per tale obiettivo è l’integrazione della compliance nel business stesso.

Daniela Mazzarone ha approfondito il contributo che l’AI può offrire nella gestione della complessità normativa, esplorando tre ambiti principali.

Il primo è la correlazione. L’intelligenza artificiale può mettere insieme in modo automatizzato tutti i requisiti delle diverse norme, rilevando eventuali interdipendenze tra le fonti: «Non si concepisce più la norma come un silo ma si costruisce una governance integrata alla luce di tutte le normative, nonché di linee guida tecniche, standard di riferimento e best practice internazionali».

Il secondo è il monitoraggio evolutivo. Le normative, infatti, evolvono costantemente; e disporre di uno strumento che funzioni «come un radar», capace di segnalare tempestivamente quali processi interni possano essere impattati da un cambiamento, può fare davvero la differenza per le organizzazioni.

Il terzo – forse il più concreto – riguarda la visibilità. Trasformare assessment periodici (e spesso time-consuming) in qualcosa di automatizzato e quasi real-time permette di offrire al board una fotografia costante dello stato di conformità, facilitando la gestione e i processi decisionali.

Tuttavia, Mazzarone ha voluto sottolineare un punto essenziale: «L’intelligenza artificiale non sostituisce assolutamente il giudizio umano» e soprattutto «non può sostituirsi all’accountability», che deve restare appannaggio esclusivo delle persone, così da garantire coerenza strategica, responsabilità ed etica nelle scelte aziendali.

Sul fronte operativo, Elsa Catalano ha descritto l’approccio adottato da Engineering per la gestione dei fornitori. Si è partiti da una due diligence approfondita già nella fase di inserimento in vendor list, con una “pulizia” di quanto presente nei sistemi: la competenza su specifici prodotti o servizi veniva spesso acquistata da piccole startup che, pur eccellenti nel loro ambito, non garantivano standard di sicurezza adeguati nella filiera.

È stato poi elaborato un questionario da utilizzare nella proposizione dell’offerta al cliente, in modo che sin dall’ingaggio siano esplicitati i requisiti di sicurezza aggiuntivi. Le priorità sono trasparenza e fiducia: se il servizio costa di più, è perché garantisce maggiore solidità.

Segue un monitoraggio periodico stringente – non annuale come in passato, ma con cadenze più ravvicinate – sull’intera filiera, che può essere by desk (con reportistica e segnalazione di campanelli d’allarme) o tramite audit tecnici con personale specializzato. Il tutto confluisce in un processo di third party risk management allineato non solo ai requisiti NIS ma anche alle best practice del mondo bancario, dove DORA impone obblighi specifici di verifica dei fornitori in capo al consiglio di amministrazione.

Nicolò Rivetti ha illustrato la filosofia che guida l’Agenzia per la Cybersicurezza Nazionale nella fase di prima applicazione della NIS2. Fino a un anno fa, l’ACN doveva supervisionare qualche centinaio di soggetti; oggi si trova a gestire decine di migliaia di organizzazioni.

L’approccio, di conseguenza, è dichiaratamente pragmatico: «È meglio chiedere un po’ meno, per portare tutti “a bordo” progressivamente, dando tempo al tempo».

L’obiettivo è essere percepiti non come “vessatori” ma come strumento di supporto. Questo non significa certo che chi sbaglia non rischi di essere punito – in merito la norma è chiara – ma che, prima di arrivare alla sanzione, il decreto prevede una serie di strumenti di supporto e monitoraggio che costituiscono attualmente il focus principale dell’Agenzia.

Ad esempio, «all’inizio dell’anno sono state inviate decine di migliaia di comunicazioni ai soggetti potenzialmente rientranti nell’ambito di applicazione», nella convinzione che sia preferibile inviare una PEC in più, piuttosto che scoprire tra qualche anno una mancata compliance e dover azionare la leva sanzionatoria.

Rivetti ha voluto chiarire anche la natura dell’obbligo di notifica degli incidenti, che non va percepito come mero adempimento: «notificare gli incidenti al CSIRT consente (e questo è vero soprattutto per i soggetti meno maturi) di avere il supporto di un centro di competenze unico, con un team di esperti che ha conoscenze stratificate nel tempo».

In questo senso la notifica è importante per il singolo soggetto, «per rimettersi in piedi e potersi difendere» da ulteriori attacchi; ma anche per il sistema nel suo complesso. Al CSIRT Italia, infatti, «si agganciano meccanismi di coordinamento a livello nazionale, europeo e sovra-europeo per gestire incidenti che assumano dimensioni di crisi».

Il relatore ha concluso con un promemoria operativo: fino al 31 dicembre 2025 è possibile – e obbligatorio per tutti i soggetti NIS – designare il referente CSIRT e i suoi sostituti. A differenza del “punto di contatto” tale referente deve necessariamente avere competenze tecniche, essendo «l’interlocutore che dovrà interagire con il CSIRT nazionale in fase di notifica per ottenere supporto».

Daniela Mazzarone ha incentrato il suo intervento finale su un tema che definisce il suo “cavallo di battaglia”, ossia il fattore umano nella cybersecurity. «Siamo l’anello debole della catena», ha ricordato; ed effettivamente i dati dimostrano che gli incidenti maggiori avvengono spesso per un click sbagliato, per inconsapevolezza o per comportamenti superficiali degli utenti.

Tuttavia, questo anello debole può trasformarsi in una leva strategica. La chiave è integrare la sicurezza nei comportamenti quotidiani, così come la si integra nelle macchine e nei sistemi operativi. E poiché i temi possono risultare noiosi, occorre trasformare la formazione tradizionale in qualcosa di stimolante.

Mazzarone ha citato la situational awareness – portare il dipendente in situazioni concrete per capire come reagirebbe – e la gamification, che prevede la creazione di programmi con competizioni interne e meccanismi di gioco capaci di coinvolgere e divertire.

Invitando a «giocare con la cybersecurity», ha ricordato come anche l’intelligenza artificiale possa aiutare in tal senso; ad esempio con tecniche che avvisano quando ci si sta comportando in modo rischioso, abilitando un cambio culturale progressivo.

Ilaria Curti ha chiuso il panel con indicazioni pratiche sulla strutturazione delle deleghe interne. Il board ha molte responsabilità e non può occuparsi di ogni dettaglio operativo: di conseguenza, serve qualcuno che gestisca l’operatività quotidiana.

Perché una delega sia effettiva, deve rispettare alcuni requisiti come stabilito dalla giurisprudenza. Innanzitutto, come requisito minimo indispensabile, il delegato deve essere competente. In secondo luogo deve avere autonomia decisionale e, crucialmente, libertà di spesa: nella cybersecurity gli interventi devono spesso essere immediati, quindi chi è delegato deve poter agire senza attendere autorizzazioni.

Infine le deleghe devono essere formalizzate correttamente, perché una struttura decisionale chiara non solo aiuta a organizzare meglio l’azienda ma facilita la ricostruzione della catena di responsabilità, semplificando la strategia difensiva in caso di problemi.

Nelle riflessioni conclusive, Laura Liguori ha individuato le parole chiave emerse dal dibattito.

Con la NIS2, si può affermare che la compliance cyber è diventata “democratica” – coinvolgendo un numero enormemente maggiore di soggetti – e ha assunto una dimensione “politica“: proteggere la propria organizzazione significa proteggere l’intero sistema.

La responsabilità degli amministratori, pur generando preoccupazione, è lo strumento che consente di considerare la cybersecurity come pilastro strategico sempre più integrato nel business. L’esecuzione operativa passa per un controllo più continuativo e dinamico sulla supply chain, per garantire dipendenti consapevoli e un’accountability diffusa.

C’è poi l’ulteriore novità, sottolineata da Rivetti, per cui la notifica di un incidente non è solo l’ammissione di una mancanza ma un contributo alla sicurezza collettiva: poiché gli incidenti capitano a tutti, condividere informazioni aiuta l’intero ecosistema a difendersi meglio.

Non solo responsabilità diffusa all’interno dell’azienda, dunque, ma della società tutta: ognuno di noi, nella propria vita quotidiana, può contribuire a una maggiore resilienza informatica tramite comportamenti più consapevoli e sicuri.

Guarda il vedo completo della tavola rotonda “NIS2 & Beyond: governance della cybersicurezza nell’era della convergenza normativa europea” tenutasi durante il Forum ICT Security 2025.

[embedded content]
Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/nis2-governance-aziendale/


Dentro la mente delle macchine: la nuova frontiera dell’interpretabilità nell’intelligenza artificiale

L’intervento “Decifrare la scatola nera: dall’opacità alla sicurezza” di Simone Scardapane, Professore Associato alla Sapienza Università di Roma, al 23° Forum ICT Security

Lo sviluppo dell’intelligenza artificiale ha rivoluzionato il nostro modo di interagire con essa: oggi possiamo dialogare in linguaggio naturale con modelli generalisti come GPT o Claude, senza possedere competenze avanzate in programmazione o raccolta dati. Questa democratizzazione dell’accesso, però, convive con una forte opacità: i modelli restano spesso “scatole nere”, difficili da comprendere e da controllare, soprattutto quando generano errori o comportamenti inattesi, esponendo l’utente a numerose problematiche. È proprio da questa tensione che ha preso le mosse l’intervento di Simone Scardapane, Professore Associato alla Sapienza Università di Roma, presentato durante il Forum ICT Security 2025 con il titolo “Decifrare la scatola nera: dall’opacità alla sicurezza”.

Al centro della riflessione, il concetto di mechanistic interpretability: lo studio delle strutture interne dei modelli per ricostruire i principi di funzionamento delle loro componenti. Un approccio che permette di individuare i “meccanismi interni” nascosti che generano le risposte, aprendo nuove strade per rendere questi sistemi più sicuri e controllabili.

Il paradosso dei modelli AI: capacità sovrumane ed errori banali

Negli ultimi tre o quattro anni, i Large Language Model hanno seguito una traiettoria di crescita impressionante, sia dal punto di vista computazionale sia per quanto riguarda la quantità di dati utilizzati nell’addestramento. Un aspetto particolarmente interessante di questa evoluzione riguarda le cosiddette emerging properties: man mano che i modelli diventano più grandi e vengono allenati su più dati, si “sbloccano” capacità che prima erano completamente assenti. Come è emerso dall’intervento, «ci sono benchmark in cui funzionano malissimo e poi, superato un certo livello di complessità, funzionano molto bene», fino a raggiungere prestazioni quasi sovrumane in diversi ambiti, dal ragionamento matematico all’analisi di immagini.

“Emergent Capabilities” (AI Index Report, 2024)

Questa dinamica genera però situazioni paradossali. Benchmark che solo un anno fa sembravano impossibili vengono oggi superati con relativa facilità dai modelli più recenti. Al contempo, gli stessi sistemi capaci di risolvere problemi complessi possono incappare in errori apparentemente banali: il professore ha citato l’esempio di un benchmark del 2025 realizzato da ricercatori dell’Università di Edimburgo, in cui i modelli venivano testati sulla capacità di leggere date e orari da orologi analogici, con risultati sorprendentemente scarsi.

“Lost in Time” (Saxena et al., 2025)

«È abbastanza buffo per chi non conosce questi modelli vedere questa contrapposizione», ha commentato il relatore, «perché ci sono questi modelli che sono quasi sovraumani sotto certi punti di vista e poi fanno degli errori completamente idioti». È proprio questa incongruenza a rendere urgente la necessità di comprendere cosa accade all’interno di questi sistemi.

Due problemi, due sfide

Da questa osservazione emergono due questioni fondamentali. La prima è di natura prettamente scientifica: come quantificare l’explainability? Come entrare effettivamente nella scatola nera per comprendere perché un modello eccelle in alcuni compiti e fallisce in altri? La seconda sfida riguarda invece la comunicazione verso gli utenti finali: una volta ottenuta questa comprensione, come renderla accessibile a chi utilizza quotidianamente questi strumenti?

L’intervento ha presentato come esempio OLMo Trace, un’interfaccia sviluppata quest’anno che permette agli utenti di evidenziare parti specifiche di una risposta generata da un modello e visualizzare quali elementi dei dati di addestramento hanno contribuito a quella particolare formulazione. «Se il modello fa un’allucinazione abbastanza strana o una risposta particolarmente strana, l’utente in maniera molto semplice può capire se questo deriva dai dati da cui eravamo partiti», ha spiegato il docente.

“OLMoTrace” (Liu et al., 2025)

Ma la vera sfida va oltre la semplice spiegazione: «Non ci interessa solo spiegare questi modelli, ma ci interessa — e questo è molto più difficile — controllarli». Non si tratta semplicemente di capire perché un modello non funziona, ma di avere «un modo preciso e chirurgico di intervenire sul comportamento di questo modello per farlo funzionare». In alcuni ambiti della computer science questo viene chiamato recourse: la possibilità di utilizzare l’informazione della spiegazione per intervenire sul modello stesso.

Dall’explainability classica alla mechanistic interpretability

Il termine explainability nell’ambito dell’intelligenza artificiale ha una storia complessa. Il relatore ha ripercorso l’evoluzione di questo campo, partendo da quello che oggi viene definito approccio “classico”, sviluppatosi circa dieci-quindici anni fa con la popolarizzazione delle reti neurali, prima dell’avvento dei Large Language Model.

L’explainability classica si concentrava principalmente sull’evidenziare quali parti dell’input fossero maggiormente rilevanti per una determinata predizione: nell’ambito della classificazione di immagini, ad esempio, si cercava di visualizzare su quali aree dell’immagine il modello si stesse concentrando. Tuttavia, questo approccio ha mostrato limiti significativi. «Quello che ci si accorge è che è veramente difficile da un lato dare questa informazione agli utenti, dall’altro farci qualcosa con questa informazione», ha osservato il professore.

“Attribution maps” (Capriotti et al., 2025)

Il problema principale era che questo tipo di explainability era stata «venduta tantissimo» nel periodo 2018-2019, con molti che proponevano soluzioni “explainable” come alternativa all’AI black box. «C’è stato un periodo in cui ci si è resi conto che per questo tipo di cose non funziona tanto bene»: i metodi si sono rivelati poco robusti, “brittle” nel gergo tecnico, e soprattutto non permettevano di intervenire effettivamente sul comportamento del modello.

La svolta è arrivata intorno al 2021, quando un gruppo di ricercatori — oggi distribuiti tra Anthropic, Google e OpenAI — ha pubblicato quello che il docente definisce un “manifesto” per proporre un nuovo paradigma: la mechanistic interpretability. L’obiettivo di questo approccio è trovare all’interno degli enormi modelli, costituiti da miliardi di parametri e rappresentazioni, quelli che vengono chiamati “circuiti” o “meccanismi interpretabili”. Il paragone, per quanto imperfetto, è con il lavoro dei neurologi che cercano meccanismi funzionali nei neuroni o nelle aree del cervello.

Dentro la scatola nera: i circuiti nascosti

Uno dei risultati più significativi emersi da questo nuovo approccio è la scoperta delle cosiddette induction heads, circuiti interni alle reti neurali che si occupano di copiare informazioni dal prompt da un punto all’altro della sequenza. Il relatore ha illustrato il meccanismo con un esempio tratto da un testo letterario: se il modello incontra “Miss Dursley” all’inizio di un testo, l’induction head è quel meccanismo che, quando il modello legge successivamente “Miss”, lo porta a completare con “Dursley” recuperando l’informazione precedente. «È un meccanismo di induzione abbastanza semplice», ha commentato, «però era molto sorprendente, molto interessante che si fosse in grado di trovare questi componenti dentro la rete neurale».

“Induction Heads” (Elhage et al., 2021)

La ricerca ha ricevuto un’accelerazione significativa quando si è riusciti ad automatizzare questo tipo di analisi. L’intervento ha fatto riferimento a uno dei contributi più importanti del campo, un blog post pubblicato da Anthropic in cui i ricercatori hanno dimostrato di essere in grado di identificare automaticamente miliardi di componenti interpretabili all’interno dei loro modelli. «Vi invito fortemente ad andare a cercare questo articolo e a leggerlo perché ci sono tantissimi esempi di queste componenti e sono tutti estremamente interessanti», ha suggerito il professore.

“Interpretable features” (Templeton et al., 2024)

Tra gli esempi più noti c’è il cosiddetto “Golden Gate neuron”, un’unità che si attiva ogni volta che viene menzionato, visto o discusso il Golden Gate Bridge. Ma i ricercatori hanno identificato anche componenti che si attivano quando il modello risponde in modo eccessivamente adulatorio (sycophantic, nel gergo tecnico), quando genera contenuti potenzialmente non sicuri, o quando utilizza capacità di ragionamento matematico.

Un’applicazione particolarmente promettente riguarda i modelli scientifici sviluppati per biologia, medicina e chimica. In questi contesti, l’analisi dei meccanismi interni ha rivelato circuiti che si attivano su parti specifiche del DNA relative a determinate proteine, mostrando «un match molto forte tra quello che lo scienziato, il biologo, il chimico si aspetterebbe dentro questi modelli e quello che effettivamente ci troviamo».

Steering: il controllo chirurgico del comportamento

La domanda fondamentale che emerge da queste ricerche è: possiamo utilizzare questa conoscenza per controllare effettivamente il comportamento dei modelli? La risposta, secondo le evidenze più recenti, sembra essere positiva. Il termine tecnico per questa capacità di intervento è steering.

Il relatore ha illustrato come le unità interpretabili identificate all’interno dei modelli possano essere manipolate direttamente: «Fondamentalmente questi sono unità interne della rete neurale su cui noi possiamo intervenire. Possiamo metterle a zero, possiamo moltiplicarle, possiamo utilizzarle come direzione nello spazio delle attivazioni». Un’applicazione concreta di questo principio sono i cosiddetti persona vectors, direzioni nello spazio dei parametri che funzionano come «bottoni che potete attivare» e che «cambiano completamente la personalità del modello», rendendolo più sicuro, più gentile, più preciso o modificandone altre caratteristiche comportamentali.

“Persona Vectors” (Chen et al., 2025)

Le implicazioni per la sicurezza sono immediate: «Se immaginate di trovare l’unità specifica che si attiva quando il modello vi sta parlando di come fare un particolare attacco informatico, se la spegnete idealmente dovreste essere in grado di togliere questa capacità al modello e quindi renderlo più safe». Questo, ha sottolineato il docente, «è il grosso motivo per cui stanno studiando questi modelli».

Un esempio illuminante riguarda un errore che qualche anno fa era diventato virale sui social network: alcuni modelli affermavano che 9.11 fosse maggiore di 9.8. Analizzando le unità che si attivavano durante questa risposta errata, i ricercatori hanno scoperto che entravano in gioco meccanismi legati all’attacco dell’11 settembre, a versetti della Bibbia e ad altri concetti completamente irrilevanti per una semplice comparazione numerica. «Queste sono ovviamente unità che non hanno nessuna rilevanza alla domanda specifica», ha osservato il professore. Disattivando chirurgicamente questi meccanismi e rigenerando la risposta, il modello forniva la risposta corretta.

Verso nuove interfacce: il Circuit Tracing

Il livello più avanzato di questa tecnologia è rappresentato dal Circuit Tracing, un meccanismo automatico che fornisce una rappresentazione circuitale simbolica dei vari meccanismi attivati durante una generazione e di come si interconnettono tra loro per produrre la risposta finale.

“Circuit tracing” (Lindsey et al., 2025)

«A sinistra avete la domanda, a destra avete la risposta. In mezzo ci sarebbe una black box che è il modello», ha spiegato il relatore. «Se avete accesso a questo tipo di tracing, fondamentalmente potete veramente andare lì, cliccarci e dire: no, questa specifica connessione tra i due meccanismi non mi sembra corretta, disattivala». Rigenerando la risposta, questa cambierà in funzione dell’intervento effettuato.

I risultati sono promettenti anche sul versante delle prestazioni: si è osservato che aumentando l’attivazione di meccanismi specifici legati al ragionamento matematico, i modelli migliorano su determinati benchmark senza alcun altro intervento. Applicazioni analoghe stanno emergendo anche nell’ambito della generazione di immagini, dove è possibile controllare quali meccanismi attivare in specifiche aree dell’output.

Conclusioni e prospettive

Il quadro delineato dall’intervento mostra un campo di ricerca in rapida evoluzione, ancora poco discusso nel dibattito pubblico ma oggetto di investimenti significativi da parte dei principali laboratori di intelligenza artificiale. «Ci sono grossi investimenti, soprattutto da OpenAI, DeepMind, Anthropic e altre startup più piccole negli Stati Uniti», ha osservato il relatore, sottolineando come questa ricerca «possa cambiare in maniera significativa quelle che saranno le interfacce avanzate, soprattutto per chi è interessato a “entrare” in questi modelli».

La mechanistic interpretability rappresenta dunque un ponte tra la comprensione scientifica dei sistemi di intelligenza artificiale e la loro governance pratica. Non si tratta solo di soddisfare una curiosità intellettuale su come funzionano questi modelli, ma di sviluppare strumenti concreti per renderli più affidabili, più sicuri e più controllabili. La possibilità di intervenire chirurgicamente sui meccanismi interni apre scenari inediti per la sicurezza informatica, permettendo potenzialmente di neutralizzare comportamenti indesiderati alla radice, anziché limitarsi a filtrarli a posteriori.

La sfida che rimane aperta riguarda il trasferimento di queste capacità agli utenti finali: come rendere accessibile questa “informazione di debug” a chi utilizza quotidianamente questi strumenti? La risposta a questa domanda determinerà in larga misura il futuro dell’interazione uomo-macchina nell’era dell’intelligenza artificiale.

Guarda il video dell’intervento completo:

[embedded content]
Profilo Autore

Professore associato all’Università Sapienza di Roma, si occupa da oltre dieci anni di ricerca in ambito di reti neurali, sia in ambito teorico che in ambiti più pratici, con applicazioni che spaziano dalle telecomunicazioni alla medicina, fisica, e neurologia. In passato è stato molto attivo in attività di divulgazione di machine learning, tramite associazioni no-profit, Meetup, e podcast. Attualmente, è ricercatore affiliato all’INFN, junior fellow della Scuola Superiore di Studi Avanzati della Sapienza, e membro della ELLIS Society.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/macchine-intelligenza-artificiale/


Rischio cyber: perché gestire la sicurezza “a sensazione” è un errore che le aziende non possono più permettersi

L’intervento di Denise Amedei al 23° Forum ICT Security ha messo in luce come la gestione del rischio cyber non possa più basarsi su percezioni soggettive, ma necessiti di strumenti capaci di quantificare l’esposizione reale delle aziende alle minacce informatiche.

Nel panorama sempre più complesso della sicurezza informatica, la capacità di misurare oggettivamente il rischio rappresenta il primo passo verso una protezione efficace. Questo il messaggio centrale dell’intervento “Misurare per comprendere: un approccio oggettivo al rischio informatico”, tenuto dalla Head of Marketing di HiSolution durante il Forum ICT Security, un’analisi lucida che ha attraversato dati allarmanti, casi concreti e soluzioni operative.

L’esperienza sul campo come fondamento

Prima di addentrarsi nel cuore della questione, la relatrice ha presentato il background aziendale che sostiene l’approccio proposto: «Quello che vi racconto oggi viene da vent’anni di esperienza sul campo», ha esordito, illustrando come HiSolution operi come Managed Service Provider con 60 consulenti specializzati al servizio di oltre 400 clienti italiani.

La filosofia aziendale ruota attorno al concetto di “serenità tecnologica”, ovvero la possibilità per i responsabili IT delle aziende clienti di concentrarsi sul proprio core business delegando la gestione delle sfide tecnologiche. Un approccio che si distingue dal classico system integrator per la sua natura proattiva: «Non andiamo con un approccio reattivo, che prevede la vendita e la risoluzione del problema quando si verifica. Il nostro approccio prevede gestione, monitoraggio e ottimizzazione per risolvere proattivamente il problema prima che si verifichi».

Il contesto italiano: numeri che non mentono

L’intervento è entrato nel vivo con una disamina del panorama nazionale delle minacce cyber, basata sui dati del Rapporto Clusit di ottobre 2025. Il quadro emerso è inequivocabile: l’Italia si conferma il terzo paese al mondo per attacchi malware e il più colpito in Europa.

Il contesto italiano degli attacchi

Ma è la severità degli incidenti a destare maggiore preoccupazione. Come ha sottolineato la speaker: «Il rapporto Clusit del 2024 ci diceva che il 70% degli attacchi erano classificati come gravi o critici. Ora siamo già all’82%. Significa che poche di queste aziende, quando vengono colpite, riescono a rialzarsi senza effetti collaterali, senza danni maggiori».

Un altro dato significativo riguarda la tempistica degli attacchi: il 91% avviene al di fuori dell’orario di lavoro, durante weekend, serate, notti o periodi di ferie. «Quest’estate c’è stato un picco altissimo di attacchi alle aziende», ha ricordato l’esperta, «quindi in un momento in cui non c’è nessuno in azienda, il danno è ancora maggiore».

Costo medio violazione dati

Sul fronte economico, le stime IBM parlano di un costo medio per violazione dei dati di circa 4,88 milioni di dollari, cifra che comprende sia i danni patrimoniali diretti (costi di ripristino, perdite operative, spese legali, sanzioni GDPR) sia i danni collaterali, spesso più insidiosi: «Se un server so quanto costa, in due settimane posso ripristinarlo, posso ricomprarlo, posso riavviarlo. La compromissione di un rapporto con un cliente non solo non posso misurarla, ma non so se riuscirò a recuperarla o meno».

La falsa sicurezza: quando ci si crede immuni

Una parte particolarmente efficace dell’intervento ha riguardato gli esempi concreti di attacchi gestiti dall’azienda, utili a sfatare il mito del “non capiterà mai a noi”.

Esempio phishing Microsoft

La relatrice ha mostrato email di phishing apparentemente banali ma devastanti nei loro effetti: «Vista così, nessuno di voi, se facessi un sondaggio per alzata di mano, mi direbbe ‘sì, questa si vede che è phishing’. Ma immaginate in un back office o in un call center: arriva questa email, le persone sono sommerse dalle chiamate, dalle cose da fare, arriva un’email simile al vero, viene cliccata, e la landing page è completamente identica alla pagina Microsoft 365». Il risultato? Credenziali rubate e dati aziendali compromessi.

Caso Louvre

Ma l’esempio più emblematico è arrivato dalle cronache internazionali: «Il sistema di sicurezza del museo più famoso al mondo e con il maggior numero di visitatori e opere, che password aveva per accedere al sistema di sicurezza? ‘Louvre’. Con questo alzo le mani, perché significa che chiunque può davvero essere attaccato».

Un aneddoto personale ha reso ancora più tangibile il messaggio: un piccolo albergo di montagna sopra Bormio, colpito da un attacco che aveva reso inutilizzabili le tessere magnetiche delle camere. «Mi sono trovata in questo albergo, l’albergatore mi ha consegnato la chiave – sono tornati alla chiave, ritornati negli anni ’80. Immaginatevi con che stato d’animo posso avergli dato la mia carta di credito o il documento d’identità. Quando mi ha chiesto ‘vuole la password del Wi-Fi?’, ho risposto: no, no, per carità, navigo col mio 5G».

Il divario tra percezione e realtà

Un passaggio cruciale dell’intervento ha riguardato i risultati di una survey condotta su aziende che hanno intrapreso percorsi di risk assessment. Prima dell’analisi, veniva chiesto ai responsabili IT di stimare il proprio livello di vulnerabilità, l’eventuale esposizione di dati nel dark web e, per chi rientrava nella normativa NIS2, la conformità percepita.

Dalla teoria alla realtà

Il confronto tra valore percepito e valore reale ha evidenziato scostamenti significativi: «Gestire a sensazione il rischio aziendale è profondamente sbagliato. È normale che siano così sfasati. L’IT manager mediamente è preso da settantamila strumenti che non parlano tra loro – il firewall, l’antivirus, le patch non applicate – sembra di avere tutto sotto controllo ma poi basta dimenticare qualcosa tra le mille cose da fare, o nella tipica settimana di ferie non applico quella patch, e vengo bucato».

HiCompliance: l’ecosistema per misurare e gestire il rischio

La seconda parte dell’intervento è stata dedicata alla presentazione della soluzione sviluppata per affrontare questa sfida: HiCompliance, una piattaforma integrata di Cyber Risk Management.

HiCompliance

L’ecosistema si articola su tre moduli proprietari di analisi. Il primo, SurfaceScan360, effettua un monitoraggio continuo delle vulnerabilità esposte, analizzando domini e indirizzi IP per identificare falle nel sistema CVE e potenziali punti di ingresso per gli attaccanti. Il secondo modulo, DarkRisk360, scandaglia il web sommerso – dark web, deep web, forum malevoli – alla ricerca di eventuali data leak già avvenuti. Il terzo componente è un questionario di assessment strutturato sui framework NIST, NIS2 e ISO 27001, compilato in collaborazione con l’azienda cliente.

«Questi dati vengono correlati da un sistema di Intelligenza Artificiale che propone la vostra percentuale di rischio», ha spiegato la speaker. «Un numero vi viene dato inizialmente: la dashboard vi dà la prima idea di quanto siete esposti».

Piano di Remediation

Ma la fotografia iniziale è solo il punto di partenza. L’azienda viene poi affiancata da un Cyber Security Manager che propone le azioni correttive attraverso un Gantt operativo: «Grazie a questo è possibile prevedere quanto ridurre il rischio, in quanto tempo e ovviamente con quale investimento».

La piattaforma include anche un sistema di gestione documentale per archiviare tutta la documentazione relativa a ISO 27001 e NIS2, oltre alla generazione automatica dell’Incident Response Plan: «Sono 90 pagine di documento che vi garantiscono la possibilità di avere un piano d’azione che vi dà sicurezza nel caso qualcosa dovesse succedere».

La questione budget: parlare la lingua del CFO

L’intervento si è concluso affrontando un tema cruciale ma spesso trascurato: la difficoltà di ottenere approvazione per gli investimenti in sicurezza.

«In questa sala so che chi si occupa di cyber security sa cosa servirebbe investire, sa quanto e quale budget servirebbe. Il problema è farlo approvare dalla finanza», ha osservato la relatrice. «I CFO sanno poco o nulla di cyber security, ma conoscono i numeri. Quando andiamo a presentare una percentuale di rischio e un piano di remediation con il relativo costo e il futuro di quella che sarà la percentuale di rischio – quindi la riduzione – è sicuramente più facile presentare a tutto il board il lavoro che si sta facendo».

Hicompliance – Premio Digital360 Awards

A conferma della validità dell’approccio, la soluzione HiCompliance ha ottenuto il riconoscimento ai Digital360 Awards 2025 nella categoria Information & Cybersecurity, selezionata tra oltre 400 progetti presentati. «Quello che è stato riconosciuto», ha concluso l’esperta, «è che effettivamente parliamo la stessa lingua delle aziende e andiamo a risolvere quello che è un problema concreto: la gestione del rischio giorno per giorno, per evitare che gli attacchi informatici possano fermare la produzione e la produttività aziendale».

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Denise Amedei è Responsabile Marketing in HiSolution, con una consolidata esperienza nella gestione strategica del marketing B2B nei settori Cybersecurity, ICT, UCC e tecnologie innovative.

Ha guidato progetti di marketing per realtà innovative in ambito ICT e AR Technology, contribuendo allo sviluppo di strategie di comunicazione e posizionamento per soluzioni di sicurezza informatica. Con oltre dieci anni di esperienza nel settore, ha maturato una profonda conoscenza delle sfide che CIO, CISO e IT Manager affrontano ogni giorno in tema di cyber resilience, compliance normativa e trasformazione digitale.

Il suo approccio unisce competenze tecniche e sensibilità business, traducendo la complessità della sicurezza informatica in valore strategico misurabile per il C-level. Ha guidato il lancio di soluzioni innovative, progettate specificamente per rispondere alle esigenze di governance, risk management e compliance delle aziende italiane.

Con una visione orientata ai risultati, Denise collabora costantemente con vendor tecnologici di primo piano e con team di esperti di cybersecurity per sviluppare strategie go-to-market che rispondano concretamente alle priorità dei decision maker IT: riduzione del rischio, ottimizzazione dei costi, serenità tecnologica.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/rischio-cyber-sicurezza/


OSINT e ADINT: impatti economici e sociali

OSINT e ADINT rappresentano oggi due delle metodologie più influenti nell’ecosistema dell’intelligence digitale moderna, rivoluzionando il modo in cui vengono raccolte, elaborate e utilizzate le informazioni per scopi di sicurezza, commerciali e di governance.

Quest’ultimo approfondimento si concentra sui meccanismi economici, tecnici e normativi che governano l’utilizzo di queste tecnologie, evidenziando come con investimenti relativamente contenuti sia possibile implementare sistemi di sorveglianza sofisticati capaci di tracciare individui, analizzare comportamenti e inferire informazioni sensibili.

La dimensione economica della privacy e della sorveglianza

L’analisi economica di OSINT e ADINT rivela una complessa interazione tra costi, benefici e dinamiche di mercato. Vines et al. (2017) forniscono un’analisi dettagliata dei costi operativi dell’ADINT, dimostrando come con un investimento di 1000 dollari sia possibile implementare sistemi sofisticati di tracciamento. Il loro studio analizza approfonditamente la struttura dei costi, evidenziando come i costi di implementazione iniziale, quelli operativi continui e quelli relativi all’analisi dei dati si combinino in modo complesso. Particolarmente significativa è la loro scoperta che i costi marginali di tracciamento diminuiscono significativamente all’aumentare del numero di obiettivi, suggerendo importanti economie di scala nelle operazioni di sorveglianza.

Montes et al. (2019) approfondiscono queste implicazioni economiche analizzando le dinamiche di mercato dell’informazione personale. Il loro modello matematico dimostra come il valore di mercato dei dati personali sia influenzato dalla granularità dell’informazione disponibile, dalla facilità di accesso ai dati attraverso piattaforme pubblicitarie e dall’esistenza di mercati secondari per l’informazione raccolta.

Gli autori dimostrano come queste dinamiche creino un c.d. “effetto moltiplicatore”, dove il valore iniziale dei dati può essere amplificato attraverso analisi successive e combinazioni con altri dataset, portando a implicazioni significative per la privacy degli individui. Questo avviene attraverso mercati secondari che ricombinano dati provenienti da diverse fonti, creando un ecosistema di sorveglianza e analisi sempre più invasivo. Tuttavia, questo effetto amplifica anche i rischi per la privacy, poiché la combinazione di dati apparentemente innocui può portare a una re-identificazione dei soggetti e a nuove forme di profilazione comportamentale.

Un altro elemento chiave è il fenomeno del “digital privacy paradox“, descritto da Dirk Bergemann et al. (2022). Questo paradosso si verifica quando gli utenti, nonostante dichiarino di dare un grande valore alla loro privacy, sono disposti a cedere i propri dati per benefici economici o servizi di valore apparentemente marginale, come sconti o accesso a contenuti personalizzati. Questo comportamento, guidato da incentivi economici e dalla mancanza di consapevolezza, alimenta mercati dei dati in cui il prezzo delle informazioni personali è spesso molto inferiore al loro reale valore economico e sociale.

In parallelo, Daron Acemoglu et al. (2022) sottolineano che i mercati dei dati tendono a generare una condivisione eccessiva a causa delle esternalità informative. Quando un individuo condivide i propri dati, produce effetti involontari sui dati altrui, riducendo il valore della privacy degli altri. Questa dinamica porta a una situazione di mercato inefficiente, in cui il prezzo dei dati è artificialmente basso e le piattaforme acquisiscono una quantità di informazioni superiore a quella socialmente desiderabile.

Meccanismi di raccolta e analisi dei dati

Il framework di privacy differenziale proposto da Dwork et al. (2006) fornisce una base matematica rigorosa per la comprensione dei meccanismi di protezione della privacy. Gli autori introducono il concetto di “budget di privacy” (ε), che quantifica il compromesso tra utilità dei dati e protezione della privacy. Il loro framework matematico dimostra come la perdita di privacy sia cumulativa attraverso query multiple e come esista un limite fondamentale alla quantità di informazione che può essere estratta mantenendo garanzie di privacy. Questo aspetto risulta particolarmente rilevante nel contesto dell’OSINT e dell’ADINT, dove le interrogazioni multiple dei sistemi pubblicitari possono portare a una progressiva erosione della privacy.

Abowd e Schmutte (2015) applicano questi concetti al contesto pratico della divulgazione statistica, dimostrando come il framework possa essere utilizzato per quantificare il rischio di re-identificazione e ottimizzare il compromesso tra accuratezza e privacy. La loro analisi risulta fondamentale per comprendere come i sistemi di sorveglianza basati su dati pubblicitari possano essere progettati per bilanciare efficacia operativa e protezione della privacy.

Impatti sulla sicurezza e sulla privacy

Acquisti et al. (2016) forniscono un’analisi approfondita delle esternalità generate dai sistemi di sorveglianza digitale. Gli autori evidenziano come gli effetti della sorveglianza si propaghino ben oltre gli obiettivi iniziali, creando esternalità dirette attraverso la perdita di privacy per individui non target e la discriminazione basata su associazioni. Particolarmente significativi sono gli effetti indiretti, che includono modifiche comportamentali dovute alla consapevolezza della sorveglianza e impatti sulla libertà di espressione. A livello sistemico, gli autori identificano problematiche legate alla concentrazione del potere informativo e alle asimmetrie informative nei mercati.

Il ruolo dell’ADINT nella sorveglianza moderna

Vines et al. (2017) forniscono un’analisi tecnica dettagliata delle metodologie di tracciamento attraverso l’ADINT. La loro ricerca dimostra come sia possibile utilizzare le piattaforme pubblicitarie per ottenere una localizzazione geografica estremamente precisa, fino a 8 metri di accuratezza, permettendo il tracciamento dei movimenti nel tempo e l’identificazione di pattern ricorrenti. Il sistema può anche essere utilizzato per il monitoraggio delle applicazioni installate e dei loro tempi di utilizzo, consentendo una profilazione comportamentale approfondita. Particolarmente significativa è la capacità di questi sistemi di operare in modo continuo nel tempo, permettendo l’inferenza di relazioni sociali e la deduzione di interessi sensibili attraverso l’analisi dei pattern di utilizzo.

Le piattaforme pubblicitarie non solo raccolgono dati personali, ma li usano anche per influenzare decisioni individuali e collettive. Ad esempio, le tecnologie di “Algorithmic Cognitive Warfare“, sviluppate in particolare in Cina, sfruttano algoritmi avanzati per identificare e influenzare bersagli specifici. Questi sistemi sono in grado di creare “ritratti cognitivi” che analizzano lo stato psicologico e i comportamenti degli utenti, utilizzando queste informazioni per diffondere contenuti mirati e influenzare opinioni e decisioni (Lange, 2024).

Implicazioni per la policy e la regolamentazione

Goldfarb e Que (2023) propongono un framework completo per la regolamentazione che integra considerazioni tecniche, economiche e sociali. A livello tecnico, gli autori enfatizzano l’importanza di standard minimi di protezione e meccanismi di trasparenza algoritmica, dal punto di vista economico invece il framework considera gli incentivi per la protezione della privacy e le strutture di mercato necessarie per garantire una competizione efficiente, mentre la dimensione sociale viene affrontata attraverso la protezione dei diritti fondamentali e l’accountability democratica. Gli autori sottolineano come questi diversi aspetti debbano essere considerati simultaneamente per creare un sistema di regolamentazione efficace e sostenibile.

Confronto con i paesi autoritari

La raccolta massiva di dati personali da parte di aziende private e governi per scopi commerciali, di sicurezza o di governance può erodere la fiducia pubblica e creare un senso di sorveglianza costante. Questo fenomeno, noto come “effetto chilling”, porta gli individui a limitare le proprie interazioni online e a modificare i propri comportamenti per timore di essere monitorati e per paura di conseguenze legali, sociali o economiche. Questo può avvenire quando ci sono leggi, regolamenti o azioni di sorveglianza che creano un senso di insicurezza o timore di repressione.

Un caso interessante è rappresentato dal c.d. “Algorithmic Cognitive Warfare“, introdotto in precedenza in questo capitolo al paragrafo 4. Questa strategia, utilizzata in maniera considerevole dalle agenzie di intelligence della Repubblica Popolare Cinese, sfrutta algoritmi avanzati per creare “ritratti cognitivi” dettagliati degli individui, mappando lo stato psicologico, i comportamenti e le reti sociali di ciascun utente. Gli algoritmi vengono progettati non solo per identificare i target, ma anche per influenzare le loro percezioni attraverso contenuti mirati e adattati in tempo reale alle loro condizioni psicologiche e comportamentali (Lange, 2024). Questo viene ottenuto attraverso varie tecniche (ibidem):

  • Raccolta e analisi di dati psicometrici: grazie ai dati raccolti da applicazioni e piattaforme digitali, è possibile costruire un quadro dettagliato delle emozioni, delle convinzioni e delle vulnerabilità di un individuo;
  • Targeting comportamentale predittivo: utilizzando modelli di machine learning, i sistemi ADINT sono in grado di anticipare i comportamenti futuri e agire in modo proattivo per influenzare le scelte dei target;
  • Amplificazione dei contenuti: gli algoritmi manipolano la visibilità di determinati contenuti per rafforzare determinate narrazioni o polarizzare gruppi sociali attraverso il fenomeno delle “bolle informative” e dei c.d. “eco-chamber“[1].
Fonte: Lange (2024)

Esaminando le tecnologie di sorveglianza, emerge un netto contrasto tra l’approccio occidentale alla privacy e quello adottato dai regimi autoritari. Un caso emblematico è rappresentato dal sistema di videosorveglianza di massa iraniano, sviluppato con tecnologia cinese di “Tiandy Technologies”, che utilizza telecamere intelligenti e sistemi di riconoscimento facciale per identificare e sanzionare automaticamente le donne che non rispettano l’obbligo del velo[2]. Questo sistema si basa su una vasta rete di telecamere di sorveglianza ed è stato significativamente potenziato nel 2022 in risposta alle proteste per Mahsa Amini, rappresentando un esempio concreto di come le tecnologie OSINT e ADINT possano essere utilizzate per il controllo sociale (Feldstein, 2019).

Il caso iraniano si inserisce in un più ampio fenomeno che Polyakova e Meserole (2019) definiscono “digital authoritarian spillover“, dove le tecnologie di sorveglianza vengono condivise tra regimi autoritari, con la Cina che emerge come principale esportatore. Come analizzato da Zuboff (2019) queste tecnologie, originariamente sviluppate per scopi commerciali in Occidente, vengono adattate per il controllo sociale in contesti autoritari.

La situazione è particolarmente preoccupante considerando il quadro normativo internazionale. Difatti, mentre l’Unione Europea ha implementato il Regolamento 2021/821 per controllare l’esportazione di tecnologie dual-use e il GDPR per proteggere i dati personali, i regimi autoritari possono aggirare queste restrizioni attraverso collaborazioni tecnologiche dirette (Deibert, 2020). Come evidenziato da Polyakova e Meserole (2019), questo ha creato un “mercato parallelo” di tecnologie di sorveglianza tra stati autoritari.

Sfide future OSINT e ADINT: bilanciamento privacy e sicurezza nazionale

L’analisi della letteratura evidenzia la natura multidimensionale degli impatti di OSINT e ADINT, sottolineando la necessità di un approccio bilanciato che consideri simultaneamente aspetti economici, tecnici e sociali. La sfida per il futuro sarà sviluppare framework regolatori che possano adattarsi all’evoluzione tecnologica mantenendo protezioni efficaci per i diritti fondamentali e solamente con una comprensione approfondita delle diverse dimensioni del fenomeno sarà possibile sviluppare risposte normative adeguate alle sfide poste da queste tecnologie.

Conclusioni

La rapida evoluzione tecnologica e la crescente digitalizzazione della società moderna hanno trasformato enormemente le modalità usate per raccogliere, elaborare e utilizzare i dati personali.

Questa tesi si è focalizzata principalmente sull’analisi approfondita delle tecniche OSINT (Open Source Intelligence) e ADINT (Advertising Intelligence), esaminando come queste metodologie di raccolta informazioni possano impattare significativamente sulla privacy degli individui. L’analisi ha evidenziato come gli strumenti pubblicitari e i dati pubblicamente disponibili possano essere utilizzati per condurre attività di sorveglianza mirata, spesso con investimenti economici relativamente contenuti.

La sezione riguardante l’ADINT ha rivelato come le piattaforme pubblicitarie possano essere sfruttate per tracciare gli individui e ricavare informazioni sensibili sul loro comportamento e le loro preferenze. La possibilità di utilizzare il targeting pubblicitario per questi scopi solleva importanti questioni etiche e di privacy, in particolar modo considerando che queste tecniche sono accessibili ad un’ampia gamma di attori, non solo alle grandi organizzazioni o alle agenzie governative.

L’analisi delle tecniche OSINT ha mostrato come l’aggregazione di informazioni provenienti da fonti pubbliche possa creare profili dettagliati degli individui, evidenziando la necessità di riconsiderare il concetto di privacy nell’era digitale. La facilità con cui queste informazioni possono essere raccolte e correlate rappresenta una sfida notevole per la protezione della privacy individuale.

La tesi ha anche esaminato le possibili contromisure tecniche e normative per proteggere gli individui da queste forme di sorveglianza. Le tecnologie c.d. “privacy-preserving”, come la privacy differenziale e le tecniche di anonimizzazione, possono offrire alcune protezioni ma devono essere bilanciate con la necessità di mantenere l’utilità dei dati per scopi legittimi. Particolare attenzione è stata dedicata all’analisi delle soluzioni che possono mitigare i rischi collegati all’Advertising Intelligence, come il controllo più rigoroso sul targeting pubblicitario e la limitazione della granularità dei dati disponibili per gli inserzionisti.

Questa tesi ha inoltre esplorato il complesso equilibrio tra la protezione della privacy e l’utilità dei dati, analizzando sia gli aspetti tecnici che quelli regolatori, con particolare attenzione al contesto europeo. L’analisi ha rivelato come questo equilibrio sia non solo una sfida tecnica ma anche una questione di fondamentale importanza sociale ed economica.

Si è evidenziato come il compromesso tra privacy e utilità dei dati sia inevitabile ma gestibile attraverso approcci formali come la privacy differenziale e come questi metodi avanzati offrano garanzie rigorose sulla protezione della privacy, permettendo allo stesso tempo di estrarre valore dai dati. Tuttavia, la loro implementazione pratica richiede una attenta calibrazione dei parametri e una profonda comprensione dei trade-off coinvolti. Si è dimostrato inoltre come diverse tecniche possano essere impiegate per raggiungere diversi livelli di protezione della privacy, ciascuna con i propri vantaggi e limitazioni.

Il contesto normativo europeo, caratterizzato dal GDPR, ha stabilito uno standard globale per la protezione dei dati personali, distinguendosi significativamente dall’approccio più frammentato adottato negli Stati Uniti. La legislazione europea pone particolare enfasi sui diritti individuali, sul consenso informato e sulla trasparenza nel trattamento dei dati, influenzando profondamente il modo in cui le organizzazioni devono gestire i dati personali. Questa differenza normativa ha importanti implicazioni per lo sviluppo e l’adozione di tecnologie privacy-preserving, creando un framework più rigido ma anche più chiaro per le organizzazioni che operano in Europa.

Un aspetto cruciale emerso dall’analisi riguarda l’economia della privacy, che ha mostrato come le organizzazioni debbano bilanciare i costi dell’implementazione di misure di protezione della privacy con i benefici derivanti dall’utilizzo dei dati. Allo stesso tempo, gli individui devono valutare il valore della loro privacy rispetto ai servizi e ai benefici che possono ottenere condividendo i loro dati. Questo equilibrio economico influenza significativamente l’adozione e l’evoluzione delle tecnologie privacy-preserving.

La presente tesi ha esaminato non solo gli aspetti tecnici ma anche le profonde differenze nell’utilizzo di metodi come OSINT e ADINT tra democrazie occidentali e regimi autoritari. Si è evidenziato come nell’Unione Europea l’utilizzo di queste tecniche di intelligence sia regolamentato da un quadro normativo che cerca di bilanciare le esigenze di sicurezza nazionale con la protezione dei diritti fondamentali dei cittadini, e il confronto con il sistema cinese ha rivelato differenze sostanziali nell’approccio alla sorveglianza digitale.

Mentre le agenzie di intelligence europee operano sotto vincoli legali e costituzionali stringenti, il sistema cinese integra tecniche come l’OSINT e l’ADINT in un più ampio apparato di controllo sociale, dove queste tecniche vengono utilizzate sistematicamente per il monitoraggio della popolazione. Questa differenza fondamentale riflette visioni contrastanti sul rapporto tra Stato e cittadino e sul valore della privacy individuale.

Le agenzie di intelligence europee hanno sviluppato framework operativi che cercano di massimizzare l’efficacia delle attività di intelligence nel rispetto dei diritti fondamentali. Questo approccio si manifesta attraverso procedure di autorizzazione e supervisione, limiti temporali alla raccolta dati e la necessità di giustificare specificamente ogni attività di sorveglianza. In contrasto, i regimi autoritari utilizzano queste tecnologie come strumenti di controllo sociale pervasivo, senza significative limitazioni legali o etiche.

La tesi ha anche evidenziato come il settore privato europeo sia soggetto a regolamentazioni più stringenti nell’uso di OSINT e ADINT rispetto ad altri contesti internazionali. Il GDPR impone limiti significativi sulla raccolta e l’uso dei dati personali, influenzando direttamente come queste tecniche possono essere impiegate per scopi commerciali. Questa compliance normativa ha portato allo sviluppo di approcci più sofisticati e rispettosi della privacy nel contesto europeo.

Inoltre, la cooperazione internazionale e lo sviluppo di standard comuni saranno fondamentali per affrontare queste sfide in un mondo sempre più interconnesso, e l’esperienza europea nel regolamentare la privacy dei dati può fornire importanti lezioni per altre giurisdizioni, contribuendo a stabilire un framework globale per la protezione dei dati personali.

Per quanto riguarda l’usabilità e l’accessibilità delle soluzioni privacy-preserving, la complessità tecnica di queste soluzioni non deve tradursi in barriere all’adozione da parte di utenti non tecnici, e dunque sarà cruciale sviluppare interfacce intuitive e meccanismi di comunicazione efficaci dei rischi per la privacy per permettere l’adozione diffusa di queste tecnologie. La formazione e l’educazione sulla privacy dei dati rappresentano un ulteriore aspetto fondamentale per il futuro, e di conseguenza è necessario aumentare la consapevolezza sia tra gli individui che tra le organizzazioni riguardo l’importanza della protezione dei dati personali e alle metodologie disponibili per garantirla.

In conclusione, mentre le sfide tecniche e normative nella protezione della privacy dei dati rimangono significative, gli sviluppi recenti forniscono ragioni di ottimismo. L’evoluzione delle tecnologie privacy-preserving, unitamente al rafforzamento del quadro normativo, specialmente in Europa, sta creando un ambiente più favorevole alla protezione dei dati personali. La continua ricerca e sviluppo in questo campo, combinata con una maggiore consapevolezza dell’importanza della privacy dei dati, suggerisce che emergeranno soluzioni sempre più efficaci per proteggere la privacy degli individui mantenendo al contempo l’utilità dei dati per la società.

L’analisi approfondita delle metodologie OSINT e ADINT rivela un panorama complesso in cui tecnologia, economia e diritti fondamentali si intersecano creando nuove sfide per la società digitale contemporanea. Questo studio ha evidenziato come le tecniche di Open Source Intelligence e Advertising Intelligence possano essere implementate con investimenti contenuti, raggiungendo livelli di precisione nella sorveglianza e profilazione comportamentale precedentemente impensabili.

Per approfondire questi temi cruciali per il futuro della privacy digitale e della sicurezza nazionale, scarica gratuitamente il white paper di Sergiu Deaconu “Open Source Intelligence e Advertising Intelligence: applicazioni e impatti in ambito industriale, civile e dell’intelligence europea”.

Fonti:

[1] Si tratta di un ambiente in cui le persone, spesso in forum online e vari social media, sono esposte principalmente a opinioni e informazioni che confermano e rafforzano le loro convinzioni preesistenti, creando un circolo vizioso in cui continueranno ad ascoltare le stesse opinioni e saranno sempre più restii a discutere con persone che hanno opinioni divergenti dalle loro.

[2] Iran resorts to security cameras, ostracism to deter unveiled women. Reuters. com.

Profilo Autore

Professionista con formazione multidisciplinare in economia, diritto e tecnologia, che unisce solide competenze accademiche a esperienza pratica nello sviluppo software. Attualmente opera come programmatore iOS e sviluppatore software, specializzandosi in Swift, C# e Python per lo sviluppo di applicazioni web e mobile e la progettazione di architetture software avanzate.

Ha conseguito una Laurea magistrale in ‘European Economy and Business Law’ presso l’Università degli Studi di Roma “Tor Vergata”, focalizzandosi su economia digitale e diritto europeo, e ha completato un Master in ‘Informatica giuridica, nuove tecnologie e diritto dell’informatica’ presso l’Università “La Sapienza” di Roma. La sua ricerca post-lauream si è concentrata sulle implicazioni di Big Data, IoT e Intelligenza Artificiale in settori strategici quali agricoltura, industria e smart cities, nonché sull’analisi delle tecniche OSINT e ADINT in relazione a privacy e sicurezza nazionale.

Certificato in Project Design & Management a livello europeo e con competenze linguistiche avanzate in inglese (IELTS 7.5), combina capacità analitiche e di leadership con una profonda comprensione dell’intersezione tra tecnologia, diritto ed economia nell’era digitale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/adint/


Gli ecosistemi digitali sotto attacco: Supply Chain Security, NIS2 e l’importanza degli SBOM

Al Forum ICT Security 2025, Vincenzo Sammartino analizza i rischi emergenti degli attacchi alla catena di fornitura e le strategie di difesa attraverso Digital Twin e Software Bill of Materials

Dal biologico al digitale: comprendere gli ecosistemi informatici

Quando si parla di cybersecurity, pensare in termini di singoli sistemi isolati non è più sufficiente. Questa consapevolezza emerge con chiarezza dall’intervento dal titolo “NIS2, Supply Chain Security e SBOM”, tenuto da Vincenzo Sammartino durante la 23ª edizione del Forum ICT Security, svoltosi a Roma il 19 e 20 novembre 2025. Sammartino, dottorando del National PhD in Artificial Intelligence presso l’Università di Pisa, ha sostituito il professor Fabrizio Baiardi, impossibilitato a partecipare per motivi di salute.

L’esperto ha aperto la sua presentazione con un’analogia tanto efficace quanto illuminante: quella tra ecosistema biologico ed ecosistema digitale. Ha spiegato che così come nell’ecosistema biologico l’energia fluisce dal basso verso l’alto della piramide alimentare, trasportando con sé non solo nutrimento ma anche tossine, funghi e batteri, allo stesso modo nell’ecosistema digitale le vulnerabilità si propagano attraverso la catena di fornitura. Ciò che per gli organismi viventi rappresentano le tossine, nel mondo digitale sono le vulnerabilità informatiche che si diffondono da un componente all’altro, da un fornitore all’utilizzatore finale.

Ecosistemi e catene alimentari

Questa prospettiva sistemica rappresenta un cambio di paradigma fondamentale per comprendere la natura degli attacchi supply chain, dove una singola vulnerabilità inserita a un determinato livello della catena può propagarsi come un’onda a tutti i sistemi che dipendono da quel componente. La sicurezza, quindi, non è più una proprietà dei singoli sistemi, ma dell’intero ecosistema informativo a cui tali sistemi appartengono.

L’industria del ransomware: un ecosistema criminale strutturato e maturo

Uno degli aspetti più inquietanti emersi dall’intervento riguarda l’evoluzione del ransomware, che è diventato ormai una vera e propria industria strutturata con attori specializzati e ben organizzati. Come ha sottolineato Sammartino, non si parla più di singoli criminali informatici, ma di vere e proprie organizzazioni che operano secondo il modello del ransomware as a service, dove diversi attori collaborano ciascuno con competenze specifiche.

Ecosistema Ransomware

Al centro di questo ecosistema criminale si trova una figura chiave: l’Initial Access Broker, ovvero chi vende l’accesso iniziale a una rete o sistema compromesso. Questo punto di accesso iniziale nella catena di fornitura viene poi sfruttato da altri attori per perpetrare l’attacco vero e proprio. L’ecosistema include sviluppatori di malware, fornitori di infrastrutture di hosting protette (bulletproof hosting), affiliati che distribuiscono il ransomware, servizi di negoziazione con le vittime e persino servizi di riciclaggio del denaro (money laundering).

La complessità dell’ecosistema della cybersecurity è stata illustrata attraverso una slide deliberatamente caotica che mostra centinaia di fornitori, servizi e prodotti interconnessi. Lo speaker ha fatto notare come dietro ogni singolo logo rappresentato ci siano in realtà tantissimi attori, e di conseguenza la superficie di attacco aumenta in maniera esponenziale. Un esempio recente citato è stato quello di Cloudflare, che nei giorni precedenti al convegno era stato al centro delle cronache per quello che inizialmente sembrava un attacco informatico ma che si è poi rivelato essere un errore di programmazione. Tuttavia, questo errore ha comunque avuto ripercussioni su numerosi altri servizi che dipendevano da Cloudflare, dimostrando quanto sia estesa e fragile la rete di interdipendenze nell’ecosistema digitale.

Anatomia di un attacco supply chain: come funziona la compromissione

Sammartino ha illustrato con precisione il meccanismo attraverso cui si sviluppa un attacco alla catena di fornitura. Il processo inizia con la scelta strategica di un fornitore: gli attaccanti non colpiscono direttamente l’obiettivo finale, ma identificano prima quali fornitori utilizza il target prescelto. Una volta individuato il fornitore più vulnerabile o strategico, gli attaccanti lo compromettono inserendo del codice malevolo all’interno del suo prodotto o servizio.

Supply chain attack

Un aspetto particolarmente insidioso di questi attacchi riguarda la scelta dei target preferiti: paradossalmente, i sistemi di sicurezza stessi rappresentano gli obiettivi ideali. Il relatore ha spiegato che questo avviene perché inserire un malware all’interno di un prodotto di sicurezza, come potrebbe essere un sistema IDS (Intrusion Detection System) o un antivirus, crea quella che viene definita una situazione Living off the Land. In pratica, il codice malevolo nascosto all’interno di uno strumento di sicurezza diventa praticamente invisibile, poiché è molto più difficile che venga rilevato proprio dal sistema che dovrebbe proteggerci.

Un punto cruciale evidenziato nell’intervento riguarda l’intero ciclo di vita del prodotto. Sammartino ha sottolineato con forza che la supply chain non coinvolge soltanto la fase di distribuzione, ma abbraccia l’intero processo di vita del prodotto e del servizio: progettazione, sviluppo, manutenzione e persino dismissione. Le vulnerabilità possono essere introdotte in qualsiasi momento e in qualsiasi fase di questo percorso.

Forniture ma non solo

Gli attori che possono rappresentare una minaccia sono molteplici: non solo fornitori diretti, ma anche fornitori dei fornitori (le cosiddette terze parti), utenti finali e soprattutto insider, ovvero dipendenti dell’azienda che volontariamente o involontariamente inseriscono codice malevolo all’interno del servizio. La vulnerabilità può annidarsi in qualsiasi fase: durante la progettazione, nello sviluppo, nella distribuzione, nell’installazione, nella manutenzione o persino nella fase di dismissione del prodotto.

Le vulnerabilità nascoste nel codice: dalla sorgente al runtime

Dal punto di vista dello sviluppo software, il relatore ha illustrato tutte le possibili fonti di vulnerabilità che possono annidarsi nelle diverse fasi di creazione di un’applicazione. Utilizzando come riferimento il framework SLSA (Supply chain Levels for Software Artifacts) proposto da Google, ha mostrato come le minacce possano manifestarsi in ogni passaggio del processo.

Supply Chain Levels x Software assurance

Nel primo blocco, a livello di codice sorgente, troviamo vulnerabilità come il poisoning del repository, ovvero l’avvelenamento del deposito di codice sorgente attraverso modifiche non autorizzate. Tuttavia, il punto più critico e attuale riguarda le dipendenze: l’uso sempre più massiccio di librerie open source all’interno dei prodotti commerciali comporta che queste librerie possano contenere vulnerabilità sfruttabili da attaccanti per scopi malevoli, come l’esfiltrazione di dati sensibili.

Ma le fonti di vulnerabilità non si fermano qui. Possono annidarsi anche nella fase di build, attraverso il caricamento di pacchetti già compromessi, e persino nelle fasi di sviluppo e runtime. Google ha proposto un’estensione del concetto di sicurezza che copre tutte queste fasi, rendendo evidente che ogni singolo passaggio dello sviluppo e dell’esecuzione di un prodotto software rappresenta una potenziale porta di ingresso per gli attaccanti.

Google version of supply chain attacks

I numeri di una minaccia crescente: dati e casi concreti

I dati presentati durante l’intervento confermano che non si tratta di minacce teoriche, ma di un fenomeno in drammatica crescita. Le statistiche di Cyble citate da Sammartino mostrano picchi sempre più elevati negli attacchi supply chain, con un incremento particolarmente significativo registrato nel 2025. Il grafico presentato evidenzia una curva in costante ascesa, con oscillazioni che però tendono sempre verso l’alto, segno che gli attaccanti hanno compreso l’efficacia di questa strategia e la stanno sfruttando sempre di più.

Numbers – grafico Supply Chain Attacks 2024-2025

Tra i casi più eclatanti e recenti citati durante la presentazione, spicca l’attacco alla piattaforma Discord Bot del marzo 2024, che ha colpito una community di oltre 170.000 membri. Gli attaccanti hanno infettato gli sviluppatori con malware in grado di rubare informazioni sensibili, utilizzando diverse tecniche tra cui il dirottamento di account GitHub, la distribuzione di pacchetti Python malevoli e l’uso di una falsa infrastruttura Python appositamente creata per ingannare gli sviluppatori.

L’attacco Okta dell’ottobre 2023 ha invece dimostrato come anche i fornitori di servizi di autenticazione e gestione delle identità possano essere compromessi. Gli attaccanti sono riusciti ad accedere a dati privati dei consumatori ottenendo le credenziali del sistema di gestione del supporto clienti, mettendo potenzialmente a rischio migliaia di organizzazioni che si affidavano ai servizi di Okta.

Nel settembre-ottobre 2023, i server JetBrains TeamCity sono stati presi di mira sfruttando una vulnerabilità critica di bypass dell’autenticazione. Questo attacco ha destato particolare attenzione per il suo potenziale impatto, dato l’utilizzo diffuso di TeamCity negli ambienti di sviluppo software. Gli stessi attori dietro il noto attacco SolarWinds sono stati identificati come responsabili di questa campagna.

Famous Supply Chain Attacks – prima parte

L’attacco a Microsoft del febbraio 2023 ha sfruttato una vulnerabilità in JFrog Artifactory, un gestore di repository binari che Microsoft utilizza per distribuire e conservare i componenti software. Gli attaccanti sono riusciti a iniettare codice malevolo in alcuni componenti software di Microsoft, ottenendo accesso alla rete e riuscendo a esfiltrare codice sorgente e altre informazioni confidenziali di estremo valore.

Anche Norton, il noto fornitore di software antivirus, non è stato immune: nel maggio 2023 è stato vittima di un attacco che ha sfruttato una vulnerabilità zero-day in un software MFT (Managed File Transfer) utilizzato dalla società madre per trasferire file tra consumatori e uffici. Gli attaccanti hanno avuto accesso alla rete di Norton e sono riusciti a sottrarre informazioni personali dei dipendenti.

L’attacco ad Airbus del gennaio 2023 ha dimostrato come anche le grandi multinazionali dell’aerospazio possano essere colpite attraverso la compromissione di un account di un dipendente di uno dei loro clienti, in questo caso Turkish Airlines. Questo caso evidenzia come la catena di fiducia possa essere sfruttata in entrambe le direzioni: non solo dai fornitori verso i clienti, ma anche dai clienti verso i fornitori.

Famous Supply Chain Attacks – seconda parte

Ma il caso che forse più di tutti ha segnato la storia recente della supply chain security rimane SolarWinds, avvenuto alla fine del 2020. In questo attacco sofisticatissimo, la società SolarWinds ha distribuito ai propri clienti un aggiornamento software legittimamente firmato che però conteneva al suo interno del malware accuratamente nascosto. I clienti avevano completa fiducia nel software perché era stato firmato, costruito e distribuito direttamente da SolarWinds attraverso i canali ufficiali. Nessuno poteva immaginare che fosse compromesso. L’attacco è riuscito a infiltrarsi in oltre 18.000 organizzazioni commerciali e governative, incluse agenzie federali statunitensi di primissimo livello, rappresentando uno dei più gravi incidenti di sicurezza informatica della storia recente.

NIS2 e le nuove normative europee: cosa cambia per le organizzazioni

L’intervento ha poi analizzato come la direttiva europea NIS2 affronti specificamente il tema della sicurezza della catena di fornitura. Sammartino ha spiegato che proprio l’esigenza di difendersi dagli attacchi supply chain rappresenta una delle ragioni principali dell’evoluzione dalla precedente direttiva NIS alla nuova NIS2, molto più stringente e articolata.

La NIS2, nello specifico all’interno dell’articolo 21, definisce dieci misure di sicurezza di base che le organizzazioni dovrebbero implementare. Tra queste, due punti affrontano direttamente la questione della catena di fornitura:

  • Il punto 4 richiede di garantire la sicurezza della catena di fornitura, comprese le misure che affrontano il rapporto tra le aziende e i loro fornitori diretti o prestatori di servizi
  • Il punto 5 impone di garantire la sicurezza nell’acquisizione, sviluppo e manutenzione di reti e sistemi informativi, inclusa la gestione e la divulgazione delle vulnerabilità
NIS2 – Articolo 21

L’articolo 21 prevede anche altre misure fondamentali: politiche di analisi dei rischi e di sicurezza dei sistemi informativi, piani di risposta agli incidenti per la gestione delle minacce attive, piani di continuità aziendale (inclusi backup e ripristino di emergenza), politiche per valutare l’efficacia delle misure implementate, formazione sulla consapevolezza e sulle migliori pratiche di sicurezza informatica, politiche sull’uso della crittografia, procedure di controllo degli accessi (in particolare per i dipendenti con accesso a dati sensibili) e sistemi di autenticazione multifattoriale e monitoraggio continuo.

Lo speaker ha però evidenziato come la normativa europea, per quanto più stringente rispetto al passato, risulti ancora meno rigorosa rispetto agli standard richiesti negli Stati Uniti. L’Executive Order 14028 del Presidente degli Stati Uniti, emanato nel maggio 2021 e intitolato “Improving the Nation’s Cybersecurity”, stabilisce infatti requisiti ancora più precisi e vincolanti.

U.S. Executive Order 14028

Questo ordine esecutivo richiede che:

  1. Tutto il software venduto al governo federale degli Stati Uniti deve includere un SBOM (Software Bill of Materials), ovvero un registro formale e dettagliato di tutti i suoi componenti e delle loro relazioni
  2. I fornitori devono implementare pratiche di sviluppo sicuro, inclusi ambienti di build sicuri, autenticazione multifattoriale obbligatoria e cifratura dei dati
  3. Il software deve essere sottoposto regolarmente a vulnerability scanning e devono essere fornite evidenze documentali di questi test
  4. Deve essere garantita e dimostrata l’integrità del codice open source utilizzato, assicurando che sia stato correttamente validato e testato

La differenza principale, ha sottolineato il relatore, sta nel livello di dettaglio e nella natura cogente delle misure richieste: mentre la NIS2 fornisce linee guida generali, l’Executive Order americano impone requisiti tecnici specifici e verificabili.

SBOM: la lista degli ingredienti del software moderno

Una delle soluzioni più innovative e concrete per affrontare i rischi legati alla supply chain è rappresentata dal concetto di Software Bill of Materials, comunemente abbreviato in SBOM. Sammartino ha utilizzato ancora una volta un’analogia con il mondo reale per spiegare questo concetto: “È come una lista di ingredienti di materie prime che si trovano all’interno di un alimento.”

Così come è relativamente semplice identificare la presenza di allergeni in un prodotto alimentare grazie all’elenco degli ingredienti riportato sull’etichetta, allo stesso modo diventa molto più facile individuare una libreria compromessa se è stata creata e mantenuta una Software Bill of Materials completa e accurata.

System Bills of Material – SBOM

Ma cosa deve contenere esattamente un SBOM? Secondo le linee guida internazionali, un SBOM rappresenta un registro formale dei dettagli e delle relazioni della catena di fornitura di qualsiasi componente utilizzato per costruire un software. All’interno di questa lista devono essere inserite tutte le dipendenze utilizzate: librerie open source, porzioni di codice prese da terze parti e l’elenco completo dei fornitori che compongono la catena di approvvigionamento.

Un SBOM efficace deve possedere alcune caratteristiche fondamentali. Innanzitutto, deve essere elaborabile automaticamente (machine-processable) in un formato ampiamente utilizzato, per consentire l’automazione dei processi di verifica. Deve contenere informazioni sufficienti sia sui componenti open source che su quelli proprietari presenti nel software, in modo da poterli correlare con altre fonti di dati, come i database delle vulnerabilità note e i bollettini di sicurezza. L’automazione rappresenta infatti un obiettivo chiave sia per la generazione che per l’utilizzo degli SBOM.

Analizzando i dati contenuti in un SBOM, un utilizzatore dovrebbe essere in grado di determinare con certezza se un determinato componente è presente in un software specifico. I dati dell’SBOM possono inoltre fornire informazioni preziose sulla provenienza dei componenti, consentendo una migliore tracciabilità e gestione del rischio. Condividere gli SBOM lungo tutta la catena di fornitura permette alle organizzazioni di formare un quadro più completo del software utilizzato e di rispondere tempestivamente alle informazioni che potrebbero indicare nuovi rischi emersi.

Il caso Log4Shell: quando sapere è più importante che rimediare

Per illustrare l’importanza pratica degli SBOM, il relatore ha analizzato in dettaglio il caso Log4Shell, la celebre vulnerabilità scoperta nel dicembre 2021 nella libreria Apache Log4j. Questa libreria di logging (registrazione degli eventi) è ampiamente utilizzata come modulo standard per l’output dei log nei sistemi Java in tutto il mondo, ed è stata classificata con un livello di criticità molto alto per la facilità con cui poteva essere sfruttata.

Why SBOM?

Il problema principale non riguardava la complessità della correzione: la vulnerabilità in sé era relativamente facile da rimediare una volta identificata. La vera sfida consisteva nel sapere quali sistemi fossero effettivamente vulnerabili. Come ha spiegato Sammartino con una frase efficace: “Il problema non era rimediare la vulnerabilità, il problema era sapere se in un sistema c’era la vulnerabilità da rimediare.”

La difficoltà derivava dal fatto che Log4j veniva solitamente utilizzata come dipendenza transitiva, ovvero come dipendenza di altre dipendenze, rendendo molto difficile identificarla senza strumenti adeguati. Le organizzazioni prive di capacità SBOM si sono trovate costrette a impegnarsi in ricerche manuali lunghe e dispendiose, rischiando di rimanere vulnerabili per settimane o mesi. Al contrario, le organizzazioni che disponevano già di SBOM aggiornati e completi sono state in grado di identificare immediatamente tutti i sistemi che utilizzavano la libreria compromessa e di rispondere in modo relativamente rapido ed efficiente.

Questo caso ha rappresentato un punto di svolta nella consapevolezza dell’importanza degli SBOM, dimostrando in modo inequivocabile che la trasparenza sui componenti software non è un lusso ma una necessità per la sicurezza moderna.

Strategie di difesa: oltre le pratiche tradizionali

L’intervento si è concluso con una panoramica delle strategie difensive più efficaci per contrastare gli attacchi alla catena di fornitura, che vanno ben oltre le pratiche di sicurezza tradizionali e richiedono un approccio innovativo e multilivello.

And now?

La prima linea di difesa consiste nella valutazione accurata della scelta del fornitore. Non è sufficiente verificare che un fornitore dichiari di avere determinate certificazioni: è necessario valutare se queste certificazioni sono supportate da evidenze sperimentali concrete e verificabili. Bisogna inoltre esaminare attentamente le politiche di sicurezza adottate dal fornitore e richiedere prove tangibili della loro effettiva implementazione.

Un secondo pilastro fondamentale è lo sviluppo secondo i principi del Secure by Design, ovvero progettare e sviluppare prodotti la cui sicurezza sia garantita fin dalle prime fasi di creazione. Come ha spiegato il relatore, questo significa intervenire durante la fase di sviluppo e, conseguentemente, durante la fase di debug, per andare a sviluppare un sistema che sia privo di vulnerabilità a partire dalla sua concezione iniziale, non cercando di “rattoppare” la sicurezza a posteriori.

Il terzo principio riguarda l’applicazione rigorosa del principio del privilegio minimo, specialmente quando si ha a che fare con fornitori di terze parti. Questo significa ridurre al minimo assoluto i privilegi di accesso di chi opera sul sistema, limitando così i potenziali impatti di una eventuale esfiltrazione di dati o compromissione del fornitore stesso.

Ma il punto più innovativo e promettente illustrato nell’intervento riguarda il What-if Engineering basato su Digital Twin, l’area di ricerca su cui stanno attualmente lavorando Sammartino e il suo supervisor, il professor Baiardi. Questo approccio consiste nel creare un gemello digitale (digital twin) completo dell’infrastruttura informatica, in modo da poter eseguire su di esso simulazioni utilizzando il metodo Monte Carlo.

La potenzialità di questa tecnologia è straordinaria: permette di fare quello che viene chiamato what-if analysis, ovvero verificare preventivamente cosa succederebbe se un determinato componente venisse aggiunto al sistema. Per esempio, prima di integrare una nuova libreria per il logging nel proprio software, si può chiedersi: quante vulnerabilità note ha questa libreria? Quali rischi comporta al sistema nel suo complesso l’inserimento di questa libreria? Quali sono i percorsi di attacco che un ipotetico attaccante potrebbe sfruttare? Qual è il rischio potenziale complessivo che l’aggiunta di questo componente introduce nel sistema?

Attraverso simulazioni condotte sul gemello digitale, è possibile ottenere risposte concrete a queste domande prima ancora di implementare le modifiche nell’ambiente di produzione reale, identificando preventivamente le vulnerabilità e progettando le appropriate contromisure. Questo approccio proattivo rappresenta un salto qualitativo enorme rispetto alla tradizionale sicurezza reattiva, che interviene solo dopo che un problema si è manifestato.

Per chi fosse interessato ad approfondire questa metodologia, Sammartino ha rimandato ai paper scientifici pubblicati dal gruppo di ricerca e alle precedenti presentazioni del professor Baiardi sull’argomento, disponibili negli atti delle scorse edizioni del Forum ICT Security.

Conclusioni: ripensare la sicurezza come proprietà ecosistemica

L’intervento di Vincenzo Sammartino ha evidenziato con chiarezza come la sicurezza informatica non possa più essere concepita come una proprietà di singoli sistemi isolati, ma debba necessariamente essere considerata a livello di ecosistema nella sua interezza. Gli attacchi supply chain sfruttano proprio le molteplici interconnessioni tra fornitori, componenti software, servizi e sistemi, rendendo indispensabile un approccio olistico e sistemico.

Le vulnerabilità, come le tossine negli ecosistemi biologici, si propagano lungo le catene di dipendenza, e un singolo punto debole può compromettere centinaia o migliaia di organizzazioni a valle. La complessità crescente dell’ecosistema digitale, con i suoi innumerevoli attori e interdipendenze, amplifica esponenzialmente la superficie di attacco e rende ogni componente un potenziale vettore di compromissione.

Per affrontare efficacemente questa sfida, è necessario un approccio multilivello che includa:

  • Trasparenza radicale attraverso l’adozione sistematica degli SBOM, che permettono di sapere esattamente cosa c’è dentro il software che utilizziamo
  • Conformità normativa rigorosa con la direttiva NIS2 e gli standard internazionali più avanzati, come quelli stabiliti dall’Executive Order americano
  • Validazione continua dei fornitori, delle loro pratiche di sicurezza e delle evidenze concrete che le supportano
  • Simulazione proattiva dei rischi attraverso tecnologie innovative come i Digital Twin, che permettono di prevedere e prevenire le vulnerabilità prima che possano essere sfruttate

Come ha efficacemente sintetizzato il relatore nella sua conclusione, la vera sfida non sta tanto nel rimediare alle vulnerabilità una volta scoperte – operazione spesso relativamente semplice dal punto di vista tecnico – quanto piuttosto nel saperle identificare tempestivamente all’interno di ecosistemi sempre più complessi, interconnessi e in continua evoluzione.

Il passaggio da una visione atomistica della sicurezza (incentrata sul singolo sistema) a una visione ecosistemica (che abbraccia l’intera catena di fornitori, dipendenze e relazioni) rappresenta non solo un’evoluzione tecnologica, ma un vero e proprio cambio di paradigma culturale. Solo attraverso questo nuovo approccio sarà possibile costruire sistemi realmente resilienti, capaci di resistere alle sofisticate minacce che caratterizzano il panorama della cybersecurity moderna.

Guarda il video completo dell’intervento:

[embedded content]
Profilo Autore

Sono un professionista con un solido background in Intelligenza Artificiale e CyberSecurity, attualmente impegnato nel dottorato nazionale in AI presso l’Università di Pisa. La mia specializzazione si concentra sull’implementazione di soluzioni innovative per la sicurezza informatica e la gestione dei dati.

Grazie al mio percorso accademico e alla mia esperienza pratica, ho sviluppato competenze approfondite nei sistemi distribuiti e nei Digital Twin, con particolare interesse per la loro applicazione nell’intelligenza artificiale e nella cybersecurity. Attualmente, le mie ricerche si focalizzano su sistemi di decomposizione di database e sull’integrazione dei Digital Twin per anticipare e mitigare minacce informatiche, sempre con un occhio di riguardo alla conformità ai regolamenti GDPR.

Con diverse pubblicazioni accademiche e presentazioni a conferenze internazionali, sono attivamente coinvolto nella condivisione di conoscenze innovative nel mio campo. La mia passione per l’AI mi spinge a esplorare costantemente nuove frontiere tecnologiche, contribuendo a progetti all’avanguardia per migliorare la sicurezza e la resilienza dei sistemi IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sbom/


Smart Grid Security: vulnerabilità della demand response e minacce beyond smart meter

La narrazione sulla sicurezza delle smart grid si è focalizzata per anni sugli smart meter, ma questa visione circoscritta non coglie la vera complessità delle moderne infrastrutture energetiche digitalizzate. Le reti elettriche intelligenti rappresentano un ecosistema cyber-fisico stratificato dove i Distributed Energy Resources (DER) proliferano esponenzialmente, e i vettori d’attacco più insidiosi si annidano nei sistemi di gestione della domanda energetica, ben oltre i dispositivi di misura.

L’architettura distribuita delle smart grid moderne

Le smart grid integrano tecnologie digitali, Internet delle Cose (IoT) e Advanced Metering Infrastructure (AMI) per abilitare flussi energetici bidirezionali, monitoraggio in tempo reale ed efficienza operativa. La generazione distribuita attraverso impianti fotovoltaici residenziali, sistemi di accumulo e veicoli elettrici richiede meccanismi sofisticati di coordinamento: qui entra in scena il demand response, la capacità di modulare dinamicamente i consumi in risposta alle condizioni di rete.

Il demand response rappresenta una componente critica per la stabilità della grid moderna. Attraverso protocolli come OpenADR (Open Automated Demand Response), sviluppato negli Stati Uniti e adottato progressivamente a livello internazionale, gli operatori comunicano in tempo reale con aggregatori di carico e sistemi di gestione energetica per orchestrare riduzioni o spostamenti dei consumi.

Le vulnerabilità critiche del protocollo OpenADR

Un’analisi delle vulnerabilità condotta sul software OpenADR ha identificato oltre 700 violazioni delle regole di sicurezza nell’implementazione open source CERT Java-based del protocollo. Le specifiche OpenADR 2.0b utilizzano messaggi XML per le transazioni tra Virtual End Nodes (VEN) e Virtual Top Nodes (VTN), ma la definizione ambigua dei transaction identifier crea vulnerabilità che facilitano attacchi di parameter tampering e falsificazione del flusso dei servizi.

Un attaccante che comprometta un VTN o inietti messaggi fraudolenti può manipolare i segnali di demand response, creando picchi di carico artificiosi o riduzioni massive coordinate. Gli attacchi di load redistribution (LR) non alterano la domanda totale di potenza ma ne modificano la distribuzione geografica e temporale, forzando il sistema SCED a riconfigurazioni costose e causando il trip di linee specifiche.

Per approfondire le sfide della protezione delle infrastrutture critiche energetiche, è essenziale comprendere le interdipendenze tra i settori energetico, ICT e trasporti.

Convergenza IT/OT: la superficie d’attacco si espande

I protocolli industriali come Modbus, DNP3 e IEC 61850 sono stati progettati in un’epoca dove l’isolamento fisico delle reti OT era considerato sufficiente. Oggi queste reti devono interfacciarsi con sistemi IT aziendali, cloud e dispositivi IoT distribuiti sul territorio, creando percorsi d’attacco che collegano vulnerabilità enterprise a componenti critiche di controllo della rete elettrica.

Gli advisory CISA e DoE hanno documentato come threat actor relativamente poco sofisticati riescano a compromettere sistemi ICS/SCADA nel settore energetico sfruttando password predefinite, dispositivi OT esposti su internet e carenze nella segmentazione di rete. Il fatto che attaccanti “unsophisticated” possano penetrare le infrastrutture critiche con effetti domino dimostra quanto sia ampia e mal protetta la superficie d’attacco.

Gli attacchi alle reti elettriche ucraine: un precedente preoccupante

Il 23 dicembre 2015, le reti elettriche di due regioni occidentali dell’Ucraina furono compromesse attraverso un cyberattacco che causò blackout per circa 230.000 consumatori per periodi da 1 a 6 ore. L’attacco, attribuito al gruppo APT Sandworm legato all’intelligence militare russa (GRU), utilizzò il malware BlackEnergy per compromettere i sistemi SCADA e aprire manualmente i circuit breaker di 30 sottostazioni.

Nel dicembre 2016, Sandworm sviluppò Industroyer, un malware significativamente più avanzato, progettato specificamente per manipolare sistemi di controllo industriale con conoscenza integrata dei protocolli IEC 60870-5-101 e IEC 61850 usati nelle sottostazioni elettriche europee. Questi attacchi hanno stabilito un precedente allarmante per la sicurezza delle grid globali, dimostrando che le capabilities per causare blackout estesi attraverso cyberattacchi esistono e sono state utilizzate in contesti di guerra ibrida.

Digital forensics nelle smart grid: sfide e complessità

Quando si verifica un incidente cyber in un ambiente industriale complesso, la capacità di ricostruire la catena degli eventi è compromessa da molteplici fattori: i sistemi SCADA non mantengono log dettagliati, molti Intelligent Electronic Devices nelle sottostazioni non hanno primitive di memoria volatile facilmente analizzabili.

La proliferazione di malware progettati per evitare tracciamento (come Stuxnet, Flames, Triton) sfrutta la fragilità dell’evidenza digitale per lanciare attacchi senza lasciare tracce. L’eterogeneità dei protocolli di comunicazione complica le indagini forensi, richiedendo competenze specialistiche nella decodifica di traffico Modbus-TCP, analisi di time-series SCADA e correlazione di eventi attraverso domini tecnologici diversi.

Il quadro normativo: NIS2 e NERC-CIP

La Direttiva NIS2 dell’Unione Europea, entrata in vigore nel gennaio 2023 con deadline di trasposizione nazionale ottobre 2024, estende significativamente l’ambito di applicazione rispetto alla NIS del 2016, coprendo esplicitamente produttori di elettricità, operatori di mercato, gestori di punti di ricarica per veicoli elettrici.

Le sanzioni NIS2 sono state inasprite: le entità essenziali rischiano multe fino a 10 milioni di euro o il 2% del fatturato globale annuale (a seconda di quale sia maggiore), mentre le entità importanti fino a 7 milioni di euro o l’1,4% del fatturato.

Negli Stati Uniti, gli standard NERC-CIP prevedono penalità che possono raggiungere 1 milione di dollari al giorno per violazione. ABB ha sottolineato che gli operatori che non implementano autenticazione multi-fattore e segmentazione di rete rischiano penalità significative.

Per una panoramica completa delle normative europee, si veda l’analisi su NIS2, CER e DORA per le infrastrutture critiche.

Intelligenza artificiale: opportunità e nuove superfici d’attacco

Framework come DerGuard sviluppato da Georgia Tech utilizzano reti neurali ricorrenti e digital twin cyber-fisici per identificare pattern anomali nei Distributed Energy Resources. I digital twin che simulano dinamicamente il comportamento della rete possono distinguere fluttuazioni legittime da manipolazioni malevole.

Tuttavia, questi approcci introducono nuove superfici d’attacco: un modello di machine learning addestrato su dati avvelenati produrrà sistematicamente decisioni errate. Gli attaccanti stanno già sperimentando tecniche di adversarial machine learning per eludere sistemi di detection basati su AI.

Veicoli elettrici: un ulteriore vettore di vulnerabilità

Ogni charging station è essenzialmente un edge device che comunica con la rete attraverso protocolli come OCPP e ISO 15118. Le vulnerabilità side-channel permettono il profiling dei veicoli attraverso l’analisi dei pattern di corrente durante la ricarica, rappresentando sia un rischio privacy che un potenziale vettore per attacchi più sofisticati.

Un attaccante che comprometta l’infrastruttura di gestione di una flotta di charging station potrebbe orchestrare picchi di carico sincronizzati attraverso migliaia di veicoli, con effetti potenzialmente destabilizzanti per la rete locale.

Threat landscape: APT e guerra ibrida

Nell’ottobre 2022, Sandworm ha causato un blackout in Ucraina coordinandolo con attacchi missilistici, utilizzando tecniche “living off the land” per compromettere un sistema MicroSCADA e inviare comandi ai remote terminal units delle sottostazioni. Questo rappresenta l’evoluzione più recente delle capabilities cyber-fisiche russe contro infrastrutture critiche.

In un contesto geopolitico teso, le smart grid rappresentano obiettivi strategici per operazioni di pre-positioning. Mentre il sistema elettrico europeo non ha ancora subito un cyberattacco su larga scala, il rischio è tutt’altro che ipotetico, con evidenze di intrusioni nei sistemi informatici di energy companies nell’UE e negli Stati Uniti.

Resilienza e difesa in profondità: verso un nuovo paradigma

La resilienza delle smart grid richiede un approccio olistico che integri prevenzione, detection, response e recovery. La segmentazione delle reti OT secondo il modello Purdue, con zone demilitarizzate tra IT e OT e controlli rigorosi sui flussi tra livelli, è diventata best practice riconosciuta, anche se la sua implementazione rimane sfidante in infrastrutture legacy.

Il mercato della cybersecurity per smart grid è stato valutato 7,5 miliardi di dollari nel 2024 e si prevede raggiunga 22,7 miliardi entro il 2034, riflettendo un CAGR dell’11,7%. Questa crescita è trainata dalla digitalizzazione rapida dei sistemi di potenza che amplia la superficie d’attacco, dai contatori intelligenti ai DER e ai caricatori EV.

Conclusioni: verso la resilienza cyber-fisica

La convergenza tra cyber warfare e infrastrutture critiche energetiche rappresenta una delle sfide più pressanti per la sicurezza nazionale. I cyberattacchi al settore elettricità sono aumentati drasticamente dal 2018, spingendo governi e utility a rafforzare le misure di resilienza mentre la connettività accelera.

Le competenze richieste sono intrinsecamente multidisciplinari: un cybersecurity expert nel dominio smart grid deve comprendere non solo tecniche di penetration testing e incident response, ma anche fondamenti di ingegneria elettrica, teoria del controllo dei sistemi di potenza e vincoli regolatori del mercato energetico.

L’evoluzione verso architetture sempre più decentralizzate basate su energia rinnovabile intermittente aumenterà la dipendenza da sistemi digitali di coordinamento e controllo. La protezione delle smart grid richiede investimenti non solo in tecnologie di difesa, ma soprattutto in formazione, ricerca e sviluppo di standard che integrino nativamente la sicurezza nelle architetture future.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/smart-grid-security/


Sicurezza SCADA e ICS tra persistenza degli attaccanti e opacità dei sistemi legacy

Quando parliamo di sicurezza dei sistemi SCADA e degli ambienti Industrial Control Systems (ICS), ci troviamo di fronte a un paradosso che raramente viene esplicitato con la necessaria chiarezza: stiamo applicando paradigmi di difesa concepiti per l’information technology a infrastrutture progettate in un’epoca in cui la connettività non era nemmeno contemplata come scenario di rischio. Questa discrasia temporale e concettuale non è una semplice curiosità storica, ma rappresenta il nucleo stesso delle vulnerabilità che caratterizzano gli ambienti di controllo industriale.

La convergenza IT-OT, termine divenuto quasi un mantra nel lessico della cybersecurity industriale, nasconde una verità scomoda: non stiamo assistendo a una vera convergenza, quanto piuttosto a una colonizzazione forzata di ecosistemi operativi da parte di tecnologie pensate per contesti radicalmente diversi. I sistemi SCADA che gestiscono infrastrutture critiche – dalle reti elettriche agli impianti di trattamento delle acque, dai processi petrolchimici ai sistemi di trasporto – sono nati in un paradigma di sicurezza basato sull’isolamento fisico e sull’oscurità attraverso la segretezza. L’air gap era la strategia difensiva per eccellenza, e la proprietà dei protocolli industriali garantiva una forma di sicurezza attraverso l’opacità.

Questo paradigma è stato progressivamente eroso non solo dalla necessità di interconnessione per finalità di efficienza operativa e manutenzione remota, ma anche dall’inevitabile obsolescenza tecnologica. I sistemi ICS hanno cicli di vita che possono estendersi per decenni, ben oltre qualsiasi orizzonte temporale concepibile per le tecnologie IT. Ne deriva una situazione in cui controllori logici programmabili (Programmable Logic Controller, PLC) che risalgono agli anni Novanta coesistono con interfacce web moderne, creando superfici d’attacco ibride che sfidano i tradizionali modelli di threat modeling.

Vulnerabilità endemiche: oltre la superficie del CVE

La narrazione comune sulla sicurezza ICS tende a concentrarsi sulle vulnerabilità software catalogate nei database CVE (Common Vulnerabilities and Exposures), sulle patch mancanti, sui protocolli industriali privi di autenticazione. Questa prospettiva, pur tecnicamente accurata, rischia di essere riduttiva. Le vulnerabilità più insidiose dei sistemi SCADA non risiedono necessariamente in falle di codice sfruttabili con exploit preconfezionati, ma nella stessa architettura epistemologica che sottende questi sistemi.

Consideriamo la questione dell’autenticazione nei protocolli industriali legacy come Modbus, DNP3 o IEC 60870-5-104. L’assenza di meccanismi crittografici in questi standard non è un difetto di progettazione nel senso convenzionale del termine: è la conseguenza di requisiti funzionali che privilegiavano la deterministica temporale, la semplicità di implementazione e la resilienza operativa rispetto a qualsiasi considerazione di sicurezza informatica. Questi protocolli, progettati decenni fa, non prevedevano autenticazione, trasmettevano in chiaro e operavano in ambienti considerati fisicamente isolati. Quando un PLC Modbus risponde a qualsiasi comando ricevuto senza verificare l’identità del mittente, non sta “sbagliando” – sta operando esattamente secondo le specifiche per cui è stato progettato.

La vulnerabilità vera, allora, non è tecnica ma sistemica: risiede nel fatto che questi protocolli sono oggi esposti a contesti di minaccia per i quali non erano stati concepiti. L’implementazione di wrapper crittografici o di soluzioni di network segmentation, per quanto necessarie, rappresentano toppe applicate a posteriori su una superficie che non era stata pensata per riceverle. Questo genera nuove categorie di rischi: l’overhead computazionale dei meccanismi di sicurezza può introdurre latenze incompatibili con i requisiti real-time dei processi industriali, mentre la complessità aggiuntiva aumenta la superficie di errori di configurazione.

Un’altra categoria di vulnerabilità frequentemente sottovalutata riguarda la dimensione fisica degli ambienti OT (Operational Technology). A differenza degli attacchi puramente informatici, gli scenari di compromissione ICS possono includere vettori che combinano accesso fisico e manipolazione digitale. La modifica di setpoint su un PLC accessibile fisicamente in un impianto poco presidiato, la sostituzione di sensori per fornire letture alterate, l’inserimento di dispositivi rogue nella rete industriale durante interventi di manutenzione: questi sono vettori d’attacco che sfuggono ai perimetri difensivi tradizionali e richiedono un approccio olistico che integri physical security, supply chain security e cybersecurity in senso stretto.

APT su ICS: anatomia di una persistenza strategica

Gli attacchi Advanced Persistent Threat (APT) che prendono di mira ambienti ICS si caratterizzano per elementi distintivi rispetto alle campagne APT convenzionali rivolte a reti corporate. La differenza fondamentale risiede negli obiettivi: mentre un’APT tradizionale mira tipicamente all’esfiltrazione di dati o all’accesso persistente per spionaggio, un’APT su ICS può avere finalità di sabotaggio, di preparazione del campo di battaglia per scenari di conflitto ibrido, o di intelligence sulla capacità di infrastrutture critiche avversarie.

L’analisi di casi paradigmatici come Stuxnet, Industroyer (anche noto come Crashoverride), Triton (anche denominato Trisis o Hatman) e gli attacchi attribuiti al gruppo Sandworm rivela pattern operativi ricorrenti che meritano attenzione analitica. La fase di reconnaissance in un’APT su ICS è significativamente più lunga e metodica rispetto agli attacchi informatici convenzionali. Gli attaccanti devono acquisire non solo competenze tecniche sui sistemi target, ma anche una comprensione profonda dei processi industriali che governano.

Nel caso di Stuxnet, scoperto nel 2010, gli operatori hanno dimostrato una conoscenza dettagliata delle centrifughe per arricchimento dell’uranio dell’impianto di Natanz in Iran e dei loro profili operativi. Il malware, sviluppato nell’ambito dell’Operation Olympic Games (attribuita a Stati Uniti e Israele), manipolava la velocità delle centrifughe da 1.064 Hz a 1.410 Hz e poi a 2 Hz, causando stress meccanico e danneggiamento di circa 1.000 centrifughe. Il worm sfruttava quattro vulnerabilità zero-day di Windows e mirava specificamente ai PLC Siemens S7-300 che controllavano i convertitori di frequenza. Particolarmente sofisticato era il meccanismo di man-in-the-middle che falsificava i dati dei sensori, facendo credere agli operatori che tutto funzionasse normalmente mentre le centrifughe venivano danneggiate.

Industroyer, utilizzato nell’attacco del 17 dicembre 2016 contro la rete elettrica ucraina, ha lasciato al buio circa un quinto di Kiev per oltre un’ora. A differenza di Stuxnet, questo malware non sfruttava vulnerabilità specifiche, ma agiva direttamente sui quattro protocolli di comunicazione utilizzati nelle sottostazioni elettriche (IEC 60870-5-101, IEC 60870-5-104, IEC 61850 e OPC DA). L’attacco era completamente automatizzato e rappresentava un’evoluzione significativa rispetto al precedente attacco del 2015 condotto con BlackEnergy, che richiedeva intervento manuale. Il framework modulare di Industroyer lo rendeva facilmente adattabile ad altre reti elettriche nel mondo.

Triton, scoperto nel 2017 presso un impianto petrolchimico in Arabia Saudita, rappresenta un caso particolarmente allarmante poiché mirava ai sistemi di sicurezza strumentata (Safety Instrumented Systems, SIS) Triconex di Schneider Electric. Questi sistemi sono progettati per prevenire incidenti catastrofici in ambienti industriali ad alto rischio. Il malware sfruttava una vulnerabilità zero-day nel firmware Triconex (versioni 10.0-10.4) e utilizzava il protocollo proprietario TriStation per comunicare con i controllori. L’attacco, tuttavia, non raggiunse il suo obiettivo finale a causa di un bug nel codice del malware stesso, che causò lo shutdown automatico dell’impianto per sicurezza, permettendo così la scoperta della compromissione. L’incidente evidenziò come un attacco riuscito avrebbe potuto causare il rilascio di sostanze tossiche o esplosioni con conseguenze potenzialmente letali.

Il gruppo Sandworm, attribuito all’unità militare russa GRU 74455, è responsabile di una serie prolungata di attacchi alle infrastrutture critiche ucraine dal 2015 in poi. Il gruppo ha utilizzato malware come BlackEnergy (attacco alla rete elettrica ucraina del dicembre 2015), Industroyer (dicembre 2016), NotPetya (giugno 2017, con danni globali stimati in oltre 10 miliardi di dollari), e più recentemente Industroyer2 (aprile 2022). L’approccio di Sandworm combina malware specifici per ICS con wiper per ostacolare il recupero, dimostrando una strategia di attacco multilivello particolarmente distruttiva.

La catena di attacco tipica prevede un ingresso attraverso la rete corporate (spesso mediante spear phishing o compromissione di fornitori), seguito da una fase di lateral movement che richiede il superamento delle segmentazioni tra IT e OT. Questa transizione è il momento critico dell’attacco e spiega perché le tecniche di compromissione dei jump host, delle engineering workstation e dei punti di accesso remoto siano così centrali nelle kill chain documentate. Una volta raggiunto l’ambiente OT, l’attaccante deve navigare architetture spesso prive di logging dettagliato, in cui l’installazione di malware persistente può avvenire con minori ostacoli rispetto agli ambienti IT altamente monitorati.

Un aspetto frequentemente trascurato nella discussione sulle APT ICS riguarda la dimensione temporale della persistenza. In ambienti corporate, la persistenza di un attaccante si misura in settimane o mesi. In ambienti ICS, può estendersi per anni. La stabilità operativa dei sistemi industriali, la riluttanza a effettuare riavvii o aggiornamenti che potrebbero interrompere la produzione, e la scarsa visibilità sulle anomalie comportamentali rendono possibile una permanenza prolungata che consente agli attaccanti di affinare la loro comprensione dell’ambiente e prepararsi per l’attivazione del payload in momenti strategicamente scelti.

Detection Engineering: limiti epistemologici e nuovi paradigmi

La detection di attività anomale in ambienti ICS solleva questioni metodologiche che vanno oltre la mera applicazione di tecnologie di sicurezza. Il principio fondamentale della detection basata su firme (signature-based), pilastro della sicurezza IT, mostra evidenti limiti in contesti dove i payload sono customizzati per target specifici e gli indicatori di compromissione hanno breve durata di vita. Le signature-based detection possono identificare varianti note di malware ICS, ma risultano inerti di fronte a zero-day tailored.

La detection anomaly-based, che rappresenta la frontiera evolutiva, si scontra però con un problema epistemologico: cosa costituisce “normale” in un ambiente ICS? A differenza delle reti IT, dove i pattern di traffico possono essere modellati statisticamente con relativa precisione, gli ambienti operativi presentano variabilità legate ai processi fisici controllati. Un impianto chimico ha profili operativi diversi a seconda della fase di produzione, delle condizioni ambientali, della domanda di output. Stabilire baseline comportamentali richiede una comprensione profonda del processo industriale stesso, non solo della dimensione cyber.

I protocolli di detection più promettenti integrano quindi approcci multi-layer: traffic analysis sui protocolli industriali per identificare anomalie di comunicazione (comandi non autorizzati, modifiche a setpoint, polling patterns inusuali), behavioral analysis sui sistemi di controllo per rilevare deviazioni dai pattern operativi normali, e process-aware detection che correla eventi cyber con dati dei sensori fisici per identificare manipolazioni che mirino a alterare il processo controllato mascherando le tracce digitali.

Un esempio paradigmatico di questa ultima categoria è rappresentato dalla detection di attacchi che manipolano i sensori per nascondere l’effetto fisico delle azioni maligne sui controllori. Se un attaccante modifica i comandi a una pompa ma simultaneamente falsifica i dati del flow meter, la detection puramente cyber potrebbe non rilevare l’anomalia. È necessaria una correlazione tra il comando inviato, l’energia consumata dalla pompa (dato tipicamente disponibile tramite smart meter o sottostazioni elettriche) e il flusso misurato per identificare la discrepanza.

Dal punto di vista forense, gli ambienti ICS presentano sfide uniche. La carenza di logging dettagliato, tipica di molti sistemi legacy, rende difficoltosa la ricostruzione delle timeline di attacco. I dati che vengono loggati sono spesso limitati a eventi operativi (allarmi di processo, cambi di stato) piuttosto che eventi di sicurezza. L’implementazione di soluzioni di centralized logging specifiche per OT (come i collector che parlano nativamente protocolli industriali e traducono gli eventi in formati SIEM-friendly) sta progressivamente migliorando questa situazione, ma rimane una sfida di deployment in ambienti dove l’inserimento di nuovi componenti di rete può richiedere lunghe validazioni e fermi impianto programmati.

La network forensics in ambiente ICS richiede competenze ibride: la capacità di analizzare capture di traffico Modbus o DNP3 per identificare comandi malformati o sequenze anomale deve combinarsi con la comprensione di cosa quei comandi significhino dal punto di vista del processo controllato. Un comando di apertura di una valvola può essere perfettamente legittimo in un contesto operativo e catastrofico in un altro; distinguere i due casi richiede knowledge engineering che vada oltre la pura analisi di network packets.

Dimensioni legali e responsabilità: il vuoto normativo operativo

Dal punto di vista del diritto digitale e della cyber law, gli ambienti ICS si collocano in una zona grigia particolarmente insidiosa. Le normative di cybersecurity settoriali stabiliscono requisiti di sicurezza, ma la loro implementazione pratica si scontra con le specificità operative degli ambienti industriali.

In ambito europeo, la Direttiva NIS2 (Direttiva UE 2022/2555), entrata in vigore il 17 gennaio 2023 e recepita dagli Stati membri entro ottobre 2024, rappresenta un passo importante verso un quadro normativo più robusto. La direttiva amplia significativamente il perimetro rispetto alla precedente NIS, includendo nuovi settori critici e introducendo obblighi più stringenti per soggetti essenziali e importanti. Tuttavia, l’applicazione retroattiva del principio di “security by design” a infrastrutture esistenti da decenni rimane più un’aspirazione che una possibilità concreta.

Negli Stati Uniti, gli standard NERC CIP (North American Electric Reliability Corporation Critical Infrastructure Protection) stabiliscono requisiti obbligatori per le utility elettriche che operano sul Bulk Electric System. Sviluppati a seguito del grande blackout del 2003 e approvati dalla Federal Energy Regulatory Commission (FERC) nel 2008, gli standard NERC CIP coprono 13 aree specifiche (da CIP-002 a CIP-014) che spaziano dall’identificazione degli asset critici alla gestione degli incidenti, dalla sicurezza fisica alla supply chain security. Il framework è prescrittivo e prevede sanzioni significative in caso di non conformità, ma la sua applicazione pratica richiede investimenti sostanziali e una trasformazione culturale delle organizzazioni.

La questione della responsabilità in caso di incidente cyber su ICS solleva interrogativi giuridici complessi. Se un attacco a un sistema SCADA causa danni fisici o feriti, la catena di responsabilità non è lineare: si articola tra il gestore dell’infrastruttura (che potrebbe aver omesso misure di sicurezza adeguate), i fornitori dei sistemi (che possono aver commercializzato prodotti con vulnerabilità note), i provider di servizi di sicurezza (che potrebbero non aver rilevato l’intrusione), e ovviamente gli attaccanti stessi (spesso attori statali o state-sponsored, quindi difficilmente perseguibili).

La disclosure di vulnerabilità in sistemi ICS rappresenta un altro nodo critico. A differenza del software consumer, dove la coordinated disclosure è pratica consolidata, le vulnerabilità ICS sollevano questioni di sicurezza nazionale. La pubblicazione di dettagli su una vulnerabilità in un sistema SCADA ampiamente deployed in infrastrutture critiche può de facto fornire una blueprint per attacchi su larga scala. Questo genera tensioni tra il principio di trasparenza, necessario per permettere ai difensori di proteggersi, e la necessità di non armare potenziali attaccanti.

Dal punto di vista della digital forensics nei procedimenti legali, la chain of custody delle evidenze da ambienti ICS presenta peculiarità: i dati possono risiedere su sistemi che non possono essere spenti per imaging tradizionale senza interrompere processi produttivi critici. Le metodologie di live forensics, già complesse in ambienti IT, diventano ulteriormente problematiche quando applicate a sistemi industriali real-time dove anche l’overhead di un’acquisizione di memoria può avere impatti operativi.

Quando la sicurezza assoluta è un’illusione: il paradigma della resilienza

La sicurezza dei sistemi SCADA e ICS richiede l’elaborazione di un framework epistemologico che superi la semplice trasposizione di paradigmi IT. Serve un approccio che integri nativamente la dimensione fisica del processo controllato, che accetti la coesistenza di tecnologie legacy con moderne soluzioni di sicurezza, che bilanci i requisiti di availability (prioritari in OT) con quelli di confidentiality (prioritari in IT).

Le tecniche di detection più efficaci saranno quelle che incorporano domain knowledge specifico del processo industriale, che utilizzano machine learning non per sostituire ma per aumentare le capacità di analisti con competenze OT. La forensics dovrà sviluppare metodologie specifiche per la preservazione di evidenze in sistemi che non possono essere fermati, per la ricostruzione di eventi in ambienti poveri di log, per la correlazione tra tracce digitali e impatti fisici.

Dal punto di vista normativo, servono framework che riconoscano la specificità degli ambienti OT senza creare vuoti di protezione. La sfida non è solo tecnica o legale, ma culturale: richiede la formazione di professionisti che parlino fluentemente sia il linguaggio della cybersecurity che quello dell’ingegneria di processo, che comprendano tanto i vettori d’attacco informatici quanto le dinamiche dei sistemi di controllo.

La sicurezza ICS rappresenta, in definitiva, un campo in cui la complessità tecnica si intreccia con implicazioni geopolitiche, questioni legali irrisolte e sfide operative concrete. È un dominio in cui l’eccellenza richiede umiltà: la consapevolezza che non esistono soluzioni universali, che ogni ambiente industriale è un ecosistema unico, e che la sicurezza assoluta è un’illusione. L’obiettivo realistico è la resilienza: la capacità di rilevare, contenere e recuperare da compromissioni che, in un mondo interconnesso, non sono più questione di “se” ma di “quando”.

Fonti:

Direttiva (UE) 2022/2555 (NIS2) sulla sicurezza delle reti e dei sistemi informativi

NERC CIP Standards – Critical Infrastructure Protection for Bulk Electric Systems

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-scada-ics/


Sovranità digitale e cybersecurity: la sfida italiana ed europea verso il 2030

Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025. Non più solo una questione di difesa, ma il terreno su cui si gioca l’autonomia tecnologica dell’Europa e la capacità dell’Italia di affermarsi come protagonista nello scenario globale.

Questo il filo conduttore della tavola rotonda di apertura del 23° Forum ICT Security, che ha riunito esponenti di primo piano del mondo istituzionale e industriale per tracciare una mappa delle opportunità e delle criticità che il Paese dovrà affrontare nei prossimi anni.

A confrontarsi sul tema sono stati Raffaele Boccardo, AD e Presidente di BV Tech; Alessandra Michelini, Presidente e AD di Telsy; Luca Tagliaretti, Executive Director dello European Cybersecurity Competence Center (ECCC); e Antonio Maria Tambato, Direttore della Direzione Innovazione e Transizione Digitale di AgID. A moderare il dibattito Matteo Lucchetti, Direttore Operativo di Cyber 4.0.

Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025: A confrontarsi sul tema sono stati Raffaele Boccardo, AD e Presidente di BV Tech; Alessandra Michelini, Presidente e AD di Telsy; Luca Tagliaretti, Executive Director dello European Cybersecurity Competence Center (ECCC); e Antonio Maria Tambato, Direttore della Direzione Innovazione e Transizione Digitale di AgID. A moderare il dibattito Matteo Lucchetti, Direttore Operativo di Cyber 4.0.

La minaccia che evolve: attacchi AI-driven e quantum computing

Il contesto in cui si inserisce la discussione è tutt’altro che rassicurante.
Matteo Lucchetti ha aperto i lavori richiamando una notizia di pochi giorni prima: il primo attacco di cyberspionaggio completamente realizzato da agenti AI, capaci di eseguire scansioni, individuare vulnerabilità e sfruttarle in modo pressoché automatico. In tale scenario, l’operatore umano è necessario esclusivamente per definire il target da colpire.

A questo si aggiunge la minaccia del quantum computing, che promette di rendere obsoleti gli algoritmi crittografici su cui si fonda l’intera infrastruttura digitale mondiale. «Una sorta di Armageddon» – per usare l’espressione del moderatore – che alcuni esperti collocano al 2030, ma che potrebbe concretizzarsi anche in un orizzonte temporale più vicino.

E poi c’è il dato strutturale: oltre il 70% dei servizi e dei prodotti di cybersecurity utilizzati in Italia è erogato da aziende non nazionali. Una dipendenza tecnologica che pone interrogativi profondi sulla reale autonomia del sistema Paese.

BV Tech racconta il gap con gli Stati Uniti: 1 a 50

Nella prima testimonianza dal mondo dell’industria, Raffaele Boccardo ha offerto una fotografia impietosa dello stato dell’arte. «Negli ultimi anni», ha osservato, «l’Italia e l’Europa hanno dormito sonni tranquilli», mentre la stragrande maggioranza dei prodotti di cybersecurity e delle tecnologie più innovative proveniva da imperi tecnologici di altri continenti.

Raffaele Boccardo, AD e Presidente BV Tech: Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025
Raffaele Boccardo, AD e Presidente BV Tech al Forum ICT Security 2025

Si parla di un rapporto di 1 a 50 tra Europa e Stati Uniti sulla Generative AI; «e sul calcolo quantistico i numeri testimoniano una distanza ancora superiore».

Una riflessione che parte da lontano: «I calcolatori sono stati pensati per essere sempre più piccoli e sempre più veloci, non intrinsecamente sicuri». Dagli anni ’60, all’incirca ogni biennio se ne dimezzava la dimensione, mentre raddoppiava la potenza. Oggi stanno arrivando architetture nuove; il calcolo quantistico è ormai prossimo e si stanno presentando nuovi scenari in ordine a sicurezza, disponibilità e integrità del dato.

BV Tech investe circa 20 milioni l’anno in tecnologie proprietarie, coprendo l’intera catena del valore della cybersecurity: assessment del rischio, compliance alle normative nazionali ed europee, prodotti e servizi di mitigazione, piattaforme e formazione, per un investimento complessivo di 200 milioni nell’arco di dieci anni. Ma sono ancora ordini di grandezza inferiori rispetto ai competitor d’oltreoceano.

Un miliardo e seicento milioni per la cybersecurity europea

Negli ultimi tempi, il quadro degli investimenti europei ha però assunto dimensioni senza precedenti. Come ha illustrato Luca Tagliaretti, entro il 2027 il bilancio complessivo dell’Unione Europea destinato allo sviluppo di tecnologie cyber affidato all’ECCC supererà il miliardo e seicento milioni di euro. A questi si aggiungono i fondi Horizon per la ricerca pura, che oscillano tra i 60 e i 90 milioni annui; un terzo del totale «è destinato allo sviluppo di nuove tecnologie, in particolare AI e quantum».

Luca Tagliaretti, Executive Director dello European Cybersecurity Competence Center (ECCC): Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025
Luca Tagliaretti, Executive Director dello European Cybersecurity Competence Center (ECCC) al Forum ICT Security 2025

L’Italia si posiziona stabilmente tra i primi Paesi beneficiari di questi finanziamenti. Tagliaretti ha citato in particolare il progetto SECURE,«di cui l’Italia è capofila insieme ad altri Stati europei», con il coordinamento di Cyber 4.0: un’iniziativa dedicata alla preparazione per il Cyber Resilience Act (CRA), che testimonia la capacità del Paese di intercettare progetti di grande respiro.

Tuttavia, emerge un paradosso. L’Italia eccelle nei grandi progetti con forte coordinamento nazionale, attraverso ACN e i centri di competenza; altri Paesi – come Grecia, Slovacchia o Romania – risultano invece più forti su progetti di piccola scala, dove startup e PMI riescono a presentare proposte interessanti anche in assenza di una regia centrale. Una riflessione che chiama in causa la capacità del tessuto imprenditoriale italiano di competere nelle dimensioni più agili.

La corsa al post-quantum: un laboratorio europeo entro dicembre

L’ECCC ha destinato circa 110 milioni di euro nel triennio 2025-2027 alle tecnologie quantum e all’intelligenza artificiale. Un dato significativo riguarda l’evoluzione della domanda: se nelle prime iniziative del 2024 le società interessate a partecipare erano poche, oggi la situazione è radicalmente cambiata. L’ultima call Horizon sul quantum ha registrato un numero di domande pari a quindici volte i fondi disponibili.

Tagliaretti ha annunciato che a dicembre verrà pubblicata la gara d’appalto per la creazione di un laboratorio europeo di prova per gli algoritmi quantistici: un’infrastruttura pensata «per mettere insieme mondo accademico e industriale», accessibile a startup, PMI e centri di ricerca a costi contenuti o persino gratuitamente. Il progetto avrà una durata quadriennale e rappresenta un tassello della strategia post-quantum pubblicata dall’UE nell’aprile 2024.

In parallelo, sono previsti altri due progetti: uno da circa 10 milioni per la transizione al post-quantum, un altro da 6-7 milioni (che partirà nel 2027) per l’implementazione di tecnologie resistenti agli attacchi quantistici negli hub nazionali e nei SOC governativi.

Rispetto alle certificazioni, Tagliaretti ha precisato che i tempi sono diversi a seconda delle tecnologie. Sull’intelligenza artificiale il lavoro è più avanzato ed esistono già dei draft elaborati da ENISA, mentre sul post-quantum non si è ancora vicini a un risultato concreto.

Il lavoro attuale – in linea con la roadmap europea sulla transizione quantum, che prevede proprio questa fase preliminare – è principalmente di mappatura: quali tecnologie sono disponibili, quali stakeholder risultano coinvolti, quali profili di rischio sarà necessario contemplare. «Entro il 2026», ha anticipato il relatore, «si chiariranno anche le ambizioni politiche dell’Unione Europea rispetto al creare una certificazione in ambito quantistico».

Telsy e la crittografia made in Italy

Sul fronte industriale, Telsy rappresenta un caso emblematico di come l’Italia possa giocare un ruolo da protagonista. L’azienda ha recentemente acquisito QTI (specializzata in quantum key distribution) e sta sviluppando prodotti di crittografia post-quantum interamente realizzati in Italia, con una filiera completamente nazionale.

Alessandra Michelini, Presidente e AD di Telsy: Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025
Alessandra Michelini, Presidente e AD di Telsy al Forum ICT Security 2025

«Quando parliamo di quantum, parliamo di tecnologie che si muovono a una velocità fotonica», ha esordito Alessandra Michelini, tracciando un parallelo illuminante con l’intelligenza artificiale: «qualche anno fa ne parlavamo come di qualcosa che sarebbe arrivato, senza riuscire a immaginare una data precisa. Oggi la usiamo in modo pervasivo nella realtà quotidiana. Il quantum seguirà probabilmente lo stesso percorso: forse sarà il 2030, forse anche prima».

La sfida, ha sottolineato Michelini, sarà evitare che i processi di standardizzazione, omologazione e certificazione – indispensabili per i prodotti di sicurezza – diventino un freno anziché un abilitatore.

L’Italia dispone oggi di «un vantaggio temporale e competitivo, fondato su un patrimonio di know-how scientifico e accademico che va preservato e valorizzato». L’auspicio è che i tavoli europei dedicati a questi temi siano il più possibile aperti, permettendo di ragionare insieme su come velocizzare il percorso e mettere a sistema questo vantaggio a livello continentale.

Sovranità digitale: non solo protezione, ma governo del dato

L’intervento di Antonio Maria Tambato (AgID) ha offerto una lettura più ampia del concetto di sovranità digitale, sottraendolo alla dimensione puramente difensiva. «Il significato del termine “sovranità”» ha chiarito «non è solo protezione, o diventerebbe isolamento. La sovranità è il governo, è lo sviluppo, è l’identità. Tutti questi aspetti vanno declinati nel digitale. Questa è la sfida più importante; ed è una sfida propria della Pubblica Amministrazione».

Antonio Maria Tambato, Direttore della Direzione Innovazione e Transizione Digitale di AgID: Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025
Antonio Maria Tambato, Direttore della Direzione Innovazione e Transizione Digitale di AgID al Forum ICT Security 2025

Il relatore ha richiamato l’attenzione sull’infrastruttura pubblica digitale italiana – dal wallet alla PDND, fino alla firma digitale e ai pagamenti elettronici – come esempio concreto di sovranità tecnologica costruita attraverso partnership tra pubblico e privato. Sono i pilastri su cui posa l’identità digitale nazionale. «Un sistema affidabile di riconoscimento dei cittadini è fondamentale per garantire allo Stato di esercitare pienamente la propria sovranità nello spazio digitale.»

La fattura elettronica, in particolare, è stata citata come caso di successo: «un passo di digitalizzazione enorme, che altri Paesi ci invidiano».

Il nodo del procurement pubblico

Sul fronte dell’intelligenza artificiale nella Pubblica Amministrazione, Tambato ha descritto un panorama in rapida evoluzione ma non privo di ostacoli significativi. Le linee guida AgID, di prossima emanazione, puntano a creare una domanda pubblica sfidante che stimoli la competitività nazionale, ma il vero “collo di bottiglia” è nel procurement.

«Se non si cambia paradigma di procurement», ha avvertito Tambato, «non si riesce a far fronte all’intelligenza artificiale».

Il messaggio alle amministrazioni è chiaro: aggregarsi, non affrontare l’intelligenza artificiale da soli, scambiarsi «esperienze e problemi, più che codice sorgente».

Tra le esperienze già avviate Tambato ha citato il progetto Reg4IA, che vede quattro regioni capofila aggregare le altre per sperimentazioni in sanità, trasporti e digitalizzazione della PA; anche INAIL e ISTAT hanno sviluppi importanti nell’ambito dell’intelligenza artificiale.

I rischi: inefficacia e immobilismo

In tale scenario, i rischi che la Pubblica Amministrazione deve fronteggiare sono duplici.

Da un lato, l’inefficacia: investimenti ingenti senza miglioramenti reali, il classico scenario di hype tecnologico che non si traduce in valore concreto. Dall’altro, l’immobilismo: una paralisi generata dalla complessità del quadro regolamentare, con un «puzzle di norme» che si sovrappongono tra loro.

Tambato ha ricordato come stia finalmente vedendo la luce il “Digital Omnibus” dell’Unione Europea, con la speranza che possa offrire un aiuto nell’interpretazione di questo intreccio di norme.

Il caso degli atti notarili e la sfida post-quantum per la PA

Tambato ha poi sollevato una questione concreta che illustra la portata della sfida post-quantum. «Oggi abbiamo la sicurezza che un atto notarile venga conservato per sempre, immutato, presso gli studi notarili o le banche. Domani, con l’avvento del post-quantum, quella certezza potrebbe venire meno».

È un problema che coinvolge l’intera filiera dei conservatori, degli identity provider, delle partnership pubblico-private che sostengono l’infrastruttura digitale nazionale. Da qui la necessità di creare campioni nazionali e lavorare insieme – AgID con ACN e l’intera filiera – altrimenti arriveranno tecnologie e mentalità estere «che ormai attraversano gli oceani molto velocemente».

L’Africa “più digitale di noi”

Una provocazione, ma non troppo: «L’Africa in questo momento è più digitale di noi. Il mondo africano ha fatto il salto totale», con una pubblica amministrazione «digitale di default», anche perché in alcuni casi mancavano infrastrutture tradizionali su cui costruire.

Un competitor inatteso, che ricorda come la partita della trasformazione digitale si giochi sempre più su scala globale.

Il Polo Strategico Nazionale e la protezione dei dati

Alessandra Michelini – che è anche membro del board del Polo Strategico Nazionale – ha approfondito il tema dell’integrazione tra infrastruttura cloud sovrana e tecnologie crittografiche proprietarie.

«Il concetto di sovranità digitale», ha osservato, «non si declina al singolare». Riguarda scelte architetturali, realizzazione dell’infrastruttura, lavoro sul dato. La cifratura di per sé non basta: bisogna garantire il ciclo di vita delle chiavi, sapere chi accede al dato, quando e perché.

Temi «collaterali ma fondamentali» su cui Telsy sta lavorando in modo sempre più serrato, per contribuire alla definizione di livelli di sicurezza differenziati in base alla classificazione dei dati (strategici, critici, ordinari) che le amministrazioni porteranno sul PSN.

Il problema della dimensione: da 1 miliardo a 10 miliardi

Raffaele Boccardo ha portato la testimonianza di BV Tech, passata in vent’anni da 10 a 200 milioni di fatturato, con un piano per raggiungere il miliardo e l’ambizione di federarsi con altri attori europei per posizionarsi intorno ai 10 miliardi nel mercato della cybersecurity continentale.

I numeri, ha spiegato, sono la chiave per comprendere la portata della sfida. «Chi progetta, realizza, gestisce infrastrutture di rete o informatiche e applicazioni domina la sicurezza, la disponibilità e l’integrità del dato». Eppure oltre il 70% delle realizzazioni italiane, in ambito sia civile che militare (con percentuali non molto diverse), «sono opera di soggetti non nazionali né europei».

Nel mercato civile italiano si parla di 10-12 miliardi, in quello della difesa ci si avvicina a 15: complessivamente, circa 25 miliardi. «Moltiplicando per 20 si ottiene il mercato europeo. Sono numeri incredibilmente grandi», che attualmente nessun player nazionale – e nemmeno l’insieme dei Paesi europei – riesce a interpretare con una forte identità e la giusta sovranità tecnologica.

Il progetto ICTalia, lanciato al Senato nel 2023, nasce proprio per «aggregare intenti coerenti in ordine al recupero di una capacità e coscienza tecnologica italiana ed europea».Il vero ostacolo, secondo Boccardo, è infatti di natura culturale. «Quanti di noi», si è chiesto, «pensano che una società con ricavi di un miliardo l’anno sia ancora “troppo piccola” per servire l’Europa?» La speranza è che tra cinque anni tutti siano convinti della necessità di lavorare insieme per costruire player nazionali ed europei più importanti e rispettati a livello globale.

“L’allineamento delle stelle”

Nel giro finale di interventi, tutti i relatori hanno espresso un cauto ottimismo sulla possibilità che l’Italia possa affermarsi come leader europeo entro il 2030.

Alessandra Michelini ha parlato di «una congiuntura particolarmente favorevole»: fondi disponibili, competenze consolidate, tecnologie già sviluppate e una normativa che accelera l’adozione. La chiave è il coordinamento tra tutti gli attori coinvolti, irrobustendo l’ecosistema cyber nazionale «per evitare che tali energie vengano dissipate».

Antonio Maria Tambato ha insistito sulla necessità di selezionare le priorità: «Sostituire completamente i chip che arrivano da oltreoceano oggi è impossibile. Bisogna programmarlo, non per soppiantarli ma per portare un’alternativa». Ricordando quando una mareggiata negli anni 2000 rese introvabili le memorie per mesi in tutto il mondo, ha concluso: «Anche questa è sovranità e libertà».

Raffaele Boccardo ha rilanciato sul tema dell’indirizzamento della spesa pubblica e privata verso gli attori nazionali ed europei. «A livello continentale parliamo di 600 miliardi. Servono collaborazioni con (e tra) le migliori università; e serve un cambio di cultura sulla dimensione».

La nota positiva: l’Europa come campione mondiale

Luca Tagliaretti ha chiuso con quella che ha definito una nota positiva. «Vedo un allineamento delle stelle in tanti campi: supercomputer, più di 70 offerte europee di gigafactory, laboratori di standardizzazione, test sui chip…» e naturalmente la cybersecurity, dove Italia ed Europa stanno emergendo tra i campioni mondiali.

Il prossimo bilancio europeo (2028-2034) prevede non solo stanziamenti significativi per la digitalizzazione e la sovranità tecnologica, ma anche una semplificazione radicale nella loro distribuzione: dagli attuali 70 fondi separati si passerà a 16-17, «per favorire sinergie ed evitare dispersioni».

In questo la Commissione UE è estremamente attiva. «Mentre anni fa il focus era soprattutto su standardizzazione e creazione di normative», ha sintetizzato Tagliaretti, l’obiettivo attuale è «permettere una politica industriale di successo dell’Unione Europea», nonché «aumentare la resilienza e le difese del nostro mercato digitale».

Le parole chiave per il futuro

Il moderatore Matteo Lucchetti ha sintetizzato i temi emersi dal dibattito in cinque direttrici: ecosistema pubblico-privato, con il coinvolgimento dell’accademia; coordinamento nazionale sotto la guida degli enti preposti; scelta strategica nell’indirizzamento della spesa; cambiamento culturale rispetto alla dimensione di mercato aggredibile; guida dell’Unione Europea nell’implementazione di un corpo normativo già pronto e di prim’ordine a livello mondiale.

Matteo Lucchetti, Direttore Operativo di Cyber 4.0 : Sovranità digitale è la parola chiave che lega intelligenza artificiale, quantum computing e cybersecurity nel dibattito inaugurale del Forum ICT Security 2025
Matteo Lucchetti, Direttore Operativo di Cyber 4.0 al Forum ICT Security 2025

La sfida per l’Italia, in definitiva, non è dimostrare di avere le competenze: quelle ci sono.
È riuscire a fare sempre più “massa e sistema”, superando la frammentazione – e la cultura del “piccolo è bello” – per costruire realtà nazionali ed europee capaci di competere su scala globale. Il tempo stringe: il 2030 è dietro l’angolo e la sovranità digitale è un’esigenza non ulteriormente rimandabile.

Guarda il vedo completo della tavola rotonda “Cybersecurity, Innovazione, Governance e Scenari Futuri” tenutasi durante il Forum ICT Security 2025.

[embedded content]
Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sovranita-digitale-cybersecurity-italia/