I deepfake rappresentano una minaccia emergente e complessa nell’ambito della sicurezza informatica, sfruttando le capacità avanzate dell’intelligenza artificiale (AI) per produrre contenuti multimediali manipolati con elevati livelli di realismo. Questa tecnologia si basa su algoritmi sofisticati e tecniche di machine learning che permettono di generare video, audio e immagini in cui il volto o la voce di un individuo vengono alterati per rappresentare scenari fittizi o ingannevoli. La diffusione di tali contenuti può determinare conseguenze significative, tra cui la disinformazione sistematica, la manipolazione politica, il danneggiamento della reputazione personale e l’insorgenza di frodi e crimini informatici. Questi rischi posizionano la tecnologia dei deepfake al centro delle sfide più pressanti nel panorama digitale contemporaneo, sia a livello tecnico che etico.
Metodologie di Creazione dei Deepfake
Le tecniche di produzione di contenuti manipolati attraverso l’uso di AI rappresentano il risultato di anni di ricerca nei settori del machine learning e delle reti neurali artificiali. Le metodologie principali comprendono:
GAN (Generative Adversarial Networks): Questa tecnologia avanzata utilizza due reti neurali contrapposte: una rete generativa, che produce contenuti sintetici, e una rete discriminativa, che valuta l’autenticità dei contenuti generati. Questa dinamica consente un miglioramento iterativo, permettendo la creazione di contenuti sempre più convincenti e realistici.
Face swapping: Processo mediante il quale un volto viene sostituito con quello di un altro individuo in un video o immagine. Inizialmente richiedeva competenze tecniche elevate, ma oggi, grazie a software automatizzati, è diventato accessibile anche agli utenti meno esperti.
Face morphing: Fusione di caratteristiche facciali di due persone per generare un volto completamente nuovo. Questa tecnica trova applicazioni sia nell’intrattenimento che in usi illeciti.
Face reenactment: Generazione di movimenti facciali ed espressioni sincronizzate con un audio predefinito. Questa metodologia è spesso utilizzata per simulare dichiarazioni o azioni mai compiute da un individuo reale.
Oltre a queste tecniche principali, il continuo sviluppo di nuovi algoritmi rende la tecnologia dei deepfake sempre più avanzata, aprendo la strada a possibilità creative ma anche a potenziali abusi significativi.
Implicazioni e Minacce
I contenuti generati tramite deepfake pongono rischi strutturali e sistemici, che si manifestano su diversi fronti. Le principali aree di impatto includono:
Disinformazione e manipolazione dell’opinione pubblica: L’uso di contenuti falsificati per attribuire dichiarazioni o comportamenti non autentici a individui o organizzazioni rappresenta un rischio per l’integrità delle informazioni pubbliche e la fiducia sociale.
Manipolazione politica: Video compromettenti o manipolati possono essere utilizzati per influenzare elezioni, destabilizzare istituzioni o danneggiare la reputazione di figure di spicco.
Cyberbullismo e danni reputazionali: Contenuti denigratori o umilianti generati tramite deepfake possono causare gravi danni psicologici, sociali e professionali alle vittime, amplificando l’effetto del cyberbullismo.
Incitamento all’odio e alla violenza: La creazione di contenuti falsificati che promuovono ideologie estremiste o fomentano conflitti sociali può incentivare disordini o attacchi mirati.
Frodi e attacchi mirati: Attraverso l’impersonificazione di figure autorevoli, i deepfake possono facilitare accessi non autorizzati a informazioni sensibili o condurre a truffe finanziarie sofisticate.
Strategie di Difesa
Contrastare le minacce associate ai deepfake richiede un approccio olistico che combini consapevolezza pubblica, innovazioni tecnologiche e pratiche critiche. Tra le strategie principali:
Analisi visiva approfondita: Monitorare dettagli visivi come anomalie nell’illuminazione, incoerenze nei movimenti facciali e presenza di artefatti digitali.
Verifica delle fonti: Consultare fonti multiple e database autorevoli per accertare l’autenticità di contenuti multimediali sospetti.
Implementazione di tecnologie avanzate: Utilizzare software di rilevamento basati su machine learning e algoritmi dedicati all’analisi di pattern specifici dei deepfake.
Promozione dell’educazione digitale: Diffondere competenze tra i cittadini per riconoscere i rischi associati ai contenuti manipolati e mitigare l’impatto di tali tecnologie.
Tecniche di Rilevazione e Autenticazione
La rilevazione di deepfake è un campo di ricerca in continua espansione. Alcuni dei metodi più promettenti includono:
Analisi dei movimenti facciali: Discrepanze nei micro-movimenti o incoerenze nella sincronizzazione con il parlato possono indicare manipolazioni.
Esame delle texture visive: Imperfezioni nella qualità della pelle, nei riflessi o nelle ombre possono rivelare alterazioni artificiali.
Analisi semantica e contestuale: Confrontare le dichiarazioni o azioni mostrate nei contenuti con informazioni verificate o contesti reali.
Sebbene le tecnologie di rilevazione stiano migliorando, i contenuti manipolati di alta qualità restano difficili da identificare con precisione assoluta, richiedendo una combinazione di metodi automatizzati e analisi umane.
Tendenze e Sviluppi Futuri
Le tecnologie alla base dei deepfake continuano a evolversi rapidamente, con implicazioni sia positive che negative. Tra i principali sviluppi:
Reti neurali avanzate: I miglioramenti nelle architetture GAN stanno aumentando la qualità e il realismo dei contenuti generati.
Tecniche di trasferimento di apprendimento: L’adattamento di modelli pre-addestrati per rilevare nuove forme di manipolazione consente una risposta più rapida ed efficace alle minacce emergenti.
AI collaborativa: La combinazione di intelligenza artificiale e intervento umano sta migliorando l’accuratezza delle tecniche di rilevazione.
Sviluppo di framework etici: La creazione di standard e normative mira a bilanciare innovazione tecnologica e protezione sociale.
Prevenzione e Mitigazione
Affrontare il fenomeno dei deepfake richiede un impegno concertato da parte di individui, istituzioni e aziende. Le azioni preventive includono:
Educazione pubblica mirata: Sensibilizzare utenti e professionisti sui rischi e le tecniche di difesa contro i contenuti manipolati.
Normative specifiche: Sviluppare e implementare leggi che regolino l’uso, la distribuzione e la creazione di deepfake.
Collaborazioni globali: Coordinare risorse e competenze a livello internazionale per affrontare le minacce in modo più efficace.
Conclusione
I contenuti manipolati generati tramite deepfake rappresentano una minaccia crescente alla sicurezza informatica, alla fiducia sociale e all’integrità delle informazioni. Tuttavia, attraverso un mix di innovazione tecnologica, consapevolezza critica e cooperazione globale, è possibile mitigare i rischi associati e proteggere individui e società dalle implicazioni più gravi di questa tecnologia.
Emerging Trends in Deepfakes and Generative AI, by A. Amodei, C. Choy, and E. Erez, arXiv preprint arXiv:2201.00581, 2022.
Recommendations for Resisting Deepfakes, by the National Institute of Standards and Technology (NIST), 2023.
Articolo a cura di Francesco Arruzzoli
Profilo Autore
Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.
Ingegneria della Sicurezza applicata ai Sistemi Spaziali: affrontare le minacce cyber nel nuovo contesto globale
Il panorama dell’ingegneria della sicurezza applicata ai sistemi spaziali sta attraversando una trasformazione profonda, con gli attacchi informatici che emergono come la minaccia più insidiosa e pericolosa.
A differenza delle minacce fisiche, che consentono un intervento immediato, i cyber attacchi sono spesso difficili da identificare e comprendere, rendendo la prevenzione e la mitigazione delle loro conseguenze estremamente complesse: in risposta a questo nuovo scenario l’ingegneria della sicurezza ha assunto un ruolo di primaria importanza, diventando un campo specializzato all’interno dell’ingegneria spaziale. Questo settore si concentra sugli aspetti critici della sicurezza nella progettazione e nello sviluppo dei sistemi spaziali, con particolare attenzione alla protezione contro le minacce cyber.
L’evoluzione del concetto di “guerra non lineare” ha introdotto un nuovo approccio metodologico alla strategia militare, in netto contrasto con le pratiche del passato. Questa definizione (coniata da Vladislav Surkov, consigliere personale di Vladimir Putin) fa riferimento a una complessa tecnica di manipolazione mediatica e finanziaria finalizzata a creare confusione e instabilità all’interno di un sistema, rendendolo vulnerabile e difficile da difendere/governare.
Due driver fondamentali guidano la sicurezza dei sistemi complessi: l’uso del sistema – soprattutto in contesti militari – e le politiche relative ai dati, che rivestono un ruolo cruciale nella protezione delle informazioni sensibili gestite dal sistema. Il contesto attuale è caratterizzato da sfide significative, con l’adozione di sistemi dual-use che rappresentano una tendenza emergente per massimizzare le sinergie finanziarie.
La cooperazione internazionale diventa sempre più essenziale per lo sviluppo e l’impiego di questi sistemi.
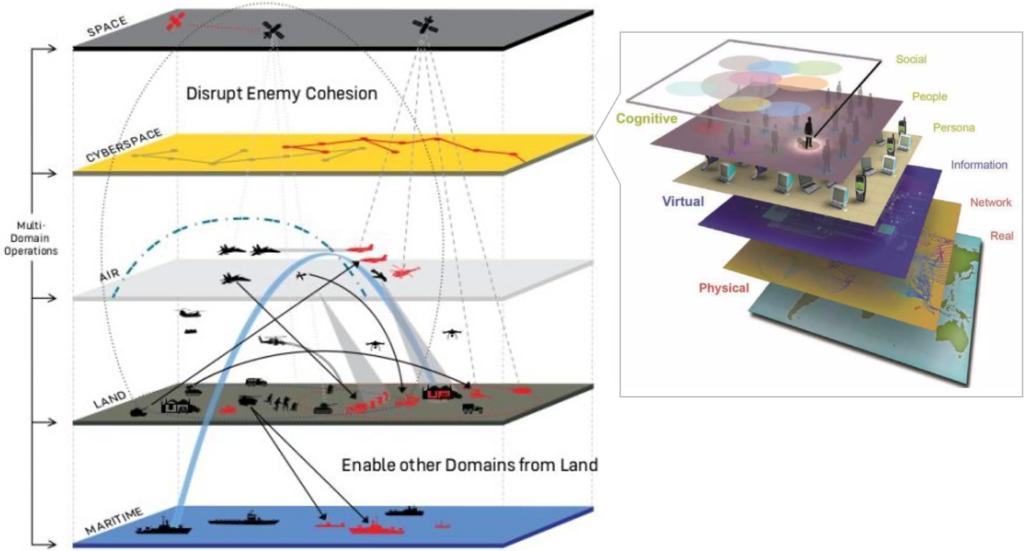
Fig 1 – I sistemi spaziali integrati nel teatro operativo
La Sicurezza dei sistemi di osservazione della Terra
I sistemi di osservazione della Terra rivestono un ruolo critico nella sicurezza, grazie alla loro capacità di fornire immagini ad alta risoluzione e di accesso globale. Tuttavia, questa stessa caratteristica li rende vulnerabili a diverse minacce: è pertanto necessario implementare misure di sicurezza per proteggere gli asset del sistema, garantendo la disponibilità, l’integrità e la confidenzialità dei dati.
La definizione di una politica di sicurezza efficace è fondamentale per affrontare le minacce cyber in modo proattivo. Questa politica dovrebbe comprendere l’identificazione degli asset da proteggere, l’analisi dei punti deboli del sistema e la valutazione delle contromisure necessarie. Tra le misure di sicurezza chiave si annoverano la certificazione Common Criteria, la protezione COMSEC e l’implementazione di sistemi crittografici.
Fig. 2 – Esempi di Asset di un Sistema Spaziale
Gestione degli asset e misure di sicurezza
Gli asset di un sistema spaziale possono includere una vasta gamma di informazioni e dati sensibili che devono essere protetti per garantire la confidenzialità, l’integrità e la disponibilità. Tra questi rientrano i dati acquisiti dai sensori di bordo, i cataloghi di richieste, gli scenari operativi per la difesa, la protezione dei dati sui link terra/bordo, nonché i database e piani di missione duali.
In particolare:
Dati acquisiti dai sensori di bordo
Questi dati rappresentano informazioni critiche raccolte dai sensori dei satelliti, come immagini e dati scientifici. La loro protezione è essenziale per evitare l’accesso non autorizzato e garantire l’integrità delle informazioni trasmesse.
Cataloghi di richieste
I cataloghi di richieste contengono informazioni sulle esigenze degli utenti e le specifiche richieste per l’acquisizione di dati da parte dei satelliti. La loro protezione è necessaria per impedire l’accesso non autorizzato e assicurare che le richieste siano autentiche e non alterate.
Scenari operativi per la Difesa
Gli scenari operativi includono piani e strategie per l’utilizzo dei satelliti in operazioni di difesa. La protezione di questi scenari è cruciale per garantire la sicurezza nazionale e prevenire l’interferenza di attori ostili.
Protezione dei dati sui link terra/bordo
I link di comunicazione tra le stazioni a terra e i satelliti sono vulnerabili agli attacchi cyber. È fondamentale implementare misure di sicurezza, come la crittografia, per proteggere i dati trasmessi e prevenire l’intercettazione o la manomissione.
Database e piani di missione duali
I database contengono informazioni critiche per la gestione e il funzionamento dei satelliti, inclusi i piani di missione duali che prevedono l’uso dei satelliti sia per scopi civili che militari. La loro protezione è essenziale per garantire la continuità operativa e prevenire accessi non autorizzati.
Negli ultimi anni la Cyber Defence è diventata una priorità per molteplici settori, inclusi i sistemi spaziali. La crescente integrazione dei sistemi satellitari con le reti esterne ha esposto queste infrastrutture a nuove vulnerabilità, rendendo i cyber attacchi una delle minacce più pericolose. In questo contesto di guerra ibrida, caratterizzato da conflitti non lineari, è emersa l’urgenza di rivedere l’approccio metodologico nell’analisi del rischio per i sistemi spaziali, adottando soluzioni di sicurezza sempre più specifiche e avanzate.
Fino ai primi anni 2000, i sistemi satellitari erano considerati relativamente al sicuro rispetto alle minacce cyber, principalmente grazie alla loro segregazione fisica dalle reti esterne. Tuttavia, con l’incremento degli attacchi informatici e l’integrazione crescente dei sistemi spaziali con le reti terrestri, è diventato evidente che anche questi sistemi necessitano di robuste misure di sicurezza. L’emergere di sistemi duali ha ulteriormente complicato il panorama, richiedendo un’attenzione particolare alle problematiche di sicurezza specifiche per il segmento spaziale.
Peculiarità della sicurezza nei sistemi spaziali
La sicurezza dei sistemi spaziali presenta sfide uniche rispetto alle reti terrestri.
Le principali peculiarità sono:
Complessità della gestione delle chiavi: negli scenari multi-operativi e multi-utenza, la gestione delle chiavi crittografiche diventa estremamente complessa.
Periodo di visibilità dei satelliti: la finestra temporale per la comunicazione con i satelliti è limitata, il che complica ulteriormente la sicurezza delle trasmissioni.
Manutenzione impossibile: l’hardware a bordo dei satelliti non può essere riparato una volta in orbita, richiedendo soluzioni di sicurezza che garantiscano la massima affidabilità.
Standard di cybersecurity non specifici: gli standard come le Common Criteria sono progettati per i sistemi terrestri e non tengono conto delle specificità dei sistemi spaziali.
I sistemi spaziali moderni sono sempre più integrati, rendendo la sicurezza una questione complessa. La protezione deve considerare tutti i componenti del sistema, dai satelliti ai centri di controllo a terra. Le misure di sicurezza devono includere:
Valutazione dei sistemi dal punto di vista cyber – inclusa la valutazione di satelliti e componenti a bordo, secondo standard come Common Criteria e FIPS.
Gestione dinamica delle chiavi – l’adozione di sistemi di gestione delle chiavi dinamici e l’implementazione di algoritmi avanzati come quelli basati su sistemi dinamici caotici.
Protezione del software di bordo – misure per garantire l’integrità del software e prevenire operazioni di reverse engineering.
Protezione elettromagnetica – valutazioni TEMPEST per garantire la sicurezza elettromagnetica dei satelliti e dei sistemi cifranti.
Analisi del rischio
L’analisi del rischio è un processo essenziale per garantire la sicurezza e la resilienza di un sistema o un’organizzazione. È cruciale che questo processo inizi considerando una serie di input fondamentali, tra cui i requisiti del cliente, gli standard di riferimento e il contesto geopolitico: i requisiti del cliente forniscono una comprensione chiara delle aspettative e delle necessità specifiche del progetto, mentre gli standard di riferimento assicurano che l’analisi e le misure adottate siano conformi alle migliori pratiche e normative del settore. Il contesto geopolitico, inoltre, influenza significativamente il panorama delle minacce e delle vulnerabilità, variando in base a fattori come stabilità politica, legislazione locale e tensioni internazionali.
Fig 3 – Processo di Analisi del Rischio
Quantum Technology applicata ai Sistemi Spaziali: la rivoluzione della Quantum Key Distribution
Negli ultimi anni le tecnologie quantistiche hanno iniziato a rivoluzionare vari settori, tra cui quello spaziale. Una delle applicazioni più promettenti è la Quantum Key Distribution (QKD), una tecnologia che permette di scambiare chiavi crittografiche in modo estremamente sicuro sfruttando le proprietà della meccanica quantistica. Questa innovazione risulta particolarmente efficace nei sistemi spaziali, dove la sicurezza delle comunicazioni è fondamentale.
La QKD si basa sui principi della meccanica quantistica per garantire la sicurezza delle chiavi crittografiche. Utilizzando fotoni entangled o singoli fotoni in stati quantistici, la QKD permette di rilevare qualsiasi tentativo di intercettazione; questo perché qualsiasi misurazione non autorizzata altera lo stato quantistico dei fotoni, rendendo immediatamente evidente la presenza di un attacco.
Peculiarità della QKD nei Sistemi Spaziali
Distanza e Sicurezza: la QKD permette la trasmissione di chiavi crittografiche su grandi distanze senza compromettere la sicurezza. Nei sistemi spaziali questa caratteristica è cruciale, data la necessità di comunicare con satelliti che orbitano a centinaia di chilometri dalla Terra.
Intercettazioni rilevabili: qualsiasi tentativo di intercettazione dei fotoni utilizzati per la QKD altera lo stato quantistico del segnale, permettendo di rilevare immediatamente una possibile intrusione. Questo garantisce un livello di sicurezza ineguagliabile rispetto ai metodi tradizionali.
Protezione dai sistemi a computer quantistici: la QKD è intrinsecamente sicura contro gli attacchi futuri che potrebbero essere realizzati con i computer quantistici. Questi dispositivi, quando saranno pienamente operativi, avranno la capacità di rompere molte delle attuali tecniche di crittografia. La QKD, invece, rimane sicura grazie alle leggi fondamentali della fisica quantistica.
Oltre alla QKD, la sicurezza delle comunicazioni nei sistemi spaziali deve considerare l’avvento dei computer quantistici. Gli algoritmi post-quantum sono progettati per resistere agli attacchi da parte di questi potenti computer: questi algoritmi si basano infatti su problemi matematici che si ritiene siano difficili da risolvere anche per i computer quantistici, come quelli legati alla teoria dei reticoli, ai codici di correzione degli errori e alle funzioni hash quantistiche.
Implementare algoritmi post-quantum nei sistemi spaziali, in combinazione con la QKD, garantisce un doppio livello di sicurezza. Da un lato, la QKD fornisce un metodo sicuro per la distribuzione delle chiavi; dall’altro, gli algoritmi post-quantum assicurano che i dati rimangano protetti anche se un avversario dovesse ottenere accesso a un computer quantistico.
La Quantum Key Distribution rappresenta una svolta significativa per la sicurezza delle comunicazioni nei sistemi spaziali. Le sue peculiarità, come la capacità di rilevare intercettazioni e la resistenza ai futuri attacchi quantistici, la rendono una tecnologia fondamentale per proteggere le informazioni sensibili trasmesse tra satelliti e stazioni terrestri. Integrando la QKD con algoritmi post-quantum, possiamo creare un’infrastruttura di comunicazione spaziale robusta e sicura, pronta ad affrontare le sfide del futuro tecnologico.
Conclusioni
L’analisi condotta evidenzia l’importanza cruciale dell’Ingegneria della Sicurezza nei sistemi spaziali, sottolineando la necessità di una protezione integrata che copra tutti i componenti, dai satelliti ai centri di controllo a terra. Le misure di sicurezza devono essere progettate in modo tale da garantire la disponibilità, l’integrità e la confidenzialità dei dati, adottando un approccio che combini valutazioni cyber, gestione dinamica delle chiavi, protezione del software di bordo e valutazioni elettromagnetiche secondo standard come Common Criteria e FIPS.
L’analisi del rischio emerge come un processo essenziale, in grado di garantire la resilienza dei sistemi attraverso l’identificazione delle minacce, la valutazione delle vulnerabilità e l’implementazione di misure di mitigazione. Questo processo deve essere continuo e adattarsi ai cambiamenti del contesto geopolitico e alle evoluzioni tecnologiche, al fine di mantenere un elevato livello di sicurezza nel tempo.
In conclusione, la protezione dei dati e dei sistemi spaziali richiede un’attenzione costante e un approccio multidisciplinare, che integri competenze tecniche, normative e di gestione del rischio.
Solo attraverso una strategia di sicurezza ben strutturata e proattiva è possibile affrontare efficacemente le sfide poste dai cyber attacchi e garantire la sicurezza delle infrastrutture spaziali in un contesto globale sempre più interconnesso e vulnerabile.
Daniele Frasca, Ingegnere elettronico, attualmente ricopre il ruolo di Security Advisor dell’Amministratore Delegato di Thales Alenia Space Italia; è inoltre Responsabile del Dipartimento di Cyber Security Engineering. Con oltre venti anni di esperienza nell’ingegneria della sicurezza e nella cybersecurity applicata ai Sistemi spaziali, ha lavorato su importanti programmi come COSMO-SkyMed, SICRAL, Copernicus e MUSIS. Ha pubblicato numerosi lavori nel campo della sicurezza e della cybersecurity per i sistemi spaziali.
Sovranità Digitale: Controllo, Sfide e Prospettive Future
La relazione “Sovranità Digitale e Intelligence”, presentata durante il 22° Forum ICT Security da Francesco Arruzzoli, Responsabile del Centro Studi Cerbeyra, ha evidenziato l’importanza cruciale del controllo delle informazioni e delle risorse tecnologiche.
L’intervento ha esplorato l’impatto degli hyperscaler – come Amazon e Google – sulla sovranità digitale, evidenziando le soluzioni adottate da queste aziende, tra cui la costruzione di data center sul territorio europeo.
Sono stati altresì discussi i rischi legati alla sovranità digitale e l’importanza di normative per la protezione dei dati: in particolare, la presentazione ha sottolineato anche la necessità di piani di emergenza per contrastare efficacemente cyber attacchi di ampia portata.
Concetti fondamentali della Sovranità Digitale
Il relatore ha introdotto il tema trattato con una citazione significativa: “La libertà è partecipare al governo della propria vita”.
Così scriveva, oltre 2000 anni fa, Marco Tullio Cicerone in un trattato sulla libertà e la sovranità: Arruzzoli ha sottolineato la sorprendente attualità di queste parole, che dopo due millenni continuano a fornire degli insegnamenti essenziali.
La sovranità di cui parlava Cicerone, infatti, è un concetto che oggi si estende al mondo digitale. Non più esclusiva del mondo fisico, la sovranità ha infatti assunto una dimensione virtuale: la sovranità digitale rappresenta il diritto di ogni individuo, organizzazione, azienda, ente pubblico o nazione di controllare le proprie informazioni, risorse tecnologiche e identità online.
Senza questo controllo si rischia di essere influenzati da poteri invisibili, perdendo la propria autodeterminazione in un mondo sempre più iperconnesso.
Pilastri della Sovranità Digitale
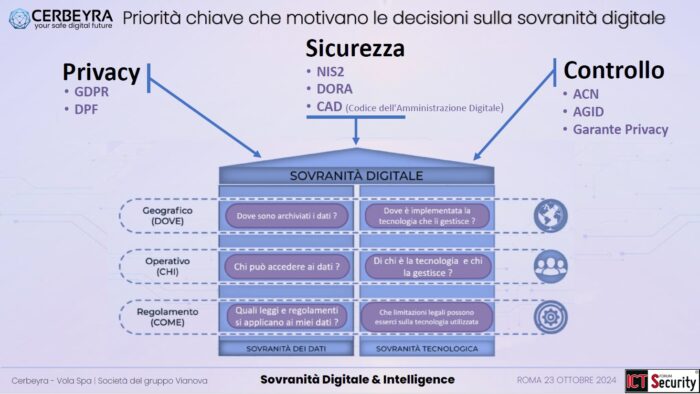
Tale sovranità digitale si fonda su due pilastri fondamentali: la sovranità dei dati e la sovranità tecnologica.
Per misurare il livello di controllo su tali domini, è utile rispondere a tre domande: dove, chi e come?
Dove: la localizzazione geografica dei dati e delle infrastrutture che li gestiscono.
Chi: chi ha accesso ai dati, nonché chi possiede e controlla la tecnologia che li amministra.
Come: i regolamenti applicabili, ossia quali leggi si applicano ai dati e quali limitazioni legali esistono nell’uso della tecnologia.
Rispondere a queste domande fornisce un metro di giudizio per valutare il livello di controllo sulla propria sovranità digitale.
Quadro normativo per la Sovranità Digitale
Questi aspetti sono già disciplinati da diverse normative. Tra queste il GDPR, che tutela della privacy dei dati; il Data Protection Framework (DPF), che regolamenta le trasmissioni digitali dei dati personali tra Stati Uniti ed Europa; infine la direttiva NIS 2, che detta norme per la sicurezza delle reti e dei sistemi informativi, insieme al DORA, la sua versione specificamente dedicata ai servizi finanziari, che entrerà in vigore nel gennaio 2025.
Inoltre, per l’Italia, il Codice dell’Amministrazione Digitale (CAD) fornisce indicazioni su come la Pubblica Amministrazione debba gestire dati e informazioni. Anche diversi organi di controllo, quali l’Agenzia per la Cybersicurezza Nazionale, l’AGID e il Garante per la Privacy, sono impegnati nella gestione di queste complesse questioni.
L’Unione Europea sta sviluppando ulteriori progetti in materia. Ne sono esempi il Cloud Service Scheme (EUCS) dell’ENISA, che mira a creare livelli di certificazione in base alla sensibilità dei dati gestiti dai fornitori di servizi cloud; o iniziative come Gaia-X, mirato alla creazione di una federazione di cloudprovider che garantiscano regole di trasparenza e sicurezza.
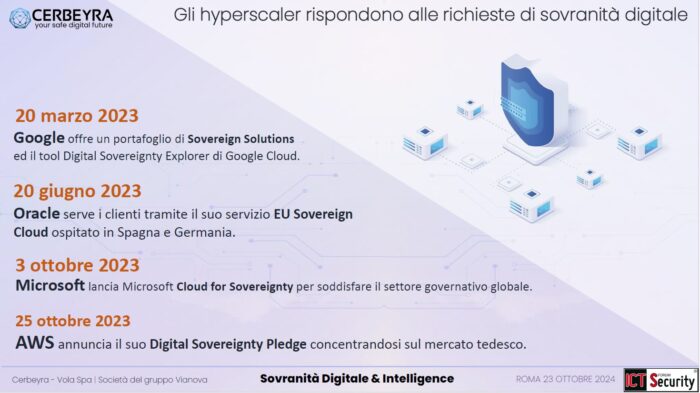
Tuttavia – secondo Arruzzoli – queste iniziative rischiano di essere compromesse, poiché uno dei principi di base è che i fornitori dei servizi siano esclusivamente europei. Ciò ha inevitabilmente suscitato la reazione delle big tech come Amazon, Google e Microsoft che, in quanto hyperscaler capaci di erogare servizi a miliardi di utenti, hanno interessi economici e politici che spesso si situano in “zone grigie” rispetto alla sovranità digitale.
Rischi e sfide della Sovranità Digitale
In risposta all’elaborazione delle normative europee per la certificazione dei fornitori di servizi cloud, queste grandi aziende hanno definito rapidamente le proprie soluzioni di sovranità digitale, costruendo data center nel territorio europeo nonché utilizzando il loro potere di lobbying per evitare di essere escluse dalla gestione della sovranità digitale dell’Unione.
Al riguardo hanno sostenuto che, se fossero escluse, il divario tecnologico tra l’Europa e il resto del mondo aumenterebbe, con conseguenze economiche negative per le imprese e le nazioni del Vecchio Continente.
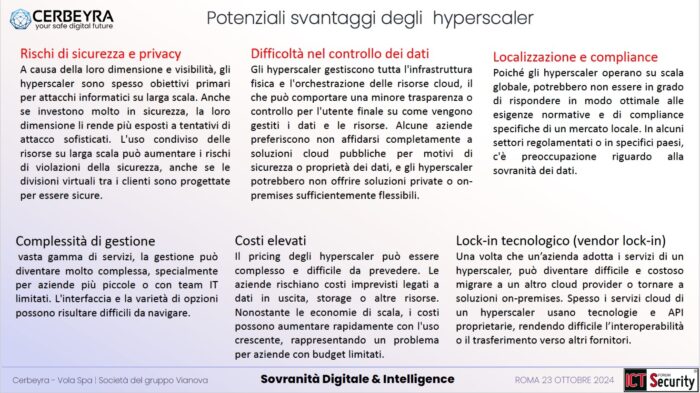
Tuttavia, il relatore ha portato l’attenzione sui principali rischi per la sovranità digitale che deriverebbero dall’affidarsi agli hyperscaler.
Il primo è relativo agli attacchi informatici: entità globali che gestiscono miliardi di utenti rappresentano, infatti, bersagli estremamente attraenti per il cybercrime e un attacco nei loro confronti potrebbe colpire simultaneamente governi e cittadini in diverse parti del mondo, rendendo estremamente difficile la gestione delle conseguenze.
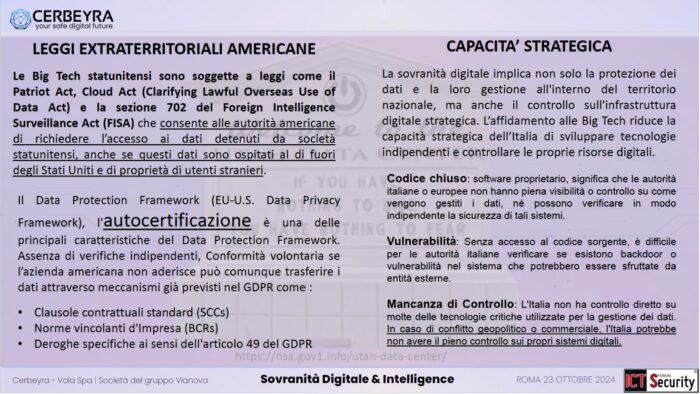
Un ulteriore rischio è legato alla compliance e alla localizzazione dei dati: chi gestisce i dati e chi ne detiene il controllo effettivo sono aspetti non sempre trasparenti. Normative come il Cloud Act, il Patriot Act e la sezione 702 del Foreign Intelligence Surveillance Act (FISA) consentono infatti alle agenzie governative USA di accedere alle infrastrutture tecnologiche delle big tech in qualsiasi Paese si trovino, anche se i dati appartengono a cittadini stranieri, potendo così aggirare qualsiasi regolamento europeo in materia.
Nonostante l’Europa abbia tentato di affrontare queste sfide con il Data Protection Framework, il relatore ha ricordato come la sua efficacia sia limitata dal fatto che si basa sull’adesione volontaria delle big tech.
Ciò solleva importanti dubbi strategici sulla sicurezza delle informazioni e sul controllo effettivo della tecnologia; soprattutto guardando al futuro sviluppo dei computer quantistici, che porteranno ad un enorme aumento della capacità di elaborare e correlare i nostri dati personali.
Sovranità Digitale: controllo e soluzioni nazionali
Per offrire un esempio concreto di mancanza di controllo sui propri dati, Arruzzoli ha citato un’applicazione utilizzata per registrare videoconferenze e analizzare i sentimenti dei partecipanti. Questa funzione viola infatti l’art. 5 dell’Artificial Intelligence Act, che vieta espressamente la deduzione delle emozioni sul posto di lavoro.
Il relatore ha pertanto evidenziato come, nonostante le leggi vigenti, esistano numerose falle nella regolamentazione e il rischio di un’estrazione illecita di dati – di cui spesso non siamo neppure consapevoli – resti elevato.
È quindi cruciale creare ecosistemi digitali nazionali in cui cittadini, aziende ed enti governativi possano avere un pieno controllo sulle proprie informazioni.
Un esempio virtuoso citato nell’intervento è rappresentato dal gruppo Vianova, operatore integrato che offre telefonia fissa, mobile e servizi avanzati di telecomunicazione impegnandosi a gestire i dati degli utenti in modo da garantire l’affidabilità e la sicurezza dei relativi processi.
Il Modello Vianova: un approccio alla Sovranità Digitale
La connettività è progettata per evitare compromissioni anche in caso di congestionamento della rete; in tal modo nel 2023 è stato possibile prevenire quasi il 70% dei disservizi ancor prima che fossero segnalati dagli utenti. I data center di Pisa e Massarosa sono conformi al livello Tier 4 e garantiscono, tanto sui servizi di hosting quanto in caso di co-location, la massima sicurezza ai dati del cliente.
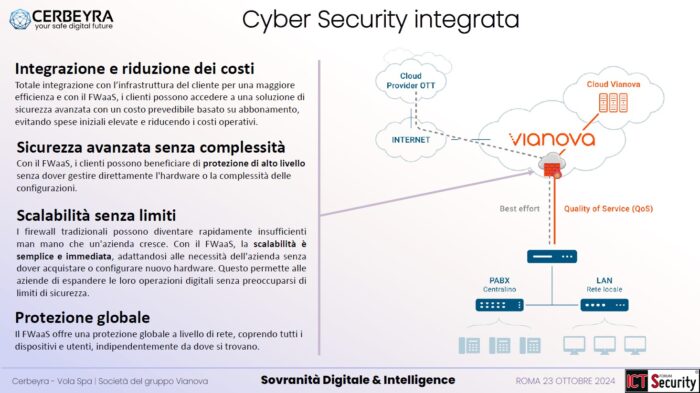
La sicurezza è integrata by design in tutte le comunicazioni, includendo servizi quali il “firewall as a service” o le connessioni private per la telefonia mobile.
Infine, l’intelligenza artificiale è implementata tramite una piattaforma di Cyber Threat Intelligence che monitora costantemente la rete e i sistemi dei clienti, rilevando vulnerabilità o anomalie per attivare immediatamente le operazioni di risposta.
Un esempio concreto citato da Arruzzoli ha riguardato l’analisi di un’attività di phishing. Nel caso esposto, la piattaforma Vianova aveva rilevato come la sandbox di Microsoft Defender non si fosse limitata a esaminare il contenuto di un’email ricevuta dal cliente ma avesse avuto accesso, durante il processo, a numerose informazioni aggiuntive.
Sebbene simili attività siano formalmente legali, il relatore ha evidenziato come si pongano – anche alla luce delle esaminate differenze normative tra Europa e Stati Uniti – seri interrogativi in merito a quale utilizzo venga fatto di tali dati, nonché all’effettivo controllo sugli stessi.
Verso una Sovranità Digitale sostenibile
In conclusione Arruzzoli ha ribadito come la sovranità digitale rappresenti la chiave per proteggere il futuro delle nazioni, dei cittadini e delle imprese.
Oggi, infatti, chi controlla i dati controlla il destino collettivo. È quindi essenziale lavorare per garantire un futuro in cui il controllo rimanga nelle mani di chi genera quei dati: un’efficace strategia di sovranità digitale deve basarsi su normative solide, infrastrutture robuste e consapevolezza diffusa, affinché il controllo delle informazioni resti in ambito locale e venga gestito in modo democratico e sicuro.
Profilo Autore
Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.
Intelligenza Artificiale Generativa nel Ciclo di Intelligence OSINT
L’intelligenza artificiale generativa ha assunto un ruolo cruciale nel ciclo dell’Open Source Intelligence (OSINT), rendendo fondamentali le scelte relative ai modelli da impiegare e alle loro modalità di utilizzo.
In quest’ottica Dario Beniamini – SANS Institute OSINT Instructor, Senior Solutions Consultant presso NUIX, nonché CEO e Co-Fondatore di Intellexia Srls – ha presentato al 22° Forum ICT Security l’intervento intitolato “NO PAIN NO GAIN – L’Intelligenza Artificiale nel Ciclo dell’Intelligence OSINT”.
Partendo da alcune definizioni utili a chiarire i concetti di intelligence e open source intelligence, Beniamini ha definito il ciclo dell’OSINT come un processo strutturato volto alla raccolta e analisi di informazioni da fonti aperte, illustrando come l’intelligenza artificiale possa migliorarne significativamente l’efficienza.
Il relatore ha esposto il contributo che può dare l’AI nelle diverse fasi di questo ciclo, condividendo alcune considerazioni legali ed etiche relative all’uso dell’AI, tra cui il rispetto delle normative vigenti e la gestione dei bias nei modelli più diffusi come ChatGPT. Ha quindi sintetizzato le maggiori difficoltà (“The Pain”) associate alla scelta del modello di intelligenza artificiale da utilizzare, per arrivare ad illustrarne i potenziali benefici (“No Pain, No Gain”).
Categorie di Intelligence
Beniamini ha esordito ricordando che l’intelligence rappresenta, essenzialmente, un processo volto a trasformare dati grezzi in informazioni operative.
In campo di intelligence esistono molteplici categorie rilevanti, tra le quali si includono:
Human Intelligence (HUMINT)
Communication Intelligence (COMINT)
Signal Intelligence (SIGINT)
Measurement and Signature Intelligence (MASINT)
Technical Intelligence (TECHINT)
Financial Intelligence (FININT)
Geospatial Intelligence (GEOINT)
Open Source Intelligence (OSINT)
Nel contesto dell’OSINT i dati vengono raccolti da fonti aperte e pubblicamente disponibili, per poi essere analizzati e validati.
Attraverso questo processo, i dati si trasformano in open source information.
Dopo essere stati sottoposti a ulteriori analisi e verifiche, possono diventare open source intelligence; oppure (qualora validati attraverso altre categorie di intelligence) evolversi in validated open source intelligence.
Open Source Intelligence (OSINT)
Il relatore ha chiarito come l’espressione “open source” non si riferisca, nel contesto dell’OSINT, all’uso di software open source; bensì a informazioni accessibili pubblicamente, a prescindere dalla difficoltà o dalle tecnologie necessarie per ottenerle.
Il processo OSINT, quindi, implica la raccolta e la valutazione di informazioni da fonti aperte.
Non sempre tali fonti sono immediatamente accessibili. Ad esempio, per accedere ad alcuni dati presenti sui social media è richiesta l’autenticazione tramite un account; inoltre alcune informazioni possono essere pubblicamente disponibili ma accessibili solo a pagamento, come ad esempio le visure camerali in Italia.
L’Open Source Intelligence comprende un ampio spettro di informazioni: dai media quali audio, video e immagini, ai testi provenienti da documenti o articoli di giornale, fino ai dati di geolocalizzazione inclusi nei post pubblicati sulle piattaforme social.
Nel tempo le categorie di intelligence si sono moltiplicate includendo termini specifici per i vari settori in cui si svolgono, come SOCMINT per le attività svolte all’interno dei social media.
Applicazioni dell’OSINT
L’OSINT è ormai parte della nostra quotidianità: a titolo di esempio, Beniamini ha citato le comuni ricerche che siamo abituati a svolgere sul web per valutare l’acquisto di un immobile o per prenotare una vacanza.
Viene altresì utilizzato da organizzazioni, risorse umane, giornalisti investigativi, governi e forze di polizia; ma anche in contesti meno leciti, come possono essere le attività di stalking, terrorismo e cybercriminalità. In questo ultimo caso l’OSINT è spesso usato per raccogliere informazioni preliminari su un obiettivo prima di un attacco di social engineering, costruendo una falsa identità o “sockpuppet”.
In ambito aziendale l’OSINT può essere utile a selezionare il personale nonché ad analizzare i livelli di soddisfazione dei dipendenti, monitorando commenti e reazioni sui social media per comprendere lo “stato di salute” dell’azienda. Trova inoltre applicazione a fini di due diligence, nel marketing, nella competitive intelligence e spesso anche nel data enrichment, dove permette di aggregare più informazioni da varie fonti aperte (a pagamento o gratuite).
Il ciclo OSINT
Nell’intervento è stato ricordato che, sebbene ne esista più di una variante, il ciclo OSINT può essere suddiviso in quattro fasi principali:
Planning e Direction – definizione degli obiettivi, delle fonti e delle regole di ingaggio. Spesso sottovalutata, questa fase è invece cruciale per evitare discrepanze tra le aspettative del committente e i risultati finali.
Collection – acquisizione delle informazioni utilizzando metodi di data crawling.
Analysis e Correlation – trasformazione dei dati grezzi in informazioni utilizzabili, attraverso tecniche di link analysis e altre metodologie.
Dissemination – presentazione al committente del report finale.
Naturalmente, il ciclo OSINT può includere anche ulteriori fasi: tra queste la validazione delle informazioni raccolte attraverso altre forme di intelligence, come la human intelligence (HUMINT), per garantire la maggiore accuratezza possibile.
Regolamentazione dell’Intelligenza Artificiale
Passando al quadro che regolamenta l’uso dell’intelligenza artificiale nel campo dell’intelligence, Beniamini ha ricordato come esistano numerose fonti normative: tra questi ha citato l’Artificial Intelligence Act in ambito di Unione Europea, l’AI Risk Management Framework del NIST negli Stati Uniti e l’Australian Artificial Intelligence Ethics Framework.
La conoscenza di questi regolamenti è fondamentale per stabilire le regole di ingaggio ed evitare che, laddove raccolte in violazione della legge, le informazioni risultino inutilizzabili.
Intelligenza Artificiale Generativa
Sebbene oggi l’intelligenza artificiale sia erroneamente associata ai soli modelli generativi (come quelli diffusi da OpenAI), in realtà è stata utilizzata per anni in molte altre forme: ad esempio gli smartphone utilizzano da tempo algoritmi di machine learning per organizzare le foto personali e creare video ricordo.
L’IA generativa, andando oltre tale modello “deterministico”, ha invece una natura “stocastica”. Il relatore ha evidenziato come ciò la renda estremamente utile per generare nuovi contenuti ma al tempo stesso imponga alcune cautele, considerando come gli output possano variare nel tempo in base a vari fattori.
Scelta del Modello di Intelligenza Artificiale
L’intervento si è quindi concentrato sul complesso tema relativo alla scelta del modello di intelligenza artificiale da adottare, ricordando come esistano numerose opzioni – ognuna con diverse implicazioni in termini di privacy e controllo sui dati – che spaziano dai modelli open source alle soluzioni commerciali.
Inoltre, a livello di software, si può optare per l’utilizzo del modello tramite API o attraverso un’interfaccia grafica, o ancora implementarlo on-premises o in cloud: il relatore ha evidenziato che, laddove si scelga una soluzione on-premises, è necessario valutare se si dispone di hardware sufficiente (come GPU di tipo NVIDIA).
Secondo Beniamini le organizzazioni dovrebbero valutare attentamente costi e risorse hardware necessarie per l’implementazione di ciascun modello, consapevoli che investire nell’IA generativa può comportare interessanti vantaggi per il loro business.
Benefici dell’Intelligenza Artificiale Generativa nel Ciclo OSINT
Richiamando il ciclo OSINT esposto in precedenza, Beniamini ha evidenziato come l’uso dell’IA generativa offra significativi benefici in ogni fase del processo.
Planning: l’IA può suggerire ulteriori fonti e termini di ricerca.
Collection: l’IA può aiutare nella creazione di script per il data gathering.
Analysis e Correlation: l’IA può velocizzare la traduzione, la trascrizione, il parsing e la sentiment analysis sui contenuti raccolti.
Dissemination: l’IA può contribuire a migliorare la presentazione del report finale, fornendo supporto nella scrittura e nella sintesi dei risultati.
Un esempio concreto: creazione di un Sock Puppet
A titolo di esempio circa l’impiego dell’IA generativa nelle attività di OSINT, Beniamini ha esposto la creazione di un “sock puppet”, ossia una falsa identità successivamente utilizzabile in operazioni di raccolta d’informazioni.
Nel caso esposto, a partire dal prompt ricevuto, ChatGPT ha generato in brevissimo tempo nome, username e dettagli relativi al profilo social di un uomo di 30 anni: sebbene alcuni aspetti richiedano ancora una verifica manuale, è evidente come l’automazione di parte del lavoro rappresenti un notevole vantaggio.
Creazione di immagini con Reti GAN
Un altro possibile impiego dell’intelligenza artificiale generativa riguarda la creazione di immagini attraverso reti GAN; nel campo dell’OSINT queste immagini sono utili per creare falsi profili che appaiano credibili e non siano riconoscibili come fake.
Il relatore ha esemplificato tale tecnica mostrando al pubblico un volto generato dall’IA combinando le caratteristiche di due volti noti (George Clooney e Brad Pitt), così creando un’immagine completamente nuova e non riconducibile ad alcuna persona reale.
Conclusione
Beniamini ha chiuso il suo intervento ribadendo che – se utilizzata con le dovute precauzioni – l’intelligenza artificiale può rappresentare uno strumento prezioso nelle attività di OSINT.
Alla luce dei notevoli benefici, i potenziali rischi connessi alla violazione della privacy e all’abuso delle informazioni possono essere limitati da un approccio consapevole e rispettoso delle normative, che massimizzi l’impatto positivo dell’IA su tutte le diverse fasi del ciclo di intelligence.
SANS Institute OSINT Instructor, Senior Solutions Consultant at NUIX, CEO and Co-Founder of Intellexia Srls
Dario Beniamini is a Senior Solutions Consultant at NUIX, CEO and Co-Founder of Intellexia Srls, and an instructor of SEC497 Practical Open-Source Intelligence. He has experience conducting OSINT and Digital Forensics investigations in both the private and public sectors. Dario is also a certified trainer for the European Judicial Training Network (EJTN), the European Union Agency for Law Enforcement Training (CEPOL), and the Italian Ministry of Interior. Dario holds a Master’s in Fraud and Operational Risk from Luiss Business School and has earned a number of professional certifications over the years, including: GCFA, GCFE, and GOSI certifications.
European Cybersecurity Competence Center (ECCC): la risposta dell’UE alle minacce informatiche globali
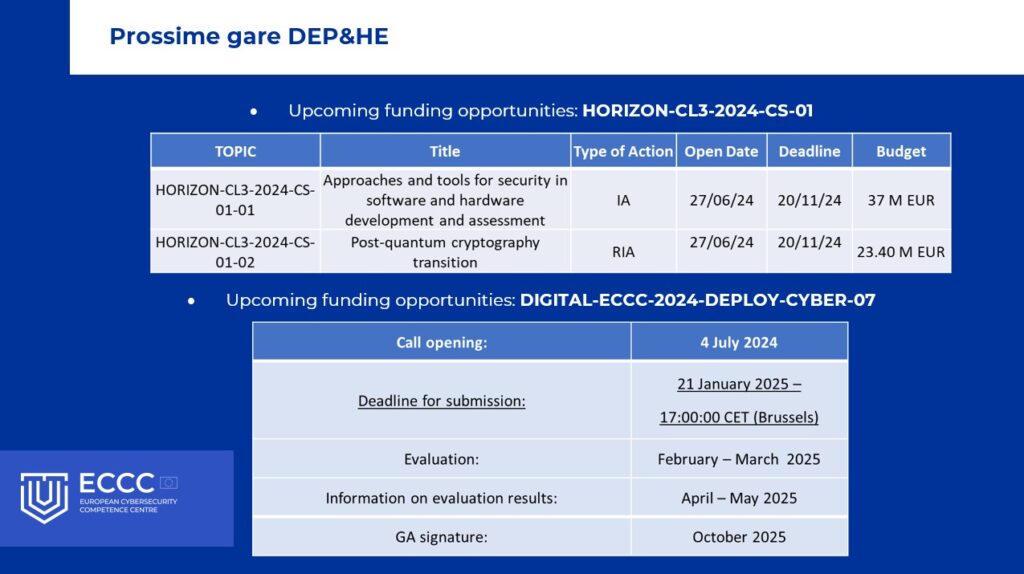
Durante l’intervento “Sinergia e cooperazione – la risposta dell’UE alle minacce informatiche globali” di Luca Tagliaretti, Executive Director, European Cybersecurity Competence Center (ECCC) al 22° Forum ICT Security vengono presentate le attività del Centro Europeo per la Competenza sulla Cyber Security, illustrando le opportunità di finanziamento disponibili e il principale obiettivo del Centro nel prossimo futuro: ossia la creazione di una comunità di stakeholder italiana ed europea per il settore della sicurezza informatica.
L’European Cybersecurity Competence Center (ECCC)
L’European Cybersecurity Competence Center – istituito dal Regolamento (UE) n. 887 del 2021 – è un volano per l’implementazione delle politiche europee sulla cybersecurity nonché per la ricerca, l’innovazione e le politiche industriali.
È nato con l’idea di sostenere la società comunitaria nell’implementazione dei regolamenti in materia, molti dei quali sono stati approvati negli anni passati ed entreranno in funzione gradualmente: alcuni sono già attivi mentre altri lo saranno nei prossimi mesi, con un impatto significativo su tutte le imprese. Pertanto è essenziale che, oltre a definire i regolamenti, sia anche possibile sostenere la loro implementazione.
L’European Cybersecurity Competence Center è stato concepito come Centro europeo e non come un semplice ufficio della Commissione (da cui, solo da poche settimane, è anche finanziariamente indipendente), perché è molto importante trattare il tema dei finanziamenti e della cybersecurity a livello europeo come una comunità e in uno spirito di squadra.
Il Centro opera all’interno dell’Università di Bucarest, al fine di creare una sinergia tra il mondo del lavoro e quello accademico.
Tre obiettivi principali
Il regolamento istitutivo dell’European Cybersecurity Competence Center prevede numerose linee d’azione, finalizzate a tre obiettivi principali.
Rafforzare la leadership e l’autonomia strategica dell’Unione Europea nel campo della sicurezza informatica: ciò significa ad esempio attuare le direttive NIS e NIS2, il Cyber Solidarity Act e il Cyber Resilience Act, quindi tutta una serie di normative che aumentano la resilienza dello spazio digitale europeo.
Sostenere la capacità tecnologica dell’Unione: questo richiede di agevolare lo sviluppo di nuove risorse tecnologiche nonché di lavorare per innalzare la generale competenza delle società, principalmente tramite attività di ricerca (programma Horizon) e implementazione (programma DEP).
Proiezione internazionale: l’ultimo obiettivo tende ad aumentare la competitività dell’industria europea nel mercato globale, dando sostegno a start-up e piccole e medie imprese (PMI), al fine di promuovere lo sviluppo tecnologico in Europa.
Azioni dell’European Cybersecurity Competence Center
Il Centro fa parte di un gruppo di agenzie europee denominate “joint undertaking” (JTs), create più o meno nello stesso periodo e focalizzate su altri aspetti relativi alle tecnologie emergenti, come supercomputer e reti 5G/6G.
L’obiettivo di tali agenzie – da perseguire in cooperazione con l’industria – è permettere la crescita organica di tutti i settori tecnologici essenziali nel contesto dell’Unione.
Tre leve d’azione principali
Per raggiungere questi obiettivi, il regolamento indica tre leve d’azione.
Leva strategica: insieme agli altri JTs e ai 27 Paesi membri, l’European Cybersecurity Competence Center ha la possibilità di stabilire l’agenda degli investimenti e delle priorità fino al 2027 per l’ambito della cybersecurity.
Leva finanziaria: per sostenere questi investimenti, il Centro è coinvolto nella gestione e nell’utilizzo dei fondi messi a disposizione dal bilancio europeo.
Comunità: al Centro è affidato anche il compito di rafforzare il coinvolgimento della società e dei potenziali beneficiari degli investimenti, ricevendo input e suggerimenti da imprese, start-up ed enti di ricerca.
Piano di Lavoro e finanziamenti
Il nostro lavoro – e quello che l’ACN fa a livello nazionale – è quindi raccogliere stimoli dalle imprese e dai centri di ricerca per contribuire alla definizione della strategia comune europea in ambito di sicurezza informatica.
L’Agenda strategica è un documento pubblico, disponibile sul nostro sito e soggetto a revisione ogni due anni (nel 2025 valuteremo eventuali modifiche), che comprende 27 azioni e 8 priorità. Le azioni coprono vari settori, dalla creazione di competenze cyber alle reti 5G, fino alle tecnologie duali e agli usi dell’intelligenza artificiale.
A partire dall’Agenda, l’European Cybersecurity Competence Center e i Paesi membri creano i piani di lavoro annuali: attualmente siamo nella fase di definizione del piano per i prossimi tre anni, che identificherà le aree di investimento, i progetti da finanziare e i fondi da utilizzare.
Per quanto riguarda gli strumenti finanziari, siamo responsabili del titolo 3 del DEP (Digital Europe Program), focalizzato sul sostegno agli investimenti in tecnologie esistenti.
Nell’ambito di questo nuovo programma, l’Agenzia copre dal 50 al 75% dei costi per tecnologie che devono essere sviluppate e messe in circolazione nel mercato europeo; il programma Horizon, invece, copre il 100% dei costi per la ricerca pura.
Dalla sua creazione nel 2021 il Centro ha pubblicato sei bandi per progetti DEP, con un investimento totale di 485 milioni di euro e circa 136 progetti finanziati. Abbiamo inoltre bandi per il programma Horizon per quasi 60 milioni di euro.
Nei prossimi mesi e fino al 2025 prevediamo investimenti per altri 220 milioni di euro, per un totale di quasi 700 milioni stanziati nell’arco di cinque anni di attività.
Partecipazione dell’Italia
Per quanto riguarda la partecipazione dell’Italia ci sono 44 beneficiari, 34 partner e 10 progetti.
L’Italia si posiziona quindi tra i primi paesi per quantità di investimenti; anche se il numero di progetti risulta minore, evidenziando come nel nostro paese arrivino soprattutto fondi relativi a bandi di grandi dimensioni.
Circa il 50% degli investimenti è destinato alle piccole e medie imprese e il 20% alle università o centri di ricerca, mentre il restante 20-25% è riferito agli enti governativi.
Bandi attuali e Progetti futuri dell’European Cybersecurity Competence Center
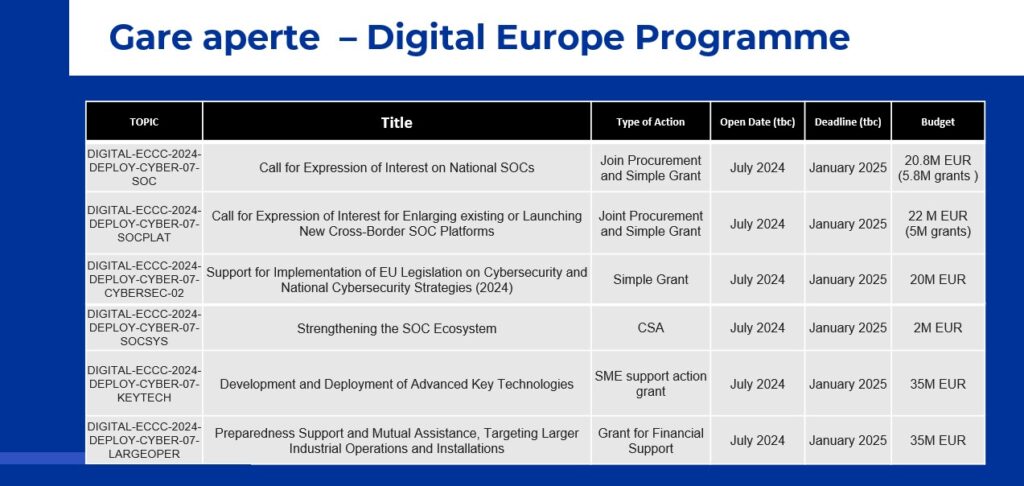
Attualmente sono aperti diversi bandi che scadranno a gennaio 2025: uno dei più importanti destina 20 milioni di euro alla creazione di SOC (Security Operations Center) e allo sviluppo di tecnologie da utilizzare negli stessi.
L’implementazione del Cyber Solidarity Act prevede la creazione di hub di coordinamento transnazionali per l’identificazione di attacchi cyber e la condivisione di informazioni in caso di attacco”. L’Italia insieme ad altri paesi europei parteciperà al primo di questi hub, al momento in fase di preparazione.
L’obiettivo è creare una rete di hub interconnessi, con un sistema di alert condiviso tra SOC nazionali ed europei, per facilitare lo scambio di informazioni in caso di attacchi informatici su larga scala: una parte significativa degli investimenti sarà, pertanto, destinata alla creazione dei centri di coordinamento nazionali e transnazionali.
Tra le priorità dell’UE per l’ecosistema cyber spiccano poi l’adozione di nuove tecnologie (come l’intelligenza artificiale, la crittografia post-quantistica o le tecnologie duali) nonché il miglioramento dell’economia e della resilienza informatica dell’Unione, con particolare attenzione al sistema sanitario e alle PMI.
Infine, come European Cybersecurity Competence Center stiamo lavorando per costruire una comunità allargata che includa – oltre ai 27 Centri di Coordinamento nazionali – tutti i vari stakeholder del settore.
Abbiamo sviluppato una piattaforma che raccoglierà tutte le entità che hanno un ruolo di responsabilità nei loro ecosistemi nazionali e che permetterà sia di raccogliere feedback, sia di promuovere opportunità di finanziamento e collaborazione. Una ventina di queste entità verranno poi selezionate per costituire un gruppo di consulenza che aiuterà il Board e l’Agenzia a stabilire le strategie future.
Il sostegno dei Paesi membri sarà essenziale nel rendere note le opportunità esistenti, creando forme di collaborazione transnazionale necessarie ad affrontare le sfide tecnologiche dei prossimi anni: il lavoro sulla comunità è fondamentale per costruire ecosistemi dove la sicurezza sia un valore condiviso.
Profilo Autore
Luca has more than 20 years of experience working with European Institutions and International Organisations, specialising in the domains of digital transformation, cybersecurity, and research and development.
Before joining the ECCC as Executive Director in 2024, he held the roles of Deputy Executive Director and Interim Executive Director of eu-LISA, the European Union Agency for the management of large-scale IT systems. Prior to that he served as head of the Global Technical Centre of the Central Bank Counterfeit Deterrence Group at the European Central Bank.
Luca’s academic achievements include an Engineering Degree from the Polytechnic University of Milan, a Master’s Degree from the School of Management of the Polytechnic of Milan (MIP), and an MBA from Oxford Brookes University. He has completed the Advanced Leadership and Management Programme (OALMP) at Saïd Business School, Oxford University, as well as the Program on Negotiation (PON) at Harvard University.
Guida Completa al Registro delle Attività di Trattamento: Elementi Minimi per Titolari e Responsabili
Il contenuto che segue fa parte di una serie di articoli dedicati al Registro dei trattamenti. In questo focus, approfondiamo gli elementi minimi richiesti nel Registro delle Attività di Trattamento, evidenziando le informazioni essenziali che ogni Titolare e Responsabile del trattamento devono includere.
Informazioni presenti nel Registro delle Attività di Trattamento
Ogni Titolare del trattamento e, ove applicabile, il suo rappresentante tengono un registro delle attività di trattamento svolte sotto la propria responsabilità. Tale registro contiene tutte le seguenti informazioni:
Il nome e i dati di contatto del titolare del trattamento e, ove applicabile, del contitolare del trattamento, del rappresentante del titolare del trattamento e del responsabile della protezione dei dati.
Le finalità del trattamento.
Una descrizione delle categorie di interessati e delle categorie di dati personali.
Le categorie di destinatari a cui i dati personali sono stati o saranno comunicati, compresi i destinatari di paesi terzi od organizzazioni internazionali.
Ove applicabile, i trasferimenti di dati personali verso un paese terzo o un’organizzazione internazionale, compresa l’identificazione del paese terzo o dell’organizzazione internazionale e, per i trasferimenti di cui al secondo comma dell’articolo 49, la documentazione delle garanzie adeguate.
Ove possibile, i termini ultimi previsti per la cancellazione delle diverse categorie di dati.
Ove possibile, una descrizione generale delle misure di sicurezza tecniche e organizzative di cui all’articolo 32, paragrafo 1.
Il contenuto del Registro rappresenta una sintesi delle attività di trattamento attivate dal Titolare o dal Responsabile anche mediante i loro rappresentanti e, quindi, da qui la necessità di predisporre una più specifica policy privacy interna da cui estrarre le informazioni utili sia per la compilazione del Registro che dell’informativa ex artt. 13 e 14 del GDPR.
Il Ruolo dei Soggetti Autorizzati al Trattamento
In tale contesto è, quindi, utile richiamare sin da ora l’attenzione circa l’importanza che rivestono i soggetti autorizzati al trattamento. Essi rappresentano coloro che, durante l’esecuzione di un trattamento dei dati, per primi conoscono la qualità del dato trattato (comune, particolare e giudiziario unitamente alle loro sottocategorie) oltre ad ogni informazione utile così da poter supportare il Titolare nel costante aggiornamento della policy privacy interna e di conseguenza del Registro.
Ai fini della compilazione del Registro dei trattamenti ed a titolo esemplificativo corre precisare che l’operazione di anonimizzazione oltre che misura di sicurezza è essa stessa un trattamento e come tale deve essere censita nel Registro dei trattamenti nonché indicato tra le informazioni presenti nell’informativa resa all’interessato.
Elementi Minimi del Registro del Responsabile
Prima di illustrare gli elementi minimi del Registro del Responsabile è utile evidenziare come tra gli obblighi del titolare all’atto della nomina di un responsabile del trattamento ex art. 28 del GDPR riscontriamo la verifica dei requisiti di cui al par. 1 dello stesso, e più in particolare essi rilevano, ai fini del principio di accountability, e anche in questo caso, per quanto attiene l’obbligo di collaborazione con l’Autorità.
Il Titolare, quindi, sarà tenuto a verificare sia la corretta applicazione del GDPR da parte del Responsabile che la corretta tenuta del Registro, anche al fine di non incorrere nelle sanzioni previste dal GDPR per la mancata o incompleta tenuta del Registro stesso.
Ciò premesso, ogni responsabile del trattamento e, ove applicabile, il suo rappresentante tengono un registro di tutte le categorie di attività relative al trattamento svolte per conto di un titolare del trattamento, contenente:
Il nome e i dati di contatto del responsabile o dei responsabili del trattamento, di ogni titolare del trattamento per conto del quale agisce il responsabile del trattamento, del rappresentante del titolare del trattamento o del responsabile del trattamento e, ove applicabile, del responsabile della protezione dei dati.
Le categorie dei trattamenti effettuati per conto di ogni titolare del trattamento.
Ove applicabile, i trasferimenti di dati personali verso un paese terzo o un’organizzazione internazionale, compresa l’identificazione del paese terzo o dell’organizzazione internazionale e, per i trasferimenti di cui al secondo comma dell’articolo 49, la documentazione delle garanzie adeguate.
Ove possibile, una descrizione generale delle misure di sicurezza tecniche e organizzative di cui all’articolo 32, paragrafo 1.
Importanza della Documentazione nel GDPR
La figura del responsabile del trattamento è contenuta nell’art. 28 GDPR che al paragrafo 1 enunciati i presupposti e le garanzie che il titolare deve verificare mentre al paragrafo 2 enunciata la procedura di nomina.
Qualora un trattamento debba essere effettuato per conto del titolare del trattamento, quest’ultimo ricorre unicamente a responsabili del trattamento che presentino garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento e garantisca la tutela dei diritti dell’interessato.
Il responsabile del trattamento non ricorre a un altro responsabile senza previa autorizzazione scritta, specifica o generale, del titolare del trattamento. Nel caso di autorizzazione scritta generale, il responsabile del trattamento informa il titolare del trattamento di eventuali modifiche previste riguardanti l’aggiunta o la sostituzione di altri responsabili del trattamento, dando così al titolare del trattamento l’opportunità di opporsi a tali modifiche.
In un rapporto tra un titolare e un responsabile, il titolare è sempre tenuto a comprovare l’adozione delle misure adeguate al caso di specie. In particolare, la mera nomina di un responsabile non è sufficiente a tenerlo indenne da eventuali responsabilità derivanti da violazioni del GDPR. Il titolare è dunque tenuto anche ad adottare tutte le misure adeguate necessarie e ivi inclusa la scelta del responsabile al fine di soddisfare i requisiti del GDPR e garantire la tutela dei diritti dell’interessato così da non incorrere nella culpa in eligendo e nella culpa in vigilando.
L’articolo si è focalizzato sull’analisi degli elementi minimi del Registro delle Attività di Trattamento, sottolineando l’importanza della documentazione e della corretta tenuta dei registri per garantire la conformità al GDPR. Nel prossimo articolo, affronteremo la compilazione del registro del Titolare e del Responsabile, fornendo linee guida utili per una corretta applicazione del regolamento. Invitiamo i lettori a scaricare il white paper dal titolo “La compilazione del Registro dei trattamenti nel nuovo quadro normativo del Reg. UE 679/2016“ per approfondire ulteriormente questi temi.
Profilo Autore
Tecnologo presso l’UAIG del CNR. Abilitato all’esercizio della professione forense.
Computing Continuum e Sicurezza Avanzata nelle Infrastrutture Distribuite
Nel suo intervento al 22° Forum ICT Security, Luigi Romano – professore di Ingegneria Informatica presso l’Università Parthenope di Napoli e presidente del Centro regionale di competenza sull’ICT della Regione Campania – ha approfondito il tema “Verso un Computing Continuum (IoT, Edge, Cloud e Dataspaces) sicuro”, fornendo un’analisi dettagliata dell’evoluzione degli scenari di calcolo negli ultimi anni e – verosimilmente – in quelli a venire.
Il concetto centrale è il “computing continuum”, che rappresenta una significativa evoluzione nella distribuzione delle risorse computazionali: il relatore ha esposto le relative tecnologie abilitanti, esaminato le principali minacce che interessano tale contesto e analizzato la superficie di attacco che lo caratterizza, delineando strategie sostenibili per garantire la sicurezza in ambienti così complessi.
Successivamente, ha presentato un caso di studio reale in cui queste tecnologie sono già state implementate con successo.
Architettura del Computing Continuum
Il computing continuum si basa su un’architettura che realizza un ecosistema in cui la produzione e l’elaborazione dei dati avvengono senza soluzione di continuità, superando i tradizionali perimetri fisici che separavano le diverse aree computazionali. In questo continuum, muovendosi da una zona all’altra, si osservano variazioni nei costi delle risorse computazionali, nella latenza, nella pervasività, nella dipendenza energetica e nella reattività del sistema. Il cloud costituisce il nucleo centrale del sistema: la terminologia “near edge” e “far edge” si riferisce proprio alla distanza rispetto al cloud, che rappresenta il cuore dell’infrastruttura computazionale.
Gran parte dell’elaborazione avviene “on-device”, quindi su dispositivi indossabili o IoT, situati all’estremità del sistema computazionale.
L’elaborazione “on-premise” viene condotta a livello domestico o aziendale.
Nel livello “far edge” i dati iniziano ad aggregarsi ed in quello “near edge” sono presenti risorse di calcolo collettive su scala nazionale.
Data Space e Sovranità Digitale
il prof. Romano ha ricordato come un elemento fondamentale del computing continuum sia l’integrazione dei data space, un concetto avanzato che trascende i limiti dei classici database, permettendo la condivisione delle informazioni senza necessariamente condividere i dati o comunque garantendo la sovranità sugli stessi.
Un’iniziativa di particolare rilevanza in questo contesto è Gaia-X, che si focalizza sullo sviluppo dei data space al fine di promuovere la sovranità digitale europea.
Fiducia e Sicurezza nel Computing Continuum
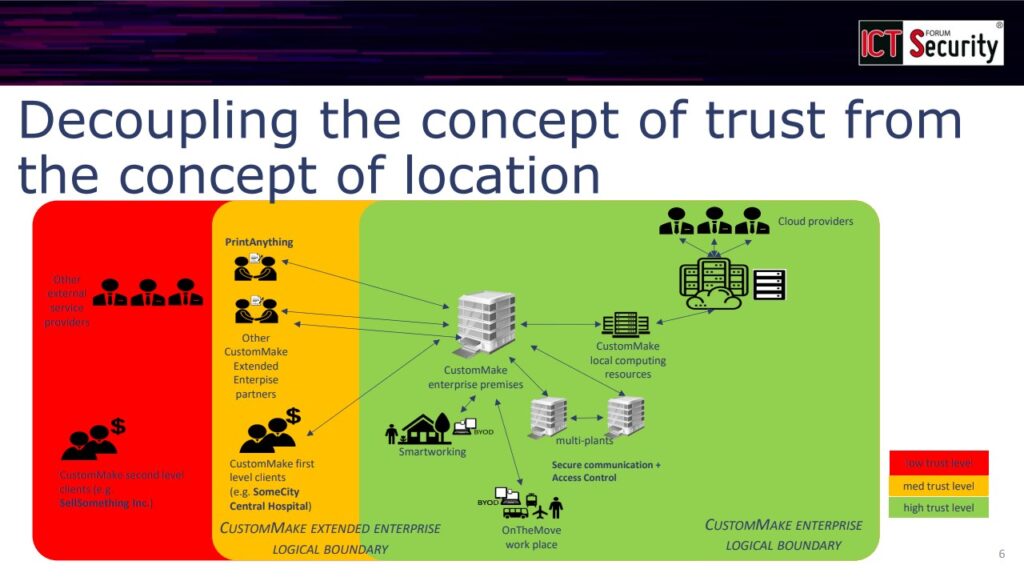
Una delle caratteristiche chiave del computing continuum è il disaccoppiamento tra il livello di fiducia (trust) richiesto al sistema e la sua collocazione fisica.
L’esempio condiviso dal relatore ha riguardato un’ipotetica azienda “Custom Make” operante nel settore del Flexible Manufacturing.
Slide dell’intervento “Verso un Computing Continuum (IoT, Edge, Cloud e Dataspaces) sicuro” tenuto al 22° Forum ICT Security dal prof. Luigi Romano
Tale azienda potrebbe avere diverse sedi fisiche, nonché dei dipendenti in smart working o in trasferta, ai quali occorre garantire – nell’interesse dell’azienda – lo stesso livello di fiducia, indipendentemente dalla loro posizione fisica e dal tipo di dispositivo utilizzato per il collegamento. L’obiettivo è, pertanto, garantire un elevato livello di fiducia su tutta l’area logica – non più perimetro – che riguarda l’azienda, senza vincolarlo alla né alla localizzazione geografica né alle risorse computazionali disponibili in loco.
Quando “Custom Make” collabora con terze parti, diventa necessario stabilire un livello di fiducia (medio) anche con questi partner. Questo approccio si estende anche ai clienti di prima linea e ad altri partner commerciali, mentre per i partner esterni può essere ridotto.
Anche per i partner e per il mondo esterno, il livello di fiducia non potrà più basarsi sul concetto di location tradizionale, né potrà essere influenzato da vincoli computazionali legati alla locazione.
Tecnologie Abilitanti del Computing Continuum
Rispetto alle tecnologie che abilitano il computing continuum, nell’intervento sono stati citati il cloud computing, l’Internet of Things (IoT) e i data space.
Il cloud computing rappresenta una vera rivoluzione tecnologica, trasformando la capacità di calcolo in una facility: vale a dire una risorsa accessibile attraverso qualsiasi rete di connettività, un po’ come avviene per l’acqua o per l’energia elettrica.
L’IoT è costituito da dispositivi in grado di raccogliere, elaborare e trasmettere dati; mentre i data space, anche alla luce della Strategia Europea per i Dati, offrono nuove opportunità economiche rispetto alla gestione e all’utilizzo delle informazioni.
Superficie di Attacco e Rischi
Nell’ambito del computing continuum, la superficie di attacco (attack surface) è estremamente ampia e presenta una vasta gamma di rischi, che interessano tanto i dispositivi IoT quanto le risorse cloud.
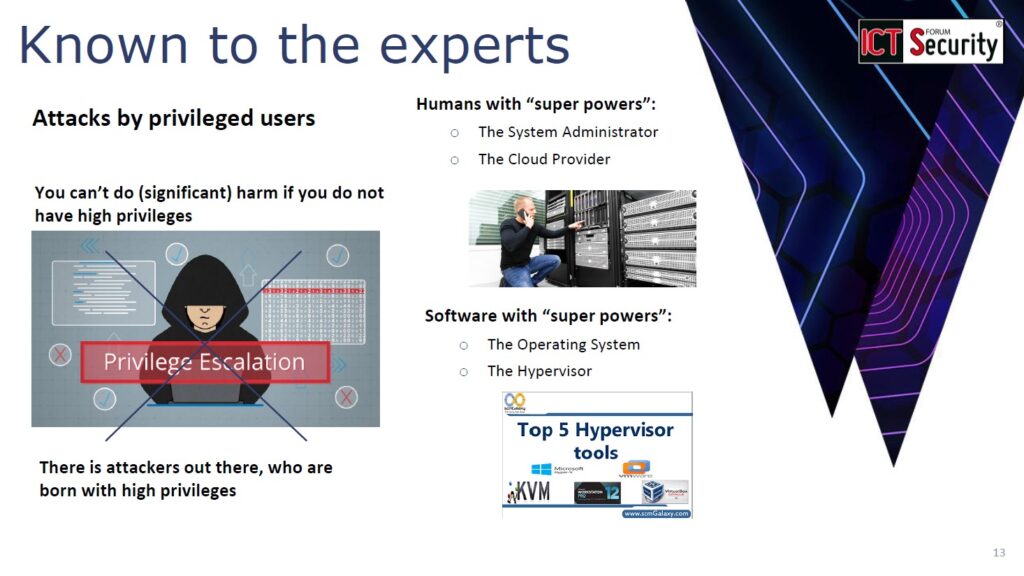
Al riguardo esistono rischi ormai noti al grande pubblico, come gli attacchi contro dispositivi medici o domestici; meno conosciuta è la possibilità di attacchi più sofisticati perpetrati da utenti privilegiati, come amministratori di sistema o cloud provider, i quali non necessitano di una fase di “privilege escalation”.
Slide dell’intervento “Verso un Computing Continuum (IoT, Edge, Cloud e Dataspaces) sicuro” tenuto al 22° Forum ICT Security dal prof. Luigi Romano
Questi utenti – che includono sia operatori umani sia componenti software, come sistemi operativi e hypervisor – rappresentano una delle maggiori sfide di sicurezza, specialmente negli ambienti cloud: se non adeguatamente gestiti, i relativi rischi potrebbero causare non solo seri danni agli utenti ma addirittura un crollo del mercato.
Approccio alla Sicurezza: Trusted Computing
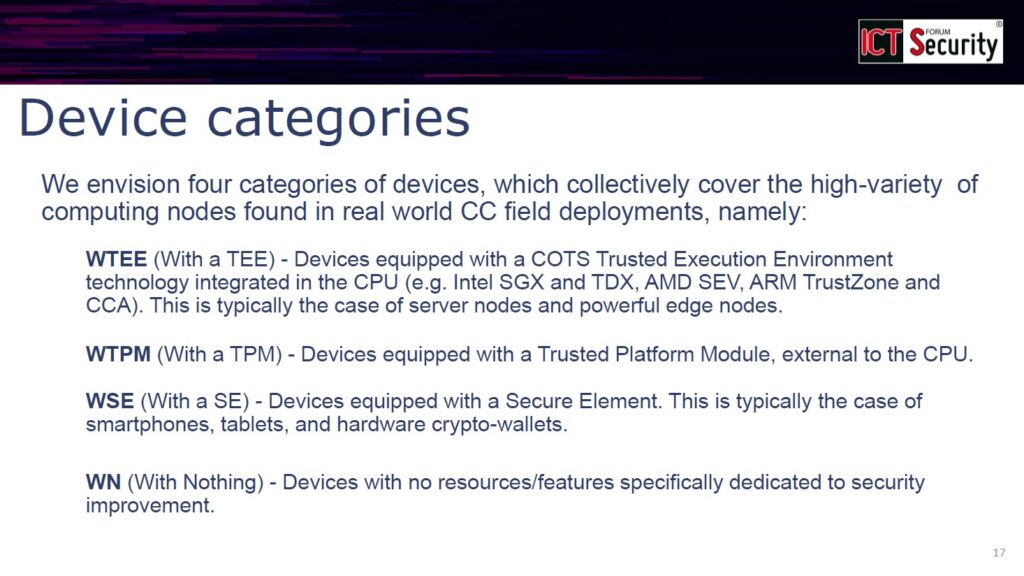
Per affrontare le sfide del computing continuum, l’approccio proposto dal prof. Romano consiste nell’accettare e gestire le sue complessità intrinseche, come l’eterogeneità dei dispositivi e la limitata sovranità sulle tecnologie che compongono i prodotti ICT.
Nell’impossibilità di ottenere una soluzione ottimale si ricerca quindi una soluzione sub-ottimale ma praticabile, applicando con un approccio di tipo “best effort” il concetto e le funzioni del “Trusted Computing” anche a dispositivi non progettati in base a tale paradigma.
Slide dell’intervento “Verso un Computing Continuum (IoT, Edge, Cloud e Dataspaces) sicuro” tenuto al 22° Forum ICT Security dal prof. Luigi Romano
In questo approccio, i vari dispositivi vengono classificati in base al livello di supporto hardware “nativo” per l’implementazione di funzioni di sicurezza: ad esempio valutando se includano un “Trusted Execution Environment” (TEE) o un “Trusted Platform Module” (TPM), o ancora se non presentino alcuna protezione specifica, per poi sviluppare le soluzioni di sicurezza più adeguate.
Caso di Studio: le Smart Grid
Questa strategia è stata applicata a un caso di studio sulle smart grid, un classico esempio di computing continuum, sviluppato nell’ambito del progetto europeo CyberSEAS.
L’architettura delle smart grid, infatti, racchiude parti “on-device” e “on-premises” per la generazione e il consumo di energia; una parte “far edge” con i concentratori; una parte “near edge” per la gestione dei distributori e, infine, il cloud.
Ciascuna di queste componenti presenta esigenze di sicurezza diverse ma tutte sono interconnesse tra loro, così evidenziando sfide di protezione particolarmente complesse.
Conclusioni
Come evidenziato dall’intervento, il computing continuum rappresenta una trasformazione radicale nella gestione delle risorse computazionali: l’integrazione di data space, IoT, edge computing e cloud offre nuove opportunità ma anche significative sfide di sicurezza, richiedendo soluzioni innovative per garantire elevati livelli di fiducia in ambienti altamente eterogenei.
In tale contesto la strategia proposta da Romano suggerisce un percorso verso una sicurezza sostenibile, che tenga conto della natura distribuita e complessa delle moderne infrastrutture computazionali.
Profilo Autore
Luigi Romano è un esperto di sicurezza e affidabilità dei sistemi distribuiti. È Professore Ordinario di Ingegneria Informatica all’ Università degli Studi di Napoli “Parthenope”, dove ricopre anche il ruolo di Prorettore alle Tecnologie Informatiche. È Presidente del Centro Regionale Information Communication Technology (CeRICT – http://www.cerict.it/en/), il centro di competenza della regione Campania sull’IT. È uno dei cinque fondatori di Trust Up srl (https://www.trustup.it/en/), uno spin-off dell’Università degli Studi di Napoli “Parthenope”, specializzato in tecnologie TEE (Trusted Execution Environment). Collabora frequentemente con ENISA, l’Agenzia Europea per la Sicurezza Informatica. È uno degli esperti selezionati da EU-CIP (https://www.eucip.eu/) per la definizione di strategie per la protezione delle Infrastrutture Critiche. È il Technical Coordinator del progetto CyberSEAS, che ha prodotto importanti risultati sulla cybersecurity dei dataspace.
Intelligenza Artificiale Privacy Preserving: un Futuro per la Protezione dei Dati Sensibili
Durante il 22° Forum ICT Security, Manuel Roveri – Professore Ordinario presso il Politecnico di Milano e Co-founder di Dhiria s.r.l. – ha esplorato le prospettive future dell’Intelligenza Artificiale Privacy Preserving, con particolare enfasi sulle tecnologie emergenti per la tutela delle informazioni personali e aziendali.
Nella relazione “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy Preserving”, il prof. Roveri ha delineato le principali sfide connesse all’implementazione dei servizi AI e al necessario bilanciamento con la tutela della privacy: ha poi illustrato tecniche di privacy-preserving computation, tra cui l’anonimizzazione e l’homomorphic encryption, fornendo esempi concreti di applicazioni ai dati genomici e satellitari.
Tra i temi affrontati anche le sfide del deep learning su dati criptati e relative potenzialità di addestramento, nonché l’importanza cruciale della privacy in tutti i servizi AI; l’obiettivo principale resta infatti garantire la riservatezza delle informazioni, tramite tecniche sofisticate di elaborazione sicura su dati criptati.
L’intervento ha evidenziato come le tecnologie emergenti possano consentire risultati avanzati senza compromettere la riservatezza delle informazioni sensibili, aprendo la strada a un futuro in cui l’intelligenza artificiale rispetti integralmente la privacy degli utenti.
Negli ultimi tempi l’intelligenza artificiale ha subito un’evoluzione sostanziale, segnata dal cambiamento radicale avvenuto all’inizio dello scorso anno.
Tale evoluzione è stata agevolata dalla disponibilità di modelli di linguaggio di grandi dimensioni: come GPT-3, sviluppato già nel 2017 e utilizzato nel 2020 per la redazione di un articolo pubblicato dal quotidiano britannico Guardian.
La svolta avvenuta nel 2023 ha riguardato il modo in cui l’AI è diventata accessibile a un pubblico molto più ampio. Se infatti nel passato l’implementazione di questi algoritmi richiedeva un team di esperti di AI, dataset su larga scala e infrastrutture di calcolo avanzate, oggi le stesse capacità sono disponibili per chiunque grazie alla diffusione dell’Artificial Intelligence-as-a-Service (AIaaS).
Analogamente ad altri servizi digitali – come quelli di posta elettronica, archiviazione, CRM – l’AIaaS non esige che l’utente comprenda l’algoritmo sottostante o l’infrastruttura su cui opera: per ottenere i risultati è sufficiente collegarsi al servizio tramite dispositivi mobili o browser e fornire i dati richiesti.
Tuttavia il relatore ha ricordato che l’uso di questi servizi, per quanto spesso gratuiti, comporta dei costi impliciti poiché implica il rilascio di dati in chiaro, imponendo un compromesso tra la comodità dei servizi e la protezione della privacy.
Pertanto, il prof. Roveri ha posto una domanda fondamentale: come progettare servizi di intelligenza artificiale che preservino la privacy dei dati?
Tecniche fondamentali per l’Intelligenza Artificiale Privacy Preserving
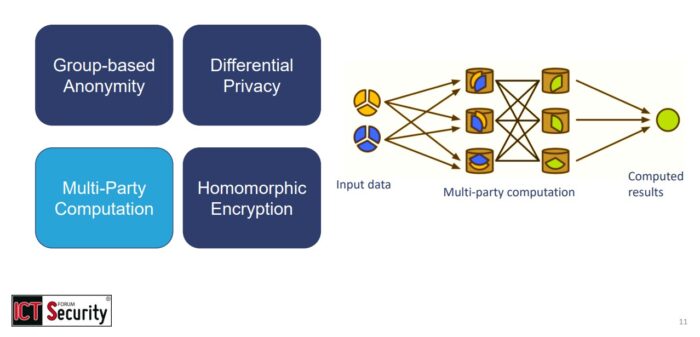
La Privacy Preserving Computation affronta questo problema mediante diverse tecniche che garantiscono la riservatezza dei dati durante il processo di elaborazione.
Tra tali tecniche, il relatore ha sintetizzato le principali:
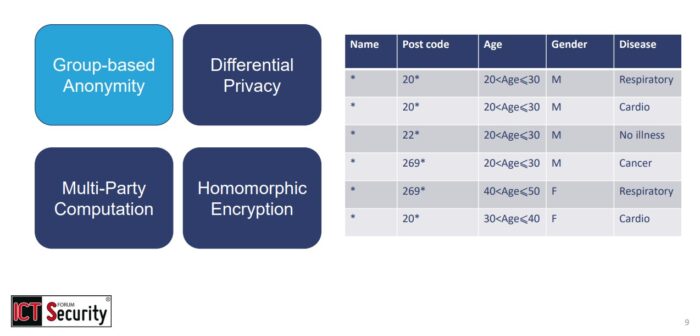
Anonimizzazione dei dati – consiste nella rimozione di tutte le informazioni sensibili presenti in un database, come nomi o identificatori di localizzazione, per impedire che i datiencryptionencryption siano associabili a specifici individui; Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
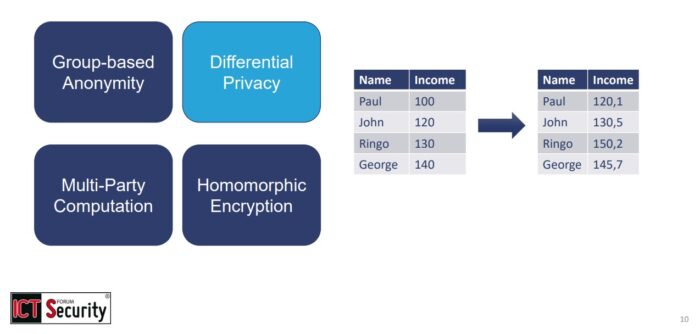
Differential Privacy – complementare al precedente, prevede l’aggiunta di “rumore statistico” al fine di perturbare i dati per consentirne l’analisi aggregata senza divulgare informazioni dettagliate sui singoli individui, preservando così la privacy; Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
Multi-Party Computation (MPC) – i dati vengono distribuiti “a pezzi”, in modo che nessuno abbia accesso completo alla totalità dei dati originali ma tutti possano collaborare per ottenere in sicurezza il risultato finale;
Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
Homomorphic Encryption (HE) – consente di elaborare i dati in forma criptata ma, a differenza di altri schemi crittografici, permette di eseguire operazioni sui dati criptati fornendo un risultato che, una volta decriptato, equivale sostanzialmente a quello delle operazioni svolte sui dati in chiaro. Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
Tipologie di Homomorphic Encryption nell’Intelligenza Artificiale Privacy Preserving
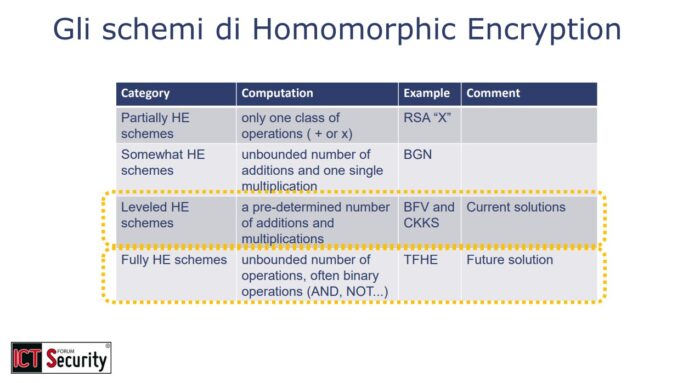
A loro volta gli schemi di homomorphic encryption si suddividono in diverse categorie, distinte in base alle loro capacità di elaborazione dei dati criptati.
Partial Homomorphic Encryption: consente l’esecuzione di una singola operazione, come la somma o il prodotto, limitando significativamente la complessità delle operazioni.
Somewhat Homomorphic Encryption: consente un numero illimitato di somme ma una sola moltiplicazione.
Leveled Homomorphic Encryption: attualmente il più utilizzato, consente un numero predeterminato di somme e moltiplicazioni che lo rendono adatto a scenari di elaborazione specifici.
Full Homomorphic Encryption (FHE): grazie al processo di bootstrapping, questo schema permette un numero illimitato di operazioni ed è considerato lo schema che in futuro potrà rivelarsi resistente agli attacchi da parte di computer quantistici.
Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
Sfide tecniche e soluzioni per l’Intelligenza Artificiale Privacy Preserving
Come ricordato da Roveri, sebbene offrano possibilità avanzate, le tecniche di homomorphic encryption presentano anche diverse sfide.
Tra queste spiccano la necessità di trasformare le operazioni non lineari in operazioni lineari (o polinomiali) e la limitazione nella lunghezza della pipeline di elaborazione, oltre a un’elevata richiesta di memoria e potenza di calcolo. Questi sono aspetti particolarmente critici per le reti di deep learning, caratterizzate proprio da operazioni non lineari, profondità di elaborazione elevata e da un’enorme richiesta di risorse computazionali.
Simili criticità sono alla base della seconda domanda posta nel corso dell’intervento: è possibile progettare reti neurali capaci di operare su dati criptati?
Per rispondere positivamente è stato citato il caso, già oggetto di una pubblicazione scientifica, della rete di elaborazione immagini AlexNet, dove le operazioni non lineari sono state sostituite con operazioni polinomiali per poter applicare l’homomorphic encryption preservando comunque un’accuratezza comparabile all’originale. Ad esempio la versione approssimata della rete, operando su immagini criptate, raggiunge un’accuratezza del 98,1% sul dataset MNIST (rispetto al 98,7% della versione originale).
I costi in termini di occupazione di memoria sono considerevoli, passando da 7.5 MB a 780 MB; anche i tempi aumentano sensibilmente, dai pochi millisecondi della rete originale ai diversi minuti richiesti dalla rete criptata.
Tuttavia il relatore ha argomentato che tali costi – oltre a essere giustificati dalla necessità di proteggere i dati lungo l’intero processo – possono essere mitigati sfruttando macchine ad alta computazione in modalità as-a-Service, tipicamente tramite il ricorso al Cloud.
L’applicazione delle tecniche privacy preserving, quindi, consente di sviluppare una pipeline di elaborazione dati completamente criptata, in cui i dati vengono cifrati con una chiave pubblica ed elaborati in forma criptata nel cloud.
In seguito, i risultati potranno essere decodificati esclusivamente dal proprietario dei dati.
Passando agli scenari in cui tale approccio sia già stato applicato con successo, il prof. Roveri ha presentato diversi esempi:
Elaborazione di dati satellitari criptati – utilizzata, in collaborazione con e-GEOS, per il rilevamento e la classificazione di oggetti nell’ambito di un progetto dell’Agenzia Spaziale Europea; in questo caso la crittografia garantisce la riservatezza dei dati sensibili provenienti da satelliti di osservazione, permettendone comunque l’elaborazione.
Elaborazione di dati genomici criptati, a cui si fa ricorso per consentire la classificazione e localizzazione primaria dei tumori senza compromettere le informazioni genomiche dei pazienti; questo approccio consente di utilizzare dati sensibili per la ricerca medica, salvaguardando la privacy dei soggetti coinvolti.
Manutenzione predittiva su dati criptati, applicata a macchinari industriali in impianti di produzione critici; ciò consente l’elaborazione dei dati per ottimizzare la manutenzione dei sistemi, senza necessità di esporre informazioni critiche.
Prospettive future per l’Intelligenza Artificiale Privacy Preserving
Il futuro dell’Intelligenza Artificiale Privacy Preserving – che in realtà, secondo il prof. Roveri, è già presente – non si limita alla fase di inferenza, estendendosi anche alla fase di addestramento sui dati criptati.
Volendo costruire un modello di elaborazione ad hoc senza divulgare informazioni sensibili, è stato illustrato come sia possibile utilizzare un training set criptato in base al quale definire un modello che preservi la privacy durante tutto il processo di apprendimento: questa evoluzione apre la strada alla possibilità di fornire sia inferenza sia addestramento personalizzati, garantendo al contempo la riservatezza delle informazioni.
In conclusione, il relatore ha quindi ribadito come l’Intelligenza Artificiale rappresenti un’area di ricerca e sviluppo cruciale per garantire un equilibrio sostenibile tra innovazione tecnologica, tutela della privacy e sicurezza dei dati.
AI Generativa, il suo impatto dirompente sulla Cybersecurity
Durante il Forum ICT Security 2024, la presentazione “Generative AI’s Emerging Disruption of Cybersecurity” di Jim Reavis – Cofondatore e Chief Executive Officer della Cloud Security Alliance (CSA) – ha esplorato il ruolo cruciale dei professionisti della sicurezza informatica nel campo dell’AI generativa.
La discussione ha incluso l’iniziativa in tema di AI security della CSA e i relativi modelli di responsabilità condivisa, evidenziando l’importanza di una comprensione approfondita dell’AI per affrontare nuove minacce e relative opportunità.
Lo stato attuale della Cybersecurity e dell’AI Generativa
In base alla sua esperienza trentennale nel settore della cybersecurity, il relatore ha esordito con la convinzione che attualmente ci si trovi nel mezzo della più grande trasformazione tecnologica mai vista.
L’impatto dell’AI generativa sta già travolgendo le aziende e ne sta ribaltando gli equilibri: come un vulcano, sta facendo tremare la terra sotto di noi.
Di conseguenza i professionisti della sicurezza informatica hanno la responsabilità di conoscere l’AI generativa più di chiunque altro, perché oggi per le organizzazioni è cruciale comprenderne implicazioni ed effetti.
Il ruolo della Cloud Security Alliance
La Cloud Security Alliance è un’organizzazione no-profit con 140 sezioni distribuite in tutto il mondo, che ha costruito una vasta comunità attraverso l’educazione, la ricerca e la condivisione delle migliori pratiche di cybersecurity a livello globale.
La strategia della CSA per l’AI security, lanciata lo scorso anno, tiene in considerazione diverse dimensioni: come l’intelligenza artificiale possa essere attaccata (es. prompt injection, data poisoning), come possa abilitare nuove modalità di attacco e, infine, come possa trasformare i processi di cybersecurity.
Nell’intervento sono quindi stati condivisi esempi concreti di aziende che sperimentano i vari aspetti dell’AI generativa, per ispirare i professionisti della cybersecurity a esplorare simili opportunità nelle loro organizzazioni.
Minacce emergenti con l’AI Generativa
Come ricordato da Reavis nel panorama attuale deepfake, attacchi di phishing sofisticati, social engineering e scansione automatizzata delle vulnerabilità nei grandi repository di GitHub stanno diventando sempre più diffusi.
Slide dell’intervento “Generative AI’s Emerging Disruption of Cybersecurity” tenuto al 22° Forum ICT Security da Jim Reavis, Co-founder and Chief Executive Officer, CSA
Le capacità di creare malware polimorfico sono nelle fasi iniziali e, sebbene preoccupanti, appaiono ancora poco sofisticate rispetto a ciò che potrebbe profilarsi nel futuro.
In un futuro non troppo lontano, infatti, si prevede che i cybercriminali potranno sfruttare agenti AI per raccogliere informazioni personali su internet e creare “gemelli digitali” tramite deepfake, riproducendo voci, immagini e comportamenti delle persone prese di mira.
Queste capacità di “clonazione” migliorano di giorno in giorno, rendendo sempre più difficile distinguere tra finzione e realtà: uno dei casi citati ha coinvolto un esperto della CSA che, a scopo sperimentale, ha clonato la propria voce così fedelmente che neppure i suoi figli e amici sono riusciti a distinguerla dall’originale.
Simili tecnologie possono essere utilizzate per attacchi estremamente mirati, ad esempio impersonando qualcuno in una conversazione per richiedere a suo nome denaro o altre transazioni, comportando incredibili cambiamenti nelle capacità offensive.
Comprendere la natura dell’AI Generativa
Reavis ha evidenziato che, nelle conferenze in tema di cybersecurity e AI, sembra che quest’ultima sia spesso vista soltanto come uno strumento per aumentare la produttività.
In realtà l’AI generativa – particolarmente nei large language models – si concentra sulla comprensione delle relazioni tra token, la previsione di sequenze e la generazione di output coerenti. Sebbene ciò possa sembrare innocuo l’evoluzione delle capacità di computazione, unita alla quantità di dati e algoritmi coinvolti, sta creando abilità tanto affascinanti quanto imprevedibili; la natura non deterministica di questi modelli significa che nemmeno i loro creatori possono prevederne le azioni.
L’AI generativa continua infatti a mostrare capacità emergenti, sviluppando nuove abilità in modo inaspettato. Alcuni la paragonano a un bambino o un adolescente: brillante ma privo di coerenza e quindi incline a errori, inesattezze o persino “allucinazioni”.
Verso l’AGI e la necessità di barriere responsabili
Il relatore ha raccontato come un dirigente del settore AI abbia sollecitato la Cloud Security Alliance ad accelerare la sua iniziativa di sicurezza suggerendo che, sulla base dei progressi nel System 2 thinking, l’AI generativa potrebbe presto avvicinarsi all’AGI (Artificial General Intelligence).
Questo dirigente ipotizza infatti che già entro la fine del 2025 i “modelli di frontiera” potrebbero arrivare a padroneggiare la maggior parte delle funzioni svolte dai lavoratori ICT, incluse quelle di cybersecurity. Tale scenario solleva significative preoccupazioni: interagire con l’AI generativa è essenziale per capire come funziona oggi e quali miglioramenti vengono apportati sia nell’addestramento dei modelli e nel miglioramento delle applicazioni, sia nella costruzione di layer di astrazione.
Se vogliamo garantire che un’AI sempre più potente rimanga benefica, è quindi urgente comprendere le implicazioni future e lavorare per creare barriere responsabili.
Il Ruolo dei Professionisti della Cybersecurity
Il relatore ha confermato che gli elementi essenziali della cybersecurity – tra cui la gestione del rischio, delle vulnerabilità e delle identità – continueranno ad essere rilevanti.
Tuttavia, oggi è anche necessario utilizzare l’AI “buona” per combattere quella “cattiva”: i professionisti della sicurezza informatica devono arrivare a comprendere ogni livello di questa tecnologia.
Slide dell’intervento “Generative AI’s Emerging Disruption of Cybersecurity” tenuto al 22° Forum ICT Security da Jim Reavis, Co-founder and Chief Executive Officer, CSA
Citando il modello di responsabilità condivisa di Microsoft, ha quindi ricordato come sia necessario implementare una sicurezza olistica per evitare che la responsabilità di garantire la sicurezza ricada solo sugli sviluppatori dei modelli di frontiera, come OpenAI o Google DeepMind. Le organizzazioni che utilizzano questi modelli per creare applicazioni hanno anch’esse responsabilità significative e devono, quindi, garantirne uno sviluppo etico e sicuro.
L’esperienza del cloud computing fornisce un confronto utile: se inizialmente la responsabilità sembrava ricadere solo sugli hyperscaler, nel tempo è diventato chiaro come dovesse essere condivisa tra tutti gli attori coinvolti.
Allo stesso modo, anche il panorama dell’AI generativa richiede un approccio collettivo per la gestione delle relative minacce.
Approcci organizzativi e Gestione del Rischio
Secondo Reavis, l’adozione efficace dell’AI generativa deve includere un approccio organizzativo che definisca chiaramente ruoli, responsabilità e collaborazione tra i dipartimenti. Per quanto la gestione del rischio rimanga centrale, la natura non deterministica dell’AI generativa richiede un approccio differente; il framework di gestione del rischio AI del NIST e le complementari risorse create dalla CSA possono aiutare le aziende ad affrontare queste sfide.
Oggi difendere le organizzazioni impone di concentrarsi maggiormente sulla governance dei dati. Il modello Zero Trust si conferma una strategia efficace per proteggere le informazioni: tuttavia, considerato che quando i dati sono inseriti nei large language models (LLM) i controlli di sicurezza vengono rimossi, è necessario replicarli in modo efficace al loro interno.
La formazione all’interno delle organizzazioni è necessaria per garantire che tutti comprendano gli obiettivi e partecipino alle responsabilità di sicurezza. Per saperne di più, Reavis ha consigliato di visitare la pagina dedicata alla safety initiative della CSA.
L’impatto dell’AI Generativa sulle Organizzazioni
Avviandosi alle conclusioni del suo intervento, il relatore ha ribadito come l’AI generativa stia ridefinendo gli assetti e producendo cambiamenti culturali all’interno delle organizzazioni.
Ha citato al riguardo l’esempio di Caleb Sima, presidente dell’AI Safety Initiative: partendo dai suoi primi contributi allo sviluppo di soluzioni di sicurezza per applicazioni web, Sima ha ricoperto ruoli di leadership nel settore finanziario ma in seguito ha scelto di impegnarsi presso la CSA, mosso da una profonda curiosità per il potere trasformativo dell’AI generativa.
Affrontare le Sfide della Cybersecurity: le “tre C”
Basandosi sulle ricerche svolte da Sima, le ultime slide condivise hanno sintetizzato le principali aree operative che i CISO devono includere per gestire la sicurezza AI: definizione del budget, analisi delle vulnerabilità, reporting, applicazione del principio least privilege, profili di compliance e misurazione, per arrivare alla gestione degli incidenti e relative azioni di risposta.
Slide dell’intervento “Generative AI’s Emerging Disruption of Cybersecurity” tenuto al 22° Forum ICT Security da Jim Reavis, Co-founder and Chief Executive Officer, CSA
Poiché queste aree sono spesso difficili da gestire, può essere utile riassumerle nelle “tre C”: Contesto, Copertura e Comunicazione.
Comprendere il contesto, infatti, è cruciale per valutare se un determinato indicatore rappresenti una minaccia reale; è poi vitale garantire un’adeguata copertura di tutte le aree del sistema (spesso il triage si basa su presupposti errati proprio a causa di una copertura limitata) nonché attuare una comunicazione efficace (dato che una scarsa comunicazione interna è spesso la principale causa di fallimento delle strategie aziendali).
Sfruttare l’AI Generativa per vincere le Sfide
Tornando all’importanza del contesto, il relatore ha ribadito che l’AI generativa eccelle nell’analizzare grandi quantità di informazioni e fornire approfondimenti utili su più dimensioni.
Ad esempio, valutare un log o una scansione di vulnerabilità potrebbe comportare la riconsiderazione di privilegi o accessi insoliti; il contesto aggiunto da recenti discussioni tra sviluppatori su Slack o Zoom potrebbe aiutare a definire la priorità della risposta ed evitare la classificazione errata di problemi critici.
Al fine di comprendere meglio la loro postura di sicurezza, alcune aziende hanno già iniziato a utilizzare l’AI per integrare nelle proprie analisi dati tratti da verbali delle riunioni, email o altre fonti informali. Questo approccio ha il vantaggio di rendere la cybersecurity più accessibile e coinvolgente anche per chi operi al di fuori dei tradizionali ruoli di sicurezza, rendendo il processo più efficiente e migliorando la qualità generale dei servizi.
Conclusioni
Alla luce di ciò – secondo Reavis – una profonda e responsabile integrazione dell’AI può inaugurare una nuova era di threat intelligence, ottimizzare i flussi di lavoro della cybersecurity e abilitare misure difensive che garantiscano la resilienza dei sistemi a fronte di avversari sempre più sofisticati.
È ormai evidente come l’AI possa supportare le organizzazioni in tutti i domini della sicurezza: analizzare vasti quantitativi di dati non strutturati per identificare i rischi in tempo reale, automatizzare le valutazioni delle vulnerabilità e fornire elementi contestuali per il processo decisionale è infatti cruciale non solo per gestire proattivamente minacce attuali e future, ma anche per evolversi in un paesaggio digitale in rapida trasformazione.
Dopo aver ribadito che l’AI generativa consentirà di tenere il passo delle minacce emergenti, con impatti positivi sull’intero settore, il relatore ha concluso confermando la determinazione della Cloud Security Alliance nel partecipare a questa trasformazione.
Panoramica dei principali Threat Actor legati agli Hostile Nation-State
Nel presente articolo si vuole ripercorrere la nascita dei concetti di minaccia cyber e di threat actor, avvenuta davvero da pochi anni e che giustifica tutti gli sforzi che attualmente si stanno compiendo per stabilire framework con cui definire lo svolgimento di un attacco e classificare/categorizzare al meglio un avversario. Successivamente, saranno analizzati i principali governi che sono oggi considerati ostili e i threat actor a loro legati, fino a introdurre una metodologia che permetta di farne una valutazione.
Dal punto di vista storico, le prime menzioni di targeted cyber threats e, in particolare, di cyber threat al di fuori degli ambiti governativi sono apparse nel 2001 durante un briefing non classificato della National Security Agency del 2010. Il termine APT[1] (o Advanced Persistent Threat) è stato invece utilizzato per la prima volta durante una discussione all’Air Force Intelligence Agency in cui si cercava un termine per classificare una specifica tipologia di attaccanti, molto ben addestrati, che con ogni probabilità erano finanziati e addestrati da enti governativi.
Una definizione attualmente condivisa di Advanced Persistent Threat è fornita dal NIST SP 800-39[2], che li descrive come:
“an adversary with sophisticated levels of expertise and significant resources, allowing it through the use of multiple different attack vectors (e.g., cyber, physical, and deception), to generate opportunities to achieve its objectives which are typically to establish and extend its presence within the information technology infrastructure of organizations for purposes of continually exfiltrating information and/or to undermine or impede critical aspects of a mission, program, or organization, or place itself in a position to do so in the future; moreover, the advanced persistent threat pursues its objectives repeatedly over an extended period of time, adapting to a defender’s efforts to resist it, and with determination to maintain the level of interaction needed to execute its objectives”.
Una caratteristica chiave di un attacco APT è l’uso congiunto di tecniche manuali e automatizzate per raggiungere i propri obiettivi, che possono consistere nella compromissione di computer e di dispositivi mobili. Gli APT sono generalmente associati ad attacchi sponsorizzati dai governi, ma sono utilizzati anche da organizzazioni criminali e da singoli individui.
Generalmente – data la loro complessità – gli APT sono attacchi multi-stage, possono richiedere anche molto tempo per essere preparati e l’aspettativa degli attaccanti è che la compromissione non sia rilevata per per molto tempo (o addirittura anni).
Le fasi che compongono un attacco APT sono le seguenti:
Observation/Social Engineering: ricerca e raccolta di dati sul target dell’attacco;
Section: delivery del malware che sarà utilizzato nell’attacco attraverso la tattica scelta (Phishing, Exploit Public-Facing Application, Drive-by Compromise,);
Discovery: dopo aver ottenuto l’accesso, gli attaccanti devono agire rapidamente per evitare il loro riconoscimento;
Catch & Exfiltration: i dati riservati del target raccolti durante l’attacco sono inviati ai server dagli attaccanti. Questa fase può essere molto lunga e può contemplare l’interazione continua tra l’attaccante e l’infrastruttura target.
Un attacco basato su APT si differenzia moltissimo dagli attacchi informatici di base e possiamo considerare almeno i seguenti aspetti distintivi:
un APT è più complesso di una generica minaccia online, in quanto la realizzazione degli strumenti impiegati e l’esecuzione dell’attacco comportano che il gruppo di attaccanti lavori a tempo pieno per realizzarla. Nel setup dell’attacco deve essere anche considerato il tempo in cui gli avversari – dopo aver trovato il primo punto di accesso all’infrastruttura target – svolgono le attività manuali necessarie a garantirne la miglior persistenza;
gli APT sono creati per perseguire specifici obiettivi (come, ad esempio, specifiche organizzazioni o determinati settori industriali) e quindi non rappresentano una minaccia generale. Per questa caratteristica, gli APT si definiscono tailored.
Nella Figura 1 sono mostrate tutte le fasi che compongono un attacco di tipo APT:
Gli attori di Advanced Persistent Threat possono appartenere ad una (a volte più d’una) tra le seguenti categorie:
Terrorists
Corporate espionage actor
Nation-state actor
Organized criminal actor
Hacktivist
Le motivazioni alla base degli attacchi APT possono variare notevolmente, ma le finalità primarie di solito rientrano tra le seguenti:
raccogliere informazioni;
ottenere un punto di ingresso per realizzare successive fasi di un attacco o all’accesso indiretto a una società legata al target o a un suo affiliato;
ottenere un guadagno finanziario;
ottenere un vantaggio competitivo su altre nazioni;
danneggiare la reputazione di un’organizzazione;
produrre interferenze a livello politico;
mettere fuori uso sistemi, dispositivi o intere infrastrutture;
condurre operazioni di Cyber Espionage (furto di proprietà intellettuali e accesso alle credenziali, finanziarie, informazioni classificate o sensibili);
condurre operazioni di Cyber Warfare;
controllare le attività di singoli o di gruppi di persone.
Solo nel 2016[3] il Segretario generale della NATO Jens Stoltenberg, nonostante gli attacchi di tipo APT siano già stati riconosciuti come minacce di alto livello che possono coinvolgere apparati e infrastrutture governativi o privati, riconosce il cyberspazio come dominio operativo.
Dopo l’attacco del 2015[4] alla rete elettrica dell’Ucraina, realizzato utilizzando il malware Black Energy, gli attacchi cyber sono equiparati per pericolosità a quelli fisici.
“We also turned our attention to cyberspace[5]. We agreed that we will recognise cyberspace as an operational domain. Just like air, sea and land. Cyber defence is part of collective defence. Most crises and conflicts today have a cyber dimension. So treating cyber as an operational domain would enable us to better protect our missions and operations.”
Nella conferenza stampa che si è tenuta a seguito dell’intervento, alla domanda di un giornalista riguardo all’implicazione del considerare gli attacchi cyber al pari dei “kinetic attack” rispetto all’attivazione dell’articolo 5[6] per la NATO, alla capacità di identificare gli autori e alla necessità di sviluppare capacità informatiche offensive all’interno della NATO, il Segretario Generale risponde in questi termini:
“We have decided that a cyber attack can trigger Article 5, meaning that a cyber attack can trigger collective defence, because we regard cyber attacks as something that can cause a lot of damage and can be very dangerous. As I said, it’s hard to imagine a conflict without a cyber dimension. So, yes, cyber can trigger Article 5, but the same time I think it’s also important to understand that cyber is not something that always triggers Article 5. […]
What we do is defensive, but it is important to develop our defensive capabilities, and it is important to be able to attribute because one of the challenges when we speak about cyber is that it’s not always easy to tell exactly who is attacking you. So everything related to attribution is one of the issues which are high on our agenda and we are developing capabilities to be better able to attribute different kinds of cyber attacks.”
Sebbene la decisione di inserire anche il cyberspazio come dominio operativo sia stata fondamentale, le tempistiche della NATO nel riconoscere tali attacchi come altamente dannosi possono apparire faziosi se si pensa che, nei primi mesi del 2010, gli esperti della National Security Agency (NSA), in collaborazione con l’Israel Defense Force (IDF), crearono il malware Stuxnet[7].
Tale malware fu in grado di agire sui PLC Siemens Simatic S7-300 adibiti al controllo delle centrifughe utilizzate per produrre l’uranio arricchito. Si stima che l’attacco potrebbe aver messo fuori uso almeno 1.000 delle 5.000 centrifughe iraniane, causando un ritardo di alcuni anni nel programma nucleare iraniano.
Naturalmente, sebbene in misura e con modalità diverse, i governi delegano parte delle attività cyber di tipo offensivo a diversi “stakeholder” che possono essere aziende, freelance o università.
L’attuale conflitto russo-ucraino sta mostrando, nella maniera più ampia possibile, quanti soggetti possano essere disposti sullo scacchiere del cyber warfare: gruppi governativi che si avvalgono di aziende private per la progettazione e sviluppo di strumenti offensivi, ransomware gang e gruppi cybercrime che collaborano con attori governativi e creano per loro uno smokescreen, gruppi (o freelance) che supportano le fasi iniziali di un attacco, quali gli Initial Access Broker (IAB)[8].
Tra le figure non governative generalmente utilizzate nello svolgimento di un attacco vi è quella dei cyber proxy.
Questi[9] conducono o contribuiscono direttamente nelle Offensive Cyber Operation che possono avere una varietà di effetti e di finalità. Oltre ad offrire la plausibile negabilità del coinvolgimento di un governo in un attacco informatico, l’utilizzo dei cyber proxy permette di incrementare la complessità/sofisticazione di un attacco, in quanto questi dispongono generalmente di elevate capability.
La Figura 3 mostra una gerarchia distinta su sei livelli (I = livello più basso, VI = livello più alto) delle minacce informatiche definita dello US Defense Science Board:
Fig. 3 – Collocazione dei cyber proxy nella tassonomia delle minacce
Il grafico riassume le distinzioni fatte confrontando le capacità degli attori statali e non statali: i cyber proxy che conducono operazioni informatiche offensive hanno spaziato dal livello I al IV. I proxy possono anche contribuire alle operazioni informatiche offensive condotte da attori governativi di livello V e VI (quali Stati Uniti, Russia e Cina).
Il Defense Science Board[10] formula due osservazioni particolarmente importanti al riguardo. In primo luogo, “gli attori di livello superiore useranno i metodi e le tecniche al livello più basso necessario per raggiungere i loro obiettivi… per evitare di esporre le loro tecniche più sofisticate” e, in secondo luogo, “gli Stati potrebbero impiegare attori non statali come delegati (proxy). In tali situazioni, le organizzazioni di livello intermedio ottengono l’accesso a capacità di livello superiore”.
Prima di indicare i governi a cui risulta associabile il numero più alto di gruppi APT, è bene fare almeno le seguenti precisazioni:
la conoscenza dei gruppi APT legati ai vari governi è sicuramente incompleta, ovvero l’attribution potrebbe essere errata o ancora in corso di approfondimento. La difficoltà principale deriva dall’assenza di una completa conoscenza e associazione tra governi e APT e occorre considerare pure la fase di attribuzione è svolta mentre sono in corso continui cambiamenti politici e le tecniche di attacco diventano più avanzate.
quand’anche un governo non abbia le risorse per sostenere le attività di gruppi APT, non vuol dire che questo non possa disporre di strumenti che – forniti ad operatori legati al governo e opportunamente addestrati – realizzino attività compatibili con quelle svolte da un gruppo APT. A titolo di esempio si può citare lo strumento Pegasus, prodotto dall’azienda israeliana NSO Group e introdotto nel mercato globale nel 2011, poi acquistato e utilizzato – per fini molto differenti – da decine di governi di tutto il mondo.
Sin da quando i governi hanno iniziato a utilizzare i cyber threat actor per incrementare la loro potenza offensiva, alcuni tra questi si sono distinti per un loro uso estensivo[11]. Tra gli Stati che devono principalmente essere presi in considerazione sono Russia, Cina, Nord Corea e Iran, visto che si stima che il 77% delle attività state-sponsored siano a loro associabili[12][13].
Naturalmente, di seguito saranno evidenziate le caratteristiche dei threat actor di questi Stati senza approcciare le loro attività in una visione complessiva e senza, quindi, esaminare eventuali motivazioni politiche.
Come mostrato nelle figure seguenti, a partire dal 2016 la numerosità degli attacchi realizzati dai threat actor di questi quattro governi (a volte indicati come big-four tra gli Stati ostili) è sempre cresciuta e la vittimologia è anche mutata al variare degli scenari e delle condizioni socio-politiche:
Fig. 4 – Incremento delle Cyber Operation tra il 2016 e il 2020 da parte di Russia, Cina, Nord Corea e Iran
Nella Figura 4 si riporta la stima, aggiornata al 2022, delle CybOp eseguiti dai diversi gruppi APT di questi quattro governi:
Fig. 5 – Stima delle Cyber Operation da parte di Russia, Cina, Nord Corea e Iran eseguite nel 2022
Sebbene l’elevato impiego di operazioni cyber offensive non sia la sola caratteristica comune ai quattro governi sopra indicati, in diverse situazioni (vedi ad esempio il conflitto russo-ucraino in cui sono apertamente schierati con la Russia) essi rappresentano anche una coalizione (con sfaccettature sicuramente diverse al proprio interno) che si oppone alle politiche della NATO.
Su questo aspetto sono disponibili molti report dell’Unione Europea, del Regno Unito, degli Stati Uniti[14] e del Canada, che descrivono le minacce (anche da un punto di vista multi-domain) rappresentate da questi Paesi[15].
Nella Figura 6 è mostrata una mappa degli Stati che appartengono alle due coalizioni ed è riportata la lista dei principali threat actor legati a governi NATO[16]:
Fig. 6 – Suddivisione tra gli stati della coalizione NATO e gli stati China, Russia, Iran e North Korea
Di seguito, per ciascuno dei quattro Stati prima indicati, si riporta una breve sintesi delle caratteristiche principali e motivazioni dei threat actor a loro legati:
Motivazioni Principali degli APT russi:
Espionage
Hybrid Warfare
Principali attori attivi nel 2022:
APT28 (alias Sofacy e Fancy Bear)
APT29 (alias Cozy Bear e Dukes)
Callisto
Gamaredon
The Dukes
Sandworm
Le avanzate capacità informatiche della Russia sono principalmente dirette a supportare gli obiettivi della sua politica estera per contrastare l’influenza occidentale in patria e a promuovere la sua posizione di leader a livello globale. La Russia considera l’Occidente, in particolare l’alleanza dell’Organizzazione del Trattato del Nord Atlantico (NATO), come una minaccia continua e centrale per gli interessi nazionali della Federazione Russa.
Motivazioni Principali degli APT cinesi:
Cyber Espionage
Intellectual Property
Theft
Principali attori attivi nel 2022:
Mustang Panda
Goblin Pand
MirrorFace
LuckyMouse
APT10
APT41
I gruppi APT sponsorizzati dal governo cinese rappresentano – nell’intero panorama internazionale – alcune delle minacce più prolifiche e ricche di risorse. Il governo di Pechino utilizza le sue capacità informatiche, tipicamente gestite o incaricate dal Ministero della Sicurezza di Stato (MSS) o dall’Esercito popolare di liberazione (PLA) per raccogliere informazioni politiche e militari, svolgere attività di cyber espionage e spiare individui di interesse.
Negli ultimi anni il governo cinese ha intrapreso iniziative legate alla modernizzazione e innovazione del Paese e, in linea con questa finalità, sono state impiegate le sue capacità informatiche offensive. Inoltre, negli ultimi dodici mesi c’è stata una tendenza continua degli APT cinesi a condurre operazioni che siano difficili da ricondurre a loro e rivolte contro una gamma più selezionata di obiettivi.
Tuttavia questi attacchi sono spesso condotti per apparire come opportunistici, ad esempio utilizzando tecniche più spesso impiegate dai gruppi cyber criminali come, ad esempio, le ransomware gang. Va sottolineato che, tra tutti i casi di spionaggio gestiti dal Dipartimento di Giustizia degli U.S.A. tra il 2011 ed il 2018, si stima che il 90% abbia coinvolto attori connessi alla Cina. Il cyber espionage posto in essere dalla Cina è fonte di preoccupazione anche per numerose agenzie di intelligence europee.
Motivazioni Principali degli APT nordcoreani:
Financial Gain
Espionage
Principali attori attivi nel 2022:
Konni
Lazarus
Andariel
APT37ù
Per la maggior parte dei gruppi APT nordcoreani, l’utilizzo della criminalità rimane la principale priorità per fornire reddito allo stato e rafforzare il proprio apparato militare. La necessità di fare cassa attraverso attacchi informatici è legata principalmente alle sanzioni delle Nazioni Unite (ONU) imposte alla Corea del Nord a causa del continuo impegno in un programma di armi nucleari. Inoltre, la crisi economica si è aggravata con l’evento della pandemia di COVID-19 e ha isolato la RPDC dalla Cina, il suo partner commerciale più vicino.
Gli obiettivi prima esposti sono ottenuti dagli APT nordcoreani attraverso operazioni di cyber spionaggio. In aggiunta a queste finalità primarie, gli APT nordcoreani hanno anche agito nella raccolta di informazioni di intelligence nell’ambito nucleare e dello spionaggio diplomatico, presumibilmente al fine di mantenere l’attuale regime al potere.
Motivazioni Principali degli APT iraniani:
Espionage
Monitoring dissidents
Sabotage
Principali attori attivi nel 2022:
APT34 (alias Helix kitten e OilRig)
APT35
MuddyWater
POLONIUM
Cutting Kitten
APT33
APT39
Le attività informatiche offensive dell’Iran,quasi esclusivamente supervisionate dalle Islamic Revolutionary Guard Corps (IRGC), sono commissionate a diverse strutture che possono essere completamente legate al governo, ad organizzazioni proxy come pure ad appaltatori indipendenti che mescolano lavoro di sicurezza, frode criminale e sviluppo di software.
Sebbene i funzionari statunitensi abbiano ipotizzato che Teheran abbia ricevuto assistenza tecnica da paesi come la Russia e la Corea del Nord, il livello di sofisticazione è commisurato alle pratiche consolidate delle comunità di hacker amatoriali.
L’attività dei gruppi APT iraniani è rimasta, nel complesso, concentrata su obiettivi tradizionali quali Israele, alcuni Paesi del Medio Oriente e i dissidenti in patria e all’estero tra la sua comunità della diaspora. In particolare i settori della difesa, delle telecomunicazioni e relativi alla tecnologia dell’informazione sono candidati ad essere, nel prossimo futuro, i probabili target dei gruppi connessi al regime iraniano, soprattutto con riferimento a entità pubbliche e private nell’area MENA (Medio Oriente e Nord Africa) e negli Stati Uniti. Una caratteristica di alcuni gruppi APT iraniani è l’impiego di tecniche di pseudo-ransomware e di tunneling in un’ampia varietà di attacchi.
Nell’ipotesi che un’azienda/organizzazione sia un target per più di un gruppo APT, una questione che ci si può porre è come dare una priorità sull’adeguamento ad un loro eventuale attacco. Chiaramente la questione vale indipendentemente che gli attaccanti siano gruppi APT, cybercrime, hacktivist, etc. Dunque, la necessità di ogni organizzazione è di disporre di una metodologia di Threat Actor Assessment.
Sebbene ogni organizzazione possa definirne una propria, possono essere utilizzate delle metodologie già disponibili che si prestano anche ad essere personalizzate.
Alla base di ciascuna metodologia occorre che si esplicitino due elementi fondamentali: una Threat Matrix e una categorizzazione delle tecniche di attacco potenzialmente impiegate dagli avversari.
Per avere una categorizzazione delle tecniche di attacco, generalmente si dovrebbe prediligere la creazione di un Cyber Threat Landscape[17] specifico per il settore industriale in cui opera l’organizzazione e, opzionalmente, si possono utilizzare strumenti di Adversary Emulation dotati di una Threat Actor Profile Knowledge-Base.
Un esempio di Data Model su cui basare il Cyber Threat Landscape è quello proposto dal CERT-EU[18] che mette in relazione i threat actor (con le informazioni ad essi connesse), le TTP (Tactics, Techniques & Procedure)[19] e i settori/target:
Fig. 7 – Esempio di Data Model
A titolo esemplificativo, tra le varie metodologie (o strumenti) che possono essere utilizzate si segnalano le seguenti:
il Threat Assessment and Remediation Analysis (TARA)[20] sviluppato dal MITRE;
le metodologie basate sui cosiddetti FAIR (Factor Analysis of Information Risk) Factors[21]. In Figura 2 è mostrata una esemplificazione di Threat Matrix basata sulle categorie FAIR;
la metodologia di Threat Actor Assessment basata su Threat Box[22], che si pone l’obiettivo di valutare intenzioni e capacità e produrre un’unica rappresentazione grafica di immediata comprensione.
Al fine di offrire un esempio concreto di Threat Actor Assessment si è creata una rappresentazione utilizzando Threat Box[23]. Per semplicità, si è sviluppato l’esempio prendendo in considerazione solo un threat actor tra tutti quelli sopra citati e legati – rispettivamente – alla Russia, alla Cina, all’Iran e alla Corea del Nord. In particolare, sono stati scelti i gruppi APT28, APT33, APT37 e APT41.
Nella Tabella 1 sono riportati i target di questi gruppi e nella Figura 8 sono mostrate in maniera comparata le principali tecniche di attacco (espresse in termini di Tactics & Techniques della MITRE ATT&CK ver. 12).
Sebbene col progetto tbat si possano ottenere automaticamente le Tactics & Techniques, si è preferito esplicitarle separatamente per evidenziare come gruppi APT diversi, che vogliono ottenere obiettivi distinti, utilizzeranno tecniche di attacco solo parzialmente sovrapponibili.
Fig. 8 – Threat Metric basata sulle categorie FAIR
Threat Actor
Suspected Attribution
Target Sectors
APT28
Russia
The Caucasus, particularly Georgia, eastern European countries and militaries, North Atlantic Treaty Organization (NATO) and other European security organizations and defense firms
APT41
China
Healthcare, telecoms, and the high-tech sector, and have historically included stealing intellectual property, higher education, travel services, and news/media firms. Their cybercrime intrusions are most apparent among video game industry targeting (including the manipulation of virtual currencies) and attempted deployment of ransomware.
APT33
Iran
Aerospace, energy
APT37
North Korea
Primarily South Korea – though also Japan, Vietnam and the Middle East – in various industry verticals, including chemicals, electronics, manufacturing, aerospace, automotive, and healthcare.
Tab. 1 – Settori target dei gruppi APT28, APT33, APT37 e APT41
Fig. 9 – Matrice ATT&CK con le TTP utilizzate dai gruppi APT28, APT33, APT37 e APT41
Per la creazione del report è necessario fornire – per ciascun threat actor – alcune informazioni di base, mentre quelle relative alle tecniche di attacco impiegate sono già presenti per i principali avversari.
La prima domanda è legata alla tipologia/categoria di attacchi realizzata dagli avversari.
Espionage: attacchi che incidono sulla riservatezza dei dati o dei sistemi;
Destructive: attacchi che hanno un impatto sull’integrità dei dati o dei sistemi;
Disruptive: attacchi che incidono sulla disponibilità di dati o sistemi;
Cyber-Crime: attacchi finalizzati al profitto finanziario a breve termine.
Gli altri elementi che si chiede di valutare sono relativi a:
Intent & Willingness, in cui si identificano le motivazioni (Intent) per cui un threat actor vuole prendere di mira un’organizzazione e quali sono i vincoli (Willingness) che possono influire sull’intento dell’attaccante;
Capabilities & Novelty, in cui si valutano le reali possibilità (Capabilities) di eseguire un certo tipo di attacco e se l’attaccante dispone di capacità di realizzare tecniche avanzate/innovative (Novelty).
Nella tabella seguente si riporta la valorizzazione delle informazioni sopra riportate rispetto ai gruppi scelti:
Tab. 2 – Valutazione degli elementi Intentions, Intent & Willingness e Capabilities & Novelty
Sulla base di queste informazioni e sulle tecniche di attacco impiegate dagli attori presi in considerazione, è stato prodotto il seguente report:
Fig. 9 – Report prodotto dal progetto tbat
Note
[1] Il concetto di Advanced Persistent Threat si riferisce al fatto che gli APT mostrano un alto livello di sofisticazione, difficile da raggiungere con strumenti automatizzati; inoltre gli attacchi utilizzano un’ampia varietà di tecniche per mantenersi offuscati e sono spesso mirati a individui specifici all’interno dell’organizzazione.
[4] Va segnalato che l’attacco del 2015 alla rete elettrica dell’Ucraina non è stato il primo tra quelli più conosciuti e di alta rilevanza, in quanto già nell’aprile del 2007 era stato accertato l’attacco mirato (molto probabilmente di matrice russa) contro diverse infrastrutture governative e private in Estonia; tra questi anche l’Operation Aurora, attribuita all’Elderwood Group per conto del PLA cinese, che nel 2009 ebbe l’obiettivo principale di ottenere l’accesso (e potenzialmente modificare) i repository dei codici sorgenti di diverse società – principalmente statunitensi – del campo IT, Network Security e Internet Provider.
[5] Possiamo definire il cyberspace come “all of the computer networks in the world and everything they connect and control. It’s not just the Internet […] cyberspace includes the Internet plus lots of other networks of computers that are not supposed to be accessible from the Internet.” (da“Cyber War: The Next Threat to National Security and What to Do About It” di Clarke, Knake – 2010)
[6]“Le parti convengono che un attacco armato contro una o più di esse in Europa o nell’America settentrionale sarà considerato come un attacco diretto contro tutte le parti, e di conseguenza convengono che se un tale attacco si producesse, ciascuna di esse, nell’esercizio del diritto di legittima difesa, individuale o collettiva, riconosciuto dall’art. 51 dello Statuto delle Nazioni Unite, assisterà la parte o le parti così attaccate intraprendendo immediatamente, individualmente e di concerto con le altre parti, l’azione che giudicherà necessaria, ivi compreso l’uso della forza armata, per ristabilire e mantenere la sicurezza nella regione dell’Atlantico settentrionale.
Ogni attacco armato di questo genere e tutte le misure prese in conseguenza di esso saranno immediatamente portate a conoscenza del Consiglio di Sicurezza. Queste misure termineranno allorché il Consiglio di Sicurezza avrà preso le misure necessarie per ristabilire e mantenere la pace e la sicurezza internazionali”, https://www.nato.int/cps/en/natohq/topics_110496.htm
[19] Le TTP descrivono come un threat actor tenta di raggiungere l’obiettivo desiderato. Le Tattiche descrivono l’obiettivo delle azioni eseguite da un attaccante. Le Tecniche forniscono una descrizione più dettagliata delle azioni stesse, mentre le Procedure dettagliano in maniera approfondita le istruzioni che l’attaccante sta utilizzando per implementare una tecnica specifica.
Esperto in sicurezza delle informazioni, digital forensic e cyber threat intelligence per grandi aziende. È stato il Practice Manager di Forensic Technology & Discovery Services (FTDS) in Fraud Investigation & Dispute Services (EY). Ricercatore nel campo di Malware e Memory Analysis, Structured Analytic Procedures (SAT), OSINT, Intelligence Investigation Techniques, Incident Responding Techniques e Cyber Threat Intelligence. Laureato in Informatica presso l’Università degli studi di Catania e docente in corsi e master in digital forensics e malware forensics.