La governance di sicurezza del Programma spaziale europeo

Il programma spaziale europeo rappresenta un elemento chiave per l’autonomia strategica dell’Unione Europea, nonché per lo sviluppo tecnologico e la sicurezza nel settore spaziale. Attraverso un complesso quadro normativo, che include il Trattato di Lisbona e regolamenti successivi, l’UE ha definito le basi legali e operative per la gestione e la sicurezza delle sue infrastrutture spaziali. Questo articolo esplora il quadro legale, gli organismi coinvolti, le regole di sicurezza e le iniziative in corso, offrendo una panoramica approfondita della governance del programma spaziale europeo.

Il quadro legale e il Programma spaziale europeo

Il Trattato di Lisbona[1] stabiliva che l’Unione potesse perseguire una politica spaziale europea, promuovendo iniziative comuni, sostenendo la ricerca e lo sviluppo tecnologico e coordinando gli sforzi necessari per l’esplorazione e l’utilizzo dello spazio. Queste iniziative – recita il Trattato – possono assumere la forma di un Programma spaziale europeo: pertanto le iniziative del Parlamento europeo e del Consiglio, come il Programma spaziale stesso o lo Space working party, possono essere ricondotte al Trattato.

Nel 2021 il Regolamento (UE) 2021/696, che abrogava i precedenti, istituiva il programma spaziale dell’Unione europea e sanciva la nascita dell’Agenzia dell’Unione europea per il programma spaziale (EUSPA). In aggiunta ai componenti Galileo e PRS, EGNOS, Copernicus, SSA/SST e GOVSATCOM, ricompresi nel Regolamento (UE) 2021/696, possiamo considerare anche il Programma dell’Unione per una connettività sicura (IRIS2) introdotto dal Regolamento (UE) 2023/588.

Di fondamentale importanza è altresì la decisione (PESC) 2021/698, che definisce i meccanismi e il ruolo Consiglio dell’Unione europea e dell’Alto Rappresentante per prevenire una minaccia alla sicurezza dell’Unione o di uno o più dei suoi Stati membri, o per attenuare le conseguenze di un danno grave agli interessi essenziali dell’Unione o di uno o più dei suoi Stati membri, derivante dal dispiegamento, dal funzionamento o dall’uso dei sistemi istituiti e dei servizi forniti nell’ambito delle componenti del programma spaziale dell’Unione, oppure in caso di minaccia al funzionamento di uno di tali sistemi o alla fornitura dei servizi.

Alcuni principi

Al fine di comprendere le dinamiche e la governance degli aspetti di sicurezza, occorre considerare due principi fondamentali.

  1. Il primo è quello sancito dall’articolo 4 (2) del Trattato sull’Unione europea[2], secondo il quale la sicurezza nazionale resta competenza esclusiva di ciascuno Stato membro. Da qui discende una notevole capacità degli Stati membri di direzionare (cd. steering), a livello degli organi comunitari, i vari dossier con impatti sulla sicurezza, compresi quelli relativi al settore spaziale.
  1. Il secondo aspetto è legato alla giurisdizione delle regole di sicurezza: a ogni istituzione europea, come alle agenzie da essi coordinate, si applicano le regole di quella istituzione. Nonostante le regole di information assurance, COMSEC e crypto discendano tutte, per sommi capi, da quelle del Consiglio[3], alla Commissione, al Parlamento e al Servizio Europeo di Azione Esterna (EEAS) si applicano le proprie regole di sicurezza. Nel Programma spaziale il medesimo principio si applica anche all’Agenzia Spaziale Europea (ESA) e all’Agenzia per i Programmi Spaziali Europei (EUSPA). Non esistono, conseguentemente, un corpus unico di regole di sicurezza e un’unica Autorità di Sicurezza a livello del Programma spaziale, bensì regole diverse, anche se omogenee.

Una governance multilivello

Il Regolamento spaziale ha ribadito due principi, ovvero (1) quello secondo cui bisogna tenere conto dell’esperienza acquisita dagli Stati membri nel settore della sicurezza e ispirarsi alle loro migliori pratiche; e (2) l’applicabilità delle regole di sicurezza del Consiglio e della Commissione, che prevedono, tra le altre cose, una separazione tra le funzioni operative e di accreditamento.

La Commissione Europea (DG DEFIS), quale programme manager, ha la responsabilità generale dell’attuazione del programma anche nel settore della sicurezza, fatte salve le prerogative degli Stati membri in materia di sicurezza nazionale.

Con il supporto di EUSPA, garantisce:

  1. la protezione dell’infrastruttura (sia spaziale sia di terra) e la fornitura di servizi, in particolare contro gli attacchi fisici e informatici, incluse le interferenze con i flussi di dati;
  2. il controllo e la gestione dei trasferimenti di tecnologia;
  3. lo sviluppo e la conservazione all’interno dell’Unione delle competenze e delle conoscenze acquisite;
  4. la protezione delle informazioni sensibili non classificate e delle informazioni classificate.

Sulla base dell’analisi del rischio e delle minacce per ciascun componente, la Commissione definisce i requisiti di sicurezza di quel componente[4] e l’identificazione della struttura per il monitoraggio della sicurezza. Per questi aspetti la Commissione è assistita, ratione materiae, dal comitato di programma in configurazione di sicurezza; i lavori sono svolti tramite gruppi di lavoro composti dagli esperti degli Stati membri.

EUSPA, oltre a contribuire alla sicurezza del Programma e a supportare la Commissione nella definizione degli aspetti di sicurezza, è responsabile per la sicurezza operativa dei componenti per i quali è responsabile della gestione (component manager), come ad esempio Galileo.

Il comitato di accreditamento di sicurezza (SAB, Security Accreditation Board), istituito presso EUSPA, è responsabile di tutte le attività necessarie a ottenere e mantenere l’accreditamento di tutti i componenti del Programma, incluse eventuali interconnessioni con altri sistemi o sottosistemi.

Il SAB adotta, in modo strettamente indipendente, le decisioni di accreditamento riferite al lancio di satelliti; le autorizzazioni necessarie a operare sistemi, sottosistemi o servizi e al dispiegamento di nuove configurazioni (system releases), incluso il segnale nello spazio; e l’autorizzazione a gestire le stazioni terrestri. Infine, per quel che concerne il Public Regulated Service (PRS[5]), adotta decisioni relative all’autorizzazioni delle entità industriali.

Con un esempio pratico, all’atto dell’avvio di un nuovo componente del Programma che implementa caratteristiche di sicurezza, sarà la Commissione a definire – con il supporto degli esperti degli Stati membri nonché attraverso il Comitato di programma in configurazione sicurezza e i propri gruppi di lavoro – i general security requirements e gli altri requisiti di sicurezza (e.g. aspetti COMSEC, di sicurezza industriale) e a monitorarne l’implementazione da parte di EUSPA ed ESA. Essi, a loro volta, implementeranno i requisiti nell’ambito delle loro precipue competenze (e.g. EUSPA quale service manager, ESA quale system design authority) e li declineranno ulteriormente in requisiti di livello inferiore, applicandoli altresì ai contratti o grant classificati che EUSPA ed ESA gestiscono quali stazioni appaltanti.

Il SAB – che, ricordiamo, è composto anch’esso dagli esperti degli Stati membri, la Commissione e il Servizio Europeo di Azione Esterna – verifica, tramite l’accreditamento di sicurezza, la corretta implementazione dei requisiti (compliance) prima di autorizzare (tramite ATO, authorization to operate) o meno le operazioni del componente stesso, di sottosistemi, network, apparati.

La sicurezza del Programma spaziale dell’Unione è, quindi, garantita tramite una governance multilivello nella quale le decisioni finali sono prese in maniera collettiva e adottate in un contesto di responsabilità condivisa per la sicurezza dell’Unione e degli Stati membri.

L’autonomia strategica della UE

Con il Regolamento 2021/696, la UE ha deciso di dotarsi di uno strumento specifico per preservare la sicurezza, l’integrità e la resilienza dei sistemi operativi dell’Unione. L’Articolo 24 si pone, infatti, l’obiettivo di essere un ulteriore scudo a salvaguardia della tecnologia e delle catene di fornitura (supply chain) fondamentali europee, al fine di garantirne l’autonomia strategica e preservare, al contempo, un’economia aperta.

I medesimi principi sono applicati anche al Programma IRIS[6].

L’Articolo 24, che viene implementato nelle condizioni di ammissibilità e di partecipazione (participating conditions) delle entità che partecipano agli appalti, alle sovvenzioni o ai premi (procurement e grant), prevede che:

  1. il soggetto giuridico ammissibile è stabilito in uno Stato membro e le sue strutture di gestione esecutiva sono stabilite nello stesso Stato membro;
  2. il soggetto giuridico ammissibile si impegna a svolgere tutte le attività pertinenti in uno o più Stati membri;
  3. il soggetto giuridico ammissibile non è soggetto al controllo di un paese terzo o di un soggetto di paese terzo.

Il meccanismo prevede, quindi, un “controllo all’ingresso” al fine di assicurarsi che i soggetti giuridici non siano sotto il controllo di attori terzi, ovvero che non vi sia la possibilità per questi ultimi di esercitare, direttamente o indirettamente, un’influenza determinante attraverso uno o più soggetti giuridici intermedi.

Come monitorano gli Stati membri l’implementazione dell’Articolo 24? Attraverso il Comitato di programma in configurazione sicurezza: le autorità competenti degli Stati membri forniscono pareri sulla definizione delle condizioni di partecipazione e, soprattutto, verificano se i soggetti giuridici in parola abbiano attuato misure sufficienti ad assicurare la protezione delle Informazioni Classificate Europee (EUCI) nonché ad assicurare l’integrità, la sicurezza e la resilienza delle componenti del programma, del loro funzionamento e dei loro servizi.

Sebbene formalmente indipendente dal Programma spaziale, è opportuno menzionare un altro strumento che contribuisce a rafforzare la competitività dell’Unione, dotando gli Stati membri e la Commissione di un mezzo per affrontare in modo globale i rischi per la sicurezza (e per l’ordine pubblico).

Il Regolamento (UE) 2019/452[7], ispirato tra gli altri al D. legge n. 21 del 2012[8] italiano che istituisce il golden power, definisce un quadro per il controllo degli investimenti esteri diretti nell’Unione. Tale Regolamento rappresenta, quindi, un ulteriore strumento per verificare, in cooperazione con gli Stati membri, se nell’ambito del Programma spaziale è in programma – o è stato realizzato – un investimento estero e intervenire di conseguenza.

Il controllo dell’export della tecnologia ad uso duale

Pur ribadendo la natura civile del Programma spaziale, il Regolamento 2021/696 sottolinea quanto, storicamente, le attività spaziali siano legate alla sicurezza; e quanto i componenti, gli apparati, i sistemi, i dati e le applicazioni abbiano una natura duale.

Il regime di controllo delle esportazioni e trasferimenti ad uso duale[9] prevede che gli Stati membri possano subordinare l’autorizzazione o il transito di determinati apparati, sistemi, software, applicazioni all’autorizzazione delle competenti autorità nazionali. Il materiale aerospaziale, il software crittografico e gli algoritmi, ad esempio, sono ricompresi nella normativa europea per il controllo dell’export.

La Strategia Europea per la Sicurezza e la Difesa

Il Programma spaziale, come la governance di sicurezza con esso stabilita, non rappresenta un monolite granitico o immutabile nel corso del suo periodo di validità[10].

Nel 2023, con la Strategia Europea per la Sicurezza e la Difesa[11], sono state infatti avviate iniziative per difendere gli interessi strategici della UE, rafforzarne la postura strategica e la capacità deterrente verso le minacce nello – e provenienti dallo – spazio.

Tra queste iniziative la Commissione Europea ha avviato, con il supporto di EUSPA, l’ISAC (Information Sharing and Analysis Centre), un centro di fusione di informazioni circa le minacce, vulnerabilità, trend e migliori pratiche relativi alla sicurezza e alla cybersicurezza, al fine di aumentare le capacità di resilienza dell’industria spaziale. Il Centro è rivolto all’industria europea, incluso il settore New Space, a università e centri di ricerca, nonché ad agenzie spaziali, ESA e CERT (Computer Emergency Response Teams) nazionali.

Per quanto concerne gli aspetti di cybersicurezza, è da sottolineare altresì il rinnovato interesse a incrementare lo scambio informativo. Ciò vede, quale perno principale, i centri operativi di sicurezza (SOC, Security Operation Centre) dei componenti del Programma. In particolare, sarà aumentata la cooperazione con il CERT-EU (il Computer Security Incident Response Team delle istituzioni della UE) e con ENISA (Agenzia dell’Unione europea per la cibersicurezza).

È altresì verosimile ritenere che anche il C-SOC (Cyber-Security Operations Centre)[12] di ESA verrà incluso, con modalità da definire, in questo sistema di sistemi.

Infine, nel panorama dei futuri sviluppi tecnologici, meritano un cenno le comunicazioni e la sicurezza quantistiche.

Al progetto SAGA (Security And cryptoGrAphic mission)[13], che prevede la creazione di una serie di satelliti quantici gestiti da ESA e un network di stazioni terrestri gestite dalla Commissione Europea (DG CONNECT), si è affiancata l’iniziativa UE EuroQCI[14]. Lo scopo del progetto è sviluppare un segmento terrestre – basato su reti di comunicazione in fibra ottica che collegano siti strategici a livello nazionale – e un segmento spaziale, basato su satelliti quantistici: EuroQCI sarà parte integrante di IRIS.

La rivoluzione quantistica, che pure presenta una serie di sfide non banali (e.g. per l’accreditamento di sicurezza), è un elemento che permetterà un significativo salto di qualità, aumentando il livello di resilienza dei nostri sistemi spaziali e la capacità di affrontare minacce di livello strategico.

Note

[1] Il Trattato di Lisbona modifica il Trattato sull’Unione Europea e il Trattato che istituisce la Comunità Economica Europea (2007/C 306/01), articolo 127(bis)

[2] Trattato sull’Unione europea (TUE) (Maastricht, 7 febbraio 1992) modificato dal Trattato di Lisbona

[3] Decisione del Consiglio del 23 settembre 2013 sulle norme di sicurezza per proteggere le informazioni classificate UE (2013/488/UE)

[4] I requisiti generali di sicurezza sono adottati quali atti di esecuzione (implementing acts), dopo l’approvazione degli Stati membri nel comitato del programma in configurazione di sicurezza

[6] Articolo 22 del Regolamento (UE) 2023/588

[7] Regolamento (UE) 2019/452 del Parlamento Europeo e del Consiglio del 19 marzo 2019, che istituisce un quadro per il controllo degli investimenti esteri diretti nell’Unione

[8] Decreto legge 15 marzo 2012, n. 21 ”Norme in materia di poteri speciali sugli assetti societari nei settori della difesa e della sicurezza nazionale, nonché per le attività di rilevanza strategica nei settori dell’energia, dei trasporti e delle comunicazioni”

[9] Regolamento (UE) 2021/821 del Parlamento Europeo e del Consiglio del 20 maggio 2021, che istituisce un regime dell’Unione di controllo delle esportazioni, dell’intermediazione, dell’assistenza tecnica, del transito e del trasferimento di prodotti a duplice uso

[10] Il Regolamento copre il quadro finanziario pluriennale (MFF, Multiannual Financial Framework) 2021-2027

[11] JOIN(2023) 9 final, Joint communication to the European Parliament and the Council “European Union Space Strategy for Security and Defence”

[12] Il C-SOC fornisce ad ESA capacità di monitoraggio ed implementazione preventiva e reattiva delle misure di cybersicurezza riferite agli assetti spaziali gestiti da ESA

[13] https://www.esa.int/ESA_Multimedia/Images/2019/04/SAGA_for_quantum_key_distribution

[14] https://digital-strategy.ec.europa.eu/it/policies/european-quantum-communication-infrastructure-euroqci
Questo articolo è stato estratto dal white paper “Quaderni di Cyber Intelligence #6” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/quaderni-di-cyber-intelligence-6/

Articolo a cura di Antonio Piccirillo

Profilo Autore

Attualmente Programme Officer nella Direzione Generale Industria della difesa e spazio (DG DEFIS) della Commissione Europea, da Ufficiale dell’Esercito Italiano è stato impiegato in Italia e in vari teatri operativi, in ruoli di comando nel settore delle telecomunicazioni e dell’information security. Si è occupato di gestione delle crisi presso l’Ufficio del Consigliere Militare della Presidenza del Consiglio dei Ministri ed è stato parte dello staff dell’Autorità Nazionale Responsabile per il Galileo PRS. Dal 2019 è nel team che si occupa della definizione e gestione degli aspetti di sicurezza del Programma Spaziale dell’Unione.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/programma-spaziale-europeo/


Threat actor, la Cyber Threat Intelligence e i principali framework di analisi

«The great accomplishments of today’s intelligence brotherhood have been of two sorts: collection and analysis»
Sherman Kent [1903-1986], Strategic Intelligence for American World Policy, 1965, xv-xvi

Introduzione

Come già messo in risalto in un precedente Quaderno SOCINT, l’essenza centrale di un’attività di Cyber Threat Intelligence (CTI) è costituita da dati e informazioni raccolte da una serie di fonti sugli attacchi attuali o potenziali contro un’organizzazione, da parte di attori malevoli[1].

Più in dettaglio, la CTI è costituita da dati e informazioni che vengono raccolti, elaborati e analizzati per comprendere le motivazioni, gli obiettivi e i comportamenti di attacco di un agente portatore di una minaccia (Threat actor, TA).

La CTI è importante per i seguenti motivi:

  1. apporta nuove informazioni su attività malevoli che sono celate, consentendo ai team di sicurezza di approntare delle risposte basate su decisioni adeguate;
  2. svela i motivi degli avversari così come le loro tattiche, tecniche e procedure (TTP) nonché gli indicatori di compromissione (IOC);
  3. aiuta a comprendere meglio il processo decisionale dell’autore della minaccia;
  4. responsabilizza e potenzia gli stakeholder aziendali, come Consigli di amministrazione, Chief information security officer (CISO), Chief information officer (CIO) e Chief technology officer (CTO) così da mitigare il rischio, diventare più efficienti e prendere decisioni più rapide basate sui dati disponibili. In questo senso, lo scopo principale della CTI è rendere consapevoli le organizzazioni dei vari rischi che devono affrontare a causa di minacce esterne, come le minacce zero-day e le minacce persistenti avanzate (Advanced persistent threat, APT).

Tra i vari strumenti che sono stati messi a punto, nel corso degli ultimi decenni, al fine di mitigare tali minacce vi sono senz’altro i framework per l’identificazione dei TA, importanti poiché forniscono un modello comune per analizzare e categorizzare le minacce informatiche, rendendo più facile per le organizzazioni comprendere e rispondere agli attacchi. Inoltre, i framework forniscono un linguaggio comune per la collaborazione e la condivisione delle informazioni tra le diverse organizzazioni e le forze dell’ordine, il che a sua volta migliora la capacità di identificare e neutralizzare i TA.

Tutto ciò si inserisce all’interno di un risoluto e ultradecennale processo di standardizzazione che la comunità CTI ha inteso portare avanti per raggiungere i fini anzidetti e che è consistita, sostanzialmente, di tre fasi principali, qui necessariamente succinte:

  1. identificare i principali elementi dei dati, quali informazioni sul tipo di minaccia, sulla gravità della stessa, sulla fonte della minaccia, sull’impatto potenziale, ecc.;
  2. sviluppare un modello di dati mediante la creazione di una tassonomia o di un’ontologia per classificare i diversi tipi di minacce e i loro attributi;
  3. definire i formati dei dati che verranno utilizzati, i più importanti dei quali possono essere considerati i framework STIX (Structured Threat Information eXpression) e TAXII (Trusted Automated eXchange of Indicator Information).

STIX è un linguaggio standardizzato per descrivere le informazioni sulle minacce informatiche sviluppato da MITRE Corporation nel 2012 ed è arrivato, ad oggi, alla versione 2.0, progettata per essere più flessibile, estensibile e facile da usare rispetto al suo predecessore 1.0. STIX 2.0 include una serie di nuove funzionalità e miglioramenti, tra cui: un’architettura più modulare che consente una più facile personalizzazione ed estensione; un modello di dati semplificato che facilita la rappresentazione di informazioni complesse sulle minacce; un supporto migliorato per gli indicatori di compromissione (IOC) e altri tipi di dati sulle minacce; un migliore supporto per la condivisione e la collaborazione tra le diverse organizzazioni utilizzatrici.

TAXII è, invece, un protocollo che consente lo scambio di informazioni sulle minacce informatiche tra diverse organizzazioni. Lo standard TAXII specifica i dettagli tecnici per lo scambio di informazioni quali il formato dei dati, i protocolli per la loro trasmissione e le misure di sicurezza che devono essere adottate per proteggere le informazioni in transito. Sono ricomprese in TAXII anche delle linee guida per l’implementazione dello stesso in diversi ambienti quali i sistemi di rilevamento delle intrusioni (IDS) e i sistemi di gestione delle informazioni e degli eventi di sicurezza (SIEM).

Lo sforzo di sintesi che viene compiuto in questo testo è, dunque, finalizzato a dar conto dei framework più importanti per l’identificazione dei threat actors nella cybersecurity, considerando che non esiste un elenco esaustivo di questi ma che i più influenti e consigliati possono essere considerati i seguenti:

  1. Intrusion Lifecycle Model;
  2. Indicator Types Model;
  3. Attributional Model.

La breve illustrazione di questi framework, a scopo prettamente divulgativo, con esempi specifici di alcuni modelli, è in grado di fornire una veloce panoramica su quali sono le principali modalità che la comunità della cyber intelligence si è data nel corso degli ultimi decenni al fine di provare a individuare e classificare la natura delle minacce informatiche e, di conseguenza, su come meglio proteggere le reti, i processi e i dati.

Intrusion Lifecycle Model (ILM)

L’ILM è un framework utilizzato per descrivere e analizzare le fasi di un attacco cyber. Questo modello è assai utile perché fornisce una visione complessiva del processo di intrusione dei TA, permettendo ai responsabili della sicurezza informatica di identificare e comprendere i punti deboli nella difesa del sistema e di pianificare una risposta più efficace. Questo modello può essere utilizzato anche per la formazione e la sensibilizzazione degli utenti, per la valutazione del rischio e per la pianificazione della sicurezza. Qui di seguito verranno brevemente illustrate le caratteristiche di quelli più utilizzati quali The Cyber Kill-Chain e il MITRE ATT&CK.

The Cyber Kill-Chain (CKC)

La CKC è un modello concettuale, attribuito alla corporation Lockheed Martin, divulgato in un paper del 2009, mediante il quale vengono illustrate le varie fasi eseguite da un avversario nel raggiungimento dei propri obiettivi di attacco. L’idea sottostante al framework, derivato dall’intelligence militare, è che il difensore deve cercare di interrompere un anello della catena, una volta individuata la fase di attacco, perché poi i passaggi sarebbero abbastanza prevedibili e passibili di contrasto e mitigazione.

«The phrase “kill chain” describes the structure of the intrusion, and the corresponding model guides analysis to inform actionable security intelligence. Through this model, defenders can develop resilient mitigations against intruders and intelligently prioritize investments in new technology or processes. Kill chain analysis illustrates that the adversary must progress successfully through each stage of the chain before it can achieve its desired objective; just one mitigation disrupts the chain and the adversary. Through intelligence-driven response, the defender can achieve an advantage over the aggressor for APT caliber adversaries»[2].

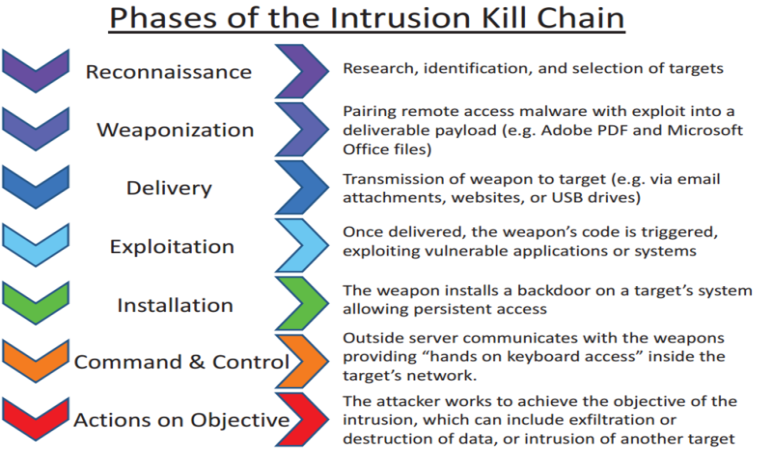
Le varie fasi della CKC sono illustrate nella figura seguente:

Le varie fasi della Cyber Kill-Chain (CKC) - threat actor e Cyber Threat Intelligence
Fonte: immagine tratta dal web.

La CKC è assai utile per avere una valutazione delle proprie capacità di difesa, ovvero può permettere di evidenziare le proprie lacune strutturali nel contrasto di minacce portate da poderosi attori quali gli APT.

Una seconda ragione è che essa può essere assai utile nelle analisi post-incidente in quanto fornisce un quadro realistico di come si è svolto l’attacco, permettendo di sezionare ogni fase e di profilare il comportamento dell’avversario e del suo eventuale successo, ovvero di fornire una vasta comprensione dell’attacco, dell’attore e di ciò che dovrebbe essere fatto, di conseguenza, per mitigare future minacce.

La terza ragione è di carattere comunicativo ma non meno importante delle altre due, in quanto il framework offre un modo semplice e potente per comunicare, con una storia lineare e con un livello di concettualizzazione semplice ed efficace, una situazione molto complessa, in cui sono presenti molti tecnicismi, sia se ci si deve relazionare ai vertici societari, oppure ai decisori pubblici o alla stampa di opinione[3].

Per tutte queste ragioni, la CKC si è largamente diffusa nella comunità InfoSec. Come tutti gli strumenti, nondimeno, essa non può coprire tutto il campo di analisi in quanto, soprattutto nella fase 7 (“Actions on Objectives”), la quale può durare anche molti mesi, si apre un campo davvero vasto in cui molto deve essere ancora svolto in termini di approfondita elaborazione teorica. Su queste basi, di conseguenza, non sono mancate critiche al riguardo[4].

«Lockheed Martin’s model is intrusion-centric, which was the focus of cyber security when it was created, and is indeed still the focus of (too) much cyber security effort today. […] Then we have the fact that the Chain is completely malware-focused. But malware is only one threat vector facing today’s networks. What about the insider threat? Social engineering? Intrusion based on remote access, in which no malware or payload is involved? The list of threat vectors facing today’s networks is far, far longer than those covered by the Chain»[5].

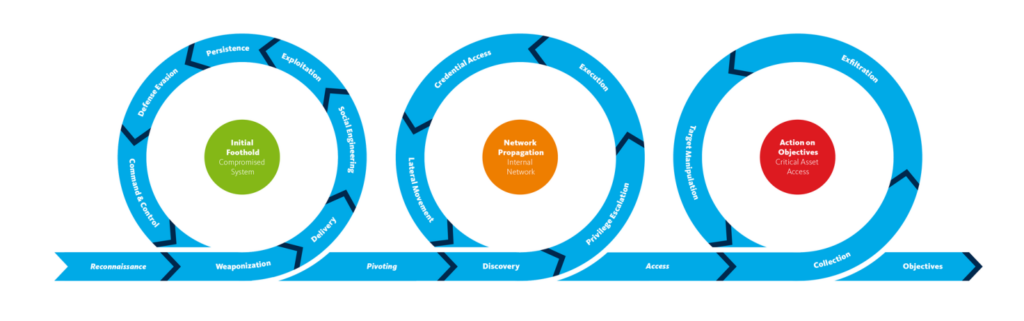
A seguito di tali critiche si sono proposti dei modelli migliorativi, quale la CKC unificata con l’Adversarial Tactics, Techniques & Common Knowledge for Enterprise (ATT&CK), quest’ultimo messo a punto dal centro di ricerca non-profit MITRE Corporation e fatto oggetto di successiva analisi.

Dalla congiunzione di questi due modelli è stato messo a punto un framework unificato, il quale consiste di 18 fasi e prevede tre punti di sintesi:

  1. Initial Foothold (Compromised System);
  2. Network Propagation (Internal Network);
  3. Actions on Objectives (Critical Asset Access)[6].
framework unificato CKC - threat actor e Cyber Threat Intelligence
Fonte: immagine tratta dal web.

MITRE ATT&CK

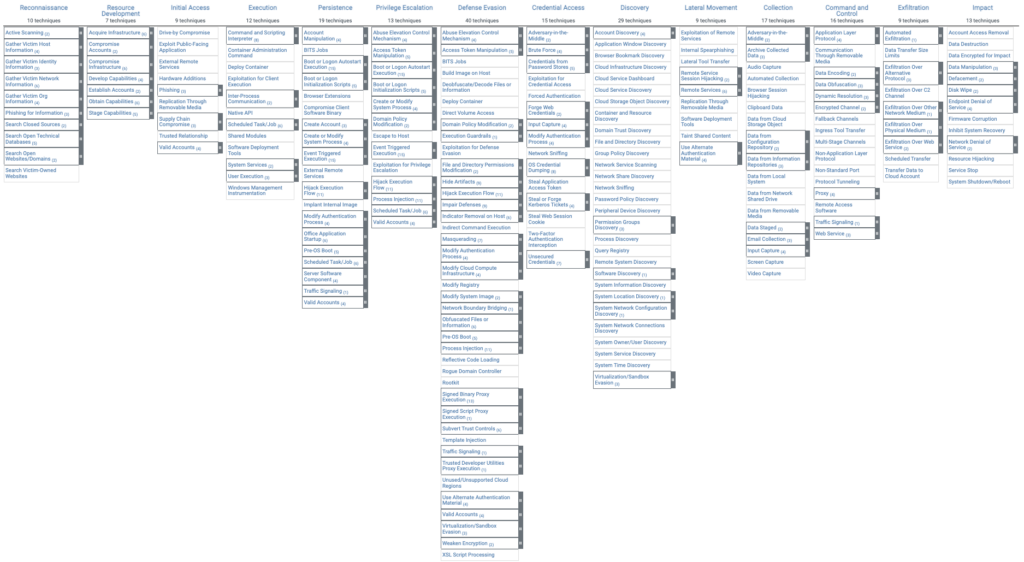
L’Adversarial Tactics, Techniques & Common Knowledge for Enterprise (ATT&CK)[7], divulgato nel 2013, prevede 14 “tattiche” Enterprise le quali rappresentano il più alto livello di astrazione; esse non hanno, tuttavia, un ordine prestabilito di esecuzione e non costituiscono, quindi, una catena di eventi come la CKC.

Le “tattiche” sono le seguenti:

  1. Reconnaissance (“the adversary is trying to gather information they can use to plan future operations”);
  2. Resource Development (“the adversary is trying to establish resources they can use to support operations”);
  3. Initial access (“the adversary is trying to get into your network”);
  4. Execution (“the adversary is trying to run malicious code”);
  5. Persistence (“the adversary is trying to maintain their foothold”);
  6. Privilege escalation (“the adversary is trying to gain higher-level permissions”);
  7. Defense evasion (“the adversary is trying to avoid being detected”);
  8. Credential access (“the adversary is trying to steal account names and passwords”);
  9. Discovery (“the adversary is trying to figure out your environment”);
  10. Lateral movement (“the adversary is trying to move through your environment”);
  11. Collection (“the adversary is trying to gather data of interest to their goal”);
  12. Command and Control (“the adversary is trying to communicate with compromised systems to control them”);
  13. Exfiltration (“the adversary is trying to steal data”);
  14. Impact (“the adversary is trying to manipulate, interrupt, or destroy your systems and data”).

Ogni “tattica” è poi composta di numerose “tecniche” così come è dato evincere dall’immagine seguente.

L’Adversarial Tactics, Techniques & Common Knowledge for Enterprise - threat actor e Cyber Threat Intelligence
Fonte: immagine tratta dal web.

In generale, il MITRE ATT&CK è uno strumento assai utile per analizzare e contrastare le minacce informatiche, ma presenta anche alcuni limiti. Tra i punti di forza del framework si può qui citare, in primo luogo, l’ampia copertura di tecniche e tattiche usate dagli attaccanti, basata su dati reali e verificabili. In secondo luogo, grazie alla sua struttura modulare e flessibile, vi è la possibilità di adattarlo a diversi contesti e scenari operativi. Infine, esso è facilmente integrabile con altri strumenti e fonti di informazione, anche grazie alla sua natura aperta e collaborativa.

Tra i punti di debolezza, invece, può essere qui sottolineata la sua complessità e vastità, il che può renderne difficile la comprensione e gestione da parte degli utenti meno esperti. Un altro aspetto critico può essere considerato la sua potenziale esposizione a manipolazioni o abusi da parte degli attori malevoli, i quali possono sfruttarlo al fine di nascondere o simulare le proprie attività. In ultimo, infine, come tutti questi tipi di modelli, vi può essere una difficoltà di applicazione a minacce emergenti o sconosciute; le quali richiedono, evidentemente, una continua revisione e aggiornamento delle relative tattiche e tecniche.

Indicator Types Model (ITM)

Gli ITM sono modelli utilizzati per classificare i segnali o le tracce lasciati dagli attaccanti durante un attacco informatico. Questi indicatori possono essere utilizzati per identificare la presenza di una minaccia e per aiutare a determinare la natura e le intenzioni dell’attaccante. Qui di seguito viene presentato il framework più conosciuto, The Pyramid of Pain.

The Pyramid of Pain (PoP)

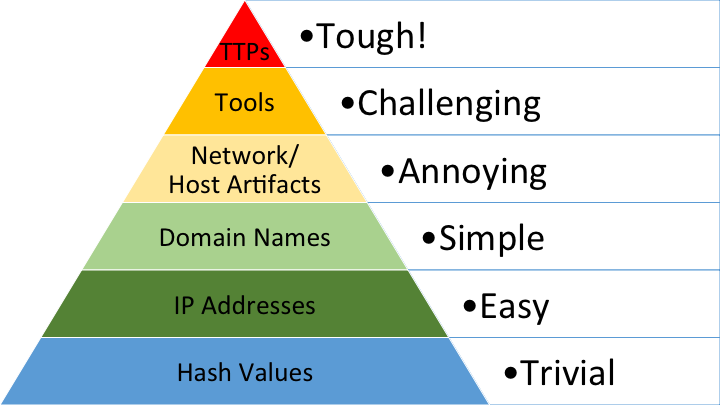
PoP nasce, nell’elaborazione del suo autore David J. Bianco, nel 2013[8], per rispondere agli incidenti e alla necessità di individuazione delle minacce al fine di migliorare il campo di applicazione degli indicatori di attacco. La “piramide” misura la potenziale utilità della propria sicurezza cibernetica, così come la difficoltà di ottenere tale livello di sicurezza, in quanto più in alto si è sulla piramide e più risorse devono essere spese dagli avversari per attaccarla.

La “Piramide del Dolore” è assai utile, perché aiuta a identificare le fasi critiche dell’attacco e a pianificare la difesa del sistema in modo più efficace. Inoltre, aiuta a valutare il potenziale danno causato da un attacco e a prioritizzare la risposta all’emergenza.

Piramide del Dolore - threat actor e Cyber Threat Intelligence
Fonte: immagine tratta dal web.

In ogni fase di azione, si ha la possibilità di rilevare le azioni dell’avversario utilizzando determinati indicatori. Ed è qui che entra in gioco la PoP: essa funge da guida per sapere come dare priorità alle proprie risorse, spesso limitate, al fine di arrecare il massimo danno ai piani dell’avversario.

Le definizioni fornite dall’autore sono le seguenti:

  • 1) Hash Values: “SHA1, MD5 or other similar hashes that correspond to specific suspicious or malicious files”;
  • 2) IP Addresses;
  • 3) Domain Names;
  • 4a) Network Artifacts: “Observables caused by adversary activities on your network”;
  • 4b) Host Artifacts: “Observables caused by adversary activities on one or more of your hosts”;
  • 5) Tools: “Software used by the adversary to accomplish their mission”;
  • 6) Tactics, Techniques and Procedures (TTPs): “How the adversary goes about accomplishing their mission, from reconnaissance all the way through data exfiltration and at every step in between”.

L’articolo del blog in cui Bianco presenta la PoP nasce a margine di un rapporto di ricerca curato dalla società Mandiant e relativo all’entità malevola APT1: l’autore si chiede perché non vi sia stata nessuna discussione pubblica sui dati/osservabili messi a disposizione dal rapporto e sembra avallare l’utilizzo consapevole degli indicatori di compromissione (IOC). Bianco, difatti, così chiude l’articolo:

«Whenever you receive new intel on an adversary (whether it be APT1/Comment Crew or any other threat actor), review it carefully against the Pyramid of Pain. For every paragraph, ask yourself “Is there anything here I can use to detect the adversary’s activity, and where does this fall on the pyramid?” Sure, take all those domains and IPs and make use of them if you can, but keep in mind that the amount of pain you cause an adversary depends on the types of indicators you are able to make use of, and create your plan accordingly».

Attributional Model

Un Attributional Model è un modello utilizzato nella cybersecurity per identificare la fonte di un attacco informatico. Il modello mira a raccogliere e ad analizzare informazioni sulle caratteristiche tecniche, le motivazioni e le opportunità degli attaccanti al fine di identificare la loro provenienza; a tal fine considera diversi fattori, come ad esempio la lingua utilizzata nel codice dell’attacco, l’ora del giorno in cui è stato effettuato, il modello di elaborazione utilizzato e altri dettagli tecnici. Queste informazioni sono confrontate con database esistenti e analizzate in base a schemi di attacchi noti per determinare la provenienza dell’attacco e l’identità degli attaccanti.

L’attribuzione degli attacchi informatici è importante perché permette di comprendere le motivazioni e le opportunità degli attaccanti, nonché di identificare eventuali tendenze e schemi ricorrenti. Inoltrepuò aiutare a prevenire futuri attacchi, poiché le organizzazioni possono utilizzare le informazioni ottenute per pianificare la difesa contro degli attaccanti specifici. Tuttavia, deve essere qui messo in rilievo che l’attribuzione degli attacchi, soprattutto quelli da parte di attori nation-state, può essere molto complessa e che non sempre è possibile determinare con certezza la fonte di un attacco informatico. Ciò premesso, uno dei principali modelli utilizzati dalla comunità InfoSec è quello del Diamond Model.

The Diamond Model (DM)

L’approccio del DM si concentra molto più sulla comprensione dell’attaccante – quali strumenti e infrastrutture usa e quali siano le sue motivazioni – rispetto ad altri modelli finora presentati (in primis, la CKC).

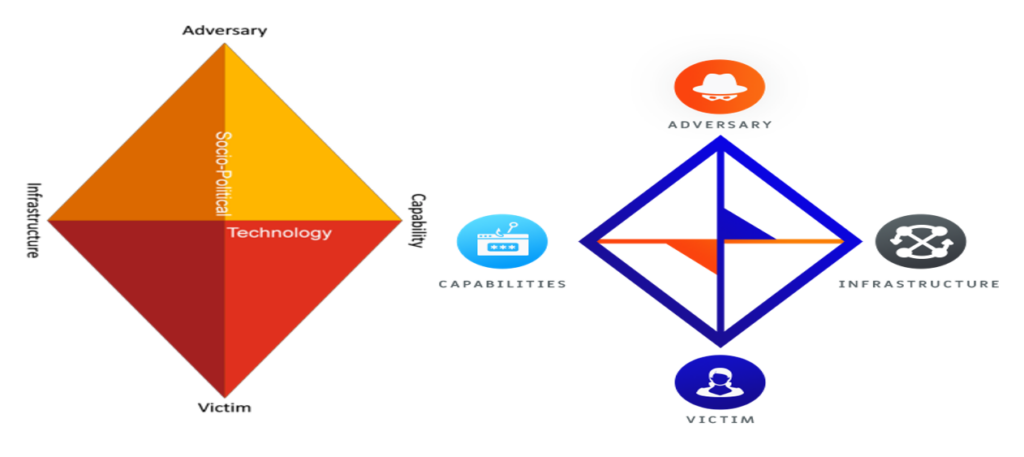
Il DM presenta un nuovo modello concettuale di analisi delle intrusioni basato sull’elemento atomico dell’attività di intrusione, l’evento, a cui corrisponde un singolo “diamante”, da cui è stato derivato il nome di questo framework.

Dell’evento vengono mostrate, nello schema riassuntivo, le funzionalità principali di ogni attività dannosa:

  1. l’avversario (badguy, email addresses, handles, network assets);
  2. la vittima (personas, network assets, email addresses);
  3. le capacità (malwares, exploits, hacker tools, stolen certs);
  4. l’infrastruttura (IP addresses, domain name, email addresses).

Come viene specificato, «for every intrusion event there exists an adversary taking a step towards an intended goal by using a capability over infrastructure against a victim to produce a result»[9].

Questi 4 concetti principali (core-features) sono connessi tra di loro mediante dei vertici i quali rappresentano una relazione unica tra gli stessi concetti e possono dar luogo a un pivoting analitico per cui, da ogni vertice, si possono raggiungere gli altri vertici. In questo senso, una vittima può “vedere” come le capacità vengono usate contro una determinata infrastruttura. Dal vertice dell’infrastruttura si può “vedere”, difatti, l’avversario manovrare le capacità contro le vittime facendo uso di determinate infrastrutture.

È evidente il ricorso alla teoria dei grafi, in quanto si fa esplicita citazione di relazioni e di vertici.

Diamond Model (DM) - threat actor e Cyber Threat Intelligence
Fonte: immagini tratte dal web.

Il framework prevede anche delle meta-caratteristiche (meta-features) quali timestamp, phase (reconnaissance, weaponization, exploitation), result (success, failure, confidentiality compromised, integrity compromised), direction (from or to the victim, bidirectional), methodology (spear-phishing, denial of service attack) e delle external resources necessarie per completare con successo l’attività degli eventi (the target’s email address or IP address, the vulnerability to exploit)[10]. Queste meta-caratteristiche non formano parte costitutiva del modello e, pertanto, possono essere aggiunte o rimosse, a seconda delle esigenze contingenti.

Altra peculiarità del framework è che esso è volutamente ad alto livello di generalità in modo da permetterne la taratura in ogni situazione, così come l’aggiunta di ulteriori sotto-caratteristiche (sub-features); a solo titolo esemplificativo, la vittima può essere ulteriormente caratterizzata come IP address, hostname, organizzazione, ecc.

Il modello, infine, può essere ulteriormente espanso con altri due strati di meta-caratteristiche: l’asse technology, che connette le infrastrutture alle capacità favorendone l’effettiva interazione; l’asse social-political, che descrive le complesse interrelazioni tra vittima e avversario.

«Analytically, the Diamond allows concepts from criminology and victimology to be applied to intrusion analysis allowing one to understand the reason a victim was chosen, the value the victim brings to the adversary, and ultimately how that relationship can be influenced and manipulated to enhance mitigation» (Caltagirone, 2013:4).

L’avversario opera in fasi multiple, utilizzando due o più eventi al fine di ottenere un risultato dannoso sulla vittima; e tale corso di azione (activity threads) può essere attentamente analizzato da un analista. «Threads not only span vertically along a single adversary-victim pair, but horizontally as adversaries take advantage of knowledge and access gained in one operation to enable other operations» (Caltagirone, 2013:4).

In ultimo, il framework permette di effettuare analisi mediante altre concettualizzazioni quali activity-attack graph, adversary processes, activity groups, activity group families ma ciò richiederebbe ben altro spazio a disposizione e, infine, potrebbe inutilmente complicare la presentazione, a soli fini didascalici, del modello stesso.

Conclusioni

Per contrastare le minacce provenienti dagli attori malevoli sempre più diffusi nell’ecosistema digitale attuale, è necessaria una strategia di cyber threat intelligence che si basi su una raccolta e analisi efficace delle informazioni relative al contesto, alle motivazioni e alle capacità degli avversari.

Esistono diversi framework di analisi che possono aiutare i professionisti della CTI a organizzare e interpretare i dati raccolti e in questo breve testo si è cercato di fornire un’iniziale categorizzazione degli stessi, individuati in: 1) Indicator Types Model; 2) Intrusion Lifecycle Model; 3) Attributional Model. All’interno di queste macro tipologie si sono velocemente presentati alcuni modelli principali, tra i quali i più conosciuti e utilizzati sono senz’altro:

  • The Cyber Kill Chain;
  • MITRE ATT&CK;
  • The Diamond Model;
  • The Pyramid of Pain.

Questa veloce presentazione non è esaustiva, pertanto, di tutti essi e ha sole funzioni di carattere esemplificativo e divulgativo, al fine di promuovere una cultura crescente dell’awareness in campo cyber security.

Come si è cercato di mettere in luce nel corso del testo, questi framework forniscono una struttura concettuale per identificare gli elementi chiave di un’operazione malevola, come gli obiettivi, le fasi, le tecniche e le contromisure. In questo senso l’utilizzo esteso di questi framework, da parte della comunità di cyber intelligence, può migliorare la qualità e l’efficienza delle analisi delle minacce, facilitando la comunicazione e la collaborazione tra gli analisti e gli altri stakeholder coinvolti nella difesa dei sistemi informatici mediante la condivisione di una modellistica e di un linguaggio comune.

Un esempio di tale processo di standardizzazione, in atto da decenni, nel campo della comunità CTI, oltre ai framework già citati, è anche quello relativo a STIX 2.0 e a TAXII, i quali sono stati brevemente presentati nell’introduzione di questo articolo.

Tutti questi modelli, considerati in maniera olistica, rappresentano quanto di più avanzato l’attuale comunità CTI sia riuscita a mettere a punto e rappresenta, assai bene, quel percorso di crescita e istituzionalizzazione che l’intero ecosistema della cybersecurity sta portando avanti in Italia e nel resto del mondo, sia in campo civile che militare, sia in campo accademico che tra i sempre più numerosi addetti ai lavori.

Note

[1] Achille Pierre Paliotta, Una riflessione preliminare sul processo di Istituzionalizzazione della Cyber Intelligence (CYBINT), in Quaderni di Cyber Intelligence #1, ICT Security Magazine, novembre 2022, https://bit.ly/3OqTXT1

[2] Eric M. Hutchins, Michael J. Cloppert, M. Rohan, Intelligence-Driven Computer Network Defense Informed by Analysis of Adversary Campaigns and Intrusion Kill Chains, Bethesda (MD), Lockheed Martin Corporation, Technical Report, 2009.

[3] Sean Mason, Leveraging The Kill Chain For Awesome, 2 December 2014, https://bit.ly/3ixdFMr.

[4] Matt Devost, Every Cyber Attacker is an Insider, 19 February 2015, https://bit.ly/2Z0bY2t.

Marc Laliberte, A Twist On The Cyber Kill Chain: Defending Against A JavaScript Malware Attack, 21 September 2016, https://bit.ly/3f2j0sX.

Tim Greene, Why the ‘cyber kill chain’ needs an upgrade, 5 August 2016, https://bit.ly/38saXDk.

[5] Giora Engel, Deconstructing The Cyber Kill Chain, 18 November 2014, https://bit.ly/2Z1xuUE.

[6] Paul Pols, The Unified Kill Chain. Designing a Unified Kill Chain for analyzing, comparing and defending against cyber attacks, Cyber Security Academy, 2017.

[7] https://attack.mitre.org/tactics/enterprise/.

[8] https://bit.ly/3f1UBUh.

[9] Sergio Caltagirone, The Diamond Model of Intrusion Analysis. A Summary, Hanover (MD), Center for Cyber Threat Intelligence and Threat Research, Technical Report, 2013.

[10] https://www.activeresponse.org/wp-content/uploads/2013/07/diamond_summary.pdf.

Questo articolo è stato estratto dal white paper “Quaderni di Cyber Intelligence #4” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/quaderni-di-cyber-intelligence-4/

Articolo a cura di Achille Pierre Paliotta

Profilo Autore

Achille Pierre Paliotta, ricercatore INAPP(ex ISFOL), afferente alla Struttura Lavoro e Professioni. Laureato in Sociologia presso l’Università La Sapienza ha conseguito, nel 2015, il Master in Data Science presso l’Università di Tor Vergata. Sta attualmente frequentando il Master in Sicurezza delle informazioni e informazione strategica presso l’Università La Sapienza. I suoi interessi di ricerca vertono su nuove tecnologie, sicurezza informatica, nuove professioni, contrattazione collettiva, welfare occupazionale, data science, blockchain, open data e deep learning.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/threat-actor-intelligence/


TSURUGI Linux: La Distro Italiana per la Cyber Security, DFIR, Malware Analysis e OSINT Avanzato con Computer Vision

In un’era in cui la sicurezza informatica e la protezione dei dati sono fondamentali, la necessità di strumenti affidabili e sicuri è più critica che mai. In questo contesto, la distribuzione Linux Tsurugi Linux si distingue come una risorsa essenziale per professionisti e appassionati di cybersecurity.

Sviluppata partendo dal kernel di Ubuntu e ricompilando sia il kernel che i moduli e customizzando l’intero sistema operativo anche graficamente, questa distribuzione offre, non solo un’ampia varietà di software Open Source per coprire molti domini della Cyber Security (Digital Forensic & Incident Response – Mobile Forensic – Malware Analisys – Osint anche con tool che sfruttano la Computer Vision anche sfruttando, a loro volta le caratteristiche di Deep Learning e Machine Learning).

Prevede inoltre un sicuro blocco di scrittura degli hard disk e delle eventuali memorie esterne collegate a livello kernel (Distro Linux unica nel suo genere) rispetto a blocchi di scrittura a livello di impostazioni di sistema, garantendo un elevato livello di sicurezza e non contaminando e modificando le eventuali memorie esterne o interne ispezionate, utilizzabile quindi anche in campi investigativi ufficiali del Law Enforcement e non solo in ambito Civile.

Tutte queste attività di Core Developer e customizzazioni sono curate dal Team Manager Giovanni “aka Sug4r” Rattaro Project founder – Tsurugi Linux and Tsurugi Acquire core developer – Tsurugi Linux team leader, Marco “aka Blackmoon” Giorgi Project founder – Tsurugi Linux and Tsurugi Acquire core developer, Massimiliano “aka YattaMax” Dal Cero New staff 2019! Tsurugi Linux and Tsurugi Acquire developer, pregevole ed importante anche il contributo degli altri componenti Francesco ‘aka dfirfpi’ Picasso Tsurugi Acquire develope e ultimo entrato nel Team ma non meno importante Mattia ‘MattiaEp’ Epifani: New staff 2023! Tsurugi Linux and Tsurugi Acquire core developer.

Tsurugi Linux non solo offre una vasta gamma di strumenti avanzati, ma garantisce anche che ogni software sia sviluppato e diffuso nel pieno rispetto delle normative sul copyright. Questo è possibile grazie al coinvolgimento di un avvocato dedicato (Avv. Costanza Matteuzzi) che supervisiona ogni fase della distribuzione, assicurando la conformità legale. Inoltre, tra gli otto sviluppatori del progetto, due membri appartengono alle forze dell’ordine italiane, portando con sé una preziosa esperienza sul campo.

Tra questi l’autore del presente articolo, Antonio “aka Visi@n” Broi New staff 2019! Digital Forensics, OSINT and Computer Vision specialist for Tsurugi Linux e Davide “aka Rebus” Gabrini Bento DFIR toolkit project leader, il cui contributo è stato fondamentale per rendere Tsurugi Linux una piattaforma di riferimento nel settore Cyber Security Pubblica e Privata più in generale.

Tsurugi Linux è disponibile per il download dal sito [https://tsurugi-linux.org] in due versioni principali: Tsurugi Laboratory e Tsurugi Acquire. La prima è disponibile sia in formato ISO che OVA, mentre la seconda, più leggera e minimale, è disponibile solo in formato ISO. Inoltre, è presente una nutrita raccolta di tools per attività di live forensic per i sistemi operativi Linux, Mac Apple e Windows, curata da Davide “Rebus” Gabrini, denominata Bento.

A seguito dello scarico dei file delle distro Linux in formato ISO o OVA o del pacchetto Bento, è possibile non soltanto verificare l’hash dei relativi file, ma anche scaricare l’intero file di testo contenente tutti gli hash e verificare l’autenticità di tale file di testo con la chiave pubblica GPG/PGP intestata al team TSURUGI-LINUX ed esposta sul relativo sito. Questa doppia sicurezza evita di scaricare cloni fake della distro.

Con il suo focus su DFIR, analisi del malware, OSINT, e computer vision, Tsurugi Linux rappresenta una soluzione completa e affidabile per affrontare le sfide della sicurezza informatica moderna “”UN ARSENALE COMPLETO DI SOFTWARE NELLA TUA CASSETTA DEGLI ATREZZI PER LA CYBER-SECURITY”.

Mentre gran parte degli strumenti sono sviluppati in diversi linguaggi, i programmi nell’area della Computer Vision, Object Detection e Facial Recognition sono scritti in Python 3 dal sottoscritto, offrendo avanzate capacità di riconoscimento facciale e comparazione di immagini da varie fonti, inclusi video e webcam, con la possibilità di creare database utilizzando le librerie pickle e KNN, unitamente ad alcuni programmi dell’area Mobile Forensic (adb2rec.py adb2recGUI.py) e O.C.R da video (video2ocr.py e video2ocrColor.py), unitamente ad altri tool riguardanti la Mobile forensic (adb2regGUI.PY) e le attività di Cloud Forensic (adb2regGUI.PY) e Osint (video2ocrCOLOR.PY).

In un periodo in cui la sicurezza dei dati è cruciale, Tsurugi Linux emerge come una distribuzione Linux sicura e versatile, pronta a supportare professionisti e organizzazioni nel loro impegno per la protezione e l’analisi dei dati digitali.

Download dell’immagine della Distro e del file di testo contenente i nomi file e i relativi algoritmi HASH e verifica del file tramite la chiave pubblica .key del Team tsurugi-linux.org

Per iniziare a utilizzare Tsurugi Linux, è fondamentale scaricare l’immagine della distribuzione e verificare la sua integrità per assicurarsi che non sia stata alterata. Dal sito [tsurugi-linux.org] e dai relativi mirror, è possibile scaricare agevolmente sia il file di testo certificato da GPG/PGP contenente gli hash delle versioni di Tsurugi Linux, sia le immagini delle distribuzioni Tsurugi Laboratory, Tsurugi Acquire o la raccolta di software freeware e Open Source “Bento”.

Scaricamento dei file

  • Chiave pubblica PGP: [Scarica qui](https://tsurugi-linux.org/tsurugi_linux_pub_key.asc)
  • File di testo con gli hash certificati PGP: [Scarica qui](https://tsurugi-linux.org/signed_hashes.sha512)

Verifica dell’integrità dei file

Per verificare l’integrità dei file scaricati, segui questi passaggi:

  1. Importare la chiave pubblica PGP del team Tsurugi Linux:
sh
$ gpg --import tsurugi_linux_pub_key.asc
  1. Verificare il file di testo contenente gli hash con la chiave pubblica PGP:
sh
$ gpg --verify signed_hashes.sha512
  1. Verificare l’hash SHA512 dei file ISO/OVA scaricati:

Per assicurarsi che i file scaricati non siano stati alterati, è necessario confrontare l’hash SHA512 del file scaricato con quello fornito nel file di testo verificato.

– Linux:

sh
$ sha512sum tsurugi_linux_2023.2.iso

– Mac:

sh
$ shasum -a 512 tsurugi_linux_2023.2.iso

– Windows:

Aprire il prompt dei comandi e digitare:

cmd
CertUtil -hashfile tsurugi_linux_2023.2.iso SHA512

Con questi comandi, puoi garantire l’integrità e l’autenticità dei file scaricati. La verifica degli hash è una misura di sicurezza essenziale per prevenire l’utilizzo di versioni compromesse della distribuzione.

Scaricando e verificando correttamente le immagini di Tsurugi Linux, potrai beneficiare della sicurezza e delle funzionalità avanzate offerte da questa distribuzione sviluppata da un team di esperti italiani.

Acquisizioni DFIR (Digital Forensic e Incident Response)

In questo capitolo esploreremo le potenzialità del sistema operativo Tsurugi Linux per le attività di Digital Forensic e Incident Response (DFIR), sia installato su un personal computer che avviato in modalità live su un computer da acquisire con tecnica “post mortem”, cioè a PC spento e avviandolo esclusivamente dal sistema operativo Tsurugi Linux e non dal suo sistema operativo originario. Sebbene non approfondiremo gli aspetti legali alla base della digital forensics sia nell’ambito penale che civile, è importante menzionare che ci sono operazioni “ripetibili” e altre “irripetibili”, e la legge che regola tali operazioni e il ruolo dell’operatore (Law Enforcement, CTU, CTPM, CTP, consulente informatico in ambito civile, Specialista Digital Forensic, ecc.) sono di grande rilevanza.

Attività Ripetibili e Irripetibili

Un’attività è considerata ripetibile se, acquisendo lo stesso dispositivo informatico (hard disk, memoria, ecc.) più volte e ricalcolando l’hash dei dati, otteniamo sempre lo stesso valore. Tuttavia, anche su questo tema ci sono state discussioni tra esperti e sentenze che hanno messo in discussione questo paradigma, soprattutto nel contesto della Mobile Forensic, dove la distinzione tra contenuto e contenitore e la modificabilità dei dati sono questioni critiche e meriterebbero una intero capitolo a tale tema per la sua complessità, per questo motivo rimando a futura pubblicazione questo tema ed a quanti già si sono espressi su tale tematic.

Strumenti Disponibili

Comandi di Base e Software di Acquisizione

  • dd e derivate: Utilizzati per creare immagini forensi bit-a-bit.
  • Guymager: Programma GUI per l’acquisizione di immagini forensi e calcolo dell’hash.
  • Autopsy: Strumento di analisi forense per il parsing dei dati digitali.
  • ILear Aleap di Alex Brignoni e UFADE: Strumenti avanzati per analisi mobile e digital forensic.

Puoi trovare una lista completa degli strumenti disponibili sul sito Tsurugi Linux:

Ugualmente elenchiamo una breve lista di alcuni tools disponibili nella tsurugi-linux.org, per aree e tipologia di software nell’ambito Cyber Security.

Aree di Acquisizione e Analisi

  1. Imaging: Acquisizione di immagini forensi.
  2. Hash: Calcolo degli hash per verificare l’integrità dei dati.
  3. Timeline: Analisi delle timeline per investigazioni cronologiche.
  4. Mount: Montaggio di dispositivi hardware o immagini forensi in vari formati.
  5. Artifacts Analysis: Analisi degli artefatti digitali.
  6. Data Recovery: Recupero di dati cancellati, orfani o eliminati.
  7. Memory Analysis: Analisi delle acquisizioni di RAM o memorie volatili.
  8. Mobile Forensic: Acquisizione e analisi di dispositivi mobili e alcuni IoT.
  9. Cloud Analysis: Analisi dei dati acquisiti dalle aree cloud.
  10. Crypto Currencies: Analisi delle blockchain.
  11. Virtual Forensic: Analisi delle copie di lavoro avviate in macchina virtuale.
  12. Password Recovery: Recupero di file o volumi di dati criptati.
  13. Reporting: Presentazione delle prove informatiche per dibattimento, contenzioso o presentazione al decision maker.

Questi strumenti e procedure ti permetteranno di eseguire acquisizioni DFIR con sicurezza e precisione, garantendo che i dati raccolti siano autentici e non alterati. Un’acquisizione e analisi forense di qualità, rispettosa delle normative vigenti e ben presentata, è cruciale per il successo in ambito investigativo, sia penale, civile che tributario.

Malware Analysis

Nel campo della sicurezza informatica, l’analisi del malware è una componente fondamentale, specialmente dopo un attacco di ransomware come il classico Crypto Locker. Anche se si dispone di ottimi backup “offline” e non semplicemente “off site”, e si ha la prudenza di non spegnere immediatamente tutti i server e computer, acquisire la RAM di qualche macchina o mandarla in ibernazione per una successiva acquisizione forense può fare la differenza. Questo approccio permette una comprensione più approfondita del ransomware e della chiave utilizzata per crittografare i dati.

Strumenti per l’Analisi del Malware

Tsurugi Linux offre una vasta gamma di strumenti per l’analisi del malware, sia per ambienti desktop che mobili. Ecco una panoramica degli strumenti e delle tecniche disponibili:

Analisi della RAM e dei File di Ibernazione

– **Volatility**: Uno dei tool principali per l’analisi della memoria.

– **Wireshark**: Per l’analisi delle connessioni di rete.

– **Elasticsearch e Suricata o Velociraptor**: Per analisi avanzate come IDS (Intrusion Detection Systems).

Analisi dei Backup dei Dispositivi Mobili

– **mvt-tools**: Ottimo per analizzare i backup di iTunes per dispositivi iOS e i backup Android.

– **ADB (Android Debug Bridge)**: Per analisi diretta sui dispositivi Android.

– **Wireshark e SpyGuard**: Per l’analisi del traffico di rete generato dai dispositivi mobili, spesso in combinazione con tecniche di white “man in the middle”.

Indici di Compromissione (IOC)

Gli strumenti come SpyGuard, fork di Tinycheck, utilizzano i famosi Indici di Compromissione (IOC). Questi strumenti sono mantenuti da Amnesty International Laboratory, importanti società francesi e Kaspersky Laboratory, e sono completamente open source.

Lista Completa degli Strumenti per Malware Analysis su Tsurugi Linux

Binary Analysis

  • PEV:
    • ofs2rva
    • pedis
    • pehash
    • pepack
    • peres
    • pescan
    • pesec
    • pestr
    • readpe
    • rva2ofs
  • RADARE2:
    • cutter
    • r2agent
    • r2pm
    • rabin2
    • radare2
    • radiff2
    • rafind2
    • ragg2
    • rahash2
    • rarun2
    • rasm2
    • rax2
  • binwalk
  • Bless Hex Editor
  • cstool
  • dwarfdump
  • hashdeep
  • ltrace
  • objdump
  • strace
  • strace-log-merge
  • vbindiff
  • XELFViewer

Debugger

  • gdb
  • heaptrace

Decoder

  • CyberChef
  • rhino
  • rhino-debugger
  • rhino-jsc

Flash Analysis

JavaScript Analysis

  • js-beautify
  • rhino
  • rhino-debugger
  • rhino-jsc

Network Analysis

Office Document Analysis

  • catdoc
  • catppt
  • docx2txt
  • ezhexviewer
  • ftguess
  • mraptor
  • msodde
  • olebrowse
  • oledir
  • oledump
  • olefile
  • oleid
  • olemap
  • olemeta
  • oleobj
  • oletimes
  • olevba
  • pyxswf
  • rtfdump
  • rtfobj
  • unoconv
  • unrtf
  • vba_extract
  • wordview
  • xls2csv
  • XMLMacroDeobfuscator

PDF Analysis

  • DiffPDF
  • diffpdf
  • pdf2dsc
  • pdf2ps
  • pdfattach
  • pdfcrack
  • pdfdetach
  • pdffonts
  • pdfgrep
  • pdfimages
  • pdfinfo
  • pdfroff
  • pdfseparate
  • pdfsig
  • pdftocairo
  • pdftohtml
  • pdftoppm
  • pdftops
  • pdftotext
  • pdfunite
  • peepdf

Sandbox

  • firejail
  • Firejail Configuration Wizard
  • firetools

Scanner

  • clamav
  • chkrootkit
  • fenrir
  • hypernode-mwscan
  • Lynis auditing tool
  • mwscan
  • pescan
  • rkhunter
  • vtscan
  • vtTool
  • yara (più occorrenze)

XOR Analysis

  • xor_encrypt_file
  • xor_key_recovery
  • xortool
  • xortool-xor

Other Tools

  • trid
  • upx_dec
  • upx-ucl
  • colorize
  • filecompare
  • pyWhat

Questi strumenti, combinati con le tecniche di analisi forense e di rete, offrono una soluzione completa per l’analisi del malware. Gli strumenti che non sono preinstallati possono essere facilmente scaricati da GitHub e installati poiché sono completamente open source.

OSINT “Open Source Intelligence con Tsurugi Linux”

La necessità di acquisire nuove capacità di OSINT (Open Source Intelligence) è sempre più rilevante non solo per gli attori istituzionali, ma anche per investigatori privati e giornalisti investigativi e piu’ in generale nell’eco sistema Cyber in quanto le entità possono essere rappresentate anche ad esempio esemplificativo e non esaustivo da :hardware, luoghi geografici o eventi nel tempo, non solo società o persone. La potenza derivante dall’acquisizione di capacità avanzate e metodologie di ricerca, validazione, analisi e disseminazione è inestimabile. Queste competenze permettono di creare report dettagliati, che vanno dalla link analysis alla timeline report, fino alla verbalizzazione e spiegazione delle connessioni di vario tipo.

Tipologie di OSINT

Le varie tipologie di OSINT comprendono:

  1. Ricerca Avanzata con Strumenti da Browser: Customizzazione delle postazioni di ricerca tramite VPN e proxy.
  2. Strumenti Enterprise: Framework a pagamento come Paterva Maltego.
  3. Framework e Programmi Open Source: OSINT Online e OSINT Offline. Ad esempio, scaricando dati localmente e poi analizzandoli, come con la Wayback Machine che conserva dati eliminati dal web, o Shodan.io che raccoglie continuamente informazioni e vulnerabilità dai dispositivi informatici.
  4. OSINT su Stringhe e Dati: Analisi di file particolari come immagini, video, file binari, PDF, DOCX, XLSX, ecc.

Le attività OSINT riguardano, piu’ in generale, dei veri e propri cicli di Intelligence da fonti disponibili sul WEB e che vanno sempre controllate e validati prima di poterle considerare “informazioni vere e attendibili” e quindi disseminate, in particolare è una ricerca che riguarda entità e la loro validità, seguita da analisi e disseminazione al “Decision Maker”. L’informazione acquisita velocemente è fondamentale poiché, se diffusa troppo tardi, potrebbe perdere la sua valenza operativa, ma altrettanto importante è la veridicità dell’informazioni e la controprova a prova di fake news vista la forte diffusione di tali info alterate per vari motivi, politici, economici, militari, etc. etc. che incidono nella vita delle persone e degli Stati.

Lingue e Tipologie di Ricerca

L’OSINT richiede spesso l’acquisizione di informazioni in lingue diverse dalla propria. È cruciale comprendere come e dove ricercare le informazioni, che variano in base alla lingua e alla tipologia, come il Social Media Monitoring rispetto al Business Tracking o al Company Tracking. Inoltre, la Blockchain Analysis per le transazioni digitali moderne richiede strumenti specifici a causa della complessità delle diverse blockchain.

Utilizzo di Machine Learning e AI

Tsurugi Linux offre strumenti come whisper-openai per la trascrizione di audio e video in testo e per la traduzione in inglese. Sebbene questi modelli di Machine Learning possano essere utilizzati offline, presentano alcune limitazioni, come l’accuratezza dell’audio e la pronuncia degli interlocutori. Nonostante ciò, rappresentano un valido aiuto investigativo, anche se richiedono convalida umana per essere presentati in tribunale (ad esempio).

OSINT su Immagini e Video

L’analisi delle immagini e dei video include la picture analysis tramite strumenti come exiftools per la lettura dei metadati e la steganografia. Ecco un elenco dei tool disponibili su Tsurugi Linux per l’analisi delle immagini:

  • Darktable
  • Sherloq
  • Depix
  • Driftnet
  • ExifRead
  • exif
  • exifprobe
  • exiftime
  • exiftool
  • exiv2
  • findimagedupes
  • ForensicPlate
  • GenPixed
  • imageDifferenceHash_dirlist
  • jpeg_extract
  • mat2
  • outguess
  • outguess-extract
  • pngcheck
  • pngcrush
  • pngsplit
  • recoverjpeg
  • seek_script
  • searchScreenshots
  • stegtools
  • steghide
  • stegsnow
  • stegosuite
  • stegoveritas
  • stegoveritas_hide_lsb
  • vinetto

Conclusione

L’OSINT con Tsurugi Linux offre un insieme potente di strumenti e tecniche per l’acquisizione, analisi e disseminazione di informazioni. Questi strumenti sono essenziali per ottenere informazioni tempestive e precise, supportando investigazioni in ambiti istituzionali, privati e giornalistici. La combinazione di tecniche avanzate e strumenti open source rende Tsurugi Linux una scelta eccellente per chiunque necessiti di capacità di intelligence all’avanguardia.

Computer Vision e Picture Analysis per OSINT avanzato, analisi di immagini, audio e video

Tsurugi Linux offre una vasta gamma di strumenti avanzati per l’analisi di immagini, audio e video, che possono essere utilizzati sia per attività di OSINT che per la mobile forensic. Questi strumenti sono progettati per eseguire compiti complessi e fornire risultati accurati e dettagliati. Di seguito sono descritti alcuni dei principali programmi e tool inclusi nella distribuzione.

Programmi per l’analisi di immagini e video

  1. adb2recGUI.py

Funzione: Questo strumento consente di eseguire screenshot e/o screen recording direttamente da un telefono cellulare Android. È particolarmente utile sia per la mobile forensic che per l’OSINT.

Caratteristiche:

  • Salvataggio automatico delle schermate o registrazioni video.
  • Scorrimento automatico verso l’alto o verso il basso.
  • Riconoscimento delle targhe delle autovetture da video dato in input, con 4 (quatto) numeri di targa ipotizzati per ogni frame di targa, questo in quanto ogni nazione ha una diversa tipologia di font ed il frame e quadratino individuato contenente il numero di targa potrebbe essere non di risoluzione ottimale.
  • Applicazione di compressione e calcolo dell’algoritmo hash al termine delle operazioni.
  1. video2ocrColor.py

Funzione: Questo tool, dotato di GUI, permette di analizzare video registrati e altri video provenienti da attività di Digital Forensic o OSINT.

Caratteristiche:

  • Estrazione frame per frame dai video.
  • Creazione di report in formato HTML con i frame cliccabili e il contenuto sottoposto a OCR.
  • Possibilità di tradurre i file di testo generati utilizzando il comando “translate” della libreria Python `googletrans`.
  1. Object Detection

object_detectionGUI.py

Funzione: Strumento per la rilevazione di oggetti in video o tramite webcam.

Caratteristiche:

  • Salvataggio degli oggetti rilevati in directory specifiche.
  • Classificazione degli oggetti rilevati in categorie come “persons”, “cats”, “dogs”, “cars”, “bicycles”, ecc.

Riconoscimento Facciale

Un’area dedicata al riconoscimento facciale è presente nella directory `/opt/computer_vision` e nel menu dedicato all’interfaccia grafica del sistema operativo. Questi strumenti sono progettati per eseguire riconoscimenti facciali accurati utilizzando tecnologie avanzate di Deep Learning e Machine Learning.

Strumento di Riconoscimento Facciale 1 a 1

il programma permetterà il riconoscimento accurato tra due immagini di visi.

Caratteristiche:

  • Individuazioni dei Key point e calcolo dell’embedding di ogni viso e comparazione tra i volti, oltre al calcolo dell’hash delle immagini confrontate.
  • Pubblicazione dell’hash nella blockchain utilizzando l’eseguibile OST (Open Time Stamps).

Strumento di Riconoscimento Facciale N:M

il programma permetterà il riconoscimento facciale accurato tra le immagini posizionate dall’investigatore nelle due directory della home “known” e “unknown” ed attraverso il programma facerec_webGUI.py con un semplice click averrà il riconoscimento facciale tra tante immagini con visi conosciuti e tante immagini di visi sconosciuti in apposito report in formato html con le immagini cliccabili e la percentuale di comparazione per ogni raffronto, tale programma prevede la comparazione di un viso per ogni immagine quindi dovranno essere effettuati dei tagli in caso di immagini con piu’ visi.

Strumento di Riconoscimento Facciale N volti su N immagini anche con più visi sulle immagini da ricercare con apposito database python KNN (Convolution Neural Network), addestrato ad ogni nuovo inserimento di nominativi in directory relativi al soggetto, tale programma permette di creare un vero e proprio database in directory per nominativo e l’addestramento “trainning” dell’intero dbase per la successiva comparazione di tutte le immagini posizionate in qualsiasi directory e contenenti immagini con diversi visi.

La directory /opt/computer_vision contiene numerosi altri programmi python per la comparazione e identificazione facciale, da utilizzare nelle investigazioni a norma di legge, che non saranno trattate in questa pubblicazione ma che ad ogni modo verranno elencate di seguito:

FACE DETECT LANDMARKS

  • Face Detection
  • Face Detect Tsurugi
  • Face Detect Landmarks Tsurugi
  • Face Landmarks Tsurugi
  • Face Recognition
  • FACE RECOGNITION WEB GUI
    • Facerec Web GUI
  • FACE RECOGNITION KNN
    • Facerec KNN GUI
    • LearnArgs KNN
    • Learn RecognizeArgs KNN
    • RecognizeArgs KNN
  • FACE ENCODING
    • Build Face Dataset
    • Encode Faces Dataset
    • Face Recognition Encoding
    • Facerec Dataset Encoding GUI
  • FACE DIRLIST
    • Facerec DirList Image
  • FACE RECOGNITION VIDEO
    • Facerec video2video (Facerec from video save Video & Image)
  • OBJECT DETECTION
    • Object detection live write video
    • Object detection live
    • Object detection video write video
    • Object detection video
    • Object detection GUI

L’utilizzo di Tsurugi Linux in modalità live, caricandola da una chiavetta USB, consente di eseguire attività investigative mantenendo la privacy e la sicurezza dei dati. Al termine delle operazioni, tutti i dati e i file temporanei vengono cancellati semplicemente riavviando il sistema operativo, poiché questi vengono caricati temporaneamente in area temp e in RAM. Questo approccio è conforme al GDPR e alle normative sulla protezione dei dati personali, a meno che le attività non siano autorizzate dall’Autorità Giudiziaria o rientrino nei poteri di iniziativa della Polizia Giudiziaria o nelle autorizzate attività d’istituto.

Altri Tool di Analisi

Tsurugi Linux include numerosi altri strumenti per la computer vision e l’analisi delle immagini, come ad esempio:

  • ExifTools: Per la lettura dei metadati.
  • Steganografia: Strumenti come steghide, stegsnow, stegosuite per rilevare informazioni nascoste nelle immagini.

Ecco un elenco non esaustivo dei tool disponibili:

  • Darktable
  • Sherloq
  • Depix
  • Driftnet
  • ExifRead
  • exif
  • exifprobe
  • exiftime
  • exiftool
  • exiv2
  • findimagedupes
  • ForensicPlate
  • GenPixed
  • imageDifferenceHash_dirlist
  • jpeg_extract
  • mat2
  • outguess
  • outguess-extract
  • pngcheck
  • pngcrush
  • pngsplit
  • recoverjpeg
  • seek_script
  • searchScreenshots
  • stegtools
  • steghide
  • stegsnow
  • stegosuite
  • stegoveritas
  • stegoveritas_hide_lsb
  • vinetto

Utilizzo Responsabile e Legale

Tutti questi strumenti sono progettati per eseguire calcoli matematici e biometrici avanzati senza memorizzare immagini o database di immagini. È fondamentale che l’uso di questi strumenti avvenga sempre nell’ambito delle attività legali e con le adeguate coperture di legge, tenendo conto della privacy e del GDPR. È inoltre essenziale che l’utilizzo dei tool di cybersecurity e analisi forense avvenga in modo etico e responsabile.

Tsurugi Linux fornisce potenti strumenti che, se usati correttamente, possono significativamente migliorare le capacità di investigazione e analisi in vari campi nonche la protezione delle infrastrutture informatiche grazie anache alla presenza di importanti programmi come Suricata, Velociraptor, Yara e molti altri che utilizzano gli indicatori MISP (Malware Information Sharing Platform & Threat Sharing) oltre ai già citati IOCs (Indicators of Compromise) già sopra citati ed utilizzati in altri programmi, assicurando allo stesso tempo il rispetto delle normative vigenti e degli standard etici.

Conclusioni

Tsurugi Linux si afferma come un sistema operativo di alta sicurezza, essenziale non solo per il sistema Italia, ma anche per l’Europa e tutti gli utilizzatori globali. La distribuzione garantisce la sicurezza dei programmi e dell’intera piattaforma, offrendo un supporto robusto per numerose attività di cybersecurity.

L’utilizzo di software open source, come quello offerto da Tsurugi Linux, presenta vantaggi significativi. La possibilità di verificare la genuinità del codice da parte di chiunque ne accresce la trasparenza e la sicurezza. Questo approccio open source consente una continua evoluzione del software, anche se la perfettibilità dei prodotti richiede un grande impegno da parte degli sviluppatori, i quali dedicano il loro tempo libero al progetto senza alcun contributo economico o legale.

Tsurugi Linux è dotato di strumenti avanzati per operare in diversi ambiti della cybersecurity, dalla DFIR (Digital Forensics and Incident Response) all’analisi del malware, dall’OSINT (Open Source Intelligence) alla computer vision e picture analysis. Tuttavia, oltre alla capacità di utilizzare questi strumenti, è sempre più importante acquisire competenze di programmazione e sviluppo di software. Questo permette di controllare meglio il software utilizzato e di creare programmi personalizzati per esigenze specifiche.

Questa pubblicazione rappresenta una semplice sintetica descrizione delle potenzialità di un intero sistema operativo con innumerevoli applicativi e programmi che coprono una vasta gamma di aree della Cyber Security (anche se non tutti sicuramente) e su ulteriori pubblicazioni saranno approfondite le varie aree e programmi in modo piu’ dettagliato e specifico con esempi da applicare sul campo e molto pragmatici.

Lo scrivente ha inserito numerosi programmi per semplificare operazioni complesse e molti altri verranno aggiunti, in particolare per la trascrizione e traduzione automatica e per l’analisi della blockchain, con l’obiettivo di ricostruire le transazioni delle blockchain pubbliche come Bitcoin, Ethereum, USDT, USDC e altre. Questi programmi sono in fase di debug e miglioramento, ma il tempo libero è prezioso e il progresso procede più lentamente rispetto ai progetti closed source.

Con il progetto Tsurugi Linux, si spera di offrire un contributo significativo alla cybersecurity italiana ed europea, pubblica e privata, senza escludere nessuno ed anche a quella Mondiale visto che la sicurezza informatica di ognuno riguarda tutti in un eco-sistema informatico sempre piu’ intrecciato e complesso a livello Globale. L’obiettivo è supportare un ecosistema sicuro e trasparente, dove la sicurezza informatica sia accessibile e verificabile da tutti, promuovendo la collaborazione e l’innovazione nel campo della cybersecurity.

Articolo a cura di Antonio ‘Visi@n’ Broi

Profilo Autore

“Antonio “aka” Vision” Broi” sviluppatore nella Distro Linux Tsurugi-Linux.org
Socio fondatore e formatore Osint e Digital Forensic nell’associazione lab4int.org

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/tsurugi-linux-cyber-security/


Valutare i rischi Cyber al tempo dell’Intelligenza Artificiale

I modelli di Intelligenza Artificiale (IA) e in particolare quelli di Machine Learning (ML), Predittivi, Generativi e “General Purpose” quali ad esempio i “Large Language Models” (LLM) come GPT, Bard/Gemini, LLaMA ecc., compaiono sempre più spesso all’interno delle applicazioni aziendali come componenti di applicazioni o per uso diretto.

E’ necessario quindi valutare i rischi di sicurezza informatica per le aziende, comunemente anche detti “Rischi Cyber”, connessi all’utilizzo di queste tecnologie. In questo articolo si danno alcune indicazioni su come approcciare la valutazione dei Rischi Cyber in presenza di modelli IA, quali sono le principali novità e cosa invece dovrebbe rimanere immutato rispetto alla tradizionale valutazione dei Rischi Cyber aziendali.

Valutazione dei Rischi Cyber

Conviene iniziare riassumendo brevemente l’approccio di base alla valutazione dei rischi [1,2]. Il punto di partenza è il possibile avverarsi di un Evento che può portare danno all’azienda. L’Evento può essere non-intenzionale, come un terremoto, un guasto, un errore umano, o intenzionale, come un attacco di “Denial of Service” in Internet.

E’ necessario quindi avere una tassonomia di Eventi che potrebbero essere nocivi e valutarne la Probabilità di Accadimento e l’eventuale Impatto (o danno).

Per ogni Evento, il Rischio Inerente è formalmente rappresentato dalla formula:

Rischio Inerente = (Probabilità di Accadimento) x Impatto

Per ridurre il Rischio Inerente si adottano delle Misure di Mitigazione del Rischio, ottenendo il Rischio Residuo associato ad ogni Evento:

Rischio Residuo = (Probabilità di Accadimento) x Impatto / Maturità delle Misure di Mitigazione

o anche

Rischio Residuo = Rischio Inerente / Maturità delle Misure di Mitigazione

Riassumendo, per ogni Evento potenzialmente nocivo va valutata la Probabilità di Accadimento, l’Impatto e la Maturità delle Misure di Mitigazione.

Rischi Cyber e Rischi Cyber dovuti all’IA

Le applicazioni che forniscono o contengono modelli di Intelligenza Artificiale sono comunque applicazioni informatiche e come tali soggette ai rischi comuni a tutte le applicazioni informatiche. Tra questi possono essere indicati ad esempio guasti all’hardware dei sistemi, guasti ai sistemi di alimentazione e di condizionamento delle sale macchine, o attacchi con malware/ ransomware, attacchi di phishing, attacchi ai sistemi di controllo accesso (quali quelli di forza bruta sulle password), eccetera.

La valutazione di tutti questi Rischi Cyber procede identica anche per le applicazioni che forniscono o contengono modelli IA, e non sono considerate in questo articolo. Nel prosieguo sono considerati solo Eventi e rischi specifici per i modelli di Intelligenza Artificiale.

Valutazione della Probabilità di Accadimento e Rischi nei Modelli di Intelligenza Artificiale: Sfide e Approcci Qualitativi

L’approccio standard alla valutazione della Probabilità di Accadimento di un Evento è di avere statistiche su periodi temporali appropriati sull’avverarsi dell’Evento. In informatica queste statistiche sono difficilmente disponibili o non esistono proprio. Infatti spesso la velocità degli sviluppi informatici è altamente superiore agli intervalli di tempo necessari per ottenere opportune statistiche, oltre alla difficoltà di raccogliere dati da molte diverse organizzazioni. Nel caso dei modelli di Intelligenza Artificiale, la novità di questa tecnologia e la rapidità del suo sviluppo implica una quasi totale assenza di statistiche su periodi di tempo sufficienti.

Come molto spesso per la valutazione dei rischi in informatica, è quindi necessario valutare qualitativamente la Probabilità di Accadimento di un Evento, adottando scale come la seguente:

  • molto bassa (o quasi mai)
  • bassa (al più una volta all’anno)
  • media (al più quattro volte all’anno)
  • alta (una o due volte al mese)
  • molto alta (ogni giorno o quasi sempre).

La valutazione è fatta sulla base delle informazioni note sull’Evento e sul sistema informatico, nostro caso il modello IA in ambito, la sua configurazione, i suoi modi d’uso, i suoi utenti ecc.

Conviene fare un paio di esempi considerando come componente IA un Large Language Model, ovvero ad esempio un ChatBot basato su un LLM. Si consideri un’applicazione esposta in Internet con registrazione per l’accesso pressoché libera; a priori quindi chiunque può registrarsi e accedere all’applicazione basata sul LLM.

Si consideri come Evento un attacco di “Prompt Injection”: solo sulla base delle notizie giornalistiche e degli articoli scientifici su questo tipo di attacchi, è possibile valutare qualitativamente che la Probabilità di Accadimento è Molto Alta.

Si consideri ora un altro modello IA addestrato con dati sintetici, generati unicamente all’interno dell’azienda, da personale interno, qualificato e molto limitato in numero. In questo caso un Evento di attacco di “Training Data Poisoning” sarà, sempre qualitativamente, molto poco probabile e quindi con Probabilità di Accadimento Molto Bassa.

Viceversa, se il modello IA è addestrato con dati scaricati con Bot da Internet e direttamente passati al modello per l’addestramento, la Probabilità di Accadimento di un Evento di attacco di “Training Data Poisoning” potrà anche essere Alta o anche Molto Alta.

Va ricordato che l’approccio adottato per la valutazione dei rischi suppone che la valutazione della Probabilità di Accadimento sia indipendente dalla presenza di Misure di Mitigazione. In altre parole, va fatta una per quanto possibile chiara distinzione tra Evento, la sua Probabilità di Accadimento, l’Impatto che l’Evento ha in caso di suo accadimento e le Misure di Mitigazione del rischio già presenti, valutando per quanto possibile in maniera indipendente gli ultimi tre fattori.

In particolare è alle volte difficile valutare quali siano le Misure di Mitigazione del rischio da considerare. Conviene ragionare su un esempio semplice: si consideri un’applicazione non esposta in Internet.

Tipicamente l’applicazione è eseguita su un server (fisico o virtuale) sulla rete aziendale (on-premises o in-cloud) che è separata da Internet da uno o più firewall che non permettono l’accesso da Internet all’applicazione. Nella valutazione dei rischi in considerazione, la non-esposizione in Internet è una caratteristica dell’applicazione, e non (formalmente) una Misura di Mitigazione del rischio, anche se questa caratteristica è in pratica realizzata da uno o più firewall.

Nella valutazione del rischio si dà quindi per scontato che la non-esposizione in Internet porti un rischio già valutato e accettato. D’altra parte, se si considera un’applicazione esposta in Internet si può ridurre parte del rischio eliminando l’esposizione in Internet; così facendo alcuni Eventi non saranno più applicabili (o più precisamente, la loro probabilità di accadimento sarà nulla o quasi) e alcune specifiche Misure di Mitigazione non saranno più strettamente necessarie, quale ad esempio l’utilizzo di Web Application Firewall.

Questo si collega a un’altra considerazione che deve essere fatta quando si considera la probabilità di accadimento degli eventi, ovvero la valutazione di eventi che vanno sotto il nome di “Black Swan”.

Come già indicato, l’avvio di una valutazione dei rischi richiede di identificare i possibili eventi nocivi, tra questi possono esserci eventi con bassissima Probabilità di Accadimento ma con altissimo Impatto potenziale.

Ad esempio, nel caso appena citato di un’applicazione non esposta in Internet, l’Evento Black Swan potrebbe essere la contemporanea compromissione di tutti i sistemi di segregazione della rete interna da Internet e la conseguente esposizione in Internet delle applicazioni aziendali.

O nel caso di un Datacenter e il suo Datacenter di Disaster Recovery, un guasto contemporaneo all’alimentazione o all’impianto di raffreddamento o alla rete di connettività che rende indisponibili entrambi allo stesso tempo.

In molti casi, come nei semplici esempi appena indicati, eventi Black Swan sono dati dall’avverarsi contemporaneamente di più Eventi semplici oggetto dell’analisi dei rischi e da questi ne può essere fatta un’analisi sia della Probabilità di Accadimento sia dei possibili Impatti.

Valutazione degli Impatti su Riservatezza, Integrità e Disponibilità nei Modelli di Intelligenza Artificiale: Classificazione e Rischi di Abuso

La valutazione degli Impatti che un Evento può avere deve essere sempre svolta considerando diversi aspetti o dimensioni di valutazione: quelli più comuni sono gli impatti economici, quelli d’immagine e quelli di conformità legislativa, a standard e certificazioni.

Per procedere alla valutazione dell’Impatto potenziale che un Evento può avere (in assenza di Misure di Mitigazione), è conveniente classificare gli Eventi secondo il tipo di impatto che potrebbero avere, ovvero se possono impattare Riservatezza, Integrità e Disponibilità (RID, in Inglese CIA) delle informazioni e/o del servizio informatico, o costituire un Abuso del sistema [Rif. 3].

Per una tradizionale applicazione informatica, un Abuso può verificarsi nel caso di utilizzo di funzionalità esistenti da parte di chi non ne è autorizzato (violazione dell’Integrità del sistema di autorizzazione dell’applicazione) o in violazione della licenza d’uso. Questo perché tutte le funzionalità e i possibili dati prodotti sono decisi, progettati e implementati dai programmatori; in altre parole, ogni dato prodotto dell’applicazione è previsto in fase di progettazione e quindi, almeno teoricamente, già noto.

Invece per i modelli IA Generativi, per loro stessa natura, vi è un ulteriore caso di Abuso quando il modello IA è utilizzato per generare dati non previsti dai programmatori e/o in violazione degli scopi dell’addestramento del modello, senza però violarne le caratteristiche RID.

Seguendo anche [Rif. 4], vengono qui considerati Eventi specifici per i modelli IA/ML che possono impattare le informazioni e/o il servizio informatico che le gestisce, organizzati secondo la caratteristica che potrebbero violare, tra Disponibilità, Integrità, Abuso e Riservatezza.

Impatto degli Attacchi e Malfunzionamenti sulla Disponibilità dei Modelli IA/ML: Rischi e Vulnerabilità

I modelli IA/ML possono essere oggetti a violazioni della loro Disponibilità con specifici attacchi o malfunzionamenti. A parte la violazione del codice con l’inserimento di back/trap-door, specifici Eventi per i modelli IA/ML possono far decadere le loro prestazioni sino a violare i livelli di Disponibilità previsti.

Come primo esempio, si considerino modelli IA/ML utilizzati in un veicolo a guida autonoma, alcuni di questi devono valutare dati provenienti dai sensori esterni in brevissimo tempo e fornire indicazioni per la guida del veicolo. Ma è possibile che per particolari dati sui quali non sono stati specificamente addestrati, questi modelli possano impiegare più tempo del previsto per svolgere le analisi.

Va ricordato che i modelli IA/ML sono addestrati su un campione di dati e non su tutti i dati possibili per cui il programmatore non può valutare a priori i tempi di esecuzione dei programmi su tutti i possibili dati in ingresso. Quello che può accadere è che il modello IA/ML non fornisca i dati nei tempi previsti, ovvero che i dati non siano disponibili nelle tempistiche previste.

L’impatto di un ritardo nella generazione dei dati può dipendere dalla quantità del ritardo; si possono quindi considerare diversi Eventi a seconda della possibile durata del ritardo nella produzione dei dati.

Un altro Evento di cui valutare il possibile Impatto, è che il modello IA/ML non sia in grado di identificare e processare i dati in ingresso producendo un risultato valido.

Ad esempio nel caso di un’immagine, il modello potrebbe non essere in grado di distinguere se è presente un cartello stradale, un’automobile o un albero, dando uguale probabilità a tutti i tre oggetti, anche se l’elaborazione è fatta nei tempi previsti.

Questo è un caso un po’ particolare di mancanza di Disponibilità, in quanto l’applicazione è disponibile, mentre quello che non è disponibile è il risultato dell’elaborazione. Un evento paragonabile per un’applicazione non IA è il caso che un errore di programmazione blocchi l’esecuzione dell’applicazione producendo al più un risultato nullo o un messaggio di errore.

Spesso l’addestramento dei modelli IA/ML, in particolare quelli più avanzati e complessi, viene esteso e integrato con nuovi dati ad esempio per migliorarne il comportamento, eliminare “Adversarial Examples” e aggiungere nuovi dati e informazioni.

L’estensione e integrazione dell’addestramento di un modello IA/ML può anche far dimenticare informazioni precedentemente imparate, e in casi estremi anche peggiorare le prestazioni di elaborazione del modello IA/ML. Quindi anche un Evento di estensione dell’addestramento può essere causa di un Impatto sulla Disponibilità di un modello IA/ML.

I precedenti tipi di Eventi sono principalmente dovuti sia all’architettura del modello IA/ML sia al processo e ai dati utilizzati per il suo addestramento. Sono però possibili anche attacchi ai modelli IA/ML, in particolare a quelli Generativi e ai Large Language Model, allo scopo sia di rallentare l’esecuzione del modello sino a quasi fermarne completamente l’elaborazione, sia di aumentare i consumi energetici in quanto i server su cui il modello è eseguito utilizzano tantissime risorse per l’elaborazione di una singola richiesta.

Questo può essere ottenuto con la preparazione ed esecuzione di specifiche richieste (“Query”) al modello costruite ad arte per poterne abusare. Questi tipi di attacco fanno anche parte degli attacchi di Abuso chiamati “Prompt Injection” o “Adversarial Prompting” [Rif. 5], ma sono qui considerati in quanto lo scopo di questi attacchi è di violare la Disponibilità del modello IA/ML [Rif. 6], per questo sono anche chiamati attacchi di tipo “AI Model DoS”.

Infine vanno anche considerati specifici Eventi relativi ai modelli IA/ML con funzionalità di tipo “Retrieval Augmented Generation (RAG)” [Rif. 7], ovvero che possono accedere a banche dati esterne, tra cui anche l’intero Internet, per integrare i dati con cui sono stati addestrati con informazioni puntuali, di dettaglio e aggiornate.

Tipicamente i dati provenienti dalle banche dati esterne sono pre-elaborati e aggiunti alla richiesta (“Query”) dell’utente per essere utilizzati come informazioni di contesto dal modello IA/ML. L’utilizzo di dati esterni può anche diventare un canale di attacco, anche solo involontario, al modello ottenendo effetti simili a quelli appena descritti per gli Eventi di “AI Model DoS”.

Violazioni dell’Integrità nei Modelli IA/ML: Attacchi Adversariali, Allucinazioni e Avvelenamento dei Dati

In una usuale applicazione informatica la violazione dell’Integrità dei dati (informazioni o codice) comporta la produzione di risultati errati sia come risultato di una elaborazione sia come semplice produzione dei dati archiviati.

Per i modelli IA/ML è possibile considerare come violazione della “Integrità” eventi in cui il risultato dell’elaborazione è errato. Quindi per i modelli IA/ML associamo al concetto di violazione dell’Integrità più che la violazione di dati quali informazioni archiviate o codice dell’applicazione, il risultato di questa violazione, ovvero il produrre risultati errati.

Gli Eventi, sia involontari che attacchi volontari, detti di Evasione e anche chiamati “Adversarial Attacks” o “Adversarial Examples”, sono forse quelli più specifici dei modelli di Machine Learning. Questi sono principalmente dovuti al processo di apprendimento dei modelli stessi e al modo in cui le informazioni apprese vengono utilizzate dai modelli durante la loro esecuzione.

In pratica sono Eventi in cui il modello sbaglia completamente su dati di ingresso molto simili a quelli di addestramento [Rif. 8]. Esempi famosi sono i cartelli stradali di stop con uno sticker giallo riconosciuti come cartelli di limite di velocità, o montature di occhiali, cappelli, trucco per il viso che portano il modello a riconoscere una persona per un’altra. Gli Impatti di un Evento di Evasione possono essere molto significativi e devono essere considerati attentamente nella valutazione dei rischi Cyber di un’applicazione IA/ML.

Altri Eventi specifici per i modelli Generativi / LLM sono chiamati Allucinazioni (o “Confabulation”) sono dovuti al fatto che questi modelli possono produrre risultati che sembrano assolutamente reali o realistici (hanno un’alta probabilità di assomigliare alla realtà derivante dai dati di addestramento), ma in realtà sono del tutto falsi, inappropriati o pericolosi. Negli ultimi due anni, sono stati riportati dagli organi di informazioni molti casi, alcuni anche clamorosi, di Eventi di Allucinazione dei modelli Generativi / LLM più famosi, a partire da ChatGPT, Bard ecc.

Altri tipi di Eventi più tradizionali di violazione dell’Integrità ma sempre molto significativi per i modelli IA/ML sono quelli di “Avvelenamento” del codice o dei dati di addestramento. In entrambi i casi si tratta di Eventi di modifica volontaria (cioè attacchi) o involontaria del codice del modello IA/ML o dei suoi dati di addestramento.

In particolare, la maggior parte dei modelli IA/ML più avanzati ha la necessità di utilizzare grandi quantità di dati di addestramento di cui è quindi difficile verificare la qualità e sicurezza; un loro “Avvelenamento” può far sì che il modello produca, almeno in alcune situazioni, risultati diversi da quelli attesi e per i quali è stato programmato, violando appunto l’Integrità di quanto prodotto.

Abuso dei Modelli IA Generativi: Rischi di Utilizzo Improprio e Impatti su Sicurezza e Conformità

Come indicato precedentemente, un Evento di Abuso per i modelli IA Generativi consiste in un utilizzo (tipicamente volontario) del modello allo scopo di ottenere risultati non previsti dai programmatori e/o in violazione degli scopi dell’addestramento del modello.

Esempi semplici, se non banali, sono la produzione da parte del modello di codice di Malware, di testi di Phishing, di Fake News, di istruzioni per la preparazione di ordigni o per la realizzazione di eventi malevoli quali attentati, rapine o furti, ma anche la generazione di immagini, video, audio in violazione di Copyright ecc.

Questi Eventi possono produrre Impatti di immagine, di conformità ma anche economici nel caso di violazione di diritti altrui ed è quindi necessario valutarne sia la Probabilità di accadimento (potrebbe anche essere nulla per certi tipi di modelli IA/ML) e i possibili Impatti.

Si possono includere tra gli Abusi, anche se dovuti direttamente al modello IA/ML stesso e non ad un uso improprio da parte di un utente finale, Eventi in cui modelli con funzionalità di tipo RAG sono in grado di eseguire azioni ad esempio su altre applicazioni raggiungibili in Internet, non previste e non lecite, quali attacchi a siti web per estrarne informazioni non direttamente accessibili [Rif. 9].

Violazioni della Riservatezza nei Modelli IA/ML: Attacchi di Estrazione e Ricostruzione dei Dati di Addestramento

L’analisi degli Eventi che possono violare la riservatezza delle informazioni elaborate da un modello IA/ML è quella più simile al caso di una applicazione informatica non IA/ML. Vi sono alcune sorgenti di informazioni che possono essere riservate: i dati di addestramento, l’architettura, il disegno e il codice del modello, i dati degli utenti che utilizzano il modello ma che non sono utilizzati per addestrare il modello stesso.

Dal punto di vista di un’analisi dei rischi specifica per i modelli IA/ML, l’unico tipo di Eventi realmente rilevante è quello che riguarda i dati di addestramento, utilizzati sia nelle fasi di pre-training che nelle fasi di fine-tuning, elaborati e memorizzati dal modello stesso. I principali Eventi che possono violare la Riservatezza delle informazioni in questo caso sono gli attacchi di Estrazione e Ricostruzione.

Questi attacchi sfruttano delle debolezze o vulnerabilità dei modelli IA/ML per estrarre dati riservati tramite l’utilizzo del modello stesso. Questo è possibile perché all’interno di un modello ML non è possibile, almeno ad oggi, implementare un sistema di controllo accessi alle informazioni, e quindi un attaccante può provare a formulare delle “Query” in modo tale da ottenere come risultato dell’elaborazione informazioni sui dati di addestramento o sulla struttura stessa del modello, e in alcuni casi di ottenere i dati stessi.

Con maggiori difficoltà, questo è possibile anche per i modelli di ML più semplici quali quelli di “Classificazione” in cui un attaccante può sottoporre al modello dei dati in ingresso così preparati da poter dedurre dalle risposte del modello se un certo dato è stato utilizzato per l’addestramento del modello stesso (questi attacchi sono chiamati di “Membership Inference”).

Strategie di Mitigazione dei Rischi Cyber nei Modelli IA/ML: L’Importanza di Governance, Formazione e Controlli Operativi

In questo articolo non sono trattate in dettaglio possibili misure di mitigazione dei rischi specifici alle applicazioni IA/ML.

È utile comunque sottolineare che forse più delle misure tecniche di sicurezza applicabili ai modelli IA/ML stessi, oggi sono forse più importanti e più efficaci misure di sicurezza di governo, processo, utilizzo e gestione di queste tecnologie. Queste includono la formazione e informazione degli amministratori IT e degli utenti sulle reali caratteristiche, potenzialità, funzionalità e rischi di utilizzo di queste tecnologie.

In altre parole, il solo fatto che tipicamente i risultati prodotti da modelli IA/ML siano elaborazione probabilistiche sulla base dei soli dati di addestramento utilizzati e non risultati esatti, decisi da chi ha disegnato l’applicazione, richiede un diverso approccio degli utenti al loro utilizzo.

D’altra parte gli sviluppatori che le programmano e gli amministratori IT che le gestiscono devono introdurre misure di sicurezza spesso esterne ai modelli IA/ML quali ad esempio filtri sui dati in ingresso e verifiche di qualità sui dati prodotti.

Il Ruolo della Supply Chain nella Valutazione dei Rischi Cyber per l’Utilizzo di Modelli IA/ML Avanzati: Sfide e Impatti delle Terze Parti

Per concludere questa breve presentazione di un possibile approccio alla valutazione dei “Rischi Cyber” dovuti a un eventuale utilizzo dei più recenti e avanzati modelli di Intelligenza Artificiale e Machine Learning, deve essere evidenziato e considerato il ruolo e il possibile impatto di terze parti e in generale della Supply Chain.

Per molti aspetti il paradigma informatico dei modelli IA/ML è molto diverso da quello di una tradizionale applicazione informatica e richiede personale con specifiche competenze per la loro creazione e gestione. Dato il rapidissimo sviluppo di queste tecnologie nell’ultimo paio di anni, è comune che all’interno delle aziende non vi siano ancora né specifiche competenze tecniche, né sensibilità del personale per comprendere le proprietà, utilizzare correttamente e valutare i rischi derivanti dall’uso di modelli IA/ML. Questo facilmente porta ad affidarsi a terze parti senza però essere in grado di valutare i possibili impatti e rischi che ne possono derivare.

Il problema è ancora più complesso in quanto ad oggi il numero di fornitori di queste tecnologie che sono all’avanguardia sono relativamente pochi, e può capitare che un servizio applicativo erogato in Internet (o “Cloud”) basato o che include tecnologie IA/ML avanzate come quelle dei modelli Predittivi, Generativi, “General Purpose” e “Large Language Models” (LLM), in realtà abbia come terza parte che fornisce integralmente la tecnologia IA/ML uno dei maggiori fornitori quali Amazon, Google, Meta, Microsoft, OpenAI ecc. La catena di fornitura, o Supply Chain, è spesso lunga e le competenze tecniche in ambito AI/ML possono risiedere all’estremo opposto della catena rispetto all’utilizzatore, e quindi difficili da verificare e valutare.

L’esempio più semplice da considerare è quello della gestione dei dati di addestramento. Per valutare i rischi derivanti dall’utilizzo di un’applicazione di Machine Learning erogata da un fornitore, bisogna comprendere su quali dati è addestrato il modello. Infatti un modello ML potrebbe essere addestrato utilizzando dati direttamente scaricati da Internet o, più probabilmente, forniti da una terza parte specializzata nella loro raccolta e preparazione.

Bisognerebbe comprendere quali procedure sono state adottate per garantire non solo la qualità dei dati, ma anche l’eticità, l’assenza di copyright o restrizioni sul loro uso, le misure di sicurezza adottate per evitare che un attaccante sia in grado di avvelenare i dati di addestramento per propri scopi che possono includere anche un attacco all’azienda che utilizza il servizio. Inoltre bisognerebbe sapere se tra i dati di addestramento sono utilizzate anche informazioni dei propri concorrenti, se sono utilizzati dati pubblici della propria azienda, se sono utilizzati i dati inviati dal personale aziendale all’applicazione nel corso del suo utilizzo (genericamente chiamati dati delle “Query”), ecc.

La complessità e al contempo novità di questa Supply Chain può quindi rendere ancora più complessa la valutazione dei Rischi Cyber connessi all’utilizzo dei più avanzati modelli di Intelligenza Artificiale e Machine Learning.

Riferimenti

[1] Quella presentata è solo una tra le più comuni metodologie di calcolo dei rischi, un altro approccio alle volte adottato per la valutazione dei rischi in informatica è quello proposto da OWASP con la “OWASP Risk Rating Methodology”

https://owasp.org/www-community/OWASP_Risk_Rating_Methodology

[2] si veda anche “Mapping LLM Security Landscapes: A Comprehensive Stakeholder Risk Assessment Proposal”, https://arxiv.org/abs/2403.13309v1

[3] NIST AI 100-2 “Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations”, https://csrc.nist.gov/pubs/ai/100/2/e2023/final

[4] OWASP, “OWASP Top 10 for Large Language Models”, https://genai.owasp.org/ ; si veda anche A. Pasquinucci, “Attacchi ai Modelli di Intelligenza Artificiale”, https://www.ictsecuritymagazine.com/articoli/attacchi-ai-modelli-di-intelligenza-artificiale/

[5] Per una breve introduzione si veda “Prompt Injection Attacks in Large Language Models”, SecureFlag, https://blog.secureflag.com/2023/11/10/prompt-injection-attacks-in-large-language-models/

[6] I. Shumailov, Y. Zhao, D. Bates, N. Papernot, R. Mullins, R. Anderson , “Sponge Examples: Energy-Latency Attacks on Neural Networks”, https://arxiv.org/abs/2006.03463

[7] Per una breve introduzione si veda ad esempio A. Kumar, “Retrieval Augmented Generation (RAG) & LLM”, https://vitalflux.com/retrieval-augmented-generation-rag-llm-examples/

[8] A. Pasquinucci, “Adversarial Attacks a Modelli di Machine Learning”, White Paper, ICT Security Magazine, https://www.ictsecuritymagazine.com/pubblicazioni/adversarial-attacks/

[9] R. Fang, R. Bindu, A. Gupta, Q. Zhan, D. Kang, “LLM Agents can Autonomously Hack Websites”, https://arxiv.org/abs/2402.06664 ; R. Fang, R. Bindu, A. Gupta, D. Kang, “LLM Agents can Autonomously Exploit One-day Vulnerabilities”, https://arxiv.org/abs/2404.08144

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/valutare-i-rischi-cyber-al-tempo-dellintelligenza-artificiale/


Sovranità digitale: certificazione Cyber di prodotti ed elementi di Rete

Sovranità digitale e processi cyber strutturati: la base per una cooperazione tecnologica efficace.

Servono processi cyber strutturati e cooperazione tecnologica; affinché le organizzazioni raggiungano una vera cyber resilienza, è necessario costruire un processo di trustability che comprenda certificazioni e conformità ma anche continui test e monitoraggio. Prevenzione e resilienza vanno di pari passo con la cooperazione, nazionale e internazionale, vista la disomogeneità dei sistemi componenti le varie reti.

Processi Strutturati per la Sovranità Digitale

Una vera cyber resilienza all’interno delle organizzazioni, può essere garantita solo in presenza di determinate condizioni: innanzitutto occorrono processi di cyber security strutturati, in quanto il continuo aumento di attacchi informatici sta duramente mettendo alla prova la resilienza degli assett organizzativi. In secondo luogo, serve tra i responsabili della sicurezza un’adeguata consapevolezza di tali processi che va sfruttata in ottica di prevenzione di qualunque evento informatico avverso.

A questi elementi va aggiunta la cooperazione tra le diverse aziende che forniscono e gestiscono i sottosistemi di un sistema tecnologico, affinché configurino i propri apparati garantendo aderenza agli stessi standard di sicurezza e dunque interoperabilità. In ultimo, ma non certo per importanza, la certificazione degli apparati e la conformità agli standard internazionali.

Va costruito quindi un processo di trustability che, per citare un intervento del Direttore del Centro di Valutazione e Certificazione Nazionale, sia come un fossato attorno a un castello, dove le porte e le pusterle rappresentano i possibili accessi malevoli che minano la cyber resilienza delle nostre reti.

Questo processo comprende certificazioni e conformità ma anche continui test e monitoraggio e centra gli obiettivi che sta implementando nell’ultimo anno la nostra agenzia per la cyber security nazionale.

Il processo di trustability, cruciale per la sovranità digitale, va garantito attraverso diversi step di cooperazione tra aziende fornitrici di uno stesso sistema ICT e/o di una stessa rete. Quindi prevenzione e resilienza vanno di pari passo con la cooperazione, nazionale e internazionale, vista la disomogeneità dei sistemi componenti le varie reti.

Standard di Sicurezza Condivisi: un Pilastro della Sovranità digitale

Gli standard di sicurezza condivisi sono necessari come base per garantire la resilienza di apparati, reti e sistemi complessi, contribuendo così alla sovranità digitale.

L’approccio a standard che utilizzavamo all’inizio degli anni 2000 per i protocolli di rete, i quali dovevano essere a standard proprio per garantire la comunicazione tra gli utenti, va ora riutilizzato per rendere le stesse reti resilienti e quindi sicure.

Gli standard internazionali hanno il grande vantaggio di essere il miglior esempio di cooperazione tra stakeholder, a vantaggio degli utenti finali oltre a garantire competizione e innovazione tecnologica prevenendo, tra l’altro, rischi di interoperabilità tra componenti di rete sempre più disomogenei, vista la globalizzazione inevitabile della manifattura.

Standard e certificazioni “adattabili” ai contesti

Gli standard sono quindi fondamentali per garantire una piattaforma comune di resilienza delle reti ma sono una condizione necessaria e non sufficiente.

È utile, infatti, che standard e certificazioni non siano localizzati nel contenuto ma adattabili ai diversi contesti. Questa è la direzione recentemente adottata nelle linee guida metodologiche del Centro di Valutazione e Certificazione Nazionale.

Questa può essere un’implementazione di un concetto avanzato di sovranità digitale: laboratori locali ma certificazioni internazionali.

Le certificazioni cyber devono rispettare corrette e differenziate analisi di rischio ma prevedere anche tempi certi. Alcuni approcci europei, mi riferisco alla EN17640, che prevede 60 giorni di certificazione, possono rappresentare il giusto compromesso per coniugare le esigenze di time-to-market con la qualità di certificazione, supportando la sovranità digitale.

Apparati certificati cyber possono essere un vero baluardo per gli attacchi hacker ed utilizzi impropri da parte della criminalità organizzata.

Bibliografia:

  1. Piccinelli L. (Giugno 2024) : Nasi, Rauti, CaoPinna, Piccinelli: Rapporto Cybercrime Fondazione Magna Grecia, a cura On.Foti presentato alla Camera dei Deputati (Presidenza Commissione Antimafia)
  2. Piccinelli L. (Novembre 2023) Processi Cyber & Cooperazione Tecnologica ed. Online www.cybersecurity360.it
  3. Piccinelli L. (Marzo 2023) Neutralità tecnologica e certificazione ed. Online www.cybersecurity360.it

Articolo a cura di Luca Piccinelli

Profilo Autore

Nel suo ruolo di Direttore del dipartimento italiano di Cyber Security, dal 2020 ha la responsabilità di sviluppare e supervisionare le politiche e le strategie di mitigazione dei rischi di sicurezza e privacy legati a tutte le operazioni aziendali, di sovrintendere alla comunicazione con i rappresentanti delle istituzioni italiane, altri interlocutori del mondo della sicurezza informatica, gli operatori di telecomunicazioni e i diversi attori del settore ICT B2B, assicurando continuità e sviluppo al Business per l’intero portafoglio prodotti Huawei.

Dopo aver conseguito un PhD in Ingegneria delle Telecomunicazioni e un Master presso l’Istituto di Scienze Militari Aeronautiche di Firenze, Luca Piccinelli ha iniziato il suo percorso professionale come ufficiale dell’Aeronautica Militare nel 1999, con la responsabilità di gestione della sicurezza informatica e del sistema di elaborazione dati dell’aeroporto di Viterbo; nel 2000 si è occupato di sistemi missilistici presso Leonardo, mentre dal 2001 al 2002 ha seguito il lancio dei primi sistemi 3G di comunicazione mobile presso British Telecom.

Nel 2003 è entrato in TIM dove si è occupato di collaudo e Ingegneria di sistemi mobili e terminali, contribuendo al lancio della tecnologia 4G, e ha svolto anche il ruolo di delegato dell’azienda presso l’organizzazione di standardizzazione 3GPP tra il 2003 e il 2006. Dal 2003 al 2012 è stato Chairman del gruppo tecnico dell’ente di certificazione internazionale dei cellulari GCF, all’interno del quale ha anche ricoperto la carica di Direttore del Board dal 2008 al 2013, siglando il primo contratto di roaming tra TIM e Verizon nel 2012.

In Huawei dal 2013, Piccinelli ha esordito come Marketing Manager responsabile delle soluzioni Core Network 4G e dei sistemi Multimedia Broadcast, per poi diventare responsabile di Innovazione, Marketing e sviluppo del Business strategico in ambito Digital Transformation, IoT e 5G nel 2015. E’ stato inoltre delegato dell’azienda presso la Strategic Committee del progetto di sperimentazione Bari-Matera 5G promosso dal Ministero dello Sviluppo Economico.
Dal 2020 Luca Piccinelli riporta al CEO Italia ricoprendo la carica di Chief Cyber Security e Privacy Officer.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sovranita-digitale/


Utilizzo dell’intelligenza artificiale nella cybersecurity dei sistemi industriali

L’articolo esplora come l’intelligenza artificiale stia influenzando la crescente sofisticazione degli attacchi cibernetici ai sistemi industriali nell’era dell’Industria 4.0, con un focus sui rischi che minacciano i sistemi di controllo industriale (ICS). Verranno analizzate le principali minacce informatiche che questi sistemi devono affrontare, mettendo in evidenza come l’adozione di tecnologie come l’intelligenza artificiale e l’Internet delle cose (IoT) abbia migliorato l’efficienza e la produttività, ma allo stesso tempo esposto le infrastrutture critiche a nuovi pericoli. Infine, si esamineranno gli strumenti basati sull’intelligenza artificiale per prevenire e mitigare questi attacchi, considerando le sfide e le opportunità offerte da tali tecnologie per la sicurezza cibernetica.

Intelligenza Artificiale e Sistemi Industriali: Proteggere l’Industria 4.0 dalle Minacce Cibernetiche

Gli attacchi cibernetici ai sistemi industriali sono diventati sempre più sofisticati e pericolosi con l’evoluzione dell’Industria 4.0.

L’Industria 4.0 ha l’obiettivo di creare un ambiente industriale per ecosistemi di produzione in tempo reale, fabbriche intelligenti e sistemi autonomi. I progetti legati all’Industria 4.0 utilizzano tecnologie dell’informazione come l’Internet delle cose (IoT), il cloud, i big data e l’intelligenza artificiale (IA). La capacità di connettere i sistemi industriali alla rete ha portato a numerosi vantaggi in termini di efficienza, produttività, manutenzione e monitoraggio; ma ha anche aumentato esponenzialmente la superficie esposta alle minacce cyber. Sistemi e processi industriali sono così diventati un nuovo obiettivo primario; in particolare, i sistemi di controllo industriale (ICS) sono diventati uno dei principali target per i cyber criminali.

Questi sistemi sono responsabili del monitoraggio e del controllo dei processi industriali, come la produzione di energia, la gestione delle forniture idriche e l’automazione delle fabbriche. Proteggere i sistemi di controllo industriale dai cyber attacchi è una priorità per garantire la sicurezza di asset che vanno oltre l’operatività di un’azienda, potendo arrivare al blocco di intere nazioni o addirittura a pericoli per la vita umana.

Rimane nella storia dei cyber attacchi quello del 23 dicembre 2015 in Ucraina, quando il malware Blackenergy ha disconnesso alcune sottostazioni elettriche della rete elettrica nazionale, causando un black out di diverse ore nella maggior parte del Paese; precedenti attacchi che hanno utilizzato il malware BlackEnergy erano stati attribuiti a Sandworm Team, gruppo criminale piuttosto noto per azioni contro sistemi SCADA/ICS. Più recentemente, a maggio del 2021, un altro attacco ha fatto molto riflettere la comunità degli esperti di sicurezza: quello in cui un ransomware ha interrotto tutte le operazioni della Colonial Pipeline, il più grande gasdotto degli Stati Uniti. L’azienda ha dichiarato di aver pagato 4,4 milioni di dollari per ripristinare la propria attività.

Introduzione ai Sistemi di Controllo Industriale (ICS) – Vulnerabilità e Convergenza IT/OT

I sistemi di controllo industriale (ICS – Industrial Control System) sono comunemente definiti come un sottoinsieme delle tecnologie operative (OT – Operational Technology) che regolano i processi industriali; e comprendono a loro volta i sistemi noti come SCADA (Supervisor Control and Data Acquisition), introdotti a partire dagli anni ‘60 per monitorare le linee di produzione e oggi spesso associati a infrastrutture su larga scala denominate DCS (Distributed Control System), ampiamente utilizzate nell’industria di processo (Fig.1).

Fig.1

Storicamente, gli ICS non sono stati progettati con caratteristiche di sicurezza “by design” e la convergenza di ambienti OT con le tecnologie dell’IT (Information Technology) nell’Industria 4.0 ha portato con sé le vulnerabilità dei sistemi IT: ad esempio la capacità di gestione remota ha connesso i sistemi ICS alla rete Internet, così esponendoli ai rischi del mondo esterno.

I sistemi OT hanno, poi, delle peculiarità che rendono difficile l’utilizzo delle misure di protezione tipiche dei sistemi IT: ad esempio la quantità di informazioni scambiate in rete, estremamente elevata ma con pacchetti di informazioni di dimensioni limitate (dell’ordine di pochi byte) e provenienti da un gran numero di fonti.

Questo significa che alcuni meccanismi, come la crittografia utilizzata per le classiche trasmissioni di dati IT o la firma digitale (usata per evitare l’alterazione dei dati), risultano di difficile adozione perché potrebbero introdurre un overhead elevato e un ritardo inaccettabile nell’elaborazione dei dati e per il controllo dell’hard real-time; in altre parole il requisito per garantire il tempo massimo di esecuzione per ogni task, essenziale per il controllo di processi industriali che il più delle volte operano a ciclo continuo (24×365).

In questo scenario anche l’utilizzo dei sistemi antivirus e le attività di patching risultano complessi da introdurre e applicare. Il tutto è reso ancora più complesso dal fatto che questi sistemi abbiano un setup molto ampio e una durata di vita di oltre dieci anni.

Va considerato inoltre che i sistemi ICS sono sempre più presenti in ambienti cyber-fisici o CPS (Cyber-Physical Systems), tra i più significativi nello sviluppo dell’informatica.

Nei CPS c’è una combinazione di processi fisici in rete integrati con componenti cibernetici, sensori e attuatori che interagiscono nel ciclo di monitoraggio e nel processo decisionale della linea di produzione: interazioni, queste, che diventano essenziali nei processi uomo-macchina e macchina-macchina tipici dello smart manufacturing e della produzione “intelligente”.

Infine, mentre i sistemi IT sono stati progettati per interagire con un operatore umano, i sistemi OT devono principalmente interfacciarsi con “sistemi fisici”, dovendo considerare elementi come reazioni chimiche, liquidi, variazioni di temperature, movimento di oggetti, etc.

Un attacco con iniezione di dati falsi, che mira a compromettere le misure di supervisione e acquisizione dati (SCADA) e a disturbare il funzionamento del sistema, è tra le cyber minacce più temute negli ambienti OT.

La valutazione dei rischi di sicurezza, nell’ambiente industriale, deve considerare non solo gli aspetti digitali ma anche quelli fisici. Questo approccio è essenziale per proteggere le persone, l’ambiente e le infrastrutture critiche dalle minacce informatiche. Nell’ambito operativo, la probabilità e l’impatto non sono gli unici due fattori da considerare: la relazione con il mondo fisico è il terzo parametro chiave nella formula della cybersecurity per l’OT.

Questo parametro aggiuntivo modifica drasticamente la valutazione del rischio e include dettagli preziosi per gli operatori, la cui postura di sicurezza è principalmente focalizzata sulla vita umana e sugli impatti per l’ambiente, ovvero asset che non vengono quasi mai presi in considerazione nell’IT.

Architetture IT/OT Integrate e Attacchi Informatici agli ICS

A titolo esemplificativo si riporta in Fig. 2 un macro esempio di architettura IT/OT integrata:

Intelligenza Artificiale nella Cybersecurity Industriale: CS Architecture based on PERA model (Williams, 1994)
Fig. 2 – ICS Architecture based on PERA model (Williams, 1994)

Gli attacchi informatici agli ICS possono essere mirati od opportunistici. I primi hanno come obiettivo immediato l’infrastruttura fisica, mentre i secondi includono un attacco contro un sistema industriale come sottoprodotto, piuttosto che come obiettivo principale.

La MITRE Corporation ha recentemente rilasciato un quadro MITRE ATT&CK per ICS [1] per modellare i percorsi di attacco verso l’OT, sotto forma di tattiche, tecniche e procedure. Alcune delle tattiche del quadro ATT&CK per ICS ricompaiono nella matrice ATT&CK generale; altre sono uniche per i sistemi di controllo industriale.

Tra le tattiche uniche vi sono l’inibizione delle funzioni di controllo, la compromissione del controllo dei processi e una categoria che elenca le varie forme di impatto che gli attacchi informatici ICS possono avere. Gli attacchi di solito non vengono eseguiti in un’unica fase e con un’unica tecnica o procedura. Al contrario, si basano su un insieme di tecniche eseguite in una sequenza nota come kill chain.

Il quadro MITRE ATT&CK per ICS aiuta a identificare le specifiche tecniche e procedure che possono essere utilizzate in ciascuna fase della kill chain per gli attacchi agli ICS. L’utilizzo di un quadro come ATT&CK for ICS permette agli operatori di sistemi di controllo industriale di comprendere meglio le minacce, di identificare le vulnerabilità e di adottare misure preventive e di mitigazione.

Inoltre, l’impiego della Threat Intelligence nell’utilizzo del MITRE ATT&CK aiuta a fornire una visione più completa e dettagliata dell’ambiente di sicurezza, consentendo di aggiornare il framework in modo più preciso e dinamico, permettendo di:

  1. identificare le tecniche usate dagli attaccanti: la Threat Intelligence fornisce informazioni sulla modalità di attacco utilizzata da ciascun gruppo di attaccanti, consentendo di mappare queste informazioni alla corrispondente tecnica nel framework MITRE ATT&CK;
  2. prioritizzare la mitigazione: la Threat Intelligence fornisce informazioni sulla gravità degli attacchi e la probabilità di successo, consentendo agli amministratori di priorizzare la mitigazione delle tecniche di attacco più pericolose in base allo scenario e alla tipologia di organizzazione;
  3. diminuire i casi di falso positivo: la Threat Intelligence fornisce informazioni sui comportamenti di attacco specifici, consentendo di ridurre gli errori dovuti a falsi positivi nelle analisi di sicurezza;
  4. fornire un contesto strategico: la Threat Intelligence fornisce un quadro più completo circa il contesto strategico , consentendo di comprendere la natura dell’attacco, la motivazione degli attaccanti e le implicazioni per l’organizzazione.

In questo complesso scenario, che vede le problematiche di sicurezza legate al mondo ICT sommarsi a quelle specifiche del settore OT, un valido aiuto nella prevenzione e contrasto a queste tipologie di attacchi cyber viene da soluzioni basate sull’intelligenza artificiale [2].

Intelligenza Artificiale e Cybersecurity nella Industry 4.0

L’intelligenza artificiale è un approccio innovativo che conferisce soprattutto capacità di apprendimento al sistema. L’utilizzo di algoritmi di deep learning e machine learning permette di sviluppare sistemi di rilevamento delle intrusioni (IDS) per combattere gli attacchi informatici, che possono compromettere sistemi di tipologia OT; ad esempio la capacità di analizzare in real time traffico intenso ma di ridotte dimensioni nonché di analizzare la corretta configurazione dei parametri dei sensori e attuatori di un sistema SCADA o, ancora, di un PLC rispetto al suo comportamento operativo.

Proprio per le peculiari ed eterogenee caratteristiche architetturali degli ambienti OT, con un approccio basato su sistemi IA in grado di utilizzare contemporaneamente modelli diversi di deep learning (DL) e machine learning (ML), è possibile creare un sistema deep ensemble.

L’ensembling è un approccio di ML che combina diversi modelli predittivi per ottenere una migliore performance di previsione rispetto a un singolo modello.

Il concetto di base dell’ensembling è che la fusione delle previsioni di più modelli può ridurre la varianza delle previsioni individuali e migliorare stabilità e accuratezza complessiva del modello predittivo, magnificando così i punti di forza dei vari modelli, che si completeranno tra loro; mentre molte debolezze degli stessi si elimineranno a vicenda.

Questo metodo innovativo di rilevamento delle anomalie utilizza un insieme di modelli di deep learning per identificare e rilevare attacchi informatici nei sistemi SCADA/ICS. Il modello deep ensemble combina e apprende in modo dettagliato le caratteristiche delle attività dannose, permettendo di distinguerle dalle attività normali. Il principale vantaggio dei modelli di deep learning utilizzati è che non si richiede una progettazione delle funzionalità né si assumono ipotesi sulla distribuzione dei dati, rendendo quindi questi sistemi molto interessanti anche per il rilevamento degli attacchi informatici in ambito ICT.

Esistono diverse tecniche di deep learning che possono essere utilizzate per contrastare i cyber attacchi.

  • Rilevazione degli attacchi: le reti neurali possono essere addestrate per rilevare attività sospette o anomale nella rete, come intrusione o attacchi DDoS. Questi modelli possono essere addestrati utilizzando dataset etichettati contenenti esempi di attività normali e attività malevole.
  • SVM (Support Vector Machine): algoritmi di apprendimento automatico che possono essere usati per rilevare attacchi basati sulle caratteristiche del traffico di rete. L’SVM è in grado di distinguere tra traffico normale ed eventuali anomalie, che possono essere indicatori di un attacco in corso.
  • Riconoscimento di malware: l’utilizzo di reti neurali per riconoscere i modelli di codice dannoso può essere utile per rilevare e isolare i malware prima che possano causare danni significativi.

Principali Modelli di Intelligenza Artificiale per la Sicurezza dei Sistemi Industriali

Di seguito si esaminano i principali modelli di intelligenza artificiale utilizzati per migliorare la sicurezza dei sistemi industriali, approfondendo come reti neurali convoluzionali, autoencoder, Deep Belief Network, GAN e Deep Reinforcement Learning possano essere impiegati per rilevare, prevenire e mitigare le minacce informatiche negli ambienti industriali sempre più complessi.

Reti neurali convoluzionali (CNN):

Si tratta di una rete neurale progettata per elaborare input memorizzati in array. L’architettura delle CNN è composta da tre tipi di strati: strati di convoluzione, strati di raggruppamento e strati di classificazione. Le CNN possono essere utilizzate per monitorare l’integrità del sistema industriale, in quanto possono analizzare flussi di dati provenienti da sensori all’interno dell’ambiente e rilevare anomalie o violazioni dei parametri di sistema, garantendo un continuo monitoraggio dell’integrità del sistema stesso.

Le CNN possono anche essere allenate per rilevare tentativi di hacking e manipolazione dei dati, potendo analizzare i log di sistema e i flussi di dati per identificare comportamenti anomali o attività sospette all’interno della rete industriale. Anche l’ambiente fisico può essere controllato attraverso le reti CNN, allenandole a rilevare intrusioni o accessi non autorizzati; tramite l’analisi di immagini o video provenienti da telecamere di sicurezza o droni, le CNN possono rilevare anomalie o comportamenti sospetti all’interno dell’ambiente industriale.

Autoencoder profondi (DAE):

Sono reti neurali in grado di analizzare e codificare dati compressi, presentando la versatilità dell’apprendimento non supervisionato. L’encoder e il decodificatore sono i componenti fondamentali dell’autoencode: un’applicazione adatta alla sicurezza dei dispositivi IoT, ai sistemi di intrusione e al rilevamento dei guasti dei sensori. Gli autoencoder di denoising sono un tipo di algoritmo di apprendimento automatico che può essere utilizzato nel campo della cybersecurity, in particolare nel contesto dei sistemi di controllo industriale. Negli ICS, i DAE di denoising possono essere utilizzati per rilevare anomalie nelle letture dei sensori e in altri flussi di dati, che potrebbero indicare una minaccia alla sicurezza informatica.

Addestrando l’autoencoder in condizioni operative normali, esso può imparare a distinguere tra dati normali e anomali; se rileva un input che si discosta significativamente dalla distribuzione normale, può segnalarlo come potenzialmente anomalo e indicativo di un problema di cybersecurity. Gli autoencoder di denoising possono essere utilizzati anche per il rilevamento e la diagnosi dei guasti nei processi industriali, il che può aiutare a prevenire le minacce alla cybersecurity attenuando gli effetti di guasti o malfunzionamenti delle apparecchiature. Identificando i potenziali problemi prima che si aggravino, i team di cybersecurity possono rispondere in modo proattivo e prevenire interruzioni su larga scala.

Deep Belief Network (DBN):

Modello generativo probabilistico che funziona con una combinazione di reti di apprendimento multistrato, supervisionate e non supervisionate. I DBN possono essere addestrati su set di dati su larga scala provenienti da attacchi informatici noti e utilizzati per estrarre informazioni preziose sui vettori di attacco, sulle tecniche e sulle vulnerabilità dei potenziali bersagli. Questi dati possono essere utilizzati per sviluppare strategie di Threat Intelligence e di risposta agli incidenti, sviluppare contromisure efficaci e migliorare la sicurezza informatica complessiva.

Rete neurale ricorrente (RNN):

Modello di apprendimento automatico adattato alle reti neurali, per imparare a mappare ingressi e uscite sequenziali. Le RNN sono in grado di analizzare il comportamento del software e rilevare gli schemi che indicano la presenza di malware. Addestrandosi su un ampio set di campioni di malware noti, le RNN possono identificare automaticamente malware nuovi o sconosciuti in base al loro comportamento.

Generative Adversarial Network (GAN):

Utilizza l’apprendimento automatico non supervisionato con due reti neurali, una delle quali svolge il ruolo di generatore e l’altra di discriminatore. La rete generatrice riceve i dati in ingresso e produce dati in uscita con caratteristiche simili ai dati reali; la seconda rete riceve i dati reali e i dati della prima rete, per verificare se i dati in ingresso siano reali o falsi. Le GAN possono essere utilizzate per generare dati sintetici, indistinguibili dai dati reali da parte del discriminatore.

Questi dati sintetici possono essere utilizzati per addestrare i modelli di apprendimento automatico a rilevare le minacce informatiche, in quanto forniscono un set di dati ampio e diversificato senza dover fare affidamento su dati sensibili o riservati provenienti dal mondo reale.

Inoltre le GAN possono essere utilizzate per generare esempi avversari, ossia input progettati per essere mal classificati dai modelli di apprendimento automatico. Questi esempi possono aiutare a identificare i punti deboli e le vulnerabilità dei modelli di apprendimento automatico, migliorandone la robustezza contro gli attacchi informatici.

Deep Reinforcement Learning (DRL):

E’ la combinazione di reti neurali profonde e algoritmi di apprendimento. La sintesi dei due algoritmi fornisce una soluzione utile in scenari in cui il processo decisionale è complesso e richiede una combinazione di percezione, cognizione e azione. Grazie alla sua capacità di migliorare i meccanismi di rilevamento, prevenzione e risposta alle minacce, negli ultimi anni il Deep Reinforcement Learning ha guadagnato un’attenzione significativa nel campo della cybersecurity.

Combinando la potenza dell’apprendimento profondo con gli algoritmi di apprendimento per rinforzo, i professionisti della cybersecurity possono sviluppare sistemi intelligenti che imparano dalle proprie esperienze per identificare e mitigare le varie minacce informatiche. Uno dei principali vantaggi del deep reinforcement learning nella cybersecurity è la sua capacità di gestire attacchi complessi e dinamici: i sistemi tradizionali e gli approcci basati sulle firme spesso faticano a rilevare attacchi zero-day o che utilizzino modelli in rapida evoluzione. I modelli di deep reinforcement learning, invece, sono in grado di apprendere dai dati storici e di adattare le proprie strategie di difesa in tempo reale, migliorando l’accuratezza e l’efficienza nel rilevare minacce sconosciute e in evoluzione.

Intelligenza Artificiale nella Cybersecurity Industriale: Opportunità, Sfide e il Ruolo del Monitoraggio Predittivo

Le ricerche in campo di ML e DL mostrano tecniche promettenti per combattere le minacce informatiche. Applicando strumenti di IA per proteggere l’ecosistema industriale, i sistemi continueranno ad imparare dai tentativi di attacco: di conseguenza, trarranno vantaggio dall’analisi predittiva per affrontare la crescente complessità dei cyber attacchi. L’intelligenza artificiale aiuta il monitoraggio per identificare modelli di attività normali e anomale con caratteristiche dannose e il monitoraggio, a sua volta, rende possibile mitigare e localizzare gli attacchi.

Tuttavia, le tecnologie IA non garantiscono una sicurezza assoluta per gli ambienti industriali. Le stesse tecnologie, infatti, vengono sfruttate anche per creare nuovi tipi di minacce avanzate: ad esempio gli attori malintenzionati utilizzano modelli ML per generare malware sempre più sofisticati, aumentando così la portata degli attacchi.

Le soluzioni basate sull’IA offrono numerosi vantaggi nel prevenire e contrastare i cyber attacchi, ma richiedono una costante evoluzione e miglioramento che tengano in conto l’evoluzione delle minacce. La combinazione di intelligenza artificiale e competenze umane specializzate può essere la strategia migliore per affrontare le sfide della sicurezza cibernetica. Attualmente utilizzare l’IA per la prevenzione e il contrasto dei cyber attacchi presenta, rispetto ai sistemi di difesa tradizionali, diversi vantaggi e alcune importanti sfide.

Di seguito una tabella riassuntiva dei principali vantaggi e svantaggi nell’utilizzo di queste tecnologie (Tab.1).

Vantaggi dell’IA nella cybersecurity
Sfide per l’utilizzo dell’IA nella cybersecurity
Rilevamento e risposta rapida: l’IA può analizzare grandi quantità di dati in tempo reale per identificare modelli sospetti o attività anomale, consentendo una risposta immediata al cyber attacco. Falsi positivi e falsi negativi: l’IA può generare allarmi erronei o non rilevare correttamente alcune minacce. È necessario un costante lavoro di perfezionamento dell’algoritmo per ridurre i falsi positivi e negativi.
Adattabilità: l’IA può apprendere in modo autonomo e migliorare continuamente le sue capacità di rilevamento e difesa, adattandosi alle nuove minacce e ai nuovi metodi utilizzati dagli aggressori. Malintenzionati che sfruttano l’IA: gli aggressori possono utilizzare l’IA per eseguire attacchi più sofisticati e sfuggire alla rilevazione, creando una sorta di “corsa agli armamenti” tra i difensori e gli aggressori.
Automazione dei processi di sicurezza: l’IA può automatizzare compiti ripetitivi come il monitoraggio del traffico di rete, l’analisi dei log e la gestione delle vulnerabilità, riducendo l’onere sui team di sicurezza. Bisogno di expertise specializzata: l’implementazione di soluzioni basate sull’IA richiede competenze tecniche avanzate, che potrebbero non essere facilmente disponibili o accessibili a tutte le organizzazioni.
Identificazione delle minacce sconosciute: l’IA può individuare e mitigare le nuove minacce cibernetiche prima che siano ampiamente riconosciute dai sistemi di difesa tradizionali. Costi elevati: l’implementazione e la gestione di sistemi di difesa basati sull’IA possono richiedere investimenti significativi in termini di infrastruttura, risorse e personale specializzato

Tab.1

In conclusione va sottolineato che queste tecnologie rivelano anche diversi problemi etici nella loro implementazione, come la mancanza di un codice morale per le macchine. Il processo decisionale può infatti avere impatti significativi, che l’Intelligenza Artificiale potrebbe non avere la capacità di valutare.

Tale incapacità di prendere decisioni che tengano conto di questioni etiche rappresenta senz’altro la principale sfida: poiché negli ambienti industriali la componente di interazione col mondo fisico è preponderante, la decisione di bloccare un sistema di produzione per isolare un attacco cyber – ad esempio – potrebbe causare enormi danni ambientali e addirittura la perdita di vite umane.

Note

[1] MITRE Corporation; https://attack.mitre.org/matrices/ics/

[2] Cyber-attacks detection in industrial systems using artificial intelligence-driven methods; 22 giugno 2022; autori: Wu Wang,Fouzi Harrou, Benamar Bouyeddou, Sidi-Mohammed Senouci, Ying Sun.

Industrial Cybersecurity

Questo articolo è stato estratto dal white paper “Quaderni di Cyber Intelligence #5” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/quaderni-di-cyber-intelligence-5/

Articolo a cura di Francesco Arruzzoli

Profilo Autore

Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/intelligenza-artificiale-cybersecurity-sistemi-industriali/


Email Security: Red flag e best practice

L’email security è fondamentale per proteggere aziende e utenti da minacce come phishing, malware e attacchi mirati attraverso la posta elettronica. In questo articolo, analizzeremo le principali red flag da tenere sotto controllo per identificare email potenzialmente pericolose e le best practice per gestirle in modo sicuro. Queste includono l’adozione di protocolli sicuri, il monitoraggio delle email sospette e la formazione periodica del personale per riconoscere minacce. Scopri come applicare strategie preventive e reattive per evitare violazioni e difendere i dati sensibili della tua organizzazione dalle minacce via email.

Il sistema di posta elettronica è diventato un’infrastruttura di comunicazione essenziale, la sua diffusione capillare rende cruciale adottare procedure di Email Security efficaci. Questo implica anche l’importanza di strumenti e tecniche di indagine forense per analizzare eventuali incidenti, per approfondire ulteriormente l’argomento, ti consigliamo la del precedente articolo ” Email Forensics: Studio di email malevola e principali tool di analisi” dove vengono illustrando metodologie e strumenti all’avanguardia per individuare messaggi sospetti o dannosi.

Email Security: Red flag

A questo punto verranno mostrate alcune mail e le relative red flag:

Email Security Red flag – Phishing URL
Figura 20. Red flag – Phishing URL

In questo caso è possibile osservare le seguenti red flag:

  • Subject che fa leva sull’urgenza di effettuare un’azione
  • Header from palesemente malevolo
  • Link che fa uso del protocollo http, tipico indice di una mail di phishing.

Nota: si tenga presente che le mail di phishing avanzato utilizzano anche protocolli sicuri come “https” quindi preso singolarmente questo indicatore non è sempre “parlante”.

Email Security Red flag – Call requested - Email Security
Figura 21. Red flag – Call requested

In questo caso invece, oltre alle evidenze precedenti, si può osservare come l’attaccante punti molto sul lato emotivo e tenti di farsi richiamare al numero indicato. Si può notate inoltre che la mail fa uso di terminologie “generiche” come “Dear customer”, questo è indice che possano esserci molteplici utenti coinvolti.

Di seguito, infine, si riportano alcune evidenze malevole, recuperabili tramite i tool precedentemente descritti, di un IP estratto dall’header di una mail.

Email Security Talos Threat Intelligence - Email Security
Figura 22. Talos Threat Intelligence

In particolare, l’analista dovrà tenere in considerazione:

  • La geolocalizzazione dell’IP, è probabile che una mail malevola sia inviata da una nazionalità con la quale l’azienda non collabora o comunque da aree note per le loro attività malevole o comunque sospette.
  • La sender IP reputation.
  • Il livello di spam segnalato nel web.
  • Eventuali blacklist.

Email Security: Best practice

  • Quando si riceve una mail da un utente sconosciuto si consiglia di evitare di rispondere e chiedere ad eventuali colleghi.
  • Le mail che fanno leva sulle urgenze e/o emozioni potrebbero essere potenzialmente malevole. Anche in questo caso si consiglia di maneggiarle con attenzione.
  • In caso venga segnalato via mail che la password è in scadenza si consiglia di utilizzare i link ufficiali di quel determinato canale e/o comunque non quelli presenti nella mail (specie se questa utilizza protocolli non sicuri come “http” o provenga da un sender sospetto/sconosciuto).
  • Se vengono richiesti dati sensibili, si invita ad utilizzare i canali sicuri ed eventualmente contattare i riferimenti noti e non quelli forniti tramite mail. Questo genere di informazione non vengono mai richieste via mail dai gestori bancari e simili.
  • Ogni allegato sospetto proveniente da un sender sconosciuto è potenzialmente malevolo. Solo i file “.txt” attualmente risultano essere sicuri in quanto contenente solo testo. Per tale ragione si invita a segnalare la mail al team di competenza. Uno dei metodi più utilizzati per riportare mail malevole tramite Outlook è col plugin “Report Message” (figura 23) attraverso il quale con pochi semplici passi l’utente potrà segnalare la mail sospetta.
Email Security Outlook Plugin – Report message - Email Security
Figura 23. Outlook Plugin – Report message
  • Ogni azienda dovrebbe abilitare la propria casella “Abuse” per la gestione delle segnalazioni di mail malevole al team di competenza.
  • Tutte le mail provenienti dall’esterno vanno maneggiate con cura. Ogni azienda dovrebbe quindi abilitare, tramite l’uso dei propri mail secure gateway, il tag esterno nel subject e/o nel body della mail, si veda figura 24. Questo tag è molto utile in quanto informerà l’utente che la mail ricevuta non proviene dal perimetro aziendale.
Email Security External Tag - Email Security
Figura 24. External Tag

Alcune soluzioni, come Proofpoint, consentono anche un’elevata personalizzazione del tag esterno sopra descritto.

  • Ogni evento noto al pubblico, come possono essere ad esempio le festività o la pandemia di Covid-19, vengono puntualmente utilizzate per avviare campagne malevole allo scopo di diffondere malware e/o altri intenti malevoli. È quindi necessario porre particolare attenzione a questo tipo di mail.
  • Ogni azienda dovrebbe avviare periodicamente (almeno una volta all’anno) campagne di awareness allo scopo di sensibilizzare le varie utenze su tematiche legate all’email security al fine di ridurre al minimo tutti i potenziali rischi degli attacchi veicolati tramite email
  • Nel caso in cui si cada in una mail di phishing e/o si clicchi su un link malevolo (può capitare a chiunque in caso di stanchezza) si consiglia di seguire il modello “Avoid FUD (Fear, Uncertainty, and Doubt)” in cui si invita a non farsi prendere dal panico e a segnalare prontamente l’attacco malevolo al team di competenza informandolo di essere caduti in una mail di phishing. Ciò aiuterà a prendere tutte le dovute precauzioni e (si spera) sollecitare anche il management ad avviare dei training per i dipendenti per sensibilizzarli sulla tematica e l’importanza di non eseguire file e/o link sospetti provenienti da sender sconosciuti.

In conclusione, quindi, l’email security è un insieme di misure preventive e reattive volte a garantire la sicurezza delle comunicazioni che avvengono tramite posta elettronica con l’obiettivo di proteggere le organizzazioni e gli utenti da possibili minacce provenienti dal web. È importante essere sospettosi di email che richiedono azioni immediate, contengano link o allegati sospetti e che provengono da mittenti non riconosciuti. In caso di dubbi sulla legittimità di un’email, è sempre consigliabile contattare direttamente l’organizzazione o la persona coinvolta utilizzando informazioni di contatto verificate, anziché rispondere o cliccare sui link forniti nell’email.

Questo articolo è stato estratto dal white paper “Email Security: Intelligenza Artificiale, Protocolli e Best Practice Contro gli Attacchi Informatici” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/email-security-intelligenza-artificiale-protocolli-e-best-practice-contro-gli-attacchi-informatici/

Articolo a cura di Fabrizio Giorgione

Profilo Autore

Fabrizio Giorgione è nato a Napoli (NA) nel 1992. Si è laureato in ingegneria informatica presso l’università degli studi del Sannio il 17 dicembre del 2018 con una tesi dal titolo: “Analisi della superficie di un sistema SCADA”. Ha sviluppato, presso il laboratorio ISWATlab, un’applicazione Android denominata “Privacy Guard” la quale valuta il rischio di privacy leakage, ovvero il furto di informazioni, sugli smartphone (http://www.iswatlab.eu/?page_id=499). Ha effettuato il tirocinio presso lo “ZLab” di “Cse Cyber Sec” nell’ambito “SOC”, “Forensic” e “Malware Analysis”. Attualmente lavora presso la società di “NTT DATA” come “Cyber security Analyst” nel SOC di Napoli. Il suo compito è quello di effettuare analisi di log, di malware e di prevenire minacce interne ed esterne alla sua azienda e ai clienti della società. Si è occupato, inoltre, del montaggio e della gestione di sonde IDS/IPS presso Telecom Italia nella sede di Roma (RM).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/email-security-tips/


Sicurezza Mobile: Proteggere i Dispositivi Android dalle Minacce Emergenti

In un’era in cui i dispositivi mobili sono diventati parte integrante della nostra vita quotidiana, l’importanza della sicurezza mobile non può essere sottovalutata. Poiché i nostri smartphone e tablet diventano sempre più il repository di una quantità sempre maggiore di dati sensibili, la necessità di proteggere questi dispositivi dalle minacce emergenti è diventata fondamentale.

Per una migliore contestualizzazione del tema, si consiglia la lettura dell’articolo precedente “Sicurezza del Sistema Operativo Android“. I contenuti presentati sono stati estratti dal testo approfondimento sulla “Sicurezza Mobile” realizzato dal Professor Alessio Merlo, Ordinario di Sistemi di Elaborazione delle Informazioni presso il CASD – Centro Alti Studi per la Difesa di Roma.

Sicurezza delle applicazioni mobili

In questo estratto ci focalizzeremo sulle problematiche di sicurezza del livello applicativo. Per semplicità assumeremo che il sistema operativo Android sia completamente sicuro. In questo caso, le vulnerabilità che tratteremo saranno solo legate alle singole app; e i corrispondenti malware sfrutteranno soltanto vulnerabilità a livello applicativo tramite i canali previsti (e protetti dall’ASF), senza l’utilizzo di side channel.

Il Phishing

Prima di discutere di vulnerabilità di app, occorre chiarire come il malware possa raggiungere il dispositivo e quindi l’app da attaccare. L’idea alla base è circuire l’utente, che ha il potere di installare/rimuovere app, per farsi installare ed eseguire. L’attacco principale che porta a questo risultato è un attacco di phishing. Nella sostanza, l’idea è far abboccare il pesce (l’utente) a un amo costruito ad hoc dall’attaccante.

Un esempio semplice è il classico link inviato per posta, dove si invita l’utente a cliccare e provare una app. A questo link si trova l’APK del malware che l’utente installa non aspettandosi certo un contenuto dannoso.

Il caso precedente, però, è molto naif. Ormai la maggior parte degli utenti è consapevole dei rischi e non abbocca a questi “ami” molto semplici: potremmo dire che questo attacco ha una probabilità di successo molto bassa, così bassa che forse per l’attaccante non è nemmeno conveniente provarlo.

Tuttavia, il phishing rimane il mezzo più efficace per permettere ai malware di arrivare all’obiettivo; nel prossimo articolo mostreremo un esempio di come gli attacchi di phishing su Android oggi siano tanto sofisticati quanto efficaci e portino, spesso, l’utente ad “abboccare all’amo” senza accorgersene.

Dentro una vulnerabilità applicativa

Ad oggi si contano innumerevoli vulnerabilità scoperte in app di diverso tipo, anche ad alta sicurezza come quelle bancarie[1]. L’esplorazione delle singole vulnerabilità sarebbe un mero esercizio tecnico per appassionati.

Da un punto di vista metodologico, è molto più importante capire il processo e i fattori che portano alla creazione, scoperta e risoluzione di una vulnerabilità applicativa. Per fare questo, ci metteremo nei panni dell’attaccante e vedremo come scoprire e attaccare una vulnerabilità specifica, che ci permetta inoltre di arrivare a conclusioni non comuni e, forse, inattese.

Partiamo direttamente dalle conclusioni:

  1. vulnerabilità che portano al furto di credenziali utente possono NON essere ad alto rischio;
  2. funzionalità introdotte in nuove versioni di Android possono aiutare a sfruttare vulnerabilità applicative e ad aumentarne il rischio;
  3. una volta scoperta una vulnerabilità, la risoluzione potrebbe non essere possibile in tempi brevi.

Per dimostrare le tesi precedenti, prenderemo in esame un insieme di vulnerabilità che riguarda i password manager[2] (d’ora in poi, PM) su Android.

I PM sono applicazioni dedicate alla gestione delle credenziali utente e nascono storicamente sul web. Ogni browser, oggi, ha un proprio PM che, ogni qual volta un utente visita un nuovo portale o servizio web, salva le credenziali inserite e le inserisce automaticamente qualora lo stesso utente torni a visitare il medesimo sito. Inoltre esiste un insieme consistente di PM generici, non legati ad alcun browser, di larga applicazione nel mondo aziendale: tra questi possiamo citare LastPass, Dashlane, KeepPassX, 1Password, Keeper, onSafe, myPassword, ma la lista è molto lunga.

La crescita esponenziale di questo tipo di software mostra l’esistenza di un business fiorente e ormai consolidato intorno a questi servizi nel web: è lo specchio dei tempi ed è “colpa” della sicurezza informatica. Nello specifico, oggi siamo costretti a ricordare password diverse e complesse per ogni sito, oltre a doverle cambiare con una certa costanza, se vogliamo seguire le “buone maniere” della cybersecurity.

Pertanto, non possiamo ricordare tutto e dobbiamo affidarci a questi servizi. Nel web, essi sono sicuri perché prima di inserire le credenziali in un sito, gli stessi lo identificano tramite il suo certificato a chiave pubblica. Se il sito non è quello atteso, i PM non inseriscono le credenziali.

In questo modo, l’uso dei PM su web ha contrastato efficacemente lo spam (che è di fatto una forma di phishing), ovvero quelle email in cui veniva chiesto all’utente di aggiornare le proprie informazioni spacciandosi per un sito bancario, fornendo però un link a un sito fraudolento. Se tale sito fosse stato uguale a quello della banca dell’utente, lo stesso non avrebbe avuto i mezzi per riconoscere la frode; mentre i PM riescono a farlo verificando il certificato.

Tornando alle app, esse di fatto sono frontend di siti web che richiedono, almeno la prima volta, di identificarsi con le medesime credenziali usati sul corrispondente portale web: l’app di Facebook usa le stesse credenziali del sito di Facebook e ugualmente vale per PayPal, Instagram, le app bancarie e via dicendo. Pertanto, i PM sono parimenti utili su smartphone e a basso costo per i propri sviluppatori, in quanto utilizzano lo stesso database di credenziali collezionate per il web.

Tuttavia, per funzionare correttamente su mobile un PM dovrebbe poter ascoltare cosa accade su un’altra app per riconoscere la schermata di login, come avviene sui tab del browser. Un osservatore attento noterà però che la sandbox di Android non permette a un’app di controllare lo stato dell’interfaccia di un’altra app, che appartiene a un altro utente a livello kernel. Per questo motivo, per una decina di anni i PM non sono mai potuti approdare su Android.

La possibilità è arrivata con Android 8, anche su pressione degli stessi sviluppatori di PM, tramite un nuovo tipo di servizio, chiamato Credential Autofill, che permette agli sviluppatori di garantire ad altre app di controllare lo stato dei campi di inserimento della propria app. Qualora lo sviluppatore dell’app implementasse questo servizio, di fatto Android permetterebbe una eccezione alla sandbox, permettendo ai PM di inserire le credenziali nei campi di login e password. Pertanto, a partire da Android 8 i PM sono potuti approdare sugli smartphone.

Come detto, ciò che rende forti sul web i PM è la loro capacità di identificare con certezza il sito web prima di inserire le credenziali. Vale la stessa cosa sugli smartphone? Come fa un PM, data una certa app, a riconoscere a quale corrispondente dominio web appartiene (mapping), in modo da inviare in sicurezza le credenziali salvate?

In Android, ciò che identifica univocamente un’app sul dispositivo e su ogni app store è il package name, ovvero il nome dell’app. Essendo le app Android nate come applicazioni Java, il package name è della forma com.esempio.app1, come da formato standard di Java. Ad esempio, il nome dell’app ufficiale di Facebook è com.facebook.katana.

Come fanno i PM su mobile a definire il mapping tra il package name di un’app (com.facebook.katana) e il corrispondente sito web (www.facebook.com)? Come possono trovarlo?

Sicurezza Mobile - LastPass: invio delle credenziali utente al malware
Figura 7: LastPass: invio delle credenziali utente al malware

Sorprenderà scoprire che questa attività è relativamente semplice nel mondo Android: basta prendere un insieme di PM dal Google Play Store, scaricarli, decompilarli e guardare dentro il codice.

L’analisi del codice di alcuni dei più famosi PM su Android (LastPass, Dashlane e Keeper) evidenzia come essi usino delle euristiche facendo assunzioni sul package name. A mero titolo di esempio, LastPass lo divide in sottostringhe divise dal punto (com.facebook.katana → “com”, “facebook”, “katana”) e prende le prime due in ordine inverso per decidere il mapping con il corrispondente dominio web di appartenenza. Pertanto, la schermata di login com.facebook.katana verrà completata dal PM con le corrispondenti credenziali utente per il dominio “facebook.com”.

Seppur possa non sembrare, questa è una vulnerabilità. Infatti, il lettore converrà che un attaccante che produca un malware sarebbe libero di dare allo stesso il package name che ritiene opportuno, purché unico. Quindi, se un malware avesse come package name “com.facebook.pippo”, LastPass gli fornirebbe le credenziali, come avviene in Figura 7.

È semplice capire che se il malware avesse anche la stessa interfaccia grafica di Facebook, qualora il PM lo completasse l’utente non si accorgerebbe di nulla e le credenziali verrebbero rubate. Si noti che la stessa cosa vale per qualunque app con credenziali come PayPal, Instagram e la maggior parte delle app bancarie o di trading.

Quanto è alto il rischio associato a questa vulnerabilità che permette di rubare le credenziali utente? Sorprendentemente, “solo” medio.

Come discusso, il rischio è il prodotto tra la probabilità e l’impatto. È evidente come l’impatto dello sfruttamento di queste vulnerabilità nei PM sia molto alto (furto di credenziali), tuttavia la probabilità di sfruttare questa vulnerabilità è un valore molto basso. Per capire, occorre immaginare il caso peggiore: un attaccante crea una copia perfetta dell’app bersaglio (e.g., PayPal) con la stessa interfaccia, chiamandola “com.paypal.pippo” in modo da farsi consegnare le credenziali da LastPass.

Tuttavia, per poter rubare le credenziali il malware deve essere installato ed eseguito; e per farlo deve spacciarsi per l’app di PayPal originale, convincendo l’utente a eliminare l’app già presente sul suo dispositivo per installare questa sconosciuta. Questo approccio rientra nel “phishing naif” di cui difficilmente un utente mobile odierno cade vittima, avendo già installate sul proprio dispositivo molte delle app bersaglio. Pertanto, la probabilità di successo è bassa e la vulnerabilità, seppur d’impatto, ha rischio medio: quindi esistono “vulnerabilità che portano al furto di credenziali utente e possono NON essere ad alto rischio (1)”.

Ma è possibile in qualche modo renderla più pericolosa, aumentando la probabilità di sfruttarla? Anche in questo caso ci viene in aiuto Android, con un’altra nuova funzionalità chiamata Instant App (IA)[3].

Sicurezza Mobile - Esempio di Instant App
Figura 8: Esempio di Instant App

Tale funzionalità permette a un utente che visiti un sito sul suo smartphone e per il quale esiste una corrispondente app, di essere notificato e di provare l’app senza installarla. Qualora l’utente accettasse, un codice eseguibile si scaricherebbe sul suo dispositivo e si eseguirebbe sullo stesso, come mostrato in Figura 8.

Ogni IA ha un package name quando viene eseguita, quindi i PM possono inviare anche ad esse le credenziali utente. Inoltre, l’interfaccia dell’IA è completamente controllata dallo sviluppatore (o dall’attaccante!) che ne decide il “look and feel”.

A questo punto, se il malware diventasse un’IA con nome “com.paypal.pippo” con una interfaccia identica all’app ufficiale di PayPal, riuscirebbe più facilmente a farsi consegnare le credenziali da LastPass senza dover essere installata sul dispositivo, tramite un attacco di phishing (come descritto in Figura 9).

Sicurezza Mobile - Attacco di phishing a LastPass basato su Instant App malevola
Figura 9: Attacco di phishing a LastPass basato su Instant App malevola

Parte tutto da un link a una pagina finta, in questo caso di Medici Senza Frontiere. Supponiamo che l’utente navighi sulla pagina e decida di donare 2 euro: egli non fa altro che cliccare su “paga con Paypal” e mettersi in attesa dell’esecuzione della propria app di PayPal, regolarmente installata sul dispositivo.

Tuttavia il link non è un comando per l’app di PayPal installata, ma un url remoto da cui viene scaricata l’IA “com.paypal.pippo” (senza icona e con il nome “Apri con” per confondere l’utente). Una volta scaricata, l’IA si esegue e mostra all’utente la stessa interfaccia della sua app PayPal. In questo modo inganna sia l’utente – che la scambia per la sua app e non si preoccupa – sia, con il suo package name, l’euristica alla base di LastPass, di fatto facendosi consegnare le credenziali senza che nessuno noti nulla di insolito.

In questo modo la probabilità di sfruttare questa vulnerabilità aumenta considerevolmente, facendo diventare elevato il valore di rischio, essendo ora alti sia la probabilità che l’impatto.

Pertanto, abbiamo mostrato come “funzionalità introdotte in nuove versioni di Android possono aiutare a sfruttare vulnerabilità applicative e ad aumentarne il rischio (2)”.

Come si risolve questa vulnerabilità? Esiste un modo sicuro per risolvere correttamente il mapping tra dominio web e app mobile, senza la necessità di ricorrere alle rischiose euristiche che abbiamo visto. Tale sistema prende il nome di Digital Asset Link (DAL) e, brevemente, mette la responsabilità sullo sviluppatore dell’app, il quale deve inserire dentro il proprio portale, in un percorso ben definito, un file JSON che contenga il package name dell’app ufficiale. In questo modo, i PM dovrebbero limitarsi ad interrogare il file nel dominio (autenticato come per i PM su web tramite certificato a chiave pubblica) per capire se l’app a cui stanno inviando le credenziali sia quella corretta.

Sfortunatamente, nel 2018 solo il 2% dei domini le cui app erano completate da PM utilizzava questa tecnologia; di fatto questo non permetteva ai PM di eliminare le euristiche, pena il poter completare solo il 2% delle app e risultare quindi inutili da un punto di vista pratico. Pertanto, la risoluzione di questo problema pesa sulle spalle degli sviluppatori: sta a loro applicare il DAL per alzare questa percentuale. Purtroppo, abbiamo in questo modo mostrato che “una volta scoperta una vulnerabilità, il fixing potrebbe non essere possibile in tempi brevi (3)”.

La protezione delle app

Se la natura open di Android è un vantaggio per produttori di smartphone e analisti di sicurezza, l’analisi della vulnerabilità precedente ha mostrato come la stessa possa essere un problema per lo sviluppatore, in quanto chiunque può scaricare, decompilare e analizzare il contenuto dell’app.

Questo ha tre dirette conseguenze:

  1. le vulnerabilità sono esposte a chiunque voglia analizzarle, come per Android;
  2. la logica dell’app è in chiaro (algoritmi usati, protocolli…);
  3. è possibile per un attaccante prendere l’app, aggiungere qualche file malizioso, rifirmarla e ridistribuirla agli utenti[4].

Come può lo sviluppatore contrastare questi tre problemi?

Riguardo il primo punto, è sua responsabilità rilasciare un’app (o una versione aggiornata di un’app) solo dopo aver provveduto a un’estesa analisi di sicurezza per la ricerca di vulnerabilità. In questo senso, esistono numerosi tool di analisi statica e dinamica (e.g., MobSF[5], Quark[6], Approver[7]) per la ricerca e la valutazione del rischio di un’app. L’analisi di sicurezza, con il supporto di tali strumenti, andrebbe svolta sulla versione finale dell’app, pronta per essere rilasciata sullo store.

Riguardo i tool di analisi statica, questi si focalizzano sulla parte di Vulnerability Assessment (VA) e si occupano di analizzare il codice dell’app per ricercare pattern di vulnerabilità noti. L’output di questa fase è una serie di potenziali vulnerabilità a cui spesso viene associato un valore di rischio, perlopiù calcolato in funzione dell’impatto. Tali vulnerabilità sono potenziali perché potrebbero essere di fatto presenti ma non sfruttabili, poiché l’effettiva probabilità che durante l’esecuzione vengano raggiunte può essere molto bassa.

A titolo di esempio, se un pezzo di codice contiene una vulnerabilità ad alto impatto ma è altamente improbabile che quello specifico pezzo di codice venga eseguito, la probabilità è molto bassa e di fatto il rischio può essere estremamente contenuto. In casi estremi, quella parte di codice potrebbe non essere mai eseguita, pertanto quella vulnerabilità risulterebbe impossibile da sfruttare. Casi come questi si chiamano “falsi positivi” e costituiscono il limite dell’analisi statica, dove un certo numero delle potenziali vulnerabilità rilevate si rivelano di fatto falsi allarmi.

L’analisi dinamica permette di verificare l’output dell’analisi statica, cercando di sfruttare effettivamente le vulnerabilità trovate sull’app in esecuzione in un ambiente controllato. Di fatto, l’analisi dinamica simula l’attività di un attaccante (PT – Penetration Testing) che provi a trovare l’algoritmo per sfruttare una vulnerabilità mentre l’app si esegue. Lo scopo è riconoscere e rimuovere i “falsi positivi”, individuando un sottoinsieme delle vulnerabilità che sono effettivamente sfruttabili, fornendo un valore di rischio affidabile, calcolato in funzione della probabilità.

Si noti però che l’utilizzo della sola analisi dinamica non è sufficiente: mentre l’analisi statica è completa (analizza tutto il codice) e rischia di trovare un soprainsieme delle effettive vulnerabilità, l’analisi dinamica soffre del problema opposto e ha il limite di non riuscire a individuare, da sola, tutte le reali vulnerabilità esistenti. Questo avviene perché l’analisi dinamica non può essere, come anche il testing, esaustiva: non si possono provare tutte le infinite combinazioni di input e le interazioni possibili con l’app. Pertanto l’analisi dinamica genera “falsi negativi”, ovvero app che la stessa etichetta come sicure in realtà contengono vulnerabilità che non è riuscita a scoprire.

Dato il set di vulnerabilità trovate (VA) e provate (PT), lo sviluppatore dovrebbe provvedere a risolverle prima rilasciare l’app. Tuttavia, anche in questo caso c’è una scelta di compromesso tra il ritardare l’uscita (anche di un singolo aggiornamento dell’app) risolvendo più vulnerabilità possibili e il rilasciare un’app vulnerabile ma in tempi ragionevoli. In generale, lo sviluppatore dovrebbe risolvere almeno le vulnerabilità a rischio più elevato prima del rilascio.

Offuscamento

Qualora lo sviluppatore volesse proteggere la propria logica di programma (come nel caso delle euristiche dei PM), l’unica possibilità è rendere il proprio codice difficilmente interpretabile da un umano che lo decompili e lo analizzi. Una simile considerazione potrebbe valere per nascondere vulnerabilità potenziali o già trovate e non risolte, attraverso un approccio “security-through-obscurity” che però va considerata come una soluzione di compromesso anche in questo caso: la storia della cybersecurity ha dimostrato che questo approccio non è molto spesso vincente come ci si aspetterebbe.

La soluzione per rendere il codice di più difficile interpretazione è l’offuscamento (obfuscation). L’offuscamento fa riferimento a un insieme di tecniche per la modifica sintattica del codice sorgente, che non modificano però la semantica (ovvero, il codice trasformato fa esattamente le stesse cose di quello originale).

Gli esempi in Figura 10 forniscono un’idea di cosa sia l’offuscamento. Nel primo caso, la modifica è una mera sostituzione dei nomi di variabili e metodi con variabili non intelligibili; nel secondo caso, l’offuscamento ha portato a modificare anche la struttura del codice, riscrivendolo in uno più lungo ed equivalente.

Questo secondo caso suggerisce come l’offuscamento possa impattare negativamente sulle performance dell’app, a seconda della tecnica scelta: in questo caso, il codice offuscato ha più istruzioni. Tuttavia, normalmente l’impatto è abbastanza trascurabile.

Sicurezza Mobile - Esempi di codice offuscato
Figura 10: Esempi di codice offuscato

Esistono diversi tool commerciali come ProGuard[8], Zymperium[9] e DashO[10] che permettono di offuscare il codice sorgente; e altri non commerciali ed estensibili come Obfuscapk[11] che esegue un offuscamento blackbox, ovvero direttamente sul codice compilato contenuto nell’APK.

Repackaging e Anti-Repackaging

Ipotizziamo un caso ideale: uno sviluppatore rilascia l’app perfetta (senza alcuna vulnerabilità) o perfettamente offuscata (non c’è modo di trovare eventuali vulnerabilità) sul Google Play Store.

Può stare tranquillo dal punto di vista della sicurezza? In un contesto diverso dal mobile, la risposta sarebbe sì. Purtroppo nel mondo mobile la risposta è necessariamente no, poiché qui esiste un fenomeno unico, quello dell’app repackaging, il cui threat model è rappresentato in Figura 11.

Sicurezza Mobile - Threat Model dell'app repackaging
Figura 11: Threat Model dell’app repackaging

In un contesto ideale, lo sviluppatore produce l’app (Step 1) e invia l’APK all’app store (Step 3). L’utente cerca l’app (Step 4), la scarica e installa (Step 5) e la esegue (Step 6). Purtroppo, anche un attaccante può cercare l’app (specie se è “di successo”), scaricarla, aggiungere del codice malevolo (Step 10), generare un nuovo APK, firmarlo e testarlo (Step 11) e, qualora funzionasse, inviarlo come una nuova app sullo store o in giro tramite web o email (Step 12), sperando che l’utente scarichi la versione repackaged anziché quella originale.

Molte app sono vittima di repackaging – WhatsApp, Telegram, Poste Italiane nonché varie banche, per citarne solo alcune – e hanno più versioni disponibili sul Google Play Store, di cui una soltanto è quella ufficiale.

Per contrastare il fenomeno, sono state proposte negli anni diverse tecniche di anti-repackaging. Seppur con qualche differenza, il principio alla base è l’inserimento nel codice di controlli di integrità nascosti tramite cifratura, per cui, se il codice dell’app viene modificato, l’esecuzione di tali controlli e la mancata verifica dell’integrità portino l’app a interrompere il suo funzionamento. Tali controlli sono inseriti dallo sviluppatore tramite tool automatici come AppIS[12], BombDroid[13] e ARMANDroid[14], prima della creazione dell’APK (Step 2).

L’attaccante a questo punto non può limitarsi ad aggiungere codice, ma deve prima vedere se l’app è protetta (Step 7) cercando, in questo caso, nel codice esistente tutti i controlli di anti-repackaging (Step 8) e disattivarli (Step 9). Ovviamente la ricerca difficilmente è esaustiva, pertanto l’attaccante deve testare il funzionamento dell’app (Step 11) dopo aver aggiunto il proprio codice. Se l’app funziona, dopo un po’ viene ridistribuita; altrimenti l’attaccante deve ricominciare a cercare altri controlli di anti-repackaging fino a quando non ne ha disattivato almeno la maggioranza.

L’obiettivo delle tecniche di anti-repackaging è di scoraggiare l’attaccante in modo che, non riuscendo a disattivare tutti i controlli, abbandoni il progetto di inserire il proprio codice dentro l’app.

L’inserimento dei controlli porta ad aggiungere righe di codice da eseguire, come per l’offuscamento; mentre, a differenza di tale tecnica, se il numero di controlli inserito è alto la dimensione dell’app può incrementare e le sue performance in esecuzione possono ridursi. Pertanto, anche in questo caso occorre arrivare a un compromesso tra il numero di controlli inseriti e le prestazioni dell’app.

Va infine detto che alcuni controlli di anti-repackaging basati sull’analisi delle similitudini tra i codici di app diverse sono implementate nel Google Play Store, finora con risultati non incoraggianti in termine di riconoscimento delle app repackaged.

L’utilizzo del VA/PT, dell’offuscamento e dell’anti-repackaging massimizzano la protezione dell’app da malware, attaccanti e curiosi. Il processo che dovrebbe essere applicato ad ogni rilascio di un’app, dal primo agli aggiornamenti successivi, è rappresentato in Figura 12.

Sicurezza Mobile - Passi per la protezione di un app prima del rilascio
Figura 12: Passi per la protezione di un app prima del rilascio

Note

[1] Talos Security. Report di sicurezza su app bancarie: https://talos-sec.com/blog/2017/10/12/report-mobile-banking-app/

[2] S. Aonzo, A. Merlo, G. Tavella, and Y. Fratantonio (2018). Phishing Attacks on Modern Android. In Proc. of the 2018 ACM SIGSAC Conference on Computer and Communications Security (CCS ’18). Association for Computing Machinery, New York, NY, USA, 1788–1801. https://doi.org/10.1145/3243734.3243778

[3] https://developer.android.com/topic/google-play-instant/overview

[4] Ricordiamo che in Android un’app è valida se firmata e integra, ma non richiede l’autenticazione dello sviluppatore tramite certificato a chiave pubblica.

[5] https://mobsf.live/

[6] https://github.com/quark-engine/quark-engine

[7] https://www.talos-sec.com/products/approver/

[8] https://www.guardsquare.com/proguard

[9] https://www.zimperium.com/

[10] https://www.preemptive.com/solutions/android-obfuscation/

[11] Aonzo, S., Georgiu, G. C., Verderame, L., & Merlo, A. (2020). Obfuscapk: An open-source black-box obfuscation tool for Android apps. SoftwareX.

[12] Song, L., Tang, Z., Li, Z., Gong, X., Chen, X., Fang, D., & Wang, Z. (2017). AppIS: Protect Android Apps Against Runtime Repackaging Attacks. Proc. of 2017 International Conference on Parallel and Distributed Systems (ICPADS). Shenzhen, China: IEEE.

[13] Zeng, Q., Luo, L., Qian, Z., Du, X., & Li, Z. (2018). Resilient decentralized Android application repackaging detection using logic bombs. Proc. of the 2018 International Symposium on Code Generation and Optimization. Wien, Austria: ACM.

[14] Merlo, A., Ruggia, A., Sciolla, L., & Verderame, L. (2021). ARMAND: Anti-Repackaging through Multi-pattern Anti-tampering based on Native Detection. Pervasive and Mobile Computing.

Questo articolo è stato estratto dal white paper “Mobile Security – Nozioni e Riflessioni” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/mobile-security-nozioni-e-riflessioni/

Articolo a cura di Alessio Merlo

Profilo Autore

Ha conseguito una laurea magistrale in Informatica nel 2005 presso l’Università degli Studi di Genova, ed il dottorato di ricerca in Informatica nel 2010 presso la stessa università. Dal 2010 la sua ricerca si concentra interamente nell’ambito della Cybersecurity, con un focus specifico sulla Mobile Security, dove negli anni contribuisce a definire metodi innovativi per l’analisi statica e dinamica della sicurezza di applicazioni Android, con ricadute in contesti reali (e.g., BYOD), a definire nuove metodologie di testing di applicazioni mobili e di protezione delle stesse quali
tecniche di offuscazione e protezione delle applicazioni da attacchi di repackaging.
Ha inoltre lavorato allo sviluppo di nuove tecnologie per l’autenticazione utente su dispositiviì mobili, a tecniche di profilazione dell’impronta energetica di attacchi e malware, ed a metodologie per la protezione dei dati personali degli utenti acquisiti dalle applicazioni mobili.
Ha contribuito alla scoperta di una serie di pericolose vulnerabilità, tra cui la Zygote Vulnerability, due vulnerabilità nei protocolli GSM ed UMTS, alcune nei Password Manager su Android, ed una sul servizio iNotify di Android, che avrebbero portato a diverse conseguenze sull’utente finale, dal furto di credenziali fino all’impossibilità di utilizzare il dispositivo mobile.
E’ autore di oltre 130 pubblicazioni scientifiche su riviste e conferenze internazionali ed ha ricevuto diversi riconoscimenti per l’attività di ricerca sulla Mobile Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-mobile-android/


Aspetti tecnici degli Adversarial Examples

I recenti progressi nel campo dell’Intelligenza Artificiale (IA) e del Machine Learning (ML) hanno portato a significativi avanzamenti in numerosi settori applicativi. Tuttavia, la ricerca ha evidenziato una classe di vulnerabilità intrinseca a questi sistemi: gli Adversarial Attacks.

Questi attacchi sfruttano le peculiarità dei modelli ML per generare input appositamente modificati, denominati Adversarial Examples, che inducono classificazioni errate pur rimanendo percettivamente indistinguibili dai dati originali per l’osservatore umano.

La presenza di Adversarial Examples solleva questioni critiche riguardo all’affidabilità e alla sicurezza dei sistemi IA/ML in applicazioni ad alto rischio.

Introduzione al Processo di Addestramento di un modello di Machine Learning

Il processo di addestramento di un modello di Machine Learning può essere descritto ad alto livello come composto da un modello ML di cui si è decisa l’architettura, di un set di parametri inizialmente ignoti e di un set di dati di addestramento. I parametri del modello ML sono inizialmente scelti con valori casuali e il processo di addestramento consiste nel calcolare il valore migliore di questi parametri (i modelli di Deep Learning hanno un elevato numero di parametri, ad esempio GPT-3/ChatGPT ne ha 175 miliardi).

Per far questo si esegue il modello ML sui dati di addestramento, di cui si conosce il risultato atteso, e si misura l’errore del risultato dell’esecuzione del modello ML rispetto al risultato corretto. Inizialmente questo errore è molto grande, visto che il modello ML ha parametri casuali, ovvero non sa nulla. Poi si modificano i parametri in modo da ridurre l’errore.

Per semplicità si consideri un modello ML basato su Reti Neurali, addestrato con dati etichettati (Supervised Learning) e si indichi con {W} il set dei parametri del modello e con {X} il set dei dati di addestramento. L’errore del modello ML sui dati di addestramento è quindi una funzione di entrambi, E({W},{X}). Scopo dell’addestramento è cambiare il valore numerico dei parametri in modo da minimizzare l’errore, ovvero trovare min{W}E({W},{X}).

Metodo del Gradiente e Minimizzazione dell’Errore

Per trovare il migliore valore dei parametri, si utilizza principalmente il “metodo del gradiente” (Gradient Descent, Cauchy, 1847) o metodi simili. Questo è un metodo iterativo facilmente implementabile numericamente e quindi in software. Il metodo procede facendo piccolissime modifiche {δW} ai parametri, {W}→{W+δW}, tali che per ogni passo viene scelta la modifica che riduce maggiormente l’errore. Cauchy dimostrò che δW=-εD{W}E({W},{X}), ove ε è un numero piccolo (ad esempio 0,001) e D{W} è la derivata della funzione errore rispetto ai parametri del modello ML. Il ciclo di calcolo (Epoca) su tutti i dati di addestramento viene ripetuto sino a quando non si raggiunge un errore molto piccolo, ad esempio inferiore all’1%.

Origine degli Adversarial Examples

Se è possibile addestrare il modello in modo che produca minimi errori, com’è possibile che vi siano Adversarial Examples? Bisogna ricordare che un modello ML apprende utilizzando uno specifico set di dati di addestramento che inizialmente non comprende gli Adversarial Examples. Il modello ML è capace di elaborare correttamente moltissimi dati che sono simili a quelli del set di addestramento, ma non tutti.

Esistono particolari dati molto simili a quelli di addestramento sui quali il modello ML compie grandi errori: e proprio questi sono gli Adversarial Examples.

In semplici modelli di studio è possibile avere un’idea dell’origine degli Adversarial Examples [Rif. 8].

Costruzione degli Adversarial Examples

È possibile utilizzare un approccio simile a quello adottato per l’addestramento per cercare e costruire degli Adversarial Examples. Si assuma per semplicità di esposizione di aver calcolato i migliori parametri del modello ML e di non modificarli più. Invece si procede a modificare di poco i dati di addestramento cercando la modifica che genera il massimo errore, in formula max{δx}E({W},{X+δX}), ove δX deve rimanere molto piccolo.

Un semplice esempio di cosa si intende per “piccola modifica” può essere fatto per un modello ML che classifica immagini. Per il modello ML ogni immagine è una lunga lista di numeri, ogni numero corrisponde al colore di un pixel dell’immagine (questo se l’immagine è in toni di grigio, per immagini a colori ogni numero è il colore di un canale, ad esempio RGB, di un pixel).

Una “piccola modifica” può essere ad esempio modificare di poco il valore di un pixel e solo per 1 numero/pixel ogni 200 (cioè il 5 per mille); in molti casi questo tipo di modifica non è percettibile dall’occhio umano. In altre parole, si modificano alcuni pixel di un’immagine in modo che per l’occhio umano non vi sia alcuna differenza con l’immagine originale, ma in modo che il modello ML interpreti la nuova immagine come qualcosa di completamente diverso, ovvero massimo errore.

Sebbene il punto di partenza sia molto simile al processo di addestramento, la matematica necessaria per risolvere questo problema è molto più complessa e una soluzione completa non è ancora nota.

Adversarial Examples: Esperimento con Convolutional Neural Network

Riportiamo i risultati di un esperimento di [Rif. 8] che utilizza un semplice modello Convolutional Neural Network per il riconoscimento di immagini e per il quale i ricercatori sono stati in grado di risolvere anche solo approssimativamente l’equazione che definisce gli Adversarial Examples. Il modello ML è addestrato su di un set di dati di addestramento (Train) e verificato su di un set di dati di prova (Test) su cui non è addestrato.

Per ogni ciclo di addestramento (Epoca) viene anche calcolato un set di Adversarial Examples (Adv), ovvero il set {Xadv=X+δX} soluzione (approssimata) dell’equazione max{δx}E({W},{X+δX}) (il calcolo contestuale dei migliori valori dei parametri per minimizzare l’errore e delle variazioni dei dati di addestramento per massimizzare l’errore è chiamato un “problema min-max”). Il risultato è espresso nella seguente tabella (i numeri indicano la percentuale di errore espressa con un numero tra 0 e 1 per i tre set di dati Train, Test, Adv, per ogni ciclo/epoca di addestramento) [Rif. 8].

Percentuale di errore espressa con un numero tra 0 e 1 per i tre set di dati Train, Test, Adv, per ogni ciclo/epoca di addestramento
Tavola 1 [fonte Rif. 8]

Al termine dell’addestramento, l’errore sul set di dati Train è inferiore allo 0,2%, sul set di dati Test (su cui non viene fatto addestramento) è circa dell’1% e il programma ha costruito un set di dati di Adversarial Examples (Adv) molto simile al set di dati Train, ma su cui il modello ML sbaglia il riconoscimento dell’immagine il 71% delle volte.

Cosa è cambiato nelle immagini Adversarial Examples rispetto alle immagini del set di Train? Spesso la modifica corrisponde all’aggiunta di “rumore bianco” all’immagine che può rendere un po’ sfocati alcuni particolari e introdurre dei piccoli punti con colori errati in maniera apparentemente casuale (difetti dell’immagine o “glitch”), simile a quanto visto in Fig. 2. Nulla, comunque, che renda all’occhio umano la nuova immagine realmente diversa da quella originale.

Ri-addestramento con Adversarial Examples

Ora è possibile addestrare il modello ML anche utilizzando il set di dati di Adversarial Examples (Adv) che è stato generato, ma utilizzando sempre il set di dati Test solo per verificare l’addestramento. Il risultato è:

Set di dati di Adversarial Examples (Adv) che è stato generato per verificare l’addestramento
Tavola 2 [fonte Rif. 8]

Gli errori finali sui set di dati di Train e di Test sono cambiati ma le differenze non sono significative per l’esercizio svolto, mentre l’errore sul nuovo set di dati di Adversarial Examples (Adv) generato è sceso dal 71% a circa il 2,8%. Il modello ML ha quindi imparato a riconoscere correttamente anche gli Adversarial Examples generati con questo procedimento e che ora non sono più “antagonisti”. Un modello ML che in pratica non ha Adversarial Examples è chiamato “robusto”; quindi questo modello ML può dirsi “robusto” almeno sino a quando non sarà trovata una nuova classe di suoi Adversarial Examples.

È importante sottolineare che dopo aver ri-addestrato il modello utilizzando anche il set di Adversarial Examples, si può generare con lo stesso procedimento un nuovo set di dati massimizzando l’errore, ma l’errore rimane molto piccolo e il modello riconosce correttamente anche questo set di dati. In altre parole, il procedimento adottato in questo esempio particolare per costruire un set di Adversarial Examples funziona solo la prima volta, poi non genera più set di Adversarial Examples.

Adversarial Examples: Limitazioni e Sfide Future

Riassumendo, è possibile minimizzare gli errori sui dati di addestramento calcolando il valore dei parametri {W} e al contempo generare un set di dati {X+δX} quasi indistinguibile dal set di dati di addestramento ma che massimizza l’errore del modello ML. Anche se poi è possibile ri-eseguire il processo di addestramento includendo gli Adversarial Examples individuati creando un modello ML robusto, ad oggi non è noto un metodo per generare tutti gli Adversarial Examples di un modello ML, ovvero garantire che gli Adversarial Examples trovati siano tutti quelli di un modello ML.

Inoltre, come indicato precedentemente, aggiornare l’addestramento di un modello ML può portare a nuovi problemi, ad esempio la “smemoratezza” (Forgetfulness, dimenticare informazioni precedentemente acquisite) o una maggiore predisposizione ad attacchi di inversione e estrazione di dati di addestramento, problematiche rilevate in alcuni modelli ML di studio.

Il messaggio che viene da questo esercizio è che il processo di addestramento attuale non è completo: l’esistenza degli Adversarial Examples non è dovuta a qualche disattenzione o peculiarità di alcuni modelli ML particolari, ma è una caratteristica di come sono costruiti i modelli ML attuali. La ricerca scientifica su questo problema è molto intensa [Rif. 1], sono stati introdotti anche standard e benchmark sulla “robustezza” dei modelli ML e sui metodi per renderli robusti [Rif. 9], ma è probabile che per poter trovare una soluzione definitiva sia necessaria una migliore comprensione (soprattutto matematica) dei modelli di Machine Learning.

Riferimenti Bibliografici

Rif. 1: N. Carlini, “A Complete List of All (arXiv) Adversarial Example Papers”, https://nicholas.carlini.com/writing/2019/all-adversarial-example-papers.html , nel solo anno 2022 risultano pubblicati quasi 3.000 articoli scientifici relativi a “Adversarial Machine Learning”

Rif. 8: Z. Kolter, A. Madry, “Adversarial Robustness – Theory and Practice”, https://adversarial-ml-tutorial.org/

Rif. 9: F. Croce, M. Andriushchenko, V. Sehwag, E. Debenedetti, N. Flammarion, M. Chiang, P. Mittal, M. Hein, “RobustBench: a standardized adversarial robustness benchmark”, https://robustbench.github.io/ , arXiv:2010.09670
Continua a leggere: scarica il white paper gratuito “Adversarial Attacks a Modelli di Machine Learning“

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/gli-adversarial-examples/
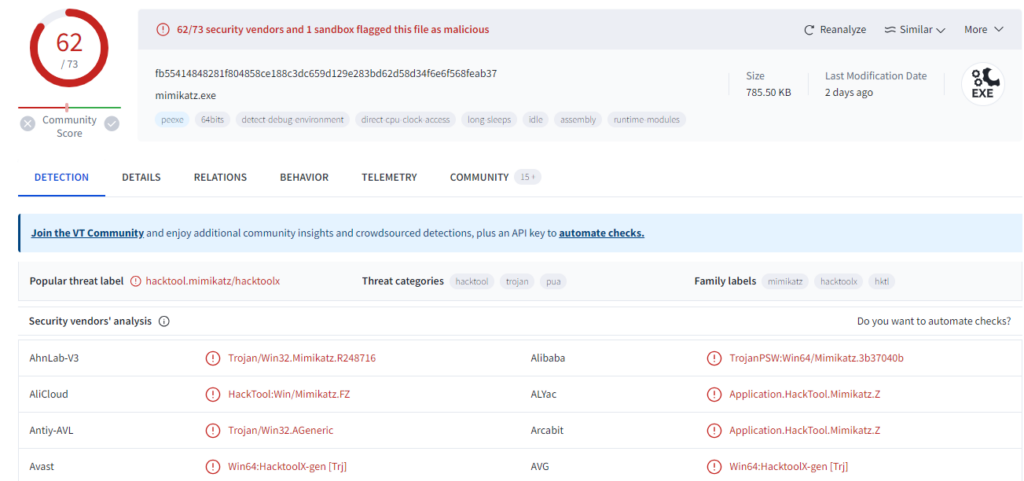


Email Forensics: Studio di email malevola e principali tool di analisi

Nell’era digitale, la sicurezza email è diventata una priorità imprescindibile per organizzazioni e individui. Questo articolo offre una guida all’Email Forensics utile ad analizzare e difendere le comunicazioni via email da minacce informatiche illustrando metodologie e strumenti all’avanguardia per individuare messaggi sospetti o dannosi.

Il testo si propone come risorsa fondamentale per chi desidera potenziare le proprie difese, fornendo best practice, indicatori chiave da monitorare e una panoramica degli strumenti più efficaci per l’analisi forense: dall’esame degli header alla verifica degli allegati, vengono trattati tutti gli aspetti critici per implementare una strategia di protezione completa.

In un contesto in cui le minacce veicolate via email diventano sempre più sofisticate, questa guida offre competenze essenziali per proteggere dati sensibili e infrastrutture IT. Per un’analisi più approfondita sull’intersezione tra sicurezza email e tecnologie emergenti, vi invitiamo a consultare il precedente articolo “Email Security e Intelligenza Artificiale“, che esplora le ultime innovazioni nel settore.

Email Forensics, come realizzare un’analisi approfondita

Quando si analizza un’email ci sono diversi fattori da tenere in considerazione:

  • Verifica dell’header from, se quindi il sender è noto oppure sconosciuto facendo caso anche ad eventuali “errori” nel dominio e/o nel nome dell’indirizzo. Questo potrebbe essere un primo chiaro segnale di una mail potenzialmente malevola.
  • Se il contenuto della mail cerca di far leva sulle nostre emozioni per ottenere delle informazioni
  • Analisi degli URL: un primo sintomo di una mail malevola riguarda l’uso del protocollo “http” invece dell’uso di un protocollo più sicuro e protetto come “https”.
  • Analisi degli allegati, utili per infettare una macchina e/o eseguire un malware, ad esempio, aprendo un file word/excel se come prima azione viene richiesto di “attivare le macro”. L’attivazione di macro di un file office è uno dei modelli d’attacco più utilizzati da molteplici malware, tra cui Emotet e da altri ransomware, per infettare le macchine destinatarie. Quest’operazione quindi in moltissimi casi è sintomo che l’allegato possa essere malevolo. Si invita quindi a non aprire e/o eseguire allegati provenienti da mittenti sconosciuti e in cui si chieda di “abilitare” le macro. Altri file da cui si consiglia di porre maggior attenzione sono gli eseguibili “.exe” e i file con estensione “.bat”.

Un’analisi più approfondita può essere effettuata tramite analizzando l’header. Quest’analisi consentirà di individuare molteplici IoC (Indicator of compromise) che aiuteranno a comprendere se effettivamente la mail risulta essere malevola. Tra le informazioni più rilevanti estraibili dall’header di un email ci sono:

  • “Connections” come sender IP da cui è partita la mail e relativi hostname/relay attraversati;
  • Envelope information (Sender e Recipient);
  • Header From, to, subject e data;
  • Return-Path;
  • SPF, DKIM e DMARC e relative configurazioni;
  • Message-ID, univoco per ogni mail;
  • MIME- Version;
  • X-Spam Status;

Per estrarre l’header di una mail è sufficiente seguire i seguenti passi:

  • Aprire la mail tramite Outlook, Thunderbird o altro software simile
  • File -> Info -> Properties -> Internet headers

Figura 11. Header Information - Email Forensics

Figura 11. Header Information - Email Forensics: header analysis
Figura 11. Header Information

Nota. Per effettuare una corretta analisi dell’header è fondamentale che la mail NON sia stata “forwadata” ma che la segnalazione ricevuta sia invece allegata nella mail. Ciò consentirà di non perdere tutte le informazioni relative alle connessioni e comunicazioni avvenute tra il sender sospetto e il recipient.

Figura 12. Segnalazione di un’email sospetta - Email Forensics
Figura 12. Segnalazione di un’email sospetta

Una volta selezionato il contenuto “dell’internet headers” sarà possibile procedere all’analisi di tutti i vari campi di interesse sin qui elencati. Tra i tool a supporto per analizzare un header si segnalano:

  • MxToolbox: https://mxtoolbox.com/EmailHeaders.aspx
  • Google Admin Toolbox: https://toolbox.googleapps.com/apps/messageheader/
  • Analyze mail header: https://mailheader.org

MxToolbox fornisce una vasta gamma di informazioni relative a:

  • Blacklist di un IP e/o dominio
  • “Delivery information”: SPF, DKIM e DMARC
  • “Relay information” con tutte le informazioni di interesse relative al flusso della mail (dal sender al recipient finale). Tramite quest’area sarà infatti possibile osservare se la mail ha attraversato qualche relay e/o hostname malevolo.
Figura 13. MX Toolbox - Email Forensics
Figura 13. MX Toolbox

Cliccando sul tasto blacklist e poi successivamente su “Detail” l’analista potrà osservare in quali di queste l’IP è stato inserito e perché quell’IP è stato classificato come malevolo da quella specifica blacklist:

Figura 14. MX Toolbox - Blacklist - Email Forensics

Non è sempre detto che se una mail proviene da un IP in blacklist sia necessariamente malevola; tuttavia, questo potrebbe essere un primo segnale di allarme per un analista.

Per effettuare ulteriori analisi degli IP estratti dall’header è possibile utilizzare diversi tool tra cui:

  • Talos: effettua analisi di IP fornendo informazioni come: ‘country, domain reputation ecc e blacklist.
  • AbuseDB: che fornisce informazioni anche sul “behavior monitoring” nel web.
  • DMarcian & Wise: che consentono l’analisi dei record SPF, DKIM e DMARC

In merito all’analisi degli URL si segnalano invece i seguenti tool:

Mentre per l’analisi degli allegati/URL si segnalano diverse sandbox tra cui:

Infine, tra i tool più noti a tutti gli analisti si segnala anche Virustotal (https://www.virustotal.com/gui/home/upload):

Figura 15. Virustotal - Email Forensics - Analyse suspicious email
Figura 15. Virustotal

le cui capacità spaziano dall’analisi di IP, URL, Hash all’analisi di file. Virustotal possiede una collezione di antivirus a cui sottoporre l’evidenza e come risultato produce un report con i risultati dell’analisi. Qualora presenti, fornirà anche informazioni relative ad eventuali “whois” degli IP sottoposti e riferimenti a potenziali attività malevole correlate. Possiede, infine, anche una sezione relativa alla community in cui ogni analista potrà fornire il proprio contributo in merito all’evidenza sottoposta. Si veda figura 16 per tutti i dettagli.

Note. Si tenga presenta che Virustotal non è in grado di individuare minacce sconosciute e/o zeroday.

Figura 16. Virustotal – Analisi hash - Email Forensics
Figura 16. Virustotal – Analisi hash

Di seguito, infine, in figura 17 è possibile osservare ulteriori tool per le analisi:

Figura 17. Email analysis tools [LetsDefend] - Email Forensics
Figura 17. Email analysis tools [LetsDefend]

Si fa presente, comunque, che ogni analisi va suffragata e approfondita, non è sempre detto che un file/IP/dominio ritenuto “pulito” lo sia effettivamente, anzi. Si invitano quindi tutti i lettori a non dare per assolute tutte le evidenze che i tool online forniranno ma di usare sempre un pensiero critico e di incrociare più fonti per avere maggiore contezza dell’analisi. È opportuno quindi porsi sempre domande, soprattutto se ci sono dei sospetti di attività malevole dai “raw logs” e i tool non ne segnalano.

“Se qualcosa può andar male, lo farà” [Legge di Murphy]

Di seguito verranno mostrati alcuni scenari di mail malevole che potrebbero essere utilizzati dagli aggressori con potenziali subject:

  • Tipologia: Malware veicolato tramite email:
    • Potenziali subject malevoli:
      • “Fattura allegata”
      • “Il protocollo del certificato medico”
      • “Domanda per la nuova indennità COVID-19”
    • Descrizione: email proveniente da un fornitore o un servizio noto contente un allegato che dichiara essere una fattura e/o un certificato medico. L’allegato contiene un file dannoso che, se aperto, può infettare il sistema con un malware e/o ransomware.

Esempio:

Figura 18. Malware veicolato tramite mail - sicurezza email - Email Forensics
Figura 18. Malware veicolato tramite mail
  • Tipologia: Phishing/Spoofing/BEC:
    • Potenziali subject malevoli:
      • “Importante: Aggiornamento della Password Richiesto”
      • “Cambio di Conto Bancario per i Pagamenti”
      • “Urgente: Problemi con il tuo account bancario”
      • “Il tuo account è stato compromesso”
    • Descrizione: email proveniente da un servizio noto contenente un messaggio che avvisa l’utente di un presunto accesso non autorizzato oppure di una password scaduta. Si chiede quindi all’utente di cliccare su un link per aggiornare la password e/o inserire informazioni sensibili (informazioni bancarie e simili). Il link porterà a un sito di phishing dove verranno catturare le informazioni inserite.

Esempio:

Figura 19. Phishing - sicurezza email - cybercrime - Email Forensics
Figura 19. Phishing

Alcune mitigazioni e analisi possibili:

  • Segnalazione della mail al team di competenza.
  • Tramite email secure gateway, verificare se è in corso una campagna malevola oppure se fa riferimento a pochi casi isolati. Per fare ciò bisognerà incrociare informazioni legate al sender email/IP/domain e subject ad esempio.
  • Blocco del sender e di eventuali IP/domini malevoli.
  • Attivare il rewriting URL così da bloccare eventuali accessi a link malevoli.
  • Far uso di sandbox per analizzare gli allegati.
  • Analisi dell’header e delle connessioni per verificare la reale provenienza della mail.

Questo articolo è stato estratto dal white paper “Email Security: Intelligenza Artificiale, Protocolli e Best Practice Contro gli Attacchi Informatici” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/email-security-intelligenza-artificiale-protocolli-e-best-practice-contro-gli-attacchi-informatici/

Articolo a cura di Fabrizio Giorgione

Profilo Autore

Fabrizio Giorgione è nato a Napoli (NA) nel 1992. Si è laureato in ingegneria informatica presso l’università degli studi del Sannio il 17 dicembre del 2018 con una tesi dal titolo: “Analisi della superficie di un sistema SCADA”. Ha sviluppato, presso il laboratorio ISWATlab, un’applicazione Android denominata “Privacy Guard” la quale valuta il rischio di privacy leakage, ovvero il furto di informazioni, sugli smartphone (http://www.iswatlab.eu/?page_id=499). Ha effettuato il tirocinio presso lo “ZLab” di “Cse Cyber Sec” nell’ambito “SOC”, “Forensic” e “Malware Analysis”. Attualmente lavora presso la società di “NTT DATA” come “Cyber security Analyst” nel SOC di Napoli. Il suo compito è quello di effettuare analisi di log, di malware e di prevenire minacce interne ed esterne alla sua azienda e ai clienti della società. Si è occupato, inoltre, del montaggio e della gestione di sonde IDS/IPS presso Telecom Italia nella sede di Roma (RM).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/email-forensics-sicurezzamail/