Cloud Computing, elementi di data security e protection

Il cambio di paradigma del cloud computing elimina la dipendenza dai server locali, consente la fruizione delle applicazioni senza soluzione di continuità e offre un’elevata disponibilità di capacità di calcolo e memorizzazione. Inoltre, offre scalabilità, flessibilità ed economicità. Di conseguenza, la sicurezza del cloud riveste un ruolo qualificante.

Principali minacce e punti deboli della sicurezza del cloud computing

Le statistiche sugli incidenti informatici che riguardano il cloud rilevano che le principali minacce riguardano l’abuso di credenziali, il cryptomining, i ransomware, il data exfiltration e gli attacchi DOS, mentre i punti deboli della sicurezza del cloud sono rappresentati da credenziali d’accesso deboli o con privilegi elevati, errori di configurazione, vulnerabilità del software di terze parti.

Le organizzazioni che affidano i loro servizi essenziali al cloud computing devono pretendere un modello che contempli il controllo degli accessi, l’adozione di tecniche di crittografia e il monitoraggio continuo del traffico di rete. Inoltre, devono verificare che sia presente una policy di accesso robusta, una gestione proattiva delle patch, gli audit di sicurezza, la valutazione delle vulnerabilità, un sistema di rilevamento delle intrusioni e gli strumenti SIEM. In sintesi, una strategia di sicurezza del cloud si fonda sulla fiducia, garantisce la protezione dei dati e il rispetto dei requisiti legali e degli standard settoriali.

Sicurezza e protezione dei dati nel cloud: gli elementi chiave per una strategia efficace

I principali elementi per la sicurezza e protezione dei dati nel cloud sono riepilogati di seguito:

  1. Confidenzialità: l’accesso ai dati è consentito solo agli utenti autorizzati;
  2. Integrità: i dati devono rimanere integri e nel formato originale;
  3. Disponibilità: gli utenti autorizzati devono fruire di un accesso affidabile;
  4. Privacy: i dati privati devono essere protetti dagli accessi non autorizzati;
  5. Data encryption: garantire la confidenzialità e la privacy tramite la crittografia dei dati;
  6. Identity and access management (IAM): garantire un accesso sicuro alle risorse cloud attraverso un sistema di gestione dell’autenticazione e delle autorizzazioni;
  7. Information protection: classificazione e protezione dei dati sensibili;
  8. Shared responsibility model: identificare il modello di distribuzione della responsabilità tra provider e organizzazione;
  9. Malicious insiders: mitigare il rischio insider;
  10. Intentional data remanence: implementare la rimozione sicura dei dati dallo storage;
  11. Business continuity plan: prevedere strategie di data backup e data recovery;
  12. Data segregation/multi-tenant services: distribuire più copie di dati su storage diversi;
  13. Data loss prevention (DLP): implementare politiche contro la perdita o il furto dei dati
  14. Data protection compliance recommendations: adottare policy per la compliance normativa.

La conduzione di un’indagine digitale deve necessariamente tenere conto di queste proprietà per un duplice motivo: da un lato serve a individuare le criticità o le vulnerabilità di un sistema cloud, dall’altro agevola la ricerca delle evidenze, come vedremo nel seguito.
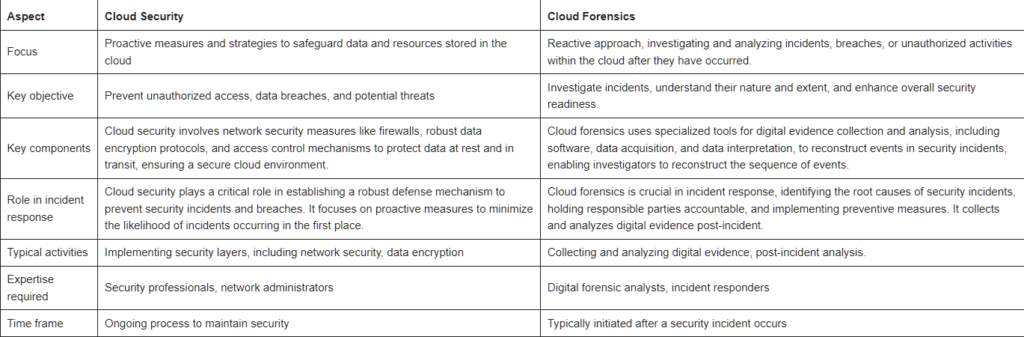
Confronto tra gli obiettivi della cloud security e della cloud forensics (Fonte: Research on cloud forensics)

Cloud computing forensics

Il cloud computing ha visto il progressivo spostamento di servizi, applicazioni e dati su infrastrutture di elaborazione e storage ubicate presso soggetti terzi rispetto ai loro utenti, gestori o proprietari. Ovviamente, anche i sistemi cloud possono essere oggetto di attività illecite, o essere a loro volta utilizzati per compiere attività di tale genere, per cui è necessario saper effettuare l’analisi forense in questi ambienti, determinare le attività eseguite su di essi o mediante essi, le modalità con cui sono state compiute e il soggetto cui sono riconducibili, ovvero comprendere i diversi livelli di responsabilità nei contenziosi di natura contrattualistica.

La specificità dei sistemi cloud, come la distribuzione e la duplicazione di dati e delle componenti applicative, o anche l’elevato livello di virtualizzazione e segmentazione, richiede specifiche metodologie di analisi forense che rendono difficilmente applicabili, se non inadatte, le metodologie sviluppate per l’analisi dei sistemi on-premise. Queste ultime sono infatti basate sul presupposto che sia possibile accedere, senza restrizioni, ai sistemi e ai dati, ipotesi che non valgono nel cloud computing.

La cloud computing forensics si pone l’obiettivo di sviluppare metodologie e strumenti per l’analisi forense dei sistemi cloud: «Cloud Computing forensic science is the application of scientific principles, technological practices and derived and proven methods to process past cloud computing events through identification, collection, preservation, examination and reporting of digital data for the purpose of facilitating the reconstruction of these events».

La letteratura scientifica prevede una sequenza di attività distinte: l’identificazione (identification) delle potenziali fonti di prova digitale, la raccolta (collection) e/o l’acquisizione (acquisition) di tali fonti, la conservazione (preservation), l’analisi (analysis) e, infine, la presentazione (reporting) dei risultati ottenuti.

Ogniuna di queste fasi è ben definita dagli standard ISO/IEC 27037:2012 “Guidelines for identification, collection, acquisition, and preservation of digital evidence” e ISO/IEC 27042:2015 “Guidelines for the analysis and interpretation of digital evidence” (a cui si rimanda per un maggiore approfondimento), ma non indicano le specifiche procedure da adottare per l’attuazione delle varie fasi in un determinato contesto. Pertanto, devono essere definite, tenendo conto delle specificità dei sistemi basati sul cloud computing, affinché sia garantito il rispetto dei requisiti che caratterizzano sia la prova digitale (autenticità e integrità), sia il procedimento e gli strumenti di analisi forense (affidabilità, ripetibilità e giustificabilità dei risultati ottenuti).

[embedded content]

Tipicamente un sistema cloud è formato da diversi sottosistemi: i client utilizzati per accedere ai servizi, le risorse virtualizzate che erogano tali servizi, le risorse fisiche utilizzate per la gestione di quelle virtualizzate e la rete che permette l’interconnessione. Mentre per la prima categoria e l’ultima categoria esistono processi consolidati (cd. Computer forensics e Network forensics), per le risorse virtualizzate e gli ambienti che le ospitano occorre sviluppare procedure specifiche. Inoltre, essendo ciascuno di tali sottosistemi diverso dagli altri, richiedono l’applicazione di procedure di analisi ulteriormente personalizzate che potremmo definire “sartoriali”.
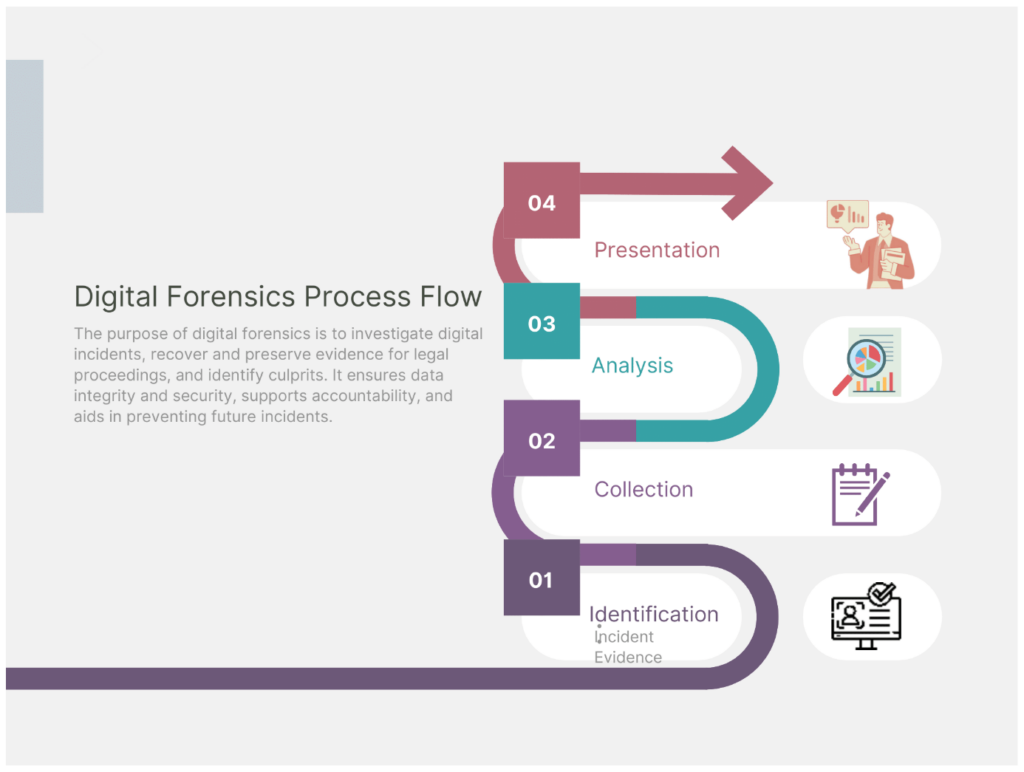
Il processo di cloud digital forensics (Fonte: Research on cloud forensics)

Identification nel contesto del cloud computing

Con il termine Identification si intende “the process involving the search for, recognition and documentation of potential digital evidence”, ovvero la ricerca, l’individuazione e la documentazione delle potenziali fonti di prova digitale. Nel contesto del cloud computing consente di individuare le risorse fisiche e virtualizzate, compresi i dati di utilizzo (p.e. i file di log, il controllo degli accessi e le attività degli utenti), potenziali fonti di prova digitale.

L’identificazione richiede:

  • la conoscenza dell’ubicazione delle risorse: per poterle localizzare all’interno del eco-sistema cloud e identificare il provider,
  • la comprensione delle modalità di accesso e fruizione delle risorse: per poterle interrogare e acquisire da remoto o on-premise,
  • il formato e la codifica dei dati: per poterli correttamente decodificare e interpretare ai fini dell’analisi (crittografia);
  • inoltre, poiché ogni sottosistema può essere distribuito da un fornitore diverso e con tecnologia diversa, occorre conoscere gli account con privilegi admin, i servizi oggetto di indagine, la tipologia, i servizi di management, monitoring e security abilitati e la mappatura dei provider.
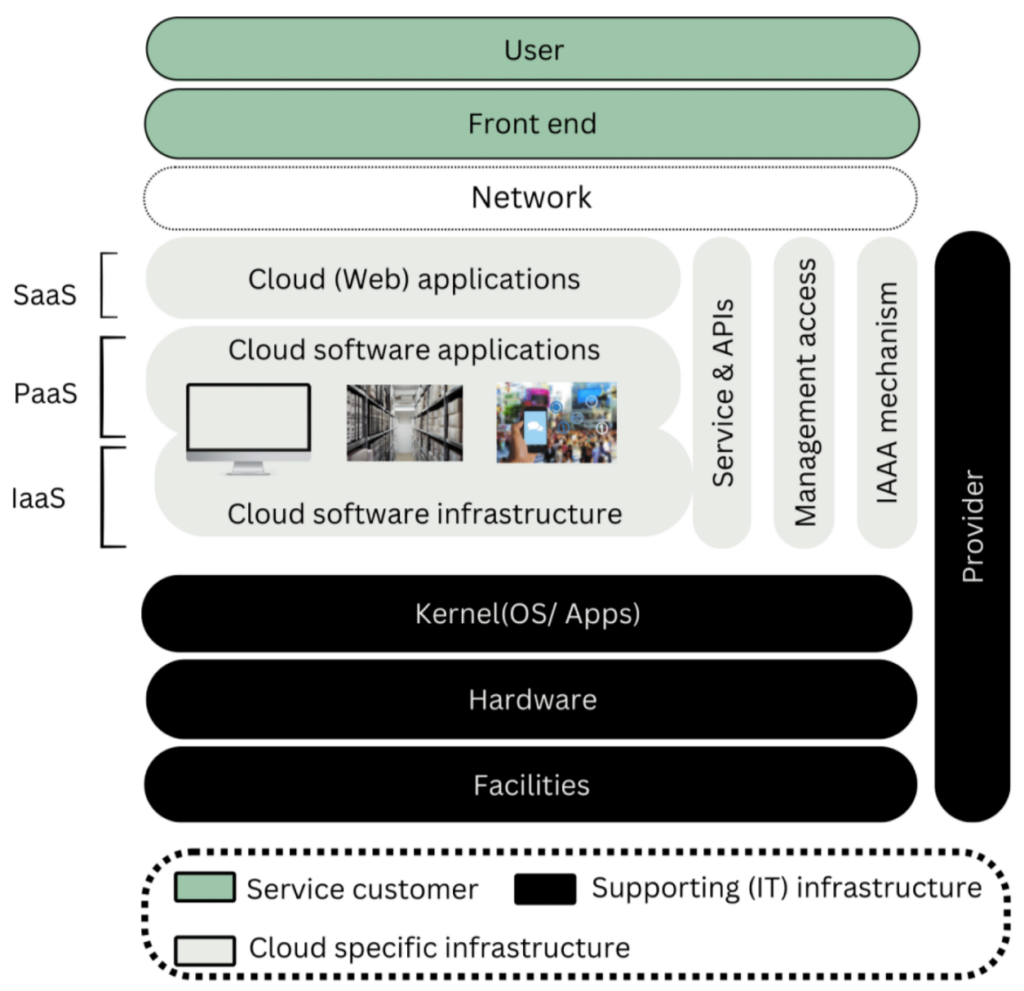
Le componenti di un Cloud Computing Service (Fonte: Research on cloud forensics)

L’identificazione non è di semplice attuazione perché occorre fare i conti con una serie di criticità:

  • indeterminazione del posizionamento delle risorse e dei dati. Il principio cardine su cui si basa il cloud computing è la flessibilità, ovvero la possibilità di replicare e migrare i dati e le risorse virtualizzate sulle varie risorse fisiche facenti parte del sistema cloud. Questo principio diventa un problema in fase di identificazione, ma può essere in parte risolto acquisendo preliminarmente:
    • i log di sistema per rintracciare le risorse all’interno dell’infrastruttura;
    • i tag utilizzati per etichettare i dati e le risorse di un determinato utente;
    • i service level agreements per comprendere gli obblighi contrattuali e le eventuali clausole che incidono sulla localizzazione o l’ubicazione geografica.
  • decentramento delle risorse e dei dati. Generalmente, le risorse e i dati non sono memorizzati in un’unica risorsa per consentirne un’ottimale disponibilità. Per ricostruire la cronologia delle localizzazioni occorre acquisire i log del framework deputati alla registrazione delle operazioni relative all’utilizzo e alla memorizzazione dei dati.
  • inaccessibilità fisica del sistema. Le risorse fisiche sono spesso inaccessibili, pertanto è necessario rivolgersi al provider per accedere alle risorse virtuali. I principali provider si stanno attrezzando per queste necessità, offrono soluzioni per l’estrazione della memoria volatile e per la realizzazione di copie del componente virtuale d’interesse.
  • cifratura dei dati. La necessità di mantenere adeguati livelli di riservatezza dei dati in un ambiente multi-tenancy di solito è soddisfatta mediante l’uso di tecniche di cifratura. Le chiavi di cifratura possono essere gestite dal provider, sottoforma di servizio, oppure direttamente dall’utente.

Per superare alcune delle criticità esposte, è opportuno che il forenser proceda a:

  • acquisire le credenziali o il token degli account con privilegi admin per accedere all’ambiente cloud dall’esterno;
  • identificare i log del servizio d’interesse e dei servizi cloud correlati;
  • individuare eventuali client utilizzati per accedere alla gestione dei cloud services;
  • chiedere la collaborazione del provider (a meno che non sia parte in causa del contenzioso) per acquisire le informazioni che non sono accessibili dall’esterno;
  • documentarsi sulle specifiche dell’ambiente da analizzare per non trovarsi impreparati nelle fasi successive;
  • acquisire le tipologie di servizi oggetto di indagine e dei servizi di supporto abilitati (identity and access management, detection and response, network application protection, data protection, compliance and auditing, ecc.);
  • identificare le regioni/zone che ospitano le virtual machine o le istanze (repliche);
  • leggere il contratto di fornitura tra utente e provider per comprendere l’oggetto del servizio di cloud, la configurazione del servizio e i service-level agreement.

Collection & Acquisition – Tecniche e strumenti per la raccolta e l’acquisizione di prove digitali negli ambienti cloud

Con la voce Collection si intende “the process of gathering items that contain potential digital evidence”, ovvero il sequestro di dispositivi che contengono delle potenziali prove digitali; mentre con il termine Acquisition si intende “the process of creating a copy of data within a defined set”, ovvero la creazione di una copia dei dati che costituiscono delle potenziali prove digitali.

Nel caso specifico, il sequestro è virtuale e potrebbe essere realizzato attraverso la disabilitazione delle utenze admin /user (oppure con il cambio password), l’inibizione dell’accesso agli utenti e il blocco delle VM, delle istanze e dei servizi (a meno che non siano servizi critici), mentre l’acquisizione consente di realizzare una copia delle risorse virtualizzate e dei dati correlati individuati durante la fase di identificazione.

Nei sistemi fisici la copia dei relativi supporti di memoria è realizzata connettendo il dispositivo ad un sistema di acquisizione mediante il quale è creata la copia. Gli ambienti cloud si caratterizzano per l’inaccessibilità fisica delle risorse, la volatilità delle risorse virtualizzate e l’uso di meccanismi di replicazione; pertanto, occorre utilizzare metodologie specifiche.

Per risolvere il problema dell’inaccessibilità è necessario acquisire i dati direttamente dall’infrastruttura del provider e, successivamente, essere trasferiti all’esterno del sistema cloud mediante un canale sicuro. Innanzitutto, occorre tenere presente che la realizzazione di questa modalità di acquisizione potrebbero presentarsi problemi di natura legale (transnazionalità), organizzative (interfacciarsi con il provider), tecnica (utilizzo di tecnologie costose e tempistiche ristrette) e forense (violazione di normative).

A riguardo possono essere utilizzate le seguenti tecniche:

  • uso delle interfacce applicative (API): i dati vengono acquisiti tramite software che si interfaccia con il sistema cloud attraverso le API (Application Programming Interface) per ottenere una copia delle risorse virtualizzate o dei dati di interesse (per i servizi di tipo SaaS).
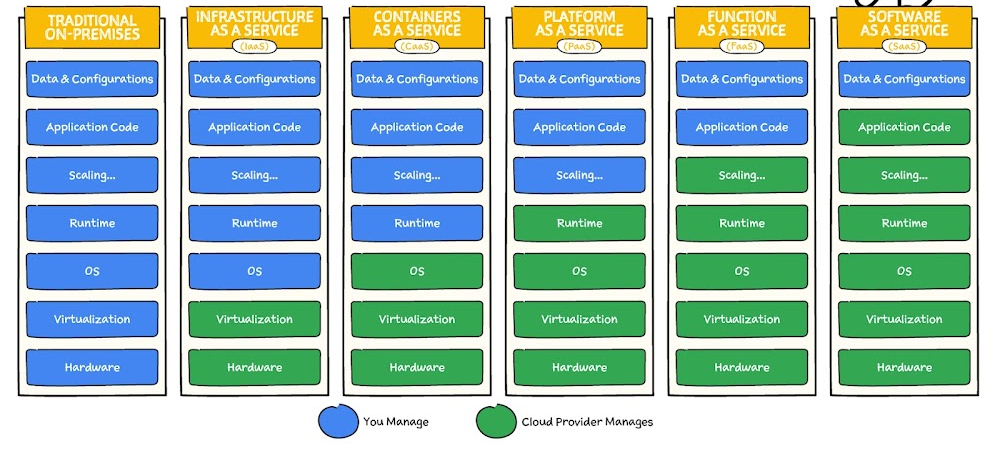
  • creazione di una copia della macchina virtuale o del container: questa operazione può essere realizzata direttamente dal forenser, tramite pannello di gestione, oppure delegata all’amministratore del cloud (per gli altri servizi di tipo IaaS, CaaS, PaaS, FaaS).
  • utilizzo dei tools di controllo: generalmente i provider offrono strumenti di gestione delle risorse e dei dati accessibili mediante web. Questi tools di controllo consentono di acquisire oltre alla copia della macchina virtuale o del servizio cloud oggetto di indagine, diversi altri dati utili alla digital forensics, per esempio i file di configurazione delle risorse virtuali, i file di log generati dalla piattaforma, i log relativi agli accessi da parte dell’utente, ecc.
  • uso dei dati per detection & response: i provider usano tools di monitoring e response per garantire che i loro servizi siano conformi a determinati standard di sicurezza e alle normative vigenti; tali strumenti rappresentano un’ottima fonte di prova e quindi devono essere acquisiti.
  • live forensics: le piattaforme di virtualizzazione offrono strumenti per l’analisi delle macchine virtuali in esecuzione. Questi strumenti possono essere utilizzati, insieme ai tradizionali strumenti di live forensics, per estrarre varie informazioni direttamente da una macchina virtuale in esecuzione senza perturbarne lo stato.
  • snapshot dello stato: le macchine virtuali consentono di effettuare lo snapshot, ossia il salvataggio dello stato di una macchina in esecuzione. Questi può contenere diverse informazioni utili quali: i processi in esecuzione, il contenuto della memoria, le sessioni di rete aperte, gli utenti collegati alla macchina virtuale.
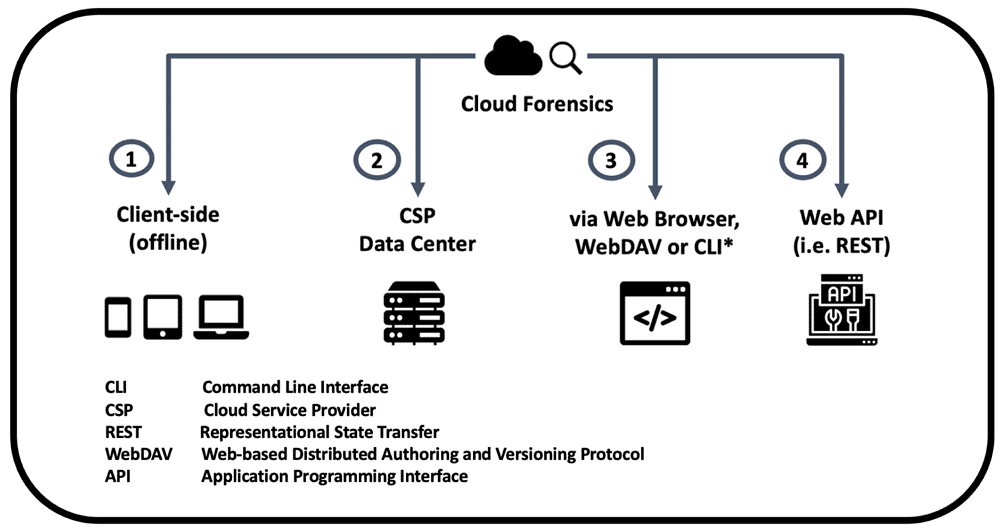
Tecniche di acquisizione via API (Fonte: open-research-europe.ec.europa.eu)

Come è noto, i servizi di tipo IaaS e PaaS si basano su risorse virtuali e, per definizione, volatili, pertanto, potrebbero essere facilmente rimosse durante l’acquisizione. Una soluzione a questa criticità è l’utilizzo dello snapshotting già indicato. Ciò presuppone che le risorse di interesse siano individuate in anticipo rispetto alla necessità di acquisizione, prima che vengano rimosse.

Inoltre, occorre tenere conto della duplicazione dei dati. I sistemi cloud sfruttano i meccanismi di replicazione dei dati per offrire adeguati livelli di prestazioni e disponibilità di servizio. La presenza di più repliche dello stesso insieme di dati può causare dei problemi durante l’acquisizione, in quanto i meccanismi di sincronizzazione delle repliche richiedono una congrua quantità di tempo per propagare le modifiche a tutte le altre repliche presenti nel sistema. Pertanto, è necessario che la procedura di acquisizione si interfacci con il gestore delle repliche in modo da ottenere la versione più recente dei dati. Inoltre, è necessario impedire che una qualunque replica venga aggiornata durante l’acquisizione tramite dei meccanismi, se presenti, di lock globali.

Infine, occorre considerare l’aspetto della crittografia. In questi casi dobbiamo prevedere anche l’acquisizione dei client da cui si è avuto accesso al cloud, per acquisire le chiavi di decifratura, ovvero chiedere al cloud provider, nel caso ne fosse provvisto.

Spesso quest’attività è delegata agli specialisti del cloud presso il provider che non hanno quella formazione e sensibilità necessaria per raccogliere e conservare meticolosamente le evidenze in conformità agli standard forensi, preservandone l’integrità e l’autenticità per potenziali procedimenti legali; pertanto, è necessario formarli o affiancarli durante la fase di acquisizione.

Di seguito un elenco, non esaustivo, di tools utilizzabili per l’acquisizione dalle piattaforme cloud: Cado, Google Cloud Forensics Utils, CloudTrail (AWS), Azure Security Center, Azure Activity Log (Azure), Cloud Monitoring (GCP), Magnet AXIOM cloud, Cellebrite UFED cloud analyzer, Mandiant CloudLens, AccessData cloud extractor, Oxygen forensic cloud extractor, ecc.

Preservation – Preservare l’integrità delle prove digitali negli ambienti cloud

Con la voce Preservation si intende “the process to maintain and safeguard the integrity and/or original condition of the potential digital evidence”, ovvero la preservazione dell’integrità delle potenziali prove digitali. Dunque, la conservazione di un’acquisizione forense deve garantire l’integrità dei dati, ovvero mantenere le stesse condizioni dell’acquisizione. Lo strumento più utilizzato nella digital forensics a tale scopo è il calcolo dei codici hash crittografici, ma per raggiungere lo stesso obiettivo nel contesto cloud occorre considerare alcune criticità:

  • duplicazione: la replica dei dati può creare problemi anche in questa fase nel caso in cui non ci siano meccanismi di lock globale, come visto per l’acquisizione.
  • volatilità: la volatilità crea potenziali criticità in quanto impedisce di preservare lo stato dei dati memorizzati su di esse. L’unica soluzione è creare uno snapshot del sistema.
  • multi-tenancy: i sistemi cloud si caratterizzano per la condivisione delle risorse tra vari utenti. Questa caratteristica solitamente è compresa nei meccanismi di virtualizzazione, per cui le risorse di ogni utente sono accessibili solo a lui (segregazione), ma non sempre ciò accade, per cui occorre fare attenzione che non vi siano file system o memorie condivise tra più utenti.

Non esiste una soluzione unica a questi problemi, ma è possibile ridurli formando una dettagliata documentazione delle fasi di acquisizione e conservazione e, inoltre, utilizzando meccanismi di firma digitale con marca temporale per cristallizzare il momento dell’esecuzione.

Analysis & Presentation – Analisi e presentazione delle prove digitali negli ambienti cloud

La fase di Analysis consente “the identification and evaluation of items of evidence from a source of potential digital evidence”, ovvero l’individuazione e la valutazione di prove digitali, partendo da una sorgente di potenziali prove digitali. Con il termine Presentation si identifica il processo che “includes describing the actions performed (…) and other aspects of the forensic process”, ovvero che comprende la descrizione delle azioni effettuate, nonché altri aspetti del procedimento seguito nell’analisi forense. In altri termini, è la presentazione dei risultati.

L’analisi delle evidenze digitali deve essere in grado di individuare e valutare le potenziali prove. Un sistema cloud è caratterizzato dalla presenza di diversi sottosistemi che interagiscono tra loro. Questa integrazione può essere complessa perché le risorse di interesse sono distribuite su diversi dispositivi. Inoltre, un provider può avvalersi di servizi erogati da altri, creando una catena di dipendenze che determina la presenza di possibili potenziali prove su più sistemi cloud.

Risulta determinante effettuare l’integrazione delle diverse fonti di prova per realizzare la ricostruzione completa degli eventi. Alcune soluzioni per effettuare adeguatamente tale integrazione si basano sull’uso di aggregatori dei file di log distinti ed aventi formato eterogeneo.

Spesso è necessario redigere la cosiddetta linea temporale (timeline), ovvero la sequenza degli eventi ordinati cronologicamente in base all’istante della loro occorrenza (timestamp) per ricostruire la successione di eventi verificatisi in un sistema cloud. Poiché gli eventi possono essere generati da dispositivi distinti, è necessario inserire nella stessa linea temporale eventi provenienti da dispositivi diversi. Ciò può essere influito negativamente dalla possibile mancata sincronizzazione degli orologi di sistema oppure dalla difficoltà di associare l’evento a una determinata risorsa. Sarebbe opportuno utilizzare sistemi di logging sicuro.

Inoltre, si può ripresentare il problema della cifratura dei dati. In questa fase le ricadute sono ulteriormente onerose a causa dell’impossibilità di decodificare dati e, quindi, una ricostruzione incompleta degli eventi verificatisi sul sistema.

Integrare la cloud forensics nella strategia di sicurezza del cloud: sfide e soluzioni per un approccio proattivo e reattivo

L’esposizione delle peculiarità del cloud computing, e delle criticità specifiche di questo ambiente di erogazione dei servizi ICT, ha evidenziato la necessità di scegliere e adottare una metodologia di analisi forense specifica per questi sistemi. Le procedure forensi devono adattarsi ai diversi modelli di erogazione e distribuzione dei servizi, garantendo l’integrità delle evidenze raccolte. La rapida evoluzione degli ambienti cloud richiede un’acquisizione e conservazione tempestiva, per evitare lacune nello svolgimento dell’iter. La solidità della credibilità delle prove si basa sulla loro conservazione sicura.

Dall’analisi emerge chiaramente che vi siano criticità importanti da dover affrontare durante un’indagine digitale. Tra questi, particolare rilievo assumono quelli dovuti alla volatilità delle risorse virtualizzate, quelli determinati dall’inaccessibilità delle risorse fisiche, quelli causati dall’uso di tecniche di cifratura dei dati e, infine, la giurisdizione dei provider. In alcuni casi è fondamentale ottenere il coinvolgimento e il supporto del provider, a meno che non sia una controparte del contenzioso, e sfruttare le tecnologie di detection e response presenti.

Spesso non si distingue l’ambito della Cloud Security da quello della Cloud Forensics. Sono due domini distinti: la cloud security si concentra sulle misure proattive per proteggere i dati e le risorse, tra cui la sicurezza della rete, la crittografia dei dati e il controllo degli accessi, mira a prevenire l’accesso non autorizzato, le violazioni dei dati e le potenziali minacce; la Cloud Forensics, d’altra parte, è un approccio reattivo che indaga e analizza incidenti, violazioni o attività non autorizzate, aiutando le organizzazioni a imparare dalle violazioni e a migliorare il proprio livello di sicurezza.

La sicurezza del cloud e la digital forensics condividono alcune tecniche, ma l’analisi forense aderisce rigorosamente alle linee guida legali per l’ammissibilità in tribunale. In una strategia di sicurezza completa è essenziale integrare l’analisi forense per affrontare efficacemente le minacce alla sicurezza come le violazioni dei dati, gli attacchi DDoS e la cattiva condotta degli insider. Pertanto, è indispensabile individuare delle modalità che incentivino i provider all’adozione di procedure che agevolino la produzione e l’acquisizione di evidenze, superando le resistenze che possono frenarne il coinvolgimento e, contemporaneamente, formare i professionisti della sicurezza cloud alla metodologia forense, per evitare che durante un incidente si perdano delle evidenze importanti.

Infine, va ricordato che la cloud forensics presenta problemi di natura giuridica dovuti all’allocazione di risorse virtuali e dati su risorse fisiche ubicate in diversi paesi che devono essere opportunamente approfonditi in altre sedi, al fine di stimolare la ricerca di soluzioni adeguate.
cloud computing forensics e cloud security, Vincenzo Calabrò

Questo articolo è stato estratto dal white paper “Cloud Computing Forensics: Peculiarità e Indicazioni Metodologiche” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/cloud-computing-forensics-peculiarita-e-indicazioni-metodologiche/

Articolo a cura di Vincenzo Calabrò
Profilo Autore

Referente Informatico e Funzionario alla Sicurezza CIS (Ministero dell’Interno).
È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha, altresì, indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics conseguendo i Masters in Data Protection e Data Governance, IT Risk Management e Sicurezza Informatica ed Investigazioni Digitali, oltre al CERT Certification in Digital Forensics rilasciato da Carnegie Mellon University, all’European Certificate on Cybercrime and E-Evidence (ECCE) rilasciato dall’European Commission’s Directorate General Justice, Freedom and Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cloud-computing-data-security/


Un’introduzione a Self-Sovereign Identity

In questo articolo, ci dedichiamo alla descrizione delle nozioni fondamentali dietro a Self-Sovereign Identity, un modello di gestione dell’identità digitale in cui gli individui hanno il pieno controllo delle proprie informazioni personali. Parleremo inoltre dei suoi punti di forza rispetto ai precedenti modelli. In futuri articoli sullo stesso tema, ci addentreremo più sugli aspetti tecnici e sulla possibilità di creare un wallet di credenziali personali.

Introduzione alle identità digitali, alle operazioni, ai sistemi che le utilizzano

Una digital identity (identità digitale) può essere descritta come un insieme di attributi che aiutano a descrivere o qualificare un’entità, che si tratti di un essere umano o di un dispositivo elettronico. Alcuni di questi attributi sono chiamati identifier (identificatori) e distinguono il titolare dell’identità all’interno di un contesto specifico. Per esempio, nel mondo fisico, una targa di un’auto o il nostro codice fiscale, possono fungere da identificatori in contesti differenti.

Le identità, fisiche o digitali, nascono per essere soggette a un processo di verifica, diviso in identification e authentication (rispettivamente, identificazione e autenticazione). Il processo di identificazione è l’associazione di un identificatore personale con il titolare dell’identità digitale che lo presenta, ad esempio fornendo un indirizzo email durante un’operazione di iscrizione su un sito Web.

Il processo di autenticazione consiste invece nel verificare l’entità identificata tramite una prova di sicurezza, solitamente mediante una password segreta o una firma digitale. Ad esempio, cliccare su un link ricevuto via email dimostra che l’indirizzo email appartiene al titolare. Queste due operazioni sono fornite dai sistemi di Identity and Access Management (IAM), servizi specializzati di cui si fidano tutte le entità coinvolte (rappresentano quindi un trusted party) [1].

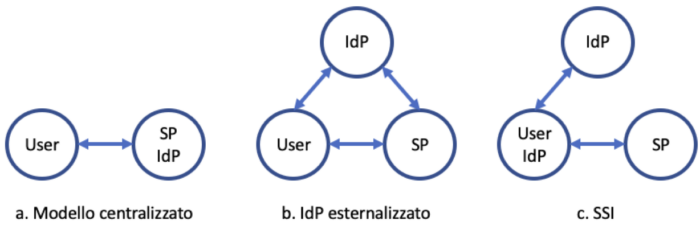
Uno IAM consiste solitamente di tre parti, rappresentate da un end-user (qualsiasi entità che possiede un’identità digitale e desidera svolgere una qualche attività), un identity provider (IdP) e un service provider (SP).

Un IdP genera e gestisce informazioni sull’identità degli utenti-entità da riconoscere (umane, software, hardware, etc), oltre a fornire servizi di autenticazione. Un SP è, con una definizione molto generale, un’organizzazione che offre servizi per i quali gli utenti hanno bisogno di fornire informazioni personali. Per una lunga fase iniziale del Web, erano gli stessi SP che implementavano soluzioni IAM come autorità centralizzate (Figura 1a).

Questo modello presenta alcuni svantaggi per gli utenti, in quanto devono gestire account differenti e mantenere per ciascuno di essi le proprie credenziali di accesso (che spesso coinvolgono password semplici), le impostazioni di sicurezza, e, in generale, tutte le informazioni relative all’account. Questo approccio rende vulnerabili al furto di password attraverso tecniche di phishing, key-logging, e malware in generale.

Per questi motivi, sono stati sviluppati successivamente standard per protocolli di federated identity (identità federata), tra cui Security Assertion Markup Language (SAML) e OpenID/OAuth, consentendo quindi agli utenti di riutilizzare identità già presenti presso vari provider spesso “social”, come Google, LinkedIn, Apple, Amazon, etc. In questo modello, l’utente deve autorizzare/negare l’IdP a condividere specifici attributi personali richiesti dall’SP che l’utente vuole utilizzare.

Questo sistema IAM di terze parti, chiamato IdP “esternalizzato”, migliora il precedente modello centralizzato su alcuni aspetti (Figura 1b): gli utenti devono essere registrati in pochi IdP per poter accedere ai servizi disponibili sul Web. Gli SP devono essere registrati con gli IdP desiderati (o con federazioni di IdP, che collaborano tra loro in modo trasparente per l’utente) per lavorare con utenti identificati e autenticati dagli IdP. Uno dei principali problemi di questo approccio è che negli IdP adesso si concentra una grande quantità di identità digitali, che fanno sì che maggior parte degli attacchi si trasferisca verso gli IdP piuttosto che ai server degli SP, come avveniva invece col modello centralizzato.

Il modello esternalizzato si è sviluppato in modo da porre anche altri svantaggi, come la formazione di oligopoli di IdP tra i quali l’identità dell’utente non è portabile, e la possibilità degli IdP di cancellare arbitrariamente un utente (e la sua identità) dalle proprie piattaforme (in caso l’IdP sia un social network, questo può avvenire anche per una violazione delle sue condizioni di utilizzo).

Figura 1: tre diversi modelli IAM: modello centralizzato, IdP esternalizzato, SSI
Figura 1: tre diversi modelli IAM

Self-Sovereign Identity

Il modello di Self-Sovereign Identity (SSI) elimina la necessità di un fornitore di identità esterno, consentendo all’utente di avere il pieno controllo della propria identità, potendo anche diventare lui stesso un IdP (Figura 1c). Gli utenti possono quindi gestire la propria identità digitale senza affidarsi a piattaforme di terze parti, facendo un passo avanti verso una maggiore privacy e sicurezza e mitigando eventi di data breach/leak [2].

SSI si basa sulla tecnologia blockchain, che fornisce un sistema decentralizzato per l’archiviazione e la verifica delle informazioni relative all’identità, resistente a manomissione. Si noti che la blockchain viene utilizzata “solamente” per memorizzare informazioni che permettono la verifica decentralizzata delle, e non memorizza quindi dati personali che al contrario rimangono all’interno di wallet digitali.

Il concetto centrale di SSI è che gli individui sono sovrani rispetto al proprio “io digitale” e hanno il controllo dei propri dati. In SSI l’identità è sovrana, duratura e portabile per qualsiasi individuo, gruppo o entità che consente l’accesso a tutti i servizi digitali pertinenti utilizzando credenziali verificabili relative all’identità pur mantenendo la privacy. Christopher Allen ha proposto dieci principi fondamentali per SSI [3], che in [4] sono stati raggruppati in tre principali gruppi riguardanti rispettivamente la sicurezza, controllabilità e portabilità dell’identità.

L’ecosistema SSI

Nell’ambito dell’SSI, introduciamo adesso un po’ di terminologia. I claim sono asserzioni fatte da un’entità riguardanti un soggetto. Un insieme di una o più affermazioni fatte da un’entità è una credential (credenziale). Se la credenziale contiene materiale crittografico che ne assicura l’integrità e l’autenticità, viene definita una veriafiable credential (VC). Un’affermazione a prova di manomissione derivata da una credenziale verificabile è chiamata verifiable claim. In SSI, le entità emettono credenziali verificabili verso gli holder (i titolari della credenziale), permettendo poi agli utenti di scegliere quali affermazioni essi vogliono condividere.

Ad esempio, una credenziale può riguardare una certificazione professionale in ambito sicurezza, ed i claim all’interno possono rappresentare la data dell’esame, il punteggio ottenuto, o il periodo di validità della certificazione.

Una verifiable presentation (VP) permette agli utenti di condividere solo le informazioni necessarie (decise dall’holder) provenienti da una o più credenziali, senza dover rivelare tutti i dettagli di una credenziale, permettendone al contempo anche le verifiche di autenticità ed integrità.

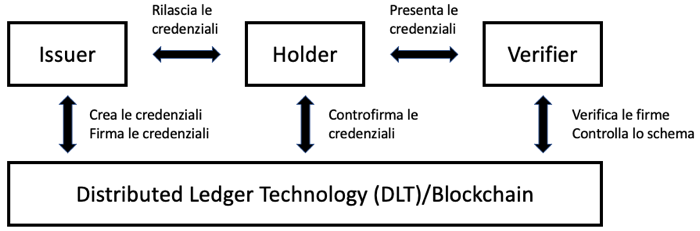
Nell’ecosistema SSI sono tre i principali attori: l’issuer crea e rilascia le credenziali ad un holder, l’holder le detiene e presenta al verifier che le richiede, e poi effettua i controlli di verifica. Figura 2 riassume le interazioni tra questi attori.

Self-Sovereign Identity: l’ecosistema SSI
Figura 2: l’ecosistema SSI

In un successivo articolo ci addentreremo nei Decentralized Identifier (DID), degli identificatori creati per essere gestiti in modo decentralizzato, i loro standard principali (W3C) [5] e le principali blockchain utilizzate.

BIBLIOGRAFIA

[1] Frederico Schardong and Ricardo Custódio. Self-sovereign identity: A systematic review, mapping and taxonomy. Sensors, 22(15):5641, 2022. URL https://doi.org/10.3390/s22155641

[2] Perché dovrei preoccuparmi della self-sovereign identity, se sono un’azienda o un cittadino?, di Efrem Zugnaz, 24 Giugno 2020. URL https://www.ictsecuritymagazine.com/articoli/perche-dovrei-preoccuparmi-della-self-sovereign-identity-se-sono-unazienda-o-un-cittadino/

[3] Christopher Allen. The path to self-sovereign identity, 26 Aprile 2016. URL https://www.lifewithalacrity.com/article/the-path-to-self-soverereign-identity/

[4] Andrew Tobin and Drummond Reed. The inevitable rise of self-sovereign identity. The Sovrin Foundation, 29(2016):18, 2016.

[5] Decentralized Identifiers (DIDs) v1.0 Core architecture, data model, and representations W3C Recommendation 19 July 2022. URL https://www.w3.org/TR/did-core/

Articolo a cura di Francesco Santini

Profilo Autore

Francesco Santini è Professore Associato presso il Dipartimento di Matematica e Informatica dell’Università degli Studi di Perugia. Si occupa da quasi venti anni di Intelligenza Artificiale e Cybersecurity, con un approccio integrato. È docente di corsi riguardanti la sicurezza per corsi di laurea magistrale in informatica e in master universitari di primo livello su protezione del dato e forensics. È relatore di tesi sulle materie di insegnamento. Organizza il programma di training CyberChallenge.it per studenti di scuole superiori e laurea triennale, ed è membro del Cybersecurity National Lab. presso il nodo di Perugia.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/intro-self-sovereign-identity/


Sicurezza del sistema operativo Android

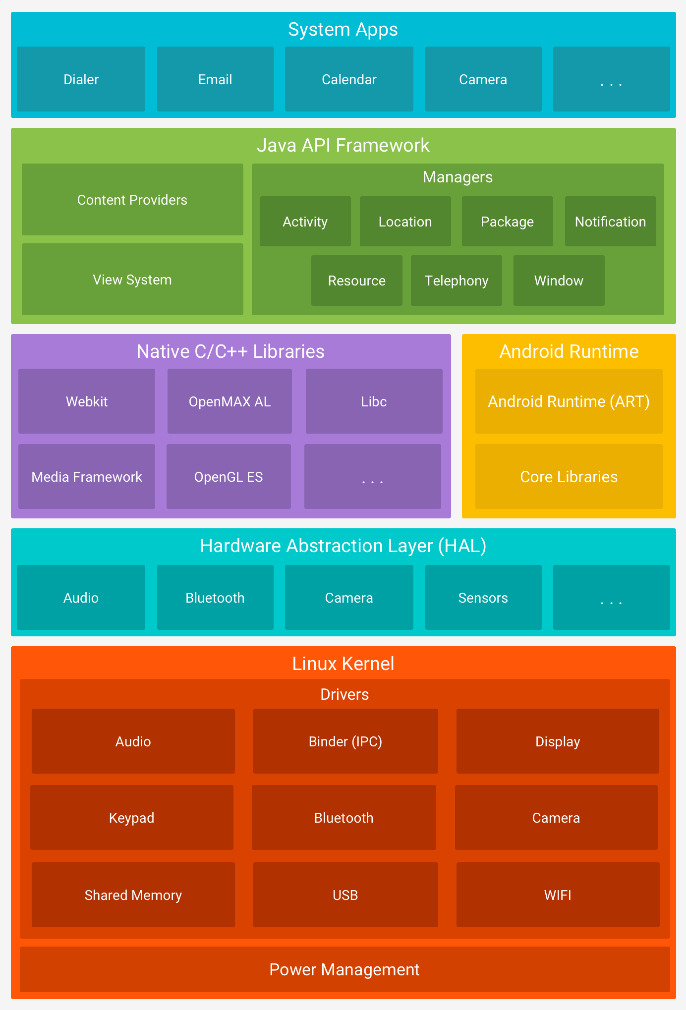
L’architettura del sistema operativo Android, rappresentata in Figura 6[1], ha caratteristiche uniche. Costruita con la filosofia di essere un ambiente completamente open, che ogni soggetto potesse modificare a suo piacimento, Android è formato da un insieme di componenti eterogenei, in buona parte “off-the-shelf” – ovvero liberamente disponibili sul mercato – e integrati.

Introdurremo brevemente le caratteristiche utili a capire il funzionamento di Android attraverso queste componenti, in modo da poter poi ragionare sulle principali problematiche di sicurezza.

Figura 6: Architettura di Android 13

Il kernel di Android (in rosso nell’immagine) è un kernel Linux generico, multi-utente, in uso su desktop e server. Una simile scelta permette ai produttori di comporre l’hardware dello smartphone che intendono commercializzare con molti gradi di libertà, in quanto è estremamente probabile che, per ogni componente hardware assemblato, sia disponibile il corrispondente driver Linux. La definizione di un kernel nuovo, ad hoc per Android, avrebbe magari potuto essere più performante, specie sui primi dispositivi con poca disponibilità hardware; tuttavia, avrebbe limitato le possibilità dei produttori di smartphone, che avrebbero dovuto attendere lo sviluppo del corrispondente driver per poter aggiungere uno specifico componente alla propria architettura, con il rischio di una riduzione della diffusione di Android.

L’Hardware Abstraction Layer (HAL – in azzurro) è un insieme di moduli di libreria, ognuno specifico per una componente hardware. Lo scopo di tutti gli HAL è semplificare la comunicazione tra i servizi dei livelli superiori del sistema operativo e l’hardware: ad esempio, questo permette ai livelli più alti del sistema operativo (in particolare al Java API Framework) di ignorare le specificità dei driver sottostanti per poter comunicare con i componenti hardware corrispondenti, nonché di utilizzare un set di istruzioni standard eseguite su astrazioni indipendenti dall’attuale componentistica dello smartphone. È compito poi delle funzioni di libreria dell’HAL tradurre i comandi nei corrispondenti sui driver specifici del kernel.

Android si basa su un insieme di librerie native (in viola), ovvero scritte in C/C++, che sono state inserite a supporto delle funzionalità, anche in questo caso, del Java API Framework e delle app. Tali librerie, ampiamente disponibili “off-the-shelf”, sono state inserite con la filosofia di riutilizzare quanto già disponibile, senza doverlo riscrivere. Rientrano in questo gruppo, tra le altre, le librerie per il rendering 2D e 3D (usate estensivamente dai videogiochi) e le librerie con i font e i codec audio/video supportati dallo smartphone.

L’Android Runtime (in giallo) è l’ambiente di esecuzione delle app. ART è una macchina virtuale in grado di eseguire il codice delle app, compilandolo nell’architettura nativa dello smartphone durante l’installazione. Per l’esecuzione, si basa su un insieme di librerie Java chiamate Core Libraries che corrispondono a un sottoinsieme dell’SDK di Java, più un insieme di classi specifiche di Android.

Il Java API Framework (in verde) implementa un insieme di servizi fondamentali che supportano l’esecuzione delle app, fornendo l’accesso ai servizi dei livelli sottostanti del sistema operativo, nonché la comunicazione tra app tramite uno specifico driver del kernel chiamato Binder. Ogni servizio è specifico per un certo tipo di attività: gestire l’installazione delle app, il loro ciclo di vita quando in esecuzione, la posizione, le telefonate e le notifiche, nonché il rendering delle schermate delle app. Questo componente del sistema operativo è stato completamente implementato da zero.

Infine, le app (in blu) occupano il livello gerarchico più alto e sfruttano tutti i servizi sottostanti per la loro esecuzione.

Aspetti e problemi di sicurezza di Android

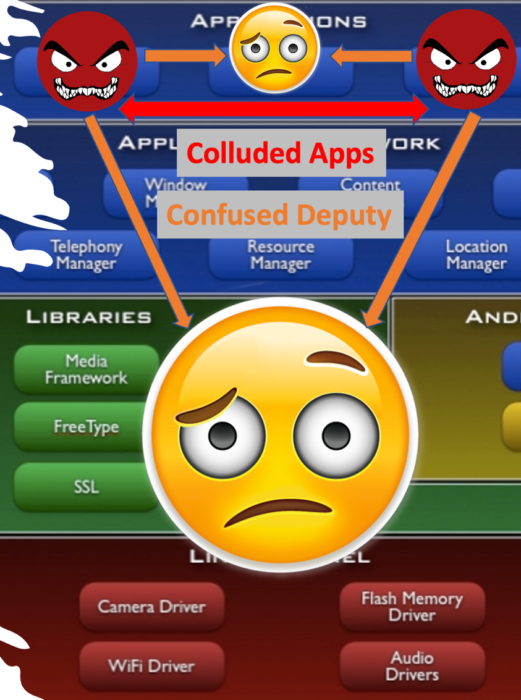
Da un punto di vista della sicurezza, il sistema operativo ha una doppia valenza. Da una parte, come ogni pezzo di software, contiene delle vulnerabilità ed è soggetto al threat model del confused deputy che abbiamo presentato precedentemente. In questo caso, come per le app, l’attacco può provenire da app malevole installate dall’utente; tuttavia alcuni attacchi possono essere eseguiti anche dall’esterno tramite le connessioni di rete (Wi-Fi, 5G, Bluetooth, NPC), anche se in letteratura questi attacchi sono molto specifici, limitati e appartenenti soprattutto alle prime versioni del sistema operativo.

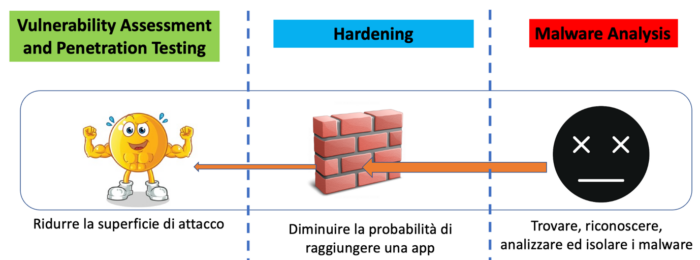
D’altra parte, Android è anche la componente che deve essere modificata in prima battuta per “hardenizzare” il canale di comunicazione tra app, per ridurre, come discusso, la probabilità che un malware installato possa attaccare con successo un’app vulnerabile o lo stesso sistema operativo. Come si può intuire la parte di hardening richiede, nel caso migliore, un’integrazione dei meccanismi di sicurezza esistenti oppure, nel caso peggiore, la loro parziale ridefinizione e riscrittura.

Sistemi di sicurezza in Android

L’eterogeneità architetturale di Android si manifesta anche nei corrispondenti sistemi di sicurezza, che prendono il nome di Android Security Framework (ASF) e sono principalmente distribuiti nel kernel e nel Java API Framework. Introdurremo di seguito i principali sistemi di sicurezza di Android senza pretese di completezza, riferendoci in particolare a quelli esistenti fin dalle prime versioni e che sono stati consolidati nel tempo, a riprova della loro affidabilità. Tuttavia, saranno sufficienti per ragionare sulle principali problematiche di sicurezza del sistema operativo.

Sistemi di sicurezza nel Kernel

In un kernel Linux generico il principale meccanismo di sicurezza è il DAC (Discretionary Access Control), applicato su ogni file del sistema, dove i permessi sono espressi in termini di diritti di lettura, scrittura ed esecuzione per il proprietario del file, per gli utenti che appartengono allo stesso gruppo del proprietario e, infine, per tutti gli altri. I permessi su ogni file sono assegnati dal proprietario in maniera insindacabile. Quest’ultimo punto è una debolezza di Android, perché permetterebbe a uno sviluppatore di avere troppo impatto sulla sicurezza del sistema.

A titolo di esempio, si supponga che uno sviluppatore dia troppi permessi ai file della propria app, fornendo accesso completo al gruppo “altri”. In questo caso, un malware installato riconoscerebbe immediatamente questa situazione e otterrebbe l’accesso a tutti i dati dell’app. Inoltre, il DAC non permette comunque di definire politiche di sicurezza che valgano per tutto il sistema e tutte le app installate.

Per superare questa limitazione, a partire da Android 4.2, il DAC è stato integrato con un modello MAC (Mandatory Access Control) tramite una componente chiamata SEAndroid (Security Enhanced Android)[2], un’estensione di SELinux[3] che permette di definire regole che valgono su tutto il sistema, di fatto limitando il problema precedente e permettendo ai produttori di scrivere le proprie politiche di sicurezza per il singolo smartphone. Samsung Knox[4] è l’implementazione di Samsung di SEAndroid sui propri dispositivi.

Infine, un sistema di sicurezza definito da Android a livello Kernel, è la Sandbox[5], che installa ogni app in un utente differente a livello Kernel, nell’ottica di aumentare la separazione tra app e diminuendo la probabilità di interazione tra malware e app.

Sistemi di sicurezza nel Java API Framework

Il Java API Framework implementa soluzioni di sicurezza native (ovvero sviluppate ad hoc per Android) per la protezione delle app e dell’utente. Uno di questi sistemi è ben noto allo stesso utente, ovvero il sistema dei permessi. Ogni app deve disporre di specifici permessi per accedere ai servizi del sistema operativo o di altre app. Alcuni permessi vengono dati di default (come, ad esempio, il permesso per accedere a Internet), mentre altri richiedono l’intervento dell’utente: a questa categoria fanno riferimento tutti i permessi che possono ledere la privacy dell’utente (ad esempio accedere alle foto o alla posizione dello smartphone), per i quali è ragionevole permettere la scelta all’utente stesso. Il mapping tra le app e i loro permessi viene gestito da un componente del Java API Framework chiamato package manager, che si occupa della quasi totalità degli aspetti di sicurezza a questo livello. È quindi il package manager che decide se una app abbia o meno i permessi richiesti per una certa operazione. Lo stesso è responsabile dell’installazione e della disinstallazione delle app.

Queste operazioni coinvolgono controlli di sicurezza importanti. In primo luogo l’app, che viene distribuita come un archivio compresso chiamato APK (Android PacKage) viene accettata solo se firmata dallo sviluppatore con la propria chiave privata. Pertanto il package manager verifica innanzitutto la firma e l’integrità di ogni file presente nell’app, installandola solo in caso di controllo con esito positivo.

Tuttavia questo controllo non identifica lo sviluppatore, che per poter firmare e distribuire le app non deve avere un certificato rilasciato da un’autorità riconosciuta: è sufficiente abbia una coppia di chiavi, pubblica e privata, che può autogenerarsi con tool ampiamente disponibili.

Pertanto, Android non ha l’obiettivo di identificare gli sviluppatori; questa è una scelta di business. Imporre l’identificazione dello sviluppatore potrebbe avere conseguenze sul numero di app sviluppate e distribuite, in quanto un certo numero di sviluppatori potrebbe non voler essere riconosciuto o avere più identità fittizie (ognuna con una coppia di chiavi diversa).

Durante l’installazione, il package manager provvede a interagire con il kernel per creare un nuovo utente a livello kernel per l’app (Sandbox) e generare in modo random il percorso dove installarla. Lo scopo di questa randomizzazione, utilizzata nelle più recenti versioni di Android, è nascondere ai malware la localizzazione delle app bersaglio, per ridurre la probabilità che queste siano individuate e attaccate.

Problemi di sicurezza in Android

Lo scopo dei meccanismi di protezione è fornire ad un sistema un insieme di garanzie di sicurezza. Ricapitolando, i sistemi di protezione dell’ASF precedentemente introdotti garantiscono:

  1. la verifica dell’integrità dell’app in fase di installazione;
  2. l’isolamento tra le app, grazie all’installazione su utenti diversi a livello kernel (Sandbox) e percorsi delle home randomici;
  3. l’autorizzazione ad accedere alle risorse del sistema e di altre app tramite i permessi;
  4. la possibilità di definire politiche di sicurezza da parte del produttore del dispositivo.

A fronte di tali garanzie, il lettore converrà che i meccanismi di protezione risultino convincenti e di fatto siano effettivamente focalizzati a ridurre la probabilità che un malware raggiunga un’app vulnerabile.

Qualora le garanzie promesse da questi – e da tutti gli altri meccanismi dell’ASF – fossero mantenute, probabilmente avremmo un sistema operativo da sempre sicuro. La storia di Android, come di qualunque altro sistema operativo, è però ricca di vulnerabilità e attacchi.

Cercheremo di capire perché, premettendo come la frase che più si addice a chi cerchi problemi di sicurezza in software complessi sia “il diavolo sta nei dettagli”.

Interazione e integrazione

Interazione. Come abbiamo visto, l’eterogeneità architetturale di Android si riscontra anche nei meccanismi dell’ASF. A livello kernel le regole di sicurezza sono espresse in termini di DAC/MAC su file e processi. A livello applicativo, le regole sono indicate in termini di permessi (“autorizzi l’app ad accedere alle tue foto?”). Appare evidente che diversi livelli dello stack Android parlino lingue diverse. In questo caso, i problemi di sicurezza si possono nascondere nell’interazione tra gli stessi: come si traduce il permesso “accesso alle foto” in un insieme di regole DAC a livello del sistema operativo che rispetti anche le regole MAC imposte dal produttore? Questa interazione avviene in modo corretto e completo? Ci possono essere conflitti o mancanze?

Non esiste documentazione ufficiale a riguardo e, qualora il lettore volesse capire come avviene ad esempio il processo di richiesta di posizione GPS da parte di un’app fino all’interrogazione del driver del GPS del dispositivo, dovrebbe analizzare il codice open-source di Android. Ma questo, ovviamente, lo può fare anche un attaccante.

Il problema dell’interazione tra meccanismi diversi è stata risolta, nel tempo, attraverso le diverse versioni di Android, seppur ogni modifica ai meccanismi di sicurezza di Android richieda comunque una verifica della correttezza di queste comunicazioni.

Integrazione. Oltre a un problema di diversità del linguaggio, l’eterogeneità architetturale di Android ha ripercussioni anche sull’integrazione tra i meccanismi di sicurezza e può snaturare algoritmi e protocolli delle singole componenti architetturali per realizzare uno specifico meccanismo.

A titolo di esempio, si consideri l’isolamento tra le app tramite la sandbox, che porta ogni app ad essere installata in un utente diverso a livello kernel. Seppur i vantaggi di questa separazione siano palesi in termini di hardening, per ottenere questo risultato alcune funzionalità native del kernel sono state modificate.

In Linux, ogni nuovo processo (figlio) viene generato a partire da un processo già esistente (padre) tramite una system call, ovvero una chiamata di funzione al kernel, detta fork[6], che dapprima crea una copia esatta del processo-padre e poi sostituisce il codice del padre nella copia con quello del processo-figlio prima di eseguirlo. Si noti che con la fork entrambi i processi appartengono al medesimo utente.

La scelta della sandbox ha portato a un utilizzo non canonico della fork. Si pensi alla seguente ipotesi: quando un utente riceve su WhatsApp un allegato che vuole aprire con un’altra app, come fa l’app di WA, che appartiene a un utente, a creare e lanciare in un nuovo processo (di un altro utente) la seconda app a livello kernel? Certamente non con l’uso standard della fork, che non prevede questa possibilità.

Android risolve il problema tramite un processo ad hoc chiamato Zygote, dove la creazione di nuovi processi avviene tramite l’uso di una fork eseguita come root (quindi con massimi privilegi) che crea il nuovo processo, inserisce il codice dell’app da eseguire e cambia la proprietà del processo da root a quello dell’utente corrispondente.

Pertanto, la scelta necessaria è stata trasformare una system call con pochi privilegi e sicura in una con massimi privilegi e ad alto rischio. La conseguenza diretta sulla sicurezza di Android è stata una serie di vulnerabilità legate a questo processo, che ha permesso a diversi attaccanti di abusarne con conseguenze significative [7], [8], [9].

Vulnerabilità dei meccanismi di sicurezza

Oltre agli esaminati problemi di integrazione e di utilizzi non standard, va notato che i meccanismi di protezione sono anch’essi pezzi di software e, come tali, possono contenere vulnerabilità sfruttabili per bypassarli.

A titolo di esempio, dalla prima versione di Android fino alla 4.2, il già discusso controllo dell’integrità dell’APK svolto dal package manager era eseguito in maniera non corretta. Per una scelta implementativa, si usavano due librerie diverse per verificare l’integrità di ogni file nell’APK e per installare i file verificati[10]. L’utilizzo di queste due librerie conteneva una vulnerabilità, chiamata Master Key Vulnerability, tale per cui se nell’APK vi fossero stati due file con lo stesso nome, la verifica dell’integrità sarebbe stata eseguita sul primo, mentre il secondo, tramite la seconda libreria, sarebbe stato installato senza essere verificato. Di conseguenza, un attaccante avrebbe potuto prendere una app legale, inserirvi tramite app repackaging (cfr. Sezione 4.3.2) un file malizioso con lo stesso nome di un altro file presente e ridistribuirla. In questo modo, qualora l’app fosse stata installata, anche il file malizioso sarebbe stato installato automaticamente dal package manager nel dispositivo, senza alcun controllo di integrità su di esso.

Questo tipo di vulnerabilità viene cercato costantemente dal gruppo di sicurezza di Google, chiamato Android Security Teams, oltre che da una comunità di ethical hacker spinti alla ricerca di nuove vulnerabilità da motivi economici: dal 2014 Google ha attivato un Bounty Program, oggi chiamato Google and Alphabet Vulnerability Reward Program[11], che remunera parti terze che rilevano e segnalano vulnerabilità nel sistema operativo.

Il risultato di questo processo è stata la scoperta e la risoluzione di un grande numero di vulnerabilità nelle diverse versioni di Android; e a “stretto giro”, ovvero entro poco tempo dall’uscita di ogni update del sistema operativo. La maggior parte degli aggiornamenti minori (ovvero non legati al rilascio e all’aggiornamento del sistema operativo a una nuova versione) sono in buona parte risoluzioni delle vulnerabilità scoperte.

A questo processo, negli anni e attraverso le diverse versioni del sistema operativo, si è affiancata un’attività di hardening sempre maggiore, spinta soprattutto da un crescente numero di malware per Android; questo ha portato Google ad applicare politiche sempre più restrittive per ridurre, da un lato, la probabilità di interazione tra malware e app vulnerabili e, dall’altro, per ridurre indirettamente il numero di vulnerabilità nelle app.

Ad esempio, in Android 9 è stato introdotto il divieto di utilizzare http nelle app, forzando l’uso di https: in questo modo si riduce la superficie di attacco dell’app forzando lo sviluppatore ad usare solo connessioni cifrate.

Per capire le ragioni di questa crescente fase di hardening da parte di Google, occorre fare una riflessione: l’ASF, così come ogni altro sistema di protezione, non è mai completo. Ovvero, non protegge tutto il sistema ma solo la maggior parte dei canali di comunicazione tra app e sistema operativo. Questo non è dovuto a pigrizia o impreparazione, ma è una “ragionevole scelta di compromesso”. I meccanismi di protezione hanno infatti un “costo” sul sistema operativo, sulle risorse del sistema e, non ultimo, sulla libertà dell’utente. Estremizzare i meccanismi di protezione può rendere il sistema molto più sicuro ma poco usabile, con la conseguenza di demotivare all’utilizzo di Android sia utenti che sviluppatori. A valle di questa riflessione, è chiaro come il processo di hardening costante svolto dalle prime all’ultima versione di Android abbia avuto come obiettivo quello di aumentare la superficie di sistema protetta dall’ASF, pur mantenendo un alto grado di usabilità.

Inoltre, l’evoluzione hardware degli smartphone ha certamente favorito lo sviluppo di nuovi meccanismi di sicurezza nelle ultime versioni di Android, che, qualora implementate su vecchi dispositivi con hardware limitato, avrebbero impattato molto più negativamente sulla “user experience”.

Side Channels

Alla fine, possiamo concludere che le ultime versioni dell’ASF forniscono una protezione più completa delle diverse componenti del sistema. Tuttavia, rimangono componenti che non sono protette o perché ritenute poco rischiose dal punto di vista della sicurezza, o perché esiste la necessità che siano condivise tra tutte le app in maniera libera. Si pensi, in questo secondo caso, alle impostazioni di sistema o alla scheda SD, entrambe per definizione accessibili da tutte le app. In particolare, la scomparsa delle schede SD dai recenti smartphone è proprio per la scelta delle app di non utilizzarle, trattandosi di una memoria condivisa e visibile a tutti.

Tuttavia queste componenti non protette possono diventare, se utilizzate opportunamente, dei canali di comunicazione non standard, detti side channels.

La storia della mobile security è ricca di esempi dove l’abuso dei side channels ha portato ad attacchi (detti side channel attacks) che hanno eluso l’ASF.

Per chiarire, nel grande numero di malware più o meno complessi che sfruttano side channel, usiamo un esempio semplice: quello del primo malware che ha dimostrato la sfruttabilità dei side channel in Android, che prende il nome di SoundComber.

SoundComber[12] è uno dei primi malware basati sul threat model delle colluded app che abbiamo presentato in Figura 2 e formato da due app all’apparenza innocue, ovvero un registratore di note vocali (con il permesso di registrare l’audio) e un calendario (con il permesso di connettersi a Internet per sincronizzare gli appuntamenti). I due malware collaborano per rubare numeri di carte di credito digitati tramite la tastiera dello smartphone usando il “volume” come side channel.

Il principio è semplice: durante una telefonata dove l’utente invia il numero della sua carta di credito via telefono, digitando sulla tastiera virtuale, il primo malware registra il tasto digitato, riconosce il numero e cambia il livello del volume audio a una intensità pari al numero digitato. Il secondo malware legge il valore guardando il livello del volume e, per ogni cifra digitata dall’utente, invia a un server esterno il valore corrispondente.

Da quando SoundComber ha dimostrato la fattibilità di questi attacchi, molti attaccanti hanno cercato potenziali side channel e sviluppato malware che li sfruttassero. D’altro canto, ogni volta che un nuovo side channel veniva scoperto e sfruttato l’ASF è evoluto di conseguenza per proteggerli, pur mantenendo, ove possibile, l’utilizzo atteso.

Tuttavia, alcune protezioni possono essere “vulnerabili” a loro volta. Le componenti “off-the-shelf” di Android possono avere potenziali side channel nativi. In questi casi, Android li limita e protegge tramite opportuni meccanismi nell’ASF. Tali protezioni possono però risultare incomplete o, appunto, vulnerabili.

È il caso del servizio inotify[13] di Linux che permette ai processi di venire notificati in caso di cambio di stato di un processo target (ad esempio quando il processo si avvia, è in esecuzione, viene bloccato…), secondo un modello publish-subscribe. Un simile servizio permetterebbe a un malware di essere notificato quando un’app bersaglio si esegue. Recentemente è stato dimostrato che la protezione dell’ASF è insufficiente e che un malware può sfruttare facilmente inotify per essere notificato circa l’avvio di un’app[14].

Ma qual è l’impatto e come si sfrutta una simile vulnerabilità? Si supponga che l’app richieda, come quasi ogni app, l’inserimento di credenziali utente. Se il malware avesse la stessa identica interfaccia grafica dell’app bersaglio e venisse notificato da inotify quando questa si esegue, esso potrebbe eseguirsi immediatamente dopo ed essere mostrato all’utente al posto di quella originale, che verrebbe lanciata e subito messa in background. In questo modo, l’utente fornirebbe le sue credenziali al malware anziché all’app legale. Si noti che questa vulnerabilità colpisce tutte le versioni di Android fino a quella attuale (13) e che, al tempo della scrittura di questo testo, non è ancora stata risolta da Google.

Discussione

La fase di hardening degli ultimi 15 anni ha reso Android particolarmente sicuro. La ricerca di vulnerabilità presenti nelle prime versioni, come quelle correlate allo Zygote o all’utilizzo di side channel semplici (come le impostazioni), sarebbe in massima parte infruttuosa. La ricerca di side channel è invece ancora promettente – come dimostrato dall’esempio di inotify – ma, rispetto ai primi side channel, aumenta la difficoltà nel poterli sfruttare una volta individuati.

Va però sottolineato che ogni nuova versione di Android contiene nuove funzionalità a supporto degli sviluppatori di app. Queste funzionalità possono nascondere nuove vulnerabilità, non presenti nelle precedenti versioni di Android.

Note

[1] Figura presa da https://developer.android.com/guide/platform

[2] Security-Enhanced Android. https://source.android.com/docs/security/features/selinux?hl=it

[3] https://www.redhat.com/en/topics/linux/what-is-selinux

[4] https://www.samsungknox.com/it

[5] Android Sandbox. https://source.android.com/docs/security/app-sandbox?hl=it

[6] https://man7.org/linux/man-pages/man2/fork.2.html

[7] https://securelist.com/attack-on-zygote-a-new-twist-in-the-evolution-of-mobile-threats/74032/

[8] Armando, A., Merlo, A., Migliardi, M., & Verderame, L. (2012). Would You Mind Forking This Process? A Denial of Service Attack on Android (and Some Countermeasures). Proc. of IFIP-Sec 2012 (p. 13-24). Heraklion, Crete: Springer.

[9] Lee, B., Lu, L., Wang, T., Kim, T., & Lee, W. (2014). From Zygote to Morula: Fortifying Weakened ASLR on Android. Proc. of 2014 IEEE Symposium on Security and Privacy. San Jose, California, USA: IEEE.

[10] J. Forristal – BlueBox (2013). Master Key Vulnerability. https://nvd.nist.gov/vuln/detail/CVE-2013-4787

[11] Google and Alphabet Vulnerability Reward Program. https://bughunters.google.com/

[12] Schlegel, R., Zhang, K., Zhou, X., Intwala, M., Kapadia, A., & Wang, a. X. (2011). SoundComber: A stealthy and context-aware sound trojan for smartphones. Proc. 18th Annual Network and Distributed System Security Symposium (NDSS ’11). San Diego, California: The Internet Society.

[13] https://man7.org/linux/man-pages/man7/inotify.7.html

[14] Ruggia, A., Possemato, A., Merlo, A., Nisi, D., & Aonzo, S. (2023). Android, Notify Me When It Is Time To Go Phishing. Proc. of the 8th IEEE European Symposium on Security & Privacy (EuroS&P 2023). Delft, The Netherlands: IEEE.

Questo articolo è stato estratto dal white paper “Mobile Security – Nozioni e Riflessioni” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/mobile-security-nozioni-e-riflessioni/

Articolo a cura di Alessio Merlo

Profilo Autore

Ha conseguito una laurea magistrale in Informatica nel 2005 presso l’Università degli Studi di Genova, ed il dottorato di ricerca in Informatica nel 2010 presso la stessa università. Dal 2010 la sua ricerca si concentra interamente nell’ambito della Cybersecurity, con un focus specifico sulla Mobile Security, dove negli anni contribuisce a definire metodi innovativi per l’analisi statica e dinamica della sicurezza di applicazioni Android, con ricadute in contesti reali (e.g., BYOD), a definire nuove metodologie di testing di applicazioni mobili e di protezione delle stesse quali
tecniche di offuscazione e protezione delle applicazioni da attacchi di repackaging.
Ha inoltre lavorato allo sviluppo di nuove tecnologie per l’autenticazione utente su dispositiviì mobili, a tecniche di profilazione dell’impronta energetica di attacchi e malware, ed a metodologie per la protezione dei dati personali degli utenti acquisiti dalle applicazioni mobili.
Ha contribuito alla scoperta di una serie di pericolose vulnerabilità, tra cui la Zygote Vulnerability, due vulnerabilità nei protocolli GSM ed UMTS, alcune nei Password Manager su Android, ed una sul servizio iNotify di Android, che avrebbero portato a diverse conseguenze sull’utente finale, dal furto di credenziali fino all’impossibilità di utilizzare il dispositivo mobile.
E’ autore di oltre 130 pubblicazioni scientifiche su riviste e conferenze internazionali ed ha ricevuto diversi riconoscimenti per l’attività di ricerca sulla Mobile Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sicurezza-del-sistema-operativo-android/


Zero Trust e Smart Industry: mettere in sicurezza Cloud, OT, IIoT, e ambienti M2M attraverso strategie avanzate di Sicurezza Informatica con l’aiuto dell’Intelligenza Artificiale

L’avanzamento della Smart Industry ha portato a un incremento significativo nell’integrazione di tecnologie innovative quali cloud computing, Operational Technology (OT), Industrial Internet of Things (IIoT) e Machine-to-Machine (M2M) communications. Questa convergenza tecnologica offre enormi benefici in termini di efficienza operativa e capacità analitica, ma solleva anche nuove sfide per la sicurezza informatica, rendendo imperativo l’adozione di strategie avanzate come il modello di Zero Trust.

Zero Trust nell’era di Industry 4.0

Il modello di Zero Trust, che segue il principio “never trust, always verify”, si rivela fondamentale nell’ambito della sicurezza industriale moderna. Questo approccio è basato sull’assunzione che attaccanti possano essere presenti sia all’interno che all’esterno della rete aziendale, quindi nessun dispositivo o utente dovrebbe essere considerato sicuro senza verifica. Originariamente focalizzato sulla micro-segmentazione della rete per controllare il traffico est-ovest, cioè il movimento laterale dei dati all’interno dei data center, il modello si è evoluto per abbracciare strategie più complesse e integrate.

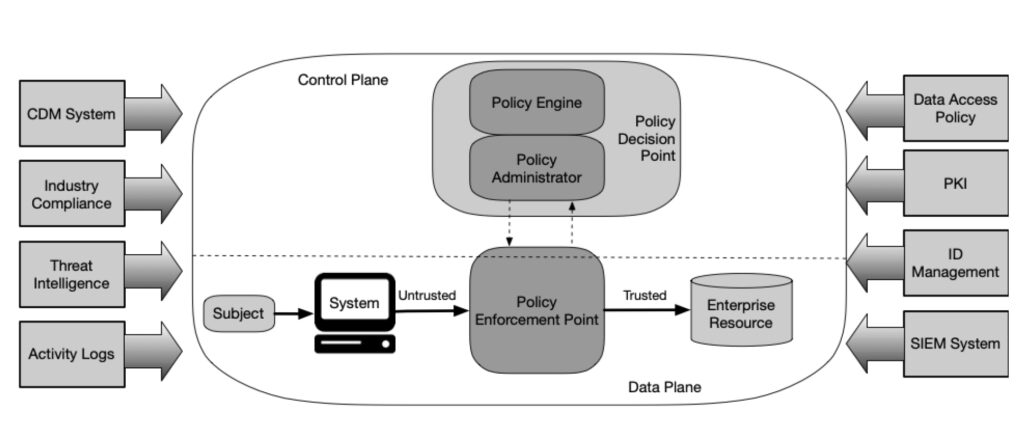
Il 2016 ha visto l’introduzione del concetto di Software Defined Perimeter (SDP) che ha ulteriormente rafforzato l’implementazione di Zero Trust, separando il piano di controllo, dove si stabilisce la fiducia, dal piano dati, dove i dati vengono trasferiti effettivamente. Questo approccio nasconde l’infrastruttura utilizzando firewall dinamici che negano tutto l’accesso non autorizzato, migliorando la sicurezza attraverso l’autenticazione di singoli pacchetti per validare utenti e dispositivi prima dell’accesso ai servizi protetti.

Integrazione e sfide di sicurezza in ambienti OT e IIoT

Nell’OT e IIoT, sistemi spesso caratterizzati da tecnologie legacy, l’adozione di Zero Trust richiede una pianificazione attenta e l’introduzione graduale di modernizzazioni o l’applicazione di strategie di micro-segmentazione per isolare e proteggere le risorse legacy. Questi ambienti sono notoriamente difficili da proteggere a causa delle loro specifiche tecniche e operazionali che differiscono notevolmente da quelle tipiche delle reti IT.

La crescente interconnessione tra dispositivi in ambito industriale, comprese le comunicazioni M2M, aumenta la superficie di attacco rendendo queste reti più vulnerabili agli attacchi cyber. Questo ha portato alla necessità di adottare misure di sicurezza robuste come la crittografia dei dati, il controllo degli accessi e l’utilizzo di strumenti di monitoraggio per prevenire accessi non autorizzati e garantire l’integrità dei dati.

Best Practices e Continuous Adaptive Risk and Trust Assessment (CARTA)

Accanto a Zero Trust, la strategia CARTA di Gartner propone un approccio ancora più ampio alla sicurezza, che include la valutazione continua del rischio e della fiducia come parte integrante delle operazioni digitali dell’azienda. CARTA si concentra su piattaforme di sicurezza adattive e programmabili che siano consapevoli del contesto, oltre all’utilizzo di analisi, AI, automazione e orchestrazione per accelerare il rilevamento e la risposta alle minacce.

Implementazione pratica del modello Zero Trust nella Industry 4.0

Per le aziende nel settore della smart industry, l’implementazione di misure di micro-segmentazione, come primo passo verso Zero Trust, rappresenta una soluzione pratica. Questo non solo migliora la sicurezza ma supporta l’integrazione continua di IT e OT, consentendo controlli di accesso specifici per i carichi di lavoro virtualizzati nei data center e nelle applicazioni cloud.

Le squadre di sicurezza OT dovrebbero abbracciare la maturazione della strategia Zero Trust e considerare la definizione di un perimetro definito dal software come obiettivo a lungo termine. La micro-segmentazione, ottenuta con tecnologie più tradizionali, dovrebbe essere sempre considerata una best practice nell’implementazione di una strategia Zero Trust.

Criticità dell’implementazione del modello zero trust nella Smart Industry

L’implementazione del modello Zero Trust nell’ambito della Industry 4.0 presenta diverse criticità, soprattutto a causa della complessità intrinseca degli ambienti industriali moderni che integrano tecnologie IT, OT, IIoT e M2M. Una delle principali sfide è la gestione delle infrastrutture legacy che non sono state progettate con le moderne pratiche di sicurezza in mente. Questi sistemi spesso non supportano protocolli di sicurezza avanzati necessari per l’adozione di Zero Trust, rendendo difficile l’implementazione di controlli di autenticazione e autorizzazione rigorosi senza compromettere la funzionalità operativa.

Inoltre, la diversità e la vastità delle macchine e dispositivi connessi nell’ambito dell’IIoT possono rendere complesso il monitoraggio continuo e l’analisi dei comportamenti di rete, essenziali per il modello Zero Trust. La necessità di aggiornare e mantenere costantemente i sistemi di sicurezza per tenere il passo con le evoluzioni tecnologiche e le nuove minacce può risultare onerosa e complessa, soprattutto per le aziende con risorse limitate.

La resistenza al cambiamento è un’altra barriera significativa. La trasformazione dei processi di sicurezza aziendali verso un approccio Zero Trust richiede un cambiamento culturale che può incontrare resistenza sia da parte degli operatori IT che OT, che potrebbero percepire queste nuove misure come un ostacolo alla produttività operativa.

Infine, la complessità nella configurazione e gestione della micro-segmentazione, essenziale per il modello Zero Trust, rappresenta una sfida tecnica notevole. L’errata configurazione può non solo ridurre l’efficacia delle misure di sicurezza, ma anche esporre l’organizzazione a nuovi rischi di sicurezza, complicando ulteriormente la protezione di dati sensibili e infrastrutture critiche.

Tutte queste criticità richiedono che l’adozione del modello Zero Trust nella Industry 4.0 sia accompagnata da una strategia ben pianificata, supporto esecutivo, investimenti adeguati in tecnologie avanzate e formazione continua per gli addetti ai lavori.

L’integrazione dell’Intelligenza Artificiale nella Sicurezza Zero Trust

L’applicazione dell’intelligenza artificiale (AI) in contesti di sicurezza Zero Trust rappresenta una pietra miliare per la smart industry, particolarmente in ambienti cloud, OT, IIoT e M2M. L’AI può migliorare significativamente l’efficacia delle misure di sicurezza attraverso la capacità di analizzare grandi volumi di dati di rete, identificare pattern di traffico anomali, e prevedere potenziali minacce prima che diventino critiche. Questo livello di analisi avanzata e predittiva è fondamentale per un’applicazione efficace del modello Zero Trust, dove la verifica continua e la valutazione del rischio sono essenziali.

Grazie all’AI, i sistemi di sicurezza possono diventare proattivi piuttosto che reattivi. Le tecnologie di apprendimento automatico (Machine Learning, ML) sono in grado di addestrarsi su vasti set di dati per riconoscere e reagire a schemi di comportamento sia noti che emergenti. Questo permette non solo di rispondere in tempo reale, ma anche di adattare le politiche di sicurezza dinamicamente in base al contesto e alle evidenze analitiche.

Inoltre, l’AI supporta la micro-segmentazione nel contesto di Zero Trust, automatizzando la configurazione delle politiche di sicurezza per specifici segmenti di rete e dispositivi, riducendo così la superficie di attacco e limitando il potenziale danno di eventuali intrusioni. L’AI può anche gestire l’autenticazione e l’autorizzazione di dispositivi e utenti in maniera più efficiente, utilizzando tecniche avanzate di riconoscimento biometrico e comportamentale che vanno oltre le tradizionali credenziali basate su password.

Un altro aspetto cruciale è l’utilizzo dell’AI per il monitoraggio continuo e l’assessment del rischio, come suggerito dalla strategia CARTA. Qui, l’AI aiuta a valutare continuamente il rischio associato ad ogni utente e dispositivo all’interno della rete, permettendo alle organizzazioni di adattare rapidamente le loro strategie di sicurezza in risposta a nuove informazioni o minacce emergenti.

Infine, la capacità dell’AI di integrare e analizzare dati provenienti da diverse fonti è vitale per creare un ecosistema di sicurezza olistico e interconnesso che supporti sia la sicurezza operativa (OT) che quella informativa (IT). Attraverso l’orchestrazione di soluzioni di sicurezza basate sull’AI, le organizzazioni possono ottenere una visione unificata e centralizzata delle minacce, migliorando la collaborazione tra le squadre IT e OT e rafforzando la resilienza complessiva della rete.

L’adozione di AI in ambito di Zero Trust non solo eleva il livello di sicurezza implementabile ma trasforma anche il modo in cui le organizzazioni affrontano e gestiscono le sfide della cybersecurity nella smart industry, rendendo le infrastrutture più intelligenti, reattive e adattabili ai cambiamenti del panorama delle minacce.

Cybersecurity nell’Era della Industry 4.0: Uno Sguardo ai Principali Standard e Framework Internazionali

Nel contesto dell’evoluzione continua delle minacce cyber e della crescente interconnessione delle infrastrutture critiche, diversi standard e framework normativi si sono affermati come pilastri fondamentali per guidare l’implementazione di robuste pratiche di cybersecurity nelle organizzazioni. Il NIST SP 800-82, specifico per la protezione dei sistemi di controllo industriale, fornisce una serie comprensiva di linee guida tecniche e raccomandazioni per assicurare i sistemi operativi da potenziali cyber attacchi. Questo standard si focalizza sull’identificazione dei rischi, la protezione delle infrastrutture, la rilevazione delle anomalie e la risposta agli incidenti, stabilendo così un modello sicuro per operazioni critiche.

Il NIST SP 800-82 è una guida del National Institute of Standards and Technology (NIST) che fornisce raccomandazioni per la sicurezza dei sistemi di controllo industriale (ICS). Lo scopo principale del documento è proteggere questi sistemi critici da minacce informatiche. Il NIST SP 800-82 si concentra su:Identificazione dei rischi: Riconoscere le vulnerabilità e le potenziali minacce per i sistemi di controllo industriale.Protezione delle infrastrutture: Implementare misure di difesa per prevenire accessi non autorizzati o attacchi dannosi.Rilevazione delle anomalie: Monitorare i sistemi in tempo reale per individuare attività sospette o non conformi.Risposta agli incidenti: Definire procedure e strategie per rispondere a potenziali violazioni o attacchi, minimizzando i danni e garantendo la continuità operativa.Questa guida è fondamentale per garantire la sicurezza in ambienti industriali e proteggere infrastrutture critiche da minacce crescenti.

Parallelamente, il NIST 800-207 delinea i principi per l’implementazione del modello di sicurezza Zero Trust. Questo framework enfatizza la necessità di una verifica continua e di una gestione dell’accesso basata sulla minimizzazione della fiducia iniziale concessa agli utenti e ai dispositivi all’interno delle reti aziendali. Il modello propone l’adozione di micro-segmentazione delle reti, autenticazione dinamica, e politiche di sicurezza basate sulle valutazioni in tempo reale del contesto e del rischio associato ad ogni richiesta di accesso ai dati.

L’IEC 62443, standard internazionale per la sicurezza delle reti e dei sistemi industriali automatizzati, offre un quadro per la gestione della sicurezza che copre tutti gli aspetti dalla progettazione alla manutenzione e dal monitoraggio alla risposta agli incidenti. Questo standard si concentra particolarmente sulla resistenza delle infrastrutture agli attacchi, fornendo linee guida su come costruire architetture di sicurezza difensive che proteggano efficacemente sia la fisicità che la virtualità delle operazioni industriali.

In aggiunta, il CISA Zero Trust Maturity Model offre un metodo per valutare e guidare l’evoluzione delle organizzazioni verso l’adozione completa del modello Zero Trust. Il modello descrive diverse fasi di maturità, da una fiducia iniziale e condizionata fino all’adozione piena di un ambiente di sicurezza in cui la verifica è costante e indipendente dalla posizione di rete dell’entità che richiede l’accesso.

Le normative come la NIS2 introducono requisiti legali specifici, come l’obbligo di implementazione della multi-factor authentication (MFA), per aumentare il livello di sicurezza delle infrastrutture critiche e garantire la protezione dei dati sensibili. Questi requisiti legali obbligano le organizzazioni a conformarsi a standard minimi di sicurezza e spesso fungono da catalizzatori per l’adozione di tecnologie e pratiche più avanzate nel campo della cybersecurity.

Una delle misure chiave promosse dalla NIS2 è l'implementazione della multi-factor authentication (MFA). L'MFA è un meccanismo di sicurezza che richiede agli utenti di fornire più di una forma di verifica per accedere a sistemi o servizi critici.

La comprensione e l’applicazione di questi standard e normative sono essenziali per le organizzazioni che operano nell’ambito della Industry 4.0, fornendo loro le basi per costruire sistemi resilienti e capaci di fronteggiare le sfide del panorama cibernetico moderno. L’armonizzazione di questi framework a livello internazionale promuove anche un approccio più uniforme e coerente alla sicurezza, essenziale in un mondo sempre più interconnesso e dipendente da tecnologie digitali avanzate.

La crescente dipendenza da soluzioni Cloud, IIoT e M2M nell’industria intelligente pone sfide uniche per la sicurezza informatica. L’adozione di un modello di Zero Trust rappresenta una risposta strategica essenziale per proteggere le infrastrutture critiche in questo nuovo ambiente digitale. Le aziende devono continuare a evolvere le loro strategie di sicurezza per fronteggiare le minacce in rapido cambiamento, garantendo così la continuità operativa e la protezione delle operazioni industriali in un’era di crescente interconnessione.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/zero-trust-e-smart-industry-mettere-in-sicurezza-cloud-ot-iiot-e-ambienti-m2m-attraverso-strategie-avanzate-di-sicurezza-informatica-con-laiuto-dellintelligenza-artificiale/


Email Security e Intelligenza Artificiale

I protection server non sono “onniscenti” e non sono in grado di comprendere il testo all’interno del body né di individuare qualunque tipo di minaccia.

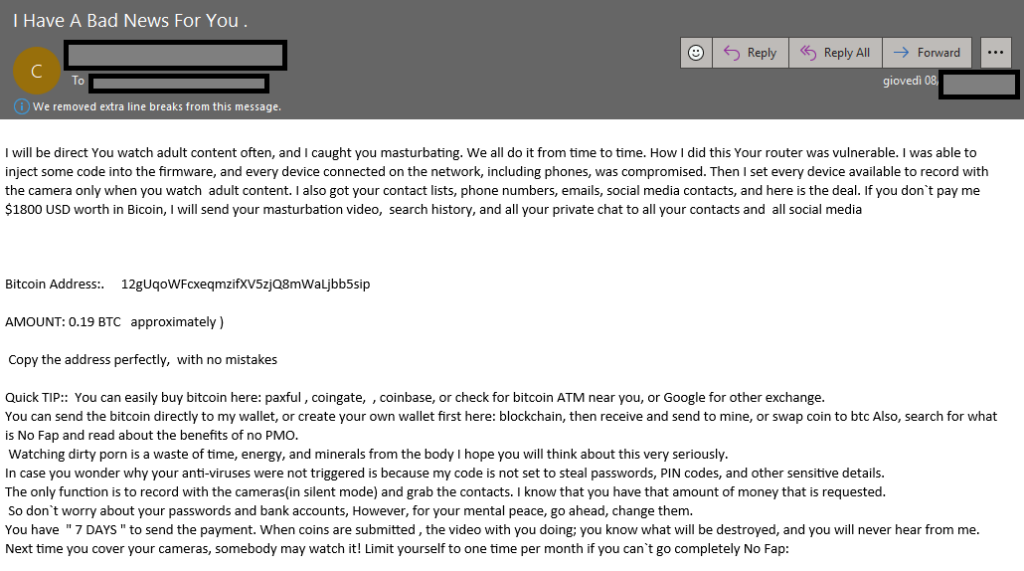
Ad esempio, le email contenente solo testo (in cui si invita l’utente ad effettuare pagamenti e/o lo si minaccia) proveniente da domini molto utilizzati (come gmail, yahoo ecc) tendenzialmente non vengono bloccate in quanto il protection server non è in grado di comprendere il “significato” del testo di una mail. Quindi una mail proveniente da “pippo@gmail.com” contenente solo testo in cui si richiede un pagamento su un certo IBAN non è sempre detto che venga bloccata, anzi. In figura 10 è possibile osservare un tentativo di frode in cui si richiede un pagamento in bitcoin per evitare che venga diffuso materiale altamente personale del dipendente.

Figura 10. Mail malevola

Come si può evincere, la mail fa leva sullo stato emozionale che può scaturire sul destinatario. Realisticamente è probabile che non abbia nemmeno a disposizione il materiale di cui parla tuttavia tenta di creare panico nel dipendente che potrebbe, se non ha effettuato alcun tipo di training contro queste minacce, andare ad eseguire le azioni richieste.

Uno dei problemi principali quindi, oltre alla mancanza di training dei dipendenti, è legata alla mancanza da parte del secure gateway di bloccare queste tipologie di mail:

  • sender proveniente da domini noti (gmail, yahoo e simili);
  • mail contenente solo testo;
  • nessuna evidenza malevola e/o di spoofing/phishing;

questo perché i mail secure gateway non sono “senzienti” e non sono quindi in grado di comprendere il testo. È in questo campo che si sta osservando l’entrata in gioco dell’intelligenza artificiale (IA). Di fatto molti secure gateway moderni stanno iniziando ad integrare le IA nei loro sistemi allo scopo di bloccare e/o prevenire un maggior numero di minacce di questo tipo e non solo. Tra le IA più note ci sono chatGTP e Gemini ma se ne potrebbero citare molte altre in base all’ambito di interesse, tra cui Synthesia, Midjourney e Stable Diffusion.

Questo articolo è stato estratto dal white paper “Email Security: Intelligenza Artificiale, Protocolli e Best Practice Contro gli Attacchi Informatici” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/email-security-intelligenza-artificiale-protocolli-e-best-practice-contro-gli-attacchi-informatici/

Articolo a cura di Fabrizio Giorgione

Profilo Autore

Fabrizio Giorgione è nato a Napoli (NA) nel 1992. Si è laureato in ingegneria informatica presso l’università degli studi del Sannio il 17 dicembre del 2018 con una tesi dal titolo: “Analisi della superficie di un sistema SCADA”. Ha sviluppato, presso il laboratorio ISWATlab, un’applicazione Android denominata “Privacy Guard” la quale valuta il rischio di privacy leakage, ovvero il furto di informazioni, sugli smartphone (http://www.iswatlab.eu/?page_id=499). Ha effettuato il tirocinio presso lo “ZLab” di “Cse Cyber Sec” nell’ambito “SOC”, “Forensic” e “Malware Analysis”. Attualmente lavora presso la società di “NTT DATA” come “Cyber security Analyst” nel SOC di Napoli. Il suo compito è quello di effettuare analisi di log, di malware e di prevenire minacce interne ed esterne alla sua azienda e ai clienti della società. Si è occupato, inoltre, del montaggio e della gestione di sonde IDS/IPS presso Telecom Italia nella sede di Roma (RM).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/email-security-e-intelligenza-artificiale/


Adversarial Machine Learning – Aspetti Scientifici

Gli Adversarial Examples illustrati nella sezione precedente non sono di per sé degli eventi di attacco ma, più precisamente, delle vulnerabilità che possono essere sfruttate da un attaccante.

Fig. 3 Reese Witherspoon o Russel Crowe? [Fonte Rif. 5]

Si consideri l’esempio riportato in Fig. 3, che riporta a sinistra un’immagine dell’attrice Reese Witherspoon, come tale riconosciuta da uno specifico modello ML studiato in [Rif. 5]. Analogamente l’immagine a destra riporta l’attore Russel Crowe, correttamente identificato dal modello ML. Viene poi sottoposta al modello ML l’immagine centrale di Reese Witherspoon a cui sono stati aggiunti dei particolari occhiali creati appositamente (la versione fisica di questi occhiali costa solo pochi Euro). Questa immagine è però riconosciuta dal modello ML come un’immagine di Russel Crowe e non di Reese Witherspoon.

Come per molti altri tipi di vulnerabilità dei sistemi IT, se questo modello ML fosse utilizzato in un sistema di controllo degli accessi, questa vulnerabilità potrebbe essere sfruttata da un attaccante per impersonare un’altra persona e accedere illegalmente a un sistema o servizio.

La presenza di Adversarial Examples non è l’unico tipo di vulnerabilità o l’unico modo per attaccare o abusare di un modello ML. Sono state proposte alcune tassonomie di attacchi e minacce ai modelli ML e in generale ai modelli di Intelligenza Artificiale, tra cui quella di Microsoft [Rif. 6] riassunta in Fig. 4 e quella di MITRE [Rif. 7], riassunta in Fig. 5.

Fig. 4 Microsoft Threat taxonomy - Failure modes in machine learning [Fonte Rif. 6]
Fig. 4 Microsoft Threat taxonomy – Failure modes in machine learning [Fonte Rif. 6]
Fig. 5 MITRE ATLAS [Fonte Rif. 7]

Senza addentrarsi in dettaglio in queste tassonomie, è utile approfondire i principali tipi di attacchi che possono sfruttare vulnerabilità dei modelli ML, inclusa quella degli Adversarial Examples.

Attacchi ai dati di addestramento

La qualità e integrità dei dati utilizzati per l’addestramento di un modello ML sono cruciali per ottenere il comportamento atteso. Per l’addestramento è inoltre spesso necessaria una grande mole di dati, spesso forniti da terze parti.

Come semplice esempio, si consideri il caso di un modello ML utilizzato per identificare messaggi di posta elettronica di SPAM. Un attaccante che vuole organizzare una campagna di SPAM è interessato ad evitare che i propri messaggi siano identificati come SPAM dal modello ML. Per far questo può cercare di inserire i propri messaggi nei dati di addestramento classificandoli come non-SPAM. Oppure può cercare di accedere ai dati di addestramento e modificare la classificazione di alcuni di essi in modo che non risultino più classificati come SPAM. Gli esempi di SPAM che forniscono i dati di addestramento del modello ML sono di norma raccolti da molte sorgenti, per lo più pubbliche: può essere pertanto sufficiente che l’attaccante riesca ad attaccare una componente della Supply Chain per sovvertire o “avvelenare” (Poisoning) il modello ML.

La modifica dei dati d’addestramento fatta alla fonte, presso eventuali terze parti che raccolgono i dati o presso l’utente finale che addestra il modello ML, può portare ad esempio alla creazione di Backdoor quali comportamenti nascosti attivabili tramite particolari sequenze di dati in input, o di Bias (una distorsione o deviazione sistematica rispetto al risultato atteso) che possono permettere ad un attaccante di utilizzare il modello ML per i propri scopi.

Attacchi al codice dei modelli di Machine Learning

Anche piccole modifiche al codice o all’eseguibile di un modello di Machine Learning possono portare a introdurre comportamenti malevoli come quelli appena descritti. Molto spesso un utente di un modello ML non costruisce da zero il codice del modello ma ottiene un modello già costruito e pre-addestrato da un fornitore, per poi completare l’addestramento con i propri dati. Un attaccante può quindi attaccare questa Supply Chain con l’intento di modificare il codice del modello ML in modo che questo, anche se ulteriormente addestrato, continui a presentare delle Backdoor, Bias o in generale dei comportamenti malevoli. Nel caso più semplice di un modello ML il cui codice sorgente è pubblico, l’attaccante può ottenere e modificare il codice, addestrare il modello ML e far sì, ad esempio tramite un’intrusione nel server che distribuisce il codice, che l’utente utilizzi il modello ML con il codice modificato.

Attacchi al modello di Machine Learning

In questo caso l’attaccante accede come utente ad un modello ML già addestrato per attaccarlo. L’attaccante può non avere alcuna informazione sul modello (attacco Black Box), qualche informazione sui dati di addestramento e/o sulla struttura del modello (attacco Grey Box), o completa informazione e disponibilità sia dei dati di addestramento sia del modello stesso (attacco White Box). In tutti i casi, l’attaccante non è in grado di modificare i dati di addestramento o il codice del modello sotto attacco se non interagendo con il modello ML stesso.

L’attaccante può quindi utilizzare direttamente il modello ML sotto attacco e analizzare i dati prodotti dal modello a seconda dei diversi input inviati al modello. Questo può permettere all’attaccante di identificare delle vulnerabilità del modello ML che possono permettergli di abusare del modello, ovvero ottenere dei risultati non previsti o a proprio favore (Inference e Model Evasion). Ad esempio l’attaccante può identificare e sfruttare a proprio favore dei Bias nel modello ML, oppure costruire degli Adversarial Examples come descritto precedentemente, o ancora identificare dei modi di utilizzo del modello ML non previsti e per i quali il modello ML non è stato specificatamente addestrato. Può essere utile presentare alcuni esempi teorici.

Riprendendo l’esempio precedente di un modello ML utilizzato per identificare messaggi di posta elettronica di SPAM, l’attaccante continua a modificare la formulazione del proprio messaggio sino a che il modello cessa di identificarlo come SPAM. Ovviamente in breve tempo i nuovi messaggi di SPAM non correttamente classificati dal modello ML vengono identificati manualmente, il che richiede un ulteriore addestramento del modello ML aggiungendo i nuovi campioni di SPAM. Ciò porta, anche in questo caso, al ben noto ciclo di attività attaccante-difensore tipico di molti sistemi di sicurezza. Come indicato precedentemente, alcuni modelli ML hanno mostrato una vulnerabilità indicata come “smemoratezza” (Forgetfulness): ovvero il fatto che ulteriori aggiornamenti di un modello ML con nuovi dati di addestramento possono portare il modello ML a dimenticare informazioni precedentemente acquisite. Se questo succedesse nel presente esempio, una volta ulteriormente addestrato il modello ML non identificherebbe più alcuni messaggi di SPAM che prima identificava correttamente.

Un altro tipico caso di studio è quello di un modello ML a supporto del processo di erogazione di un mutuo, prestito o finanziamento. L’attaccante, utilizzando il modello, scopre che questo ha dei Bias e che alcune classi di richiedenti (identificati per gruppo sociale o geografico, etnia ecc.) sono favorite dal modello ML nell’ottenere l’erogazione a discapito di altre. L’attaccante può quindi formulare la domanda in modo da presentarsi al modello ML come parte di un gruppo favorito e quindi avere maggiori possibilità di ottenere il finanziamento, anche se in realtà non gli sarebbe dovuto.

Altri esempi sono i modelli ML a supporto dei sistemi di controllo accessi e videosorveglianza. Come descritto precedentemente, l’identificazione da parte di un attaccante di Adversarial Examples per un modello ML utilizzato a questi scopi può permettere all’attaccante di aggirare un sistema di controllo degli accessi o evitare di essere riconosciuto da un sistema di videosorveglianza.

Invece di abusare dei risultati di un modello ML, un attaccante può essere interessato al modello ML stesso: alla sua architettura, al suo codice sorgente e ai dati con cui è stato addestrato. Sempre interagendo con un modello ML, l’attaccante può quindi cercare di estrarre informazioni interne al modello stesso. Come esempio di questo tipo di attacco si può considerare non un modello ML per la classificazione di immagini ma un ChatBot come il famoso ChatGPT. Questi tipi di modelli ML interagiscono con l’utente e producono tipicamente testi o immagini. Con opportune richieste al modello ML e analizzando le risposte ottenute, l’attaccante può dedurre e in alcuni casi ottenere copia di alcuni dati utilizzati per l’addestramento del modello, che possono anche essere riservati. Alcuni di questi modelli ML apprendono anche dalle richieste e dalle interazioni con gli utenti; e analogamente un attaccante potrebbe venire a conoscenza di informazioni fornite in input al modello ML da un altro utente, in alcuni casi violandone la privacy. Sempre con opportune richieste al modello ML, l’attaccante potrebbe venire a conoscenza dell’architettura, configurazione e anche del valore di alcuni parametri. Si tratta quindi di attacchi il cui scopo è l’inversione del modello ML e/o l’estrazione o furto di informazioni dal modello stesso.

Infine alcuni di questi attacchi possono anche essere sfruttati per rendere il modello non operativo, nel senso che il modello non è più in grado di svolgere il compito per cui è stato costruito e addestrato. Ad esempio, nel caso di un modello ML per il riconoscimento di immagini o messaggi di posta elettronica di SPAM, il modello dopo l’attacco non riconosce più alcuna immagine o messaggio di SPAM. Si può quindi classificare l’effetto di questi attacchi come un particolare tipo di Denial of Service.

Vulnerabilità e Sicurezza Proattiva

Come già accennato all’inizio di questo articolo, per gestire la “sicurezza” dei modelli di Machine Learning è possibile adottare l’approccio usuale alla gestione della sicurezza IT (o Cyber-sicurezza). Anche se di tipo e con caratteristiche diverse, i modelli di ML e in generale di Intelligenza Artificiale sono applicazioni IT e, come tali, possono avere delle vulnerabilità specifiche che possono essere sfruttate da un attaccante. Chi ne gestisce la sicurezza può quindi sottomettere a verifica queste applicazioni prima che siano messe in produzione per individuare l’eventuale presenza di queste vulnerabilità. Verifiche simili – in termini di approccio – a quelle svolte con i Penetration Test (o Red Teaming) per un’applicazione Web prima del rilascio in produzione, dovrebbero essere fatte anche per i modelli di Machine Learning al fine di identificare l’eventuale presenza di vulnerabilità quali quelle brevemente descritte in questo articolo.

Riferimenti Bibliografici

Rif. 5: M. Sharif, S. Bhagavatula, L. Bauer, M.K. Reiter, “Accessorize to a Crime: Real and Stealthy Attacks on State-of-the-Art Face Recognition”, https://users.cs.northwestern.edu/~srutib/papers/face-rec-ccs16.pdf

Rif. 6: Microsoft “Threat taxonomy – Failure modes in machine learning”, https://learn.microsoft.com/en-us/security/engineering/

Rif. 7: MITRE “Adversarial Threat Landscape for Artificial-Intelligence Systems (ATLAS)”, https://atlas.mitre.org/

Continua a leggere: scarica il white paper gratuito “Adversarial Attacks a Modelli di Machine Learning“

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/adversarial-machine-learning-aspetti-scientifici/


Cloud computing forensics: peculiarità e indicazioni metodologiche

Il Cloud computing è il principale modello di deployment dei servizi online, applicazioni, risorse e dati; è adottato da tutte le organizzazioni, indipendentemente dal settore, dalle dimensioni o dalle esigenze di calcolo e/o di storage. Di conseguenza, è cresciuto il contezioso avente ad oggetto il cloud, ovvero i servizi e i dati in cloud. La specificità, la complessità e l’eterogeneità dell’ambiente cloud, rispetto agli ambiti on-premise, richiedono un approccio e un metodo di conduzione delle indagini digitali ad hoc. In questo articolo provo a evidenziare le peculiarità tecniche e descrivere una metodologia conforme agli standard di settore e agli obiettivi prescritti dalle norme.

Introduzione

Il Cloud computing è il principale modello di deployment dei servizi online, applicazioni, risorse e dati; è adottato da tutte le organizzazioni, indipendentemente dal settore, dalle dimensioni o dalle esigenze di calcolo e/o di storage. Di conseguenza, è cresciuto il contezioso avente ad oggetto il cloud, ovvero i servizi e i dati in cloud. Le principali controversie, fin qui registrate, hanno riguardato:

  • i termini e/o le condizioni di servizio. Spesso i contratti di fornitura dei servizi in cloud sono generici e lacunosi, in particolar modo nella definizione dei service-level agreement (SLA), oppure non sono conformi alle normative e regolamenti vigenti, per esempio in tema di cybersecurity, continuità operativa e privacy, e ciò genera il contenzioso in fase di esecuzione del contratto;
  • la violazione alla sicurezza e/o alla privacy dei dati o dei servizi. Il cloud computing è indubbiamente più esposto a questa tipologia di minacce, per cui è necessario conoscere le tecniche di indagine specifiche per le violazioni che hanno compromesso la confidenzialità, l’integrità e la disponibilità dei dati o dei servizi in cloud;
  • lo sfruttamento della capacità di calcolo e/o memorizzazione. La disponibilità elevata di risorse offerte dal cloud computing è divenuto un obiettivo dei criminali informatici per perpetrare attività illecite o sfruttare la capacità di calcolo a carico di altri.

La specificità, la complessità e l’eterogeneità dell’ambiente cloud, rispetto agli ambiti on-premise, richiedono un approccio e un metodo di conduzione delle indagini digitali ad hoc. In questo articolo provo a evidenziare le peculiarità tecniche e descrivere una metodologia conforme agli standard di settore e agli obiettivi prescritti dalle norme vigenti.

Cloud computing

Definizione e proprietà funzionali

Il termine cloud computing indica una modalità di erogazione di servizi ICT offerti da alcuni operatori (provider) a una moltitudine di utenti (user) in modalità on demand e pay-per-use. Questi servizi sono erogati mediante infrastrutture hardware e software di proprietà dei provider o della stessa organizzazione senza una gestione attiva diretta da parte dell’utente; questi ultimi accedono attraverso le tecnologie e i protocolli di rete. Tipicamente un sistema cloud si compone di uno o più data center organizzati secondo un’architettura distribuita. Il principio cardine del cloud computing è la virtualizzazione: tutte le risorse di elaborazione, memorizzazione e trasmissione sono virtuali, ovvero ottenute sfruttando tecniche di emulazione implementate su risorse fisiche. Un tipico sistema cloud utilizza i gestori delle risorse (Hypervisor per la distribuzione di macchine virtuali, Container Engine per la distribuzione dei servizi o microservizi), che hanno il compito di amministrare le risorse fisiche dell’infrastruttura, allocandole dinamicamente alle diverse risorse virtualizzate (macchine virtuali o container) che condividono tale infrastruttura.

I principali vantaggi del cloud computing non si limitano solo alla riduzione dei tempi e dei costi, ma anche all’agilità e alla scalabilità. In particolare, i sistemi cloud sono caratterizzati da proprietà funzionali con un impatto significativo sulle investigazioni digitali:

  • Distribuzione geografica delle risorse: i data center che ospitano l’hardware di un sistema cloud sono organizzati secondo un’architettura distribuita, ovvero sono partizionate su un set di siti indipendenti, ubicati a distanza tra di loro. Di conseguenza, le risorse e i dati relativi ad uno specifico utente possono essere ubicati su una pluralità di dispositivi diversi, per cui può risultare complesso individuare l’ubicazione di tutti i dati riconducibili a tale utente, oltre a rappresentare un grosso problema in termini di giurisdizione territoriale.
  • Elasticità, scalabilità e flessibilità: l’utente di un servizio cloud può variare dinamicamente la quantità e la tipologia di risorse allocate. Pertanto, le risorse utilizzate da un utente in uno specifico arco temporale possono non essere più nella disponibilità di tale utente in un momento successivo e rischia di creare false istanze.
  • Gestione dinamica delle risorse: i sistemi cloud impiegano politiche di gestione delle risorse in cui quelle virtualizzate possono essere fatte migrare tra le varie risorse fisiche. Per cui può divenire ancora più complesso individuare tutti i dati e le risorse riconducibili ad un determinato utente, nonché ricostruire la sequenza di risorse fisiche su cui sono stati allocati.
  • Multi-tenancy: in un sistema cloud coesistono servizi riconducibili a soggetti diversi (tenant) che condividono le stesse risorse fisiche. La multi-tenancy produce due effetti: consente di ottenere adeguati livelli di privatezza dei dati grazie all’adozione di meccanismi crittografici; rende difficile risalire alla paternità degli artefatti presenti su una determinata risorsa fisica.
  • Trasferimento della responsabilità: gli utenti di un sistema cloud non hanno la possibilità di esercitare un livello di controllo completo sulle proprie risorse virtualizzate e hanno difficoltà a comprendere come vengono gestiti i propri dati. Il livello di controllo dipende dalla modalità di erogazione del servizio. Più la risorsa virtuale è profonda, più l’utente disporrà di controlli sulle risorse e viceversa.

La natura distribuita dei sistemi cloud, la condivisione tra utenti diversi, l’uso di tecnologie di virtualizzazione, l’adozione di meccanismi di replicazione e migrazione di risorse e dati, una stratificazione di responsabilità dovuta alla presenza di componenti forniti da soggetti diversi, pongono svariate criticità che il forenser deve essere in grado di comprendere e, opportunamente, acquisire e gestire, al fine di preservare le proprietà di genuinità, immodificabilità e verificabilità della potenziale evidenza.

Tipologia di fruizione dei servizi

Tipicamente i servizi in cloud sono erogati in una delle modalità di seguito indicate, talvolta combinate tra loro, ovvero:

  • On-premise: è il modello in cui l’hardware, le applicazioni, la connettività e tutti gli altri strumenti necessari, per esempio per la sicurezza o la scalabilità, sono di proprietà; pertanto, la gestione e la responsabilità ricade sulla stessa organizzazione;
  • Infrastructure-as-a-Service (IaaS): è il modello in cui il provider offre l’accesso on-demand a server fisici e virtuali, storage e reti in hosting sul cloud, l’infrastruttura IT di back-end per eseguire le applicazioni e i carichi di lavoro sul cloud, denominato Hypervisor. Esempi di servizi erogati in IaaS: Amazon Web Services (AWS), Google Cloud Platform (GCP);
  • Container as a Service (CaaS): è un modello in cui il provider consente l’accesso on-demand ad ambienti in cui sono offerti i servizi di base, denominati Container Engine, per eseguire le applicazioni (Container). Esempi di servizi erogati in CaaS: Docker e Google Kubernetes Engine (GKE);
  • Platform-as-a-Service (PaaS): è un modello in cui il provider consente l’accesso on-demand a una piattaforma di hosting su cloud, pronta all’uso e completa, per lo sviluppo, l’esecuzione, la manutenzione e la gestione di applicazioni, denominati Servless runtime. Esempi di servizi erogati in PaaS: Heroku, Google App Engine, Microsoft Azure App Service;
  • Function as a Service (FaaS): è un modello in cui il provider consente l’accesso on-demand per creare ed eseguire il deployment di una piccola porzione di codice o di una funzione che esegue un’attività specifica (per esempio un Microservizio). Quando viene eseguita una funzione, il cloud provider aggiunge scalabilità secondo necessità. Esempi di servizi erogati in FaaS: AWS Lambda, Azure Functions, Google Cloud Functions;
  • Software-as-a-Service (SaaS): è un servizio che consente l’accesso on-demand a software applicativo in hosting sul cloud e pronto all’uso. Esempi di servizi erogati in SaaS: Salesforce, Google Workspace, Microsoft 365 e SAP Business ByDesign.

Nell’ambito delle investigazioni digitali, la comprensione della tipologia di erogazione di servizio cloud riveste un ruolo fondamentale perché aiuta a comprendere l’oggetto dell’indagine, il tipo di evidenze da acquisire, gli strumenti e la metodologia da utilizzare; inoltre, consente di tracciare il confine tra le informazioni utente e quelle del provider, individuare le responsabilità in termini contrattuali e, in caso di incidente, la corretta attribuzione dell’eventuale condotta colposa e/o dolosa. L’immagine sottostante raffigura sinteticamente l’ambito di controllo e la responsabilità nelle diverse configurazioni di cloud.

Modelli di deployment – Livelli di Responsabilità (Fonte: Google cloud)

In informatica forense è fondamentale comprendere il concetto ‘As a service’. Esso si riferisce al modo in cui gli asset IT vengono utilizzati e alla differenza sostanziale tra cloud computing e IT tradizionale. Nell’IT tradizionale, un’organizzazione usa gli asset IT, hardware, software di sistema, strumenti di sviluppo, tools per la sicurezza, applicazioni, che acquista, installa, gestisce e di cui effettua la manutenzione nel proprio data center on-premise. Nel cloud computing, il provider di servizi cloud è il proprietario e il responsabile della gestione e della manutenzione degli asset; il cliente utilizza tali asset tramite una connessione Internet e paga in base a un abbonamento o con la modalità PAYG (pay-as-you-go – pagamento a consumo). Inoltre, nella pratica, i servizi di cui fruisce un utente del cloud sono forniti da diverse entità; pertanto, è fondamentale mappare i vari strati e le responsabilità al fine di identificare le evidenze e attribuire la corretta paternità.

Modelli di deployment dei sistemi

Un modello di deployment specifica come è realmente implementata un’architettura software su un’infrastruttura fisica, per esempio tramite l’allocazione di più istanze software su diverse componenti dell’infrastruttura fisica; pertanto, è fondamentale comprenderla prima di avviare un’indagine digitale. In un determinato sistema possono coesistere diversi modelli di deployment, che si possono differenziare tra loro per l’obiettivo che cercano di perseguire: prestazione del sistema, disponibilità dei servizi erogati, sicurezza e/o privatezza dei dati, costo. Molti obiettivi sono divergenti, per cui non è possibile che siano tutti massimizzati.

In ambito cloud sono stati sviluppati diversi modelli di deployment, ognuno progettato per massimizzare determinato obiettivi, tra cui:

  • cloud pubblico: i provider offrono le risorse ad una pluralità di utenti, nessuno dei quali ha l’accesso esclusivo alle risorse. Il cloud pubblico consente all’utente di ottenere un vantaggio economico, per quanto riguarda i costi di avvio e di gestione, e di sgravarsi dalla responsabilità del rischio operativo inerente all’infrastruttura IT. Tuttavia, non consente agli utenti di esercitare un controllo completo sulle risorse utilizzate e, pertanto, risulta poco adatto agli scenari business-oriented, in cui il controllo è essenziale;
  • cloud privato: è concepito per l’utilizzo esclusivo da parte di un solo soggetto utente. Di conseguenza, offre il miglior grado di controllo su prestazioni, affidabilità e sicurezza, a discapito dei costi operativi;
  • cloud ibrido: è una combinazione tra cloud privato e pubblico e cerca di coniugare i vantaggi di entrambe, evitando al contempo gli svantaggi. In un cloud ibrido parte dell’infrastruttura è utilizzata esclusivamente da un unico soggetto, mentre la parte restante è messa a disposizione di altri. L’unica criticità di questa soluzione consiste nel prevedere dei meccanismi e delle politiche in grado di mantenere separate la partizione pubblica da quella privata;
  • multi-cloud: è una combinazione di servizi cloud di due o più fornitori compatibili con specifici requisiti e con il carico di lavoro richiesto. In altri termini, il multi-cloud è una tecnologia cloud ibrida agile e flessibile che utilizza molti servizi di infrastruttura cloud pubblica per ottimizzare le performance, i costi di gestione e la continuità operativa.
Modelli di deployment – Tradizionale, pubblico, privato, ibrido, multi cloud

Questo articolo è stato estratto dal white paper “Cloud Computing Forensics: Peculiarità e Indicazioni Metodologiche” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/cloud-computing-forensics-peculiarita-e-indicazioni-metodologiche/

Articolo a cura di Vincenzo Calabrò

Profilo Autore

Referente Informatico e Funzionario alla Sicurezza CIS (Ministero dell’Interno).
È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha, altresì, indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics conseguendo i Masters in Data Protection e Data Governance, IT Risk Management e Sicurezza Informatica ed Investigazioni Digitali, oltre al CERT Certification in Digital Forensics rilasciato da Carnegie Mellon University, all’European Certificate on Cybercrime and E-Evidence (ECCE) rilasciato dall’European Commission’s Directorate General Justice, Freedom and Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cloud-computing-forensics-peculiarita-e-indicazioni-metodologiche/


Cos’è la Mobile Security?

La mobile security è una branca della cybersecurity che si occupa specificamente degli aspetti di sicurezza legata ai dispositivi mobili (smartphone, tablet, watch, smart tv…), alla loro interazione con i servizi esterni e alla protezione dell’utente e dei suoi dati personali.

Nozioni preliminari

Per capire gli obiettivi della mobile security occorre introdurre il concetto di threat model, legato ai dispositivi mobili. Un threat model serve a fare assunzioni sulle capacità di un attaccante in un dato ecosistema, ed è il primo passo per capire e studiare problemi di cybersecurity in ogni sua declinazione.

Ricordiamo che nello scenario descritto nella Figura 1 gli utenti cercano e installano app per aumentare le funzionalità del proprio dispositivo. Dal punto di vista della sicurezza, le app possono essere o vulnerabili o malware. Nella prima categoria rientrano app benevole ma che, fisiologicamente, presentano dei problemi di sicurezza, definite vulnerabilità. In dettaglio, una vulnerabilità è un bug dell’app che ha un impatto sulla sicurezza del sistema o dell’utente. In un’assunzione realistica ogni app, come ogni software, presenta necessariamente qualche vulnerabilità. L’insieme di vulnerabilità di un software prende il nome di superficie di attacco.

I malware sono invece app malevole sviluppate dall’attaccante al fine di sfruttare vulnerabilità; il primo obiettivo è spingere l’utente ad installarle e/o eseguirle sul proprio dispositivo. Per questo motivo, i malware tendono a camuffarsi da app innocue, o si nascondono dentro app già esistenti tramite un processo, tipico del solo mondo mobile, che si chiama repackaging (cfr. Sezione 4.3.2).

Figura 2: Threat model del Confused Deputy e delle Colluded Apps

In questo scenario, il threat model di riferimento è rappresentato in Figura 2, dove si assume che l’attaccante sia in grado di trovare vulnerabilità esistenti in una qualsiasi app o versione del sistema operativo Android. Inoltre, l’attaccante può produrre un malware e distribuirlo sugli app store ufficiali e non, nonché tramite canali terzi (e.g., caricandolo su un sito o inviandolo via e-mail), per sfruttare le vulnerabilità scoperte. Infine, si assume che il malware riesca a eseguirsi sullo smartphone, tramite interazione con l’utente o sfruttando le caratteristiche di Android. Una volta eseguito, lo stesso cerca di attaccare l’app vulnerabile o Android, sfruttando i canali di comunicazione messi a disposizione del sistema operativo. Infine, si assume che ogni app benevola non sia a conoscenza di alcuna propria vulnerabilità.

Tale threat model prende il nome di confused deputy, nome che sottolinea l’impossibilità dell’app di distinguere se le sue interazioni avvengano con un’altra app lecita o con un malware che sfrutti qualche sua vulnerabilità.

Una variante del confused deputy è quella delle colluded apps dove il malware, per ridurre le probabilità di essere identificato, divide il codice malevolo su più app maliziose ma all’apparenza innocue. Tuttavia, l’interazione tra queste app permette di perpetrare l’attacco.

Valutare il peso di una vulnerabilità: il concetto di rischio

La valutazione della pericolosità di una vulnerabilità si esprime in termini di rischio. Il rischio associato ad una vulnerabilità è il prodotto tra due metriche, ovvero la probabilità e l’impatto (Rischio = Probabilità x Impatto). La probabilità indica la facilità con cui un attaccante potrebbe sfruttare con successo la vulnerabilità. Facendo un paragone con il mondo reale, la probabilità indica quanto sia facile per un ladro violare la serratura di una casa ed entrarvi.

L’impatto si riferisce alle conseguenze di un attacco riuscito che sfrutta la vulnerabilità. Ad esempio, se l’attaccante, sfruttando la vulnerabilità, riesce ad impossessarsi di numeri di carte di credito, l’impatto sarà alto. Secondo il paragone precedente, l’impatto valuta quanto il ladro riesce a rubare una volta penetrato in casa.

Figura 3: Valore di Rischio associato alla Zygote Vulnerability (2011)

A titolo di esempio, la Figura 3 indica il valore di rischio di una vera vulnerabilità[1] su una scala da 1 a 10. L’alto valore di rischio (7.8) è dovuto ad un buon valore di impatto (6.9) e all’estrema facilità, per un malware, di sfruttarla (10).

Specializzazioni della Mobile Security

La mobile security si articola in specializzazioni (o branche) principali, rappresentate in Figura 4:

  1. Vulnerability Assessment & Penetration Testing (VA/PT): persegue la definizione di metodologie di analisi dei sistemi operativi mobili e delle app al fine di riconoscere potenziali vulnerabilità (VA) e verificarne la sfruttabilità da parte di un attaccante (PT); l’obiettivo finale è scoprire e risolvere vulnerabilità in modo da diminuire la superficie di attacco delle app e del sistema operativo da parte dei malware.
  2. Hardening: studia e crea tecniche atte ad incrementare la protezione dei sistemi operativi e delle app, spesso sotto forma di estensione e miglioramento dei sistemi di protezione esistenti. Lo scopo dell’hardening è ridurre la probabilità che un malware riesca a raggiungere e sfruttare una vulnerabilità, pur garantendo le interazioni legali tra app e sistema operativo tramite i canali di comunicazione previsti.
  3. Malware Analysis: si occupa di cercare, analizzare e isolare nuovi pattern malevoli e malware che compaiono sugli app store, a prescindere dalle vulnerabilità che questi intendano sfruttare.
Figura 4: Principali specializzazioni della Mobile Security e loro obiettivi primari obiettivi primari (2011)

Sicurezza e Privacy sono due concetti che spesso possono confondere. Alcuni possono tendere a pensare che essi siano in qualche modo interconnessi, o che la privacy sia un sotto-caso particolare della security. I concetti sono, in realtà, ortogonali, avendo threat model diversi e molto ben distinti.

Figura 5: Threat model di sicurezza (5°) e privacy (5b) nell’ecosistema mobile

Nel mondo mobile, il threat model classico della security è il già discusso confused deputy, mostrato in Figura 5a. In questo caso, un’app vulnerabile che contiene dati di uno o più utenti viene attaccata con successo da un malware, portando ad un conseguente furto di dati personali dell’utente conservati nel database dell’app vulnerabile. Si noti che, sebbene questo attacco coinvolga il furto di dati personali, questo è a tutti gli effetti un problema di sicurezza.

Il threat model per la privacy nell’ecosistema mobile è invece mostrato in Figura 5b. Gli sviluppatori delle app utilizzano delle librerie, chiamate librerie di analytics[2], offerte da grossi player dell’ICT come Meta (Facebook, Instagram, WhatsApp) e Google stesso. Tali librerie consentono agli sviluppatori di un’app di catturare eventi generati dagli utenti che hanno installato e usano l’app nel mondo, per fini di monitoraggio le cui motivazioni possono essere molteplici (miglioramento dell’app, aggiunta di funzionalità, analisi dei tempi medi di utilizzo, …).

Come si può intuire i dati raccolti da queste librerie di analytics, oltre che essere messi a disposizione dello sviluppatore della singola app, sono conservati anche dagli stessi fornitori delle librerie. Questi dati contengono informazioni sensibili, come le preferenze e le ricerche dell’utente, con quali altre app o siti interagiscono in un certo momento, ecc. Tali informazioni sensibili sono appetibili per aziende terze; pertanto, una buona parte del business model di questi player, che raccolgono dati sensibili tramite le librerie di analytics, si basa sulla vendita a terze parti di questi dati. Affinché questo avvenga in maniera legale, deve essere garantita la privacy degli utenti che hanno prodotto quei dati. Per questo motivo, i dati vengono dapprima aggregati e anonimizzati secondo tecniche allo stato dell’arte e poi venduti. In alcuni casi, dati aggregati e anonimizzati possono essere resi pubblici. In ogni caso se un attaccante, interno a qualche azienda (tali attori malevoli, sia nel campo della security che della privacy, vengono chiamati insider threat) o esterno, in caso di rilascio pubblico dei dati, sia in grado di de-anonimizzare qualche dato collegando anche solo un dato sensibile all’identità di una persona fisica, questo è un problema di violazione della privacy.

Come si può vedere, i due threat model sono molto differenti e i problemi che la security e la privacy affrontano nel contesto operativo mobile sono ragionevolmente ortogonali tra loro.

Obiettivi e costi dell’attaccante

Il malware non è altro che il mezzo tramite il quale un attaccante raggiunge il dispositivo e perpetra l’attacco a una vulnerabilità. Il malware deve essere sviluppato dall’attaccante e distribuito in modo da raggiungere lo smartphone. Per questo secondo punto esistono diverse tecniche, tra le quali la più famosa è il phishing (cfr. Sezione 4.1).

Riguardo lo sviluppo di un malware, questo processo ha costi in termini di tempo e risorse per l’attaccante. Pertanto, un malware viene prodotto solo se è conveniente per l’attaccante, ovvero se le probabilità di successo sono ragionevolmente alte e il guadagno derivante sensibilmente maggiore dei costi richiesti per realizzare il malware. Se “il gioco non vale la candela”, un attaccante non produce il malware e si interessa ad altri obiettivi. Da questo punto di vista, la protezione fornita dai sistemi di sicurezza ha in primis un effetto demotivante: più un sistema diventa difficile da attaccare e minore è il guadagno nel farlo, più il numero di malware è destinato con il tempo a diminuire.

Nel prosieguo ci concentreremo separatamente sulla sicurezza di Android e quella delle app. Prima di procedere, è importante sottolineare che i malware che attaccano Android hanno un obiettivo diverso rispetto a quelli che attaccano specifiche app.

Nel primo caso, l’obiettivo principale è prendere il controllo del sistema operativo (rooting) e, conseguentemente, di tutto il sistema. In caso di successo, ogni sistema di sicurezza di Android verrebbe bypassato e l’attaccante avrebbe pieno accesso a tutte le app e le risorse del sistema. La categoria di attacchi che persegue questo obiettivo prende il nome di privilege escalation e si basa sostanzialmente sullo sfruttamento di vulnerabilità nel sistema operativo. Inoltre, la privilege escalation può essere anche parziale: il malware non arriva a controllare l’intero sistema, ma almeno ad acquisire più diritti di quelli che spettano ad un’app.

Un obiettivo secondario di malware per il sistema operativo è bypassare i meccanismi di sicurezza per trovare nuovi canali di attacco alle app. Questi prendono il nome di side channel (cfr. Sezione 3.2.3).

Nel caso di malware che attaccano le app, questi sono realizzati per sfruttare una o più vulnerabilità specifiche di una o più app, che tendono a raggiungere seguendo i canali di comunicazione forniti (e protetti) da Android, o tramite i già citati side-channel. L’obiettivo è pertanto rubare dati contenuti nell’app (e.g., carte di credito, informazioni sensibili) oppure sfruttare le funzionalità dell’app all’insaputa dell’utente (e.g., usare un’app bancaria per fare trasferimenti di denaro).

Si noti che un malware si focalizza spesso su un insieme di app che condividono le stesse – o un sottoinsieme – delle vulnerabilità che sa attaccare. Questo è abbastanza comune per due motivi: in primis molte app si basano sulle stesse librerie che, se vulnerabili, rendono parimenti vulnerabili tutte le app che le usano; inoltre le app spesso hanno una radice comune, ovvero sono personalizzazioni di app generiche (chiamate white label[3]): anche in questo caso, una vulnerabilità presente nella versione generica dell’app è presente con buona probabilità in tutte le sue personalizzazioni.

Le white label personalizzate sono abbastanza comuni negli app store, soprattutto nelle categorie delle attività commerciali: i titolari di queste attività non hanno, da una parte, “tempo e risorse” per creare un’app assumendo sviluppatori o affidandone lo sviluppo from scratch ad aziende terze, e, dall’altra, non hanno necessità di app particolarmente sofisticate (molte app sono solo informative e mappano le informazioni di un sito web).

Note

[1] Armando, A., Merlo, A., Migliardi, M., & Verderame, L. (2012). Would You Mind Forking This Process? A Denial of Service Attack on Android (and Some Countermeasures). Proc. of IFIP-Sec 2012 (p. 13-24). Heraklion, Crete: Springer.

[2] https://www.appbrain.com/stats/libraries/tag/analytics/android-analytics-libraries

[3] https://www.appmachine.com/blog/white-label-app

Questo articolo è stato estratto dal white paper “Mobile Security – Nozioni e Riflessioni” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/mobile-security-nozioni-e-riflessioni/

Articolo a cura di Alessio Merlo

Profilo Autore

Ha conseguito una laurea magistrale in Informatica nel 2005 presso l’Università degli Studi di Genova, ed il dottorato di ricerca in Informatica nel 2010 presso la stessa università. Dal 2010 la sua ricerca si concentra interamente nell’ambito della Cybersecurity, con un focus specifico sulla Mobile Security, dove negli anni contribuisce a definire metodi innovativi per l’analisi statica e dinamica della sicurezza di applicazioni Android, con ricadute in contesti reali (e.g., BYOD), a definire nuove metodologie di testing di applicazioni mobili e di protezione delle stesse quali
tecniche di offuscazione e protezione delle applicazioni da attacchi di repackaging.
Ha inoltre lavorato allo sviluppo di nuove tecnologie per l’autenticazione utente su dispositiviì mobili, a tecniche di profilazione dell’impronta energetica di attacchi e malware, ed a metodologie per la protezione dei dati personali degli utenti acquisiti dalle applicazioni mobili.
Ha contribuito alla scoperta di una serie di pericolose vulnerabilità, tra cui la Zygote Vulnerability, due vulnerabilità nei protocolli GSM ed UMTS, alcune nei Password Manager su Android, ed una sul servizio iNotify di Android, che avrebbero portato a diverse conseguenze sull’utente finale, dal furto di credenziali fino all’impossibilità di utilizzare il dispositivo mobile.
E’ autore di oltre 130 pubblicazioni scientifiche su riviste e conferenze internazionali ed ha ricevuto diversi riconoscimenti per l’attività di ricerca sulla Mobile Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cose-la-mobile-security/


Struttura di una mail, Email secure gateway e relativo mail flow

Struttura di un’email

Come si può evincere dalla figura 8, ogni mail ha le seguenti componenti:

  • Connessioni: da quale mail server (e relativo IP) è inviata la mail, quali eventuali “relay” ha attraversato e qual è il mail server destinatario. Di seguito alcuni esempi relativi alle connessioni:
    • Sender HELO Domain, informazione utilizzata per avviare una connessione SMTP e relativa conversazione con un altro mail server.
    • Sender IP
    • Sender hostname
  • “Envelope Information”: sono tutte quelle informazioni che possono essere utilizzate per filtrare le conversazioni a livello di mail server tra cui:
    • Envelope sender, ovvero, il reale mittente della mail. Questi potrebbe non combaciare con l’header from, il nome che il destinatario vedrà quando riceverà la mail. Quando queste due informazioni non combaciano c’è la possibilità che vi sia un potenziale tentativo di spoofing
    • Envelope Recipient.
  • Body, tutto ciò che viene scritto e inserito all’interno di una mail tra cui: testo, URL ed eventuali allegati ma anche informazioni relative alla dimensione del messaggio.
  • “Header information”: riguarda tutte le informazioni relative a From, To, Date, Subject e Reply-To di un’email. I threat actors possono facilmente spoofare queste informazioni. È fondamentale che chiunque riceva mail sospette riesca a riconoscerle segnalandole prontamente ai team dedicati che procederanno poi con ulteriori analisi e relativi filtraggi.
Figura 8. Struttura di una mail

Email secure gateway e relativo mail flow

Ogni volta che si invia una mail ci sono diversi step, si veda la figura 9, che vengono effettuati. Di seguito verrà illustrato un classico invio di una mail da un sender verso un recipient:

  1. Il sender invia un messaggio al recipient. Il mail server, una volta compreso che il recipient è esterno all’organizzazione, procederà col contattare il “message trasfer agent” (MTA), ovvero il mail server responsabile dello smistamento da un server a un altro della posta elettronica, per la gestione della richiesta.
  2. Il sending MTA effettuerà una query DNS per ottenere tramite l’MX (mail exchange) record, ovvero il responsabile della ricezione dei messaggi indirizzati a una casella di posta elettronica, informazioni per indirizzare la mail verso il destinatario. L’MX specificherà quindi il mail server autorizzato ad accettare il messaggio inviato.
  3. A questo punto il sending MTA, utilizzando le informazioni ottenute dall’MX, contatterà l’MTA del recipent per stabilire una connessione. Come si evince dalla figura 9, il recipient utilizza un email secure gateway per proteggere il proprio servizio di posta e per gestire tutti i tentativi di connessione, il sistema è anche noto come protection server.
  4. Il protection server processerà quindi il messaggio in inbound, verificando ad esempio:
    • Che il sender non sia in una blacklist/whitelist.
    • Che non ci siano filtri configurati che possano bloccare la mail.
    • Che la mail non contenga allegati e/o URL malevoli.
    • Che i record SPF, DKIM e DMARC siano correttamente configurati.

    E molte altre azioni che varieranno a seconda del vendor utilizzato.

  1. Una volta completata l’analisi, il protection server classificherà la mail (spam, phishing ecc.) e se non malevola, e conseguentemente considerata legittima, procedendo quindi con l’invio al mail server del recipient che consegnerà infine la mail al destinatario.
Figura 9. Mail flow
Figura 9. Mail flow

Un email secure gateway, quindi, protegge le comunicazioni che avvengono tramite posta elettronica da minacce come malware, phishing, spam e simili. Di seguito alcune delle principali funzionalità:

  • Categorizzazione delle mail: il gateway esamina tutti i messaggi in arrivo per identificare e bloccare le email indesiderate, come spam e phishing. Questo processo coinvolge l’analisi delle connessioni della mail, degli header e di eventuali URL e/o allegati per individuare potenziali minacce. Ogni mail avrà un determinato score (tipicamente da 0 a 100) e una tipologia (spam_score, phishing_score ecc) che le verrà assegnata al termine dell’analisi. In base a questo score il secure gateway procederà con una determinata azione (consegna, quarantena ecc).
  • Gestione di blacklist e whitelist (note anche come blocklist e passlist). All’interno delle blacklist vengono inseriti tutti quei sender/domini/IP che sono classificati come malevoli. Viceversa, nelle whitelist verrà inserito tuttò ciò che è considerato legittimo. Si tenga presente che inserire un sender in whitelist può esporre l’azienda a potenziali attacchi in quanto quel particolare indirizzo (mail o anche IP) verrà considerato come non malevolo anche in caso di compromissione. Inoltre, i sender in whitelist tipicamente non sono sottoposti ad alcun tipo di controllo da parte dell’antispam. Si consiglia pertanto di maneggiare le whitelist con cura ed eventualmente monitorarle periodicamente prediligendo maggiormente l’uso delle blacklist (metodologia considerata più sicura).
  • Antivirus e antimalware per rilevare e bloccare malware presenti negli allegati delle email impedendo che i file malevoli raggiungano il destinatario. In alcuni casi il secure gateway supporta anche l’uso di sandbox per l’esecuzione degli allegati così che possa verificare se effettivamente sono malevoli o comunque effettuano comportamenti inattesi e/o sospetti.
  • Rewriting degli URL: questa funzionalità riscrive tutti gli URL e analizza i link presenti nelle email una volta cliccati verificando se conducono a siti web dannosi o phishing o se vengono effettuate connessioni malevole. Se il link è sospetto, il gateway potrà quindi bloccare l’azione intrapresa per evitare l’infezione della macchina o comunque azioni nel sito sospetto.
  • Analisi comportamentale per rilevare modelli di comportamento anomalo, aiutando a identificare attività sospette o attacchi avanzati. Può osservare, analizzare e filtrare, ad esempio, se vi è un massivo invio di mail e/o documenti verso l’esterno tramite email bloccando prontamente una potenziale esfiltrazione.
  • Gestione delle mail in outbound, ad esempio, tramite regole che definiscono la dimensione massima di una mail in uscita verso un recipient esterno (o anche interno al perimetro di monitoraggio). Così facendo si limiterà la quantità di documenti inviata verso l’esterno e si invoglierà l’uso di strumenti più sicuri per la condivisione di materiale sensibile e/o riservato evitando così una potenziale esfiltrazione di dati tramite mail.
  • Verifica e controllo dei record SPF, DKIM e DMARC.
  • Segnalazione della mail quarantenate, agli utenti abilitati, tramite strumenti come il digest così da consentire eventualmente all’utente di richiederne la rimozione al team di competenza.
  • Gestione e supporto di campagne awareness: in questi casi si costruiscono delle campagne mail “malevole” ad hoc per comprendere quanto l’azienda è suscettibile a campagne di spam/phishing e quali sono gli utenti con minor sensibilità sulla tematica. L’obiettivo sarà quello di sensibilizzare i dipendenti verso tale tematica inducendoli a trattare le mail con la dovuta attenzione e a segnalare ogni mail malevola tramite l’apposito canale interno al team di competenza. Queste campagne sono quindi, dei veri e propri training per i dipendenti.
  • Reportistica e monitoraggio per consentire agli amministratori di sistema di tenere traccia delle attività e delle minacce consentendogli anche di rispondere rapidamente a eventuali incidenti di sicurezza. Queste servono anche a comprendere se l’azienda è stata presa di mira da eventuali hackers e/o coinvolta in delle campagne malevole.

Di seguito alcuni dei principali vendor nel campo dell’email security:

  • Microsoft O365
  • Proofpoint Email Security
  • Darktrace Antigena Mail
  • Cisco Email Security
  • Barracuda Email Security Gateway
  • FireEye Email Security

Prima di scegliere una soluzione, è importante valutare le specifiche esigenze dell’organizzazione, tenendo conto di fattori come le dimensioni dell’azienda, il livello di protezione richiesto e il budget disponibile. Ogni fornitore ha le proprie caratteristiche e funzionalità uniche, quindi la scelta dipenderà dalle esigenze specifiche richieste.

Questo articolo è stato estratto dal white paper “Email Security: Intelligenza Artificiale, Protocolli e Best Practice Contro gli Attacchi Informatici” disponibile in maniera libera e gratuita al seguente link: https://www.ictsecuritymagazine.com/pubblicazioni/email-security-intelligenza-artificiale-protocolli-e-best-practice-contro-gli-attacchi-informatici/

Articolo a cura di Fabrizio Giorgione

Profilo Autore

Fabrizio Giorgione è nato a Napoli (NA) nel 1992. Si è laureato in ingegneria informatica presso l’università degli studi del Sannio il 17 dicembre del 2018 con una tesi dal titolo: “Analisi della superficie di un sistema SCADA”. Ha sviluppato, presso il laboratorio ISWATlab, un’applicazione Android denominata “Privacy Guard” la quale valuta il rischio di privacy leakage, ovvero il furto di informazioni, sugli smartphone (http://www.iswatlab.eu/?page_id=499). Ha effettuato il tirocinio presso lo “ZLab” di “Cse Cyber Sec” nell’ambito “SOC”, “Forensic” e “Malware Analysis”. Attualmente lavora presso la società di “NTT DATA” come “Cyber security Analyst” nel SOC di Napoli. Il suo compito è quello di effettuare analisi di log, di malware e di prevenire minacce interne ed esterne alla sua azienda e ai clienti della società. Si è occupato, inoltre, del montaggio e della gestione di sonde IDS/IPS presso Telecom Italia nella sede di Roma (RM).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/struttura-di-una-mail-email-secure-gateway-e-relativo-mail-flow/


AIIA, lo strumento per una governance responsabile dell’Intelligenza Artificiale

Nel contesto attuale, caratterizzato dalla crescente pervasività dell’Intelligenza Artificiale, agli iniziali entusiasmi per il potenziale innovativo di questa tecnologia stanno seguendo importanti riflessioni circa i suoi potenziali rischi.

È noto come l’Artificial Intelligence Act dell’Unione Europea, approvato nel marzo 2024, abbia introdotto l’obbligo di condurre valutazioni d’impatto per i sistemi AI ritenuti “ad alto rischio”.

Tale scelta riflette la crescente consapevolezza che l’AI – pur offrendo enormi opportunità – può comportare, se non adeguatamente regolamentata e monitorata, pericoli significativi: fra questi le possibilità di errori o bias sottesi alle decisioni automatizzate, nonché l’impiego di strumenti basati sull’AI a fini di manipolazione o distorsione dei processi democratici.

La medesima consapevolezza è alla base della recente Convenzione Quadro del Consiglio d’Europa che stabilisce regole condivise circa l’impatto dell’Intelligenza Artificiale in campo di “Human Rights, Democracy and the Rule of Law”.

AI Impact Assessment: scopi, principi ed elementi chiave

Da simili considerazioni ha origine l’AI Impact Assessment (AIIA), finalizzato proprio a valutare gli impatti dei sistemi basati sull’Intelligenza Artificiale.

In concreto si tratta di un processo di valutazione ad ampio raggio teso a identificare, analizzare e mitigare i potenziali impatti negativi dell’AI sulla società, l’economia e i diritti individuali.

Considerata la costante evoluzione delle tecnologie interessate, esso dovrebbe essere concepito come un processo iterativo che accompagni i sistemi AI lungo tutto il loro ciclo di vita, partendo dalla progettazione per arrivare fino alle fasi di sviluppo e implementazione.

L’AI Impact Assessment si svolge alla luce dei principi condivisi a livello internazionale in tema di “safe and trustworthy AI”, in particolare:

  • accountability and transparency;
  • fairness, safety, security and resilience;
  • explainability and interpretability;
  • validity and reliability;
  • privacy.

Allo scopo di valutare i potenziali impatti dei sistemi AI, vanno considerati diversi elementi chiave.

  1. Analisi del contesto: valutazione dell’ambiente in cui il sistema verrà utilizzato.
  2. Identificazione degli stakeholder: mappatura di tutti i soggetti potenzialmente influenzati dal sistema.
  3. Valutazione dei rischi: identificazione e quantificazione dei possibili impatti negativi.
  4. Misure di mitigazione: sviluppo di strategie per ridurre o eliminare i rischi identificati.
  5. Monitoraggio continuo: implementazione di meccanismi per valutare l’impatto del sistema nel tempo.

Il Joint Research Centre (JRC) della Commissione Europea sottolinea l’importanza di coinvolgere in tale processo esperti di diverse aree – dai profili più tecnici agli esperti di etica, diritto e scienze sociali – per garantire che la valutazione avvenga secondo un approccio sistemico e multidisciplinare.

La diffusione dell’AIIA in Italia e nel mondo

Nel documento “State of implementation of the OECD AI Principles”, l’OCSE evidenzia come diversi paesi stiano già adottando framework specifici per l’AIIA.

A titolo di esempio il Canada ha sviluppato uno strumento di valutazione dell’impatto algoritmico per le agenzie governative, mentre il Regno Unito ha introdotto delle linee guida per l’uso etico dell’AI nel settore pubblico.

Sempre rispetto al mondo dei pubblici servizi – ove il bilanciamento fra tecnologie emergenti e diritti dei cittadini appare particolarmente complesso – il rapporto “AI WATCH: Artificial Intelligence for the public sector” del già citato JRC richiama, quali esempi “virtuosi”, le strategie di AI Governance messe in atto da Spagna e Norvegia.

Anche in Italia il tema è oggetto di attenzione da parte degli organismi regolatori: sin dal 2020, il Comitato Nazionale per la Bioetica citava l’importanza di integrare le valutazioni d’impatto dell’AI con considerazioni etiche, in particolare rispetto alla possibilità di errori o alle sue potenziali ricadute discriminatorie verso i cittadini.

Nel parere “Intelligenza Artificiale e Medicina: aspetti etici” il Comitato raccomanda infatti che l’AIIA includa una valutazione approfondita delle implicazioni etiche, soprattutto in ambiti sensibili come la sanità, sottolineando “la rilevanza di strumenti che garantiscano l’affidabilità della IA, mediante validazione, e riducano, nei limiti del possibile, l’opacità, gli errori e le possibili discriminazioni dovute a cause tecnologiche e/o umane”.

Il futuro dell’AIIA tra compliance e innovazione

L’AI Impact Assessment si configura, quindi, come un elemento chiave nella governance responsabile dell’Intelligenza Artificiale: esso può rappresentare un ponte tra innovazione tecnologica e tutela dei diritti individuali, contribuendo a creare ecosistemi AI che siano non solo avanzati ma anche etici, sostenibili e rispettosi delle persone.

La sfida per il futuro sarà quella di standardizzare le metodologie di AIIA, garantendo al contempo la flessibilità necessaria per adattarsi ai rapidi progressi tecnologici e alle diverse esigenze di settore.

Sarà inoltre essenziale promuovere una cultura della valutazione d’impatto tra gli sviluppatori e gli implementatori di sistemi AI, affinché l’AIIA non si riduca a mero adempimento normativo ma diventi una prassi consolidata e condivisa, cruciale anche per garantirsi la piena fiducia degli utenti finali.

In conclusione, l’AI Impact Assessment si sta affermando come strumento indispensabile per guidare un’adozione responsabile dell’Intelligenza Artificiale, raccogliendo le preoccupazioni circa i suoi potenziali effetti nocivi e contribuendo a plasmare un futuro in cui l’innovazione tecnologica proceda di pari passo con il benessere sociale ed economico, nonché con la tutela dei diritti fondamentali.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/aiia-lo-strumento-per-una-governance-responsabile-dellintelligenza-artificiale/