Disciplina nazionale alla luce della legge n. 48 del 2008: best practices e standard internazionali
Già a partire dagli ultimi decenni del secolo scorso, il legislatore ha iniziato ad attenzionare le dinamiche giuridiche connesse al mondo dell’informatica, anche nell’ambito penalistico giungendo, su impulso della Raccomandazione n. 9 del 1989 del Consiglio d’Europa[1], alla promulgazione della legge n. 547 del 1993, rubricata “Modificazioni ed integrazioni alle norme del Codice penale e del Codice di procedura penale in tema di criminalità informatica”. Ma l’attuazione di previsioni normative specifiche concernenti la materia della digital forensics si è avuta solamente più avanti nel tempo: è solo con la legge n. 48 del 2008, di ratifica ed esecuzione della “Convenzione di Budapest” del Consiglio di Europa sulla criminalità informatica (firmata nella capitale ungherese in data 23 novembre 2001[2]), che è stata inserita nell’ordinamento nazionale una disciplina focalizzata, oltreché sulla previsione del crimine informatico in sé, anche sul procedimento di acquisizione delle evidenze digitali rinvenute all’interno di sistemi informatici e sulla loro successiva conservazione.
Per quel che riguarda tali materie, la legge di ratifica della Convenzione ha avuto l’onere di dover apportare concetti innovativi in un quadro codicistico, quale quello del codice di procedura penale attualmente vigente e risalente al 1988, inserendovi una tematica, per l’appunto la ricerca della prova informatica, difficilmente prevedibile al momento della sua entrata in vigore. Nel fare ciò, la l. 48 del 2008 ha operato una serie di modifiche al Titolo III del Libro III e al Titolo IV del V del codice di rito introducendo nuove disposizioni in tema di ispezione, perquisizione e sequestro di supporti informatici nonché di acquisizione e conservazione delle evidenze digitali in essi rinvenute.
In particolare, per quanto riguarda il Titolo III del Libro III c.p.p. in tema di mezzi di ricerca della prova, le modifiche hanno interessato gli artt. 244, 247 (al quale è stato aggiunto il comma 1 bis), 248, 254 (a seguito del quale è stato inoltre inserito l’art. 254 bis), 256, 259-260 e, per quanto riguarda il Titolo IV del Libro III in tema di attività a iniziativa della polizia giudiziaria, gli artt. 352, 353 e 354.
Per ciò che concerne strettamente la materia della digital forensics, nell’introdurre le novità normative, la strategia del legislatore non è stata inserire tra le norme codicistiche disposizioni volte a indicare nel dettaglio le modalità per effettuare ispezioni o perquisizioni su supporti informatici, ovvero per eseguirne il sequestro. Infatti, né all’interno del codice né di altre fonti legislative sono state inserite specifiche procedure obbligatorie che le persone deputate alle operazioni, si tratti dellla polizia giudiziaria o di un consulente tecnico, debba seguire e rispettare, a pena di nullità, per visionare, acquisire, analizzare e conservare le evidenze informatiche.
Si è invece optato per una soluzione maggiormente flessibile, che di fatto lascia all’operatore un’ampia libertà di scelta in merito alla migliore modalità da adottare in relazione al caso concreto che gli si propone di volta in volta.
Nello specifico, la l. 48 ha stabilito – mediante apposite interpolazioni all’interno degli artt. 244 sull’ispezione informatica, 247 co. 1 bis sulla perquisizione informatica, 254 bis e 260 sul sequestro di supporti informatici e apposizione dei sigilli, nonché 352 e 354 sulla perquisizione e sequestro urgenti dei medesimi – che nel condurre tali attività, in caso di ispezioni e perquisizioni, occorre procedere «adottando misure tecniche dirette ad assicurare la conservazione dei dati originali e ad impedirne l’alterazione» (art. 244 co. 2, 247 co. 1 bis e 352 co. 1 bis c.p.p.) e che, per eseguire il sequestro di dati digitali, è necessario che «la loro acquisizione avvenga mediante copia di essi su adeguato supporto, con una procedura che assicuri la conformità dei dati acquisiti a quelli originali e la loro immodificabilità» (artt. 254 bis, 260 e 354 c.p.p.).
Quindi, nell’ottica della legge in questione, ciò che occorre fare non è attenersi a percorsi prestabiliti: è semplicemente agire adottando tecniche volte a non alterare il dato, al fine di conservarne l’autenticità e l’attendibilità. In pratica la legge n. 48 del 2008, senza imbrigliare l’operatore in modalità precise, si è limitata ad inserire nel codice esclusivamente l’obbligo di seguire delle linee guida generali, aperte all’innovazione (si tenga presente che le linee guida possono cambiare, oltre che in relazione alla situazione, anche con il progresso tecnologico), finalizzate a garantire la salvaguardia dell’integrità del dato digitale e la sua successiva verificabilità, a pena di inutilizzabilità processuale dello stesso[3].
Difatti, mediante la normativa in questione, è stato introdotto nel nostro ordinamento l’obbligo per le autorità inquirenti di fare ricorso, in caso di ispezioni, perquisizioni o sequestri di supporti e dati informatici, alle c.d. best practices, intese come «quel comportamento, non necessariamente codificato o contenuto in manuali, che è ritenuto dalla comunità scientifica e dagli operatori tecnici come la modalità corretta per effettuare determinate operazioni informatiche su specifici dispositivi o supporti»[4].
Più specificamente, le best practices vanno considerate veri e propri principi guida[5] cui conformarsi al fine di dare credibilità alle operazioni svolte sui dati informatici. Principi he lasciano tuttavia un certo grado di manovra al soggetto che materialmente conduce l’acquisizione della digital evidence, il quale avrà dunque un margine di apprezzamento circa le modalità da adottare; anche se, in ogni caso, dovrà attuare quelle ritenute migliori in relazione al caso concreto, sempre nell’ottica di garantire l’integrità del dato e la genuinità del risultato finale, «adottando le misure tecniche dirette ad assicurare la conservazione dei dati originali e ad impedirne l’alterazione» (art. 244 co. 2, 247 co. 1 bis e 352 co. 1 bis c.p.p.) e facendo ricorso a «…una procedura che assicuri la conformità dei dati acquisiti a quelli originali e la loro immodificabilità» (artt. 254 bis, 260 e 354 c.p.p.).
In dottrina, i principi cardine delle best practices sono stati riassunti come segue: «adottare estrema cautela nel sequestrare computer o servizi informatici che muovono servizi di telecomunicazione critici, e prediligere, se possibile, la continuità aziendale effettuando copie su supporti adeguati e non interrompendo, così, l’azione delle macchine e dei servizi; prestare attenzione a non alterare i dati durante le operazioni di ricerca delle fonti di prova; quando si effettua una duplicazione, assicurarsi che siano garantite la conformità della copia all’originale e la sua immodificabilità». In termini più diretti, quindi, «corrette modalità di conservazione, procedure di duplicazione efficaci, garanzie di non alterabilità ed extrema ratio del sequestro di servizi sono, in conclusione, i quattro principi della forensics introdotti nel nostro ordinamento»[6].
Se da un lato la scelta di non disciplinare procedure di digital forensics dettagliate risulta corretta, poiché situazioni differenti potrebbero necessitare di approcci differenti (nonché in ragione della moltitudine di scenari che occorrerebbe prevedere a livello normativo), da altro lato va sottolineato come venga lasciato ampio spazio interpretativo all’autorità procedente.
Proprio in ragione di ciò, a livello internazionale è stata avvertita l’esigenza di creare degli standard, c.d. S.O.P. (Standard Operating Procedure)[7], capaci di indicare delle linee guida generali fruibili da chiunque e di individuare i passaggi chiave rispetto ai quali una buona indagine che applichi strumenti di digital forensics non può prescindere per garantire un risultato certo in termini di integrità della digital evidence e conoscibilità delle varie fasi operative per una loro verifica ex post.
Premesso che a livello nazionale non esiste uno standard universalmente seguito da tutte le autorità inquirenti [8], le quali applicano modalità operative differenti nell’espletamento delle rispettive funzioni, gli standard maggiormente utilizzati e dai quali maggiormente viene preso spunto sono gli standard ISO/IEC[9]:
Standard ISO/IEC 27037:2012 (Information security management systems);
Standard ISO/IEC 27000:2013 (Guidelines for identification, collection, aquisition and preservation of digital evidence);
Standard ISO/IEC 27041:2015 (Guidances on assuring suitability and adequacy of incident investigative method);
Standard ISO/IEC 27042:2015 (Guidelines for the analysis and interpretation of digital evidence);
Standard ISO/IEC 27043:2015 (Incident investigation principles and processes);
Standard ISO/IEC 27050:2019, diviso in quattro parti e concernente l’electronic discovery.
Esistono anche altri standard elaborati da enti diversi, aventi in ogni caso tutti il medesimo obiettivo: garantire l’attendibilità, sotto i differenti aspetti, delle attività di digital forensics e dunque delle risultanti digital evidence.
Elemento comune tra gli standard internazionali è l’indicazione, all’interno delle loro linee guida, di alcuni soggetti specifici chiamati a intervenire: il Digital Evidence First Responder (DEFR), ovvero chi per primo fornisce il proprio intervento sulla scena del crimine ed eventualmente, se non vi è possibilità di dilazionare le operazioni, procede all’acquisizione del materiale digitale rinvenuto, e il Digital Evidence Specialist (DES), il soggetto dotato delle competenze tecniche di settore e chiamato ad attuare le procedure della digital forensics (che può coincidere con la figura del DEFR[10]).
L’attenzione delle S.O.P. richiamate, in particolare dello standard ISO/IEC 27037:2012[11], si è concentrata anche nell’indicazione metodica e cronologica delle fasi del processo di digital forensics, con l’individuazione di un modello procedurale dettagliatamente definito. Nello specifico l’intero procedimento viene sistematicamente suddiviso in passaggi ben distinti gli uni dagli altri, sebbene concatenati tra loro secondo un ordine logico-temporale.
Tali fasi si articolano come segue:
identificazione della digital evidence nel contesto della presunta scena criminis;
raccolta, acquisizione e analisi del materiale informatico raccolto;
valutazione del medesimo in base alle esigenze d’indagine.
Tutti i passaggi vanno attuati tenendo a mente i principi cardine della catena di custodia, volti a conseguire una corretta gestione dei dati – e dei supporti dai quali sono estratti – durante la loro manipolazione, al fine di tutelarne l’integrità durante ciascuna fase e nei momenti di passaggio dall’una all’altra.
Parte della dottrina[12] ha ravvisato l’esigenza di aggiungere un ulteriore step a conclusione dell’intero processo, consistente nella presentazione all’autorità inquirente/giudiziaria, o anche al difensore della persona indagata, del risultato ottenuto dal reperto informatico dopo averlo analizzato e valutato. Infatti occorre sottolineare che il processo di digital forensics e la lettura delle determinazioni ricavate dalle digital evidence che vi si estrapolano sono dotati di un alto grado di tecnicità, tale da risultare di difficile comprensione per l’“utente finale”. Soggetto, quest’ultimo, molto spesso esterno al settore e al quale i risultati investigativi andranno esposti con un linguaggio accessibile, ai fini del loro corretto utilizzo in sede processuale.
Note
[1] M. LIMONE, “Cloud computing – aspetti contrattuali, risvolti normativi e tutela della privacy”, Tricase (LE), 2018, p. 10, come citato in R. MURENEC, op. cit., p. 25, dove si precisa che detta raccomandazione, successiva a quella del 30 aprile 1980 del medesimo organo denominata “informatica e diritto”, già a partire dal 1989 invitava i paesi UE ad integrare le proprie singole legislazioni con normative ad hoc in contrasto a fenomeni criminosi come l’accesso abusivo a sistemi informatici e frodi informatiche.
[2] La Convenzione di Budapest rappresenta la prima normativa proveniente da un organo dell’Unione Europea volta a disciplinare il settore giuridico del cybercrime e delle investigazioni digitali col chiaro obiettivo di uniformare le legislazioni dei paesi europei in merito al contrasto del fenomeno della criminalità informatica, avente per sua natura uno spiccato connotato di transnazionalità. Ad oggi la Convenzione è stata firmata dalla quasi totalità dei paesi europei. In Italia l’iter di ratifica è iniziato l’11 maggio 2017 e si è concluso con la promulgazione della legge n. 48 del 2008 e con la sua entrata in vigore il 5 aprile del medesimo anno, sebbene con qualche iniziale incertezza relativamente alla data di entrata in vigore fugata dal chiarimento della Suprema Corte Sent. Cass., II Sez., n. 11135 del 13 marzo 2009, pronunciatasi in conferma del giorno del 5 aprile. Per un resoconto più dettagliato, sul punto si veda S. ATERNO, op. cit., pp. 784-785.
[3] F. GIUNCHEDI, “Le malpractices nella digital forensics Quali conseguenze sull’inutilizzabilità del dato informatico?”, in Archivio Penale, settembre–dicembre 2013, fasc. 3, anno LXV, p. 825.
[4] A. COLAIOCCO, “La rilevanza delle best practices nell’acquisizione della digital evidence alla luce delle novelle sulla cooperazione giudiziaria”, in Archivio Penale – Cultura penale e spirito europeo, n. 1 del 2019, p. 2.
[6] G. ZICCARDI, “L’ingresso della computer forensics nel sistema processuale italiano”, in “Sistema penale e criminalità informatica. Profili sostanziali e processuali nella Legge attuativa della Convenzione di Budapest sul cybercrime (l. 18 marzo 2008, n. 48)” a cura di L. LUPARIA, Milano, 2009, p. 170, come citato in A. COLAIOCCO, op. cit., pp. 2 e 3.
[7] Le S.O.P. son definibili come dei documenti che forniscono appositi standard operativi indicando i passaggi chiave di determinate procedure e le regole per eseguirli correttamente.
[8] Per un esempio di modalità operative di digital forensics di una forza di polizia del nostro Ordinamento si veda G. COSTABILE, op. cit., pp. 20 e ss., dove viene riportato l’esempio delle procedure tecniche delle quali si serve la Guardia di Finanza, basate sulla Circolare GdF 1/2018 denominata “Manuale operativo in materia di contrasto all’evasione e alle frodi fiscali”.
[9]Cfr. Ivi, pp. 8 e ss. dove vengono elencati e analizzati i principali standardISO/IEC, con particolare riferimento allo standard ISO/IEC 27037:2012.
[10] S. ATERNO, op. cit., p. 783, dove si specifica che in Italia non è consentita la coincidenza tra i due soggetti e pertanto la figura del first responder nel nostro Ordinamento è da rinvenirsi in quella del primo investigatore interveniente sulla scena, mentre quella del Digital Evidence Specialist è invece assimilabile al consulente specialista. Si veda anche R. MURENEC, op. cit., p. 217, dove tale ultima figura viene denominata Digital Forensics Expert e qualificata come “la figura professionale esperta di crimini informatici che si occupa di identificare, preservare e analizzare le informazioni contenute all’interno di dispositivi digitali [… al fine di] raccogliere elementi probatori…”. Come da quest’ultimo autore citato si veda altresì A. CONTALDO e F. PELUSO, “E-detective: l’informatica giuridica e le applicazioni della Digital Forensics”, PM Edizioni, Verazze (SV), 2018, p. 201 e ss., dove vengono evidenziati ulteriori approfondimenti su tale figura.
[11] Si segnala che lo standard ISO/IEC 27037 negli anni ha subito degli aggiornamenti. Attualmente l’ultima versione è quella del 2017, la quale a sua volta ha recepito la versione del 2016.
[12] In tal senso si vedano G. COSTABILE, op. cit., p. 9 e S. ATERNO, op. cit., p. 781.
Articolo a cura di Francesco Lazzini
Profilo Autore
Laureato in giurisprudenza con successivo conseguimento dei master in Scienze Forensi (Criminologia-Investigazione-Security-Intelligence) e in Informatica giuridica, nuove tecnologie e diritto dell’informatica. Attività di studio postuniversitario focalizzata in materia di indagini con l’utilizzo del captatore informatico e digital forensics.
Le infrastrutture critiche all’intersezione tra dispositivi cyber-fisici e Cyber Threat Intelligence
Framework generale di riferimento
I sistemi di controllo industriale (Industrial control systems) ICS/OT (Operational technology) costituiscono, ormai da diversi anni, uno dei target principali degli attori malevoli.
Numerosi e significativi attacchi informatici si sono concentrati, difatti, su infrastrutture critiche e sistemi industriali e, tra questi, il più alto profilo di minacce è stato quello dell’attacco ransomware portato alla Colonial Pipeline[1], avvenuto nel 2021.
Nonostante gli sviluppi recenti, connotati da una forte consapevolezza sia dei decisori politici che dei board aziendali, con l’adozione conseguente di stringenti misure di difesa e resilienza, la sicurezza informatica, all’interno della Pubblica amministrazione e delle infrastrutture critiche, sembra costituire tuttora un vulnus evidente come testimoniano tutti gli attacchi sin qui avvenuti. La numerosità di questi eventi – ovvero gli attacchi alle strutture critiche, in primo luogo sanitarie ma anche imprese private di ogni ordine e grado – non ha fatto che rendere di pubblica evidenza quello che si poteva facilmente ipotizzare già in precedenza. Vale a dire che esisteva un problema di messa in sicurezza di tali infrastrutture.
Non è sfuggito a nessuno, difatti, come la cybersecurity sia assurta, quasi all’improvviso, a una tra le più importanti priorità collettive: dapprima durante la crisi pandemica legata al Covid-19 (vale qui evidenziare, a solo titolo esemplificativo, il data breach occorso alla Regione Lazio) e all’utilizzo pervasivo della modalità lavorativa dello “smart working” (Paliotta 2022) e, in un momento successivo, a seguito dell’invasione da parte della Federazione Russa dell’Ucraina, con la conseguente attività di cyber warfare messa in atto dai principali attori nation-state. Non è un caso che tutto ciò sia arrivato all’attenzione delle più alte cariche dello Stato e abbia fatto segnare, nell’agosto del 2021, l’atto di nascita dell’Agenzia per la cybersicurezza nazionale (ACN).
Gran parte della complessità delle imprese che operano con sistemi ICS/OT deriva dal bilanciamento della rapida evoluzione tecnologica con un crescente livello di sofisticazione e conoscenza tecnica, da parte degli autori delle minacce, relativi a reti, componenti dei sistemi di controllo, protocolli industriali, dispositivi hardware, ecc. Del resto questi sistemi misti, definiti in letteratura come cyber-fisici, costituiscono il punto di intersezione laddove sistemi informatici e fisici si incontrano. L’elemento centrale è, pertanto, la connessione di Internet e dei computer con il mondo fisico dei dispositivi e dei sensori (Lee et alii 2015). I nuovi sistemi ICS/OT così creati sono in grado, infine, di controllare, ottimizzare e configurare in modo autonomo i propri parametri di funzionamento. Tutto ciò è avvenuto all’interno di un quadro generale di digitalizzazione spinta (Zong et alii 2017), ancora in fieri, che in Germania (Acatech 2013) e Italia (Paliotta 2018) è conosciuto con il nome di Industria 4.0 (Zezulka et alii 2016), il quale è vieppiù caratterizzato dall’uso crescente dei sensori dell’internet delle cose (Internet of things o IoT), delle macchine intelligenti (Brynjolfsson & McAfee 2011), dei big data (Kitchin 2014) e dell’intelligenza artificiale (AI).
A livello definitorio e in prima approssimazione, così come si può desumere da uno dei primi documenti istituzionali, quello messo a punto dal National Institute of Standards and Technology (NIST), nel 2011: «Industrial control system (ICS) is a general term that encompasses several types of control systems, including supervisory control and data acquisition (SCADA) systems, distributed control systems (DCS), and other control system configurations such as skid-mounted Programmable Logic Controllers (PLC) often found in the industrial sectors and critical infrastructures» (Stouffer et alii 2011:2-1).
È intorno alla prima decade del nuovo millennio che forti preoccupazioni sulla sicurezza degli ICS/OT, in particolare nel contesto delle infrastrutture critiche nazionali, iniziano pubblicamente a palesarsi, seppur i primi documenti e interviste[2] sono da farsi rinvenire addirittura a qualche decennio prima (Lüders 2006). Ma è solo nel 2010, quando scoppia, in maniera eclatante, il caso Stuxnet[3] (Langner 2011) che la sicurezza degli ICS/OT entra in maniera diffusa nel discorso pubblico e governativo e acquisisce la rilevanza odierna (Stouffer et alii 2011; 2013; 2015). In questo contesto, già nel 2013, il Presidente Barack Obama emetteva un Executive Order al riguardo: «The cyber threat to critical infrastructure continues to grow and represents one of the most serious national security challenges we must confront. The national and economic security of the United States depends on the reliable functioning of the Nation’s critical infrastructure in the face of such threats».
Differenze principali tra sistemi ICS/OT e sistemi IT
I sistemi ibridi ICS/OT, sviluppatisi all’intersezione tra componente digitale e fisica, si caratterizzano in maniera distintiva nei confronti dei sistemi IT tradizionali a cui sono spesso paragonati. «A modern ICS is a complex system that depends on many different components and technologies to monitor and control physical processes; along with many of the managerial, administrative, and regulatory responsibilities associated with this task. The heart of ICSs are operational technology (OT) which supports availability and safety of critical processes. Modern-day ICSs have incorporated information technology (IT) based on the system functions desired in the overall system» (Hahn 2016:51).
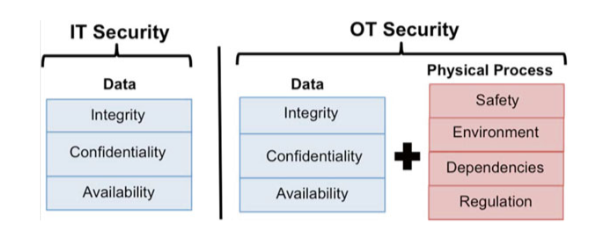
V’è da asserire, invero, che le differenze sono assai cospicue, soprattutto dal punto di vista della cybersecurity, come viene evidenziato in Figura 1. In linea generale, i sistemi IT si concentrano sui dati a riposo o in transito; mentre quelli ICS/OT monitorano e gestiscono dati che apportano modifiche in tempo reale ai dispositivi a cui sono collegati, mediante input fisici e azioni fisiche controllate.
È intorno alla metà degli anni Novanta del secolo scorso che iniziava la convergenza tra sistemi OT e IT, intesi questi ultimi come la tecnologia relativa allo sviluppo, manutenzione e utilizzo di computer, software e reti per l’elaborazione e la distribuzione di dati. «In the past, because industrial control systems used proprietary hardware and software, this interconnection focused primarily on just being able to communicate. The introduction of Ethernet and Microsoft Windows into industrial control systems in the mid-1990s, followed by the development of OPC interfaces, greatly simplified this problem, but at the cost of exposing the ICS to security threats previously known only to IT systems»[4].
Figura 1. Operational requirements of OT versus IT Fonte: Hahn 2016:53
In maniera dettagliata, in un blog di cui qui si riportano brevi stralci[5] ma a cui si rimanda per un approfondimento complessivo, anche dal punto di vista della cybersecurity, tali differenze sono state catalogate in 10 aspetti principali:
Obiettivi di sicurezza – i sistemi IT hanno l’obiettivo primario di proteggere i dati (confidenzialità) mentre, al contrario, quelli ICS/OT di preservare l’integrità del processo produttivo e la disponibilità dei suoi componenti[6]: la confidenzialità dei dati è senz’altro importante, ma la perdita di produzione si traduce in un’immediata decurtazione di reddito[7].
Segmentazione della rete – le reti ICS/OT possono essere viste come intranet industriali con due requisiti di sicurezza prioritari. Innanzitutto, dalle reti ICS/OT non dovrebbe essere consentito l’accesso a Internet o alla posta elettronica. In secondo luogo, queste dovrebbero essere difese rigorosamente dalle reti di altri impianti, in particolare da quelle con accesso a Internet. Le reti ICS/OT spesso dispongono di sistemi di input/output (I/O) remoti collegati all’ICS/OT tramite modem su reti pubbliche, reti pubbliche virtuali (VPN) e collegamenti satellitari, mentre le reti IT non lo sono.
Network topology – molti sistemi IT sono di grandi dimensioni rispetto a un tipico ICS/OT e contengono data center, intranet e reti Wi-Fi. I sistemi ICS/OT, invece, sono spesso piccoli[8] e dispongono solo di un database di configurazione e uno storico relativo a dati/eventi. Questi sistemi, inoltre, rimangono relativamente statici per anni.
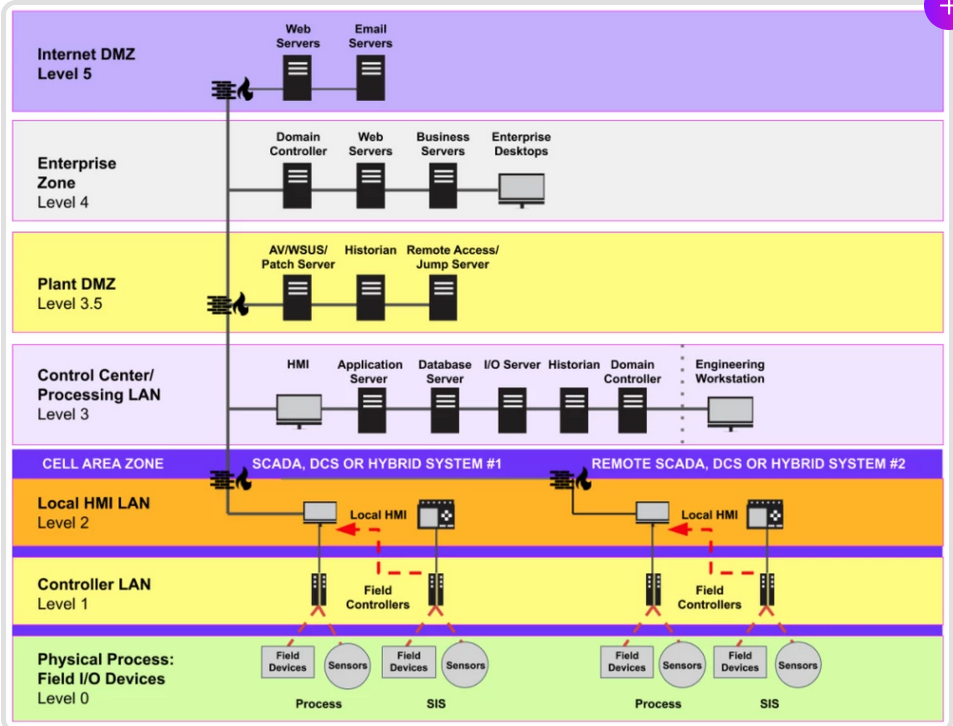
Partizionamento funzionale – l’approccio più comune adottato dai sistemi IT è dividere il sistema in varie partizioni amministrative per limitare al meglio l’accesso degli utenti alle risorse informative; i gruppi creati vengono utilizzati per controllare l’accesso a questi computer e ai loro oggetti (file, cartelle, eseguibili, ecc.) attraverso la definizione di elenchi di controllo di accesso (ACL). Il partizionamento degli ICS/OT è molto diverso in quanto è suddiviso in diversi livelli (0, 1 e 2), come definito dal modello di riferimento Purdue[9]. Il livello 0 rappresenta il processo fisico, il livello 1 il controllo e monitoraggio e il livello 2 il controllo di supervisione. I sistemi IT, in genere, non dispongono delle policy, delle procedure e degli strumenti per gestire la rete di livello 2 così come i controller e i dispositivi I/O di livello 1.
Figura 2. Essentials of the Purdue Model Fonte: <https://claroty.com/blog/ics-security-the-purdue-model>
Componenti fisici – i sistemi IT sono composti principalmente da reti, workstation e server standardizzati a cui si può accedere e che si possono amministrare. Al contrario, gli ICS/OT sono sistemi proprietari strettamente integrati, composti da componenti generalmente realizzate su misura ed estranei ai sistemi IT.
User accounts– gli account del sistema operativo IT vengono utilizzati per autenticare l’utente durante l’accesso e per identificare a quali risorse del sistema operativo lo stesso può accedere. Il sistema ICS/OT è un sistema distribuito completo composto da applicazioni di configurazione, funzionamento e manutenzione, database e giornale di eventi. Essi utilizzano quasi sempre controlli di accesso basati su ruoli (ad es. operatori, ingegneri di processo e di manutenzione) per concedere/negare l’accesso a dati e ai dispositivi di controllo.
Sistemi strumentati di sicurezza (SIS) – gli ICS/OT spesso includono SIS integrati, ma distinti, relativi alla sicurezza dell’impianto. Questi sono responsabili del mantenimento del funzionamento del processo ponendo lo stesso in uno stato sicuro quando vengono rilevate minacce alla sicurezza. I sistemi IT non dispongono di sistemi analoghi al SIS.
Software non testato – i sistemi IT sono, in genere, sistemi aperti che consentono di eseguire software standard e di evolversi nel tempo. Gli ICS/OT, invece, sono generalmente sistemi chiusi e implementati su una specifica configurazione hardware e del sistema operativo.
Patching – i sistemi IT dispongono normalmente di un software di gestione delle patches che installa automaticamente gli aggiornamenti di sicurezza dopo il loro rilascio. D’altra parte, non è raro che le patches vengano rinviate o posticipate a tempo indeterminato negli ICS/OT in quanto la loro implementazione richiede test, approvazione, pianificazione e convalida per garantire un controllo sicuro e ripetibile. Inoltre, poiché il ciclo di vita degli ICS/OT è piuttosto lungo[10], per molti sistemi non più recenti le patches non sono più disponibili (ad esempio, ci potrebbero essere ICS/OT ancora in funzione che eseguono Windows NT e Windows XP).
Inconvenienti legati alla sicurezza – le misure di sicurezza accettabili nei sistemi IT potrebbero non essere accettabili negli ICS/OT, soprattutto quelli che diminuiscono le prestazioni dei processi produttivi oppure quando sono legati al tempo di esecuzione.
Quelle sin qui individuate costituiscono alcune differenze principali tra i sistemi industriali IT e ICS/OT, le quali determinano requisiti di sicurezza diversi per la risposta agli incidenti, all’ambiente e alla sicurezza, alla progettazione del sistema, al rilevamento delle minacce e all’architettura di rete. Questo perché, in buona sostanza, i sistemi IT sono relazionati al mondo dei dati digitali, mentre quelli ICS/OT al mondo cyber-fisico.
Vettori di attacco e Cyber Threat Intelligence
In generale, gli attori malevoli fanno uso di specifici vettori – come Internet o l’ingegneria sociale – per compromettere i sistemi sotto attacco. Un attacco primario può anche generare un attacco secondario, il cui obiettivo è installare malware che possa essere utilizzato come pivot per altri attacchi. Non si può non ricordare qui che anche l’accesso da remoto, ampiamente utilizzato durante la crisi pandemica da Covid-19 per permettere di lavorare in “smart working”, può essere considerato un vettore.
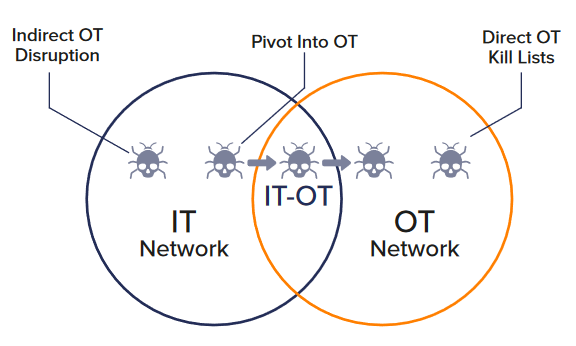
Anche il cosiddetto processo di convergenza tra sistemi IT e OT costituisce un ampio vettore di attacco e, in questo senso, i possibili percorsi di attacco possono essere di tre tipi se si adotta uno schema come quello della Figura 3.
Essi includono:
colpire direttamente i sistemi ICS/OT;
compromettere i sistemi IT da cui dipendono i sistemi ICS/OT;
sfruttare la crescente convergenza tra sistemi IT/OT per far leva, successivamente, su un attacco più ampio.
Figura 3. The Threat Landscape. Varieties of Industrial Ransomware Fonte: DarkTrace 2021:3.
Ransomware che colpiscono direttamente i sistemi OT. Esistono almeno 7 famiglie di ransomware che contengono comandi progettati per interferire o bloccare specificamente i processi ICS/OT. La maggior parte dei ceppi, compreso EKANS, contiene 20-30 comandi che mirano ai processi ICS/OT all’interno di una “lista di eliminazione dei processi” di oltre 1.000 voci. CLOP è l’unico ceppo noto che attacca circa 150 processi ICS/OT da una kill list contenente 1.425 comandi. I comandi aggiuntivi utilizzati da CLOP includono processi che supportano la supervisione dei controllori logici programmabili (PLC) e dell’interfaccia uomo-macchina (HMI). Se presi di mira, potrebbero compromettere la capacità di un ingegnere di visualizzare e controllare la produzione (DarkTrace 2021:3).
Ransomware che colpiscono indirettamente gli OT tramite la compromissione degli IT. Il ransomware può anche interrompere indirettamente gli ecosistemi ICS/OT compromettendo i sistemi IT vitali su cui si basa l’OT stesso, compresi i sistemi IT che svolgono un ruolo di monitoraggio della sicurezza e garantiscono la visibilità delle operazioni. Questo percorso di attacco è stato utilizzato anche nel caso Colonial Pipeline, in quanto il ransomware non ha mai infettato direttamente i dispositivi OT, ma la società ha deciso di interrompere preventivamente le operazioni per evitare potenziali problemi di sicurezza (ibidem).
Ransomware che sfruttano la convergenza dei sistemi IT/OT. Il ransomware può sfruttare intenzionalmente la convergenza IT/OT: lo riporta DarkTrace rispetto a un incidente che ha coinvolto un impianto di gas naturale negli Stati Uniti, nel 2019, in cui l’attaccante ha infettato dapprima i sistemi IT tramite ingegneria sociale (e-mail di phishing) per poi effettuare un pivoting e passare all’OT. Quando il ransomware si è diffuso, sono stati compromessi sia i dispositivi IT che quelli OT. Sebbene i PLC responsabili delle operazioni non siano stati direttamente colpiti, ciò ha compromesso la visibilità delle operazioni, tanto che la società ha deciso di interrompere le operazioni per due giorni al fine di evitare potenziali effetti distruttivi (ibidem).
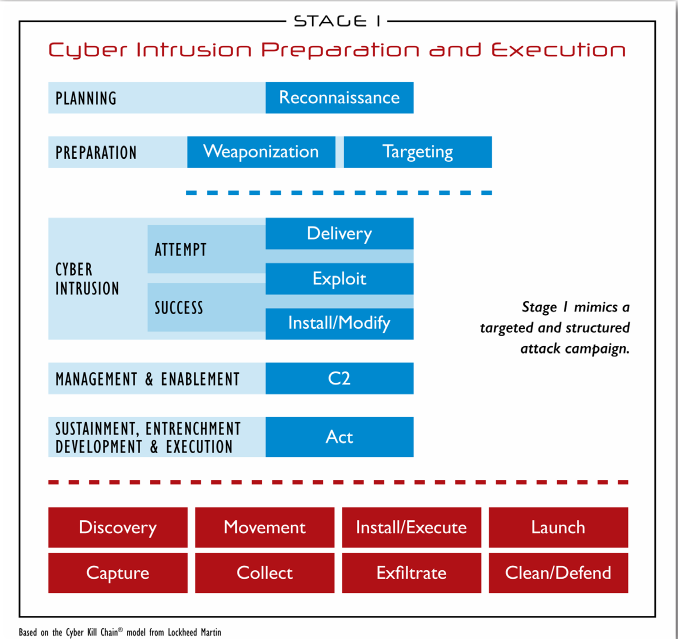
Gli attori malevoli prendono di mira i sistemi ICS/OT non mediante singoli incidenti e data breaches, quanto piuttosto attraverso una campagna di sforzi che consente loro l’accesso e fornisce informazioni sufficienti per poter avere un effetto distruttivo sui processi e sulle attività delle infrastrutture critiche. Comprendere a che punto è l’avversario nella sua campagna di penetrazione dei sistemi aziendali può consentire ai difensori di prendere decisioni più informate in materia di sicurezza e gestione del rischio. Ed è proprio in questo caso che può essere d’aiuto il framework della Cyber Kill Chain (Hutchins et alii 2011), adattata per i sistemi ICS/OT in quanto «this knowledge of the adversary’s operations can help defenders appreciate the attacker’s possible intent, level of sophistication, capabilities and familiarization with the ICS, which together work to unveil the potential impact of the attack on an organization» (Assante & Lee 2015:1). Per portare a termine un vero e proprio attacco cyber-fisico, piuttosto che un attacco caratterizzato da spionaggio, interruzione dell’ICS/OT o furto di proprietà intellettuale, è necessario che gli avversari inizino un attacco in due fasi, così come mostrato in Figura 4.
La prima fase di un attacco informatico ai sistemi ICS/OT è il tipo di attività che ha lo scopo di ottenere l’accesso alle informazioni, conoscere il sistema e fornire meccanismi per sconfiggere le protezioni del perimetro interno od ottenere l’accesso agli ambienti di produzione. È importante sottolineare che un attore malevolo può eseguire la Fase 1 anche contro una rete di fornitori o partner, ottenendo così informazioni vitali per condurre in porto il proprio attacco.
Questa fase è caratterizzata dalle seguenti attività:
1) pianificazione (reconnaissance, attività volta a ottenere informazioni su qualcosa attraverso l’osservazione o altri metodi di rilevamento);
2) preparazione (weaponization o targeting: con il primo termine si intende la modifica di un file altrimenti innocuo, come un documento, allo scopo di consentire ulteriori azioni dell’avversario, mentre con targeting si intende il processo di analisi e definizione delle priorità degli obiettivi e di abbinamento di azioni letali e non letali a tali obiettivi per ottenere gli effetti desiderati);
3) intrusione cyber (delivery; exploit; install o modify: la consegna ha a che fare con un’interazione dell’avversario con la rete da attaccare; l’exploit è il vettore utilizzato per eseguire azioni dannose; l’installazione di una funzionalità dell’attore malevolo o la modifica di funzionalità esistenti del difensore costituiscono ulteriori possibili attività dell’attaccante);
4) gestione e attivazione (command & control – C2: vale a dire l’utilizzo di una connessione di rete tramite una funzionalità precedentemente installata);
5) sostegno, radicamento, sviluppo ed esecuzione (act: comprende moltissime azioni dell’attore malevolo, tra le quali, a solo titolo esemplificativo, la scoperta di nuovi sistemi o dati, il movimento laterale all’interno della rete, l’installazione e l’esecuzione di funzionalità aggiuntive, l’avvio di tali funzionalità, la cattura delle comunicazioni trasmesse come le credenziali degli utenti, la raccolta delle informazioni desiderate, l’esfiltrazione di tali dati e le tecniche anti-forensi quali la cancellazione delle tracce lasciate nell’attacco, ecc.).
Figura 4. The Industrial Control System Cyber Kill Chain Fonte: Assante & Lee 2015:2,8
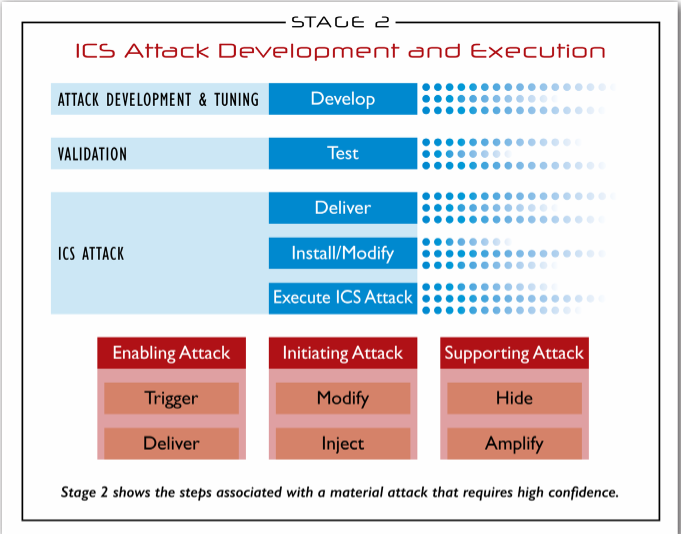
La Fase 1 può essere considerata completata quando l’aggressore è riuscito a compromettere la sicurezza di un ICS/OT ed è in grado di passare alla Fase 2. È in questa fase, dunque, che l’attaccante deve utilizzare le conoscenze acquisite nella prima fase per sviluppare e testare in modo specifico una sua funzionalità in grado di attaccare in modo significativo l’ICS/OT.
La Fase 2 è caratterizzata dalle seguenti attività:
1) sviluppo e messa a punto dell’attacco (develop: l’attore malevolo sviluppa una nuova funzionalità su misura per colpire una specifica implementazione ICS/OT. Questo sviluppo avverrà molto probabilmente mediante l’esfiltrazione dei dati)
2) validazione (test: l’attaccante deve testare la sua funzionalità su sistemi simili o configurati allo stesso modo, se vuole che la funzionalità abbia un impatto significativo e affidabile)
3) attacco (delivery; install /modify; execute: l’ultima fase è l’aggressione in cui l’avversario porta la funzionalità nel sistema, la installa o modifica la funzionalità del sistema esistente e poi esegue l’attacco, che a sua volta può avere molte sfaccettature – es. attacchi preparatori o concomitanti – che non è possibile qui dettagliare).
Dalle brevi esemplificazioni sin qui presentate, si evidenzia come i sistemi ICS/OT debbano affrontare sfide di cybersicurezza peculiari, derivanti dalla convergenza degli ambienti di tecnologia operativa (OT) e tecnologia dell’informazione (IT). In questo contesto la Cyber Threat Intelligence (CTI) svolge un ruolo fondamentale, consentendo alle imprese di rilevare e contrastare in modo proattivo le minacce emergenti, le vulnerabilità e le campagne di attacco; le aziende possono rafforzare, pertanto, le proprie capacità di risposta agli incidenti informatici, provvedere alla mitigazione proattiva dei potenziali rischi, migliorare le strategie di gestione del rischio e promuovere una cultura proattiva della sicurezza. Una CTI specifica per i sistemi ICS/OT enfatizza, infatti, la fornitura di informazioni tempestive e utilizzabili consentendo alle società di identificare le minacce emergenti, le vulnerabilità zero-day e le campagne di attacco in corso, anche mediante l’utilizzo del modello ICS Cyber Kill Chain.
Conclusioni
Da sempre, i sistemi ICS/OT sono soggetti a costanti minacce generate da attori malevoli. Questi utilizzano molteplici vettori per sferrare un attacco informatico. In questo contesto, anche le continue innovazioni tecnologiche non possono non rappresentare degli emergenti vettori di attacco da un lato ma, dall’altro, anche degli indispensabili ausili da utilizzare per la difesa proattiva: «The large-scale use of newer technologies – such as 5G cellular networks, artificial intelligence, pervasive machine-to-machine communications, and advanced data analytics – both advantages and additional uncertainties and may significantly change the ICS risk landscape» (CISA 2020:ii).
Ciò impone una stretta collaborazione con i fornitori di tecnologia – non solo ICS/OT – per sviluppare, incentivare e condividere tecnologie innovative nel campo della cybersecurity che potranno ridurre le barriere di implementazione nelle infrastrutture critiche, in primis l’utilizzo dell’intelligenza artificiale. Sempre in ottica proattiva e predittiva, bisognerà anche migliorare la qualità e la fedeltà dei big dati raccolti, i quali consentiranno di avere prodotti analitici di alta qualità e orientati all’azione quotidiana.
In conclusione, come si è cercato di mettere in evidenza in questo breve testo, con l’evoluzione dei nuovi framework di attacco, dei dispositivi legacy, delle opzioni tecnologiche e dei vincoli di risorse, la sfida più grande per la sicurezza delle tecnologie e dei processi dei sistemi ICS/OT è l’integrazione della tecnologia legacy e obsoleta con i moderni sistemi IT. Ciò implica una maggiore consapevolezza di questa situazione, la quale si deve riflettere nella messa a punto di una serie di policy aziendali e, in generale, tale awareness deve assurgere alla massima priorità dei vertici societari. Entro tale panorama la condivisione delle informazioni sulle minacce principali, grazie alla Cyber Threat Intelligence, così come le strategie innovative basate sull’intelligenza artificiale, potrebbero essere implementate anche nelle organizzazioni nazionali, prevedendo un maggiore sviluppo del partenariato pubblico-privato e anche una migliore osmosi tra agenzie nazionali e infrastrutture critiche.
Riferimenti bibliografici
Akademie der Technikwissenschaften (ACATECH) (2013), Recommendations for implementing the strategic initiative Industrie 4.0. Securing the future of German manufacturing, Acatech Report
Assante M. J., Lee R. M. (2015), The Industrial Control System Cyber Kill Chain, SANS Institute, October, pp. 24 <https://na-production.s3.amazonaws.com/documents/industrial-control-system-cyber-kill-chain-36297.pdf>
biden administration (2021), Improving the Nation’s Cybersecurity, Executive Order (EO) 14028 of May 12, <https://www.whitehouse.gov/briefing-room/presidential-actions/2021/05/12/executive-order-on-improving-the-nations-cybersecurity/>
Brynjolfsson E., McAfee A. (2011), Race Against the Machine. How the Digital Revolution is Accelerating Innovation, Driving Productivity, and Irreversibly Transforming Employment and the Economy, Lexington (MA), Digital Frontier Press
Cybersecurity and Infrastructure Security Agency (cisa) (2020), Securing Industrial Control systems. A Unified Initiative FY 2019-2023, Arlington (VA), Cybersecurity and Infrastructure Security Agency, July
DarkTrace (2021), Defending Critical Infrastructure Against Ransomware, Cambridge (UK), DarkTrace, pp. 12, <https://www.cisa.gov/sites/default/files/ICSJWG-Archive/QNL_JUN_21/DT_WP_Ransomware_Industrial_Web_Eng_S508C.pdf>
Hahn A. (2016), Cyber-security of SCADA and Other Industrial Control Systems, in Colbert E. J. M & Kott A. (eds.) Cyber-security of SCADA and Other Industrial Control Systems, Fairfax (VA), Springer International, pp. 51-68
Hutchins E. M., Cloppert M. J. Amin R. M. (2011), Intelligence-Driven Computer Network Defense Informed by Analysis of Adversary Campaigns and Intrusion Kill Chains, Bethesda (MD), Lockheed Martin Corporation, pp. 14
Kitchin R. (2014), The Data Revolution. Big Data, Open Data, Data Infrastructures & Their Consequences, London (UK), Sage
Langner R. (2011), Stuxnet. Dissecting a Cyberwarfare Weapon, IEEE Security & Privacy, v. 9, n. 3, pp. 49-51, May-June
Lee J., Bagheri B., Kao H.-A. (2015), A Cyber-Physical Systems architecture for Industry 4.0-based manufacturing systems, Manufacturing Letters, vol. 3, pp. 18-23
Lüders S. (2006), CERN tests reveal security flaws with industrial network devices, The Industrial Ethernet Book 35 (CERN-OPEN-2006-074), pp. 12-23
Mueller P., Yadegari B. (2012), The Stuxnet Worm, University of Arizona, <https://www2.cs.arizona.edu/~collberg/Teaching/466-566/2012/Resources/presentations/topic9-final/report.pdf>
Obama administration (2013), Improving Critical Infrastructure Cybersecurity, Executive Order (EO) 13636 of February 12, Federal Register, v. 78, n. 33, Tuesday, February 19, <https://www.govinfo.gov/content/pkg/FR-2013-02-19/pdf/2013-03915.pdf>
Paliotta A. P. (2018), La web news coverage di Industria 4.0 in Italia e Germania, INAPP Paper, n. 14, pp. 23, dicembre
Paliotta A. P. (2022), Cyberspazio e sicurezza digitale nel lavoro agile emergenziale, in Zucaro R. (a cura di), Verso lo smart working. Un’analisi multidisciplinare di una sperimentazione naturale, INAPP Report 30, pp. 132-147
Stouffer K. A., Falco J. A., Scarfone K. A. (2011), Guide to Industrial Control Systems (ICS) Security – Supervisory Control and Data Acquisition (SCADA) systems, Distributed Control Systems (DCS), and other control system configurations such as Programmable Logic Controllers (PLC), Special Publication (NIST SP) – 800-82, Gaithersburg (MD), National Institute of Standards and Technology
Stouffer K. A., Falco J. A., Scarfone K. A. (2013), Guide to Industrial Control Systems (ICS) Security, Special Publication (NIST SP) – 800-82 Rev 1, Gaithersburg (MD), National Institute of Standards and Technology
Stouffer K. A., Pillitteri V., Abrams M, Hahn A. (2015), Guide to Industrial Control Systems (ICS) Security, Special Publication (NIST SP) – 800-82 Rev 2, Gaithersburg (MD), National Institute of Standards and Technology
Zezulka F., Marcon P., Vesely I., Sajdl O. (2016), Industry 4.0. An Introduction in the phenomenon, International Federation of Automatic Control (IFAC)-PapersOnLine, vol. 49, n. 25, pp. 8-12
Zhong R. Y., Xu X., Klotz E., Newman S. T. (2017), Intelligent Manufacturing in the Context of Industry 4.0. A Review, Engineering, vol. 3, pp. 616-630
Note
[1] Colonial Pipeline trasporta 2,5 milioni di barili al giorno di benzina, gasolio, jet fuel e altri prodotti raffinati attraverso 5.500 miglia (8.850 km) di oleodotti e trasporta il 45% delle forniture di carburante della costa orientale degli Stati Uniti. La società subiva un attacco ransomware da parte di DarkSide la quale aveva iniziato le proprie operazioni di cybercrime a partire dal 10 agosto 2020. Cfr. <https://www.bleepingcomputer.com/news/security/darkside-new-targeted-ransomware-demands-million-dollar-ransoms/>. È da evidenziare che nel comunicato stampa pubblicato su un sito del dark web (8/10/2021) DarkSide spergiurava di non attaccare ospedali, scuole, organizzazioni, nonprofits oppure obiettivi governativi. Il lancio del ransomware avveniva con le seguenti affermazioni: «we are a new product on the market, but that does not mean that we have no experience and we came from nowhere. We received millions of dollars profit by partnering with other well-known cryptolockers. We created DarkSide because we didn’t find the perfect product for us. Now we have it». Tutti i siti riportati in questo articolo sono stati visitati il 27 agosto 2023.
[2] Cfr. Interview with Joseph Weiss, Cyberwar Frontline, Public Broadcasting Service (PBS), March 5, 2003, <http://www.pbs.org/wgbh/pages/frontline/shows/cyberwar/interviews/weiss.html>.
[3]«Stuxnet is a sophisticated worm designed to target only specific Siemens SCADA (industrial control) systems. It makes use of an unprecedented four 0-day vulnerabilities – attacks that make use of a security vulnerability in an application, before the vulnerability is known to the application’s developers. It also uses rootkits – advanced techniques to hide itself from users and anti-malware software – on both Windows and the control computers it targets. It employs two stolen digital certificates to sign its drivers, and its creators needed a large amount of knowledge of its targeted systems. It was discovered in June 2010, but an early version appeared a year earlier. It is widely suspected of targeting Iran’s uranium enrichment program, since it is rather specific about what it attacks, and this matches the Iranian Natanz enrichment plant» (Mueller & Yadegari 2012:1).
[6]«A control system has several unique attributes. Number one, a control system must be absolutely highly reliable. It can’t shut down very often. So, unlike a business system where you can shut it down over the weekend, the system that controls the power plant must have almost 100 percent reliability or some form of backup to maintain the 100 percent reliability. It is extremely important», Interview with Joseph Weiss, cit.
[7] Quando la Colonial Pipeline è stata attaccata nel maggio 2021, la società ha pagato l’equivalente di oltre 4 milioni di dollari in bitcoin poche ore dopo la richiesta di riscatto, anche se circa 2,3 milioni di dollari sono stati successivamente recuperati dalle forze dell’ordine.
[8] «Operational technologies are also increasingly commoditized, prevalent, and used in applications that may be smaller in scale than industrial processes, which further contributes to cybersecurity risk. These applications are growing exponentially and migrating into domains not previously automated or connected to the internet (e.g., automobiles, medical devices, smart buildings and homes, pipelines, aviation). Adding to the ICS risk topography is the deployment of 5G networks, which reduces reliance on traditional network routers, thus limiting the ability of security providers to monitor for and prevent malicious traffic» (CISA 2020:4).
[9] Il Modello Purdue è lo standard per la costruzione di un’architettura di rete ICS/OT che supporta la sicurezza OT separando i livelli della rete. Questa separazione consente di mantenere un flusso gerarchico dei dati tra i vari livelli. Se implementata correttamente, le imprese possono stabilire un “vuoto d’aria” tra i sistemi ICS/OT e i sistemi IT, il quale consente di applicare controlli di accesso efficaci senza ostacolare le operazioni.
[10]«Risk to traditional ICS once predominantly arose from human error and accidents, natural disasters, and acts of physical sabotage. Traditional ICS can have 30-year lifecycles and are purpose-built, stand-alone systems designed for reliability rather than security» (CISA 2020:4).
Articolo a cura di Achille Pierre Paliotta
Profilo Autore
Achille Pierre Paliotta, ricercatore INAPP(ex ISFOL), afferente alla Struttura Lavoro e Professioni. Laureato in Sociologia presso l’Università La Sapienza ha conseguito, nel 2015, il Master in Data Science presso l’Università di Tor Vergata. Sta attualmente frequentando il Master in Sicurezza delle informazioni e informazione strategica presso l’Università La Sapienza. I suoi interessi di ricerca vertono su nuove tecnologie, sicurezza informatica, nuove professioni, contrattazione collettiva, welfare occupazionale, data science, blockchain, open data e deep learning.
Il ruolo del responsabile del trattamento nella gestione della sicurezza dei dati: aspetti contrattuali e pratici
Il contesto normativo
La gestione della digital transformation richiede un approccio differente rispetto al passato, le analisi e le valutazioni dei processi aziendali devono basarsi sulle conoscenze tecniche delle attività che si vogliono eseguire e soprattutto della normativa che disciplina tali attività.
La digitalizzazione dei processi aziendali può essere avviata solo se i soggetti coinvolti gestiscano le risorse informatiche in modo consapevole e responsabile.
In questi ultimi anni il legislatore, sia italiano e sia Europeo, ha seguito con molto interesse l’evoluzione tecnologica. Dal 2016 ad oggi sono entrate in vigore numerose norme che hanno e stanno condizionando l’andamento del mercato e le scelte delle aziende. In particolare, il Regolamento eIDAS, la Direttiva NIS, il GDPR ed il Regolamento IA hanno di fatto disciplinato gli aspetti cruciali del processo di digitalizzazione delle principali attività di business, come ad esempio: l’identità digitale; la conservazione dei documenti informatici; la sottoscrizione dei contratti con una delle firme elettroniche, l’utilizzo della Pec e dei sistemi di recapito.
In questo contesto, sempre più aziende esternalizzano i propri processi lavorativi, affidando a terzi la loro gestione come, ad esempio, nel caso dell’emissione e conservazione della fattura elettronica, dell’utilizzo di software CRM in cloud e della gestione on line dei processi di vendita.
L’esternalizzazione dei processi aziendali comporta inevitabilmente sia il trasferimento di dati personali all’esterno della propria organizzazione e sia l’incarico a soggetti terzi di gestirli per nostro conto.
Esternalizzare il trattamento dei dati, di cosa dobbiamo preoccuparci?
Il GDPR definisce il responsabile del trattamento come quel soggetto che tratta i dati personali per conto del titolare del trattamento. Ciò significa che se un fornitore, tramite i propri servizi, tratta i dati personali del proprio cliente nell’interesse di quest’ultimo e per le finalità e secondo le istruzioni fornite dallo stesso cliente, allora ricopre il ruolo di Responsabile del trattamento[1].
In questo ambito la norma impone al titolare del trattamento di verificare se il soggetto a cui vuole affidare il trattamento dei propri dati personali presenti “…garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento e garantisca la tutela dei diritti dell’interessato.”
L’articolo 28 del GDPR stabilisce un metodo rigoroso per scegliere i fornitori di servizi che, quindi, dovranno essere valutati sia dal punto di vista commerciale e sia per la loro capacità di garantire l’attuazione di misure tecniche e organizzative idonee a garantire che il trattamento sia conforme alla normativa.
La verifica della capacità e conoscenze del fornitore rappresenta il punto di partenza per rendere compliance i trattamenti dei dati affidati a soggetti terzi.
E’ importante, quindi, predisporre degli strumenti, come ad esempio questionari o check-list, che permettano di intervistare il fornitore e raccogliere tutte quelle informazioni necessarie a valutare: le conoscenze specialistiche (ad esempio, le competenze tecniche in materia di misure di sicurezza e procedure per gestire le violazione dei dati), l’affidabilità (il possesso di certificazioni ISO, quali ad esempio la ISO/IEC 27001),e le risorse utilizzate per trattare i dati personali (ad esempio, il coinvolgimento di sub-fornitori).
Nell’ambito di questo processo valutativo anche la reputazione del fornitore sul mercato può essere un fattore pertinente che il titolare del trattamento deve tenere conto.
Devo formalizzare l’accordo con il fornitore?
Sottoscrivere un “Data processing Agreement” è l’altra condizione per rendere l’esternalizzazione del trattamento dei dati personali conforme al GDPR.
Il Titolare del trattamento, concluso il processo preliminare di valutazione, deve stipulare con il fornitore, che svolge il ruolo di responsabile del trattamento, in forma scritta anche in formato elettronico, un contratto o qualsiasi altro atto giuridico.
Il contratto dovrà avere ad oggetto il trattamento dei dati esternalizzati e deve prevedere l’obbligo per il fornitore stesso di rispettare i modi, i tempi e le istruzioni impartite dal titolare del trattamento su come trattare e proteggere i dati personali.
L’importanza di un DPA trova il suo fondamento nella necessità di stabilire in modo chiaro e puntuale i termini e le condizioni di trattamento dei dati personali, nonché i ruoli ed i compiti delle parti coinvolte. Questo accordo serve non solo a definire gli aspetti pratici del trattamento dei dati, ma anche a delineare le responsabilità legali e le procedure in caso di incidenti che coinvolgano i dati personali.
Il contratto stipulato con il responsabile del trattamento rappresenta, nell’ambito del GDPR, uno dei pochi casi in cui la presenza di un valido documento coincida con l’adempimento di un obbligo normativo.
Infatti, laddove, sussista un rapporto tra il titolare ed il responsabile del trattamento, in assenza di un accordo, l’Autorità di Controllo competente (Garante della privacy) potrà infliggere una sanzione amministrativa pecuniaria sia al Titolare sia al Responsabile del trattamento per violazione dell’Articolo 28, paragrafo 3.
Il Garante della privacy, in diversi provvedimenti sanzionatori, ha evidenziato e ribadito come “sia il Titolare sia il Responsabile del trattamento hanno la responsabilità di garantire l’esistenza di un contratto o di un altro atto giuridico che disciplini il trattamento”.[2]
Quali sono gli elementi chiave del Data Processing Agreement?
Il contenuto del DPA è delineato in modo puntuale nel terzo comma dell’articolo 28 del GDPR, che stabilisce i principali aspetti che l’accordo deve disciplinare.
Predisporre un contratto limitandosi a riportare in modo pedissequo quanto specificato dalla norma, vuol dire sottovalutare, o ignorare aspetti concreti che caratterizzano il trattamento dei dati (istruzioni su come trattare i dati o le garanzie di sicurezza) ed esporsi alle sanzioni amministrative e danni alla reputazione.
I provvedimenti sanzionatori adottati dal Garante della Privacy, anche recentemente, dimostrano che ancora oggi, dopo diversi anni dall’entrata in vigore del GDPR, si tende a considerare il DPA come un mero adempimento formale sottovalutando e non rispettando le indicazioni elencate nell’articolo 28 del GDPR.
L’accordo è una componente strategica per la conformità al GDPR, pertanto, è necessario che sia predisposto valutando ed analizzando attentamente e in modo concreto e non formale i rischi specifici legati al trattamento dei dati e le misure di sicurezza tecnico ed organizzative da attuare.
Il Garante, in un recente provvedimento[3], ha sanzionato il Titolare ed il Responsabile del trattamento perché il DPA si limitava a “a riportare pedissequamente le previsioni richieste dall’art. 28, par. 3, del Regolamento”.
Il DPA, quindi, deve essere predisposta in modo da rappresentare in modo chiaro:
1 – Contesto del trattamento:
Il contesto in cui i dati personali verranno trattati è di fondamentale importanza. Ogni DPA deve contenere una chiara definizione: dello scopo del trattamento, della tipologia dei dati trattati e delle categorie di interessati cui si riferiscono i dati. In questo modo viene delineato il perimetro entro il quale il Responsabile effettuerà il trattamento, assicurando così, che tutte le relative attività siano pertinenti e limitate allo scopo concordato.
Pertanto, limitarsi ad un semplice e formale collegamento tra il DPA ed il contratto di servizi potrebbe non essere sufficiente per definire tutti gli aspetti attinenti il trattamento dei dati.
2 – Obblighi di assistere il titolare:
L’accordo deve dettagliare l’obbligo del Responsabile del trattamento di assistere il titolare nel garantire la conformità con i vari requisiti del GDPR. In particolare, il responsabile deve assistere il titolare del trattamento:
nella gestione, ove possibile, delle risposte alle richieste degli interessati nell’ambito dell’esercizio dei diritti riconosciuti dal GDPR;
nel garantire il rispetto degli obblighi sulla sicurezza dei dati personali e sulla eventuale notifica di una violazione dei dati personali all’Autorità di Controllo ed agli interessati.
nella predisposizione della valutazione d’impatto e consultazione preventiva quando sia richiesta dalla norma.
Fornire tutte le informazioni necessarie per dimostrare il rispetto degli obblighi normativi.
Titolare e Responsabile del trattamento devono, quindi, prevedere procedure per gestire in modo efficace tutti questi aspetti ed in particolare modo per gestire eventuali violazioni dei dati personali senza ingiustificato ritardo.
3 – Obbligo di garantire la sicurezza e la riservatezza:
Un altro aspetto cruciale dell’esternalizzazione del trattamento dei dati personali riguarda l’adozione delle misure di sicurezza tecnico organizzative.
Ricordo che il GDPR attribuisce al titolare del trattamento la responsabilità, per qualsiasi trattamento di dati personali effettuato direttamente, o tramite altri che abbiano eseguito attività per suo conto, di adottare misure tecniche e organizzative adeguate, affinché il trattamento sia conforme alla disciplina in materia di protezione dei dati personali.
In ragione di questo obbligo, l’accordo deve contenere istruzioni pratiche su come trattare i dati, anche sotto il profilo della sicurezza, nonché l’obbligo per il Responsabile di adottare tutte le misure tecniche e organizzative necessarie per garantire un livello di sicurezza adeguato al rischio (Articolo 32 del GDPR)[4].
Il Titolare, considerato che in ogni caso rimane responsabile dell’attuazione delle misure tecniche e organizzative, anche dopo la stipula del DPA, deve verificare le garanzie offerte dal Responsabile anche mediante attività di revisione degli accordi e ispezioni presso la sua organizzazione. Pertanto, nell’accordo deve essere previsto il diritto del Titolare di effettuare audit e ispezioni per verificare la conformità del responsabile del trattamento con quanto previsto nel DPA. Questo aspetto è cruciale per fornire trasparenza e garantire che le misure di sicurezza siano adeguate e costantemente aggiornate.
4 – Sub responsabili
Il GDPR introduce la facoltà per il Responsabile di trattare i dati personali del titolare tramite un altro responsabile che, anche se non previsto dalla norma, comunemente prende il nome di Sub-responsabile.
Il DPA deve chiarire le modalità e le condizioni con cui il Responsabile può avvalersi di altri sub-responsabili. In particolare, il Titolare deve decidere se attribuire al fornitore una autorizzazione generale ad avvalersi di sub-responsabili, o subordinare questa decisione a singole e specifiche autorizzazioni rilasciate volta per volta.
La possibilità di creare nell’ambito del trattamento una filiera di soggetti determina di fatto un rapporto gerarchico tra tutti i soggetti coinvolti con la conseguenza che il Titolare impartisce delle istruzioni al Responsabile, il quale impartisce a sua volta istruzioni, nella misura in cui esse non siano incompatibili con quelle ricevute dal Titolare, al sub responsabile.
5- Durata del trattamento
La determinazione della durata del trattamento dei dati o il criterio per determinarla nonché e la gestione delle azioni post-scadenza sono aspetti critici per assicurare una gestione dei dati personale in modo conforme (privacy by design).
Il trattamento dei dati, tranne qualche eccezione espressamente previste dalla norma, deve essere limitato al tempo necessario per realizzare gli scopi per cui sono stati nascosti.
Definire la conclusione del trattamento e la conseguente cancellazione dei dati è anche un modo per attuare una strategia proattiva per mitigare i rischi, rafforzare la fiducia con gli interessati (la durata deve essere inserita nell’informativa privacy), e ottimizzare l’uso delle risorse.
Nel DPA, quindi, è importante definire sia la durata dell’accordo e le azioni da attuare post scadenza (restituzione o cancellazione dei dati) e sia la durata del trattamento durante la validità dell’accordo. Infatti, può succedere che durante la validità dell’accordo, venga raggiunto lo scopo del trattamento (ad esempio scadenza del termine legale di conservazione delle fatture elettroniche) o cessi la base giuridica (ad esempio revoca del consenso) i dati debbano essere cancellati e non trattati. Il titolare del trattamento, nonostante non sia espressamente previsto nell’art. 28, per queste casistiche deve prevedere e fornire al responsabile delle istruzioni sui tempi e le modalità di cancellazione o restituzione dei dati personali.
Conclusione
Nell’ambito di un modello organizzativo privacy definire ruoli e responsabilità di tutti i soggetti coinvolti nel trattamento dei dati personali è essenziale sia per rispettare i diritti degli interessati e sia per evitare danni provocati da sanzioni amministrativi, o danni di immagine.
Esternalizzare i processi aziendali solleva questioni giuridiche e tecniche importanti per la tutela dei dati personali. Valutare le capacità professionali e operative di un fornitore di servizi dev’essere un’attività non solo formale, ma soprattutto concreta.
Il titolare deve accertare in concreto se il fornitore che ricopre il ruolo di Responsabile del trattamento offra quelle garanzie e competenze necessarie per supportarlo nel processo di tutela dei dati personali.
I Provvedimenti del Garante sopra richiamati confermano che l’accordo tra Titolare e Responsabile, in cui vengono specificate pratiche operative efficaci, obblighi e responsabilità, permette di formalizzare e attuare una gestione responsabile della sicurezza dei dati personali garantendo così la conformità alla normativa, ma anche e soprattutto rafforzando la trasparenza e la fiducia con gli interessati.
Note
[1] Linee guida 07/2020 sui concetti di titolare del trattamento e di responsabile del trattamento ai sensi del GDPR Versione 2.0 Adottate il 7 luglio 2021
[4] Provvedimento del 17 settembre 2020 [9461168] – Ordinanza di ingiunzione – 11 febbraio 2021 [9562852]
Articolo a cura di Andrea Battistella
Profilo Autore
Avvocato cassazionista, DPO, Digital Transformation Advisor, titolare dello Studio Legale Battistella (www.battistella.legal). Nell’arco di quindici anni di attività ha maturato una profonda expertise negli aspetti giuridici connessi ai temi legali del data protection, della digitalizzazione dei processi aziendali, con particolare riferimento alla gestione del ciclo di vita del valore legale del documento informatico ed alla gestione delle attività di e-commerce. Relatore in workshop ed eventi formativi, nonché autore di articoli e pubblicazioni. sui temi relativi alla firma digitale e data protection. Presidente dell’associazione culturale Centro Studi Informatica Giuridica (CSIG) di Pescara e socio fondatore dell’Associazione Prodigitale, associazioni che promuovono la diffusione della cultura digitale in campo giuridico ed economico.
Sicurezza aziendale: geopolitica e intelligence a supporto del ciclo attivo e passivo nella definizione di un’analisi di risk management
Partendo da una visione complessiva che vede l’intelligence inserirsi perfettamente all’interno dei processi decisionali aziendali – e perciò declinabile come metodologia generale che trova una sua naturale collocazione tra le varie fasi di tali processi – anche l’elemento geopolitico assume una rilevanza strategica di prim’ordine e concorre pienamente a supportare lo sviluppo di un percorso di selezione delle informazioni, di un processo di analisi e di un processo decisionale propri del ciclo dell’intelligence.
In un contesto globalizzato dove le aziende operano e si confrontano con competitor internazionali, soprattutto le dinamiche geopolitiche rappresentano una delle variabili che maggiormente determina il successo o l’insuccesso del business, oltre che la sua sicurezza. Tali dinamiche sono a loro volta caratterizzate da elementi geografici che nel loro insieme condizionano le scelte degli Stati e, a cascata, coinvolgono persone e società che in questi scenari sono attori non secondari. Volendo scomodare Jared Diamond e quanto scrisse a fine anni ’90 nel suo “Armi, acciaio e malattie. Breve storia del mondo negli ultimi tredicimila anni”, tutte le attività umane che hanno forgiato la storia sono state rese possibili dalla geografia e dall’ecologia, dando dei vantaggi ad alcuni popoli rispetto ad altri; più in generale la geografia non solo le ha rese possibili ma soprattutto le ha condizionate, decidendo i destini dei popoli.
Conclusa questa prima parte introduttiva sulla geografia – dove abbiamo descritto l’effetto deterministico del terreno nel rapporto uomo/territorio – e venendo a una definizione generale di geopolitica, possiamo prendere a modello quella presentata dall’enciclopedia online Treccani, dove essa viene descritta come “il complesso di problemi politici che traggono origine da fatti d’ordine territoriale, specie quando si consideri lo Stato come un organismo che nasce, si sviluppa e decade, e che, al pari degli esseri viventi, ha bisogno di uno spazio vitale”. Secondo questa definizione, la geopolitica è una disciplina che connette l’elemento geografico all’evoluzione delle scelte politiche di uno Stato, che necessariamente influiscono, a vari livelli, sull’agire dei diversi soggetti che operano soprattutto in contesti globali. Soggetti che, come le aziende, escono dai confini degli Stati nei quali hanno sede o sono comunque fortemente condizionati da eventi extra nazionali; i quali, solo a una prima analisi alquanto superficiale, sembrano riguardarle in parte. Lo studio e la comprensione dei fenomeni geopolitici diventa perciò un metodo fondamentale per le aziende per orientarsi nel mondo, comprendendo e anticipando le conseguenze dei comportamenti politici che hanno effetti sulle loro attività, sia a livello macro che a livello più circoscritto. La geopolitica va quindi ascritta tra gli strumenti di analisi che possiamo ritrovare all’interno del bagaglio metodologico che è proprio dell’intelligence, uno strumento che ne affina ulteriormente le capacità previsionali riducendo, per quanto possibile, quel grado di incertezza (e di rischio!) che pur sempre le organizzazioni devono affrontare nella loro quotidianità operativa.
Ma in che termini la geopolitica può influenzare il business e i rischi connessi? Per rispondere possiamo partire prendendo in considerazione i due estremi di un’organizzazione aziendale, ovvero il ciclo attivo e il ciclo passivo. Infatti, nella definizione delle strategie aziendali legate alla parte delle vendite (ciclo attivo) e a quella degli approvvigionamenti (ciclo passivo), l’elemento geopolitico diventa determinante per definire delle strategie di business e valutarne una parte dei rischi, all’interno di quello che abbiamo definito il ciclo di intelligence aziendale, al fine di ridurre al minimo gli effetti negativi di fattori esogeni. Infatti l’uso stesso delle mappe, caratteristica propria della geopolitica, contribuisce solo in parte a spiegare e ad anticipare gli eventi che portano a dei cambiamenti nei rapporti tra gli attori statuali. Questo processo analitico, con una buona approssimazione, ci permette di fotografare gli interessi delle comunità quando queste si muovono all’interno di un territorio finito e, conseguentemente, ci aiuta a comprendere l’intersecarsi degli interessi dei popoli con quelli dei loro vicini (relazione territorio/uomo), necessitando però di un maggior approfondimento analitico.
A livello aziendale, entrando nell’ambito della business intelligence (organizzazione interna del lavoro, quindi ciclo passivo) e della competitive intelligence (analisi per il ciclo attivo), lo studio dell’evolversi dei rapporti uomo/territorio sopra descritti può sostenere solo una parte del processo decisionale, agendo però sulla base di valutazioni fatte con metodo scientifico. La geopolitica assume perciò un ruolo determinante ai fini di una evoluzione integrata del concetto stesso di intelligence economica, diventando in ultima analisi uno strumento (non l’unico ovviamente) di valutazione degli eventi comuni, sia per gli Stati che per le aziende. In questi termini, con un approccio di insieme molto più simile e complementare nell’elaborare la comprensione dei rischi e delle opportunità, entrambe le entità possono muoversi con una condivisione di obiettivi maggiore, e quindi indirizzarsi verso quello che possiamo definire il “sistema Paese”. Una geopolitica che contribuisce significativamente alla fase in cui si vede Stato e aziende “fare sistema”, poiché pone le basi per un metodo di analisi condiviso, accomunando di conseguenza entrambi nella medesima percezione di quelli che sono gli interessi per la propria sopravvivenza.
Entrando maggiormente in dettaglio circa gli effetti che gli eventi geopolitici producono sulle aziende, si rende necessaria l’esigenza di attingere al bagaglio delle esperienze, abbandonando per un attimo quello legato alla teoria geopolitica. In questi termini possiamo facilmente calarci nella contemporaneità, prendendo ad esempio gli eventi (attuali per chi scrive) che stanno condizionando il biennio 2022/2023 e che condizioneranno per molti anni gli equilibri tra Stati, imponendo anche alle aziende un cambiamento epocale nel modo stesso di fare business. Laddove vediamo una geopolitica essere il punto di incontro tra la storia, la geografia (territorio e risorse) e la strategia (intesa come volontà e relativo piano di azione per raggiungere degli obiettivi), ecco che la guerra in Ucraina, stravolgendo questi elementi, assume per le aziende il significato di un cambiamento geopolitico epocale che condizionerà la loro stessa esistenza, al pari di altri eventi chiave che hanno segnato le prime due decadi del XXI secolo, se non con un impatto ancora maggiore.
LA GEOPOLITICA A SUPPORTO DEL RISK MANAGEMENT
Ma in che misura le aziende possono difendersi per ridurre al minimo gli effetti di situazioni di questa natura? Esistono delle prassi che possono supportare le organizzazioni nella tutela del ciclo attivo e di quello passivo?
Una risposta a questa domanda potrebbe prendere forma partendo da una analisi di risk management aziendale “arricchita” con elementi di analisi geopolitica, utili per meglio comprendere i rischi ai quali le aziende vanno incontro. Partendo da uno schema classico di risk management, come prima cosa identifichiamo subito la necessità di strutturare tutte le nostre argomentazioni ponendoci come obiettivo l’inserimento dei sopra citati elementi di analisi in ogni fase che caratterizza il processo di gestione del rischio e di tutte le relative sottocategorie. Fatte queste considerazioni, lo schema generale dovrebbe assumere i seguenti connotati:
FASE 1
Identificazione del rischio:
Categoria
Processo/aspetto
Evento potenziale
Potenziali cause
Valutazione dell’impatto dell’evento (danni).
FASE 2
Risk assessment:
Analisi del rischio inerente (rischio intrinseco) – Probabilità del rischio – Impatto – Risk rating (matrice rischio)
Control assessment (controllo attuale/situazione esistente/azioni in essere)
Analisi del rischio residuo – Probabilità del rischio – Impatto – Risk rating (definizione delle priorità).
FASE 3
Trattamento del rischio:
Opzione trattamento
Piano d’azione
Riferimento/piano obiettivi
Responsabile dell’attività
Scadenza/Deadline.
FASE 4
Monitoraggio e riesame del rischio:
Individuazione/Scelta dei metodi di monitoraggio/revisione
Registrazione del progresso e conformità
Stato
Valutazione dell’efficacia ed eventuali note.
Fase 1. Nella parte di identificazione del rischio, limitatamente ai cicli attivo/passivo come da premessa iniziale, possiamo individuare le categorie business per la parte commerciale (ciclo attivo) e la categoria business continuity per la parte approvvigionamenti (ciclo passivo). Circa l’indicazione dell’evento potenziale, quindi il rischio, volendo distinguere i due cicli possiamo far emergere una serie di rischi comuni ad entrambi e altri specifici per l’uno o l’altro ciclo.
Già in questa prima fase la geopolitica ci viene in aiuto, dando modo di identificare anche rischi che un’analisi meno attenta avrebbe tralasciato.
Nello specifico, prendendo ad esempio un’azienda manifatturiera, la geopolitica perde il suo valore determinativo (quello che genericamente viene chiamato “rischio geopolitico”) per assumere invece un valore esplicativo, contribuendo perciò alla definizione stessa dei rischi in base a valutazioni che si basano sull’analisi geopolitica degli eventi passati, di quelli attuali e di quelli potenzialmente verificabili. Per le aziende del comparto OT/IT, dove il fattore tempo ha maggiore rilevanza rispetto ad altri settori per quanto riguarda l’evoluzione tecnologica, il contributo della geopolitica assume un ruolo se vogliamo ancor maggiore in termini di supporto alle analisi. Alla luce di ciò, la suddivisione in cicli si delinea quindi nel modo seguente:
Rischi afferenti il ciclo attivo (es. cliente o distributore): rischio paese (stabilità politica), rischio esposizione finanziaria, rischio tasso cambio valuta (se contratto non in Euro o Dollari), rischio indiretto su tasso di cambio (importatore costretto a interrompere il rapporto causa svalutazione della moneta nazionale), rischio interruzione flussi finanziari che alimentano la commessa/produzione (costi iniziali commerciali, amministrativi e di progettazione, poi per impegno risorse per acquisto materiali, soprattutto se lavorazione su commessa: elevato livello di customizzazione del prodotto che riduce la capacità di virare un prodotto da un cliente ad un altro), rischio domanda variabile, rischio concorrenza, rischio introduzione nuova tecnologia, rischi legali, rischio regolamenti più restrittivi, rischio trasporti, rischio aumento costi (materie prime, logistica, energia), rischi IT e sicurezza informatica, rischi obsolescenza tecnologica (soprattutto OT/IT), rischi legati alla sicurezza del personale in loco (installatori se parliamo di ordini a commessa – travel security), rischio terrorismo, rischio catastrofi naturali, rischio pandemie e rischi politici generali (che amplificano i rischi precedenti).
Rischi afferenti il ciclo passivo (es. fornitore): rischio paese (stabilità politica), rischio esposizione finanziaria, rischio tasso cambio valuta (se contratto non in Euro o Dollari), rischio indiretto su tasso di cambio (fornitore costretto ad interrompere il rapporto causa svalutazione della moneta nazionale), rischi qualitativi sul prodotto (soprattutto in presenza di scarsa automazione e di un mercato del lavoro dinamico che crea una potenziale perdita frequente di personale qualificato in attività a scarso valore di automazione), rischio interruzione della catena di fornitura (interruzione della catena produttiva, anche subfornitori), rischi legali, rischio regolamenti più restrittivi, rischio trasporti, rischio aumento costi (materie prime, logistica, energia), rischi IT e sicurezza informatica, rischi obsolescenza tecnologica (soprattutto OT/IT nella supply chain), rischio terrorismo, rischio catastrofi naturali, rischio pandemie, rischi politici generali (che amplificano i rischi precedenti). Sempre nella fase 1, una volta individuato il rischio, il risk management prevede un successivo passaggio che porta all’individuazione delle potenziali cause del rischio. In questa fase l’analisi geopolitica permette di scandagliare in maniera più approfondita i vari elementi che determinano o meno il verificarsi di un dato evento. A conclusione della prima fase, il successivo passaggio è rappresentato dalla valutazione dei principali impatti dell’evento di rischio che va poi ad introdurre la seconda fase: il risk assessment.
Fase 2. Nella parte di risk assessment il primo passaggio operativo è dato dall’analisi del rischio inerente, con relativa identificazione di 3 parametri, di cui il terzo è la risultante dell’interazione dei primi due:
Probabilità
Impatto
Risk rating (matrice rischio scala 1-25)
Il successivo passaggio della fase 2 è rappresentato dal control assessment, ovvero la verifica delle azioni che l’azienda ha posto in essere relativamente alla presa in carico dei rischi individuati (fotografia di come viene trattato il rischio). Il successivo passaggio, l’analisi del rischio residuo, rielabora i parametri di rischio inerente (possibilità, impatto e risk rating) alla luce dell’impatto che tali azioni producono, mitigandone gli effetti. I risultati di questo processo portano alla classificazione di un dato rischio riconducendolo al contesto aziendale che, nel nostro caso, circoscriviamo al ciclo passivo e al ciclo attivo dell’azienda.
Conclusa la seconda fase, con la fase 3 si passa allo step successivo della nostra analisi di risk management: il trattamento del rischio. La prima azione di questo processo è indicata come opzione trattamento, ovvero la valutazione di come procedere nel trattare il rischio residuo risultante del risk assessment, che possiamo così riassumere:
evitare/eliminare;
ridurre;
condividere;
trasferire;
accettare.
Soprattutto con riferimento alle prime 4 opzioni, il passaggio successivo è quello che descrive il piano d’azione eventuale. In tale fase può essere associata un’attività di miglioramento che, ove richiesta, si pone l’obiettivo di implementare la gestione del rischio residuo e di ridurne ulteriormente gli effetti negativi sul business. Nella fase 3 vengono anche individuati dei referenti interni dei piani d’azione e definita una timeline per la loro esecuzione.
Un ultimo passaggio – la fase 4 dello schema proposto sopra – riguarda la fase di monitoraggio e riesame del rischio e rappresenta in un certo senso la fase più delicata del risk management. Vista la dinamicità degli eventi esterni, è proprio in questa fase che la geopolitica entra nuovamente in gioco, in quanto rappresenta lo strumento di analisi che meglio si adatta al mutare di questi. Infatti, un’analisi geopolitica mirata ha la capacità di comprendere la dinamicità degli eventi esterni e di contribuire a ridurne gli effetti negativi, supportando una corretta gestione del rischio nella fase di monitoraggio.
LA GEOPOLITICA A SUPPORTO DEL RISK MANAGEMENT
A conclusione di questa breve descrizione del risk management, viene ora da chiedersi in che modo l’analisi geopolitica può essere utile per sostenere le attività di una azienda, diventando quindi strumento indispensabile all’interno del ciclo di intelligence aziendale. Anche in questo caso è necessario ricorrere al piano dell’esperienza, descrivendo in breve quelle che possono essere delle situazioni tipo.
Con riferimento alla guerra russo-ucraina, se facessimo un passo indietro rispetto alla data di inizio delle ostilità, con l’invasione russa ai danni dell’Ucraina del 24 febbraio 2022 (quindi il periodo a cavallo tra la fine del 2021 e l’inizio del 2022), possiamo ritenere che allora fosse possibile ipotizzare l’inizio di un conflitto armato? Ovvero: riferendoci sempre all’ambito di ciclo attivo e passivo, un’azienda con delle attività in territorio ucraino o in quello russo (o in entrambi), nel periodo antecedente l’inizio della guerra possedeva degli elementi validi per poter valutare il rischio inerente, il rischio residuo, ma soprattutto avviare una fase di monitoraggio e riesame del rischio, se già operativi in quell’area?
La risposta a questa domanda si può individuare soprattutto partendo dalla fase 4 di monitoraggio e riesame del rischio. Infatti gli eventi del periodo preso in considerazione potevano sicuramente rientrare nell’ambito della fase 2, limitatamente alla valutazione del rischio inerente (ad esempio il “rischio paese” generico) e del rischio residuo (“che effetti avrebbe sulla mia attività?”) anche senza dover ricorrere ad un’approfondita analisi geopolitica. Al contrario, nel caso del monitoraggio e riesame del rischio (fase 4), una simile analisi si sarebbe resa necessaria per sviluppare un corretto risk assessment che tenesse conto dell’evolversi della situazione. A sostegno di questa tesi si potrebbe portare ad esempio un tipico caso di azienda manifatturiera chiamata a realizzare un impianto “chiavi in mano”. Nel monitoraggio costante del rischio, l’analisi geopolitica può assumere una valenza importante per aiutare il management aziendale nella gestione del progetto e anche a definire un’eventuale exit strategy che possa limitare al minimo gli effetti di un rischio imminente (soprattutto se già presenti sul territorio con attività in fase di avanzamento). Se volessimo prendere in esame il rischio di interruzione dei flussi finanziari, partendo dal fatto che l’esecuzione di un progetto chiavi in mano per la fornitura di impianti prevede degli stati di avanzamento, anche per la parte relativa ai pagamenti si deve considerare che una struttura-tipo di contratto disciplina diversi passaggi. Un caso tipico è quello che prevede, ad esempio, il pagamento del 10% alla firma del contratto, un ulteriore 20% all’approvazione progetto, un 60% al FAT (Factory Assembling Test) e infine un 10% al SAT (Site Assembling Test). Indipendentemente dal tipo di copertura finanziaria (L/C, garanzia bancaria o assicurazione del credito, solo per citarne alcune), l’azienda che realizza il progetto si assume comunque numerosi rischi – approvvigionarsi dei materiali, impegnare risorse umane, progettare ed eseguire degli impianti (con un elevato livello di customizzazione, perciò non facilmente rivendibili ad altri soggetti in caso di interruzione del rapporto con il cliente), condividere know-how tecnico – per i quali è previsto il pagamento solo al completamento dell’attività.
In uno scenario simile, la fase di realizzazione degli impianti risulta essere quella a più alto tasso di rischio, essendo la più onerosa in termini di investimento per chi produce: si acquistano i materiali, si entra in fase di esecuzione e realizzazione degli impianti e ci si prepara per i FAT. Nell’ipotesi in cui dovesse saltare il collaudo finale l’azienda si troverebbe in uno scenario di:
esposizione finanziaria verso fornitori (ed esposizione interne legata al costo sostenuto per finanziare l’attività svolta dei propri dipendenti)
interruzione dei flussi finanziari (mancato incasso dell’attività svolta).
Nel contesto della guerra in Ucraina, pur trovandoci in un caso di forza maggiore solitamente previsto nelle clausole dei contratti, un evento geopolitico di questa portata ha un tale impatto che solo una valutazione sostenuta da competenze geopolitiche avrebbe potuto ridurne gli effetti. Infatti, con l’evolversi dello scenario di crisi a fine 2021, un’azienda coinvolta in quel mercato (o anche in quello russo, considerando le possibili sanzioni in risposta a una potenziale invasione) avrebbe potuto gestire il rischio con un certo anticipo rispetto all’inizio del conflitto, se sostenuta da una puntuale analisi geopolitica. Agendo sul monitoraggio e riesame del rischio (fase 4 del processo di risk management), se si fosse ritenuto il rischio come “molto alto” nella scala di rating (impatto “catastrofico”, probabilità “quasi certa”) già a partire da fine 2021, i mesi antecedenti all’inizio delle ostilità sarebbero serviti per cercare di completare un eventuale stato di avanzamento in corso; oppure per interrompere l’attività prima di iniziarne uno nuovo, mettendo in sicurezza le proprie risorse finanziarie. Specificatamente nel settore OT/IT – soprattutto se riferito al ciclo passivo e ai rischi connessi all’obsolescenza tecnologica nella supply chain – avere un fornitore strategico in un’area caratterizzata da una situazione simile a quella del territorio ucraino di fine 2021 (con l’aggravante del fattore tempo connesso all’evoluzione tecnologica specifica di questo settore) avrebbe richiesto una capacità di analisi più attenta rispetto ad altri settori e, quindi, un ricorso ancora maggiore all’analisi geopolitica nella fase di monitoraggio del rischio.
In conclusione – osservando come le aziende operino in un contesto di globalizzazione, inserite perciò in un processo di interdipendenze economiche, sociali, culturali, politiche e tecnologiche i cui effetti hanno una rilevanza planetaria – dalle valutazioni appena esposte emerge la necessità di acquisire maggiori competenze geopolitiche all’interno delle aziende stesse. In questi termini l’analisi geopolitica si inserisce nel processo decisionale, non solo a supporto del ciclo di intelligence ma anche contribuendo al monitoraggio e al riesame dei rischi nel risk management aziendale: così delineandosi quale strumento indispensabile per valutare con metodo scientifico il continuo mutare delle condizioni in cui le aziende si trovino a operare.
Articolo a cura di Massimiliano Alzetta
Profilo Autore
Massimiliano Alzetta svolge la funzione di Sales e Marketing Director presso Lamitex S.p.A, azienda attiva nel settore dell’interior design. Precedentemente è stato Vice Sales Director di Maddalena S.p.A. Laureato in Relazioni Internazionali e successivamente in Politica Internazionale e Diplomazia con lode presso l’Università degli Studi di Padova, ha concluso un corso di perfezionamento in Intelligence e sicurezza nazionale presso l’Università degli Studi di Firenze e conseguito un master in Intelligence & ICT con lode presso l’Università degli Studi di Udine. Da sempre attento al mondo dell’intelligence, soprattutto in ambito aziendale, fa parte della SOCINT sin dagli inizi ed è membro della Commissione CTI e Cyber Warfare.
Tecniche di acquisizione delle evidenze digitali: copia bit a bit e funzione di hash
Procedendo secondo una linea cronologica, esaurite le operazioni del sopralluogo giudiziario – ovvero una volta individuate, identificate e raccolte le evidenze digitali – si apre la fase dell’acquisizione del materiale informatico rinvenuto e giudicato di interesse ai fini processuali.
L’acquisizione della evidenza digitale, che insieme ai passaggi della catena di custodia del dato acquisito rappresenta il momento di maggiore criticità del processo di digital forensics, può essere definita come il momento afferente alla fase di indagine dove viene eseguita l’esfiltrazione controllata della digital evidence dal sistema informatico perquisito/ispezionato e/o sottoposto a sequestro ai fini del suo trasferimento su altro supporto, mediante particolari tecniche di copiatura e con l’utilizzo di strumentazioni tali da garantirne la completa integrità e genuinità.
Si è già accennato, trattando di sopralluogo giudiziario, agli accorgimenti operativi da adottare in caso di rinvenimento di dispositivi attivi, per i quali si dovrà ricorrere alla live forensics analysis e, in caso di rinvenimento di dispositivi spenti, sottoponibili ad acquisizione post mortem, nonché della differenza di modalità operative a seconda della natura del dispositivo da analizzare. Quale che sia lo stato di rinvenimento o la tipologia di sistema sul quale si agisce, il risultato delle attività di acquisizione non cambia, sostanziandosi in ogni caso nell’ottenimento della memoria da analizzare sotto forma della c.d. copia forense.
Più propriamente la copia forense, anche detta bit stream image o copia bit a bit, consiste nella copiatura integrale del contenuto digitale della memoria del sistema inquisito, che si esegue, per l’appunto, trascrivendo su un altro dispositivo ogni singolo bit presente al suo interno, compresi gli spazi vuoti tra files e gli elementi cancellati (ma non definitivamente eliminati) dal sistema, o loro frammenti. In buona sostanza, quindi, la copia forense è l’identica riproduzione, in perfetta clonazione, della memoria oggetto di indagine, che materialmente si utilizzerà per l’effettuazione dei successivi passaggi del procedimento di digital forensics.
Se correttamente eseguita e opportunamente documentata, anche mediante videoregistrazione, l’acquisizione in copia forense permette di mantenere intatti i dati contenuti nella memoria di origine, consentendo in un secondo momento di poter valutar e l’attendibilità dei dati estratti, anche al fine di verificare che sia avvenuto correttamente il trasferimento nel dispositivo di destinazione.
Sotto un altro aspetto, l’importanza della bit stream image si riflette poi nella fase di determinazione cronologica degli eventi, in quanto tale metodo di copiatura permette di mantenere inalterati anche i metadati relativi ai file acquisiti (come data e ora di salvataggio), permettendo di ricostruire con precisione la timeline delle operazioni condotte sul dispositivo originale. Ricostruzione cronologica che, tuttavia, potrebbe risultare inesatta in caso di applicazione di tecniche di anti forensics sul dispositivo sorgente atte a complicare o depistare le indagini, come ad esempio l’utilizzo di programmi di crittografia per cifrare i dati o l’attuazione di stratagemmi volti alla precostituzione del c.d. alibi informatico.
Dal punto di vista tecnico, la copia forense si ottiene mediante l’uso di particolari strumenti hardware con funzione di write blocking che, una volta collegati al sistema contenente i dati da acquisire, permettono la duplicazione dei dati in sicurezza all’interno della memoria di destinazione, oppure usando appositi software di estrazione dati installati sul dispositivo che si adopera per la manovra. È chiaro che nel caso in cui detti strumenti siano difettosi o settati non correttamente, la duplicazione potrebbe presentare delle difformità rispetto alla memoria sorgente, con conseguenti problemi in ordine all’attendibilità delle operazioni.
Occorre pertanto che in sede di esecuzione delle operazioni venga specificato con quale strumento si stia procedendo, in modo da poterne verificare – anche a posteriori – l’attendibilità.
Infine, per garantire l’integrità e l’identicità della copia forense e la conformità delle copie che si possono estrarre dalla medesima, è necessario apporvi la firma digitale mediante la c.d. funzione di hash.
Una volta ottenuta la copia forense, infatti, è necessario che la stessa non subisca alterazioni, così da mantenerne l’identicità all’originale. Per garantire tale identicità la copia va, per l’appunto, “firmata” mediante il calcolo della funzione di hash, che offre la possibilità di verificare l’integrità del documento per poterne stabilire la veridicità nelle successive fasi investigative e giudiziali, marchiandolo con un’impronta digitale individualizzante, in grado di dare completa certezza relativamente all’origine del reperto e all’integrità del suo contenuto.
La funzione di hash consiste in un calcolo matematico (o meglio un algoritmo) non invertibile, ossia è che opera in una sola direzione, che applicato al documento ne traduce il contenuto – inteso come testo di lunghezza arbitraria – riducendolo a una stringa di lunghezza fissa. Tale stringa, chiamata valore di hash e anche detta checksum crittografico o message digest, costituisce l’impronta digitale univoca che caratterizza il documento sottoposto al processo di hashing.
La creazione di tale stringa – che più semplicemente è costituita da una serie prefissata di bit frutto della traduzione mediante calcolo di hash del testo originale – permette di verificare che non vi siano state modifiche, anche accidentali, sul dato digitale che si analizza.
Per la verifica è sufficiente paragonare la stringa che si sta esaminando con quella del documento dalla quale è stata estratta copia: se le due stringhe risultano identiche significa che vi è altresì identicità del contenuto digitale sul quale sono state apposte, con conseguente certezza riguardo all’integrità.
Inoltre, la funzione di hash si rivela uno strumento efficace anche in chiave di semplificazione e riduzione temporale. Se infatti è possibile estrarre più copie forensi del dispositivo sorgente mediante bit stream image, è altrettanto vero che la lentezza di questo metodo comporta tempi non indifferenti e non previene il rischio cui la memoria da acquisire resta soggetta, consistente nella possibilità che possa subire alterazioni non volute, così portando alla creazione di copie forensi divergenti tra loro.
La funzione di hash in parte ovvia a queste problematiche, poiché, una volta calcolatone il valore sulla copia, sarà possibile procedere direttamente alla duplicazione della copia medesima, estraendo in buona sostanza ulteriori copie dalla copia. Per verificare la correttezza della copia, infatti, sarà sufficiente leggere in comparazione il valore di hash.
Articolo a cura di Francesco Lazzini
Profilo Autore
Laureato in giurisprudenza con successivo conseguimento dei master in Scienze Forensi (Criminologia-Investigazione-Security-Intelligence) e in Informatica giuridica, nuove tecnologie e diritto dell’informatica. Attività di studio postuniversitario focalizzata in materia di indagini con l’utilizzo del captatore informatico e digital forensics.
ISO/IEC 42001: un sistema di gestione dell’intelligenza artificiale
In un contesto di rapida evoluzione tecnologica, l’Intelligenza Artificiale (IA) si è affermata come una forza trainante nei più diversi settori industriali e operativi.
Nel contesto delineato, lo standard ISO/IEC 42001:2023 assume un’importanza cruciale, offrendo un quadro normativo chiaro e strutturato per l’integrazione responsabile dell’Intelligenza Artificiale all’interno delle organizzazioni. Tale norma stabilisce i requisiti per l’implementazione, la manutenzione e il miglioramento continuo di un sistema di gestione dell’IA, mirando a guidare le organizzazioni nello sviluppo, nell’utilizzo e nel monitoraggio dei sistemi IA in maniera responsabile.
Partendo dalla premessa che l’IA può comportare specifiche considerazioni, come l’utilizzo per la presa di decisioni automatiche talvolta in modo non trasparente o non spiegabile, ISO/IEC 42001 enfatizza la necessità di una gestione specifica che superi quella dei sistemi IT tradizionali. A questo si aggiunge la peculiarità dei sistemi IA che, apprendendo continuamente, modificano il loro comportamento durante l’utilizzo, richiedendo particolare attenzione per assicurare che l’uso responsabile persista nonostante le evoluzioni comportamentali.
Incorporando tali sistemi all’interno delle strutture gestionali esistenti, l’adozione di un sistema di gestione dell’IA secondo lo standard ISO/IEC 42001 rappresenta una decisione strategica per ogni organizzazione, che deve tener conto delle proprie esigenze e obiettivi, delle dimensioni e della struttura, oltre che delle aspettative delle parti interessate; pertanto, attraverso l’applicazione di questo standard, le organizzazioni possono non solo rispondere efficacemente ai rischi associati all’IA ma anche sfruttare le sue potenzialità per innovare e migliorare continuamente le proprie operazioni in modo etico e sostenibile.
L’ISO/IEC 42001 si configura come uno strumento di inestimabile valore per assicurare che l’implementazione dei sistemi di intelligenza artificiale avvenga nel rispetto dei principi di sicurezza, eticità e trasparenza, cruciali soprattutto nei settori più sensibili. In particolare, lo standard delinea specifiche linee guida per la valutazione dei rischi associati all’IA, trattando in modo approfondito i rischi e le opportunità che devono essere considerati per garantire che il sistema di gestione dell’IA possa raggiungere i risultati previsti, prevenire o ridurre effetti indesiderati e perseguire il miglioramento continuo.
Esso inoltre impone che le organizzazioni stabiliscano criteri di rischio AI, supportino valutazioni di rischio coerenti, validi e comparabili e gestiscano il trattamento dei rischi con soluzioni adeguate, evidenziando l’importanza di documentare tutte le azioni intraprese in questo contesto. Fondamentalmente, lo standard richiede che le organizzazioni mantengano una dichiarazione di applicabilità che dettagli i controlli necessari, giustificando le inclusioni e le esclusioni.
La portata dell’ISO/IEC 42001 si estende quindi oltre la mera integrazione tecnologica, offrendo una base per la gestione olistica dell’IA che include la formulazione di politiche AI, la definizione di obiettivi e la pianificazione strategica allineata con la direzione strategica dell’organizzazione. Ciò assicura che l’adozione dell’IA non solo rispetti i requisiti normativi e legali ma si armonizzi anche con gli obiettivi etici e di business dell’entità, promuovendo un ambiente in cui l’innovazione tecnologica proceda di pari passo con la responsabilità sociale e la conformità normativa.
L’armonizzazione dello standard ISO/IEC 42001 con altri standard di gestione internazionali permette un’integrazione fluida e coerente delle pratiche di gestione dell’IA nelle strutture esistenti delle organizzazioni, promuovendo una sinergia tra vari aspetti della gestione aziendale, come la qualità, la sicurezza, la sicurezza informatica e la privacy. Questo approccio non solo facilita l’adozione dello standard stesso da parte delle organizzazioni che già implementano altri sistemi di gestione conformi alle norme ISO, ma rafforza anche l’efficacia delle politiche e delle procedure di gestione dell’IA, assicurando che esse siano allineate con le migliori pratiche e i requisiti legali internazionali.
Lo standard è strutturato per essere applicabile a un’ampia varietà di organizzazioni, indipendentemente dalle loro dimensioni o dal settore di operatività. Esso prevede specifici requisiti per la documentazione, la pianificazione e la valutazione delle performance del sistema di gestione dell’IA, assicurando che ogni aspetto, dal rischio alla conformità e all’innovazione, sia adeguatamente monitorato e gestito.
Implementando l’ISO/IEC 42001, le organizzazioni possono dimostrare concretamente il loro impegno verso una gestione responsabile dell’IA, potenziando la fiducia tra i clienti, i regolatori e le parti interessate, mentre simultaneamente si adattano a un ambiente regolamentato in continua evoluzione. Inoltre, tale standard aiuta le organizzazioni a identificare e sfruttare le opportunità legate all’IA, minimizzando i rischi associati e garantendo che le tecnologie siano usate in modo etico e sostenibile.
L’ISO/IEC 42001 si erge dunque come uno strumento complementare all’AI Act, puntando a fornire un metodo strutturato e standardizzato per l’integrazione delle migliori pratiche di gestione dei rischi e conformità nel settore dell’IA. Questa sinergia tra normativa e standardizzazione facilita le organizzazioni nell’attuazione di soluzioni di intelligenza artificiale che non solo rispettano i requisiti legislativi ma superano le aspettative etiche e di responsabilità sociale.
Il framework offerto dall’ISO/IEC 42001 permette alle organizzazioni di classificare i rischi associati ai sistemi di IA in categorie ben definite, consentendo loro di implementare controlli proporzionati al livello di rischio identificato. In questo modo, le organizzazioni possono garantire che i sistemi di IA siano non solo efficaci e efficienti, ma anche sicuri, trasparenti e giusti, in linea con i principi fondamentali dell’AI Act.
Questa norma aiuta quindi le organizzazioni a:
Identificare e valutare i rischi specifici dell’IA: attraverso processi dettagliati di valutazione del rischio e gestione del trattamento del rischio, come prescritto nello standard.
Implementare controlli efficaci: basati sui requisiti di rischio e i controlli di riferimento forniti nell’annesso della norma.
Monitorare e rivedere continuamente l’efficacia del sistema di gestione dell’IA: assicurando che i sistemi di IA siano soggetti a miglioramenti continui e adattati alle mutevoli esigenze legislative e operative.
Inoltre, l’approccio basato sul rischio promosso dall’ISO/IEC 42001 assicura che le misure adottate siano proporzionate alla natura e alla gravità dei rischi associati alle specifiche applicazioni di IA, facilitando così un equilibrio tra innovazione tecnologica e obblighi normativi. Questo non solo ottimizza le risorse ma rafforza anche la fiducia del pubblico e dei regolatori nelle capacità di gestione del rischio dell’organizzazione.
Lo standard ISO/IEC 42001 pone un accento decisivo sulla trasparenza e “spiegabilità”, elementi fondamentali per garantire che le decisioni adottate o assistite dai sistemi di IA siano comprensibili agli utenti finali. Questo aspetto è essenziale per costruire fiducia e per permettere un controllo efficace delle decisioni automatiche, particolarmente in contesti in cui le implicazioni possono essere significative, come nella sanità o nella gestione finanziaria.
Incoraggiando un utilizzo etico dell’IA, lo standard mira anche a rispettare i diritti umani e ad adempiere alle normative vigenti, rafforzando la necessità di integrare considerazioni etiche fin dalle fasi iniziali della progettazione e dello sviluppo dei sistemi di IA. Questo approccio proattivo aiuta a prevenire problemi legati alla privacy e alla sicurezza dei dati, garantendo che i sistemi di IA operino in modo sicuro e rispettoso della privacy degli individui.
ISO/IEC 42001 fornisce quindi una guida chiara su come le organizzazioni possono strutturare i loro sistemi di gestione dell’IA per affrontare e minimizzare i rischi, promuovendo al contempo un’innovazione responsabile. Questo standard non solo migliora la sicurezza e la fiducia nei sistemi di IA ma contribuisce anche a stabilire una base solida per la crescita sostenibile e etica delle tecnologie emergenti.
L’impegno verso lo standard ISO/IEC 42001 riflette una maturità organizzativa che riconosce l’importanza di integrare principi di responsabilità e sicurezza nell’uso dell’intelligenza artificiale. La guida metodologica offerta dallo standard fornisce un percorso chiaro per le organizzazioni che desiderano assicurare che il loro utilizzo dell’IA sia non solo innovativo ma anche in linea con i valori etici e le normative vigenti.
Il processo di allineamento a questo standard non è solo una misura precauzionale; è un investimento strategico che può differenziare un’organizzazione sul mercato, migliorare la fiducia del cliente e della società civile, e ridurre il rischio legale e operativo. Inoltre, l’approccio strutturato per la gestione dei rischi e la compliance, nonché per il monitoraggio e il miglioramento continuo delle pratiche di IA, si traduce in un ciclo di gestione che perpetua l’innovazione e la crescita sostenibile.
L’integrazione di un modello di governance come quello promosso dall’ISO/IEC 42001 può anche catalizzare ulteriori innovazioni all’interno delle organizzazioni, stimolando lo sviluppo di nuove soluzioni di IA che non solo rispettano i più alti standard di sicurezza e eticità, ma che sono anche progettate per superare le aspettative di tutte le parti interessate, dal cliente finale ai regolatori.
In conclusione, l’adozione di ISO/IEC 42001 rappresenta un passo fondamentale per le organizzazioni che aspirano a posizionarsi come leader nel campo dell’IA responsabile e sostenibile, proiettandole verso un futuro in cui tecnologia e etica si fondono in un unico, armonioso percorso di progresso tecnologico.
Articolo a cura di Francesco Capparelli e Lara Maugeri
Profilo Autore
Avvocato, Certified Ethical Hacker, Auditor di diversi schemi di certificazione (ISO/IEC 27001, ISO 22301, ISO 37001, ISO/IEC 20000-1, ISO 9001) e Project Manager. Chief Cybersecurity Advisor di ICT Cyber Consulting, Quality and Information Security Manager di ICTLC S.p.A., Of Counsel di ICT Legal Consulting, membro del CdA dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati e Senior Fellow Researcher nel framework Horizon Europe. Autore di manuali, pubblicazioni e articoli scientifici sui temi relativi alla data protection e alla sicurezza informatica.
Profilo Autore
Cyber Security Specialist – ICT Cyber Consulting
Laurea Magistrale in Scienze Filosofiche all’Università di Catania. Certificazioni CISCO: IT Support, Cyber Security & Networking.
Attività di sopralluogo giudiziario in caso di indagini su sistemi informatici
L’acquisizione della digital evidence è la fase del processo di digital forensics, successiva all’individuazione dell’evidenza informatica, che mira alla sua estrazione, mediante copiatura, dal supporto elettronico e contestuale trasferimento su altro supporto, in uso agli organi inquirenti, ove l’elemento acquisito viene “cristallizzato” e conservato per essere analizzato ai fini del suo eventuale utilizzo in sede dibattimentale.
Sebbene la fase di acquisizione sia da considerarsi il momento essenziale dell’intero procedimento, essa, cronologicamente, si colloca solo a seguito di una serie di operazioni che rientrano nella più ampia fase del sopralluogo giudiziario sulla scena del crimine[1]. Operazioni dalle quali dipende la corretta riuscita di tutta la fase investigativa e che sono finalizzate all’osservazione della scena criminis (o presunta tale), all’identificazione delle fonti di prova e alla loro successiva raccolta mediante l’applicazione di tecniche e metodologie atte a preservarne la genuinità.
In caso di ritrovamento di strumenti elettronici all’interno del locus commissi delicti, o in generale in caso di indagini su sistemi informatici, tali attività non possono prescindere dalla messa in sicurezza del dispositivo e dalla protezione del suo contenuto digitale in modo da impedirne mutazioni. Attività che inoltre non possono nemmeno prescindere dalla sua analisi esterna e dalla seguente descrizione dello stato di rinvenimento delle componenti hardware[2](ivi comprese, oltre al corpo del dispositivo in sé, anche eventuali periferiche come chiavette usb, hard-disk, etc.), anche mediante fotografia.
Se la descrizione del dispositivo costituisce un’attività intuibilmente semplice – essendo sufficiente annotare il luogo di ritrovo, eventuali segni di usura o di rottura, se spento, acceso o in stand-by etc. – il congelamento dei dati salvati nel dispositivo o nella sua memoria istantanea in talune circostanze potrebbe rivelarsi un’attività delicata e non scevra dal rischio di alterazioni indesiderate, che potrebbero verificarsi anche a seguito delle scelte operative adottate da chi è chiamato ad intervenire.
È appena il caso di precisare che dette scelte variano a seconda del contesto in cui si opera, dei dati che si intende acquisire e delle circostanze che possono presentarsi nel caso concreto (si pensi ad una batteria quasi scarica, ad un computer connesso alla rete Internet, etc.) oppure, infine, variano con riguardo alla tipologia di dispositivo con cui si ha a che fare e sulla scorta del quale cambiano altresì le tecniche di acquisizione.
Deve tenersi conto del fatto, per l’appunto, che le tecniche di digital forensics si differenziano a seconda del supporto informatico oggetto di indagine a causa delle caratteristiche proprie di ciascun sistema: pertanto, se l’indagine riguarda un telefono cellulare, uno smartphone o un tablet occorrerà adottare le tecniche della mobile forensics, nel caso di un PC quelle della computer forensics, o ancora, nel caso in cui l’acquisizione debba avvenire da sito web, la procedura sarà ancora differente dovendosi tenere in considerazione ulteriori variabili, quali ad esempio la possibilità di modifica del sito da parte di altri utenti, che rendono necessaria l’applicazione di un approccio metodologico differente. Le tecniche differiranno anche a seconda del tipo di memoria che contiene le informazioni ritenute di interesse, ponendosi una divergenza operativa tra memorie di massa − come un disco rigido, una pennetta usb o un cd, dvd, floppy disk etc., dove i dati vengono immagazzinati e, in linea generale, restano immutati (c.d. disk forensics) – e memoria RAM, dove la facilità di dispersione dei dati impone attenzioni particolari (c.d. memory forensics)[3].
Ad ogni modo, a prescindere da quale sia il supporto con cui gli investigatori hanno a che fare, esistono alcune precauzioni comuni che si rendono opportune ai fini della salvaguardia delle possibili fonti di prova, una volta che queste siano state riconosciute e identificate come tali.
Prima di tutto occorre verificare se il dispositivo sia in funzione, in stand-by oppure spento. Quest’ultima situazione è quella meno rischiosa, poiché ad apparecchio già spento è molto difficile che si producano modificazioni indesiderate del suo contenuto digitale, che potrà quindi essere estratto anche a distanza di tempo, con l’ovvio accorgimento di assicurarsi che medio tempore non vengano effettuate accensioni che non si dovessero rendere necessarie per circostanze particolari. Le attività di estrazione da dispositivo spento sono denominate operazioni “post-mortem” e, in genere, rientrano nelle c.d. attività ripetibili ex art. 359 c.p.p.
Viceversa, in base allo stesso principio, quando il dispositivo viene rinvenuto acceso o in stand-by e vi sono ragioni per ritenere che le informazioni di interesse possano essere contenute all’interno della memoria temporanea (RAM), per sua natura estremamente volatile e suscettibile alla cancellazione con lo spegnimento, o sussistano altre circostanze peculiari come la non rimovibilità del supporto dal luogo d’installazione, l’estrazione dovrà avvenire direttamente sul sistema in accensione – salvo, in ogni caso, che condizioni impeditive ne impongano la disattivazione[4] – applicando le c.d. tecniche di “live forensics” e «tenendo conto che ogni operazione effettuata sul sistema potrebbe portare all’alterazione dei dati»[5].
L’esecuzione di analisi e acquisizioni di dati in modalità live forensics comporta indubbiamente un maggior rischio rispetto alle attività eseguite post mortem; con l’ulteriore considerazione che le operazioni condotte su dispositivi accesi andrebbero ricomprese, almeno in linea teorica, tra gli atti irripetibili ex art. 360 c.p.p., producendosi giocoforza in tali casi delle modificazioni dello stato originale del contenuto digitale che, di conseguenza, ai fini dell’attendibilità processuale delle evidenze estratte e a garanzia del diritto di difesa, devono essere annotate e descritte adeguatamente.
Tra i primissimi accorgimenti da apprestare quando si agisce su un dispositivo attivo vi è quello di impedirne l’uso da parte di soggetti non autorizzati e porlo in una situazione di isolamento rispetto a possibili interferenze esterne, in modo da prevenire alterazioni da terzi che potrebbero sfruttare un qualche tipo di collegamento con il device, come connessioni internet o bluetooth.
L’isolamento può essere realizzato inserendo il congegno all’interno di una c.d. gabbia di Faraday, cioè un contenitore che non permette la penetrazione di segnali elettromagnetici, oppure mediante l’utilizzo di un jammer, strumento che inibisce (entro il suo raggio d’azione) la capacità degli apparecchi elettronici di emettere o ricevere segnali e onde radio. In caso di impossibilità d’uso di simili strumentazioni una soluzione valida potrebbe essere anche impostare il dispositivo offline attivando la “modalità aereo”, qualora presente tra le funzioni del sistema.
Sempre in sede di sopralluogo giudiziario gli organi inquirenti potrebbero ritenere utile l’espletazione di attività preliminari, anche dette “preview”, volte ad esaminare il contenuto delle apparecchiature rinvenute nel corso di ispezioni o perquisizioni, col fine di valutare se possa effettivamente trattarsi di materiale utile per le indagini oppure di materiale superfluo, potendo così determinarsi di porre sotto sequestro solamente alcuni dispositivi oppure solo le unità di memoria esterna del dispositivo analizzato.[6]
Giunti a questo punto, in estrema sintesi, è possibile affermare che in caso di rinvenimento di dispositivi elettronici durante le fasi del sopralluogo giudiziario, la polizia giudiziaria o gli altri soggetti chiamati a intervenire sono tenuti ad attuare una serie di operazioni volte ad assicurare la buona riuscita delle successive fasi investigative, che si potrebbero schematizzare come segue:
messa in sicurezza del dispositivo, anche mediante isolamento da interferenze esterne e comunque impedendone l’uso da parte di soggetti non autorizzati;
descrizione del dispositivo (anche mediante foto o video), annotazione delle sue particolarità (usura, eventuali componenti rotte, etc.) e stato di rinvenimento (se acceso, in stand-by oppure spento);
se spento non accendere e, se acceso o in stand-by, evitarne spegnimenti che non siano necessari;
annotazione e descrizione di tutti i passaggi del dispositivo e di eventuali analisi preliminari del contenuto.
Una volta concluse queste fasi e trasportato in laboratorio il dispositivo rinvenuto, salvo eventuali necessità che rendano necessario proseguire nel luogo del ritrovamento (o dell’ispezione/perquisizione), si può far seguito al successivo passaggio del processo di digital forensics, consistente nell’acquisizione delle digital evidence giudicate di interesse.
Appare opportuno precisare che se in linea di principio tali operazioni, in quanto atti investigativi, ricadono nella competenza del Pubblico Ministero e della polizia giudiziaria, non di rado accade che, quando il quantitativo di dati da estrarre è considerevole e non sussiste pericolo di inquinamento del possibile materiale probatorio identificato, tali organi nominino per l’esecuzione delle attività in questione un ausiliario di polizia giudiziaria. Tale figura, che deve essere scelta tra soggetti con comprovata esperienza tecnica nel settore, talvolta può rivestire un ruolo centrale in questa fase investigativa, potendosi rivelare un valido ausilio non solo per la conduzione materiale dell’estrazione dei dati ma anche nella selezione delle informazioni digitali da acquisire.
Note
[1] Per una puntuale definizione di sopralluogo giudiziario, inteso come «esame della scena del crimine», si veda D. CURTOTTI, “Rilievi e accertamenti sul locus commissi delicti nelle evoluzioni del codice di procedura penale”, in “Manuale delle investigazioni sulla scena del crimine Norme, tecniche, scienze, logica”, a cura di D. CURTOTTI e L. SARAVO, G. Giappichelli Editore, Pioltello (MI), 2019, p. 45, dove, rilevata l’assenza della locuzione sopralluogo giudiziario all’interno del codice di rito, l’esame della scena del crimine viene definito come «quel complesso di attività poste in essere dalla polizia giudiziaria, dal consulente tecnico del pubblico ministero e della difesa, aventi natura tecnica e scientifica, esperibili sul locus commissi delicti, sia nell’immediatezza della scoperta del fatto di reato che nell’esecuzione di eventuali successivi accessi, finalizzate ad isolare, descrivere e analizzare lo scenario, nonché ricercare, esaminare e repertare le tracce ivi rinvenute». Tale definizione appare pienamente calzante anche in ambito di sopralluogo su supporti elettronici e sistemi informatici.
[2] Per hardware si intendono le «componenti di base, non modificabili, di un apparecchio o di un sistema(alimentatori, componenti circuitali fissi, unità logiche, ecc.)», https://www.treccani.it/vocabolario/hardware/.
[3] Altre discipline che rientrano nell’area della digital forensics sono la cloud forensics, per l’analisi e acquisizione da sistemi cloud, la network forensics, avente ad oggetto l’analisi e l’acquisizione da sistemi di rete e il traffico delle comunicazioni che vi transitano, la database forensics, volta ad analizzare ed acquisire quanto è contenuto all’interno di database.
[4] Si pensi ad esempio ad analisi da eseguire su apparecchi dallo spegnimento dei quali potrebbero derivare situazioni di pericolo come sistemi di gestione del traffico aereo o ferroviario, sistemi militari atti alla difesa nazionale come sistemi radar e scudi balistici etc. o macchinari in ambito sanitario.
[5] R. MURENEC, op. cit. p. 123 e, ugualmente, G. COSTABILE, op. cit., p. 13, dove tra gli altri dati istantanei che potrebbero essere compromessi con lo spegnimento vengono indicati a titolo esemplificativo: processi attivi nel momento del rinvenimento, stato schede di rete e tabelle di routing.
[6] G. COSTABILE, op. cit., p. 12, dove in ottica esemplificativa si afferma che una simile modalità operativa potrebbe comportare risultati positivi in caso di indagini sulla pedopornografia online «dove l’identificazione di materiale illecito detenuto con dolo (quindi presente sull’hard disk e non cancellato) può portare al sequestro dei soli hard disk “inerenti”, lasciando fuori dal sequestro materiale “neutro” rispetto alle indagine», mentre non sarebbe funzionale «per stabilire un c.d. alibi informatico o dove si rende necessario analizzare anche i file cancellati o di sistema», vista la necessità per queste ultime ipotesi di effettuare il sequestro di tutto il materiale contenente dati.
Articolo a cura di Francesco Lazzini
Profilo Autore
Laureato in giurisprudenza con successivo conseguimento dei master in Scienze Forensi (Criminologia-Investigazione-Security-Intelligence) e in Informatica giuridica, nuove tecnologie e diritto dell’informatica. Attività di studio postuniversitario focalizzata in materia di indagini con l’utilizzo del captatore informatico e digital forensics.
Sicurezza cibernetica, Internet e processi industriali
Quando nel 1969 venne utilizzata per la prima volta la rete Arpanet per collegare tra loro quattro università statunitensi, mai si sarebbe immaginato un pianeta interconnesso ai livelli raggiunti oggi.
Siamo ormai entrati nella Quarta Rivoluzione Industriale, cioè in un mondo in cui il più piccolo dispositivo – sia esso un computer personale, un oggetto domestico o un componente di un impianto industriale – è raggiungibile e gestibile dovunque ci si trovi: cosa che, per l’epoca, era pura fantascienza.
Questa meravigliosa evoluzione, che permette ciò che era considerata pura fantasia sino a 50 anni fa, ha permesso inizialmente di risparmiare notevoli quantità di denaro in viaggi superflui per tecnici informatici di ogni ordine e grado; ma oggi questo beneficio è esteso a ingegneri di processo per linee produttive industriali, ricercatori e qualunque altra professione che richieda l’utilizzo di un personal computer per poter essere svolta. Sono così sorte nuove e impegnative sfide per tutti coloro che si occupano di sicurezza cibernetica, ovvero la scienza che studia come prevenire, mitigare ad un livello accettabile i rischi connessi al mondo industriale, informatico e delle telecomunicazioni.
Oggi si sta finalmente iniziando a considerare la sicurezza cibernetica una necessità imprescindibile, sia nella pubblica amministrazione (non solo esclusivamente nel mondo militare, in cui esiste da lungo tempo) sia anche nel mondo dell’industria e dei servizi privati. L’Italia è un paese in cui il settore industriale vale il 20% del PIL (dati Istat) e in cui la componente principale è il manifatturiero, che copre oltre il 71% con un numero di addetti superiore ai 3,7 milioni.
Attualmente l’industria fa un uso massiccio di strumenti informatici ma, soprattutto, di componenti elettronici che operano nel mondo fisico: come sensori o attuatori responsabili di effettuare misurazioni di grandezze fisiche (temperatura, pressione, portata, ecc.) e PLC (Programmable Logic Controller), piccoli computer in grado di elaborare i segnali digitali e analogici provenienti dai sensori e dagli attuatori; questi ultimi sono formati da CPU, memorie (RAM, ROM, EPROM o EEPROM) e schede di comunicazione per connessioni a dispositivi vari, tra cui gli standard più comuni sono RS232 e RS422/RS485.
La componente informatica che governa questi dispositivi è chiamata comunemente SCADA (Supervisory Control And Data Acquisition). L’elemento che fa dialogare i sistemi industriali, sia tra di loro e sia con i tipici software informatici, è il protocollo TCP/IP, fondamento delle reti private, di internet e dei sistemi di comunicazione attuali usati in ambiente industriale. La Scala ISO/OSI è il primo riferimento per comprendere come funzionano le reti TCP/IP, di qualunque natura esse siano, tanto industriali quanto informatiche in senso stretto.
Per esempio i protocolli Profinet, ModBus, OPC UA sono protocolli applicativi che funzionano al livello 7 della Scala di riferimento ISO/OSI e che quindi possono essere trattati come i normali protocolli applicativi che usiamo anche per la parte informatica, ovvero HTTP, HTTPS, SMTP, ecc.
Invece protocolli come EtherCat, che hanno alte prestazioni in termini di velocità nella trasmissione dei messaggi, possono essere anche inseriti in frame UDP/IP; ma solo nel caso in cui l’applicazione preveda la necessità di trasporto su lunghe distanze oppure per altre esigenze molto specifiche.
Se aggiungiamo il fatto che oggi la maggior parte delle aziende di automazione richiede di potersi collegare da remoto per effettuare interventi manutentivi, monitoraggio del funzionamento e in ultima istanza per fare manutenzione predittiva per via dello sviluppo esponenziale dell’intelligenza artificiale, la sfida per gli operatori e responsabili della sicurezza cibernetica, non solo in ambito ICT (Information and Communication Technology) ma anche industriale (Operational Technology – OT), è sempre più ardua.
La difesa e la preservazione della capacità economica aziendale, oltre alla tutela del suo know how o patrimonio informativo, si è di fatto estesa nella stragrande maggioranza dei casi anche alla parte industriale, obbligando manager e tecnici a riformulare i piani di continuità operativa e sicurezza cibernetica delle proprie aziende o impianti. A titolo esemplificativo – ma non esaustivo – si pensi a tutte quelle aziende in cui vengono miscelati i componenti in quantità precise e in condizioni ambientali predeterminate, per le quali sono stati necessari anni di ricerca e sviluppo oltre a milioni di euro di investimenti.
Ricercatori ed esperti di sicurezza cibernetica (sempre in numero troppo esiguo rispetto alla domanda odierna) hanno elaborato diverse strategie per mitigare i rischi provenienti dagli ambienti industriali: la cosa fondamentale da considerare è che sono tutte complementari e, di norma, attuarne una singolarmente non mitiga i rischi in senso assoluto.
La prima strategia raccomandata è avere visibilità.
Con questo si intende la capacità di avere contezza di quali apparati ci aspettiamo di vedere installati nella nostra rete e di avere immediato avviso se ne vengono rilevati di nuovi, sapendo che tipo di segnali industriali (Profinet, ModBus, ecc.) ci aspettiamo di vedere o meno. Infatti, per raggiungere questo ultimo scopo, la maggior parte dei sistemi che fanno sicurezza cibernetica in ambito OT prevedono una fase di apprendimento del comportamento dei dispositivi sulla rete, che in tale periodo vanno a leggere i valori scritti nelle variabili dei vari protocolli rilevati, permettendo alla fine una “detection” molto puntuale di qualsiasi anomalia che possa essere significativa ai fini dell’integrità del processo industriale.
Un potenziale malintenzionato che abbia ottenuto un accesso alla rete industriale e voglia tentare un sabotaggio potrebbe collocare, all’interno della rete, un malware in grado di intercettare i messaggi e alterarne i valori nelle variabili, tanto da poter sabotare il processo, nei casi peggiori arrivando a causare danni per milioni di euro.
Il caso più famoso in tempi recenti è stato quello del malware STUXNET, sviluppato dal governo statunitense al fine di sabotare l’impianto di arricchimento dell’uranio di Natanz in Iran. Questo è un esempio in cui l’interconnessione dei sistemi industriali con quelli informatici ha permesso la conduzione di un attacco che ha impiegato anni per poter essere perpetrato, ma in cui l’assenza di tecnologia in grado di rilevare variazioni del contenuto dei protocolli utilizzati sulla rete ha permesso all’attacco di avere successo. Questo malware fu realizzato per poter funzionare anche su sistemi SCADA.
La seconda strategia raccomandata è la segregazione di rete, ovvero la separazione della rete in più segmenti mantenendo il controllo (autorizzazione e visibilità) del traffico tra i vari dispositivi. Questo approccio è anche uno dei requisiti fondamentali del modello ISO27001 Annex A13.1, standard di riferimento per la certificazione di qualità dei sistemi informatici, considerato come il passaggio fondamentale per il miglioramento sostanziale della postura cibernetica in qualsiasi ambiente in cui ci siano sistemi informatici e/o produttivi.
La scelta oculata di tecnologie che possano fornire visibilità e bloccare messaggi dei protocolli industriali anomali è la migliore – se non l’unica – possibilità per proteggersi dagli attacchi più sofisticati che oggi il crimine organizzato è in grado di perpetrare. L’esperienza dimostra che l’utilizzo di firewall infrastrutturali (da non confondere con quelli del perimetro) usati per la separazione delle reti al posto dei tradizionali Switch Layer 3 di rete migliora significativamente sia la visibilità, sia le capacità di mitigazione.
È contestualmente raccomandato l’utilizzo di tecnologie che abbiano conoscenza dei protocolli industriali specifici, in modo da bloccare efficacemente anche possibili attacchi che operino a questo livello. I sistemi di Privileged Access Management (PAM) sono tra le tecnologie più recentemente introdotte per monitorare e limitare attivamente quello che gli operatori con diritti amministrativi fanno sui sistemi, specialmente da remoto. Si tratta di un metodo molto efficiente per verificare con certezza le azioni eseguite e limitare le azioni eseguibili nei differenti contesti operativi.
La terza strategia raccomandata è l’utilizzo di sistemi di sorveglianza e monitoraggio che permettano di essere avvisati in tempo reale su tutte le anomalie che raggiungano una determinata soglia di allarme. Questo fondamentale componente del sistema di sicurezza cibernetica permette di stabilire con attenzione le soglie ragionevoli per non incorrere in falsi positivi che possono “desensibilizzare” gli operatori preposti alla sorveglianza attiva. Proprio per questo, è suggeribile dotarsi di un servizio di Security Operation Center (SOC) specifico per il mondo OT, in cui la fase iniziale di analisi e valutazione è fondamentale per il giusto “tuning” o regolazione della sensibilità degli allarmi.
Lo standard di riferimento per la sicurezza informatica in ambito industriale è IEC 62443 (precedentemente ISA99) dell’International Electrotechnical Commission (IEC). Dal 2002, la International Society of Automation (ISA) si occupa di queste tematiche e di inoltrare proposte di aggiornamenti all’American National Standards Institute (ANSI).
A tale proposito, la quarta strategia raccomandata è adottare un modello di gestione in linea con lo standard IEC 62443. Questo standard è destinato sia ai system integrator sia agli utenti finali, sia anche ai costruttori di componenti. Ognuno ha una serie di controlli da implementare, che indica il livello di maturità del sistema.
La sicurezza della Supply Chain è considerata universalmente come il nuovo elemento fondamentale ai fini del controllo della postura di sicurezza cibernetica di un’organizzazione. La scarsa cultura in questo ambito nelle aziende che trattano automazione industriale è purtroppo assai comune: veicolare un malware, anche per scarsità di procedure, è assai semplice. Adottare processi in linea con quanto previsto da questa norma è caldamente raccomandato.
Le organizzazioni più virtuose oggi si stanno dotando di servizi di “Security Operation Center” specifici il mondo Operational Tecnology, che vengono comunemente chiamati SOC OT. Questo servizio che richiede una fase di analisi ed avvio, permette a regime di incrementare l’efficacia della prevenzione degli attacchi cibernetici sugli ambienti produttivi, sfruttando le capacità di apprendimento delle sonde vengono posizionate sulle reti produttive, i modelli di intelligenza artificiale ed i firewall con capacità di intervento sui protocolli industriali.
Con l’introduzione della direttiva europea NIS 2 entrata in vigore il 18 gennaio 2023 e che dovrà essere recepita dagli Stati membri entro il 18 ottobre 2024, l’adozione di servizi di questo tipo si renderà sempre più necessaria al fine di soddisfare quanto previsto dalla direttiva.
Possiamo dunque affermare che il controllo della propria postura di sicurezza cibernetica deve essere tra le prime aree di investimento per le aziende produttive del nostro tessuto industriale, in considerazione del fatto che il valore delle potenziali perdite economiche date dalla somma di danni emergenti e lucro cessante appare sproposito rispetto agli investimenti che potrebbero essere richiesti per gestire la postura cyber in modo corretto, senza contare le sanzioni a cui si andrebbe incontro qualora le normative attuali e quelle annunciate dovessero essere violate.
Raccomandiamo, quindi, un’attenta valutazione dei rischi e una corretta assegnazione di risorse al fine di gestire questo importante elemento a tutela degli interessi comuni del mondo industriale.
Articolo a cura di Gabriele Minniti
Profilo Autore
È un informatico specialista in Sicurezza Informatica e Sicurezza delle informazioni con oltre 15 anni di esperienza. Ha conseguito molteplici certificazioni internazionali in ambito tecnologico ed ha lavorato in Germania ed Inghilterra per importanti aziende costruttrici di tecnologie per la Sicurezza Informatica. Nel corso della sua carriera è stato chiamato sia come consulente che come docente per entità afferenti al comparto della Difesa. Fondatore di WhySecurity srl, oggi si occupa di supporto ad indagini difensive collaborando con investigatori privati, svolge analisi di rischio economico connesso al rischio informatico e offre servizi SOC a favore dei propri clienti.
Bias nell’Intelligenza Artificiale: Strategie e Norme ISO per la Valutazione e il Controllo
I sistemi AI trovano ormai dilagante applicazione in ogni ambito della nostra vita e cultura attraverso, ad esempio, i modelli di Machine Learning (ML), ma, come molte volte accade, non si hanno informazioni chiare su come il modello abbia “imparato” e prodotto un determinato output.
Ecco, quindi, come un sistema di gestione dedicato all’AI può costituire un importante strumento a supporto di una corretta governance e controllo di tali modelli.
A tal proposito, la norma ISO 42001:2023 introduce molti di questi concetti, come nel caso della clausola 9.1, che individua proprio gli indicatori dedicati, o dei controlli previsti dall’Allegato A, che riportano la necessità di avere la contezza dei risultati: i controlli della classe A.6.2, da esempio, richiedono la verifica e la validazione delle misure.
Altro punto focale, sempre oggetto di richiamo quando si ragiona in punto di sistemi intelligenti, è quello che va a toccare i concetti di analisi dei rischi e di valutazione d’impatto.
A supporto dello standard ISO/IEC 42001:2023 Sistema di Gestione dell’AI ci sono altre norme che guidano ad una corretta analisi e implementazione dei controlli, quali
la norma ISO/IEC 42005 – Tecnologia dell’informazione — Intelligenza artificiale (AI) Valutazione d’impatto dei sistemi IA, e
la ISO/IEC 23894, Information technology — Artificial intelligence — Risk Management.
Con riferimento, specificamente, ai modelli di ML e alla loro verifica, possono venire in aiuto alcune norme dedicate, comprese quelle sulla qualità dei dati, come ad esempio:
ISO/IEC 4213 Information technology — Artificial intelligence — Assessment of machine learning classification performance,
ISO/IEC 6254 Information technology — Artificial intelligence — Objectives and approaches for explainability of ML models and AI systems,
ISO/IEC 23053 Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML), e
ISO/IEC 5259 1-5 Data quality for analytics and machine learning (ML) ISO/IEC 5339.
Dal momento che, come si è accennato ed è ormai noto, una delle problematiche intrinseche più rilevanti dei sistemi algoritmici è – a tutt’oggi – costituita dalla loro opacità e scarsa comprensibilità, è evidente come sia sempre più necessario affidarsi a specifiche metodologie al fine di meglio comprendere la correttezza del modello in uso.
Ancora di più se si pensa ad un ulteriore aspetto di complessità dell’AI, ossia quello che coinvolge la distorsione algoritmica o bias, intesa come forma di distorsione cognitiva causata dal pregiudizio in grado di influenzare ideologie, opinioni e comportamenti. Il bias è, per semplificare, un errore nel processo di apprendimento che deriva da assunzioni errate.
Con il precipuo scopo di indagare tale specifico aspetto è nata la ISO 24027:2021, che descrive metodologie e meccanismi per scoprire e trattare i bias nei sistemi di intelligenza artificiale, che vengono descritti, nelle definizioni, come:
“bias”, ossia una differenza sistematica nel trattamento[1] di determinati oggetti, persone o gruppi rispetto ad altri;
“bias cognitivo umano”[2], che si verifica quando gli esseri umani elaborano e interpretano le informazioni;
“bias di conferma”, quel tipo di bias cognitivo umano che favorisce le previsioni dei sistemi di intelligenza artificiale che confermano credenze o ipotesi preesistenti.
Nel documento si analizzano varie fonti di distorsioni indesiderate nei sistemi di AI, ricondotte a 3 categorie principali (distorsioni cognitive umane; distorsioni dei dati; distorsioni introdotte da decisioni ingegneristiche), così come il trattamento delle stesse durante i singoli stadi del ciclo di vita del sistema intelligente, a partire dalla raccolta dei dati, per passare alla progettazione, allo sviluppo, alle fasi di test e. arrivare al monitoraggio e alla validazione continui.
Sebbene si tenda ad attribuire al concetto di distorsione sempre un’accezione negativa, la norma in oggetto apre spiegando che, in realtà, gli effetti dei bias possono essere positivi, neutri o negativi, come si è cercato di sintetizzare nella tabella che segue:
Effetto positivo
L’introduzione di errori/bias può servire a raggiungere un risultato equo.
Ad esempio, l’introduzione di una distorsione nella fase decisionale di un processo di selezione di personale con date caratteristiche al fine di compensare “tare” nei data set dovute alla sottorappresentazione consolidata nel tempo di tali professionalità.
Effetto neutro
La distorsione porta il sistema intelligente a classificare erroneamente un dato elemento, ma senza impatti particolari.
Ad esempio, una vettura a guida autonoma riconosce come ostacolo un cassonetto, ma lo classifica erroneamente come idrante.
Effetto negativo
Il bias porta con sé conseguenze indesiderate (etici o non ricadenti su profili etici)
Ad esempio, può limitare le opportunità delle persone interessate (distorsioni che favoriscono candidati di un sesso piuttosto che di un altro) o incidere negativamente nella classificazione di qualcosa (es. una galassia)
Ciò premesso, resta tuttavia evidente come la perplessità prevalente relativa ai pregiudizi sia la facilità con cui gli stessi possono propagarsi in un sistema, a cui corrisponde – per contro – la difficoltà di riconoscerli e mitigarli. Tale aspetto va peggiorando tanto più il sistema è automatizzato (e tante più AI contribuiscono all’automazione), poiché in tal caso la supervisione umana diventa sempre meno efficace e, quindi, i bias negativi (anche involontari) trovano una facile via di sopravvivenza.
È bene evidenziare come mentre è decisamente probabile che in un sistema possano essere rintracciate più fonti di bias contemporaneamente, è, invece, assai improbabile che l’analisi di un sistema possa rilevarli tutti.
Alla luce di tutto quanto sopra descritto e in particolare con riferimento alle metodologie applicabili, si ritiene, quindi, di una certa utilità soffermarsi sulla cd. “matrice di confusione”, che costituisce uno strumento per analizzare gli errori compiuti da un modello di machine learning.
Nello specifico, come evidenzia la ISO 24027:2021, tale matrice riporta il numero di falsi positivi, falsi negativi, veri positivi e veri negativi e include ulteriori criteri di prestazione derivati da questi valori, come riportato nell’immagine seguente
Poiché una matrice di confusione contiene e confronta più parametri, consente un’analisi dettagliata delle prestazioni di un classificatore ed è utile per aggirare o scoprire i punti deboli dei singoli parametri.
Consideriamo per semplicità un classificatore binario dove le classi si identificano con SI e NO.
Figura 1: la matrice di confusione
Dove Tp = Veri Positivi, Fn = Falsi Negativi, Fp = Falsi Positivi e Tn = Veri Negativi.
Ad esempio, il modello analizza 100 risultati (identificazione di immagini di animali: cane e gatto) e le classifica come risultati veri o falsi. In 70 casi il modello classifica correttamente (cani) mentre in 30 sbaglia (gatti).
Figura 2: esempio di numerica nella matrice.
Come indicato nella figura 1, possono verificarsi quattro casi:
True positive (Tp) Se la classe prevista è SI nella prima riga e prima colonna ed è uguale alla classe effettiva il modello ha risposto correttamente SI.
True negative (Tn) Se la classe prevista è NO nella seconda riga e seconda colonna ed è uguale alla classe effettiva, il modello ha risposto correttamente NO.
False positive (Fp) Se la classe prevista è SI ma è diversa dalla classe effettiva, quindi nella seconda riga e prima colonna, il modello ha sbagliato a rispondere SI.
False negative (Fn) Se la classe prevista è NO ma è diversa dalla classe effettiva, cioè prima riga e seconda colonna, il modello ha sbagliato a rispondere NO.
Per soddisfare anche i controlli delle norme e le guide dalle norme ISO sopra citate è opportuno introdurre le metriche di una matrice di confusione.
Accuratezza: l’accuratezza complessiva del modello, definita come il rapporto tra le previsioni corrette e il numero totale di previsioni. Indica la proporzione di esempi che sono stati previsti correttamente.
Precisione: la precisione del modello, definita come il rapporto tra i veri positivi e il numero totale di esempi previsti come positivi. Indica la proporzione di esempi previsti come positivi e che sono effettivamente positivi.
Richiamo: il richiamo del modello, definito come il rapporto tra i veri positivi e il numero totale di esempi effettivamente positivi. Indica la proporzione di esempi positivi che sono stati previsti correttamente come positivi.
Punteggio F1: il punteggio F1 è una media ponderata della precisione e del richiamo ed è calcolato come. Fornisce un’unica metrica che bilancia sia la precisione che il richiamo.
Specificità (Specificity):La specificità rappresenta la proporzione di veri negativi rispetto al totale delle istanze negative effettive. Misura quanto il modello è bravo a identificare le istanze negative.
ROC Curve (Receiver Operating Characteristic Curve):La curva ROC è un grafico che mostra la relazione tra il tasso di veri positivi e il tasso di falsi positivi al variare della soglia di classificazione. A mano a mano che la soglia varia, i punti ROC vengono disegnati e collegati, e l’area sotto la curva ROC (AUC) può essere utilizzata come misura dell’efficacia del modello.
Accuratezza
L’accuratezza misura la percentuale delle previsioni esatte sul totale delle istanze. È l’inverso del tasso di errore. È compreso tra 0 (peggiore) e 1 (migliore). Essa indica quante volte il nostro modello ha correttamente classificato un item nel nostro dataset rispetto al totale.
Infatti, la formula per l’accuratezza è la divisione tra numero di risposte corrette e il totale delle risposte. Vale a dire che non ci permette di comprendere il contesto nel quale stiamo operando.
Deve essere sempre considerata nel contesto del modello. Ad esempio, è sconsigliato usare la accuratezza come metrica di valutazione quando operiamo con un dataset sbilanciato, dove le classi sono distribuite in maniera impari. Se la accuratezza non è altro che il rapporto tra risposte corrette sul totale, allora se una classe compone il 90% del nostro dataset e il nostro modello (erroneamente) classifica ogni esempio nel dataset con quella classe specifica, allora la sua accuratezza sarà del 90%.
Si potrebbe quindi pensare che il modello sia molto performante, quando in realtà è molto lontano dall’esserlo.
ACC = (Tp+Tn)/(Tp+Tn+Fp+Fn) = 1 – ERR (1)
Figura 3: Accuratezza, nell’esempio Accuratezza = (40+30)/(40+20+10+30)= 70%
dove ERR è il tasso di errore, cioè, misura la percentuale di errore delle previsioni sul totale delle istanze. È compreso tra 0 (migliore) e 1 (peggiore).
ERR = (Fp+Fn)/(Tp+Tn+Fp+Fn) (2)
Figura 4: Tasso errore, nell’esempio, Tasso di errore = (20+10)/(40+20+10+30)= 30%
Precisione
La precisione è la percentuale delle previsioni positive corrette (Tp) sul totale delle previsioni positive del modello (giuste Tp o sbagliate Fp).
La precisione non è altro che l’accuratezza calcolata solo per classi positive. Essa è anche chiamata specificità positiva poiché definisce quanto sensibile è uno strumento quando c’è il segnale da riconoscere. Di fatto, la metrica ci informa quanto spesso siamo corretti quando classifichiamo una classe come positiva.
Un modello con alta precisione ci allerterà poche volte, ma quelle volte che lo farà possiamo essere abbastanza sicuri che si tratti veramente di un dato inteso come intruso.
Pr = Tp/(Tp+Fp) (3)
Figura 5: Precisione nell’esempio, Precisione = 40/(40+10) =80%
Richiamo o sensitività
Il richiamo o sensitività è la percentuale delle previsioni positive corrette (Tp) sul totale delle istanze positive. È compreso tra 0 (peggiore) e 1 (migliore). Se siamo interessati a riconoscere quanti più classi positive possibili, allora il nostro modello dovrà avere un richiamo alto.
In pratica significa che qui dobbiamo tener conto dei falsi negativi invece dei falsi positivi. Il richiamo viene anche chiamato sensibilità perché all’aumentare del richiamo, il nostro modello diventa sempre meno preciso e classifica anche classi negative come positive.
Un modello ad alta precisione è conservativo, ma introduce anche molto rumore di fondo.
Risulta quindi impossibile avere un modello con alta precisione e alto richiamo. Infatti, queste due metriche sono complementari: se aumentiamo una, l’altra deve diminuire. Si tratta del precision/recall trade-off.
Rec = Tp/(Tp+Fn) (4)
Figura 6: Richiamo nell’esempio, Recall = 40/(40+20) = 67%
Specificità
La specificità è la percentuale delle previsioni negative corrette (Tn) sul totale delle istanze negative. È compresa tra 0 (peggiore) e 1 (migliore).
Sp = Tn/(Tn+Fp) (5)
Figura 7: Specificità nell’esempio, Specificità = 30/(10+30) = 75%
Tasso dei falsi positivi
Il tasso dei falsi positivi (False Positive Rate) è la percentuale delle previsioni positive errate (Fp) sul totale delle istanze negative. Compreso tra 0 (migliore) e 1 (peggiore).
Fpr = Fp/(Tn+Fp) (6)
Figura 8: Tasso dei falsi positivi nell’esempio, Tasso falsi positivi = 10/(10+30) = 25%
Punteggio F
Il punteggio F (F-Score) è la media armonica delle metriche Precision e Recall. Varia da 0 (peggiore) a 1 (migliore).
A questo punto è chiaro che usare precisione o richiamo come metrica di valutazione è difficile perché possiamo solo usarne una a scapito dell’altra. Il punteggio F1 risolve proprio questo problema. Il punteggio F1 combina precisione e richiamo in una sola metrica. Questa è la media armonica di precisione e richiamo, ed è probabilmente la metrica più usata per valutare modelli di classificazione binaria. Se il punteggio F1 aumenta, vuol dire che il modello ha aumentato le performance per precisione, richiamo o per entrambi
F1 = (2* Rec*Pre)/Rec+Pre (7)
Nell’esempio: Punteggio F = (2*Recall*Precisione)/(Recall+Precisione) = 0.73 (8)
ROC-AUC
La metrica ROC-AUC si basa su una rappresentazione grafica della curva ROC (receiving operating characteristic curve).
“le curve ROC […] sono degli schemi grafici per un classificatore binario. Lungo i due assi si possono rappresentare la sensibilità e (1-specificità), rispettivamente rappresentati da True Positive Rate (TPR, frazione di veri positivi) e False Positive Rate (FPR, frazione di falsi positivi). In altre parole, si studiano i rapporti fra allarmi veri (hit rate) e falsi allarmi.” Tratto da Wikipedia
Figura 9: Curva ROC
AUC significa Area Under the Curve (area al di sotto della curva). Se poniamo l’attenzione sulla linea blu, vediamo che al di sotto di essa c’è di fatto una area più grande rispetto alle linee verde arancione. La linea tratteggiata indica una metrica di ROC-AUC del 50%.
Di conseguenza un buon modello avrà una ROC-AUC grande, mentre un modello scarso si posizionerà vicino alla linea tratteggiata, che non è altro che un modello che risponde in maniera casuale.
La metrica ROC-AUC è anche molto utile per confrontare diversi modelli uno contro l’altro.
Coefficiente di correlazione di Matthews (MCC)
Questo serve per valutare correttamente anche modelli addestrati su dataset non bilanciati.
La formula si comporta come un coefficiente di correlazione. Essa è compresa tra +1 e -1. Un valore che tende a +1 misura la qualità delle predizioni del nostro classificatore anche in contesti con classi sbilanciate nel dataset, poiché indica una correlazione tra valori reali osservati e previsioni fatte dal nostro modello.
Possiamo introdurre, altri calcoli di verifica, coinvolgendo calcoli algebrici e la meccanica quantistica. In particolare, introduciamo il quadrato di un binomio
(a+b)2 = a2+ b2+2*a*b (10)
dove, i quadrati sono considerati la probabilità di accadimento e il doppio prodotto è l’interferenza.
Quindi possiamo estendere le formule sopra citate (recall, sensibilità, etc.) e considerando il rapporto tra il doppio prodotto e la somma dei quadrati
2ab/a2+b2 (11)
ottenendo:
Precisione:
InPr = (2*Tp*Fp)/(Tp2+Fp2), che nell’esempio assume il valore 0.47 (12)
Recall:
InRec = (2*Tp*Fn)/(Tp2+Fn2), che nell’esempio assume il valore 0.8 (13)
Specificità:
InSp = (2*Tn*Fp)/(Tn2+Fp2), che nell’esempio assume il valore 0.6 (14)
Queste formule forniscono il rapporto tra l’interferenza e la somma di probabilità.
Per concludere, dunque, per raggiungere una visione ed un controllo completi dei sistemi di intelligenza artificiale, pare imprescindibile puntare alla conoscenza tanto della parte umanistica, etica, psicologica e giuridica, quanto della componente più prettamente tecnica, che a sua volta non potrà prescindere dal supporto fornito dagli standard di settore, in parte qui analizzati.
Note
[1] Il trattamento è qualsiasi tipo di azione, inclusa la percezione, l’osservazione, la rappresentazione, la previsione o la decisione.
[2] i pregiudizi cognitivi umani influenzano il giudizio e il processo decisionale.
Articolo a cura di Stefano Gorla e Avv. Anna Capoluongo
Profilo Autore
Consulente e formatore in ambito governance AI, sicurezza e tutela dei dati e delle informazioni; Membro commissione 533 UNINFO su AI; Comitato di Presidenza E.N.I.A. Membro del Gruppo di Lavoro interassociativo sull’Intelligenza Artificiale di Assintel Auditor certificato Aicq/Sicev ISO 42001, 27001, 9001, 22301, 20000-1, certificato ITILv4 e COBIT 5 ISACA, DPO Certificato Aicq/Sicev e FAC certifica, Certificato NIST Specialist FAC certifica, Referente di schema Auditor ISO 42001 AicqSICEV. Master EQFM. È autore di varie pubblicazioni sui temi di cui si occupa. Relatore in numerosi convegni.
Profilo Autore
Avvocato Data Protection & ICT | Data Protection Officer UNI 11697 | membro dell’EDPB’s Support Pool of Experts | Membro Women For Security | Membro Osservatorio sulla Giustizia Civile Tribunale Milano (Gruppo sul danno da illecito trattamento dei dati personali) | Afferente B-ASC (Università Milano-Bicocca Applied Statistics Center) | Vicepresidente Institute for Research of Law Economical and Social Studies| Membro Gruppo di Lavoro sull’AI di ANORC | Docente a c. (Università di Padova, Sole24Ore Business School), Comitato di Presidenza E.N.I.A.
A.I. tra “nebbie” e “nuvole”: L’intelligenza artificiale per lo sviluppo del Fog e Cloud Continuum
Introduzione al Cloud Continuum e all’Intelligenza Artificiale
La relazione tra intelligenza artificiale e cloud continuum è sempre più importante e rilevante nel panorama tecnologico attuale. L’intelligenza artificiale si basa sull’elaborazione di enormi quantità di dati e sulla capacità di apprendere e adattarsi in modo autonomo, mentre il cloud continuum offre un unico ecosistema formato da una vasta gamma di risorse di calcolo e di archiviazione accessibili da ovunque. Potremmo definire il Cloud Continuum un’esperienza senza soluzione di continuità tra l’elaborazione centralizzata e quella distribuita, tra data center on premise, cloud pubblici e privati, strutture fog e di edge computing, un’evoluzione che va oltre il concetto tradizionale di cloud computing. Non si tratta solo di una tecnologia ma di una topologia in cui molte tecnologie cloud vengono integrate creandone una nuova che collega tutto. Un connubio perfetto tra una tecnologia “affamata” di informazioni come l’I.A. e un’altra abilitante a tutte le informazioni.
Evoluzione del Cloud Computing: Fog e Edge Computing
Il Cloud Continuum mira quindi ad integrare e rendere trasparenti 3 componenti fondamentali delle tecnologie cloud: il cloud computing che riporta i dati a un server centrale per l’archiviazione e l’analisi, il fog computing e l’edge computing che consentono di eseguire analisi e altre funzioni ai margini della rete, localmente, proprio alla fonte dei dati.
L’intelligenza artificiale, finora sviluppatasi prevalentemente nel cloud computing, in questa nuova visione architetturale (Fig.1) si espande ulteriormente anche al Fog Computing ed all’Edge Computing, ambito fino ad ora utilizzato principalmente in sistemi locali basati sull’Internet delle Cose (IoT), progettati con l’obiettivo di ridurre il traffico di dati verso il cloud analizzando parte dei dati localmente ed inviando solo informazioni “semilavorate”, in modo da poter essere utilizzati anche in ambienti con bassa latenza e larghezza di banda.
In particolare l’utilizzo dell’I.A. nel Fog Computing sta emergendo come una soluzione sempre più interessante al problema dell’elaborazione dei dati nell’IoT, che nel frattempo si sta trasformando in AIoT (Artificial Intelligence+IoT), amplificando potenza e velocità di analisi rispetto ai dispositivi finali, essendo questa la componente più vicina ai dispositivi IoT rispetto alle risorse cloud più potenti.
Fig 1
L’integrazione dell’IA nella gestione delle risorse Cloud
Con l’aumento dell’utilizzo dell’I.A. e del Machine Learning (ML), a tutti i vari livelli, i carichi di lavoro del cloud, fog e edge computing stanno diventando sempre più diversificati e dinamici. La convergenza tra fog computing ed intelligenza artificiale, richiede però l’uso di una gestione più intelligente delle risorse.
Nelle tradizionali piattaforme di cloud computing, la gestione delle risorse viene effettuata utilizzando approcci euristici tradizionali senza considerare carichi di lavoro diversi e dinamici. La maggior parte di questi metodi si basa su statiche euristiche configurate offline per determinati scenari di carico di lavoro, che non sono in grado di scalare le applicazioni in fase di esecuzione in base al modello e al comportamento del carico di lavoro.
L’intelligenza artificiale sta entrando anche nei meccanismi di gestione dinamica delle risorse tra i vari stack, l’utilizzo di tecniche I.A./ML per ottimizzare le politiche di gestione delle risorse e potrebbero essere utilizzate per modellare e prevedere metriche a livello di applicazione ed infrastruttura, alfine di ottimizzare l’orchestrazione delle attività e delle risorse migliorando la qualità delle decisioni di provisioning, fino a predirle.
Il Futuro del Cloud Continuum e l’IA
Lo sviluppo del Cloud Continuum riveste così un aspetto fondamentale per gestire le nuove sfide allo sviluppo della futura generazione di applicazioni e servizi, un futuro dove l’utilizzo del cloud non sarà on demand ma permanente e costante e non riguarderà una singola problematica, informazione o file ma il “contesto”.
Per garantire questa costante permanenza nella nostra quotidianità, il cloud continuum deve necessariamente diventare più pervasivo, dalla domotica, all’automotive, dai device mobili ai social network, i contesti per il monitoraggio delle nostre vite diventano sempre più ampi, e l’integrazione di un’I.A. connessa al cloud in tutti i nostri sistemi e processi, sembra essere l’obiettivo a breve e medio termine.
L’I.A. diventa così il “driver” principale per uno sviluppo simbiotico con il Cloud Continuum, che non punta solo a migliorare la produttività e la qualità della nostra vita ma a cambiare definitivamente anche il modo di interagire, sostituendo tastiera e mouse con i sistemi conversazionali dell’I.A. generativa (LLM).
Uno dei primi esempi di integrazione pervasiva è sicuramente il chat bot CoPilot di Microsoft che essendo radicato nel sistema operativo, elimina le catene della limitazione del contesto. L’intero computer, ogni file e ogni dato diventa il contesto.
Dal processo di analisi olistico alla risoluzione avanzata di problemi, l’intera dinamica dell’interazione tra utenti e macchine cambia radicalmente, il cloud continuum entra, a pieno titolo, grazie all’intelligenza artificiale, nel loop decisionale delle nostre scelte.
Considerazioni sulla Sicurezza e l’Etica nel Cloud Continuum
Tutto quello che finora avevamo capito sugli algoritmi di profilazione, a volte eticamente discutibili, che spesso ci suggeriscono e condizionano nelle scelte, sta per svilupparsi in un ambito completamente nuovo: il contesto, che eclisserà i parametri tradizionali degli attuali algoritmi, con il potere derivante da un’intelligenza artificiale in grado di comprende ed utilizzare “il contesto” dei nostri dati e del nostro comportamento.
Una potenzialità senza eguali se paragonata alle tecnologie passate e tutto questo in un mondo dove gli esseri umani sono sempre più connessi, a gennaio 2024 circa 5,54 miliardi di persone in tutto il mondo utilizzano Internet, costituendo il 70,4% della popolazione mondiale (Fonte: Worldometer).
Il cloud continuum potrà permettere di accedere istantaneamente ai tutti nostri dati in tempo reale e alle nostre applicazioni ovunque ci troviamo, senza la necessità di complessi processi di migrazione e integrazione, aumenterà esponenzialmente la produttività in modo sempre più distribuito, efficiente e flessibile, utilizzando la potenza ottimale di calcolo disponibile negli ambienti cloud e multi-cloud.
Fig 2
Il cloud continuum permetterà all’I.A. di interconnettere ed analizzare tutte le informazioni a noi associate, qualsiasi nostra traccia digitale prodotta potrà essere collegata e correlata al nostro contesto (Fig.2).
Il cloud continuum con la sua struttura permette all’I.A. di sfruttare al meglio la sua componente più rivoluzionaria: i modelli linguistici di grandi dimensioni (LLM).
Gli LLM sono reti neurali artificiali che hanno una notevole capacità nell’elaborazione del linguaggio naturale, la generazione di linguaggi generici e altri compiti.
Nello specifico, questi modelli sono in grado di analizzare dati non strutturati, esattamente gli stessi che utilizza l’essere umano per comunicare e apprendere: testi, immagini, video, etc..
Nel 2023 il volume dei dati analizzati dalle I.A. è stato di circa 120 Zettabyte, (per avere un’idea delle dimensioni, uno Zettabyte corrisponde a circa 36000 anni di un video in HD), numero questo in costante crescita nei prossimi anni.
Di tutti i dati analizzati solo il 20% sono dati strutturati, il rimanente 80% appartiene a dati non strutturati: dati presi dai siti web di informazione, dai video di Youtube, da documenti nei repository open source fino ai post dei social network.
L’uso del Continuum Cloud, potenzialmente, permetterà all’I.A. di accedere a qualsiasi “forma” di dato, analizzarla e correlarla ai relativi contesti.
Lo sviluppo del Cloud Continuum permetterà inoltre ai modelli I.A. di crescere ed elaborare sempre più informazioni personali direttamente supervisionate da noi, immaginate ad es. Copilot di Microsoft a cui chiedete di generare documenti di presentazione, leggere mail di lavoro o personali, classificarle e magari ad alcune, rispondere. L’integrazione di un chat bot all’interno di un sistema operativo che è presente nel browser, negli strumenti di produttività, nei sistemi di posta e comunicazione, ha l’enorme vantaggio di poter addestrare l’I.A. a comprendere meglio il nostro modo di essere, il nostro pensiero, su cosa è corretto e sbagliato relativamente al nostro contesto. Questa interazione, che sarà sempre più continuativa e quotidiana, permetterà all’I.A. di evolvere più velocemente nella “comprensione” delle informazioni, seguendo un processo di crowdsourcing. Grazie al crowdsourcing (“folla” dall’inglese crowd) un gran numero di persone può partecipare attivamente a risolvere processi complessi suddividendoli in micro task, nel nostro caso è addestrare l’I.A. a comprendere ciò che analizza.
Ogni richiesta che noi facciamo all’I.A., ogni correzione concettuale che gli diamo, stiamo di fatto facendo del micro training all’I.A., la quale imparerà e condividerà la singola esperienza fatta con ognuno di noi nella sua capacità globale di rispondere alle esigenze di tutti e il Cloud Continuum gli permetterà di avere un’esperienza “sensoriale” su tutto il dominio cibernetico, costante ed in tempo reale.
Una nuova e rivista schiera di agenti virtuali si sta affacciando nel nostro mondo, da versioni sempre più “intelligenti” di assistenti come Siri, Google e Alexa ad assistenti smart con tante funzionalità di I.A. che porteremo sempre in tasca con noi (come ad es. Rabbit R1 – https://www.rabbit.tech/).
E’ inutile dire che tutto ciò porta inevitabilmente a dubbi e perplessità sulla sicurezza dei sistemi e sulla riservatezza e privacy delle informazioni. Alcuni vedono il cloud continuum come l’ennesima enfasi sulla centralizzazione dei dati e delle risorse informatiche, rendendo le organizzazioni ancora più dipendenti dalle grandi corporations che detengono e gestiscono queste enormi infrastrutture e l’integrazione con l’I.A. amplifica queste preoccupazioni.
Un Continuum Cloud che potrebbe facilitare la migrazione verso l’ambiente digitale, potrebbe contestualmente aprire a nuove vulnerabilità e minacce, rendendo le nostre informazioni più sensibili ancora più vulnerabili agli attacchi informatici e alla violazione della privacy, ambienti gestiti da entità esterne di cui non si conosce veramente l’affidabilità e la sicurezza.
Se consideriamo le ingenti risorse necessarie allo sviluppo dei sistemi di I.A. e la capacità del Cloud Continuum di aggregare e gestire risorse eterogenee (pubbliche e private) in un unico ecosistema, le disponibilità economiche necessarie sono effettivamente appannaggio solo di poche e grandi corporations (che hanno fatturati simili al PIL di piccolo Stato) come mostrato nei grafici in figura 3 e 4 per l’anno 2023.
Fig. 3Fig. 4
La democratizzazione di queste tecnologie e l’etica nell’uso delle risorse è un tema sicuramente vitale per lo sviluppo di applicazioni e servizi sempre più personalizzati, per migliorare, in sicurezza, la qualità della nostra vita. Il rapido sviluppo dell’intelligenza artificiale potrebbe però portare ad una maggiore dipendenza da sistemi automatizzati, rischiando di limitare la libertà individuale e la diversità delle scelte.
Bilanciamento tra Innovazione e Protezione dei Diritti Individuali
Si ripropone un tema ormai annoso, periodico e costante e cioè che è fondamentale trovare un equilibrio tra l’innovazione tecnologica, la protezione dei diritti e delle libertà individuali, per garantire che il progresso sia realmente benefico per la società nel suo complesso.
L’imprenditore miliardario hi-tech Bryan Johnson, proprietario della società di biohacking BionTech, considerato un guru della Silicon Valley, ha dato una rappresentazione del futuro dell’I.A. molto interessante, rappresentando rispetto alle attuali capacità umane, in quanta parte l’I.A. ci sostituirà in queste attività e quanto invece l’essere umano potrà fare grazie all’I.A. (Fig.5).
Fig.5
Immagine che parla da sé e alquanto suggestiva, un’opportunità incredibile e una nuova conoscenza ci aspettano, saremo in grado di gestirla?
Articolo a cura di Francesco Arruzzoli
Profilo Autore
Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.