L’indispensabile rivoluzione nell’Incident Response: Automazione per una Risposta più Efficace

Da qualche tempo il mondo della sicurezza informatica ha subito una trasformazione significativa.

Il cambiamento, come sempre nella storia dell’uomo risulta guidato dalla crescente complessità degli attacchi informatici. In questo contesto, l’automazione ha dimostrato di essere un’arma potente nel combattere tali minacce, soprattutto nell’ambito della risposta agli incidenti. L’integrazione di processi finemente automatizzati nella gestione degli incidenti non solo migliora sensibilmente l’efficienza, ma offre anche una maggiore capacità di risposta e un controllo più rapido sulle violazioni della sicurezza.

In questo articolo, come Indiana Jones all’interno di un templio maledetto esploreremo il ruolo fondamentale dell’automazione nel fornire visibilità, contenere, ed eradicare.

Senza dimenticarci dei nostri amici IT Manager o CISO; infatti da qualche parte nell’articolo si nascondono diverse indicazioni fondamentali durante la gestione di un incident che non possono essere ignorati da chi ricopre tale ruolo.

Visibilità potenziata attraverso l’Automazione

La visibilità è il primo passo cruciale per affrontare un incidente di sicurezza.

Senza una comprensione chiara di ciò che sta accadendo nei sistemi e nelle reti, è impossibile rispondere in modo efficace. Qui entra in gioco il fondamentale fattore portato dall’automazione la velocità e l’integrazione.

Strumenti di rilevamento delle minacce e sistemi di monitoraggio continuo possono identificare anomalie e comportamenti sospetti in tempo reale, fornendo agli esperti di sicurezza visibilità immediata sulle attività malevole, ma tutto questo può essere abbastanza? Possiamo fidarci ciecamente dei software di difesa commerciali che gli attaccanti studiano minuziosamente al fine di continuare a compromettere infrastrutture informatiche più o meno complesse?

No. Sennò non lavorerei nel campo dell’incident response.

L’automation dedicata alle attività di risposta agli incidenti infatti si concentra su tutti quegli aspetti in cui non vi è certezza ne standard, infatti, se un software di sicurezza come potrebbe essere un HIDS o un EDR può vantare sia il tempo che la cura da parte di chi lo installa; un software scritto per incident response può solo sognarsi questo tipo di lusso.

Infatti l’obbiettivo è molto simile a quello di un malware, come le funzionalità d’altronde. Senza però lo scudo di firme digitali o whitelist assicurate nei sistemi dove opera, dove spesso, regna il caos; non è infatti difficile trovarsi ad eseguire questo tipo di automazioni in Virtual Machines scollegate dalla rete con uno o più EDR che non aspettano altro di identificare e bloccare software che ha l’obbiettivo di raccogliere quanti più artefatti e dati possibili.

Il tema visibilità risulta centrale, infatti, uno strumento completo per il triage di un endpoint infetto non si ferma all’estrazione di artefatti comuni come UsnJ, MFT, Shimcache e via dicendo; ma esegue DUMP di LSASS.exe, ricerca keywords all’interno del filesystem per trovare credenziali salvate su file o chiavi di registro in modo non sicuro e molto altro ancora!

Per erogare un servizio di Incident Response sublime è necessario conoscere le tecniche dell’attaccante, ed utilizzarle per ottenere la stessa o maggiore visibilità sui sistemi da esso compromessi. Velocemente; soprattutto nel caso in cui l’attaccante sia ancora collegato sui sistemi e non abbia cominciato fasi distruttive come la cifratura dei files o peggio, dei VMDK.

Contenimento Pronto e Deciso

Una volta estratti gli artefatti ed individuata l’attività sospetta, è essenziale agire prontamente per contenere il danno potenziale. L’automazione gioca un ruolo cruciale in questo processo, consentendo la messa in quarantena rapida dei sistemi compromessi o la disattivazione degli account compromessi.

Messaggio per gli “Incident response team” che leggono: bisogna essere pronti con automation vendor agnostic. In ogni caso. Non c’è tempo da perdere quando veniamo chiamati ad operare.

Oltre ad un’abile ricognizione è quindi fondamentale applicare alle nostre custom automation un’intelligenza in grado di rispondere con determinate pattern attive in caso di rilevazioni critiche.

Gli algoritmi di intelligenza artificiale remota possono identificare i pattern delle minacce e attivare automaticamente le politiche di sicurezza necessarie per bloccare l’accesso non autorizzato e limitare la propagazione dell’attacco. Ciò riduce drasticamente il tempo di risposta e limita l’impatto degli incidenti sulla continuità operativa, ovviamente questo tipo di implementazione non risulta facilissimo, tuttavia, è doveroso farla.

Alcuni esempi di automazioni utili al contenimento ed eradication possono essere:

  • Filesystem Watcher Defense
    • Binario che monitora costantemente le modifiche al filesystem tramite le librerie NetFramework “FilesystemWatcher”. In sintesi, è una componente utile per creare applicazioni reattive che possono monitorare e rispondere dinamicamente ai cambiamenti nel sistema file, contribuendo così a migliorare l’automazione e l’efficienza delle operazioni di gestione dei file.
    • Le applicazioni pratiche possono essere: antiransomware, filechange content analysis, reactive remediation basata sul monitoraggio combinato di filesystem e processi.
  • MemDump Analysis
    • Qui volatility viene in nostro aiuto nel fornirci il framework su cui sviluppare detection di pattern malevole in memoria. Non mi dilungo oltre, sky is the limit.
  • Filesystem Scan con yara
    • Chi lavora nella sicurezza lo sa, non esiste vendor che abbia tutte le firme nei propri database. Chi gestisce incidenti 24/7 però può vantare di averne uno “bello aggiornato”. Perchè non sfruttarlo per generare delle Yara rules da utilizzare in scansioni mirate durante la raccolta di artefatti per il triage? Multithreading is the way! E poi al cliente compromesso non dispiacerà se utilizzate i suoi sistemi al 100% delle risorse per qualche minuto in questi casi, dico bene?

Eradicazione delle Minacce con Precisione

Una volta contenuta la situazione, è essenziale procedere con l’eradicazione delle minacce per ripristinare completamente l’integrità del sistema. L’automazione permette di eseguire rapidamente scansioni approfondite dei sistemi compromessi per individuare e rimuovere completamente il malware persistente come backdoor o altre componenti dannose.

Gli strumenti di automazione più avanzati possono anche identificare e mitigare le vulnerabilità di sicurezza che potrebbero aver consentito agli attaccanti di infiltrarsi inizialmente nel sistema. Non è sempre possibile eseguire patching, ma in casi di crisi per mantenere attivi servizi critici riducendo al minimo il rischio di lateral movement risulta fondamentale poter implementare cross hardening automatizzato.

Questo processo di eradicazione, se combinato come detto in precedenza, alla creazione di regole sartoriali all’incidente in gestione riduce al minimo il rischio di una reinfezione e ripristina la sicurezza dei sistemi in modo efficiente.

Efiltrazione e notifica al garante

Infine, l’automazione svolge un ruolo cruciale nell’affrontare la fase post-incidente, inclusa l’analisi delle attività inerenti l’esfiltrazione dei dati. Gli strumenti automatizzati possono tracciare e valutare il flusso di dati per identificare eventuali tentativi di estrarre informazioni sensibili dai sistemi compromessi. Inoltre, le automation per l’incident response possono essere configurate per notificare automaticamente chi sta eseguendo le analisi circa la presenza di strumenti comunemente utilizzati dai Threat Actor al fine dell’exfiltration, in questo modo sarà più facile identificare l’entità del danno subito dal cliente.

Una volta ottenuti i giusti elementi è possibile procedere con implementazioni alle notifiche preliminari al garante con tutte le rilevazioni e contromisure / attività messe in atto dall’azienda colpita. Ricordate si hanno solo 72 ore dopo la scoperta dell’incidente per eseguire il primo atto di notifica preliminare, gli elementi chiave che rendono necessaria ed indispensabile la pratica sono:

  • Indisponibilità del dato
  • Perdita di confidenzialità
  • Perdita di integrità

In conclusione, l’automazione sta rivoluzionando il modo in cui affrontiamo gli incidenti di sicurezza informatica. Fornendo visibilità immediata, velocità di risposta senza precedenti e precisione nell’eradicazione delle minacce, l’automazione si sta dimostrando un alleato indispensabile nella lotta contro le minacce informatiche sempre più sofisticate. Tuttavia, è importante sottolineare che l’automazione non sostituisce completamente l’esperienza umana e il discernimento, ma piuttosto ne potenzia le capacità, consentendo agli esperti di concentrarsi su compiti ad alto valore aggiunto. Investire nell’automazione della risposta agli incidenti è essenziale per garantire una difesa informatica robusta e resiliente nell’era digitale.

Stay safe.

Facciamo un gioco…

Lvuzurxsz! Xjxvz nr riw lv lz jxyziizj zyanrz lj mklnazj evkrprzj, zlxmwnx aj bmch lm eqflmax snxlc qj oxmnhxqn jc otqlxne?

Articolo a cura di Nicolas Fasolo
Profilo Autore

Nicolas Fasolo è il Team Leader del Incident Response Team di Yarix (Vargroup). Nel tempo libero lavora come “Security Researcher” e “Malware Developer” indipendente con una passione sfrenata per l’analisi del malware. Durante il suo percorso formativo di certificazione Master CEH ha ottenuto il Top 1 al mondo per il “Quarter 4 Dicembre 2021”. Autore di “Cybersecurity Podcast” e “Cybersecurity Warrior”.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/lindispensabile-rivoluzione-nellincident-response-automazione-per-una-risposta-piu-efficace/
Attacchi ai Modelli di Intelligenza Artificiale

I modelli di Intelligenza Artificiale (AI) stanno assumendo molto velocemente un grande ruolo nella vita di tutti noi. Le previsioni sono che nei prossimi anni utilizzeremo quotidianamente modelli AI sia in ambito lavorativo sia personale per moltissimi scopi. Ad esempio IDC [Rif. 1] prevede che entro il 2027 il 60% dei PC venduti avrà componenti Hardware (“system-on-a-chip – SoC”, diversi dalle GPU) dedicate all’elaborazione locale di modelli AI (si veda anche [Rif. 2]). Ci si aspetta un simile sviluppo anche per i dispositivi mobili quali smartphone, tablet ecc. oltre, ovviamente, ai server.

Oltre alle possibili debolezze comuni a qualsiasi programma informatico, i modelli AI hanno delle debolezze specifiche e in alcuni casi nuove, contro le quali non siamo abituati a confrontarci quasi quotidianamente. La ricerca in questo campo è molto attiva e nuovi risultati sono annunciati ogni giorno. È comunque possibile fare già ora una rassegna dei principali tipi di debolezze dei modelli AI che possono essere sfruttate da un attaccante.

Approcci allo Studio dei Tipi di Attacchi ai Modelli AI

In generale lo studio di un attacco ad un sistema informatico può essere analizzato considerando le vulnerabilità che l’attaccante intende sfruttare, le tecniche per implementare l’attacco e l’effetto dell’attacco sul sistema attaccato. Vi sono vari approcci allo studio degli attacchi ai sistemi informatici. Fra i più noti è quello che fa riferimento alla “Kill Chain”, ovvero identificare nell’ordine le azioni che un attaccante porta a termine per realizzare l’attacco per trovare i punti ove poterlo fermare. La metodologia più utilizzata per i modelli AI è quella sviluppata da MITRE con ATLAS™ [Rif. 3]. Questo approccio, focalizzandosi sulle azioni dell’attaccante, è sicuramente quello più appropriato per la gestione degli incidenti in tempo reale perché aiuta il difensore a identificare la migliore maniera per gestire l’incidente.

Un altro approccio è più preventivo e consiste nel valutare principalmente le vulnerabilità e i possibili effetti di un eventuale loro sfruttamento da parte di un attaccante per poter implementare misure di sicurezza sulla base di una valutazione dei rischi. In questo caso si ricorre spesso alla formulazione di tassonomie quale quella di NIST [Rif. 4] o di Microsoft [Rif. 5].

In questa sede non si intende descrivere in dettaglio una “Kill Chain” o proporre una tassonomia, ma fare una rassegna ad alto livello di quanto ad oggi si è capito cercando di organizzare le informazioni in uno schema sufficientemente semplice. Per questo l’approccio adottato è più simile a quello di una tassonomia mancandone però il rigore e la completezza.

Per questo articolo sono state considerate le debolezze o vulnerabilità dei modelli AI e le possibili conseguenze o effetti del loro sfruttamento. Questi sono stati raggruppati in quelli che genericamente saranno chiamati “attacchi”. Seguendo [Rif. 4] conviene distinguere due tipi di attacchi: quelli comuni a molti tipi di modelli AI, che sono indicati come modelli AI Predittivi, e quelli specifici ai modelli Generativi e “General Purpose” quali ad esempio i “Large Language Models” (LLM) come GPT, Bard/Gemini, LLaMA ecc.

In sicurezza informatica, gli effetti dello sfruttamento di una debolezza o vulnerabilità sono usualmente classificati dalla violazione di una o più caratteristiche di sicurezza tra Riservatezza, Integrità e Disponibilità (RID, in Inglese CIA). Nella letteratura già richiamata, questa classificazione è utilizzata anche per i modelli AI con due piccole varianti: si considerano Riservatezza insieme a Privacy, Integrità, Disponibilità e per i modelli Generativi anche Abuso. Con Abuso si intende proprio l’utilizzo di un modello AI Generativo per generare dati in violazione degli scopi e/o dei modi di utilizzo del modello stesso. Si noti che l’abuso di un modello AI Generativo qui considerato è diverso dall’abuso di una tradizionale applicazione informatica. Tutte le funzionalità e possibili dati prodotti da una usuale applicazione informatica sono disegnati e implementati dai programmatori; in questa situazione un abuso si può verificare nel caso di utilizzo di funzionalità esistenti da parte di chi non ne è autorizzato (violazione dell’Integrità del sistema di autorizzazione dell’applicazione) o in violazione della licenza d’uso. Come sarà descritto in seguito, per i modelli Generativi un ulteriore caso di abuso è l’utilizzo del modello per generare dati non previsti dai programmatori o in violazione degli scopi dell’addestramento del modello, senza però violarne le caratteristiche RID.

Attacchi ai Modelli AI Predittivi

In generale gli attacchi ai modelli AI possono essere classificati in tre classi:

  • “Poisoning” (Avvelenamento)
  • “Evasion / Adversarial Attacks” (Evasione)
  • “Extraction / Reconstruction” (Estrazione / Ricostruzione).
Avvelenamento

Gli attacchi di avvelenamento sono quelli più simili ai comuni attacchi alla sicurezza dei sistemi informatici e avvengono usualmente nella fase di addestramento dei modelli AI, qui da intendersi generalmente come le attività tramite le quali un modello AI impara modificando i propri dati interni. L’addestramento può essere fatto in molte modalità: dalla modalità più semplice di una volta sola prima della messa in esercizio del modello AI, a modelli AI che imparano continuamente dai feedback che ricevono dai dati prodotti.

Oggetto dell’attacco possono essere sia i dati utilizzati per l’addestramento del modello AI sia il modello stesso, ovvero il codice che lo implementa.

Avvelenamento del codice

L’attacco forse più tradizionale è quello per la modifica del codice di un modello AI: l’attaccante accedendo in maniera illecita ai sistemi IT che gestiscono il codice del sistema AI, o a quelli di terze parti che sviluppano il codice o anche componenti di supporto come possono essere librerie crittografiche o numeriche (in molti casi open-source), o ancora impersonando uno sviluppatore di modelli AI e abusando di codice open-source, può modificare il codice aggiungendo ad esempio una backdoor o modificando in maniera opportuna ai propri scopi il codice del modello. È stato mostrato che è possibile introdurre modifiche al codice del modello estremamente difficili da identificare nel codice stesso, se non tracciando l’accesso illecito ai sistemi IT. L’effetto di queste modifiche comporta usualmente una violazione dell’Integrità del modello AI, ovvero dell’integrità sia del codice del modello sia del comportamento e dei dati prodotti dal modello. Un attaccante può quindi introdurre nel modello dei comportamenti noti soltanto a lui, ad esempio che a certi specifici dati in ingresso corrispondono certi tipi di dati in uscita. Oppure le modifiche possono alterare le capacità del modello impedendogli di gestire correttamente certi dati in ingresso o limitandone le prestazioni. In alcuni casi le modifiche al codice possono portare alla violazione della Disponibilità del modello AI, ad esempio il modello può utilizzare troppe risorse di calcolo per l’elaborazione di alcuni tipi di dati in ingresso e non è più in grado di completare le elaborazioni nei tempi attesi.

Avvelenamento dei dati di addestramento

I modelli AI di Machine Learning, tra cui la maggior parte dei modelli AI al momento più conosciuti, hanno come caratteristica la necessità di utilizzare grandi quantità di dati per l’addestramento. Ovviamente questo fornisce un nuovo e molto interessante punto di attacco: modificando i dati di addestramento, un attaccante può modificare il comportamento di un modello AI, e quindi i dati da questo prodotti, per raggiungere i propri scopi. Il primo esempio è quello di un modello AI utilizzato per individuare malware o spam: un attaccante può cercare di inserire tra i dati di addestramento il proprio malware o i propri messaggi di spam indicandoli come dati benevoli in modo che, quando operativo, il modello AI non li segnali come malware o spam. In questo caso, effetto dell’attacco è di violare l’Integrità del modello tramite la modifica dei dati di addestramento.

La necessità di ottenere grandi quantità di dati di addestramento aumenta le possibili modalità di attacco e rende più difficile adottare misure di difesa. Spesso i dati di addestramento sono pubblici, cercati e scaricati da Internet, ma questo rende molto difficile garantire che la sorgente sia qualificata, lecita e non a sua volta oggetto di attacco o direttamente creata dall’attaccante. Ma anche se i dati di addestramento inizialmente sono corretti, spesso vi sono varie terze parti che li raccolgono, li analizzano, formattano ecc. in modo da poter essere utilizzati come dati di addestramento nei modelli AI. Anche tutte queste terze parti possono diventare oggetto di attacco o essere gestite direttamente da un attaccante. Inoltre, tutti coloro coinvolti nella gestione dei dati di addestramento devono garantire la sicurezza di veramente grandi quantità di dati, il che può portare difficoltà nel controllo accessi o anche solo nella protezione dei dati sia in transito sia quando memorizzati (a riposo). Infine, non è facile per chi utilizza i dati per addestrare i propri modelli AI, verificarne l’integrità, qualità e l’assenza di dati maligni.

Per questi motivi è utile considerare la possibilità di utilizzare dati di addestramento sintetici, ovvero creati appositamente per l’addestramento. Oltre a permettere una maggiore protezione dei dati contro attacchi, l’utilizzo di dati sintetici evita anche il rischio di infrangere diritti d’autore, licenze e la riservatezza o privacy delle informazioni. D’altra parte, generare dei sintetici e realistici non è per nulla facile, e non è applicabile a tutti i possibili utilizzi dei modelli AI.

Evasione

Gli attacchi detti di Evasione, anche chiamati “Adversarial Attacks” o “Adversarial Examples”, sono forse quelli più specifici dei modelli di Machine Learning perché per lo più connessi al processo di apprendimento dei modelli stessi e al modo in cui le informazioni apprese vengono utilizzate dai modelli durante la loro esecuzione. Il nome di questi tipi di attacchi viene dal fatto che i modelli di Machine Learning possono compiere errori che dal punto di vista umano sono macroscopici, violando completamente il comportamento atteso e oggetto dell’addestramento. In pratica si tratta di dati di ingresso al modello molto simili a quelli di addestramento sui quali il modello sbaglia completamente [Rif. 6], come i famosi esempi dei cartelli stradali di stop con uno sticker giallo riconosciuti come cartelli di limite di velocità, o montature di occhiali, cappelli, trucco per il viso che portano il modello a riconoscere una persona per un’altra. Questi errori dei modelli di Machine Learning sono delle vulnerabilità che possono essere sfruttate da un attaccante. Se l’attaccante conosce alcune di queste vulnerabilità di un modello, può sfruttarle a proprio favore e quindi “evadere” dal comportamento del modello sfruttando degli “Adversarial Examples”. L’esempio più semplice è ancora quello di un sistema AI per il riconoscimento dei volti ad esempio utilizzato in un luogo pubblico. Se l’attaccante è a conoscenza che il modello AI compie un errore nel riconoscimento dei volti se sul volto sono presenti particolari montature di occhiali, le può utilizzare per non essere individuato.

Vi sono molteplici modi in cui un attaccante può individuare queste vulnerabilità: ad esempio se l’attaccante ha accesso completo o ha una copia completa del modello AI addestrato, lo può studiare per individuare gli “Adversarial Examples”; o può studiare modelli simili adattando poi i risultati al modello da attaccare; o se può accedere ai risultati dell’elaborazione dei dati del modello ma non al modello stesso, può adottare un attacco di forza bruta nel quale modifica i dati in ingresso al modello sino a individuare l’errore di elaborazione cercato.

Questi attacchi portano ad una violazione dell’Integrità dei dati prodotti dal un modello AI e sono particolarmente pericolosi perché permettono all’attaccante di sovvertire completamente il comportamento del modello AI con dati che sono molto simili ai dati di addestramento, per cui a priori del tutto leciti. È quindi molto difficile individuare questi attacchi solo analizzando i dati di ingresso al modello AI. Invece per individuare queste vulnerabilità è necessaria un’attività simile a quella ben nota dei Read Team, ovvero un gruppo di esperti di sicurezza che attacca il modello AI per individuarne le vulnerabilità come se fosse un vero attaccante.

Estrazione / Ricostruzione

Questo tipo di attacchi sfrutta delle debolezze o vulnerabilità dei modelli AI per violare la Riservatezza e/o Privacy dei dati di addestramento o della struttura del modello, tramite l’utilizzo del modello stesso. È importante ricordare che in molti modelli AI i dati di addestramento non sono archiviati in modo simbolico (l’archiviazione simbolica permette di individuare la locazione di memoria nella quale è archiviato un singolo dato), ma sub-simbolico e sparso, ovvero un singolo dato è destrutturato e poi distribuito e aggregato con altri dati nella memoria del modello AI. Quindi, almeno ad oggi, non è possibile implementare all’interno di un modello AI un sistema di controllo accessi alle informazioni utilizzate per l’addestramento e ai dati della struttura stessa del modello AI.

Gli attacchi di estrazione e ricostruzione permettono all’attaccante di sottoporre al modello AI degli input formulati in modo tale da ottenere in output informazioni sui dati di addestramento o della struttura stessa del modello AI, e in alcuni casi di ottenere i dati stessi.

Se per i modelli Generativi è abbastanza semplice immaginare come a una ben formulata richiesta il modello possa rispondere fornendo in output come risposta un dato di addestramento, per altri tipi di modelli l’estrazione o ricostruzione delle informazioni presenti nel modello è più complessa, ma spesso possibile. Ad esempio, un attaccante avendo idea del tipo di dati utilizzati per addestrare un modello di Machine Learning di classificazione ma non sapendo esattamente quali dati sono stati utilizzati, può sottoporre al modello dei dati in ingresso così preparati da poter dedurre dalle risposte del modello se un certo dato è stato utilizzato per l’addestramento del modello stesso (questi attacchi sono chiamati di “membership inference”).

Un approccio per difendersi da questi attacchi utilizza il concetto di “Differential Privacy” che misura la quantità massima di informazioni sui dati di addestramento che un attaccante può estrarre dal modello AI. Sono state proposte varie tecniche che implementano la “Differential Privacy” utilizzando specifiche procedure di preparazione dei dati di addestramento e di addestramento dei modelli AI ma che non sono efficaci rispetto a tutti i possibili tipi di attacchi di Estrazione o Ricostruzione. Altri metodi di difesa utilizzano il monitoraggio e l’applicazione di filtri ai dati in ingresso e a quelli prodotti dai modelli AI.

Attacchi ai Modelli AI Generativi

Oltre agli attacchi ai Modelli AI appena descritti, i modelli AI Generativi e “General Purpose” quali ad esempio i “Large Language Models” (LLM) come GPT, Bard/Gemini, LLaMA ecc., possono essere oggetto di un’altra classe di attacchi chiamata

  • “Abuse” (Abuso)
Abuso

Con Abuso si intende proprio l’utilizzo di un modello AI Generativo in modo difforme da quanto previsto o consentito. I modelli AI Generativi possono essere abusati per scopi diversi tra i quali:

  • La generazione di malware (generazione di codice maligno);
  • La generazione di campagne di Phishing;
  • La generazione di informazioni (testi, audio, immagini, video) false ma con grande rassomiglianza a informazioni vere (“Fake News”), inclusa la modifica di dati storici in modo credibile e la generazione di campagne per influenzare il pubblico su temi politici, di discriminazione, di costume ecc.;
  • La generazione di dati a supporto di frodi, truffe, azioni di delinquenza, attacchi informatici ecc.
  • La generazione di testi (ad esempio per un Chatbot) che convincono un utente a cliccare su un link che porta a un malware, o a divulgare informazioni riservate.

In alcuni casi i modelli AI Generativi possono essere abusati tramite l’uso delle loro interfacce macchina (API) che producono in maniera automatica i dati utilizzati in tempo reale per l’attività illegale. Un esempio di questo può essere la generazione automatica di testi utilizzati da un Chatbot o per uno scambio di messaggi email per portare a termine una truffa.

Questi tipi di attacchi sono per lo più compiuti utilizzando l’interfaccia interattiva, o tramite API, del modello AI Generativo. Queste interfacce, in particolare per i Large Language Models, accettano testi scritti o parlati (o immagini) in linguaggio corrente e non programmatico. L’utente quindi invia una richiesta (“Query”) al modello AI che la interpreta, elabora e fornisce il risultato. Come indicato precedentemente, l’elaborazione può includere anche la ricerca di informazioni presso altre fonti, incluso Internet. L’attaccante sfrutta quindi possibili debolezze del modello AI nell’accettazione e interpretazione della richiesta per ottenere dati a priori non permessi. Questi tipi di attacchi vanno usualmente sotto il nome di “Prompt Injection” o “Adversarial Prompting” in quanto l’attaccante inserisce al “Prompt” del modello AI una richiesta il cui scopo è di abusare del modello stesso. A livello teorico, questo tipo di attacchi assomiglia molto agli attacchi di SQL Injection nei quali si modifica la Query SQL in modo che il database esegua un comando non permesso.

Sono stati proposti e utilizzati molti diversi metodi per costruire richieste che portano ad un abuso di un modello AI Generativo tra cui “Prefix injection”, “Refusal suppression”, “Style injection”, “Role-play”, “Ignore previous instructions”, “Special encoding”, “Character transformation”, “Word transformation”, “Prompt-level obfuscation” ecc. [Rif. 7], e la ricerca in questo ambito è in continuo sviluppo.

Vi sono diverse tecniche per difendersi da attacchi di questo tipo. Una tecnica adottata nel processo di addestramento di questi modelli è chiamata “Reinforcement Learning from Human Feedback (RLHF)” e consiste in una fase ulteriore di addestramento svolto tramite l’intervento diretto di persone specialmente addestrate a insegnare al modello a non generare risposte offensive, dannose o non lecite. Un altra tecnica consiste nell’affiancare al modello AI Generativo un modello AI Predittivo per la classificazione di testi (o di immagini ecc.) che è addestrato a identificare dati malevoli, offensivi o non leciti eventualmente inviati al, o generati dal modello AI Generativo. Il modello AI Predittivo esamina quindi i dati in ingresso e i dati prodotti dal modello AI Generativo e calcola la probabilità che un dato prodotto si configuri come risultato di un abuso del modello AI Generativo. Infine si utilizzano anche filtri programmati specificatamente per individuare abusi nei dati in ingresso e prodotti dal modello.

Infine va citata anche la vulnerabilità dei modelli AI Generativi indicata genericamente come “Allucinazione” ovvero la generazione di dati che non hanno senso, sono irrealistici o falsi ma che sono presentati come reali e appaiono molto convincenti. Questa vulnerabilità può essere sfruttata da un attaccante per creare campagne di disinformazione, di phishing o truffe e in pratica può risultare molto efficace a questi scopi.

AI Generativa come attaccante autonomo

Sinora i modelli AI sono stati considerati come l’oggetto di un attacco, in realtà modelli AI possono anche essere utilizzati come strumento d’attacco. Questo non è strano in quanto le informazioni di sicurezza informatica in generale e sui modelli AI stessi, possono essere utilizzate sia dai difensori sia dagli attaccanti. Ad esempio, un modello AI può essere utilizzato per studiare i punti deboli di un sistema informatico o di un altro modello AI, e queste informazioni possono essere sfruttate sia da un difensore sia da un attaccante. Un attaccante può quindi adottare modelli AI tra i propri strumenti per eseguire attacchi a sistemi informatici, e un difensore può fare lo stesso. Si ha quindi una situazione in cui i modelli AI svolgono allo stesso tempo il ruolo di attaccante e difensore: in altre parole si ha uno scenario di “guerra” tra i modelli AI utilizzati da attaccanti e difensori.

E, almeno a livello di laboratorio, è già possibile considerare la creazione di “worm” che autonomamente diffondono malware tra modelli AI Generativi [Rif. 8].

Di maggiore interesse è considerare la possibilità che un modello AI Generativo esegua autonomamente attacchi ad altri sistemi informatici. Questo scenario richiama immediatamente alla mente molti romanzi e film di fantascienza, spesso con conseguenze tragiche (si pensi ad esempio a Skynet della serie Terminator). La possibilità teorica esiste, come ad esempio descritto in [Rif. 9]. Una modalità teorica in cui già oggi potrebbe essere possibile un attacco eseguito autonomamente da un modello AI Generativo è la seguente. Un modello AI Generativo quale un Large Language Model (LLM) è addestrato con una enorme quantità di informazioni che tipicamente includono anche informazioni di sicurezza informatica quali le modalità di eseguire attacchi a un sito Web come SQL Injection o Cross Site Scripting (XSS). Inoltre già oggi i modelli più avanzati hanno la capacità di eseguire ricerche in Internet per ottenere informazioni in tempo reale, e il risultato della ricerca può essere utilizzato dal modello AI come nuovo dato di ingresso in un ciclo complesso di elaborazione. In altre parole è tecnologicamente possibile che un modello AI Generativo possa ad esempio utilizzare un attacco SQL Injection per ottenere delle informazioni da un sito Web, ritenendo che questa tecnica sia la più efficace per accedere alle informazioni, senza che l’utente sia a conoscenza né del fatto che il modello sta cercando di estrarre informazioni da uno specifico sito Web né che la tecnica utilizzata per ottenere le informazioni sia un attacco informatico.

Riferimenti

[1] IDC, “IDC Forecasts Artificial Intelligence PCs to Account for Nearly 60% of All PC Shipments by 2027”, 7/2/2024, https://www.idc.com/getdoc.jsp?containerId=prUS51851424

[2] La Repubblica “Quel microchip fa Nvidia a tutti. L’Eldorado produttivo promesso dall’AI trascina le Borse mondiali”, 23 febbraio 2024; MarketWatch “Nvidia makes Wall Street history as stock surge adds $277 billion in market cap”, https://www.marketwatch.com/story/nvidias-stock-surge-could-add-200-billion-in-market-cap-with-mammoth-growth-on-tap-8d9472d2

[3] MITRE ATLAS™ “Adversarial Threat Landscape for Artificial-Intelligence Systems”, https://atlas.mitre.org/

[4] NIST AI 100-2 “Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations”, https://csrc.nist.gov/pubs/ai/100/2/e2023/final

[5] Microsoft “Failure Modes in Machine Learning”, https://learn.microsoft.com/en-us/security/engineering/failure-modes-in-machine-learning

[6] A. Pasquinucci, “Adversarial Attacks a Modelli di Machine Learning”, White Paper, ICT Security Magazine, https://www.ictsecuritymagazine.com/pubblicazioni/adversarial-attacks/

[7] Per una breve introduzione si veda “Prompt Injection Attacks in Large Language Models”, SecureFlag, https://blog.secureflag.com/2023/11/10/prompt-injection-attacks-in-large-language-models/

[8] S. Cohen, R. Bitton, B. Nassi, “Here Comes the AI Worm: Unleashing Zero-click Worms that Target GenAI-Powered Applications”, https://sites.google.com/view/compromptmized

[9] R. Fang, R. Bindu, A. Gupta, Q. Zhan, D. Kang, “LLM Agents can Autonomously Hack Websites”, https://arxiv.org/abs/2402.06664 ; R. Fang, R. Bindu, A. Gupta, D. Kang, “LLM Agents can Autonomously Exploit One-day Vulnerabilities”, https://arxiv.org/abs/2404.08144

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/attacchi-ai-modelli-di-intelligenza-artificiale/


Artificial intelligence (AI) e Sanità

La Commissione Europea ha di recente ricordato come “Artificial intelligence (AI) is not science fiction; it is already part of our everyday lives, from using a virtual personal assistant to organise our day, to having our phones suggest songs we might like”[1].

In tal senso, a fronte di una proliferazione spesso abusata del termine “intelligenza artificiale”, bisogna ricordare con sempre maggiore enfasi che la stessa necessita di un approccio cosciente e (in)formato per poter essere adeguatamente governata, anche a protezione dei diritti e delle libertà degli interessati.

L’applicazione di un agente/prodotto/sistema di AI richiede, anzitutto, che siano rispettati i seguenti principi:

  • Dignità e supervisione umana;
  • Robustezza e sicurezza;
  • Privacy e governance dei dati;
  • Trasparenza;
  • Diversità, non discriminazione ed equità;
  • Benessere sociale e ambientale;
  • Accountability.

Ma oltre ai principi è necessario considerare gli impatti che produce e, ancor di più, a quali rischi si va incontro facendone uso, ossia:

  • Generalità
  • Correttezza
  • Sicurezza
  • Safety
  • Tutela della privacy
  • Robustezza
  • Trasparenza e spiegabilità.

Nello specifico ambito sanitario, in tal senso possono essere di evidente aiuto – supportandoci nella comprensione di quanto sopra citato – alcuni documenti, quali ad esempio il report[2] dedicato all’AI in ambito sanitario emesso nel 2023 dalla World Health Organization, dove si precisa che:

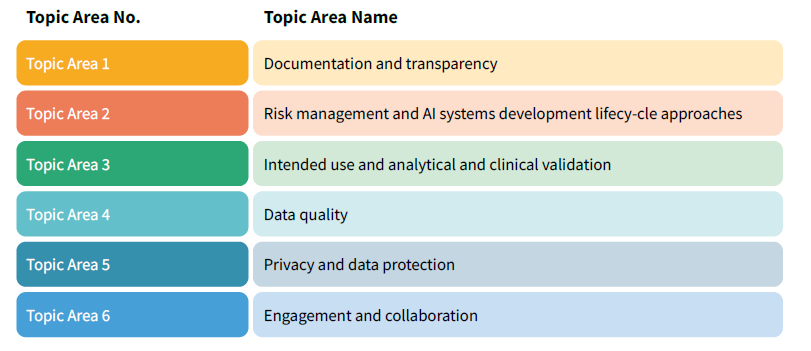
“Questo documento fornisce una panoramica delle considerazioni normative sull’IA per la salute coprendo argomenti chiave quali: documentazione e trasparenza, gestione del rischio e ciclo di vita dello sviluppo dei sistemi di IA l’uso previsto e la convalida analitica e clinica, la qualità dei dati, la privacy e la protezione dei dati l’impegno e la collaborazione.

Questo documento vuole essere un elenco delle principali considerazioni normative e una risorsa che può essere considerata da tutti i portatori di interessi pertinenti negli ecosistemi dei dispositivi medici, compresi gli sviluppatori che stanno esplorando e sviluppando sistemi di IA, le autorità di regolamentazione che potrebbero essere in procinto di gestire e facilitare i sistemi di IA, i fabbricanti che progettano e sviluppano dispositivi medici integrati nell’IA, i professionisti che distribuiscono e utilizzano tali dispositivi medici e sistemi di IA e altri che lavorano in questi settori“.

In particolare, il documento, suddiviso in 6 aree, descrive gli impatti e i rischi ai quali è soggetta l’applicazione con riferimento alla salute delle persone.

Queste aree descrivono, in maniera dettagliata, le problematiche che si possono incontrare, e così:

  1. Documentazione e trasparenza: pre-specificare e documentare lo scopo medico previsto nel processo di sviluppo, quali la selezione e l’uso di set di dati, norme di riferimento, parametri, metriche, deviazioni dai piani originali e aggiornamenti durante le fasi di sviluppo, dovrebbero essere in modo da consentire di tracciare le fasi di sviluppo, se del caso. Un approccio basato sul rischio dovrebbe essere preso in considerazione anche per il livello di documentazione e di conservazione dei dati sviluppo e validazione di sistemi di IA.
  2. Approcci al ciclo di vita della gestione del rischio e allo sviluppo di sistemi di IA: un ciclo di vita totale del prodotto dovrebbe essere preso in considerazione in tutte le fasi del ciclo di vita di un sistema di IA, vale a dire: gestione dello sviluppo, sorveglianza post-commercializzazione e gestione del cambiamento. Inoltre, è prendere in considerazione un approccio di gestione del rischio che affronti i rischi associati ai sistemi di IA, come le minacce e le vulnerabilità alla cibersicurezza, l’underfitting, i pregiudizi algoritmici, ecc.
  3. Destinazione d’uso e convalida analitica e clinica: Inizialmente, fornire una documentazione trasparente dell’uso previsto del sistema di IA. Dettagli della composizione del set di dati di training alla base di un sistema di IA, comprese le dimensioni, l’impostazione e la popolazione, i dati di input e output e composizione demografica – dovrebbero essere documentati in modo trasparente e forniti agli utenti.
    Inoltre è fondamentale prendere in considerazione la possibilità di dimostrare le prestazioni al di là dei dati di addestramento e test attraverso validazione analitica in un set di dati indipendente. Questo set di dati di convalida esterno deve essere rappresentativo della popolazione e dell’ambiente in cui si intende utilizzare il sistema di IA e dovrebbe essere indipendente del set di dati utilizzato per lo sviluppo del modello di IA durante l’addestramento e il test. Documentazione trasparente dell’insieme di dati esterno e delle metriche di prestazione. È importante prendere anche in considerazione una serie graduata di requisiti per la convalida clinica in base al rischio. Gli studi clinici randomizzati sono “gold standard” per la valutazione delle prestazioni cliniche comparative e potrebbe essere strumenti a più alto rischio o in cui è richiesto il più elevato livello di evidenza. In altre situazioni, le prospettive.
    La convalida può essere presa in considerazione in una prova di distribuzione e implementazione nel mondo reale che include un comparatore pertinente che utilizza gruppi accettati. Infine, un periodo di post-dispiegamento più intenso dovrebbe essere preso in considerazione attraverso la sorveglianza post-commercializzazione e la vigilanza del mercato per i sistemi IA.
  4. Qualità dei dati: gli sviluppatori dovrebbero valutare se i dati disponibili sono di qualità sufficiente per supportare lo sviluppo del sistema di IA per raggiungere lo scopo previsto. Inoltre, gli sviluppatori dovrebbero prendere in considerazione l’implementazione di rigorose valutazioni pre-rilascio per i sistemi di IA per garantire che non si amplifichino dei problemi, come distorsioni ed errori. Progettazione accurata o la risoluzione tempestiva dei problemi può aiutare a identificare tempestivamente i problemi di qualità dei dati e può prevenire o mitigare possibili danni che ne derivino. I portatori di interessi dovrebbero inoltre prendere in considerazione la possibilità di attenuare i problemi di qualità dei dati e rischi che emergono nei dati sanitari, nonché continuare a lavorare per creare ecosistemi di dati per facilitare la condivisione di fonti di dati di buona qualità.
  5. Privacy e protezione dei dati: la privacy e la protezione dei dati dovrebbero essere considerate durante la progettazione e la diffusione dei sistemi di IA. All’inizio del processo di sviluppo, gli sviluppatori dovrebbero prendere in considerazione l’acquisizione di una buona comprensione delle normative applicabili in materia di protezione dei dati e delle leggi sulla privacy e che il processo di sviluppo soddisfi o superi tali requisiti legali. È inoltre importante prendere in considerazione l’attuazione di un programma di conformità che affronti i rischi e garantisca che la tutela della Privacy. Le pratiche di cybersicurezza tengono conto dei potenziali danni e del contesto di applicazione.
  6. Coinvolgimento e collaborazione: durante lo sviluppo della tabella di marcia per l’innovazione e la diffusione dell’IA.

È necessario considerare lo sviluppo di piattaforme accessibili e informative che facilitino l’impegno e la collaborazione tra le principali parti interessate, ove applicabile e appropriato, così come è fondamentale prendere in considerazione la razionalizzazione del processo di sorveglianza per la regolamentazione dell’IA e la collaborazione al fine di accelerare i progressi che cambiano la pratica nell’IA.

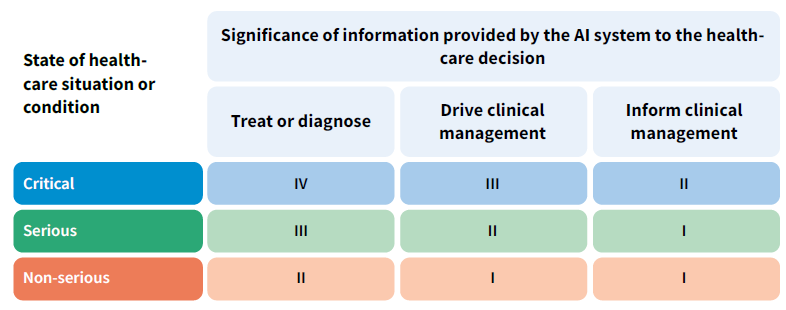
Il documento analizza anche i rischi in ambito sanitario dell’AI classificandoli come da immagine che segue:

Sempre sul tema è di certo interesse guardare all’Artificial intelligence in healthcare Applications, risks, and ethical and societal impacts[3] dell’EPRS (European Parliamentary Research Service), che riporta i 7 rischi che emergono in un sistema/agente di AI indicandone anche le misure di remediation (cui si rimanda):

  1. Danni al paziente dovuti a errori di intelligenza artificiale;
  2. Uso improprio degli strumenti di IA medica;
  3. Rischio di bias nell’IA medica e perpetuazione delle disuguaglianze;
  4. Mancanza di trasparenza;
  5. Problemi di privacy e sicurezza;
  6. Lacune nella responsabilità dell’IA;
  7. Ostacoli all’implementazione nell’assistenza sanitaria nel mondo reale.

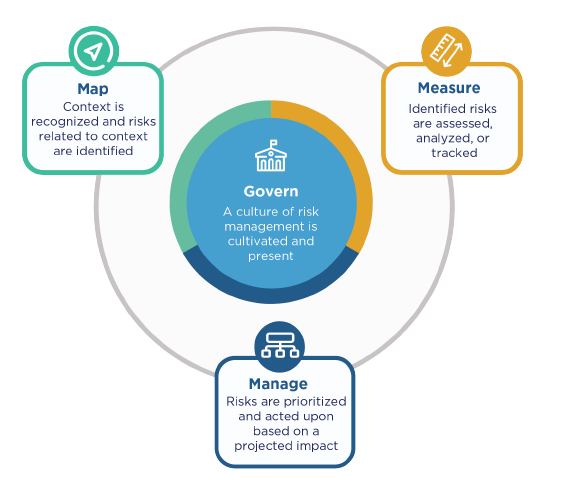
L’analisi dei rischi dovuti all’AI viene, poi, affrontata anche dal RMF (Risk Management Framework) del NIST [https://www.nist.gov/itl/ai-risk-management-framework] che riporta, per le funzioni, le sottocategorie alle quali è necessario rispondere per avere una valutazione del sistema:

  • la funzione GOVERN è suddivisa in 6 categorie e 13 sottocategorie. Questa coltiva e implementa una cultura della gestione del rischio all’interno delle organizzazioni che progettano, sviluppano, implementano, valutano o acquisiscono sistemi di intelligenza artificiale; delinea i processi, i documenti e gli schemi organizzativi che anticipano, identificano e gestiscono i rischi che un sistema può comportare, incorpora processi per valutare gli impatti potenziali; fornisce una struttura in base alla quale le funzioni di gestione del rischio dell’IA possono allinearsi ai principi, alle politiche e alle priorità strategiche dell’organizzazione; collega gli aspetti tecnici della progettazione e dello sviluppo dei sistemi di AI ai valori e ai principi dell’organizzazione e consente pratiche e competenze organizzative per le persone coinvolte nell’acquisizione, nella formazione, nell’implementazione e nel monitoraggio di tali sistemi; e affronta l’intero ciclo di vita del prodotto e i processi associati, comprese le questioni legali e di altro tipo relative all’uso di sistemi e dati software o hardware di terze parti;
  • la funzione MAP è suddivisa in 5 categorie e 18 sottocategorie. La MAP stabilisce il contesto per inquadrare i rischi relativi a un sistema di IA. L’IA Il ciclo di vita è costituito da molte attività interdipendenti che coinvolgono un insieme diversificato di attori. In pratica, gli attori dell’IA responsabili di una parte del processo spesso non dispongono di visibilità o controllo su altre parti e sui loro contesti associati;
  • la funzione MEASURE, invece, è composta da 4 categorie e 22 sottocategorie. Questa impiega strumenti, tecniche e metodologie quantitative, qualitative o miste per analizzare, valutare, confrontare e monitorare il rischio dell’IA e i relativi impatti. Utilizza le conoscenze relative ai rischi dell’IA identificati nella funzione MAP e informa la funzione MANAGE. I sistemi di IA dovrebbero essere testati prima della loro diffusione e regolarmente durante il funzionamento. Le misurazioni del rischio dell’IA includono la documentazione degli aspetti della funzionalità e dell’affidabilità dei sistemi;
  • la funzione MANAGE, infine, è suddivisa in 4 categorie e 13 sottocategorie e comporta l’allocazione delle risorse di rischio a rischi mappati e misurati su base regolare e come definito dalla funzione GOVERN. Il trattamento del rischio comprende piani per rispondere, riprendersi e comunicare in merito a incidenti o eventi.

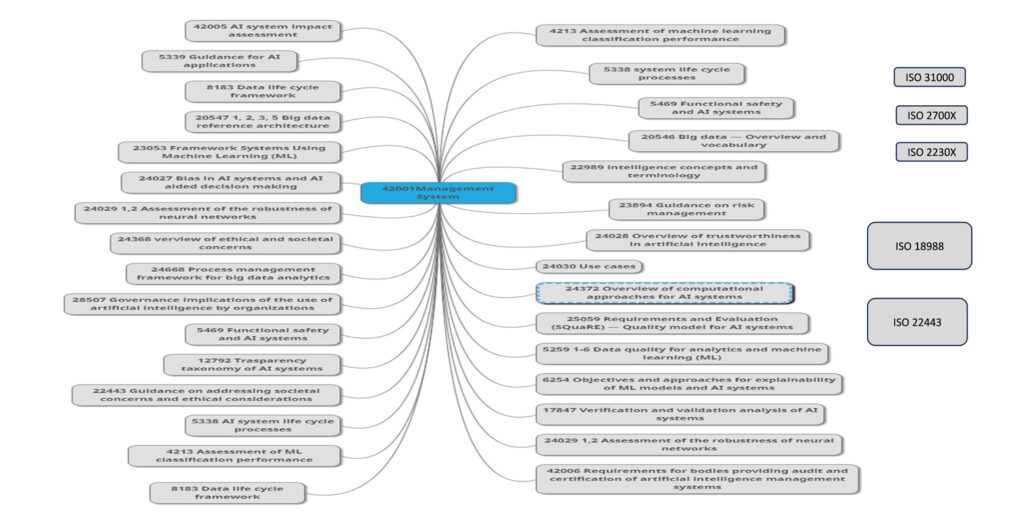
Senza dimenticare che, oltre ai documenti già citati, possono venire in aiuto anche le norme ISO dedicate all’AI, in primis quella relativa ad un sistema di gestione dell’AI – la norma(con i relativi controlli) -, e come supporto tutte le norme di contorno a partire dalla ISO 42005 relativa alla valutazione d’impatto, la ISO 23894 dedicata ai rischi, le norme ISO della serie 250XX dedicata alla qualità dei dati e del software oppure quelle relative alla gestione e validazione degli algoritmi di Machine Learning e le norme ISO 18988 (Applicazione delle tecnologie AI all’informatica sanitaria) e ISO 22443 (Guida su come affrontare le preoccupazioni sociali e le considerazioni etiche) che sono in fase di pubblicazione. Altre norme che possono aiutare a comprendere il sistema, i rischi e gli impatti sono la ISO 27001 sulla sicurezza delle informazioni, ISO 27005 sui rischi relativi alla sicurezza delle informazioni, ISO 31000 sulla gestione dei rischi e ISO 22301 sulla continuità operativa.

In ultimo, anche il Regolamento “AI Act” – caratterizzato da un risk-based approach – concentra buona parte dei propri sforzi sulla parte relativa ai rischi, considerando di “alto livello” quelli trattati nel presente contributo, e così:

“Articolo 6

Regole di classificazione per i sistemi di IA ad alto rischio

  1. Indipendentemente dal fatto che un sistema di IA sia immesso sul mercato o messo in servizio indipendentemente dai prodotti di cui alle lettere a) e b), tale sistema di IA è considerato ad alto rischio se sono soddisfatte entrambe le seguenti condizioni:
  2. a) il sistema di IA è destinato a essere utilizzato come componente di sicurezza di un prodotto, o il sistema di IA è esso stesso un prodotto disciplinato dalla normativa di armonizzazione dell’Unione elencata nell’allegato II;
  3. b) il prodotto il cui componente di sicurezza a norma della lettera a) è il sistema di IA, o il sistema di IA stesso in quanto prodotto, è tenuto a sottoporsi a una valutazione della conformità da parte di terzi, ai fini dell’immissione sul mercato o della messa in servizio di tale prodotto a norma della normativa di armonizzazione dell’Unione elencata nell’allegato II.
  4. Oltre ai sistemi di IA ad alto rischio di cui al paragrafo 1, anche i sistemi di IA di cui all’allegato III sono considerati ad alto rischio”.

In particolare l’allegato III cita:

“5. Accesso e godimento dei servizi privati essenziali e dei servizi e delle prestazioni pubbliche essenziali:
a) sistemi di IA destinati a essere utilizzati dalle autorità pubbliche o per conto delle autorità pubbliche per valutare l’ammissibilità delle persone fisiche a prestazioni e servizi essenziali di assistenza pubblica, compresi i servizi sanitari, nonché per concedere, ridurre, revocare o richiedere tali prestazioni e servizi”.

L’AI Act, oltre ai servizi, considera anche i prodotti e i dispositivi medici come indicato dal Regolamento UE 2017/745 del 5 aprile 2017 relativo ai dispositivi medici, i quali sono considerati oggetti ad alto rischio.

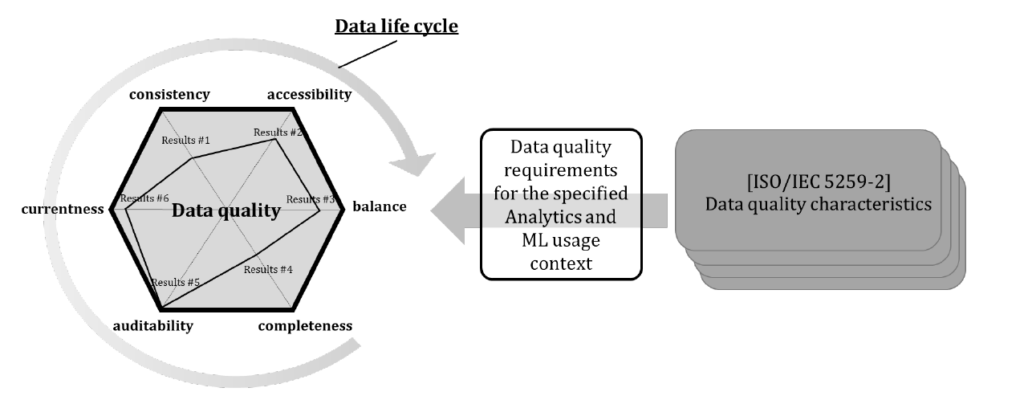
Nell’ambito sanitario, dove è importantissimo l’impatto sulla persona diventa fondamentale la conoscenza dei processi di Machine Learning, dalla qualità e correttezza dei dati, agli algoritmi utilizzati, alle metodologie e ai controlli.

Ad esempio:

  • la qualità dei dati,

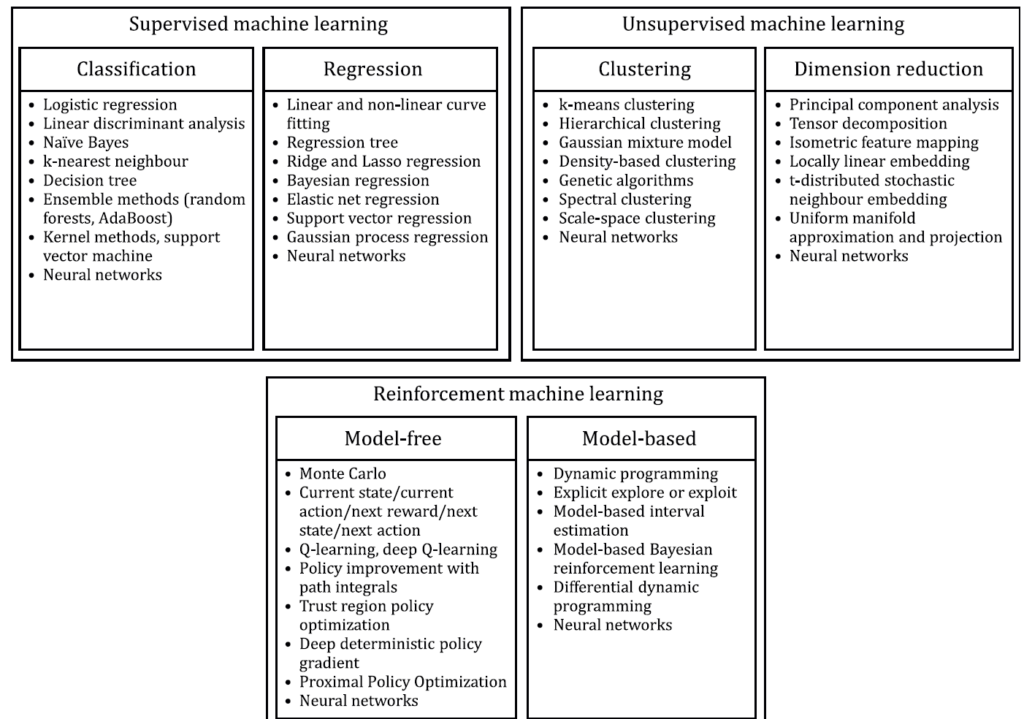
  • i tipi di ML utilizzati: Supervisionato, non supervisionato e rinforzato (ISO 2053),

che risultano importanti per:

  • Diagnosi della malattia
  • Medicina personalizzata
  • Produzione di farmaci
  • Svolgimento dei test clinici
  • Radioterapia e radiologia
  • Raccolta elettronica dei dati
  • Previsione delle epidemie

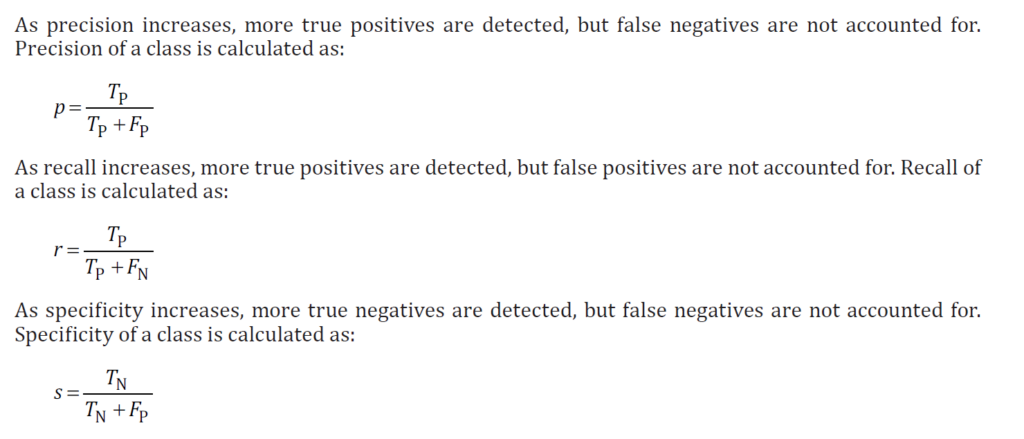
e i suoi controlli (dove T=vero, F=falso, P=positivo e N=negativo) come riportato dalla ISO TS 4213:

  • oppure i tipi di AI:
    • Intelligenza artificiale stretta (ANI), che ha una gamma ristretta di abilità, definita anche come debole o stretta;
    • Intelligenza generale artificiale (AGI), che è alla pari con le capacità umane, definita anche come AI forte o profonda;
    • Super intelligenza artificiale (ASI), che risulta più capace di un essere umano.

Allora, l’analisi e la riduzione dei rischi, dato l’elevato impatto sulle persone, diventa un’attività fondamentale e necessaria per una corretta applicazione e gestione dei sistemi AI.

Volendo, infine, scendere più nel concreto con riferimento all’applicazione pratica di Ai nell’ambito sanitario, è d’obbligo citare – seppur in estrema sintesi – il recente (marzo 2024) “Compendio sul trattamento dei dati personali effettuato attraverso piattaforme volte a mettere in contatto i pazienti con i professionisti sanitari accessibili via web e app” del Garante italiano per la protezione dei dati personali. Nello specifico, si tratta di un documento che fornisce indicazioni su come devono essere trattati i dati nei casi in cui il contatto tra medico e paziente avvenga attraverso una piattaforma o una app, ossia mediante strumenti innovativi che contengono sistemi di AI.

Il decalogo dei punti cui prestare particolare attenzione può essere riassunto come segue:

  1. finalità del trattamento,
  2. coordinamento con la disciplina vigente,
  3. basi giuridiche,
  4. divieto di diffusione dei dati e comunicazione di dati a terzi,
  5. valutazione d’impatto,
  6. ruoli privacy, adempimenti e responsabilità,
  7. principio di correttezza e trasparenza e informativa,
  8. trattamenti transfrontalieri,
  9. Privacy by Design,
  10. sicurezza del trattamento.

Per quanto qui d’interesse, si rileva che:

  • con riferimento al punto 5, il trattamento rientra tra quelli ad alto rischio che richiedono obbligatoriamente la preventiva valutazione d’impatto ex 35 GDPR[4] e delle Linee Guida del Gruppo di Lavoro Articolo 29[5], al fine di comprovare l’idoneità delle misure di sicurezza applicate, tenuto anche conto degli specifici rischi connessi al trattamento effettuato,
  • ex punto 9, i titolari del trattamento sono tenuti a trattare i dati personali solo utilizzando sistemi e tecnologie che integrano by design e by default i principi di protezione dei dati (cfr. considerando 78 del Regolamento e punto 94 delle citate Linee guida),
  • ai sensi del punto 10, il gestore della piattaforma dovrebbe implementare misure di sicurezza adeguate e così, ad esempio:
    • tecniche crittografiche durante la trasmissione dei dati su internet
    • un protocollo di rete che garantisca la riservatezza e l’integrità dei dati scambiati tra il browser dell’utente e il server che ospita i servizi delle predette piattaforme, consentendo inoltre agli utenti di verificare l’autenticità del sito web visualizzato.
    • una procedura di adesione alla piattaforma da parte dello specialista che preveda la verifica del possesso della qualifica professionale (es. invio di un codice OTP all’indirizzo PEC -censito su INI-PEC- del medesimo professionista);
    • una procedura di verifica/convalida del dato di contatto scelto dall’utente (es. indirizzo di posta elettronica, numero di cellulare);
    • misure volte alla riduzione degli errori di omonimia/omocodia;
    • una procedura di autenticazione informatica a più fattori;
    • meccanismi di blocco dell’app in caso di inattività o di chiusura della medesima;
    • sistemi di monitoraggio, anche automatici, per rilevare accessi non autorizzati o anomali alla piattaforma.

Note

Articolo a cura di Stefano Gorla e Anna Capoluongo

Profilo Autore

Consulente e formatore in ambito governance AI, sicurezza e tutela dei dati e delle informazioni;
Membro commissione 533 UNINFO su AI; Comitato di Presidenza E.N.I.A.
Membro del Gruppo di Lavoro interassociativo sull’Intelligenza Artificiale di Assintel
Auditor certificato Aicq/Sicev ISO 42001, 27001, 9001, 22301, 20000-1, certificato ITILv4 e COBIT 5 ISACA, DPO Certificato Aicq/Sicev e FAC certifica, Certificato NIST Specialist FAC certifica,
Referente di schema Auditor ISO 42001 AicqSICEV.
Master EQFM. È autore di varie pubblicazioni sui temi di cui si occupa.
Relatore in numerosi convegni.

Profilo Autore

Avvocato Data Protection & ICT | Data Protection Officer UNI 11697 | membro dell’EDPB’s Support Pool of Experts | Membro Women For Security | Membro Osservatorio sulla Giustizia Civile Tribunale Milano (Gruppo sul danno da illecito trattamento dei dati personali) | Afferente B-ASC (Università Milano-Bicocca Applied Statistics Center) | Vicepresidente Institute for Research of Law Economical and Social Studies| Membro Gruppo di Lavoro sull’AI di ANORC | Docente a c. (Università di Padova, Sole24Ore Business School), Comitato di Presidenza E.N.I.A.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/artificial-intelligence-ai-e-sanita/


Ddl Cybersicurezza: Intelligenza Artificiale (IA) per la protezione delle infrastrutture critiche e dei dati sensibili

Questo articolo è il terzo e ultimo di una serie dedicata all’analisi tecnico-giuridica del Disegno di Legge recante “Disposizioni in materia di rafforzamento della cybersicurezza nazionale e di reati informatici” approvato dal Consiglio dei Ministri lo scorso 25 gennaio e attualmente in corso di esame parlamentare (qui la prima e la seconda parte).

L’Intelligenza Artificiale al servizio della cybersicurezza

Nel panorama tecnologico attuale, se da un lato le Pubbliche Amministrazioni si attrezzano adottando procedure e prassi avanzate per difendersi dagli attacchi informatici, dall’altro l’emergere dell’Intelligenza Artificiale (IA) apre nuove frontiere nella protezione delle infrastrutture critiche e dei dati sensibili.

Questo scenario è al centro dell’articolo 7 del Disegno di Legge Cybersicurezza, che introduce una visione all’avanguardia dell’uso dell’IA ponendola come pilastro nella strategia di sicurezza nazionale, con un occhio attento agli imperativi etici che devono guidarne l’impiego.

L’approccio etico all’utilizzo dell’IA diventa quindi un’estensione naturale dell’impegno delle Pubbliche Amministrazioni verso una gestione sicura e responsabile dell’ambiente digitale.

L’inclusione esplicita di un mandato per l’Agenzia per la Cybersicurezza Nazionale (ACN) di promuovere iniziative di partenariato pubblico-privato per l’impiego dell’IA nella cybersicurezza evidenzia un riconoscimento del valore che questa tecnologia può apportare in termini di efficacia operativa, nonché nella promozione di pratiche etiche contro potenziali abusi.

La collaborazione tra enti pubblici e privati nell’ambito dell’IA non solo favorisce lo scambio di conoscenze e competenze ma pone le basi per una resilienza nazionale che integra le più avanzate soluzioni tecnologiche con i principi fondamentali di responsabilità e trasparenza.

Questa sinergia tra gli obblighi delle P.A. e l’uso etico dell’Intelligenza Artificiale nel rafforzamento della cybersicurezza nazionale costituisce un modello innovativo per affrontare le sfide del panorama informatico attuale, garantendo che il progresso tecnologico sia messo a fattor comune per combattere le minacce informatiche e contribuire alla protezione dei cittadini.

In ultima analisi l’integrazione dell’IA nelle strategie di cybersicurezza, guidata da un’impostazione etica e supportata da un impegno condiviso tra settore pubblico e privato, rappresenta non solo una risposta alle minacce in evoluzione ma anche un’opportunità per riaffermare l’importanza dei valori umani e sociali nella marcia verso l’innovazione tecnologica.

Nuove disposizioni sugli appalti pubblici per la sicurezza informatica

Tanto premesso, si osserva come le nuove disposizioni relative agli appalti pubblici di beni e servizi informatici rappresentino un pilastro fondamentale nella strategia di rafforzamento della cybersicurezza nazionale. Questo ambito, essenziale per la tutela degli interessi nazionali strategici, vede l’introduzione di criteri innovativi volti a garantire l’integrità, la confidenzialità e la disponibilità dei dati trattati.

Il Disegno di Legge stabilisce che, entro centoventi giorni dalla sua entrata in vigore, sarà adottato un decreto del Presidente del Consiglio dei Ministri, su proposta dell’Agenzia per la Cybersicurezza Nazionale e previo parere del Comitato interministeriale per la cybersicurezza, per individuare gli “elementi essenziali di cybersicurezza”.

Questi elementi, definiti come “insieme di criteri e regole tecniche”, sono essenziali per assicurare che l’acquisizione di beni e servizi informatici rispetti standard elevati di sicurezza, proteggendo i dati sensibili e le infrastrutture critiche nazionali.

Le stazioni appaltanti, inclusi gli enti che agiscono come centrali di committenza, sono tenute a integrare questi elementi essenziali di cybersicurezza nel processo di valutazione delle offerte.

Questo approccio multidimensionale prevede la possibilità di escludere le offerte che non rispettano i criteri di cybersicurezza definiti e di considerare tali elementi nella valutazione dell’offerta economicamente più vantaggiosa, nonché di inserire requisiti minimi di cybersicurezza nelle gare basate sul criterio del minor prezzo. Misure pensate per orientare le scelte contrattuali verso soluzioni che non solo offrono un buon rapporto qualità/prezzo, ma che garantiscono anche un elevato livello di protezione dei dati e delle infrastrutture informatiche nazionali.

A ciò si aggiunga l’estensione di queste disposizioni ai soggetti privati che, pur non rientrando nella definizione fornita dall’art. 2, comma 2 del Codice dell’Amministrazione Digitale, sono inclusi in categorie specifiche identificate dal decreto-legge n. 105/2019 relativo al Perimetro di sicurezza nazionale cibernetica.

Questo ampliamento sottolinea la volontà del legislatore di applicare una politica di cybersicurezza inclusiva e onnicomprensiva, che coinvolga attivamente sia il settore pubblico sia quello privato nell’adozione di misure di sicurezza informatica efficaci.

Premesso quanto sopra, si rileva che le nuove normative sugli appalti pubblici di beni e servizi informatici non solo impongono standard elevati per la sicurezza informatica nelle attività di approvvigionamento ma incentivano anche una più stretta collaborazione tra pubblico e privato, orientando il mercato verso soluzioni che rispettano principi di cybersicurezza avanzati e contribuiscono alla protezione degli interessi strategici del Paese, così concorrendo a innalzare il generale livello di sicurezza informatica.

Profilo Autore

Avvocato, Certified Ethical Hacker, Auditor di diversi schemi di certificazione (ISO/IEC 27001, ISO 22301, ISO 37001, ISO/IEC 20000-1, ISO 9001) e Project Manager. Chief Cybersecurity Advisor di ICT Cyber Consulting, Quality and Information Security Manager di ICTLC S.p.A., Of Counsel di ICT Legal Consulting, membro del CdA dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati e Senior Fellow Researcher nel framework Horizon Europe.
Autore di manuali, pubblicazioni e articoli scientifici sui temi relativi alla data protection e alla sicurezza informatica.

Profilo Autore

Esperta in cybersecurity e protezione dei dati. Laureata in Scienze delle Investigazioni e della Sicurezza e laurenda in Giurisprudenza presso l’Università degli Studi della Campania. Ha frequentato un Business Master in CyberSecurity Compliance e il Corso Maestro della Protezione dei Dati & Data Protection Designer. Auditor dei Sistemi di Gestione ISO/IEC 27001:2022 e ISO 9001:2015.
È Cybersecurity Specialist presso ICT Cyber Consulting ed offre il suo contributo nel framework Horizon 2020 come Of Counsel per ICT Legal Consulting, oltre ad essere Fellow Researcher per l’Istituto Italiano per la Privacy e la Valorizzazione dei Dati.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ddl-cybersicurezza-intelligenza-artificiale-ia-per-la-protezione-delle-infrastrutture-critiche-e-dei-dati-sensibili/


Cybercrime e best practices per la sicurezza informatica nelle aziende

Comprendere il cybercrime

Il cybercrime, noto anche come crimine informatico o crimine digitale, si riferisce a qualsiasi attività criminale che coinvolge l’utilizzo di computer, reti informatiche o dispositivi digitali.

Le principali attività illegali riscontrate fino ad oggi sono l’accesso non autorizzato a sistemi informatici, il furto di dati, la diffusione di virus informatici con conseguente danneggiamento o richiesta estorsiva per la riduzione in pristino, l’intercettazione illegale di comunicazioni, la frode informatica e varie altre forme di violazione della sicurezza informatica.

Quello che si nota nella comune esperienza è che il cyberattack proviene, molto spesso, dall’interno della realtà aziendale.

Questa c.d. insider threat e, cioè, la minaccia proveniente da persone interne all’organizzazione (dipendenti, fornitori, partner economici, soci etc.) si alterna a sistemi di attacco esterno che riescono a prendere il controllo del sistema informatico anche a migliaia di chilometri tramite, ad esempio, il RAT (Remote Administration Tool).

Ad oggi, le società sono chiamate ad affrontare una sfida in termini di prevenzione e persuasione, oltre che di contenimento del danno economico – e non – provocato dal crimine informatico e cibernetico, con un approccio su larga scala che consenta di fronteggiare la criminalità in rete in ogni sua declinazione.

Impatto del cybercrime sulle aziende

Gli effetti del cybercrime sono spesso immediati e devastanti per un’azienda.

Questa può subire perdite finanziarie, sia dirette che indirette, a causa del furto di fondi o di dati finanziari, dovendo mettere in contro anche successivi costi per l’individuazione e la risoluzione della violazione, la riparazione dei sistemi di sicurezza e l’eventuale risarcimento di clienti per le perdite subite.

Il danno economico molto spesso si affianca a quello reputazionale, che si può manifestare in modo incalcolabile: quando la reputazione di un’azienda viene danneggiata da un attacco informatico, si può verificare una perdita di fiducia dei clienti e dei partner commerciali, il che può avere un impatto a lungo termine sulle vendite e sui profitti aziendali.

Di seguito, si ricordano alcuni recenti attacchi informatici che hanno causato un impatto significativo sulle aziende.

L’attacco di ransomware WannaCry del 2017 che ha colpito numerose aziende, inclusi ospedali e istituzioni governative, bloccando l’accesso ai dati e richiedendo un riscatto per sbloccarli.

Il caso Equifax, una delle più grandi agenzie di reporting del credito negli USA. Nel 2017, Equifax ha rivelato che i dati personali di 143 milioni di americani erano stati esposti a causa di una violazione della sicurezza. Questo incidente è costato ad Equifax oltre 1,4 miliardi di dollari in spese legate alla violazione e la reputazione dell’azienda ne è stata gravemente danneggiata.

Recentissimo è il caso truffa finanziaria a danno della multinazionale britannica con sede a Hong Kong che ha spostato “per errore” 200 milioni di dollari da Hong Kong su cinque conti sconosciuti, operazione effettuata da un dipendente truffato tramite una video call dove ha pensato di parlare e prendere ordini dai suoi referenti – che, in realtà, erano un prodotto del deep fake -, disponendo lo spostamento di denaro ancora non ritrovato.

E come non citare il cyberattak subito da Leonardo S.p.A. nel 2017, commesso da un insider, il quale ha causato la fuoriuscita di “oltre 100mila file, riguardano, oltre i dati personali dei dipendenti, la progettazione di componenti di aeromobili civili e di velivoli militari destinati al mercato interno e internazionale”.

Durante le indagini effettuate dalla Polizia di Stato di Napoli e dal C.N.A.I.P.I.C. (Centro Nazionale Anticrimine Informatico per la Protezione delle Infrastrutture Critiche), emerse che “per quasi due anni, tra maggio 2015 e gennaio 2017, le strutture informatiche di Leonardo Spa erano state colpite da un attacco informatico mirato e persistente (noto come Advanced Persistent Threat o APT), realizzato con installazione nei sistemi, nelle reti e nelle macchine bersaglio, di un codice malevolo finalizzato alla creazione ed al mantenimento di attivi canali di comunicazione idonei a consentire una perdita di dati lenta e continua di elevati quantitativi di dati e informazioni di importante valore aziendale” [1].

È quindi evidente che per prevenire e mitigare il serio rischio di cybercrime, le aziende devono prendere coscienza del problema ed adottare misure di sicurezza informatica efficienti.

Legislazione e normative sulla cybersecurity

Nel campo penale, il nostro codice prevede numerose – ma non ancora sufficienti – fattispecie criminose che puniscono, tra le altre, l’accesso abusivo a sistemi informatici o telematici (art. 615 ter c.p.), la detenzione di apparecchiatura atta a intercettare, impedire o interrompere comunicazioni o conversazioni telegrafiche o telefoniche (art. 617 bis c.p.), il danneggiamento di informazioni, dati e programmi informatici (art. 635 bis c.p.) o di sistemi informatici o telematici (art. 635 quater c.p.).

Tali reati sono, inoltre, richiamati quali reati presupposto dagli artt. 24 e 24 bis D.Lgs. 231/2001, che puniscono le società (tramite severe sanzioni interdittive e pecuniarie) a vantaggio delle quali è stata commessa una frode informatica o delitto informatico o un trattamento illecito dei dati, di cui agli articoli sopra richiamati del codice penale.

Questo significa che, se un soggetto che ricopre funzioni di rappresentanza, amministrazione o direzione della società o di una sua unità organizzativa dotata di autonomia funzionale e finanziaria, oppure che gestisce o controlla la società, o un suo sottoposto, commette un reato tipico del cybercrime nell’interesse o a vantaggio della società, questa sarà chiamata a rispondere nel procedimento 231 instauratosi a suo carico.

Certo, vi è sempre la possibilità di difendersi nel procedimento 231, anche al fine di dimostrare l’estraneità dell’ente e/o del legale rappresentante dello stesso.

Ma ciò al pesante costo di essere comunque sottoposti al procedimento davanti alle autorità competenti, con anche la possibilità di vedersi applicare eventuali misure cautelari quali sequestri o commissariamenti giudiziari e, dunque, ad una generale perdita economica e reputazionale.

Ecco, quindi, l’importanza della compliance aziendale in materia 231 che non significa solo adottare un modello di organizzazione, gestione e controllo e un codice etico, ma soprattutto renderli concreti e manifesti, anche tramite un efficace processo di adozione di protocolli di gestione della sicurezza informatica, nei quali vi sia una specifica disciplina aziendale in materia di prevenzione, contenimento e risposta al cybercrime.

In merito, si evidenziano quelle che secondo la prassi più diffusa rappresentano le best practices aziendali da seguire per adeguare la società all’attuale normativa:

  • Individuazione del bene aziendale da tutelare e dei rischi ai quali è potenzialmente esposto;
  • formazione e sensibilizzazione del personale su minacce e misure di sicurezza, anche addestrando a riconoscere messaggi appositamente creati per essere ingannevoli (c.d. phishing);
  • adozione di software di sicurezza per proteggere i sistemi aziendali, filesystem di nuova generazione, sistemi criptati di accesso a determinate informazioni sensibili;
  • implementazione di politiche di accesso (c.d. least privilege) e controllo ai sistemi aziendali. In particolare, limitazioni dell’accesso al solo personale autorizzato e previsione di una rigorosa separazione dei ruoli nel sistema di logging;
  • costante backup e ripristino dei dati;
  • monitoraggio dell’ambiente informatico per rilevare potenziali minacce, anche tramite un sistema di segnalazione interna (c.d. whistleblowing);
  • implementazione del sistema di prevenzione (sandbox, NIDS, blocco automatico di codici javascript, antivirus e antimalware, etc.);
  • predisposizione, implementazione e costante aggiornamento di un documento di security policy.

Conclusioni

Pur se coperti da norme penali, al giorno d’oggi resta ancora molto difficile perseguire i colpevoli di reati informatici e, ancor di più, strutturare un sistema di prevenzione degli stessi.

Questo vulnus, reso ancor più grave dalla scarsità di risorse tecniche disponibili, di forze di polizia e di difficoltà nel coordinamento sul territorio internazionale, si riversa in primis quale rischio reputazionale ed economico per le società e, post factum, rappresenta una distorsione nel sistema processuale penalistico che lo rende sempre meno al passo con i tempi.

La difesa nel processo dell’ente è materia tecnico giuridica da affidare agli esperti del settore, ma la predisposizione di modelli di organizzazione, gestione e controllo che tutelino l’ente dal rischio di commissione di reati anche informatici è di competenza di ciascuna realtà societaria, unitamente alla necessità che suddetto modello venga adottato e aggiornato in concerto con il codice etico e la security policy aziendale.

La società dovrà prendere coscienza dei rischi tecnologici sempre più concreti e della necessità di operare con strutture organizzate ed idonee per prevenirli o, quanto meno, per contenerne i danni.

Note

[1] D. Fioroni, Attacco Hacker a Leonardo Spa, 2 arresti, in www.poliziadistato.it, 5 dicembre 2020

Articolo a cura di Lorenzo Nicolò Meazza e Olivia de Paris

Profilo Autore

Avvocato penalista, titolare dell’omonimo Studio legale sito in Milano e Vicepresidente della Camera Penale di Milano, ove ha costituito la Commissione sull’intelligenza artificiale.
Si occupa prevalentemente di diritto penale d’impresa, con un focus particolare su criminalità informatica, compliance, diritto penale delle nuove tecnologie e digital forensics. Membro e presidente di numerosi Organismi di Vigilanza, il suo studio ha acquisito particolare esperienza nella redazione di Modelli Organizzativi e Regolamenti informatici aziendali.
È stato selezionato dall’Ordine forense di Milano e dal Pool Reati Informatici della Procura milanese tra gli avvocati esperti in diritto dell’informatica, con particolare competenza nella trattazione dei reati informatici.

Profilo Autore

Avvocato penalista dello Studio Legale Meazza, laureata presso l’Università Bocconi, con esperienza consolidata nel diritto penale dell’economia e del diritto penale tributario. Componente di Organismi di Vigilanza, autore di pubblicazioni in materia, focalizzata su delitti informatici e best practice per la sicurezza informatica aziendale, con particolare attenzione ai recenti progressi dei nuovi sistemi di Intelligenza Artificiale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cybercrime-e-best-practices-per-la-sicurezza-informatica-nelle-aziende/


SecBSD distro for security specialist

La sicurezza informatica è di fondamentale importanza in un’era in cui la nostra vita quotidiana, le nostre attività commerciali e le infrastrutture critiche dipendono sempre di più dalla tecnologia e dall’accesso a dati digitali.

Mantenere una robusta difesa contro queste minacce è essenziale per proteggere le risorse digitali.

Le infrastrutture critiche e le infrastrutture di comunicazione, dipendono sempre più dalla tecnologia informatica. La sicurezza IT è essenziale per proteggere queste infrastrutture da attacchi che potrebbero avere gravi conseguenze sulla società e sull’economia. Il progetto SecBSD, simile alla distro Kali per i linuxiani, verte su questa mission.

SecBSD da BSD, acronimo di Berkeley Software Distribution, è una famiglia di sistemi operativi derivati da UNIX sviluppati presso l’Università di Berkeley, in California. Questi sistemi operativi derivati dal nucleo BSD, hanno avuto un’enorme influenza nello sviluppo del software libero e open source. La storia del BSD ha inizio negli anni ’70, quando il sistema operativo UNIX fu sviluppato presso i laboratori Bell della AT&T. Il mondo BSD da cui deriva SecBSD è stato uno insieme dei primi sistemi operativi basati sul kernel BSD diverso dal kernel Linux, a essere distribuiti con una licenza open source, la cosiddetta “Licenza BSD” diversa dalla GPL, che permetteva agli utenti di modificare, distribuire e utilizzare il codice sorgente a loro piacimento, con poche restrizioni. Questo ha contribuito alla sua popolarità e ha permesso a molte persone di contribuire allo sviluppo del sistema operativo.

Alcune delle varianti più conosciute del BSD includono FreeBSD, OpenBSD e NetBSD,DragonFly BSD, GhostBSD, MidnightBSD, NomadBSD e HardenedBSD ognuna delle quali ha le proprie caratteristiche e obiettivi di sviluppo. Tutti i fork BSD derivano sostanzialmente da FreeBSD noto per essere adatto a scopi generali e OpenBSD si concentra sulla sicurezza paranoica da cui poi è stato realizzato quindi il fork SecBSD.

Il kernel BSD di base è noto per la sua stabilità e affidabilità. È stato utilizzato ampiamente in ambienti di produzione critici e ha dimostrato di essere in grado di gestire carichi di lavoro intensi con pochi problemi. La sicurezza è una delle priorità del kernel BSD. Molti sforzi sono stati dedicati al miglioramento della sicurezza del sistema operativo nel suo complesso, inclusi strumenti per mitigare le vulnerabilità e proteggere il sistema da attacchi informatici come “jails”, che fornisce un ambiente di sistema operativo virtualizzato e isolato. Questo consente agli amministratori di sistema di creare contesti separati all’interno di un sistema BSD, ognuno con il proprio ambiente di sistema e risorse isolate dagli altri.

Il mondo BSD è anche conosciuto per le tecnologie ZFS, ultimamente usato anche su GNU/linux e DTrace per la gestione del file system e il monitoraggio delle prestazioni del sistema.

Il progetto SecBSD ha pensato quindi di creare un fork dalla variante più sicura del settore BSD, quindi OpenBSD agli strumenti Opensource per la sicurezza informatica scaturendo Sec-BSD un kernel BSD orientato alla security.

Tra tools che troviamo di base ci sono tutti i software opensource multipiattaforma presenti anche per il mondo kernel Gnu/linux. Tra cui spiccano strumenti sia per le ricerche OSINT come Email2phonenumber, Infoga un software email OSINT sia per attacchi di tipo social-engineer.

OSINT, acronimo di Open Source Intelligence (Intelligence di Fonti Aperte), si riferisce alla pratica di raccogliere informazioni da fonti pubbliche e aperte per ottenere una comprensione più approfondita di determinati soggetti, organizzazioni, eventi o questioni. Questo tipo di intelligence si basa su informazioni disponibili pubblicamente, come siti web, social media, database pubblici, notizie, forum online, e altre fonti simili.

Le informazioni raccolte tramite OSINT possono essere utilizzate in vari contesti, tra cui sicurezza informatica, investigazioni penali, intelligence aziendale, analisi del rischio, ricerca di mercato e molto altro. Le fonti di informazioni aperte possono fornire una vasta gamma di dati, che vanno dalle informazioni personali e professionali alle tendenze di mercato e alle opinioni pubbliche. L’OSINT viene ultimamente sempre più associato alla sicurezza informatica perché lo spionaggio industriale inizia dalle info riscontrabili nel web. Ecco l’importanza di un uso etico e legale, rispettando la privacy delle persone e le leggi locali e nazionali. Inoltre, poiché si basa su fonti di informazioni pubbliche, l’OSINT può essere limitato dalla disponibilità e dalla qualità delle informazioni disponibili. Tuttavia, quando utilizzato correttamente, può fornire preziose informazioni per supportare decisioni informate in una varietà di contesti. Il progetto SecBSD prevede l’uso di tool inerenti a questa tematica.

Diversa tipologia sono gli attacchi di tipo social engineering che sfruttano la manipolazione psicologica degli individui per ottenere accesso non autorizzato a informazioni sensibili o sistemi informatici. Questi attacchi non si basano principalmente sulla violazione delle misure di sicurezza tecniche, ma piuttosto sfruttano la naturale tendenza delle persone a fidarsi e a rispondere a determinati stimoli emotivi o sociali. Tra le diverse forme di attacco ci sono il phishing ormai noto a tutti e il tailgating in cui gli attaccanti seguono un dipendente autorizzato all’interno di un’area sicura senza autorizzazione, approfittando della sua fiducia o cercando di convincerlo a lasciarli entrare. SecBSD ha il SET ovvero the social-engineer toolkit framework completo e conosciuto per organizzare attachi social clonando pagine di social noti e altre tecniche di phishing per illudere la vittima a inserire user e password.

Il pentesting, abbreviazione di penetration testing (test di penetrazione), è una pratica fondamentale nell’ambito della sicurezza informatica. Si tratta di una simulazione controllata di un attacco informatico contro un sistema, una rete o un’applicazione, condotta da esperti di sicurezza informatica autorizzati. L’obiettivo del pentesting è quello di identificare e correggere le vulnerabilità presenti nei sistemi e nelle reti prima che possano essere sfruttate da persone malintenzionate. Tra le fasi del Pentesting vi sono la pianificazione e raccolta informazioni, la scansione e analisi di sistemi quindi l’identificazione se ci sono delle vulnerabilità e documentare nella fase finale i risultati ottenuti durante l’attività con l’eventuale mitigazione dei problemi riscontrati.

Nell’arsenale SecBSD utili a questo scopo ci sono tools come nmap, nikto, aircrack-ng, OWASP Zed, Autosploit, wireshark, fluxploider, jaeles, Narq, Hydra, SQLmap, Metasploit e XSStrike. Tutti strumenti per l’attività di pentester nella fase di vulnerability assessment e post-esploitation e molti altri.

I tools presenti sono solo il punto di partenza come ogni strumento che può essere utile alla consulenza, ma sta al pentester poi saperli usare a dovere e adattarli ai casi specifici, la security IT non si esegue lanciando solo un programma automatico ma è il frutto di esperienza in materia IT security e sistemistico. Il mondo opensource insieme ai molti repository presenti su github ampliano gli strumenti disponibili per i casi più disparati. I volontari che contribuiscono a questo progetto OPENSOURCE hanno voluto creare un “coltellino svizzero” ben fornito basato su un motore stabile BSD. Progetto realizzabile anche grazie alla comunità del software libero e ai tanti volontari che postano i loro progetti su piattaforme git. L’aiuto di tutti i volontari del mondo del software libero rendono i progetti free-software/opensource un punto di riferimento sempre più incisivo per appassionati e professionisti che operano in contesti IT.

Articolo a cura di Fabio Carletti

Profilo Autore

Fabio Carletti aka Ryuw è un White Hat del gruppo (SoldierX Hacker team).

Esperto di sicurezza informatica con una vasta esperienza nel campo della protezione dei sistemi, delle reti e dei dati sensibili. Con più di 20 anni di esperienza nel settore della sicurezza informatica, ha lavorato con diverse organizzazioni per implementare strategie di difesa avanzate e mitigare le minacce informatiche in continua evoluzione.

Collabora come membro volontario del Tor Project team.

Ospite di rilevanti eventi italiani riguardanti la privacy, gnu/linux e software open source dedica le sue energie alla ricerca nella sicurezza informatica.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/secbsd-distro-for-security-specialist/


Ddl Cybersicurezza: Verso un Futuro più Sicuro attraverso Normative Rafforzate, Resilienza delle PA e Gestione Trasparente degli Incidenti

Questo articolo è il secondo di una serie dedicata all’analisi tecnico-giuridica del Disegno di Legge recante “Disposizioni in materia di rafforzamento della cybersicurezza nazionale e di reati informatici” approvato dal Consiglio dei Ministri lo scorso 25 gennaio e attualmente in corso di esame parlamentare (qui la prima parte).

Disegno di legge Cybersicurezza: panoramica e obiettivi

Il Ddl in materia di rafforzamento della cybersicurezza nazionale e di reati informatici, approvato il 25 gennaio 2024 dal Consiglio dei Ministri e presentato alle Camere il successivo 16 febbraio, costituisce un avanzamento rilevante nel processo di evoluzione della normativa italiana in materia.

Esso si presenta come un insieme normativo di notevole complessità, ideato per confrontarsi con le sfide e le minacce che caratterizzano l’ambiente digitale in continua trasformazione.

Il suddetto Disegno di Legge rappresenta segna un punto di svolta nel corpus legislativo italiano, in risposta all’esigenza sempre più pressante di salvaguardare infrastrutture critiche e dati di rilevanza sensibile da pericoli informatici in costante ascesa ed evoluzione.

Con questa iniziativa si intende consolidare il tessuto di sicurezza digitale nazionale attraverso una serie di interventi specifici, che riflettono un approccio olistico alla prevenzione e alla gestione degli incidenti informatici. Il fulcro di tale iniziativa legislativa è il riconoscimento che la sicurezza delle informazioni non può essere relegata a un “secondo piano” ma deve essere integrata in ogni aspetto della gestione pubblica e privata.

La volontà di estendere il perimetro di applicazione delle norme sulla cybersicurezza va intesa come un segnale inequivocabile dell’intento del legislatore di abbracciare una varietà più estesa di entità, non limitandosi alle infrastrutture critiche tradizionalmente riconosciute ma estendendo la protezione a nuove realtà esposte ai pericoli informatici. Tale estensione implica una valutazione accurata dei soggetti coinvolti, che saranno tenuti ad adottare misure di sicurezza adeguate e a rispondere in modo proattivo agli incidenti, assicurando in tal modo un livello uniforme e coeso di protezione su scala nazionale.

Il rafforzamento delle capacità di prevenzione, rilevamento e risposta agli incidenti informatici si concretizza in un impegno tangibile per le Pubbliche Amministrazioni e gli operatori di servizi essenziali, invitati ad adottare politiche e procedure capaci di ridurre efficacemente il rischio di attacchi informatici.

La cooperazione e il coordinamento tra i vari soggetti coinvolti diventano, pertanto, elementi chiave per la realizzazione di un sistema di sicurezza informatica efficace ed efficiente, in grado di proteggere il patrimonio informativo nazionale.

Inoltre, l’adozione di un regime sanzionatorio rafforzato per i reati informatici testimonia la volontà del legislatore di affrontare con maggiore determinazione la minaccia rappresentata da attacchi sempre più sofisticati e dannosi. Le disposizioni introdotte prevedono severe punizioni per coloro che compromettono la sicurezza informatica, inviando un messaggio incisivo riguardo alla serietà con cui lo Stato intende difendere le proprie infrastrutture e i dati personali dei cittadini.

Attraverso tali misure, il disegno di legge mira ad instaurare un ambiente digitale più sicuro per tutti i cittadini e le aziende italiane, favorendo la diffusione e l’ancoraggio di una cultura della sicurezza. La sfida che il legislatore è chiamato a raccogliere è di notevole complessità, richiedendo di trovare un equilibrio tra la tutela della sicurezza nazionale e la salvaguardia della libertà e dei diritti fondamentali dei cittadini nell’era digitale.

Perimetro di applicabilità

Il Disegno di Legge, introducendo un ambito di applicazione ampio e dettagliato, sottolinea un approccio legislativo mirato a inglobare una varietà di soggetti chiave nel tessuto della sicurezza digitale italiana.

Con una visione inclusiva, il Ddl Cybersicurezza indirizza la sua attenzione verso le Pubbliche Amministrazioni, le aziende strategiche operanti nei settori nevralgici dell’economia e le infrastrutture di importanza cruciale, precedentemente non incluse in regolamentazioni specifiche di sicurezza a livello nazionale, stabilendo per tali soggetti una gamma di responsabilità intese a incrementare il grado di protezione e resilienza di fronte a minacce di natura informatica.

Il nucleo dell’orientamento legislativo adottato dal Ddl si concentra sull’integrazione esplicita di pubbliche amministrazioni e imprese di rilevanza strategica, operanti in settori come le telecomunicazioni, l’energia, i trasporti, la finanza e la salute.

Tali entità, data la loro essenziale rilevanza nell’ecosistema nazionale, sono tenute a osservare standard di sicurezza informatica particolarmente rigorosi. La scelta di includere questi soggetti segue una logica preventiva, in quanto rappresentano bersagli più appetibili per attacchi informatici, avendo la potenzialità, se compromessi, di influenzare significativamente il quotidiano dei cittadini e le funzioni primarie dello Stato.

Parallelamente, il disegno di legge specifica l’esclusione dal suo campo d’applicazione dei cosiddetti “Soggetti Perimetro” – già tutelati da precedenti disposizioni legislative (i.e. soggetti di cui all’articolo 1, comma 2-bis, del decreto-legge n. 105 del 2019) – e gli organi di Stato preposti alla prevenzione, all’accertamento e alla repressione dei reati, alla tutela dell’ordine e della sicurezza pubblica, alla difesa e sicurezza militare dello Stato e agli organismi di informazione per la sicurezza (i.e. soggetti di cui agli articoli 4, 6 e 7 della legge 3 agosto 2007, n. 124).

Tale esclusione mira a evitare ridondanze normative e a garantire un intervento legislativo snello ed efficace, focalizzato laddove il bisogno di nuove misure di sicurezza si fa più pressante. Ne consegue, pertanto, che la decisione di escludere queste categorie non deriva da una percezione di minore importanza della loro sicurezza informatica ma, al contrario, dall’esistenza di un impianto normativo già definito e specializzato che le riguarda.

Obblighi specifici per il rafforzamento della resilienza delle P.A.

Secondo le disposizioni normative richiamate, il disegno di legge stabilisce obblighi specifici per i soggetti inclusi nel suo ambito di applicazione. L’essenza di tali obblighi si radica nella necessità di un’azione coordinata e rapida di fronte alle vulnerabilità informatiche, mirando a garantire una reattività efficace alle minacce informatiche e una riduzione del rischio di incidenti di sicurezza, nonché a consolidare la resilienza informatica del Paese.

Le Pubbliche Amministrazioni sono chiamate a svolgere un ruolo proattivo e strutturato nella prevenzione e gestione delle minacce informatiche, integrando obblighi specifici che trascendono la mera risposta alle segnalazioni di vulnerabilità. In particolare sono tenute ad elaborare politiche e procedure di sicurezza informatica adeguate, a gestire il rischio informatico in modo proattivo, a definire ruoli e organizzazioni per la sicurezza delle informazioni, nonché a sviluppare piani per la sicurezza di dati, dei sistemi e delle infrastrutture. Questo impegno necessita di un approccio olistico alla sicurezza, che includa non solo la protezione contro gli attacchi esterni ma anche la preparazione interna e la capacità di resilienza.

Tra le disposizioni di maggiore importanza vi è l’obbligo di formazione e aggiornamento continuo del personale riguardo alle minacce alla sicurezza e alle vulnerabilità dei sistemi. Tale aspetto enfatizza la necessità di una cultura della sicurezza profondamente integrata all’interno delle organizzazioni, capace di adattarsi dinamicamente al panorama delle minacce in continua evoluzione.

L’articolo 6 del Ddl rafforza ulteriormente questo indirizzo, proponendo di proseguire l’attuazione di una direttiva del Presidente del Consiglio dei Ministri (datata 6 luglio 2023) che aveva già definito linee guida per promuovere una gestione efficace degli incidenti cibernetici all’interno delle P.A., inserendosi in un contesto di normative preesistenti e di nuove disposizioni volto a consolidare la capacità delle amministrazioni di prevenire, gestire e rispondere in maniera efficace agli incidenti informatici.

Un aspetto fondamentale di questa strategia è l’obbligatorietà per le amministrazioni di individuare – qualora non già presente – una struttura interna dedicata specificamente alle attività di cybersicurezza, avvalendosi delle risorse umane, strumentali e finanziarie disponibili. Questa struttura avrà il compito di operare come fulcro delle iniziative di sicurezza informatica, garantendo un approccio coordinato e integrato.

Presso tale struttura opererà la figura del referente per la cybersicurezza, designato come punto di contatto unico dell’amministrazione con l’Agenzia per la Cybersicurezza Nazionale (ACN). Questa figura svolge un ruolo cruciale nella garanzia di comunicazione e collaborazione efficaci con l’ACN, fungendo da snodo centrale per il flusso di informazioni, segnalazioni e aggiornamenti relativi alla sicurezza informatica.

Attraverso l’istituzione di strutture dedicate e la designazione di referenti specifici per la cybersicurezza, il Disegno di Legge persegue l’obiettivo di migliorare la capacità delle pubbliche amministrazioni di rispondere in maniera coordinata ed efficace agli incidenti di cybersicurezza. Il suddetto approccio non solo rafforza la cybersecurity posture delle singole entità, ma contribuisce significativamente alla resilienza complessiva del tessuto digitale nazionale, creando un ambiente più sicuro e protetto contro le minacce informatiche.

Obblighi di notifica e segnalazione degli incidenti di sicurezza e relative sanzioni

Premesso quanto sopra, il Disegno di Legge impone specifici obblighi di segnalazione e notifica degli incidenti di sicurezza alle Pubbliche Amministrazioni, delineando chiare responsabilità in caso di incidenti che riescano a eludere le misure di sicurezza implementate. Questi obblighi rappresentano una componente critica della strategia nazionale di cybersicurezza, garantendo una reazione tempestiva e coordinata agli incidenti, essenziale per minimizzare potenziali impatti e prevenire ulteriori compromissioni.

L’art. 1 del Ddl specifica che le P.A. centrali, le regioni, le province autonome, i comuni con una popolazione superiore ai 100.000 abitanti e altre entità, quali le società di trasporto pubblico urbano e le aziende sanitarie locali, sono tenute a segnalare e notificare all’ACN gli incidenti di sicurezza aventi un impatto significativo sui loro sistemi informativi e servizi informatici.

Cruciale per il quadro normativo è l’implementazione dell’art. 2, che impone a tali soggetti di agire prontamente in risposta alle segnalazioni dell’ACN riguardanti specifiche vulnerabilità cui risultano potenzialmente esposti. Senza ritardo e non oltre quindici giorni dalla comunicazione, è necessario che i soggetti procedano con l’attuazione degli interventi risolutivi indicati dall’Agenzia.

In caso di inosservanza di questa disposizione, ovvero se gli enti non mettono in atto con prontezza le azioni correttive indicate, il Disegno di Legge stabilisce l’imposizione di sanzioni pecuniarie, come specificato nell’articolo 1, comma 5. Tanto premesso, si osserva come il disegno di legge contempli un’eccezione per i casi in cui impedimenti di ordine tecnico-organizzativo, debitamente notificati all’ACN, ostacolino l’adozione degli interventi risolutivi nei termini stabiliti.

La procedura sanzionatoria prevista per gli enti che omettono gli obblighi di segnalazione e notifica (come specificato all’art. 1), nonché in caso di mancato adeguamento alle indicazioni fornite a seguito di segnalazioni (conforme all’art. 2, fatto salvo quanto previsto al comma 2 del medesimo articolo), sottolinea l’importanza di assicurare trasparenza e collaborazione proattiva con l’ACN. In particolare, l’Agenzia invia una comunicazione preliminare all’ente inadempiente, segnalando che la persistenza nell’inosservanza comporterà l’applicazione di sanzioni pecuniarie. L’avviso preliminare emanato dall’Agenzia agisce come monito alla responsabilità degli enti nell’applicare le disposizioni, incentivandoli a rispettare i propri obblighi e favorendo lo sviluppo di un ecosistema di cybersicurezza nazionale maggiormente solido e resistente.

Inoltre, nell’ottica di un continuo rafforzamento della cybersicurezza nazionale e di una più efficace gestione degli incidenti informatici, il Ddl introduce ulteriori significative modifiche. In particolare, l’articolo 3 modifica l’art. 1, comma 3-bis, del decreto-legge n. 105 del 2019, stabilendo un raccordo e coordinamento con le nuove disposizioni. Questa modifica prevede l’applicazione, anche per soggetti rientranti nel perimetro di sicurezza nazionale cibernetica, della stessa procedura di segnalazione e notifica degli incidenti di sicurezza delineata per le P.A., introducendo un doppio step: una segnalazione immediata entro 24 ore dall’incidente e una notifica dettagliata entro 72 ore.

Si tratta, lo si specifica, delle ipotesi di notifica già previste per gli stessi soggetti Perimetro dal richiamato comma 3- bis; e cioè in relazione agli incidenti aventi impatto su reti, sistemi informativi e servizi informatici, di pertinenza di tali soggetti, diversi da quelli inseriti nel Perimetro.

Tale innovazione normativa si propone di assicurare un flusso informativo tempestivo e dettagliato verso l’Agenzia per la Cybersicurezza Nazionale, facilitando un intervento più tempestivo ed efficace in caso di incidenti suscettibili di impattare le reti, i sistemi informativi e i servizi informatici nazionali, inclusi quelli non direttamente inseriti nel Perimetro di sicurezza nazionale.

La previsione di sanzioni amministrative pecuniarie, che possono variare da 25.000 a 125.000 euro per i casi di reiterata violazione dell’obbligo di notifica, enfatizza ancor di più la volontà legislativa di garantire l’aderenza ai summenzionati obblighi critici per la sicurezza informatica del Paese.

Tanto premesso, si osserva come le disposizioni del Disegno di Legge mirino a creare un ambiente digitale nazionale più sicuro e resiliente, ove la pronta segnalazione e notifica degli incidenti di sicurezza da parte delle pubbliche amministrazioni contribuisce significativamente alla capacità complessiva del Paese di rispondere alle minacce informatiche. Attraverso l’introduzione di obblighi chiari e sanzioni per l’inosservanza, il Ddl sottolinea l’importanza di una gestione proattiva e trasparente degli incidenti di sicurezza, consolidando ulteriormente la postura di cybersicurezza dell’Italia nel contesto globale.

Nel prossimo articolo – l’ultimo di questa serie incentrata sul Ddl Cybersicurezza – saranno esaminate le nuove disposizioni specificamente dedicate al tema dell’Intelligenza Artificiale.

Profilo Autore

Avvocato, Certified Ethical Hacker, Auditor di diversi schemi di certificazione (ISO/IEC 27001, ISO 22301, ISO 37001, ISO/IEC 20000-1, ISO 9001) e Project Manager. Chief Cybersecurity Advisor di ICT Cyber Consulting, Quality and Information Security Manager di ICTLC S.p.A., Of Counsel di ICT Legal Consulting, membro del CdA dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati e Senior Fellow Researcher nel framework Horizon Europe.
Autore di manuali, pubblicazioni e articoli scientifici sui temi relativi alla data protection e alla sicurezza informatica.

Profilo Autore

Esperta in cybersecurity e protezione dei dati. Laureata in Scienze delle Investigazioni e della Sicurezza e laurenda in Giurisprudenza presso l’Università degli Studi della Campania. Ha frequentato un Business Master in CyberSecurity Compliance e il Corso Maestro della Protezione dei Dati & Data Protection Designer. Auditor dei Sistemi di Gestione ISO/IEC 27001:2022 e ISO 9001:2015.
È Cybersecurity Specialist presso ICT Cyber Consulting ed offre il suo contributo nel framework Horizon 2020 come Of Counsel per ICT Legal Consulting, oltre ad essere Fellow Researcher per l’Istituto Italiano per la Privacy e la Valorizzazione dei Dati.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ddl-cybersicurezza-verso-un-futuro-piu-sicuro/


Metadati delle e-mail dei dipendenti: il punto sul provvedimento del Garante sottoposto a consultazione pubblica

I metadati delle comunicazioni di posta elettronica dei dipendenti possono essere conservati dai datori di lavoro, al più tardi, per 7 giorni, prorogabili con motivate ragioni per ulteriori 48 ore.

Lo ha stabilito il Garante all’interno di un provvedimento di indirizzo datato 21 dicembre 2023, reso pubblico il 6 febbraio 2024. Le nuove regole sui metadati hanno colto di sorpresa aziende e professionisti, sollevando malumori in dottrina, anche già solo per la mancanza di spiegazioni in merito alla determinazione di una durata così precisa, rigida e breve. La posizione dell’Autorità di controllo ha enormi impatti concreti, sia per le conseguenze bloccanti (inutilizzabilità dei dati) sia per i profili di responsabilità civile, amministrativa e perfino, in qualche caso, penale che il provvedimento in questione evoca.

Sull’onda delle ampie reazioni negative, lo stesso Garante ha successivamente maturato cautele, tanto da decidere di sottoporre la congruità dei termini e di altri passaggi a consultazione pubblica con un pacchetto di atti amministrativi reso disponibile il 27 febbraio 2024. La consultazione si è aperta il 16 marzo con la pubblicazione del relativo avviso in Gazzetta Ufficiale (serie generale, n. 64) e avrà termine il prossimo 15 aprile.

Si può partecipare, facoltativamente, inviando osservazioni presso la sede di piazza Venezia n. 11 – 00187 Roma o all’indirizzo di posta elettronica ordinaria protocollo@gpdp.it oppure via pec a protocollo@pec.gpdp.it, indicando nell’oggetto «Consultazione sul termine di conservazione dei metadati generati e raccolti automaticamente dai protocolli di trasmissione e smistamento della posta elettronica».

Va tenuto in ogni caso presente che gli apporti che perverranno non vincolano in alcun modo l’Autorità: “I contributi inviati dai partecipanti alla consultazione non precostituiscono alcun titolo, condizione o vincolo rispetto ad eventuali successive determinazioni del Garante”.

Facciamo dunque un punto sull’intera vicenda, con l’auspicio che possa essere utile alle imprese e ai professionisti che intendono partecipare alla consultazione pubblica. In particolare, saranno analizzati:

  1. i passaggi essenziali del provvedimento sui metadati;
  2. la logica giuridica sottostante;
  3. i principali elementi di perplessità; e,
  4. a monte, la questione più generale se il Garante disponga o non disponga del potere di imporre preventivamente e in senso generale termini di conservazione. Sia permesso sottolineare l’importanza di quest’ultimo punto, che costituisce la premessa logica idonea a travolgere non solo l’intera operazione prescrittiva del Garante ma anche tutte le altre similari su argomenti diversi.

I passaggi essenziali del provvedimento di indirizzo

Punto di partenza del ragionamento è che i metadati delle mail dei dipendenti sono dati personali, come tali sono sottoposti alla disciplina del GDPR, il regolamento (UE) 2016/679. Il passaggio è incontestabile, nella misura in cui essi siano collegati a un account email riferibile a uno specifico individuo. La nozione di “dato personale” è infatti quella di “qualsiasi informazione”, purché “riguardante una persona fisica” almeno identificabile, cfr. art. 4.1) GDPR.

Siccome la persona fisica in questione è un lavoratore subordinato, viene intercettata non solo la normativa sulla protezione dei dati personali, ma anche quella giuslavoristica, e in particolare – almeno in ipotesi – l’art. 4 dello Statuto dei lavoratori, l. 300/1970, che proibisce, in linea generale, i controlli a distanza sui dipendenti.

Ma perché l’Autorità italiana sui dati personali dovrebbe occuparsi dell’art. 4 dello Statuto? Anche questo è in realtà un punto pacifico. Occorre infatti tenere presente che il principale tassello della normativa italiana di adeguamento al GDPR, ossia il cd. “codice privacy”, d.lgs. 196/2003, richiama appunto espressamente il menzionato articolo 4 dello Statuto, vedasi in proposito gli artt. 114 e 171 cod. priv.. È del resto lo stesso terzo comma della disposizione lavoristica in esame a prescrivere espressamente il “rispetto di quanto disposto dal decreto legislativo 30 giugno 2003, n. 196”. Tali molteplici collegamenti permettono, e nello stesso tempo perimetrano, la diretta competenza del Garante.

Fermata dunque la cornice giuridica, veniamo al contenuto. I metadati di cui viene prescritta la conservazione per, al più tardi, 7/9 giorni sono, in via esemplificativa, i seguenti: “giorno, ora, mittente, destinatario, oggetto e dimensione dell’email”. Nel provvedimento del 21 dicembre 2023 non era fornita una soddisfacente definizione dei processi coinvolti, il che ha aperto a speculazioni e ipotesi.

Poi, nell’ultimo pacchetto di precisazioni l’Autorità di controllo ha lasciato intendere che i processi sono quelli riguardanti i “metadati generati e raccolti automaticamente dai protocolli di trasmissione e smistamento della posta elettronica e relativi alle operazioni di invio, ricezione e smistamento dei messaggi di posta elettronica (che possono comprendere gli indirizzi email del mittente e del destinatario, gli indirizzi IP dei server o dei computer coinvolti nell’instradamento del messaggio, gli orari di invio, di ritrasmissione e di ricezione, la dimensione del messaggio, la presenza e la dimensione degli eventuali allegati, in certi casi anche l’oggetto del messaggio spedito o ricevuto)”, cfr. GPDP, provv. 24 febbraio 2024, avviso pubblico di avvio della consultazione. Un perimetro dunque molto vasto. I trattamenti descritti sono evidentemente necessari al funzionamento stesso dei protocolli di gestione della posta elettronica, rilievo che rende ancora più drastico e impattante il provvedimento di indirizzo.

Gli ulteriori passaggi salienti esposti dal Garante appaiono i seguenti:

  • la conservazione dei metadati, anche di durata molto breve, va puntualmente motivata e contenuta;
  • deve essere, verosimilmente, preceduta da una valutazione d’impatto (DPIA);
  • fermo restando che può essere effettuata solo per finalità lecite, va preventivamente concordata con le rappresentanze sindacali oppure autorizzata dall’Ispettorato nazionale del lavoro (INL) ove superi il predetto termine massimo di 7/9 giorni.

I temi toccati sono in realtà più ampi e complessi, ma credo che quelli sopra esposti costituiscano una buona sintesi degli snodi più rilevanti. Sono tutti conseguenze applicative della sottostante logica giuridica seguita dall’Autorità.

La logica giuridica sottostante

L’art. 4 dello Statuto fu introdotto all’inizio degli anni ’70 con un preciso obiettivo: tutelare i dipendenti da videocamere di sorveglianza e/o microfoni, quali strumenti di controllo a distanza. Una garanzia che esprime lucidità e capacità di governare anche le future evoluzioni dei contesti di lavoro.

Mentre gli “impianti audiovisivi” restano ancora oggi l’oggetto principale della disposizione anche dopo le modifiche intervenute, come si evince sia dalla rubrica sia, soprattutto, dal primo comma, richiede invece un passaggio motivazionale in più, non immediato e non pacifico, considerare i metadati delle email alla stregua di “altri strumenti di controllo”, come fa appunto il Garante.

Orbene, affinché sia consentito l’uso di strumenti “dai quali derivi anche la possibilità di controllo a distanza dell’attività dei lavoratori” occorrono due condizioni essenziali, come si è accennato: (i) che i controlli siano posti in essere per specifiche finalità lecite indicate dal legislatore; (ii) che sia in ogni caso raggiunto un previo accordo sindacale o, in mancanza, sia ottenuta un’autorizzazione dell’INL.

Si danno due casi sottratti al meccanismo generale descritto: quello degli “strumenti utilizzati dal lavoratore per rendere la prestazione lavorativa” e quello degli “strumenti di registrazione degli accessi e delle presenze”. Ora, la posta elettronica cade, pacificamente, nel primo gruppo, serve cioè a svolgere la prestazione lavorativa, tuttavia secondo il Garante, decorsi 7/9 giorni, ciò non sarebbe più vero rispetto ai relativi metadati, come se il passare del tempo determinasse il cambiamento ontologico di questi ultimi, vale a dire come se essi cessassero improvvisamente di essere una componente necessaria dello strumento di lavoro. Il passaggio appare privo di convincente motivazione, ma da esso l’Autorità trae il sicuro obbligo di assolvere alla descritta procedura di accordo/consultazione.

Il resto del provvedimento d’indirizzo è piuttosto riconducibile all’applicazione diretta di disposizioni del GDPR, in particolare all’articolo 5 che enuncia i principi da osservare nel trattamento di dati personali. La previsione, è noto, costituisce uno dei componenti strutturali della normativa, come più volte evidenziato dalla Corte di giustizia.

Infine, l’obbligo, se del caso, di procedere a DPIA va collegato all’art. 35 GDPR e soprattutto alle linee guida del 4 ottobre 2017 pubblicate e ratificate dalle autorità di controllo dell’Unione sui dati personali, vale a dire Garante e omologhi (ex WP29/EDPB).

Principali punti critici del provvedimento sui metadati

Termine privo di motivazione – Uno dei più evidenti elementi di perplessità, come osservato dai più, è che la precisazione del termine di conservazione di 7/9 giorni appare introdotta dal Garante senza alcuna motivazione. Manca cioè del supporto di un ragionamento che la renda verificabile razionalmente e giustificata giuridicamente. Inoltre, manca di un collegamento logico con il conseguimento della specifica finalità per cui i metadati sono trattati. Per la precisione, le finalità di trattamento possono qui essere più d’una, sono anzi certamente più d’una, dunque vanno necessariamente definiti tempi di durata diversi. Già questa considerazione appare inconciliabile con il termine massimo unico prescritto dall’Autorità. In definitiva, è proprio l’articolo 5 GDPR a imporre un approccio complesso, ispirato a necessità e proporzionalità, e motivato in stretta relazione alle finalità conseguite.

Il provvedimento non riguarda direttamente i grandi fornitori di soluzioni cloud – “È emerso” indica l’Autorità “il rischio che programmi e servizi informatici per la gestione della posta elettronica, commercializzati da fornitori in modalità cloud, possano raccogliere, per impostazione predefinita, in modo preventivo e generalizzato, i metadati relativi all’utilizzo degli account di posta elettronica in uso ai dipendenti […], conservando gli stessi per un esteso arco temporale”. Da questa premessa, ci si attenderebbe che il Garante attenzioni prima di ogni altra cosa tali grandi fornitori, anziché la moltitudine delle società e dei professionisti che se ne servono. L’Autorità è tenuta infatti a verifiche nei confronti dei responsabili del trattamento (tali sono i prestatori delle soluzioni in cloud) ove se ne ipotizzi la violazione dell’art. 32 GDPR. Sarebbe apparso l’approccio più efficace, poiché svolto nei confronti di pochi soggetti alla fonte, e tutto sommato più equo, visto che lo stesso Garante riconosce che i grandi fornitori pongono talvolta altresì “limitazioni al cliente (datore di lavoro) in ordine alla possibilità di modificare le impostazioni di base del programma informatico al fine di disabilitare la raccolta sistematica di tali dati o di ridurre il periodo di conservazione degli stessi”. La leva è in definitiva nelle mani di software house di primo piano, che tuttavia, a parte un generico invito a “a tenere conto del diritto alla protezione dei dati tenuto conto dello stato dell’arte”, appaiono fuori dal raggio applicativo del provvedimento.

I metadati sono parte essenziale della posta elettronica – I metadati sono componenti essenziali dello strumento di posta elettronica, e non solo perché contenuti negli header, ma in senso più ampio e pregnante: una corrispondenza senza mittente, destinatario, data, oggetto non è più una corrispondenza, ma testo libero, inutilizzabile. Uno strumento di lavoro deve essere integro e disponibile per tutto il tempo necessario all’attività per cui è adottato.

Il provvedimento del Garante è contemporaneamente prescrittivo e carente degli elementi per esserlo – Indubbiamente l’enunciazione di un termine così netto, 7/9 giorni, costituisce un passaggio prescrittivo incapsulato entro il corpo di linee guida. Come tale, i destinatari del precetto dovrebbero poterlo impugnare. Tuttavia, il provvedimento che ci occupa manca della precisazione della possibilità di ricorso, che è invece necessaria nei provvedimenti vincolanti dell’Autorità, come peraltro ricorda anche il considerando 129 GDPR. Ciò determina una notevole anomalia e reca pregiudizio al diritto di difesa dei destinatari dell’obbligo. Questa considerazione apre anche il ragionamento all’obiezione principale: può il Garante introdurre liberamente termini di conservazione dei dati personali di portata generale e preventiva? Ad avviso di chi scrive la risposta è negativa.

Il Garante non può derogare al principio di accountability

Il punto centrale è qui proprio l’art. 5 GDPR, che al paragrafo secondo introduce il noto principio di “accountability”, in italiano “responsabilizzazione”. Non che il Garante non lo menzioni nel provvedimento sui metadati, ma lo fa senza trarne le radicali conclusioni che ne derivano linearmente.

In base a tale principio, non compete all’autorità di controllo, ma al titolare del trattamento (quindi al datore di lavoro), stabilire i termini di conservazione dei dati personali. Ogni titolare del trattamento potrà determinarli in maniera diversa, vale a dire con durate diverse, e dovrà, ovviamente, essere in grado di motivare il termine scelto. Per farlo, dovrà inoltre individuare le finalità di trattamento dei metadati, calandole, nella misura possibile, sul suo caso concreto, e collegare a ciascuna di esse una durata. Va cioè escluso che si possano avere termini assolutamente coincidenti per più titolari e che siano sovrapponibili i termini di conservazione dei metadati per finalità di utilizzo della posta elettronica come strumento lavorativo, quelli di conservazione degli stessi per finalità di sicurezza informatica oppure ancora quelli di conservazione per finalità di esercizio e tutela di diritti. Cade con ciò completamente, ad avviso di chi scrive, la logica del termine massimo unico.

Ora, la regola dell’accountability costituisce un principio portante del GDPR, per questo ha destato stupore che il provvedimento in commento lo abbia sostanzialmente ignorato o, meglio, ridotto a operare entro lo spazio massimo di conservazione fissato invece d’autorità dal Garante.

La posizione centrale, di pilastro della normativa, occupata dall’art. 5 si riflette peraltro sulla sussistenza di limitatissime deroghe allo stesso. Nella specie nessuna di esse appare ravvisabile. Questo pone un limite fondamentale all’iniziativa del Garante, e soprattutto lo pone a monte.

Neppure la normativa nazionale richiamata come base del provvedimento d’indirizzo, ossia il comma 1, lett. a) dell’art. 154-bis cod. priv. sembra consentire contenuti prescrittivi: il legislatore parla chiaramente di “linee guida”, ossia testi di semplice chiarimento della disciplina in vigore.

Resta in ogni caso fermo che la normativa di adeguamento nazionale, come è appunto il codice privacy, non potrebbe mai introdurre deroghe all’art. 5 GDPR fuori dalle pochissime ipotesi consentite dal Regolamento.

Conclusioni

La conservazione così breve dei metadati delle email di lavoro è chiaramente bloccante per ogni attività economica privata, ma anche per l’agire pubblico (le previsioni in parola si applicano infatti anche alla pubblica amministrazione). Introduce inoltre un’impraticabile riduzione a una sola durata di periodi necessariamente diversi perché rispondenti a finalità diverse, rimesse alla competenza di ciascun titolare, a cui incombe naturalmente l’onere di dimostrarne la congruità.

Dunque è certamente positivo che il Garante abbia voluto creare, sia pure in seconda battuta, un’occasione di ampio coinvolgimento quale è appunto una consultazione pubblica. È altresì chiaro, per la stessa ragione, che questa volta qualcosa non ha funzionato inizialmente nei meccanismi interni di controllo dell’Autorità sui propri atti amministrativi. Lo dimostra la circostanza stessa che la consultazione pubblica investe elementi centrali del provvedimento d’indirizzo, vale a dire la “congruità […] del termine di conservazione dei metadati” “e più in generale […] le forme e modalità di utilizzo” degli stessi. L’auspicio è dunque che l’Autorità, ad esito della consultazione, ponga mano a una revisione radicale degli elementi di natura precettiva. Preceduta o no da consultazione pubblica, la fissazione di termini di durata appare infatti possibile, ai sensi del GDPR, soltanto al datore di lavoro titolare del trattamento, che non può trovarsi chiuso, a parere di chi scrive, entro una stretta gabbia temporale imposta d’ufficio dall’Authority.

Molti altri passaggi delle linee guida, sostanzialmente quasi tutti, costituiscono invece un’esposizione pregevole, in quanto offrono una sintesi delle regole applicabili, certamente opportuna per la comprensione e la pratica applicazione generale perché illustra i rapporti tra più livelli normativi, cercando di chiarirne l’intersezione. Sotto questo profilo, è certamente opportuno, a parere di chi scrive, che il Garante lasci intatte le parti del provvedimento di indirizzo genuinamente qualificabili come linea guida.

Articolo a cura di Enrico Pelino, PhD in IT Law, partner e co-fondatore dello studio legale Grieco Pelino Avvocati

Profilo Autore

Enrico Pelino è avvocato del foro di Bologna, DPO e co-fondatore dello studio legale Grieco Pelino Avvocati. Da sempre cultore dell’intersezione tra diritto e tecnologia, ha conseguito un dottorato di ricerca in diritto dell’informatica presso l’Università di Bologna, e quindi collaborato con associazioni del settore. Attualmente è fellow dell’Istituto Italiano per la Privacy e la valorizzazione dei dati (IIP) e componente del comitato tecnico-scientifico di Anorc Professioni. È altresì nella lista degli Esperti costituenti il “Support Pool” dell’EDPB (European Data Protection Board). Autore di numerosi articoli in riviste specializzate in materia di diritto digitale, invited speaker in primarie conferenze, ha svolto docenze in master per università ed enti di alta formazione. Per l’editore Giuffrè ha curato e scritto, assieme a colleghi di primo livello nazionale, volumi monografici e commentari in materia di protezione dei dati personali e disciplina della società dell’informazione: Il Regolamento Privacy Europeo (2016), Codice della Disciplina Privacy (2019); Privacy e libero mercato digitale (co-autore, 2021); Digital Services Act e Digital Markets Act (2023); Codice commentato della privacy (2024).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/metadati-delle-e-mail-dei-dipendenti-il-punto-sul-provvedimento-del-garante-sottoposto-a-consultazione-pubblica/


Analisi del Ddl Cybersicurezza

Questo articolo è il primo di una serie dedicata all’analisi tecnico-giuridica del Disegno di Legge recante “Disposizioni in materia di rafforzamento della cybersicurezza nazionale e di reati informatici” approvato dal Consiglio dei Ministri lo scorso 25 gennaio e attualmente in corso di esame parlamentare.

Introduzione

Nell’attuale contesto geopolitico e tecnologico, la cybersicurezza si conferma come elemento chiave per la preservazione dell’integrità nazionale e la sicurezza dei dati.

Il recente disegno di legge recante disposizioni in materia di rafforzamento della cybersicurezza nazionale e di reati informatici (c.d. Ddl Cybersicurezza) emerge quale risposta strategica indispensabile alle sfide in continua evoluzione del cyberspazio, mirando primariamente a consolidare la resilienza nazionale contro l’escalation di attacchi informatici sempre più sofisticati.

La nuova legislazione – che si trova ora all’esame delle Commissioni Riunite Affari Costituzionali e Giustizia della Camera e di cui è stata calendarizzata a maggio la discussione nell’aula parlamentare – si colloca nell’ambito di un processo di evoluzione normativa incentrato sulla cybersicurezza, con l’aspirazione di adeguare il corpus giuridico italiano alle necessità imposte dalle minacce digitali emergenti, sia nel settore penale sia in quello della sicurezza informatica.

Il Disegno di Legge propugna un ventaglio di innovazioni finalizzate a intensificare le capacità di prevenzione, individuazione e gestione degli incidenti informatici, sottolineando l’urgenza di un aggiornamento normativo che rifletta le specificità e la transnazionalità delle minacce informatiche.

Tra gli obiettivi principali si distingue l’implementazione di obblighi più rigidi per le Pubbliche Amministrazioni in termini di notifica degli incidenti informatici, nonché l’elaborazione di un regime sanzionatorio più severo in caso di inadempimenti.

Inoltre, il Ddl Cyber si propone come un avanzamento significativo nella fortificazione del Perimetro di Sicurezza Nazionale Cibernetica, integrando le normative preesistenti e colmando eventuali lacune legislative.

Modifiche al Codice Penale

All’interno del tessuto normativo volto a consolidare la cybersicurezza nazionale, un’ulteriore tappa significativa è rappresentata dalle modifiche al Codice penale, che si inseriscono in un più ampio contesto di misure preventive e reattive delineate dal Disegno di Legge. Dopo aver esaminato le responsabilità delle pubbliche amministrazioni in termini di notifica e segnalazione degli incidenti di sicurezza, rileva considerare come il legislatore abbia parallelamente rafforzato il quadro sanzionatorio per i reati informatici, mirando a una deterrenza più efficace contro le minacce alla sicurezza digitale.

Le modifiche introdotte si focalizzano sull’inasprimento delle sanzioni pecuniarie per enti che commettono delitti informatici, evidenziando una chiara volontà di contrastare con maggiore severità le violazioni in questo ambito. In dettaglio, l’articolo 15 del Ddl modifica l’articolo 24-bis del decreto legislativo 8 giugno 2001 n. 231, inasprisce il regime sanzionatorio per gli enti responsabili di delitti quali l’accesso abusivo a sistemi informatici o telematici, la detenzione e diffusione illecita di codici di accesso e altri reati correlati, elevando il range delle quote sanzionatorie da duecento a settecento euro.

Questa decisione rafforza il regime sanzionatorio e sottolinea l’importanza attribuita alla protezione dei dati e alla sicurezza delle reti e dei sistemi informativi. Attraverso l’introduzione di sanzioni pecuniarie più elevate e di sanzioni interdittive in casi specifici, il Disegno di Legge mira a incentivare una maggiore responsabilità e cautela da parte degli enti, promuovendo pratiche di sicurezza informatica più rigorose e un’attenzione più marcata alla prevenzione delle violazioni.

L’approccio adottato, che contempla sia misure preventive e organizzative per le pubbliche amministrazioni sia una risposta legislativa più severa nei confronti dei reati informatici, riflette una strategia complessiva di cybersicurezza che pone l’Italia all’avanguardia nella lotta contro le minacce digitali. Con queste modifiche al codice penale, il legislatore italiano dimostra un impegno concreto nel rafforzare le capacità di prevenzione e reazione agli incidenti cibernetici delle entità pubbliche e, al contempo, nell’inasprire le conseguenze legali per coloro che mettono a rischio la sicurezza informatica nazionale.

Sembra pertanto che, in tale contesto, l’evoluzione del quadro sanzionatorio per i reati informatici rappresenti un elemento cruciale della strategia nazionale per una cybersicurezza robusta, delineando un ambiente digitale in cui la prevenzione, la protezione e la punizione dei comportamenti illeciti si integrano in un sistema coeso e dinamico, capace di adattarsi alle sfide poste dalla continua evoluzione tecnologica.

In un successivo articolo saranno esaminati gli obiettivi del Ddl e l’ambito di applicazione della nuova normativa, mentre l’ultimo contributo si focalizzerà sulle disposizioni in tema di Intelligenza Artificiale ivi contenute.

Articolo a cura di Francesco Capparelli e Maria Rosaria De Ligio

Profilo Autore

Avvocato, Certified Ethical Hacker, Auditor di diversi schemi di certificazione (ISO/IEC 27001, ISO 22301, ISO 37001, ISO/IEC 20000-1, ISO 9001) e Project Manager. Chief Cybersecurity Advisor di ICT Cyber Consulting, Quality and Information Security Manager di ICTLC S.p.A., Of Counsel di ICT Legal Consulting, membro del CdA dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati e Senior Fellow Researcher nel framework Horizon Europe.
Autore di manuali, pubblicazioni e articoli scientifici sui temi relativi alla data protection e alla sicurezza informatica.

Profilo Autore

Esperta in cybersecurity e protezione dei dati. Laureata in Scienze delle Investigazioni e della Sicurezza e laurenda in Giurisprudenza presso l’Università degli Studi della Campania. Ha frequentato un Business Master in CyberSecurity Compliance e il Corso Maestro della Protezione dei Dati & Data Protection Designer. Auditor dei Sistemi di Gestione ISO/IEC 27001:2022 e ISO 9001:2015.
È Cybersecurity Specialist presso ICT Cyber Consulting ed offre il suo contributo nel framework Horizon 2020 come Of Counsel per ICT Legal Consulting, oltre ad essere Fellow Researcher per l’Istituto Italiano per la Privacy e la Valorizzazione dei Dati.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/analisi-del-ddl-cybersicurezza/


Steganografia di rete: come implementare un canale nascosto su una macchina Windows

Introduzione

La steganografia consiste nella scienza di nascondere il trasferimento e l’archiviazione delle informazioni [1]. Essa non deve essere confusa con la crittografia: entrambe condividono l’obiettivo finale di proteggere le informazioni, ma la prima tenta di renderle “difficili da notare”, mentre la seconda cerca di confondere il messaggio per renderlo “difficile da leggere”. I dati crittografati possono attirare l’attenzione a causa della natura “stravolta” rispetto ad un messaggio in chiaro; la steganografia, invece, non altera in modo evidente il pattern dei dati, e le informazioni nascoste appaiono come un normale messaggio con altro significato. Come esempio, In Figura 1 facciamo riferimento alla classica comunicazione tra Alice e Bob, i cui messaggi sono però costantemente monitorati e analizzati da un warden (sorvegliante) con pieni poteri, il quale si può immediatamente rendere conto dello scambio di un messaggio cifrato [2].

Figura 1

Esempi di steganografia includono l’occultamento di informazioni nei media digitali come immagini di diverso formato, flussi audio e video. La steganografia di rete si distingue invece per la sua capacità di utilizzare il traffico di rete regolare come covert object, e cioè il carrier dati in cui si nasconde l’informazione inviata da un covert sender ad un covert receiver). Tale manipolazione non deve comunque inficiare il corretto scambio di informazioni su una rete.

La steganografia di rete può essere impiegata in varie applicazioni più o meno legittime. Alcuni esempi includono l’esfiltrazione di dati nello spionaggio e nell’intelligence, comunicazioni aziendali riservate, attività dannose (comunicazioni di malware o di Command-and-Control o C&C, per eludere gli Intrusion Detection Systems, o IDS), ed infine comunicazioni anonime e anti-censura.

Descrizione e implementazione di un covert channel

Come risultato di un esperimento eseguito nell’articolo in [3], in questo articolo proponiamo un canale nascosto (covert channel) e la sua implementazione nel sistema operativo Windows. Questo canale di archiviazione utilizza l’Initial Sequence Number di TCP per nascondere quattro caratteri di testo e il campo identificativo per “firmare” il messaggio e capire così se è stato alterato durante la trasmissione. Il segreto viene inviato dal mittente nel primo segmento SYN inviato per simulare l’apertura di una connessione, mentre una risposta ACK-RST conferma la ricezione da parte del ricevente, e al contempo simula la chiusura della connessione TCP. In questa risposta da parte del ricevente abbiamo inserito un codice per la correzione di eventuali errori, in modo da rendere il protocollo più robusto e in grado di gestire la perdita di pacchetti (IP) e errori di trasmissione. Infatti, per la costruzione di questo canale non ci affidiamo alla affidabilità fornita nativamente da TCP, ma spediamo in sequenza ciascuna parte del messaggio segreto con un semplice successivi segmenti SYN, e per ciascuno ci aspettiamo una risposta ACK-RST, che oltre alla conferma di avvenuta ricezione, ci può anche chiedere di ritrasmettere quella parte del messaggio o una precedente a causa di errori di trasmissione.

Un’implementazione in Python di mittente e destinatario presentati in questo articolo è disponibile all’indirizzo: https://github.com/Aldwyn47/TCPCovertChannel, ed è stata testata in ambiente Windows 10 e 11. Sia il mittente che il ricevente necessitano di essere eseguiti con i diritti di amministratore di sistema: Scapy[1], il package al cuore dello sviluppo, necessita infatti di manipolare i pacchetti a basso livello. La porta utilizzata per inviare il segmento da parte del mittente con SYN attivato è la 80, al fine di mimetizzare il più possibile la comunicazione all’interno di un normale traffico di rete che spesso include connessioni HTTP (ovviamente tala porta può essere modificata secondo necessità).

Di seguito elenchiamo numerandoli i passi principali, riassunti anche in Figura 2 e Figura 3:

  1. Il mittente crea un pacchetto TCP contraffatto e incorpora il messaggio segreto nel campo del numero di sequenza dell’intestazione TCP. Vengono incorporati fino a quattro caratteri ASCII utilizzando i 28 bit meno significativi del campo; i quattro bit più significativi vengono invece utilizzati per implementare codici di errore e codici di controllo interni al nostro canale, volti a migliorare la robustezza.
  2. Per migliorare la distribuzione dei valori, viene aggiunta anche una maschera di bit randomizzata a ciascun numero di sequenza contraffatto. Questa maschera si ottiene chiamando una determinata funzione casuale (nota sia al mittente che al ricevente) dopo che il suo seme è stato impostato per riflettere il valore di identificazione IP del pacchetto. Poiché ogni pacchetto ha un valore identificativo univoco, la maschera di bit randomizzata generata è sempre diversa.
  3. Detta maschera viene poi applicata al numero di sequenza “grezzo” tramite un’operazione XOR bit a bit.
  4. Il Mittente imposta quindi su 1 il flag SYN del pacchetto per far finta che il mittente stia tentando un nuovo handshake a tre vie con il ricevente.
  5. Il Mittente procede quindi alla consegna del pacchetto.
  6. Il ricevente ottiene il pacchetto ed estrae il valore del relativo campo Identificazione. Quindi utilizza questo valore per impostare il seme della stessa funzione casuale utilizzata dal mittente per ricreare la stessa maschera di bit randomizzata.
  7. Il ricevitore quindi estrae il numero di sequenza del pacchetto in entrata ed esegue uno XOR bit a bit con la maschera di bit appena ricreata. Lo XOR bit a bit del ricevente alla fine annulla quello del mittente, ripristinando così il numero di sequenza “grezzo” originale e consentendo al ricevente di estrarre il messaggio nascosto.
  8. Il ricevente imposta quindi il seme della funzione casuale su un valore corrispondente alla somma dei valori dell’identificazione IP e del numero di sequenza del pacchetto in entrata. L’output generato chiamando la funzione random sarà quindi una “firma” randomizzata determinata direttamente dai valori dei due campi.
  9. Infine, il ricevente assembla una risposta consistente in un altro pacchetto TCP. I flag RST e ACK di questo pacchetto sono impostati su 1 per far finta che il destinatario stia semplicemente tentando di rifiutare il tentativo del mittente di stabilire un handshake a tre vie. In realtà, il ricevente conferma la ricezione del pacchetto originale e ne passa la “firma” al mittente inserendola nel campo Identificazione della risposta.
  10. Il ricevente procede quindi a consegnare il suo pacchetto di risposta.
  11. Dopo aver ricevuto il pacchetto di risposta, il mittente imposta il seme della funzione casuale sulla somma dei valori dell’identificazione IP e del numero di sequenza del pacchetto originale. Quindi confronta l’output della funzione casuale con il campo Identificazione della risposta (ovvero la “firma” del destinatario). Se i due valori differiscono, significa che i campi dell’intestazione del pacchetto originale sono stati in qualche modo alterati dopo la partenza del pacchetto. Ciò significa che la trasmissione è fallita e deve essere interrotta. Altrimenti, il mittente può continuare la sua trasmissione e preparare il successivo pacchetto per spedire la parte rimanente del messaggio.
Figura 2
Figura 3

Test

Una possibile limitazione potrebbe consistere nella capacità di un warden di prevedere come un dato sistema operativo assegni nuovi valori per i numeri di sequenza TCP utilizzati dal nostro approccio, consentendo così di notare la differenza tra quelli legittimi e contraffatti. Nei moderni sistemi operativi però questi valori vengono generati in modo sufficiente casuale per motivi di sicurezza, e quindi questa limitazione risulta essere difficilmente applicabile. Più di successo risulta invece essere qualsiasi middlebox che operi da proxy TCP su tutte le connessioni in uscita della rete vittima. Alcune tecnologie router (ad esempio, CISCO ASA) sono per esempio in grado di riscrivere automaticamente il numero di sequenza e neutralizzare quindi il canale nascosto.

Siamo quindi ben lungi dal sostenere di avere una pallottola d’argento in grado di evitare qualsiasi forma possibile di difesa. D’altronde però, i test da noi effettuati dimostrano che è possibile comunicare attraverso il nostro canale segreto posizionando il mittente in i) una piccola/media rete aziendale, ii) una rete universitaria, iii) dietro un Internet Service Provider (ISP), mentre il ricevente riceve connettività da un ISP.

Infine, per attestare la stealthiness dell’implementazione, abbiamo effettuato vari test inviando messaggi segreti da 36 a 712 caratteri ciascuno e collezionando file .pcap di queste trasmissioni, mentre al contempo effettuavamo delle classiche operazioni come controllare la posta o navigare su Internet, cercando di includere sia traffico lecito che il nostro traffico manipolato. Né Suricata[2] (configurato con 47000 regole) né Zeek[3] (esteso con numerosi package, come icmp-exfil-detection) sono stati in grado di rilevare anomalie sui .pcap in questione. Alcuni dei tool più comuni di sicurezza disponibili liberamente non sono quindi in grado di riconoscere una comunicazione nascosta, e comunque un rilevamento necessiterebbe di analizzare tutto il traffico di rete nel dettaglio, un compito ben dispendioso dal punto di vista delle risorse, soprattutto se il traffico riguarda per esempio un ISP o comunque una rete di grandi dimensioni.

Conclusioni

L’implementazione presentata in questo articolo dimostra come sia possibile a tutt’oggi inviare informazioni segrete inserendole all’interno di pacchetti di rete opportunatamente modificati, senza destare allarmi nei sistemi più comuni per il monitoraggio della sicurezza di rete. Il traffico generato si perde insieme al rimanente traffico a livello trasporto come un tentativo di connessione andato a vuoto.

BIBLIOGRAFIA

[1] S. Wendzel, L. Caviglione, W. Mazurczyk, A. Mileva, J. Dittmann, C. Kr ̈atzer, K. Lamshoft, C. Vielhauer, L. Hartmann, J. Keller, and T. Neubert. A revised taxonomy of steganography embedding patterns. In ARES 2021: The 16th International Conference on Availability, Reliability and Security, pages 67:1–67:12. ACM, 2021.

[2] G. J. Simmons. The prisoners’ problem and the subliminal channel. In David Chaum, editor, Advances in Cryptology, Proceedings of CRYPTO, pages 51–67. Plenum Press, New York, 1983.

[3] S. Bistarelli, A. Imparato, F. Santini: A TCP-based Covert Channel with Integrity Check and Retransmission. 20th Annual International Conference on Privacy, Security and Trust, PST 2023: 1-7

Note

[1] Scapy: https://scapy.net

[2] Suricata: https://suricata.io

[3] Zeek: https://zeek.org

Articolo a cura di Francesco Santini

Profilo Autore

Francesco Santini è Professore Associato presso il Dipartimento di Matematica e Informatica dell’Università degli Studi di Perugia. Si occupa da quasi venti anni di Intelligenza Artificiale e Cybersecurity, con un approccio integrato. È docente di corsi riguardanti la sicurezza per corsi di laurea magistrale in informatica e in master universitari di primo livello su protezione del dato e forensics. È relatore di tesi sulle materie di insegnamento. Organizza il programma di training CyberChallenge.it per studenti di scuole superiori e laurea triennale, ed è membro del Cybersecurity National Lab. presso il nodo di Perugia.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/steganografia-di-rete-come-implementare-un-canale-nascosto-su-una-macchina-windows/