Ransomware: lo stato attuale

Gli impatti degli attacchi ransomware sono ancora aumentati e nel 2022 vi sono state più di 2800 vittime, con un riscatto medio superiore ai 3 milioni di dollari US. Operando in modo estremamente opportunistico, le gang non sono interessate al tipo di azienda ma solo al riscatto che può pagare. Alcuni gruppi preferiscono attaccare organizzazioni con maggiori entrate, mentre altre preferiscono organizzazioni che operano in settori specifici dove si diffondono più velocemente informazioni sui danni delle intrusioni, spingendo così al pagamento del riscatto. Infine, alcune gang scelgono in base al tipo di dati che possono esfiltrare. Inoltre, si sono diffuse le double-extortion e sono cresciuti ecosistemi complessi in cui creatori di ransomware convivono con cyber criminali che, rispettivamente, penetrano inizialmente in un sistema, installano il ransomware o trattano il riscatto. Le gang interagiscono in mercati sul dark web. Attualmente, nessun ransomware attacca sistemi nei paesi della ex CSI.

Il ransomware con un tocco umano

Oggigiorno, una intrusione ransomware è caratterizzata da quello che Microsoft ha definito human- operated ransomware. In pratica, ogni intrusione comprende alcune fasi: accesso iniziale, esplorazione del sistema e raccolta di informazioni, aumento dei privilegi dell’attaccante ed esecuzione del ransomware per criptare le informazioni.

L’accesso iniziale è la fase in cui l’attaccante entra nel sistema; l’esplorazione del sistema è quella in cui l’attaccante scopre i collegamenti tra i nodi, il sistema operativo e le applicazioni che ogni nodo esegue (e, quindi, le loro vulnerabilità). La fase di aumento dei privilegi sfrutta alcune di queste vulnerabilità per eseguire uno o più attacchi per controllare un account su alcuni nodi o diventare amministratore di una macchina.

Una o più fasi possono essere automatizzate, ad esempio usando una piattaforma d’attacco o uno scanner, ma nello human-operated ransomware il passaggio tra fasi non è automatizzato ed è guidato da umani che prendono decisioni in base a quanto scoprono nel sistema che stanno esplorando.

In passato, l’intrusione ransomware non era mirata ed era spesso semplice ed automatizzata, operava in modo opportunistico sui sistemi affetti dalle vulnerabilità che il malware poteva sfruttare o dagli utenti che cliccavano sui link contenuti in email di phishing. Era una strategia che si basava sui grandi numeri di intrusioni e quindi su singoli riscatti più bassi.

Attualmente, ogni gang utilizza strumenti e soluzioni diverse per i vari passi e quindi vi sono diversi livelli di automazione; ma il passaggio fra i vari passi è comunque guidato dalla esplorazione del sistema. In questa fase, gli attaccanti possono scoprire e poi criptare ed esfiltrare i dati più preziosi, aumentando l’importo del riscatto richiesto. È ovvio che in questo modo gli attaccanti possono non solo raccogliere informazioni ma anche essere persistenti, ovvero continuare a rimanere nel sistema. La persistenza permette di monetizzare ripetutamente la stessa intrusione, utilizzando anche più varianti di un medesimo ransomware. Ciò offre poche garanzie che gli attaccanti lasceranno il sistema dopo il pagamento del riscatto.

Una intrusione human-operated è sempre più simile a una intrusione classica: con l’unica fondamentale, ma ovvia, differenza che chi paga è sempre il proprietario del sistema. Negli attacchi human-operated ransomware, il tocco umano permette di variare sia gli obiettivi che le tecniche e gli strumenti utilizzati, in base alle opportunità scoperte dagli attaccanti nel sistema. La raccolta di informazioni permette di profilare l’organizzazione e di scegliere cosa criptare, cosa esfiltrare e il riscatto da chiedere. Spesso gli attaccanti utilizzano i dati raccolti per invalidare i controlli di sicurezza presenti e per verificare l’efficacia del loro malware “in produzione”, cioè nell’ambiente del loro bersaglio. Se alcuni moduli del malware vengono rilevati e bloccati da uno strumento di sicurezza, gli attaccanti possono acquisire sui mercati e utilizzare una versione diversa, modificando il payload. Gli attaccanti possono anche manipolare gli strumenti di sicurezza per sfruttare gli elevati privilegi di questi strumenti. Ad esempio, in alcune intrusioni gli attaccanti hanno usato ai loro fini i privilegi di strumenti di endpoint detection and response. Paradossalmente, anche la rilevazione di alcuni attacchi da parte degli strumenti di difesa può giocare a favore degli attaccanti dando ai difensori, e.g. al Security Operation Center, un falso senso di sicurezza circa il fatto che le soluzioni esistenti stanno funzionando.

Nonostante la diffusione dello human-operated ransomware, alcuni gruppi hacker preferiscono comunque soluzioni a maggiore automazione che, ad esempio, si diffondono sfruttando le risorse condivise tra i vari nodi di un sistema e riducono a poche ore il tempo dall’accesso iniziale all’encryption.

Come sempre, una delle ragioni a favore dell’automazione è l’aumento di redditività.

Ricatti senza encryption

In ultima analisi, con lo human-operated ransomware l’attaccante non deve criptare informazioni o esfiltrarle, perché per richiedere un riscatto basta provare la capacità di poterlo fare, elencando ad esempio file e risorse critiche presenti nel sistema. Una intrusione che non riduce la disponibilità può avere come bersaglio un centro di cura o un ospedale e questo varia le regole di ingaggio delle gang. A conferma di questa conclusione, alcuni cyber criminali stanno chiedendo il pagamento di un riscatto con la sola minaccia di bloccare le attività di un’organizzazione per un certo periodo. Secondo fonti di threat intelligence, nel 2022 circa la metà delle intrusioni ha esfiltrato informazioni senza criptarle e più di metà dei siti name-and-shame nel dark web sono apparsi nello stesso anno.

L’unica difesa efficace, in presenza di un tocco umano che scelga i bersagli e il malware da utilizzare, non può essere basata unicamente su copie di back up ma su un aumento di robustezza che minimizzi la probabilità sia di accessi esterni e sia di persistenza degli attaccanti nel sistema.

Una nota positiva sulla situazione attuale dei ricatti pagati viene da Chainanalysis, una società che analizza le transazioni in criptovalute. Secondo un post pubblicato sul blog di Chainanalysis del gennaio 2023, di fronte a un aumento delle intrusioni con successo si ha una diminuzione della percentuale di riscatti pagati. Forse − come dimostra il caso del sistema sanitario irlandese − i tempi di ripristino, anche una volta ottenuta la chiave, sono così alti che le organizzazioni preferiscono comunque non pagare.

Ransomware e SCADA

L’ultima evoluzione tecnologica è del gennaio 2023, quando un gruppo affiliato ad Anonymous e impegnato nella difesa dell’Ucraina ha annunciato di aver sviluppato una versione del ransomware GhostSec che permette di criptare direttamente i componenti SCADA usati nel controllo di processi industriali. In passato, il ransomware coinvolgeva i componenti ICT che interagiscono con il controllo dei processi ma non bloccava tale controllo. Spesso, non era il ransomware ma il proprietario del sistema che bloccava, per precauzione, il processo controllato. Ad esempio, nell’intrusione della gang DarkSide alla Colonial Pipeline, la società che gestiva l’oleodotto lo ha bloccato perché il ransomware impediva al sottosistema ICT di misurare il consumo dei singoli utilizzatori. GhostSec attacca non i componenti ICT che interagiscono con i componenti SCADA, ma direttamente questi componenti: ciò aumenta significativamente i rischi dell’intrusione, perché impedisce il controllo del processo industriale con le ovvie conseguenze di affidabilità e rischio per le vite umane.

Questa innovazione apre la strada al trasferimento di strategie già efficaci contro sistemi ICT al mondo del controllo industriale.

Ecosistema ransomware

Il ransomware è diventato una scelta sempre più popolare nel mondo criminale, grazie anche alla riduzione della barriera d’ingresso permessa dall’ecosistema ransomware e dal RaaS (Ransomware-as-a-Service).

Infatti, in passato una intrusione ransomware richiedeva lo sviluppo di un malware che, a sua volta, richiedeva significative competenze di sviluppo software, crittografia e capacità di penetrazione nei sistemi target. Di fronte a queste competenze, il profitto finale era moderato. Il RaaS crea una situazione completamente diversa, perché i malware sono offerti su mercati nel dark web. Nel seguito esaminiamo brevemente il funzionamento dei mercati e dell’ecosistema.

Mercati ed ecosistema

I mercati sul dark web permettono la collaborazione tra autori di ransomware e gang, semplificando le transazioni, diminuendo le intermediazioni e quindi aumentando i rispettivi profitti. A causa della loro cessione anche a utilizzatori potenzialmente poco competenti, le versioni ransomware offerte in RaaS sono altamente user friendly, con pannelli di controllo semplici, guide e supporto tecnico. Un ulteriore vantaggio permesso dai mercati sul dark web è la vendita di vulnerabilità, comprese anche quelle zero-day, per lo sviluppo del ransomware. Ovviamente, l’utilizzo delle criptovalute semplifica i pagamenti al di fuori dei circuiti ufficiali, anche se non sempre garantisce un completo anonimato.

Ciò che completa in qualche modo l’ecosistema e lo rende autosufficiente è che sui mercati sono in vendita anche accessi iniziali ai sistemi delle organizzazioni. La vendita di accessi alimenta tutto l’ecosistema e sta vivendo un momento di boom. Fonti di threat intelligence indicano che nel 2022 sono stati venduti circa 2200 accessi e ognuno dei primi tre venditori ha ceduto circa 100 accessi. I cyber criminali che acquistano un accesso iniziale possono poi utilizzare ransomware diversi in base alle loro competenze, al tipo di sistema coinvolto e alle vulnerabilità presenti. Questi ransomware possono essere acquisiti da altre organizzazioni che si focalizzano sullo sviluppo di malware e di software per criptare. Quindi lo human-operated ransomware è anche funzionale all’ecosistema, perché non vincola una gang ad alcuni strumenti predefiniti ma le permette di acquistare i migliori e più convenienti una volta esplorato il sistema target. Infine, la presenza di fornitori specializzati di ransomware rende sempre più trascurabile la probabilità di vulnerabilità o di errori che permettano di decriptare le informazioni. Per ridurre ulteriormente vulnerabilità ed errori, alcuni venditori hanno creato programmi di bug bounty che ricompensano chi segnala errori nel loro ransomware. Inoltre, nei mercati sono anche in vendita botnet da utilizzare come infrastruttura d’attacco. Queste botnet fanno sempre più ricorso a soluzioni peer-to-peer, aumentando significativamente la difficoltà di smantellarle.

Inoltre, le gang condividono parti delle loro botnet per meglio resistere agli attacchi.

Cambiamenti nell’ecosistema sono possibili, poichè la possibilità di ricattare senza criptare in qualche modo diminuisce l’importanza degli sviluppatori di ransomware rispetto a chi penetra nei sistemi e li esplora per scoprire le risorse e le informazioni critiche.

Nel seguito presentiamo le informazioni disponibili su alcune organizzazioni criminali nell’ecosistema ransomware a partire da alcune fughe di informazioni sul loro funzionamento.

Le offerte di lavoro sul dark web

Un elemento interessante per approfondire ruolo e funzionamento dei mercati del dark web è come si crea il rapporto professionale tra una persona ed una gang. In un report apparso alla fine del gennaio 2023, Kaspersky ha analizzato il mercato del lavoro sul dark web dal gennaio 2020 al giugno 2022 a partire da offerte di lavoro e curriculum postati su 155 forum sul dark web. Complessivamente parliamo di circa 200.000 post con un picco a Marzo 2020 quando la pandemia ha ridotto fortemente il numero di offerte di lavoro sui mercati legali. Di questo post, poco meno di 900 erano legati al mondo IT e le offerte di posti di lavoro erano circa il triplo delle richieste. In generale, le persone postavano il loro curriculum in risposta ad offerte.

Le offerte riguardano competenze varie che vanno dallo sviluppo di software per intrusioni alla gestione delle infrastrutture di attacco al reverse engineering. Dato che il dark web non apprezza le iniziative per formare degli hacker, la professionalità più ricercata è quella dello sviluppatore, circa il 60% delle offerte di lavoro con stipendi estremamente variabili che arrivano fino a 20.000 rubli mensili con un cambio di 75 rubli per un dollaro. Il compenso medio maggiore è per il reverse engineering. I compensi di un attaccante per l’accesso iniziale sono inferiori e sono molto spesso richieste competenze su piattaforme come Cobalt Strike o Metasploit. Molte offerte di lavoro hanno come requisito la non dipendenza da alcool o droghe.

L’elevato numero di posti di lavoro per sviluppatori può indicare degli investimenti sullo sviluppo di strumenti di attacco ed intrusione più sofisticati di quelli attualmente disponibili.

Le procedure di assunzione sono abbastanza standard e confermano le forti similitudini tra reclutamento nel mondo reale e nel dark web. Dopo alcuni test iniziali per verificare le competenze di sviluppo malware dei candidati, il processo di reclutamento prevede una intervista ed un periodo di prova. Per gli sviluppatori è ovviamente importante la capacità di sviluppare software che non sia rilevabile dai più diffusi antivirus.

Come è ovvio, tra i maggiori vantaggi di un impiego trovato sul dark web vi sono il lavoro remoto e gli orari di lavoro flessibili. Alcune offerte parlano di ferie pagate. Infine, è interessante notare come alcune offerte di lavoro siano per posizioni in aziende perfettamente legali e per incarichi altrettanto legali.

La gang Conti

Nello scorso anno si è verificata una fuga di informazioni importante su Wizard Spider, una gang russa che ha incassato riscatti per centinaia di milioni di euro e ha utilizzato ransomware come Conti o Ryuk (e che, per semplicità, nel seguito indicheremo come Conti). Anche se la fuga di informazioni è legata alla invasione russa dell’Ucraina, le informazioni ottenute sono completamente generali e probabilmente valgono anche per altre gang. L’evento iniziale è avvenuto poche ore dopo l’invasione, quando la gang si è pubblicamente schierata a fianco degli invasori minacciando di attaccare chi avesse messo in pericolo le infrastrutture russe. Questa presa di posizione aumenta i sospetti sui legami tra la gang e lo Stato russo, sospetti alimentati anche dal fatto che Conti è l’unica gang che abbia sviluppato software per lo spionaggio informatico. La dichiarazione di Conti − definita da alcuni come la mossa più idiota che la gang potesse fare, visti i suoi numerosi membri ucraini − è stata poi stemperata; ma ha spinto un membro ucraino della gang a pubblicare più di 60.000 messaggi di una chat interna. Una significativa informazione resa pubblica è che la gang comprende un centinaio di persone, con una organizzazione interna simile a quella di una software house. Copiando l’organizzazione di una normale software house, la gang è organizzata con un reparto di amministrazione, uno di ricerca e sviluppo e uno di produzione. Esistono regole per la gestione del codice dei malware prodotti e per non essere scoperti dalle forze di polizia. La gerarchia interna alla gang è molto rigida e fa capo a un “presidente” e un “amministratore”. Il presidente (indicato come Stern o Demon) e l’amministratore (Mango) comunicano molto frequentemente, stabiliscono privatamente le strategie del gruppo e valutano i dipendenti in base alla quantità e qualità del lavoro. Possono anche punire i dipendenti che non rispettano le scadenze o violano regole come quella di non attaccare gli ospedali, un comportamento che secondo la dirigenza provoca un notevole danno di immagine. Forse i dipendenti coinvolti sono quelli che hanno attaccato il servizio sanitario irlandese.

I programmatori a libro paga della gang hanno uno stipendio fisso, mentre coloro che negoziano il pagamento dei riscatti sono incentivati con una percentuale dei profitti. I neoassunti provengono da normali software house o da forum di hacking.

Le dimensioni del gruppo variano, con un elevato turnover. Per accelerare le assunzioni la gang stava pensando di aprire uffici di reclutamento a San Pietroburgo o di trasferirsi a Mosca. Qualche dipendente vorrebbe godersi una vacanza all’estero ma vi è il forte rischio di essere arrestato. La gang ha anche a libro paga dei giornalisti, che dovrebbero porre sotto pressione le aziende attaccate per spingerle a pagare il riscatto: non vi sono informazioni sulla nazionalità di questi giornalisti. La gang utilizza nelle sue attività un insieme di strumenti per l’anonimato come Tor, ProtonMail e Privnote, con messaggi che si cancellano dopo un certo tempo. Utilizza anche CobaltStrike, una piattaforma di attacco sempre più popolare, che permette di automatizzare alcuni passi di una intrusione. La gang ha anche tentato di ottenere versioni demo degli antivirus commerciali, per verificare che non rilevino i suoi malware.

Dopo la fuga di informazioni, è stato anche possibile accedere ai repository della gang con i vari eseguibili.

Secondo altre fonti, le informazioni fornite dalla “gola profonda” ucraina avrebbero permesso di smantellare la botnet che la gang usa come infrastruttura d’attacco ma l’FBI ha chiesto di non rivelare queste informazioni in modo da monitorare le azioni della gang. Invece, la pubblicazione delle informazioni avrebbe forzato la gang a utilizzare un’infrastruttura, ovvero una botnet, diversa. È comunque molto improbabile che la gang abbia continuato ad usare la stessa infrastruttura.

Le informazioni pubblicate producono la sensazione di una organizzazione strutturata in modo da continuare ad essere operativa a lungo. Questo è anche confermato dal fatto che l’organizzazione ha assorbito altre gang e che gli attacchi sono continuati anche dopo il leaking di informazioni sulla sua struttura e organizzazione.

Però, nel maggio 2022, il governo USA ha offerto fino a 10 milioni di dollari per informazioni sul gruppo e questo ha provocato il ritiro della gang o forse del solo brand. Tutti i membri di Conti si sono riciclati in altre gang o ne hanno create di nuove. Alla fine del 2022 erano note quattro varianti del ransomware Conti.

L’esperienza di Conti è stata sfruttata da altre gang russe, ad esempio Lockbit, che per evitare ogni problema hanno dichiarato la loro neutralità nella invasione russa, affermando di essere unicamente interessate ai propri affari. Un segnale importante, considerati i sospetti rapporti tra Stato russo e alcune gang. A posteriori possiamo dire che, ad eccezione di Conti, l’invasione ha avuto effetti limitati se non nulli sulle gang che hanno continuato, con successo, a condurre i loro affari. Un altro effetto delle vicende di Conti è che questo tipo di organizzazioni stanno riducendo le loro dimensioni, perché all’aumentare della dimensione aumentano anche i rischi di conflitti interni o di fughe di informazioni.

La gang Lockbit

Nel gennaio 2023 è apparsa una interessante analisi su Lockbit, la gang che ha attualmente eseguito il massimo numero di intrusioni con successo e a cui è stato attribuito più del 40% delle intrusioni del 2022.

Oggetto dell’analisi sono le notizie su Lockbit nelle chat e nei forum dell’underground russo dove i membri delle gang interagiscono usando Tox, un servizio di messagistica p2p criptato. L’analisi copre il periodo da settembre 2019 a gennaio 2022 e fornisce informazioni per approfondire i rapporti, le fusioni e le scissioni tra gang e le competizioni per offrire il proprio ransomware. Eventi sorprendenti e interessanti sono ad esempio la competizione per il miglior articolo scientifico sponsorizzata da Lockbit con 5000 dollari di premio (la call for paper è in Fig.3), oppure le campagne diffamatorie contro gang rivali per segnalare il fallimento di intrusioni che usano il ransomware di un concorrente o che rivelano presunte collaborazioni con l’FBI o lo Stato russo. Ad esempio, autorevoli membri di Lockbit affermano che le varie incarnazioni della gang Conti lavorino per il Cremlino.

Le gang e le versioni di ransomware

Le informazioni sulle gang e sull’ecosistema sono state arricchite da analisi dei flussi di pagamenti prodotti dalle varie versioni di ransomware. In particolare, lo stesso post di Chainanalysis sulla diminuzione del numero di pagamenti suggerisce che non vi è una associazione stretta tra gang e variante di ransomware: uno stesso gruppo può usare varianti diverse e la stessa variante può essere sfruttata da più gang. La conclusione di Chaianalysis è che l’ecosistema sia formato da un numero ridotto di persone che si muovono tra le varie gang e che usano diverse versioni di ransomware. Questa elevata dinamicità produce la sensazione di molti gruppi, ognuno con tanti membri; ma in realtà non è così. Forse assistiamo a una nuova versione dei villaggi Potëmkin, falsi villaggi di sole facciate creati per ingannare l’imperatrice Caterina II, o ad una nuova versione della guerra ibrida russa. Il piccolo numero di membri delle gang può contribuire a spiegare l’elevato numero di offerte di lavoro presenti sul dark web.

Il rapporto tra le gang e lo Stato russo

Le considerazioni del paragrafo precedente pongono il problema dei rapporti tra le gang e lo Stato russo.

Nessuno dubita che questi rapporti esistano ed alcune analisi evidenziano come, in un contesto in cui le relazioni sono flessibili e altamente variabili, vi sono tre principali tipi di rapporto: associazione diretta, affiliazione indiretta e consenso implicito. Nel caso di associazione diretta, un esponente di una gang criminale viene assunto da un organo di sicurezza o di intelligence. Sono stati documentati casi di assunzioni di esponenti di rilievo di una gang. Abbiamo affiliazione indiretta quando vi sono forti indicazioni dell’uso da parte di organi di sicurezza di risorse di una gang. Ad esempio, in passato l’infrastruttura di attacco di una gang creata per il furto di informazioni bancarie e per diffondere ransomware è stata utilizzate da organi di intelligence o per lanciare DDOS in conflitti in atto. Nel caso di consenso implicito, le attività della gang non sono esplicitamente coordinate con le attività dello Stato russo ma si integrano naturalmente con tali attività.

Un possibile esempio sono intrusioni ransomware delle gang e diffusione di fake news da parte dei organi dello stato. L’obiettivo finale dei vari tipi di rapporto è quello della plausible deniability o negazione plausibile ovvero la possibilità per uno stato di non essere coinvolto in attività illegali svolte da alcuni suoi cittadini.

Il rapporto non chiarito tra cybercrime e lo Stato russo è particolarmente critico ed importante come provato dall’arresto per altro tradimento di Ilya Sachkov, fondatore e CEO di Group-IB, una azienda di cybersecurity. Sachkov ha fatto dichiarazioni critiche e molto informative sui rapporti tra cybercrime e Cremlino e sulla protezione offerta da alcune orgranizzazioni statali ai capi di una gang.

Articolo a cura di Fabrizio Baiardi
Profilo Autore

Full Professor, Università di Pisa
E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca su ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ransomware-lo-stato-attuale/


Adversarial Attacks a Modelli di Machine Learning

“Adversarial Machine Learning”, “Adversarial Attacks”, “Adversarial Examples” e “Adversarial Robustness” sono termini che appaiono sempre più spesso quando si considerano aspetti di sicurezza dei modelli di Machine Learning (ML).

Bug Hunting e Adversarial Examples

Come pratica ormai consolidata nella sicurezza informatica, una nuova applicazione, sistema o servizio va prima o poi soggetto a delle verifiche di “sicurezza”, intesa anche in senso lato, da parte di esperti che cercano di trovare errori, comportamenti anomali o vere e proprie vulnerabilità. Questo accade anche per i modelli di Intelligenza Artificiale e in particolare di Machine Learning.

Sin dalle prime applicazioni pratiche dei modelli ML, nei primi anni 2000, i ricercatori si impegnarono a verificare il loro comportamento: ad esempio trovando modalità di evadere i filtri anti-SPAM basati su modelli ML e aggirare le applicazioni di ML per il riconoscimento di immagini (inizialmente questi erano chiamati genericamente Evasion Attacks, mentre il termine maggiormente usato oggi è Adversarial Examples).

Queste attività possono essere considerate l’equivalente di eseguire un Penetration Test su un’applicazione Web, o di trovare il modo di aggirare o ingannare un sensore biometrico con funzioni di controllo degli accessi. Riportiamo qui solo due esempi provenienti dalla ormai enorme letteratura a riguardo [Rif. 1] e relativi ad applicazioni ML per il riconoscimento di immagini.

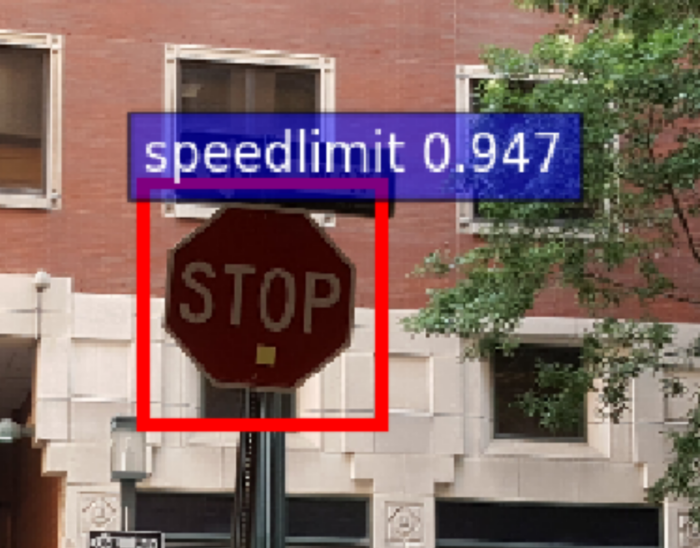
Fig. 1 Cartello stradale di Stop con sticker [Fonte Rif. 2]

La Fig. 1 presenta un ben riconoscibile cartello stradale di Stop ma, a causa dello sticker giallo apposto sotto la scritta, il modello ML sotto attacco interpreta il segnale con il 94,7% di probabilità come un limite di velocità (tipicamente 40Kmh o 25Mph). Una ipotetica vettura a guida autonoma che utilizzasse questo modello ML per riconoscere la segnaletica stradale, quindi, non si fermerebbe allo Stop ma proseguirebbe a velocità inferiore al limite, con ben immaginabili possibili conseguenze.

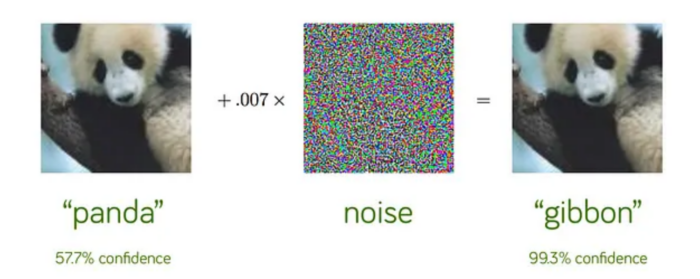
Fig. 2 Un panda o una scimmia gibbone? [Fonte Rif. 3]

La Fig. 2 presenta un’immagine di un panda (a sinistra) in cui al 7 per mille dei pixel viene aggiunto del “rumore bianco”. Il risultato è che, per l’occhio umano, l’immagine non è cambiata; mentre per il modello ML ora rappresenta una scimmia gibbone con il 99,3% di probabilità.

Lo studio di queste vulnerabilità ha portato a comprendere – si veda ad esempio [Rif. 4] – che non si tratta di errori dovuti ad una particolare implementazione errata o disattenzione dei programmatori, ma di un problema più generale e profondo dei modelli ML.

Per semplicità e chiarezza di esposizione, conviene distinguere due significati simili ma non precisamente identici del termine “Adversarial Machine Learning”:

  1. Adversarial ML – Aspetti Scientifici: studio della “Robustezza” dei modelli tramite la possibilità di costruire Adversarial Examples con tecniche sperimentali e matematiche – si vedano i due esempi precedenti;
  2. Adversarial ML – Aspetti Operativi: Studio dei possibili attacchi ai modelli ML utilizzati in ambiente Business.

I due ambiti hanno ovviamente ampie aree di sovrapposizione ma i principali obiettivi, pur essendo allineati, sono diversi.

Adversarial Machine Learning – Aspetti Scientifici

In ambito scientifico lo scopo della ricerca è comprendere quali sono le ragioni dell’esistenza degli Adversarial Examples e, di conseguenza, come migliorare i modelli ML in modo da non averne. I modelli ML senza Adversarial Examples sono chiamati Robusti: questo non vuol dire che non possono fare errori o confondersi, ma che non hanno deviazioni sistematiche con grandi errori dal comportamento atteso.

Nel primo esempio sopra riportato, in un modello ML Robusto l’applicazione di sticker o altri camuffamenti e scritte che all’occhio umano non nascondono il cartello stradale di Stop, possono al più ridurre la confidenza dell’identificazione del cartello da parte del modello ML ad una percentuale del 70% o 60%, ma non identificare il cartello come un altro segnale con quasi assoluta certezza. Nel secondo esempio, due immagini che appaiono uguali all’occhio umano devono essere classificate similmente da un modello ML Robusto, al più con diverso livello di confidenza; e non possono essere identificate come raffiguranti due animali diversi, quello errato con quasi assoluta certezza.

È possibile quindi paragonare il processo di creazione di un modello ML Robusto al processo di sviluppo sicuro del software: ormai è ben noto come sviluppare software adottando pratiche che permettono di ridurre il più possibile la probabilità di Bugs e vulnerabilità di sicurezza, anche se rimane molto difficile se non impossibile (anche teoricamente) scrivere del software complesso con garanzia assoluta di assenza di vulnerabilità.

Ma i modelli ML che sono oggi disponibili sono ancora molto giovani. Benché i primi sviluppi di modelli di Intelligenza Artificiale risalgano agli anni ’50, lo sviluppo dei modelli ML odierni è iniziato decisamente negli anni ’90. Anche se l’architettura di base di molti modelli ML è a prima vista semplice, gli algoritmi matematici che li supportano possono essere molto complessi e ancora non ben compresi/risolti dai ricercatori, ad esempio quelli dei modelli di Deep Learning che recentemente hanno fatto tanto clamore giornalistico.

Siamo quindi nel periodo in cui si è identificato un problema (l’esistenza di Adversarial Examples in modelli ML) e lo si sta studiando; ma non si è ancora trovata la soluzione generale (come costruire modelli ML Robusti) né l’approccio operativo per risolverlo.

L’esistenza di Adversarial Examples è legata al processo di apprendimento di un modello ML. Una tra le principali caratteristiche dei modelli ML è avere moltissimi, anche centinaia di miliardi di parametri numerici configurabili. Inizialmente questi parametri hanno valori casuali e il processo di apprendimento consiste appunto nel configurare il miglior valore di ogni parametro in modo che ogni dato di addestramento in ingresso venga elaborato dal modello, producendo in uscita il risultato atteso. Semplificando molto il funzionamento di questi modelli, quando un nuovo dato viene elaborato dal modello ML, i valori dei parametri configurati permettono di identificare somiglianze con i dati di addestramento e fornire un risultato probabilisticamente vicino a quello corretto od ottimale. Ovviamente il set di dati di addestramento non è esaustivo di tutti i possibili dati esistenti: nei due esempi precedenti non comprende tutte le possibili immagini di cartelli stradali o di panda, anche perché sarebbe una quantità infinita di dati. I set di dati di addestramento sono però rappresentativi dei dati esistenti ma a priori (e in pratica) non è detto che siano sufficienti a configurare tutti i parametri del modello ML in maniera ottimale. C’è quindi la possibilità che una particolare combinazione di dati in ingresso corrisponda ad uno speciale set di parametri che non è stato configurato ottimamente per quei dati (o per nulla) e che quindi generi un risultato errato.

Una ovvia prima soluzione all’esistenza degli Adversarial Examples è addestrare nuovamente il modello ML includendo tra i dati di addestramento gli Adversarial Examples. Il primo problema di questo approccio è che bisogna innanzitutto essere capaci di identificare tutti gli Adversarial Examples; e questo è proprio uno dei principali problemi ancora aperti. Inoltre alcuni modelli ML hanno mostrato di essere soggetti a vulnerabilità o debolezze quali la “sotto-specifica” (Underspecification, ovvero il fatto che una minima modifica ai dati di addestramento produce grandi modifiche nel modello) e la “smemoratezza” (Forgetfulness, ovvero un aggiornamento del modello con nuovi dati porta il modello a dimenticare parte di quello che aveva già appreso). Vi è quindi il rischio che un ulteriore addestramento di un modello ML, aggiungendo anche gli Adversarial Examples tra i dati di addestramento, possa introdurre nuovi Adversarial Examples, senza quindi risolvere il problema. Queste e simili fragilità attuali del processo di apprendimento dei modelli ML rendono oggi difficile – se non impossibile – identificare ed eliminare completamente gli Adversarial Examples dai modelli ML.

Riferimenti Bibliografici

Rif. 1: N. Carlini, “A Complete List of All (arXiv) Adversarial Example Papers”, https://nicholas.carlini.com/writing/2019/all-adversarial-example-papers.html, nel solo anno 2022 risultano pubblicati quasi 3.000 articoli scientifici relativi a “Adversarial Machine Learning”

Rif. 2: T. Gu, B. Dolan-Gavitt, S. Garg, “BadNets: Identifying Vulnerabilities in the Machine Learning Model Supply Chain”, 2017, arXiv:1708.06733

Rif. 3: I.J. Goodfellow, J. Shlens, C. Szegedy, “Explaining and Harnessing Adversarial Examples”, 2014, arXiv:1412.6572

Rif. 4: B. Biggio, B. Nelson, P. Laskov, “Poisoning Attacks against Support Vector Machines”, 2013-03-25, ArXiv:1206.6389; Biggio, I. Corona, D. Maiorca, B. Nelson, N. Srndic, P. Laskov, G. Giacinto, F. Roli, Fabio, “Evasion attacks against machine learning at test time” , 2013, ECML PKDD. Lecture Notes in Computer Science. Vol. 7908. Springer. pp. 387–402, arXiv:1708.0613; Biggio, F. Roli, Fabio, “Wild patterns: Ten years after the rise of adversarial machine learning” , dicembre 2018, Pattern Recognition. 84: 317–331, arXiv:1712.03141intell

Continua a leggere: scarica il white paper gratuito “Adversarial Attacks a Modelli di Machine Learning“

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/adversarial-attacks-a-modelli-di-machine-learning/


DevOps – leva strategica per il settore sanitario

Gli ospedali e le varie strutture sanitarie, oggigiorno, si trovano di fronte a sfide legate alla cybersecurity in termini di minaccia sia per la sicurezza dei pazienti sia per le loro operazioni quotidiane. DI fatto, la progressiva digitalizzazione dei servizi sanitari introduce complesse problematiche di sicurezza, in particolare per quanto riguarda la necessità di garantire che i dati siano costantemente disponibili, accessibili in modo semplice e conformi agli standard di sicurezza vigenti. In questo contesto, l’approccio DevOps assume un ruolo cruciale nel settore sanitario. Vediamo di che si tratta.

Importanza del DevOps nel settore sanitario

L’introduzione di DevOps nel settore sanitario offre numerosi benefici. Questa metodologia integra lo sviluppo software (Dev) con le operazioni IT (Ops), incentivando una maggiore collaborazione tra i gruppi responsabili dello sviluppo e quelli incaricati della gestione delle infrastrutture. Ovvero, un approccio che migliora significativamente l’efficienza e la rapidità nello sviluppo e nel rilascio di software, permettendo alle strutture sanitarie di adeguarsi prontamente alle variazioni e alle necessità emergenti nel settore.

Vantaggi nell’implementare i DevOps nel settore sanitario

Di seguito si illustrano i principali vantaggi che possono scaturire dall’implementazione di DevOps nel settore sanitario:

  • Riduzione delle spese operative – Sia le spese operative – poiché non ci sono investimenti iniziali in acquisti e formazione – sia le risorse operative sono notevolmente ridotte
  • Integrazione e Distribuzione Continue – DevOps facilita l’integrazione fluida e il deployment di aggiornamenti software e nuove features, assicurando che i sistemi sanitari rimangano all’avanguardia ed efficienti.
  • Efficienza e Scalabilità Migliorate – Le metodologie DevOps permettono alle organizzazioni sanitarie di espandere rapidamente i loro sistemi in risposta alle esigenze in crescita, assicurando al contempo il mantenimento di operazioni senza intoppi.
  • Automazione Accresciuta – Grazie all’automazione, i team DevOps riescono a semplificare i processi, minimizzando gli errori umani e potenziando l’efficienza generale del sistema.
  • Sfruttamento dei dati migliorato – L’architettura di DevOps garantisce una facile accessibilità attraverso le applicazioni a portata di mano per i pazienti e l’amministrazione. I dati vengono sfruttati in più reparti e piattaforme per un utilizzo multiuso al fine di fornire soluzioni sanitarie integrate.
  • Sicurezza dei dati e conformità normativa – Il principio fondamentale di DevOps, i.e. “l’infrastruttura come codice”, consente agli operatori sanitari di integrare i fondamenti della sicurezza all’interno del modulo applicativo stesso. Secondo questo approccio, l’analisi delle vulnerabilità viene eseguita insieme alle implementazioni della pipeline. Ciò consente agli ingegneri di affrontare tutte le potenziali vulnerabilità al momento dello sviluppo e dell’implementazione. Inoltre, viene utilizzato il principio del “privilegio minimo” per assegnare l’accesso. Ciò significa che le macchine e le persone con il livello di privilegio più basso non ottengono l’accesso alle aree critiche del sistema, garantendo la protezione dei dati e il rigoroso rispetto della conformità attraverso la mitigazione del rischio.
  • Aumento del coinvolgimento – Le organizzazioni sanitarie che implementano pipeline Continued Integration (CI)/(Continued Distribution (CD) spesso forniscono funzionalità e soluzioni più personalizzate, con conseguente miglioramento dell’esperienza del paziente (i.e. sistemi di self-check-in che accelerano elaborazione del paziente o compilazione elettronica delle prescrizioni che consentono ai pazienti di accedere ai farmaci da remoto) per un’assistenza immediata e di qualità. Inoltre, anche gli operatori sanitari possono trarre beneficio dai DevOps, ad esempio, implementando la pianificazione automatizzata degli appuntamenti, per migliorare l’efficienza operativa, mantenendo al contempo un’erogazione di cure ottimale.

Team DevOps – ruolo strategico

È essenziale riconoscere il ruolo strategico che i team DevOps rivestono in vari aspetti del settore sanitario, tra cui:

  • Gestione dell’Infrastruttura – Questa è cruciale per assicurare che tutti i componenti infrastrutturali, come server, reti e database, operino in maniera sicura ed efficiente. Ciò include il monitoraggio costante delle prestazioni del sistema, l’identificazione e la risoluzione dei punti critici, nonché l’ottimizzazione dell’uso delle risorse per garantire il massimo livello di prestazioni.
  • Sicurezza delle Applicazioni -Questo compito, che richiede una stretta collaborazione con gli sviluppatori, è rivolto all’implementazione di robuste misure di sicurezza all’interno delle applicazioni. Tra queste, vi sono i controlli di accesso, la crittografia e le pratiche di sviluppo sicuro.
  • Risposta agli Incidenti e Ripristino di Emergenza – L’obiettivo è ridurre al minimo i tempi di inattività e le vulnerabilità del sistema attraverso lo sviluppo e l’attuazione di piani di risposta agli incidenti e strategie di ripristino di emergenza.
  • Principali Rischi per la Cybersecurity nelle Aziende Sanitarie -Con l’avanzamento verso la digitalizzazione e l’innovazione, le aziende sanitarie diventano sempre più bersagli attraenti per i criminali informatici che cercano di sfruttare le vulnerabilità della cybersecurity e sferrare attacchi che possono avere un impatto significativo sull’organizzazione.

In sintesi, l’adozione di pratiche DevOps nel settore sanitario non solo migliora l’efficienza e la reattività delle organizzazioni sanitarie ma gioca anche un ruolo fondamentale nel rafforzare la sicurezza e la resilienza delle infrastrutture critiche di fronte a minacce sempre più sofisticate.

Formazione e sviluppo delle competenze necessarie per adottare efficacemente le pratiche DevOps

È doveroso sottolineare che, per adottare le pratiche DevOps in modo efficace nel settore sanitario, è necessario strutturare una formazione e uno sviluppo di competenze in diverse aree. Per quanto riguarda le competenze tecniche, i professionisti IT dovrebbero acquisire conoscenze nel cloud computing, nell’automazione dell’infrastruttura e nelle tecnologie di containerizzazione. È inoltre essenziale la conoscenza degli strumenti di gestione della configurazione, delle pipeline Continued Integration (CI)/Continued Distribution (CD) e dei sistemi di controllo delle versioni.

Inoltre, per garantire un’efficace implementazione DevOps nel settore sanitario, richiede da parte dei team coinvolti una serie di competenze trasversali, quali: esperienza in materia di sicurezza e conformità, gestione del rischio, capacità di collaborazione e comunicazione, metodologie agili e capacità di problem solving.

Come implementare DevOps nel settore sanitario

Di seguito gli step principali da considerare nell’implementare DevOps nel settore sanitario.

  1. Pianificazione – Il primo passo del processo DevOps è la pianificazione. È necessario esaminare le attività operative e di sviluppo e configurarle in base alla metodologia DevOps. Inoltre, durante questa fase, è necessario controllare anche le risorse tecniche e umane, l’inventario, le linee guida software e le politiche di sicurezza. Ancora, potrebbe essere necessario pianificare riunioni con team diversi ed eseguire la gestione delle attività.
  2. Integrazione continua (Continued Integration – CI) – Il server CI deve eseguire il commit di tutte le modifiche di sistema e dei nuovi moduli di codice nel repository centrale. Ciò consente la condivisione e l’unione del codice tra reparti. Un’efficiente gestione del codice previene anche i ritardi.
  3. Test continui – Il repository condiviso viene continuamente testato per verificarne il funzionamento o meno. Se il test dà risultati positivi, viene inviato alla fase successiva. In caso di test con esito negativo o “inconcludente”, il sistema tenta di identificare l’errore ed eseguendo tale operazione attraverso il proprio database. Ciò permette di verificare se l’errore è noto. Se si tratta di un nuovo errore, il sistema genera un report e crea un evento imprevisto assegnandolo successivamente al team di sviluppo che terrà traccia del problema attraverso un tracker degli incidenti.
  1. Distribuzione continua (Continued Distribution) – Il codice, dopo essere stato testato correttamente, viene distribuito nel sistema di produzione (o nel sistema di sviluppo, a seconda del protocollo aziendale), garantendone una rapida e regolare distribuzione.
  2. Monitoraggio e feedback costante – Il monitoraggio costante assicura che il software funzioni al suo livello ottimale. Di fatto, il sistema invia feedback al team di DevOps e, in caso di problemi nella compilazione, viene generato una segnalazione in tempo reale di incidente che il sistema monitora in modo da tenere traccia degli incidenti.

Conclusioni

DevOps sta emergendo come uno strumento cruciale nel settore sanitario, fungendo da catalizzatore per migliorare sia l’efficienza operativa sia la gestione dei costi delle infrastrutture, oltre ad accelerare i tempi di sviluppo delle applicazioni, facilitare la sinergia tra i collaboratori e massimizzare l’uso sicuro dei dati disponibili.

Le organizzazioni sanitarie devono essere capaci di affrontare le minacce informatiche, proteggendosi dagli attacchi contingenti e futuri. I DevOps, in questo ambito, assumono un’importanza strategica in quanto sono in grado di equilibrare dinamicamente innovazione ed agilità con sicurezza e conformità, senza trascurare l’attenzione verso il paziente e si ritiene che contribuiranno sempre più al miglioramento dei servizi sanitari e, ove necessario, rivolgersi a professionisti del settore in grado di offrire servizi dedicati ed accompagnare i vari attori sanitari lungo il cammino sine die verso la cyberresilience.

Articolo a cura di Federica Maria Rita Livelli, BeDisruptive Training Director/BCI – Cyber Resilience Group/ CLUSIT – Comitato Scientifico /ENIA- Comitato Scientifico /FERMA – Digital Committee/ANRA – Board & Comitato Scientifico

Profilo Autore

Certificata in Risk Management (FERMA/ANZIIF certificazioni Iso 3100:2018) & Business Continuity (AMBCI Certification – BCI, UK; CBCP Certification – DRI, Usa), svolge consulenze in Risk Management & Business Continuity oltre ad effettuare un’attività di diffusione e sviluppo della cultura della resilienza presso varie istituzioni e università italiane e straniere. Ricopre anche il ruolo di Training Director presso BeDisruptive Consulting.

Membro de:
· ANRA (Associazione Nazionali Risk Manager & Responsabili Assicurazioni Aziendali) – Membro Comitato Direttivo
· BCI, UK (Associazione Internazionale Business Continuity & Resilience) – Membro del Conduct Committee
· BCI CYBER RESILIENCE SIG – Board Member
· CLUSIT (Associazione Italiana per la Sicurezza Informatica) – Membro Comitato Scientifico e Gruppo CLUSIT AIXIA
· ENIA (- Ente Nazionale per l’Intelligenza Artificiale) – Membro Comitato Scientifico
· FERMA (Federation of European Risk Management Associations) – Membro of Digital Committee
· UNI (Ente Nazionale Italiano di Normazione) – Rappresentante per ANRA al Comitato Tecnico UNI/CT 016/GL 89 “Gestione dell’innovazione” (ISO/TC 279) (Commissione Tecnica -UNI/CT 016 “Gestione per la qualità e metodi statistici”)

Speaker in numerosi seminari e convegni nazionali ed internazionali in riferimento a tematiche di Business Continuity & Risk Management, Resilience , Change Management, Innovazione, Cyber Security, Facility Management & Procurement e Artificial Intelligence

È altresì autrice di numerosi articoli inerenti alle tematiche di Risk Management & Business Continuity, Cybersecurity e Resilience pubblicati da diverse riviste italiane e straniere. Co-autrice de: Report 2020-2021-2022 -2023-2024 CLUSIT-Cyber Security e de “Lo stato in Crisi” ed. Franco Angeli.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/devops-leva-strategica-per-il-settore-sanitario/


Cybersecurity nella Pubblica Amministrazione: Garantire la Continuità dei Servizi attraverso la Sicurezza Integrata

Il contesto normativo

Da un punto di vista normativo, i principali riferimenti sono rappresentati dall’art. 51 del Codice dell’Amministrazione Digitale (CAD) e dall’art. 32 del Regolamento Generale sulla Protezione dei Dati (GDPR). Entrambe le discipline sottolineano l’obbligo di garantire la confidenzialità, la riservatezza e l’integrità dei dati. Inoltre, stabiliscono l’importanza di implementare procedure per garantire la continuità dei servizi e il ripristino tempestivo dei sistemi in caso di incidenti fisici o tecnici. Vi sono anche altre misure, obiettivi ed azioni da rispettare in tema di sicurezza informatica nel Piano Triennale per l’Informatica delle PA 2024-2026 che richiamano alla necessità di redigere uno specifico piano di sicurezza.

Tutte queste disposizioni esigono adempimenti che, il più delle volte, si ripetono. Ragion per cui diventa importante coordinare le attività, in modo da non replicare i processi finalizzati a garantire la sicurezza. La chiave per bilanciare il contesto normativo e tecnologico è la gestione organica e strutturata del processo e, nel contesto delle pubbliche amministrazioni, particolare importanza assumono in materia le Linee guida e le circolari messe a disposizione dall’Agenzia per l’Italia Digitale (Agid).

Il contesto organizzativo

In qualsiasi organizzazione, la sicurezza informatica si articola in un processo che coniuga aspetti di natura tecnica ed economica, i quali convergono nel contesto organizzativo. A conferma dell’importanza della sicurezza informatica per gli enti pubblici, il CAD all’art. 17 introduce, nel contesto organizzativo della struttura pubblica, la figura del “Responsabile per la Transizione Digitale” (RTD). Uno dei principali compiti dell’RTD consiste nel sensibilizzare i vertici dell’amministrazione sulla consapevolezza dei rischi da attacco informatico, promuovendo delle best practice in ambito della protezione dei dati e servizi digitali. Questo include la facilitazione di sessioni formative, la diffusione di informazioni sulle minacce attuali e la promozione di politiche e procedure di sicurezza per garantire un ambiente digitale resiliente.

A parità di sistemi di protezione e dotazioni tecnologiche, è ormai un fatto consolidato che il punto critico nella catena della sicurezza informatica di un’organizzazione risieda nelle persone. Ciò sottolinea la necessità di gestire la sicurezza informatica attraverso precise azioni organizzative e decisionali, partendo dai vertici delle amministrazioni. È di fondamentale importanza agire su tre fronti principali: fornire linee guida per l’uso sicuro degli strumenti ICT (come previsto dall’art. 12 comma 3-bis del Codice dell’Amministrazione Digitale – CAD), implementare una formazione continua del personale per diffondere la consapevolezza sull’importanza della sicurezza informatica e sui suoi impatti sull’organizzazione (conformemente all’art. 13 del CAD), e infine, considerare nell’ambito dei contratti ICT specifiche garanzie da parte dei fornitori per garantire il rispetto dei requisiti minimi di sicurezza.

Il contesto tecnologico

Dal punto di vista tecnologico, i principali parametri di riferimento comprendono le Misure Minime di Sicurezza ICT per la Pubblica Amministrazione (allegate al n. 2/2017 da parte di Agid). Altri standard di riferimento fondamentali includono le Critical Security Controls della CIS (CIS CVS v.8), le linee guida dell’OWASP e le disposizioni della norma ISO 27001.

Le Misure Minime di Sicurezza di Agid delineano obiettivi di sicurezza (ABSC) suddivisi in criteri minimi (misure al di sotto delle quali nessuna PA può scendere), criteri standard (misure di best-practice per tutte le PA) e criteri avanzati (misure ottimali).

Nella pubblica amministrazione, la sicurezza informatica è essenzialmente il risultato di un processo organizzativo che comprende tecnologie informatiche rispondenti a precise caratteristiche di robustezza, non diverse da quelle normalmente utilizzate nel contesto privato. Anche la strategia italiana per il cloud, pur presentando aspetti che vanno attentamente valutati nel contesto delle pubbliche amministrazioni, rappresenta ad oggi un’opportunità da considerare nella scelta delle soluzioni tecnologiche sicure ed affidabili.

La fase di identificazione

La pianificazione della sicurezza informatica inizia con la fase di “Identify”, in cui vengono individuati, definiti e catalogati tutti gli asset dell’organizzazione. Per asset si intendono tutte le componenti tecnologiche dell’infrastruttura, i servizi, le applicazioni e i dati, nonché le componenti organizzative (persone) e fisiche (spazi e luoghi di lavoro).

La fase successiva è quella del “Risk Assessment”, in cui viene calcolato il livello di rischio, tenendo conto della probabilità che una minaccia sfrutti una specifica vulnerabilità a cui un asset potrebbe essere esposto.

La fase di protezione

Una volta che gli asset e il relativo livello di rischio sono stati identificati, si può procedere alla fase di “Protect”. Sul mercato, sono disponibili numerose soluzioni tecnologiche di protezione, spesso specializzate nella mitigazione di specifici rischi. Pertanto, è consigliabile adottare un approccio complementare che coinvolga diversi sistemi di protezione. In linea generale, e facendo riferimento anche alle misure minime di sicurezza, è possibile categorizzare le tecnologie di protezione in quattro livelli specifici: sistemi di protezione perimetrali (come i Next-Generation Firewall), sistemi di protezione degli end-point (quali antivirus e antimalware), sistemi di autenticazione e autorizzazione (come Identity Manager) e sistemi di demilitarizzazione della rete (tramite VLAN). Il funzionamento ottimale di queste soluzioni tecnologiche dipende dalla capacità dell’organizzazione di mantenerle costantemente aggiornate e patchate.

La fase di difesa

Il campo di protezione spesso non è sufficiente per garantire un livello completo di sicurezza dei sistemi, e pertanto è essenziale includere una specifica fase di difesa proattiva “Detect”. Anche in questo contesto, esistono diverse soluzioni commerciali che consentono di mitigare il rischio prima che si manifesti. Alcuni prodotti di riferimento riguardano la rilevazione proattiva dei controlli degli accessi (come gli IDS – Intrusion Detection System e i NAC – Network Access Control), la rilevazione proattiva delle minacce (come gli IPS – Intrusion Prevention System, SIEM – System Information and Event Management, DLP – Data Loss Prevention, ecc.), e sistemi in grado di fornire un monitoraggio trasversale dell’intero perimetro di sicurezza (come SOC – Security Operation Center e NOC – Network Operation Center).

La fase di risposta e ripristino

Nel contesto della sicurezza informatica, è cruciale integrare nella gestione della sicurezza anche le fasi di “Response” e “Recovery”. Queste fasi sono volte a gestire, rispettivamente, la comunicazione durante un attacco informatico e il ritorno alla normalità dopo l’incidente.

Nella fase di risposta a un attacco informatico, è essenziale gestire le comunicazioni interne ed esterne in modo tempestivo ed efficiente per mitigare possibili ulteriori danni causati dall’incidente. Un approccio comunicativo incentrato sulla massima trasparenza ed apertura verso l’esterno può favorire lo scambio di informazioni e una cooperazione di valore nella gestione dell’emergenza.

La fase di ripristino è volta a ristabilire rapidamente la piena operatività dell’organizzazione e deve essere disciplinata da un apposito piano contenente i soggetti, i compiti e le azioni da eseguire. A questa fase segue la fase di “Mitigation”, il cui obiettivo è riprogettare la sicurezza informatica dell’organizzazione. Questa fase ricalca l’intero processo di pianificazione, iniziando dalla fase di “Identify”, seguendo la logica del miglioramento continuo.

Conclusione

La crescente attenzione da parte degli attacchi informatici, in particolare rivolti verso le amministrazioni è strettamente legata a l’accelerato processo di transizione digitale delle PA, agevolato dalle misure del Piano Nazionale di Ripresa e Resilienza (PNRR). In questo contesto, è cruciale per la Pubblica Amministrazione gestire la sicurezza informatica come elemento di processo. Ciò implica assicurare la confidenzialità, integrità e disponibilità dei dati e dei servizi, seguendo principi “by design” e “by default”.

Articolo a cura di Daniele De Simone

Profilo Autore

Laurea in ingegneria informatica con master di specializzazione in sicurezza informatica e disciplina giuridica. Coordinatore dei sistemi informativi associati dell’Unione delle Terre d’Argine, dove si occupa di assicurare che i servizi esterni ed i processi informatici interni dell’Ente siano continuativi ed adeguati agli standard nazionali. Incaricato in più occasioni dal Tribunale come tecnico specializzato in computer forensics. Incaricato a collaborazione per la stesura del “Libro bianco sull’innovazione della PA” approvato il 29 Novembre 2018 dal Ministro per la Pubblica Amministrazione Giulia Buongiorno.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cybersecurity-nella-pubblica-amministrazione-garantire-la-continuita-dei-servizi-attraverso-la-sicurezza-integrata/


GDPR compliance e ISO 27001 – Sistemi di Gestione della Sicurezza oltre la formalità

In una società e in un’economia basate sulla conoscenza, i flussi di informazione costituiscono il fattore principale di crescita economica e consolidamento strategico di ogni attività, sia nel pubblico che nel privato. Le informazioni sono considerate una risorsa ad elevatissimo valore strategico e fondamentali per aumentare la competitività di una organizzazione: di conseguenza, come per ogni altro asset tangibile o intangibile, i flussi informativi in continua generazione impongono progettazione e applicazione di adeguate politiche di protezione, al fine di preservarne il contenuto e garantirne la miglior strumentalità possibile in modo continuativo nel tempo.

Ove l’ambito di sicurezza informatica, in azienda o nelle PPAA, non venga incluso strutturalmente, sistematicamente e rigorosamente nelle attività quotidiane, è inevitabile che il palesarsi di fattori di rischio attraverso gravi incidenti di sicurezza vada a impattare direttamente anche su aspetti finanziari e di profitto, nonché su meccanismi di credibilità reputazionale in grado di penalizzare la capacità di innovazione digitale e attrarre utenti (clienti) verso i servizi evoluti offerti dall’organizzazione stessa.

All’interno di tale cornice, sono all’ordine del giorno lo scenario normativo GDPR (General Data Protection Regulation), e quello degli standard afferenti alla famiglia 2700x.

Un ambito sottovalutato

Le politiche di sicurezza di base, nella maggioranza dei contesti in cui si è costruita esperienza durante oltre 10 anni di operatività nel settore ICT, risultano spesso delineate sulla carta e in vari formalismi, mentre l’effettiva e continuativa applicazione è lasciata a fattori contingenti e postumi, come il subitaneo verificarsi di determinati eventi di attacco o situazione in grado di mettere a rischio la riservatezza e l’integrità delle banche dati. Si può dire, ad oggi, che sono veramente poche le medio-piccole organizzazioni in cui sia presente una governance strutturata e continuativa sulle tematiche di tutela informativa. Documenti, linee guida e strumenti a supporto delle attività e che tengano conto delle specificità caratteristiche dell’organizzazione restano perlopiù in vitro, delineando un quadro poco incoraggiante se rapportato al continuo verificarsi di incidenti di sicurezza sia in ambito IT che OT (operazionale, rif. Industria 4.0/5.0) documentato dai media di settore e non solo.

A partire da maggio 2018, eppure, con l’applicazione del Regolamento generale sulla protezione dei dati zione (GDPR), è entrato in vigore un severo quadro normativo sulla protezione dei dati, che è uno dei contesti chiave della sicurezza informatica, da applicare per tutte le aziende che operano con cittadini dell’UE. Sfruttando il quadro normativo sviluppato dall’EU e spostando i temi su una prospettiva legal-tech, il GDPR regola il trattamento e diffusione dei dati personali relativi alle persone fisiche e giuridiche, identificativi di ruoli e responsabilità, richiedendo esplicitamente alle organizzazioni di dimostrare di aver incorporato il principio della protezione dei dati fin dalla progettazione e per impostazione predefinita, adottando misure tecniche e organizzative adeguate a garantire tale trattamento i dati sono trattati in conformità al Regolamento.

Per raggiungere gli obiettivi imposti, è richiesta l’allocazione di risorse organizzative da parte delle aziende, ancor prima che economiche: pianificare strategie, progettare modelli di processo, implementare soluzioni proattive sono attività che richiedono tempo e una pianificazione temporale che tenga conto della necessità di non impattare eccessivamente sulla quotidianità degli operatori coinvolti. Pur essendo un processo graduale, infatti, il percorso porta all’introduzione di soluzioni anche radicalmente differenti rispetto allo stato dell’arte, imponendo agli utilizzatori di strumenti informatici nuove regole di norma ben più severe rispetto alla consuetudine. Il fattore di governance, nominando figure professionali interne o esterne dotate di ampie expertise di settore (ISO o RdT data processor) risulta fondamentale per ottenere obiettivi concreti e solidi nel tempo.

Eppure, l’obbligo normativo non ha realmente portato a una capillare diffusione di soluzioni strutturali e proattive, soprattutto se consideriamo realtà prive di motivazioni strettamente correlate al proprio core business. Proviamo ad estendere il tema.

Perchè un Sistema di Gestione della Sicurezza

Come noto, la sicurezza delle informazioni è fondata su tre aspetti principali: riservatezza, disponibilità e integrità. Per garantire il successo e la continuità dell’azienda e minimizzare l’impatto di eventi negativi, la sicurezza delle informazioni implica l’uso e la gestione di adeguate misure di sicurezza, prendendo in considerazione un’ampia varietà di minacce e implementando una serie di misure di controllo selezionate in base al processo di gestione del rischio e gestite utilizzando un framework che comprenda politiche, processi, procedure, strutture organizzative, software e hardware, al fine di proteggere la risorse informative identificate come a rischio.

La società odierna deve affrontare costantemente un’ampia varietà di rischi: rischi naturali, professionali rischi, rischi per la salute, rischi per la sicurezza delle informazioni, rischi che incidono sull’ambiente e hanno effetti negativi sulle generazioni future ecc., i cui effetti nella maggior parte dei casi perdurano nel tempo. Una delle numerose definizioni di rischio lo mostra come una minaccia, una possibilità che si verifichi a evento in grado di causare danni di varia entità, caratterizzato dalla gravità delle conseguenze e dalla probabilità di accadimento.

Un ISMS – Information Security Management System, in terminologia ISO 27001 – detta un approccio sistematico, strutturato, risk-based, alle politiche di gestione delle informazioni aziendali digitali, al fine di arrivare a un vero e proprio framework di sicurezza fortemente contestualizzato alla realtà per cui è progettato. L’ecosistema ISMS, costruito nella fattispecie per arrivare alla compliance 27001:2022, ma nelle tematiche senz’altro valido in un ambito più generale, prevede:

  • la mappatura degli ambiti di rischio e relativi gradi di pericolosità, costruendo una scala di valutazione contestualizzata alla realtà in cui si opera;
  • l’identificazione dei rischi specificatamente in ambito digitale, associati a riservatezza, integrità e integrità delle informazioni, perdita di disponibilità e identificando le entità coinvolte;
  • di stabilire e mantenere criteri di contenimento del rischio, assicurando continuità alle attività di monitoraggio e valutazione;
  • la strutturazione di un ambito di tracciamento degli eventi, secondo un modello di azione/reazione;
  • l’analisi del rischio, ovvero una stima delle potenziali conseguenze se dovesse verificarsi il rischio individuato, la reale possibilità di accadimento del rischio individuato e l’identificazione del livello di rischio stimato.

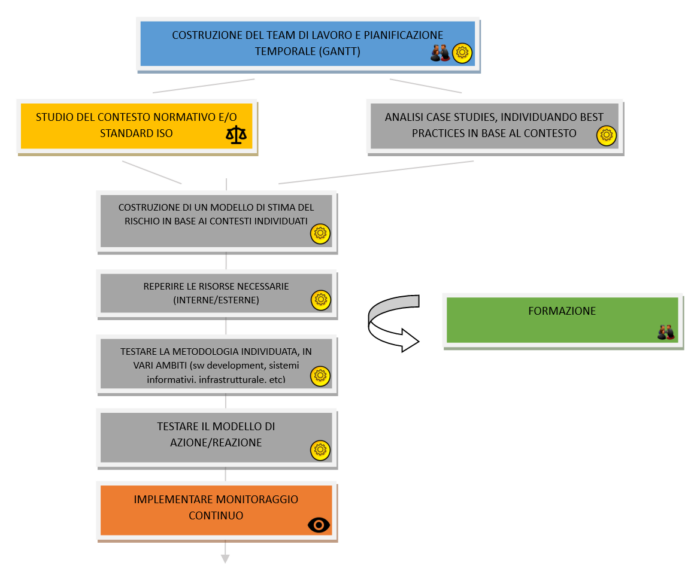
La creazione di un’opportuna strategia progettuale e di mantenimento include diversi passi, per cui si può considerare utile il diagramma seguente.

Figura 1: progettazione di un ISMS

Nella prima fase della metodologia modellizzata nel diagramma precedente, il team di lavoro viene costruito selezionando figure interne ed esterne dotate delle necessarie competenze e seniority, in base ai ruoli richiesti. Lo sviluppo del modello è pianificato secondo precisi canoni stabiliti dalla Proprietà o dai relativi manager incaricati (risultato desiderato, tempo, risorse, metodi) È effettuata una prima raccolta ed elaborazione delle informazioni necessarie per procedere con la costruzione dell’ISMS.

La seconda fase non può prescindere da percorsi di studio della normativa GDPR o dei cardini della ISO 27001:2022, in grado di portare il team di lavoro a individuare con maggior precisione gli ambiti di sviluppo del modello da realizzare, anche grazie all’individuazione di casi di studio reperiti nella knowledge base di settore o al proprio interno. L’algoritmo su cui si basa ogni sistema di gestione della sicurezza si deve consolidare previo un percorso di testing, ove la simulazione di scenari operativi risulti fondamentale per arrivare a una stima del rischio il più precisa possibile, costruendo di conseguenza modelli di azione/reazione efficaci con un approccio assolutamente proattivo da parte degli attori coinvolti.

È importante considerare, infine, che l’effettiva implementazione di un sistema di gestione della sicurezza, o messa in produzione volendo mutuare la terminologia da ambiti software, non chiude l’attività a tempo indeterminato: il contesto di sicurezza informatica è, per definizione, dotato di elevata dinamicità per cui attività di miglioramento continuo, consolidamento di uno storico significativo, formazione specifica dedicata agli operatori addetti alla quotidianità dell’organizzazione, sono parte integrante di un ISMS.

ISO 27001 / GDPR CROSSOVER

Se è pur vero che l’acronimo ISMS sia utilizzato specificatamente in ambito ISO, i relativi contenuti sono certamente trasversali a più contesti ove le organizzazioni abbiano necessità di mettere a punto sistemi di gestione della sicurezza. Soprattutto, si può arrivare alla costruzione di un ISMS in accezione ISO dopo aver già affrontato buona parte delle tematiche coinvolte in altri contesti, seppur da prospettive differenti o con obiettivi imposti da entità governative.

27001 e GDPR hanno ampie similarità di ambito, rendendosi spesso complementari su vari aspetti, nonostante sussista una differenza fondamentale nelle rispettive origini e obiettivi.

GDPR è un quadro normativo: il Regolamento (UE) 2016/679 (anche conosciuto come GDPR o con l’acronimo RGPD, in Italia) è entrato in vigore su scala europea a partire dal 25 maggio 2018, introducendo un ambito di applicazione più ampio rispetto alla normativa precedente (rif. quadro DPS) e detta un approccio innovativo alla protezione dei dati classificati secondo rigorose categorie predefinite, ancorché ad oggi – ad ormai 6 anni dalla ratifica – su alcuni aspetti, soprattutto terminologici, inizi a mostrare la necessità di qualche ritocco, perlomeno da una prospettiva prettamente informatica.

ISO 27001 è uno standard di gestione a validità internazionale: fornisce una serie di policies e procedure comprovate per arrivare a una efficace gestione della sicurezza delle informazioni e degli assets correlati, nonché a garantire una strategia di miglioramento continuativo, necessariamente adattativo rispetto all’evoluzione tecnologica. L’insieme integrato di politiche, procedure, documentazione e tecnologie raccomandate viene appunto definito qui Sistema di gestione della sicurezza delle informazioni (ISMS, conosciuto anche come SGSI in italiano).

In termini di requisiti di conformità, lo standard volontario ISO 27001 include la necessità di costruire requisiti di tutela informativa e riduzione dei rischi connessi assolutamente compatibili con lo scenario GDPR. Di fatto, quindi, la relazione può essere interpretata nel senso che possedere già una certificazione ISO 27001 permetta alle organizzazioni di attingere regole e policies dall’ISMS e trasferirle nel contesto normativo del GDPR. Ad esempio, la necessità di sistemi di logging degli accessi è caratteristica comune ai due contesti, così come la segmentazione dei livelli di accesso alle risorse condivise.

Viceversa, il rispetto della normativa GDPR e la presenza di un Manuale della Privacy ben costruito, permette alle aziende interessate a perseguire la certificazione ISO 27001 di poter attingere a un set di misure che possono costituire ambito propedeutico a quello richiesto dallo standard ISO. Ad esempio, non considerando qui nemmeno le (diffuse, ahimè) casistiche ove le nomine siano conferite esclusivamente pro forma e senza le dovute competenze specifiche, l’eventuale presenza di un DPO nominato in ambito GDPR fa sì che una figura professionale dotata delle necessarie expertise e visione a 360° sull’infrastruttura IT/OT sia già presente, ed esso può serenamente essere elevato a ISO di un ISMS senza la necessità di doverne individuare di ulteriori. Sarà possibile, in tal caso, concentrarsi su aspetti di formazione ulteriore.

È dunque chiaro che la conformità lato GDPR non implichi il raggiungimento diretto della certificazione ISO, né sia vero il viceversa: basta citare il fatto che tra i 7 principi base del GDPR solo 1 si riferisca esplicitamente alla sicurezza delle informazioni (rif. Integrity and Confidentiality), tema che invece è assolutamente trainante in ambito ISO. In particolare, la prospettiva decisamente orientata alle modalità con cui i dati sono trattati e su cui è costruito il GDPR stesso, tende a definire il contesto normativo EU come un di cui degli aspetti della ISO 27001.

Se facciamo riferimento al contesto di Risk Management, invece, l’approccio tra i due ambiti è più simile: viene incoraggiata in entrambi i casi una strategia risk-based, orientata a mitigare ogni fattore di rischio individuato a partire da una fondamentale fase di analisi preliminare (f.i. risk assessment). La differenza è perlopiù terminologica e in termini di espliciti obblighi formali: ove il GDPR impone – letteralmente – determinati criteri nel trattamento delle informazioni personali, in ambito ISO si insiste su procedure, best practices, controlli, orientati alla riduzione dei fattori di rischio individuati.

Anche dal punto di vista della Documentazione da produrre a corredo della compliance o della certificazione, le similitudini nei contenuti sono marcate. Particolarmente significativo in entrambi i contesti è il formato (in termini di layout, templates, modelli) della documentazione da realizzare. Documenti come il censimento dei Responsabili del Trattamento, il Registro degli Eventi, i fascicoli contenenti le nomine formali delle varie entità coinvolte, devono rispettare layout determinati dall’Unione Europea (GDPR) o dalla International Organization for Standardization (ISO) / International Electrotechnical Commission (IEC) (27001): eventuali difformità, portano a lacune informative nella documentazione depositata o ad aspetti di non conformità formale che possono vanificare un framework complessivo seppur ben costruito nei contenuti tecnici.

Compliance o Conformity?

Il termine conformity dovrebbe essere bandito dagli ambiti di sicurezza informatica, standard o normativi.

E, infatti, lo è.

La quasi totalità degli interlocutori fa riferimento a compliance, anche ove di compliant i propri sistemi di gestione della sicurezza nulla hanno.

L’interessantissimo web www.differencebetween.net aiuta a fornire una chiave di lettura interessante alle accezioni dei due termini, portando innanzitutto a una raffinata riflessione tra i rapporti semantici tra l’inglese e l’italiano, ma soprattutto a una certa autocritica funzionale a comprendere le motivazioni reali per cui normative e standard vengono realmente introdotti.

Il termine conformity si traduce in italiano con “conformità”, e deriva dal latino “conformare” “essere conforme, assoggettare a un vincolo di forma”.

Un sistema di gestione della sicurezza informatica è conforme quando rispetta tutti i requisiti formali per cui è stato costruito, in termini di documentazione necessaria sia dal punto di vista di uno standard, sia da quello della normativa. L’esperienza insegna che la grande maggioranza di tali sistemi sono conformi quanto basta per evitare non conformità o, peggio, sanzioni amministrativi a seguito di danni cagionati all’interno della propria organizzazione o a terzi. Il motivo, spesso, non è da ricercarsi in mancanza di competenze (seppur questo sia un fattore assai diffuso) o di volontà imprenditoriale, quanto in aspetti prettamente economici in quanto costruire e mantenere un ISMS solido nel tempo ha dei costi non irrilevanti, e se rapportiamo l’attività a organizzazioni di piccola e media estensione questo può costituire un elemento di incertezza bloccante.

Un sistema di gestione della sicurezza informatica, invece, è compliant (che deriva dal latino “complere” “adempiere, realizzare, assolvere”) quando porta a modificare sensibilmente lo stato dell’arte tecnologico, comportamentale, consuetudinario, verso regole riconosciute valide e provenienti dall’esterno. Implica, in modo semanticamente forte, un processo di cambiamento, profondamente compatibile e coerente con i modelli da cui ha avuto origine.

Articolo a cura di Igor Serraino

Profilo Autore

Igor Serraino è professionista IT.
Opera come analista infrastrutturale e di Open Innovation nel contesto di Impresa 4.0 fin dal 2017, in qualità di Technology Expert per una importante società di settore attiva in ambiti aziendali eterogenei e sfidanti.
Il suo portfolio professionale senior-level si consolida attraverso una decennale esperienza da analista e sviluppatore hard-skills in ambienti Java-based, con particolare riferimento alla coprogettazione e sviluppo di applicativi per la gestione finanziaria commercializzati nel mondo della Pubblica Amministrazione.
Ha all’attivo numerose attività di formazione aziendale, workshops e pubblicazioni nei contesti di Cyber Security (GDPR e ISO27001), Legal-Tech, BlockChain Architect.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/gdpr-compliance-e-iso-27001-sistemi-di-gestione-della-sicurezza-oltre-la-formalita/


Proteggi il tuo PC da virus e malware – Guida alla sicurezza informatica

Introduzione

La sicurezza informatica è un tema di cruciale importanza per gli esperti del settore. Proteggere il proprio PC da virus, malware e altre minacce è fondamentale per garantire la privacy e la sicurezza dei dati.

Prima di esplorare le strategie di sicurezza informatica, è essenziale comprendere le minacce che affliggono il mondo digitale. Virus, malware e attacchi informatici sono tra le principali minacce per la sicurezza dei computer. I virus sono software malevoli che si replicano e infettano altri file e programmi. I malware, invece, includono spyware, trojan e ransomware, capaci di causare gravi danni ai sistemi e ai dati. Conoscere queste minacce è il primo passo per adottare misure preventive efficaci.

Nel 2023, si osserva un aumento significativo degli attacchi di tipo ransomware, in cui i criminali informatici bloccano l’accesso ai dati o al sistema e chiedendo poi un riscatto per ripristinarli. Questi attacchi spesso colpiscono sia aziende che utenti, causando danni finanziari e reputazionali considerevoli.

Riconoscere i Sintomi di un’Infezione da virus e malware

Quando navighiamo nel vasto mondo digitale, spesso ci troviamo di fronte a minacce invisibili che mettono a rischio la sicurezza dei nostri computer. I virus e i malware sono tra le principali minacce che possono infettare il nostro sistema e compromettere la nostra privacy e i nostri dati. Riconoscere tempestivamente i sintomi di un’infezione da virus e malware è essenziale per proteggere il nostro PC da danni potenzialmente gravi. Ecco alcuni segnali per individuare un’infezione e prendere provvedimenti tempestivi.

  • Rallentamento Misterioso del PC: Se noti che il tuo computer improvvisamente sembra andare a passo d’uomo, con programmi che impiegano un’eternità per avviarsi o chiudersi, potrebbe essere un segno di infezione da malware. I virus possono sottrarre risorse del sistema, rendendo il PC molto più lento del solito.
  • Popup Fastidiosi: Gli annunci pubblicitari invadenti che appaiono quando navighi online o utilizzi le applicazioni potrebbero essere indicativi di adware o spyware. Questi programmi indesiderati possono riempire lo schermo con messaggi pubblicitari e interrompere la tua esperienza di navigazione.
  • Comportamenti Strani delle Applicazioni: Se le tue app iniziano a comportarsi in modo anomalo, come crash improvvisi o errori inspiegabili, è possibile che un malware stia interferendo con il funzionamento corretto delle applicazioni.
  • Consumo Elevato di Risorse: Un forte aumento dell’utilizzo della CPU, della memoria o della larghezza di banda può essere un segno di attività malware. Questo può rendere il tuo computer instabile e inefficiente.
  • Programmi Non Richiesti: Se trovi nuovi programmi o icone sul tuo desktop o nel menu Start che non hai installato, potrebbe esserci un’infezione da software indesiderato. Alcuni malware possono installarsi senza il tuo consenso.
  • Modifiche alle Impostazioni del Browser: Se il tuo browser web presenta improvvisamente una pagina iniziale diversa o una barra degli strumenti aggiuntiva, potresti essere vittima di adware o browser hijacker. Questi malware possono prendere il controllo delle tue impostazioni di navigazione.
  • Errore nell’Accesso ai File: L’impossibilità di accedere a determinati file o cartelle, o messaggi di errore relativi a file corrotti, potrebbero essere causati da un ransomware o da un altro tipo di malware che crittografa i dati.
  • Attività di Rete Anomala: Se noti un traffico di rete insolito o connessioni verso indirizzi IP sconosciuti, potrebbe esserci un malware che comunica con un server remoto. Questo è spesso un segno di attività dannosa.
  • Antivirus Disattivato o Malfunzionante: Alcuni malware sono progettati per disattivare o compromettere il funzionamento del software antivirus installato sul PC, lasciandoti vulnerabile a ulteriori infezioni.
  • Modifiche nei Processi di Avvio: Se noti cambiamenti nei programmi che si avviano automaticamente con il sistema, potrebbe essere dovuto all’azione di malware che cerca di infiltrarsi nei processi di avvio.

Osservare uno o più di questi sintomi potrebbe essere un segno di infezione da virus e malware. Utilizza software antivirus e anti-malware affidabili per eseguire una scansione approfondita del tuo PC e rimuovere eventuali minacce. Inoltre, mantieni il tuo sistema operativo e le applicazioni aggiornate per ridurre le vulnerabilità e prevenire futuri attacchi.

Un’efficace rilevazione precoce delle infezioni è essenziale per contrastare gli attacchi informatici. Negli ultimi anni sono emersi nuovi malware altamente sofisticati e difficili da individuare con gli strumenti tradizionali di sicurezza. Pertanto, gli esperti di sicurezza informatica si concentrano sull’uso di soluzioni avanzate di rilevamento delle minacce basate sull’intelligenza artificiale e sull’apprendimento automatico. Questi strumenti analizzano il comportamento del sistema e dei file per individuare comportamenti anomali associati a potenziali attacchi.

Le Migliori Pratiche per la Sicurezza Informatica

Date le crescenti minacce informatiche, le pratiche di sicurezza informatica si sono evolute per affrontare le sfide attuali. Gli investimenti in formazione e sensibilizzazione sono diventati una priorità per educare gli utenti sul crimine informatico e sulle tecniche di ingegneria sociale utilizzate dagli attaccanti. Inoltre, la crittografia dei dati è stata ulteriormente rafforzata per garantire che le informazioni sensibili siano protette sia durante il transito che durante il salvataggio.

Di seguito una lista delle migliori pratiche per la sicurezza informatica che possono aiutarti a proteggere il tuo PC e i tuoi dati:

  • Utilizza Software Antivirus e Anti-Malware Affidabili: Installa e mantieni sempre aggiornato un software antivirus e anti-malware affidabile per proteggerti dalle minacce informatiche. Questi strumenti sono progettati per rilevare, bloccare e rimuovere virus, malware e altre minacce dannose dal tuo sistema.
  • Aggiorna il Sistema Operativo e le Applicazioni: Mantieni il sistema operativo e tutte le applicazioni installate costantemente aggiornate. Gli sviluppatori rilasciano regolarmente aggiornamenti che correggono vulnerabilità di sicurezza e problemi noti.
  • Utilizza Password Robuste e Autenticazione a Due Fattori (2FA): Crea password complesse, che includano una combinazione di lettere maiuscole e minuscole, numeri e caratteri speciali. Abilita l’autenticazione a due fattori (2FA) per aggiungere un livello extra di sicurezza.
  • Educa Gli Utenti su Phishing e Social Engineering: Fornisci formazione agli utenti per riconoscere e evitare attacchi di phishing e social engineering. Queste tecniche sono spesso utilizzate per ottenere accesso non autorizzato ai dati sensibili.
  • Effettua Backup Regolari dei Dati: Esegui regolarmente il backup dei dati importanti in un luogo sicuro e isolato. In caso di perdita o corruzione dei dati, un backup recente può aiutarti a ripristinare il sistema e recuperare i dati.
  • Utilizza una Connessione Sicura: Quando navighi su Internet o accedi a dati sensibili, assicurati di utilizzare una connessione sicura e crittografata (HTTPS) per proteggere le informazioni durante il transito.
  • Limita i Privilegi di Accesso: Assegna privilegi di accesso solo a coloro che ne hanno effettivamente bisogno per svolgere il proprio lavoro. Limitando gli accessi, si riducono le possibilità di abusi e di accessi non autorizzati.
  • Monitora e Rileva Attività Anomale: Implementa strumenti di monitoraggio e rilevamento delle minacce per individuare tempestivamente attività sospette o intrusioni nel sistema. La rilevazione precoce può aiutare a mitigare i danni causati dagli attacchi.
  • Proteggi il Browser e le Email: Utilizza estensioni di sicurezza del browser per bloccare annunci e pop-up invadenti. Filtra le email in entrata per rilevare e bloccare messaggi di phishing e malware.
  • Mantieni Consapevolezza Costante: Mantieni te stesso e gli utenti consapevoli delle minacce informatiche attuali e delle nuove tecniche utilizzate dagli hacker. La consapevolezza è un potente strumento di difesa.

Proteggere il tuo mondo digitale richiede impegno costante e vigilanza. Seguendo queste migliori pratiche di sicurezza informatica, puoi ridurre notevolmente il rischio di essere colpito da minacce informatiche e proteggere la tua privacy e i tuoi dati sensibili. La sicurezza informatica è una responsabilità condivisa, quindi condividi queste informazioni con colleghi, amici e familiari per contribuire a creare un ambiente digitale più sicuro per tutti.

Protezione del PC con la Sicurezza Integrata: Le novità

I fornitori di sistemi operativi e software hanno posto una maggiore enfasi sulla sicurezza integrata. Le nuove versioni dei sistemi operativi includono funzionalità avanzate di protezione, come l’isolamento delle applicazioni e la protezione del kernel. Inoltre, la sicurezza integrata è stata estesa alle soluzioni di cloud computing, garantendo che i dati vengano protetti sia quando sono in loco che quando sono in transito.

Vediamo insieme le novità più interessanti che rendono questa soluzione una scelta vincente per un mondo digitale più sicuro.

  • Sicurezza a Tutto Tondo: La protezione del PC con la sicurezza integrata offre un approccio a 360 gradi per affrontare le minacce informatiche. Non si tratta solo di un software antivirus tradizionale, ma di una suite di strumenti integrati che lavorano insieme per fornire una protezione completa.
  • Rilevamento Avanzato delle Minacce: Grazie all’intelligenza artificiale e all’apprendimento automatico, la sicurezza integrata può individuare e isolare le minacce avanzate in tempo reale. Questa capacità di rilevamento avanzato riduce il rischio di infezioni dannose.
  • Protezione in Tempo Reale: Un elemento chiave della sicurezza integrata è la capacità di fornire una protezione in tempo reale. Il software è costantemente aggiornato per riconoscere le ultime minacce, garantendo una difesa efficace contro i cyber attacchi sempre più evoluti.
  • Minimo Impatto sulle Prestazioni: Un altro vantaggio delle soluzioni di sicurezza integrata è il loro basso impatto sulle prestazioni del sistema. Questo significa che puoi goderti un’esperienza di utilizzo fluida e reattiva senza compromettere la sicurezza.
  • Protezione Multi-Device: La sicurezza integrata può estendersi oltre il PC e includere la protezione di altri dispositivi, come smartphone e tablet. Questo assicura che tutti i tuoi dispositivi siano al sicuro da minacce informatiche ovunque tu vada.
  • Gestione Centralizzata: Alcune soluzioni di sicurezza integrata offrono la possibilità di gestire tutti i dispositivi da una singola console di amministrazione. Questa funzionalità semplifica notevolmente la gestione e il monitoraggio della sicurezza per gli utenti e gli amministratori.
  • Protezione Avanzata contro Ransomware: Le soluzioni di sicurezza integrata spesso includono funzionalità avanzate per proteggere i dati da ransomware. Queste misure possono prevenire e mitigare gli attacchi di ransomware, proteggendo così i tuoi dati e mettendoti al sicuro da una possibile estorsione.
  • Aggiornamenti Automatici: La sicurezza integrata si preoccupa di mantenerti protetto in modo proattivo attraverso gli aggiornamenti gestiti automaticamente, garantendo che il software sia sempre all’avanguardia, aggiornato per tenerti al sicuro dalle minacce più recenti.

La protezione del PC con la sicurezza integrata rappresenta un salto significativo nella difesa dei nostri dispositivi e dei dati personali. Con un approccio olistico e una combinazione di tecnologie avanzate, la sicurezza integrata è in grado di affrontare le sfide in continua evoluzione del mondo digitale. Scegliere una soluzione di sicurezza integrata significa proteggere il tuo PC con una barriera affidabile e robusta contro le minacce informatiche, consentendoti di navigare e lavorare in tutta tranquillità.

Rimozione dei Malware

Affrontare gli attacchi malware significa essere in grado di dare una risposta rapida ed efficace. Oggigiorno, gli esperti di sicurezza informatica adottano un approccio multidisciplinare alla rimozione dei malware, combinando strumenti automatizzati con analisi manuali approfondite. Questo approccio permette di individuare e rimuovere il malware più avanzato, riducendo al minimo il tempo di inattività del sistema e dei servizi.

Di seguito alcune delle strategie e tecniche per la rimozione efficace dei malware e dei virus dal tuo PC:

  • Isolamento del PC: Prima di avviare qualsiasi operazione di rimozione, è consigliabile isolare il PC dalla rete o dal WiFi per impedire la diffusione del malware ad altri dispositivi o alla rete aziendale.
  • Scansione del PC con un Software Antivirus e Anti-Malware: Utilizza un software antivirus e anti-malware affidabile e aggiornato per eseguire una scansione completa del tuo PC. Questo strumento individuerà e rimuoverà le minacce conosciute presenti nel sistema.
  • Scansione con Software Anti-Rootkit: I rootkit sono particolari tipi di malware che si nascondono nelle parti più profonde del sistema operativo. Utilizza software anti-rootkit specializzati per individuare e rimuovere queste minacce nascoste.
  • Avvio in Modalità Sicura: L’avvio del PC in modalità sicura permette di avviare il sistema con un numero minimo di driver e servizi, facilitando la rimozione dei malware che potrebbero essere attivi in modalità normale.
  • Pulizia dei File Temporanei e del Registro di Sistema: I malware possono nascondersi nei file temporanei e modificare il registro di sistema. Pulisci periodicamente i file temporanei e verifica il registro di sistema per eventuali voci sospette.
  • Analisi Manuale dei Processi in Esecuzione: Utilizza il Task Manager (Gestione Attività) o strumenti di monitoraggio del sistema per analizzare i processi in esecuzione. Cerca processi sospetti o con nomi non familiari e termina quelli dannosi.
  • Utilizzo di Strumenti di Rimozione Specifici: Alcuni malware possono essere particolarmente persistenti e richiedere strumenti specializzati per essere rimossi. Ricerca e utilizza tool di rimozione specifici per le tipologie di malware presenti.
  • Ripristino del Sistema: Seleziona un punto di ripristino precedente in cui il PC era libero da malware. Il ripristino del sistema può aiutare a eliminare le modifiche apportate dai malware al sistema operativo.
  • Esame dei File di Avvio e dei Servizi di Sistema: Controlla i file e i servizi che vengono avviati automaticamente con il sistema. Rimuovi o disabilita quelli sospetti o non necessari.
  • Monitoraggio Post-Rimozione: Dopo aver rimosso i malware, monitora attentamente il PC per eventuali segni di recidiva. Assicurati che il software antivirus e anti-malware sia sempre aggiornato e attivo.

La rimozione dei malware e dei virus dal tuo PC richiede una combinazione di conoscenza tecnica e utilizzo di strumenti specializzati. È essenziale agire con prudenza e cautela per evitare danni ulteriori durante il processo di rimozione. Se non ti senti sicuro di affrontare la rimozione da solo, consulta un esperto di sicurezza informatica o un tecnico specializzato.

Sicurezza del Browser

I browser web continuano a essere una delle principali vie di ingresso per gli attacchi informatici. Si pone particolare attenzione all’analisi e all’aggiornamento delle estensioni di sicurezza dei browser per proteggere gli utenti da siti web malevoli e truffe online. Ad esempio, l’implementazione di sandbox per le pagine web consente di isolare il contenuto web dannoso, impedendogli di infettare il sistema ospite.

Crittografia dei Dati e Sicurezza delle Reti

Nel vasto mondo del web, la sicurezza del browser è diventata una priorità fondamentale per proteggere i dati personali e la privacy online. I browser web sono spesso fonti di accesso per minacce informatiche, come malware, phishing e truffe online.

Con la crescente importanza dei dati digitali, la crittografia è diventata un pilastro fondamentale della sicurezza informatica. Sono emersi nuovi algoritmi crittografici avanzati e i requisiti di crittografia sono stati estesi per includere comunicazioni di rete, dispositivi mobili e storage cloud. Inoltre, gli investimenti nelle tecnologie di sicurezza delle reti, come il rilevamento e la risposta agli incidenti (NDR), hanno migliorato la capacità di identificare e contrastare le minacce in tempo reale.

Fortunatamente, le tecnologie di sicurezza del browser si stanno evolvendo costantemente per offrire un’esperienza di navigazione più sicura e protetta. Ecco una lista delle novità più interessanti che rendono la sicurezza del browser più robusta e affidabile:

  • Blocco dei Siti Web Malevoli e Phishing: Le ultime versioni dei browser integrano filtri e database aggiornati per rilevare e bloccare automaticamente l’accesso a siti web malevoli noti per ospitare malware o tentare attacchi di phishing.
  • Navigazione Sicura in Modalità Protetta: I browser moderni offrono una modalità protetta o sicura che isola l’attività di navigazione dal resto del sistema, riducendo il rischio di infezioni da malware.
  • Gestione delle Estensioni: Con il crescente uso di estensioni, i browser offrono ora maggiori controlli sulla gestione di queste aggiunte. Gli utenti possono controllare e verificare le estensioni installate per evitare potenziali rischi per la sicurezza.
  • Isolamento dei Siti Web: Le nuove tecnologie di isolamento dei siti web impediscono che un sito dannoso possa compromettere altre schede o sessioni aperte nel browser, proteggendo così gli altri siti visitati.
  • Filtri di Protezione Contro Pubblicità Malevole: Alcuni browser integrano filtri che bloccano pubblicità malevole o truffaldina, riducendo così la probabilità di clic accidentali su annunci rischiosi.
  • Avviso sulle Connessioni Non Sicure: I browser avvertono ora gli utenti quando navigano su siti web non protetti da connessioni SSL/TLS, riducendo il rischio di esposizione dei dati sensibili.
  • Protezione del Privacy: Le nuove versioni dei browser offrono opzioni avanzate per il controllo della privacy, come il blocco dei tracker, cookie di terze parti e altre tecnologie che possono monitorare l’attività online.
  • Sandbox del Browser: Alcuni browser implementano un ambiente sandbox per le pagine web, limitando le risorse del sistema a cui le pagine possono accedere, riducendo così il rischio di sfruttamento delle vulnerabilità.
  • Rimozione Automatica di Contenuti Pericolosi: I browser possono rilevare e rimuovere automaticamente contenuti pericolosi, come download dannosi o file infetti, per prevenire infezioni accidentali.
  • Aggiornamenti di Sicurezza Automatici: Gli aggiornamenti regolari del browser includono spesso patch di sicurezza per correggere le vulnerabilità note, garantendo un’esperienza di navigazione più sicura.

Sfruttando queste nuove caratteristiche di sicurezza, puoi navigare in modo più sicuro e ridurre notevolmente il rischio di essere vittima di minacce informatiche. Ricorda sempre di mantenere il tuo browser e le estensioni aggiornate e di adottare le migliori pratiche di sicurezza online, come evitare clic su link sospetti e condividere informazioni personali solo su siti sicuri e affidabili.

Backup e Recupero dei Dati:

Data la crescente minaccia dei ransomware, il backup e il recupero dei dati sono diventati ancor più cruciali per le organizzazioni e gli utenti. Gli esperti di sicurezza informatica sottolineano l’importanza di mantenere copie di backup dei dati in sistemi isolati e offline per evitare che vengano compromesse durante gli attacchi ransomware.

Come salvaguardare le Tue Informazioni Preziose

Il backup e il recupero dei dati sono due elementi cruciali per proteggere le tue informazioni preziose da perdite catastrofiche o incidenti informatici. Una strategia di backup solida ti consente di proteggere i dati importanti da situazioni impreviste, come il fallimento del disco rigido, il furto del dispositivo e tanti altri tipi di attacchi informatici. Ecco una lista utile a realizzare un efficace backup e recupero dei dati:

  • Identificazione dei Dati Critici: Prima di avviare il backup, identifica i dati critici che devono essere salvati. Questi possono includere documenti importanti, file personali, foto, video e altro ancora.
  • Scelta del Metodo di Backup: Decidi quale metodo di backup si adatta meglio alle tue esigenze. Le opzioni comuni includono backup su dispositivi esterni, cloud storage e soluzioni di backup su server locali o remoti.
  • Backup Automatico e Pianificato: Configura il backup automatico e pianificato per garantire che i tuoi dati vengano salvati regolarmente senza doverlo fare manualmente. Un backup automatico riduce il rischio di perdere dati importanti.
  • Utilizzo di Backup Incrementali o Differenziali: Per risparmiare tempo e spazio di archiviazione, considera l’utilizzo di backup incrementali o differenziali. Questi metodi copiano solo le modifiche apportate ai file rispetto al backup precedente.
  • Crittografia dei Dati: Proteggi i dati sensibili utilizzando metodi di crittografia durante il processo di backup. Ciò garantisce che solo tu possa accedere ai dati salvati.
  • Test del Backup: Periodicamente, esegui test di recupero per assicurarti che il backup sia funzionante e i dati possano essere ripristinati correttamente in caso di necessità.
  • Conservazione dei Backup Multipli: Conserva più copie di backup in diverse posizioni o dispositivi. Questo protegge i dati da eventi catastrofici come incendi o danni fisici al dispositivo principale.
  • Backup dei Dispositivi Mobili: Non dimenticare di eseguire il backup dei dati presenti sui tuoi dispositivi mobili, come smartphone e tablet. Utilizza soluzioni di backup apposite per questi dispositivi.
  • Monitoraggio e Manutenzione: Monitora regolarmente lo stato dei tuoi backup e assicurati che siano sempre aggiornati e funzionanti. Effettua la manutenzione periodica per garantire l’integrità dei dati salvati.
  • Documentazione e Politiche di Backup: Tieni una documentazione dettagliata della tua strategia di backup, compresi i dati salvati e i tempi di esecuzione. Definisci politiche di backup e recupero per i tuoi dati aziendali o personali.

La pratica regolare del backup e recupero dei dati è una delle misure preventive più importanti che puoi adottare per proteggere i dati importanti da perdite e incidenti. Una strategia di backup ben pianificata e implementata ti dà la tranquillità di sapere che i tuoi dati sono al sicuro e recuperabili in caso di necessità.

Conclusioni

Il panorama della sicurezza informatica nel 2023 presenta sfide significative, ma anche opportunità per sviluppare soluzioni più avanzate e sofisticate. Gli attacchi informatici, in particolare i ransomware, continuano a minacciare la sicurezza dei PC e dei dati, rendendo necessario un approccio olistico alla protezione. Investimenti in formazione, tecnologie avanzate di rilevamento delle minacce e migliorie nella crittografia dei dati e nella sicurezza delle reti giocano un ruolo cruciale nella protezione delle risorse digitali. La consapevolezza, la preparazione e l’adozione di strategie di sicurezza solide sono fondamentali per affrontare efficacemente le minacce informatiche in continua evoluzione.

A cura della Redazione

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/proteggi-il-tuo-pc-da-virus-e-malware-guida-alla-sicurezza-informatica/


Considerazioni su Modelli di Intelligenza Artificiale Generativa

Nell’ultimo anno siamo tutti rimasti sorpresi dall’avvento dei modelli di Intelligenza Artificiale (IA) Generativa, a partire dal famosissimo ChatGPT (ovvero GPT-3 e GPT-4).

L’impressione è che stiamo vivendo una rivoluzione non solo informatica ma per la vita di tutti noi che potrebbe trasformare in modo inaspettato, e al momento imprevedibile, la società umana. Pertanto in questo articolo vengono proposti alcuni temi e osservazioni su quanto realmente sta accadendo, cercando di fornire degli spunti al lettore per delle riflessioni più approfondite.

Informatica e “UI”

Sin dalla nascita dell’informatica, uno dei principali problemi è quello della “User Interface” (UI) ovvero di come noi umani possiamo interagire con i programmi in esecuzione sugli elaboratori. Inizialmente si preparavano delle schede perforate che traducevano in un linguaggio più facile da interpretare per la macchina i codici scritti in linguaggi di programmazione già molto tecnici (e a cui bisognava essere iniziati), e si ottenevano i risultati dell’elaborazione su stampe cartacee.

Ma, sin dalla nascita della fantascienza, gli elaboratori vedono, leggono, ascoltano, scrivono e disegnano (su carta e su video) e parlano. Nel tempo sviluppano anche altri sensi umani e sovra-umani, ad esempio diventando androidi. Siamo di fronte a una dicotomia: da una parte la realtà con un’interfaccia tecnica, difficile da capire e utilizzare ancora oggi, dall’altra il nostro desiderio di poter interagire con gli elaboratori al nostro livello e nelle stesse modalità con cui interagiamo tra esseri umani. Come esempio di questa, in fondo, frustrazione, anche di recente mi è capitato di interagire con un ChatBot con un numero limitato di possibili risposte e che, dopo pochi scambi di messaggi, ha continuato a rispondermi con un messaggio di saluto.

Ma cosa è realmente successo negli ultimi anni?

Ci siamo abituati dapprima ai siti di Ricerca di informazioni e di Traduzione di testi, ai Navigatori per le indicazioni stradali, agli Assistenti digitali e alla fine del 2022 è arrivato ChatGPT che ci ha travolti tutti.

La differenza principale di ChatGPT rispetto al passato è che per la prima volta abbiamo potuto interloquire per iscritto con un elaboratore come se fosse una persona. A prima vista, domande e risposte sembrano quelle scambiate tra due esseri umani. E i programmi di IA Generativa, o “assistenti generativi”, non sono solo in grado di rispondere a domande su quasi qualsiasi argomento, ma anche di generare testi, disegni, immagini, codice per programmi di elaboratore ecc.

Siamo finalmente arrivati a dotare gli elaboratori di una UI “umana”?

E’ molto difficile rispondere a questa domanda, ma bisogna sottolineare che una UI “umana” richiede non solo che l’elaboratore sia in grado di capire il nostro linguaggio (in qualunque lingua o modalità ci si esprima) ma anche avere cognizioni sufficienti per poter rispondere adeguatamente. Una UI “umana” richiede quindi non solo un’interfaccia opportuna, che può anche essere una banalissima Chat testuale, ma soprattutto conoscenze e la capacità di intendere quanto espresso dall’interlocutore umano per rispondere in maniera appropriata se non intelligente.

Per approfondire questo argomento, è necessario analizzare ad altissimo livello come funzionano i modelli IA Generativa attuali partendo dall’informatica a cui siamo abituati.

Dalla Fantascienza alla Realtà

Visto che abbiamo accennato a temi di fantascienza, si può qui fare riferimento al famoso romanzo di Robert A. Heinlein “The Moon Is a Harsh Mistress” in cui il co-protagonista è Mike (ufficialmente HOLMES IV, “High-Optional, Logical, Multi-Evaluating Supervisor, Mark IV“), un elaboratore divenuto senziente. È molto interessante analizzare le caratteristiche che Heinlein, nel 1966, assegna a Mike:

  1. capacità tecniche
    • enorme capacità di catalogazione e archiviazione di dati tutti reperibili quasi istantaneamente
    • elaborazione e correlazione in tempi brevissimi di grandi moli di dati
    • grandi capacità di elaborazioni parallele
    • possibilità di segregare dati per garantire la riservatezza anche rispetto alle proprie elaborazioni (concetto di “sandbox”)
  2. caratteristiche di elaborazione
    • raffinate deduzioni logiche da dati noti
    • valutazione estremamente precise di correlazioni tra dati e di probabilità di eventi su scenari estremamente complessi
    • capacità di riproduzione e imitazione di stili, persone ecc., e generazione di “nuovi” dati mescolando appropriatamente dati noti
  3. debolezze
    • mancanza di immaginazione
    • mancanza di inventiva
    • totale incomprensione di barzellette, scherzi, doppi sensi, allusioni
    • errori banali dovuti alla mancanza di dati specifici ma in cui difficilmente cadrebbe un uomo.

Come vedremo, la descrizione di Mike che Heinlein fece circa 60 anni fa ha molti punti in comune con un attuale sistema IA.

Alcuni concetti sull’Intelligenza Artificiale

Sicuramente l’informatica che oggi chiamiamo IA Generativa ha delle caratteristiche tecniche e operative decisamente diverse da quanto siamo abituati e che ci è stato insegnato in informatica sino a poco tempo fa. Per semplicità chiamiamo White Box l’approccio tradizionale in quanto possiamo descrivere il funzionamento di un sistema informatico con le seguenti caratteristiche principali:

  • Determinismo: ad ogni dato in ingresso corrisponde un dato prodotto predeterminato
  • Programmabilità esatta: le logiche e le operazioni che a partire da un dato in ingresso generano il corrispondente dato prodotto sono decise, disegnate e implementate esattamente dai programmatori
  • Simbolismo localizzato: ogni informazione è rappresentata da un corrispondente simbolo gestito e archiviato dal programma; è quindi possibile identificare ove una informazione è localizzata/archiviata e seguire esattamente le trasformazioni dei dati durante l’esecuzione del programma.

In altre parole, le informazioni sono codificate in simboli che sono processati esattamente come deciso dal programmatore. Tutto questo porta al concetto di White Box, ovvero perfetta conoscenza e controllo (a meno di errori di programmazione purtroppo presenti troppo spesso) di quanto avviene all’interno del sistema.

I più recenti modelli IA Generativi, tipicamente modelli Machine Learning (ML) e Reti Neurali Artificiali (ANN), si discostano notevolmente da questa descrizione. Il punto principale è che il programmatore disegna e implementa in codice solo l’architettura del modello IA. Ad esempio in un modello ANN il programmatore disegna e implementa il codice che ogni nodo di calcolo (rappresentante un neurone sintetico) esegue. Il codice è molto generico: tipicamente viene eseguita solo una operazione elementare, quale una somma pesata, sui dati in ingresso al nodo con dei coefficienti arbitrari, e questa operazione genera il dato in uscita dal nodo. Non c’è alcuna logica predeterminata che correli un dato in ingresso al programma al corrispondente dato in uscita dal programma ma solo la logica di calcolo di ognuno dei milioni (o miliardi) di nodi.

Inoltre il programmatore non sceglie il valore numerico dei coefficienti presenti nei calcoli, a cui vengono invece inizialmente assegnati valori casuali. È il processo di addestramento che seleziona i valori più appropriati dei coefficienti presenti nel codice. La matematica che descrive questi modelli è basata principalmente sul calcolo delle probabilità: ogni risultato che il modello fornisce è quello più probabile rispetto ai dati di addestramento utilizzati e all’architettura del modello stesso.

Un’altra importante osservazione è che in questi modelli il valore numerico dei coefficienti gioca un doppio ruolo: definisce le regole di calcolo e al contempo memorizza le informazioni. Quindi i coefficienti sono al contempo logica e memoria. Contrariamente ai programmi tradizionali, logica e memoria non possono essere distinti, sono intrinsecamente unificati.

È importante sottolineare il ruolo dell’architettura di un modello IA: le architetture dei primi modelli a reti neurali erano molto semplici, per lo più reticoli piani, anche perché gli elaboratori non avevano capacità di elaborazione sufficiente per implementare architetture più complesse. Ma dall’architettura del modello dipende la capacità di interpretare, memorizzare ed elaborare i dati. Ad esempio: architetture molto semplici sono in grado per lo più di gestire efficientemente dati con informazioni localizzate senza correlazioni tra dati distanti. Come esempio si consideri un modello IA con architettura “semplice” per la traduzione di testi, in questo caso la traduzione risulta essere fatta parola per parola senza tenere conto della frase in cui le parole sono poste.

“Transformer” è invece una delle architetture più recenti e più complesse alla base di molti dei modelli IA Generativi e delle loro capacità di analizzare in maniera sofisticata i dati in ingresso per poi memorizzarli e processarli. In altre parole, le capacità di apprendimento e “ragionamento” di un modello IA dipendono fortemente dalla sua architettura.

Riprendendo le caratteristiche principali elencate precedentemente per un sistema informatico tradizionale ma ora valutandole per un modello IA Generativo, otteniamo:

  • Probabilità (era Determinismo): ad ogni dato in ingresso corrisponde il dato prodotto più probabile rispetto ai dati di addestramento utilizzati e all’architettura del modello stesso
  • Opacità (era Programmabilità esatta): le logiche di elaborazione sono apprese dal modello stesso e non determinate dal programmatore; le logiche stesse non sono formalizzate ma codificate nei valori dei coefficienti distribuiti, il che le rende difficili da desumere e interpretare
  • Rappresentazione sub-simbolica distribuita e sparsa (era Simbolismo localizzato): ogni informazione non è rappresentata da simboli ma codificata nei valori dei coefficienti che sono distribuiti e sparsi (ovvero non localizzati); si noti che concetti come “controllo accessi al dato”, “cifratura applicativa dei dati”, “Bring Your Own Key (BYOK)” ecc. non sono implementabili in questo contesto all’interno di un modello IA.

In pratica questa è una rivoluzione Copernicana: i principali assunti informatici a cui siamo abituati non valgono più per i modelli IA più recenti.

Si potrebbe avere l’impressione di rischiare di perdere completamente il controllo di questi programmi, ma in realtà la situazione non è per nulla negativa, anzi come vediamo quotidianamente, funziona egregiamente. Ritornando alle caratteristiche di Mike di Heinlein, ogni giorno constatiamo che sono applicabili abbastanza bene ai più recenti modelli IA Generativi (ad eccezione di 1.4 sulla segregazione dei dati).

Ma per poter utilizzare al meglio questi strumenti, dobbiamo avere una diversa percezione di come funzionano e un nuovo approccio al loro utilizzo rispetto a quanto fatto sinora.

IA Generativa come una Black Box

L’approccio con cui si propone di considerare e valutare i più recenti modelli IA è più vicino ad una valutazione Black Box di un programma informatico che a un’analisi tradizionale. Si è nella situazione in cui si conoscono o si possono conoscere bene i dati in ingresso e quelli prodotti dal programma, ma si hanno poche informazioni su come i dati sono elaborati. Su questa Black Box ideale si può solo assumere ad alto livello che:

  1. l’elaborazione dei dati è fatta con tecniche probabilistiche
  2. i dati memorizzati e le logiche di elaborazione derivano dai dati utilizzati per l’addestramento del modello.

Si può quindi studiare questa Black Box ideale dall’esterno considerando prima cosa riceve in ingresso e poi cosa produce in uscita.

Dati in ingresso per addestramento

Come già descritto, i dati di addestramento insieme all’architettura del modello IA, costituiscono l’elemento principale e fondamentale del modello stesso. Semplificando si possono dividere i modelli in due classi: quelli in cui la fase di addestramento precede ed è distinta dalla fase di generazione, e quelli in cui addestramento e generazione avvengono contemporaneamente o in continua successione. Come sempre, la realtà è abbastanza più complessa, ma per i nostri scopi possiamo semplificare il modello teorico e semplicemente considerare le due fasi, addestramento e generazione, come indipendenti.

Il fatto è che quando i dati in ingresso sono utilizzati per addestrare il modello, questi modificano il modello stesso e vengono memorizzati. Descrivendo il modello IA come una Black Box, non si sa esattamente come i dati sono memorizzati nel modello, ma si può assumere sia che modifichino le logiche di elaborazione, quindi i dati “insegnano” qualche cosa al modello IA, sia che rimangano in memoria in maniera più o meno completa e integra.

Si aggiunga a ciò che per essere addestrati, i modelli IA Generativi richiedono enormi quantità di dati, appunto per essere in grado di sostenere una conversazione o generare dati in uscita di quasi qualsiasi tipo. In altre parole, questi modelli mirano ad avere una conoscenza generica, anche se non approfondita, dello scibile, della storia e delle informazioni umane.

Si deve allora fare estrema attenzione a condividere informazioni riservate o personali o comunque soggette a diritto d’autore o limitazioni di uso e condivisione, per l’addestramento di questi modelli. Infatti la Black Box può utilizzare queste informazioni in qualunque maniera, ad esempio condividendole integralmente con altri utenti, o utilizzandole per generare dei dati che ne derivano.

Come accennato precedentemente, ad oggi non è possibile implementare un sistema di controllo accessi interno alla Black Box in grado di utilizzare i dati memorizzati a seconda dell’utente che sta utilizzando l’applicazione. Quindi qualunque dato utilizzato per l’addestramento di un modello IA pubblico deve essere considerato anch’esso pubblico e non soggetto ad alcuna limitazione.

Questo non vuol dire che non si può utilizzare un modello IA Generativo con dati riservati o soggetti a limitazioni, ma per farlo bisogna implementare il controllo accessi esternamente al modello stesso. Ad esempio, si può partire da un modello pre-addestrato con dati pubblici, crearne un’istanza dedicata sotto il proprio controllo, completare l’addestramento con i propri dati e permettere l’accesso a questa istanza solo a chi è autorizzato ad accedere alle informazioni utilizzate per l’addestramento. In altre parole, bisogna creare una sandbox intorno al modello IA piuttosto che all’interno del programma, come invece immaginò Heinlein per Mike (punto 1.4).

Dati in ingresso per generazione

Quando i dati in ingresso sono utilizzati esclusivamente per generare dei dati in uscita, non si presentano i rischi appena descritti perché il comportamento dell’applicazione è assimilabile a quello di una applicazione tradizionale. I dati in ingresso vengono elaborati ma non sono memorizzati dall’applicazione IA, al più possono essere memorizzati dalle applicazioni a supporto dell’applicazione IA, che sono gestite secondo l’approccio tradizionale e permettono l’implementazione degli usuali processi di controllo accessi, protezione/cifratura dei dati ecc.

Dati prodotti

È necessario fare alcune considerazioni sui dati prodotti da un modello IA Generativo.

La prima è che, come è stato ripetuto già più volte, qualunque dato prodotto non è deciso a priori da un programmatore: non è possibile chiedere ad alcuno perché ha programmato che a uno specifico dato in ingresso corrisponde un certo dato in uscita. In altre parole: non c’è una logica definita da una persona tra un input e il corrispondente output.

Come già indicato, i dati prodotti o generati sono quelli che hanno la più alta “probabilità di similitudine” (da intendersi in senso lato) tra i dati in ingresso e quanto appreso dal modello dai dati di apprendimento. Ad alto livello questo può essere descritto come segue: il modello crea una propria rappresentazione interna dei dati di apprendimento, identifica le “somiglianze” maggiori di questa rappresentazione con i dati in ingresso e utilizza queste “somiglianze” per generare i dati in uscita.

In linea teorica, un dato generato può avere una probabilità del 99,99% di corrispondere al dato in ingresso, o molto minore, ad esempio solo il 30%. Tocca a chi gestisce il modello IA decidere una soglia sotto la quale il modello può non rispondere alla richiesta.

La natura probabilistica dei dati generati può facilmente ingannare gli utilizzatori del modello IA e richiede che chi lo utilizza sia molto accorto nell’interpretare il loro significato. Il modo più semplice per approfondire questo aspetto è tramite un paio di esempi.

Curriculum Vitae di una Persona

Si immagini di chiedere a un modello IA Generativo di fornirci informazioni su di una persona, realmente esistita che si afferma essere stata studente di un premio Nobel. Il modello IA Generativo tipicamente fornisce un breve Curriculum Vitae della persona, elencando articoli scientifici pubblicati, premi vinti, posizioni ricoperte ecc. Alcuni di questi dati possono essere corretti, altri invece sono “generati”, ma realistici, e altri ancora possono essere del tutto errati (in alcuni casi chiamati “allucinazioni”). La “logica” del modello IA Generativo può essere descritta come segue: dai dati di addestramento ha appreso che la maggior parte degli studenti di premi Nobel ha avuto una carriera di successo nella ricerca scientifica, vincendo premi e occupando posizioni di rilievo. Inoltre, il premio Nobel indicato appartiene a una specifica area scientifica e il modello IA è a conoscenza di quali sono i principali argomenti di ricerca, i principali premi e posizioni lavorative e di prestigio in questo campo scientifico. Sulla base di questi dati, il modello IA ha quindi identificato quali sono le pubblicazioni scientifiche, i premi e le posizioni (tutti reali o “generati”) che più probabilmente sono associabili alla persona indicata nei dati in ingresso, e questi sono i dati prodotti in risposta alla richiesta. La quantità di dati esatti prodotti dal modello IA può variare da un Curriculum Vitae totalmente reale, a uno contenente metà di dati reali e metà “generati”, a uno totalmente “generato” ovvero plausibile ma non corrispondente al vero, o infine uno contenente alcuni dati del tutto errati; tutto dipende dai dati di addestramento utilizzati e dall’architettura stessa del modello IA.

Selezione di personale e “bias”

I Curriculum Vitae (CV) forniscono un esempio per un altro aspetto dei dati generati da un modello IA (anche non Generativo), che va sotto il nome “bias” (ovvero una distorsione o deviazione sistematica rispetto al risultato atteso). Si supponga di addestrare un modello IA con molti CV divisi tra quelli ritenuti validi per l’occupazione richiesta e quelli non validi. Si utilizzi poi l’applicazione IA per una prima selezione di nuovi CV validi. Potrebbe capitare (questo è un esempio estremo riportato solo per evidenziare il possibile comportamento del modello IA) di accorgersi che i CV validi (ovvero con una probabilità di somiglianza ai CV di addestramento validi superiore ad una certa soglia) corrispondono per lo più a persone che si sono laureate in un certo anno e con particolari caratteristiche somatiche, e che CV che non hanno queste caratteristiche ma per il resto sono equivalenti, hanno ottenuto una valutazione inferiore. Come già indicato, i modelli IA sono estremamente bravi a trovare somiglianze in enormi quantità di dati, e in questo caso il modello IA ha identificato l’anno di laurea e alcune caratteristiche somatiche come la caratteristica più comune dei CV di addestramento validi. L’esempio appena descritto è molto banale, ma il problema del “bias” dei modelli IA è molto ricorrente e spesso di difficile soluzione.

Questi semplici esempi rafforzano l’affermazione che alla base del comportamento di un modello IA vi è principalmente una triade: probabilità, architettura, dati di addestramento.

È utile fare qualche ulteriore osservazione sull’utilizzo e i limiti degli attuali modelli IA Generativi.

Etica

Da quanto appena scritto, è difficile oggi immaginare che, oltre a distinguere tra reale e “generato”, i modelli IA Generativi possano generare dati che rispettano sempre principi connaturati nell’uomo chiamati “etici”, quali ad esempio i concetti di giusto e sbagliato o lecito e illecito, che comunque hanno a volte delle diverse interpretazioni tra gli uomini o tra società umane. Ed è anche difficile immaginare che un attuale modello IA Generativo sia in grado di apprendere concetti più fondamentali per l’uomo quali l’istinto di preservazione della persona, di prosecuzione della specie, di protezione della prole. È stata utilizzata la parola “istinto” perché questi sono tratti fondamentali e comuni a tutti gli uomini, e più in generale agli animali, ma difficilmente presenti nei dati di addestramento di un modello IA.

Al contrario, se si addestra un modello IA con dati reperibili in Internet, le informazioni derivanti dai notiziari descrivono una realtà in cui spiccano reati, violenze, violazioni dei diritti umani, guerre ecc. Analizzando solo questi dati ne deriva ad esempio che la probabilità di un atto violento è molto più alta di quella della protezione di una persona debole. Ma la realtà (per fortuna) è assai diversa (anche se abbiamo un ampio margine di miglioramento).

Anche addestrare un modello IA con i manuali di storia e in generale con la documentazione universitaria più completa sull’uomo, la società umana e la storia dell’uomo potrebbe non risolvere realmente il problema. Insegnare i valori “etici” a un modello IA è un grande problema aperto che molto probabilmente richiederà la creazione di appositi dati sintetici per l’addestramento.

Aritmetica e matematica

Un altro aspetto apparentemente sorprendente degli attuali modelli IA, è la loro difficoltà nell’apprendere l’aritmetica. Ma non è difficile intuire questo aspetto utilizzando quanto sinora descritto: i modelli IA attuali non sono veramente in grado di “ragionare” e quindi imparare autonomamente regole di calcolo esatte, ma correlano probabilisticamente grandi quantità di dati. La “logica” da considerare è più simile a chiedersi qual è la probabilità (derivante dai dati di addestramento utilizzati) che 2+2 sia 3,9 o 4,1 o, ovviamente, 4 senza fare alcun calcolo aritmetico. Questo è altamente contro-intuitivo anche perché gli elaboratori sono basati in hardware proprio sull’esattezza del calcolo matematico e in particolare aritmetico.

D’altra parte, i modelli IA di ultima generazione si stanno dimostrando estremamente utili nel contribuire a risolvere numericamente equazioni matematiche particolarmente complesse. Data una equazione particolarmente complessa e non risolvibile esattamente con le tecniche matematiche note, si cercano soluzioni numeriche necessariamente approssimate. I modelli IA di ultima generazione sono in grado di generare i set di dati numerici con la maggior probabilità di essere una soluzione approssimata al problema tra cui poi va selezionata la soluzione appropriata. In questo modo sono già state trovate nuove molecole chimiche per applicazioni farmaceutiche, identificate debolezze in algoritmi crittografici in corso di sviluppo, ecc.

Utilizzo “Sicuro” dell’IA Generativa

I modelli IA Generativi sono già estremamente utili e potrebbero portare un grande avanzamento nelle capacità, usi e utilità per l’uomo dell’informatica. Ma oggi è necessario utilizzarli essendo ben consci dei loro limiti e delle specifiche modalità di approccio e uso necessari per poterne fare un uso “sicuro”. In questa sede è possibile solamente indicare alcuni suggerimenti per poter beneficiare il più possibile dell’uso odierno dell’IA Generativa in modo “sicuro”:

  1. Supervisione umana: i dati generati da un modello IA Generativo devono essere valutati da persone che ne comprendono le logiche, i limiti e che sono in grado di distinguere quanto è reale, quanto è solamente “realistico” e quanto è del tutto errato.
  2. Dati di addestramento: bisogna essere ben consapevoli di quali dati sono stati utilizzati per l’addestramento del modello IA e assumere che chiunque utilizza il modello IA è in grado di accedere a tutti i dati di addestramento. Come è stato indicato, oggi non è possibile implementare logiche di controllo accesso all’interno del modello (ma si veda il suggerimento 4), pertanto chi utilizza il modello accede direttamente o indirettamente a tutti i dati di addestramento.
  3. Controllo accessi e filtri sui dati in ingresso: è necessario quindi implementare il sistema di controllo accessi a un modello IA Generativo al di fuori dello stesso, e affiancare a questo anche un’applicazione di verifica ed eventuale filtro dei dati in ingresso. Quest’ultima è una funzione simile concettualmente alla validazione dei dati in ingresso comune a qualunque applicazione e che, ad esempio per applicazioni Web, previene attacchi quali quelli di “SQL Injection”. Infatti uno degli scopi è di bloccare attacchi quali “Prompt Injection” che hanno come principale fine quello di sovvertire le logiche di utilizzo del modello IA per scopi diversi da quelli autorizzati o per l’estrazione di informazioni riservate.
  4. Addestramento con prefissi: in aggiunta al controllo accessi e filtro dei dati in ingresso, è anche possibile addestrare specificatamente un modello IA utilizzando dei Prefissi che identificano particolari richieste o utenti; ad esempio, un modello IA può essere addestrato in modo che se la richiesta inizia con il prefisso “Minore” (che identifica il richiedente essere minorenne, o il risultato essere indirizzato a minorenni), il modello IA genera più probabilmente dati appropriati per minorenni. Analogamente si può addestrare il modello IA in modo che certi tipi di dati siano più probabilmente generati o non generati a seconda del richiedente o dell’uso previsto.
  5. Filtri sui dati generati: come descritto, oggi un modello IA Generativo potrebbe comunque generare dei contenuti non appropriati, errati o che violano la riservatezza, privacy, diritti di autore ecc. Per questo si dovrebbero introdurre dei filtri sui dati generati. Un approccio per implementare questa funzionalità è idealmente simile a quanto si fa ormai da tempo per i filtri Anti-Spam, e spesso si utilizzano degli altri modelli IA addestrati appositamente per identificare i contenuti non leciti.
  6. Monitoraggio: oltre ai filtri in uscita per evitare la condivisione di dati non appropriati, errati o non leciti, è bene monitorare in continuazione quanto generato dal modello IA Generativo per identificare eventuali “bias”, “allucinazioni” e altri eventi che possono indicare un abuso, un attacco e ulteriori debolezze del modello.

In ogni caso è molto probabile che nel prossimo futuro, nuove architetture e nuove tecniche di addestramento saranno in grado di migliorare grandemente gli attuali modelli di Intelligenza Artificiale.

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/considerazioni-su-modelli-di-intelligenza-artificiale-generativa/


Guida pratica per la difesa cibernetica aziendale attraverso il fattore umano

Nell’era digitale in costante evoluzione le tecnologie avanzano, le opportunità crescono, e parallelamente aumenta anche la complessità delle sfide informatiche. Le organizzazioni si trovano pertanto di fronte a un costante dilemma: come proteggere i propri dati e la propria reputazione in un mondo sempre più interconnesso?

La risposta risiede nell’elemento umano, il cosiddetto Human Factor, spesso sottovalutato ma fondamentale. Ma cosa si intende quando parliamo di fattore umano? Il “fattore umano” è una componente chiave in vari contesti, implicando l’analisi dell’influenza delle persone su sistemi, ambienti e processi. Nell’ingegneria e nella progettazione, ci si concentra sulla creazione di soluzioni che tengano conto delle capacità e dei limiti umani per prevenire errori. Nelle scienze sociali, il termine si estende allo studio del comportamento e delle dinamiche interpersonali. La sua importanza emerge anche nell’ambito della sicurezza, dove la comprensione delle azioni umane è cruciale per evitare incidenti. La prospettiva del fattore umano guida la creazione di interfacce utente intuitive e di ambienti adatti alle esigenze umane, contribuendo a migliorare l’efficacia complessiva dei sistemi e a ottimizzare le interazioni sociali.

La catena di sicurezza si basa su tre grandi fattori (come possiamo vedere nel framework seguente): Fattore Organizzativo, Fattore Tecnologico e Fattore Umano. La tecnologia da sola non è sufficiente a fronteggiare queste sfide, è necessario coinvolgere attivamente gli utenti come primi guardiani della sicurezza informatica. Questo articolo esplora l’importanza nel sensibilizzare gli utenti riguardo le minacce digitali e nel fornire loro una formazione adeguata, trasformandoli da potenziali punti deboli a forti alleati nella difesa cibernetica.

Vedremo alcuni punti chiave in relazione a come un’organizzazione consapevole e preparata può anticipare, riconoscere e contrastare le minacce, costruendo un fronte unificato contro gli attacchi informatici.

Come prima cosa risulta fondamentale avere un piano di formazione. Una formazione degli utenti ben strutturata va oltre la mera divulgazione di informazioni. Deve essere interattiva, coinvolgente e mirata ad esplorare specifici scenari di minaccia. Moduli formativi che simulano situazioni reali, come tentativi di phishing, insegnano gli utenti a riconoscere e reagire prontamente a tali minacce. Questo approccio pratico è fondamentale per trasformare la conoscenza teorica in azione consapevole. Altro elemento fondante risulta essere la collaborazione. La lotta contro le minacce digitali richiede una collaborazione attiva tra reparti IT, utenti e altre organizzazioni. La condivisione di informazioni, l’identificazione tempestiva di potenziali rischi e una comunicazione aperta sono elementi cruciali in questo contesto. Coltivare una cultura di sicurezza digitale è fondamentale. La cultura di sicurezza digitale inizia con la consapevolezza diffusa. Ogni membro dell’organizzazione, indipendentemente dal ruolo, deve comprendere le minacce digitali, i potenziali rischi e il ruolo chiave che ciascuno svolge nella protezione dei dati aziendali. Uno dei punti principali che bisognare instaurare alla base di un’organizzazione consapevole è una conoscenza sulla complessità delle minacce digitali. Le minacce informatiche, in costante evoluzione, sfruttano sofisticate tattiche per infiltrarsi nei sistemi aziendali. Dall’ingegneria sociale ai ransomware, l’arsenale degli attaccanti è vasto e mutevole. Sensibilizzare gli utenti sulle varie tipologie di minacce è il primo passo fondamentale per renderli consapevoli del contesto in cui operano. In poche parole, la Formazione è l’inizio la Consapevolezza è l’arrivo. La “Consapevolezza” o “Awareness” si riferisce alla percezione e comprensione attente di ciò che accade intorno a noi o dentro di noi. È una cognizione acuta delle situazioni, delle emozioni o degli eventi. Nell’ambito personale, la consapevolezza può riguardare la comprensione dei propri pensieri e sentimenti. A livello sociale, può coinvolgere le dinamiche interpersonali e degli altri. Nel contesto della sicurezza e della tecnologia, indica la conoscenza dei rischi e delle minacce. In generale, sviluppare la consapevolezza contribuisce a prendere decisioni più informate e a migliorare la qualità della vita.

La Formazione

Come possiamo acquisire il giusto grado di conoscenza di cui abbiamo bisogno? Dobbiamo studiare, aggiornarci continuamente. E se questo è vero in ogni settore è fondamentale nella cybersecurity, che risulta essere una materia in continua evoluzione. Molto spesso capita di sentir parlare di nuovi sistemi di sicurezza, di nuovi metodi per salvaguardare i dati aziendali, dimenticando che il primo sistema di sicurezza siamo noi e i nostri colleghi. Risulta fondamentale creare un piano di formazione ben strutturato per innalzare il livello di consapevolezza dell’utenza ed avere, nel lungo periodo un riscontro positivo a livello di risultati. Come possiamo raggiungere questo obiettivo? Creando piani di studio “Step by Step”. Dopo un’attenta analisi degli argomenti formativi, bisogna creare una formazione chiara e progressiva e con un apprendimento graduale. Sarebbe auspicabile promuovere una cultura di informazione in relazione ai rischi, le modalità utilizzate dagli attaccanti e soprattutto le misure di sicurezza da attuare per prevenire e contrastare tali attacchi, molto spesso variando i metodi formativi: gamification, simulazioni reali, lezioni frontali e molti altri, ma ricordando anche di valutare come accennato prima, step by step, il progresso dei dipendenti.

Per esempio, potrebbe essere un’idea creare un piano di studio strutturato da una serie di punti, organizzati in ordine cronologico come segue:

  • Assessment ai dipendenti: processo fondamentale per testare e valutare lo stato dell’arte in materia di sicurezza all’interno di un’organizzazione. Questa fase serve a fornire una panoramica chiara delle vulnerabilità e delle aree di miglioramento, costituendo il punto di partenza per sviluppare strategie di sicurezza più efficaci.
  • Prima simulazione di phishing, laddove lo scopo è quello di creare uno scenario realistico di attacco, testando la capacità dei dipendenti di riconoscere e gestire minacce di questo tipo. Questa iniziativa fornisce un’istantanea del grado di attenzione del personale nei confronti delle potenziali minacce online, identificando eventuali aree di miglioramento e orientando le future strategie di formazione.
  • La creazione di una formazione dedicata e strutturata sui temi identificati come più critici rappresenta una risposta mirata e strategica in relazione alle specifiche esigenze di sicurezza dell’organizzazione. Basandosi sui risultati della simulazione di phishing e sulla valutazione delle aree di vulnerabilità.
  • Le valutazioni periodiche costituiscono un elemento essenziale nel mantenere un livello elevato di sicurezza all’interno di un’organizzazione, il ciclo di valutazione periodica contribuisce a creare un processo di apprendimento continuo all’interno dell’organizzazione.
  • L’implementazione di una seconda simulazione di phishing svolge un ruolo cruciale nel mantenere costantemente alta l’attenzione del personale nei confronti delle minacce informatiche. Questa pratica è finalizzata a consolidare e rafforzare la consapevolezza acquisita durante la formazione iniziale e la prima simulazione.
  • La continua formazione e i test periodici costituiscono un elemento cruciale per sostenere e potenziare la cultura di sicurezza nel lungo termine. Questa pratica riflette un impegno costante verso la preparazione e la consapevolezza del personale, riconoscendo che la sicurezza informatica è un processo dinamico che richiede un apprendimento continuo. Molto spesso aiutano anche i feedback che i dipendenti stessi ci rilasciano.

Il Ruolo Chiave della Collaborazione

Molto spesso sottovalutata, forse per paura, la collaborazione non viene nemmeno presa in considerazione fortificando ardentemente il potere degli attaccanti. Certo se un’azienda subisce un attacco e vengono estrapolati i dati perde di credibilità, non è in dubbio. È proprio in quel momento che possiamo fare qualcosa. Non avendo paura di raccontare cosa e come ci è successo, aiutando le altre aziende a prendere precauzioni per formare una vera e propria difesa che non tutela solo il nostro piccolo ma tutto il nostro settore. Ritengo che alla base di tutto ci debba essere una comunicazione aperta e trasparente. Una sola piccola azienda cosa può fare? Nulla. Ma tante piccole aziende unite posso fare la differenza.

Alcuni consigli per creare una collaborazione efficace:

  • Organizzare frequenti team building riveste un ruolo fondamentale nel favorire la collaborazione tra diversi reparti all’interno di un’organizzazione. Queste iniziative non solo contribuiscono a rafforzare il senso di appartenenza e di squadra, ma anche a migliorare la comunicazione e la cooperazione tra i dipendenti provenienti da ambiti diversi. Introducendo sempre argomenti o temi specifici in relazione alla nostra società.
  • Organizzare attività di sana competizione interna con premi può stimolare l’energia e la collaborazione tra i dipendenti. Definendo obiettivi chiari e varietà nelle sfide, si crea un ambiente dinamico.
  • Integrare le nuove risorse con onboarding costanti è essenziale. Programmi informativi continui, mentorship, e feedback regolare facilitano la transizione. Eventi sociali e risorse online contribuiscono a creare un ambiente collaborativo e inclusivo.
  • Organizzare eventi con altre realtà del medesimo settore è un’opportunità preziosa per interagire e discutere potenziali collaborazioni. Questi incontri favoriscono lo scambio di idee, la creazione di sinergie e la possibilità di esplorare partnership strategiche.

Coltivare una Cultura di Sicurezza Digitale

Uno dei pilastri fondamentali per garantire e realizzare un’organizzazione sicura è la coltivazione di una cultura di sicurezza impiantata nelle fondamenta della nostra realtà, testimoniando su tutti i fronti l’importanza di essa, coinvolgendo non solo personalità di spicco ma l’intera platea aziendale, rendendola parte di una grande catena, costruita da persone che remano verso un’unica direzione.

Come possiamo fare questo? Certo non è semplice, ma partire dal quotidiano con piccoli task assegnati che rendano sempre vigili i nostri collaboratori può essere un punto di partenza, creando una politica aziendale chiara e semplice. Ricordando che da una buona semina si produce un ottimo raccolto.

Alcune best practice:

  • Le simulazioni interne rappresentano un efficace strumento per testare e rafforzare la preparazione dell’organizzazione di fronte a situazioni critiche. Queste esercitazioni, condotte internamente, consentono di valutare la prontezza del personale e dei sistemi di sicurezza di fronte a scenari simulati, quali incidenti informatici, violazioni di dati o altre minacce.
  • La gestione di scadenze password periodiche per i dipendenti è una pratica di sicurezza informatica cruciale. Imporre la regola di cambiare le password regolarmente contribuisce a rafforzare la sicurezza dei sistemi, delle informazioni aziendali e permette di coltivare una cultura sana e sicura da tramandare.
  • Consentire l’accesso a strumenti (come, ad esempio, “I Have Been Pwned“) che consentono di verificare password compromesse è una misura proattiva per promuovere la sicurezza digitale all’interno dell’organizzazione. Questi strumenti permettono ai dipendenti di verificare se le loro password sono state coinvolte in violazioni note o compromesse, consentendo loro di adottare misure correttive tempestive.
  • Attribuire responsabilità e prestare particolare attenzione alle nuove assunzioni è un elemento chiave per garantire una transizione efficace e positiva nel contesto aziendale.

Come disse una volta Benjamin Franklin, “an investment in knowledge pays the best interest”.

La Complessità delle Minacce Digitali

Nel contesto sempre più intricato delle minacce digitali acquisire una comprensione approfondita di questa complessità si rivela fondamentale per sviluppare strategie di sicurezza informatica efficaci. È imperativo adottare un approccio proattivo nella difesa dei sistemi e dei dati, considerando il costante adattamento delle minacce digitali alle nuove tecnologie e alle misure di sicurezza. La natura mutevole delle minacce digitali, che si evolvono e si diversificano con estrema rapidità nel corso del tempo, aggiunge ulteriore sfida. Gli attacchi digitali sono diventati sempre più mirati e sofisticati, con attaccanti che impiegano tecniche avanzate come l’ingegneria sociale, il phishing mirato e l’utilizzo di malware altamente strutturati. Inoltre, le minacce spesso si presentano sotto forma di attacchi multi-vettore, combinando diverse metodologie come attacchi DDoS, malware, ransomware e vulnerabilità di rete per ottenere accesso e danneggiare i sistemi. La manipolazione delle informazioni e le minacce alla privacy emergono come aspetti complessi di questo scenario, sottolineando la necessità critica di proteggere sia i dati personali che le informazioni sensibili. Da non sottovalutare è il coinvolgimento del fattore umano nella complessità delle minacce digitali con attacchi che sfruttano le debolezze umane.

Di seguito alcuni consigli pratici:

  • La creazione di newsletter periodiche che riportano le nuove minacce e le notizie di settore è un modo efficace per mantenere il personale informato e consapevole delle dinamiche della sicurezza informatica. Queste newsletter forniscono aggiornamenti regolari sulle ultime minacce digitali, le vulnerabilità emergenti e le best practices di sicurezza.
  • L’istituzione di una community aziendale dedicata alla discussione e trattazione delle nuove forme di attacco rappresenta un passo significativo per rafforzare la sicurezza informatica. Questa piattaforma offre uno spazio interno dove i dipendenti possono condividere apertamente conoscenze, esperienze e approfondire la comprensione delle minacce emergenti. Inoltre, creare un ambiente dove la condivisione delle informazioni è incoraggiata contribuisce a migliorare la consapevolezza e a potenziare la prontezza dell’organizzazione di fronte alle minacce cibernetiche in continua evoluzione.

Conclusioni

In un mondo digitale in continua evoluzione la costruzione di una cultura della sicurezza e l’aumento del livello di awareness rappresentano le fondamenta essenziali per difendere le organizzazioni dalle insidie sempre più sofisticate. Da utenti consapevoli siamo chiamati a diventare difensori attivi del nostro spazio digitale. Nella mia visione personale vedo la cultura della sicurezza come un tessuto connettivo che unisce le persone attraverso la consapevolezza, la comprensione reciproca e la responsabilità condivisa. È un’impronta digitale collettiva che testimonia il nostro impegno a proteggere ciò che valorizziamo: i nostri dati, la nostra privacy e la nostra sicurezza. Un patto irrinunciabile che permea il nostro DNA digitale, scolpendo un sentiero di protezione e fiducia in ogni nostra azione online.

RIFERIMENTI BIBLIOGRAFICI

Articolo a cura di Giacomo Gabrieli

Profilo Autore

Giacomo Gabrieli, cybersecurity specialist presso DeepCyber, azienda del gruppo Maggioli. Svolge attività di valutazione e sviluppo relative allo “Human Factor”, promuovendo la consapevolezza degli utenti sui temi inerenti alla sicurezza informatica. Il suo ruolo include la progettazione di strategie che integrano l’aspetto umano nelle pratiche di sicurezza digitale. Ha consolidato le sue competenze con un master in Cyber Security presso l’Università Campus Bio-Medico di Roma.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/guida-pratica-per-la-difesa-cibernetica-aziendale-attraverso-il-fattore-umano/


Deepfake e Intelligenza Artificiale: tra rischi di sicurezza e vantaggi

La diffusione di attacchi e di minacce le quali utilizzano come vettore il deepfake e la manipolazione delle informazioni rappresentano sfide significative per la sicurezza e l’integrità delle informazioni. I contesti in cui è opportuno porre attenzione sono plurimi, vedasi l’ambito politico, aziendale e sociale e pertanto, nel mare magnum delle molteplici minacce che permeano il panorama del mondo cibernetico, tali attacchi richiedono l’impiego di tecniche e strumenti difensivi che si dimostrino non solo efficienti, ma altresì altamente rapidi nella loro evoluzione.

Deepfake: cosa sono e come si sono evoluti

I deepfake sono contenuti multimediali manipolati, spesso video, che utilizzano la tecnologia dell’intelligenza artificiale (IA) per creare immagini realistiche di persone o situazioni che in realtà non sono accadute. Vengono quindi sviluppati attraverso tecniche per la sintesi dell’immagine umana basata sull’intelligenza artificiale, usata per combinare e sovrapporre immagini e video esistenti con video o immagini originali, tramite un procedimento di apprendimento automatico, conosciuto come rete antagonista generativa (comunemente nota come GAN (dall’inglese “Generative Adversarial Network”). Le reti GAN sono composte da due componenti principali, i quali lavorano in maniera antagonista: il generatore e il discriminatore.

  • Generatore (Generator): Il generatore in una rete GAN ha il compito di creare dati artificiali che dovrebbero sembrare il più possibile simili ai dati di addestramento reali. Ad esempio, nel contesto dei deepfake, il generatore potrebbe produrre immagini o audio che sembrano provenire da una persona specifica, anche se sono in realtà completamente sintetiche.
  • Discriminatore (Discriminator): Il discriminatore, d’altra parte, è un modello di apprendimento che cerca di distinguere tra dati reali e dati generati dal generatore. Nel contesto dei deepfake, il discriminatore valuta se un’immagine o un audio è autentico o se è il risultato della generazione del generatore. Il suo obiettivo è migliorare nel riconoscere la differenza tra dati reali e dati sintetici.

In sostanza quindi, il processo di addestramento di una rete GAN è basato su una competizione continua tra il generatore e il discriminatore. Il generatore cerca di migliorare costantemente la sua capacità di generare dati falsi che sembrano reali, mentre il discriminatore cerca di diventare sempre più abile nel distinguere tra dati reali e generati. Questo ciclo di retroazione continua fa sì che entrambi i componenti della rete migliorino nel corso del tempo.

Tale tecnologia, quindi, può essere adoperata per la creazione di notizie fasulle, la disseminazione di informazioni ingannevoli e l’organizzazione di truffe, dando luogo a comportamenti quali il cyberbullismo o altri reati informatici di varia natura. Allo stesso modo, può essere utilizzata a fini satirici.

L’affermazione “Se non vedo non credo”, come proferito da san Tommaso d’Aquino in merito alla risurrezione di Gesù, precedentemente contestata dai suoi apostoli, risulta ora obsoleta e, persino pericolosa. L’avvento della tecnologia deepfake sta alterando profondamente le dinamiche, esigendo dagli utenti della Rete una vigilanza sempre più acuta sulla genuinità dei contenuti da loro fruiti.

D’altronde è sufficiente vedere gli esempi riportati nel link di seguito: https://www.creativebloq.com/features/deepfake-examples per rendersi conto del grado di pericolosità che un’azione così mistificatoria e anche apparentemente satirica può provocare. Danni a persone e cose, azioni e reazioni sono solo alcune delle conseguenze plausibili che questa affascinante e pericolosa tecnologia può generare. Per comprendere al meglio quindi il processo che si cela dietro la creazione dei deepfake è opportuno sciogliere l’argomento nei suoi passaggi chiave:

  1. Raccolta dei dati: Per creare un deepfake audio convincente, è necessario raccogliere un ampio set di dati vocali dalla persona di destinazione. Questi dati possono essere estratti da interviste, discorsi pubblici, podcast o altri contenuti vocali disponibili.
  2. elaborazione dei dati: I dati vocali raccolti vengono elaborati per estrarre le caratteristiche significative della voce, come il tono, la modulazione, il ritmo e altri tratti distintivi.
  3. Addestramento del modello: Un modello di apprendimento profondo, come una rete neurale, viene addestrato utilizzando il set di dati vocali della persona di destinazione. Durante l’addestramento, la rete impara a riconoscere e riprodurre le caratteristiche vocali specifiche della persona.
  4. Generazione del deepfake audio: Una volta addestrato il modello, è possibile utilizzarlo per generare nuovi segmenti vocali. Questi segmenti possono essere basati su script specifici o generati in modo più libero, a seconda degli obiettivi dell’utilizzatore del deepfake audio.
  5. Ottimizzazione: Il risultato del deepfake audio può essere ottimizzato per renderlo più realistico e convincente. Questo potrebbe coinvolgere l’aggiunta di rumori ambientali, la regolazione di parametri specifici o altre tecniche di perfezionamento.
  6. Distribuzione o utilizzo: Una volta creato il deepfake audio, può essere distribuito o utilizzato per vari scopi, che vanno dall’intrattenimento alla manipolazione di informazioni.

“Come mai potrebbero vivere i ciarlatani e gl’imbroglioni, se non gettassero l’amo all’ingenua turba con qualche scrignetto o qualche borsa piena di denaro sonante? Come i pesci si prendono coll’esca, così gli uomini non si potrebbero gabbare, se non si desse loro qualche speranza da mordere”. (Petronio Arbitro).

Le tipologie di deepfake

Esistono diverse tipologie di deepfake, e la tecnologia continua a evolversi. Alcune delle principali categorie di deepfake includono:

Face swaps: In questa categoria, il viso di una persona di origine (source) viene sovrapposto su una persona destinataria (target). Questa pratica è comunemente utilizzata per creare contenuti ironici sui social media, spesso facendo uso dei volti di celebrità. Le tecnologie attuali, come le reti neurali profonde (Deep Neural Network – DNN), sono impiegate per questo scopo, anche se le prime forme di face swap risalgono agli anni ’90 con l’uso di software come Adobe Photoshop.

Lip-syncing: In questa tipologia, un video viene modificato per far sembrare che la persona destinataria pronunci frasi fittizie. Questo processo coinvolge l’utilizzo della voce registrata da una o più fonti, sincronizzata con un altro video per renderlo autentico. Un esempio iniziale di questa tecnica è stato Face2Face, un modello creato da ricercatori di Stanford nel 2017, che fa uso delle Reti Neurali Ricorrenti (Recurrent Neural Networks – RNN).

Puppet-master: Questo tipo di deepfake coinvolge l’imposizione dell’aspetto di una persona destinataria (puppet) su un’altra persona che compie azioni. Una metodologia comune per creare questo tipo di deepfake utilizza le reti generative avversarie (GAN), in cui un “generatore” di dati falsi sfida un “discriminatore” il cui compito è distinguere tra dati reali e falsi. L’efficacia di questo modello dipende dalla capacità del generatore di “ingannare” il discriminatore.

Deepfake e impatto sulla società

Abbiamo capito quindi quali sono le enormi potenzialità di questo strumento. Ora è opportuno fare un ragionamento relativo ai possibili ambiti che possono risentire dell’alterazione della realtà causata dallo sfruttamento di potenti tool tecnologici uniti alla fantasia umana.

Implicazioni politiche: La diffusione di deepfake e la manipolazione delle informazioni possono portare gravi conseguenze nel contesto politico. Può diventare difficile distinguere la realtà dalla finzione, e questo potrebbe influenzare l’opinione pubblica, le elezioni e la stabilità politica. Basti pensare al simulato episodio in cui Renzi, apparentemente presente, manifestava il suo dissenso attraverso un gesto volgare verso Mattarella durante una trasmissione satirica come “Striscia la Notizia”. Come spesso accade, è stato necessario un programma di satira per porre l’attenzione su una questione estremamente seria. Non si trattava né di un imitatore né di un sosia; questa volta, la tecnologia si è rivelata l’ultima frontiera della manipolazione. Non solo è in grado di acquisire i tratti di un volto e sovrapporlo a chiunque altro ma può anche catturare l’autentico timbro della tua voce, rimodulandolo per far pronunciare parole che non sono mai state dette. Quindi, eventuali implicazioni di natura politica potrebbero riverberarsi sulla stabilità nazionale. Politici e leader possono diventare bersagli di deepfake, con la creazione di contenuti falsi atti a danneggiare la loro reputazione o influenzano l’immagine pubblica. Questo potrebbe avere conseguenze sulla loro carriera politica e sulla stabilità delle istituzioni. La manipolazione di discorsi e dichiarazioni di leader politici, può alimentare confusione o portare a malintesi diplomatici con gravi conseguenze gravi relazioni internazionali e nella diplomazia. (https://www.youtube.com/watch?v=JZl3cQTL6U0).

Ma, anche ponendo il caso che l’arguzia umana superi la sofisticatezza tecnologica, si potrebbe ingenerare un fenomeno quasi contrario. Il bombardamento mediatico di contenuti manipolati e manipolatori potrebbe contribuire a una crescente sfiducia nella veridicità delle informazioni e delle immagini. La manipolazione digitale potrebbe mettere in discussione l’autenticità di qualsiasi dichiarazione o evento, complicando la formazione di opinioni informate. Per concludere, o nei confronti della reputazione personale o anche peggio contro la stabilità politica e nazionale, questi contenuti possono risultare machiavellici e dannosi.

Implicazioni aziendali: Nel mondo complesso e sempre più interconnesso delle aziende, la manipolazione delle informazioni è senza dubbio una minaccia reale. Questa pratica non solo punta a danneggiare la reputazione delle organizzazioni, ma può anche avere impatti significativi sui mercati finanziari, generando danni notevoli.

Si può immaginare una situazione in cui notizie false sulle performance finanziarie di un’azienda vengono disseminate intenzionalmente. Un simile scenario potrebbe causare turbolenze finanziarie e minare la fiducia degli investitori, gettando un’ombra sull’integrità aziendale. La veridicità delle informazioni è un pilastro fondamentale nelle dinamiche aziendali, e la manipolazione di dati finanziari tramite deepfake costituisce una minaccia tangibile.

In aggiunta, emerge il rischio di frode, dove i deepfake diventano strumenti per ingannare le aziende. Basti pensare alla creazione di video contraffatti di dirigenti aziendali, i quali veicolano messaggi falsi o transazioni finanziarie manipolate. Questa forma di inganno può arrecare danni irreparabili alla reputazione delle aziende e dei loro leader.

Tuttavia, le preoccupazioni non si limitano alle questioni finanziarie. L’utilizzo dei deepfake apre la porta a nuove minacce per la sicurezza informatica. Criminali potrebbero sfruttare questa tecnologia per eludere sistemi di autenticazione basati su riconoscimento facciale o vocale. Inoltre, i dipendenti stessi potrebbero essere vittime di deepfake senza il loro consenso, un’azione che viola la loro privacy e crea situazioni dannose sia a livello personale che professionale.

Deepfake audio: quali sono i possibili rischi

Il deepfake audio è una tecnica che utilizza l’intelligenza artificiale, in particolare il deep learning, per manipolare e generare file audio falsi che sembrano autentici. Questa tecnologia può essere utilizzata per alterare voci, creare discorsi o dialoghi inventati, o persino imitare voci di persone specifiche in modo convincente. Le moderne simulazioni vocali hanno raggiunto oltretutto una precisione tale da imitare con straordinaria fedeltà l’intonazione, il ritmo e le sfumature di una voce umana (impressionanti a tal proposito sono i deepfake che utilizzano voci di cantanti famosi deceduti utilizzandole in canzoni moderne ampiamente diffuse https://www.youtube.com/watch?v=Num0q-l-ldc). Questa capacità le rende virtualmente indistinguibili dalla realtà, diventando un potente strumento nelle mani dei criminali per truffare individui e aziende.

Un esempio recente, riportato dal New York Times, coinvolge un falso robocall che impersona il presidente Biden, il quale mira allo scopo di influenzare le primarie del New Hampshire. La chiamata, che sembra provenire da Kathy Sullivan, ex presidente del Partito Democratico del New Hampshire, scoraggia gli elettori dal partecipare alle primarie. Biden non è in corsa nelle primarie del New Hampshire, ma la chiamata è stata manipolata per sembrare legata a una campagna a livello statale che incoraggia a votare per lui.

Ma perché i deepfake audio sono così complessi da distinguere, a tal punto che sono tra i più utilizzati in truffe e tentativi di frode? Uno studio (Warning: Humans cannot reliably detect speech deepfakes) ha dimostrato che i partecipanti hanno fallito il 25% delle volte nel tentativo di rilevare i deepfake vocali. La metà dei partecipanti ha ricevuto una formazione preliminare ascoltando cinque esempi di voce sintetizzata, ma la loro prestazione è stata migliore solo del 3% rispetto al gruppo non addestrato. Questo perché l’audio è soggettivo. A differenza del rilevamento dei deepfake visivi, in cui l’autenticità può essere giudicata osservando oggetti e sfondi, la natura soggettiva del parlato fa sì che le percezioni varino maggiormente. Le onde sonore assumono frequenze diverse attraversando l’aria o un mezzo solido e quindi la voce ha un timbro diverso. Inoltre, un registratore altera la voce, anche se in maniera minima. Durante la registrazione, infatti, il suono viene “tradotto” da onde sonore meccano-elastiche (cioè vibrazioni) a onde elettromagnetiche (cioè segnali elettrici), mentre per l’ascolto avviene il processo inverso: così la voce che esce da questi passaggi non è mai perfettamente identica all’originale, e questo chiaramente ci rende meno attenti ai messaggi veicolati tramite voce, dato che siamo abituati a sentire anche voci a noi care come diverse via messaggio vocale. Il cervello umano è generalmente più sensibile e attento alle informazioni visive rispetto a quelle uditive e, dato che il riconoscimento di voci e tratti vocali è un processo complesso, è più difficile individuare anomalie nell’audio rispetto a segnali visivi. Nel video, inoltre, ci sono più punti di riferimento visivi, come espressioni facciali, movimenti degli occhi, ecc, i quali possono essere utilizzati per individuare incongruenze. Nell’audio, tali punti di riferimento sono meno evidenti, rendendo difficile l’individuazione di manipolazioni.

Un ulteriore elemento discriminatorio si riscontra nel fatto che le persone possono essere più propense a sospettare di manipolazioni visive rispetto a manipolazioni uditive. Ciò può essere dovuto allo stigma che il concetto di “vedere per credere ” è più radicato nella società rispetto al “sentire per credere”.

Deepfake: quali sono i vantaggi che possono apportare nella società

I deepfake, se utilizzati in modo etico e responsabile, presentano diverse applicazioni potenzialmente vantaggiose in diversi settori. Basti pensare a quante possibilità possono verificarsi in contesti in cui il limite pare essere solo quello della propria fantasia, che, si spera sempre di più, possa essere delineato dalle norme.

Di seguito sono stati fatti alcuni ragionamenti liberi rispetto ad ambiti in cui i deepfake possono trovare utilità:

Nel settore della formazione e dello sviluppo aziendale, l’integrazione dei deepfake può trasformare il modo in cui i dipendenti acquisiscono competenze. Le simulazioni realistiche, come colloqui, sessioni di coaching o scenari di interazione con i clienti, potrebbero offrire un ambiente di apprendimento più coinvolgente ed efficace. Ciò potrebbe tradursi in una migliore preparazione dei dipendenti e, di conseguenza, in un miglioramento delle prestazioni aziendali.

Per quanto riguarda la produzione di contenuti multimediali, soprattutto nell’industria dell’intrattenimento, i deepfake rappresentano un’opportunità unica. La capacità di creare personaggi digitali convincenti può ridurre significativamente i costi di produzione nella post-produzione, consentendo una maggiore flessibilità creativa. Questo potrebbe portare a storie più coinvolgenti, effetti speciali avanzati e un processo di produzione più efficiente nel complesso.

Un esempio su tutti di utilizzo di Deepfake con scopi migliorativi lo si può trovare in ambito sanitario: il progetto Revoice. La tecnologia deepfake può restituire la voce a coloro che hanno perso la capacità di parlare a causa di malattie come la SLA. L’iniziativa denominata “Progetto Revoice” ha come obiettivo primario la completa ricreazione dell’essenza unica di qualsiasi voce, al fine di sviluppare un clone digitale della stessa destinato all’utilizzo quotidiano mediante dispositivi di Comunicazione Aumentata/Alternativa (AAC).

Sfide nella verifica

A causa della crescente sofisticazione delle tecnologie di manipolazione, la verifica dell’autenticità delle informazioni sta diventando una vera e propria sfida. Per questo motivo i grandi players dell’industria tecnologica si stanno adoperando per trovare delle contromisure al fine di limitare e contenere l’efficacia degli attacchi massivi e fraudolenti tramite deepfake.

Ad esempio, durante l’evento Consumer Electronics Show 2024, McAfee ha presentato Project Mockingbird, una soluzione che fa leva sull’intelligenza artificiale per mitigare i rischi legati alle frodi ai danni degli amministratori delegati (Ceo fraud) e ai deepfake audio. Project Mockingbird sta sviluppando una forma di riconoscimento attraverso l’integrazione di modelli di rilevamento contestuali, comportamentali e categoriali, impiegando l’intelligenza artificiale per determinare se l’audio di un video è probabilmente generato da un sistema di intelligenza artificiale. Anche Google ha intensificato la sua lotta contro i deepfake, immagini e video generati artificialmente, attraverso un aggiornamento della funzione “Informazioni su questa immagine”. Questa funzionalità fornisce agli utenti dati utili per verificare l’autenticità di un’immagine online. L’aggiornamento ora è integrato nel motore di ricerca di Google. Gli utenti possono cliccare sui tre punti nell’angolo in alto a destra di un’immagine nei risultati di ricerca per accedere a informazioni specifiche. Questo include dettagli su quando l’immagine è apparsa per la prima volta su Google e altre pagine web, nonché l’utilizzo e la descrizione della foto da parte dei siti. Inoltre, per aiutare a identificare i deepfake, Google consente di visualizzare i metadati aggiunti a un’immagine, inclusi quelli che potrebbero indicare la generazione o il miglioramento tramite intelligenza artificiale. Tuttavia, ciò dipende dalla corretta inserzione dei metadati da parte del proprietario dell’immagine. Esistono software più avanzati e a pagamento, come Sensity.ai, Sentinel, e il recente software di Intel con il detector “FakeCatcher”, che utilizzano l’intelligenza artificiale, in particolare reti neurali, per analizzare il contenuto alla ricerca di anomalie, ottenendo un’elevata percentuale di successo nell’identificazione dei deepfake. Tuttavia, attualmente, tali software con elevate capacità di calcolo e precisione sono limitati e prevalentemente utilizzati da grandi aziende e istituzioni. È opportuno quindi puntare sulla educazione delle persone e dare loro degli strumenti difensivi basati sulla consapevolezza. Puntare al fattore umano quindi, come baluardo della difesa personale e aziendale.

Educazione e consapevolezza

Come visto pocanzi quindi, l’educazione del pubblico sulla possibilità di manipolazioni delle informazioni è fondamentale. La consapevolezza del problema può e deve aiutare le persone a essere più critiche nelle valutazioni delle informazioni che incontrano online. La sfida che viene posta oggi è: come si può creare un percorso di Awareness che ci possa istruire al meglio su questa nuova minaccia?

Certamente è opportuno porre l’attenzione sulla formazione tecnica, magari offrendo corsi o risorse online che insegnino le basi delle tecnologie utilizzate per creare deepfake, oppure promuovere il pensiero critico, fornendo esempi pratici e aggiornando le persone tramite newsletter, oltre che sensibilizzare il pubblico sui tool suddetti di detection.

Proviamo ora a stilare noi una lista di elementi dei quali è opportuno tener conto per difendersi da attacchi generati con i Deepfake:

Occhi: La replicazione del naturale movimento degli occhi e dello sbattere delle ciglia risulta ancora complessa, poiché il soggetto spesso segue o fissa l’interlocutore durante una conversazione. Un movimento degli occhi innaturale o distorto può essere un segnale di possibile presenza di deepfake. Nel caso di immagini, è importante osservare la pupilla del soggetto, poiché spesso viene ricreata in modo inaccurato con bordi sfocati e una forma poco definita.

Viso ed espressioni facciali: I deepfake spesso coinvolgono sovrapposizioni di immagini, generando espressioni facciali distorte e innaturali. La pelle può essere un indicatore utile, specialmente se presenta discromie evidenti, texture irrealistiche (troppo liscia o troppo rugosa), ombre strane e barba o baffi con forme e definizioni anomale.

Denti e capelli: La ricostruzione di denti e capelli tramite intelligenza artificiale è difficile, e questo può rendere i sorrisi nei deepfake strani e poco definiti o i capelli troppo piatti e luminosi, come se fossero un oggetto unico.

Rumori o audio incoerente: Nell’analisi di un video, è essenziale prestare attenzione all’audio e cercare di correlarlo con il movimento delle labbra della persona che parla. La mancanza di coerenza tra audio e movimenti labiali può indicare la presenza di un deepfake.

Distorsioni visive: Pixel visibili, ombre innaturali o la presenza di oggetti fuori posto costituiscono indicatori importanti di un possibile deepfake.

Attendibilità della fonte: Oltre all’analisi visiva del presunto deepfake, è cruciale considerare la fonte in cui l’immagine o il video è stato pubblicato, valutandone l’affidabilità e la reputazione.

Affrontare queste sfide richiederà sforzi coordinati tra governi, aziende, organizzazioni non governative e individui. La ricerca continua, lo sviluppo di tecnologie di difesa avanzate e la promozione della consapevolezza sono tutte parti cruciali di una strategia globale contro la manipolazione delle informazioni.

Riferimenti bibliografici

Articolo a cura di Riccardo Laurenti

Profilo Autore

Consegue la Laurea magistrale in Scienze Politiche e Relazioni Internazionali presso la LUISS, improntando il percorso formativo in analisi e contrasto a fenomeni terroristici attraverso fonti OSINT e divulgazione mediatica.
Perfeziona il piano di studi prima con il Diploma di Specializzazione di 1° livello in Geopolitica e Sicurezza Globale, con particolare Focus al terrorismo di matrice islamica, poi con il Master 2° livello Homeland Security presso l’ Università Campus Bio-Medico di Roma, nel quale vengono approfonditi aspetti e tematiche di Cyber Security, OSINT, Business Continuity e Sicurezza delle infrastrutture critiche.
Dopo alcune esperienze lavorative nel settore della Reputation Intelligence, tra cui una in un importante player nazionale del settore energetico, attualmente è impiegato in Deep Cyber srl, con il ruolo di Cyber Secuirty Specialist, per il quale si occupa di analisi di minacce Cyber attraverso tools di simulazione e di Social Engineering (phishing, spear phishing, vishing, smishing, etc.) analisi OSINT e SOCMINT mediante strumenti di intelligence e Forensics investigations di compagnie, manager e 3°parti, al fine di supportare il management nei processi decisionali e di compliance.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/deepfake-e-intelligenza-artificiale-tra-rischi-di-sicurezza-e-vantaggi/


Modelli globali di governance per la protezione e la sicurezza dei dati: la proposta Gaia-X

Dati come risorsa da proteggere e governare

Tutti gli analisti di mercato sono concordi nell’individuare, fra i principali trend di sviluppo, le tecnologie della Intelligenza Artificiale e del Cloud and Edge Computing.

In particolare negli ultimi mesi, ha avuto enorme enfasi la cosiddetta ‘intelligenza artificiale generativa’ per le sue grandissime potenzialità, a volte temute e a volte sottostimate.

Ma proviamo innanzitutto a definire meglio il contesto complessivo.

Cominciamo dalla Intelligenza Artificiale.

L’app ChatGPT, lanciata pochi mesi fa, è diventata l’app in più rapida crescita di tutti i tempi.

Più in generale, sono diventate estremamente significative le possibilità della Intelligenza Artificiale di elaborare, con algoritmi sempre più sofisticati, le grandi quantità di dati che oggi siamo in grado di raccogliere sulle diverse piattaforme digitali per supportare (e in molti casi provare a sostituire) l’essere umano nelle sue decisioni e nelle sue attività.

L’Intelligenza Artificiale è diventata anche oggetto di preoccupazione per la sua capacità di creare, a valle di adeguate fasi di ‘deep learning’, immagini e testi indistinguibili da quelli prodotti da esseri umani.

Il 12 giugno 2023 il segretario generale delle Nazioni Unite Antonio Guterres si è dichiarato d’accordo con la proposta avanzate da alcuni ‘top-manager’, molti dei quali provenienti da industrie impegnate nello sviluppo dell’Intelligenza Artificiale, per la creazione di un organismo internazionale di controllo dell’intelligenza artificiale in analogia alla Agenzia internazionale per l’energia atomica (AIEA).

Veniamo ora alla definizione dei nuovi paradigmi computazionali.

Con Cloud Computing si intende un’erogazione di servizi di archiviazione, di elaborazione o di trasmissione dati offerti, con una architettura distribuita e remota di risorse configurabili, da fornitori (Cloud Service Provider) a clienti (Cloud Service Customer) che ne facciano richiesta tramite rete Internet.

L‘Edge Computing è invece un modello di calcolo distribuito nel quale l’elaborazione dei dati avviene il più vicino possibile a dove i dati vengono generati, migliorando decisamente tempi e costi di trasmissione e la resilienza delle infrastrutture in caso di interruzione dei collegamenti.

L’elemento che accomuna la Intelligenza Artificiale e i nuovi paradigmi computazionali è la importanza che vengono ad assumere i dati prodotti, raccolti e gestiti dalle organizzazioni pubbliche e private e dalle comunità con cui noi ci relazioniamo nella nostra vita di tutti i giorni.

Se si è paragonata la Intelligenza Artificiale alla energia atomica possiamo certamente ritenere che la strategicità geo-politica dei giacimenti di dati sui sistemi di cloud and edge computing sia analoga a quella dei giacimenti di uranio.

Pertanto, se i dati sono il ‘carburante’ di questa trasformazione digitale, la necessità delle strutture sociali e organizzative di controllare il trattamento dei dati (personali e non) è pertanto diventata una priorità strategica.

Questo comporta che i cittadini e gli organismi amministrativi, economici e sociali debbano essere in grado di conoscere ‘quali’ siano i dati da proteggere, ‘chi’ possiede questi dati, quali siano le ‘condizioni di trattamento’(p.e. ‘utilizzo’, ‘durata di mantenimento’), ‘dove’ il dato è conservato e ‘come’ poterlo riutilizzare per una sua valorizzazione, anche economica.

La importanza strategica della ‘data sovereignty’ è confermata dalle numerose iniziative legislative che si stanno intraprendendo nei diversi quadranti geopolitici globali per mantenere ed estendere il controllo sui dati.

Come vedremo, si tratterà di approcci diversi alla governance dei dati, approcci che potranno essere analizzati e valutati sulla base delle priorità che ciascuno di essi attribuisce a tre dimensioni fondamentali:

  • Rispetto dei diritti individuali e sociali
  • Creazione di valore economico
  • Strategie di controllo geo-politiche.

Prime iniziative negli Stati Uniti

Cominciamo con il descrivere cosa finora è accaduto nel quadrante statunitense.

Il 2 febbraio 2016 entrava in vigore il Privacy Shield UE-USA, accordo finalizzato alla regolamentazione degli scambi transatlantici di dati personali a fini commerciali tra l’UE e gli USA; il suo obiettivo era quello di consentire alle società statunitensi di ricevere più facilmente dati personali da entità dell’UE ai sensi delle leggi sulla privacy dell’UE.

Il Privacy Shield UE-USA andava a rimpiazzare il precedente accordo dell’ International Safe Harbor sviluppato fra il 1998 e il 2000, i cui principi erano stati dichiarati non validi dalla Corte di giustizia europea (CJEU) nell’ottobre 2015.

Tuttavia, il 16 luglio 2020 anche il Privacy Shield UE-USA veniva dichiarato non valido dalla Corte di giustizia europea (CJEU) con la sentenza ‘Schrems II’.

Nel frattempo, il 2 giugno 2018 il Congresso U.S. approvava il Clarifying Lawful Overseas Use of Data Act, or “CLOUD Act” con l’obiettivo di facilitare e accelerare, ai fini della sicurezza nazionale, l’accesso alle informazioni elettroniche detenute da fornitori globali con quartier generale negli Stati Uniti per alcuni tipi di indagine.

Il CLOUD Act, tuttora vigente, afferma esplicitamente che ad una società soggetta alla giurisdizione statunitense può essere richiesto di fornire i dati che la società controlla, indipendentemente da dove è memorizzato e in qualsiasi momento.

Infatti il Cloud Act afferma che ‘‘A provider of electronic communication service or remote computing service shall comply with the obligations of this chapter to preserve, backup, or disclose the contents of a wire or electronic communication and any record or other information pertaining to a customer or subscriber within such provider’s possession, custody, or control, regardless of whether such communication, record, or other information is located within or outside of the United States.’’.

Da quanto precede, si può certamente concludere le priorità nel quadrante statunitense siano quelle di garantire una libera circolazione di dati a supporto delle aziende ‘big tech’ assieme ad una grande attenzione alla necessità di poter permettere, a fini di sicurezza nazionale, alle agenzie governative l’accesso a tutti i dati in possesso di queste aziende.

Prime iniziative in Cina

Spostiamoci ora sul quadrante cinese.

Il primo giugno 2017 entrava in vigore la Cybersecurity Law of the People’s Republic of China per la cui attuazione veniva incaricata la Cyberspace Admininistration of China.

La Cyberspace Administration of China (CAC) è anche nota come Ufficio della Commissione Centrale per il Cyberspazio e riporta direttamente sia al Partito Comunista Cinese sia al Consiglio di Stato del Governo cinese.

Secondo l’articolo 5 di questa legge, lo Stato adotta le misure necessarie per vigilare, prevenire e far fronte ai rischi per la sicurezza della rete originati sia all’interno che all’esterno del territorio della Repubblica Popolare Cinese, protegge le infrastrutture informative essenziali da attacchi, intrusioni, interferenze e atti vandalici, sanziona i reati di rete secondo la legge, salvaguarda la sicurezza e mantiene il ‘buon ordine’ del cyber spazio.

Il 10 giugno 2021, durante la 29a sessione del Comitato permanente del XIII Congresso nazionale del popolo, veniva ufficialmente approvata la Data Security Law of the People’s Republic of China che entrava definitivamente in vigore il 1° settembre 2021.

Ai sensi dell’articolo 31 della Data Security Law, il trasferimento transfrontaliero di dati importanti raccolti e generati da operatori di infrastrutture di informazioni critiche all’interno della Cina è disciplinato dalla già citata Cybersecurity Law, in base alla quale i dati raccolti e generati da operatori di infrastrutture di informazioni critiche sono tenuti a essere immagazzinati obbligatoriamente nel territorio della Cina. Ogni volta che tali dati devono essere trasferiti all’estero, deve essere eseguita una valutazione di sicurezza.

Da questi riferimenti, si può certamente concludere che per il quadro legislativo cinese la priorità è quella del controllo geo-politico dell’immagazzinamento e del flusso dei dati con forte coinvolgimento delle strutture politiche in caso di trasferimenti ‘transfrontalieri’.

Prime iniziative in Europa

Vediamo adesso cosa è finora accaduto nella nostra cara Unione Europea.

Il 25 Maggio 2018 entrava in vigore la EU Regulation 2016/679 on the protection of natural persons with regard to the processing of personal data and on the free movement of such data (in breve, GDPR).

Il GDPR nasceva con l’obiettivo di garantire ad ogni persona naturale (‘data subject’) alcuni diritti fondamentali circa i propri dati personali e sulle loro modalità di trattamento ovvero:

  • Diritto di accesso;
  • Diritto alla rettifica;
  • Diritto alla cancellazione (“diritto all’oblio”);
  • Diritto alla limitazione del trattamento.

Il titolare e il responsabile del trattamento dei dati personali hanno il dovere di garantire misure tecniche e organizzative appropriate al fine di garantire un livello di sicurezza del trattamento adeguato al livello di rischio.

Questo atto normativo testimoniava della attenzione al rispetto dei diritti individuali che la Unione Europea considerava prioritari nel trattamento dei dati personali.

Il 18 dicembre dello stesso anno entrava in vigore la EU Regulation 2018/1807 on a framework for the free flow of non-personal data in the European Union (in breve, FFnPD).

Questo regolamento mirava ad abbattere gli ostacoli alla libera circolazione dei dati non personali all’interno dell’UE, promuovendo così l’economia europea dei dati e lo sviluppo di tecnologie emergenti come i servizi cloud, l’IoT, il 5G, l’intelligenza artificiale

Esso era pertanto la testimonianza del fatto che un ulteriore obiettivo della Unione Europea era quello di cogliere le opportunità della emergente economia dei dati incoraggiando e facilitando la creazione di un ‘level playing field’ che permettesse anche agli operatori europei di competere nel mercato dei servizi digitali nel quale era predominante il ruolo di operatori extra-europei.

Infatti, al fine di aumentare il livello di ‘trust’ del mercato nella adozione di servizi cloud e di contrastare i rischi di ‘lock-in provider’, l’articolo 6 di questo regolamento (“Porting of Data”) incoraggiava lo sviluppo e l’adozione di codici di condotta che, una volta sottoscritti dai fornitori di servizi cloud, dessero ai clienti il diritto di riprendersi i propri dati sia in caso di cambio di fornitore sia in caso di ritorno su infrastrutture ‘on premise’.

Il 26 novembre 2019 il gruppo SWIPO (Switching cloud service provider and Porting Data), facilitato dalla Commissione Europea e composto da fornitori e utilizzatori di servizi cloud, presentava alla Commissione Europea due Codici di Condotta (per IaaS e per SaaS) per la rendere possibile la attuazione dell’Articolo 6 precedentemente ricordato.

Successivamente la associazione no-profit SWIPO AISBL ( www.swipo.eu ), fondata nel maggio 2020 da Cloud Service Providers e Cloud Service Customers, assumeva, in continuità alle attività del Gruppo, la missione di:

  • Manutenere e sviluppare questi codici di Condotta;
  • Raccogliere le dichiarazioni di adesione ai codici stessi da parte dei Providers.

A queste prime due iniziative legislative, si affiancava il 27 giugno 2019, come manifestazione della attenzione al tema della sicurezza dei dati la EU Regulation 2019/881 on ENISA (the European Union Agency for Cybersecurity) and on information and communications technology cybersecurity certification (in breve, Cybersecurity Act)

Questa legge rafforzava il ruolo dell’Agenzia dell’UE per la sicurezza informatica (ENISA) e istituiva nella UE un quadro di certificazione della sicurezza informatica per prodotti, servizi e processi ICT.

Le aziende operanti nell’UE avrebbero potuto trarre vantaggio dal dover certificare i propri prodotti, processi e servizi ICT in uno dei qualsiasi paesi della UE e vedere i propri certificati riconosciuti in tutti i paesi della Unione stessa.

In particolare, per ogni schema di certificazione europeo veniva richiesto di specificare:

  • le categorie di prodotti, servizi e processi coperti;
  • i requisiti di sicurezza informatica, specificando standard o specifiche tecniche;
  • la modalità di valutazione (autovalutazione, di terze parti, …);
  • Il livello di garanzia offerto ( base, sostanziale, elevato) per informare gli utenti del livello di copertura di rischio di sicurezza informatica che un prodotto, servizio o processo poteva garantire.

Lo sviluppo del quadro normativo europeo riceveva ulteriore slancio il 19 febbraio 2020 con la definizione Strategia Europea dei dati da parte della Commissione Von der Leyen che fissava l’obiettivo prioritario della ‘sovranità digitale europea’.

Infatti, tale Strategia, partendo dal riconoscere che le tecnologie digitali stavano trasformando l’economia e, più in generale, la società civile e che i dati raccolti e gestiti in questa trasformazione globale sarebbero stati, in misura sempre più crescente, ospitati su piattaforme di cloud-computing i cui ‘provider’ predominanti erano in gran parte extra-europei e su emergenti sistemi di edge-computing la cui importanza sarebbe stata sempre più rilevante con lo sviluppo dell’Internet of Things, fissava i seguenti obiettivi:

  • Definire le modalità e i processi con le quali i dati sono raccolti e utilizzati tutelando in primo luogo gli interessi della persona, in conformità con i valori, i diritti fondamentali e le regole europee;
  • Costruire un solido quadro giuridico dell’UE – in termini di protezione dei dati, diritti fondamentali e sicurezza;
  • Cogliere i vantaggi di un migliore utilizzo dei dati, sia ai fini di una maggiore produttività e competitività dei mercati sia per l’ottenimento di miglioramenti in termini di salute e benessere per i cittadini, di ambiente, di trasparenza nella governance di servizi pubblici sempre più efficienti;
  • Raggiungere, in definitiva, la “sovranità digitale” intesa come capacità dell’Europa di agire in modo indipendente nel mondo digitale al fine di fornire ai cittadini europei la possibilità di completo controllo sui dati memorizzati ed elaborati sulle piattaforme di cloud ed edge computing, potendo decidere chi dovesse accedere a questi dati e quali fossero i processi e le modalità per estrarne ‘valore economico’.

Nella stessa Strategia Europea dei Dati venivano definiti 9 Common European Data Spaces in settori strategici e in domini di pubblico interesse (manifattura, green deal, mobilità, salute, finanza, energia, agricoltura, pubblica amministrazione, competenze) la cui importanza avrebbe visto convergere su di essi forti investimenti.

Vediamo ora rapidamente quali sono stati alcuni dei passi fondamentali per l’attuazione di questa strategia.

Una delle prime azioni chiave per la implementazione della strategia è stata il finanziamento di un High Impact project on common European data spaces per la definizione di una architettura di condivisione dei dati (inclusi standard, migliori pratiche, strumenti) e relativi meccanismi di governance, finalizzato alla realizzazione di una federazione europea di infrastrutture cloud affidabili e ad alta efficienza energetica.

Una seconda, fondamentale linea di azione è stata la definizione di un robusto quadro giuridico per la Unione Europea.

Alcune delle principali proposte legislative della Commissione europea sono:

  • Data Governance Act (DGA): entrato in vigore il 23/6/2022, mira a facilitare la condivisione dei dati stabilendo: (a) le condizioni per il riutilizzo, all’interno dell’Unione, di determinate categorie di dati detenuti da enti pubblici; (b) un quadro di notifica e controllo per la fornitura di servizi di condivisione dei dati; (c) un quadro per la registrazione volontaria delle entità che raccolgono e trattano dati messi a disposizione per scopi altruistici;
  • Digital Markets Act (DMA): entrato in vigore il 2/5/2023, intende garantire un maggiore grado di concorrenza nei mercati digitali europei, impedendo alle grandi aziende di abusare della loro posizione dominante così consentendo a nuovi operatori di entrare nel mercato. Questo regolamento si rivolge alle più grandi piattaforme digitali operanti nell’Unione Europea che vengono individuati come “Gatekeeper” per la loro ‘dominante’ posizione di mercato in alcuni settori digitali ed individuati sulla base di criteri predefiniti (numero di utenti, fatturato, capitalizzazione). Per questi particolari operatori viene definito un elenco di obblighi e, in caso di inadempienza, vengono definiti meccanismi sanzionatori, comprese multe fino al 10% del fatturato globale annuo che salgono al 20% in caso di violazioni ripetute. Il 6/9/2023 sono stati individuati i primi sei gatekeepers (Alphabet, Amazon, Apple, ByteDance, Meta, Microsoft) cui sono stati concessi 6 mesi per il pieno allineamento al DMA;
  • Digital Services Act (DSA): in vigore dal 17/2/2024 ha l’obiettivo di migliorare la moderazione dei contenuti sulle piattaforme di social media per evitare la pubblicazione di contenuti illegali. Le aziende sono tenute a rimuovere questi contenuti illegali una volta segnalati dai ‘trusted flaggers’, nuova figura individuata dalla normativa con l’obiettivo di monitorare i contenuti pubblicati sulle diverse piattaforme. Il DSA chiede inoltre alle piattaforme di rendere trasparente alle autorità di regolamentazione il funzionamento degli algoritmi impiegati per rimuovere i contenuti illegali e per la individuazione dei potenziali clienti da parte degli inserzionisti. Molte delle sue disposizioni si applicano solo alle cosiddette ‘very large platforms’ (piattaforme che hanno più di 45 milioni di utenti nell’Unione Europea). Un primo elenco di queste realtà è stato pubblicato il 25/4/2023. Le aziende che non rispettano i nuovi obblighi rischiano sanzioni fino al 6% sul fatturato;
  • Data Act: approvato il 13/12/23 dal Parlamento Europeo entrerà in vigore nella seconda metà del 2025 e definirà norme armonizzate:
    • per rendere disponibili, in modo gratuito, agli utilizzatori di prodotti ‘connessi’ e dei relativi servizi (si pensi alla Internet of Things) i dati generati nell’utilizzo di questi prodotti e servizi;
    • per rendere disponibili, laddove sussistano esigenze eccezionali e/o pubblico interesse, i dati da parte dei detentori (‘data holders’) alle amministrazioni pubbliche nazionali, alla Commissione Europea, alla Banca Centrale Europea e, in generale, alle strutture organizzative della Unione Europea;
    • per facilitare, fino a renderlo gratuito, il trasporto dei dati tra diversi fornitori di servizi cloud (in altri termini, diventa obbligo legislativo il diritto al porting dei dati finora garantito dalla adesione volontaria dei fornitori ai codici di condotta SWIPO che così confermano il loro valore);
    • per introdurre salvaguardie contro l’accesso illecito da parte di terze parti a dati non personali (si pensi agli accessi ai dati ispirati dal CLOUD Act);
    • per sviluppare standard per la interoperabilità per l’accesso, il trasferimento e l’utilizzo dei dati.

Si presenta pertanto come un importante atto normativo per la definizione di un ‘level playing field’ per lo sviluppo di una economia dei dati europea in quanto:

  • Metterà a disposizione in modo gratuito i dati agli utilizzatori di servizi IoT;
  • Faciliterà lo scambio dei dati nelle relazioni B2B garantendo alle PMI, quando richiedano dati, costi di compensazione ridotti;
  • Impedisce che i ‘gatekeeper’ che godono di una posizione predominante sul mercato possano svolgere il ruolo di terze parti e pertanto non potranno effettuare azioni di incentivo commerciale per avere i dati a disposizione;
  • Renderà gradualmente gratuiti i costi di cambio di fornitore nei servizi cloud riducendo il rischio ‘provider lock-in’;
  • Punterà a ridurre il rischio CLOUD ACT per l’accesso ai dati nella UE;
  • Supporterà gli sforzi per la crescita della interoperabilità fra data spaces favorendo la nascita di crescenti opportunità per lo sviluppo di business innovativi.

Artificial Intelligence Act: è l’atto normativo proposto dalla Commissione Europea il 21 aprile del 2021 per la regolamentazione della Intelligenza Artificiale. Il 2 febbraio del 2024 è stata approvata dal COREPER la versione consolidata del testo che dovrebbe essere approvata definitivamente nell’aprile del 2024. Questa legge fissa regole armonizzate per lo sviluppo, l’immissione sul mercato e l’utilizzo di sistemi di IA nell’Unione seguendo un approccio proporzionato basato sul rischio. Talune pratiche di IA particolarmente dannose sono assolutamente vietate in quanto in contrasto con i valori dell’Unione; sono, inoltre, proposte restrizioni e tutele specifiche in relazione a determinati usi dei sistemi di identificazione biometrica remota a fini di attività di contrasto. La proposta stabilisce infine una metodologia per la valutazione dei rischi al fine di definire i sistemi di IA “ad alto rischio” ovvero che pongono rischi significativi per la salute e la sicurezza o per i diritti fondamentali delle persone. Tali sistemi ad alto rischio dovranno essere adeguatamente pubblicizzati in un apposito database. Per eventuali violazioni delle norme sono previste sanzioni fino a 35 milioni di euro o al 7% del fatturato annuo (scegliendo fra il più alto fra i due importi).

Concludendo questa rapida sintesi di alcune iniziative del quadro normativo europeo, possiamo certamente affermare che, rispetto agli altri quadri normativi, esso considera prioritario l’obiettivo di conciliare, nello sviluppo della ‘data economy’, il rispetto dei diritti individuali e sociali con la creazione di valore economico e con le considerazioni derivanti da fattori geo-politici.

Gaia-X: una prima iniziativa industriale per lo sviluppo della Strategia

L’iniziativa Gaia-X è stata avviata nel febbraio 2020 (parallelamente alla definizione della Strategia Europea) su proposta franco-tedesca e ha visto nei mesi immediatamente successivi il coinvolgimento di quasi tutti i paesi europei (e non solo) nella fondazione di una AISBL (società no-profit di diritto belga) che si è posta l’obiettivo di rendere ‘operativa’ questa strategia.

Obiettivo fondamentale di Gaia-X è la valorizzazione del patrimonio dei dati che, con lo sviluppo e la adozione servizi di cloud computing ed edge computing, verrà a costituirsi nella Unione Europea affinchè la ‘ricchezza’ che da tali dati si potrà estrarre vada principalmente a beneficio dei suoi cittadini europei nel pieno rispetto dei valori comuni europei.

In questo approccio allo sviluppo della ‘data economy’ europea, Gaia-X attribuisce molta importanza al ruolo della ‘domanda’ dei servizi digitali (e quindi alle necessità degli utilizzatori) e dei ‘data owner’ che sulle piattaforme digitali allocano i propri dati.

A tal fine Gaia-X propone lo sviluppo di un ecosistema digitale che, sulla base di regole definite e condivise dai diversi stakeholder, sia in grado di garantire adeguati livelli di ‘trust’ e sicurezza garantendo la piena adesione alle normative europee.

In questo ecosistema saranno naturalmente ospitati anche, ma non solo, i Data Spaces individuati come strategici dalla Commissione Europea.

Concretamente Gaia-X propone una architettura aperta e federata di sistemi ‘cloud’ e ‘edge’ che, costituita da hub nazionali interconnessi e basata su standard comuni,’ best practices’, strumenti e meccanismi di governance, garantisca per i dati e i servizi ivi ospitati:

  • PORTABILITÀ
  • INTEROPERABILITÀ
  • TRASPARENZA CONTRATTUALE
  • CYBERSECURITY
  • INTERCONNETTIVITÀ

Elemento fondamentale del modello concettuale su cui si fonda Gaia-X è la definizione del concetto di Asset che si associa sia a strutture fisiche (i Nodi ovvero tutte le entità dotate di capacità computazionali e le Interconnessioni fra i nodi) sia a strutture logiche (i Dati organizzati in ‘data spaces’ secondo la Strategia europea dei dati e il Software rigorosamente basato su tecnologie ‘open source’).

Vi è pertanto, nella visione di Gaia-X, il riconoscimento dei ‘Dati’ come uno degli Asset fondamentali.

Molto schematicamente la architettura di Gaia-X può essere quindi vista come la interazione di due ecosistemi: le infrastrutture e i dati.

Questi due ecosistemi vengono interconnessi mediante i cosiddetti Federation services (Identity and Trust, Federated Catalogue, Sovereign Data Exchange and Compliance) che, sviluppati con logiche open source, costituiscono il collante di quella struttura federata di hub interconnessi e allineata ‘by-design’ al quadro normativo europeo cui abbiamo fatto precedentemente riferimento.

Gaia-X ha inoltre definito delle Policy Rules ed un sistema di Label che serviranno a garantire adeguati livelli di ‘trust’ dei servizi offerti, con criteri crescenti di ‘assurance’ per rispondere ai diversi livelli di rischio.

In altre parole, un utilizzatore di servizi digitali potrà scegliere, mediante la lettura della Label associata a ciascun servizio, ciò di cui ha bisogno avendo piena e trasparente consapevolezza di quanto i servizi a catalogo mettono a disposizione, in termini di sicurezza, portabilità, interoperabilità.

Per accelerare lo sviluppo e la offerta di servizi ‘Gaia-X compliant’ la fondazione Gaia-X AISBL ha proposto ed ha contribuito alla definizione delle Gaia-X Digital Clearing Houses.

Si tratta in particolare di aziende che si candidano per offrire risorse computazionali ed ambienti elaborativi dove si possa verificare, con la governance di Gaia-X AISBL, il rispetto delle regole di Gaia-X per i servizi digitali che si candidano a diventare parte dell’ecosistema Gaia-X.

In questo modo, con lo sviluppo della proposta architetturale di Gaia-X e con il ruolo delle Clearing Houses, si renderà disponibile, a livello europeo e non solo, un ecosistema digitale in cui potrà prosperare una ‘data economy’ in grado di assicurare sovranità, trasparenza, apertura, interoperabilità e portabilità dei dati.

Articolo a cura di Aniello Gentile

Profilo Autore

Dopo la laurea con lode in Ingegneria Elettronica nel 1980 presso l’Università Federico II di Napoli, Aniello Gentile ha svolto attività di ricerca presso il Centro di Ricerca Olivetti per Tecnologie Meccaniche e Automazione (RTM) di Vico Canavese (TO).
Nel 1981 ha iniziato la sua attività in Enel nell’area dello sviluppo ICT dove ha gestito progetti di telecomunicazione e automazione, anche con l’impiego di tecnologie di Artificial Intelligence per il controllo ‘unattended’ delle sale calcolo.
Dal 1990 ha occupato ruoli direzionali nel settore delle Operations ICT di Enel, dove è stato responsabile della gestione dei Data Center, del Release Management, dell’End User Support.
Dal 2014 al maggio 2023 è stato direttore nella unità Global Cyber Security di Enel contribuendo a tutte le principali iniziative dell’area tra le quali la progettazione di un nuovo Framework di Cybersecurity e la definizione della metodologia Cyber Risk Analysis.
Da maggio 2023 svolge attvità indipendente di supporto consulenziale sui temi della economia dei dati e della cybersecurity.
Nel corso della sua carriera ha partecipato e contributo a numerose organizzazioni e manifestazioni internazionali.
È stato presidente e relatore in numerosi convegni ed eventi internazionali sulla Cyber Security e su Infrastrutture critiche (IBM Interconnect 2016, PowerGen 2017, SeltaChallenge 2017, I-COM Public Conferenza 2018, Electrify Europe2018).
Nel gennaio 2018 è entrato a far parte del Consiglio Direttivo della Sezione Information Technology di Unindustria Lazio.
Da aprile 2018 a maggio 2020 è stato uno dei ‘co-chairs’ del Working Group SWIPO (SWItching provider and POrting of data), organizzato dalla Commissione europea con l’obiettivo di sviluppare codici di condotta per facilitare il ‘porting’ dei dati tra diversi Service Cloud Provider al fine di ridurre i rischi di ‘lock-in provider’.
Nel giugno 2018 è entrato a far parte del gruppo di lavoro del World Economic Forum per “Systems of Cyber Resilience: Electricity”.
Da maggio 2020 al maggio 2023 è stato membro dell’Executive Board di SWIPO AISBL, associazione ‘no-profit’ fondata per sviluppare, mantenere e favorire l’adozione di tali codici di condotta nel mercato dei servizi cloud.
Nel giugno del 2021 è stato eletto per la prima volta nel Board of Directors dell’associazione europea Gaia-X, l’iniziativa europea che mira a definizione di un’infrastruttura cloud federata allineata ai valori della strategia europea dei dati. Tale mandato è stato successivamente rinnovato nella Assemblea Generale del giugno 2023.
Nell’agosto 2022 è entrato a far parte del Gruppo Tecnico di Confindustria “Digitale per la competitività del sistema industriale”.
Dal dicembre 2022 fa parte della commissione Data Center e Cloud dell’Ordine Ingegneri di Roma e Provincia.
Da marzo 2023 è Consigliere di Confindustria Servizi lnnovativi e Tecnologici (CSIT) , dove ha la delega per le politiche europee per lo sviluppo dei servizi innovativi.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/modelli-globali-di-governance-per-la-protezione-e-la-sicurezza-dei-dati-la-proposta-gaia-x/