Superare le sfide dei dati nell’Intelligenza Artificiale
L’intelligenza artificiale è un mostro vorace e assetato di dati. Sfortunatamente, i problemi legati ai dati – qualità, quantità, velocità, disponibilità e integrazione con i sistemi di produzione – continuano a persistere come un ostacolo importante al successo dell’implementazione aziendale di questa tecnologia.
I requisiti sono facili da capire, ma notoriamente difficili da eseguire: fornire input utilizzabili e di alta qualità per le applicazioni e le funzionalità di intelligenza artificiale nel posto giusto in modo affidabile, sicuro e tempestivo (spesso in tempo reale). Quasi un decennio dopo che la sfida è diventata evidente, molte imprese continuano a lottare con i dati di intelligenza artificiale: troppi, troppo pochi, troppo sporchi, troppo lenti e isolati dai sistemi di produzione. Il risultato è un panorama di colli di bottiglia diffusi nella formazione, nell’inferenza e nell’implementazione più ampia, e, più seriamente, un scarso ritorno sull’investimento.
Secondo gli ultimi studi di settore, i problemi legati ai dati sono alla base del tasso di successo basso e stazionario (circa il 54%, secondo Gartner) nel trasferire le prove di concetto (POC) e i progetti pilota di intelligenza artificiale aziendale in produzione. I problemi legati ai dati sono spesso alla base di problemi correlati alla conformità normativa, alla privacy, alla scalabilità e agli eccessi di costo. Questi possono avere un effetto raffreddante sulle iniziative di intelligenza artificiale, proprio mentre molte organizzazioni contano sulla tecnologia e sui gruppi aziendali per offrire rapidamente vantaggi aziendali e competitivi significativi dall’intelligenza artificiale.
La chiave: disponibilità dei dati e infrastruttura di intelligenza artificiale Data l’aspettativa crescente di CEO e consigli di amministrazione per guadagni a due cifre in termini di efficienza e fatturato da queste iniziative, liberare il controllo dei dati sull’espansione e l’industrializzazione dell’intelligenza artificiale deve diventare una priorità strategica per le imprese.
Ma come? Il successo di tutti i tipi di intelligenza artificiale dipende fortemente dalla disponibilità, dalla capacità di accedere a dati utilizzabili e tempestivi. Ciò, a sua volta, dipende da un’infrastruttura di intelligenza artificiale in grado di fornire dati e facilitare facilmente l’integrazione con l’IT di produzione. Porre l’accento sulla disponibilità dei dati e su un’integrazione rapida e fluida con i sistemi aziendali aiuterà le organizzazioni a fornire applicazioni e funzionalità di intelligenza artificiale più affidabili e utili.
Per capire perché questo approccio abbia senso, prima di passare alle soluzioni, diamo uno sguardo ai problemi legati ai dati che soffocano l’intelligenza artificiale e le iniziative delle imprese:
Qualità dei dati: I dati sporchi, incompleti o inaccurati possono compromettere seriamente l’efficacia e l’affidabilità dei modelli di intelligenza artificiale. Le organizzazioni devono investire tempo e risorse nella pulizia e nel miglioramento della qualità dei dati per garantire che i modelli di intelligenza artificiale producano risultati accurati e affidabili.
Quantità di dati: L’intelligenza artificiale richiede grandi quantità di dati per funzionare in modo efficace. Tuttavia, molte organizzazioni faticano a raccogliere e gestire enormi quantità di dati provenienti da fonti diverse. È essenziale creare un ecosistema di dati ben organizzato e scalabile per sfruttare appieno i benefici dell’intelligenza artificiale.
Velocità dei dati: La velocità con cui i dati vengono generati, elaborati e utilizzati dall’intelligenza artificiale può avere un impatto significativo sull’efficacia delle applicazioni e delle funzionalità. Le organizzazioni devono assicurarsi che i loro sistemi di intelligenza artificiale possano gestire e analizzare rapidamente i dati per produrre risultati tempestivi e pertinenti.
Disponibilità dei dati: L’accesso ai dati è un prerequisito fondamentale per l’intelligenza artificiale. Tuttavia, molte organizzazioni devono affrontare problemi di accesso ai dati a causa di silos informativi, problemi di privacy e restrizioni normative. Le imprese devono lavorare per eliminare questi ostacoli e garantire che i dati siano facilmente accessibili a tutti i team e le funzioni che ne hanno bisogno.
Integrazione con i sistemi di produzione: L’intelligenza artificiale deve essere ben integrata con i sistemi di produzione per offrire vantaggi pratici. Molte organizzazioni incontrano difficoltà nell’integrare l’intelligenza artificiale con i loro sistemi esistenti, il che può ostacolare l’adozione e l’implementazione di soluzioni basate sull’intelligenza artificiale.
Per affrontare questi problemi, le organizzazioni devono concentrarsi su due aree chiave: migliorare la disponibilità dei dati e costruire un’infrastruttura di intelligenza artificiale solida e flessibile. Alcuni passi che le organizzazioni possono intraprendere includono:
Implementare soluzioni di data governance per garantire la qualità, la coerenza e la sicurezza dei dati.
Investire in tecnologie di big data e data lake per organizzare, archiviare e gestire grandi volumi di dati provenienti da diverse fonti.
Adottare piattaforme di intelligenza artificiale scalabili e modulari che facilitino l’integrazione con i sistemi di produzione esistenti.
Creare processi e politiche per garantire la condivisione e l’accesso ai dati tra i vari team e funzioni all’interno dell’organizzazione.
Formare il personale su come utilizzare l’intelligenza artificiale e incoraggiare una cultura di apprendimento continuo per mantenere le competenze rilevanti e aggiornate.
Collaborare con partner e fornitori esterni per accedere a nuove fonti di dati e competenze tecniche.
Implementare misure di sicurezza e privacy dei dati per proteggere le informazioni sensibili e conformarsi alle normative sulla protezione dei dati.
Monitorare e valutare regolarmente l’efficacia e la precisione dei modelli di intelligenza artificiale per garantire che forniscano risultati affidabili e aggiornati.
Sperimentare e innovare con nuove tecniche e metodologie di intelligenza artificiale per mantenere un vantaggio competitivo nel mercato in rapida evoluzione.
Adottare un approccio etico e responsabile all’uso dell’intelligenza artificiale, tenendo conto delle implicazioni sociali, economiche e ambientali delle tecnologie basate sull’intelligenza artificiale.
Affrontando questi problemi e mettendo in atto queste strategie, le organizzazioni possono sfruttare al meglio l’intelligenza artificiale e cogliere le opportunità offerte da questa tecnologia rivoluzionaria. Attraverso un’adozione intelligente e responsabile dell’intelligenza artificiale, le imprese possono migliorare l’efficienza, aumentare la produttività, ridurre i costi e sviluppare nuovi prodotti e servizi innovativi, migliorando così la loro posizione nel mercato globale.
Articolo a cura di Michele Russo
Profilo Autore
Un’esperienza di oltre 20 anni nel settore IT, nello sviluppo e nella gestione di soluzioni Enterprise per alcune tra le maggiori istituzioni finanziarie italiane e su progetti di integrazione di soluzioni informative multi tenant ad alto impatto tecnologico. Ho un background aziendale eterogeneo con particolari competenze nella gestione e nel controllo del ciclo di vita dei progetti nonché nell’applicazione della metodologia di Enterprise Architecture. Attualmente ricopro il ruolo di Chief of IT Architecture and Technology presso IBL Banca S.p.A.
Risk Management e Data Modeling, una sinergia irrinunciabile
Appare oramai sempre più chiaro che, nelle organizzazioni, il risk management è un elemento irrinunciabile per l’attuazione di strategie di governance aziendale coerenti con il contesto, per la prevenzione di violazioni dei requisiti di compliance e per una preparazione efficace alla gestione degli incidenti. Di fatto, l’approccio GRCI – per l’appunto Governance, Risk Management, Compliance, Incident Handling – si configura come un utile modello a supporto del principio di accountability, che pervade le normative cogenti e volontarie a presidio di differenti materie con le quali le organizzazioni sono chiamate a confrontarsi. Basti pensare alla regolamentazione relativa alla responsabilità amministrativa per le organizzazioni, alla tutela dell’ambiente, alla salute e sicurezza sul lavoro, alla protezione dei dati personali, alla prevenzione dei reati informatici e alle best practices finalizzate a garantire la continuità operativa. Tutti ambiti in cui la gestione del rischio gioca un ruolo fondamentale.
Le aree critiche del risk management
Nonostante il risk management sia entrato a pieno titolo nella sfera della cogenza normativa, in alcuni casi ormai da molti anni, seguita però a rappresentare motivo di tentennamento per molte organizzazioni, che si arenano del tutto, oppure subiscono un rallentamento cronico nell’attuazione del processo. Ciò, a sua volta, genera un disallineamento tra l’attualità del contesto aziendale e l’output restituito dal processo stesso, perennemente anacronistico o comunque spesso un passo indietro.
Le ragioni sono spesso riconducibili ad alcune argomentazioni ricorrenti. Al primo posto bisogna annoverare l’incapacità delle metodologie diffuse di fornire rappresentazioni concrete, attraverso l’espressione del rischio in formato economico. Le scale qualitative spesso impiegate risultano poco comprensibili o attraenti per i soggetti che invece godono dell’autorità di spesa; insomma manca quasi sempre l’ultima cifra in basso a destra, che AD e CDA ben comprendono. Poi c’è il problema della verosimiglianza del concretizzarsi degli scenari di rischio presi in esame. Elemento che se da un lato soffre una profonda differenza di interpretazione tra il management ed i vertici aziendali, dall’altro è ingiustamente considerato quale peso di paritaria importanza rispetto alla gravità di accadimento di eventi dannosi, generando enfasi o deresponsabilizzazioni ai limiti del ridicolo. Leve, queste, solitamente impiegate per screditare la valenza dell’attività stessa.
Doveroso segnalare anche la profonda frattura tra le indicazioni normative fornite circa il risk management e le metodologie di riferimento da impiegare. Di fatto l’incarico di colmare questo divario è demandato ai poli formativi (università, centri di formazione) associazioni e ai consulenti, troppo spesso, più o meno bene preparati sulla specifica materia oggetto di riflessione, ma un po’ impacciati sul risk management.
Così procedendo, tempi e costi di attuazione del processo lievitano, rendendo quasi plausibile l’affermazione scellerata, ma da molti sposata, secondo la quale possa costar meno pagare la sanzione oppure i danni dell’incidente piuttosto che cercare di prevenirli.
Zone d’ombra dei sistemi tecnologici di supporto e proposte risolutive
Ma in tutto questo, la tecnologia che fine ha fatto? Praticamente, non pervenuta. Il mercato offre prodotti di risk management che possono essere più o meno classificabili secondo tre categorie principali: i gratuiti o low cost, in alcuni casi così semplici(stici) negli aspetti presi in considerazione, tanto da risultare praticamente inutili, i tool a pagamento (con costo ancora accessibile) che però sono molto difficilmente personalizzabili al contesto e alle caratteristiche dell’organizzazione che intende utilizzarli e difficilmente impiegabili per adottare un approccio olistico alla gestione del rischio, ed in ultimo i tool a pagamento (dal costo inaccessibile), ovviamente riservati solo alle grandi organizzazioni. Risultato? Un foglio di calcolo singolo, con poche tabelle regna sovrano, con risultati anche in questo caso pressoché inutili.
Quindi risulterebbe nient’affatto deprecabile l’ipotesi secondo cui sarebbe meglio che ciascuna organizzazione pensasse a sviluppare la propria soluzione. Ma perché ciò possa essere realizzabile, producendo risultati utili, occorre tenere bene in considerazione un aspetto fondamentale: la metodologia di valutazione e trattamento del rischio impiegata non può esimersi dallo sconfinare e cooperare con la definizione del data modeling che le sarà di supporto; pena la rigidità del risultato – in caso di prevalenza del metodo – o la depersonalizzazione del metodo impiegato – in caso di prevalenza della struttura dei dati adottata dallo strumento. Errore, questo, non così poco diffuso e che, nel corso dell’ultimo ventennio, ha notevolmente contribuito ad indebolire la consapevolezza circa il fatto che la tecnologia impiegata, perché risulti proficua, deve essere piegata al processo progettato. Quindi, le caratteristiche che la contraddistinguono, non dovrebbero mai finire per modificare o alterare il processo in questione.
Multidimensionalità dell’informazione e conclusioni
La realtà si esprime con dati. E insieme di dati costituiscono informazioni, utili per capire e decidere le azioni da intraprendere. Tanto più i set di dati sono organizzati in entità ben stabilite, correlate tra loro attraverso vincoli espliciti e arricchite per mezzo di molteplici attributi, tanto più tenderanno a raccontare la realtà in modo completo e comprensibile. La nostra geometria ci insegna a descrivere oggettivamente un ambiente con tre dimensioni: lunghezza, altezza e profondità. Ma se cambiamo il punto di vista nello spazio abbiamo la possibilità di ottenere differenti declinazioni dello stesso ambiente. Basti pensare alle informazioni relative ai rischi come un cubo. Ognuna delle sei facce consente di inquadrare “il problema” da un punto di vista differente. Coloro i quali hanno conservato qualche reminiscenza degli studi di filosofia ricorderanno il mito della caverna di Platone: la realtà è una copia di un’idea originaria, visione parziale vincolata al punto di vista occupato da colui che la percepisce. In modo più concreto, analizzando ad esempio i rischi sulla sicurezza di un cluster omogeneo di informazioni, i process owner vorranno comprendere la situazione adottando una visione per processo, l’IT tenterà di avere una visione per asset fisici – “pezzi di ferro” -, un DPO vorrà vedere se e quali rischi riguardano i trattamenti di dati personali. Tutti punti di vista differenti ma legittimi. Però, in assenza di un coordinamento sul data modeling di supporto, il processo rischia di essere attuato in modo indipendente da tutti gli attori coinvolti, con duplicazioni rischiose in termini di efficienza ed incoerenze di input ed output resi inefficaci.
Se attualmente risulta complesso plasmare conoscenze e competenze per un risk manager, immaginiamo quanto potrà essere complesso integrarle con quelle che appartengono al mondo del data management. Ma non impossibile; piuttosto, doveroso. Nel mentre, in attesa di framework tecnico-operativi attendibili e più attenti alla modellazione dei dati, il tentativo di prendere un po’ di confidenza con le tabelle pivot di Excel, sarebbe un primo significativo passo in avanti.
Articolo a cura di Alberto Buzzoli
Profilo Autore
Promuove sinergia, creatività ed innovazione progettando metodologie e strumenti per connettere strategie di business, modelli d’organizzazione, sistemi di gestione e tecnologie dell’informazione. Si occupa di governance aziendale, risk management, compliance e incident handling – formazione specialistica e comunicazione incluse – in ambito di sicurezza integrata, con particolare approfondimento in materia di sicurezza delle informazioni e protezione dei dati personali. E’ specializzato nella progettazione e nell’auditing di servizi CRM per il mercato bancario, assicurativo e finanziario. Nel 2012 ha fondato la community di professionisti INTOUT – In Mind Innovation, con l’obiettivo di integrare know how eterogenei in un unico centro di competenza, favorendo lo sviluppo e la divulgazione di soluzioni sempre nuove ed utili, volte ad incrementare la cultura delle organizzazioni e la maturità dei modelli impiegati nei processi di analisi e gestione dei rischi.
Algocrazia, sicurezza e protezione dati: tra black box e sorveglianza di massa, avanza il bisogno dell’Algoretica
La parola “algocrazia”, nota già dalla fine degli anni Novanta, negli ultimi tempi ha iniziato a farsi strada nel dibattito tecno-politico globale animando numerosi interrogativi rispetto ai profili etici, giuridici e di cybersecurity che la accompagnano.
Il termine è stato coniato dal sociologo della globalizzazione Aneesh Aneesh, che nel paper del 2002 ”Technologically Coded Authority” lo utilizza nel senso di «rules of the code (or of an algorithm) as an organizational model capable of replacing the rules of an office», anticipando il profilarsi di un sistema di governance in cui l’autorità è sempre più incorporata nella tecnologia.
Oggi indica “il crescente utilizzo degli algoritmi informatici e dell’intelligenza artificiale al fine di esercitare il controllo su qualsiasi aspetto della vita quotidiana” (dal vocabolario Treccani). Nell’arco di vent’anni il concetto di algocrazia ha quindi assunto – tanto sul piano semantico quanto nella percezione sociale – una connotazione via via più negativa, finendo per coincidere con l’ipotesi distopica di un abuso della tecnologia in danno dei diritti e della sicurezza delle persone.
Algoritmi ovunque: sorveglianza di massa, giustizia predittiva e risvolti etici delle tecnologie AI
L’idea di una crescente “onnipresenza” degli algoritmi non è certamente una cospirazione infondata. Di fatto la capacità di elaborare in tempi rapidissimi enormi quantità di dati ha reso questo strumento la base fondante di innumerevoli tecnologie di uso quotidiano, prime fra tutte le piattaforme social su cui ogni giorno miliardi di persone lavorano, si informano e comunicano tra di loro.
Dalla sanità alla giustizia, dall’istruzione al controllo delle frontiere, sono poi moltissimi gli ambiti in cui governi, istituzioni pubbliche e organizzazioni sovranazionali delegano importanti scelte a una o più “rules of the code”.
Ciò permette di ottimizzare flussi di lavoro e servizi di ogni tipo, anche grazie alle sempre più sofisticate capacità di “autoapprendimento” che caratterizzano i sistemi AI/ML. Ma è evidente come questa tendenza legittimi molte riserve: specie rispetto al concreto rischio che tali sistemi, riproducendo i bias che potrebbero caratterizzare i dati con cui sono alimentati, finiscano per replicare discriminazioni di varia natura ovvero per facilitare pratiche di sorveglianza digitale su oppositori politici o giornalisti (non solo negli Stati autoritari, come dimostra il recente caso dello spyware Predator in Grecia su cui attualmente indaga la Procura Europea).
Per comprendere quanto tali sistemi possano avere impatti rilevanti anche su persone comuni basti pensare alle misure adottate durante la pandemia da Covid-19, quando molti Paesi hanno scelto di affidarsi agli algoritmi per mappare i contagi e contenere la diffusione del virus, suscitando diverse critiche in termini di privacy individuale; o alla gestione dei flussi migratori diretti verso gli Stati occidentali, dove l’automazione dei controlli e la raccolta massiccia di dati biometrici minacciano i diritti fondamentali delle persone coinvolte.
Ulteriori e delicati ambiti applicativi dei sistemi AI sono l’E-justice e il cosiddetto predictive policing, nei quali i dubbi circa l’eticità di scelte sganciate da ogni valutazione umana – per sua natura incline a cogliere sfumature impossibili per una macchina – si sommano alle ormai solide ricerche che espongono la scarsa affidabilità e il potenziale gravemente discriminatorio di decisioni automatizzate ammesse in settori così complessi.
Lacune giuridiche e sviluppi in campo di Data Protection
Il rischio di abusi è in parte amplificato dal fatto che l’uso degli algoritmi (particolarmente nei sistemi di Intelligenza Artificiale) rappresenti ancora una “zona grigia” nel diritto positivo. Sebbene esistano da decenni, infatti, questi strumenti restano ancora in larga parte privi di una specifica disciplina giuridica.
Il quadro sta cambiando in forza di numerose iniziative legislative, tra cui l’AI Act in attesa di approvazione del Parlamento UE; ma per adesso il principale argine allo “strapotere degli algoritmi” è rappresentato dalla normativa sulla protezione dei dati personali.
Ovvero, nel contesto europeo, dal GDPR: poiché per il loro funzionamento è necessario raccogliere, archiviare, trattare (e talvolta diffondere) importanti moli di informazioni, questi strumenti possono spesso andare contro le previsioni in tema di Data Protection, come avvenuto nel conflitto tra OpenAI e il Garante della privacy.
In Italia, sempre in forza del Regolamento, il tema inizia a essere oggetto di attenzione anche da parte del legislatore. Ne è esempio il cd. Decreto Trasparenza del 2022, il quale prevede specifici obblighi informativi a carico del datore di lavoro che utilizzi “sistemi decisionali o di monitoraggio automatizzati […] ai fini dell’assunzione o del conferimento dell’incarico, della gestione o della cessazione del rapporto di lavoro”, imponendo inoltre puntuali valutazioni d’impatto rispetto all’impiego di tali sistemi.
Il valore degli algoritmi per la sicurezza informatica (e non solo)
Fra le numerose applicazioni dei sistemi di AI a base algoritmica vi è la sicurezza informatica, ove da tempo sono impiegati per il monitoraggio di reti e sistemi nonché per attività di Threat Detection e Offensive Security.
I citati e condivisibili timori non escludono, infatti, l’utilità degli algoritmi in alcuni specifici contesti. Eppure anche qui essi possono rivelarsi armi a doppio taglio: come osservato rispetto ad altri campi di applicazione, l’impiego di algoritmi non sicuri o dataset viziati da pregiudizi di vario tipo rischia di inficiare interi processi o prodotti applicati su larga scala, con immaginabili conseguenze a livello di sicurezza personale, aziendale e perfino nazionale.
Va infatti considerato come il crimine informatico abbia imparato da tempo ad approfittare dell’automazione, in particolare di LLM come ChatGPT, per definire attacchi basati sul linguaggio (soprattutto di tipo BEC – Business Email Compromise) sempre più mirati, oltre che – nel caso di hacktivism o attori Nation-State – per “inquinare” l’opinione pubblica diffondendo propaganda politica e disinformazione in rete.
Di recente anche l’ENISA ha ribadito l’urgenza di uniformare e irrobustire gli standard di cybersecurity per l’AI: reali vantaggi sembrano allora poter discendere solo da un approccio prudente, che sappia cogliere le opportunità tecnologiche senza ignorare il pericolo di usi distorti o vulnerabilità ancora ignote.
Dall’opacità delle black box all’Ethical AI
La natura proprietaria della maggior parte degli algoritmi impiegati nei sistemi di AI impedisce, infatti, ad autorità pubbliche e ricercatori indipendenti di indagarne a fondo il funzionamento e i potenziali difetti, così portando a un’oggettiva mancanza di trasparenza circa queste “black box” dotate di grandissimo potere.
Dubbi e riserve in merito al crescente dominio algoritmico sembrano condivisi addirittura da personalità in prima linea nel loro sviluppo: come dimostra la discussa proposta di una moratoria di sei mesi nell’addestramento dei sistemi AI per consentire di sviluppare regole condivise e controlli di sicurezza volti a prevenirne i rischi, avanzata da Elon Musk insieme ad altri noti nomi della tech industry globale.
Sebbene per diversi critici si tratti di una strategia comunicativa più che di autentici scrupoli morali, la richiesta di privilegiare la ricerca sull’Ethical AI e lo stratificarsi del dibattito in materia confermano come l’algocrazia sia molto più di una parola temporaneamente alla moda, rappresentando al contrario uno dei campi su cui si giocheranno importanti sfide tecnologiche e culturali del prossimo futuro.
Cybersecurity per le infrastrutture critiche: una panoramica degli strumenti impiegati nel settore nucleare
Introduzione
La cyber sicurezza per le infrastrutture critiche presenta delle peculiarità che vanno approfondite con un approccio diverso rispetto alla normale attività di un SOC. Abbiamo pertanto considerato il settore “critico” per eccellenza che una potenziale riuscita di un cyber attacco implica per i risvolti ambientali, psicologici sulla popolazione, economici e di security&safety. Come viene affrontata e valutata la cyber resilienza nel settore nucleare e su quali linee guida e standards specifici si basa è lo scopo che ci prefiggiamo per fornire a chi si occupa di altre infrastrutture critiche spunti di riflessione e di confronto.
Come è definita una Infrastruttura Critica
A seguito degli attentati del 11 settembre 2001 e a seguire con gli attacchi terroristici verificatesi in Medio Oriente, Inghilterra, Francia USA e Spagna, il termine infrastruttura critica ha assunto sempre più valore in contesti più diffusi dell’economia e politica nazionale.
La definizione riportata all’art. 2 della Direttiva della Commissione Europea [1] definisce come infrastruttura critica:
“…un bene, un sistema o parte di esso situato negli Stati membri che è essenziale per il mantenimento delle funzioni sociali vitali, della salute, della sicurezza, dell’incolumità, del benessere economico o sociale delle persone e la cui interruzione o distruzione avrebbe un impatto significativo in uno Stato membro a causa del mancato mantenimento di tali funzioni”.
La lista dei settori ove individuare le infrastrutture critiche è riportata nell’ Allegato della Direttiva e sostanzialmente considera 11 settori primari, tra i quali spiccano i seguenti settori: Energia, Trasporti, Settore Bancario e Finanziario, Salute, Acqua, Infrastrutture digitali, Spazio.
Tale nuova lista integra ed espande la precedente direttiva 2008/114/CE e tende ad uniformarsi con le linee guida di nazioni come gli Stati Uniti. Una lista più articolata viene infatti fornita dalla Agenzia Americana di Cybersecurity CISA per un totale di 16 aree di infrastrutture critiche [2].
Purtroppo in tutti gli ambiti menzionati, una crescente attenzione alla security è stata necessaria a partire dagli attacchi terroristici del 2001.
Agli attacchi fisici si sono sempre più aggiunti altre tipologie di minacce e la minaccia cibernetica ha sempre più aumentato la propria influenza poiché ai terroristi si sono aggiunti criminali, Stati, etc. per scopi diversi, che vanno dalle richieste di pagamento di riscatto ad azioni di spionaggio fino a situazioni di vere e proprie cyber war.
Storia dei principali attacchi cyber nel settore nucleare
L’infrastruttura nucleare, considerata sia a livello tecnico che come impatto sociale è una fra le più critiche, ed è da sempre stata oggetto di minacce. Ovviamente dal dominio cyber non potevano mancare ulteriori spunti di preoccupazione. Rispetto ad altri settori, ove gli attacchi hanno generato danni consistenti e prolungati nel tempo, il settore nucleare ha finora risposto in maniera determinata e risolutiva probabilmente a causa dei propri intrinsechi elevati standards di sicurezza. Ciò non di meno in alcuni casi gli attacchi sono stati particolarmente sofisticati e molto dannosi seppur non impattanti l’area critica del processo produttivo.
Nella Tab. 1 vengono elencati i principali e noti attacchi informatici a strutture nucleari e relative conseguenze.
Anno
Centrale NPP
Tipo di attacco
Danni subiti
2003
Davis-Besse
Slammer worm
Sistemi di visualizzazione dei parametri di sicurezza inaccessibili agli operatori
2006
Browns Ferry
Overflow del Sistema di controllo di processo e PLC basati su Ethernet
La semplice incompatibilità della tecnologia può portare a incidenti informatici senza necessariamente comportare alcun intento doloso
2007
Aurora Generator Test c/o Idaho National Laboratory
Un computer prende il controllo tramite la vulnerabilità presente durante un esperimento.
Danneggiamento del generatore Diesel
2008
Hatch
Aggiornamento del software applicato ad un solo computer
Sistema bloccato
2010
Linea di arricchimento dell’uranio presso Natanz – Iran
Attacco tramite Stuxnet
Danneggiate circa 1000 centrifughe
2014
Monju – Japan
Attacco Malware
Furto di informazioni
2014
Gori – S. Korea
Attacco Malware
Furto di informazioni
2015
Ukrainian grid
Attacco tramite BlackEnergy3
Circa 6 ore di sistema offline
Tab. 1: Incidenti Cyber nel settore nucleare [3], [4]
Approccio strutturato di IAEA e WINS alla cybersecurity
La IAEA è l’Agenzia incaricata dall’ONU per la sicurezza nucleare a tutti i livelli. Oltre a funzioni ispettive e attività di ricerca, si occupa anche di formazione degli operatori e degli enti di regolamentazione nazionali, consulenza e attività di guida.
In particolare sono di riferimento per tutti gli operatori del settore nucleare le linee guida che IAEA emette sotto forma di Nuclear Security Series (NSS).
Il documento NSS N. 42-G riguarda la Computer Security for Nuclear Security [5].
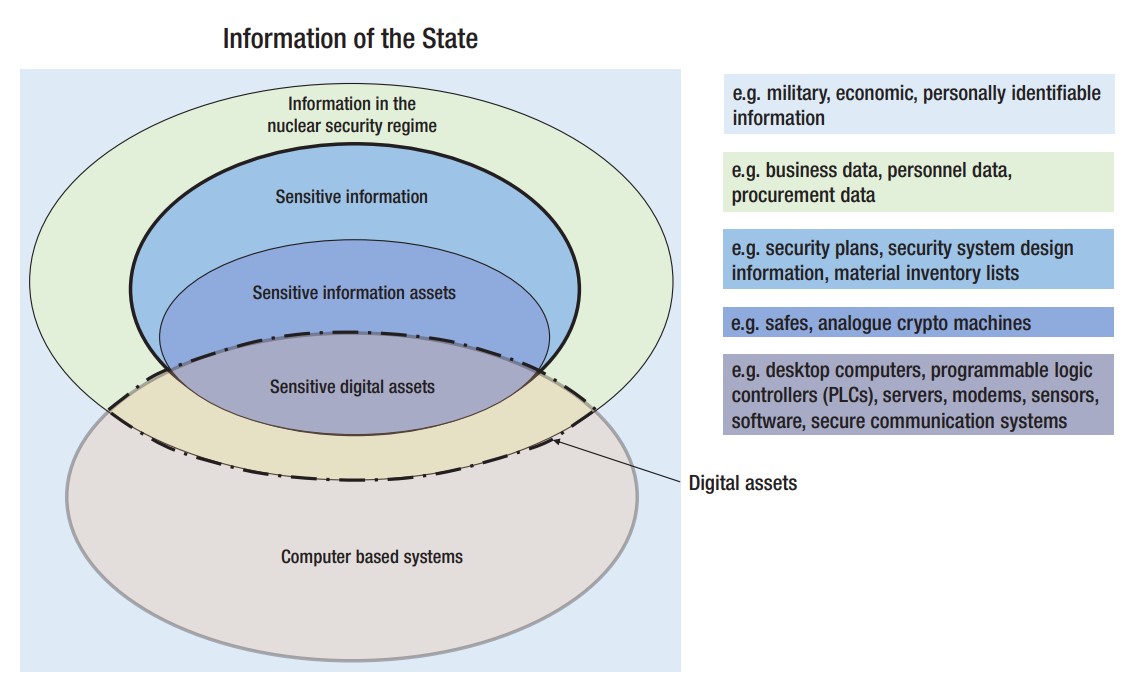
In tale documento è molto esplicativo il concetto di Information Security applicato nel settore nucleare confrontato con lo stesso concetto a livello di Stato. La Fig. 1 di tale linea guida identifica in maniera molto chiara l’evoluzione tra informazione critica e relativa security dal livello esterno fino alla area critica, ove la Operation Technology (OT) si fonde con la Information Technology (IT) ed evidenzia in concreto il più alto rischio in questa zona di mix di tecnologie (e possibili vulnerabilità).
Fig.1: Regimi di sicurezza delle informazioni digitali nello Stato e nel settore nucleare [5]
IAEA, sulla base delle criticità, definisce dei livelli per tutta l’area security e quindi applicabile anche alla area cyber che vanno dal livello 5 (requisiti minimi) al livello 1, ove è richiesta la massima protezione.
Oltre all’applicazione delle normali e approfondite tecniche di Incident Response e di una solida struttura SOC tipica di tutte le strutture di cybersicurezza, l’approccio per il nucleare presenta delle criticità specifiche che vedono in prima analisi l’inversione della regola C.I.A. (Confidentiality – Integrity – Avaliability) che normalmente si applica ai sistemi di information technology. La prima attività durante un Incident Response e Recovery per un sistema OT applicato al campo nucleare è la Avaliability: la compromissione di un sensore o di un loop di controllo è più critica rispetto alla Confidentiality (almeno nel momento di prima risposta all’incidente).
L’approccio alla valutazione del rischio indicato dalla IAEA trova maggior riscontro in varie linee guida o documenti mandatory. Uno schema di approccio ai potenziali rischi segue quanto indicato nella norma ISO/IEC 27005 [6]
In particolare il Word Institute for Nuclear Security (WINS) [7] pubblica varie linee guida sotto forma di Best Practice per il settore nucleare.
La BPG (Best Practice Guide) 4.11 [8] e la più dettagliata BPG 4.3 [9] forniscono gli elementi per una valutazione e risposta efficiente integrando aspetti di protezione fisica a processi di Incident Response tipici della cybersecurity, con il risultato finale di una accresciuta e complementare resilienza dell’impianto.
Il dominio cyber è trasversale a tutti gli altri domini. Questo significa che esso è intrinsecamente più pericoloso essendo la sicurezza complessiva dipendente dal livello di interdipendenza dei vari domini e risultando di fatto al valore più basso dei singoli.
L’effetto della crescente digitalizzazione ed automazione è di fatto un altro fattore da focalizzare. La necessità di mantenimento della superiorità tecnologica in molti settori ha portato di contro ad un aumento della possibile superficie di attacco e quindi all’aumento di potenziali vulnerabilità. Per le infrastrutture critiche, settore nucleare a maggior ragione, tali aspetti vanno verificati sia in fase di realizzazione del sistema informativo e di OT sia durante l’esercizio con appositi monitoraggi ed audits mirati. L’approccio DBT (Design Based Threat) utilizzato per lo sviluppo della security di facilities nucleari è a maggior ragione da applicare per gli aspetti IT e OT sia per il nucleare vero e proprio che per la filiera dei sistemi con un certo livello di radioattività, inclusi sistemi medicali, di controllo industriale e di gestione dei relativi trasporti.
In tal senso sono molte le linee guida emesse da IAEA e WINS e liberamente consultabili e molto utili per una verifica o progettazione del sistema informativo e di OT dell’infrastruttura.
Un altro aspetto molte volte trascurato e spesso inteso come conflittuale specialmente sulle infrastrutture critiche e il binomio Safety e Security: quale privilegiare?
Nella realtà dei fatti è dimostrato che entrambi gli aspetti sono da considerarsi e sviluppare in maniera parallela e concorrenziale per la salvaguardia del sistema infrastrutturale. Nel settore nucleare questo processo è ben integrato e anche in questo caso appositi documenti possono essere di riferimento per gli operatori. Il report INSAG-24 [10] emesso dalla IAEA affronta proprio gli aspetti di questa duplice sfida e che si può estendere a tutti i settori critici.
Modello di maturità delle capacità di sicurezza informatica (C2M2)
Per concludere questo breve excursus sugli strumenti di base per la creazione della consapevolezza di cybersecurity nel settore nucleare, un ulteriore strumento fortemente impiegato è l’audit (interno o tramite peer assessment) eseguito in base al modello di maturità delle capacità di cyber resilienza. ENISA (Agenzia Europea per la sicurezza delle reti e delle informazioni) ha di recente pubblicato un tool dedicato alla valutazione della maturità da parte degli Stati [11].
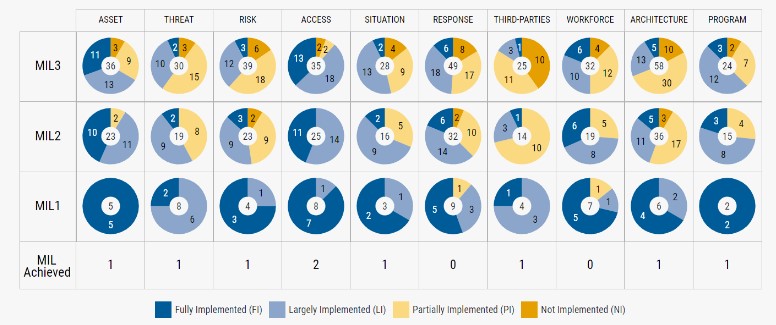
Un approccio più strutturato dedicato alle strutture energetiche critiche e molto utilizzato per il settore nucleare è il modello C2M2 sviluppato dal Dipartimento dell’Energia (DoE) degli Stati Uniti [12]. La messa a disposizione del modello C2M2 [13] implementabile immediatamente rende tale modello del DoE tra i più diffusi. La sua completezza nelle valutazioni delle varie aree potenzialmente vulnerabili (356 punti da valutare) lo rende inoltre un potente strumento nella valutazione della resilienza della struttura critica. La valutazione si basa su 10 domini che vengono sviluppati in questionari mirati e che toccato le seguenti aree di valutazione:
Asset, Change, and Configuration Management (ASSET)
Threat and Vulnerability Management (THREAT)
Risk Management (RISK)
Identity and Access Management (ACCESS)
Situational Awareness (SITUATION)
Event and Incident Response, Continuity of Operations (RESPONSE)
Third-Party Risk Management (THIRD-PARTIES)
Workforce Management (WORKFORCE)
Cybersecurity Architecture (ARCHITECTURE)
Cybersecurity Program Management (PROGRAM)
Per ciascuna area viene calcolato il relativo Livello Indicatore di maturità (MIL) da MIL0 a MIL3. Al completamento del percorso di valutazione, il risultato finale mostra lo stato di maturità nelle singole 10 aree, quali punti implementare e quali risultano critici. In Fig. un esempio tratto dal sito DoE [12]
Fig. 2: Esempio risultato della valutazione tramite il tool messo a disposizione dal DoE [13]
La valutazione mediante audit di terza parte o peer per quanto riguarda la resilienza cibernetica di una struttura operante nel settore nucleare prende spunto dalla guida IAEA [14], specifica per “Computer Security at Nuclear Facilities”. Se da un lato la base di tale guida è la norma ISO 27002 [15], l’adattamento alle esigenze di safety e security nel settore nucleare porta a considerare in ottica OT e di global security tutti i vari domini su cui tale valutazione si basa, la preparazione del personale coinvolto, le esercitazioni svolte o programmate, etc.
Una analisi C2M2 fatta internamente o in maniera peer permette facilmente di individuare le criticità e di risolverle in maniera più strutturata e consapevole prima di passare ad una verifica più formale.
Conclusioni
Il miglior modo di difendere le infrastrutture dal punto di vista security e cybersecurity è di accrescere la consapevolezza a tutti i livelli delle potenziali vulnerabilità e di come rispondere e mitigare gli effetti di un possibile attacco. Il settore nucleare è per propria natura quello che nel tempo è stato sia di deterrenza ma anche di richiamo per attori malevoli. L’impatto emotivo sulla popolazione civile di un possibile “guasto” o “cyberattacco” si decuplica se il settore interessato e quello nucleare. Nel tempo pertanto si è sviluppata una resilienza e consapevolezza dei rischi che in altri settori è stata in via embrionale fino ad anni più recenti. La panoramica delle linee guida, tools ed approcci mostrata in questo breve articolo si spera possa essere di confronto e di spunto per lo sviluppo della cyber resilienza in altri settori.
Bibliografia
[1] DIRETTIVA (UE) 2022/2557 DEL PARLAMENTO EUROPEO E DEL CONSIGLIO del 14 dicembre 2022 del Parlamento europeo e del Consiglio relativa alla resilienza dei soggetti critici e che abroga la direttiva 2008/114/CE del Consiglio.
[5] IAEA – NSS N. 42-G Computer Security for Nuclear Security – Implementing Guide – 2021
[6] ISO/IEC 27005:2022- Information security, cybersecurity and privacy protection — Guidance on managing information security risks, ISO, Geneva (2022)
[15] ISO/IEC 27002:2022- Information security, cybersecurity and privacy protection — Information security controls, ISO, Geneva (2022)
Articolo a cura di Alberto Monici
Profilo Autore
Dopo la Laurea in Ingegneria Elettronica al Politecnico di Milano e il Master in Information Technology presso il CEFRIEL, si è occupato di collaudi e prove tecnologiche in vari settori sviluppando al contempo software dedicati per applicazioni OT. A queste attività ha affiancato periodi di ricerca e studio sulle nuove tecnologie applicate a infrastrutture critiche e Structural Health Monitoring approfondendo tematiche di Machine Learning e Cybersecurity applicate a architetture OT/IT. Attualmente è CEO di ETS Sistemi Industriali e di ABtech Innovazioni e Consulenze Tecnologiche oltre che WINS Academy Ambassador for Italy.
Una riflessione preliminare sul processo di istituzionalizzazione della Cyber Intelligence
«There is nothing more necessary than good intelligence to frustrate a designing Enemy: and nothing that requires greater pains to obtain» George Washington a Robert Hunter Morris, 1 January 1756
«Cyber is such a perfect prefix. Because nobody has any idea what it means, it can be grafted onto any old word to make it seem new, cool and therefore strange, spooky” New York magazine, 23 December 1996
Aspetti concettuali e definitori propedeutici a un processo di istituzionalizzazione della cyber intelligence
L’attuale campo disciplinare della Cyber Security (CS) è connotato da un’inflazione di termini definitori di cui Cyber Threat Intelligence (CTI), Cyber Intelligence (CI) e Cyber Counter Intelligence (CCI) ne rappresentano esempi preclari. Tutti e tre, difatti, sono costrutti concettuali chiaramente collegati gli uni agli altri in quanto vi sono sì differenze sostanziali tra gli stessi ma vi sono altrettanti aspetti comuni, sia nei metodi di collazione delle informazioni che nel loro più generale modus operandi. Vi è da dire, inoltre, che le stesse definizione di CTI, CI e CCI che si ritrovano comunemente in documenti ufficiali, articoli scientifici, materiale divulgativo e pubblicitario non sono per nulla univoche e, dunque, con significativi gradi di variabilità interna. Una breve esposizione, di carattere definitorio, può senz’altro esemplificare tale aspetto.
Si può iniziare da quello relativo alla CTI in cui è centrale il concetto di minaccia la quale è «any circumstance or event with the potential to adversely impact organizational operations (including mission, functions, image, or reputation), organizational assets, or individuals through an information system via unauthorized access, destruction, disclosure, modification of information, and/or denial of service. Also, the potential for a threat-source to successfully exploit a particular information system vulnerability».
Una definizione di CTI, utilizzata da un fornitore di servizi, è la seguente: «Threat intelligence is data that is collected, processed, and analyzed to understand a threat actor’s motives, targets, and attack behaviors. Threat intelligence enables us to make faster, more informed, data-backed security decisions and change their behavior from reactive to proactive in the fight against threat actors».
In questo caso, l’accento è posto sull’acquisizione di dati mentre in una definizione utilizzata da una società di consulenza viene evidenziato l’aspetto della conoscenza basata sulle evidenze empiriche, dunque, con modalità non troppo dissimili dalla precedente. «Threat intelligence is evidence-based knowledge, including context, mechanisms, indicators, implications and actionable advice, about an existing or emerging menace or hazard to assets that can be used to inform decisions regarding the subject’s response to that menace or hazard».
In una terza definizione, essa è maggiormente incentrata sulle motivazioni, intenzioni e metodi messi in atto dagli attori malevoli. «Cyber threat intelligence is knowledge about adversaries and their motivations, intentions, and methods that is collected, analyzed, and disseminated in ways that help security and business staff at all levels protect the critical assets of the enterprise».
Se si passa a prendere in esame il costrutto di CCI si nota la stessa variabilità. Essa viene definita come «all efforts made by one intelligence organization to prevent adversaries, enemy intelligence organizations or criminal organizations from gathering and collecting sensitive digital information or intelligence about them via computers, networks and associated equipment».
In essa sono contemplate, in buona sostanza, tutte le misure atte a identificare, penetrare o neutralizzare le azioni dell’avversario e il focus è non solo sull’intrusione, ma anche sull’intento dell’attore malevolo e sulle modalità operative da questi utilizzate. Essa si connota, dunque, come un sottocampo della CI, di cui ne rappresenta una postura prettamente offensiva.
Il concetto di CI può essere inteso in termini più generali rispetto a quelli di CCI e CTI in quanto ci si riferisce agli «efforts made by intelligence organizations to prevent adversaries or enemy intelligence organizations from gathering and collecting sensitive information or intelligence about them».
In un’altra definizione l’accento è posto sulle modalità di raccolta delle informazioni, ovvero «the acquisition and analysis of information to identify, track, and predict cyber capabilities, intentions, and activities to offer courses of action that enhance decision-making».
Come si è potuto vedere da questa breve esposizione, ridotta solo per ragioni di spazio, vi sono concetti quali CI, CCI e CTI che si sovrappongono in parte tra di loro ma anche con una forte variabilità nell’utilizzo dello stesso termine.
Vi è, infine, da aggiungere che lo stesso concetto CI è interessato da tali ambiguità semantiche sia dal lato del concetto di “intelligence” il quale viene spesso utilizzato, in maniera intercambiabile, sia con quello di “dati” e di “informazioni sia con quello di cyber (spazio) il quale, anch’esso, viene spesso inteso come un sottocampo di quello di “Information Environment” (IE).
Tornando alla disamina dei tre costrutti concettuali della CI, CTI e CCI, nell’interpretazione degli stessi può essere utile far riferimento a quello che viene chiamato il ciclo dell’intelligence mediante il quale i dati grezzi vengono identificati, raccolti e poi sviluppati in informazione rifinita, messa a disposizione del processo decisionale. In questo senso, si può operare una suddivisione analitica tra intelligenza tattica, operazionale e strategica.
Facendo uso di questo framework operativo si può mettere in evidenza che la CTI sembra essere caratterizzata soprattutto da un livello tattico ed operazionale così come, a livello di scala, essa agisce tipicamente su un livello prettamente organizzativo, mentre la CI è caratterizzata da un livello strategico, in quanto è più legata a un focus olistico e, in qualità di attori, riguarda i vertici aziendali e i decisori politici a livello nazionale. La CTI mira, difatti, al rilevamento di possibili indicatori di minaccia al livello dell’analista operativo e, considerato il flusso continuo di dati, il suo utilizzo necessita di essere abbondantemente filtrato prima di essere utilizzato, come informazione strategica, dai responsabili delle decisioni strategiche.
La CCI, invece, è la stessa CI, intesa in maniera speculare, ovvero impiegata con una postura prettamente offensiva tesa a colpire le attività e le risorse degli avversari. È per questa ragione che il suo utilizzo è più sporadico e viene poco enfatizzata nei documenti ufficiali, negli articoli scientifici e nel materiale divulgativo in quanto tipicamente di competenza delle autorità militari e statuali, ovvero non nell’effettiva disponibilità delle imprese.
Del resto, tale interpretazione viene sottolineata anche in letteratura. «The focus on CTI is more due to a catch-phrase in marketing services than real understanding of the concepts. CTI as is provided cannot be considered true intelligence as it is a stream of data; it is not in context and it is limited in how actionable it is. Whilst network security devices and cyber security analysts can use CTI as an aid in detecting possible threats, the real intelligence is the analysis and interpretation of any indicators that have found matches in the network. Therefore, CTI on its own is of limited use; it needs to correlated with internal data (processing) to provide possible threat detections, which can then be analysed and interpreted to form an improved view of the threat environment».
Come si può evincere da questo lungo estratto la CTI si riferisce ai dati che vengono raccolti, elaborati e analizzati per comprendere le motivazioni, gli obiettivi e i comportamenti di attacco di un attore malevole. L’intelligence relativa alle minacce cibernetiche consente, difatti, di prendere decisioni di sicurezza basate sui dati le quali sono più rapide, più informate così come, più in generale, di cambiare il comportamento di difesa cibernetica da uno meramente reattivo a uno più proattivo. Si tratta di una tipica conoscenza basata sulle evidenze apportate dai dati, vale a dire data-driven, relativa alle minacce esistenti o emergenti o sui rischi per gli asset, sia essi aziendali oppure statuali.
Di tutt’altra natura, invece, l’essenza precipua della CI la quale si situa a un livello superiore e può racchiudere, dunque, al suo interno, come sottocampi specifici sia la CCI che la CTI. In questo senso, la CI riesce a ricomprendere al suo interno gli aspetti tattici e operazionali davvero importanti al fine di includere sia l’ambiente tecnologico e operativo delle minacce sia per identificare ciò che è legato al fattore umano ed è basato, dunque, su una serie di fattori organizzativi interni. Nello stesso tempo, la CI riesce ad esplicare tutta la sua funzione precipua al livello laddove vengono prese le decisioni strategiche, nell’interesse della nazione o dell’azienda.
Il passaggio da una conoscenza tipicamente tecnica e operativa a quella di più alto livello rappresenta un passaggio obbligato compiuto da tutte le discipline che, nel corso del loro sviluppo, hanno consolidato e sistematizzato vieppiù il loro background di conoscenze teoriche tanto da divenire un campo disciplinare ampiamente legittimato a livello internazionale, con un crescente peso all’interno dei boards aziendali e nei livelli apicali delle entità statuali, con propri percorsi di studi universitari, conferenze e riviste scientifiche dedicate. Il che vuol dire, sostanzialmente, l’aver contribuito a creare una diffusa comunità di esperti i quali si riconoscono in una serie di principi scientifici, codici deontologici e di tecniche operative.
È chiaro, dunque, che per un ulteriore consolidamento di un processo di istituzionalizzazione della tematica della CS appare rilevante accentuare, ancor di più, rispetto a quanto fatto finora gli aspetti legati alla CI. L’intelligence a tutto tondo da svolgere anche nel dominio cyber non può che basarsi sulla centralità di tale componente ed essa abbisogna di essere maggiormente innervata dalle competenze di altre discipline, siano esse appartenenti alle scienze “dure” ma anche a quelle latamente umanistiche. Tale percorso, del resto, è lo stesso compiuto, già in precedenza, dalla disciplina madre, ovvero quella degli studi dedicati all’Intelligence. Detto in altri termini, in un campo quale quello della CI dove sembrano predominare gli aspetti tecnico informatici e che da questi traggono la loro stessa esistenza materiale (reti, hardware, software, ecc..) potrebbe essere, invece, nondimeno utile fuoriuscire in direzione di un percorso nettamente multidisciplinare piuttosto che solo disciplinare, peraltro del tutto complementari.
Anche solo da un punto di vista della pratica professionale quotidiana le competenze apportare da altre discipline possono essere, in moltissimi casi, di estremo interesse per la CI, in quanto la metodologia per affrontare i problemi conoscitivi e i processi decisionali sono sostanzialmente gli stessi. L’intelligence è, allo stesso tempo, un prodotto e un processo di raccolta, elaborazione, analisi e utilizzo delle informazioni per soddisfare un obiettivo ben preciso.
In una conferenza del 2012 veniva messo in evidenza proprio questo aspetto comune a più discipline. «Professionals in other fields… also face many similar challenges to those that exist in intelligence analysis, including: difficulties acquiring information from a wide variety of sources, vetting and evaluating the information that is acquired, deriving understanding and meaning from that information, impact of deadlines, editing, and other production processes on accuracy of analysis and assessment, problems in dissemination and distribution to consumers or customers, managing relationship between producer and consumer (role, responsibility, independence & objectivity), developing professional infrastructure (recruit, select, train, & develop personnel; code of ethics), and overcoming impact of changing technology and alternative information distribution systems. How do practitioners in various non-intelligence fields overcome these kinds of challenges? How are their challenges similar to or different from those that exist in the intelligence arena? What can be learned from the comparison?»
In definitiva, molte delle sfide che la CI affronta non sono uniche come si può credere a un primo e superficiale sguardo e questo anche perché una certa insularità e tecnofilia del campo disciplinare può ostacolare la messa in comune di metodologie e pratiche da parte di altre discipline.
Conclusioni
A livello di costrutti concettuali il campo disciplinare della CI è attraversato da tensioni definitorie promosse da parte di tutte le entità e gli attori che ne fanno parte. Tale frammentazione è, tuttavia, indizio sia di una crescita impetuosa che di un carente consolidamento a livello disciplinare. A questo riguardo, ulteriori indagini dovrebbero essere svolte in una prossima fase, anche mediante ricerche qualitative di analisi testuale, al fine di acquisire maggiori informazioni in merito a tale aspetto.
Dalla breve disamina qui condotta sono emerse delle differenze tra il concetto di CI e quello di CTI mentre quello di CCI appare speculare a quello di CI. Tra tutti e tre i termini la CI viene considerata maggiormente adatta a sottolineare il carattere olistico, strategico e di alto livello di tale disciplina emergente mentre quello di CTI sembra far riferimento soprattutto a un livello organizzativo, localizzato su scala locale nonché tattico ed operazionale.
Un altro aspetto che emerge dalla breve ricognizione sul campo, svolta con modalità di fonti aperte, è che la prevalenza delle definizioni attualmente in uso deriva soprattutto dal campo delle agenzie governative e del settore commerciale dei fornitori di tecnologia e servizi della CS e già ciò appare essere un indizio di un parziale o carente processo di istituzionalizzazione di tale tematica. In buona sostanza, nel suo sviluppo continuano a prevalere aspetti istituzionali ed economici piuttosto che esigenze correlate allo sviluppo di un campo scientifico univoco e ben determinato.
Si ritiene inoltre che, riguardo all’ulteriore consolidamento disciplinare della CI, potrebbe giovare non solo una maggiore acribia di tipo concettuale quanto piuttosto un orientamento teorico maggiormente comprensivo dell’apporto di altre discipline scientifiche, in una tipica ottica multidisciplinare. Il passaggio da un insieme di tecniche e metodologie, di attività e di pratiche professionali, in direzione di una disciplina scientifica orientata da una conoscenza istituzionalizzata necessita, difatti, a parere dello scrivente, di una serie di ulteriori passaggi i quali devono per forza ricomprendere sia una chiarificazione concettuale che una maggiore definizione dei suoi confini disciplinari.
Vale qui sottolineare, en passant, che la multidisciplinarità riguarda lo studio di una tematica non in una sola disciplina ma in più discipline contemporaneamente ma essa rimane sempre al servizio, prettamente in funzione ancillare, della disciplina centrale, che in questo caso sarebbe la CI.
Un ulteriore aspetto è quello, infine, dell’orientamento al valore sotteso a questa tematica così come alla socializzazione diffusa delle basilari tecniche e metodologie corrispondenti, ad esempio in termini di cyber igiene divulgata presso tutto il corpo sociale, che la società nel suo complesso considera degna di rappresentare l’interesse collettivo. Quest’ultimo aspetto sembra, oggigiorno, essere in via di consolidamento sia per l’incremento degli attacchi ransomware i quali hanno accresciuto tantissimo il valore sociale e collettivo della sicurezza cibernetica sia per il crescente processo di digitalizzazione del Paese, anche a seguito delle ingenti risorse messe a disposizione del pino Nazionale di Ripresa e Resilienza (PNRR) il quale non potrà che accentuare maggiormente tale orientamento al valore.
In conclusione, la consapevolezza finale che deriva da questa breve esposizione è che per una piena comprensione della valenza strategica della CI essa non possa essere declinata solo dal punto di vista tecnico e tecnologico.
Il campo della CI è, di fatto, socialmente e culturalmente costruito in quanto lo spazio cibernetico è uno spazio costantemente ri-descritto e ri-negoziato e il cui potere può essere appannaggio anche da parte di piccole entità organizzative quali gli attivisti, le gang cybercriminali di media entità oppure potenti entità di emanazione statuale. Intesa in questo senso, il fondamento multidisciplinare della CI ha come precipuo focus di interesse il tessuto costitutivo di molteplici discipline in vista del consolidamento della CI. Ciò implica che quest’ultima debba sempre più mettere in conto una relativa espansione del campo di analisi al fine di includere nuove teorie e nuove metodologie; ciò significa tendere verso una più complessiva integrazione del più ampio contesto socioeconomico entro cui essa si situa ed è storicamente situata.
Achille Pierre Paliotta, ricercatore INAPP(ex ISFOL), afferente alla Struttura Lavoro e Professioni. Laureato in Sociologia presso l’Università La Sapienza ha conseguito, nel 2015, il Master in Data Science presso l’Università di Tor Vergata. Sta attualmente frequentando il Master in Sicurezza delle informazioni e informazione strategica presso l’Università La Sapienza. I suoi interessi di ricerca vertono su nuove tecnologie, sicurezza informatica, nuove professioni, contrattazione collettiva, welfare occupazionale, data science, blockchain, open data e deep learning.
Il furto di identità e come non facilitarlo – il luogo comune “non ho nulla da nascondere”
In questo articolo analizzeremo cosa significhi proteggere la nostra privacy, prendendo in considerazione alcuni possibili comportamenti perpetrati da soggetti definiti, qui, semplicemente “attaccanti.” Cercheremo di capire quali dati possano costituire un rischio e come fare per non divulgarli. Inoltre guarderemo la questione “lato attaccante”, per capire cosa farà dei nostri dati e perché potrebbe essere nocivo. Le basi tecniche cui faremo riferimento sono il world wide web – ipertesto consultabile attraverso un browser – e il fatto che certe pagine web non siano accessibili a chiunque ma richiedano un’autenticazione (spesso: username e password).
QUALI DATI PRIVATI È POSSIBILE REPERIRE IN RETE?
Di ogni tipo: per rendercene conto, basta inserire in un moderno motore di ricerca (Google, Bing, ecc.) alcune semplici parole chiave come “carta d’identità”, “documento”, “passaporto” o “denuncia”, selezionando i risultati di tipo “immagine”. Oltre a immagini di volti, possiamo facilmente reperire nomi, indirizzi, numeri di telefono, codici fiscali… il che, in un mondo onesto, non costituirebbe un problema. Ma il mondo pullula di disonesti.
Si potrà dire: i proprietari li hanno messi in rete e nella maggioranza dei casi sapevano quello che facevano. Non sono del tutto d’accordo, soprattutto relativamente alle conseguenze indirette, di cui discuteremo.
Inoltre, la pubblicazione sul web non è l’unica sorgente di dati personali; questi possono essere condivisi in molti modi, per esempio usando una rete sociale (Instagram, Facebook, TikTok ecc.) che a sua volta si poggia sul web, con una differenza che deriva da quella esistente fra surface web e deep web.
Appartengono al surface web tutti i siti che possono essere consultati da un motore di ricerca; appartengono al deep web (da non confondere con il dark web) i siti che non possono essere raggiunti da un motore di ricerca per vari motivi, uno dei quali è la necessità di sapersi autenticare. Per completezza, aggiungiamo che appartengono al dark web tutti i siti che offrono pagine web attraverso una “overlay network” (rete sovrapposta) come la rete Tor e che possono essere consultati esclusivamente tramite il Tor browser; non essendo questi raggiungibili da un normale motore di ricerca, tecnicamente appartengono al deep web (che naturalmente non si esaurisce nel dark web).
Precisata la differenza, c’è da dire che un enorme quantitativo di dati personali è affidato al deep web e, almeno in linea di principio, non disponibile alla visione di chiunque. Si tratta spesso di foto e video che appartengono alla sfera più privata, incluso il fatto che spesso includono volti di minori (cosa che in teoria dovrebbe essere soggetta ad autorizzazione). Dati protetti, dunque? La risposta, purtroppo, è no. Anche assumendo che i server che realizzano la rete sociale – chiamiamola S – non siano e non saranno compromessi, rimane il fatto che gli “amici” ottenuti attraverso la rete sociale possono spesso visualizzare tali informazioni.
Facciamo chiarezza. Assumiamo che S, attenta alla privacy e moderna, divida il pubblico, rispetto a un utente X, in più fasce: A. quella con cui si condividono contenuti soggetti a selezione; B. quella degli amici stretti con cui si condivide tutto, con qualche possibile eccezione; C. quella degli utenti di S (inclusi i non amici di X), con si può scegliere di condividere qualcosa; D. il resto del mondo (che include i non iscritti a S), con cui si condivide ciò che si reputa pubblico.
Anche supponendo che un utente possa configurare e caratterizzare completamente le fasce A, B, C e D, quanti saranno disposti a farlo? In molti casi prevarranno le impostazioni di default scelte dall’applicazione. Anche se i comportamenti di default saranno privacy preserving (non sempre è così!) è comunque compito di X definire le eccezioni, sia in positivo che in negativo, e non è scontato che X lo faccia. Ci sono poi reti sociali in cui la privacy è, a causa dello scopo della rete, poco attuata dagli utenti (es. LinkedIn, app di dating).
Inoltre, poche reti sociali consentono a X di definire i permessi di visione agli “amici degli amici”. Il che si traduce nel fatto che, per quanto attenti possiamo essere nel concedere gli accessi, dipenderemo spesso dai comportamenti dei nostri contatti. Ad esempio, supponiamo di voler tenere privato il numero di cellulare, per cui lo diamo solo a pochi contatti stretti: cosa ci garantisce rispetto alla richiesta automatica di WhatsApp, Signal o Line di accedere alla rubrica? Può darsi che gli amici stretti consegneranno a queste app la loro rubrica, per non parlare del fatto che potrebbero decidere di dare il nostro numero a qualcuno senza consultarci in proposito.
Dal lato dell’attaccante, è possibile reperire dati sia attraverso un motore di ricerca, sia diventando utente di una rete sociale e ottenendone dati che diventano così accessibili: questo può essere fatto sia di persona, sia usando una specifica applicazione. Una delle tecniche più antiche, ma ancora attuali, è prendere contatto con un uomo attraverso un profilo social che mostra la foto di una donna avvenente: pochi sapranno resistere alla tentazione di accogliere una nuova amica attraente.
COME SONO CEDUTI I DATI?
In realtà ciò è stato discusso nella Sez. 1. Tuttavia, non abbiamo ancora menzionato un fatto centrale e ricorrente. Siamo tutti utenti del web, a prescindere dalle reti sociali: e i siti web vorrebbero sapere alcune informazioni di base sugli utenti, per migliorare gli avvisi pubblicitari da mostrare (ad esempio, appare un po’ goffo mostrare a un uomo avvisi destinati a un pubblico femminile). Ecco che nascono alcune domande di base, quali sesso, fascia di età, malattie croniche, vizi, bisogno di credito/mutui, composizione del nucleo familiare ecc. Tutto – o quasi – è considerato lecito al fine di acquisire queste informazioni, che nella maggior parte dei casi saranno trattate in maniera automatica.
Un meccanismo di base che spicca fra gli altri è quello dei cookies. Come noto, il protocollo per l’acquisizione dei file che caratterizzano il contenuto di un sito è http, un protocollo stateless (senza memoria). Per ovviare a tale limite (talvolta tecnicamente rilevante) è stato introdotto il meccanismo dei cookies:
un server web, nel trasmettere informazioni a un browser, può decidere autonomamente di inviare dei frammenti di informazione (spesso dei numeri) chiamati appunto cookies. Ovviamente il server conterrà una tabella che associa a ciascun numero varie informazioni;
il browser riceve i cookies e, se non espressamente istruito a fare diversamente, li conserva fino a una data di scadenza (spesso più lontana della data media di dismissione del dispositivo). Il cookie spesso descrive la pagina di attuale visualizzazione;
il browser, nel mandare una richiesta qualunque a un server web, controlla se conservi cookies non scaduti provenienti da quel server e, se sì, li invia al server assieme alla richiesta;
lo scambio di cookies fra server e browser avviene di norma silenziosamente, senza che l’utente ne abbia percezione. Il numero di cookies ricevuto da un browser in un giorno di navigazione può facilmente raggiungere diverse migliaia;
ogni browser possiede un “contenitore” in cui depositare e da cui attingere cookies;
tale contenitore è diverso da browser a browser e da utente ad utente (anche se condividono lo stesso dispositivo).
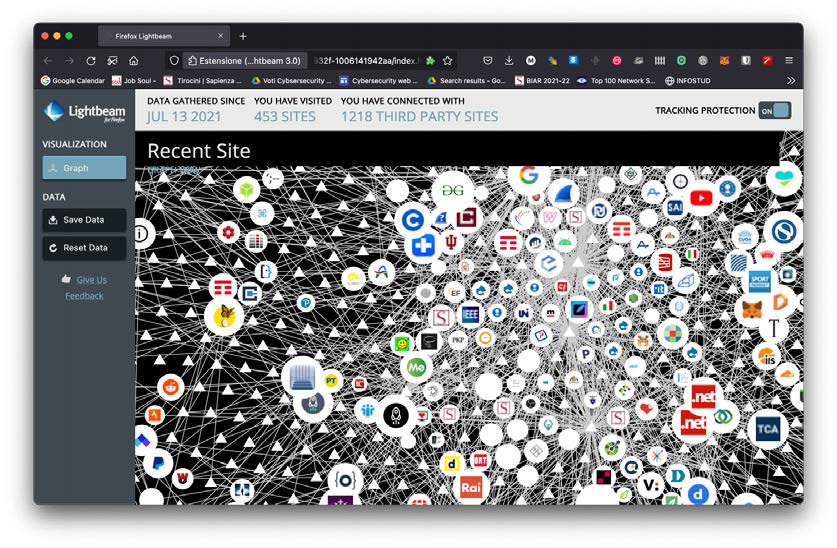
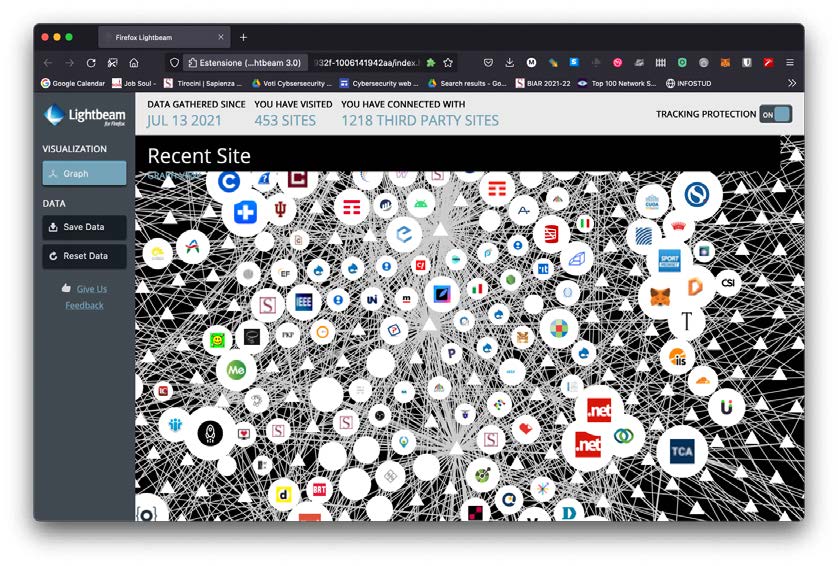
Inoltre occorre tenere presente che, se si visita il sito W, questo offrirà presumibilmente contenuti provenienti da altri siti, diciamo Y e Z. Per tale ragione W si chiama “first party” (prima parte) e Y e Z si chiamano “third parties” (terze parti). Non è difficile comprendere che i cookies ricevuti da siti di terze parti servono principalmente a queste ultime per ricostruire informazioni sull’attività di navigazione di un utente e, in particolare, sui contenuti consultati. Invece i cookies di prima parte hanno spesso una valenza tecnica, conservando informazioni su un’avvenuta autenticazione e su una preferenza di navigazione. In definitiva, è consigliabile l’approccio basato sul configurare il browser in modo che rifiuti automaticamente i cookies di terze parti (è possibile, anche se talvolta va cercato). Il meccanismo che contempla pagine composte da contenuti provenienti da diversi siti fa sì che nascano relazioni fra siti, che possono portare alla condivisione di informazioni. La Figura 1 mostra le relazioni fra siti visitati in quasi un anno da parte dell’autore; in Figura 2 ne è mostrato un frammento.
Figura 1. Illustrazione fornita dall’add-on LightBeam per la visualizzazione delle relazioni fra siti web visitati.Figura 2. Dettaglio frammento di LightBeam.
Oggi sono molti gli add-on (componenti aggiuntivi) disponibili per dotare un browser di una migliore capacità di controllo dei cookies; non approfondiremo questo dettaglio, privilegiando i concetti di base. Inoltre ci sono molti browser, ciascuno con una sensibilità diversa rispetto alla tutela della riservatezza dei dati degli utenti. Fra questi prevale, ai fini del controllo della privacy, quello prodotto da Mozilla e noto con il nome di Firefox. I web server usano anche altri meccanismi di tracciamento, talvolta molto più tecnici, che giustificano il ricorso alla modalità di navigazione chiamata privata o anonima.
Si tratta di una modalità nata nel passato per obiettivi differenti, che oggi offre ancora alcuni aspetti interessanti. La modalità privata non lo è davvero (il server web riceve ugualmente il nostro IP), tuttavia in questa modalità i browser allestiscono un nuovo contenitore per i cookies (e per altre informazioni) che nasce vuoto e durante la navigazione riceve tutti i cookies somministrati, anche fornendoli, ma che viene distrutto alla chiusura del browser, perdendo automaticamente tutti i dati collezionati. In questo modo renderà vana la somministrazione di cookies di qualunque tipo, inclusi quelli “buoni” (es., autenticazione avvenuta).
QUALE CESSIONE DATI È DA CONSIDERARSI RISCHIOSA E PERCHÉ?
Dalle riflessioni precedenti capiamo facilmente la molteplicità dei meccanismi che consentono all’attaccante di collezionare i nostri dati. A questi vanno aggiunti quelli di esfiltrazione, che attaccano un server per estrarne i dati contenuti: in particolare, le password. In effetti il riuso delle password, pratica prediletta da molti utenti, favorisce fortemente il furto d’identità, in cui l’attaccante può impersonare la vittima e agire passivamente o attivamente in sua vece. Esistono varie tipologie di furto di identità; ed è abbastanza pacifico che sebbene i meccanismi lesivi della privacy discussi in Sez. 2 possano essere fastidiosi, condizionando la pubblicità ricevuta, di norma non conducono a furti di identità. Tuttavia, ci sono stati casi emblematici in cui giganti del web sono incorsi in famosi scandali unendo tecniche disparate: ad esempio il caso Facebook-Cambridge Analytica, ove i dati di 87 milioni di utenti FB furono usati con scopi di propaganda politica.
In effetti sembrerebbe naturale domandarsi se i meccanismi illustrati in Sez. 2 non potrebbero essere sfruttati dalle forze dell’ordine a fini investigativi, o trovare addirittura applicazioni forensi. Se da un lato appare scontato che la disponibilità dei dati presso i siti che effettuano tracciamento costituisca un patrimonio di indubbio interesse che potrebbe facilitare analisi, profilazione psicologica, valutazioni ecc., dall’altro dobbiamo prendere atto che il concetto di confine nazionale, per quanto riguarda la rete, ha perso ogni significato. Così assistiamo ad aziende od organizzazioni che si trovano in uno Stato, ma che conservano i dati su qualche server localizzato in altro Stato. Ne deriva la difficoltà, per le forze dell’ordine, di ottenere tali dati, rendendosi in genere necessarie rogatorie internazionali dai tempi lunghi (poco compatibili con quelli dell’investigazione) e dagli esiti incerti. Questo perché manca una legislazione comune di valenza internazionale, anche se la UE ha recentemente fatto significativi passi avanti in tal senso. Eppure, la magistratura dello Stato ove risiedano i dati potrebbe ordinarne sequestro ed esportazione, chiarendo che in caso di cifratura c’è l’obbligo di fornirne le chiavi.
Più significativa per i nostri scopi è invece la valenza degli atti descritti in Sez. 1, nonché dell’esfiltrazione della password.
Va premesso che in generale esistono due tipi di attacco informatico: “a pioggia” e “mirato”. Nei primi si è attaccati per il semplice fatto di essere utenti di Internet; nei secondi invece l’attacco è legato al nostro ruolo, status o funzione e integra un’azione espressamente studiata per noi. Va detto che il rapporto fra questi è dell’ordine di 100 a 1: ne consegue che la somma dei danni provocati dagli attacchi a pioggia diventa considerevole sul piano quantitativo mentre, nel caso degli attacchi mirati, questi possono produrre danni ingenti in ragione della loro maggiore “qualità”.
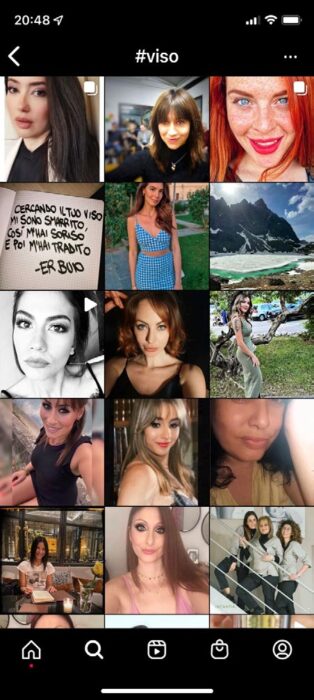
In aggiunta, gli attacchi mirati sono molto onerosi – non molti possono permettersi i costi necessari alla progettazione – e pertanto sono solitamente imputabili a gruppi motivati e ben organizzati, talvolta anche a governi nazionali. Qui ci concentreremo solamente sugli attacchi a pioggia poiché, nella situazione evocata dal titolo, le vittime sono persone “qualsiasi” che ritengono di non aver nulla da nascondere. Mettiamoci nei panni di un attaccante che dedica tempo e sforzi per realizzare attacchi a pioggia (usando i meccanismi descritti in Sez. 1), eventualmente resi più efficaci da password o dati esfiltrati in seguito a qualche attacco a server. L’attaccante colleziona dunque dati ottenuti con questi meccanismi, correlando le varie informazioni relative allo stesso soggetto: in Figura 3, l’esito di una semplice ricerca su un celebre social. Nel tempo, i dati correlati attribuiti a uno stesso soggetto diventano corposi: quello è il momento maturo per venderli e, a tale scopo, cosa c’è di meglio di un mercato nero raggiungibile nel dark web?
Figura 3. Ricerca dell’hashtag #viso su Instagram.
Dunque assistiamo alla messa in vendita di nomi, indirizzi, foto, e-mail ecc. relativi a uno stesso soggetto; e questo viene fatto per moltissimi soggetti.
Esaminiamo, a seguire, i due principali tipi di abusi che i legittimi proprietari dei dati possono subire: il furto d’identità e la presenza in raccolte estranee di dati.
Nel primo caso, l’acquirente è spesso una persona che vuole intentare una truffa ai danni di altri individui o di istituti finanziari (bancari, assicurativi ecc.). Per organizzare tale frode, il truffatore ha bisogno di usare identità “normali” – molto meglio avere dati reali che creare identità fittizie con il pericolo di qualche dimenticanza – così rendendo la sua opera più robusta e a prova di numerose verifiche. Il risultato è che risulterà molto più credibile ed efficace nel portare la truffa a compimento. Naturalmente le forze dell’ordine conoscono bene il fenomeno; tuttavia le vittime di furti d’identità potranno rimanere all’interno di liste di potenziali sospetti, consultate ogni volta che si verifichi una frode in rete.
Il secondo caso fa riferimento al ben noto fenomeno della pedopornografia in rete. È piuttosto frequente il caso in cui il criminale si sia procurato una collezione di materiali pornografici relativi a minori, concentrati su dettagli anatomici e mancanti di volti specifici o figura del corpo. È pratica comune ricorrere a fotomontaggi o, semplicemente, all’arricchimento della collezione mediante immagini prese da chi “non ha nulla da nascondere”, per suggerire il volto o la figura del minore o di un suo parente stretto. Basta una qualche compatibilità nel colore della pelle. Anche in questo caso, ammesso il successo nel dimostrare l’estraneità, si rischia l’inclusione in liste di possibili sospetti.
ALTRE MINACCE
Finora ci siamo focalizzati sugli attacchi a pioggia. Nel caso di attacchi mirati, diversamente, non c’è limite alle conseguenze ottenibili; basti citare i deepfake, consistenti nell’uso di tecniche di machine learning (considerata parte dell’intelligenza artificiale) che mediante l’uso di autoencoders o reti generative avversarie (GAN) riescono, a partire da alcune immagini date, ad “addestrare” reti generative neurali all’alterazione delle immagini stesse. Il fenomeno ha acquisito notorietà nel 2017, quando queste tecniche furono usate per associare volti di attrici famose ai corpi nudi di modelle compiacenti. Tra i più celebri s’includono anche un video di Putin che annuncia la resa dell’Ucraina e uno di Obama, dove l’ex Presidente USA afferma che “stiamo entrando in un’era in cui i nostri nemici possono far dire a chiunque qualunque cosa in ogni momento”.
I deepfake accrescono fortemente la difficoltà di distinguere immagini genuine da quelle alterate: esistono anche numerose app che mettono a disposizione questa possibilità, alimentando però diversi dubbi sull’opportunità di depositare dati (come immagini di volti reali) all’interno di database il cui uso è per lo meno opaco.
Articolo a cura di Fabrizio D’Amore
Profilo Autore
Docente presso l’Università degli Studi di Roma “La Sapienza”, membro del Cyber Intelligence and Information Security Center
Cybercrime-as-a-Service (CaaS). Il ruolo delle transazioni in criptovalute nel Darknet
«The potential criminality associated with computers can be eclipsed only by the difficulty in identifying and investigating these crimes» David L. Carter (1995:22)
Introduzione
Fin dal giorno della sua caduta, a causa di un furto provocato mediante una ben congegnata tecnica di ingegneria sociale (social engineering), l’essere umano si è trovato costantemente immerso nelle attività criminose compiute dai suoi simili e nei connessi tentativi di occultare tali attività.
Queste attività si connotano per essere il più elusive possibili, inafferrabili quanto basta, tanto da aver dato vita, spesse volte, a processi e giudizi sommari al fine di poter ristabilire l’ordine economico, politico e sociale messo costantemente in pericolo da singoli e gruppi umani. Del resto, una scia di conseguenze dirette e indirette fa seguito a ogni atto criminoso e non stupisce che tutti i gruppi umani abbiano cercato di limitare la loro perniciosa diffusione; per non dire poi che tali atti sono all’opposto del perseguimento di uno sviluppo ottimale, il quale costituisce l’obiettivo precipuo di ogni collettività organizzata.
Ciò premesso, il processo di digitalizzazione – le cui fondamenta sono da rinvenirsi a seguito del secondo conflitto mondiale, con la messa a punto della teoria dell’informazione e dei primi modelli di computer – si è vieppiù accompagnato al correlato sviluppo della criminalità informatica (cybercrimes, e-crimes, electronic crimes, internet crimes, netcrimes, computer-related crimes).
A questo riguardo, già l’utilizzo di un’estesa terminologia mostra assai bene che in questo campo non vi è ancora una rigorosa concettualizzazione; ma ciò vale anche, in generale, per tutti i termini correlati alla cybersecurity e alla cyber intelligence (Paliotta 2022a). Si comprende, del resto, come una definizione rigorosa di tale campo di studi sarebbe di vitale importanza non solo per l’investigazione scientifica del fenomeno ma anche perché piccole variazioni nella concettualizzazione del cybercrime potrebbero influenzarne la misurazione e lo stesso contrasto da parte delle forze dell’ordine (Carter 1995; Brenner 2004; Broadhurst 2006; Barn & Barn 2016; Phillips et alii 2022; Paliotta 2022b).
Uno dei principali fattori insiti nella difficoltosa stima della criminalità informatica è, difatti, proprio la mancanza di definizioni rigorose, di tassonomie e sistemi di classificazione in grado di tenere conto dell’ampia gamma dei reati informatici. A questa situazione si sta ponendo rimedio in alcuni paesi, quali gli Stati Uniti, mediante un atto legislativo ad hoc, il “Better Cybercrime Act” (Paliotta 2022b). Il problema della carente concettualizzazione è ulteriormente aggravato dalla considerazione che la legislazione in materia di cybercrime, nelle varie giurisdizioni statuali, non è né sistematica né uniforme; e che a tale mancanza di unità corrispondono altrettanti sforzi internazionali frammentati e non continuativi, anche se la recente firma del “Second Additional Protocol” della Convenzione di Budapest sembra andare nell’auspicata direzione di un maggiore coordinamento fra Stati.
Il cybercrime si può definire, per i fini che qui interessano, come lo svolgimento di un’attività criminale in cui un artefatto digitale (hardware e software) può essere sia lo strumento utilizzato per l’attacco malevolo sia l’obiettivo dello stesso, oppure ambedue, che sia o meno collegato a Internet, escludendo al contempo i reati tradizionali che sono solo facilitati dall’uso dell’hardware. Quest’ampia definizione permette di superare diverse difficoltà terminologiche perché, ad esempio, essa non coprirebbe i crimini tradizionali come l’omicidio se, in ipotesi, l’aggressore usasse una tastiera per colpire e uccidere la propria vittima. Vi verrebbe ricompreso, invece, il caso di un agente malevolo che introducesse dispositivi USB contenenti software dannoso ai fini della distruzione, deterioramento, alterazione, danneggiamento dei dati contenuti su un computer anche quando questi non fosse collegato a un network.
Il primo criminale condannato per crimini elettronici sembra sia stato, nel 1981, Ian Murphy – alias “Captain Zap” – per aver penetrato e alterato il dispositivo orario della fatturazione dell’American Telephone & Telegraphs (AT&T) al fine di ottenere tariffe scontate durante il normale orario di attività commerciale.
Riguardo alla tipologia dei reati, la Convenzione sul cybercrime distingue quattro diversi tipi di condotte:
offese contro la confidenzialità, integrità e disponibilità (CIA) di computer, dati e sistemi [art. 2, accesso illegale; art. 3, intercettazione illegale; art. 4, interferenze sui dati; art. 5, interferenze sui sistemi; art. 6, uso improprio dei dispositivi];
offese relative ai computer [art. 7, contraffazione dei computer; art. 8, frodi relative ai computer];
offese relative al contenuto [art. 9, offese relative alla pedopornografia];
offese relative al copyright [art. 10, offese relative alla violazione del copyright].
Senza scendere in maggiori dettagli, in questa sede si può mettere in evidenza che la deterrenza contro il cybercrime è una componente integrale di una strategia nazionale di cybersecurity e di protezione delle infrastrutture critiche, come si può evincere anche dalla recente divulgazione di quella italiana (ACN 2022).
L’oggetto precipuo del cybercrime è un artefatto digitale e, dunque, il luogo di elezione di tali attività criminose non può che essere la rete, nella sua componente clearnet ma, ancor di più, in quella darknet.
Così come nella rete sono diffusi i negozi on-line, dove gli utenti possono vendere e comprare ciò che vogliono, sono altrettanti diffusi dei luoghi virtuali dove possono essere venduti ed offerti beni e servizi illegali. Si tratta dei cosiddetti Black Markets, i quali adottano funzionalità assai comuni sulla rete (quali la reputazione, che varia in base ai feedback rilasciati dai clienti) ma soprattutto una modalità definita “central escrow service” che rassicura la domanda e l’offerta che gli scambi vengono effettuati in maniera consona a quanto convenuto tra i due contraenti.
A solo titolo esemplificativo, qualora un prodotto/servizio acquistato non venisse consegnato, l’acquirente può contattare il “central escrow service” e chiedere il blocco del pagamento al venditore.
Anche nel caso di tali mercati, il presupposto principale si basa sulla mutua fiducia che quanto pattuito sia effettivamente consegnato e pagato; nondimeno possono verificarsi casi di truffa. In tali mercati digitali sono vieppiù diffusi i servizi di messaggistica basati su tecniche crittografiche, quali Pretty Good Privacy (PGP) in modo da permettere la cifratura dei messaggi tra le parti e aumentare così il livello di sicurezza e anonimato degli stessi.
Una delle peculiarità del darknet che si vuole qui mettere in evidenza è la fornitura dei servizi e beni secondo il modello Anything as-a-Service (XaaS): i potenziali clienti si interfacciano con delle console web caratterizzate da un’elevata facilità di utilizzo le quali sottintendono, tuttavia, una notevole complessità dell’architettura basata su un grado di automazione interna che generalmente fornisce livelli variabili di tolleranza e resilienza ai guasti e un’alta scalabilità, ovvero la capacità di aumentare/diminuire i carichi di lavoro relativi alla fornitura di beni e servizi. I servizi XaaS permettono anche un notevole risparmio sui costi di gestione rispetto alle infrastrutture tradizionali, oltre a una user experience facilitata: per tali ragioni sono ampiamente presenti in quasi tutte le aree di business.
In questo testo si ipotizza che la diffusione attuale del cybercrime, principalmente basato sui forum e sui mercati digitali, venga spiegata almeno in parte dalla fornitura XaaS delle attività criminose; e che tali caratteristiche facilitino l’approccio al crimine informatico anche da parte di un’ampia frangia di neofiti i quali sono messi nelle migliori condizioni per poter iniziare una soddisfacente carriera in questo settore economico, emergente sia in termini di costi benefici sia di profitti realizzabili in brevissimo tempo.
Tale tendenza è da ricollegarsi a un processo crescente di servitizzazione dell’economia e di commodificazione delle minacce informatiche (malware, ransomware, exploit) le quali trovano un mercato sempre più fiorente, atto ad accoglierle e utilizzarle su una superficie di attacco che si è estesa oramai a tutte le imprese – anche le piccole e piccolissime – e ai singoli consumatori. Si tratta, in un certo modo, di una globalizzazione e volgarizzazione delle cyber threats, nel senso che esse possono colpire qualsiasi segmento del corpo sociale, a cui deve necessariamente fare da contraltare, per la loro difesa, un’altrettanta diffusa cyber awareness.
Un esempio di tal genere, nonché una delle ragioni del perché non sia consigliabile condividere informazioni personali in rete, è trattato in questo stesso Quaderno, nel capitolo “Il furto di identità e come non facilitarlo – il luogo comune “non ho nulla da nascondere” (D’Amore 2022).
La versione più diffusa di tale modello di affari, qui definibile come Cybercrime-as-a-Service (CaaS), è senz’altro quella del Ransomware-as-a-Service (RaaS), divenuta tristemente nota anche in Italia a seguito della crisi pandemica e dei relativi attacchi effettuati da molteplici gruppi, alcuni composte da giovanissimi cyber criminali, quali Lapsus$ Team (Paliotta & Guzzo 2022a) e Killnet Legion.
Ciò premesso, nelle pagine seguenti viene affrontato il tema di come si stia sempre più sviluppando un mercato delle attività cyber criminose che adotta vieppiù modalità commerciali, connotandosi sempre più come un vero e proprio comparto economico specializzato.
Di conseguenza, come era facile attendersi, l’emersione di tali mercati digitali sta provocando una forte reazione da parte delle forze di polizia, in uno sforzo congiunto a livello internazionale con l’obiettivo del loro contrasto e chiusura; così come mostrato nella Fig. 1, relativa a uno degli ultimi casi in ordine di tempo (Hydra), che verrà qui brevemente esaminato.
Fig.1 Screenshot del sito Hydra, chiuso dalle forze dell’ordine statunitensi e di altri Paesi. Fonte: https://bit.ly/3txi7SB
Un ulteriore aspetto preso in esame, strettamente connaturato al fenomeno oggetto di studio, è relativo alla moneta utilizzata per gli scambi su tali mercati criminali, che non può che essere quella in grado di assicurare al meglio l’anonimità delle transazioni economiche in rete. Si tratta ovviamente delle criptovalute e, sempre più in questi ultimissimi anni, della Decentralized Finance (DeFi). Quest’ultima è una tecnologia finanziaria (fintech) emergente, basata su registri distribuiti sicuri simili a quelli utilizzati dalle criptovalute. Le caratteristiche principali che ne hanno determinato il successo, anche all’interno del darknet, sono la mancanza di un controllo preventivo da parte delle banche e delle istituzioni finanziarie nonché la relativa sicurezza dei protocolli di scambio utilizzati, l’utilizzo di un wallet digitale entro cui conservare le criptovalute e la possibilità di effettuare transazioni in tempo reale sulla rete.
Nel resto dell’articolo verrà preso in esame il caso di Hydra, una piattaforma da collegarsi alla Federazione Russa: il quale servirà a illustrare, con un certo grado di dettaglio, le caratteristiche precipue di un CaaS al fine di formulare ipotesi circa i motivi della loro costante adozione presso un così ampio numero di cyber criminali.
Il ruolo dei marketplace: il caso HYDRA
Il 5 aprile 2022, il Dipartimento del Tesoro degli Stati Uniti (U.S. Department of the Treasury’s Office of Foreign Assets Control – OFAC) ha sanzionato il mercato darknet più grande e importante del mondo, l’Hydra Market, operante in lingua russa con 19.000 account di venditori e oltre 17 milioni di profili clienti, al fine di interrompere la proliferazione delle attività di criminalità informatica, vendita di droghe e altri servizi illegali disponibili attraverso il sito con sede nella Federazione Russa. All’operazione congiunta hanno collaborato il Dipartimento di Giustizia degli Stati Uniti, l’FBI, la Drug Enforcement Administration, l’IRS-CI e l’Homeland Security Investigations. L’azione statunitense è stata rafforzata dalla cooperazione internazionale con la polizia criminale federale tedesca (Bundeskriminalamt – BKA) la quale ha spento i server Hydra localizzati in Germania e sequestrato bitcoin per un valore di 25 milioni di dollari. Il fatturato della piattaforma era stato stimato in almeno 1,23 miliardi di euro nel solo 2020. In particolare, il “Bitcoin Bank Mixer” (Fig. 2), un servizio utilizzato per l’offuscamento delle transazioni digitali, aveva reso le indagini delle forze dell’ordine molto difficili, come affermato dalla polizia stessa. La necessità di far uso di un “Bitcoin Bank Mixer” si spiega colla considerazione che, sebbene gli indirizzi bitcoin siano pseudoanonimizzati, l’intera storia finanziaria di un account viene meticolosamente registrata sulla blockchain. Le tracce create sono pubbliche e tracciabili, il che contrasta con la promessa di anonimità. I mixer o tumbler Bitcoin rispondono a questa esigenza, non sempre per motivi illegali, in quanto sono dei software o servizi che mescolano le criptovalute di diversa provenienza in modo da offuscarne completamente gli account di provenienza originali.
Nel giorno della presentazione alla stampa della chiusura di Hydra, la segretaria del Tesoro statunitense Janet L. Yellen aveva affermato che gli attori malevoli che hanno fatto uso di ransomware e coloro che sono coinvolti in altri crimini informatici devono essere considerati come una potenziale minaccia per gli interessi degli Stati Uniti e ciò costituisce uno dei fattori alla base della decisione di chiudere i server di Hydra. Un secondo fattore determinante è stata la volontà di interrompere l’infrastruttura finanziaria degli attori malevoli che fanno uso di ransomware richiedendo pagamenti in valuta virtuale a causa della loro natura anonima e dei mezzi di scambio non facilmente rintracciabili: «Our actions send a message today to criminals that you cannot hide on the darknet or their forums, and you cannot hide in Russia or anywhere else in the world. In coordination with allies and partners, like Germany and Estonia, we will continue to disrupt these networks».
Il vice procuratore generale Lisa O. Monaco aveva dichiarato: «The Department of Justice will not allow darknet markets and cryptocurrency to be a safe haven for money laundering and the sale of hacking tools and services. Our message should be clear: we will continue to go after darknet markets and those who exploit them. Together with our partners in Germany and around the world, we will continue our work to disrupt the ecosystem that allows these criminal actors to operate».
La lotta contro il riciclaggio di denaro da un lato e il cybercrime dall’altro, ben esemplificato dalle minacce estorsive legate al ransomware, sono divenute una priorità assoluta dell’Amministrazione Biden anche a seguito degli attacchi alle infrastrutture critiche, tra cui quella relativa alla Colonial Pipeline avvenuta il 7 maggio 2021 e a cui aveva fatto seguito l’Executive Order presidenziale del 15 aprile 2021 in tema di attività cybercriminali.
Anche lo «sviluppo responsabile delle risorse digitali» rappresenta una priorità delle amministrazioni d’oltreoceano, come si può evincere dall’Executive Order 14067 del 9 marzo 2022, “Ensuring Responsible Development of Digital Assets” in cui si dà priorità agli sforzi per identificare e mitigare i rischi di finanziamento illecito nell’ecosistema delle risorse digitali.
Le transazioni su Hydra venivano condotte in criptovaluta e gli operatori della piattaforma addebitavano una commissione per ogni transazione. L’indagine svolta dall’OFAC ha anche evidenziato che oltre 8 milioni di dollari erano da collegarsi ai proventi del ransomware ed erano stati trasferiti attraverso la criptovaluta di Hydra, comprese le transazioni con i gruppi cybercriminali Ryuk, Sodinokibi e Conti, tra gli altri. Citando un rapporto di Chainalysis, l’OFAC ha riportato che circa l’86% di tutti i bitcoin illeciti ricevuti dagli scambi di valuta virtuale russi nel 2019 provenivano da Hydra.
Inizialmente disponibile solo attraverso la rete TOR, Hydra era nota per la vendita di narcotici ma con il passare del tempo aveva allargato il suo raggio di azione commerciale includendovi, tra altre offerte, carte di credito rubate, documenti contraffatti (inclusi quelli di identità), banconote false e tools di attacco informatico. Grazie a quest’ampia offerta di beni e servizi, anno dopo anno i volumi di transazioni annuali avevano fatto registrare un cospicuo incremento, passando da una stima di 9,4 milioni di dollari nel 2016 ad almeno 1,37 miliardi di dollari nel 2020 (Fig. 3) con un tasso di crescita del 624% nei suoi tre anni più recenti, dal 2018 al 2020.
In un recente rapporto (Chainalysis-Flashpoint 2021) viene messo in risalto come una caratteristica del successo di Hydra dipendesse dal richiedere ai potenziali fornitori di beni e servizi illeciti requisiti rigorosi. A partire almeno da luglio 2018, gli amministratori di Hydra (identificabili almeno in una dozzina di operatori) avevano fissato, difatti, la regola di almeno 50 vendite effettuate con successo prima che venissero consentiti i prelievi e che un account eWallet dovesse contenere almeno 10.000 dollari prima di poter operare sulla piattaforma.
A seguito di una transazione i venditori di Hydra, reclutati sulla piattaforma stessa (Fig. 4) distribuivano le merci illecite in determinati luoghi fisici, occultandoli in forma anonima, a volte sepolti o nascosti in un luogo poco appariscenti. Gli acquirenti ricevevano la posizione solo dopo l’acquisto – spesso utilizzando valuta virtuale – e potevano così recuperare la merce illecita. «With the help of an invisible army of young couriers, Hydra is monopolising Russia’s traditional street drug trade. Like a real-life videogame, the online stores on Hydra employ drug dealers known as kladmen (“treasuremen” or “droppers”), whose job is to stash drugs in GPS-tagged hiding spots ready for pick up by online buyers. It’s a street-tech workaround in a country where the postal system is slow and unreliable and regular street drug dealing is highly risky. It’s basically Pokémon Go for drugs».
Un’altra restrizione attuata era relativa ai principali Paesi di destinazione dei fondi in criptovalute. Le visualizzazioni dei dati geospaziali, riferiti ai flussi transazionali di Hydra, confermano queste restrizioni vedendo nella Federazione Russa di gran lunga la principale destinazione dei fondi provenienti da tutti i conti Hydra (sia acquirenti che venditori). I venditori di Hydra dovevano anche obbligatoriamente convertire i loro guadagni in rubli, la valuta fiat russa, per cui non sorprende che gli scambi siano basati esclusivamente o principalmente nella Federazione Russa e nei paesi un tempo appartenenti all’Unione sovietica (Azerbaijan, Moldova, Tajikistan, Ucraina, Kazakistan, Bielorussia, Uzbekistan, Armenia, Kyrgyzstan). Infine, Hydra conduceva gli affari in un modo rigoroso e secondo un codice di condotta supervisionato da un hub centralizzato, tanto da imporsi su tutti i concorrenti. «While in other markets vendors pay once to open an account, on Hydra every one of its estimated 5,000 shops has to pay a monthly rent. This starts at $100 a month and rises to $1,000 a month for an enhanced account, known as a Trusted Seller, whose ads appear on the top banner. Trusted Sellers must have racked up at least 1,000 transactions and customer disputes should not exceed seven percent of the total number of orders per month».
Da evidenziare, infine, che l’unico periodo di inattività degno di nota della piattaforma si era verificato durante un breve periodo di tempo, alla fine di marzo 2020, coincidente con l’inizio della pandemia di Covid-19.
In Fig. 5 viene mostrata una lista pubblicata su Hydra relativa un servizio di prelievo bitcoin in cash out. A questo riguardo, è stato frequentemente messo in risalto il ruolo della piattaforma: «However, to say Hydra is just a darknet market is misleading – Hydra also offers sophisticated cash-out services that are designed to let users move large volumes of illicit cryptocurrency covertly, and as such could also function as a money laundering service for sanctioned Russian entities».
Le attività illecite svolte sulla darknet Hydra avevano un collegamento con l’exchange di valute virtuali Garantex, fondato nel 2019, la cui maggioranza delle operazioni vengono svolte a Mosca e San Pietroburgo, originalmente con sede nella Repubblica d’Estonia. Nel febbraio 2022, a Garantex era stata ritirata l’autorizzazione a fornire servizi di valuta virtuale perché erano state rilevate carenze significative in materia di riciclaggio AML/CFT [Countering the Financing of Terrorism] oltre a diverse connessioni tra Garantex e i wallets utilizzati per svolgere attività criminali. Anche in questo caso un’operazione congiunta, svolta tra le forze dell’ordine statunitensi e le loro controparti estoni, ha permesso di scoprire che Garantex ha facilitato oltre 100 milioni di dollari in transazioni associate ad attori illeciti e mercati darknet. Questa somma includeva quasi 6 milioni di dollari provenienti dal gruppo russo di Ransomware-as-a-Service (RaaS) Conti e altri 2,6 milioni di dollari da Hydra. A Garantex è stato applicato l’Executive Order presidenziale 14024 per aver operato nel settore dei servizi finanziari della Federazione Russa, anche a seguito delle sanzioni economiche applicate a quest’ultima per l’invasione militare dell’Ucraina e le potenziali elusioni messe in essere per aggirarle.
Conclusioni
Il darknet si può definire come uno spazio virtuale popolato da una tipologia ben determinata di singoli e di gruppi umani intrinsecamente connessi tra loro, con una serie di attività che per loro natura si collocano entro uno spazio non regolato dalle leggi comuni. È uno spazio digitale che ha tra le sue caratteristiche precipue il ricollocamento delle tradizionali attività di carattere criminoso in un nuovo contesto digitale. È facilmente accessibile grazie alla tecnologia di anonimizzazione TOR (ma sempre più presente anche nel clearnet) ed è il luogo dove si svolge, a tutti gli effetti, un’economia su scala globale grazie alle moderne criptovalute, bitcoin in primis. Seppur digitale, il darknet esiste in uno spazio sociale, economico e politico molto reale, creato da una ben determinata comunità virtuale che opera in un mondo apparentemente senza confini, che sfrutta l’anonimato ai suoi fini e riesce a colmare il divario digitale, nell’interazione socioeconomica, tra parti interessate alla compravendita di beni e servizi illeciti. È questo il caso della piattaforma Hydra, illustrata brevemente nelle pagine precedenti.
In base alla disamina di questo caso, possono essere tratte alcune considerazioni di carattere generale. Innanzitutto, il cybercrime stava già cambiando in modo significativo, in linea con una tendenza di accentuata digitalizzazione presente nella società intera, ma si deve evidenziare che esso ha fatto segnare uno sviluppo ancora maggiore a seguito della crisi pandemica da Covid-19 (D’Amore 2021) e dell’invasione dell’Ucraina da parte della Federazione Russa, per l’incremento delle attività malevole da parte degli attori nation-state. Ambedue le crisi hanno cambiato il quadro generale della società globale, soprattutto nel mondo occidentale, tanto che attualmente le statistiche mostrano che i crimini informatici hanno superato i reati “tradizionali”.
Tale incremento è da mettere in stretta correlazione con un modello di servizio XaaS che qui si è definito come Crime-as-a-Service (CaaS). Numerosi fornitori hanno ovviamente venduto strumenti e servizi di hacking tramite il darknet Hydra, per esempio. Ma su tali piattaforme è possibile anche richiedere una sorta di hacking “a noleggio”, con servizi altamente personalizzati forniti da professionisti, quali l’accesso illegale agli account online di obiettivi ben determinati, scelti dell’acquirente. Il caso che si è qui illustrato con maggior dettaglio è quello relativo a Hydra; non solo perché esso era il più grande ed esteso al mondo ma anche perché, fino al momento della chiusura, poteva essere considerato davvero un caso di successo. Alcune caratteristiche strutturali gli avevano permesso di operare e prosperare in un ambiente fortemente competitivo come il mercato darknet. Come è stato sinteticamente osservato, «Hydra opened as a less-antagonistic option to its now-defunct competitor, Russian Anonymous Marketplace (aka “RAMP”), which was notorious for eliminating its competition via DDoS attacks and operator doxxing. Following the takedown of RAMP, Hydra built networks across Russia’s regions and helped to vertically integrate some aspects of drug production and trade». Un tale modello di CaaS di successo rappresenta pertanto un caso paradigmatico: grazie alla standardizzazione e diffusione della tecnologia attuale, alla globalizzazione economica e alle recenti tendenze geopolitiche, esso sembra essere il più rispondente a una sorta di democratizzazione e volgarizzazione delle attività cyber criminali, rendendole più comuni, più lucrative, più facili da commettere e più difficili da individuare.
In questo senso anche l’usuale distinzione tra la criminalità “organizzata” e quella commessa dai “colletti bianchi” va sfumando sempre più, in quanto gli stessi gruppi criminali tradizionali diventano più sofisticati e mettono a frutto i loro capitali illeciti e le loro competenze tecnologiche per ricavarsi una nicchia, altamente profittevole, nel processo di digitalizzazione attuale. Per questa ragione possiamo aspettarci dei cambiamenti nelle pratiche e nei metodi di commissione dei crimini a scopo di lucro, così come dei diversi autori di reati, forse provenienti da uno spettro più ampio della società. La tecnologia porterà cambiamenti anche nelle tecniche di prevenzione, individuazione e investigazione nonché in quelle di attacco, grazie alle nuove tecnologie – intelligenza artificiale in primis – come mostrato nel contributo “Cognitive Security” presente in questo stesso Quaderno (Arruzzoli 2022).
Tra tutti i servizi offerti sui mercati darknet quello attualmente di maggior successo, oltre alla vendita di stupefacenti, è indubbiamente il RaaS, il quale viene offerto come modello di franchising perché consente anche ai neofiti, anche senza competenze pregresse di programmazione (script kiddies), di divenire degli attaccanti attivi e prendere così parte all’economia del CaaS. Da questo punto di vista, si tratta di un processo incipiente di “democratizzazione” del crimine informatico, in grado di offrire alle persone comuni e ai player più piccoli una sorta di entry level in tale mercato riducendo, al contempo, il rischio di esposizione per coloro che si trovano in cima alla catena del valore. Ad esempio, in una tipica ipotesi di insider threat, un dipendente insoddisfatto potrebbe decidere di collaborare con uno sviluppatore RaaS per infettare la propria organizzazione dall’interno al fine di condividere il risultante profitto criminoso. Del resto, tale eventualità si appresta a divenire sempre più comune anche grazie a dei veri e propri spot pubblicati sui canali dei social networks, tra i quali Telegram, tanto da rappresentare un aspetto assai rilevante nel caso di alcuni gruppi, ad esempio Lapsus$ Team (Paliotta & Guzzo 2022).
In base alla breve disamina svolta in questo articolo si può infine concludere che, essendo la criminalità informatica connaturata a una dimensione internazionale, la lotta alla stessa richieda un approccio globale e uno sforzo congiunto di diverse entità statali. Le sfide giuridiche, tecniche e istituzionali poste dal cybercrime, difatti, sono globali e di vasta portata; e possono essere affrontate solo attraverso una strategia coerente che tenga conto, in un quadro di cooperazione internazionale del ruolo delle diverse entità e delle iniziative già esistenti. La chiusura di Hydra, che fa seguito a quelle di simili altre piattaforme, mostra anche un aspetto di cyber intelligence, propedeutico a tali chiusure, svolto dalle entità statali, dalle forze dell’ordine e finanche dai vendor commerciali. L’attività di ricognizione delle darknet (seppur onerosa, non solo in termini di tempo, per la numerosità dei siti e delle conversazioni da monitorare) è senz’altro strategica dal punto di vista dei risultati che si riescono a raggiungere. Come è stato opportunamente messo in risalto, «l’intelligence sul Dark Web può garantire l’accesso a informazioni strategiche e tattiche sulle intenzioni avverse dei cyber criminali. Ciò consente di calcolare il rischio imminente o quello potenziale ed il suo tempo di accadimento». È chiaro che tale attività pone una serie di sfide non semplici da affrontare in quanto vi sono forti tendenze al mimetismo, all’inganno, all’utilizzo di codici di linguaggio o di peculiari espressioni linguistiche che hanno l’obiettivo di “offuscare” l’intenzionalità criminosa alla base di tali interazioni. Per ovviare a tali problematiche sono state messe a punto molteplici tecniche (a solo titolo esemplificativo, il darknet spidering e l’authorship analysis) le quali costituiscono le basi di una moderna pre-reconnaissance cyber threat intelligence. Tra le entità istituzionali esistenti in Italia è indubbio che una tale attività dovrebbe essere svolta dalla neocostituita Agenzia per la Cybersicurezza Nazionale (ACN), rafforzando le capacità di proattività della stessa in linea con la sua missione di favorire la cyber resilienza, poiché aiuterebbe l’individuazione e la classificazione delle minacce desumibili dalle interazioni delle comunità criminali del darknet, da condividere successivamente con i singoli Security Operations Center (SOC) delle infrastrutture critiche, collegate in rete in una sorta di HyperSOC.
Un ultimo aspetto riguarda, infine, il ruolo delle valute virtuali; come si è visto il metodo di pagamento preferito sui mercati darknet, nell’erronea convinzione che esse siano un mezzo di scambio anonimo e non tracciabile. Le tecniche adottate da Hydra avevano permesso uno scambio crescente di fondi illeciti attraverso i wallets associati e, nello stesso tempo, la piattaforma aveva adottato «increasingly strict KYC [Know Your Customer] and AML [Anti-Money Laundering] roles on cryptocurrency exchanges by sellers offering various cashout services ranging from transfers using compromised P2P exchange accounts, to “hidden treasure” cashout, where cash is hidden at a specific location, often underground». Del resto, i pagamenti collegati all’attività estorsiva dei ransomware sono spesso richiesti in valuta virtuale per simili motivi. Le chiusure delle piattaforme darknet degli ultimissimi anni mostrano, tuttavia, che lo scambio pseudoanonimo di criptovalute non è sempre etichettabile come prono al crimine: in più occasioni, i servizi illeciti che riguardavano le criptovalute si sono mostrati tracciabili all’ispezione delle forze dell’ordine e moltissimi mercati sono stati chiusi, in gran parte a causa della trasparenza intrinseca della blockchain.
Tutto ciò può forse far realisticamente pensare che l’epoca d’oro del darknet sia giunta finalmente all’epilogo e che una larga porzione del cybercrime abbia perso la sua Tortuga digitale. Alcune autorità di settore sembrano esserne convinte, o almeno così sembrerebbe stando a un comunicato emesso dall’Europol a seguito dell’Operation DisrupTOR del settembre 2020: «The golden age of dark web marketplace is over. Operations such as these highlight the capability of law enforcement to counter encryption and anonymity of dark web market places. Police no longer only takes down such illegal marketplaces – they also chase down the criminals buying and selling illegal goods through such sites. The dark web is not a fairy tale – vendors and buyers are no longer hidden in the shadow».
Effettivamente, però, si possono nutrire molti dubbi al riguardo in quanto ad una chiusura corrispondono altrettante aperture di nuove piattaforme. Si è altresì consapevoli che gli antichi mestieri del criminale e del poliziotto continueranno a esistere, seppure in modalità ampiamente digitalizzate.
Riferimenti bibliografici
Agenzia per la Cybersicurezza Nazionale (ACN) (2022), “Strategia Nazionale di Cybersicurezza”, Roma, ACN, pp. 32;
Arruzzoli Francesco (2022), “Cognitive security”, Quaderni di Cyber Intelligence n. 2, ICT Security Magazine Press;
Barn Ravinder, Balbir Barn (2016), “An ontological representation of a taxonomy for cybercrime”, Twenty-Fourth European Conference on Information Systems (ECIS), Istanbul (TR), pp. 15;
Brenner Susan W. (2004), “Cybercrime Metrics. Old Wine, New Bottles?”, Virginia Journal of Law and Technology, v. 9, n. 13, Fall, pp. 54;
Broadhurst Roderic G. (2006), “Development in the global law enforcement of cyber-crime”, Policing. An International Journal of Police Strategies and Management, v. 29, n. 2, pp. 408-433;
Carter David L. (1995), “Computer Crime Categories. How Techno-Criminals Operate”, FBI Law Enforcement Bulletin, v. 64, n. 7, July, pp. 21-26;
D’Amore Fabrizio (2021), “La cybersecurity ai tempi del Covid19: stato dell’arte e nuovi scenari di attacco”, Agenda digitale”, 23 luglio, https://bit.ly/3rpuAHr;
D’Amore Fabrizio (2022), “Il furto di identità e come non facilitarlo – il luogo comune “non ho nulla da nascondere””, Quaderni di Cyber Intelligence n. 2, ICT Security Magazine Press;
Flashpoint – Chainalysis (2021), “Hydra. Where The Crypto Money Laundering Trail Goes Dark. Sequencing Cryptocurrency Flows on the Russian Cybercrime Market “Hydra””, Report, pp. 16;
Gercke Marco (2012), “Understanding cybercrime. Phenomena, challenges and legal response”, ITU Telecommunication Development Bureau, Geneva (CH);
Paganini Pieluigi (2021), “Ransomware: una nuova evoluzione delle pratiche estorsive”, CyberSecurity 360, 14 maggio, https://bit.ly/34a6ck9;
Paliotta Achille Pierre (2021), “La crittologia moderna. Dalla società dell’informazione all’informazione quantistica”, Tesi di Master SIIS discussa il 21 giugno, pp. 54;
Paliotta Achille Pierre (2022a), “Una riflessione preliminare sul processo di Istituzionalizzazione della Cyber Intelligence (CYBINT)”, Quaderni di Cyber Intelligence n. 1, ICT Security Magazine Press;
Paliotta Achille Pierre (2022b), “Dagli Usa la legge “benchmark” che può essere utile anche in Italia”, Il Sussidiario, 20 aprile, pp. 2, https://bit.ly/3rQOBGv;
Paliotta Achille Pierre, Antonio Guzzo (2022a), “Il modello di business della cybergang Lapsus$ Team – L’importanza della leva comunicativa e del fattore umano”, ICT Security Magazine, 28 marzo, pp. 4, https://bit.ly/3Dj18Hm;
Paliotta Achille Pierre, Antonio Guzzo (2022b), “Attacchi cyber, Italia fragile: serve una nuova istruzione di base”, Agenda digitale, 31 marzo, pp. 2, https://bit.ly/36EjIxQ;
Phillips Kirsty, Julia C. Davidson, Ruby R. Farr, Christine Burkhardt, Stefano Caneppele, Mary P. Aiken (2022), “Conceptualizing Cybercrime. Definitions, Typologies and Taxonomies”, Forensic Science, n. 2, pp. 379-398;
Articolo a cura di Achille Pierre Paliotta, Ricercatore senior della Struttura Mercato del Lavoro dell’INAPP (ex ISFOL).
Profilo Autore
Achille Pierre Paliotta, ricercatore INAPP(ex ISFOL), afferente alla Struttura Lavoro e Professioni. Laureato in Sociologia presso l’Università La Sapienza ha conseguito, nel 2015, il Master in Data Science presso l’Università di Tor Vergata. Sta attualmente frequentando il Master in Sicurezza delle informazioni e informazione strategica presso l’Università La Sapienza. I suoi interessi di ricerca vertono su nuove tecnologie, sicurezza informatica, nuove professioni, contrattazione collettiva, welfare occupazionale, data science, blockchain, open data e deep learning.
Il presente contributo ha lo scopo di proporre un’analisi di alto livello sul concetto di “analisi del rischio cibernetico” in relazione all’evoluzione degli scopi e delle metodologie di intelligence. La competizione tra le diverse entità statuali si è allargata partendo dal tradizionale ambito delle potenzialità dell’apparato militare di ciascun attore.
Oltre il potenziale militare è sempre più prevalente quello economico, cioè la capacità delle imprese di ciascun paese di generare innovazione, di esportare, di aumentare la filiera del valore aggiunto portando, se possibile, a fare dipendere altri paesi da sé.
L’aumento esponenziale del fenomeno dello spionaggio industriale, con un elevato utilizzo degli strumenti cibernetici, può essere ricondotto principalmente a:
La sempre maggior presenza di informazioni sensibili e proprietà intellettuale in possesso di imprese e centri di ricerca scientifica e tecnologica.
L’elevato tasso di profitto per gli attori statuali o para-statuali che praticano operazioni di intelligence in modalità cibernetica allo scopo di sottrarre segreti industriali, idee innovative e/o know-how tecnologico.
La difficoltà per le intelligence dei paesi target nel contrastare azioni cibernetiche ostili.
I settori tecnologici che costituiscono i target più appetibili sono i seguenti:
Tecnologie dell’informazione e della comunicazione;
Tecnologie militari, e in particolare sistemi marittimi e tecnologie aerospaziali e aeronautiche;
Tecnologie energetiche a bassa emissione di anidride carbonica;
Nuovi materiali e tecnologie manifatturiere avanzate, tra cui le nanotecnologie;
Tecnologie biomediche e farmaceutiche; Tecnologie avanzate di produzione agricola, tra cui quelle basate sull’ ingegneria genetica.
Nel nostro paese è cresciuta la sensibilità delle istituzioni sul tema e si è arrivati alla recente costituzione dell’Agenzia per la Cibersicurezza Nazionale incaricata di prendere ogni iniziativa attua a garantire una maggiore sicurezza e resilienza del mondo IT italiano. Per le citate implicazioni sulla sicurezza nazionale italiana tali azioni devono procedere di concerto con l’operare degli apparati di intelligence al fine di contrastare azioni ostili da parte attori statuali e para statuali ne confronti del nostro paese.
Il World Economic Forum ha pubblicato il “Global Risk Landscape 2021” da quale si evince che gli attacchi cibernetici comportino un rischio (probabilità x impatto) più elevato rispetto agli attacchi terroristici, alle crisi alimentari, alla disoccupazione e a tutta una serie di altri rischi che riempiono in ogni istante i notiziari radiotelevisivi e i social.
Le motivazioni sono:
il funzionamento delle moderne economie è sempre di più basato sulle tecnologie digitali;
l’interdipendenza delle Infrastrutture critiche aumenta costantemente;
aumento del rischio che un danno prodotto in un nodo del sistema si ripercuota sui nodi circostanti con effetti a catena potenzialmente catastrofici.
In questo contesto gli obiettivi delle attività di intelligence sono molteplici: difesa dell’interesse nazionale, contrasto alla competizione economica condotta in maniera surrettizia, tutela delle libertà individuali ed in ultima analisi del sistema democratico.
L’intelligence economica sta assumendo un ruolo sempre più rilevante al fine di evitare danni consistenti alla competitività dello stato e delle singole aziende. In particolare lo spionaggio industriale mira alla sottrazione di capitale intellettuale delle singole aziende privandole del loro asset di maggiore importanza e mettendone a rischio la stessa sopravvivenza. Un attacco spionistico, condotto da un’azienda concorrente o da un apparato d’intelligence straniero, sottrae know-how all’azienda colpita, azzerandone il possibile rendimento nel tempo di investimenti eseguiti. La particolare configurazione del sistema industriale italiano, con una forte prevalenza di PMI, rende indispensabile l’avvio di una politica di sensibilizzazione sui temi della sicurezza cibernetica e della protezione del patrimonio informativo, rivolta alle figure apicali delle PMI stesse. La sicurezza cibernetica non può essere vista come un costoso e fastidioso accessorio dell’attività d’impresa.
L’Agenza per la Cibersicurezza Nazionale deve porsi come attore primario di questa attività di diffusione e mantenimento della sensibilità ai temi della sicurezza cibernetica da parte delle PMI, attori imprescindibili del sistema economico nazionale.
L’Unione Europea considera la sicurezza cibernetica come obiettivo prioritario dell’attività di tutela del patrimonio informativo da parte degli stati membri e, a tale proposito, ha emanato la direttiva NIS e si prepara ad emanarne una seconda versione allo scopo di una migliore gestione del rischio cibernetico. La logica che pare intravedersi nella direttiva NIS è “secure us to secure me”; ne consegue che il presupposto fondamentale per il conseguimento di una maggiore sicurezza sistemica è, quindi, l’adozione di best practices da parte dei singoli attori.
Il rischio cibernetico non impatta solo la singola impresa ma ha anche una importante componente sistemica che è «il rischio che un attacco (o altri eventi avversi) in un singolo componente di un ecosistema infrastrutturale critico, causi ritardi significativi, diniego, guasto, interruzione o perdita, tali da influire sui servizi non solo nella componente originaria, ma anche nelle componenti dell’ecosistema logicamente e / o geograficamente correlate.
La magnitudo dell’impatto deriva da:
aumento costante della superficie digitale;
crescita della velocità della trasformazione digitale;
semplicità ed economicità della realizzazione degli attacchi;
aumento della complessità delle minacce.
Affrontare il rischio sistemico vuol dire lavorare su tre livelli: quello interno e dell’ecosistema dei principali stakeholder dell’azienda; quello degli upstream provider e quello degli eventi esterni imprevisti. Quest’ultimo livello comporta una rinnovata importanza delle attività di intelligence in quanto gli organismi preposti sono attori imprescindibili per l’individuazione di azioni ostili che impattano sul “rischio sistemico” dei singoli soggetti economici.
Lo strumento più idoneo per una mitigazione del rischio efficace (non esiste in nessuna organizzazione un contesto con rischio uguale a zero) è l’adozione di adeguate metodologie di Analisi del Rischio, di tipo quantitativo o qualitativo, al fine di considerare tutte le possibili vulnerabilità di diversa natura valutando la probabilità di accadimento di eventi negativi legati ad esse. Si passa dalla “logica dell’adempimento” alla “logica della responsabilità”, laddove il singolo operatore, attraverso l’Analisi del Rischio deve essere in grado di identificare le minacce incombenti sulla protezione del proprio patrimonio informativo con l’individuazione delle vulnerabilità presenti e, attraverso un processo di Gestione del Rischio, la definizione di adeguate contromisure.
Le metodologie di Analisi del Rischio più conosciute ed utilizzate sono:
ISO:IEC 27005: unico standard internazionale de iure.
NIST SP800-30: standard federale adottato dagli Stati Uniti.
Magerit: standard nazionale spagnolo adottato da ENISA (European Network and Information Security Agency).
Octave: sviluppata dalla Carnegie-Mellon University per soddisfare le esigenze del Department of Defence degli Stati Uniti.
Normalmente lo standard ISO:IEC 27005 è quello ritenuto più utilizzato e ritenuto più idoneo, specialmente in ambito IT.
Il crescente aumento della cyberwarfare nella competizione globale tra stati ed aziende rende necessario l’utilizzo di metodologie e strumenti allo scopo di conseguire un adeguato livello di protezione degli asset aziendali o statuali. A tal fine sarebbe auspicabile l’adozione di metodologie di Analisi del Rischio tra gli strumenti in uso da parte della Agenzia per la Cibersicurezza Nazionale.
In generale ogni soggetto si caratterizza per la presenza di rischi collegati al proprio business aziendale ed è costretto a definire una soglia minima di esposizione al rischio (cd. “Rischio accettabile”). La definizione di questa soglia è un processo molto complesso e critico che può essere governato unicamente attraverso modalità di “Gestione del Rischio” metodiche e formali.
In particolare la Gestione del Rischio si caratterizza nell’applicazione sistematica di:
Politiche di gestione
Procedure
Azioni
Volte all’esecuzione delle seguenti fasi inerenti al rischio:
Identificazione
Analisi
Valutazione
Mitigazione controllo eventuale
La Gestione del Rischio è, quindi, un processo volto ad assicurare che gli impatti dovuti a minacce incombenti su vulnerabilità di sistemi e processi IT siano contenuti a livelli accettabili a fronte di costi sostenibili da parte dell’organizzazione del soggetto. Per raggiungere tale obiettivo è necessario un adeguato bilanciamento tra l’esposizione al rischio ed i costi di mitigazione attraverso l’implementazione di adeguate contromisure e controlli.
L’adozione di una metodologia formale per la gestione del rischio è preferibile in quanto ha le seguenti caratteristiche:
Oggettività
Ripetibilità
Verificabilità anche da attori esterni
Automatizzabili
Applicabilità ad organizzazioni anche complesse
Fornitura di risultati confrontabili anche nel tempo
Misurabilità dell’efficacia con possibilità di azioni correttive
Un adeguato programma di Gestione del Rischio deve quindi prevedere i seguenti passi:
Analisi del contesto e dichiarazione dell’ambito
Identificazione e valorizzazione degli asset
Classificazione degli asset
Individuazione delle minacce e delle vulnerabilità
Determinazione dei rischi
Valutazione degli impatti
Trattamento dei rischi
Sensibilizzazione alle tematiche di sicurezza degli utenti
Effettuazione di attività di monitoraggio e revisione costanti
Comunicazione dei risultati
È opportuna una classificazione delle terminologie adottate nel processo di esecuzione della Gestione del Rischio:
Asset: qualsiasi bene materiale o immateriale, persone comprese, che costituiscono un valore per l’organizzazione dell’operatore.
Vulnerabilità: caratteristica intrinseca di qualsiasi processo o sistema IT che può provocare, anche per azione indotta, eventi indesiderati che possono comportare danni all’organizzazione.
Minaccia: evento potenziale che se attuato porta a conseguenze indesiderate o perdite all’organizzazione dell’operatore.
Agente di Minaccia: entità in grado di attuare, deliberatamente o meno, una minaccia.
Rischio: probabilità del verificarsi di una minaccia attraverso lo sfruttamento di una vulnerabilità.
Impatto: conseguenza indesiderata che si abbatte sull’organizzazione dell’operatore in seguito al verificarsi di un rischio.
La valutazione del rischio è un processo che comporta analisi di tipo quantitativo così come qualitativo. La determinazione dell’impatto, ad esempio, comporta una quantificazione delle grandezze di entrambe le tipologie:
1) Quantitative in quanto direttamente ed oggettivamente misurabili:
perdite di fatturato e/o di utili di bilancio;
incremento dei costi di produzione;
costi sostenuti per la risoluzione di anomalie.
2) Qualitative non oggettivamente misurabili:
perdita di credibilità con ricadute sull’immagine dell’organizzazione;
danni indiretti ad interessi dell’organizzazione
violazioni della riservatezza delle informazioni.
La stessa frequenza o probabilità di accadimento può aversi nelle tipologie suddette, quantitativa, ad esempio nel caso di stima del verificarsi di un black-out elettrico, oppure qualitativa come la stima della probabilità di essere oggetto di attacco informatico.
Più in generale un approccio quantitativo presenta:
Punti di forza:
Rischi ai quali si riesce a dare priorità secondo l’impatto economico ed asset in funzione del loro valore economico.
Aiuto alla gestione del rischio con una puntuale definizione del ritorno dell’investimento sostenuto per la mitigazione del rischio stesso.
Facilità di comprensione da parte dei vertici aziendali dei risultati ottenuti dalle attività poste in essere per la mitigazione del rischio.
Punti di debolezza:
I valori degli impatti assegnati ai rischi sono frutto di valutazioni soggettive da parte delle strutture organizzative interessate.
Necessità di dover impiegare molto tempo e costi elevati al fine di raggiungere un obiettivo misurabile.
Non misurabilità di tutti i valori necessari
Altresì l’approccio qualitativo presenta:
Punti di forza:
Migliore comprensione dell’importanza relativa dei rischi al fine di un’adeguata assegnazione delle priorità.
Maggiore facilità di condivisione degli obiettivi tra le diverse strutture aziendali.
Non occorre una quantificazione delle minacce.
Non è necessaria una determinazione economica del valore economico degli asset.
Punti di debolezza:
Insufficiente granularità dei rischi più significativi.
Difficoltà nel giustificare investimenti economici volti alla mitigazione del rischio in assenza di un’analisi costi/benefici quantitativa.
Risultati che vengono influenzati dalle qualità professionali del gruppo di lavoro preposto all’analisi del rischio.
Una soluzione per una più efficace azione di analisi del rischio consiste nell’adozione di un approccio intermedio o semi qualitativo con l’individuazione di classi di valori definite da intervalli di una certa ampiezza con l’associazione alla classe più congrua di ciascun valore di occorrenza e impatto.
Tali attività di gestione del rischio sono già in essere nelle realtà di maggiori dimensioni del nostro paese; tuttavia e innegabile la necessità di un maggiore implementazione delle stesse. Un alto fattore di rischio è dato dalla situazione delle PMI italiane in questo campo; scarsità di investimenti e di consapevolezza in questo campo rendono le PMI estremamente esposte ad attività ostili di intelligence straniere volte all’acquisizione di delicate informazioni industriali ed economiche.
La notevole importanza delle PMI nel settore economico italiano rende urgente un’azione di difesa delle stesse attraverso un ruolo di stimolo alla sensibilità sulle tematiche della cyberguerra da parte dell’Agenzia per la Cibersicurezza Nazionale. Dal canto loro gli apparati di intelligence devono essere coinvolti per l’esecuzione di attività di contrasto alle ingerenze estere anche attraverso l’uso di tecniche Humint ed Osint, che costituiscono un imprescindibile mèzzo di difesa dell’interesse economico nazionale.
Articolo a cura di Andrea Giordani
Profilo Autore
Andrea Giordani è un esperto senior di sicurezza dei sistemi informativi. Ha conseguito rilevanti certificazioni internazionali nella materia ed ha una notevole esperienza di sviluppo sicuro dei sistemi IT nonché in molteplici attività di governance della sicurezza IT. Già lead auditor presso aziende per la verifica della certificazione ISO_27001 e 27002, ha svolto attività di audit e di verifica dell’analisi del rischio presso rinomati clienti internazionali per determinare lo stato di sicurezza dei loro sistemi informativi deputati alle operazioni finanziare svolte con carta di credito. Ha conseguito un Master di II livello in Intelligence e Sicurezza. Attualmente è membro della commissione Cyber Threat Intelligence e Warfare presso la Società Italiana di Intelligence.
«La guerra si fonda sull’inganno» L’Arte della Guerra, Sun Tzu
Il social engineering – o ingegneria sociale – è una disciplina che sfrutta processi cognitivi di influenzamento, inganno e manipolazione per indurre una persona a compiere un’azione o a comunicare informazioni riservate.
La storia è Maestra di vita, e l’arte di ingannare l’avversario non si sviluppa certamente con la nascita dei computer e della sicurezza informatica: probabilmente la più antica prova di un attacco di ingegneria sociale si trova nella Bibbia, Genesi 27, dove Rebecca inganna suo marito Isacco facendogli benedire il secondogenito Giacobbe, rendendolo il suo successo re, invece di Esaù, che era il maggiore.
Ma i libri di storia sono pieni di episodi in cui si sono perpetrati inganni e tranelli, sicuramente l’esempio scolastico per eccellenza è quello del Cavallo di Troia, che i Greci usarono per espugnare la città di Troia (non per nulla con il termine “Trojan Horse” intendiamo un tipo di codice o software dannoso che sembra legittimo ma può prendere il controllo del tuo computer, progettato per danneggiare, interrompere, rubare o in generale infliggere altre azioni dannose ai tuoi dati o alla tua rete).
Le azioni criminali basate sull’ingegneria sociale, di cui abbiamo notizie fin dalla notte dei tempi, possono concretizzarsi con o senza l’ausilio di tecnologia.
Purtroppo è un dato di fatto che l’ingegneria sociale si è evoluta nel tempo da una tecnica di attacco che puntava esclusivamente sul carisma e l’abilità dell’attaccante verso una strategia ibrida, ancora più incisiva e subdola che sfrutta sia le abilità cognitive che quelle informatiche.
Questo è stato reso possibile negli ultimi anni grazie alla crescita della digitalizzazione della comunicazione con la diffusione dei social (fucina inesauribile di informazioni) e dei vari servizi di messaggistica. L’ingegnere sociale sfrutta, per l’appunto, la percezione distorta che l’utente medio ha di questi strumenti, ritenendoli puramente virtuali, privi di insidie e scollegati dal mondo reale.
I cybercriminali sanno che l’ingegneria sociale funziona meglio quando ci si concentra sulle emozioni delle persone. Approfittare delle emozioni umane è molto più facile che hackerare una rete o cercare delle vulnerabilità.
Il principio alla base dell’ingegneria sociale è quello di sfruttare il fattore umano, ovvero mettere le persone in situazioni in cui si sa già che faranno affidamento sulle forme più comuni di interazione sociale, come la tendenza a fidarsi delle persone e a rivelare informazioni private (magari pubblicando sui social network), il desiderio di un professionista nel dimostrare acume e superiorità nel suo campo, la tendenza della maggior parte delle persone ad essere più disponibili verso chi mostra interesse nei loro riguardi.
L’attacco fa, dunque, leva su tratti caratteristici dell’essere umano, come la disponibilità e la buona fede dell’attaccato, l’ignoranza e la disattenzione o, ancora, la paura, l’urgenza, la gratitudine.
“Si possono investire milioni di dollari per i propri software, per l’hardware delle proprie macchine e per dispositivi di sicurezza all’avanguardia, ma se c’ è anche solo un unico dipendente della nostra azienda che può essere manipolato con un attacco di ingegneria sociale, tutti i soldi investiti saranno stati inutili” (dal libro l’Arte dell’Inganno di Kevin Mitnick).
In un contesto caratterizzato dall’incessante ricerca di nuovi e più sofisticati sistemi tecnologici di difesa informatica, tali da rendere le reti sempre più impenetrabili ed i software sempre più sofisticati, ciò che indebolisce il processo di security dagli attacchi di cognitive hacking è proprio l’uomo. Le tattiche utilizzate per eseguire un buon attacco di ingegneria sociale si basano principalmente sull’elicitation (e “elicitazione”) termine inglese che consiste nel porre domande preparate apposta, tramite un insieme di tecniche e metodi (utilizzati dai professionisti dell’intelligence e della cyber intelligence) per raccogliere informazioni di nascosto.
In sostanza, un professionista dell’intelligence si impegna in una conversazione con l’obiettivo di raccogliere informazioni e, utilizzando metodi di elicitazione, carpisce le informazioni di cui ha bisogno senza che l’obiettivo si renda conto di essere sfruttato per ottenere informazioni, che possono essere successivamente utilizzate in una campagna di ingegneria sociale su larga scala.
L’elicitazione è un’attività poco rischiosa e difficile da individuare. Spesso e volentieri chi cade vittima rivelando informazioni importanti, neanche si rende conto di come sia potuta uscire l’informazione e, se anche una domanda ad un secondo ripensamento dovesse risultare sospetta, le vittime tendono a considerarla una domanda a cui avrebbero potuto rispondere oppure no, in cui nessuno si ricorda del contenuto delle informazioni che sono trapelate. Basta fare al bersaglio individuato la domanda giusta al momento giusto e tutte le porte si apriranno.
“Se il vostro avversario ha un carattere iroso, dovete tentare di irritarlo, se è arrogante, provate a incoraggiare la sua arroganza… Colui che è in grado di muovere il proprio avversario lo fa creando una situazione che indurrà il nemico a compiere una certa mossa; questi alletta il nemico con qualcosa che l’altro pensa di poter far suo. Tiene in movimento il nemico facendogli pendere davanti un’esca e poi attaccandolo con truppe scelte.” (Sun Tzu, l’Arte della Guerra)
Ma se un qualsiasi cittadino, “custode” di informazioni riservate, rischia di mettere a repentaglio la propria sicurezza e di chi gli sta intorno, pensiamo cosa potrebbe verificarsi se la vittima è un soggetto che svolge un’attività di Pubblica Sicurezza.
In ambito di Sicurezza Nazionale, l’utilizzo di reti informatiche non classificate, come Facebook, Twitter, Instagram (solo per citarne i più conosciuti), espone le Forze Armate a rischi sempre più elevati di perdita di informazioni sensibili che, se inserite in un opportuno ciclo di intelligence, possono arrecare un notevole danno alla sicurezza del contingente militare, delle operazioni in corso e più in generale della Difesa.
Si può a questo punto provare a definire il concetto di cyber-intelligence come l’insieme degli sforzi e delle attività svolte da o per conto di un’organizzazione, progettate e messe in atto per identificare, tracciare, misurare e/o monitorare, attraverso l’utilizzo di strumenti informatici, le minacce digitali, i dati e/o le operazioni di un avversario.
Data la peculiarità e la complessità delle attività che si celano dietro questo termine, le operazioni di cyber-intelligence spesso possono non essere sufficienti da sole a fornire al decisore una visione informativa completa. In questi casi, dunque, ad esse potranno essere affiancati altri metodi d’intelligence tradizionali come, prima fra tutti, la Human intelligence (HUMINT) o la Signal intelligence (SIGINT). Infatti, a differenza delle armi nucleari e delle altre armi di distruzione di massa, le c.d. cyber-weapons non richiedono particolari infrastrutture, né tantomeno materiali speciali e, spesso, neppure conoscenze tecniche particolarmente approfondite per essere predisposte. In quest’ottica, quindi, si dovrebbe fare esclusivo affidamento sulle poche, spesso labili, tracce elettroniche lasciate dall’avversario nelle fasi preliminari all’attacco informatico, ovvero quelle di footprinting o fingerprinting.
I tradizionali metodi di cyber-intelligence per la raccolta di informazioni riservate, pertanto, potrebbero mostrare il fianco quando l’obiettivo è quello di comprendere a pieno le capacità e/o le intenzioni reali del nemico, qualora non vengano comunque affiancati anche da attività similari nel “mondo fisico”. Un ulteriore elemento che si collega a quanto appena analizzato e che pertanto, seppure brevemente, deve essere tenuto in debita considerazione, è quello relativo alle tecniche d’ingegneria sociale, di cui finora abbiamo discusso. Non si deve dimenticare, infatti, che la maggior parte dei malware o delle tecniche di phishing, ad esempio, utilizzano, seppur in maniera generalizzata e non mirata, delle tecniche di ingegneria sociale per far sì che l’utente del sistema informatico sia invogliato ad aprire l’allegato infetto, ovvero ritenga valido e credibile il contenuto della mail ricevuta.
Appare evidente allora che, per fronteggiare una simile minaccia, che basa la sua forza sull’insicurezza degli strumenti tecnologici, sulla poca accortezza degli utenti e sulle tecniche di ingegneria sociale, un primo argine alla possibile fuoriuscita di informazioni classificate e sensibili viene proprio da policies di cyber security stringenti, accorte e, soprattutto, specificatamente tarate sulle esigenze operative del contingente che in un’ottica di sicurezza nazionale, va intesa come la capacità di resistere alle minacce intenzionali e non intenzionali attuate contro i sistemi informatici a rilevanza nazionale, nonché di rispondere e rimediare a dette azioni.
In una società che ormai poggia le fondamenta sul concetto stesso di informazione e sulla rilevanza che questo concetto ha all’interno dei meccanismi di funzionamento di tutti i sistemi cibernetici, su cui si basa il dialogo e l’infosharing tra i vari Stati su cui poggia il perno delle discussioni in atto a livello internazionale al fine di armonizzare il quadro normativo e gli standard di sicurezza, risulta particolarmente intuitivo comprendere come impossessarsi, proteggere e usare la maggior quantità possibile di esse sia lo sforzo più rilevante a supporto di un’efficace strategia di vittoria per molti dei conflitti che saranno combattuti in futuro. Se è vero, infatti, che: “In linea di massima, a proposito della battaglia, l‘attacco diretto mira al coinvolgimento; quello di sorpresa, alla vittoria” (Sun Tzu, l’Arte della Guerra), allo stato attuale, proprio gli attacchi informatici possono essere ancora in grado di conseguire con facilità questo espediente.
“Se l’intelligence è indispensabile per comprendere la realtà, la cyber Intelligence lo è ancora di più per orientarsi nella realtà e nel suo doppio: le galassie in espansione del web” (Cyber intelligence, Mario Caligiuri).
Articolo a cura di Giuseppe Maio
Profilo Autore
Giuseppe Maio è Security Advisor in ambito Governance, Risk and Compliance (GRC) per un importante società di Consulenza strategica. Dopo aver conseguito una laurea in Giurisprudenza presso l’Università Mediterranea di Reggio Calabria, ha frequentato un master di II Livello presso l’Università LUISS Guido Carli in “Cybersecurity: Politiche Pubbliche, Normative e Gestione”. Attualmente è membro della Commissione Cyber Threat Intelligence & Warfare presso la Società Italiana di Intelligence.
Quantum Hacking – Hackerare la crittografia quantistica
Il Quantum Hacking figura da tempo sui radar degli esperti di sicurezza, preannunciandosi come prossima frontiera degli attacchi informatici nonché come futura “big cybersecurity threat”.
Post-Quantum Cryptography (PQC), a che punto siamo?
La crittografia è una tecnologia dall’impiego estremamente pervasivo e risulta oggi cruciale nella protezione di innumerevoli processi tecnologici, dalle comunicazioni via web ai pagamenti elettronici.
Richiedendo potenze di calcolo smisurate – ancora proibitive per le capacità delle macchine attualmente disponibili – e costi altrettanto elevati, ad oggi tali tecnologie non hanno infatti affrontato il banco di prova della diffusione commerciale, restando circoscritte agli ambienti della ricerca accademica o industriale.
L’ombra del Quantum Hacking sul futuro della crittografia
Con l’espressione Quantum Hacking si fa riferimento all’insieme di tecniche che si ipotizza potranno essere messe a punto, allorché saranno disponibili quantum computer che abiliteranno la potenza di calcolo richiesta, per violare i sistemi di comunicazione protetti da protocolli di crittografia, al fine di esfiltrarne dati o compiere altre attività malevole.
E se il fatto che i canali protetti da crittografia quantistica possano astrattamente essere violati è già di per sé fonte di preoccupazione, le principali minacce alla sicurezza deriverebbero dalla possibilità di farlo senza lasciare alcuna traccia.
Appare intuitivo come in tal modo gli attacchi informatici potrebbero protrarsi per lungo tempo: così da un lato consentendo agli autori di muoversi indisturbati entro il perimetro colpito e produrre danni significativi, dall’altro ritardando notevolmente quelle attività di remediation post-attacco che sappiamo essere fondamentali anche in seguito all’avverarsi di minacce informatiche meno futuristiche.
In attesa di ulteriori sviluppi della tecnologia, di certo c’è solo che il crimine informatico sarà come sempre pronto a sfruttare a proprio vantaggio ogni eventuale falla o vulnerabilità emergente, rendendo opportuno includere l’analisi dei rischi connessi al Quantum Hacking in ogni discussione, simulazione o ricerca condotta in tema di Post-Quantum Cryptography.