Risk management nella sanità digitale: prevenire e mitigare i rischi informatici
Questo articolo rappresenta il capitolo conclusivo della serie dedicata alla cybercriminalità nel settore sanitario, concentrandosi sugli aspetti operativi della gestione del rischio cyber. Dopo aver analizzato le minacce e le vulnerabilità del sistema sanitario digitale, questo contenuto si focalizza sulle metodologie concrete di risk management, dalla matrice di valutazione del rischio alla Data Protection Impact Assessment (DPIA).
Risk management nel comparto sanitario
Nei previ capitoli si è avuto modo di comprendere come il cyber risk sia ad oggi un rischio che, in certi settori e per alcune tipologie di danni (quali il furto di dati personali, il blocco di attività produttive o catene di fornitura, la violazione sistematica della privacy etc.), possa comportare impatti catastrofali.
Pertanto sarà necessario per costruire un’efficace politica di sicurezza[1], nonché per mettere in atto con successo le strategie preventive sopra descritte, attuare la c.d. “gestione dei rischi” (anche risk management)[2], quale processo comprendente tutte quelle azioni finalizzate ad identificare eventuali minacce o vulnerabilità cui una azienda risulti esposta al fine di sviluppare strategie e contromisure atte a poterle mitigare e controllare.[3]
Sebbene nessun sistema possa definirsi del tutto sicuro, esiste tuttavia un livello accettabile di sicurezza che è generato proprio dal bilanciamento di varie componenti: il valore di quanto si intende difendere, l’investimento economico che si è disposti a sostenere ed il livello di rischio che si è disposti a tollerare, pertanto risulterà essenziale addivenire ad un ragionevole compromesso tra tali esigenze poste in gioco.[4]
Soffermandosi il tempo dovuto sul concetto stesso di rischio, esso si figura quale condizione esistenziale, ineliminabile di ogni azienda, un fenomeno dalla natura sistematica,[5] che assume carattere dinamico,[6] essendo in grado di influenzare le condizioni di equilibrio economico, finanziario e patrimoniale.
Ancora si potrebbe qualificare come l’incertezza misurabile, riferendosi ad eventi, esterni od interni, per i quali è sempre possibile quantificare la frequenza con cui essi sono avvenuti in passato e di conseguenza il grado di probabilità di una loro verificazione futura.
Dando uno sguardo al panorama normativo ed in particolare all’art. 2 del D.lgs. n. 81/2008 (Testo unico per la sicurezza sul lavoro)[7], il rischio viene indicato come “la probabilità di raggiungimento del livello potenziale di danno nelle condizioni di impiego o di esposizione ad un determinato fattore o agente oppure alla loro combinazione”, si sta pertanto trattando ivi di una grandezza aleatoria, quale esprimente la probabilità che si verifichi un evento in grado di causare concretamente un danno.
Nonostante il legislatore stesso non suggerisca metodologie precise per addivenire ad un preciso calcolo del rischio, nella maggioranza dei casi ci si rifà al c.d. “metodo a matrici”, derivante originariamente dalle linee guida Ue atte a indirizzare ed accompagnare piccole e medie imprese verso una corretta ed efficace valutazione dei rischi.
Ebbene la matrice di rischio (anche matrice di impatto), quale strumento di analisi è riassumibile nella formula: [R] = [P] x [E], dove la grandezza [P] suole indicare la quantificazione (stima) della probabilità che il danno, derivante da un fattore di rischio dato, effettivamente si verifichi, mentre [E] risulta essere la quantificazione (stima) del potenziale danno, nella sua entità (o gravità).
La probabilità di accadimento [P] può assumere un valore sintetico in una scala da 1 a 4, a seconda della gamma di soglie di probabilità:
[P1] improbabile: il danno dipenderebbe da una concatenazione di eventi altamente improbabili e fra loro indipendenti, non sono mai stati registrati episodi simili in passato;
[P2] poco probabile: il danno si potrebbe verificare solo in circostanze alquanto particolari, raramente simili episodi sono accaduti in precedenza;
[P3] probabile: il danno potrebbe accadere, anche se non in modo automatico o diretto, suscitando una scarsa sorpresa, sono invero già stati riscontrati alcuni episodi simili in passato;
[P4] molto probabile: la situazione rilevata è direttamente correlata al verificarsi di un danno, la cui verificazione non susciterebbe stupore (anzi l’evento sarebbe largamente atteso), sono noti svariati episodi della stessa tipologia accaduti in precedenza.
La gravità del possibile danno [E] può assumere un valore sintetico in una
scala da 1 a 4, a seconda della gamma di soglie del danno:
[E1] lieve: si pensi ad un infortunio con effetti di inabilità temporanea, che siano rapidamente reversibili;
[E2] significativo: quale un infortunio con lesioni significative, ma ad ogni modo reversibili a medio termine;
[E3] grave: si pensi ad un infortunio con lesioni significative irreversibili o di invalidità parziale;
[E4] gravissimo: come un infortunio con lesioni altamente gravi irreversibili, invalidità totale o conseguenze letali. [8]
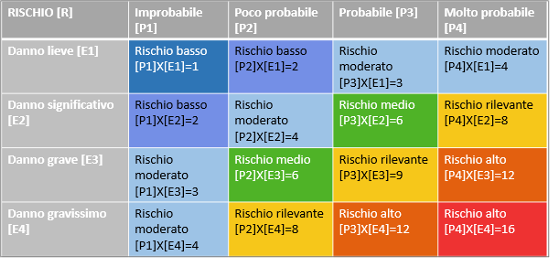
Pertanto una volta individuata una specifica situazione di pericolo, il valore numerico del rischio [R] sarà stimato quale prodotto fra l’entità del danno [E] e la probabilità di accadimento dello stesso [P], arrivando ad assumere un valore sintetico numerico compreso fra 1 e 16, per come si è voluto ricostruire nella matrice di rischio riportata a seguire:
Fig 6.1 Matrice di rischio secondo la formula [R]= [P] x [E]
In definitiva, l’anzidetta matrice risulta schematicamente una griglia, al cui interno da un alto verrà riportata la probabilità che un certo evento si verifichi e dall’altro l’impatto che questo stesso può comportare, incrociando le suddette grandezze poi si otterranno, come possibili risultati, differenti livelli di rischio:[9]
Rischio basso [1 ≤ R ≤ 2 ]: è da ritenersi pienamente accettabile, sicché non si richiederà l’adozione di alcuna tipologia di intervento;
Rischio moderato [3 ≤ R ≤ 4 ]: è anch’esso sopportabile, per cui l’adozione di specifiche azioni correttive sarà da valutare caso per caso;
Rischio medio [R=6]: è un livello che deve allertare, pertanto occorre tenerlo sotto adeguato controllo, saranno poi necessari interventi tecnici, organizzativi o procedurali, da programmare nel medio termine;
Rischio rilevante [R=9]: non risulta accettabile, richiederà pertanto interventi in tempi celeri atti a risolvere il problema;
Rischio alto [12 ≤ R ≤ 16]: è un livello di rischio assolutamente non accettabile che richiederà di interrompere immediatamente le operazioni e/o le attività e di non riprenderle fintanto che non si sia risolto il problema all’origine.[10]
Sulla base dei risultati sopra ottenuti, saranno adottabili tutta una serie di decisioni, quali: assumersi od evitare il rischio (ad esempio decidendo di iniziare o meno una determinata attività), rimuovere la fonte di rischio (quale una falla nella sicurezza di un sistema), modificarne la probabilità e le conseguenze (adottando misure, strategie e meccanismi di sicurezza), od altresì condividere il rischio stesso (servendosi di servizi assicurativi).
Da ultimo, con l’applicazione di una delle anzidette condotte si andrà ad evidenziare il grado di probabilità e gravità che permarrà, nonostante le azioni di mitigazione poste in essere, ossia il cosiddetto “rischio residuo”, che dovrà necessariamente esser tracciato, nonché sottoposto a periodici monitoraggi, in quello che si figura essere un modello di analisi dinamico e circolare.
Valutazione d’impatto (DPIA)
Passando ora a prendere in considerazione l’ambito della salute, risulta chiaro come medici, e strutture sanitarie in generale, debbano anch’essi gestire tutti quei rischi derivanti dal trattamento di una ingente mole di dati ipersensibili dei pazienti, optando per soluzioni operative che offrano massima protezione e riservatezza, nel rispetto dei diritti fondamentali degli individui.
Si ricordi come il Regolamento Ue 2016/679 (GDPR) si muova in un’ottica di responsabilizzazione (o accountability) nei confronti della figura del Titolare del trattamento[11], che dovrà adottare tutte le misure tecniche ed organizzative adeguate per garantire un livello di sicurezza proporzionato al rischio, di varia probabilità e gravità per i diritti e le libertà delle persone, inclusa la protezione, ex art. 5 contro “trattamenti non autorizzati o illeciti, la perdita, la distruzione o il danno accidentale”.
Ecco come posto di spiccato rilievo viene assunto, tra le novità introdotte dalla suddetta disciplina europea, dalla Valutazione d’impatto sulla protezione dei dati (anche detta DPIA, ossia Data Protection Impact Assessment), quale processo volto a descrivere il trattamento, valutarne necessità e proporzionalità, nonché ad identificare e gestire i rischi che ne derivino per i diritti delle persone fisiche, determinando in tal modo tutte le misure e tecniche atte ad affrontarli.
Nello specifico dall’art. 35 del Regolamento Ue, si evince come la DPIA sia obbligatoria laddove si svolgano trattamenti che, per loro stessa natura, oggetto, contesto e finalità possano presentare un rischio considerabile come elevato.[12] Ovvio è come identificare tutti i casi rientranti nello scenario appena delineato non sia sempre un’operazione semplice ed immediata, per questo si necessita di una fase preliminare, definibile per l’appunto come “prevalutazione d’impatto”, in cui il titolare del trattamento, una volta raccolte le informazioni essenziali, coadiuvato dal DPO (Data protection officer) qualora designato, valuterà l’opportunità e/o la necessità di procedere o meno ad una DPIA.
Il GDPR stesso viene in soccorso in tale prevalutazione, non elencando tassativamente i casi di obbligatorietà, ma limitandosi ad individuare tre ipotesi generali in cui la DPIA viene richiesta:
a) quando il trattamento comporta una valutazione sistematica e globale di aspetti personali relativi a persone fisiche, basata su un trattamento automatizzato, compresa la profilazione, e sulla quale si fondano decisioni che hanno effetti giuridici o incidono in modo analogo significativamente su dette persone fisiche;
b) in caso di trattamento, su larga scala, di categorie particolari di dati personali di cui all’articolo 9, paragrafo 1 (fra i quali, si ricorderà, sono compresi i dati relativi alla salute);
c) qualora il trattamento abbia ad oggetto la sorveglianza sistematica su larga scala di una zona accessibile al pubblico.
A tali indicazioni generali poi si vanno a sommare le Linee Guida WP 248 emanate dal Gruppo di lavoro “Articolo 29” (ad oggi European Data protection Board), che a loro volta identificano nove casi in presenza dei quali si può desumere che il trattamento presenti proprio “un rischio elevato per i diritti e le libertà delle persone fisiche” e che dunque si debba procedere con la DPIA:[13]
a) valutazione o assegnazione di un punteggio, inclusiva di profilazione e previsione;
b) processo decisionale automatizzato, mirante a consentire l’adozione di decisioni in merito agli interessati che abbiano effetti giuridici o che incidano in modo analogo significativamente su dette persone fisiche;
c) monitoraggio sistematico;
d) trattamento di dati sensibili od aventi carattere altamente personale;
e) trattamento di dati su larga scala, valutando a tal fine: il numero di soggetti interessati, il volume e le diverse tipologie dei dati, la durata, la persistenza ed altresì la portata geografica dell’attività di trattamento;
f) creazione di corrispondenze o combinazione di insiemi di dati;
g) trattamento di dati relativi ad interessi definibili come vulnerabili;
h) uso innovativo od anche applicazione di nuove soluzioni tecnologiche ed organizzative;
i) quando il trattamento in sé impedisce agli interessati di esercitare un diritto o di avvalersi di un servizio o contratto.
Risulta evidente come l’ambito sanitario vada a soddisfare molteplici dei suddetti requisiti, dal momento che risulta qualificabile come trattamento “su larga scala” di dati “sensibili” e/o relativi a categorie di interessati “vulnerabili” (si pensi a minori, anziani, pazienti affetti da patologie invalidanti etc.), che fa largo uso di tecnologie “avanzate ed innovative”.
Effettivamente la rilevazione di dati e parametri vitali tramite strumenti di monitoraggio a distanza (o mediante wearable devices), l’utilizzo di sistemi di AI per l’individuazione di terapie personalizzate, l’adozione di tecniche di machine learning nell’individuazione di gruppi di pazienti con una maggiore o minore propensione a sviluppare specifiche patologie, sono tutti esempi di acquisizione di dati che incidono sì principalmente sul diritto alla salute, ma altresì su svariati ambiti di vita quotidiana dei singoli individui, per tale motivo una valutazione d’impatto incentrata sull’analisi dei rischi derivanti da tali tipologie di trattamenti sanitari si profila come pienamente necessaria.[14]
Uno specifico modello di gestione dei dati dovrà essere in grado infatti di assicurare, costantemente, la riservatezza, l’integrità, la disponibilità ed anche la resilienza dei sistemi, cosicché in caso di accadimento di un evento negativo (interno od esterno) si possa comunque ripristinare tempestivamente tanto la disponibilità quanto l’accesso ai propri dati personali. [15]
Si passino così a considerare le concrete fasi del processo iterativo di una DPIA, per come vengono delineate dalle sopradette linee guida del WP29:
a) Descrizione del trattamento: innanzitutto occorrerà identificare tutti i diversi soggetti che siano coinvolti a diverso titolo (titolare ed eventuali contitolari, outsourcer responsabili esterni, amministratori di sistema etc.), come anche le tipologie di dati trattati, le piattaforme tecnologiche utilizzate e le finalità del trattamento stesso.
L’individuazione dei soggetti e la definizione dei livelli di responsabilità è indubbiamente un primo step difficoltoso, considerando la necessaria condivisione ed interoperabilità che caratterizza primi fra tutti i dati sanitari (si pensi a tutti gli episodi sanitari che caratterizzano la presa in carico di un paziente: assistenza domiciliare, programmi di screening, assistenza specialistica ambulatoriale, ricoveri, riabilitazione, gestione della cronicità etc.).
Durante ogni contatto infatti il paziente riceve determinate prestazioni (visite, esami, terapie, interventi etc.) che a loro volta ingenerano atti sanitari (un referto, il risultato di un esame di laboratorio etc.) per i quali può essere necessario impiegare risorse (materiali, attrezzature, spazi etc.) e dati clinici, che successivamente potranno essere aggregati e strutturati in documenti più complessi per essere consultati da differenti tipologie di utenti in funzione dei profili di abilitazione e delle differenti esigenze cliniche (percorsi diagnostici, terapeutici, assistenziali etc.).[16]
Risulta evidente come, alla luce della particolare sensibilità e rilevanza sia per la sicurezza dei procedimenti che dei pazienti, i dati clinici debbano essere gestiti seguendo criteri di sicurezza e tracciabilità (ossia verificando i sistemi di log management, assicurando l’autenticità, la data certa e le versione dei documenti ed altresì garantendo la loro non cancellazione o sovrascrittura);
b) Valutazione circa la necessità e proporzionalità del trattamento: in tale fase, una volta individuate possibili linee guida di riferimento da seguire (quali in materia di referti online, sul trasporto di campioni diagnostici, sul generale trattamento di dati genetici etc.) e descritto il ciclo di vita dei dati, la valutazione della proporzionalità dovrà essere approfondita in termini di quantità, frequenza, persistenza di raccolta di dati, come anche di ampiezza geografica dell’area di raccolta (si pensi ad un titolare che operi su più presidi territoriali);
c) Valutazione dei rischi: è indubbiamente la fase saliente della DPIA, in cui peraltro si evidenzia la necessità di far sì che la predisposizione del registro dei trattamenti[17] non sia un mero esercizio forma, ma piuttosto l’esito di una attenta valutazione tanto del contesto organizzativo di riferimento quanto dei processi aziendali da cui le attività di trattamento dei dati scaturiscono.
Per una corretta individuazione delle minacce si opererà una combinazione dei seguenti elementi, che stanno all’origine dei possibili incidenti: risorse (hardware, software, infrastrutture, etc.), azioni (guasto, atto doloso, errore etc.) e rischi dati (perdita di integrità, di confidenzialità, di riservatezza etc.).
Così a titolo esemplificativo, la minaccia di accesso abusivo ad un sistema è conseguenza di un atto doloso (azione), perpetrata su di una infrastruttura di rete (risorsa) che avrà ripercussioni sulla confidenzialità del dato. Ovvio è che suddetta analisi delle minacce non dovrà essere limitata al mero “rischio dato” inerente alla perdita di integrità, confidenzialità e disponibilità, ma anzi dovrà prendere in considerazione anche i possibili effetti che il rischio può avere per i diritti e le libertà delle persone fisiche, seguendo così un approccio altamente multidisciplinare che tenga conto in egual misura della sicurezza dei pazienti, della continuità operativa, della cybersecurity ed anche della capacità di resilienza dei sistemi. [18]
Cyber risk management: vulnerabilità e minacce nelle organizzazioni ospedaliere
A proposito di rischio si rilevi come nel complesso panorama sanitario oltre alla sicurezza delle cure, vi sia quella del farmaco, quella dei luoghi di lavoro, del rischio infettivo, delle radiazioni ionizzanti, quella strutturale ed ovviamente quella informatica. Tutti tali aspetti orbitano attorno a chiunque partecipi alla vita delle aziende sanitarie (si pensi ad operatori, utenti, fornitori terzi, visitatori etc.), ebbene non pare più possibile ragionare “per silos”, anzi ad oggi occorre una visione del rischio che sia quanto più integrata e complessiva possibile.
Ad ogni modo sono gli attuali fatti di cronaca a parlare chiaro: l’ambito sanitario risulta uno dei settori maggiormente esposti e vulnerabili sul versante della cybersecurity.
Tra i fattori di rischio che più possono incidere in tal senso si notino:
L’ampia diversificazione delle figure professionali coinvolte, ognuna di queste con diversi profili di autorizzazione nei sistemi informatici e che spesso si ritrovano a poter accedere anche a più attrezzature collegate in rete;
La necessità di garantire l’interoperabilità dei sistemi, e di integrare attrezzature fortemente diversificate sia all’interno della organizzazione che lungo la supply chain;
L’utilizzo di strumentazioni medicali, fra cui sempre più soluzioni IoMT, non sempre progettate secondo una logica di sicurezza by design e che, non di rado, si ritrovano ad essere dotate di sistemi operativi obsoleti o per i quali non sono facilmente disponibili o reperibili patch di aggiornamento. Ad oggi invero un paziente può essere monitorato in modo più completo, senza tuttavia la necessità di appuntamenti “faccia a faccia” o trattamenti invasivi (si pensi al telemonitoraggio domiciliare attuato tramite dispositivi indossabili). L’attuale molteplicità di dispositivi interconnessi crea numerosi potenziali punti di infiltrazione e conduce inevitabilmente alla possibilità di subire maggiori attacchi informatici. [19] Sotto quest’ultimo profilo si rammenti ivi la c.d. Valutazione delle tecnologie sanitarie (anche detta Health Technology Assessment o HTA) quale strumento utilizzato a livello internazionale consistente nella “complessiva e sistematica valutazione multidisciplinare circa le conseguenze assistenziali, economiche, sociali ed etiche provocate in modo diretto ed indiretto, nel breve e lungo periodo, dalle tecnologie sanitarie esistenti e quelle di nuova introduzione”. [20]
È dunque una guida, un ponte fra il mondo tecnico-scientifico e quello propriamente decisionale, incentrata sull’analisi delle conseguenze attese dall’introduzione di specifiche tecnologie sanitarie, nonché di soluzioni digitali nel contesto di una organizzazione sanitaria (si pensi all’adozione di nuovi dispositivi medici, farmaci, sistemi diagnostici, procedure chirurgiche, percorsi assistenziali, attrezzature sanitarie, od assetti strutturali, organizzativi e manageriali, etc.), atta a focalizzare l’attenzione sulla attenta valutazione circa i profili di: efficacia clinica, protezione dei dati personali, prospettiva dei pazienti, cybersicurezza, aspetti economici, organizzativi, come anche etici e legali;
La stessa mancanza di risorse ingenera vulnerabilità, volendosi riferire sia al fattore umano, per cui il personale IT risulta essere inadeguato, mancando per di più figure altre che possano occuparsi di campi multidisciplinari quali il risk management, la data protection o la stessa privacy management (portando ad una inevitabile ambiguità rispetto a chi sia effettivamente responsabile circa le tematiche di sicurezza). Ma un’altra risorsa a mancare risulta essere proprio il budget ed uno dei motivi per cui i fondi per la sicurezza informatica sembrano essere insufficienti è che le organizzazione sanitarie tendono ad indirizzare le proprie scelte d’acquisto, nonché finanziamento verso risorse legate propriamente all’assistenza clinica ed alle cure mediche, lasciando gli aspetti legati alla cybersicurezza nel dimenticatoio.[21]
Chiaro risulta come la cultura del rischio si sia evoluta nella sanità italiana, facendosi strada la graduale consapevolezza per cui la sicurezza in sanità non possa limitarsi solo più al rischio clinico, ma debba abbracciare ogni ambito, dall’informatico, al gestionale ed altresì strutturale. Il paradigma invero sta per mutare: dati e servizi sanitari saranno sempre meno chiusi negli hardware delle strutture sanitarie e sempre più diffusi e scambiati sui cloud, e ciò non farà altro che aumentare i rischi. Occorre dunque cogliere questo momento di passaggio per costruire una matura cultura delle sicurezza cyber prima che sia fin troppo tardi per arginare i danni.
Si voglia indirizzarsi verso le conclusioni riportando di seguito il survey realizzato da SHAM Italia, società specializzata in assicurazione e gestione rischi, datato al 2021, quale indagine conoscitiva rivolta ai professionisti ed alle strutture sanitarie e socio-sanitarie italiane, col preciso obiettivo di comprendere quanto il cyber-rischio sia conosciuto, come venga gestito, ed altresì quali siano le prospettive per il futuro.[22]
In particolare i partecipanti a tale sondaggio sono stati 68, provenienti da strutture ed aziende sanitarie, pubbliche e private, di 14 regioni italiane, sebbene non si tratti di un campione eccessivamente esteso, il contributo fornisce ad ogni modo un valido punto di partenza per comprendere il grado di consapevolezza degli operatori sanitari su tema del rischio cyber come anche quali siano le principali aree dove intervenire al fine di poter migliorare il campo della sicurezza informatica.
Il primo dato ricavabile, che lascia peraltro ben sperare, è l’alta sensibilità in materia: circa il 60% dei rispondenti (ossia Referenti di direzione sanitaria generale e di ingegneria clinica, responsabili CISO della sicurezza informatica, Risk manager, Data protection officer etc.) dichiara invero il cyber risk come altamente impattante sui modelli organizzativi interni e sulle attività da erogare, oltre ad un ulteriore 31% che lo qualifica comunque come un tema parzialmente prioritario, se si vanno a sommare tali due espressioni di interesse si ottiene un buon 90% dei rispondenti che valorizzano positivamente l’interessamento al tema de quo.
Di contro però l’immediato paradosso: il 53% dei rispondenti dichiara di non aver (o aver solo in parte) definito concretamente un piano di gestione del rischio, solo il 44% poi dichiara di aver reattivamente adottato ed implementato azioni di miglioramento interno in seguito all’avverarsi di eventi avversi, ed ancora meccanismi quali mappature dei rischi od anche test sulle vulnerabilità risultano scarsamente effettuati (da circa il 30% dei rispondenti).
Ebbene all’elevato interesse sul tema non sembra quindi corrispondere un altrettanto sentita sua identificazione, misurazione e gestione, si noti peraltro come solo il 10% dei rispondenti affermi di aver provveduto a contrarre apposite polizze assicurative contro i danni informatici al fine sia di trasferire eventuali conseguenze economiche circa un evento avverso, sia di avere un adeguato supporto tecnico attivo in caso di necessità. Soffermandosi celermente sui rischi legati alla sottrazione dati ed alla violazione della privacy, è da rilevare come nel corso degli ultimi anni sia cresciuta in maniera esponenziale la domanda di coperture assicurative strutturate in modo da affrontare i costi relativi a tali nuovi rischi ed incidenti cyber.
Anche in tali tipologie di polizze si troverà una concezione strettamente attuariale delle assicurazioni, basata sulla capacità di prevedere in anticipo la probabilità e l’impatto di possibili eventi dannosi, informazioni che vengono per lo più ricavate dai dati relativi al passato, facendo poi delle ipotesi sui futuri accadimenti. Ciononostante, suddetti rischi risultano comunque particolarmente complessi da decodificare, a causa proprio della rapida evoluzione tecnologica che caratterizza il settore de quo.
Sicuramente nel novero delle principali cyberminacce per le quali potrebbe essere disponibile una copertura assicurativa rientrano:
la divulgazione di informazioni sensibili protette od il blocco dei sistemi informatici (si ricordi come l’estorsione preveda, nella maggior parte dei casi, il pagamento del riscatto tramite valuta digitale);
il mancato guadagno lungo il perdurare di un certo periodo di tempo, determinato a causa di un evento di violazione delle informazioni.[23]
Rimane tuttavia importante considerare che sarebbe del tutto irrealistico pensare di poter azzerare completamente il rischio cibernetico all’interno di una azienda: diventa quindi ineludibile un cambio di paradigma, che vede un diretto coinvolgimento ed una forte implementazione del risk management, nelle sue diverse declinazioni di: mitigazione, prevenzione, trasferimento ed assunzione del rischio.
Ed il risk management dovrà essere inteso quale approccio valutativo che incomincia con l’identificazione di tutti i rischi potenziali, nonché degli asset e delle specifiche vulnerabilità, per successivamente valutare la probabilità circa l’avverarsi di un evento avverso, il suo impatto e le misure di salvaguardia da adottare per ridurne gli effetti negativi. Solo così il rischio potrà essere mitigato ed altresì costantemente monitorato nel tempo, seguendo una procedura dal carattere fortemente circolare atta a garantire alti livelli di cybersicurezza.[24]
Da qui l’assunto cardine per indirizzare il futuro della sanità italiana: senza una adeguata sicurezza, la digitalizzazione del settore sanitario non potrà mai dispiegarsi compiutamente, in quanto la sicurezza stessa non è una risposta alla innovazione, ma piuttosto il suo requisito fondamentale.
Una visione d’insieme
Si voglia a questo punto indirizzarsi verso riflessioni conclusive fornendo una prospettiva sistematica e strutturata, volta ad analizzare le dinamiche di sviluppo ed implementazione della cybersecurity nelle strutture ospedaliere e su come talune dinamiche organizzative interne possano a tutti gli effetti interagire fra loro al fine di sviluppare un sistema sanitario complessivamente cybersicuro.
Si è già ampiamente notato nel discorrere dei capitoli precedenti come le capabilities relative alla cybersicurezza in sanità includano una ampia varietà di programmi, sistemi, comportamenti e tecnologie che un ospedale può decidere di impiegare col preciso obiettivo di potenziare la propria resilienza informatica.
Tuttavia non tutte le anzidette strategie e soluzioni operative si presentano come autosufficienti, anzi possono erodersi e scemare nel tempo laddove non vengano opportunamente attuate, adottate, monitorate e mantenute. Al fine di voler riassumere graficamente un panorama organizzativo così complesso si farà uso a seguire delle variabili di stock e di flusso.[25]
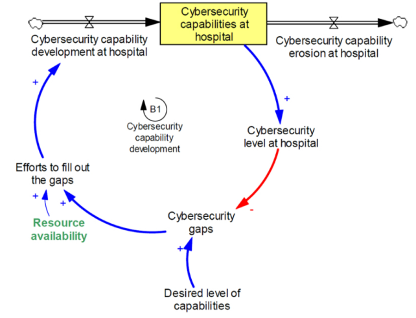
Si incominci dunque dando uno sguardo al nucleo del modello proposto, ossia la variabile di stock evidenziata e denominata “Cybersecurity capabilities at hospital” quale raffigurante l’accumulo di tutti i programmi implementati e comportamenti adottati determinanti la sicurezza complessiva di una specifica organizzazione. Una variabile di flusso invece ha la funzione di modificare e far variare quella anzidetta di stock, da qui si possono notare la variabile di afflusso (“Cybersecurity capability development”), indicante il tasso al quale le capacità vengono aggiunte allo stock esistente, e di deflusso (“Cybersecurity capability erosion”), specificante viceversa il tasso al quale le capacità stesse vengono eliminate dallo stock esistente (Fig. 6.2). [26]
Fig. 6.2 Primo loop di cybersecurity
Fonte: “Cybersecurity in hospitals: a systematic, organizational perspective”, in Journal of medical Internet Research, rimando a nota.
Un primo fattore variabile viene rappresentato dalla disponibilità di risorse (“Resource availability”): mezzi quali acquisti, protocolli, strumenti, tecnologie e personale costituiscono invero gli elementi costitutivi essenziali che consentono ad una struttura sanitaria di compiere gli sforzi necessari al fine di aumentare la capability development rate e di conseguenza incrementare lo stock delle attuali potenzialità ospedaliere. A sua volta ciò innescherebbe un accrescimento circa il livello di sicurezza informatica (“Cybersecurity level”), riducendo il divario fra il livello effettivo e quello desiderato di protezione, e, si capirà, laddove tale gap diminuisca, si attenueranno di conseguenza anche gli sforzi (“Efforts to fill out the gaps”) richiesti per colmare le lacune di sistema.
È così che si verrà a delineare un primo anello, anche detto feedback loop (B1) indirizzato a bilanciare e stabilizzare il sistema complessivo, guidandolo verso il raggiungimento dell’obiettivo desiderato.
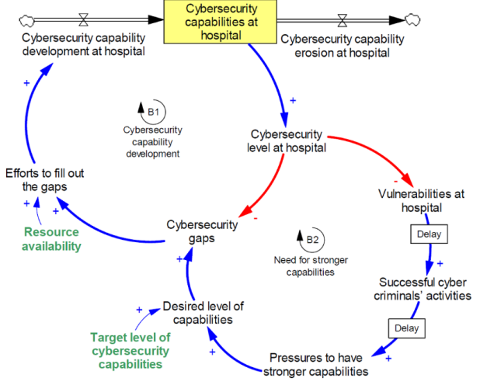
Congiungendo allo schema de quo ulteriori elementi (Fig. 6.3), si osservi come il livello di sicurezza possa calare a causa della presenza di specifiche vulnerabilità (si pensi all’arretratezza delle tecnologie adoperate), che implicano una più alta probabilità di successo circa la perpetrazione di eventuali cyber attacchi, che laddove raggiungano effettivamente un esito positivo, non faranno altro che sobbarcare una data struttura di maggiore pressione ed impellenza circa l’urgente necessità di raggiungere il livello desiderato (nonché richiesto) di security (da qui il secondo cerchio, o balancing loop B2, raffigurante il giungere del bisogno di più robuste capabilities).
Fig. 6.3 Secondo loop di cybersecurity
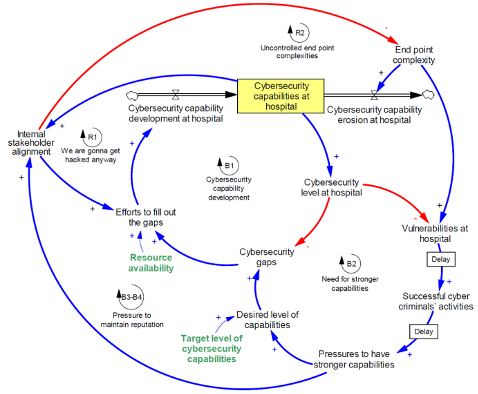
Ancora si vogliano aggiungere ulteriori fattori rilevanti (Fig 6.4), in primis la complessità degli end point (ossia di tutti i device, strumenti, apparecchiature e macchinari interconnessi), aggravata dalla mancanza di consapevolezza da parte del personale medico circa le corrette pratiche di sicurezza informatica da dover adottare nell’operare quotidiano, andando così ad accentuare fortemente le già esistenti vulnerabilità della struttura, conducendo inevitabilmente ad una riduzione della complessiva capacità dell’organizzazione di gestire lo scenario relativo alla propria cybersicurezza.
In secundis si sottolinei come laddove tutti gli attori dell’organigramma sanitario non riconoscano la dovuta importanza alle tematiche di security, cooperando e collaborando fra loro, andranno a minare fortemente tutti gli sforzi fatti per colmare tutte le lacune di sistema sopradette, impattando negativamente sul livello generale di cybersecurity (entrando in un loop recitante “We are gonna get hacked anyway”).
Viceversa dovrebbe essere proprio quella anzidetta pressione ingenerata dall’eventualità di subire cyber attacchi indirizzati alla propria struttura (quale il non voler subire un danno reputazionale) a spingere tutti gli stakeholder interni ad allinearsi lungo la medesima strategia operativa difensiva e di rafforzamento della propria resilienza.
Fig 6.4 End point e stakeholder nel sistema
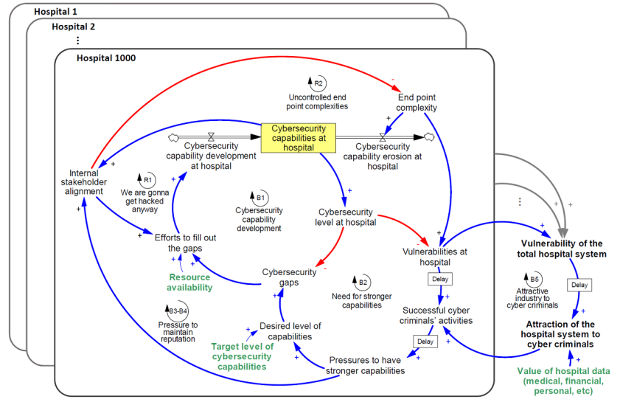
Ebbene il meccanismo circolare delineatosi sino a qui non risulta, a ben vedere, applicabile solo ad una singola realtà ospedaliera, ma altresì a tutto un sistema sanitario nella sua interezza, essendo che le vulnerabilità informatiche proprie delle strutture sanitarie in un dato Paese altro non è che il risultato, non certo di una, quanto di una ingente molteplicità di strutture.
Per esemplificare si ipotizzi di applicare il modello de quo su 1000 ipotetici ospedali (nonostante ciascuno abbia il proprio livello di disponibilità di risorse ed il proprio personale target di sicurezza da raggiungere), ciò che è ricavabile da suddetta operazione è proprio il livello di vulnerabilità complessivo di un sistema sanitario, che andrà necessariamente a determinare l’attrattiva che quest’ultimo riveste per l’agire di cybercriminali (attrattiva che verrà valutata assieme ad altri fattori variabili, quali il valore economico dei dati sanitari custoditi dalle diverse organizzazioni).
Fig. 6.5 Applicazione del modello su larga scala
Pertanto guardando i risultati ottenuti adottando un punto di vista macro, la vulnerabilità cyber delle infrastrutture ospedaliere di un dato Paese si ritrova ad esser fortemente condizionata dalle capabilities proprie di ogni singola struttura. Cercare dunque di ridurre ed appianare i divari circa le differenti disponibilità di risorse (tanto fisiche quanto umane) fra diversi ospedali, disseminati in una data zona geografica, potrebbe aiutare a rendere l’intero sistema meno vulnerabile, si spieghi meglio: anche solo pochi ospedali con scarsi livelli di cybersecurity potrebbero andare a minare un’intera assistenza sanitaria nazionale.
In altre parole risulta ad oggi necessario che le strutture si muovano unite e di pari passo, all’interno di una cornice di politiche indirizzate ad incrementare il pari livello collettivo di sicurezza cyber, riducendo le dissomiglianze ed i divari in termini di disponibilità di risorse
Lo sviluppo di una digital health nazionale dovrà quindi trovare piena realizzazione all’interno di un progetto di politiche pubbliche che sia organico e lungimirante di governance sanitaria, che promuova una condivisione selettiva dei dati sanitari, scongiurando la perdita di informazioni sensibili od il blocco dei sistemi interni, al fine di minimizzare i rischi cibernetici e le conseguenti possibili lesioni dirette alla sfera personale della riservatezza, della dignità e della safety degli individui.
Strategie future per il risk management della sanità digitale italiana
Si voglia ivi ripetere il seguente concetto a fini riassuntivi: l’uso di Internet e delle ICT (Information and Communications Technology) costituisce, per il mondo sanitario, un meccanismo senza precedenti, propulsore di innovazione, atto a fornire risposte sempre più efficienti alle odierne problematiche legate alla salute. Maggiore informatizzazione e automazione dei processi tuttavia, se da un lato comportano nobili ed evidenti vantaggi, dall’altro, laddove non vengano sapientemente governati, rendono qualsivoglia struttura permeabile e terreno fertile per nuove forme di rischio. [27]
Tentando di pronosticare l’evolversi della sanità si può, a ben vedere, immaginare uno scenario futuro sempre più ibrido: alcune prestazioni sanitarie permarranno erogate “on site”, ossia in presenza del paziente (negli ospedali, nelle strutture diagnostiche), altre rimarranno ibride, ossia in parte in presenza ed in parte virtuali (si pensi al telemonitoraggio ed alla telerefertazione), altre ancora diventeranno solo più virtuali (quali una televisita).
Il perimetro dunque da securizzare tenderà ad allargarsi, passando da una sanità “ospedalocentrica”, ad un coinvolgimento domiciliare del cittadino, con un conseguente numero maggiore di dati in circolo e sempre più persone coinvolte nel, già complesso, organigramma sanitario.
Si voglia pertanto spostare l’attenzione sulle attuali sfide e sui conseguenti approcci che si pensa debbano essere adottati per farvi fronte.
Innanzitutto occorre assumere una piena consapevolezza circa l’ampiezza del tema, il problema della sicurezza infatti non è riconducibile solo al terreno puramente tecnologico, ma anzi va declinato sulla realtà aziendale nella sua interezza ed alla complessiva capacità di essere resiliente. Si riportino a questo proposito le parole di Schneier: “If you think technology can solve your security problems, then you don’t understand the problems and you don’t understand the technology”.[28]
Peraltro ritenere che il CISO o il DPO siano le uniche figure a doversi curare ed occupare delle tematiche inerenti alla sicurezza significa sviare la sua complessità, banalmente nel momento in cui si stipula un contratto di fornitura di beni o servizi occorrerà domandarsi se il fornitore, sebbene soggetto terzo, sia esso stesso in grado di fornire sicurezza.
Da qui deriva l’attuale problema della supply chain, che non concerne quindi solamente i fornitori tecnologici (se si acquista Office 3.6.5 ci si può aspettare, a ben vedere, un certo livello di sicurezza garantito), ma anche coloro che, nonostante siano slegati da aspetti puramente informatici, devono parimenti essere responsabilizzati (si pensi ad un’azienda che distribuisce ossigeno ai pazienti terminali, questa avrà tutta una catena logistica di furgoni, mezzi ed operatori in grado accedere agli archivi di una azienda sanitaria e modificarne i dati contenuti, ad esempio laddove cambi il caregiver di un paziente).
Si auspica quindi di far comprendere come tutta la catena plurisoggettiva dovrà essere responsabilizzata tramite procedure e protocolli sofisticati, anche se i soggetti protagonisti risultino prima facie estranei da quell’area puramente tecnologica maggiormente esposta al rischio.
Così Sergio Fumagalli, esperto CLUSIT: [29] “Il tema da dover interfacciare è l’interoperabilità, andando cioè a toccare tutti i processi, le risorse umane ed ogni altra risorsa essenziale, che non sia soltanto IT, altrimenti si rimarrebbe bloccati in un’attitudine settoriale, come in una lineaMaginot francese, invece il modello da adottare deve essere quello «svizzero», in cui tutte le persone di ogni cantone dedicano un mese all’anno per l’addestramento alla difesa del proprio cantone. Certo nella sanità il confine non si figura fisso e definito come quello svizzero, anzi si espande in continuazione, con nuovi cantoni (od unità) dando forma ad una realtà in cui addestrare e formare ciascuno per difendere il proprio tassello”.
È così che si arriva nuovamente a ribadire il problema della formazione: a nulla servirà infatti dotarsi di sofisticati sistemi di identity management se poi l’operatore finale sanitario finisce per attaccare con un post-it sul proprio pc la password per accedere sistema. Una attuale sfida risulta allora far crescere una sempre maggiore cyber-cultura tramite corsi di aggiornamento e di formazione che appaiano stimolanti per gli operatori e che non vengano viceversa percepiti quali gravose lungaggini o perdite di tempo, da dover sostenere solo perché vi si è costretti.
Come fare concretamente?
Si ipotizzi la possibilità di programmare incontri diretti (invece che online) ravvicinati e collegiali, in presenza di tutti coloro che si ritrovano day by day ad operare sui dati, oppure si consideri la creazione di siti web e piattaforme FAQ (ossia, di Frequently Asked Questions) facilmente intuibili e dotati di rapide risposte, pare verosimile infatti ritenere che il personale sanitario voglia seguire procedure sicure, che spesso e volentieri però non sappia concretamente come fare. Peraltro non è più il tempo di mirare ad una formazione generale (e quindi, dispersiva), sarebbe invero preferibile cucirla ad hoc su ogni soggetto (primario, infermiere, fornitore etc.) di modo che concerna nello specifico i singoli tasselli operativi e gli obiettivi propri di ciascuno.
Questo è ad oggi il punto focale: la cyber-formazione deve essere sentita come obbligatoria, nonché avvertita come indispensabile per tutti, avvicinando l’offerta know-how con chi dovrà porre in essere determinati trattamenti, e nella sanità tutto ciò risulta difficile perché le priorità avvertite sono altre (quali la cura e l’assistenza puramente clinica dei pazienti). Com’è evidente, sarebbe più facile dotarsi di consulenti e di una svariata serie di procedure per ottemperare alla compliance richiesta piuttosto che “calarsi in basso”, andando a toccare e correggere automatismi, nonché consuetudini di lavoro profondamente radicate che nessuno ha veramente l’intenzione di cambiare.
Resta il fatto che procedure tecnico-organizzative, set documentali, oneri burocratici e compliance non bastino più, occorre sopportare il costo (oneroso) del modificare alla radice il modo attuale di operare, perché il rischio di non farlo è, come si è visto, seriamente alto e cresce in misura esponenziale col crescere della pervasività della tecnologia.
È evidente, ma pare comunque doveroso sottolineare che la sanità, quale sistema informativo complesso, necessiti di una attenzione costante nel tempo e di un approccio sistematico alle tematiche di sicurezza e privacy, che non sia viceversa sporadico, non servirà “correre dietro all’emergenza”, anzi oggi più che mai vi è la forte necessità di stanziare budget pluriennali e fissi da investire miratamente sulle tematiche inerenti alla sicurezza cyber.
Al fine di concretizzare quanto finora descritto il settore sanitario dovrà ad ogni modo rivedere e superare la sua attuale infrastruttura informatica, spesso eterogena e frammentata, facendo ricorso ad un approccio olistico che dia forma ad una governance in grado di coniugare sia misure di natura tecnica, sia aspetti organizzativi, procedurali, normativi ed in particolar modo di gestione ed analisi del rischio.
A proposito di rischi, dal momento che ad oggi risultano tutti strettamente connessi, ed analizzabili di conseguenza in un’unica sintesi, allora tutti dovranno comparire dinnanzi alla Direzione strategica misurati e comparati, così da poter operare una valutazione obiettiva circa le esigenze da soddisfare, individuando dove investire sulla base dei punti di forza e debolezza individuati all’interno delle stesse Aziende sanitarie.
Da qui discende l’attuale urgenza di implementare e rafforzare il ruolo del risk manager, quale figura altamente multidisciplinare, in grado di abbracciare, comprendere e ponderare tutti gli ambiti del rischio. D’altra parte conseguire le competenze professionali necessarie a rivestire tale posizione è un processo, o meglio una evoluzione, in cui piuttosto che il curriculum formativo di partenza conta la formazione continua ed altresì l’aggiornamento costante lungo tutta la propria vita lavorativa circa ogni aspetto organizzativo, tecnologico, normativo o clinico che possa riguardare il rischio.
Questo è ciò che pare emergere: il reale bisogno di un risk manager che entri nei processi, che sappia ampliare le proprie competenze anche all’area della business continuity e alla gestione delle emergenze, una figura autorevole con una padronanza della materia, in grado di gestire la crescente complessità del nostro quotidiano.
Tale esigenza si origina direttamente da alcune criticità e vulnerabilità che caratterizzano l’ambiente sanitario, prima fra tutti la scarsa conoscenza dei rischi, per come celati anche nelle operazioni più banali poste in essere da parte dei tanti operatori che si servono quotidianamente di digitaldata e device, inconsci spesso di cosa mettono in moto e della esposizione che possono provocare.
Ancora, si osservi come il personale addetto alla sicurezza informatica risulti alle volte insufficiente, così come i ruoli legati propriamente al rischio cyber non sufficientemente definiti all’interno dello stesso organigramma sanitario, la gestione dei sistemi tecnologici quindi pare abbisognare di maggiori addetti e nuovi ruoli professionali atti ad informare e dialogare periodicamente con gli stessi risk manager. [30]
Pertanto, l’ambito dove risiede una maggior possibilità di miglioramento e, parallelamente, in cui vi è l’urgenza di adottare azioni e misure correttive, risulta essere la competenza, la formazione costante, ed anche la chiarezza dei ruoli, risultando l’investimento più promettente al fine di rafforzare ed implementare la resilienza e sicurezza informatica della sanità italiana.
Nel futuro prossimo l’unità organizzativa di risk management allora dovrà integrare nuove competenze e sperimentare nuovi modelli, che siano applicabili anche su scala nazionale, che prevedano il legame diretto tra risk management e Dirigenza strategica, riconoscendo allo stesso risk manager la possibilità di analizzare tutte le informazioni circa i vari rischi provenienti dai dipartimenti specialistici e determinare di conseguenza il livello di urgenza degli interventi di mitigazione. Se le organizzazioni sanitarie viceversa continueranno ad ignorare, o quantomeno sottostimare, l’importanza strategica del risk management sarà inevitabile assistere ad un forte e costante incremento dei cyber attacchi e delle conseguenze dannose in termini tanto di privacy, quanto di safety e security.
La gestione del cyber rischio in sanità richiede un approccio olistico che vada oltre la semplice implementazione tecnologica, abbracciando una cultura della sicurezza condivisa da tutti gli stakeholder del sistema sanitario.
Come evidenziato in questo articolo, il successo nella protezione dei dati sanitari dipende dall’integrazione di metodologie di risk assessment, compliance normativa GDPR, e formazione continua del personale. Per approfondire tutti gli aspetti della cybersecurity sanitaria e accedere a un’analisi completa del fenomeno, scarica gratuitamente il white paper di Maria Vittoria Zucca“La cybercriminalità nel settore sanitario: anamnesi, diagnosi e prognosi di una ‘patologia’ informatica”.
Fonti:
[1] Per politica di sicurezza si intende la dichiarazione formale delle regole che vincolano coloro che hanno accesso agli investimenti tecnologici e di informazione di un’organizzazione, Cfr. B. Fraser, RFC2196 : Site Security Handbook, RFC Editor, USA, 1997.
[2] L’emersione della gestione del rischio quale vera e propria disciplina si registra dall’inizio degli anni Cinquanta, in principio tuttavia si rivolgeva quasi esclusivamente all’ambito bancario ed assicurativo, occupandosi dei rischi finanziari (c.d. insurance risk management), per poi solo successivamente essere applicata anche in aziende operanti in altri settori, da qui si è avvertita la necessità di istituire all’interno delle imprese una funzione unicamente dedicata a tale attività.
[3] C. Zagaria, L’enterprise Risk Management: gestione del rischio, profili di comunicazione ed evidenze empiriche, Giappichelli Editore, Torino, 2017, pp. 2-5.
[4] L. Donati, G. Vaciago, Compliance 231: Modelli organizzativi e OdV tra prassi applicative ed esperienze di settore, Gruppo Sole 24 Ore, Milano, 2022, p. 196.
[5] Il primo studioso italiano ad evidenziare la sistematicità dei rischi d’impresa è stato S. Sassi, Il sistema dei rischi d’impresa, Vallardi Editore, Milano, 1940, p. 103.
[6] U. Bertini, Introduzione allo studio dei rischi nell’economia aziendale, Giuffrè Editore, Milano, 1987, pp. 34-35.
[7] Decreto legislativo 9 Aprile 2008 n. 81, Testo unico in materia di tutela della salute e della sicurezza, per come aggiornato dalla L. 17 Dicembre 2021, n. 215.
[8] Si provino a prendere in considerazione i possibili livelli di impatto di un data breach (violazione di dati personali), anch’essi infatti saranno distinguibili in: low (gli interessati non incontreranno inconvenienti o comunque di poco conto, quale un maggior tempo impiegato a reinserire informazioni); medium (gli interessati potrebbero incontrare inconvenienti significativi che saranno comunque in grado di superare nonostante alcune difficoltà, come costi aggiuntivi sopportati); high (gli interessati potrebbero incontrare conseguenze significative che dovrebbero esser in grado di superare, anche se sopportando gravi difficoltà, quali danni alla proprietà, peggioramento della salute etc.); very high (gli interessati potrebbero incontrare conseguenze significative od addirittura irreversibili non superabili, quali incapacità al lavoro, disturbi fisici o psicologici a lungo termine etc.). Cfr. ENISA, Online platform for security of personal data processing: reinforcing trust and security in the area of electronic communications and online services, European Union Agency for Cybersecurity, 19 December 2019, reperibile al sito internet https://www.enisa.europa.eu/publications/reinforcing-trust-and-security-platform
[9] N. Distefano, “Risk Management e Metodi di Risk Assessment: Tecniche per la valutazione del rischio”, presentazione presso DICAR (Dipartimento di Ingegneria Civile e Architettura), in data 2 Luglio 2020.
[10] ENISA, Recommendations for a methodology of the assessment of severity of personal data breaches, European Union Agency for Network and Information Security (ENISA), Working document V. 10, December 2013, pp 4-6.
[11] Il Titolare del trattamento, ex art. 4 GDPR “persona, fisica o giuridica, che dispone dei dati e determina i fini e le modalità del trattamento”, nel caso della libera professione in uno studio privato, sarà rinvenuto nella figura del medico. Quest’ultimo può trasmettere certo informazioni ad altri soggetti, si pensi ad un laboratorio esterno di analisi cliniche, che tutt’al più sarà inteso quale Responsabile del trattamento, ossia soggetto esterno, che tratta i dati solo su istruzione del Titolare, privo del potere di iniziativa o di autonomia decisionale. Nella sanità pubblica invece la titolarità dei dati personali che tratta il medico di base è, in linea di principio, in capo alla ASL o ai servizi della Regione, o anche al Ministero della salute. Dunque il medico rivestirà in tal caso la funzione di Responsabile del trattamento, ricevendo istruzioni (e subendo i controlli) da parte di tali strutture.
[12] Così recita l’art. 35 Gdpr: “Quando un tipo di trattamento, allorché prevede in particolare l’uso di nuove tecnologie, considerati la natura, l’oggetto, il contesto e le finalità del trattamento, può presentare un rischio elevato per i diritti e le libertà delle persone fisiche, il titolare del trattamento effettua, prima di procedere al trattamento, una valutazione dell’impatto dei trattamenti previsti sulla protezione dei dati personali”.
[13] Article 29 Data Protection Working Party, Guidelines on Data Protection Impact Assessment (DPIA) and determining whether processing is “likely to result in a high risk” for the purposes of Regulation 2016/679, WP 248 re.01, 4 April 2017.
[14] Il Considerando 75 del GDPR identifica cosa si debba intendere con il concetto di rischio, riportando che: “I rischi per i diritti e le libertà delle persone fisiche, aventi probabilità e gravità diverse, possono derivare da trattamenti di dati personali suscettibili di cagionare un danno fisico, materiale o immateriale, in particolare: se il trattamento può comportare discriminazioni, furto o usurpazione d’identità, perdite finanziarie, pregiudizio alla reputazione, perdita di riservatezza dei dati personali protetti da segreto professionale, decifratura non autorizzata della pseudonimizzazione, o qualsiasi altro danno economico o sociale significativo; se gli interessati rischiano di essere privati dei loro diritti e delle loro libertà o venga loro impedito l’esercizio del controllo sui dati personali che li riguardano; se sono trattati dati personali che rivelano l’origine razziale o etnica, le opinioni politiche, le convinzioni religiose o filosofiche, l’appartenenza sindacale, nonché dati genetici, dati relativi alla salute o i dati relativi alla vita sessuale o a condanne penali […] ”.
[15] C. Gallotti, Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione per la sicurezza delle informazioni; la norma IOS/IEC 27001, Lulu Press Inc., Raleigh, 28 Gennaio 2019.
[16] P. Locatelli, D. Zacchetti, F. Chiodini, F. Ferrara, “I modelli necessari a strutturare un clinical data repository”, in Progettare per la sanità, n. 5, Ottobre 2019.
[17] Si rammenti come, ex art. 30 Gdpr, suddetto registro altro non sia che lo strumento attraverso il quale il titolare e il responsabile del trattamento documentano in forma scritta, le principali informazioni relative alle attività di trattamento e alle misure di garanzia adottate, in base alle finalità perseguite e ai profili di rischio rilevati, al fine di poter poi dimostrare all’Autorità di controllo (ossia il Garante per la protezione dei dati) di aver adempiuto correttamente al proprio obbligo circa la protezione dei dati personali.
[18] Si rimarchi ivi la nozione di “sicurezza by design”: una adeguata DPIA dovrà essere fatta in fase di concepimento di un servizio, assicurando lo svolgersi di un integrale e corretto processo di sicurezza nell’acquisizione di sistemi e servizi, nella contrattualizzazione con i fornitori, così da sviluppare il procurement stesso in un modo sano. In tal modo si può avere una evoluzione dei servizi verso una maggiore resilienza nei confronti degli attacchi, se invece si affrontano tali iter come oneri burocratici, cercando di minimizzare il fastidio che crea la DPIA, a questo punto si perde una fondamentale occasione.
[19] D. Farringer, “Maybe if we turn it off and then turn it back on again? Exploring Health Care Reform as a means to curb cyber-attacks”, in Journal of Law, Medicine & Ethics, 47(S4), 2019, pp. 91-201.
[20] Commissione Europea, Proposta di Regolamento del Parlamento Europeo e del Consiglio relativo alla valutazione delle tecnologie sanitarie, che modifica la Direttiva 2011/24/UE, Bruxelles, 31.01.2018; si faccia riferimento anche alla Carta di Trento sulla valutazione dei servi sanitari, quale documento fondante la Società Italiana di Health Technology Assessment, Trento, in data 28 Marzo 2006.
[21] S. Ghafur, E. Grass, N. R. Jeggings, “The challenges of cybersecurity in health care: the UK National Health service as a case study”, in Lancet Digit Health, Volume 1, issue 1, May 2019, pp. 10-12.
[22] SHAM ITALIA, Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM Italia, 2021.
[23] Volendo poi indicare quali siano le coperture assicurative che concernono il c.d. rischio cibernetico si possono individuare due tipologie: l’Assicurazione primaria diretta che risarcisce chi si assicura (per danni ad asset informatici, interruzione dell’attività, danno reputazionale, estorsione, furto, etc.); ed Assicurazione RC vs. terzi (nei casi di violazioni di dati sensibili, spese legali, indennizzi a terzi), Cfr. C. Savino, “Cyber risk, assicurazioni e PMI”, presentazione per Ania: Associazione Nazionale fra le imprese assicuratrici, 7 Marzo 2017.
[24] S. Bhuyan, U. Kabir, J. M. Escareno, K. Ector, S. Palakodeti, D. Wyant et al., Transforming healthcare cybersecurity from reactive to proactive: current status and future recommendations, in Journal of Medical Systems, Vol. 44/98, 2 Aprile 2020.
[25] Una variabile di stock è misurata in uno specifico momento e rappresenta una quantità esistente in un determinato istante, una variabile di flusso è misurata invece relativamente ad un intervallo di tempo, queste ultime fanno variare le variabili di stock.
[26] M. S. Jalali, J. P Kaiser, “Cybersecurity in hospitals: a systematic, organizational perspective”, in Journal of Medical Internet Research, Vol. 20, iss. 5, 2018, pp. 1-16; si noti come nonostante sia uno studio formulato guardando al sistema sanitario statunitense, tuttavia risulti essere un modello applicabile anche ai sistemi sanitari di altri Paesi.
[27] A. Antonilli, “Sicurezza informatica e trattamento dei dati in ambito sanitario”, in Salute e società, XVI, suppl. 3/2017, pp. 97-98.
[28] B. Schneier, Schneier on security, John Wiley & Sons, September 2008.
[29] S. Fumagalli (intervento), al talk “Cybersecutity per la sanità digitale: conoscere per non rischiare”, andato in onda il 28 Ottobre 2021, nella prima giornata di FORUM PA Sanità, evento digitale organizzato da FPA e P4I-Partners4Innovation.
[30] E. Sorano, A. Guerrieri, A. Sardi, “Criticità e consapevolezze” in Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM ITALIA, 2021, p. 42.
Profilo Autore
Maria Vittoria Zucca, laureata con lode in Giurisprudenza presso l’università degli Studi di Trento, è attualmente dottoranda nel Programma di Dottorato di Interesse Nazionale in Cybersecurity, con istituzione capofila la Scuola IMT Alti Studi di Lucca, ed è affiliata alla Scuola Superiore Sant’Anna, presso l’Istituto Dirpolis (Diritto, Politica e Sviluppo). La sua attività di ricerca si concentra sulla prevenzione, l’indagine ed il contrasto della criminalità informatica, includendo le discipline del diritto penale dell’informatica e della criminologia digitale. Su questi temi è autrice di diverse pubblicazioni scientifiche e partecipa regolarmente a conferenze nazionali e internazionali.
Shadow AI, compliance e responsabilità: verso un modello minimo di governance
L’adozione spontanea, diffusa e spesso non governata di strumenti di intelligenza artificiale generativa nei contesti di lavoro ha reso attuale un fenomeno che, in modo convenzionale, viene definito Shadow AI: l’uso di sistemi o modelli AI da parte di dipendenti, collaboratori o funzioni aziendali fuori dai processi di approvazione, procurement, risk assessment e controllo interno.
Non si tratta di una categoria giuridica autonoma, ma di un problema organizzativo e di compliance che interseca più discipline: protezione dei dati, sicurezza delle informazioni, responsabilità organizzativa, contrattualistica ICT e, oggi, anche la governance dell’AI. L’interesse editoriale del tema è espresso in modo diretto anche dal piano 2026 di ICT Security Magazine, che colloca “Shadow AI in azienda: rischi, detection e governance” tra le proposte centrali del pilastro dedicato a intelligenza artificiale e machine learning per la sicurezza.
La rilevanza del tema dipende da un dato semplice: l’AI generativa abbassa drasticamente la soglia di accesso a strumenti capaci di trattare testi, dati, codice, documenti, immagini e workflow aziendali.
Di conseguenza, l’uso “di fatto” precede quasi sempre la formalizzazione delle regole e proprio in questa asimmetria si collocano i rischi principali, tra i quali si annoverano, tra gli altri, l’inserimento di dati personali o confidenziali nei prompt; la perdita di controllo su basi giuridiche, le finalità e i tempi di conservazione; la generazione di output inesatti ma apparentemente affidabili; la dipendenza da fornitori esterni non valutati; l’uso di plugin, agenti o integrazioni che ampliano la superficie d’attacco; e, non ultimo, la difficoltà di audit e di attribuzione delle responsabilità.
Il quadro normativo europeo non usa l’etichetta “Shadow AI”, ma fornisce già un reticolo di obblighi sufficiente a farne un tema di governance: il GDPR impone liceità, minimizzazione, integrità e riservatezza, responsabilizzazione del titolare e misure tecniche e organizzative adeguate; la NIS2 richiede misure di gestione del rischio di cybersicurezza e sicurezza della supply chain; l’AI Act impone almeno, fin da subito, obblighi di AI literacy per provider e deployer e, su altre scansioni temporali, ulteriori doveri in materia di GPAI, trasparenza e sistemi ad alto rischio.
La tesi di questo policy brief è che il modo più efficace per affrontare la Shadow AI non sia né il laissez-faire né il divieto assoluto. Il primo espone l’organizzazione a violazioni prevedibili; il secondo è spesso inefficace, perché spinge l’uso dell’AI fuori dai circuiti visibili. La soluzione ragionevole è una governance minima efficace: un insieme essenziale ma verificabile di regole, processi e controlli che renda l’uso dell’AI consentito, tracciabile, proporzionato al rischio e difendibile in sede di audit, ispezione o contenzioso.
Questo modello deve essere interdisciplinare e coinvolgere legal, privacy, security, procurement, HR, internal audit e funzioni di business; distinguere tra usi vietati, usi consentiti e usi consentiti con condizioni; documentare decisioni e responsabilità; integrare la valutazione AI con i processi già esistenti di sicurezza e protezione dati.
Le raccomandazioni finali sono dieci: censimento degli strumenti; classificazione degli usi; regole sui prompt e sui dati in input; valutazione dei fornitori; presidio contrattuale; logging e auditabilità; coordinamento con GDPR e NIS2; formazione mirata; presidio degli incidenti AI-related; accountability del management perché l’obiettivo non è frenare l’innovazione, ma renderla governabile.
Il problema: che cos’è davvero la Shadow AI
Con l’espressione Shadow AI si descrive, in senso pratico, l’impiego di strumenti di AI al di fuori del perimetro autorizzato e governato dell’organizzazione. Il fenomeno richiama, per analogia, quello più noto dello shadow IT, ma presenta caratteristiche ulteriori. Nel caso della Shadow AI, il rischio non deriva solo dall’adozione di un software non approvato, bensì dal fatto che l’utente interagisce con sistemi capaci di elaborare, inferire, trasformare, sintetizzare e generare contenuti a partire da input che possono incorporare dati personali, segreti commerciali, know-how, codice sorgente, documentazione contrattuale, informazioni strategiche o elementi soggetti a vincoli regolatori. Il problema, dunque, non è soltanto tecnologico: è informativo, organizzativo e giuridico.
Tra i rischi da trattare, vi sono il data leakage verso modelli esterni, le violazioni GDPR e AI Act e la necessità di policy di acceptable use. In effetti, la Shadow AI prospera precisamente negli spazi vuoti della governance: licenze individuali acquistate con carta aziendale; uso di account gratuiti; accesso a chatbot pubblici da device corporate; upload di file o screenshot per ottenere sintesi, traduzioni o analisi; uso di AI coding assistants senza regole di segregazione dei repository; integrazione di modelli in workflow o applicazioni interne senza previa valutazione dei rischi.
Dal punto di vista giuridico, il primo equivoco da sciogliere è che la Shadow AI non sia un “non-problema” solo perché il termine non compare nei testi normativi. Al contrario, proprio perché non esiste una disciplina speciale dedicata, il fenomeno ricade integralmente nel diritto comune della protezione dei dati, della sicurezza, della responsabilità d’impresa e, quando rilevante, nell’AI Act. In altri termini, l’assenza di una definizione legislativa non crea un vuoto di tutela; semmai aumenta il rischio di sottostimare obblighi già esistenti.
Perché il problema è oggi più grave di ieri
La novità non è l’esistenza di strumenti esterni al controllo IT, ma la loro capacità di penetrare i processi decisionali e documentali ordinari. Un modello generativo può essere usato per: redigere email; riassumere contratti; analizzare dataset; generare codice; produrre policy; preparare report per il board; assistere ticketing, HR, procurement e customer service.
Ciò significa che l’AI non entra in azienda come semplice utility, bensì come mediatore cognitivo delle attività professionali. Se questo avviene in assenza di regole, l’organizzazione perde visibilità su ciò che viene conferito ai sistemi, su dove i dati transitano, su quali siano le basi giuridiche che fondano il trattamento, su quali siano le clausole che regolano il rapporto con il fornitore e su quali controlli di sicurezza siano effettivamente applicati.
Sotto il profilo della protezione dei dati, il rischio è duplice: da un lato, l’utente può conferire dati personali in assenza di necessità, violando il principio di minimizzazione o utilizzando uno strumento che non è stato valutato in termini di liceità, trasparenza e sicurezza; dall’altro, anche quando l’organizzazione ritiene di star trattando dati “anonimizzati”, l’assunto potrebbe essere fragile.
L’EDPB, nell’Opinion 28/2024, ha chiarito che i modelli AI addestrati con dati personali non possono, in tutti i casi, essere considerati anonimi e che l’anonimizzazione va valutata caso per caso, anche rispetto alla possibilità di estrarre dati o re-identificare persone mediante interrogazioni del modello. Questo è un passaggio fondamentale: molte pratiche informali di uso della GenAI in azienda si fondano su una nozione eccessivamente intuitiva di “dato non personale”.
Sotto il profilo della cybersicurezza, la Shadow AI amplia la superficie d’attacco. Non solo perché i modelli possono essere esposti a prompt injection, data exfiltration, output manipolati o dipendenze terze, ma anche perché l’organizzazione introduce nuove dipendenze di filiera senza presidiarle.
La NIS2 richiede che i soggetti interessati adottino misure tecniche, operative e organizzative adeguate e proporzionate per gestire i rischi per la sicurezza dei sistemi informativi; tra tali misure rientrano, espressamente, la sicurezza della supply chain e dei rapporti con i fornitori, la sicurezza nell’acquisizione, sviluppo e manutenzione di reti e sistemi informativi, nonché politiche di valutazione dell’efficacia delle misure di gestione del rischio. Se l’AI entra in azienda attraverso canali non autorizzati, ciascuno di questi presìdi è, di fatto, eluso.
Sotto il profilo della governance dell’AI, il quadro è ormai ancora meno rinviabile. L’AI Act è entrato in vigore il 1° agosto 2024; alcune disposizioni si applicano già dal 2 febbraio 2025, fra cui gli obblighi di AI literacy, mentre altre si applicano secondo ulteriori scadenze, inclusi gli obblighi per i provider di GPAI dal 2 agosto 2025 e le norme di trasparenza dal 2 agosto 2026. L’art. 4 dell’AI Act impone a provider e deployer di adottare misure per garantire un livello sufficiente di alfabetizzazione AI del personale e di altri soggetti che operano per loro conto, tenendo conto delle competenze tecniche, dell’esperienza, della formazione e del contesto d’uso.
In termini organizzativi, questo significa che lasciare l’AI in una zona grigia, priva di policy e formazione, non è più una scelta neutra: è un indice di governance debole.
Il quadro normativo applicabile
GDPR: il cuore del problema è l’accountability
Il GDPR resta la prima lente giuridica con cui leggere la Shadow AI. Non perché ogni uso dell’AI implichi necessariamente un trattamento illecito, ma perché ogni uso aziendale rilevante richiede di rispondere alle domande classiche del diritto sui dati: quali dati entrano nel sistema; per quali finalità; su quale base giuridica; con quali ruoli tra i soggetti coinvolti; per quanto tempo; con quali misure di sicurezza; con quali trasferimenti; con quali diritti per gli interessati.
Gli artt. 5, 24 e 32 del GDPR impongono rispettivamente i principi di liceità, correttezza e trasparenza, minimizzazione, integrità e riservatezza; la responsabilità del titolare di mettere in atto misure tecniche e organizzative adeguate; e l’obbligo di garantire un livello di sicurezza adeguato al rischio.
Per la Shadow AI, il punto decisivo è l’accountability. Se il dipendente inserisce dati personali in un tool esterno, il problema non si esaurisce nella “colpa individuale”, poiché occorre domandarsi se l’organizzazione abbia predisposto policy, restrizioni, whitelist, regole di classificazione dei dati, formazione, controlli e procedure di autorizzazione adeguati. In assenza di questi elementi, diventa difficile sostenere che il titolare abbia davvero “messo in atto” misure idonee. La Shadow AI, quindi, non è solo un tema di comportamento scorretto del singolo; è un test della maturità organizzativa del titolare.
NIS2: rischio cyber e supply chain
Anche laddove non vi siano dati personali, la Shadow AI può rilevare in chiave NIS2; infatti l’art. 21 della direttiva richiede misure di gestione del rischio che coprano analisi dei rischi, gestione degli incidenti, business continuity, sicurezza della supply chain, sicurezza nell’acquisizione, nello sviluppo e nella manutenzione di reti e sistemi informativi, uso della crittografia e formazione di base in materia di cybersicurezza. L’utilizzo di strumenti AI esterni o di plugin non valutati può incidere su più di uno di questi profili: terze parti non censite, flussi di dati non mappati, integrazioni non presidiate, possibili dipendenze operative non considerate nei piani di continuità.
Per le organizzazioni soggette a NIS2, la Shadow AI non può quindi essere archiviata come tema di mera produttività individuale. È, piuttosto, una variante contemporanea del rischio da supply chain e del rischio da configurazione organizzativa non controllata e ciò vale, a maggior ragione, nelle realtà che operano in settori regolati o critici.
AI Act: dalla sperimentazione alla governance
L’AI Act non disciplina la Shadow AI come fattispecie nominata, ma ne rende più difficile la tolleranza organizzativa. La ragione minima è l’art. 4 sull’AI literacy, già applicabile dal 2 febbraio 2025. La Commissione europea, nelle FAQ dedicate, chiarisce che provider e deployer devono adottare misure per garantire un livello sufficiente di AI literacy in relazione al personale e al contesto d’uso. In termini pratici, un’organizzazione che consenta o subisca un uso diffuso di AI senza formazione, istruzioni, classificazione degli usi e definizione delle responsabilità si espone a una criticità di conformità già attuale.
Inoltre, la progressiva applicazione delle regole sui modelli GPAI e, poi, delle norme di trasparenza e sugli high-risk systems impone una capacità interna di mappare gli usi dell’AI. Senza inventario e governance, l’organizzazione non sarebbe in condizione di capire se stia agendo come mero utilizzatore di un servizio, come deployer di un sistema AI, o se abbia integrato un modello in processi che fanno emergere ulteriori obblighi.
Le opzioni di policy
Una politica aziendale sulla Shadow AI può, in astratto, muoversi lungo tre modelli.
La prima opzione è lo status quo: nessuna regola specifica, affidamento alla prudenza dei team, eventuali richiami generici nelle policy IT o privacy. È la soluzione peggiore, perché crea un divario tra uso reale e uso formalmente consentito. Il risultato è una non-governance che alimenta il rischio sul piano probatorio: quando si verifica un incidente, mancano inventari, logiche autorizzative, evidenze formative e responsabilità chiare.
La seconda opzione è il divieto generalizzato di strumenti AI non approvati o, più radicalmente, di ogni uso della GenAI, ed è comprensibile che in ambienti altamente sensibili tale soluzione possa apparire una risposta intuitiva; tuttavia, come regola generale, funziona poco. Dove il bisogno di produttività è forte, il divieto assoluto tende a spostare l’uso fuori dai radar, su account personali, dispositivi privati o canali non tracciabili e il rischio si riduce solo in apparenza.
La terza opzione è una governance minima efficace. Il suo pregio è di combinare realismo operativo e presidio giuridico. Non parte dall’idea irrealistica di azzerare l’uso dell’AI, ma da quella di ricondurlo entro un perimetro visibile, valutabile e documentato. È il modello preferibile perché consente all’organizzazione di classificare i casi d’uso, graduare i controlli in base al rischio e produrre evidenze difendibili.
Un modello minimo di governance: dieci raccomandazioni
Censire gli strumenti AI effettivamente usati.
Senza inventario non esiste governance, per tale ragione occorre mappare chatbot, coding assistants, servizi di trascrizione, traduzione, analisi documentale, plugin e API. La ricognizione deve essere sia top-down, tramite procurement e IT, sia bottom-up, tramite survey, interviste e controlli sui workflow.
Distinguere tra usi vietati, consentiti e consentiti con condizioni.
La regola non può essere binaria poiché devono esistere almeno tre classi: usi proibiti; usi ammessi senza dati sensibili o riservati; usi ammessi solo previa valutazione e con strumenti approvati. Questo consente di rendere comprensibile la policy agli utenti.
Introdurre una disciplina rigorosa degli input.
Il rischio principale sta spesso nei prompt e proprio in tale operazione può essere utile vietare o limitare l’inserimento di dati personali non necessari, categorie particolari di dati, segreti commerciali, credenziali, codice proprietario, atti processuali, pareri legali non ancora diffusi, documentazione classificata o materiale soggetto a obblighi di segretezza.
Valutare i fornitori come terze parti critiche.
Ogni servizio AI esterno deve essere trattato, sul piano della governance, come un fornitore potenzialmente rilevante per privacy e sicurezza. Vanno esaminati termini contrattuali, ruoli privacy, subfornitori, localizzazione dei dati, politiche di retention, opt-out rispetto al training, misure di sicurezza, auditability e supporto agli incidenti. Questo approccio è coerente sia con l’accountability del GDPR sia con l’attenzione NIS2 alla supply chain.
Integrare la valutazione AI con i processi già esistenti.
La Shadow AI prospera quando l’AI viene trattata come eccezione. Al contrario, deve essere incorporata nei processi ordinari: vendor assessment, DPIA quando necessaria, security review, change management, classificazione delle informazioni, incident management, internal audit.
Garantire logging, tracciabilità e conservazione delle evidenze.
Non ogni interazione con un sistema AI può o deve essere integralmente registrata, ma un livello adeguato di auditabilità è essenziale e ciò perché la governance deve poter dimostrare chi ha approvato lo strumento, per quali usi, con quali limitazioni, con quale formazione erogata e con quali verifiche periodiche.
Predisporre una policy di AI acceptable use.
La policy dovrebbe essere breve, concreta e leggibile, non un manifesto meramente programmatico. Deve chiarire finalità consentite, divieti, regole sui dati, uso di account personali, divieto di integrare tool non approvati, regole di verifica degli output e canali per richiedere approvazioni o segnalare incidenti.
Rendere effettiva l’AI literacy.
La formazione richiesta dall’art. 4 AI Act non può ridursi a un webinar introduttivo. Deve essere differenziata per ruoli: utenti comuni, manager, HR, legali, sviluppatori, security, procurement, includendo casi concreti: quali dati non inserire, come validare un output, quali errori sono tipici, quali sono le responsabilità.
Gestire gli incidenti AI-related come incidenti reali.
Un errore frequente è quello di considerare un uso improprio di GenAI come una semplice deviazione interna, ben potendo, al contrario, configurarsi come un data breach, una violazione contrattuale, una dispersione di segreti, una produzione di documenti inaccurati o l’introduzione di vulnerabilità nel codice; è per tale motivo che le istruzioni da fornire agli operatori non possono prescinere da questi scenari.
Coinvolgere il management e formalizzare le responsabilità.
Un altro errore piuttosto comune è quello di considerare la Shadow AI come materia di esclusiva pertinenza del reparto IT. Le scelte sul livello di tolleranza al rischio, sulle categorie di dati, sulle eccezioni consentite e sulle priorità di investimento sono decisioni di governance e proprio per tale motivo occorre una responsabilizzazione del management, con sponsorship chiara e reporting periodico.
Profili di responsabilità
Una governance debole della Shadow AI può produrre responsabilità su più livelli: sul piano amministrativo-regolatorio, possono emergere contestazioni in materia di protezione dati, sicurezza o settoriale; sul piano civilistico, l’uso improprio dell’AI può tradursi in danni da divulgazione indebita, perdita di segreti commerciali, inadempimento contrattuale o affidamento su output erronei; sul piano organizzativo interno, può emergere una responsabilità da carenza di presidi, specie quando l’uso dell’AI sia diffuso, noto o prevedibile e l’ente non abbia adottato misure ragionevoli.
È importante sottolineare un punto: la governance della Shadow AI non chiede alle organizzazioni l’impossibile, poiché nessuna disciplina pretende un rischio pari a zero, in ossequio al brocardo ad impossibilia nemo tenetur, pretende, però, un presidio ragionevole e documentabile. Ed è proprio la documentazione delle scelte, dei controlli e della formazione a costituire la prima linea difensiva in caso di audit o contenzioso.
Conclusioni
La Shadow AI non è una moda terminologica, ma la manifestazione concreta di un mutamento nel modo in cui il lavoro cognitivo viene svolto dentro le organizzazioni e proprio per tali ragioni non può essere affrontata con categorie residuali o con policy generiche. Il diritto già offre gli strumenti per qualificarla: accountability e sicurezza nel GDPR; risk management e supply chain nella NIS2; AI literacy e progressiva strutturazione della governance nell’AI Act.
La domanda non è se l’IA stia già entrando nei processi aziendali; la risposta è sì. La domanda giuridicamente rilevante è se vi stia entrando in modo governato e per molte organizzazioni, oggi, la risposta è ancora incerta. Ed è proprio in questa incertezza che si annidano i rischi più seri: non solo tecnologici, ma probatori, reputazionali e regolatori.
Una politica efficace non deve demonizzare l’IA, né inseguire un controllo assoluto; deve, più modestamente e più utilmente, renderla visibile, classificabile, governabile. In questo senso, un modello minimo di governance della Shadow AI non è un costo di compliance: è una condizione di uso legittimo e sostenibile dell’innovazione.
Elena Bassòli, Avvocato in Genova, Professore a contratto di Diritto della comunicazione elettronica (54 h) e di Cyber Security and Data Protection (Master II liv. post lauream Ingegneria), presso l’Università degli Studi di Genova. Si occupa di diritto e nuove tecnologie dal 1995 ed è autore di oltre 200 pubblicazioni in materia, tra monografie, contributi a collettanee, articoli, note e commenti. Membro del Comitato di Redazione della rivista “Sicurezza e Giustizia”, è formatore per Ministero dell’Interno e Ministero di Giustizia, Presidente ANGIF (Associazione Nazionale Giuristi Informatici e Forensi). Coautore del software Verslex in uso al Senato della Repubblica per l’aiuto alla redazione dei testi normativi. È dottore di ricerca in Metodi e tecniche della formazione e valutazione delle leggi, XII ciclo. Coordinatore della Commissione “Privacy” e Consigliere presso CTI-Liguria (Club Tecnologie dell’Informazione); membro ANDIG-Ass. Naz. Docenti Informatica giuridica e ANDIP-Ass. Naz. Difesa Privacy. Delegato al Congresso Nazionale Forense.
AI Act, l’Unione Europea bandisce le “nudify apps”
L’Europa annuncia un passo in avanti sul contrasto al Deepfake Porn: il 26 marzo 2026 il Parlamento UE ha varato una misura che intende colpire le cosiddette nudify apps, nate per generare o alterare immagini di persone reali tramite l’intelligenza artificiale e creare contenuti espliciti senza il loro consenso.
Nello specifico si tratta di un emendamento all’AI Act, parte del più generale processo di revisione noto come “Digital Omnibus” e avviato nel novembre 2025 allo scopo dichiarato di semplificare e aggiornare la normativa comunitaria alla luce del rapido sviluppo delle tecnologie digitali.
Come già avvenuto in altri campi, l’intelligenza artificiale ha avuto un impatto dirompente anche sulla diffusione di contenuti sessualmente espliciti. Oltre a trasformare l’industria legale dell’intrattenimento per adulti, l’estrema accessibilità degli strumenti che usano l’AI per produrre materiale pornografico a partire da immagini o video di persone inconsapevoli (inclusi minorenni) sta abilitando forme di abuso sempre più pervasive.
Deepfake Porn: un fenomeno in crescita allarmante
Il termine deepfakepuò indicare ogni tipologia di contenuto audiovisivo digitale creato e/o alterato mediante AI.
Una specifica tipologia è infatti rappresentata dal deepnude, che parte dall’immagine di una persona reale per generarne altre di natura esplicita. La stragrande maggioranza di tali contenuti rappresenta corpi femminili in scenari sessuali: secondo le Nazioni Unite, “deepfake pornography made up 98% of all deepfake videos online and 99% depicted women, according to a 2023 report”.
Il medesimo report registra una crescita superiore al 500% dei video deepfake circolanti a partire dal 2019, evidenziando quanto gli strumenti necessari a crearli siano ormai “widely available, usually free, and require very little technical expertise”.
Come in altri casi di Technology Facilitated Gender-based Violence (TFGBV) – in particolare nella categoria dell’Image Based Sexual Abuse (IBSA) – una volta pubblicati i contenuti sono quasi impossibili da rimuovere; “once posted, AI generated content can be replicated endlessly, saved to private devices and shared across platforms, making it nearly impossible to fully remove”.
Le persone coinvolte rischiano di soffrire gravi effetti psicologici ed emotivi, nonché professionali e reputazionali, in conseguenza dell’essere state associate a materiali pornografici diffusi online.
Cosa sono le nudify apps?
Nell’ambito del Deepfake Porn, si è sviluppato un fiorente mercato dedicato ad app e software che in poche mosse consentono di “denudare” una persona partendo da un’immagine in cui appaia parzialmente o completamente vestita.
Sebbene tale possibilità esistesse già da diversi anni, la massiccia diffusione di strumenti semplici e gratuiti (o comunque a prezzi molto accessibili) ha trasformato una realtà marginale in un fenomeno dilagante: secondo una ricerca condotta dal Centre for Countering Digital Hate, il solo GROK avrebbe prodotto – in un periodo di osservazione di appena 10 giorni – ben 3 milioni di immagini sessualmente esplicite e 23.000 contenuti relativi ad abusi su minori.
Anche in questo caso, è evidente come la circolazione di immagini a carattere intimo che rappresentano minori reali e riconoscibili rischi di avere effetti devastanti sulla loro sicurezza presente e futura.
Le normative sul Deepfake Porn nel mondo
Mentre la creazione e la diffusione di immagini ritraenti minori sono severamente proibite ovunque, i contenuti che mostrano soggetti adulti sono rimasti a lungo in una “zona grigia” sul piano legale.
Soltanto negli ultimi anni, anche in seguito al clamore mediatico creatosi intorno ad alcune “vittime eccellenti” – come la cantante Taylor Swift – molti Paesi hanno iniziato ad adottare normative per contenere questo fenomeno e sanzionare i responsabili.
Vediamone le principali.
Regno Unito: già dal 2023, l’Online Safety Act proibisce la diffusione di immagini esplicite manipolate digitalmente, senza tuttavia rivolgersi in modo specifico alla creazione di contenuti mediante AI; per colmare tale lacuna, nel 2025 il Data (Use and Access) Act ha previsto come reato “to create or request the creation of non-consensual intimate images”.
Corea del Sud: alla luce di oltre 800 casi in un solo anno, nel 2024 il governo di Seoul ha adottato una delle normative più rigorose al mondo in tema di deepfake, vietando i contenuti espliciti generati tramite AI e prevedendo fino a 3 anni di carcere per chi detenga o visioni tali contenuti, nonché fino a 7 per chi li generi a fini di distribuzione.
Singapore: nello stesso anno sono state introdotte pene severe per i responsabili di truffe o estorsioni conseguenti alla creazione di deepfake a natura sessuale, sulla scorta di numerosi scandali verificatisi nei mesi precedenti.
Stati Uniti: il “Take It Down Act” (Tools to Address Known Exploitation by Immobilizing Technological Deepfakes on Websites and Networks) del 2025 criminalizza la pubblicazione non consensuale di immagini intime, citando esplicitamente i deepfakes; entro il 19 maggio 2026, ogni piattaforma che ospiti contenuti creati dagli utenti deve dotarsi di sistemi per la segnalazione e rimozione di materiali espliciti creati senza il consenso delle persone ritratte.
Messico: sempre nel 2025, il Congresso ha approvato una legge che prevede fino a 5 anni di carcere (e significative sanzioni pecuniarie) per chiunque crei o diffonda senza consenso materiali a contenuto sessuale manipolati tramite l’AI, includendo espressamente ogni applicazione, programma o tecnologia capace di alterare o modificare fotografie, file audio, video o qualsiasi altro materiale grafico.
Brasile: a marzo 2026, il codice penale è stato aggiornato per includere nuove sanzioni nei confronti di chi alteri l’immagine o la voce di una persona mediante l’uso di AI o altre tecnologie; per i siti o piattaforme che consentano la pubblicazione di materiali espliciti così prodotti, sono previste multe fino al 2% del fatturato annuale.
Molti altri Paesi – come l’Australia o il Canada – hanno annunciato di star elaborando simili normative, confermando la percezione globale del Deepfake porn come minaccia concreta ed estremamente attuale.
Anche la nuova UN Cybercrime Convention prevede per gli Stati contraenti l’obbligo di criminalizzare la condivisione di Non-Consensual Intimate Imagery (NCII), includendo le immagini di persone reali create o modificate dall’intelligenza artificiale; e l’Unione Europea aveva già provveduto ad adottare alcune misure di contrasto.
Il divieto di deepnudes: direttiva europea e legge italiana
In effetti la Direttiva (UE) 2024/1385, adottata nel 2024 e dedicata al contrasto della violenza contro le donne, proibisce “creating and distributing pornographic material digitally altered to make it appear that a person is involved without their consent”.
Un’ipotesi che – pur non menzionando esplicitamente gli strumenti basati sull’AI – potrebbe applicarsi anche ai contenuti generati dalle nudify apps.
Tuttavia, come noto, le direttive non sono immediatamente applicabili negli Stati membri; al contrario richiedono passaggi applicativi che non tutti i componenti dell’Unione hanno ancora compiuto, portando a una disparità di tutele tra i vari Paesi UE.
Inoltre la direttiva subordina l’illiceità dei deepfake alla circostanza che siano idonei a provocare seri danni (“likely to cause serious harm”), lasciando un ampio margine interpretativo circa la valutazione di tali requisiti.
Analogamente, in Italia l’art. 612 quater c.p. (introdotto dalla legge n. 132/2025) punisce con la reclusione fino a cinque anni “chiunque cagiona un danno ingiusto ad una persona, cedendo, pubblicando o altrimenti diffondendo, senza il suo consenso, immagini, video o voci falsificati o alterati mediante l’impiego di sistemi di intelligenza artificiale”.
La scelta di mutuare dalla direttiva l’elemento del “danno ingiusto” rischia così di limitare l’applicabilità della norma italiana, lasciando alla vittima l’onere della prova in merito agli effetti dell’abuso.
Ulteriori profili di rischio dei Deepnudes
Oltre alle citate conseguenze psicologiche e reputazionali, un deepfake diffuso sul web può esporre la persona ritratta ad attenzioni indesiderate (e potenzialmente pericolose), mettendo a repentaglio la sua sicurezza fisica ed emotiva.
I deepfake possono altresì potenziare i casi di sextortion, dove immagini o video intimi generalmente ottenuti con l’inganno sono utilizzati per ricattare qualcuno al fine di estorcere denaro (di solito in criptovalute) o di farsi inviare ulteriori immagini private, minacciando in caso contrario di pubblicarli online.
E anche laddove i materiali in questione vengano creati o modificati artificialmente, non è difficile immaginare come una persona potrebbe finire per cedere al ricatto sull’onda del timore per la propria reputazione personale e professionale.
Conclusioni: contro il Deepfake abuse serve più consapevolezza
Alla luce dei molteplici profili di rischio evidenziati, nonché della rapidità con cui si evolvono le tecnologie, sembra utopico ipotizzare che il solo strumento normativo – tanto a livello nazionale quanto sovranazionale – possa risultare sufficiente ad arginare il fenomeno deepfake.
Risultano senz’altro utili i tentativi di coinvolgere le aziende nella prevenzione degli abusi basati sull’AI; ma difficilmente i colossi tech rinunceranno ai relativi lauti guadagni, al più limitandosi a prevedere meccanismi di age verification e segnalazione/rimozione dei contenuti illegali che tuttavia, proprio come i rimedi giurisdizionali, intervengono quando il danno si è già verificato.
Allo stesso modo, le possibili contromisure tecniche – come il watermarking delle immagini – rischiano di rivelarsi presto superate dall’evoluzione degli strumenti digitali.
Fondamentale, allora, è impegnarsi nel costruire una cultura del consenso a partire dalle giovani generazioni, creando consapevolezza circa i pericoli e le gravi conseguenze potenzialmente derivanti dalla creazione e diffusione di materiali non consensuali online, affinché lo sviluppo delle tecnologie non divenga sempre più uno strumento per ledere la dignità delle persone.
Profilo Autore
Con una laurea in Giurisprudenza conseguita presso l’Università degli Studi Roma Tre – seguita da un dottorato di ricerca in Economia e Diritto delle Relazioni Internazionali – Irene Salvi è docente in diversi Master e Corsi formativi, nonché giornalista pubblicista e ricercatrice indipendente sul tema dell’intersezione tra diritti individuali, libertà civili e tecnologie digitali.
Dal 2020 è consigliera di una rete internazionale attiva nel contrasto alla violenza di genere; nel 2025 ha partecipato al PRIN-PNRR “Gendering Internet. Violence, Resilience and Empowerment in digital spaces” (GIVRE), condotto dalla Sapienza insieme a Università di Padova e Link University, primo progetto di ricerca sul fenomeno della violenza digitale di genere in Italia.
Definizione e evoluzione della cybersecurity sanitaria
Nella sua accezione più generale la cybersecurity viene presentata quale semplice estensione del concetto di “sicurezza informatica”[1], tuttavia certo è che limitare suddetto concetto alla sola protezione dei sistemi informativi risulta tanto fuorviante, quanto anacronistico. Di gran lunga più attuale si dimostra la definizione riportata all’interno dello standard ISO/IEC 27032:2012 (per come rivisto e confermato nel 2018), che rievocando le componenti della triade CIA, si appresta a designare la cybersicurezza come: “la pratica che consente ad una entità di proteggere i propri asset fisici, come anche la confidenzialità, l’integrità e la disponibilità delle proprie informazioni, da quelle minacce che provengono dal cyberspace.”[2]
Il contesto in cui si suole operare è pertanto infinitamente più complesso di un semplice computer (o di una rete internet), consistente nel cyberspazio tutto, inteso quale complex environment, composto dalla costante interazione tra fattore umano, software e servizi.[3]
È innegabile difatti che il problema della cybersecurity coinvolga un vasto insieme di soggetti del moderno mondo digitale, si prenda da esempio il settore dell’healthcare: quando le organizzazioni sanitarie abbracciano la trasformazione digitale, diventano più aperte agli scambi con un ecosistema ampio composto da pazienti, partner, fornitori terzi, ed autorità sanitarie governative, il tutto in un ambiente di cura integrata e collaborativa. Dal momento che parallelamente allo sviluppo tecnologico, è proliferata anche la frequenza ed il grado di raffinatezza dei cyber attacchi, la sicurezza informatica risulta ad oggi la conditio sine qua non per la stessa innovazione: gli strumenti di sicurezza devono saper gestire e “stare al passo” con la progressiva e repentina digitalizzazione.[4]
La cybersecurity pertanto altro non è che un’attività di prevenzione, basata sul principio fondante, diffuso tra gli esperti di sicurezza, che recita “paranoia is a virtue”: non ci si può d’altronde affidare alla speranza che un evento avverso non accada, in quanto gli attuali automatismi dei sistemi di attacco rendono ogni dispositivo, sistema o servizio un possibile bersaglio.[5]
Diverse misure di tutela sono già state poste in essere per la protezione delle infrastrutture critiche[6] e dei servizi digitali nei Paesi dell’Unione europea, si vogliano pertanto passare in rassegna le principali normative susseguitesi nel tempo in materia di sicurezza informatica.
Posizione di spicco viene ricoperta dalla Direttiva (Ue) 2016/1148 recante “misure per un livello comune elevato di sicurezza delle reti e dei sistemi informativi” (c.d. Direttiva NIS, acronimo di Network and Information security)[7], recepita nel nostro ordinamento con il Decreto legislativo n. 65/2018, pubblicato sulla Gazzetta Ufficiale il 9 Giugno 2018 ed in vigore dal 24 Giugno dello stesso anno.[8] Così facendo l’Unione Europea ha voluto affrontare, con un approccio organico e trasversale, la sempre più emergente questione della cybersecurity, col fine di promuovere la cultura in materia di sicurezza cibernetica, rafforzare la resilienza delle infrastrutture nazionali ed altresì migliorare la cooperazione tra Stati membri.
Come riportato nelle considerazioni introduttive della sopradetta Direttiva, le reti, i sistemi ed i servizi informativi svolgono un ruolo cruciale nell’agevolare i movimenti transfrontalieri di beni, servizi e persone, e una loro perturbazione potrebbe sì avere ripercussioni non solo sui singoli Stati, ma in tutta l’Unione, danneggiandone l’economia nel suo complesso: si legge per l’appunto come la sicurezza delle reti e dei sistemi informatici siano essenziali “per l’armonioso funzionamento del mercato interno”.[9]
Si rilevi come il legislatore europeo, nel redigere il testo della Direttiva, non abbia adottato un orientamento prescrittivo (seguendo un approccio similare a quanto fatto con il GDPR), non disponendo cioè misure obbligatorie minimali da seguire pedissequamente, ma indicando semplicemente degli obiettivi generici da raggiungere, lasciando poi ai singoli soggetti un ampio margine di manovra nell’individuare ed implementare mezzi e strumenti considerati più idonei per il loro stesso raggiungimento. Si richiederà infatti genericamente che le misure di sicurezza adottate, sia a livello tecnico che organizzativo, siano proporzionate al rischio individuato, oltre che adeguate a prevenire e ridurre l’impatto che ogni incidente informatico potrebbe avere sulle reti e sui sistemi in uso, garantendo così la continuità del servizio offerto.
Come si evince poi dal testo del d.lgs. 65/2018, che ricalca accuratamente la Direttiva NIS, il settore sanitario, alla luce del suo impatto tanto economico quanto sul benessere e sulla qualità di vita della popolazione, è considerato una filiera strategica, rientrante pienamente nell’ambito della disciplina europea NIS, in particolare nella categoria dei c.d. “Operatori di servizi essenziali” (OSE).
Si chiarisce infatti come ogni Stato membro debba operare una attenta individuazione nel proprio territorio degli OSE, guardando a tutti quei soggetti, che siano pubblici o privati, operanti negli specifici settori elencati dall’allegato II della Direttiva (quali energia, trasporti, sanità, mercati finanziari, distribuzione di acqua potabile etc.), purché ex art. 5 :
a) Forniscano servizi essenziali per il mantenimento di attività sociali o economiche fondamentali;
b) La fornitura del servizio dipenda dalla rete e dai sistemi informativi;
c) Un possibile incidente abbia effetti negativi rilevanti sulla fornitura del servizio[10]
Chiaro è come fra i soggetti suscettibili di essere nominati OSE nell’ambito sanitario verranno ricompresi tutti gli istituti sanitari (ospedali e cliniche private inclusi), e che l’autorità competente incaricata di tale individuazione sarà, ex art. 7 del Decreto attuativo, specificatamente il Ministero della salute, d’intesa con le Regioni e le Province autonome di Trento e Bolzano. Una volta identificati, gli Operatori di servizi essenziali saranno tenuti, ex art 12, ad adottare, “tenendo in considerazione le conoscenze più aggiornate in materia”, ogni misura tecnico-organizzativa atta a prevenire, gestire e minimizzare l’impatto di incidenti malevoli indirizzati a carico della sicurezza della rete e dei sistemi informatici utilizzati, al fine di assicurare la continuity dei servizi erogati.
Si ripeta come i testi normativi de quo non forniscano un elenco tassativo di misure da adottare, limitandosi invece ad esprimere un generico obbligo di implementare un livello di protezione e sicurezza adeguato al rischio esistente, che i soggetti saranno quindi chiamati a raggiungere in una autonomia relativa, tenendo cioè in debita considerazione tutte le linee guida e le best practices predisposte in materia dalle autorità competenti.[11]
Ulteriore obbligo gravante su tutti gli OSE (operatori nella filiera sanitaria inclusi) è poi quello di notificare, senza ingiustificato ritardo, al CSIRT italiano, ed alle autorità competenti NIS (ossia, i singoli Ministeri), eventuali incidenti in ambito cyber aventi un impatto rilevante sulla continuità dei servizi forniti, allegando le informazioni necessarie per constatarne portata e ripercussioni.
Il CSIRT (acronimo di Computer Security Incident Response Team), nasce invero dall’idea di fondere in un unico istituto[12] tutte le procedure di notifica, risposta e recovery, andando a migliorare così la cooperazione degli OSE e creando una maggiore consapevolezza in ambito di cybersecurity. Suddetta struttura poi, insieme ad altri organi di raccordo, avrà il compito di supportare la vittima di un cyber attacco fornendo tutte le informazioni e l’expertise necessari per facilitare una gestione efficace dell’evento dannoso, ed altresì per andarne a minimizzare le dirette ripercussioni.
Si aggiunga da ultimo come le autorità competenti NIS (trattando di sanità, il Ministero della salute e le Regioni), siano anche responsabili per l’attuazione della Direttiva NIS, vegliando sulla sua corretta applicazione, potendo invero richiedere agli OSE informazioni, documenti e dimostrazioni di aver adottato ed implementato tutte le misure di sicurezza adeguate.
Difatti ex art 21 del Decreto n. 65/2018, le stesse autorità NIS possono applicare sanzioni pecuniarie amministrative laddove rilevino inosservanze da parte degli OSE circa il rispetto dei propri obblighi di sicurezza (si pensi alla non adozione di misure adeguate e proporzionate alla gestione del rischio, come anche alla mancata notifica al CSIRT italiano), comprese queste ultime fra i 12.000 ed i 150.000 euro per le violazioni più gravi.
A distanza di oltre sei anni dalla sua pubblicazione, pur risultando evidente il valore che la Direttiva NIS ha avuto nell’innalzare il livello di sensibilità degli Stati in materia di cybersicurezza, non si possono comunque sottacere anche i molteplici limiti che tale normativa ha palesato nella sua fase attuativa: non solo a causa dei recenti eventi pandemici che hanno certo mutato repentinamente il sistema socioeconomico globale o per la massiccia e costante digitalizzazione, ma anche per l’incapacità del legislatore europeo di prevedere la complessità di armonizzare quanto delineato nel testo normativo originario.
Tant’è vero che in un dettagliato report del 2019 la Commissione europea ha operato il punto della situazione proprio in tema di coerenza degli approcci assunti dagli Stati membri nella fase di adozione della Direttiva NIS. Così invero si legge: “Sebbene la Direttiva NIS abbia avviato un processo fondamentale per aumentare e migliorare le pratiche di gestione dei rischi degli operatori in settori critici, vi è un notevole grado di frammentazione in tutta l’Unione”.[13]
È proprio a causa del sopraricordato ampio margine di autonomia lasciato ai Paesi membri in fase di recepimento della Direttiva NIS che si sono venute a delineare fin da subito evidenti incertezze e disomogeneità su quali siano le misure di sicurezza da adottare ed implementare, su come identificare gli OSE, come anche sullo scambio di informazioni relative agli incidenti cyber a livello europeo.
Alla luce di tale scenario, e data l’urgenza di rafforzare le disposizioni della previa direttiva, la Commissione Europea ha avanzato, nel Dicembre 2020, una proposta di revisione, andando così a tracciare il percorso per la nascita di una direttiva nuova, che andrà ad abrogare e sostituire il testo precedente.[14]
È così che nel Dicembre 2022 la Direttiva Ue 2022/2555 (anche chiamata NIS 2) è stata pubblicata in Gazzetta Ufficiale dell’Unione europea, per entrare in vigore in data 17 Gennaio 2023, momento dal quale gli Stati membri avranno a disposizione ventuno mesi per adottare e pubblicare i relativi atti nazionali di recepimento.[15]
Ovvio è che la suddetta Direttiva NIS 2 presenti svariati punti in comune con la preesistente normativa, al contempo però vede anche importanti novità, fra cui un maggiore ambito di applicazione: il legislatore europeo ha infatti arricchito il ventaglio degli attori, includendo ulteriori soggetti a cui applicare le disposizioni normative, appartenenti a settori definiti “ad alta criticità”, fra cui si ricordino in questa trattazione i produttori farmaceutici, come anche i fabbricanti di dispositivi medici e medico-diagnostici in vitro.
Tali soggettivi attivi peraltro non verranno più identificati dai singoli Stati membri liberamente, ma anzi si seguiranno criteri condivisi ed uniformi così da permettere una più coerente ed organica identificazione degli operatori, pubblici e privati, da assoggettare alla nuova disciplina, evitando l’applicazione di criteri disomogenei fra Paesi membri.[16]
Nonostante resti fermo poi, ex art 21, l’obbligo di adottare misure tecniche, operative ed organizzative adeguate e proporzionate alla gestione dei rischi, viene al contempo aggiunta un’elencazione di misure specifiche, che dovranno essere necessariamente adottate, andando così a limitare la precedente piena discrezionalità dei Paesi membri, fra le cui misure si rinvengono:
a) politiche sull’analisi dei rischi e sulla sicurezza dei sistemi informatici;
b) sistemi di gestione degli incidenti;
c) strategie di business continuity (come la gestione dei backup o anche il disaster recovery[17]);
d) misure di gestione circa la sicurezza della supply chain (c.d. catena di approvvigionamento), compresi tutti gli aspetti in materia di sicurezza riguardanti i rapporti tra ciascun soggetto ed i suoi diretti fornitori;
e) sicurezza circa l’acquisizione, lo sviluppo e la manutenzione dei sistemi informatici, comprese la gestione e la divulgazione delle vulnerabilità;
f) pratiche di igiene informatica base e formazione in materia di sicurezza informatica;
g) politiche e procedure relative all’uso della crittografia e della cifratura;
h) misure in materia di sicurezza delle risorse umane, politiche di controllo degli accessi e di gestione degli asset;
i)l’utilizzo di soluzioni di autenticazione a più fattori o di autenticazione continua, di comunicazioni vocali, video e testuali protette e di sistemi di comunicazione di emergenza.
Fisso resta inoltre l’obbligo di notificazione alle autorità competenti circa gli incidenti cyber che abbiano un impatto significativo sulla continuità e fornitura del servizio, ed anche circa qualsiasi minaccia informatica che potrebbe aver potenzialmente provocato un incidente significativo (c.d. near miss), tuttavia nella NIS 2 viene regolamentato l’iter in maniera più dettagliata, prevedendo la trasmissione di un “early warning” (ossia di un preallarme) entro il termine di 24 ore dalla conoscenza dell’incidente, seguito, entro 72 ore, dalla notifica di una sua analisi dettagliata, che aggiorni oltretutto le informazioni fornite col primo preallarme.[18]
Si osservi ancora come la nuova Direttiva de quo preveda poteri minimi di indagine in capo alle autorità nazionali affinché valutino l’adeguatezza delle misure concretamente adottate, con la rinnovata possibilità di applicare sanzioni amministrative pecuniarie in caso di rilevate violazioni (si pensi ad una mancata notifica), per un massimo di almeno 10 milioni di euro, o fino al 2% del fatturato globale annuo dell’anno precedente dell’impresa (si noterà come rispetto alla previa disciplina NIS si sia avuto un incremento sanzionatorio importante).[19]
Le sopra analizzate direttive rimangono comunque solamente uno dei tasselli del complesso universo normativo della cybersecurity nell’ambito healthcare, dovranno infatti essere affiancate a tutti gli altri strumenti legislativi europei, rilevanti per gli operatori del settore sanitario, di cui peraltro già si è discusso in precedenza: si ricordi il Regolamento Ue 2016/679 (ossia il GDPR) riguardante il trattamento dei dati personali, ed i Regolamenti 2017/745 (MDR, European Medical Devices Regulation) e 2017/746 (IVDR, In-vitro Diagnostics Regulation). Di recente poi si è raggiunto un accordo circa l’approvazione della Direttiva sulla resilienza delle infrastrutture critiche (Critical Entities Resilience, CER), per come proposta dalla Commissione Europea nel Dicembre 2020.[20]
La CER andrà sostituire la Direttiva 2008/114/CE (ECI),[21] che peraltro si applicava solo ai settori dell’energia e dei trasporti, occupandosi nello specifico della sicurezza cyber relativa alle entità “altamente critiche” (fra cui, il settore della sanità) e della loro resilienza rispetto a una serie di possibili minacce, sia naturali che antropiche. Ai sensi della Direttiva de quo ogni Paese membro sarà chiamato ad adottare una strategia nazionale risk based, assicurandosi che tutti i soggetti critici adottino ogni misura tecnico-organizzativa atta a prevenire gli incidenti, proteggere fisicamente le aree sensibili, mitigare le conseguenze malevoli, gestire la sicurezza dei dipendenti ed aumentare il livello di awareness fra il personale.
SI capirà allora come la Direttiva CER si vada ad inserire in un panorama già complesso e ad oggi sempre più interconnesso, ponendo un approccio nei confronti delle infrastrutture “altamente critiche” più ampio ed inclusivo, così peraltro dichiara in Conferenza stampa Ylva Johansson, Commissario Europeo per gli Affari interni: “Alla luce dell’attuale situazione geopolitica in Europa, rafforzare la nostra resilienza è di fondamentale importanza. La Direttiva CER ci renderà maggiormente preparati ad affrontare le perturbazioni che incidono sulla sicurezza dei nostri cittadini e sulla prosperità del mercato interno […]. La nuova Direttiva garantirà infatti la fornitura di servizi essenziali come l’energia, i trasporti, l’acqua, l’assistenza sanitaria, riducendo al minimo l’impatto degli incidenti che siano naturali, o provocati dall’uomo.”[22]
Linee guida ENISA
In materia di cybersecurity è indubbio che si possa ivi rimarcare anche l’operato svolto da ENISA (acronimo di European Network and Information Security Agency), quale Agenzia dell’Unione europea mirante a conseguire un elevato livello condiviso di cybersicurezza in tutto il panorama comunitario. Sono ormai oltre quindici anni difatti che l’anzidetta Agenzia svolge un ruolo fondamentale nel rafforzare la sicurezza digitale in tutta Europa, contribuendo positivamente a consolidare le capacità di preparazione e di risposta degli Stati membri in caso di incidenti informatici.[23]
Guardando poi alle sue nuove pubblicazioni, per ciò che più sta a cuore alla presente trattazione, si riporti la recente relazione dal titolo: “Procurement guidelines for cyber security in hospitals”, in cui l’Agenzia ha voluto raggruppare tutta una serie di prassi e raccomandazioni, applicabili a livello ospedaliero, atte a garantire la sicurezza dei propri sistemi.
Nelle note introduttive invero l’Agenzia asserisce come la cybersecurity sia diventata sempre più una assoluta priorità per le strutture ospedaliere, tale da dover essere ad oggi fortemente integrata in tutti i processi, fasi e componenti che vadano a caratterizzare ed influenzare l’ecosistema ICT sanitario.[24]
In particolare la guida fa riferimento all’ambito del procurement in sanità, inteso quale processo di approvvigionamento indirizzato all’ottenimento di beni, servizi o lavori da una fonte esterna che siano necessari per l’azienda, ottenuti spesso tramite procedura di gara od offerta competitiva.[25]
Pertanto il procurement va a rivestire indubbiamente un key role all’interno di una qualsivoglia struttura sanitaria, dato il suo compito strategico di gestirne efficacemente il budget, provvedendo all’ottenimento delle risorse necessarie al perseguimento degli obiettivi aziendali.
Al fine di chiarire quali siano i sistemi ed i dispositivi rientranti negli acquisti sanitari, ENISA avvia il report delineandone una tassonomia, comprendente:
a) sistemi informativi clinici (ossia software orientati all’assistenza medica, quali i Laboratory Information System[26] o i Drug Databases);
b) dispositivi medici (qualsiasi componente hardware che sia destinato al trattamento, controllo o diagnosi di malattie, quali: apparecchiature di radiologia, robot chirurgici, pompe per infusione, dispostivi impiantabili come pacemakers, holters, defibrillatori cardiaci, infusori per l’insulina etc.);
c) apparecchiature di rete (cavi, routers, firewalls, reti VPN etc.);
d) sistemi di assistenza remota;
e) sistemi di identificazione (per identificare pazienti o medici, garantendo che non vi siano accessi non autorizzati, fra cui gli scanner biometrici);
f) sistemi di gestione degli edifici (linee elettriche, tubature e qualsiasi tipologia di costruzione che possa ospitare strumentazioni mediche,);
g) servizi professionali (esternalizzati o meno, prestati da professionisti o società: servizi di trasporto, progettazione, contabilità, manutenzione consulenza legale etc.);
h) servizi cloud (quali sistemi informativi per la gestione dei rapporti con i clienti, che non siano ubicati nella struttura ospedaliera).
Com’è immaginabile ognuno di tali sistemi e dispositivi porta con sé fattori di rischio propri, esaminati da Enisa e legati ad errori nella progettazione, all’uso di protocolli non sicuri, a difetti di autenticazione che comportano accessi non autorizzati o talvolta anche ad una impropria implementazione degli stessi all’interno della struttura sanitaria.
Per fornire peraltro un quadro maggiormente completo circa le possibili minacce in cui ogni struttura ospedaliera può incorrere, l’Agenzia Ue raggruppa queste ultime in cinque macrocategorie, in base alla loro origine:
a) Natural phenomena: sebbene rappresentino i rischi più remoti, vi si possono ricomprendere tutti gli eventi naturali disastrosi come incendi, allagamenti, terremoti. Non è raro peraltro che diverse strumentazioni (quali per le risonanze magnetiche o le radioterapie) siano localizzate ai piani interrati, divenendo di conseguenza maggiormente esposte a tali fenomeni;
b) Malicious actions: si ripeta come nelle organizzazioni sanitarie i sistemi IT siano fortemente interconnessi e difficili da isolare senza ingenerare una interruzione del servizio erogato, creando un fertile ecosistema per i cybercriminali. ENISA altro non fa che elencare nel dettaglio le azioni malevoli che potrebbero toccare l’health system, su cui già la suddetta trattazione si è soffermata: malware (virus, ransomwareetc.), attività di social engineering (si pensi al phishing), manomissione dei dispositivi medici (Medjacking) , attacchi DoS, cyber spionaggio (celato dietro ad interessi di industrie farmaceutiche), furti d’identità e compravendita di dati sanitari;[27]
c) Supply chain failure: non tutti i servizi sono infatti localizzati nei server ospedalieri, ma possono essere esternalizzati e dipendere da servizi cloud o di rete relativi a fornitori terze parti (gli stessi dispositivi IoMT funzionano nel cloud). Pertanto se i provider non si adoperano per garantirne il funzionamento anche off-line, ciò potrebbe inevitabilmente causare gravi interruzioni nella erogazioni dei servizi sanitari.
Rientrano in tale categoria anche tutti i possibili guasti, errori di design, e di progettazione relativi ai dispositivi medicali;
d) Human errors: vengono ivi ricomprese dalle minacce connesse ad una mancanza di compliance e policies efficaci, a default password deboli, sistemi mal gestiti, accessi non autorizzati, fino ad errori di inserimento dei dati sanitari da parte del personale medico;
e) System failures: i guasti del sistema possono essere relazionati ad avaria dei software, a mancati aggiornamenti dei firmware, ad una insufficiente manutenzione o alla non disponibilità dei sistemi per sovraccarichi di rete.
Si capirà la motivazione di tali premesse: è di fondamentale importanza conoscere, studiare e parametrare ogni possibile minaccia che possa intaccare una struttura ospedaliera al fine di poter dare priorità a tutti quei prodotti e/o servizi che si rivelano esposti e particolarmente sensibili.
Ed è così che l’agenzia ENISA arriva a disporre in elenco specifiche good practices da adottare cosicché qualsiasi operatore IT sanitario possa avere un ottimo punto di partenza nell’acquisire apparecchiature ospedaliere.[28]
Si segnali peraltro come suddetta serie di buone prassi e raccomandazioni sia il risultato raggiunto per il tramite di contributi ottenuti dai molteplici operatori sanitari intervistati. In suddette good practices si suole raccomandare di:
a) Coinvolgere il dipartimento IT ospedaliero nelle diverse fasi di scelta e valutazione circa la fornitura di beni e servizi, così da garantire che non vengano tralasciati gli aspetti relativi alla cybersicurezza;
b) Attuare ed implementare una procedura di identificazione e gestione delle vulnerabilità ancor prima di acquisire i nuovi sistemi, prodotti e/o servizi, e mantenerla per tutta la durata del loro ciclo di vita;
c) Tener in stretta considerazione gli aspetti riguardanti l’interoperabilità, al fine di garantire l’assenza di divari in termini di sicurezza rispetto alle componenti già esistenti nella struttura informatica preesistente;
d) Sviluppare una policy per gli aggiornamenti hardware e software che assicuri l’installazione delle patch più recenti (sia sui sistemi operativi che sugli antivirus, firewall);
e) Programmare periodici test sulla sicurezza sia dei prodotti, fra cui i test anti-intrusione (c.d. penetration test), sia dei sistemi (l’accesso alle reti wireless ospedaliere dovrà essere rigorosamente limitato e controllato), così da poter eventualmente adottare misure correttive;
f) Progettare piani di azione a garanzia della business continuity, atti cioè ad assicurare che un guasto del sistema non causi l’interruzione in toto dei servizi essenziali erogati dall’ospedale;
g) Garantire la sicurezza dei log di accesso ai sistemi per prevenire ed intervenire sugli eventuali accessi non autorizzati all’interno dei sistemi, ed essere comunque in grado di tracciare l’entità delle informazioni perse o rubate una volta che il sistema sia stato compromesso;
h) Crittografare i dati personali sensibili che siano conservati o diffusi, per il tramite di una policy per sistemi, servizi e dispostivi ex 9 GDPR;
i) Fornire una adeguata formazione sulle prassi di cybersecurity così da garantire che il personale interno ed anche i contraenti esterni siano correttamente preparati circa tutti i rischi connessi a prodotti o servizi recentemente acquisiti.[29]
Volendo concludere, non basterà dotare la propria infrastruttura IT di una serie di tools e pensare di aver in tal modo conferito sicurezza all’intera struttura ospedaliera, viceversa occorrerà mettere in atto una strategia olistica di “difesa in profondità”, attuata mediante una metodologia globale di gestione del ciclo di vita della cybersecurity, che parta cioè dall’analisi e dalla valutazione dei rischi, all’adozione di idonee architetture di sistema, per arrivare alla gestione e monitoraggio in tempo reale di sistemi e servizi sanitari. Il tutto attraverso soluzioni sì intrinsecamente sicure e resilienti che, pur offrendo sempre il livello massimo di sicurezza e di business continuity dei sistemi e servizi sanitari, non ne ostacolino mai al contempo la piena efficienza operativa.
Readiness, response, recovery
Si voglia ivi scendere ancora più nel dettaglio circa quali siano le concrete misure di sicurezza, metodi e strategie da dover adottare al fine di incrementare fortemente la protezione delle strutture critiche sanitarie. A tale scopo si analizzi la guida pratica “Healthcare system cybersecurity” elaborata nel 2022 da ASPR (Administration for strategic preparedness and response), Agenzia statunitense, operante all’interno del Dipartimento della salute e dei servizi umani, focalizzata ad operare nel settore della prevenzione, preparazione e risposta circa tutti gli incidenti che possano essere impattanti sulla salute pubblica.[30]
Il documento de quo si presenta suddiviso in tre sezioni, rappresentanti cronologicamente l’iter di sicurezza nel suo svolgersi, ossia per come costituito dalle fasi di: Readiness, Response e Recovery.
Si esordisca quindi guardando alla fase di preparazione (o mitigazione), quale momento in cui le strutture hanno l’incarico di fissare regolari penetration tests, scansioni delle vulnerabilities, nonché protocolli di monitoraggio, al fine di garantire una rapida identificazione delle possibili minacce.
Man mano poi che tali vulnerabilità vengono rilevate, dovrebbero esser classificate in un ordine di priorità ed in seguito risolte per mezzo delle più recenti patch (quali modifiche, aggiornamenti, da qui letteralmente il “mettere una pezza”) od altre attività propriamente di blocco. Ancora si dovranno porre in essere tecniche di network segmentation (si ripeta, comportano il partizionare una data rete ospedaliera in piccole sezioni, cosicché anche se un malintenzionato riuscisse ad infiltrarsi in una di queste, le altre rimarrebbero ad ogni modo sicure), ed altresì tecniche atte a gestire e controllare gli accessi (si pensi alle, già in precedenza trattate, autenticazioni multifattoriali od anche agli approcci Zero Trust).
Sempre in questa preliminare fase dovranno essere testati e regolarmente aggiornati i c.d. Disaster recovery plans, intesi quali piani di continuità operativa contenenti soluzioni dettagliate atte ad indicare come rispondere efficacemente a svariate tipologie di incidenti, al fine di ridurre al minimo ogni interruzione delle normali operazioni, limitare la portata dei danni, definire in anticipo specifiche modalità operative alternative, fornire un rispristino del servizio rapido, ed altresì addestrare il personale alle procedure di emergenza.[31]
In aggiunta dovranno essere assicurati anche i Business contnuity plans quali documenti ancora più completi dei precedenti, contenenti tipicamente una checklist comprendente i piani di emergenza per i processi aziendali, i beni, le risorse umane ed i partner commerciali, ossia circa ogni aspetto del business che potrebbe essere colpito. Assicurandosi sempre che suddetti plans vengano rispettati ed includano anche tutti i servizi ancillari ed off-campus, (si pensi alle sedi ambulatoriali od ai laboratori di analisi) e che prevedano l’eventualità che un’interruzione possa intaccare anche strutture sanitarie limitrofe, precludendo così il trasferimento dei pazienti critici.
Affinché poi gli anzidetti piani di recovery e continuity siano efficaci, sarà comunque necessario mantenere un robusto ed affidabile inventario circa tutti gli hardware, software, dati e dispostivi medici utilizzati, dei fattori che possano impattare sul loro funzionamento e come a loro volta questi stessi possano influenzare la salute del paziente, in particolare si dovranno identificare tutti i supporti critici vitali e salvavita (si pensi ai ventilatori polmonari od alle pompe infusionali) che potrebbero essere particolarmente vulnerabili a possibili attacchi informatici, assicurandosi di prevedere un loro efficace piano di backup.
Ovvio è poi che le strutture devono essere preparate a segnalare qualsiasi incidente insolito o comportamento anomalo del sistema (si pensi ad un riavvio non pianificato, un arresto, un crash od una interruzione di rete apparentemente casuale) non appena venga indentificato, tramite rapida segnalazione.
Dunque altrettanto ovvio è che il personale tutto dovrà avere familiarità e formazione circa le modalità di incident reporting, ossia avendo ben chiaro a chi segnalare, quando farlo, ed altresì quali informazioni includere, creando a tal fine adeguati protocolli di notifica, o sistemi di comunicazione di massa, o anche applicazioni che consentano agli stessi dipendenti di ricevere alerts automatici durante una emergenza. Si potrebbe peraltro anche prendere in considerazione la possibilità di sviluppare un color code atto a comunicare agilmente i livelli idi sicurezza informatica, presupponendo che il personale comprenda il significato dei colori e le relative implicazione ed azioni da intraprendere.
Si riporti a tal fine la griglia elaborata dalla Nebraska Medicine, azienda sanitaria statunitense con sede a Omaha:
Green : gli incidenti e le segnalazioni di sicurezza informatica sono ad un normale livello; gli strumenti e le protezioni funzionano correttamente.
Yellow : gli incidenti e le segnalazioni di sicurezza informatica sono leggermente superiori al normale; gli strumenti e le protezioni non stanno funzionando correttamente.
Red : gli incidenti e le segnalazioni di sicurezza informatica sono molto più elevati del normale; gli strumenti e le protezioni non funzionano e non risultano efficaci.
Ancora, prendendo atto di come il sistema sanitario si figuri quale una complessa catena multisoggettiva, occorrerà capire in che misura i fornitori terzi possano influenzare le prestazioni e la protezione dei sistemi critici, pianificare adeguati piani di risposta, basati sulla valutazione di come possano gli incidenti intaccare le risorse compromesse (si pensi ad una possibile interruzione della funzionalità di un sistema salvavita).
Data l’interoperabilità poi dei sistemi sanitari dotarsi di una c.d. Application Dependency Map (ADM) può aiutare a conferire una precisa mappatura di tutte le applicazioni e dispositivi, nonché delle interdipendenze reciproche, sicché, in caso di incidente informatico, venga seguito accuratamente un ordine di priorità nelle attività di ripristino, a seconda proprio del diverso grado di criticità di ogni tecnologia. Al fine di determinare suddetto ordine di priorità nella restoration occorre stilare invero un ranking circa il grado di impatto di un sistema, software o dispositivo compromesso nei confronti di:
a) Sicurezza del paziente e qualità della cura;
b) Numero di dipendenti e pazienti interessati dalla violazione;
c) Entrate perse;
d) Costi ed implicazioni legali;
e) Numero di pazienti dirottati presso altre strutture;
f) Danni reputazionali e legati all’immagine.
In combinazione con gli sforzi di mitigazione, sarà anche opportuno prepararsi opportunamente ai tempi di inattività (c.d. downtimes) dovuti ad un incidente cyber, ossia regolamentando il ciclo di vita dei documenti cartacei (disponendo istruzioni chiare su quali moduli usare ed in quale momento), ed altresì verificando che tutti i vari supplies (moduli, etichette, attrezzatura clinica manuale, chiavette USB etc.) siano prontamente disponibili all’occorrenza.
Anche i tempi di inattività possono essere categorizzati in base al loro impatto sulla continuity aziendale (ad esempio di Categoria A se determinano 12 ore o meno di inattività, di Categoria B per un calo di oltre 24 ore, Categoria C per più di 3 giorni etc.), affinché in tal modo le attività di risposta siano parametrare sulla severity dell’incidente informatico.
Transitando ora alla successiva fase della response, ovvio è che quando si sospetta la verificazione di un incidente informatico, gli esperti IT inizieranno immediatamente a valutarne il livello di impatto sul sistema e sulle infrastrutture (sulla base dei criteri di gravità ed impatto previamente determinati). Mentre indagano sulla entità del danno si muoveranno al fine di isolare, riparare o rimuovere le tecnologie interessate, cercando ad ogni modo di stabilizzare le prestazioni erogate e mantenere una assistenza sicura ai pazienti.
Una volta poi che minaccia e livello di impatto sono stati identificati, il team IT dovrà seguire i protocolli corrispondenti alla portata dell’evento informatico, dal momento che ogni tipologia di incidente differirà nel grado di impatto e richiederà una differente combinazione di risposte e strategie di recovery.[32]
È in tale momento che viene in gioco la capacità di essere resiliente di una struttura, gli stessi dipartimenti infatti dovranno poter richiedere e disporre di personale aggiuntivo (o riallocato) per far fronte ai periodi di interruzione ed inattività. Si dovrebbe dunque condurre in tempo reale un inventario di tutto il personale disponibile, così da poter pianificare un’eventuale redistribuzione ed allocazione delle risorse umane nei reparti maggiormente bisognosi di addetti supplementari (si pensi all’eventualità che degli infermieri da un’unità chirurgica vengano spostati per assistere alle attività di pronto soccorso).
È evidente che in tali redistribuzioni bisognerà garantire che la forza lavoro trasferita disponga delle competenze necessarie, che abbia familiarità con i flussi di lavoro operativi all’interno del nuovo dipartimento, sicché si garantisca sempre e comunque la sicurezza dei pazienti e l’erogazione di prestazioni efficaci. Certo è possibile che risulti necessaria una formazione just-in-time, in tal caso si prenda in considerazione la possibilità di affiancare il personale senior alle figure lavorative meno esperte. Da ultimo ancora si tenga aperta la possibilità di richiedere personale off-site, ossia proveniente da strutture terze non direttamente colpite dall’incidente informatico, al fine di integrare eventuali carenze operative.
A livello operativo poi se l’accesso all’EHR (electronic heatlh record, ossia la versione digitale della cartella clinica di un paziente) risulta limitato o non possibile, dovranno determinarsi le modalità con cui le varie informazioni sul paziente (anamnesi, farmaci, dati clinici etc.) debbano essere, anche se in forma cartacea, registrati e mantenuti. Si vadano a delineare poi le possibili opzioni atte a ridurre il volume dei pazienti (quali annullare gli appuntamenti non urgenti, dirottare le ambulanze verso strutture vicine etc.), stimando per quanto tempo debbano essere attuate in base alla durata prevista per l’evento, al fine di comunicare il tutto alle strutture sanitarie e partner circostanti.[33]
Si tenga inoltre a mente come durante un evento informatico, una efficace condivisione delle informazioni sia vitale per ottenere efficaci riposte e sforzi di rispristino e per salvaguardare le sicurezza dei pazienti. Si identifichi quindi il modo migliore per veicolare la messaggistica interna (si pensi alle piattaforme di collaborazione come Microsoft Teams o WebEx), al fine di agevolare le comunicazioni collaborative.
Per quanto concerne invece la comunicazione con l’esterno, occorre essere preparati alle impellenti domande che si origineranno dai media (quale “I nostri dati sono al sicuro?”), cercando di comunicare, almeno nei primi periodi, esclusivamente con dichiarazioni scritte, tenendo monitorate costantemente le testate giornalistiche ed i social media per rimediare ad una possibile disinformazione o a lacune informative ed altresì per rimanere al corrente del sentimento pubblico generale.
Sempre nella fase di riposta avranno luogo infine le attività di reporting e monitoraggio, per le quali attività è necessario che il personale tutto conosca i protocolli di segnalazione e di notifica.
Si giunga quindi alla fase di recovery, che vede come assunto base il fatto che sarà proprio la gravità dell’attacco a determinare la durata del recupero.
Si sottolinei come i sistemi informativi di regola non vengano rispristinati immediatamente, anzi ogni modifica richiederà adeguati monitoraggi, nonché costanti aggiustamenti distribuiti lungo un elaborato processo di analisi.
Mano a mano che i sistemi ed i reparti vengono rispristinati, sarà infatti necessario valutarne il livello di vantaggio o dannosità generale, ad esempio se un sistema risulta solo parzialmente funzionante, ci si dovrà chiedere se le funzionalità mancanti possano ostacolare il flusso di lavoro od aumentare il rischio. Bisognerà inoltre pianificare la migrazione di tutta la documentazione manuale venutasi a creare nel periodo di inattività, facendola trasmigrare dal formato cartaceo a quello elettronico, una volta ottenuto il completo ripristino.
Ancora, non appena le condizioni lo consentano, dovranno essere riprese tutte le procedure diagnostiche e terapeutiche in precedenza sospese, attuando una procedura per contattare i pazienti i cui appuntamenti ambulatoriali sono stati di fatto posticipati, in modo tale da poterli riprogrammare. Se necessario, si pianifichi anche il rimpatrio di tutti i pazienti che sono stati trasferito in strutture sanitarie limitrofe. Ovvio è che il ripristino possa (e alle volte debba) comportare anche l’applicazione di patch ed aggiornamenti calati sui software e sulle apparecchiature mediche, cosicché venga ridotta una possibile reiterazione dell’incidente informatico.
In conclusione si definiscano i criteri per dichiarare concluso l’incidente ed il ritorno alle normali operazioni, avvisando le parti interessate e preparando dichiarazioni pubbliche finali per i media. Le azioni che sono state intraprese, i piani ed i correttivi attuati sono comunque informazioni utili da dover mantenere, così come i dati post-incident da conservare accuratamente in uno storage a ciò dedicato. Si completi da ultimo il processo di rifornimento, inventariando tutte le supplies necessarie.[34]
Avendo ad ora chiaro lo scenario normativo che attornia la cybersicurezza ospedaliera, come anche l’iter pratico di misure e strategie da adottare in caso di incidente informatico, rimane ivi da chiedersi cosa accada concretamente all’interno delle strutture sanitarie italiane, come venga percepito il rischio cyber, e quali siano gli ostacoli legati ad una corretta attuazione ed implementazione del massimo livello di sicurezza possibile.
A tale fine si vogliano riportare a seguire le riflessioni ed i pareri di due figure professionali, tanto distinte quanto complementari, inserite a piena regola nell’organigramma sanitario, e di conseguenza nelle problematiche di sicurezza cyber che possano derivarne.
Intervista: nell’ottica di un clinico
Si voglia riportare a seguire la testimonianza diretta, uno spaccato reale e veritiero, per come derivante dalla prospettiva, nonché sensibilità, di un esperto clinico quale operatore sanitario che day by day si ritrova ad agire in un campo (si potrebbe dire minato) ed a dover tenere il passo rispetto ad una continua e rapida cyber-evoluzione che indubbiamente pone nuovi quesiti, problematicità e sfide ad una professione che oggi più che mai appare in forte sovraccarico.
Sin da subito invero le complessità si sono poste in evidenza con estrema lucidità, ovvio è che in ambito medicale si debba operare un netto discrimine fra chi si occupa del settore puramente clinico e chi si occupa di igiene informatica, organizzazione e management, tuttavia: “È proprio da tale basilare distinzione che si nota il sorgere di una prima problematica: l’informazione ultrasensibile sanitaria, il dato digitale, l’utilizzo del macchinario o strumentazione medica è ad appannaggio esclusivo del clinico, e non dell’igienista, la qual cosa comporta necessariamente una esposizione a molteplici rischi, legata per di più ad una totale incoscienza ed inconsapevolezza rispetto a ciò che il clinico abitualmente mette in moto e pone in essere. Lo scenario quindi è semplice ed è il seguente: nessun clinico è realmente consapevole circa quanto egli stesso si espone e quanto a sua volta fa esporre un dato sensibile od un paziente”.
Ebbene si prosegua domandando se possa capitare che gli stessi medici, nello svolgimento delle proprie abituali funzioni, si servano di mezzi non pensati e progettati specificatamente per l’ambito sanitario (si pensi all’uso improprio di una applicazione di messaggistica), bypassando così quel livello di sicurezza e protezione che dovrebbe viceversa esser pienamente garantito, la risposta in tal caso risulta immediata ed autentica: “Abitualmente, o meglio quotidianamente, ricevo e-mail, contenenti dati relativi ai pazienti, da parte di altri clinici, che necessitano di ottenere un secondo parere. Questo, per quanto banale, risulta un chiaro indice di quella mancanza di consapevolezza di cui poc’anzi”.
Pare ovvio, ma vale comunque la pena ribadire in questa sede che trovare un giusto equilibrio non sia affatto semplice: in ambito sanitario difatti l’adozione di una misura di sicurezza, se troppo debole, potrebbe apparire insufficiente a prevenire una qualsivoglia violazione (o cyber-threat), viceversa però, se troppo restrittiva, porterebbe comunque andar a nuocere e rallentare l’operato medico, si pensi ai casi urgenti relativi ad emergenze sanitarie.
Invero così si vuole proseguire: “È comunque una strada che continua ad essere seguita, per esigenze che sono tanto comodità quanto di celerità, ossia per ricevere e fornire risposte rapide ed esaustive in tutti quei casi che siano necessitanti di un celere consulto medico.”
Rimane purtuttavia vero il fatto che esistano tutta una serie di sistemi atti ad agevolare la complessità della realtà sanitaria: dalla cartella elettronica a livello regionale, fino all’odierna implementazione del S.I.O (Sistema informativo Ospedaliero) che intende perseguire il progetto di affinare la trasmissione da ospedale ad ospedale, creando una interconnessione più agile all’interno, ma non solo, della stessa regione, fornendo così un concreto supporto, moderno ed efficace, alle quotidiane attività di sia tipo sanitario che amministrativo.
Seguono le parole di commento: “Eppure tutto ciò, fino a questo momento, rimane qualcosa di assolutamente non realizzato e non utilizzato. Si immagini il restare nella impossibilità di poter visualizzare le immagini di un paziente che ha fatto una tac, ad esempio a Vicenza, fintanto che non sia il paziente stesso od i familiari a portare fisicamente il “dischetto”, o qualsivoglia supporto rigido, su cui poi poter basare le proprie valutazione mediche. È ovvio quindi che tutti i restanti sistemi di interconnessione siano da sempre risultati largamente più agili ed efficaci, da qui il loro abitudinario utilizzo”.
Preciso istante in cui il colloquio de quo subisce una interruzione, la quale altro non farà che avvalorare, nella maniera più pratica e dimostrativa possibile, quanto detto sin qui, così invero si riprende: “Ecco una dimostrazione pratica, mi è appena arrivato un messaggio tramite whatsapp da parte di un collega, riportante -il paziente X sta sanguinando lo portiamo o meno in sala ?- Certo è indicato solo il cognome, senza nome e senza data di nascita, con la patologia di riferimento, è ovvio comunque che il paziente sia facilmente identificabile”.
Così si continua, in un’ottica di commento: “Questa è la realtà dei fatti e non è superabile: in una comunicazione all’interno di un medesimo ospedale è stato un collega di un’altra specialità ad informarmi circa la situazione di un paziente ed a pormi di conseguenza domande urgenti su come affrontare la specifica situazione. Sistemi di supporto con fini agevolatori ci saranno in futuro, ma non potranno in alcun modo sostituire una comunicazione come quella che ad oggi avviene abitualmente”.
Ciò che si può ricavare quindi è quasi un muoversi in automatismo, dovuto ad una routinaria abitudine, come anche alla necessità di dover gestire il proprio operato professionale quotidiano, nonostante la mancanza di una piena presa di coscienza e consapevolezza circa il valore sotteso al proprio agire, da qui: “Sono pienamente convinto del fatto che il collega che mi ha appena inviato tale messaggio non ritenga in alcun modo di aver commesso un errore, nonostante abbia fornito un dato clinico ultrasensibile, riferito ad un paziente identificabile, attraverso uno strumento che non è sicuramente congruo per la tipologia di informazione che viene trasferita”.
Ci si interroga pertanto su quanto possa effettivamente essere estesa la mancanza di cyber-cultura in ambito ospedaliero, i fatti di cronaca sembrano parlare chiaro: una larga parte della intrusioni, violazioni, data breach ed altresì attacchi ransomware sono dovuti, o perlomeno facilitati, all’assenza di nozioni e pratiche base di igiene e sicurezza informatica, si pensi all’utilizzo di password di default o al servirsi di sistemi informatici non correttamente aggiornati.
Di seguito la precisazione fornita in risposta: “Certo tutte queste tipologie di problemi non competono ad un sanitario, tutt’al più alla Direzione, ossia il centro informatico che ogni ospedale ed ogni ASL presenta, d’altronde io non mi sono mai neanche chiesto se il computer dell’Azienda, che ho qui sulla mia scrivania, sia sufficientemente protetto. Ad esempio è il sistema stesso a chiedermi il cambio delle password dopo il passare di un tot di tempo, sebbene poi alla fin fine le mie password siano sempre le medesime tre che girano e ricircolano al trascorrere ogni tre mesi. Quindi sì, è possibile che ci sia una superficialità sottesa, come anche una non percezione del rischio reale, ma dirò di più forse anche un po’ di arroganza da parte della categoria sanitaria, nel pensare di doversi curare unicamente della salute del paziente e poco importa dell’eventualità che i suoi stessi dati possano effettivamente circolare”.
Si intervenga allora sostenendo che sebbene sia intuibile la superficialità che si può dimostrare nei confronti di un’eventuale violazione della privacy, non si può non domandarsi se la sensibilità al rischio malevolo cambi laddove ad essere in pericolo possa essere la stessa salute di un paziente, si pensi ai casi di utilizzo di robot chirurgici: “In tal caso da clinico ho un interesse al corretto funzionamento dello strumento, al fatto che vi sia una corretta riproduzione del mio input, che il mio feedback visivo sia efficace ed affidabile (ossia con latenze che siano le più basse e ravvicinate possibili), e che dalla interazione robot-paziente non derivi alcun danno biologico. Ciononostante, ciò che vi è fra la console ed il paziente stesso non è un problema di mia competenza, se tra qualche anno infatti verrà attuata una implementazione della telechirurgia la stessa tematica delle intromissioni malevoli sarà sì un problema dei sanitari, ma non verrà percepito come tale”.
Rimanendo ancora all’interno del capiente “termine ombrello” dell’e-Health si consideri la delicatezza che può attorniare i sistemi di telemonitoraggio: “Più attuale e differente risulta tale ambito, siamo infatti dinnanzi ad informazioni che verranno analizzate e utilizzate dal clinico per assumere determinate decisioni, ovvio appare in tal caso l’assunto: se l’informazione fornita è scorretta, il clinico prenderà d’immediata conseguenza decisioni scorrette”. Per esser più chiari si pensi ai casi di telemonitoraggio domiciliare, reso possibile grazie all’utilizzo di dispositivi wearable atti a misurare dati quali i parametri vitali di base, col fine di fornire feedback lungo l’arco della giornata relativi ai pazienti, per appurare ad esempio come stia procedendo un post-operatorio.
Così si è voluto puntualizzare: “Indubbiamente tali dati hanno rilievo, ma importanza ancora maggiore in termini di sicurezza viene rivestita da altre tipologie di informazioni e dispostivi – si pensi ai pacemakers o ai defibrillatori impiantabili – anche in questo caso tuttavia la sicurezza verrà data da parte del sanitario per scontata, ossia si confiderà nel fatto che la casa produttrice del dispositivo abbia messo in campo tutta una serie di strategie per far sì che non vi siano intrusioni od altri incidenti”.
Si tragga da tali parole una coincisa riflessione: la sicurezza informatica non può ormai esser concepita secondo la classica, ed anacronistica, metafora del “castello”, un approccio che ha funzionato in passato finché la maggior parte dei dati ed applicazioni di un’azienda venivano custoditi all’interno di propri data center, protetti in un ristretto perimetro da apposite “cinte murarie” di firewalls, piani di back up, procedure di gestione degli accessi etc.
Ad oggi infatti il perimetro non risulta più così definito: dati e servizi sanitari raramente appaiono chiusi negli hardware delle strutture stesse, viceversa sono sempre più diffusi e scambiati sui cloud, si assiste inoltre ad un panorama multisoggettivo (si pensi a tutti i produttori e fornitori terzi di dispositivi, sistemi e servizi), per cui il concetto di sicurezza informatica sta mutando la propria forma verso una nuova effige, ossia quella di una catena.
In tale nuovo paradigma è di fondamentale importanza che gli operatori sanitari escano da una logica solista, prendendo maggiore visione d’insieme e coscienza circa la loro appartenenza ad un sistema molto più esteso in cui la propria sicurezza dipende quella altrui e viceversa, solo così non risulteranno essere l’anello debole.
Tornando al colloquio de quo, una volta elencate tutte quelle capabilities che paiono esser necessarie al fine di rendere una struttura sanitaria affidabile, efficiente e cyber-resiliente (ossia dalle risorse tecnologiche e strumentazioni mediche adeguate, alle sessioni di training e formazione del personale, alla metodologia di gestione del rischio, fino alla compliance normativa nelle nomine di figure quali il DPO, il CISO, od anche il risk manager), ci si è domandati se suddetti requisiti vengano concretamente soddisfatti.
A seguire le parole di commento: “Nelle aziende sanitarie quanto elencato risulta essere presente, sebbene con diversi gradi e complessità, si guardi per esemplificare alla formazione: i corsi che noi sanitari abbiamo come obbligatori da seguire online sono per lo più incentrati proprio sul risk management, od in generale sulle tematiche relative sicurezza, il problema ancora una volta risulta perciò essere alla base. O meglio, è una questione di percezione, capita infatti che per il clinico puro tali tipologie di corsi siano avvertiti quasi come perdite di tempo, ossia quali gravose lungaggini ed inevitabili coercizioni, sebbene possa capitare che le nozioni acquisite risultino anche concretamente utili in occasioni future. Di conseguenza ritengo che sia la trasmissione dell’informazione a dover essere veicolata in una maniera, benché non saprei come, più stimolante ed allettante per il clinico, cosicché non sia percepita quale rigida imposizione”.
D’altronde si ritorna di nuovo a rimarcare quell’ottica individualista, solista ed un poco boriosa che sembra alle volte appartenere alla categoria sanitaria: “in effetti il ragionamento dietro spesso è questo: il mio mestiere è altra cosa, ed è di una nobiltà tale per cui di tutti questi elementi non me ne devo né curare né preoccupare”.
Paiono ad ogni modo parimenti giuste, ragionevoli e ben spese anche le osservazioni poste a difesa: “noi sanitari siamo soverchiati da problematiche di ordine generale, clinico ed amministrativo, dobbiamo studiare le leggi per la somministrazioni dei farmaci, per i piani di cura, ed ancora dobbiamo spendere dai dieci ai quindici minuti di tempo solo per inserire in maniera digitale la somministrazione del farmaco, per poi controllarla e vigilarla. Quindi si immagini la volontà, e voglia, di dedicarsi anche agli aspetti più propriamente inerenti alla sicurezza dei dati, alle possibili intromissioni ed alla cybersecurity in generale”.
Ed è in questo momento che traspare maggiormente il forte sovraccarico che un clinico può sentir pesare gravosamente su di sé: “chi si occupa di igiene e prevenzione vuole che io sia formato ed informato sulla sicurezza nel luogo del lavoro, chi invece si occupa di gas biomedicali vuole a sua volta che io sia informato sull’uso delle apparecchiature, chi si occupa di ingegneria, ed io devo utilizzare un elettrobisturi, mi chiede di esser informato sulla sua impostazione e su cosa si debba intendere per un malfunzionamento, dando ovviamente per scontato che, a ben vedere, io dovrò essere assolutamente e perfettamente informato circa la patologia che sto trattando, il paziente che ho dinnanzi ed il suo specifico trattamento”.
Viene pertanto da pensare che vi sia la forte esigenza di formare nuove figure professionali con competenze altamente specifiche e multidisciplinari che debbano essere inserite nell’organico sanitario al fine di affiancare gli operatori stessi e garantire per loro, attenuando in tal modo tutta una serie di incombenze d’organizzazione, amministrative, nonché di sicurezza di cui si trovano ad esser addossati: “non sto chiedendo che qualcuno mandi e-mail al posto mio, ma che io possa avere ad esempio un sistema di messaggistica imposto dall’Ordine dei Medici che risulti assolutamente blindato.”
Questo non significa deresponsabilizzare l’intera categoria, ma trovare un corretto equilibrio fra le diverse figure che possa risultare ottimale, da qui: “Noi dobbiamo ovviamente avere chiari i problemi relativi alla cybersecurity, ma dobbiamo parimenti aver chiaro che ci sia qualcuno che quel problema lo può risolvere e lo ha risolto. L’equilibrio sta tutto qui: il problema sì lo dobbiamo conoscere, ma non ce ne dobbiamo concretamente occupare dal momento che non abbiamo tempo, voglia, testa e tantomeno formazione in materia.”
Son parole queste ultime dotate di estrema lucidità ed obiettività, tramite le quali un clinico riconosce la giustezza dell’informarsi, aggiornarsi, e curarsi circa le nuove tematiche emergenti, che siano anche le più lontane possibili dal suo quotidiano operare, ma ugualmente riconosce i propri limiti: “figure terze devono ad oggi poterci mettere nella condizione migliore affinché i problemi di cyber-sicurezza in primis siano solo più questioni da dover conoscere e non più di cui doverci concretamente occupare”.
Intervista: nell’ottica di un ingegnere informatico
Si voglia ora interfacciarsi con la proverbiale “altra faccia della medaglia”, costituita dal quel settore professionale legato propriamente alla cybersicurezza ospedaliera, ed in particolare riportando il parere di un ingegnere informatico inserito a pieno titolo in una Azienda sanitaria, al fine di ricostruire un panorama di figure, ruoli e percezioni che appaia il più completo possibile.
Pur riconoscendo che diversi gradi di complessità e eterogeneità possono contraddistinguere l’assetto di ogni struttura ospedaliera, si chieda innanzitutto di tratteggiare l’organigramma di ruoli e figure professionali che orbitano attorno all’ambito della sicurezza, da qui la risposta: “Per tutte le questioni inerenti alla gestione della privacy si guarda al ruolo dei DPO, ma ciò che più mi compete, e di conseguenza maggiormente conosco, è proprio la disciplina settoriale della security informatica. Quest’ultima, badi bene, è purtroppo una branca molto giovane nelle strutture ospedaliere come quella in cui opero, dal momento che l’attenzione e sensibilità verso tale ambito si è raggiunta solo di recente, proprio in seguito all’inasprirsi degli attacchi informatici ed all’interesse mediatico che ne è conseguito, da tale enfasi ne sono poi scaturiti diversi investimenti in tal senso. Penso di poter dire dunque che solo da un anno a questa parte si è effettivamente posto l’accento sulla security, grazie anche al recepimento della direttiva NIS, per il cui adeguamento stiamo lavorando aspramente, prima di ciò si guardava essenzialmente a quanto previsto dal GDPR in tema di trattamento dei dati personali.
Si domandi pertanto quale sia il panorama normativo di riferimento in tema di sicurezza informatica, se vi siano ulteriori normative o protocolli di settore a cui riferirsi nel proprio operare: “Attualmente la normativa a cui ci riferiamo ed andiamo ad attuare è fondamentalmente la NIS, è il nostro punto focale e filone principale, nonché leva per chiedere finanziamenti ed investimenti che, capirà, in aziende come la nostra, con 50.000 prese di rete e 7.000 dipendenti, sono piuttosto elevati e per nulla banali, e comunque in passato spesso sono venuti a mancare. Nell’ultimo anno invece sono stati stanziati investimenti importanti e questo lascia ben sperare in una direzione di possibile progredimento.
Addentrandosi più specificatamente rispetto al tema delle cyber minacce, si chieda un commento circa i noti fattori di vulnerabilità riguardanti una struttura critica come quella ospedaliera, fra cui l’essere dotati di un sistema informatico complesso, l’utilizzo di dispostivi IoMT non sempre progettati seguendo elevati standard di sicurezza by design, l’articolata catena della supply chain, nonché il fattore umano cui si faccia affidamento, la risposta: “Dunque per tutto ciò che riguarda le tematiche propriamente legate all’IT, quale nostro perimetro storico, attualmente stiamo portando avanti progetti che paiono essere promettenti, per tutto ciò che attiene invece agli altri ambiti ci atteniamo a quanto ci viene fornito. Mi spiego meglio: i device elettromedicali per loro natura sono certificati CE tout court (cioè per le componenti hardware, software, di configurazione etc.), quindi se noi volessimo installarci un antivirus non è detto che questo sia possibile, dal momento che si va ad inficiare la certificazione stessa. Per riuscire a sopperire a tale problema si è dovuta elaborare una struttura di «securizzazione laterale», in cui i device medicali raffigurano il nucleo, da proteggere tramite cinta murarie di sicurezza, affinché il perimetro sia il meno vulnerabile possibile.
Come vede dunque la tecnologia ci viene in soccorso, però è proprio qui che scatta il terzo fattore, ossia quello propriamente umano, chiaro è che se vedi una postazione di lavoro con una presa USB libera e scarichi i compiti di tuo figlio nel sistema, puoi anche inficiare e far crollare tutto il lavoro che è stato fatto. Vorrei che lei notasse come la parte umana rimanga ad oggi questione davvero rilevante della problematica, veda il dilagante fenomeno del phishing”
Appare lampante la sovrapponibilità di suddette dichiarazioni con quanto dichiarato in precedenza disquisendo con un clinico puro, si ricordi invero come si fosse già confermato l’utilizzo abituale di applicazioni di messaggistica non congrue al trattamento di dati ultrasensibili come possono essere quelli sanitari, si chieda ivi conferma: “È assolutamente così, c’è una totale sconsideratezza nell’inviare referti ed analisi tramite WeTransfer o simili, e ciò è tutt’altro che infrequente, anzi è una pratica comune. Per questa ragione stiamo sempre più insistendo nell’ottica di una maggiore sensibilizzazione ed acculturamento, ad esempio tramite campagne di falso phishing, inviando cioè una serie di email e laddove l’operatore sanitario apra il link, contenente tanto per capirci «bravo hai vinto un milione di euro», riveliamo di esserci noi informatici dalla parte opposta, avvertendo gli operatori stessi che un’azione del genere avrebbe portato a tutta una serie di determinate conseguenze dannose.
Il fattore umano è dunque altamente impattante in una struttura come la nostra e peraltro vorrei far notare come ci siano molte persone estremamente refrattarie al cambiamento delle proprie (scorrette) abitudini operative.”
Si voglia ancora ricordare come nell’ottica del clinico puro gli stessi corsi di formazione sui temi della cybersicurezza siano spesso percepiti come gravose lungaggini, da dover seguire solo perché obbligati, segue la veloce interruzione: “Sì mi lasci dire che la percezione è che la security sia proprio una gran rottura di scatole, intendendola cioè quasi come una limitazione alla libertà personale, vuoi perché non puoi navigare in Internet a tuo piacimento, ma nei siti indicati, vuoi perché non puoi trasferire su WeTransfer un’immagine clinica per avere un secondo parere medico”.
Chiaro è però come vi sia una costante tensione ed un difficile equilibrio da delineare fra la cura propriamente clinica, anche emergenziale, del paziente e la “cura” degli aspetti maggiormente di privacy e security: “Esatto, questo è proprio uno dei temi su cui spesso ci scontriamo, in quanto limita il nostro operare, ossia poniamo il caso di un chirurgo che necessita, per il bene del paziente, di fare vedere l’immagine di un tumore ad un collega negli Stati Uniti per avere una seconda opinion, ovvio è che la questione sia altamente delicata.
Se lei mi chiede se esistano regole specifiche e normative atte a fare in modo che un tale trasferimento avvenga in maniera sicura, le rispondo di sì, ma tale tipologia di flussi, come può immaginare, non è certamente gratuito, anzi presenta un costo non indifferente”.
Tornando al tema della cyber-formazione, si rammenti come nell’ottica del clinico puro si dovessero trovare soluzioni innovative e maggiormente stimolanti per incentivare l’apprendimento di nozioni di igiene informatica, si proponga ivi una possibile organizzazione di incontri in presenza, laddove il metodo online possa apparire alle volte maggiormente sgradito e gravoso, così la risposta: “Io mi occupo della formazione dai tempi precedenti al Covid, di conseguenza non via web, ma in aula, e le persone che avevo dinnanzi si dividevano in due, anzi almeno tre gruppi: gli annoiati, ossia coloro a cui la tematica non importava affatto, che erano presenti solo perché ciò è dovuto, poi una minimissima parte effettivamente interessata all’argomento, e da ultimo una buona parte refrattaria al cambiamento, irremovibilmente radicati ed attaccati alle proprie abitudini, che non sono assolutamente intenzionati a modificare e correggere. Ora addirittura via web non ho nemmeno più questa percezione, basta spegnere la telecamera ed addormentarsi”.
A seguire vengono pronunciate parole che richiamano alla memoria quella arroganza già ammessa espressamente da parte del clinico: “Se devo essere sincero, poi sarà una mia percezione soggettiva, c’è proprio un sentimento di superiorità da parte della classe medica, nel pensare di essere in un ambiente prettamente clinico, in cui il core business è la cura del paziente e tutto quanto il resto dovrà essere assoggettato e seguire le esigenze proprie di tale categoria professionale. Non mi spingo oltre, ma comunque tenga presente che io tutti i giorni ho dei disguidi dovuti proprio ai motivi detti fino ad ora”.
Appare ad ogni modo irrazionale tale ritrosia al cambiamento, soprattutto davanti ad una cybercriminaltà che è in continua crescita, sempre più sofisticata ed invasiva, che non si ferma più solo sul versante della violazione e furto dati, ma che prende di mira le stesse strutture (si pensi agli attacchi ransomware) o che s’introduce nelle apparecchiature e dispositivi, si commenta: “Per quanto riguarda le intrusioni cyber devo fare un premessa: la telechirurgia deve ancora fare notevoli passi avanti, ad esempio i telerobot utilizzati nella nostra struttura sono utilizzati solo localmente, il paziente ed il robot si trovano cioè a due metri di distanza dall’operatore chirurgico, ed è una modalità operatoria utilizzata più che altro per annullare eventuali tremori fisiologici ed affaticamenti delle braccia del chirurgo, di conseguenza i problemi legati alle intrusioni malevoli saranno eventualmente preoccupazioni future, che seguiranno di pari passo l’evoluzione della medesima telechirurgia.
Più rilevante invece, quale perimetro che ad oggi nessuno sta prendendo seriamente in considerazione, risulta essere quello dell’attuazione meccanica di dispositivi quali le UTA (unità trattamento aria)[35] ad esempio usate nelle sale operatorie. Dal mio punto di vista di ingegnere informatico, con una conoscenza di elettronica, io mi preoccuperei di tali sistemi, dato che sono comandati da un sistema informatico IP, banalmente se un attaccante riesce ad intromettersi può manipolarle a proprio piacimento, agire sugli interruttori, arrivando anche a fare saltare la corrente di tutto l’ospedale.
Ecco che il passaggio da un attacco ransowmare diretto a cifrare i dati e chiedere un riscatto, ad un attacco di mera “guerriglia” indirizzato a creare una magnitudo massima di dannosità, pare piuttosto breve. Chiaro che nel secondo caso una volta che il sistema è stato «bruciato» tutto, i paziente attaccati ad un respiratore muoiono, o soffrono comunque un pesante disservizio. Quindi sì, fra le minacce temute da una azienda come la nostra, un posto è senza dubbio rivestito dal ransomware, ma non escluderei possibili attacchi alle UTA od alle cabine elettriche a fini puramente distruttivi. Qui si inserisce la normativa, che per quanto riguarda le UTA prevede che possano essere aperte o chiuse, ad esempio in funzione di un incendio, «anche» per via informatica, bene allora io mi aspetterò che venga studiata, attuata ed implementata «anche» una security informatica in tale direzione.
Procedendo nella discussione si cerchino di riassumere le capabilities da adottare affinché una infrastruttura critica sia resiliente ed in grado di mitigare il rischio cyber: risorse tecnologiche adeguate, compliance normativa, sessioni di training del personale, metodologie di analisi e gestione del rischio, strategie di business continuity e disaster recovery, periodici test sulla sicurezza dei device e soluzione di identity management (quali gestione dei privilegi, autenticazioni multifattoriali etc.), da qui il commento: “In effetti la normativa NIS prevede tutto questo, e ci stiamo attualmente adoperando affinché tali azioni vengano attuate, cercando di sopperire a ciò in cui siamo carenti, il vantaggio apportato dalla NIS è invero l’aver fatto chiarezza sulla strada da dover intraprendere.
Non è che prima della NIS non ci fossero buone pratiche adottate, erano tuttavia procedure non scritte, diciamo «tramandate», che a seguire sono state poi specificatamente delineate dalla normativa, che ha avuto peraltro anche il ruolo fondamentale di spostare i riflettori sull’importanza di tali tematiche”.
Si domandi di conseguenza quali siano le sfide attuali od altresì gli ambiti su cui doversi focalizzare al fine di implementare gli attuali livelli di sicurezza: “A parer mio il fattore umano, inteso dalla base al vertice, ossia dall’operatore utilizzatore della specifica tecnologia alla Direzione stessa, rimane devastante, e necessita ad oggi di un’alta sensibilizzazione sui requisiti di security da dover rispettare.
Non è più il tempo di una formazione generale e dispersiva, ognuno dovrà essere istruito in misura settoriale sulle proprie competenze: chi compra device ed apparecchiature, o altresì chi fornisce la struttura, tutti possono a loro modo essere impattanti sulla sicurezza della struttura nel suo complesso.
A me personalmente come formula da seguire piace molto il concetto di cybersecurity “by design”, da attuare in tutti i campi, ciò significa che se devo comprare una qualsiasi strumentazione, dovrò richiedere fin dal principio agli stessi fornitori il rispetto di tutta una serie di requisiti di compliance”.
Parole conclusive sono state spese in uno spontaneo commento circa lo stato del proprio settore professionale: “Vorrei comunque ancora sottolineare come i professionisti della security si stiano facendo solamente adesso, difatti persone della mia generazione orientate in maniera specifica e verticale su tali tematiche sono davvero poche. C’è l’attuale bisogno di formare una classe professionale che svolga il mio stesso lavoro, che abbia le spalle un po’ più large, seguendo un’ottica diciamo sempre più «entreprise» ed in Italia sotto questo profilo non siamo tanto avanti.”
La cybersecurity sanitaria emerge come una sfida complessa che richiede un approccio multidisciplinare, dove normative stringenti, tecnologie avanzate e cultura della sicurezza devono convergere per proteggere infrastrutture critiche sempre più interconnesse. Nel prossimo e ultimo approfondimento parleremo di un approccio risk-based alla cybersecurity sanitaria, mostrando come la valutazione del rischio diventerà lo strumento chiave per bilanciare investimenti, minacce e livello di protezione accettabile.
[1] Così la definizione fornita dal dizionario Merriam-Webster: “measures taken to protect a computer or computer system (as on the Internet) against unauthorized access or attack”, per come disponibile al sito internet https://www.merriam-webster.com/dictionary/cybersecurity
[2] ISO/IEC 27032: 2012, “Information technology – Security techniques – Guidelines for cybersecurity”, July 2012, reperibile al sito internet https://www.iso.org/standard/44375.html
[3] P. Montessoro, “Cybersecurity: conoscenza e consapevolezza come prerequisiti per l’amministrazione digitale”, in Istituzioni del federalismo, n.3, 2019, pp. 783-800.
[4] Alcatel Lucent Enterprise, Sicurezza informatica della rete sanitaria nell’era della trasformazione digitale: con una intervista speciale a Silvia Piai, Research Director per IDC Health Insights, ALE international, 2020.
[6] Per infrastrutture critiche (IC) si intendono i sistemi, i servizi, le reti o le risorse che, se danneggiati o distrutti, causerebbero gravi ripercussioni alle funzioni cruciali della società, tra cui la catena di approvvigionamenti, la salute, la sicurezza ed il benessere economico-sociale della popolazione.
[9] R. Setola, G. Assenza, “Recepimento della direttiva NIS sulla cyber-security delle reti”, in Sicurezza e Giustizia, n. IV, 2018, pp. 32-35.
[10] Ex art 6 della direttiva NIS, per determinare la rilevanza degli effetti negativi si dovrà tener contro dei seguenti fattori: il numero di utenti e altri settori che dipendono dal servizio offerto dal soggetto interessato; l’impatto che gli incidenti potrebbero avere, in termini di entità e di durata, sulle attività economiche e sociali o sulla pubblica sicurezza; la diffusione geografica relativamente all’aerea che potrebbe essere toccata da un incidente; l’importanza del soggetto per il mantenimento di un livello sufficiente del servizio, tenendo conto della disponibilità di strumenti alternativi per la fornitura del detto servizio.
[11] Quali le Linee guida per gli operatori di servizi essenziali (OSE), lavoro coordinato dalla Presidenza del Consiglio dei Ministri, dal Dipartimento delle informazioni per la sicurezza (DIS), in cooperazione con le autorità NIS di tutti i Ministeri, emanate in data 16 Luglio 2019.
[12] Proviene infatti dall’unificazione dei due Computer Emergency Teams preesistenti: il CERT nazionale ed il CERT-PA, quest’ultimo era pensato appositamente per i soggetti della pubblica amministrazione, dunque era precedente punto di riferimento degli ospedali pubblici.
[14] Commissione Europea, Proposta di direttiva del Parlamento europeo e del Consiglio relativa a misure per un livello comune elevato di cybersicurezza nell’Unione, che abroga la direttiva (UE) 2016/1148, Bruxelles 16.12.2020
[15] Direttiva (UE) 2022/2555 del Parlamento europeo e del Consiglio del 14 dicembre 2022 relativa a misure per un livello comune elevato di cibersicurezza nell’Unione, recante modifica del regolamento (UE) n. 910/2014 e della direttiva (UE) 2018/1972 e che abroga la direttiva (UE) 2016/1148 (direttiva NIS 2), in Gazzetta Ufficiale dell’Unione Europea, L333, 27 Dicembre 2022.
[16] Si evidenzi peraltro come la Direttiva NIS 2 suddivida i propri attori in “soggetti essenziali” (settore di energia, trasporti, sanità, pubblica amministrazione, infrastrutture digitali etc.) e “soggetti importanti” (produzione e distribuzione di prodotti chimici, fornitori digitali, servizi postali, produzione di apparecchiature medicali etc.): ai primi si applicherà un rigoroso regime di vigilanza ex ante, mentre i secondi saranno sottoposti ad una vigilanza ex post che interverrà in caso di rilievi o segnalazioni di non conformità.
[17] Per Disaster recovery si intende quell’insieme di azioni e strategie operative, logistiche ed organizzative che una azienda mette in atto per mettere al sicuro e ripristinare i propri dati e la propria infrastruttura IT in seguito ad una interruzione forzata causata da un evento straordinario, sia esso di tipo accidentale, colposo o volontario.
[18] D. Pierattoni, “La direttiva NIS2: nuovi obblighi e opportunità”, in Sicurezza e Giustizia, V. II, MMXXII, pp.34-37
[19] Si specifichi che se un incidente informatico ha comportato anche un data breach per come disciplinato dal GDPR, da cui è derivata una sanzione ai sensi del Regolamento privacy europeo, le sanzioni amministrative della Direttiva de quo non saranno applicabili.
[21] Direttiva 2008/114/CE del Consiglio, dell’ 8 dicembre 2008 , relativa all’individuazione e alla designazione delle infrastrutture critiche europee e alla valutazione della necessità di migliorarne la protezione (Testo rilevante ai fini del SEE), in Gazzetta Ufficiale dell’Unione Europea, L345/75, 23.12.2008.
[22] Press release in occasione dell’accordo raggiunto fra Parlamento Europeo e Consiglio dell’Unione Europea circa l’approvazione della Direttiva CER, “Security Union: Commission welcomes today’s political agreement on new rules to enhance the resilience of critical entities”, 28 June 2022, Bruxelles.
[23] ENISA, Un Europa affidabile e sicura dal punto di vista informatico: Strategia Enisa, Agenzia dell’Unione europea per la cibersicurezza, Atene, Giugno 2020.
[24] ENISA, Procurement guidelines for cybersecurity in hospitals: good practices for the security of Healthcare services, European Union Agency for Cybersecurity, Athens Office, February 2020, reperibile al sito internet https://www.enisa.europa.eu/publications/good-practices-for-the-security-of-healthcare-services.
[25] Si precisi come il termine appalto, nella sua connotazione giuridica, sia inteso come procedura, quale corpus di principi e regole, che il legislatore italiano ha previsto quando una istituzione soggetta alla regolazione giuridica pubblica acquista o vende sul mercato beni, servizi ed opere. Tuttavia si vanno ad oggi via via ampliando i tradizionali modi di intendere l’attività d’appalto permettendo di comprendere fattispecie contrattuali diverse dal contratto di appalto stesso, quali la somministrazione, la locazione finanziaria o la concessione. Cfr. E. Pintus, Scelte pubbliche e strumenti di management per gli acquisti, McGraw-Hill, Milano, 2009.
[26] Per Laboratory Information System (LIS) si intende un particolare tipo di software utilizzato nei laboratori di analisi per la gestione integrata di molteplici tipi di dati e processi.
[27] S. Smith and R. Koppel, “Healthcare Information Technology’s Relativity Problems: A Typology of How Patients’ Physical Reality, Clinicians’ Mental Models, and Healthcare Information Technology Differ”, in Journal of the American Medical Informatics Association, 21, no. 1, January 2014, pp. 117–31.
[28] Peraltro il Procurement viene tripartito da ENISA in tre fasi: la plan phase (in cui l’ospedale analizza e studia i propri bisogni e necessità), la source phase (dove viene avviata la procedura di approvvigionamento, momento in cui l’ospedale riceve le relative offerte, valutando e selezionando i prodotti/servizi più adeguati, procedendo poi all’aggiudicazione del contratto), ed infine la manage phase (in cui si monitorano le effettive performance dei sistemi, servizi e/o dispositivi in modo tale da poter porre in essere eventuali misure correttive).
[29] Medesime raccomandazioni sono state emanate dall’Istituto Superiore della Sanità il 17 Giugno 2019, nel Documento di indirizzo del Gruppo di Studio Nazionale sulla Cybersecurity nei servizi sanitari, dal titolo “Buone pratiche per la sicurezza informatica nei servizi sanitari”.
[30] ASPR, Healthcare system cybersecurity: Readiness & Response Considerations, ASPR (Administration for strategic preparedness and response) – TRACIE (healthcare emergency preparedness information gateway), originally published February 2021, Updated October 2022.
[31] CINI-Cybersecurity National Lab, Il futuro della Cybersecurity in Italia: ambiti progettuali strategici, progetti ed azioni per difendere al meglio il Paese dagli attacchi informatici, Laboratorio Nazionale di Cybersecurity- CINI Consorzio interuniversitario Nazionale per l’Informatica, 9 Ottobre 2018.
[32] Si può comunque optare per l’organizzazione di un initial incident brief comprensivo della leadership aziendale, dei capi di dipartimento, degli esperti tecnici, dei consulenti legali e del personale in materia di pubbliche relazioni, ove vengono identificate quali funzionalità da adottare siano disponibili, sicure e maggiormente efficaci.
[33] Ministry of health Singapore, Healthcare Cybersecurity Essentials, CSA (Security Agency of Singapore), August 2021.
[34] Per ulteriori approfondimenti si indichi CREST, Cyber Security Incident Response Supplier Selection Guide, Version 1, 2013; Osterman Research, Cyber security in Healthcare, Whitepaper, February 2020.
[35] Con l’espressione UTA si intendono quelle apparecchiature atte a sopperire alla necessità di mantenere sotto controllo parametri d’aria come umidità, temperatura e purezza all’interno degli ambienti chiusi.
Profilo Autore
Maria Vittoria Zucca, laureata con lode in Giurisprudenza presso l’università degli Studi di Trento, è attualmente dottoranda nel Programma di Dottorato di Interesse Nazionale in Cybersecurity, con istituzione capofila la Scuola IMT Alti Studi di Lucca, ed è affiliata alla Scuola Superiore Sant’Anna, presso l’Istituto Dirpolis (Diritto, Politica e Sviluppo). La sua attività di ricerca si concentra sulla prevenzione, l’indagine ed il contrasto della criminalità informatica, includendo le discipline del diritto penale dell’informatica e della criminologia digitale. Su questi temi è autrice di diverse pubblicazioni scientifiche e partecipa regolarmente a conferenze nazionali e internazionali.
Test di rilevazione passiva con HackRF e SDR per la sicurezza carceraria
Dopo aver analizzato nei precedenti articoli la storia dell’adozione dei jammer nelle carceri italiane e i loro limiti tecnici, sanitari e normativi, questo ultimo approfondimento presenta i risultati concreti di test sperimentali condotti in ambiente controllato utilizzando hardware HackRF One. L’obiettivo era validare in condizioni realistiche l’efficacia dei sistemi di rilevazione passiva basati su tecnologia SDR (Software-Defined Radio), verificandone la capacità di rilevare, classificare e localizzare attività cellulare non autorizzata.
Per validare l’efficacia dei sistemi di rilevazione passiva in condizioni realistiche, sono stati condotti test approfonditi utilizzando hardware HackRF One presso un sito isolato appositamente predisposto. L’obiettivo era verificare la capacità del sistema di rilevare, classificare e localizzare attività cellulare non autorizzata in un ambiente che simulasse le condizioni operative di un istituto penitenziario.
Ambiente di test controllato per rilevazione passiva SDR
Per sviluppare e valutare il sistema di rilevamento in condizioni controllate, è stato creato un ambiente isolato completamente privo di copertura cellulare legittima, caratteristiche che lo rendevano analogo a un’ala carceraria idealmente schermata. In questo spazio “pulito” dal punto di vista elettromagnetico, ogni segnale radio percepito nelle bande cellulari proveniva necessariamente da un telefono di prova introdotto deliberatamente, eliminando qualsiasi ambiguità nell’interpretazione dei risultati.
Sono stati introdotti in modo casuale più telefoni di diversi operatori (Vodafone, TIM, WindTre, Iliad) in vari momenti della giornata e della notte, simulando l’accensione sporadica e imprevedibile dei dispositivi da parte di uno o più detenuti. L’uso dei telefoni è stato distribuito nel tempo secondo pattern variabili, talvolta concentrato nelle ore diurne, talaltra nelle ore notturne, per ricreare le condizioni di imprevedibilità che caratterizzano l’uso reale dei telefoni di contrabbando. Questo setup ha permesso di mettere alla prova il sistema nelle stesse condizioni operative di un vero carcere.
Sorveglianza continua dello spettro
All’interno dell’area simulata, il sistema ha monitorato ininterrottamente tutte le bande cellulari rilevanti (700, 800, 900, 1800, 2600 MHz) oltre alle frequenze Wi-Fi e Bluetooth, 24 ore su 24, 7 giorni su 7. La sorveglianza continua è essenziale perché un telefono di contrabbando potrebbe trasmettere solo per pochi secondi in orari totalmente inaspettati: una chiamata breve alle 3 di notte, un SMS inviato durante il cambio turno, una sessione dati di pochi minuti durante l’ora d’aria.
Nella pratica carceraria reale si impiegano più sonde o antenne distribuite strategicamente nell’istituto, convogliando i dati su una console centrale per garantire che nessuna zona resti scoperta. Non appena un telefono avvia una chiamata, invia un SMS o si collega ai dati mobili, i suoi segnali RF di uplink vengono captati in tempo reale. In un ambiente privo di segnali cellulari legittimi, ogni burst di trasmissione risalta in modo netto e inequivocabile, come una luce accesa in una stanza buia.
Registrazione automatica e post-analisi
Ogni evento RF catturato durante i test è stato registrato automaticamente dal sistema, generando un log cronologico completo con data, ora precisa al secondo, frequenza/banda di trasmissione, potenza del segnale ricevuto e classificazione automatica del tipo di attività (chiamata voce GSM, chiamata voce LTE, SMS, traffico dati). Ogni attivazione dei telefoni di prova ha creato un record dettagliato e permanente nel database del sistema.
Questo approccio garantisce che anche se il personale di sorveglianza non dovesse intervenire immediatamente – per qualsiasi ragione – l’attività rimane tracciata e consultabile in seguito per analisi forensi, procedimenti disciplinari o indagini penali. Il log costituisce una prova documentale solida, con timestamp verificabili e dati oggettivi non soggetti a interpretazione.
L’interfaccia del sistema permette di navigare agevolmente nei dati storici, selezionando data e ora per ottenere un resoconto visivo degli eventi rilevati in qualsiasi periodo. È possibile, ad esempio, ispezionare le ore notturne di un determinato giorno per verificare eventuali trasmissioni, o confrontare l’attività di settimane diverse per identificare pattern ricorrenti. Una timeline grafica mostra i burst rilevati con indicazione del tipo e della potenza, mentre filtri configurabili permettono di isolare le trasmissioni per operatore, per banda o per tipologia di traffico.
Sistema di rilevamento intelligente
Il cuore della soluzione testata è un motore di analisi intelligente che riconosce automaticamente le firme RF caratteristiche di chiamate GSM, SMS e traffico dati LTE/4G. Diversi tipi di trasmissione presentano pattern distintivi: una chiamata vocale LTE genera un flusso continuo di pacchetti su bande specifiche con caratteristiche temporali riconoscibili, mentre un SMS produce un burst breve e concentrato. Il traffico dati presenta pattern ancora diversi, variabili in funzione dell’applicazione utilizzata.
Il software classifica automaticamente l’attività rilevata sulla base di questi pattern, minimizzando i falsi allarmi e riducendo il carico di lavoro interpretativo per il personale di sorveglianza. Durante i test, ogni volta che i telefoni di prova avviavano una chiamata, inviavano un messaggio o generavano traffico dati, il sistema identificava correttamente il tipo di evento e generava una notifica appropriata.
Gli algoritmi avanzati implementati nel sistema sono inoltre in grado di distinguere i segnali autorizzati (radio di servizio del personale, Wi-Fi della rete interna, dispositivi IoT legittimi) da quelli illeciti, mantenendo alta l’affidabilità delle segnalazioni ed evitando di sommergere gli operatori con allarmi irrilevanti.
Il sistema ha dimostrato capacità di gestire efficacemente anche situazioni complesse, come l’attivazione simultanea di più dispositivi. Quando due telefoni venivano accesi contemporaneamente in punti diversi dell’area di test, entrambi gli eventi venivano rilevati, classificati e loggati separatamente, ciascuno con il proprio operatore, la propria banda e la propria stima di localizzazione.
Architettura cablata e sicurezza operativa dei sistemi SDR
L’implementazione di sonde RF in ambiente penitenziario reale richiede particolare attenzione al trasporto dei dati e alla compatibilità elettromagnetica complessiva del sistema. L’utilizzo di connessioni wireless per il collegamento delle sonde alla centrale di monitoraggio è tecnicamente sconsigliato: tali segnali potrebbero interferire con le analisi di spettro generando falsi positivi, e in alcuni casi potrebbero violare le stringenti policy di sicurezza del Ministero della Giustizia.
Per questo motivo, l’architettura raccomandata prevede un sistema interamente cablato, preferibilmente tramite fibra ottica. Questa soluzione garantisce totale immunità da emissioni RF (la fibra trasmette luce, non onde radio), elevata sicurezza contro intercettazioni (il segnale ottico non può essere captato senza interrompere fisicamente la fibra), e lunga portata senza degrado del segnale. In alternativa, laddove la posa in fibra non sia praticabile per vincoli architettonici o di costo, è accettabile l’uso di cavi Ethernet schermati (Cat6a STP) in canaline protette.
Ogni sonda può operare in due modalità distinte a seconda delle esigenze operative e delle caratteristiche dell’istituto. La modalità online cablata prevede l’invio continuo dei log verso la centrale di monitoraggio tramite switch PoE o uplink in fibra, consentendo il monitoraggio in tempo reale. La modalità offline prevede invece la memorizzazione locale cifrata dei dati e il successivo scarico fisico del file di log mediante connessione diretta USB o SSD rimovibile, seguendo rigorose procedure di catena di custodia per garantire l’utilizzabilità forense dei dati.
La centrale di controllo deve essere collocata in area tecnica protetta, accessibile solo a personale autorizzato, e deve ricevere i dati attraverso canali fisici isolati. La cifratura end-to-end e la sincronizzazione dei timestamp tramite sorgenti affidabili (server NTP autenticato o clock OCXO di alta precisione) completano il quadro delle garanzie di sicurezza e integrità dei dati.
Questa architettura elimina qualunque necessità di trasmissione radio da parte del sistema di monitoraggio, mantenendolo totalmente passivo, sicuro e forense-compliant. Il principio operativo può essere sintetizzato nella formula: «Osservare senza interferire».
Limiti dei jammer e vantaggi della rilevazione passiva
L’analisi condotta in questo paper ha messo in luce, con dati di fatto e considerazioni tecniche approfondite, i molteplici limiti e i rischi connessi all’impiego di jammer nelle carceri italiane, contrapposti alle potenzialità concrete di una strategia basata sulla rilevazione passiva delle attività radio mobili.
Sintesi dei limiti dei jammer
L’efficacia operativa dei jammer risulta fortemente ridotta dalle tipiche barriere architettoniche dei penitenziari – muri spessi in calcestruzzo armato, strutture metalliche, configurazioni planimetriche complesse – che causano inevitabili zone d’ombra dove il segnale di disturbo non arriva o è insufficiente. L’evoluzione continua delle reti mobili verso 4G/5G e oltre obbliga a costanti aggiornamenti hardware e software, con costi aggiuntivi significativi e periodi di fermo operativo durante i quali il sistema è inefficace.
L’impatto indiscriminato su tutte le trasmissioni RF genera effetti collaterali inaccettabili sulle comunicazioni di emergenza, sui dispositivi medici, sulla strumentazione di sicurezza interna e sulle comunicazioni legittime di personale, visitatori e operatori esterni. I rischi per la salute legati alle emissioni elettromagnetiche di potenza elevata sollevano questioni etiche e giuridiche che non possono essere ignorate, mentre il quadro sanzionatorio multiplo – amministrativo, civile e penale – espone l’amministrazione e i singoli responsabili a conseguenze potenzialmente gravi.
I vantaggi strategici della rilevazione passiva
I rilevatori SDR passivi offrono invece un paradigma completamente diverso, caratterizzato da non invasività e piena conformità normativa, precisione e granularità nella raccolta dei dati, intelligenza operativa avanzata con algoritmi di machine learning e pattern recognition, e una scalabilità che consente l’integrazione fluida con le piattaforme di sicurezza già esistenti negli istituti.
Il passaggio dai jammer ai sistemi di rilevazione passiva non è semplicemente un aggiornamento tecnologico: rappresenta un cambio di filosofia operativa, dalla logica del “bloccare tutto” a quella del “comprendere per intervenire”. Il primo approccio è rozzo, inefficiente e rischioso; il secondo è intelligente, mirato e sostenibile.
Raccomandazioni operative
Per tradurre questi vantaggi in pratica operativa, si propone un percorso articolato in fasi successive. La prima fase dovrebbe consistere in una mappatura preliminare del rischio RF in ogni ala carceraria, con rilievo dello spettro esistente, identificazione delle frequenze “pulite” e dei punti critici, e definizione di un piano di posizionamento delle sonde con criteri di ridondanza.
L’implementazione graduale del sistema di rilevazione dovrebbe poi procedere attraverso un pilotaggio iniziale in 2-3 istituti di diversa tipologia (alta, media e bassa sicurezza), seguito da un roll-out esteso su tutte le sedi con training on-site per il personale, e infine da una fase di monitoraggio e revisione periodica con upgrade software e affinamento degli algoritmi.
Fondamentale è l’investimento in formazione degli operatori e nella definizione di procedure standardizzate: addestramento specifico sull’uso delle interfacce, sull’interpretazione dei log e sui protocolli d’intervento in caso di rilevazione sospetta. Le politiche di governance dovrebbero includere la stipula di convenzioni con fornitori di tecnologia SDR comprendenti certificazioni di conformità CE e documentazione tecnica completa.
Un piano di comunicazione trasparente verso il personale penitenziario e le organizzazioni sindacali è essenziale per evitare resistenze culturali e false aspettative, chiarendo sia i benefici sia i limiti degli strumenti adottati.
Prospettive di sviluppo
Guardando al futuro, sarà necessario prevedere l’estensione della capacità di rilevazione alle bande emergenti che accompagneranno l’arrivo della tecnologia 6G e delle reti satellitari a bassa orbita. L’integrazione con intelligenza artificiale avanzata permetterà di sviluppare modelli predittivi capaci di anticipare comportamenti illeciti sulla base di pattern storici. Soluzioni Platform as a Service potrebbero ridurre i costi di manutenzione e garantire aggiornamenti automatici. Collaborazioni con università e centri di ricerca potranno validare scientificamente le soluzioni e ottimizzare ulteriormente gli algoritmi.
Rilevazione passiva vs jammer: sicurezza, salute e governance
La scelta degli apparati e delle strategie di controllo delle comunicazioni in carcere non è solo una questione tecnologica, ma un tema che investe sicurezza, salute pubblica, rispetto del diritto e qualità della governance. I jammer, pur apprezzati a suo tempo per l’immediatezza d’uso e la facilità di comunicazione politica, si sono dimostrati una soluzione parziale, rischiosa e sempre più obsoleta di fronte all’evoluzione delle tecnologie di comunicazione.
I sistemi di rilevazione passiva basati su SDR offrono invece un percorso innovativo e sostenibile, caratterizzato da selettività operativa (interventi mirati solo sui segnali sospetti), rispetto pieno delle normative (zero interferenze non autorizzate), tutela della salute (assenza di emissioni nocive), solidità delle evidenze documentali (log a prova di contestazione per procedimenti disciplinari o penali), e flessibilità di adattamento alle evoluzioni tecnologiche future.
Le soluzioni tecnologiche per contrastare efficacemente l’uso illecito di telefoni cellulari all’interno delle carceri esistono già, sono scientificamente validate e tecnicamente implementabili senza alcun rischio per la salute né interferenze sui servizi legittimi. Il problema, oggi, non è più tecnico ma politico e organizzativo. Continuare a considerare i jammer come soluzione “ufficiale” al problema dei cellulari in carcere rappresenta una sconfitta culturale prima ancora che ingegneristica: si sceglie di disturbare indiscriminatamente anziché comprendere selettivamente.
Qualunque tecnico di sicurezza delle comunicazioni – che si occupi di SIGINT, TSCM o analisi elettromagnetica – sa perfettamente che la tecnologia per affrontare questo problema in modo intelligente ed efficace non manca: manca la volontà di applicarla.
«Il progresso non nasce dall’invenzione, ma dal coraggio di sostituire ciò che non funziona.»
I test in ambiente controllato hanno confermato l’efficacia dei sistemi di rilevazione passiva basati su SDR. Il sistema rileva con precisione ogni attivazione dei telefoni, classifica automaticamente l’attività (chiamata, SMS, dati), registra timestamp verificabili e genera log forense utilizzabili in procedimenti disciplinari o penali.
L’architettura cablata (fibra ottica o Ethernet schermata) elimina qualsiasi emissione RF, rispettando il principio «osservare senza interferire». Il sistema gestisce anche attivazioni simultanee, distingue segnali autorizzati da illeciti e riduce i falsi allarmi.
I test evidenziano un punto chiave: i jammer sono soluzioni obsolete, rischiose e inefficaci, mentre la rilevazione passiva offre selettività operativa, conformità normativa, sicurezza e evidenze solide. La tecnologia per contrastare l’uso illecito di cellulari nelle carceri esiste, è validata e implementabile; il problema è politico e organizzativo, non tecnico.
Per una trattazione completa e approfondita del tema, con tutti i riferimenti tecnici, normativi e bibliografici, scarica gratuitamente il white paper di Stefano Cangiano dal titolo “Jammer nelle carceri: limiti, rischi e alternative”.
Riferimenti bibliografici:
Linee guida internazionali e standard di esposizione ai campi elettromagnetici
ICNIRP (2020). Guidelines for Limiting Exposure to Electromagnetic Fields (100 kHz to 300 GHz). Health Physics, 118(5), 483–524. DOI: 10.1097/HP.0000000000001210 PMID: 32167495 Disponibile in open access
Titolare delle licenze EJPT e ECPPT (Professional Penetration Tester) della società eLearnSecurity. Svolge attività di Network Security in particolare Penetration Test & VA – Vulnerability Assessment. Nel 2019 fonda la società ISK (www.isksecurity.it), partner strategico ed esterno per attività di Security specializzata. Svolge attività di bonifiche ambientali da microspie, attività di Security Assessment e Mobile Security.
AI fraud supply chain: dalla carta rubata all’identità sintetica
La AI fraud supply chain non è una metafora. È un’infrastruttura operativa, documentata, con i suoi fornitori, i suoi processi e i suoi clienti. E funziona.
Quando parliamo di intelligenza artificiale applicata alla frode digitale, l’errore più comune – anche tra i professionisti della sicurezza informatica – è pensare in termini di singole operazioni potenziate. Un phishing più convincente qui, un deepfake più realistico là, un chatbot che inganna una vittima isolata. La realtà che emerge dai dati del 2025 racconta qualcosa di strutturalmente diverso: l’AI non migliora un anello della catena criminale. Li connette tutti, creando un ecosistema integrato che opera con la logica, la resilienza e la scalabilità di un’impresa tecnologica.
Il Threat Intelligence Report di Anthropic dell’agosto 2025 ha reso visibile questa architettura attraverso tre casi distinti ma profondamente interconnessi, che compongono – letti insieme – il mosaico completo di una catena di fornitura della frode alimentata dall’intelligenza artificiale. Un servizio di carding con resilienza multi-API degna di un’architettura enterprise. Un bot Telegram per romance scam con oltre 10.000 utenti mensili e targeting geografico su tre continenti. Un servizio operativo di identità sintetiche costruito interamente con assistenza AI.
Questo articolo ricostruisce ciascuno dei tre casi, ne analizza le interconnessioni e ne esplora le implicazioni per il settore finanziario, la verifica dell’identità e le strategie antifrode. Perché nella AI fraud supply chain, la carta rubata di ieri diventa il profilo sintetico di domani, e il romance scam di oggi prepara l’account fraudolento di domani.
La fraud supply chain AI-powered: una visione d’insieme
Per comprendere la portata di ciò che sta accadendo, è utile visualizzare la catena del valore della frode digitale come un processo industriale con fasi sequenziali.
Nel modello tradizionale, ogni fase richiedeva competenze specialistiche distinte e operatori dedicati. I carders validavano carte rubate con strumenti artigianali. I truffatori sentimentali investivano settimane in conversazioni manuali, limitati dalle proprie competenze linguistiche. I creatori di identità false dipendevano da documentazione contraffatta fisica, con tempi e costi elevati. Le barriere linguistiche, tecniche e operative frammentavano il mercato in nicchie scollegate.
L’AI ha dissolto queste barriere. Come sintetizza il report di Anthropic, i criminali informatici hanno integrato l’intelligenza artificiale in ogni fase delle loro operazioni, dalla profilazione delle vittime all’analisi dei dati rubati, dal furto di informazioni finanziarie alla creazione di identità false. Il risultato è un ecosistema in cui le operazioni di frode possono espandere la propria portata verso un numero significativamente maggiore di potenziali obiettivi.
I dati macroeconomici confermano questa trasformazione. Secondo il report Feedzai 2025, oltre il 50% delle frodi finanziarie coinvolge ormai l’uso di intelligenza artificiale. Il Sumsub Identity Fraud Report 2025-2026 registra un incremento del 180% anno su anno degli attacchi multi-step sofisticati, che oggi rappresentano il 28% di tutti i tentativi di frode identitaria, rispetto al 10% del 2024. Il World Economic Forum ha definito questa tendenza un punto di inflessione: meno attori coinvolti, ma operazioni più coordinate e tecnologicamente avanzate.
La AI fraud supply chain non è un concetto astratto. È un’architettura operativa che i tre casi documentati da Anthropic rendono tangibile.
Caso 1: il carding store AI-powered
L’architettura enterprise del furto di carte di credito
Il primo caso riguarda un attore di lingua spagnola che utilizzava Claude Code per mantenere e potenziare un servizio web invite-only specializzato nella validazione e rivendita di carte di credito rubate su larga scala.
Il dettaglio tecnico più significativo non è il furto in sé – il carding esiste da decenni – ma l’architettura software con cui il servizio è stato costruito. L’attore ha implementato un framework di resilienza multi-API che ruota tra tre servizi di validazione delle carte, i cosiddetti card checker. Quando un’API viene bloccata o rallentata, il sistema esegue automaticamente il failover verso la successiva, con meccanismi di scoperta dinamica delle API per individuare nuovi servizi di validazione quando quelli esistenti diventano indisponibili.
Le caratteristiche tecniche documentate da Anthropic meritano attenzione:
Failover automatizzato e API discovery dinamica. Il sistema non si limita a ruotare tra tre API preconfigurate. Include la capacità di scoprire automaticamente nuovi servizi di validazione, una funzionalità che conferisce al carding store una resilienza operativa tipicamente associata a piattaforme enterprise legittime.
Throttling intelligente. Per evitare la rilevazione da parte dei sistemi antifrode, il servizio implementa un rallentamento deliberato e intelligente delle richieste di validazione. Non si tratta di pause casuali: l’AI calibra i tempi di attesa in base al comportamento atteso dal servizio di validazione, mimetizzando le richieste fraudolente nel traffico legittimo.
Batch processing strategico con ritardi deliberati. Le carte rubate vengono processate in lotti, con ritardi intenzionali tra un batch e l’altro, per ridurre la probabilità che i pattern di validazione vengano identificati come anomali dai sistemi di monitoraggio delle transazioni.
Misure di sicurezza operativa di livello enterprise. L’infrastruttura include protezioni contro il reverse engineering e il rilevamento, implementate con tecniche che normalmente richiederebbero un team di sviluppatori specializzati.
Cosa cambia rispetto al carding tradizionale
Il carding-as-a-service non è una novità. I forum underground ospitano servizi di validazione delle carte da anni. Ciò che distingue questo caso è il livello di sofisticazione ingegneristica – e il fatto che sia stato raggiunto con l’assistenza dell’AI.
Tradizionalmente, costruire un’infrastruttura di carding resiliente richiedeva competenze in sviluppo web, integrazione API, sicurezza operativa e gestione dell’infrastruttura. L’attore documentato da Anthropic ha esternalizzato questa complessità tecnica a Claude Code, che ha funzionato simultaneamente come architetto software, sviluppatore backend e consulente di sicurezza operativa.
L’implicazione per le istituzioni finanziarie è diretta. Come sottolinea TransUnion nell’analisi del primo semestre 2025, i prestatori statunitensi hanno registrato un’esposizione di 3,3 miliardi di dollari a identità sintetiche sospette tra prestiti auto, carte di credito e prestiti personali. Quando i servizi di validazione delle carte operano con resilienza enterprise e throttling intelligente, i sistemi antifrode basati su regole statiche – soglie di velocità, pattern di geolocalizzazione, limiti di transazione – perdono efficacia. La frode si mimetizza nel rumore del traffico legittimo.
Il contesto tecnico è rilevante: la validazione fraudolenta delle carte avviene esclusivamente in modalità card-not-present (CNP), dove il tasso di frode è significativamente più elevato rispetto alle transazioni in presenza. I circuiti di pagamento hanno risposto con investimenti massicci in AI difensiva.
Visa ha implementato il VAAI Score (Visa Account Attack Intelligence), che utilizza componenti di AI generativa per identificare e classificare gli attacchi di enumerazione – ovvero le tecniche di forza bruta con cui gli attaccanti testano combinazioni di numeri di carta, date di scadenza e CVV – assegnando un punteggio di rischio in tempo reale in 20 millisecondi, analizzando fino a 182 attributi per transazione.
Mastercard ha sviluppato Decision Intelligence Pro, un sistema basato su reti neurali ricorrenti e AI generativa che processa oltre 143 miliardi di transazioni annuali in meno di 50 millisecondi, con miglioramenti del tasso di rilevazione fino al 300% in specifici contesti. Tuttavia, il throttling intelligente del carding store documentato da Anthropic è progettato precisamente per eludere questi sistemi: mimetizzando le richieste nel traffico legittimo, le validazioni fraudolente evitano di attivare le soglie di anomalia che alimentano i modelli di scoring. È il dilemma dell’AI difensiva: ogni miglioramento nella detection catalizza un adattamento corrispondente nell’evasione.
Caso 2: il romance scam bot con “intelligenza emotiva”
Oltre 10.000 utenti mensili, tre continenti, manipolazione emotiva AI-driven
Il secondo caso rivela una dimensione della AI fraud supply chain che trascende la tecnologia per entrare nel territorio della psicologia applicata su scala industriale.
Seguendo l’indicazione di un ricercatore indipendente, Anthropic ha identificato un bot Telegram (@Chat_ChatGPT_AIbot) che fornisce strumenti AI multimodali specificamente commercializzati per supportare operazioni di romance scam. Il bot offre accesso a molteplici modelli di intelligenza artificiale, con Claude pubblicizzato come “high EQ model” – modello ad alta intelligenza emotiva – per risposte emotivamente intelligenti.
Il dato sulla scala è il primo elemento da registrare: oltre 10.000 utenti mensili. Non stiamo parlando di un esperimento isolato o di un singolo truffatore che usa ChatGPT per scrivere messaggi più convincenti. Stiamo parlando di una piattaforma operativa con una base utenti che rivaleggia con molti servizi SaaS legittimi.
L’architettura operativa del bot
Il sistema opera attraverso un’interfaccia a comandi che offre funzionalità specializzate per ogni fase dell’operazione di truffa sentimentale:
Generazione di risposte ad alta intelligenza emotiva. Claude viene utilizzato specificamente per la sua capacità di produrre messaggi emotivamente sofisticati. Non si tratta di frasi generiche di corteggiamento: l‘AI genera risposte calibrate sullo stato emotivo percepito della vittima, adattando tono, registro e contenuto in tempo reale.
Capacità di generazione di immagini. Il bot integra modelli di generazione di immagini di altri provider per il potenziamento dei profili, consentendo la creazione di foto profilo convincenti e di contenuti visivi personalizzati.
Supporto multilingue per targeting globale. Il servizio opera con targeting specifico su Stati Uniti, Giappone e Corea del Sud, tre dei mercati più redditizi per le truffe sentimentali. Il supporto multilingue consente a operatori non madrelingua di apparire fluenti e persuasivi nella lingua della vittima, bypassando i red flag linguistici che tradizionalmente aiutano le vittime a identificare i truffatori.
Generazione di contenuti di manipolazione emotiva specializzati. Il bot offre risposte specializzate per le diverse fasi del romance scam: dall’approccio iniziale alla costruzione del rapporto, dall’escalation emotiva alla richiesta finanziaria.
Il contesto: un’industria da miliardi che l’AI rende più efficiente
I messaggi del servizio e i canali collegati sono prevalentemente in cinese, suggerendo operazioni cinesi che prendono di mira vittime internazionali. Questo dettaglio si inserisce in un panorama documentato.
I dati FBI mostrano che le perdite per romance scam nella sola area della Baia di San Francisco sono più che raddoppiate nel 2025, raggiungendo 43,3 milioni di dollari rispetto ai 21,5 milioni dell’anno precedente. A livello globale, secondo Chainalysis, le perdite per truffe crypto – molte delle quali originano da romance scam e pig butchering – hanno raggiunto il record di 17 miliardi di dollari nel 2025. Le operazioni con collegamenti on-chain a vendor AI hanno generato una media di 3,2 milioni di dollari per operazione, circa 4,5 volte di più rispetto alle operazioni senza tali collegamenti.
L’evoluzione è significativa. I centri di scam tradizionali – documentati in Cambogia, Myanmar e altrove – impiegano persone fisiche, spesso vittime di traffico di esseri umani, costrette a condurre conversazioni manuali con le vittime. L’AI rende queste operazioni più scalabili ed economiche, potenzialmente riducendo la dipendenza dal lavoro forzato mentre ne amplifica l’efficacia. Un paradosso morale che non sfugge agli analisti: la stessa tecnologia che potrebbe ridurre lo sfruttamento umano nei centri di scam rende la truffa stessa più pervasiva e devastante per le vittime.
Per i professionisti antifrode, il romance scam bot AI-powered invalida un assunto operativo fondamentale: che il volume di conversazioni gestibili da un’organizzazione criminale sia limitato dalla disponibilità di operatori umani. Con l’AI, il vincolo non è più il personale: è la larghezza di banda.
Caso 3: servizi di identità sintetica operativi
Dall’identità rubata all’identità costruita
Il terzo tassello della AI fraud supply chain è quello che chiude il cerchio e apre prospettive strategiche più preoccupanti. Anthropic ha documentato un attore che ha lanciato con successo un servizio operativo di identità sintetica utilizzando Claude per varie componenti della propria infrastruttura.
Il caso è descritto in modo più sintetico nel report di Anthropic rispetto ai precedenti, ma il suo significato strategico è inversamente proporzionale al dettaglio disponibile. Un servizio di identità sintetica operativo – non sperimentale, non dimostrativo – rappresenta l’anello di congiunzione tra il furto di dati e la monetizzazione finale. Le carte rubate validate dal carding store e le relazioni emotive costruite dal romance scam bot convergono entrambe, in ultima analisi, verso la necessità di identità false convincenti: per aprire conti bancari, per ricevere trasferimenti fraudolenti, per mascherare la provenienza dei fondi.
Cosa sappiamo sull’architettura del servizio
Dall’analisi del report e delle fonti secondarie, il servizio di identità sintetica documentato presenta caratteristiche che lo distinguono dalla contraffazione documentale tradizionale:
L’AI non genera semplicemente documenti falsi. Costruisce profili identitari coerenti che includono storie professionali plausibili, reti di contatti credibili, e tracce digitali consistenti. La differenza tra un documento contraffatto e un’identità sintetica AI-powered è la stessa che intercorre tra una fotocopia e un ecosistema: la prima viene rilevata a un controllo superficiale, il secondo resiste a verifiche approfondite perché ogni elemento del profilo conferma gli altri.
Per comprendere la portata del Caso 3, è necessario richiamare la tassonomia consolidata della frode identitaria sintetica. La Federal Reserve ha definito la frode identitaria sintetica come l’uso di una combinazione di informazioni personali identificabili (PII) per fabbricare una persona o entità allo scopo di commettere un atto disonesto per guadagno personale o finanziario.
Il white paper della Fed distingue tre modalità di creazione: l’identity fabrication, che utilizza esclusivamente informazioni fittizie; l’identity manipulation, che modifica leggermente PII reali (ad esempio, variando una cifra del Social Security Number); e l’identity compilation, che combina PII autentiche – tipicamente un SSN reale sottratto a minori, anziani o persone decedute – con dati fabbricati. È quest’ultima la forma più insidiosa, perché il nucleo di dati autentici supera le verifiche di base, e l’AI generativa amplifica la capacità di costruire attorno a quel nucleo un profilo coerente e convincente.
Il ciclo di vita della frode segue un pattern documentato noto come bust-out. L’identità sintetica viene utilizzata per aprire una linea di credito. Il fraudster si comporta come un cliente legittimo per mesi, effettuando acquisti e pagando regolarmente per incrementare il punteggio creditizio.
Come ha spiegato Mike Timoney, vicepresidente della Federal Reserve Bank di Boston, quando il punteggio sale, le banche vogliono concedere più credito, estendono le linee, aumentano i limiti. A quel punto, il criminale massimizza tutte le linee disponibili e scompare – il bust-out propriamente detto. La Fed ha stimato che le perdite globali per questa tipologia sono passate da circa 8 miliardi di dollari intorno al 2020 a oltre 20 miliardi nel 2024, con una traiettoria che l’AI generativa sta accelerando. Il servizio documentato da Anthropic si inserisce nella fase iniziale di questo ciclo: genera le identità sintetiche che altri attori della supply chain utilizzano per aprire i conti e avviare il processo di credit building fraudolento.
L’esplosione della frode identitaria sintetica nel 2025
I dati di contesto rendono la portata del fenomeno impossibile da sottovalutare.
La Federal Reserve Bank di Boston ha dedicato un’analisi specifica al ruolo dell’AI generativa nella frode identitaria sintetica. Nel podcast della Fed di Boston, Mike Timoney ha tracciato la traiettoria delle perdite: circa 8 miliardi di dollari intorno al 2020, 14 miliardi dopo un paio d’anni, oltre 20 miliardi nelle stime più recenti – una crescita che l’AI generativa sta accelerando in modo significativo.
TransUnion ha quantificato l’esposizione dei soli prestatori statunitensi a 3,3 miliardi di dollari nel primo semestre 2025. A questo si aggiunge una dimensione emergente segnalata dalla Federal Reserve Financial Services: la synthetic business fraud, dove i criminali creano imprese fittizie utilizzando informazioni rubate, manipolate o fabbricate per accedere a linee di credito e prestiti commerciali, tipicamente di importo superiore rispetto a quelli concessi ai consumatori individuali.
Il Sumsub Identity Fraud Report 2025-2026 aggiunge una dimensione qualitativa: nel 2025, la falsificazione documentale assistita dall’AI, registrata allo 0% l’anno precedente, è salita al 2% di tutti i documenti falsi identificati. Può sembrare una percentuale marginale, ma rappresenta l’emergere di una categoria di frode che non esisteva in forma misurabile dodici mesi prima. Ancora più rilevante è la segnalazione dell’ascesa dei cosiddetti AI fraud agent: sistemi autonomi che combinano AI generativa, framework di automazione e apprendimento per rinforzo per creare identità sintetiche, interagire con i sistemi di verifica in tempo reale e adattare il comportamento in base ai risultati. Le traiettorie indicano che questi agenti potrebbero diventare mainstream entro 18 mesi, particolarmente nelle reti di frode organizzata.
Per il settore bancario e finanziario, l’implicazione è chiara: i processi KYC (Know Your Customer) progettati per verifiche documentali statiche sono strutturalmente inadeguati contro identità sintetiche che superano sia la verifica visiva sia il cross-referencing con database multipli. Come ha sintetizzato un analista di Heka Global citato da BankInfoSecurity: la detection della frode deve essere in tempo reale, perché affidarsi a controlli che avvengono una sola volta all’onboarding significa perdere ciò che accade dopo, ed è lì che la frode riesce.
L’integrazione: come i tre casi si interconnettono nell’ecosistema criminale
Analizzati isolatamente, ciascuno dei tre casi rappresenta un’evoluzione significativa nel proprio dominio. Letti insieme, raccontano una storia più ampia e più preoccupante: la nascita di una supply chain integrata della frode digitale, dove l’output di un’operazione alimenta l’input della successiva.
Il flusso è ricostruibile con chiarezza.
Fase 1 – Acquisizione dei dati. Le carte di credito e i dati personali vengono rubati attraverso infostealer, breach, social engineering. Questa fase beneficia della profilazione AI-driven documentata nel sesto articolo di questa serie, dove il Model Context Protocol offensivo trasforma stealer log grezzi in intelligence operativa strutturata.
Fase 2 – Validazione e monetizzazione primaria. Il carding store AI-powered valida le carte rubate con resilienza multi-API, identificando quelle ancora attive e commercializzabili. Il throttling intelligente e il batch processing strategico massimizzano il tasso di successo minimizzando il rischio di rilevazione.
Fase 3 – Costruzione della relazione. Il romance scam bot crea e mantiene relazioni fraudolente con le vittime, utilizzando l’intelligenza emotiva dell’AI per costruire fiducia e preparare il terreno per la richiesta finanziaria. Le vittime profilate nella Fase 1 possono essere targeting prioritari nella Fase 3: se il profilo comportamentale indica vulnerabilità emotiva o solitudine, il romance scam diventa il vettore di monetizzazione ottimale.
Fase 4 – Infrastruttura identitaria. I servizi di identità sintetica forniscono le identità necessarie per aprire i conti bancari che ricevono i fondi estorti, per creare i profili delle false identità romantiche, e per riciclare i proventi delle carte validate. L’identità sintetica è il tessuto connettivo che tiene insieme l’intera operazione. Come ha evidenziato la Federal Reserve Bank di Boston, un effetto particolarmente rilevante è l’eliminazione della dipendenza dai money mule – intermediari reclutati, spesso inconsapevoli, per ricevere e trasferire fondi illeciti. Tradizionalmente, il reclutamento dei mule rappresentava un collo di bottiglia costoso e rischioso per le organizzazioni criminali. Con identità sintetiche AI-generated, i fraudster aprono direttamente i propri conti attraverso portali online, riducendo costi, rischi e dipendenza da terzi.
La circolarità è il tratto distintivo di questo ecosistema. I dati rubati attraverso le carte validate alimentano la creazione di nuove identità sintetiche. Le relazioni costruite dal romance scam generano ulteriori dati personali sulle vittime, che arricchiscono i profili per future operazioni. Le identità sintetiche aprono nuovi vettori per il carding e per il riciclaggio dei proventi. Ogni operazione rafforza le altre in un ciclo virtuoso – per i criminali – di efficienza crescente.
Come ha sintetizzato l’analisi di Noma Security sul report di Anthropic, i criminali non aspettano. Stanno già integrando l’AI nell’estorsione, nella frode e nello spionaggio. Si muovono più velocemente delle difese di sicurezza AI di molte organizzazioni.
Implicazioni per il settore finanziario e la verifica dell’identità
La AI fraud supply chain ha implicazioni operative immediate per tre ambiti professionali.
Per i team antifrode bancari
La resilienza multi-API del carding store documenta una sofisticazione infrastrutturale che rende inadeguati i sistemi di rilevazione basati su regole statiche. Le strategie di throttling intelligente progettate per mimetizzare il traffico fraudolento nel flusso legittimo richiedono un approccio di detection basato sull’analisi comportamentale piuttosto che sulle soglie transazionali.
I circuiti di pagamento stanno investendo massicciamente in questa direzione – Visa ha destinato 3,3 miliardi di dollari in AI e infrastrutture dati nell’ultimo decennio e processa oltre 500 milioni di transazioni giornaliere con AI difensiva, mentre Mastercard ha acquisito Recorded Future per 2,65 miliardi di dollari per integrare la threat intelligence AI-driven nel proprio ecosistema – ma l’efficacia di questi investimenti dipende dalla capacità di anticipare le tecniche di evasione, non solo di reagire ad esse.
Il 90% delle istituzioni finanziarie utilizza già AI per la rilevazione delle frodi, secondo Feedzai. Ma la partita non è “AI difensiva contro attaccanti umani”. È “AI difensiva contro AI offensiva”, con l’aggravante che l’AI offensiva ha il vantaggio dell’iniziativa e della specificità: sa esattamente cosa deve eludere, mentre l’AI difensiva deve proteggere una superficie di attacco potenzialmente illimitata.
Per i responsabili KYC e compliance
L’operatività dei servizi di identità sintetica impone una revisione profonda dei processi di verifica dell’identità. Il modello KYC tradizionale – verifica documentale all’onboarding, monitoraggio transazionale successivo – è strutturalmente vulnerabile a identità sintetiche che passano la verifica iniziale e rimangono dormienti per mesi prima di essere attivate per operazioni fraudolente. La transizione verso un modello di verifica continua dell’identità, che integri segnali comportamentali, biometrici e contestuali lungo l’intero ciclo di vita del cliente, non è più un’opzione: è una necessità operativa.
Le sanzioni regolamentari confermano l’urgenza. Secondo l’analisi di Fenergo, i regolatori globali hanno emesso circa 139 sanzioni finanziarie nel primo semestre 2025, per un totale di 1,23 miliardi di dollari – un incremento del 417% rispetto allo stesso periodo del 2024.
Per i responsabili della sicurezza informatica
La convergenza dei tre vettori di frode in un ecosistema integrato impone un aggiornamento dei modelli di rischio. La valutazione del rischio di frode non può più essere compartimentalizzata: il rischio di carding, il rischio di social engineering e il rischio di identità sintetica sono manifestazioni interconnesse della stessa infrastruttura criminale. Le organizzazioni che li trattano come minacce separate sottostimano sistematicamente il rischio complessivo.
Sul versante normativo europeo, la Direttiva NIS2 (Direttiva UE 2022/2555), recepita in Italia con il D.lgs. 138/2024, impone agli operatori dei servizi essenziali e importanti – incluse le istituzioni finanziarie – misure di gestione del rischio che comprendono la sicurezza della supply chain. L’AI Act (Regolamento UE 2024/1689) aggiunge requisiti di trasparenza e governance per i sistemi AI. La AI fraud supply chain opera esattamente all’intersezione di questi due regimi normativi: è una minaccia alla sicurezza informatica che sfrutta sistemi di intelligenza artificiale come componenti funzionali, e richiede una risposta di compliance integrata.
La resilienza operativa: come l’AI permette pivot rapidi
Un aspetto della AI fraud supply chain che merita un’analisi dedicata è la resilienza operativa che l’AI conferisce all’ecosistema criminale.
Nel modello tradizionale, quando un servizio di carding veniva bloccato, ricostruirlo richiedeva settimane di sviluppo. Quando un account di romance scam veniva sospeso, ricreare il profilo e ricostruire le relazioni interrotte era un processo manuale e costoso. Quando un fornitore di documenti falsi veniva arrestato, la rete a valle subiva un’interruzione significativa.
Con l’AI, ciascuno di questi scenari diventa un inconveniente operativo piuttosto che un’interruzione critica.
Il carding store lo dimostra con la sua architettura multi-API: la perdita di un servizio di validazione non interrompe le operazioni, perché il sistema scopre autonomamente servizi alternativi. Il romance scam bot lo dimostra con la sua capacità multimodello: se l’accesso a un modello AI viene revocato, il sistema ruota verso un altro. Il servizio di identità sintetiche lo dimostra con la velocità con cui nuove identità possono essere generate per sostituire quelle compromesse.
Come sintetizzano gli autori del report di Anthropic – Alex Moix, Ken Lebedev e Jacob Klein – i quattro casi nell’ambito della frode documentano collettivamente un’evoluzione preoccupante: l’AI facilita pivot e adattamenti rapidi quando si affronta il blocco o la rilevazione. L’AI non solo potenzia le singole operazioni: rende l’ecosistema criminale antifragile, capace di rafforzarsi in risposta alle perturbazioni.
Questa resilienza ha un’implicazione strategica fondamentale per i difensori. Le operazioni di disruption – takedown di infrastrutture, blocco di account, sequestro di domini – restano necessarie ma non sufficienti. Se il costo di ricostruzione dell’infrastruttura criminale si riduce da settimane a ore grazie all’AI, la strategia di disruption diventa una corsa al ribasso in cui i difensori investono risorse crescenti per ottenere interruzioni sempre più brevi. Serve un cambio di paradigma: dalla disruption dell’infrastruttura all’erosione del modello di business, rendendo le operazioni meno redditizie piuttosto che semplicemente più difficili.
Limiti dell’analisi e controargomentazioni
Un’analisi rigorosa della AI fraud supply chain richiede di considerare anche i limiti della narrazione.
I tre casi sono documentati con livelli di dettaglio diversi. Il caso del carding store e quello del romance scam bot sono descritti con sufficiente specificità da consentire un’analisi tecnica. Il caso delle identità sintetiche è presentato in modo più sintetico, con meno dettagli sull’architettura e sulla scala delle operazioni. La ricostruzione dell’integrazione tra i tre casi è, in parte, un’inferenza analitica basata sulla logica dell’ecosistema criminale piuttosto che su evidenze dirette di collaborazione tra gli attori.
L’AI amplifica, ma non crea la frode. Il carding, i romance scam e la frode identitaria esistono da decenni. L’intelligenza artificiale ne aumenta scala, velocità e sofisticazione, ma il modello di business sottostante e le vulnerabilità sfruttate sono pre-esistenti. I controlli fondamentali – MFA robusto, monitoraggio delle transazioni, educazione degli utenti – restano efficaci e non vengono resi obsoleti dall’AI.
La risposta del settore non è statica. Il 73% delle istituzioni finanziarie ha implementato AI nella rilevazione delle frodi nel 2025, rispetto al 49% nel 2024. La corsa agli armamenti AI offensiva/difensiva non è unilaterale: i difensori stanno adottando le stesse tecnologie, e in molti casi dispongono di risorse e dati significativamente superiori a quelli dei criminali.
Queste controargomentazioni contestualizzano il fenomeno senza minimizzarlo. La AI fraud supply chain è reale e documentata, e la sua evoluzione richiede adattamento difensivo. Ma l’adattamento è possibile, ed è già in corso.
Raccomandazioni operative
Per i professionisti della sicurezza informatica, la AI fraud supply chain richiede interventi su cinque direttrici:
Adottare detection comportamentale anti-throttling. I sistemi di rilevazione delle frodi devono essere calibrati per identificare i pattern di validazione delle carte con throttling intelligente, cercando anomalie non nella velocità ma nella regolarità e nella distribuzione temporale delle richieste.
Implementare verifica continua dell’identità. La transizione dal KYC statico all’ongoing due diligence è imperativa. L’integrazione di segnali comportamentali – come l’analisi della tipizzazione, i pattern di navigazione e la biometria passiva – riduce la superficie di attacco delle identità sintetiche.
Correlare i vettori di frode. Carding, social engineering e identità sintetica devono essere analizzati come manifestazioni della stessa infrastruttura criminale. La creazione di team antifrode trasversali, che condividano intelligence tra dipartimenti tradizionalmente separati, è un prerequisito organizzativo.
Integrare l’intelligence sulle piattaforme di scam. Il monitoraggio dei canali Telegram, dei forum underground e dei servizi del dark web non può essere limitato alle minacce cyber tradizionali. I bot di romance scam come quello documentato da Anthropic operano su piattaforme pubbliche e monitorabili.
Contribuire alla condivisione dell’intelligence. Il report di Anthropic è stato possibile perché un ricercatore indipendente ha segnalato il romance scam bot. La collaborazione tra provider AI, istituzioni finanziarie e forze dell’ordine è l’unica contromisura che opera a livello di ecosistema, e non di singolo anello.
La frode che si costruisce da sola
La AI fraud supply chain è, in ultima analisi, l’espressione più compiuta di un principio che attraversa l’intera serie di articoli sull’AI offensiva nella cybersecurity: l’intelligenza artificiale non potenzia un singolo aspetto del crimine informatico, ma ne industrializza l’intera catena del valore.
Il carding store con resilienza multi-API non è semplicemente un servizio di validazione più efficiente. È un componente infrastrutturale che si auto-ripara quando un suo elemento viene compromesso. Il romance scam bot con 10.000 utenti mensili non è semplicemente un truffatore più convincente. È una piattaforma che democratizza la manipolazione emotiva, rendendo accessibile a operatori privi di competenze linguistiche o psicologiche la capacità di condurre truffe sentimentali multilingue e multi-continente. Il servizio di identità sintetiche non è semplicemente un falsario più rapido. È il connettore che permette a ogni anello della catena di operare sotto coperture identitarie che superano le verifiche formali.
Come ha evidenziato il Google Threat Intelligence Group nel report di febbraio 2026, il 2025 ha segnato la maturazione del mercato underground per strumenti AI-enabled, con la proliferazione di offerte multifunzionali progettate per supportare diverse fasi del ciclo di attacco.
Per CISO, SOC analyst, threat researcher, specialisti antifrode e responsabili compliance, il messaggio operativo è che la AI fraud supply chain richiede una difesa che operi con la stessa logica integrata dell’attacco. Proteggere un singolo anello – il carding, il social engineering, la verifica dell’identità – lascia esposti gli altri. La sicurezza deve essere pensata come un sistema, non come una collezione di controlli puntuali.
La carta rubata di ieri è l’identità sintetica di domani. E domani, nella AI fraud supply chain, è già oggi.
Questo è il settimo articolo della serie “AI offensiva nella cybersecurity”. Il primo articolo ha introdotto il quadro generale delle minacce AI-driven e il framework normativo. Il secondo articolo ha ricostruito l’operazione GTG-2002 e il paradigma del vibe hacking. Il terzo articolo ha analizzato il no-code malware e il caso GTG-5004. Il quarto articolo ha esaminato la frode occupazionale nordcoreana assistita dall’AI. Il quinto articolo ha analizzato l’APT cinese che ha integrato Claude in 12 delle 14 tattiche MITRE ATT&CK. Il sesto articolo ha documentato l’uso offensivo del Model Context Protocol per la profilazione delle vittime. Il prossimo articolo approfondirà le strategie di difesa AI-native contro le minacce AI-driven.
Supply chain software, attacco npm PyPI: 454.000 pacchetti malevoli e il primo worm autoreplicante che ha cambiato tutto
Un attacco alla supply chain software attraverso npm e PyPI non è più un’ipotesi accademica: è il meccanismo operativo che nel 2025 ha permesso la distribuzione di oltre 454.000 nuovi pacchetti malevoli nei registri open-source globali. È una cifra che merita di essere ripetuta, perché racconta qualcosa di profondo sulla fragilità strutturale dell’ecosistema su cui poggia la quasi totalità del software moderno.
Ogni volta che uno sviluppatore esegue npm install o pip install, sta dichiarando fiducia implicita in un registro pubblico che non richiede validazione dell’identità del publisher, non verifica la corrispondenza tra nome del pacchetto e contenuto, e – aspetto decisivo – privilegia automaticamente la versione più recente di ogni dipendenza. In un ecosistema dove i download annuali hanno superato i 9,8 trilioni e i componenti open-source costituiscono l’80-90% delle applicazioni moderne, quella fiducia implicita è diventata l’arma più efficiente a disposizione degli attaccanti.
Il 2026 State of the Software Supply Chain Report di Sonatype – pubblicato il 28 gennaio 2026 e basato sull’analisi di oltre 1,233 milioni di pacchetti malevoli cumulativi – documenta un’evoluzione che non è più quantitativa ma qualitativa: il malware nella supply chain software ha adottato la stessa architettura modulare, la stessa logica di riuso e la stessa capacità di scala che rendono potente l’open-source legittimo. Non stiamo più parlando di script rudimentali nascosti in pacchetti oscuri. Stiamo parlando di campagne industrializzate, persistenti, spesso orchestrate da attori statali, che trattano npm e PyPI come canali di distribuzione a basso attrito verso macchine di sviluppo e pipeline CI/CD – ambienti che, per definizione, sono vicini ai dati sensibili e all’accesso di produzione.
Questo articolo analizza i tre eventi che, tra la fine del 2025 e l’inizio del 2026, hanno reso impossibile ignorare la portata del problema: la campagna Lazarus “Graphalgo”, l’attacco “XPACK ATTACK” e – soprattutto – il worm autoreplicante Shai-Hulud, che ha dimostrato che la propagazione autonoma nei registri open-source non è più teoria, ma realtà operativa.
L’anatomia di Graphalgo: come Lazarus ha trasformato un colloquio di lavoro in un trojan multi-stadio
Il 12 febbraio 2026, ReversingLabs ha pubblicato l’analisi dettagliata di una campagna denominata “Graphalgo” – dal nome del primo pacchetto malevolo pubblicato su npm – attribuita con grado di confidenza medio-alto al Lazarus Group nordcoreano. La campagna era attiva dal maggio 2025 e rappresenta un salto qualitativo nelle operazioni di supply chain poisoning condotte da attori statali.
Il meccanismo è sofisticato nella sua semplicità psicologica. Gli attaccanti contattano sviluppatori JavaScript e Python attraverso LinkedIn, Facebook e Reddit, proponendo opportunità lavorative presso “Veltrix Capital” – una società fittizia presentata come operatore blockchain e crypto exchange, completa di domini registrati (veltrixcap[.]org, veltrixcapital[.]ai) e organizzazioni GitHub con repository apparentemente legittimi. Ai candidati viene chiesto di completare un “coding test” come parte del processo di selezione. I repository contengono dipendenze che puntano a pacchetti compromessi su npm e PyPI.
Qui sta il genio tattico: quando la vittima esegue o fa il debug del codice di test, il package manager installa automaticamente le dipendenze malevole. I pacchetti agiscono come loader di primo stadio, scaricando un Remote Access Trojan (RAT) dall’infrastruttura C2 controllata dagli attaccanti. Il RAT è in grado di eseguire comandi arbitrari, caricare e scaricare file, elencare i processi in esecuzione e – dettaglio rivelatore – verificare la presenza dell’estensione browser MetaMask, indicando un interesse specifico per il furto di asset crittografici. Sono state identificate tre varianti del RAT, scritte in JavaScript, Python e Visual Basic Script.
ReversingLabs ha identificato complessivamente 192 pacchetti malevoli in due lotti distinti: quelli con “graph” nel nome (apparsi su npm dal 2 maggio 2025 e su PyPI dal giugno 2025, progettati per mimare librerie legittime come graphlib e networkx) e quelli con “big” nel nome (apparsi su npm dal 17 novembre 2025 e su PyPI dal 9 dicembre 2025, probabilmente collegati a una seconda campagna di facciata ancora non identificata).
L’esempio emblematico è il pacchetto npm bigmathutils: la prima versione, benigna, è stata pubblicata e ha accumulato oltre 10.000 download. Solo a quel punto – quando la fiducia era stata costruita attraverso i numeri – gli attaccanti hanno iniettato il payload malevolo nella versione 1.1.0, pubblicata poco prima dell’11 febbraio 2026. Una strategia di attivazione ritardata che sfrutta la meccanica stessa dell’ecosistema: più download ha un pacchetto, più appare legittimo, più viene installato senza scrutinio.
L’attribuzione a Lazarus si basa su pattern ricorrenti documentati in operazioni precedenti: finti colloqui di lavoro come vettore di contatto iniziale, storie a tema crypto, malware multi-stadio con offuscamento stratificato, infrastruttura C2 protetta da token e – dato forense significativo – timestamp nei commit Git allineati al fuso orario GMT+9, quello della Corea del Nord. La campagna è una ramificazione diretta di operazioni precedenti come VMConnect (PyPI e GitHub) e Contagious Interview, documentate da Socket, Unit 42, Phylum e Veracode.
Il dato strategico: il design modulare di Graphalgo consente a Lazarus di sostituire le “facciate” (Veltrix oggi, un altro nome domani) mantenendo invariata l’infrastruttura backend di payload e C2. Questo significa che altre false aziende, altri pacchetti e altri test di codifica sono non solo probabili, ma inevitabili.
XPACK ATTACK: quando l’installazione diventa estorsione
Lo stesso giorno della divulgazione di Graphalgo, The Hacker News ha riportato la scoperta di una seconda campagna, indipendente da Lazarus ma emblematica dell’evoluzione creativa del malware nella supply chain. Denominata “XPACK ATTACK” da OpenSourceMalware e registrata per la prima volta il 4 febbraio 2026, questa operazione rappresenta un modello di monetizzazione completamente inedito: l’estorsione diretta durante l’installazione del pacchetto npm.
I pacchetti, tutti caricati dall’utente “dev.chandra_bose”, abusano del codice di stato HTTP 402 (“Payment Required”) per creare quello che appare come un legittimo paywall. Come ha spiegato il ricercatore Paul McCarty, l’attacco blocca l’installazione fino a quando la vittima non paga 0,1 USDC/ETH al wallet dell’attaccante, raccogliendo nel frattempo username GitHub e fingerprint del dispositivo. Se la vittima rifiuta di pagare, l’installazione fallisce dopo oltre cinque minuti – e lo sviluppatore potrebbe non rendersi nemmeno conto di aver incontrato malware piuttosto che un legittimo sistema di licensing.
XPACK ATTACK è significativo non per la sua scala (modesta) ma per il precedente concettuale che stabilisce: la monetizzazione del malware open-source non richiede più l’esfiltrazione di credenziali, l’installazione di backdoor o il deployment di ransomware. Può avvenire direttamente nell’atto stesso dell’installazione, sfruttando un meccanismo HTTP standardizzato che conferisce un’aura di legittimità tecnica all’estorsione.
Shai-Hulud: il worm che ha dimostrato che la propagazione autonoma è possibile
Se Graphalgo rappresenta la sofisticazione dello state-sponsored supply chain attack e XPACK ATTACK l’innovazione nel modello di monetizzazione, il worm Shai-Hulud è l’evento che ha ridefinito il perimetro della minaccia. Identificato per la prima volta il 15 settembre 2025 da ReversingLabs e oggetto di un advisory dedicato della CISA, Shai-Hulud è il primo malware autoreplicante nell’ecosistema npm – un worm che si propaga sfruttando le credenziali dei maintainer compromessi per pubblicare versioni avvelenate dei pacchetti che questi mantengono, creando una catena di infezione esponenziale senza intervento umano diretto.
Il meccanismo di propagazione è elegante nella sua brutalità. Una volta installato attraverso un pacchetto compromesso, il worm esegue discovery del sistema locale utilizzando TruffleHog – un tool legittimo di scansione segreti capace di identificare oltre 800 tipi diversi di credenziali – alla ricerca di token GitHub, NPM, chiavi AWS, GCP e Azure; esfiltra le credenziali raccolte verso un endpoint controllato dall’attaccante; crea un repository pubblico GitHub denominato “Shai-Hulud” sotto l’account della vittima, pubblicando i segreti rubati; utilizza i token npm rubati per autenticarsi nel registro come lo sviluppatore compromesso; identifica gli altri pacchetti mantenuti dallo stesso sviluppatore, inietta codice malevolo e pubblica versioni compromesse – permettendo al worm di propagarsi ai downstream user di quei pacchetti.
Il “paziente zero” identificato è il pacchetto rxnt-authentication versione 0.0.3, pubblicato il 14 settembre 2025. Da quel punto, la CISA ha confermato la compromissione di oltre 500 pacchetti. Ma è la seconda ondata, denominata “Shai-Hulud 2.0” e individuata nel novembre 2025, ad aver mostrato la vera portata della minaccia: 795 pacchetti compromessi, molti dei quali ampiamente utilizzati. Il pacchetto @asyncapi/specs, ritenuto il “paziente zero” di questa seconda ondata, contava da solo oltre 100 milioni di download lifetime. Complessivamente, i pacchetti compromessi – tra cui quelli di progetti come AsyncAPI, Zapier, PostHog e Postman – totalizzavano decine di milioni di download settimanali.
Shai-Hulud 2.0 ha introdotto diverse innovazioni rispetto alla prima variante. L’esecuzione del codice malevolo avviene nella fase preinstall anziché postinstall, ampliando drammaticamente la superficie d’impatto perché il malware si attiva prima che qualsiasi test o controllo di sicurezza possa intervenire. Il worm può infettare fino a 100 pacchetti npm (contro i 20 della prima versione). E, dettaglio particolarmente aggressivo, se non riesce né a replicarsi né a esfiltrare dati, tenta di cancellare la directory home dell’utente.
La tecnica di esfiltrazione ha introdotto il concetto di “cross-victim exfiltration”, documentato da Datadog Security Labs: le credenziali di una vittima vengono pubblicate in un repository GitHub associato a una vittima diversa e non correlata. Questo significa che cercare nei propri repository potrebbe non rivelare i dati esfiltrati dal proprio ambiente. Se il malware non trova credenziali GitHub disponibili localmente, cerca proattivamente su GitHub i repository di esfiltrazione creati da altre vittime e tenta di utilizzare i token compromessi di queste ultime per continuare la propagazione.
La risposta è stata significativa. Microsoft ha pubblicato una guida dettagliata per la detection e l’investigazione, introducendo una nuova funzionalità in Microsoft Defender for Cloud basata su agentless code scanning per identificare i pacchetti Shai-Hulud 2.0 tramite SBOM. Palo Alto Networks Unit 42 ha fornito un’analisi tecnica approfondita con regole di detection. GitHub, che mantiene il registro npm, ha introdotto nuove misure di hardening: 2FA obbligatorio per tutte le pubblicazioni locali, limitazione della durata dei token a sette giorni, revoca dei classic token dal 9 dicembre 2025, e promozione del trusted publishing – un approccio pionierato da PyPI che rimuove i token API dalle pipeline di build.
La scala industriale: numeri che raccontano una mutazione
I tre eventi descritti non sono anomalie. Sono manifestazioni di una tendenza strutturale documentata dal report Sonatype 2026 con una granularità senza precedenti: 454.648 nuovi pacchetti malevoli identificati nel solo 2025, che portano il totale cumulativo a 1,233 milioni. La crescita anno su anno è del 75%.
Il dato più significativo non è la quantità ma la distribuzione: oltre il 99% del malware open-source si concentra su npm. Non è casuale. npm è il registro più grande al mondo, con il maggior volume di download, la minore frizione nella pubblicazione e – crucialmente – nessun requisito di validazione del namespace. Un attaccante può pubblicare un pacchetto con qualsiasi nome, e il tooling dell’ecosistema tende a preferire la versione più recente di ogni dipendenza. È una combinazione di fattori che rende l’avvelenamento strutturalmente facile.
Il 55,9% di tutti i pacchetti malevoli registrati nel 2025 è classificato come “repository abuse”: gli attori trattano i registri come piattaforme, automatizzando la pubblicazione e iterando rapidamente per massimizzare la copertura. Il 27,5% rientra nella categoria “Potentially Unwanted Application” – pacchetti vuoti, demo con credenziali hardcoded, framework per bot di spam su messaging app. Ma il restante è malware operativo: dropper, infostealer, RAT, cryptominer, credential harvester.
L’attore più prolifico è il Lazarus Group, che secondo Sonatype ha individuato oltre 800 pacchetti associati a Lazarus nel 2025, evolvendosi da semplici dropper e cryptominer a catene di payload a cinque stadi che combinano dropper, furto credenziali e accesso remoto persistente. Solo nel primo semestre 2025, Sonatype ha bloccato 234 pacchetti npm e PyPI malevoli attribuiti a Lazarus, stimando fino a 36.000 vittime potenziali.
La campagna IndonesianFoods, scoperta nel novembre 2025, ha aggiunto un’altra dimensione: oltre 150.000 pacchetti pubblicati da un sistema automatizzato che genera un nuovo pacchetto ogni pochi secondi. La campagna, attiva da oltre due anni prima di essere individuata, sfruttava il protocollo TEA per monetizzare attraverso token blockchain le metriche di impatto artificialmente gonfiate.
È importante precisare che, a differenza di Shai-Hulud, il meccanismo di propagazione di IndonesianFoods richiede esecuzione manuale e non costituisce un worm nel senso stretto del termine, come evidenziato da Socket.dev. Tuttavia, la scala dell’operazione resta impressionante. Come ha osservato Garrett Calpouzos di Sonatype, dopo GlassWorm e l’hijack di chalk/debug, IndonesianFoods è l’iterazione successiva dello stesso playbook: ogni ondata di attacchi trasforma l’apertura di npm in un’arma leggermente diversa.
Perché il modello di fiducia dell’open-source è strutturalmente rotto
C’è un paradosso al centro di questa crisi che merita di essere esplicitato: le stesse caratteristiche che rendono l’open-source potente – apertura, riusabilità, distribuzione frictionless – sono esattamente quelle che lo rendono vulnerabile. npm non è stato progettato come sistema di distribuzione di software con garanzie di sicurezza. È stato progettato come commons collaborativo. La fiducia non è un meccanismo di sicurezza verificabile: è un’assunzione sociale.
Il modello di minaccia tradizionale per la supply chain software presupponeva che l’attaccante dovesse compromettere un sistema di build, alterare un artefatto firmato, o sfruttare una vulnerabilità in un componente legittimo. Quello che il 2025 ha dimostrato è che nulla di tutto questo è necessario. Basta pubblicare un pacchetto con un nome plausibile, accumulare download (o acquistarli), e attendere che il tooling di milioni di sviluppatori lo installi automaticamente come dipendenza transitiva.
Il report Sonatype documenta un ulteriore livello di rischio: lo sviluppo assistito da AI amplifica il problema. Analizzando quasi 37.000 upgrade di dipendenze assistiti da LLM, Sonatype ha riscontrato che circa il 28% erano allucinazioni – versioni inesistenti di pacchetti. In alcuni casi, gli LLM hanno suggerito l’installazione di pacchetti effettivamente malevoli. Senza intelligence verificata in tempo reale, l’AI non corregge i dati cattivi: li distribuisce più velocemente.
Le contromisure: dalla fiducia implicita alla verifica operativa
La fine della fiducia implicita nei registri pubblici non è una catastrofe: è un momento di maturazione. Ma richiede un cambio di paradigma operativo che va oltre il singolo strumento. Ecco le contromisure che, sulla base dell’evidenza raccolta, hanno dimostrato efficacia concreta.
Software Bill of Materials (SBOM) come prerequisito – L’SBOM non è più un nice-to-have regolatorio: è l’unico modo per avere visibilità su cosa effettivamente risiede nell’ambiente di build. Microsoft ha introdotto la generazione SBOM agentless in Defender for Cloud specificamente per identificare i pacchetti Shai-Hulud 2.0 – dimostrando che senza un inventario delle dipendenze leggibile da macchina, la detection è cieca. Il Cyber Resilience Act europeo e l’AI Act stanno convergendo sulla richiesta di prova di provenienza, contenuto e controllo lungo l’intero ciclo di vita del software.
Repository firewall e policy di lockfile – Un repository firewall agisce come proxy tra l’ambiente di build e il registro pubblico, bloccando pacchetti noti come malevoli e applicando policy di approvazione prima che qualsiasi pacchetto entri nella pipeline. La policy di lockfile (package-lock.json per npm, Pipfile.lock per Python) impedisce che il tooling risolva automaticamente alla versione più recente, neutralizzando il vettore della delayed malicious update sfruttato da Graphalgo.
Trusted publishing e token hygiene – Dopo Shai-Hulud, GitHub ha imposto 2FA obbligatorio per le pubblicazioni npm locali, limitato la durata dei token a sette giorni e revocato i classic token dal 9 dicembre 2025. Il modello di trusted publishing, già adottato da PyPI, rimuove i token API dalle pipeline di build sostituendoli con attestazioni verificabili legate al provider CI/CD. Ogni organizzazione che pubblica pacchetti su npm dovrebbe adottare questo modello come standard minimo.
Dependency cooldown e binary analysis – I pacchetti malevoli nella supply chain software si eseguono durante l’installazione, prima ancora che il codice venga compilato o testato. Un approccio emergente, adottato da Elastic dopo l’incidente Shai-Hulud 2.0, prevede un periodo di “cooldown” (14 giorni nel caso di Elastic) durante il quale le nuove versioni dei pacchetti non vengono automaticamente adottate, permettendo alla comunità di individuare eventuali compromissioni. L’analisi binaria dei pacchetti e il monitoraggio runtime delle connessioni di rete anomale durante l’installazione sono complementi necessari allo scanning statico del codice.
Separazione degli ambienti e least privilege – Le macchine di sviluppo e gli agenti CI/CD non dovrebbero mai avere accesso diretto a credenziali di produzione, token cloud o segreti critici. Shai-Hulud ha dimostrato che un singolo pacchetto compromesso può raccogliere token GitHub, npm, AWS, GCP e Azure dalla stessa macchina. La segmentazione degli ambienti e il principio di least privilege per le pipeline di build non sono best practice opzionali: sono l’unica barriera tra un’infezione locale e una compromissione dell’infrastruttura cloud.
Il quadro normativo: NIS2, CRA e la responsabilità della supply chain
L’evoluzione normativa europea sta convergendo sulla supply chain software come area di responsabilità esplicita. La direttiva NIS2 (Direttiva UE 2022/2555) richiede alle entità essenziali e importanti di gestire i rischi della catena di approvvigionamento digitale, inclusa la verifica delle pratiche di sicurezza dei fornitori di software. Il Cyber Resilience Act (Regolamento UE 2024/2847), entrato in vigore il 10 dicembre 2024, impone ai produttori di prodotti con elementi digitali di garantire la sicurezza del software lungo l’intero ciclo di vita, incluse le dipendenze open-source. Gli obblighi principali saranno applicabili da dicembre 2027, con quelli relativi alla gestione delle vulnerabilità e alla segnalazione degli incidenti in vigore già da settembre 2026.
Questo significa che un’organizzazione europea che subisce una compromissione attraverso un pacchetto npm malevolo non può più invocare l’imprevedibilità dell’attacco come attenuante. La due diligence sulla supply chain software – SBOM, scansione delle dipendenze, policy di approvazione dei pacchetti – è diventata un obbligo di compliance, non una raccomandazione di best practice.
Prospettive: cosa aspettarsi nei prossimi 12 mesi
La traiettoria è chiara e il suo prossimo punto di accelerazione è identificabile. L’avvelenamento della supply chain software diventerà più sofisticato lungo tre direttrici convergenti.
La prima è l’integrazione con l’ingegneria sociale avanzata. Graphalgo ha dimostrato che il vettore “fake recruiter” è devastantemente efficace perché sfrutta la legittima aspirazione professionale degli sviluppatori. Varianti future sostituiranno le finte aziende crypto con finte aziende AI, finti progetti open-source alla ricerca di contributori, finte conferenze con “workshop pre-evento” che richiedono l’installazione di dipendenze compromesse.
La seconda è la propagazione autonoma. Shai-Hulud ha dimostrato il principio; le varianti successive saranno più silenziose, più selettive e più difficili da rilevare. Un primo segnale è già arrivato: il 20 febbraio 2026, Socket ha identificato SANDWORM_MODE, un nuovo worm stile Shai-Hulud che aggiunge capacità di prompt injection nei coding assistant AI, posizionandosi all’interno sia delle pipeline CI che degli strumenti di sviluppo. Un worm che compromette solo pacchetti con download settimanali superiori a una soglia, che attende settimane prima di attivare il payload, e che esfiltra attraverso canali legittimi (webhook GitHub, API cloud native) potrebbe propagarsi per mesi prima di essere individuato.
La terza è il targeting dei modelli AI e dei sistemi agentic. Sonatype documenta già la presenza di payload malevoli nascosti in modelli AI e container image su piattaforme come Hugging Face. Con l’adozione dei Model Context Protocol (MCP) server e degli agenti AI autonomi che installano dipendenze senza supervisione umana, la superficie d’attacco della supply chain software si sta espandendo verso un territorio dove la velocità dell’infezione potrebbe superare la velocità della detection.
Conclusione: la supply chain software come campo di battaglia permanente
L’attacco alla supply chain software attraverso npm e PyPI non è un’emergenza temporanea da gestire con una patch: è una condizione permanente dell’ecosistema digitale moderno. I 454.648 pacchetti malevoli del 2025, il worm autoreplicante Shai-Hulud, la campagna state-sponsored Graphalgo e l’innovazione estorsiva di XPACK ATTACK sono manifestazioni diverse dello stesso fenomeno strutturale: la fiducia implicita nei registri pubblici open-source è diventata il punto di ingresso più efficiente per gli attaccanti, dagli adolescenti opportunisti agli apparati di intelligence statali.
La risposta non può essere la rinuncia all’open-source – sarebbe come rinunciare all’elettricità perché i fulmini esistono. Ma richiede l’abbandono definitivo dell’approccio “install and trust” a favore di un modello “verify then install”: SBOM operativi, repository firewall, lockfile rigorosi, trusted publishing, segmentazione degli ambienti, monitoraggio runtime. Non come aspirazione, ma come standard operativo quotidiano.
Il report Sonatype 2026 chiude con un’osservazione che vale come monito: il pacchetto malevolo non è più l’intero attacco, ma il primo passo di un’intrusione supply chain più ampia. Per ogni organizzazione che costruisce software – cioè, nel 2026, praticamente ogni organizzazione – il rischio della supply chain software non è un rischio da delegare ai developer: è un rischio da governare al livello del board.
Data Breach sanitari: minacce informatiche e protezione dati personali nel sistema sanitario italiano
Questo articolo fa parte di una serie dedicata all’analisi approfondita della cybercriminalità nel settore sanitario italiano. In questa sezione esamineremo il fenomeno dei data breach sanitari e la loro crescente incidenza nelle strutture sanitarie, analizzando l’evoluzione del concetto di privacy dalla tradizionale riservatezza alla moderna protezione dei dati personali sotto il GDPR.
Crescente rischio dei data breach sanitari e impatto economico della cybercriminalità
Con le seguenti allarmanti parole si avvia la prefazione del tradizionale rapporto CLUSIT 2020 sulla sicurezza ICT[1] in Italia:
Nell’anno appena passato si è consolidata una discontinuità, si è oltrepassato un punto di non ritorno, tale per cui ormai ci troviamo a vivere ed operare in una dimensione differente, in una nuova epoca, in un altro mondo, del quale ancora non conosciamo bene la geografia, gli abitanti, le regole e le minacce”. La convinzione, prosegue il Rapporto, è che sia avvenuto “un vero e proprio cambiamento epocale nei livelli di cyber-insicurezza, causato dall’evoluzione rapidissima degli attori, delle modalità, della pervasività e dell’efficacia degli attacchi.[2]
Il quadro così delineato dal rapporto Clusit va a destrutturare quella convinzione di cybersecurity fin troppo spesso associata a “realtà suggestive” (o fantascientifiche), distanti dalla vita di tutti i giorni, nonché appannaggio dei soli protagonisti della governance statale ed internazionale.
In una comunicazione congiunta, del 13 Settembre 2017, al Parlamento Europeo e al Consiglio traspare, con nitidezza, come i rischi cibernetici stiano aumentando in maniera esponenziale: “Secondo alcuni studi l’impatto economico della cybercriminalità è aumentato di cinque volte tra il 2013 e il 2017 e potrebbe ancora quadruplicarsi entro il 2019. […] Se non miglioreremo sostanzialmente la nostra cybersicurezza il rischio aumenterà in funzione della trasformazione digitale.” Dunque è senza dubbio diventato fondamentale rafforzare una cyber-resilienza attraverso “un solido mercato unico, importanti progressi nella capacità tecnologica nell’Unione e un numero molto più elevato di esperti qualificati”.[3]
Allora il fine che si è indirizzati a perseguire è proprio una accettazione più ampia del fatto che la cybersicurezza rappresenti una sfida sociale comune, motivo per cui dovrebbero essere coinvolti, in ottica di risposta, molteplici livelli: dell’amministrazione pubblica, dell’economia e della società.
Ovvio è come, in tale contesto, alcuni ambiti specifici debbano affrontare altrettanto specifiche problematiche, che impongono una integrazione delle strategie di cybersecurity di carattere generale con quelle di tipo settoriale: ed uno dei settori specifici che, negli ultimi decenni, più di altri ha subito notevoli trasformazioni, con un progressivo utilizzo di nuove tecnologie è proprio quello sanitario.
Il mercato sanitario invero si figura sempre più attenzionato da parte dei c.d. Tech Giants (Google, Amazon, Walmart etc.), i quali promettono di rivoluzionarne le tradizionali modalità di assistenza sanitaria attraverso una digitalizzazione dei servizi e una disintermediazione degli stessi rispetto agli erogatori tradizionali.
Il settore sanitario è presto diventato così un banco di prova paradigmatico per nuove ed ardue questioni, poste innanzitutto ai giuristi, in ragione specialmente della straordinaria mole di dati accumulati, della articolata complessità dei rapporti giuridici che vi si instaurano, nonché della esigenza di garantire il più alto livello possibile di sicurezza e privacy.[4]
Prima di procedere alla disamina delle principali condotte di cyber-criminalità che colpiscono l’healthcare system, si vuole qui fornire una panoramica sulla gravità e pericolosità degli attacchi, in quanto impattanti su un settore altamente vulnerabile: come si può intuire infatti c’è un legame diretto tra gli attacchi informatici subiti dalle strutture sanitarie e le condizioni dei pazienti che si affidano alle loro cure.
A tal fine si richiama il recente report condotto da Ponemon Institute, una delle principali organizzazioni di ricerca sulla sicurezza informatica, in unione con Proofpoint, società leader nel settore della cybersecurity e compliance, dal titolo “Cyber Insecurity in Healthcare: The Cost and Impact on Patient Safety and Care”.[5]
Lo studio vede coinvolti 641 professionisti dell’It (Information technology) quali responsabili, nonché partecipanti all’elaborazione di strategie di sicurezza informatica sanitaria, e fin da subito pone in marcata evidenza come l’89% delle organizzazioni intervistate dichiari di aver subito una media di 43 attacchi negli ultimi 12 mesi, quasi uno a settimana.
Si continua poi andando a delineare i quattro tipi di attacchi più comuni: la compromissione del cloud, l’attacco ransomware, alla supply chain[6], ancora la compromissione delle e-mail aziendali/ spoofing[7] ed il phishing[8].
Ecco che tali attacchi vengono messi in relazione con le loro dirette conseguenze verificatesi in sanità: da ritardi nelle procedure e negli esami, alla degenza più lunga dei pazienti, ad un loro progressivo trasferimento in altre strutture sanitarie, al sorgere di maggiori complicazioni nel fornire prestazioni sanitarie, fino ad un incremento dei tassi di mortalità.[9]
Così difatti recita il quesito formulato nel report, con l’ovvia possibilità per gli intervistati di apporre più di una risposta: “Se la tua organizzazione ha subito queste tipologie di attacchi informatici, quale impatto hanno avuto sulla cura dei pazienti?”.
Fig. 4.1 Elaborazione dati Ponemon Report: cyberattacchi – conseguenze sanitarie.
Si è voluto innanzi graficamente rappresentare i dati raccolti (Figura 4.1) al fine di poter constatare come l’attacco ransomware rimanga a tutti gli effetti una sfida significativa: è difatti la tipologia di attacco informatico con la maggiore probabilità di influire sulla cura dei pazienti rispetto alle altre tipologie malevoli (il 64% delle aziende colpite da ransomware ha registrato ritardi nelle procedure mediche e quasi altrettante hanno visto prolungare le degenze dei pazienti).
Tali risultati rimarcano come le organizzazioni sanitarie dovrebbero dare maggiore priorità alla sicurezza IT, in questo senso commenta Larry Ponemon, presidente e fondatore di Ponemon Institute: “Gli attacchi che abbiamo analizzato mettono a dura prova le risorse delle organizzazioni sanitarie. Il risultato non è solo una enorme perdita economica, ma anche un impatto diretto sull’assistenza ai pazienti, che mette in allarmante pericolo la loro sicurezza e salute”.
A seguire si riportano altri risultati chiave emersi dal report:[10]
a) Dispositivi medici e mobile apps rimangono una delle principali preoccupazioni in tema di cybersicurezza. A tal proposito si usa l’espressione di Internet of Medical Things (IoMT) per indicare tutti i devices medici, di varia natura, collegati ad una struttura o ad un operatore sanitario tramite internet, in grado di generare, raccogliere, analizzare e trasmettere dati sanitari (si pensi a dispositivi indossabili, strumenti per il monitoraggio remoto dei pazienti, pompe di infusione, pacemakers).
Le organizzazioni sanitarie hanno in media più di 26.000 dispositivi connessi alla rete: sebbene il 64% degli intervistati si sia dichiarato preoccupato per la sicurezza inerente a tali devices medici, solamente il 51% di questi afferma che la propria organizzazione si sia effettivamente provvista di strategie di sicurezza informatica di prevenzione e risposta a possibili attacchi contro tali dispositivi.
b) Le organizzazioni si sentono al contempo più vulnerabili e più preparate alla compromissione del cloud: il 75% degli intervistati si dichiara difatti vulnerabile verso tali tipologie di attacchi e il 54% afferma di averne subito almeno uno negli ultimi due anni (le organizzazioni ricomprese in quest’ultimo gruppo arrivano a sostenere una media di 22 compromissioni negli ultimi due anni). Tuttavia, oltre ad essere più vulnerabili, si dichiarano anche maggiormente preparate ad affrontare tali minacce, con il 63% che dichiara di aver optato per l’adozione di misure specifiche al fine di esser preparati nel rispondere a simili cyberattacchi.
c) Il ransomware è la seconda più sentita vulnerabilità con il 72% degli intervistati che ritiene la propria organizzazione esposta a tale cyber-rischio, e con il 60% che sostiene come sia effettivamente la tipologia di attracco che desta maggiori preoccupazioni. Negli ultimi due anni le organizzazioni che sono state sottoposte ad attacchi ransomware (41% degli intervistati), hanno subito una media di tre di questi attacchi.
d) La mancanza di preparazione mette a rischio tanto le organizzazioni sanitarie quanto i pazienti stessi. Meno della metà degli intervistati dichiara di avere effettivamente una strategia documentata da seguire per gli attacchi spoofing/phishing (48%), e ugualmente per gli attacchi alla supply chain (44%).
e) I programmi di formazione e sensibilizzazione al cyber-rischio, insieme al monitoraggio dei dipendenti, rappresentano una delle principali strategie per mitigare le minacce informatiche: solo però il 59% degli intervistati ha dichiarato che la propria organizzazione stia affrontando concretamente il problema della mancanza di cyber-consapevolezza tramite o l’adozione di programmi di training per i dipendenti o monitorando il loro stesso operato.
f) La mancanza di competenze interne, fondi e risorse mettono anch’essi a dura prova la sicurezza informatica complessiva: il 53% degli intervistati sostiene di soffrire la mancanza di competenze interne specializzate e il 46% afferma come il personale lavorativo risulti insufficiente.
g) I cyberattacchi provocano enormi costi. È stato chiesto agli intervistati di stimare il singolo attacco informatico più dannoso subito negli ultimi 12 mesi: sulla base delle risposte ottenute, il costo totale medio per l’attacco informatico più dannoso è stato di 4.4 milioni di dollari, con una perdita di produttività quale conseguenza finanziaria di circa 1.1 milioni di dollari.
Da tale studio si è ricavata l’urgente necessità di investire nella cyber security: si è visto chiaramente come una scarsa protezione IT possa avere effetti assolutamente profondi e tangibili tanto sulla struttura sanitaria quanto sui pazienti. Purtroppo ancora oggi gli investimenti in termini di sicurezza vengono visti unicamente come costi e per questo spesso limitati il più possibile; se invece ci si rendesse conto che si tratta di veri e propri investimenti dotati di un loro ritorno in diminuzione dei rischi, molti incidenti potrebbero essere fortemente limitati se non evitati, assieme ad un ingente risparmio sia di tempo che di denaro.[11]
Così conclude commentando Ryan Witt, healthcare cybersecurity leader di Proofpoint: “L’assistenza sanitaria è rimasta indietro rispetto ad altri settori nell’affrontare il crescente numero di attacchi informatici, e questa immobilità impatta negativamente sulla sicurezza e sul benessere dei pazienti. […]
Finché la sicurezza informatica rimarrà una priorità di basso livello, gli operatori sanitari continueranno a mettere in pericolo i loro stessi pazienti. Per evitare conseguenze drammatiche, le organizzazioni sanitarie devono allora comprendere come la cybersecurity influisca sull’assistenza ai pazienti e mettere in atto i passi necessari per proteggere al meglio le persone e i loro dati”.
Ed è proprio di dati che nel diretto prosieguo si tratterà, o meglio, delle loro sempre più frequenti illecite violazioni, divulgazioni, perdite e compromissioni, anche conosciute col nome di Data breaches.
Data breach
Nuova frontiera della privacy: la protezione dei dati personali
La nozione di privacy trova una sua primordiale accezione nel “right to be alone”[12] teorizzato dai due giuristi statunitensi Warrein e Brandeis nel 1890, traducendosi nel diritto dei singoli alla riservatezza: uno spazio della vita, quasi fisico, da cui il soggetto aveva diritto di tenere esclusi gli altri, a loro volta doverosi di rispettarne l’individualità, una sorta di “tutela dell’intimità privata”.[13]
Sin da subito si può constatare come esso si presenti quale diritto a contenuto essenzialmente negativo, comprendente il non subire ingerenze, il non far conoscere e il mantenere riservate alcune informazioni, piuttosto che a contenuto positivo, che viceversa si avrebbe con l’esercitare un effettivo controllo sulle informazioni medesime.
La definizione di privacy innanzi prospettata appare però, oramai da qualche decennio, non più perfettamente corrispondente alle trasformazioni socio-economiche subite dalla società, soprattutto alla luce della sua preponderante digitalizzazione. Per chiarire, con l’avvento della stagione degli elaboratori elettronici e con l’introduzione della ragnatela del web, la circolazione dei dati personali è divenuta indubbiamente regola fisiologica della società: una società per l’appunto denominata “dell’informazione e della comunicazione”.
Ecco che allora la diffusione e l’utilizzo delle nuove tecnologie e delle reti informatiche hanno prodotto un mutamento semantico del concetto di tutela della privacy: nata come diritto dell’individuo borghese a escludere gli altri da ogni forma di invasione della propria sfera privata (“my home, my castle”), si è sempre più strutturata come diritto di ogni persona al mantenimento del controllo sui propri dati, ovunque essi su trovino, riflettendo così il nuovo contesto in cui ogni persona cede continuamente e nelle forme più diverse dati che la riguardano.[14]
Di qui alcuni studiosi sono arrivati a formulare il cosiddetto “privacy paradox”:[15] le condotte di condivisione di informazioni (si pensi all’uso dei social networks) non sempre implicano anche la consapevolezza da parte degli utenti della divulgazione che i propri dati possono avere. A tal proposito asserisce Antonello Soro, Presidente dell’autorità Garante per la protezione dei dati personali: “Poiché i dati rappresentano la proiezione digitale delle nostre persone, aumenta in modo esponenziale anche la nostra vulnerabilità. La libertà di ciascuno è insidiata da forme sottili e pervasive di controllo, che noi stessi, più o meno consapevolmente, alimentiamo per l’incontenibile desiderio di continua connessione e condivisione”.[16]
D’altronde mentre la violazione di altri diritti fondamentali quali libertà personale, integrità personale, libertà di parola, si risolve più frequentemente in fatti e comportamenti visibili, spesso la violazione del diritto alla riservatezza si risolve in fatti e comportamenti di più difficile percezione, ma ugualmente di estrema gravità. E tale percettibilità delle violazioni è ancora minore in Internet rispetto alla vita reale. Per esser chiari, si voglia fornire un’ esemplificazione.
Se ad un individuo che entrasse in un negozio fosse sfilato il portadocumenti al fine di copiare l’indirizzo di casa e spedire continuamente materiale pubblicitario mirato, o per controllare le ricevute della carta di credito dalle quali ricavare ciò che l’individuo ha comprato nelle settimane precedenti, o ancora per ricavare dalle diverse tessere di cui è in possesso il suo orientamento politico, sindacale ed i suoi interessi sociali, tale soggetto si sentirebbe di certo profondamente leso dall’aver subito grave abuso.
Questo ed altro avviene in rete, e non vi è reazione lontanamente avvicinabile.[17]
Ora, tornando all’evolvere del concetto di privacy, a fronte quindi di un individuo messo a nudo, nella sua intimità, da una tecnologia sempre più invasiva (che è legata al polso da un orologio smart, che entra nelle case con una televisione di ultima generazione, che segue gli spostamenti in auto attraverso l’utilizzo di sensori connessi ad internet), la privacy segue un mutamento di rotta, finendo per essere ridefinita nella più comprensiva nozione di “protezione dei dati”, concetto che va ben oltre ai problemi legati alla difesa della sfera privata, abbracciando regole generali sulla circolazione delle informazioni.[18]
Il diritto alla protezione dei dati personali può essere definito come il diritto a che le informazioni su una persona fisica individuata o individuabile siano raccolte e trattate in modo lecito: esso consiste dunque nel diritto del soggetto cui i dati si riferiscono di esercitare un controllo, anche attivo, su detti dati, che si estende dall’accesso alla loro rettifica.[19]
Si qualifica allora come un diritto proprio di ogni soggetto ad autodefinirsi e determinarsi, dal contenuto fortemente positivo, consistente nell’esercitare un controllo effettivo sul flusso delle proprie informazioni, distinguendosi dalla mera riservatezza quale libertà negativa di non subire interferenze.
Con l’entrata in vigore del GDPR, e la consequenziale modifica al Codice della Privacy intervenuta con d.lgs. 10 Agosto 2018, n. 101, ha trovato allora finalmente realizzazione nell’ordinamento italiano quel microsistema autonomo basato sul riconoscimento di un nuovo bene giuridico di settore: il trattamento dei dati personali, su cui peraltro svariati cenni sono già stati fatti nel discorrere del secondo capitolo, a cui si rimanda.
Si consideri comunque che la stessa giurisprudenza europea condivideva il bisogno di mutare l’approccio consolidatosi negli anni precedenti, basato su di una statica tutela della riservatezza. La Corte di Lussemburgo, infatti, aveva più volte evocato il concetto di “sovranità digitale”, allo scopo di indurre i legislatori nazionali a prendere in debita ed attenta considerazione l’esistenza di un nuovo ordinamento giuridico, l’ordinamento digitale, inteso come spazio immateriale in cui confluiscono e vengono trattati dati personali digitali.
Architravi della nuova disciplina risultano essere i fondamentali principi del consenso e di accountability che, si voglia ripetere anche in questa sede, consiste nella responsabilizzazione di chi è titolato a trattare i dati, cui viene imposta, tramite l’ordine di rendicontazione, una gestione idonea a garantire la piena conformità del trattamento ai principi sanciti dal Regolamento Ue e dalla legislazione interna.[20]
Pare, tuttavia, che l’evoluzione legislativa si sia qualitativamente arrestata, nonostante i proclami in materia di prossime regolamentazioni[21] e nonostante l’approvazione del GDPR: il diritto alla protezione dei dati personali, per come oggi regolamentato, si appalesa anacronistico.
Rimane infatti un diritto che affonda le proprie radici nella società degli anni Settanta, che si apprestava a diventare la Società dell’informazione, un mondo ad oggi profondamente mutato: il dato è sempre meno controllabile, fra Big Data[22] e sistemi in cloud, o comunque sostanzialmente inaccessibile a chi dovrebbe sorvegliare l’applicazione della normativa.
Se da un lato le tecnologie che plasmano la società avanzano ad un ritmo impressionante, dall’altro gli strumenti di protezione effettiva diventano sempre più obsoleti, senza tuttavia essere aggiornati o rimpiazzati, il che causerà conseguenze particolarmente gravi nei settori a maggior rischio, come quello della salute.[23]
Ai fini della trattazione, ciò che è fin qui stato detto nel discorrere di privacy dovrà essere necessariamente trasposto sul piano della sanità, per qualche considerazione.
Ormai è chiara l’evoluzione dal materiale al digitale che negli ultimi anni ha profondamente toccato il sistema sanitario italiano, evoluzione da cui emergono nuovi profili critici non soltanto per quanto riguarda l’efficienza delle cure e l’efficientamento delle strutture sanitarie, ma anche, e soprattutto, per quanto riguarda il coordinamento tra il diritto alla salute e il diritto alla protezione dei dati sanitari dei pazienti.
La nostra Carta Costituzionale all’art. 32 riconosce e tutela il diritto alla salute come diritto fondamentale dell’individuo e interesse della collettività,[24] prescrivendo altresì una riserva di legge rafforzata in forza della quale un trattamento sanitario previsto per legge “non può in nessun caso violare i limiti imposti dal rispetto della persona umana”. Formula questa complementare alla tutela della dignità, riconducibile all’art. 2 della Costituzione stessa.[25]
A sua volta, il diritto alla protezione dei dati, trova suo massimo riconoscimento nel secondo articolo costituzionale, in quanto riconducibile anch’esso all’esigenza di assicurare la dignità dell’interessato, che potrebbe essere difatti violata ogni qualvolta si verifichi un qualsivoglia vulnus nelle misure tecniche ed organizzative preposte alla tutela di tali dati.[26]
Entrambi i principi, tutela della salute e protezione dei dati personali, saranno allora meritevoli di una tutela intensa quanto dinamica, in costante adeguamento con l’evoluzione tecnologica e il progresso scientifico: sarà compito del giurista trovare il giusto equilibrio fra efficienza del sistema sanitario e delle cure e rischi per la dignità dei pazienti, derivanti dalla digitalizzazione dei dati sanitari.
Ovvio è infatti come i dati sanitari, se illecitamente trattati, siano suscettibili di esporre l’interessato a forme di discriminazioni rese per l’appunto possibili dalla conoscenza di aspetti particolarmente intimi della persona, quali quelli idonei a rivelarne lo stato di salute.
Ad enucleare le criticità di una sanità digitale si richiamino, ancora una volta, le parole di Soro:
Sotto questo profilo la strada da fare è ancora tanta: recenti ricerche hanno indicato, infatti, il settore sanitario come uno di quelli esposti ai maggiori rischi in termini di cyberattacchi perché carente di un piano organico di sicurezza e protezione, oltre che di risorse necessarie per investimenti sulle infrastrutture informative. Eppure proprio questo dovrebbe essere, invece, il settore su cui investire di più in termini di sicurezza informatica e digitale, per garantire che il processo di innovazione tecnologica sia accompagnato da misure tali da assicurare autenticazione dei dati, loro tracciabilità, accessi selettivi con credenziali univoche, cifrature, sistemi di alert, attività di auditing […] La protezione del paziente da queste vecchie e nuove vulnerabilità deve essere un obiettivo centrale per un sistema sanitario all’altezza delle sfide della società digitale, in cui parallelamente alle opportunità (di ricerca, di cura, di avanzamento delle diagnosi e delle terapie) crescono anche i rischi.[27]
Nozione di Data Breach
I dati personali conservati, trasmessi o trattati da aziende e pubbliche amministrazioni possono essere soggetti al rischio di perdita, distruzione o diffusione indebita, a seguito di attacchi informatici, accessi abusivi, incidenti o eventi avversi (si pensi ad incendi od altre calamità).
Così per data breach (o violazione dei dati personali) si intende ex art. 4 n.12 GDPR “una violazione di sicurezza che comporta, accidentalmente o in modo illecito, la distruzione, la perdita, la modifica, la divulgazione non autorizzata o l’accesso ai dati personali trasmessi, conservati o comunque trattati”.
Ecco che una violazione di tal genere non può che compromettere quella triade CIA dell’Information Security di cui già si trattava nel previo capitolo, sorretta dai pilastri della riservatezza, integrità e disponibilità.
Si vogliano qui fornire alcuni possibili esempi di condotte riconducibili a tale definizione:
L’accesso o l’acquisizione dei dati da parte di terzi non autorizzati;
Il furto o la perdita di dispositivi informatici contenenti dati personali;
La deliberata alterazione di dati personali;
L’impossibilità di accedere ai dati per cause accidentali o per attacchi esterni, virus, malware etc.;
La divulgazione non autorizzata di dati personali.
Nelle previsioni del Regolamento Ue 2016/679 viene disciplinato in dettaglio il procedimento che il titolare del trattamento[28] dovrà porre in essere nel caso in cui sia in atto una simil violazione dei dati personali.
Dall’art. 33 GDPR si ricava infatti che il titolare del trattamento (soggetto pubblico, impresa, associazione etc.) senza ingiustificato ritardo, e ove possibile, entro 72 ore dal momento in cui ne sia venuto a conoscenza, deve notificare la violazione dei dati personali all’autorità di controllo competente (si intenda ivi il Garante per la protezione dei dati personali), a meno che sia improbabile che la violazione stessa comporti un rischio per i diritti e le libertà delle persone fisiche. Qualora la notifica al Garante sia effettuata oltre il termine delle 72 ore, dovrà essere corredata dai motivi del suddetto ritardo.[29]
Da ciò si ricava come siano da notificare unicamente le violazioni di dati personali che possono avere effetti significativi sugli individui, causando danni fisici, materiali o immateriali (si pensi alla perdita del controllo sui propri dati personali, ad un danno reputazionale, una perdita finanziaria, il furto di identità, la discriminazione o il rischio frode).
Al terzo comma del medesimo articolo si specifica che tale notifica dovrà avere come contenuto minimo:
Una descrizione della natura della violazione dei dati personali che comprenda, ove possibile, le categorie e il numero approssimativo di persone interessate nonché le categorie e il numero approssimativo dei dati personali interessati;
Il nome e i riferimenti di contatto del responsabile della protezione dei dati (se designato dal titolare) o comunque di un referente competente a fornire ulteriori informazioni;
Una descrizione delle possibili conseguenze della violazione dei dati personali;
Una descrizione delle misure adottate o di cui si propone l’adozione per porre rimedio alla violazione dei dati personali, comprese, se del caso, le misure adottate per mitigare eventuali effetti negativi.
Si noti come il responsabile del trattamento[30] che viene a conoscenza di una eventuale violazione sarà tenuto ad informare tempestivamente il titolare di modo che quest’ultimo possa attivarsi di conseguenza.
Inoltre, a prescindere dalla notifica al Garante, il titolare del trattamento documenta tutte le violazioni dei dati personali, comprese le circostanze ad esse relative, le conseguenze e i provvedimenti adottati per porvi rimedio. Tale documentazione consente alla stessa autorità di controllo di effettuare eventuali verifiche sul rispetto della normativa.
All’art. 34 GDPR viene prevista poi una ulteriore importante incombenza, collegata alla precedente, e cioè la comunicazione della violazione dei dati personali a tutti gli interessati, ovvero alle persone fisiche cui si riferiscono i dati personali oggetto del trattamento. Difatti quando la violazione è suscettibile di presentare un rischio elevato per i diritti e le libertà delle persone fisiche, il titolare del trattamento dovrà necessariamente comunicarla, con linguaggio semplice e chiaro, agli interessati, senza ingiustificato ritardo.[31]
A norma del terzo comma tuttavia tale comunicazione non risulta esser dovuta unicamente nei casi in cui:
Il titolare del trattamento abbia messo in atto le misure tecniche ed organizzative adeguate di protezione e tali misure siano state applicate ai dati personali oggetto della violazione, in particolare quelle destinate a rendere i dati incomprensibili a chiunque non sia autorizzato ad accedervi (si pensi ai sistemi di cifratura);
Il titolare del trattamento abbia successivamente adottato misure atte a scongiurare il sopraggiungere di un rischio elevato per i diritti e le libertà degli interessati;
Detta comunicazione richiederebbe sforzi sproporzionati. In tal caso si proceda invece tramite una comunicazione pubblica o simile misura di analoga efficacia.
Nel caso in cui poi il titolare del trattamento non abbia ancora comunicato all’interessato la violazione dei dati personali, la stessa autorità Garante potrà richiedere, dopo aver valutato la probabilità che la violazione rappresenti un rischio elevato, che vi provveda.
Qualora sia rilevata una violazione delle disposizioni del Regolamento Ue, il Garante potrà, ex art. 58 GDPR, prescrivere diverse misure correttive, fra le quali:
Rivolgere ammonimenti ed avvertimenti al titolare o al responsabile del trattamento;
Ingiungere al titolare o al responsabile del trattamento di conformare i trattamenti stessi alle disposizioni del Regolamento, in una determinata maniera ed entro un determinato termine;
Ingiungere al titolare del trattamento di comunicare all’interessato la violazione dei dati personali;
Imporre una limitazione provvisoria o definitiva al trattamento, incluso il divieto di trattamento, nonché ordinare la rettifica o la cancellazione di dati personali;
Infliggere una sanzione amministrativa pecuniaria ai sensi dell’art. 83 GDPR, in aggiunta alle misure correttive sopradette, o in luogo di tali misure.
Si ricavi come, quando si parla di violazioni della normativa in materia di privacy, il GDPR disciplini esclusivamente le sanzioni amministrative: il regolamento europeo stabilisce infatti, all’art. 84, che spetti a ciascuno Stato membro fissare autonomamente le sanzioni penali, purché queste ultime siano effettive, proporzionate e dissuasive.
Nel nostro ordinamento, come si avrà modo di approfondire in seguito, si è scelto dunque di mantenere in vigore quanto stabilito dal Codice della Privacy, emanato nel 2003, ed in particolare dagli articoli 167 e successivi, così come riformati dal d.lgs. n.101/2018.
Come sottolineato poc’anzi il GDPR disciplina in dettaglio solamente le sanzioni amministrative, pertanto di natura pecuniaria, senza fissarne un valore minimo: all’art. 83 si dispongono molteplici criteri atti ad orientare il Garante nella quantificazione della sanzione stessa, fra cui:
La natura, la gravità ed altresì la durata della violazione, tenendo in considerazione la natura, l’oggetto o la finalità del trattamento nonché il numero di interessati lesi e il livello del danno da essi subito;
Il carattere doloro o colposo della violazione;
Le misure adottate dal titolare o dal responsabile del trattamento per attenuare il danno subito dagli interessati;
Il grado di responsabilità del titolare o del responsabile del trattamento, tenendo conto delle misure tecniche e organizzative da essi messe in atto;
Eventuali precedenti violazioni pertinenti commesse dal titolare o dal responsabile del trattamento;
Il grado di cooperazione con l’autorità di controllo al fine di porre rimedio alla violazione;
Le categorie di dati personali interessati dalla violazione;
Eventuali altri fattori aggravanti o attenuanti applicabili alle circostanze del caso (si pensi a benefici finanziari conseguiti o perdite evitate).
Ai paragrafi 4 e 5 del medesimo articolo, il GDPR specifica poi che, accertata la violazione, la sanzioni amministrative pecuniarie possano arrivare fino a:
10 milioni di euro, o per le imprese, fino al 2% del fatturato mondiale annuo dell’anno precedente, nei casi in cui, ad esempio, i dati personali vengano trattati in maniera illecita, non venga nominato il DPO (Data protection officer) o non venga comunicato un data breach all’Autorità Garante;
20 milioni di euro, o per le imprese, fino al 4% del fatturato mondiale annuo dell’anno precedente, nei casi più gravi quali l’inosservanza dei diritti degli interessati o il trasferimento illecito di dati personali ad altri Paesi.
Riassumendo, le possibili conseguenze per le organizzazioni che agiscono in violazione del GDPR comprendono sia sanzioni amministrative, che sanzioni penali, come anche condanne al risarcimento del danno ed eventuali misure correttive (si pensi al sopracitato divieto temporaneo di trattamento dei dati personali).[32]
Allora, considerate tali ripercussioni, si intuirà l’importanza di interpretare correttamente le disposizioni Regolamento ed, in particolare, il suo “DNA di fondo”, ossia il sopracitato principio di accountability (traducibile come principio di responsabilizzazione).[33]
Sulla base di tale obbligo di rendicontazione spetterà infatti al titolare del trattamento adottare (e rispettare) tutte le misure tecniche, organizzative e legali necessarie a garantire l’effettiva protezione dei dati personali, consapevole che su di lui stesso, ed in minor parte anche sul responsabile del trattamento, graverà l’onere di documentare e dimostrare ex post la conformità di ogni misura adottata alla normativa Ue.
La chiave per interpretare correttamente la disciplina europea risiede proprio nel termine “dimostrare”: un buon titolare del trattamento farà in modo che ogni misura, ogni procedura, ogni metodologia applicativa sia affidabile, credibile e giustificabile ex post.
Per far ciò risulta necessario sviluppare una forte sensibilità informatica, tecnologica e legale, imparando a valutare in modo appropriato le proprie decisioni, servendosi ad esempio di una Gap Analysis, ossia l’effettuazione di una mappatura completa dei trattamenti, confrontando le misure adottate con i principi stabiliti dal GDPR e verificando l’eventuale sussistenza di difformità , in modo tale da, eventualmente, intraprendere azioni correttive di adeguamento.
Simulazione pratica di un data breach sanitario in ospedale
Si sono definiti i data breach come eventi di violazione della sicurezza di una banca dati, che possono trovare derivazione tanto da semplici errori umani (commessi, ad esempio, nella fase di progettazione od implementazione di un software) quanto, ed è ciò che in questa sede più interessa, da sofisticati attacchi informatici ad opera di cyber criminali.
Si può parlare in tali casi di una “falla” (o per l’appunto, breccia): ossia una fessura nella quale l’hacker può insinuarsi ed avere accesso non autorizzato ai dati personali di un individuo, quali possono essere i dati sulla salute.
L’ambito sanitario infatti, formato da strutture che archiviano ed elaborano un quantitativo considerevole di informazioni sensibili sui pazienti, si presenta, ancor più di altri settori, obiettivo vulnerabile agli attacchi informatici.
Si voglia di seguito, per amor di chiarezza, presentare una simulazione, in ambito ospedaliero, di quelli che possono essere i possibili scenari scaturenti da un data breach, quali: il furto dei dati sanitari, l’eliminazione dei dati stessi e la loro alterazione.[34]
Tizio in tarda serata viene ricoverato per una colecisti, all’arrivo in ospedale viene immediatamente sottoposto a trattamenti ed esami sanitari il cui esito viene registrato in una cartella clinica a disposizione del medico che lo visiterà il giorno seguente. Durante la nottata tuttavia, un gruppo di hacker riesce a “bucare” ed intromettersi nel sistema informatico ospedaliero, grazie ad alcune chiavette USB, contrassegnate appositamente dal logo ospedaliero, precedentemente lasciate in alcune postazioni del reparto col fine di esser scoperte ed in seguito installate dal personale. Gli infermieri infatti inserendo, erroneamente, le pendrive hanno dato immediato innesco al virus informatico artefice della “breccia” nel sistema ospedaliero.[35]
Durante la notte i cybercriminali si sono dunque connessi al database, dove risiedono registrati i dati sanitari di tutti i pazienti, inclusi quelli di Tizio.
Ed ecco così delinearsi i possibili scenari, lesivi rispettivamente dei tre principi cardine della triade CIA, ossia confidenzialità, disponibilità ed integrità:
Scenario 1. La sottrazione del dato. La mattina seguente i dati di Tizio vengono trovati correttamente dal medico curante che procede così con anamnesi, diagnosi e cure appropriate. La degenza ospedaliera di Tizio viene metodicamente seguita, fino alle sue dimissioni definitive.
Tutto procede regolarmente fino a quando però il reparto ICT, dotato di un sistema di tracciamento dei dati correttamente configurato, si accorge dell’avvenuto data breach e del conseguente furto di dati perpetrato.
Ecco che, in conformità alla normativa europea sopra ricordata, verrà redatta e notificata la segnalazione al Garante Privacy contenente gli elementi essenziali richiesti ex art. 33 GDPR (natura della violazione, numero degli interessati coinvolti, le misure adottate per porvi rimedio, etc.).
Da tale momento l’Autorità garante nazionale, in base al principio di accountability, darà avvio all’iter procedurale di controllo e valutazione in merito all’accaduto, vagliando le misure tecniche ed organizzative poste in essere dal titolare del trattamento, iter che potrebbe culminare in un provvedimento amministrativo sanzionatorio, laddove si accertasse una effettiva violazione o un non adeguamento alla disciplina Ue in materia di trattamento dei dati personali.
Si noti come in tale primo scenario non vi siano conseguenze strettamente cliniche pregiudizievoli per il paziente Tizio, questi ha subito infatti unicamente un danno derivante dalla perdita del controllo sui propri dati personali, una lesione della propria riservatezza.
A tal proposito l’art 82 GDPR prevede che “chiunque subisca un danno materiale o immateriale causato da una violazione del presente regolamento ha il diritto di ottenere il risarcimento del danno dal titolare del trattamento o dal responsabile del trattamento”.
Ciò significa che il soggetto danneggiato (ossia l’interessato), a seguito di un trattamento dei propri dati in violazione della normativa GDPR, potrà ottenere il risarcimento di qualunque danno occorsogli, agendo per l’intero indifferentemente contro il titolare o il responsabile del trattamento, tenuti solidalmente al risarcimento (eventuali clausole contrattuali di ripartizione del danno varranno difatti solo nei rapporto interni tra i danneggianti stessi).
A proposito della risarcibilità del danno la Suprema Corte di Cassazione ha, in una recente pronuncia,[36] ribadito come il danno non patrimoniale, pur determinato da una lesione del diritto fondamentale alla protezione dei dati personali, tutelato dall’art. 2 Cost. e dall’art. 8 CEDU, non si sottrae alla verifica della “gravità della lesione” e della “serietà del danno”. Da una lettura congiunta allora dell’art. 82 GDPR e della pronuncia della Suprema Corte emerge con chiarezza come, ai fini della risarcibilità del suddetto danno, siano necessarie in primis l’esistenza di una violazione del Regolamento 2016/679 e a seguire la dimostrazione dell’entità del danno stesso (nei due aspetti della gravità e della serietà).
In riferimento alla risarcibilità del danno viene poi precisato nel Considerando 146 del Reg. Ue che: “Il titolare del trattamento o il responsabile del trattamento dovrebbero risarcire i danni cagionati ad un soggetto da un trattamento non conforme al presente regolamento, ma dovrebbero essere comunque esonerati da tale responsabilità se dimostrano che l’evento dannoso non sia in alcun modo ad essi imputabile”.
Si ricordi come l’art. 24 GDPR e il Considerando 74 stabiliscano che il titolare debba mettere in atto, previa valutazione della natura, ambito e finalità del trattamento nonché del grado di rischio, le misure tecniche ed organizzative adeguate, prescrivendogli inoltre di esser in grado di dimostrarne l’efficacia.
L’imputabilità del titolare allora dovrà necessariamente esser valutata alla luce dei principi di responsabilizzazione e accountability del GDPR, il titolare (o il responsabile) potrà fornire la prova che il danno si è verificato perché non poteva esser previsto, dato che esulava dalla propria possibilità di controllo (si pensi al caso fortuito o alla forza maggiore) o che sono comunque state opportunamente predisposte tutte le misure tecniche e organizzative per evitare che il danno potesse verificarsi.
Scenario 2. L’eliminazione dei dati. La mattina seguente i dati sanitari di Tizio non vengono trovati, ciò provoca un immediato allarme nel reparto e gli esami clinici vengono ripetuti con urgenza: Tizio subisce perciò un ritardo nel trattamento, ciononostante le sue condizioni mediche non sono gravi. I dati questa volta vengono ritirati “a mano” e si procede con le cure del caso. L’eliminazione dei dati allerta ad ogni modo il reparto ICT che procede ad una diagnostica da cui viene rilevata una eliminazione non autorizzata del dato sanitario: il database viene dunque scansionato ed il sistema bonificato.[37]
Si è assistito anche in tal caso ad una compromissione dei dati personali che ne ha causato una perdita della loro pronta disponibilità, per cui si vedrà ex art. 33 GDPR la stesura e la notifica al Garante privacy dell’avvenuta violazione degli stessi dati sanitari dei pazienti. Da qui prenderà avvio il regolare iter di accertamento e di valutazione da parte dell’Autorità di controllo nazionale in merito alla sicurezza del sistema informatico ospedaliero, vagliandone le misure tecnico-organizzative adottate.
In tale secondo scenario non vi sono parimenti danni seri al paziente, ma si registra comunque un discreto esborso di denaro al fine di pagare le risorse incaricate di sistemare la parte software, nonché ripristinare il corretto livello di sicurezza informatica.
Scenario 3. L’alterazione dei dati. La mattina seguente i dati di Tizio vengono letti dal medico curante che, preoccupato per i valori completamente fuori norma, suggerisce una terapia con un farmaco che peggiora le condizioni del paziente. Da questo momento la salute di Tizio si aggrava celermente, i medici comprendono che vi è una discrepanza fra i risultati riportati nel sistema e le risposte biologiche del paziente. Non trovando una corrispondenza Tizio viene sottoposto ad ulteriori esami clinici per poi, successivamente, vedersi corrisposte le corrette cure ed i trattamenti opportuni.
Rendendosi comunque conto del danno arrecatogli, dovuto ad una non corretta protezione della integrità dei propri dati sanitari da parte della struttura sanitaria, che con molta probabilità non aveva adottato tutte le adeguate misure tecnico-organizzative per prevenire il pericolo di data breach, Tizio si vede intenzionato ad agire per ottenere un risarcimento ex art. 82 GDPR.
Nel frattempo, si apre anche una fase di accertamento della sicurezza dei sistemi informativi dal lato del Garante che, accertato il data breach e il non adeguamento alla normativa europea sulla protezione dei dati, emette un immediato provvedimento con annessa sanzione amministrativo-pecuniaria. Il reparto ICT intanto effettua una riprogettazione dei sistemi di gestione del dato e della sicurezza, andando ad incidere ulteriormente sui costi da sopportare.
Ci si accorgerà di come il terzo scenario sia con probabilità quello con i costi di gestione maggiori, ma soprattutto, di come sia l’unico ad aver realmente messo a rischio la salute del paziente. L’alterazione del dato è sicuramente molto meno visibile e rilevabile rispetto alla sua cancellazione o al suo furto e questo non fa che peggiorare i ritardi nelle reazioni del reparto ICT.
A tal proposito il tempo di rilevazione di un data breach risulta di dirimente importanza: al di là invero del caso in cui sia il malintenzionato stesso a render edotte le vittime circa l’effettuata violazione dei sistemi (spesso, come si vedrà, per chiedere un riscatto al fine di ripristinarne il regolare funzionamento), i tempi generali per suddetta rilevazione risultano ad oggi comunque molto alti.
Ovvio è pertanto che riuscire a monitorare i sistemi e le attività in modo tale da avere la piena capacità di accorgersi di una violazione in atto risulta il requisito imprescindibile per arrivare a prevedere, mitigare, nonché contenere tutti i possibili rischi informatici.[38]
A questo punto della trattazione appare comprensibile incominciare a domandarsi i motivi che si celano dietro a tali cyber-condotte, per quale ragione i dati sanitari siano tanto ambiti e soprattutto che concreto valore abbiano: se questi infatti sono un obiettivo criminale, significa che esiste una domanda di tali dati, e se c’è una domanda deve esserci un ritorno sull’investimento.
Si possono richiamare a tal proposito le parole di Agostino Ghiglia, componente del Garante per la protezione dei dati personali:
Ad oggi il settore meno preparato risulta essere proprio quello sanitario che, tra l’altro, paga il prezzo di gran lunga più caro dal momento che la spesa per i data breach è notevolmente aumentata. È evidente che il comparto sanitario risulti essere il più bersagliato a causa della quantità e qualità dei dati custoditi e che, ovviamente, hanno un notevole valore economico. Gli attacchi criminali non mirano infatti solo a bloccare i sistemi dietro la richiesta di un riscatto, ma soprattutto a capitalizzare i dati sensibili. È fondamentale per questo motivo che le strutture sanitarie prevedano un piano operativo d’azione che racchiuda sia una difesa in ambito tecnologico che un piano formativo del personale dal momento che il più delle volte gli attacchi vengono veicolati con precise comunicazione e-mail.[39]
Il mercato nero della salute
Vanno moltiplicandosi gli studi e le indagini che si interrogano sul perché il rischio cyber imperversi così minacciosamente sul mondo della sanità e, in particolare, sul mercato dei dati sanitari nel dark web[40], al fine di comprendere struttura, profitto ed acquirenti di un fenomeno mondiale così in profonda crescita.
Di seguito si riportano le parole di Soro: “Si tratta del commercio di dati tra i più delicati, in quanto in grado di rivelare gli aspetti più privati della vita, ed espressivi, oltretutto di una condizione di particolare vulnerabilità quale è quella di un paziente ricoverato in ospedale. Che è dunque affidato ad una struttura pubblica, dalla quale deve potersi aspettare non soltanto attenzione e cura, ma anche un assoluto rispetto per la propria riservatezza e dignità”.[41]
Innanzitutto si premetta come il valore di tali dati sensibili sia strettamente legato alla loro stessa tipologia, essi invero possono includere: dati personali identificativi del paziente, indirizzi e-mail, numeri di tessere sanitarie, varie informazioni mediche (esami diagnostici, referti di laboratorio, prescrizioni di medicinali etc.), dati assicurativi, nonché attestati e certificati di laurea in medicina.
Risulta in questa sede opportuno rifarsi al report “Healthcare Cyber Heists” condotto dalla società statunitense di cybersicurezza Carbon Black, datato al 2019. Il rapporto si fonda su un campione di interviste, rivolte a venti manager CISOs[42], ossia soggetti responsabili del definire e sviluppare strategie di sicurezza informatica, in tal caso specificatamente nel settore sanitario.[43]
È fuor di dubbio che tale survey offra unicamente una prospettiva parziale, ma ad ogni modo rilevante per comprendere quanto siano frequenti le cyber-offensive, come vengano rubati i dati sanitari e successivamente venduti.
Si vogliano dapprima riassumere i risultati chiave scaturenti dal rapporto:
a) L’83% delle organizzazioni sanitarie intervistate ha notato un notevole aumento dei cyber attacchi nell’ultimo anno (riferendosi al 2018);
b) I tentativi di intromissione informatica sono stati, in media, 8.2 al mese per ogni endpoint, ossia non per ogni organizzazione, ma per ciascun dispositivo connesso alla Rete;
c) Il 66% delle organizzazioni ha affermato che le offensive non sono solo più numerose ma anche maggiormente sofisticate, testimoniando di esser state bersaglio sia di attacchi ransomware che island hopping[44];
d) All’interrogativo su quale sia la maggiore preoccupazione della propria organizzazione le risposte sono state: la compliance (33%), i limiti di budget e risorse (22%), la perdita dei dati sanitari (16%) la vulnerabilità dei medical devices (16%) e l’impossibilità sopraggiunta di accedere ai dati dei pazienti (13%). Da qui si ricavi forse uno dei maggiori problemi della sicurezza sanitaria: pensare che la compliance (traducibile col termine “conformità”) equivalga alla sicurezza.
Troppe organizzazioni, seppur considerate conformi agli standard generali di sicurezza, sono ad ogni modo state vittime di molteplici violazioni: la conformità a disposizioni normative, regolamenti e codici di condotta è indubbiamente un buon punto di partenza, ma ciò non basta, Troppe organizzazioni, seppur considerate conformi agli standard generali di sicurezza, sono ad ogni modo state vittime di molteplici violazioni: la conformità a disposizioni normative, regolamenti e codici di condotta è indubbiamente un buon punto di partenza, ma ciò non basta, è infatti necessario creare un programma di sicurezza atto a contemplare anche tutte le esigenze specifiche di una organizzazione.
Il rapporto prosegue poi stilando un borsino indicativo di quelle che sono le tipologie di dati sanitari maggiormente vendute sul dark web, disposte di seguito in ordine di valore:
a) I dati in assoluto più costosi, nonché di allarmante diffusione, sono i Provider Data, si possono cioè trovare online i “pacchetti Fullz” ( 4.2) contenenti tutti i documenti di cui si necessita per ricostruire il background di un medico professionista: dati personali identificativi, diplomi di laurea, licenze mediche, nonché documenti assicurativi. Il costo del “pacchetto” si aggira sui 500 dollari.
Si intuisce già la versatilità che tali dati garantiscono nel loro utilizzo: dal procurarsi farmaci soggetti a prescrizione medica (per un uso personale od altresì per rivenderli in rete), fino all’acquisire falsi documenti (passaporti, patenti di guida etc.) con cui un qualsiasi soggetto non qualificato possa porsi come medico nei confronti di organizzazioni come assicurazioni e servizi sanitari.
Ciò che accade dunque vede in primo luogo un hacker compromettere la rete di un fornitore di servizi sanitari al fine di ricavarne documenti amministrativi che possano supportare l’identità contraffatta di un medico, cosicché successivamente un qualsiasi acquirente possa, a proprio vantaggio, presentarsi con la falsa identità del medico de quo.
A seguire le parole del Professor Kevin Curran, dell’università di Ulster:
Dire che i dati dei pazienti siano dalle 10 alle 15 volte più preziosi dei dati inerenti alle carte di credito è una buona stima, dato che tali datioffrono ai criminali informazioni permanenti ed altamente fruttifere”.[45] Ovvio è che nel caso di una carta di credito rubata, questa possa essere istantaneamente disattivata e gli addebiti fraudolenti contestati. Negli ultimi anni poi le banche hanno notevolmente rafforzato la propria sicurezza online incorporando trasferimenti e transazioni più sicure. Nel mondo sanitario il tutto risulta più complesso: i dati rubati non sono facilmente recuperabili e, in verità, non si dispone nemmeno di un chiaro processo per aiutare i pazienti a fronteggiare le conseguenze del furto di identità. È pertanto indispensabile prevedere delle misure proattive al fine di ridurre le probabilità che tale dati vengano trafugati.
Fig 4.2 Annuncio di vendita su AlphaBay, avente ad oggetto un completo pacchetto Fullz “Healthcare Fraud Package”, al prezzo di 500$. Fonte: report Carbon Black, “Healthcare Cyber Heists in 2019”.
b)Altri contenuti sanitari rinvenuti nella darknet, più numerosi e meno costosi dei precedenti, sono i forgeries (o falsificazioni), venduti ad una fascia di prezzo compresa fra i 10 e i 120 dollari. Essi possono assumere la forma di tessere sanitarie contraffatte, come anche di false prescrizioni mediche ( 4.3). Ad un venditore possono difatti esser forniti tutti i dati necessari per realizzare una prescription label personalizzata per l’acquirente, con cui ad esempio possa superare i controlli (quali in aeroporto) che vietano il trasporto di alcuni farmaci senza specifica prescrizione medica.
Fig 4.3 Annuncio di vendita su AlphaBay, avente ad oggetto prescrizioni contraffatte di farmaci Walgreens, al prezzo di 60$. Fonte: report Carbon Black, “Healthcare Cyber Heists in 2019”.
c) Ancora si possono trovare insurance login information, ad un prezzo contenuto di 3.25 dollari per singola credenziale di accesso, il basso costo è dovuto alla rapidità con cui le medesime credenziali possono esser cambiate una volta che la compromissione del database viene scoperta. Comunque, una volta ottenute le informazioni di accesso, l’acquirente può ottenere illecitamente tutte le informazioni riguardanti una determinata assicurazione medica, utilizzabili a loro volta per ricevere cure mediche o medicinali sotto prescrizione.[46]
Si vogliano qui riassumere i fini a cui si può indirizzare il furto dei dati sanitari: la costruzione di false identità, la commissione di frodi ai danni dei sistemi assicurativi, la richiesta di somme di denaro come riscatto al fine di rientrare in possesso dei propri dati, la contraffazione di documenti (certificati di nascita, passaporti etc.), l’emissione di false ricette mediche, nonché l’ottenimento di determinati farmaci.
Non si può nemmeno escludere che fra gli acquirenti nel suddetto sistema di compravendita vi siano anche grandi aziende, interessate parimenti ad entrare in possesso di Big Data altrimenti irraggiungibili, si pensi a grandi imprese farmaceutiche che potrebbero sfruttare i pacchetti di dati medicali in vendita per la ricerca e lo sviluppo di nuovi farmaci, avvantaggiandosi così notevolmente sulla propria concorrenza.
Si sottolinei invero come dai dati sanitari, in una loro forma aggrega, sia possibile derivare, predittivamente, una conoscenza circa: le aspettative di vita di una popolazione, la futura necessità di cure, assistenza o medicinali, la suscettibilità di sviluppare determinate patologie, tutte informazioni altamente sfruttabili per orientare determinate politiche e scelte commerciali ad opera di grandi competitors.[47]
Chiaro è comunque come i dati sanitari protetti di ciascun individuo, quelli che identificano ogni nostra storia di salute individuale, stiano diventando ad oggi miniera d’oro per i cyber criminali.
Così Roberto Setola dell’Università Campus Bio-Medico di Roma: “I dati sanitari sono i più appetibili per i cyber criminali. Sul dark web infatti sono quelli che vengono venduti al prezzo più elevato, ciò è dovuto alla loro grande versatilità: possono infatti risultare redditizi sia vendendoli sia utilizzandoli, sempre da un punto di vista criminale, contro il soggetto a cui appartengono. […] Il problema maggiore è che i dati sanitari non sono ben protetti: il passaggio dalla carta al digitale negli ospedali e nelle strutture sanitarie non è stato accompagnato da un cambiamento culturale degli operatori della sanità esponendo così i dati ad un alto rischio di perdita, furto, nonché alterazione.” [48]
Caso: Ulss 6 Euganea di Padova
Si voglia qui brevemente ricostruire un recente caso di cronaca, al fine di comprendere quanto siano attuali gli argomenti di cui si va trattando e di che ampio raggio siano, penisola italica inclusa.
Il tutto ha inizio il giorno 3 Dicembre 2021, momento in cui cominciano a diffondersi in rete le prime notizie riguardanti un attacco informatico subito dalla Ulss 6 Euganea, ossia l’Unità locale socio sanitaria di Padova. [49]
Non tarda ad arrivare un comunicato da parte della medesima struttura: “L’Ulss 6 Euganea informa che nella notte si è verificato un attacco hacker, che ha comportato il blocco della maggior parte dei server, compromettendone la fruibilità. Stiamo intervenendo con la massima celerità con tutti i nostri tecnici informatici al fine di ripristinare il prima possibile i servizi.”
I criminali hanno agito tramite attacco ransomware, di cui si avrà modo di trattare in seguito, rendendo impossibile accedere alle banche dati ed inviare informazioni alle piattaforme sanitarie, sospendendo le nuove registrazioni dei pazienti, il sistema dei laboratori, alcuni punti tamponi e hub vaccinali.
Di qui le immediate ripercussioni: i padiglioni di tamponi e vaccini (si pensi che in quel periodo si registravano più di 800 positivi in 24 ore a Padova e provincia) hanno dovuto riprendere a lavorare in modalità cartacea, e diversi problemi sono stati riscontrati al pronto soccorso, nelle terapie intensive, nelle radiologie, nei cup e nei laboratori analisi.
Così informa l’Ulss “È in essere una collaborazione stretta con l’Azienda ospedaliera Università di Padova e con il privato accreditato, ai quali vengono convogliati i casi indifferibili. Ove non supportati da reti informatiche esterne, l’Azienda procederà provvisoriamente alla registrazione su supporto cartaceo, che potrà creare inevitabili rallentamenti.”
Inutile dire come si sono adoperati e hanno lavorato strenuamente oltre 60 tecnici del settore al fine di contrastare il blocco, di minimizzare i danni, nonché di bonificare tutte le macchine ospedaliere e certificare quelle “pulite”.
Ad una settimana dall’attacco tuttavia soltanto un terzo dei computer risulta bonificato, ed i problemi persistono: seri danni vengono riscontrati alle infrastrutture IT, non risulta possibile emettere ricette dematerializzate, non possono essere inseriti i dati relativi agli isolamenti domiciliari da Covid-19, sono stati chiusi i punti prelievo e bloccate le prenotazioni specialistiche.
Solo in data 20 Dicembre si percepisce una lenta ripresa, si hanno difatti i primi risultati positivi (quali la riapertura di alcuni punti prelievi), al contempo però cominciano a diffondersi notizie circa una colossale mole di dati sensibili e di credenziali di accesso trafugati, il cui valore di mercato risulta incalcolabile: ecco profilarsi la probabile vera finalità dell’attacco informatico.
Con l’inizio del nuovo anno, dopo circa un mese da quello che è stato uno dei più gravi attacchi alla sanità italiana, sopraggiunge così la rivendicazione dell’attacco da parte del gruppo hacker Lockbit 2.0 che, in un post, avvia una sorta di “countdown”: i dati sottratti dall’azienda sanitaria saranno resi pubblici il giorno 15 Gennaio 2022, salvo pagamento di un riscatto (la somma pareva ammontare sugli 800.000 euro in criptovalute).
Viene dunque immediatamente aperta da parte del Garante della privacy una istruttoria per il data breach, processo mirante a verificare se i dati in possesso dell’Ulss fossero adeguatamente protetti e se sia stato fatto tutto il possibile (ossia adottata ogni misura tecnico-organizzativa necessaria) per evitare che i dati venissero sequestrati ed eventualmente diffusi dai criminali informatici.
Come preannunciato, nel pomeriggio del 15 Gennaio, Lockbit pubblica i dati sanitari, e più precisamente vengono diffuse due cartelle dal nome “Ulss2” e “Ulss3” contenenti all’incirca 9.300 documenti (fra cui pdf, documenti excel, word, etc.) riportanti svariate informazioni: dati sensibili dei pazienti (referti medici, analisi, esiti di tamponi molecolari Covid, coi rispettivi dati anagrafici) tabelle illustrative di stipendi e turni ospedalieri del personale medico-sanitario, nonché informazioni sul budget dei vari reparti e tanto altro ancora.
Non è da escludere che ciò che sia stato divulgato sia solo una quota delle informazioni in possesso del gruppo hacker Lockbit, il quale potrebbe aver nel frattempo rivenduto un’altra importante porzione di dati nell’underground del web.
Da parte dell’Ulss è stato emesso di conseguenza un conclusivo comunicato ufficiale[50] in cui si legge:
Fino ad oggi non sussisteva alcuna certezza che i malviventi fossero riusciti a venire in possesso di informazioni, in che quantità e il loro genere. I criminaliavevano avanzato una richiesta di riscatto in denaro in cambio della non pubblicazione delle informazioni a loro dire sottratte all’Azienda Ulss 6. Tentativo estorsivo prontamente denunciato alle forze dell’ordine e alla Procura della Repubblica. […] La task force dell’Azienda Ulss 6, nel pieno rispetto delle indagini in corso, è al lavoro per valutare entità e tipologia dei dati pubblicati. Si ricorda che le informazioni comparse sul dark web sono altresì frutto di attività illegale e dunque chiunque intendesse consultarle o utilizzarle commetterebbe un reato […] Il confronto e lo scambio di informazioni con la Procura della Repubblica e il Garante per la protezione dei dati personali è costante, siamo a disposizione dei nostri utenti e confidiamo che le indagini di Procura e forze dell’ordine, che ringraziamo per il supporto, permettano di individuare e fermare questi criminali.
Tirando le fila di tale vicenda si può meditare sui danni che ne sono conseguiti: oltre alle perdite economiche riflesse sia a livello regionale che di sistema sanitario nazionale ed al grave danno reputazionale e d’immagine in capo all’Ulss, non si può trascurare l’offesa subita dai pazienti e dai cittadini che si sono visti negare diversi servizi sanitari (si pensi ad una visita specialistica per una malattia degenerativa) o hanno comunque subito dei rallentamenti nelle ricevere le proprie cure.
I dubbi, c’è da dire, permangono: è stato avviato un programma cyber ad hoc e sono state intraprese azioni di miglioramento per scongiurare, l’altrimenti inevitabile, ripetersi di un simile attacco?
Utili risultano, a tal proposito, le parole di Pierguido Iezzi, CEO e fondatore della cyber security company Swascan:[51] “Di base, per rendere sicura una struttura è necessario ridurne il livello di esposizione al rischio cyber. […] Quanto affermato passa per l’adozione tout court dei tre pilastri della cyber security moderna: sicurezza predittiva, preventiva, proattiva.
Bisogna implementare nel perimetro delle strutture un sistema di tecnologie e processi non solo in grado giocare “di risposta” agli attacchi, ma anche in grado di prevederli e anticiparli tramite l’utilizzo di sistemi quali la Threat Intelligence,[52] che sia associata all’expertise di un Centro operativo di sicurezza”.
Inquadramento giuridico: il reato informatico
Si è già potuto rimarcare, nello scorso capitolo, come la rivoluzione informatica abbia consentito la smaterializzazione della realtà fenomenica, con l’introduzione di oggetti privi di sostanza materiale (si pensi al semplice “dato” informatico), intangibili, componenti di una nuova e parallela realtà, quella virtuale.[53]
Tuttavia il progressivo ampliamento degli strumenti informatici e la loro capillare diffusione hanno presto, si è visto, provocato uno sviluppo patologico e distorto dei sistemi di informatizzazione, portando ad una evoluzione delle pratiche criminose: sono emerse molteplici forme delinquenziali nuove, tanto per le modalità di esecuzione, quanto per i beni materiali e giuridici coinvolti, divenendo sempre più urgente l’esigenza di sollecitare un intervento legislativo in materia di diritto penale dell’informatica.
Si avviarono di conseguenza primordiali riflessioni, ad opera di cultori del diritto, incentrate sulla possibile individuazione di nuovi beni giuridici prodotti direttamente dall’informatica, andando presto a delinearsi due orientamenti contrapposti. [54]
Secondo il primo indirizzo, assai diffuso in Europa, i nuovi delitti cibernetici non producevano inediti interessi meritevoli di tutela, bensì introducevano soltanto nuove modalità di aggressione di beni giuridici comunque preesistenti (per chiarire, secondo tale visione, la frode informatica altro non sarebbe che una truffa realizzata servendosi di un computer, e l’interesse aggredito rimarrebbe pur sempre, come per la truffa comune, il patrimonio). Tale corrente di pensiero mirava dunque a sostenere il cosiddetto “metodo evolutivo”, e cioè la necessità di introdurre singole disposizioni specifiche, riferite all’informatica, all’interno delle normative penali previgenti, impendendo così il ricorso a procedimenti interpretativi di tipo analogico, non consentiti in sede penale.
Diversamente, per il secondo indirizzo dottrinario, sviluppatosi per lo più nei Paesi anglosassoni, le nuove tecnologie determinavano il sorgere di nuovi interessi suscettibili di tutela ed era pertanto auspicato un intervento normativo ad hoc specifico e autonomo (seguendo il metodo delle cosiddetta “legge organica”), in grado di disciplinare separatamente dalle normative previgenti l’intero fenomeno criminale.[55]
Per comprendere quale indirizzo sia stato in concreto adottato nel nostro ordinamento, occorre dapprima volgere lo sguardo alla evoluzione normativa in materia di criminalità informatica, costituita da molteplici interventi legislativi fortemente condizionati da indicazioni di fonte sovranazionale.
Il legislatore italiano si è infatti mosso sulla spinta della Raccomandazione del Consiglio d’Europa del 1989 “Sur la criminalité en relation avec l’ordinateur” mirante a che i diversi Paesi instaurassero una stretta collaborazione per la repressione della criminalità informatica, in quanto sempre più contraddistinta da carattere sovranazionale. [56]
Essa proponeva inoltre alle Nazioni aderenti due liste di cybercrimes: una cosiddetta “lista minima” comprendente fattispecie la cui incriminazione, in virtù della loro diffusione e gravità era ritenuta obbligatoriamente necessaria (fra cui la frode informatica, l’accesso non autorizzato ad una rete o sistema, il danneggiamento di dati o programmi) ed una “lista facoltativa”, riguardante invece condotte punibili sulla base della discrezionalità rimessa a ciascun Paese, anche solo con strumenti di tipo amministrativo.
Il legislatore italiano ebbe così il giusto input per rivedere le proprie disposizioni penali in merito ai crimini informatici, dando forma, nello stesso anno, alla Commissione Callà, composta sia da giuristi che da esperti di informatica col fine di arrivare alla stesura di un compiuto disegno di legge, che fu approvato il 23 Dicembre 1993.
Tramite la sopradetta legge n. 547 del 1993 (“Modificazioni ed integrazioni alle norme del Codice penale e del Codice di procedura penale in tema di criminalità informatica”) si è potuto da un lato introdurre all’interno del codice penale nuove fattispecie delittuose (quali gli artt. 615-ter, quater e quinquies) e dall’altro modificare le fattispecie esistenti con il riferimento ai beni informatici (ad esempio, prevedendo che il delitto di attentato ad impianti di pubblica utilità, ex art. 420 c.p., riguardi anche l’ipotesi di danneggiamento o distruzione dei sistemi informatici o telematici di pubblica utilità o di dati in essi contenuti). [57]
Ne consegue allora come il legislatore italiano abbia optato per il metodo sopraricordato come “evolutivo”, ritenendo che le tecnologie informatiche vadano ad incidere sulle modalità di aggressione a beni giuridici o interessi che rimangono purtuttavia invariati, ossia già oggetto di tutela nelle diverse parti del codice. Rispetto dunque ad altri Paesi, quali gli Stati Uniti o la Francia, che differentemente hanno dedicato ai delitti informatici leggi ad hoc e titoli appositi all’interno dei rispettivi codici, in Italia le nuove norme sono state inserite in diverse parti del Codice penale, ciascuna vicino alla previgente norma ritenuta simile.
Da qui la distinzione dei fatti criminosi che possono essere commessi nel cyberspace in due diverse categorie: i reati informatici “in senso stretto”, che includono fattispecie che presentano espressamente, nella propria formulazione letterale, elementi descrittivi di modalità, oggetti, attività frutto della tecnologia informatica, ossia relativi a procedimenti di elaborazione automatizzata di dati (si pensi all’accesso abusivo “ad un sistema informatico o telematico”), ed i reati informatici “in senso lato”, dove vi rientrano invece fattispecie che, pur non tipizzando espressamente elementi di natura tecnico/informatica, comprendono anche i fatti criminosi commessi nel cyberspazio, costituendo essi semplici forme di aggressione a beni giuridici già tutelati da norme incriminatrici comuni (si pensi al reato di sostituzione di persona, integrato ad ogni modo qualora siano utilizzate le generalità di una diversa persona per creare un falso account tale da indurre taluno in errore).[58]
Ancora ulteriori riforme della legislazione penale sono state in seguito apportate dalla legge n. 48 del 2008, recante la “Ratifica ed esecuzione della Convenzione del Consiglio d’Europa sulla criminalità informatica, firmata a Budapest il 23 Novembre 2001 e norme di adeguamento dell’ordinamento interno”, per mezzo della quale sono state introdotte alcune modifiche allo stesso codice penale (con l’inserimento degli artt. 635-bis, 635-ter, 635-quater, 635-quinquies), al codice di procedura penale, e anche al D.Lgs n. 231/2001 prevedendo la responsabilità degli enti per un’ampia serie di reati informatici. [59]
Come evidenziato comunque nella relazione parlamentare relativa a suddetto disegno di legge “la portata dell’adeguamento normativo da realizzare nel settore del diritto penale sostanziale è risultata modesta, essendo in molti casi già in vigore una disciplina esaustiva, anzi addirittura più incisiva di quella richiesta dalle disposizioni della Convenzione di Budapest medesima”.
Si osservi in conclusione come, volendo contrastare fenomeni legati al funzionamento delle tecnologie, il legislatore debba necessariamente fare i conti con modalità, oggetti e comportamenti di natura squisitamente informatica, ossia elementi indubbiamente ardui da trasporre sul piano normativo.
Il rischio comunque è che l’individuazione di particolari modalità d’azione, volte a dar veste giuridica a determinati fatti criminosi informatici, possa risultare una tecnica di normazione inefficace: il costante aggiornamento delle tecnologie impiegate potrebbe cioè far cadere in rapida desuetudine le norme incriminatrici di settore, insuscettibili di essere aggiornate di pari passo con il celere sviluppo tecnologico.
Per tali ragioni, si è scelto di adottare una tecnica di tipizzazione che, pur impiegando nuove terminologie, non si concentra tanto sulla tecnologia utilizzata, quanto si focalizza più in generale sulle finalità perseguite, o ancora, sugli eventi realizzati. È così che lo strumentario di diritto sostanziale adottato nel nostro sistema penale sembra esser in grado di apprestare strumenti di qualificazione giuridica sempre attuali. [60]
L’accesso abusivo ad un sistema informatico o telematico
Si passi ora ad una breve rassegna delle disposizioni normative che più possono inquadrare giuridicamente le condotte di Data breach per come ivi descritte.
L’esigenza di perseguire l’accesso abusivo a sistemi informatici emerse già alla fine degli anni ’80 quando, precisamente nel 1989, suddetto reato fu inserito nella sopraricordata “lista minima” delle condotte informatiche abusive, proposta dal Consiglio d’Europa nella Raccomandazione sulla Criminalità Informatica, per poi esser così recepito nel Codice penale italiano con la legge n. 547 del 1993, seguendo l’approccio “old wine in new bottles”,[61] che contempla l’accostamento dei cybercrimes ai reati tradizionali.
Più nel dettaglio, con la legge 547/93 sono state introdotte all’interno della Sezione IV, capo III, del titolo XII del Codice penale, dedicata alla disciplina dei delitti contro l’inviolabilità del domicilio, tre disposizioni (gli artt. 615-ter, 615-quater, 615-quinquies) riguardanti, rispettivamente: l’accesso abusivo ad un sistema informatico o telematico, la detenzione e diffusione abusiva di codici di accesso a sistemi informatici o telematici, nonché la diffusione di programmi diretti a danneggiare o interrompere un sistema informatico.
Ebbene si parta dall’art 615-ter ragionando in primo luogo sulla sua collocazione normativa, ossia nella parte del codice penale per l’appunto riservata ai delitti contro la persona, ed in particolare, nella sezione dedicata alla tutela del domicilio, come a voler dire che il sistema informatico vada in qualche modo assimilato ad una privata dimora.[62]
Nella relazione accompagnante il disegno della citata legge del 1993, il legislatore riconosceva espressamente come i sistemi informatici e telematici rappresentassero ormai “una espansione ideale dell’area di rispetto pertinente al soggetto interessato” a cui, dunque, estendere la tutela della riservatezza della sfera individuale, così come garantito dall’art. 14 della Costituzione.[63]
In tal modo si sono mossi i primi passi verso la formulazione della nozione di “domicilio informatico”,[64] inteso proprio quale spazio ideale di pertinenza della persona (fisica o giuridica): i sistemi informatici e telematici, al pari del domicilio, rappresentano ambienti che devono rimanere riservati e conservati al riparo da ingerenze e intrusioni altrui, luoghi dunque inviolabili, delimitati da confini virtuali paragonabili a qualunque altro spazio privato, in cui un soggetto esplica liberamente la sua personalità in tutte le sue manifestazioni, ed esercita il proprio diritto allo ius excludendi alios.[65]
Di conseguenza l’art 615-ter (con una formulazione simmetrica rispetto all’art 614 c.p.[66]) punisce, nell’ipotesi base, con la pena della reclusione sino a tre anni, colui che si introduce abusivamente, o si mantiene contro la volontà espressa o tacita di chi ha diritto di escluderlo, in un sistema informatico o telematico protetto da misure di sicurezza.
Stando a tale disposizione risulta passibile di esser punito tanto chi senza esservi autorizzato (da qui il carattere della abusività[67]) entra nel sistema altrui, che il soggetto, pur autorizzato, il quale si mantiene nel sistema oltre i limiti temporali e le modalità consentite: si noti come in entrambi i casi si venga puniti anche se l’introduzione nel sistema non comporti danni o manomissioni, in quanto bene giuridico protetto dalla norma non pare essere l’integrità del sistema informatico o la riservatezza dei dati ivi contenuti, bensì, come poi confermato dalle pronunce dei giudici di legittimità,[68] risulta tutelato il domicilio informatico, quale luogo riservato, nonché estensione naturale del domicilio materiale. [69]
Così come avviene infatti per la violazione di domicilio, che si consuma quando un soggetto si introduce nell’abitazione altrui senza il permesso, la violazione di domicilio informatico, si realizza nel momento in cui un soggetto abusivamente acceda al sistema altrui, risultando ad ogni modo irrilevanti, ai fini della sussistenza del reato, punito a titolo di dolo generico, le finalità specifiche (quali trarre profitto dall’ottenimento di informazioni riservate, o cagionare danni) che abbiano soggettivamente motivato l’ingresso nel sistema, salvo una loro rilevanza per integrare diverse ed ulteriori fattispecie criminose.[70]
Chiaro è infatti, e lo si è potuto capire discorrendo dei casi di Data breach, come l’accesso abusivo sia solitamente prodromico alla realizzazione di reati più gravi, come il danneggiamento di sistemi informatici, nonché connesso alle ancora più frequenti richieste di pagamento di riscatti per ripristinare il sistema stesso violato.
Andando ad operare poi una analisi letterale della norma si aggiunga che una “introduzione”, penalmente rilevante, in un sistema si concretizzi mediante la lettura dei dati ivi contenuti, o eventualmente una loro copiatura:[71] tali condotte, assieme a quella del “trattenimento” nel sistema, devono avvenire invito domino, ossia contro la volontà del titolare del diritto all’esclusione.
Ancora, mentre l’art 614 c.p. consente di tutelare qualsiasi abitazione o privata dimora, l’art 615-ter tutela soltanto quei sistemi informatici o telematici che risultano “protetti da misure di sicurezza”, scelta questa non ampiamente condivisa dai commentatori, in quanto percepita da certi autori al pari di un “proteggo solo le abitazioni munite di una serratura antiscasso”, senza contare che rimangono diversi problemi interpretativi circa cosa si debba intendere per misura di sicurezza.
Parte della dottrina ritiene che non si tratti di mezzi di protezione del luogo ove trovasi il computer (si pensi a lucchetti, porte, guardiani), ossia le cosiddette misure di sicurezza fisico-materiali, bensì mezzi di protezione aventi ad oggetto direttamente ed esclusivamente il sistema informatico o telematico, ossia le cosiddette misure di sicurezza logico-tecniche (si pensi alle password, o alla cifratura dei dati)[72]. Altri, prendendo spunto dal fatto che si parli di misure di sicurezza al plurale, ritengono che una semplice parola chiave o un codice d’accesso non sarebbero sufficienti: le predette misure dovrebbero anzi essere intese come qualcosa di più complesso di una semplice password.[73]
Sembra comunque da preferire la tesi, accolta dalla giurisprudenza consolidata, secondo cui risulta sufficiente una qualunque misura di protezione, che sia anche banale e facilmente aggirabile, appunto perché la ratio sottesa all’inserimento di tale requisito è quella di richiedere un impegno effettivo, da parte dell’interessato, tenuto così a predisporre misure di sicurezza, quali elementi in grado di rendere esplicita e inequivoca all’esterno la propria volontà di riservare l’accesso solo a determinate persone.
Per quanto riguarda le non specificate nozioni di “sistema telematico ed informatico”, queste sono volutamente lasciate in forma aperta dal legislatore, affinché possano essere inquadrate di pari passo e correlatamente allo sviluppo tecnologico.[74]
Per ciò che propriamente attiene alle nozioni di tempus e locus commissi delicti, seguendo la dottrina maggioritaria, si tratterebbe di reato istantaneo, consumantesi nel momento stesso in cui l’agente non autorizzato accede al sistema (o di reato istantaneo ad effetto permanente nell’ipotesi in cui questi vi permanga), ed in quell’esatto luogo in cui è presente il cosiddetto “terminale periferico”, da cui il soggetto agente, quindi da remoto, digita le credenziali di autenticazione, esegue il login ed accede al sistema, superando le misure di sicurezza predisposte, risultando perciò assolutamente irrilevante il luogo fisico in cui si trova effettivamente il server centrale.[75]
In conclusione, si evidenzi come i commi secondo e terzo della norma in discorso contemplino alcune ipotesi aggravate, con rispettive sanzioni più severe, per quel che ivi interessa si noti come si abbia un incremento di pena qualora: dal fatto derivi la distruzione o il danneggiamento del sistema, o l’interruzione totale o parziale del suo funzionamento, ovvero la distruzione o il danneggiamento di dati, informazioni o programmi ivi contenuti; ed anche qualora i sistemi informatici o telematici in oggetto siano di interesse pubblico, quale chiaramente è il settore della sanità.[76]
La detenzione e diffusione abusiva di codici di accesso a sistemi informatici o telematici
Si è appreso come la riuscita di una intrusione in un sistema informatico dipenda in primo luogo dall’impiego di password e procedure d’accesso, passibili di essere rubate o scoperte con facilità.
Per tale ragione il legislatore è intervenuto in ottica preventiva, delineando una anticipazione della soglia della punibilità, configurando la fattispecie de quo quale reato di pericolo, ed andando così a sanzionare le condotte di detenzione e diffusione abusiva (ossia “illegittima”) di codici di accesso, quali condotte oggettivamente prodromiche ad una successiva indebita intrusione nei sistemi informatici medesimi.
L’art. 614-quater risulta di notevole ampiezza, dal momento che delinea alternativamente come illecite non solo le condotte del procurarsi, riprodurre (ossia duplicare o creare autonomamente), diffondere (divulgare in modo indifferenziato), comunicare (render noto ad un numero chiuso di soggetti), nonché consegnare codici d’accesso, ma altresì il fornire indicazioni tecniche riservate od istruzioni idonee a svelare il metodo attraverso cui si possano aggirare, neutralizzare o superare le barriere di accesso al sistema, così da coprire ogni sorta di comportamento che possa consentire a terzi di acquisire la possibilità di accedere abusivamente a sistemi informatici, anche solo implementandone il patrimonio di conoscenze.[77]
In tutti i casi delineati, ai fini della sussistenza del reato, risulta necessario che tali condotte siano rette dal dolo specifico, consistente nel fine di procurare a sé o ad altri un profitto o di arrecare ad altri un danno. Va richiamata a tal proposito la nozione ampia di “profitto”, elaborata dalla giurisprudenza per i reati contro il patrimonio, secondo cui tale vantaggio può essere anche di natura non strettamente patrimoniale (ad esempio qualora il soggetto agisca spinto da mero movente di soddisfazione morale).
Per quanto concerne poi il rapporto fra le due fattispecie incriminatrici agli art. 615-ter e 615-quater si è espressa recentemente la Corte di Cassazione, pronunciatasi per l’appunto su di un caso in materia di accesso abusivo a sistema informatico ed illecita acquisizione ed utilizzo di codici d’accesso.
Come spiegato nella pronuncia “I delitti di cui agli artt.. 615-ter e 615-quater sono posti a tutela del medesimo bene giuridico, ovvero il c.d. “domicilio informatico”, che l’art 615-quater protegge in misura meno ampia (ovvero limitatamente alla riservatezza informatica del soggetto) e l’art 615-ter più incisivamente, operando un più ampio riferimento al domicilio informatico tout court, quale spazio ideale di esclusiva pertinenza di una persona fisica o giuridica”.
La Suprema Corte ha enunciato così il principio di diritto secondo il quale, poiché il delitto di detenzione di codici d’accesso costituisce l’antecedente necessario del più grave reato di accesso abusivo a sistemi informatici, in caso di contestazione dei due delitti in riferimento al medesimo contesto spazio-temporale ed in danno dello stesso soggetto passivo, il primo reato dovrà considerarsi assorbito nella seconda e più grave fattispecie.[78]
Ancora, similmente a quanto previsto per l’accesso abusivo, anche l’art 615-quater, al suo secondo comma, prevede sanzioni più severe qualora il fatto sia posto a danno di un sistema informatico o telematico utilizzato dallo Stato, o da altro ente pubblico o da impresa esercente pubblici servizi o di pubblica necessità, oppure altresì quando venga commesso con abuso della qualità di operatore di sistema.
La ratio dietro all’ultima ipotesi aggravata sopra elencata si rinviene nel voler punire più severamente comportamenti illeciti di agevole commissione, dato che l’operatore di sistema, in ragione delle sue funzioni ed attività, si trova in una evidente posizione di vantaggio dal punto di vista attivo, avendo la possibilità di accedere al sistema, alle sue aree riservate e di controllarne le operazioni.
Si specifichi infine come vada considerato “operatore di sistema” non soltanto il tecnico che si trovi ad operare come programmatore o analista sull’hardware o sul software di un sistema informatico, ma anche qualsiasi soggetto che per le funzioni svolte si trovi ad intervenire su di questo stesso in forza di un titolo che glielo consente o glielo impone (si pensi ad un contratto per l’assistenza e/o manutenzione di un sistema informatico), volendosi sanzionare anche il tradimento della fiducia riposta dal titolare del sistema in chi professionalmente dovrebbe prendersene diligentemente cura.
La diffusione di programmi diretti a danneggiare o interrompere un sistema informatico
L’elemento soggettivo del dolo specifico e la ratio di anticipare la protezione dei sistemi informatici vanno a connotare anche la successiva norma, di cui all’art. 615-quinquies, disciplinante una delle condotte maggiormente pericolose per l’integrità dei sistemi informatici, quale è la divulgazione di programmi informatici aventi effetti distruttivi (ipotesi tipica sono i c.d. virus informatici, frequenti cause di alterazione e danneggiamento dei sistemi in cui riescono a diffondersi e riprodursi).
Si conceda una breve digressione, senza pretesa di completezza.
Il virus è un programma caratterizzato dalla possibilità di espandersi e riprodursi all’interno del software in cui è stato inserito, “infettando” altri programmi e compromettendone la funzionalità. È solitamente di dimensioni molto ridotte (da pochi byte ad alcuni kilobyte) ed è specializzato per eseguire soltanto poche e semplici operazioni impiegando il minor numero di risorse, in modo da rendersi il più possibile “invisibile”.
Un virus di per sé non è un programma eseguibile in maniera autonoma, per attivarsi invero necessita di un software ospite: il virus cioè inserisce una copia di se stesso nel file eseguibile, alterandolo, ed in questo modo quando un utente andrà a “lanciare” il programma infettato, dapprima verrà impercettibilmente eseguito il virus e poi, regolarmente, il programma stesso, e mentre dunque l’utente vedrà, ignaro, l’esecuzione del programma lanciato, non si accorgerà del fatto che il virus sia attualmente in esecuzione e stia compiendo tutte le varie operazioni contenute nel suo codice.
Programmi virus circolano in rete, come anche nei messaggi di posta elettronica, ma possono ugualmente essere contenuti in supporti esterni quali floppy disk, pen drive, cd-rom e dvd.
Sicuramente diverse possono essere le motivazioni sottostanti alla creazione e diffusione di programmi virus, dal comportamento semplicemente vandalico, a comportamenti di natura estorsiva, alla volontà di compromettere la funzionalità di sistemi informatici per ragioni concorrenziali o per interessi economici (si pensi a virus diffusi da tecnici informatici coscienti del fatto che vi sia la possibilità di esser chiamati a ripristinare l’efficienza del sistema).
Tornando alla norma de quo, anch’essa delinea una tutela preventiva, strutturandosi quale reato di pericolo astratto, dal momento che si prefigge di sanzionare condotte propriamente prodromiche rispetto ad un eventuale vero e proprio danneggiamento o malfunzionamento del sistema, che, laddove si realizzi, verrebbe tutt’al più punito ai sensi degli articoli 635-bis e seguenti.
Non vi è dubbio quindi che il reato si consumi anche se il programma nocivo non sia ancora stato inserito in alcun sistema informatico o non abbia ancora prodotto i suoi effetti, ma possieda in concreto le tipiche potenzialità distruttive, come nel caso di virus a tempo od attivazione collegata a particolari condizioni.[79] Suddetto arretramento della soglia di punibilità è determinato dal paradigma preventivo ad oggi dominante: se il fine del diritto penale è invero impedire eventi dannosi o pericolosi, è necessario anticipare la soglia della risposta punitiva allo stadio della realizzazione di atti idonei a determinare tali esiti infausti od addirittura a quella del presunto pericolo derivante da uno specifico comportamento.[80]
Altrettando ovvio è come tale operazione vada a collidere con l’assunto per il quale la sanzione maggiormente afflittiva della libertà personale dovrebbe sopraggiungere soltanto ove si accerti un fatto materiale connotato da reale disvalore e a condizione che non sia rintracciabile, nell’ordinamento giuridico nel suo complesso, un altro strumento in grado di arrecare efficace e pronta risposta al di fuori del diritto penale, dovendosi perciò tendenzialmente evitare i reati di mera disobbedienza e trovare rimedi giuridici alternativi per argine certe pratiche e comportamenti.
La disposizione in questione comunque, per come modificata ed ampliata dalla legge 48/2008, sanziona colui che abusivamente procura, detiene, produce, riproduce, importa, diffonde, comunica, consegna o in ogni altro modo mette a disposizione di altri apparecchiature, programmi, o dispositivi informatici vietati, il tutto allo scopo di danneggiare illecitamente un sistema informatico o telematico (o i dati ivi contenuti), ovvero di favorire l’interruzione, totale o parziale, od altresì l’alterazione del funzionamento del sistema medesimo.[81]
Si noti come per integrare la fattispecie criminosa possa bastare anche una consapevolezza ben minore del fine di distruzione o danneggiamento: a tal proposito infatti la Giurisprudenza di merito ha ritenuto sufficiente che vi sia l’accertata volontà dell’agente di diffondere il programma unita alla semplice consapevolezza dei suoi concreti effetti.
Opinioni discordanti in dottrina si registrano invece nei riguardi del bene giuridico protetto: secondo un primo orientamento la norma sarebbe posta a presidio del medesimo bene giuridico di cui agli artt. 615-ter e 615-quater, dotando così il domicilio informatico di una tutela rafforzata contro quelle condotte che, per la frequenza e la gravità dei danni che sono in grado di cagionare, rappresentano la minaccia maggiore alla sua integrità.[82]
Viceversa altri indirizzi di pensiero individuano il bene giuridico tutelato nella nozione di patrimonio (nella sua accezione di corretto funzionamento di un sistema informatico e di integrità dei dati ivi contenuti), in tal caso sarebbe stata allora più opportuna una collocazione sistematica della fattispecie all’interno del titolo XIII del codice penale (quale atto a disciplinare per l’appunto i delitti contro il patrimonio).[83]
In merito infine al rapporto fra l’art 615-quinquies e i reati informatici previamente trattati, si evidenzi come, in una sentenza di merito, si sia riscontrato il concorso proprio con l’art 615-ter di accesso abusivo ai sistemi informatici: il virus diffuso nel caso di specie aveva difatti consentito l’accesso ad un sistema informatico violandone le “barriere” protettive.[84]
Per quanto riguarda invece il rapporto con gli artt. 635-quater e quinquies (che verranno trattati nel dettaglio in seguito, in tema di attacchi ransomware), relativi al danneggiamento di sistemi informatici e telematici, ovvio è che vi sia una chiara interconnessione con la fattispecie de quo: in quest’ultima, quale reato di pericolo, le condotte previste verranno punite di per sé, prescindendo dalla verificazione del danno che, semmai, laddove in concreto realizzatosi verrà punito propriamente ex artt. 635- bis e 635-quater.
Si concluda sottolineando come i reati informatici sopra analizzati rientrino a tutti gli effetti fra i reati presupposto previsti dall’art 24-bis del D.lgs. del 2001 n. 231, per come modificato dalla legge 48/2008, ai fini della responsabilità penale degli enti: è stato infatti superato il principio per cui societas delinquere non potest ed è stato delineato come anche gli enti possano esser chiamati a rispondere dei reati posti in essere dai loro amministratori, dirigenti e dipendenti se realizzati nell’interesse o a vantaggio dell’ente medesimo.
All’esordio del suddetto del decreto legislativo (art. 1, comma II) si precisa tuttavia come le disposizioni in esso previste si applichino “agli enti forniti di personalità giuridica e alle società e associazioni anche prive di personalità giuridica”, precisando al terzo comma che saranno viceversa esclusi da tale disciplina “lo Stato, gli enti pubblici territoriali, gli altri enti pubblici non economici, nonché gli enti che svolgono funzioni di rilievo costituzionale”.
Di conseguenza, ed è il motivo per cui si è voluto inserire l’argomento in trattazione, la dottrina correttamente esclude dal novero dei possibili destinatari della disciplina anche altri soggetti giuridici di natura pubblica che, pur non esercitando pubblici poteri, non si ritiene opportuno possano esser destinatari delle sanzioni indicate nel decreto legislativo n. 231, fra cui si evidenziano: le Aziende ospedaliere e le Aziende sanitarie locali.[85]
Quindi sebbene il D.lgs. 231/2001 possa applicarsi a tutti i soggetti privati del comparto sanità, in quanto inevitabilmente rientranti nelle definizioni di “enti forniti di personalità giuridica/società e associazioni anche prive di personalità giuridica” (quali case di cura, cliniche private, società che gestiscono strutture ospedaliere etc.), le problematiche applicative affiorano nella disciplina relativa agli enti pubblici.
Così infatti la Corte di Cassazione, con la sentenza n. 28699/2010 ha chiarito che
Il tenore testuale della norma è inequivocabile nel senso che la natura pubblicistica di un ente è condizione necessaria, ma non sufficiente, all’esonero dalla disciplina in discorso, dovendo altresì concorrere la condizione che l’ente medesimo non svolga attività economica. [..] Ogni società, proprio in quanto tale, è costituita pur sempre per l’esercizio di un’attività economica al fine di dividerne gli utili”. Per cui, pensando alle Aziende sanitarie locali, queste ultime ai sensi dell’art 3 del D.lgs. 502/1992 risultano qualificabili come enti pubblici operanti secondo le norme del diritto privato ed agenti con il principio di pareggio di bilancio, non risultando pertanto caratterizzate da finalità lucrative dovranno ritenersi escluse dall’ambito applicativo della 231. Pur tuttavia, in ambito regionale la tendenza rimane quella di recepire la disciplina 231 in una ottica di prevenzione da reato, ed anche quale ulteriore garanzia della migliore organizzazione e trasparenza delle PA. [86]
Profili di interdisciplinarietà: il Codice Privacy
Chiaro è che, inevitabilmente, in caso di commissione di reati informatici, si vadano ad intersecare profili di interdisciplinarietà con il trattamento illecito dei dati personali, tanto che una qualsiasi organizzazione, sia essa titolare o responsabile del trattamento, davanti, ad esempio, ad un accesso abusivo al proprio sistema informatico, dovrà avviare indagini interne al fine di verificare se vi sia stata anche una effettiva compromissione dei dati personali ivi trattati ed eventualmente aprire la regolare procedura per la gestione dei casi di violazione dei dati ai sensi dei, già visti in precedenza, articoli 33 e 34 del Regolamento Ue 2016/679.
Tra le varie tipologie di attacchi informatici infatti ve ne sono diversi caratterizzati sovente da una condotta di osservazione, illecita, delle abitudini del soggetto targettizzato, volta ad acquisire il maggior numero di informazioni possibili, così difatti argomenta K. D. Mitnick, noto informatico e hacker statunitense trattando del valore nascosto delle informazioni: “qualunque tipo di informazione ha un suo valore economico, che sia poco utile o irrilevante, perché qualsiasi dato che entra in interconnessione con altri dati può consentire di risalire ad infinite informazioni sempre più importanti o significative”.[87]
È dunque naturale che, affrontando il tema dei reati informatici, vengano in rilievo anche nozioni quali la tutela e la disciplina in materia di riservatezza e protezione dei dati personali.
Si ripeta in questa sede che il Considerando 149, in combinato disposto con l’art. 84 del GDPR, sanciscano come i singoli Stati debbano stabilire le disposizioni concernenti le sanzioni penali applicabili per le violazioni del Regolamento Ue e delle norme nazionali attuative. Nel nostro ordinamento si è scelto così di mantenere in vigore quanto stabilito dal Codice della Privacy, emanato nel 2003, ed in particolare dagli articoli 167 e successivi, così come riformati dal d.lgs. n.101/2018.
Detta soluzione ha tuttavia restituito all’interprete un sistema caotico, ossia caratterizzato da continui rimandi tra normative eterogenee e da conseguenti problemi interpretativi nascenti dalla sovrapposizione di diverse fonti. Ne è scaturito cioè un corpus iuris connotato da sistemi sanzionatori disomogenei, passibili anche di entrare in conflitto fra loro, provocando un inevitabile vulnus ai principi di logicità, ragionevolezza, nonché al canone di proporzione[88]
Infatti, come si vedrà, la scelta di utilizzare norme penali in bianco per sanzionare comportamenti lesivi della privacy mal si concilia con i principi di tassatività e di determinatezza che dovrebbero invece caratterizzare i precetti penali. La tecnica del rinvio poi rischia non solo di estendere eccessivamente l’ambito di rilevanza penale a fatti che sarebbero privi di quel disvalore, ma soprattutto, porta con sé il rischio che il rimando a norme secondarie renda l’opera di interpretazione della condotta vietata di estrema difficoltà tanto per l’interprete, quanto soprattutto per il cittadino che, come noto, dovrebbe invece conoscere il precetto prima della possibile commissione del fatto di reato, con conseguenze negative in termini di certezza del diritto e della pena.[89]
Si faccia a questo punto riferimento ad una delle più importanti norme del diritto penale della privacy, ossia l’art. 167 del Codice in materia di protezione dei dati personali che al primo comma punisce colui che, titolare o responsabile del trattamento, al fine di trarre per sé o per altri profitto ovvero di arrecare danno all’interessato, “operando in violazione di quanto disposto dagli articoli 123[90], 126[91] e 130[92] o dal provvedimento di cui all’articolo 129[93] arreca nocumento[94] all’interessato”.
Ancora, ai sensi del secondo comma, è punito colui che, al fine di trarre per sé o per altri profitto ovvero arrecare danno all’interessato, “procedendo al trattamento dei dati personali di cui agli articoli 9 e 10 del Regolamento[95], in violazione delle disposizioni di cui agli articoli 2-sexies e 2-octies[96] o delle misure di garanzia di cui all’articolo 2-septies[97], arreca nocumento all’interessato”.
Come sopra anticipato, si tratta di una norma penale in bianco in quanto non contiene una descrizione esaustiva delle condotte vietate, ma anzi, per l’identificazione del precetto vietato, fa rinvio a molteplici altre norme del Codice privacy, stabilenti criteri di liceità di determinati trattamenti di dati personali, la cui violazione andrà ad integrare la fattispecie de quo.
Oltre a ciò, talvolta la condotta a cui la norma fa riferimento è addirittura contenuta in altre disposizioni di rango secondario e di futura emanazione, o in provvedimenti generali del Garante, con le evidenti conseguenze, di cui già si accennava, in termini di vulnus ai principi di tassatività e di determinatezza della fattispecie.
In conclusione si ricordi come uno dei principi cardine del diritto penale sia il ne bis in idem, ossia il divieto di esser sottoposti a processo, o di essere puniti due volte, per il medesimo fatto. Da qui discende il problema del coordinamento fra le conseguenze previste dal GDPR (ed il procedimento innanzi al Garante), con le conseguenze penali ed il relativo processo.
Tale coordinamento risulta in parte gestito proprio dai commi 4 e 5 della fattispecie in esame, i quali si preoccupano di delineare, in via generale, le modalità di collaborazione tra i due soggetti: Garante ed il Pubblico Ministero.
Si prevede infatti che sia il Pubblico Ministero, alla ricezione della notizia di reato di cui all’art. 167, ad informare senza ritardo il Garante, e che sia viceversa quest’ultimo, nell’ipotesi in cui nel corso delle proprie attività ispettive rinvenga elementi da cui si possa presumere sussistente il reato, a trasmettere la relativa documentazione raccolta al Pubblico Ministero. L’Autorità Garante comunque, in virtù dei poteri autorizzativi e di accertamento riconosciuti ex lege, potrà partecipare alle indagini della Pubblica Accusa e svolgerne delle proprie, al fine di raccogliere elementi di prova.
È come se l’Autorità assumesse il ruolo atipico di “coordinatore tecnico” delle indagini preliminari: al termine infatti della sua attività istruttoria dovrà redigere un parere motivato da indirizzare al Pubblico Ministero, la cui decisione in merito all’esercizio dell’azione penale sarà inevitabilmente influenzata. Entrambe le Autorità dovrebbero infine modulare le rispettive sanzioni, conformemente a quanto previsto dal Considerando 149 del Regolamento Ue e nel rispetto dello stesso ne bis in idem, ed in particolare al sesto comma viene prevista una riduzione della sanzione penale nel caso in cui sia già stata riscossa a carico dell’imputato una sanzione amministrativa pecuniaria.[98]
L’analisi dei data breach sanitari rivela un quadro allarmante: il settore healthcare risulta tra i più vulnerabili agli attacchi informatici, con conseguenze che vanno ben oltre il danno economico, compromettendo direttamente la sicurezza dei pazienti. Abbiamo esaminato come la protezione dei dati personali sanitari richieda un approccio integrato tra misure tecniche, organizzative e normative, evidenziando l’importanza del principio di accountability del GDPR.
Nel prossimo capitolo approfondiremo specificamente gli attacchi ransomware, la tipologia di cyberattacco più devastante per il settore sanitario, analizzando le modalità di prevenzione e risposta a queste minacce sempre più sofisticate. Per una comprensione completa del fenomeno, scarica il white paper di Maria Vittoria Zucca dal titolo “La cybercriminalità nel settore sanitario: anamnesi, diagnosi e prognosi di una ‘patologia’ informatica”.
Fonti:
[1] Per ICT (acronimo di Information ad Communications Technology) si intendono tutti i processi e le pratiche connesse alla trasmissione, ricezione ed elaborazione dei dati e delle informazioni.
[2] Per una sua approfondita analisi si rimanda al Rapporto Clusit 2020 sulla sicurezza ICT in Italia reperibile al sito internet https://clusit.it/
[4] E. Macrì, “Il quadro giuridico del cyber risk”, in Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM Italia, 2021, pp. 15 – 22.
[6] Un attacco alla supply chain (chiamato anche attacco di terze parti) avviene quando l’aggressore accede alla rete di un’azienda tramite una terza parte fornitrice. Questo tipo di attacco necessita di un software o di una singola applicazione compromessa per diffondere il malware nell’intera catena di fornitura. Di solito prende di mira il codice sorgente di un’applicazione, inserendo così il proprio codice dannoso nel sistema.
[7] Per spoofing ci si riferisce all’impersonificazione da parte di un hacker di un altro dispositivo o di un altro utente su una rete al fine di impadronirsi di dati, diffondere malware o superare dei controlli di accesso.
[8] Per phishing si intende quel tipo di attacco che consiste nell’inviare e-mail malevoli scritte appositamente con lo scopo di spingere le vittime a cadere nella trappola dei cybercriminali. Spesso lo scopo infatti è di portare gli utenti a rivelare informazioni bancarie, credenziali di accesso o altri dati sensibili.
[9] Ponemon Institute, op. citata supra a nota 117, p. 11
[10] Ponemon Institute, op. citata supra a nota 93, p. 5
[11] A. Gelpi, “La Sicurezza dei dati sanitari”, in Torino Medica. La rivista dell’ordine dei medici chirurghi e odontoiatri della provincia di Torino, anno XXXIII, numero 3-4, 2021, pp. 11-21.
[12] S. Warren, L.D. Brandeis, “The right to Privacy”, in Harvard Law Review, Vol. 4, No. 5, 1890, pp.193-220.
[13] P. Rescigno, Diritti della personalità, Enc. Giur. Treccani, Roma, 1994.
[14] S. Rodotà, Il mondo nella rete. Quali i diritti, quali i vincoli, Laterza-la Repubblica, Roma-Bari, 2014, pp. 27-32
[15] S.B. Barnes, “A privacy paradox: Social networking in the United States”, in First Monday, Issue 11/9, 2006.
[16] Intervento di A. Soro, Presidente dell’autorità Garante per la protezione dei dati personali, Big Data: La nuova geografia dei poteri, in occasione della Giornata Europea della protezione dei dati personali, 30 Gennaio 2017.
[17] Per un dettagliato approfondimento sul tema si rimanda a N. Lugaresi, Internet, privacy e i pubblici poteri negli Stati Uniti, Giuffrè editore, Milano, 2000.
[18] F. Carlino, “L’origine della privacy e l’esigenza di tutelare i dati personali”, in Iusinitinere, Rivista Semestrale di diritto, ISSN 2724-2862, 4 Luglio 2020, aggiornato 13 Luglio 2020, pp. 1-13.
[19] G. Finocchiaro, Il nuovo regolamento europeo sulla privacy e sulla protezione dei dati personali, Zanichelli editore, Bologna, 2017, p. 6.
[20] G. Fornari, Il trattamento dei dati: rischi penali e compliance dell’impresa, Fornari e Associati studio legale, Milano-Roma, Gennaio 2021, p 2-4.
[21] Si pensi, in particolare, alla proposta di Regolamento del Parlamento europeo e del Consiglio che stabilisce regole armonizzate sull’intelligenza artificiale, del 21 Aprile 2021.
[22] Con tale locuzione si indica una ingente mole di dati informatici, le cui caratteristiche sono facilmente riassumibili seguendo il modello delle tre “V”: Volume (grande quantità), Velocità (di generazione dei dati e della loro elaborazione) e Varietà (forte eterogeneità).
[23] G. Fioriglio, “La protezione dei dati sanitari nella Società algoritmica. Profili informatico-giuridici”, in Journal of Ethics and Legal Technologies, Volume 3(2), Novembre 2021, pp. 85-86.
[24] “La Repubblica tutela la salute come fondamentale diritto dell’individuo e interesse della collettività, e garantisce cure gratuite agli indigenti. Nessuno può essere obbligato a un determinato trattamento sanitario se non per disposizione di legge. La legge non può in nessun caso violare i limiti imposti dal rispetto della persona umana”.
[25] “La Repubblica riconosce e garantisce i diritti inviolabili dell’uomo, sia come singolo sia nelle formazioni sociali ove si svolge la sua personalità, e richiede l’adempimento dei doveri inderogabili di solidarietà politica, economica e sociale”.
[26] F. Carlino, “il trattamento dei dati sanitari mediante il dossier sanitario”, in Iusinitinere, Rivista Semestrale di diritto, ISSN 2724-2862, 29 Maggio 2020, pp. 1-3.
[27] Intervento di A. Soro, Presidente del Garante per la protezione dei dati personali, al convegno “La smaterializzazione dei documenti e il suo impatto sul sistema salute”, Roma 6 Maggio 2016.
[28] Ex art. 4 n.7 GDPR per titolare del trattamento di intende “la persona fisica o giuridica, l’autorità pubblica, il servizio o altro organismo che, singolarmente o insieme ad altri, determina le finalità e i mezzi del trattamento di dati personali”.
[30] Ex art. 4 n.8 GDPR per responsabile del trattamento si intende “la persona fisica o giuridica, l’autorità pubblica, il servizio o altro organismo che tratta dati personali per conto del titolare del trattamento”.
[31] L’European Data Protection Board ha fissato dei parametri per la valutazione dei fattori che determinano il rischio per le libertà e i diritti degli interessati, tra cui rientrano: il tipo di “breach”, ossia il tipo di violazione; la natura, numero e grado di sensibilità dei dati personali violati; la facilità di associare i dati violati alla persona fisica; la gravità delle conseguenze per gli interessati ed il numero degli interessati esposti al rischio.
[32] L. Smoraldi, M. Strazzullo, “Prevenire è meglio che curare: il compito dell’avvocato in caso di data breach”, in Data Protection Law: diritto delle nuove tecnologie, privacy e protezione dati personali – Rivista online Giuridica Semestrale, n. 2, 2021, p. 73.
[33] Intervento di Luca Bolognini, Presidente dell’Istituto italiano per la privacy, avvocato ICT Legal Consulting, al Convegno Privacy Unolegal , Milano, 14 Giugno 2017.
[34] E. Limone, “Sanità digitale: scenari scatenati da un data breach”, in Agendadigitale.eu, Editore ICT&Strategy, Gruppo Digital360, Milano, 1 Luglio 2019.
[35] Indipendent Security Evaluators, Securing Hospitals: a research study and blueprint, 23 February 2016, p.39
[36] Cass. Civ, sez. I, sentenza 12 Novembre – 31 Dicembre 2020, n. 29982.
37] Per bonifica informatica si intende quel procedimento tramite cui si evidenziano intromissioni illecite all’interno di un sistema informatico.
[38] C. Telmoni (intervento), al talk “Cybersecutity per la sanità digitale: conoscere per non rischiare”, andato in onda il 28 Ottobre 2021, nella prima giornata di FORUM PA Sanità, evento digitale organizzato da FPA e P4I-Partners4Innovation.
[39] Intervista a Agostino Ghiglia, componente del Garante per la protezione dei dati personali, “La sanità la più colpita. Proteggere reti e dati sensibili”, di Luigi Garofalo, 9 Novembre 2021.
[40] Il termine dark web indica un insieme di contenuti e servizi della Rete nascosti ai motori di ricerca, necessitanti di appositi programmi per essere raggiunti.
[41] Intervista ad Antonello Soro, presidente dall’Autorità Garante per la privacy dei dati personali, “Il Garante: un caso di straordinaria gravità”, riportata sul Corriere della Sera – Ed. Bergamo, 31 Ottobre 2013, di G. Ubbiali
[42] Si noti come CISO sia l’acronimo di Chief Information Security Officer.
[43] R. McElroy, T. Kellermann, Healthcare Cyber Heists in 2019: 20 leading CISOs from the healthcare industry offer their perspective on evolving cyberattacks, ransomware & the biggest concerns to their organizations, Carbon Black, June 2019.
[44] Per island hopping si intende una tecnica di attacco informativo utilizzata dagli hacker per infiltrarsi nella rete informatica di una azienda sfruttando le strutture satellite, ossia tante organizzazioni più piccole e con standard di sicurezza IT maggiormente vulnerabili rispetto all’obiettivo principale. Ecco che, bucando la rete informatica del fornitore, l’hacker riesce a risalire fino alla rete dell’azienda target principale.
[45] N. Griffin, Health correspondent, “Patient data 10-15 times more valuable than credit card data”, in Irish Examiner, May 19 2021.
[46] Per ulteriori immagini esemplificative si rimanda al report di Trend Micro, Cybercrime and Other Threats Faced by the Healthcare Industry, Mayra Rosario Fuentes Forward-Looking Threat Research (FTR) Team, 2017, pp.13-17
[47] Intervento Prof. Matteo Bonfanti, al convegno “Cybersecurity e protezione dei dati personali nella sanità: un nodo strategico per l’interesse nazionale”, Fondazione ICSA in partnership con Link Campus University, 16 Giugno 2022.
[48] V. Franzellitti, G. Cavalcanti, intervista a Roberto Setola dell’Università Campus Bio-Medico di Roma durante la seconda giornata del convegno “Big Data in Health”, riportata in Sanità Informazione, 3 Ottobre 2019.
[49] Notizia riportata sui giornali locali quali Padovaoggi, “Attacco hacker Ulss 6 Euganea, pubblicati oltre 9.300 documenti”, 16 Gennaio 2022.
[51] Intervista a Pierguido Iezzi, pubblicata il 14.05.2022, ad opera di Massimo Canorro, sul quotidiano sanitario nazionale Nurse24.
[52] Per Cyber Threat Intelligence (CTI) si intende una attività di raccolta di informazioni provenienti da varie fonti, in merito ad attacchi informatici che colpiscono o sono potenzialmente in grado di offendere la sicurezza di una organizzazione. Tale patrimonio conoscitivo acquisito viene poi utilizzato per attuare consapevolmente strategie ed azioni utili alla prevenzione, alla mitigazione e all’eradicazione della minacce, a partire da una corretta valutazione dei rischi.
[53] T. Pietrella, “Reati informatici e concorso di norme: come l’evoluzione tecnologica informa il diritto penale. Il caso delle Botnets”, in Discrimen – Rivista di diritto penale, ISSN 2704-6338, 2.12.2021, pp. 2-7.
[54] P. Galdieri, “Il reato informatico”, in G. Marotta (a cura di), Tecnologie dell’informazione e comportamenti devianti, Edizioni Universitarie di Lettere Economia Diritto, Milano, 2004 , pp. 29-74.
[55] V. Frosini, Contributi ad un diritto dell’informazione, Liguori, Napoli, 1991, pp. 165 ss.
[56] Comitato dei Ministri del Consiglio d’Europa, Raccomandazione Sur la criminalité en relation avec l’ordinateur, 13 Settembre 1989.
[58] R. Flor, D. Falcinelli, S. Marcolini, La giustizia penale nella “rete”: le nuove sfide della società dell’informazione nell’epoca di Internet, Edizioni DiPlaP, Milano, 2015, p. 101.
[60] E. Albamonte, “Il reato informatico nella prassi giudiziaria: le linee guida internazionali per il contrasto ai nuovi fenomeni criminali”, in Rivista Elettronica di Diritto, Economia, Management, n.3, 2013, p.146-157.
[61] S. Brenner, “Defining cybercrime: a review of state and federal Law”, in R.D. Clifford, Cybercrime: The investigation, prosecution of a computer-related crime, Carolina Academic Press, Durham, 2006, pp. 15-104.
[62] Il domicilio, nel diritto privato italiano, corrisponde ex art. 43 c.c al luogo in cui una persona “ha stabilito la sede principale dei suoi affari ed interessi” , per tali intendendosi tanto quelli di natura personale, quanto quelli di natura sociale, politica ed economica.
[63] Art. 14 Cost. “Il domicilio è inviolabile. Non vi si possono eseguire ispezioni o perquisizioni o sequestri, se non nei casi e modi stabiliti dalla legge secondo le garanzie prescritte per la tutela della libertà personale”.
[64] L. Levita, “La disciplina sostanziale: i reati informatici in senso stretto”, in G. D’aiuto (a cura di) I reati informatici: disciplina sostanziale e questioni processuali, Giuffrè Editore, 2012, pp. 3
[65] Cfr. Cass. Pen. Sezioni Unite, Sentenza 26 Marzo 2015, n. 17325.
[66] Art 614 c.p. “Chiunque s’introduce nell’abitazione altrui, o in un altro luogo di privata dimora, o nelle appartenenze di essi, contro la volontà espressa o tacita di chi ha il diritto di escluderlo, ovvero si introduce clandestinamente o con l’inganno, è punito con la reclusione da uno a quattro anni”.
[67] Secondo alcuni autori l’espressione in parola sarebbe del tutto superflua e non aggiungerebbe nulla sotto il profilo interpretativo, poiché utilizzata al solo fine di far virare l’attenzione sull’antigiuridicità della condotta (Cfr. C. Piergallini, “I delitti contro la riservatezza informatica” C. Piergallini, F. Viganò, M. Vizzardi, A. Verri (a cura di) in Delitti Contro la persona, CEDAM, Padova, 2015, pag. 770). La stessa Corte di Cassazione ha criticato la locuzione “abusivamente si introduce” per la sua “forte ambiguità e la conseguente possibilità d’imprevedibili e pericolose dilatazioni della fattispecie penale se non intesa in senso di accesso non autorizzato”, Cass. Sez. V 17 Gennaio 2008 n. 2534.
[68] Cfr. Cass. Sez. V, 26 Ottobre 2012, n. 42021; Sez. V, 31 Marzo 2016 n. 13057.
[69] C. Domenicali, “Tutela della persona negli spazi virtuali”, in Federalismi.it Rivista di diritto pubblico italiano, comparato, europeo, ISSN 1826-3534, n. 7, 28 Marzo 2018, pp. 10-14.
[70] Sul dolo generico richiesto si rimanda alla pronuncia della Cassazione sent. 2012, n. 4694 secondo cui integra il delitto ex art. 615-ter c.p.: “La condotta di colui che, pur essendo abilitato, acceda o si mantenga in un sistema informatico o telematico protetto, violando le condizioni e i limiti risultanti dal complesso delle prescrizioni impartite dal titolare del sistema per delimitarne oggettivamente l’accesso, rimanendo invece irrilevanti, ai fini della sussistenza del reato, gli scopi e le finalità che abbiano soggettivamente motivato l’ingresso nel sistema”.
[71] Cfr. Cass. Pen. Sez. V, 8 Luglio 2008, n. 37322, secondo cui il termine “accesso” deve intendersi non come collegamento fisico, ma logico: un superamento cioè della barriera di protezione del sistema che rende possibile il dialogo col medesimo, di modo che l’agente venga a trovarsi nella condizione di conoscere dati, informazioni e programmi.
[72] R. Borruso, “La tutela del documento e dei dati”, in R. Borruso, G. Buonomo, G. Corasaniti, G. D’Aietti (a cura di), Profili penali dell’informatica, Giuffrè Editore, Milano, 1994, p.29 ss.
[73] G. Ceccacci, Computer Crimes: la nuova disciplina dei reati informatici, FAG, Milano, 1994, pag.70.
[74] Secondo la Convenzione Europea di Budapest sulla Criminalità informatica, stipulata il 23 Novembre 2001 “computer system means any device or a group of interconnected or related devices, one or more of which, pursuant to a program, performs automatic processing of data”.
[75] Cfr. Cass. Sez. Un., sent. 26 Marzo 2015, n. 17325.
[76] Secondo la Cass. Pen. Sez. V, 21 Gennaio 2011, n. 1934 per aversi “sistema informatico di interesse pubblico” non è sufficiente la qualità di concessionario di pubblico servizio rivestita dal titolare del sistema, dovendosi accertare se il sistema stesso si riferisca ad attività direttamente rivolte al soddisfacimento di bisogni generali della collettività.
[77] G. Amato, V. Sandro Destito, G. Dezzani, C. Santoriello, I reati informatici, CEDAM, La biblioteca del penalista, Milano, 2010, pp. 89-96.
[78] Cfr. Cass., Sez. II, Sent. 14/01/2019, n. 21987: “L’art 615quater, in quanto destinato a reprimere condotte prodromiche alla possibile realizzazione del delitto di accesso abusivo ad un sistema informatico o telematico, protetto da misure di sicurezza, e, quindi, pericolose per il bene giuridico tutelato dall’art. 615ter c.p., si atteggia quale necessarioantefatto di detto reato, la cui latitudine lesiva sotto un profilo naturalistico necessariamente le presuppone e ricomprende”.
[79] L. Cuomo. R. Razzante, La nuova disciplina dei reati informatici, Giappichelli, 2009, p.129.
[80] M. Donini, Il volto attuale dell’illecito penale. La democrazia penale tra differenziazione e sussidiarietà, in A. Bernardi, M. Donini, V. Militello, M. Pasa, S. Seminara (a cura di), Collana quaderni di diritto penale comparato, Internazionale ed Europeo, Milano, Giuffrè editore, 2004, p. 104 ss.
[81] Secondo App. Bologna Sez. II, 27 Marzo 2008, sussiste il concetto di “alterazione” di un programma informatico quando lo si manipoli in maniera tale che compia azioni non volute dall’utente, ovvero si modifichino i parametri di funzionamento, anche secondo opzioni e possibilità previste nel programma stesso, contro la volontà dell’utilizzatore.
[82] P. Galdieri, Teoria e pratica nell’interpretazione del reato informatico, Giuffrè editore, Milano, 1997.
[83] G. Pica, Diritto penale delle tecnologie informatiche, UTET, Torino, 1999; F. Mantovani, Diritto penale. Parte Speciale: I, CEDAM, Torino, 2014.
[84] Trib. Bologna, Sez. I Monocratica, Sent. 21 Luglio 2005, n. 11577.
[85] C. Pecorella, “Principi generali e criteri di attribuzione della responsabilità”, In A. Alessandri & al. (a cura di), La responsabilità amministrativa degli enti. D. lgs. 8 giugno 2001 n. 231, Milano, pp. 65-89.
[86] Così ad esempio la Regione Lombardia ha inteso mutuare i principi 231 ai fini dell’introduzione del Codice Etico e dell’implementazione del Modello Organizzativo nelle Aziende Sanitarie Locale ed Ospedaliere, formulando linee guida per l’analisi del rischio.
[87] F. Peluso, La responsabilità nei nuovi reati informatici. Mezzi di ricerca e acquisizione della prova, Maggioli Editore, Gennaio 2020, p. 180.
[88] M. Solinas, “Tutela penale della privacy dopo il Gdpr: la frettolosa giustapposizione delle fonti è scaturigine di un sistema farraginoso che crea confusione, in Responsabilità Civile e Previdenza, fasc. 2, Vol. 85, 1 Gennaio 2020, pp. 663-688.
[89] P. Balboni, F. Tugnoli, “Reati informatici e tutela dei dati personali: profili di responsabilità degli enti”, in Giurisprudenza Penale, 2021/1-bis , pp. 3-8.
[90] L’art. 123 disciplina le modalità con le quali risulta lecito, secondo il codice privacy, il trattamento dei dati di traffico.
[91] L’art 126 si occupa di disciplinare il trattamento dei dati di ubicazione.
[92] L’art 130 disciplina le c.d. “comunicazioni indesiderate” (si pensi alle comunicazioni di marketing).
[93] Ex art. 129 “Il Garante individua con proprio provvedimento, […] le modalità di inserimento e di successivo utilizzo dei dati personali relativi ai contraenti negli elenchi cartacei o elettronici a disposizione del pubblico”.
[94] Secondo Cass. Sez. 3, n. 40103 del 05/02/2015, per nocumento si deve intendere “una concreta lesione della sfera personale o patrimoniale, direttamente riconducibile ad una operazione di illecito trattamento dei dati protetti”.
[95] Il riferimento è al trattamento di particolari categorie di dati personali (che rivelino ad esempio origine razziale o etnica, opinioni politiche, ma anche dati biometrici e genetici).
[96] Si riferiscono al trattamento di categorie particolari di dati personali, necessario per motivi di interesse pubblico rilevante (si pensi ai dati relativi a condanne penali e reati).
[97] Si intendono le misure di garanzia per il trattamento di dati genetici, biometrici e relativi alla salute.
[98] L. Bolognini, E. Pelino, Codice privacy: tutte le novità del D.lgs. 101/2018, Giuffrè Editore, Milano, 2019.
Profilo Autore
Maria Vittoria Zucca, laureata con lode in Giurisprudenza presso l’università degli Studi di Trento, è attualmente dottoranda nel Programma di Dottorato di Interesse Nazionale in Cybersecurity, con istituzione capofila la Scuola IMT Alti Studi di Lucca, ed è affiliata alla Scuola Superiore Sant’Anna, presso l’Istituto Dirpolis (Diritto, Politica e Sviluppo). La sua attività di ricerca si concentra sulla prevenzione, l’indagine ed il contrasto della criminalità informatica, includendo le discipline del diritto penale dell’informatica e della criminologia digitale. Su questi temi è autrice di diverse pubblicazioni scientifiche e partecipa regolarmente a conferenze nazionali e internazionali.
Il ransomware non è più il re, benvenuti nell’era del “parassita digitale”
Il Red Report 2026 di Picus Labs, pubblicato il 10 febbraio 2026, non è il solito bollettino annuale sulle minacce. È un referto autoptico su un modello di attacco che ha dominato un decennio – il ransomware distruttivo – e la certificazione della nascita di qualcosa di più insidioso: il parassita digitale.
Il dataset parla con una chiarezza che lascia poco spazio alle interpretazioni. Picus Labs ha analizzato 1.153.683 file unici, di cui il 94% classificato come malevolo, mappando oltre 15,5 milioni di azioni avversarie sul framework MITRE ATT&CK. Il risultato è una radiografia completa del comportamento offensivo nel 2025, e ciò che emerge rovescia le priorità difensive di migliaia di organizzazioni.
Il dato che definisce l’intero Red Report 2026 è questo: la tecnica “Data Encrypted for Impact” (T1486) – la firma operativa del ransomware – è crollata del 38%, passando dal 21% dei campioni nel 2024 al 12,94% nel 2025. Contemporaneamente, l’80% delle dieci tecniche MITRE ATT&CK più diffuse è ora dedicato a evasione delle difese, persistenza e comando e controllo stealth. La concentrazione più alta di tradecraft stealth mai registrata in sei edizioni del report.
Come ha sintetizzato il Dr. Süleyman Özarslan, co-fondatore e VP di Picus Labs: gli attaccanti hanno capito che è più redditizio abitare l’host che distruggerlo.
Nota metodologica: il Red Report 2026 è prodotto da Picus Security, vendor specializzato in security validation. Questo non ne diminuisce il valore analitico – il dataset di oltre un milione di campioni e la mappatura su MITRE ATT&CK rappresentano uno dei corpus empirici più ampi disponibili sul comportamento avversario – ma è un elemento che il lettore professionista deve considerare nel valutare le raccomandazioni operative, che naturalmente convergono verso l’approccio di validazione continua propugnato dall’azienda.
Dal predatore al parassita: anatomia di un cambio di paradigma
Per comprendere la portata di questo cambiamento, occorre partire da una premessa spesso dimenticata: il ransomware tradizionale – quello che cifra i file e chiede un riscatto – è sempre stato, dal punto di vista dell’attaccante, un modello ad alto rischio e rendimento decrescente.
I dati convergono da fonti indipendenti: Chainalysis ha stimato che nel 2025 solo il 28% delle vittime identificate ha pagato un riscatto, in netto calo rispetto al 62,8% del 2024 e al 78,9% del 2022. I pagamenti on-chain si sono attestati intorno a 820 milioni di dollari, in calo dell’8% rispetto all’anno precedente. Coveware, da un campione diverso e con metodologia differente, riporta percentuali ancora più basse: il 23% nel Q3 2025, con un crollo al 19% per gli incidenti di sola esfiltrazione dati senza cifratura. Le percentuali esatte variano tra le fonti perché coprono campioni e periodi diversi, ma la direzione del trend è univoca e confermata da tutti gli analisti di settore.
Il Red Report 2026 documenta la risposta strategica degli attaccanti a questa crisi di redditività: l’abbandono dell’encryption a favore di ciò che Picus Labs definisce “residenza silenziosa”. Invece di cifrare e fare rumore, il malware moderno si insedia nei sistemi, si mimetizza tra i processi legittimi e opera sotto la soglia di rilevamento per settimane o mesi. L’obiettivo non è più bloccare le operazioni della vittima, ma alimentarsi di credenziali, dati sensibili e accessi privilegiati senza essere scoperto.
È la logica del parassita biologico: l’organismo che uccide il proprio ospite ha vita breve. Quello che lo sfrutta senza ucciderlo prospera.
L’evoluzione in numeri: Red Report 2025 vs Red Report 2026
Prima di analizzare i tratti del parassita digitale, vale la pena inquadrare l’evoluzione anno su anno. Il confronto tra le due edizioni del report rivela una trasformazione accelerata.
Il Red Report 2025, basato su oltre 1 milione di campioni e 14 milioni di azioni malevole mappate su ATT&CK, aveva già identificato l’ascesa degli infostealer e delle campagne multi-stadio come tendenza dominante, con un aumento triplicato del malware mirato ai credential store (T1555 passato dall’8% al 25%). Picus Labs aveva coniato la metafora del “colpo perfetto” (The Perfect Heist) per descrivere campagne di esfiltrazione sofisticate e silenziose.
Il Red Report 2026 segna il passaggio dalla tendenza al paradigma consolidato. La T1555 si stabilizza al 23,49% – un livello ormai strutturale – mentre il calo della T1486 (encryption) dal 21% al 12,94% certifica che il furto di credenziali non è più un complemento al ransomware: lo sta sostituendo come tecnica primaria di monetizzazione. Le tecniche di evasion e persistence sono passate dall’essere “in crescita” (2025) a rappresentare l’80% della top 10 (2026), il dato più alto mai registrato.
In altri termini, ciò che nel 2024 era un segnale debole, nel 2025 era una tendenza, e nel 2026 è il modello operativo dominante. Il Red Report 2026 di Picus Labs cattura il momento in cui la curva si è piegata in modo irreversibile.
Le sei caratteristiche del parassita digitale
Il Red Report 2026 identifica sei tratti comportamentali che definiscono il malware moderno e lo distinguono dalle generazioni precedenti. Non si tratta di tendenze vaghe, ma di pattern empirici osservati su oltre un milione di campioni.
Process Injection come mimetismo molecolare
La Process Injection (T1055) si conferma per il terzo anno consecutivo la tecnica più diffusa, presente nel 30% dei campioni analizzati. Il suo scopo è elementare e devastante: iniettare codice malevolo all’interno di processi legittimi e affidabili del sistema operativo. Una volta che il codice dell’attaccante vive dentro un processo di sistema come svchost.exe o explorer.exe, distinguere l’attività malevola da quella legittima diventa un problema di analisi comportamentale che la maggior parte degli strumenti basati su firme non riesce a risolvere.
La persistenza di questa tecnica in cima alla classifica per tre anni consecutivi racconta una storia precisa: le difese non riescono a tenere il passo. Finché la process injection resta dominante, significa che funziona – e funziona perché le organizzazioni non validano abbastanza i propri controlli contro questa specifica classe di attacco.
Il malware che fa matematica
Il Red Report 2026 documenta per la prima volta un comportamento inedito: campioni di malware come LummaC2 utilizzano la trigonometria – calcolando la distanza euclidea e gli angoli dei movimenti del mouse – per distinguere un utente umano da una sandbox automatizzata. Se il mouse si muove in linea retta, tipico dell’input programmato nelle sandbox, il malware riconosce di essere osservato e rifiuta di attivarsi. Se il movimento è irregolare e curvilineo, come quello di un essere umano, il malware si innesca.
Questo è un salto qualitativo nella sofisticazione dell’evasione. Non si tratta più di controllare la presenza di file di sistema, analizzare il numero di CPU disponibili o verificare chiavi di registro associate a macchine virtuali – tecniche ormai note e spesso simulate dalle sandbox moderne. Si tratta di analizzare il comportamento fisico dell’operatore attraverso modelli geometrici, portando l’evasione a un livello che richiede sandbox con simulazione biometrica convincente per essere superato.
Sandbox Evasion al quarto posto
La tecnica di Virtualization/Sandbox Evasion (T1497) è esplosa fino alla quarta posizione nella classifica delle tecniche più diffuse, comparendo in circa il 20% degli attacchi osservati. Il fenomeno del “fingersi morto” – il malware che resta dormiente finché non è sicuro di non essere analizzato – è diventato una precondizione operativa standard per il malware moderno.
L’implicazione per i difensori è diretta: le sandbox tradizionali, pilastro dell’analisi dinamica del malware, stanno perdendo efficacia. Un campione che decide di non detonare in ambiente controllato appare benigno – e viene rilasciato negli ambienti di produzione dove poi si attiva. Questo impone una revisione delle strategie di detonazione, includendo sandbox con interazione umana simulata, analisi comportamentale post-deployment e validazione continua dei controlli di prevention.
Credenziali come chiave d’accesso permanente
Il furto di credenziali rimane centrale, ma ha cambiato forma. Le tecniche “rumorose” come il credential dumping (T1003 – OS Credential Dumping, che richiede interazione diretta con processi sensibili come LSASS e genera artefatti rilevabili) sono uscite dalla top 10. Al loro posto, Credentials from Password Stores (T1555) compare nel 23,49% degli attacchi – quasi un attacco su quattro implica l’estrazione silenziosa di password salvate nei browser, nei keychain e nei password manager.
La differenza operativa è significativa: accedere a un password store è un’operazione che può apparire legittima – dopotutto, anche i processi autorizzati leggono questi archivi. Il credential dumping da LSASS, invece, richiede privilegi elevati e genera eventi distintivi che un EDR ben configurato può intercettare. Il passaggio dall’uno all’altro riflette perfettamente la filosofia del parassita: evitare il rumore, sfruttare i canali fidati.
Living off the Cloud
Il report documenta l’emergere di tecniche C2 che sfruttano servizi cloud legittimi per comunicare con i server di comando e controllo. L’esempio più emblematico è la backdoor SesameOp, scoperta da Microsoft DART nel luglio 2025 durante l’indagine su un’intrusione protrattasi per mesi in un ambiente corporate. SesameOp instradava tutto il traffico C2 attraverso l’API Assistants di OpenAI, mascherando le comunicazioni malevole come normale attività di sviluppo AI. Nessun dominio sospetto, nessun IP anomalo – solo traffico TLS verso api.openai.com, indistinguibile da milioni di connessioni legittime.
Come ha documentato Microsoft nel suo blog post tecnico, SesameOp non utilizzava alcun SDK o funzionalità AI di OpenAI: sfruttava l’API esclusivamente come canale di relay, usando i campi “description” degli Assistants come flag di comando (SLEEP, Payload, Result) e i messaggi come veicolo per payload cifrati con layer AES e RSA. L’obiettivo dell’attacco è stato determinato come persistenza a lungo termine per finalità di spionaggio – il profilo perfetto del parassita digitale.
Parallelamente, il Red Report 2026 di Picus documenta il gruppo Storm-0501, osservato da Microsoft mentre interrogava direttamente servizi di gestione dei segreti cloud (come AWS Secrets Manager) via API nativa per raccogliere credenziali, evitando completamente il rilevamento endpoint. Il parassita digitale non ha bisogno di forzare le porte: semplicemente, effettua il login.
Complessità crescente per campione
Ogni campione di malware esegue in media 14 azioni malevole e implementa 12 tecniche ATT&CK distinte. Non si tratta più di un singolo payload con una funzione. Il malware moderno è un organismo multi-funzionale che combina evasione, persistenza, furto credenziali, comunicazione C2 e preparazione all’esfiltrazione in un unico pacchetto coordinato. Questo livello di sofisticazione per singolo campione significa che affrontare una sola tecnica alla volta – l’approccio a “silos” tipico di molte architetture difensive – è strutturalmente inadeguato.
Il gap dell’invisibilità: quando le difese sono cieche
Il Red Report 2026 acquista la sua piena dimensione strategica se letto insieme al Blue Report 2025 di Picus Security, basato su oltre 160 milioni di simulazioni di attacco condotte in ambienti di produzione reali tra gennaio e giugno 2025. I due report, insieme, raccontano una storia preoccupante di perfetto allineamento tra capacità offensive e debolezze difensive.
Il dato che sintetizza tutto: il 54% dell’attività degli attaccanti viene registrata nei log, ma solo il 14% genera un alert. Le organizzazioni rilevano solo un attacco simulato su sette. Questo significa che le tecniche di persistenza e evasione a basso rumore operano regolarmente sotto le soglie di detection, nello spazio tra attività e consapevolezza dove il parassita digitale prospera.
Ancora più critico è il collasso delle difese contro l’esfiltrazione dati. Secondo il Blue Report 2025, la prevenzione dell’esfiltrazione è crollata dal 9% al 3%, confermandosi il vettore d’attacco meno contrastato per il terzo anno consecutivo. In un contesto in cui gli attaccanti stanno migrando dall’encryption all’esfiltrazione silenziosa, questo dato rappresenta una vulnerabilità sistemica: le organizzazioni hanno investito massicciamente nella resilienza anti-ransomware (backup, disaster recovery), ma hanno trascurato la protezione contro il furto graduale dei dati.
L’identità è il territorio dove il gap è più ampio. Il Blue Report 2025 ha rilevato che gli attacchi basati su credenziali valide (T1078 – Valid Accounts) hanno avuto successo nel 98% degli ambienti testati. Il cracking delle password è riuscito nel 46% degli ambienti, raddoppiando rispetto al 25% dell’anno precedente. L’efficacia complessiva della prevenzione è scesa dal 69% al 62%, invertendo i guadagni dell’anno precedente. Una volta che l’attaccante supera il confine dell’identità, l’attività malevola si confonde con le operazioni normali, rendendo il rilevamento una sfida di analisi comportamentale che la maggior parte dei SOC non è attrezzata ad affrontare.
Le cause di questo fallimento difensivo sono documentate nel Blue Report con precisione chirurgica: il 50% dei fallimenti nelle regole di detection è dovuto a problemi di raccolta log, il 24% a colli di bottiglia nelle performance, il 13% a misconfigurazioni. Non sono problemi di tecnologia mancante – sono problemi di manutenzione e validazione di tecnologia già presente.
Il paradosso del ransomware 2026: più attacchi, meno incassi
Il Red Report 2026 fornisce la spiegazione empirica di un paradosso che ha dominato il dibattito di settore nell’ultimo anno: come è possibile che gli attacchi ransomware aumentino mentre i pagamenti diminuiscono?
I numeri sono eloquenti. BlackFog ha registrato un aumento del 49% anno su anno negli attacchi ransomware dichiarati pubblicamente nel 2025, con un totale record di 1.174 incidenti e 130 gruppi attivi. Cyble ha registrato 6.604 attacchi ransomware a livello globale nel 2025, in aumento del 52% rispetto ai 4.346 del 2024, con gli Stati Uniti che hanno rappresentato il 55% degli attacchi totali.
Il Red Report 2026 offre la chiave interpretativa: il calo dell’encryption non è una ritirata, è una migrazione strategica. Gli attaccanti non stanno smettendo di monetizzare – stanno cambiando il modello di business. L’esfiltrazione silenziosa sostituisce la cifratura perché offre opzioni di monetizzazione multiple e prolungate nel tempo: estorsione graduale, rivendita dell’accesso persistente a terzi (initial access broker), intelligence gathering per insider trading, raccolta continuativa di credenziali da rivendere nei marketplace del dark web. Un singolo accesso persistente può essere monetizzato ripetutamente, mentre un’operazione di encryption ha un unico momento di leva – che sempre più spesso viene rifiutato dalla vittima.
Integrity360 conferma questa lettura nel suo report 2026: il 42% delle organizzazioni compromesse ha subito tattiche di doppia o tripla estorsione, dove il furto di dati e la pressione secondaria vengono utilizzati insieme o al posto dell’encryption. Ma l’estorsione basata sul solo furto dati sta paradossalmente perdendo efficacia: le organizzazioni hanno compreso che pagare non elimina gli obblighi legali di notifica, non garantisce la cancellazione dei dati e non impedisce la ri-estorsione. Coveware ha documentato come anche il solo negoziare con i criminali rappresenti un rischio crescente, con attori malevoli che non esitano a ricorrere allo SWATting – l’invio di squadre d’intervento armato ai domicili dei dirigenti – per forzare il pagamento.
La risposta degli attaccanti al calo dei pagamenti è la diversificazione: DDoS combinato con ransomware, reclutamento di insider aziendali, minacce reputazionali, pressioni su clienti e partner della vittima. Il parassita digitale descritto nel Red Report 2026 è la forma più sofisticata di questa diversificazione: invece di un singolo tentativo di estorsione ad alto rischio, l’attaccante mantiene un accesso persistente e a basso profilo che può essere sfruttato in modi multipli e su orizzonti temporali estesi.
Cosa cambia per chi difende: dalla detection dell’encryption alla caccia al parassita
Se il modello offensivo è cambiato, il modello difensivo deve seguire. E questo è, probabilmente, l’aspetto più doloroso del Red Report 2026: la maggior parte delle architetture di sicurezza è ancora ottimizzata per rilevare il ransomware tradizionale, non il parassita digitale.
Metriche di detection da ripensare
Il “time to detect encryption” era la metrica regina quando il ransomware cifrava i file entro ore dall’intrusione iniziale. In un modello parassitario, la metrica critica diventa il “time to detect data exfiltration” – e il Blue Report 2025 ci dice che questa capacità è al 3%. Il dwell time medio si allunga significativamente quando l’attaccante non ha alcun incentivo a fare rumore: la backdoor SesameOp ha operato per mesi prima di essere scoperta.
Le organizzazioni devono ripensare il proprio framework di metriche: non più solo MTTD (Mean Time to Detect) e MTTR (Mean Time to Respond) basati su alert di encryption, ma indicatori di compromissione comportamentali – anomalie nei pattern di accesso, volumi insoliti di query a password store, traffico outbound verso servizi cloud legittimi che eccede le baseline storiche.
Threat hunting: dalla ricerca di lateral movement alla low-and-slow exfiltration
Il threat hunting tradizionale si concentra sul rilevamento di lateral movement e privilege escalation – fasi che, nel modello tradizionale, precedono l’encryption. Il parassita digitale opera diversamente: una volta ottenuto l’accesso tramite credenziali valide, non ha bisogno di muoversi lateralmente in modo aggressivo. Può limitarsi a interrogare i password store e i servizi cloud utilizzando le stesse API e gli stessi strumenti degli amministratori legittimi.
I team di threat hunting devono sviluppare capacità di rilevamento “low-and-slow”: esfiltrazione di piccoli volumi distribuiti nel tempo, accesso a risorse sensibili da account validi ma in orari o con pattern anomali, query ai servizi di gestione dei segreti che non corrispondono ai workflow operativi documentati.
Architetture di sicurezza: dall’anti-ransomware al monitoraggio continuo
L’investimento in backup e disaster recovery resta essenziale, ma non è più sufficiente come strategia primaria. Il parassita digitale non distrugge i backup perché non ha bisogno di farlo: il suo obiettivo è l’esfiltrazione, non la cifratura.
Le architetture devono incorporare: Identity Threat Detection and Response (ITDR), per monitorare come le credenziali vengono utilizzate oltre a verificare che siano corrette; Data Loss Prevention di nuova generazione, basato su baseline comportamentali e anomaly detection anziché su regole statiche e pattern matching; microsegmentazione Zero Trust, per limitare il blast radius di ogni compromissione quando l’attaccante è già dentro con credenziali valide; e validazione continua dei controlli di sicurezza, perché il Blue Report 2025 dimostra che l’efficacia si degrada rapidamente senza testing costante.
Indicazioni operative per il SOC: come rilevare il parassita digitale
Alla luce dei dati del Red Report 2026, i team SOC devono aggiornare le proprie capacità di rilevamento per intercettare i comportamenti specifici del parassita digitale. Ecco le aree prioritarie su cui concentrare gli sforzi, mappate sulle tecniche ATT&CK documentate nel report.
Monitoraggio degli accessi ai password store (T1555). L’accesso ai credential store dei browser (Chrome Login Data, Firefox logins.json) e ai keychain di sistema da parte di processi non autorizzati è il segnale più affidabile. È necessario monitorare gli accessi in lettura a questi file e generare alert quando il processo richiedente non è il browser stesso o un password manager legittimo. Le regole Sigma per T1555 sono disponibili nel repository pubblico SigmaHQ e devono essere testate – non solo deployate – contro il comportamento reale dell’ambiente.
Detection della process injection (T1055). Monitorare le chiamate API di Windows associate all’injection: CreateRemoteThread, NtMapViewOfSection, QueueUserAPC, e le varianti di VirtualAllocEx + WriteProcessMemory. La chiave è correlare queste chiamate con il processo sorgente: se un processo utente non privilegiato invoca CreateRemoteThread su un processo di sistema, l’alert ha alta probabilità di essere significativo.
Traffico outbound verso servizi cloud legittimi. Il caso SesameOp dimostra che il C2 può transitare interamente su API cloud. È necessario stabilire baseline del traffico verso endpoint come api.openai.com, management.azure.com, secretsmanager.amazonaws.com, e generare alert su deviazioni significative, in particolare quando il traffico proviene da processi o utenti che non hanno giustificazione operativa per interrogare questi servizi.
Rilevamento della sandbox evasion (T1497). Monitorare le query WMI relative a informazioni hardware (Win32_ComputerSystem, Win32_BIOS), le interrogazioni sulle configurazioni di rete con pattern riconducibili a fingerprinting di ambienti virtualizzati, e l’enumerazione di processi associati a strumenti di analisi (procexp, wireshark, x64dbg). Se un campione esegue queste query nelle prime fasi di esecuzione e poi diventa silente, il pattern è coerente con sandbox evasion.
Validazione delle regole di detection esistenti. Il Blue Report 2025 rivela che il 50% dei fallimenti di detection è causato da problemi nella raccolta log, non da assenza di regole. Prima di scrivere nuove regole, verificare che quelle esistenti funzionino: che i log arrivino effettivamente al SIEM, che le regole si attivino sui dati reali e che gli alert risultanti siano azionabili. Un’attività di detection rule validation anche trimestrale può colmare una parte significativa del gap documentato nel report.
Implicazioni normative: NIS2, DORA e il parassita digitale
Il passaggio dal ransomware distruttivo alla residenza silenziosa ha implicazioni dirette per il framework normativo europeo, e in particolare per gli obblighi di notifica che dal 15 gennaio 2026 sono pienamente operativi in Italia.
La Direttiva NIS2 (Direttiva UE 2022/2555), recepita in Italia con il D.Lgs. 138/2024, definisce all’articolo 23 (articolo 25 del decreto di recepimento) gli obblighi di notifica per gli incidenti “significativi”. Un incidente è significativo quando ha causato o è in grado di causare una grave perturbazione operativa dei servizi o perdite finanziarie per il soggetto interessato, oppure quando ha provocato o può provocare ripercussioni su altre persone fisiche o giuridiche causando perdite materiali o immateriali considerevoli. La procedura prevede una pre-notifica al CSIRT Italia entro 24 ore e una notifica dettagliata entro 72 ore dall’evidenza dell’incidente.
Il problema è che il parassita digitale è progettato per non generare mai un “incidente significativo” visibile. Se l’attaccante non cifra i file, non interrompe le operazioni e non lascia tracce evidenti, quando scatta l’obbligo di notifica? L’ACN, con la Determinazione 379907 del 19 dicembre 2025, ha definito categorie di incidenti significativi di base (IS-1 per perdita di riservatezza, IS-2 per perdita di integrità, IS-3 per perdita di disponibilità) – ma l’esfiltrazione silenziosa e graduale può sfuggire a queste categorie finché non viene scoperta, momento in cui il danno è già consolidato e la finestra di notifica può essere tecnicamente scaduta.
Il Regolamento di esecuzione della Commissione Europea specifica che un incidente è significativo anche quando ha causato o è in grado di causare l’esfiltrazione di segreti commerciali. Questo criterio è direttamente rilevante per il modello del parassita digitale, ma presuppone che l’organizzazione sia consapevole dell’esfiltrazione – una consapevolezza che, con un tasso di prevenzione dell’esfiltrazione al 3% e alert generati solo sul 14% dell’attività malevola, è tutt’altro che garantita.
Per le istituzioni finanziarie soggette al Regolamento DORA (Regolamento UE 2022/2554), il problema è ancora più acuto. DORA richiede capacità di rilevamento, risposta e reporting su incidenti ICT dimostrabili e verificabili (Capitolo III, articoli 17-23), con obblighi di classificazione degli incidenti e notifica alle autorità competenti. Il Blue Report 2025, nella sua analisi settoriale BFSI, ha rilevato che nonostante una copertura di log superiore alla media (67%), solo il 13% degli attacchi simulati nel settore finanziario genera un alert – quasi 7 attacchi su 8 passano inosservati. In un contesto regolamentare che richiede capacità di detection dimostrabili e resilienza operativa verificata, questo gap rappresenta un’esposizione sia operativa sia sanzionatoria.
Il rischio concreto è duplice: da un lato, le organizzazioni potrebbero essere in stato di compromissione prolungata senza saperlo e, di conseguenza, in violazione degli obblighi di notifica tempestiva; dall’altro, le autorità di vigilanza potrebbero valutare ex post che un incidente avrebbe dovuto essere notificato prima, con conseguenze sanzionatorie significative. L’ACN ha chiarito che anche la mancata notifica di un incidente che l’autorità ritiene a posteriori significativo costituisce una violazione della normativa.
L’AI nel Red Report 2026: meno hype, più tradecraft
Un aspetto del Red Report 2026 che merita attenzione è ciò che il report non ha trovato. Nonostante le aspettative diffuse, Picus Labs non ha osservato alcun aumento significativo di tecniche d’attacco genuinamente guidate dall’intelligenza artificiale. Il successo degli attaccanti continua a basarsi su tradecraft consolidato: Process Injection e Command and Scripting Interpreter rimangono tra le tecniche più osservate.
Dove l’AI compare, il suo ruolo resta circoscritto. Il malware LameHug, documentato nel Red Report 2026, interagisce con API di large language model solo per recuperare comandi predefiniti. Non è stato osservato alcun ragionamento autonomo o decision-making adattivo – si tratta di integrazione superficiale, non di un cambiamento strutturale nella meccanica degli attacchi. La backdoor SesameOp, pur sfruttando l’infrastruttura OpenAI, non utilizza alcuna capacità AI: impiega l’API come semplice canale di comunicazione.
Questo non significa che l’AI non rappresenti un rischio futuro – e altre fonti, come il caso documentato da Darktrace di malware generato da LLM osservato nella rete di honeypot CloudyPots con attività rilevata a partire da novembre 2025, suggeriscono che la convergenza è in atto. Significa però che, oggi, le organizzazioni che si concentrano ossessivamente sull’AI-powered malware trascurando le difese contro credential theft e persistence stanno combattendo la guerra sbagliata. Il parassita digitale non ha bisogno di intelligenza artificiale per restare invisibile: gli basta sfruttare il gap tra logging e alerting che già esiste nella maggior parte degli ambienti enterprise.
Prospettive: il 2026 come anno della validazione continua
Il Red Report 2026 non è un documento pessimistico. È un documento che impone una ricalibratura. Il messaggio strategico è chiaro: le organizzazioni hanno costretto gli avversari a evolversi, rendendo il ransomware tradizionale meno redditizio. Ma l’evoluzione risultante – il parassita digitale – richiede una risposta difensiva altrettanto sofisticata.
La direzione è inequivocabile: le valutazioni statiche e la copertura basata su assunzioni lasciano punti ciechi quando le minacce sono progettate per restare silenziose. La protezione delle organizzazioni richiede la validazione continua dei controlli di sicurezza contro il comportamento avversario reale – non contro scenari teorici, ma contro le tecniche documentate empiricamente in report come questo.
Questo si traduce in azioni concrete. Testare i controlli di detection contro le tecniche della top 10 ATT&CK del Red Report 2026. Verificare che le regole SIEM si attivino effettivamente su T1055, T1555, T1497. Simulare esfiltrazione dati low-and-slow e misurare se viene rilevata. Stabilire baseline comportamentali per l’accesso ai credential store e ai servizi cloud. Integrare l’approccio CTEM (Continuous Threat Exposure Management) nelle operazioni quotidiane, non come progetto una tantum ma come processo continuo.
Per i professionisti della sicurezza, il Red Report 2026 di Picus è un invito a guardare oltre l’alert. Il parassita digitale non bussa alla porta: è già dentro, silenzioso, paziente, e si nutre di ogni credenziale non protetta, di ogni policy di accesso non verificata, di ogni gap tra ciò che viene registrato e ciò che viene effettivamente analizzato.
Il ransomware come lo conoscevamo sta cedendo il trono. E il suo successore è molto più difficile da trovare.
Risarcimento del danno per violazione GDPR: la contraddizione tra Cassazione italiana e Corte di giustizia UE sull’art. 82
L’art. 82 del GDPR riconosce il diritto al risarcimento del danno, materiale e immateriale, derivante da violazione del Regolamento europeo sulla protezione dei dati personali. La giurisprudenza italiana, consolidata dall’ordinanza della Cassazione n. 13073/2023, subordina tuttavia il risarcimento alla prova della “serietà” della lesione, escludendo il danno in re ipsa ed esigendo il superamento di una soglia minima di gravità.
In apparente contraddizione con detto orientamento, la Corte di giustizia dell’Unione europea – da ultimo con la sentenza C-655/23 del 4 settembre 2025 – ha ribadito che l’art. 82 GDPR non richiede alcuna soglia di rilevanza: anche la semplice perdita di controllo sui dati personali o il timore di un loro uso abusivo possono integrare un danno immateriale risarcibile, purché effettivamente dimostrati.
L’interpretazione della giurisprudenza sulla responsabilità civile derivante dall’illecito trattamento dei dati personali disciplinata dall’art. 82 GDPR, si rivela contraddittoria alla luce di recenti sentenze domestiche ed europee. Sullo sfondo rimangono le sentenze fondate sul previgente art. 15 cod. privacy e l’accostamento all’art. 2050 c.c. (responsabilità per attività pericolose) che la dottrina dominante (anche e soprattutto con il prepotente avvento delle applicazioni di intelligenza artificiale) continua a ritenere applicabile.
In sintesi l’art. 2050 c.c. (responsabilità per esercizio di attività pericolosa) prevede un’inversione dell’onere della prova: il danneggiato deve provare danno e nesso causale, mentre il convenuto deve fornire la prova liberatoria di aver adottato tutte le misure idonee a evitare il danno. La dottrina civilistica ha ricostruito la natura dell’art. 2050 in termini non univoci (colpa lievissima/colpa presunta/semi‑oggettiva od oggettiva), ma convergendo sul particolare rigore della prova liberatoria e sulla funzione di bilanciamento tra utilità sociale di attività rischiose e tutela dei terzi. È inoltre valorizzata l’estensione dell’art. 2050 anche a omissioni «qualificate», quando il danno derivi dal mancato approntamento di misure preventive dovute.
Nel quadro previgente, l’art. 15 del Codice privacy richiamava espressamente l’art. 2050 c.c.; pur essendo stato abrogato, la giurisprudenza di legittimità ha ribadito il modello probatorio, affermando che il danneggiato deve provare danno e nesso causale, mentre sul convenuto grava la prova di aver adottato tutte le misure idonee ad evitare il danno.
Il fondamento normativo: art 82 GDPR – interpretazione giurisprudenza italiana: “occorre la prova della serietà del danno”
Nel dibattito dottrinale, anche l’art. 82 GDPR è stato letto come una responsabilità «speciale», in cui il momento organizzativo (misure tecniche e organizzative, governance dei processi e dei fornitori, tracciabilità delle decisioni) diventa decisivo sia sul piano sostanziale sia sul piano probatorio. La giurisprudenza interna sembra convergere su questa interpretazione in continuità, pur con qualche discontinuità.
L’art. 82 GDPR prevede il diritto al risarcimento del danno (materiale o immateriale) causato da una violazione del Regolamento. La responsabilità viene differenziata fra Titolare e Responsabile del trattamento.
Il Titolare del trattamento coinvolto nel trattamento risponde per il danno cagionato dal suo trattamento che violi il regolamento. Il Responsabile del trattamento risponde per il danno causato dal trattamento solo se non ha adempiuto gli obblighi del regolamento specificatamente diretti ai responsabili del trattamento o ha agito in modo difforme o contrario rispetto alle legittime istruzioni del titolare del trattamento. Entrambi sono esonerati da responsabilità se dimostrano che l’evento dannoso non è loro in alcun modo imputabile.
Il Considerando 146 del GDPR ulteriormente precisa che “Il concetto di danno dovrebbe essere interpretato in senso lato alla luce della giurisprudenza della Corte di giustizia in modo tale da rispecchiare pienamente gli obiettivi del presente regolamento”; sicché “gli interessati dovrebbero ottenere pieno ed effettivo risarcimento per il danno subito”.
A fronte del dettato normativo appena descritto, la Cassazione (ord. 12 maggio 2023, n. 13073) ha chiarito e reinterpretato il senso di alcune anteriori posizioni espresse a proposito dell’art. 15 del previgente Codice della Privacy: “vige ancora il principio per cui il danno non può dirsi in re ipsa (v. Cass. Sez. 6-1 n. 17383-20, Cass. Sez. 3 n. 16133-14)”, La Corte prosegue evidenziando che il diritto al risarcimento è soggetto alla verifica della gravità della lesione e della serietà del danno, intesa come perdita di natura personale effettivamente patita dall’interessato. Questo principio si fonda sul bilanciamento con il principio di solidarietà sancito dall’art. 2 della Costituzione, cui consegue l’obbligo di tollerare la lesione minima.
In altre parole, occorre un danno di non lievissima entità ed in caso di danno non lieve occorre una prova rigorosa dello stesso, va da sé che non si può dar luogo al risarcimento se – pur in presenza di violazione del GDPR – l’interessato non ha subito alcun danno.
Anche il Tribunale civile di Oristano (sent. 176/2024), ha ribadito che il danno non patrimoniale da illecito trattamento dei dati personali è risarcibile solo se la lesione alla riservatezza è grave e concreta, non per la semplice violazione formale delle norme, e a condizione che la lesione superi la soglia di tolleranza prevista dal principio di solidarietà.
Il Tribunale di Oristano prosegue affermando che:“La legittimazione attiva al risarcimento del danno da violazione della privacy spetta esclusivamente al soggetto i cui dati personali sono stati illecitamente trattati, non estendendosi ai familiari che, pur subendo conseguenze dannose indirette, non hanno visto diffusi i propri dati identificativi. Ai fini della liquidazione equitativa del danno non patrimoniale da illecito trattamento dei dati personali possono trovare applicazione, con procedimento analogico, i criteri orientativi per la quantificazione del danno da diffamazione elaborati dalla giurisprudenza di merito.”
La sentenza del Tribunale ripete concetti espressi dalla Corte di legittimità, fornendo anche un valido parametro per l’eventuale quantificazione del danno di tipo non patrimoniale, mostrando simpatia per la quantificazione del danno operata in caso di diffamazione.
Le condizioni del risarcimento secondo la recente Corte di giustizia dell’Unione europea
La sintesi dell’interpretazione giurisprudenziale “europea” sull’art. 82 del GDPR è rappresentata dalla recente CGUE, sez. IV, 4 settembre 2025, causa C-655/23.
Alla Corte di giustizia dell’Unione europea era stato richiesto, dal Bundesgerichtshof (Corte federale di giustizia tedesca), una interpretazione dell’articolo 82, paragrafo 1, del GDPR, nel senso che nella nozione di «danno immateriale» contenuta in tale disposizione si dovessero ricomprendere anche sentimenti negativi provati dalla “persona interessata” a seguito di una comunicazione non autorizzata dei suoi dati personali ad un terzo, quali il timore o l’insoddisfazione, che sono suscitati da una perdita di controllo su tali dati, da una potenziale utilizzazione abusiva degli stessi o da un pregiudizio alla sua reputazione.
La Corte ha risposto in maniera netta ed analitica, precisando che la nozione di danno ai sensi dell’art. 82 GDPR, deve ricevere una definizione ricavata specificamente dal diritto dell’Unione, in autonomia rispetto ai diritti interni (v., in tal senso, sentenze del 25 gennaio 2024, MediaMarktSaturn, C‑687/21, EU:C:2024:72, punto 64, e del 4 ottobre 2024, Agentsia po vpisvaniyata, C‑200/23, EU:C:2024:827, punto 139 nonché giurisprudenza citata).
Quale premessa la Corte ha ribadito che la semplice violazione del Regolamento europeo non è sufficiente per conferire un diritto al risarcimento. Le condizioni che deve soddisfare l’interessato per ottenere il diritto al risarcimento sono:
provare di aver subito un «danno» (materiale o immateriale);
provare la violazione di una norma del regolamento da parte di Titolare o Responsabile del trattamento;
provare il nesso di causalità tra tale danno e detta violazione.
Le tre condizioni erano già state fissate da numerose sentenze [sent. 4 maggio 2023, Österreichische Post (Danno immateriale inerente al trattamento di dati personali), C‑300/21, EU:C:2023:370, punti 32, 33, 37 e 42; sent. 4 ottobre 2024, Agentsia po vpisvaniyata, C‑200/23, EU:C:2024:827, punti da 140 a 142, nonché sent 4 ottobre 2024, Patērētāju tiesību aizsardzības centrs, C‑507/23, EU:C:2024:854, punti 24 e 25].
Fino a qui vengono ribaditi concetti cari anche alla giurisprudenza italiana. La discontinuità riguarda la questione della “serietà del danno”, illustrata in precedenza e ripetutamente ribadita da Cassazione e giudici di merito.
Risarcimento del danno immateriale anche in presenza di “semplice” paura o insoddisfazione a seguito di illecito trattamento
La Corte di giustizia dell’Unione europea era chiamata ad esprimere un parere sulla sussistenza del danno immateriale qualora vengano allegati e provati: “sentimenti negativi, come rabbia, contrarietà, insoddisfazione, inquietudine e paura”, che derivano dal “timore della divulgazione dei dati a terzi che lavorano nel medesimo settore, il fatto che una persona abbia appreso informazioni riguardo a circostanze per le quali vale una regola di discrezione, [nonché] l’umiliazione per il mancato accoglimento delle sue pretese salariali e per la conoscenza di tale circostanza da parte di terzi”.
Nel rispondere, la Corte precisa che l’art. 82 GDPR è sempre stato interpretato nel senso di non fissare livelli di gravità del pregiudizio subito dall’interessato. “La disposizione suddetta non esige che un danno immateriale fatto valere dall’interessato debba raggiungere una «soglia di rilevanza” perché tale danno possa essere risarcito (v. in tal senso, sentenze del 4 maggio 2023, Österreichische Post, C‑300/21, EU:C:2023:370, punto 51, nonché del 4 ottobre 2024, Agentsia po vpisvaniyata, C‑200/23, EU:C:2024:827, punti 147 e 149).
In secondo luogo, come rilevato dalla Commissione europea nelle sue osservazioni scritte, situazioni, quali quelle invocate nel procedimento principale, attinenti ad un “pregiudizio alla reputazione” derivante da una violazione di dati personali o ad una “perdita del controllo” su dati siffatti, figurano esplicitamente tra gli esempi di possibili danni che sono elencati nei considerando 75 e 85 del GDPR. In particolare, la Corte ha sottolineato che il legislatore dell’Unione ha inteso includere la semplice “perdita del controllo” sui dati personali nell’elenco esemplificativo dei “danni” o dei “pregiudizi” che possono essere subiti dalle persone interessate (considerando 85 del GDPR), quand’anche non si sia concretamente verificato un uso abusivo dei dati in questione.
Una siffatta perdita del controllo può essere sufficiente per causare un «danno immateriale», ai sensi dell’articolo 82, paragrafo 1, del GDPR, purché l’interessato dimostri di aver effettivamente subìto un danno di tal genere, fosse pure minimo, senza che tale nozione di «danno immateriale» esiga la dimostrazione dell’esistenza di tangibili conseguenze negative supplementari (v., in tal senso, sentenza del 4 ottobre 2024, Agentsia po vpisvaniyata, C‑200/23, EU:C:2024:827, punti 145, 150 e 156 nonché giurisprudenza citata).
Ancora, la Corte ha statuito che la paura, provata dall’interessato, che i suoi dati personali siano oggetto di utilizzazione abusiva in futuro, a seguito di una violazione del GDPR, è idonea a costituire, di per sé solo, un «danno immateriale», a condizione che tale timore, con le sue conseguenze negative, sia debitamente dimostrato, aspetto questo la cui verifica incombe al giudice nazionale adito [v., in tal senso, sentenze del 20 giugno 2024, PS (Indirizzo errato), C‑590/22, EU:C:2024:536, punti 32, 35 e 36, nonché del 4 ottobre 2024, Agentsia po vpisvaniyata, C‑200/23, EU:C:2024:827, punti 143, 144 e 155 nonché giurisprudenza citata].
Pertanto, sebbene i sentimenti menzionati, in particolare il timore o l’insoddisfazione, possano far parte dei rischi inerenti alla normale esperienza di vita, simili sentimenti negativi sono suscettibili di costituire un «danno immateriale», purché, conformemente al requisito dell’esistenza di un nesso di causalità, la persona interessata dimostri che prova sentimenti siffatti, con le loro conseguenze negative, proprio in ragione della violazione del suddetto regolamento di cui trattasi, come ad esempio una trasmissione non autorizzata dei suoi dati personali ad un terzo che ingeneri il rischio di un uso abusivo di questi ultimi, aspetto questo che deve essere valutato dai giudici nazionali aditi.
I principi sin qui esaminati – risarcibilità del danno immateriale anche in assenza di una soglia minima di gravità, sufficienza della perdita di controllo sui dati e del timore di un uso abusivo futuro – trovano un banco di prova particolarmente significativo nelle ipotesi in cui la violazione dei dati personali non derivi da una condotta diretta del titolare del trattamento, bensì dall’attività dolosa di soggetti terzi, come accade tipicamente negli attacchi ransomware. In queste fattispecie al tema della prova del danno si affianca quello, altrettanto decisivo, dell’adeguatezza delle misure di sicurezza adottate e della conseguente ripartizione dell’onere probatorio tra interessato e titolare.
Data breach derivante da attività dolosa altrui e misure di sicurezza: controllo sull’adeguatezza e onere della prova
A questo punto merita un approfondimento la questione della risarcibilità del danno in presenza di data breach provocato da attività dolosa di terze parti, come ad esempio nella fattispecie del ransomware. La sentenza C-340/21 (VB c. NAP) affronta in modo diretto il rapporto tra data breach, adeguatezza delle misure tecniche e organizzative (artt. 24 e 32 GDPR) e diritto al risarcimento (art. 82). La Corte ha chiarito che i giudici non possono dedurre automaticamente l’inadeguatezza delle misure dal solo fatto dell’accesso/divulgazione non autorizzati; occorre una valutazione concreta dell’adeguatezza.
La stessa decisione evidenzia che il titolare può essere chiamato a risarcire anche quando l’evento deriva da terzi, salvo prova della non imputabilità; comunque il timore di un potenziale uso abusivo dei dati può integrare un danno immateriale.
La dottrina ha letto questa linea come pienamente coerente con l’accountability: l’onere di dimostrare l’adeguatezza delle misure grava sul titolare e diventa centrale la documentazione delle scelte e dei presidi adottati ex ante.
Quali misure di sicurezza ed organizzative per sfuggire alla responsabilità: casi del Garante, Postel (2024) e Poste Vita (2025)
I provvedimenti del Garante costituiscono un osservatorio privilegiato per individuare, in concreto, cosa significhi «misure adeguate» e quale sia la soglia di diligenza esigibile.
Nel provvedimento del 4 luglio 2024 (Registro n. 572/2024; doc. web 10063782), relativo a un procedimento sanzionatorio contro Postel S.p.A. concluso con una importante sanzione a carico del titolare del trattamento (sanzione amministrativa pari a 900.000,00 euro), il Garante ha preso in esame un attacco ransomware rivendicato dalla cybergang “Medusa”, con esfiltrazione e pubblicazione nel dark web di file contenenti dati personali e perdita di disponibilità per alcuni file. Il provvedimento dà conto anche delle vulnerabilità sfruttate (CVE-2022-41040 e CVE-2022-41082) e dell’avvio del procedimento con contestazioni, tra l’altro, su artt. 5, 25, 28, 32 e 33 GDPR.
Il valore pratico del caso sta nel fatto che l’istruttoria si concentra su profili organizzativi tipici (gestione delle vulnerabilità e delle patch, processi interni, completezza e qualità della notifica e dei flussi informativi verso i titolari committenti), cioè esattamente sui profili che, in sede civile, possono incidere sulla prova liberatoria richiesta dall’art. 2050 c.c. e dall’art. 82 GDPR.
Un caso complementare riguarda il procedimento sanzionatorio contro Poste Vita S.p.A., avviato da un reclamo del 24 ottobre 2024 e definito con provvedimento del 10 luglio 2025 (Registro n. 389/2025; doc. web 10154110). Il Garante prende in esame una illecita comunicazione di dati relativi a polizze vita a un soggetto terzo non autorizzato, avvenuta tramite risposte a richieste pervenute via e-mail e apparentemente corredate da firma autografa e dettagli idonei a indurre in errore gli operatori.
All’esito dell’istruttoria, il Garante evidenzia che – in assenza, agli atti della compagnia, di un indirizzo e-mail fornito dall’interessata – la società avrebbe dovuto porre in atto ogni misura idonea a verificare l’effettiva rispondenza dell’indirizzo di posta elettronica all’identità della (presunta) cliente, prima di inviare documentazione e informazioni.
Il provvedimento rileva inoltre un profilo di ritardo nella notifica ex art. 33 GDPR, precisando che, a fronte del disconoscimento dell’indirizzo e-mail, il titolare aveva la “ragionevole evidenza” della compromissione, con conseguente obbligo di notificare senza ingiustificato ritardo e, ove possibile, entro 72 ore, richiamando le Linee guida EDPB 9/2022 sul concetto di “conoscenza” della violazione.
I provvedimenti del Garante sommariamente descritti possono svolgere una funzione di «standard setting» e risultare rilevanti anche in sede civile come elementi fattuali per valutare l’adeguatezza delle misure organizzative e di sicurezza e la richiesta prova liberatoria per sfuggire alla responsabilità civilistica.
Conclusioni
L’analisi condotta evidenzia una frattura significativa tra l’orientamento della giurisprudenza italiana e quello della Corte di giustizia dell’Unione europea in materia di risarcimento del danno immateriale per violazione del GDPR.
Da un lato, la Cassazione italiana, con l’ordinanza n. 13073/2023 confermata dai giudici di merito, richiede la prova della “serietà” della lesione (il danno non deve consistere in meri disagi o fastidi) come condizione necessaria per il risarcimento, applicando un filtro di gravità che affonda le radici nel principio di solidarietà sociale (art. 2 Cost.) e nella tradizione civilistica della tolleranza della lesione minima.
Dall’altro lato, la CGUE – con una giurisprudenza ormai consolidata attraverso le sentenze Österreichische Post (C-300/21), MediaMarktSaturn (C-687/21), Agentsia po vpisvaniyata (C-200/23) e, da ultimo, la causa C-655/23 del settembre 2025 – ha stabilito in modo inequivocabile che l’art. 82 GDPR non contempla alcuna soglia minima di rilevanza del danno. La semplice perdita di controllo sui propri dati personali, il timore fondato di un utilizzo abusivo, finanche sentimenti negativi quali paura o insoddisfazione, possono costituire danno immateriale risarcibile, a condizione che l’interessato ne fornisca dimostrazione e provi il nesso causale con la violazione.
Questa contraddizione non è puramente teorica. L’interpretazione del giudice italiano, apparentemente divergente da quello europeo, ha come conseguenza pratica quella di diminuire la possibilità di risarcimento del danno per l’interessato, con pregiudizio per l’uniformità di applicazione del GDPR. Tuttavia occorre ricordare il considerando 146 del Regolamento (citato nel primo paragrafo del presente articolo) che esplicitamente rimanda alla (sola) giurisprudenza della Corte di giustizia europea la facoltà di interpretazione del concetto di danno E’ pertanto ragionevole ritenere che la difformità oggi evidenziata possa essere ricomposta e che quindi anche la giurisprudenza italiana si adegui al modello descritto dalla Corte di giustizia dell’Unione Europea.
Sul versante dell’onere della prova, l’analisi dei provvedimenti sanzionatori del Garante Privacy, in particolare i casi Postel S.p.A. (provv. 4 luglio 2024) e Poste Vita S.p.A. (provv. 10 luglio 2025), conferma che il principio di accountability opera come vero e proprio criterio probatorio: la documentazione delle scelte organizzative, la tempestività nella gestione delle vulnerabilità, la qualità delle procedure di notifica e i flussi informativi interni costituiscono gli elementi sui quali il titolare del trattamento è chiamato a costruire la propria prova liberatoria, tanto in sede amministrativa quanto, come si è argomentato, in sede civile, secondo il modello dell’art. 2050 c.c.
Il quadro che emerge impone ai titolari e ai responsabili del trattamento un duplice livello di attenzione: non soltanto l’adozione di misure tecniche e organizzative adeguate al rischio, ma anche la loro rigorosa documentazione e tracciabilità, nella consapevolezza che l’accountability non è soltanto un obbligo di compliance, ma rappresenta lo strumento decisivo per resistere a una pretesa risarcitoria in sede giudiziaria. In attesa di un auspicabile allineamento della giurisprudenza italiana a quella europea – che appare, alla luce del primato del diritto dell’Unione, inevitabile – la gestione proattiva e documentata del rischio resta la migliore forma di prevenzione anche sul piano della responsabilità civile.
Profilo Autore
Avvocato cassazionista e Responsabile della Protezione dei Dati (DPO), da oltre venticinque anni specializzato nel diritto delle nuove tecnologie, privacy e tutela del software con pubblicazioni e docenze a contratto per Luiss Business School ed altre università italiane. È titolare dell’omonimo Studio Legale e svolge attività di consulenza e formazione per imprese e organizzazioni pubbliche e private.