PIPL: la disciplina cinese dei trasferimenti transfrontalieri dei dati
In data 1° novembre 2021 è entrato in vigore in Cina il Personal Information Protection Law of the People’s Republic of China (“PIPL”, 个人信息保护法) che ha introdotto una regolamentazione dei dati personali in Cina. Dopo otto mesi dalla sua emanazione le autorità cinesi hanno introdotto nuove regole per il trasferimento transfrontaliero dei dati personali.
Più precisamente, come indicato nel GDPR, Capo V “Trasferimenti di dati personali verso paesi terzi o organizzazioni internazionali”, anche nel PIPL, Capo III “Regole per la fornitura transfrontaliera di dati personali” sono indicati i requisiti che devono essere rispettati per tale procedimento.
Ai sensi dell’art. 38, qualora un responsabile del trattamento dei dati personali[1] debba fornire dati personali al di fuori del territorio della Repubblica popolare cinese deve soddisfare i seguenti elementi:
superamento di una valutazione di sicurezza da parte del Cyberspace Administration of China (“CAC”, 国家互联网信息办公室);
certificazione di protezione dei dati personali condotta da un’organizzazione professionale, nelle vesti di ente terzo, in conformità con il Cyberspace Administration of China (“CAC”, 国家互联网信息办公室);
stipulare un contratto standard con il destinatario estero secondo il contratto tipo formulato dal Cyberspace Administration of China (“CAC”, 国家互联网信息办公室) stabilendo sia i diritti e gli obblighi di entrambe le parti;
altre condizioni previste da leggi, regolamenti amministrativi dal Cyberspace Administration of China (“CAC”, 国家互联网信息办公室).
Standard Contractual Clauses (SCC)
In data 30 giugno 2022, il Cyberspace Administration of China (“CAC”, 国家互联网信息办公室) ha condiviso un draft intitolato “Provisions on the Standard Contract for the Cross-border Transfers of Personal Information” (“Draft Provisions”, 个人信息出境标准合同规定) per la consueta consultazione pubblica, la quale si concluderà il 29 luglio 2022.
Come si evince dall’art. 38 del PIPL, par. 3, il contratto standard è uno strumento legale a cui un’entità può ricorrere per essere compliant nei trasferimenti dei dati personali al di fuori della Cina. Inoltre, giova ricordare che tale contratto dovrà essere sottoscritto e depositato presso il governo cinese.
Ai sensi dell’art. 4 delle “Draft Provisions”, il contratto standard si può utilizzare solo se un’entità è in grado di soddisfare tutti i seguenti requisiti:
il soggetto in questione non deve risultare nella categoria dei Critical Information Infrastructure Operators (CIIO);
la gestione dei dati personali deve essere inferiore ad 1 milione di persone;
dal 1° gennaio dell’anno precedente, la quantità cumulativa di dati personali fornite all’estero non ha raggiunto le 100.000 persone;
dal 1° gennaio dell’anno precedente, la fornitura cumulativa di dati personali sensibili all’estero non ha raggiunto 10.000 persone.
Inoltre, l’entità, prima di fornire dati personali all’estero, è obbligata a condurre preventivamente una valutazione d’impatto sulla protezione dei dati personali, prestando attenzione alla legittimità e la necessità del trattamento dei dati personali, la quantità ed il grado di sensibilità dei dati che vengono trasferiti all’estero e i rischi che il trasferimento di quest’ultimi può comportare per i diritti degli interessati. In aggiunta, con l’obiettivo di garantire un trasferimento dei dati sicuro si dovrà tener conto della responsabilità e degli obblighi assunti dal destinatario all’estero, e verranno valutati i rischi di perdita o manomissione dei dati, analizzando anche la normativa del paese di corrispondenza.
Alla luce di tali considerazioni, come indicato “Draft Provisions”, il contratto standard deve contenere i seguenti elementi:
le informazioni di base dei responsabili del trattamento dei dati personali e dei destinatari all’estero, inclusi, a titolo esemplificativo ma non esaustivo, nome, indirizzo, nome di contatto, informazioni di contatto;
la finalità, la portata, il tipo, la sensibilità, la quantità, il metodo, il periodo di conservazione, il luogo di conservazione dei dati personali oggetto di trasferimento all’estero;
la responsabilità e gli obblighi dei responsabili del trattamento dei dati personali e dei destinatari all’estero, nonché le misure tecniche per prevenire i rischi per la sicurezza che possono derivare dal trasferimento di quest’ultimi;
l’impatto delle politiche e dei regolamenti sulla protezione delle informazioni personali del paese o della regione in cui si trova il destinatario all’estero sul rispetto dei termini del presente contratto;
i diritti degli interessati e le modalità per esercitare quest’ultimi;
le clausole per la risoluzione del contratto e per la responsabilità per inadempimento contrattuale.
Guidelines for Cybersecurity Standards
In data 24 giugno 2022, il China’s National Information Security Standardization Technical Committee ha condiviso le “Practical Guidelines for Cybersecurity Standards – Specification for Security Certification of Cross-Border Processing of Personal Information” (“Certification Specification”, 网络安全标准实践指南—个人信息跨境处理活动安全认证规范).
Lo scopo di tale documento è fornire gli elementi necessari per l’attuazione di uno degli schemi di certificazione del Personal Information Protection Law of the People’s Republic of China (“PIPL”, 个人信息保护法), ovvero la certificazione in relazione alle attività di trattamento che coinvolgono determinati trasferimenti di dati transfrontalieri.
Pertanto, sarà possibile ottenere la certificazione per determinate attività:
trattamento transfrontaliero di dati personali tra filiali o affiliate di una società multinazionale o della stessa entità economica;
trattamento dei dati personali coperto dalla portata extraterritoriale del PIPL (art. 3, par. 2), ovvero quando lo scopo è di analizzare e valutare le attività delle persone fisiche domestiche al di fuori del territorio della Repubblica popolare cinese.
Conclusioni
In conclusione, è ragionevole comparare le “Certification Specification” del diritto cinese con quanto indicato dall’art. 47 del GDPR, le “Binding Corporate Rules” (BCR). Queste ultime sono strumenti a cui gruppi societari ricorrono con l’obiettivo di trasferire dati personali da un Paese comunitario ad un Paese terzo. Pertanto, nel contesto globalizzato della Data Economy, il riconoscimento al trasferimento di dati personali tramite le BCR è un grande vantaggio che le filiali di multinazionali possono trarre e l’intervento del legislatore cinese in materia di protezione dei dati personali testimonia l’importanza che le aziende, esercenti attività commerciale in Cina, devono riservare alle nuove norme cinesi.
Note
[1] Giova ricordare che ai sensi dell’art. 9 del PIPL i responsabili del trattamento dei dati personali sono responsabili delle loro attività di trattamento dei dati personali e adottano le misure necessarie per salvaguardare la sicurezza dei dati personali che trattano.
Articolo a cura di Luca Barbieri
Profilo Autore
Luca Barbieri è laureato in Giurisprudenza presso l’Università Luiss Guido Carli con tesi intitolata “From cyber espionage to cyber warfare: a criminal comparative analysis between Italy, USA and China”, nella materia di Diritto Penale, con il Prof. A. Gullo. Durante l’Exchange Program, presso la Beijing Normal University di Pechino, ha sostenuto numerosi esami in diritto cinese e cyber security. Inoltre, ha conseguito il Master universitario di secondo Livello in “Responsabile della protezione dei dati personali: Data Protection Officer e Privacy Expert” presso l’Università Roma Tre. Attualmente collabora in uno studio legale specializzato in diritto delle nuove tecnologie, privacy e cyber security.
Il Principio di Accountabilty nel Nuovo Regolamento UE 2016/679 – Prima Parte
Con l’entrata in vigore del Regolamento UE 2016/679 (di seguito “GDPR”), il concetto di “dato proprietario” si evolve nel concetto di “controllo del dato”, per agevolare così la libera circolazione dei dati personali. Ne è riprova l’art. 1 del GDPR, che al paragrafo 1 recita: “Il presente regolamento stabilisce norme relative alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché norme relative alla libera circolazione di tali dati”. Ai sensi del par. 3, la libera circolazione dei dati personali nell’Unione non può essere limitata né vietata per motivi attinenti alla protezione delle persone fisiche con riguardo al trattamento dei dati personali.
Attori e criteri del trattamento dei dati nel GDPR
In questo rinnovato contesto e al fine di proteggere i diritti e le libertà fondamentali delle persone fisiche – in particolare il diritto alla protezione dei dati personali – l’art. 1, par. 2 del GDPR ha introdotto alcune importanti novità nella disciplina del trattamento dei dati personali[1], la più rilevante delle quali attiene al nuovo approccio al rischio basato sul principio di accountability (responsabilizzazione). Saranno di seguito brevemente esaminati alcuni articoli del GDPR nei quali è riscontrabile il predetto principio, strettamente connesso alla compliance del titolare del trattamento.
Tale principio non rappresenta una novità, anzi: il suo esordio è avvenuto inizialmente con la Convenzione OCSE del 1980, il cui Par. 14 recita: “Il responsabile del trattamento dei dati dovrebbe essere responsabile del rispetto delle misure che rendono effettivi i principi indicati sopra” e successivamente ha trovato collocazione nel Parere n. 3/2010 del gruppo WP 29[2]. Trattasi dunque di un principio “ampio”, idoneo a permeare le varie fasi nelle quali il trattamento si articola, che richiede un approccio di tipo dinamico e non statico tale da manifestarsi in un modello organizzativo in costante evoluzione.
Figura principale del principio di accountability è il titolare del trattamento[3] (oppure i contitolari, in presenza di più titolari) che assume tale ruolo non in virtù di una disposizione ma ipso iure quando, “singolarmente o insieme ad altri, determina le finalità e i mezzi del trattamento di dati personali” ai sensi dell’art. 4, par. 1 n. 7 del GDPR[4]. Analogo ragionamento deve essere svolto nell’ipotesi di determinazioni dei mezzi e delle finalità del trattamento dei dati personali tra due o più titolari, quando si rientra nell’istituto della contitolarità ex art 26[5] del GDPR.
Il regime di contitolarità[6] non si instaura a seguito di un accordo tra due o più contitolari ma con la presenza degli elementi costitutivi della titolarità; e cioè la determinazione congiunta delle finalità e dei mezzi per uno o più trattamenti.
Esaminati brevemente sia la figura che gli elementi costitutivi del titolare e dei contitolari, occorre evidenziare il rilievo del principio di accountability in alcune fasi del trattamento (che decorre dalla fase di progettazione per giungere alla sua conclusione, ivi inclusa la fase di conservazione e/o eliminazione dei dati personali oggetto del trattamento).
Il titolare oppure i contitolari del trattamento sono tenuti a comprovare che il trattamento dei dati personali sia svolto in coerenza con l’art. 5 del GDPR; in particolare, dopo aver assunto le misure di sicurezza (art. 5 par. 1 lett. f) e verificata l’efficacia delle stesse, sono tenuti, se necessario, a riesaminarle e ad aggiornarle a conferma della dinamicità del principio di accountability.
La protezione dei dati personali fin dalla progettazione di un trattamento, così come la protezione per impostazione predefinita, è un’attività necessaria per poter avviare qualsiasi trattamento: entrambe implicano l’adozione di misure tecniche e organizzative adeguate alla luce delle analisi dei rischi, se necessario della valutazione d’impatto e da ultimo, ricorrendone i presupposti, della consultazione preventiva, così da soddisfare i requisiti ex art. 25 del GDPR.
Con l’avvio del trattamento il titolare è tenuto, ai sensi degli art. 13 e 14, a rendere a ciascun interessato l’informativa per comunicare gli elementi essenziali del trattamento – quali ad esempio il titolare, il responsabile per la per la protezione dei dati, le basi giuridiche, le finalità etc. – nonché per comunicare il procedimento per l’esercizio dei diritti che il Regolamento gli attribuisce.
Tra le basi giuridiche di cui il titolare può avvalersi c’è il consenso dell’interessato che, come da art. 7 paragrafo 1 del GDPR, può essere acquisito secondo il principio della libertà della forma e in aderenza al principio di responsabilizzazione sancito dall’art. 5 paragrafo 2, che recita: “Qualora il trattamento sia basato sul consenso, il titolare del trattamento deve essere in grado di dimostrare che l’interessato ha prestato il proprio consenso al trattamento dei propri dati personali”.
Il Considerando n. 32 del GDPR, poi, specifica quanto segue: “ilconsenso dovrebbe essere espresso mediante un atto positivo inequivocabile con il quale l’interessato manifesta l’intenzione libera, specifica, informata e inequivocabile di accettare il trattamento dei dati personali che lo riguardano, ad esempio mediante dichiarazione scritta, anche attraverso mezzi elettronici, o orale”.
Il titolare, ricorrendone la necessità, può nominare un Responsabile ex art. 28[7] del GDPR purché questi sia in possesso dei requisiti previsti dal paragrafo 1 e cioè, nel caso di trattamenti da effettuarsi per suo conto, deve ricorrere unicamente a responsabili del trattamento che presentino garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento e garantisca la tutela dei diritti dell’interessato in omaggio, anche nel caso di specie al principio di accountability.
La nomina di un responsabile, infatti, non esime il titolare dall’eventuale culpa in eligendo nel caso sia nominato un responsabile non in possesso di garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate, nonché dalla culpa in vigilando dovuta al mancato controllo delle attività delegate al responsabile ex art. 28 del GDPR.
La forma scritta ad substantiam, anche elettronica, richiesta dall’art. 28 rappresenta infatti solo una cornice del contratto o dell’atto giuridico a norma del diritto dello Stato o dell’Unione che disciplinerà e definirà, in dettaglio, gli elementi richiesti a norma del paragrafo 3[8] non essendo consentito al titolare delegare il controllo nei confronti del responsabile.
La Commissione, con la decisione in nota[9], ha recentemente approvato le clausole contrattuali tipo che soddisfano i requisiti per i contratti tra titolari e responsabili del trattamento di cui all’articolo 28, paragrafi 3 e 4, del regolamento (UE) 2016/679 e all’articolo 29, paragrafi 3 e 4, del regolamento (UE) 2018/1725.
Al titolare è richiesto un ruolo “produttivo” per documentare quanto previsto nell’art. 28, par. 1 del GDPR così da poter dimostrare l’accountability. Esso può essere esonerato da rivendicazioni di terzi per azioni cagionate e non conformi ai dettati degli accordi con il responsabile esclusivamente nel caso in cui quest’ultimo (fatti salvi gli arti. 82, 83, e 84) violi il GDPR, determinando finalità e mezzi del trattamento tali da essere considerato egli stesso titolare del trattamento in argomento.
Note
[1]Art. 4, par. 1 n. 1 – «dato personale»: qualsiasi informazione riguardante una persona fisica identificata o identificabile («interessato»); si considera identificabile la persona fisica che può essere identificata, direttamente o indirettamente, con particolare riferimento a un identificativo come il nome, un numero di identificazione, dati relativi all’ubicazione, un identificativo online o a uno o più elementi caratteristici della sua identità fisica, fisiologica, genetica, psichica, economica, culturale o sociale.
[3]Art. 4, par. 1 n. 7 – «titolare del trattamento» la persona fisica o giuridica, l’autorità pubblica, il servizio o altro organismo che, singolarmente o insieme ad altri, determina le finalità e i mezzi del trattamento di dati personali: quando le finalità e i mezzi di tale trattamento sono determinati dal diritto dell’Unione o degli Stati membri, il titolare del trattamento o i criteri specifici applicabili alla sua designazione possono essere stabiliti dal diritto dell’Unione o degli Stati membri.
[4] La determinazione congiunta delle finalità e dei mezzi e non l’accordo tra le parti rappresenta il fatto costitutivo della contitolarità. L’autonomia privata, pertanto, non può derogare alle disposizioni poste a presidio dei diritti degli interessati
Allorché due o più titolari del trattamento determinano congiuntamente le finalità e i mezzi del trattamento, essi sono contitolari del trattamento. Essi determinano in modo trasparente, mediante un accordo interno, le rispettive responsabilità in merito all’osservanza degli obblighi derivanti dal presente regolamento, con particolare riguardo all’esercizio dei diritti dell’interessato, e le rispettive funzioni di comunicazione delle informazioni di cui agli articoli 13 e 14, a meno che (e nella misura in cui) le rispettive responsabilità siano determinate dal diritto dell’Unione o dello Stato membro cui i titolari del trattamento sono soggetti. Tale accordo può designare un punto di contatto per gli interessati.
L’accordo di cui al paragrafo 1 riflette adeguatamente i rispettivi ruoli e i rapporti dei contitolari con gli interessati. Il contenuto essenziale dell’accordo è messo a disposizione dell’interessato.
Indipendentemente dalle disposizioni dell’accordo di cui al paragrafo 1, l’interessato può esercitare i propri diritti ai sensi del presente regolamento nei confronti di e contro ciascun titolare del trattamento.
[6]Tale ricostruzione è confermata in EDPB, Guidelines 07/2020 on the concepts of controller and processor in the GDPR adopted 02 September 2020, n. 61, pagg. 19 e 20, che così recita: “Joint controllership also requires that two or more entities have exerted influence over the means of the processing. This does not mean that, for joint controllership to exist, each entity involved needs in all cases to determine all of the means. Indeed, as clarified by the CJEU, different entities may be involved at different stages of that processing and to different degrees. Different joint controllers may therefore define the means of the processing to a different extent, depending on who is effectively in a position to do so.”
Analoga ricostruzione è presente nella sentenza judgment in Fashion ID, C-40/17ECLI: EU:2018:1039, paragraph 74.
[7]Art. 4, par. 1 n. 8 – «responsabile del trattamento»: la persona fisica o giuridica, l’autorità pubblica, il servizio o altro organismo che tratta dati personali per conto del titolare del trattamento.
I trattamenti da parte di un responsabile del trattamento sono disciplinati da un contratto o da altro atto giuridico a norma del diritto dell’Unione o degli Stati membri, che vincoli il responsabile del trattamento al titolare del trattamento e che stipuli la materia disciplinata e la durata del trattamento, la natura e la finalità del trattamento, il tipo di dati personali e le categorie di interessati, gli obblighi e i diritti del titolare del trattamento. Il contratto o altro atto giuridico prevede, in particolare, che il responsabile del trattamento:
a) tratti i dati personali soltanto su istruzione documentata del titolare del trattamento, anche in caso di trasferimento di dati personali verso un paese terzo o un’organizzazione internazionale, salvo che lo richieda il diritto dell’Unione o nazionale cui è soggetto il responsabile del trattamento; in tal caso, il responsabile del trattamento informa il titolare del trattamento circa tale obbligo giuridico prima del trattamento, a meno che il diritto vieti tale informazione per rilevanti motivi di interesse pubblico;
b) garantisca che le persone autorizzate al trattamento dei dati personali si siano impegnate alla riservatezza o abbiano un adeguato obbligo legale di riservatezza;
c) adotti tutte le misure richieste ai sensi dell’articolo 32;
d) rispetti le condizioni di cui ai paragrafi 2 e 4 per ricorrere a un altro responsabile del trattamento;
e) tenendo conto della natura del trattamento, assista il titolare del trattamento con misure tecniche e organizzative adeguate, nella misura in cui ciò sia possibile, al fine di soddisfare l’obbligo del titolare del trattamento di dare seguito alle richieste per l’esercizio dei diritti dell’interessato di cui al capo III;
f) assista il titolare del trattamento nel garantire il rispetto degli obblighi di cui agli articoli da 32 a 36, tenendo conto della natura del trattamento e delle informazioni a disposizione del responsabile del trattamento;
g) su scelta del titolare del trattamento, cancelli o gli restituisca tutti i dati personali dopo che è terminata la prestazione dei servizi relativi al trattamento e cancelli le copie esistenti, salvo che il diritto dell’Unione o degli Stati membri preveda la conservazione dei dati;
h) metta a disposizione del titolare del trattamento tutte le informazioni necessarie per dimostrare il rispetto degli obblighi di cui al presente articolo e consenta e contribuisca alle attività di revisione, comprese le ispezioni, realizzati dal titolare del trattamento o da un altro soggetto da questi incaricato.
Con riguardo alla lettera h) del primo comma, il responsabile del trattamento informa immediatamente il titolare del trattamento qualora, a suo parere, un’istruzione violi il presente regolamento o altre disposizioni, nazionali o dell’Unione, relative alla protezione dei dati.
[omissis].
[9] Decisione di esecuzione (UE) 2021/915 della Commissione del 4 giugno 2021 relativa alle clausole contrattuali tipo tra titolari del trattamento e responsabili del trattamento a norma dell’articolo 28, paragrafo 7, del regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio e dell’articolo 29, paragrafo 7, del regolamento (UE) 2018/1725 del Parlamento europeo e del Consiglio (Testo rilevante ai fini del SEE) https://eur-lex.europa.eu/legal-content/IT/TXT/HTML/?uri=CELEX:32021D0915&from=EN.
Articolo a cura di Massimo Ippoliti
Profilo Autore
Tecnologo presso l’UAIG del CNR. Abilitato all’esercizio della professione forense.
Il ruolo della ricerca della cyber security nel settore life science
Introduzione: il contesto della politica UE
Nella nuova strategia dell’Unione Europea la cybersecurity ha assunto ab initio una significativa importanza per la sicurezza dell’Unione stessa, in quanto i cittadini devono essere tutelati dalle minacce informatiche.
Nel 2020 il Presidente della Commissione Europea ha dichiarato che “stiamo vivendo nel decennio digitale europeo”. Alla fine del 2020, la Commissione europea e l’Alto rappresentante hanno presentato una comunicazione congiunta su “The EU’s Cybersecurity Strategy for the Digital Decade”.
Nella premessa del relativo documento viene enunciato che “l’economia, la democrazia e la società dell’UE dipendono, ora più che mai, da strumenti digitali e connettività sicuri e affidabili. Pertanto, la cybersecurity risulta essenziale per dare origine ad un’Europa digitale, verde e resiliente”.
Inoltre, il panorama industriale dell’UE è sempre più digitalizzato e connesso e ciò comporta anche che gli attacchi informatici abbiano un impatto sulle industrie e gli ecosistemi di gran lunga superiore rispetto al passato. Tali minacce sono aggravate dalle tensioni geopolitiche riguardanti la rete Internet globale e aperta e il controllo delle tecnologie lungo l’intera catena di approvvigionamento. Compresi componenti elettronici, analisi dei dati, cloud, reti più veloci e più intelligenti con il 5G e oltre, crittografia, intelligenza artificiale (IA), nonché nuovi e affidabili paradigmi di calcolo e di elaborazione dati come blockchain, cloud-to-edge e calcolo quantistico.
Con il documento “The EU’s Cybersecurity Strategy for the Digital Decade” l’UE vuole ricoprire il ruolo di attore consapevole delle sfide che dovranno essere affrontate nei prossimi anni. Più precisamente, l’obiettivo è realizzabile in tre modi:
In primo luogo, sta cercando di assumere un ruolo guida nella definizione delle regole globali per l’uso della tecnologia e lo fa da molto tempo. Cerca, ove possibile, di creare un consenso globale sugli strumenti e sui meccanismi per lo sviluppo di tecnologie sicure e resilienti. L’UE collabora con i partner, attori statali e non statali, per costruire un quadro coerente e affidabile per la cooperazione;
In secondo luogo, l’UE ha sviluppato un discorso di “open strategic autonom” che cerca di svilupparsi una narrativa coerente a livello di UE per lo sviluppo di capacità a livello di UE per rispondere alle minacce nel mondo.
In terzo luogo, nel 2022 dovrebbe essere proposto il kit di strumenti politici dell’UE che sarà incentrato sulla direttiva NIS (attualmente in fase di revisione), sul Cybersecurity Act (2019) e sui prossimi Cybersecurity Resilience and Semiconductor Acts[1]. Il Consiglio europeo ha anche chiesto a Join Cyber Unit[2] per sviluppare ulteriormente il kit di strumenti per la cybersecurity dell’UE;
In quarto luogo, l’UE sta investendo nella ricerca e nello sviluppo della cybersecurity. L’ECCC, European Cybersecurity Competence Centre, dimostra l’impegno in questo settore in un contesto politico e di ricerca europeo. Ciò include lo sviluppo di soluzioni e strumenti tecnologici che consentano una risposta efficace ai rischi e alle minacce informatiche attuali e futuri. Queste includono tecnologie dell’informazione e della comunicazione nuove ed emergenti e sono progettate per implementare efficacemente le tecnologie di prevenzione dei rischi.
Alla luce di questi elementi, è ragionevole affermare che la sicurezza del cyberspazio continuerà ad essere un progetto in corso. I numerosi sforzi richiesti per sviluppare iniziative che supportano lo sviluppo delle competenze in questo settore stanno dando origine ad un cambio di paradigma. Pertanto, risultano fondamentale la ricerca e l’innovazione.
Ricerca e innovazione
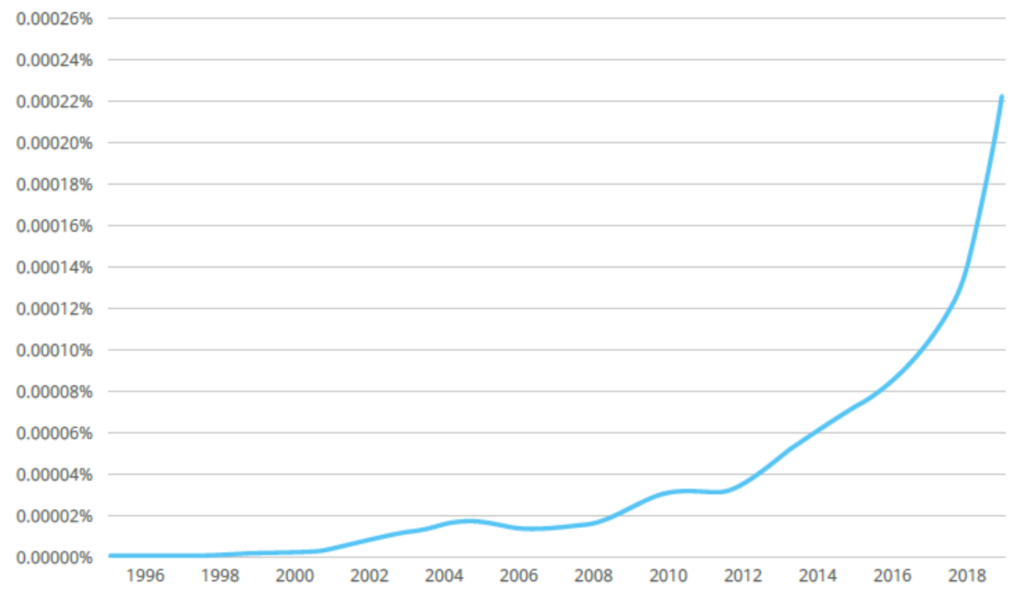
L’emergere di questo campo, testimoniato dalla crescita esponenziale della letteratura in materia a partire dal 2013 circa (con le cosiddette rivelazioni Snowden), indica che il termine “cybersecurity” è emerso negli ultimi anni.
Figura 1: Google Ngram del termine “cybersecurity” 1995-2021
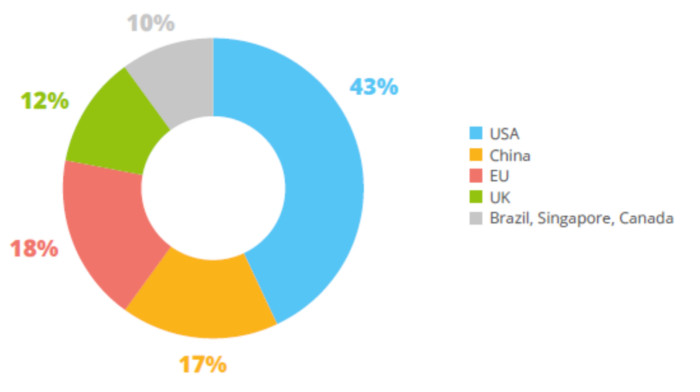
L’UE e le agenzie europee di finanziamento della ricerca contribuiscono con un gran numero di risorse alla ricerca nel campo della cybersecurity, ma esse non sono di gran lunga le principali agenzie di finanziamento al mondo per la ricerca pubblicata nel campo.
La figura 2 identifica i finanziamenti forniti da diversi enti per la ricerca nel campo della cybersecurity che è stata indicizzata nel Web of Knowledge (ossia articoli sottoposti a revisione paritaria su riviste scientifiche). Ciò mostra chiaramente che le agenzie di finanziamento della ricerca statunitensi dominano il campo, con circa il 43% della ricerca pubblicata in questo ampio campo supportato da finanziamenti pubblici dal governo degli Stati Uniti.
Figura 2: Fonti di finanziamento per la ricerca nel campo della cybersecurity (Fonte: Web of Science)
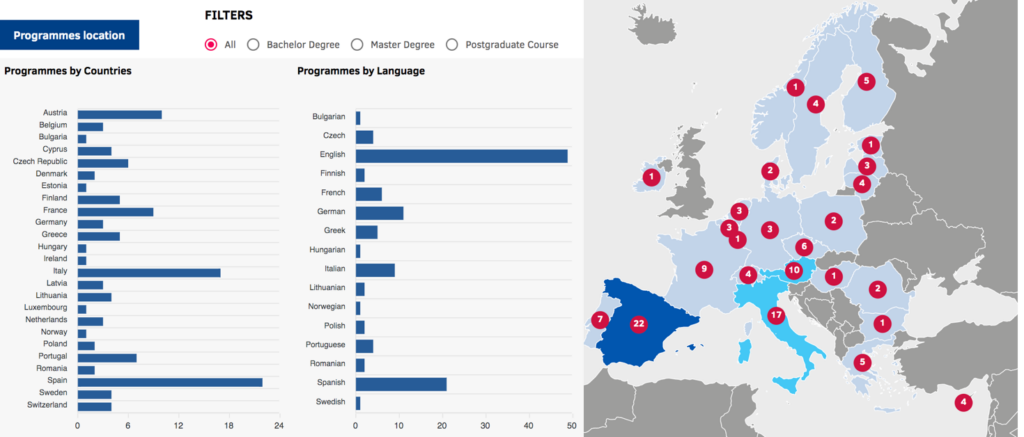
In aggiunta, il grafico delinea il quadro degli altri paesi. L’Atlante europeo della cybersecurity evidenzia circa 750 centri di ricerca che lavorano sulle questioni della cybersecurity nell’UE[3]. Più precisamente, in Italia sono 58.
Figura 3: CYBERHEAD – Cybersecurity Higher Education Database
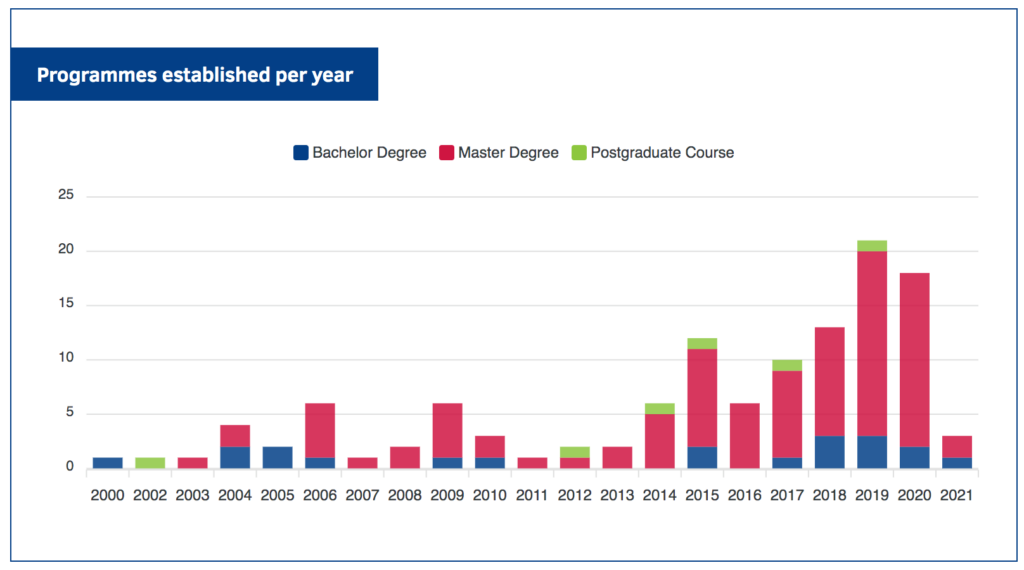
In termini di istruzione e formazione, il database dell’istruzione superiore sulla cybersecurity (CyberHEAD) è il più grande database convalidato dell’istruzione superiore sulla cybersecurity nei paesi dell’UE e dell’EFTA. È stato il principale punto di riferimento per tutti i cittadini che desiderano migliorare le proprie conoscenze nel campo della cybersecurity. Pertanto, i giovani talenti possono prendere decisioni informate sulla varietà di possibilità offerte dall’istruzione superiore in materia di cybersecurity e di conseguenza le università possono attrarre studenti di alta qualità motivati a mantenere l’Europa sicura.
Figura 4: Programmi stabiliti per anno
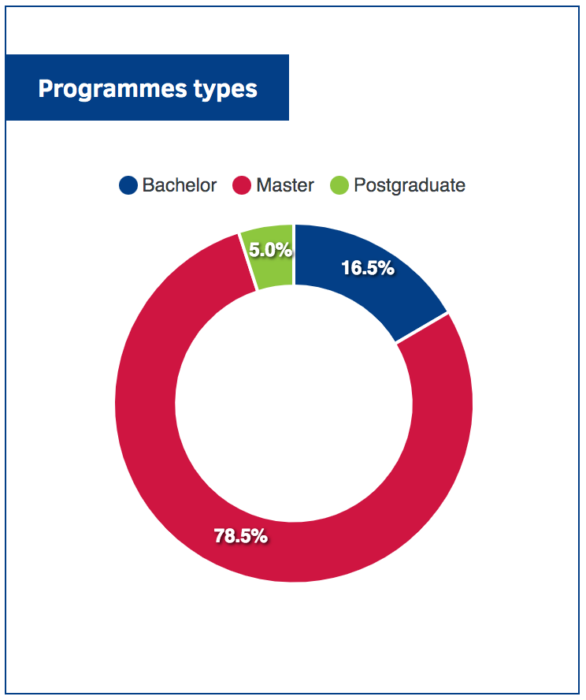
In questo portale sono disponibili 125 programmi educativi in quasi tutti gli Stati membri dell’UE e dell’EFTA. In Italia vi sono 17 programmi nelle più prestigiose università.
Questi programmi indicano la crescente necessità di sviluppare approcci olistici per affrontare le minacce alla sicurezza e i rischi associati alla crescente importanza e all’emergere di nuove tecnologie iperconnesse che stanno plasmando il nostro mondo. Allo stesso tempo, molti istituti si stanno concentrando sulle competenze tecnologiche necessarie per essere all’avanguardia nella ricerca a livello mondiale. Nell’Unione europea esistono numerosi progetti, iniziative e reti che promuovono il settore della cybersecurity nell’UE.
Figura 5: Tipologie di programma
Il panorama della ricerca sulla cybersecurity comprende un’ampia gamma di attività diverse, che toccano la ricerca tecnica e sociale, nonché le politiche in questo ambito. L’integrazione tra questi filoni di azione deve essere affrontata in modo olistico nella ricerca per farlo garantire che i risultati abbiano il massimo impatto. Dobbiamo costruire ponti tra diverse discipline e parti interessate al fine di garantire l’accettazione e il coinvolgimento con la ricchezza del panorama della ricerca sulla cybersecurity nell’UE.
Applicazione dell’Intelligenza artificiale
L’intelligenza artificiale (IA) risulta fondamentale per le ambizioni e la strategia dell’UE per il decennio digitale. L’intelligenza artificiale continuerà a trasformare il modo in cui le aziende e le organizzazioni lavorano, gestiscono i dati e interagiscono con gli utenti attraverso una combinazione di tecnologie avanzate, come Machine Lear (ML), Natural Language Processing (NLP) e il cognitive computing. Vi sono ancora aree in cui sono necessarie ulteriori attività di ricerca e sviluppo per promuovere un’IA affidabile e che sostenga i diritti dei cittadini dell’UE e rispetti i valori dell’UE. Pertanto, è necessario discernere tra l’IA usata per proteggere e l’IA usata per danneggiare. I potenziali criminali sono altamente innovativi e possono sviluppare algoritmi, soluzioni o procedure che alla fine diventeranno nuovi standard nell’arena della criminalità informatica. Inoltre, anche un sistema “sicuro e affidabile” potrebbe essere successivamente dirottato da un altro attore con intenzioni dannose.
I partecipanti all’intersezione tra cybersecurity e intelligenza artificiale spesso si trovano intrappolati nel mezzo della creazione di conoscenze e iniziative di mercato, come la ricerca accademica che si mescola alla ricerca e sviluppo in modo più sfocato del solito, la letteratura peer-reviewed che coesiste con i principali attori coinvolti nelle questioni relative all’IA e alla cybersecurity alle loro condizioni, le principali agenzie di consulenza e consulenti, tutti contribuiscono al progresso collettivo di questo campo di ricerca.
IA per migliorare le difese della cybersecurity
La ricerca dovrebbe concentrarsi su attività comuni di cybersecurity, come la previsione e la prevenzione di attacchi, rilevamento di minacce e intrusioni, risposta, pianificazione e altre aree, e in che modo le attività, le tecniche e i metodi di IA e ML possono essere applicati a indirizzarli. Gli strumenti di intelligenza artificiale offrono prestazioni elevate a basso costo e in tempo reale. In particolare, IA e ML possono automatizzare il rilevamento delle minacce, utilizzando metodi di riconoscimento dei modelli e rilevamento delle anomalie.
Inoltre, i sistemi basati sull’intelligenza artificiale possono anche prevedere i punti di attacco più vulnerabili, consentendo agli operatori di pianificare e allocare le risorse di conseguenza.
IA per per orchestrare gli attacchi cyber
Successivamente, la ricerca dovrebbe avere come obiettivo la protezione dell’IA dal suo possibile utilizzo per orchestrare attacchi informatici, nonché dagli attacchi a meccanismi e strumenti basati sull’IA. Gli aggressori sfruttano l’IA per aumentare l’efficienza dell’attacco, scoprire punti di ingresso vulnerabili, identificare punti deboli precedentemente sconosciuti, automatizzare il meccanismo di attacco ed estenderne l’impatto.
Le attività di ricerca e innovazione dovrebbero valutare regolarmente la validità del modello sviluppato, esaminare attentamente il set di dati disponibile per rilevare ed eliminare le distorsioni e gli squilibri esistenti, nonché sviluppare set di dati standardizzati, per riprodurre e confrontare in modo affidabile le soluzioni basate sull’intelligenza artificiale esistenti.
Cybersecurity in life science
I governi e gli esperti di sicurezza hanno identificato il settore “life science” come particolarmente vulnerabile alla criminalità informatica. L’importanza di rivedere le questioni relative alla cybersecurity nella life science, e in particolare nelle biotecnologie, non è diversa da molte altre infrastrutture critiche (ad esempio l’industria chimica, la fisica nucleare, ecc.). Tuttavia, la mancanza di consapevolezza e di controlli di cybersecurity specifici per affrontare i rischi e le implicazioni a lungo termine che possono avere implicazioni per la vita stessa conferisce un senso di urgenza alla necessità di rivedere questo argomento dal punto di vista della ricerca.
Quando si tratta di cybersecurity, l’innovazione sta rapidamente diventando un’arma a doppio taglio per i clienti delle scienze biologiche.
Pertanto, come sottolineato dall’ENISA nel report “Research and Innovation”, emerge il termine cyberbiosecurity il quale mira a identificare e mitigare i rischi per la sicurezza promossi dalla digitalizzazione della biologia e dall’automazione delle biotecnologie.
La cyberbiosecurity è stata inizialmente definita come la “comprensione delle vulnerabilità alla sorveglianza indesiderata, alle intrusioni e alle attività dannose che possono verificarsi all’interno o alle interfacce di scienze mediche e biologiche, dimensione cyber-fisica, catena di approvvigionamento e sistemi infrastrutturali”[4].
Conclusioni
Investire nella cybersecurity è di fondamentale importanza, affinché i cittadini possano fidarsi e beneficiare delle innovazioni, della connettività e dell’automazione, come pure per salvaguardare i diritti e le libertà fondamentali, compresi i diritti alla riservatezza e alla protezione dei dati personali nonché la libertà di espressione e di informazione.
Sebbene l’Europa sia in prima linea come contributore globale alla ricerca e innovazione nella cybersecurity, ci sono diverse sfide che devono essere affrontate sul panorama globale.
In primo luogo, ai ricercatori è richiesto un approccio interdisciplinare. Poiché l’ecosistema digitale continua ad espandersi con l’Internet-of-Things (IoT) e altri dispositivi connettono individui, organizzazioni e catene del valore tramite telefoni cellulari, sistemi centrali, data center e anche dispositivi aerei, l’IA può ricoprire un fattore chiave e la tecnologia sottostante in diversi settori come le telecomunicazioni mobili di prossima generazione, la cybersecurity e le biotecnologie (es. cyber biosecurity e synthetic biology). Si prevede che lo sviluppo del 6G raggiungerà la maturità tecnologica e la standardizzazione nel prossimo decennio, con un impatto sul modo in cui le persone interagiscono con il mondo digitale oltre il 2030. Il 6G si baserà sull’IA per la sua funzione di livello fisico principale e consentirà un’ampia gamma di nuove applicazioni basate sull’intelligenza artificiale.
Inoltre, risultano fondamentali l’organizzazione e il coordinamento degli sforzi di ricerca tra gli stati nel contesto globale. In tale scenario, l’UE dovrebbe continuare a collaborare con i partner internazionali per promuovere un modello politico e una visione del ciberspazio fondato sullo Stato di diritto, sui diritti umani, sulle libertà fondamentali e sui valori democratici che generino sviluppo sociale, economico e politico a livello globale e contribuiscano a un’Unione della sicurezza.
[4] Randall S Murch, William K So, Wallace G Buchholz, Sanjay Raman, and Jean Peccoud. Cyberbiosecurity: An emerging new discipline to help safeguard the bioeconomy. Frontiers in bioengineering and biotechnology, 6:39, 2018.
Articolo a cura di Luca Barbieri
Profilo Autore
Luca Barbieri è laureato in Giurisprudenza presso l’Università Luiss Guido Carli con tesi intitolata “From cyber espionage to cyber warfare: a criminal comparative analysis between Italy, USA and China”, nella materia di Diritto Penale, con il Prof. A. Gullo. Durante l’Exchange Program, presso la Beijing Normal University di Pechino, ha sostenuto numerosi esami in diritto cinese e cyber security. Inoltre, ha conseguito il Master universitario di secondo Livello in “Responsabile della protezione dei dati personali: Data Protection Officer e Privacy Expert” presso l’Università Roma Tre. Attualmente collabora in uno studio legale specializzato in diritto delle nuove tecnologie, privacy e cyber security.
Protezione dei dati, la Cina multa la Didi Global per 1,2 miliardi di dollari
Si è conclusa giovedì l’indagine che ha visto al centro dell’attenzione la Didi Global Inc che rappresenta una delle più grandi piattaforme tecnologiche per la mobilità al mondo. L’Autorità per la regolamentazione della sicurezza informatica cinese (CAC) ha multato per 1,2 miliardi di dollari l’azienda per aver violato alcune delle principali leggi in ambito data protection.
La società con sede in Cina offre un’ampia gamma di servizi tramite le sue app in tutto il mondo (America Latina, Asia-Pacifico e Africa) arrivando ad affermarsi leader del mercato di ride-hailing. La decisione arriva proprio nel momento in cui l’azienda si affacciava al mercato azionario americano mettendo così in guardia milioni di investitori.
Secondo la Cyberspace Administration of China (CAC) la Didi avrebbe violato pesantemente la privacy dei suoi utenti. Il colosso avrebbe raccolto illegalmente negli ultimi sette anni, quindi a partire dal 2015, milioni di informazioni sui suoi clienti danneggiando così la sicurezza nazionale.
La multa inflitta corrisponde a 8,026 miliardi di yuan, corrispondenti a 1,2 miliardi di dollari, e le violazioni sono costate 1 milione di yuan al fondatore ed amministratore delegato Cheng Wei ed altrettanto al presidente Jean Liu.
La società Didi, sostenuta dall’azienda americana Uber Technologies Inc e dalla giapponese SoftBank Group Corp, tramite una dichiarazione rilasciata dal proprio account Weibo, ha dichiarato di accettare la decisione del CAC e di aver già cominciato la procedura di verifica delle violazioni.
Didi Chuxing, dopo esser entrata nel mercato azionario americano, puntava alla borsa di Hong Kong cercando di quotarsi, secondo i piani iniziali, proprio nei mesi estivi. Tuttavia, ha dovuto sospendere questi progetti a tempo indeterminato a causa della decisione delle autorità cinesi.
Il provvedimento preso dall’autorità cinese si incastra perfettamente all’interno di un quadro normativo in continua evoluzione per quanto riguarda la tutela dei cittadini rispetto alle violazioni di cyber sicurezza. Sembra, così, solo uno dei tanti segnali forti che il governo cinese dà alle sue aziende intimandole di rispettare la privacy dei cittadini.
Blockchain e Data Protection: (in)compatibilità fra GDPR e tecnologie DLT
In un precedente contenuto in tema di Distributed Ledger Technologies (DLT) e protezione dati sono state analizzate le principali fonti normative e le definizioni maggiormente condivise dalla comunità internazionale, al fine di ricostruire l’esatto contesto giuridico e terminologico di riferimento per la materia trattata.
La trasversalità delle tecnologie DLT – in particolare della blockchain – a numerosi e rilevanti settori di attività economica, finanziaria, commerciale ne impongono infatti il contemperamento con la disciplina nazionale e comunitaria. Quest’ultima, rappresentata in primo luogo dal GDPR, oggi risulta peraltro ampliata dal Regolamento 2022/858 che istituisce un regime pilota per le infrastrutture di mercato basate su tecnologie a registro distribuito (la maggior parte delle previsioni acquisterà vigore a partire dal 2023).
La prospettiva europea
A riprova dell’attenzione degli organi UE sul tema, già nel 2019 lo European Parliamentary Research Service (EPRS) pubblicava la ricerca condotta dal Panel for the Future of Science and Technology (STOA) “Blockchain and the General Data Protection Regulation. Can distributed ledgers be squared with European data protection law?”, frutto di un approfondito esame del quadro normativo e tecnologico esistente al fine di rispondere alla domanda posta nel titolo.
Ma questa ricerca, pur dettagliata, non risolve certo ogni questione che solleva: resta ad esempio da chiedersi se chiunque conduca transazioni capaci di produrre effetti nel territorio UE sia tenuto all’osservanza del GDPR, con gli annessi oneri di compliance (ad esempio svolgere la DPIA) e soprattutto se, laddove siano riscontrate violazioni o inottemperanze della relativa disciplina, vada soggetto ad alcun tipo di sanzioni.
Domande tuttora aperte, come anche la scelta delle possibili soluzioni; specie considerando che a breve il quadro sarà significativamente impattato dalla citata proposta di Regolamento MiCA, volta a disciplinare il mercato dei cryptoasset – dove l’impiego di database distribuiti è la regola, non l’eccezione – in chiave antiriciclaggio e di prevenzione delle frodi.
Aspetti problematici: tipologie di dati e principi del trattamento
Il Regolamento del 2018, fra le sue numerose statuizioni, dedica ampio spazio ai principi di correttezza e trasparenza che devono permeare ogni processo di gestione dei dati personali: principi in apparenza coerenti con il pianeta blockchain, che della trasparenza ha sempre fatto una delle sue bandiere (come riconosciuto anche nel documento UE) ma spesso difficili da applicare sul piano concreto.
Va ancora una volta ricordato che, ai sensi dell’art. 4 del GDPR, si definisce dato personale “qualsiasi informazione riguardante una persona fisica identificata o identificabile… [come] il nome, un numero di identificazione, dati relativi all’ubicazione, un identificativo online o uno o più elementi caratteristici della sua identità fisica, fisiologica, genetica, psichica, economica, culturale o sociale”.
Al di là delle opzioni di anonimizzazione ammesse dall’impiego di tecnologie DLT, infatti, l’abbinamento di una chiave pubblica a tutte le transazioni condotte facendone uso potrebbe ben consentire l’identificazione della persona fisica che utilizza quella specifica chiave, così da riportare queste informazioni entro il concetto di “dato personale” previsto dal Regolamento.
E il diritto all’oblio?
Le cose si complicano se ricordiamo che il GDPR, come d’altronde il Codice in materia di protezione dei dati personali italiano, esige sia sempre possibile identificare titolare e responsabile del trattamento dei dati, verso cui ogni interessato potrà far valere eventuali richieste di rettifica o rimozione degli stessi.
Rispetto alle piattaforme permissioned il problema dell’identificazione si attenua grazie alla necessaria registrazione/autorizzazione a cui va soggetto chiunque intenda farsi nodo della rete; la persona o ente incaricato di rilasciare tali autorizzazioni sarà, tendenzialmente, titolare del trattamento ai sensi del GDPR. Meno intuitiva è la soluzione per le permissionless, dove l’ingresso di nuovi soggetti non è subordinato ad alcuna forma di controllo “centrale”.
Inoltre le caratteristiche di immodificabilità di quanto immesso in una blockchain o altra piattaforma DLT – previste a garanzia della certezza e stabilità delle transazioni – appaiono in evidente conflitto con la pretesa legale di veder modificati, se non cancellati, i propri dati; aspetto che tuttavia la ricerca UE, richamando l’art. 17 del GDPR, solennemente definisce “strumento di autodeterminazione” nella gestione delle informazioni personali (“an important tool towards more informational self-determination”).
Anche su questo fronte, che include il delicato tema del diritto all’oblio, le questioni poste dallo STOA restano per lo più irrisolte: nel prossimo articolo, conclusivo di questa breve panoramica sul rapporto fra Distributed Ledger Technologies e tutela dei dati personali, saranno esaminate le differenti soluzioni regolatorie ipotizzabili per il futuro.
Il crescente ruolo dell’AI in ambito militare: la visione della Russia
L’Intelligenza Artificiale (AI) rappresenta l’archetipo di quelle che vengono definite disruptive technologies: ovvero tecnologie capaci di trasfigurare completamente i contesti su cui intervengono, che in questo caso appaiono innumerevoli e di rilevanza globale.
L’impiego dell’AI ha già rivoluzionato strumenti e strategie nei settori più svariati, dal marketing alla sicurezza pubblica e privata. Tra chi fa ricerca sul tema c’è chi arriva a definirla una nuova forma di potere coloniale, anche in ragione della sua progressiva applicazione a fini di controllo delle frontiere. È proprio in questo senso – soprattutto nel campo militare – che vanno profilandosi le trasformazioni più rilevanti, non di rado potenzialmente deleterie per i diritti delle persone coinvolte.
Applicando i paradigmi dell’Intelligenza Artificiale ai contesti bellici si comprende infatti come il concetto di guerraibrida riguardi tanto i vari piani (geo-fisico, economico, logistico, informatico) in cui si declinano le ostilità, quanto gli strumenti con cui le guerre contemporanee vengono condotte. Esiste una dimensione sempre più “immateriale” dei conflitti, lontana dal corpo a corpo delle battaglie novecentesche ma non per questo meno incisiva; a farne parte sono le azioni di cyber warfare contro infrastrutture digitali che mostrano quotidianamente il loro potenziale di rischio, come anche le campagne di propaganda e disinformazione online mirate a orientare il consenso mediatico o elettorale, fondate sull’elaborazione di enormi quantità di dati. L’AI “armata” (weaponized Artificial Intelligence) implica un ulteriore passaggio, che traduce gli effetti del digitale in una dimensione pienamente “fisica”.
Vanno infatti considerate anche le vere e proprie armi a cui l’Intelligenza Artificiale apporta o potrà apportare un potenziamento in chiave di pianificazione strategica ed esecuzione operativa. Non più semplicemente controllo remoto di meccanismi semi-autonomi – il riferimento più immediato è ai droni, presenti sugli scenari bellici sin dagli anni Duemila e oggi sempre più indipendenti nell’individuazione degli obiettivi – o strumenti di analisi e diagnostica per i mezzi militari maggiormente efficaci. Nel prossimo futuro la ricerca pare promettere un livello di automazione tale da consentire a chi controlli la relativa tecnologia forti vantaggi competitivi sul terreno di conflitto, con la possibilità di ridurre le perdite e prevedere in anticipo le mosse avversarie. Naturalmente gestire tali strumenti e le immense quantità di dati necessarie ad alimentarli implica rischi esponenziali, nel caso in cui il nemico riesca ad entrarne in possesso.
Il tema, ancora in divenire, delle cosiddette Lethal Autonomous Weapons Systems o LAWS è già stato oggetto dei primi tentativi di regolamentazione internazionale tesi a includere questa tecnologia emergente nella cornice dei principi generali del diritto umanitario. Fra le regole individuate dal Gruppo di esperti in materia (comprensivo di rappresentanti dei governi, ricercatori e imprenditori dell’AI) riunitosi a Ginevra nel 2017 spicca inoltre la necessità di garantire cybersecurity e accountability dei sistemi, oltre al connesso divieto di mantenere la responsabilità decisionale a livello umano anziché delegarla a procedure automatizzate.
La presa di parola degli organismi sovranazionali muove, d’altronde, dalla consapevolezza che da anni numerose potenze statali destinano ingenti investimenti a esplorare le possibili applicazioni dell’AI al comparto militare.
Tra queste notoriamente la Russia, il cui governo non fa mistero del proprio interesse per queste tecnologie. Ma se in Europa e USA la ricerca in materia avviene per lo più a livello accademico e nell’industria privata, a Mosca (come pure a Pechino) l’Intelligenza Artificiale è un affare di Stato: gran parte degli sviluppi in campo di automazione e robotica provengono da aziende pubbliche o comunque facenti capo al Ministero della Difesa, con tanto di istituti bancari dedicati. Tra i filoni destinatari dei maggiori investimenti risultano la modernizzazione e la riorganizzazione di un apparato bellico – nei domini terrestri, marittimi, aerei, spaziali – in alcuni casi datato all’epoca sovietica.
Da un lato quindi è chiara l’esigenza di “svecchiare” il comparto militare, anche in considerazione dei molteplici fronti di guerra aperti dall’aggressiva politica estera del Cremlino; dall’altra appare forte la volontà di proseguire la tradizionale attenzione russa all’innovazione tecnologica, già evidente ai tempi della Guerra Fredda, nonché di tenere il passo nella corsa internazionale agli armamenti (digitali) che vede negli sviluppi futuribili dell’AI uno degli obiettivi più ambiziosi. La Russia si è dichiarata contraria a imporre limiti condivisi alla ricerca sulle LAWS, come del resto anche gli USA.
Analogamente a ogni altra tecnologia dual-use, l’impiego di strumenti dotati di Intelligenza Artificiale include certamente prospettive “benefiche”: è il caso dei dispositivi volti all’esplorazione dei luoghi per prevenire vittime civili, o dei robot dedicati alle operazioni di sminamento post-belliche. Ma resta chiaro il potenziale distruttivo di armi ipoteticamente slegate da ogni controllo e valutazione umana, specie ove unito alla frequente opacità delle tecnologie (qui ulteriormente rafforzata dal segreto militare) e alla possibile creazione di nuove vulnerabilità in contesti altamente critici.
Rischi severi, tali da imporre regole condivise e una puntuale analisi di tutti i rischi prima di poter consentire un’inclusione di questi strumenti fra i mezzi legittimamente impiegati nelle controversie internazionali.
App e Sicurezza nazionale: come cambia la cyber security in Cina
Cyber security cinese: quadro normativo
In Cina sono state condivise le nuove regole che disciplineranno le app mobili e, come dichiarato dal Cyberspace Administration of China (“CAC”, 国家互联网信息办公室), quale responsabile del coordinamento dell’attuazione del quadro di revisione della cyber security cinese, tali regole supporteranno un “sano sviluppo del settore tecnologico”. Più precisamente, l’utilizzo sempre più frequente nella popolazione cinese delle app mobili ha dato origine a nuove possibili minacce, pertanto, secondo l’agenzia risultano necessarie regole che “siano soggette a revisione con l’obiettivo di adattarsi ai nuovi sviluppi”[1].
Nel dettaglio, tali norme entreranno in vigore dal 1° agosto e obbligheranno i fornitori a non utilizzare le app per svolgere attività che possano mettere in pericolo la sicurezza nazionale.
Inoltre, giova ricordare che le app mobili in grado di influenzare l’opinione pubblica saranno soggette ad una revisione della sicurezza. Più precisamente, il Cyberspace Administration of China, in collaborazione con altri 12 dipartimenti governativi (collettivamente noto come il “Working Mechanism”), ha pubblicato il 4 gennaio 2022 le “New Measures for Cybersecurity Review” (网络安全审查办法).
Tali misure estendono la revisione della cyber security alle attività di trattamento dei dati svolte dagli operatori di piattaforme Internet ed alcune società cinesi quotate all’estero.
In particolare, come si evince dall’art. 5 dal provvedimento “New Measures for Cybersecurity Review”, i CIIO (Critical Information Infrastructure Operators) che acquistano prodotti e servizi di rete e gli operatori di piattaforme di rete (网络平台运营者) che svolgono attività di elaborazione dei dati devono segnalare all’Ufficio competente la revisione di cyber security se tali attività influiranno o potranno incidere sulla sicurezza nazionale.
Per richiedere un riesame della sicurezza informatica, le società interessate dovranno presentare i seguenti elementi:
Un modulo di dichiarazione;
Rapporti di analisi che influiscono o possono influire sulla sicurezza nazionale;
Documenti di appalto, accordi, contratti da firmare o offerta pubblica iniziale (IPO) e altri documenti di domanda di quotazione da presentare;
Altro materiale necessario per il lavoro di revisione della sicurezza della rete.
In aggiunta, l’art. 10 afferma che la revisione della cyber security verte sui determinati fattori di rischio per la sicurezza nazionale, ad esempio:
Il rischio di controllo, interferenza o distruzione illegale di infrastrutture informatiche critiche determinato dall’uso di prodotti e servizi;
Il danno alla continuità operativa dell’infrastruttura informativa critica causato dall’interruzione della fornitura di prodotti e servizi;
La sicurezza, l’apertura, la trasparenza e la diversità delle fonti di prodotti e servizi, l’affidabilità dei canali di approvvigionamento e il rischio di interruzioni dell’approvvigionamento dovute a fattori politici, diplomatici, commerciali e di altro tipo;
La conformità dei fornitori di prodotti e servizi alle leggi, ai regolamenti amministrativi e alle regole dipartimentali cinesi;
Il rischio che dati di base o una grande quantità di informazioni personali vengano rubati, trapelati, danneggiati, utilizzati illegalmente o che escano illegalmente dal paese;
Viene menzionato il rischio che l’infrastruttura dell’informazione chiave, i dati principali o una grande quantità di informazioni personali siano influenzati, controllati o utilizzati in modo dannoso da governi stranieri;
Altri fattori che possono mettere in pericolo la sicurezza dell’infrastruttura dell’informazione critica, la sicurezza della rete e la sicurezza dei dati.
Il nuovo provvedimento include anche l’obbligo per gli utenti di autenticare la propria identità tramite i seguenti elementi:
Numeri di cellulare;
Numeri di carta d’identità;
Codici di credito sociale unificati.
Tuttavia, i fornitori di app avranno il compito di controllare la veridicità di quanto affermato dagli utenti. Per le ipotesi di falsa dichiarazione agli utenti verrà impossibilitato l’utilizzo di tali servizi.
Il caso DiDi
Sono numerosi gli episodi in cui le società sono state soggette a tale revisione, secondo i dati del Ministero dell’Industria e dell’Information Technology negli ultimi due anni il numero di app è sceso da 4,49 milioni a 2,31 milioni.
I casi di revisione che hanno riscosso maggiori interessi sono avvenuti il 2 e 5 luglio 2021. Più precisamente, il Cyberspace Administration of China (“CAC”, 国家互联网信息办公室) ha dichiarato di aver avviato revisioni di cyber security nei confronti di quattro app mobili, nel dettaglio:
DiDi Chuxing Inc la quale gestisce piattaforme di trasporto passeggeri. L’azienda fornisce soluzioni di mobilità, cloud computing e altri servizi basati su applicazioni. DiDi opera in Cina e nel resto del mondo[2];
Yunmanman funziona come un software mobile. L’azienda offre principalmente servizi di spedizione del trasporto merci e servizi logistici intelligenti. Yunmanman fornisce servizi principalmente in Cina;
Huochebang è un fornitore di una piattaforma logistica per camion online. L’azienda fornisce una piattaforma di trasporto merci su camion O2O (Online-to-Offline) che fornisce servizi integrati a camionisti e spedizionieri in Cina;
BOSS Zhipin è una piattaforma di reclutamento online in Cina[3].
Pertanto, il 4 luglio 2021, il Cyberspace Administration of China (“CAC”, 国家互联网信息办公室), dopo la revisione ha annunciato che l’app Didi comportava una grave violazione della legge “raccogliendo e utilizzando illegalmente informazioni personali”, pertanto l’Ufficio ha avanzato la richiesta di rimozione dell’app Didi dagli app store cinesi[4].
Giova ricordare che la revisione della cyber security è stata inizialmente indicata dall’art. 35 della Legge sulla cyber security della Repubblica popolare cinese (中华人民共和国网络安全法) in forza del quale gli operatori di infrastrutture informatiche critiche che acquistano prodotti e servizi di rete in grado di incidere sulla sicurezza nazionale, devono superare il riesame della sicurezza nazionale organizzato dal dipartimento nazionale di informazione sulla rete in collaborazione con i servizi competenti del Consiglio di Stato.
Conclusioni
In conclusione, è oggettivo come per il governo cinese la principale finalità di tali revisioni nei confronti delle aziende tech non risiede nelle sanzioni, ma nella possibilità di ricoprire un ruolo di “key player” nelle decisioni aziendali, concedendo queste ultime anche l’1% delle loro azioni allo Stato, di conseguenza i funzionari potranno avere maggiore voce in capitolo nella gestione delle loro attività. Marvin Chen, analista di Bloomberg Intelligence, ha descritto tali indiscrezioni come “un segno che le autorità di regolamentazione stanno dando seguito al loro impegno di porre fine alla repressione delle piattaforme tecnologiche, che probabilmente continuerà a migliorare il sentiment sul settore”[5].
Luca Barbieri è laureato in Giurisprudenza presso l’Università Luiss Guido Carli con tesi intitolata “From cyber espionage to cyber warfare: a criminal comparative analysis between Italy, USA and China”, nella materia di Diritto Penale, con il Prof. A. Gullo. Durante l’Exchange Program, presso la Beijing Normal University di Pechino, ha sostenuto numerosi esami in diritto cinese e cyber security. Inoltre, ha conseguito il Master universitario di secondo Livello in “Responsabile della protezione dei dati personali: Data Protection Officer e Privacy Expert” presso l’Università Roma Tre. Attualmente collabora in uno studio legale specializzato in diritto delle nuove tecnologie, privacy e cyber security.
Blockchain e Data Protection: prospettive future nelle policy UE
I precedenti articoli dedicati al rapporto fra tecnologie DLT e tutela dei dati personali hanno rispettivamente esposto il contesto giuridico-terminologico di riferimento e i punti di contatto, nonché di potenziale contrasto, fra tali strumenti e la cornice comunitaria. Quest’ultima, rappresentata in primo luogo dal GDPR, oggi risulta peraltro ampliata dal Regolamento 2022/858 che istituisce un regime pilota per le infrastrutture di mercato basate su tecnologie a registro distribuito (la maggior parte delle previsioni acquisterà vigore a partire dal 2023).
Qui – a chiusura di una sintetica disamina ispirata dalla ricerca UE“Blockchain and the General Data Protection Regulation. Can distributed ledgers be squared with European data protection law?” – si guarderà alle possibili soluzioni che negli anni a venire dovranno armonizzare l’impiego, presumibilmente sempre più massiccio, delle Distributed Ledger Technologies con i principi della Data Protection facenti parte del patrimonio normativo europeo.
DLT e GDPR: le proposte dell’EPRS
Come già emerso nel secondo contenuto, il principale elemento critico nella relazione fra tecnologie distribuite e tutela dei dati personali risiede nella difficoltà – stante la natura decentralizzata delle prime – di identificare i responsabili del trattamento dei secondi garantendone l’accountability, particolarmente nelle blockchain permissionless. Ma anche l’immodificabilità delle transazioni condotte su un registro distribuito suscita non pochi problemi, rendendo difficile (quando non impossibile) l’esercizio dei diritti alla rettifica o alla cancellazione dei propri dati attribuiti al titolare dagli articoli 16 e 17 GDPR.
Assunte tali difficoltà la citata ricerca UE ipotizza comunque che queste tecnologie, in quanto strumenti di Data Governance, possano contribuire agli obiettivi del Regolamento; indicando a tal fine tre distinte opzioni, che intendono rappresentare altrettante proposte rivolte al legislatore comunitario.
La prima opzione di policy apre alla possibilità di individuare delle linee guida interpretative del GDPR (senza che ne siano necessarie modifiche, in quanto cornice neutrale applicabile a ogni tipo di tecnologia) per facilitarne un’attuazione uniforme nei vari Stati membri, nel contesto di una data-economy in rapida evoluzione;
la seconda ipotesi prevede il sostegno all’adozione di codici di condotta e meccanismi di certificazione da parte del settore privato, che meglio saprebbe individuare possibili casi d’uso e identificare le diverse tipologie di informazioni trattate;
l’ultima azione riguarda il supporto alla ricerca, per integrare le conoscenze attualmente disponibili con indagini interdisciplinari (es. sugli algoritmi di consenso) ed esperimenti volti a individuare nuovi protocolli blockchain che possano dimostrarsi “compliant by design”.
Ma non c’è solo l’Europa
Il citato Regolamento UE n. 858, adottato lo scorso 30 maggio, parte proprio dalla “tokenizzazione” degli strumenti finanziari in atto per sottolineare la necessità che tale tendenza venga contemperata con l’economia “reale”: a tale scopo designa l’ESMA – European Securities and Markets Authority come soggetto centrale incaricato di rilasciare eventuali autorizzazioni e monitorare le relative attività, prevedendo taluni standard essenziali a difesa degli investitori e della stabilità dei mercati per evitare vuoti di disciplina (“regulatory loopholes”) che lascino spazio a incertezze o ad abusi.
Anche la Banca d’Italia, con la recente “Comunicazione in materia di tecnologie decentralizzate nella finanza e cripto-attività” (datata 2 giugno 2022), evidenzia la scarsità di regole condivise per questi “ecosistemi decentralizzati”, rammentando che “la forte connessione esistente tra tali fenomeni e le istanze di mantenimento della stabilità finanziaria e monetaria costituisce la ragione per cui le banche centrali osservano e monitorano con grande attenzione l’operatività di tali soggetti”. Tra le caratteristiche che le tecnologie DLT impiegate in ambito finanziario devono necessariamente garantire, il documento menziona continuità del servizio, resilienza agli attacchi informatici, scalabilità ed efficienza (sia economica sia ambientale) e una governance “robusta e identificabile”: tutte senz’altro necessarie a fini di stabilità dei mercati finanziari ma, in effetti, anche per garantire la salvaguardia dei dati personali a vario titolo coinvolti.
Ma le tecnologie distribuite esistono e prosperano anche al di fuori dei confini europei, senza tenere in alcun conto i confini geografici o i vari “paletti” imposti dalle normative locali; qualunque previsione, per quanto stringente, rischia allora di risultare evanescente e poco risolutiva rispetto a transazioni i cui effetti si propagano in un mercato globale sempre più smaterializzato.
Nell’impossibilità di concepire – e di far rispettare – una disciplina della materia organicamente internazionale, per l’Europa l’alternativa percorribile sembra allora seguire nel solco di una disciplina “minima” che si limiti a mantenere gli standard a protezione dei dati personali aggiornati al mutevole contesto tecnologico: approccio sicuramente rispettoso delle cornici nazionali e maggiormente flessibile rispetto alle novità di mercato, purché si sia consapevoli dei “regulatory loopholes” paventati dall’EPRS e si rimanga pronti a gestire le inevitabili criticità o controversie con un’accorta valutazione case by case.
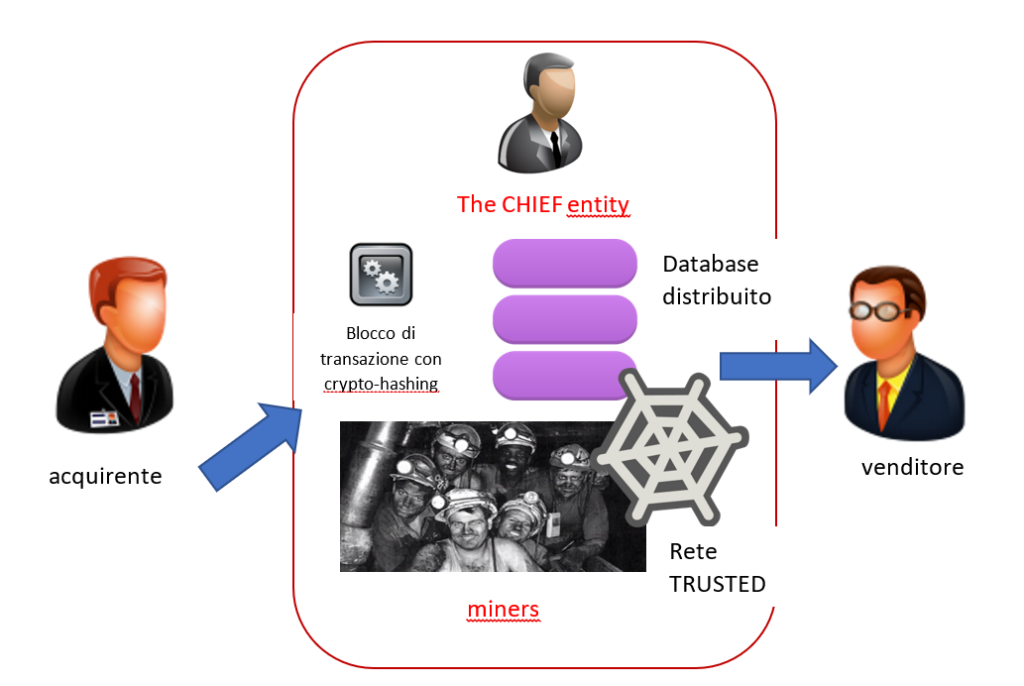
A partire dall’idea innovativa documentata nel whitepaper “Bitcoin: A Peer-to-Peer Electronic Cash System” (2008) del sì celeberrimo ma fisicamente ignoto Satoshi Nakamoto, la Blockchain si è sviluppata negli anni come un paradigma tecnologico applicabile in contesti non più esclusivamente correlati alle criptovalute. Se Bitcoin ne è stata la prima reale declinazione su larga scala, ad oggi se ne ritrova ampio margine di crescita nel contesto degli Smart Contracts/Chaincode, della notarizzazione dei processi, della diffusione di una cultura informativa digitale che sta virando con sempre maggior decisione su concetti innovativi come la decentralizzazione e distribuzione del consenso.
Due delle più diffuse e mature tecnologie Blockchain sono Ethereum e Hyperledger, e spesso per semplificarne i tratti essenziali e per agevolare la scelta su quale delle due preferire per il proprio modello, si è soliti focalizzare la distinzione in termini di <open + public + Permissionless (Ethereum)>, piuttosto che <closed + private + Permissioned (Hyperledger)>.
Possession e Ownership
Premessa doverosa è comprendere la distinzione di base che vi è tra possession e ownership, e come essa si applichi al contesto Blockchain: nel caso del primo termine, traducibile in italiano come “possesso”, si fa riferimento a un aspetto correlato al controllo fisico di un oggetto o di una entità, per cui il possessore ha più diritto di qualunque altro di reclamarne la proprietà. Nel caso della ownership, traducibile appunto in italiano come “proprietà”, il riferimento è all’acquisizione (o concessione) di diritti nei confronti di qualunque altra entità di utilizzare, disporne, distruggerlo, secondo una scala di possesso definita/indefinita su base temporale.
Come si declini tale concetto – applicato al paradigma Blockchain – anche in termini prettamente legali è tutt’ora materia di studio di (poche e selezionate) figure specialistiche in giurisprudenza, ma se rapportiamo il tutto nel contesto di una rete decentralizzata basata sul consenso distribuito è senza dubbio corretto affermare che il concetto di ownership sia preponderante rispetto a quello di possession: con tale termine si definisce nel paradigma stesso l’immutabilità della proprietà, se non fino a quando l’effettivo proprietario non verifichi una modifica alla ownership stessa. Il mondo degli NFT (non-fungible tokens), spesso luogo di fraintendimenti e banalizzazioni concettuali proprio causati da una certa complessità della basi teoriche su cui si fonda, propone un’ottima concretizzazione del concetto, codificando la proprietà nella Blockchain come un record (crittografato) e riferito a un oggetto dotato di una qualche caratteristica unica.
In un contesto Blockchain, la semantica della ownership può assumere particolarità specifiche a seconda della tipologia di rete che è stata realizzata, sulla base di criteri di accesso, visibilità, restrizione, validazione del consenso.
Permissionless vs Permissioned
Alla base, la distinzione sottesa dai due termini è correlata al modo con cui la rete viene realizzata by design: Permissionless implica la partecipazione aperta, Permissioned implica la restrizione della partecipazione ad alcuni partecipanti selezionati in base a determinati criteri. L’ambito di applicabilità dell’apertura al mondo piuttosto che di una selettiva (elitaria) restrizione è correlato all’interazione con la rete Blockchain e in particolare alla partecipazione al processo di validazione del consenso.
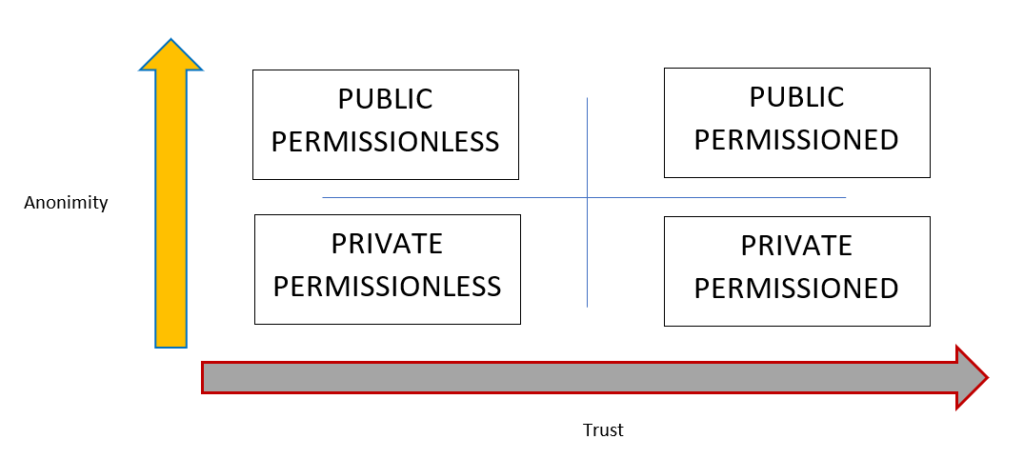
Public Permissionless vs Public Permissioned vs Private Permissionless vs Private Permissioned
Tradizionalmente, le reti Blockchain sono suddivise in Permissionless e Permissioned, come esplicitato nel paragrafo precedente, ma le recenti declinazioni del paradigma in termini di nuove tecnologie e particolarità nell’ambito degli Smart Contracts, hanno richiesto un ulteriore livello di raffinamento nella definizione della tassonomia di una rete.
Ecco, dunque, l’introduzione di due ulteriori discriminanti, public e private, qualificatori che in verità sono già ben noti ad analisti e sviluppatori software, seppur secondo semantiche differente: è proprio su una presunta assonanza di significato che può nascere una errata interpretazione. Proviamo a chiarire.
In una Blockchain pubblica, chiunque è libero di unirsi e partecipare alle attività principali della rete, operando in base a uno schema incentivante che incoraggia i nuovi partecipanti a aderire e mantenere agile la rete. Le Blockchain pubbliche offrono una soluzione particolarmente efficace dal punto di vista di una architettura veramente decentralizzata, democratizzata e priva di autorità. Non esistono entità con autorità sul sistema complessivo.
Figura 1: struttura a Blockchain pubblica
Una Blockchain privata consente solo l’ingresso selezionato di partecipanti verificati, ovvero che abbiano passato un predeterminato processo di controllo basato su algoritmica specifica; l’operatore di rete (in altri contesti, l’admin) ha il diritto di convalidare, sovrascrivere, modificare o eliminare le entità attestate sulla rete. E dunque presenta almeno una autorità centrale dotata di alto livello di privilegio.
La distinzione principale tra Blockchain pubbliche e private consiste nel controllo di chi è autorizzato a partecipare alla rete: le reti private eseguono un protocollo di consenso che decide i diritti di mining e le ricompense e mantengono il registro condiviso (distribuited ledger). Una Blockchain privata dunque non è realmente decentralizzata ed è rappresentabile come un registro distribuito che opera nello stesso modo di un database chiuso e sicuro, basato by design su tecniche di crittografia.
Figura 2: struttura a Blockchain privata
Ora: che senso può avere dunque parlare di Public Permissioned o Private Permissionless Blockchain? I qualificatori sembrerebbero in antitesi! La chiave di lettura di tali tipologie di reti, ad oggi in rapida diffusione, è da ricercarsi nella necessità di colmare la necessità di reti che posseggano caratteristiche derivate da entrambe le accezioni, Permissioned e Permissionless. Una soluzione possibile è rintracciabile nelle Consortium Blockchain (dette anche “Federated” o “Consorzi”), ottimali in contesti in cui è necessaria una collaborazione a livello dell’intera organizzazione, con una forte richiesta di scalabilità architetturale e sicurezza.
Le Public Permissioned sono di fatto una particolarità dei cosiddetti Consorzi: consentono a chiunque di unirsi alla rete autorizzata previa un’adeguata verifica della propria identità, nonché l’assegnazione di autorizzazioni selezionate e designate per eseguire esclusivamente determinate attività sulla rete. Ad esempio, Ripple, una delle più grandi criptovalute diffuse al 2022, supporta proprio i ruoli basati sulle autorizzazioni per i partecipanti.
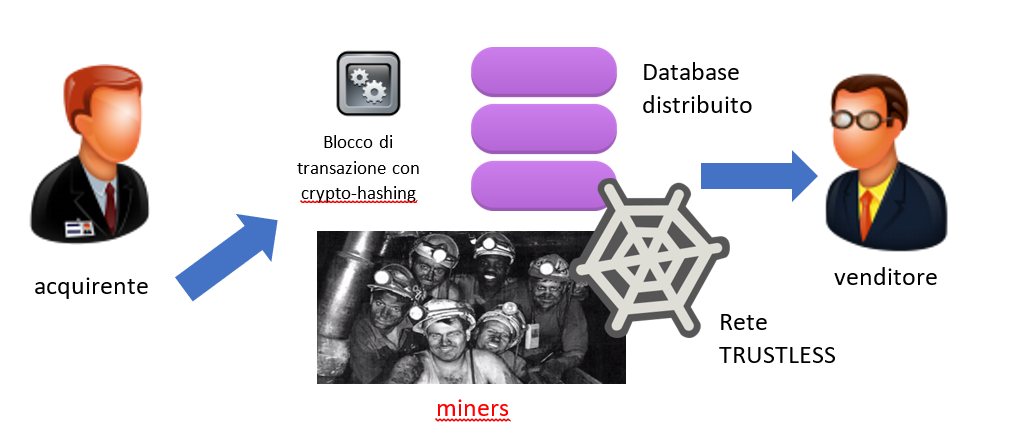
Figura 3: tipico anonymity/trust schema Blockchain
Al contrario, una Private Permissionless Blockchain rappresenta una particolarità che recentemente si sta diffondendo come ottimale per applicazioni di tipo Smart Contracts: in modo simile alle reti Public Permissionless, chiunque può partecipare alla costruzione di un nodo in una rete Private Permissionless. Tuttavia, a differenza della Blockchain pubblica, gli altri nodi ne riconosceranno l’esistenza ma non condivideranno alcun dato, in coerenza con la natura di privata della rete. Gli Smart art Contracts su queste reti private non solo definiscono chi è autorizzato ad eseguire azioni contrattuali, ma anche chi è autorizzato a leggere il contratto e tutti i dati relativi. Per ottenere ciò, le soluzioni Private Permissionless non creano un’unica catena condivisa da tutti, ma ogni istanza di un contratto intelligente ha la sua catena ad hoc. In altre parole: distribuzione di uno Smart Contract su una rete Private Permissionless crea automaticamente una catena (laterale) privata associata a quel contratto.
Questa ultima accezione è senza dubbio l’evoluzione più significativa del paradigma Blockchain, soprattutto se si rapporta il tutto a tematiche prettamente giuridiche: in che modo uno Smart Contract basato su Private Permissionless può riflettere 1:1 la contrattualistica attuale?
The bottom line
Basare la scelta della tipologia di Blockchain da realizzare sulla relativamente semplice distinzione tra pubblica o privata ha rappresentato, per diversi anni, il criterio preponderante durante la fase di analisi e di progettazione architetturale astratta del modello di sviluppo.
Le ampie possibilità offerte dalla tecnologia di ambienti come HyperLedger, soprattutto se correlate alla diffusione degli applicativi di Smart Contracts, hanno portato gli analisti a perfezionare la tassonomia di Blockchain di tipo Permissioned: esse sono infatti in grado di offrire un buon compromesso tra la rigidità paradigmatica della Blockchain stessa e le varie necessità applicative, configurare un ambiente sicuro, perimetrato e accessibile anche da entità esterne alla Blockchain stessa.
Articolo a cura di Igor Serraino
Profilo Autore
Igor Serraino, Ingegnere dell’Informazione, opera nel settore della consulenza ICT e da progettista sviluppatore software in ambienti Java. È attivo nel contesto Impresa 4.0 in qualità di Technology Expert per una importante società di settore, consolidando quotidianamente le proprie expertises in ambiti aziendali eterogenei e complessi. Il suo portfolio professionale si consolida tecnicamente attraverso una pluriennale esperienza da analista e sviluppatore freelance, in ambienti Java based – full stack, con particolare riferimento ad applicativi finanziari orientati alla commercializzazione per la Pubblica Amministrazione. Completano il profilo costanti collaborazioni in ambiti legal-tech, Cyber security, Blockchain (CBSA), e numerose partecipazioni da relatore nelle edizioni SMAU nazionali.
Cyber Deception Technology & Hybrid Warfare – Parte 1
Cyber Deception tra arte e tecnologia dell’inganno
Considerata l’ampiezza dei temi da trattare e la loro stretta correlazione, ho suddiviso l’articolo in due parti, in questa prima parte tratteremo la Cyber Deception Technology e le sue principali caratteristiche.
La Cyber Deception Technology è l’insieme delle tecnologie, metodologie, strategie e tattiche utilizzate per creare scenari verosimili di infrastrutture tecnologiche ICT e di strutture di informazioni il cui fine è ingannare potenziali attaccanti in modo da indurli ad interagire con questi cyber ambienti, permettendo così lo studio comportamentale dell’attaccante e riducendo, a volte annullando completamente, la loro capacità offensiva. L’obiettivo è quindi quello di riprodurre alla perfezione il target appetibile per un agente ostile, senza che esso possa rendersene conto, cercando di adattare l’ambiente fittizio dinamicamente, in modo da poter analizzare e anticipare le mosse del nemico.
Nella Cyber Deception la componente tecnologica non è quindi il solo elemento principale, ma come accade per il social engineering è necessario tener conto dell’aspetto cognitivo dell’attacco. Per rendere interattivi e credibili i processi e i dati di sistema artefatto la “User Experience” deve essere del tutto simile a sistemi “vulnerabili” reali. Le vulnerabilità che devono attrarre l’attaccante devono essere credibili, ad es. la misconfiguration di un dispositivo che permette l’accesso non autorizzato ad un sistema, non deve essere troppo banale ma deve lasciar pensare che sia un errore di distrazione umana in fase di configurazione.
In questi ultimi mesi, la Cyber Deception è divenuto un tema molto caldo in quanto stiamo assistendo ad una vera e propria “svolta” nella tipologia degli attacchi cyber, tipologie di attacchi che richiedono ulteriori livelli di sicurezza da implementare nelle organizzazioni, proprio come la Cyber Deception Technology. Il conflitto tra Russia e Ucraina ha reso sempre più evidente il concetto di guerra ibrida di quinta generazione [1], che vede il cyberspazio come nuova dimensione per il combattimento.
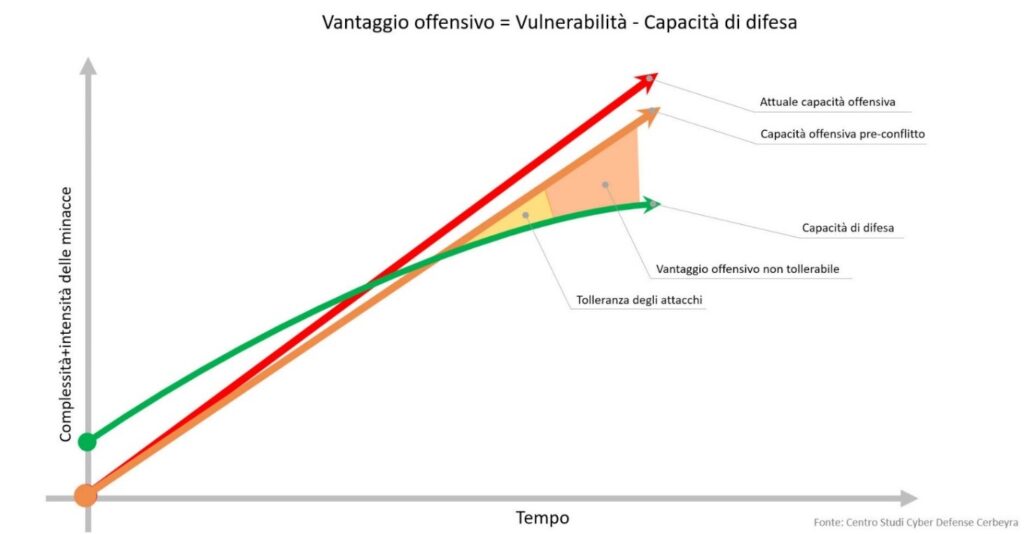
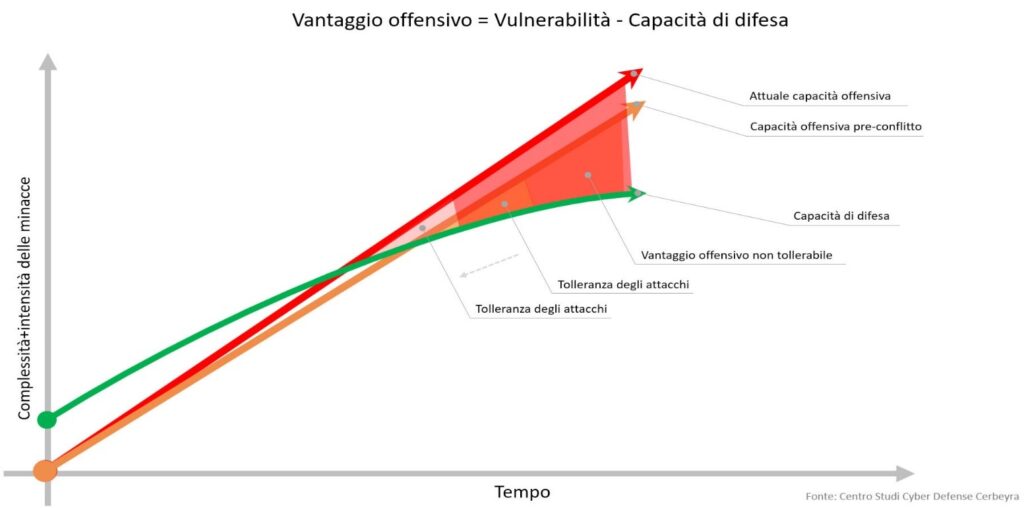
In figura 1 viene rappresenta la complessità e l’intensità delle minacce pre-conflitto rispetto alle capacità di cyber difesa media delle organizzazioni, dove si nota l’area di tolleranza agli attacchi e l’area non tollerabile.
Fig.1
Se analizziamo invece la capacità offensiva, nell’attuale stato di conflitto (Fig.2), notiamo come l’area di NON TOLLERANZA sia significativamente aumentata e quella di TOLLERANZA si sia invece drasticamente abbassata.
Questo scenario evolutivo negli attacchi cyber è principalmente dovuto ai seguenti principali fattori :
Una maggiore attività massiva nel numero degli attacchi, anche attraverso sistemi automatici gestiti tramite tecnologia di intelligenza artificiale.
Attacchi mirati al blocco di infrastrutture tecnologiche e servizi ICT, distruzione dei dati presenti nei sistemi informativi.
Maggiore complessità degli attacchi.
Fig.2
Nuovi scenari di cyber minaccia richiedono nuove soluzioni di cyber difesa, o meglio, un maggiore e più sofisticato utilizzo di tecnologie di cyber difesa già esistenti.
Occorre sviluppare una strategia ed una tattica di cyber difesa che possa sfruttare ed introdurre nuovi approcci, tra queste, la strategia del cyber-inganno attraverso tecnologie di cyber-deception, può risultare estremamente efficiente, per indebolire la capacità offensiva degli attaccanti e per sviare l’attenzione del nemico dagli asset “core” dell’azienda. La cyber-deception permette una difesa intelligente e pro-attiva nei casi di violazione del perimetro di cyber difesa delle organizzazioni.
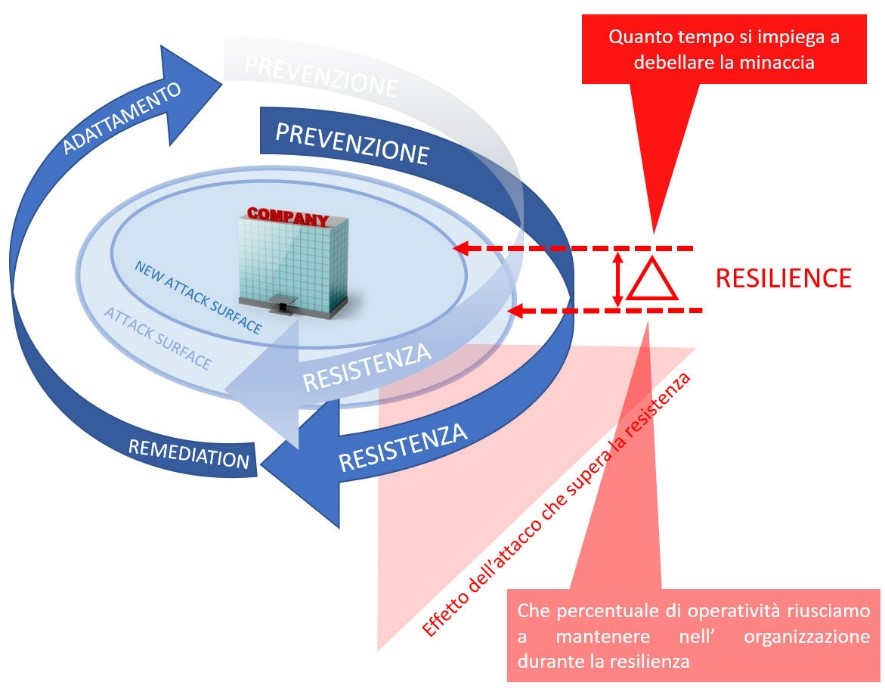
Diminuire il GAP temporale, la tempestività, tra rilevamento di agenti ostili e attività di difesa è uno dei fattori principali nella gestione della cyber resilience delle organizzazioni (Fig.3).
Fig.3
L’aspetto interessante della tecnologia di Cyber Deception è che a differenza della maggior parte dei sistemi di difesa informatici, che si basano su una continua analisi del traffico e delle attività ICT presenti nei sistemi di una organizzazione, alla ricerca di anomalie e agenti ostili, la cyber-deception si basa su una difesa attiva , in grado di “attirare”, rilevare e difendere da agenti ostili (ad es. malware, botnet, cyber criminali, etc..) gli asset dell’organizzazione, andando ad individuare attività malevoli che possono muoversi lateralmente all’interno della rete e dei sistemi ICT.
Sicuramente l’aspetto più interessante di questa tecnologia è la sua capacità di essere poco invasiva nella sua implementazione tecnica ed economica, i suoi benefici sono esponenziali rispetto all’investimento (mediamente rispetto ad un 20% di effort si ottiene l’80% dei risultati), e di rilevare attività illecite senza generare significativi falsi positivi, rispetto invece ai sistemi di difesa tradizionale che spesso oltre ad un elevato numero di falsi positivi comportano anche impatti importanti nelle performance dei sistemi controllati con un costo economico e di risorse spesso non trascurabile.
L’obiettivo principale della Cyber Deception è ingannare l’attaccante, portare l’attaccante a concentrarsi su finti obiettivi, affetti da apparenti vulnerabilità che attirano e catturano la sua attenzione, uno “specchietto per le allodole”, in poche parole, trappole per raggirare l’avversario. Se l’agente ostile innesca una delle trappole, il sistema di deception traccia tutte le sue attività, cercando di individuare più informazioni possibili sull’avversario.
Ad es. come abbiamo visto, nell’attuale contesto storico dove il conflitto tra Russia e Ucraina ha visto aumentare in maniera esponenziale gli attacchi cyber, l’utilizzo del paradigma della Cyber Deception permette di dirottare una buona parte di questi attacchi verso falsi obiettivi, ridimensionando così il gap tra le soluzioni di cyber difesa e la tolleranza agli attacchi.
Maggiore è il tempo di permanenza dell’avversario nel sistema di cyber deception, minore è il tempo e le risorse che dedica ai reali asset. Più rapida ed evidente diviene la sua rilevazione e maggiore sarà la capacità di tracciare i suoi riferimenti, vettori di attacco ed attività all’interno dell’organizzazione. Informazioni queste essenziali per i difensori, poiché, come accennato sopra per la cyber resilience, il rilevamento tempestivo e la risposta agli incidenti, sono elementi fondamentali.
I principali sistemi e metodologie utilizzate, da molti anni nella cyber deception, sono rappresentati dalle Honeypot e Honeynet.
Il nome Honeypot (barattolo di miele) si ricollega al mondo “esoterico” dello spionaggio, dove si utilizzano spesso delle esche per attirare la vittima designata. Nell’ambito dello spionaggio spesso queste esche servono per compromettere spie nemiche ed ottenere informazioni riservate. In ambito informatico l’honeypot si comporta in modo simile, attrae l’agente ostile su un sistema o servizio apparentemente reale e “debole”, fungendo da esca, distraendo l’attaccante dai reali bersagli.
La Honeynet è una rete formata da sistemi, dispositivi ed applicazioni honeypot ad alta interazione che simula una rete di produzione reale, come ad es. host con applicazioni che “emulano” servizi e dati apparentemente reali (ad es. sito web, ftp server, mail server, etc..). Con l’avvento della virtualizzazione la possibilità di creare honeynet è divenuta estremamente facile ed economica.
Le honeypot come le honeynet sono ambienti altamente controllati, ma mentre nelle Honeypot il sistema di controllo e monitoraggio degli attacchi è collocato al suo interno, esponendo la Honeypot al rischio di disattivazione e/o identificazione, nelle honeynet sia non un prodotto o singolo host ma bensì un’ architettura, composta da più honeypot, dove il ruolo di controllo e monitoraggio delle attività malevoli è concentrato sull’ honeywall: un sistema gateway, del tutto trasparente all’aggressore, che separa la rete honeynet dal mondo reale (Fig.4).
Fig.4 (Es. di implementazione di una Honeynet)
Usare le honeypot ha diversi vantaggi nell’individuazione delle intrusioni, ad es. hanno un basso tasso di falsi positivi, poiché per sua stessa definizione, una honeypot non dovrebbe ricevere alcun tipo di contatto dal mondo esterno, qualsiasi attività registrata in entrata dovrebbe quindi essere un tentativo di esplorazione o intrusione, qualsiasi IP dovesse contattare l’Honeypot potrebbe essere facilmente tracciato e verificato, non verrebbe “nascosto” dal traffico complessivo di tutta la rete dell’organizzazione, e dovendo gestire un traffico molto limitato le honeypot non richiedono molte risorse HW & SW.
Un’altra caratteristica specifica delle tecnologie di cyber deception è appunto la simulazione avanzata di servizi e sistemi, questo oltre a far perdere tempo dall’agente ostile, che non si rende immediatamente conto di essere di fronte ad un sistema “fake”, permette di studiare nel dettaglio le tecniche utilizzate dall’aggressore per effettuare gli attacchi. Le honeypot vengono di solito rese particolarmente esposte e vulnerabili, proprio per essere più appetibili per gli attaccanti. Generalmente tra due host l’attaccante si concentrerà per primo su quello più debole, ad es. le honeypot rispondono a scansioni network e mostrano servizi in chiaro, rispetto ad una più sicura rete aziendale.
Rispetto a sistemi di difesa tradizionali come firewall e antivirus, l’honeypot non viene creata per bloccare determinate attività ma per raccoglie informazioni utili a capire le minacce esistenti e scoprire l’emergere di nuove minacce. A differenza dei metodi puramente difensivi, come ad es. i sistemi di rilevamento delle intrusioni (IDS), che cercano di evitare l’interazione con l’attaccante, l’honeypot si basa invece sull’idea di interazione pro-attiva con l’attaccante.
In genere le honeypot sono sviluppate in base al tipo di minaccia che si vuole analizzare, tra le principali:
Spam Honeypot – utilizzano un falso indirizzo e-mail in una posizione nascosta, ad es. del sito aziendale, dove solo un raccoglitore automatico di indirizzi (“harvester”) può trovarlo. Siccome lo l’unico scopo dell’indirizzo mail è quello di fare da trappola, quando utilizzato si è sicuri al 100% che qualsiasi mail si riceva sia uno spam. Conoscendo poi il contenuto della mail di spam è possibile bloccare messaggi simili inviati ad altre mail aziendali e bloccare automaticamente l’IP del mittente tramite una blacklist.
DB Honeypot – simula un database esca e può essere impostato per monitorare vulnerabilità applicative ed individuare attacchi basati su SQL Injection, sfruttamento dei servizi SQL, abuso delle autorizzazioni e come falsa fonte dati da esfiltrare.
Malware Honeypot – imita applicazioni,servizi software e chiamate a servizi API per attrarre attacchi malware. Spesso questa tipologia di Honeypot è utilizzata per eliminare vulnerabilità nelle API, o per studiare i malware e sviluppare software antimalware.
Spider Honeypot – ha lo scopo di intrappolare i webcrawler (spider), creando illusorie pagine Web e link accessibili soltanto dall’attaccante. Questa tipologia di Honeypot viene sfruttata ad esempio per rilevare bot dannosi e crawler di piattaforme pubblicitarie.
E’ possibile sviluppare Honeypot ad alta o bassa interazione. Gli Honeypot a bassa interazione raccolgono meno informazioni, sono nella maggior parte dei casi molto economici e sono meno sofisticati nell’emulazione, sono pensati più per far perdere tempo e per dare un allarme in caso di contatto con un agente ostile che per studiarlo. Ad es. Google Hack Honeypot (GHH) è un sistema economico, progettato per essere vulnerabile alle query sofisticate dei motori di ricerca, allo scopo di attirare gli hacker e rilevarne il comportamento. GHH inserisce un link invisibile sul sito web dell’utente che può essere rilevato solo attraverso l’utilizzo di operatori di ricerca avanzati. Un altro esempio è honeynet Honeyd (http://www.honeyd.org/), un software open source che crea host virtuali su una rete. Gli host possono essere configurati per eseguire servizi arbitrari e personalizzati per simulare determinati sistemi operativi.
I sistemi Honeypot ad alta interazione sono più sofisticati, generalmente utilizzano più risorse di sistema ed il loro scopo principale è non solo trattenere l’ostile il più possibile nel proprio “sistema” ma studiarlo approfonditamente, cercando di testare il suo livello di skill.
Proprio per queste caratteristiche di studio ed analisi le honeypot/honeynet sono state nella maggior parte dei casi utilizzate esclusivamente in ambito di ricerca ed accademico. Negli ultimi anni però i sistemi di cyber deception si sono evoluti, oggi offrono una maggiore automazione sia per il rilevamento che per l’implementazione delle difese sulla base dei dati raccolti, è diventata una tecnologia matura per fornire un ulteriore importante livello di sicurezza ai framework di cyber security delle organizzazioni, soprattutto in realtà di grandi dimensioni e geograficamente distribuite, dove oltre a segnalare la presenza di agenti ostili possono :
Ridurre i tempi di isolamento e contenimento dell’intruso nella rete attaccata.
Velocizzare i tempi di mitigazione delle minacce.
Dalla raccolta dei loro dati è possibile ottenere suggerimenti su come migliorare la sicurezza dei sistemi e delle infrastrutture.
La possibilità di distribuire sensori (Honeypot) nell’infrastruttura ICT riduce l’effort necessario al monitoraggio delle infrastrutture ICT.
Possono essere utilizzati per produrre misurazioni relative agli indicatori IOC (Indicatore di Compromissione) e TTP (Tattiche, Tecniche e Procedure).
Come tutte le metodologie e tecnologie anche quella delle honeypot/honeynet ha i suoi limiti e controindicazioni, ad es. gli unici attacchi che una honeypot può vedere sono quelli rivolti contro di lei, quindi il fatto che una honeypot non registra una minaccia non vuol dire che non esista.
E’ importante che una honeypot sia ben configurata per trarre in inganno gli agenti ostili, nel caso un attaccante si accorgesse dell’inganno, potrebbe concentrarsi sui target reali trascurando le honeypot o potrebbe creare finti attacchi sulle honeypot, magari fornendo false informazioni, per distrarre l’attenzione dal vero exploit rivolto ai sistemi di produzione dell’organizzazione.
Infine un attaccante esperto potrebbe accedere a honeypot non perfettamente configurate e comprometterle, per poi sfruttarle per introdursi nei sistemi dell’organizzazione.
In generale i vantaggi delle honeypot/honeynet superano di gran lunga i rischi.
Per chi volesse avere un approccio più “hands on” sulla tematica, ho sviluppato una semplice HoneyPot “MyHoneyPot” (Fig.5) ad alta interattività su ambiente Windows a scopo esclusivamente didattico, trovate l’applicazione sul mio link Github:
L’applicazione permette di emulare alcuni dei principali servizi di rete su cui è possibile personalizzare alcuni parametri.
Fig.5
Ad es. è possibile attivare un servizio web http selezionando la porta ed il contenuto html da visualizzare (Fig.6)
Fig.6
Se un host si connette al servizio viene tracciato (Fig.7), segnalato e tutte le attività registrate sui file di log.
Fig.7
In conclusione, la tecnologia della Cyber Deception è sicuramente un livello aggiuntivo di difesa che utilizza un approccio diverso, strategicamente importante in uno scontro quotidiano contro attaccanti sconosciuti, ci permette di creare mondi virtuali all’interno del nostro cyberspazio, dove attirare ed intrappolare gli agenti ostili in infiniti percorsi privi di uscita, dandogli l’illusione di aver a disposizione l’intera organizzazione.
“Potrei essere rinchiuso in un guscio di noce e tuttavia ritenermi Re di uno spazio infinito..” William Shakespeare, Amleto, atto II, scena II
Riferimenti
[1]. “LE PROSPETTIVE DELLA CYBER INTELLIGENCE”, Commissione di Studi Cyber Threat Intelligence e Cyber Warfare, CAPITOLO 5, Cyber-Enabled Information Warfare di Francesco Arruzzoli, anno 2022 ISBN 979-12-80111-32-6
Articolo a cura di Francesco Arruzzoli
Profilo Autore
Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.