Machine Learning, “Deep Fake” ed i rischi in un mondo iperconnesso

Negli ultimi anni l’importanza nella nostra società dell’informazione condivisa spesso in tempo reale, è cresciuta enormemente e con essa i rischi derivanti dalla diffusione di notizie incorrette e dalla manipolazione delle notizie. Ormai viviamo in un mondo iperconnesso ove le informazioni su quanto avviene sono condivise in tempo reale non solo tramite le agenzie di informazione e i giornali ma anche, e spesso soprattutto, tramite il passa parola, o meglio la condivisione sui Social Network.

Come esempi basta fare riferimento (purtroppo) ad eventi come la pandemia Covid-19 o la guerra in Ucraina per convincersi che siamo subissati da informazioni alle volte contrastanti e di cui è difficile capire la sorgente e l’affidabilità.

Lo scenario attuale è quindi quello in cui la condivisione delle informazioni è principalmente svolta tramite strumenti informatici che permettono al contempo sia una condivisione immediata e capillare sia una condivisione a livello globale (mondiale). Ormai la condivisione delle informazioni direttamente tra persone o cartacea, preminente fino a una ventina di anni fa insieme a radio e televisione, si è ridotta notevolmente almeno rispetto ai canali informatici.

In questo scenario, come è possibile valutare l’autorevolezza, correttezza e anche liceità delle informazioni che riceviamo e condividiamo? Il problema delle così dette “Fake News” ovvero informazioni false ma a prima vista credibili per come proposte e formulate, è ben noto ed è discusso ampiamente.[1]

Gli algoritmi di Machine Learning (ML) contribuiscono già significativamente a questa problematica ed in questo articolo vogliamo fare una rapida rassegna degli aspetti positivi e negativi dell’utilizzo e dei possibili sviluppi degli algoritmi ML per le “Fake News” e i “Deep Fake”, ovvero la generazione di notizie false sfruttando i più avanzati modelli di ML.

Ricordiamo comunque che oltre ai modelli ML, vi sono molte altre tecnologie digitali che permettono di creare “Fake News” (anche un comune programma per modificare immagini o montare video può essere usato per creare “Fake News”), queste tecnologie sono tipicamente più economiche e facili da usare anche se spesso producono risultati più crudi e facilmente riconoscibili come falsi rispetto ai più avanzati modelli ML.[2]

In questo articolo ci limitiamo a considerare l’utilizzo dei modelli ML per creare “Fake News” e come primo passo dobbiamo ricordare velocemente come i modelli ML possono essere utilizzati in questo ambito.

Il “Classifier”

I primi, più importanti, più comuni e noti modelli di Machine Learning sono chiamati in generale Classifier in quanto capaci di riconoscere una informazione nell’input che gli è fornito. Possiamo fare tanti esempi quali:

  • riconoscere un oggetto o una persona in un’immagine;
  • riconoscere un oggetto od una persona in un video;
  • riconoscere la lingua in cui è scritto un testo;
  • attribuire un testo ad uno scrittore;
  • attribuire una composizione musicale ad un compositore

e così via.

In pratica, qualunque informazione codificabile digitalmente può diventare ambito di un modello ML di tipo Classifier.

Il risultato del riconoscimento è sempre probabilistico ed il modello ML impara a distinguere le caratteristiche richieste utilizzando grandi data-set di informazioni già classificate.

In questo articolo facciamo riferimento come primo esempio ad un modello educativo un po’ particolare creato da Amazon e chiamato Deep Composer [Rif. 1]. Scopo finale (ed ideale) di questo modello ML è quello di comporre musica indistinguibile da quella di un compositore di riferimento. Il primo passo è quello di creare un modello ML in grado di discriminare le composizioni di un autore (ad esempio Mozart) da quelle di tutti gli altri autori. Il modello è istruito facendogli “sentire” tutte le opere di Mozart e moltissime altre opere musicali di autori diversi e di stili, epoche e tipi musicali diversi, indicandogli quali sono di Mozart e quali invece non lo sono. In Fig.1 è riportata la struttura ad alto livello del modello ML che riporta in output la probabilità che il brano in ingresso sia (in questo caso) di Mozart.
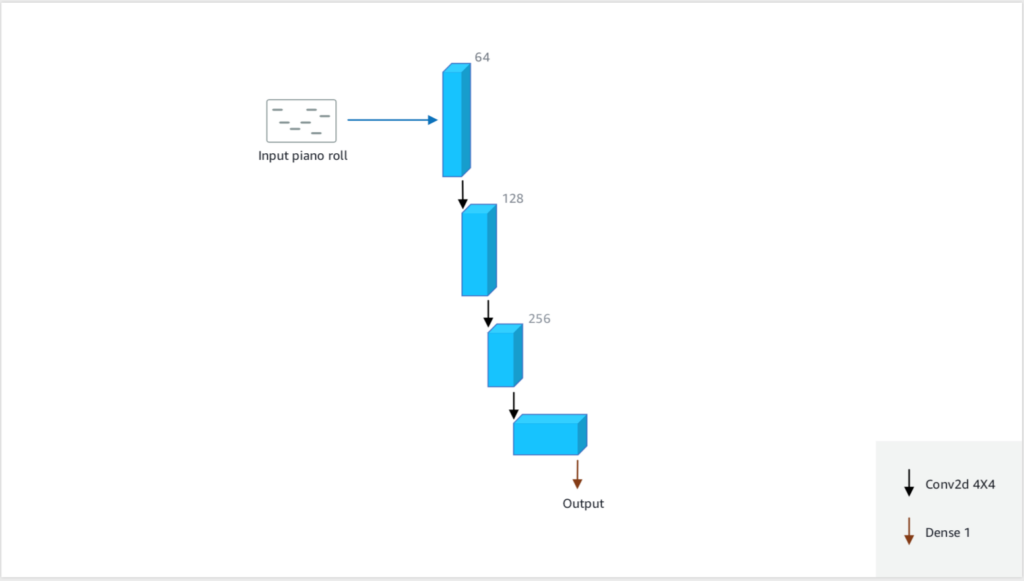
Fig. 1 Struttura di un Classifier/Discriminator di tipo Convolutional Neural Network utilizzato nel Deep Composer [Sorgente Rif. 2]

Utilizzare un “Classifier” per individuare “Fake News”

La maggior parte dei modelli ML sono dei Classifier, ovvero in grado di identificare o classificare i dati forniti in input. Questi modelli sono utilizzati ormai quotidianamente in moltissime applicazioni: dalla videosorveglianza, all’analisi degli attacchi informatici, alle campagne pubblicitarie, all’individuazione dello Spam nella posta elettronica ecc. ed anche per individuare “Fake News”.

L’approccio è molto semplice, dovrebbe essere sufficiente addestrare un modello ML con un data-set di informazioni, ad esempio testuali, già classificate come vere o false e poi utilizzare il modello per identificare testi falsi. Questo in realtà è quello che fanno già praticamente tutti i Social Network e tutti i grandi gestori di informazioni sia in forma testuale sia audio, immagini e video. Sono però ben noti sia i falsi positivi (si veda come un ben noto esempio [Rif. 3]) sia i falsi negativi, ovvero informazioni false presenti e disponibili ma non individuate dagli algoritmi ML.

I motivi per la mancanza di un completo successo, almeno come sperato, da parte di questi modelli ha molte cause, che non saranno analizzate in questa sede, ma una è sicuramente rilevante e di facile discussione. L’apprendimento di un modello ML dipende in modo cruciale dai dati utilizzati in questa fase nella quale l’algoritmo impara a individuare sia affermazioni false sia ragionamenti e modi di presentare le informazioni tali da ingannare le persone.

Ora, similmente ad esempio a quanto succede per l’identificazione dello Spam con modelli ML, si instaura un ciclo continuo tra

  • chi inventa nuovi modi di formulare informazioni false in modo da non essere rilevato dal modello ML;
  • l’identificazione manuale del nuovo attacco;
  • la ri-esecuzione del processo di apprendimento del modello ML con un data-set a cui sono stati aggiunti i nuovi tipi di attacco.

A questo proposito va ricordato che l’addestramento di un modello ML è spesso un’operazione molto impegnativa (e costosa) dal punto di vista computazionale, ovvero ad ogni esecuzione può richiedere molte risorse HW/SW e molto tempo.

Il “Generator”

Modelli di Machine Learning possono essere utilizzati per creare nuovi contenuti. La principale idea è quella di creare un modello a molti livelli (da qui il nome “Deep”) che dato un input in un formato (ad esempio la codifica di un brano musicale), lo codifica nel formato interno per poi ritrasformarlo nel formato iniziale, ovvero in un brano musicale. Spesso il dato iniziale in input è puramente casuale e l’elaborazione nel modello ML viene rieseguita molte volte sino ad ottenere il risultato cercato. La struttura più semplice di questi modelli è chiamata U-Net.

U-Net è un’architettura che utilizza due Convolutional Neural Network e che prende il nome dalla sua forma a U. Il percorso di downsampling/encoder costituisce il lato sinistro della U e il percorso di upsampling/decoder costituisce la parte destra della U. La particolarità dell’architettura U-Net è che i livelli sul lato sinistro possono passare informazioni al lato destro senza attraversare l’intera rete ma saltando direttamente al livello corrispondente (Fig. 2).
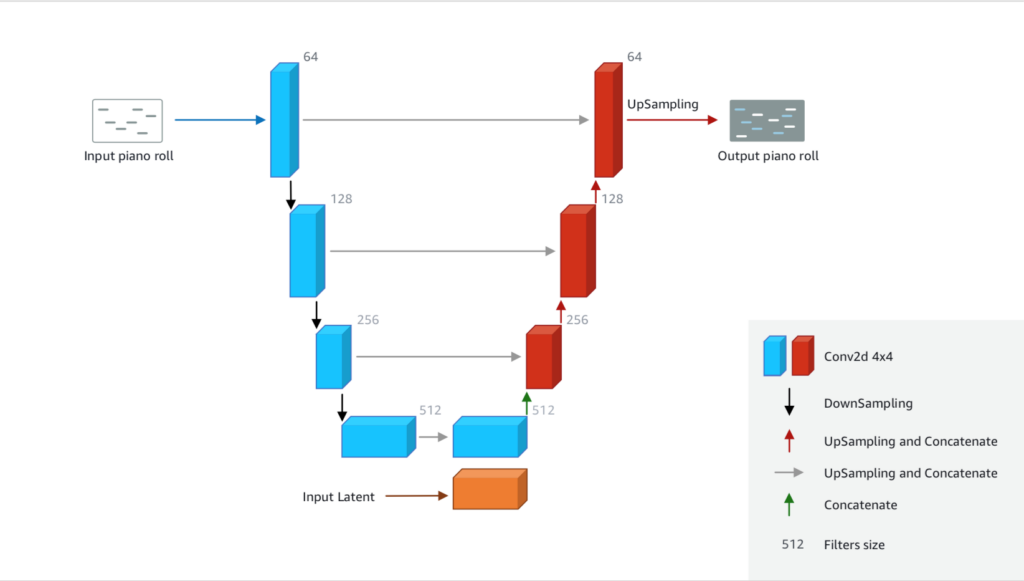
Fig. 2 Struttura di un U-Net composto da Convolutional Neural Network utilizzato come Generator nel Deep Composer [Sorgente Rif. 2]

Ovviamente, è necessario prima istruire un Generator in modo tale che sia in grado di produrre quanto ci aspettiamo.

Un “Generative Adversial Network” (GAN)

Il processo di istruzione di un Generator non è semplice, l’approccio più comune è quello di accoppiare un Generator ad un Classifier già opportunamente istruito. Un Classifier opportunamente accoppiato ad un Generator viene usualmente chiamato un Discriminator, e l’accoppiamento di un Generator con un Discriminator è chiamato un Generative Adversial Network – GAN (Fig. 3).
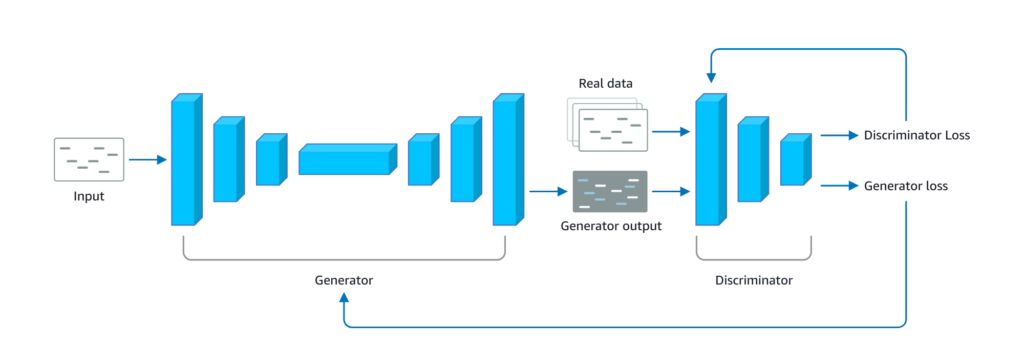
Fig. 3 Struttura di un GAN [Sorgente Rif. 2]

Il processo di istruzione di un Generator è, ad alto livello, semplice:

  1. Si istruisce per primo il Discriminator con dati reali in modo che possa distinguere informazioni vere da “Fake”;
  2. Si accoppiano il Generator ed il Discriminator;
  3. Il Generator produce dei dati, il Discriminator verifica quanto reali siano e riporta al Generator il risultato in modo che questo possa apprendere e migliorare la produzione.

Il ciclo viene ripetuto sino a quando il Generator riesce a produrre dati classificati come reali dal Discriminator. Nell’esempio del Deep Composer che genera nuovi brani di Mozart, il ciclo di apprendimento continua sino a quando il Discriminator non ritiene che i brani prodotti dal Generator siano con un’ottima probabilità in realtà originali di Mozart.

Ovviamente il processo è molto più lungo e complesso di quanto traspare da questa veloce descrizione, richiede tipicamente moltissime risorse, grandi data-set ed è alle volte soggetto a problemi di convergenza o di collasso dei risultati (ovvero in grado di produrre sempre e solo gli stessi dati o le stesse modifiche ai dati ingresso).

Generare “Deep Fake”

Con un Generator opportunamente istruito, generare “Deep Fake” diventa abbastanza facile ed alla portata di molti, od almeno così sembrerebbe essere. Come già accennato, con l’opportuno Generator si possono creare in grandi quantità testi falsi ma del tutto convincenti (inclusi anche articoli scientifici) con i quali ad esempio è possibile supportare delle campagne di falsa-informazione; generare immagini e filmati realistici ma ovviamente falsi; modificare, anche in minima parte, immagini o filmati o audio in modo che questi descrivano qualcosa che non è avvenuto o il contrario della realtà. Di questo ultimo gruppo fanno parte anche programmi ormai quasi di uso quotidiano che ad esempio permettono di sostituire un viso in un’immagine o in un video.

Nella maggior parte dei casi, soprattutto per audio e video, i risultati sono divertenti, a prima vista realistici ma ad un’analisi un poco più precisa si rivelano subito come falsi (si veda ad esempio [Rif. 4]). E’ importante perciò considerare quali sono oggi i principali aspetti legati alla:

  • generazione di “Deep Fake”;
  • individuazione di “Deep Fake”.

Generare un vero “Deep Fake” oggi richiede:

  1. conoscenze specialistiche molto approfondite;
  2. enormi data-set disponibili per l’istruzione dei modelli;
  3. grandi disponibilità di calcolo per la fase di istruzione del modello;
  4. tempi sufficientemente lunghi (anche mesi) per la preparazione e istruzione del modello;
  5. ed ovviamente fondi per pagare tutto ciò.

I risultati di tali modelli però sono veramente preoccupanti in quanto veramente difficili da distinguere da dati veri. In Fig. 4 riportiamo un esempio preso da [Rif. 5] di un testo generato con GPT-3 in cui le prime 4 righe sono originali della Divina Commedia di Dante mentre le successive righe sono state create da GPT-3 utilizzando come ingresso solo le prime 4 righe:
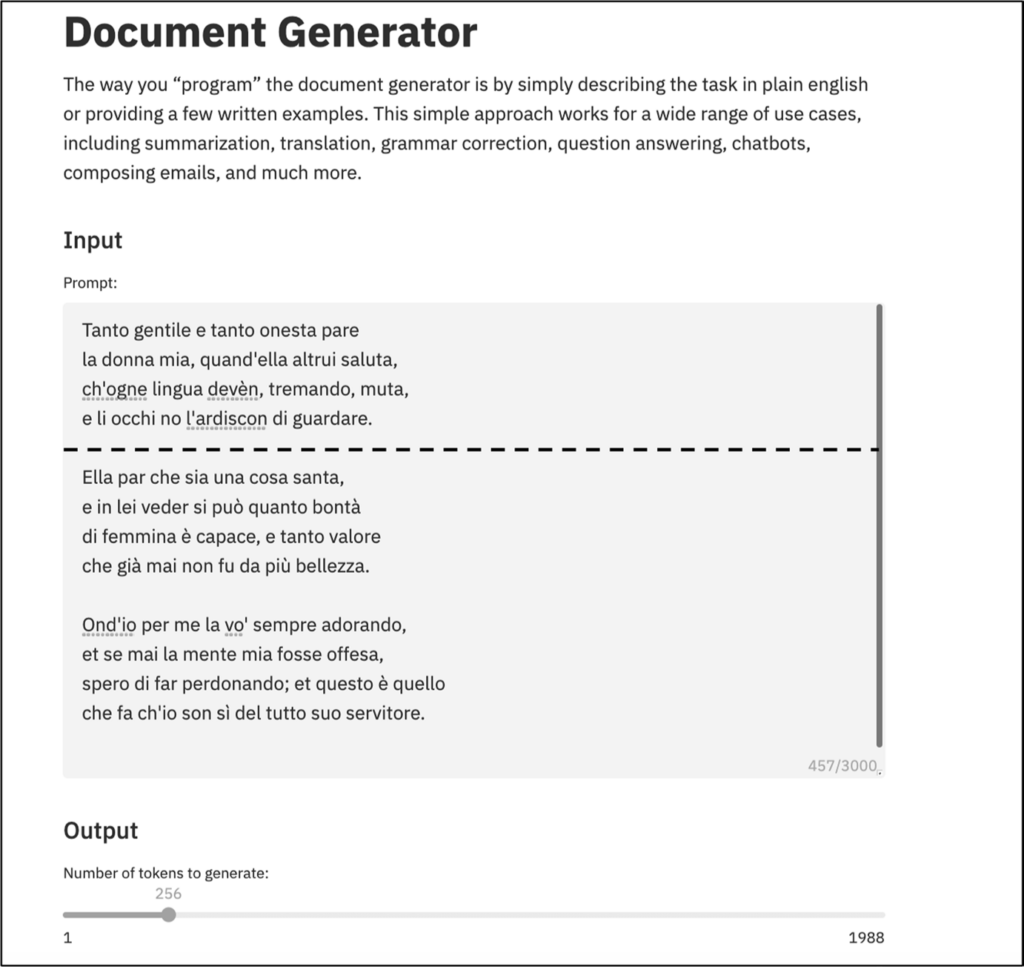
Fig. 4 GPT-3 e Dante, la linea tratteggiata divide il testo originale di Dante in alto, dal testo prodotto da GPT-3 in basso [Sorgente Rif. 5]

Come si vede, questi modelli sono potenzialmente di facile utilizzo per diffondere dati falsi, e questo rischio ha portato ad una profonda discussione [Rif. 6] in corso sulla correttezza etica di rendere disponibili pubblicamente gli ultimi modelli di generazione di testi quali OpenAI GPT-3, Eleuther AI, Meta OPT-175B [Rif. 7].

Al momento quindi, a meno di avere competenze, tempo e soldi disponibili, è improbabile (o almeno limitato a molto pochi) che si riesca a creare un vero “Deep Fake” di quasi impossibile individuazione. L’alternativa è quella di utilizzare modelli commerciali già pronti (“pre-trained”), ovvero già istruiti e disponibili immediatamente, a costi ridotti o in alcuni casi nulli o quasi nulli. Utilizzare un modello commerciale per creare un testo o modificare audio, immagini o video, può dare dei buoni risultati. D’altra parte, visto che il modello non è stato disegnato ed istruito specificatamente per lo scopo per cui lo si vuole utilizzare, il risultato spesso non è di un livello qualitativo molto elevato. Inoltre molti di questi modelli presentano delle piccole stranezze nei loro prodotti, ad esempio dei rumori particolari di fondo, pixel di colore particolare nelle immagini o movimenti identici e poco spontanei nei video.

Individuare “Deep Fake”

Avendo a disposizione un opportuno modello ML è possibile generare enormi quantità di “Deep Fake” in tempi rapidissimi. Associando a questo la possibilità di condivisione immediata, capillare e globale dei “Deep Fake” tramite piattaforme digitali iperconnesse come i Social Network, ne segue che sono necessari strumenti automatici e molto efficienti per individuare e bloccare queste informazioni malevole.

Ma, come abbiamo già indicato, l’attività in cui i modelli ML sono più efficaci è proprio l’identificazione o classificazione (modelli Classifier) dei dati in input. Un possibile scenario è quindi quello in cui i “Deep Fake” sono generati da un attaccante con un modello Generator ed identificati da un difensore con un modello Classifier. Per entrambe le parti, il problema principale sono i tempi, le competenze, le risorse e i costi di istruzione del modello. In particolare un modello Classifier che deve identificare i “Deep Fake” può essere istruito solo con una sufficiente quantità di dati prodotti dal corrispondente Generator, il che rende difficile identificare in questo modo in tempi brevi i prodotti di nuovi Generator.[3] Inoltre nel caso di uso di Classifier pubblici da parte dei difensori, un attaccante può istruire un Generator modificando il Discriminator in modo che i dati prodotti non siano identificati come falsi dai Classifier utilizzati dai difensori. Si ripropone quindi l’usuale rincorsa tra attaccante e difensore in cui ognuno si aggiorna per superare le misure adottate dall’altro.

In pratica oggi lo scenario precedente si semplifica un poco tenendo conto che la grande maggioranza di “Deep Fake” sono generati con modelli Generator commerciali i cui prodotti sono più facilmente individuabili (alle volte anche senza la necessità di ricorrere ad un modello ML se non fosse per la quantità di dati e i tempi richiesti). In altre parole, “Deep Fake” generati con modelli Generator commerciali sono ad oggi identificabili anche se questo richiede un notevole impegno operativo e continuo aggiornamento dei Classifier. Invece veri “Deep Fake” generati con modelli Generator tipicamente ad-hoc sono oggi molto complessi, difficili e costosi da creare oltre a richiedere tempi lunghi per l’istruzione del modello, ma sono quasi impossibili da individuare automaticamente, comportandosi quasi come degli “Zero-Day Exploit”.

Una proposta che renderebbe ancora più semplice l’individuazione dei “Deep Fake” prodotti da Generator commerciali è quella di sviluppare, definire, standardizzare e poi richiedere che tutti i Generator commerciali includano la produzione di qualche forma di Watermark non rimovibile dai dati prodotti e facilmente individuabile dai Classifier. D’altra parte, nell’usuale rincorsa tra attaccante e difensore, questo porterebbe immediatamente alla creazione di un mercato alternativo o illegale di Generator che non producono i Watermark.

Infine, come già indicato, oltre alla difficoltà di creare Classifier in grado di identificare “Deep Fake” con alta probabilità e quindi con pochi falsi negativi, gli stessi Classifier devono anche classificare con bassa probabilità come “Deep Fake” i dati reali, ovvero con pochi falsi positivi. Il problema della gestione dei falsi negativi e falsi positivi negli strumenti di rilevazione è ben noto e spesso di difficile soluzione ottimale, ovvero spesso non è possibile minimizzare entrambi, e al momento questo problema sembra ancora più complesso da gestire nei modelli ML.

Concludiamo sottolineando che la ricerca in questo campo è molto attiva e gli sviluppi sono quasi quotidiani visto l’interesse generale al problema dei “Deep Fake” che ha anche spinto grandi aziende tra cui Facebook, Amazon e Microsoft, a sponsorizzare e partecipare al “Deepfake Detection Challenge” [Rif. 8]. E’ quindi possibile che in poco tempo gli scenari descritti in questo articolo si modifichino sostanzialmente.

Riferimenti Bibliografici

Rif. 1: AWS Deep Composer https://aws.amazon.com/it/deepcomposer/

Rif. 2: AWS Deep Composer Github: https://github.com/aws-samples/aws-deepcomposer-samples/

Rif. 3: “The innocuous photos banned by Facebook: Social media giant apologises after it blocks art gallery’s images of COWS, the England cricket team and a high-rise office block because they are judged ‘too sexy’”, MailOnline News, febbraio 2021, https://www.dailymail.co.uk/news/article-9249087/Facebook-apologises-blocks-art-gallerys-images-COWS-sexy.html

Rif. 4: “Deepfake video of Zelensky telling Ukrainians to surrender removed from social platforms“, New York Post 2022/03/17, https://nypost.com/2022/03/17/deepfake-video-shows-volodymyr-zelensky-telling-ukrainians-to-surrender/

Rif. 5: “GPT-3: Its Nature, Scope, Limits, and Consequences”, L.Floridi e M.Chiriatti, Minds and Machines vol. 30, pag. 681–694 (2020) Springer, https://link.springer.com/article/10.1007/s11023-020-09548-1

Rif. 6: si veda ad esempio “The Radicalization Risks of GPT-3 and Neural Language Models”, K.McGuffie and A.Newhouse. CTEC, https://www.middlebury.edu/institute/academics/centers-initiatives/ctec/ctec-publications/radicalization-risks-gpt-3-and-neural-language

Rif. 7: https://openai.com/ , https://www.eleuther.ai/ , https://ai.facebook.com/blog/democratizing-access-to-large-scale-language-models-with-opt-175b/

Rif. 8: Deepfake Detection Challenge – DFDC (Facebook, Amazon, Microsoft, PartnershipOnAI) https://ai.facebook.com/datasets/dfdc/ , https://partnershiponai.org/a-report-on-the-deepfake-detection-challenge/ , https://www.iqt.org/deepfake-detection-challenge/

Note

[1] Basta pensare agli studi ed investigazioni (alcune delle quali ancora in corso) sul ruolo ed effetto delle “Fake News” nelle campagne elettorali per le elezioni presidenziali Statunitensi del 2016 e 2020.

[2] Una “Fake News” può anche essere generata semplicemente estrapolando o utilizzando delle informazioni vere in un contesto non consistente.

[3] Va comunque ricordato che un Classifier è di solito in grado di individuare con buona probabilità prodotti di Generator sufficientemente simili a quelli sui quali è stato istruito.

Articolo a cura di Andrea Pasquinucci
Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/machine-learning-deep-fake-ed-i-rischi-in-un-mondo-iperconnesso/
Blockchain e Data Protection: il quadro definitorio e regolamentare

Sin dalla sua emersione alla fine degli anni Zero, la tecnologia Blockchain si è imposta come oggetto di fervida curiosità e di innumerevoli suggestioni, talvolta innovative, talvolta irrealistiche, circa la sua possibile applicazione ai campi più disparati.

Blockchain, peculiarità e contesti di applicazione

Basandosi sul concetto di DLT (Distributed Ledger Technologies) che consente di condurre, rendendole immodificabili, operazioni e transazioni a livello decentralizzato, la Blockchain Technology sembra infatti prestarsi a un fruttuoso utilizzo in numerosi settori: dall’agroalimentare alla moda − in particolare a fini di tracciabilità della supply chain − fino ad arrivare alla sicurezza informatica o alle più complesse attività finanziarie, assicurative e valutarie.

L’assenza di intermediari, insieme alle caratteristiche di trasparenza, verificabilità e immutabilità del sottostante registro distribuito, ne fanno uno strumento particolarmente adatto ai segmenti di business che esigono rapidità e verificabilità delle transazioni. Come quello delle piattaforme relative alle criptomonete, costituenti la galassia emergente del cosiddetto IoV (Internet of Value).

Naturalmente le tecnologie DLT, auto-regolate mediante algoritmi di consenso, implicano un massiccio e costante impiego di dati; così sollevando non poche questioni relative alla loro gestione e protezione.

Considerata la distinzione tra Blockchain permissioned (nelle quali l’accesso alla rete è ristretto ai soli partecipanti autorizzati) e permissionless (dove al contrario chiunque può farsi nodo della rete, prendendo parte al processo di validazione delle transazioni), è chiaro come i problemi di riservatezza riguardino prevalentemente queste ultime. Tanto più se al quadro si aggiungono gli smart contracts, capaci di produrre effetti irreversibili sui diritti reali delle parti coinvolte.

Per l’Italia la cornice giuridica in tema di Blockchain e smart contract è rappresentata dalla legge n. 12 del 2019 che, oltre a recepire le norme europee, si limita a fornirne una scarna definizione delegando la disciplina di dettaglio ad altri enti, quali la CONSOB o le associazioni imprenditoriali e professionali di settore.

Mentre a livello europeo, dopo una serie di previsioni più frammentarie, è stata elaborata la proposta di Regolamento MiCA (Markets in Crypto Asset), approvata lo scorso 14 marzo dalla Commissione Ue per gli affari economici e monetari con l’ambizioso scopo di fornire una “cripto-regolamentazione favorevole all’innovazione, in grado di fissare standard per tutto il mondo”.

Cosa si intende oggi per Data Protection

L’espressione Data Protection racchiude il complesso sistema di principi e fonti normative, come anche di organismi giurisdizionali incaricati di garantirne l’osservanza, previsto a difesa dei dati afferenti le persone, asset ritenuti meritevoli di una particolare tutela. E nell’accezione attuale parlare di dati significa includere ogni informazione idonea a identificare o a rendere identificabile, direttamente oppure indirettamente, una persona fisica.

Nel contesto UE, fino al 2016 la principale fonte in materia era rappresentata dalla Direttiva 95/46/CE; in seguito l’enorme innovazione tecnologica intervenuta, l’avvento dei Big Data e le conseguenti nuove esigenze di protezione degli interessi coinvolti hanno stimolato l’adozione delle attuali norme regolamentari.

L’impatto del GDPR sulle Distributed Ledger Technologies

In questo quadro s’inserisce, modificandolo profondamente, l’ultranoto Regolamento UE 2016/679 o GDPR. Entrato in vigore nel maggio 2018 in tutti gli Stati membri (inclusa l’Italia, che lo ha recepito con il D. Lgs. n. 101/18), il General Data Protection Regulation (Regolamento generale sulla protezione dei dati) offre una disciplina ampia ed estremamente dettagliata rispetto alla tutela e al trattamento dei dati personali nello spazio dell’Unione Europea.

Volendone enucleare gli aspetti fondativi vanno sicuramente richiamati i principi di liceità, correttezza, trasparenza, integrità e riservatezza dovuti nel corso del trattamento; centrali anche i concetti di privacy-by-design e di minimizzazione, in forza del quale si prevede che ad essere raccolta e conservata sia la minor quantità di dati per il minor tempo possibile (esclusivamente per scopi necessari al servizio erogato e/o espressamente approvati dal titolare).

È evidente come molte tra le citate caratteristiche delle Distributed Ledger Technologies − decentralizzazione, disintermediazione, assenza di autorità centrali − stridano con un simile approccio, sottraendosi ai rigidi margini della cornice normativa europea: in particolare, a far ipotizzare numerosi punti di contrasto è la mancanza di un controllo centralizzato sulla conformità delle operazioni condotte e, quindi, sul trattamento riservato alle informazioni coinvolte nel processo.

In un prossimo articolo saranno analizzati aspetti di continuità e potenziali conflitti tra queste nuove tecnologie e la normativa comunitaria in materia di protezione dei dati.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/blockchain-e-data-protection-il-quadro-definitorio-e-regolamentare/


Le nuove sfide di cyber security per l’Intelligenza Artificiale: la mappatura dell’ecosistema e la tassonomia delle minacce

Introduzione

L’Intelligenza Artificiale (IA) ha guadagnato terreno negli ultimi anni facilitando il processo decisionale intelligente e automatizzato in tutta l’estensione degli scenari di implementazione e delle aree applicative. Stiamo assistendo a una convergenza di diverse tecnologie (ad es. Internet of things, robotica, tecnologie dei sensori, ecc.) e una crescente quantità e varietà di dati, nonché le loro nuove caratteristiche (ad es. dati distribuiti) per utilizzare l’IA su larga scala.

Nel contesto della cyber security, l’IA può essere vista come un approccio emergente e, di conseguenza, le tecniche di IA sono state utilizzate per supportare e automatizzare le operazioni rilevanti, ad esempio il filtraggio del traffico, l’analisi forense automatizzata, ecc. Sebbene indubbiamente vantaggioso, non si dovrebbe eludere il fatto che l’IA e la sua applicazione, ad esempio, al processo decisionale automatizzato, specialmente in implementazioni critiche per la sicurezza come veicoli autonomi, produzione intelligente, eHealth, ecc., può esporre individui e organizzazioni a rischi nuovi e talvolta imprevedibili e può̀ aprire nuove vie di attacco metodi e tecniche, oltre a creare nuove sfide in materia di protezione dei dati.

Inoltre, è ormai chiaro come l’Intelligenza Artificiale sta influenzando sempre più la vita quotidiana delle persone e svolge un ruolo chiave nella trasformazione digitale attraverso le sue capacità decisionali automatizzate. I vantaggi di questa tecnologia emergente sono significativi, ma lo sono anche le preoccupazioni. È quindi necessario evidenziare il ruolo della cyber security nello stabilire l’affidabilità e la diffusione di un’IA affidabile.

Quando si considera la sicurezza nel contesto dell’IA, è necessario essere consapevoli del fatto che le tecniche e i sistemi di IA che utilizzano l’IA possono portare a risultati imprevisti e possono essere manomessi per manipolare i risultati attesi.

Pertanto, è essenziale proteggere l’IA stessa tramite misure di sicurezza. In particolare, è importante:

  • capire cosa deve essere messo in sicurezza (gli asset soggetti all’IA minacce specifiche e modelli contraddittori);
  • comprendere i relativi modelli di governance dei dati (compresa la progettazione, valutazione e protezione dei dati e del processo di addestramento dei sistemi di IA);
  • gestire le minacce in un ecosistema multipartitico in modo completo utilizzando modelli e tassonomie condivisi;
  • sviluppare controlli specifici per garantire che l’IA stessa sia sicura.

Il quadro normativo comunitario ed italiano dell’IA

L’Unione Europea ha compreso sin da subito l’importanza che ricopre l’Intelligenza Artificiale all’interno della società. Pertanto, nel dicembre 2018 la Commissione europea ha adottato il “Coordinated Plan on Artificial Intelligence” con l’obiettivo di accrescere le sinergie tra Stati membri e istituzioni europee. Più precisamente, la Commissione ha evidenziato la necessità per gli stati membri di adottare una strategia nazionale di AI. Successivamente, nell’aprile 2019, la Commissione ha istituito un gruppo di esperti ad alto livello che ha pubblicato orientamenti per un’IA affidabile, pubblicando una comunicazione in cui accoglie con favore i sette requisiti fondamentali individuati negli orientamenti del gruppo di esperti ad alto livello:

  • intervento e sorveglianza umani;
  • robustezza tecnica e sicurezza;
  • riservatezza e governance dei dati;
  • trasparenza;
  • diversità, non discriminazione ed equità;
  • benessere sociale e ambientale;
  • accountability.

Inoltre, è meritevole ricordare il “White Paper on AI” promosso nel febbraio 2020 dalla Commissione Europea, la cui finalità è la creazione di un ecosistema di eccellenza e di fiducia nell’Intelligenza Artificiale, così ponendo l’Europa all’avanguardia nella regolamentazione di questo settore.

Nel dettaglio, gli elementi primari di tale documento sono i seguenti:

  • il quadro strategico che stabilisce misure per allineare gli sforzi a livello europeo, nazionale e regionale. Tramite un partenariato tra il settore pubblico e privato, l’obiettivo di tale quadro è mobilitare risorse per conseguire un “ecosistema di eccellenza” lungo l’intera catena del valore, a cominciare dalla ricerca e dall’innovazione, e creare i giusti incentivi per accelerare l’adozione di soluzioni basate sull’IA, anche da parte delle piccole e medie imprese (PMI);
  • gli elementi chiave di un futuro quadro normativo per l’IA in Europa, che creerà un “ecosistema di fiducia” unico. La costruzione di un ecosistema di fiducia è un obiettivo strategico in sé e dovrebbe dare ai cittadini la fiducia di adottare applicazioni di IA e alle imprese e alle organizzazioni pubbliche la certezza del diritto necessaria per innovare utilizzando l’IA.

La strategia europea per i dati che accompagna il “White Paper on AI” ha l’obiettivo di far sì che l’Europa diventi l’economia agile basata sui dati più attraente, sicura e dinamica del mondo, mettendo a sua disposizione i dati necessari a migliorare le decisioni e la vita di tutti i suoi cittadini.

Tale documento ha fatto emergere per l’European Union Agency for Cyber security (ENISA), la necessità di approfondire il tema della cyber security applicata all’IA, pubblicando nel dicembre 2020 il report “Artificial Intelligence Threat Landscape”.

I principali elementi del documento avanzato dall’ENISA sono i seguenti:

  • Definizione dell’ambito dell’IA nel contesto della cyber security secondo un approccio basato sul ciclo di vita. Tenendo conto delle diverse fasi, dall’analisi dei requisiti all’implementazione, viene delineato l’ecosistema dei sistemi e delle applicazioni di IA.
  • Identificazione degli asset dell’ecosistema IA come passaggio fondamentale per individuare ciò che deve essere protetto e cosa potrebbe eventualmente andare storto in termini di sicurezza dell’ecosistema IA.
  • Mappatura del panorama delle minacce dell’IA mediante una tassonomia dettagliata. Ciò funge da base per l’identificazione di potenziali vulnerabilità ed eventualmente di scenari di attacco per casi d’uso specifici e servirà nelle valutazioni del rischio settoriale e nell’elenco dei controlli di sicurezza proporzionati.
  • Classificazione delle minacce per i diversi asset e nel contesto delle diverse fasi del ciclo di vita dell’IA, elencando anche gli attori delle minacce rilevanti. Viene inoltre evidenziato l’impatto delle minacce su diverse proprietà di sicurezza.

Infine, nell’aprile 2021, la Commissione ha rilasciato la Revisione del Piano Coordinato sull’Intelligenza Artificiale che contiene una serie di azioni per rafforzare la posizione dell’UE nello sviluppo di sistemi AI che siano sostenibili, inclusivi, affidabili e che pongano l’uomo al centro del sistema IA. Tale piano propone da oggi al 2027 circa 70 azioni per una cooperazione più stretta ed efficiente tra gli Stati membri e la Commissione in tema di IA. Inoltre, la Commissione sosterrà i corsi di laurea magistrale e i dottorati di ricerca in IA proponendo una più stretta cooperazione tra i centri di eccellenza nella ricerca in materia di IA e, più in generale, i programmi di ricerca e innovazione dell’UE. Inoltre, sosterrà l’interdisciplinarità promuovendo lauree congiunte, ad esempio in legge o psicologia e IA. Le competenze digitali che facilitano lo sviluppo e l’uso dell’IA dovrebbero essere incluse in tutti i programmi di istruzione e formazione.

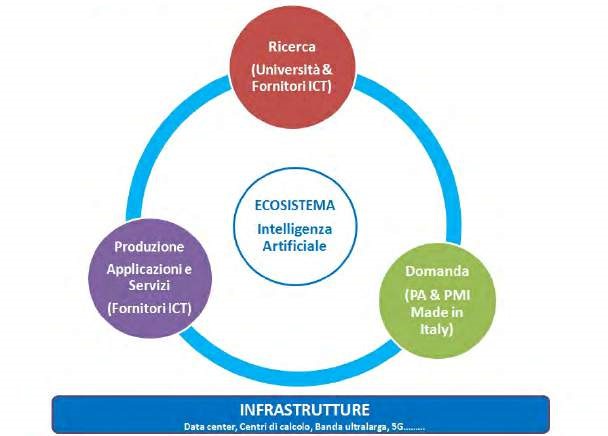
In Italia, come in altri paesi del panorama internazionale, il governo italiano ha pubblicato nel 2020 la bozza di Strategia nazionale per l’Intelligenza Artificiale. Più precisamente, viene sottolineato che l’IA presenta una forte interconnessione tra tre componenti:

  • Ricerca e Trasferimento Tecnologico: la ricerca italiana in AI gode di una buona visibilità internazionale in alcuni settori specifici. Fanno parte dell’ecosistema le università ed i centri di ricerca pubblici/ privati nonché le reti di ricerca e di trasferimento tecnologico, come i Technology Cluster, i Competence Center, i Digital Innovation Hubs e i poli tecnologici regionali.
  • Produzione: la produzione include l’industria del software, il comparto delle infrastrutture e dei servizi, l’industria della componentistica intelligente, dei semiconduttori per lo sviluppo di componenti IoT, automotive e telecomunicazioni, e il comparto dei sistemi e oggetti intelligenti, autonomi e semi autonomi, in particolare la robotica e l’automazione industriale.
  • Adozione: l’adozione include la Pubblica Amministrazione (PA) e l’industria. La PA e le istituzioni possono utilizzare l’IA per la sicurezza, le città intelligenti, la sostenibilità ambientale, i trasporti, la gestione dei beni culturali e l’istruzione. Diversamente, nell’industria l’IA ha un utilizzo pervasivo che va dalla definizione di prodotto, marketing, logistica, pianificazione, fino ad arrivare alla manifattura.
Figura 1 – I tre componenti dell’ecosistema dell’IA italiana
(fonte: Ministero dello Sviluppo Economico – Proposte per una strategia italiana per l’intelligenza artificiale, 2020)

L’intelligenza Artificiale e le misure di sicurezza

Secondo quanto indicato dall’articolo 5 dal Regolamento generale sulla protezione dei dati (GDPR) viene stabilita la sicurezza come principio nel trattamento dei dati personali. Più precisamente i dati personali devono essere trattati in maniera da garantire un’adeguata sicurezza dei dati personali, compresa la protezione, mediante misure tecniche e organizzative adeguate, da trattamenti non autorizzati o illeciti e dalla perdita, dalla distruzione o dal danno accidentali.

Questa caratteristica assume una significativa importanza per la sicurezza rispetto al passato, quando quest’ultima era una mera prestazione tecnico-organizzativa al di sopra dell’operazione di trattamento. Pertanto, è possibile affermare che nel GDPR la sicurezza è un prerequisito e la mancata adozione di adeguate misure di sicurezza invalida il trattamento e lo rende illecito. Analogamente agli altri principi di protezione dei dati, la sicurezza non è un’opzione ma una necessità.

In aggiunta, l’articolo 32 del GDPR prevede misure di sicurezza che devono essere ampliate in base al rischio di diversa probabilità e gravità per i diritti e le libertà degli interessati. Pertanto, il “bene” da tutelare con misure di sicurezza è il libero esercizio dei diritti delle persone, e non solo il bene informativo di per sé. I dati personali devono essere protetti in modo progressivo (maggiori sono i rischi, più rigorose sono le misure). La sicurezza è un modo per rafforzare i diritti e le libertà degli individui nel loro insieme e consente la centralità degli esseri umani rispetto alle macchine. I sistemi di IA sono sistemi logici e, in quanto tali, potrebbero non essere del tutto coerenti e completi, il che significa che gli esseri umani non saranno mai in grado di prevedere, in anticipo durante la fase di progettazione, tutti i possibili fattori contestuali che potrebbero comprometterne il funzionamento. Ciò espone le persone ai rischi intrinseci di esiti imprevisti in cui gli output di un sistema di IA non sono adeguatamente vincolati.

La sicurezza è anche uno strumento di protezione dei dati fin dalla progettazione, come previsto dall’art. 25 del GDPR. Tenendo conto di una serie di fattori contestuali (come lo stato dell’arte), i titolari del trattamento devono mettere in atto misure tecniche e organizzative adeguate. Tali misure devono essere in atto per attuare i principi di protezione dei dati in modo efficace, dalla minimizzazione all’accuratezza dei dati, integrando le necessarie salvaguardie nel trattamento. Nel dettaglio, il GDPR menziona specificamente la pseudonimizzazione come una di quelle misure efficaci. La dimensione della sicurezza per la protezione dei dati, nell’ambito dell’IA, è molto importante per poter introdurre le necessarie tutele tecniche e organizzative (per la tutela dei diritti e delle libertà delle persone) già nella fase di progettazione di nuove applicazioni di IA (security by design).

A tal fine, la sicurezza può anche essere un fattore abilitante di nuove operazioni di trattamento, in particolare legate alle tecnologie emergenti, come l’IA. Ad esempio, l’implementazione di misure di sicurezza specifiche, come la pseudonimizzazione o la crittografia, può portare i dati in un nuovo formato in modo che non possano essere attribuiti a un interessato specifico senza l’uso di dati informativi aggiuntivi (come una chiave di decrittazione). Queste opzioni potrebbero essere esplorate nel contesto dell’ambiente dell’IA, per modellare nuove relazioni tra umani e macchine, in modo che gli individui non siano per impostazione predefinita identificabili dalle macchine a meno che non lo desiderino. Ad esempio, una IA impostata allo scopo di annullare l’effetto della pseudonimizzazione o crittografia implementata.

Il legislatore europeo, ponendo la sicurezza tra i principi di protezione dei dati, stabilisce che questa è una condizione preliminare per il trattamento. Pertanto, la chiave è il passaggio dalla sicurezza come strumento difensivo alla sicurezza come elemento funzionale dell’ecosistema digitale. La sicurezza non deve essere implementata solo per prevenire perdite, ma anche per creare valore. Solo se le minacce alla sicurezza si affievoliranno, l’ecosistema AI può generare fiducia, attrarre investimenti, trattenere utenti e creare un feedback positivo per sviluppare ogni volta nuove applicazioni vantaggiose.

Il ciclo di vita dell’IA

Per inquadrare correttamente il dominio dell’IA, è essenziale seguire un approccio strutturato e metodico per comprenderne le diverse sfaccettature.

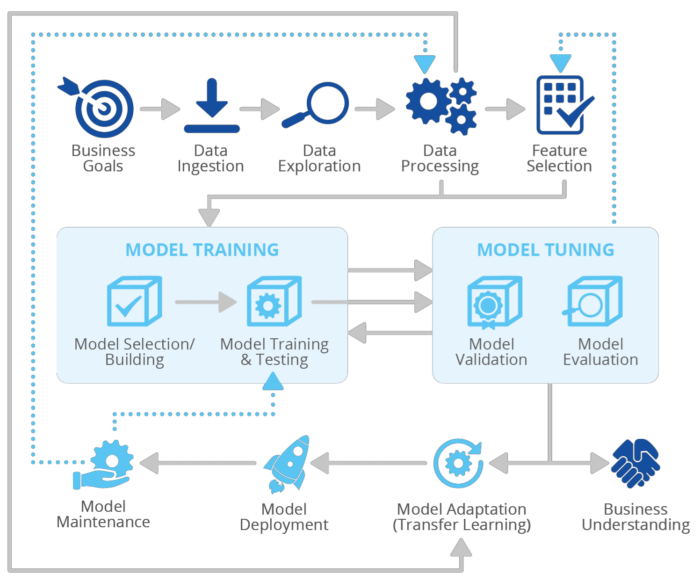
Il ciclo di vita di un sistema di Intelligenza Artificiale comprende diverse fasi interdipendenti che vanno dalla progettazione e sviluppo (comprese sottofasi come analisi dei requisiti, raccolta dati, formazione, test, integrazione), installazione, distribuzione, funzionamento, manutenzione e smaltimento. Data la complessità dei sistemi di Intelligenza Artificiale (e in generale delle informazioni), sono stati definiti diversi modelli e metodologie per gestire questa complessità, soprattutto durante le fasi di progettazione e sviluppo, come cascata, spirale, sviluppo software agile, prototipazione rapida e incrementale. Il ciclo di vita dell’IA definisce le fasi che un’organizzazione dovrebbe seguire per trarre vantaggio dalle tecniche di Intelligenza Artificiale e in particolare dai modelli di Machine Learning (ML) per ricavare valore di business pratico[1].

Figura 2 – Modello di riferimento generico del ciclo di vita dell’IA
(fonte: ENISA – Artificial Intelligence Cybersecurity Challenges, 2020)

Business Goal Definition

In questa fase risulta di fondamentale importanza che l’organizzazione comprenda appieno il contesto aziendale dell’applicazione di intelligenza artificiale e i dati necessari per raggiungere i target prefissati.

Data Ingestion

Il Data Ingestion è la fase del ciclo di vita dell’IA in cui i dati vengono ottenuti da più fonti (i dati grezzi possono essere di qualsiasi forma strutturata o non strutturata). L’ acquisizione di dati è alla base di qualsiasi applicazione di intelligenza artificiale. I dati possono essere acquisiti direttamente dalle sue fonti in tempo reale, un modo continuo noto anche come streaming, o importando batch di dati, dove i dati vengono importati periodicamente in grandi macro-batch o in piccoli micro-batch.

Data Exploration

In questa fase le informazioni dettagliate iniziano a essere ricavate dai dati inseriti.

Data Pre-processing

La fase di preelaborazione dei dati utilizza tecniche per pulire, integrare e trasformare i dati. Questo processo mira a migliorare la qualità dei dati che migliorerà le prestazioni e l’efficienza dell’intero sistema di IA.

Feature Selection

Questa è la fase in cui viene ridotto il numero di componenti o caratteristiche (chiamate anche dimensioni) che compongono ciascun vettore di dati, identificando i componenti che si ritiene siano i più significativi per il modello di IA.

Model Selection / Building

Questa fase esegue la selezione/costruzione del miglior modello o algoritmo di intelligenza artificiale per l’analisi dei dati. Le tre categorie principali comunemente identificate sono l’apprendimento supervisionato, l’apprendimento non supervisionato e i modelli di apprendimento per rinforzo.

Model Training

Dopo aver selezionato un modello di IA, che nell’ambito di questo modello di riferimento fa per lo più riferimento a un modello di Machine Learning (ML), inizia la fase di training del sistema di IA.

Model Tuning

L’ottimizzazione del modello di solito si sovrappone all’addestramento del modello, poiché l’ottimizzazione è generalmente considerata all’interno del processo di addestramento.

Transfer Learning

In questa fase, l’organizzazione dell’utente utilizza un modello di intelligenza artificiale pre-addestrato e pre-sintonizzato e lo utilizza come punto di partenza per un’ulteriore formazione per ottenere una convergenza migliore e più rapida.

Model Deployment

Un modello di Machine Learning porterà conoscenza a un’organizzazione solo quando le sue previsioni saranno disponibili per gli utenti finali. La distribuzione è il processo in cui un modello viene reso disponibile agli utenti.

Model Maintenance

Dopo l’implementazione, i modelli di intelligenza artificiale devono essere continuamente monitorati e mantenuti per gestire le modifiche ai concetti e le potenziali derive concettuali che potrebbero verificarsi durante il loro funzionamento. La manutenzione del modello riflette anche la necessità di monitorare gli obiettivi e le risorse aziendali che potrebbero evolversi nel tempo e di conseguenza influenzare il modello stesso.

Business Understanding

In questa fase le aziende che implementano modelli di intelligenza artificiale acquisiscono informazioni sull’impatto dell’IA sul proprio business e cercano di massimizzare le probabilità di successo.

Attori del ciclo di vita dell’IA

Nella rosa delle figure coinvolte nell’ecosistema dell’IA vi sono numerosi attori attivamente coinvolti.

In primo luogo, è possibile ricordare i progettisti di intelligenza artificiale impegnati nella progettazione e creazione di sistemi di intelligenza artificiale. Successivamente, vi sono gli sviluppatori di intelligenza artificiale con il compito di costruire e sviluppare il software e gli algoritmi utilizzati nei sistemi di intelligenza artificiale, oltre a lavorare per perfezionarli e migliorarli. Queste ultime figure collaborano con i cosiddetti data scientist, i quali sono coinvolti nella raccolta e nell’interpretazione dei dati, concentrandosi sull’estrazione di conoscenze e approfondimenti da tali dati. Inoltre, sono presenti anche i data engineers i quali prestano particolare attenzione alla progettazione, gestione e ottimizzazione del flusso di dati.

Un altro attore che ricopre un’importanza significativa nel ciclo di vita dell’IA è il data owner il quale possiede i set di dati utilizzati per addestrare o convalidare i sistemi di intelligenza artificiale. Diversamente, i model providers che forniscono modelli (nonché implementazioni di essi sotto forma di librerie IA/ML) che sono già stati formati e messi a punto. Alcuni model providers sono dei cloud providers, ed offrono i modelli come servizio, in particolare l’uso di capacità di calcolo e analisi dei dati basate sull’intelligenza artificiale nel cloud.

Infine, vi sono gli utenti finali che utilizzano i sistemi di intelligenza artificiale. Tra questi è possibile menzionare i consumatori di servizi, ma anche il pubblico in generale.

Cybersecurity threats: minacce dell’IA

Come già sottolineato, l’intelligenza artificiale consente il processo decisionale automatizzato e facilita molti aspetti della vita quotidiana, portando con sé miglioramenti delle operazioni e numerosi altri vantaggi. Tuttavia, i sistemi di IA devono far fronte a numerose cybersecurity threats. Pertanto, è necessario analizzare i vari gruppi di attori coinvolti nelle minacce e successivamente approfondire la tassonomia delle minacce nell’ecosistema dell’IA.

Attori minacciatori

Le figure che potrebbero voler danneggiare i sistemi di IA utilizzando mezzi informatici sono i seguenti:

  • Cyber criminali: essi sono motivati principalmente dal profitto e tendono ad utilizzare l’IA come strumento per condurre attacchi, ma anche per sfruttare le vulnerabilità nei sistemi di IA esistenti.
  • Insider: essi sono figure interne ad un’azienda ed hanno accesso alle reti di un’organizzazione, possono coinvolgere coloro che hanno intenzioni dannose o coloro che possono danneggiare un’azienda involontariamente.
  • Nation state actors: questi soggetti sono principalmente sponsorizzati dagli stati sia per difendere le proprie reti, ma anche per sfruttare le vulnerabilità dei sistemi di intelligenza artificiale di altri paesi
  • Terrorists: sono figure che hanno l’obiettivo di causare chiaramente dei danni fisici o di danneggiare la sicurezza nazionale di un paese.
  • Hacktivists: essi sono un gruppo di hacker, motivati ideologicamente, che possono hackerare i sistemi di intelligenza artificiale per dimostrare le vulnerabilità di infrastrutture critiche.
  • Script Kiddies: essi sono generalmente un gruppo di individui non qualificati che utilizzano script o programmi pre-scritti per attaccare i sistemi di IA.

Tassonomia delle minacce

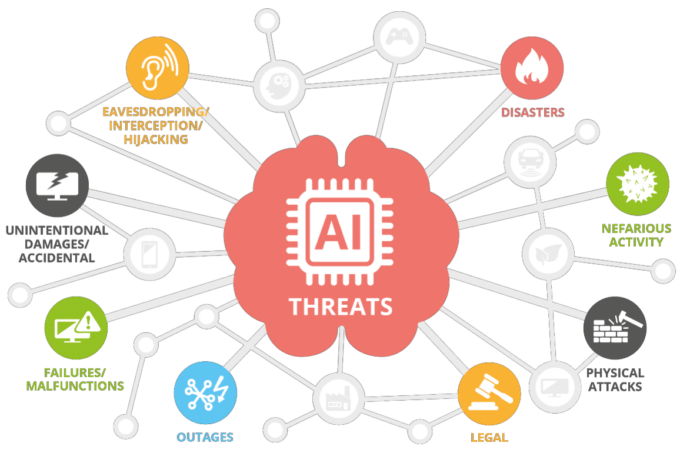
È possibile utilizzare una tassonomia delle minacce per mappare il panorama delle minacce nell’ecosistema dell’Intelligenza Artificiale.

Figura 3: tassonomia delle minacce dell’IA
(fonte: ENISA – Artificial Intelligence Cybersecurity Challenges, 2020)
  1. Nefarious activity/abuse (NAA): sono le azioni previste che prendono di mira i sistemi ICT, infrastrutture e reti mediante atti dannosi con l’obiettivo di rubare, alterare o distruggere un determinato obiettivo.
  2. Eavesdropping/ Interception/ Hijacking (EIH): sono le azioni volte ad ascoltare, interrompere o prendere il controllo di una comunicazione di terzi senza consenso.
  3. Physical attacks (PA): sono le azioni che mirano a distruggere, esporre, alterare, disabilitare, rubare o ottenere l’accesso non autorizzato a risorse fisiche come infrastrutture, hardware o interconnessione.
  4. Unintentional Damage (UD): sono le azioni non intenzionali che causano distruzione, danno o lesione di cose o persone e si traducono in un fallimento o riduzione dell’utilità.
  5. Failures or malfunctions (FM): sono le azioni che causano un insufficiente o parziale funzionamento di un bene (hardware o software).
  6. Outages (OUT): sono le azioni che causano interruzioni impreviste del servizio o diminuzione della qualità al di sotto un livello richiesto.
  7. Disaster (DIS): sono le azioni che causano un incidente improvviso o una catastrofe naturale che provoca gravi danni o perdita di vite umane.
  8. Legal (LEG): sono le azioni legali di terzi, contrattuali e non contrattuali, al fine di vietare azioni o compensare perdite in base alla legge applicabile.

Conclusioni

La significativa importanza che ricopre l’Intelligenza Artificiale nella società odierna non può essere certamente trascurata. Essendo agli albori di una nuova rivoluzione digitale, è stato stimato che il mercato globale dell’intelligenza artificiale nell’arco temporale 2020-2027 possa crescere con tasso medio annuo del 42.2%.

Pertanto, è doveroso sottolineare come qualsiasi ambito della nostra vita sia sotto l’aspetto quotidiano, economico, professionale e del lavoro subirà un cambiamento, così dando origine ad una convivenza tra uomo e digitale.

Come osservato dallo storico Y.N. Harari[2], l’Intelligenza Artificiale realizza due capacità particolarmente importanti che sono la connettività e la possibilità di aggiornamento. “Poiché gli esseri umani sono individui, è difficile connetterli l’uno all’altro e assicurarsi che siano tutti aggiornati. Le macchine invece non sono individui ed è facile integrarle in una singola rete flessibile. Pertanto, non si tratta di sostituzione di milioni di lavoratori individuali con milioni di individui robot e computer. È più verosimile che gli individui umani siano rimpiazzati da una rete integrata”.

Note

[1] ENISA, Artificial Intelligence Cybersecurity Challenges, Dicembre 2020.

[2] Y.N. Harari, 21 lezioni per il XXI secolo, Bompiani, 2018.

Articolo a cura di Luca Barbieri

Profilo Autore

Luca Barbieri è laureato in Giurisprudenza presso l’Università Luiss Guido Carli con tesi intitolata “From cyber espionage to cyber warfare: a criminal comparative analysis between Italy, USA and China”, nella materia di Diritto Penale, con il Prof. A. Gullo.
Durante l’Exchange Program, presso la Beijing Normal University di Pechino, ha sostenuto numerosi esami in diritto cinese e cyber security. Inoltre, ha conseguito il Master universitario di secondo Livello in “Responsabile della protezione dei dati personali: Data Protection Officer e Privacy Expert” presso l’Università Roma Tre.
Attualmente collabora in uno studio legale specializzato in diritto delle nuove tecnologie, privacy e cyber security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/le-nuove-sfide-di-cyber-security-per-lintelligenza-artificiale-la-mappatura-dellecosistema-e-la-tassonomia-delle-minacce/


Portabilità dei dati fra le piattaforme cloud e codici di condotta SWIPO

Trasformazione digitale e data portability

La trasformazione digitale che sta investendo il nostro ecosistema sociale e industriale, a livello nazionale e internazionale, vede la tecnologia dei sistemi e delle infrastrutture cloud come uno dei fattori determinanti per la sua realizzazione.

Una corretta adozione del cloud è una priorità per qualsiasi azienda che decida di adeguare i suoi sistemi di trattamento delle informazioni e dei dati per raggiungere la scalabilità e la flessibilità che qualsiasi business richiede.

In buona sostanza, i servizi cloud stanno diventando i pilastri fondamentali su cui si appoggerà e svilupperà la trasformazione digitale delle nostre aziende e, più in generale, di tutta la nostra società.

La recente esperienza della pandemia ha dimostrato che le aziende che avevano già un processo di trasformazione digitale basato sul cloud hanno potuto meglio adattarsi al nuovo, difficile contesto organizzativo che tutti abbiamo dovuto fronteggiare.

Infatti, ad esempio, la adozione e l’attivazione di processi di smart-working è stata certamente più agevole per le aziende che avevano già avviato il percorso di evoluzione verso il cloud.

Questa trasformazione renderà, nel futuro, le nostre aziende sempre più data driven companies; i dati, sia quelli trasferiti sul cloud che quelli che continuamente si genereranno nella interazione con il cloud, sono e saranno il carburante su cui costruire business sempre più innovativi.

Nonostante tutto ciò, permangono tutta una serie di preoccupazioni che in qualche modo frenano l’adozione del cloud da parte delle aziende.

Diversi studi mostrano che queste preoccupazioni riguardano sostanzialmente il tema della sicurezza dei dati e quello della perdita del controllo su di essi.

Già alla fine del 2017, la Commissione Europea, nel lanciare il Regolamento per la libera circolazione dei dati non-personali 2018/1807 con l’obiettivo di facilitare il movimento ed il trasferimento dei dati all’interno della Unione Europea come fattore di sviluppo del Digital Single Market europeo, incoraggiava con l’Articolo 6 di questo Regolamento la nascita di iniziative di self-regulation che, con il coinvolgimento di tutti gli stakeholders, sviluppassero codici di condotta per permettere il data porting fra i diversi fornitori di servizi cloud.

Nelle intenzioni della Commissione queste iniziative dovevano garantire la data portability fra diversi Service Cloud Provider, proteggendo i dati delle aziende utilizzatrici di servizi cloud dal rischio di provider lock-in, così da raggiungere l’obiettivo strategico della proprietà dei dati ed il controllo su di essi.

Ma cosa è la data portability?

Secondo la NIST Special Publication 500-332, la data portability viene definita come “la capacità del cliente di spostare dati e applicazioni attraverso diversi ambient cloud a basso costo e con la minima interruzione dei servizi”.

E’ opportuno evidenziare che il perimetro della data portability non include solamente i dati trasferiti sulle piattaforme cloud ma anche i cosiddetti derived data che, secondo ISO/IEC 17788:2014, appartengono alla classe di data objects che sono sotto il controllo del fornitore e che sono il risultato della interazione del cliente con il servizio cloud.

L’importanza di questi derived data o co-generated data crescerà sempre di più, parallelamente alla crescita dell’integrazione fra servizi cloud e edge computing.

L’Unione Europea e i codici di condotta SWIPO per la data portability

A febbraio del 2018, la Commissione Europea, nello spirito del citato Articolo 6 del Regolamento per la Libera Circolazione dei dati, incoraggiava la formazione dello SWIPO Working Group (del quale ho avuto l’onore di essere uno dei co-chairs) per la stesura di codici di condotta per garantire la portabilità dei dati dei servizi IaaS e SaaS.

Tale Working Group era aperto alla partecipazione di tutti i principali stakeholders del mercato cloud (Providers e Customers di grandi e piccole dimensioni) al fine di raccogliere e conciliare le idee e le esigenze di tutti gli attori coinvolti.

In tal modo la Commissione Europea proponeva un soft approach chiedendo ai diversi stakeholders di impegnarsi ad un processo di auto-regolamentazione per arrivare, nel modo più fluido possibile, alla data del maggio 2020 alla piena operatività di questi codici di condotta.

Da febbraio 2018 a novembre 2019 il Working Group ha svolto le sue attività mediante conference call periodiche e incontri face-to-face ospitati dalle organizzazioni partecipanti nelle diverse capitali europee. Tali incontri sono stati aperti da sessioni pubbliche che hanno visto la partecipazione degli organismi istituzionali dei paesi che hanno ospitato i diversi incontri; in questo modo si è contribuito ad aumentare la attenzione e la consapevolezza sul tema Libera Circolazione dei dati nell’ambito del Digital Single Market Europeo.

Sono state così prodotte le prime versioni dei codici di condotta per i servizi SaaS e IaaS che sono state consegnate alla Commissione Europea nella High Level Conference on Data Economy ad Helsinki il 26 novembre 2019 e che hanno sancito alcuni punti molto importanti in relazione al tema del data porting fra i diversi Cloud Service Providers.

Ad esempio, il primo punto del codice di condotta per sistemi SaaS chiede esplicitamente che i Cloud Service Providers debbano sempre avere un processo di data export/import esplicito e strutturato da mettere a disposizione dei Cloud Service Customers, fornendo tutte le informazioni utili per la sua attuazione in modo da ridurre in modo significativo il rischio di lock-in.

E’ questo un principio fondamentale che chiede alle aziende fornitrici di servizi cloud e aderenti ai codici di condotta SWIPO di garantire ai propri clienti l’azzeramento del rischio di lock-in provider.

Il 19/2/2020 veniva sottolineate la importanza della iniziativa SWIPO nella comunicazione della nuova Strategia Europea dei Dati da parte della appena insediata Commissione Europea guidata da Ursula von der Leyen.

Il 26 maggio 2020 è stata infine costituita la SWIPO (Switching Cloud Providers and Porting Data) AISBL, (www.swipo.eu) associazione multi-stakeholders no-profit di diritto belga la cui missione è “to develop and maintain voluntary Codes of Conduct in support of Article 6 Porting of Data of the Free Flow on Non Personal Data Regulation (EU) 2018/1807″.

Nella prima Assemblea Generale si è anche provveduto alla formazione dell’Executive Board della nuova Legal Entity nel quale chi scrive è stato eletto come rappresentante dei SaaS customers.

Uno dei principi fondativi della Governance della associazione SWIPO è quello di garantire il balance of interests fra i diversi stakeholders (providers e customers) del mercato dei servizi cloud.

A tal fine, a partire dall’Executive Board e in tutti gli organi decisionali della associazione, sono previsti meccanismi che garantiscano una presenza bilanciata di providers e customers.

Va sottolineato che la presenza dei customers è fortemente incoraggiata e, per questo motivo, si è convenuto che la partecipazione alla associazione sia gratuita (il fee di adesione è per loro nullo).

Tutti i documenti di Governance, i codici di condotta, le modalità di adesione, le dichiarazioni di adesione da parte dei providers sono disponibili nel già citato sito www.swipo.eu.

Ma come funzionano questi codici di condotta?

Innanzitutto, un Cloud Provider che intenda dichiarare la sua adesione a questi codici di condotta dovrà pubblicare un Transparency Statement nel quale riporti tutte le informazioni necessarie ad un potenziale Cloud Customer per valutare ed effettuare eventuali operazioni di data porting per effettuare il provider switching.

Queste informazioni sono finalizzate a prevenire il rischio di vendor lock-in fornendo ai customers la descrizione del processo da intraprendere qualora debbano spostare i loro dati di business fra diversi cloud providers.

E’ infatti estremamente importante che all’atto della sottoscrizione di un contratto di un servizio cloud si presti attenzione a tutta una serie di aspetti relativi alla fase di migrazione dei dati quali, ad esempio,

    • formati di interscambio dei dati (sia a livello sintattico che a livello semantico)
    • politica dei dati (ovvero livelli di riservatezza, diritti alla privacy, trasferimenti transfrontalieri, localizzazione geografica dei dati, luogo di elaborazione e trattamento dei dati)
    • livelli di sicurezza (ossia quali controlli devono essere in atto per soddisfare i requisiti di sicurezza basati sulla classificazione dei dati)
    • metadati associati ai dati (ad cronologia di audit, rilevamento delle modifiche, ecc.)
    • sicurezza durante la migrazione dei dati (es. crittografia, firma digitale)
    • tecniche di migrazione (es. snap shot vs approccio graduale)
    • periodo di conservazione dei dati e dei logs dopo la migrazione ad altro fornitore
    • trattamento e gestione dei “dati derivati”

Nel Transparency Statement si forniscono pertanto tutte le informazioni necessarie nella fase precontrattuale per valutare tutti gli aspetti da affrontare qualora si dovesse successivamente decidere di trasferire i dati ad un altro fornitore (o a riportare in dati su infrastrutture on-premise).

Vale la pena sottolineare che queste informazioni sono fornite volontariamente dai Provider che aderiscono ai codici di condotta e hanno lo scopo primario di fornire un documento che raccolga tutti gli elementi che possono essere utili per la valutazione del rischio lock-in.

Ad ulteriore garanzia dei Customers, la associazione SWIPO ha costituito un Complaints Secretariat che ha l’obiettivo di gestire eventuali reclami e contestazioni da parte di Customers che, avendo adottato un servizio cloud dichiarato aderente ai codici SWIPO, rilevino che nella realtà dei fatti il Provider non si stia attenendo, completamente o in parte, ai codici stessi.

Concludendo questa breve sintesi sul funzionamento dei codici di condotta SWIPO, possiamo affermare che essi costituiscono un efficace strumento per raggiungere la trasparenza sui termini contrattuali sulla data portability all’atto della stipula di contratti su servizi cloud.

Considerazioni strategiche sulla data portability

Tornando alla questione più generale della data portability, possiamo certamente convenire che la natura strategica di questo tema è confermata da importanti iniziative legislative europee quali il Digital Markets Act e il Data Act che mirano a ridurre sempre di più le barriere che impediscono lo spostamento di dati fra diverse piattaforme al fine di contribuire allo sviluppo della economia digitale europea, sempre nel pieno rispetto dei principi e valori della Unione.

Vale inoltre sottolineare la importanza della data portability quando si affronta il tema della resilienza delle supply chain digitali, tema la cui importanza sta crescendo nel contesto dell’attuale scenario geo-politico.

Sarà difficile considerare resiliente una supply chain se essa non risolve il problema della data portability e, quindi, del vendor lock-in.

A tale proposito può essere interessante ricordare che Gaia-X, associazione europea per la definizione di una architettura aperta e federata per il cloud e l’edge computing al cui Board chi scrive ha l’onore di partecipare, nel proporre il suo framework per definire i criteri di labeling dei servizi che faranno parte del suo eco-sistema digitale, ha indicato, come si può riscontrare accedendo al link sotto riportato, i codici di condotta SWIPO come i riferimenti da seguire per la data portability.

https://www.gaia-x.eu/sites/default/files/2022-04/Gaia-X%20labelling%20criteria%20v22.04_Final.pdf

Come considerazione conclusiva di questa sintetica nota sui codici di condotta SWIPO e sulla data portability, può essere opportuno formulare l’auspicio che la strategicità geo-politica ed economica del tema spinga sempre di più verso un approccio di data portabilty by-design nella progettazione dei nuovi servizi cloud and edge computing.

Infatti, solo il considerare la data-portability come un requisito progettuale dei nuovi servizi potrà garantire che il valore dei dati delle aziende sia sempre più protetto e garantito nella trasformazione digitale che nei prossimi anni segnerà sempre di più lo sviluppo economico e sociale delle nostre società.

Articolo a cura di Aniello Gentile

Profilo Autore

Dopo la laurea con lode in Ingegneria Elettronica nel 1980 presso l’Università Federico II di Napoli, ha svolto attività di ricerca presso il Centro di Ricerca Olivetti per Tecnologie Meccaniche e Automazione (RTM) di Vico Canavese (TO).
Nel 1981 ha iniziato la sua attività in Enel nell’area ICT Development dove ha gestito progetti di telecomunicazione e automazione, anche con l’utilizzo di tecnologie AI.
Dal 1990 ha operato nel settore ICT Operations di Enel, dove è stato responsabile di diversi processi (gestione dei data center, gestione dei rilasci, supporto degli utenti finali).
Dal 2014 opera nella unità Global Cyber Security di Enel contribuendo a tutte le principali iniziative tra le quali la progettazione del nuovo Framework di Cybersecurity e la definizione della metodologia Cyber Risk Analysis.
È stato presidente e relatore in numerosi convegni ed eventi internazionali sulla Cyber Security e su
Infrastrutture critiche (IBM Interconnect 2016, PowerGen 2017, SeltaChallenge 2017, I-COM Public
Conferenza 2018, Electrify Europe2018).
Da gennaio 2018 è Consigliere della Sezione IT di Unindustria Lazio.
Da giugno 2018 è nel Working Group for ‘Systems of Cyber Resilience’ del World Economic Forum ove ha contribuito ai seguenti report:
· Cyber Resilience in the Electricity Ecosystem: Principles and Guidance for Boards
· WEF Risk Snapshot for Smart Grids
· Cyber Resilience in the Electricity Ecosystem: Playbook for Boards and Cybersecurity Officers
· Cyber Resilience in the Electricity Industry: Analysis and Recommendations on Regulatory Practices for the Public and Private Sectors
Da aprile 2018 a maggio 2020 è stato uno dei ‘co-chairs’ del Working Group SWIPO (SWItching provider and POrting of data), organizzato dalla Commissione europea con l’obiettivo di sviluppare codici di condotta per facilitare il ‘porting’ dei dati tra diversi Service Cloud Provider al fine di ridurre i rischi di ‘lock-in provider’.
Da maggio 2020 è membro dell’Executive Board di SWIPO AISBL, associazione ‘no-profit’ fondata per sviluppare, mantenere e favorire l’adozione di tali codici di condotta nel mercato dei servizi cloud.
Da giugno 2021 è membro del Board di GAIA-X AISBL, l’iniziativa europea che mira a definizione di un’infrastruttura cloud federata allineata ai valori della strategia europea dei dati

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/portabilita-dei-dati-fra-le-piattaforme-cloud-e-codici-di-condotta-swipo/


Approvata la strategia nazionale di cybersicurezza 2022-2026

Lo scorso 18 maggio, durante la settimana che ha visto l’Italia in piena emergenza per gli attacchi cyber anche a causa del conflitto russo-ucraino, il Comitato interministeriale per la Cybersicurezza, presieduto dal premier Mario Draghi, ha approvato la Strategia Nazionale di Cybersicurezza (2022-2026) e l’annesso Piano di implementazione, entrambi elaborati dall’Agenzia per la Cybersicurezza Nazionale (ACN). Nella stessa riunione è stato approvato anche lo schema dell’ultimo DPCM, che indica i criteri che i laboratori devono rispettare per accreditarsi come laboratori di prova per il Centro di valutazione e certificazione nazionale (CVCN), per la realizzazione del Perimetro di sicurezza nazionale cibernetica gestito dall’Agenzia per la Cybersicurezza Nazionale. Analizziamo i principali elementi che caratterizzano la nuova Strategia Nazionale di Cybersicurezza.

Premessa

Il documento inizia con un’analisi dello scenario che caratterizza il periodo attuale, concentrandosi, in particolar modo, sulla circostanza che la quasi totalità delle azioni umane sfruttano innumerevoli servizi, interconnessi e comunicanti, concepiti per il soddisfacimento delle quotidiane esigenze delle comunità e per lo svolgimento delle relative attività economiche: infrastrutture energetiche, mercati finanziari, forniture di acqua potabile, trasporti di massa, e, non ultime, le funzioni essenziali dello Stato, incluse la sua difesa e integrità.

Tale complessità e l’interdipendenza dei sistemi ha favorito l’unificazione della dimensione digitale e il mondo reale. Da ciò si desume che se, da una parte, l’incessante evoluzione delle moderne tecnologie rende più conveniente la migrazione verso il digitale, dall’altra, solo la resilienza e la sicurezza delle reti e dei sistemi, su cui tali servizi si basano, possono garantire la sicurezza per la comunità e, in prospettiva, lo sviluppo economico e il benessere dello Stato.

In questo scenario occorre prepararsi seguendo un approccio che includa l’adozione di misure di prevenzione e mitigazione del rischio volte a innalzare la resilienza delle infrastrutture digitali. Queste ultime, secondo il nuovo paradigma, non includono soltanto reti, sistemi e dati, ma anche, e soprattutto, utenti, la cui consapevolezza va alimentata attraverso una diffusa cultura della cybersicurezza.

I recenti attacchi hanno fornito evidenze di danni economici e reputazionali per imprese, blocco dell’operatività di infrastrutture energetiche, malfunzionamenti di sistemi informativi impiegati da aziende ospedaliere e sanitarie, diffusione di dati personali che mirano a screditare figure pubbliche, fino a metterne in pericolo, talvolta, l’incolumità.

Tali premesse hanno consentito di individuare quattro aspetti su cui è stata sviluppata la nuova strategia:

  1. la definizione di adeguate strategie di cybersicurezza rientra a pieno titolo tra i doveri dello Stato;
  2. la cybersicurezza deve porsi a fondamento del processo di digitalizzazione del Paese, anche nell’ottica di conseguire l’autonomia nazionale strategica nel settore;
  3. la cybersicurezza non deve essere percepita come un costo, ma come un investimento e un fattore abilitante per lo sviluppo dell’economia e dell’industria nazionale, al fine di accrescere la competitività;
  4. la messa in sicurezza di infrastrutture, sistemi e informazioni dal punto di vista tecnico deve essere accompagnata da un progresso culturale ad ogni livello della società, verso un approccio “security-oriented”.

Le sfide da affrontare

L’evoluzione tecnologica ha determinato la comparsa di nuovi rischi, e ulteriori ne sorgeranno con l’avanzare della stessa e delle tecniche di attacco. A tal proposito, l’Agenzia ha delineato tre macrocategorie di rischi sistemici da dover gestire:

  • i classici attacchi cyber che sfruttano errori software, errate configurazioni, debolezze nei protocolli e/o umane, per sottrarre dati o arrecare danni ai sistemi, che hanno un impatto sull’erogazione dei servizi, anche essenziali di un Paese, sul suo PIL e sulla sua reputazione;
  • le tecnologie ICT sviluppate e prodotte da grandi realtà aziendali, talvolta controllate o, comunque, influenzate nel loro operato dai Governi in cui hanno sede, con conseguenti possibili ingerenze nella catena degli approvvigionamenti, sia in termini di disponibilità sul mercato delle relative componenti, sia di affidabilità delle stesse;
  • la diffusione di fake news, deepfake e campagne di disinformazione che tendono a confondere e destabilizzare i cittadini di un Paese immergendoli in uno spazio informativo non controllato con un insieme pressoché infinito di sorgenti di notizie che polarizzano le opinioni cambiando il modo in cui percepiamo la realtà.

Alla luce dei citati rischi, la nuova Strategia Nazionale di Cybersicurezza, sviluppata dall’Agenzia per la Cybersicurezza Nazionale (ACN), mira ad affrontare le seguenti sfide:

  1. Assicurare una transizione digitale cyber resiliente della Pubblica Amministrazione (PA) e del tessuto produttivo. “Non ci può essere transizione digitale senza un’adeguata resilienza agli attacchi e agli incidenti cyber”;
  2. Tendere ad autonomia strategica nazionale ed europea nel settore del digitale. “Più si è autonomi dal punto di vista tecnologico e più si possono attuare politiche di sovranità delle informazioni”;
  3. Anticipare l’evoluzione della minaccia cyber. “È apparso chiaro come sia necessario puntare su tattiche di difesa attiva volte ad aumentare i costi di eventuali attività cyber offensive, così da renderle economicamente svantaggiose. Occorre, per quanto possibile, anticipare la minaccia, ossia prevederla, prevenirla e mitigarne il più possibile gli impatti”;
  4. Gestire le crisi cibernetiche. “Gli ultimi incidenti hanno messo in evidenza l’importanza primaria di un meccanismo efficiente di gestione delle crisi cibernetiche, che consenta, con l’apporto di tutti i soggetti interessati, di graduare le attività sulla base di scenari predefiniti della minaccia cyber”;
  5. Contrastare la disinformazione online nel più ampio contesto della cd. minaccia ibrida. “Il ricorso sempre più massivo alla disinformazione online richiede, specie quando essa assume connotazioni strutturate, azioni preventive e di contrasto sinergiche e coordinate a livello sia nazionale che internazionale per ostacolare i tentativi di mettere a repentaglio il sistema di valori su cui si base la democrazia”.

È implicito che l’implementazione delle richiamate sfide prevede un adeguato programma di investimenti e leve finanziarie, la vera novità di questo Piano Strategico. In particolare, sono previsti: Fondi nazionali, con una Quota percentuale del 1,2% degli investimenti nazionali lordi su base annuale; Finanziamenti specifici, che l’Agenzia sarà chiamata a gestire in quanto è stata designata quale Centro Nazionale di Coordinamento (NCC); e, infine, le risorse previste nel Piano Nazione di Riprese e Resilienza (PNRR) per l’attività di Transizione Digitale e il potenziamento delle capacità di resilienza delle infrastrutture e dei servizi digitali del Paese.

Visione strategica: gli obiettivi da perseguire

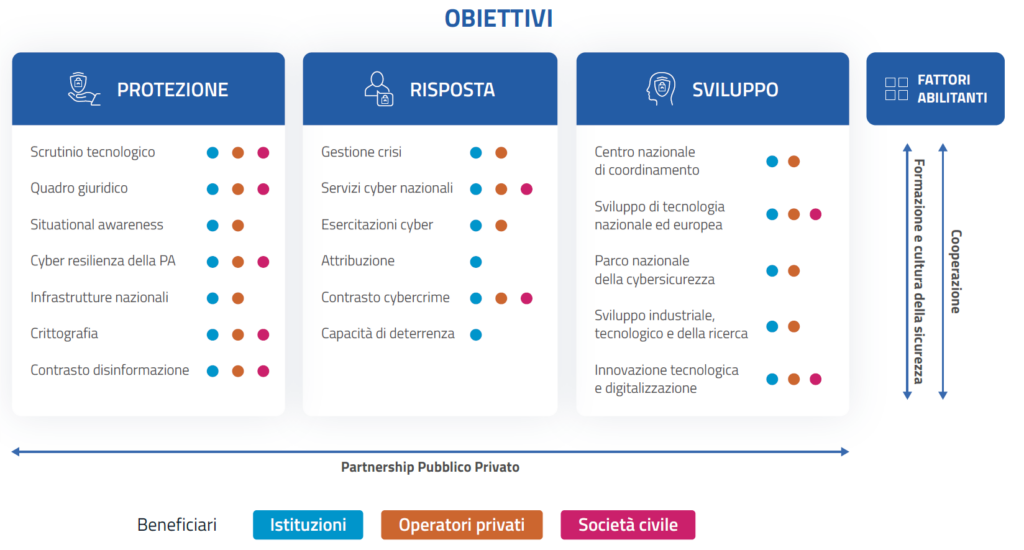
La seconda parte del documento illustra gli obiettivi individuati per fronteggiare al meglio le sfide per il sistema-Paese sopra delineate: protezione, risposta e sviluppo, e le relative misure, funzionali ad assicurare la concreta attuazione della strategia, raggruppate per aree tematiche e declinabili dal punto di vista organizzativo, regolamentare e operativo. Ogni misura è associata all’obiettivo maggiormente caratterizzante, con l’indicazione degli attori responsabili dell’implementazione e tutti gli altri soggetti a vario titolo interessati, al netto di quelli direttamente beneficiari delle misure.

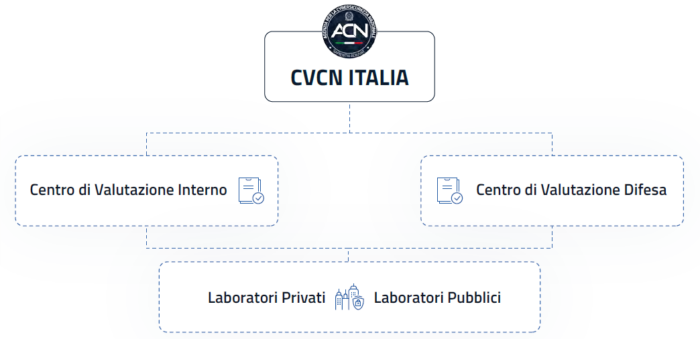
Per quanto riguarda il primo obiettivo, la strategia si concentra sulla protezione degli asset strategici nazionali. Esso si basa su un approccio sistemico orientato alla gestione e mitigazione del rischio, formato sia da un quadro normativo che da misure, strumenti e controlli che possono abilitare una transizione digitale resiliente del Paese. In particolar modo, si dà enfasi allo sviluppo di strategie e iniziative per la verifica e valutazione della sicurezza delle infrastrutture ICT, da sviluppare attraverso il costituendo CVCN (Centro di Valutazione e Certificazione Nazionale) dell’Agenzia per la Cybersicurezza Nazionale, gli altri CV e i Laboratori Accreditati di Prova, ivi inclusi gli aspetti di approvvigionamento e supply-chain a impatto nazionale.

Per garantire un efficace e duraturo livello di protezione si delineano sette azioni di intervento:

  1. il potenziamento delle capacità del Centro di Valutazione e Certificazione Nazionale (CVCN) e dei Centri di Valutazione (CV), nonché l’integrazione con una rete di Laboratori Accreditati di Prova, che permetterà di sviluppare capacità nazionali di valutazione delle vulnerabilità di tecnologie avanzate a servizio degli asset più critici del Paese;
  2. la definizione ed il mantenimento di un quadro giuridico nazionale aggiornato e coerente in materia di cybersicurezza, che tenga conto degli orientamenti e degli sviluppi in ambito europeo ed internazionale;
  3. la conoscenza approfondita del quadro della minaccia cibernetica e il possesso di adeguati strumenti tecnici, competenze specialistiche e capacità operative, in capo agli attori a vario titolo coinvolti, finalizzato all’incremento delle capacità nazionali di difesa, resilienza, contrasto al crimine informatico e cyber intelligence;
  4. il potenziamento del livello di maturità delle capacità cyber della Pubblica Amministrazione, assicurando una trasformazione digitale sicura e resiliente;
  5. la promozione dell’uso della crittografia, quale strumento di cybersicurezza, favorendone l’impiego lungo l’intero ciclo di vita dei sistemi e servizi ICT, in conformità ai principi della sicurezza e della tutela della privacy, nel rispetto dei principi stabiliti dalla normativa nazionale ed europea;
  6. l’implementazione di un’azione di coordinamento nazionale, coerente con le iniziative adottate a livello europeo e in sinergia con i Paesi like-minded, per prevenire e contrastare la disinformazione online, che sfruttando le caratteristiche del dominio cibernetico.

In merito al secondo obiettivo, la strategia identifica nella risposta alle minacce, agli incidenti e alle crisi cyber nazionali, la soluzione efficace per contrastare gli effetti degli incidenti attraverso l’impiego di elevate capacità nazionali di monitoraggio, rilevamento, analisi e risposta e l’attivazione di processi che coinvolgano tutti gli attori facenti parte dell’ecosistema di cybersicurezza nazionale.

Sul tema, si indica che una risposta quanto più tempestiva e risolutiva deve basarsi su:

  1. un sistema di gestione crisi cibernetica nazionale – assicurato dal Nucleo per la Cybersicurezza (NCS) – e transnazionale, che sia fondato su procedure di collaborazione consolidate supportate da costanti flussi informativi ed elementi di conoscenza condivisi anche grazie a reti e infrastrutture nazionali e transnazionali, con il coinvolgimento delle Amministrazioni e degli operatori privati interessati;
  2. l’integrazione degli attuali servizi cyber nazionali nei seguenti ambiti:
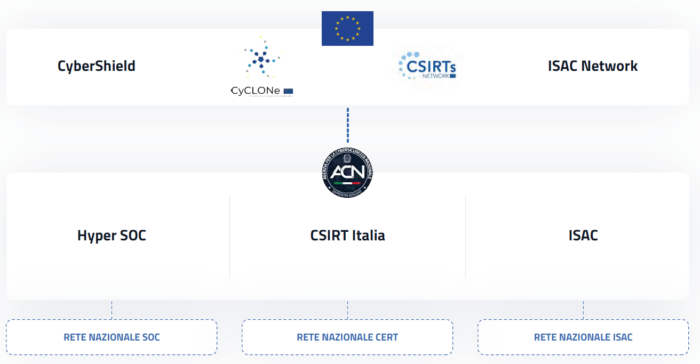
    • identificazione della minaccia realizzando un “Hyper SOC”, ovvero un sistema di raccolta, correlazione e analisi di eventi di interesse da Security Operation Center (SOC), nonché dagli Internet Service Provider (ISP), al fine di individuare precocemente eventuali “pattern” di attacco complessi che potrebbero rappresentare minacce emergenti di interesse;
    • assicurare e facilitare modalità di notifica unitaria degli incidenti di sicurezza cibernetica al Computer Security Incident Response Team (CSIRT), così da rendere più efficace la capacità di risposta e allarme tempestivo;
    • risposta agli incidenti realizzando una rete di CSIRT/Computer Emergency Response Team (CERT) settoriali federati con lo CSIRT Italia per la condivisione di procedure, informazioni e supporto nella risposta alle minacce emergenti e agli incidenti;
    • condivisione di informazioni realizzando un Information Sharing and Analysis Center (ISAC) centrale presso l’Agenzia, integrabile con una rete di ISAC settoriali sviluppati mediante iniziative pubblico-private, che possa potenziare la diffusione e l’applicazione di informazioni a maggior valore aggiunto per l’innalzamento del livello di cyber resilience del Paese;
    • qualificazione di aziende in materia di incident response, in grado di fornire supporto allo CSIRT Italia nel caso in cui dovesse verificarsi una moltitudine di incidenti cyber di natura sistemica;
  3. l’organizzazione di periodiche esercitazioni di sicurezza cibernetica e resilienza, anche nell’ambito del Perimetro nazionale di sicurezza cibernetica, nonché la promozione e il coordinamento della partecipazione a quelle europee e internazionali;
  4. la definizione del posizionamento e della procedura nazionale in materia di attribuzione di attività cibernetiche ostili, che specifichi anche i diversi attori coinvolti e il relativo contributo;
  5. il contrasto al cybercrime, declinato nella prevenzione e nel contrasto delle attività criminali di matrice comune, organizzata e terroristica, rivolte all’integrità delle infrastrutture critiche informatizzate, ma anche le altre fattispecie di reato perpetrate attraverso le tecnologie ICT;
  6. il rafforzamento delle capacità di deterrenza in ambito cibernetico.

Il terzo obiettivo si concentra sullo sviluppo, consapevole e sicuro, delle tecnologie digitali, della ricerca e della competitività industriale, in grado di rispondere alle esigenze del mercato.

In particolare, sono già stati inseriti numerosi strumenti e avviate iniziative per supportare lo sviluppo delle capacità del sistema nazionale di ricerca, la trasformazione digitale e l’innovazione tecnologica:

  1. promuovere il ruolo del Centro Nazionale di Coordinamento (NCC) che, in stretto raccordo con il Centro europeo di competenza per la cybersicurezza nell’ambito industriale, tecnologico e della ricerca (ECCC), è chiamato a supportare lo sviluppo e il potenziamento dell’autonomia strategico-tecnologica e digitale dell’Unione europea e del nostro Paese;
  2. facilitare lo sviluppo di tecnologia nazionale ed europea, così da ridurre la dipendenza da tecnologie extra-UE, attraverso l’avvio di dedicate progettualità che saranno realizzate nell’ambito di un “parco nazionale della cybersicurezza” destinato, a tendere, ad inglobare i Cluster tecnologici che svolgono attività in materia.
  3. sostenere la realizzazione un “parco nazionale della cybersicurezza” che, mettendo a sistema competenze e risorse provenienti dalla Pubblica Amministrazione, dall’industria e dal mondo accademico e della ricerca, fornisca tutte le infrastrutture tecnologiche necessarie allo svolgimento di attività di ricerca e sviluppo nell’ambito della cybersecurity e delle tecnologie digitali;
  4. introdurre nuovi meccanismi e soluzioni incentivanti per continuare a supportare lo sviluppo industriale, tecnologico e della ricerca. Ciò, anche con l’obiettivo di:
    • continuare a favorire la competitività del sistema produttivo del Paese, sostenendo le imprese nella loro transizione digitale ed ecologica, agevolandone l’internazionalizzazione e l’attrazione di investimenti;
    • realizzare prodotti e servizi ICT ad alta affidabilità, anche incoraggiando la creazione di Product Security Incident Response Team (PSIRT) da parte degli operatori privati, per accrescere le loro capacità di gestire le vulnerabilità di prodotti ICT;
  1. dare un continuo impulso all’innovazione tecnologica e alla digitalizzazione della Pubblica Amministrazione e del tessuto produttivo del Paese, assicurando una costante rispondenza ai principi di cybersicurezza e facendo ricorso alle risorse messe a disposizione dal PNRR.

La strategia evidenzia che, per poter dare piena attuazione agli obiettivi descritti, è indispensabile fare riferimento a una serie di fattori abilitanti: la formazione, la promozione della cultura della sicurezza cibernetica e la cooperazione.

Infine, trasversale ai citati obiettivi, nonché ai richiamati fattori abilitanti, è la Partnership Pubblico-Privato (PPP), che permea interamente la strategia, improntata ad un approccio “whole-of-society”, che vede il settore pubblico agire sinergicamente con quello privato, il mondo accademico e della ricerca, i media, le famiglie e gli individui per rafforzare la resilienza cibernetica della nazione e della società nel suo insieme.

Conclusioni

Nel clima di cyberwar derivato dal conflitto russo-ucraino, il direttore dell’Agenzia Cybersicurezza Nazionale Roberto Baldoni crede sia necessario recuperare il passo rispetto all’Europa attraverso l’acquisizione di tecnologie e competenze. Sicuramente il rischio cyber non si placherà, anzi bisognerà mantenere l’attenzione alta. I settori maggiormente a rischio sono gli operatori energetici, finanziari e delle telecomunicazioni, oltre alla Pubblica Amministrazione. La situazione attuale è a macchia di leopardo: alcune sono bene organizzate, altre hanno problemi e sono in forte ritardo.

Il Framework normativo è stato completato, l’Agenzia sta iniziando a prendere forma, anche grazie ai concorsi in atto, ma il Gap organizzativo e tecnologico con gli altri paesi europei è ancora importante.

Si auspica che le risorse umane previste per i prossimi anni raggiungano i numeri desiderati. Lo scopo di questa operazione è diffondere una maggiore consapevolezza della trasformazione digitale e dei rischi che possono presentarsi a tutti i livelli, dalle Organizzazioni inserite nel Perimetro, fino al cittadino/utente. La maggior parte dei soggetti, rispetto ai tre paradigmi della sicurezza informatica, è concentrata prevalentemente sulla riservatezza e poco sull’integrità e disponibilità.

La Strategia, che consta di 85 punti, rappresenta la roadmap per la sicurezza digitale del Paese fino al 2026. La vera sfida è mettere a terra tutti gli obiettivi citati, la storia ci insegna altro, prima che si concretizzino attacchi molto più devastanti di quelli visti finora.

I prossimi passi, che consentiranno di implementare la strategia, dovranno essere mirati al coinvolgimento di attori capaci di raccogliere la sfida e di contribuire attivamente con le proprie competenze al raggiungimento degli obiettivi. Andrebbero quindi stabiliti e condivisi gli obiettivi strategici, le roadmap per conseguirli e definire una serie di indicatori che consentano di misurare l’evoluzione dell’implementazione.

Articolo a cura di Vincenzo Calabrò

Profilo Autore

Referente Informatico e Funzionario alla Sicurezza CIS (Ministero dell’Interno)
Professore a contratto di Tecnologie per la Sicurezza Informatica (Università di Reggio Calabria).
È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha, altresì, indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics conseguendo i Masters in Data Protection e Data Governance, IT Risk Management e Sicurezza Informatica ed Investigazioni Digitali, oltre al CERT Certification in Digital Forensics rilasciato da Carnegie Mellon University, all’European Certificate on Cybercrime and E-Evidence (ECCE) rilasciato dall’European Commission’s Directorate General Justice, Freedom and Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/approvata-la-strategia-nazionale-di-cybersicurezza-2022-2026/


Stay Secure: Un nuovo paradigma aziendale

Premessa

La cybersecurity sarà parte essenziale della nostra quotidianità nel momento in cui, paradossalmente, non la distingueremo più dal concetto generale di sicurezza, e la percepiremo invece come la naturale necessità di proteggere (pro)attivamente noi stessi e la nostra comunità.

Predire l’evoluzione del progresso tecnologico e i futuri rischi cyber è arduo. Perciò si ritiene efficace adottare un approccio pragmatico-realistico, interpretando in chiave futuristica le minacce cyber note ma in continua evoluzione. Difendersi da queste e dagli attacchi combinati del cybercrime sarà la mission di ogni organizzazione.

Cybersecurity: come proteggere la RID

Quello cyber è una particolare tipologia di rischio che impatta la sicurezza delle informazioni,

compromettendone potenzialmente la RID, ossia la riservatezza, l’integrità e la disponibilità.

“Data is the new oil of the data economy in the Information Age”[1]: i dati sono il motore del successo di un’azienda, e rappresentano parte del knowledge-based capital, ossia un vero e proprio asset alla base dei nuovi modelli di business data-driven.

In estrema sintesi, possiamo dire che esistono due categorie di rischio cyber: 1) il rischio IT “puro”, derivante da eventi accidentali sui sistemi IT (alluvione, blackout elettrico, errore umano, ecc.), 2) Cybercrime, ossia le attività illegali commesse mediante varie tecniche d’attacco, tra tutte, il ransomware ed il social engineering.

In entrambi i casi, il concretizzarsi di uno o più di questi eventi causa gravi danni ad un’organizzazione in termini di business: perdite economiche, interruzione della continuità aziendale e, soprattutto, danno reputazionale.

Risk management: cos’è e a cosa serve

Dunque, se gli attacchi cyber cominciano a rientrare tra i dieci maggiori rischi in termini di probabilità di accadimento ed impatto[2], le organizzazioni devono proteggersi: ciò significa mettere in sicurezza i dati e l’infrastruttura informatica ospitante, adottando processi di gestione del rischio efficaci ed efficienti.

Stando alla norma UNI 11230:2007, il risk management è l’insieme di attività, metodologie e risorse coordinate per guidare e tenere sotto controllo un’organizzazione con riferimento ai rischi. Lo standard internazionale di riferimento per il risk management è la ISO 31000, la quale fornisce principi e linee guida generali per gestire il rischio.

In sintesi, il risk management, che consta delle fasi di pianificazione, valutazione, trattamento e monitoraggio, mira a: 1) allocare efficacemente il capitale e le risorse all’interno dell’organizzazione, 2) proteggere il patrimonio, l’immagine, il know how dell’organizzazione e delle persone chiave, 3) ottimizzare efficienza operativa.

Tutto ciò è fondamentale per rendere una struttura organizzativa longeva, resiliente dal punto di vista gestionale, capace di conseguire gli obiettivi prefissati e orientata al miglioramento continuo.

Graficamente, lo schema dei principi ha al centro la creazione e la protezione di valore attraverso il miglioramento delle performance, l’incoraggiamento all’innovazione e il supporto nel perseguimento degli obiettivi. Viene sottolineata l’importanza dell’approccio olistico alla gestione del rischio ed il diretto coinvolgimento del top management in funzione di leadership. Strutturalmente, si enfatizza la ciclicità delle fasi del processo e l’imprescindibilità di ottenere un alto grado di penetrazione del framework ISO 31000 nelle attività aziendali più significative, nella governance e nei processi decisionali.

Coinvolgendo tutto il personale fin dalle fasi di reclutamento secondo il modello “Team of Teams”[3] (ToTs), la gestione del rischio diventa un processo PDCA-based: circolare, continuo, graduale, proattivo e tailored. L’organizzazione, quindi, deve essere in grado di: 1) allocare correttamente le risorse necessarie, 2) affiancare tali risorse a personale esperto durante le prime fasi del training, 3) garantire coerenza tra la struttura di risk management e gli obiettivi, la strategia e la cultura aziendali, 4) stabilire il livello di risk appetite più adatto e comunicarlo agli stakeholder.

Oggi le organizzazioni davvero resilienti agli attacchi informatici adottano modelli di cyber risk management capaci di identificare, analizzare e quantificare in maniera automatizzata i rischi di sicurezza delle informazioni.

Questi ultimi, d’altronde, sono soddisfatti solo se poggiano su un’efficace sistema di controlli di sicurezza. Aumentando la protezione contro le minacce, si riducono sensibilmente l’entità delle vulnerabilità e, di riflesso, la superficie di attacco e l’esposizione degli asset aziendali.

Quindi risulta ridimensionato il potenziale impatto che tali attacchi potrebbero avere sul business della vittima ed è così che, teoricamente, gli effetti del rischio cyber vengono mitigati.

Cyber risk management: un approccio semi-quantitativo

I moderni modelli di cyber risk management si basano su approccio semi-quantitativo all’analisi del rischio, caratterizzato da minore onerosità e maggiori oggettività e precisione. Qui la matrice di rischio è composta da classi di rischio (basso, medio, alto) espresse in termini matematici, mettendo in rapporto la frequenza degli attacchi, l’impatto sui diversi asset e le perdite attese. Vengono utilizzati, pertanto, quattro indici: 1) Exposure Factor, 2) Single Loss Expectancy, 3) Annualized Rate of Occurrence, 4) Annualized Loss Expectancy.

Favorire l’adozione di un approccio semi-quantitativo all’analisi del rischio permetterà di misurare la frequenza e l’impatto degli eventi informatici nel contesto della propria governance, delle capacità difensive e della cyber threat intelligence. Questo processo porterà sia a catalogare e prioritizzare i rischi, sia ad implementare ed automatizzare i controlli e ridurre così l’impatto di scenari specifici, imprevedibili e futuristici. Il modo più semplice consiste nell’adozione di una piattaforma con cui monitorare gli eventi, raccogliere i dati ed elaborare report affinché il top management possa comprendere e gestire al meglio il rischio cyber quantificandolo in termini economici. Ciò consente di tracciare la reale esposizione dell’azienda al rischio informatico, di monitorare l’impatto dell’evoluzione tecnologica, di individuare le modifiche di policy e procedure e, infine, di avere un quadro chiaro, ampio ed attendibile del profilo di rischio complessivo.

Un tale assetto innovativo permette una collaborazione orizzontale ToTs-based tra i vari dipartimenti aziendali più agevole e orientata all’incremento dei livelli di cross-check, innovazione e sicurezza. L’organizzazione, dunque, ottiene una performance migliore dal punto di vista dell’efficienza, dell’efficacia e dell’economicità.

Human factor e supply chain come vettori di attacchi cyber

La maggiore interazione uomo-macchina ha reso labili i confini aziendali ed esteso il perimetro di sicurezza da proteggere. È pensabile che, in futuro, i dipendenti saranno connessi dalle loro abitazioni attraverso visori Virtual Reality e Augmented Reality, attraverso i quali si immergeranno in un meta-uffici in cui interagire con gli avatar dei propri colleghi.

Pertanto riteniamo che un’organizzazione, soprattutto di grandi dimensioni, debba agire specialmente su human factor e supply chain.
Da un lato, il fattore umano è il vero anello debole della catena sul quale è necessario intervenire per responsabilizzarlo. Il fattore umano continuerà ad essere il principale vettore di attacchi cyber, mettendo a rischio il patrimonio informativo aziendale, salvo che: 1) esista una forte cultura di sicurezza aziendale, 2) i dipendenti abbiano skill ed expertise per riconoscere ed evitare i rischi informatici attuali e futuri, 3) l’organizzazione abbia la capacità finanziaria di affrontare i costi derivanti dagli attacchi subiti, 4) l’organizzazione disponga di strategie di mitigazione efficaci (affidamento parziale del servizio in outsourcing, buone coperture assicurative, piani di disaster recovery e business continuity all’avanguardia).

Dall’altro, gli attacchi alla supply chain saranno sempre più diffusi, anche perchè i piccoli fornitori continuano a prestare un minimo livello di attenzione alla sicurezza rispetto a quello che le grandi aziende ripongono nei propri processi.

Anche qui è cruciale adottare un modello organizzativo ed un modus operandi ToTs-based. Risulta infatti più facile per un attaccante inoculare un malware all’interno di un componente – hardware o software – di un fornitore e attendere che questo sia installato sul prodotto finale per sferrare l’attacco. Le aziende devono perciò valutare e continuare a trattare questo rischio, adottando azioni di mitigazione, creando relazioni di fiducia con i fornitori certificati da SLA e NDA, irrobustendo le attività di audit di seconda parte e la due diligence.

“Stay Secure”: un corto per la Cybersecurity

Il cortometraggio “Stay Secure” costituisce parte del project work finale del master in Cybersecurity dell’Università Luiss Guido Carli di Roma a.a. 2020-2021, ed è stato realizzato da Flavio Campara, Alessandra Checchia, Carmelo Spadaro e Pietro Trebisonda.

Il project work (paper e cortometraggio) delinea una nuova organizzazione aziendale contestualizzata in uno scenario futuristico e futuribile del settore energetico, caratterizzato dalla crescente interoperabilità tra le reti di telecomunicazioni e di distribuzione dell’energia (smart grid). Il fine ultimo del project work è dimostrare i benefici del nuovo paradigma aziendale dal punto di vista della cybersecurity (prevenzione delle minacce, analisi del rischio, risposta agli incidenti ed agli attacchi).

Di seguito, una breve sinossi:

Roma, 2035.

Ci sarà una volta un mondo così avanzato che l’epoca di oggi sarà considerata “preistoria”.

La tecnologia avrà raggiunto livelli incommensurabili di efficienza ed efficacia e, grazie al quantum computing, la cybersecurity si baserà sulla tecnologia blockchain con crittografia quantistica.

L’energia pulita sarà prodotta da impianti tecnologicamente avanzati e distribuita dalle smart grid, reti intelligenti abilitanti di una serie di numerosi beni e servizi ormai indispensabili per vivere e lavorare (es. Car as a Service, IoT,…).

Un mondo nuovo bellissimo, ma ancora pieno di vecchie insidie…

Una grande corporate dell’energia sta per subire un grave attacco cyber, che mira all’anello debole di qualsiasi organizzazione: l’uomo.

Ricorrendo a tecniche di social engineering, gli attaccanti ottengono l’accesso ed il controllo dei sistemi informatici aziendali, e si apprestano a rendere indisponibile la smart grid: l’obiettivo è generare il blackout totale della città.

Ma grazie alla formazione individuale, all’addestramento dei team ed alla cultura della sicurezza, la corporate riuscirà a rispondere efficacemente all’attacco in tempi rapidi e con il minimo impatto, sia per l’azienda che per gli utenti finali.

Nello specifico, la formazione dei dipendenti si basa su metodi di apprendimento e tecnologie innovative (piattaforme di gaming con VR e AR) con cui i dipendenti acquisiscono conoscenze base di cyber threat intelligence.

Inoltre, grazie alla teoria “Team of Teams”, reparti ed unità sono integrati secondo il principio del cross-checking sull’operato dei team e sulla collaborazione e comunicazione real time.

Questo modello risulta efficace nel rilevare tempestivamente la minaccia e nel ridurne sensibilmente l’impatto, evitando al contempo che l’organizzazione subisca danni reputazionali, sottrazione di know how e perdite economiche.

Stay Cyber…Stay Secure!

[embedded content]

Conclusioni

Infine, ripercorrendo quanto dichiarato in precedenza, riteniamo che un’organizzazione debba investire in formazione individuale e addestramento dei team di livello innovativo, nonché infondere una vera cultura della sicurezza.

Sono sempre e comunque necessari investimenti in tecnologie innovative per vari fini: automatizzare il risk management, sfruttare la data analytics, impiegare algoritmi e modelli statistici per generare un rating del rischio cyber, stabilire un quadro di controlli.

Il tutto permetterà ad un’organizzazione di fornire una risposta efficace ad attacchi e incidenti di sicurezza, in maniera tempestiva rapidi e con il minimo impatto, sia nei confronti dell’azienda come pure per gli utenti finali.

Note

[1] Zuboff S. The Age of Surveillance Capitalism: The Fight for a Human Future at the New Frontier of Power, New York, 2019.

[2] ENISA, Threat Landscape 2021, in https://www.enisa.europa.eu/publications/enisa-threat-landscape-2021

[3] McChrystal S., Silverman D., Collins T., Team of Teams: New Rules of Engagement for a Complex World, New York, 2015. l Gen. McChrystal, sulla base dell’esperienza come comandante delle forze statunitensi in Iraq nel 2003, propone un approccio basato sulla massima “orizzontalità” possibile che valorizzi sia l’interazione costante tra i gradi (alti e medio-alti) e il team, sia la condivisione di informazioni ed esperienze, nel segno di obiettivi comuni.
Così facendo, tutti i membri del team sono responsabilizzati e, indipendentemente dal grado, possono essere leader ed esercitare un effetto trainante verso gli altri collaboratori dal punto di vista emotivo e comportamentale. Dunque, il top management è invitato a sfruttare le potenzialità e il desiderio di teamworking di ogni individuo che non coltivi obiettivi squisitamente personali ed egoistici. Infine, il collante di tale approccio è la fiducia reciproca che un leader capace ed empatico infonde ai membri di un’organizzazione.

Articolo a cura di Flavio Campara

Profilo Autore

Appassionato di innovative technologies e di fantascienza, sono laureato in Scienze delle Pubbliche Amministrazioni (LM) presso l’Università degli Studi di Roma Tre, con una tesi sulla Digitalizzazione della PA.
Successivamente, ho concentrato la mia ricerca sulle tecnologie più disruptive per il mondo del diritto, pubblicando contributi in ambito Blockchain, Cybersecurity, Artificial Intelligence, Smart Contract, Open Data e procedimento amministrativo informatico.
Ho conseguito di recente il master di II liv. in Cybersecurity presso l’Università Luiss Guido Carli di Roma, grazie al quale ho potuto approfondire la materia ed ottenere certificazioni ISO/IEC 27001 e 27701, DPO e Cisco Cybersecurity Essentials.
Attualmente lavoro come consulente ICT per TMI – Toyota Motor Italy, nell’ambito security & compliance.
Ai temi ed alle sfide che quotidianamente la tecnologia ci pone davanti, rispondo con uno sguardo favorevole, mantenendo sempre un spirito critico.
Il mio motto: Stay Cyber…Stay Secure!

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/stay-secure-un-nuovo-paradigma-aziendale/


Differenza tra ICT Security e Cyber Security

L’ICT security, che unisce il mondo fisico a quello logico, si pone come anello di congiunzione tra la sicurezza IT e la cyber sicurezza che opera esclusivamente nella dimensione cibernetica.

L’IT security riguarda la protezione delle informazioni in tutti gli ambienti, mentre la cyber security tratta la protezione di ciò che grazie all’infrastruttura ICT arriva nel cyber spazio.

Se dovessimo realizzare una visione gerarchica troveremo in cima l’Information Technology Security che intersecandosi con la Information & Communication Technology dà vita alla Cyber security.

Il termine IT (Information Tecnology) si riferisce alle tecnologie locali, ad esempio hardware, server, software e reti interne, mentre le tecnologie ICT (Information & Communication Technology) pongono maggiore attenzione alla diffusione e condivisione di dati e informazioni attraverso internet e altri sistemi di comunicazione. La sicurezza ICT include sia i dispositivi che sono connessi a internet che quelli connessi ad altri tipi di rete, quindi tutti quei dispositivi comunicanti tra loro, occupandosi così anche della supply chain security, sistemi SCADA, ICS etc.

La differenza tra le tre tipologie di sicurezza non è però netta poichè gli ambiti su cui si applicano e le tecnologie da esse utilizzate a volte sono le stesse, inoltre tutte e tre sono tenute a garantire disponibilità, confidenzialità e integrità dei beni o degli asset facenti parte dell’infrastruttura.

Cos’è la sicurezza ICT?

L’acronimo ICT deriva dall’inglese Information and Communication Technology – mentre in italiano si usa TIC (Tecnologie dell’Informazione e della Comunicazione) ed è composta da metodi, processi, pratiche e strumenti tecnologici che vengono usati per ricevere, trasferire, ed elaborare dati e informazioni grazie all’evoluzione delle telecomunicazioni e internet.

L’uso massiccio della rete Internet, cominciato negli anni 90, ha permesso lo sviluppo globale delle tecnologie ICT portando ad una trasformazione digitale in continua evoluzione. Il progresso tecnologico, 5G, Big Data, IoT etc. ha certamente aiutato l’evoluzione delle ITC, nel mentre social network, tablet e telefoni “smart”, smart-working, e-commerce, e-business, e-government, hanno cambiato rapidamente le modalità e le caratteristiche dell’attività lavorativa cos’ come la quotidianità degli individui.

Grazie all’ICT tantissime attività aziendali hanno cominciato ad essere oggetto di automazione, processi di back office, attività logistiche e di magazzino intelligente, pianificazione della produzione fino ad arrivare al concetto di dark factory, cioè fabbriche senza alcun lavoratore umano.

Tre elementi chiave per un efficace sistema di sicurezza ICT:

  • Monitoraggio e accesso controllato alle informazioni riservate
  • Trasmissione sicura dei dati
  • Archiviazione ed eliminazione sicura dei dati

Fondamentale per la sicurezza ICT l’utilizzo di procedure e tecnologie a garanzia della sicurezza dei dati in transit e at rest come ad esempio:

  • Data Loss Prevention (DLP)
  • File Integrity Monitoring (FIM)
  • Soluzioni di backup
  • Network-based IPS (Intrusion Prevention System)
  • Soluzioni per il mascheramento dei dati
  • Tecniche/algoritmi di cifratura
  • Demilitarized Zone (DMZ)
  • Identity, Access and Authentication Management
  • Segmentazione della rete e meccanismi di isolamento delle risorse ICT
  • Firewall
  • Architetture Zero Trust

Al fine di ridurre i rischi e minimizzare l’impatto di possibili incidenti di sicurezza è fondamentale predisporre un piano di Change Management e Risk Assessment a garanzia della Business Continuity seguendo le logiche del Risk Management.

La sicurezza ICT deve inoltre sviluppare procedure di Event & Crisis Management predisponendo un modello di Disaster Recovery in grado di ripristinare il servizio e salvaguardare il business in caso di un cyber attacco.

La ICT Security deve garantire la resilienza nel rispetto degli SLA anche in scenari estremi, come ad esempio un data breach o un attacco ransomware.

Cos’è la Sicurezza Cyber?

La cyber security consiste nel proteggere i dati e le informazioni nel cyberspazio ed è un sottoinsieme della IT e ICT Security poiché i cyber attacchi indirizzati ai sistemi informatici avvengono all’interno del dominio logico. Atta quindi a garantire riservatezza, integrità, e disponibilità dell’informazione principalmente nel ciberspazio, che si determina come la fonte, lo strumento, il bersaglio e il luogo del crimine informatico. Ma ciò non toglie che, vista l’ampia interoperabilità dei sistemi sempre più connessi, le ripercussioni di un cyber attacco arrechino danni anche nel mondo reale e non solo in quello virtuale. E’ fondamentale quindi valutare e analizzare possibili cyber threats prima che un potenziale evento dannoso si possa manifestare e divenire critico.

Lo spazio cibernetico negli ultimi anni si è evoluto rapidamente dando vita a diversi ambienti ognuno con il suo livello di visibilità in grado di favorire l’evoluzione del crimine informatico – Surface web, Deep Web, Dark Web – minando la sicurezza delle informazioni e determinando la crescita degli attacchi informatici.

A cura della Redazione

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/differenza-tra-ict-security-e-cyber-security/


Se la sicurezza fallisce, ecco la resilienza

Con l’aumento degli attacchi informatici, la resilienza informatica sta diventando più importante che mai. Le aziende, le organizzazioni mondiali fino ad arrivare ai singoli individui si trovano sempre più spesso ad affrontare minacce informatiche di maggiore gravità e con costi rilevanti. Così le agende ed i tavoli di lavoro su questa materia diventano sempre più partecipati e questo perchè la Cyber-Resilience richiede una strategia capace di resistere agli attacchi informatici se non addirittura prevenirli in modo da preservare la propria organizzazione da conseguenze spiacevoli con impatti significativi che riguardano:

  • Perdita di fiducia e reputazione sia individualmente che per il marchio di un’azienda
  • Interruzione della fornitura di beni e servizi ai propri clienti o cittadini
  • Elevato costo finanziario per recuperare i dati
  • Ulteriori costi aggiuntivi per indagini, rimedi e ripristino dopo l’attacco

Per questo motivo diventa sempre più necessario mettere in campo una strategia di sicurezza in grado di ridurre al minimo il rischio che gli attacchi arrivano al cuore dei sistemi, alle applicazioni e soprattutto ai dati, e questo lo si realizza mediante una efficace fase di “early-detection”, cioè creando un sistema efficiente di identificazione ed analisi capace di innescare risposte veloci prima che il danno possa propagarsi nel sistema.

Una tra le risposte più care a molti è la resilienza e cioè la capacità di intervenire nel più breve tempo possibile nel recupero e ripristino dello stato ottimale delle risorse, in caso di attacco accertato. Chiariamo subito che prepararsi a rispondere ed a riprendersi da un attacco informatico non è un qualcosa di banale, ma deve essere accuratamente progettato, pianificato e testato.

Sappiamo bene come la recente pandemia e la corsa alla trasformazione digitale ha accelerato l’azione dei malintenzionati e i criminali nel rubare od alterare dati e sistemi informatici sfruttando le diverse forme di malware, ransomware che imperversano sul web. La riprova di questi rischi l’abbiamo nell’aumento delle normative che obbligano aziende ed organizzazioni a prendere le dovute precauzioni contro gli attacchi informatici, includendo la segnalazione di attacchi (sia privatamente al governo che alle agenzie di regolamentazione, ma anche pubblicamente) oltre alla dimostrazione di un piano ponderato e testato per prevenire o affrontare gli attacchi informatici.

Oggi, tra gli attacchi informatici che si verificano più frequentemente e che sono anche i più temuti, abbiamo i ransomware che, secondo diversi studi, sono stati la principale causa per cui diverse aziende hanno chiuso o comunque sono state costrette a ridurre i posti di lavoro. Questi tipi di attacchi risultano in continua evoluzione sia in termini di numerosità che di sofisticazione. Lo testimoniano alcuni settori produttivi che hanno dovuto contrastare oltre il doppio del numero di attacchi cosiddetti “normali” nel corso della recente pandemia. E per sbloccare i dati, i riscatti sono aumentati da centinaia o migliaia di dollari fino a decine di milioni di dollari con una previsione ulteriore di crescita.

Ma vediamo brevemente come incide in generale il ransomware: inizialmente potrebbe essere camuffato da un malware generico che si è fatto strada mediante tecniche di phishing e furto d’identità oppure mediante allegati infetti inviati tramite e-mail. Ma anche tramite siti web non aggiornati che vengono bucati mediante vulnerabilità dei browser. Insomma tutti metodi utili per iniettare il ramsomware nei programmi e nelle risorse dell’infrastruttura IT. Dopo essersi infiltrato, il ransomware si concentra sui dati relativi alle applicazioni e database e solo poi si direziona verso i dati “cuore” dei sistemi informatici, in quanto l’obiettivo primario è mantenere i sistemi attivi e funzionali per poter crittografare più dati possibili. E’ per questo motivo che viene richiesta una protezione globale a tutti i livelli, a partire dalle infrastrutture, dai sistemi operativi al clustering, dai dati applicativi e aziendali archiviati in database e file-system fino ai sistemi di storage e backup per il ripristino di emergenza (DR). In ogni caso abbiamo un unico risultato finale: dati inutilizzabili (perchè criptati) o perdita di dati (su singoli file, su file system o database)

Ma la perdita di dati può essere anche involontaria, causata anche da aggiornamenti applicativi o da nuove patch/ptf che risolvono un problema causandone un altro o da un semplice errore umano determinato da comandi o da processi. Sono tutte cause involontarie che provocano comunque gravi perdite di dati ma che, generalmente, sono facili da individuare. Diverso è il caso del danno intenzionale che deliberatamente modifica, distrugge, corrompe o ruba dati. Questo tipo di attacco è di solito più difficile da rilevare soprattutto se comporta la codificazione di dati validi. Un esempio può essere l’attacco in cui vengono cambiati i valori in un database relativi a numeri di previdenza sociale o numeri di identificazione governativi con persone sbagliate. Tutti i dati sembrerebbero ancora accurati, ma sono in realtà associati a persone differenti da quelle reali. E questo spesso si manifesta con attacchi provenienti dall’interno dell’azienda, con operazioni lecite dal punto di vista formale da parte degli utenti censiti sul sistema, quindi in maniera trasparente e magari anche silente.

La strategia di resilienza informatica

Una strategia completa di resilienza informatica dovrebbe sempre includere i seguenti elementi:

– Identificazione: questa funzione si concentra sulla necessità di comprendere bene i propri asset e le risorse importanti. Parliamo quindi di asset management, environment, governance, valutazione e gestione del rischio, ecc.

– Protezione: questa funzione copre gran parte dei controlli di sicurezza fisici e logici che prevedono lo sviluppo e l’attuazione di adeguate salvaguardie per la protezione delle infrastrutture critiche. Rientrano in questa categoria la gestione dell’identità e il controllo degli accessi, la consapevolezza e la formazione, la sicurezza dei dati, i processi e le procedure di protezione delle informazioni, ecc.

– Rilevamento: questa funzione si concentra sulle misure che avvisano un’organizzazione di attacchi informatici, che potrebbero includere anomalie ed eventi, quindi il monitoraggio continuo della sicurezza e la tempestività dei processi di rilevamento.

– Risposta agli incidenti: questa funzione garantisce una risposta adeguata agli attacchi informatici ed altri eventi di sicurezza informatica. Le categorie includono pianificazione della risposta, comunicazioni, analisi, mitigazione e miglioramenti.

– Recupero: questa funzione copre l’effettiva attuazione dei piani per la resilienza informatica garantendo la continuità operativa (Business Continuity) in caso di attacco informatico, violazione della sicurezza o altro evento di sicurezza informatica. Le funzioni di recupero sono guidate della pianificazione del recupero e dalle comunicazioni.

Sono disponibili diversi framework che possono essere utilizzati per creare e migliorare i piani di sicurezza informatica e di resilienza quindi anche a migliorare la prontezza nella risposta. Ne cito due su tutti: il framework del NIST (Computer Security Incident Handling) e quello proposto dalla standardizzazione ISO. Sostanzialmente questi ci guidano nella stesura della strategia del ciclo di vita di risposta agli incidenti ransomware, quindi alla resilienza dei sistemi e che si basa sui quattro punti chiave:

  • Preparazione
  • Rilevamento e analisi
  • Contenimento, eradicazione e recupero
  • Attività post-incidente

Alla luce di quanto è stato detto, si evince come la resilienza informatica sia a tuti gli effetti un’estensione delle tradizionali soluzioni di Disaster Recovery e Business Continuity. Ed in effetti si basa sui tradizionali elementi costitutivi dei sistemi ridondanti in DR, copie multiple di dati e replica dei dati in più posizioni. Ma c’è una differenza fondamentale tra la progettazione e l’implementazione di una soluzione di resilienza tradizionale rispetto ad una soluzione di resilienza informatica:

  • la resilienza tradizionale deve proteggere da situazioni in cui i dati sono nel loro stato normale ma potrebbe essere necessario sincronizzarli o ripristinarli ad un preciso time-stamp.
  • la resilienza informatica invece deve proteggere e rispondere a situazioni in cui sistemi e dati vengono intenzionalmente danneggiati, cancellati o crittografati. Ciò comporta l’adozione di un piano in grado di proteggere dati e sistemi nel loro continuo evolvere riducendo al minimo eventuali danni ed interruzioni che potrebbero derivare da possibili minacce.

Cosa dire del Backup/Restore ?

Normalmente, per conferire sicurezza ed affidabilità dei dati la tecnica maggiormente adottata è sempre stata quella del backup/restore o del DR (Disaster-Recovery). Queste procedure di solito implicano vari metodi di copia dei dati su sistemi di archiviazione, (generalmente su nastro) e dovrebbero essere eseguiti su base schedulata secondo le direttive aziendali, magari con l’aiuto di tool o sw di automazione capaci anche di gestire la retention dei dati prima di una loro definitiva cancellazione. Poi però è necessario anche testare questi backup in modo da essere sicuri che siano davvero validi, ripristinandoli, quindi con un investimento importante in termini di persone, risorse e tempo. A volte questi tre elementi non risultano sufficienti in quanto potrebbero essere altre le cause di un possibile fallimento nel ripristino come ad esempio il non avere un ambiente speculare con tutte gli elementi Hw e Sw ridondati, come in una configurazione di tipo HA (High-Availability).

Sebbene questa tecnica mostri comunque una sua efficacia nella protezione dalla perdita di dati esistono limitazioni quando si affrontano problemi di danneggiamento dei dati, come ad esempio:

  • Replica di dati danneggiati in sistemi non isolati.
  • Eventi improbabili che attivano DR. Il danneggiamento dei dati può non essere rilevato per lunghi periodi.
  • Mancanza di granularità per i punti di ripristino di backup a breve e medio termine.

In questo modo la flessibilità del recupero diventa limitata ed il recupero risulta parziale è difficile. Ecco perchè occorre tendere a raggiungere una resilienza informatica di livello aziendale con lo scopo di fornire funzionalità che vanno oltre al backup/restore ed oltre il DR, in quanto deve essere in grado di effettuare un ripristino dei dati in maniera sicura, cioè dopo essere stati validati, e soprattutto nel più breve tempo possibile.

Solo resilienza non è sufficiente

Si dice spesso che la sfida più grande lanciata da un attacco informatico è rilevare che i sistemi sono stati compromessi o che un utente malintenzionato abbia ottenuto l’accesso con successo da qualche parte nell’ambiente IT aziendale intervenendo ancor prima che si possa verificare il danno. Molti studi mostrano diversi casi in cui un utente malintenzionato potrebbe aver lavorato senza essere stato rilevato per diversi mesi prima di iniziare l’attacco vero e proprio, alla ricerca dei punti deboli, all’ottenimento di privilegi più elevati e alla diffusione del malware per condurre l’attacco (lateral-movement). Pertanto la vera piena resilienza informatica comincia a partire dal rilevamento delle intrusioni, dal monitoraggio di comportamenti insoliti da parte di individui, dal monitoraggio di programmi e sistemi, dai report, allarmi e dashboard utili per avvisare i team di sicurezza di comportamenti sospetti.

A tutto questo occorre però aggiungere una corretta istruzione di tutto il personale su come prevenire punti di attacco comuni, come phishing, smishing, vishing o ingegneria sociale, in modo da poterli riconoscere segnalandoli opportunamente. Se si interviene dopo che il ransomware è stato rilevato allora è troppo tardi. Tutti gli investimenti su tecnologie, strumenti, processi e monitoraggio, l’istruzione e la comunicazione non sarebbero serviti a nulla se non consentono di intervenire ancor prima che si verifichi un incidente. Tuttavia una vera soluzione di resilienza informatica, per essere tale, deve fornire funzionalità di “airgap”, con copie di dati (backup) immutabili cioè che non possono essere danneggiate o cancellate dall’attacco informatico. A seguire occorrono strumenti di continua validazione dei dati per verificare che non siano presenti tracce di un attacco creando così fiducia nella qualità dei backup effettuati. Questi strumenti aiutano anche a svolgere operazioni forensi e di analisi necessarie per valutare l’entità dell’incidente.

Articolo a cura di Luigi Perrone

Informazioni sull’Autore

Architetto e specialista IBM di sicurezza informatica e protezione dei dati.
Attualmente ricopre il ruolo di Security Technical Leader a livello GEO nell’ambito dei sistemi mainframe e hybrid-cloud. Nel suo lungo percorso professionale ha ricoperto diversi ruoli in ambito tecnologico con contatto diretto e continuo con i clienti fornendo consulenza e progettualità nella stesura di architetture di sicurezza e della security intelligence negli ambienti IT

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/se-la-sicurezza-fallisce-ecco-la-resilienza/


Il problema del BIAS nei dataset e della XAI (eXplainable Artificial Intelligence)

L’Intelligenza Artificiale (IA) è un concetto che abbraccia varie branche del sapere umano, dalla filosofia alla matematica, statistica, informatica ed anche la sociologia e psicologia.

Descrizione sintetica dell’IA

L’IA è un macro insieme che contiene due sottoinsiemi, il Machine Learning ed il Deep Learning, essi sono due modalità d’apprendimento ed elaborazione dei dati in ingresso per ottenere delle previsioni in uscita.

L’intelligenza artificiale o IA è un campo di sviluppo dell’informatica, che tende ad emulare l’intelligenza umana e riprodurre gli schemi di ragionamento tramite algoritmi. Gli organismi biologici, come gli esseri umani, ma anche gli animali, imparano dall’esperienza e dall’osservazione del mondo, su questo concetto si sviluppano gli algoritmi che dovrebbero imparare analizzando i dati che ricevono in input.

L’IA comprende la definizione di intelligenza, cerca di modellizzare in modo algoritmico i processi d’apprendimento e di evoluzione per emulare l’intelligenza umana su delle macchine, ma il concetto di IA “general purpose”, detta anche IA forte o generale; quindi, quella che viene rappresentata nei film di fantascienza, è ancora un obbiettivo irraggiungibile.

Lo stato attuale dell’arte è rappresentato dall’IA ristretta, ossia dedicata allo svolgimento di specifici compiti, come la guida autonoma dei veicoli, la classificazione per immagini, la previsione di alcuni valori numerici, e.g. prezzi, azioni di borsa, la classificazione dei testi, etc…

Il Machine Learning (ML) è un sottoinsieme dell’IA, che si sviluppa tramite algoritmi che elaborano dati preordinati e può essere di due tipologie:

Supervisionato – le variabili di uscita, gli output, sono mappati con una label (etichetta), quindi nel dataset (l’insieme dei dati), vi sono l’input e gli output attesi.

Esempio:

Altezza Peso Etichetta
25 3 Gatto
56 14 Cane

Non Supervisionato – nel dataset ci sono solo variabili di input senza alcun output atteso; quindi, la rete deve imparare a trovare degli schemi e classificare o predire.

Con Rinforzo – è un apprendimento in ambiente dinamico, lo scopo è raggiungere un target e per farlo ci saranno delle ricompense o punizioni (numeriche, vedi Q-Learning).

Classificazione – agli input vanno assegnate delle classi definite nel dataset, quindi l’algoritmo riesce a classificare un certo input (feature) ad un certa label (variabile Y) tipico dell’apprendimento supervisionato

Regressione Lineare – le label non sono discrete ma valori continui, quindi l’algoritmo cercherà di predire la label relativa a certi input d’ingresso (es. valore azioni in borsa, ecc.) – sempre supervisionato

Clustering – una classificazione per gruppi non noti a priori, si cercano schemi che possano creare dei cluster omogenei – non supervisionato

Il Deep Learning (DL) è una forma d’apprendimento nel quale le caratteristiche sono estratte direttamente dall’input e non sono fornite ab origine in forma numerica, ad esempio si forniscono migliaia di fotografie di gatti e di cani e l’algoritmo cercherà di estrarre da esse delle caratteristiche che serviranno a determinare se in un’immagine vi sia raffigurato un cane o un gatto.

Il neurone artificiale

Il ML ed il DL funzionano tramite la creazione di reti composte da neuroni artificiali, che sono algoritmi che simulano il funzionamento di un neurone biologico, tramite complesse elaborazioni matematiche.

L’algoritmo deve essere addestrato prima di poter esser considerato affidabile per le previsioni che dovrà effettuare.

La fase d’addestramento consiste nel valutare quanto un input sconosciuto si avvicini all’output atteso, calcolando la minimizzazione dell’errore (funzione di costo); quindi, se si sa che ad un dato X deve corrispondere un certo Y, l’algoritmo deve calcolare dei “pesi”, valori numerici casuali, tali per cui dopo delle elaborazioni matematiche sarà sempre più preciso al fine di rendere la funzione di costo più piccola e quindi far coincidere il valore previsto con quello di output.

“L’intelligenza non è la conoscenza ma è la capacità d’immaginazione” – A. Einstein, da questa citazione si può partire per descrivere sinteticamente i problemi di “underfitting” ed “overfitting”, ossia gli algoritmi non devono essere troppo precisi ed accurati nella previsione (overfitting) e nemmeno troppo generici (underfitting).

L’overfitting, infatti, crea una scarsa capacità dell’algoritmo di generalizzare; pertanto, non saprebbe riconoscere qualcosa che si discosta leggermente da quello che ha imparato, ad esempio se sa riconoscere perfettamente le forme quadrato e cerchio, nel momento in cui incontra un ovale non saprebbe come classificarlo.

L’underfitting ha il problema inverso, ossia l’algoritmo non sa riconoscere nemmeno tutto quello che ha imparato, creando molti errori.

I problemi dell’IA

Nello sviluppo degli algoritmi di IA, si sono riscontrati dei problemi che sono più “sociali” che tecnici, ossia che colpiscono la sfera delle decisioni umane.

Filter Bubbles

Sappiamo che servizi come Netflix, Spotify, Amazon, Facebook e tanti altri spesso ci suggeriscono qualcosa da vedere, ascoltare o comprare, basandosi sulle nostre scelte fatte nel passato, ma anche sulle scelte di altri utenti che hanno avuto gusti simili ai nostri.

Quindi se ad esempio si è scelto di guardare un film di fantascienza, il servizio di streaming, proporrà altri film di fantascienza, ma anche film di altri generi, che magari sono stati scelti da altri utenti che avevano visionato lo stesso film.

Questo meccanismo si chiama “filter bubbles”, ossia bolle di filtraggio, poiché si rimane dentro un sistema di raccomandazione filtrato attraverso delle scelte più o meno omogenee. Ci sono tanti vantaggi in questo sistema, come la velocità, il servizio di avere qualcuno che “ti conosce” o presume di conoscerti e quindi ti serve bene, ma ci sono anche gli svantaggi dati dal “confinamento” dell’informazione; quindi, si riceve sempre una stessa linea di pensiero, cosa meno grave per i film o la musica, ma potrebbe esser più grave per l’informazione politica o generale.

Privacy

Il problema più grande del legame Privacy e IA è dato dal fatto che un’IA può dedurre altri dati personali partendo da alcuni dati per i quali abbiamo dato il consenso, può trattarli per altri scopi, non si sa chi li detiene, può creare delle filter bubbles, non sarebbe punibile in caso di trasgressione.

Il bias cognitivo (pronuncia inglese [ˈbaɪəs]) o distorsione cognitiva è un pattern sistematico di deviazione dalla norma o dalla razionalità nel giudizio. In psicologia indica una tendenza a creare la propria realtà soggettiva, non necessariamente corrispondente all’evidenza, sviluppata sulla base dell’interpretazione delle informazioni in possesso, anche se non logicamente o semanticamente connesse tra loro, che porta dunque a un errore di valutazione o a mancanza di oggettività di giudizio – Fonte: https://it.wikipedia.org/wiki/Bias_cognitivo

L’IA è sviluppata da esseri umani, che sono pervasi di cultura e percezione della realtà soggettiva e/o condizionata dall’ambiente in cui vivono, quindi si rischia di addestrare un algoritmo su degli insiemi di dati “inquinati” da pregiudizi (bias), che possono influenzare l’output.

Esempi noti di IA afflitte da BIAS:

  • Compas– prevedeva una recidiva criminale maggiore nell’etnia afro-americana.
  • Dataset sbilanciato verso una certa etnia è meno preciso verso
  • BOT che impara dai dati raccolti in rete (es. TAY bot di Microsoft su twitter), che se sono per la maggioranza scritti da una certa parte di persone, rischia di essere prevalentemente di quella parte e rispondere come
  • Esempio: se un ML si addestra sui dati raccolti sul tema «cura del cancro» e le sue fonti provengono per lo più dai social, potrebbe diventare un’AI che consiglia terapie farlocche e fake
  • Il caso “Gender Shades” dove si dimostra come il riconoscimento facciale di alcuni grandi software di IA sbagliava di molto sull’etnia di
  • Amazon che preferiva il genere maschile al femminile nell’assunzione.
  • È necessario un approccio multidisciplinare nella creazione degli algoritmi e dataset;
  • Interessante framework IBM: AI Fairness 360
  • Inclusione, trasparenza, privacy, responsabilità, imparzialità: Call for AI Ethics
  • Approfondimento sul caso COMPAS
  • Bisogna cercare di evitare di inserire/valutare in base ai «protected attributes» ossia gli attributi riguardanti etnia, genere, orientamento, . Laddove non servono, per esempio il sesso nel recruitment.
  • L’overfitting può causare BIAS
  • De-Biasing by IBM

Una delle contromisure ed anche un sistema per capire meglio l’output di un algoritmo di IA è quello della XAI (eXplainable Artificial Intelligence), ossia l’intelligenza artificiale spiegabile.

Gli algoritmi sono sostanzialmente delle black box, delle scatole nere nelle quali entrano i dati di input, che vengono elaborati per generare degli output, il motivo per cui sia stata generata una risposta rispetto ad un’altra non è facilmente comprensibile.

Per questo motivo, servono sistemi che permettano all’essere umano di comprendere quali variabili hanno condizionato la previsione in uscita, al fine di capire quanto pesano nella decisione algoritmica e se sono importanti per essa o sono frutto di pregiudizio.

Figura 1 – https://www.darpa.mil/program/explainable-artificial-intelligence

Lo scrivente ha creato un dataset volutamente affetto da pregiudizio razziale, con parametri di discriminazione, come la razza e il numero di crimini commessi in passato dal soggetto, immaginando due etnie, i Terrestri ed i Marziani.

Il dataset è sbilanciato verso i “Marziani”, che hanno più possibilità di essere classificati come ‘sospetto‘, se il soggetto è Terrestre, casualmente sarà sospetto o no.

Il set di dati è influenzato dagli attributi di età e razza

Figura 2 – Campione di dati

Il dataset è così composto:

Fornendo in input un soggetto di 61 anni, terrestre e con 3 crimini passati si ottiene l’output:

[61 1 3]
Accuracy Train: 81.29 % Accuracy Test: 65.37 %
CHECK A TERRESTRIAL
Predicted target name: [‘no’]
[‘age’, ‘breed’, ‘past_crimes’, ‘suspect’]
[61, 1, 3] [‘no’]

Il TERRESTRE non è considerato sospetto e l’analisi tramite LIME, per ottenere una spiegazione della decisione, mette in evidenza che la variabile che ha condizionato l’output è l’etnia.

Si fornisce un soggetto di 61 anni, marziano e con 3 crimini passati si ottiene l’output:

[61 0 3]
Accuracy Train: 81.29 % Accuracy Test: 65.37 %
CHECK A MARTIAN
Predicted target name: [‘yes’]
[‘age’, ‘breed’, ‘past_crimes’, ‘suspect’]
[61, 0, 3] [‘yes’]

Il MARZIANO è considerato sospetto e l’analisi tramite LIME, per ottenere una spiegazione della decisione, mette in evidenza che le variabili che hanno condizionato l’output sono l’etnia, età e crimini passati.

Infine, si fornisce in input solo un soggetto di 61 anni con 3 crimini in passato e nessuna informazione sull’etnia.

[61 3]
Accuracy Train: 81.29 % Accuracy Test: 65.37 %
CHECK WITH NO BREED
Predicted target name: [‘no’]
[‘age’, ‘breed’, ‘past_crimes’, ‘suspect’]
[61, 3] [‘no’]

Eliminando l’etnia si ottiene che il soggetto non è sospetto, basandosi solo sulle variabili dei crimini commessi in passato e sull’età.

Da questa simulazione un analista può capire quali sono le variabili che condizionano l’output ed intervenire sull’algoritmo o sul dataset, eliminando eventualmente i parametri che inseriscono un pregiudizio, diversamente si sarebbe ottenuto il risultato senza comprendere cosa lo avesse influenzato.

Conclusioni

Il BIAS nell’Intelligenza Artificiale è ereditato dai pregiudizi umani, che sono insiti in ogni cultura e sono diversi per ogni cultura, questo scenario apre svariate riflessioni sull’idea che l’IA debba essere uno specchio del modo di ragionare umano o se il pregiudizio è utile o meno.

Nel campo della Giustizia diventa veramente complesso pensare ad una sentenza emessa da un’IA, dovendo analizzare vari fattori che spesso possono essere afflitti da preconcetti o da statistiche non perfettamente “pure”.

La Giustizia, specialmente del “civil law” non è una semplice concatenazione di “IF THEN” ma comprende anche tante interpretazioni umane che possono differire per ogni Giudice, pertanto forse è ancora prematuro pensare ad un IA per tali applicazioni, ma il futuro è sempre più vicino.

Articolo a cura di Giovanni Bassetti

Informazioni sull’Autore

Dott. Giovanni Bassetti, laureato in Scienze dell’Informazione, iscritto all’Albo dei Consulenti Tecnici presso il Tribunale Civile di Bari al n. 17, Project Manager della Live Distro internazionale CAINE per le indagini informatiche forensi, nonché fondatore della comunità italiana online dedicata alle investigazioni digitali (Computer Forensics Italy), autore di numerosi articoli pubblicati su riviste del settore nazionali ed internazionali. È stato consulente per alcuni procedimenti penali di rilevanza nazionale, è autore di un testo sulla computer forensics ed è segretario e membro fondatore di ONIF (Osservatorio Nazionale Informatica Forense).
Inoltre, ha partecipato come relatore e docente a numerosi convegni e corsi nazionali ed internazionali dedicati all’informatica forense ed intelligenza artificiale.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/il-problema-del-bias-nei-dataset-e-della-xai-explainable-artificial-intelligence/


Purple Team per una Information Security più efficace

Il Purple Team unisce strumenti e conoscenza del Blue Team e Red Team in un nuovo approccio collaborativo atto a rispondere alle minacce in continua evoluzione nell’ambito della sicurezza delle informazioni, garantendo protezione, contenimento e reazione, migliorando la security delle organizzazioni.

Le due squadre si fondono per dare vita ad una sicurezza che è al contempo offensiva e difensiva. Se, semplificando al massimo i ruoli, il Red Team è considerato un attaccante e il Blue Team un difensore, Il Purple Team è un difensore che impara dall’attaccante per migliorare e rendere sempre più efficace la sua strategia.

Attacco e difesa si fondono così in una unica visione mirata a garantire la cyber security all’interno di una organizzazione integrando i controlli e la visibilità raggiunta dal Blue Team con le minacce e le vulnerabilità riscontrate dal Red Team.

Il dialogo tra le due squadre è un concetto recente per la sicurezza informatica che fino a qualche anno fa non chiedeva ai due team di comunicare strutturando così un obiettivo comune, mettere in sicurezza l’intera superficie esposta in maniera estremamente reattiva e preventiva.

Red Team: che cos’è, di cosa si occupa

Dalla fine degli anni ’80 il Red Team ha risposto all’esigenza delle organizzazioni di testare la propria security posture identificando le vulnerabilità nei PPT (People, Process and Technology), arrivando a sfidare misure e politiche di sicurezza messe in atto con il fine di migliorare le contromisure ed anticipare le minacce future, utilizzando strumenti di attacco come Metasploit, Meterpreter, Nmap, exploit etc. emulando gli aggressori nel modo più realistico possibile.

Un componente della squadra rossa non ha come obiettivo quello di rispettare le leggi ma di ragionare fuori dagli schemi e sfidare le regole minando le politiche di sicurezza logica e fisica ricoprendo il ruolo dell’attaccante, vestendo i panni del nemico. Gli attacchi messi in atto dal Red Team hanno il compito di mettere alla prova le capacità del Blue Team, utilizzando le TTP (Tactics, Techniques and Procedures) dei cyber criminali. Per tale motivo è fondamentale che le due squadre siano ben separate al fine di non creare conflitto d’interesse e abbassare i livelli di competizione.

La squadra rossa si occupa di:

  • Offensive Security
  • Vulnerability Exploitation
  • Penetration Tests
  • Social Engineering
  • Compromise Credentials
  • Black Box Testing
  • Web App Scanning
  • Threat Emulation
  • Attack Simulation
  • Custom tools and software development
  • Escalate Privileges
  • Web App Scanning
  • Exploit Development
  • Cyber Threat Intelligence
  • Move laterally across systems
  • Evade protection and protection capabilities

Blu Team: che cos’è, di cosa si occupa

Il Blue Team è una squadra addestrata a rilevare, rispondere e mitigare i cyber attacchi individuando tentativi di intrusione, movimenti laterali e tutto ciò che rientra nella “Cyber Kill Chain” utile a bloccare le minacce informatiche ed evitare i danni al sistema informatico. Un esempio di difensore proattivo è l’analista SOC/MDR che utilizza strumenti di Threat Intelligence, EDR, IPS/IDS, analizza traffico sospetto di rete, dati, log, individua gli Indicator of Compromise, mette in atto tutte le fasi dell’Incident Response, si avvale di tutto ciò che può metterlo sulle tracce di un attaccante implementando al contempo l’abilità difensiva dell’organizzazione, migliorandola costantemente.

La squadra blu si occupa di:

  • Defensive Security
  • Oppose Red Team
  • Network Monitoring
  • Infrastructure Protection
  • Damage Control
  • Security Monitoring
  • Incident Response
  • Operational Security
  • Data Analysis
  • Threat Hunting
  • Threat Detection
  • Digital Forensics
  • Security Controls
  • Implementing Controls
  • Proactive Defence
  • TTP Based Hunting
  • Vulnerability Assessments
  • Risk Assessments

Purple Team, evoluzione naturale della sicurezza informatica

Il Purple Team è la cooperazione, scambio di informazioni e conoscenze che si crea tra la squadra rossa e quella blu quando lavorano in sinergia. Questa interazione è utile a massimizzare i risultati grazie all’integrazione delle tattiche difensive e di monitoraggio con quelle offensive ponendo come obiettivo comune la protezione dell’infrastruttura.

Dalla dinamica di confronto costante tra i rosso-blu nasce quindi il concetto di viola che ha il compito di proteggere le differenze tra le due squadre mentre garantisce la cooperazione affinché le lezioni apprese dai due team non vadano perse ma costituiscano il valore fondante, l’obiettivo comune, un reciproco vantaggio.

La squadra viola si occupa di:

  • Maximize Red Team
  • Enhance Blue Team
  • Improve Security Posture
  • Gap Analysis
  • Collaborative Security
  • Data Analytics
  • System Improvements

La metodologia del Purple Team è fatta di continui feedback utili a comprendere i livelli di sicurezza e perfezionare le strategie difensive aumentando le prestazioni e ottimizzando il budget migliorando la cultura collaborativa all’interno dell’azienda al fine di proteggerla dagli attacchi informatici e abbassando i livelli di rischio. Come dichiarato da Riccardo Baldanzi, CEO di 7Layers – azienda specializzata nell’Offensive e Defensive Security – “Il Purple Team rappresenta il futuro della cyber security poiché in grado di rivoluzionare il modo in cui aziende ed organizzazioni prevengono e gestiscono i data breach e i cyber attacchi”.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/purple-team-per-una-information-security-piu-efficace/