Open Source e cybersecurity per un software sicuro

sicurezzaOgni tipo di software include degli elementi Open Source. E oggi, particolarmente nel contesto dell’Industria 4.0, non c’è attività lavorativa che non implichi l’utilizzo di software: qualunque sia la tipologia di business o il settore in cui si opera, il software (con le sue inevitabili componenti Open Source) è un fattore abilitante per la maggior parte delle operazioni, rappresentando una componente essenziale per il lavoro di tutti noi.

L’onnipresenza dell’Open Source

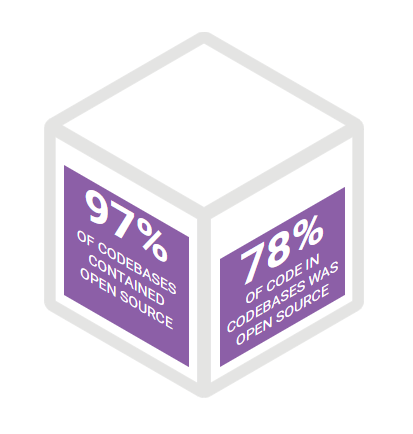
L’obiettivo del report “Open Source Security and Risk Analysis” (OSSRA) ‒ curato dal Synopsys Cybersecurity Research Center (CyRC) in base alle ricerche svolte nel 2021 su oltre 2400 code bases commerciali usate in 17 organizzazioni ‒ è fornire alle aziende un quadro completo della propria filiera operativa. Ciò richiede, naturalmente, consapevolezza circa le origini e il funzionamento degli strumenti di lavoro utilizzati al suo interno: tecnologie, application security, sistemi operativi e piattaforme digitali a cui sono quotidianamente affidate funzioni centrali e spesso critiche, quali la condivisione di dati relativi ai clienti o utenti finali, la gestione di macchine connesse (come nel caso delle infrastrutture OT) o il funzionamento degli stessi SOC fondamentali a garantire la sicurezza.

La ricerca mostra probabilità vicine al 100% circa l’utilizzo di componenti Open Source all’interno di qualsiasi software. Questi elementi rappresenterebbero addirittura la maggioranza del codice, con una media rilevata del 78%.

L’analisi offre anche indicazioni pratiche su come individuare e gestire questa tipologia di codice, per ridurre al minimo gli inevitabili rischi connessi al suo impiego, quali vulnerabilità non patchate o conflitti di licenze, circostanze che possono generare impatti di vario livello; inclusi problemi legati alla responsabilità sul piano legale, talvolta tali da compromettere la stessa sopravvivenza dell’azienda. I processi di software development devono avere come obiettivo la protezione e la sicurezza.

Perché utilizzare l’Open Source?

L’utilizzo di software Open Source, oltre ad essere inevitabile, comporta innumerevoli vantaggi. Lo conferma la sua estrema popolarità: tra i principi fondanti dell’OS vi sono infatti la gratuità e la possibilità di apportare infinite modifiche per rispondere alle esigenze degli utilizzatori, fintanto che siano rispettati i termini previsti dalle varie licenze.

Un altro punto a favore dell’Open Source è la capacità di fornire i “mattoni” con cui costruire architetture digitali complesse, mettendo a disposizione degli sviluppatori materiali gratuiti da “ricombinare” in nuove forme a tutto vantaggio della creatività (nonché del budget). Ecco perché la maggior parte dei prodotti software odierni non viene creata da zero ma, al contrario, partendo da componenti già esistenti che vengono di volta in volta ri-assemblati per fare fronte a nuovi e diversi obiettivi.

Includere l’Open Source nei processi è ormai imperativo, considerato che ‒ rileva ancora il report ‒ rappresenta “la base fondante di ogni applicazione a cui ci affidiamo”.

Il software Open Source è sicuro?

Se da un lato il software OS non appare intrinsecamente meno affidabile dei software proprietari o commerciali, dall’altro non risulta neanche più sicuro; vista la rilevata pervasività di elementi Open Source all’interno di ogni tipo di software, si tratta certo di un’informazione rilevante. Al riguardo il report OSSRA 2022 (il settimo dedicato al tema) evidenzia che “l’Open Source è ovunque: ciò determina la necessità di una sua adeguata implementazione. Identificare, monitorare e gestire questi elementi risulta vitale in un’ottica di software security”. La centralità del software nei processi, con l’annessa pervasività del software libero al loro interno, fa infatti sì che i suoi pregi e difetti finiscano per influenzare e condizionare tutti gli ambiti in cui viene utilizzato.

Come ogni prodotto umano, nessun software è perfetto; e l’Open Source non fa eccezione.

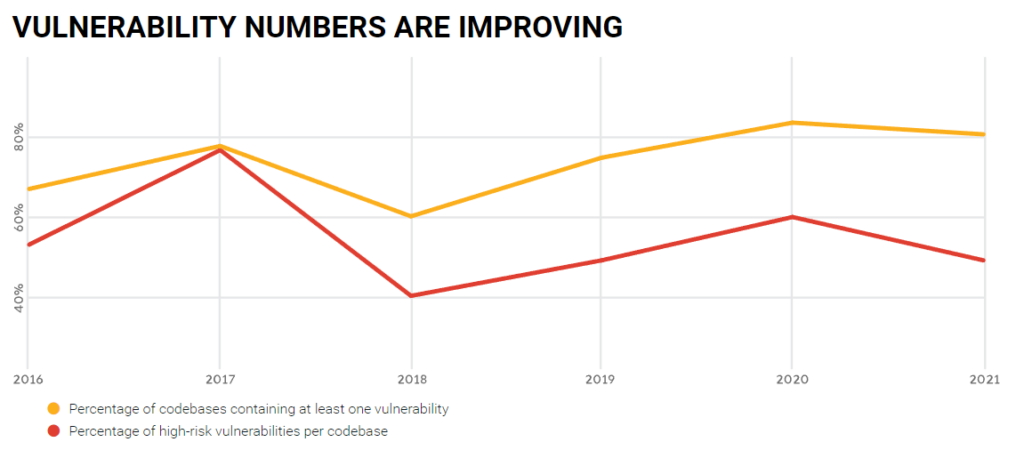
Fra i trend esposti dalla ricerca, è comunque incoraggiante notare come la percentuale di codice che presenta almeno una vulnerabilità di origine Open Source appaia in lieve calo (dall’84% del 2020 all’81%). Ancora più significativo il declino (dal 60% al 49%) della presenza di vulnerabilità ad alto rischio. Per quanto positive, queste tendenze non si traducono nell’assenza di problemi: il dato dell’81% risulta ancora a favore dei potenziali attori malevoli, e non di chi intenda contrastarli. Allo stesso modo, il fatto che la metà delle librerie di codice sorgente presenti vulnerabilità note implica una superficie d’attacco molto ampia a disposizione dei cybercriminali.

Vulnerabilità dell’Open Source

Uno degli indicatori di quanto sia urgente, per le organizzazioni, sforzarsi di mettere in sicurezza il software libero e ridurre la superficie esposta al rischio cyber proviene dalla rilevanza dei settori coinvolti: tra quelli esaminati ci sono infatti IoT, aviazione e automotive, trasporti e logistica, che mostrano vulnerabilità in oltre il 60% del codice impiegato. In comparti altrettanto essenziali (internet e mobile apps, settore educativo ed energetico, marketing, FinTech, eCommerce e retail, industriale e manifatturiero, robotica e software as a service/SaaS) la percentuale risulta uguale o superiore al 50%.

Inoltre, alcune delle vulnerabilità note appaiono persistenti e persino in crescita: secondo gli esperti, tra le code bases esaminate “l’88% conteneva versioni non aggiornate delle componenti Open Source […] anche laddove aggiornamenti o patch siano disponibili, queste non vengono applicate con regolarità”.

Va ricordato che si parla di vulnerabilità pubblicamente note: questo significa che anche i nostri nemici le conoscono e sanno di poterle sfruttare a proprio vantaggio. Come sintetizzato dal report, “si può concludere che alcuni team di DevSecOps facciano fatica a tenere il passo dei rischi veicolati dall’Open Source”.

Rischi e vantaggi dell’Open Source nel lungo periodo

La buona notizia emersa dalla relazione redatta da Synopsys – azienda americana che si occupa della qualità del software, in forte crescita in Italia grazie al regional sales manager Emanuele Buriali d’Arezzo – è che proprio una delle peggiori vulnerabilità di origine Open Source rilevate potrebbe, in una prospettiva di lungo periodo, aiutare le organizzazioni a prestare maggiore attenzione alla sicurezza dei software.

Log4Shell, un gruppo di vulnerabilità riscontrato nella libreria Open Source Apache Log4j, era già presente in centinaia di milioni (se non miliardi) di sistemi, siti e servizi prima di diventare pubblico nel dicembre 2021. Si tratta di vulnerabilità di tipo “remote code execution”: quindi idonee a permettere agli attaccanti di ottenere il controllo remoto dei dispositivi che utilizzano applicazioni in Java, uno dei linguaggi di programmazione più diffusi al mondo.

Proprio in ragione del suo impatto, l’indagine ha rilevato come Log4Shell abbia spinto numerose organizzazioni a prendere atto di molte questioni relative all’uso dell’Open Source nel loro business:

  • i progetti Open Source sono creati e animati da volontari, non da operatori commerciali; di conseguenza, patch e aggiornamenti di sicurezza non vengono “offerti” agli utenti ma devono essere “scaricati” da questi ultimi.
  • Alcuni progetti OS finiscono per essere abbandonati e non subire più alcuna manutenzione: pertanto, eventuali difetti o vulnerabilità che emergano al loro interno non vengono presi in carico da nessuno.
  • Se i progetti Open Source più popolari possono contare su un’ampia comunità impegnata a “prendersi cura” del codice, esistono milioni di progetti meno diffusi in cui solo una decina di persone (o meno) si occupa della loro manutenzione; ciò può significare che un progetto non riceve aggiornamenti da anni.
  • Molti sviluppatori, presi dall’entusiasmo per ciò che una componente Open Source può offrire ai loro prodotti, tendono ad applicarla senza verificarne l’affidabilità; questo può portarli a ignorare eventuali rischi e a tralasciare quei controlli di sicurezza che sono, invece, richiesti per ogni software commerciale o proprietario.
  • Le componenti Open Source non sono di per sé più sicure o meno sicure del software “proprietario”; una loro cattiva gestione, in ogni caso, può comportare significativi pericoli per il business.

Come tutelarsi dalle vulnerabilità dell’Open Source?

Un buon punto di partenza può essere il Software Bill of Materials (SBOM), che offre un inventario dettagliato di tutte le componenti presenti in una determinata collezione di codice sorgente insieme a informazioni sul gruppo di volontari che l’ha creata, restrizioni imposte da ogni licenza attiva, eventuali vulnerabilità note e collegamenti con altre componenti software (dette dependencies) necessarie al suo funzionamento. Si tratta, in sostanza, di una “lista degli ingredienti” relativa alla supply chain del software. SBOM svolge una funzione impossibile da effettuare “a mano”: ossia scavare nelle profondità della dependency chain, per garantirne piena e completa visibilità.

Ancora secondo l’indagine OSSRA, “le software dependencies coincidono con i maggiori rischi all’interno della supply chain. L’unico modo per ridurre al minimo tali rischi è utilizzare SBOM, che traccia le dependencies e i relativi pericoli, consentendo di pianificare le azioni necessarie ad affrontarli nel corretto ordine di priorità”.

Indubbiamente, un programma SBOM può rappresentare una risorsa fondamentale in caso vengano scoperte vulnerabilità rilevanti. Nel citato caso di Log4j, un’organizzazione dotata di uno SBOM aggiornato avrebbe potuto condurre una semplice ricerca sul proprio database per scoprire se quella specifica libreria OS fosse presente in qualsiasi punto della sua catena di software; sapendo, in caso positivo, di dover velocemente individuare e applicare le necessarie patch. Con una soluzione di questo tipo si sarebbe potuto evitare gran parte del caos derivato da Log4Shell così come le notti insonni trascorse da molti sviluppatori e security team nel periodo natalizio.

Come confermano gli analisti di Synopsys, infatti, “la corsa alle attività di remediation è stata spesso frutto di una mancata consapevolezza, da parte delle organizzazioni, sulla presenza e la posizione di componenti Log4j all’interno dei loro sistemi. [Pertanto] è importante ricordare che il problema non è l’Open Source in sé, quanto la sua insufficiente o inadeguata gestione”.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/open-source-e-cybersecurity-per-un-software-sicuro/


La Governance dell’AI attraverso le norme ISO

Premessa

L’“Intelligenza Artificiale” (il cui acronimo è IA in italiano e AI in inglese) è una disciplina appartenente al mondo dell’informatica presente tra gli addetti ai lavori da molto tempo. E’ un termine coniato nel 1956, ma solo negli ultimi anni si sta manifestando grazie al periodo di innovazione tecnologica senza precedenti in tanti campi diversi in cui stiamo vivendo. Tra l’altro l’Intelligenza Artificiale al giorno d’oggi può sfruttare la potenza di calcolo quasi illimitata del cloud e ancora più elevati livelli di efficienza e velocità di calcolo dei Super Computer e/o la condivisione in reti di computer.

Aggiungendo a tutto ciò il costo decrescente dello storage, l’aumento esponenziale dei volumi di dati che si possono usare per addestrare le IA, e la comparsa di piattaforme e framework open source, si ottiene una combinazione straordinariamente potente di tecnologie e capacità.

Tutto questo contribuisce a far diventare l’Intelligenza Artificiale un effetto predominante.

Ma cos’è effettivamente l’Intelligenza Artificiale?

È difficile definire l’Intelligenza Artificiale, perché a seconda del contesto o delle persone essa può assumere significati diversi.

Non esiste una definizione unica e unanimemente accettata di “intelligenza artificiale”.

Una delle tante definizioni dice che: l’Intelligenza Artificiale è un insieme di tecnologie differenti che interagiscono per consentire a dispositivi e/o apparecchiature di percepire, comprendere, agire e apprendere con livelli di intelligenza simili a quelli umani.

Pertanto tecnologie come il machine learning e l’elaborazione del linguaggio naturale rientrano tutte nell’ambito dell’Intelligenza Artificiale. Ciascuna di esse si sta evolvendo lungo il proprio percorso e, quando applicate in combinazione con dati, analytics e automazione, possono aiutare le aziende a raggiungere i propri obiettivi, sia che si tratti di migliorare il servizio dei clienti o di ottimizzare la supply chain.

L’intelligenza artificiale in generale è più simile a ciò che si vede nei film di fantascienza, dove apparecchiature dotate di “sensi” emulano l’intelligenza umana, pensando in modo strategico, astratto e creativo, con la capacità di gestire una serie di compiti complessi. Sebbene le macchine possano svolgere alcune attività meglio degli esseri umani (per esempio l’elaborazione dei dati), questa visione pienamente realizzata dell’Intelligenza Artificiale generale nella realtà non esiste ancora. Ecco perché la collaborazione uomo-macchina è cruciale nel mondo di oggi, ne consegue pertanto che l’Intelligenza Artificiale rimane un’estensione delle capacità umane, non un sostituto.

È del 21 aprile 2021 la presentazione, da parte della Commissione europea, di una proposta di regolamento UE sull’Intelligenza artificiale che, di fatto, istituisce un quadro di riferimento volto a normare il mercato dell’Unione Europea su questa attuale e delicata materia. Con la proposta “Regolamento del Parlamento europeo e del Consiglio che stabilisce norme armonizzate in materia di intelligenza artificiale e che modifica alcuni atti legislativi dell’Unione” la Commissione europea punta l’attenzione sull’interrelazione tra l’utilizzo di strumenti di IA nella nostra realtà quotidiana e tutela dei dati personali, sottolineando i limiti da dover imporre per assicurare un corretto uso di grandi quantitativi di informazioni (per lo più dati personali) quale premessa necessaria per un tale inevitabile processo di sviluppo.

Questi gli obiettivi che chiaramente emergono dalla Proposta di Regolamento UE sull’Intelligenza artificiale:

  • assicurare che i sistemi di IA immessi sul mercato dell’Unione Europea e utilizzati siano sicuri e rispettino la normativa vigente in materia di diritti fondamentali e i valori dell’Unione;
  • assicurare la certezza del diritto per facilitare gli investimenti e l’innovazione nell’IA;
  • migliorare la governance e l’applicazione effettiva della normativa esistente in materia di diritti fondamentali e requisiti di sicurezza applicabili ai sistemi di IA;
  • facilitare lo sviluppo di un mercato unico per applicazioni di IA lecite, sicure e affidabili nonché prevenire la frammentazione del mercato

Anche l’International Organization for Standardization (più conosciuta come ISO) tramite il comitato ISO/IEC JTC 1/SC 42 Artificial Intelligence, non da meno ha in cantiere una nuova norma la ISO/IEC 42001 Information Technology – Artificial intelligence – Management system un nuovo Sistema di Gestione sull’Intelligenza Artificiale.

Governance dell’IA

La proposta di Regolamento da parte della UE sull’Intelligenza Artificiale del 21 aprile 2021 e la draft opinion del 02 marzo 2022, introducono in maniera molto forte i concetti di rischio, di sistema e di governance.

Il sistema AI è quindi considerato attraverso un approccio olistico ed integrato.

Alcuni degli articoli presenti, che vengono anche richiamati negli allegati VI e VII, introducono in maniera chiara il concetto di sistema e del suo controllo.

L’art. 9 (con gli artt. 11 e 13) pone il focus su un sistema di gestione dei rischi, in particolare riportando l’attenzione sugli incidenti (art- 62). Tale sistema di gestione richiama sia modelli che metodologie note, che contemplano il concetto di sistema, e che possono in qualche modo essere d’aiuto integrandosi con altri framework sono ad esempio: la ISO 31000, il CSF NIST e il NIST 800-53, la ISO 27005 e la ISO 22301 della continuità operativa.

La gestione dei rischi diventa quindi una forzante per guidare il sistema AI, attraverso metodologie e prassi consolidate.

L’art. 12 richiama alcuni concetti fondamentali della ISO 27001 e del CSF NIST cioè la registrazione e la gestione degli eventi (log) che permettono il monitoraggio, la gestione del loro ciclo di vita dei rischi e la gestione della tracciabilità.

L’art. 15 tratta gli argomenti tipici della cybersecurity, della security by design comprese ad esempio: le metriche, la resilienza, la gestione dei back up.

L’art 17, invece richiama proprio il concetto di Sistema di Gestione della Qualità. Nel documento Opinion Draft viene richiesta la cancellazione dell’obbligatorietà per le società che trattano AI di dover possedere un sistema certificato di Qualità. (“Richiedere ad ogni fornitore di stabilire un sistema di gestione della qualità per un sistema ad alto rischio è sproporzionato e ingiustificato. Creerebbe enormi costi e oneri amministrativi. Allo stesso tempo, non ha valore aggiunto in quanto la maggior parte dei suoi elementi sono già o possono almeno essere inclusi nella valutazione del rischio di cui all’articolo 9. Inoltre, molti sistemi di intelligenza artificiale rientrano già nei sistemi di gestione della qualità esistente, come quelli definiti dalla ISO 9001. Se l’UE vuole promuovere l’innovazione nell’IA, in particolare da parte delle PMI e delle start-up europee, non deve sovraccaricarli di obblighi inutili”).

Se è pur vero che l’implementazione di un sistema di gestione della Qualità comporta degli oneri, è anche vero che può portare (se fatto bene) enormi benefici sia all’organizzazione che agli utenti/Clienti.

Non solo proprio collegandosi agli allegati, è fondamentale introdurre il concetto di controllo e misura (assessment) richiamato dalla norma ISO 19011 e dal controllo di conformità della ISO 37301 (artt. 19 e 43).

La norma che definisce un sistema di gestione per la qualità (ISO 9001) è la norma che ha guidato l’introduzione della struttura HLS (Hight Level Structure) comune a tutte le norme ISO certificabili compresa la norma ISO 27001.

Essa è suddivisa in 7 capitoli dove sono presenti i requisiti che il sistema deve soddisfare.

Viene riportata nella figura sottostante l’HLS della norma ISO 9001. (Fonte: I quaderni della Qualità «Struttura di Alto Livello e ISO 9001:2015» – UNI 2015)
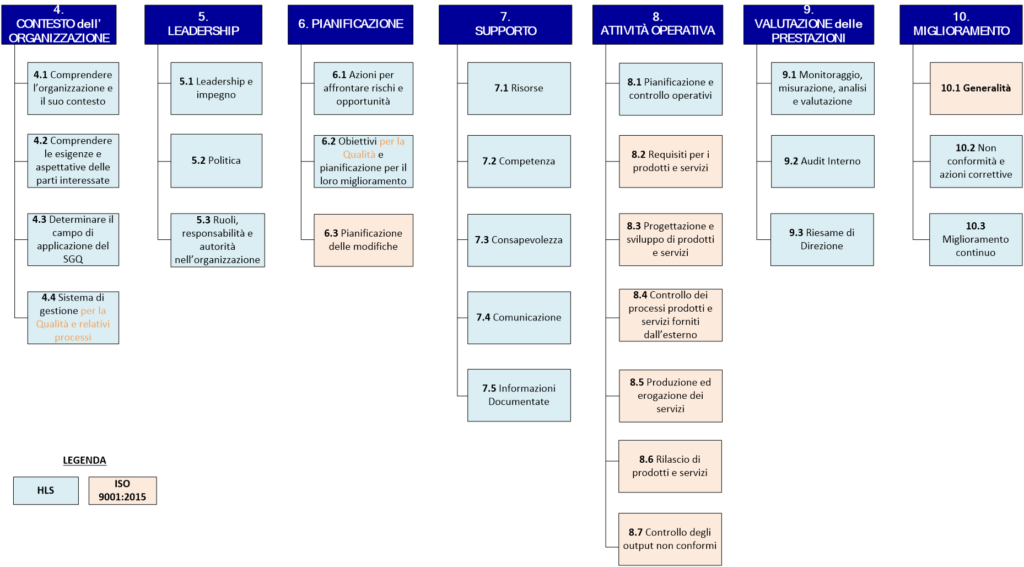
Tale suddivisione: 4 Contesto, 5 Leadership, 6 Pianificazione, 7 Supporto, 8 Attività Operative, 9 Monitoraggio e 10 Miglioramento (attraverso il concetto di Azioni Correttive dell’art. 21), permette il soddisfacimento dei requisiti elencati nell’art. 17, quali ad esempio: la redazione e diffusione delle Policy, delle procedure la realizzazione di test e di assessment, la gestione degli incidenti, la gestione delle risorse, la gestione della comunicazione, il ciclo di vita dei dati.

Per semplicità riportiamo alcune considerazioni sui 7 capitoli individuati sopra.

Contesto: riguarda la conoscenza organizzativa e si suddivide in contesto esterno ed interno. In particolare per il contesto esterno: l’organizzazione deve individuare i fattori che influenzano il sistema di gestione, i requisiti (cosa vogliono) le parti interessate, i clienti, i fornitori, il contesto fisico e ambientale, quello sociale, quello normativo e quello tecnologico. Per il contesto interno abbiamo: l’organizzazione, le risorse, i processi, la governance, il contesto fisico e quello logico (infrastrutture).

Leadership: l’organizzazione deve impegnarsi a dimostrare la sua leadership attraverso la governance, la redazione di policy, la sensibilizzazione delle persone, la definizione organizzativa (ruoli e responsabilità), l’attribuzione delle risorse e promuovendo il miglioramento continuo.

Pianificazione: il capitolo relativo alla pianificazione si suddivide in due parti. La prima è dedicata all’analisi dei rischi, quindi alla metodologia dei rischi, all’individuazione e al trattamento. La seconda invece richiede la definizione precisa degli obiettivi organizzativi e specifici.

Supporto: per poter seguire le policy declinate prima, raggiungere gli obiettivi è necessario che l’organizzazione definisca e attribuisca le corrette risorse. Questo implica non solo le risorse economiche, finanziarie, strutturali ma anche le risorse umane attraverso la competenza (formazione), la consapevolezza dei rischi e delle attività. Essendo un sistema di gestione ecco che la parte relativa alla gestione documentale è fondamentale anche in ottica di accountability, inoltre è opportuno definire un processo di comunicazione relativo a tutti gli items di sistema: obiettivi, documenti, politiche, indicatori, dati, etc.

Attività operative: questo è il capitolo più “libero” della norma, in quanto si riferisce proprio alle attività/processi tipici dell’organizzazione. Le attività devono essere quindi pianificate e controllate, riprende l’analisi dei rischi ripotandola ai singoli processi, introduce gli indicatori e le attività di dettaglio (progettazione, erogazione del servizio e realizzazione prodotto, i controlli, il post vendita).

Valutazione delle prestazioni: qui vengono definiti i sistemi di misura (chi, come, quando, con cosa, valutazione) sui processi e sui prodotti/servizi e sul sistema di gestione attraverso gli audit interni ed il riesame della direzione.

Miglioramento: nell’ultimo capito si affrontano le tematiche relative alle non conformità del sistema, all’implementazione delle eventuali azioni correttive ed al processo del miglioramento continuo che deve essere integrato in ogni attività aziendale.
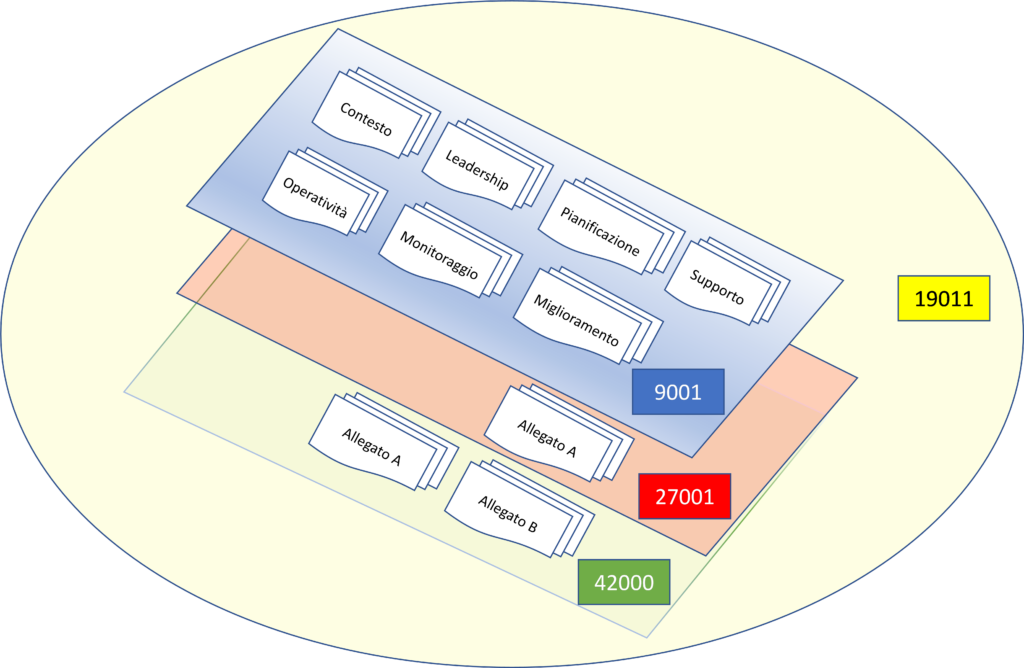
In quest’ottica della struttura HLS si inserisce anche la norma ISO 42000 dedicata alla governance dell’Intelligenza Artificiale della quale riportiamo l’HLS.

4 Contesto dell’organizzazione
4.1 Comprendere l’organizzazione e il suo contesto
4.2 Comprendere le esigenze e le aspettative delle parti interessate
4.3 Determinazione dell’ambito di applicazione del sistema di gestione dell’IA
4.4 Sistema di gestione AI
5 Leadership
5.1 Leadership e impegno
5.2 Politica
5.3 Ruoli, responsabilità e autorità
6 Pianificazione
6.1 Azioni per affrontare rischi e opportunità
6.1.1 Generalità
6.1.2 Valutazione del rischio dell’IA
6.1.3 Trattamento del rischio di IA
6.1.4 Valutazione d’impatto del sistema di IA
6.2 Obiettivi dell’IA e pianificazione per raggiungerli
6.3 Pianificazione delle modifiche
7 Supporto
7.1 Risorse
7.2 Competenza
7.3 Consapevolezza
7.4 Comunicazione
7.5 Informazioni documentate
7.5.1 Generalità
7.5.2 Creazione e aggiornamento di informazioni documentate
7.5.3 Controllo delle informazioni documentate
8 Funzionamento
8.1 Pianificazione e controllo operativo
9 Valutazione delle prestazioni
9.1 Monitoraggio, misurazione, analisi e valutazione
9.2 Audit interno
9.2.1 Generalità
9.2.2 Programma di audit interno
9.3 Riesame della direzione
9.3.1 Generalità
9.3.2 Input di revisione della direzione
9.3.3 Risultati del riesame della direzione
10 Miglioramento
10.1 Miglioramento continuo
10.2 Non conformità e azioni correttive

La norma si compone di un corpo centrale (HLS) e due appendici. La prima riguarda una serie di controlli/contromisure dedicate, ma non esaustive, all’IA. Questi controlli hanno la stessa forma e ispirazione della ISO 27001. I controlli vengono elencati riportando l’obiettivo generale, il controllo dedicato ed una linea guida all’implementazione dello stesso.

La seconda appendice tratta invece i possibili obiettivi, nella gestione dei rischi, organizzativi legati all’IA

Riportiamo l’elenco dei controlli relativi all’Allegato A:

A.1 Generalità
A.2 Politiche per IA
A.2.1 Generale

Obiettivo: Fornire direzione di gestione e supporto per l’IA in conformità con i requisiti aziendali e requisiti legali applicabili (ad es. legislazione e contratti).

A.2.2 Politica IA

Controllo: La politica di IA stabilita in base ai requisiti della Clausola 5.2 dovrebbe guidare l’organizzazione approccio alla gestione dei propri obiettivi legati all’IA.

A.2.3 Allineamento con altre politiche organizzative

Controllo: L’organizzazione dovrebbe determinare dove altre politiche possono essere influenzate o applicate al suo ruolo con rispetto ai sistemi di intelligenza artificiale.

A.2.4 Riesame della politica in materia di IA

Controllo: La politica in materia di IA dovrebbe essere riesaminata a intervalli pianificati o se si verificano cambiamenti significativi per garantire la sua idoneità, adeguatezza ed efficacia continue.

A.3 Organizzazione interna

Obiettivo: Creare il quadro di gestione attraverso il quale i controlli per l’IA possono essere istituiti e resi operativi.

A.3.1 Generale

Obiettivo: Creare il quadro di gestione attraverso il quale i controlli per l’IA possono essere istituiti e operazione in un’organizzazione.

A.3.2 AI ruoli e responsabilità

Controllo: I ruoli e le responsabilità per l’IA dovrebbero essere definiti e assegnati in base alle esigenze dell’organizzazione.

A.3.3 Sistema di comunicazione

Controllo: L’organizzazione dovrebbe definire e mettere in atto un processo per riportare le segnalazioni ed il ruolo dell’organizzazione rispetto a un sistema di intelligenza artificiale durante tutto il suo ciclo di vita.

A.4 Risorse per AI
A.4.1 Generale

Obiettivo: Garantire che l’organizzazione tenga conto delle risorse (inclusi componenti e risorse) del sistema AI al fine di comprendere e affrontare appieno rischi e impatti.

A.4.2 Documentazione delle risorse

Controllo: L’organizzazione dovrebbe identificare e documentare tutte le risorse pertinenti necessarie per il ciclo di vita del sistema e delle sue fasi di IA e altre attività correlate all’IA rilevanti per l’organizzazione.

A.4.3 Risorse di dati

Controllo: Come parte dell’identificazione delle risorse, l’organizzazione dovrebbe documentare le informazioni sui tipi di dati risorse utilizzate per il sistema di intelligenza artificiale.

A.4.4 Risorse di strumenti

Controllo: Come parte dell’identificazione delle risorse, l’organizzazione dovrebbe documentare le informazioni sui tipi di risorse di computing utilizzate per il sistema di intelligenza artificiale.

A.4.5 Risorse di sistema e di calcolo

Controllo: Come parte dell’identificazione delle risorse, l’organizzazione dovrebbe documentare le informazioni sui tipi di risorse del sistema utilizzate per il sistema di intelligenza artificiale (dove e quali).

A.4.6 Risorse umane

Controllo: Nell’ambito dell’identificazione delle risorse, l’organizzazione dovrebbe documentare le informazioni sui tipi di risorse umane utilizzate per il sistema di intelligenza artificiale.

A.5 Valutazione degli impatti dei sistemi di IA
A.5.1 Generale

Obiettivo: Valutare gli impatti del sistema per le parti interessate del sistema di intelligenza artificiale durante tutto il suo ciclo di vita.

A.5.2 Processo di valutazione d’impatto del sistema IA

Controllo: L’organizzazione dovrebbe attuare, ove necessario, un processo di valutazione d’impatto (vedi GDPR) del sistema.

A.5.3 Documentazione delle valutazioni d’impatto dei sistemi di IA

Controllo: L’organizzazione dovrebbe documentare i risultati delle valutazioni d’impatto del sistema di IA e conservare i risultati per un periodo di definizioni.

A.5.4 Valutazione dell’impatto su individui e gruppi di individui

Controllo: L’organizzazione dovrebbe valutare e documentare i potenziali impatti dei sistemi di IA su individui o gruppi di individui durante tutto il ciclo di vita del sistema (ad esempio: parzialità ed equità; trasparenza e spiegabilità; privacy; sicurezza e salute; finanza; Diritti umani).

A.5.5 Valutazione degli impatti sociali

Controllo: L’organizzazione dovrebbe valutare e documentare i potenziali impatti sociali connessi al suo utilizzo, fornitura e sviluppo di sistemi di IA (ad esempio: l’ambiente (anche attraverso l’impatto sul consumo energetico e sull’efficienza energetica); l’economia; processi democratici; salute e sicurezza della società in generale; norme, tradizioni, cultura e valori).

A.5.6 Valutazione delle opportunità

Controllo: L’organizzazione dovrebbe contemplare e documentare le opportunità derivanti dall’utilizzo dei sistemi AI durante tutto il loro ciclo di vita.

A.6 Ciclo di vita dello sviluppo del sistema IA
A.6.1 Guida alla gestione per lo sviluppo di sistemi di IA

Obiettivo: Garantire che l’organizzazione implementi processi e obiettivi per la progettazione responsabile e sviluppo di sistemi di IA.

A.6.1.1 Obiettivi per lo sviluppo responsabile del sistema di IA

Controllo: L’organizzazione dovrebbe identificare e documentare gli obiettivi per guidare lo sviluppo di un’IA responsabile e integrare tali obiettivi in tutte le fasi del ciclo di vita dello sviluppo (ad esempio: equità; responsabilità; trasparenza; affidabilità; sicurezza; privacy e sicurezza; accessibilità, etc.).

A.6.1.2 Processi per lo sviluppo responsabile della progettazione di sistemi di IA

Controllo: L’organizzazione deve definire, documentare e implementare i passaggi necessari per l’applicazione, provisioning e sviluppo di sistemi di IA attraverso il loro ciclo di vita (ad esempio: fasi del ciclo di vita del processo di sviluppo; requisiti di prova; requisiti in materia di controllo umano; in quali fasi dovrebbero essere effettuate le valutazioni d’impatto; formazione delle aspettative e delle norme in materia di dati (ad esempio quali dati possono essere utilizzati, fornitori di dati approvati e etichettatura); competenze richieste o formazione per gli sviluppatori di sistemi di IA o entrambi; criteri di rilascio; le approvazioni e le approvazioni necessarie nelle varie fasi; controllo delle modifiche; coinvolgimento delle parti interessate).

A.6.2 Fasi di sviluppo del sistema IA

Obiettivo: Definire le regole e i requisiti per ogni fase o fase del processo di sviluppo del sistema di intelligenza artificiale.

A.6.2.1 Requisiti e specifiche di sistema IA

Controllo: L’organizzazione deve specificare e documentare i requisiti per i nuovi sistemi di intelligenza artificiale o i miglioramenti per sistemi esistenti.

A.6.2.2 Progettazione e sviluppo di sistemi di IA

Controllo: L’organizzazione deve documentare la progettazione e lo sviluppo del sistema di intelligenza artificiale in base all’organizzazione obiettivi, requisiti documentati e criteri di specificazione (ad esempio: approccio all’apprendimento automatico (supervisionato o non supervisionato); algoritmi utilizzati; come verrà addestrato il modello e con quali dati; valutazione e perfezionamento dei modelli; componenti hardware e software; codice; etc.).

A.6.2.3 Verifica e convalida del sistema IA

Controllo: L’organizzazione dovrebbe definire e documentare le misure di verifica e convalida per il sistema di IA e specificare i criteri per il loro utilizzo (ad esempio: metodologie e strumenti di prova; dati di convalida della selezione e dati di prova; requisiti dei criteri di rilascio).

A.6.2.4 Distribuzione del sistema IA

Controllo: L’organizzazione deve documentare un piano di distribuzione, inclusi i componenti che verranno distribuiti in quali ambienti e garantire che tutti i requisiti siano soddisfatti prima della distribuzione.

A.6.2.5 Funzionamento e monitoraggio del sistema IA

Controllo: L’organizzazione dovrebbe definire e documentare gli elementi necessari per il funzionamento in corso del sistema IA. Come minimo questo dovrebbe includere il monitoraggio del sistema e delle prestazioni, riparazioni, aggiornamenti e supporti.

A.7 Dati per sistemi di IA

Obiettivo: Garantire che l’organizzazione comprenda il ruolo e l’impatto dei dati nei sistemi di intelligenza artificiale nell’applicazione e lo sviluppo, la fornitura o l’uso di sistemi di intelligenza artificiale durante il loro cicli di vita.

A.7.1 Generale
A.7.2 Dati per lo sviluppo e il miglioramento del sistema IA

Controllo: L’organizzazione dovrebbe definire, documentare e implementare processi di gestione dei dati relativi allo sviluppo di sistemi di IA (ad esempio: implicazioni per la vita privata e la sicurezza dovute all’uso di dati, alcuni dei quali possono essere di natura sensibile; minacce alla sicurezza e alla protezione che possono derivare dallo sviluppo di sistemi di IA dipendenti dai dati; aspetti di trasparenza e spiegabilità, compresa la provenienza dei dati e la capacità di fornire una spiegazione di come i dati vengono utilizzati per determinare l’output di un sistema di intelligenza artificiale se il sistema richiede trasparenza e spiegabilità; rappresentatività dei dati di formazione rispetto al dominio operativo di utilizzo; l’esattezza e l’integrità dei dati).

A.7.3 Acquisizione dei dati

Controllo: L’organizzazione dovrebbe determinare e documentare i dettagli sull’acquisizione e la selezione dei dati utilizzati nei sistemi di intelligenza artificiale (ad esempio: categorie di dati necessari per il sistema di IA; quantità di dati necessari; fonti di dati (tipo: dati interni, acquistati, condivisi, aperti); caratteristiche della fonte di dati (statica, trasmessa, raccolta, generati automaticamente); dati demografici e caratteristiche dell’interessato; trattamento preventivo dei dati (usi precedenti, conformità alla privacy e sicurezza requisiti); provenienza dei dati).

A.7.4 Qualità dei dati per i sistemi di IA

Controllo: L’organizzazione deve definire e documentare i requisiti per la qualità dei dati (definizione: il grado in cui il le caratteristiche dei dati soddisfano le esigenze dichiarate e implicite quando vengono utilizzate in condizioni specificate).

A.7.5 Provenienza dei dati

Controllo: L’organizzazione dovrebbe definire e documentare un processo per verificare e registrare la provenienza di dati utilizzati nei suoi sistemi di intelligenza artificiale durante i cicli di vita dei dati e del sistema di intelligenza artificiale.

A.7.6 Pretrattamento dei dati

Controllo: L’organizzazione dovrebbe definire e documentare le proprie esigenze e approcci alla pre-elaborazione dei dati (ad esempio: esplorazione statistica dei dati (distribuzione, media, mediana, deviazione standard, intervallo); pulizia (cioè correzione delle voci, gestione delle voci mancanti); imputazione (ossia metodi di compilazione delle voci mancanti); normalizzazione; ridimensionamento; etichettatura della/e variabile/e bersaglio/i; codifica (ad esempio conversione di variabili categoriche in numeri)).

A.8 Informazioni per gli utenti dei sistemi di IA
A.8.1Generale

Obiettivo: Garantire che gli utenti del sistema di intelligenza artificiale dispongano delle informazioni necessarie per comprendere e valutare i loro rischi e impatti (potenziali danni e benefici).

A.8.2 Documentazione di sistema per gli utenti

Controllo: L’organizzazione deve determinare e fornire la documentazione necessaria agli utenti del sistema.

A.8.3 Comprensione delle informazioni fornite

Controllo: Le informazioni fornite agli utenti del sistema di IA dovrebbero essere chiare e comprensibili, anche per i non utenti tecnici.

A.8.4 Relazione esterna

Controllo: L’organizzazione deve fornire funzionalità per la segnalazione degli impatti negativi del sistema.

A.9 Utilizzo di sistemi di IA
A.9.1 Generale

Obiettivo: Garantire che l’organizzazione utilizzi l’intelligenza artificiale in modo responsabile e secondo le politiche organizzative.

A.9.2 Processi per un uso responsabile dell’IA

Controllo: L’organizzazione dovrebbe definire e documentare i processi dell’uso responsabile dei sistemi di intelligenza artificiale (esempio: approvazioni richieste; costi, anche per il monitoraggio e la manutenzione continui; requisiti di approvvigionamento approvati; requisiti legali applicabili all’organizzazione).

A.9.3 Obiettivi per un uso responsabile dell’IA

Controllo: L’organizzazione dovrebbe identificare e documentare gli obiettivi per guidare l’uso responsabile dei sistemi di intelligenza artificiale (ad esempio: equità; responsabilità; trasparenza; affidabilità; sicurezza; privacy e sicurezza; accessibilità, etc.).

A.10 Rapporti tra terze parti
A.10.1 Generalità

Obiettivo: Garantire che, quando terze parti sono coinvolte in qualsiasi fase del ciclo di vita del sistema di intelligenza artificiale, l’organizzazione comprende le proprie responsabilità e rimane responsabile di queste, pur essendo in grado di valutare e mitigare il rischio di fare affidamento su terzi per le responsabilità loro assegnate.

A.10.2 Attribuzione delle responsabilità

Controllo: L’organizzazione dovrebbe garantire che le responsabilità all’interno del ciclo di vita del proprio sistema di intelligenza artificiale siano assegnate tra l’organizzazione, i suoi partner, fornitori, clienti e terze parti.

A.10.3 Fornitori

Controllo: L’organizzazione dovrebbe garantire che i suoi fornitori si impegnino ad attuare i controlli appropriati del presente allegato.

A.11 Sicurezza delle informazioni
A.11.1 Generale

Obiettivo: Garantire che i sistemi di intelligenza artificiale siano sicuri e utilizzati in modo sicuro.

A.11.2 Politica di sicurezza delle informazioni

Controllo: I criteri di sicurezza delle informazioni dell’organizzazione devono considerare le esigenze di sicurezza delle informazioni di Sistemi di IA durante l’intero ciclo di vita del sistema di IA in quanto rilevanti per il loro ruolo e in conformità con queste politiche.

A.11.3 Misure di sicurezza delle informazioni

Controllo: Dovrebbero essere definite nuove misure di sicurezza delle informazioni e le misure esistenti dovrebbero essere adattate come necessario per affrontare le minacce alla sicurezza delle informazioni specifiche dell’IA.

Riportiamo anche l’Allegato B con i possibili obiettivi organizzativi, legati all’IA, nella gestione dei rischi:

B.1 Generalità

Il presente allegato delinea i potenziali obiettivi organizzativi che possono essere presi in considerazione dall’organizzazione quando gestione dei rischi. Il presente allegato non intende essere esaustivo o applicabile a tutte le organizzazioni. Le l’organizzazione dovrebbe determinare gli obiettivi che sono rilevanti per loro. Informazioni più dettagliate su questi obiettivi e la loro relazione con la gestione del rischio possono essere trovati in ISO/IEC CD 23894. La valutazione dei sistemi di IA, inizialmente, regolarmente e quando giustificata, fornisce prove per la valutazione di un sistema IA sistema contro obiettivo organizzativo.

B.2 Correttezza

L’applicazione inappropriata di sistemi di IA per il processo decisionale automatizzato può essere ingiusta per specifici persone o gruppi di persone.

B.3 Sicurezza

Nel contesto dell’IA e in particolare per quanto riguarda i sistemi di IA basati su approcci ML, diverse nuove i problemi di sicurezza dovrebbero essere considerati al di là dei classici problemi di sicurezza delle informazioni e del sistema.

B.4 Safety

La sicurezza si riferisce all’aspettativa che un sistema non conduca, in condizioni definite, a uno stato in cui

la vita umana, la salute, la proprietà o l’ambiente sono in pericolo.

B.5 Tutela della privacy

L’uso improprio o la divulgazione di dati personali e sensibili (ad es. cartelle cliniche) può avere effetti dannosi su interessati. Pertanto, la protezione della privacy è diventata una delle principali preoccupazioni nell’analisi dei big data e nell’intelligenza artificiale.

B.6 Robustezza

Nell’IA, le proprietà di robustezza dimostrano la capacità (o l’incapacità) del sistema di avere comparabili prestazioni su nuovi dati come sui dati su cui è stato addestrato o sui dati delle operazioni tipiche.

B.7 Trasparenza e spiegabilità

La trasparenza si riferisce sia alle caratteristiche di un’organizzazione che gestisce sistemi di IA sia a quelle dei sistemi stessi. La spiegabilità si riferisce alle spiegazioni dei processi rilevanti per lo sviluppo, implementazione e utilizzo di un sistema di IA.

Come si può notare la ISO 42000, permette di implementare un sistema di gestione relativo alla governance dell’intelligenza artificiale comprendendo e riassumendo altre norme ISO di settore quali Qualità, Sicurezza delle Informazioni e Continuità Operativa.

L’applicazione della ISO 42000 aiuta quindi l’organizzazione a gestire e a controllare i dati (secondo IDC nel 2018 sono stati gestiti 18 zettabyte che potranno diventare 175 nel 2025), i processi sia interni che esterni relativi all’erogazione di un servizio o alla realizzazione di un prodotto AI garantendone anche l’accountability e la conformità.

Inoltre un’applicazione rigorosa del sistema permette il controllo, attraverso degli indicatori specifici, dei principi di AI:

  • Dignità e supervisione umana;
  • Robustezza e sicurezza;
  • Privacy e governance dei dati;
  • Trasparenza;
  • Diversità, non discriminazione ed equità;
  • Benessere sociale e ambientale;
  • Accountability.

e dei processi, dei flussi, il ciclo di vita, la correttezza dei dati, l’analisi dei bias, ruoli e responsabilità, etc.

Permette anche dei controlli/contromisure relative ai rischi AI:

  • Perdita di autonomia personale
  • Responsabilità per i danni causati dai sistemi di IA
  • Rischio di errori e manipolazione dell’IA
  • Manipolazione, sorveglianza e comportamento illecito
  • Perdita della privacy
  • Mancanza di trasparenza dell’IA
  • Perdita degli aspetti umani nelle relazioni sociali e mancanza di protezione della vita umana e della dignità umana
  • Restrizione della pluralità delle opinioni e della concorrenza
  • Perdita dei posti di lavoro

Conclusioni

L’interesse dimostrato sia con la proposta di Regolamento da parte della UE che della predisposizione di una norma da parte dell’ISO per proporre dei requisiti per l’evoluzione dell’Intelligenza Artificiale sta a dimostrare una vera e propria attenzione per questa disciplina.

Per quanto ogni giorno milioni di persone tentino fiduciosamente di svelare i numerosi segreti che l’Intelligenza Artificiale nasconde, non si è ancora in grado di affermare con certezza quale sia il futuro che ci attende: alla luce delle conoscenze attuali, l’Intelligenza Artificiale potrebbe rivelarsi la più importante disciplina/tecnologia mai creata, ma, allo stesso modo, potrebbe rappresentare di contro una delle gravi minacce che l’umanità abbia finora conosciuto.

Articolo a cura di Stefano Gorla e Attilio Rampazzo

Informazioni sull’Autore

Stefano Gorla è nato a Milano, si è laureato in fisica nucleare presso l’Università di Padova. Ha insegnato per qualche anno Matematica e Fisica presso alcuni licei.
Da anni si occupa di privacy e sicurezza dei dati attraverso un approccio sistemico e olistico.
Consulente e formatore in ambito sicurezza e tutela dei dati e delle informazioni e relatore in numerosi convegni.
Auditor ISO 27001, DPO Certificato FAC Certifica, NIST Specialist Certificato Fac Certifica, Certificato COBIT5 ISACA, Master EQFM.
Ha maturato notevoli esperienze come Referente Privacy (DPO) e consulente in tali ambiti.
È autore di varie pubblicazioni sul tema.

Informazioni sull’Autore

Attilio Rampazzo, CISA CRISC, CDPSE
Consulente di Sistemi Informativi e di Sistemi di Gestione in ambito ICT. Ha maturato un’esperienza pluriennale nello sviluppo e conduzione di progetti informativi in ambito bancario e finanziario, nei quali la qualità̀ e la sicurezza della Sicurezza delle Informazioni hanno ricoperto un ruolo determinante.
Già trainer accreditato APMG per ITIL, ISO 20000-1 e Cobit 5.
Docente ai corsi LA ISO/IEC 27001, ISO/IEC 20000-1, ISO 22301 riconosciuti AICQ SICEV.
Svolge attività̀ come Lead Auditor presso primari OdC italiani accreditati da Accredia

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-governance-dellai-attraverso-le-norme-iso/


Cos’è la OT Security e come si relaziona con la sicurezza IT

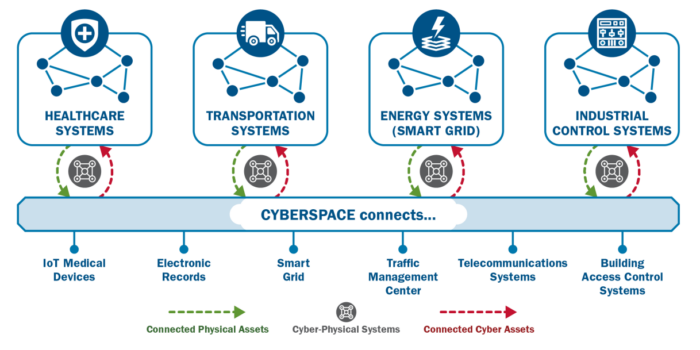
La sicurezza OT (Operational Technology) si occupa solitamente della protezione dei sistemi Industriali: sistemi di controllo distribuito (DCS, Distributed Control System), sistemi di controllo industriale (ICS, Industrial Control System), reti di controllo supervisione e acquisizione dati (SCADA, Supervisory Control And Data Acquisition), controllo dei processi (PLC, Programmable Logic Controller), l’internet delle cose industriale (IIoT, Industrial Internet of Things), automazione degli edifici (BAS, Building Automation System), così come dei sistemi PACS (Physical Access Control Systems).

L’OT security è un campo relativamente nuovo nella sicurezza informatica in grado di avere ripercussioni sul mondo fisico ed impattare sia sulla security che sulla safety a 360° poiché coinvolge persone, tecnologie e processi in quelle che vengono definite infrastrutture critiche.

Fonte: www.cisa.gov

Cos’è la sicurezza OT?

L’OT Security deve garantire il controllo in real time, l’adattabilità, la disponibilità e la continuità di funzionamento, la confidenzialità e l’integrità dei dati. Deve essere in grado di sostenere e proteggere le reti di automazione utilizzate per controllare i processi fisici, come i servizi di emergenza, impianti di produzione farmaceutici, chimici, i trasporti, la distribuzione di energia, acqua, petrolio e gas, da attacchi informatici. Un problema di sicurezza in questo contesto di infrastrutture critiche determinerebbe gravi danni sospendendo quelli che sono definiti servizi essenziali e causando perdite economiche, come ad esempio in caso di fermo della produzione, e perfino conseguenze peggiori come la manomissione di un impianto idrico o la perdita di vite umane.

I dispositivi che compongono l’infrastruttura OT non sono stati progettati per sostenere la connettività che la trasformazione digitale impone e i costi di aggiornamento che l’industria si trova a dover affrontare sono molto elevati poiché i sistemi OT sono stati progettati per durare oltre 30 anni e quindi con tecnologia legacy, perciò il rinnovamento di tutti i macchinari risulta spesso una spesa molto alta a cui è difficile fare fronte.

Ma visti i casi di cronaca, che hanno determinato l’interruzione di servizi primari come quelli energetici, l’investimento nella OT cybersecurity negli ultimi anni è diventato sempre più ingente ed impellente. Gruppi di cyber criminali si stanno sempre più specializzando nell’attaccare le infrastrutture critiche, incentivati anche da forti finanziamenti statali come nel caso dello state-sponsored hacking. Ciò avviene perché questo tipo di crimine è in grado di condizionare la geopolitica come si vede anche nel conflitto russo-ucraino garantendo agli autori del crimine l’anonimato vista la difficile attribuzione del cyber attacco.

Come ridurre il rischio informatico negli ambienti OT

Per ridurre il rischio cyber, l’OT Security manager deve applicare una strategia che prevede:

  • controllo accessi e gestione privilegi attraverso la predisposizione di Intrusion Detection System (IDS)
  • segmentazione della rete
  • soluzioni di antivirus e utilizzo di sistemi di Endpoint Detection and Response (EDR)
  • monitoraggio della rete
  • analisi dei log
  • vulnerability assessment
  • penetration testing
  • stabilire corrette policy di sicurezza
  • programmi di valutazione/audit
  • approccio zero trust

Convergenza tra IT e OT

La convergenza tra IT e OT nasce con la trasformazione digitale che determina la necessità dei sistemi industriali ad essere sempre più connessi generando così maggiori vulnerabilità e nuovi rischi per la sicurezza ma anche maggiore sostenibilità, facilità di gestione, flessibilità, competitività nel settore industriale.

L’affermarsi della OT cybersecurity avviene per garantire una risposta all’esigenza di monitorare e controllare l’infrastruttura OT da remoto che ha generato nell’ultimo decennio un impressionante aumento del numero di attacchi informatici indirizzato alle infrastrutture critiche dovuto sia al collegamento a reti IP che al numero sempre più crescente di endpoint. Ciò rende sempre più difficile per le organizzazioni di identificare tutti i dispositivi connessi alla rete e la loro relativa messa in sicurezza generando così un quantitativo di vulnerabilità mai visto prima, alimentando il rischio di cyber attacchi grazie all’avanzare dei sistemi IoT, al cloud computing e ai tool di hacking che diventano di giorno in giorno sempre più sofisticati e facilmente reperibili.

L’Industrial IoT (IIoT) sfida l’Operational Technology

L’Industrial Internet of Things (IIoT) è stato un fattore determinante nel causare la non sicurezza delle infrastrutture OT progettate inizialmente esclusivamente per connessioni interne.

L’IIoT è una rete di oggetti fisici che trasmettono dati. Si tratta in genere di una serie di dispositivi industriali, macchine, sensori, attuatori o controller connessi a internet o ad una intranet per consentire il monitoraggio e il funzionamento da remoto, con lo scopo di migliorare l’efficienza, ridurre i costi e aumentare la redditività.

Differenza tra OT Security e IT Security

La sicurezza IT e OT sono campi diversi con obiettivi diversi.

L’IT Security ha come requisito base la confidenzialità, integrità e disponibilità dei dati mentre la sicurezza OT si concentra su una tecnologia che non è stata progettata per essere connessa alla rete e le comunicazioni avvengono tipicamente machine-to-machine. Per tale motivo i volumi di traffico negli ambienti industriali sono generalmente inferiori a quelli degli ambienti IT e ciò determina un vantaggio in quanto è più facile monitorare rete e traffico identificando velocemente le anomalie, segno di un eventuale attacco. Ciò viene incontro a quello che è il requisito base della OT security, la disponibilità, le risorse devono essere ininterrottamente accessibili al fine di garantire la continuità operativa.

A cura della Redazione

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cose-la-ot-security-e-come-si-relaziona-con-la-sicurezza-it/


Ransomware e finanza, i principali trend secondo l’Intelligence Finanziaria

Il FinCEN (Financial Crimes Enforcement Network) evidenzia un forte aumento di attacchi ransomware nei primi mesi del 2021, valutando in 590 milioni di dollari l’importo dei pagamenti estorti tramite ransomware tra il 1 gennaio e il 30 giugno 2021. Il dato è preoccupante: in soli sei mesi è stato superato il valore totale guadagnato dagli autori degli attacchi nell’anno precedente, che ammontava a 416 milioni di dollari, evidenziando così un aumento dei pagamenti dei riscatti del 42% rispetto al 2020, il trend sembra mantiene una crescita esponenziale. Gli analisti avvertono che di questo passo si arriverà nel prossimo anno ad un numero di attacchi ransomware pari alla somma di tutti quelli avvenuti nei 10 anni precedenti.

Il Financial Crimes Enforcement Network è l’ufficio governativo per la lotta contro i reati finanziari amministrato dal Dipartimento del tesoro degli Stati Uniti d’America. Si occupa quindi di riciclaggio di denaro, traccia le persone che operano in maniera sospetta, monitora transazioni elettroniche complesse tramite ricerche e divulgazioni su beni ed attività, e riferisce al Sottosegretario al Tesoro per il Terrorismo e l’Intelligence Finanziaria.

L’analisi si basa sulle segnalazioni di attività sospette (Suspicious Activity Reports, SAR) presentate dalle istituzioni finanziarie al FinCEN, un totale di 635 report e 458 transazioni confermate, che forniscono un’utile panoramica sulla crescente minaccia provocata da questo tipo di malware. Nel 2021 gli Stati Uniti sono stati i più colpiti, con 34.816.097 attacchi, seguiti da Giappone, Australia e Italia (6.097.979) che si posiziona così al quarto posto annoverando tra i settori più colpiti la Sanità, la Pubblica Amministrazione, il Manufacturing, il Tech e il Banking.

I trend del cyber crime individuati dall’Intelligence Finanziaria

Lo scopo dei ricercatori era quello di individuare le tendenze di comportamento degli autori degli attacchi ransomware, per comprendere meglio come individuarli e come difendersi.

Gli esperti di FinCEN hanno identificato, all’interno del periodo di riferimento, 68 cosiddette “varianti”, ovvero versioni del ransomware appartenenti a differenti autori. Di queste 68 varianti hanno analizzato le 10 più comuni per ottenere i trend nei pagamenti dei riscatti.

Il report conferma la predilezione degli hacker verso l’utilizzo di criptovalute, soprattutto Bitcoin, con un incremento nell’utilizzo di Monero, criptovaluta anonima.

In media, i riscatti si aggirano sui 100mila dollari, ma le cifre variano significativamente, con una maggioranza che si attesta comunque sotto i 250mila.

Il canale di comunicazione preferenziale per contattare le vittime rimane The Onion Router (TOR), software che permette l’anonimato sul web, oppure email criptate o meno.

I trucchi degli hacker per riciclare gli introiti e aggirare la legge

Gli analisti di FinCEN hanno poi individuato 6 modalità relative alle 10 varianti analizzate con cui gli hacker riciclano gli introiti derivanti da attacchi ransomware.

Nello specifico:

  • Pagamenti in criptovalute anonime (AEC)
  • Evitare di usare più volte gli stessi indirizzi Wallet.
  • Utilizzo di exchange centralizzati di criptovalute convertibili (CVC) per i prelievi
  • Ricorso alla pratica del “chain hopping” per nascondere le proprie tracce sulle blockchain, convertendo CVC in diverse CVC prima di trasferire i fondi su un’altra
  • Aumento nell’uso di servizi di mixing, quindi siti o software creati per nascondere l’identità del proprietario delle CVC.
  • Preferenza di exchange decentralizzati o altre applicazioni legate alla finanza decentralizzata per convertire i proventi illeciti

Consigli e indicazioni su come proteggersi dai ransomware

Gli analisti raccomandano innanzitutto di utilizzare indicatori di compromissione (IOC) e sistemi di allarme che possano fermare o almeno individuare e segnalare eventuali attività malevole. Si invita inoltre a contattare tempestivamente le forze dell’ordine.

È comunque importante considerare che la crescita delle minacce legate ai ransomware è dovuta anche all’aumento delle segnalazioni alle autorità, quindi ad una maggiore attenzione, capacità e volontà da parte delle vittime di rendere noti questo tipo di cyber attacchi.

I ransomware restano attualmente una delle minacce più pericolose per i settori pubblici e privati, ed è sempre bene che le aziende adottino programmi di cyber security sia per evitare di incorrere in sanzioni, sia per ridurre drasticamente la possibilità di essere vittima dei cyber attacchi.

A cura della Redazione

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ransomware-e-finanza-i-principali-trend-secondo-lintelligence-finanziaria/


La CyberSecurity per i droni – Tipologie di attacchi

Introduzione

Con il progresso della tecnologia, i campi di applicazione dei droni non sono più limitati ai laboratori o alla difesa; pertanto, possono essere utilizzati anche da hobbisti. Si moltiplicano le applicazioni dei droni in svariati ambiti della nostra vita economica e sociale e parallelamente crescono le possibilità che questi siano oggetti di attacchi cyber.

CyberSecurity e droni

Durante la cerimonia di apertura delle Olimpiadi di Tokyo, 1824 droni hanno disegnato coreografie nel cielo che erano tanto sorprendenti quanto impressionanti se si pensa al livello di raffinatezza e tecnologia che uno spettacolo del genere abbia potuto supportare.

Non si tratta solo di creare coreografie spettacolari, ma anche di utilizzare veicoli aerei gestiti remotamente in ambito militare, utili per portare connettività in posti difficilmente raggiungibili, registrare riprese per realizzare servizi fotografici e a supporto di attività turistiche, di arte e cultura, eventi. Anche l’industria fa abbondante utilizzo di droni. Si va da attività di monitoraggio in ambienti pericolosi a monitoraggio continuo di aree di grande estensione. Il monitoraggio è un servizio di cui anche il territorio, le città intelligenti ne beneficiano. Ovviamente gli utilizzi sono molteplici e lo saranno sempre di più in funzione di una tecnologia che sta facendo enormi progressi e costi che progressivamente si abbassano rendendo accessibile questi dispositivi sempre ad un maggior numero di persone.

Il successo dei droni è legato all’accelerazione digitale. Molti servizi costruiti sui droni possono essere realizzati grazie al fatto che possono raccogliere informazioni e trasmetterle, possono essere connessi a Internet e questo introduce un tema da non sottovalutare per IoT, e ancor meno per IoD (Internet of Drones): la possibilità che i dispositivi possano subire un attacco di tipo cyber. Sui droni, infatti, è presente un software che permette di essere controllati, di svolgere attività, di ricevere comandi da una console che a sua volta è collegata a un sistema complesso, che spesso coinvolge il cloud.

Quindi, anche se si parla di IoD, si tratta di un insieme di elementi IT (non classici) collegati per poter adempiere ad un servizio specifico.

STRIDE Framework

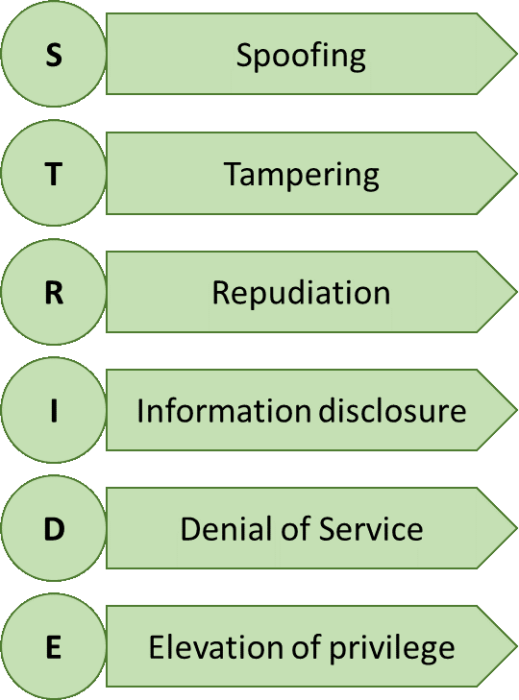
Il primo passo per proteggersi dagli attacchi alla sicurezza informatica è comprendere il possibile spazio delle minacce. Coloro che vogliono proteggersi dagli attacchi di cybersecurity per stare al passo con potenziali avversari devono essere creativi, proattivi e consapevoli delle capacità degli avversari. L’enumerazione dei possibili tipi di attacchi futuri richiede un’attenta revisione dello spazio delle minacce consentito dalle tecnologie esistenti ed emergenti. Potrebbe essere utile che tale revisione sia radicata in un quadro consolidato di possibili tipi di minacce e potrebbe anche essere utile compilare questo quadro utilizzando metodi di brainstorming formalizzati per aiutare a scoprire possibili minacce. Uno di questi framework è la tassonomia STRIDE di Adam Shostack per la modellazione delle minacce, che delinea sei aree in cui possono essere classificate le minacce alla sicurezza. Sebbene la tassonomia STRIDE sia stata originariamente sviluppata per l’uso nello sviluppo di software, le sei aree che copre sono utili anche per enumerare le minacce relative alla cybersecurity e agli UAS.

Figure 1 – La tassonomia delle minacce STRIDE

All’interno del framework STRIDE, la S rappresenta lo Spoofing” e definisce l’insieme di minacce che violano i protocolli di autenticazione, consentendo a un utente malintenzionato di fingere di essere qualcuno che non è. Nel caso della cybersecurity legata agli UAS, in cui i droni sono un obiettivo, lo spoofing potrebbe includere il fingere di essere la macchina ricevente autorizzata per i dati dei droni.

La T nel framework STRIDE rappresenta “Tampering“, che implica la violazione dell’integrità di un sistema sotto attacco apportando modifiche ad esso. Nel caso della sicurezza informatica relativa agli UAS, in cui i droni vengono utilizzati come arma cibernetica, potrebbero verificarsi manomissioni se un drone viene utilizzato per fornire malware a un computer bersaglio utilizzando la vicinanza per accedere a una rete wireless non protetta. Tale malware potrebbe potenzialmente infettare macchinari di alto valore, come apparecchiature in fabbriche o centrali elettriche, o attaccare obiettivi ad alto impatto come sistemi idrici e reti elettriche.

R rappresenta “Repudiation“, in cui gli aggressori ripudiano dall’assumersi la responsabilità di un’azione. Questa minaccia è la meno rilevante per il dominio della sicurezza informatica relativo agli UAS. Un possibile esempio è quando un operatore di droni potrebbe affermare di non aver intenzionalmente bloccato un dispositivo accusando la perdita di controllo di un difetto di progettazione nella rete di comunicazione.

Nel caso della cybersecurity relativa agli UAS, la manomissione potrebbe verificarsi se un drone viene utilizzato per fornire malware a un computer bersaglio utilizzando la vicinanza per accedere a una rete wireless non protetta. Tale malware potrebbe potenzialmente infettare macchinari di alto valore, come apparecchiature di fabbriche o centrali elettriche, o attaccare obiettivi ad alto impatto come i sistemi idrici e le reti elettriche.

I si riferisce alla “Information disclosure”, ovvero alle violazioni del principio di riservatezza. Negli attacchi di propagazione delle informazioni, un agente rilascia informazioni a qualcuno senza le credenziali appropriate per riceverle. Le minacce alla divulgazione di informazioni potrebbero includere l’infiltrazione in un sistema di dati del sensore UAS per accedere a video, audio o altri dati. Un agente può anche divulgare informazioni e in seguito utilizzare il ripudio per declinare la responsabilità per questa azione

La D sta per “Denial of Service” e si riferisce all’opposizione della disponibilità di una risorsa necessaria per il corretto funzionamento del sistema attaccato. Un esempio di negazione del servizio è quando gli UAS sono presi di mira e potrebbero causare l’infezione del software di controllo dei droni per rendere i dispositivi non rispondenti agli input dell’utente.

Infine, la E nel quadro STRIDE sta per “Elevation of privilege” e comporta la violazione del principio di autorizzazione a compiere un’azione che non è consentita a compiere. Un esempio di autorizzazione privilegiata è quando gli UAS sono obiettivi e potrebbero comportare il dirottamento di un drone che si spaccia per controllore legittimo. Quando gli UAS vengono utilizzati come arma cibernetica, potrebbero essere utilizzati per fornire dati, codice o altri segnali per debilitare o alterare il comportamento del sistema sotto attacco.

CyberSecurity Kill Chain

All’interno di un dato scenario di attacco, c’è una grande diversità nel modo in cui un drone può essere considerato vulnerabile. Supportando il framework STRIDE, la kill chain della cybersecurity consente a un utente di identificare quando e come un particolare sistema è vulnerabile all’interno di uno scenario. Ciò potrebbe consentire la progettazione di una difesa informata contro una minaccia specifica. Ad esempio, un tale approccio potrebbe identificare un anello debole in una lunga catena di comunicazioni, come l’impossibilità di proteggere un segnale wireless a casa di un dipendente, piuttosto che concentrare gli sforzi sull’ulteriore rafforzamento della crittografia presso il data warehouse centrale.

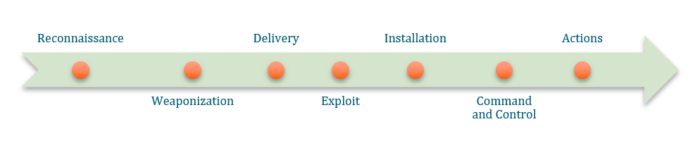
La kill chain cybersecurity identifica sette fasi (reconnaissance, weaponization, delivery, exploitation, installation, command and control, e actions) di un cyber attacco. La catena rappresenta una sequenza ordinata in cui ogni fase identifica un’azione intrapresa da un attaccante. Ogni fase presenta anche un’opportunità per il rilevamento degli attacchi. Poiché le fasi sono sequenziali, la diagnosi precoce è associata a conseguenze meno dirompenti e soluzioni meno costose.

Mentre l’azione difensiva dipende da dove si trova un’azione all’interno della catena e specificare dove si trova il drone sulla catena di uccisione della sicurezza informatica facilita l’adozione di misure di sicurezza efficaci.

Figure 2 – CyberSecurity Kill Chain

Cyber attacchi su un UAV

Allargando il contesto allo scenario reale in cui i droni sono inseriti in un ecosistema che include app, mobile, web server, internet, allora le modalità di attacco possono moltiplicarsi in quanto tipiche ed estremamente utilizzate in altri ambiti. Se compromettere infatti un drone richiede competenze specifiche, attaccare un application server è nel DNA degli attaccanti.

Esistono diversi modi per condurre un attacco informatico su un UAV:

  • Password theft: utilizzando mezzi diversi, tra cui dizionario, forza bruta e assalti matematici. Gli attacchi al dizionario in diverse varianti utilizzano frasi, numeri e simboli specifici per violare la password. Gli attacchi che utilizzano la forza bruta possono essere rilevati in password brevi tentando tutte le possibili configurazioni. Ad esempio, il software Aircrack-ng, i metodi statistici utilizzano dati statistici per decidere se una parola viene indovinata correttamente da un byte. Si otterranno i dettagli necessari da “leaks” nei vettori di configurazione dell’entità di destinazione e si cercheranno le chiavi fondamentali per utilizzare interamente la forza bruta;
  • Man in The Middle (MITM): è un processo mediante il quale un utente malintenzionato monitora il contatto tra due parti e ha accesso a dati sensibili (che possono modificare) senza il consenso degli utenti nell’attacco. Si verificano molti tipi di attacchi MITM, come Eavesdropping e la manipolazione degli URL;
  • Denial of Service (DoS): consente all’intruso di comandare e mantenere l’accesso a un dispositivo o a una rete. L’intrusione richiede risorse applicative inondando il sistema di richieste o pacchetti, come potenza di calcolo o memoria. Un attacco a un UAV può essere un’applicazione di deautenticazione, che inibirà la comunicazione con l’UAV a una velocità estrema;
  • GPS Jamming: l’attaccante produce un segnale GPS-jamming che interferisce con i segnali GPS, causando un malfunzionamento nell’UAV del ricevitore GPS;
  • GPS Spoofing: è un attacco simile al GPS Jamming, che è più sofisticato poiché l’attaccante invia un messaggio falso che può modificare la direzione dell’UAV piuttosto che produrre segnali distraenti;
  • Drone Botmaster: metodo per utilizzare prima un drone per costruire e poi controllare una botnet nascosta rivolta a Internet. Un drone migliorato effettua tre voli su un’area urbana. Durante il primo volo, il drone rileva e raccoglie informazioni sulle reti WiFi all’interno dell’area di attacco. Il secondo volo viene utilizzato per accedere alle reti vulnerabili. Durante il viaggio finale, il drone si unisce alle reti compromesse e arruola gli host locali in una botnet.

Simulazione di un attacco di deauthentication

L’attacco ad un drone sfrutta la vulnerabilità del sistema di comunicazione tra il drone e la stazione di controllo.

Molti dei droni commercializzati e di libero utilizzo (peso sotto i 250gr), si connettono alla stazione di controllo tramite connessione WiFi, presentandosi come Access Point ed accettando connessioni in ingresso.

Questa connessione è una connessione aperta, quindi senza protezione WPA/WPA2.

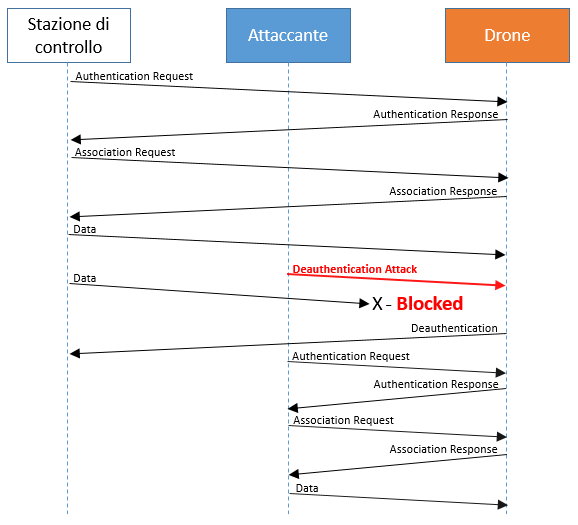
Il sistema di comunicazione si presta ad un attacco di deauthentication, che consente ad un attaccante di disconnettere la stazione di controllo dal drone e connettersi direttamente al drone prendendone il controllo.

La simulazione dell’attacco condotta sfrutta questa vulnerabilità ed agendo con un semplice apparato Raspberry Pi si è in grado di bombardare la comunicazione WiFi tra stazione base e drone (fase di deauthentication); inoltre, agganciando il drone mediante una seconda scheda WiFi e sostituendosi alla stazione di controllo, si è in grado di prendere il controllo del drone con lo scopo di catturare anche le immagini che il drone acquisisce mediante la sua telecamera.

Figura 3 – WI-Fi deauthentication attack

Conclusioni

L’enorme aumento dell’uso di droni e UAV ha portato a una nuova era dell’aviazione di veicoli aerei autonomi sia in ambito civile che militare, offrendo numerosi vantaggi tra cui economici, commerciali, industriali, principalmente grazie alla loro autonomia, flessibilità e facilità di utilizzare la natura, a basso costo e consumo energetico. Tuttavia, il loro utilizzo ha portato all’emergere di molti problemi di sicurezza e privacy, che si sono manifestati attraverso vari attacchi informatici, minacce e sfide.

Ad esempio, senza un efficiente IDS (Intrusion Detection System), i droni possono essere seriamente compromessi ed essere utilizzati per condurre attacchi informatici o fisici contro individui e proprietà.

Particolare attenzione va poi data ai dati raccolti dai droni che richiedono consapevolezza e conoscenza delle regole e del senso civico da parte di chi guida il drone, ma richiedono anche estrema attenzione da parte di chi conserva e gestisce questi dati.

La buona notizia è che mentre il perimetro di un attacco a questi dispositivi è estremamente vario, è possibile fare affidamento su diverse pratiche di sicurezza già sviluppate per IoT e IT, inclusi i framework descritti e garantendo che almeno:

  • il firmware e il software dei droni siano continuamente aggiornati, ci siano sistemi di autenticazione attivi e robusti. Idealmente, tutti i controlli necessari per i dispositivi IoT dovrebbero essere necessari anche sull’IT;
  • i droni vivano in un ecosistema sicuro e quindi applicano i controlli di sicurezza e che su di essi si attivi l’opportuna governance.

In conclusione, il pericolo è sempre sottovalutato, ed è questa la causa che determina il successo di alcuni cyber-attacchi: in questo caso quelli contro i droni. La CyberSecurity è sempre un parametro imprescindibile da tenere in considerazione: a partire dall’azienda produttrice fino al soggetto finale, dove la security by design ancora una volta si rivela il giusto enabler.

Articolo a cura di Domenico Raguseo, Rosita Galiandro, Giuseppe Marullo e Antonio De Chirico

Informazioni sull’Autore

Domenico Raguseo è Responsabile della Unit di CyberSecurity di Exprivia. Precedentemente ha ricoperto il ruolo di CTO della divisione IBM Security nel Sud Europa. Ha una decennale esperienza manageriale e nel campo della cybersecurity in diverse aree. Domenico collabora con diverse università nell’insegnamento su tematiche relative alla cybersecurity sia come Professore a contratto che invitato come lettore per seminari. Domenico è stato IBM Master inventor grazie a una moltitudine di brevetti e pubblicazioni in diverse discipline (Business Processes, GLI AUTORI © Clusit 2020 249 ROI, Messages and Collaborations, Networking). Infine, è apprezzato speaker, autore e blogger in eventi nazionali ed internazionali. In particolare, da diversi anni collabora con il Clusit come autore

Informazioni sull’Autore

Rosita Galiandro ha conseguito la laurea Magistrale in Sicurezza Informatica presso l’Università di Bari.
Attualmente ricopre il ruolo di Responsabile Osservatorio CyberSecurity presso Exprivia.
Contribuisce alle attività di prevendita, ha partecipato a progetti di risk assessment e GDPR compliance e collabora in piani di insegnamento con diverse università nell’ambito CyberSecurity e nel progetto CyberChallenge.IT. Fa parte della community Women For Security.

Informazioni sull’Autore

Giuseppe Marullo è responsabile dei Servizi di OT security di Exprivia. Precedentemente è stato presales in Blue Coat e Symantec per clienti enterprise in ambito network and cloud security. Ha fatto parte dello WW SWAT team e di X-Force in IBM, come SME di network security e computer forensics.

Informazioni sull’Autore

Responsabile del Security Operation Center di Exprivia. Ha lavorato nella Polizia di stato per oltre 27 anni, di cui 15 operando all’interno della Polizia Postale e delle Comunicazioni nelle attività investigative e di contrasto al Cybercrime ed alla pedopornografia online. Ha operato come CTU per diverse Procure e negli ultimi anni coordinava il team di specialisti del Centro Unico di Backup della Polizia di Stato.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-cybersecurity-per-i-droni-tipologie-di-attacchi/


SAST: uno strumento necessario per la strada verso il “secure by design”

L’incremento delle minacce provenienti da attacchi informatici, rende necessaria l’adozione di pratiche e metodologie ben definite, volte a ridurre i rischi di sicurezza provenienti dallo sviluppo di applicazioni non sicure.

Più nello specifico, il modello “legacy”, in cui i controlli di sicurezza dell’applicativo in sviluppo venivano affidati ad un team specifico di esperti di sicurezza e solo quando l’applicazione era praticamente prossima alle fasi di rilascio, ad oggi risulta essere un modello obsoleto e non sufficientemente adatto a prevenire e mitigare eventuali vulnerabilità del codice.

Al contrario, si è potuto osservare che per abbattere drasticamente i rischi di sicurezza durante lo sviluppo applicativo e pubblicare applicazioni più robuste in termini di sicurezza, è necessario includere i processi di security all’interno di tutto il ciclo di vita del software (SDLC) a partire dalle prime fasi di design architetturale, attraverso tutte le fasi di implementazione e test, fino alle fasi di rilascio e manutenzione del software. Solitamente si fa riferimento a questo processo con il termine DevSecOps: la security si integra ai processi di DevOps in maniera automatizzata e senza avere un impatto negativo in termini di velocità di rilascio software e adattamento ai cambiamenti (pilastri portanti del DevOps).

Implementare correttamente la metodologia DevSecOps richiede diversi step (tra cui un vero e proprio cambiamento culturale relativo alla formazione di quello che potremmo definire “security mindset” di tutte le figure coinvolte nello sviluppo software), ma in questo articolo analizzeremo più nel dettaglio una particolare categoria di tool che possono essere facilmente integrati nelle pipeline di sviluppo software al fine di ricercare vulnerabilità nel codice prima che la nostra applicazione venga rilasciata in produzione.

Identificare e correggere un problema di sicurezza nel nostro codice sorgente durante le fasi di sviluppo porta notevoli vantaggi in termini di facilità, velocità della correzione del problema e riduzione dei costi.

A cosa servono e come funzionano i tool SAST

SAST sta per “Static Application Security Testing”. Scannerizzando il codice sorgente di un’applicazione (“white box” testing), questi strumenti vanno alla ricerca di vulnerabilità all’interno del nostro codice senza bisogno di eseguire l’applicazione stessa (da cui il termine “static”).

Ci sono varie categorie di bug che possono essere identificate da questi tool, tra cui:

  • utilizzo di funzioni pericolose
  • mancata validazione dell’input
  • mancato controllo dell’errore
  • utilizzo di algoritmi di cifratura troppo deboli
  • utilizzo di secrets/chiavi private/password all’interno del codice sorgente

Una funzionalità che rende molto potenti i tool SAST è chiamata Taint Analysis: attraverso questa tecnica è possibile tracciare i dati che sono stati modificati (“tainted”) dall’utente e che potenzialmente possono finire in qualche funzione vulnerabile. Se tali input (in questo contesto chiamati “source”) non vengono propriamente validati prima di finire nella funzione finale (chiamata “sink”) abbiamo chiaramente trovato una vulnerabilità. Attraverso questo tipo di analisi è possibile identificare velocemente un elevato numero di vulnerabilità spesso riscontrate in applicazioni Web, tra le quali SQL injection, Cross-site scripting, Server Side Template Injection, Remote Code Execution.

Inoltre, molti di questi tool mettono a disposizione dell’utente la possibilità di scrivere le proprie regole di matching, che possono quindi essere specifiche per l’applicazione che stiamo sviluppando. Ad esempio, supponiamo che stiamo sviluppando un’applicazione Web che espone delle API: usando un valido tool SAST, potremmo facilmente implementare una regola custom che verifichi che uno specifico sottoinsieme di endpoint esposti dalla nostra API, implementano correttamente il controllo dell’accesso, ovvero che l’utente che sta richiedendo il servizio sia effettivamente autorizzato a farlo. Questa categoria di vulnerabilità è chiamata “Broken Access Control” ed è alla prima posizione dell’OWASP Top 10 del 2021.

In che modo questi tool operano sul codice sorgente alla ricerca di vulnerabilità?

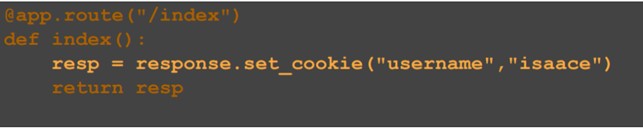
Una semplice ed immediata soluzione potrebbe essere quella di usare delle espressioni regolari. Consideriamo ad esempio il seguente estratto di codice Python (usando il framework Flask):

Nella chiamata response.set_cookie() non sono esplicitamente settati i flag httponly, secure, samesite (che di default sono impostati a false). Il nostro obiettivo è quello di verificare che tali flag siano impostati nella maniera corretta, in modo da mitigare possibili vulnerabilità (ad esempio XSS diventa molto meno efficace se i cookie sono configurati con il flag httponly).

Potremmo semplicemente scrivere la seguente espressione regolare per verificare che ogni volta che utilizziamo la funzione set_cookie() nel nostro codice, abbiamo correttamente settato i flag di sicurezza del cookie:

grep -RE 'response\.set_cookie\('  path/to/code

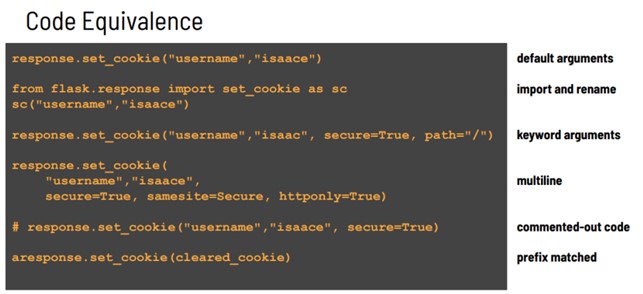
Purtroppo, questa soluzione non è affatto completa ed affidabile. Infatti consideriamo i seguenti esempi:

Fondamentalmente dovremmo riscrivere la nostra espressione regolare per considerare una molteplicità di casi possibili:

  • l’import della libreria è stato rinominato
  • gli argomenti della funzione sono stati divisi su più righe
  • il codice commentato non dovrebbe essere considerato
  • etc.

È quindi evidente che l’approccio “regex” è molto limitato e non riesce a coprire in maniera significativa il nostro obiettivo.

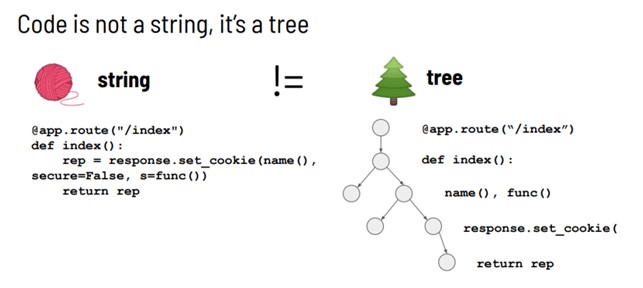
Quello che invece viene fatto dai tool SAST più avanzati, è rappresentare il codice sorgente come un albero, più nello specifico un Abstract Syntax Tree, lo stesso tipo di struttura dati che viene utilizzata dai compilatori per rappresentare la struttura del codice di un programma.

Utilizzando questa rappresentazione formale del codice sorgente sotto forma di albero, è possibile considerare il codice da un punto di vista semantico, rimuovendo le ambiguità e ottenendo un matching molto più preciso dei pattern che stiamo ricercando all’interno del codice.

Semgrep

Semgrep è un tool SAST open source molto potente, versatile e facilmente estendibile. Supporta più di 20 linguaggi di programmazione e oltre a fornire il vero e proprio motore di parsing e analisi del codice sorgente, mette a disposizione una libreria di più di 1500 regole predefinite che coprono un gran numero di vulnerabilità per molti linguaggi (Java, Go, JavaScript, Python, Ruby, etc..).

A differenza di altri strumenti simili, Semgrep dà la possibilità di scrivere le proprie regole di matching utilizzando il semplice formato YAML. Non è quindi necessario conoscere uno specifico linguaggio di programmazione per estenderne le funzionalità.

L’utilizzo principale di questi tool è sicuramente l’integrazione nelle pipeline di CI/CD: possiamo eseguire Semgrep ad ogni “push” sul nostro repository in modo da bloccare l’introduzione di possibili bug fin dal principio. A seconda dell’exit code ritornato da Semgrep, possiamo immediatamente notificare lo sviluppatore di un possibile bug introdotto nella sua ultima modifica ed evitare di compilare un’applicazione vulnerabile.

È anche possibile integrare Semgrep sul proprio IDE preferito e avviare lo scan quando viene eseguito un commit locale, in modo da avere un riscontro immediato della qualità e sicurezza del codice su cui stiamo lavorando.

Per esplorare le potenzialità di Semgrep, consideriamo il seguente codice di esempio (Python):

1 import subprocess as sp
2 sp.call("ls -a .")  # OK perchè argomento è una costante
3 dir = "/tmp"
4 sp.call("ls -a " + dir) # OK perchè argomento è una costante
5 sp.call(dir, shell=True) # OK perchè argomento è una costante
6 sp.call(nonstring) # Possibile vulnerabilità
7 sp.call(nonstring, shell=True) # Possibile vulnerabilità

Vogliamo che Semgrep ci notifichi un errore nel caso in cui l’argomento passato alla funzione call() del modulo subprocess non sia una costante. Questo perchè potrebbe accadere che l’argomento della funzione possa essere controllato dall’utente, che ovviamente causerebbe una grave falla di sicurezza (un attaccante potrebbe eseguire comandi arbitrari).

Usando Semgrep possiamo scrivere la seguente regola per identificare questo errore:

rules:
  - id: subprocess-call
    patterns:
    - pattern: subprocess.call(...)
    - pattern-not: subprocess.call("...", ...)

Analizziamo più nel dettaglio la regola:

  • id non è altro che l’identificativo della regola
  • le condizioni definite sotto la parola chiave patterns sono in una relazione di AND logico
  • la parola chiave pattern sta ad indicare che vogliamo matchare tutte le chiamate alla funzione call. Da notare che abbiamo usato l’operatore … come argomento della funzione. Questo operatore (chiamato ellipsis) sta ad indicare che vogliamo ottenere tutte le chiamate della funzione, a prescindere da quali siano i suoi argomenti
  • la parola chiave pattern-not indica che vogliamo escludere le chiamate alla funzione call che hanno come primo argomento una qualsiasi costante (notare che abbiamo inserito l’operatore di ellipsis dentro doppi apici). Poichè la chiamata alla funzione può prevedere ulteriori argomenti, abbiamo anche specificato un altro operatore di ellipsis come secondo argomento
  • notare che le righe 4 e 5 non vengono matchate dalla regola, in quanto Semgrep è in grado di “propagare” l’informazione che la variabile dir è in realtà una costante (definita nella riga 3)
  • notare che nella riga 1, l’import del modulo subprocess è stato rinominato in sp senza tuttavia avere nessun effetto nel modo in cui Semgrep esegue la ricerca (rinominare un elemento non ha nessun effetto “semantico” sul nostro codice)

Con questa semplice regola verremo notificati ogni volta che all’interno del nostro codice usiamo una funzione potenzialmente pericolosa (in questo caso la creazione di un nuovo processo) il cui argomento non è una costante predefinita.

Ovviamente, questo è un esempio molto semplice ma dimostra le grandi potenzialità dello strumento. Esistono molti altri operatori logici e filtri di pattern-matching a disposizione dell’utente che sono consultabili nella documentazione ufficiale del progetto.

Conclusioni

Includere strumenti SAST all’interno delle pipeline di CI/CD è un tassello fondamentale verso il raggiungimento dell’obiettivo finale: rendere la security una parte attiva del processo di sviluppo software, con il fine ultimo di sviluppare applicazioni più sicure e robuste.

Adottare questi strumenti può sicuramente dare benefici immediati, ma per produrre applicazioni più sicure è necessario seguire una metodologia ben definita e che include:

  • Threat modeling e analisi dei rischi di sicurezza dell’applicazione
  • Implementazione di strumenti SCA (Software Composition Analysis) per la verifica di vulnerabilità presenti su componenti open source di terze parti
  • Analisti dinamica dell’applicazione (DAST) alla ricerca di vulnerabilità verificabili a runtime
  • Fornire security workshop/training agli sviluppatori allo scopo di formare un proprio “security mindset” ed accrescere le conoscenze in ambito security

Sorint.Lab, società specializzata in consulenza IT, ha recentemente definito un gruppo di lavoro incentrato proprio verso questa direzione, il cui nome è (non a caso) SSL (Shift Security Left). Lo scopo del team è quello di supportare clienti che hanno necessità di sviluppare un applicativo che sia conforme ai moderni standard di sicurezza seguendo un approccio “secure by design”, in cui i processi di sicurezza sono integrati fin dal principio e attraversano l’intero ciclo di sviluppo del software.

Sorint.lab ha una specifica competenza nella security: è quindi spesso protagonista in contesti internazionali dove si parla di security. L’azienda è stata recentemente protagonista alla conferenza Insomnihack di Ginevra (una delle più famose a livello europeo sul tema security) dove ha presentato un software realizzato da Cesare Pizzi (Security Analyst di Sorint.lab), REW-sploit, per facilitare e semplificare l’analisi di codice malevolo. REW-sploit, attraverso la CPU emulation, può aitutare un analista e/o reverse engineer ad indirizzare più velocemente le investigation di codice malevolo basato su frameworks come Metasploit e CobaltStrike (ma non solo): grazie allo strumento è possibile estrarre informazioni vitali dal codice criptato e/o offuscato, permettendo di focalizzare più velocemente l’indagine e comprendere il comportamento generale dell’attacco.

Riferimenti:

A cura di Luca Pierluigi Famà, Security Consultant di Sorint.Lab

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sast-uno-strumento-necessario-per-la-strada-verso-il-secure-by-design/


Finanza decentralizzata e sfide di sicurezza: gli Smart Contracts

Nell’articolo precedente ho spiegato che cos’è la finanza decentralizzata (DeFi) e le sue applicazioni fornendo una panoramica sullo Smart Contract e il protocollo Compound, di seguito mi concentrerò sui problemi legati alla sicurezza.

Sicurezza degli Smart Contracts

Il primo aspetto relativo alla sicurezza riguarda lo smart contract in sé. Lo smart contract è a tutti gli effetti una applicazione, un programma; è un codice che rappresenta le regole del gioco, come i vari attori possono interagire in maniera legittima con lo smart contract, ed è codificato all’interno di un programma che, a basso livello, è compatibile con la Ethereum Virtual Machine, specifica funzionale di una macchina astratta che esegue il programma dello smart contract.

Su un piano più alto gli smart contract sono implementati in linguaggi di alto livello, il più famoso dei quali è Solidity.

A tutti gli effetti uno smart contract è però un programma ed è, quindi, soggetto ad errori.

I programmi possono essere scritti male per tanti motivi, perché sono progettati o implementati male; tali errori o bug – e questo non riguarda ovviamente le sole applicazioni di finanza decentralizzata, ma i programmi in generale – possono trasformarsi in vulnerabilità, in scenari che utenti maliziosi dello smart contract possono sfruttare per ottenere dei vantaggi, come ad esempio effettuare attacchi contro gli smart contract facendo leva sugli errori di progettazione o programmazione.

Gli smart contract non sono esenti da questo tipo di problematiche: ci sono stati casi famosissimi di smart contract mal scritti che hanno causato gravi problemi agli autori e agli utenti. Ne deriva che essere certi che uno smart contract sia stato correttamente implementato rappresenta un aspetto molto importante.

Per realizzare uno smart contract corretto rispetto ad una specifica, esistono due strategie. Una riguarda l’utilizzo di blocchi base, che realizzano pezzi di funzionalità di uno smart contract, per poi mettere insieme, attraverso dei meccanismi ben definiti, questi pezzi fondamentali per creare un oggetto più complesso e dalle funzionalità più ricche; che però, essendo stato costruito su oggetti considerati affidabili e sicuri, vanno a realizzare un prodotto a sua volta considerato affidabile e sicuro.

Questo approccio offre un’assurance molto forte circa la sicurezza di ciò che si è realizzato, affinché esegua in maniera corretta la specifica cui era destinato: quindi, sembrerebbe essere l’approccio perfetto.

Il problema e i limiti di questo approccio risiedono nel fatto che non tutto è costruibile attraverso la composizione di elementi base semplici e sicuri.

Esistono casi in cui bisogna scrivere uno smart contract che non è, purtroppo, realizzabile utilizzando semplicemente questi blocchi base; in questo scenario sarò costretto a inserire del codice che non proviene da questi blocchi fondamentali e che quindi inquina e “degrada” la mia assurance sull’oggetto finale.

Il secondo approccio, che vediamo negli altri due punti della slide, riguarda l’ex-post assessment. Quindi in questo caso si scrive lo smart contract, in maniera coscienziosa, in una specie di draft e questa “bozza” dello smart contract viene analizzata da alcuni tool – i due più importanti sono ConsenSys/Mythril e Certora – i quali svolgono un assessment molto complesso basato su concetti che riguardano la prova matematica di correttezza di una specifica rispetto allo smart contract.

Vediamo citato anche il framework utilizzato da questi due tool, che effettuano un assessment rispetto a una libreria di vulnerabilità note.

La storia degli smart contract è infatti abbastanza ricca: essi esistono ormai da svariati anni e ciò ha permesso di accumulare una serie di scenari di sicurezza che rappresentano altrettante vulnerabilità, poi inserite all’interno di una libreria.

L’assessment serve quindi a capire se lo smart contract che è stato scritto contenga delle vulnerabilità note. Ciò fa già intuire il limite di questo tipo di tool, perché essi consentono, appunto, di fornire un’assurance solo rispetto a vulnerabilità già note fino a quel momento.

Non è detto però che lo smart contract realizzato sia totalmente esente da vulnerabilità e realizzi la specifica in maniera corretta, perché quella specifica potrebbe non essere stata ancora inserita all’interno della libreria dalla quale attingono questi tool.

Quindi in teoria potremmo definire la specifica del nostro smart contract sulla base delle estensioni di questi tool, ma si tratta di un’operazione molto complessa e della quale bisogna valutare il costo, decisamente diverso rispetto a un controllo di tipo standard.

Chiaramente questi due approcci sono ortogonali tra loro: non è detto che l’uno o l’altro debba essere utilizzato in maniera mutuamente esclusiva, potendo invece essere utilizzati insieme. Se è possibile, andrebbe utilizzato al massimo OpenZeppelin, inquinandolo magari con del codice scritto appositamente – del codice custom – e poi passare questo draft di smart contract scritto attraverso questi tools di assessment. Avremo così una doppia assurance – ciascuno ne fornisce una diversa – e, componendo queste due attività insieme, ne risulta un buon sistema per capire se uno smart contract sia sicuro oppure no.

Esistono però anche altri problemi di sicurezza.

Nella slide vedete un esempio di smart contract che realizza un token di tipo ERC-20: se utilizzo OpenZeppelin questo smart contract si realizza in maniera molto semplice generando un token ERC-20 full-fledged.

Quindi, compilando lo smart contract e mettendolo sulla blockchain di Ethereum realizzo effettivamente un nuovo token (come ce ne sono a centinaia già presenti sul mercato) e posso addirittura manipolarli: quindi venderli, comprarli, crearli, perché questo è un token mintable.

Posso creare token attraverso wallet assolutamente standard; Metamask, che implementa appunto l’interfaccia ERC-20, sarà in grado di riconoscere questo token e di effettuare operazioni sui token attraverso gli utenti.

In poche righe di codice, appena sette, ho realizzato un token ERC-20.

La cosa importante è che questo token è realizzato grazie alle componenti fondamentali che OpenZeppelin mette a disposizione, con una ragionevole assurance che il codice lì scritto – e quindi il token che viene implementato – realizzi in maniera corretta una specifica minimale ERC-20.

Passiamo ad altri aspetti di sicurezza. Abbiamo già detto che gli smart contract realizzano degli scenari finanziari, anche molto complessi, in maniera decentralizzata. Capita, però, molto spesso che per realizzare questi scenari si abbia bisogno di apprendere elementi che non si trovano all’interno della blockchain.

La blockchain garantisce l’integrità dello smart contract e in generale dell’intera rete, quindi garantisce che le regole dello smart contract vengano seguite: essa però non può in alcun modo garantire che le informazioni provenienti dall’esterno siano effettivamente affidabili.

Ogni qualvolta si dipende da elementi che provengono dal mondo esterno alla blockchain si crea una dipendenza di trust tra lo smart contract e un attore esterno, perché si tratta di iniettare all’interno della blockchain le informazioni che provengono dal mondo esterno.

Con un’applicazione di finanza decentralizzata che consente di acquistare un pacchetto assicurativo contro, ad esempio, il rialzo del prezzo del petrolio (un tipico contratto future), questo contratto può essere realizzato sulla blockchain in maniera decentralizzata, senza intermediari ma soltanto con l’aiuto di qualcuno – il cosiddetto oracolo – che, dall’esterno, inietta nello smart contract il prezzo del petrolio.

Chiaramente, per essere sicuri che stia iniettando all’interno della blockchain dei dati accurati e affidabili, l’oracolo dovrà essere affidabile a sua volta; l’argomento degli oracoli è molto discusso e da parecchi anni esistono misure volte a mitigare il rischio che l’oracolo si comporti in maniera disonesta, perché l’oracolo può essere esso stesso un membro della comunità finanziaria e quindi avere un bias affinché un contratto si comporti in una certa maniera. Quindi, pur non esistendo garanzie assolute, sono stati ideati dei meccanismi che riducono la dipendenza rispetto a un singolo oracolo.

Il modo più semplice è utilizzare oracoli multipli e avere una specie di regola del consenso, in cui si assume che in un dato istante di tempo non tutti gli oracoli siano disonesti e che, comunque, una certa parte degli oracoli rimanga onesta: se tutti gli oracoli che forniscono il prezzo del petrolio, o perlomeno una certa parte rispetto a una soglia definita nello smart contract, mi dicono che il prezzo del petrolio è x e sono in accordo tra loro – quindi raggiungono un consenso – allora posso fidarmi sul fatto che il prezzo del petrolio sia effettivamente quello.

Chiaramente si assume che in un certo istante di tempo solo una percentuale di oracoli sia disonesta (ad esempio, il 33%) e che quindi un terzo degli oracoli si comporti in maniera disonesta; ma è semplicemente un’assunzione, nessuno garantisce che sia poi effettivamente verificata.

L’altro approccio, non sempre possibile, è prevede di avere un’informazione che lo smart contract possa verificare.

Se per ipotesi affermiamo che nello smart contract, nella dApp che realizza un’applicazione di finanza decentralizzata, si definisce che il prezzo del petrolio deve derivare da Bloomberg (ad esempio utilizzando un’API di Bloomberg in un certo endpoint, che ha una certa URL) l’oracolo può fornire una prova che il colloquio che ha avuto con Bloomberg si sia effettivamente verificato; insieme all’informazione trasmessa, allo smart contract viene dunque inviata anche una prova dell’interazione che l’oracolo ha avuto con la fonte dell’informazione stessa. Lo smart contract verifica questa prova di interazione e, se la verifica va a buon fine, l’informazione viene effettivamente assunta. A questo punto lo smart contract dà seguito a tutti gli effetti, che dovranno essere messi in pratica secondo le norme dello smart contract stesso.

Un ulteriore aspetto di sicurezza riguarda l’immutabilità degli smart contract: una volta inseriti sulla blockchain, questi non possono essere più modificati. Però può succedere di accorgersi, dopo aver immesso lo smart contract sulla blockchain, che esso contiene degli errori che potrebbero rappresentare delle vulnerabilità.

Tradizionalmente esiste un processo di sicurezza informatica, chiamato patch management, per poter modificare il codice dell’oggetto difettoso in maniera da correggere questo difetto per il futuro.

Idealmente in una blockchain questo non è possibile, perché il codice dello smart contract non può essere modificato da nessuno; è una regola fondamentale delle blockchain, che garantisce l’integrità del sistema ma al tempo stesso rappresenta un vincolo non indifferente rispetto a questo tipo di problematiche.

Per correggere un errore in uno smart contract sono allo studio diverse soluzioni: il trend attuale è quello dei cosiddetti contratti proxy.

Proxy contracts, cosa sono e come funzionato

Ovvero contratti che realizzano solo la parte di interfaccia dello smart contract, separata dalla parte di implementazione delle regole dello smart contract, che si trova in un differente contratto. Quindi le dApp, la parte tradizionale di un’applicazione di finanza decentralizzata (per esempio applicazione web), non interagiranno con lo smart contract che realizza e implementa le regole dello smart contract ma interagiranno con questo proxy contract, ovverosia un contratto intermedio che non fa altro che prendere le richieste dell’applicazione web e trasferirle al contratto che poi realizzerà, in effetti, le regole dello smart contract.

In questo modo è possibile successivamente, in caso di bisogno, effettuare un upgrade al codice dello smart contract, cambiare l’indirizzo di destinazione del proxy contract e, in un certo istante di tempo, cambiare l’indirizzo: in questo modo tutte le dApp che stavano utilizzando quello smart contract non applicheranno più il vecchio smart contract, ma utilizzeranno quello nuovo in maniera completamente trasparente.

È importante capire che questa è una problematica significativa. Pensate a cosa potrebbe succedere trovando un problema di sicurezza, una vulnerabilità, all’interno di uno smart contract come Compound, che di per sé non realizza tutto lo stack di un’applicazione di finanza decentralizzata ma la sola parte di smart contract.

Chi gestisce, implementa e fa evolvere Compound non è detto conosca tutte le dApp che utilizzano Compound, perché l’indirizzo di Compound è assolutamente libero: sarebbe dunque molto complicato modificare le dApp per utilizzare un contratto diverso, aggiornato e con una fix di sicurezza rispetto al contratto precedente. In caso ciò non fosse possibile e si realizzasse questo meccanismo del proxy contract ci sarebbero altre problematiche perché, cambiando la destinazione delle richieste verso il proxy compact su un nuovo contratto (che ha una fix di sicurezza), rimarrebbe il problema dello storage.

Il contratto di per sé ha una vita, uno stato in ogni istante di tempo che viene costantemente aggiornato delle transazioni che insistono su questo smart contract; e questo stato deve essere trasferito nel nuovo smart contract, il che è un’operazione non banale.

Per ovviare a questo problema si sta pensando di implementare un ulteriore tipo di contratto: gli storage contract, contratti molto basic, esattamente come un proxy contract che realizza una semplice interfaccia verso un altro smart contract.

Storage contract, cos’è e come funziona

Lo storage contract realizza quello che nell’informatica tradizionale sarebbe un database, un sistema di storage molto semplice.

Per far migrare il proxy contract è necessario farlo puntare al nuovo contratto aggiornato, che non avrà storage e punterà al vecchio storage, quindi al contratto che veniva utilizzato dal vecchio smart contract.

Utilizzando proxy contract e storage contract è possibile realizzare una “aggiornabilità” per correggere errori di sicurezza che è assimilabile a quella dei sistemi tradizionali.

Ciò induce a una maggiore complessità del sistema e, in particolare, quando si deve lanciare una transazione verso il proxy contract si devono in realtà lanciare diverse transazioni verso altri contratti; e questo ha un costo sulla rete Ethereum, perché lanciare la trattazione di altri contratti ha un costo maggiore rispetto a una transazione interna, limitata a un solo contratto.

Questo tipo di operazioni, quindi, ha un costo che va tenuto in considerazione.

Un piccolo addendum rispetto alle precedenti informazioni riguarda la possibilità di far “suicidare” un contratto.

A livello di blockchain, ma non a livello di smart contract, è possibile dichiarare un contratto come “deceduto”. Si può dire alla blockchain che quel contratto, da un certo momento in poi, non deve essere più utilizzato e qualsiasi transazione diretta verso quel contratto dovrà essere considerata non valida: tutte le dApp che insistono su quel contratto non saranno più funzionanti e dovranno necessariamente aggiornare il proprio puntatore al contratto giusto.

Questo è un modo, se volete più brutale, per forzare la rete di qualsiasi applicazione che sta utilizzando lo smart contract senza sapere a priori quali siano queste applicazioni. Sembra che io mi contraddica, ma poter far suicidare un contratto deve ovviamente rientrare fra le regole del contratto stesso: infatti OpenZeppelin, ad esempio, realizza una classe di smart contract che è, appunto, “suicidabile”. Ma se dichiaro suicidabile un contratto con OpenZeppelin, questo avrà automaticamente tale funzionalità; una funzionalità base che tutti i contratti dovrebbero avere, in quanto in sua assenza quel contratto continuerà a vivere in maniera indefinita – magari contenendo al suo interno una vulnerabilità di sicurezza – e potranno esserci applicazioni che continuano a utilizzare il contratto fallato, con conseguenze imprevedibili e potenzialmente molto gravi.

Ulteriori aspetti di sicurezza riguardano la parte tradizionale della dApp di finanza decentralizzata, come appunto il back-end, la parte di API e la parte di front-end web o mobile: anch’essa fa parte della dApp di finanza decentralizzata e deve essere considerata quando si analizzano gli aspetti di sicurezza informatica.

Non c’è nulla di specifico e peculiare rispetto a qualsiasi altra applicazione web, quindi si utilizzano gli strumenti che normalmente vengono impiegati per analizzare e per rendere sicure le applicazioni web o le applicazioni mobili di tipo tradizionale.

L’unico elemento specifico delle dApp, ripeto, è la necessità di una gestione corretta da un punto di vista di interagibilità con l’utente, quindi l’aspetto di trust tra il wallet e l’applicazione web che realizza l’applicazione di dApp centralizzata.

L’ultimo aspetto che voglio trattare riguarda la confidenzialità. Le blockchain funzionano molto bene: la relativa visione, l’idea di una coreografia implementata da attori assolutamente paritari tra loro che realizzano un sistema assolutamente integro nelle regole che esso stesso definisce, è assolutamente e tecnicamente molto attraente. Tutto questo però ha un costo.

Tutte le blockchain di tipo mainstream di cui abbiamo conoscenza – come Bitcoin, Ethereum e così via – in realtà richiedono che tutte le transazioni siano sempre osservabili da chiunque voglia utilizzare la blockchain. Quindi, se si utilizza una blockchain e ci si vuole fidare di essa, si deve poter osservare tutto quello che succede al suo interno; e se ci sono transazioni che viaggiano all’interno della blockchain bisogna poterle osservare, in conflitto con la confidenzialità.

Questo è un aspetto sostanzialmente diverso rispetto ad applicazioni tradizionali che gestiscono altri aspetti finanziari della nostra vita. La mia banca non dovrà dire a chiunque qual è il saldo del mio conto, quali transazioni io faccio sul mio conto corrente: semplicemente non è richiesto. Nella blockchain, invece, questo è un elemento presente.

Esistono alcune blockchain che in qualche maniera hanno implementato meccanismi che preservano la confidenzialità delle transazioni, perché in realtà quello che è richiesto dalla blockchain è che consenta non tanto di poter osservare le transazioni, ma di avere la garanzia che esse siano conformi ai contratti definiti dagli smart contract.

Quindi, ad esempio, si può ottenere una transazione cifrata su cui avere la garanzia del contenuto, pur non conoscendo il contenuto della trattazione: così come nel caso di un bonifico non conosco chi effettua il bonifico né la quantità di denaro movimentata, però ho la garanzia che la persona che ha inviato quel denaro avesse un saldo che gli consentiva di trasferire quella determinata quantità di denaro. Questa è l’unica informazione a mia disposizione; e se, pur non avendo visibilità totale delle transazioni, si ha questa garanzia, la blockchain continua a funzionare. Questo è un tipo diverso di blockchain.

Le due principali sono Monero – che però non è utile per applicazioni di finanza decentralizzata perché è una specie di Bitcoin ma con transazioni confidenziali, quindi realizza una specifica applicazione finanziaria di trasferimento di liquidità – e Zcash, che implementa un vero e proprio meccanismo di smart contract totalmente confidenziali, dove si ha la garanzia che le transazioni siano conformi alle regole definite.

Ethereum, la principale piattaforma di realizzazione di applicazioni di finanza decentralizzata, contiene già al proprio interno le tecnologie che sono utilizzate da Zcash, che è stato precursore rispetto a questo tipo di applicazioni non solo ad alta integrità, ma ad alta confidenzialità.

La stessa tecnologia utilizzata da Zcash, le zero knowledge proof, è attualmente presente all’interno di Ethereum e può già essere utilizzata per incrementare parti confidenziali di uno smart contract. Una realtà che già esiste, quindi; e che va tenuta in considerazione quando si realizzano applicazioni di finanza decentralizzata.

Riassumendo: abbiamo parlato di smart contract, di dApp che realizzano applicazioni di finanza decentralizzata e abbiamo velocemente osservato i principali aspetti di sicurezza di questo tipo di applicazioni. Spero di essere stato esaustivo!

Il contenuto è tratto dal mio intervento al Cyber Security Virtual Conference di cui è disponibile il video completo.

A cura di Cristiano Paris, Consigliere di AIEA – Capitolo di Milano di ISACA

Informazioni sull’Autore

Cristiano Paris si è laureato con lode nel 2002 in Ingegneria Informatica presso l’Università di Roma “Tor Vergata”. Dal 2004 al 2007 dirige il laboratorio di innovazione e ricerca di Land S.r.l. dove sviluppa un innovativo algoritmo per l’utilizzo di tecnologie di firma digitale per autenticare documenti cartacei, brevettato in Italia. Successivamente, dal 2007 al 2016 è IT Auditor presso il Servizio Revisione interna di Banca d’Italia. Dal 2016 è in distacco temporaneo presso la Banca Centrale Europea e attualmente ricopre il ruolo di Senior Cyber Security Expert presso il Direttorato Infrastrutture finanziarie e sistemi di pagamento. Dal 2019 è membro del consiglio direttivo di AIEA, capitolo di Milano di ISACA, dove si occupa di innovazione.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/finanza-decentralizzata-e-sfide-di-sicurezza-gli-smart-contracts/


Minacce e sistemi di pagamento in evoluzione: rilasciata la v.4 dello standard PCI DSS

Il Payment Card Industry Data Security Standard evolve in data 31/03/2022 con il PCI DSS v4.0.

Tale aggiornamento si è reso necessario a causa dell’evoluzione delle minacce e dei rischi annessi, mutati negli ultimi anni, e l’avanzare delle recenti modalità di pagamento che hanno arricchito il panorama dei pagamenti elettronici, introducendo nuove sfide e nuovi rischi.

Mossi da questi cambiamenti e con l’obiettivo di innalzare ulteriormente il livello di sicurezza delle organizzazioni che operano in tali ambiti (memorizzando, elaborando o trasmettendo i dati delle carte di pagamento) e cercando di razionalizzare ed allineare ulteriormente i criteri con gli altri standard di settore, i brand che si occupano di trasferimento di denaro e i vari stakeholder coinvolti, hanno lavorato per definire una nuova versione.

Quindi, a nove anni dall’uscita della versione 3 (novembre 2013) e a quattro dall’ultima release attualmente in uso 3.2.1 (maggio 2018), viene pubblicata la nuova versione dello standard v.4 che introduce una serie di cambiamenti significativi.

Entrando maggiormente nel dettaglio, le modifiche introdotte sono riconducibili a tre macroaree:

  • Evoluzione dei requisiti: modifiche per garantire che lo standard sia aggiornato con le minacce e le tecnologie emergenti e i cambiamenti nel settore dei pagamenti.
  • Chiarimenti o linee guida: formulazione, spiegazione, definizione, guida aggiuntiva e/o istruzioni aggiornate per aumentare la comprensione o fornire ulteriori informazioni o indicazioni su un argomento particolare.
  • Struttura o formato: riorganizzazione del contenuto, inclusa la combinazione, la separazione e la rinumerazione dei requisiti per allinearne il contenuto.

Particolare attenzione è da incentrare sulla evoluzione dei requisiti. In tale area, infatti, ricadono due ulteriori modifiche sostanziali, che hanno l’obiettivo di innalzare la sicurezza sia a livello di processo sia a livello tecnologico:

  • Evoluzione di requisiti esistenti.
  • Implementazione di nuovi requisiti.

All’interno della prima categoria, a titolo di esempio, possiamo identificare le seguenti modifiche:

  • Definizioni di ruoli e responsabilità su molti ambiti tecnologici e di processo.
  • Aumento della lunghezza della password e il numero di tentativi di autenticazione non validi.
  • Formazione sulla sensibilizzazione alla security per includere la consapevolezza delle minacce e delle vulnerabilità che potrebbero influire sulla sicurezza del CDE.

Invece, per quanto riguarda l’implementazione si segnalano:

  • Controlli tecnici per impedire la copia e/o il trasferimento di PAN quando si utilizzano tecnologie di accesso remoto.
  • Revisione di tutti gli accessi per applicazione e account di sistema e relativi privilegi di accesso.
  • Implementare l’autenticazione a più fattori (MFA) per tutti gli accessi al CDE.
  • Eseguire scansioni di vulnerabilità interne tramite scansioni autenticate

Ulteriore cambiamento significativo introdotto dalla v.4 consiste nella modalità di valutazione che potrà essere utilizzata. Infatti, la grande variazione che viene introdotta è che, affiancato ad una valutazione tradizionale come previsto per le precedenti versioni, sarà possibile effettuare una valutazione mediante “approccio personalizzato”, ossia un approccio risk base, che definisce gli ambiti a cui applicare gli assessment partendo da un’attività di analisi dei rischi mirata sui target determinati.

Come per tutte le versioni, è stato previsto un periodo di transizione in cui lo standard v.4 e v.3.2.1 coesisteranno, e che potranno essere utilizzati per validare le entità oggetto di valutazione. La data di ritiro della v.3.2.1 è stata definita al 31 marzo 2024. Dopo tale data sarà obbligatorio effettuare validazioni PCI DSS esclusivamente sulla versione 4 dello standard.

È doveroso precisare che, pur se in un periodo iniziale sarà possibile validarsi sul vecchio schema di conformità, è importante per le entità soggette a PCI DSS iniziare sin da subito ad analizzare ed approcciare le richieste della versione 4. In questo modo, tali entità avranno il tempo per definire i corretti piani di intervento necessari a modificare e/o implementare tutti gli accorgimenti richiesti senza incorrere, al momento dello switch off della versione 3.2.1, a validazioni dei perimetri di analisi “non conformi”.

Articolo a cura di Paolo Sferlazza e Maurizio Priola

Informazioni sull’Autore

Socio fondatore di Gerico Security Srl lavora come advisor, auditor e trainer nel campo della sicurezza delle informazioni, continuità operativa, gestione dei servizi IT e sicurezza delle carte di pagamento.
Ha accompagnato primarie aziende e infrastrutture critiche italiane nell’ottenimento della certificazione ISO/IEC 27001, ISO 22301 e ISO/IEC 20000.
È un Qualified Security Assessor riconosciuto dal PCI Council per la certificazione dei sistemi di pagamento PCI DSS. Ha conseguito la certificazione CISA, CISM, CRISC di ISACA, ed è auditor qualificato e tiene docenze sugli schemi ISO/IEC 27001, ISO 22301, ISO/IEC 27001 e ISO 9001 ed è iscritto ai registri AICQ SICEV quale auditor sulla sicurezza delle informazioni e continuità operativa. Ha inoltre ottenuto altre certificazioni nel campo della sicurezza delle informazioni e dell’IT governance tra cui OPST, COBIT e ITIL. Ha progettato ed erogato docenze, anche in ambito militare, su tematiche di Information Risk Management, ITIL. Ha effettuato audit interno, assessment e consulenza in merito all’accreditamento dei laboratori VA rispetto alla 17025. Si occupa si sicurezza delle informazioni nel mondo specifico dell’automotive in conformità con lo standard di settore TISAX.
Collabora con primari enti di certificazione come auditor di terza parte.

Informazioni sull’Autore

Security Advisor nel campo della sicurezza delle informazioni, sicurezza delle carte di pagamento e gestione dei servizi IT presso Gerico Security Srl.
Qualified Security Assessor riconosciuto dal PCI SSC per la certificazione dei sistemi di pagamento PCI DSS, e in possesso inoltre delle certificazioni CISM, PCI-P, Lead Auditor ISO/IEC 27001, CSX, OPST, COBIT e ITIL.
Ha supportato primarie aziende nell’ottenimento della certificazione ISO/IEC 27001 e PCI DSS.
Inoltre, supporta clienti per il raggiungimento della conformità allo standard di settore TISAX per la sicurezza delle informazioni per il settore specifico dell’automotive.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/minacce-e-sistemi-di-pagamento-in-evoluzione-rilasciata-la-v-4-dello-standard-pci-dss/


Il modello di business della cybergang Lapsus$ Team – L’importanza della leva comunicativa e del fattore umano

Il mondo del cybercrime risulta essere un settore non solo non in crisi ma uno dei più dinamici e caratterizzato da modalità elevate di customizzazione del servizio nonché ampia flessibilità di fruizione dello stesso. Ne fanno fede la nascita continua di gruppi i quali si vanno strutturando al livello di qualsiasi impresa commerciale. In questo senso, si è parlato, ad esempio, del modello di business del Ransomware-As-A-Service (RaaS) mutuandolo dalla realtà del cloud computing, per cui è possibile dotarsi non solo di un ben fornito kit di ransomware e tools di attacchi vari ma anche delle consuete funzionalità di assistenza clienti, almeno per i wannabe più sprovveduti, quali il supporto diretto 24/7, chatbots, tutorials, recensioni dei clienti, forum ad hoc, esempi d’uso.

In tale ecosistema cybercriminale che si può considerare in via di forte espansione, anche grazie all’ampio risalto ottenuto a livello mediale (hype), si assiste alla nascita di moltissime start-up. Tra tutti questi gruppi ha avuto un rilievo preponderante negli ultimi mesi, quello di Lapsus$, fatta eccezione per Hive che ha recentemente colpito RFI. Lapsus$ si è reso protagonista non solo di una serie di attacchi ad imprese di alto profilo quali Samsung, Ndivia, Okta, Ubisoft e buon’ultima anche Microsoft quanto piuttosto per alcune caratteristiche peculiari. Due di queste modalità sono costituite dall’utilizzo compulsivo dei social networks e dei mass media a fini comunicativi e da alcune modalità inedite di reclutamento di coloro che si potrebbero tranquillamente chiamare i basisti o delle quinte colonne all’interno delle imprese hackerate.

Sebbene gli attacchi di Lapsus$ siano frequenti e le loro vittime di alto profilo, le loro tattiche vengono descritte dagli addetti ai lavori come dilettantistiche. O almeno così appaiono ai professionisti della sicurezza informatica. Prima di arrivare a discutere di questo punto cruciale vale la pena ripercorrere, tuttavia, seppur brevemente, perché Lapsus$ costituisce una sorta di piccolo studio di caso, meritevole di attenta considerazione.

Lapsus$ Team inizia la sua attività estorsiva alla fine del 2021, riuscendo a porsi sotto i riflettori mass mediali, per la prima volta, lo scorso 10 dicembre dopo essersi preso il merito di un attacco al Ministero della Salute brasiliano bloccando l’accesso ai certificati di vaccinazione COVID-19 e ad altre informazioni vitali del sistema sanitario pubblico. Un messaggio scritto in portoghese veniva lasciato sul sito web compromesso in cui si affermava di aver rubato e cancellato 50TB di dati. Il 10 dicembre veniva creato anche il canale Telegram omonimo il cui primo paragrafo del primo messaggio postato era costituito dalla notizia dell’attacco effettuato al Ministero, il secondo la sollecitazione allo stesso Ministero di venir contattati al fine della restituzione dei dati per evitare la pubblicazione degli stessi mentre il terzo era diretto a tutti i giornalisti che volevano effettuare un’intervista al gruppo. Il messaggio veniva pubblicato sia in inglese che in portoghese brasiliano. Seguivano altri messaggi in cui veniva specificato che l’unico obiettivo del Lapsus$ Team era quello monetario e che le loro motivazioni non avevano nulla a che fare con ragioni politiche.

Il giorno successivo, l’11 dicembre, venivano postati due messaggi. Nel primo, scritto in inglese, veniva riportato, in maniera laconica, che il sito del Ministero era ancora down mentre nel secondo, scritto in portoghese, veniva testualmente affermato: “Qualche sondaggio. Cosa dobbiamo hackerare in seguito? Suggeritecelo. Qualche dipartimento governativo? Un’impresa corrotta? Ditecelo!”.

Come si può constatare veniva ricercato il contatto diretto con altri gruppi hacker, tuttavia al di fuori dei canali tradizionali di questa comunità professionale quali il Raid Forum e i siti collocati nel Dark web. L’obiettivo verosimile di tale strategia poteva essere quello di raggiungere un impatto mediale e, nello stesso tempo, cercare di avere una larga base di proseliti e fiancheggiatori.

Sempre con l’obiettivo di mostrare la strategia in statu nascenti di questo gruppo malevole, il 12 dicembre oltre a un messaggio scritto in inglese in cui veniva comunicato in uno screenshot che il database del Ministero era stato attaccato era sempre un successivo messaggio, scritto in portoghese, quello in cui si affermava: “Ricordiamo a tutti i membri di unirsi all’account [del canale del gruppo]. Sentitevi liberi di invitare amici! L’appoggio della comunità è apprezzato! (se volete che invadiamo [invadamos] altro, chiedetelo)”. In un altro messaggio definito come “declaração oficial”, scritto in ambedue le lingue, oltre a venir rintuzzate alcune affermazioni pubblicate sui mass media brasiliani definite come bugie perché riportavano delle affermazioni ufficiali riguardo le esfiltrazioni di dati in cui “nulla era stato ottenuto, nessuno aveva i dati” faceva seguito una “notas extras” in cui oltre a dolersi che non si comprendevano le ragioni per cui si voleva diffamare Lapsus$ Team veniva specificato che l’unica cosa che il gruppo perseguiva era la monetizzazione dell’atto, cioè, parlando in modo “comune”, “we want money, it’s just a matter of paying us”.

Seguivano altri messaggi e altri attacchi che non vale qui richiamare per motivi di spazio se non l’ultimo effettuato a Microsoft e gli ultimissimi eventi, almeno alla data di stesura del presente testo, in data 26 marzo. Alla stessa data, il canale Telegram raggiungeva la ragguardevole cifra di più di 52.000 iscritti.

Il 20 marzo la cybergang aveva diffuso, difatti, sempre nel canale Telegram, uno screenshot di un account di Azure DevOps in cui si potevano vedere dei test project riferibili a Microsoft: Bing_STC-SW; Bing_Test_Agile; Bing_UX; BingCubator; Bing-Source; Compliance_Engineering; Cortana; Creative-Authoring. Da quest’immagine sembrava essere stato effettuato un accesso al codice sorgente del motore di ricerca Bing (Bing-Source) e probabilmente anche di quello dell’assistente vocale Cortana, o almeno era quanto si lasciava intendere nel messaggio postato. Sempre nello stesso screenshot si potevano vedere, nella sezione laterale sinistra della web app, alcuni ulteriori repository quali “mscomdev”, “microsoft” e “msblox”. In una nota diffusa sul proprio dito, Microsoft affermava che l’indagine interna aveva rilevato che solo un singolo account era stato compromesso e che non fossero stati coinvolti codici o dati del cliente, garantendo così un accesso limitato agli hacker. Veniva anche affermato che la diffusione della notizia sui social del data breach non ancora terminato aveva avuto l’effetto di porre in essere con successo delle attività di mitigazione che avevano attenuato l’esfiltrazione dei dati.

Le ultime notizie relative a Lapsus$ Team sembrano essere quelle relative allo smantellamento dell’attore malevole, anche se al momento presente il condizionale è d’obbligo. Dalle dichiarazioni effettuate a mezzo stampa da parte dell’ispettore Michael O’Sullivan della polizia di Londra, in una dichiarazione a “The Verge”, si può leggere quanto segue. “La polizia della città di Londra ha condotto un’indagine con i suoi partner sui membri di un gruppo di hacker. Sette persone di età compresa tra i 16 e i 21 anni sono state arrestate in relazione a questa inchiesta. Ora sono state rilasciate ma sono ancora tutte sotto indagine”. Prima di questi arresti, sempre nel Regno Unito, un ragazzo di 16 anni era stato accusato di essere la mente del gruppo. Secondo un report pubblicato da “Bloomberg” a identificarlo sarebbe stata una squadra di ricercatori di sicurezza assoldata dalle società attaccate da Lapsus$. Secondo il profilo stilato in queste analisi, il ragazzo sarebbe un ex amministratore di Doxbin, un portale in cui cercare e condividere informazioni private relative alle persone fisiche. Prima di rivendere la guida del sito, il ragazzo avrebbe diffuso via Telegram tutto l’archivio di Doxbin.

Con quest’ultimo evento mediale potrebbe terminare la brevissima ma assai conosciuta storia di questa cybergang. Seppur fugace tale storia ha degli aspetti assai interessanti. Innanzitutto, Lapsus$ Team non avrebbe mai utilizzato un ransomware, eventualità peraltro così comune in questi ultimi tempi, quanto piuttosto avrebbe cercato di esfiltrare i dati delle compagnie summenzionate e utilizzare tale tecnica a solo fini estorsivi.

Il secondo aspetto che si è sin qui messo in risalto è l’utilizzo dei social networks (in questo caso un’app di messaggistica) da parte di Lapsus$ Team che, tuttavia, appare essere un tratto distintivo non solo di questo gruppo ma anche di altri che vi fanno ampiamente ricorso, ad esempio Conti.

Il terzo aspetto che rappresenta un elemento precipuo del modello di business di questo gruppo è il ricorso alle tecniche di ingegneria sociale basate sul telefono quali la SIM-swapping oppure accedere agli account di posta elettronica dei dipendenti delle organizzazioni target oppure effettuare chiamate telefoniche simulando situazioni emergenziali in corso. In questo senso, anche per altri dettagli su cui qui non è possibile dilungarsi per ragioni di spazio, le tecniche e tattiche informatiche adottate potrebbero essere considerate anche di tipo amatoriale ma i risultati ottenuti mostrano invece, altrettanto bene, quanta incidenza svolga il fattore umano in un attacco malevolo. E i risultati che si possono ottenere se ad essere attaccate con successo sono corporation che hanno fatto della sicurezza informatica un loro tratto organizzativo distintivo facendo uso di tutte le più attuali sofisticazioni cibernetiche nel difendere il loro perimetro aziendale. Ma anch’esse devono scontare il fatto che nulla possono quando ad essere attaccato con successo è l’essere umano, quasi sempre con tattiche non necessariamente sofisticate e basate sui molteplici bias umani. E qui si può davvero parafrasare quanto affermato, a suo tempo, dal crittografo statunitense, professionista della sicurezza informatica nonché specialista della privacy, Bruce Schneier. “If you think technology can solve your security problems, then you don’t understand the problems and you don’t understand the technology”.

Lapsus$ Team si concentra, difatti, sulla compromissione delle identità degli utenti per accedere a un’impresa, rubare dati preziosi ed estorcere la vittima. Il 10 marzo, difatti, la cybergang pubblicava sempre sul suo account Telegram un appello teso a sollecitare l’emersione di eventuali basisti: “we recruit employee/insider at the following!!!” seguito da quattro liste di possibili obiettivi da parte dell’attore malevolo:

  • imprese telefoniche (Claro, Telefonica, ATT e altre simili);
  • grandi imprese/corporation di software e di gaming (Microsoft, Apple, Elecronic Arts (EA), IBM e altre simili);
  • imprese di callcenter e Business Process Management (BPM) (Atento, Teleperformance e altre simili);
  • servers hosts (OVH, Locaweb e altri simili).

Nel testo veniva messo in risalto, in caratteri maiuscoli, come il gruppo non fosse interessato alla fornitura di dati da parte delle eventuali quinte colonne quanto piuttosto quello di fornire un accesso VPN o Citrix. “TO NOTE: WE ARE NOT LOOKING FOR DATA, WE ARE LOOKING FOR THE EMPLOYEE TO PROVIDE US A VPN OR CITRIX TO THE NETWORK, or some anydesk.

If you are not sure if you are needed then send a DM and we will respond!!!”.

L’appello veniva rivolto anche a chiunque fosse in grado di fornire tali accessi, dunque anche a eventuali fornitori o alla comunità hacker in generale. “If you are not a employee here but have access such as VPN or VDI then we are still interested”.

Il messaggio si chiudeva con quello che è forse l’aspetto più rilevante del post, vale a dire “You will be paid if you would like. Contact us to discuss that”. Detto in altri termini, si ricercavano sia gli elementi prezzolati ma anche coloro che per motivi di rivalsa e di risentimento erano disposti a procurare un elevato danno per l’azienda per cui lavorano. In tutti questi casi l’obiettivo del gruppo malevolo era quello di riuscire a procurarsi l’accesso alle credenziali e l’approvazione dell’autenticazione a più fattori (MFA).

L’ultimo messaggio della chat Telegram risale al 25 marzo. “È giunto alla nostra attenzione che molti utenti stanno impersonando lo staff di Lapsus$. Ricordiamo che chiunque affermi di essere Lapsus$ è molto probabilmente falso, l’unico nome utente pubblico è @Lapsusjobs”, ovvero un contatto in cui si può lavorare come insider ed essere pagato, anche se viene ricordato, in ultimo “Lapsus$ will never have “double your bitcoin” scheme”, non raddoppierà mai i bitcoin già pattuiti.

Una cybergang la cui probabile fine ha scombinato i piani di molti insider ma è quasi sicuro che questo modello di business criminale verrà portato avanti da altre realtà stante la sua efficacia operativa.

Articolo a cura di Achille Pierre Paliotta e Antonio Guzzo

Informazioni sull’Autore

Achille Pierre Paliotta, ricercatore INAPP(ex ISFOL), afferente alla Struttura Lavoro e Professioni. Laureato in Sociologia presso l’Università La Sapienza ha conseguito, nel 2015, il Master in Data Science presso l’Università di Tor Vergata. Sta attualmente frequentando il Master in Sicurezza delle informazioni e informazione strategica presso l’Università La Sapienza. I suoi interessi di ricerca vertono su nuove tecnologie, sicurezza informatica, nuove professioni, contrattazione collettiva, welfare occupazionale, data science, blockchain, open data e deep learning.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/limportanza-della-leva-comunicativa-e-del-fattore-umano-nel-modello-di-business-della-cybergang-lapsus-team/


Sviluppare capacità di risposta agli incidenti SaaS

Ogni team di sicurezza ha un piano di risposta agli incidenti. Una strategia e una preparazione avanzate sono assolutamente indispensabili per garantire una risposta rapida a data breach, ransomware e numerose altre sfide, ma la maggior parte delle aziende ha sviluppato un piano di risposta agli incidenti anni fa, se non decenni fa, e lo rivede solo periodicamente. Questo è certamente un problema.

Quante organizzazioni hanno sviluppato un piano di risposta agli incidenti dedicato ad affrontare i rischi dell’era del software-as-a-service (SaaS)? Troppo poche.

Pensiamoci bene, la risposta di un team di sicurezza aziendale alla violazione di una soluzione SaaS gestita da una terza parte è, necessariamente, molto diversa dalla risposta a un attacco alla rete, al data center o agli endpoint aziendali. Questo non solo perché il team di sicurezza ha meno controllo sull’ambiente SaaS, ma anche perché ha meno informazioni che aiuterebbero in modo fondamentale ad attuare l’azione di risposta. Una risposta efficace all’attacco richiede una serie di passaggi: identificazione, contenimento ed eliminazione della minaccia; recupero delle attività; imparare la lezione dall’esperienza. Ma l’identificazione, il contenimento e l’eliminazione richiedono un accesso e una visibilità approfonditi nel software di sistema e nei relativi file di log.

Ora, consideriamo ciascuna delle applicazioni SaaS su cui fa affidamento un’azienda. Il team di sicurezza quanta visibilità ha veramente in quei sistemi? E come si svolgerebbe un’indagine sull’incidente se l’applicazione SaaS subisse una violazione?

Se non si conosce la risposta a queste domande, è decisamente necessario un cambiamento.

SaaS Triage

Ecco una storia basata su una serie di eventi che sappiamo essere realmente accaduti. La società che chiameremo “A” aveva un solido piano di risposta agli incidenti, basato su anni di esperienza, con indagini in loco e analisi forensi, ma non aveva prestato la necessaria attenzione a come quel piano avrebbe dovuto essere modificato nel caso di problemi con un’applicazione SaaS.

Poi, è accaduto che un dipendente rendesse pubblica la registrazione di un meeting che includeva alcune informazioni aziendali proprietarie altamente riservate. Il suo intento non era malevolo. Nel tentativo di essere d’aiuto e rendere le informazioni disponibili ai nuovi dipendenti, aveva collocato la registrazione in un repository nell’applicazione di videoconferenza in cloud tramite la quale si era tenuta la riunione. Per fortuna, un collega attento ha notato questo errore e ha informato il team di sicurezza.

La prima cosa di cui la società A si è resa conto, è che non aveva accesso ai propri log con questo provider di servizi di videoconferenza. Non aveva nemmeno molte informazioni sulle loro impostazioni di sicurezza. Fortunatamente, quando hanno contattato il provider, il loro referente ha compreso le preoccupazioni e ha coinvolto immediatamente le risorse giuste. Hanno subito scoperto che la registrazione non era protetta, che chiunque nel mondo con l’URL corretto poteva accedervi e che non avevano nemmeno il permesso di modificare le impostazioni di sicurezza.

Questa è stata una situazione di crisi che inizialmente ha lasciato tutti i membri del team di sicurezza impotenti. Non avevano visibilità sul fatto che qualcuno potesse aver approfittato della situazione, quindi, non avevano idea di quali potessero essere le implicazioni o le strategie di mitigazione del rischio. Era difficile accettare che fossero stati ciechi di fronte a questo particolare rischio SaaS.

Tuttavia, una volta individuata la portata del problema, hanno lavorato a stretto contatto con il fornitore di servizi di videoconferenza su due fronti: hanno chiesto al fornitore di modificare immediatamente le impostazioni per rendere privato il video in questione e hanno richiesto l’accesso a tutti i log pertinenti. Hanno esaminato i download del video e le visualizzazioni all’interno della piattaforma di videoconferenza, correlando i log SaaS con i loro log interni per determinare quali azioni avevano coinvolto persone al di fuori dell’azienda.

Il risultato è stato rassicurante, perché non c’era stato alcun accesso proveniente dall’esterno della loro rete aziendale. Hanno però imparato la lezione da questa esperienza e hanno cambiato le loro procedure e le loro impostazioni in ogni piattaforma di videocomunicazione che utilizzano per evitare che i video siano condivisibili pubblicamente.

Due Diligence & Incident Response

Questo esempio dimostra che incidenti di sicurezza sulle piattaforme SaaS possono verificarsi e se non ci prepariamo in anticipo, potremmo trovarci nella situazione di non potere fare molto per rimediare. Cosa fare quindi? Ecco un elenco delle migliori pratiche di sicurezza SaaS sviluppato da Netskope.

Valutare la sicurezza dall’inizio

Una revisione della sicurezza dovrebbe essere una componente fondamentale della due diligence in ogni decisione che riguardi la selezione di una applicazione SaaS. Mentre un’azienda esamina i potenziali vendor, il team di sicurezza dovrebbe chiedere quali funzionalità di logging sono disponibili, chi ha accesso ai file di log e qual è il processo di risposta agli incidenti, nel caso qualcosa vada storto.

Molti provider SaaS stanno iniziando ad entrare nello spazio della security, considerando come una ulteriore opportunità di vendita il supporto ai team di sicurezza dei clienti. È un approccio che non condivido, ma che sta diventando abbastanza comune. In molti casi l’offerta dei servizi SaaS standard è ambigua, e i clienti che desiderano accedere ai log devono pagare di più. Ovviamente, in un simile contesto, la gestione del rischio di un fornitore deve avvenire prima della firma del contratto poiché una volta che l’azienda ha selezionato una soluzione SaaS a un prezzo specifico, il team di sicurezza dovrà affrontare una dura battaglia per aggiungere funzionalità di logging a un costo maggiore.

Non dimenticare la supply chain del software

La valutazione della gestione del rischio del fornitore dovrebbe includere anche un’analisi approfondita della supply chain del software SaaS. Questo aspetto mi ricorda un altro aneddoto in cui una certa organizzazione, chiamiamola società B, aveva una solida relazione di fiducia con un vendor, decidendo così di migrare alla soluzione SaaS di quest’ultimo senza una opportuna due diligence. Purtroppo, non si sono resi conto dell’errore finché un provider di software esterno, apparentemente estraneo alla catena, ha subito un attacco ransomware

È risultato così che la soluzione SaaS era stata costruita a partire dalla piattaforma di un vendor terzo, che non era stata concepita nativamente in cloud, né era predisposta per gestire sistemi in cloud. Quando questa piattaforma ha subito l’attacco ransomware, la società B ha scoperto non solo di non avere lei stessa alcuna visibilità sull’incidente, ma che anche il provider SaaS non aveva ugualmente visibilità, Il vendor terzo non comunicava direttamente con la società B, e l’analsi dell’evento ha richiesto diverso tempo al provider SaaS.

Cosa ci insegna questo incidente? Dal momento che le supply chain delle applicazioni SaaS sono complesse e distribuite, i team di sicurezza non dovrebbero mai rinunciare alla due diligence, anche se sono fiduciosi nel vendor con cui stanno stipulando un contratto.

Creare i contatti giusti

Un’altra componente importante del processo di due diligence SaaS è stabilire contatti all’interno della funzione di sicurezza del fornitore. Nell’incidente della società A con il fornitore di servizi di videoconferenza, il loro contatto di vendita si è mosso rapidamente e li ha aiutati a contenere il rischio. Tuttavia, i team di vendita cambiano e talvolta non rispondono per vari motivi. In alcuni scenari, contattare le vendite per un problema di sicurezza potrebbe ritardare la risposta agli incidenti.

Le funzioni di supporto dei fornitori SaaS svolgono un ruolo importante nelle relazioni con i clienti, ma hanno flussi di lavoro interni che possono anche creare inutili ritardi in caso di crisi. Lo scenario ideale è che il team di sicurezza del cliente abbia contatti diretti all’interno del gruppo di sicurezza del fornitore, a cui sia possibile rivolgersi in caso di emergenza.

Pianificare la risposta agli incidenti SaaS

All’inizio di quest’anno, la Cloud Security Alliance (CSA) ha rilasciato un framework di risposta agli incidenti cloud che fornisce indicazioni eccellenti su come i clienti dovrebbero reagire a un attacco a una soluzione cloud. Netskope ha sviluppato un approccio leggermente diverso, ma con una parziale sovrapposizione. Ogni piano di risposta agli incidenti SaaS dovrebbe:

  • Specificare quali azioni verranno intraprese quando viene scoperto un incidente, sia il triage immediato che gli sforzi di contenimento ed eliminazione a lungo termine. Queste azioni possono includere la messa offline dei sistemi, la messa in quarantena dei dispositivi, la limitazione della connettività degli utenti e/o l’avviso alle parti interessate dal problema. La CSA raccomanda di sviluppare una scala di classificazione degli incidenti che correla ogni tipo di evento di sicurezza con la risposta appropriata.
  • Delineare ruoli e responsabilità, nonché contatti di emergenza e canali di comunicazione preferiti presso ciascun provider SaaS.
  • Definire come funzioneranno il monitoraggio e gli alert all’interno di ciascuna soluzione SaaS.
  • Chiarire i metodi attraverso i quali il team di sicurezza interno acquisirà visibilità su un incidente. Idealmente, ciò comporterà l’accesso ai log di tutte le attività di gestione e delle chiamate API su ciascuna piattaforma SaaS utilizzata dall’organizzazione.
  • Fornire un processo post mortem per apprendere le lezioni dall’incidente e incorporare tali conoscenze nel processo di miglioramento continuo della sicurezza. Applicare le lezioni di un incidente per un’applicazione ad altre soluzioni SaaS rafforza la sicurezza del cloud in tutta l’organizzazione.
Leggere tute le ‘release note’

Il cambiamento è un processo molto rapido nel cloud. In molti casi, le migliori informazioni a disposizione dei clienti del cloud per comprendere tali modifiche si presentano sotto forma di note di rilascio (release notes). I team IT che si destreggiano tra una miriade di soluzioni che sembrano aggiornarsi continuamente potrebbero non scendere nei dettagli di ogni release minore, ma dovrebbero.

Indipendentemente dal fatto che una release introduca nuove funzionalità o risolva un problema della release precedente, le modifiche introdotte potrebbero avere implicazioni indesiderate per la sicurezza. Le modifiche ad alcune caratteristiche del prodotto potrebbero modificare il funzionamento di altri componenti e gli utenti dovrebbero (almeno) ristabilire le impostazioni di sicurezza che la versione ha alterato.

Le note di rilascio sono la notifica del vendor di queste situazioni. Non esaminare attentamente ciascuna di esse comporta che il team di sicurezza non capirà cosa sta cambiando e le lacune di sicurezza appena create potrebbero sfuggire all’attenzione. In Netskope, consideriamo prioritario garantire che tutto il nostro team di sicurezza sia istruito sulle potenziali implicazioni ogni volta che uno dei nostri fornitori SaaS pubblica una nuova release.

Richiedi di più dai vendor SaaS

Un’azienda media ha circa 1.200 fornitori di servizi cloud. Alcuni di questi sono provider di infrastructure-as-a-service o platform-as-a-service, che tendono a offrire ai clienti un maggiore controllo sul proprio ambiente di sicurezza. Ma circa il 90% dei vendor cloud di un’azienda sono fornitori SaaS. Ciò significa che l’organizzazione di sicurezza di un’azienda è responsabile della protezione dei dati all’interno di oltre 1.000 applicazioni, sulle quali ha un controllo minimo e una visibilità limitata.

Le applicazioni SaaS sono diventate troppo importanti per le operazioni aziendali perché i team di sicurezza possano lasciare che questa situazione continui. Dobbiamo assicurarci di essere coinvolti nella selezione, nell’architettura e nella progettazione di ogni soluzione SaaS utilizzata dalla nostra organizzazione. Dobbiamo pensare costantemente a come rispondere a una violazione della sicurezza SaaS. Dobbiamo adattare i nostri piani di risposta agli incidenti on-premise per adattarli al mondo SaaS, modificando i nostri runbook per diverse soluzioni SaaS. Infine, dal punto di vista professionale, dobbiamo insistere affinché i nostri vendor SaaS forniscano le informazioni di cui abbiamo necessità per gestire efficacemente il rischio di sicurezza informatica della nostra azienda.

A cura di James Robinson, Deputy CISO & Director, Netskope

Informazioni sull’Autore

Deputy CISO & Director, Netskope

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sviluppare-capacita-di-risposta-agli-incidenti-saas/